
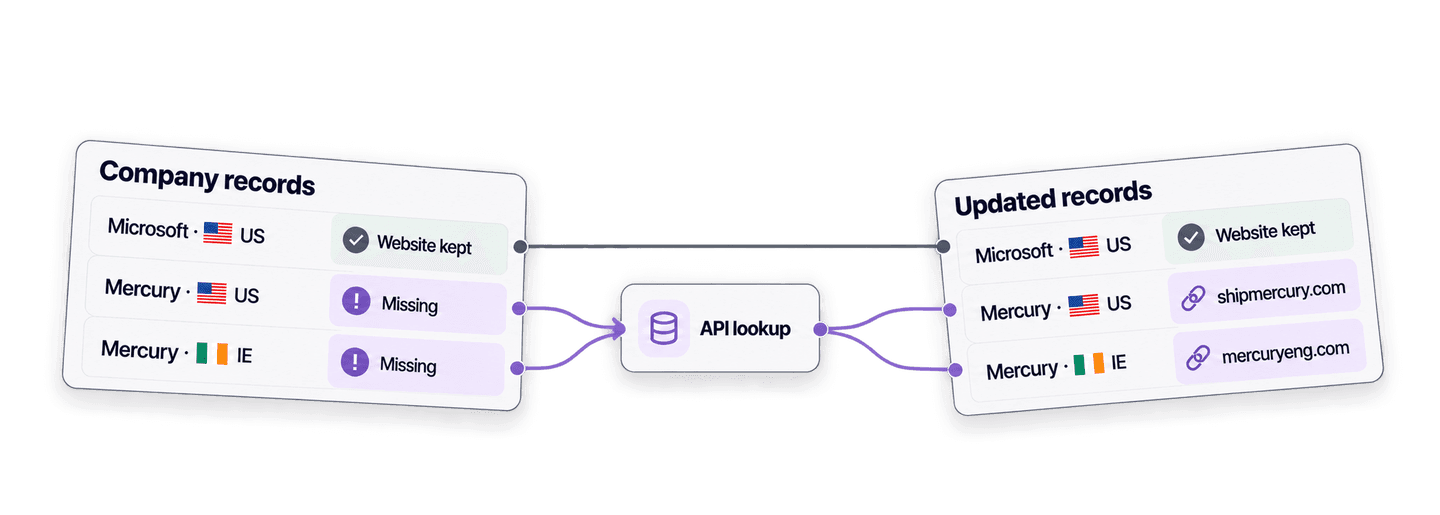
Hvis du vil finde en virksomheds website ud fra virksomhedsnavnet i Python, skal du sende navnet og eventuelle landeoplysninger til Datablists Company Name to Domain API. API'et behandler opslaget i baggrunden og returnerer derefter domænet og den fulde website-URL.
Først viser jeg dig en enkel API-forespørgsel i Python. Derefter genbruger jeg den samme funktion til kun at udfylde de manglende websites i en liste over virksomhedsposter, mens eksisterende URL'er bevares.
Hvis du foretrækker en regnearksbaseret brugerflade, kan du følge vores guide til at finde websites fra virksomhedsnavne i bulk.
💡 Kort fortalt
Byg én Python-funktion, der finder websites ud fra virksomhedsnavne, og brug den til at udfylde poster med tomme websitefelter uden at overskrive kendte URL'er.
- Input: Virksomhedsnavne med valgfri landeoplysninger.
- Output: Domæne, fuld website-URL, konfidensniveau, resultatstatus og brugte credits.
Konfigurer Python og din Datablist API-nøgle
I dette eksempel bruger jeg Requests-pakken til at foretage synkrone HTTP-kald. Installer den i et virtuelt miljø:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requestsDu skal også have et Datablist Growth-abonnement, da adgang til REST API'et er en Growth-funktion. Opret en Personal API Key på din Datablist API-kontoside, og gem den derefter i en miljøvariabel:
export DATABLIST_API_KEY="exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2"🔑 Har du allerede en API-nøgle? Ældre nøgler bruger formatet
auth0|<userId>:<accountId>:<secret>:1. De understøttes fortsat. Brug din eksisterende nøgle præcis, som den blev genereret – du behøver ikke udskifte den eller ændre formatet.
Erstat eksempelværdien ovenfor med den nøgle, der er genereret på din kontoside. Opslag efter virksomhedswebsites bruger credits. Før scriptet skaleres, gennemgår jeg de to muligheder, der koster henholdsvis 1 og 2,5 credits. Du finder de aktuelle abonnementspriser på Datablists prisside.
Slå ét virksomhedswebsite op med Python
Opret en fil med navnet find_company_websites.py. Scriptet indsender navnene, venter på opgaven og henter resultaterne i én funktion. Hvert input bruger dit stabile post-ID som inputId, så du kan knytte hvert resultat til den rigtige post, selv hvis rækkefølgen i svaret ændrer sig.
import json
import os
import time
import uuid
import requests
API_BASE_URL = "https://api.datablist.com/v1"
def find_domains(companies, api_key):
headers = {
"Accept": "application/json",
"Content-Type": "application/json",
"X-API-Key": api_key,
}
inputs = [
{
"inputId": company["id"],
"data": {
"companyName": company["company_name"],
"targetCountry": company.get("country", ""),
},
}
for company in companies
]
unique_id = f"python-domain-lookup-{uuid.uuid4().hex}"
payload = {
"enrichmentId": "company-name-to-domain",
"uniqueId": unique_id,
"settings": {
"workflow": "dataset_google",
"countryOverwrite": True,
"acceptNonRoot": True,
},
"inputs": inputs,
}
print(f"Task uniqueId: {unique_id}")
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} ended with status {task['status']}: {task.get('error')}"
)
results = []
cursor = None
while True:
params = {"limit": 100}
if cursor is not None:
params["cursor"] = cursor
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}/results",
headers=headers,
params=params,
)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
break
return results
api_key = os.environ["DATABLIST_API_KEY"]
companies = [
{
"id": "direct-microsoft-us",
"company_name": "Microsoft",
"country": "US",
}
]
lookup_results = find_domains(companies, api_key)
for result in lookup_results:
print(json.dumps(result, indent=2))Kør det fra den terminal, hvor du eksporterede nøglen:
python find_company_websites.pyHer er resultatet for Microsoft:
{
  "inputId": "direct-microsoft-us",
  "status": "success",
  "outputs": {
    "companyUrl": "https://microsoft.com",
    "companyDomain": "microsoft.com",
    "domainConfidence": "High"
  },
  "creditsUsed": "1",
  "error": null
}
Brug inputId til at knytte resultatet til den oprindelige post. status kan være success, no_result, error eller skipped. Et vellykket resultat kan indeholde companyDomain, den fulde companyUrl og domainConfidence. creditsUsed viser prisen for dette input, mens error forklarer en fejl på elementniveau.
Funktionen foretager tre typer API-kald i en fast rækkefølge.
Først indsender den opslaget. Payloaden indeholder indstillingerne og virksomhedsposterne. POST-kaldet returnerer 202 Accepted, og @id er det opgave-ID, som de næste kald skal bruge:
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]Hvis DATABLIST_API_KEY ikke er angivet, udløser Python en KeyError, når miljøvariablen slås op, før der foretages en HTTP-forespørgsel. Eksportér variablen, og kør scriptet igen. Hvis variablen indeholder en ugyldig nøgle, når POST-kaldet frem til API'et og returnerer HTTP 401. Kopiér en aktuel Personal API Key fra din kontoside, og erstat den ugyldige værdi.
Derefter poller den opgaven. POST-kaldet starter arbejdet i baggrunden, så scriptet aflæser opgaven hvert tredje sekund, indtil den får statussen completed, failed eller stopped:
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)Hvis opgaven fejler på grund af manglende credits, har fejlen årsagen credits_error. Tilføj credits, eller vent på, at dine månedlige credits fornyes. Gennemgå eventuelle resultater, der allerede er returneret, og indsend derefter kun de uafsluttede inputs i en ny opgave.
Til sidst henter den alle resultatsider. Hvert svar føjer resultater til listen og leverer cursoren til den næste forespørgsel:
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
breakDen henter næste side, indtil nextCursor er null.
Scriptet udskriver det genererede uniqueId før POST-kaldet. Hvis forbindelsen afbrydes, før du modtager svaret på oprettelsen, bør du først hente din opgaveliste og kontrollere statussen, inden du opretter endnu en opgave:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-name-to-domain"Find opgaven, hvor uniqueId matcher den værdi, scriptet genererede, og kopiér derefter dens @id. Liste-endpointet kan filtrere efter enrichmentId, men ikke efter uniqueId. Brug @id sammen med de samme status- og resultat-URL'er som scriptet. Hvis opgaven stadig er aktiv, skal du fortsætte med at polle den. Hvis den er stoppet eller fejlet, skal du kontrollere, om der findes delvise resultater, før du indsender inputtene igen.
Forstå datamatch og fallback med landekontekst
Scriptet bruger dataset_google, som er den anbefalede standardindstilling. Datablist søger først i sine virksomhedsdatasæt. Hvis et match mangler eller er modstridende, kan Google bruges som fallback. Mulige matches kontrolleres, før der returneres et konfidensniveau.
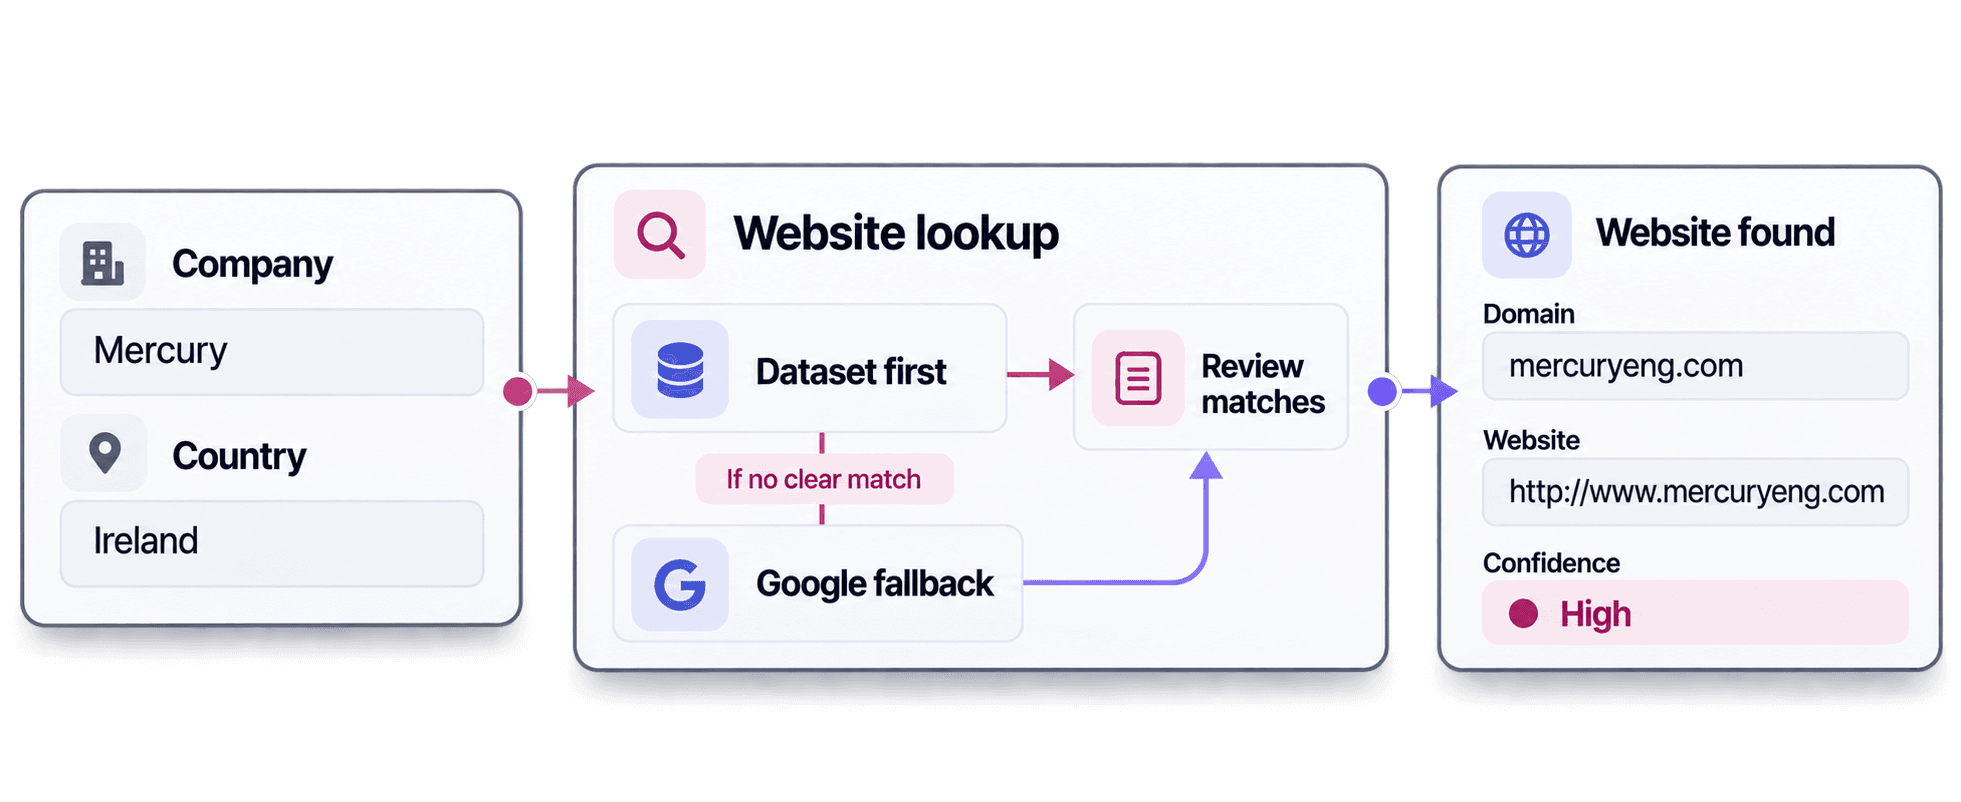
Landekontekst hjælper, når navne kan henvise til flere virksomheder. I dette eksempel gav det samme virksomhedsnavn forskellige resultater:
MercurymedUSreturneredeshipmercury.comoghttps://www.shipmercury.com/.MercurymedIEreturneredemercuryeng.comoghttp://www.mercuryeng.com.
Begge havde konfidensniveauet High. Landekonteksten hjælper opslaget med at vælge mellem virksomheder med samme navn, mens konfidensniveauet gør det lettere at afgøre, hvilke resultater der skal gennemgås.
Når et match også afhænger af branche, virksomhedsstørrelse eller anden forretningskontekst, kan du bruge AI Agent-workflowet til research. Føj oplysningerne til din AI Agent-prompt, så den kan undersøge den ønskede virksomhed med en mere detaljeret forretningskontekst.
Udfyld kun manglende websites i dine poster
Nu hvor find_domains() kan finde et website ud fra et virksomhedsnavn, kan du genbruge funktionen til kun at udfylde manglende websites i dine virksomhedsposter. Poster, der allerede har et website, sendes ikke til API'et. Deres værdier forbliver derfor uændrede, og de bruger ingen credits til opslag.
I find_company_websites.py skal du erstatte alt fra companies = [ til og med det afsluttende print-loop med blokken nedenfor. Behold tildelingen af api_key ovenover. Kontrollen for tomme værdier håndterer None, en tom streng og mellemrum. Der foretages intet API-kald, hvis alle websites allerede er udfyldt.
records = [
{
"id": "crm-001",
"company_name": "Microsoft",
"country": "US",
"website": "https://www.microsoft.com",
},
{
"id": "crm-002",
"company_name": "boulangerie du palais lyon",
"country": "FR",
"website": "",
},
{
"id": "crm-003",
"company_name": "Mercury Engineering",
"country": "IE",
"website": None,
},
{
"id": "crm-004",
"company_name": "Mercury",
"country": "US",
"website": " ",
},
{
"id": "crm-005",
"company_name": "Datablist",
"country": "FR",
"website": "https://www.datablist.com",
},
{
"id": "crm-006",
"company_name": "Mercury",
"country": "IE",
"website": None,
},
]
def website_is_missing(value):
return not isinstance(value, str) or not value.strip()
records_to_lookup = [
record for record in records if website_is_missing(record.get("website"))
]
lookup_results = (
find_domains(records_to_lookup, api_key) if records_to_lookup else []
)
results_by_id = {result["inputId"]: result for result in lookup_results}
for record in records:
if not website_is_missing(record.get("website")):
record["website_lookup"] = {"status": "not_requested"}
continue
result = results_by_id.get(record["id"])
if result is None:
record["website_lookup"] = {
"status": "missing_result",
"domain": None,
"confidence": None,
"credits": None,
"error": {
"code": "missing_result",
"message": "No result was returned for this inputId.",
},
}
continue
outputs = result.get("outputs") or {}
if result["status"] == "success" and outputs.get("companyUrl"):
record["website"] = outputs["companyUrl"]
record["website_lookup"] = {
"status": result["status"],
"domain": outputs.get("companyDomain"),
"confidence": outputs.get("domainConfidence"),
"credits": result.get("creditsUsed"),
"error": result.get("error"),
}
print(json.dumps(records, indent=2))Koden indekserer resultaterne efter inputId og gennemgår derefter de oprindelige poster i deres oprindelige rækkefølge. Objektet website_lookup gemmer resultatet og oplysninger til gennemgang ud for hver behandlet post, også når et resultat mangler eller ikke lykkes.
For crm-001 returnerer website_is_missing() værdien False, fordi Microsoft-URL'en allerede er angivet. Posten føjes ikke til records_to_lookup, så API'et modtager den aldrig. Sammenfletningen bevarer websitet og registrerer statussen som not_requested.
For crm-002 er websitefeltet tomt, så forespørgslen sender bageriet med inputId: crm-002. API'et returnerer det samme inputId. results_by_id bruger det til at finde det korrekte resultat, hvorefter sammenfletningen skriver https://boulangerie-du-palais-lyon.eatbu.com til posten uden at være afhængig af resultaternes rækkefølge.
| ID | Virksomhed | Website efter sammenfletning | Status | Domæne | Konfidens | Credits |
|---|---|---|---|---|---|---|
crm-001 | Microsoft · US | https://www.microsoft.com | not_requested | |||
crm-002 | boulangerie du palais lyon · FR | https://boulangerie-du-palais-lyon.eatbu.com | success | boulangerie-du-palais-lyon.eatbu.com | High | 1 |
crm-003 | Mercury Engineering · IE | https://mercuryeng.com | success | mercuryeng.com | High | 1 |
crm-004 | Mercury · US | https://www.shipmercury.com/ | success | shipmercury.com | High | 1 |
crm-005 | Datablist · FR | https://www.datablist.com | not_requested | |||
crm-006 | Mercury · IE | http://www.mercuryeng.com | success | mercuryeng.com | High | 1 |
Bageriet bruger det virksomhedsspecifikke subdomæne boulangerie-du-palais-lyon.eatbu.com. Behold denne værdi i stedet for at forkorte den til eatbu.com, og gem den præcise adresse fra companyUrl. Indstillingen acceptNonRoot: true tillader også en hostet virksomhedsside, hvor adressen indeholder en sti efter hostnavnet. Derfor er den fulde URL vigtig i begge tilfælde.
En fuldført opgave kan stadig indeholde elementer med statussen no_result, error eller skipped. Eksemplet ændrer kun website, når statussen er success, og companyUrl findes. Ved no_result forbliver websitefeltet tomt, og statussen er fortsat synlig i website_lookup. Kontrollér først virksomhedsnavnet og landet. Hvis et af inputtene er forkert, skal du rette det og indsende posten i en ny opgave. Ellers bør det tomme websitefelt bevares, så posten kan gennemgås manuelt.
Beregn credits før du skalerer scriptet
Alle fem opslag i eksemplet returnerede success med konfidensniveauet High og brugte i alt 5 credits.
Et opslag, der løses via datasættet, koster 1 credit. Et opslag, der behandles med Google, koster 2,5 credits. Du betaler kun for den anvendte metode, ikke for begge. Ved 1.000 inputs betyder det 1.000 credits, hvis alle findes via datasættet, eller 2.500 credits, hvis alle behandles med Google. Det er budgetscenarier og ikke en garanti for, at alle opslag lykkes.
Flyt skyderen for at sammenligne creditforbruget for din liste.
Med en pris på 20 USD for 20.000 credits koster de to scenarier henholdsvis 1 USD og 2,50 USD. Growth-abonnementet betales separat og omfatter i øjeblikket 20.000 månedlige credits, som bruges før tilkøbte credits. Se de aktuelle priser, da abonnements- og pakkepriser kan ændre sig.
Én opgave accepterer op til 10.000 inputs med en grænse på 16 KiB pr. input og 10 MiB pr. forespørgsel. Dette eksempel bruger blokerende Requests-kald til at indsende, polle og hente resultater fra en mindre asynkron Datablist-opgave. Det vedligeholdte repository indeholder også eksempler på CSV-batching og ikke-blokerende klienter.
Næste skridt
Når du har bekræftet, at et returneret website tilhører den ønskede virksomhed, kan du scrape dets Impressum med Python og føje juridiske virksomhedsoplysninger samt URL'en til den juridiske kildeside til den samme leverandørpost. Hold gennemgangen af website-match adskilt fra den efterfølgende dataudtrækning.
Erstat eksempelposterne med et mindre udsnit af dine egne data, kør scriptet, og gennemgå de sammenflettede poster. Behold stabile ID'er og landekontekst, og skaler først op, når scriptet bevarer kendte websites og udfylder de forventede tomme felter. Du kan tage udgangspunkt i de vedligeholdte Company Name to Domain API-eksempler på GitHub, hvis du vil have et script til download, CSV-batching eller en asynkron version.