
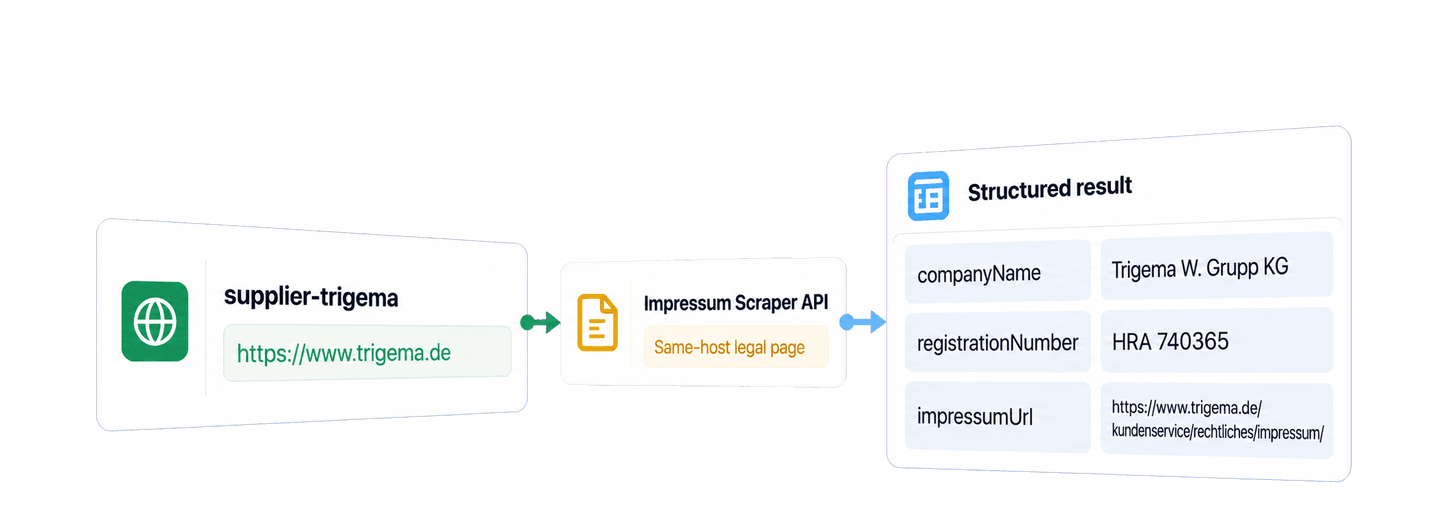
Vil du scrape Impressum-data i Python uden at bygge din egen crawler, kan du bruge Datablists Impressum Scraper API sammen med Requests-biblioteket. Du angiver URL'erne til virksomhedernes websites, hvorefter API'et finder hvert websites Impressum-side og udtrækker strukturerede virksomheds- og kontaktoplysninger.
I dette eksempel bruger jeg to etablerede tyske brands: tøjproducenten Trigema og outdoor-brandet VAUDE. Et lille, kørbart Python-eksempel udfører opslaget og gemmer derefter de udtrukne oplysninger og Impressum-kildens URL sammen med hver leverandørpost.
📌 Kort fortalt
Brug Datablists Impressum Scraper API til at omdanne tyske virksomhedswebsites til strukturerede virksomheds- og kontaktdata. Python-eksemplet indsender to websites, venter på baggrundsopgaven, henter alle resultatsider og gemmer URL'en til den fundne juridiske side sammen med hver post.
- Input: URL'er til tyske virksomhedswebsites.
- Output: Virksomheds- og kontaktoplysninger samt linket til den oprindelige Impressum-side.
💡 Foretrækker du en no-code-løsning? Brug Datablists Impressum Scraper til at udtrække disse virksomhedsoplysninger uden at skrive kode.
Opsæt din API-nøgle og dit Python-miljø
Opret en Datablist-konto, og opret derefter en Personal API Key. Adgang til REST API'et er tilgængelig med Growth-abonnementet. Her er et eksempel på nøglens format:
auth0|exampleuser:exampleaccount:EXAMPLE_TOKEN_NOT_VALID:1Eksportér din egen nøgle som DATABLIST_API_KEY:
export DATABLIST_API_KEY="your-personal-api-key"Til dette Python-eksempel bruger jeg pakken requests. Opret en fil med navnet
scrape_impressum.py, og installer pakken:
python -m pip install requestsHvert indsendt website bruger 10 credits. Eksemplet med to websites nedenfor bruger 20 credits, når begge input behandles.
Byg funktionen scrape_impressums()
Indsæt hele dette script i scrape_impressum.py:
import json
import os
import time
import uuid
import requests
def scrape_impressums(suppliers, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]
payload = {
"enrichmentId": "impressum-scraper",
"uniqueId": str(uuid.uuid4()),
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
suppliers = [
{
"id": "supplier-trigema",
"label": "Trigema",
"website_url": "https://www.trigema.de",
},
{
"id": "supplier-vaude",
"label": "VAUDE",
"website_url": "https://www.vaude.com",
},
]
impressum_results = scrape_impressums(suppliers, api_key)
for result in impressum_results:
print(json.dumps(result, ensure_ascii=False))Kør hele scriptet med:
python scrape_impressum.pyFunktionen følger API'et i tre trin. Den indsender website-inputtene, venter på, at opgaven bliver færdig, og henter derefter alle resultatsider.
Indsend website-inputtene
Scriptet omdanner hver leverandør til et API-input som dette:
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]inputId er din egen stabile identifikator. data.websiteUrl er virksomhedens
startside, som scraperen undersøger. Brug virksomhedens eget website frem for et katalog eller en profil på sociale medier. Payloaden vælger den offentlige enrichment
impressum-scraper og bruger et tomt settings-objekt, fordi dette API ikke kræver offentlige indstillinger.
POST-requesten opretter en baggrundsopgave. Datablist accepterer requesten og
returnerer et task-objekt, hvor @id identificerer den pågældende kørsel. Funktionen bruger dette ID til at opbygge URL'erne til status og resultater.
Et forkortet svar ved oprettelsen ser sådan ud:
{
  "@id": "task-id",
  "enrichmentId": "impressum-scraper",
  "status": "queued",
  "links": {
    "self": "https://api.datablist.com/v1/enrichments/tasks/task-id",
    "results": "https://api.datablist.com/v1/enrichments/tasks/task-id/results"
  }
}
queued betyder, at requesten er accepteret – ikke at resultatet er klar. Scriptet tager det returnerede @id med videre til de næste to trin, så du ikke behøver at kopiere task-URL'er manuelt. Det kalder også raise_for_status(), før hvert svar læses. En godkendelses- eller valideringsfejl stopper derfor ved den HTTP-request, der mislykkedes, i stedet for at blive forvekslet med et gennemført opslag.
Vent på baggrundsopgaven
Datablist behandler opgaven i baggrunden. Eksemplet kontrollerer dens status hvert tredje sekund, indtil den når completed, failed eller stopped.
Requests er et blokerende Python-bibliotek, så dit lokale script venter under disse kald, selvom selve API-opgaven kører i baggrunden.
Hvis opgaven afsluttes med failed eller stopped, udløser funktionen en fejl, der indeholder opgavens ID og slutstatus. Gem dette ID, når du undersøger den eksisterende opgave, i stedet for straks at indsende det samme betalte arbejde igen.
Hent alle resultatsider
Når opgaven er færdig, anmoder scriptet om op til 100 resultater ad gangen. Reglen for paginering er enkel: Hent næste side, indtil nextCursor er null. Når cursoren indeholder en værdi, sender scriptet den med den næste request.
Sammenkæd ikke de returnerede poster med din applikation ud fra deres placering på listen. Resultaterne kan komme i en anden rækkefølge end de indsendte input. Brug inputId som join-nøgle.
Sådan finder API'et en Impressum-side
Startsiden er udgangspunktet, ikke den side API'et forventer at udtrække data fra.
Impressum Scraper bruger AI til at undersøge interne links på det angivne hostnavn og identificere en Impressum-side eller en tilsvarende juridisk side eller kontaktside. Det er vigtigt, fordi linket kan ligge under betegnelser som Rechtliches, Kontakt eller Legal i stedet for på /impressum.
Hvis AI ikke finder et passende internt link, prøver scraperen de almindelige stier
/impressum og /imprint på samme host. Når den har fundet en kildeside, udtrækker AI oplysninger om juridisk virksomhedsnavn, adresse, kontakt, registrering, momsnummer og kilde i ét resultat. Den bruger ikke en søgemaskine og går ikke videre til et eksternt katalog.
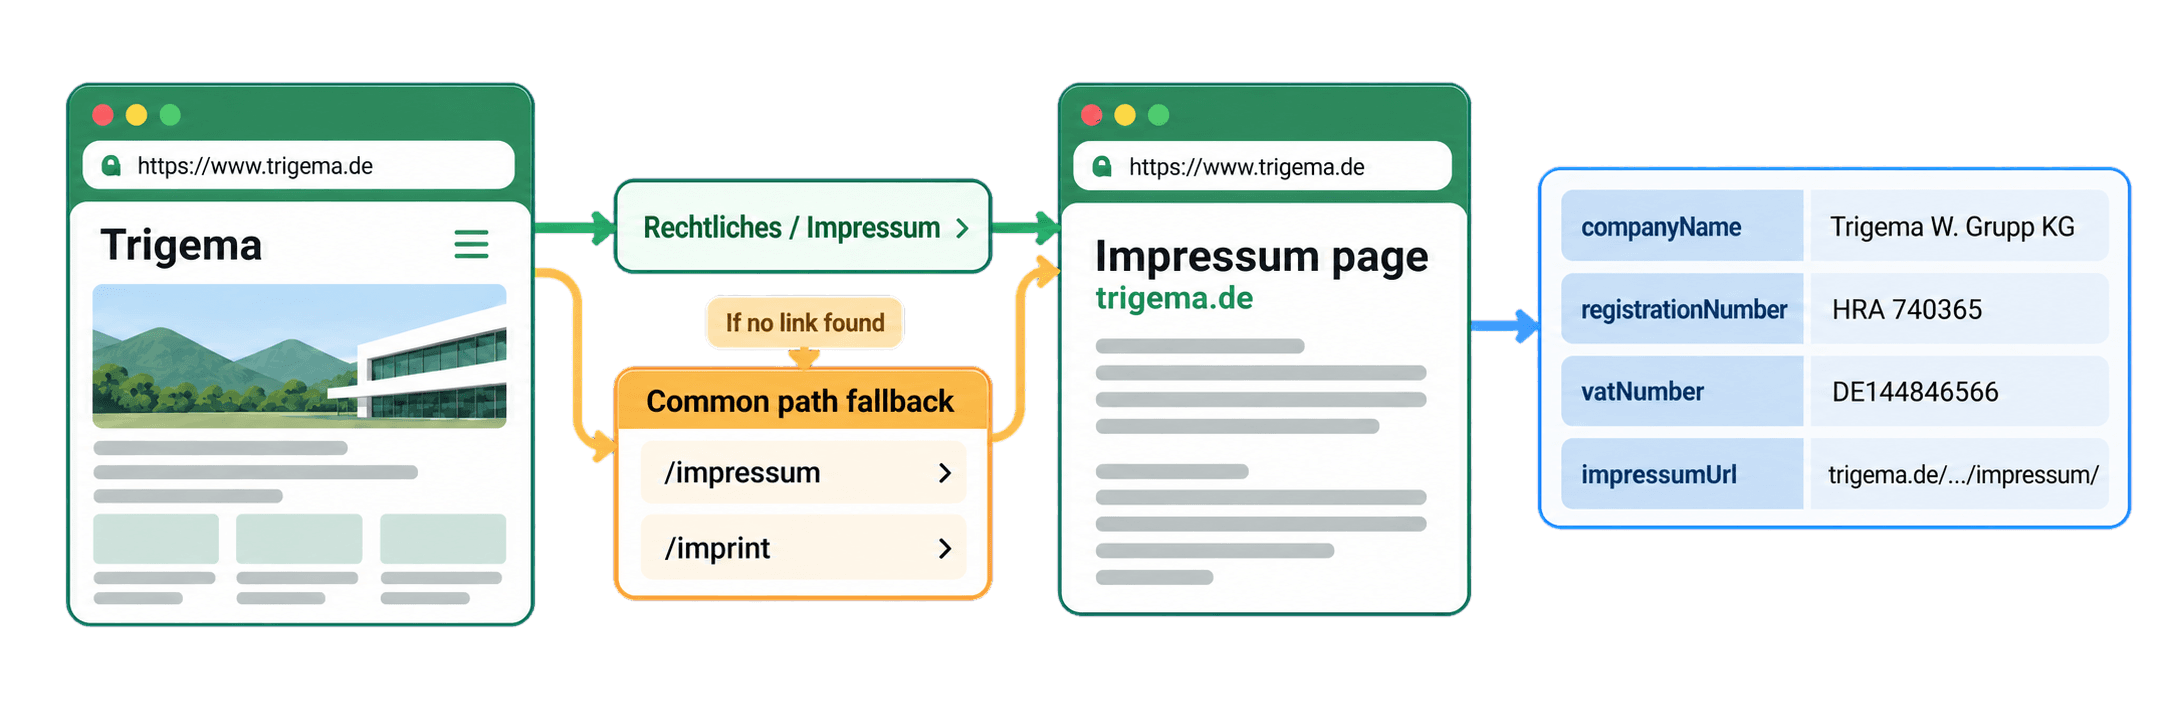
De to resultater viser i praksis, hvordan stierne kan variere. Trigema returnerede
/kundenservice/rechtliches/impressum/, mens VAUDE returnerede
/de/de/impressum.html. Gem impressumUrl sammen med hvert resultat, fordi feltet dokumenterer den præcise kildeside bag de udtrukne oplysninger.
Forstå resultaterne fra Trigema og VAUDE
Her er et kompakt uddrag af de to eksempelresultater.
📘 Eksempler på e-mailadresser: E-mailadresserne er maskeret med
**nedenfor. API'et returnerer de fulde adresser.
[
  {
    "inputId": "supplier-trigema",
    "status": "success",
    "outputs": {
      "firstName": "Wolfgang",
      "lastName": "Grupp",
      "companyName": "Trigema W. Grupp KG",
      "postalAddress": "Josef-Mayer-Str. 31-35, D-72393 Burladingen",
      "emailAddress": "b**@trigema.de",
      "registrationNumber": "HRA 740365",
      "vatNumber": "DE144846566",
      "impressumUrl": "https://www.trigema.de/kundenservice/rechtliches/impressum/",
      "agentConfidenceScore": 90
    },
    "creditsUsed": "10",
    "error": null
  },
  {
    "inputId": "supplier-vaude",
    "status": "success",
    "outputs": {
      "firstName": "Antje",
      "lastName": "von Dewitz",
      "companyName": "VAUDE Sport GmbH & Co. KG",
      "postalAddress": "Vaude Straße 2, 88069 Tettnang",
      "emailAddress": "s**@service.vaude.com",
      "registrationNumber": "HRA 631071",
      "vatNumber": "DE203894755",
      "impressumUrl": "https://www.vaude.com/de/de/impressum.html",
      "agentConfidenceScore": 95
    },
    "creditsUsed": "10",
    "error": null
  }
]
Begynd med navnene. Trigema er leverandørnavnet i Python-inputtet, mens
Trigema W. Grupp KG er det juridiske virksomhedsnavn, der er udtrukket fra Impressum-siden. Den samme forskel ses for VAUDE: Inputnavnet er VAUDE, mens den returnerede virksomhed er VAUDE Sport GmbH & Co. KG. Ved at gemme begge værdier kan du bevare det genkendelige navn, dit team bruger, og samtidig tilføje den juridiske enhed fra virksomhedens eget website. Det er især nyttigt, når du sammenligner en leverandørpost med en faktura, en kontrakt eller et andet virksomhedsdatasæt, hvor det længere juridiske navn kan være anvendt.
De returnerede felter besvarer forskellige researchspørgsmål:
firstNameoglastNameindeholder navnet på den administrerende direktør eller stifter, som er udtrukket fra siden, når det findes. Her er det Wolfgang Grupp og Antje von Dewitz.postalAddressindeholder virksomhedsadressen fra den juridiske side, mens felterne med e-mail og telefonnummer indeholder de kontaktoplysninger, der er offentliggjort dér.registrationNumberogvatNumberbevarer de identifikatorer, der står på siden. For Trigema er værdierneHRA 740365ogDE144846566; for VAUDE er deHRA 631071ogDE203894755. Det giver dig konkrete værdier, som du kan sammenligne med identifikatorerne i dine eksisterende leverandørdata.impressumUrlidentificerer den side, der blev brugt til udtrækningen. Feltet er adskilt fra den indsendte startside, fordi det ene registrerer den virksomhed, du tog udgangspunkt i, mens det andet dokumenterer kilden til de juridiske virksomhedsoplysninger.
Begge poster har status: success og brugte 10 credits.
agentConfidenceScore er et signal fra 0 til 100, som hjælper dig med at prioritere manuel kontrol. Det er ikke en procentangivelse af nøjagtigheden. Outputfelter kan stadig være tomme, hvis en værdi mangler på siden eller ikke kan udtrækkes. Gem derfor postens status, og åbn den returnerede Impressum-URL, når en oplysning er vigtig for dit næste trin.
Det dokumenterede output kan også indeholde køn, telefonnummer og andre kontaktoplysninger. Se den aktuelle struktur i API-dokumentationen til Impressum Scraper.
Omdan outputtet til leverandørdata
Det direkte API-kald virker allerede. Nu kan du sætte det ind i en konkret opgave med leverandørresearch. Ved identifikation eller onboarding af leverandører har du måske allerede et stabilt ID, det korte navn, dit team bruger, og en startside. Impressum-resultatet tilføjer den juridiske virksomhed bag websitet, dens offentliggjorte identifikatorer og kontaktoplysninger samt den side, hvor oplysningerne blev fundet.
Følgende kodestykke indekserer resultaterne efter inputId og opbygger lokale poster til virksomhedsresearch. Tilføj det efter kaldet til scrape_impressums() i det komplette script:
results_by_id = {
result["inputId"]: result for result in impressum_results
}
company_research = []
for supplier in suppliers:
result = results_by_id[supplier["id"]]
company_research.append(
{
"supplier_id": supplier["id"],
"supplier_label": supplier["label"],
"website_url": supplier["website_url"],
"status": result["status"],
"outputs": result.get("outputs", {}),
"credits_used": result["creditsUsed"],
"error": result.get("error"),
}
)
print(json.dumps(company_research, indent=2, ensure_ascii=False))For Trigema bevarer posten supplier-trigema, visningsnavnet Trigema og
https://www.trigema.de. Det indlejrede outputs-objekt tilføjer
Trigema W. Grupp KG, virksomhedens adresse og identifikatorer, Wolfgang Grupps returnerede navn og URL'en til den oprindelige Impressum-side. VAUDE-posten følger samme kæde fra navnet VAUDE og startsiden til VAUDE Sport GmbH & Co. KG og virksomhedens egen kildeside. Du kan nu sammenligne eller gruppere poster efter juridisk virksomhed uden at miste den oprindelige leverandøridentitet, som satte researchen i gang.
Posten samler de returnerede oplysninger, den gennemførte API-status, forbruget på 10 credits og den offentlige fejlværdi med leverandørens ID, navn og website.
Den vigtige regel ved sammenfletningen er opslaget i dictionary-objektet ud fra leverandør-ID'et. Det forbinder stadig det rigtige resultat, hvis API'et returnerer VAUDE før Trigema. Kodestykket beholder også mislykkede elementresultater i company_research, fordi det ikke filtrerer efter status. Et element med no_result eller error forbliver tilgængeligt med sit ID og sin fejl i stedet for at forsvinde fra din kontrolkø.
Koden forbereder lokale researchposter. Du kan serialisere listen eller sende den videre til din egen kode uden at foretage endnu et API-kald.
Beregn prisen på API-kald
Impressum Scraper bruger fast 10 credits pr. indsendt website. De to websites i eksemplet brugte i alt 20 credits. Med samme sats bruger 1.000 websites 10.000 credits.
Growth-abonnementet giver adgang til REST API'et og inkluderer credits i abonnementet. Du kan købe ekstra credits som top-up, når du har brug for flere. Adgang via abonnementet, inkluderede credits og køb af top-ups er separate dele af prisen. Tjek derfor Datablists aktuelle priser, før du planlægger en større kørsel.
Løs typiske fejl uden at betale to gange
Scriptet stopper før første request
Hvis DATABLIST_API_KEY mangler, udløser scriptet fejlen Set DATABLIST_API_KEY before running this script. Eksportér variablen i den samme terminal, og kør filen igen:
export DATABLIST_API_KEY="your-personal-api-key"
python scrape_impressum.pyAPI'et afviser requesten
response.raise_for_status() stopper ved en HTTP-fejl. Kontrollér, at du har angivet en gyldig Personal API Key, og at din konto har adgang til REST API'et. Det adskiller sig fra en manglende variabel: En ugyldig værdi når frem til API'et og modtager et HTTP-svar.
Opgaven mislykkes eller stopper
Den udløste fejl indeholder opgavens ID og status. Undersøg den eksisterende opgave, dens resultater og dens credit-felter, før du opretter en ny opgave. En mislykket eller stoppet opgave kan stadig indeholde resultater og credit-forbrug, så en omgående gentagelse kan medføre, at du betaler for det samme arbejde to gange.
Et resultat er ufuldstændigt
En afsluttet opgave kan indeholde no_result, error eller ufuldstændige output på elementniveau. Gem postens inputId, status, impressumUrl, når den er tilgængelig, og den offentlige error. Kontrollér, at inputtet er virksomhedens egen startside eller roddomæne, og undersøg derefter websitet, før du beslutter, om endnu et opslag er relevant.
Dokumentationen om tasks forklarer statusser, paginering af resultater, opgavehistorik, grænser og opbevaring mere detaljeret.
Næste trin
Du har nu en kørbar Python-integration med Requests, som indsender tyske virksomhedswebsites, venter på Impressum Scraper-opgaven, henter alle resultatsider og gemmer strukturerede virksomhedsoplysninger med deres kilde-URL'er i lokale poster til leverandørresearch.
Udskift de to eksempelleverandører med dine egne stabile ID'er og website-URL'er.
Gennemgå derefter hver returneret impressumUrl, før du bruger de udtrukne felter i din videre proces. Du kan hente det vedligeholdte
synkrone Requests-eksempel
eller skifte til projektets
asynkrone HTTPX-eksempel,
når du har brug for ikke-blokerende samtidighed.