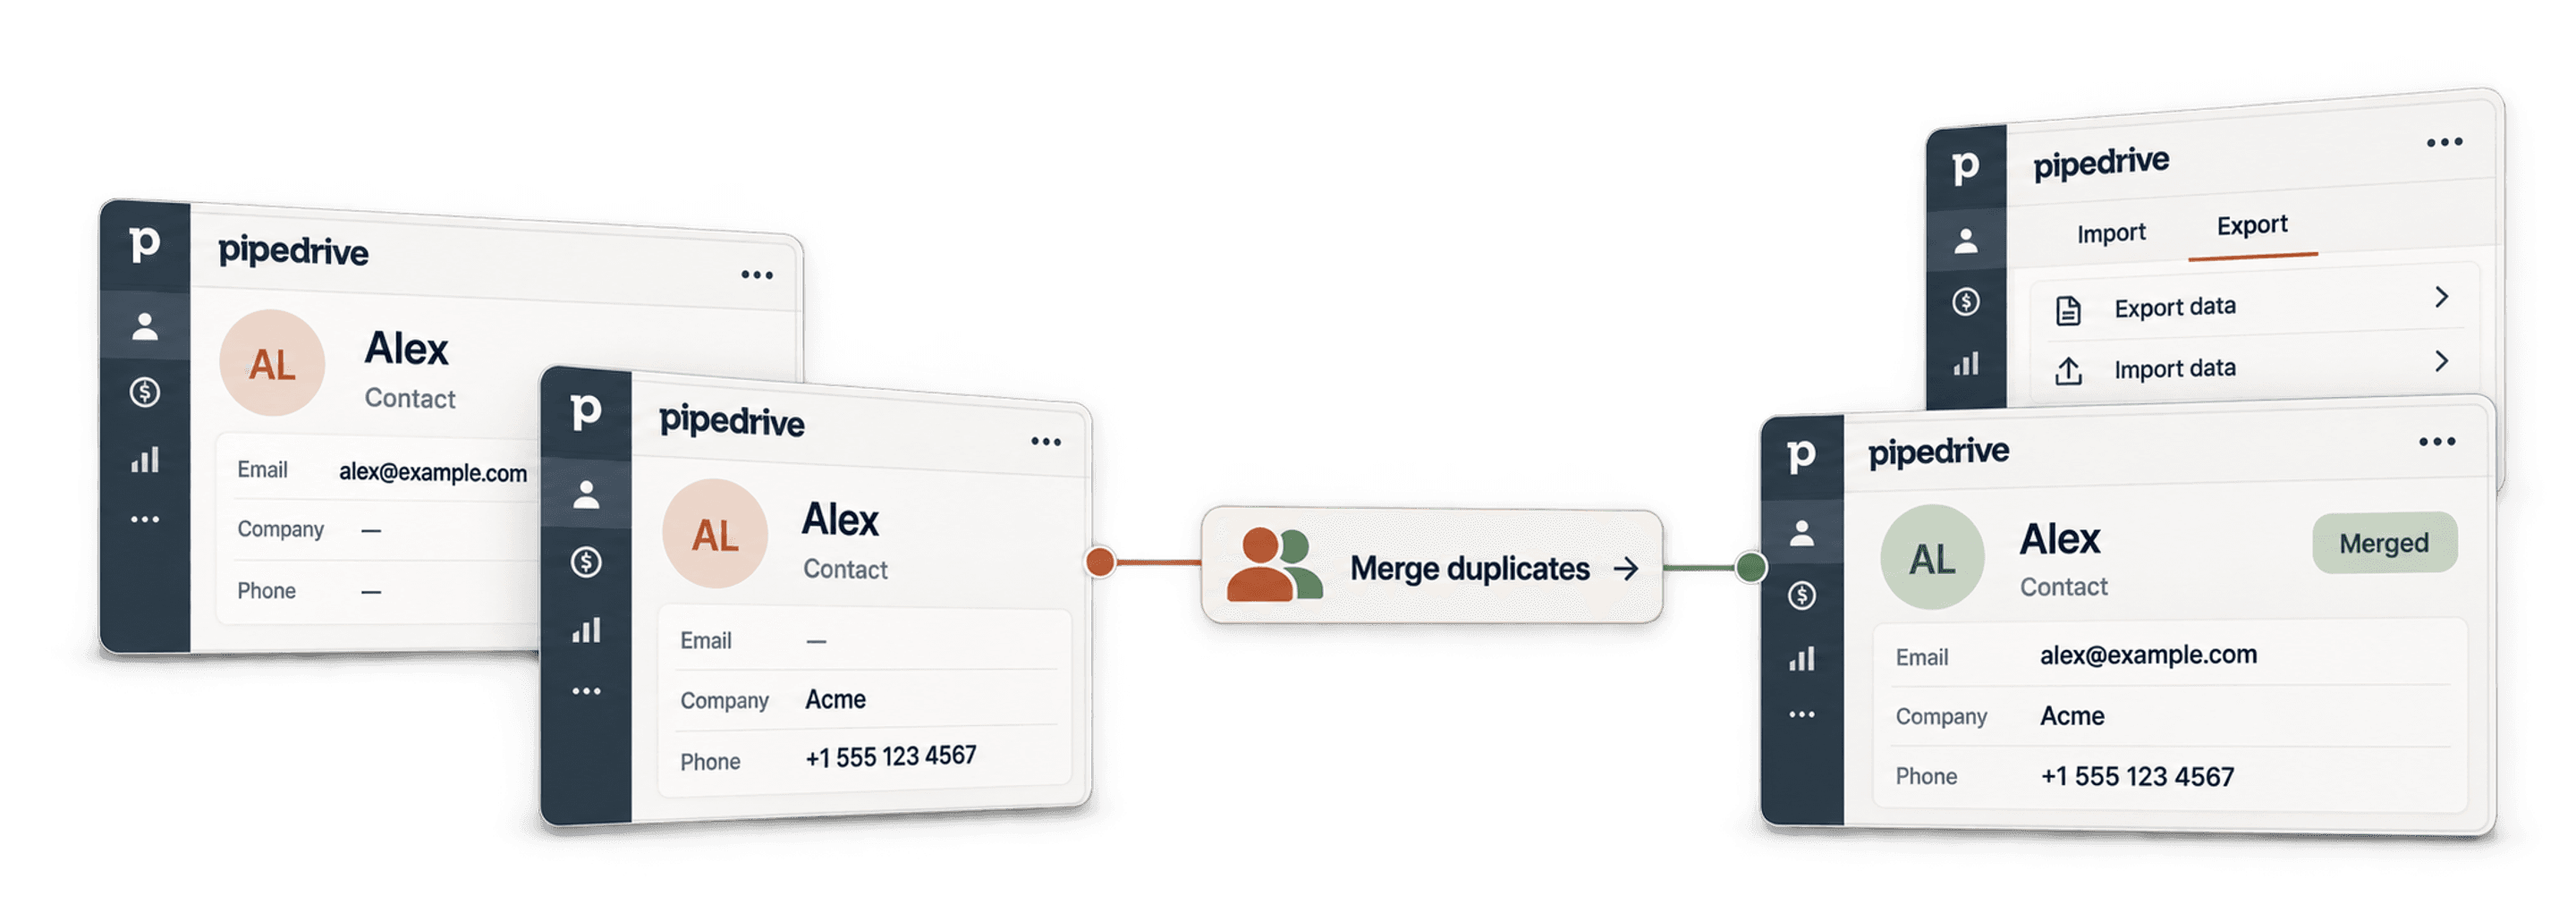
Pour fusionner en masse les doublons dans Pipedrive avec Datablist, importez vos People ou Organizations, identifiez les groupes potentiels à partir d’une clé fiable, vérifiez la fiche principale et les valeurs en conflit, puis synchronisez les modifications validées vers Pipedrive. Conservez une copie du fichier de modifications exporté afin de pouvoir contrôler les fiches obtenues.
Pipedrive propose déjà une fonction de fusion des doublons, qu’il est judicieux de tester en premier. Ses règles de correspondance recherchent soit un même nom de personne associé à un email, un numéro de téléphone ou une organisation, soit un même nom d’organisation associé à une adresse. Certaines fiches peuvent donc passer entre les mailles du filet lorsque le nom de l’entreprise varie ou que le site web constitue la meilleure clé de rapprochement.
Dans ce guide, nous utilisons Datablist pour vérifier les correspondances en commençant par l’email ou le site web, puis par la similarité des noms d’entreprise lorsque c’est pertinent. Vous pourrez exporter les modifications et les appliquer à Pipedrive après avoir vérifié quelle fiche doit être conservée.
Si ces règles de correspondance ne couvrent pas vos données, le Duplicates Finder de Datablist vous permet d’utiliser d’autres clés et de choisir comment résoudre les conflits. Le workflow comporte trois étapes, suivies d’une comparaison avec l’outil natif de Pipedrive :
- Importez vos People et/ou Organizations Pipedrive dans Datablist
- Détectez et fusionnez les doublons avec des algorithmes avancés
- Synchronisez les fusions en masse vers Pipedrive
- Découvrez les limites de la fusion native de Pipedrive
Étape 1 : importer vos contacts Pipedrive
Commencez par importer vos données Pipedrive dans Datablist. Placez les People et les Organizations dans des collections distinctes afin que chaque traitement utilise les bons identifiants et champs de correspondance.
1. Créez une nouvelle collection Datablist
Dans Datablist, une collection fonctionne comme une feuille de calcul dans laquelle vous stockez et nettoyez vos données. Chaque collection contiendra soit vos contacts Pipedrive (People), soit vos entreprises (Organizations).
- Pour dédupliquer les People, créez une collection dédiée aux People.
- Pour dédupliquer les Organizations, créez une collection dédiée aux Organizations.
- Si vous devez nettoyer les deux, créez deux collections distinctes : une pour les People et une pour les Organizations.
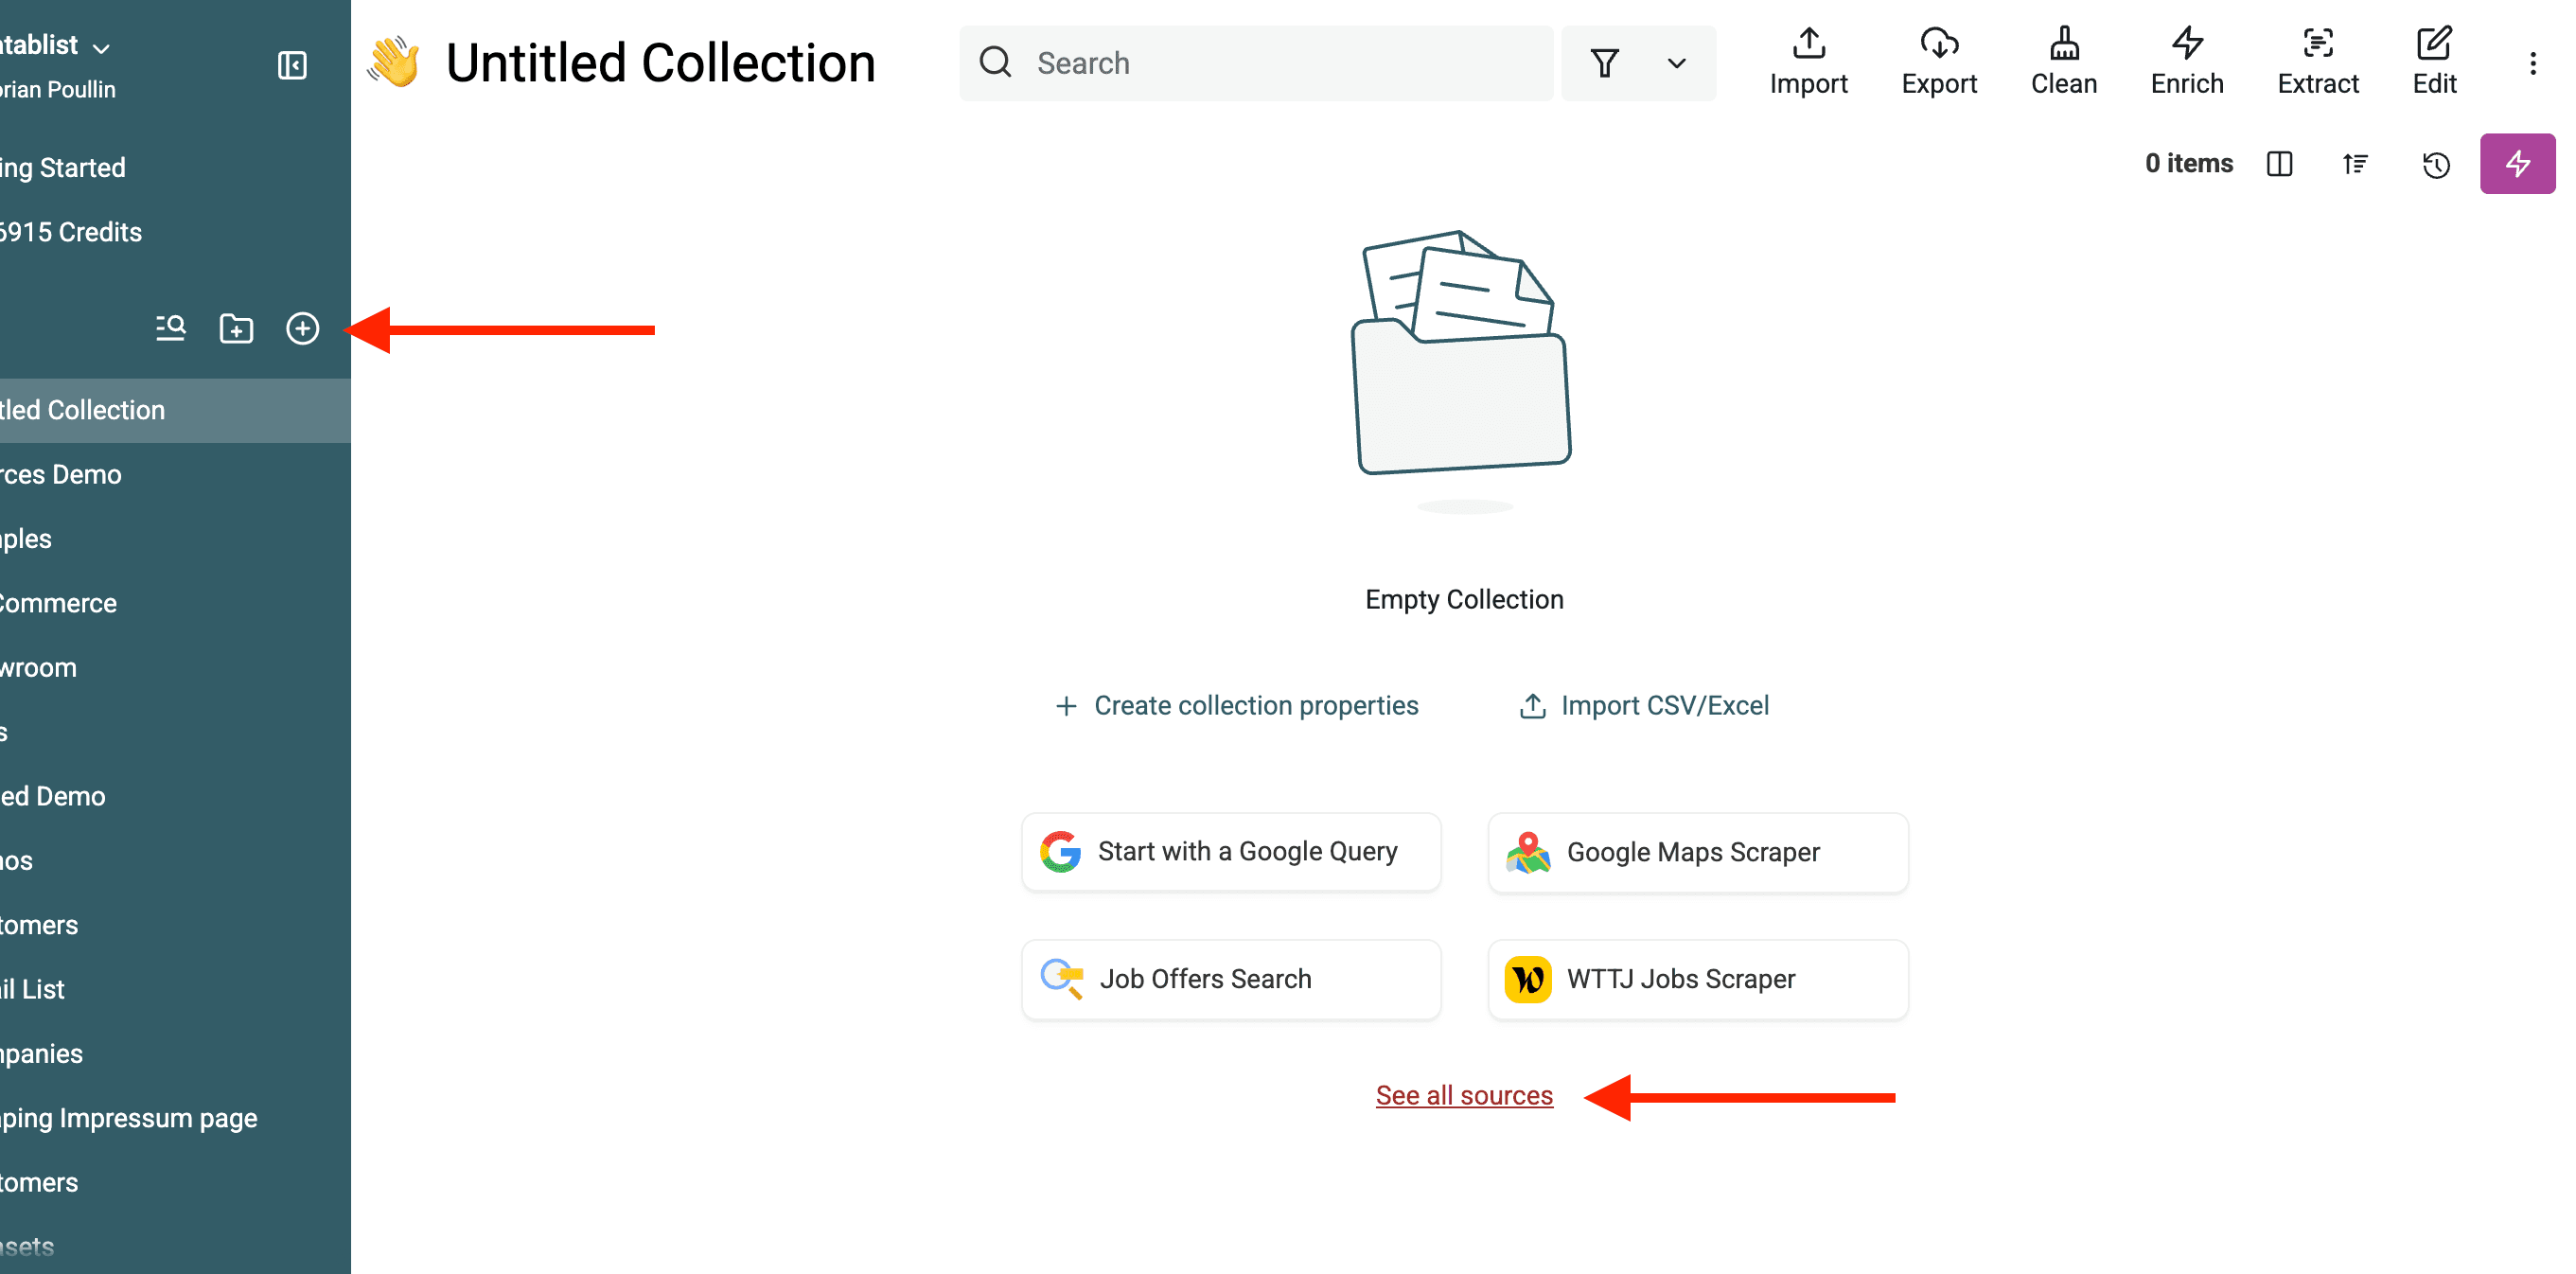
2. Sélectionnez « Source → Pipedrive »
Datablist se connecte directement à votre compte Pipedrive via l’API.
Dans votre collection Datablist, ouvrez Import → sélectionnez Source → choisissez Pipedrive. Vous pouvez également passer directement par le lien « See all sources » sur l’écran de démarrage de la collection.
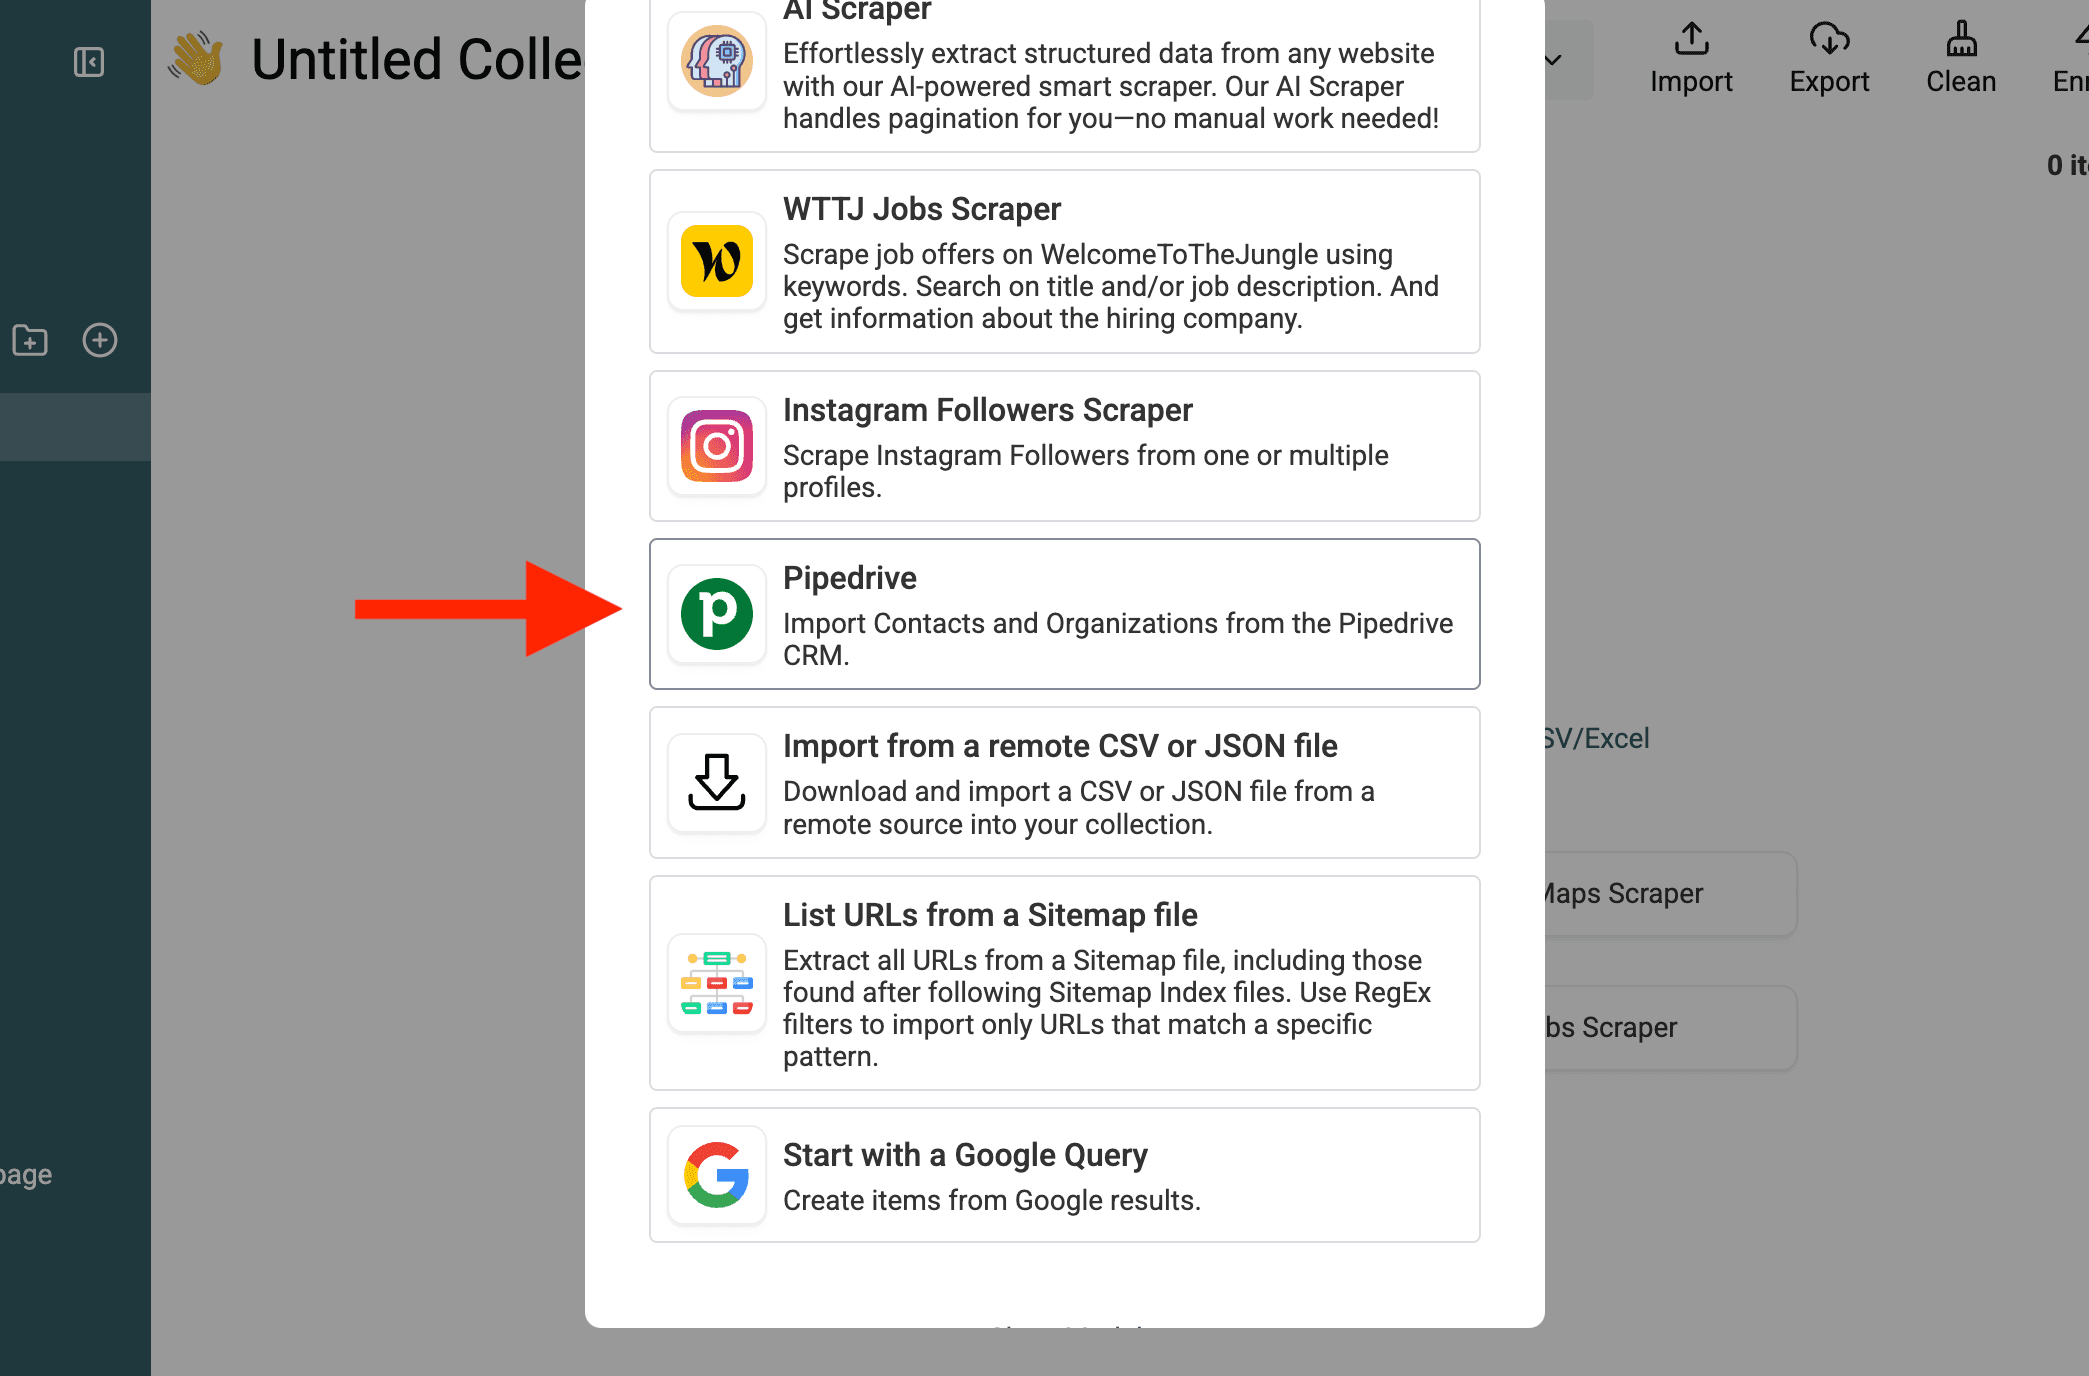
3. Trouvez votre clé API Pipedrive
Vous devrez renseigner votre clé API Pipedrive.
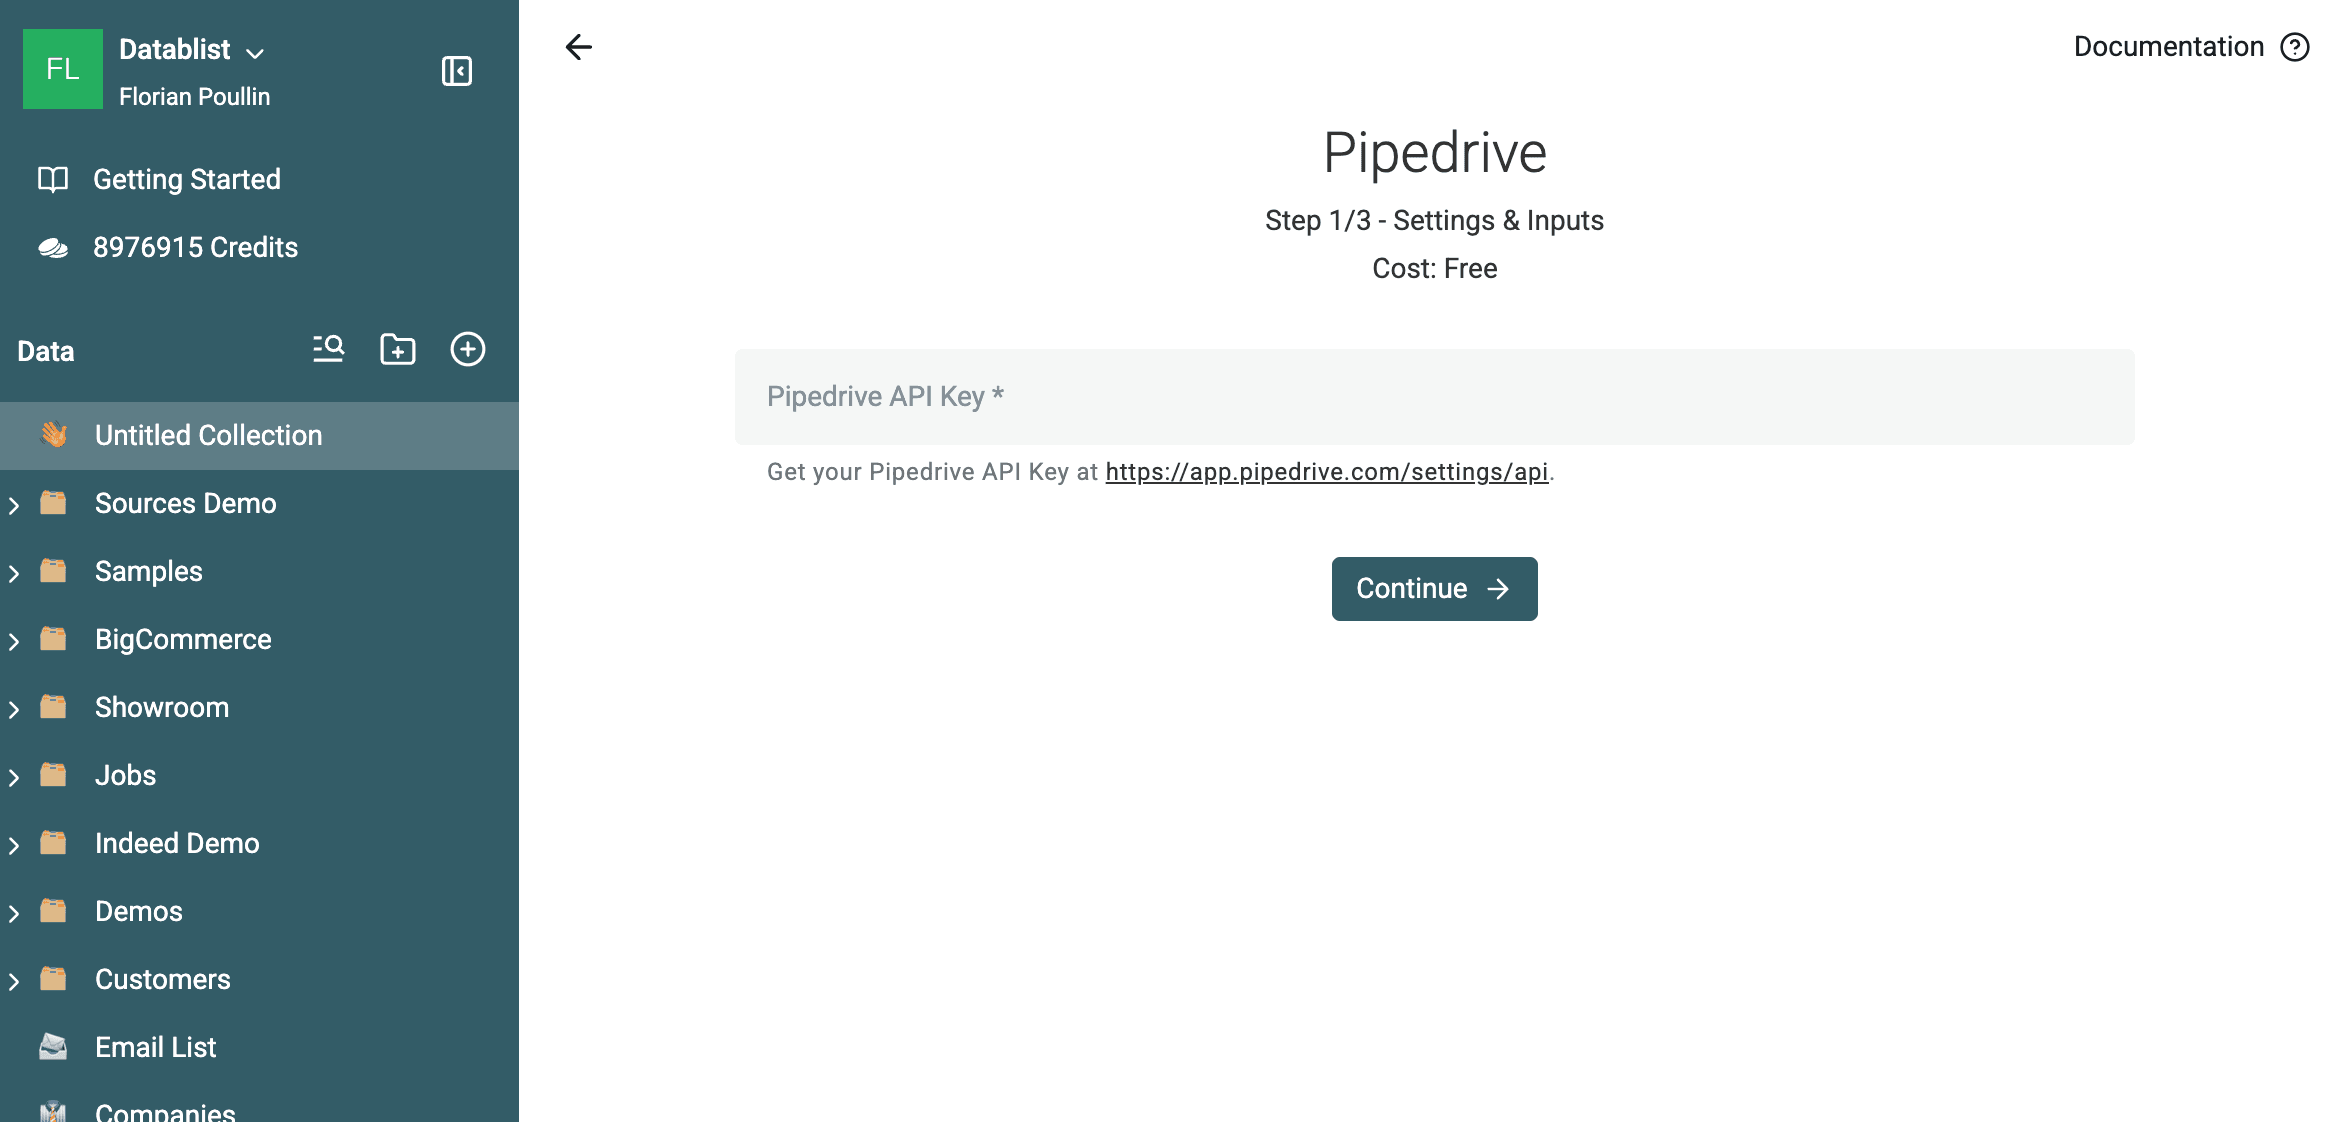
Votre clé API Pipedrive est indispensable pour relier Datablist à votre compte Pipedrive. Accédez aux paramètres API de Pipedrive, copiez votre clé API personnelle, puis collez-la dans Datablist.
4. Choisissez People ou Organizations
Une fois la connexion établie, choisissez les données à importer :
- Pour nettoyer les doublons de contacts, sélectionnez People.
- Pour nettoyer les doublons d’entreprises, sélectionnez Organizations.
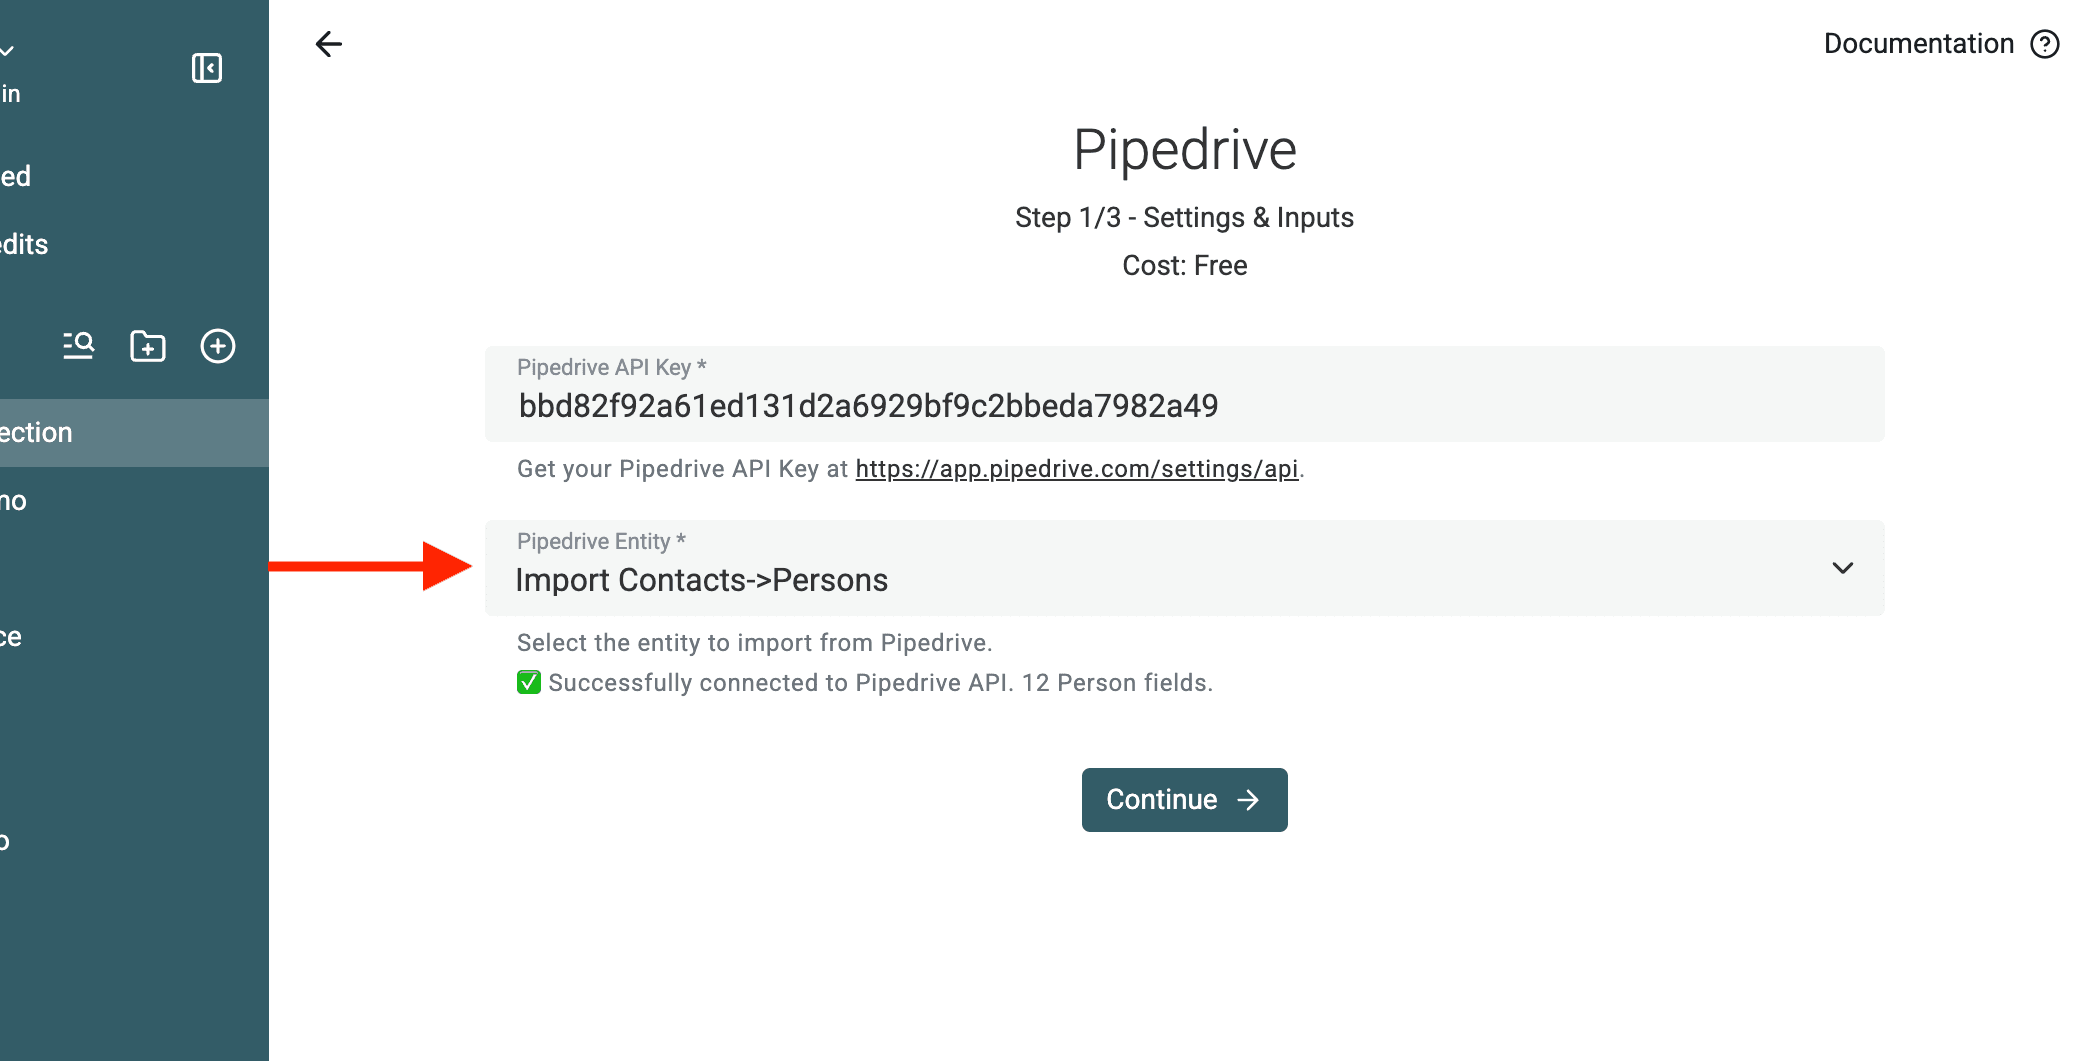
Remarque : si vous avez besoin des deux, importez-les séparément dans deux collections différentes.
Pourquoi séparer les collections ? - Pipedrive ne stocke pas les People et les Organizations de la même façon. Vous ne pouvez pas dédupliquer les deux types de fiches simultanément. Les séparer garantit des résultats fiables.
5. Datablist récupère tous les champs Pipedrive
Après avoir sélectionné People ou Organizations, Datablist importe :
- Les champs Pipedrive standards (Name, Email, Phone, Website, etc.).
- Les champs personnalisés que vous avez créés dans Pipedrive.
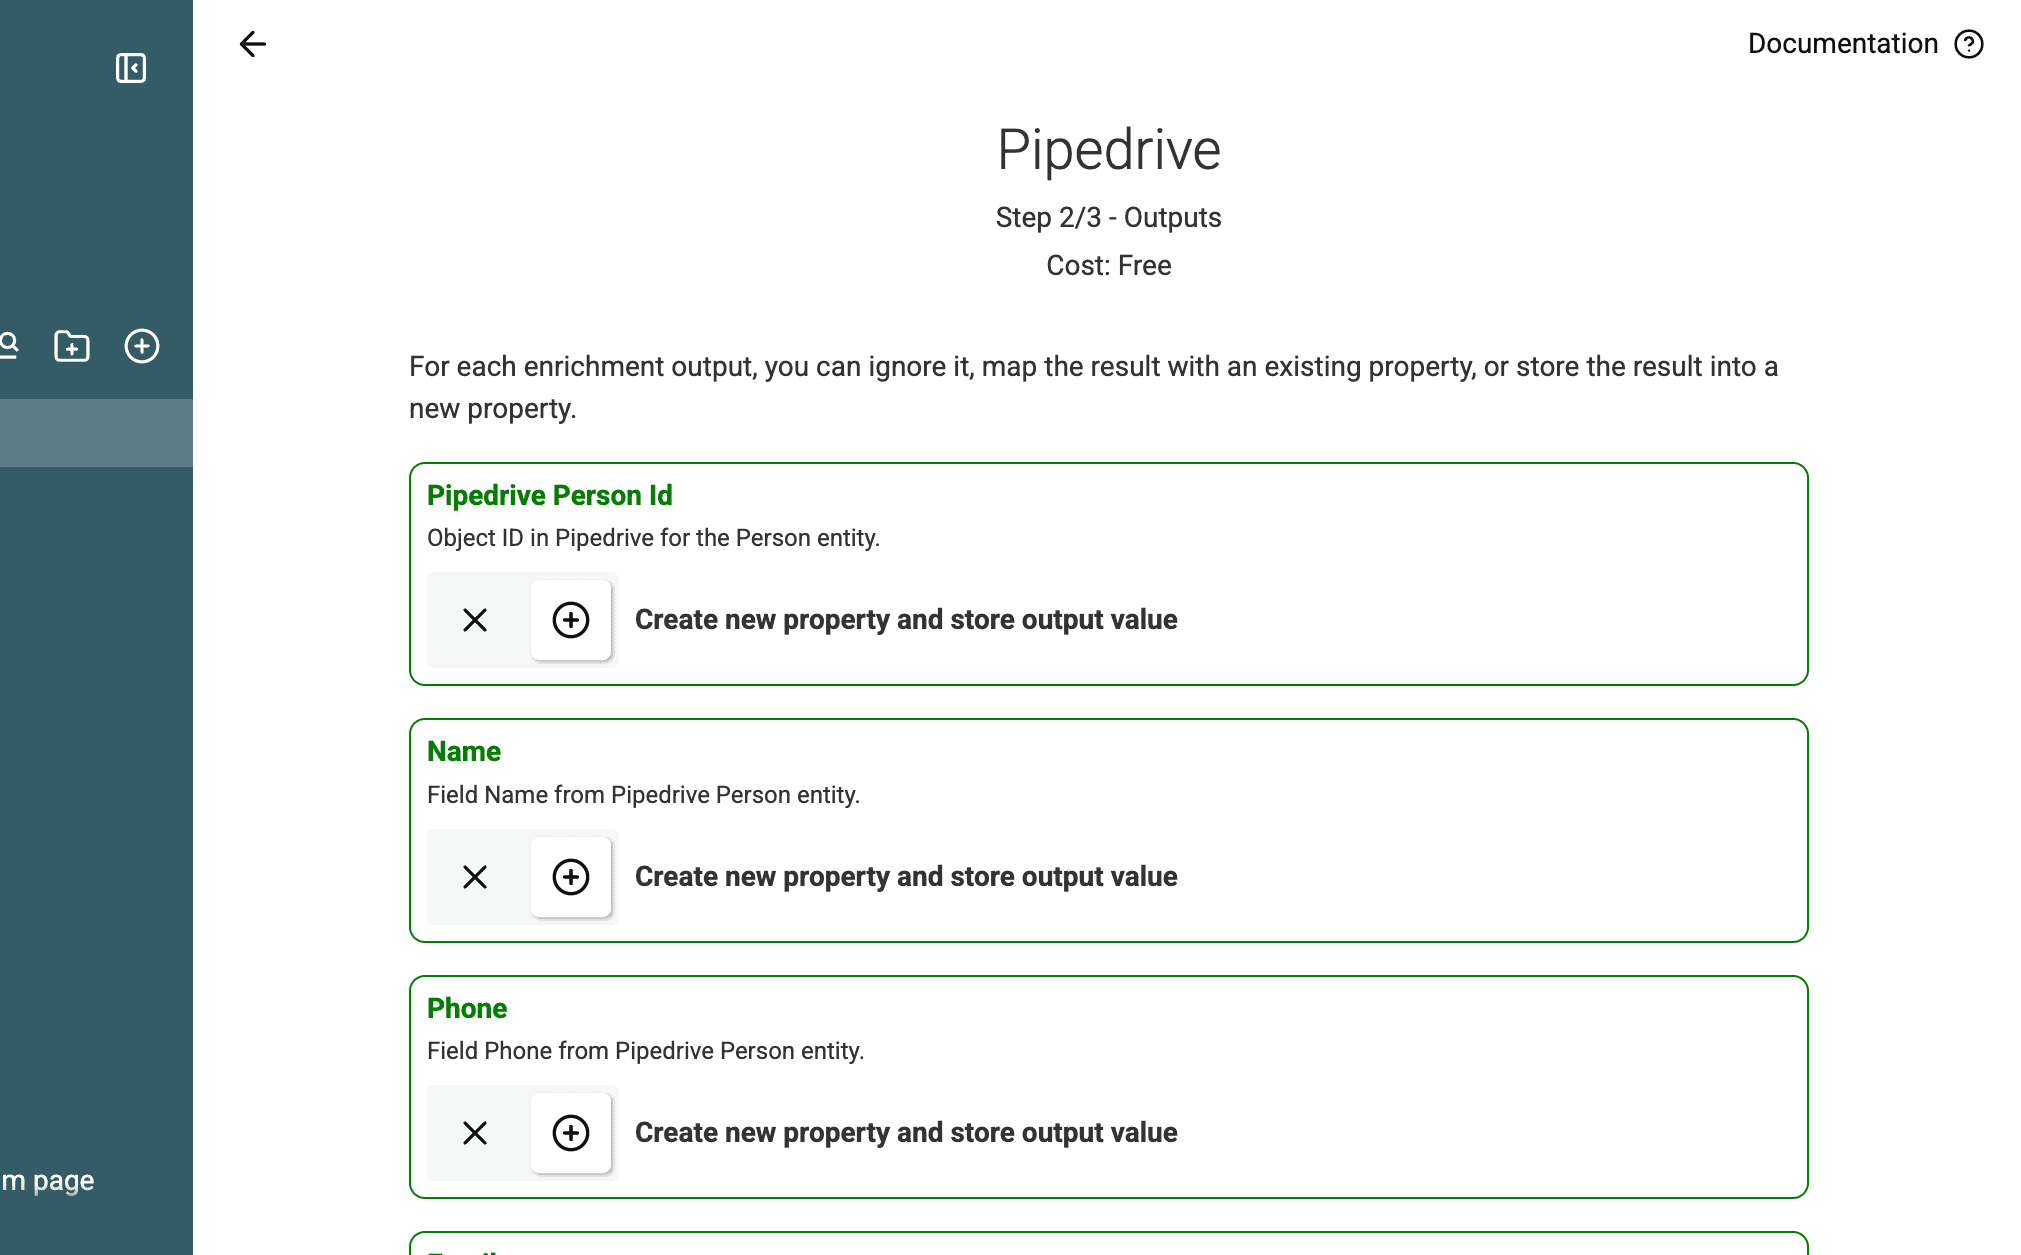
Vous disposez ainsi de toutes les données utiles à la déduplication.
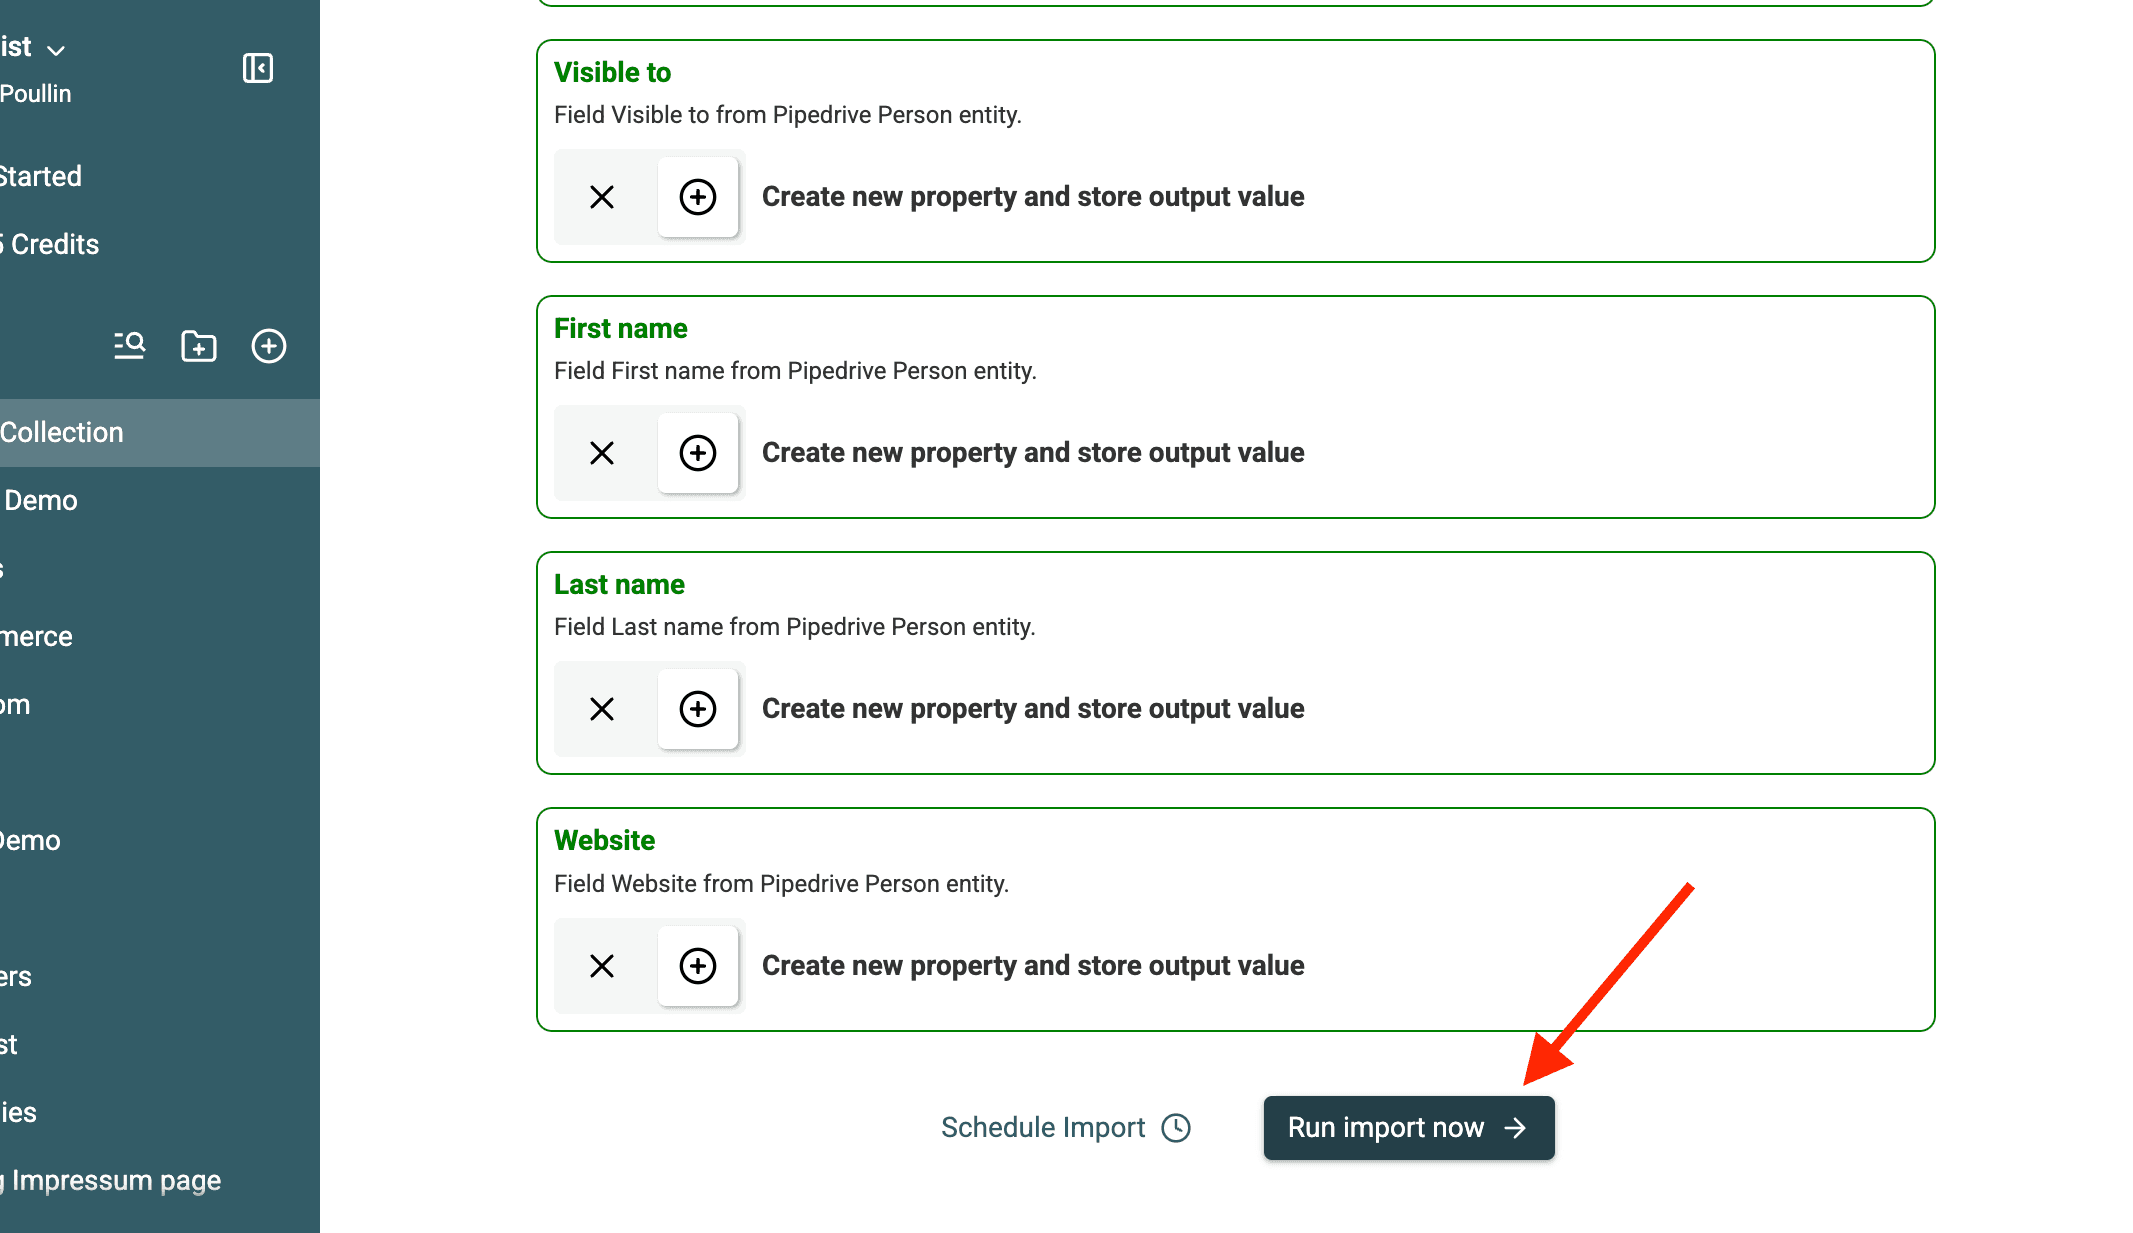
6. Lancez l’import
Cliquez sur Import pour commencer à récupérer vos données. La durée de l’opération dépend du nombre de fiches.
Datablist traite vos contacts et les structure en vue de leur déduplication.
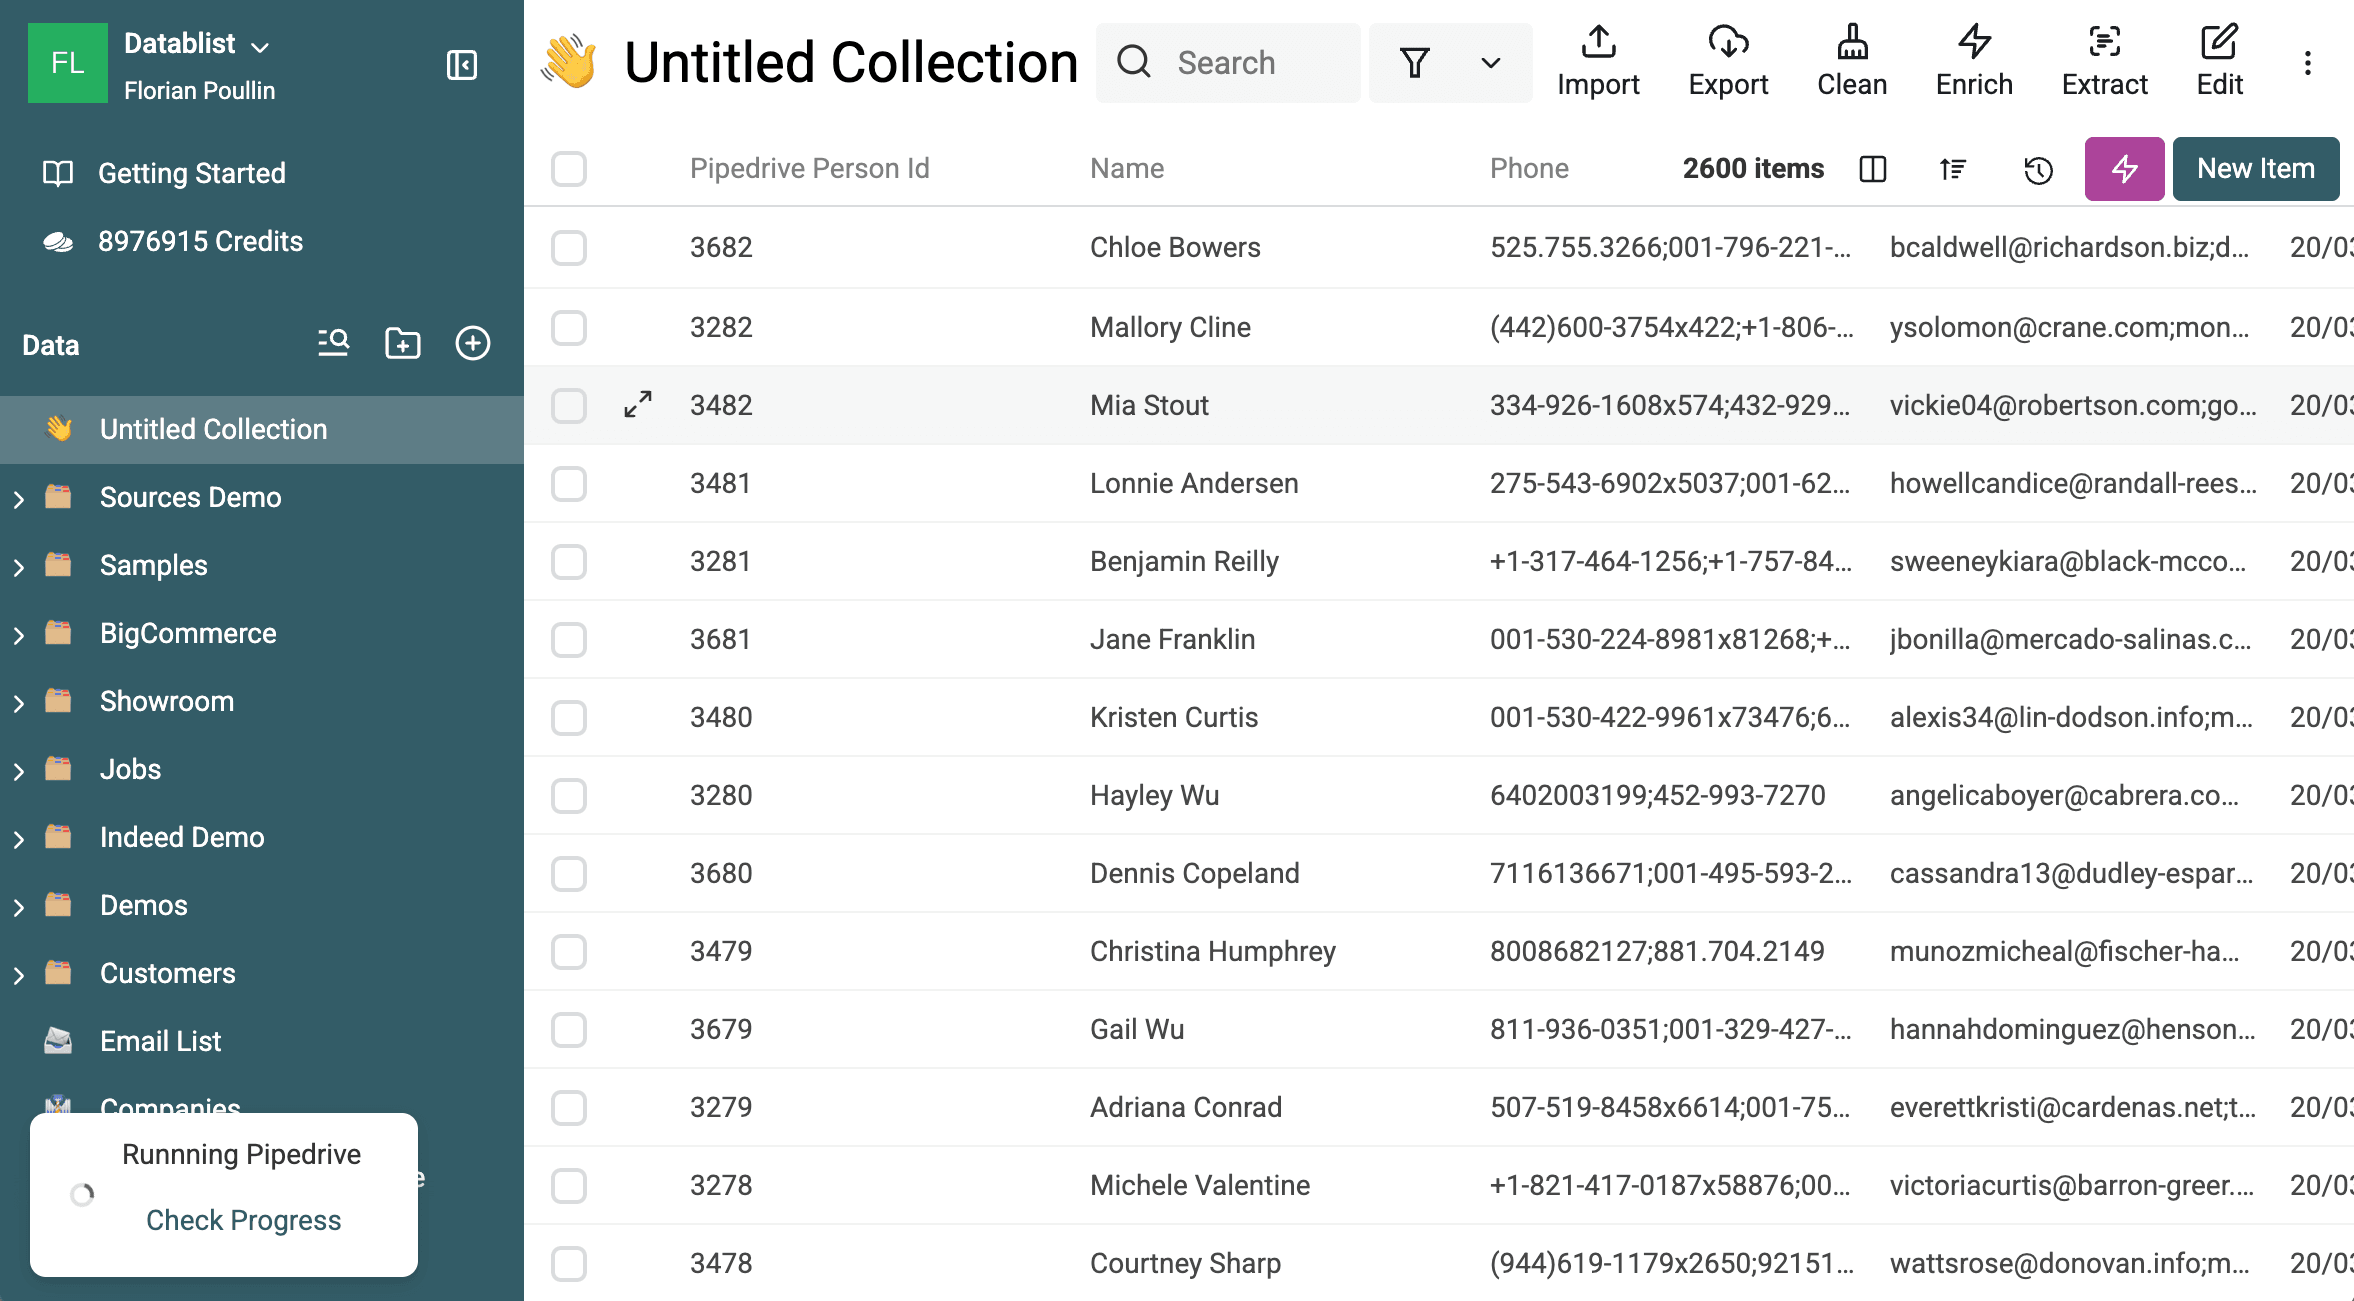
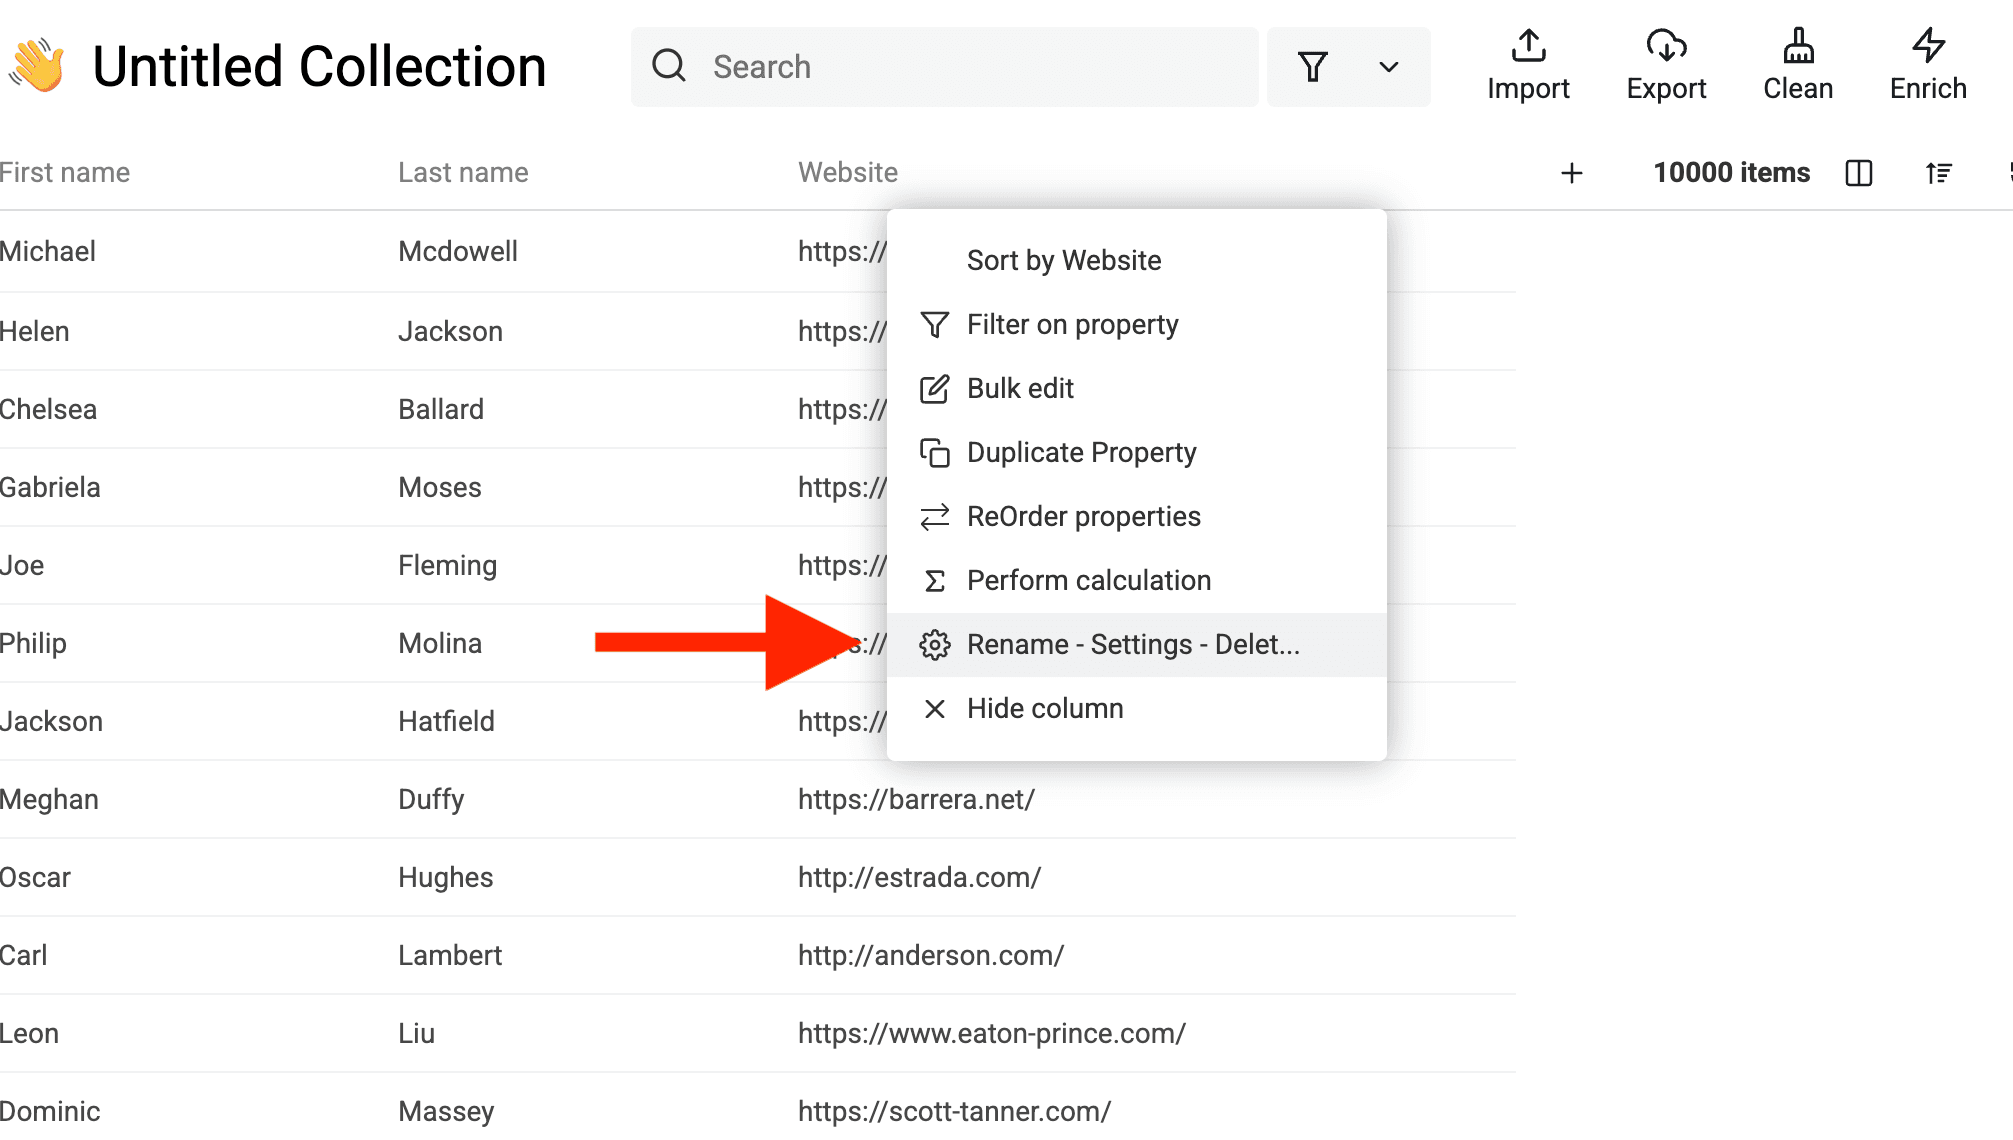
Modifiez le type de données des URL
Le Duplicates Finder de Datablist dispose de processeurs spécifiques pour les Emails, les URLs, etc. Si vos données contiennent des sites web, définissez le type de leur propriété sur URL.
Plusieurs adresses email et numéros de téléphone
Lorsqu’un contact possède plusieurs adresses email ou numéros de téléphone dans Pipedrive, ces valeurs sont regroupées dans un seul champ et séparées par un point-virgule ;.
Exemple :
- John Doe possède deux adresses email dans Pipedrive :
john@company.cometj.doe@gmail.com. - Dans Datablist, il apparaît ainsi : Email :
john@company.com;j.doe@gmail.com
Datablist peut ainsi traiter correctement les valeurs multiples pendant la déduplication.
Si vous souhaitez ensuite obtenir une adresse email ou un numéro de téléphone par ligne de CSV, utilisez le CSV Rows Splitter après avoir exporté votre fichier nettoyé.
Une fois l’import terminé, vos données sont prêtes à être dédupliquées. Passons maintenant à la détection des doublons avec des techniques de rapprochement avancées.
Étape 2 : détecter les doublons Pipedrive
Maintenant que vos contacts ou organisations Pipedrive sont dans Datablist, il est temps de détecter les doublons. Contrairement à l’outil natif de Pipedrive, Datablist utilise des algorithmes de rapprochement avancés pour repérer les fiches similaires, même lorsque les noms diffèrent légèrement ou que certaines coordonnées sont manquantes.
Voici comment procéder :
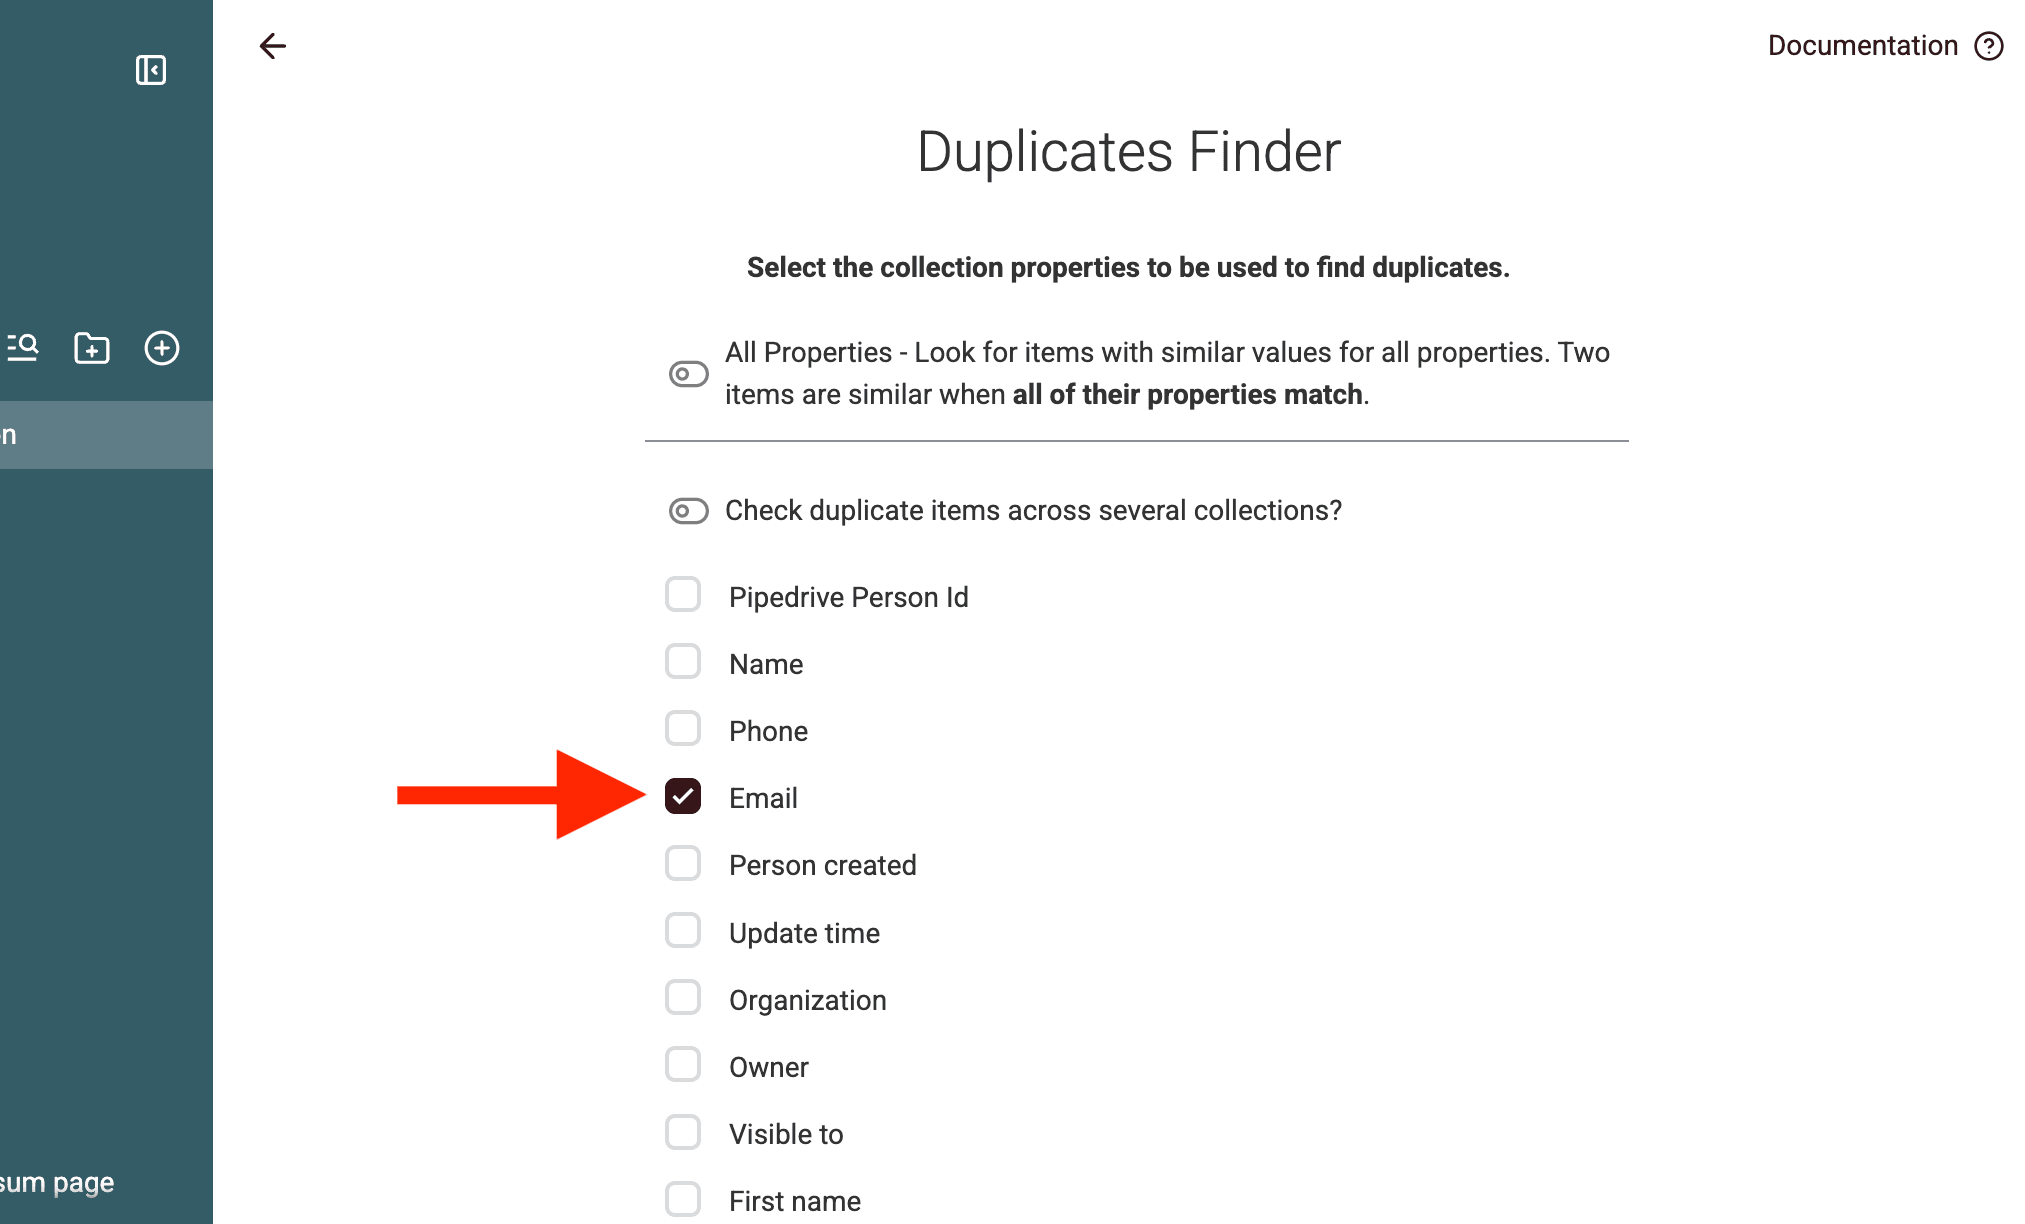
1. Ouvrez Duplicates Finder et choisissez une propriété
Dans votre collection Datablist, ouvrez Clean → Duplicates Finder.
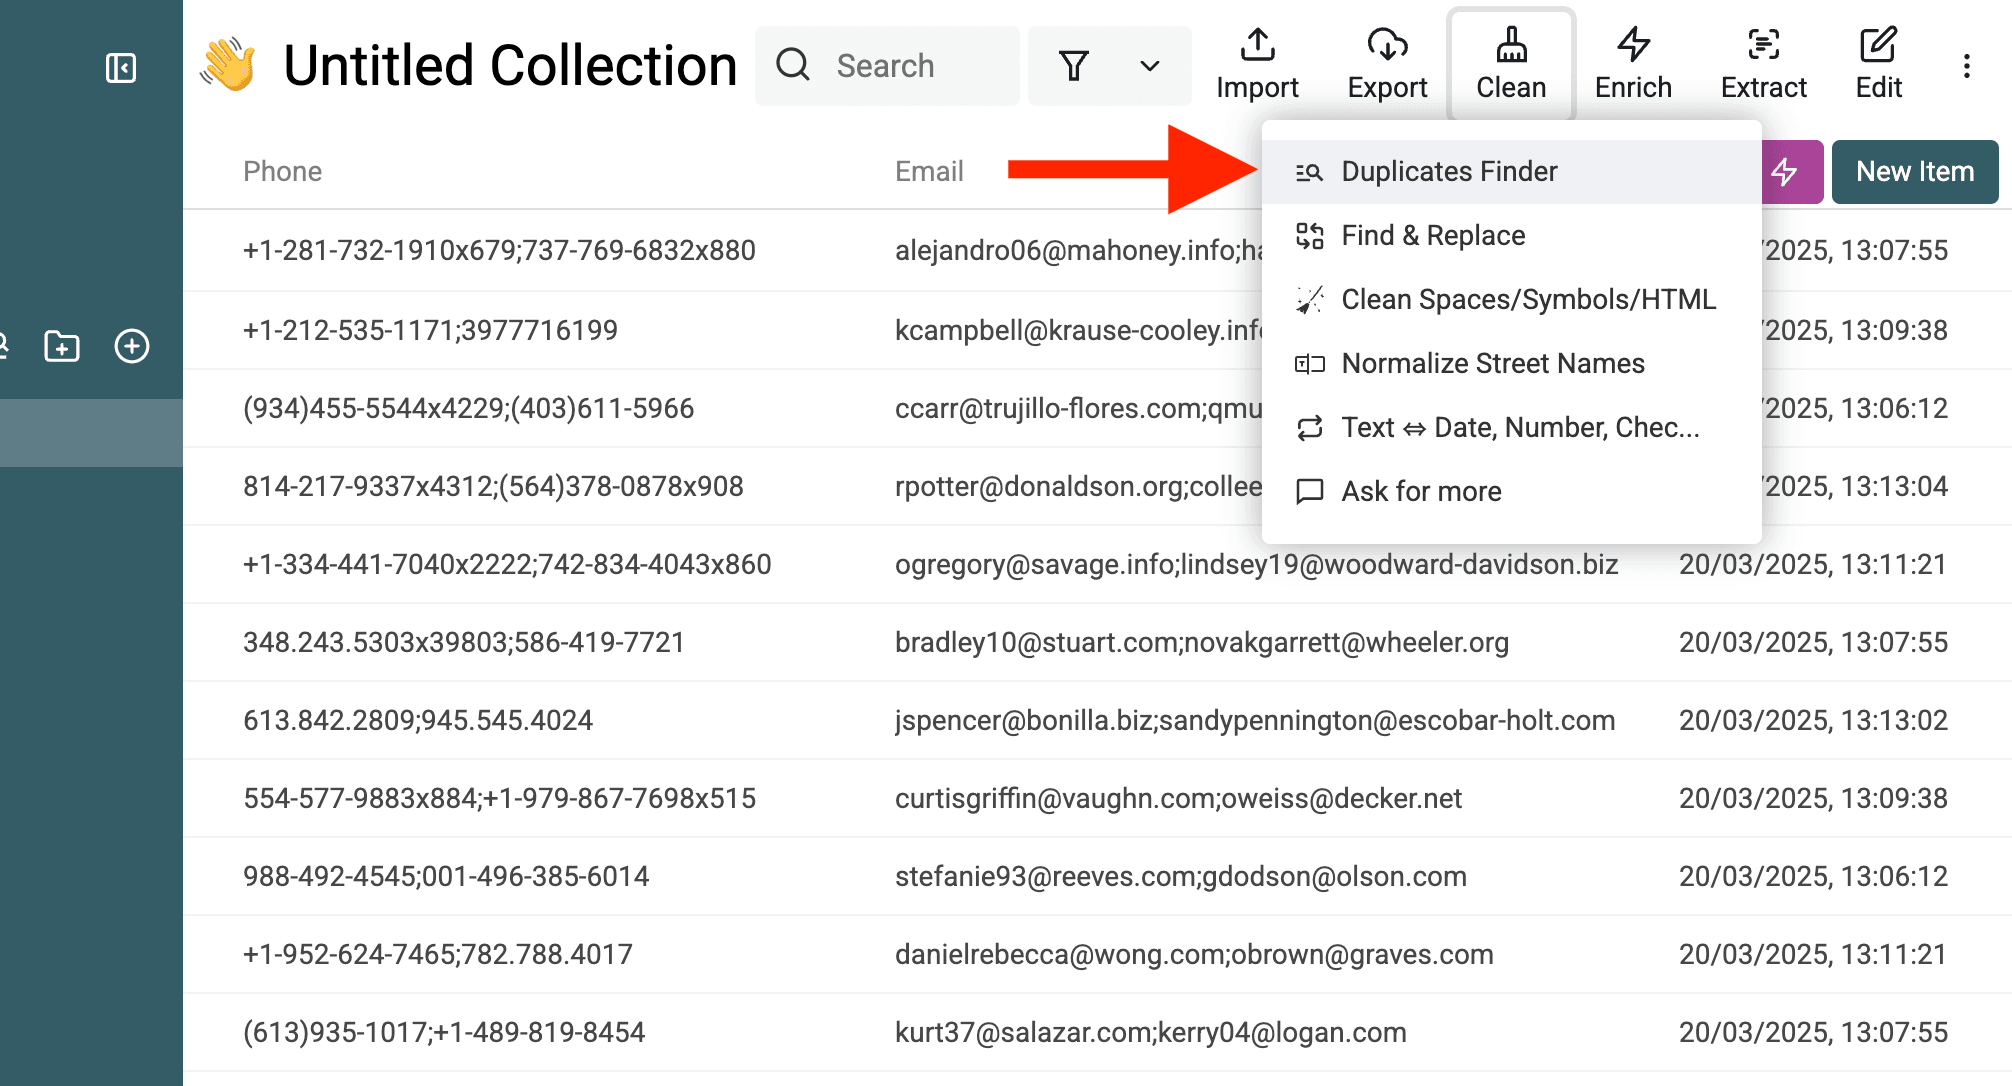
Une propriété de déduplication est le champ utilisé par Datablist pour détecter les doublons. Le meilleur choix dépend du type de données :
- Pour les People : utilisez Email — la valeur la plus fiable — ou Name si les emails sont absents ou incohérents.
- Pour les Organizations : utilisez Website en priorité, ou Name si aucun site web n’est disponible.
💡 Exemple :
- Si « Google » possède deux fiches, l’une avec
Google LLCet l’autre avecGoogle, Datablist les identifiera comme des doublons grâce à la similarité de leurs noms.
2. Lancez la déduplication
Pour obtenir les meilleurs résultats, ne fusionnez pas tout en une seule fois. Procédez par itérations :
1️⃣ Premier passage : recherchez les correspondances sur Email pour les People ou sur Website pour les Organizations. Vous détecterez ainsi les doublons évidents. 2️⃣ Deuxième passage : recherchez les correspondances sur Name pour les People ou les Organizations afin d’identifier les doublons associés à la même entité malgré des emails différents.
🔹 Pourquoi procéder en deux étapes ?
- Si vous recherchez simultanément une correspondance sur Email + Name, de légères variations de nom — comme « John Doe » et « Johnathan Doe » — peuvent empêcher le rapprochement.
- Un premier passage basé sur l’email traite d’abord les correspondances exactes et limite les erreurs.
Cas particulier des emails multiples et des noms d’entreprise
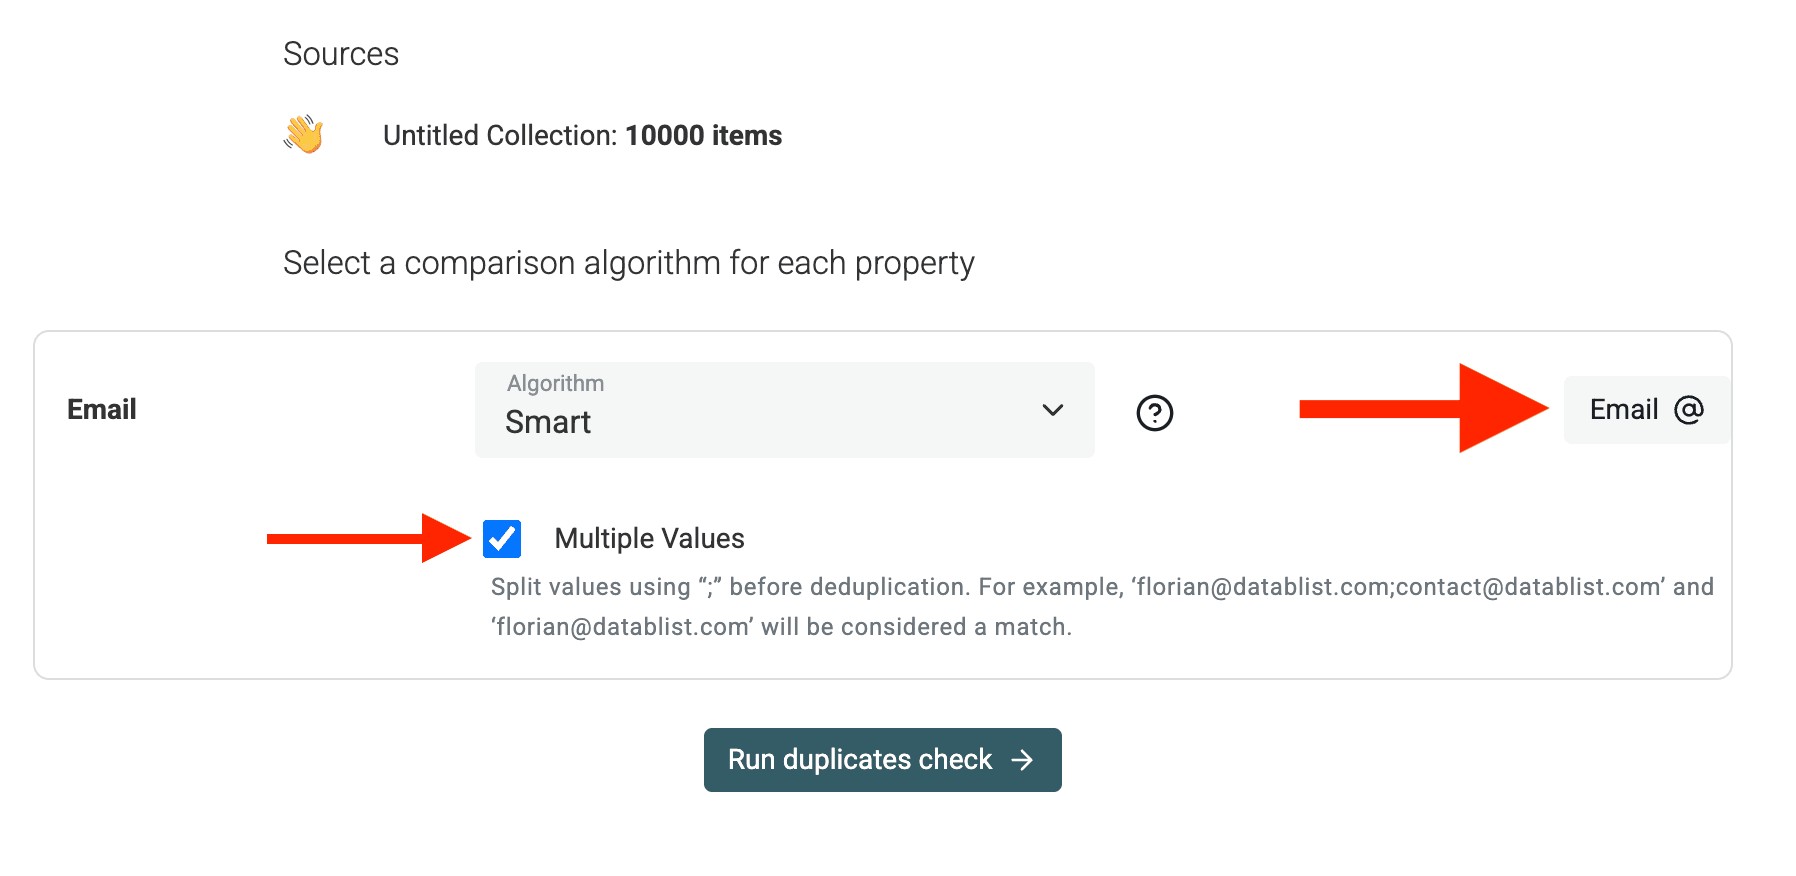
Certains champs Pipedrive contiennent plusieurs valeurs, notamment les emails et les numéros de téléphone.
Si vous dédupliquez des champs comme Emails ou Phones contenant plusieurs valeurs séparées par ;, activez le mode « Multiple Values » dans Datablist. Ainsi, une fiche contenant john@company.com; j.doe@gmail.com sera correctement rapprochée d’une autre qui contient uniquement john@company.com.
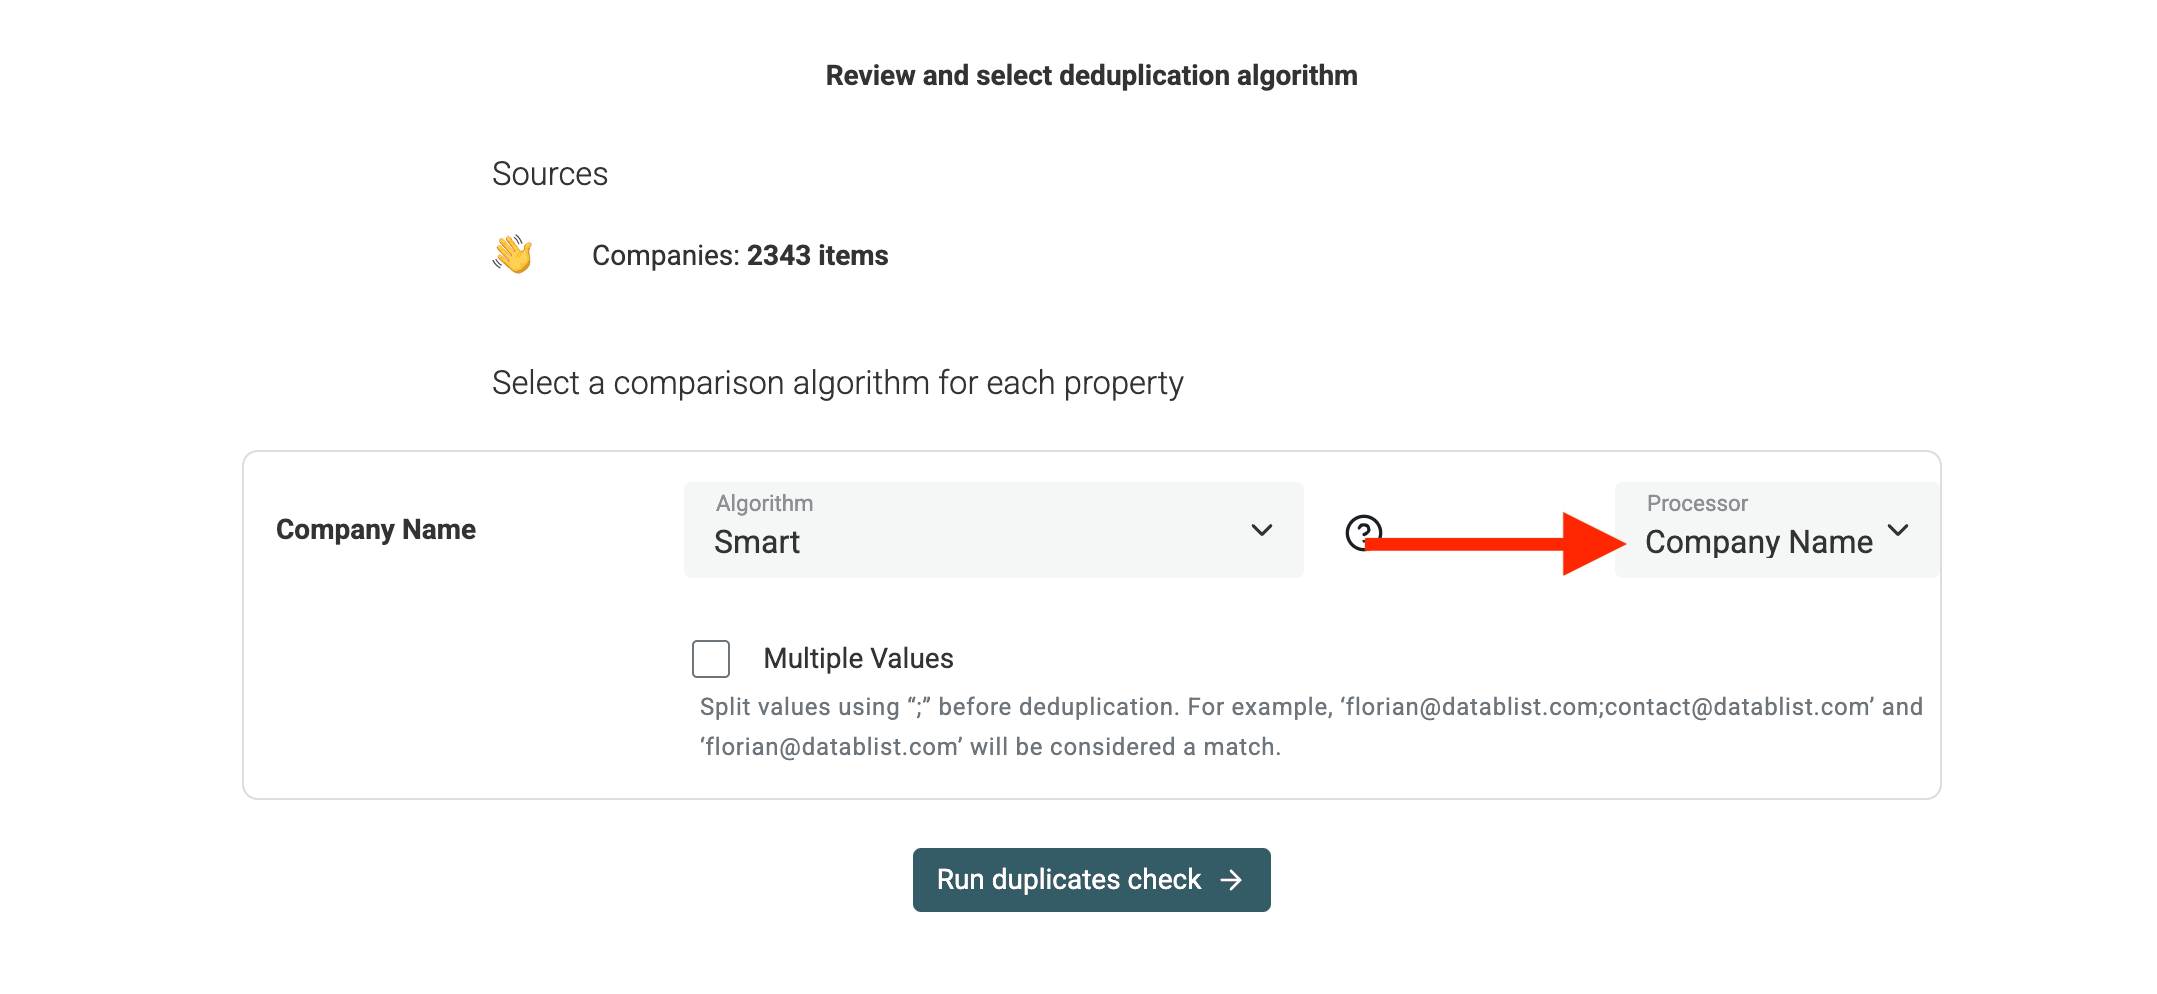
Pour une déduplication basée sur les noms d’entreprise, Datablist Duplicates Finder propose un processeur dédié qui gère les formes juridiques et les termes superflus.
Si vous dédupliquez des sites web, utilisez le processeur
URL.
3. Vérifiez les doublons et les valeurs en conflit
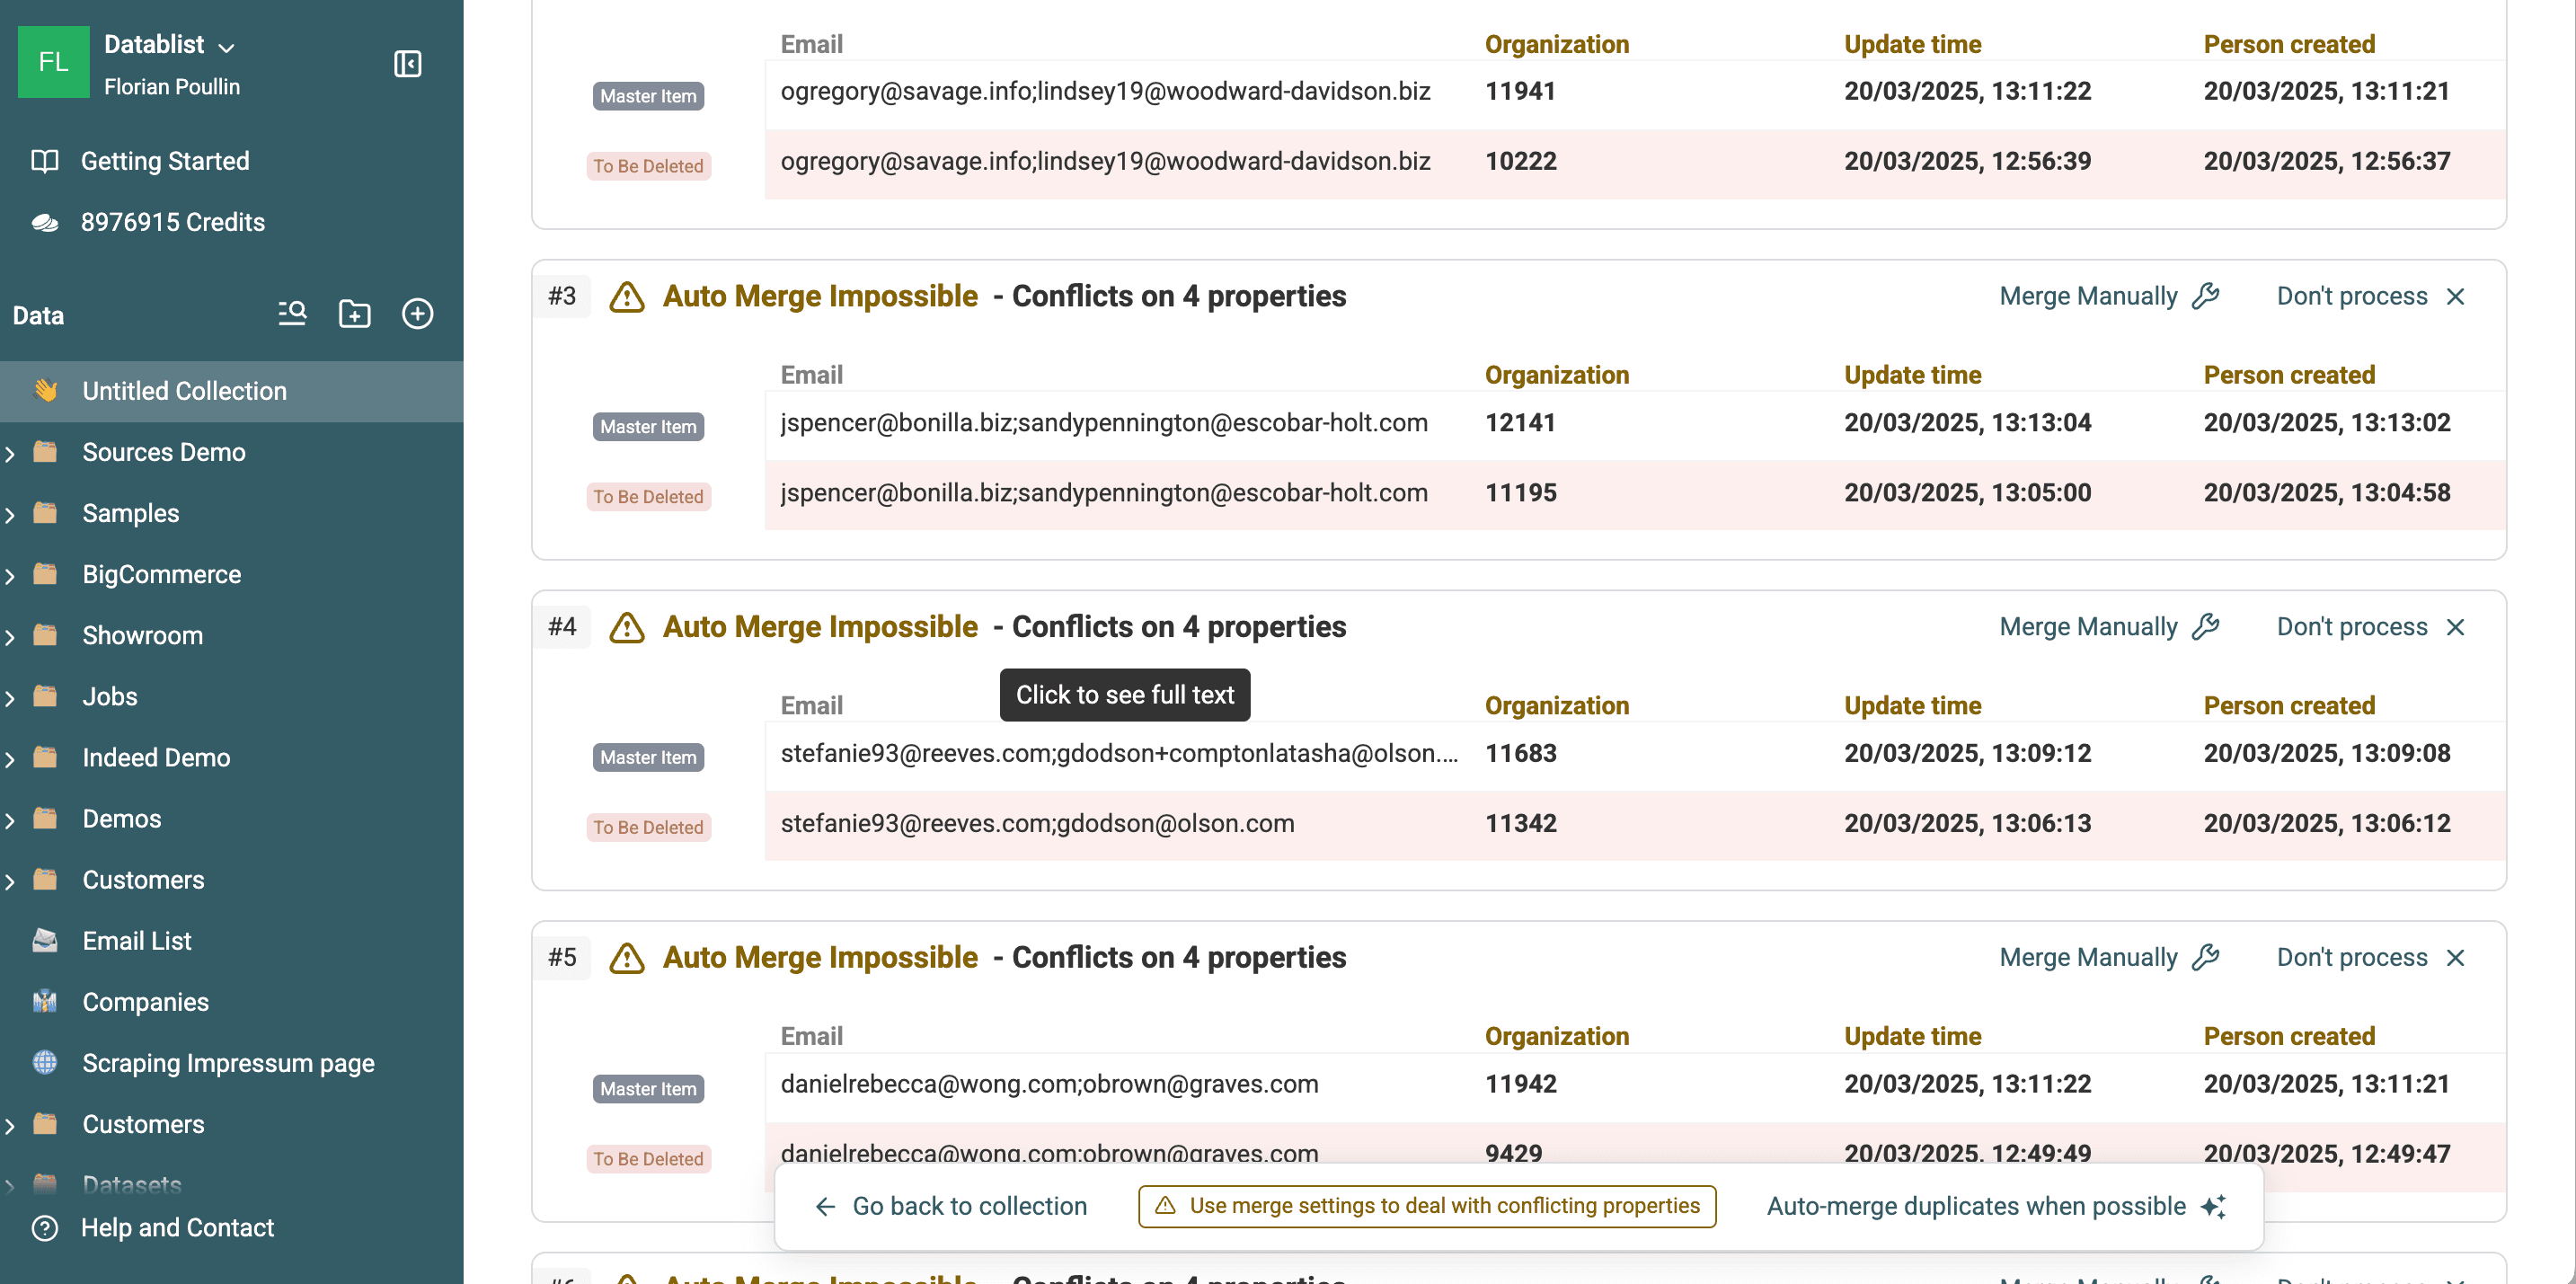
Une fois l’analyse terminée, Datablist rassemble les doublons.
- Vous verrez des groupes de People ou d’Organizations similaires. Nous les appelons « Duplicate Groups ».
- Chaque groupe indique la raison de la correspondance — email, nom ou site web — ainsi que les éventuels conflits de données.
3.a. Comprendre les Duplicate Groups
Chaque groupe de doublons contient plusieurs fiches considérées comme représentant la même entité.
- Certains groupes peuvent être fusionnés automatiquement, car leurs données sont identiques ou complémentaires.
- D’autres nécessitent une vérification manuelle, car leurs informations sont contradictoires.
💡 Exemple :
- Si deux fiches « John Doe » ont la même adresse email, mais des numéros de téléphone différents, Datablist les détectera comme des doublons tout en signalant le numéro de téléphone comme un champ en conflit.
3.b. Définir les règles de fusion des conflits
Comprendre les conflits
Un conflit apparaît lorsque des contacts en doublon possèdent des valeurs différentes dans un même champ. Deux fiches peuvent, par exemple, mentionner des intitulés de poste ou des numéros de téléphone différents. Datablist met ces conflits en évidence afin que vous puissiez choisir la valeur à conserver.
Gérer les conflits
Datablist propose une interface intuitive pour résoudre efficacement les conflits et préserver des données propres et fiables.
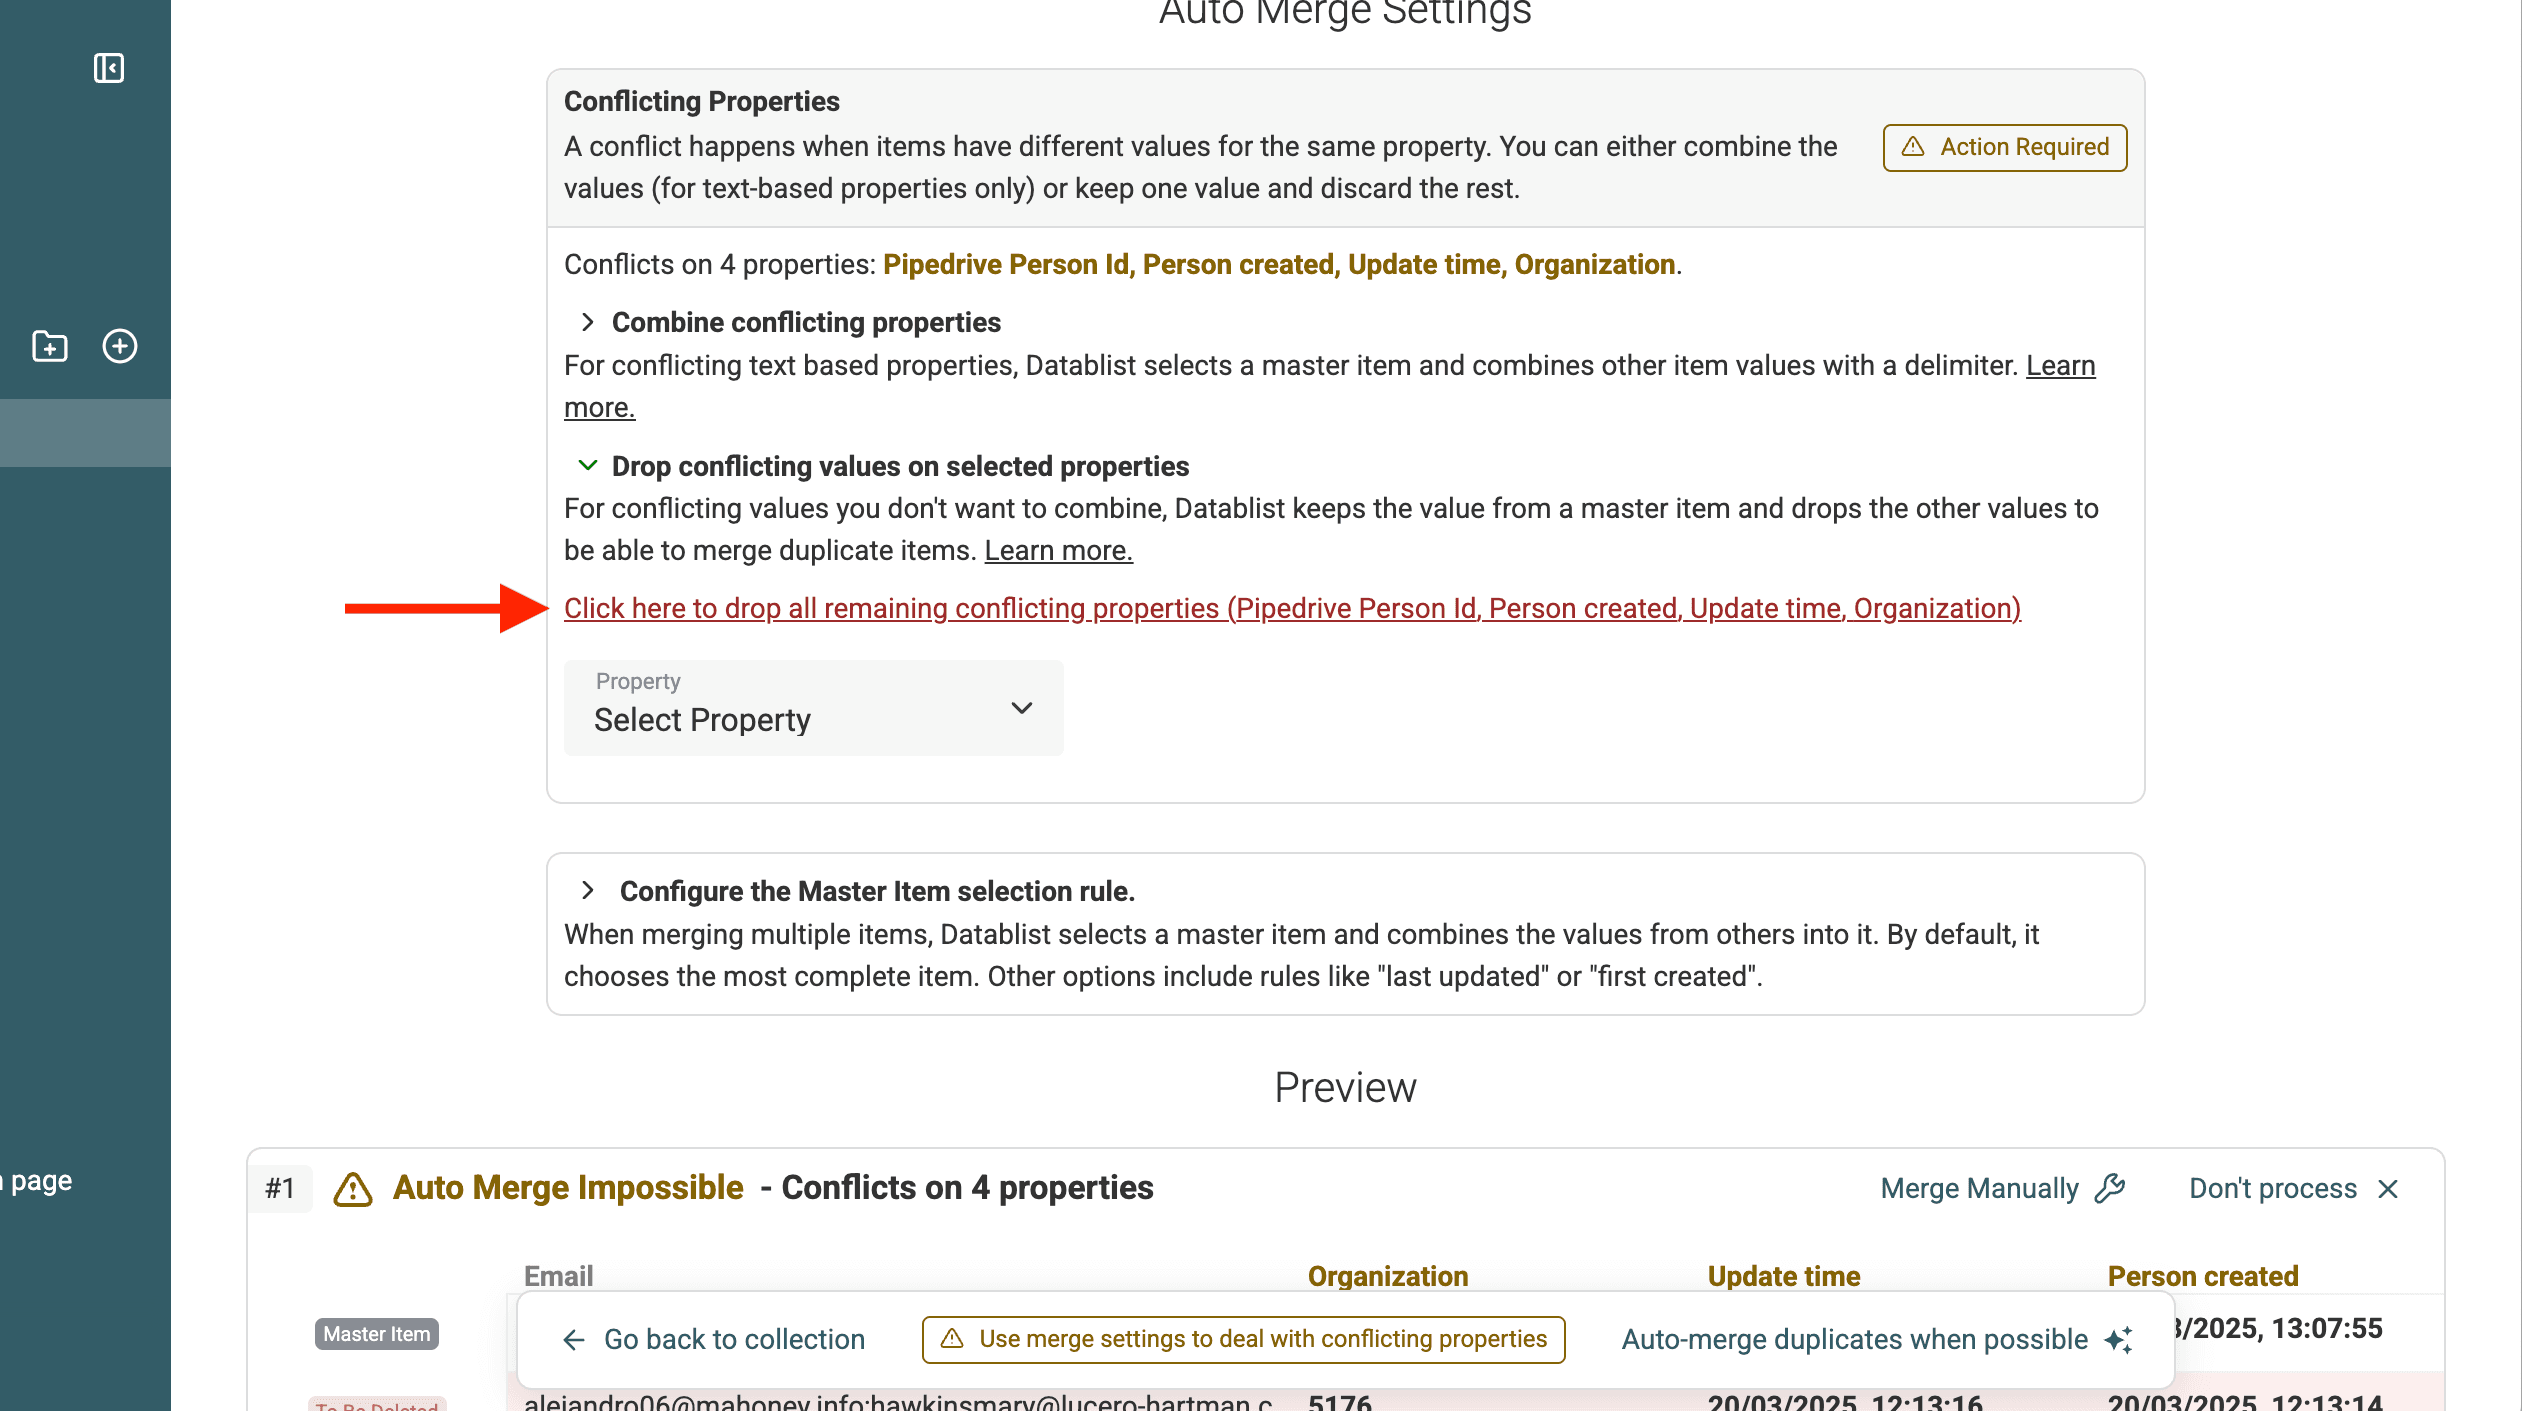
- Combine Values : combinez les valeurs lorsqu’elles sont complémentaires, par exemple plusieurs numéros de téléphone ou plusieurs notes.
- Conserver une valeur et supprimer les autres : si une fiche est clairement plus complète et que vous souhaitez écarter les autres valeurs, sélectionnez « Drop conflicting values... ».
Pour les réglages Combine conflicting values et Drop conflicting values, un raccourci permet de sélectionner automatiquement toutes les propriétés en conflit.
Sélectionnez une fiche principale
Vous pouvez également définir la façon dont Datablist choisit la fiche principale. Lors de la fusion des doublons, Datablist conserve une fiche, met ses champs à jour et supprime les autres afin de n’en garder qu’une seule.
Plusieurs règles permettent de déterminer cette Master Record :
- Most Complete : sélectionne la fiche qui comporte le plus de champs renseignés.
- Last Updated : sélectionne la fiche modifiée le plus récemment.
- First Created : sélectionne la fiche la plus ancienne selon sa date de création.
- Highest Value : sélectionne la fiche dont la propriété choisie possède la valeur la plus élevée. Si plusieurs fiches ont la même valeur, la plus récente est retenue.
- Lowest Value : sélectionne la fiche dont la propriété choisie possède la valeur la plus faible. Si plusieurs fiches ont la même valeur, la plus récente est retenue.
- Matching Value : sélectionne la fiche qui contient une valeur précise dans la propriété choisie. Si aucune fiche ne correspond, le groupe n’est pas fusionné.
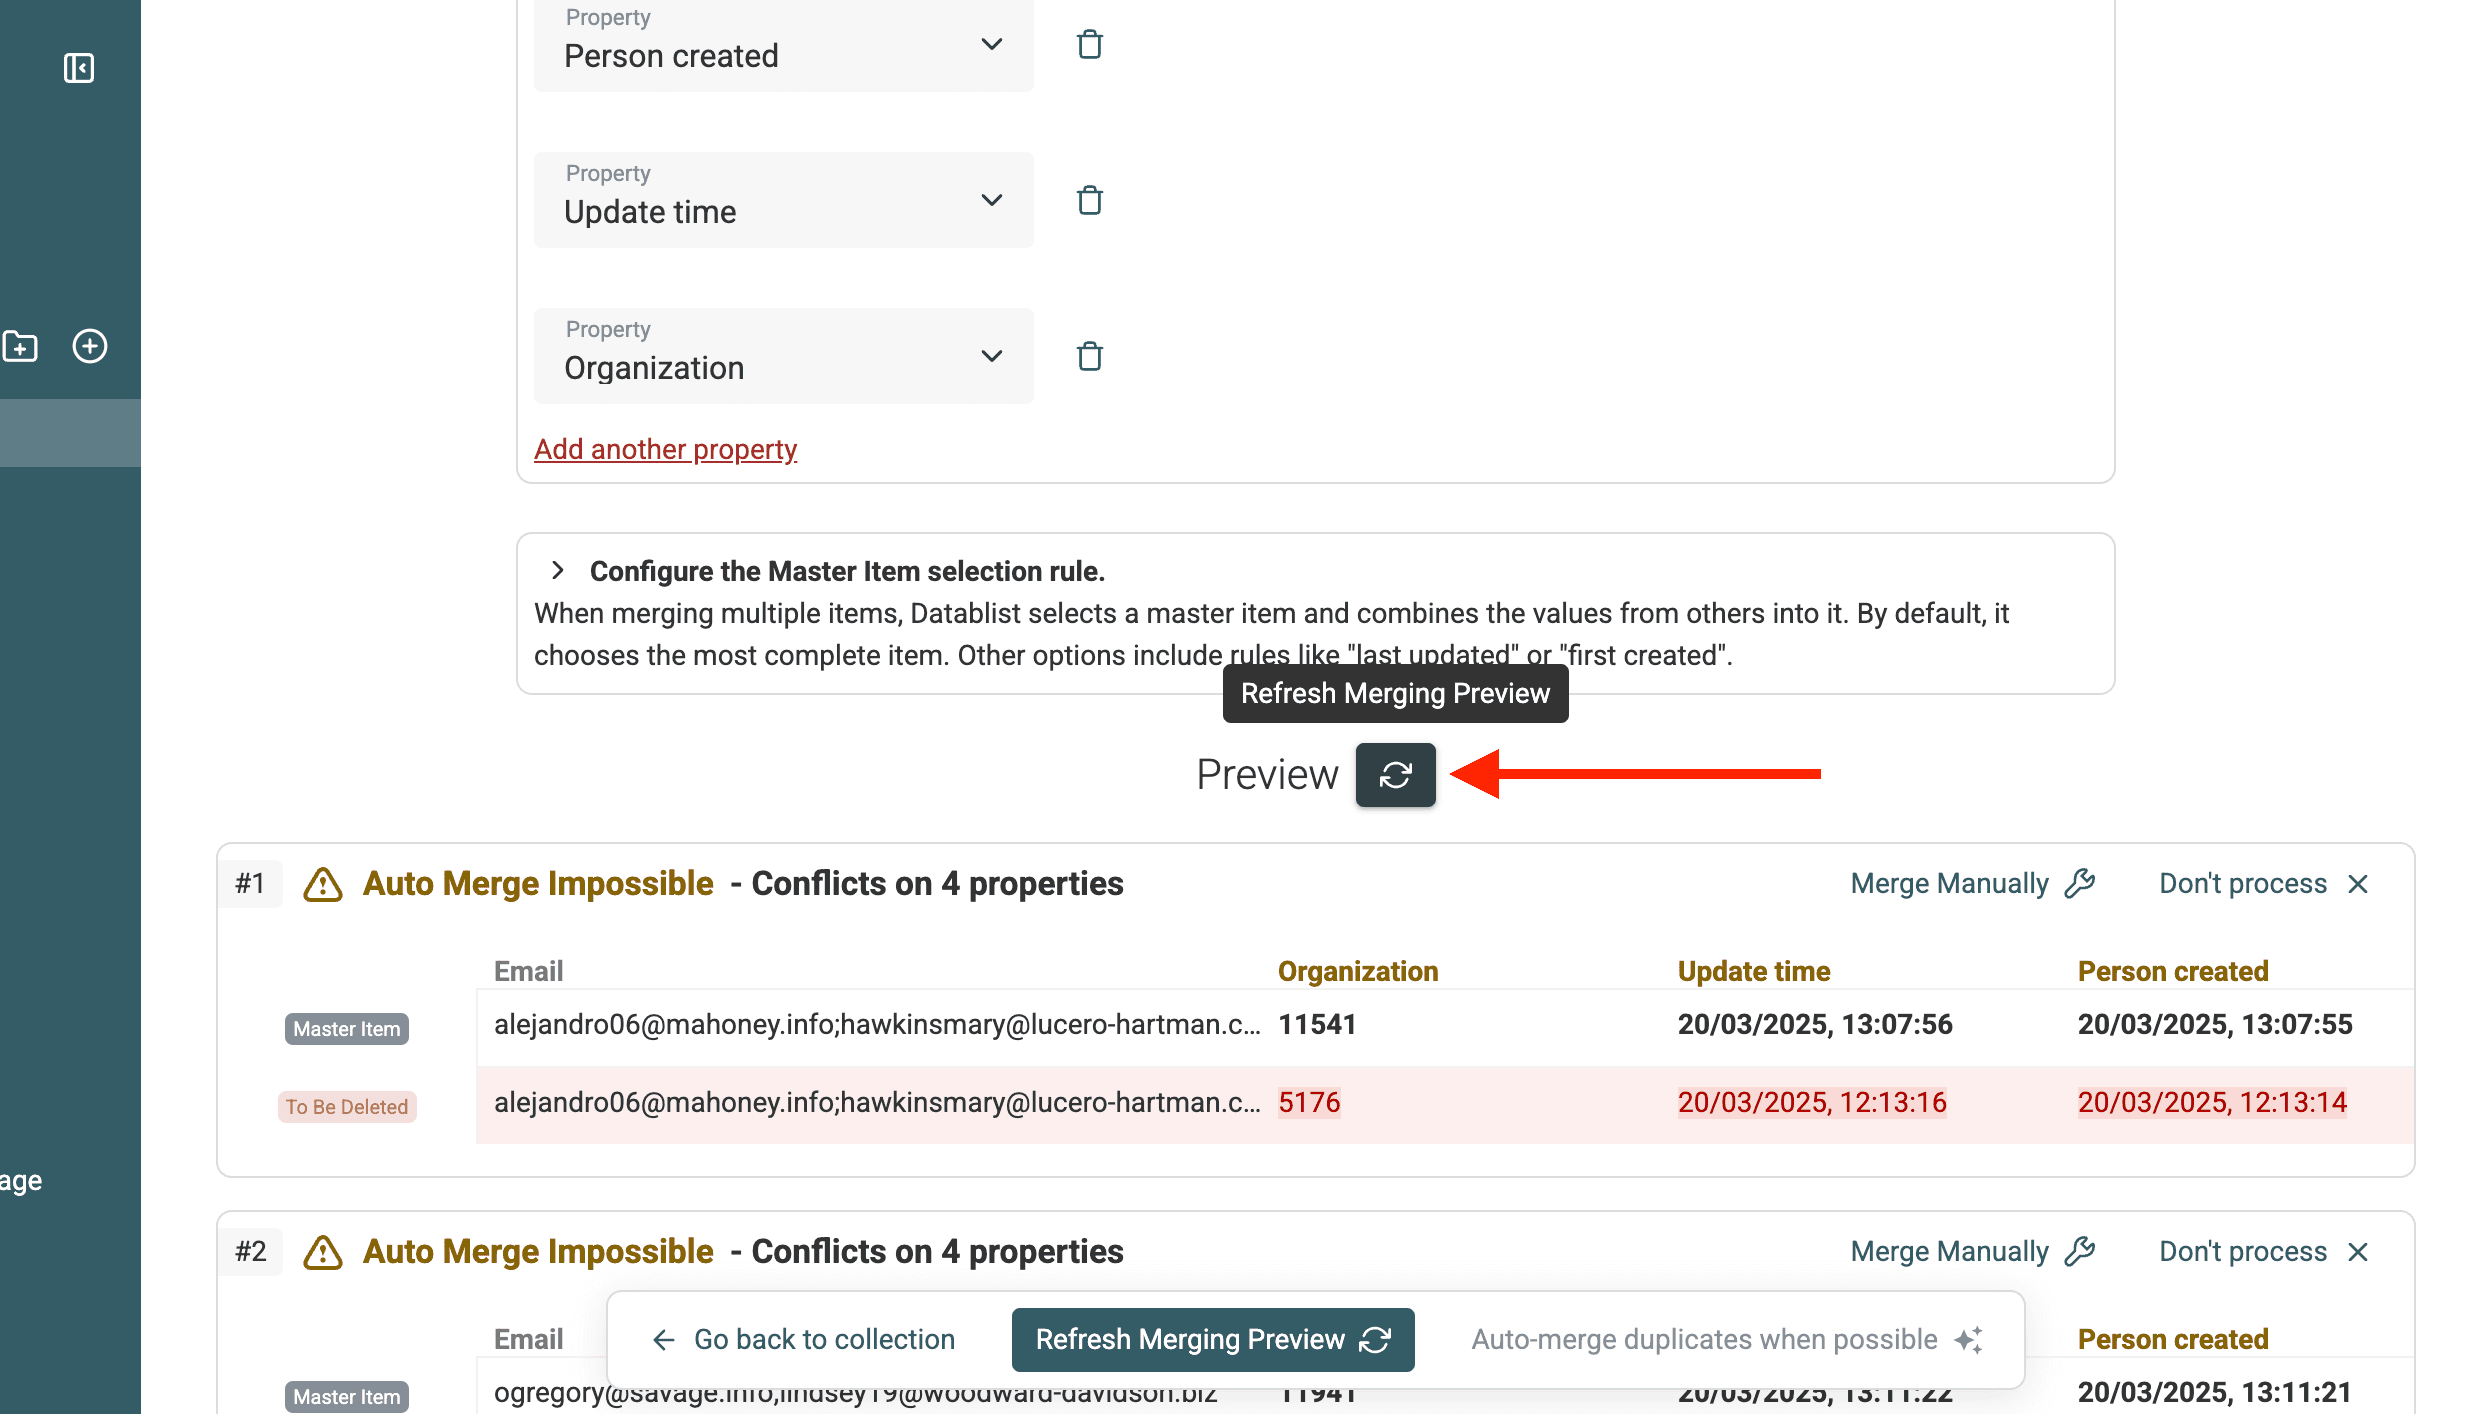
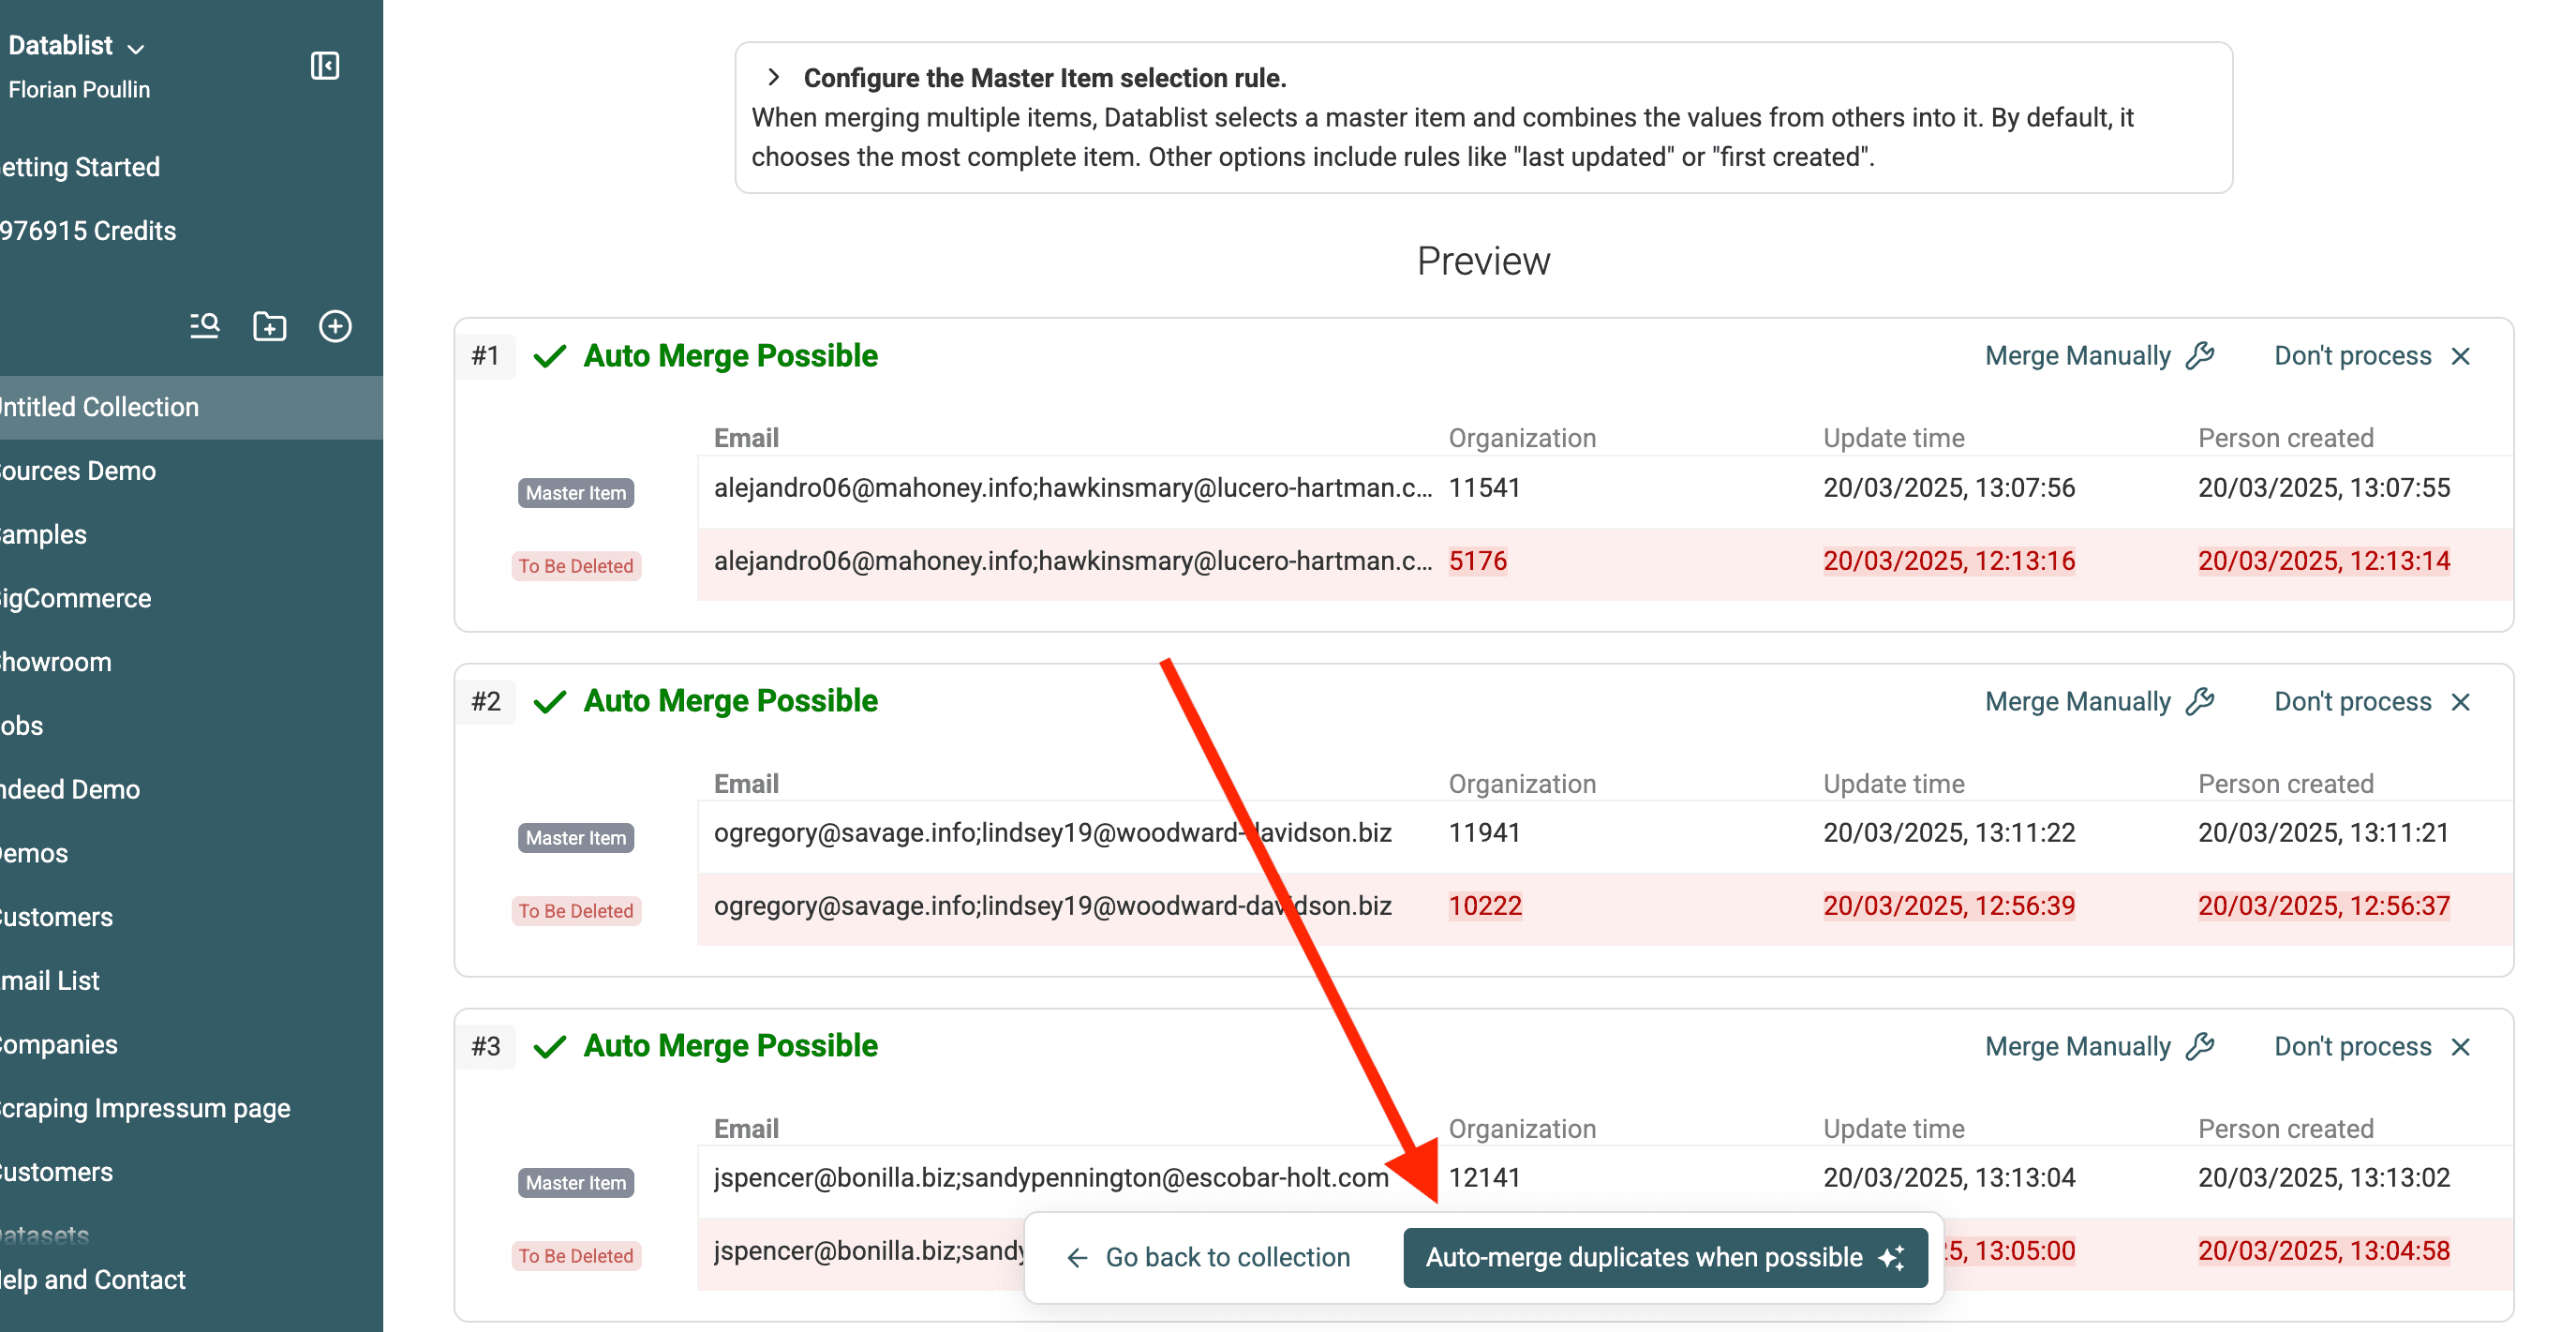
Datablist affiche une prévisualisation des modifications prévues. Vous pouvez voir les fiches qui seront supprimées, les valeurs qui seront combinées, etc.
Après avoir défini tous les réglages de fusion, cliquez sur « Refresh » pour actualiser la prévisualisation.
🔹 Exemple : fusion de deux contacts
L’exemple suivant montre le résultat de ces règles de fusion :
- Drop Conflicting values sur le champ
Name. - Combine Conflicting values sur le champ
Phone.
| Champ | Contact 1 | Contact 2 | Résultat fusionné |
|---|---|---|---|
| Nom | John Doe | Johnathan Doe | John Doe |
| john@company.com | john@company.com | john@company.com | |
| Téléphone | 555-1234 | 555-5678 | 555-1234; 555-5678 |
3.c. Fusionner automatiquement les doublons
Lorsque la prévisualisation vous convient, cliquez sur « Auto-merge duplicates when possible ». Datablist appliquera alors les règles de fusion à tous les groupes de doublons.
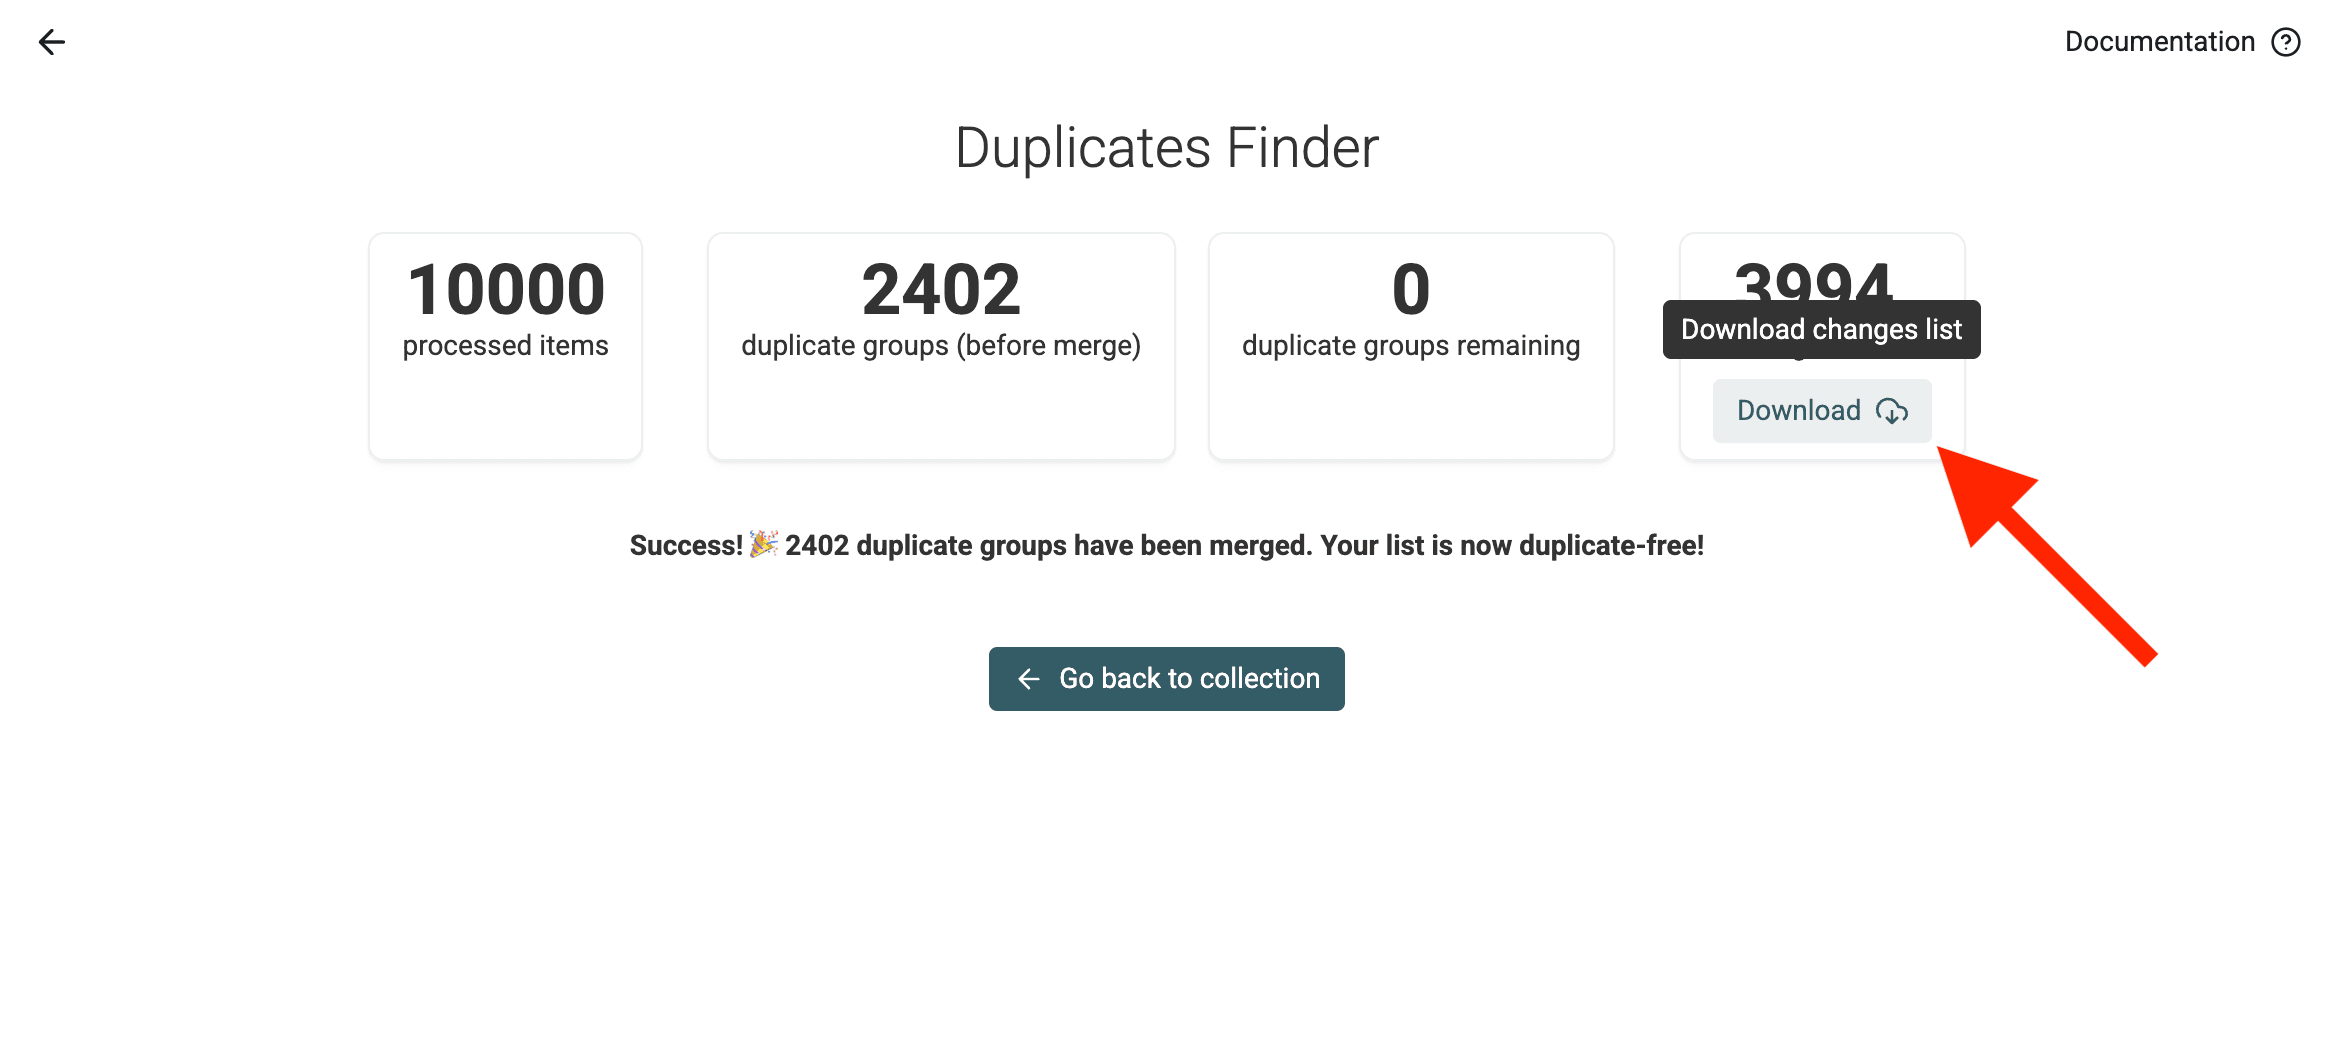
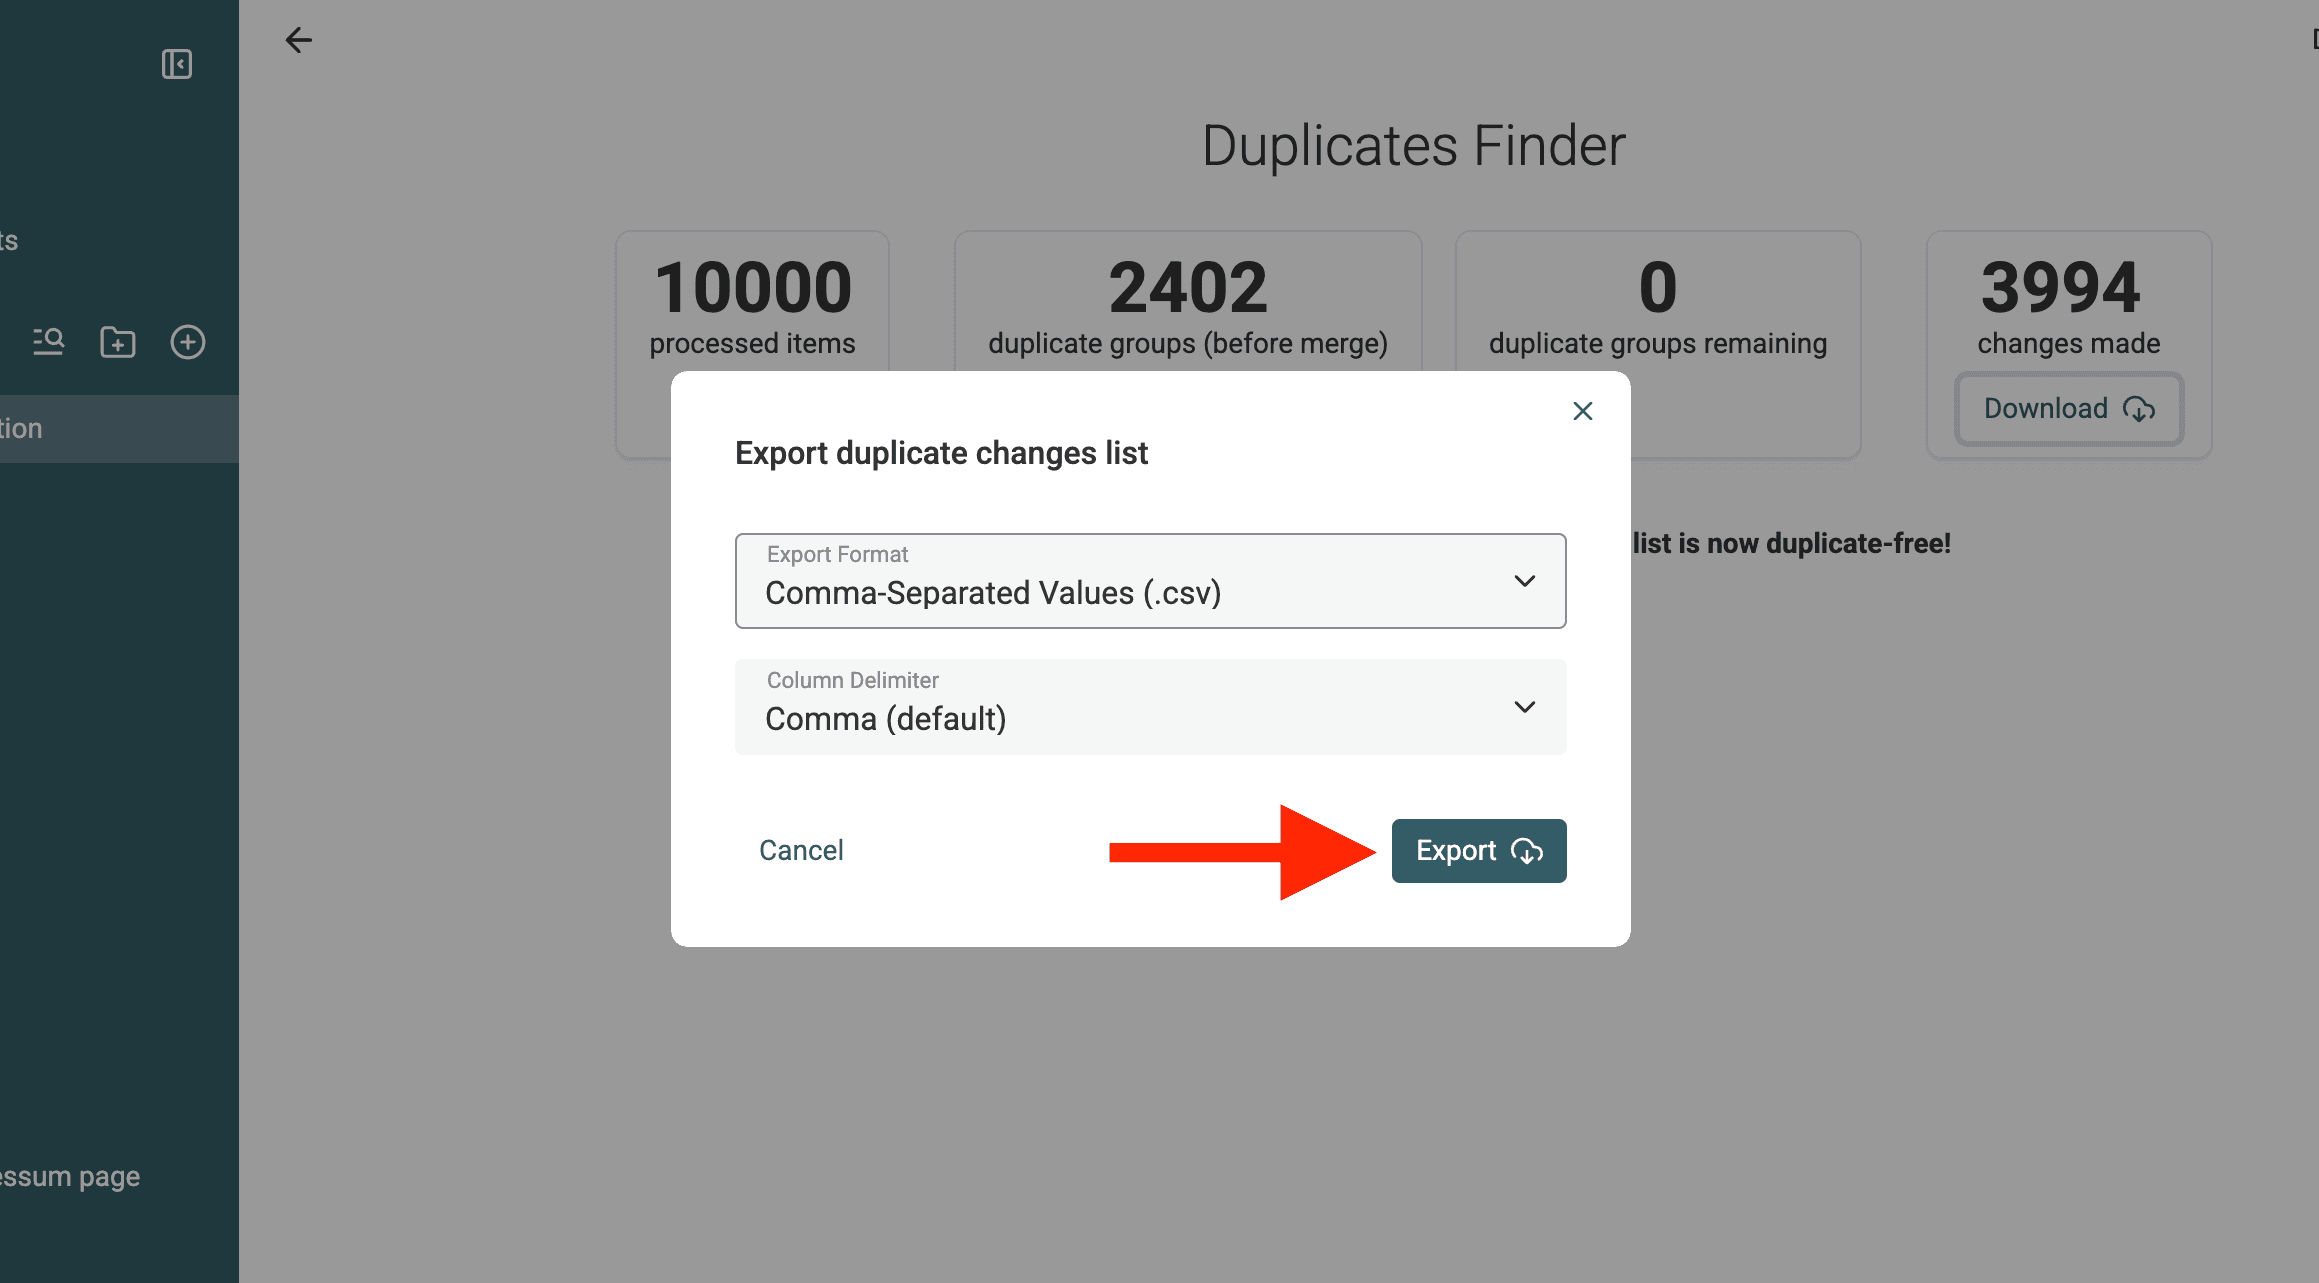
3.d. Télécharger le fichier de modifications
⚠️ Vous AUREZ BESOIN de ce fichier de modifications pour fusionner et mettre à jour les fiches dans votre CRM Pipedrive.
Étape 3 : synchroniser les fusions vers Pipedrive
Vos doublons sont maintenant fusionnés dans Datablist. La dernière étape consiste à synchroniser les données nettoyées vers Pipedrive afin de maintenir votre CRM à jour.
Pour cela, nous utiliserons le fichier de modifications téléchargé à l’étape précédente — voir 3.d. Télécharger le fichier de modifications. Ce fichier répertorie toutes les fiches fusionnées, les doublons supprimés et les champs mis à jour.
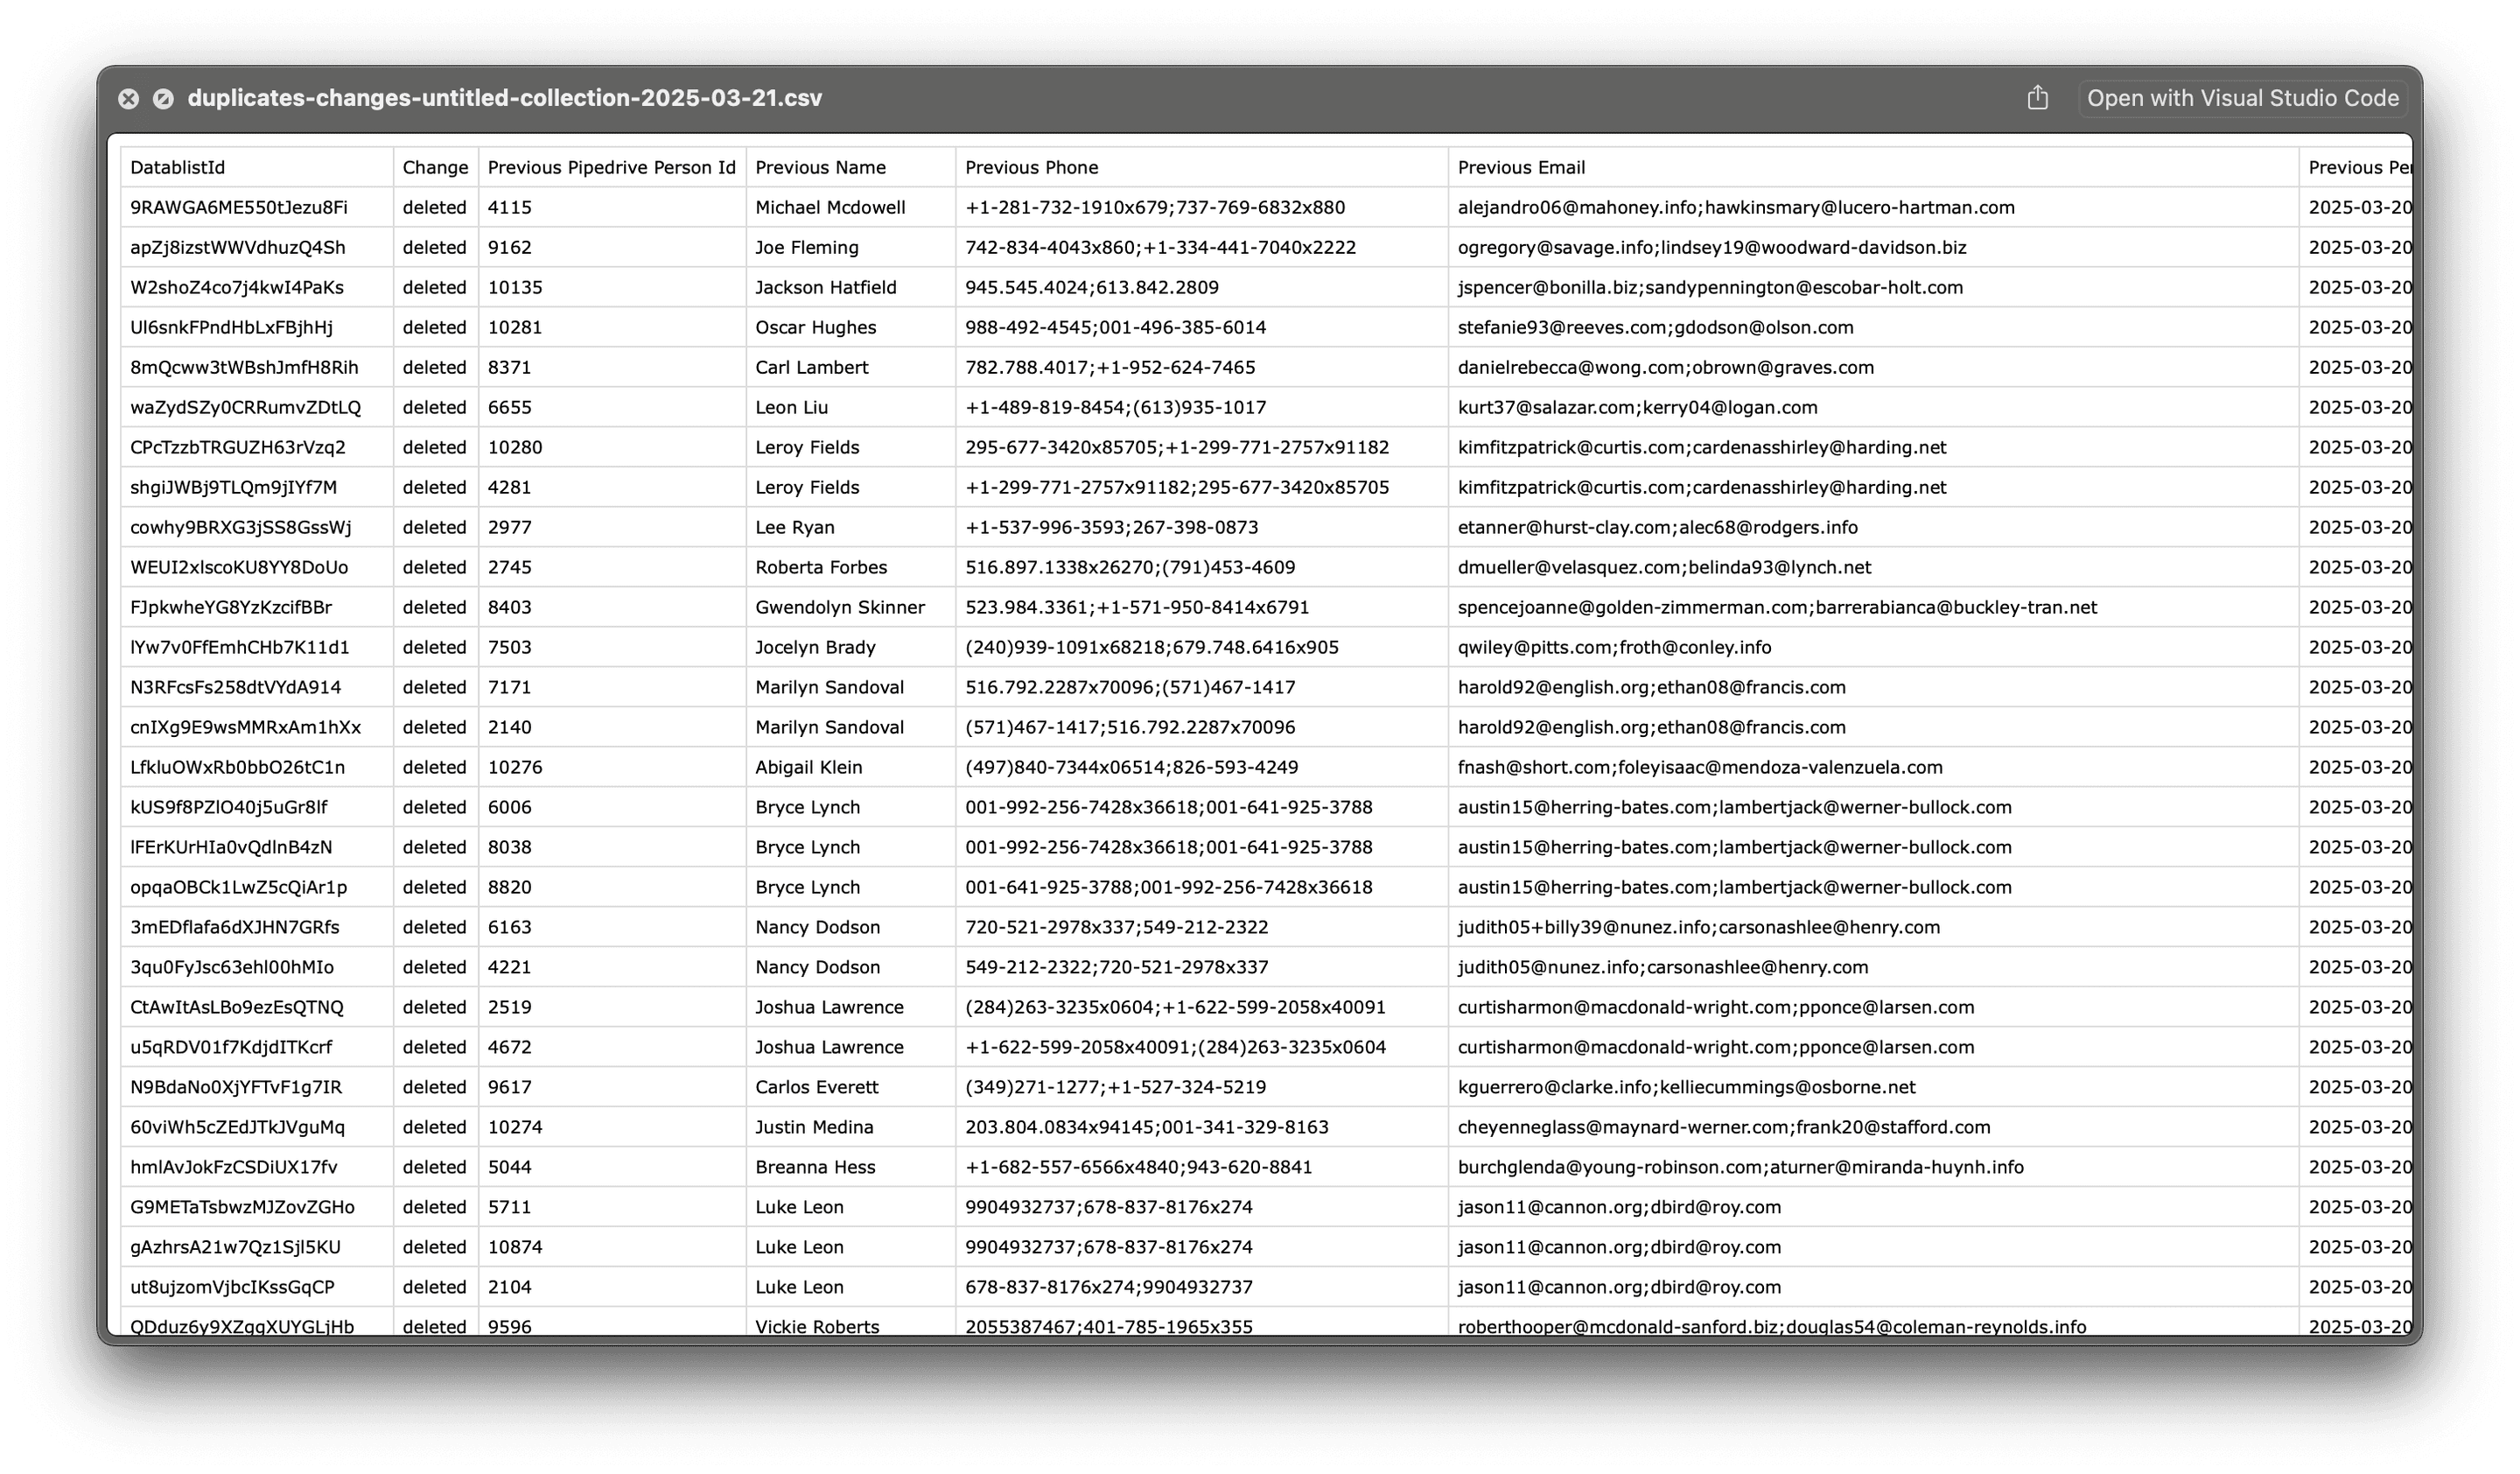
Ce Changes Log contient :
✅ Updated Records → Les contacts ou Organizations modifiés, par exemple après la combinaison d’emails, de numéros de téléphone ou de noms. Les anciennes données et les nouvelles valeurs mises à jour sont indiquées.
✅ Deleted Records → Les doublons fusionnés dans une fiche principale. Le fichier contient l’id de la fiche supprimée et l’id de la fiche principale qui la remplace. Ces fiches doivent être supprimées dans Pipedrive.
3.a. Importer le fichier de modifications
Pour appliquer ces modifications dans Pipedrive, créez une nouvelle collection et importez-y le fichier de modifications.
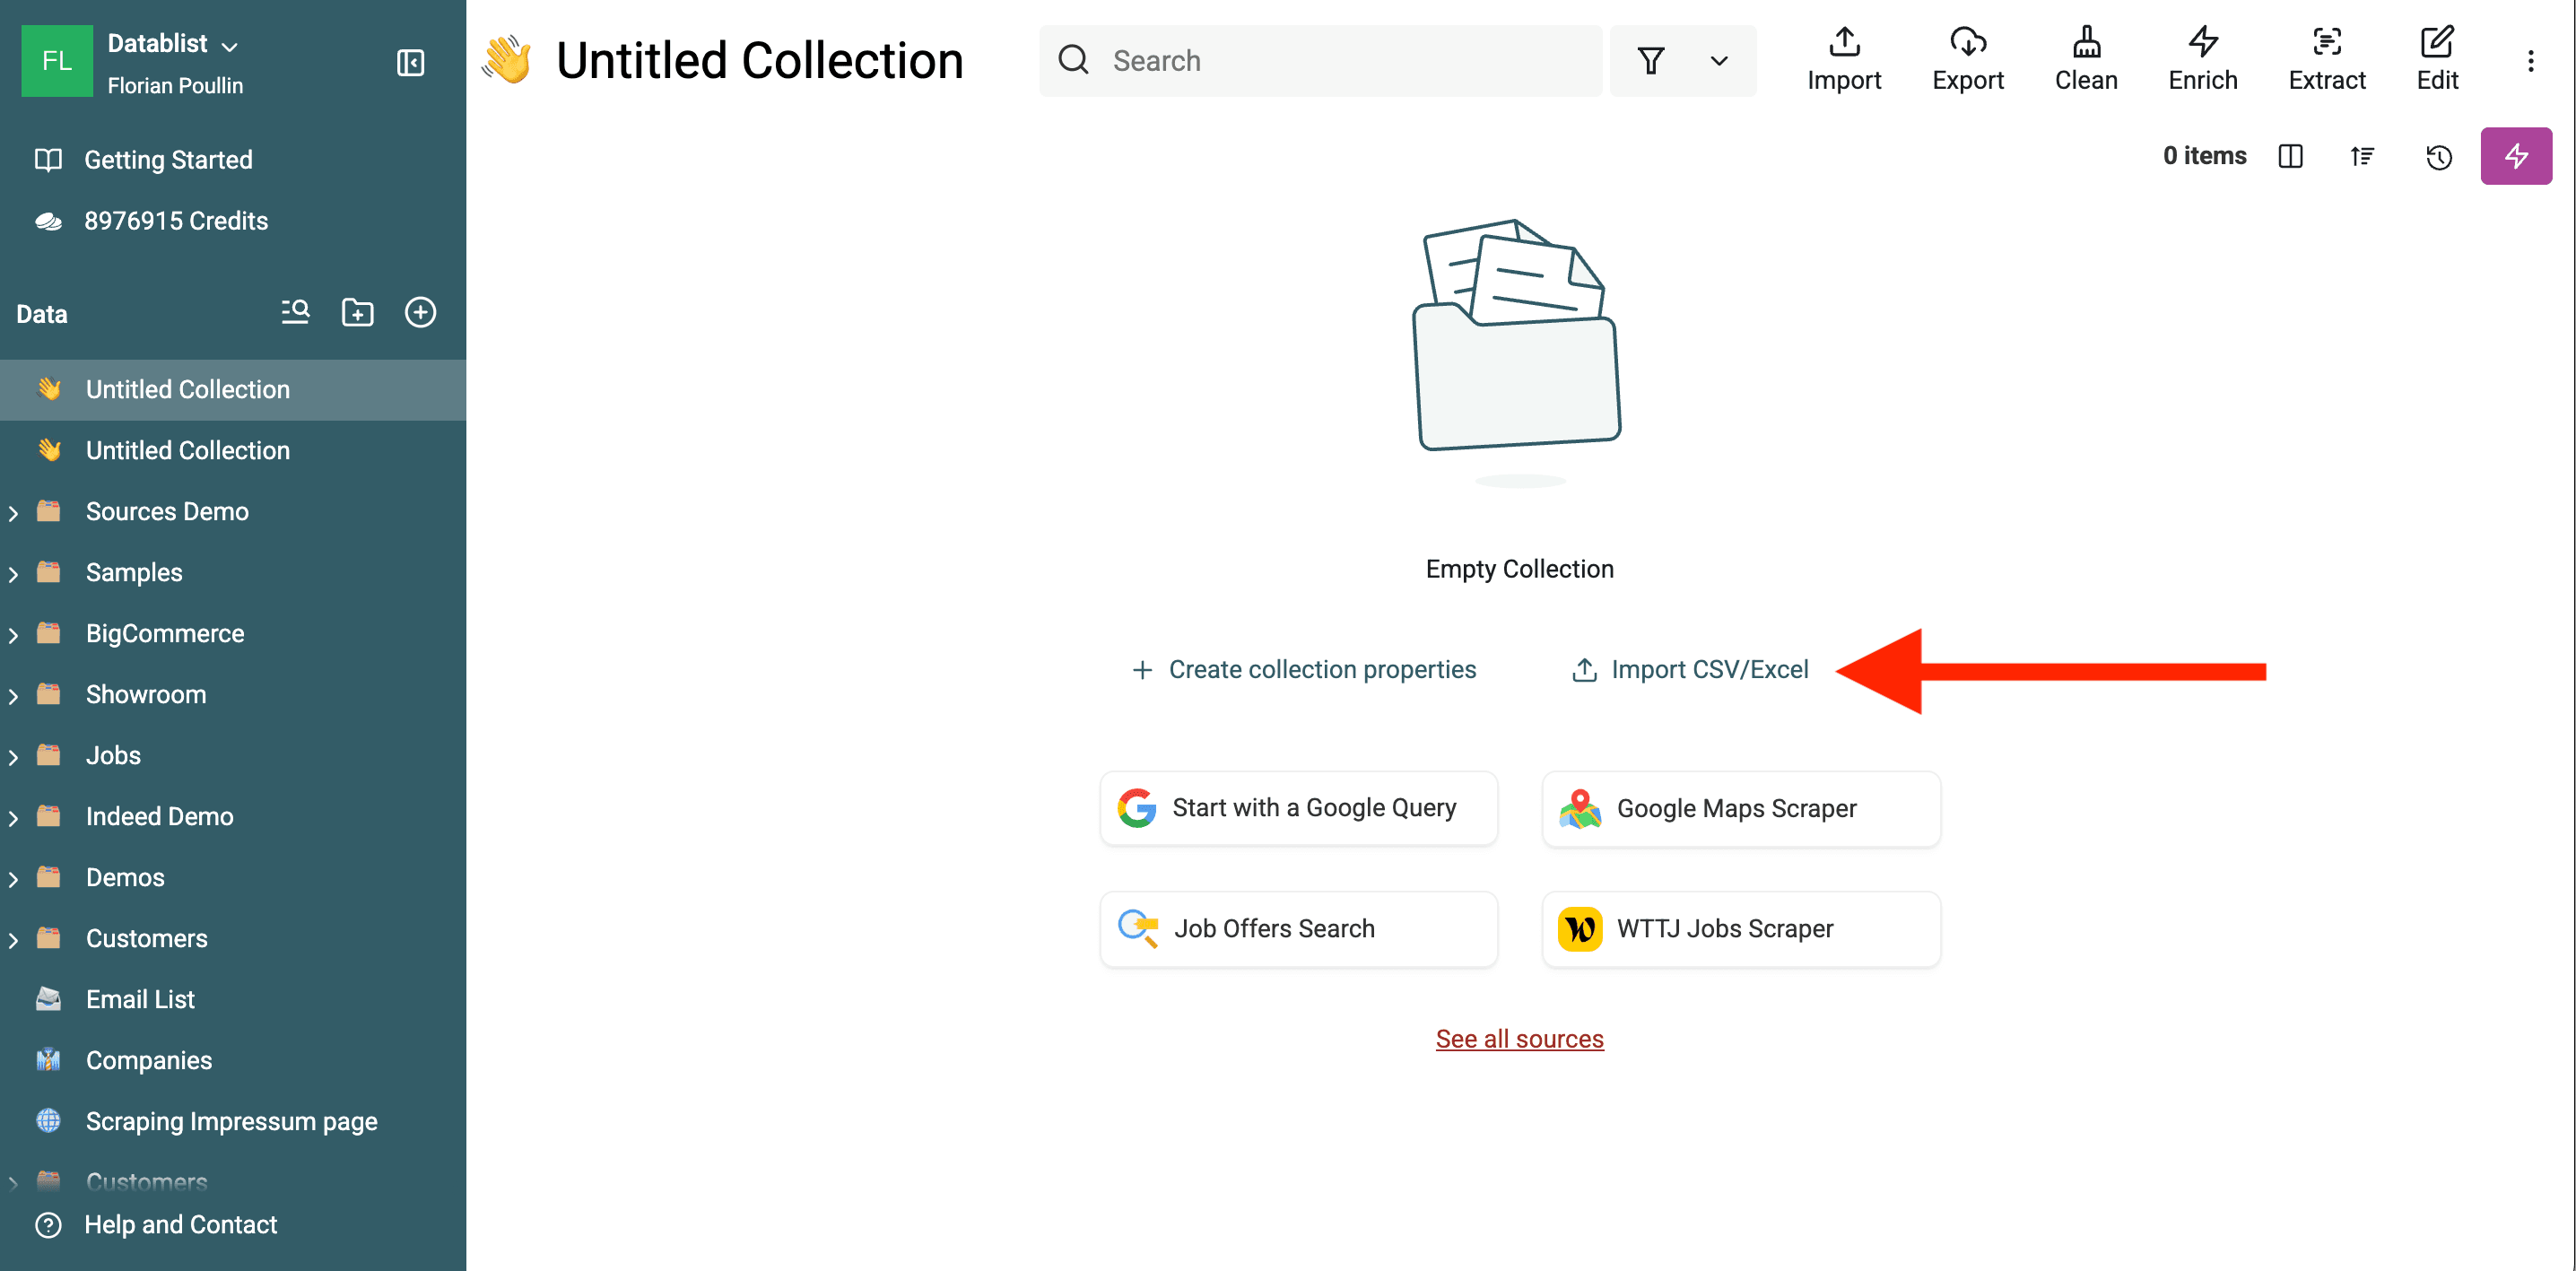
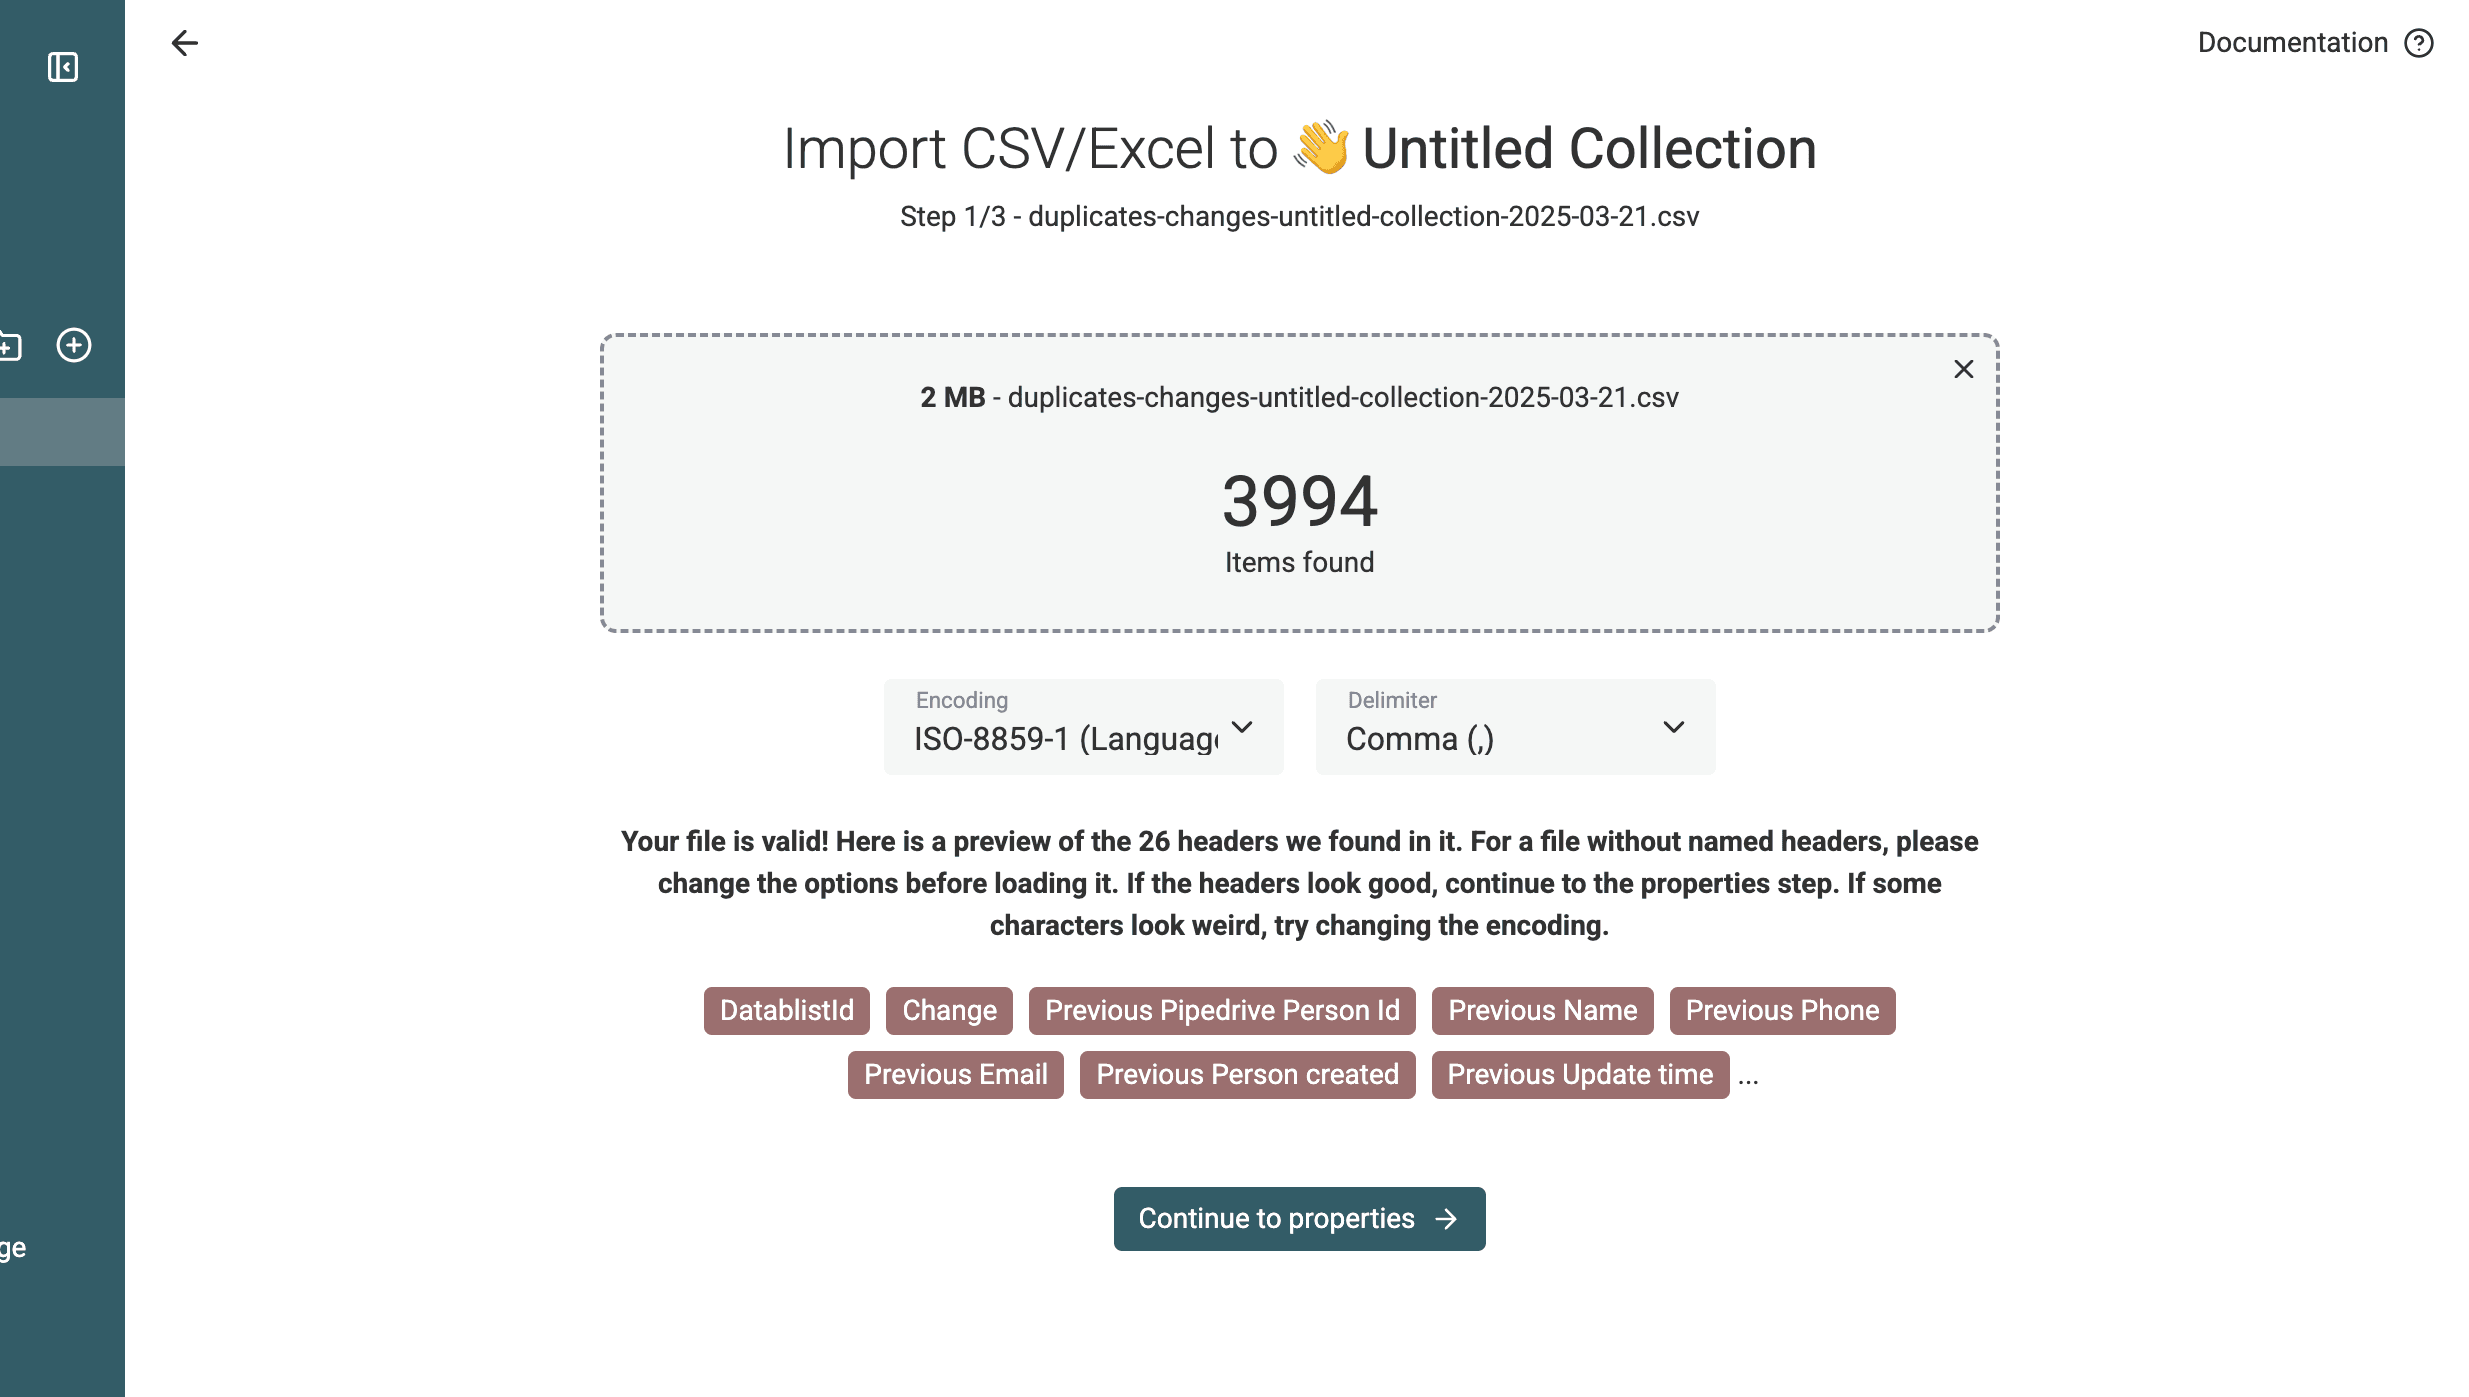
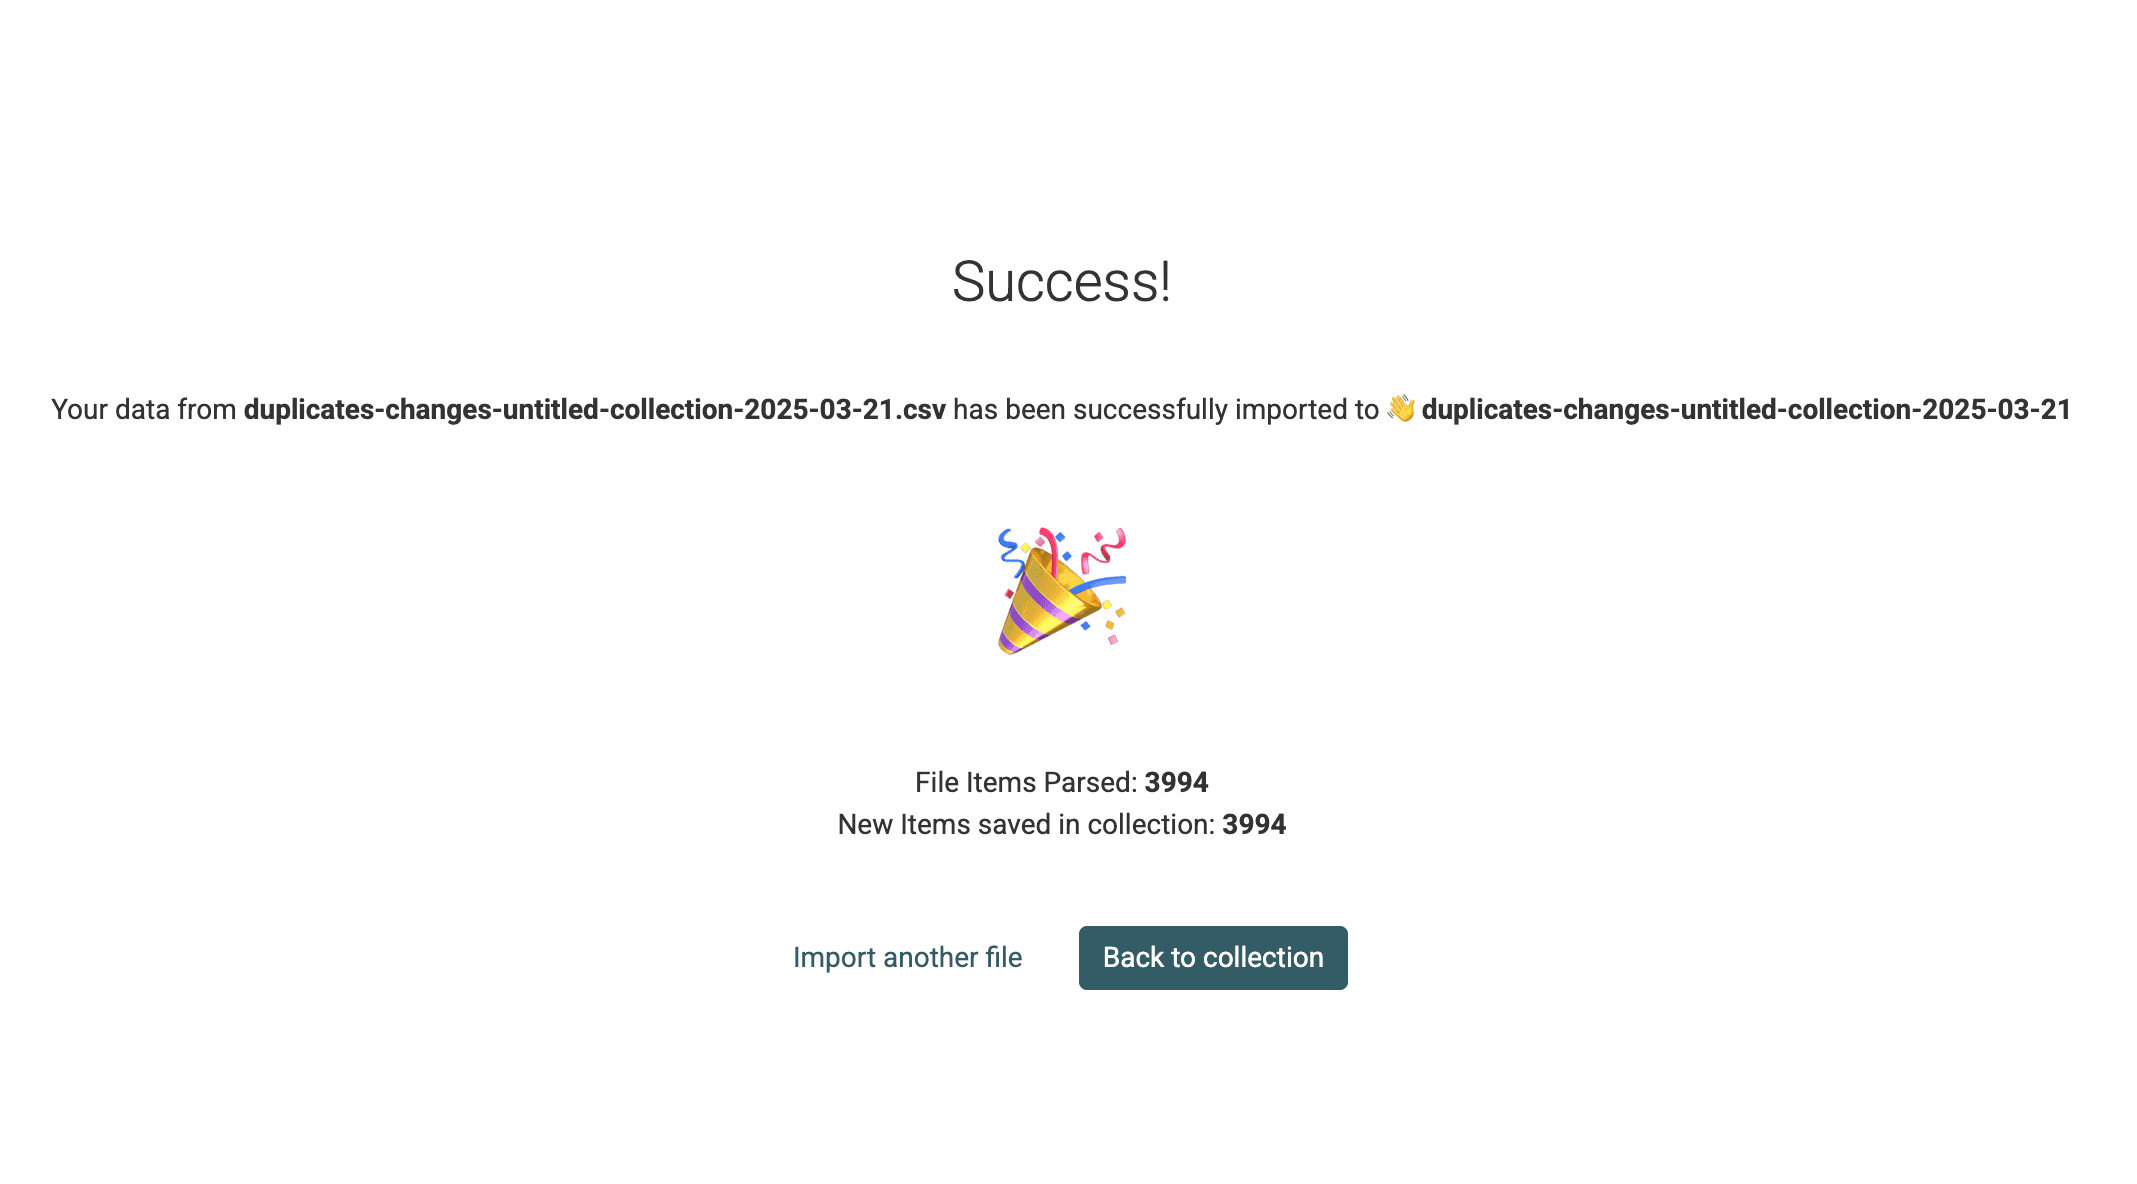
Vous obtenez une collection contenant les opérations de fusion.
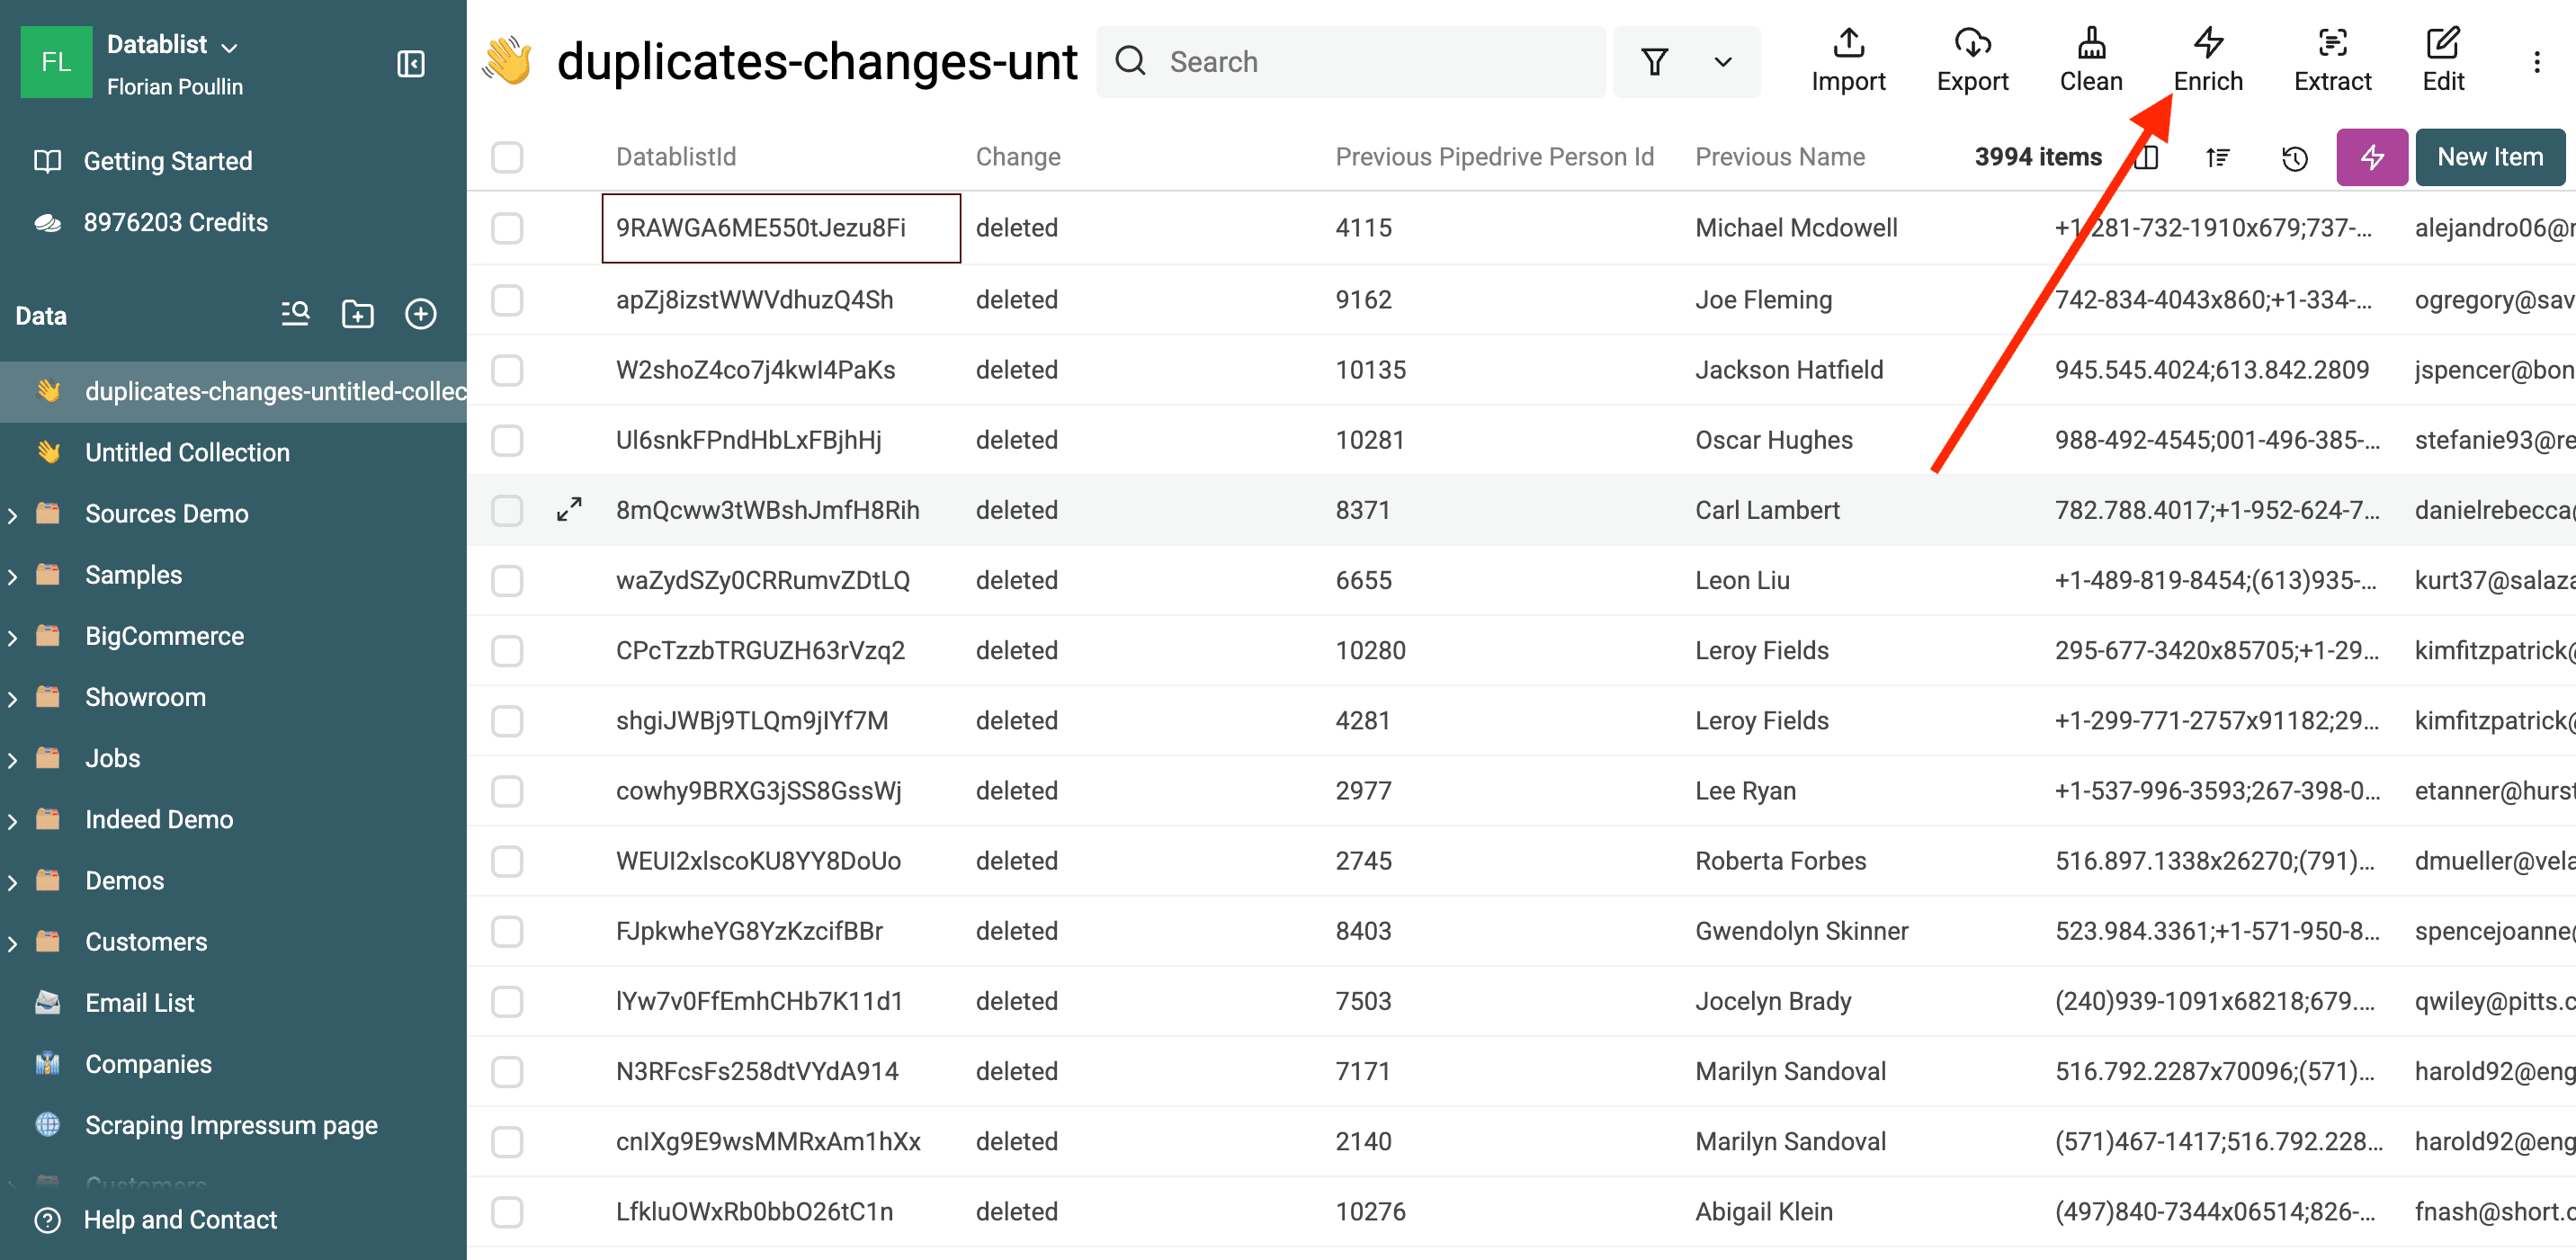
3.b. Fusionner et supprimer les doublons
Pour appliquer ces modifications, commencez par demander à Pipedrive de fusionner les fiches « deleted » dans les fiches « master ».
Pipedrive propose une API de fusion pour regrouper les fiches en doublon. C’est celle que nous allons utiliser.
Pour les profils techniques, voici son fonctionnement :
- Utilisez l’endpoint
/organizations/:id/mergepour les Organizations. - Utilisez l’endpoint
/persons/:id/mergepour les People. - La fiche en doublon est supprimée et ses données sont transférées vers la fiche principale.
💡 Exemple de requête API :
PUT https://api.pipedrive.com/v1/persons/{duplicate_id}/merge?api_token=YOUR_API_KEY
{
  "merge_with_id": "{master_record_id}"
}
🔹 Pourquoi utiliser l’API de fusion ?
- Elle garantit que les deals, activités et notes associés restent rattachés à la fiche principale.
- Les données sans conflit, comme les numéros de téléphone ou emails supplémentaires, sont automatiquement conservées.
Pas de panique - Datablist dispose d’un enrichment natif qui appelle cet endpoint Pipedrive à votre place.
Commencez par sélectionner uniquement les lignes dont l’opération de modification est deleted.
Dans le menu Enrich, sélectionnez ensuite Pipedrive Merge Duplicates.
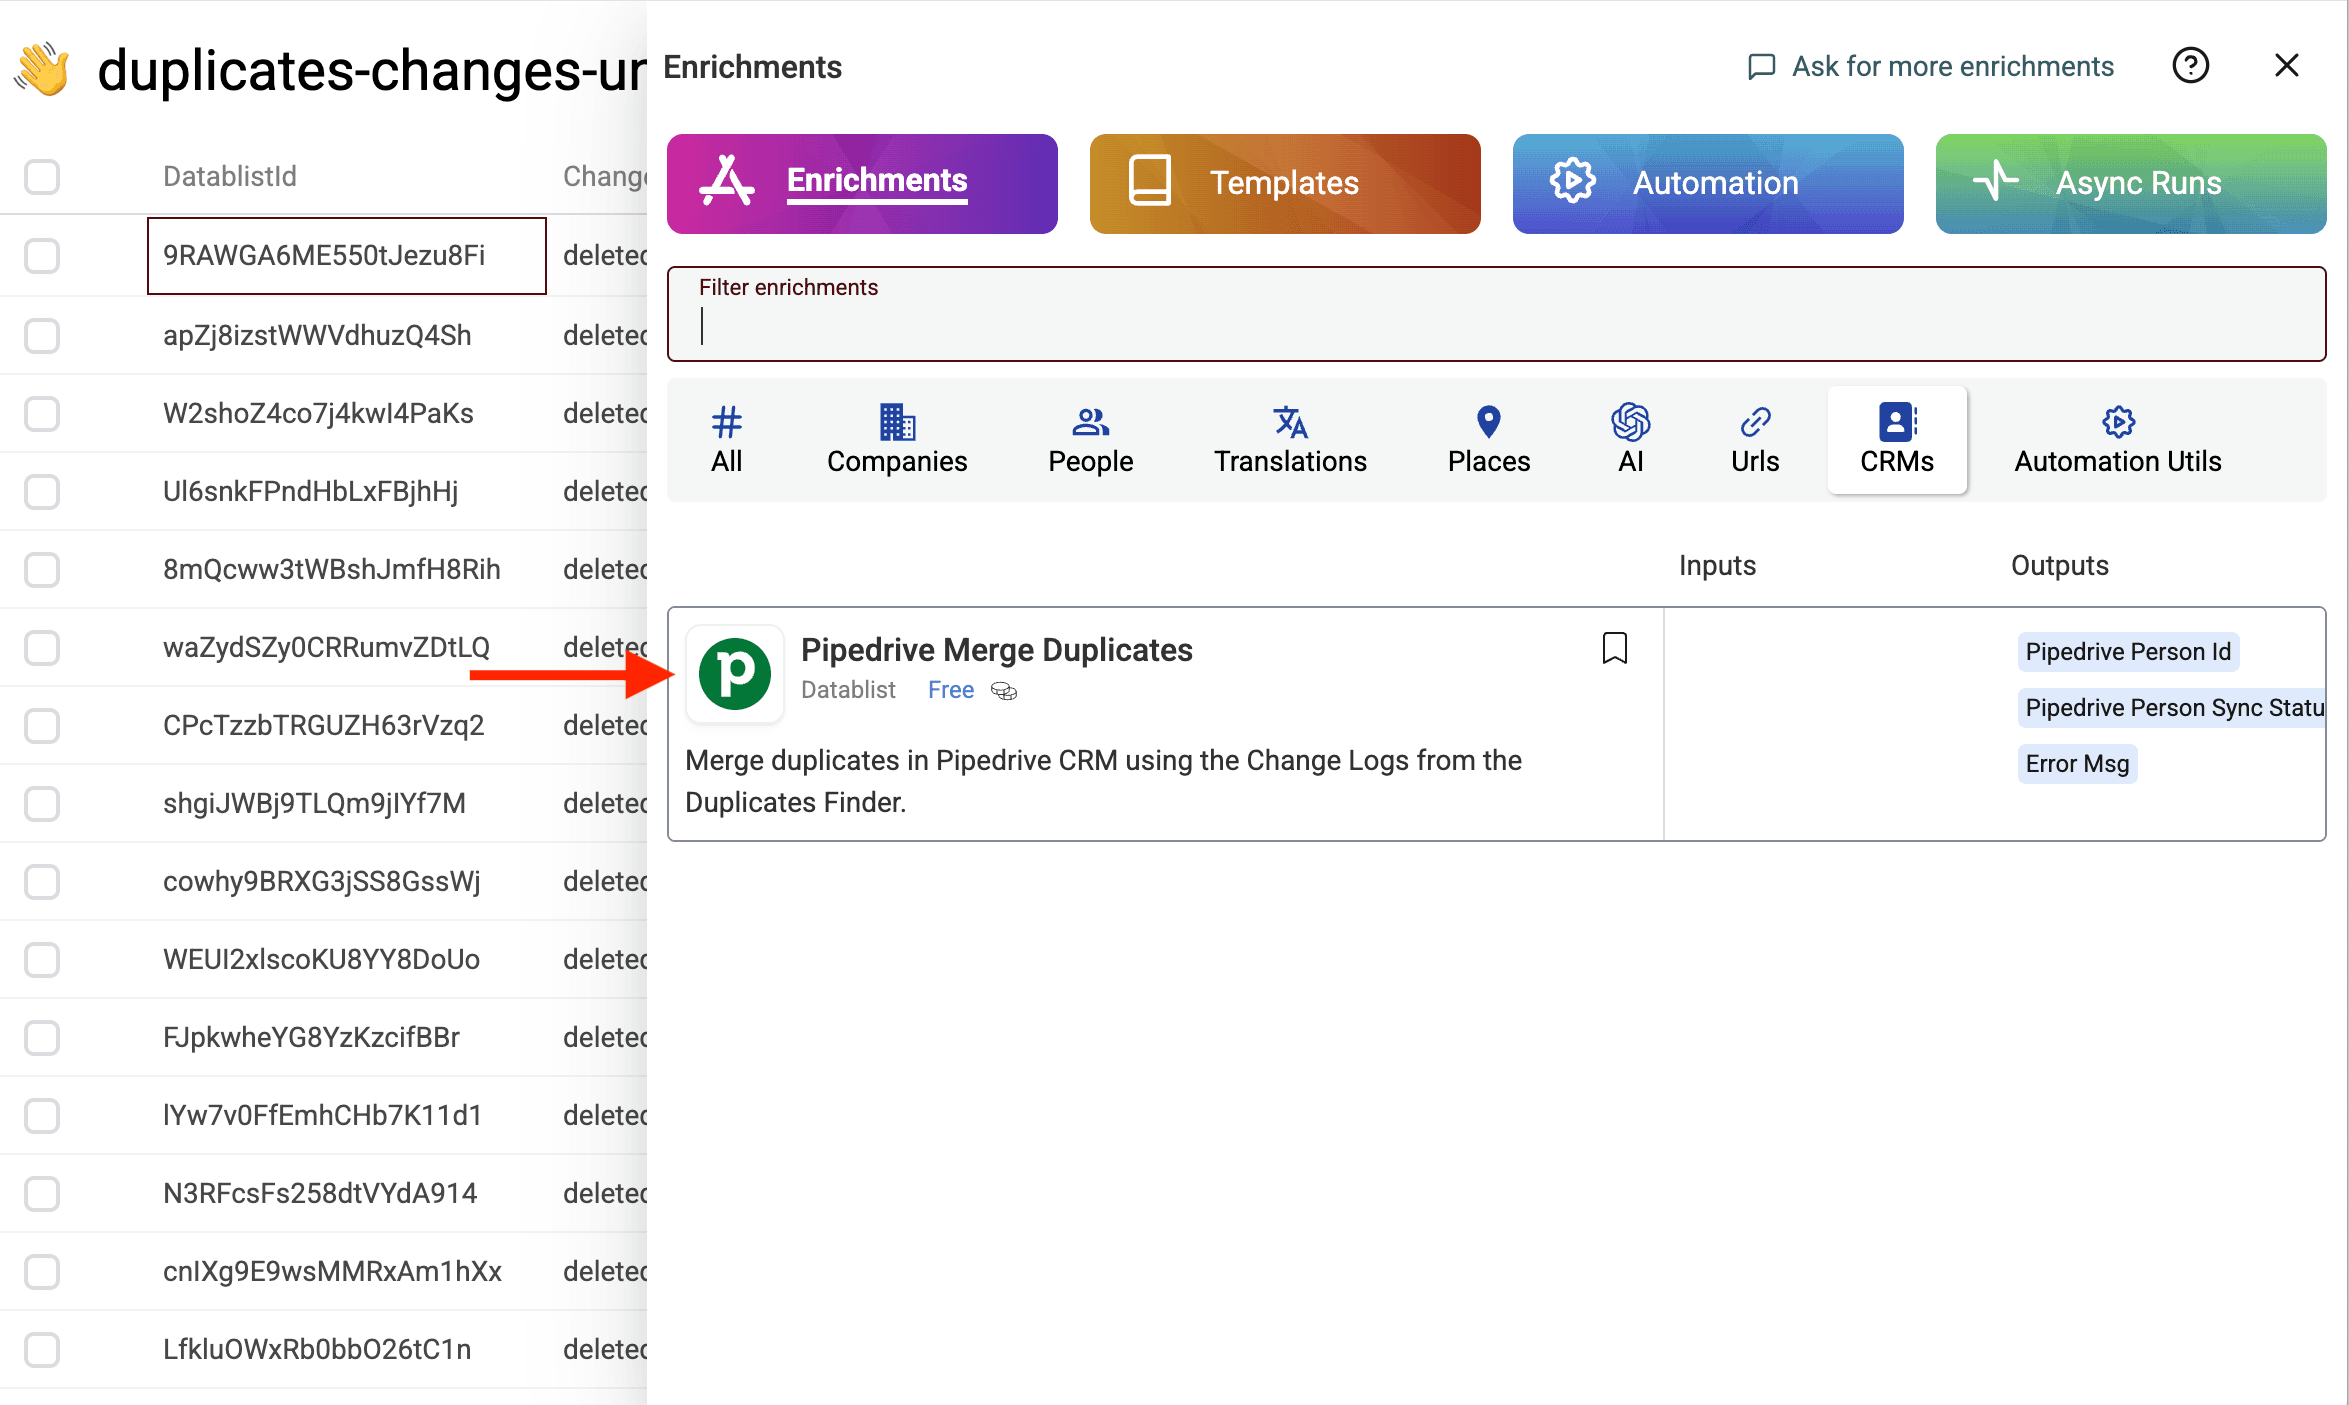
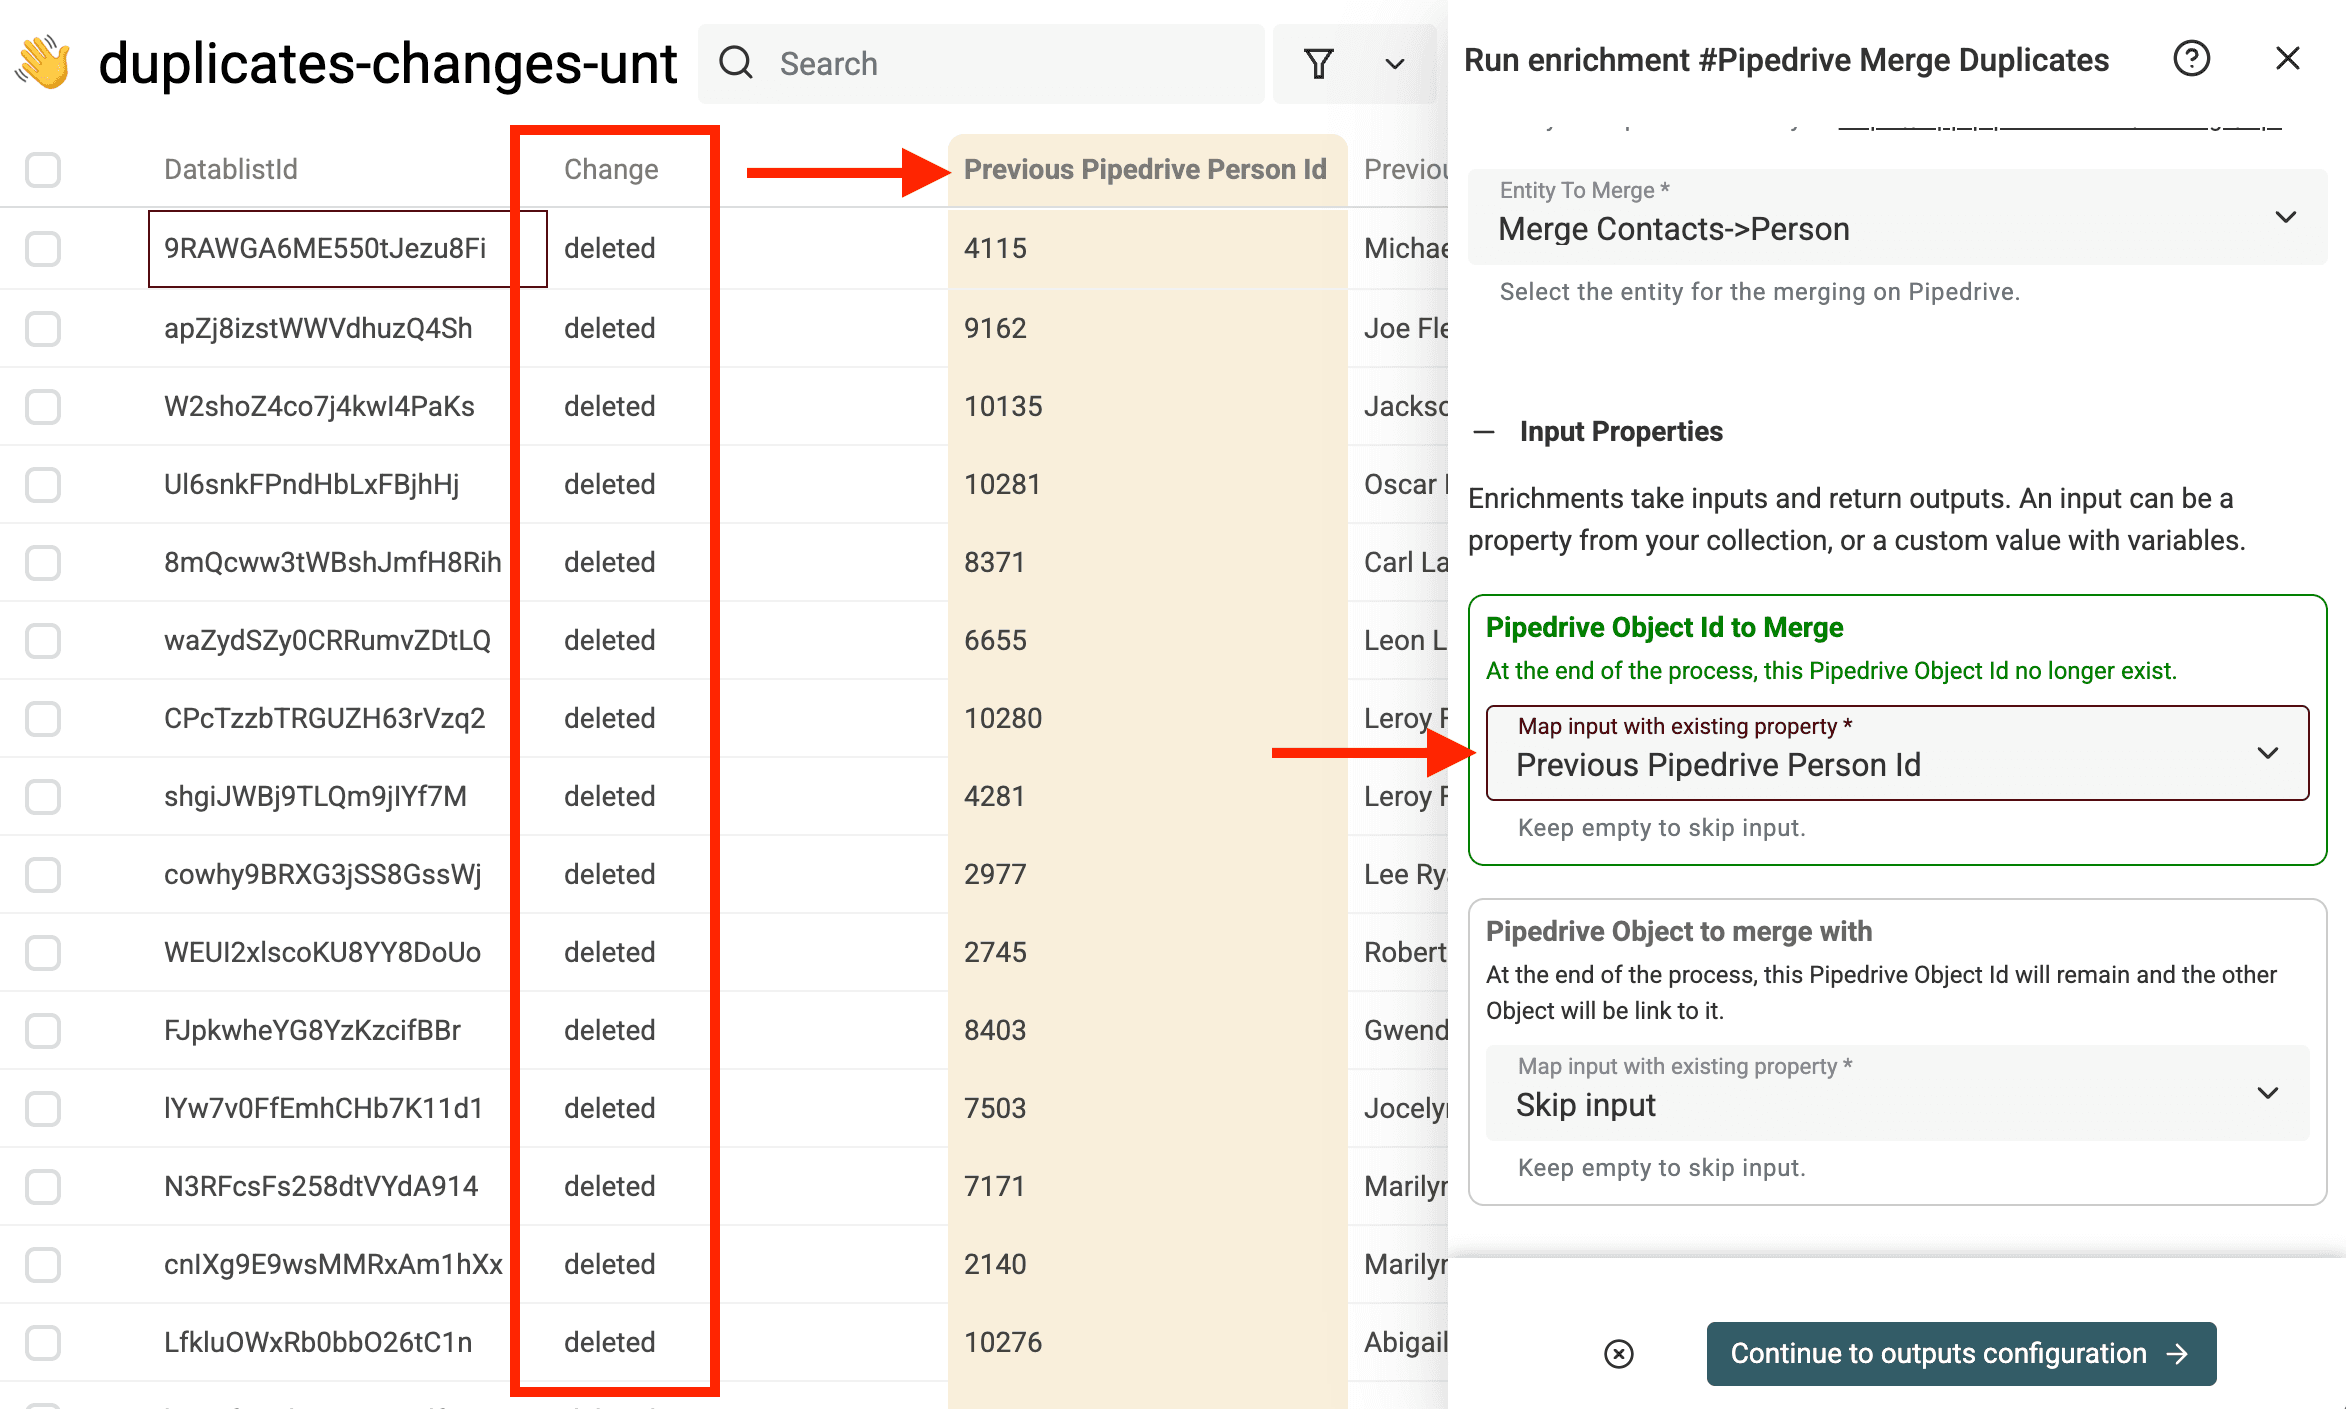
Avant de lancer l’enrichment Pipedrive Merge Duplicates, vérifiez que la colonne des modifications n’affiche que la valeur « deleted ».
Saisissez votre clé API Pipedrive, puis configurez l’entité Pipedrive à fusionner.
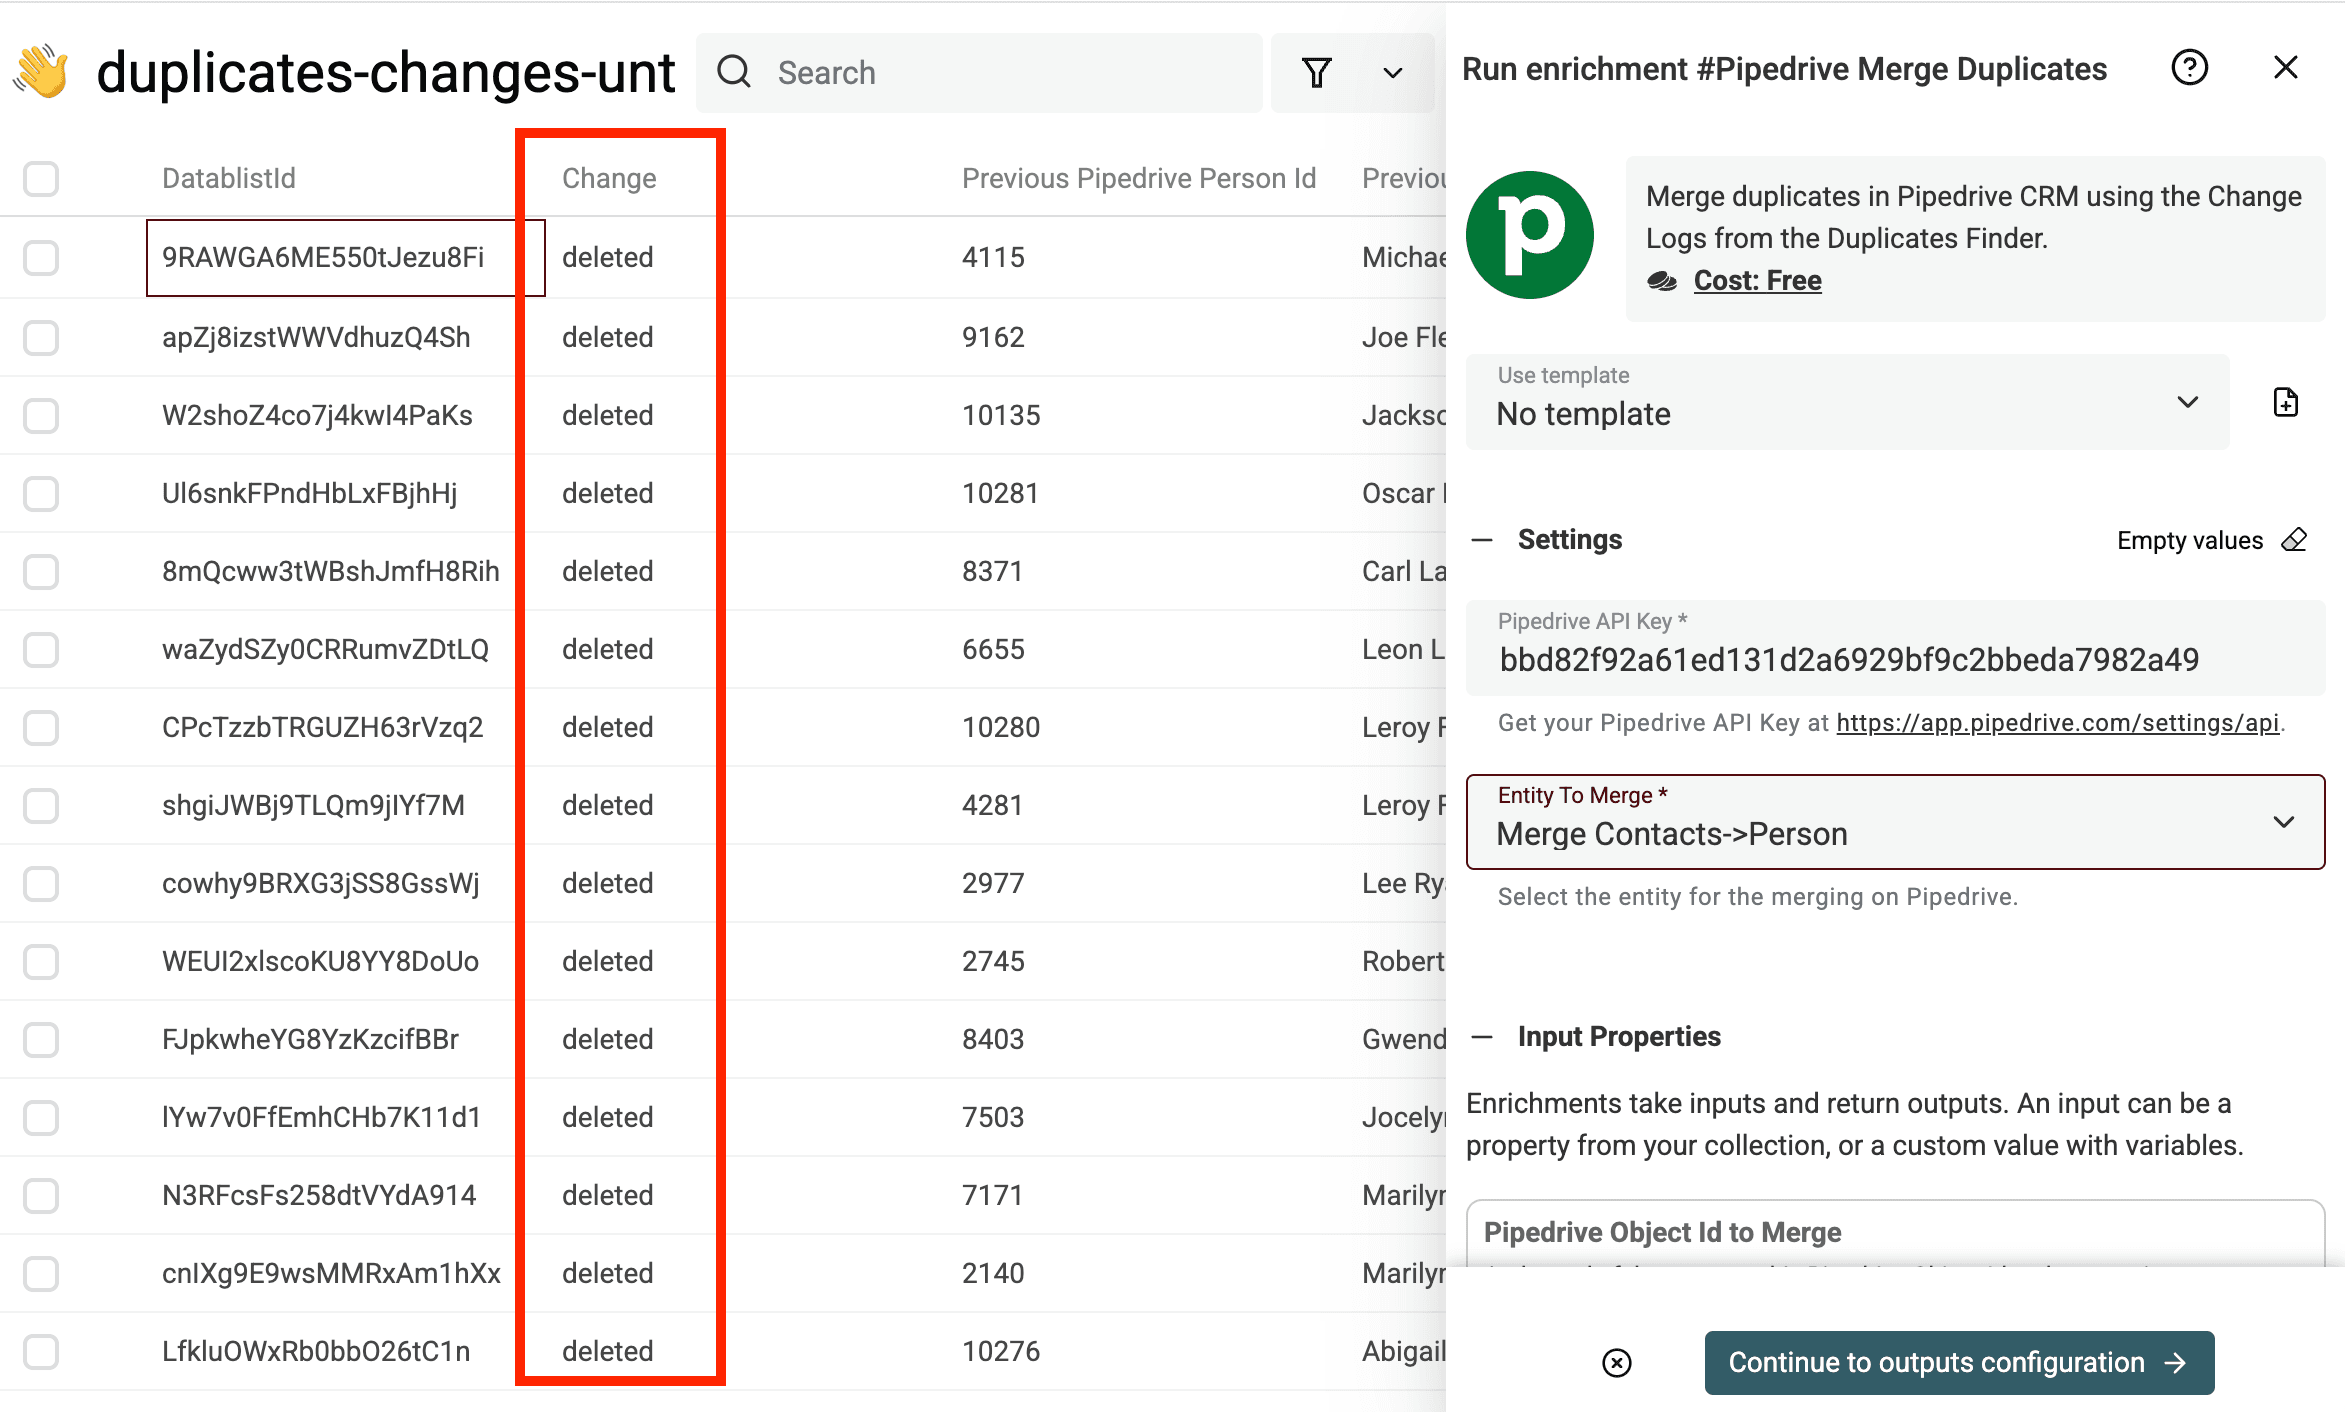
Dans les inputs, associez Pipedrive Object Id to Merge au champ Previous Pipedrive Person Id.
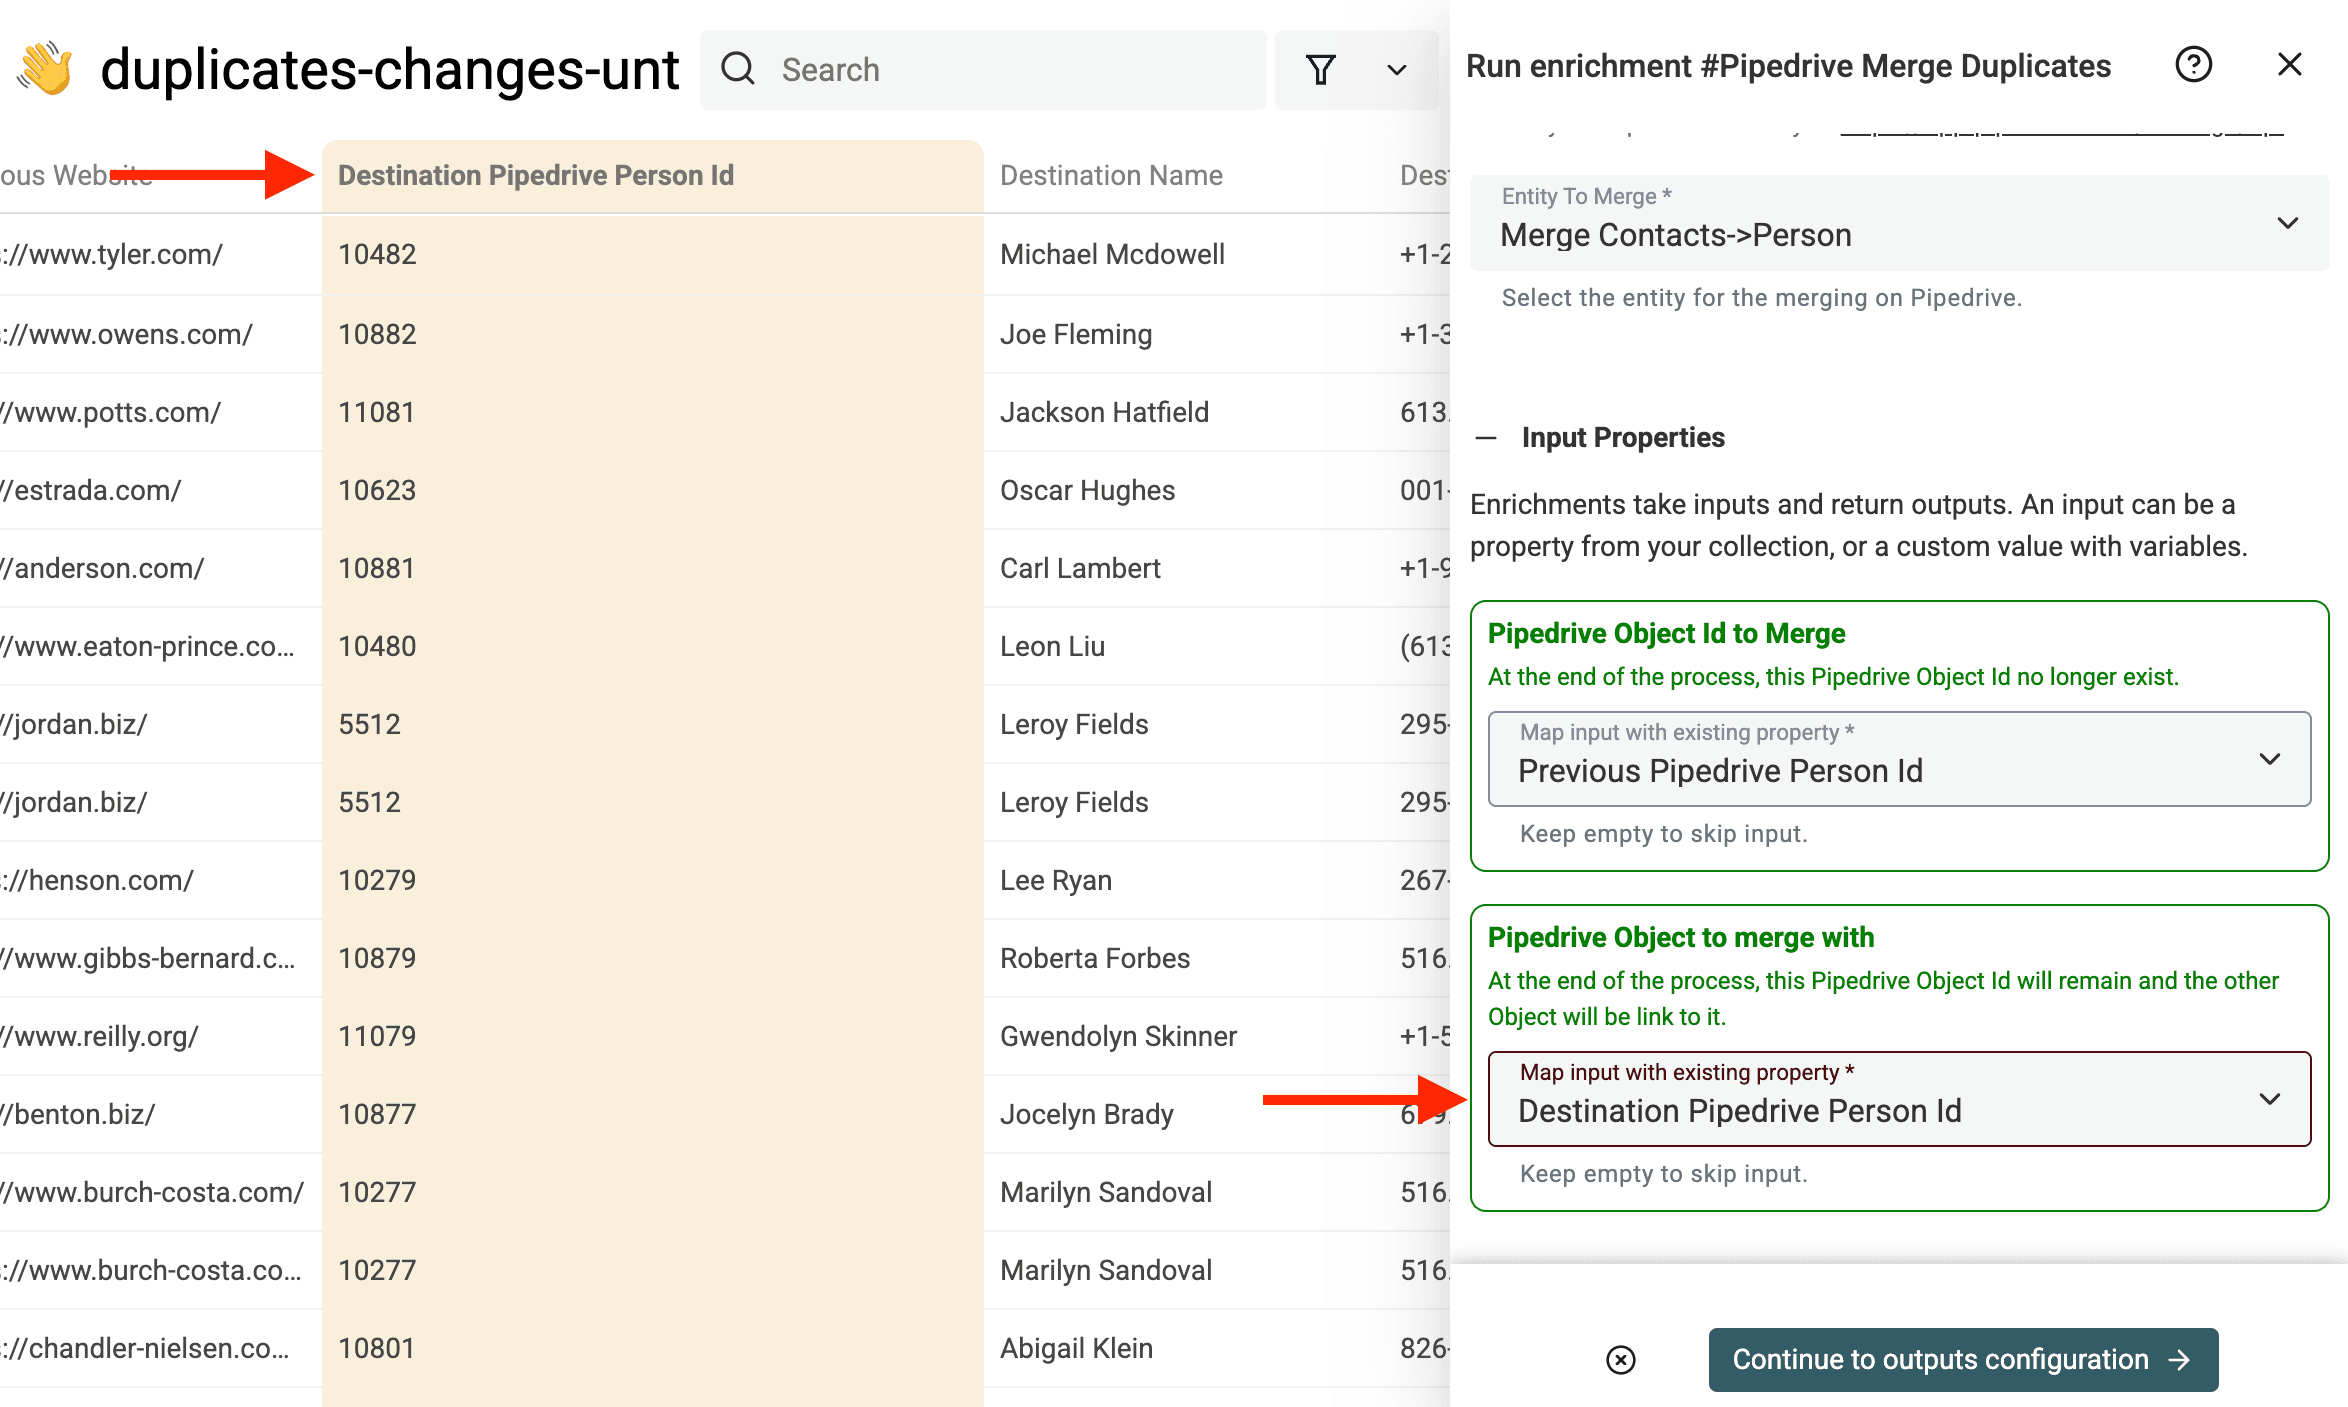
Pour Pipedrive Object to merge with, sélectionnez le champ Destination Pipedrive Person Id.
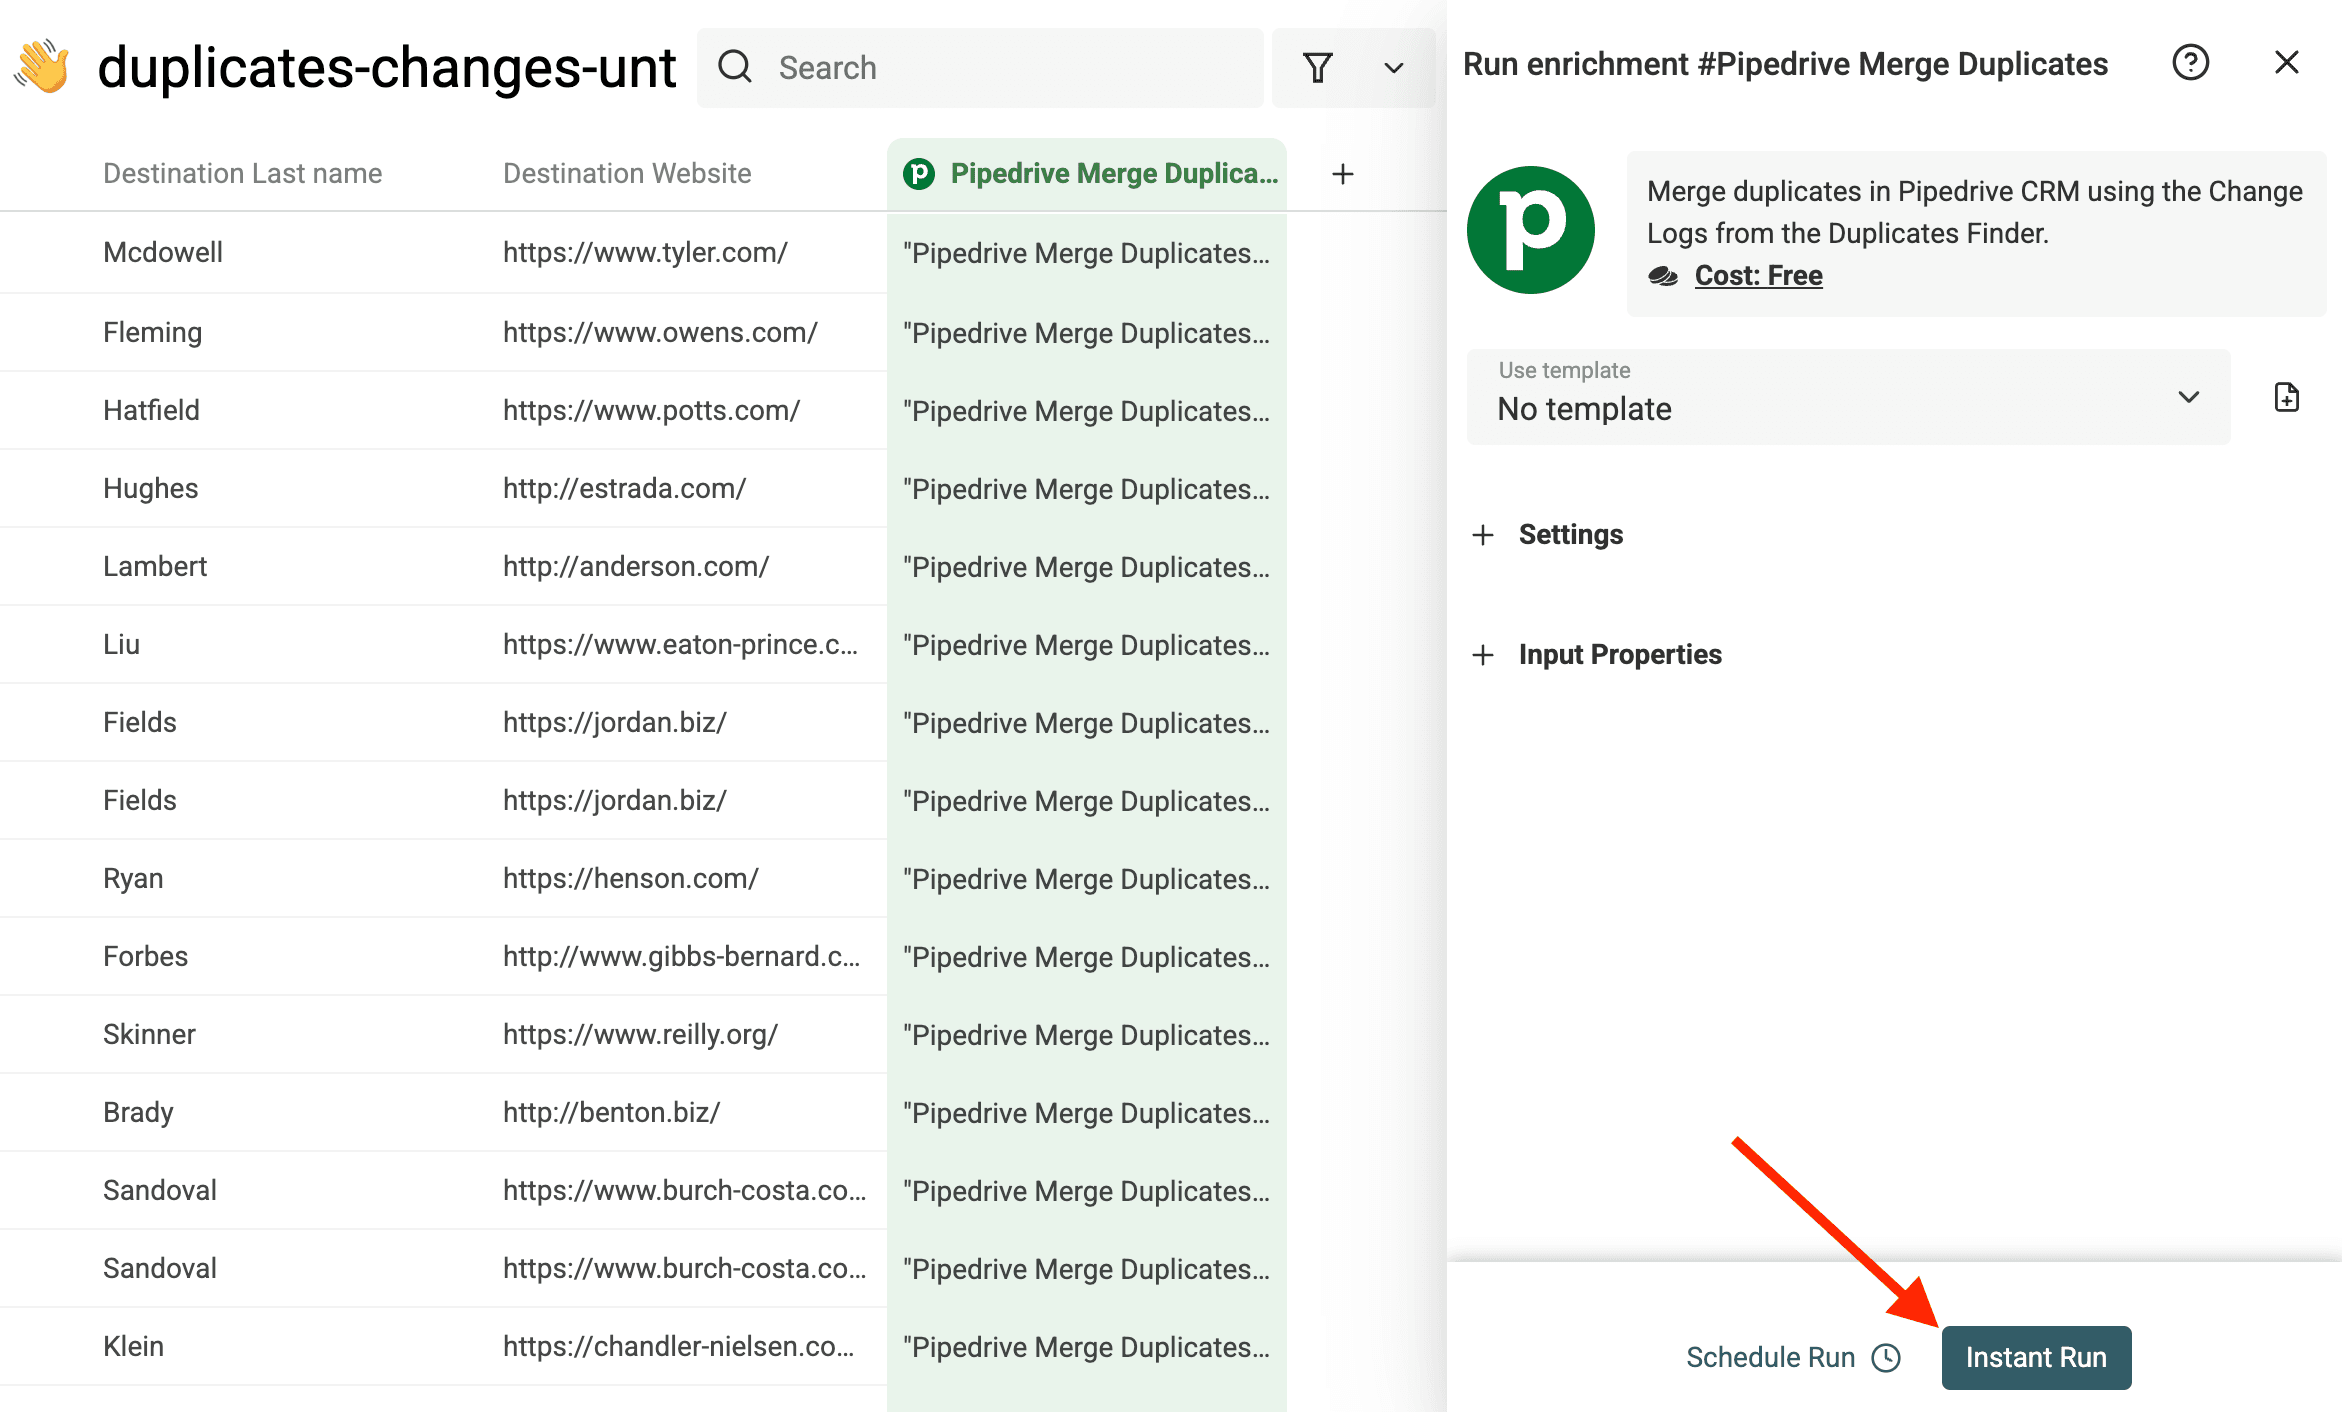
Lancez ensuite le processus de fusion.
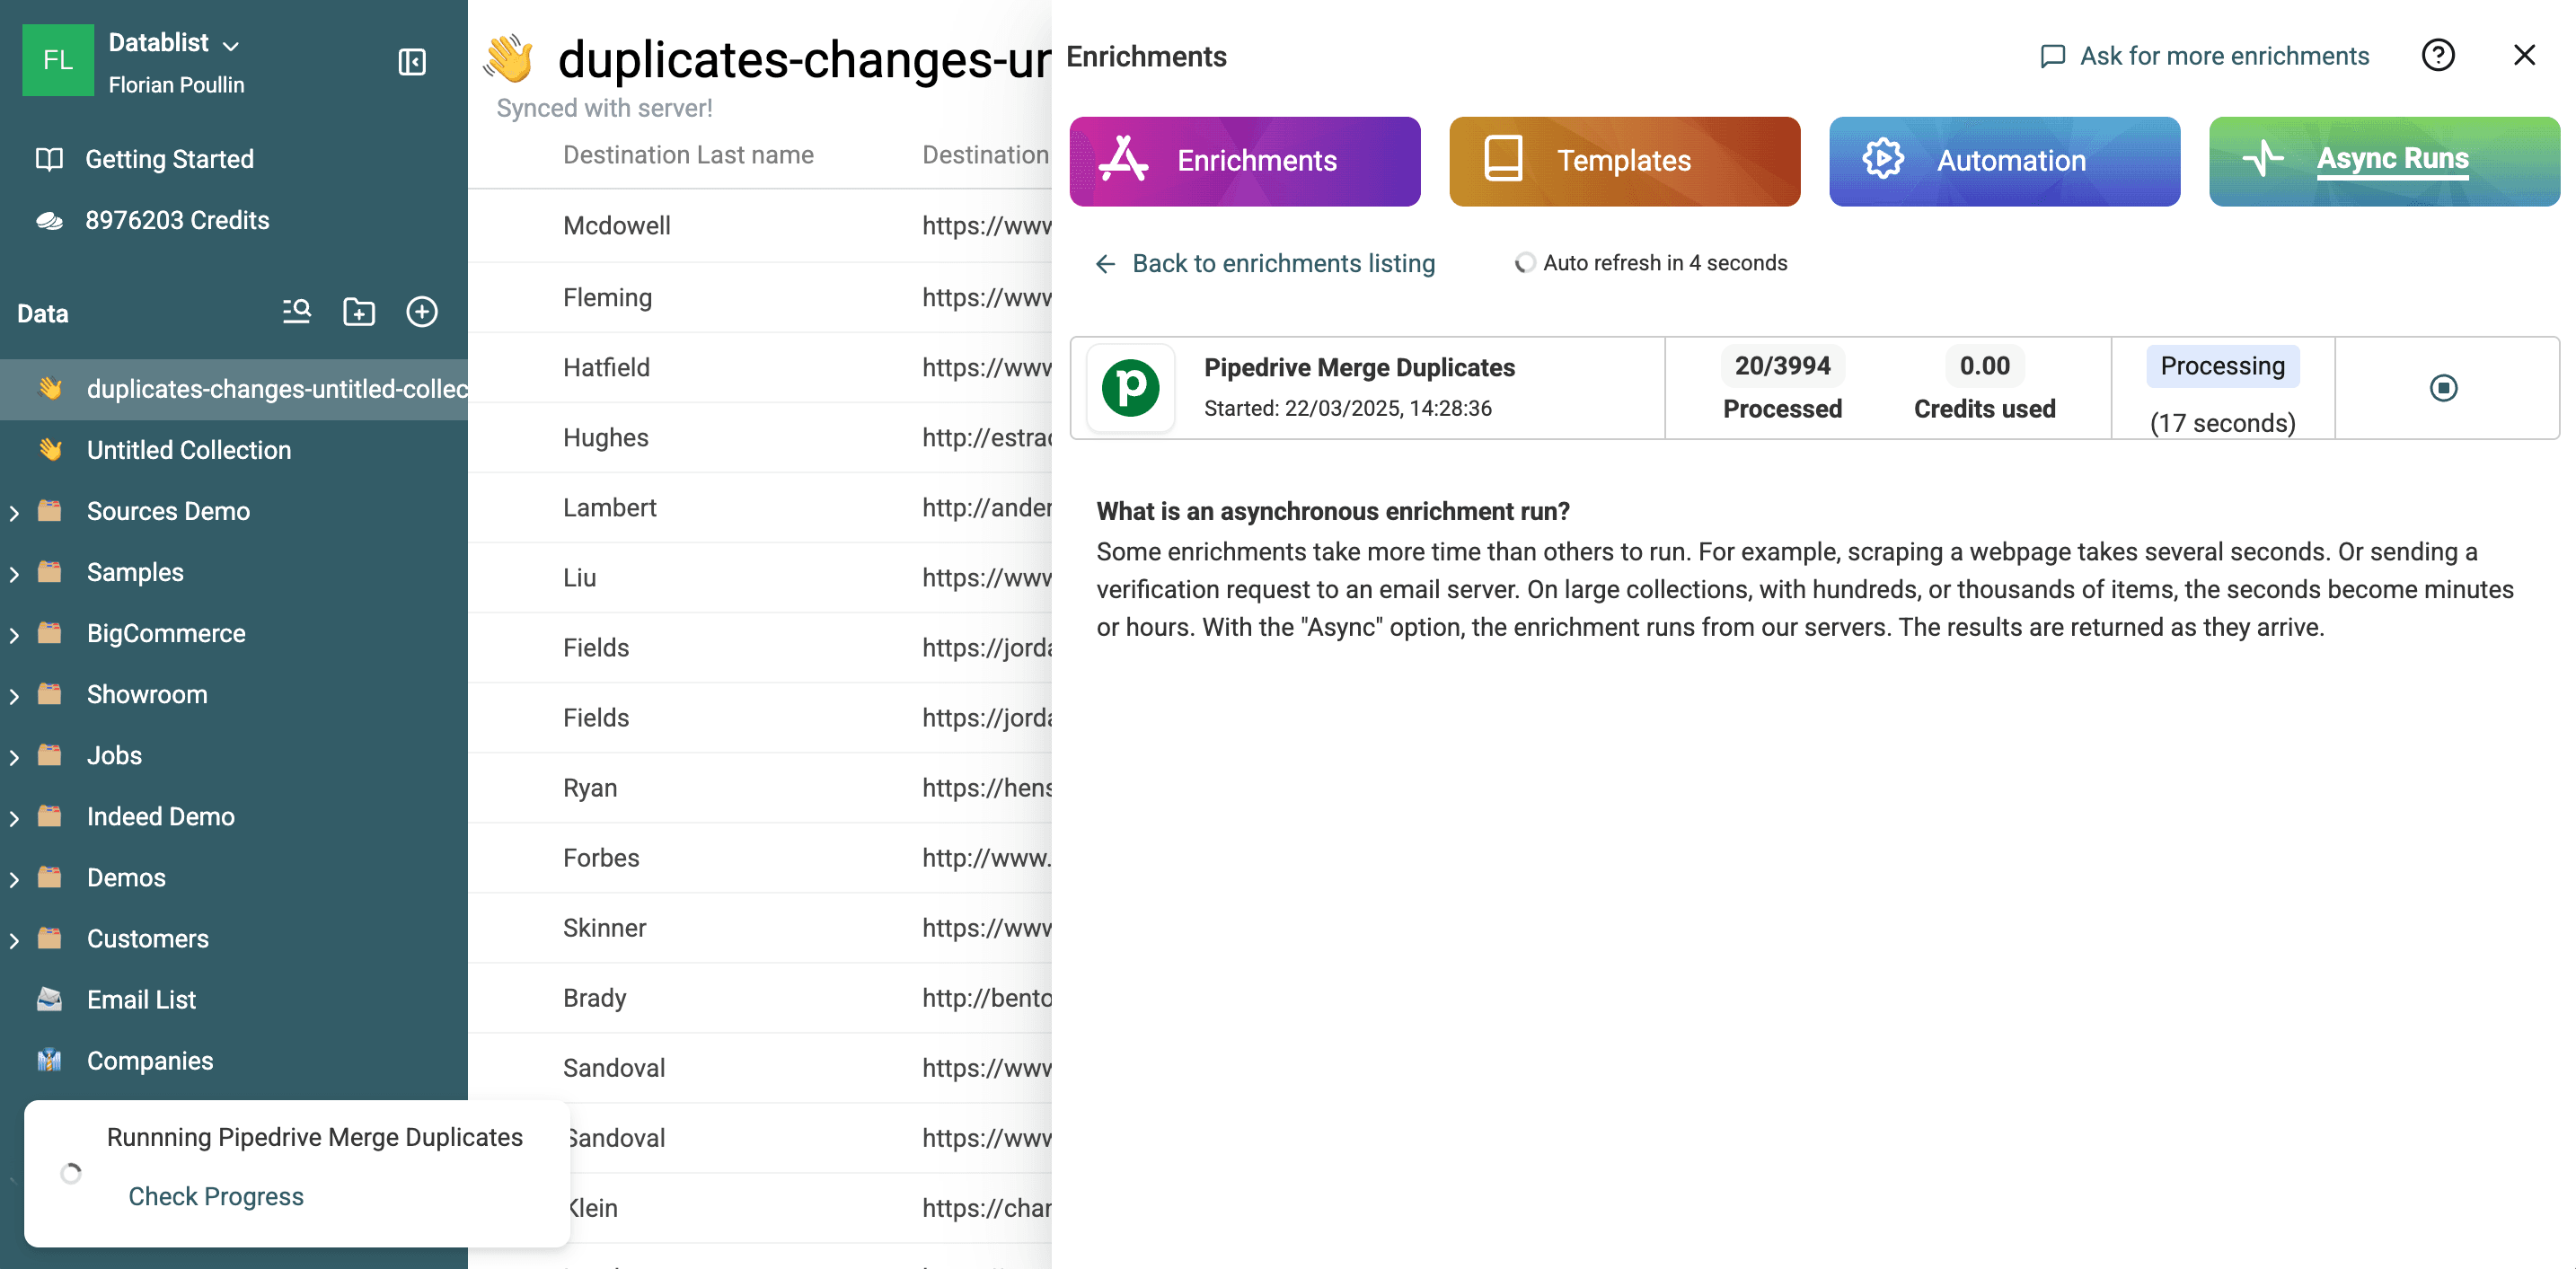
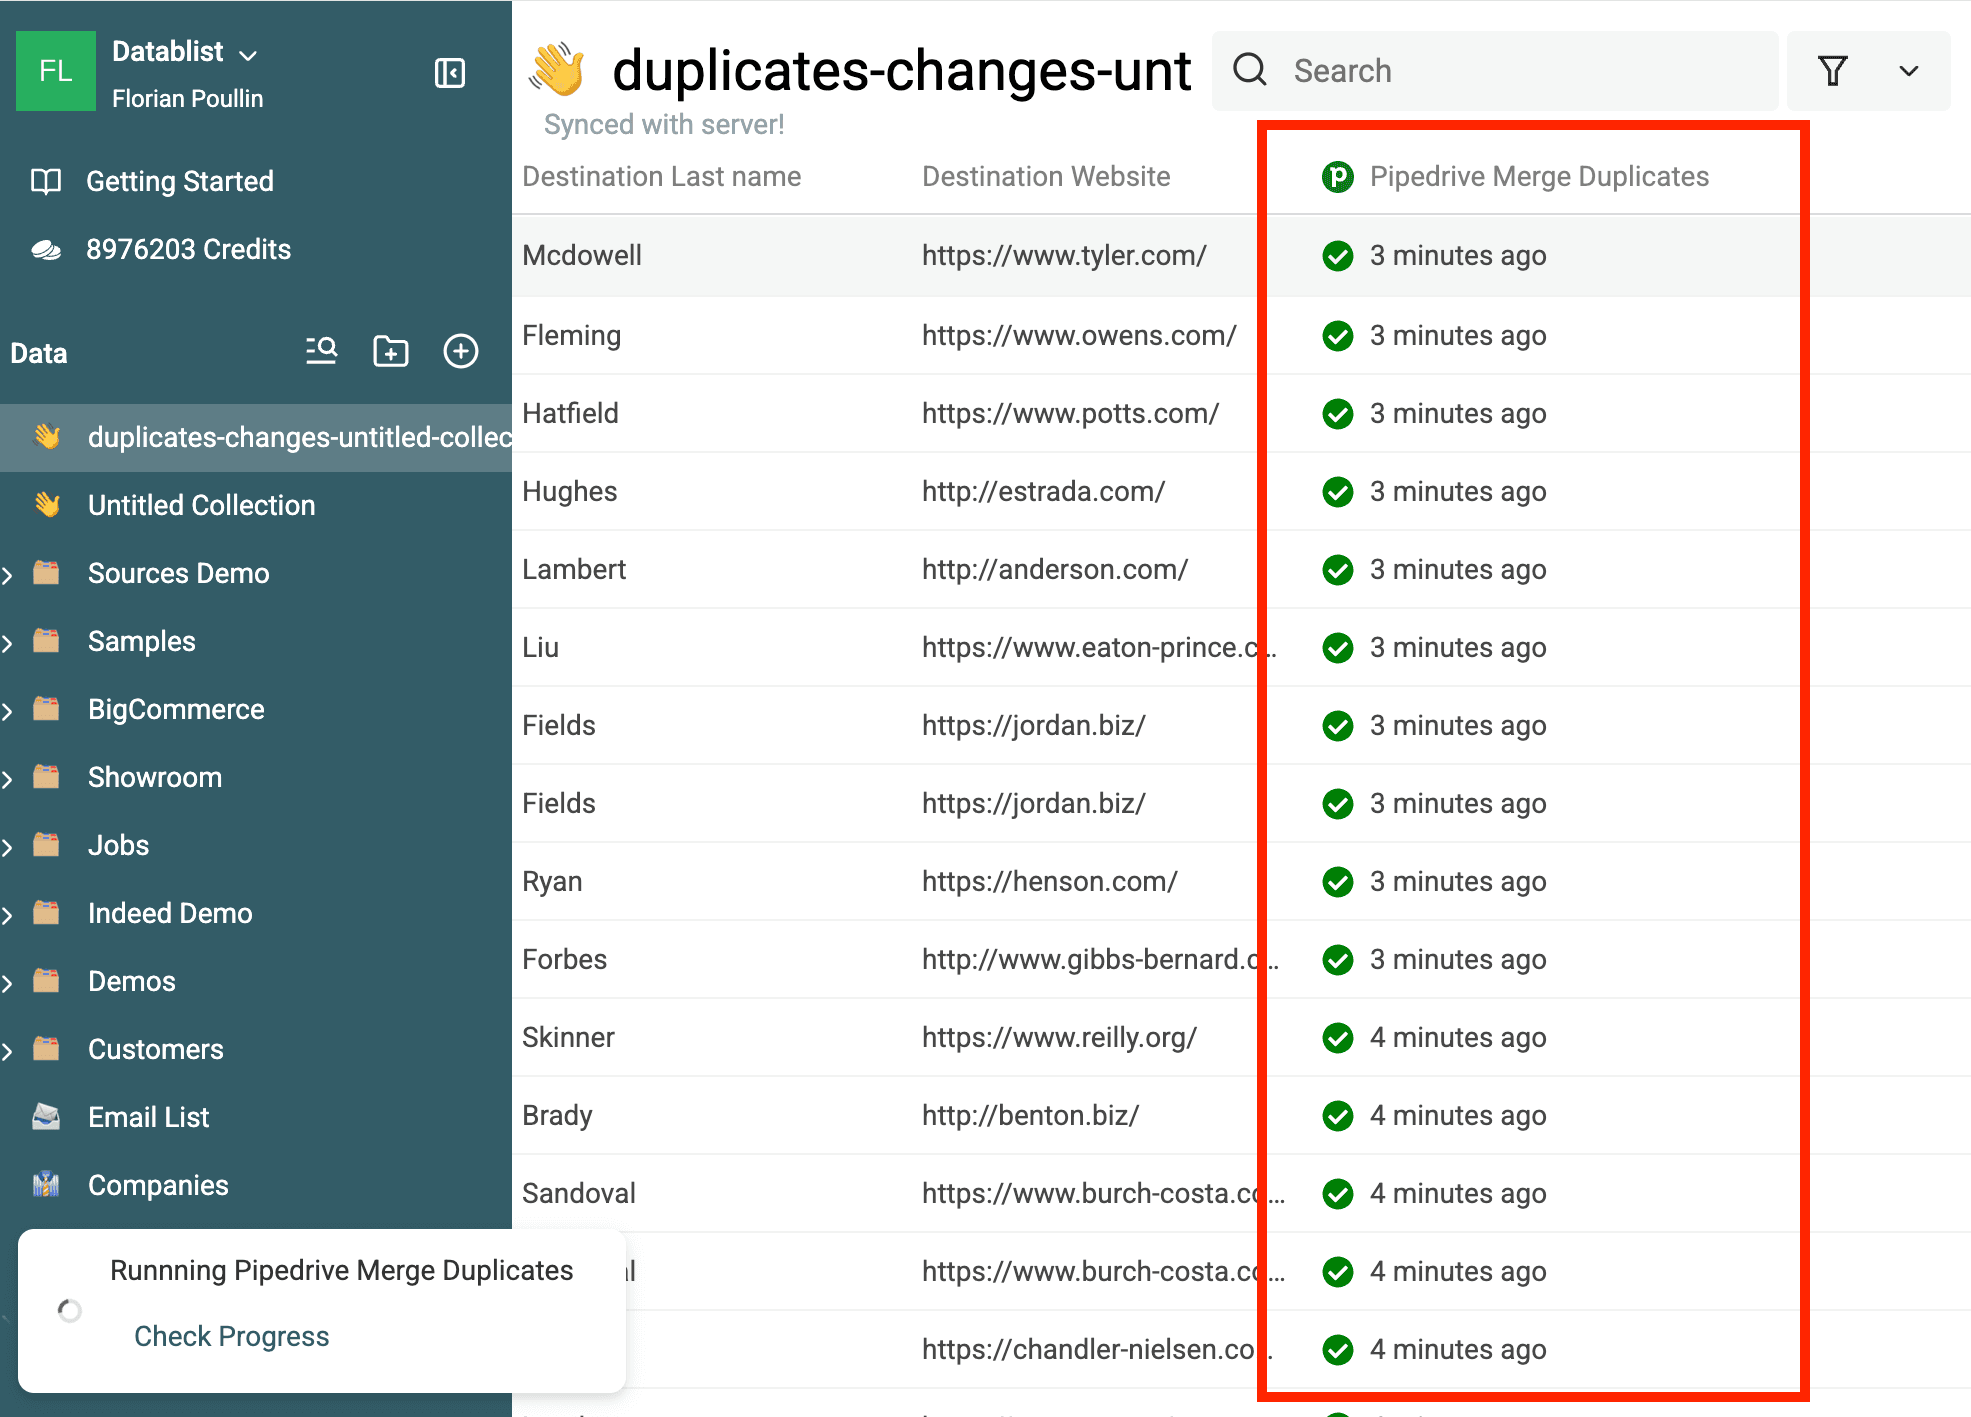
Vous pouvez suivre sa progression directement dans Datablist.
Le statut de la fusion apparaît sur chaque ligne de la collection.
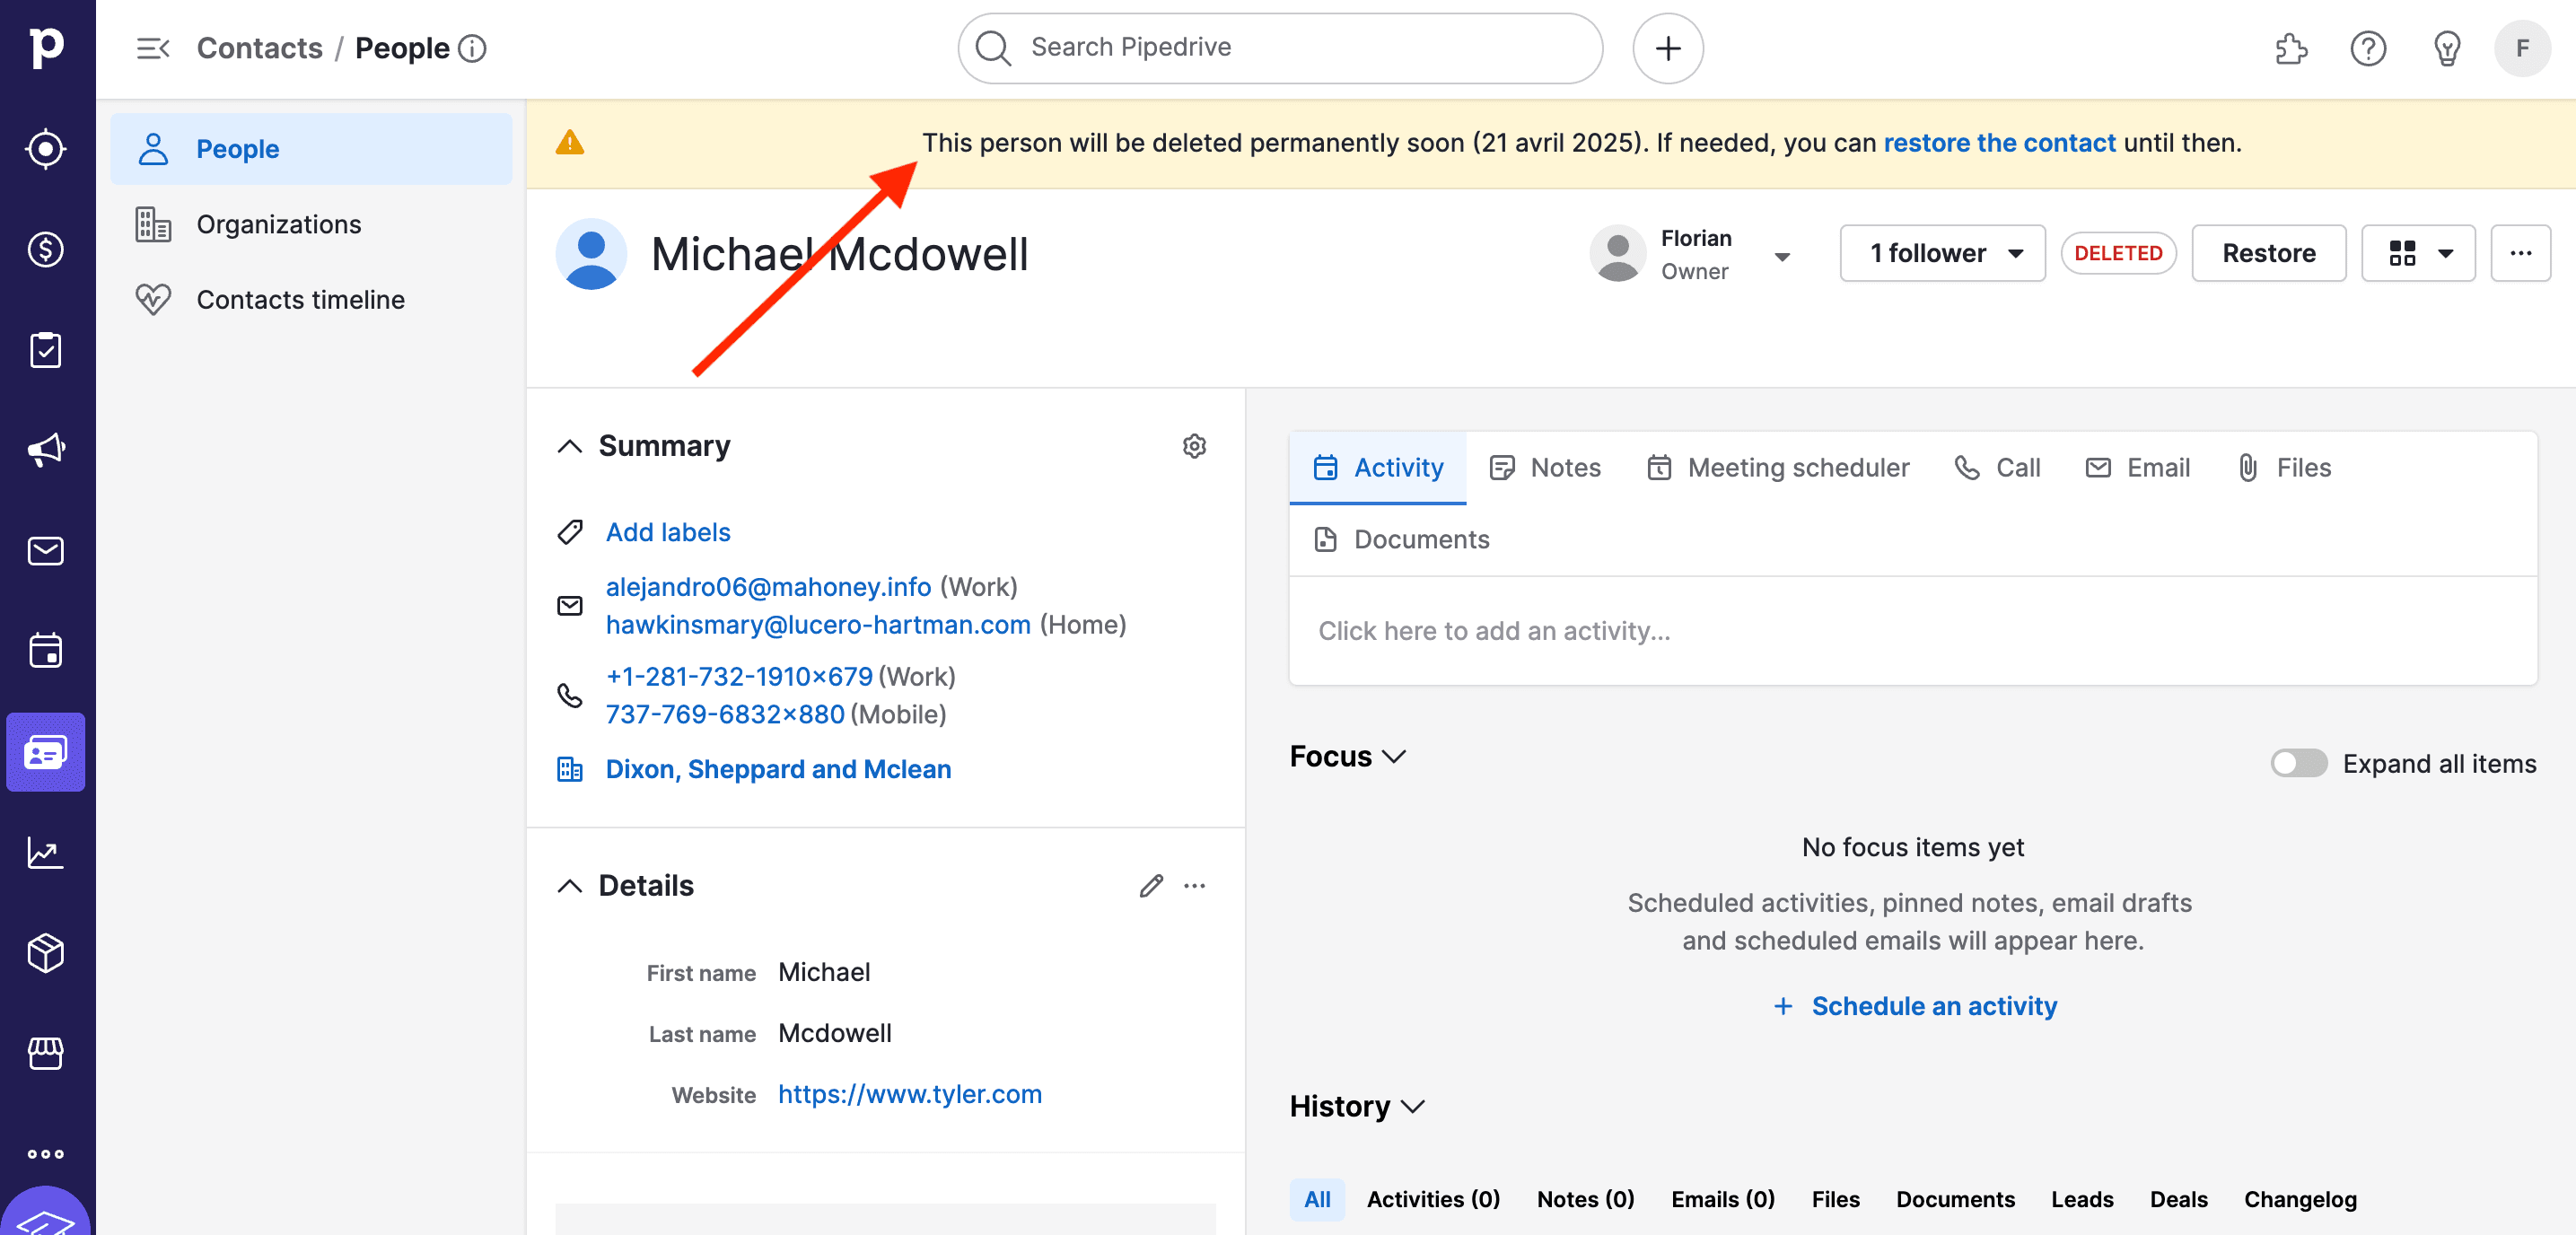
Vous pouvez vérifier la fiche Pipedrive qui sera supprimée. Ouvrez-la — pour les People, l’URL est https://app.pipedrive.com/person/:ID. Un message s’affichera en haut de l’écran.
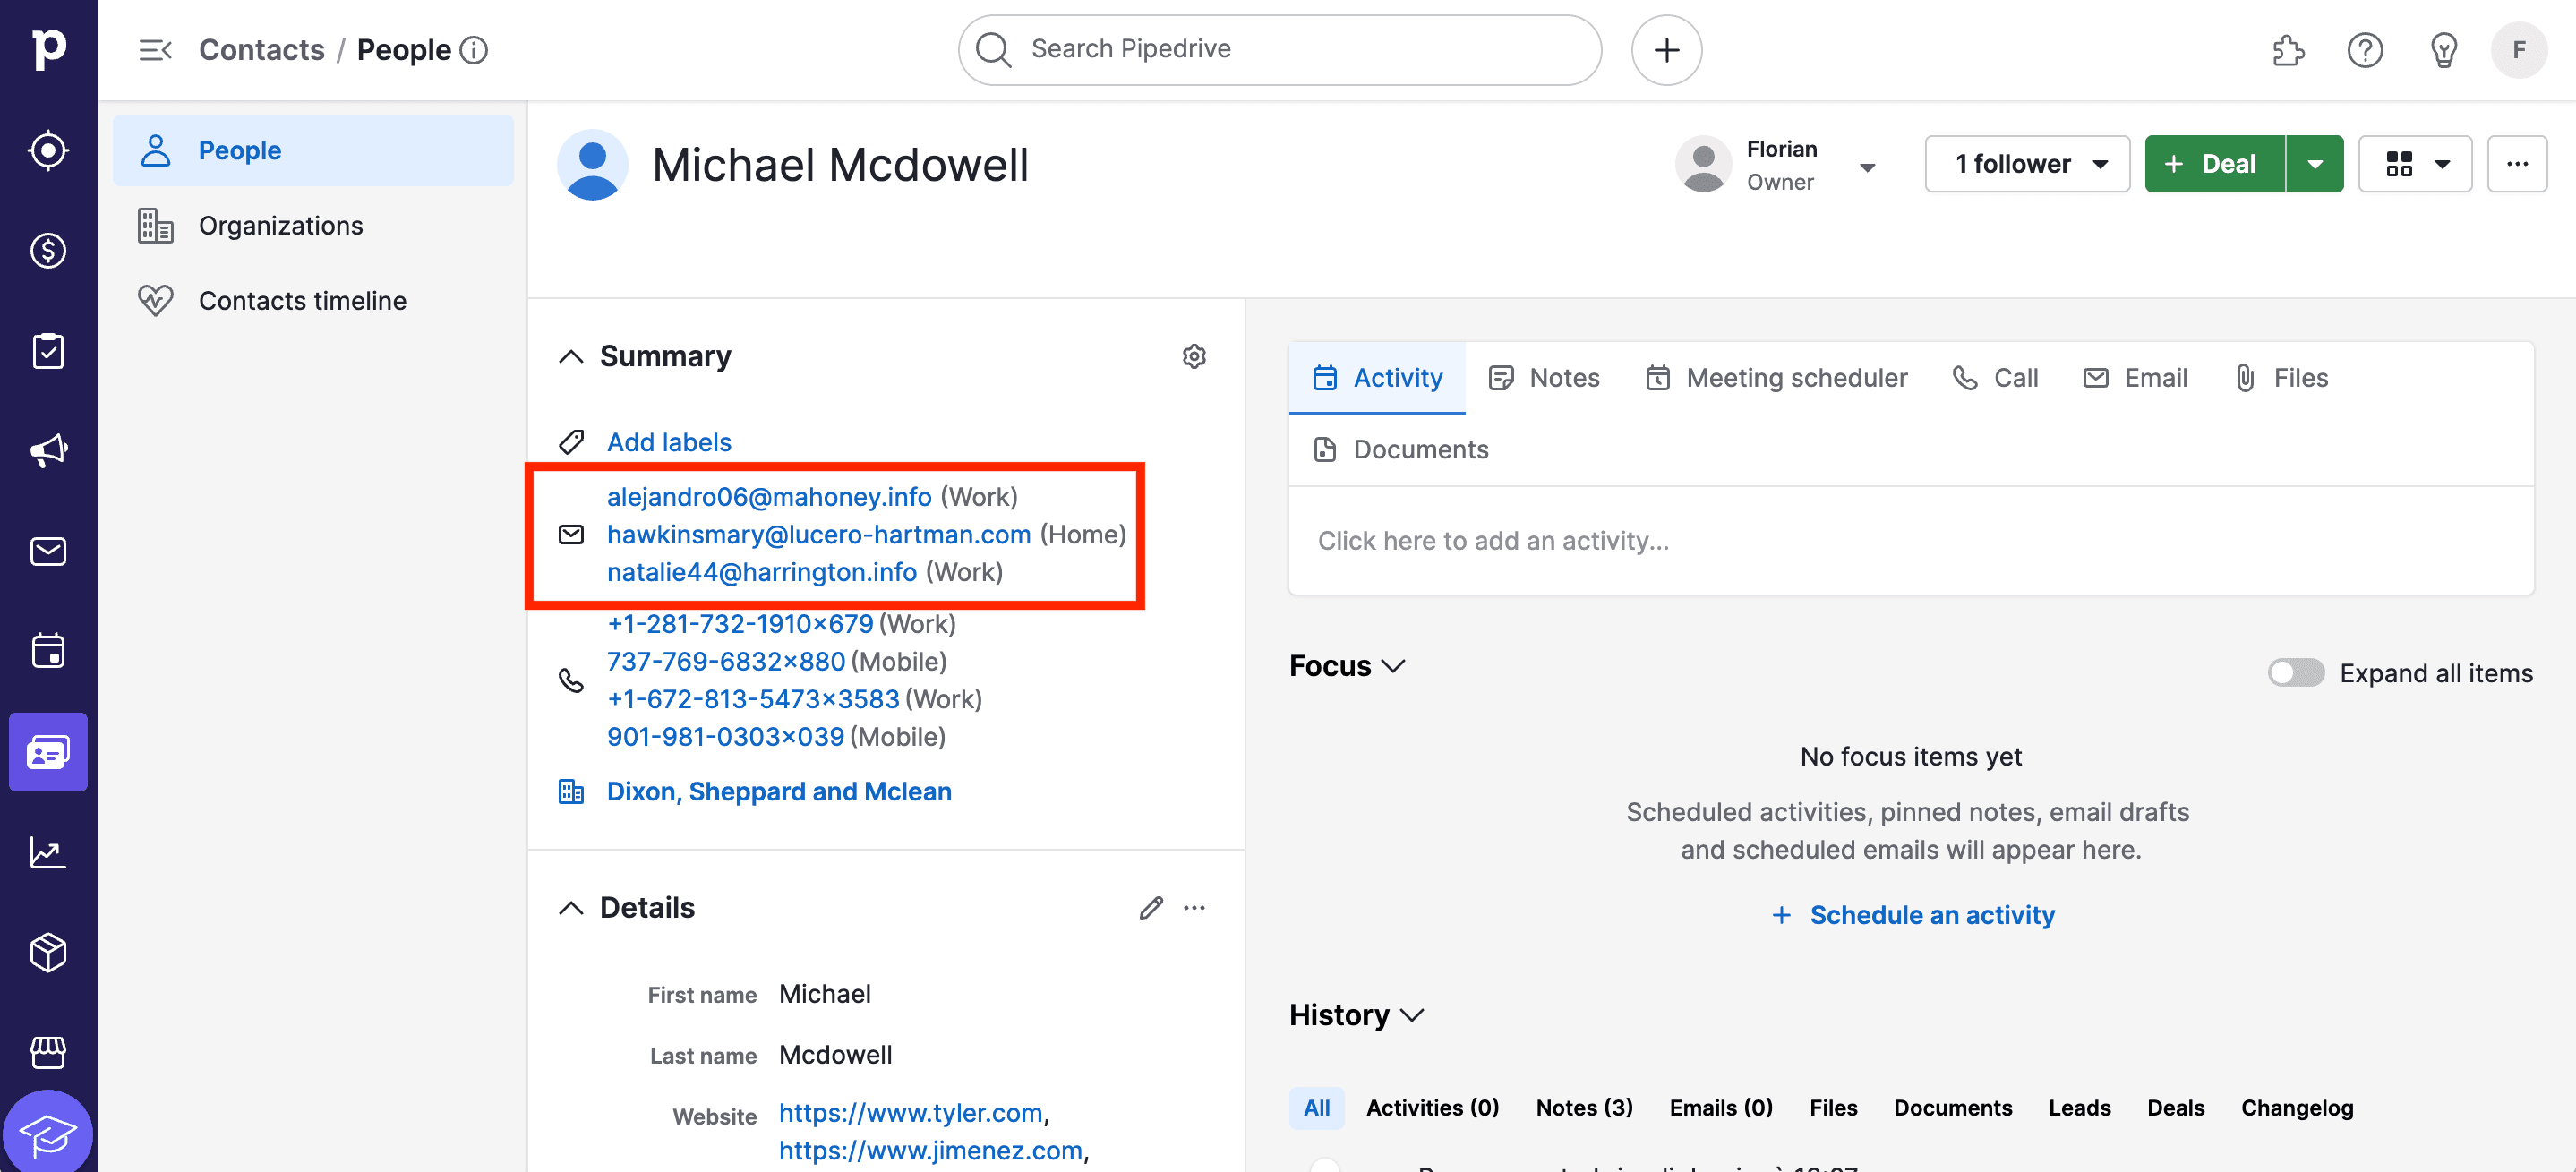
Les données fusionnées apparaîtront également dans les fiches principales.
3.c. Synchroniser les fiches mises à jour
À l’étape précédente, nous avons utilisé l’API de fusion Pipedrive pour regrouper les doublons dans leur fiche principale.
Cependant, pendant cette opération, Pipedrive ajoute les valeurs de la fiche en doublon à celles de la fiche principale. Vous risquez donc de vous retrouver avec plusieurs sites web similaires, entre autres.
Pour corriger cela, nous allons mettre à jour les fiches principales restantes avec les données propres obtenues après la fusion dans Datablist.
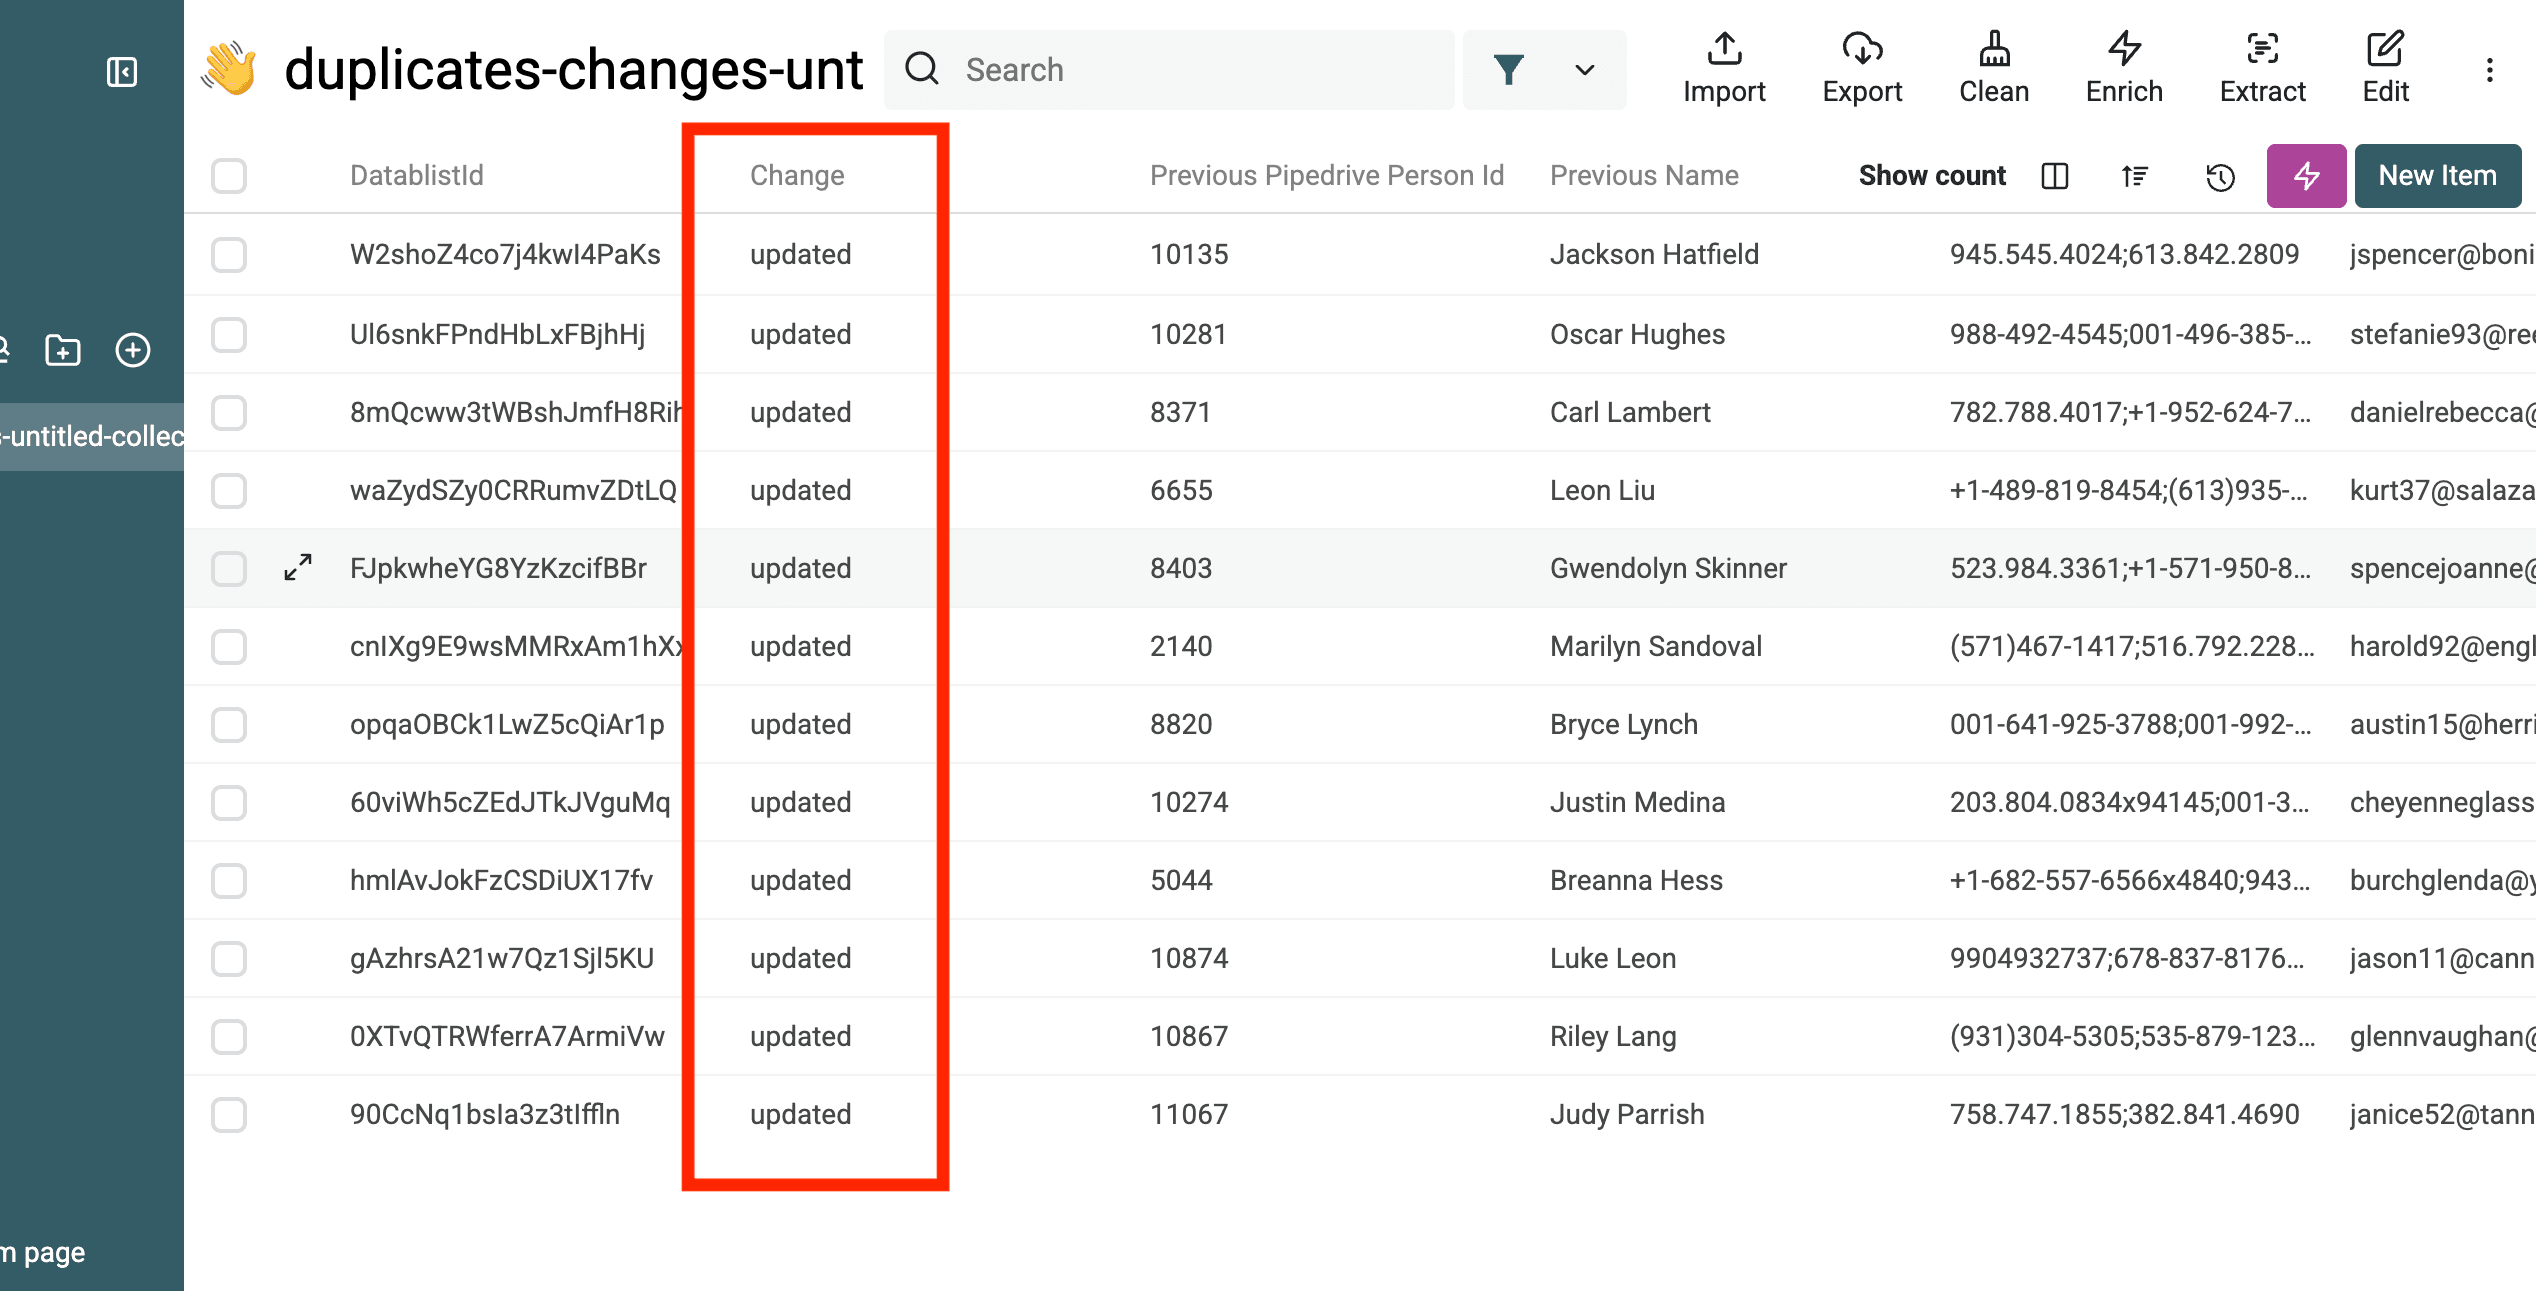
Dans la collection du fichier de modifications, filtrez la colonne change afin de n’afficher que l’opération updated.
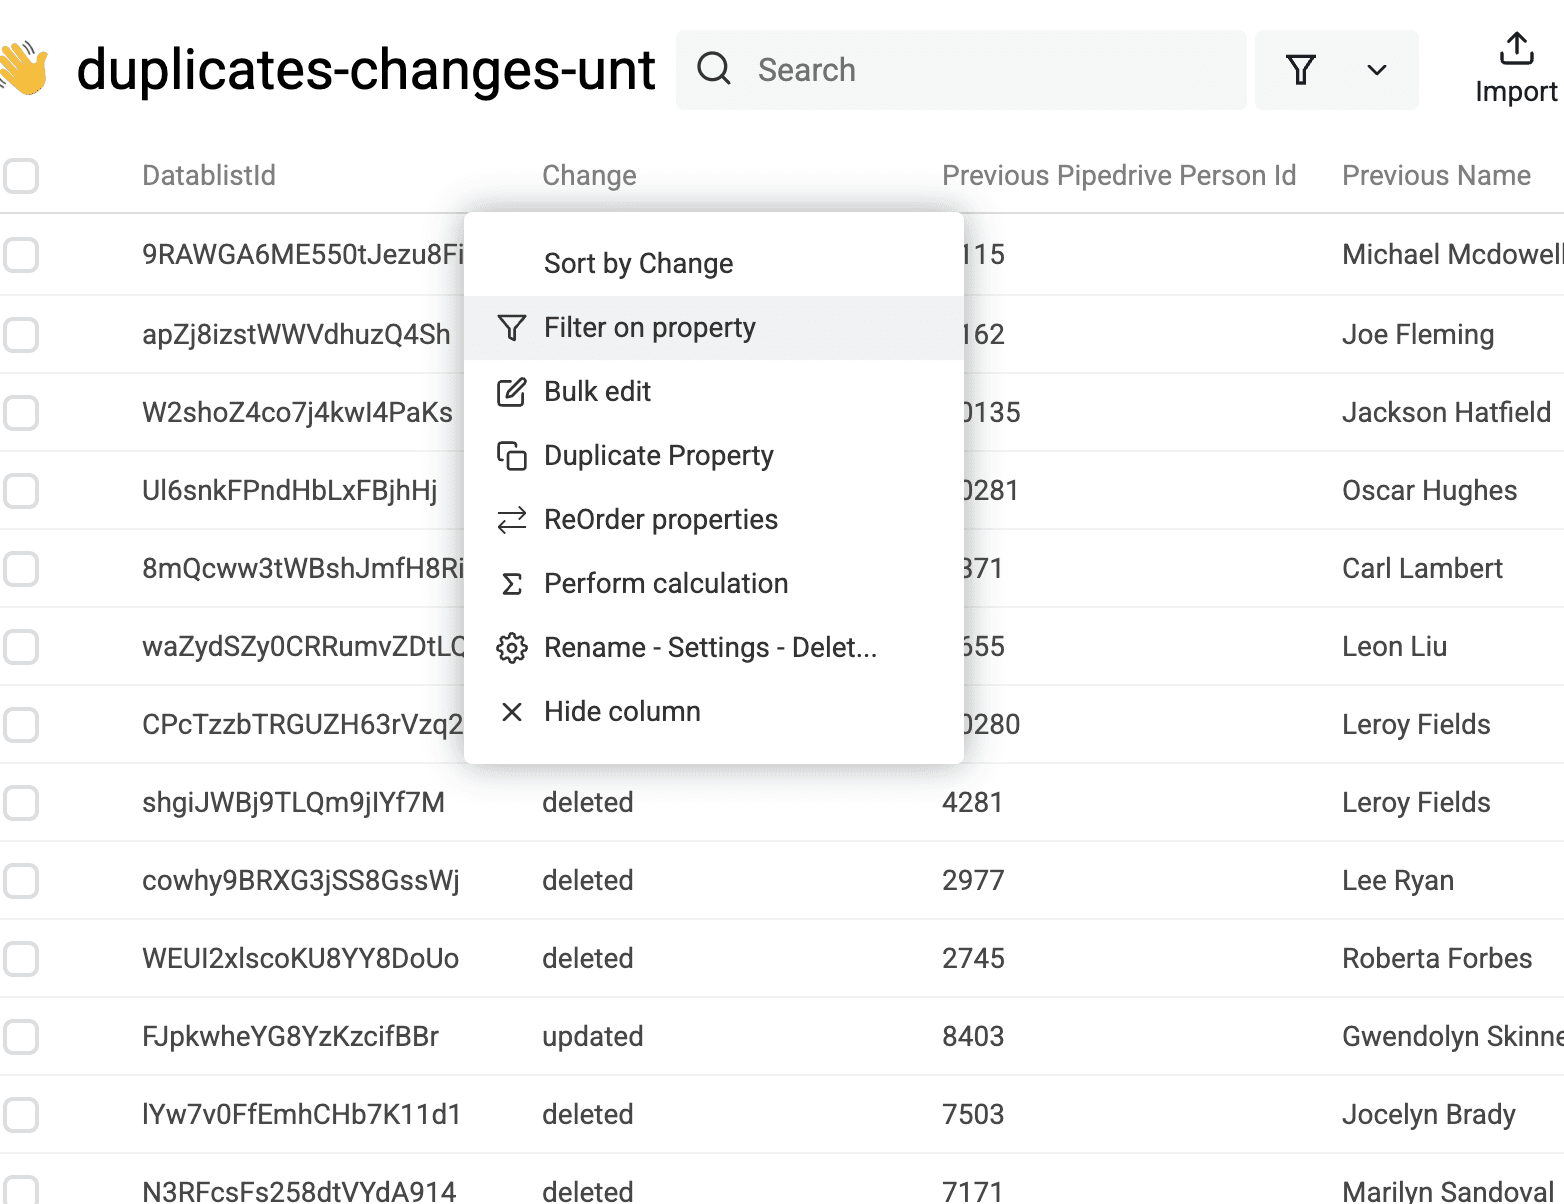
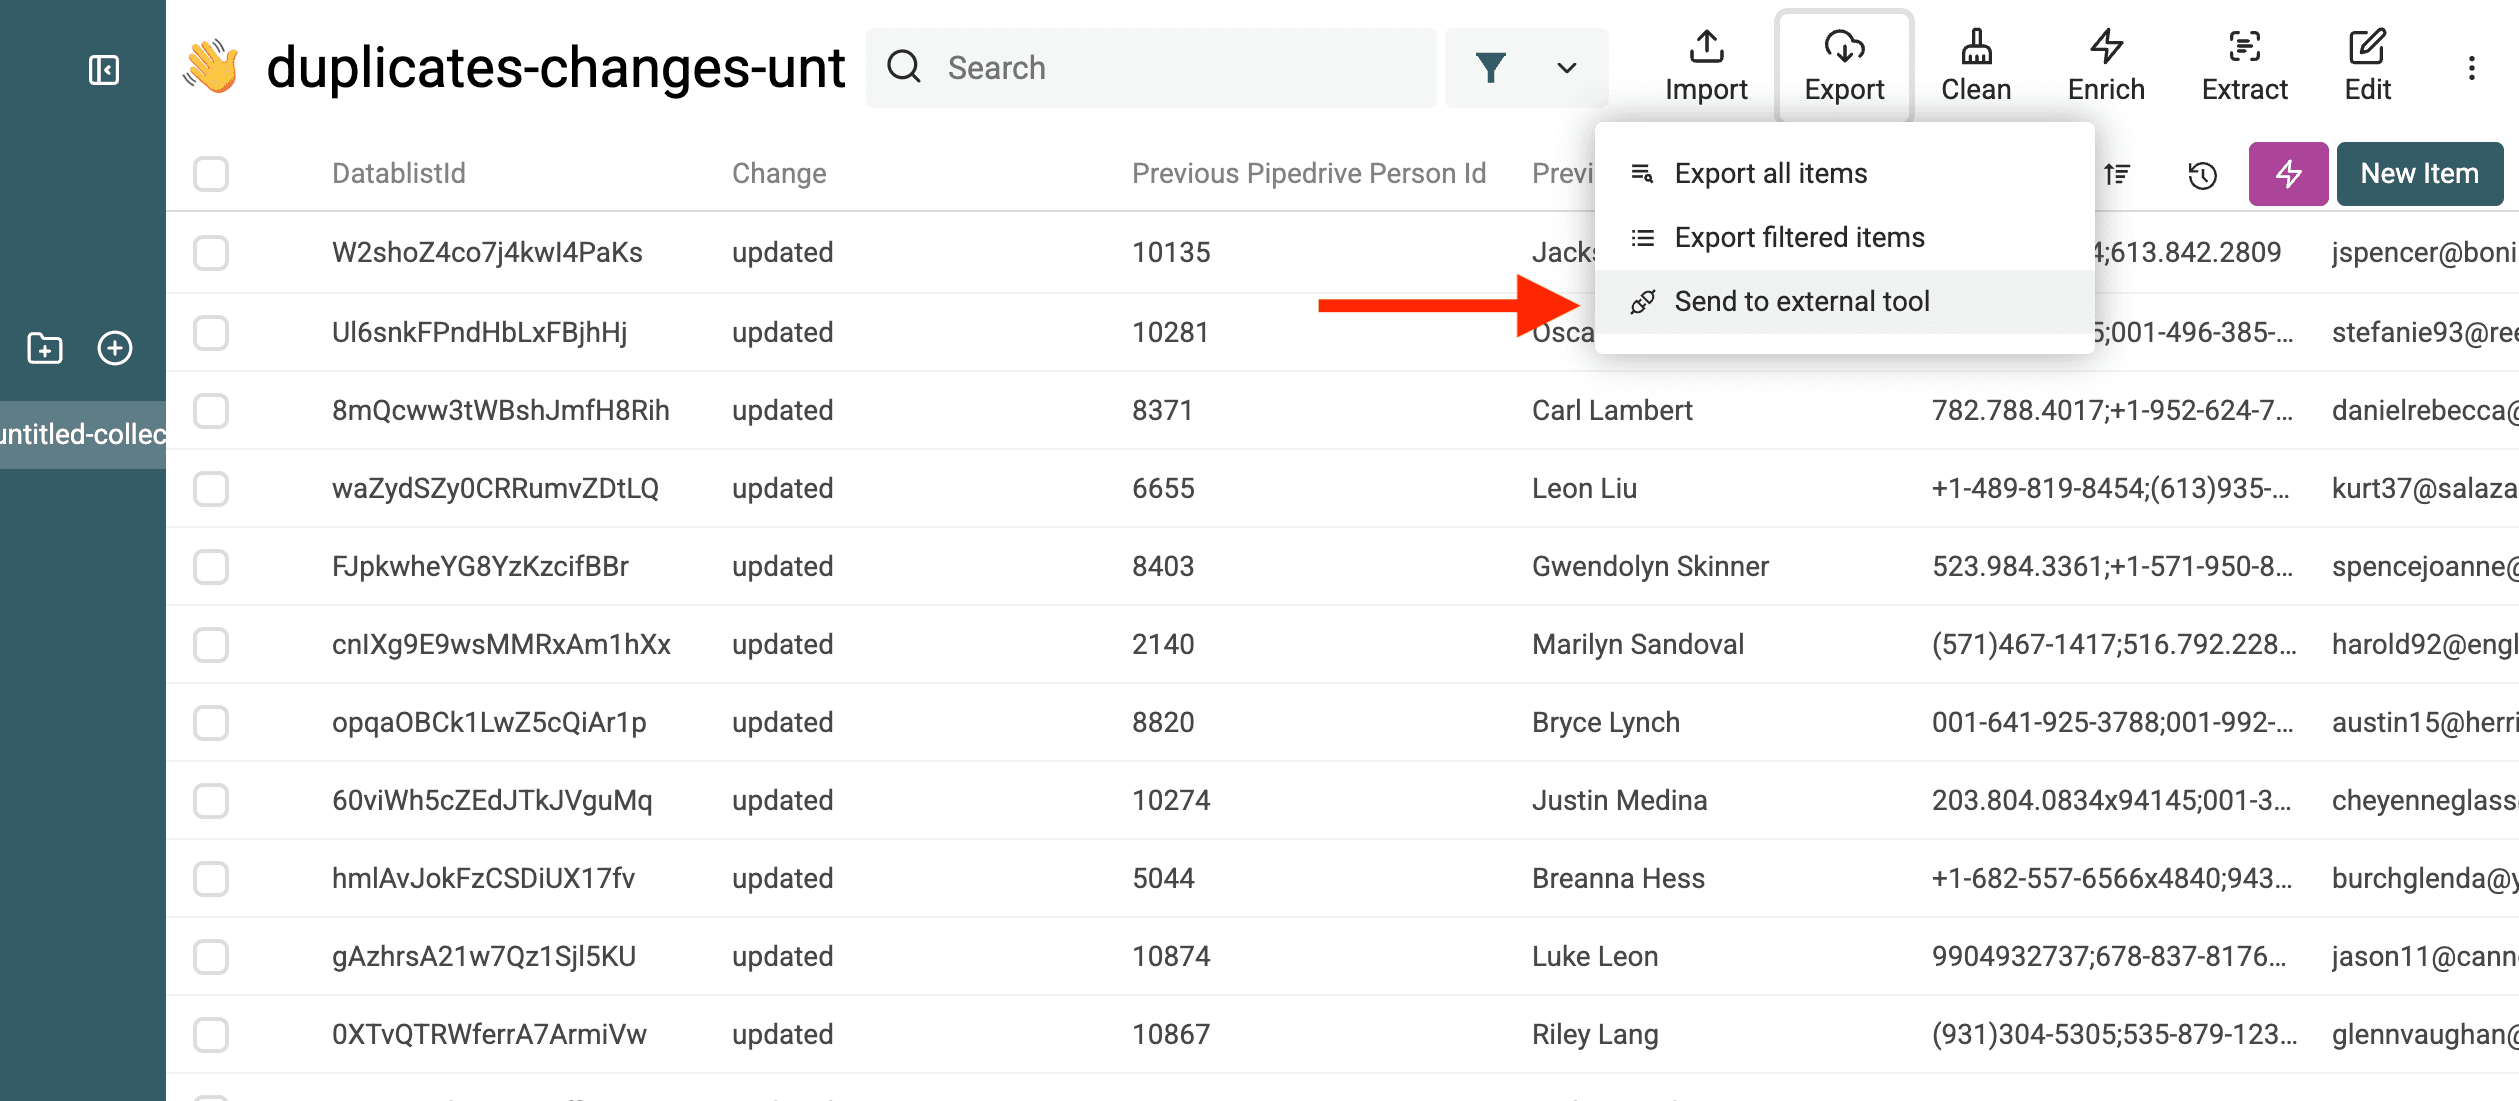
Cliquez ensuite sur Export → Send to external tool.
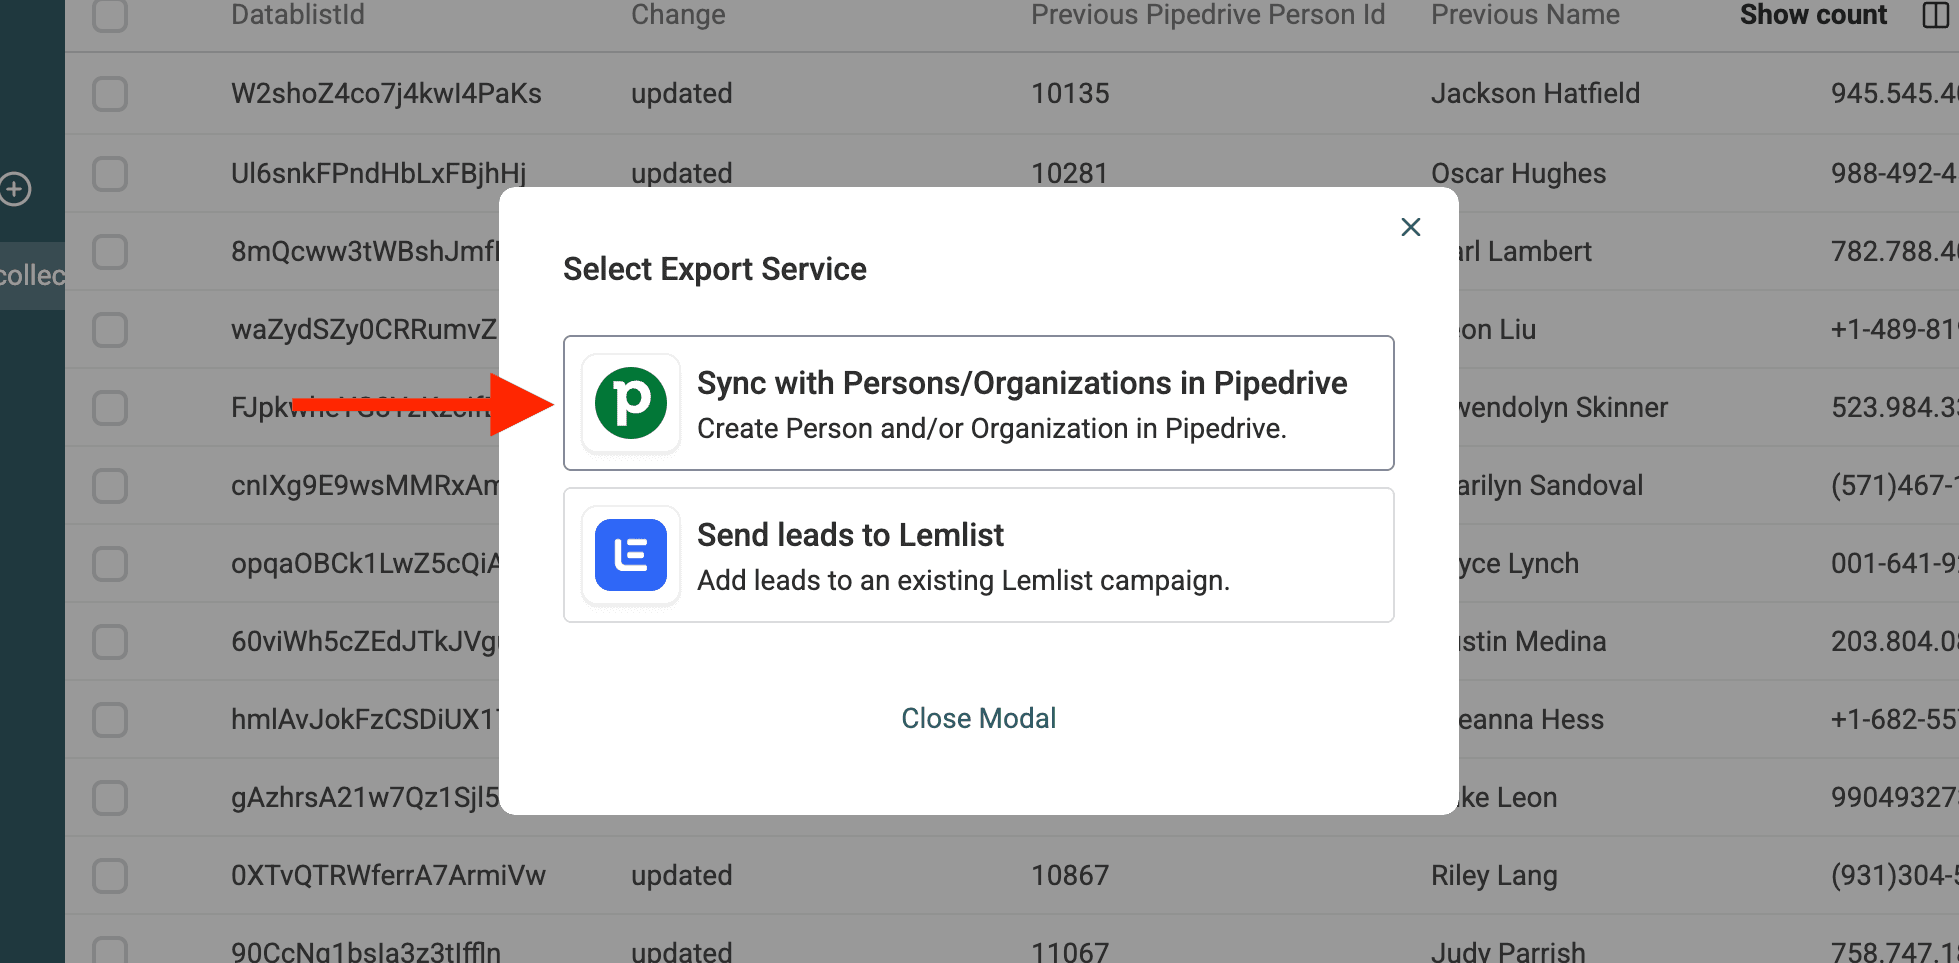
Sélectionnez Sync with Persons/Organizations in Pipedrive.
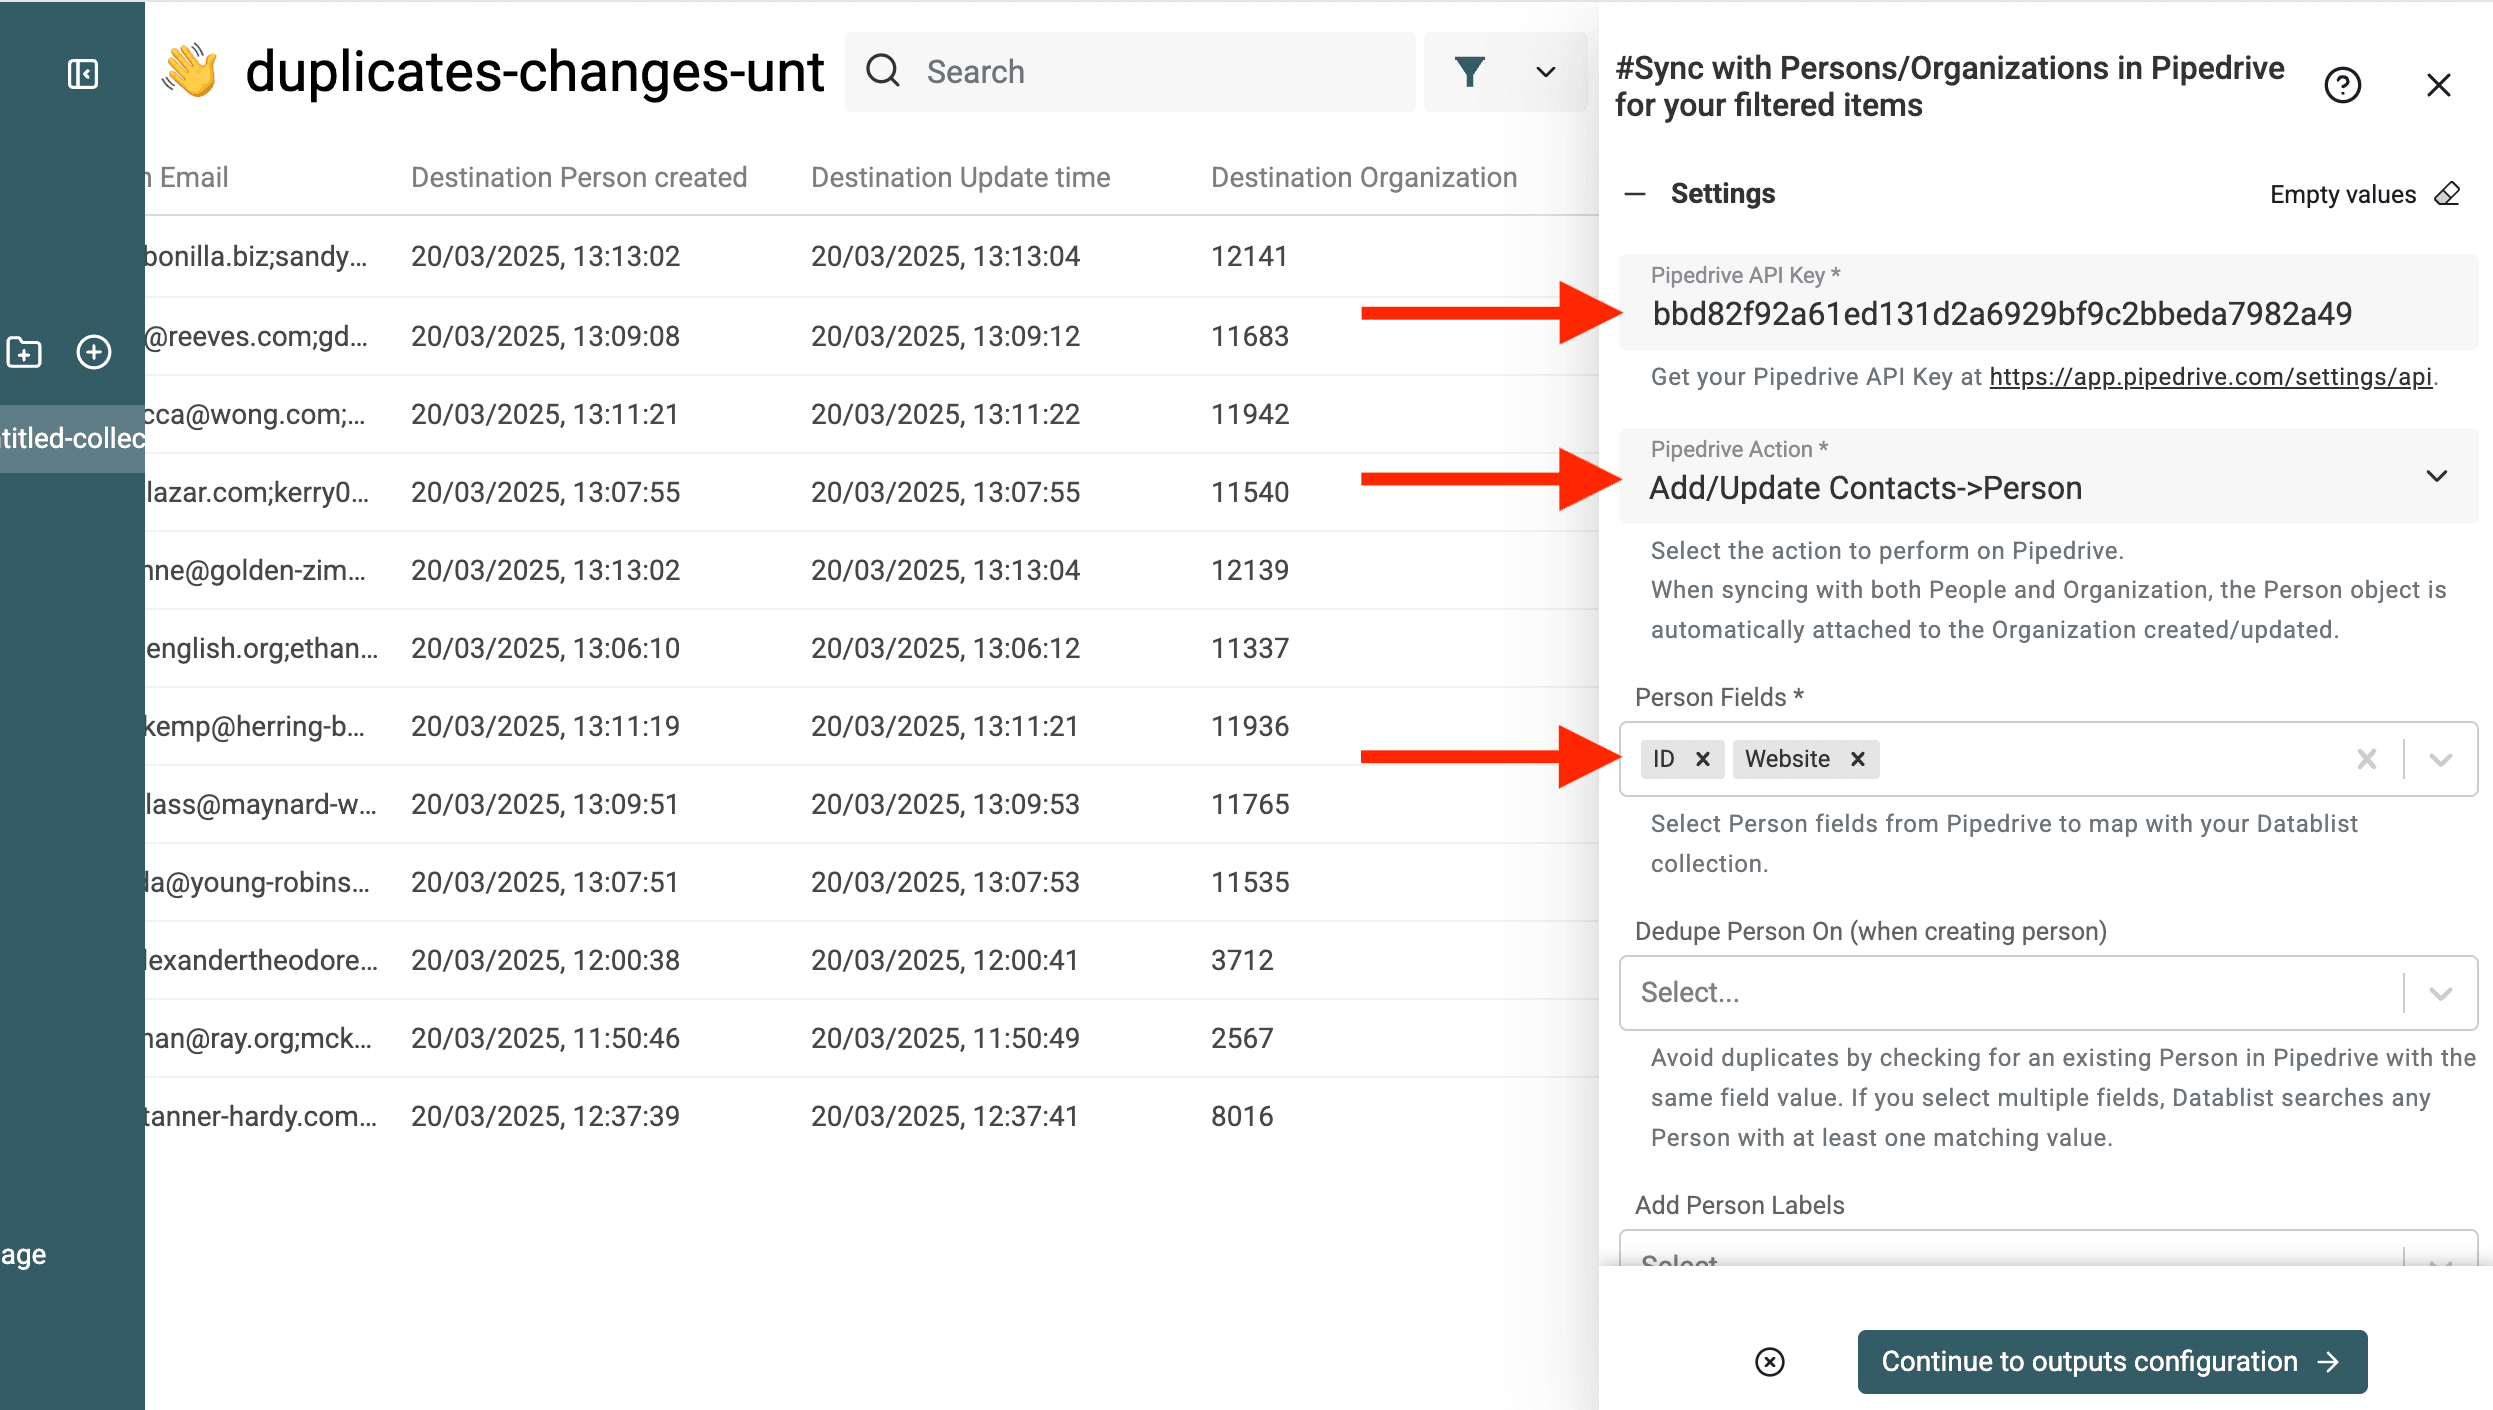
Saisissez votre clé API Pipedrive et sélectionnez l’entité à mettre à jour : People ou Organizations.
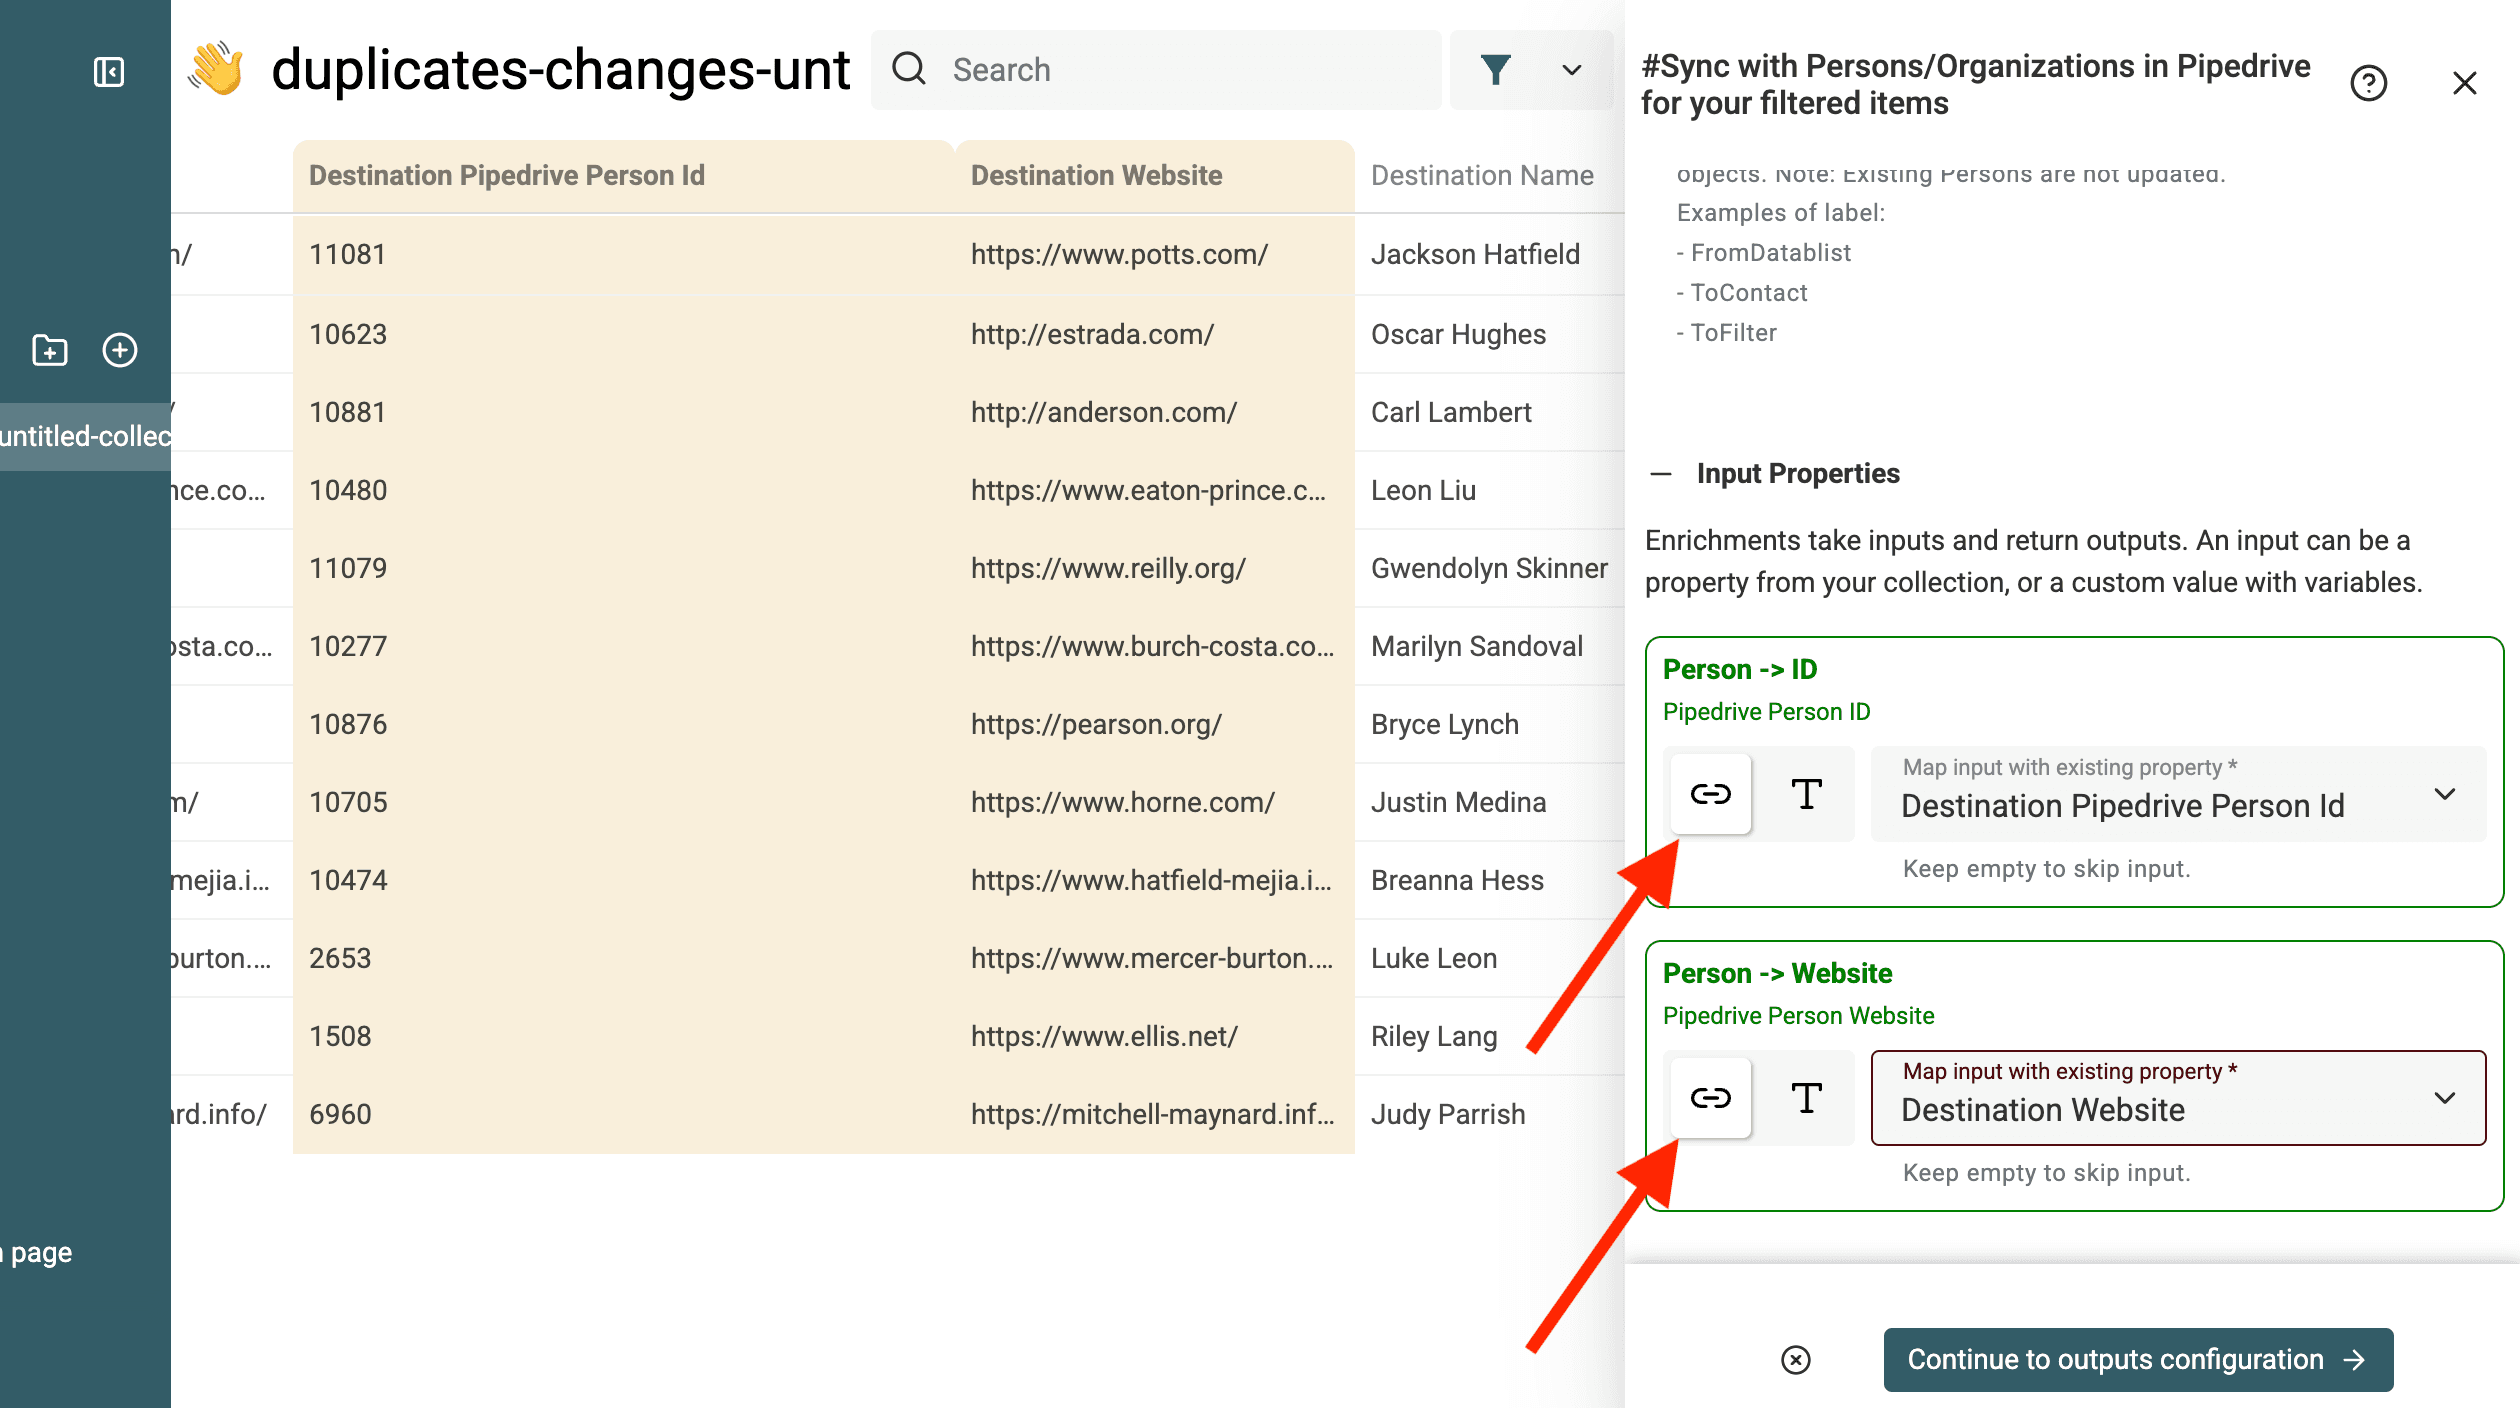
Sélectionnez le champ ID ainsi que les champs que vous souhaitez actualiser avec les valeurs nettoyées.
Important - Vous devez sélectionner le champ
IDpour mettre à jour les données au lieu de créer de nouvelles fiches.
Dans cet exemple, je ne mets à jour que le champ du site web. Je sélectionne donc ID et Website.
Dans la section Inputs, associez les champs Destination XX correspondants.
Configurez les outputs afin d’obtenir le statut de la mise à jour.
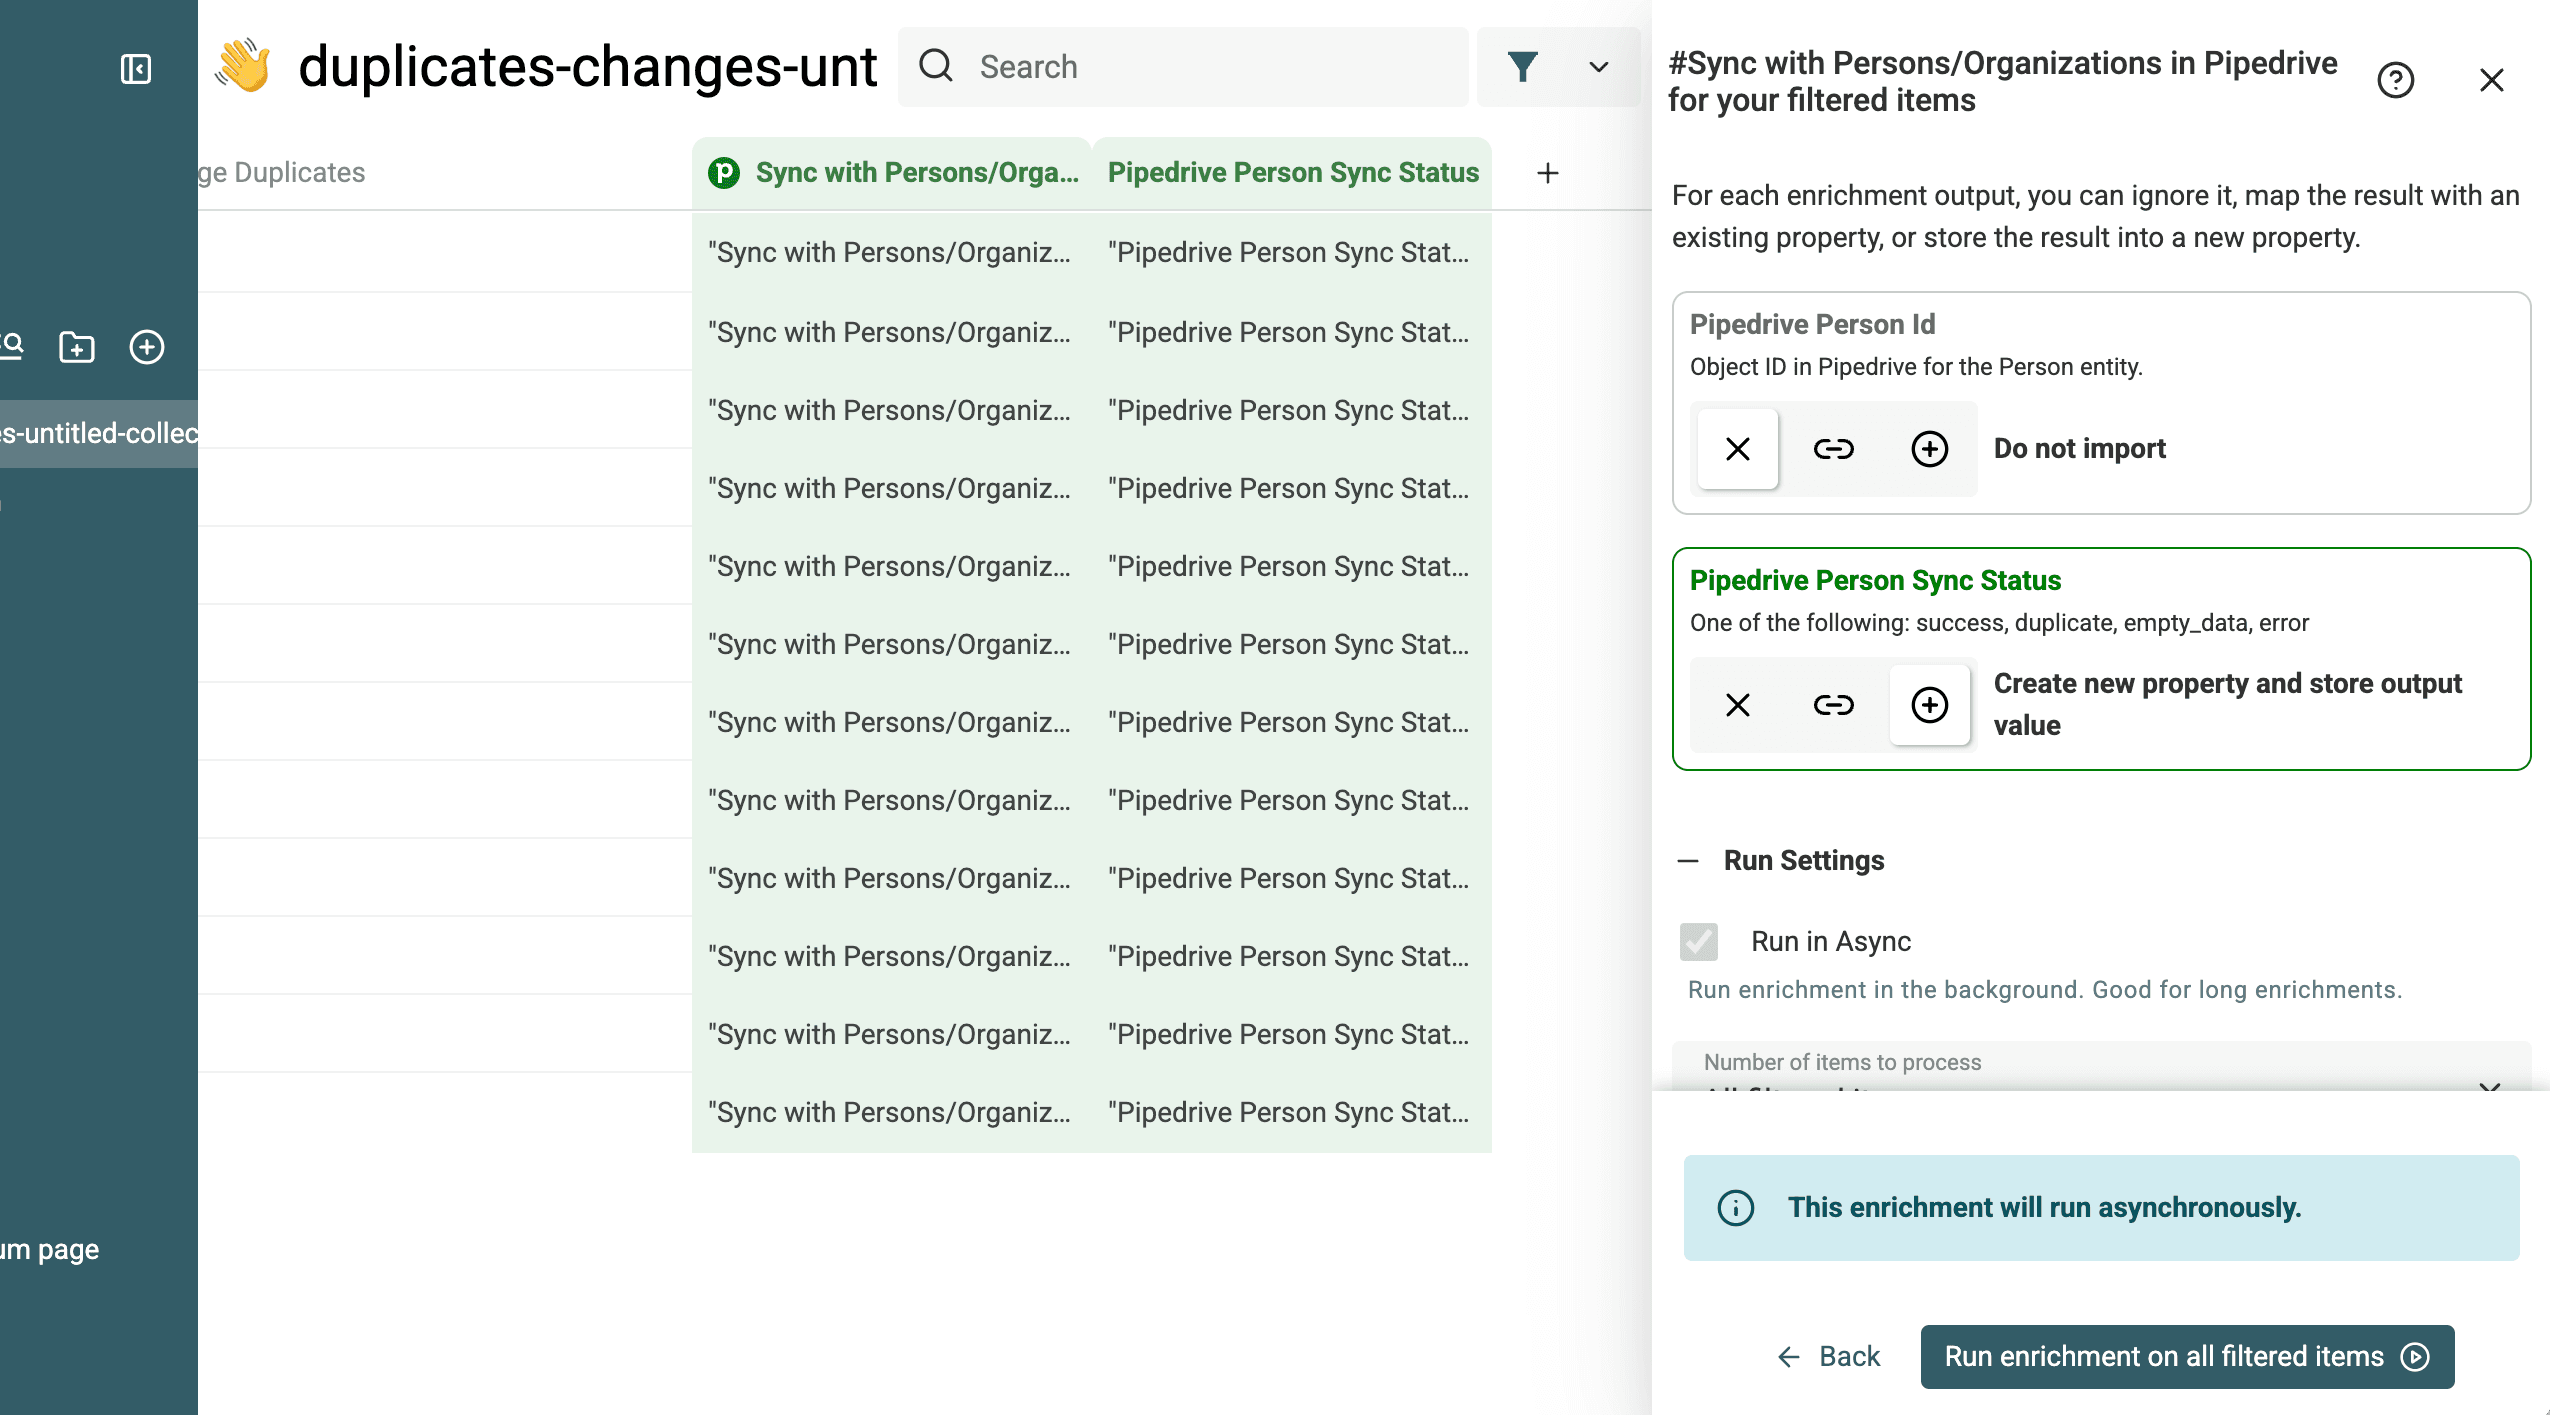
Lancez ensuite le processus.
Vous pouvez contrôler le résultat dans la liste Changelog de votre fiche Pipedrive.
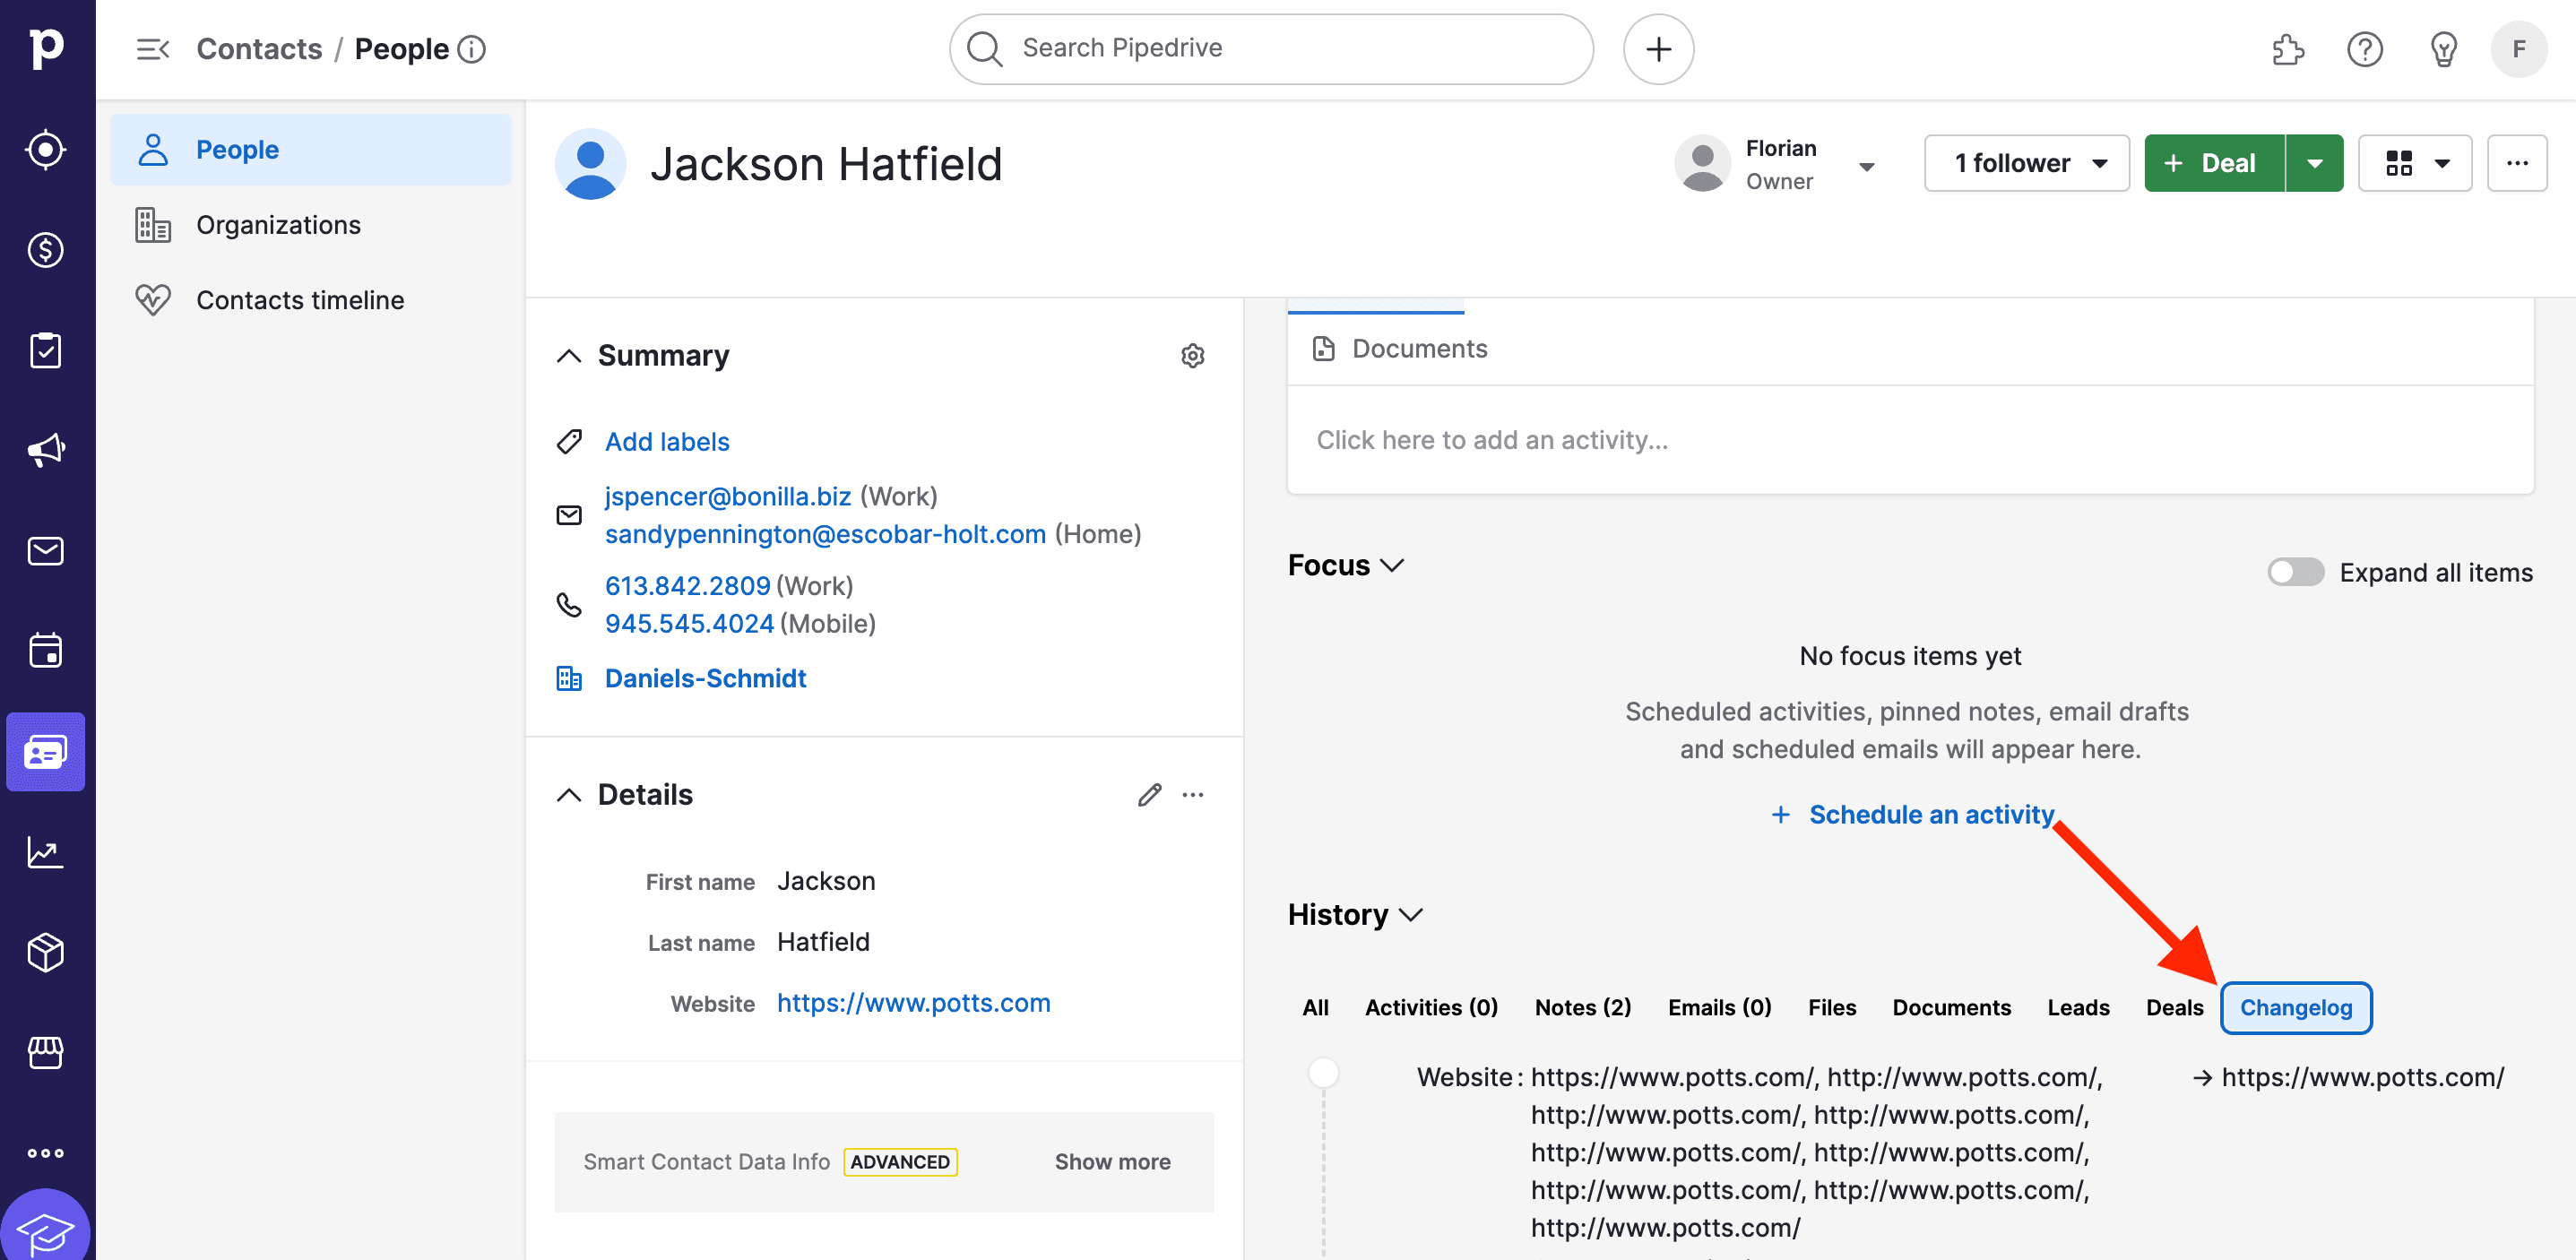
3.d. Vérifier les fiches fusionnées dans Pipedrive
C’est terminé ! Vous avez : ✅ Importé vos données dans Datablist. ✅ Détecté et fusionné les doublons avec des algorithmes intelligents. ✅ Synchronisé les données nettoyées vers Pipedrive.
Contrôlez plusieurs fiches de destination dans Pipedrive, en particulier celles qui comportaient des champs en conflit. Avant de considérer le traitement comme terminé, vérifiez que les activités et les coordonnées attendues sont toujours rattachées aux bonnes fiches.
Limites de la fusion des doublons dans Pipedrive
L’outil natif de Pipedrive est utile pour les doublons qui répondent à ses règles de correspondance publiées. Utilisez Datablist lorsque vous devez comparer une autre clé ou vérifier les groupes avant d’appliquer un grand nombre de fusions.
1. Clés de correspondance
Pour les personnes, Pipedrive associe le nom à l’email, au numéro de téléphone ou à l’organisation. Pour les organisations, il compare le nom et l’adresse. Le partage d’un même site web ne fait pas partie, à lui seul, des critères documentés. Dans Datablist, vous pouvez commencer par l’email pour les People ou le site web pour les Organizations, puis examiner séparément les groupes potentiels basés sur les noms. Ne fusionnez jamais deux personnes uniquement parce qu’elles appartiennent à la même organisation ou portent un nom courant.
2. Vérification d’un lot important
Pipedrive fournit une liste des doublons potentiels à vérifier. Le processus Datablist présenté dans ce guide vous permet d’examiner les groupes et d’exporter un fichier de modifications, puis de lancer l’action de fusion Pipedrive sur les lignes sélectionnées. Vérifiez la prévisualisation et testez d’abord un petit lot avant d’appliquer de nombreuses fusions.
3. Conflits entre les champs
Datablist vous permet de choisir une fiche principale et de prévisualiser le traitement des valeurs en conflit. Confirmez ces choix avant de lancer la fusion dans Pipedrive. La fusion Pipedrive peut elle-même ajouter les valeurs du doublon à la fiche de destination : utilisez donc l’étape de synchronisation suivante si vous devez appliquer les valeurs finales nettoyées.
4. Conserver un fichier de modifications
Enregistrez le fichier de modifications exporté par Datablist avant d’appliquer les fusions. Il contient les identifiants des fiches sources et de destination de ce workflow, ce qui facilite la vérification des résultats et l’analyse ultérieure de fiches précises. Il ne remplace toutefois pas une sauvegarde de vos données Pipedrive.
Si les suggestions natives de Pipedrive couvrent vos doublons, vérifiez-les directement dans l’outil. Si vous avez besoin d’une correspondance par site web, d’un nettoyage des noms d’entreprise ou de règles de gestion des conflits par lot, suivez le workflow Datablist ci-dessus et contrôlez les modifications dans Pipedrive.