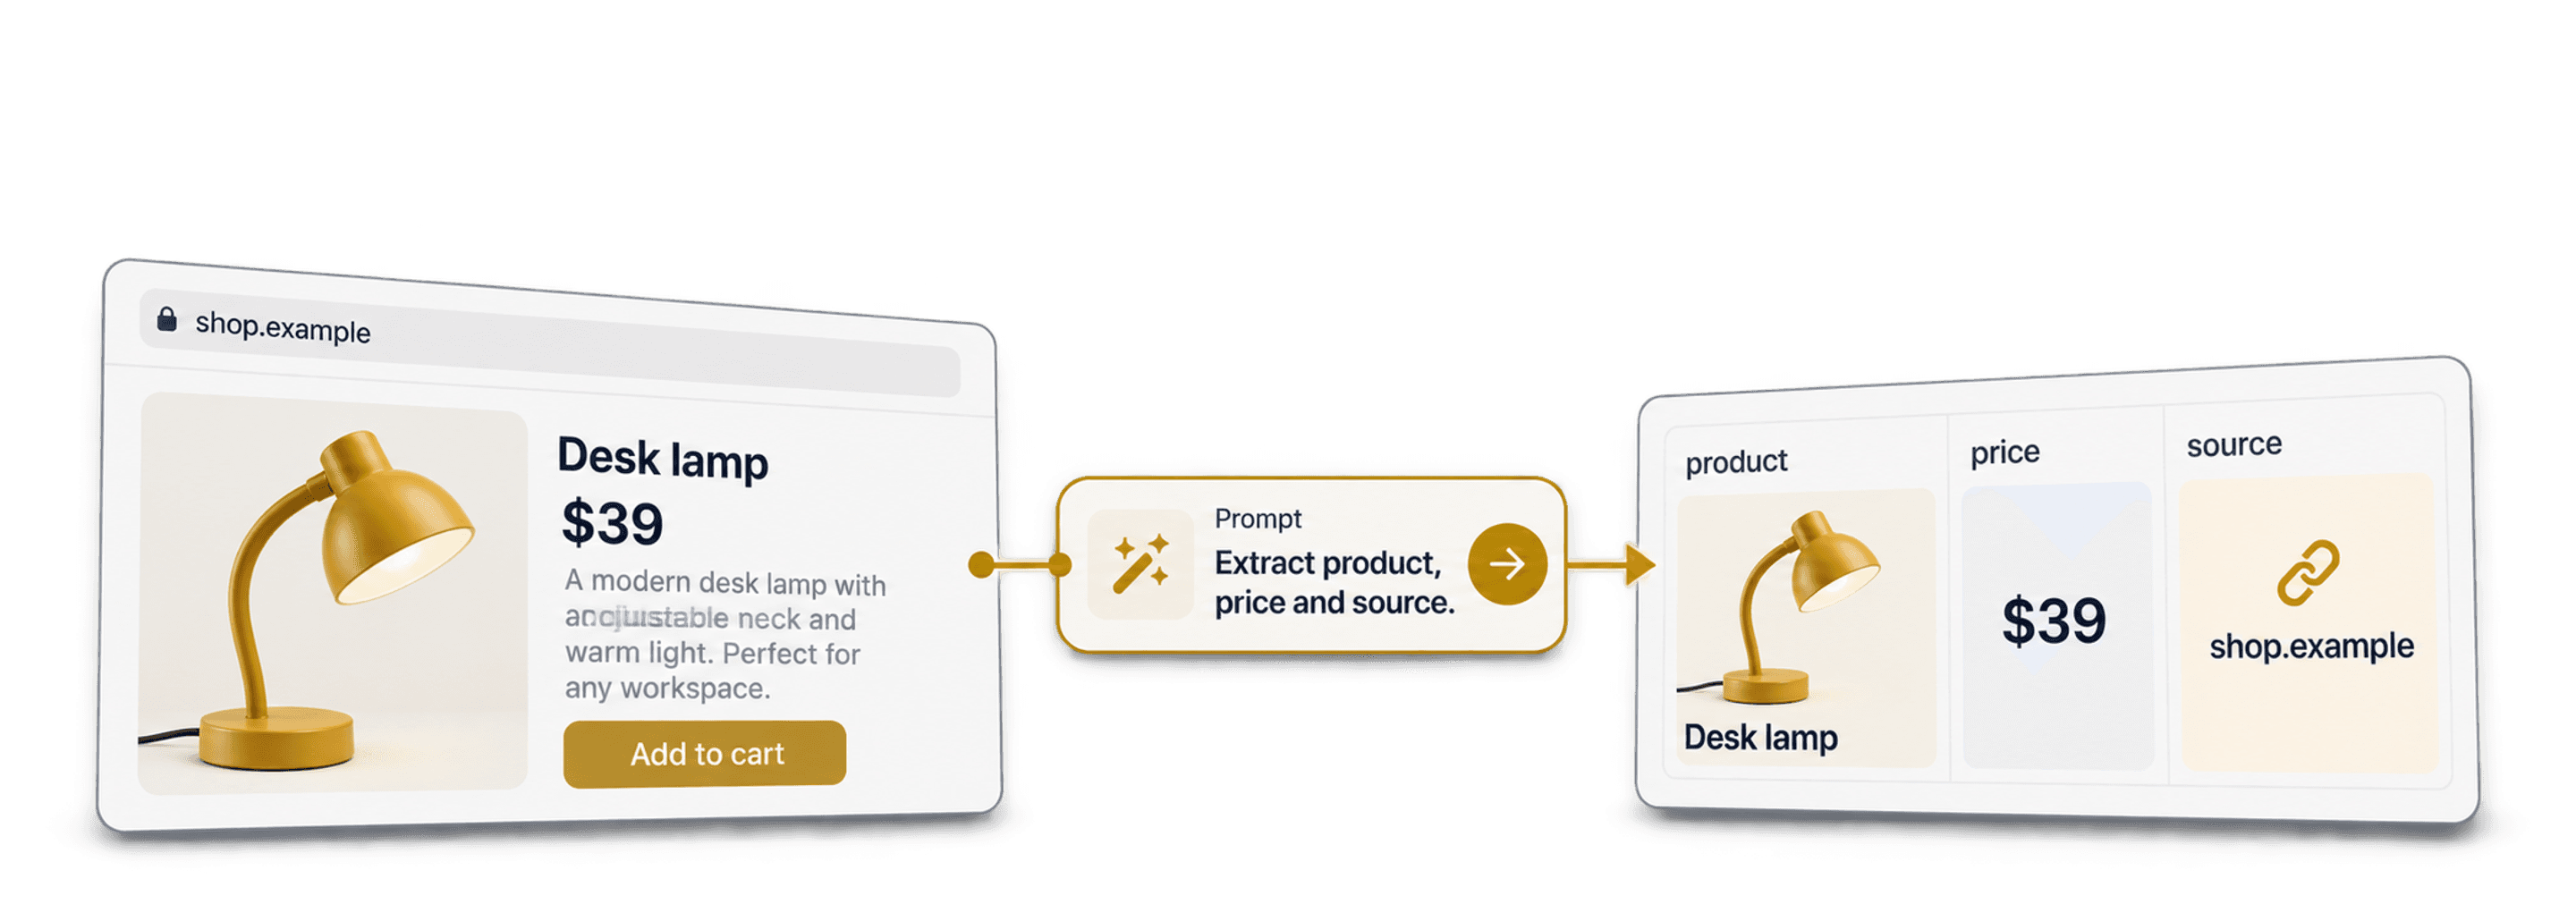
Todo scraper baseado em código é criado para a estrutura de um único site. Assim que você aponta o mesmo script para outro site, os seletores deixam de encontrar os elementos, a página retorna vazia e o script para de funcionar.
Com um prompt, isso não acontece. Basta descrever o que você quer em palavras simples, e um agente de AI interpreta cada página do zero, em vez de depender de regras programadas para um único layout.
É essa mudança que permite extrair dados de praticamente qualquer site sem código e obter informações limpas em minutos, não em horas.
📌 Resumo para quem está com pressa
A ideia central: você não precisa de um scraper diferente para cada site. Scrapers baseados em código ficam presos à estrutura de um único site, enquanto um agente de AI Scraping se adapta a diferentes páginas usando apenas um prompt em linguagem natural.
Este artigo explica como uma única ferramenta consegue extrair dados de praticamente qualquer site e mostra como fazer isso com o AI Scraping Agent da Datablist.
O que você aprenderá:
- Por que scrapers baseados em código e templates deixam de funcionar em sites diferentes
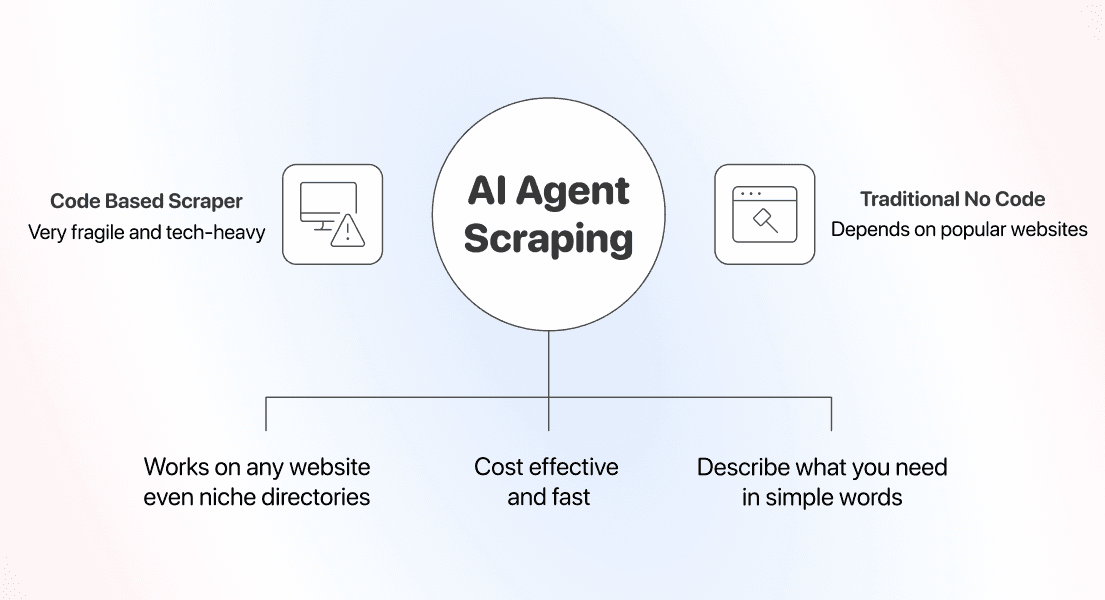
- Como o AI Scraping se compara aos métodos no-code tradicionais
- Um passo a passo para extrair dados de qualquer site
O que você verá neste guia
- O que realmente significa extrair dados de qualquer site sem código
- Como o AI Scraping se compara aos métodos no-code e com código
- O que procurar em uma ferramenta que funciona em qualquer site
- Passo a passo com o AI Scraping Agent da Datablist
- Perguntas frequentes
O que significa extrair dados de qualquer site
Há dois anos, fazer web scraping sem código normalmente significava trabalhar com um site popular para o qual já existia um template pronto. Isso mudou desde que a AI se tornou acessível a todos.
Agora, a promessa é literal: você aponta uma ferramenta para praticamente qualquer página pública e recebe dados limpos e estruturados, sem precisar escrever scripts.
Por que web scraping exigia código
Scrapers tradicionais são scripts mapeados para o HTML de um único site. Eles procuram seletores, nomes de classes e padrões de paginação específicos daquela página.
Isso funciona bem até o alvo mudar. Se você apontar o mesmo script para outro site e nada corresponder às regras definidas, ele retornará linhas vazias ou exibirá um erro.
Como funciona um web scraper no-code
Um web scraper no-code elimina o script por completo. Em vez de escrever código, você configura o que deseja por meio de uma interface visual ou de instruções escritas.
Essa é a categoria que a maioria das pessoas já conhece, embora as ferramentas disponíveis sejam bem diferentes entre si. Por isso, vamos dividi-las em duas subcategorias:
- Ferramentas point-and-click e baseadas em templates: você seleciona os campos em uma página ou carrega um template pronto para um site popular.
- Agentes de AI Scraping: você descreve os dados em linguagem natural, e o agente descobre como extraí-los.
As duas opções eliminam o código, mas somente uma elimina a dependência de o site ser popular ou previsível.
Por que agora é possível extrair dados sem código
A mudança está na forma como a AI interpreta uma página. Um AI scraping agent analisa o conteúdo da página junto com o seu prompt e decide o que deve extrair.
Essa abordagem de AI Scraping elimina a dependência de seletores programados, o que explica seu potencial: não existe uma regra fixa que possa quebrar quando o layout muda, pois o agente relê a página a cada execução.
AI Scraping vs. métodos tradicionais sem código
No-code não é uma categoria homogênea. A diferença entre os métodos fica evidente quando o site é muito específico ou quando uma página popular altera seu layout.
Scrapers com código: poderosos, mas presos a um site
Criar seu próprio scraper em Python ou JavaScript oferece controle total. Você define cada seletor, regra de paginação, nova tentativa e timeout.
Cada script, porém, é criado para um único site, exige um desenvolvedor e deixa de funcionar sempre que o layout muda. Sim, scrapers baseados em código têm baixo custo de execução, mas trazem outro tipo de despesa: um script por site, um desenvolvedor de prontidão e manutenção a cada atualização das páginas monitoradas.
Para uma equipe que extrai dados de vários sites, esse custo cresce rapidamente. Cinco fontes podem significar cinco scripts e cinco problemas diferentes para corrigir toda semana.
Scrapers point-and-click: fáceis até o site ser nichado
Ferramentas baseadas em templates e point-and-click foram os primeiros scrapers no-code de verdade. Elas funcionam bem em sites populares porque alguém já criou o template ou porque a página é simples o bastante para configurar visualmente.
Os problemas aparecem quando você quer extrair dados de páginas menos conhecidas, como diretórios de nicho, lojas regionais ou qualquer site com um layout incomum, para os quais muitas vezes não existe um template pronto.
Assim como os scrapers com código, essas ferramentas dependem de uma estrutura estável. Quando o site muda, as seleções salvas quebram, os dados param de chegar e você precisa corrigir tudo.
AI Scraping: um prompt que se adapta a qualquer site
O AI Scraping resolve dois problemas:
- Configurações intermináveis
- Scrapers que quebram quando o site de destino muda de estrutura
Você só precisa descrever os dados desejados, indicar uma URL ao agente e receber linhas estruturadas.
Como o agente interpreta cada página no momento da extração, o mesmo prompt pode ser usado em sites diferentes. Página de produto, diretório ou página de listagem: o fluxo de trabalho não muda.
É aqui que entra o AI Scraping Agent da Datablist. Ele recebe uma URL e um prompt em linguagem natural para que você possa extrair dados de praticamente qualquer site sem código, em minutos, não em horas. Além disso, facilita muito a limpeza de dados, pois as informações extraídas chegam a uma planilha na qual você pode remover duplicatas e enriquecer os dados imediatamente.
Comparamos os métodos de scraping no-code com base nas métricas mais importantes 👈🏽
Como escolher uma ferramenta para qualquer site
Depois de entender que um AI Scraper é melhor do que um scraper específico para cada site, a questão passa a ser em qual ferramenta confiar. Para mim, há três critérios: cobertura, estabilidade e facilidade de uso.
Cobertura: funciona em sites de nicho e long tail?
A cobertura é o primeiro teste. Muitas ferramentas afirmam extrair dados de qualquer site, mas, na prática, dependem de uma biblioteca de templates prontos apenas para páginas populares.
A pergunta mais importante é: a ferramenta consegue trabalhar em um site que nunca viu antes?
Agentes orientados por prompts passam nesse teste porque não dependem de templates. Se seus alvos incluem diretórios de nicho ou sites regionais, esse é o critério mais relevante.
Uma forma rápida de testar: experimente a ferramenta no site mais incomum da sua lista e veja se ela consegue extrair os dados.
Manutenção: a ferramenta quebra quando o site muda?
A manutenção do scraper costuma ser o custo sobre o qual ninguém fala. Seletores, regras de paginação e proxies deixam de funcionar quando o site de destino muda o layout, e alguém precisa corrigi-los.
Uma ferramenta presa a regras fixas transfere esse trabalho para você. Cada alteração de layout vira um pequeno reparo, e os ajustes nunca terminam de verdade.
Um agente de scraping orientado por prompts evita a maior parte desse problema porque relê a página em cada execução, em vez de confiar nos seletores de ontem. O prompt continua igual mesmo quando a página muda.
Facilidade de uso: como deve ser um scraper no-code
O último teste é saber se você realmente consegue operar a ferramenta sem um desenvolvedor. Uma solução universal não ajuda as equipes de recrutamento, operações ou marketing se exigir um engenheiro para funcionar.
Avalie do ponto de vista do seu trabalho. Você consegue escrever um prompt simples, mapear alguns campos e exportar o resultado por conta própria?
Foi para isso que o AI Scraping Agent da Datablist foi criado: escreva um prompt, configure os campos e exporte os dados. Sem código, sem desenvolvedor e sem configuração específica para cada site.
Se você ainda não sabe qual ferramenta combina com a sua lista de sites, fizemos uma comparação direta dos melhores scrapers no-code 👈🏽
Guia passo a passo para extrair dados de sites
Agora vamos à prática. Todo o processo abaixo acontece dentro da Datablist, a plataforma de automação de workflows criada para AI Scraping e enriquecimento de dados.
Você fornece uma URL e um prompt simples, e a plataforma retorna dados estruturados de praticamente qualquer site sem código, em minutos, não em horas. Sem desenvolvedor e sem configuração específica para cada site.
Neste passo a passo, faremos duas coisas:
- Configurar e executar a extração
- Definir uma propriedade única para impedir que futuras execuções importem a mesma linha duas vezes
Como usar o AI Scraping Agent da Datablist
Para demonstrar essa capacidade em um caso real, executaremos o AI Scraping Agent em uma página de categoria da GymShark, mas todas as etapas funcionam da mesma forma em qualquer site indicado por você.
Antes de começar, você precisará de:
- Uma conta na Datablist
- A URL da página que deseja processar
- Uma lista clara dos campos que deseja extrair
- Exemplos para qualquer campo que possa gerar interpretações equivocadas
- Um limite aproximado de páginas para a execução
Etapa 1: crie uma conta e uma Collection
Primeiro, crie sua conta na Datablist.com.
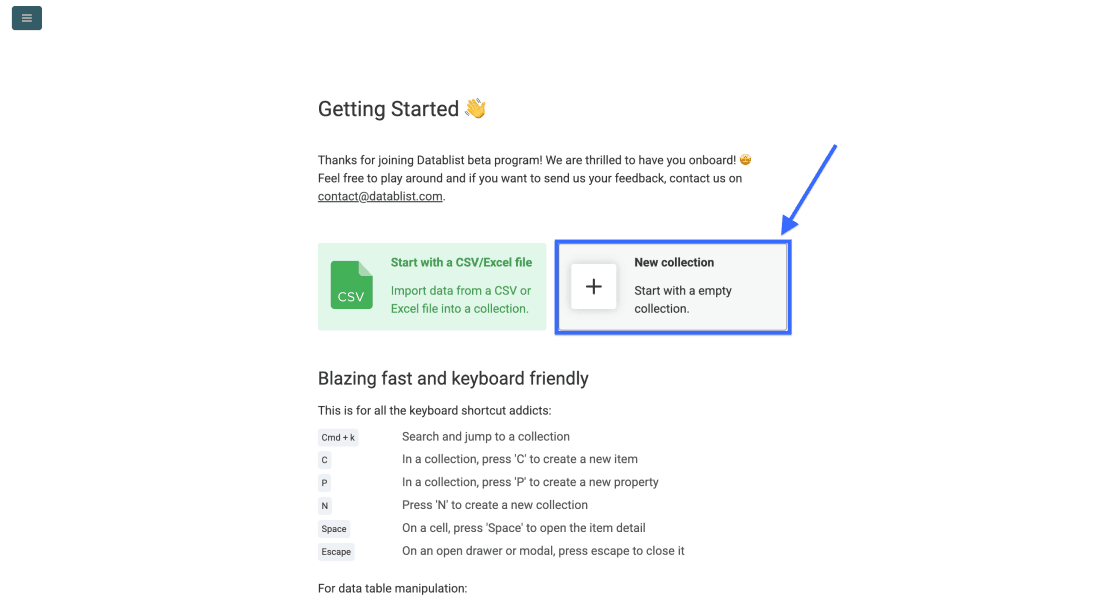
Depois, crie uma New Collection para armazenar os dados que você extrairá.
Etapa 2: abra o AI Agent - Site Scraper
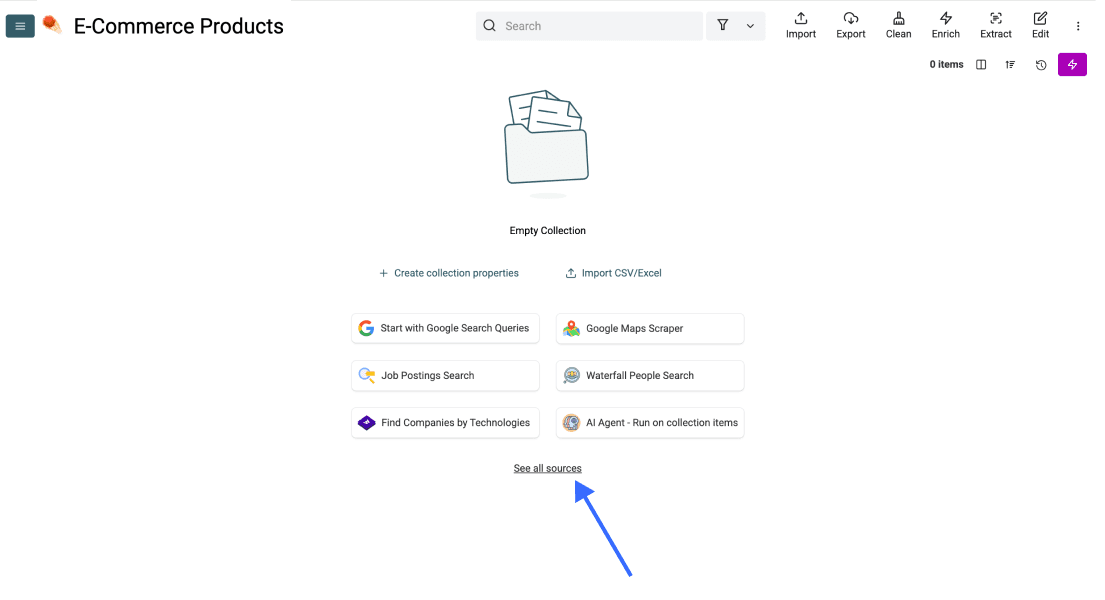
Na nova Collection, clique em See all sources.
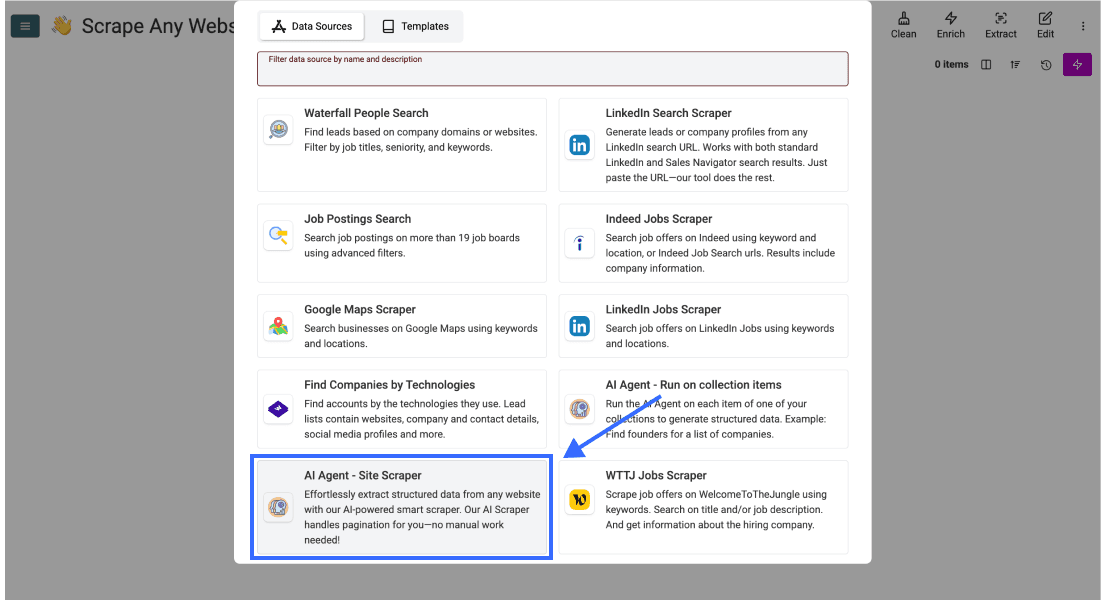
Role a tela para baixo e selecione AI Agent - Site Scraper.
Etapa 3: escreva o prompt e configure a tarefa
Cole a URL de destino no primeiro campo. Neste exemplo, usaremos uma página de categoria da GymShark, mas você pode extrair dados de qualquer site.
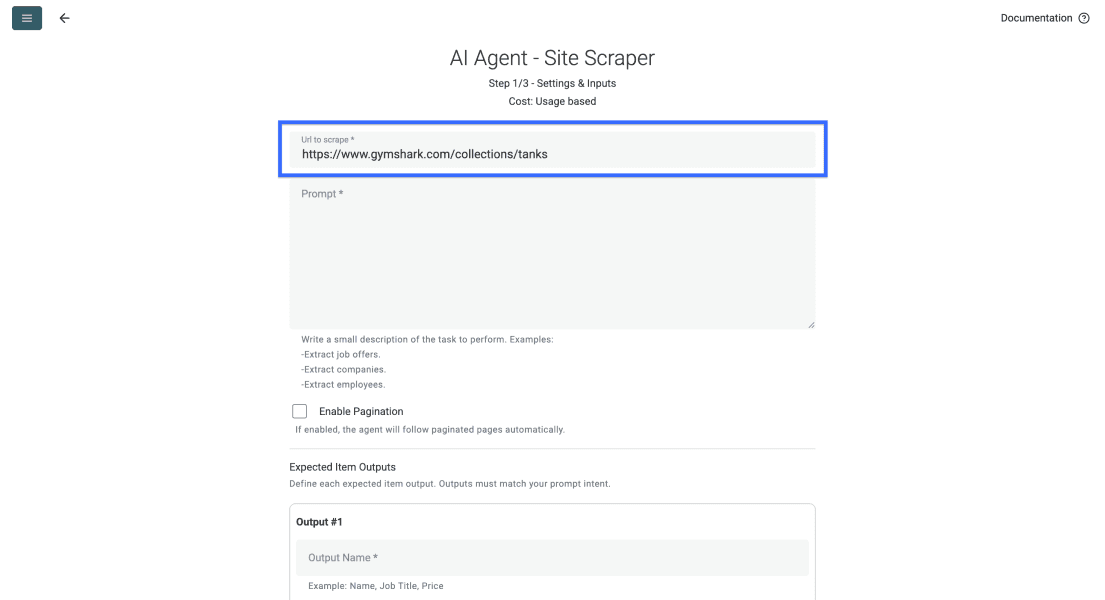
Em seguida, role até o campo de prompt e descreva o que o agente deve extrair de cada página. Você também encontra abaixo um exemplo de prompt.
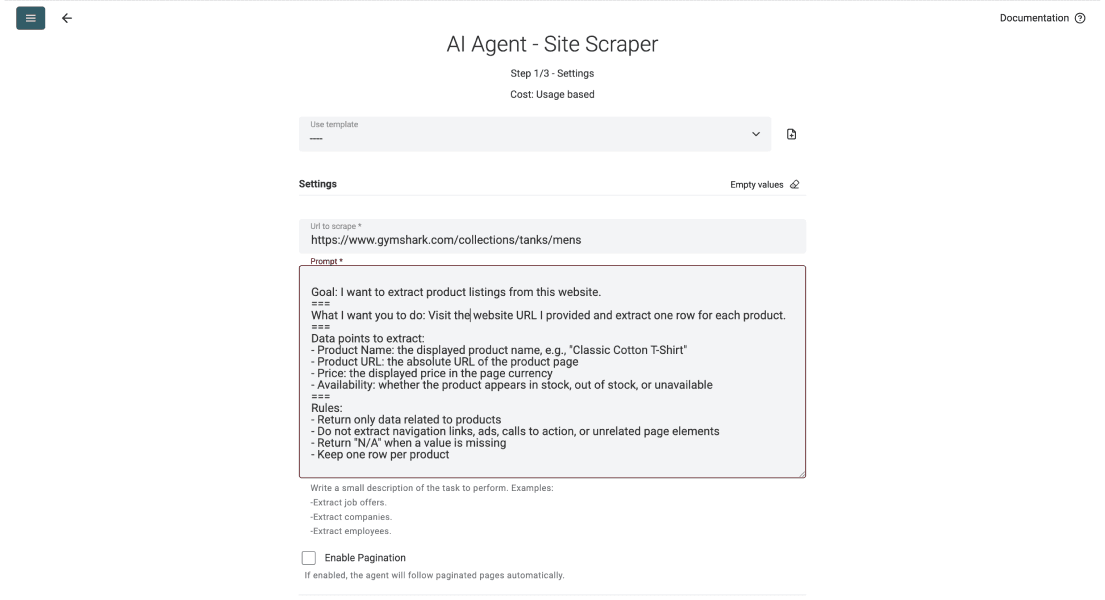
Um bom prompt informa ao agente o que extrair, o que ignorar e como cada linha deve ser estruturada. Você pode copiar o modelo abaixo e substituí-lo pelos seus próprios campos.
Objetivo: quero extrair listagens de produtos deste site.
.===
O que você deve fazer: acesse a URL fornecida e retorne uma linha por produto.
.===
Dados a extrair:
- Nome do produto (exemplo: "Camiseta clássica de algodão")
- URL do produto: o link absoluto para a página do produto
- Preço: o preço exibido na moeda da página
- Disponibilidade: em estoque, fora de estoque ou indisponível
.===
Erros a evitar:
- Retorne apenas dados de produtos; ignore navegação, anúncios e calls to action
- Retorne "N/A" quando um valor estiver ausente
- Mantenha uma linha por produto
O agente segue as instruções com muito mais precisão quando o prompt nomeia cada campo e fornece um exemplo. Prompts vagos são a principal razão para resultados desorganizados.
Siga estas regras para escrever prompts para agentes de AI e obtenha resultados mais limpos 👈🏽
Quando terminar o prompt, defina quantas páginas o agente deverá processar.
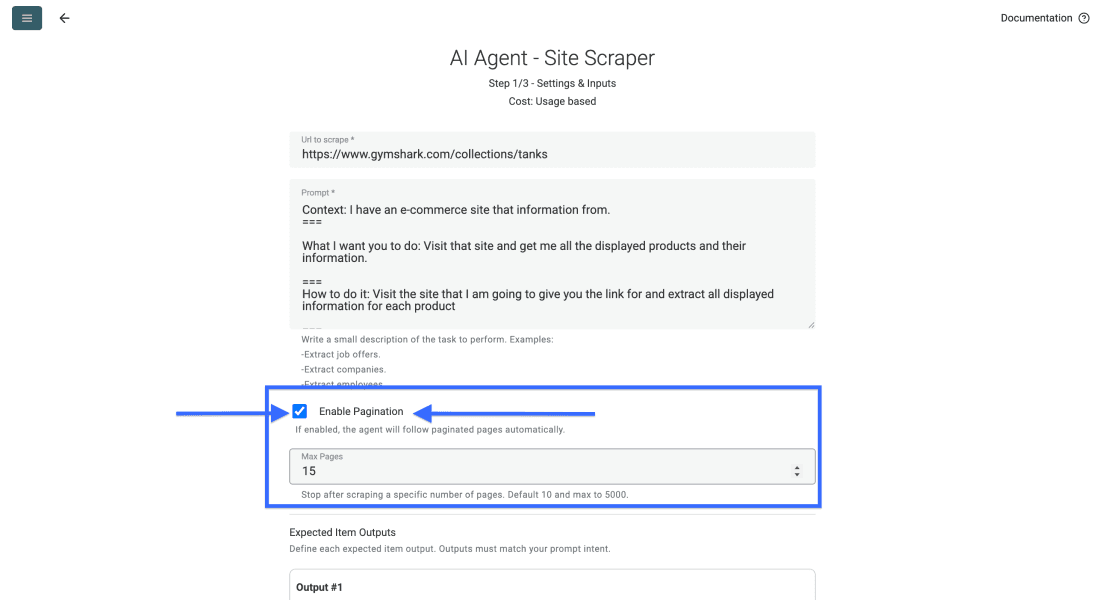
📘 Sobre a paginação em páginas de listagem
A maioria das páginas de listagem divide os resultados em várias páginas. Defina o limite conforme a parte do site que deseja processar. A Datablist aceita até 5.000 páginas por execução.
Depois de definir o prompt e o limite de páginas, role para baixo e configure os campos de saída.
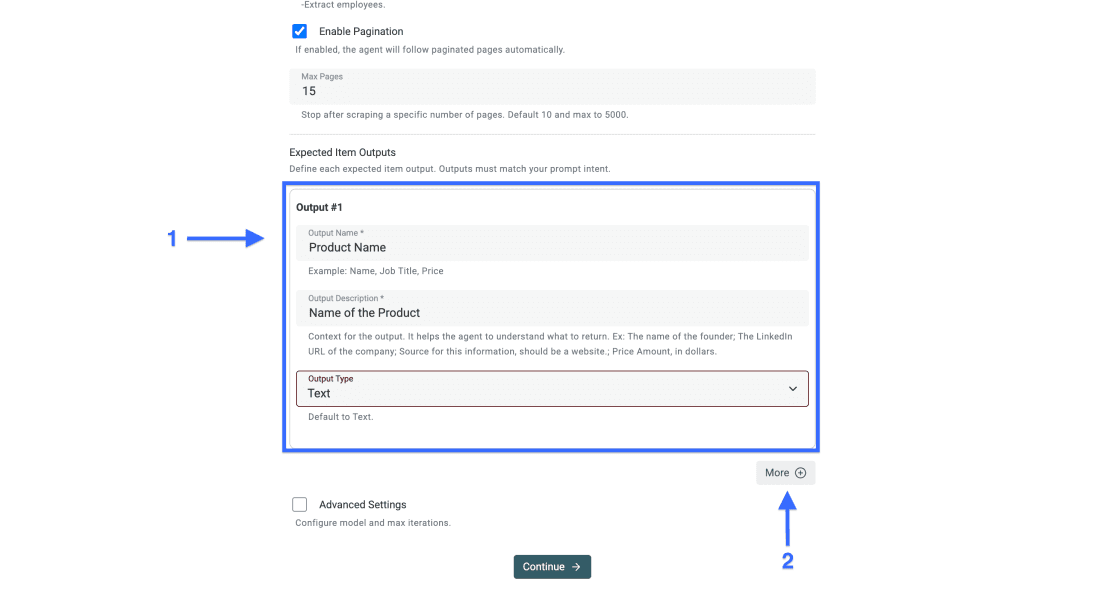
Etapa 4: defina os campos de saída
Ao escrever seu próprio prompt, os campos de saída devem corresponder aos dados solicitados. Uma coluna por campo ajuda a manter tudo organizado.
Para cada saída:
- Defina o nome do dado em Output Name
- Adicione uma Output Description clara, com um exemplo quando for útil
- Escolha o Output Type correto, como texto, número, URL ou email
- Clique em More para adicionar outros campos de saída
Etapa 5: configure as Advanced Settings
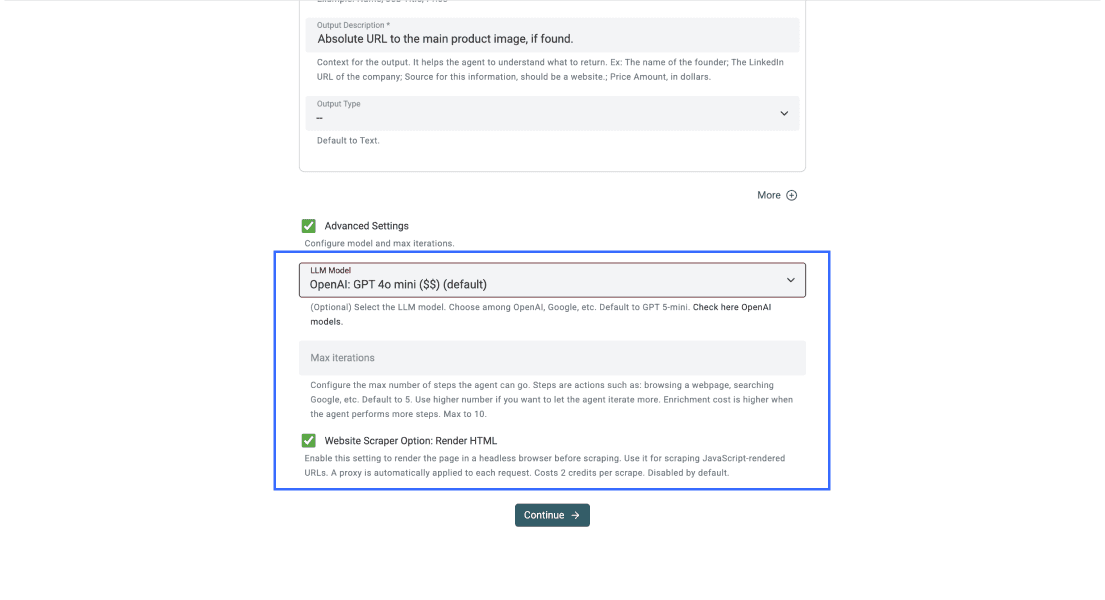
Com as saídas definidas, marque a caixa ao lado de Advanced Settings e aplique estas configurações:
- LLM: OpenAI GPT-4o mini, por oferecer a melhor relação entre desempenho e preço
- Max iterations: 10
- Render HTML: ativado, algo essencial para sites que carregam conteúdo com JavaScript
Depois disso, o painel Advanced Settings deverá ficar assim.
Etapa 6: execute o scraping
Quando o prompt, as saídas e as configurações estiverem prontos, clique em Continue.
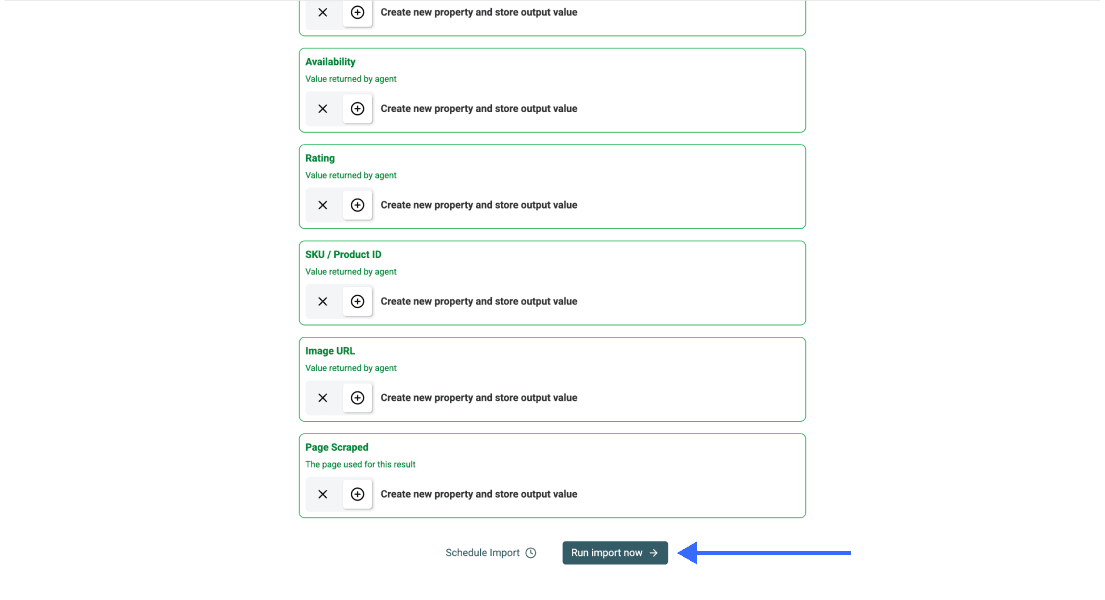
A Datablist criará uma propriedade para cada saída configurada. Agora você pode verificar se não esqueceu nada e clicar em Run Import Now quando estiver pronto para iniciar o scraping.
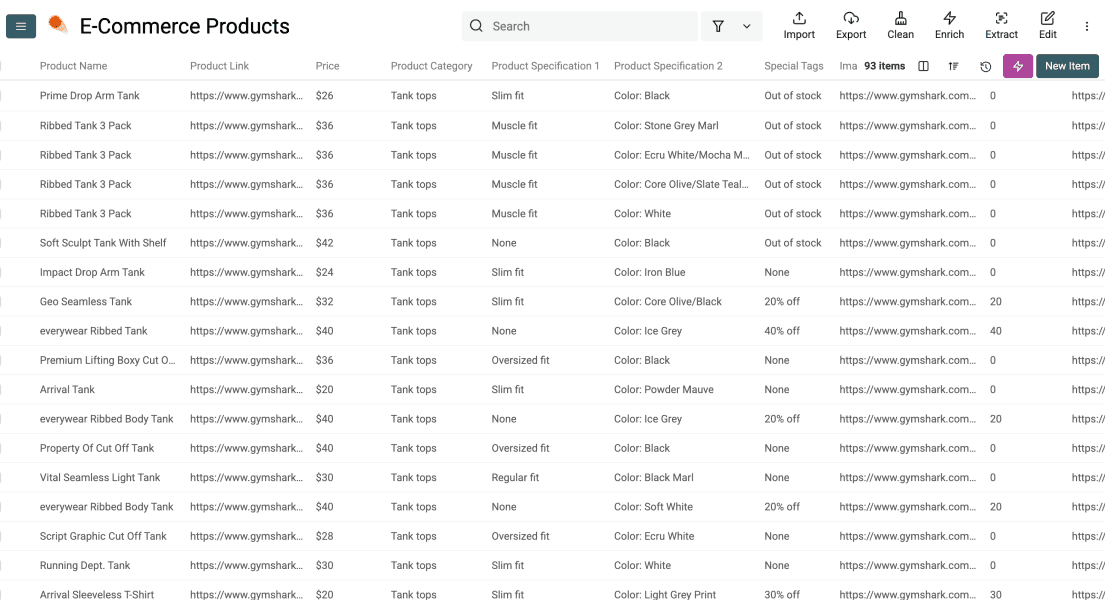
Após alguns minutos, as linhas aparecerão na sua Collection, prontas para limpeza, enriquecimento, deduplicação ou exportação.
Se você pretende executar o scraping novamente, siga a seção abaixo para definir primeiro uma coluna única e evitar importar a mesma linha duas vezes.
Como evitar duplicatas em scrapings recorrentes
Agora mostrarei como evitar duplicatas na Datablist definindo um identificador único antes de repetir uma tarefa de scraping.
Etapa 1: escolha um identificador único
Primeiro, escolha a coluna que a Datablist deverá usar para detectar duplicatas.
Por exemplo, se você estiver extraindo produtos, use um valor estável como URL do produto ou URL do item. Para empresas, use o domínio da empresa ou a razão social.
💡 Escolha um identificador estável
Escolha um valor que pertença a apenas uma linha. URLs de produtos ou itens, domínios de empresas e endereços de email geralmente funcionam melhor do que nomes, pois estes podem se repetir.
Etapa 2: abra as configurações da coluna
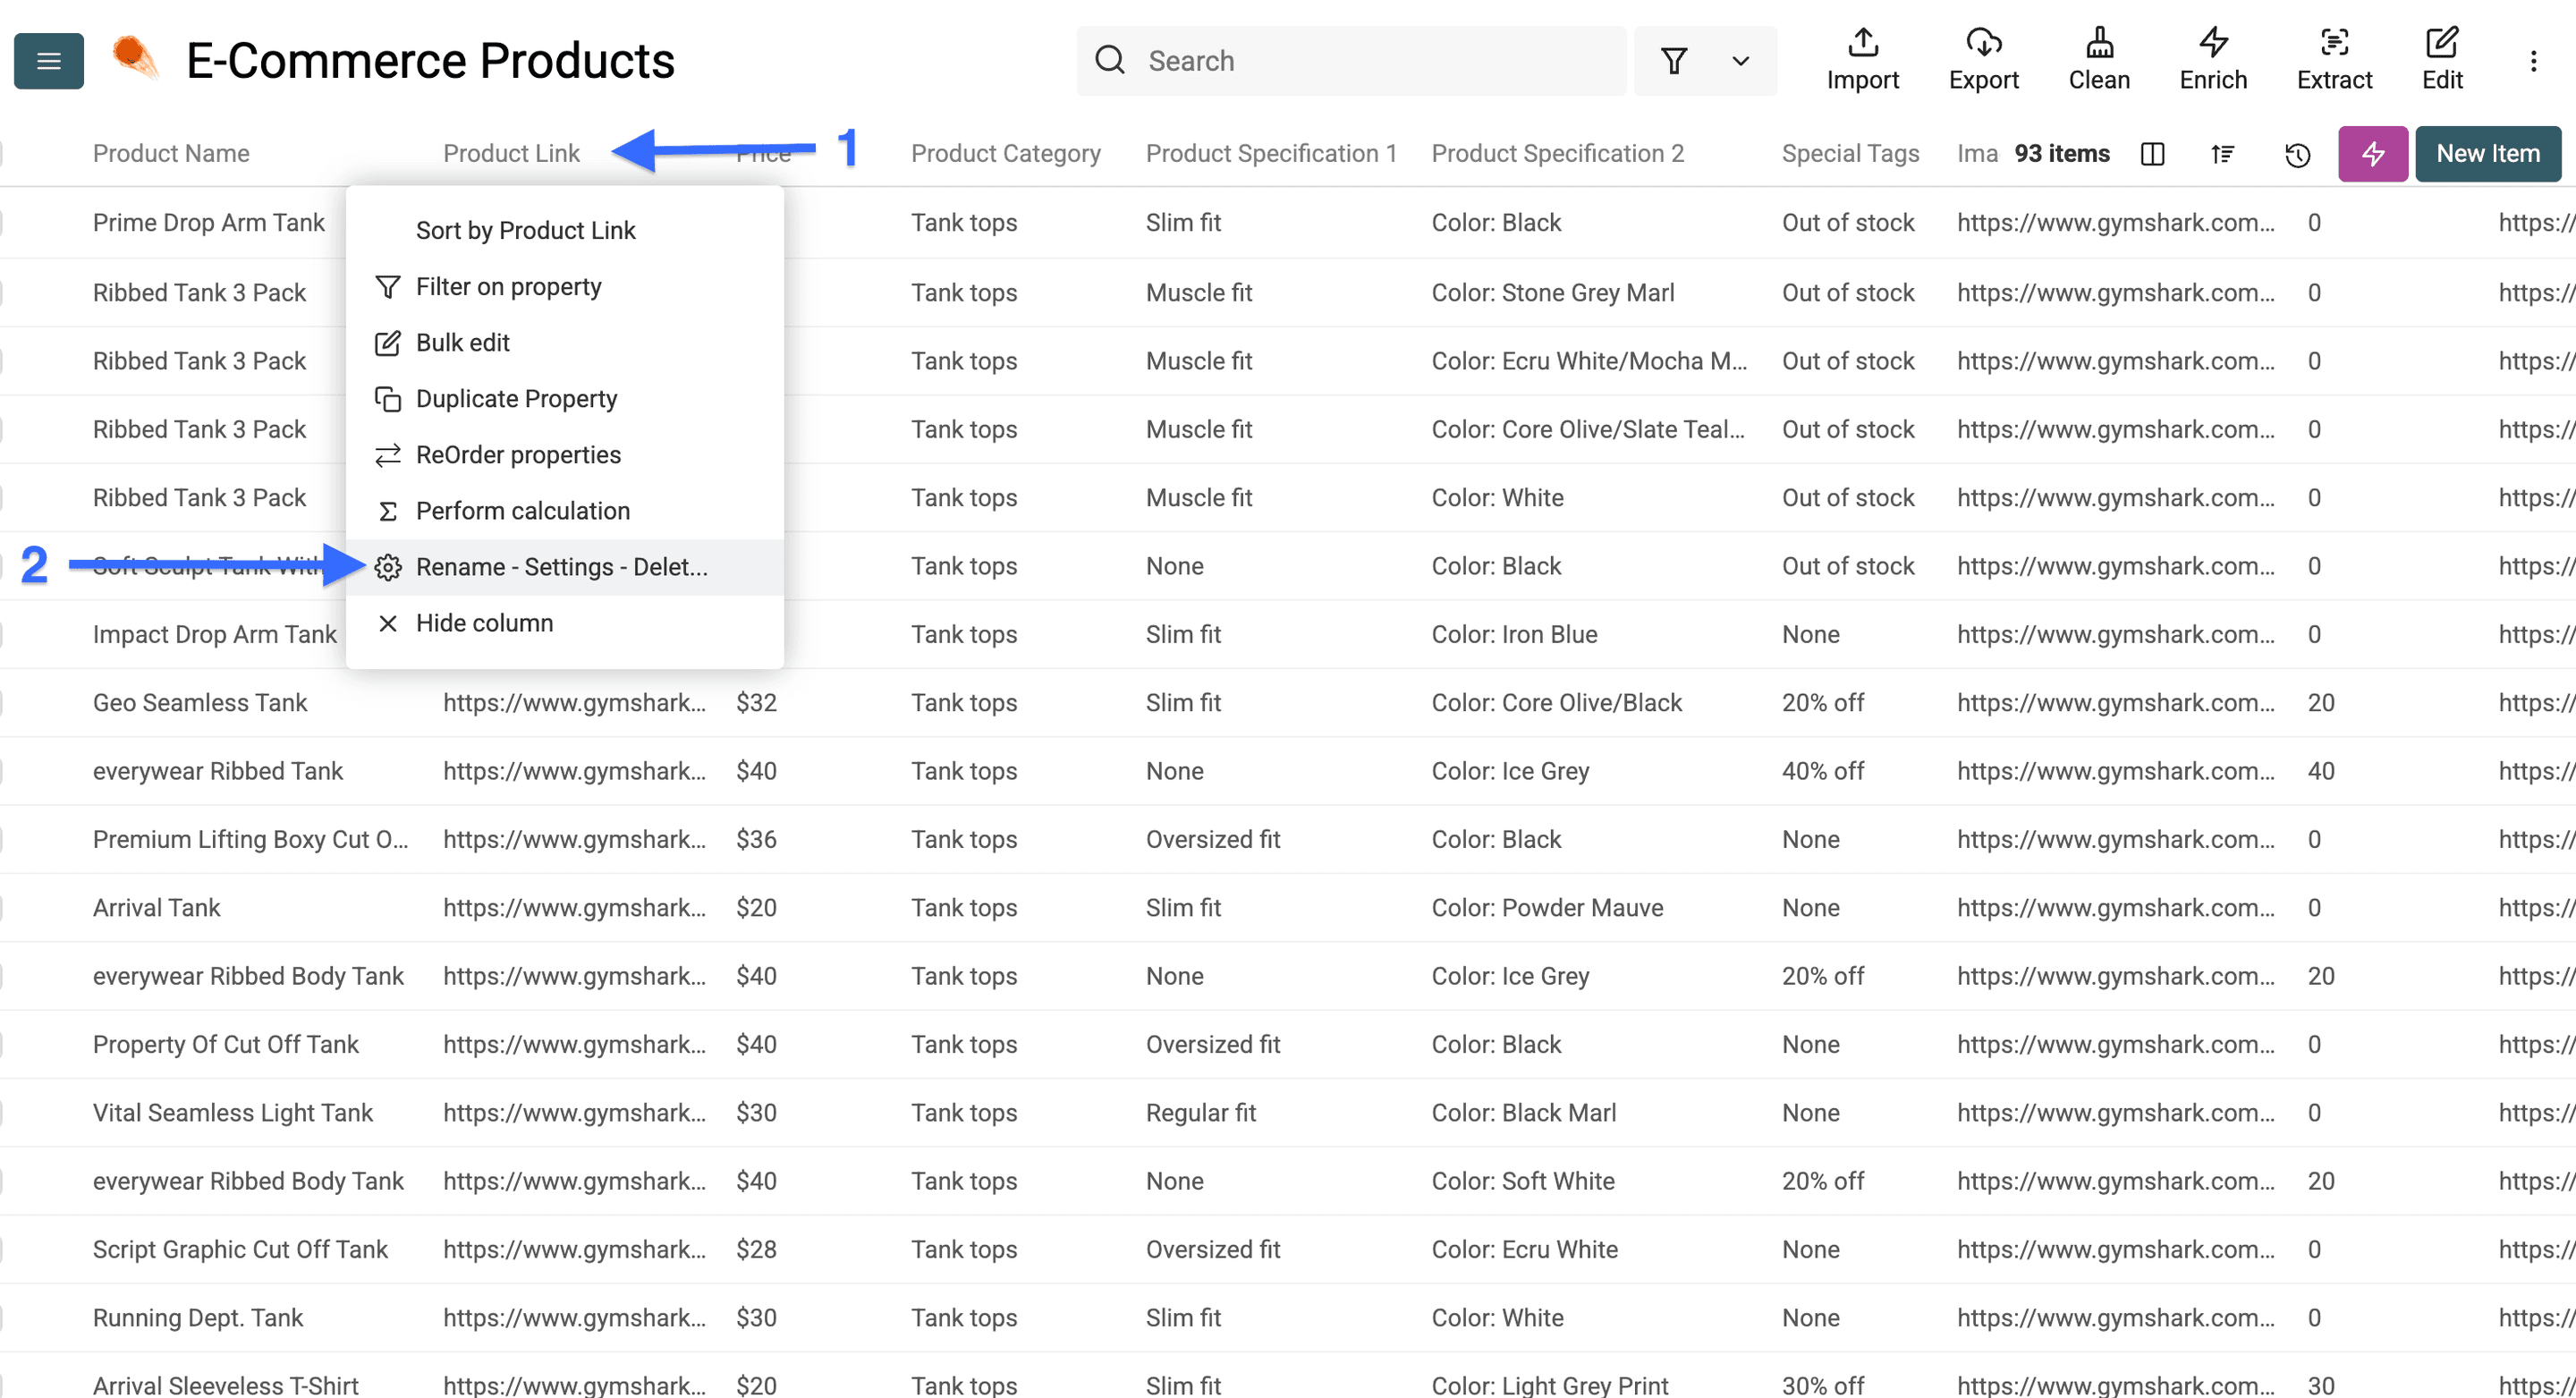
Clique no cabeçalho da coluna que será usada como identificador único.
Depois, selecione Rename - Settings - Delete.
Etapa 3: impeça valores duplicados
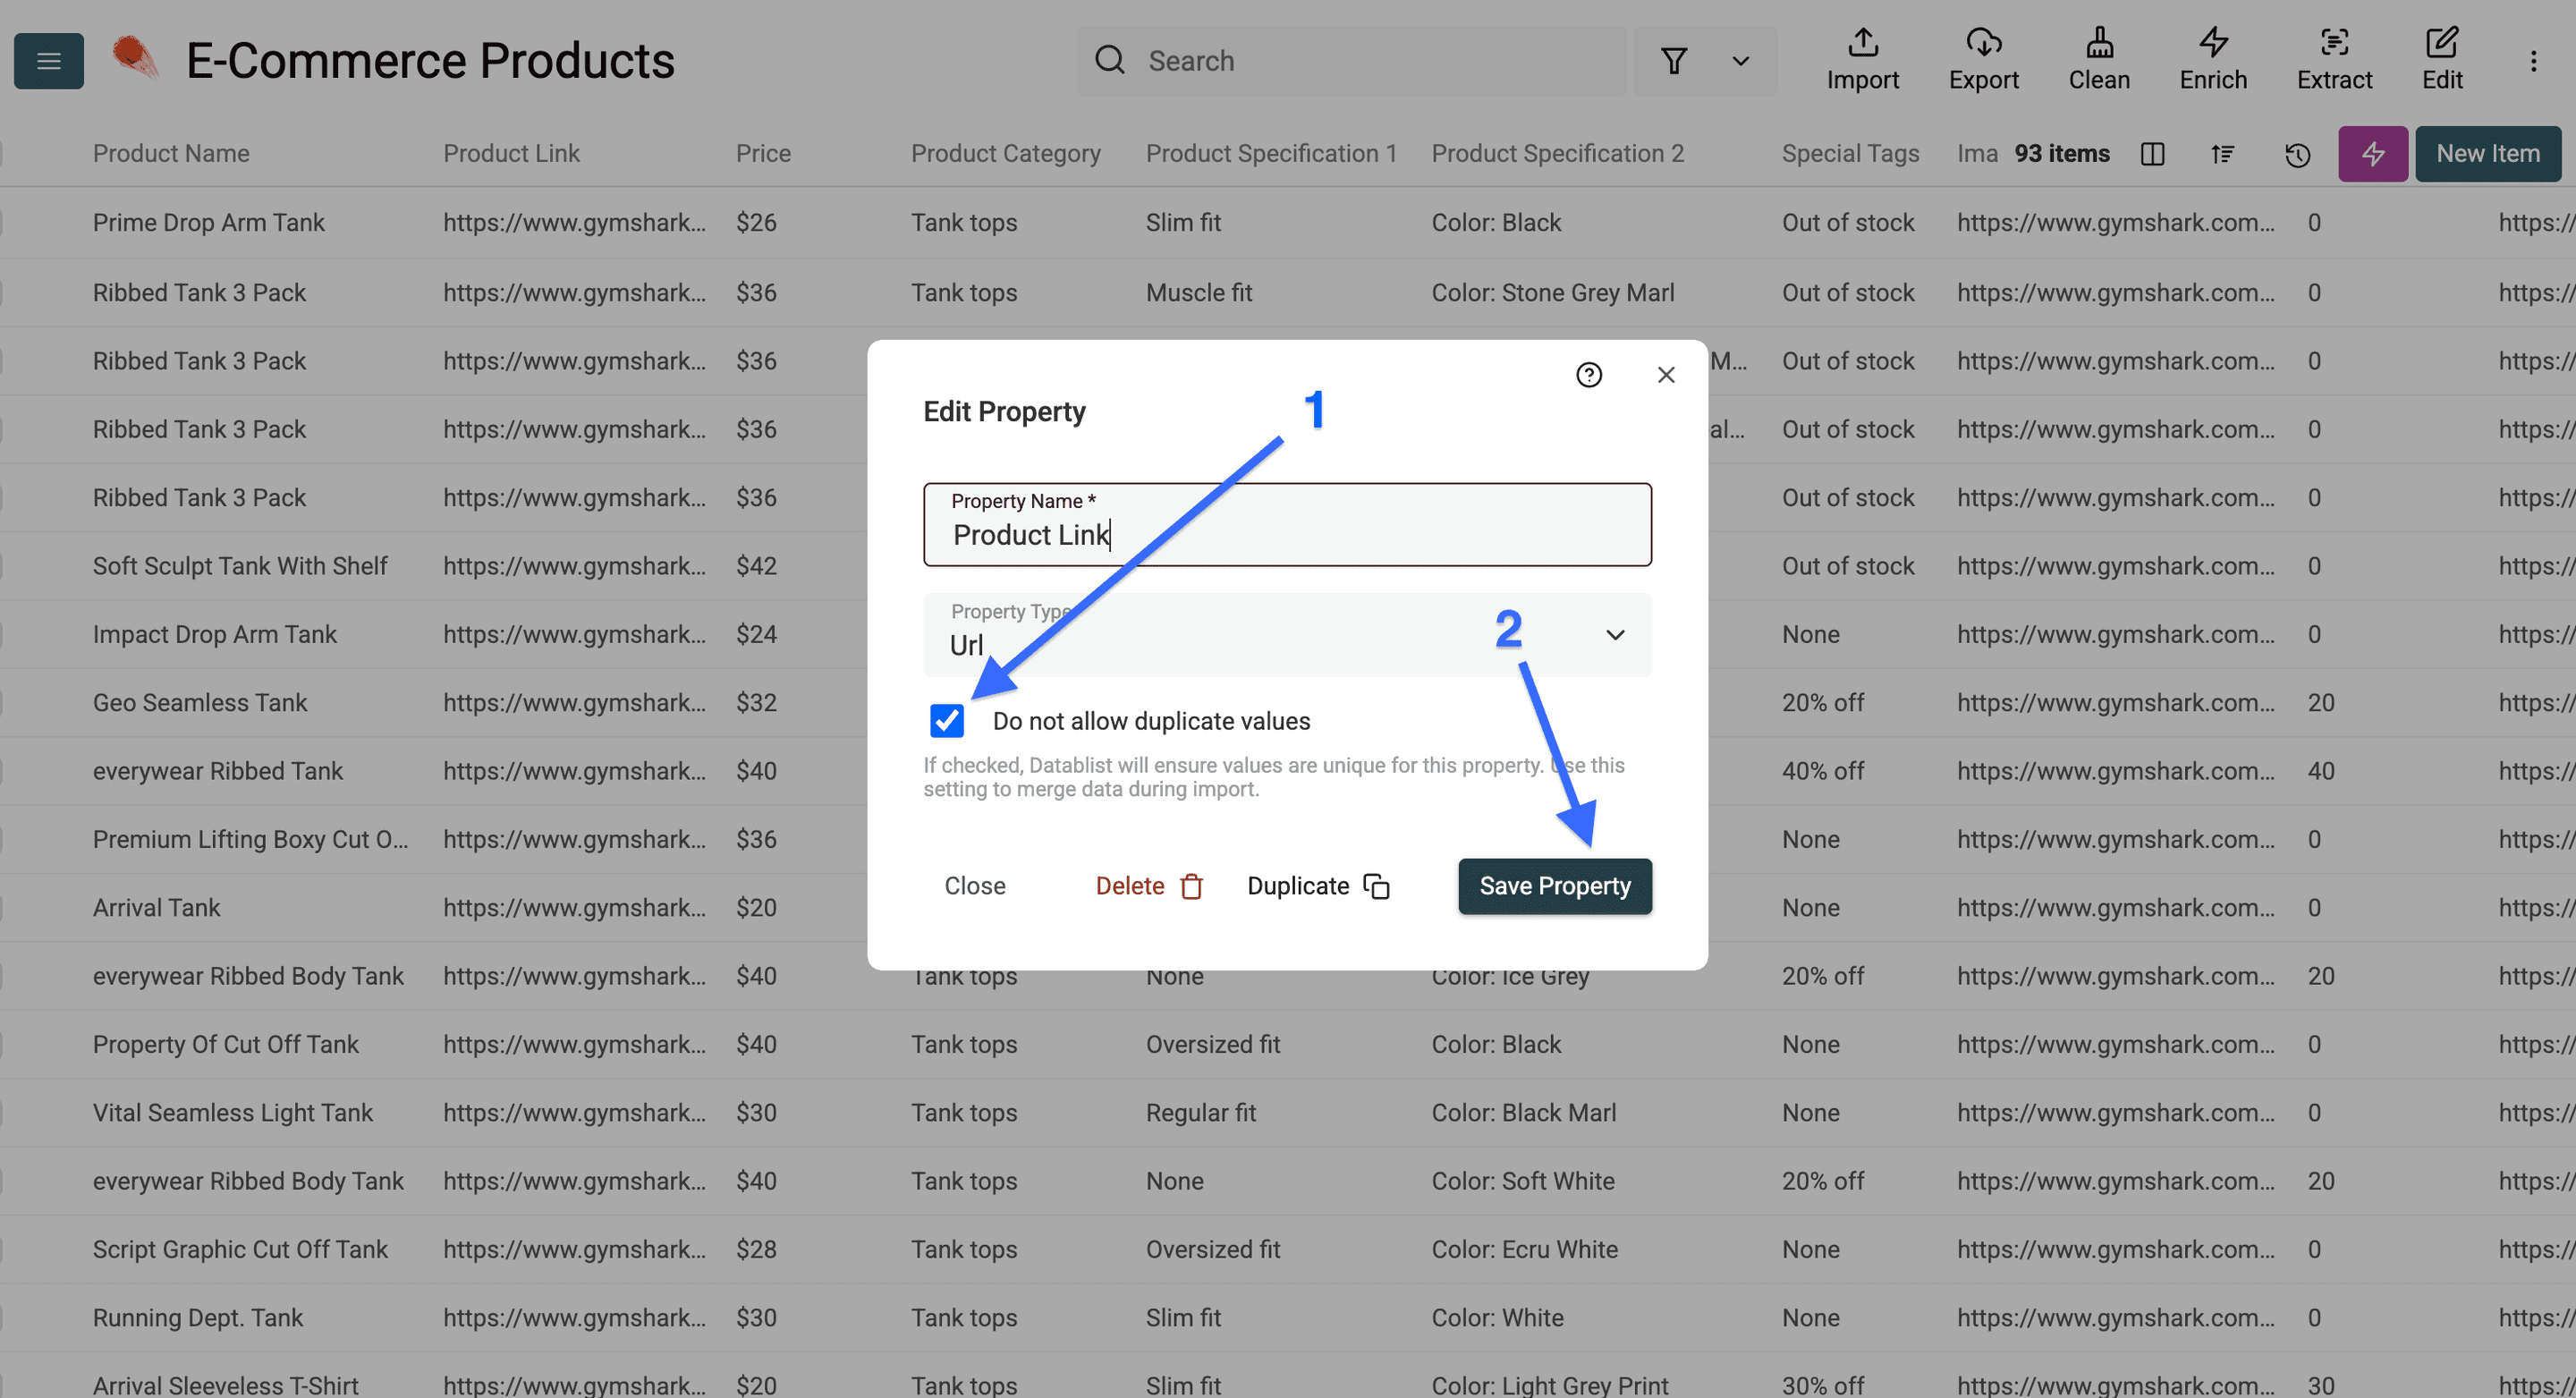
Marque a caixa Do not allow duplicate values.
Em seguida, clique em Save Property.
Etapa 4: confira o ícone de chave
Depois que a coluna for salva, a Datablist exibirá um ícone de chave ao lado do nome dela.
Esse ícone confirma que a coluna agora é um identificador único.
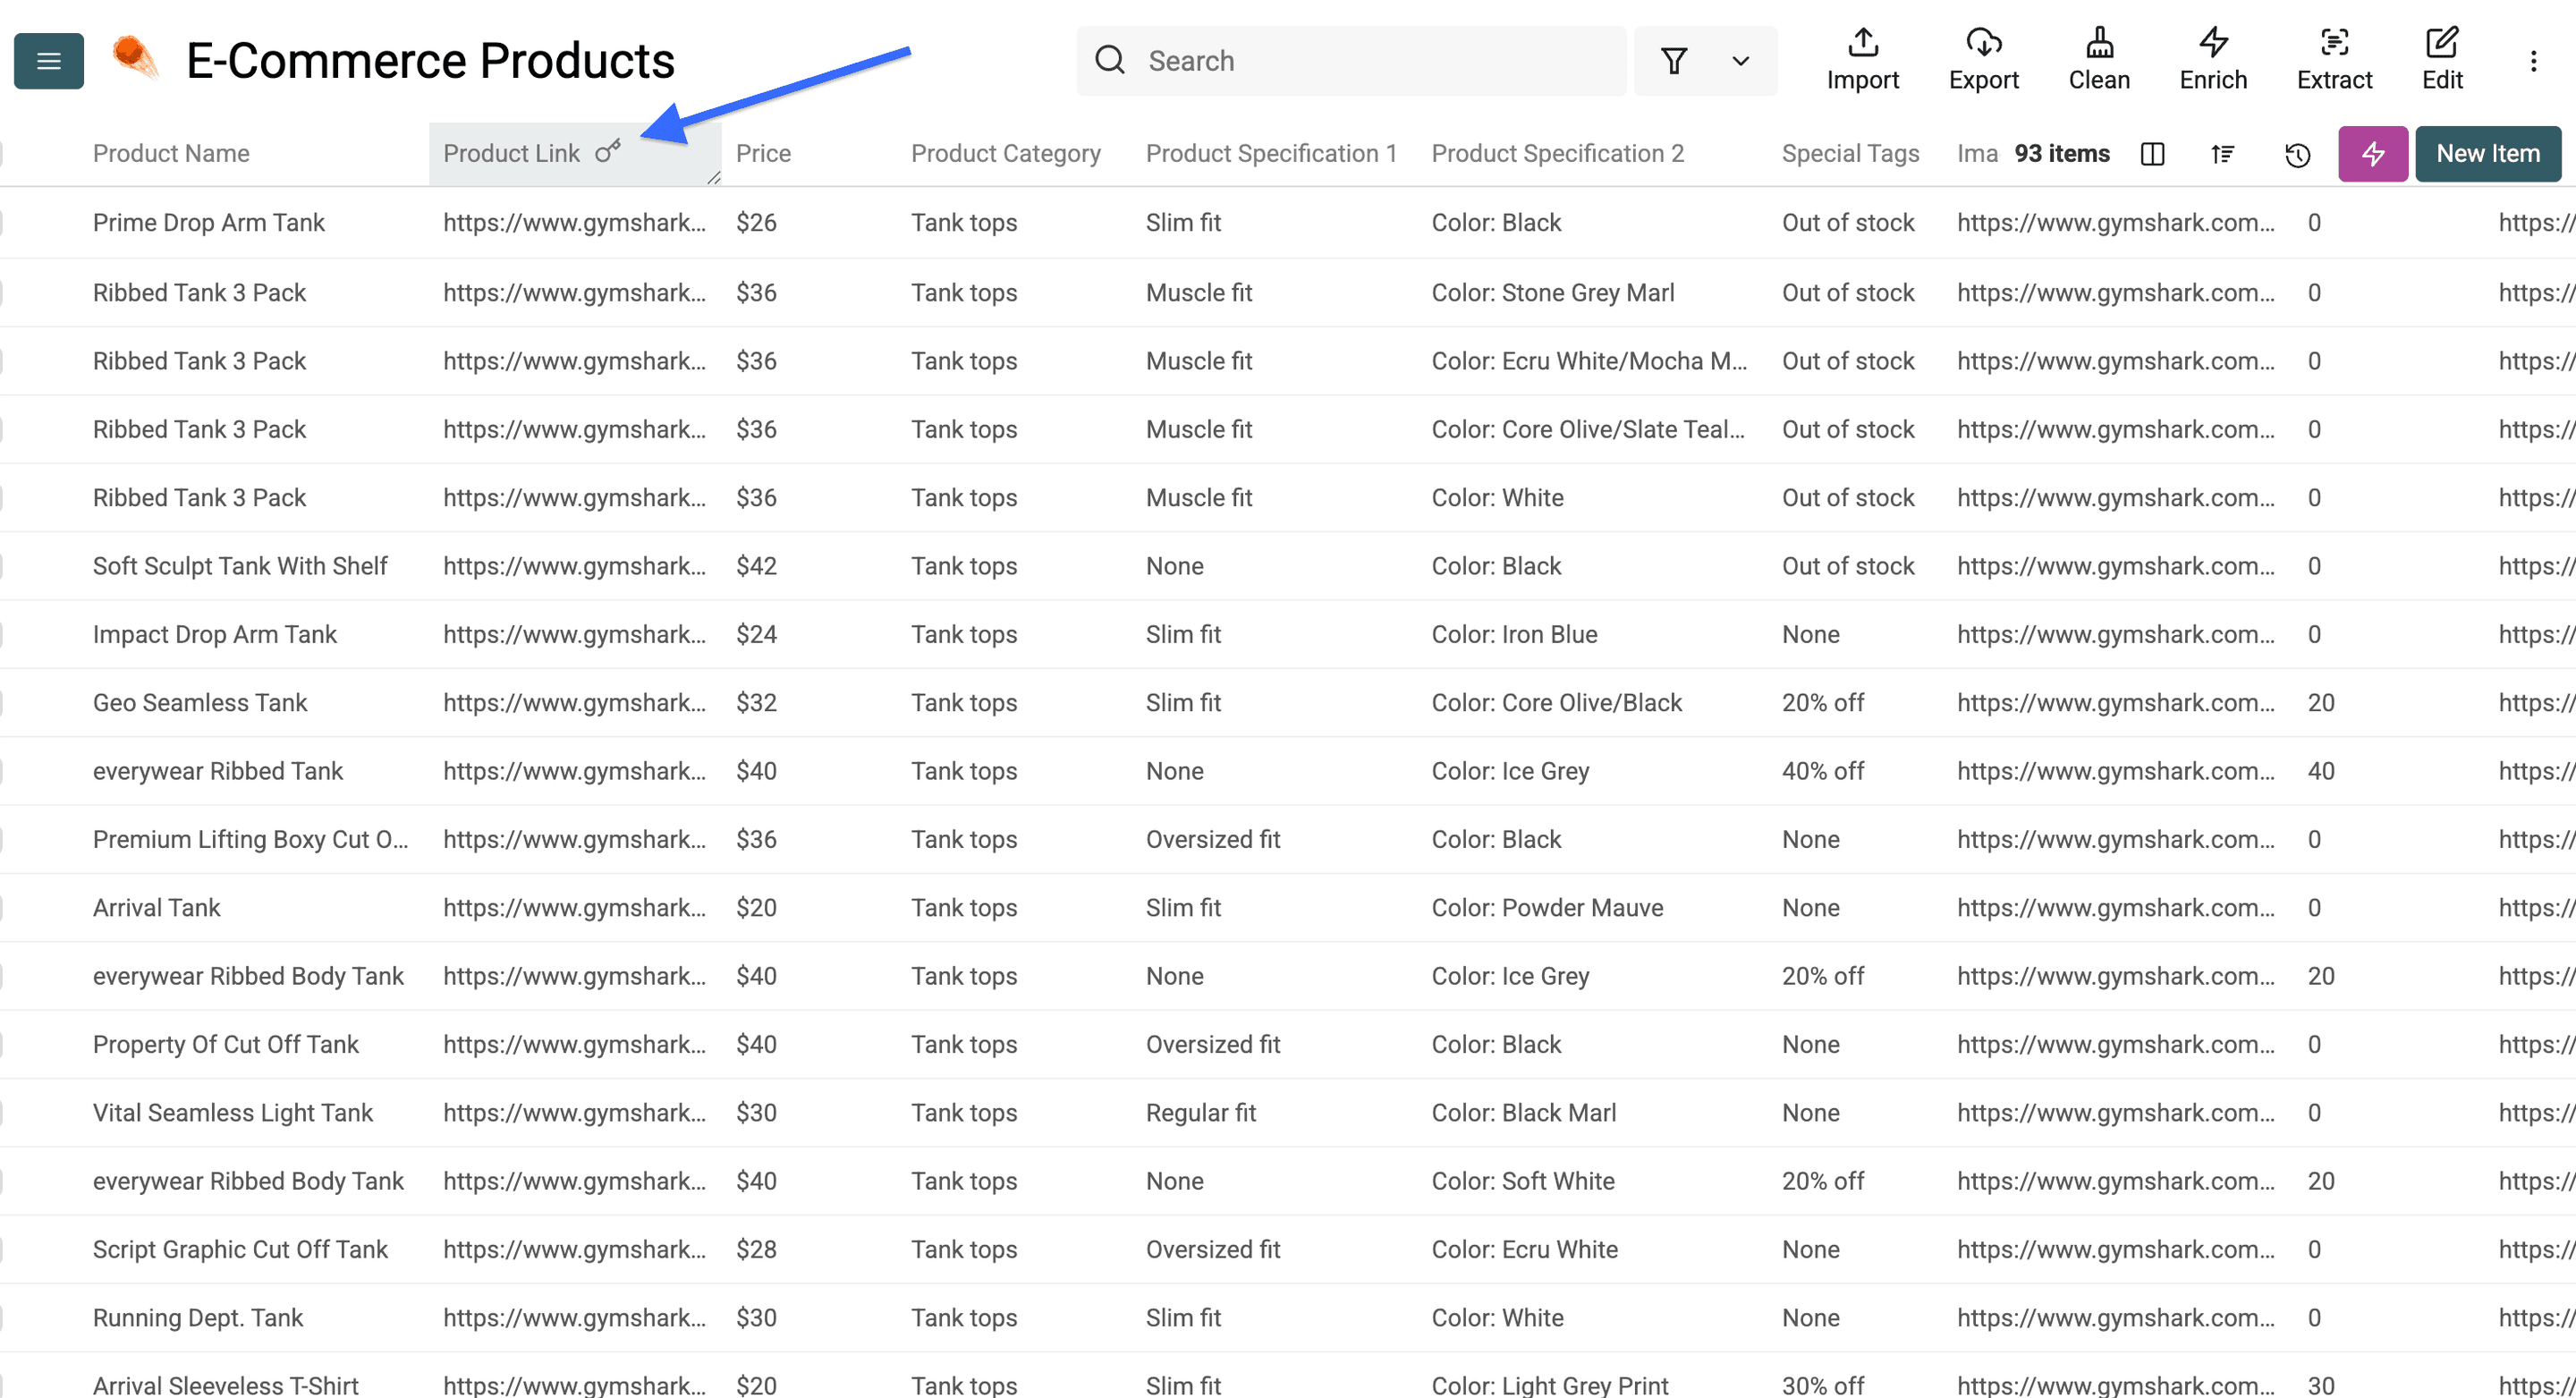
A partir daí, quando você executar novamente o mesmo scraping, source ou importação, a Datablist adicionará somente linhas com novos valores únicos. Assim, sua Collection continuará limpa quando o processo for repetido.
Pare de configurar scrapers e comece a usar prompts
A verdadeira mudança não está em uma única ferramenta. Uma página combinada com um prompt em linguagem natural substituiu o modelo de um script por site, que tornava o web scraping tão frágil. É por isso que o mesmo workflow consegue extrair dados de qualquer site, seja um diretório, um marketplace ou uma loja de nicho.
Perguntas frequentes sobre web scraping sem código
O AI Scraping Agent extrai dados de qualquer site?
Ele funciona em praticamente qualquer site público. Como interpreta cada página usando um prompt, em vez de um template fixo, consegue se adaptar até mesmo a sites que nunca viu.
A Datablist oferece teste grátis do web scraper?
Sim. Você pode começar gratuitamente, criar uma Collection e testar o AI Scraping Agent sem pagar.
Preciso escrever código para usar o AI Scraping Agent?
Não. Você descreve o que deseja em linguagem natural, mapeia alguns campos de saída e inicia a execução. Não há scripts para escrever nem reescrever quando um site muda o layout. É por isso que a Datablist ajuda você a extrair dados de praticamente qualquer site sem código.
Quais dados o AI Scraping Agent pode extrair?
Tudo o que estiver visível na página e for solicitado: nomes de produtos, preços, URLs, disponibilidade, dados de contato, listagens e muito mais. Você define os campos no prompt e nas saídas. Observação: o AI Scraper da Datablist não consegue extrair informações do backend, como a disponibilidade em estoque, quando elas não são exibidas no site público.
Quanto custa extrair dados de sites com a Datablist?
As execuções de scraping consomem créditos conforme o uso, então você paga pelo que processar. Fazer um pequeno teste antes de uma extração completa é a forma mais econômica de validar a configuração.
Posso exportar os dados para CSV ou Excel?
Sim. Assim que as linhas chegarem à sua Collection, você poderá limpar, deduplicar, enriquecer e exportar os dados, inclusive para CSV e Excel, diretamente da Datablist.
O que significa fazer web scraping sem código?
Significa extrair dados estruturados de uma página sem escrever ou manter um script. Em vez de programar seletores, você configura uma ferramenta ou descreve em linguagem natural, por meio de um prompt, os dados que deseja extrair.
É mesmo possível extrair dados de qualquer site sem código?
Com um AI Scraping Agent, você pode extrair dados de praticamente qualquer site público sem código, pois os agentes de AI se adaptam a diferentes layouts usando um único prompt. Ainda assim, páginas protegidas por login ou sistemas anti-bot robustos podem apresentar dificuldades.
Qual é a diferença entre AI Scraping e web scraping tradicional?
O scraping tradicional executa um script programado para a estrutura de um único site. O AI scraping interpreta a página com um prompt em cada execução, permitindo que a mesma configuração se adapte a vários sites.
Por que scrapers quebram quando o layout muda?
Um scraper procura seletores e padrões específicos da página. Quando o site modifica esses elementos, o script deixa de encontrar os dados e passa a retornar resultados vazios ou erros até que alguém o reescreva.
O que é um web scraper no-code e como funciona?
Um web scraper no-code extrai dados sem programação. Ferramentas point-and-click permitem selecionar campos visualmente, enquanto agentes de AI Scraping recebem um prompt em linguagem natural e extraem os dados para você.
Quanto tempo leva para extrair dados sem código?
Depende da ferramenta utilizada, mas, tomando a Datablist.com como exemplo, a configuração leva apenas alguns minutos: crie sua conta, escreva um prompt, mapeie os campos e execute. O scraping em si geralmente termina em 5 a 10 minutos, dependendo da quantidade de páginas processadas.