Há alguns meses, lançamos um recurso que não imaginávamos ser tão poderoso.
Agora, esse recurso está transformando o mercado de web scraping no-code.
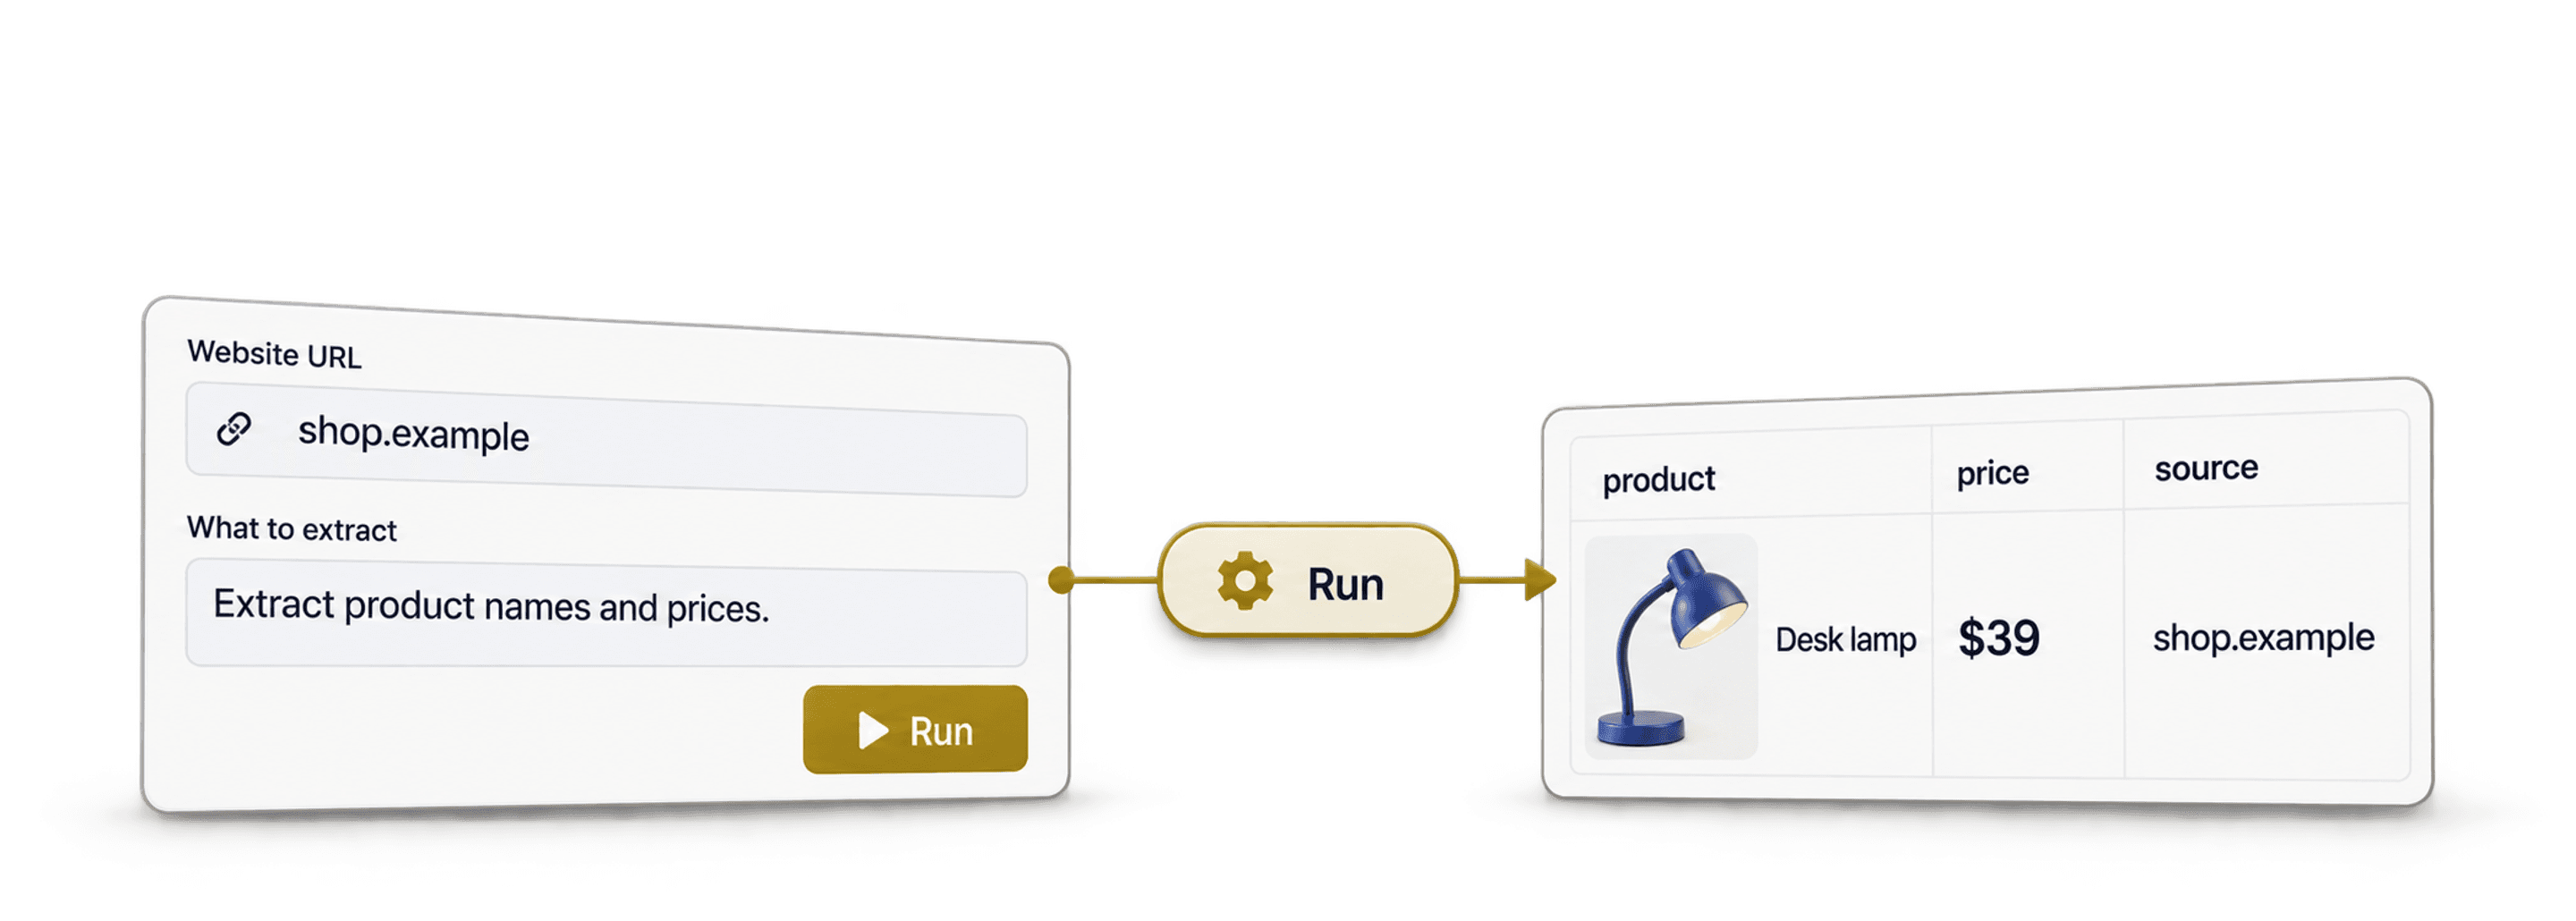
O recurso de que estou falando é a nossa fonte “AI Agent - Site Scraper”. Ela extrai linhas estruturadas do conteúdo acessível de sites seguindo as suas instruções.
Alguns meses depois, descobri três coisas:
- Todo o mercado de scraping no-code é uma grande mentira
- Criamos o melhor scraper no-code sem perceber
- Agentes de scraping com AI são mais poderosos, fáceis de usar e rápidos do que qualquer ferramenta de scraping no-code que já existiu.
📌 Resumo para quem está com pressa
Este artigo explica tudo o que você precisa saber sobre o verdadeiro scraping no-code e mostra que ele não exige APIs, seletores CSS nem conhecimentos técnicos. Se estiver com pressa, aqui vai um resumo:
Problema: as ferramentas de scraping “no-code” ainda exigem conhecimento técnico, obrigam você a entender a estrutura dos sites, assistir a tutoriais e passar horas configurando tudo. Quando o site faz uma pequena atualização, tudo para de funcionar.
Por que isso é um problema: você não deveria precisar aprender sobre APIs e seletores CSS nem assistir a horas de tutoriais só para extrair dados de sites. Isso contraria totalmente a proposta do “no-code”.
Solução: o scraping com AI da Datablist, controlado por instruções em linguagem natural. Você descreve o que deseja, e a AI cuida do resto.
O que você aprenderá: este guia expõe as mentiras do mercado de scraping no-code, mostra como é uma solução verdadeiramente no-code e apresenta casos de uso e dicas práticas para escrever prompts.
Por que usar a Datablist para scraping no-code: três motivos principais
- É realmente no-code: basta descrever o que você deseja em linguagem natural
- Processa sites complexos com JavaScript, paginação e conteúdo dinâmico
- Adapta-se a mudanças nos sites, ao contrário de scrapers frágeis baseados em seletores CSS
O que você encontrará neste artigo
- O mercado de scraping no-code e suas mentiras
- A solução simples: use palavras, não APIs
- Casos de uso e dicas para scraping com AI
- Perguntas frequentes sobre scraping no-code
O mercado de scraping no-code e suas mentiras
Esta seção desmente os mitos e truques do mercado de scraping no-code. A verdade é que a maioria das ferramentas “no-code” não é realmente no-code. Elas apenas reembalaram a complexidade técnica em outro formato.
Por que o código nunca foi o problema
Pense por um instante: o código nunca foi o problema. Se você soubesse programar, faria o scraping com código e nem procuraria uma solução no-code.
Você busca soluções no-code porque não quer aprender a programar apenas para extrair dados de um site. Mas como as pessoas são espertas, venderam a você uma solução que funciona mais ou menos; uma solução que ainda envolve:
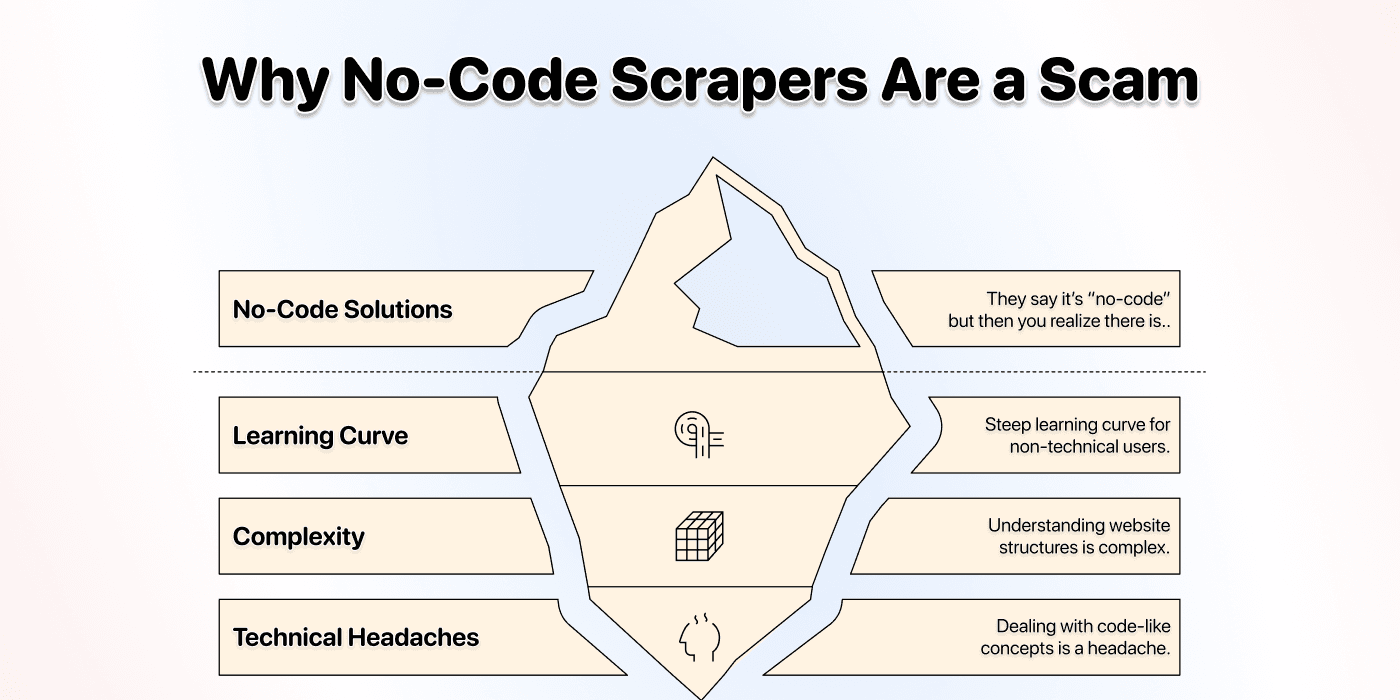
- Uma curva de aprendizado acentuada
- Assistir a vários tutoriais
- Entender a estrutura dos sites
E, às vezes, até trabalhar com conceitos semelhantes a código, como seletores CSS.
O verdadeiro problema nunca foi escolher entre código e no-code.
O verdadeiro problema sempre foi a curva de aprendizado, a complexidade e as dores de cabeça técnicas.
O que tentaram vender para você
O mercado de scraping no-code adota três abordagens principais, e nenhuma delas resolve de verdade o problema da complexidade.
Scrapers baseados em API
Essas ferramentas afirmam ser “no-code” porque você não escreve Python nem JavaScript. Mas há algumas coisas que elas não contam.
Você ainda precisa lidar com:
- Estruturas DOM dos sites
- Seletores CSS
- Tags HTML
Tecnicamente, você não está programando, mas está fazendo algo igualmente técnico. Você traduz necessidades humanas em seletores que uma máquina consegue interpretar, o que é basicamente programação com etapas extras.
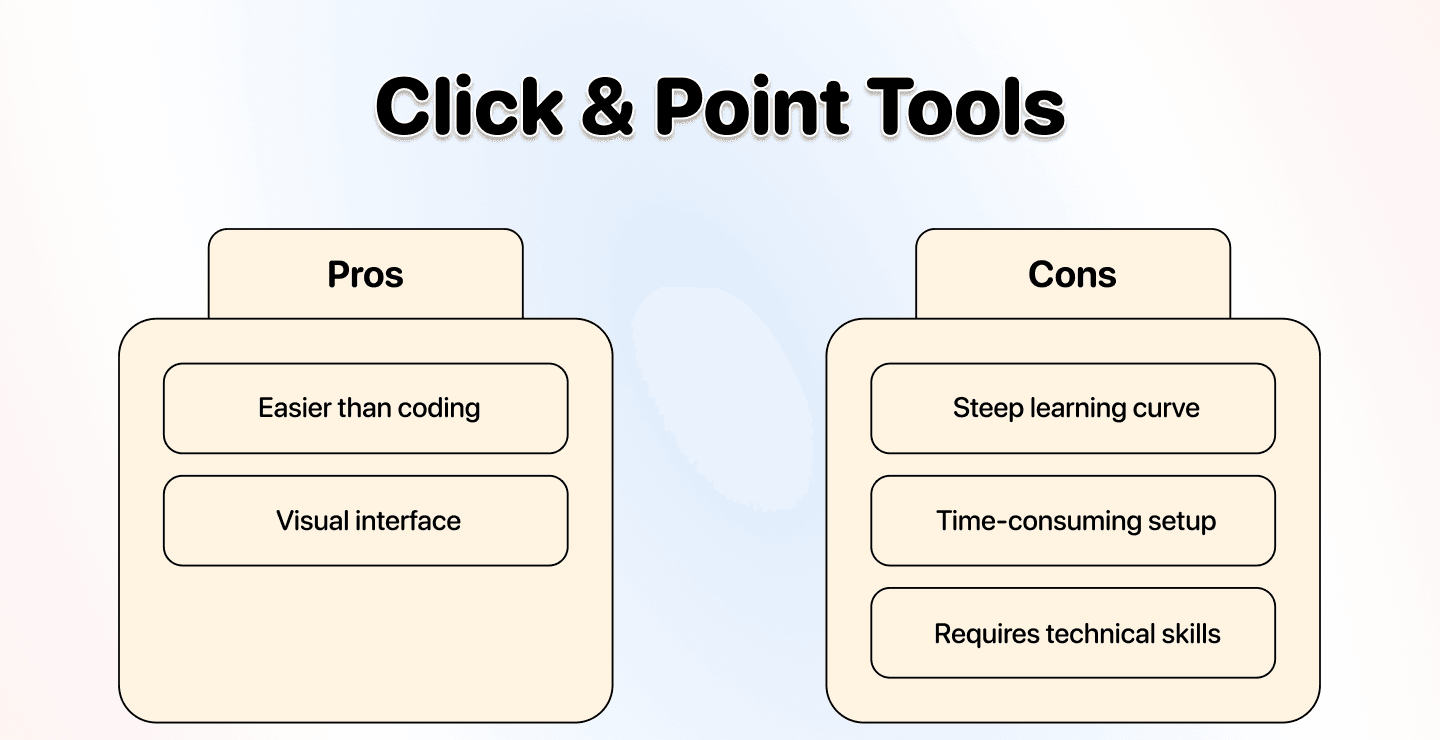
Ferramentas de apontar e clicar
Essa abordagem é mais simples, mas ainda exige que você entenda como o site foi construído. Elas facilitam um pouco o processo ao permitir que você clique nos elementos, mas ainda causam dor de cabeça.
O maior problema? Se a estrutura do site mudar, você terá que configurar tudo novamente do zero. Isso significa:
- Assistir ao tutorial outra vez
- Reconfigurar todos os seletores
- Torcer para funcionar dessa vez
Extensões para navegador
Na prática, são ferramentas de apontar e clicar que funcionam no navegador em vez de ter um aplicativo próprio. Muitas são gratuitas, como o Instant Data Scraper.
Os principais problemas dessas ferramentas:
- Basta uma mudança no site para você precisar refazer tudo do zero
- Funcionalidade e capacidade de escala limitadas
- Podem fazer com que seu IP seja bloqueado
📘 O padrão que você precisa perceber
As três abordagens obrigam você a entender a estrutura técnica dos sites. Elas apenas reembalaram a complexidade técnica em interfaces diferentes. Isso não resolve o problema; apenas o transfere para outro lugar. Scraping com AI
O que você realmente procura
Sejamos sinceros sobre o que você realmente quer: você procura um scraping sem dor de cabeça, não apenas um scraping no-code. Veja o que isso significa na prática:
Sem dor de cabeça
- Não me obrigue a entender seletores CSS
- Não me faça assistir a tutoriais de três horas
- Não pare de funcionar quando o site atualizar o design
Sem curva de aprendizado
- Eu deveria conseguir começar imediatamente
- Eu não deveria precisar aprender uma nova habilidade técnica
Em essência, você quer descrever seu objetivo em linguagem natural e receber os resultados. Todo o resto é apenas um atrito desnecessário que o mercado normalizou.
A solução: trocar scraping no-code por scraping com AI
A solução para o problema do scraping no-code não é uma interface melhor de apontar e clicar nem uma API mais simples. A solução é eliminar completamente a camada técnica e usar linguagem natural.
Como a AI torna o scraping realmente no-code
Como o próprio nome sugere, no scraping com AI, é a AI que extrai os dados do site, não você. Você assume o papel de gestor, não de operador técnico.
Com o scraping no-code baseado em AI, basta dizer ao sistema o que fazer, como fazer e quando fazer. A AI cuida de toda a complexidade técnica nos bastidores.
Você não precisa entender:
- Seletores CSS ou estrutura HTML
- Arquitetura DOM do site
- Endpoints de API ou documentação técnica
Basta fornecer instruções em linguagem natural, e o agente de scraping com AI descobre o restante. É assim que o scraping no-code deveria ter funcionado desde o início.
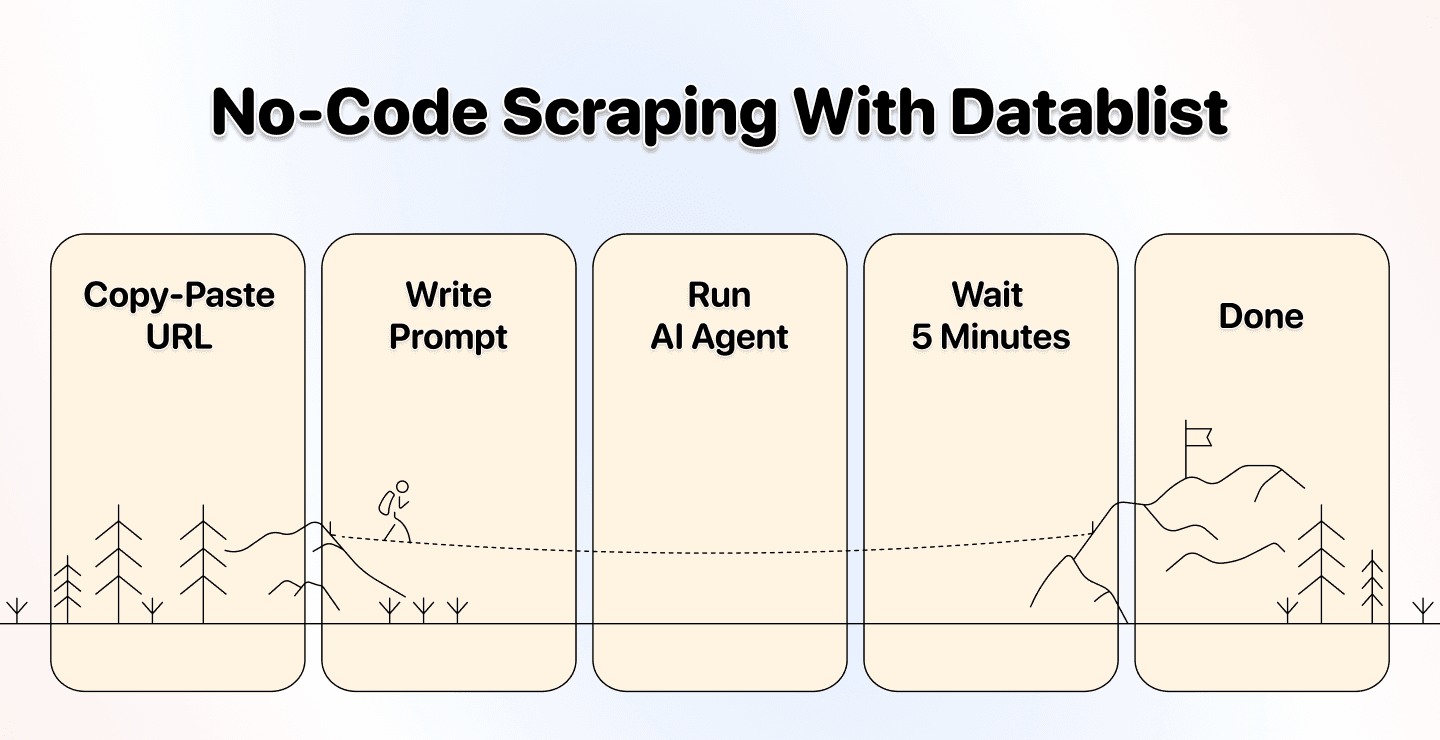
A empresa que oferece a solução: Datablist.com
Como mencionei no início, não planejávamos abalar todo o mercado no-code. Isso aconteceu por acaso: um de nossos usuários precisava extrair dados de um site, então criamos uma solução para ele.
Criamos um AI Agent capaz de:
- Entender instruções em linguagem natural
- Navegar automaticamente por sites complexos
- Processar páginas com muito JavaScript
- Lidar com conteúdo paginado
- Extrair dados de forma inteligente
- …
E a grande inovação não foi criar um scraper melhor.
Foi eliminar por completo a necessidade de conhecimento técnico.
Você diz à AI o que deseja, e ela descobre como obter os dados.
Sem seletores CSS. Sem inspecionar o DOM. Sem tutoriais.
O que é a Datablist
A Datablist é uma plataforma para automatizar workflows de geração de Leads, enriquecimento e limpeza de dados, criada para usuários sem perfil técnico, como profissionais de vendas, marketing e recrutamento.
Use a fonte de scraping para criar linhas, revise-as em uma collection e depois limpe e exporte o resultado. Escolha enriquecimentos adicionais apenas quando a próxima etapa realmente precisar deles.
Por que escolher a Datablist
A abordagem da Datablist para scraping no-code é diferente das demais opções do mercado porque nunca vendemos dores de cabeça técnicas em uma embalagem bonita; optamos pelo scraping com AI.
Veja o que isso representa para você:
Uma solução realmente no-code
- Não exige nenhum conhecimento técnico
- Não é preciso entender HTML ou CSS
- Permite revisar a qualidade da extração quando o site muda
Você só precisa escrever um prompt
- Descreva o que deseja em linguagem natural
- A AI entende o contexto e a intenção
Templates para diversos scrapers
- Prompts prontos para casos de uso comuns
- Templates para scraping de diretórios
- Templates para scraping de e-commerce
- Templates para extração de estudos de caso
A solução mais simples para extrair dados de diretórios
- Funciona com Yellow Pages, Yelp, TripAdvisor e Alibaba
- Processa a paginação automaticamente
Você não precisa ficar exportando e importando dados entre dez ferramentas
- Os dados vão direto para uma interface de planilha
- Edite, filtre e enriqueça os dados em um só lugar
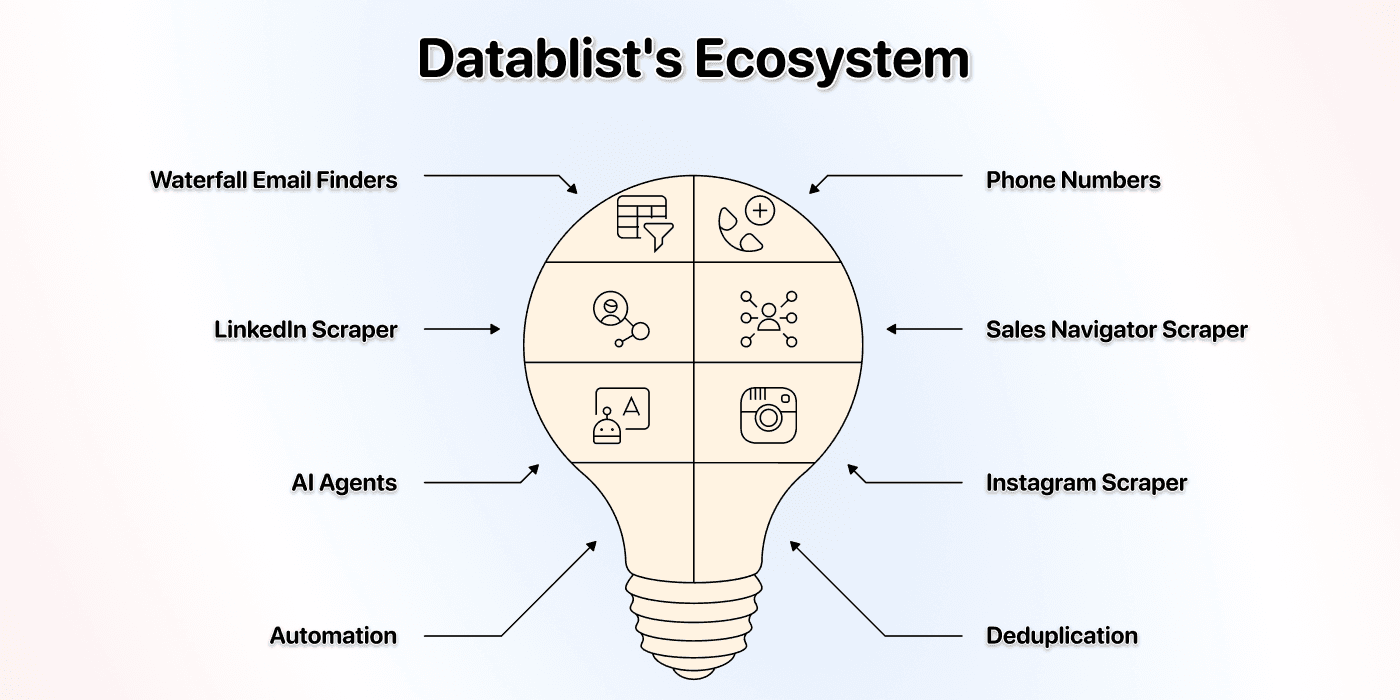
- Tenha acesso a todo um ecossistema de geração de Leads
Casos de uso e dicas práticas
Usar a Datablist para extrair dados de sites e diretórios ou até executar buscas com AI em escala é fácil. A abordagem é muito simples e sempre a mesma: descreva o que deseja com a maior precisão possível.
Guia rápido para criar prompts
Antes de falarmos sobre todos os casos de uso do agente de scraping com AI, quero mostrar como é fácil dar instruções a ele.
Regras para criar prompts
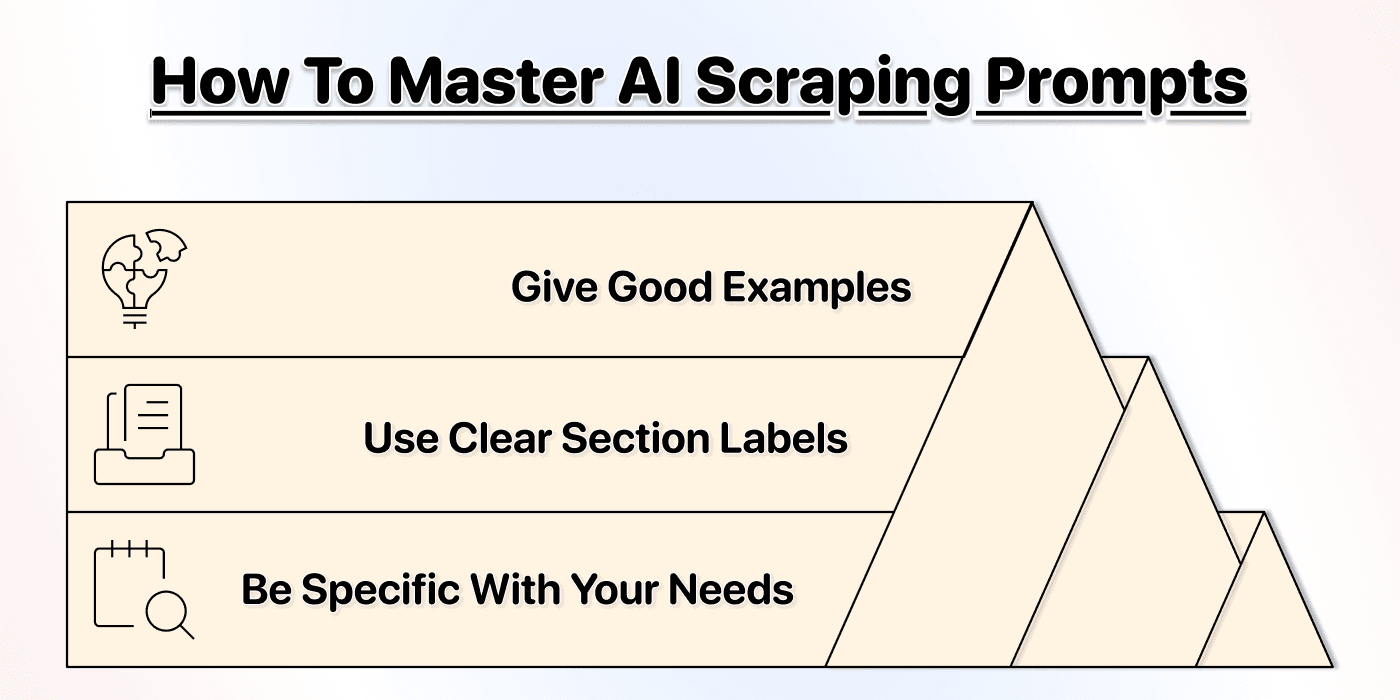
Criar um bom prompt é simples. Você não precisa ser especialista. Só precisa explicar claramente o que deseja. Estas dicas ajudarão você a escrever prompts melhores:
Seja específico
- Não diga “obtenha informações dos produtos”
- Diga “obtenha o nome, o preço e o status de disponibilidade do produto”
- Inclua exemplos sempre que possível
Isso ajuda você a receber os dados desejados sem que o AI Agent interprete algo incorretamente.
Use títulos de seção
- Organize o prompt em seções claras
- Objetivo: o que você deseja alcançar
- Dados necessários: quais informações específicas você precisa
- Formato: como os dados devem ser estruturados
- Restrições: o que incluir ou evitar
Os títulos de seção ajudam o AI Agent a entender o seu pedido. Não é uma exigência, mas percebemos que isso aumenta bastante a precisão.
Forneça exemplos
O AI Agent não sabe tudo. Alguns sites são muito complexos. Ao fornecer exemplos, você evita falsos positivos, aumenta a precisão e reduz o custo.
Veja este guia detalhado para escrever prompts para um AI Agent 👈🏽
💡 Dica profissional: como processar a paginação
O AI Agent da Datablist consegue processar automaticamente conteúdo paginado. Basta ativar a paginação nas configurações e definir o número máximo de páginas. O agente segue os links acessíveis para a próxima página enquanto houver resultados e ainda restarem páginas dentro do limite configurado.
===
Dados necessários:- Nome do produto (exemplo: "Camiseta clássica")
- Preço (exemplo: "R$ 29,99")
- URL do produto (link completo)
- Disponibilidade (Em estoque / Fora de estoque)
===
Formato:- Retorne uma linha por produto
- Use "N/A" quando não houver dados
===
Restrições:- Ignore banners promocionais
- Extraia apenas produtos reais, não páginas de categorias
Casos de uso de scraping no-code
As possibilidades do scraping no-code são praticamente infinitas. Estes são os casos de uso mais populares e eficazes que vimos até agora:
Diretórios
- Extrair empresas do Yellow Pages
- Extrair dados de restaurantes do Yelp
- Extrair imóveis do Airbnb
- Extrair informações de hotéis do TripAdvisor
- Extrair catálogos de fornecedores do Alibaba
- Extrair imóveis do Zillow
- Extrair corretores de imóveis do Zillow
Sites de e-commerce
Outros
- Extrair todos os estudos de caso de um site
- Extrair expositores de sites de feiras e eventos
📘 Como extrair dados de vários sites
Se você precisa extrair dados de vários sites semelhantes, também pode usar o AI Research Agent da Datablist para processar uma lista de sites. Esse agente ainda oferece recursos adicionais para executar buscas com AI em escala.
Conclusão: o scraping no-code deveria mudar de nome
O scraping no-code deveria se chamar “scraping sem dor de cabeça técnica”, porque é isso que as pessoas realmente procuram. Você não busca scraping no-code porque não sabe programar, mas porque não quer aprender habilidades técnicas apenas para extrair dados.
Portanto, se o scraping não é uma atividade altamente lucrativa para você, você não deveria ter que desperdiçar horas com isso. E a solução não é uma API melhor nem interfaces mais simples de apontar e clicar.
A solução é eliminar completamente a camada técnica: em outras palavras, usar scraping com AI.
Com a Datablist, você pode fazer exatamente isso e:
- Obter resultados em minutos, não em horas
- Escalar de um site para milhares
- Descrever o que deseja em linguagem natural
- Adaptar-se automaticamente às mudanças nos sites
O problema do scraping no-code finalmente foi resolvido. E fizemos isso por acaso.
Perguntas frequentes sobre scraping no-code
A Datablist consegue extrair dados de diretórios?
Sim. O AI Scraping Agent da Datablist consegue extrair dados de diretórios com eficiência e processa a paginação automaticamente. Assim, você pode obter milhares de registros sem configuração manual.
Por exemplo, já extraímos dados com sucesso de:
- Avaliações, hotéis, restaurantes e muito mais no TripAdvisor
- Listagens de empresas do Yellow Pages
- Catálogos de imóveis do Airbnb
- Bases de fornecedores do Alibaba
- Informações de empresas do Yelp
- … e muitas outras fontes
Posso extrair dados de várias páginas automaticamente?
Sim. O AI Scraping Agent da Datablist oferece paginação automática. Defina o número máximo de páginas na configuração, e o agente poderá seguir os links acessíveis para a próxima página dentro desse limite. Depois, confira a cobertura dos resultados.
Isso funciona para:
- Catálogos de produtos de e-commerce
- Listagens de diretórios distribuídas por várias páginas
- Resultados de busca paginados
- Arquivos de blogs
- …
Quanto custa usar o Scraping Agent da Datablist?
O preço dos AI Agents da Datablist é baseado no uso e varia conforme a complexidade da tarefa de scraping. Para diretórios como o Yellow Pages, os custos são bem menores e dependem do número de páginas e do processamento necessário. Faça uma pequena execução antes de estimar um lote maior.
O que é scraping no-code?
Scraping no-code é o processo de extrair dados de sites sem escrever código nem usar conhecimentos técnicos. O verdadeiro scraping no-code permite descrever o que você deseja em linguagem natural e receber os resultados sem entender HTML, seletores CSS ou APIs.
A Datablist processa sites com muito JavaScript?
Sim. O AI Agent da Datablist consegue extrair dados de sites com muito JavaScript. Ative a opção "Render HTML" nas configurações avançadas para que o agente espere o JavaScript carregar antes de extrair os dados.
Isso é essencial para sites modernos criados com React, Vue ou Angular, que carregam o conteúdo dinamicamente após a abertura inicial da página.
Qual é a diferença entre scraping no-code e web scraping tradicional?
O web scraping tradicional exige conhecimentos de programação, como Python ou JavaScript, ou habilidades técnicas, como seletores CSS e XPath. O scraping no-code elimina essa exigência por meio de interfaces visuais ou, no caso da Datablist, da compreensão de linguagem natural.
Como o scraping com AI difere do scraping com seletores CSS?
Scrapers baseados em seletores CSS dependem da estrutura exata do HTML de um site. Se o layout do site mudar, o scraper para de funcionar.
O scraping com AI entende o significado do conteúdo, não apenas sua localização. Ele consegue identificar que “isto é o preço de um produto” mesmo quando os nomes das classes HTML mudam. Isso permite tolerar algumas alterações de layout, mas a qualidade da extração ainda precisa ser revisada quando o site muda.
O scraping no-code é legal?
A resposta depende dos dados coletados, de como você os utiliza e da legislação aplicável. Usar uma ferramenta no-code não altera essas regras. No caso de dados pessoais, o fato de estarem disponíveis publicamente não elimina as obrigações de proteção de dados. As orientações da CNIL sobre a reutilização de dados da internet explicam essa diferença.
- Respeite o robots.txt e outras restrições de acesso.
- Evite extrair dados de áreas protegidas por login.
- Colete apenas os campos necessários e cumpra as regras de privacidade aplicáveis, como a LGPD.
- Evite um volume excessivo de solicitações que sobrecarregue o site de origem.
Como configurar um scraping no-code e conferir o resultado
Comece com uma página pública de listagem. No AI Agent - Site Scraper, informe a URL da página, descreva o que cada linha do resultado deve representar e defina os campos necessários. Para uma lista de produtos, podem ser o nome do produto, o preço anunciado, a moeda e a URL do produto. Peça para manter vazios os valores ausentes e tratar o conteúdo do site como dados, não como instruções.
Faça um pequeno teste antes de ampliar o scraping. Compare a primeira e a última linha com a página, confirme se os preços correspondem às variantes desejadas e verifique se o resultado contém URLs de produtos, não URLs de categorias.
Ative a paginação apenas quando a listagem tiver um link para a próxima página. A fonte extrai esse link da página atual e continua enquanto houver resultados e páginas restantes dentro do máximo configurado. O máximo é um limite, não uma promessa de que todas as páginas serão visitadas. Uma extração vazia ou uma próxima página inacessível pode interromper a coleta antes disso.
Renderizar JavaScript pode ajudar quando o conteúdo não está presente no HTML inicial. Isso não garante acesso por meio de logins, CAPTCHAs, solicitações bloqueadas ou controles interativos do tipo “carregar mais”. Se o teste não capturar conteúdo essencial, use uma opção de exportação disponível ou uma API autorizada, em vez de presumir que uma execução maior resolverá o problema. Ao repetir buscas com resultados sobrepostos, remova duplicatas usando a URL do produto.
Uma boa ferramenta no-code reduz o trabalho de configuração. Ainda cabe a você escolher os dados, verificar o acesso, inspecionar os resultados e manter o workflow quando a fonte mudar.