
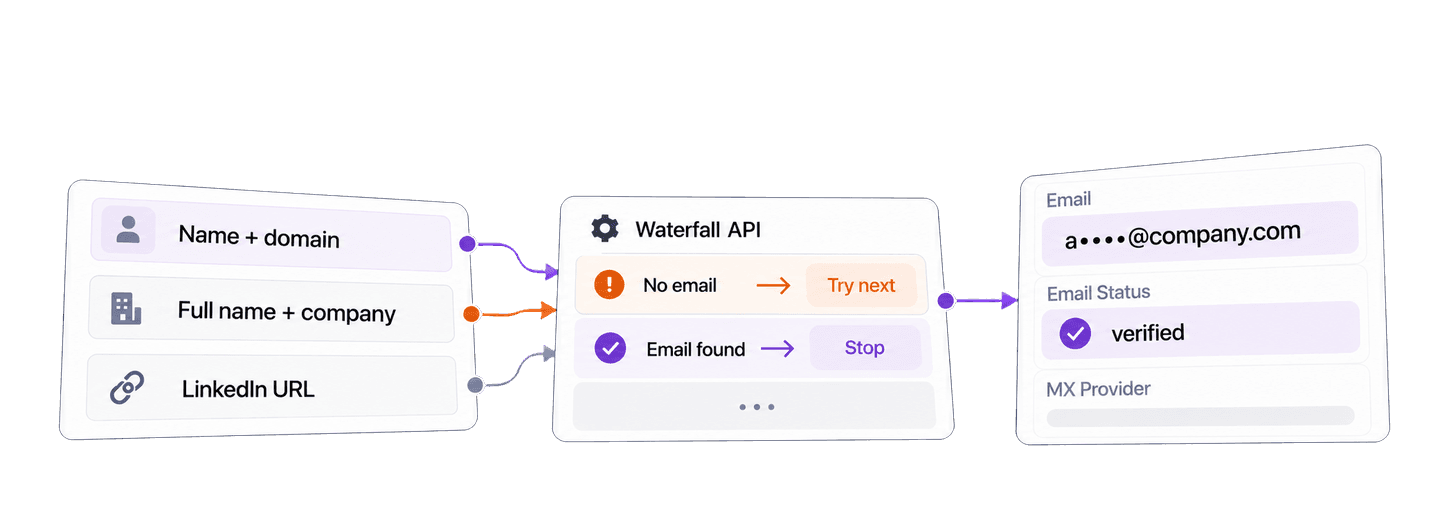
Find arbejdsmails i Python ved at sende en persons navn og virksomhedsoplysninger eller en offentlig LinkedIn-profil-URL til Datablists Waterfall Email Finder API med Requests-biblioteket. API'et returnerer den fundne arbejdsmail, adressens leveringsstatus og mailudbyder.
Det komplette eksempel nedenfor slår Satya Nadella op hos microsoft.com og Reid Hoffman hos greylock.com. Det venter på baggrundsopgaven og henter alle resultatsider. Derefter genbruger vi resultaterne til at oprette en lokal liste over verificerede kontakter, som er klar til kampagnegennemgang.
📌 Kort fortalt
Brug én Python-funktion til at sende kendte kontakter til Waterfall Email Finder API, vente på opgaven og indsamle de arbejdsmails, der bliver fundet. Klargør derefter de verificerede kontakter til kampagnegennemgang, mens uløste kontakter bevares på din kildeliste.
- Input: For- og efternavn med et virksomhedsdomæne, fuldt navn med et virksomhedsnavn eller en offentlig LinkedIn-profil-URL.
- Output: En arbejdsmail med
emailStatusogmxProviderefterfulgt af en lokal gennemgangsliste, der kun indeholder kontakter med en mailadresse.
💡 Foretrækker du en no-code-løsning? Brug Datablists Waterfall Email Finder til at finde arbejdsmails fra en collection uden at skrive kode.
Opsæt Python, Requests og din API-nøgle
I dette Python-eksempel bruger vi pakken requests. Opret en fil med navnet find_work_emails.py, og installer derefter Requests:
python -m pip install requestsOpret en Personal API Key på din Datablist API-kontoside. Adgang til REST API kræver Growth-abonnementet. Eksportér nøglen i den terminal, hvor du vil køre scriptet:
export DATABLIST_API_KEY="your-api-key"Vellykkede resultater fra Waterfall Email Finder bruger også credits. I afsnittet om omkostninger nedenfor adskiller vi disse credits fra det abonnement, der giver API-adgang.
Find arbejdsmails med én Python-funktion
Indsæt følgende komplette script i find_work_emails.py:
import json
import os
import time
import uuid
import requests
def find_emails(people, api_key, settings):
"""Submit one email-finder task, wait, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-email-finder",
"uniqueId": unique_id,
"settings": settings,
"inputs": people,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
},
{
"inputId": "contact-reid-hoffman",
"data": {
"firstName": "Reid",
"lastName": "Hoffman",
"companyNameOrDomain": "greylock.com",
},
},
]
lookup_results = find_emails(people, api_key, settings)
for result in lookup_results:
print(json.dumps(result, indent=2))Kør det fra den samme terminal:
python find_work_emails.pyDu kan også downloade det vedligeholdte Requests-eksempel. Når du har styr på den blokerende version, finder du også et asynkront HTTPX-alternativ i repository'et.
Funktionen foretager tre typer kald i denne rækkefølge.
Først sender den opgaven. Hvert inputId er dit stabile kontakt-ID. Det indlejrede data-objekt indeholder de felter, der bruges til opslaget. POST-kaldet returnerer 202 Accepted med @id, som er det opgave-ID, de efterfølgende kald bruger. Koden udskriver uniqueId, før opgaven sendes, så du stadig har en værdi til gendannelse, hvis svaret går tabt.
Derefter følger den opgavens status. Datablist behandler opgaven i baggrunden. Denne Requests-klient venter og kontrollerer opgaven hvert tredje sekund, indtil dens status er completed, failed eller stopped. Requests blokerer, mens klienten venter, men selve API-opgaven forbliver asynkron.
Til sidst henter den resultaterne. En opgave kan have flere resultatsider. Løkken fortsætter med at hente sider, indtil nextCursor er null. Brug inputId frem for rækkefølgen i svaret til at knytte hvert resultat til den oprindelige kontakt.
Vælg den rette inputmetode til dine kontaktdata
Én opgave bruger én inputmetode. Behold den samme find_emails()-funktion, og erstat værdierne for settings og people med den metode, der matcher dine kildedata.
Vælg et inputId, der er unikt i opgaven, og som allerede tilhører kildekontakten, når det er muligt. Et CRM-record-ID eller et andet permanent Lead-ID fungerer godt. Datablist returnerer værdien sammen med resultatet, så du kan matche records uden at sammenligne navne eller gå ud fra, at svaret følger inputrækkefølgen.
Når du har separate navnefelter og et virksomhedsdomæne, skal du bruge sourceKind: "name_company". Et kendt domæne er den mest entydige virksomhedsidentifikator:
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
}
]
lookup_results = find_emails(people, api_key, settings)Når dine kildedata har ét navnefelt og et virksomhedsnavn, skal du aktivere useFullName:
settings = {"sourceKind": "name_company", "useFullName": True}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"fullName": "Satya Nadella",
"companyNameOrDomain": "Microsoft",
},
}
]
lookup_results = find_emails(people, api_key, settings)Når du har URL'en til en offentlig personprofil, skal du bruge LinkedIn-metoden:
settings = {"sourceKind": "linkedin"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"linkedInProfile": "https://www.linkedin.com/in/satyanadella/"
},
}
]
lookup_results = find_emails(people, api_key, settings)Denne metode accepterer en offentlig linkedin.com/in/...-profil-URL som personkontekst til mailopslaget. Profil-URL'er fra Sales Navigator understøttes ikke.
Hvis du selv vil vælge udbydernøgler og deres rækkefølge, kan du læse vores guide til en brugerdefineret waterfall. Den administrerede waterfall, vi bruger her, kræver ingen udbyderspecifik opsætning.
Sådan finder den administrerede waterfall en mail
Ved en forespørgsel med navn og virksomhed bruger API'et et angivet domæne direkte. Hvis du angiver et virksomhedsnavn, forsøger det først at omsætte navnet til et brugbart virksomhedsdomæne. Ved en LinkedIn-forespørgsel renser det den offentlige profil-URL og omdanner de tilgængelige person- og virksomhedsoplysninger til den kontekst, som de relevante mailudbydere har brug for.
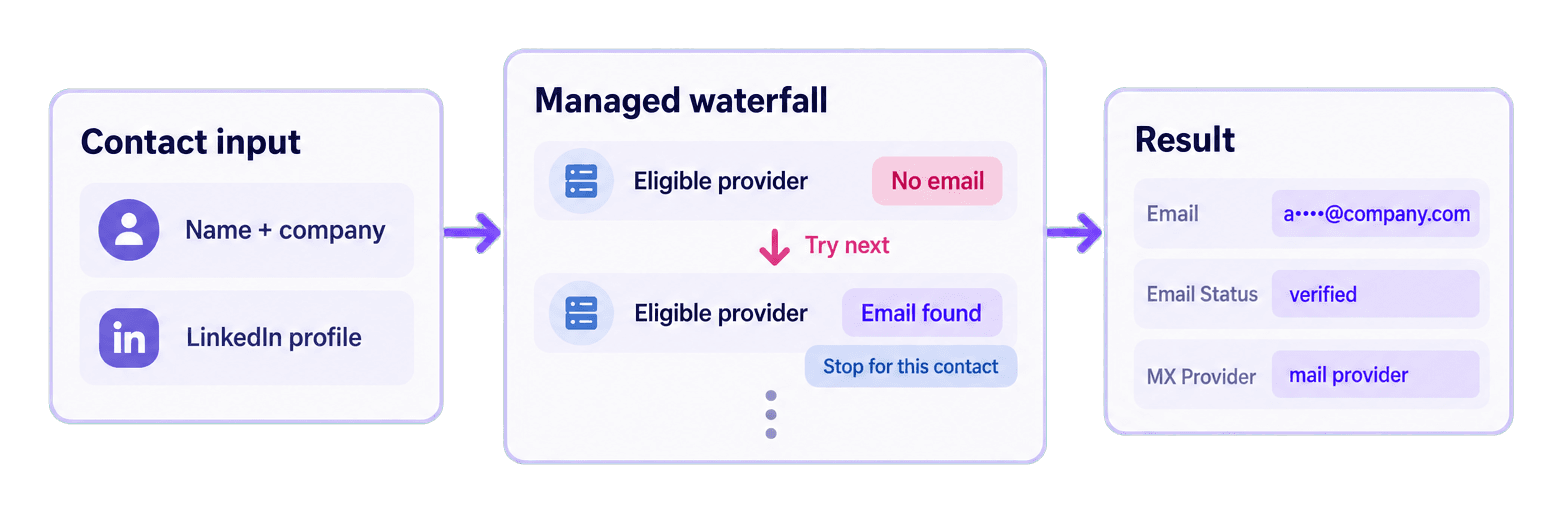
Den administrerede waterfall sender en uløst kontakt til en relevant udbyder. Hvis der ikke kommer en brugbar mailadresse retur, kan en anden relevant udbyder forsøge med den samme kontakt. For den enkelte kontakt stopper rækkefølgen, så snart en arbejdsmail accepteres. Standardsvaret oplyser ikke, hvilken finder der blev brugt.
Derfor styrker en waterfall international outreach
Udbydere af arbejdsmails bruger forskellige datasæt, og deres dækning varierer derfor mellem lande og markeder. Én udbyder finder måske intet resultat for en kontakt i en bestemt region, mens en anden har de nødvendige data til at finde adressen.
For et sales- eller growth-team giver en waterfall hver uløst kontakt endnu en mulighed for at blive fundet, før kontakten udelades fra outreach-listen. Det kan genfinde kontakter, som et workflow med én udbyder ville overse, samtidig med at teamet bevarer en ensartet teknisk proces.
Datablist administrerer rækkefølgen af relevante udbydere bag én API-integration. Du sender kontakten én gang og modtager ét samlet resultatformat i stedet for selv at bygge og vedligeholde en separat integration til hver udbyder og sammenflette svarene.
Læs alle resultaterne
Eksempelopgaven returnerede to vellykkede resultater. Mailadresserne er maskeret nedenfor.
{
  "taskId": "2286103ce43748828e27ce71b9cc526b",
  "results": [
    {
      "inputId": "contact-satya-nadella",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "microsoft",
        "emailFound": "s*******@microsoft.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "contact-reid-hoffman",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "mimecast",
        "emailFound": "r*******@greylock.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
emailFound er den returnerede arbejdsmail. emailStatus beskriver dens leveringsstatus på opslagstidspunktet, og mxProvider identificerer mailhostingudbyderen, når oplysningen er tilgængelig. Begge records er verified, og hver af dem brugte 25 credits.
Kampagnekoden nedenfor placerer verified-resultater i campaign_contacts og andre fundne adresser i needs_verification. Værdien creditsUsed er den autoritative pris for hvert resultat.
Det administrerede standardresultat indeholder ikke finderProvider. Feltet er et betinget output for et gyldigt navn-og-virksomhed-workflow med brugerdefinerede nøgler, så scriptet bør ikke udlede det fra mxProvider.
Klargør fundne mails til kampagnegennemgang
Når det direkte opslag virker, skal du tilføje denne blok nederst i scriptet, efter at lookup_results er returneret. Den bruger det opslag, du allerede har kørt, til at klargøre lokale kontakter til kampagnegennemgang.
results_by_id = {result["inputId"]: result for result in lookup_results}
campaign_contacts = []
needs_verification = []
for person in people:
result = results_by_id.get(person["inputId"])
if result is None:
continue
if result["status"] != "success":
continue
if not result["outputs"].get("emailFound"):
continue
contact = person.copy()
contact["result"] = result
if result["outputs"].get("emailStatus") == "verified":
campaign_contacts.append(contact)
else:
needs_verification.append(contact)
print(json.dumps({
"campaign_contacts": campaign_contacts,
"needs_verification": needs_verification,
}, indent=2))results_by_id gør rækkefølgen i svaret irrelevant. For Satya læser løkken contact-satya-nadella fra den oprindelige people-liste, finder resultatet med samme inputId, kopierer kilderecorden og vedhæfter hele API-objektet under result. Fordi adressen findes, og dens status er verified, placeres kontakten i campaign_contacts. Reid følger samme forløb, selv hvis hans API-resultat ankommer først.
De tre betingelser gør beslutningslogikken nem at forstå. Den første springer en kontakt over, hvis der ikke blev returneret et matchende resultat. Den anden springer fejl på rækkeniveau og andre statusser end success over. Den tredje kræver en faktisk emailFound-værdi. Ved at vedhæfte hele result-objektet bevarer du status, outputs, creditforbrug og fejlfelt til senere gennemgang.
En fundet mail med en anden leveringsstatus placeres i needs_verification. Et manglende resultat, en fejl på rækkeniveau eller et resultat uden emailFound kommer ikke med på nogen af de to klargjorte lister. Den oprindelige people-liste forbliver tilgængelig til rettelser eller senere research.
Beregn prisen på Waterfall Email Finder API
Den administrerede standard-waterfall bruger 25 credits for hver fundet arbejdsmail. Et mislykket standardopslag bruger 0 credits. Læs creditsUsed fra hvert resultat i stedet for at gange det samlede antal indsendte kontakter.
En fundet mail med statussen unverified bruger stadig 25 credits, selvom den lokale kampagnekode placerer den i needs_verification frem for campaign_contacts.
De to fundne mails i eksemplet brugte 50 credits. Til budgetplanlægning:
- 100 fundne arbejdsmails bruger 2.500 credits.
- 1.000 fundne arbejdsmails bruger 25.000 credits.
- En større inputliste kan bruge færre credits end
kontakter × 25, fordi opslag uden resultater ikke koster credits.
Adgang til REST API kræver Growth-abonnementet. Med den aktuelle top-up-pris i USD giver $20 dig 20.000 credits, hvilket svarer til $0,001 pr. credit. Ved den pris har 25.000 credits en værdi på $25. Abonnementet afregnes separat fra denne creditberegning. Se Datablists prisside for aktuelle oplysninger om abonnementer og pakker.
Løs typiske fejl og gendan en opgave
API-nøglen mangler. Scriptet udløser Set DATABLIST_API_KEY before running this script., før det foretager en request. Eksportér variablen i den aktuelle terminal, og kør filen igen.
API'et returnerer en godkendelsesfejl. raise_for_status() rapporterer HTTP-fejlen. Kopiér en aktuel Personal API Key, kontrollér, at headeren X-API-Key bruger den, og kør først scriptet igen, når loginoplysningerne er rettet.
Kontoen har ikke nok credits. Kontrollér saldoen på kontoen. Tilføj credits, eller vent på abonnementets næste tildeling, før du sender flere opgaver.
Inputfelterne matcher ikke den valgte metode. Brug separate navnefelter eller fullName med name_company, eller brug linkedInProfile med linkedin. Ret kontakten, og send den med én konsekvent metode.
Opgaven har statussen failed eller stopped. Scriptet udløser en RuntimeError, der indeholder opgave-ID'et, slutstatussen og en eventuel opgavefejl. Gennemgå opgaven og alle tilgængelige resultater, før du beslutter, hvilke kontakter der stadig kræver et opslag.
POST-svaret gik tabt. Kopiér det uniqueId, der blev udskrevet, før opgaven blev sendt. Hent en liste over dine opgaver med den samme nøgle:
curl "https://api.datablist.com/v1/enrichments/tasks" \
-H "X-API-Key: $DATABLIST_API_KEY"Find opgaven med det udskrevne uniqueId, kopiér dens @id, og fortsæt derefter med URL'en til opgavestatus eller resultater. På den måde kan du gendanne den eksisterende opgave frem for automatisk at sende kontakterne igen. Dokumentationen til task API beskriver opgavens livscyklus og resultatslutpunkter.
Næste skridt
Du har nu én blokerende Python Requests-funktion til de tre understøttede inputmetoder og et lokalt filter, der klargør fundne, verificerede mails til kampagnegennemgang.
Erstat de to eksempelkontakter med et lille udsnit af dine researchede kontakter. Vælg den inputmetode, der matcher dine data, kør opslaget, og gennemgå emailStatus, før du bruger en adresse. Til et workflow med større lister kan du læse, hvordan du finder mails i stor skala. Det vedligeholdte GitHub-repository indeholder de blokerende og asynkrone Python-eksempler, som kan downloades.