
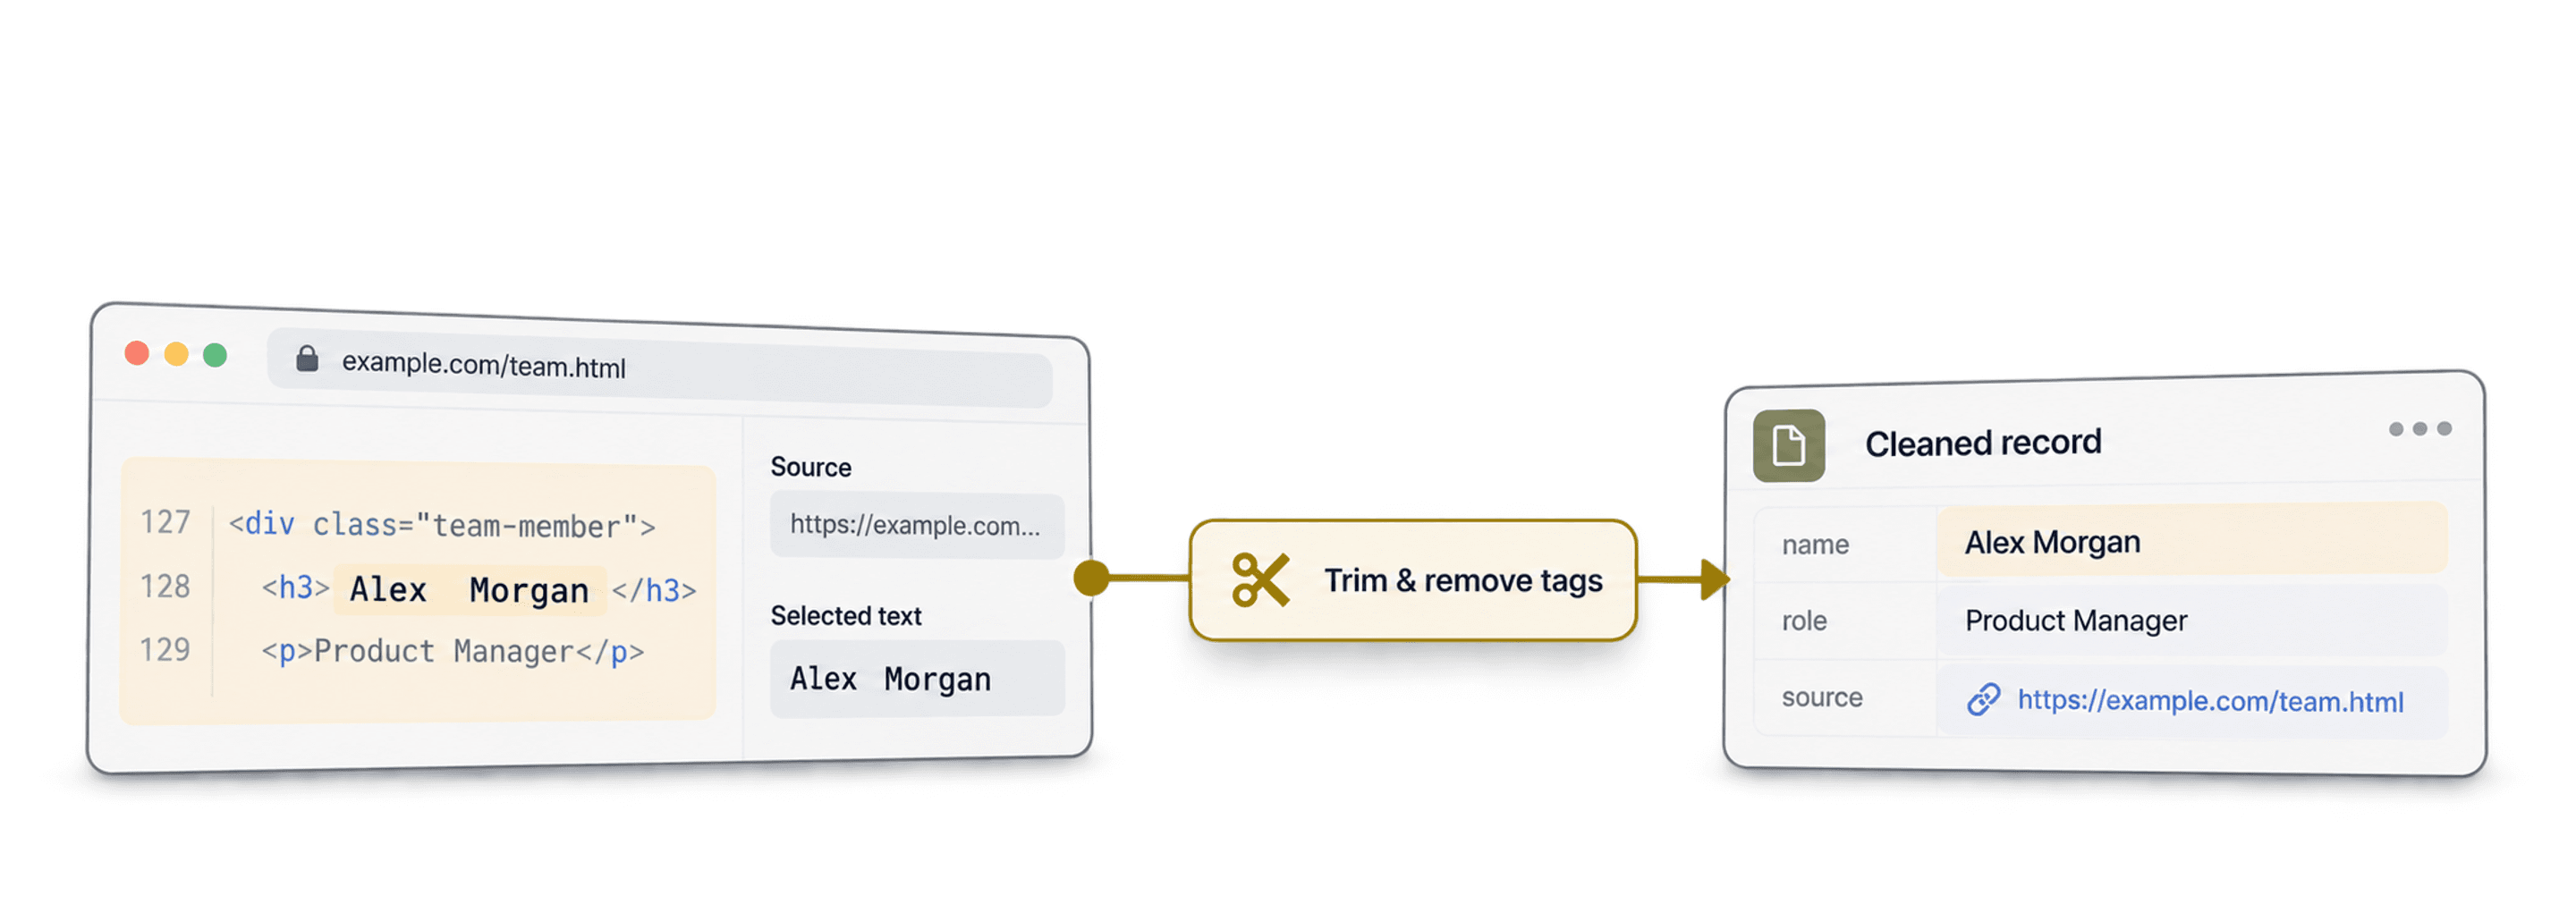
Per pulire i dati di web scraping, conserva prima di tutto i valori grezzi, normalizza i campi che utilizzerai, controlla i record duplicati e verifica i dati di contatto prima dell'esportazione.
Parto sempre da una copia separata del file sorgente, perché un valore apparentemente più pulito può aver perso informazioni. La query di un URL può identificare una variante di prodotto, mentre uno zero iniziale può far parte di un ID account. Conserva quindi l'URL sorgente e il testo originale insieme ai campi ripuliti.
Per una lista di contatti ottenuta tramite scraping, segui questo ordine:
- Importa i dati e controlla i tipi di colonna suggeriti. Mantieni gli identificativi come Text.
- Rimuovi HTML e spazi superflui dai testi descrittivi, quindi standardizza solo i campi necessari per filtrare o trovare corrispondenze.
- Converti date e quantità dopo averne verificato il formato.
- Individua i duplicati usando un identificativo affidabile, come l'email, quindi decidi quali valori conservare.
- Controlla la sintassi delle email e le informazioni sul dominio, esamina le eccezioni ed esporta la lista pulita.
Gli strumenti descritti qui sotto permettono di completare ogni passaggio in Datablist senza formule. Gli esempi mostrano quali valori controllare prima di applicare una trasformazione all'intera collection.
Ecco un riepilogo delle operazioni di pulizia illustrate nell'articolo:
- Convertire il testo in Datetime, Number e Boolean
- Convertire HTML in testo, rimuovendo i tag
- Rimuovere gli spazi superflui dai testi
- Normalizzare i dati
- Rimuovere i simboli dai testi
- Dividere il nome completo in nome e cognome
- Eliminare i record duplicati
- Verificare gli indirizzi email
- Estrarre nomi di persone o aziende dai testi
Importare dati da CSV o con copia e incolla
Datablist è uno strumento ideale per pulire i dati. È un editor CSV online con funzionalità di pulizia, modifica in blocco e arricchimento. E può gestire milioni di elementi in ogni collection.
Apri Datablist, crea una collection e carica il file CSV contenente i dati estratti.
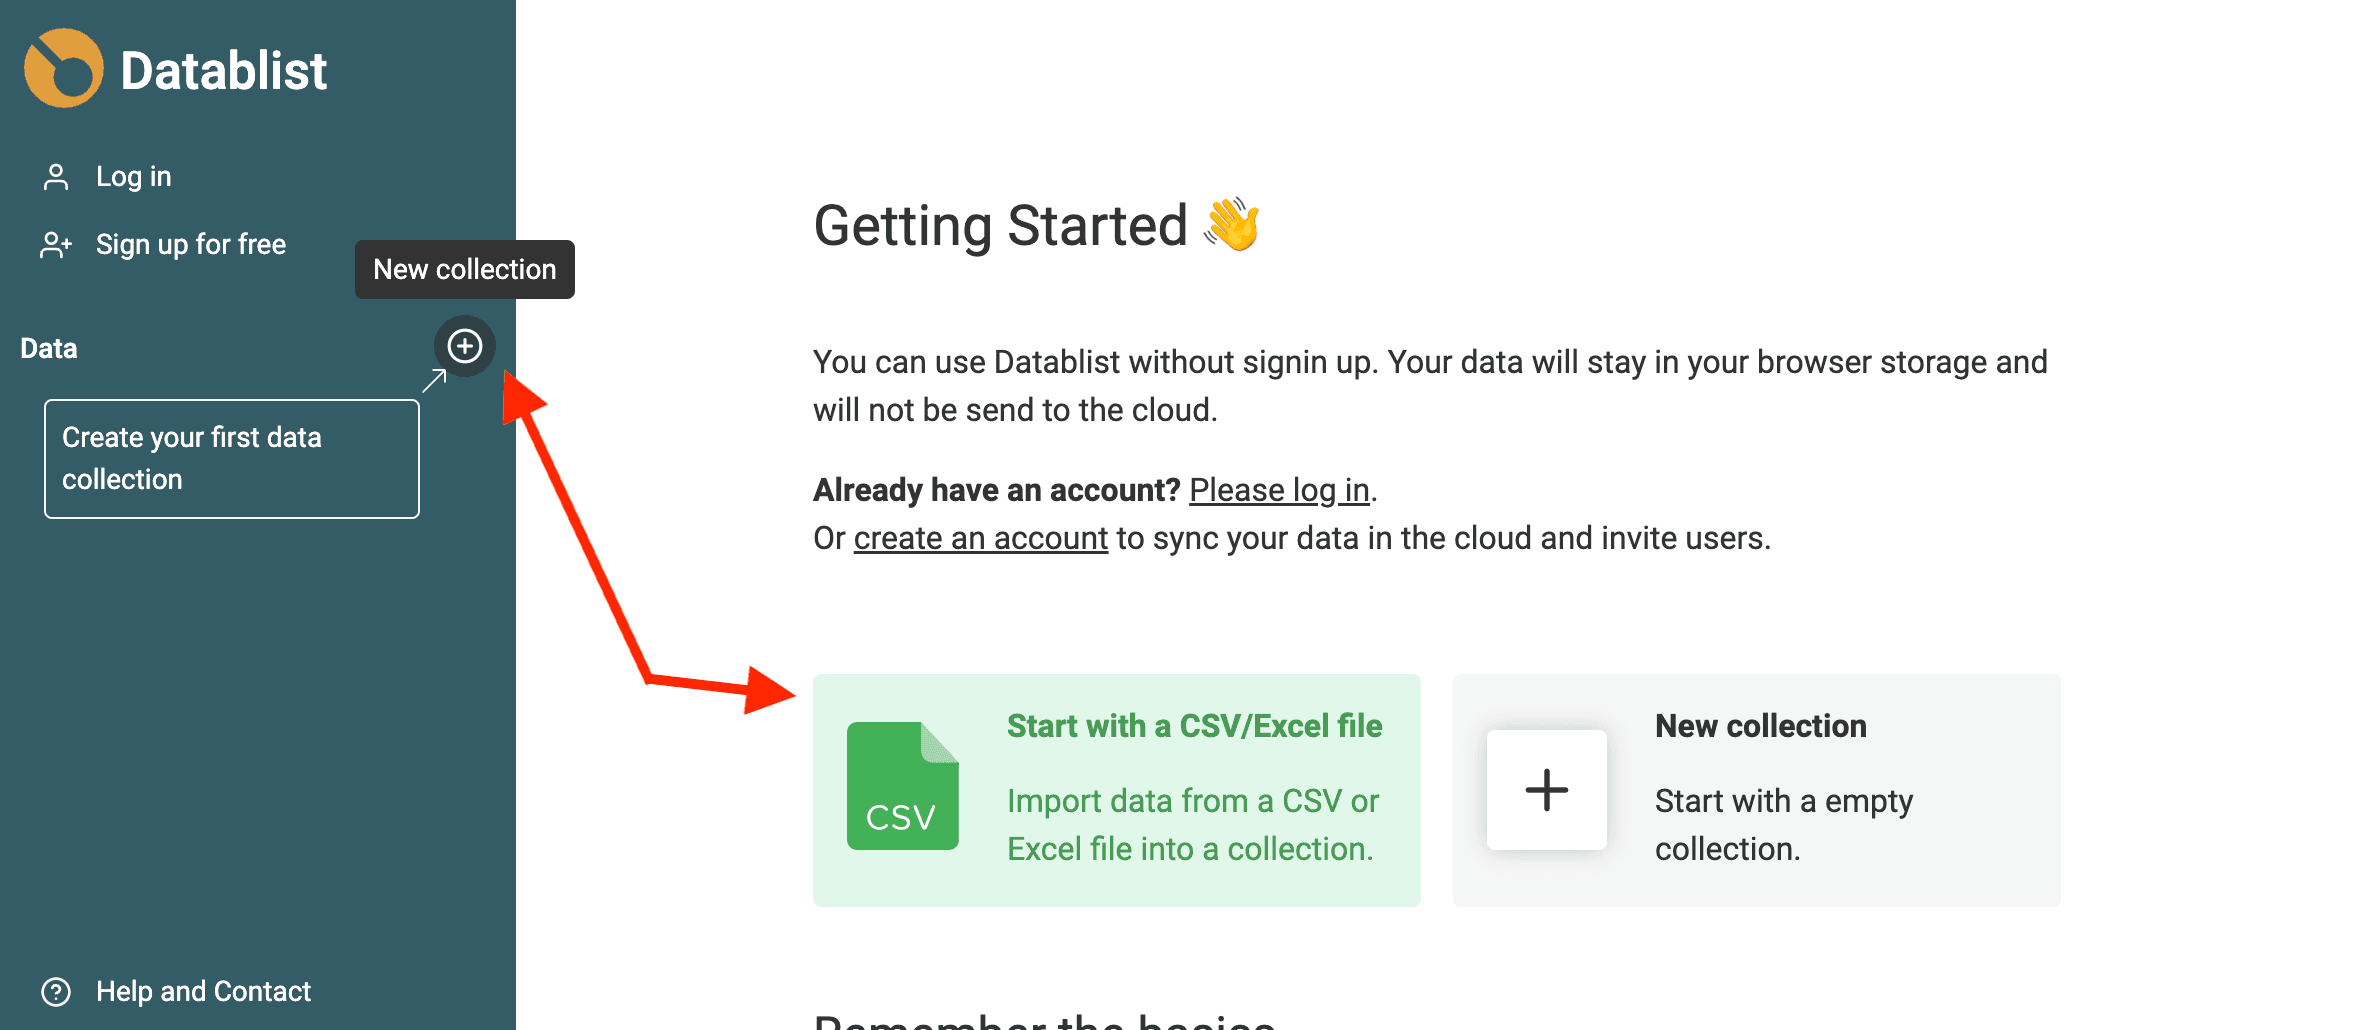
Per creare una nuova collection, fai clic sul pulsante + nella barra laterale. Quindi seleziona "Import CSV/Excel" per caricare il file. In alternativa, usa la scorciatoia nella pagina introduttiva per passare direttamente all'importazione.
Rilevamento automatico del formato
L'assistente di importazione di Datablist riconosce automaticamente indirizzi email, Datetime in formato ISO 8601, Boolean, Number, URL e altro ancora, purché siano formattati correttamente.
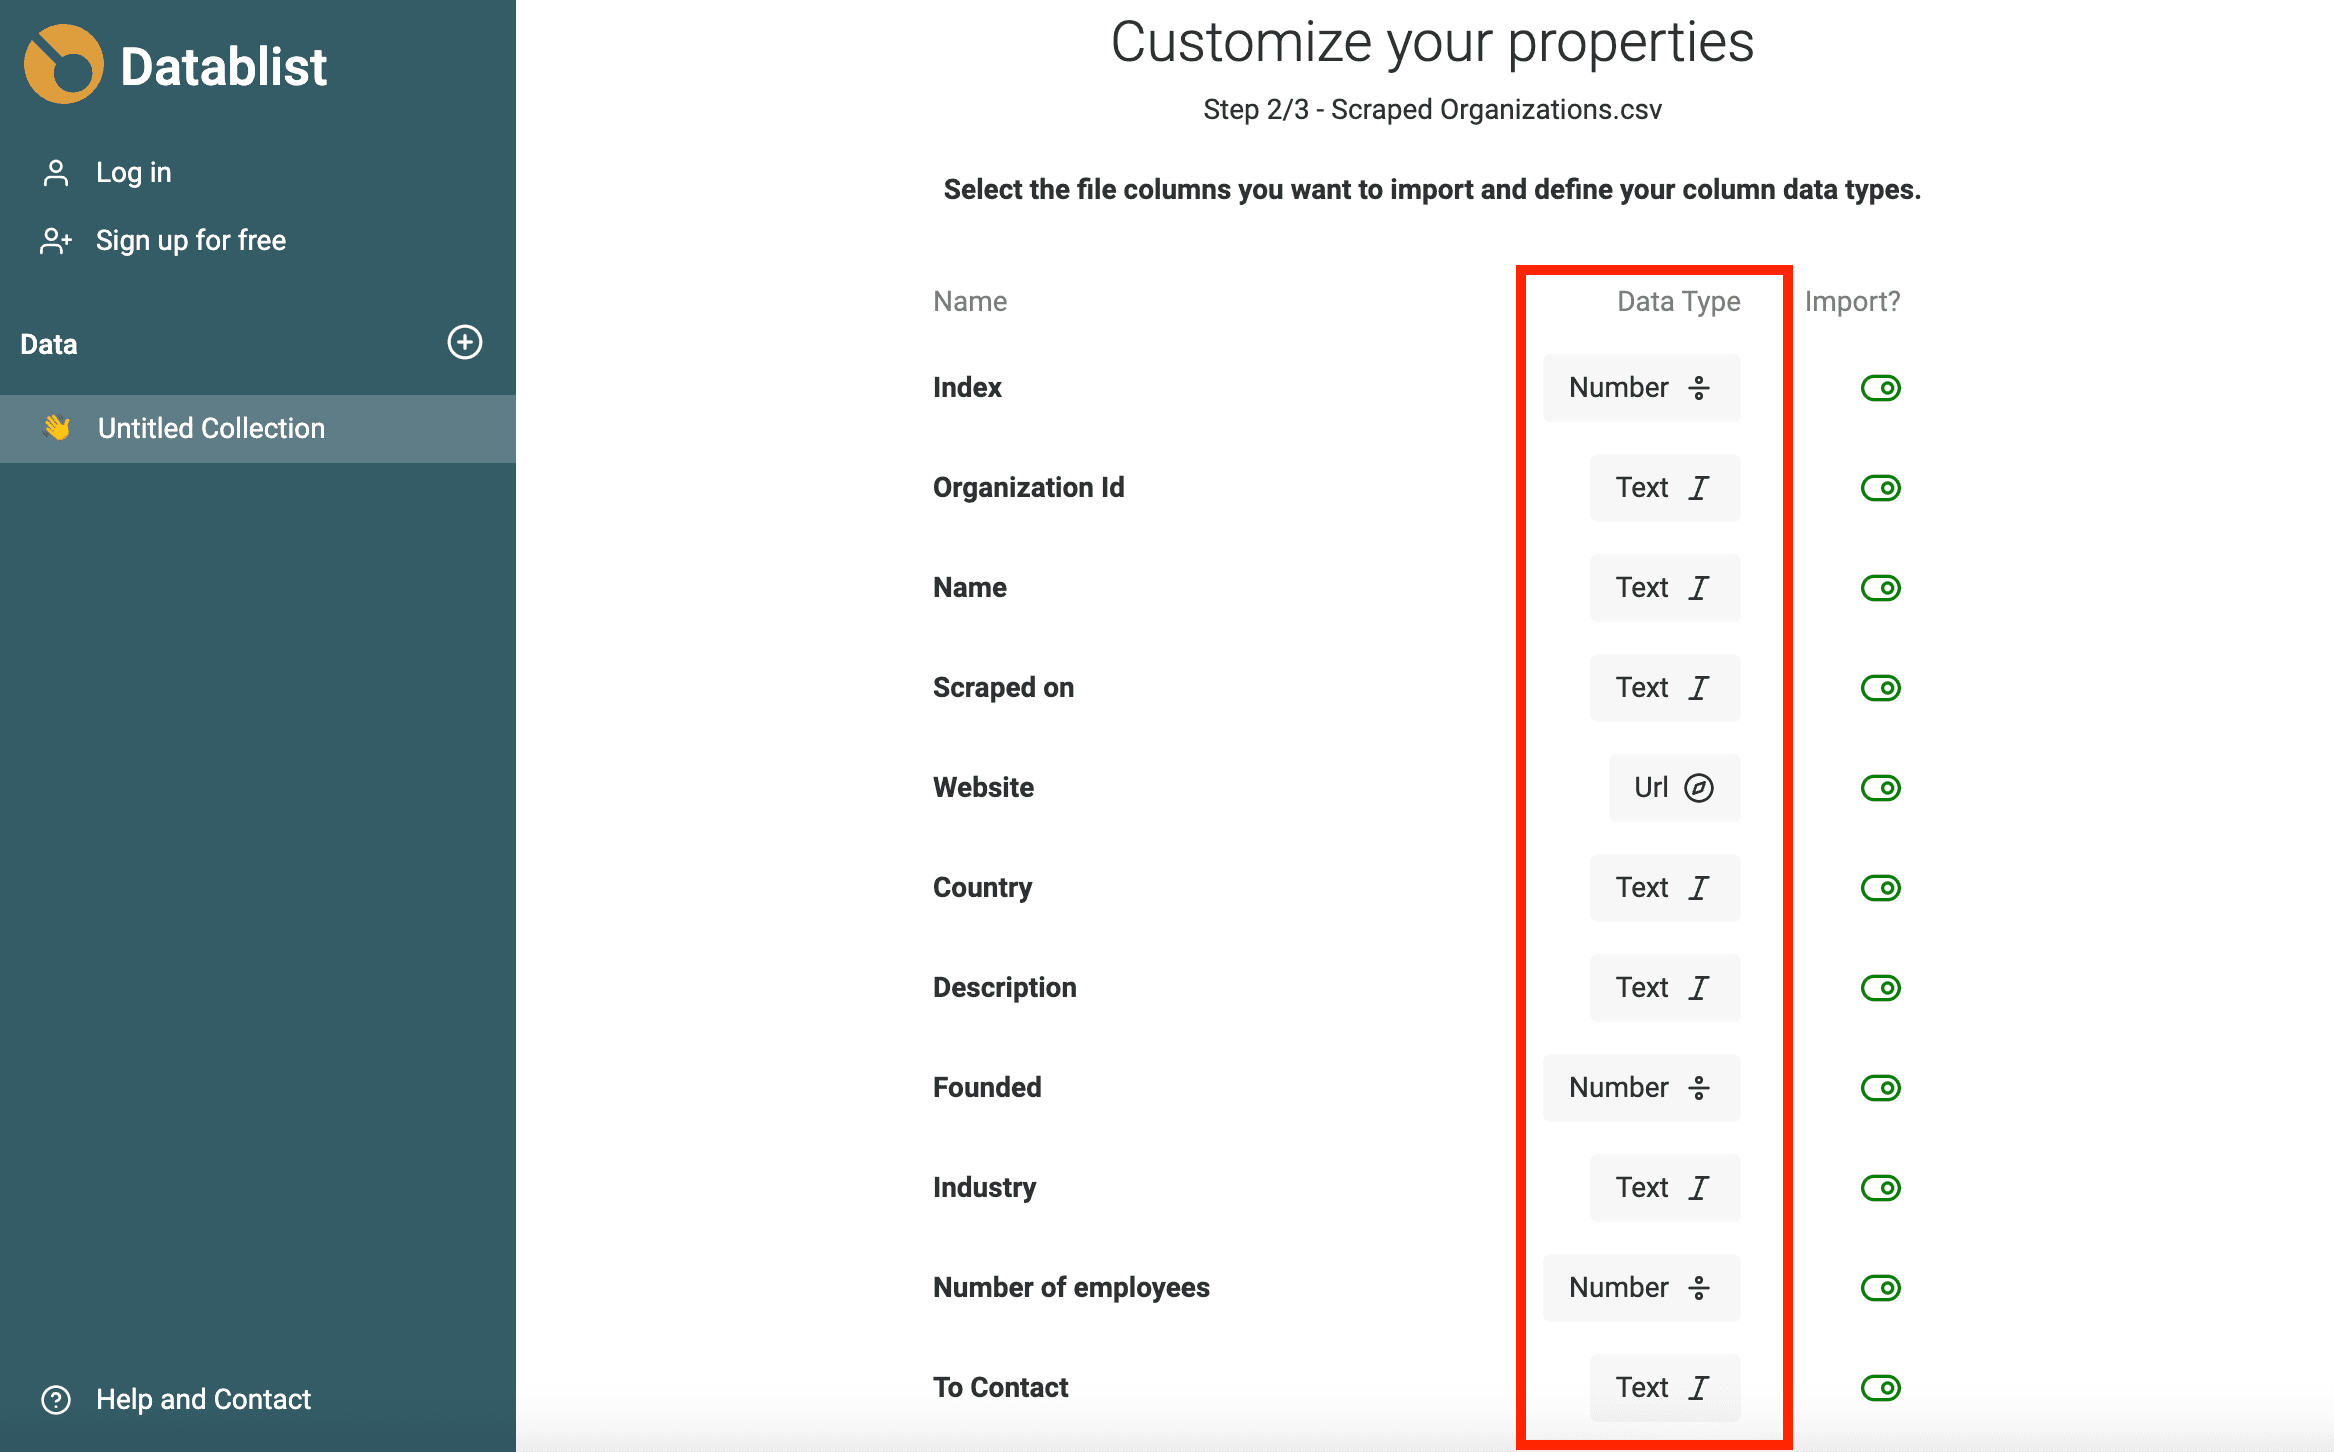
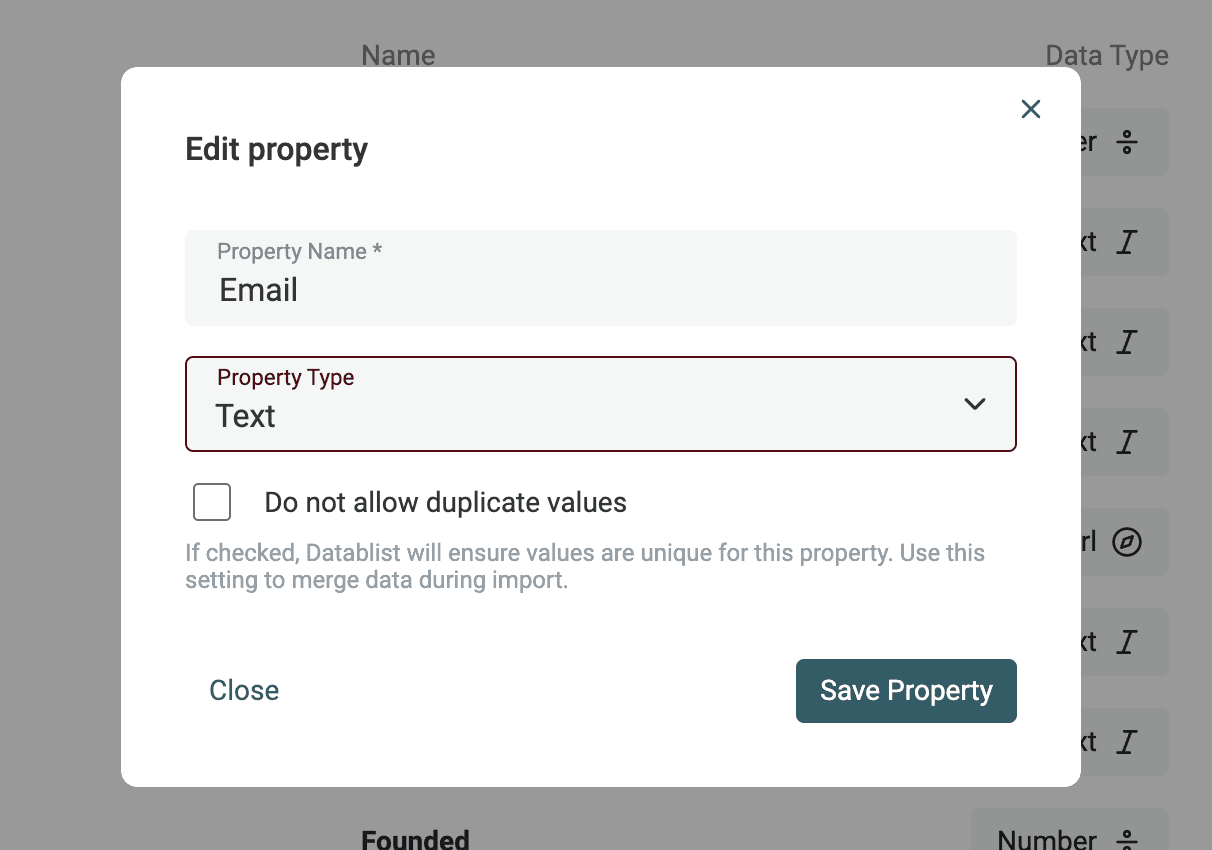
Se i dati richiedono un'analisi più complessa, per esempio a causa di formati data diversi o errori negli URL o nelle email, importali come proprietà Text. Nella prossima sezione vedremo come convertire le proprietà Text in Datetime, Boolean o Number.
Convertire testo in Datetime, Boolean e Number
Marie Kondo dice: "La vita comincia davvero dopo aver messo ordine in casa". Lo stesso vale per i dati estratti: "Le vendite cominciano davvero dopo aver messo ordine nei dati"! 😅
Filtrare una data (data di creazione, data di finanziamento e così via), un numero (prezzo, numero di dipendenti) o un booleano è molto più semplice quando questi valori sono oggetti nativi e non semplice testo.
Apri lo strumento "Text to Datetime, Number, Checkbox" dal menu "Clean".
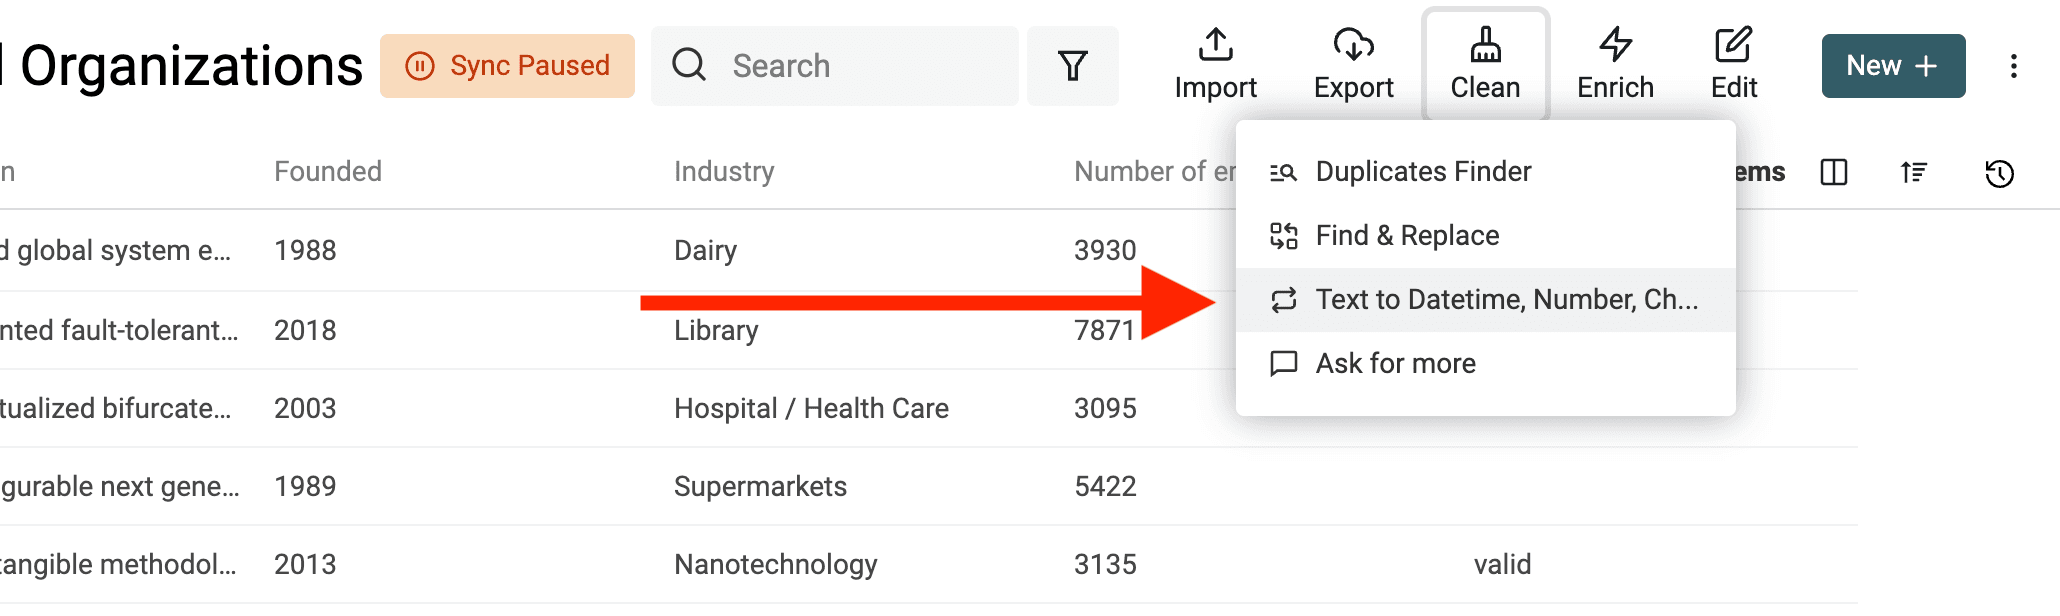
Convertire qualsiasi testo nel formato Datetime
Datetime utilizza il formato internazionale ISO 8601, basato su una struttura definita. Se i dati adottano questo formato, durante l'importazione verrà creata automaticamente una proprietà Datetime in cui memorizzarli.
Per valori Date e Datetime in altri formati, devi indicare il formato utilizzato affinché Datablist possa convertirli in valori Datetime strutturati.
Seleziona la proprietà da convertire, quindi "Convert to Datetime".
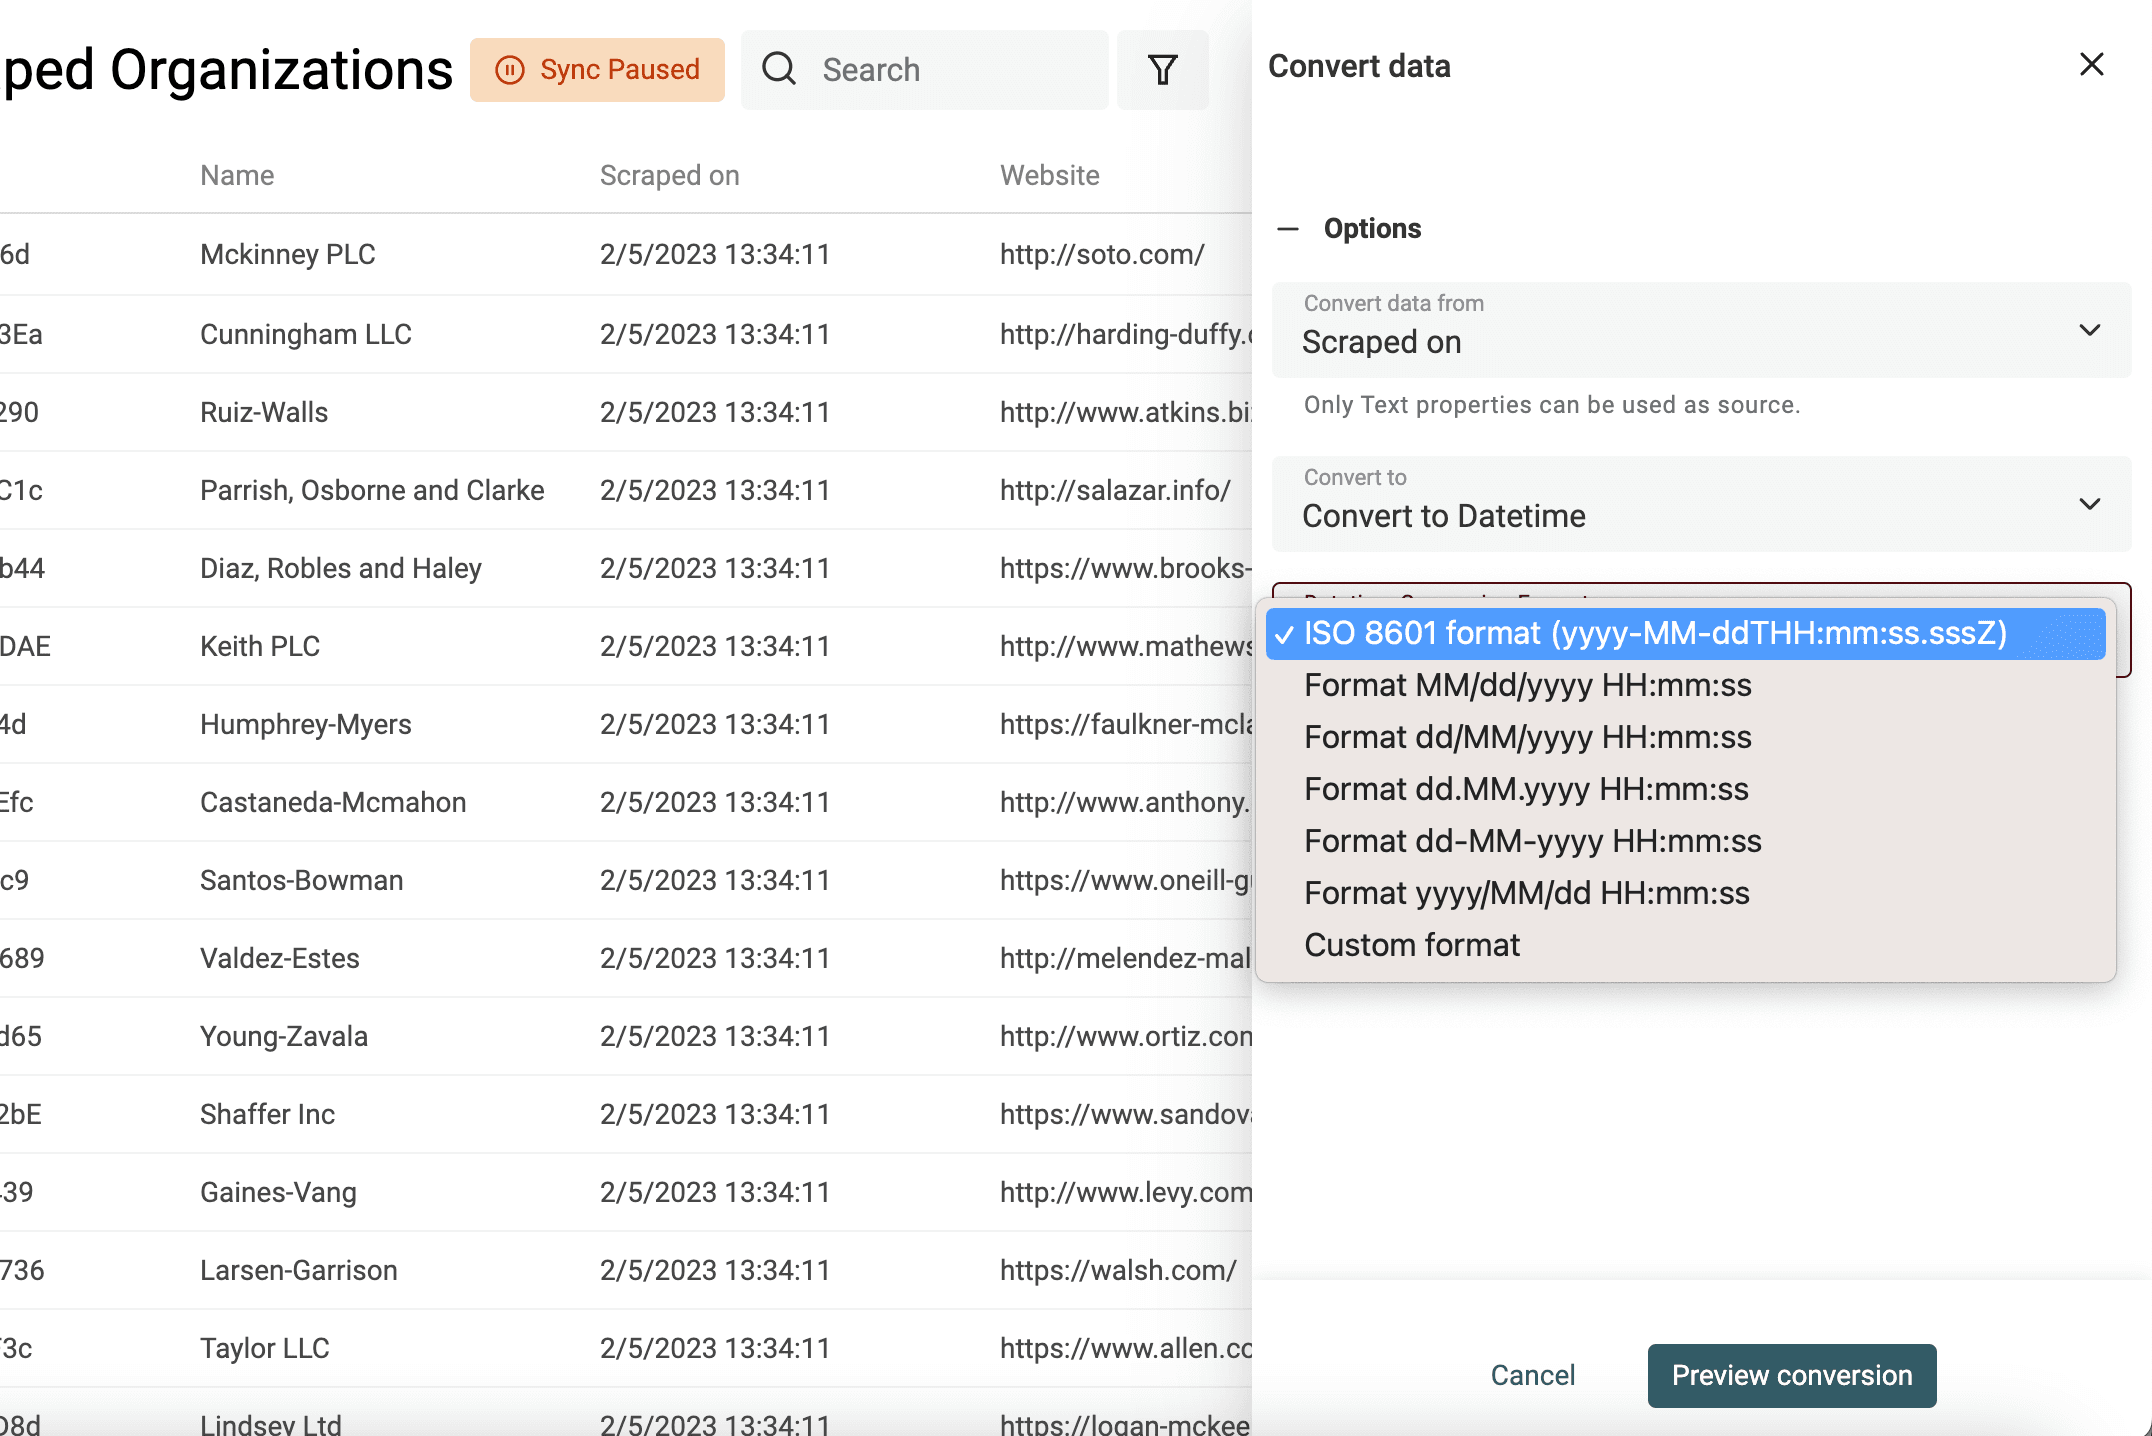
Sono disponibili i formati più comuni, inclusi quelli usati da Google Sheets ed Excel. Puoi anche selezionare "Custom format" per definire un formato personalizzato.
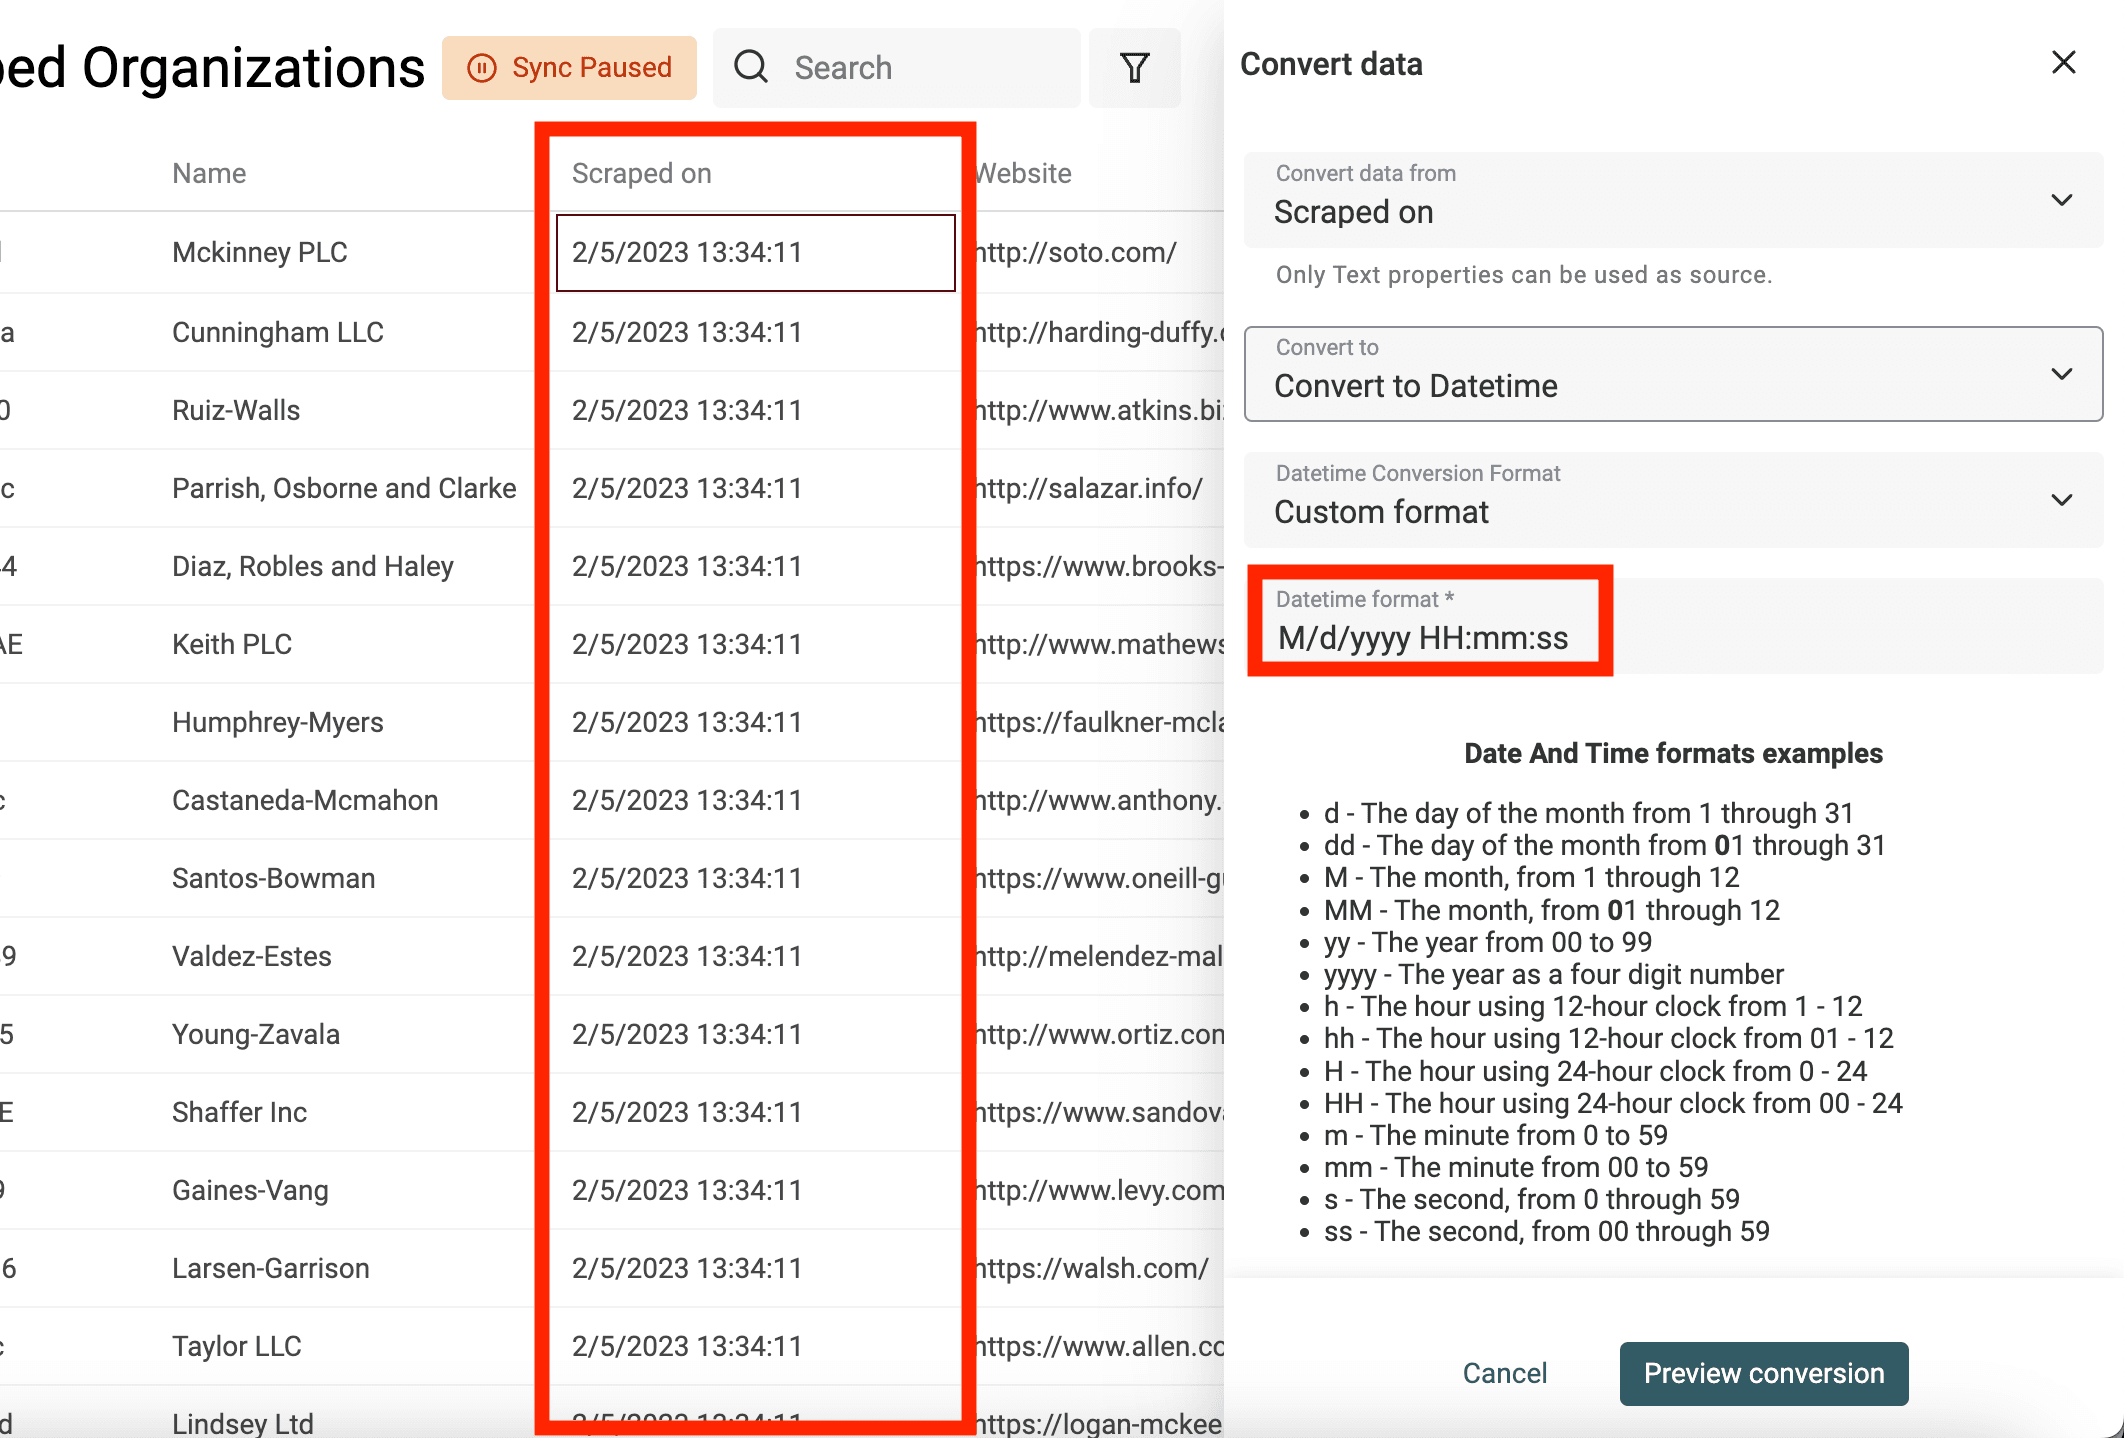
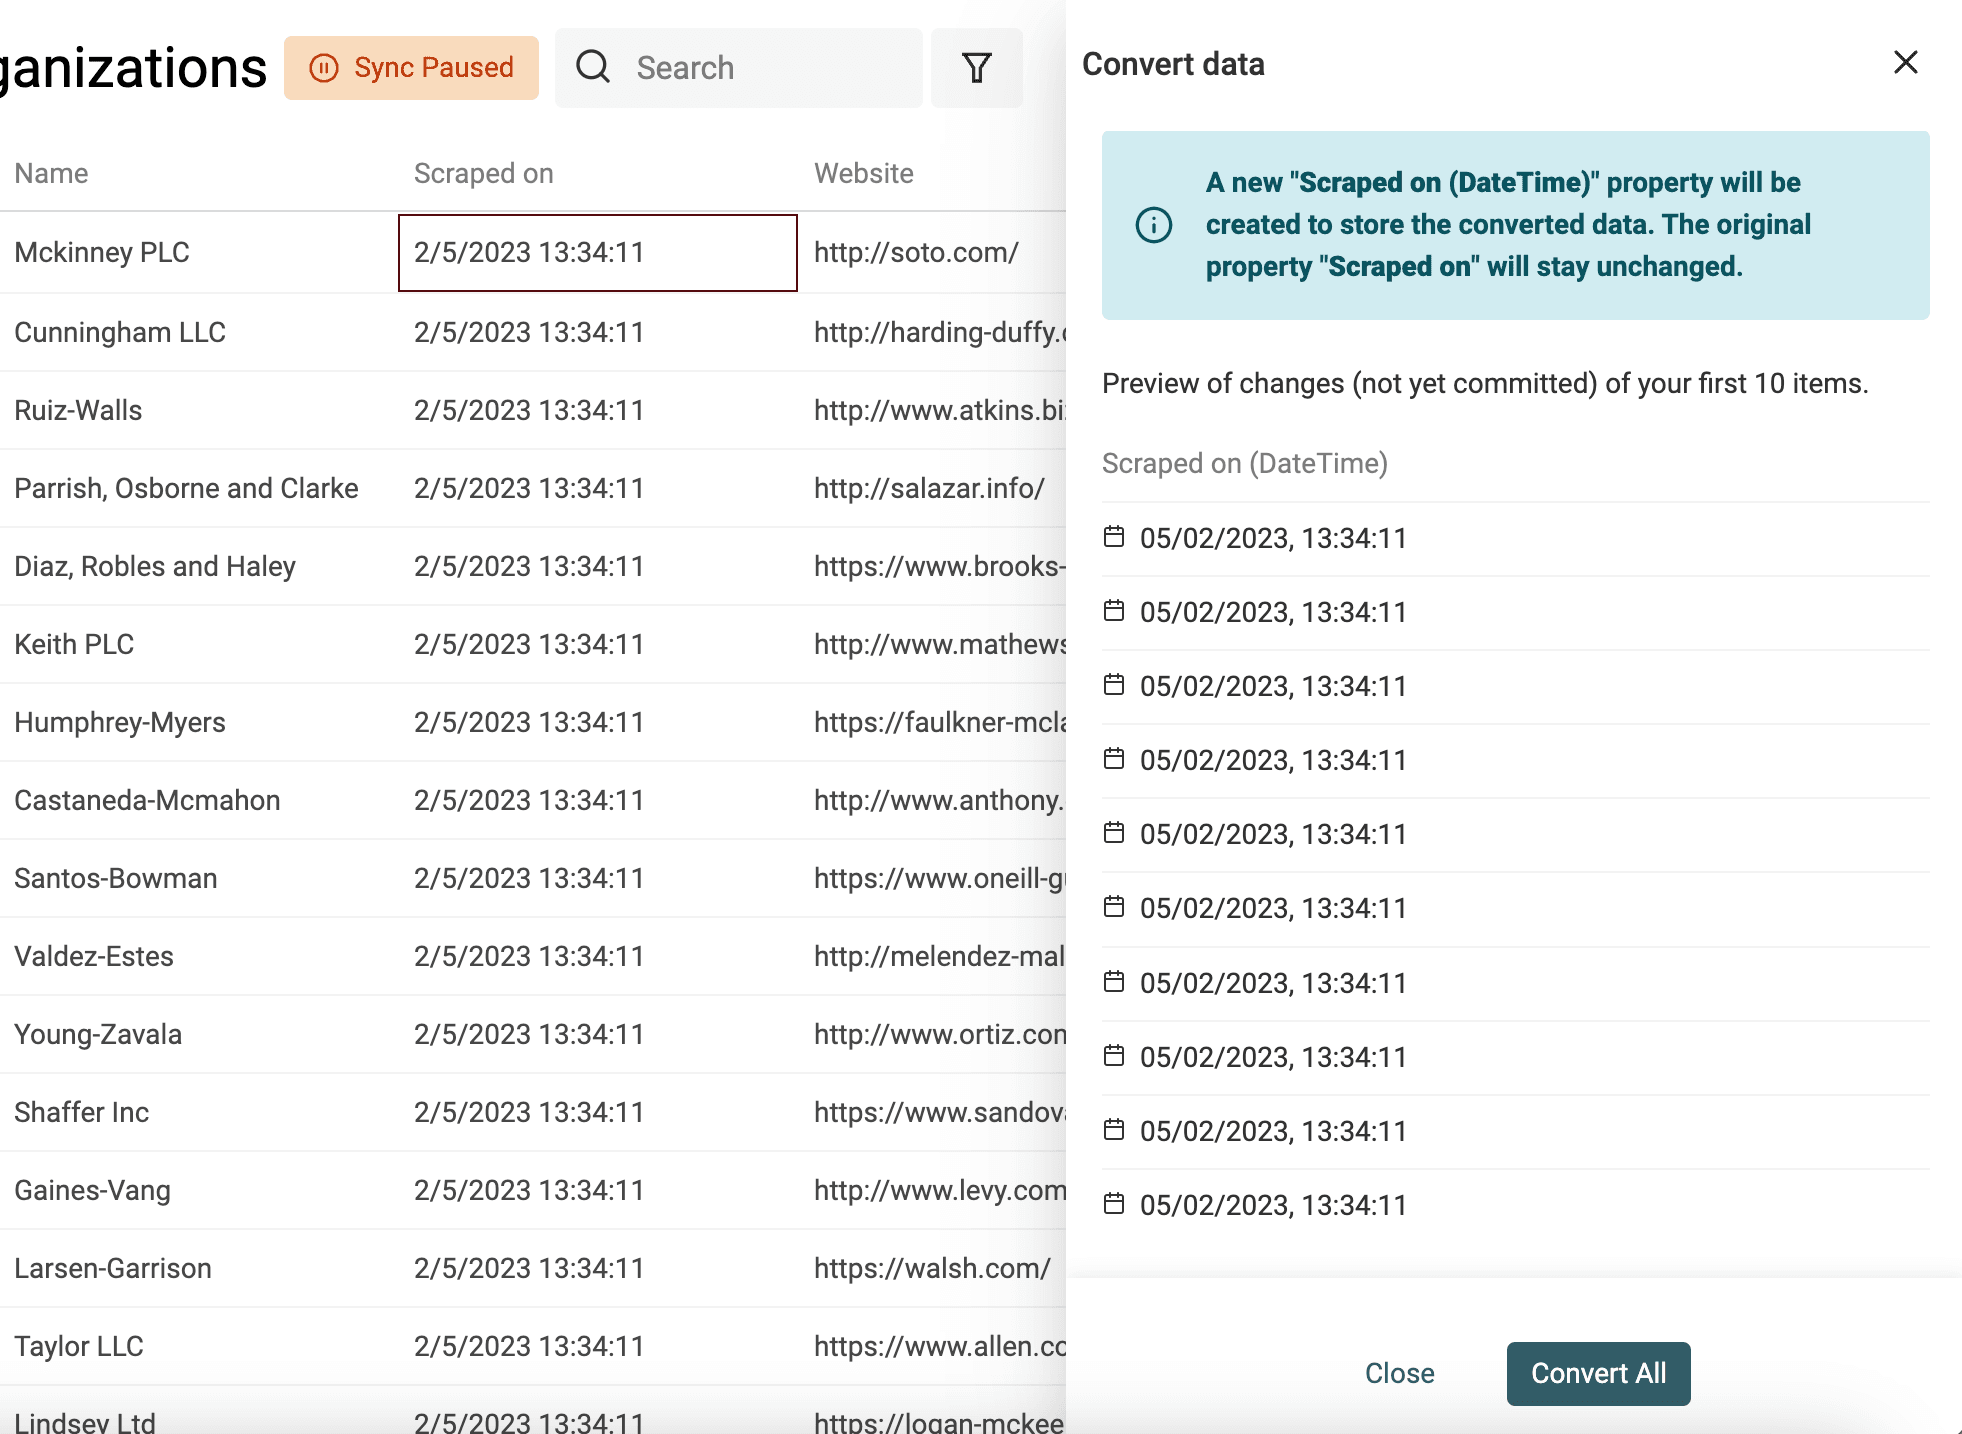
👉 Per saperne di più sui formati Datetime personalizzati, consulta la nostra documentazione. Apri la guida
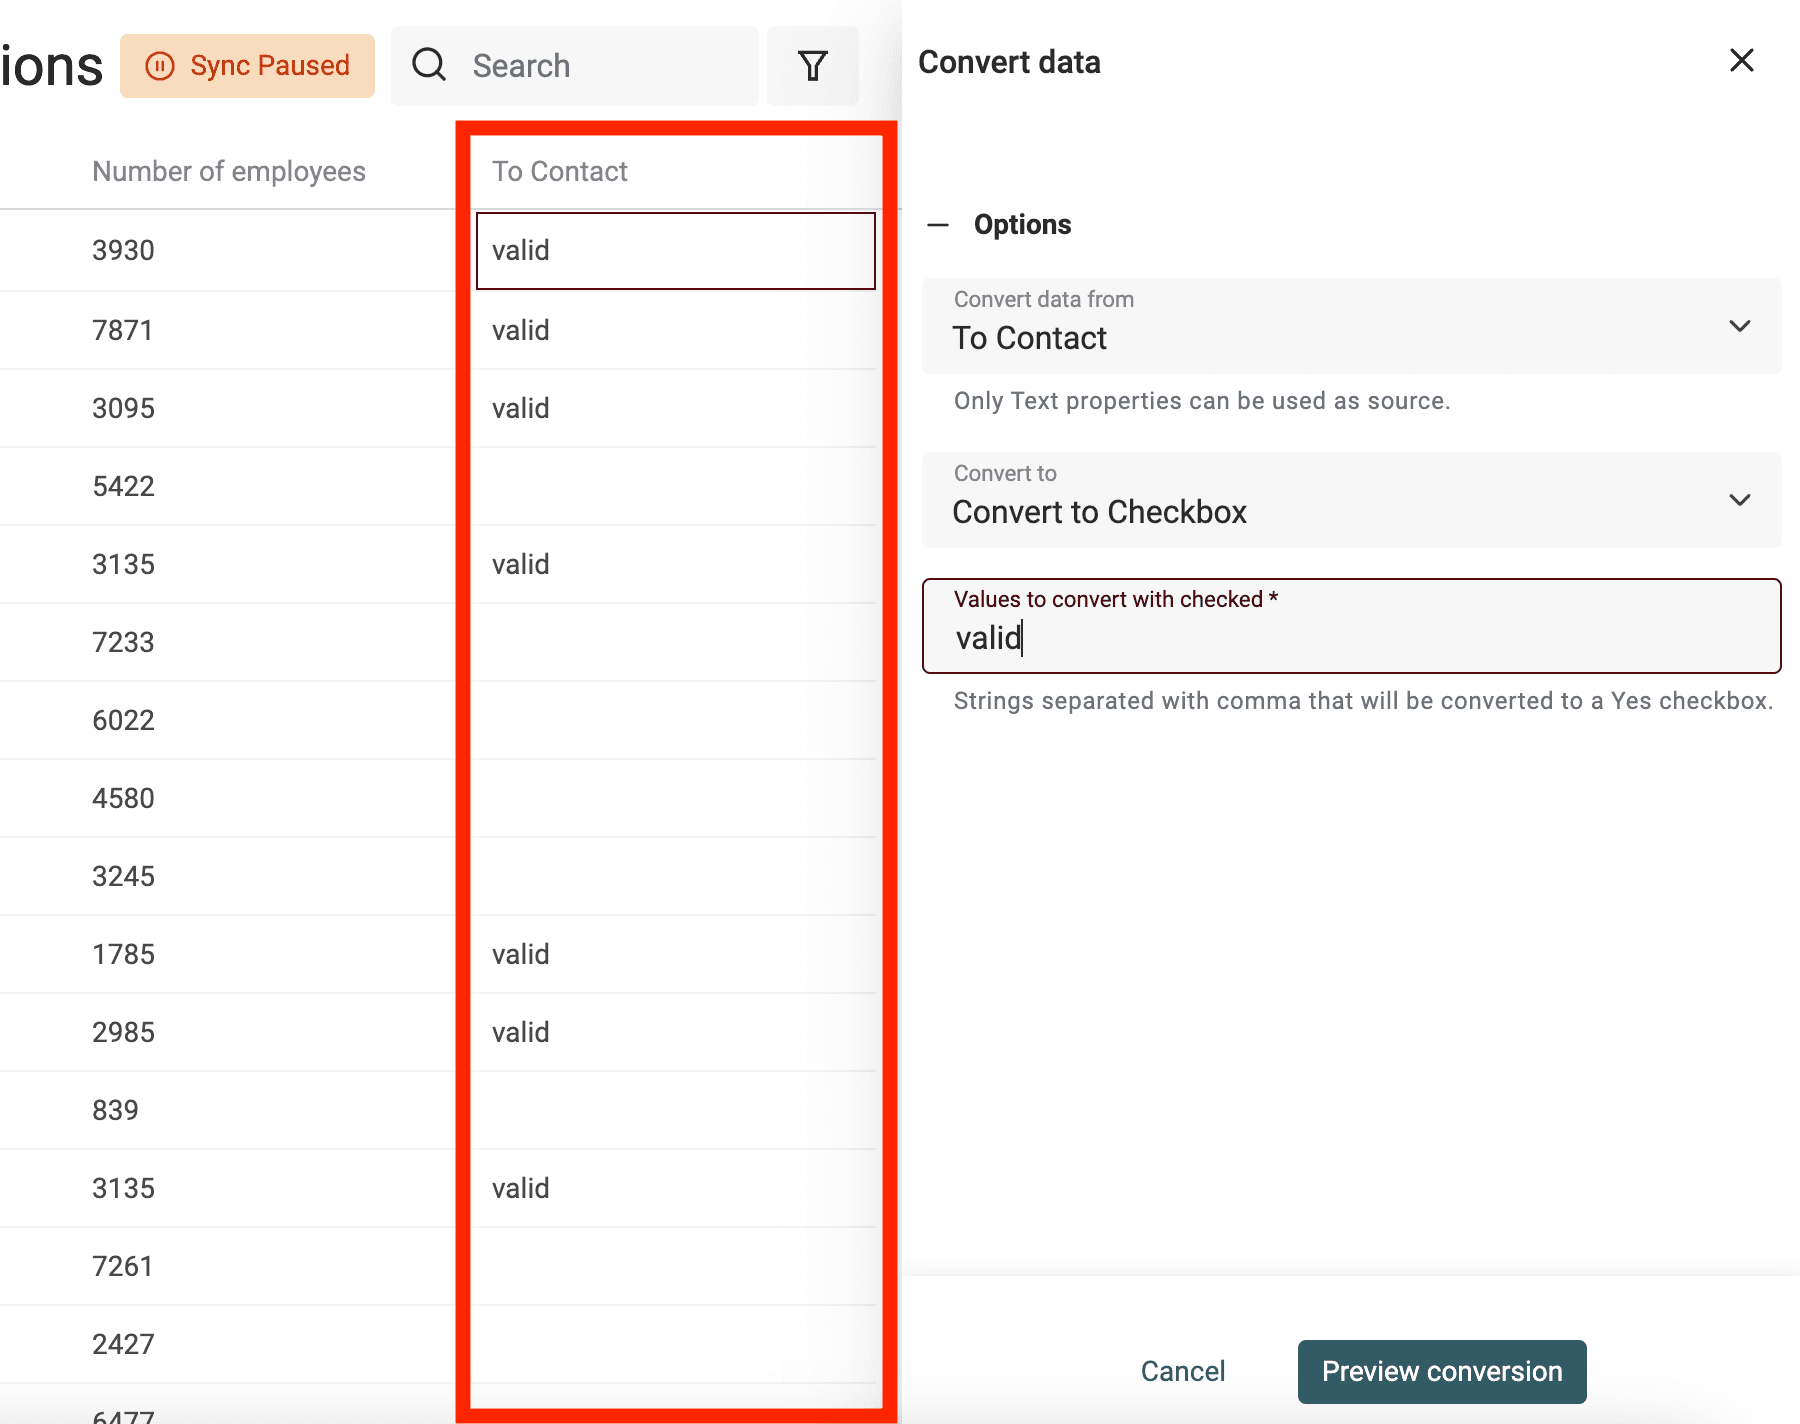
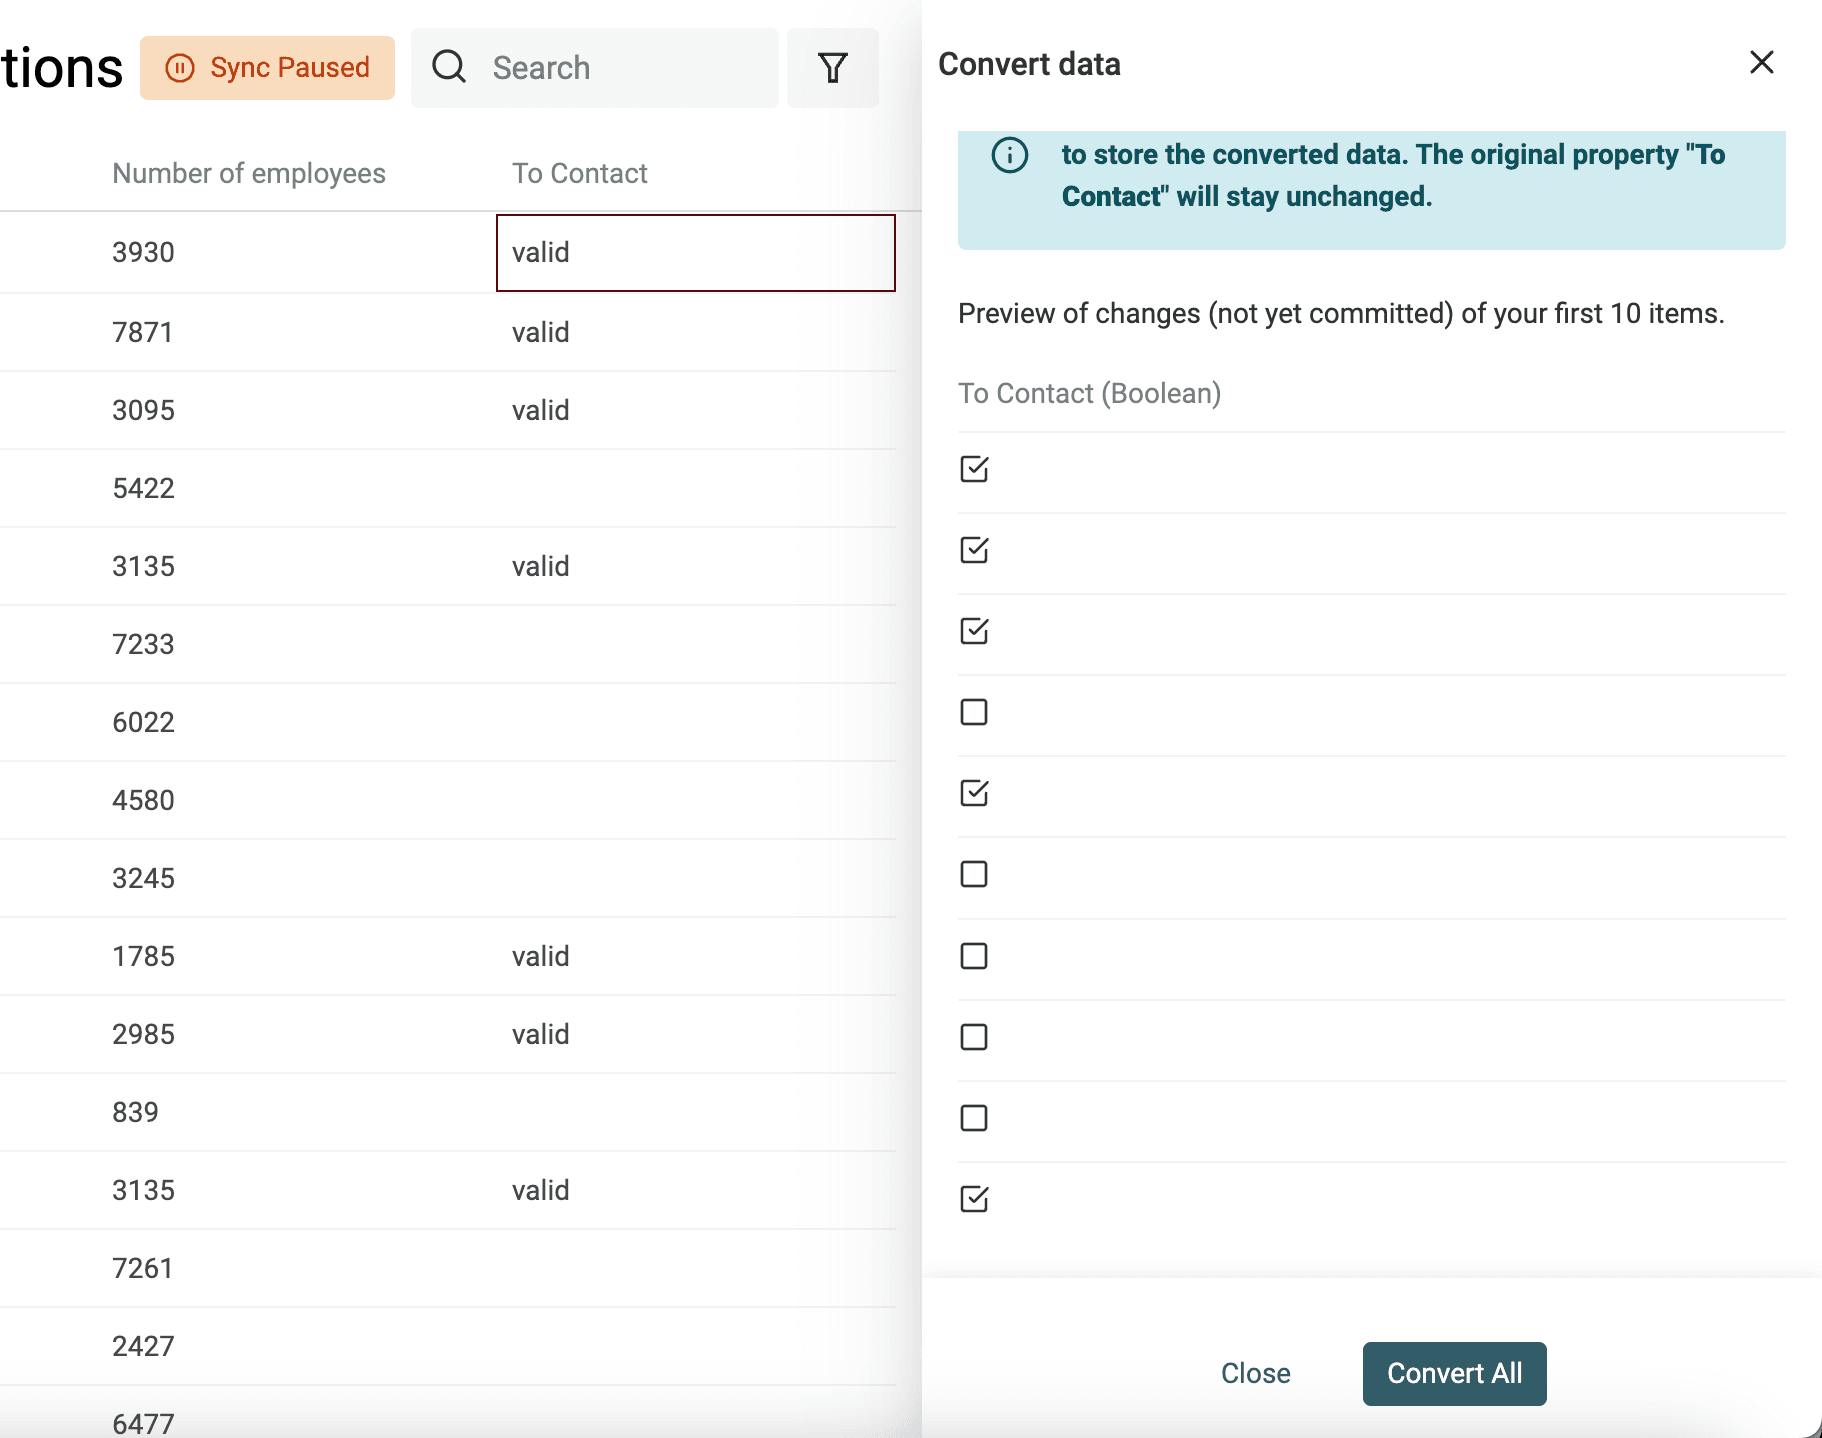
Creare Checkbox (Boolean) dai valori testuali
Durante l'importazione, Datablist converte automaticamente le colonne contenenti valori come "Yes, No" o "TRUE, FALSE" in proprietà Checkbox. Per conversioni più complesse, utilizza il convertitore.
Definisci i valori, separati da virgole, che devono generare una casella selezionata. Tutti gli altri produrranno una casella non selezionata.
Estrarre valori numerici dai testi
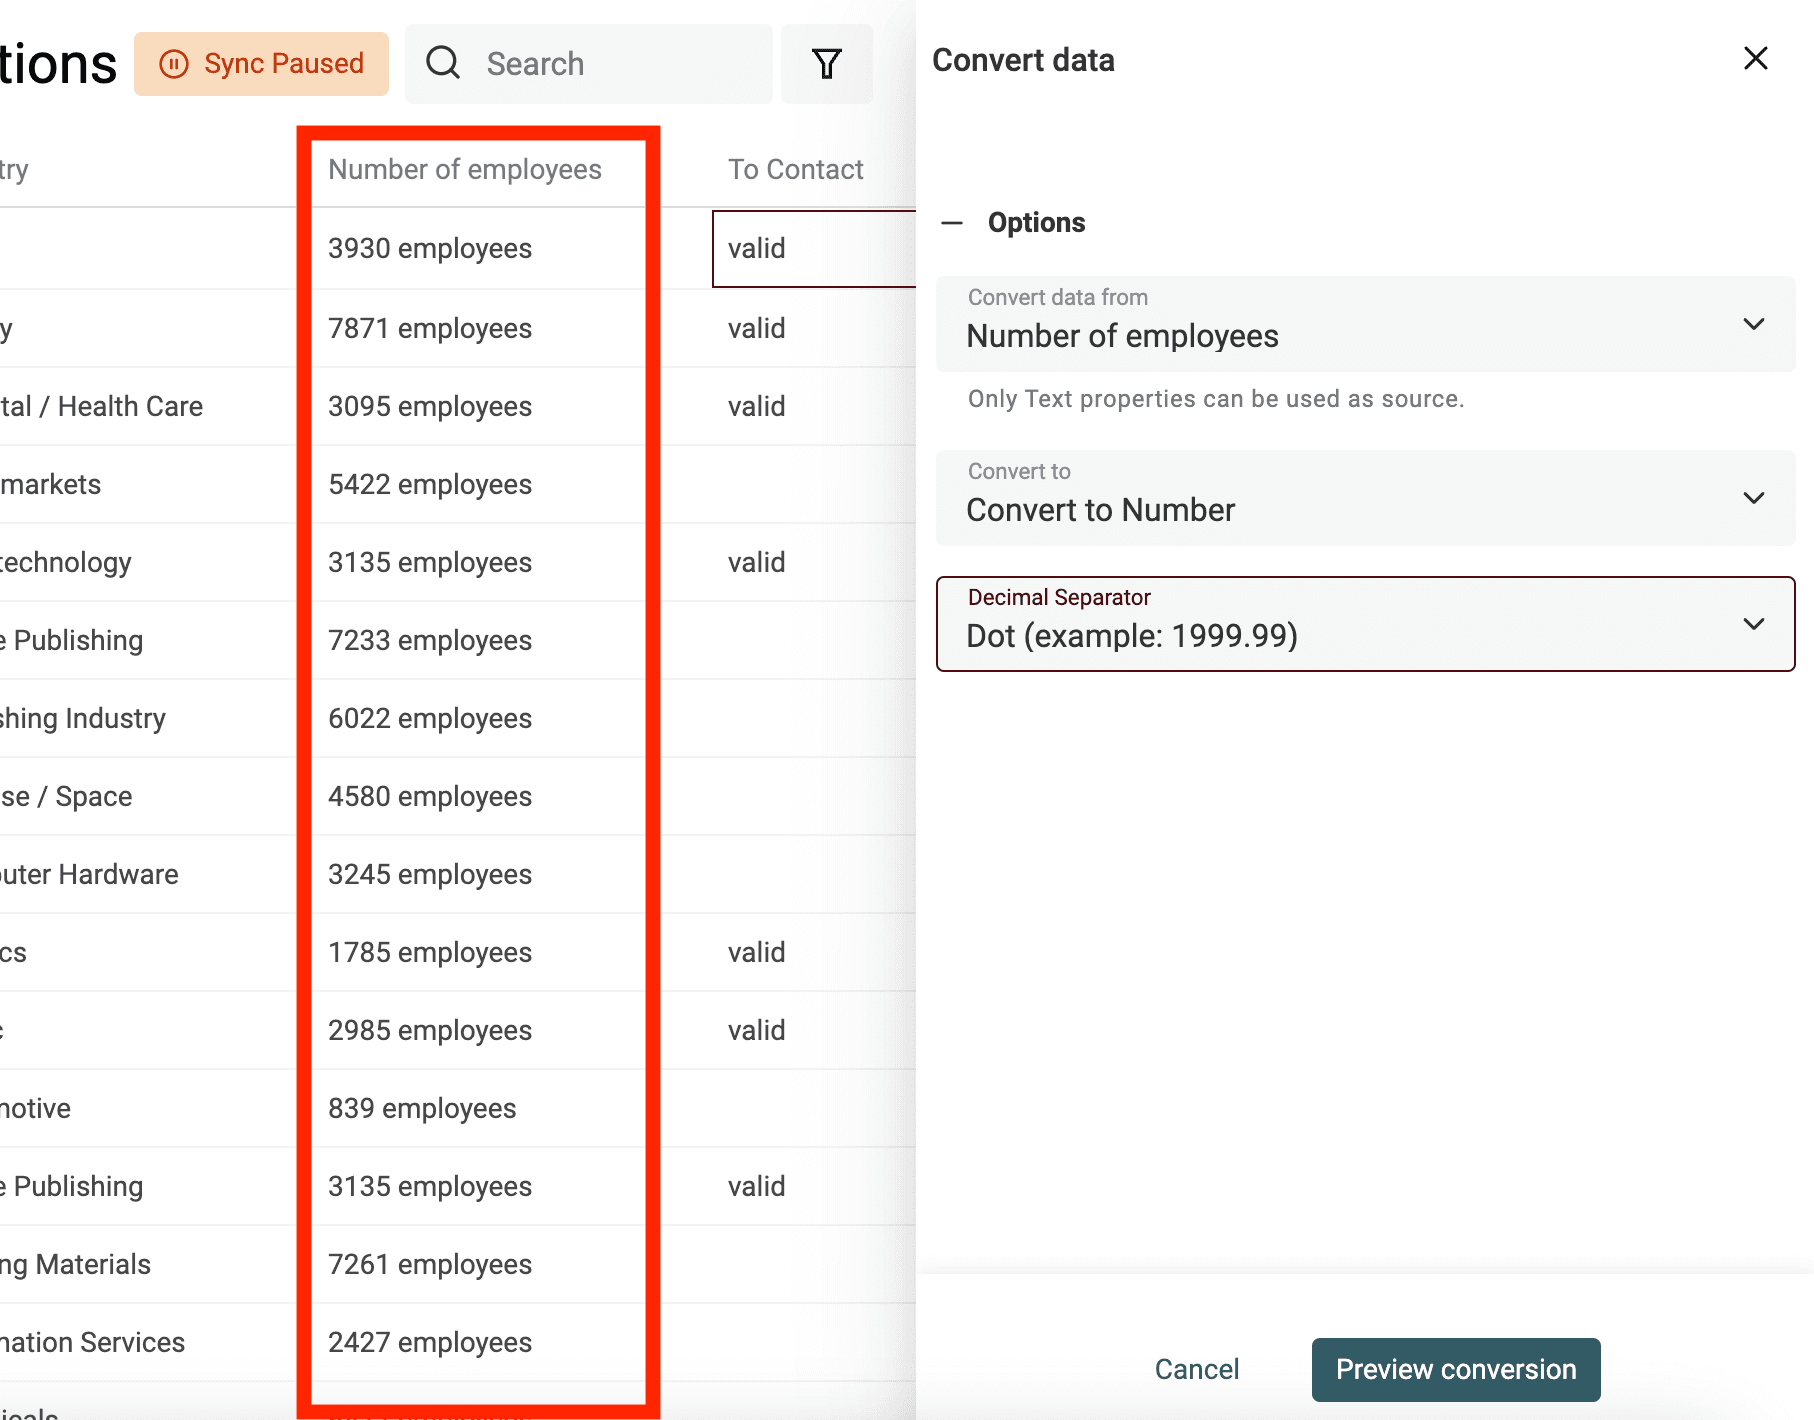
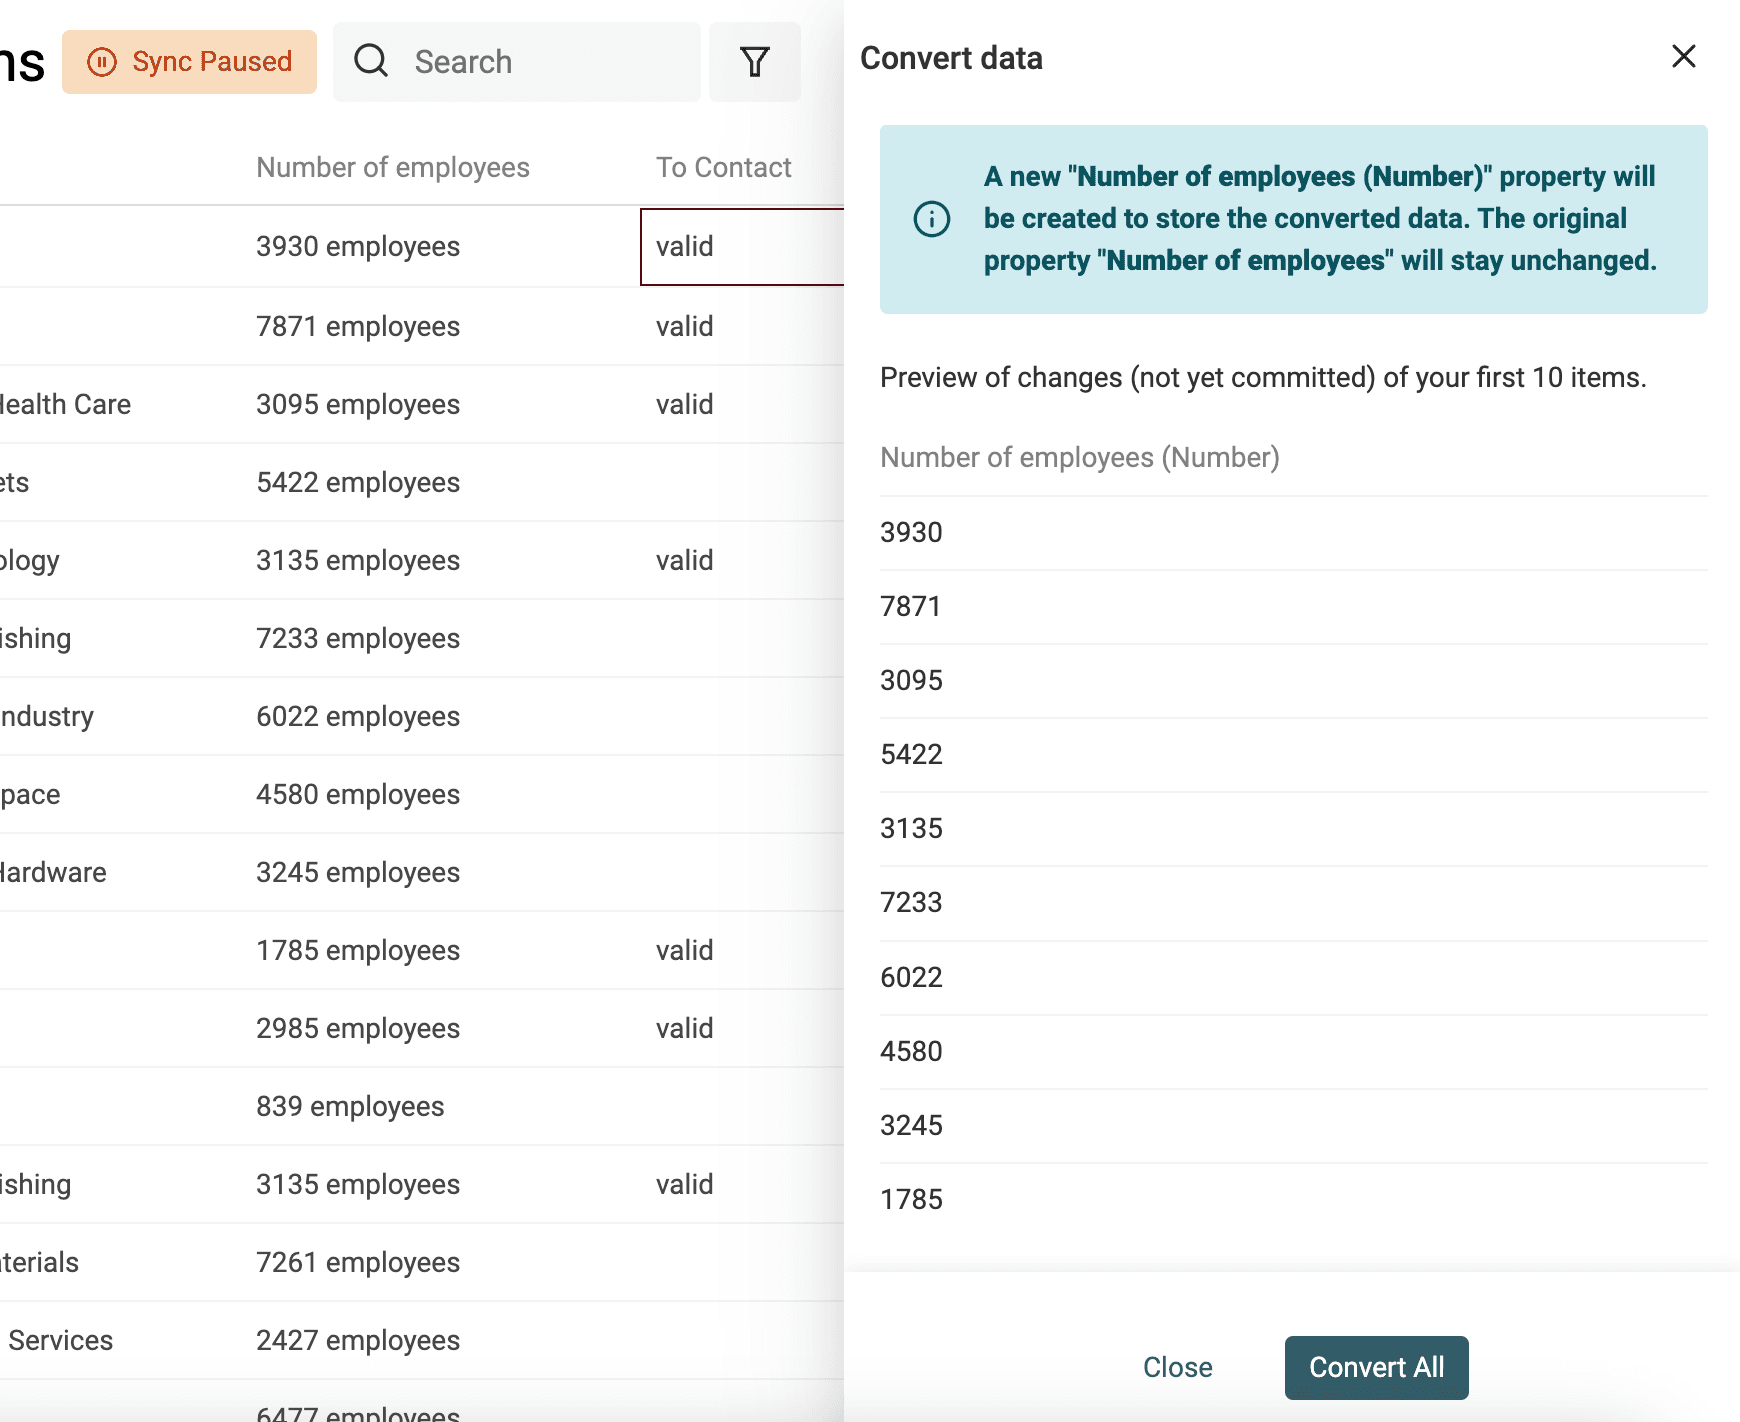
Usa il convertitore "Text to number" per:
- Normalizzare i numeri con separatori decimali e delle migliaia personalizzati
- Estrarre numeri da testi che contengono lettere
👉 Per saperne di più sulla conversione dei numeri, consulta la nostra documentazione. Apri la guida
Pulire i dati di web scraping
Convertire HTML in testo
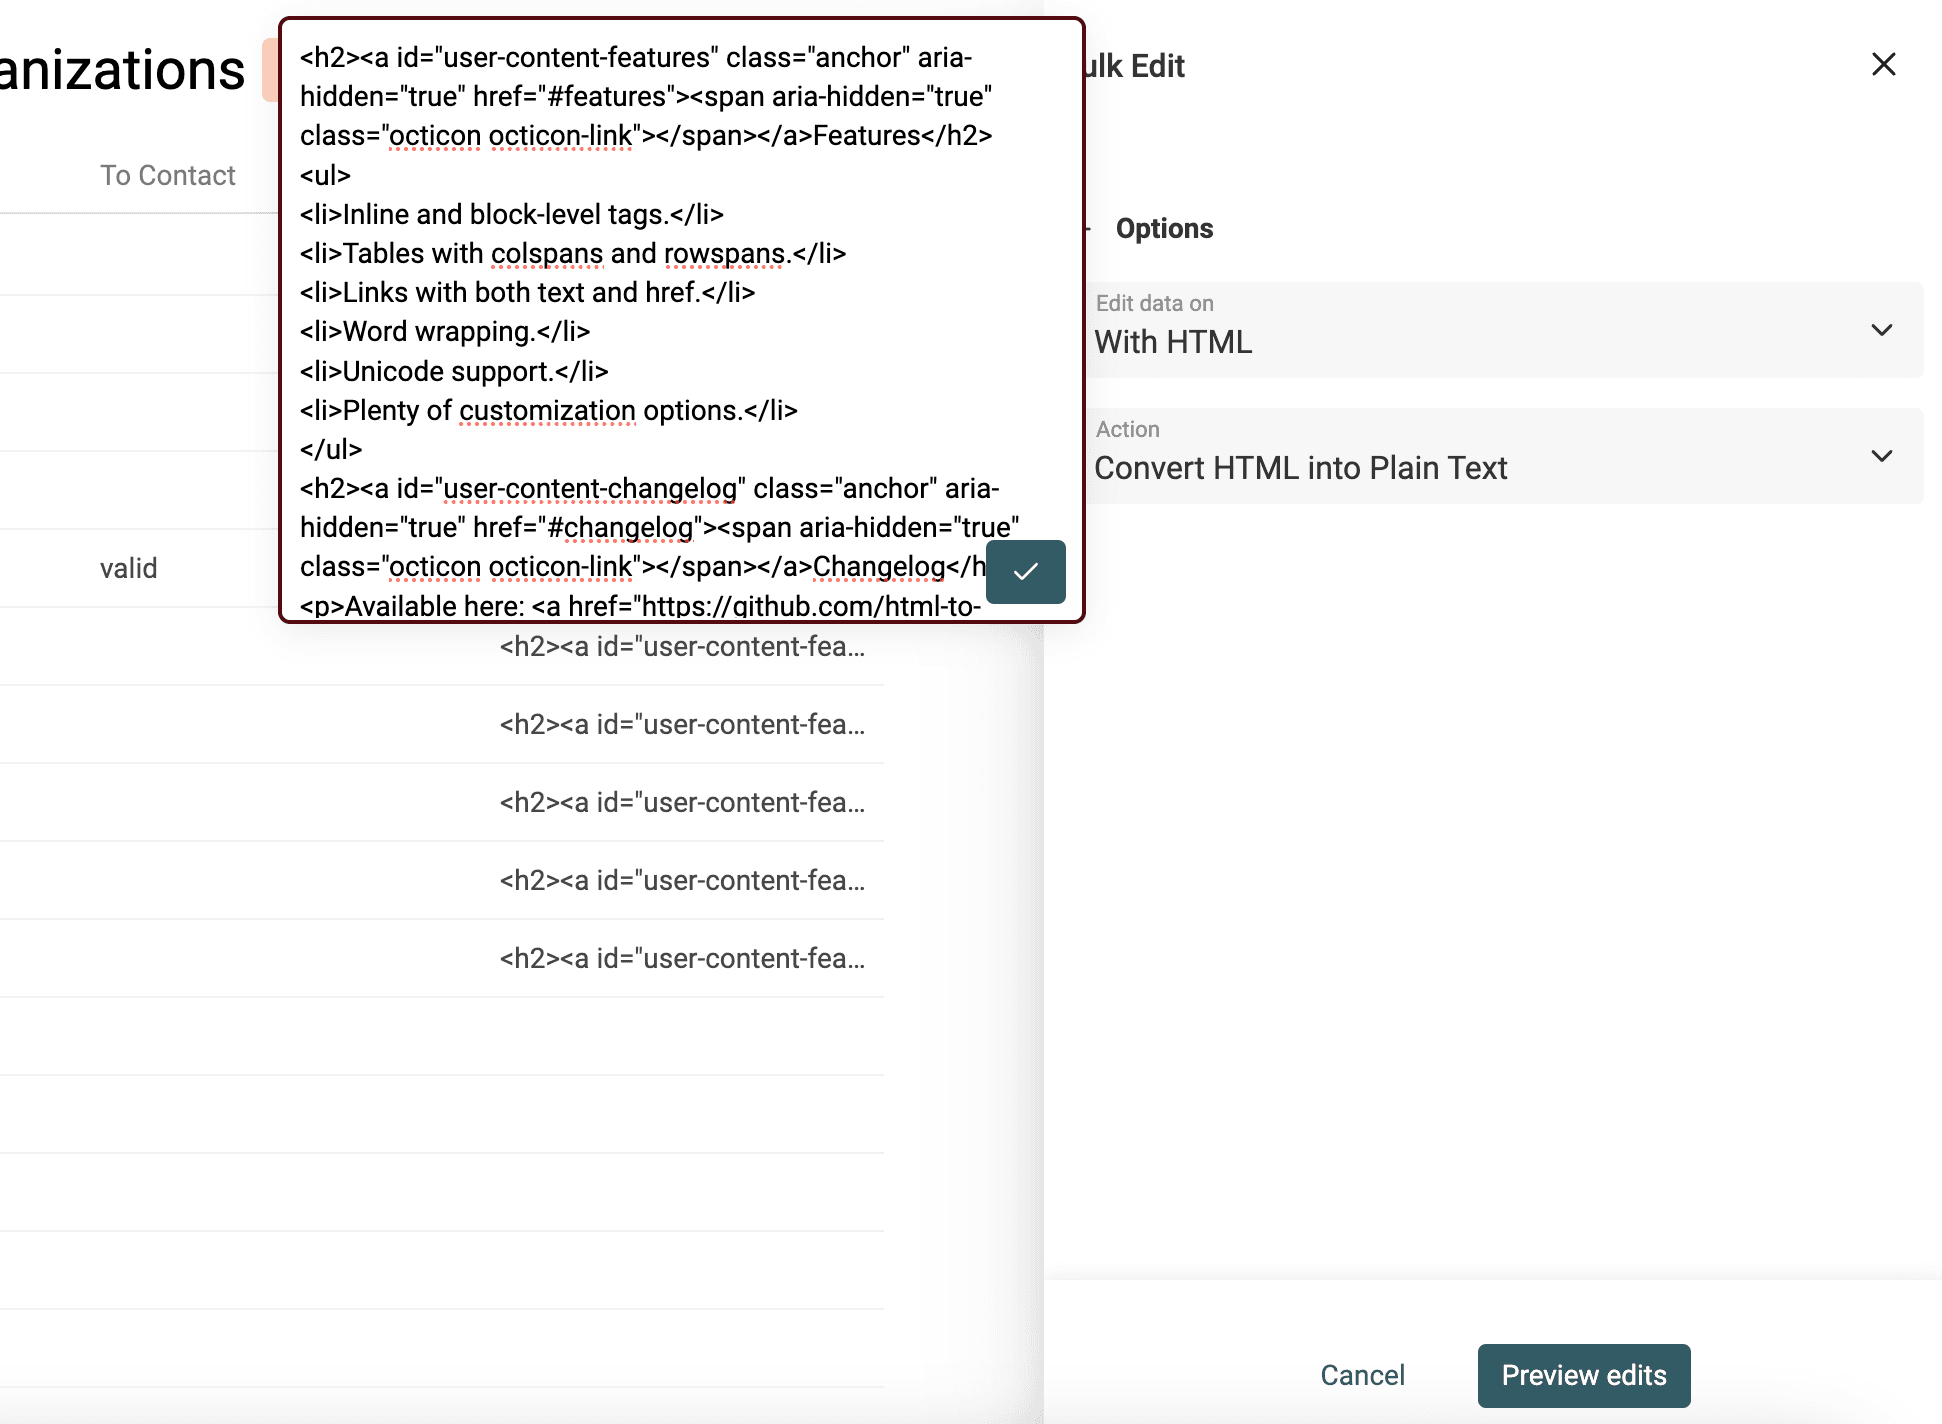
Gli strumenti di scraping analizzano il codice HTML, quindi i testi estratti possono contenere tag HTML.
Il codice HTML include link, immagini ed elenchi puntati, oltre a paragrafi e contenuti su più righe.
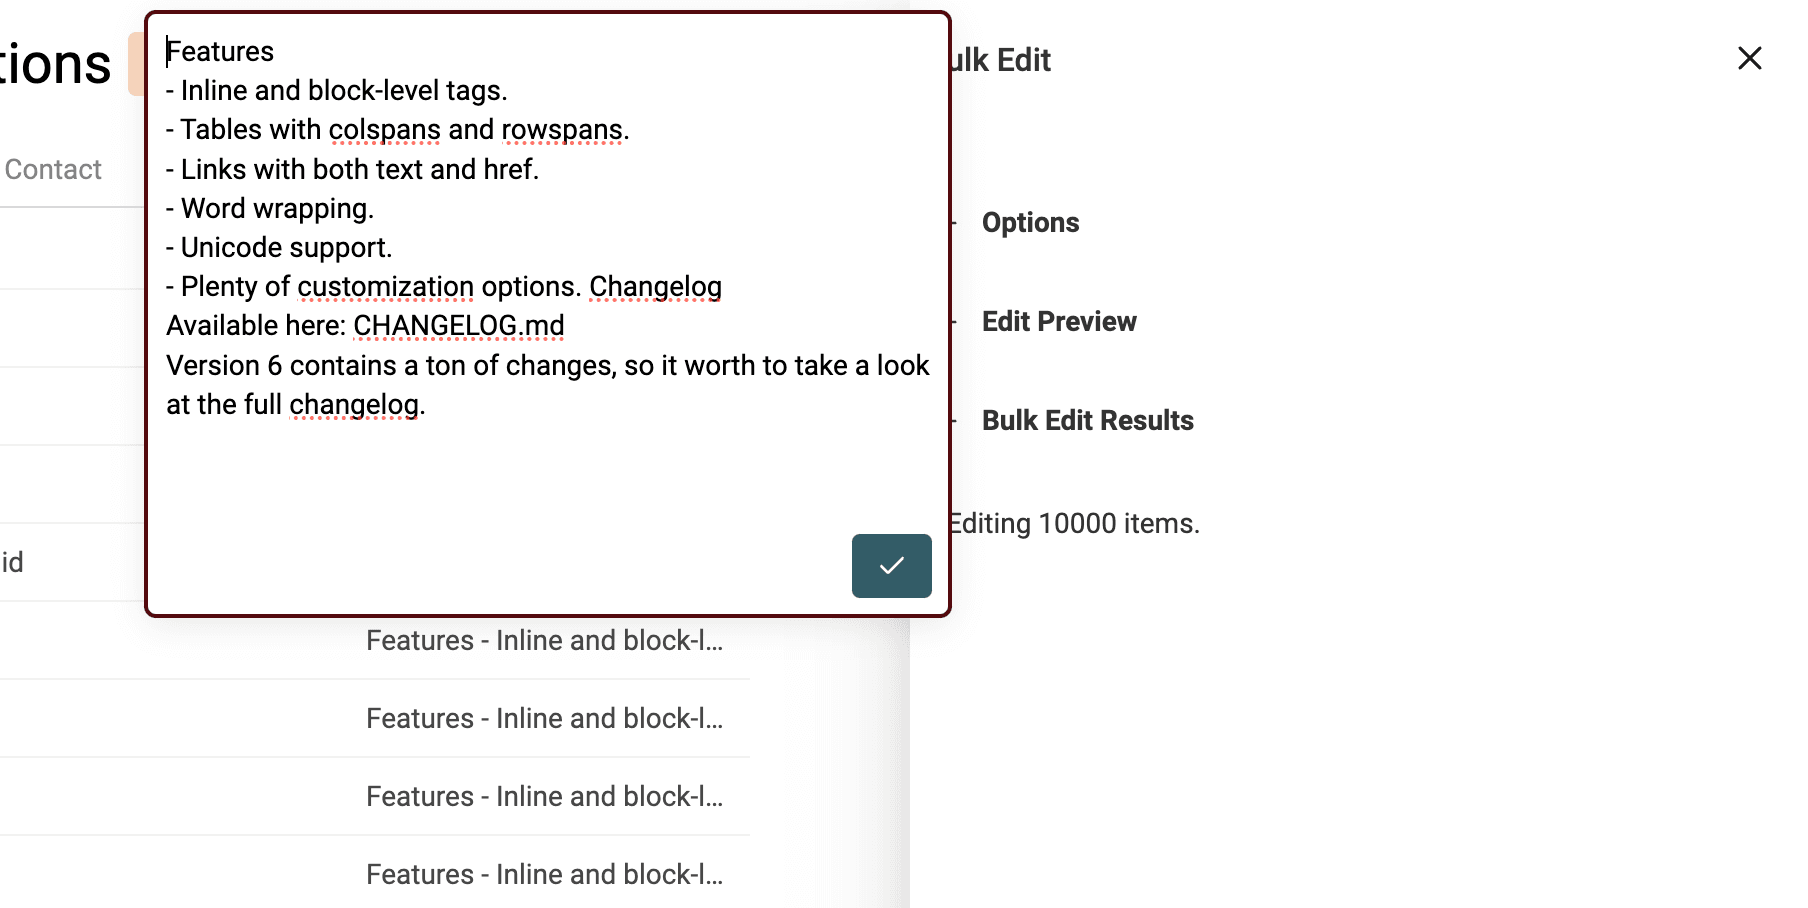
L'obiettivo è mantenere parte della struttura offerta dall'HTML, trasformando però il codice illeggibile in testo semplice.
Il convertitore HTML to Text di Datablist conserva le interruzioni di riga e trasforma i punti elenco in liste precedute da -.
Per convertire in testo semplice i contenuti con tag HTML, apri lo strumento Bulk Edit dal menu Edit.
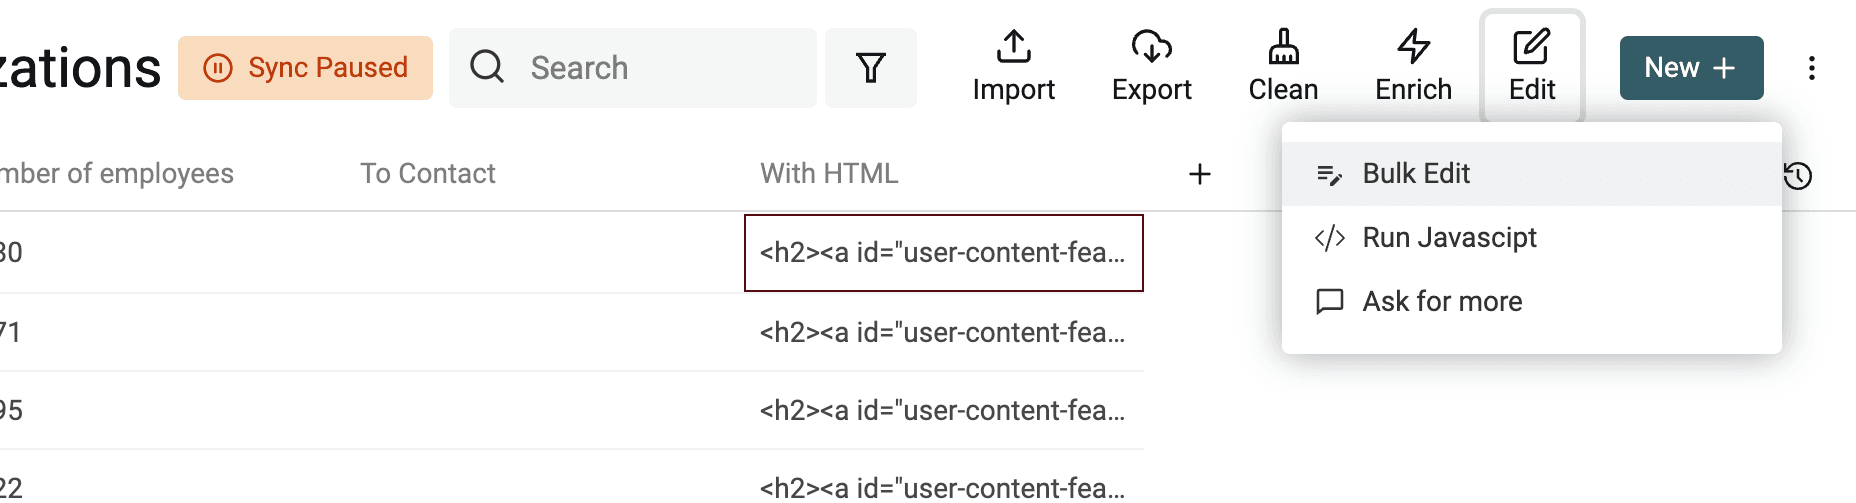
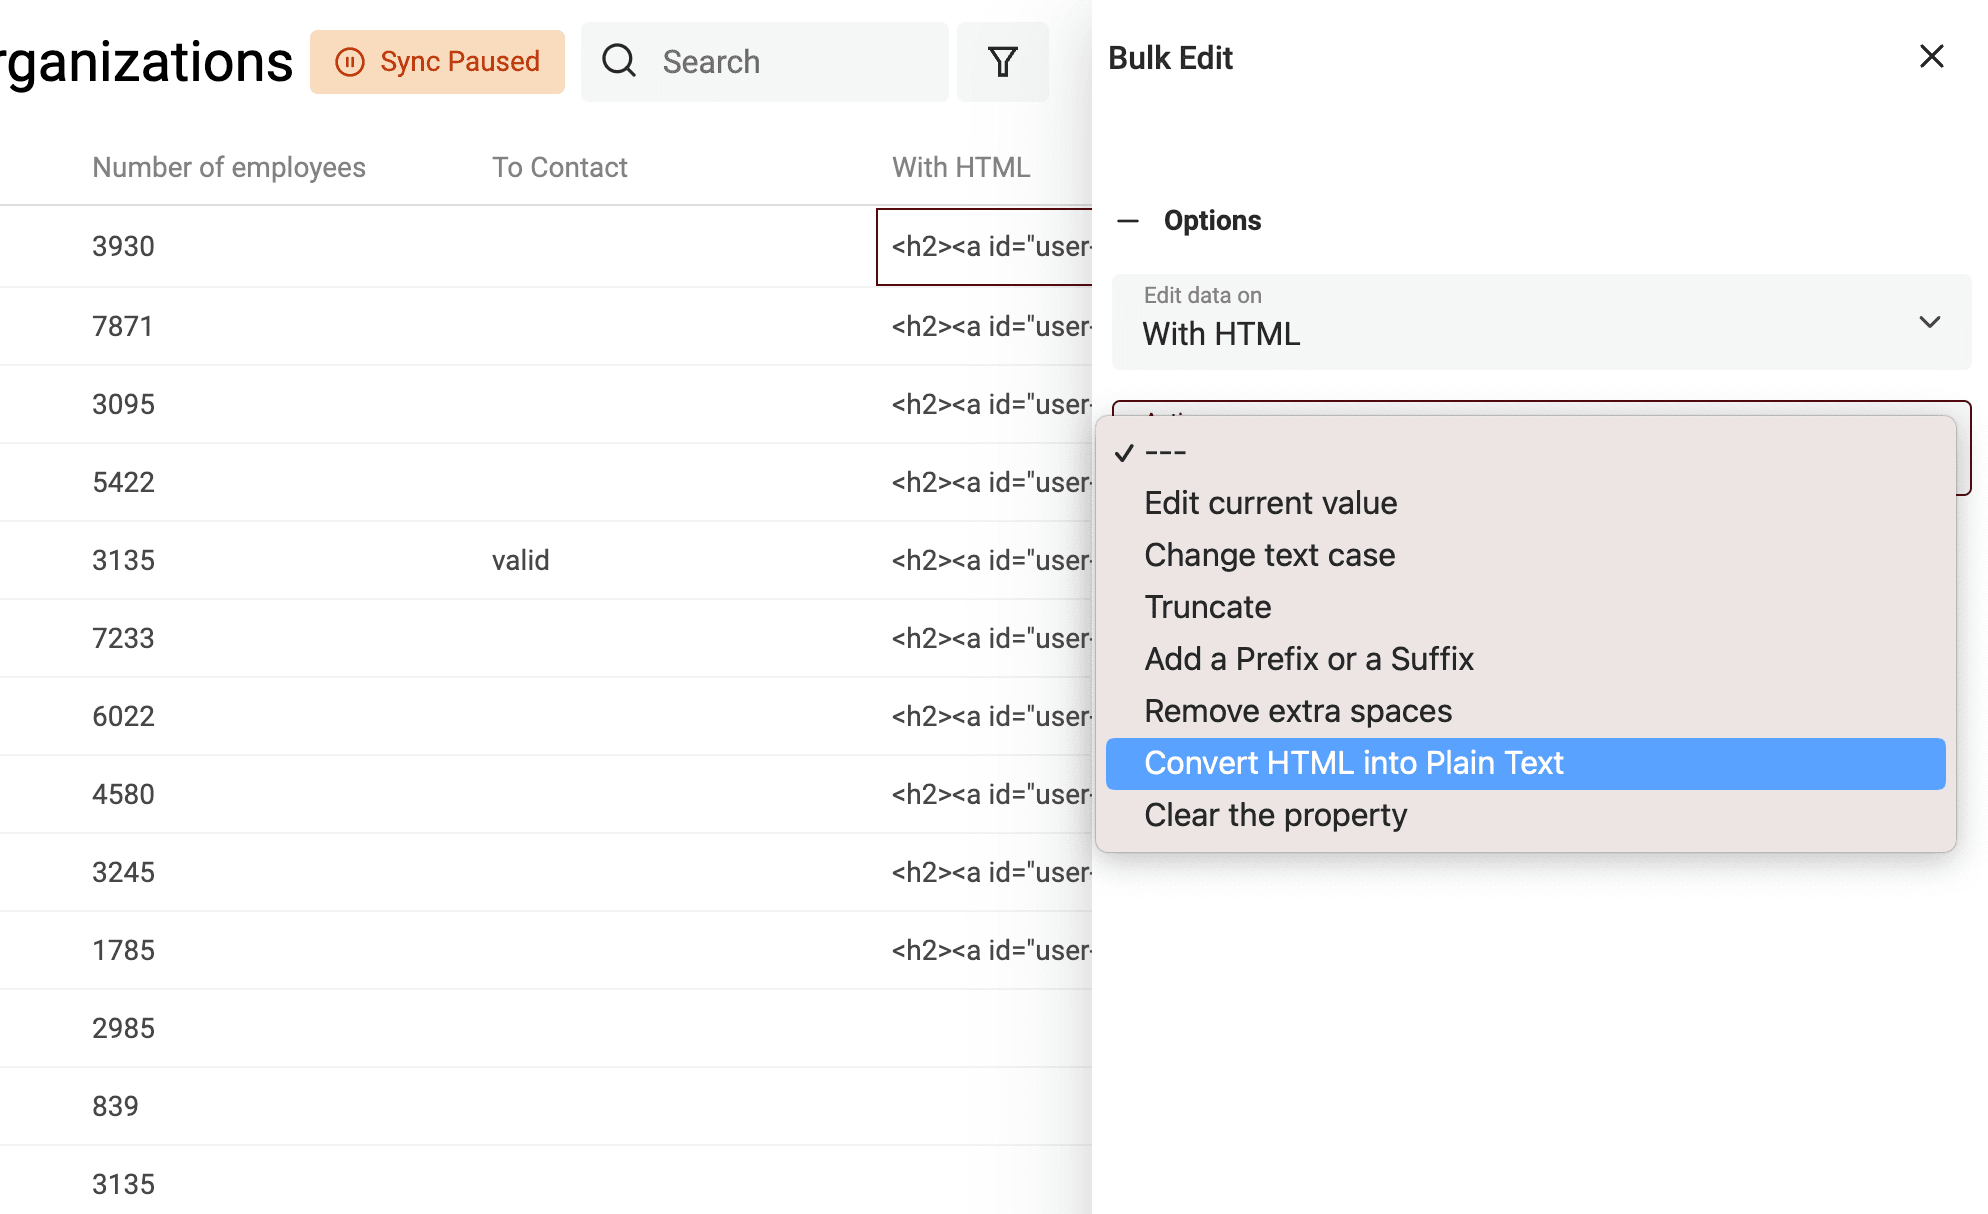
Seleziona la proprietà contenente i tag HTML, quindi scegli "Convert HTML into plain text".
Rimuovere gli spazi superflui
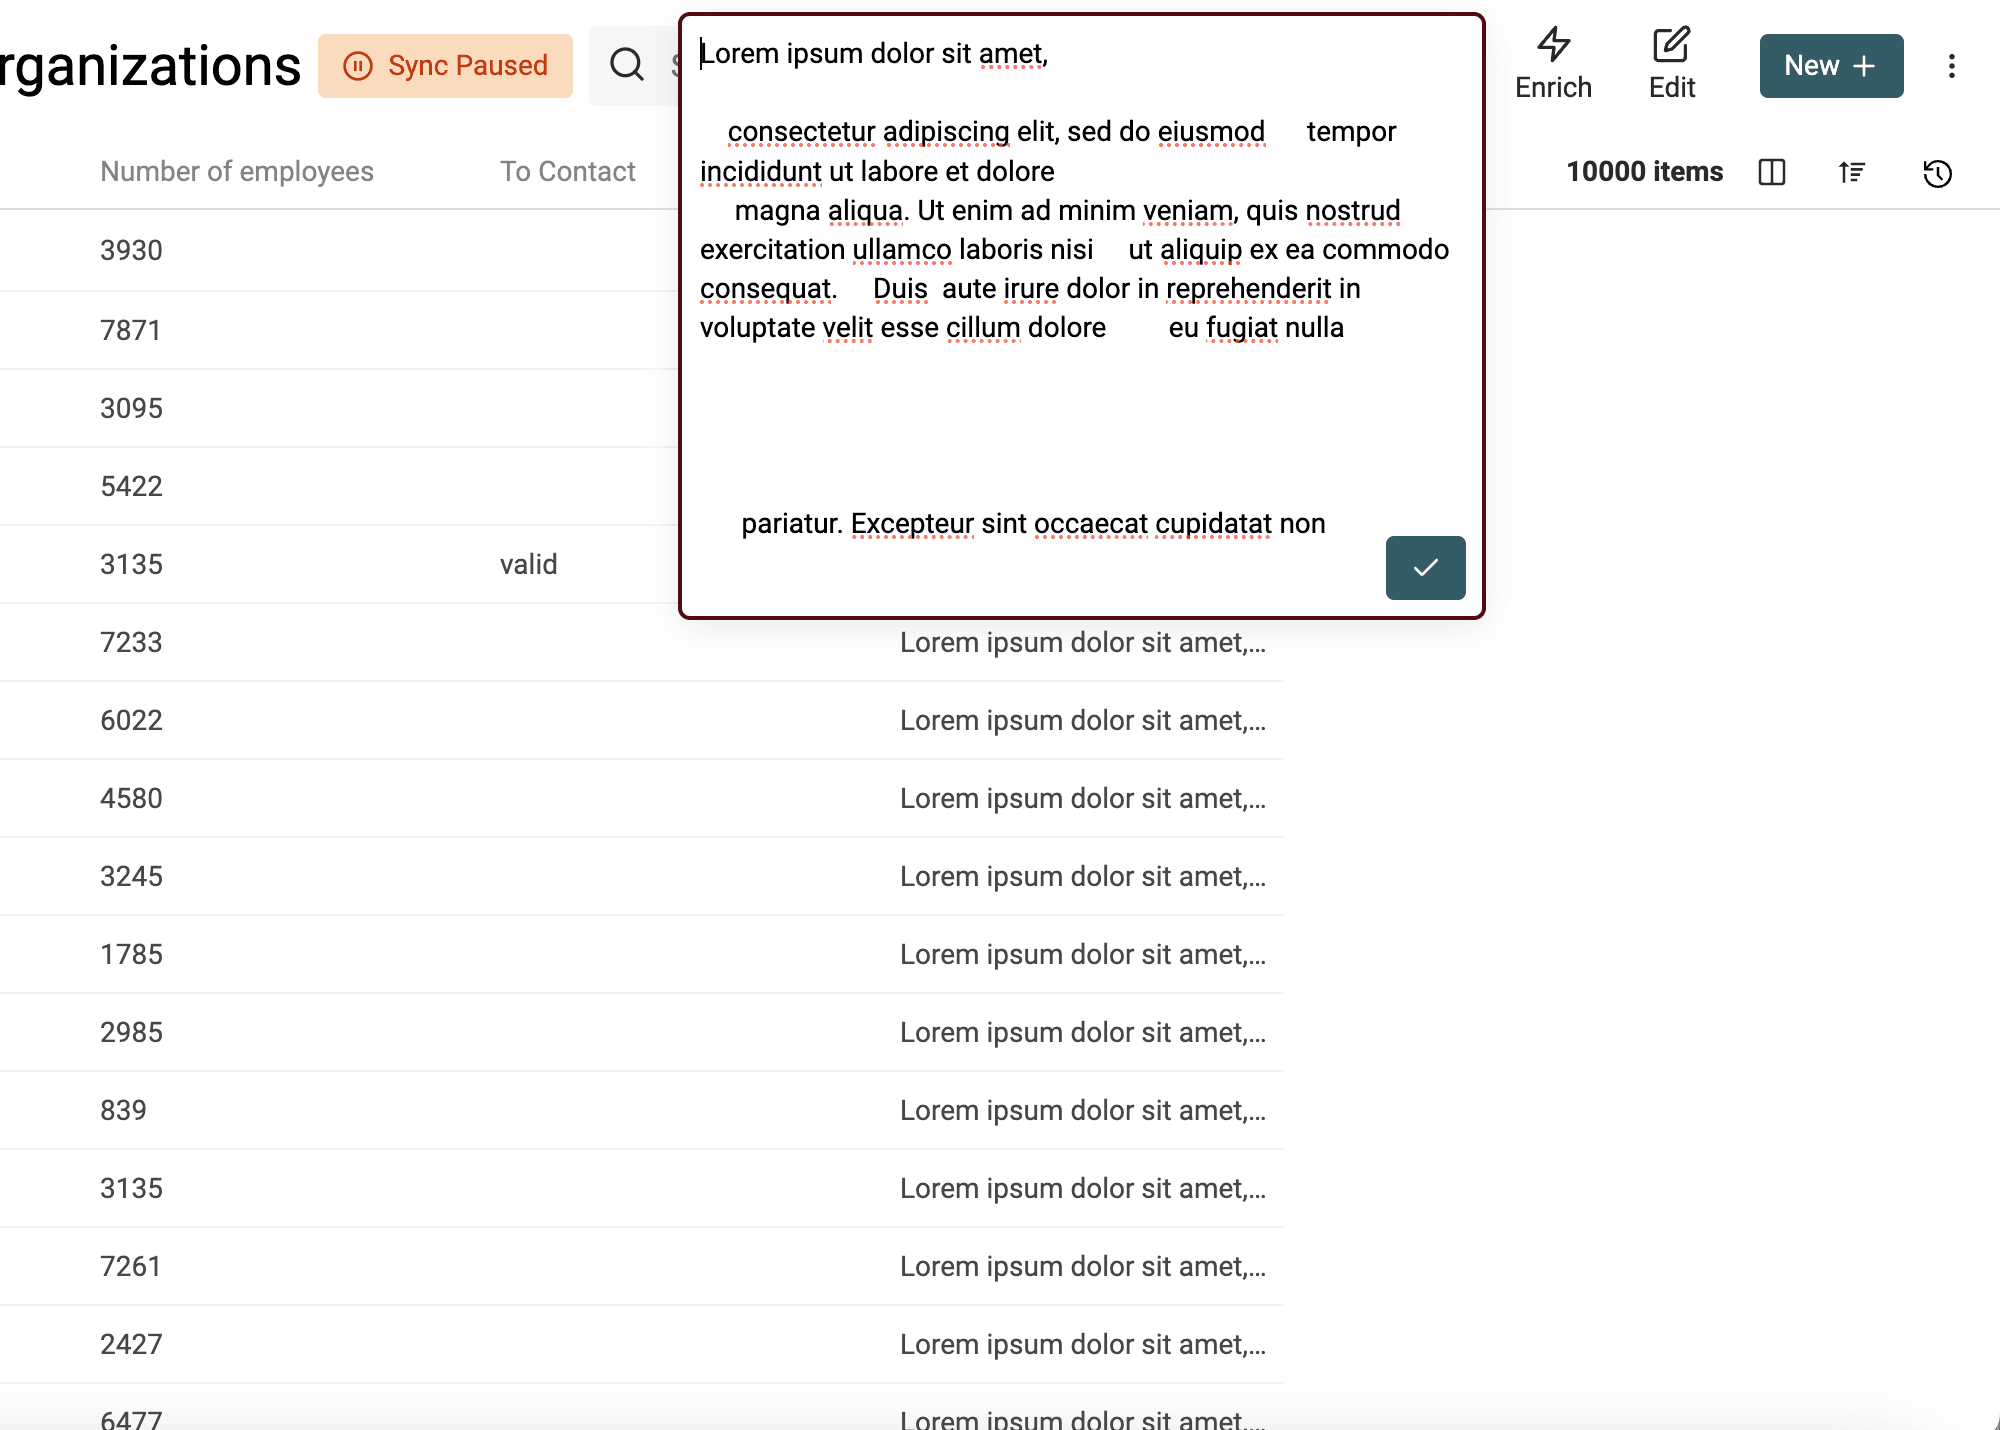
Un altro problema frequente nei dati estratti è la presenza di spazi superflui, dovuti a nuove righe, caratteri Tab e altri caratteri che rappresentano spazi in HTML.
Datablist include uno strumento di pulizia che consente di eliminarli.
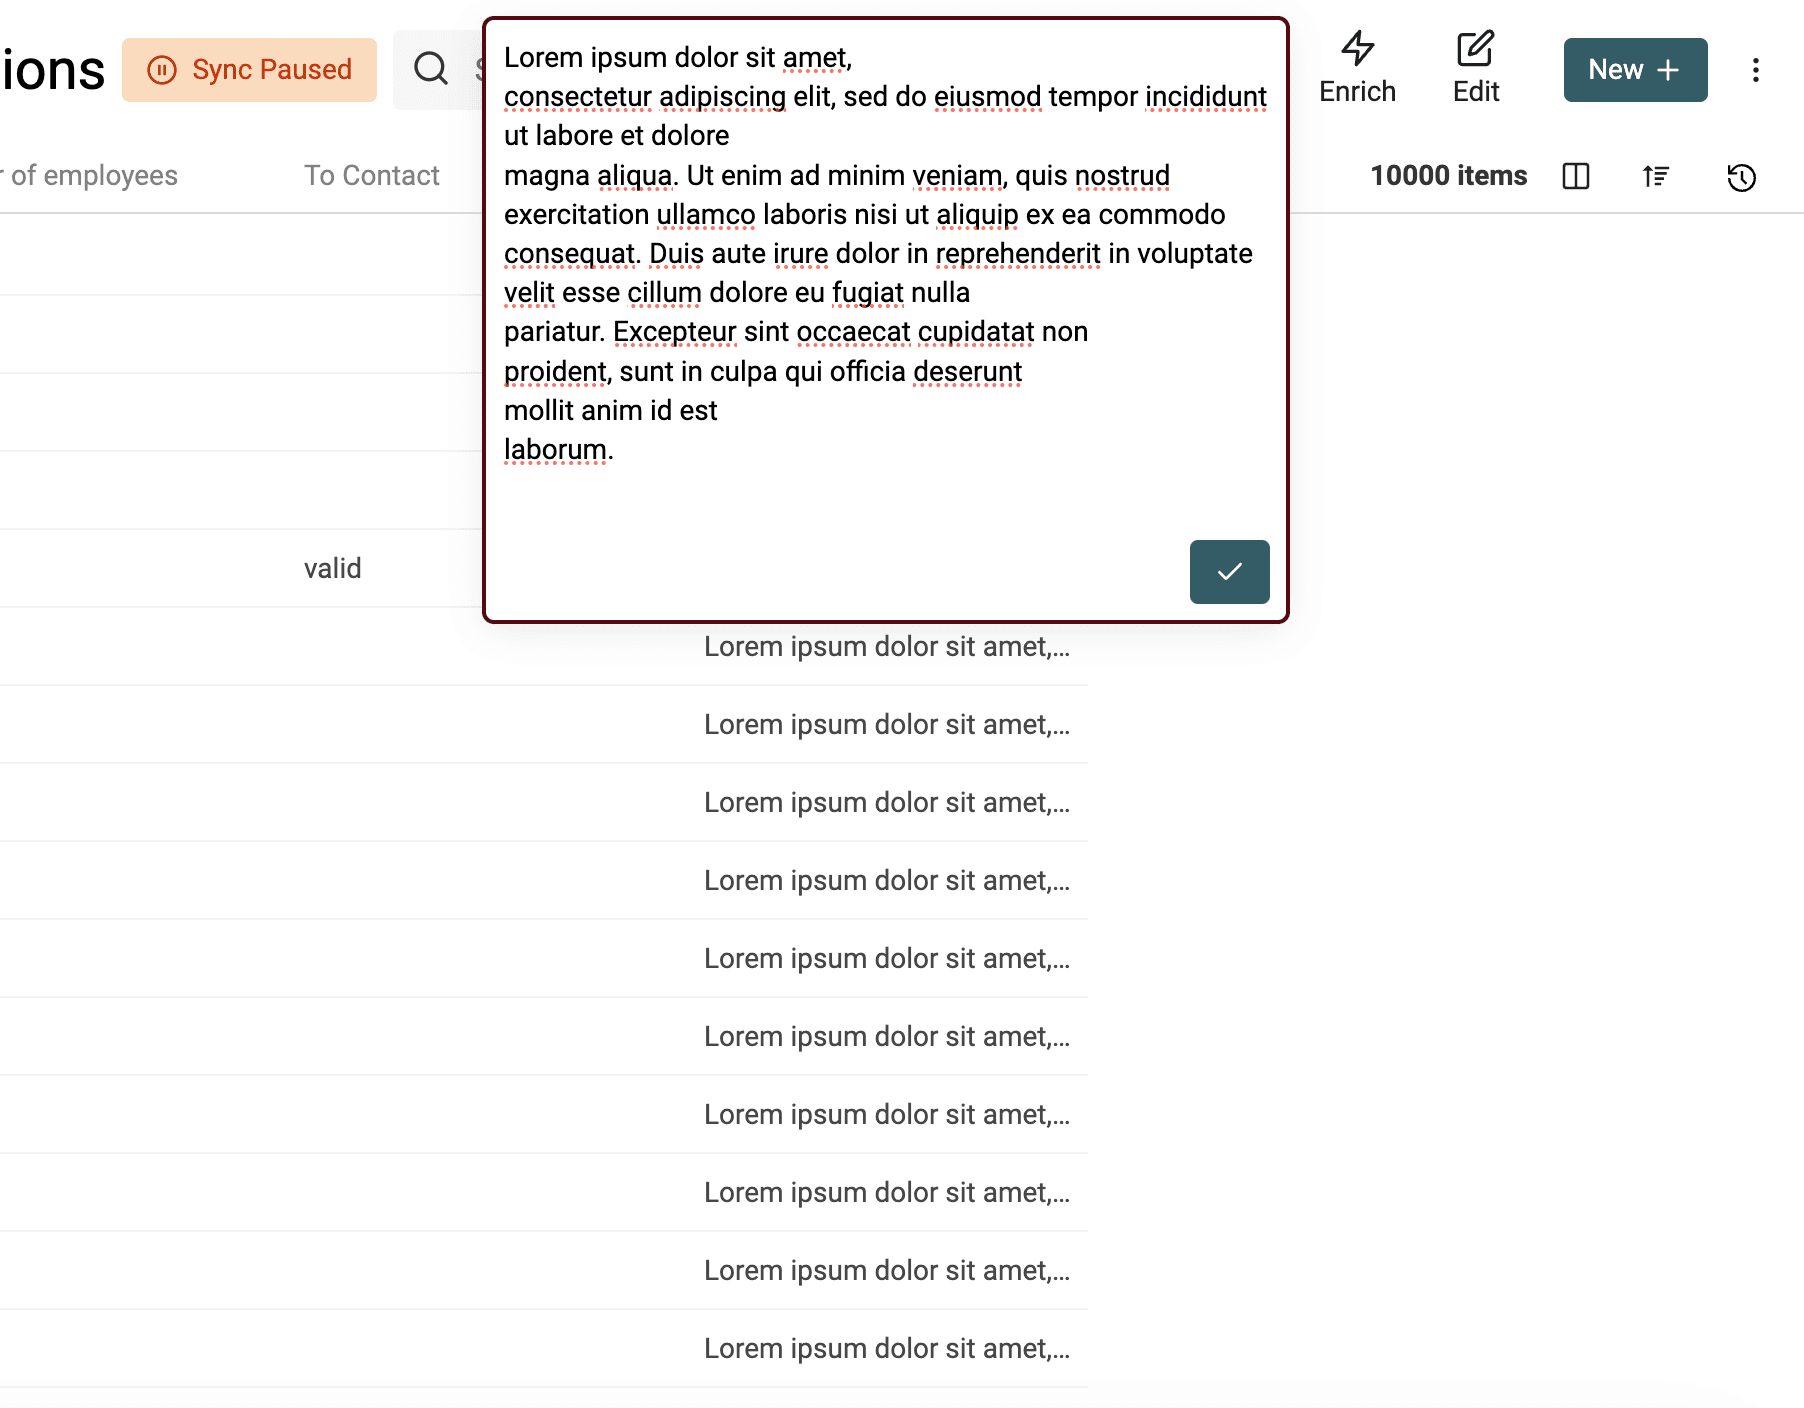
- Rimuove gli spazi in eccesso tra le parole
- Elimina le righe vuote
- Rimuove gli spazi iniziali e finali da ogni riga
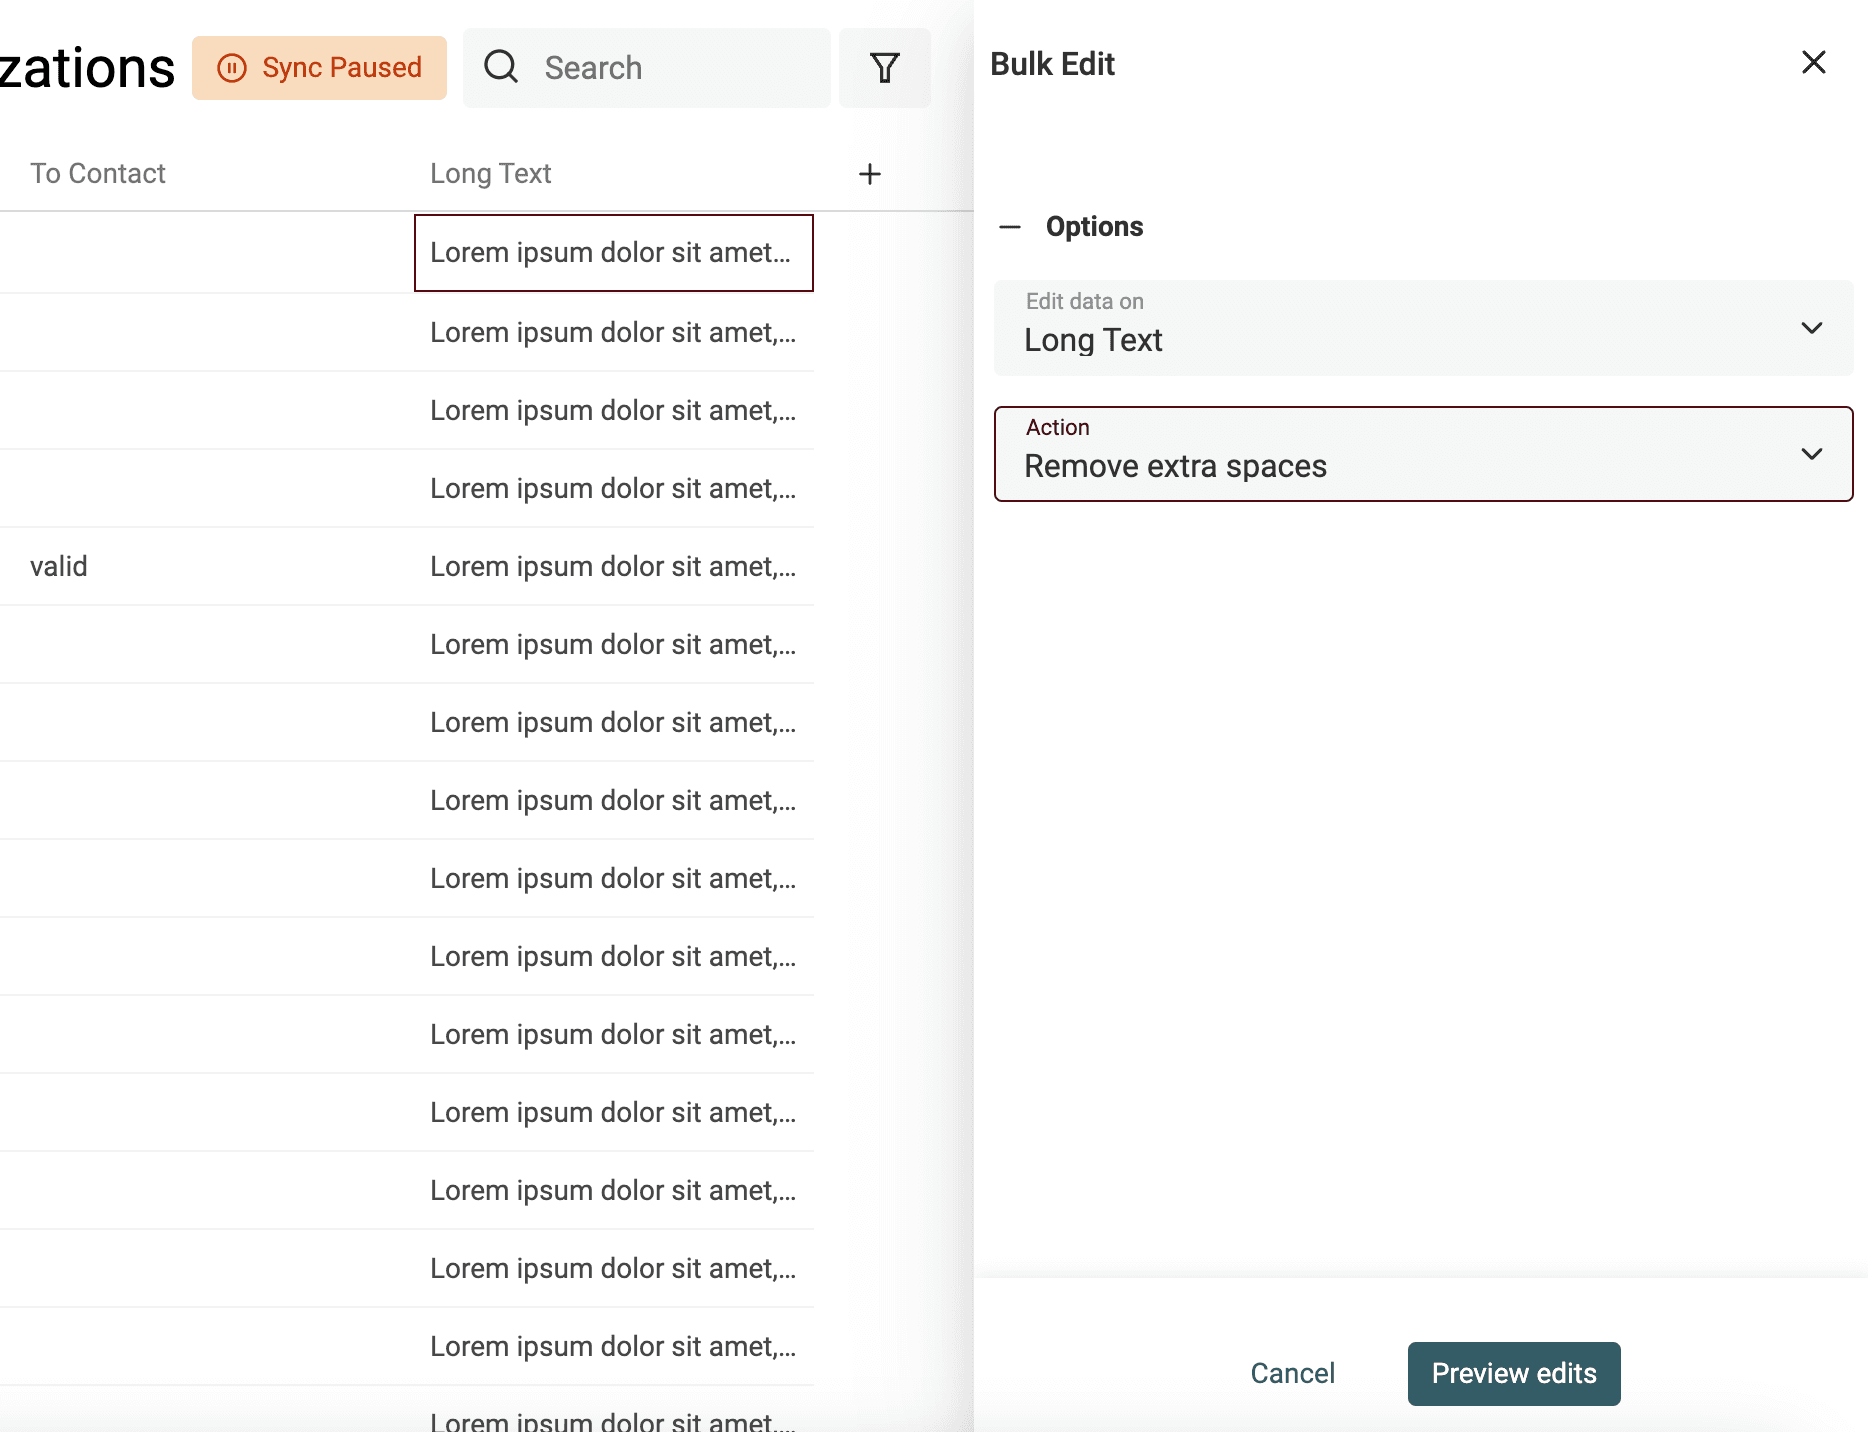
Per eliminare gli spazi superflui, apri "Bulk Edit" dal menu "Edit". Seleziona la proprietà e l'azione "Remove extra spaces".
Uniformare maiuscole e minuscole
Modificare maiuscole e minuscole è semplice. Apri lo strumento "Bulk Edit" dal menu "Edit".
Seleziona la proprietà da elaborare e usa l'azione "Change text case".
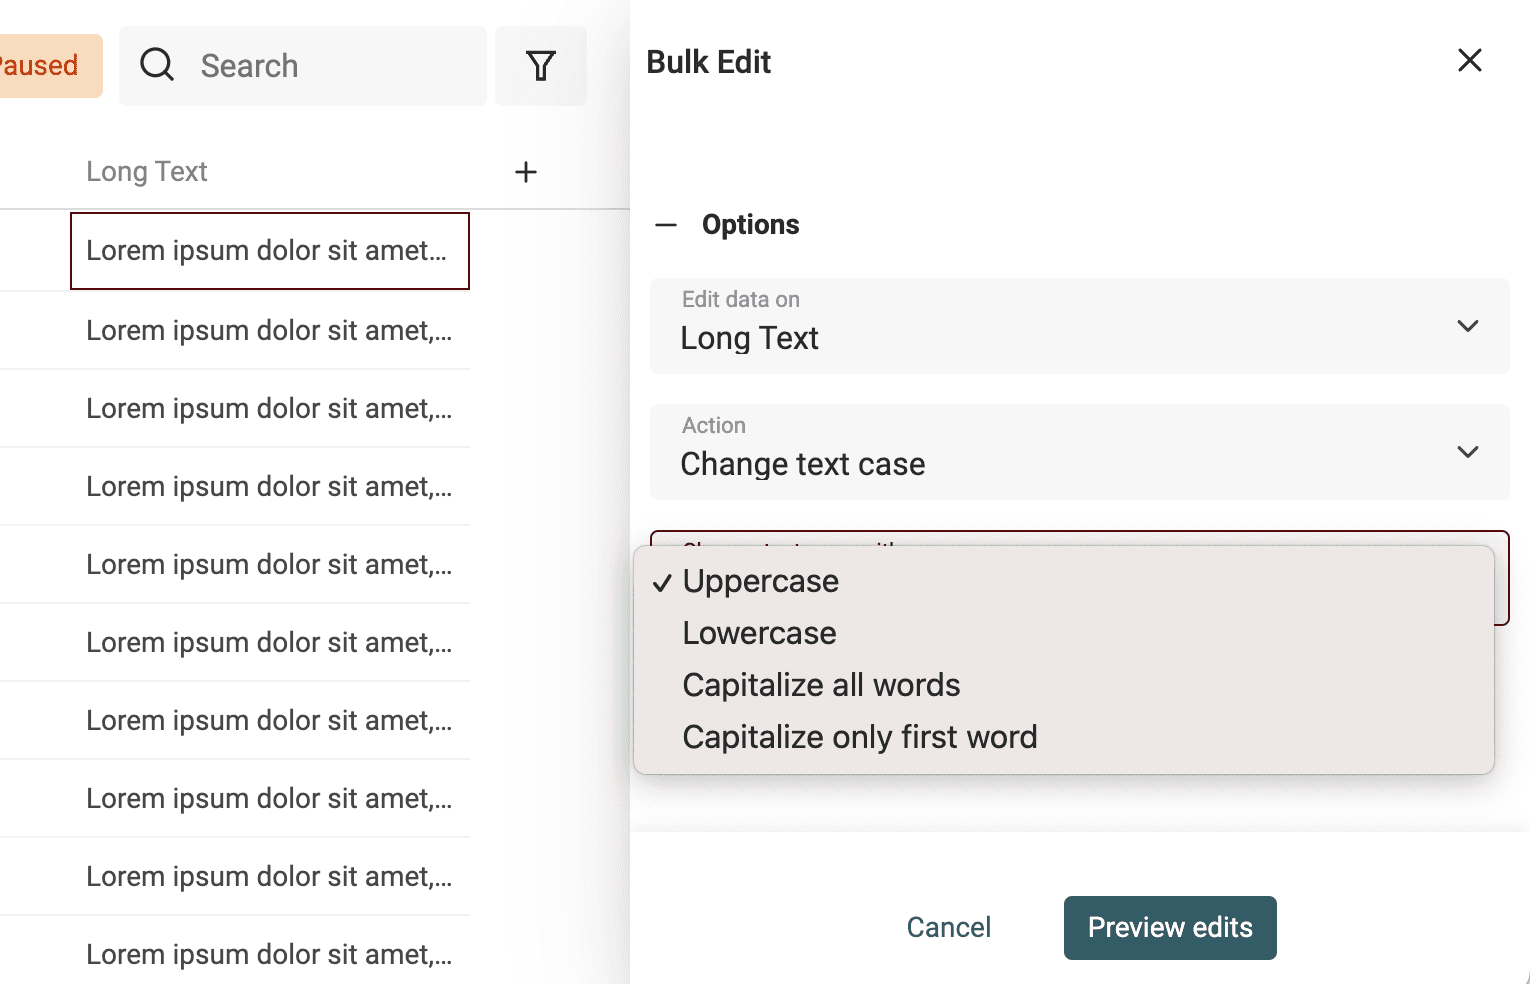
Sono disponibili quattro modalità:
- Uppercase - Converte tutte le lettere in maiuscolo. Esempio:
john=>JOHN - Lowercase - Converte tutte le lettere in minuscolo. Esempio:
API=>api - Capitalize - Scrive in maiuscolo la prima lettera di ogni parola. Esempio:
john is a good man=>John Is A Good Man - Capitalize only the first word - Scrive in maiuscolo solo la prima lettera della prima parola. Esempio:
john is a good man=>John is a good man
Rimuovere i simboli dai testi
I testi estratti da pagine HTML o inseriti dagli utenti, per esempio i titoli dei profili LinkedIn, possono contenere simboli, emoticon e altri caratteri che interferiscono con l'elaborazione. Una semplice emoticon alla fine di un nome può impedire che venga rilevato da un algoritmo di deduplicazione.
Datablist include un processore che rimuove dai dati tutti i simboli non testuali.
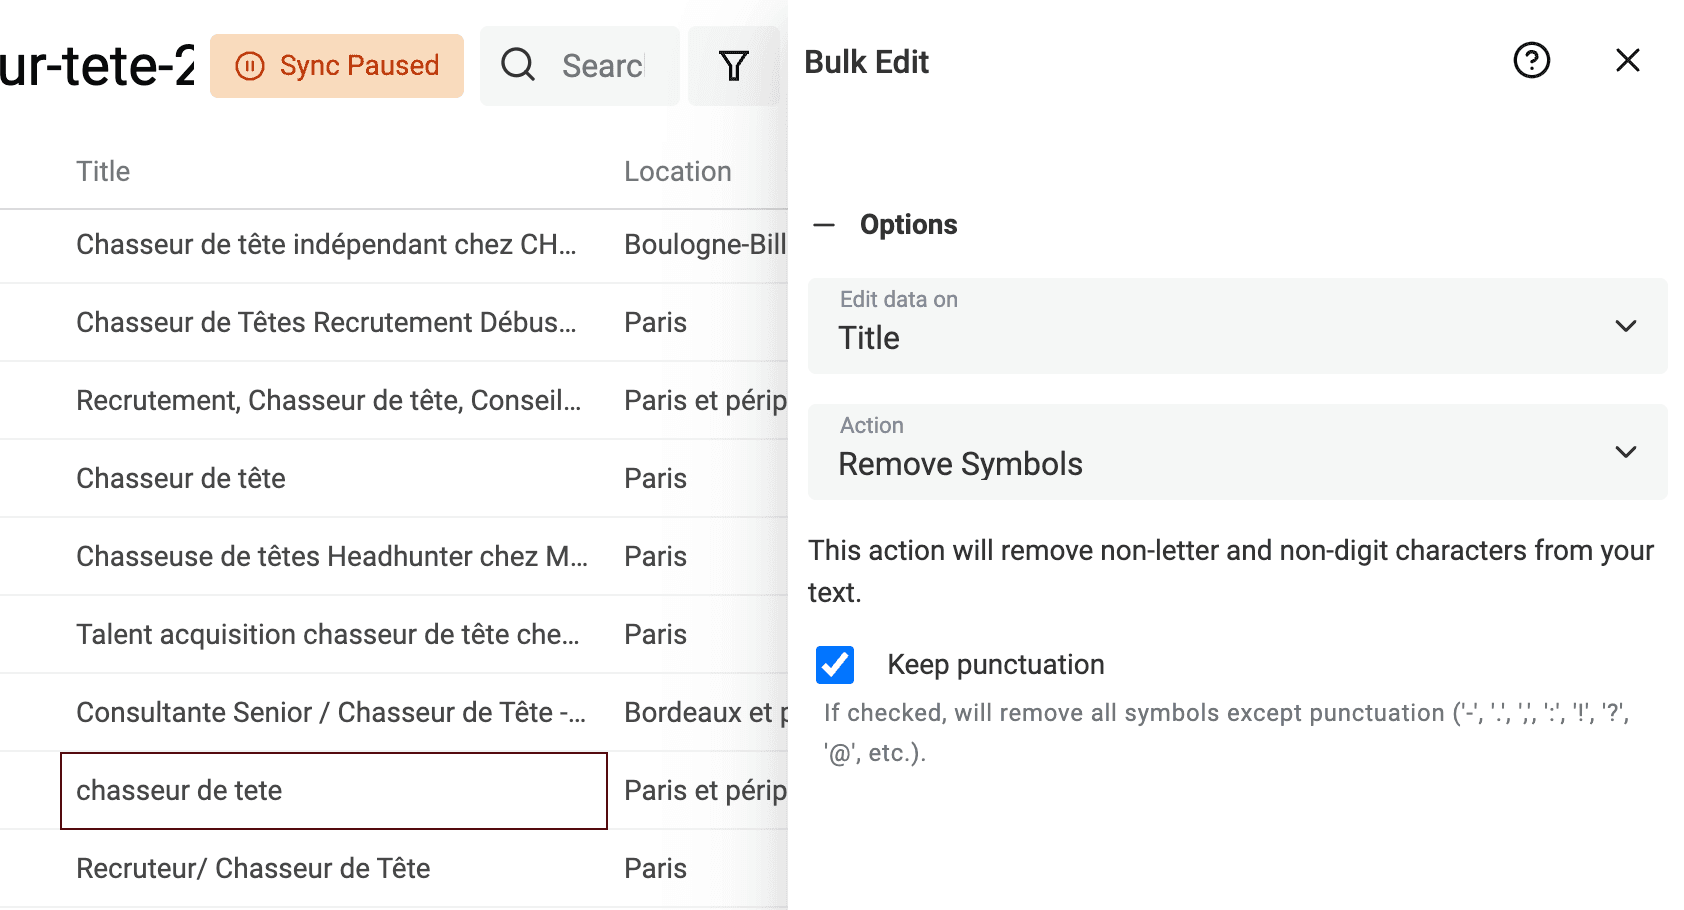
Fai clic su "Bulk Edit" nel menu "Edit", seleziona una proprietà di testo e scegli la trasformazione "Remove symbols".
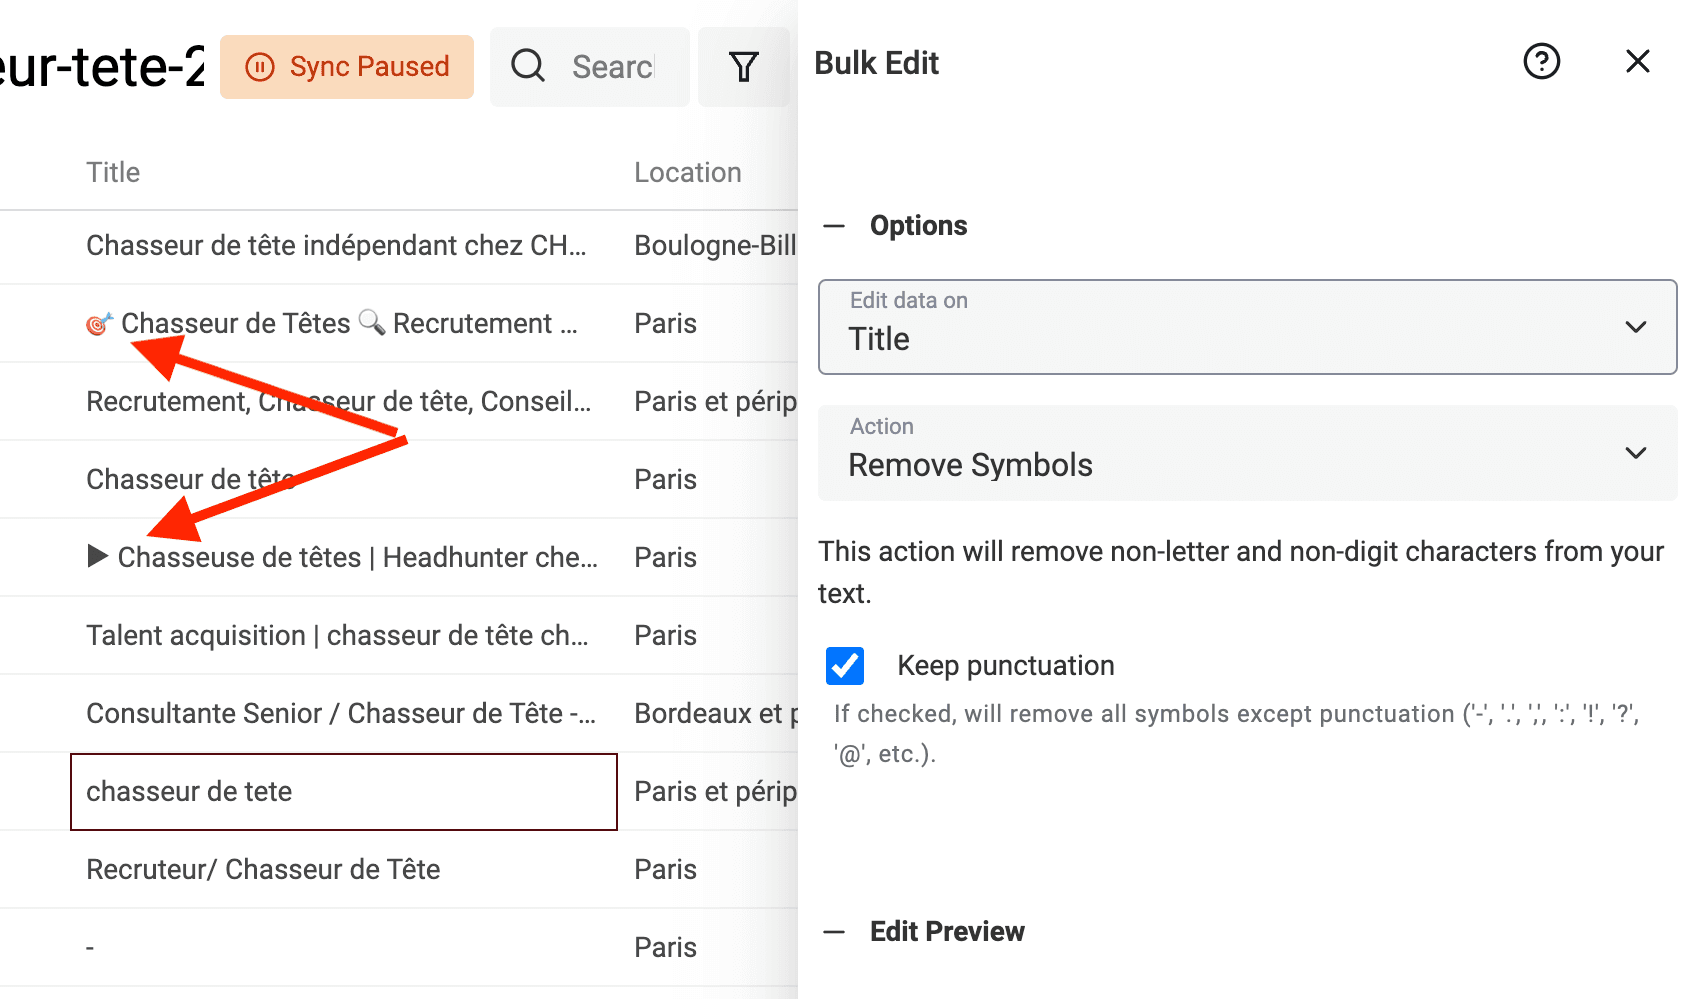
Se l'anteprima è corretta, avvia la trasformazione per elaborare gli elementi.
Normalizzare con Find and Replace
Per creare segmenti nelle tue liste di prospect, devi normalizzare i dati.
- Normalizzare le job title
- Normalizzare Paesi e città
- Normalizzare gli URL
- E così via
L'obiettivo è trasformare una proprietà con testo libero in una proprietà con un numero limitato di opzioni, oppure ricondurre i testi a una forma più essenziale, per esempio trasformando URL con percorsi nel semplice dominio.
Datablist offre un potente strumento Find and Replace, compatibile sia con testo semplice sia con le espressioni regolari.
Le espressioni regolari sono complesse, ma estremamente potenti.
Ecco alcuni esempi di utilizzo delle RegEx per pulire i dati.
Rimuovere i parametri di query da un URL
Alcuni parametri URL servono a tracciare una campagna; altri identificano un prodotto, una variante, un risultato di ricerca o un numero di pagina. Rimuoverli tutti può far confluire record diversi nello stesso URL.
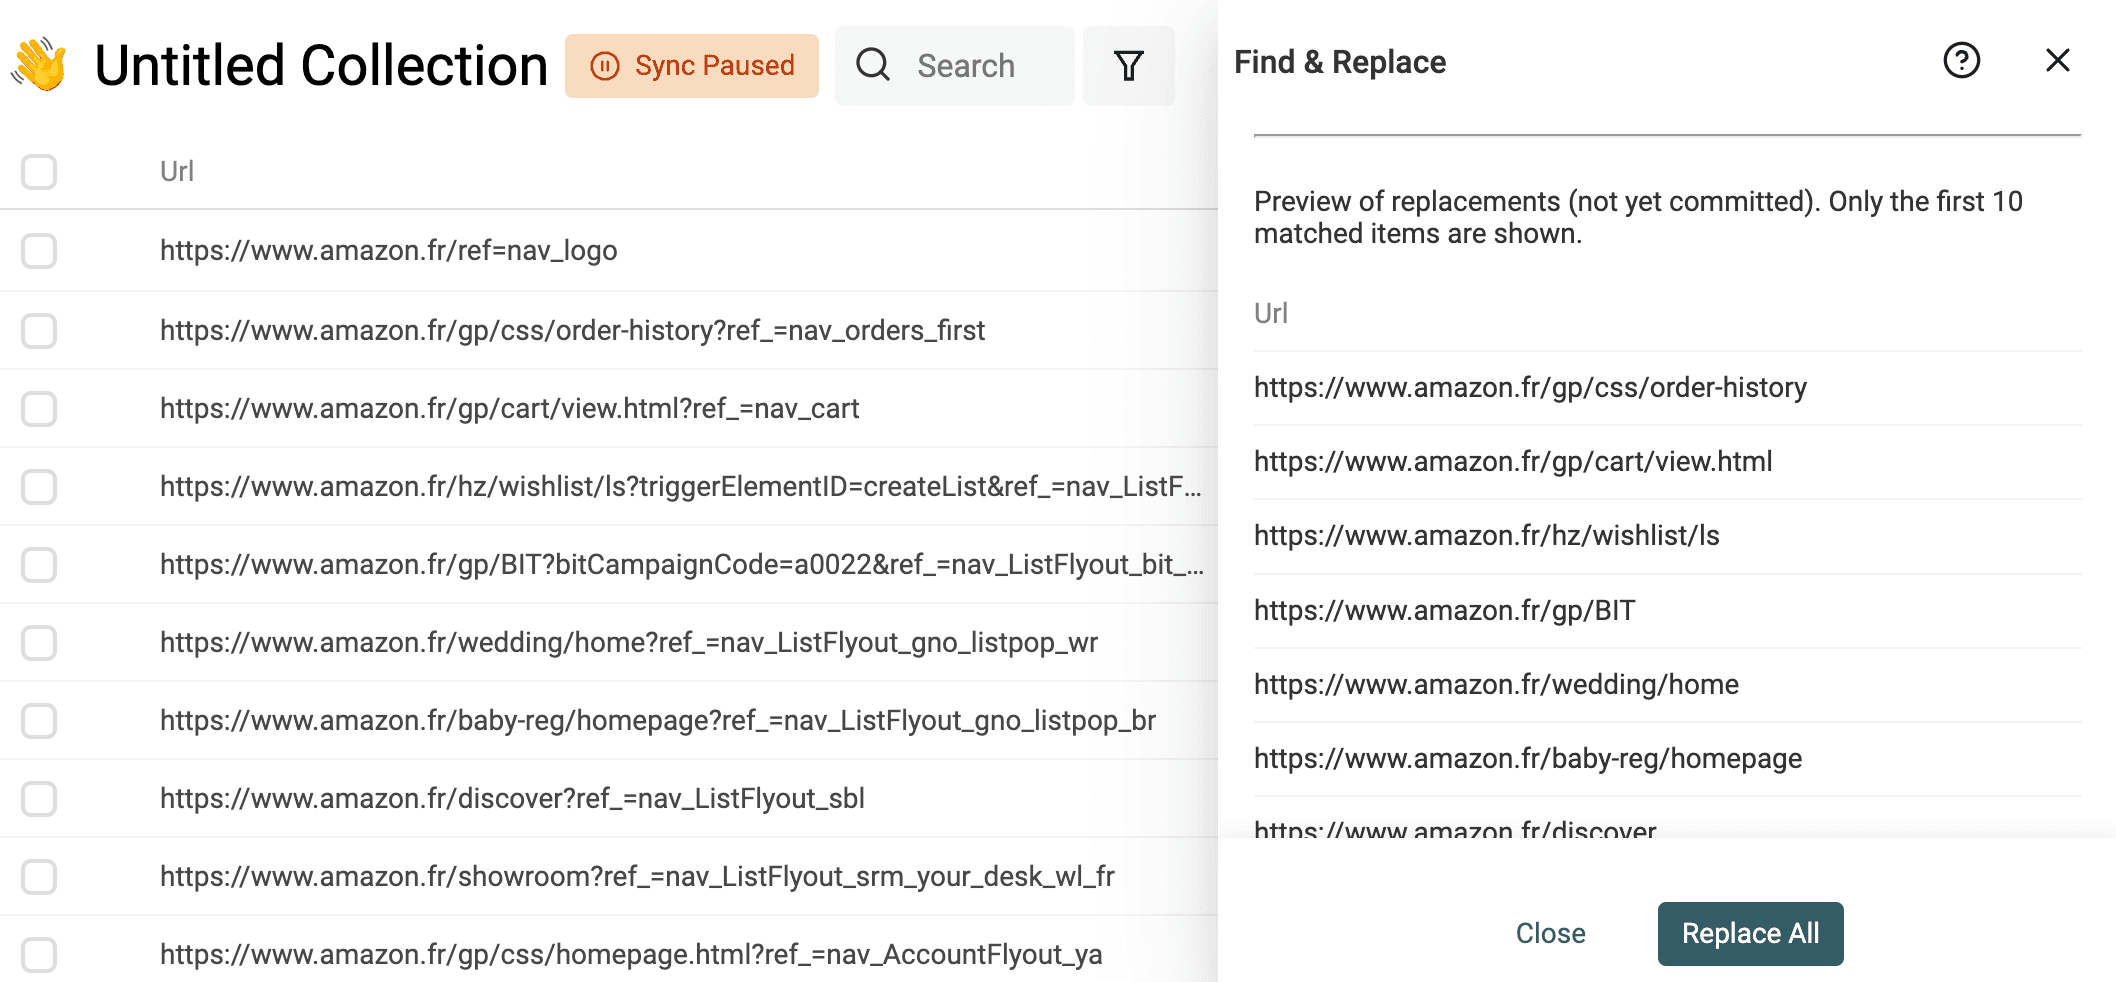
Per prima cosa, duplica la proprietà contenente l'URL sorgente. Usa l'espressione seguente solo dopo aver verificato che tutti i parametri di query presenti nella colonna possano essere eliminati. Per esempio, rimuove ?utm_source=newsletter dall'URL di una pagina, ma eliminerebbe anche ?variant=blue dall'URL di un prodotto. Se la variante è rilevante, conserva la query oppure rimuovi soltanto i parametri di tracking con una trasformazione separata.
Per eliminare l'intera query, seleziona Match using regular expression e usa questa espressione lasciando vuoto il campo di sostituzione:
\?.*$
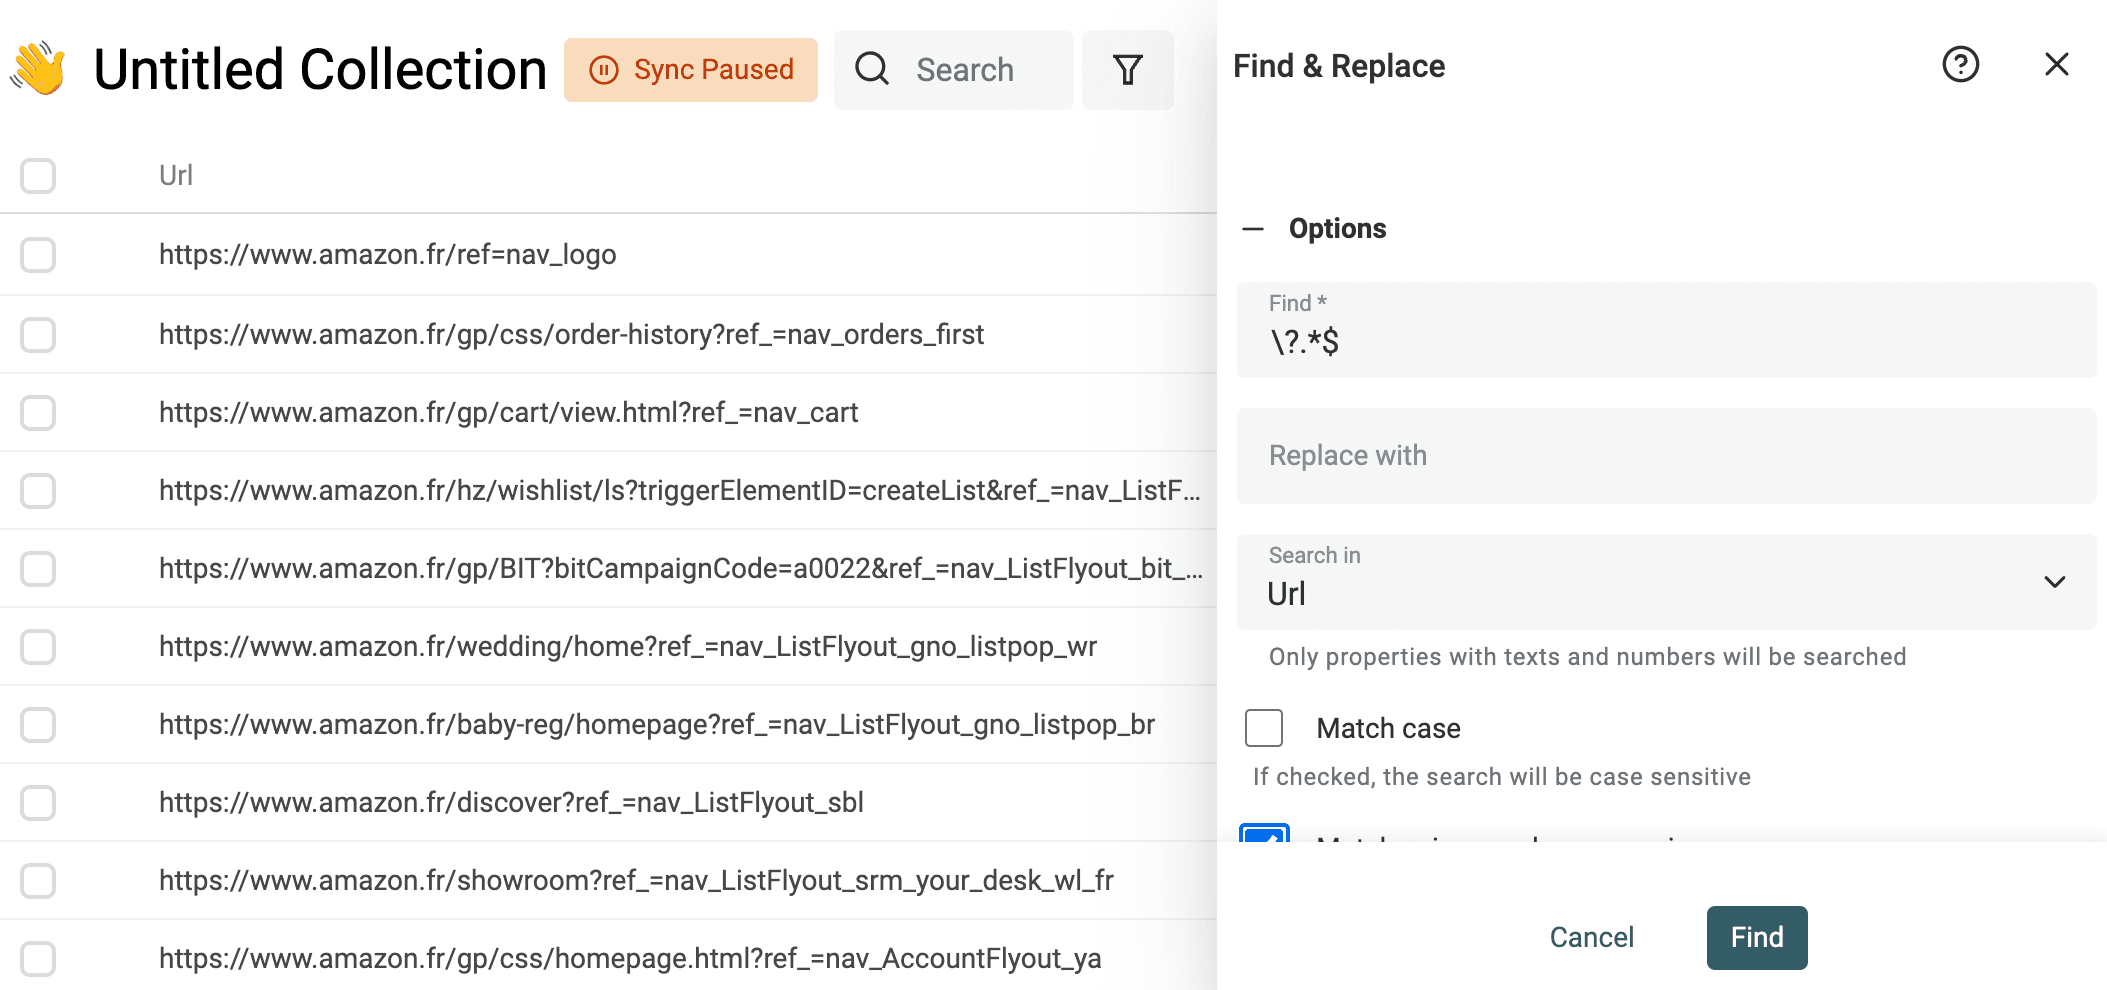
Controlla nell'anteprima gli URL con e senza query string, quindi applica la trasformazione esclusivamente alla copia della proprietà URL, e solo se gli indirizzi continuano a identificare le pagine corrette.
Estrarre il dominio dagli indirizzi email
Find and Replace può essere usato anche per estrarre il dominio di un'email, ovvero la parte successiva a @. Attenzione: non sempre corrisponde al sito web dell'azienda, perché un contatto potrebbe utilizzare un provider di posta personale.
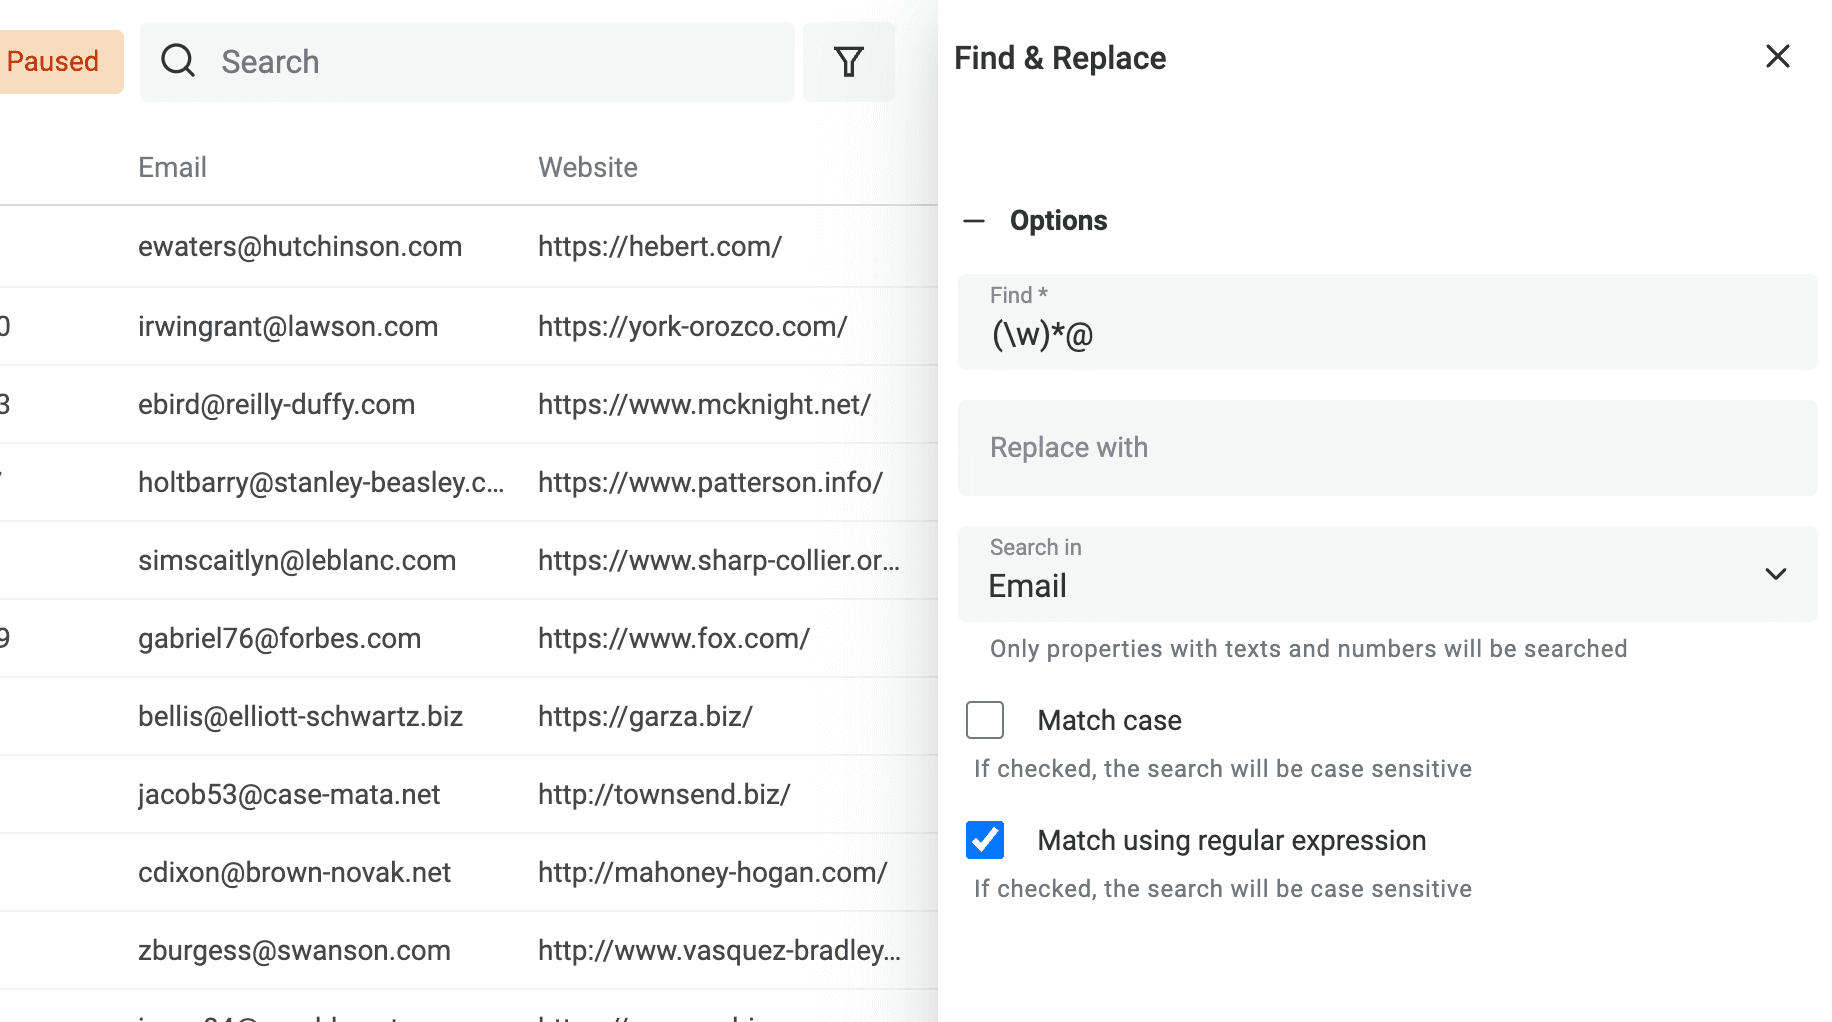
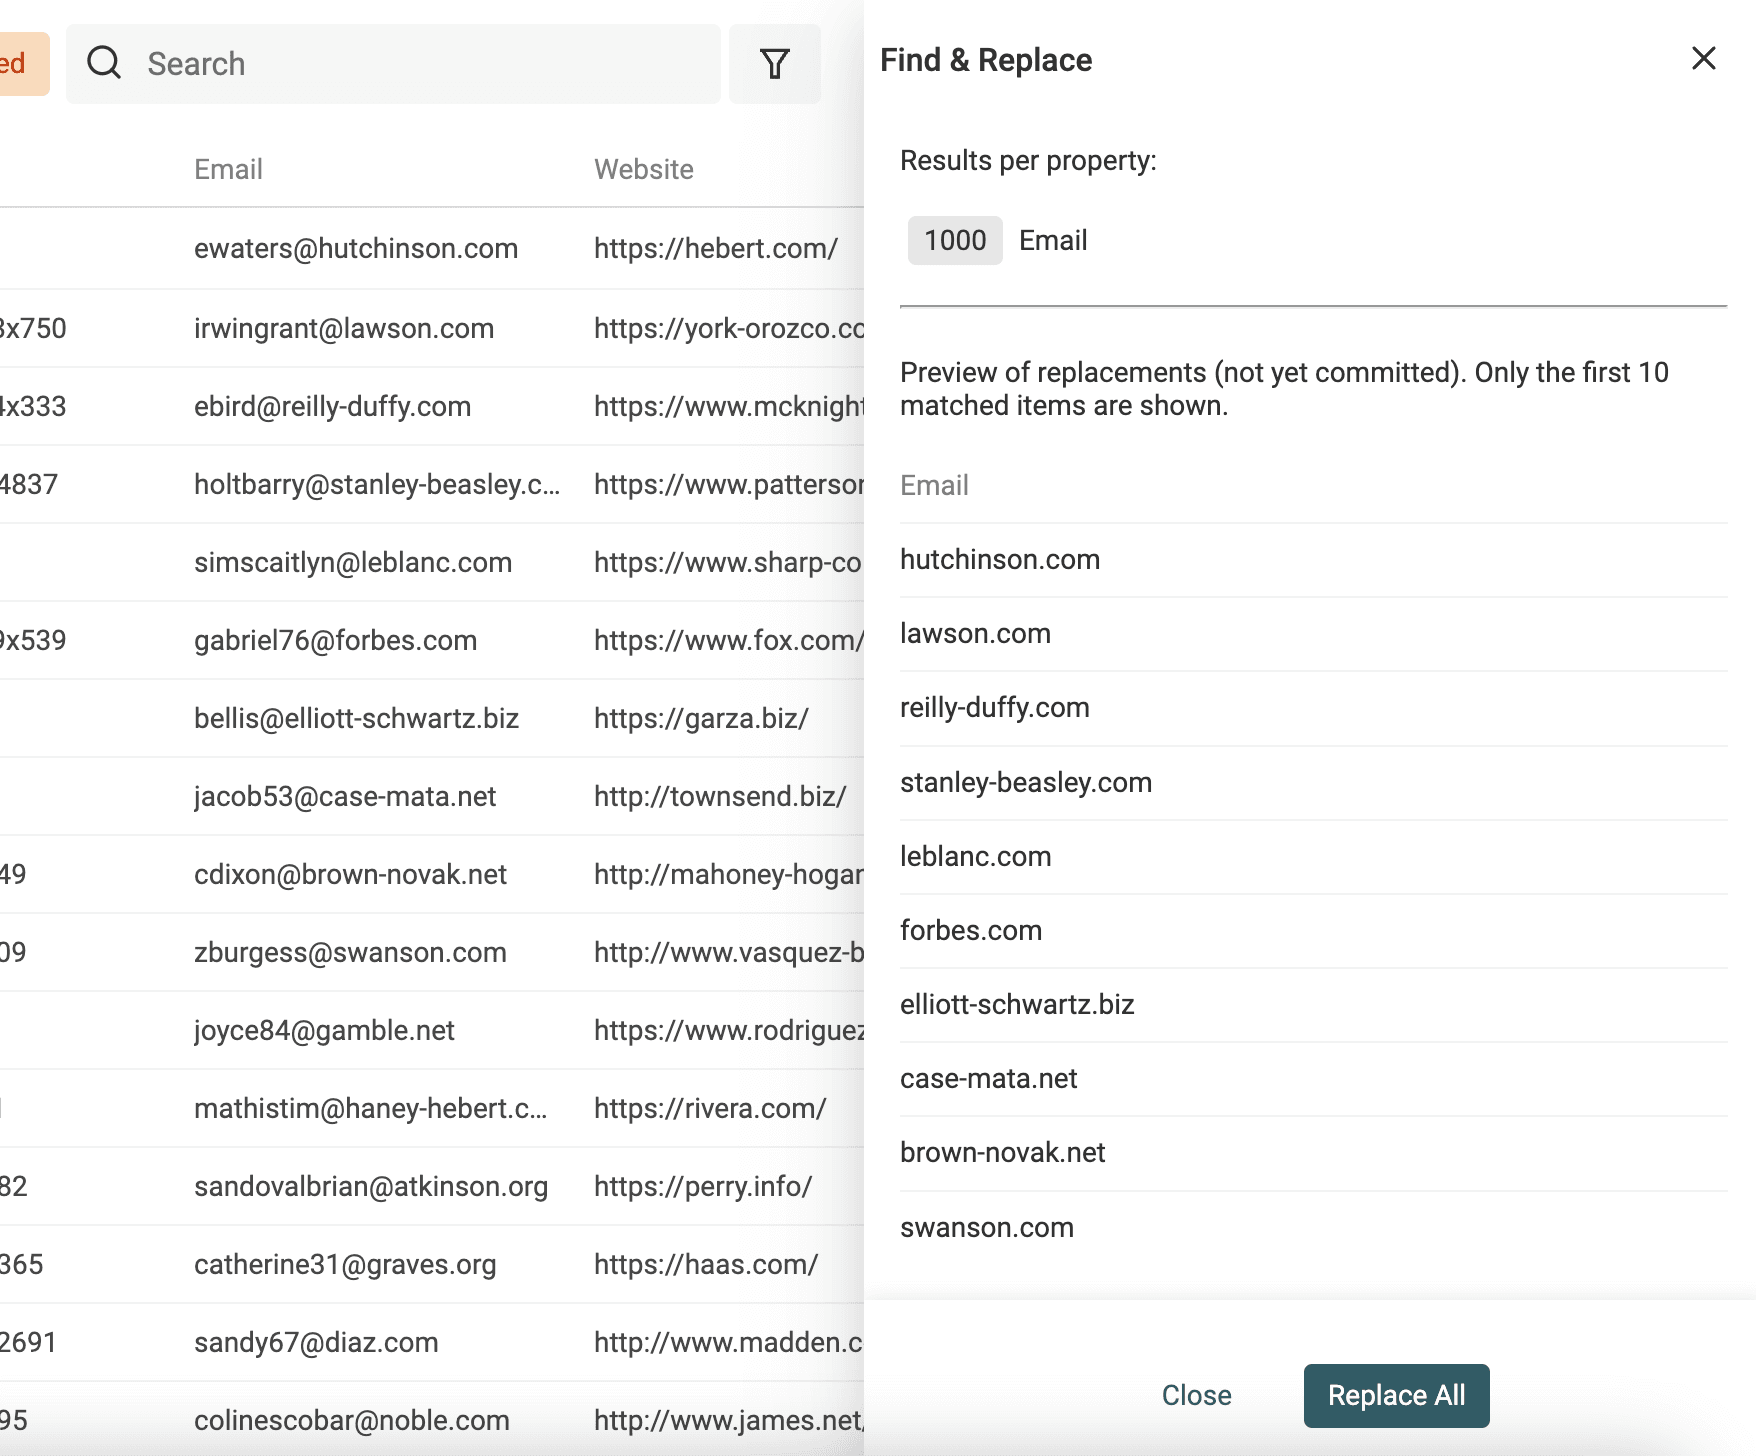
Duplica la proprietà email per conservare i dati sorgente. Per le celle che contengono un solo indirizzo email in formato semplice, usa questa espressione regolare lasciando vuoto il campo di sostituzione:
^[^@\s]+@(?=[^@\s]+$)
L'espressione gestisce parti locali con punti, segni più e trattini. Per esempio, jane.smith+sales@example.com diventa example.com. Lo screenshot meno recente qui sotto usa un pattern più restrittivo: utilizza invece l'espressione riportata sopra.
Prima rimuovi gli spazi circostanti. Le celle con un nome visualizzato, più indirizzi o email malformate richiedono una pulizia separata. Questa trasformazione estrae il dominio, ma non verifica l'esistenza della casella email.
👉 Per saperne di più, consulta la documentazione di Find and Replace. Apri la guida
Dividere il nome completo in nome e cognome
Quando fai scraping di liste di Lead, spesso ottieni contatti con un "Full Name" da dividere in "First Name" e "Last Name". Saper separare correttamente un nome nelle sue diverse parti è un passaggio fondamentale.
Separare i campi del nome aiuta a rivolgersi correttamente ai contatti e a mappare i dati in un CRM. Conserva il nome completo per poter controllare eventuali suddivisioni errate: il solo nome non consente di determinare il genere o il titolo di una persona.
Dividere i nomi può essere complesso. Fortunatamente, Datablist offre uno strumento intuitivo che separa il "Name" in due valori usando lo spazio come delimitatore.
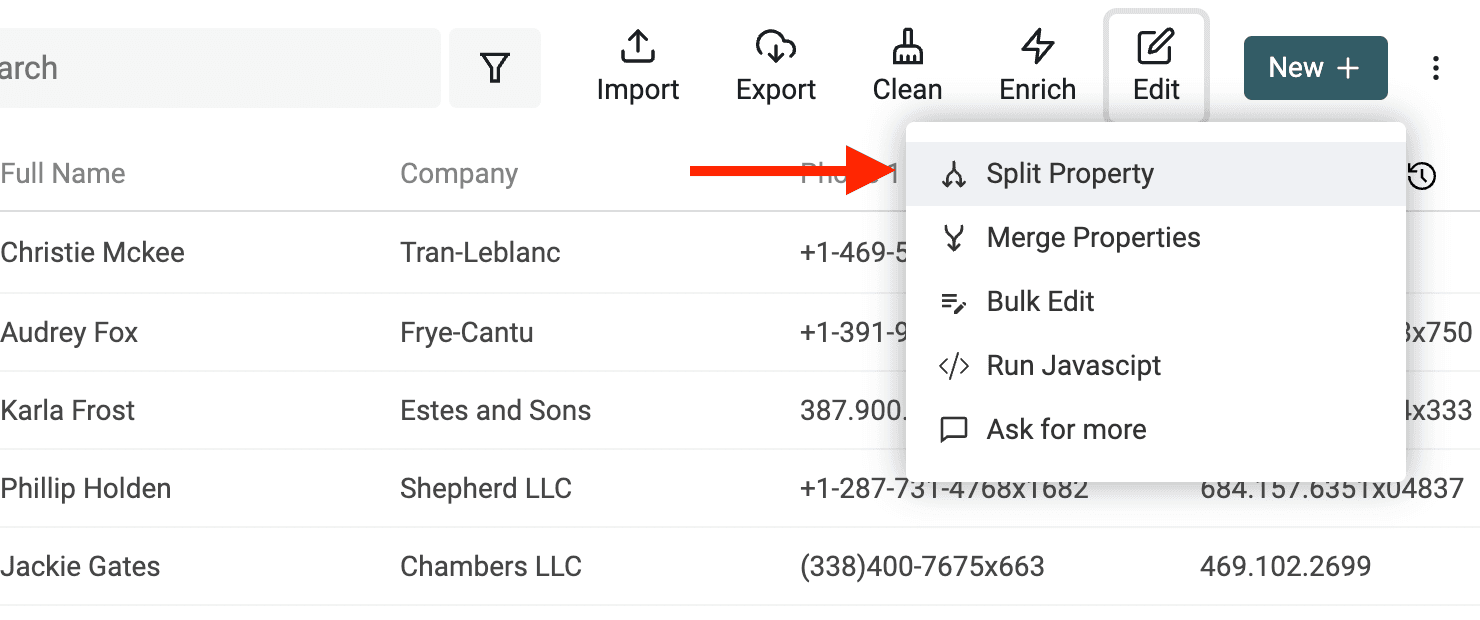
Per iniziare, apri lo strumento "Split Property" dal menu "Edit".
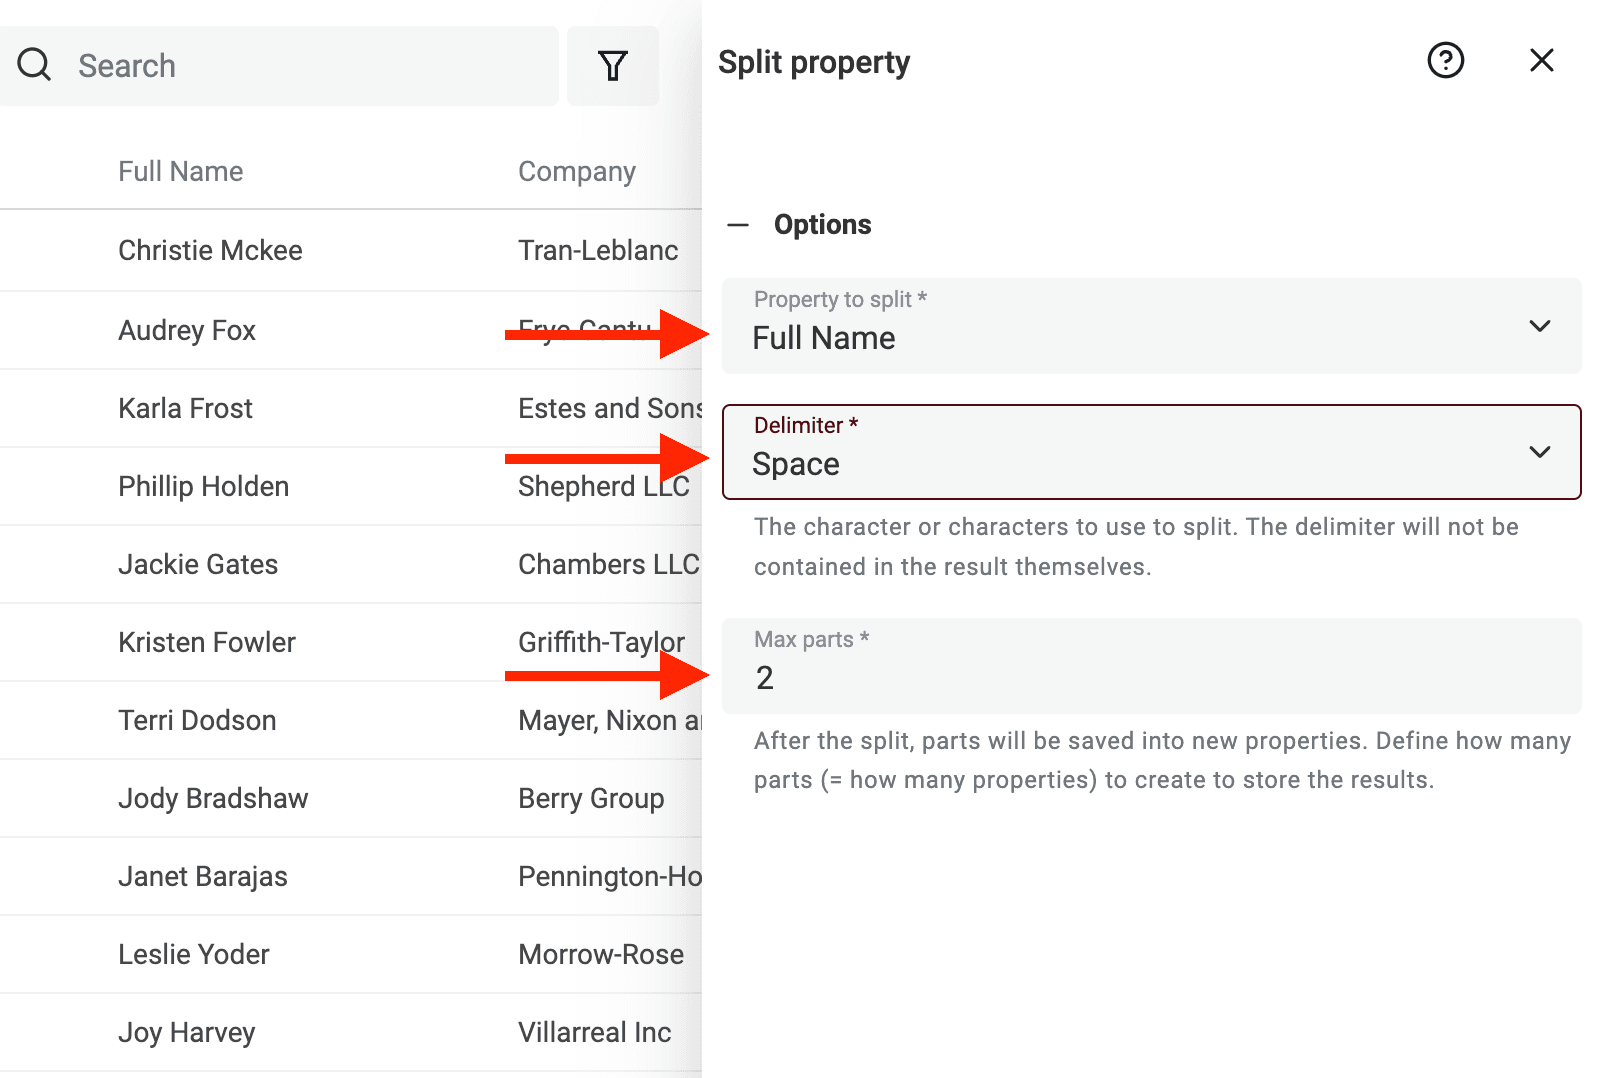
Seleziona la proprietà contenente i nomi da suddividere. Scegli Space come delimitatore e imposta a 2 il numero massimo di parti.
Avvia l'anteprima. Datablist analizzerà i primi 10 elementi per mostrare il risultato. Se è corretto, fai clic su "Split Property" per applicare l'algoritmo a tutti gli elementi correnti.
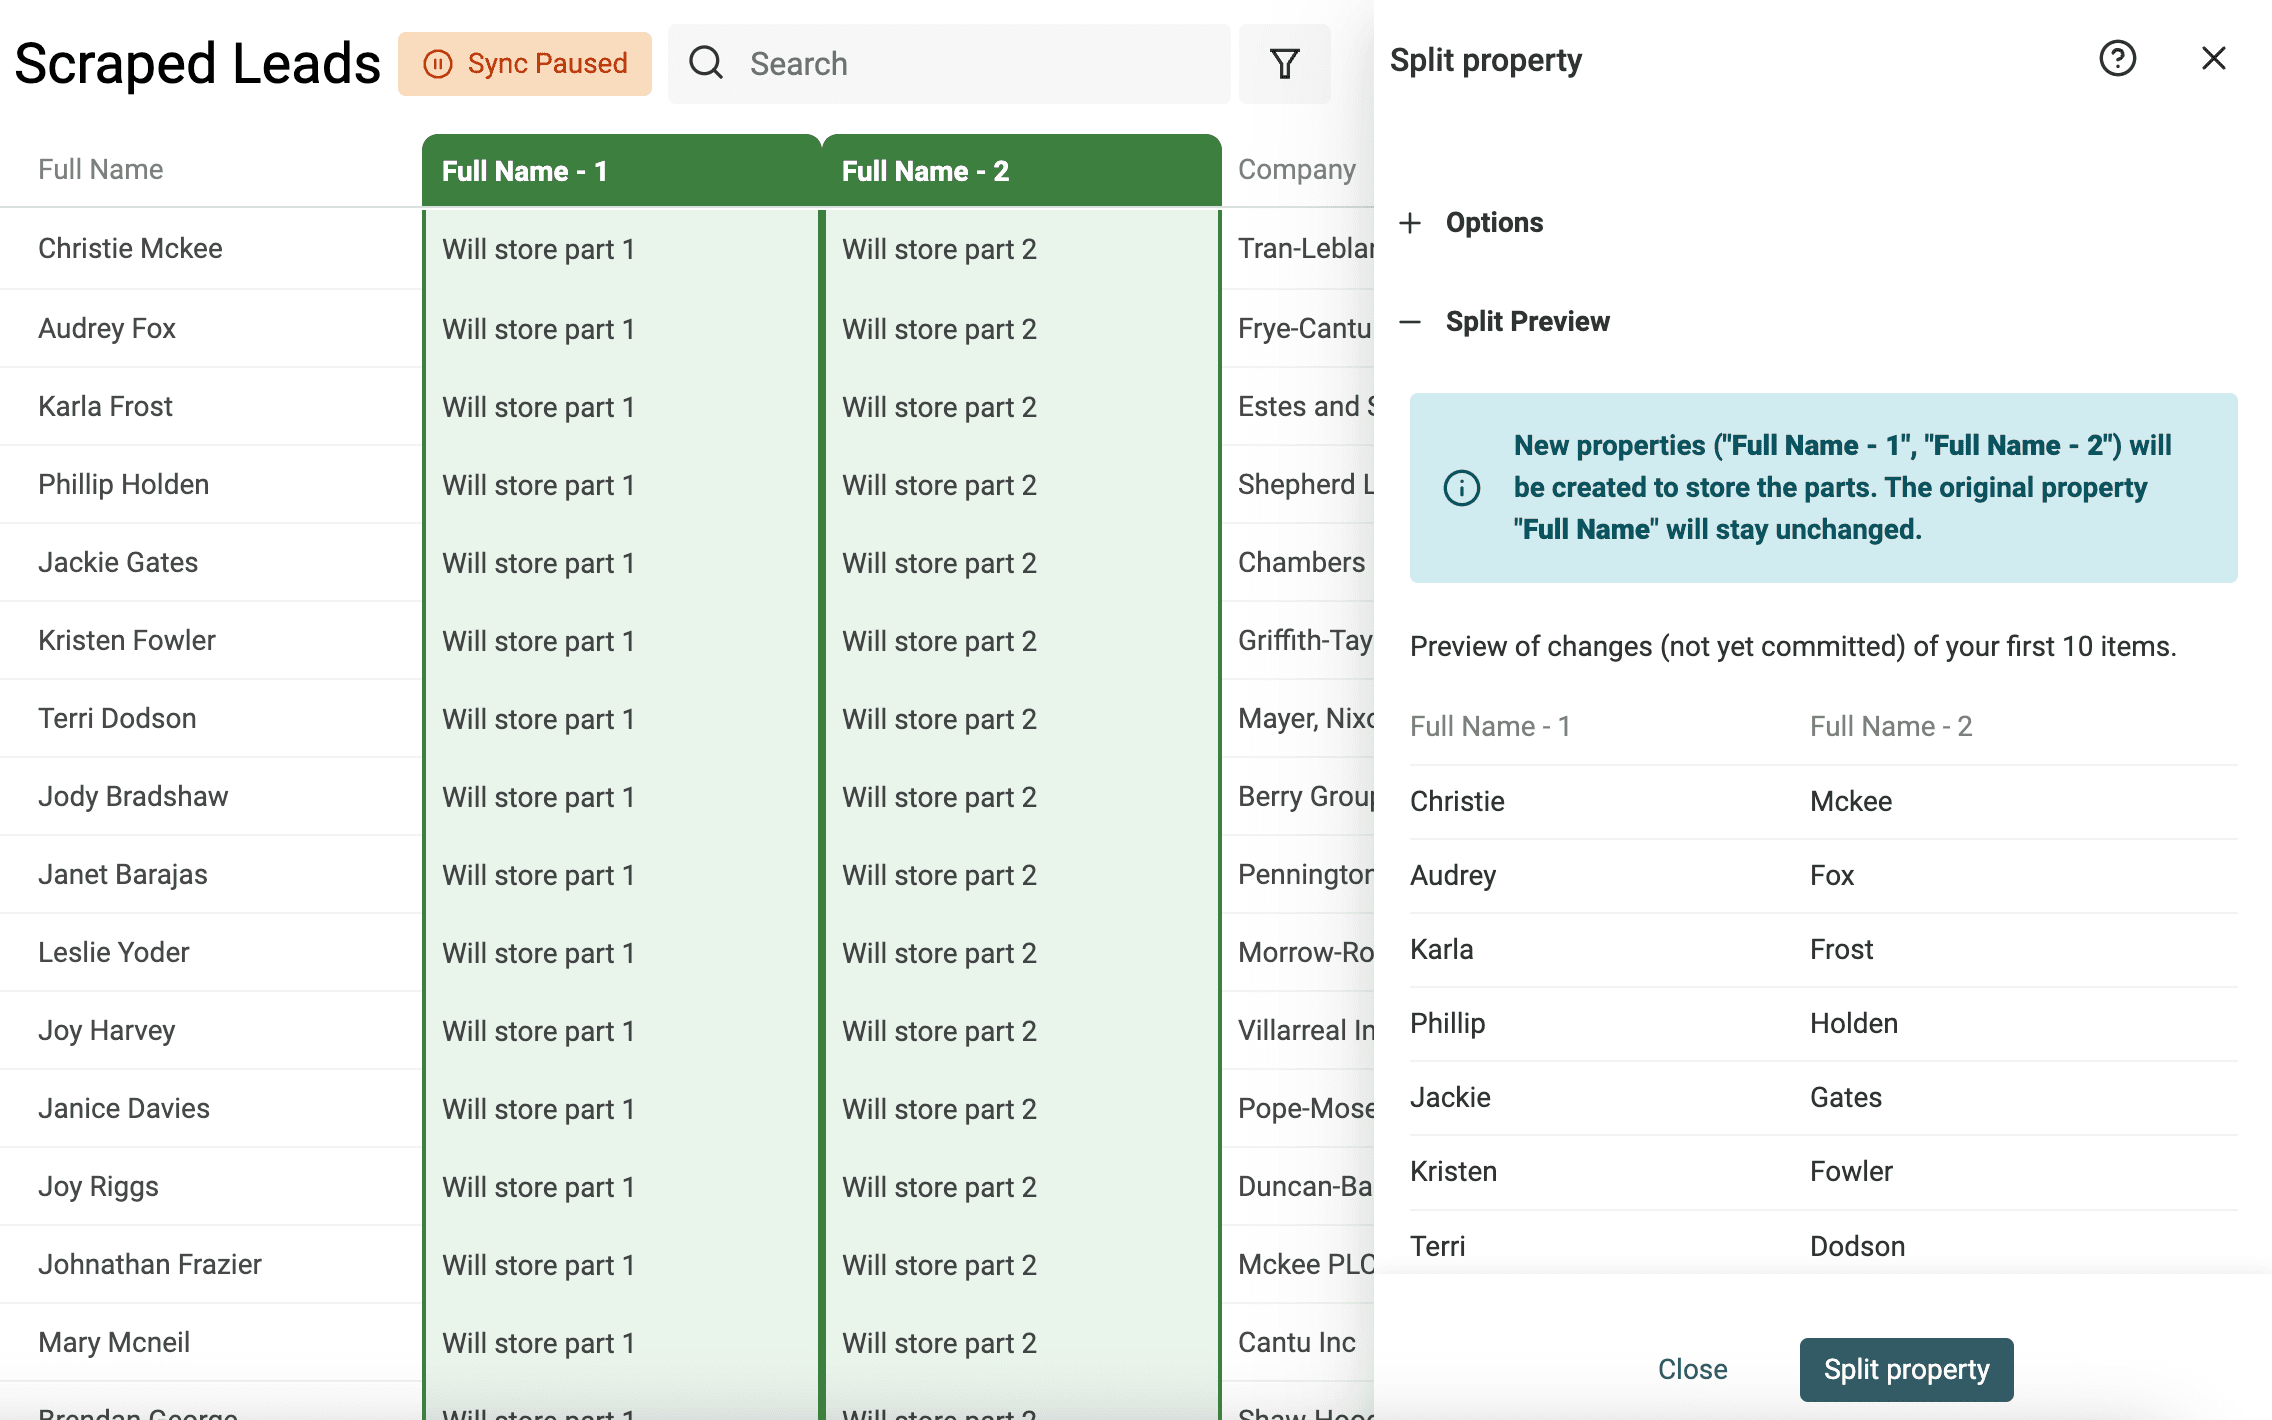
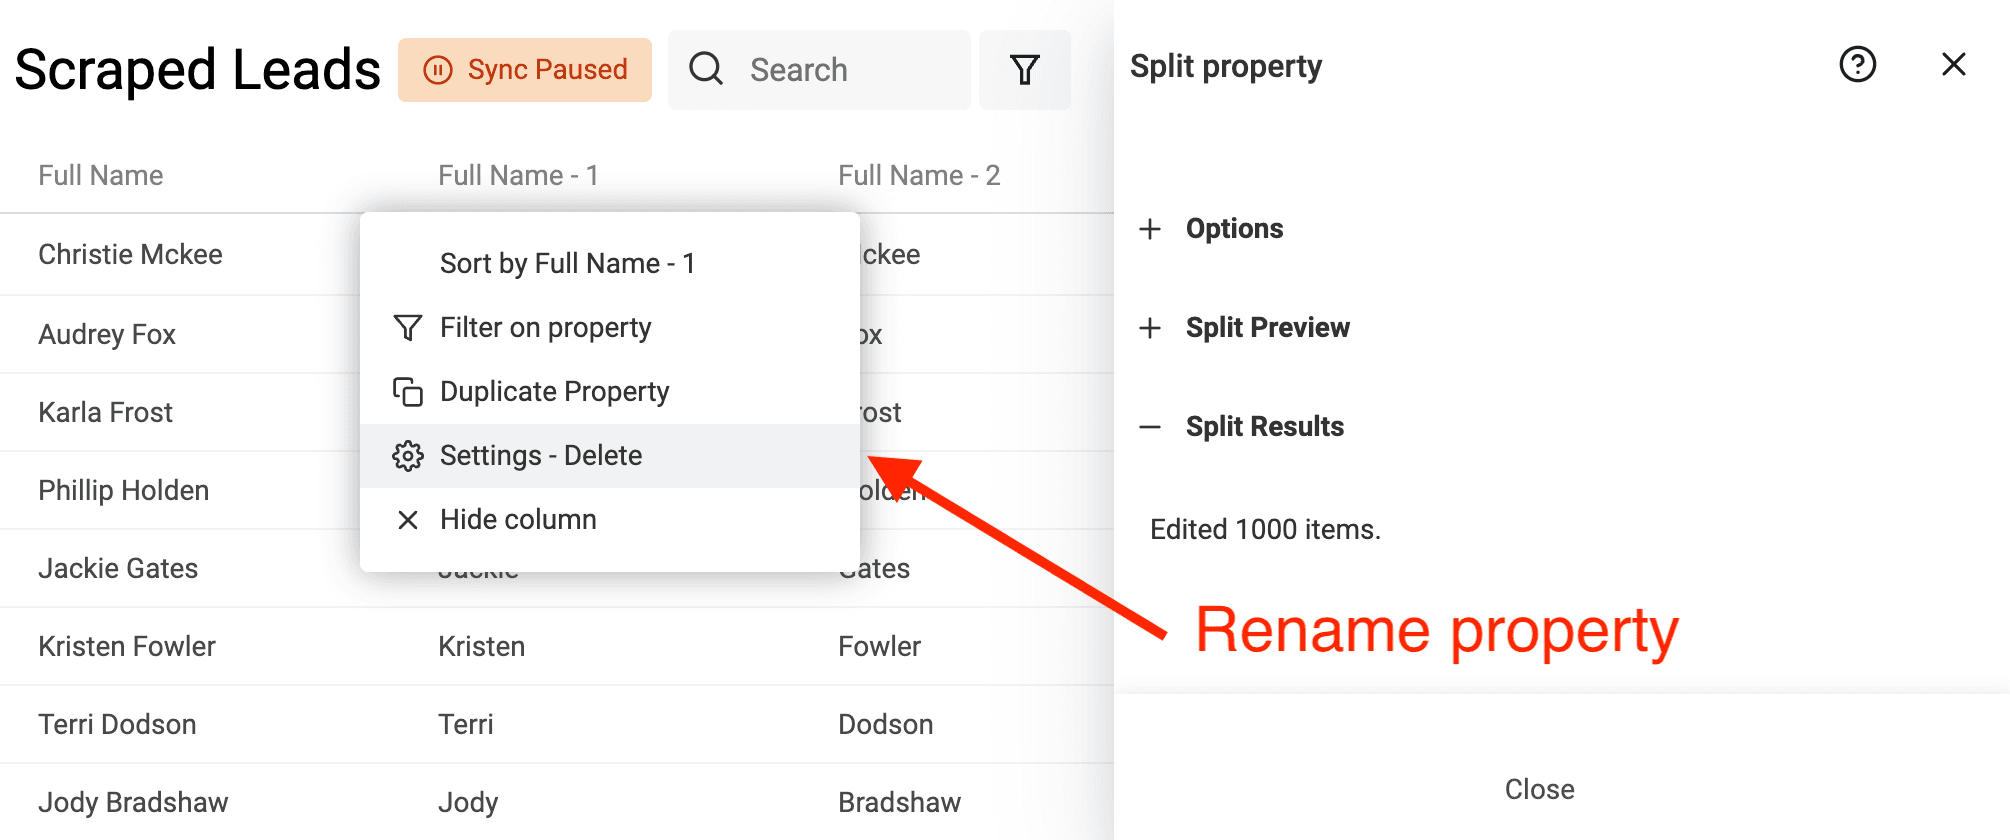
Al termine, rinomina le due proprietà create come "First Name" e "Last Name".
Questo esempio riguarda la suddivisione dei nomi secondo la convenzione occidentale, che in genere prevede nome e cognome. La procedura può essere più complessa con nomi appartenenti ad altre culture, che possono includere più nomi propri o cognomi. Lo stesso vale quando sono presenti titoli o suffissi.
Eliminare i record duplicati
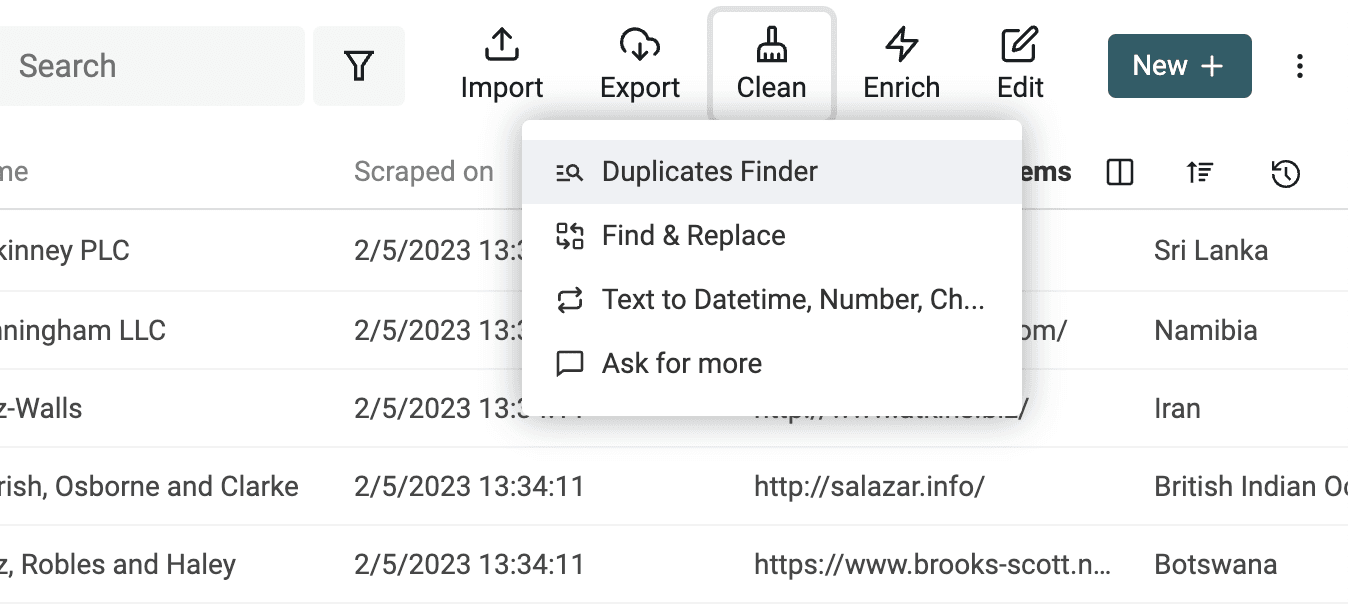
Apri Clean > Merge duplicates quando più righe contengono informazioni che vuoi conservare. Usa Remove duplicates quando vuoi mantenere una riga invariata ed eliminare le altre. Lo screenshot seguente mostra una versione precedente del menu.
Seleziona le proprietà che identificano in modo univoco un record. In genere parto dall'email del contatto o dall'URL del prodotto, anziché dal solo nome dell'azienda. Non serve normalizzare ogni campo quando è già disponibile una chiave di corrispondenza affidabile.
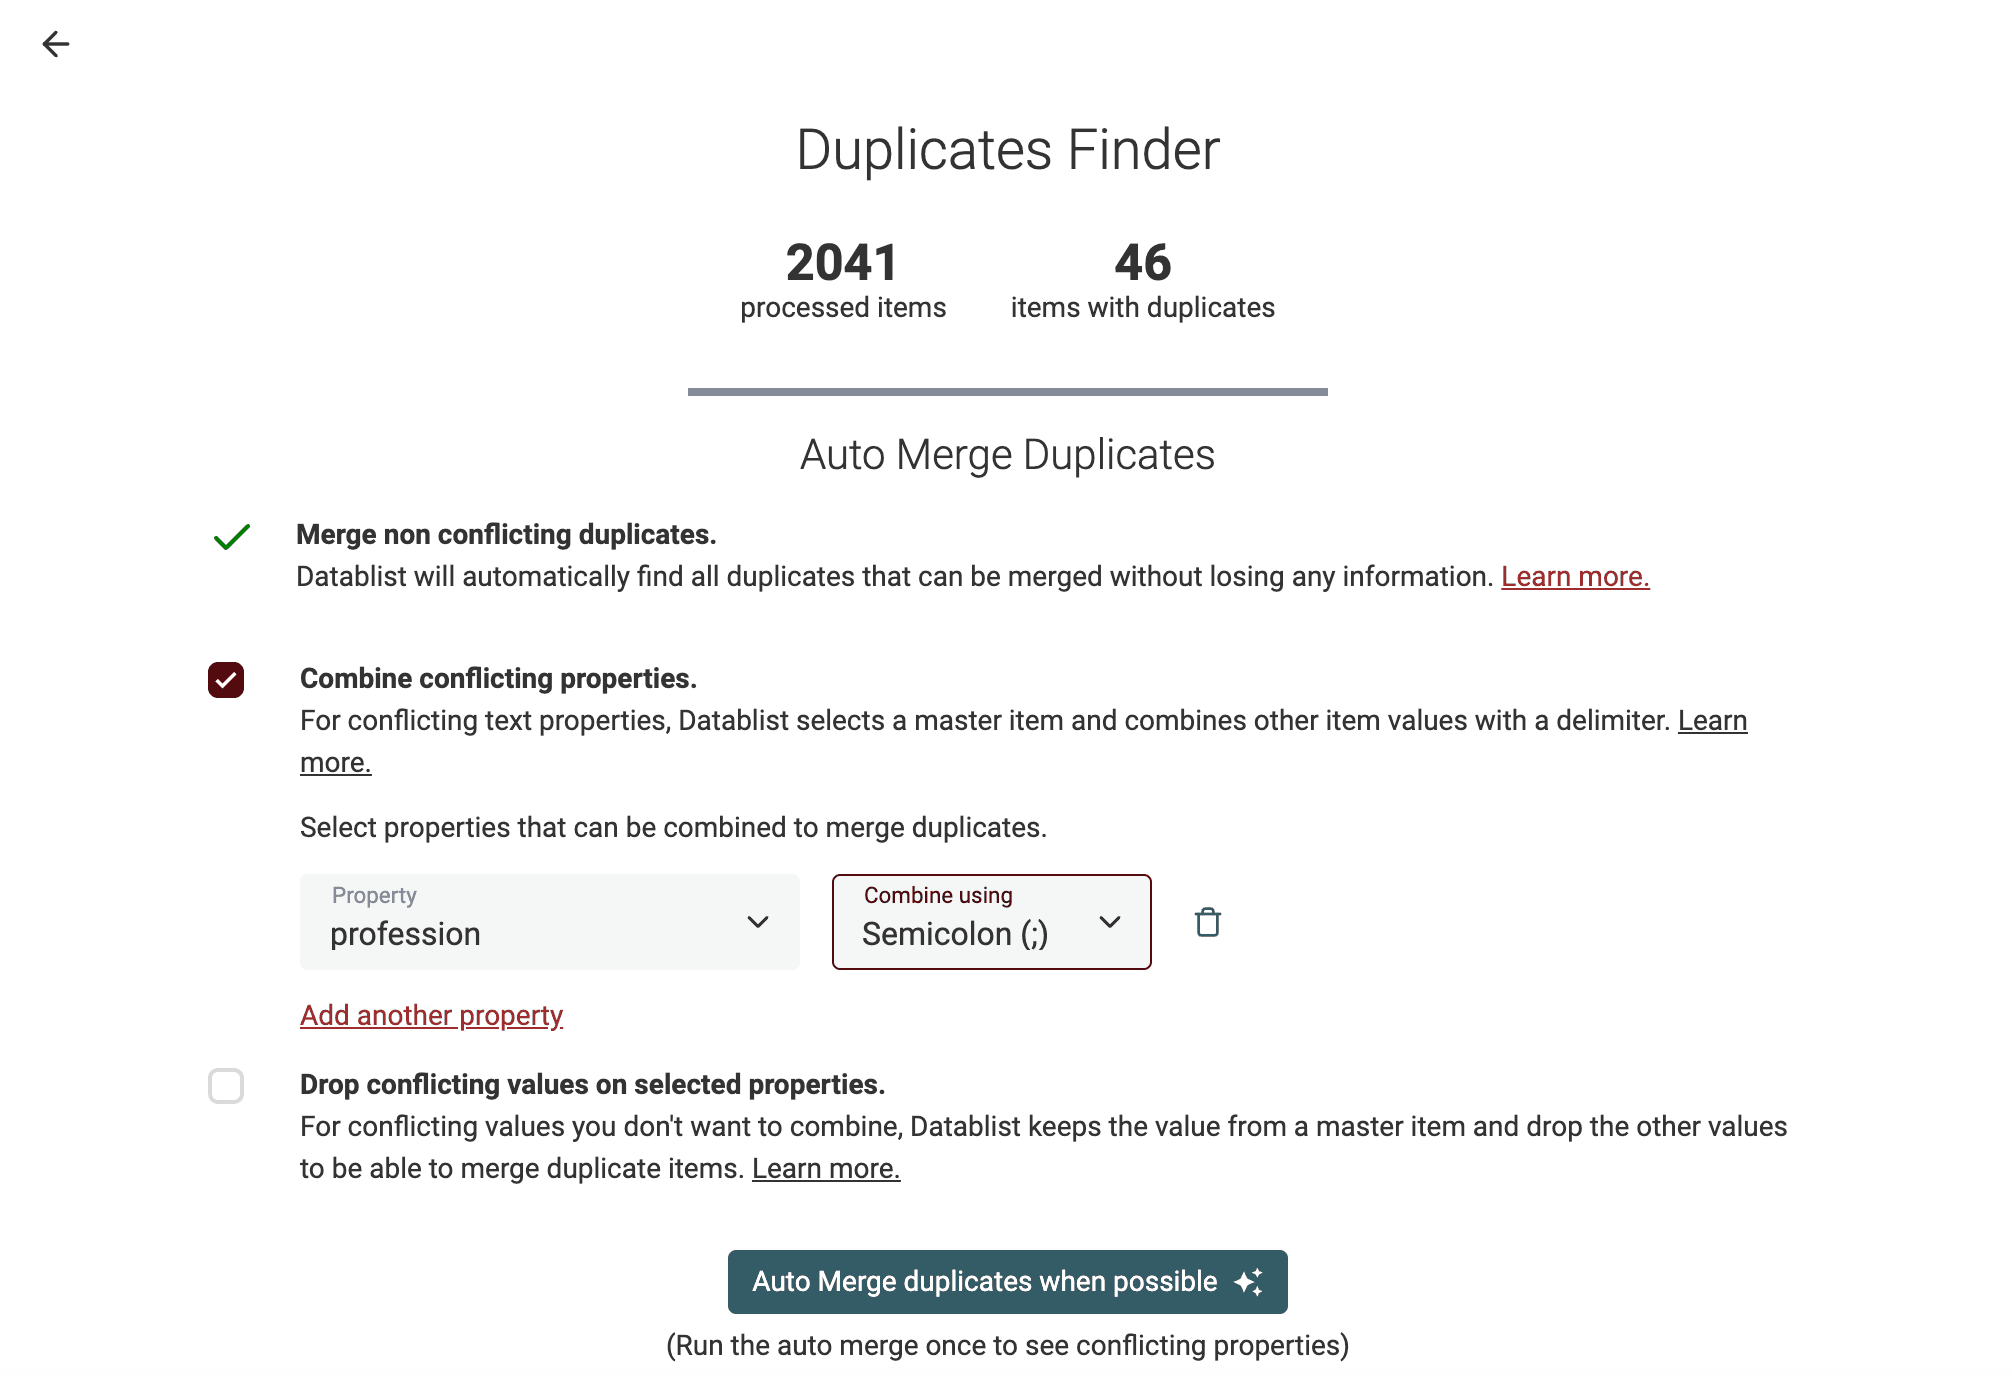
Il controllo crea gruppi da esaminare senza modificare i dati. Nell'area dei risultati, scegli Merge and preserve data, controlla Record to keep e configura le regole in Resolve conflicting values. Combina i valori testuali se devi conservarli entrambi; mantienine uno solo se sei disposto a eliminare gli altri.
Controlla i gruppi Ready prima di fare clic su Merge ready groups. Se scegli invece la rimozione, verifica che le righe eliminate non contengano dati aggiuntivi, perché questa modalità lascia invariata la riga conservata.
👉 Consulta la nostra guida per scoprire come unire i duplicati nei file CSV. Apri la guida
Verificare gli indirizzi email
I dati ottenuti tramite scraping possono essere obsoleti, contenere errori di battitura o non essere validi. Questo vale soprattutto per gli indirizzi email ricavati con lo scraping.
Quando i dati sono generati dagli utenti, nel database possono finire indirizzi email falsi o appartenenti a provider temporanei.
Datablist dispone di uno strumento integrato per verificare migliaia di indirizzi email.
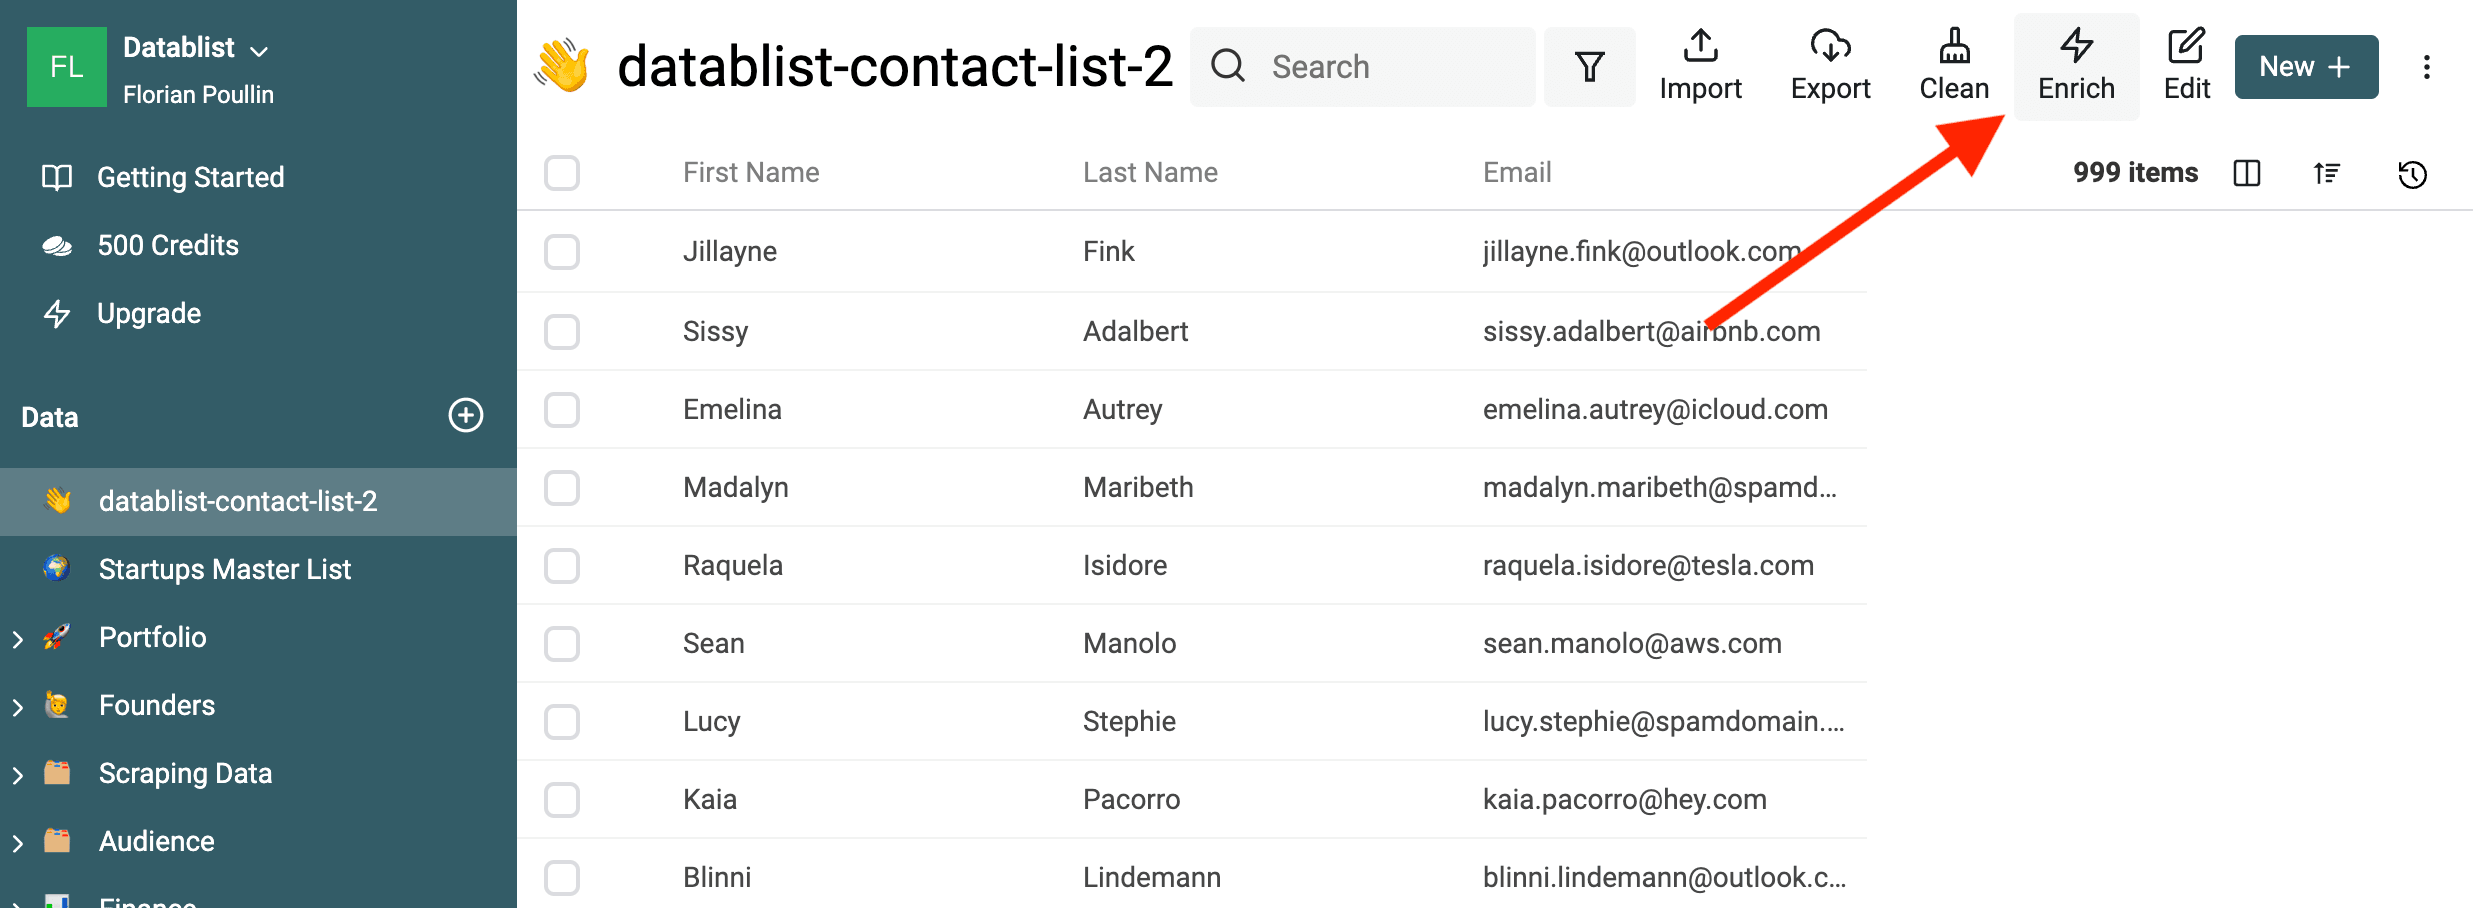
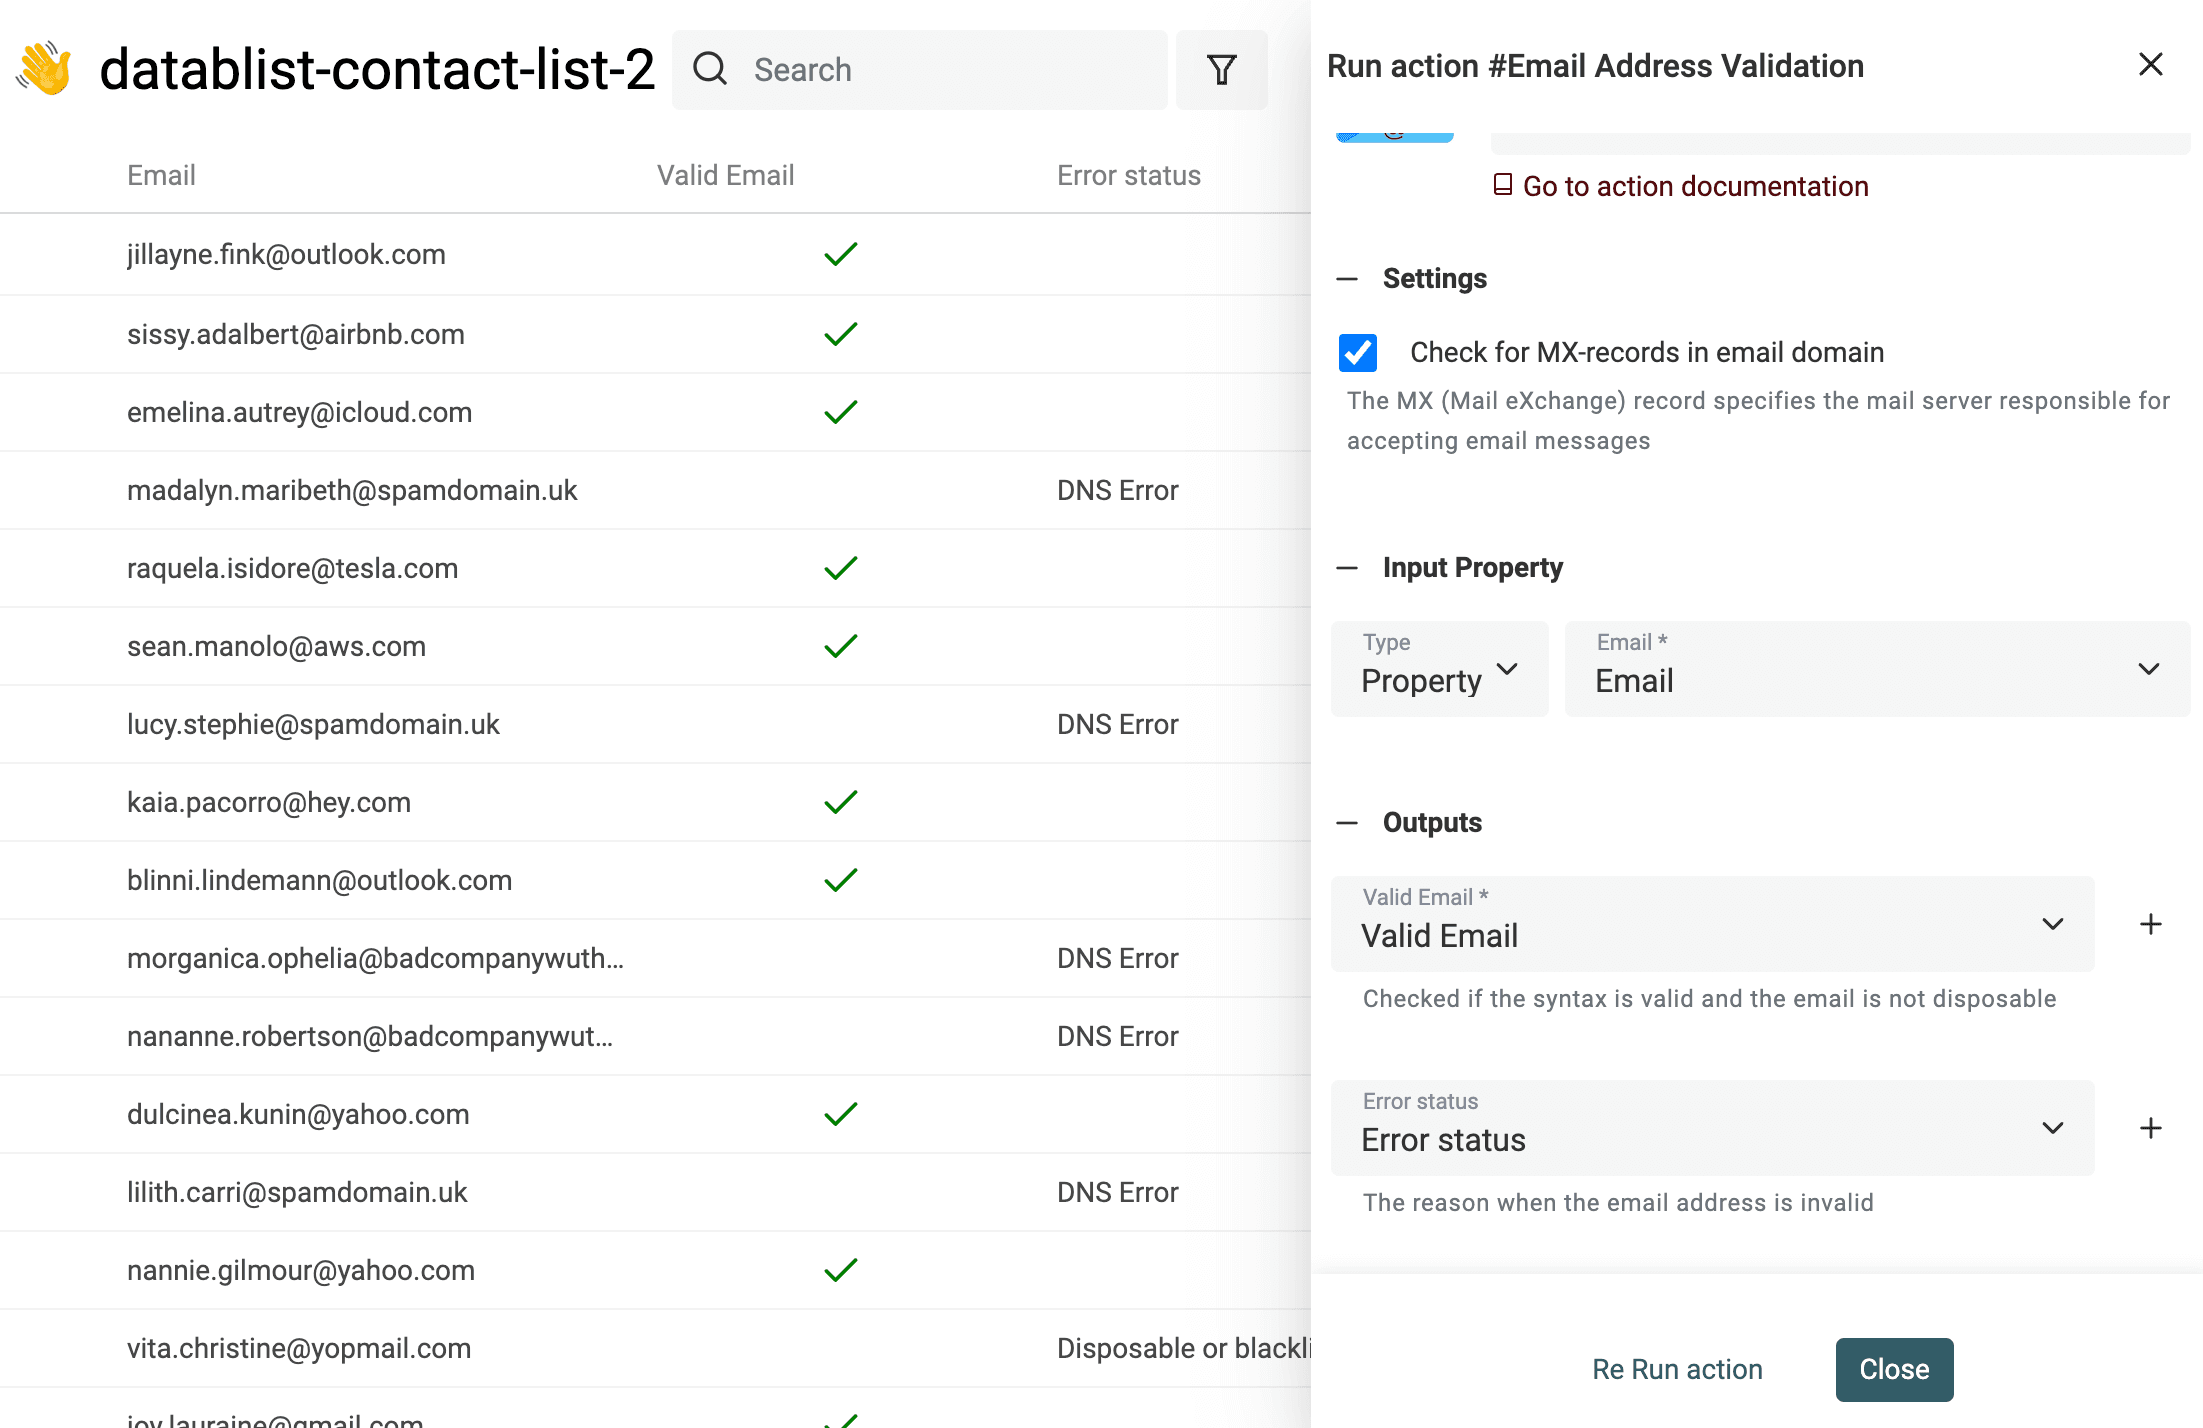
Il servizio gratuito di pulizia delle email controlla la sintassi, i domini usa e getta e, quando l'opzione è attiva, i record MX del dominio. Questi controlli non dimostrano che una specifica casella esista né che un messaggio verrà consegnato. Conserva lo stato o la motivazione restituita per poter esaminare le eccezioni.
Il servizio offre:
- Analisi della sintassi email - Segnala gli indirizzi malformati, per esempio quelli privi del simbolo
@o con un dominio in formato non valido. - Controllo dei provider usa e getta - Rileva le email temporanee cercando i domini appartenenti a provider di Disposable Email Address (DEA), come Mailinator, Temp-Mail, YopMail e altri.
- Controllo dei record MX del dominio - Cerca i record del mail server del dominio, a meno che non venga attivata l'opzione Disable MX-records analysis. Esamina i risultati DNS mancanti o non riusciti separatamente dagli errori di sintassi: il controllo riguarda il dominio, non la singola casella.
- Segmentazione tra email business e personali - Se raccogli prospect tramite lead magnet o vuoi segmentare la tua base utenti, può essere utile distinguere i contatti con email aziendale da quelli con email personale. Il servizio di verifica fornisce questa informazione per arricchire i dati dei contatti.
👉 Consulta la nostra guida per scoprire come pulire una lista email. Apri la guida
Estrarre nomi di persone o aziende dai testi
Quando si estraggono testi da siti web o altre fonti, spesso è utile individuare i nomi di persone e aziende. Queste informazioni possono servire per numerose attività, dalla lead generation all'analisi dei competitor. Tuttavia, estrarre nomi da testi non strutturati può essere difficile: i nomi assumono forme diverse e possono trovarsi all'interno di blocchi di testo più ampi.
Una delle difficoltà principali è l'ampia varietà di convenzioni e formati usati nelle diverse culture e lingue. In alcune culture, per esempio, il cognome precede il nome, mentre in altre avviene il contrario. Alcune persone hanno più nomi propri, altre nessuno. Inoltre, i nomi possono contenere errori, abbreviazioni o formati non standard, che rendono difficile individuarli tramite semplici tecniche di pattern matching.
Un approccio comune consiste nell'usare il Named Entity Recognition (NER), una tecnica di elaborazione del linguaggio naturale che identifica e classifica le entità presenti in un testo. I modelli NER possono essere addestrati a riconoscere diversi tipi di entità, tra cui persone, organizzazioni e luoghi, e personalizzati per gestire convenzioni e varianti differenti.
Datablist include un potente modello "Named Entity Recognition" (NER), eseguibile direttamente sui testi. È addestrato in arabo, tedesco, inglese, spagnolo, francese, italiano, lettone, olandese, portoghese e cinese.
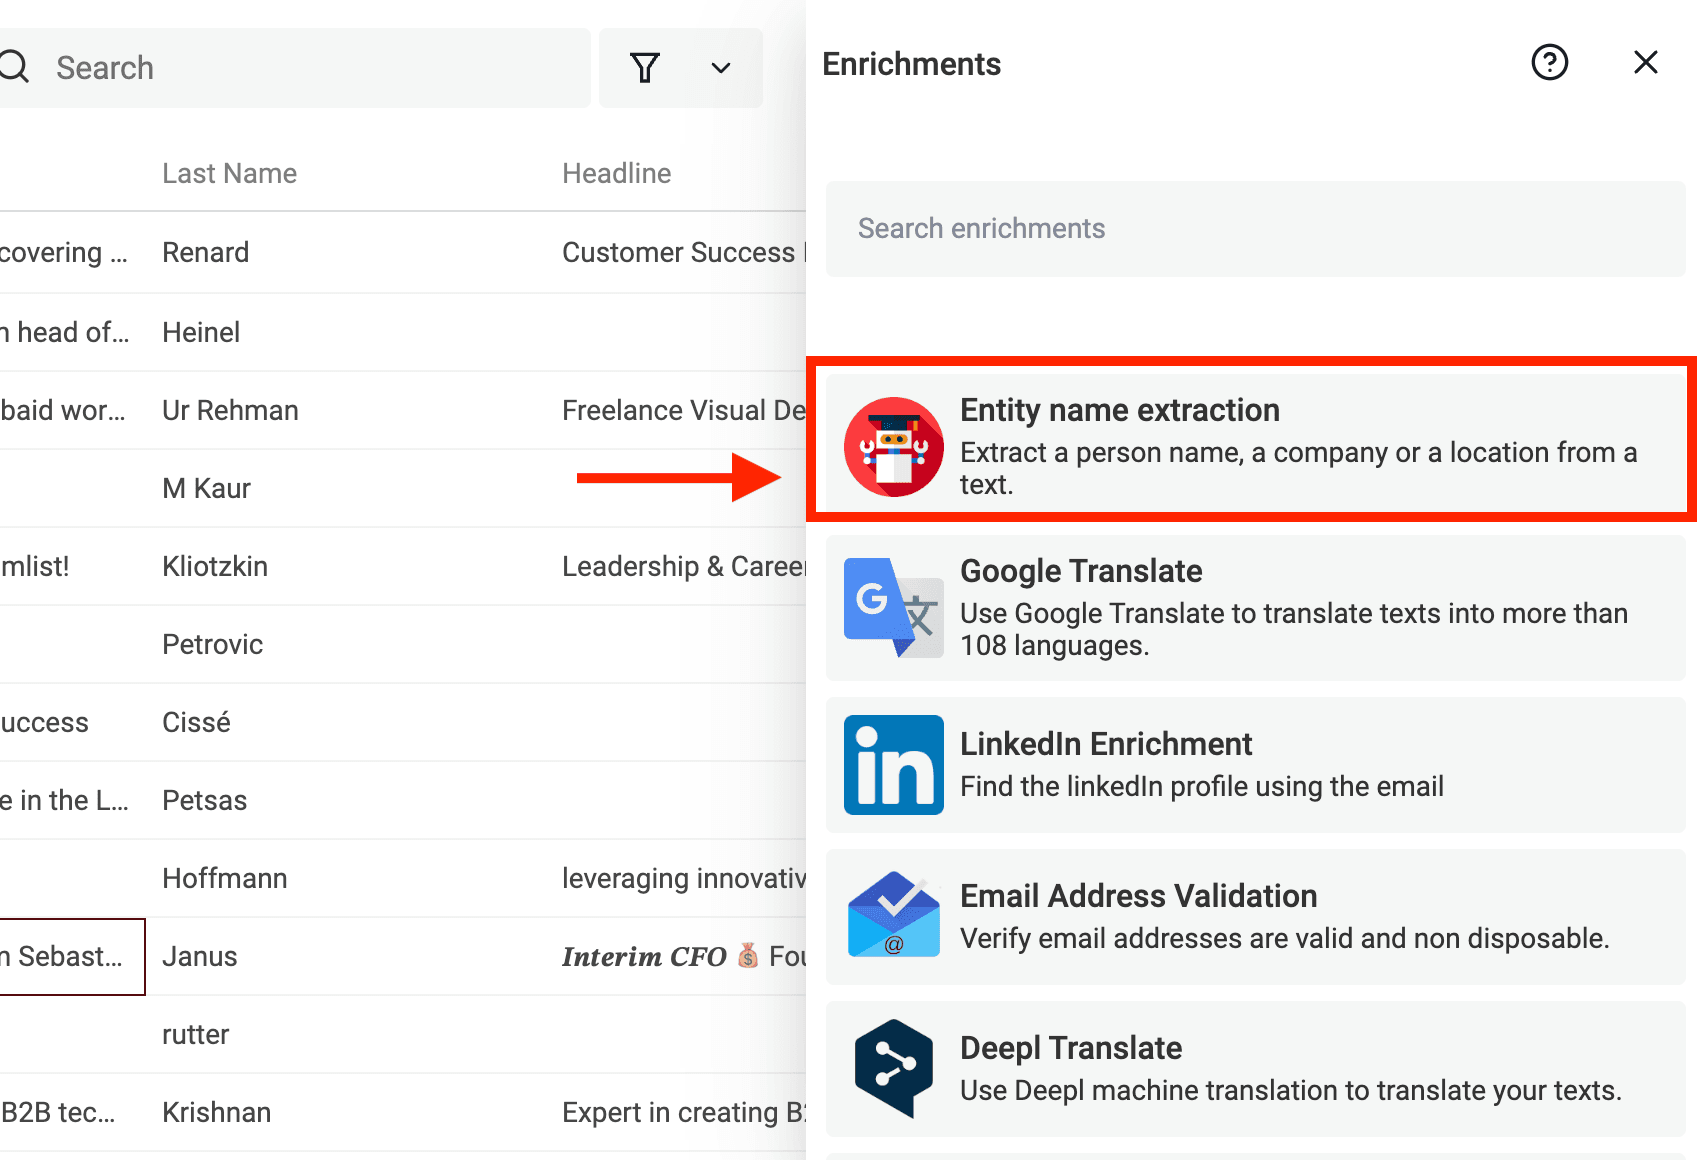
Seleziona "Entity name extraction" dal menu "Enrichments".
Nelle opzioni di input, seleziona la proprietà contenente il testo da cui estrarre i nomi.
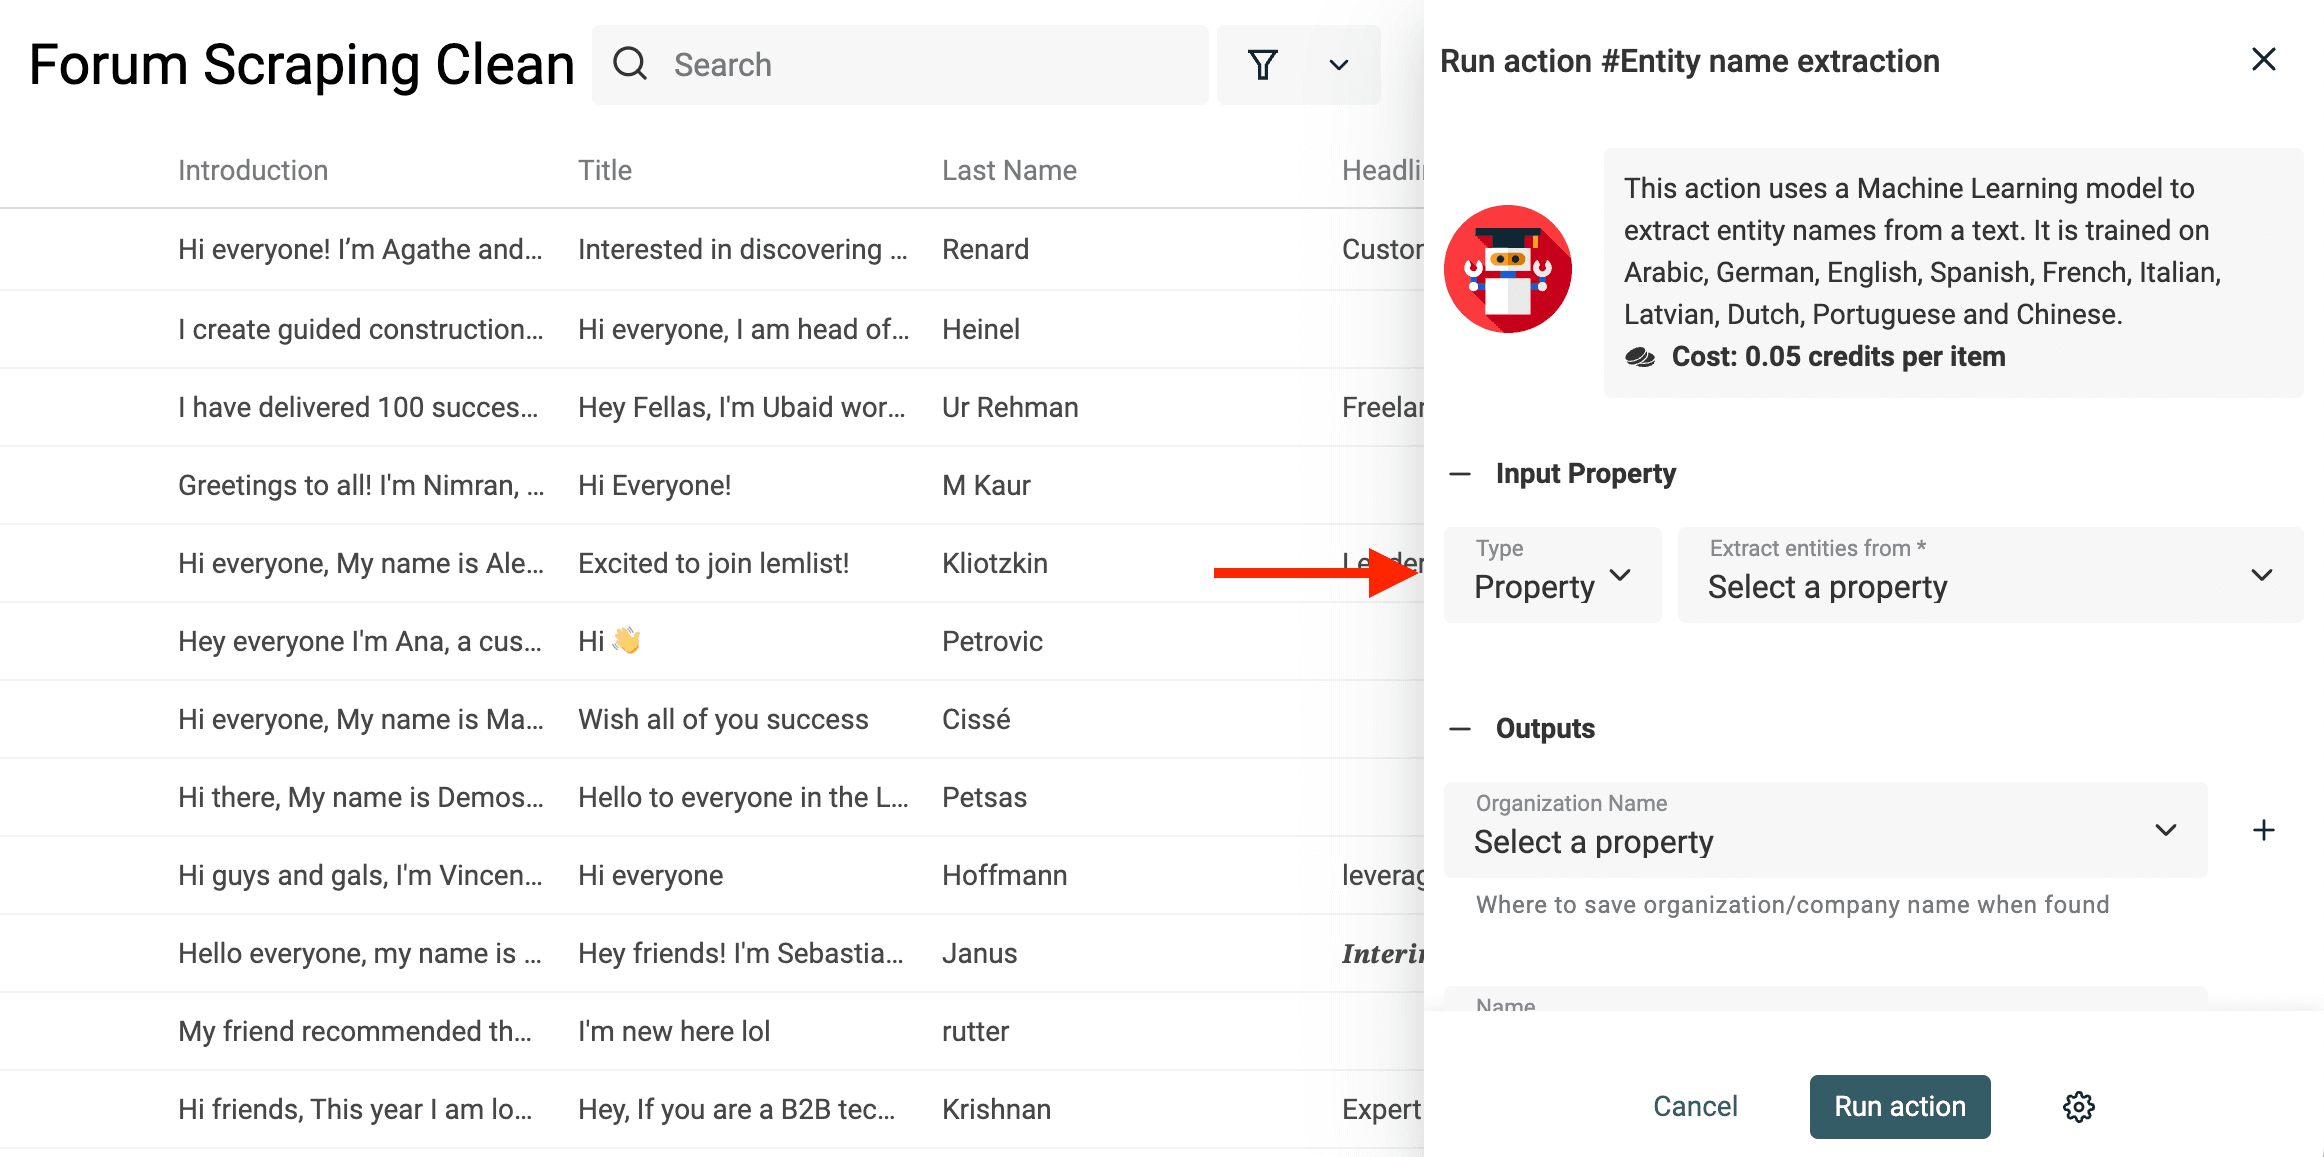
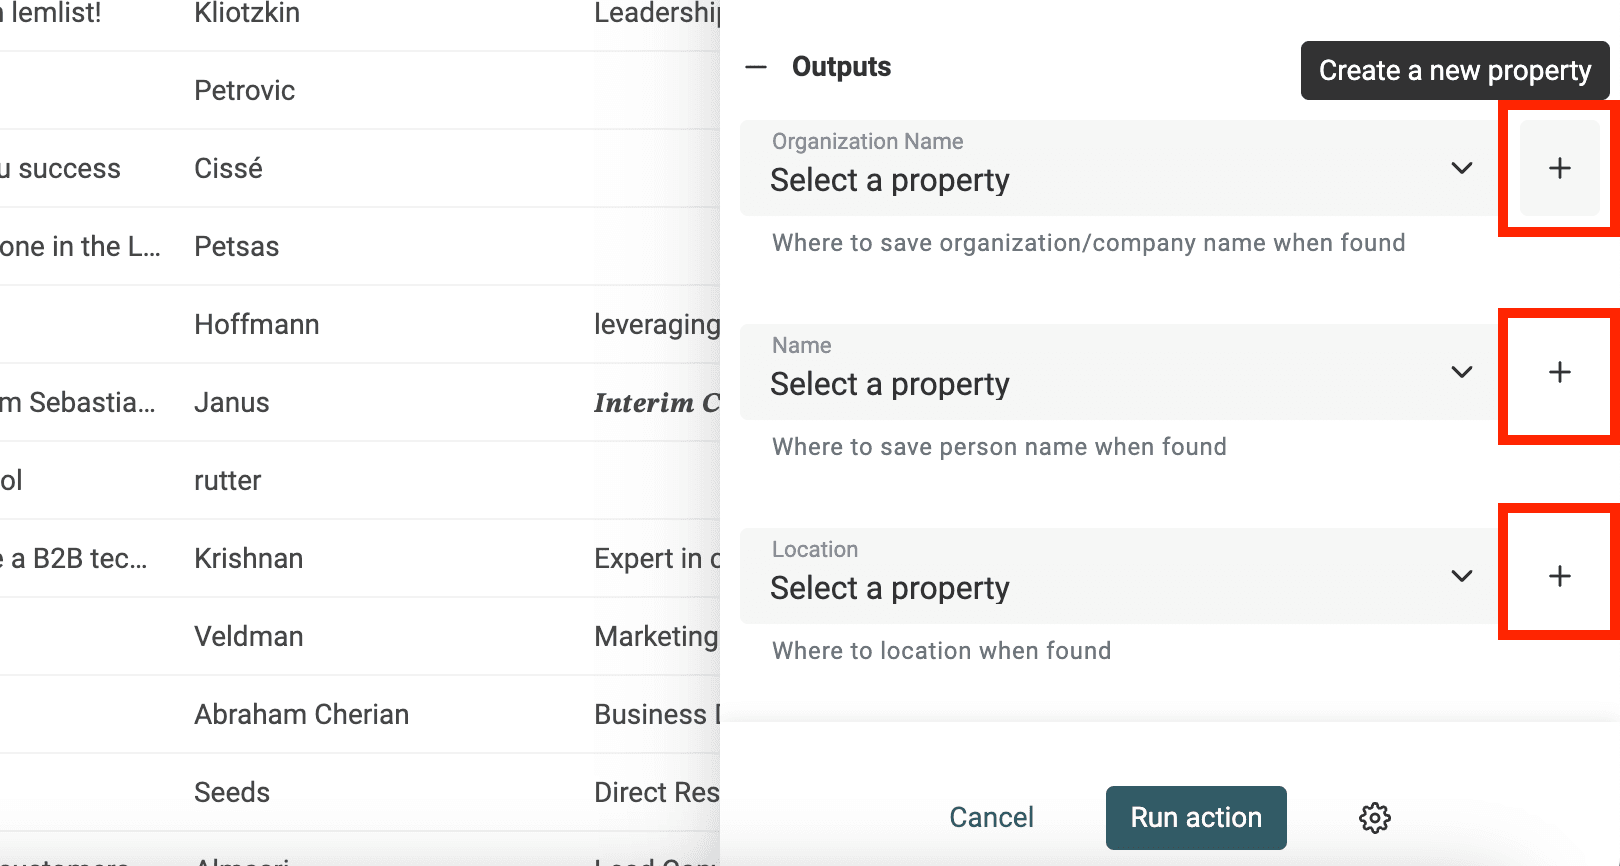
Nella sezione degli output, fai clic sul pulsante "Create a new property" per ogni tipo di nome che vuoi estrarre.
Datablist Entity Name extractor cerca:
- Organization Name: per esempio, aziende.
- Person Name: nome completo oppure First Name/Last Name.
- Location: città, Paesi e luoghi.
Infine, avvia l'enrichment.
Ti serve aiuto per pulire i dati?
Sono sempre alla ricerca di feedback e di nuovi problemi di data cleaning da risolvere. Contattami per raccontarmi il tuo caso d'uso.