
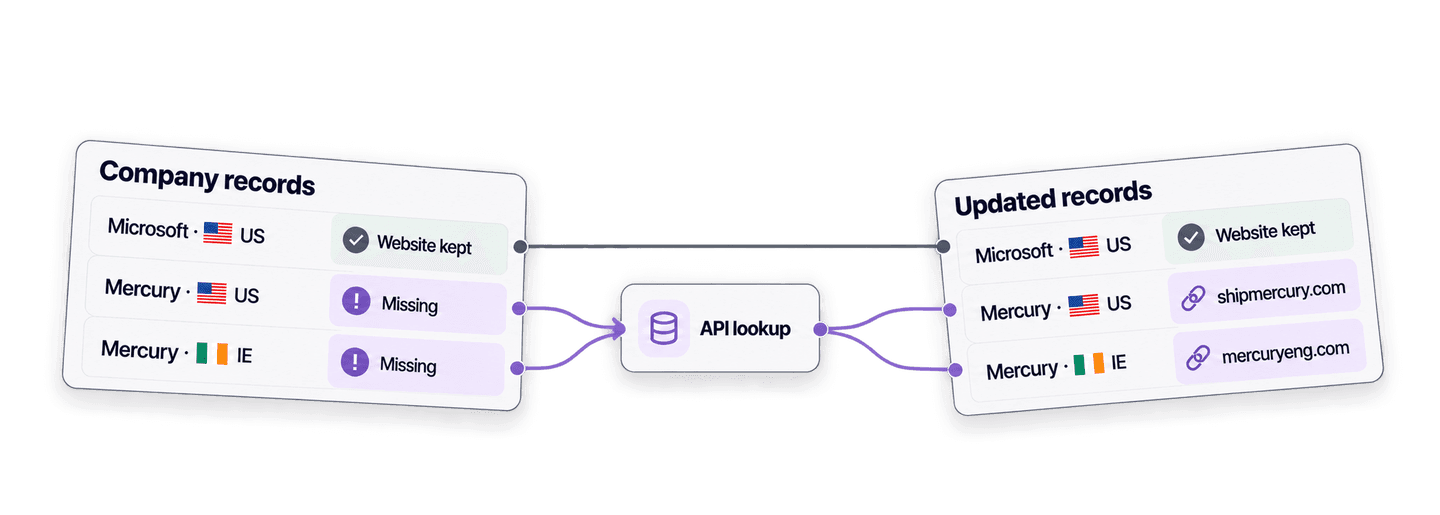
Om vanuit een bedrijfsnaam een bedrijfswebsite te vinden in Python, stuur je de naam en eventuele landinformatie naar Datablists Company Name to Domain API. De API verwerkt de zoekopdracht op de achtergrond en retourneert vervolgens het domein en de volledige website-URL.
Eerst laat ik je een eenvoudige Python API-request zien. Daarna hergebruik ik dezelfde functie om alleen de ontbrekende websites in een lijst met bedrijfsrecords aan te vullen, zonder bestaande URL's te overschrijven.
Werk je liever met een spreadsheetachtige interface? Volg dan de handleiding om in bulk bedrijfswebsites op naam te vinden.
💡 Samenvatting voor wie weinig tijd heeft
Bouw één Python-functie die websites bij bedrijfsnamen vindt en gebruik deze om records met een leeg websiteveld aan te vullen zonder bekende URL's te vervangen.
- Input: bedrijfsnamen met optionele landinformatie.
- Output: domein, volledige website-URL, betrouwbaarheid, resultaatstatus en verbruikte credits.
Python en je Datablist API-key instellen
Voor dit voorbeeld gebruik ik het Requests-package om synchrone HTTP-calls uit te voeren. Installeer het in een virtual environment:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requestsJe hebt ook een Datablist Growth-abonnement nodig, omdat toegang tot de REST API een Growth-feature is. Maak een Personal API Key aan via de API-accountpagina van Datablist en sla deze vervolgens op in een environment variable:
export DATABLIST_API_KEY="exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2"🔑 Heb je al een API-key? Oudere keys gebruiken
auth0|<userId>:<accountId>:<secret>:1. Deze blijven ondersteund. Blijf je bestaande key precies gebruiken zoals deze is gegenereerd; je hoeft hem niet te vervangen of opnieuw te formatteren.
Vervang de voorbeeldwaarde hierboven door de key die op je accountpagina is gegenereerd. Zoekopdrachten naar bedrijfswebsites verbruiken credits. Voordat we het script opschalen, leg ik uit wanneer een zoekopdracht 1 of 2,5 credits kost. De actuele abonnementsgegevens vind je op de prijzenpagina van Datablist.
Eén bedrijfswebsite opzoeken met Python
Maak een bestand met de naam find_company_websites.py. Het script verstuurt de namen, wacht tot de taak klaar is en haalt de resultaten op binnen één functie. Voor elke input wordt je vaste record-ID als inputId gebruikt. Zo kun je ieder resultaat aan het juiste record koppelen, zelfs als de volgorde van de response verandert.
import json
import os
import time
import uuid
import requests
API_BASE_URL = "https://api.datablist.com/v1"
def find_domains(companies, api_key):
headers = {
"Accept": "application/json",
"Content-Type": "application/json",
"X-API-Key": api_key,
}
inputs = [
{
"inputId": company["id"],
"data": {
"companyName": company["company_name"],
"targetCountry": company.get("country", ""),
},
}
for company in companies
]
unique_id = f"python-domain-lookup-{uuid.uuid4().hex}"
payload = {
"enrichmentId": "company-name-to-domain",
"uniqueId": unique_id,
"settings": {
"workflow": "dataset_google",
"countryOverwrite": True,
"acceptNonRoot": True,
},
"inputs": inputs,
}
print(f"Task uniqueId: {unique_id}")
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} ended with status {task['status']}: {task.get('error')}"
)
results = []
cursor = None
while True:
params = {"limit": 100}
if cursor is not None:
params["cursor"] = cursor
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}/results",
headers=headers,
params=params,
)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
break
return results
api_key = os.environ["DATABLIST_API_KEY"]
companies = [
{
"id": "direct-microsoft-us",
"company_name": "Microsoft",
"country": "US",
}
]
lookup_results = find_domains(companies, api_key)
for result in lookup_results:
print(json.dumps(result, indent=2))Voer het script uit in de terminal waarin je de key hebt geëxporteerd:
python find_company_websites.pyDit is het resultaat voor Microsoft:
{
  "inputId": "direct-microsoft-us",
  "status": "success",
  "outputs": {
    "companyUrl": "https://microsoft.com",
    "companyDomain": "microsoft.com",
    "domainConfidence": "High"
  },
  "creditsUsed": "1",
  "error": null
}
Gebruik inputId om dit resultaat aan het oorspronkelijke record te koppelen. status heeft de waarde success, no_result, error of skipped. Een geslaagd resultaat kan companyDomain, de volledige companyUrl en domainConfidence bevatten. creditsUsed toont hoeveel credits voor deze input zijn afgeschreven, terwijl error een fout op itemniveau toelicht.
De functie voert achtereenvolgens drie soorten API-calls uit.
Eerst wordt de zoekopdracht verstuurd. De payload bevat de instellingen en bedrijfsrecords. De POST-call retourneert 202 Accepted; @id is de taak-ID die voor de volgende calls nodig is:
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]Als DATABLIST_API_KEY niet is ingesteld, geeft Python tijdens het opvragen van de environment variable een KeyError voordat een HTTP-request wordt uitgevoerd. Exporteer de variabele en voer het script opnieuw uit. Bevat de variabele een ongeldige key, dan bereikt de POST-call de API en wordt HTTP 401 geretourneerd. Kopieer een actuele Personal API Key van je accountpagina en vervang de ongeldige waarde.
Vervolgens wordt de taak gepolld. De POST-call start de verwerking op de achtergrond. Daarom leest het script de taak elke drie seconden uit, totdat deze de status completed, failed of stopped bereikt:
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)Als de taak mislukt doordat er onvoldoende credits beschikbaar zijn, bevat de foutmelding de reden credits_error. Voeg credits toe of wacht tot je maandelijkse credits worden vernieuwd. Controleer eventuele resultaten die al zijn geretourneerd en verstuur daarna alleen de onafgeronde inputs in een nieuwe taak.
Tot slot worden alle resultaatpagina's opgehaald. Iedere response voegt resultaten aan de lijst toe en levert de cursor voor het volgende request:
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
breakDe functie blijft pagina's ophalen totdat nextCursor gelijk is aan null.
Het script toont de gegenereerde uniqueId vóór de POST-call. Valt de verbinding weg voordat je de response voor het aanmaken van de taak ontvangt, vraag dan eerst je takenlijst op om de status te controleren voordat je een nieuwe taak aanmaakt:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-name-to-domain"Zoek de taak waarvan de uniqueId overeenkomt met de door het script gegenereerde waarde en kopieer vervolgens de @id. Het endpoint voor de takenlijst kan filteren op enrichmentId, maar niet op uniqueId. Gebruik de @id met dezelfde status- en resultaat-URL's als in het script. Blijf pollen als de taak nog actief is. Is de taak gestopt of mislukt, controleer dan eerst of er deelresultaten zijn voordat je de inputs opnieuw verstuurt.
Datasetmatching en de landafhankelijke fallback
Het script gebruikt dataset_google, de aanbevolen standaardinstelling. Datablist controleert eerst zijn bedrijfsdatasets. Ontbreekt een match of zijn de resultaten tegenstrijdig, dan kan Google als fallback worden gebruikt. Mogelijke matches worden gecontroleerd voordat er een betrouwbaarheidsniveau wordt geretourneerd.
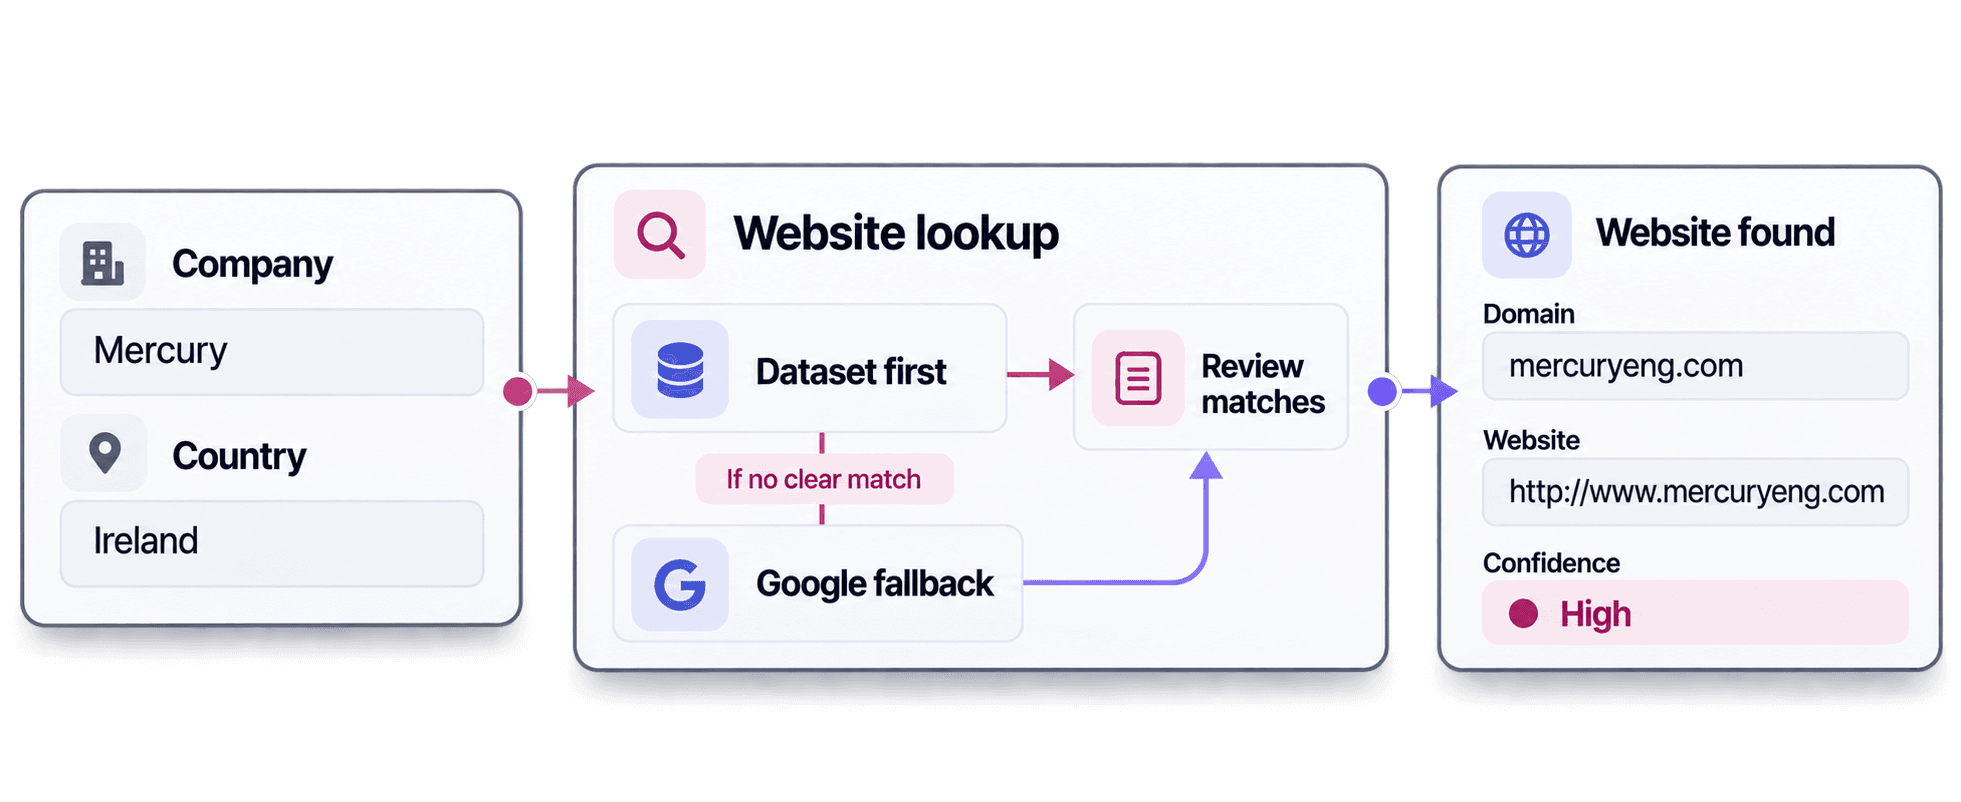
Landinformatie helpt bij dubbelzinnige namen. In dit voorbeeld leverde dezelfde bedrijfsnaam verschillende resultaten op:
MercurymetUSretourneerdeshipmercury.comenhttps://www.shipmercury.com/.MercurymetIEretourneerdemercuryeng.comenhttp://www.mercuryeng.com.
Beide resultaten hadden een High confidence. Landinformatie helpt de zoekfunctie onderscheid te maken tussen bedrijven met dezelfde naam. De confidence helpt je bepalen welke resultaten handmatig moeten worden gecontroleerd.
Als de juiste match ook afhangt van de branche, bedrijfsgrootte of andere zakelijke context, gebruik dan de AI Agent research-workflow. Voeg deze informatie aan de AI Agent-prompt toe, zodat de Agent met uitgebreidere bedrijfscontext naar het bedoelde bedrijf kan zoeken.
Alleen ontbrekende websites in records aanvullen
Nu find_domains() een website op basis van een bedrijfsnaam kan vinden, kun je de functie hergebruiken om alleen ontbrekende websites in je bedrijfsrecords aan te vullen. Records die al een website bevatten, slaan de API over. Hun waarden blijven daardoor ongewijzigd en ze verbruiken geen credits.
Vervang in find_company_websites.py alles vanaf companies = [ tot en met de laatste print-loop door het onderstaande blok. Laat de toewijzing aan api_key erboven staan. De controle op lege waarden verwerkt None, een lege string en alleen spaties. Als alle websites al zijn ingevuld, wordt er geen API-call uitgevoerd.
records = [
{
"id": "crm-001",
"company_name": "Microsoft",
"country": "US",
"website": "https://www.microsoft.com",
},
{
"id": "crm-002",
"company_name": "boulangerie du palais lyon",
"country": "FR",
"website": "",
},
{
"id": "crm-003",
"company_name": "Mercury Engineering",
"country": "IE",
"website": None,
},
{
"id": "crm-004",
"company_name": "Mercury",
"country": "US",
"website": " ",
},
{
"id": "crm-005",
"company_name": "Datablist",
"country": "FR",
"website": "https://www.datablist.com",
},
{
"id": "crm-006",
"company_name": "Mercury",
"country": "IE",
"website": None,
},
]
def website_is_missing(value):
return not isinstance(value, str) or not value.strip()
records_to_lookup = [
record for record in records if website_is_missing(record.get("website"))
]
lookup_results = (
find_domains(records_to_lookup, api_key) if records_to_lookup else []
)
results_by_id = {result["inputId"]: result for result in lookup_results}
for record in records:
if not website_is_missing(record.get("website")):
record["website_lookup"] = {"status": "not_requested"}
continue
result = results_by_id.get(record["id"])
if result is None:
record["website_lookup"] = {
"status": "missing_result",
"domain": None,
"confidence": None,
"credits": None,
"error": {
"code": "missing_result",
"message": "No result was returned for this inputId.",
},
}
continue
outputs = result.get("outputs") or {}
if result["status"] == "success" and outputs.get("companyUrl"):
record["website"] = outputs["companyUrl"]
record["website_lookup"] = {
"status": result["status"],
"domain": outputs.get("companyDomain"),
"confidence": outputs.get("domainConfidence"),
"credits": result.get("creditsUsed"),
"error": result.get("error"),
}
print(json.dumps(records, indent=2))De code indexeert de resultaten op inputId en loopt daarna in de oorspronkelijke volgorde door de records. Het object website_lookup bewaart naast ieder verwerkt record de uitkomst en de gegevens voor controle, inclusief mislukte of ontbrekende resultaten.
Voor crm-001 retourneert website_is_missing() de waarde False, omdat de URL van Microsoft al aanwezig is. Het record wordt niet aan records_to_lookup toegevoegd en bereikt de API dus nooit. Tijdens het samenvoegen blijft de website behouden en wordt de status vastgelegd als not_requested.
Bij crm-002 is het websiteveld leeg. Het request verstuurt de bakkerij daarom met inputId: crm-002. De API retourneert dezelfde inputId. results_by_id gebruikt deze om het juiste resultaat te vinden, waarna de merge https://boulangerie-du-palais-lyon.eatbu.com in dat record opslaat zonder afhankelijk te zijn van de volgorde van de resultaten.
| ID | Bedrijf | Website na samenvoegen | Status | Domein | Confidence | Credits |
|---|---|---|---|---|---|---|
crm-001 | Microsoft · US | https://www.microsoft.com | not_requested | |||
crm-002 | boulangerie du palais lyon · FR | https://boulangerie-du-palais-lyon.eatbu.com | success | boulangerie-du-palais-lyon.eatbu.com | High | 1 |
crm-003 | Mercury Engineering · IE | https://mercuryeng.com | success | mercuryeng.com | High | 1 |
crm-004 | Mercury · US | https://www.shipmercury.com/ | success | shipmercury.com | High | 1 |
crm-005 | Datablist · FR | https://www.datablist.com | not_requested | |||
crm-006 | Mercury · IE | http://www.mercuryeng.com | success | mercuryeng.com | High | 1 |
De bakkerij gebruikt een bedrijfsspecifiek subdomein: boulangerie-du-palais-lyon.eatbu.com. Bewaar deze waarde in plaats van hem terug te brengen tot eatbu.com en sla het exacte adres uit companyUrl op. Dankzij de instelling acceptNonRoot: true is ook een gehoste bedrijfspagina toegestaan waarvan het adres na de hostnaam nog een pad bevat. In beide gevallen is de volledige URL dus belangrijk.
Ook een voltooide taak kan items met de status no_result, error of skipped bevatten. In het voorbeeld wordt website alleen gewijzigd als de status success is en companyUrl aanwezig is. Bij no_result blijft het websiteveld leeg en blijft de status zichtbaar in website_lookup. Controleer eerst de bedrijfsnaam en het land. Is een van beide onjuist, corrigeer de waarde dan en verstuur dat record in een nieuwe taak. Laat het websiteveld anders leeg, zodat duidelijk blijft dat het handmatig moet worden gecontroleerd.
Credits voor zoekopdrachten vooraf berekenen
Alle vijf de zoekopdrachten uit het voorbeeld retourneerden success met High confidence en verbruikten samen 5 credits.
Een zoekopdracht die via de dataset wordt opgelost, kost 1 credit. Een zoekopdracht die met Google wordt verwerkt, kost 2,5 credits. Je betaalt alleen voor het gebruikte pad, niet voor beide. Voor 1.000 inputs betekent dit 1.000 credits als alles via de dataset wordt gevonden, of 2.500 credits als alles Google gebruikt. Dit zijn planningsscenario's en geen garantie dat iedere zoekopdracht slaagt.
Verschuif de slider om het creditverbruik voor jouw lijst te vergelijken.
Bij $20 voor 20.000 credits kosten deze scenario's respectievelijk $1 en $2,50. Het Growth-abonnement staat hier los van en bevat momenteel 20.000 maandelijkse credits, die vóór extra gekochte credits worden gebruikt. Controleer de actuele prijzen, omdat abonnements- en pakketwaarden kunnen veranderen.
Eén taak accepteert maximaal 10.000 inputs, met een limiet van 16 KiB per input en 10 MiB per request. Dit voorbeeld gebruikt blokkerende Requests-calls om één kleine asynchrone Datablist-taak te versturen, te pollen en de resultaten ervan op te halen. De onderhouden repository bevat ook voorbeelden voor CSV-batching en non-blocking clients.
Volgende stappen
Zodra je hebt gecontroleerd dat een geretourneerde website bij het bedoelde bedrijf hoort, kun je het Impressum scrapen met Python. Zo voeg je juridische bedrijfsgegevens en de URL van de juridische bronpagina aan hetzelfde leveranciersrecord toe. Houd de controle van de websitematch gescheiden van deze latere extractie.
Vervang de voorbeeldrecords door een kleine selectie uit je eigen data. Voer daarna het script uit en controleer de samengevoegde records. Gebruik vaste ID's en landinformatie en schaal pas op nadat je hebt bevestigd dat het script bekende websites behoudt en de juiste lege velden invult. Je kunt beginnen met de onderhouden Company Name to Domain API-voorbeelden op GitHub als je het downloadbare script, CSV-batching of een asynchrone versie wilt gebruiken.