
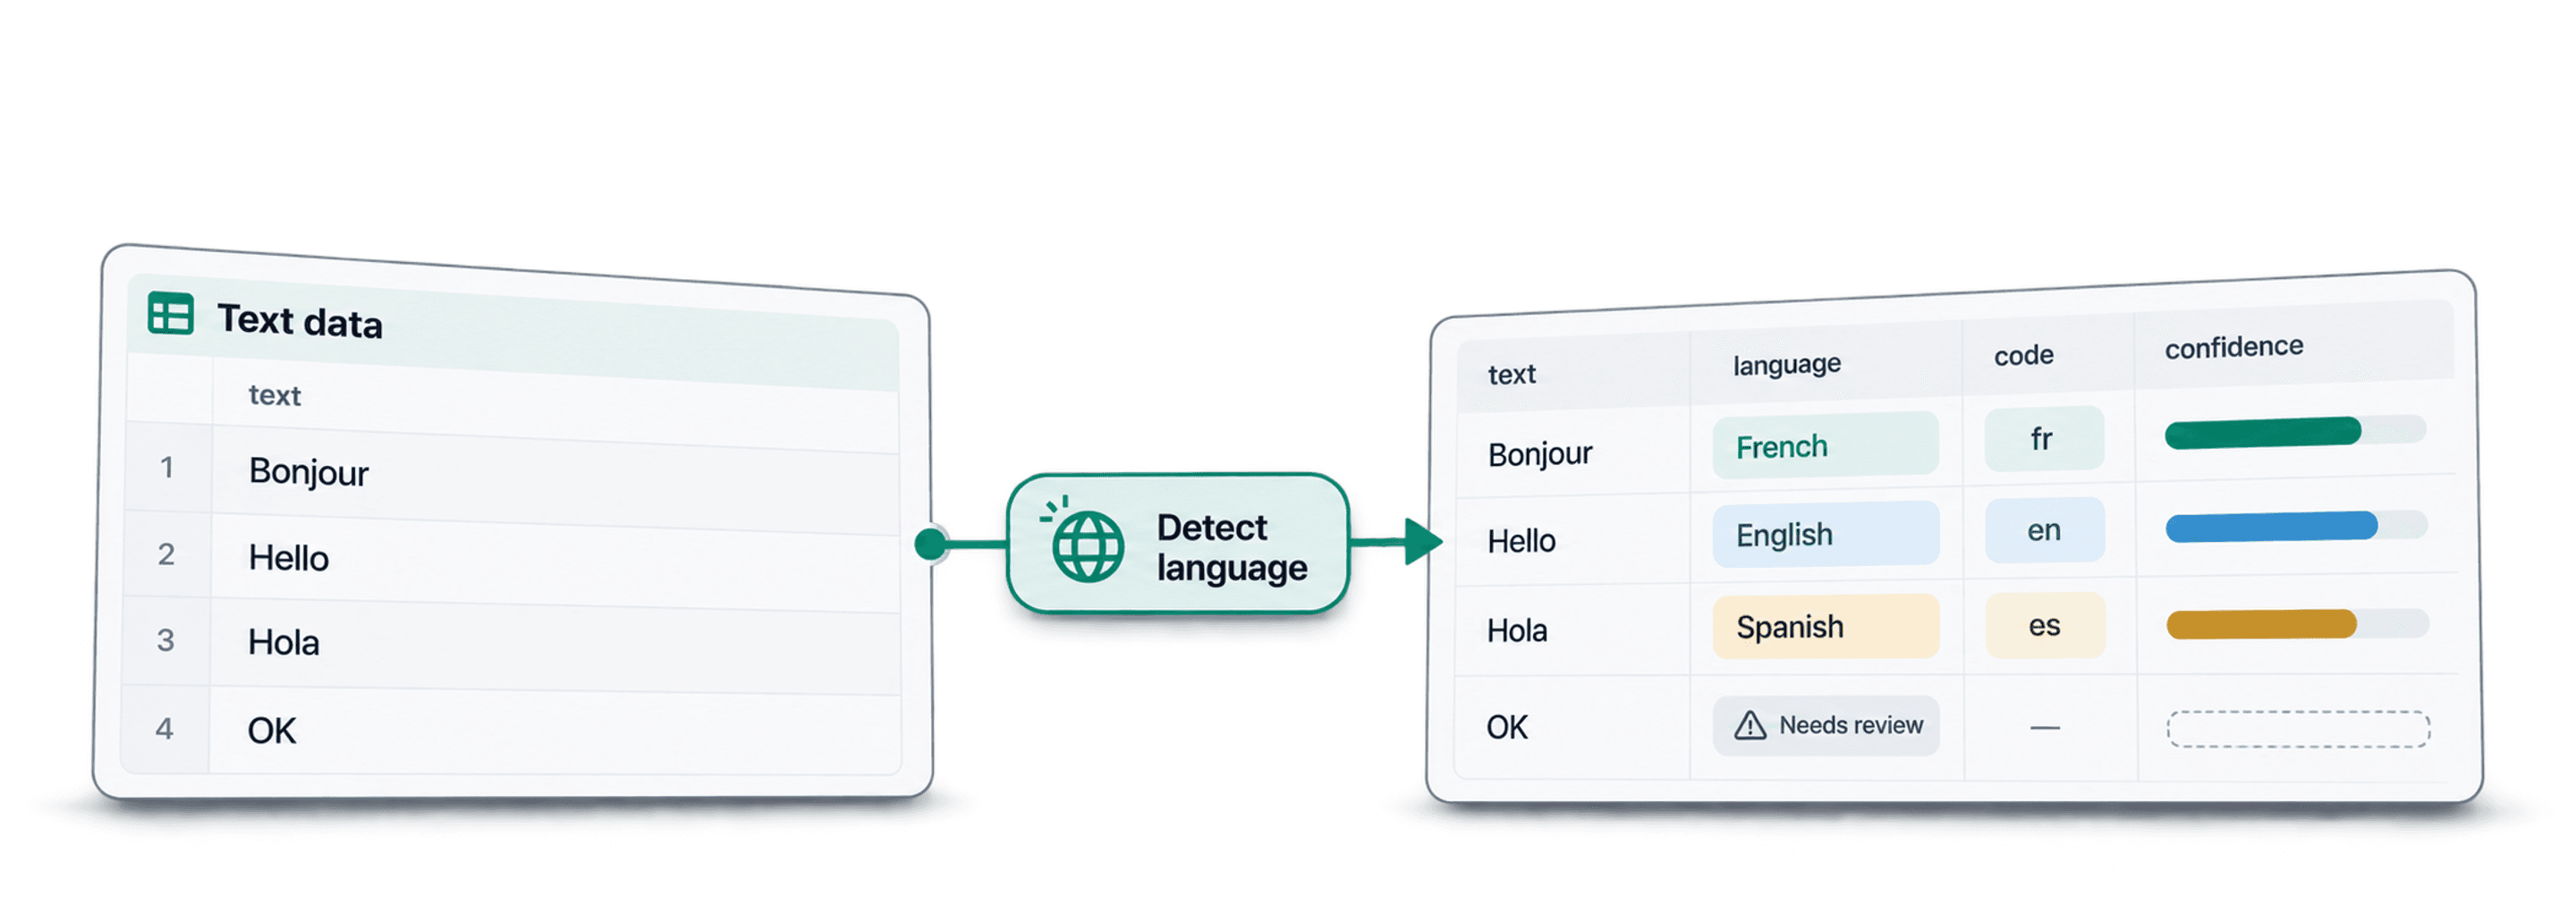
Se você precisa detectar o idioma de cada linha de um dataset, o fluxo mais organizado é adicionar colunas de idioma diretamente ao arquivo que já utiliza. Importe o arquivo CSV ou Excel para o Datablist, execute a detecção de idioma na coluna de texto, confira os níveis de confiança e exporte o dataset enriquecido ou prossiga com a tradução, o direcionamento ou a segmentação.
Prefiro essa abordagem a copiar as linhas para um chatbot porque o resultado continua estruturado por linha. Você recebe o nome do idioma, um código de idioma ISO e um nível de confiança em cada registro. Assim, a próxima etapa fica muito mais simples: filtrar linhas em francês, enviar linhas em espanhol para tradução, revisar resultados com baixa confiança ou remover registros sem texto aproveitável.
Neste guia, usarei um dataset de perfis em vários idiomas, mas o mesmo fluxo funciona para tickets de suporte, respostas de pesquisas, avaliações, descrições de produtos, páginas extraídas e anotações de CRM.
Se os dados vierem de páginas de avaliações, o guia de scraping do Trustpilot explica como preservar as URLs das avaliações e verificar amostras filtradas sobrepostas antes da análise de idioma.
🔑 Comece pelo detector específico
Se a única tarefa for detectar o idioma, comece pelo enrichment de detecção de idioma. Use o ChatGPT apenas quando precisar de regras personalizadas ou de uma decisão combinada.
Links rápidos
- Resposta direta
- Dataset de exemplo
- Etapa 1: importe o arquivo CSV ou Excel
- Etapa 2: selecione o enrichment de detecção de idioma
- Etapa 3: configure entradas e saídas
- Etapa 4: revise os idiomas detectados
- Etapa 5: filtre, exporte ou prossiga com a tradução
- Custo: créditos fixos por linha
- Alternativa: use o ChatGPT para regras personalizadas
Resposta direta
Para detectar o idioma de cada linha de um dataset, importe seu arquivo CSV ou Excel para o Datablist, abra o menu Enrich e selecione o enrichment Detect Language from a Text. Na etapa Inputs, escolha a coluna de texto que deseja analisar. O Datablist grava o nome do idioma detectado, o código do idioma e o nível de confiança em novas colunas, pelo preço fixo de 0.05 crédito por linha.
A etapa mais importante é a revisão. A detecção de idioma é uma tarefa de classificação, e o nível de confiança indica quais linhas podem avançar e quais merecem uma segunda análise. Em geral, linhas com alta confiança podem seguir para o próximo fluxo. Linhas com baixa confiança, entradas inválidas ou nenhum resultado devem ser filtradas antes da exportação.
Esse é o fluxo que uso quando o resultado precisa permanecer associado às linhas originais. Uma fórmula de planilha pode ajudar em casos simples, mas normalmente falha com textos em vários idiomas, trechos curtos, células vazias e exportações desorganizadas. Um chatbot consegue responder a alguns exemplos, mas não entrega um dataset organizado com um resultado por linha.
Dataset de exemplo
Nesta demonstração, uso um CSV de perfis sociais. Ele tem cinco colunas:
| ID do perfil | Nome completo | Título | Bio | Empresa |
|---|---|---|---|---|
C8C1DXQBNP | Maya Collins | Founder building analytics tools for customer teams | I help sales teams clean messy lead lists... | Northstar Labs |
61M25JUEHM | Lucas Bernard | Responsable support client pour une marketplace | Je construis des workflows simples... | Market Loop |
Y45G9QU71C | Sofia Romero | Especialista en CRM y automatizacion comercial | Consultora de operaciones enfocada... | Talent Desk |
RL20HHREOT | Felix Wagner | Tech Recruiter fuer Produktteams | Ich helfe Teams dabei... | Cleanbase |
TT384W44MW | Aoi Nakamura | 営業チーム向けCRMコンサルタント | 多言語の問い合わせを分類... | Northstar Labs |
O arquivo não inclui uma coluna de idioma de propósito. Quero que o Datablist acrescente essa informação, em vez de apenas confirmar um rótulo que eu já tenha fornecido.
O dataset também contém linhas problemáticas: bios vazias, títulos curtos, nomes de empresas, nomes de usuário, URLs, números e trechos em vários idiomas. Gosto de usar esse tipo de arquivo porque ele mostra o que acontece fora das linhas perfeitas de uma demonstração. Exportações reais sempre têm alguns registros que precisam de revisão.
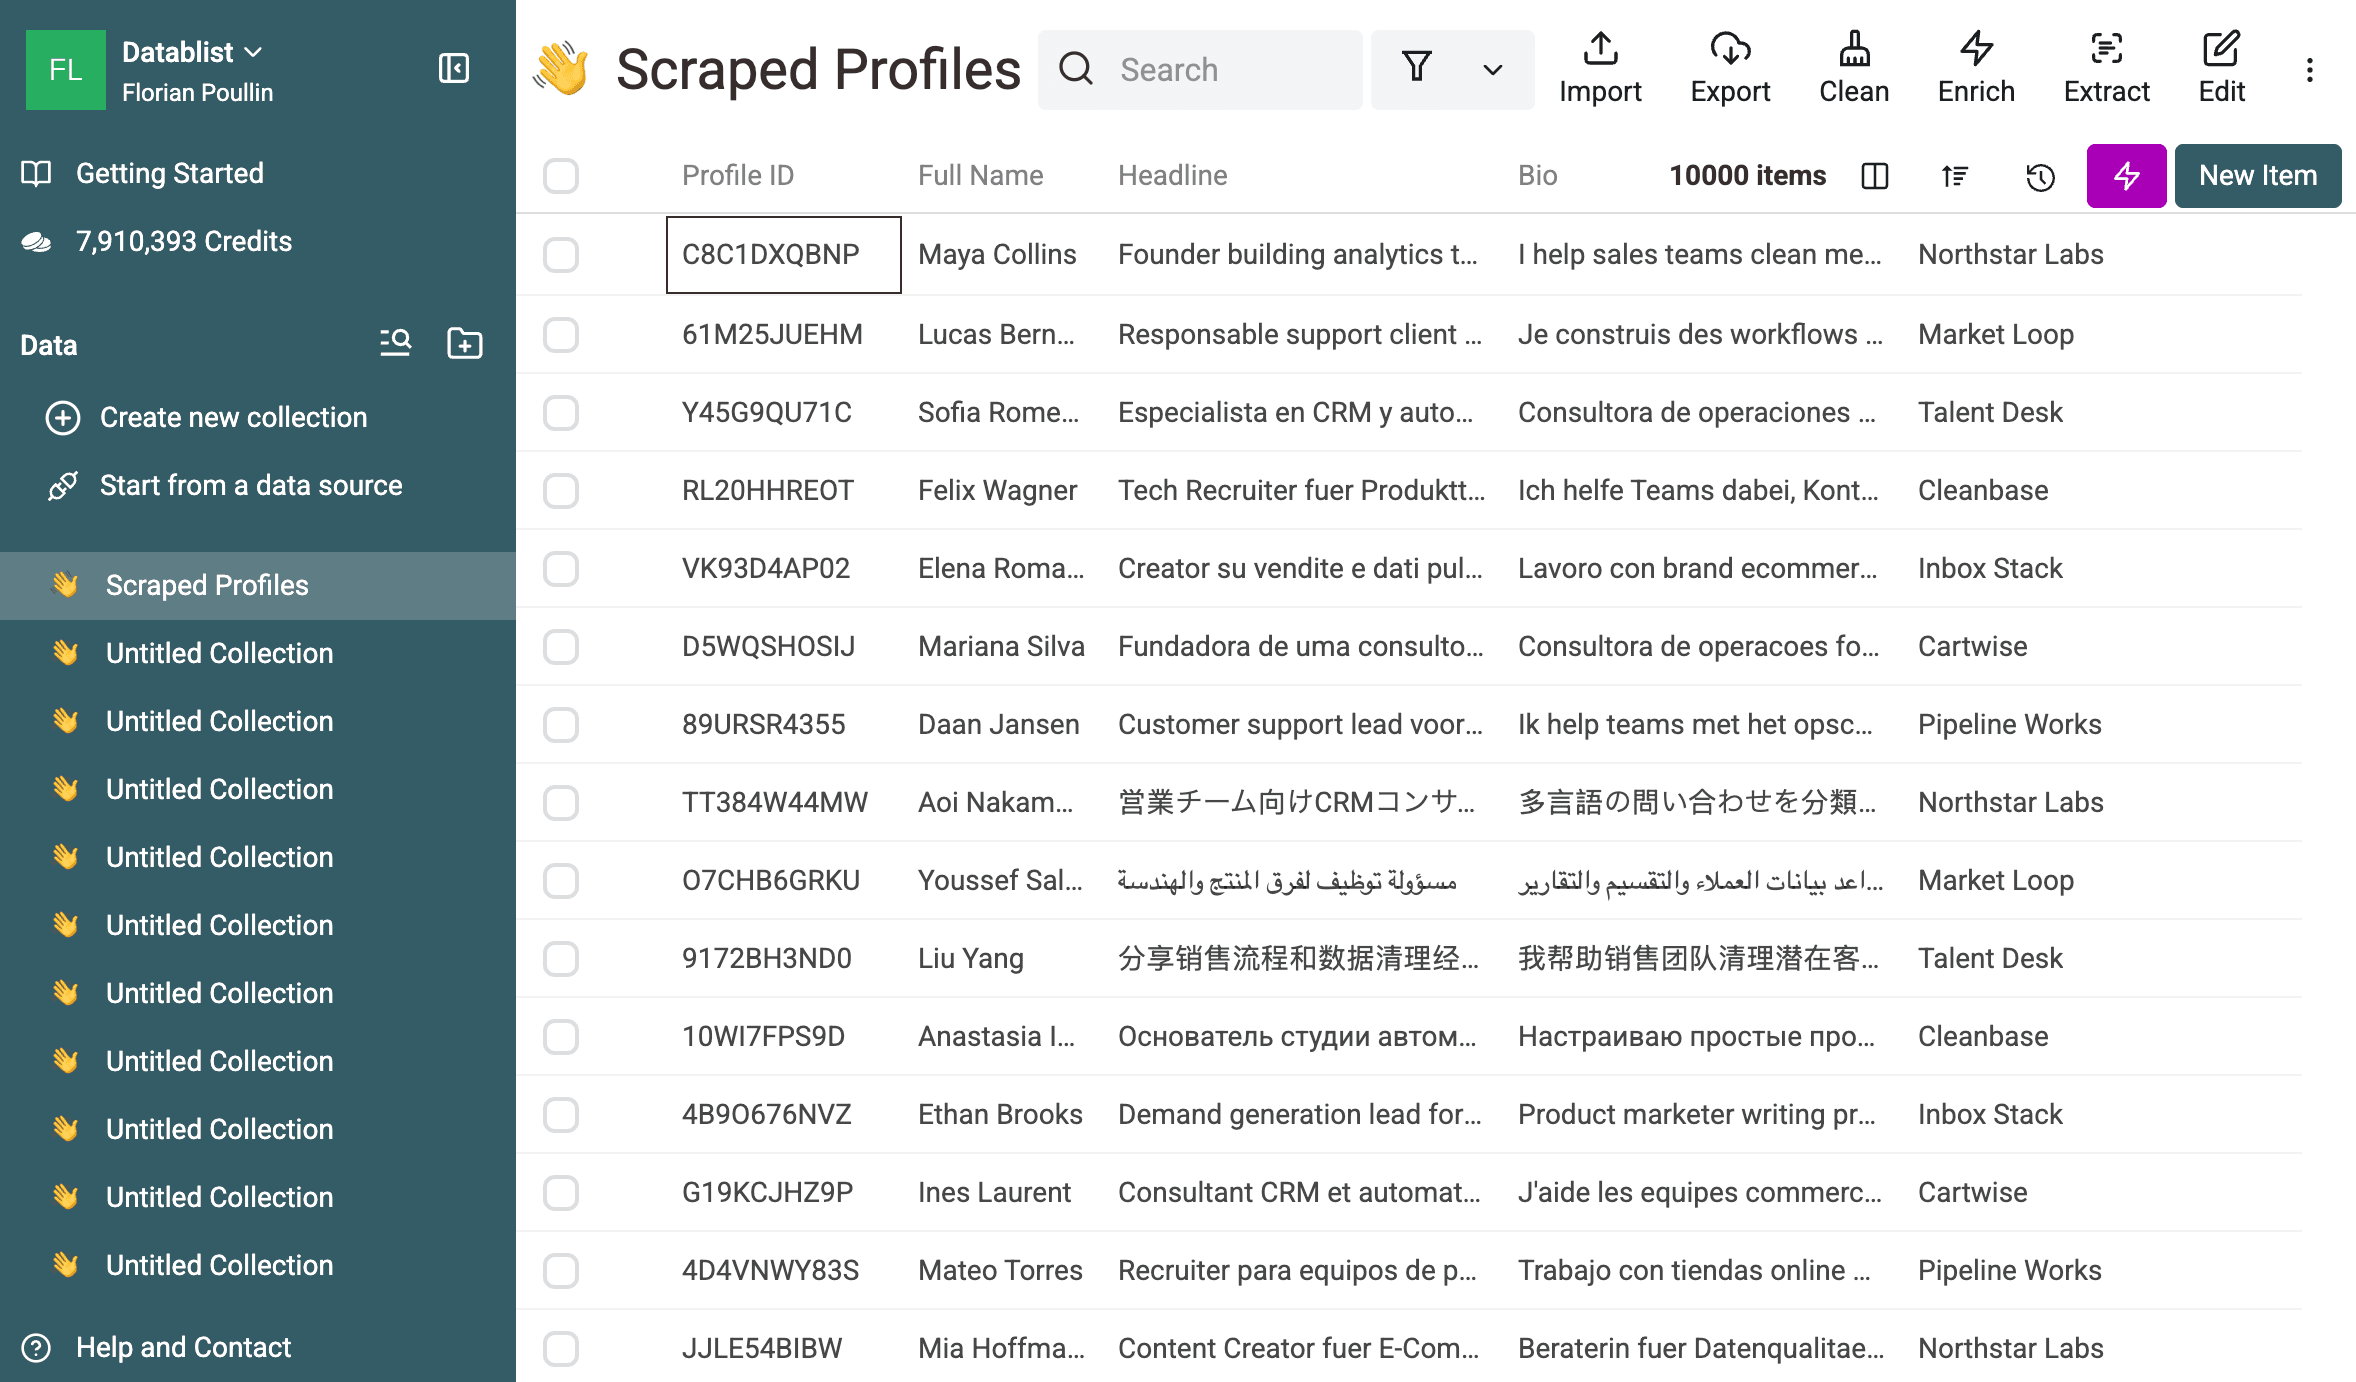
Neste exemplo, uso Headline e Bio como sinais de idioma. Se seu dataset tiver tickets de suporte extensos ou descrições de produtos em uma única coluna, basta uma coluna de entrada. Quando cada linha contém campos curtos, combinar duas colunas de texto costuma dar mais contexto ao detector.
Etapa 1: importe o arquivo CSV ou Excel
Comece com um arquivo CSV ou Excel que tenha uma linha por registro e pelo menos uma coluna de texto. Abra o Datablist, crie uma collection e importe o arquivo. Você pode usar o editor de CSV do Datablist nesse fluxo.
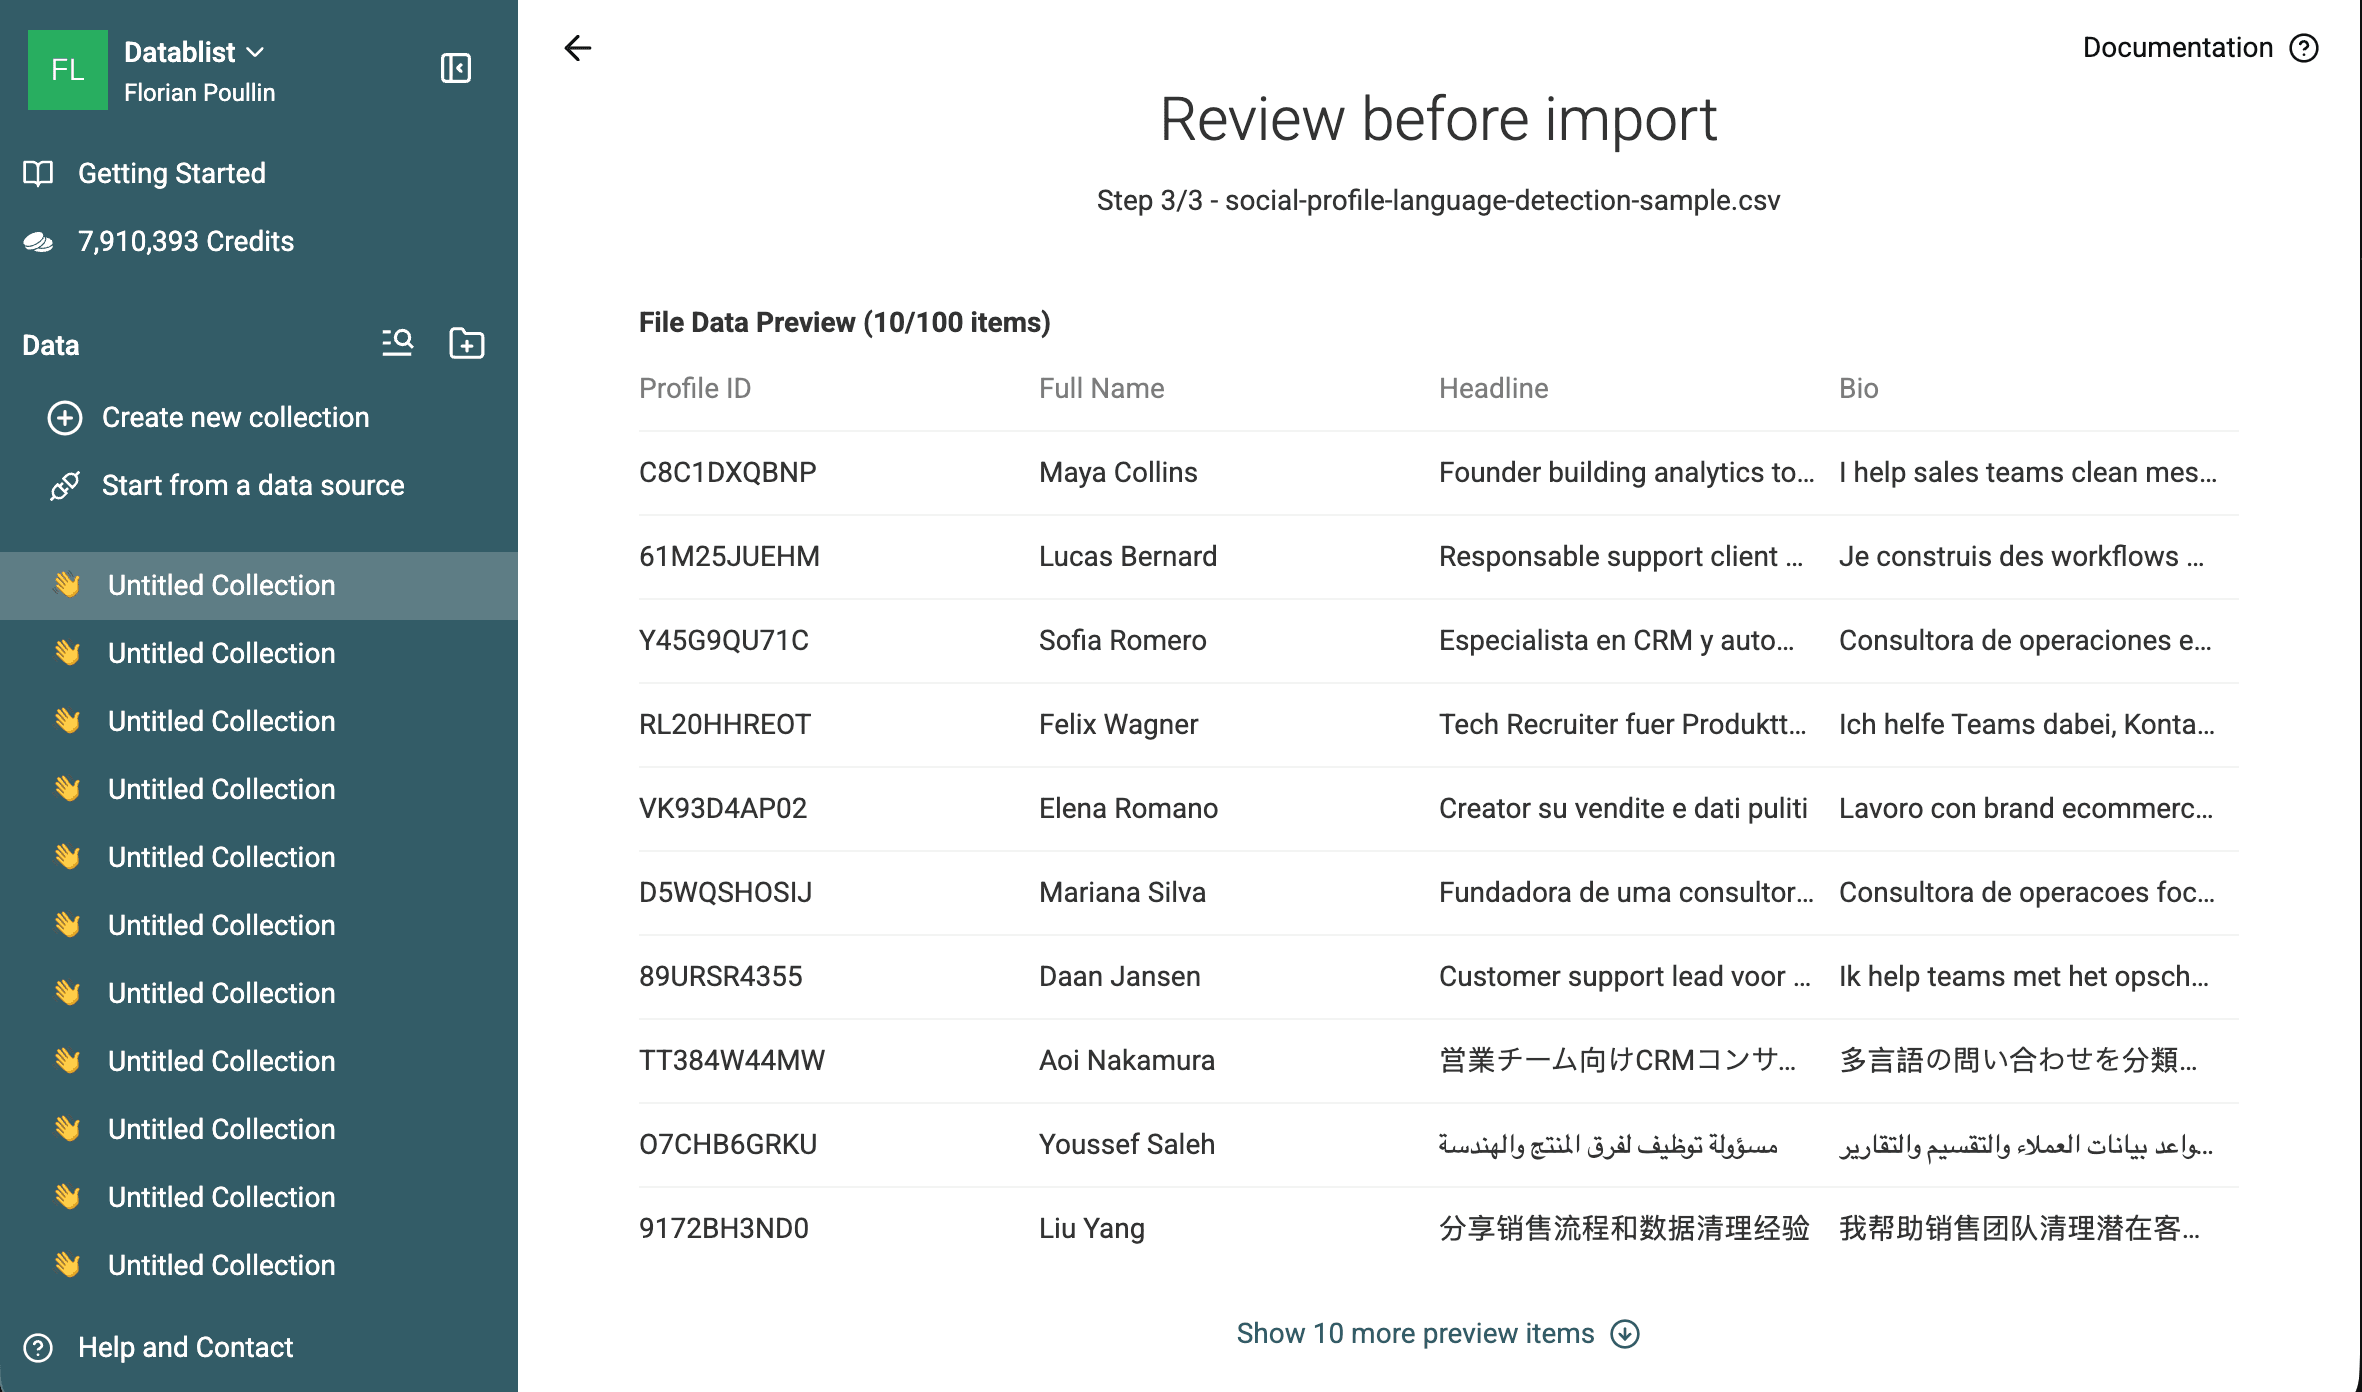
Na tela de revisão da importação, confira os nomes das colunas e verifique se os campos de texto relevantes foram importados como campos de texto. No meu exemplo, os campos importantes são Headline e Bio. Não uso Full Name, Company nem Profile ID na detecção, pois são sinais de idioma pouco confiáveis.
Mantenha as colunas de texto originais inalteradas. Costumo criar novas colunas de saída em vez de sobrescrever os dados de origem, pois isso facilita a revisão. Se algum resultado parecer estranho, você poderá compará-lo imediatamente com o texto original.
💡 Mantenha uma coluna de ID estável
Se o arquivo precisar voltar para outro sistema depois, preserve uma coluna de ID, como
Profile ID, ID do ticket, SKU do produto ou ID do registro no CRM. Isso torna a exportação e a correspondência mais seguras.
Etapa 2: selecione o enrichment de detecção de idioma
Depois de importar o dataset, abra o menu Enrich e procure a detecção de idioma. Selecione o enrichment Detect Language from a Text.
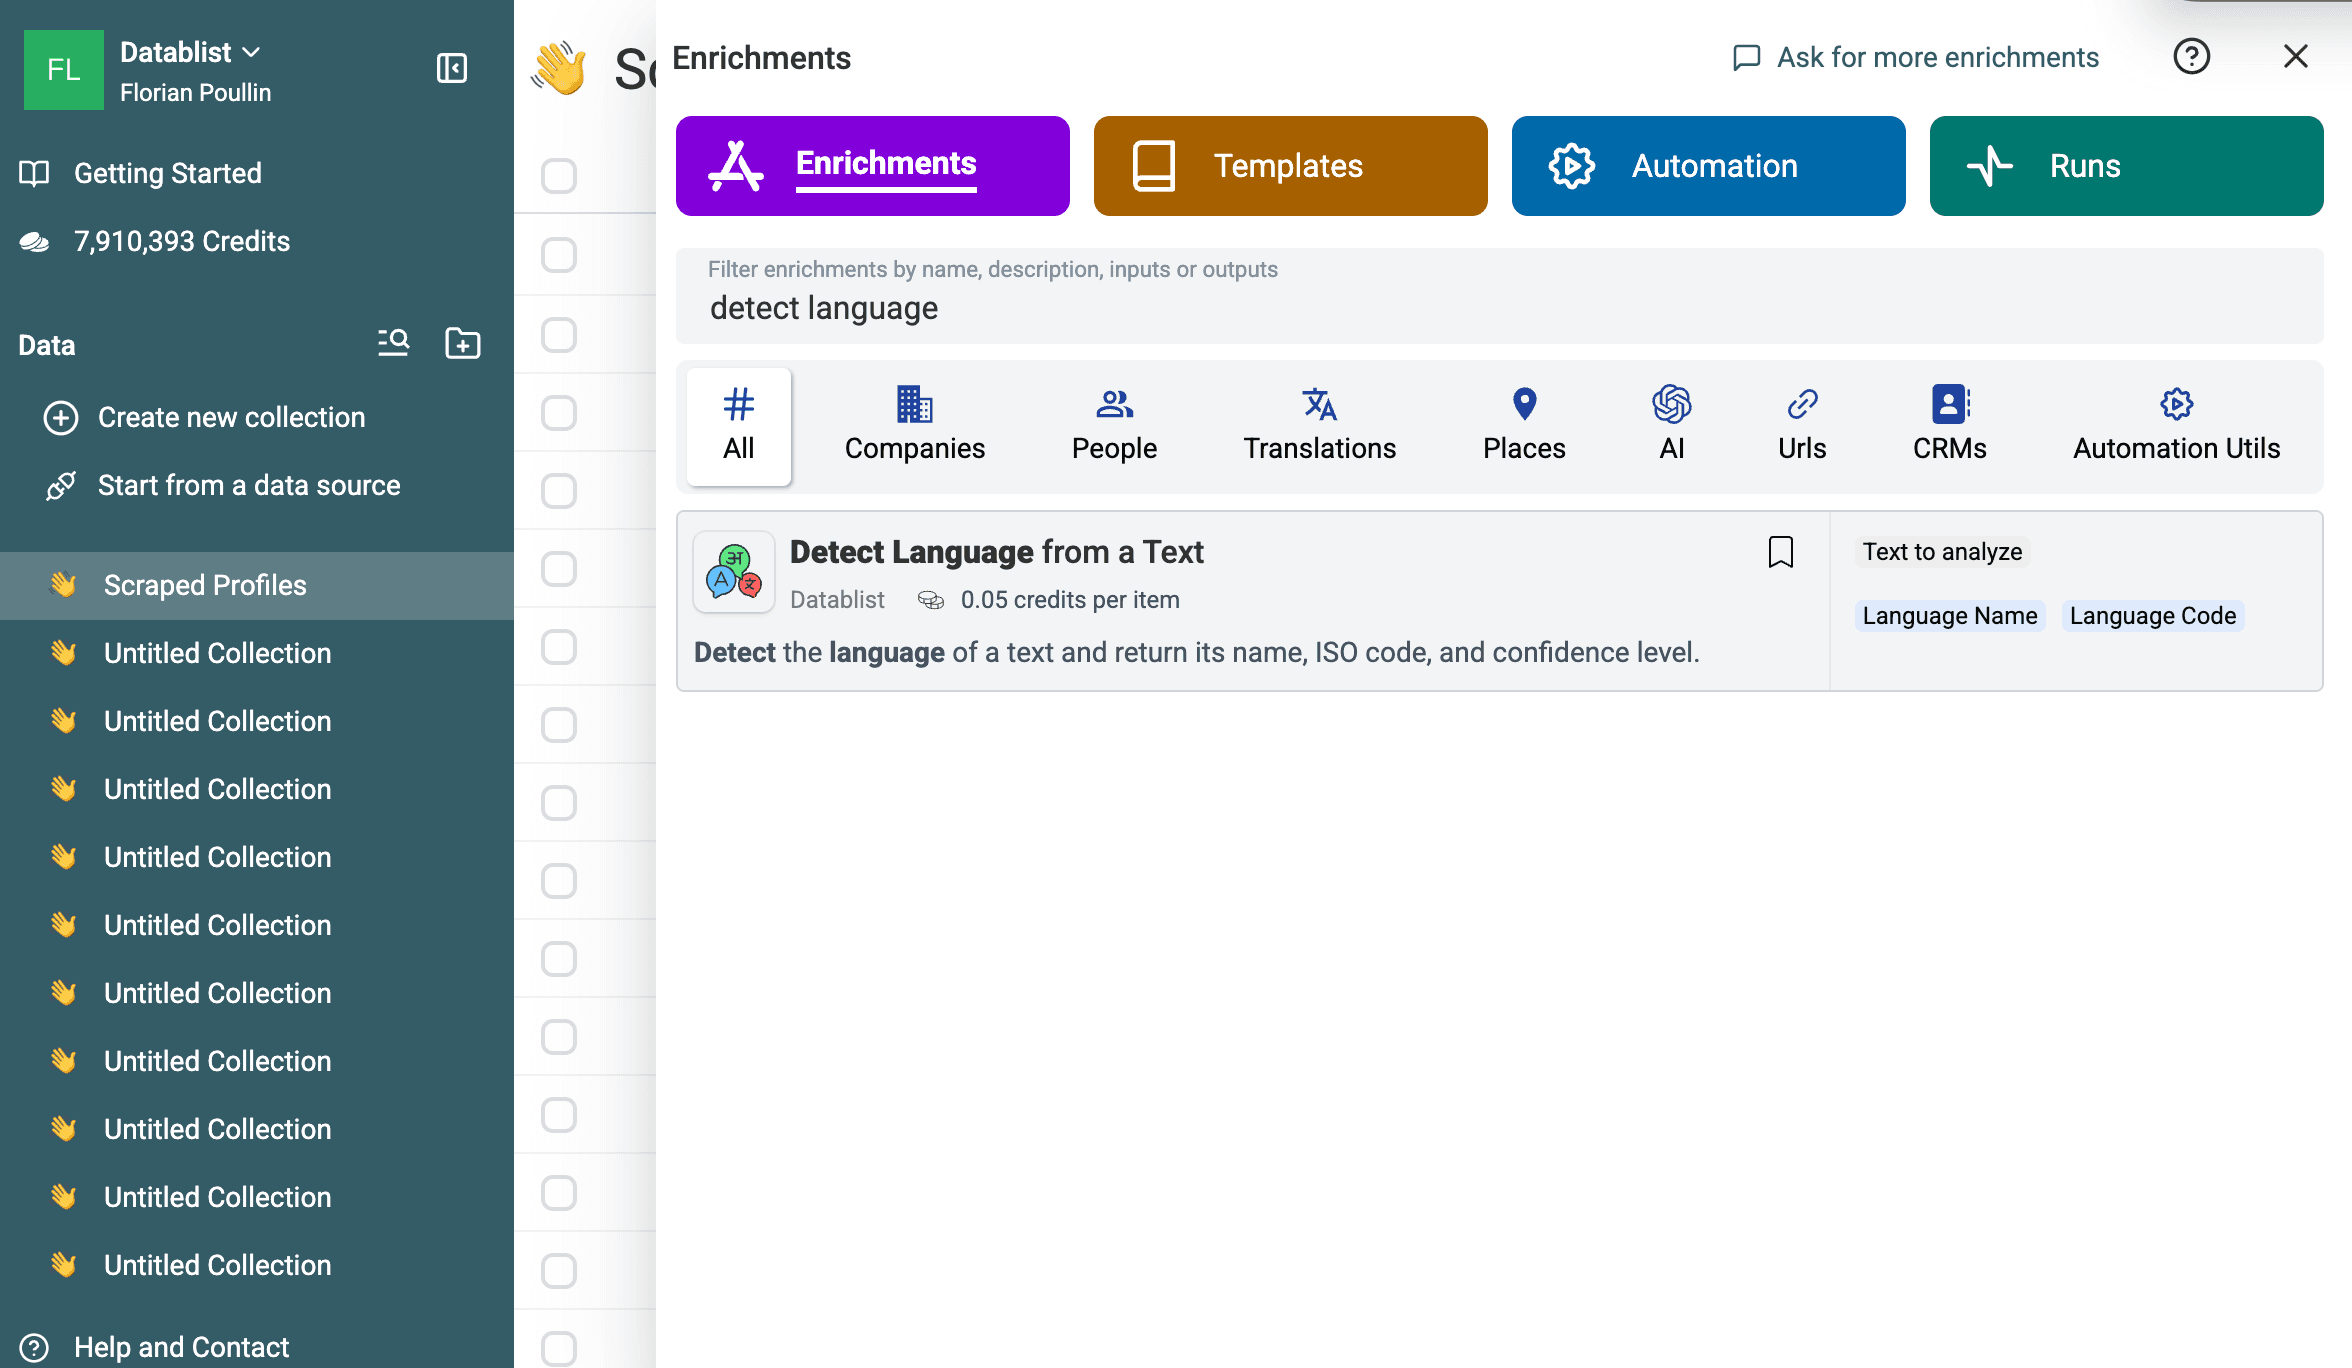
Esse enrichment é executado linha por linha. Para cada item, ele lê o texto de entrada e retorna:
Language Name, como English, French, Spanish ou German.Language Code, comoen,fr,esoude.Language Confidence, como High, Medium, Low ou Very Low.
Esse é o formato de resultado de que preciso para trabalhar com planilhas. O nome do idioma é fácil de ler. O código é útil para automações e ferramentas de tradução. O nível de confiança mostra onde é necessário revisar.
Evite usar campos pouco informativos, como nomes, IDs, usernames, URLs, códigos numéricos ou nomes de empresas, como única entrada. Em geral, eles não contêm sinais de idioma suficientes. Se o dataset tiver textos curtos, selecione um segundo campo de texto antes de executar o enrichment.
Etapa 3: configure entradas e saídas
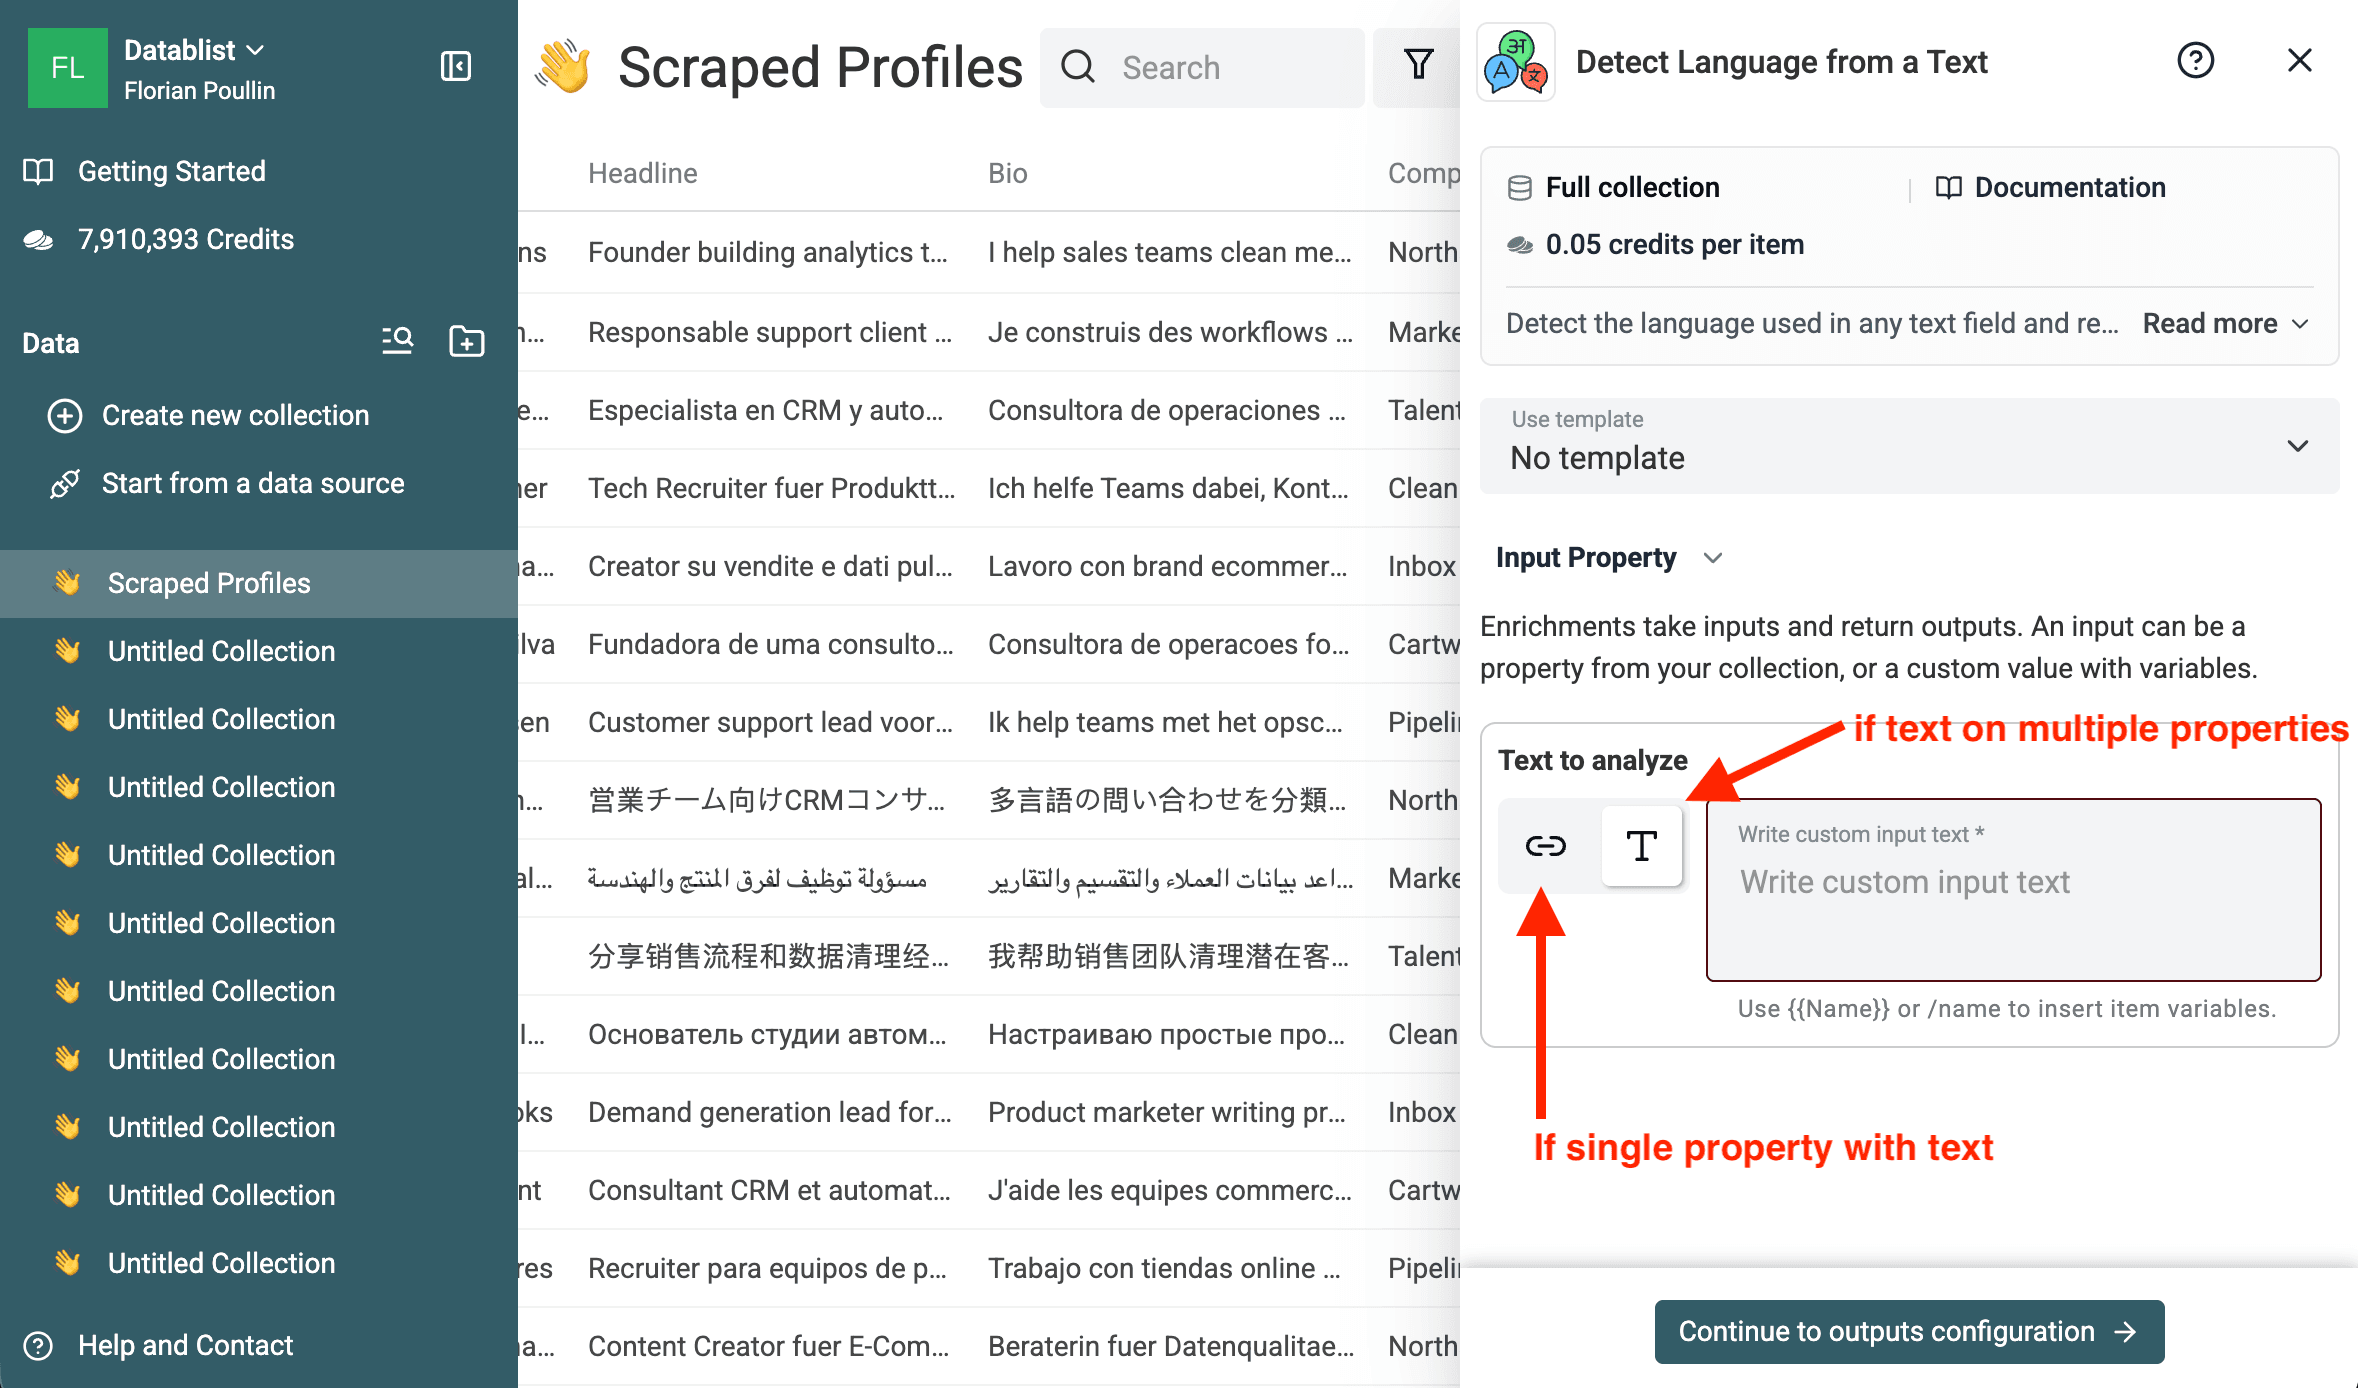
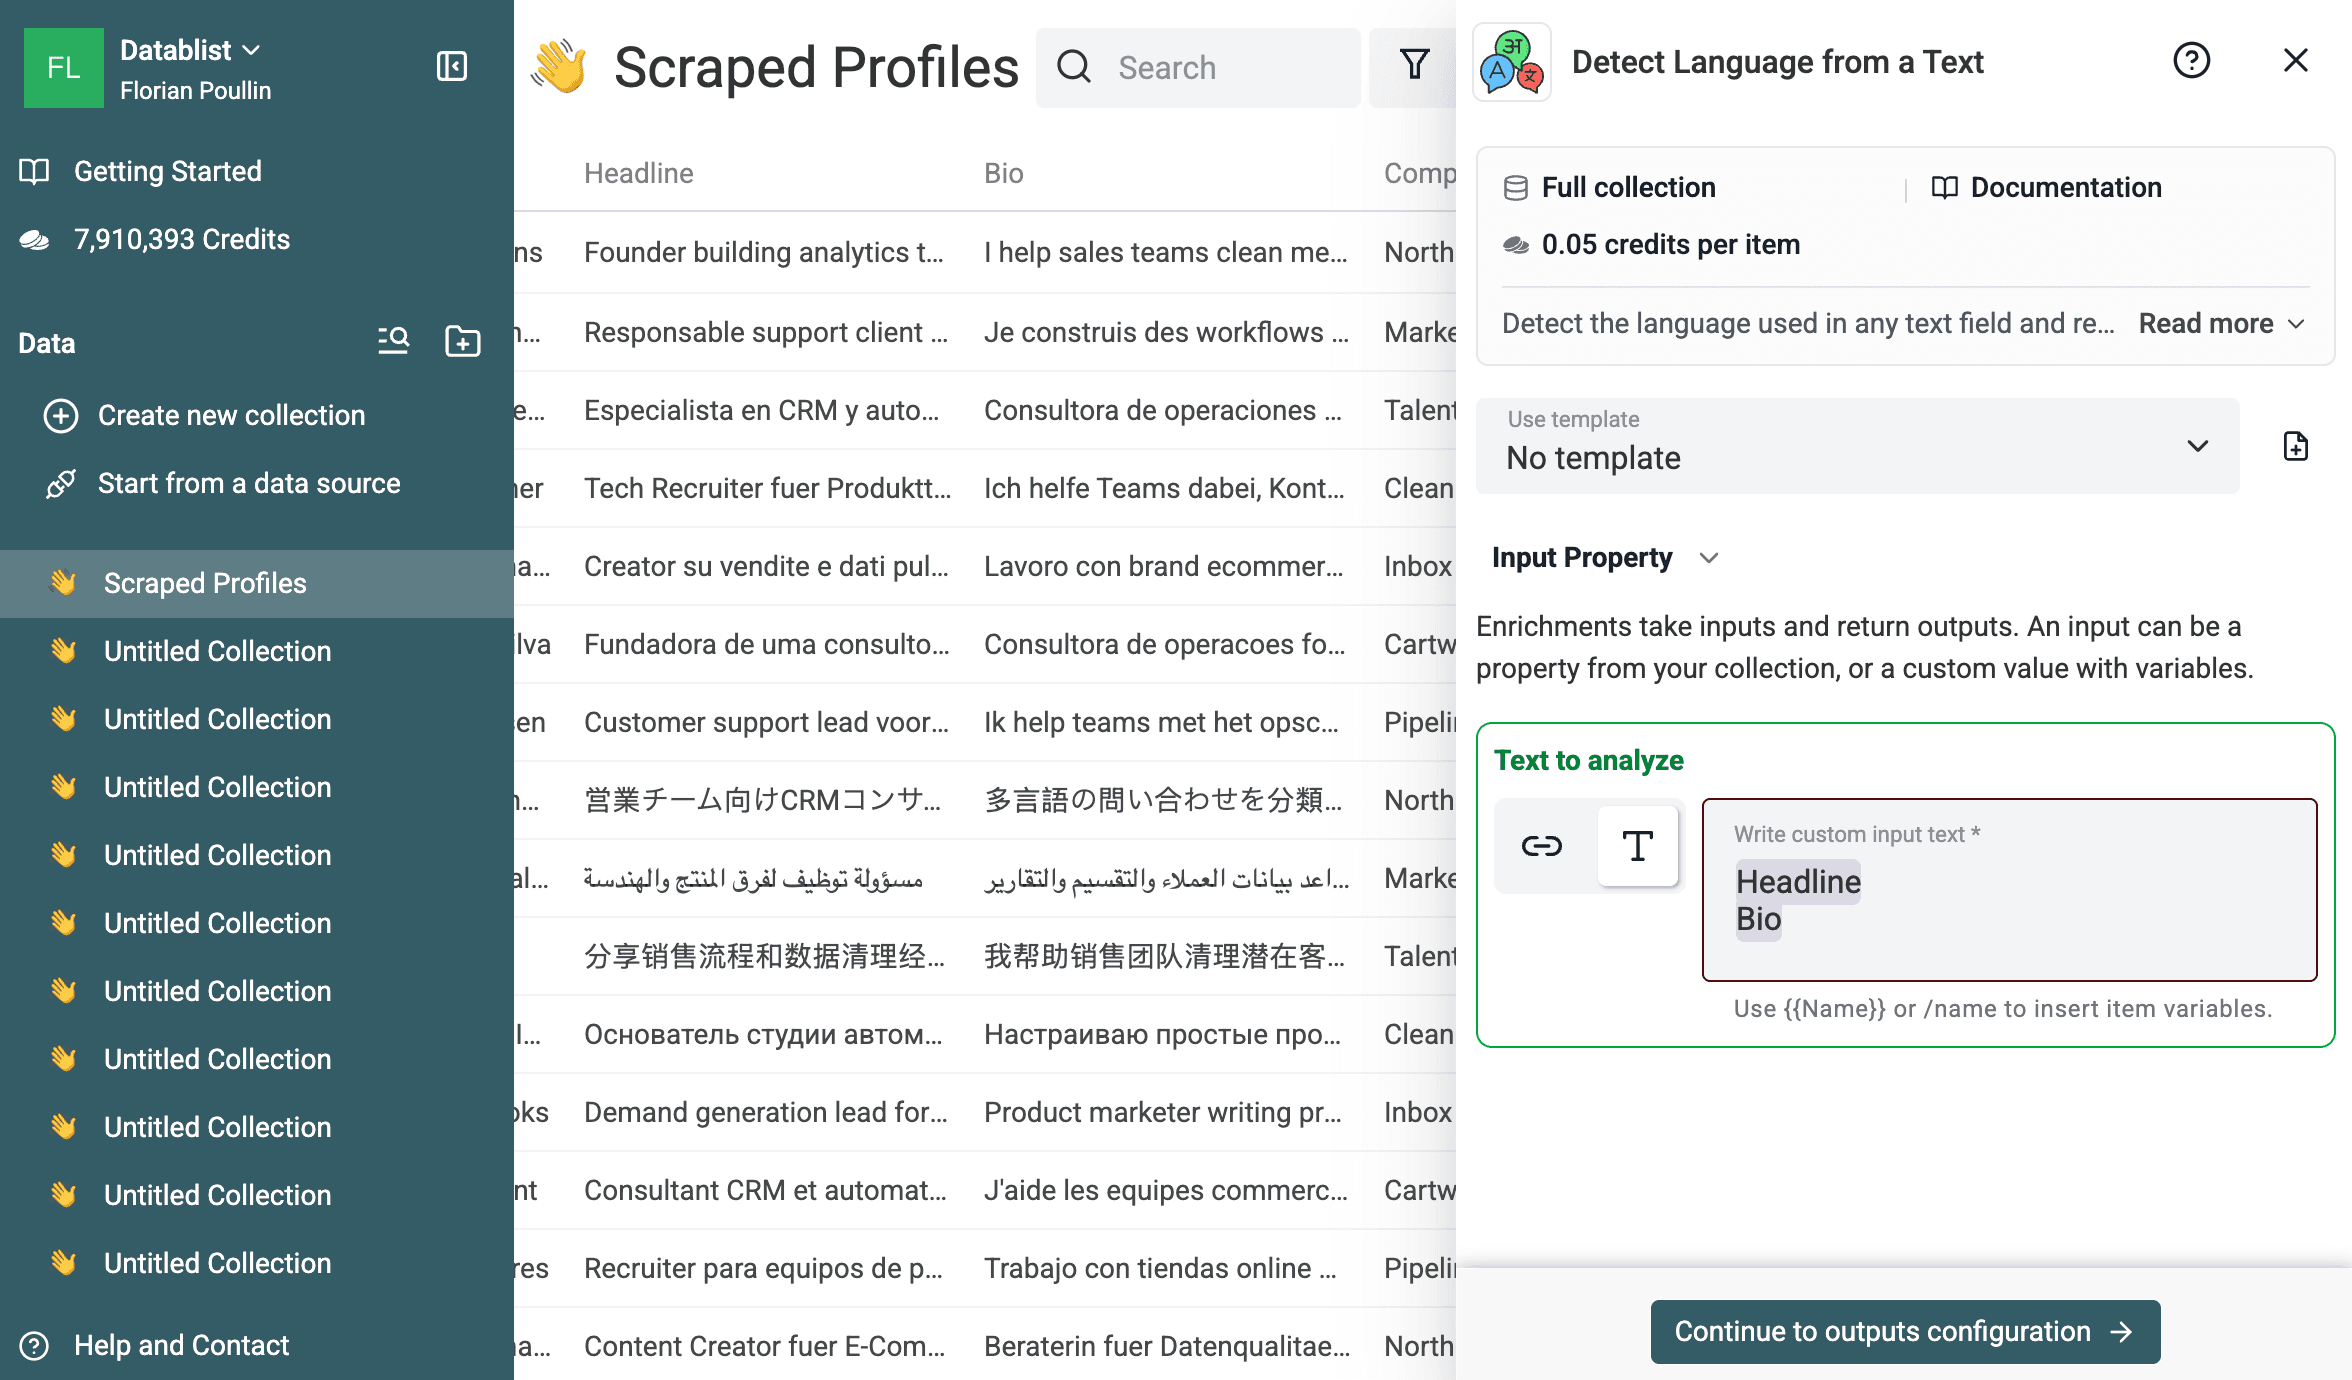
Na etapa Inputs, escolha o texto que o Datablist deverá analisar. Você pode selecionar uma propriedade ou criar uma entrada personalizada com várias propriedades.
No dataset de perfis, uso uma entrada personalizada com Headline e Bio. Isso é importante porque algumas linhas têm uma bio curta, outras têm um título útil e algumas estão desorganizadas. Combinar os dois campos oferece mais contexto ao detector sem exigir uma nova coluna manual.
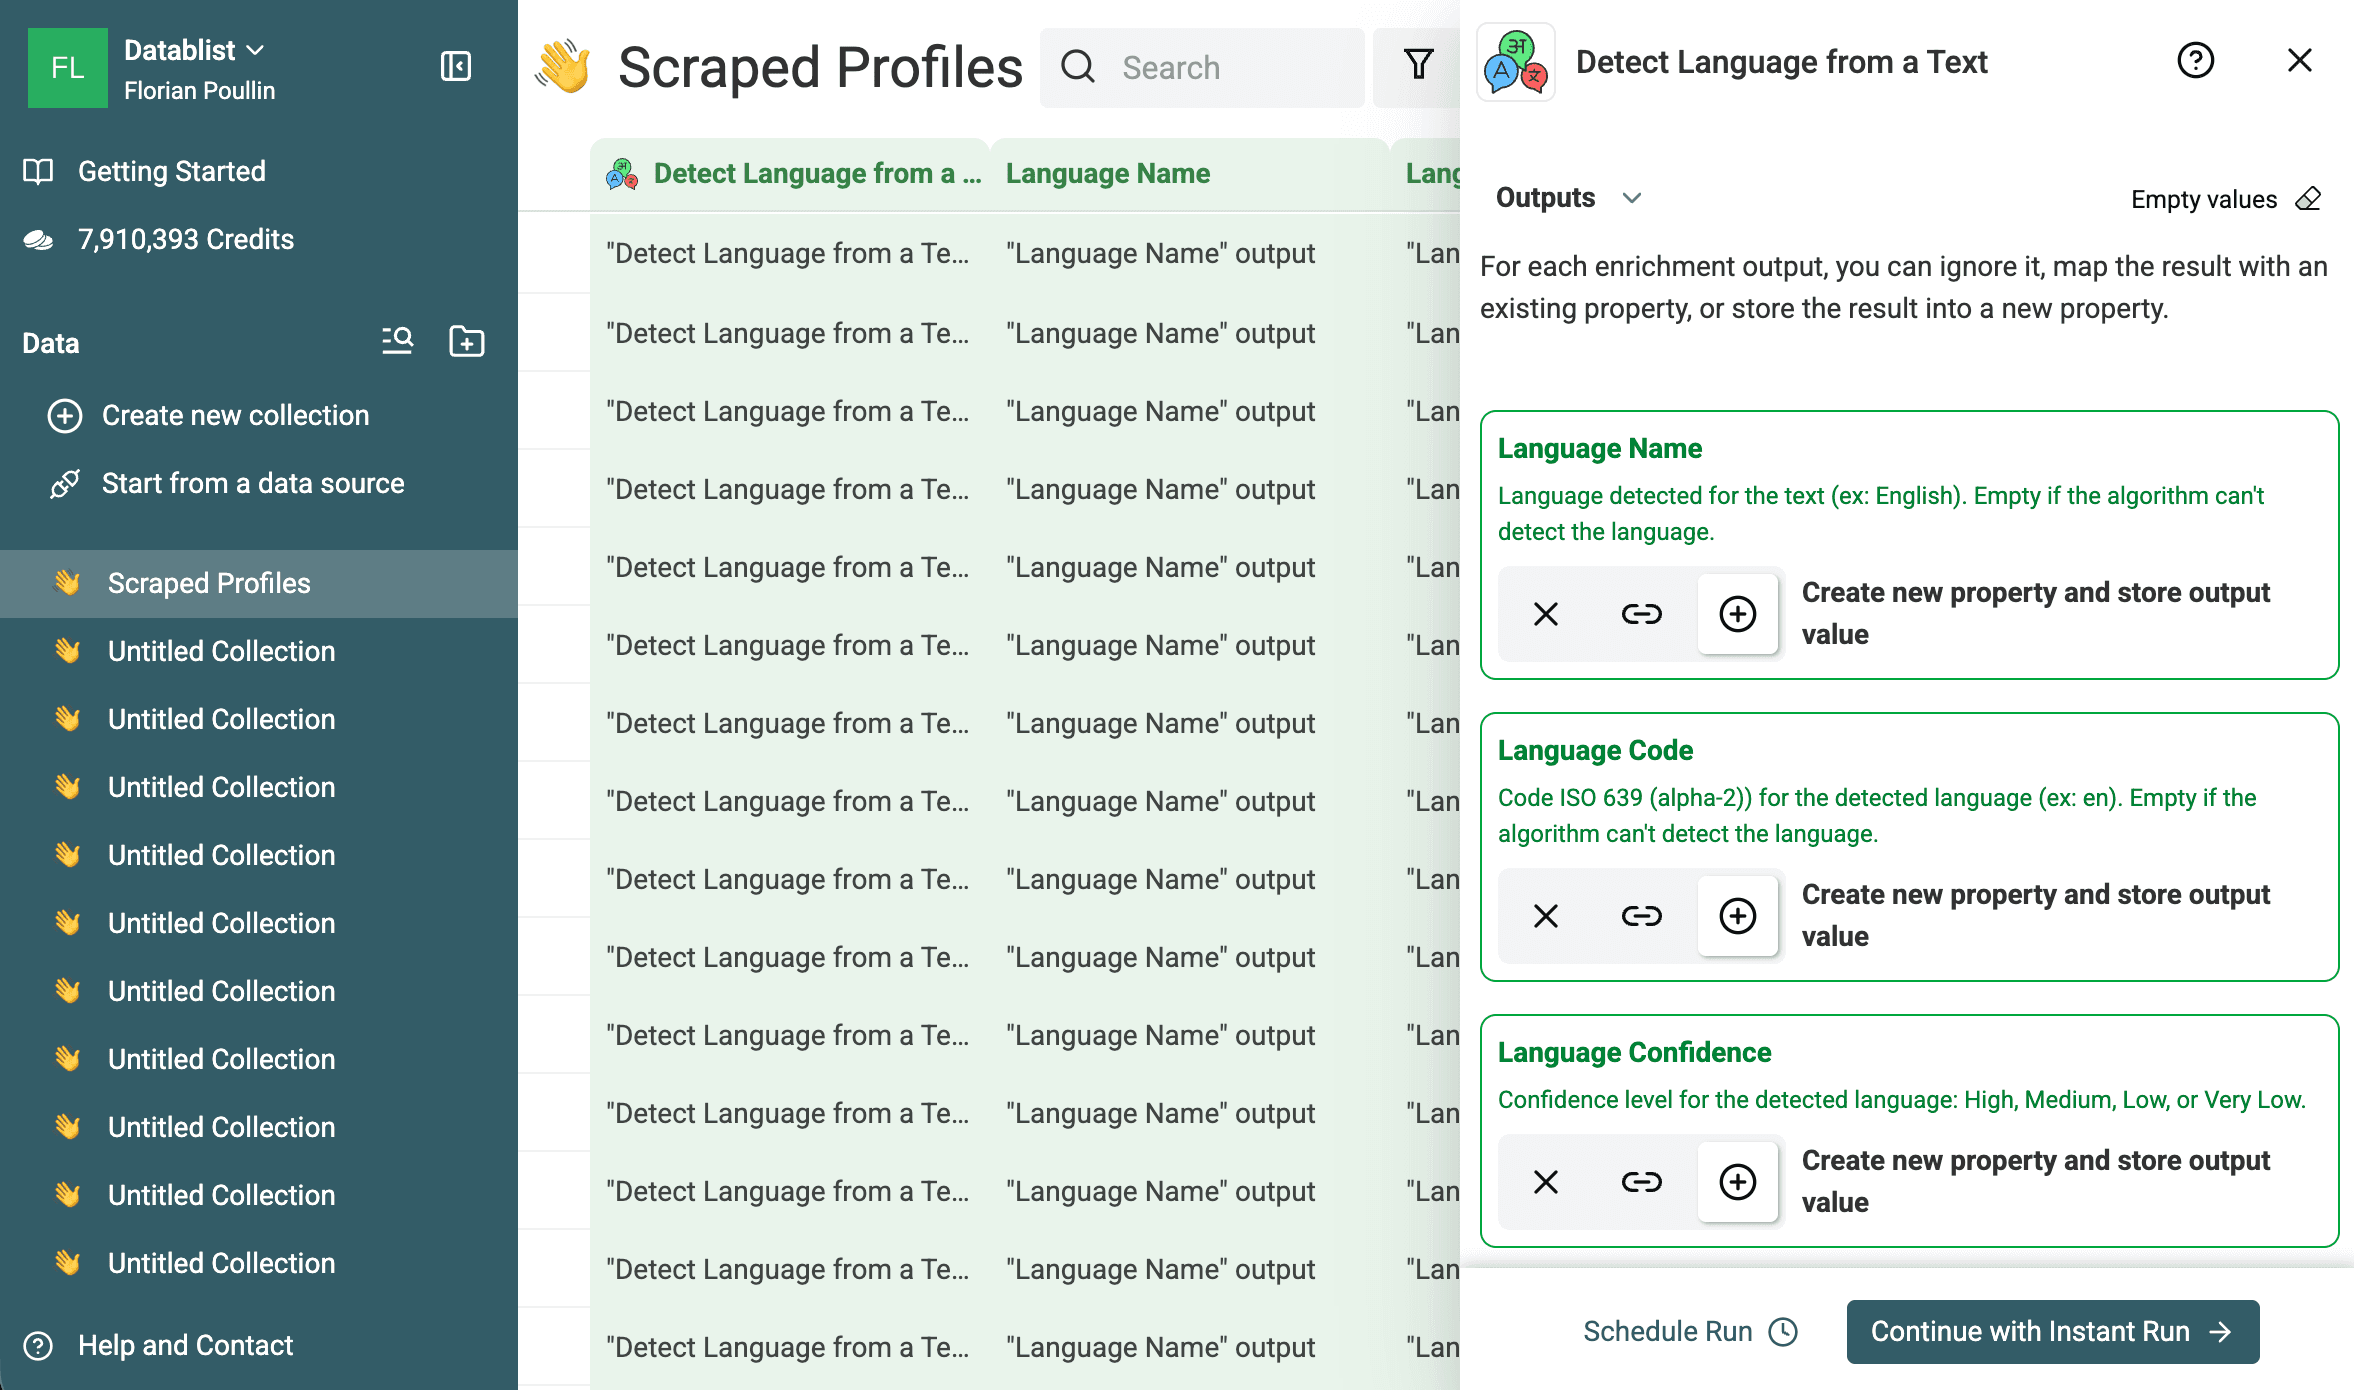
Em seguida, configure as colunas de saída. Normalmente, crio novas colunas para:
Language NameLanguage CodeLanguage Confidence
Uma coluna com o status da execução ajuda a isolar linhas que falharam, tinham uma entrada inválida ou não retornaram resultados.
Antes de processar o arquivo inteiro, execute o enrichment nas primeiras dez linhas. Faço isso até em fluxos simples porque permite identificar rapidamente um mapeamento incorreto. Se você selecionar Company por engano no lugar de Bio, verá resultados ruins antes de gastar créditos com todo o dataset.
⚠️ Textos curtos são mais difíceis
Trechos de uma palavra, marcas, handles, números e URLs podem não conter sinais de idioma suficientes. Trate linhas com baixa confiança ou sem resultado como uma fila de revisão, não como falhas.
Quando a primeira execução apresentar bons resultados, processe as linhas restantes.
Etapa 4: revise os idiomas detectados
A primeira execução de teste deve mostrar as novas colunas de idioma ao lado dos dados originais. No exemplo abaixo, o Datablist detectou inglês, francês, espanhol, alemão, italiano, português, holandês, japonês, árabe e chinês nas primeiras linhas.
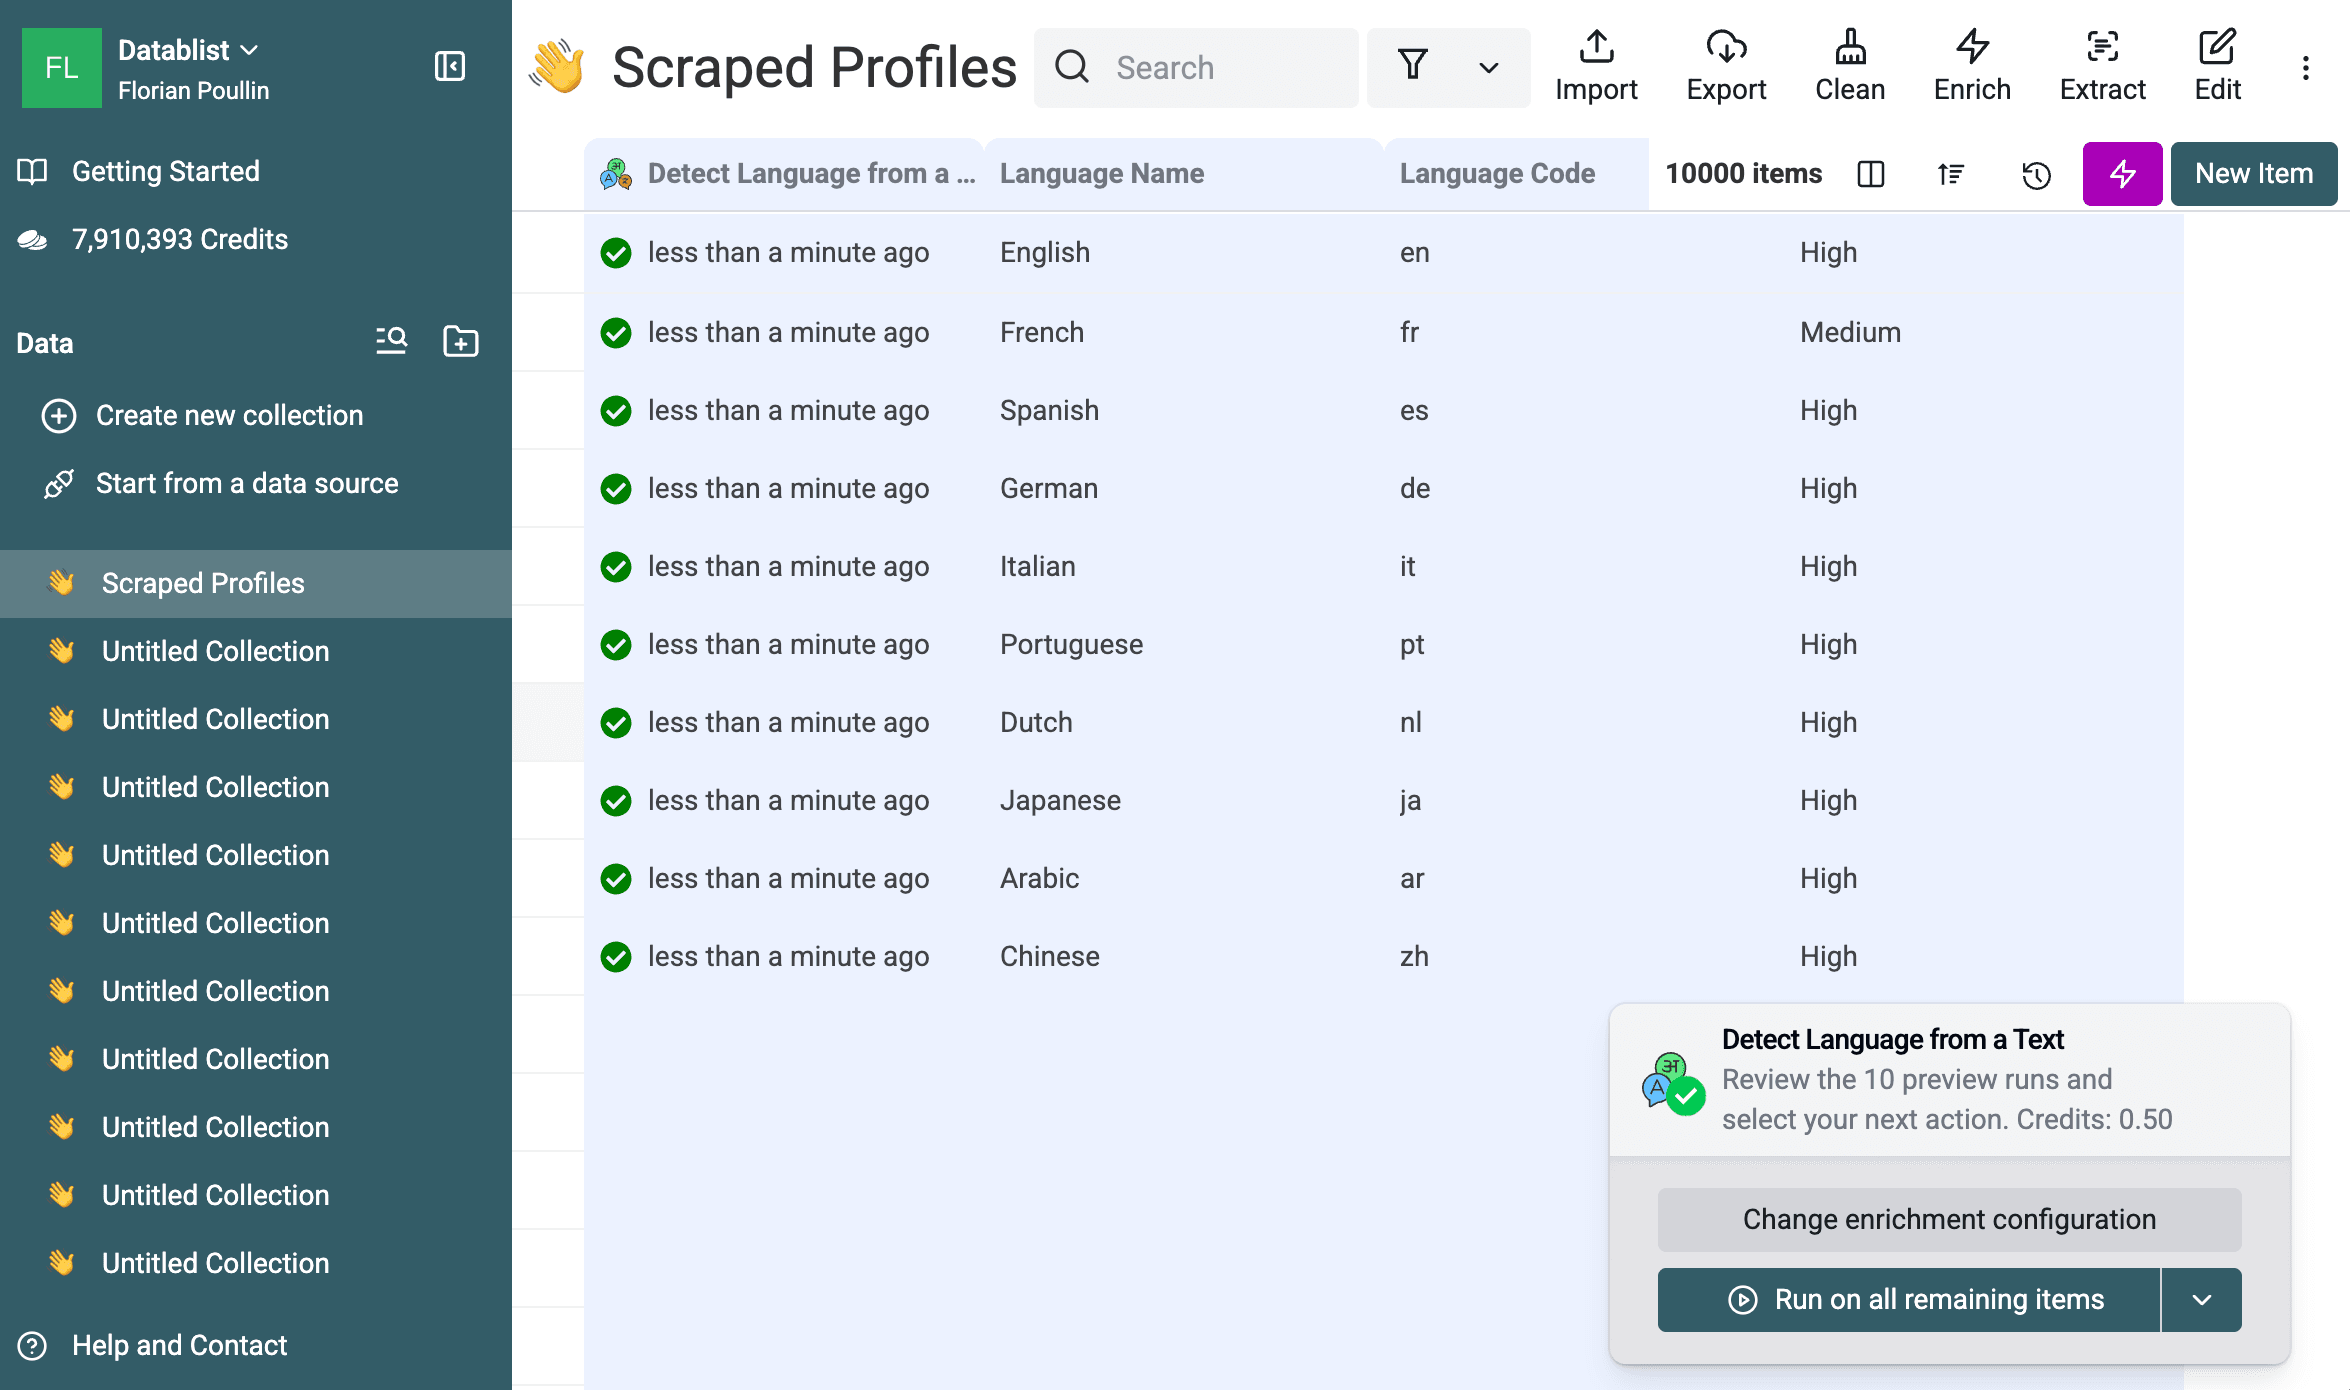
Este é o tipo de tabela de resultados que você pode esperar:
| ID do perfil | Padrão do texto | Nome do idioma | Código do idioma | Confiança | Precisa de revisão |
|---|---|---|---|---|---|
C8C1DXQBNP | Bio em inglês | Inglês | en | Alta | Não |
61M25JUEHM | Bio em francês | Francês | fr | Média | Talvez |
Y45G9QU71C | Bio em espanhol | Espanhol | es | Alta | Não |
RL20HHREOT | Bio em alemão | Alemão | de | Alta | Não |
| linha vazia | Bio em branco e título pouco informativo | Sem resultado ou inválido | em branco | em branco | Sim |
| linha apenas com handle | @marketloop | Sem resultado ou baixa confiança | em branco | Baixa | Sim |
Não trato a confiança como uma decisão final de negócio, mas como um sinal de direcionamento. High e Medium costumam ser suficientes quando a próxima etapa é preparar a tradução ou fazer uma segmentação ampla. Linhas Low, Very Low, inválidas ou sem resultado devem ser revisadas antes do envio de emails, da atribuição de tickets de suporte ou da atualização de um CRM.
📘 A confiança agiliza a revisão
A confiança não substitui o julgamento. Ela indica onde concentrar sua atenção primeiro.
Se a precisão for importante, crie uma coluna simples Needs Review após a execução. Marque-a como Yes quando a confiança for Low ou Very Low, quando a entrada for inválida ou quando o Datablist não retornar nenhum resultado. Assim, a parte problemática do dataset vira uma pequena fila de trabalho.
A detecção de idioma é um bom exemplo de classificação com AI: cada linha é atribuída a uma classe, e a confiança ajuda a decidir quais registros podem avançar.
Etapa 5: filtre, exporte ou prossiga com a tradução
Depois que as colunas de idioma forem preenchidas, filtre o dataset antes de exportá-lo ou executar o próximo fluxo.
Comece pela confiança. Abra o menu da coluna Language Confidence e filtre as linhas com baixa confiança. Revise-as primeiro, pois são as mais propensas a conter texto vazio, trechos curtos, conteúdo em vários idiomas ou valores que não representam uma linguagem.
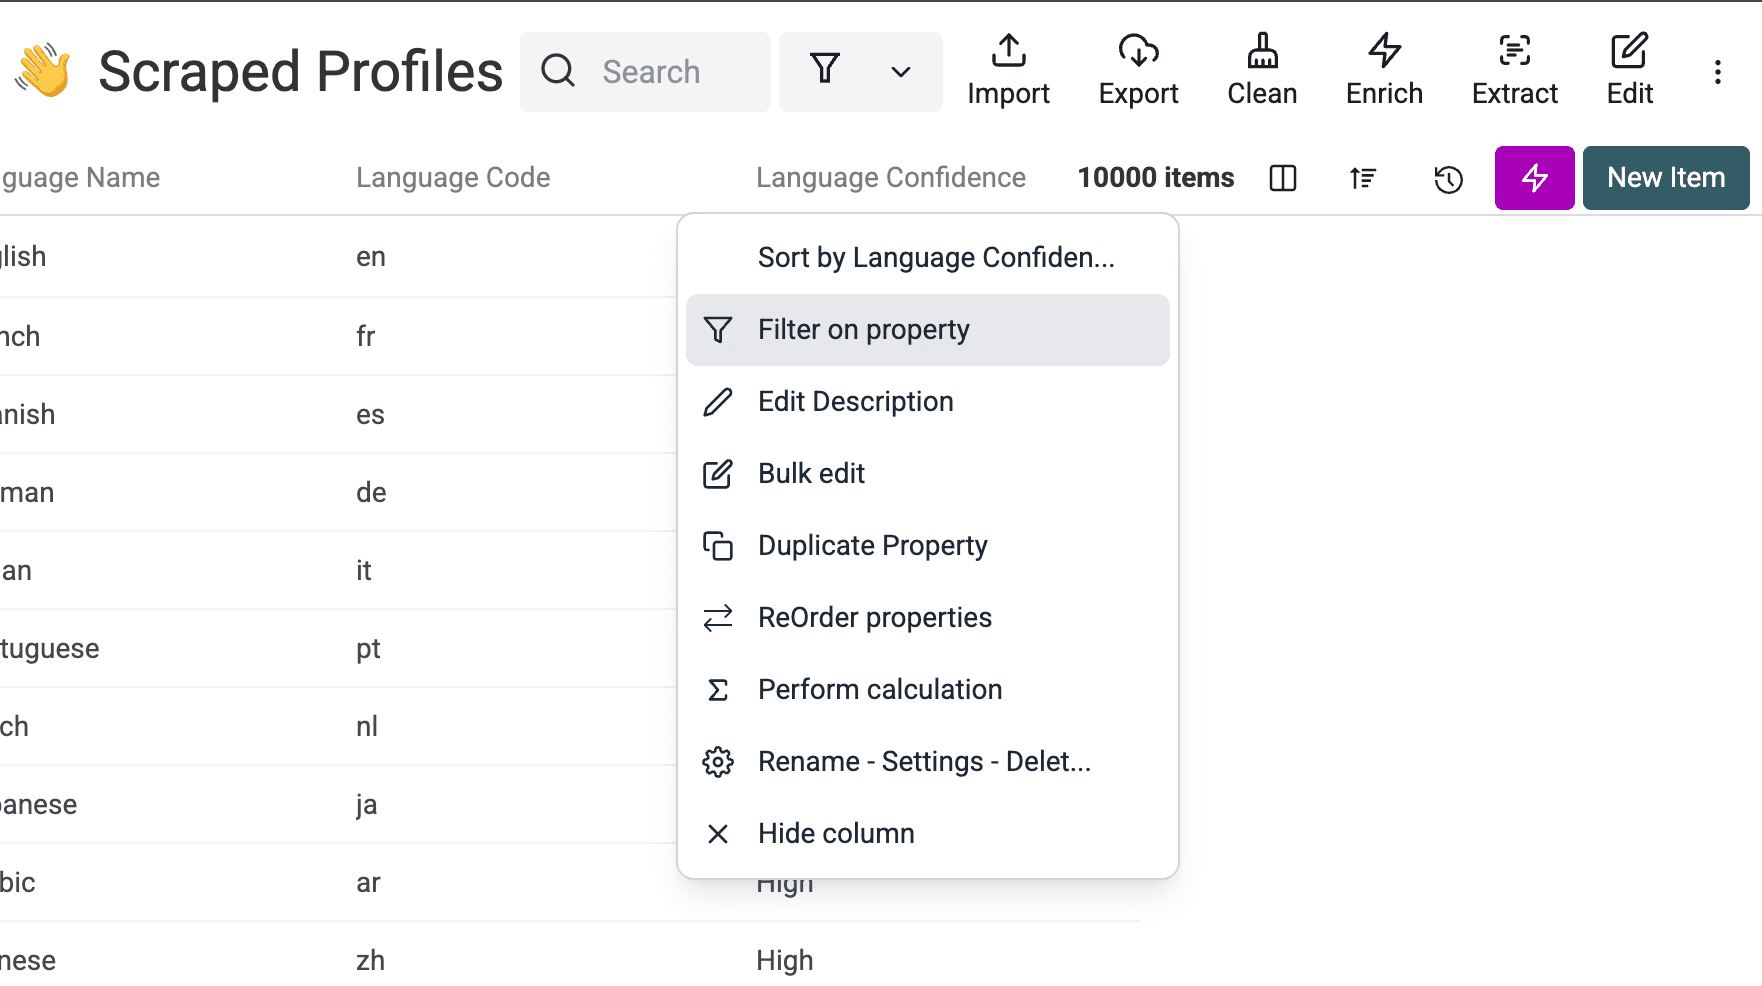
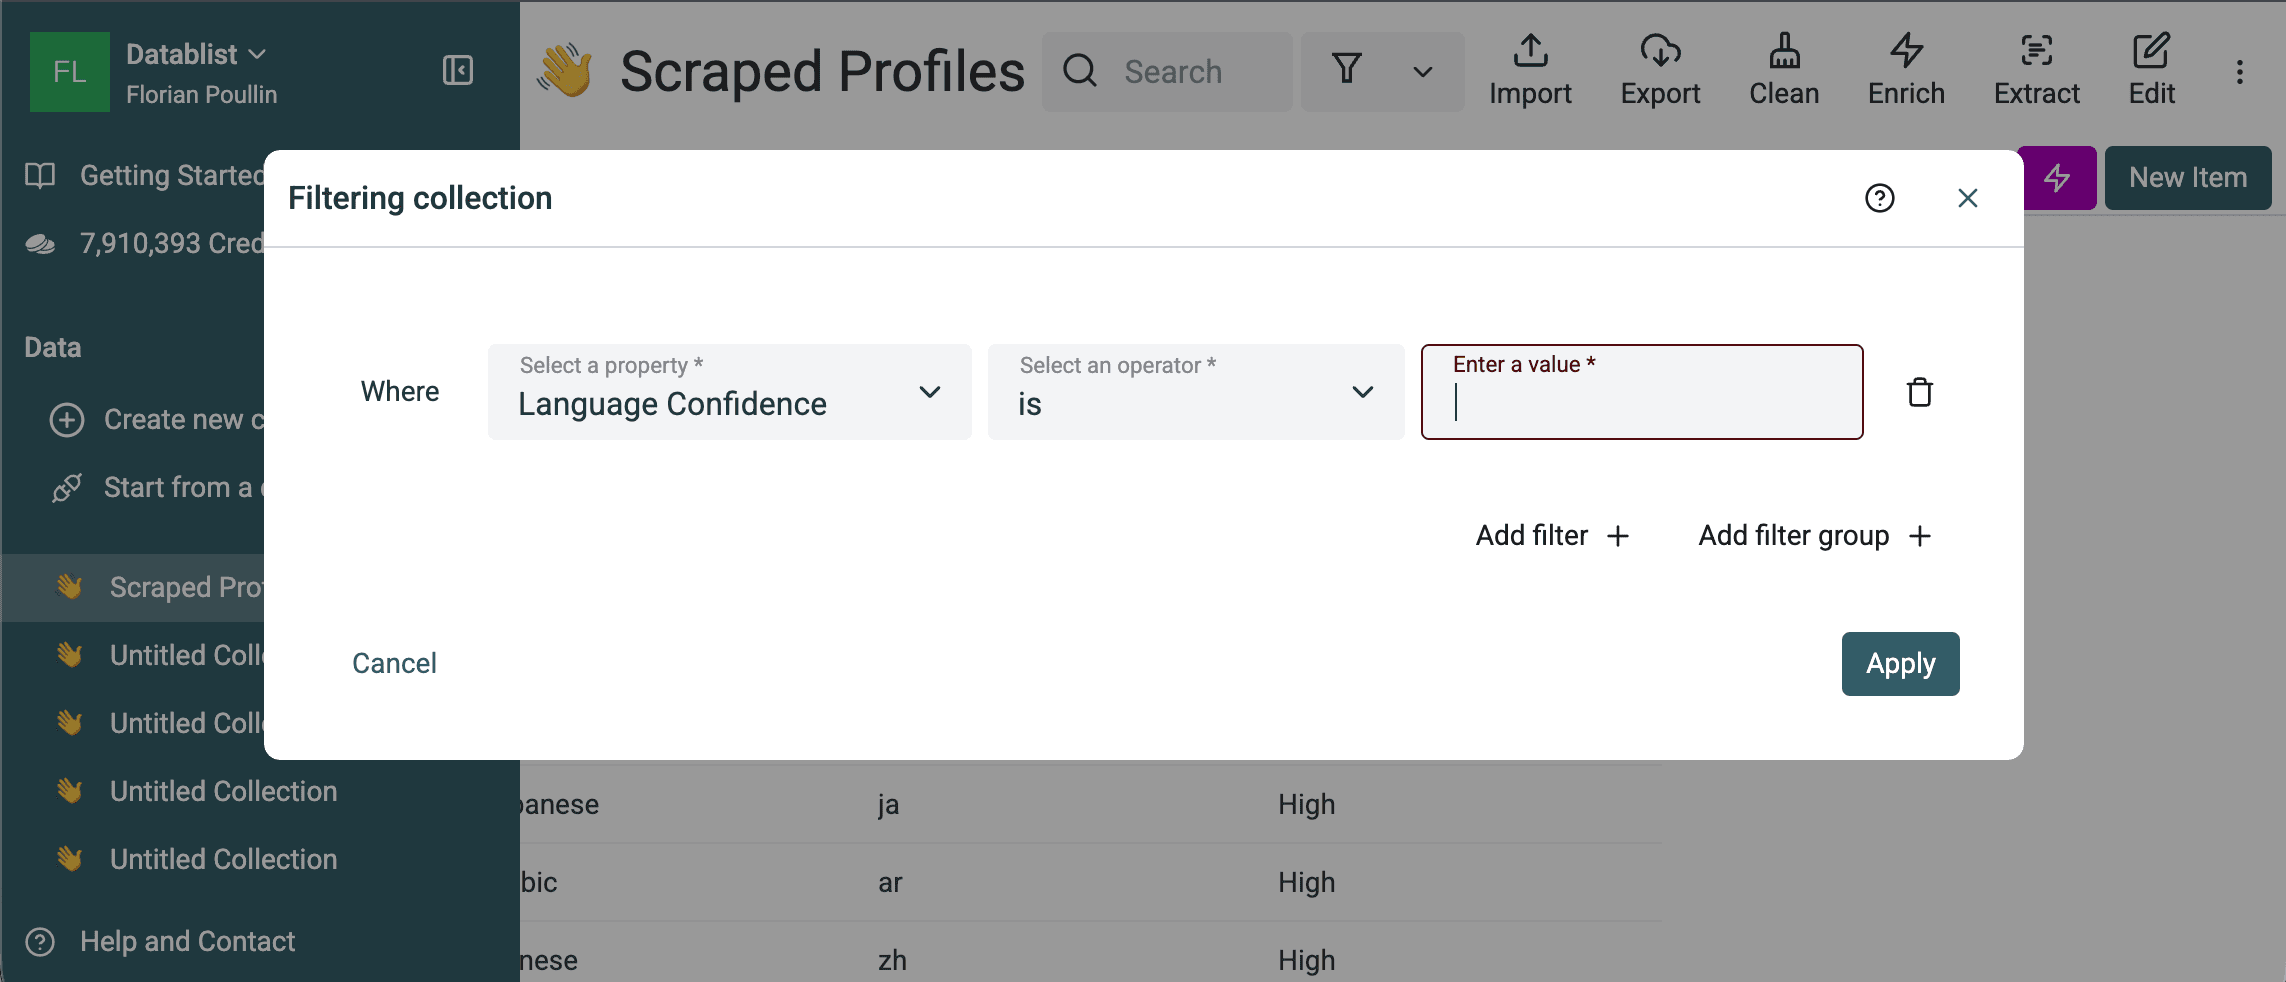
Depois, filtre por Language Code quando precisar de segmentos específicos por idioma. Por exemplo:
- Envie as linhas
fr,es,deeitpara tradução. - Direcione tickets de suporte
jaezhpara a equipe certa. - Mantenha somente as linhas em inglês para uma campanha.
- Remova linhas inválidas antes de importar o arquivo para um CRM.
Se a próxima etapa for a tradução, use o código do idioma para preparar o arquivo antes de traduzir arquivos CSV online. Quando um arquivo contém vários idiomas, prefiro detectar primeiro o idioma de origem. Isso evita traduzir linhas que já estão no idioma de destino e torna a revisão mais previsível.
Quando o dataset estiver organizado, exporte-o para CSV ou Excel. Mantenha o texto original, o nome e o código do idioma, a confiança e os campos de revisão. Essas colunas permitem explicar depois por que uma linha foi enviada para tradução, direcionamento ou revisão manual.
Custo: créditos fixos por linha
O enrichment Detect Language from a Text custa 0.05 crédito por linha. O preço é fixado pela quantidade de linhas. Ele não muda porque uma linha tem um título curto e outra contém um ticket de suporte extenso, uma descrição de produto, uma avaliação ou um trecho de página extraída.
Considerando a recarga inicial do Datablist de 20.000 créditos por US$ 20, cada crédito equivale a US$ 0,001. Isso resulta nestes custos aproximados:
| Linhas | Créditos usados | Custo aproximado |
|---|---|---|
| 1.000 | 50 créditos | US$ 0,05 |
| 10.000 | 500 créditos | US$ 0,50 |
| 100.000 | 5.000 créditos | US$ 5,00 |
Esse é um dos motivos pelos quais uso o enrichment específico antes de recorrer ao ChatGPT. Os preços do ChatGPT/OpenAI dependem dos tokens de entrada e saída. Processar uma bio curta com um LLM custa pouco, mas tickets extensos, descrições de produtos, avaliações e textos de páginas custam mais porque contêm mais tokens. Com o enrichment de detecção de idioma, cada linha custa os mesmos 0.05 crédito, independentemente do volume de texto enviado.
Novos usuários também podem testar esse fluxo com 500 créditos grátis ao se cadastrarem com um endereço de email de domínio empresarial. A 0.05 crédito por linha, os 500 créditos cobrem 10.000 detecções de idioma.
Alternativa: use o ChatGPT para regras personalizadas
A detecção simples de idioma normalmente não precisa de um LLM. O enrichment específico é a melhor primeira opção porque a saída é fixa: nome do idioma, código e confiança. Ele também tem um custo previsível por linha, enquanto o custo do ChatGPT/OpenAI depende do volume de tokens.
Use o ChatGPT ou a OpenAI quando o resultado depender de regras de negócio. Por exemplo, você pode querer:
- Classificar linhas em vários idiomas como
Mixed, em vez de escolher um idioma principal. - Combinar a detecção de idioma com a classificação da intenção do cliente.
- Adicionar um campo
Needs Reviewcom base nos seus próprios limites. - Retornar uma justificativa curta para auditoria de linhas ambíguas.
- Tratar variantes regionais ou nomes de produtos de uma maneira específica.
O Datablist permite executar prompts do ChatGPT em linhas de CSV ou Excel com o enrichment Ask ChatGPT/OpenAI. Use variáveis de prompt para inserir os valores de cada linha no prompt.
Veja um prompt simples para o mesmo dataset de perfis:
Detecte o idioma principal deste texto.

Texto:
{{Bio}}

Se o texto estiver vazio, contiver principalmente números, for uma URL ou for curto demais para decidir, retorne "No result" e marque Needs review como Yes.
Use saídas definidas:
| Nome da saída | Tipo | Instruções |
|---|---|---|
Language name | Texto | Idioma principal da bio ou do título. Retorne No result quando não houver sinais de idioma suficientes. |
ISO 639-1 code | Texto | Código de duas letras, como en, fr, es ou de. Deixe em branco quando não houver resultado. |
Confidence | Select ou texto | High, Medium ou Low. |
Needs review | Select ou texto | Yes para textos vazios, ambíguos, em vários idiomas ou com baixa confiança. Caso contrário, No. |
Reason | Texto | Observação curta opcional para fluxos de auditoria. Ignore-a se precisar apenas dos rótulos. |
🔍 Use o ChatGPT para regras, não para detecções rotineiras
Se a saída exigir um julgamento além de “qual é este idioma?”, o ChatGPT pode ser útil. Se você só precisa dos códigos de idioma, continue com o enrichment específico.
O erro mais comum é pedir ao ChatGPT que retorne um parágrafo. Isso gera trabalho extra de limpeza. Armazene cada saída em sua própria coluna para poder filtrar, ordenar, exportar e reutilizar os dados.
Checklist de controle de qualidade
Antes de usar o arquivo enriquecido, normalmente verifico estas linhas:
- De 20 a 50 linhas aleatórias entre vários idiomas detectados.
- Linhas com confiança Low ou Very Low.
- Linhas com entrada inválida ou sem resultado.
- Bios curtas, handles, URLs, números e textos que contêm apenas o nome da empresa.
- Linhas em vários idiomas nas quais o “idioma principal” pode ser subjetivo.
- Códigos ISO esperados pela próxima ferramenta.
O limite adequado depende do fluxo. A preparação para tradução admite uma pequena fila de revisão manual. O direcionamento de suporte exige mais cuidado, pois um idioma incorreto pode enviar um ticket à pessoa errada. A segmentação de Outbound também precisa de revisão, porque enviar uma mensagem no idioma errado demonstra falta de atenção.
Para a maioria dos arquivos, o caminho mais rápido é simples: confie em High, examine Medium quando o texto for curto e revise as linhas Low, Very Low, inválidas e sem resultado.
Casos de uso e variações
Equipes de suporte podem detectar o idioma dos tickets antes de direcioná-los. Isso é útil quando uma única caixa de entrada recebe mensagens de vários países e a equipe precisa de uma triagem inicial rápida.
Equipes de pesquisa podem detectar o idioma das respostas abertas antes da análise. Eu faria isso antes da tradução para manter os dados de origem organizados.
Equipes de vendas e recrutamento podem segmentar bios de perfis antes do Outbound. Uma coluna com o código do idioma facilita a atribuição de responsáveis ou a preparação de mensagens localizadas.
Equipes de ecommerce podem detectar o idioma das descrições de produtos antes da localização. Se um catálogo tiver conteúdo misto de fornecedores, a detecção ajuda a separar o que precisa ser traduzido daquilo que já está pronto.
Fluxos de scraping seguem o mesmo padrão. Ao extrair páginas de vários mercados, detecte o idioma de cada página antes de decidir o que manter, traduzir ou descartar.
Se a coluna Bio estiver vazia em muitas linhas, execute o enrichment em Headline ou combine os dois campos na entrada. Costumo combinar campos quando ambos são curtos e usar apenas um quando ele já contém frases completas.
Solução de problemas
Se o texto estiver vazio, espere uma entrada inválida ou nenhum resultado. Filtre essas linhas e decida se prefere removê-las ou preencher outro campo de texto.
Se a linha contiver apenas uma URL, um handle, um número, um ID ou o nome de uma marca, não confie automaticamente no resultado. Esses valores oferecem poucos sinais de idioma ao detector.
Se a linha contiver vários idiomas, trate o resultado como o idioma principal e verifique a confiança. Em fluxos rigorosos, crie um rótulo Mixed separado com o ChatGPT ou faça uma revisão manual.
Se um idioma menos comum aparecer no arquivo, revise uma amostra antes de confiar no resultado em grande escala. O enrichment aceita muitos idiomas comuns, mas inspecionar os casos extremos antes da exportação continua sendo a prática mais segura.
Se o arquivo for grande, execute primeiro as dez primeiras linhas e depois uma amostra maior, se necessário. Quando o mapeamento das entradas e as colunas de saída estiverem corretos, processe todo o dataset.
Conclusão
A maneira mais prática de detectar idiomas em uma planilha é manter o fluxo estruturado por linha. Importe o arquivo CSV ou Excel, selecione Detect Language from a Text, escolha uma ou mais colunas de texto, crie saídas para nome, código e confiança do idioma e revise as linhas com baixa confiança antes da exportação.
Use o enrichment específico para a detecção normal de idiomas. Ele oferece as colunas necessárias sem exigir código nem um prompt personalizado, e o custo permanece fixo por linha. Recorra ao ChatGPT quando precisar de regras de negócio, rótulos para conteúdo em vários idiomas ou uma lógica adicional de revisão.
Comece com um pequeno teste, confira os resultados e só então processe o arquivo inteiro. Essa verificação rápida costuma economizar muito mais tempo do que consome.
FAQ
Como detectar o idioma de cada linha de um arquivo CSV?
Importe o CSV para o Datablist, selecione Detect Language from a Text no menu Enrich, mapeie a coluna de texto na etapa Inputs e armazene o nome, o código e a confiança do idioma em novas colunas.
Posso detectar idiomas em linhas do Excel sem programar?
Sim. Importe o arquivo Excel para o Datablist e execute o enrichment de detecção de idioma na coluna de texto. Os resultados são gravados no dataset e podem ser exportados para CSV ou Excel.
Quais colunas de saída devo adicionar?
Use Language Name, Language Code e Language Confidence. Adicione uma coluna Needs Review se quiser isolar linhas Low, Very Low, inválidas ou sem resultado.
O que significa a confiança na detecção de idioma?
A confiança indica o provável grau de confiabilidade do idioma detectado. Use-a como sinal para revisão. Resultados High e Medium normalmente podem avançar, enquanto Low e Very Low merecem ser inspecionados.
O que fazer com resultados de baixa confiança?
Filtre-os para uma fila de revisão. Verifique se o texto é curto demais, está vazio, contém vários idiomas ou é composto por nomes, URLs, handles ou números.
Posso detectar o idioma antes de traduzir um CSV multilíngue?
Sim. Detecte primeiro o idioma de origem e filtre pelo código do idioma antes da tradução. Assim, você evita traduzir linhas que já estão no idioma de destino.
Quanto custa a detecção de idioma em massa?
Detect Language from a Text custa 0.05 crédito por linha. Com 20.000 créditos por US$ 20, o custo aproximado é de US$ 0,05 para 1.000 linhas, US$ 0,50 para 10.000 e US$ 5 para 100.000. Novos usuários com email de domínio empresarial podem testar o recurso com 500 créditos grátis, suficientes para 10.000 detecções.
Devo usar o ChatGPT para detectar idiomas em massa?
Use o ChatGPT quando precisar de regras personalizadas ou de uma classificação combinada. Para uma detecção simples, o enrichment específico é a opção inicial mais fácil e tem custo fixo por linha. O ChatGPT/OpenAI pode ficar mais caro quando as linhas contêm textos extensos, pois o custo dos LLMs depende de tokens.
O que acontece se o texto estiver vazio, for uma URL ou muito curto?
Um texto vazio é inválido, enquanto um texto sem sinais claros de idioma pode não retornar resultado ou apresentar baixa confiança. Filtre essas linhas antes da exportação ou tradução.
Posso detectar o idioma pelo título do perfil em vez da bio?
Sim, mas os títulos costumam ser curtos. Se possível, combine Headline e Bio na entrada para que o Datablist tenha mais texto para analisar.
Posso exportar nomes e códigos ISO de idiomas para CSV ou Excel?
Sim. Depois de executar o enrichment, exporte o dataset com o texto original, o nome e o código do idioma, a confiança e os campos de revisão.