
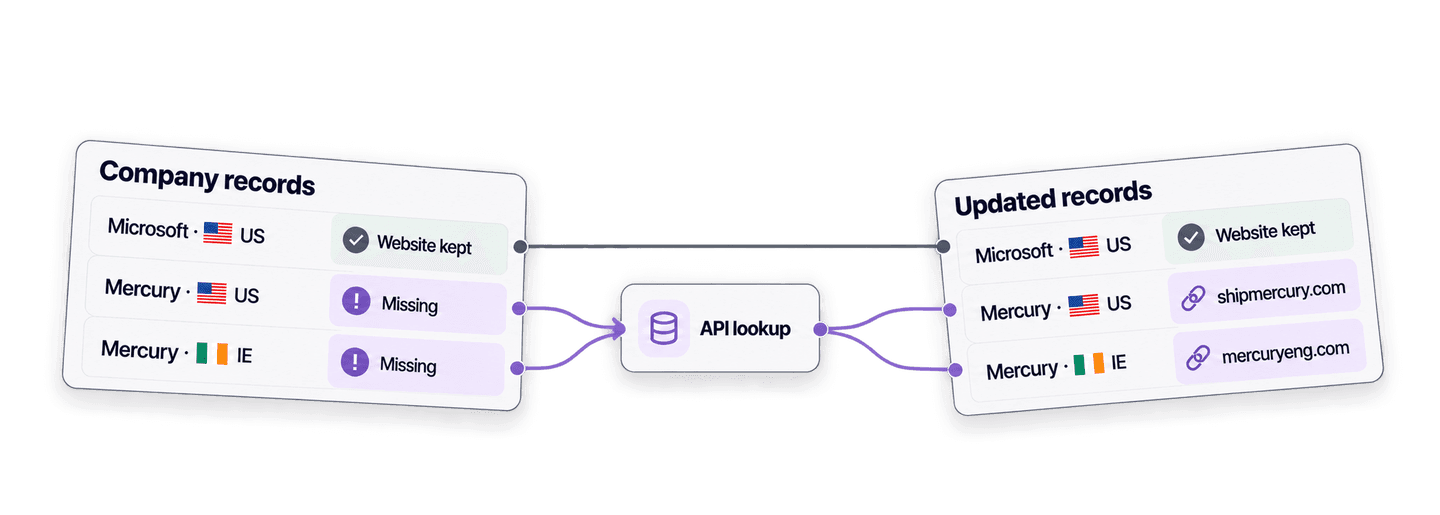
Para encontrar o site de uma empresa a partir do nome em Python, envie o nome e, se disponível, o país para a API Company Name to Domain da Datablist. A API processa a pesquisa em segundo plano e devolve o domínio e a URL completa do site.
Primeiro, vou mostrar uma requisição simples à API em Python. Depois, reutilizarei a mesma função para preencher apenas os sites em falta numa lista de empresas, preservando as URLs já existentes.
Se preferir uma interface semelhante a uma folha de cálculo, consulte o guia para encontrar sites de empresas em massa.
💡 Resumo para quem tem pressa
Crie uma função em Python para encontrar sites a partir de nomes de empresas e use-a para completar registos sem site, sem substituir URLs conhecidas.
- Input: nomes de empresas, com país opcional.
- Output: domínio, URL completa do site, nível de confiança, estado do resultado e créditos utilizados.
Configure o Python e a chave da API Datablist
Neste exemplo, utilizo o pacote Requests para fazer chamadas HTTP síncronas. Instale-o num ambiente virtual:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requestsTambém precisa de um plano Datablist Growth, pois o acesso à REST API é uma funcionalidade desse plano. Crie uma Personal API Key na página da API da sua conta Datablist e guarde-a numa variável de ambiente:
export DATABLIST_API_KEY="exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2"🔑 Já tem uma chave de API? As chaves antigas utilizam
auth0|<userId>:<accountId>:<secret>:1e continuam a ser aceites. Continue a usar a sua chave exatamente como foi gerada; não precisa de a substituir nem de alterar o formato.
Substitua o valor de exemplo acima pela chave gerada na página da sua conta. As pesquisas de sites de empresas consomem créditos. Antes de dimensionarmos o script, explicarei os percursos de 1 e 2,5 créditos. Os valores atuais dos planos estão na página de preços da Datablist.
Pesquise o site de uma empresa em Python
Crie um ficheiro chamado find_company_websites.py. O script envia os nomes, aguarda a conclusão da tarefa e obtém os resultados através de uma única função. Cada input utiliza o ID estável do seu registo como inputId, permitindo associar cada resultado ao registo correto mesmo que a ordem da resposta mude.
import json
import os
import time
import uuid
import requests
API_BASE_URL = "https://api.datablist.com/v1"
def find_domains(companies, api_key):
headers = {
"Accept": "application/json",
"Content-Type": "application/json",
"X-API-Key": api_key,
}
inputs = [
{
"inputId": company["id"],
"data": {
"companyName": company["company_name"],
"targetCountry": company.get("country", ""),
},
}
for company in companies
]
unique_id = f"python-domain-lookup-{uuid.uuid4().hex}"
payload = {
"enrichmentId": "company-name-to-domain",
"uniqueId": unique_id,
"settings": {
"workflow": "dataset_google",
"countryOverwrite": True,
"acceptNonRoot": True,
},
"inputs": inputs,
}
print(f"Task uniqueId: {unique_id}")
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} ended with status {task['status']}: {task.get('error')}"
)
results = []
cursor = None
while True:
params = {"limit": 100}
if cursor is not None:
params["cursor"] = cursor
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}/results",
headers=headers,
params=params,
)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
break
return results
api_key = os.environ["DATABLIST_API_KEY"]
companies = [
{
"id": "direct-microsoft-us",
"company_name": "Microsoft",
"country": "US",
}
]
lookup_results = find_domains(companies, api_key)
for result in lookup_results:
print(json.dumps(result, indent=2))Execute-o no terminal onde exportou a chave:
python find_company_websites.pyEste é o resultado da Microsoft:
{
  "inputId": "direct-microsoft-us",
  "status": "success",
  "outputs": {
    "companyUrl": "https://microsoft.com",
    "companyDomain": "microsoft.com",
    "domainConfidence": "High"
  },
  "creditsUsed": "1",
  "error": null
}
Utilize inputId para associar o resultado ao registo original. O status pode ser success, no_result, error ou skipped. Um resultado bem-sucedido pode incluir companyDomain, a URL completa em companyUrl e domainConfidence. O campo creditsUsed indica o custo desse input, enquanto error explica uma falha ao nível do item.
A função faz três tipos de chamadas à API, por esta ordem.
Primeiro, envia a pesquisa. O payload contém as definições e os registos das empresas. O POST devolve 202 Accepted, e @id é o ID da tarefa necessário para as chamadas seguintes:
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]Se DATABLIST_API_KEY não estiver definida, o Python gera um KeyError ao procurar a variável de ambiente, antes de fazer qualquer requisição HTTP. Exporte a variável e volte a executar o script. Se a variável contiver uma chave inválida, o POST chega à API e devolve o código HTTP 401. Copie uma Personal API Key atual da página da sua conta e substitua o valor inválido.
Em segundo lugar, consulta o estado da tarefa. Como o POST inicia um processo em segundo plano, o script verifica a tarefa a cada três segundos até esta chegar a completed, failed ou stopped:
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)Se a tarefa falhar por falta de créditos, o motivo indicado no erro será credits_error. Adicione créditos ou aguarde a renovação dos créditos mensais, verifique os resultados já devolvidos e envie apenas os inputs por concluir numa nova tarefa.
Em terceiro lugar, obtém todas as páginas de resultados. Cada resposta acrescenta resultados à lista e fornece o cursor para a requisição seguinte:
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
breakO script continua a obter páginas até nextCursor ser null.
Antes do POST, o script apresenta o uniqueId gerado. Se a ligação cair antes de receber a resposta de criação, liste primeiro as suas tarefas e verifique o respetivo estado antes de criar outra:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-name-to-domain"Encontre a tarefa cujo uniqueId corresponde ao valor gerado pelo script e copie o respetivo @id. O endpoint de listagem permite filtrar por enrichmentId, mas não por uniqueId. Utilize o @id com as mesmas URLs de estado e resultados utilizadas pelo script. Se a tarefa ainda estiver ativa, continue a consultar o estado. Se tiver parado ou falhado, verifique se existem resultados parciais antes de voltar a enviar os inputs.
Entenda a correspondência e o fallback por país
O script utiliza dataset_google, a opção predefinida recomendada. Primeiro, a Datablist consulta os seus datasets de empresas. Se não encontrar uma correspondência ou detetar informações contraditórias, pode recorrer ao Google como fallback. Antes de devolver um nível de confiança, verifica as correspondências possíveis.
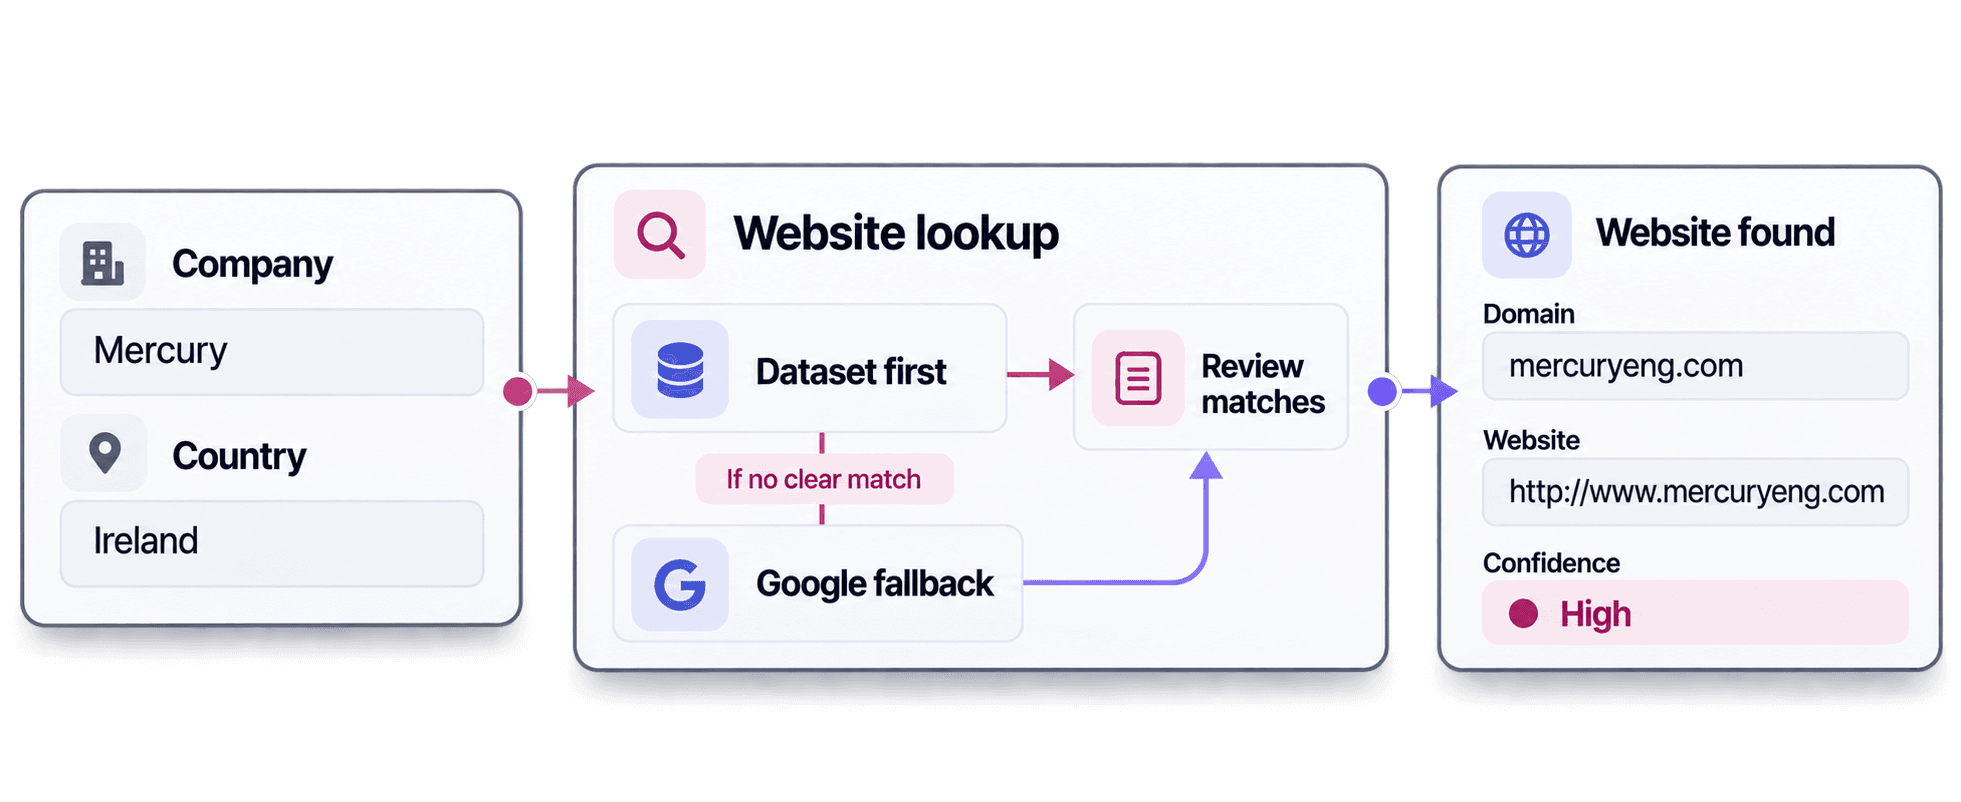
O país ajuda a distinguir nomes ambíguos. Neste exemplo, o mesmo nome de empresa gerou resultados diferentes:
MercurycomUSdevolveushipmercury.comehttps://www.shipmercury.com/.MercurycomIEdevolveumercuryeng.comehttp://www.mercuryeng.com.
Ambos apresentaram um nível de confiança High. O país ajuda a pesquisa a escolher entre empresas com o mesmo nome, enquanto o nível de confiança permite decidir que resultados precisam de revisão.
Quando a correspondência também depender do setor, da dimensão da empresa ou de outro contexto de negócio, utilize o workflow de pesquisa do AI Agent. Inclua esses dados no prompt do AI Agent para que este pesquise a empresa pretendida com mais contexto.
Preencha apenas os sites em falta nos seus registos
Agora que find_domains() consegue encontrar um site a partir do nome da empresa, reutilize a função para preencher apenas os sites em falta nos seus registos. Os registos que já têm um site não passam pela API. Assim, os valores permanecem inalterados e não consomem créditos de pesquisa.
No ficheiro find_company_websites.py, substitua todo o conteúdo desde companies = [ até ao ciclo de impressão final pelo bloco abaixo. Mantenha a atribuição de api_key acima. A verificação de campos vazios abrange None, uma string vazia e espaços em branco. Se todos os sites estiverem preenchidos, não é feita qualquer chamada à API.
records = [
{
"id": "crm-001",
"company_name": "Microsoft",
"country": "US",
"website": "https://www.microsoft.com",
},
{
"id": "crm-002",
"company_name": "boulangerie du palais lyon",
"country": "FR",
"website": "",
},
{
"id": "crm-003",
"company_name": "Mercury Engineering",
"country": "IE",
"website": None,
},
{
"id": "crm-004",
"company_name": "Mercury",
"country": "US",
"website": " ",
},
{
"id": "crm-005",
"company_name": "Datablist",
"country": "FR",
"website": "https://www.datablist.com",
},
{
"id": "crm-006",
"company_name": "Mercury",
"country": "IE",
"website": None,
},
]
def website_is_missing(value):
return not isinstance(value, str) or not value.strip()
records_to_lookup = [
record for record in records if website_is_missing(record.get("website"))
]
lookup_results = (
find_domains(records_to_lookup, api_key) if records_to_lookup else []
)
results_by_id = {result["inputId"]: result for result in lookup_results}
for record in records:
if not website_is_missing(record.get("website")):
record["website_lookup"] = {"status": "not_requested"}
continue
result = results_by_id.get(record["id"])
if result is None:
record["website_lookup"] = {
"status": "missing_result",
"domain": None,
"confidence": None,
"credits": None,
"error": {
"code": "missing_result",
"message": "No result was returned for this inputId.",
},
}
continue
outputs = result.get("outputs") or {}
if result["status"] == "success" and outputs.get("companyUrl"):
record["website"] = outputs["companyUrl"]
record["website_lookup"] = {
"status": result["status"],
"domain": outputs.get("companyDomain"),
"confidence": outputs.get("domainConfidence"),
"credits": result.get("creditsUsed"),
"error": result.get("error"),
}
print(json.dumps(records, indent=2))O código indexa os resultados por inputId e, em seguida, percorre os registos originais pela ordem inicial. O objeto website_lookup mantém o resultado e os dados necessários para revisão junto de cada registo processado, incluindo resultados sem sucesso ou em falta.
Para crm-001, website_is_missing() devolve False, porque a URL da Microsoft já existe. O registo não é adicionado a records_to_lookup, pelo que nunca é enviado à API. A combinação preserva o site e regista o estado como not_requested.
Para crm-002, o site está vazio, por isso a requisição envia a padaria com inputId: crm-002. A API devolve o mesmo inputId. O dicionário results_by_id utiliza-o para encontrar o resultado correto, e a combinação grava https://boulangerie-du-palais-lyon.eatbu.com nesse registo sem depender da ordem dos resultados.
| ID | Empresa | Site após combinação | Estado | Domínio | Confiança | Créditos |
|---|---|---|---|---|---|---|
crm-001 | Microsoft · US | https://www.microsoft.com | not_requested | |||
crm-002 | boulangerie du palais lyon · FR | https://boulangerie-du-palais-lyon.eatbu.com | success | boulangerie-du-palais-lyon.eatbu.com | High | 1 |
crm-003 | Mercury Engineering · IE | https://mercuryeng.com | success | mercuryeng.com | High | 1 |
crm-004 | Mercury · US | https://www.shipmercury.com/ | success | shipmercury.com | High | 1 |
crm-005 | Datablist · FR | https://www.datablist.com | not_requested | |||
crm-006 | Mercury · IE | http://www.mercuryeng.com | success | mercuryeng.com | High | 1 |
A padaria utiliza um subdomínio específico, boulangerie-du-palais-lyon.eatbu.com. Preserve esse valor em vez de o reduzir a eatbu.com e guarde o endereço exato devolvido em companyUrl. A definição acceptNonRoot: true também permite páginas empresariais alojadas cujo endereço inclui um caminho após o hostname. Por isso, a URL completa é importante nos dois casos.
Uma tarefa concluída pode ainda conter itens com o estado no_result, error ou skipped. O exemplo só altera website quando o estado é success e existe um companyUrl. Em caso de no_result, o site continua vazio e o estado permanece visível em website_lookup. Verifique primeiro o nome e o país da empresa. Se algum dos inputs estiver incorreto, corrija-o e volte a enviar esse registo numa nova tarefa. Caso contrário, mantenha o site vazio e assinale-o para revisão manual.
Calcule os créditos antes de escalar o script
As cinco pesquisas do exemplo devolveram success com nível de confiança High e consumiram um total de 5 créditos.
Uma pesquisa resolvida pelo dataset custa 1 crédito. Uma pesquisa processada com o Google custa 2,5 créditos. Paga apenas pelo percurso utilizado, não pelos dois. Para 1.000 inputs, isso representa 1.000 créditos se todos forem resolvidos pelo dataset ou 2.500 créditos se todos utilizarem o Google. Estes valores servem para planeamento e não garantem que todas as pesquisas terão sucesso.
Mova o seletor para comparar o consumo de créditos da sua lista.
Com um preço de 20 dólares por 20.000 créditos, esses cenários custam 1 dólar e 2,50 dólares. A subscrição Growth é cobrada à parte e inclui atualmente 20.000 créditos mensais, utilizados antes dos carregamentos adicionais. Consulte os preços atuais, pois os valores dos planos e pacotes podem mudar.
Uma tarefa aceita até 10.000 inputs, com um limite de 16 KiB por input e 10 MiB por requisição. Este exemplo utiliza chamadas bloqueantes do Requests para enviar, acompanhar e obter os resultados de uma pequena tarefa assíncrona da Datablist. O repositório mantido pela equipa também inclui exemplos de processamento de ficheiros CSV em lotes e clientes não bloqueantes.
Próximos passos
Depois de confirmar que o site devolvido pertence à empresa pretendida, pode extrair o Impressum com Python para adicionar os dados legais da empresa e a URL da página legal de origem ao mesmo registo de fornecedor. Mantenha a revisão da correspondência do site separada da extração posterior.
Substitua os registos de exemplo por uma pequena amostra dos seus próprios dados. Depois, execute o script e analise os registos combinados. Preserve IDs estáveis e o país, e só aumente a escala depois de confirmar que o script mantém os sites conhecidos e preenche os campos vazios esperados. Pode começar pelos exemplos atualizados da API Company Name to Domain no GitHub se quiser descarregar o script ou consultar versões com processamento de CSV em lotes e execução assíncrona.