
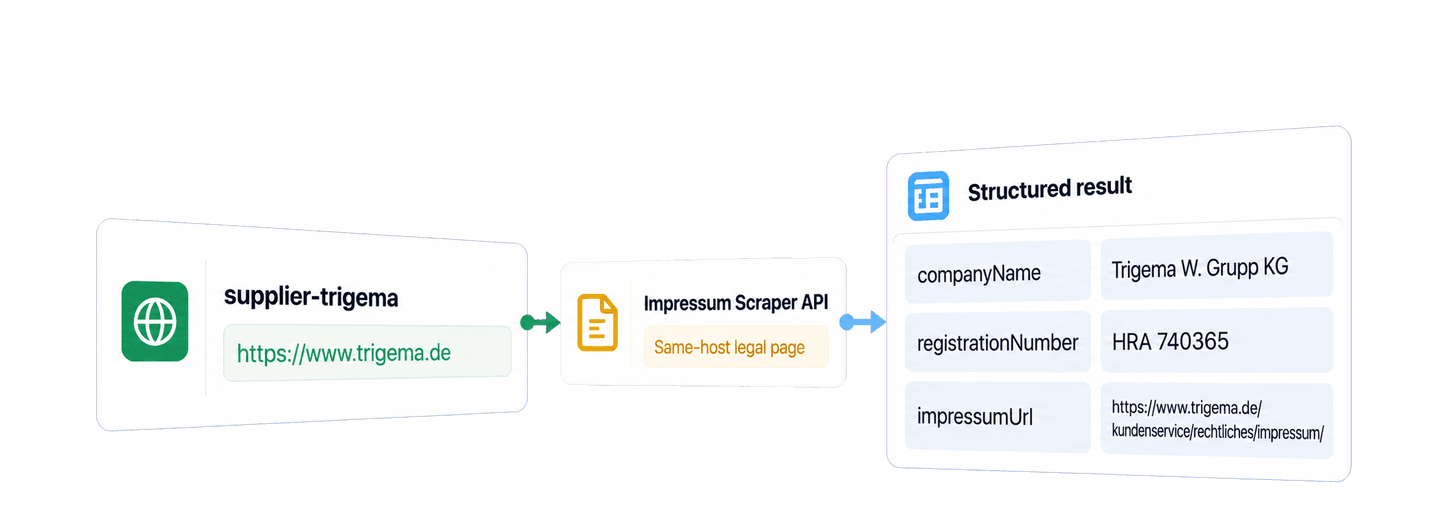
Para extrair dados de Impressum em Python sem criar um crawler próprio, use a API Impressum Scraper da Datablist com a biblioteca Requests. Você fornece as URLs dos sites das empresas, a API localiza a página de Impressum de cada site e extrai dela dados estruturados da empresa e de contato.
Neste exemplo, uso duas marcas alemãs consolidadas: a fabricante de roupas Trigema e a marca de produtos para atividades ao ar livre VAUDE. Um pequeno exemplo executável em Python faz a consulta e mantém os dados extraídos e a URL de origem do Impressum junto a cada registro de fornecedor.
📌 Resumo para quem tem pressa
Use a API Impressum Scraper da Datablist para transformar sites de empresas alemãs em dados estruturados da empresa e de contato. O exemplo em Python envia dois sites, aguarda a tarefa em segundo plano, recupera todas as páginas de resultados e mantém a URL da página legal encontrada junto a cada registro.
- Entrada: URLs de sites de empresas alemãs.
- Saída: Dados da empresa e de contato, além do link de origem do Impressum.
💡 Prefere uma solução no-code? Use o Impressum Scraper da Datablist para extrair esses dados empresariais sem escrever código.
Configure sua chave de API e o ambiente Python
Crie uma conta na Datablist e, em seguida, uma Personal API Key. O acesso à REST API está disponível no plano Growth. Veja um exemplo do formato da chave:
auth0|exampleuser:exampleaccount:EXAMPLE_TOKEN_NOT_VALID:1Exporte sua própria chave como DATABLIST_API_KEY:
export DATABLIST_API_KEY="your-personal-api-key"Neste exemplo em Python, uso o pacote requests. Crie um arquivo chamado
scrape_impressum.py e instale o pacote:
python -m pip install requestsCada site enviado consome 10 créditos. O exemplo abaixo, com dois sites, usa 20 créditos quando ambas as entradas são processadas.
Crie a função scrape_impressums()
Cole este script completo em scrape_impressum.py:
import json
import os
import time
import uuid
import requests
def scrape_impressums(suppliers, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]
payload = {
"enrichmentId": "impressum-scraper",
"uniqueId": str(uuid.uuid4()),
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
suppliers = [
{
"id": "supplier-trigema",
"label": "Trigema",
"website_url": "https://www.trigema.de",
},
{
"id": "supplier-vaude",
"label": "VAUDE",
"website_url": "https://www.vaude.com",
},
]
impressum_results = scrape_impressums(suppliers, api_key)
for result in impressum_results:
print(json.dumps(result, ensure_ascii=False))Execute o script completo com:
python scrape_impressum.pyA função usa a API em três etapas. Ela envia os sites, aguarda a conclusão da tarefa e depois recupera todas as páginas de resultados.
Envie os sites para a API
O script transforma cada fornecedor em uma entrada da API como esta:
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]inputId é seu identificador estável. data.websiteUrl é a página inicial da empresa que o scraper vai analisar. Use o site oficial da empresa, e não um diretório ou perfil em rede social. O payload seleciona o enrichment público impressum-scraper e usa um objeto settings vazio, pois essa API não exige configurações públicas.
A requisição POST cria uma tarefa em segundo plano. A Datablist aceita a requisição e retorna um objeto de tarefa cujo @id identifica essa execução. A função usa esse ID para montar as URLs de status e resultados.
Uma versão resumida da resposta de criação é semelhante a esta:
{
  "@id": "task-id",
  "enrichmentId": "impressum-scraper",
  "status": "queued",
  "links": {
    "self": "https://api.datablist.com/v1/enrichments/tasks/task-id",
    "results": "https://api.datablist.com/v1/enrichments/tasks/task-id/results"
  }
}
queued significa que a requisição foi aceita, não que o resultado esteja pronto. O script leva o @id retornado para as duas etapas seguintes, portanto você não precisa copiar manualmente as URLs da tarefa. Ele também chama raise_for_status() antes de ler cada resposta. Assim, um erro de autenticação ou validação interrompe o processo na requisição HTTP que falhou, em vez de ser confundido com uma consulta concluída.
Aguarde a tarefa em segundo plano
A Datablist processa a tarefa em segundo plano. O exemplo verifica o status a cada três segundos até chegar a completed, failed ou stopped. Requests é uma biblioteca Python bloqueante. Por isso, seu script local aguarda durante essas chamadas, embora a tarefa da API seja executada em segundo plano.
Se a tarefa terminar com failed ou stopped, a função gera um erro que inclui o ID e o status final da tarefa. Guarde esse ID ao investigar a tarefa existente, em vez de reenviar imediatamente o mesmo trabalho pago.
Recupere todas as páginas de resultados
Quando a tarefa termina, o script solicita até 100 resultados por vez. A regra de paginação é simples: busque a próxima página até que nextCursor seja null. Quando o cursor contém um valor, o script o envia na requisição seguinte.
Não relacione os registros retornados ao seu aplicativo pela posição na lista. Os resultados podem chegar em uma ordem diferente daquela das entradas enviadas. Use inputId como chave de associação.
Como a API encontra uma página de Impressum
A página inicial é o ponto de partida, não a página da qual a API espera extrair os dados. O Impressum Scraper usa AI para analisar os links internos do host informado e identificar um Impressum ou uma página legal ou de contato equivalente. Isso é importante porque o link pode aparecer com nomes como Rechtliches, Kontakt ou Legal, em vez de estar disponível em /impressum.
Se a AI não encontrar um link interno adequado, o scraper testa os caminhos comuns /impressum e /imprint no mesmo host. Depois de acessar uma página de origem, a AI extrai os dados da entidade jurídica, endereço, contato, registro, VAT e fonte, reunindo tudo em um único resultado. Ela não usa mecanismos de busca nem consulta diretórios externos.
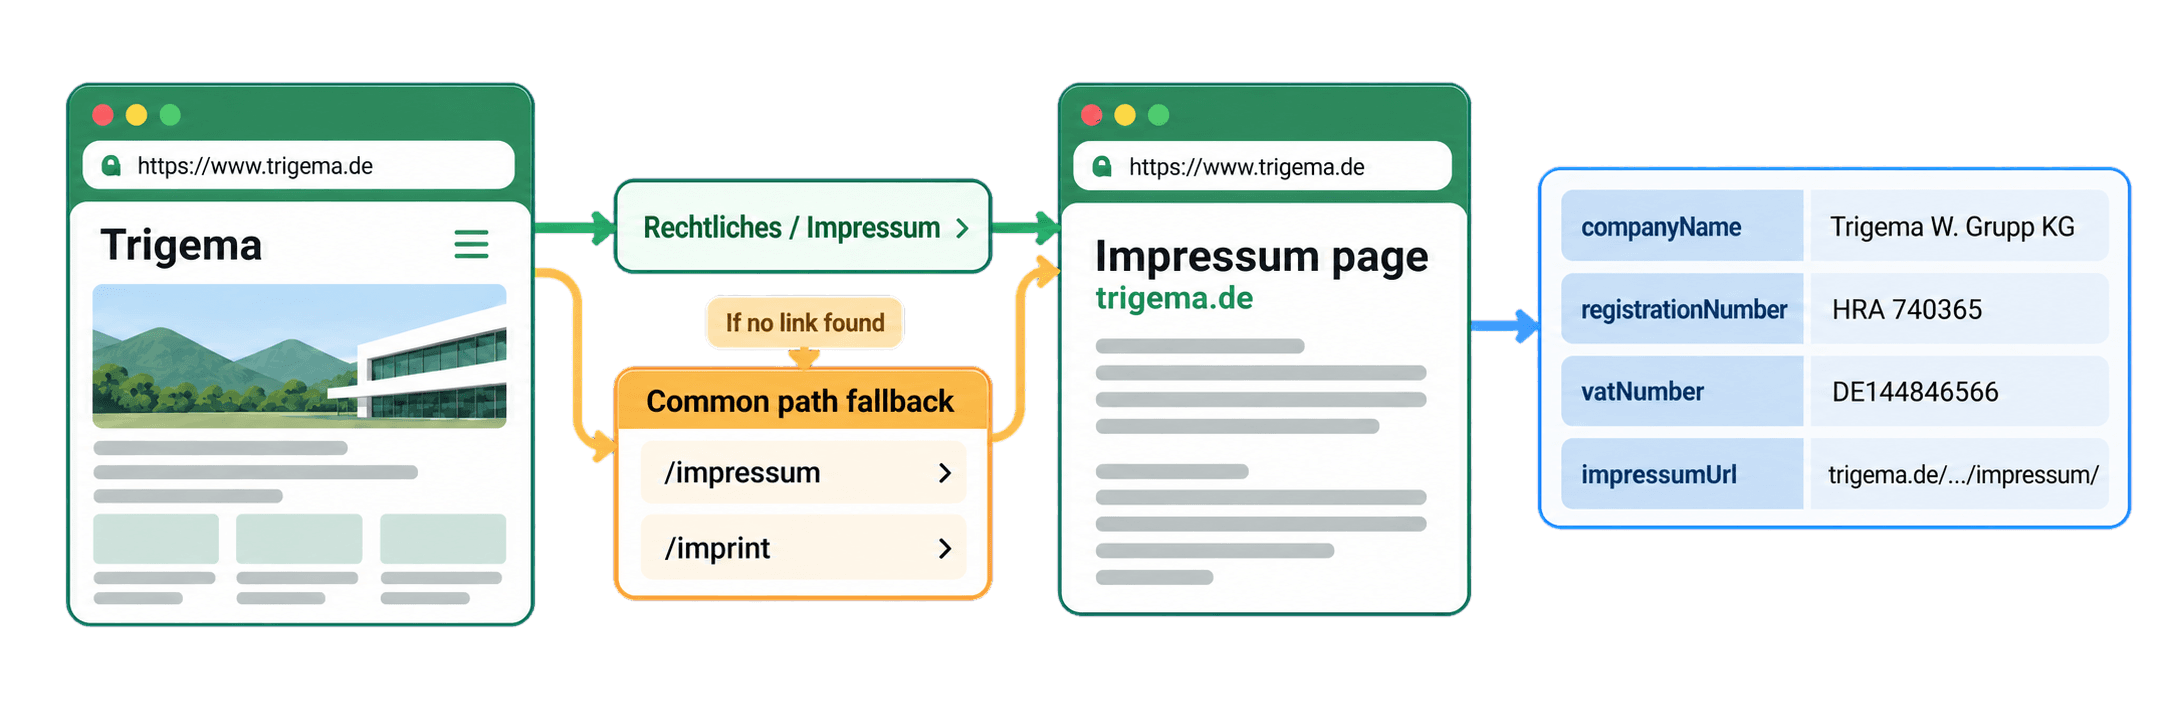
Os dois resultados mostram essa variação de caminhos na prática. A Trigema retornou /kundenservice/rechtliches/impressum/, enquanto a VAUDE retornou /de/de/impressum.html. Mantenha impressumUrl em cada resultado, pois esse campo registra a página exata usada como fonte dos dados extraídos.
Analise os resultados da Trigema e da VAUDE
Veja um trecho resumido dos dois resultados de exemplo.
📘 Exemplos de endereços de email: Os emails abaixo estão ocultos com
**. A API retorna os endereços completos.
[
  {
    "inputId": "supplier-trigema",
    "status": "success",
    "outputs": {
      "firstName": "Wolfgang",
      "lastName": "Grupp",
      "companyName": "Trigema W. Grupp KG",
      "postalAddress": "Josef-Mayer-Str. 31-35, D-72393 Burladingen",
      "emailAddress": "b**@trigema.de",
      "registrationNumber": "HRA 740365",
      "vatNumber": "DE144846566",
      "impressumUrl": "https://www.trigema.de/kundenservice/rechtliches/impressum/",
      "agentConfidenceScore": 90
    },
    "creditsUsed": "10",
    "error": null
  },
  {
    "inputId": "supplier-vaude",
    "status": "success",
    "outputs": {
      "firstName": "Antje",
      "lastName": "von Dewitz",
      "companyName": "VAUDE Sport GmbH & Co. KG",
      "postalAddress": "Vaude Straße 2, 88069 Tettnang",
      "emailAddress": "s**@service.vaude.com",
      "registrationNumber": "HRA 631071",
      "vatNumber": "DE203894755",
      "impressumUrl": "https://www.vaude.com/de/de/impressum.html",
      "agentConfidenceScore": 95
    },
    "creditsUsed": "10",
    "error": null
  }
]
Comece pelos nomes. Trigema é o nome do fornecedor informado no input do Python, enquanto Trigema W. Grupp KG é a razão social extraída do Impressum. A mesma diferença aparece no caso da VAUDE: o nome de entrada é VAUDE, e a empresa retornada é VAUDE Sport GmbH & Co. KG. Manter os dois valores permite preservar o nome conhecido pela sua equipe e, ao mesmo tempo, adicionar a entidade jurídica exibida no próprio site da empresa. Isso é especialmente útil ao comparar o registro de um fornecedor com uma nota fiscal, um contrato ou outra base de dados empresariais que possa usar a razão social completa.
Os campos retornados respondem a diferentes questões da pesquisa:
firstNameelastNamecontêm o nome do diretor executivo ou fundador extraído da página, quando encontrado. Neste caso, são Wolfgang Grupp e Antje von Dewitz.postalAddresstraz o endereço comercial extraído da página legal, enquanto os campos de email e telefone fornecem os dados de contato publicados nela.registrationNumberevatNumberpreservam os identificadores exibidos na página. Para a Trigema, esses valores sãoHRA 740365eDE144846566; para a VAUDE, sãoHRA 631071eDE203894755. Assim, você obtém valores concretos para comparar com os identificadores já armazenados nos dados dos seus fornecedores.impressumUrlidentifica a página usada na extração. Ela é diferente da página inicial enviada: uma registra a empresa da qual você partiu, enquanto a outra registra a fonte dos dados jurídicos.
Ambos os registros têm status: success e consumiram 10 créditos. O agentConfidenceScore é um indicador de 0 a 100 que ajuda a priorizar a revisão. Ele não representa uma porcentagem de precisão. Os campos de saída ainda podem ficar vazios quando um dado não aparece na página ou não pode ser extraído. Por isso, mantenha o status do item e abra a URL do Impressum retornada quando alguma informação for importante para a etapa seguinte.
A saída documentada também pode incluir gênero, número de telefone e outros dados de contato. Consulte a documentação da API Impressum Scraper para ver o schema atual.
Transforme a saída em registros de fornecedores
A chamada direta à API já funciona. Agora, vamos inseri-la no contexto de uma pesquisa de fornecedores. A descoberta ou o onboarding de fornecedores pode fornecer um ID estável, o nome curto usado pela sua equipe e uma página inicial. O resultado do Impressum acrescenta a entidade jurídica por trás desse site, seus identificadores e dados de contato publicados, além da página em que essas informações apareceram.
O snippet a seguir indexa os resultados por inputId e cria registros locais de pesquisa empresarial. Adicione-o após a chamada a scrape_impressums() no script completo:
results_by_id = {
result["inputId"]: result for result in impressum_results
}
company_research = []
for supplier in suppliers:
result = results_by_id[supplier["id"]]
company_research.append(
{
"supplier_id": supplier["id"],
"supplier_label": supplier["label"],
"website_url": supplier["website_url"],
"status": result["status"],
"outputs": result.get("outputs", {}),
"credits_used": result["creditsUsed"],
"error": result.get("error"),
}
)
print(json.dumps(company_research, indent=2, ensure_ascii=False))Para a Trigema, o registro preserva supplier-trigema, o nome de exibição Trigema e https://www.trigema.de. O objeto outputs aninhado acrescenta Trigema W. Grupp KG, seu endereço e identificadores, o nome retornado de Wolfgang Grupp e a URL de origem do Impressum. O registro da VAUDE segue o mesmo encadeamento: parte do nome VAUDE e da página inicial e chega a VAUDE Sport GmbH & Co. KG e à sua própria página de origem. Agora você pode comparar ou agrupar registros pela entidade jurídica sem perder a identidade original do fornecedor que motivou a pesquisa.
O registro mantém juntos os dados retornados, o status de sucesso da API, o consumo de 10 créditos e o valor público de erro, além do ID, nome e site do fornecedor.
A principal regra de merge é a consulta ao dicionário pelo ID do fornecedor. Ela continua associando o resultado correto mesmo que a API retorne a VAUDE antes da Trigema. O snippet também mantém resultados de itens sem sucesso em company_research, pois não aplica filtros por status. Um item com no_result ou error permanece disponível com seu ID e erro, em vez de desaparecer da sua fila de revisão.
Esse código prepara registros locais de pesquisa. Você pode serializar a lista ou encaminhá-la ao seu próprio código downstream sem fazer outra chamada à API.
Estime o custo da API
O Impressum Scraper usa uma tarifa fixa de 10 créditos por site enviado. Os dois sites do exemplo consumiram 20 créditos no total. Com a mesma tarifa, 1.000 sites usam 10.000 créditos.
O plano Growth oferece acesso à REST API e inclui créditos na assinatura. Recargas opcionais adicionam mais créditos quando necessário. O acesso ao plano, os créditos incluídos e a compra de recargas são componentes separados do custo. Portanto, consulte os preços atuais da Datablist antes de planejar uma execução maior.
Resolva problemas sem repetir trabalho pago
O script para antes de fazer uma requisição
Se DATABLIST_API_KEY estiver ausente, o script gera o erro Set DATABLIST_API_KEY before running this script. Exporte a variável no mesmo terminal e execute o arquivo novamente:
export DATABLIST_API_KEY="your-personal-api-key"
python scrape_impressum.pyA API rejeita a requisição
response.raise_for_status() interrompe a execução quando ocorre um erro HTTP. Verifique se você forneceu uma Personal API Key válida e se sua conta tem acesso à REST API. Esse caso é diferente da ausência da variável: um valor inválido chega à API e recebe uma resposta HTTP.
A tarefa falha ou é interrompida
O erro gerado contém o ID e o status da tarefa. Analise a tarefa existente, seus resultados e os campos de créditos antes de criar outra. Uma tarefa com status failed ou stopped pode manter resultados e consumo de créditos. Portanto, repeti-la imediatamente pode duplicar trabalho pago.
Um resultado está incompleto
Uma tarefa concluída pode conter no_result, error ou saídas incompletas no nível de cada item. Mantenha o inputId, o status, o impressumUrl, quando disponível, e o error público do registro. Verifique se a entrada é a página inicial ou o domínio raiz da própria empresa e analise o site antes de decidir se vale a pena fazer outra consulta.
A documentação de tarefas explica com mais detalhes os status, a paginação de resultados, o histórico de tarefas, os limites e a retenção.
Próximos passos
Agora você tem uma integração executável com Python Requests que envia sites de empresas alemãs, aguarda a tarefa do Impressum Scraper, recupera todas as páginas de resultados e mantém dados empresariais estruturados e suas URLs de origem em registros locais de pesquisa de fornecedores.
Substitua os dois fornecedores do exemplo por seus próprios IDs estáveis e URLs de sites. Em seguida, revise cada impressumUrl retornado antes de usar os campos extraídos no seu processo downstream. Você pode baixar o
exemplo síncrono mantido com Requests
ou usar o
exemplo assíncrono com HTTPX
do repositório quando precisar de concorrência não bloqueante.