
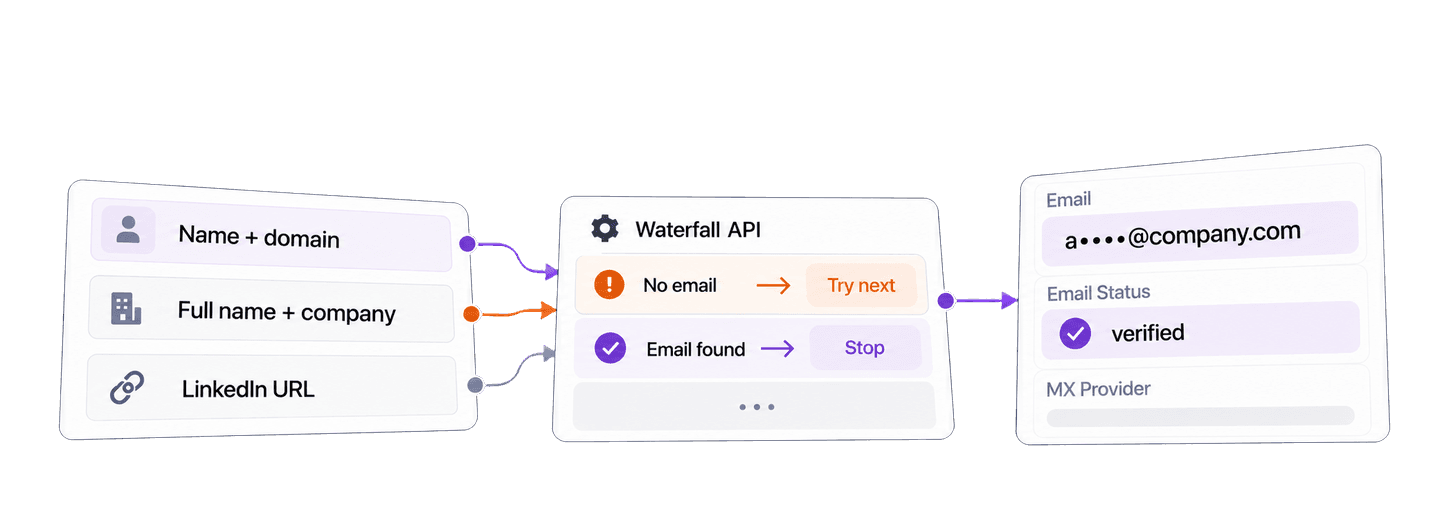
Para encontrar e-mails profissionais com Python, envie o nome e os dados da empresa de uma pessoa — ou a URL pública do perfil dela no LinkedIn — para a Waterfall Email Finder API da Datablist usando a biblioteca Requests. A API retorna o e-mail profissional encontrado, o status de entregabilidade do endereço e o provedor de e-mail.
O exemplo completo abaixo pesquisa Satya Nadella em microsoft.com e Reid Hoffman em greylock.com. Ele aguarda a tarefa em segundo plano e recupera todas as páginas de resultados. Depois, reutilizaremos esses resultados para preparar uma lista local de contatos verificados para revisão antes da campanha.
📌 Resumo para quem está com pressa
Use uma única função Python para enviar contatos conhecidos à Waterfall Email Finder API, aguardar a tarefa e coletar os e-mails profissionais encontrados. Em seguida, prepare os contatos verificados para revisar a campanha, mantendo na lista de origem aqueles que não foram localizados.
- Input: nome e sobrenome com o domínio da empresa, nome completo com o nome da empresa ou URL pública de um perfil do LinkedIn.
- Output: e-mail profissional com
emailStatusemxProvider, seguido de uma lista local para revisão contendo apenas contatos com e-mail.
💡 Prefere uma solução no-code? Use o Waterfall Email Finder da Datablist para encontrar e-mails profissionais em uma collection sem escrever código.
Configure Python, Requests e sua chave de API
Neste exemplo em Python, usamos o pacote requests. Crie um arquivo chamado find_work_emails.py e instale o Requests:
python -m pip install requestsCrie uma Personal API Key na página da sua conta de API da Datablist. O acesso à REST API requer o plano Growth. Exporte a chave no terminal em que você executará o script:
export DATABLIST_API_KEY="your-api-key"Os resultados bem-sucedidos do Waterfall Email Finder também consomem créditos. A seção sobre custos abaixo diferencia esses créditos da assinatura que dá acesso à API.
Encontre e-mails profissionais com uma função Python
Cole o script completo abaixo em find_work_emails.py:
import json
import os
import time
import uuid
import requests
def find_emails(people, api_key, settings):
"""Submit one email-finder task, wait, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-email-finder",
"uniqueId": unique_id,
"settings": settings,
"inputs": people,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
},
{
"inputId": "contact-reid-hoffman",
"data": {
"firstName": "Reid",
"lastName": "Hoffman",
"companyNameOrDomain": "greylock.com",
},
},
]
lookup_results = find_emails(people, api_key, settings)
for result in lookup_results:
print(json.dumps(result, indent=2))Execute-o no mesmo terminal:
python find_work_emails.pyVocê também pode baixar o exemplo mantido com Requests. Depois de entender a versão bloqueante, consulte no repositório a alternativa assíncrona com HTTPX.
A função faz três tipos de chamada, nesta ordem.
Primeiro, ela envia a tarefa. Cada inputId é o ID estável do seu contato. O objeto data aninhado contém os campos usados na pesquisa. O POST retorna 202 Accepted com @id, o ID da tarefa utilizado nas chamadas seguintes. O código exibe o uniqueId antes do envio para que você ainda tenha um valor de recuperação caso a resposta seja perdida.
Depois, ela consulta o status da tarefa. A Datablist processa a tarefa em segundo plano. Este client Requests aguarda e verifica a tarefa a cada três segundos até que ela esteja completed, failed ou stopped. O Requests fica bloqueado durante a espera, mas a tarefa da API continua sendo assíncrona.
Por fim, ela recupera os resultados. Uma tarefa pode ter várias páginas de resultados. O loop continua buscando páginas até que nextCursor seja null. Use inputId, e não a ordem das respostas, para associar cada resultado ao contato de origem.
Escolha o tipo de input para os seus contatos
Cada tarefa usa apenas um modo de input. Mantenha a mesma função find_emails() e substitua os valores de settings e people pela opção correspondente aos seus dados de origem.
Sempre que possível, escolha um inputId que seja único dentro da tarefa e já pertença ao contato de origem. O ID de um registro do CRM ou outro ID de Lead permanente são boas opções. A Datablist devolve esse valor com o resultado, permitindo associar os registros sem comparar nomes nem presumir que a ordem da resposta será igual à dos inputs.
Quando você tiver o nome e o sobrenome separados, além do domínio da empresa, use sourceKind: "name_company". Um domínio conhecido é a forma mais clara de identificar a empresa:
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
}
]
lookup_results = find_emails(people, api_key, settings)Quando sua fonte tiver um único campo para o nome e o nome da empresa, habilite useFullName:
settings = {"sourceKind": "name_company", "useFullName": True}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"fullName": "Satya Nadella",
"companyNameOrDomain": "Microsoft",
},
}
]
lookup_results = find_emails(people, api_key, settings)Quando você tiver a URL pública do perfil da pessoa, use a opção do LinkedIn:
settings = {"sourceKind": "linkedin"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"linkedInProfile": "https://www.linkedin.com/in/satyanadella/"
},
}
]
lookup_results = find_emails(people, api_key, settings)Essa opção aceita a URL pública de um perfil linkedin.com/in/... como contexto sobre a pessoa para a busca do e-mail. URLs de perfis do Sales Navigator não são aceitas.
Se você precisar escolher as chaves dos provedores e definir a ordem deles, consulte o guia de waterfall personalizado. O waterfall gerenciado usado aqui não exige configurações específicas para cada provedor.
Como o waterfall gerenciado encontra um e-mail
Em uma solicitação com nome e empresa, a API usa diretamente o domínio informado. Quando você fornece o nome da empresa, ela primeiro tenta associá-lo a um domínio corporativo válido. Em uma solicitação pelo LinkedIn, ela limpa a URL pública do perfil e transforma os dados disponíveis sobre a pessoa e a empresa no contexto exigido pelos provedores de e-mail compatíveis.
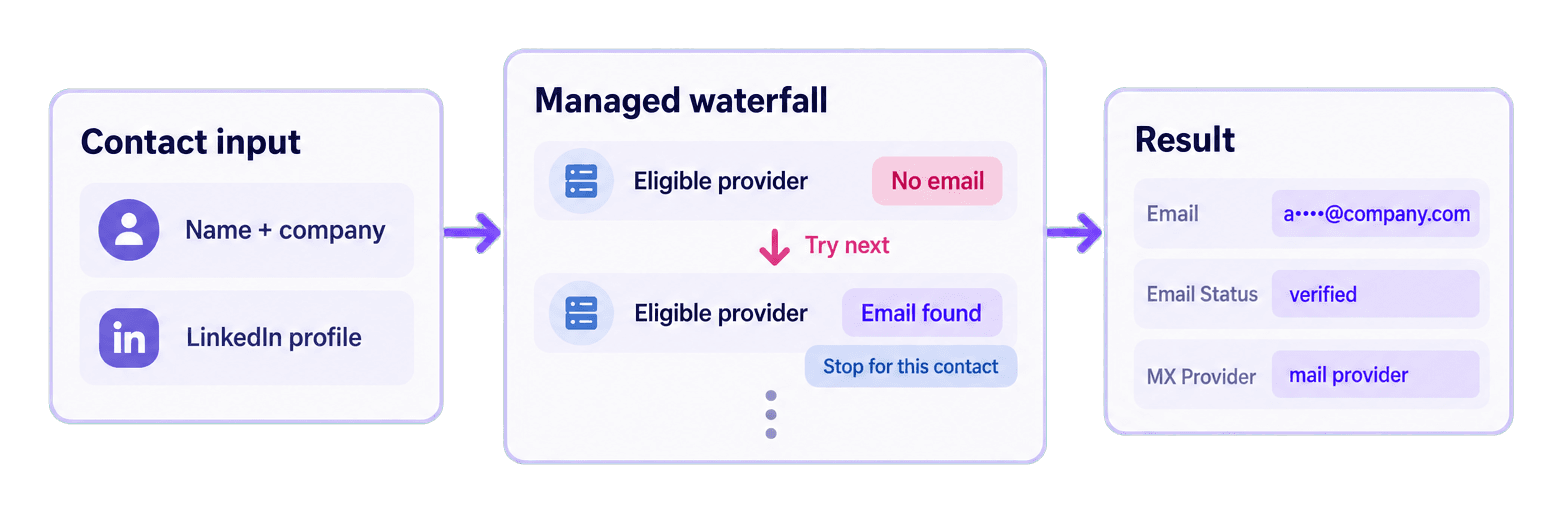
O waterfall gerenciado envia cada contato ainda não localizado a um provedor compatível. Se nenhum e-mail válido for retornado, outro provedor disponível poderá tentar encontrar o mesmo contato. Para esse contato, a sequência é interrompida assim que um e-mail profissional é aceito. A resposta padrão não informa qual finder foi usado.
Por que um waterfall melhora o Outbound internacional
Os provedores de e-mails profissionais usam bases de dados diferentes, por isso a cobertura varia entre países e mercados. Um provedor pode não encontrar um contato em determinada região, enquanto outro dispõe dos dados necessários para localizar o endereço.
Para equipes de vendas ou Growth, o waterfall oferece uma nova oportunidade de localizar cada contato antes que ele seja excluído da lista de Outbound. Isso permite recuperar contatos que um fluxo com apenas um provedor deixaria passar, mantendo um processo técnico consistente para toda a equipe.
A Datablist gerencia a sequência de provedores compatíveis por trás de uma única integração de API. Você envia o contato uma vez e recebe um formato de resultado único, em vez de criar e manter uma integração separada para cada provedor e depois consolidar as respostas por conta própria.
Entenda todos os resultados
A tarefa do exemplo retornou dois resultados bem-sucedidos. Os endereços de e-mail foram ocultados abaixo.
{
  "taskId": "2286103ce43748828e27ce71b9cc526b",
  "results": [
    {
      "inputId": "contact-satya-nadella",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "microsoft",
        "emailFound": "s*******@microsoft.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "contact-reid-hoffman",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "mimecast",
        "emailFound": "r*******@greylock.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
emailFound é o e-mail profissional retornado. emailStatus descreve a entregabilidade no momento da pesquisa, enquanto mxProvider identifica o provedor de hospedagem de e-mail quando essa informação está disponível. Os dois registros estão como verified, e cada um consumiu 25 créditos.
O código de campanha abaixo coloca os resultados verified em campaign_contacts e mantém os outros endereços encontrados em needs_verification. O valor de creditsUsed é a referência oficial do custo de cada resultado.
O resultado gerenciado padrão não contém finderProvider. Esse campo é um output condicional de um fluxo válido e personalizado por chave, baseado em nome e empresa. Portanto, o script não deve deduzi-lo a partir de mxProvider.
Prepare os e-mails para revisar a campanha
Quando a pesquisa direta estiver funcionando, adicione este bloco ao final do script, depois que lookup_results for retornado. Ele prepara os contatos localmente para a revisão da campanha usando a pesquisa que você acabou de executar.
results_by_id = {result["inputId"]: result for result in lookup_results}
campaign_contacts = []
needs_verification = []
for person in people:
result = results_by_id.get(person["inputId"])
if result is None:
continue
if result["status"] != "success":
continue
if not result["outputs"].get("emailFound"):
continue
contact = person.copy()
contact["result"] = result
if result["outputs"].get("emailStatus") == "verified":
campaign_contacts.append(contact)
else:
needs_verification.append(contact)
print(json.dumps({
"campaign_contacts": campaign_contacts,
"needs_verification": needs_verification,
}, indent=2))results_by_id torna irrelevante a ordem das respostas. Para Satya, o loop lê contact-satya-nadella na lista people original, encontra o resultado com o mesmo inputId, copia o registro de origem e anexa o objeto completo da API em result. Como o endereço está presente e seu status é verified, o contato entra em campaign_contacts. Reid segue o mesmo caminho, mesmo que o resultado dele chegue primeiro pela API.
As três condições deixam a decisão fácil de entender. A primeira ignora um contato quando nenhum resultado correspondente é retornado. A segunda ignora erros de linha e outros estados que não sejam de sucesso. A terceira exige que exista um valor em emailFound. Anexar o objeto result completo preserva o status, os outputs, o consumo de créditos e o campo de erro para uma análise posterior.
Um e-mail encontrado com outro status de entregabilidade entra em needs_verification. Um resultado ausente, um erro de linha ou um resultado sem emailFound fica de fora das duas listas preparadas. A lista people original continua disponível para correções ou pesquisas futuras.
Calcule os custos da Waterfall Email Finder API
O waterfall gerenciado padrão consome 25 créditos por e-mail profissional encontrado. Uma pesquisa padrão sem resultado consome 0 crédito. Leia o valor de creditsUsed em cada resultado, em vez de multiplicar o total de contatos enviados.
Um e-mail encontrado com status unverified também consome 25 créditos, mesmo que o código local da campanha o coloque em needs_verification, e não em campaign_contacts.
Os dois e-mails encontrados neste exemplo consumiram 50 créditos. Para fazer seu planejamento:
- 100 e-mails profissionais encontrados consomem 2.500 créditos.
- 1.000 e-mails profissionais encontrados consomem 25.000 créditos.
- Uma lista de input maior pode consumir menos créditos do que
contatos × 25, pois as pesquisas sem resultado não são cobradas.
O acesso à REST API exige o plano Growth. Pela tarifa atual de recarga em dólares americanos, US$ 20 compram 20.000 créditos, o equivalente a US$ 0,001 por crédito. Nessa tarifa, 25.000 créditos correspondem a US$ 25 em créditos. A assinatura é cobrada separadamente desse cálculo. Consulte a página de preços da Datablist para conferir os detalhes atualizados dos planos e pacotes.
Corrija erros comuns e recupere uma tarefa
A chave de API não foi definida. O script gera Set DATABLIST_API_KEY before running this script. antes de fazer uma solicitação. Exporte a variável no terminal atual e execute o arquivo novamente.
A API retorna um erro de autenticação. raise_for_status() informa a falha HTTP. Copie uma Personal API Key válida, confirme que o header X-API-Key está usando essa chave e só execute o script novamente depois de corrigir a credencial.
A conta não tem créditos suficientes. Verifique o saldo da conta. Adicione créditos ou aguarde a próxima liberação de créditos do plano antes de enviar novas tarefas.
Os campos de input não correspondem ao modo selecionado. Use campos separados para o nome ou fullName com name_company; com linkedin, use linkedInProfile. Corrija o contato e envie-o usando um único modo consistente.
A tarefa está como failed ou stopped. O script gera um RuntimeError com o ID da tarefa, o status final e o erro disponível. Analise a tarefa e todos os resultados disponíveis antes de decidir quais contatos ainda precisam ser pesquisados.
A resposta do POST foi perdida. Copie o uniqueId exibido antes do envio. Liste suas tarefas com a mesma chave:
curl "https://api.datablist.com/v1/enrichments/tasks" \
-H "X-API-Key: $DATABLIST_API_KEY"Encontre a tarefa com o uniqueId exibido, copie seu @id e continue pela URL de status ou de resultados da tarefa. Assim, você recupera a tarefa existente em vez de reenviar automaticamente os contatos. A documentação da task API explica o ciclo de vida e os endpoints de resultados.
Próximos passos
Agora você tem uma função Python bloqueante com Requests para os três tipos de input compatíveis, além de um filtro local que prepara os e-mails encontrados e verificados para revisão antes da campanha.
Substitua os dois contatos do exemplo por uma pequena amostra dos contatos que você pesquisou. Escolha o tipo de input correspondente aos seus dados, execute a busca e revise o emailStatus antes de usar um endereço. Para trabalhar com listas maiores, veja como encontrar e-mails em escala. O repositório mantido no GitHub oferece exemplos para download em Python, tanto bloqueantes quanto assíncronos.