
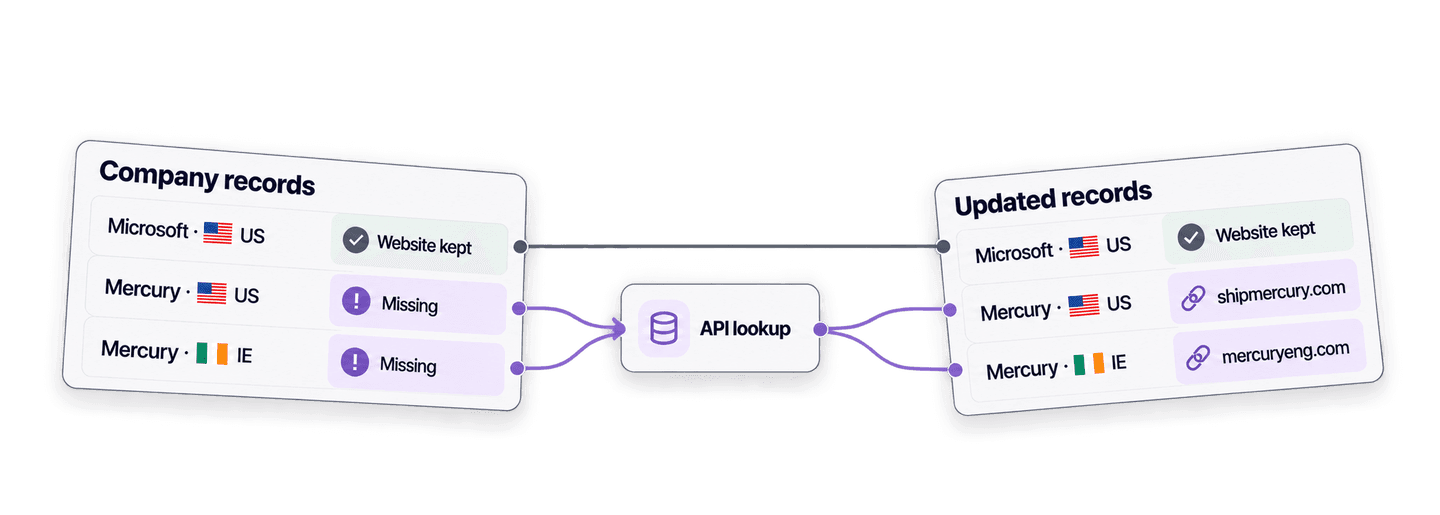
للعثور على موقع شركة انطلاقًا من اسمها في Python، أرسل الاسم وأي معلومات متاحة عن البلد إلى Company Name to Domain API من Datablist. تعالج API عملية البحث في الخلفية، ثم تُرجع النطاق وعنوان URL الكامل للموقع.
سأعرض لك أولًا طلب API بسيطًا باستخدام Python. بعد ذلك، سأعيد استخدام الدالة نفسها لملء المواقع المفقودة فقط في قائمة سجلات الشركات، مع الاحتفاظ بعناوين URL الموجودة مسبقًا.
إذا كنت تفضّل واجهة شبيهة بجداول البيانات، فاتبع دليل البحث المجمع عن مواقع الشركات انطلاقًا من أسمائها.
💡 ملخص لمن يريد الوصول إلى النتيجة سريعًا
أنشئ دالة واحدة في Python تعثر على المواقع من أسماء الشركات، ثم استخدمها لاستكمال السجلات ذات المواقع الفارغة دون استبدال عناوين URL المعروفة.
- المدخلات: أسماء الشركات مع معلومات اختيارية عن البلد.
- المخرجات: النطاق، وعنوان URL الكامل للموقع، ودرجة الثقة، وحالة النتيجة، وعدد Credits المستخدمة.
إعداد Python ومفتاح Datablist API
في هذا المثال، أستخدم حزمة Requests لإجراء طلبات HTTP متزامنة. ثبّتها داخل بيئة افتراضية:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requestsستحتاج أيضًا إلى خطة Datablist Growth، لأن الوصول إلى REST API إحدى ميزات Growth. أنشئ Personal API Key من صفحة Datablist API في حسابك، ثم ضعه في متغير بيئة:
export DATABLIST_API_KEY="exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2"🔑 هل لديك API key بالفعل؟ تستخدم المفاتيح القديمة الصيغة
auth0|<userId>:<accountId>:<secret>:1، وما زالت مدعومة. واصل استخدام مفتاحك الحالي كما تم إنشاؤه تمامًا؛ فلا حاجة إلى استبداله أو تغيير تنسيقه.
استبدل القيمة التجريبية أعلاه بالمفتاح الذي تم إنشاؤه في صفحة حسابك. تستهلك عمليات البحث عن مواقع الشركات Credits. سأشرح مساري التكلفة، Credit واحدة و2.5 Credits، قبل توسيع نطاق تشغيل السكربت. ويمكنك الاطلاع على القيم الحالية للخطط في صفحة أسعار Datablist.
البحث عن موقع شركة واحدة باستخدام Python
أنشئ ملفًا باسم find_company_websites.py. يرسل السكربت الأسماء، وينتظر اكتمال المهمة، ثم يجلب النتائج ضمن دالة واحدة. يستخدم كل إدخال المعرّف الثابت لسجلك بوصفه inputId، حتى تتمكن من ربط كل نتيجة بالسجل الصحيح، ولو تغيّر ترتيب الاستجابة.
import json
import os
import time
import uuid
import requests
API_BASE_URL = "https://api.datablist.com/v1"
def find_domains(companies, api_key):
headers = {
"Accept": "application/json",
"Content-Type": "application/json",
"X-API-Key": api_key,
}
inputs = [
{
"inputId": company["id"],
"data": {
"companyName": company["company_name"],
"targetCountry": company.get("country", ""),
},
}
for company in companies
]
unique_id = f"python-domain-lookup-{uuid.uuid4().hex}"
payload = {
"enrichmentId": "company-name-to-domain",
"uniqueId": unique_id,
"settings": {
"workflow": "dataset_google",
"countryOverwrite": True,
"acceptNonRoot": True,
},
"inputs": inputs,
}
print(f"Task uniqueId: {unique_id}")
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} ended with status {task['status']}: {task.get('error')}"
)
results = []
cursor = None
while True:
params = {"limit": 100}
if cursor is not None:
params["cursor"] = cursor
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}/results",
headers=headers,
params=params,
)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
break
return results
api_key = os.environ["DATABLIST_API_KEY"]
companies = [
{
"id": "direct-microsoft-us",
"company_name": "Microsoft",
"country": "US",
}
]
lookup_results = find_domains(companies, api_key)
for result in lookup_results:
print(json.dumps(result, indent=2))شغّله من نافذة Terminal نفسها التي صدّرت فيها المفتاح:
python find_company_websites.pyهذه نتيجة Microsoft:
{
  "inputId": "direct-microsoft-us",
  "status": "success",
  "outputs": {
    "companyUrl": "https://microsoft.com",
    "companyDomain": "microsoft.com",
    "domainConfidence": "High"
  },
  "creditsUsed": "1",
  "error": null
}
استخدم inputId لربط هذه النتيجة بالسجل الأصلي. تكون قيمة status واحدة من success أو no_result أو error أو skipped. وقد تتضمن النتيجة الناجحة companyDomain وعنوان companyUrl الكامل وdomainConfidence. يوضح creditsUsed التكلفة الخاصة بهذا الإدخال، بينما يشرح error سبب تعذّر معالجة عنصر بعينه.
تُجري الدالة ثلاثة أنواع من استدعاءات API بالترتيب.
أولًا، ترسل طلب البحث. تتضمن الحمولة الإعدادات وسجلات الشركات. يعيد طلب POST الاستجابة 202 Accepted، ويكون @id هو معرّف المهمة الذي تحتاج إليه الاستدعاءات التالية:
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]إذا لم يكن DATABLIST_API_KEY مضبوطًا، فسيُطلق Python الخطأ KeyError عند محاولة قراءة متغير البيئة، قبل إجراء أي طلب HTTP. صدّر المتغير ثم شغّل السكربت مجددًا. وإذا كان المتغير يحتوي على مفتاح غير صالح، فسيصل طلب POST إلى API ويعيد خطأ HTTP 401. انسخ Personal API Key حاليًا من صفحة حسابك واستبدل به القيمة غير الصالحة.
ثانيًا، تستعلم عن حالة المهمة دوريًا. يبدأ طلب POST المعالجة في الخلفية، لذلك يقرأ السكربت حالة المهمة كل ثلاث ثوانٍ إلى أن تصبح completed أو failed أو stopped:
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)إذا فشلت المهمة لعدم توفر Credits، فسيكون سبب الخطأ credits_error. أضف Credits أو انتظر تجدد رصيدك الشهري، وراجع أي نتائج أُعيدت بالفعل، ثم أرسل المدخلات غير المكتملة فقط ضمن مهمة جديدة.
ثالثًا، تجلب جميع صفحات النتائج. تضيف كل استجابة النتائج إلى القائمة، وتوفر المؤشر اللازم للطلب التالي:
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
breakتواصل الدالة جلب الصفحات حتى تصبح قيمة nextCursor مساوية لـ null.
يطبع السكربت قيمة uniqueId التي تم إنشاؤها قبل طلب POST. إذا انقطع الاتصال قبل تلقي استجابة إنشاء المهمة، فاعرض قائمة مهامك أولًا للتحقق من حالتها قبل إنشاء مهمة أخرى:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-name-to-domain"ابحث عن المهمة التي تتطابق قيمة uniqueId فيها مع القيمة التي أنشأها السكربت، ثم انسخ @id الخاص بها. تتيح لك نقطة نهاية القائمة التصفية حسب enrichmentId، ولكن ليس حسب uniqueId. استخدم @id مع عناوين URL نفسها التي يستخدمها السكربت للحالة والنتائج. إذا كانت المهمة لا تزال نشطة، فواصل الاستعلام عن حالتها. وإذا توقفت أو فشلت، فتحقق من النتائج الجزئية قبل إعادة إرسال المدخلات.
فهم مطابقة البيانات والبحث الاحتياطي حسب البلد
يستخدم السكربت dataset_google، وهو الخيار الافتراضي الموصى به. تتحقق Datablist أولًا من قواعد بيانات الشركات لديها. وإذا كانت المطابقة مفقودة أو متعارضة، فيمكنها استخدام Google كخيار احتياطي. وتتحقق من النتائج المحتملة قبل إرجاع درجة الثقة.
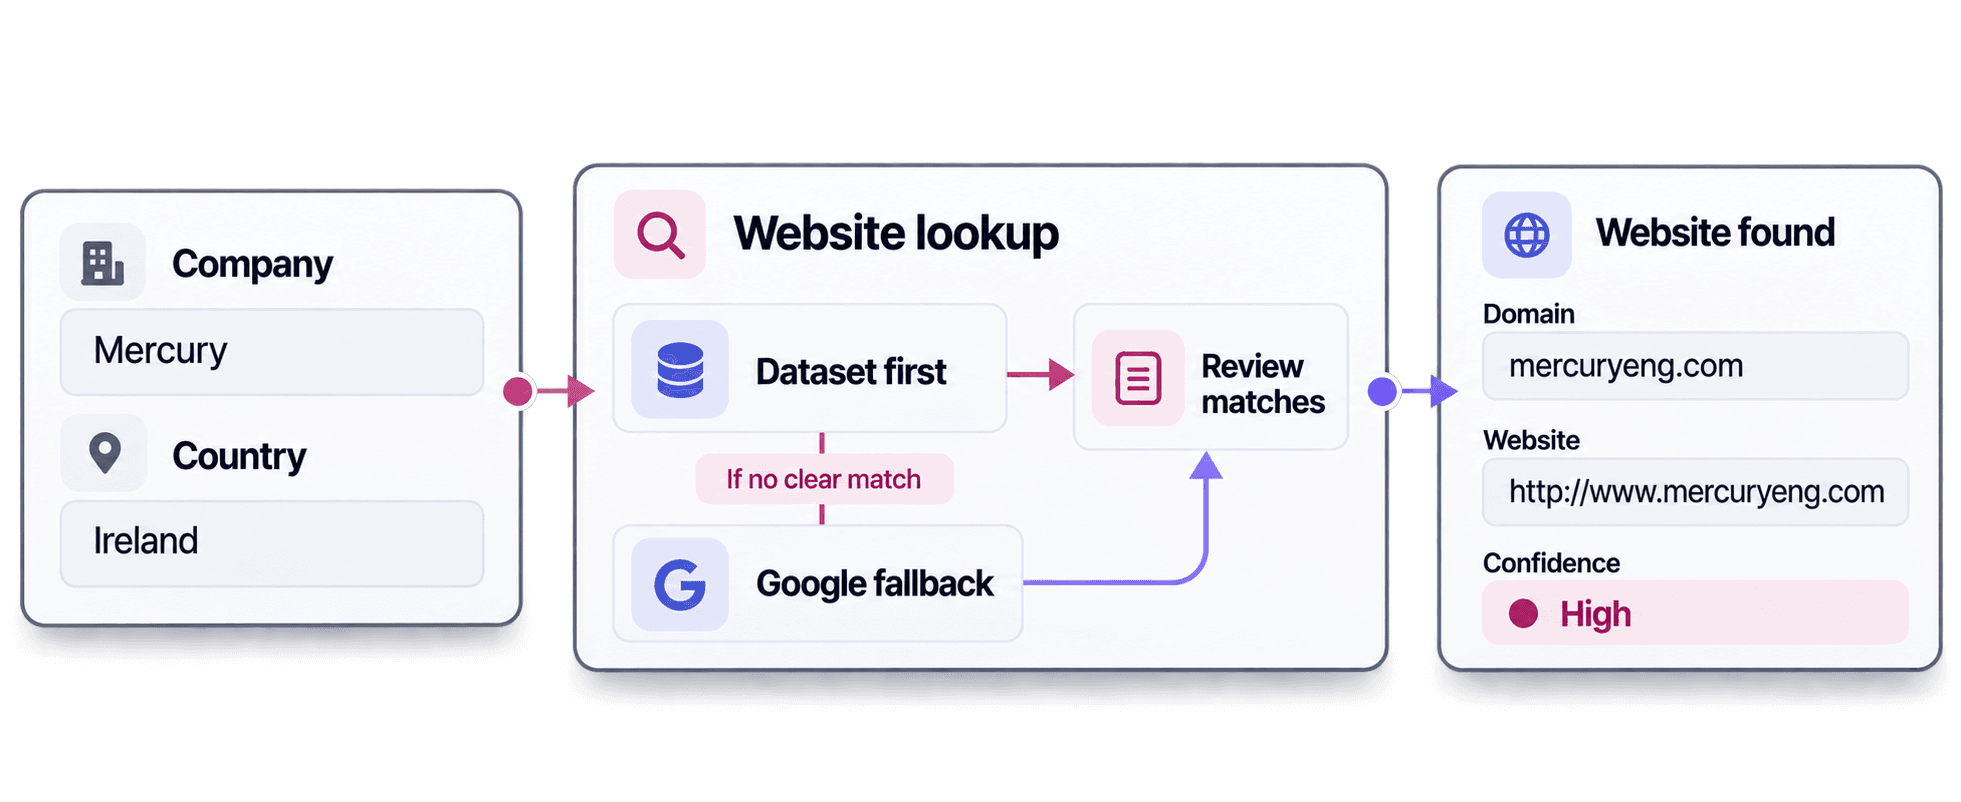
تساعد معلومات البلد على تمييز الأسماء المتشابهة. في هذا المثال، أعطى اسم الشركة نفسه نتائج مختلفة:
- أعادت
MercuryمعUSالنطاقshipmercury.comوالعنوانhttps://www.shipmercury.com/. - أعادت
MercuryمعIEالنطاقmercuryeng.comوالعنوانhttp://www.mercuryeng.com.
حصلت النتيجتان على درجة ثقة High. تساعد معلومات البلد أداة البحث على الاختيار بين الشركات ذات الاسم نفسه، بينما تساعدك درجة الثقة في تحديد النتائج التي تحتاج إلى مراجعة.
عندما تعتمد المطابقة أيضًا على القطاع أو حجم الشركة أو معلومات تجارية أخرى، استخدم مسار بحث AI Agent. أضف هذه التفاصيل إلى Prompt الخاص بـ AI Agent ليتمكن من البحث عن الشركة المقصودة استنادًا إلى سياق تجاري أغنى.
ملء المواقع المفقودة فقط في سجلات تطبيقك
بعد أن أصبحت find_domains() قادرة على العثور على موقع من اسم الشركة، أعد استخدامها لملء المواقع المفقودة فقط في سجلات شركاتك. تتجاوز السجلات التي تحتوي على موقع بالفعل استدعاء API، وبذلك تبقى قيمها دون تغيير ولا تستهلك أي Credits للبحث.
في find_company_websites.py، استبدل كل شيء بدءًا من companies = [ وحتى حلقة الطباعة الأخيرة بالكتلة أدناه. احتفظ بتعيين api_key الموجود فوقها. يتعامل فحص الحقل الفارغ مع None والسلسلة الفارغة والمسافات. ولا يُجرى أي استدعاء API عندما تكون جميع المواقع مملوءة.
records = [
{
"id": "crm-001",
"company_name": "Microsoft",
"country": "US",
"website": "https://www.microsoft.com",
},
{
"id": "crm-002",
"company_name": "boulangerie du palais lyon",
"country": "FR",
"website": "",
},
{
"id": "crm-003",
"company_name": "Mercury Engineering",
"country": "IE",
"website": None,
},
{
"id": "crm-004",
"company_name": "Mercury",
"country": "US",
"website": " ",
},
{
"id": "crm-005",
"company_name": "Datablist",
"country": "FR",
"website": "https://www.datablist.com",
},
{
"id": "crm-006",
"company_name": "Mercury",
"country": "IE",
"website": None,
},
]
def website_is_missing(value):
return not isinstance(value, str) or not value.strip()
records_to_lookup = [
record for record in records if website_is_missing(record.get("website"))
]
lookup_results = (
find_domains(records_to_lookup, api_key) if records_to_lookup else []
)
results_by_id = {result["inputId"]: result for result in lookup_results}
for record in records:
if not website_is_missing(record.get("website")):
record["website_lookup"] = {"status": "not_requested"}
continue
result = results_by_id.get(record["id"])
if result is None:
record["website_lookup"] = {
"status": "missing_result",
"domain": None,
"confidence": None,
"credits": None,
"error": {
"code": "missing_result",
"message": "No result was returned for this inputId.",
},
}
continue
outputs = result.get("outputs") or {}
if result["status"] == "success" and outputs.get("companyUrl"):
record["website"] = outputs["companyUrl"]
record["website_lookup"] = {
"status": result["status"],
"domain": outputs.get("companyDomain"),
"confidence": outputs.get("domainConfidence"),
"credits": result.get("creditsUsed"),
"error": result.get("error"),
}
print(json.dumps(records, indent=2))يفهرس الكود النتائج حسب inputId، ثم يمر على السجلات الأصلية بالترتيب. يحتفظ الكائن website_lookup بالنتيجة وتفاصيل المراجعة بجوار كل سجل تمت محاولة معالجته، بما في ذلك النتائج غير الناجحة أو المفقودة.
بالنسبة إلى crm-001، تعيد website_is_missing() القيمة False لأن عنوان Microsoft موجود بالفعل. لا يُضاف السجل إلى records_to_lookup، ولذلك لا تستلمه API مطلقًا. تحافظ عملية الدمج على موقعه وتسجل الحالة not_requested.
بالنسبة إلى crm-002، يكون حقل الموقع فارغًا، لذلك يرسل الطلب المخبز مع inputId: crm-002. تعيد API قيمة inputId نفسها، ويستخدمها results_by_id للعثور على النتيجة الصحيحة. بعد ذلك، تكتب عملية الدمج https://boulangerie-du-palais-lyon.eatbu.com في ذلك السجل دون الاعتماد على ترتيب النتائج.
| ID | الشركة | الموقع بعد الدمج | الحالة | النطاق | درجة الثقة | Credits |
|---|---|---|---|---|---|---|
crm-001 | Microsoft · US | https://www.microsoft.com | not_requested | |||
crm-002 | boulangerie du palais lyon · FR | https://boulangerie-du-palais-lyon.eatbu.com | success | boulangerie-du-palais-lyon.eatbu.com | High | 1 |
crm-003 | Mercury Engineering · IE | https://mercuryeng.com | success | mercuryeng.com | High | 1 |
crm-004 | Mercury · US | https://www.shipmercury.com/ | success | shipmercury.com | High | 1 |
crm-005 | Datablist · FR | https://www.datablist.com | not_requested | |||
crm-006 | Mercury · IE | http://www.mercuryeng.com | success | mercuryeng.com | High | 1 |
يستخدم المخبز نطاقًا فرعيًا خاصًا بالنشاط التجاري، وهو boulangerie-du-palais-lyon.eatbu.com. احتفظ بهذه القيمة بدل اختصارها إلى eatbu.com، واحفظ العنوان الدقيق الموجود في companyUrl. يسمح الإعداد acceptNonRoot: true أيضًا بصفحة نشاط تجاري مستضافة يتضمن عنوانها مسارًا بعد اسم المضيف، لذلك يبقى عنوان URL الكامل مهمًا في الحالتين.
قد تتضمن المهمة المكتملة عناصر بحالة no_result أو error أو skipped. لا يغيّر المثال قيمة website إلا عندما تكون الحالة success ويكون companyUrl موجودًا. عند ظهور no_result، يظل الموقع فارغًا وتبقى الحالة ظاهرة في website_lookup. تحقق أولًا من اسم الشركة والبلد. إذا كان أحد الإدخالين خاطئًا، فصححه وأرسل ذلك السجل ضمن مهمة جديدة. وإلا، فاترك الموقع الفارغ ظاهرًا للمراجعة اليدوية.
تقدير Credits قبل توسيع نطاق السكربت
أعادت عمليات البحث الخمس في المثال الحالة success بدرجة ثقة High، واستهلكت 5 Credits إجمالًا.
تكلّف عملية البحث التي تُحسم عبر قاعدة البيانات Credit واحدة. أما العملية التي تُعالج باستخدام Google فتكلف 2.5 Credits. أنت تدفع مقابل المسار المستخدم، وليس كليهما. بالنسبة إلى 1,000 إدخال، يعني ذلك 1,000 Credit إذا حُسمت جميعها عبر قاعدة البيانات، أو 2,500 Credit إذا استخدمت جميعها Google. هذه سيناريوهات للتخطيط، وليست ضمانًا لنجاح كل عملية بحث.
حرّك شريط التمرير لمقارنة استهلاك Credits لقائمتك.
عند دفع 20 دولارًا مقابل 20,000 Credit، تبلغ تكلفة هذين السيناريوهين دولارًا واحدًا و2.50 دولار. اشتراك Growth منفصل، ويتضمن حاليًا 20,000 Credit شهريًا تُستخدم قبل الأرصدة الإضافية. راجع الأسعار الحالية، لأن قيم الخطط والباقات قد تتغير.
تقبل المهمة الواحدة ما يصل إلى 10,000 إدخال، بحد أقصى 16 KiB لكل إدخال و10 MiB لكل طلب. يستخدم هذا المثال استدعاءات Requests حاجبة لإرسال مهمة Datablist صغيرة وغير متزامنة، والاستعلام عن حالتها، وجلب نتائجها. ويتضمن المستودع الذي تتم صيانته أيضًا أمثلة على معالجة ملفات CSV على دفعات وClients غير حاجبة.
الخطوات التالية
بعد التأكد من أن الموقع المُعاد يخص النشاط التجاري المقصود، يمكنك استخراج صفحة Impressum باستخدام Python لإضافة البيانات القانونية للشركة وعنوان URL لصفحة المصدر القانونية إلى سجل المورّد نفسه. أبقِ مراجعة مطابقة الموقع منفصلة عن عملية الاستخراج اللاحقة.
استبدل السجلات التجريبية بعينة صغيرة من بياناتك، ثم شغّل السكربت وافحص السجلات بعد دمج النتائج. احتفظ بمعرّفات ثابتة ومعلومات البلد، ولا توسّع نطاق التشغيل إلا بعد التأكد من أن السكربت يحافظ على المواقع المعروفة ويملأ الحقول الفارغة المتوقعة. ويمكنك البدء من أمثلة Company Name to Domain API التي تتم صيانتها على GitHub إذا أردت سكربتًا قابلًا للتنزيل، أو معالجة ملفات CSV على دفعات، أو إصدارًا غير متزامن.