
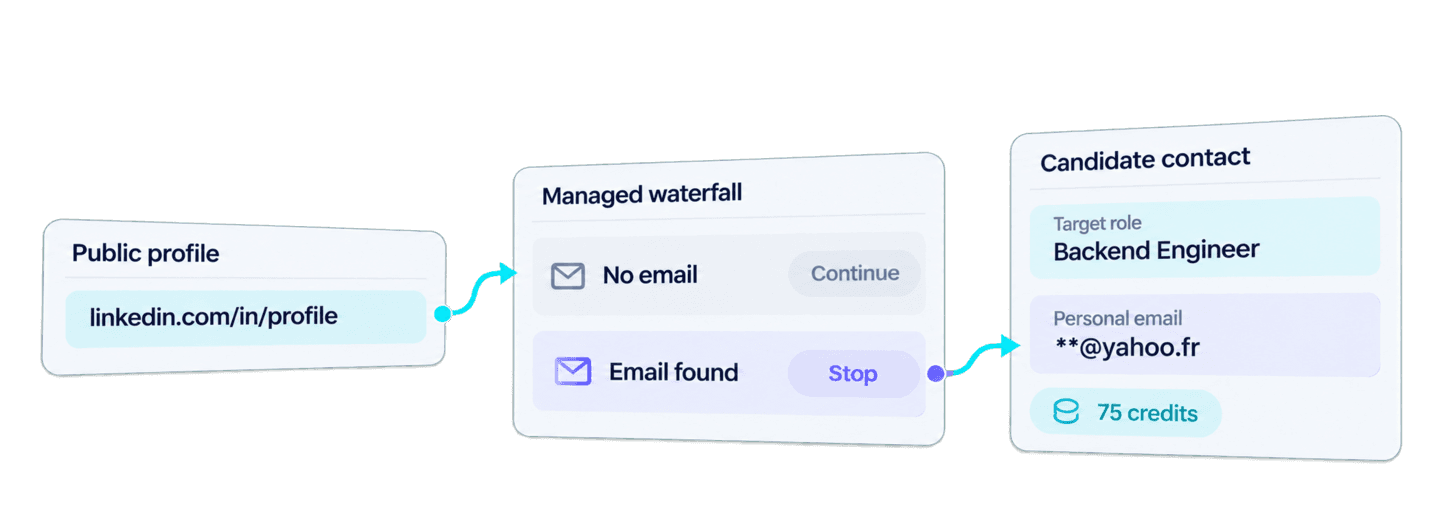
يمكنك العثور على الإيميلات الشخصية من LinkedIn باستخدام Python عبر إرسال روابط الملفات الشخصية العامة بصيغة linkedin.com/in/... إلى Waterfall Personal Email Finder API من Datablist. تشغّل الـ API تسلسلاً مُداراً من مزوّدي بيانات البريد الإلكتروني المؤهلين، وتُرجع عنواناً شخصياً عندما يعثر أحدهم على نتيجة.
يرسل المثال الكامل أدناه باستخدام Requests مهمة واحدة تعمل في الخلفية، وينتظر اكتمالها، ثم يسترجع جميع صفحات النتائج. وبعد نجاح البحث، ستعيد استخدام الكائنات المُرجعة لإعداد سجلات تواصل خاصة بالتوظيف، بحيث يبقى اسم كل مرشح ورابط LinkedIn والدور المستهدف بجانب الإيميل الذي تم العثور عليه.
يبحث هذا الـ workflow عن إيميل شخصي مستقل عن جهة العمل الحالية للمرشح. إذا كنت تحتاج بدلاً من ذلك إلى عنوان مرتبط بشركة الشخص، فاتبع الدليل المنفصل حول العثور على إيميل العمل من ملف LinkedIn.
🔑 ملخص لمن لا يملكون وقتاً طويلاً
أدخل أسماء المرشحين وروابط ملفاتهم العامة على LinkedIn والأدوار المستهدفة. يعثر workflow المبني بلغة Python على الإيميلات الشخصية المتاحة، ويحتفظ بكل عنوان مع بيانات التوظيف الأصلية الخاصة بالمرشح.
- المدخلات: أسماء المرشحين وروابط ملفاتهم العامة بصيغة
linkedin.com/in/...والأدوار المستهدفة.- المخرجات: الإيميلات الشخصية التي تم العثور عليها، مع بيانات المرشحين المطابقة.
💡 هل تفضّل حلاً دون كتابة كود؟ استخدم Waterfall Personal Email Finder من Datablist للعثور على الإيميلات الشخصية دون برمجة.
إذا كان مصدرك يتضمن الأسماء من دون روابط الملفات الشخصية، فابدأ بـالعثور على ملفات LinkedIn العامة باستخدام Python، ثم مرّر هذه الروابط إلى الـ API.
إعداد Python وRequests ومفتاح Datablist API
في هذا المثال، أستخدم Python مع حزمة requests. أنشئ ملفاً باسم find_personal_emails.py، ثم ثبّت Requests:
python -m pip install requestsأنشئ Personal API Key في حسابك على Datablist، ثم صدّره كمتغير بيئة:
export DATABLIST_API_KEY='your-api-key'يتوفر الوصول إلى REST API ضمن خطة Growth. كما تستهلك كل نتيجة ناجحة لإيميل شخصي رصيداً من credits، وسأحسب التكلفة في القسم المخصص لذلك أدناه.
العثور على إيميل شخصي بدالة Python واحدة
تتضمن قائمة candidates القابلة للتعديل في هذا السكربت سجلاً واحداً للتوظيف. تمثل target_role مثالاً لقيمة من المصدر تبقى محلية داخل workflow التوظيف. لا يدخل في payload الخاص بالـ API سوى candidate_id وlinkedin_url.
import json
import os
import time
import uuid
import requests
def find_personal_emails(candidates, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": candidate["candidate_id"],
"data": {"profileUrl": candidate["linkedin_url"]},
}
for candidate in candidates
]
unique_id = str(uuid.uuid4())
print(f"Recovery uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-personal-email-finder",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(f"Task {task_id} {task['status']}: {task.get('error')}")
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
candidates = [
{
"candidate_id": "candidate-florian-poullin",
"name": "Florian Poullin",
"linkedin_url": "https://www.linkedin.com/in/florianpoullin/",
"target_role": "Backend Engineer",
}
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
personal_email_results = find_personal_emails(candidates, api_key)
for result in personal_email_results:
print(json.dumps(result, indent=2))شغّل الملف من نافذة Terminal نفسها:
python find_personal_emails.pyيمكنك أيضاً تنزيل مثال Requests المتزامن الذي تتم صيانته باستمرار. يحافظ السكربت أعلاه على تسلسل الإرسال والاستعلام الدوري وتقسيم النتائج إلى صفحات، مع استخدام معرّفات المرشحين الواردة من سجلات المصدر.
إرسال طلب البحث
تحوّل الدالة كل مرشح إلى input للـ API. تستقبل inputId المعرّف الثابت للمرشح، بينما تستقبل data.profileUrl رابط ملف الشخص العام على LinkedIn. يلزم استخدام رابط قياسي بصيغة linkedin.com/in/.... ولا تُعد روابط Sales Navigator أو صفحات الشركات أو القيم الفارغة أو الأسماء التي لا تتضمن روابط ملفات شخصية مدخلات صالحة لهذه الإضافة enrichment.
يستخدم الطلب waterfall-personal-email-finder باعتباره enrichmentId، مع كائن settings فارغ، كما هو موضح في وثائق Waterfall Personal Email Finder API. يطبع السكربت قيمة uniqueId التي أنشأها قبل الإرسال. احتفظ بهذه القيمة لأنها تتيح لك تحديد مهمة موجودة إذا انقطع الاتصال بعد قبول الـ API للطلب.
في ما يلي body الكامل للطلب في مثال الملف الشخصي الواحد:
{
  "enrichmentId": "waterfall-personal-email-finder",
  "uniqueId": "55001d29-4fb9-4fe2-9497-80f4b346eed7",
  "settings": {},
  "inputs": [
    {
      "inputId": "candidate-florian-poullin",
      "data": {
        "profileUrl": "https://www.linkedin.com/in/florianpoullin/"
      }
    }
  ]
}
يعيد الإرسال الناجح استجابة HTTP 202 Accepted تتضمن معرّف المهمة في @id. وتستمر المعالجة على خوادم Datablist بعد إرسال هذه الاستجابة.
انتظار المهمة التي تعمل في الخلفية
يظل سكربت Requests منتظراً محلياً بينما يشغّل الخادم المهمة في الخلفية. ويتحقق من المهمة كل ثلاث ثوانٍ، ويواصل الانتظار ما دامت حالتها queued أو running. عند وصول المهمة إلى completed، ينتقل السكربت إلى استرجاع النتائج. أما إذا أصبحت الحالة failed أو stopped، فيعرض خطأ يتضمن معرّف المهمة ورسالة الخطأ المتاحة.
استرجاع جميع صفحات النتائج
تعيد نقطة نهاية النتائج معرّف المصدر لكل صف وحالته ومخرجاته وعدد credits والخطأ. يطلب الاستدعاء الأول ما يصل إلى 100 نتيجة. ويجلب الصفحة التالية إلى أن تصبح قيمة nextCursor مساوية لـnull.
تحافظ نتائج المهمة على ترتيب المدخلات. كما تظل inputId رابطاً صريحاً بين كل نتيجة وسجل المرشح الخاص بها، حتى عند توزيع النتائج على عدة صفحات.
عند تكييف المثال لمعالجة مزيد من السجلات، حافظ على ثبات كل candidate_id الوارد من نظام المصدر. تضمن هذه القيمة إمكانية دمج البيانات بطريقة متوقعة عندما تتضمن المهمة عدة صفحات من النتائج.
كيف يعثر Waterfall على إيميل شخصي
ينظف Datablist رابط ملف LinkedIn العام المُرسل، ثم يمرر الملف الذي لم تُعثر له على نتيجة عبر مزوّدي الإيميلات الشخصية المؤهلين حالياً، واحداً تلو الآخر. إذا لم يُرجع أحد المزوّدين عنواناً قابلاً للاستخدام، يمكن أن ينتقل الملف إلى المزوّد المؤهل التالي. وعندما يعثر مزوّد على إيميل صالح، يتوقف التسلسل لهذا الملف ويعيد العنوان في outputs.emailFound.
يدير Datablist المزوّدين المؤهلين، ولذلك لا يحتاج التكامل إلى طلبات خاصة بكل مزوّد أو كود fallback. تعرض النتيجة العامة حصيلة البحث عن الإيميل، وليس ترتيباً ثابتاً للمزوّدين أو سجلاً لمحاولات البحث.
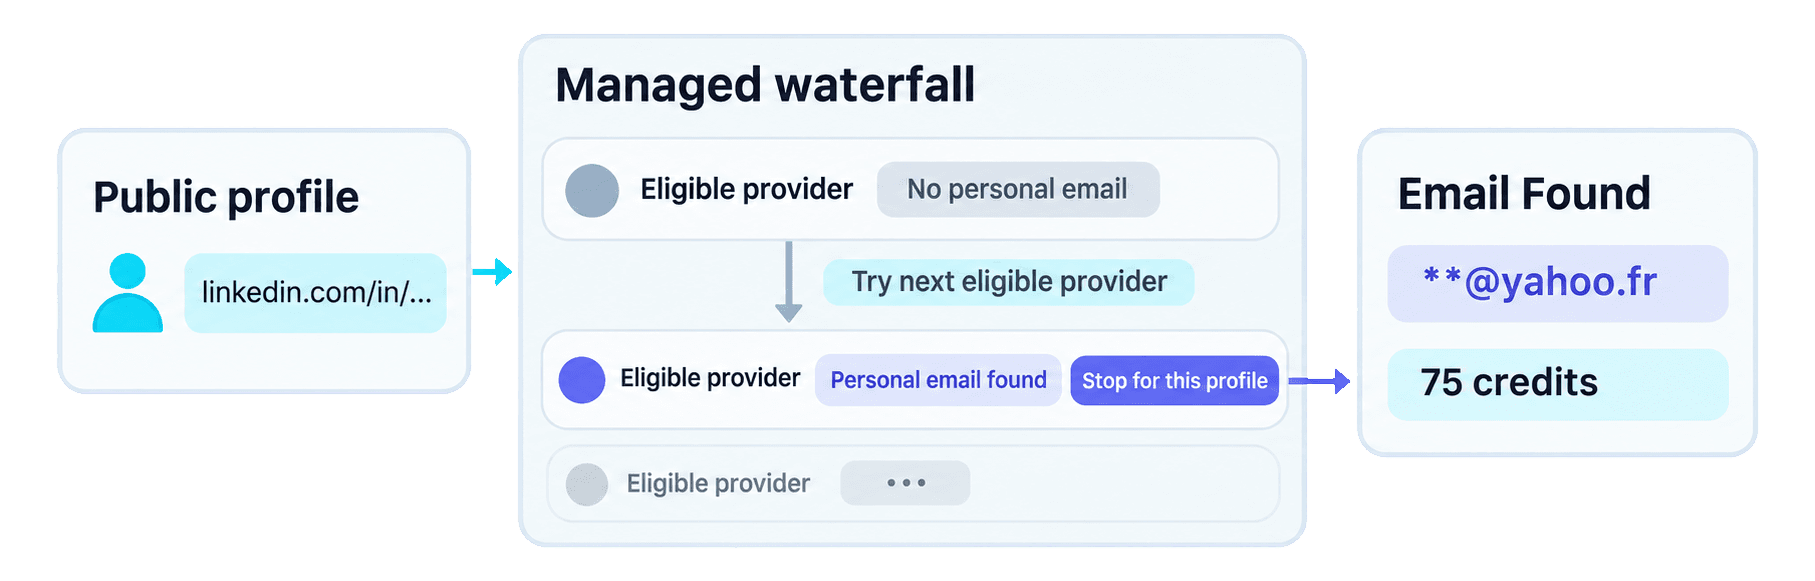
يمثل Waterfall طريقة البحث. أما polling فله وظيفة مختلفة: إذ يتيح لعميل Python انتظار اكتمال المعالجة التي تجري في الخلفية.
لماذا يفيد Waterfall فرق التوظيف الدولية
يعتمد مزوّدو الإيميلات الشخصية على مجموعات بيانات مختلفة، ولذلك تتفاوت نقاط قوتهم من بلد وسوق إلى آخر. عندما لا يجد المزوّد الأول إيميلاً لمرشح، قد يعثر عليه مزوّد آخر ضمن Waterfall.
تحصل فرق التوظيف العاملة في عدة بلدان على تغطية أوسع للمزوّدين من خلال تكامل API واحد. ويتولى Datablist إدارة التسلسل، ما يساعد الفريق على استعادة بيانات تواصل قد لا يعثر عليها البحث عبر مزوّد واحد، من دون ربط عدة APIs وصيانتها.
قراءة النتيجة الكاملة
📘 إيميل مخفي جزئياً: استُبدل الجزء المحلي من العنوان بالرمز
**أدناه. تتضمن نتيجة الـ API القيمة الكاملة.
في ما يلي صفحة النتائج الكاملة لمدخل المرشح:
{
  "taskId": "b5de73ffaa3f4f349c125d7c85125bb4",
  "results": [
    {
      "inputId": "candidate-florian-poullin",
      "status": "success",
      "outputs": {
        "emailFound": "**@yahoo.fr"
      },
      "creditsUsed": "75",
      "error": null
    }
  ],
  "nextCursor": null
}
تمثل inputId مفتاح الدمج مع المرشح في المصدر. وتتضمن outputs.emailFound العنوان الشخصي. أما creditsUsed فهي القيمة المعتمدة للرصيد المستهلك لهذا الصف، وتعني error: null أن الـ API لم تُرجع خطأ على مستوى الصف. وتؤكد قيمة cursor الفارغة عدم وجود صفحة نتائج تالية لهذه الاستجابة.
تعامل مع العنوان باعتباره وسيلة تواصل مرتبطة بالملف المُرسل، وراجعه قبل استخدامه في التوظيف.
إعداد سجلات المرشحين لمراجعة مسؤول التوظيف
بعد عودة نتائج البحث، يمكنك إعداد قائمة محلية لمراجعتها من مسؤول التوظيف من دون إرسال طلب API آخر. تعيد الكتلة التالية استخدام متغيرَي candidates وpersonal_email_results الحاليين:
results_by_id = {
result["inputId"]: result for result in personal_email_results
}
prepared_contacts = []
for candidate in candidates:
result = results_by_id.get(candidate["candidate_id"])
if not result or result.get("status") != "success":
continue
email_found = result.get("outputs", {}).get("emailFound")
if not email_found:
continue
prepared_contact = candidate.copy()
prepared_contact["result"] = result
prepared_contacts.append(prepared_contact)
print(json.dumps(prepared_contacts, indent=2))بالنسبة إلى candidate-florian-poullin، يعثر البحث في القاموس على النتيجة التي تحمل inputId نفسها. يحتفظ السجل المنسوخ باسم Florian Poullin ورابط LinkedIn والدور المستهدف التجريبي Backend Engineer. ثم يرفق كائن الـ API الكامل داخل result، حيث يستطيع مسؤول التوظيف قراءة result.outputs.emailFound.
تبدأ الحلقة من قائمة المرشحين المصدرية. وإذا لم تُعثر مستقبلاً على نتيجة، أو ظهر خطأ في صف، أو كانت النتيجة مفقودة، أو كانت emailFound فارغة، تظل قائمة المصدر من دون تغيير ولا يُضاف السجل إلى prepared_contacts.
لإنشاء عملية مراجعة أوسع واستخدام قنوات تواصل أخرى، اقرأ دليل العثور على عنوان إيميل المرشح لمسؤولي التوظيف.
تقدير تكلفة Waterfall Personal Email Finder API
يستهلك كل إيميل شخصي يتم العثور عليه 75 credits، بينما لا يستهلك البحث الذي لا يعثر على نتيجة أي credits. ولحساب الإنفاق الفعلي، اقرأ creditsUsed في كل نتيجة بدلاً من ضرب العدد الإجمالي للملفات الشخصية المُرسلة.
معادلة التخطيط هي:
عدد الإيميلات الشخصية التي تم العثور عليها × 75 credits
على سبيل المثال، إذا أرسلت 100 ملف شخصي وأنتج 20 منها إيميلاً شخصياً، فستستهلك المهمة 20 × 75 = 1,500 credits. هذه عملية حسابية للتخطيط وليست معدل نتائج متوقعاً. وبالنسبة إلى الميزانيات الأكبر، يستهلك العثور على 100 إيميل 7,500 credits، بينما يستهلك العثور على 1,000 إيميل 75,000 credits.
وفق سعر الشحن الأساسي الحالي بالدولار الأمريكي، فإن $20 / 20,000 credits = $0.001 لكل credit. وبالتالي، يستهلك كل إيميل يتم العثور عليه ما قيمته $0.075 من credits، وتستهلك 100 نتيجة ما قيمته $7.50. يقدّر هذا الحساب قيمة credits المستهلكة فقط، أما اشتراك Growth المطلوب للوصول إلى REST API فيُحتسب بصورة منفصلة. راجع أسعار Datablist للاطلاع على الخطط وباقات credits الحالية.
إصلاح الأخطاء الشائعة واستعادة مهمة موجودة
تحدث معظم المشكلات قبل الإرسال، أو ضمن طلب HTTP، أو في نتيجة فردية. استخدم موضع الخطأ لتحديد الإجراء التالي:
- غياب
DATABLIST_API_KEY: يتوقف السكربت محلياً قبل إرسال أي طلب. صدّر متغير البيئة، ثم شغّل الملف مجدداً. - فشل مصادقة HTTP: تحقق من Personal API Key في
DATABLIST_API_KEY. ترسله الدالة ضمن header باسمX-API-Key. صحّح بيانات الاعتماد قبل إعادة الإرسال. - رابط ملف شخصي غير مدعوم: استبدل رابط Sales Navigator أو صفحة الشركة أو القيمة الفارغة أو الرابط غير الصحيح بملف شخص عام بالصيغة
linkedin.com/in/.... - credits غير كافية: تحقق من رصيد الحساب وcredits المتاحة قبل إرسال مزيد من المهام.
- حالة المهمة
failedأوstopped: افحص خطأ المهمة والنتائج المتاحة واستهلاك credits قبل تحديد ما يجب تشغيله مجدداً. - صف بلا نتيجة أو يتضمن خطأ: احتفظ بمرشح المصدر للمراجعة أو لاستخدام قناة تواصل أخرى. لا يوضح البحث غير الناجح سبب تعذّر العثور على العنوان.
إذا فُقدت استجابة POST، فاعرض قائمة مهامك قبل إنشاء مهمة أخرى. ابحث في الاستجابة عن uniqueId التي طبعها السكربت، ثم انسخ @id الخاص بالمهمة المطابقة:
curl "https://api.datablist.com/v1/enrichments/tasks?enrichmentId=waterfall-personal-email-finder&limit=100" \
--header "X-API-Key: $DATABLIST_API_KEY"
TASK_ID='paste-matching-task-id'
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID" \
--header "X-API-Key: $DATABLIST_API_KEY"
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID/results" \
--header "X-API-Key: $DATABLIST_API_KEY"إذا لم تظهر المهمة المطابقة في أول استجابة لسجل المهام، فاتبع pagination cursor المُعاد وتحقق من الصفحة التالية. واصل التحقق من المهمة المستعادة أو استرجع نتائجها المتاحة بدلاً من إنشاء مهمة مدفوعة أخرى تلقائياً. تغطي وثائق المهام تفاصيل دورة الحياة وتقسيم النتائج إلى صفحات ومدة الاحتفاظ بها.
الخطوات التالية
أصبح لديك الآن دالة Python Requests قابلة لإعادة الاستخدام مع روابط ملفات LinkedIn العامة، وآلية دمج تعتمد على معرّفات ثابتة لإعداد نتائج الإيميلات الشخصية مع سياق المصدر الخاص بكل مرشح.
استبدل القائمة التجريبية بمجموعة صغيرة من سجلات مرشحيك، واحتفظ بمعرّف ثابت ودور مستهدف لكل سجل، ثم راجع كل جهة اتصال مُعدة قبل استخدامها في عملية التوظيف. وعندما يحتاج تطبيقك إلى concurrency غير حاجب، استخدم مثال HTTPX غير المتزامن الذي تتم صيانته باستمرار باعتباره خطوة التنفيذ التالية.