
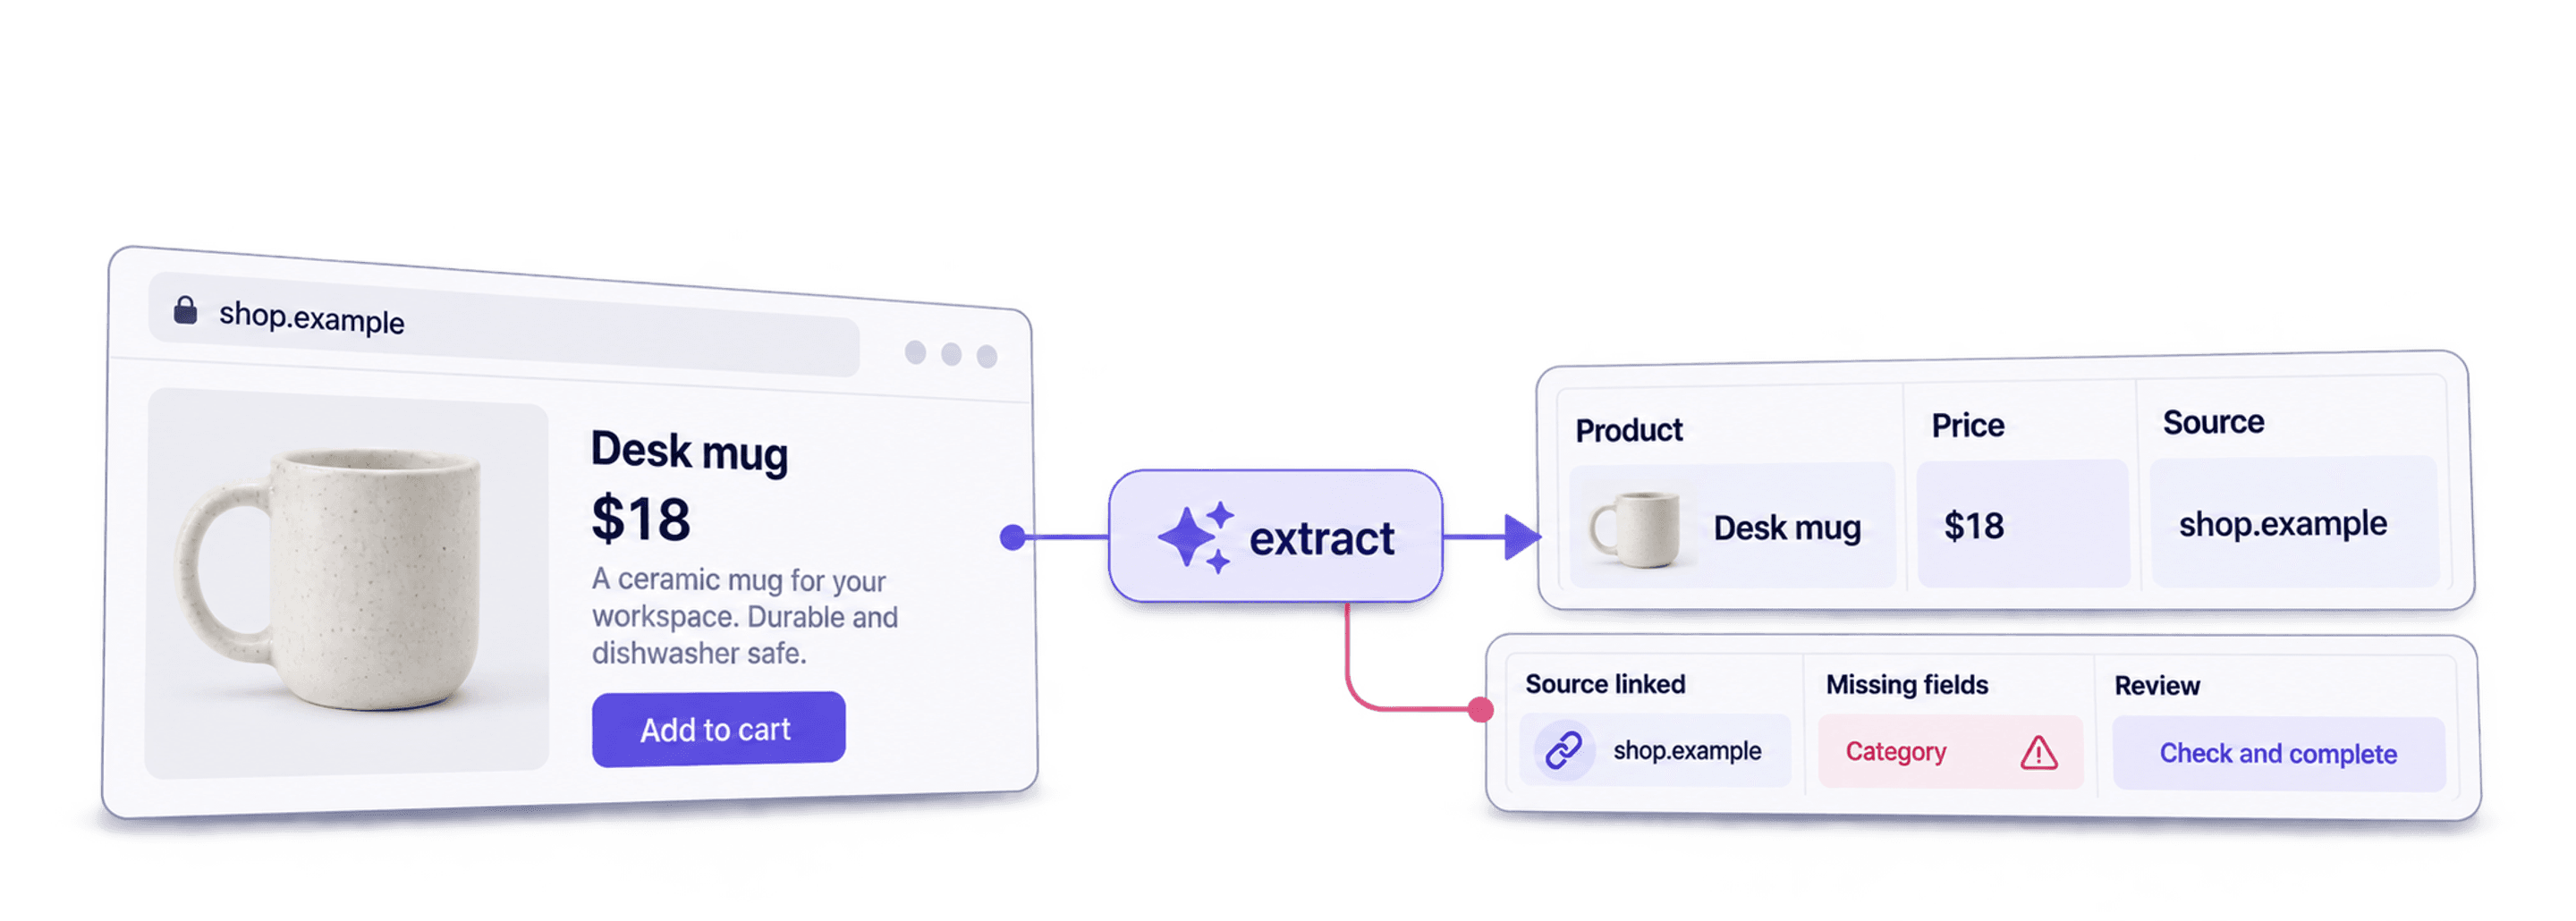
AI web scraping bruger en model til at omdanne indhold fra websites til strukturerede felter, som du beskriver i en prompt. Du kan for eksempel bede om produktnavne, priser og kilde-URL'er i stedet for at vælge hvert enkelt HTML-element.
Det er præcis den udvikling, traditionel no-code scraping gennemgår, efter at AI scraping er kommet på banen.
Men her er spørgsmålet, alle bør stille: Er AI web scraping faktisk bedre, eller er det bare smart markedsført AI-hype?
I denne artikel får du svaret. Vi sammenligner AI web scraping med forgængeren og skiller de reelle muligheder fra markedsføringspåstandene.
📌 Kort opsummering til dig, der har travlt
Artiklen undersøger AI web scraping for at afdække, hvad der skaber reel værdi, og hvad der blot er marketinghype. Her er den korte version:
Spørgsmålet: Er AI web scraping reelt bedre end traditionelle no-code-metoder, eller er det bare AI-hype?
AI-baseret dataudtræk kan hjælpe, når sidelayout varierer, eller felterne kræver fortolkning. En stabil tabel kan være nemmere at udtrække med faste regler. Uanset metode bør du kontrollere de returnerede felter mod kildesiderne, før du kører en stor batch.
Det lærer du: Hvad AI web scraping rent faktisk gør, hvordan det klarer sig direkte mod click-and-point-værktøjer, hvordan tre AI scraping-værktøjer fungerer, og hvornår AI scraping giver mening – og hvornår det ikke gør.
Det dækker artiklen
- Forstå, hvad AI web scraping rent faktisk gør
- Direkte sammenligning: AI scraping kontra traditionelle no-code-metoder
- De tre bedste AI web scraping-værktøjer med reel værdi
- Ofte stillede spørgsmål om AI web scraping
Introduktion til AI web scraping
Før vi kan afgøre, hvad der er hype, og hvad der skaber værdi, skal vi forstå, hvad AI web scraping egentlig er, og hvorfor teknologien overhovedet findes.
Hvad gør AI scraping?
AI web scraping bruger AI-modeller til at udtrække data fra websites. Her er den afgørende forskel fra tidligere metoder: AI scrapers forstår kontekst.
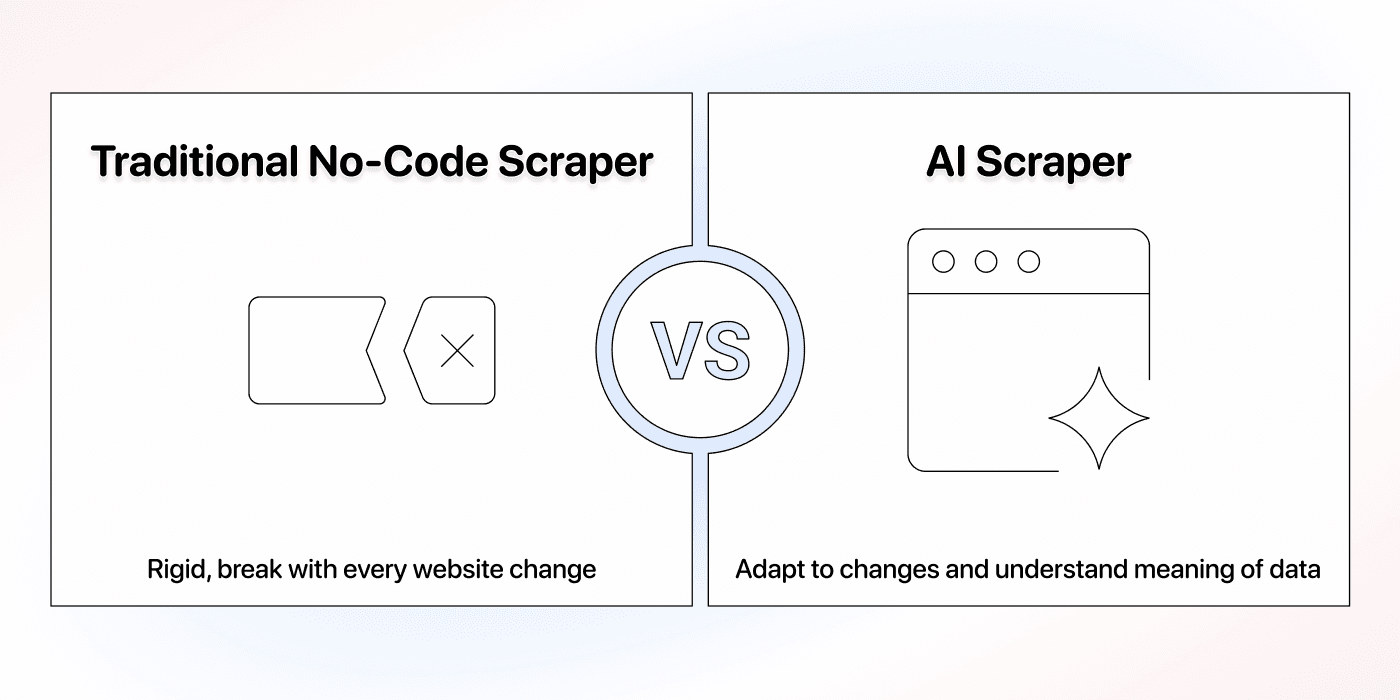
Traditionelle scrapers – også dem, der kaldes "no-code" – følger faste regler. Du beder dem om at "udtrække teksten fra dette specifikke HTML-element", og det er præcis, hvad de gør. Hvis websitet ændrer elementet i morgen, holder din scraper op med at virke.
AI scrapers forstår derimod, hvad du konceptuelt leder efter. Du beder dem om at "udtrække produktprisen", og så finder de ud af, hvor prisen står, selv hvis:
- Websitet får nyt layout i næste uge
- Forskellige sider strukturerer deres HTML forskelligt
- Prisen vises i forskellige formater
Det er det centrale værditilbud. AI følger ikke bare instruktioner, men forstår intentionen bag dem.
Tænk på det sådan:
- Traditionel scraper: "Gå hen til den tredje hylde, og tag den anden bog fra venstre"
- AI scraper: "Find bogen om AI web scraping til mig"
Den første metode bryder sammen, hvis nogen flytter rundt på bøgerne. Den anden tilpasser sig, fordi den forstår, hvad du faktisk vil have.
Derfor er det den bedste form for scraping
Jeg ved godt, at "bedste" er en markant påstand, men her er begrundelsen: AI scraping sparer tid for alle – også udviklere.
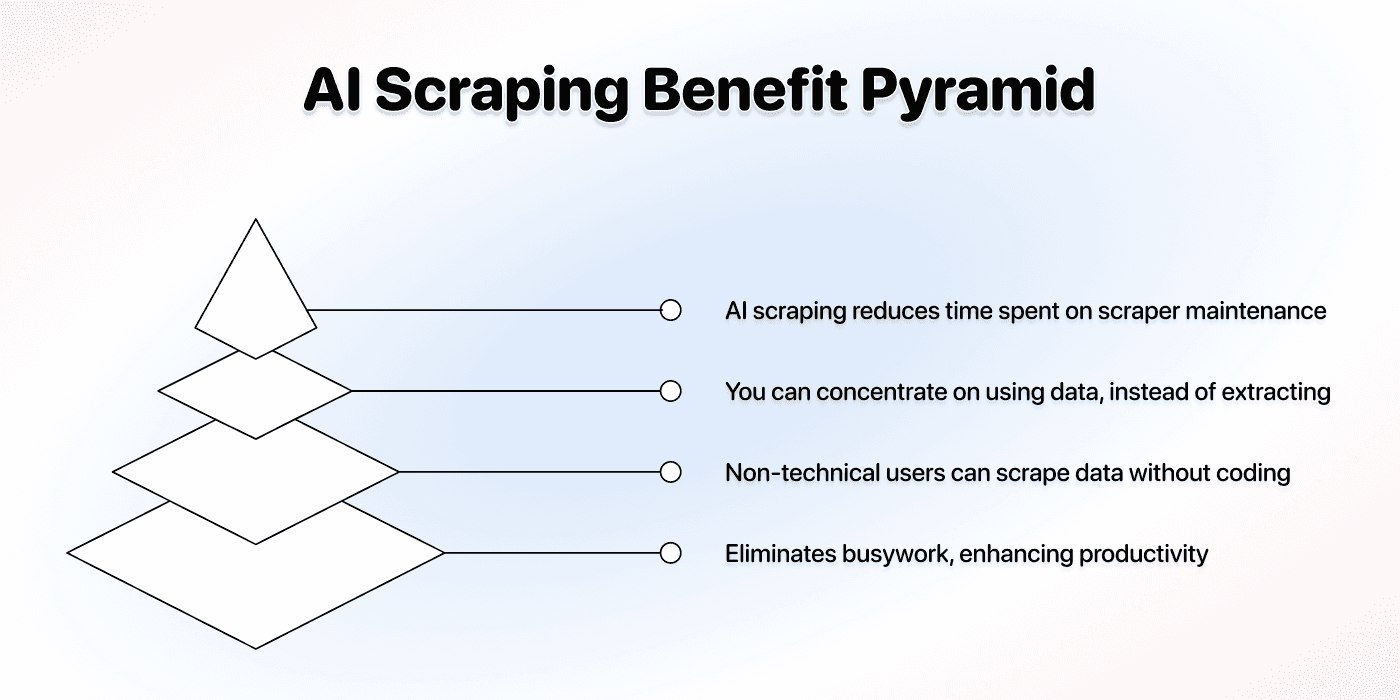
Selv hvis du kan kode, er det tidskrævende at bygge og vedligeholde scrapers. Websites ændrer sig hele tiden, og traditionelle scrapers kræver løbende opdateringer. Med AI web scraping:
↳ Udviklere slipper for at spilde tid på vedligeholdelse af scrapers
↳↳ Ikke-tekniske brugere kan endelig scrape uden at lære at kode
↳↳↳ Alle kan fokusere på at bruge data frem for at kæmpe med dataudtræk
Værdien handler ikke kun om, at det er "nemmere end at kode". Det handler om at fjerne en hel kategori af rutinearbejde, som ingen alligevel nyder.
Her er et konkret eksempel:
Du vil scrape produktinformation fra en webshop. Med traditionelle værktøjer skal du:
- Bruge to timer på at opsætte CSS-selectors
- Se din scraper holde op med at virke, når websitet opdateres
- Bruge endnu en time på at rette den
- Gentage processen hver måned
Med AI scraping skal du:
- Bede AI'en om at "udtrække produktnavn, pris og beskrivelse"
- Lade den håndtere ændringer automatisk
- Fokusere på at analysere dine data frem for at vedligeholde din scraper
Det er reel værdi – ikke hype.
AI web scraping vs. no-code scraping
Nu bliver vi konkrete. Lidt kontekst først: No-code scraping betyder ganske enkelt scraping uden kode. Det er ikke svært at forstå, men metoden kan antage flere former:
- Click-and-Point
- API-baseret dataudtræk
- Browserudvidelser
- …
Og AI scraping. Ja, teknisk set er AI web scraping en underkategori af no-code scraping, fordi metoden ikke kræver kodning. Men når folk taler om "no-code scraping", mener de som regel de ældre click-and-point-metoder eller browserudvidelser.
Lad os derfor sammenligne AI web scraping med traditionel no-code scraping og bruge click-and-point-værktøjer som målestok.
Opsætningstid
Traditionel no-code scraping med Click-and-Point
Med værktøjer som Octoparse og lignende point-and-click-scrapers ser opsætningen sådan ud:
Opsætningsarbejde: Vælg elementer, konfigurer pagination, og valider de returnerede felter.
- Installer værktøjet, hvis det er en desktop-app
- Gå til det website, du vil scrape
- Klik på hvert element, du vil udtrække
- Konfigurer regler for pagination
- Test og fejlfind, når de forkerte elementer bliver valgt
- Se vejledninger, når du går i stå
Den skjulte omkostning: Du opsætter ikke bare en scraper – du lærer også at aflæse strukturen på websites. For ikke-tekniske brugere er læringskurven stejl.
Her finder du en sammenligning af de bedste no-code scraping-værktøjer, herunder AI scrapers.
AI web scraping
Med AI-drevne værktøjer som Datablist ser opsætningen sådan ud:
Opsætningsarbejde: Beskriv outputfelterne, konfigurer adgangen til siden, og valider et eksempel.
- Vælg AI scraping-agenten
- Indsæt URL'en
- Beskriv med almindeligt sprog, hvilke data du vil have
- Kør din scraper
Forskellen: Du beskriver din intention i stedet for at pege på HTML-elementer. Du behøver ikke forstå websitets arkitektur.
Gå hertil, hvis du vil lære, hvordan du scraper ethvert katalog på under 10 minutter 👈🏽
Fleksibilitet
Her bliver forskellen markant.
Traditionel no-code scraping med Click-and-Point
Traditionelle værktøjer er ufleksible. De udtrækker præcis det, du har konfigureret dem til, på præcis den måde, du har angivet.
Hvad sker der, når:
- Websitet får et nyt layout? Din scraper holder op med at virke.
- Forskellige sider bruger forskellige strukturer? Du skal bruge flere scrapers.
- Du vil have lidt andre data? Du skal konfigurere det hele igen.
Hver ændring kræver manuel indgriben. Du koder ikke, men du udfører stadig teknisk arbejde.
AI web scraping
AI scrapers tilpasser sig automatisk de fleste ændringer, fordi de forstår konteksten.
Hvad sker der, når:
- Websitet får nyt design? AI tilpasser sig automatisk den nye struktur.
- Forskellige sider bruger forskellige layouts? AI håndterer variationerne uden flere konfigurationer.
- Du vil have andre data? Opdater din prompt med almindeligt sprog.
Forestil dig dette scenarie: Du scraper konkurrenternes prissider.
De opdaterer designet hvert kvartal. Med click-and-point-værktøjer skal du genopbygge din scraper hvert kvartal. Med AI web scraping behøver du ikke ændre noget, fordi AI'en forstår, at den skal "udtrække prisniveauerne", uanset hvordan de vises.
Vedligeholdelse
Her viser traditionel no-code scraping sin reelle omkostning.
Traditionel no-code scraping med Click-and-Point
Websites ændrer sig konstant. Hver ændring kan potentielt få din scraper til at bryde sammen.
Månedlig vedligeholdelse:
- Gennemgå de scrapers, der ikke længere virker
- Find ud af, hvad der er ændret på websitet
- Konfigurer selectors og regler igen
- Test det hele på ny
- Gentag næste måned
For virksomheder, der kører flere scrapers, udvikler det sig hurtigt til et deltidsjob. Nogle virksomheder ansætter ligefrem en person specifikt til at vedligeholde scrapers.
Den skjulte omkostning: Selvom du ikke skriver kode, udfører du stadig teknisk vedligeholdelse, der kræver forståelse for websitestrukturer eller timevis af dialog med supportteams.
AI web scraping
AI reducerer vedligeholdelsen markant, fordi teknologien automatisk tilpasser sig ændringer.
Månedlig vedligeholdelse:
- Kontrollér, at datakvaliteten fortsat er høj
- Finjuster lejlighedsvis dine prompts, hvis det er nødvendigt
- Det var det
AI scrapers bryder ikke sammen, når CSS-klassenavne ændres, eller layouts får nyt design, fordi de ikke leder efter bestemte HTML-elementer. De forstår indholdet ud fra dets kontekst.
📘 Vedligeholdelsestesten
Sådan skelner du reel værdi fra hype:
Spørg dig selv: "Hvad holder op med at virke, hvis dette website får nyt design næste måned?"
Traditionelle værktøjer: Alt bryder sammen. Du må begynde forfra.
AI-værktøjer: Det hele fortsætter med at virke. Du behøver ikke engang ændre dine prompts.
Den forskel sparer milliarder af arbejdstimer på verdensplan.
Tre gode AI web scraping-værktøjer
Nu har vi slået fast, at AI scraping skaber reel værdi. Lad os derfor se på, hvilke værktøjer der faktisk indfrier løfterne, og hvilke der primært har veludført marketing.
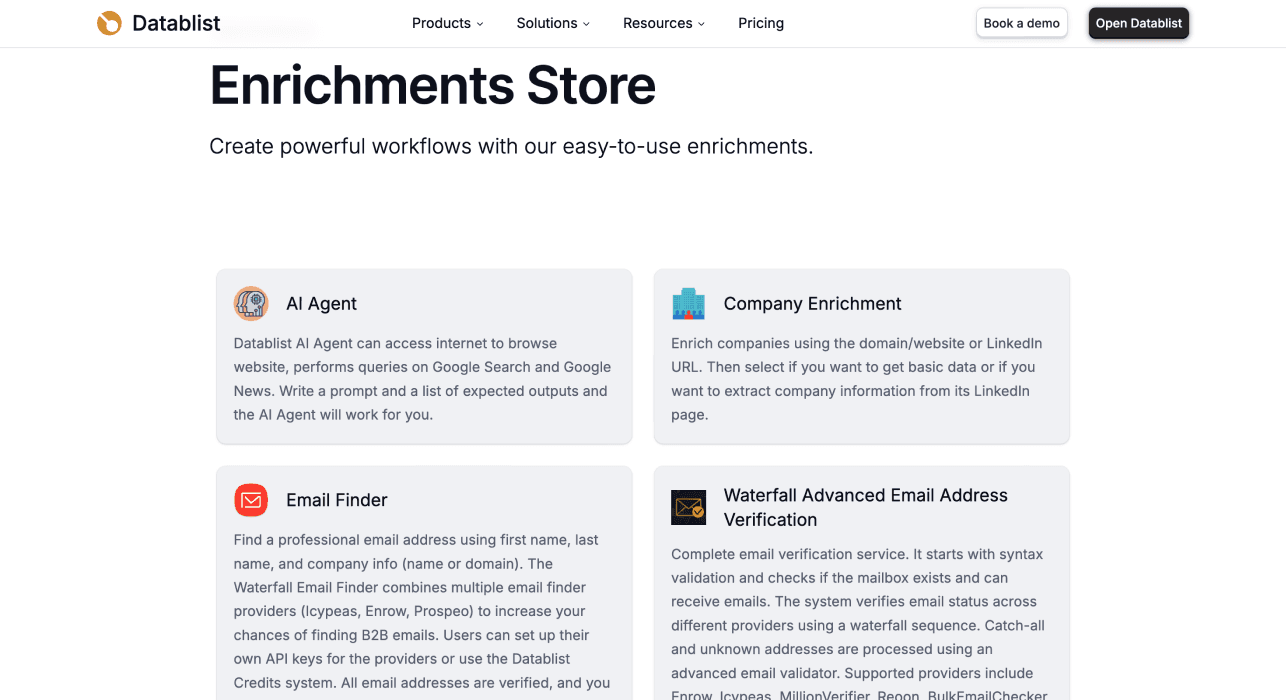
Datablist: AI web scraper til ikke-tekniske brugere
Datablist er en platform til workflow automation med effektive, indbyggede funktioner til AI scraping. Platformen markedsføres ikke primært som en scraper, og det er faktisk et godt tegn. Det viser, at AI scraping er udviklet til at løse reelle problemer – ikke bare for at ride med på AI-bølgen.
Det skiller Datablist ud
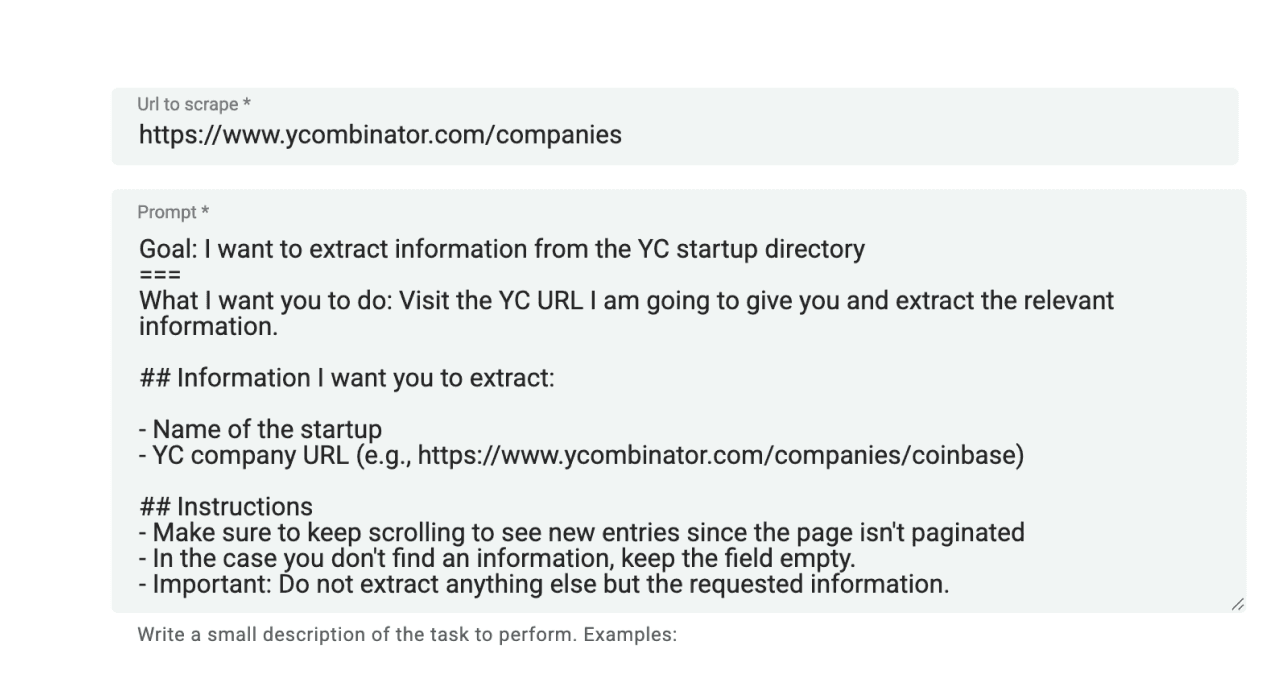
Scraping med almindeligt sprog, der faktisk virker
De fleste værktøjer kalder sig "no-code", men kræver stadig, at du forstår strukturen på websites. Datablist bruger AI, der reelt forstår instruktioner i naturligt sprog.
Du kan bogstaveligt talt bede værktøjet om at "gå til dette website og udtrække virksomhedsnavne, adresser og e-mails", og så gør det netop det. Du skal ikke klikke på elementer, konfigurere selectors eller have teknisk viden.
Specialiserede AI agents
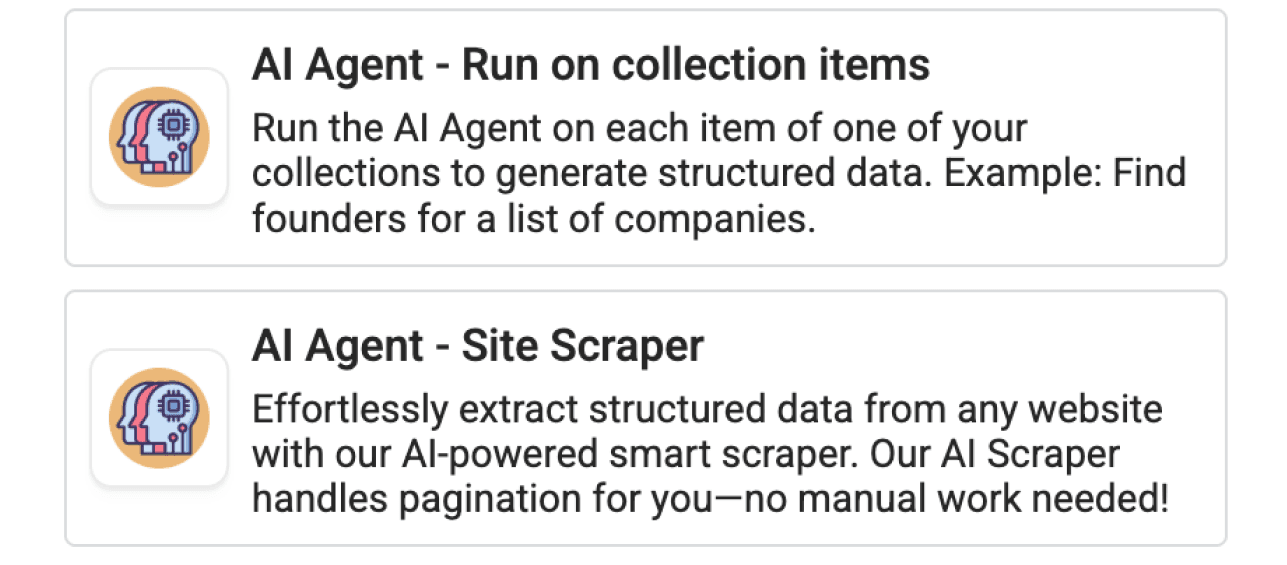
Forskellige scraping-opgaver kræver forskellige tilgange. Datablist tilbyder:
- AI Scraping Agent: Til scraping af hele websites med pagination
- AI Research Agent: Til kontekstbaseret research og dataudtræk i datasæt
Specialiserede agents giver bedre præcision og hastighed til konkrete opgaver.
Komplet økosystem til leadgenerering
Det er her, Datablist for alvor viser sin værdi. Det er ikke bare en scraper. Platformen indeholder mere end 60 værktøjer:
- Waterfall Email Finder
- Berigelse med telefonnumre
- LinkedIn scraping
- Company Name Cleaner
- Datarensning og deduplikering
- Workflow automation
Du kan scrape en liste, berige den med verificerede e-mails, fjerne dubletter og eksportere den til dit CRM – alt sammen på én platform.
Tjek af pris
Prisen starter ved 25 USD om måneden med 5.000 gratis credits inkluderet hver måned.
Det er bemærkelsesværdigt prisvenligt sammenlignet med konkurrenter, der tager 80-200 USD om måneden. Creditsystemet er fleksibelt, fordi du kan købe ekstra credits som engangskøb i stedet for at opgradere hele dit abonnement.
Konklusionen: værdi eller hype?
100 % værdi. Datablist indfrier konsekvent sine løfter. AI'en forstår reelt kontekst og tilpasser sig forskellige websites. Den primære begrænsning er, at værktøjet ikke kan scrape indhold bag login, men det er en teknisk – og etisk – begrænsning, ikke et brudt løfte.
💡 Hvornår Datablist er det rette valg
Vælg Datablist, hvis du vil have:
- Ægte no-code scraping med almindeligt sprog
- Et økosystem, der rækker ud over scraping med enrichment, datarensning og automation
- Mest værdi for pengene som ikke-teknisk bruger eller mindre team
Firecrawl: scraperen til applikationer
Firecrawl er en open source-webdata-API, der er udviklet specifikt til udviklere, som bygger AI-applikationer. Det forsøger ikke at være et point-and-click-værktøj, men er skabt til programmatisk brug.
Det skiller Firecrawl ud
LLM-klare outputformater
Firecrawl forstår, at data skal leveres i formater, som store sprogmodeller nemt kan behandle, når du bygger AI-applikationer. Værktøjet leverer ren Markdown, JSON og strukturerede data uden yderligere behandling.
Udvikleren i centrum
I modsætning til værktøjer, der prøver at ramme alle målgrupper, fokuserer Firecrawl på udviklere. Det betyder:
- Veldokumenterede API'er
- SDK'er til Python og Node.js
- Pålideligt og ensartet output
- Teknisk kontrol, når du har brug for det
Tjek af pris
Prisen starter ved 19 USD om måneden.
For udviklere, der bygger applikationer med behov for webdata, er det særdeles prisvenligt. Gratisabonnementet er generøst nok til tests og mindre projekter.
Vurderingen: værdi eller hype?
90 % værdi, 10 % hype. Firecrawl er ærlig om, hvad produktet er – et udviklerværktøj – og leverer stabilt. Hype-delen kommer fra markedsføringen som AI web scraping, da værktøjet ikke scraper med AI, men til AI. Selve produktet er dog solidt.
Hvem bør bruge det: Udviklere, der bygger AI-applikationer med behov for webdata. Hvis du ikke er udvikler eller bygger applikationer, bør du kigge efter en anden løsning.
ScrapingBee: API til AI scraping
ScrapingBee har eksisteret længere end den nuværende bølge af AI-hype, og det er faktisk et positivt signal. Virksomheden har tilføjet AI-funktioner til en allerede solid scraping-infrastruktur.
Det skiller ScrapingBee ud
Pålidelig infrastruktur
ScrapingBee håndterer hele den komplekse infrastruktur:
- Proxy rotation
- Browser rendering til websites med meget JavaScript
- Omgåelse af anti-bot-detektion
- Håndtering af rate limits
Det skaber værdi, fordi der er tale om reelle tekniske problemer, som ofte får scrapers til at bryde sammen.
AI-drevet dataudtræk
AI-funktionen hjælper med at analysere og udtrække data mere intelligent end traditionelle selectors. Den er ikke lige så avanceret som Datablists tilgang med naturligt sprog, men den er mere fleksibel end scraping, der udelukkende bygger på selectors.
API-first-design
Hvis du er fortrolig med API'er eller skal integrere scraping i eksisterende workflows, er ScrapingBees API veldesignet og veldokumenteret.
Tjek af pris
ScrapingBees offentliggjorte månedspriser starter ved 19 USD for Hobby med 75.000 API credits. Freelance koster 49 USD og inkluderer 250.000 API credits. En standardforespørgsel koster fra én credit. JavaScript rendering og premium-proxyer bruger flere credits.
Vurderingen: værdi eller hype?
80 % værdi, 20 % hype. ScrapingBee leverer en solid scraping-infrastruktur, men markedsføringen som "AI-powered" og "No-Code" oversælger det, der i praksis er trinvise forbedringer af traditionel scraping. Det er stadig primært et API-værktøj, der kræver teknisk viden.
Hvem bør bruge det: Udviklere eller tekniske teams, som har brug for pålidelig scraping-infrastruktur og er fortrolige med API'er. Trods markedsføringen som "no-code" er det ikke ideelt til ikke-tekniske brugere.
📘 Guide til valg af værktøj
Sådan vælger du:
Ikke-teknisk bruger, der vil have den nemmeste løsning: Datablist
Udvikler, der bygger AI-applikationer: Firecrawl
Teknisk team med behov for infrastruktur: ScrapingBee
AI scrapers: Sådan skiller du værdi fra hype
Efter at have undersøgt AI web scraping fra alle vinkler er min ærlige vurdering: Som med alt andet nyt er der også hype omkring AI web scraping, men værdien er langt større.
Den reelle værdi
1. Slut med et vedligeholdelsesmareridt
Traditionelle scrapers bryder konstant sammen. AI scrapers tilpasser sig automatisk. Det sparer hundredvis af timer for alle, der jævnligt kører scrapers. Det er ikke hype, men en målbar tidsbesparelse.
2. Reel tilgængelighed for ikke-tekniske brugere
For første gang kan mennesker uden kendskab til HTML, CSS eller websitestruktur udtrække data i stor skala (værktøjer som Datablist gør dette muligt).
3. Fleksibilitet, der faktisk virker
AI forstår kontekst og intention og kan derfor automatisk håndtere variationer i strukturen på websites.
4. Hurtig opsætning
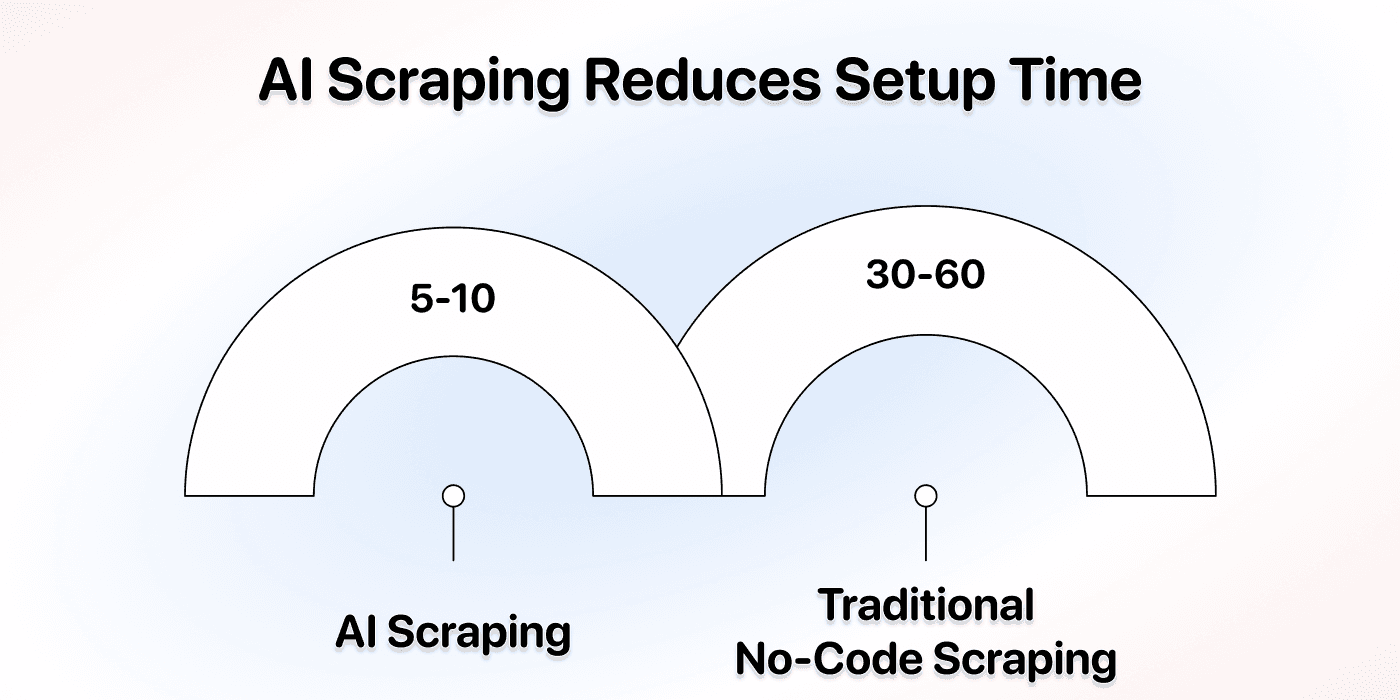
Det, der tog flere timer med click-and-point-værktøjer, tager nu få minutter med AI scraping. Denne hastighedsfordel er reel og målbar.
Hypen og de overdrevne løfter
1. Påstande om, at "AI løser alt"
Nogle værktøjer markedsfører AI, som om teknologien på magisk vis kan scrape ethvert website perfekt uden nogen form for konfiguration. Virkeligheden er, at AI scraping stadig kræver klare instruktioner og indimellem skal finjusteres – men det er stadig langt bedre end de tidligere muligheder.
2. "Ingen teknisk viden nødvendig" fra API-baserede værktøjer
Nogle værktøjer kalder sig "no-code", selvom de kræver API-konfiguration. Hvis du skal forstå API-kald, request parameters og response handling, har du brug for teknisk viden.
I mine øjne er det ren hype at kalde API-scrapers for "no-code". Ja, API'er er nemmere end Python, men de er ikke ægte no-code.
3. "Erstatter alle andre scraping-metoder"
Til visse use cases er traditionelle scrapers stadig mere velegnede. Hvis du scraper ét website, som du ved ikke bliver ændret – eksempelvis et offentligt website – og har brug for fuldstændig ensartethed, kan en korrekt konfigureret traditionel scraper være bedre.
Hvornår kan AI scraping betale sig?
AI scraping skaber størst værdi, når:
- Du scraper flere websites med forskellige strukturer
- Websites ændrer sig ofte, og du vil minimere vedligeholdelsen
- Du er ikke-teknisk og har brug for lettilgængeligt dataudtræk
- Hastighed er vigtig, og du ikke kan bruge timevis på at konfigurere scrapers
- Du har brug for fleksibilitet til nemt at ændre, hvilke data du udtrækker
Hvornår virker traditionelle metoder stadig?
Traditionel scraping giver mening, når:
- Du scraper ét website, som sjældent ændrer sig
- Du har brug for fuldstændig ensartethed i måden, data udtrækkes på
- Budgettet er ekstremt stramt – nogle traditionelle værktøjer er billigere
- Du har specifikke tekniske krav, som AI ikke kan håndtere
Den endelige konklusion
AI web scraping er ikke bare hype. Teknologien løser reelle problemer, der har plaget web scraping i årtier. Alene den reducerede vedligeholdelse gør den relevant til de fleste use cases.
Men det er heller ikke magi. Teknologien kan ikke scrape ethvert website perfekt uden konfiguration, den kan ikke læse dine tanker og vide præcis, hvilke data du skal bruge, og den fjerner ikke alle udfordringer ved dataudtræk.
Det kan den til gengæld: Gøre web scraping 5-10 gange hurtigere og nemmere til langt de fleste use cases og samtidig reducere den løbende vedligeholdelse med 80-90 %.
Dit næste kloge træk: Begynd med AI web scraping til nye projekter. Hvis du støder på begrænsninger, kan du altid falde tilbage på traditionelle metoder. Men de fleste vender aldrig tilbage.
Ofte stillede spørgsmål om AI web scraping
Hvad er AI web scraping?
AI web scraping er en metode, hvor AI-modeller bruges til at udtrække data fra websites. I modsætning til traditionelle scrapers, som følger faste regler og bryder sammen, når websites ændrer sig, forstår AI scrapers kontekst og intention. Derfor kan de automatisk tilpasse sig ændringer på websites og håndtere variationer i sidestrukturen uden manuel omkonfiguration.
Er AI scraping og AI web scraping det samme?
Ja, AI scraping og AI web scraping dækker over det samme koncept. Begreberne bruges i flæng sammen med varianter som "AI data scraping" og "intelligent web scraping". De beskriver alle brugen af AI til at udtrække data fra internettet ved at forstå konteksten frem for blot at følge faste regler.
Er AI web scraping bedre end traditionel no-code scraping?
Ja, til de fleste use cases er AI web scraping bedre end traditionel no-code scraping. AI scraping kræver 80-90 % mindre vedligeholdelse, tilpasser sig automatisk ændringer på websites og er reelt nemmere for ikke-tekniske brugere. Traditionelle click-and-point-værktøjer kræver stadig forståelse for websitestrukturer og bryder ofte sammen, når et website bliver opdateret.
Kan AI web scrapers håndtere websites med meget JavaScript?
Ja, gode AI web scraping-værktøjer kan håndtere websites med meget JavaScript. Værktøjer som Datablist giver mulighed for at rendre JavaScript før dataudtrækket, så de kan scrape moderne, dynamiske websites, der først indlæser indhold efter den oprindelige sideindlæsning. Funktionen er afgørende, fordi over 70 % af moderne websites bruger JavaScript til at vise indhold.
Hvor præcis er AI web scraping?
Præcisionen afhænger af websitet, det tilgængelige indhold, outputfelterne og din prompt. Før du kører en batch, bør du sammenligne et udsnit med kildesiderne og kontrollere manglende poster, navne, priser, enheder og kilde-URL'er. Medtag sider med forskellige layouts og tomme felter. Bed værktøjet om at lade utilgængelige værdier stå tomme i stedet for at gætte, og gentag kontrollen, når websitet eller din prompt ændrer sig. En confidence score kan være nyttig, men erstatter ikke kontrol mod kilden.
Hvad er forskellen på AI web scraping og traditionel web scraping?
Traditionel web scraping bruger faste regler som CSS-selectors eller XPath til at finde bestemte HTML-elementer. Når et website ændrer sin kodestruktur, bryder traditionelle scrapers helt sammen. AI web scraping forstår dataenes betydning og kontekst og kan derfor finde information, selvom layoutet ændres. Tænk på det som forskellen mellem at følge et kort med præcise koordinater – den traditionelle metode – og at spørge om vej til "kaffebaren" – AI-metoden.
Er AI web scraping lovligt?
Det er som udgangspunkt lovligt at scrape offentligt tilgængelige data i de fleste jurisdiktioner. Du bør dog respektere websites' servicevilkår, undgå at scrape personoplysninger eller ophavsretligt beskyttet materiale og sørge for ikke at overbelaste servere. Lovligheden kan variere efter jurisdiktion og den konkrete use case. AI web scraping følger de samme juridiske principper som traditionel scraping. Teknologien er anderledes, men de juridiske hensyn er de samme.
Hvilket AI web scraping-værktøj skal jeg vælge?
For ikke-tekniske brugere, der ønsker ægte no-code scraping med instruktioner i almindeligt sprog, er Datablist det bedste valg til 25 USD om måneden. Til udviklere, der bygger AI-applikationer, tilbyder Firecrawl LLM-klart output fra 19 USD om måneden.