
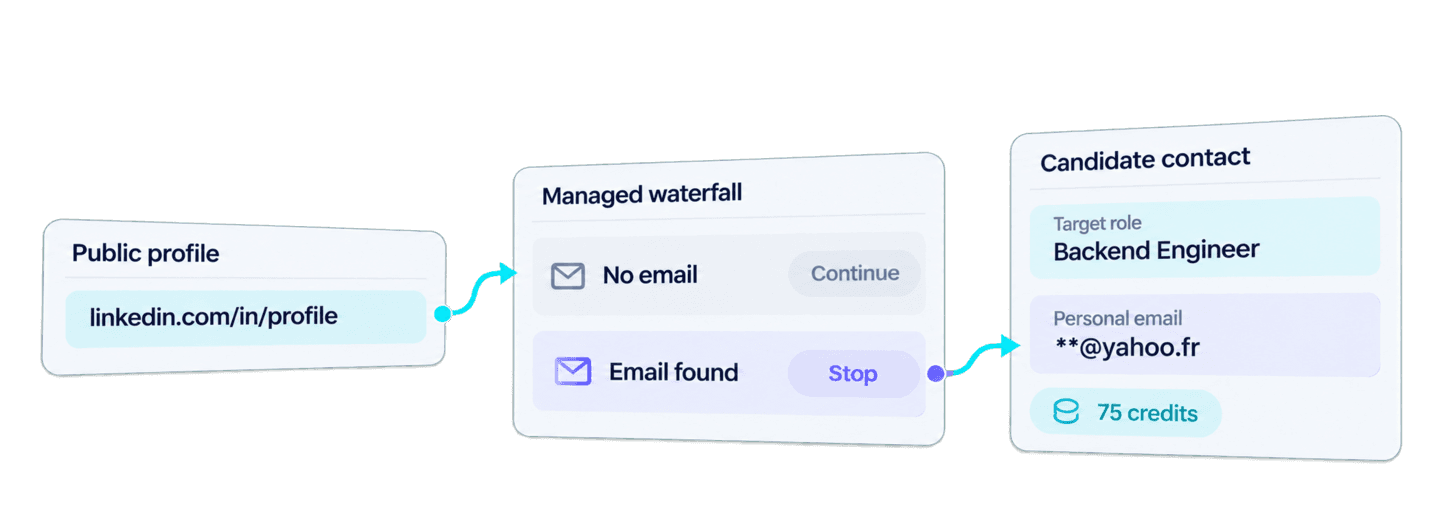
Du kan finde private e-mails fra LinkedIn med Python ved at sende offentlige linkedin.com/in/...-profil-URL'er til Datablists Waterfall Personal Email Finder API. API'et kører en administreret sekvens af relevante e-mailudbydere og returnerer en privat adresse, når en af dem finder et resultat.
Det komplette Requests-eksempel nedenfor opretter én baggrundsopgave, venter på, at den bliver færdig, og henter alle resultatsider. Når opslaget virker, kan du genbruge de returnerede objekter til at oprette kontaktposter til rekruttering, hvor kandidatens navn, LinkedIn-URL og målrolle gemmes sammen med den fundne e-mail.
Dette workflow leder efter en privat e-mailadresse, der er uafhængig af kandidatens nuværende arbejdsgiver. Har du i stedet brug for en adresse, der er knyttet til personens virksomhed, kan du følge den separate guide til at finde en arbejdsmail fra en LinkedIn-profil.
🔑 Kort fortalt
Angiv kandidaternes navne, offentlige LinkedIn-profil-URL'er og målroller. Python-workflowet finder tilgængelige private e-mails og gemmer hver adresse sammen med de rekrutteringsoplysninger, du begyndte med.
- Input: Kandidatnavne, offentlige
linkedin.com/in/...-profil-URL'er og målroller.- Output: Fundne private e-mails gemt sammen med de tilhørende kandidatoplysninger.
💡 Foretrækker du en no-code-løsning? Brug Datablists Waterfall Personal Email Finder til at finde private e-mails uden at skrive kode.
Hvis dine kildedata indeholder navne, men ingen profil-URL'er, skal du først finde offentlige LinkedIn-profiler med Python og derefter sende URL'erne til dette API.
Opsæt Python, Requests og din Datablist API-nøgle
I dette eksempel bruger jeg Python med pakken requests. Opret en fil med navnet find_personal_emails.py, og installer derefter Requests:
python -m pip install requestsOpret en Personal API Key på din Datablist-konto, og eksportér den som en miljøvariabel:
export DATABLIST_API_KEY='your-api-key'Adgang til REST API'et er inkluderet i Growth-abonnementet. Et vellykket resultat med en privat e-mail bruger også credits, som jeg beregner i afsnittet om omkostninger nedenfor.
Find en privat e-mail med én Python-funktion
Listen candidates, som kan redigeres i scriptet, indeholder én rekrutteringspost. target_role er et eksempel på en kildeværdi, der forbliver lokal i rekrutteringsworkflowet. Kun candidate_id og linkedin_url sendes med i API-payloaden.
import json
import os
import time
import uuid
import requests
def find_personal_emails(candidates, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": candidate["candidate_id"],
"data": {"profileUrl": candidate["linkedin_url"]},
}
for candidate in candidates
]
unique_id = str(uuid.uuid4())
print(f"Recovery uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-personal-email-finder",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(f"Task {task_id} {task['status']}: {task.get('error')}")
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
candidates = [
{
"candidate_id": "candidate-florian-poullin",
"name": "Florian Poullin",
"linkedin_url": "https://www.linkedin.com/in/florianpoullin/",
"target_role": "Backend Engineer",
}
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
personal_email_results = find_personal_emails(candidates, api_key)
for result in personal_email_results:
print(json.dumps(result, indent=2))Kør filen fra den samme terminal:
python find_personal_emails.pyDu kan også downloade det vedligeholdte synkrone Requests-eksempel. Scriptet ovenfor følger den samme sekvens med oprettelse, polling og paginering, men bruger kandidat-id'er fra kildeposterne.
Send opslaget
Funktionen omdanner hver kandidat til et API-input. inputId får kandidatens stabile id, mens data.profileUrl får URL'en til personens offentlige LinkedIn-profil. Der kræves en almindelig linkedin.com/in/...-URL. Sales Navigator-URL'er, virksomhedssider, tomme værdier og navne uden profil-URL'er er ikke gyldige input til denne enrichment.
Requesten bruger waterfall-personal-email-finder som enrichmentId og et tomt settings-objekt som vist i API-dokumentationen til Waterfall Personal Email Finder. Scriptet viser det genererede uniqueId, før opgaven sendes. Gem værdien, da den gør det muligt at identificere en eksisterende opgave, hvis forbindelsen afbrydes, efter at API'et har accepteret requesten.
Her er den komplette request body til eksemplet med én profil:
{
  "enrichmentId": "waterfall-personal-email-finder",
  "uniqueId": "55001d29-4fb9-4fe2-9497-80f4b346eed7",
  "settings": {},
  "inputs": [
    {
      "inputId": "candidate-florian-poullin",
      "data": {
        "profileUrl": "https://www.linkedin.com/in/florianpoullin/"
      }
    }
  ]
}
En vellykket indsendelse returnerer HTTP 202 Accepted med opgavens id i @id. Behandlingen fortsætter på Datablists servere efter dette svar.
Vent på baggrundsopgaven
Requests-scriptet blokerer lokalt, mens serveren kører baggrundsopgaven. Det kontrollerer opgaven hvert tredje sekund og fortsætter, så længe status er queued eller running. Når opgaven har statussen completed, går scriptet videre til at hente resultaterne. En opgave med statussen failed eller stopped udløser en fejl med opgave-id'et og den tilgængelige fejlmeddelelse.
Hent alle resultatsider
Resultatendpointet returnerer hver rækkes kilde-id, status, outputs, credits og fejl. Den første request beder om op til 100 resultater. Den henter næste side, indtil nextCursor er null.
Opgaveresultaterne bevarer inputrækkefølgen. inputId giver fortsat hvert resultat en entydig forbindelse til kandidatposten, også på tværs af flere resultatsider.
Når du tilpasser eksemplet til flere poster, skal hvert candidate_id forblive stabilt i kildesystemet. Denne værdi gør det nemt og forudsigeligt at sammenkæde data, når opgaven har flere resultatsider.
Sådan finder Waterfall en privat e-mail
Datablist renser den indsendte offentlige LinkedIn-profil-URL og sender den uafklarede profil gennem de aktuelt relevante udbydere af private e-mails én efter én. Hvis en udbyder ikke returnerer en brugbar adresse, kan profilen fortsætte til den næste relevante udbyder. Når en udbyder finder en brugbar e-mail, stopper sekvensen for den pågældende profil og returnerer adressen som outputs.emailFound.
Datablist administrerer de relevante udbydere, så din integration ikke behøver udbyderspecifikke requests eller fallback-kode. Det offentlige resultat viser e-mailresultatet frem for en fast rækkefølge af udbydere eller en historik over forsøg.
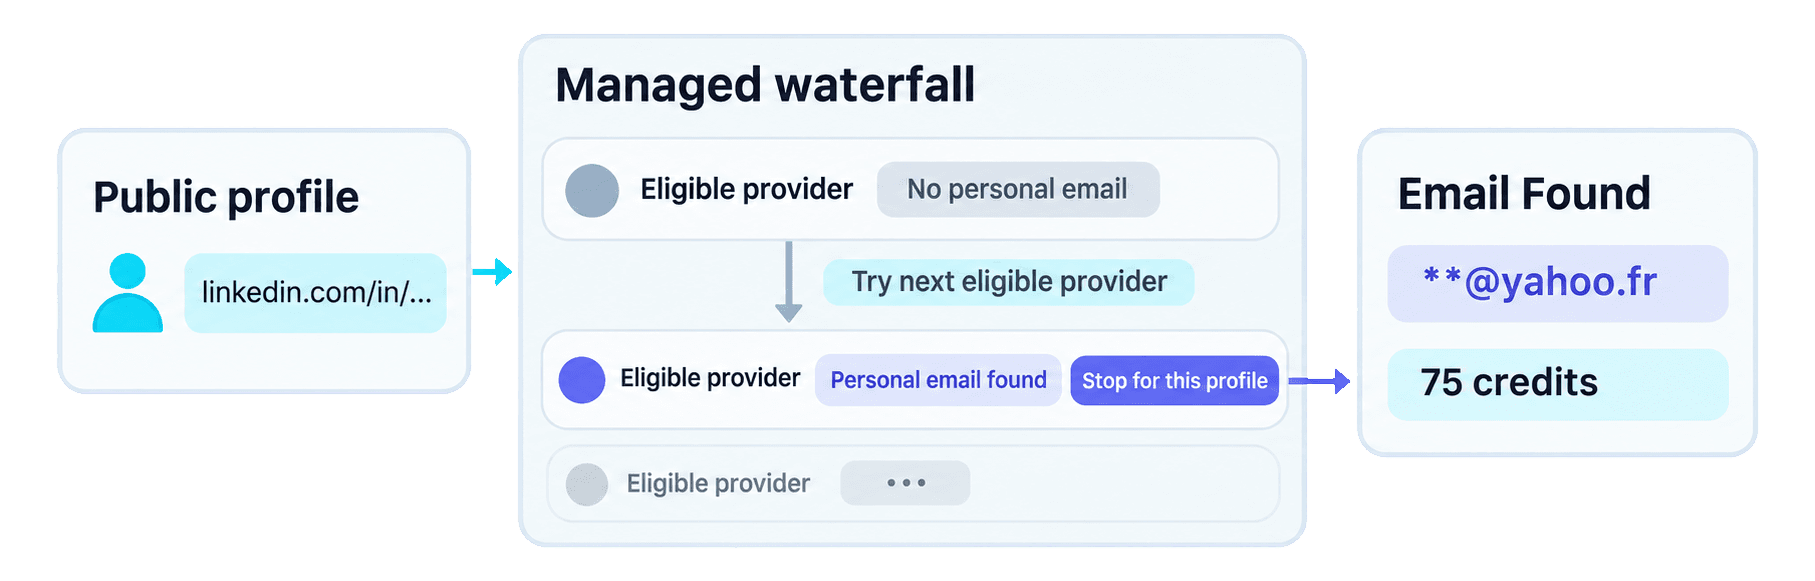
Waterfall er selve opslagsmetoden. Polling har en anden funktion: Det lader Python-klienten vente på, at baggrundsarbejdet bliver færdigt.
Derfor hjælper Waterfall internationale rekrutteringsteams
Udbydere af private e-mails bruger forskellige datasæt, og deres styrker varierer derfor fra land til land og marked til marked. Hvis den første udbyder ikke har en e-mail til en kandidat, kan en anden udbyder i Waterfall-sekvensen måske finde en.
Rekrutteringsteams, der arbejder på tværs af flere lande, får en bredere dækning af udbydere gennem én API-integration. Datablist administrerer sekvensen, så teamet kan finde kontaktoplysninger, som et opslag hos en enkelt udbyder måske ville overse, uden at skulle forbinde og vedligeholde flere udbyder-API'er.
Læs hele resultatet
📘 Maskeret e-mail: Den lokale del af adressen er erstattet med
**nedenfor. Dit API-resultat indeholder den fulde værdi.
Her er hele resultatsiden for kandidatinputtet:
{
  "taskId": "b5de73ffaa3f4f349c125d7c85125bb4",
  "results": [
    {
      "inputId": "candidate-florian-poullin",
      "status": "success",
      "outputs": {
        "emailFound": "**@yahoo.fr"
      },
      "creditsUsed": "75",
      "error": null
    }
  ],
  "nextCursor": null
}
inputId er den nøgle, der forbinder resultatet med kandidaten i kildedataene. outputs.emailFound indeholder den private adresse. creditsUsed er den autoritative pris for rækken, og error: null betyder, at API'et ikke returnerede en fejl på rækkeniveau. Den tomme cursor bekræfter, at svaret ikke har flere resultatsider.
Betragt adressen som en mulig kontaktkanal, der er knyttet til den indsendte profil, og gennemgå den, før du bruger den til rekruttering.
Klargør kandidatkontakter til recruiterens gennemgang
Når opslaget er færdigt, kan du oprette en lokal liste, som recruiteren kan gennemgå, uden endnu en API-request. Følgende blok genbruger de eksisterende variabler candidates og personal_email_results:
results_by_id = {
result["inputId"]: result for result in personal_email_results
}
prepared_contacts = []
for candidate in candidates:
result = results_by_id.get(candidate["candidate_id"])
if not result or result.get("status") != "success":
continue
email_found = result.get("outputs", {}).get("emailFound")
if not email_found:
continue
prepared_contact = candidate.copy()
prepared_contact["result"] = result
prepared_contacts.append(prepared_contact)
print(json.dumps(prepared_contacts, indent=2))For candidate-florian-poullin finder opslaget i dictionary'en resultatet med det samme inputId. Den kopierede post beholder Florian Poullins navn, LinkedIn-URL og målrollen Backend Engineer fra eksemplet. Derefter tilføjes hele API-objektet under result, hvor recruiteren kan aflæse result.outputs.emailFound.
Loopet tager udgangspunkt i kandidatlisten fra kilden. Et fremtidigt manglende resultat, en rækkefejl, et manglende resultatsvar eller et tomt emailFound ændrer ikke kildelisten og bliver ikke føjet til prepared_contacts.
Hvis du vil have en bredere proces til gennemgang og flere kontaktkanaler, kan du læse guiden til at finde en kandidats e-mailadresse som recruiter.
Beregn prisen på Waterfall Personal Email Finder API
Hver fundet privat e-mail koster 75 credits. Et opslag uden resultat koster 0 credits. Når du skal beregne det faktiske forbrug, bør du aflæse creditsUsed for hvert resultat i stedet for at gange det samlede antal indsendte profiler.
Formlen til budgetlægning er:
fundne private e-mails × 75 credits
Hvis du eksempelvis indsender 100 profiler, og 20 af dem giver en privat e-mail, bruger opgaven 20 × 75 = 1.500 credits. Det er et regneeksempel til planlægning, ikke en forventet hitrate. Ved større budgetter koster 100 fundne e-mails 7.500 credits, mens 1.000 fundne e-mails koster 75.000 credits.
Med den aktuelle grundpris for optankning i USD svarer $20 / 20.000 credits = $0,001 pr. credit. Én fundet e-mail bruger derfor credits til en værdi af $0,075, mens 100 fundne e-mails bruger credits til en værdi af $7,50. Estimatet viser værdien af de anvendte credits. Growth-abonnementet, som kræves for adgang til REST API'et, afregnes separat. Se Datablists priser for aktuelle abonnementer og credit-pakker.
Løs typiske fejl, og gendan en eksisterende opgave
De fleste problemer opstår før indsendelsen, i HTTP-requesten eller i et enkelt resultat. Brug fejlens placering til at vælge den næste handling:
- Manglende
DATABLIST_API_KEY: Scriptet stopper lokalt, før det sender en request. Eksportér miljøvariablen, og kør derefter filen igen. - Fejl i HTTP-godkendelsen: Kontrollér din Personal API Key i
DATABLIST_API_KEY. Funktionen sender den i headerenX-API-Key. Ret adgangsoplysningerne, før du sender opgaven igen. - Profil-URL'en understøttes ikke: Erstat en Sales Navigator-URL, virksomhedsside, tom værdi eller ugyldig URL med en offentlig personprofil i formatet
linkedin.com/in/.... - For få credits: Kontrollér kontoens saldo og tilgængelige credits, før du indsender flere opgaver.
- Opgaven har statussen
failedellerstopped: Undersøg opgavefejlen, de tilgængelige resultater og credit-forbruget, før du beslutter, hvad der stadig skal køres. - En række har intet resultat eller en fejl: Behold kandidaten fra kildedataene til gennemgang eller en anden kontaktkanal. Et mislykket opslag forklarer ikke, hvorfor en adresse ikke var tilgængelig.
Hvis POST-svaret går tabt, skal du hente en liste over dine opgaver, før du opretter en ny. Søg i svaret efter det uniqueId, som scriptet viste, og kopiér derefter den matchende opgaves @id:
curl "https://api.datablist.com/v1/enrichments/tasks?enrichmentId=waterfall-personal-email-finder&limit=100" \
--header "X-API-Key: $DATABLIST_API_KEY"
TASK_ID='paste-matching-task-id'
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID" \
--header "X-API-Key: $DATABLIST_API_KEY"
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID/results" \
--header "X-API-Key: $DATABLIST_API_KEY"Hvis den matchende opgave ikke findes i det første svar fra opgavehistorikken, skal du følge den returnerede pagineringscursor og kontrollere næste side. Fortsæt med at kontrollere den gendannede opgave, eller hent dens tilgængelige resultater, i stedet for automatisk at oprette endnu en betalt opgave. Dokumentationen om opgaver beskriver livscyklus, paginering og opbevaring af resultater.
Næste skridt
Du har nu én genanvendelig Python Requests-funktion til offentlige LinkedIn-profil-URL'er samt en sammenkædning via stabile id'er, der kombinerer fundne private e-mails med hver kandidats oprindelige kontekst.
Erstat kandidatlisten i eksemplet med et lille udvalg af dine egne kandidatposter, behold et stabilt id og en målrolle på hver post, og gennemgå alle klargjorte kontakter, før du bruger dem i din rekrutteringsproces. Når din applikation har brug for non-blocking concurrency, kan du bruge det vedligeholdte async HTTPX-eksempel som næste trin i implementeringen.