Lo stack tecnologico di un’azienda rivela la sua propensione all’acquisto meglio di quasi qualsiasi altro dato. Un’azienda che ha appena adottato un data warehouse avrà presto bisogno di strumenti che vi si integrino. Se invece utilizza tre app di project management sovrapposte, è probabile che qualcuno sia insoddisfatto e stia cercando un’alternativa.
Il targeting tecnografico trasforma questi segnali in un metodo replicabile per trovare e classificare gli account, senza affidarsi soltanto a ipotesi basate sui dati firmografici.
In questo articolo vedremo cosa sono i dati tecnografici, dove reperirli, come costruire un modello di scoring e quali errori fanno perdere tempo prezioso ai team Sales.
📌 Riepilogo per chi va di fretta
Cosa troverai nell’articolo: il targeting tecnografico utilizza lo stack tecnologico di un’azienda — CRM, strumenti di marketing e infrastruttura — per individuare e classificare gli account più pronti all’acquisto.
Punti chiave:
- I dati sullo stack rivelano una propensione all’acquisto che dati firmografici e intent data, da soli, non riescono a cogliere.
- Nessuna fonte copre l’intero stack: scanner di siti web, annunci di lavoro e database di vendor colmano lacune diverse.
- Un semplice modello di scoring a punti trasforma le tecnologie rilevate in una lista di account ordinata e subito utilizzabile.
In sintesi: i team che ottengono i risultati migliori dal targeting tecnografico mantengono i dati puliti e aggiornati, applicando criteri di scoring coerenti.
Cos’è davvero il targeting tecnografico
I dati tecnografici descrivono i software, le piattaforme e l’infrastruttura utilizzati da un’azienda: CRM, marketing automation, sistemi di pagamento, strumenti di analytics, CDN, piattaforme e-commerce e molte altre categorie.
Il targeting tecnografico utilizza i dati sullo stack per decidere a chi vendere e con quale priorità. Si affianca agli altri due pilastri della prioritizzazione account-based:
- Dati firmografici: settore, numero di dipendenti, fatturato
- Intent data: download di contenuti, visite al sito web
- Dati tecnografici: gli strumenti utilizzati dietro le quinte
La differenza sta nel livello di precisione. I dati firmografici descrivono il profilo di un’azienda. Gli intent data ne mostrano l’interesse. I dati tecnografici ne descrivono l’ambiente operativo reale, avvicinandoti molto di più a un problema concreto che il tuo prodotto può risolvere.
Perché il tech stack supera i soli dati firmografici
I dati firmografici indicano chi potrebbe acquistare
Un filtro come “aziende SaaS, 50–500 dipendenti, Nord America” restituisce un ampio bacino di potenziali clienti. Non rivela però quali di queste aziende abbiano davvero il problema risolto dal tuo prodotto.
Due aziende possono avere dati firmografici identici e trovarsi in situazioni d’acquisto completamente diverse. Una dispone già di una soluzione matura. L’altra cerca di svolgere lo stesso lavoro combinando fogli di calcolo e un collaboratore part-time.
Ecco perché le liste basate soltanto sui dati firmografici tendono ad appiattire i tassi di risposta. Chi lavora su una lista di “aziende SaaS con 50–500 dipendenti” non può avviare la conversazione in modo diverso con chi ha già risolto il problema e con chi, invece, lo sta affrontando proprio adesso. La lista non contiene segnali utili per distinguere i due casi. Ogni account riceve lo stesso messaggio iniziale generico.
I dati tecnografici indicano chi è pronto ora
I dati sullo stack colmano questa lacuna. Se vendi un plugin per Shopify, sapere che un’azienda utilizza Shopify Plus anziché BigCommerce è un requisito determinante, non un’informazione accessoria. Se il tuo strumento si integra con Snowflake, un’azienda che ha adottato Snowflake nell’ultimo trimestre è un account molto più caldo rispetto a una che utilizza ancora un data warehouse on-premise.
I dati tecnografici fanno emergere anche opportunità di sostituzione dei competitor. Un’azienda che usa uno strumento legacy nella tua categoria, soprattutto se non riceve più aggiornamenti importanti, è una potenziale candidata al cambiamento e non soltanto a un primo acquisto.
Da dove provengono davvero i dati tecnografici
Non esiste un’unica fonte attendibile per l’intero stack di un’azienda. Un approccio solido combina alcune delle seguenti fonti:
- Strumenti di scansione dei siti web (BuiltWith, Wappalyzer): rilevano tecnologie front-end come pixel di analytics, CDN, piattaforme CMS e widget di pagamento analizzando il codice pubblico di un sito
- Dati dichiarati dai vendor (HG Insights, G2, Datanyze): aggregati da strumenti di IT asset management, partnership con vendor e recensioni degli utenti
- Annunci di lavoro: una ricerca per “amministratore Salesforce” o “data engineer Snowflake” è un segnale diretto e attuale delle tecnologie utilizzate da un’azienda e, spesso, di quelle su cui sta investendo
- Record DNS e SSL: rivelano provider di hosting, infrastruttura email e fornitori di soluzioni per la sicurezza
- Case study e comunicati stampa: i vendor pubblicano i loghi dei propri clienti; è una fonte affidabile, anche se incompleta
- Forum di assistenza e community: quando cercano pubblicamente una soluzione a un problema, gli sviluppatori citano spesso il proprio stack esatto
Nessuna fonte copre tutto. Gli scanner dei siti web non rilevano gli strumenti interni che non interagiscono mai con il front-end, come CRM o data warehouse. Gli annunci di lavoro possono arrivare dopo l’effettiva adozione. Combinare due o tre fonti offre una copertura nettamente superiore rispetto all’uso di una sola.
Copertura e aggiornamento sono problemi diversi
È utile distinguere due domande che spesso vengono confuse: una fonte è in grado di rilevare uno strumento? E quanto è recente il dato una volta rilevato?
Gli scanner dei siti web sono in genere aggiornati — possono eseguire una nuova scansione ogni settimana — ma poco profondi, perché vedono soltanto ciò che è esposto nel codice pubblico. Gran parte dei software di back office resta quindi esclusa. I database alimentati dai vendor vanno più in profondità e spesso rilevano strumenti interni come CRM e data warehouse, ma vengono aggiornati più lentamente, talvolta ogni trimestre. Questi dati provengono infatti da integrazioni con partner o sondaggi periodici, non da scansioni in tempo reale.
La conclusione pratica è semplice: usa fonti rapide ma superficiali per intercettare segnali legati al timing, come un nuovo pixel o una nuova CDN installati questo mese, e fonti più lente ma approfondite per definire lo stack di base. Nessuna delle due, da sola, offre un quadro accurato e aggiornato.
Come creare un framework di segnali tecnografici
I dati grezzi sullo stack sono soltanto un elenco di strumenti finché non li organizzi in segnali sui quali puoi agire.
Segnali per categoria o per strumento specifico
Per prima cosa, stabilisci se ti interessa la categoria o il vendor specifico. Se il tuo strumento si collega a “qualsiasi CRM”, è sufficiente rilevare la categoria, cioè sapere che l’azienda dispone di un CRM. Se invece l’integrazione funziona soltanto con HubSpot, devi identificare il vendor esatto.
I segnali a livello di categoria coprono un bacino più ampio e sono più facili da rilevare con affidabilità. Quelli legati a un vendor specifico sono più precisi, ma richiedono dati più puliti: classificare in modo errato il CRM di un’azienda comprometterebbe la qualità della lista senza che sia immediatamente evidente.
Le lacune nello stack come opportunità
Una lacuna può essere preziosa quanto una corrispondenza. Se vendi una soluzione di data enrichment e un’azienda ha un CRM e una piattaforma di marketing automation, ma nessuno strumento di enrichment, quella lacuna diventa il fulcro della proposta commerciale. Crea una logica di rilevamento del tipo “ha X e Y, ma non Z”, invece di cercare soltanto corrispondenze positive.
I cambiamenti dello stack nel tempo
Una fotografia dello stack aziendale è utile. La cronologia dei cambiamenti lo è ancora di più. Gli strumenti che monitorano installazioni e rimozioni nel tempo permettono di segnalare:
- Nuove adozioni: si è appena aperta una finestra d’acquisto
- Rimozioni di strumenti: un segnale di churn o insoddisfazione, potenzialmente legato a un competitor
- Più strumenti simultanei nella stessa categoria: probabile valutazione o migrazione in corso
I segnali basati sui cambiamenti superano regolarmente quelli statici nel determinare il momento giusto per l’outreach, perché indicano una fase precisa in cui il team sta già prendendo decisioni.
Scoring e prioritizzazione degli account per tech stack
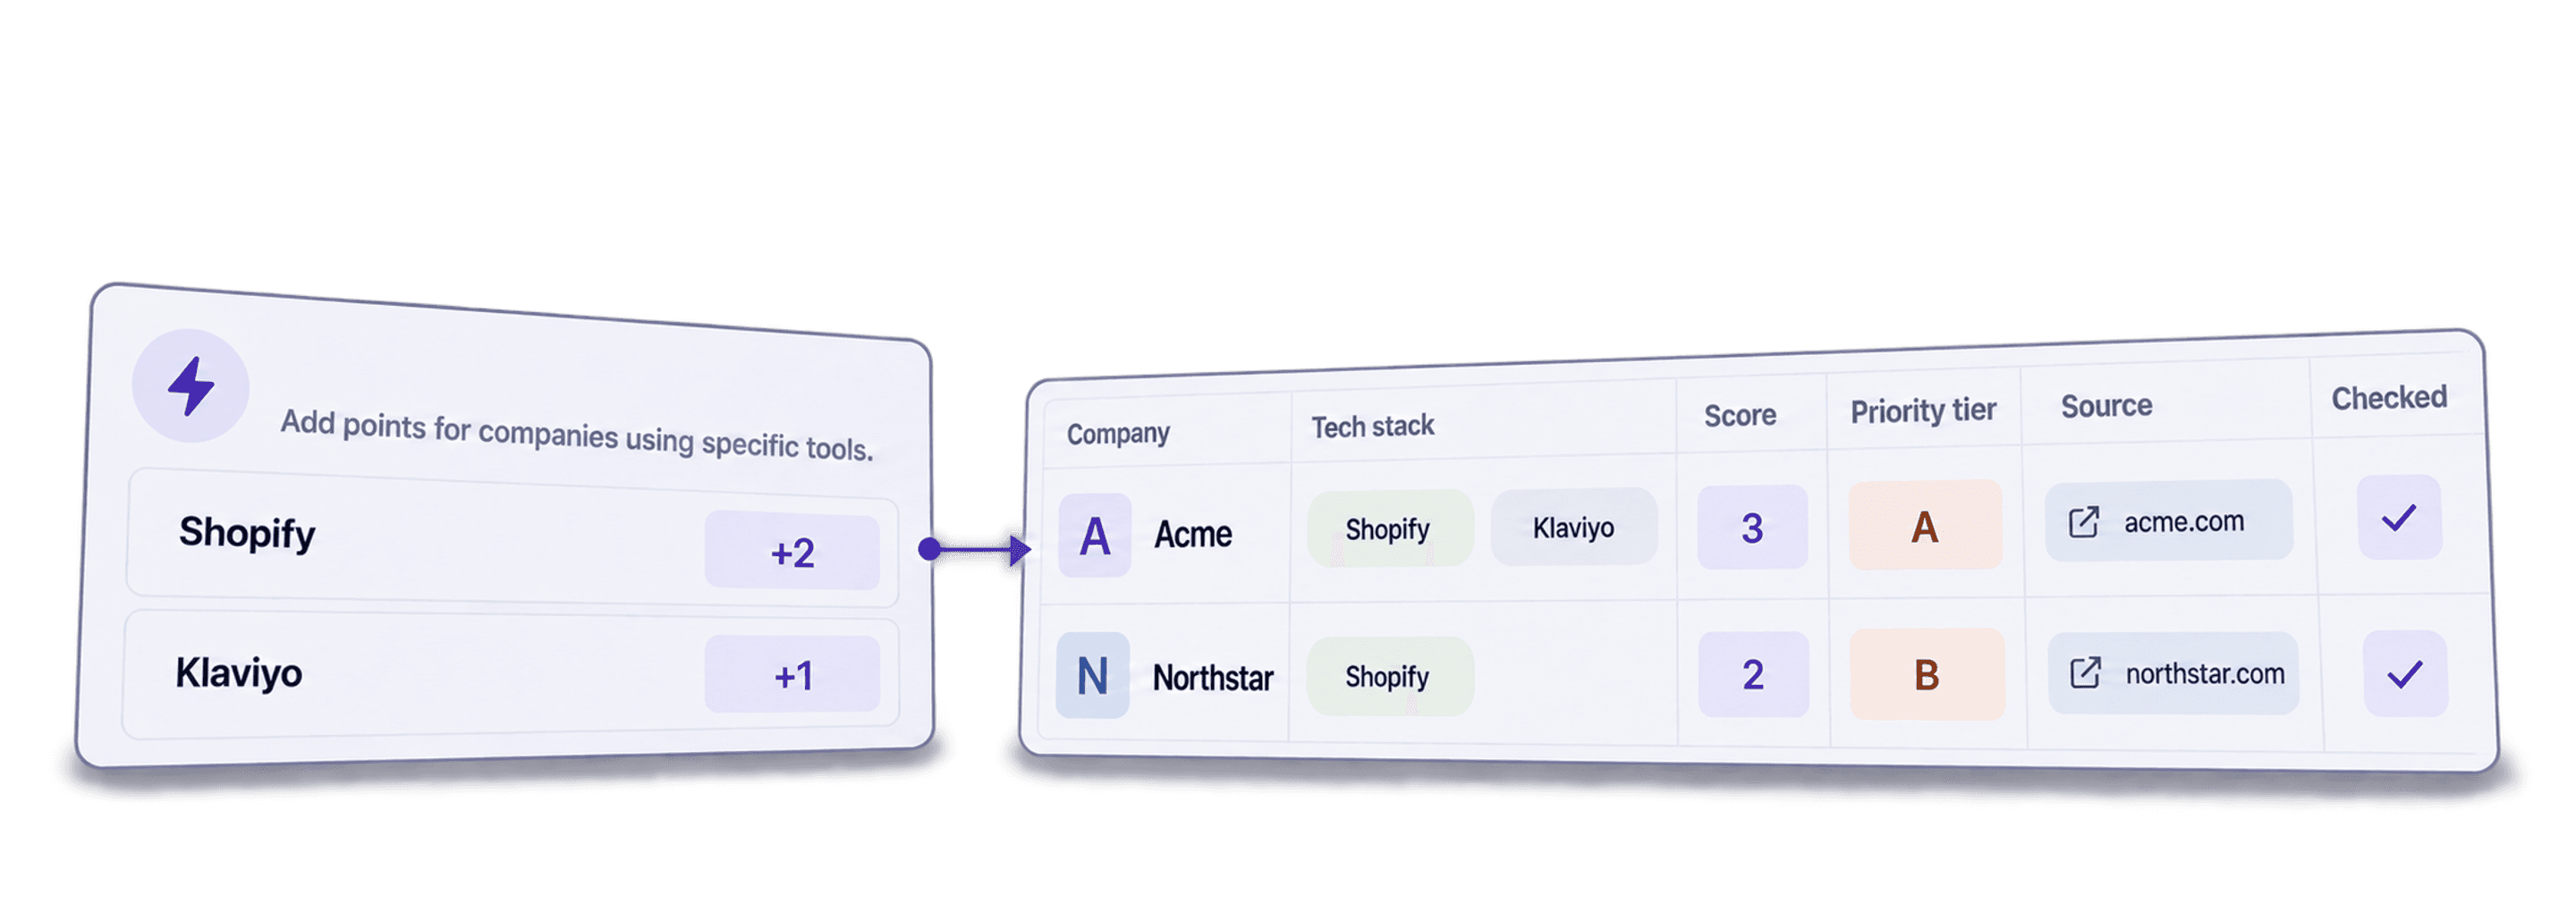
Una volta raccolti i segnali, trasformali in una lista ordinata anziché lasciarli in un elenco piatto. Un semplice modello a punti funziona bene:
- +30: utilizza uno strumento con cui il tuo prodotto si integra direttamente
- +20: utilizza un competitor con debolezze note in un’area specifica
- +15: presenta una lacuna di categoria coerente con il tuo caso d’uso principale
- +10: ha aggiunto o rimosso di recente uno strumento rilevante, negli ultimi 90 giorni
- +10: un annuncio di lavoro menziona un ruolo legato alla categoria del tuo prodotto
- 15: utilizza uno strumento che rende superfluo il tuo prodotto
Pesare i segnali in base alla forza dell’intento
Non tutti i segnali meritano lo stesso peso. Un annuncio di lavoro guarda al futuro — l’azienda prevede di inserire una persona in quel ruolo — mentre uno strumento installato descrive una situazione già esistente. Se il tuo ciclo di vendita è breve, assegna più peso agli strumenti attivi e installati. Se fai account planning sul lungo periodo, dai maggiore importanza agli annunci.
Integrare dati tecnografici, firmografici e comportamentali
I dati tecnografici funzionano meglio come livello aggiuntivo, non come filtro isolato. Un modello pratico combina tre input:
- La compatibilità firmografica — settore, dimensioni e area geografica — definisce il bacino idoneo.
- Il punteggio tecnografico ordina quel bacino in base alla propensione all’acquisto indicata dallo stack.
- Gli intent data — visite e download — risolvono i casi di parità e segnalano chi sta svolgendo ricerche attive.
Gli account con un punteggio elevato in tutte e tre le aree appartengono alla fascia prioritaria. Quelli con un’ottima compatibilità tecnografica ma ancora nessun engagement restano adatti all’Outbound. Richiedono semplicemente un approccio diverso rispetto a chi ha già visitato la pagina dei prezzi.
Questa suddivisione in fasce determina anche il canale e il messaggio, non soltanto l’ordine di priorità. Un account con elevata compatibilità firmografica e tecnografica, ma basso engagement, è adatto a un cold email preciso che faccia riferimento allo stack: hai abbastanza contesto per essere specifico senza aspettare che mostri interesse. Un account con engagement elevato ma scarsa compatibilità tecnografica potrebbe invece non meritare alcun contatto commerciale: forse sta soltanto conducendo un’analisi dei competitor o scrivendo un articolo che cita casualmente la tua categoria.
Errori comuni nel targeting tecnografico
- Considerare un rilevamento come una certezza. Gli scanner producono falsi positivi e falsi negativi. Uno strumento rilevato sei mesi fa potrebbe non essere più in uso. Aggiorna regolarmente i dati e considera le rilevazioni provenienti da un’unica fonte come ipotesi, non come fatti.
- Affidarsi troppo a un solo provider. La copertura varia in base al settore e alle dimensioni aziendali. Un provider efficace per il SaaS enterprise potrebbe esserlo molto meno per l’e-commerce mid-market.
- Ignorare i segnali negativi. I team creano liste di target ma trascurano un elenco altrettanto utile: gli account da de-prioritizzare perché utilizzano già uno strumento che rende superfluo il tuo.
- Attribuire lo stesso punteggio a tutte le integrazioni. Un’azienda che utilizza il tuo principale integration partner è più promettente di una che usa un partner associato raramente a una conversione.
- Lasciare invecchiare le liste. I dati sullo stack cambiano continuamente. Un aggiornamento almeno trimestrale evita che i punteggi perdano attendibilità.
- Trascurare il “perché” dietro uno strumento rilevato. Nella maggior parte delle piattaforme, un account di prova usato per una valutazione appare identico a un’implementazione aziendale in produzione. Prima di considerare confermate le rilevazioni di maggior valore, verificale con un secondo segnale, come un annuncio di lavoro o un case study.
Workflow per creare una lista di target tecnografici
- Definisci l’insieme dei segnali. Elenca gli strumenti, le categorie e le combinazioni rilevanti in base agli stack effettivi dei tuoi migliori clienti attuali.
- Raccogli dati grezzi da almeno due fonti, includendo sia segnali front-end, come la scansione dei siti web, sia back-end, come annunci di lavoro e dati dei vendor.
- Pulisci e standardizza i nomi dei vendor. Senza una normalizzazione preliminare, i dati grezzi possono riportare “Salesforce”, “Salesforce.com” e “Salesforce CRM” come tre voci distinte.
- Applica il tuo modello di scoring per classificare la lista unificata e ripulita.
- Instrada gli account per fascia. Assegna quelli con punteggio alto ai Sales rep per l’outreach diretto, inserisci quelli intermedi in sequenze di nurturing ed escludi quelli con punteggio basso.
Il passaggio 3 è quello in cui fallisce la maggior parte dei progetti tecnografici. Unire gli export di uno strumento di scansione, uno scraper di annunci di lavoro e un database di vendor produce in genere nomi disordinati, duplicati e formattati in modo incoerente. Ripulirli prima di procedere rende affidabile tutto il resto del modello.
Esempio pratico di scoring tecnografico
Immaginiamo un’azienda che vende una customer data platform (CDP) con integrazioni native per Segment e Snowflake.
- Un account che utilizza Segment, Snowflake e uno strumento email legacy, ma nessuna CDP, ottiene un punteggio alto: sono presenti entrambe le integrazioni richieste, oltre a una lacuna evidente in linea con il caso d’uso principale.
- Un account che usa Segment ma anche una CDP concorrente ottiene un punteggio medio: la compatibilità con l’integrazione è buona, ma la categoria è già coperta e il pitch deve concentrarsi sulla sostituzione.
- Un account che non utilizza Segment né Snowflake, ma nell’ultimo mese ha pubblicato tre annunci per “data engineer, migrazione del data warehouse”, rientra nella fascia futura: non è pronto oggi, ma vale la pena ricontattarlo il prossimo trimestre.
Classificare questi tre account in modo diverso, anziché inserirli tutti in un’unica lista di “prospect CDP”, rappresenta l’intero valore dello scoring tecnografico.
Come mettere in pratica il targeting tecnografico
Il targeting tecnografico non sostituisce i dati firmografici e gli intent data. È una lente più precisa da sovrapporre a entrambi. I team che ne traggono il massimo non sono quelli dotati degli strumenti di rilevamento più sofisticati, ma quelli rigorosi nell’aggiornare i dati, normalizzare i nomi dei vendor prima dello scoring e ricalibrare il peso dei segnali man mano che il prodotto e le integrazioni evolvono.
Inizia in piccolo: scegli i due o tre strumenti o categorie che meglio caratterizzano i tuoi clienti attuali, configura prima il rilevamento di questi elementi e amplia il modello quando inizierà davvero a generare conversazioni commerciali migliori.