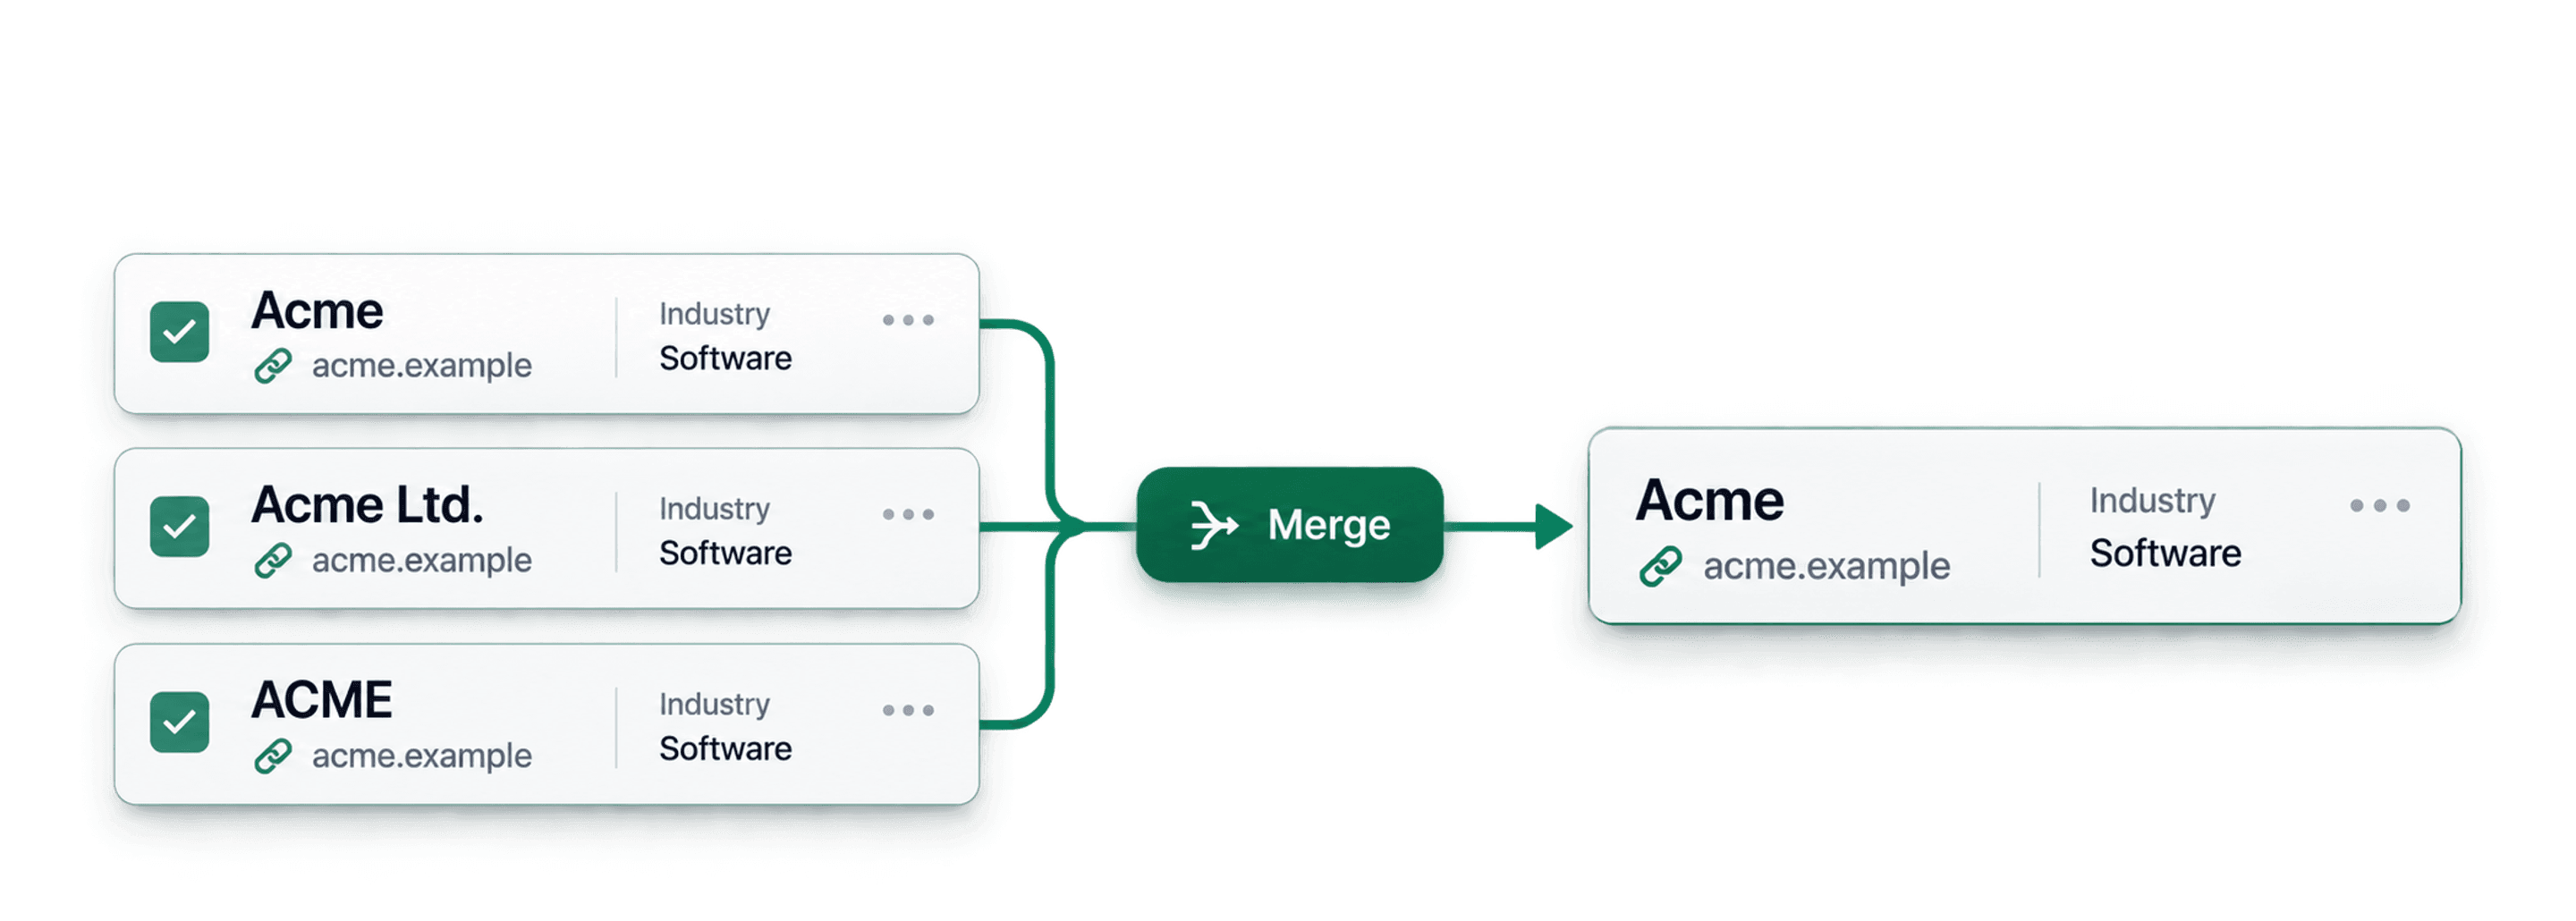
Per trovare nomi di aziende duplicati, confronta prima un dominio stabile, poi usa il matching dei nomi aziendali normalizzati per i record privi di un sito web affidabile. Esamina i gruppi proposti prima di unirli, perché due aziende possono avere lo stesso nome breve o generico.
Questa guida spiega come:
- Importare l’elenco con i nomi delle aziende
- Trovare siti web e nomi aziendali corrispondenti
- Unire i record aziendali duplicati
Best practice per deduplicare elenchi di aziende
Usa l’identificatore più affidabile disponibile. Un sito web o dominio normalizzato è un punto di partenza migliore rispetto al nome, perché aziende diverse possono condividere nomi come Acme Services. Conserva il nome originale dell’azienda, il sito web e l’ID del record CRM in proprietà separate, così potrai verificare ogni corrispondenza e ricondurre la riga pulita alla sua origine.
Esegui il matching dei nomi in un secondo passaggio. Il processor Company Name rimuove prima del confronto i termini legali, geografici e aziendali più comuni. In questo modo può associare Cedar Group LLC e Cedar, ma può anche far sembrare simili due aziende che non hanno alcun legame. Per i record senza dominio, confronta un altro campo, come Paese, città o indirizzo, prima di decidere se unirli. Una corrispondenza del nome al 100% non dimostra che le aziende siano la stessa entità.
Quando un gruppo contiene numeri di telefono, owner o note differenti, controlla Why matched e scegli quali valori conservare. Se ti serve una traccia per l’audit, esporta prima i gruppi di duplicati. Procedi con l’unione solo quando sai spiegare perché i record si riferiscono alla stessa azienda.
Se vuoi creare una colonna separata con i nomi puliti per pochi record, usa il Company Name Cleaner gratuito prima di importare l’elenco. Mantieni i valori originali accanto ai risultati. La pulizia facilita il confronto dei nomi, ma non stabilisce quali aziende debbano essere unite.
Passaggio 1: importa l’elenco con i nomi delle aziende
Per iniziare, importa in Datablist il tuo elenco di aziende. Se disponibile, mantieni una colonna con il dominio o il sito web. In genere, il dominio identifica un’azienda in modo più affidabile rispetto al solo nome.
Per riprodurre il workflow misurato qui sotto, scarica il campione di 1.000 righe per la deduplicazione. Contiene 800 entità create appositamente, incluse 50 coppie con varianti del nome aziendale e del sito web.
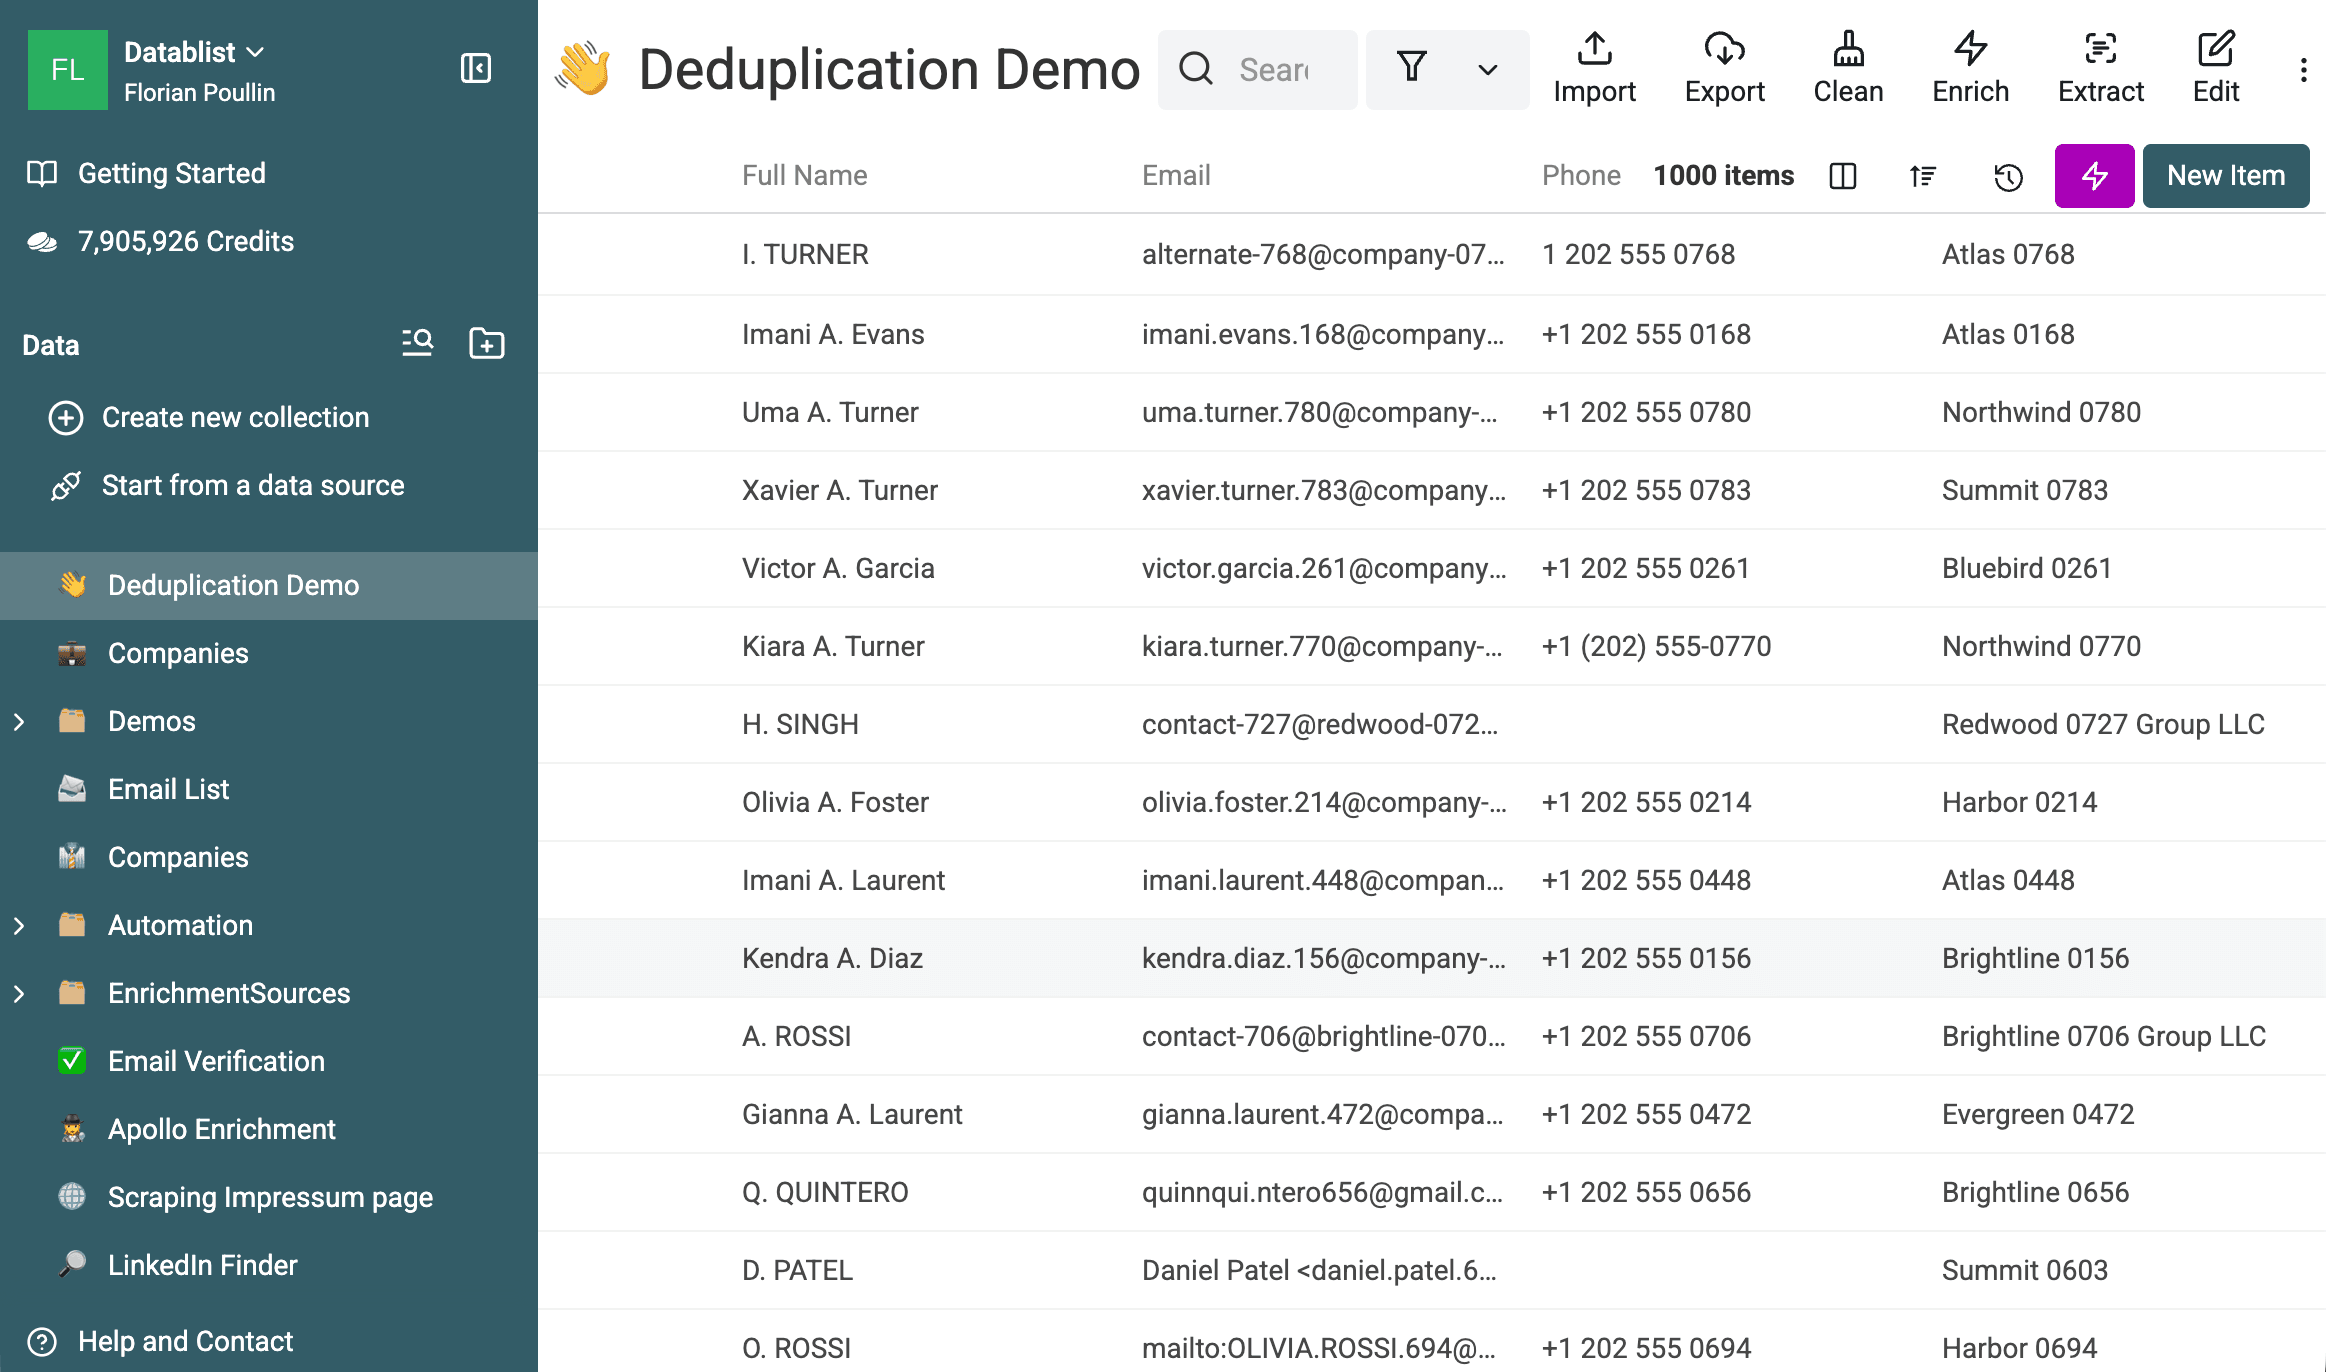
Controlla le proprietà importate e, se necessario, imposta Website come URL. La
proprietà Company può rimanere di tipo Text.
Passaggio 2: trova siti web e nomi aziendali corrispondenti
Apri Clean > Merge duplicates per individuare i record aziendali corrispondenti.
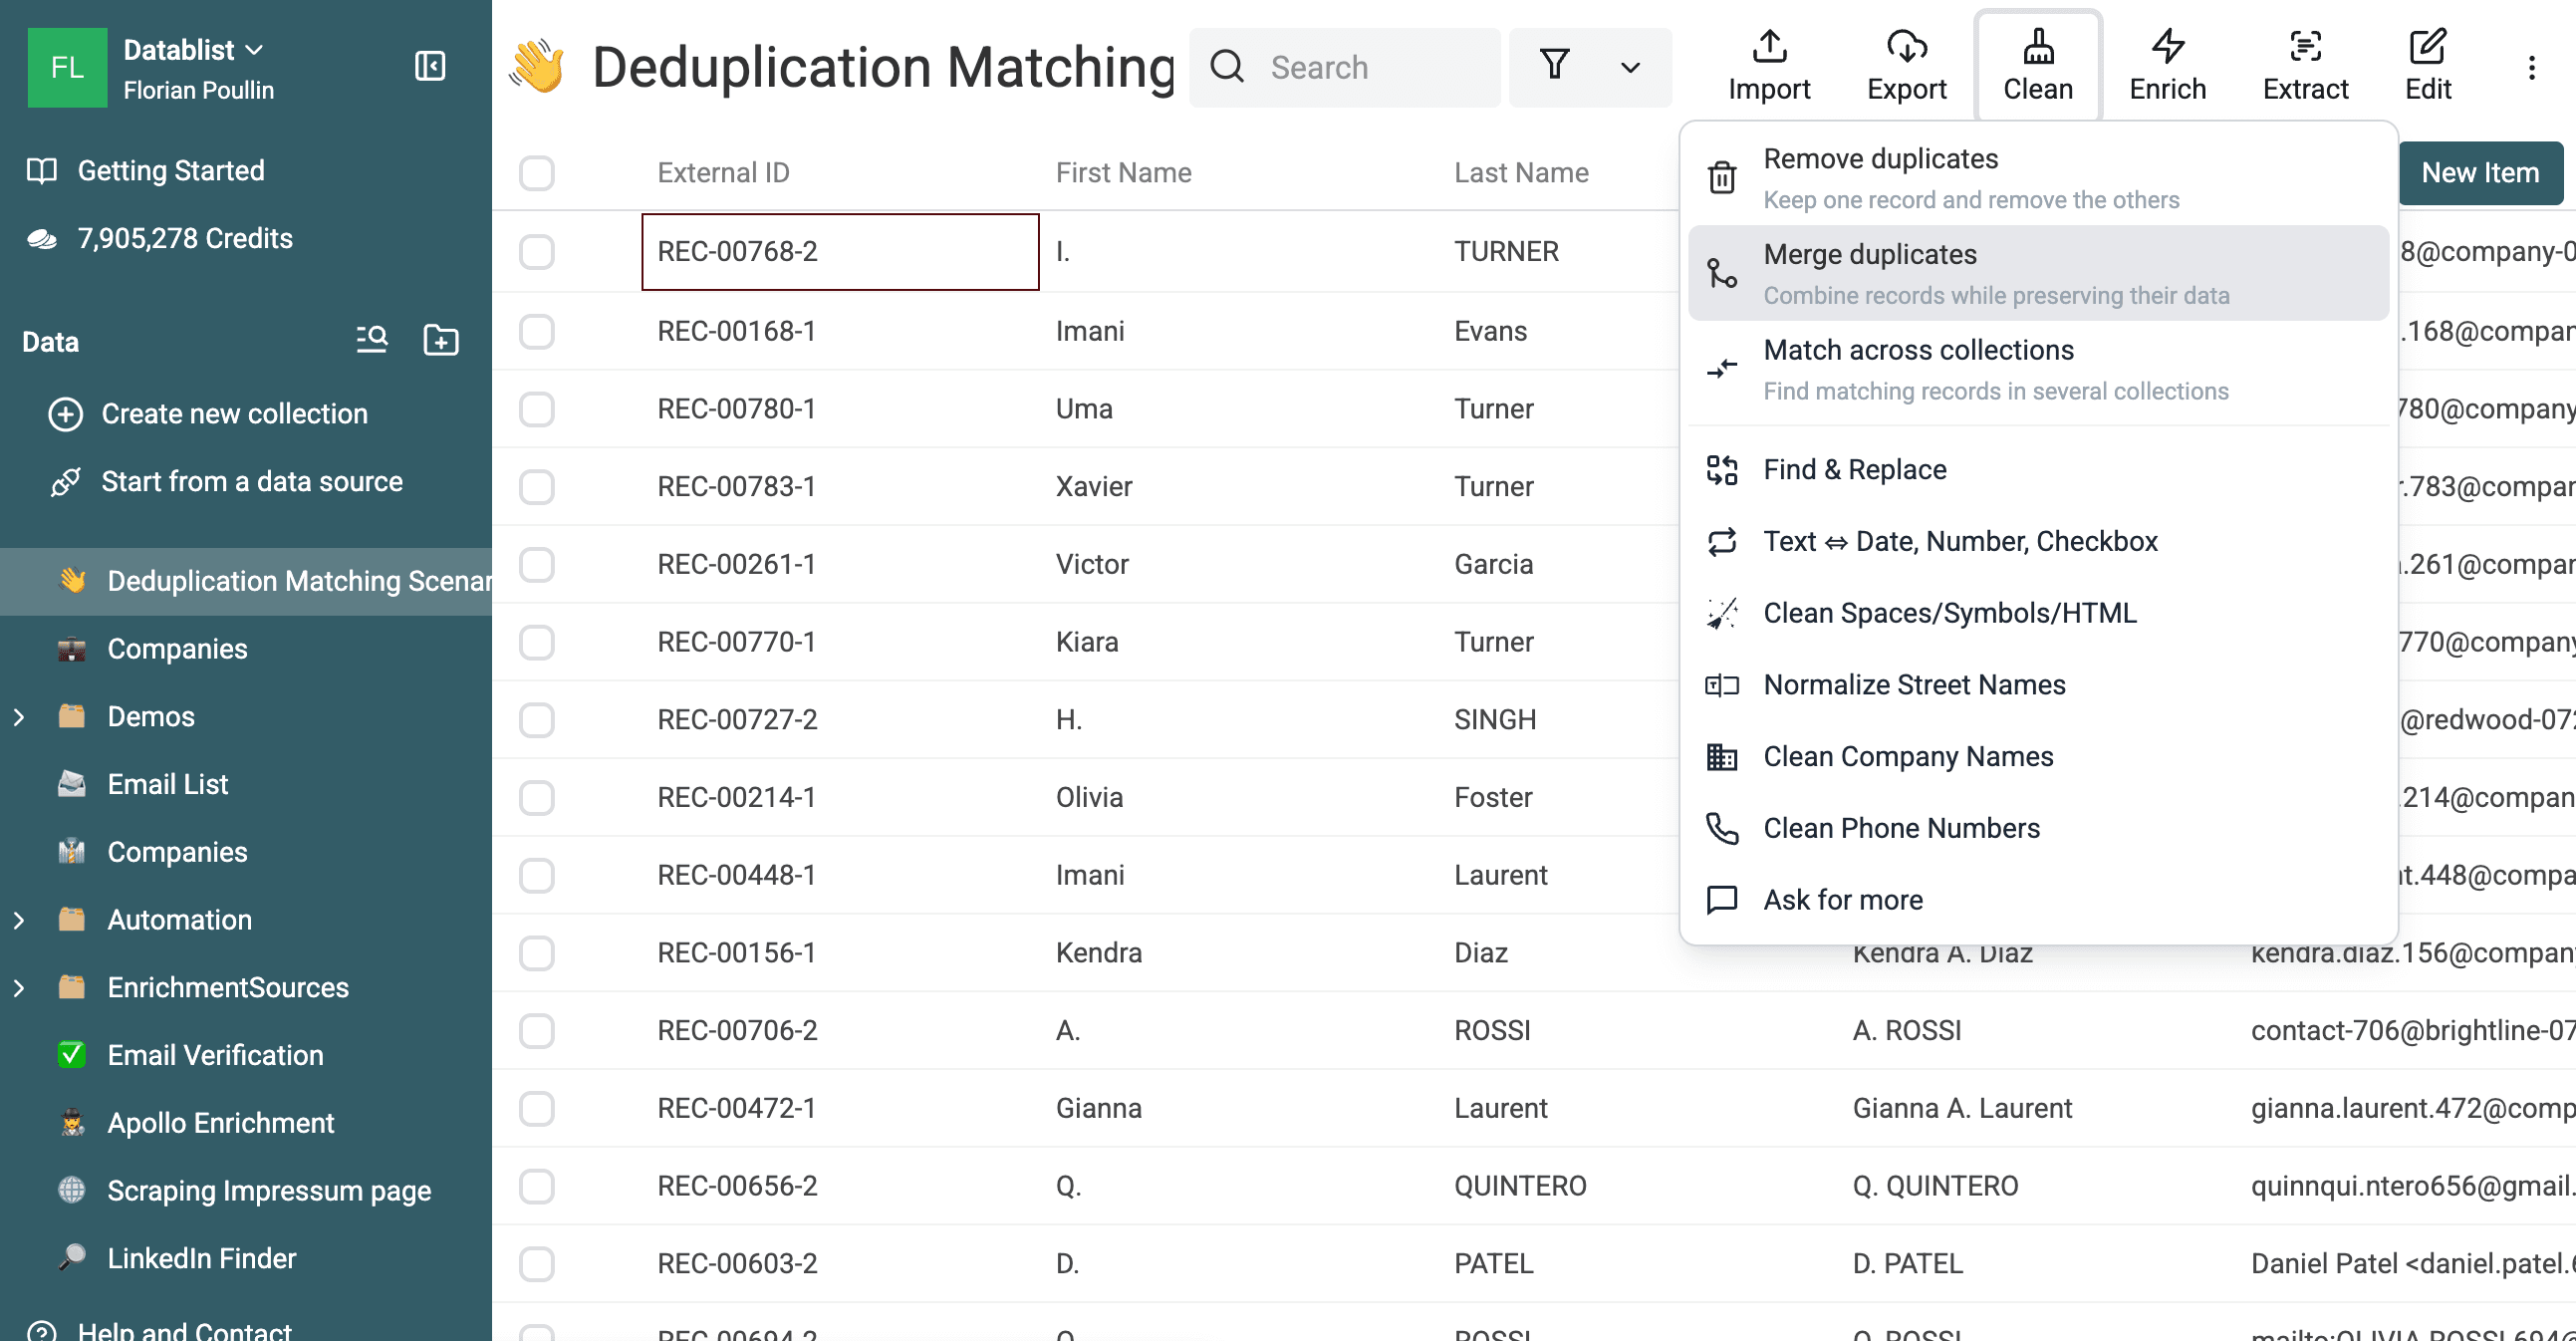
Se l’elenco contiene siti web, esegui prima il matching su questi dati. Poi avvia un passaggio separato sui nomi aziendali per le righe prive di un sito web o dominio affidabile.
Trova i siti web aziendali corrispondenti
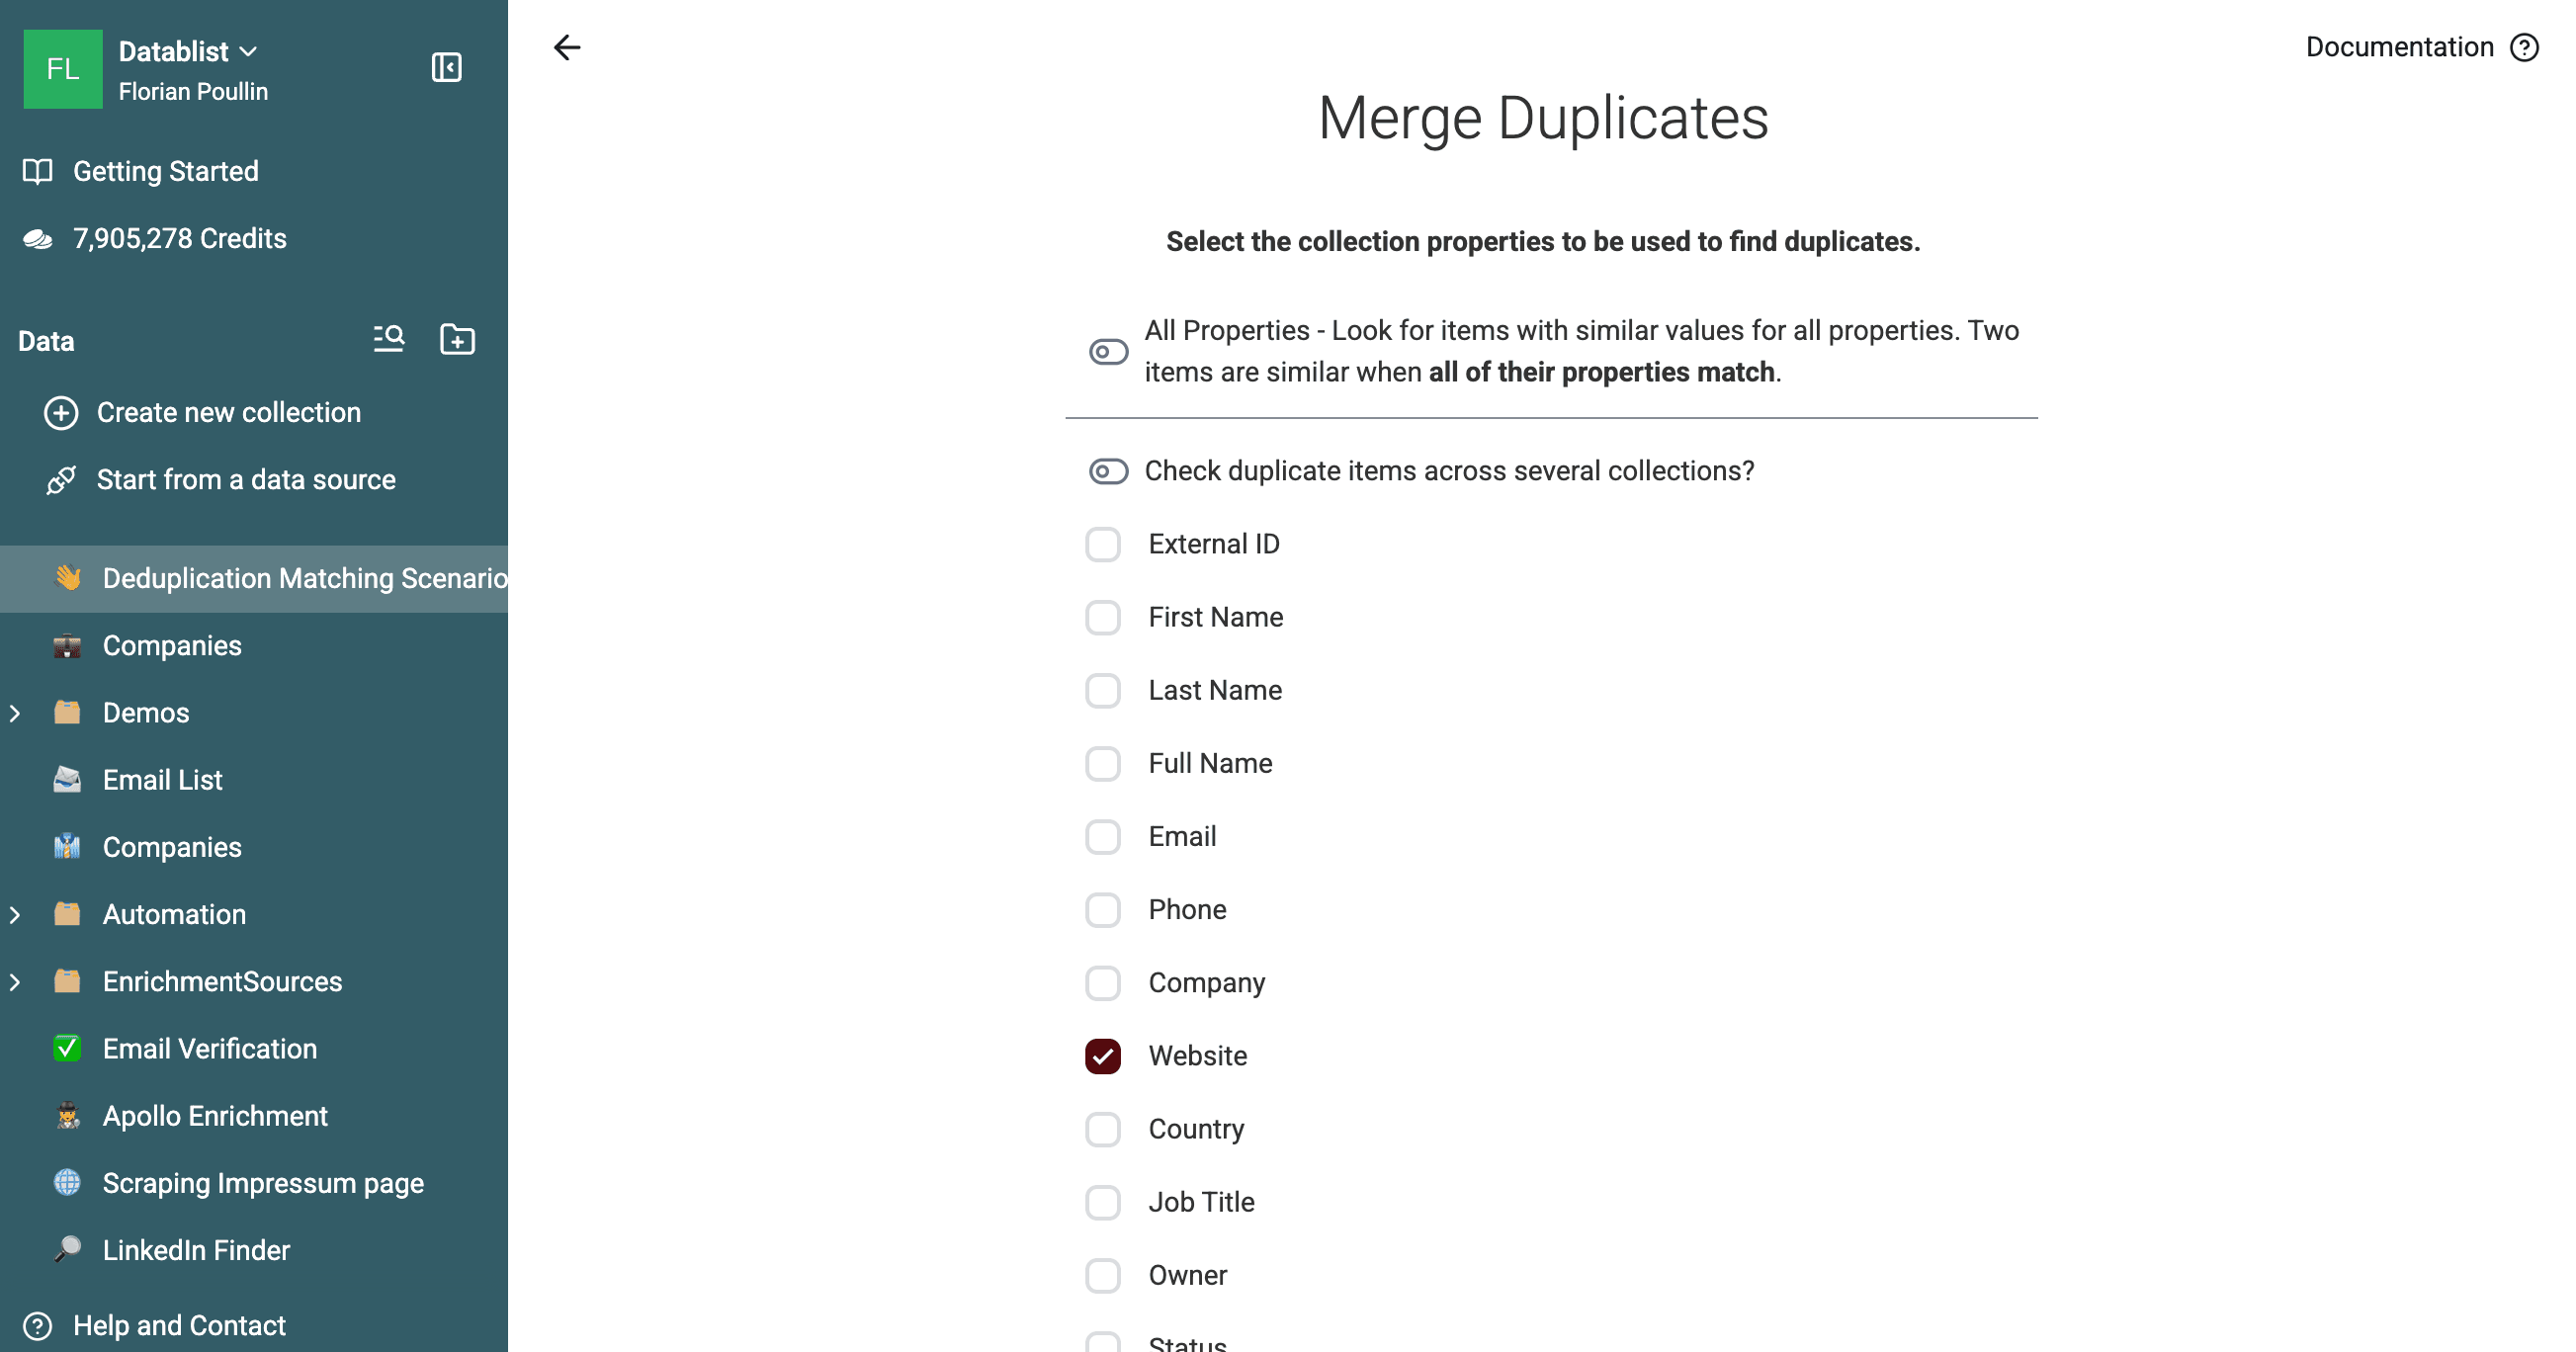
Disattiva All Properties e seleziona soltanto Website.
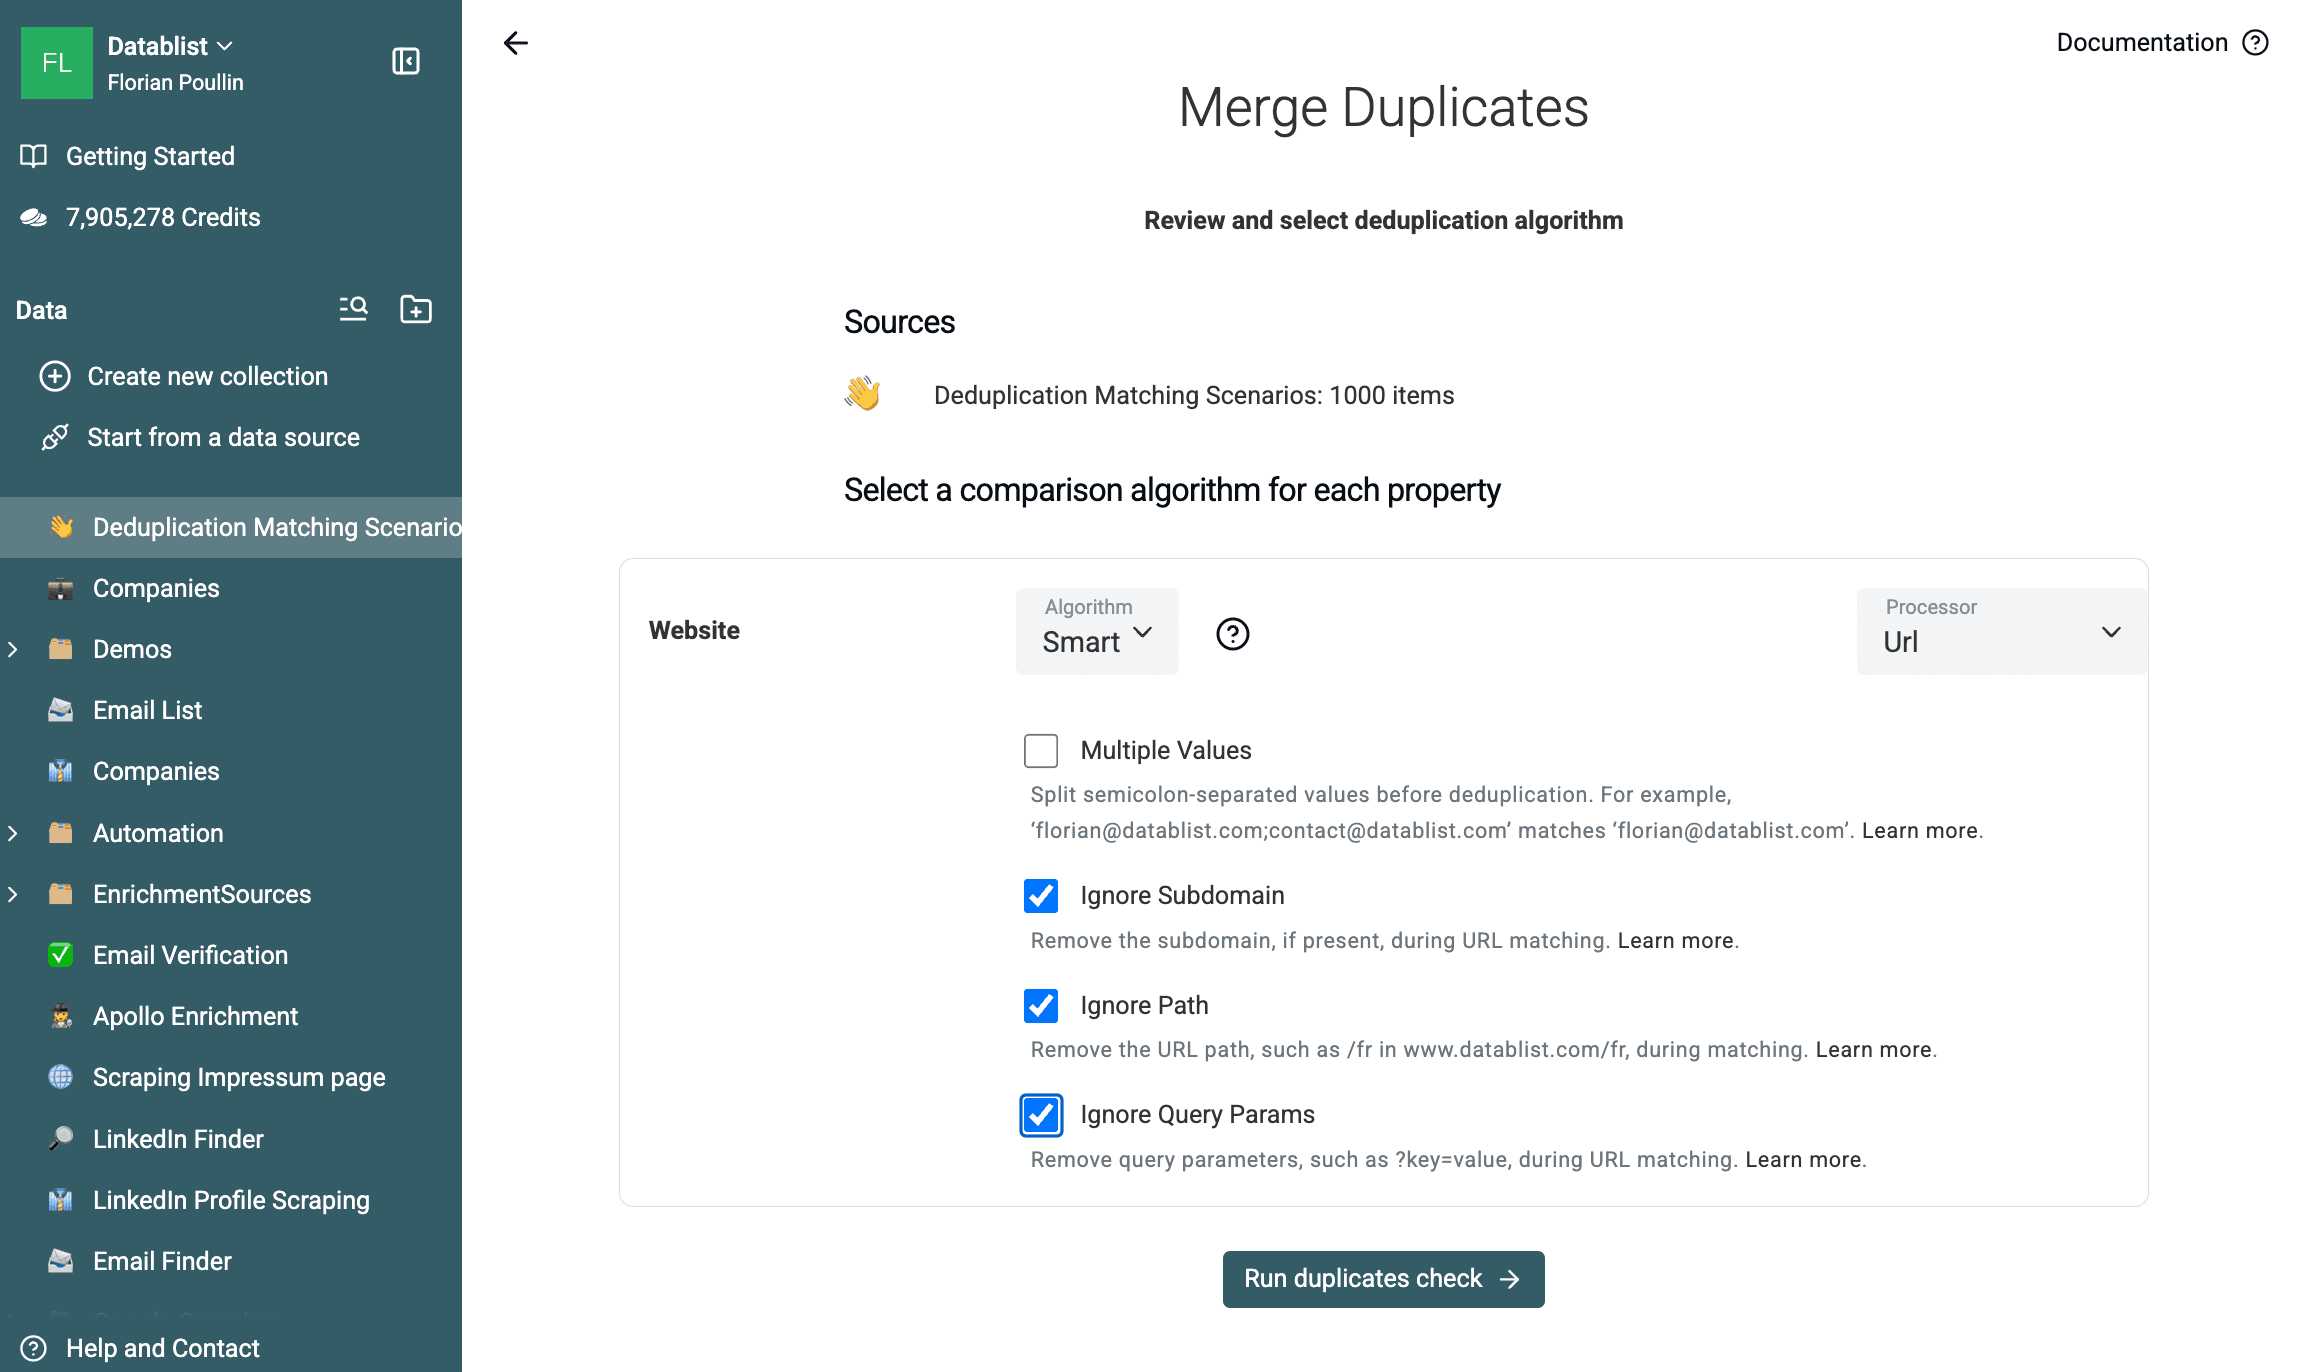
Scegli Smart con il processor URL. Il processor ignora le differenze di protocollo e gli slash finali. Attiva queste impostazioni facoltative quando sono adatte ai tuoi dati:
- Ignore Subdomain considera i sottodomini come appartenenti allo stesso dominio registrato.
- Ignore Path confronta il dominio senza i percorsi delle pagine.
- Ignore Query Params rimuove i parametri di tracciamento e gli altri parametri di query prima del confronto.
Usa queste opzioni con attenzione. Due sottodomini o percorsi possono indicare account, filiali, prodotti o sedi distinti. Mantieni queste differenze quando sono rilevanti.
Il passaggio sui siti web ha restituito 200 gruppi di due righe nel campione da 1.000 record. Cinquanta coppie contengono varianti di URL create appositamente, mentre 150 coppie condividono già lo stesso valore Website. La verifica dei gruppi esportati non ha rilevato corrispondenze tra entità diverse.
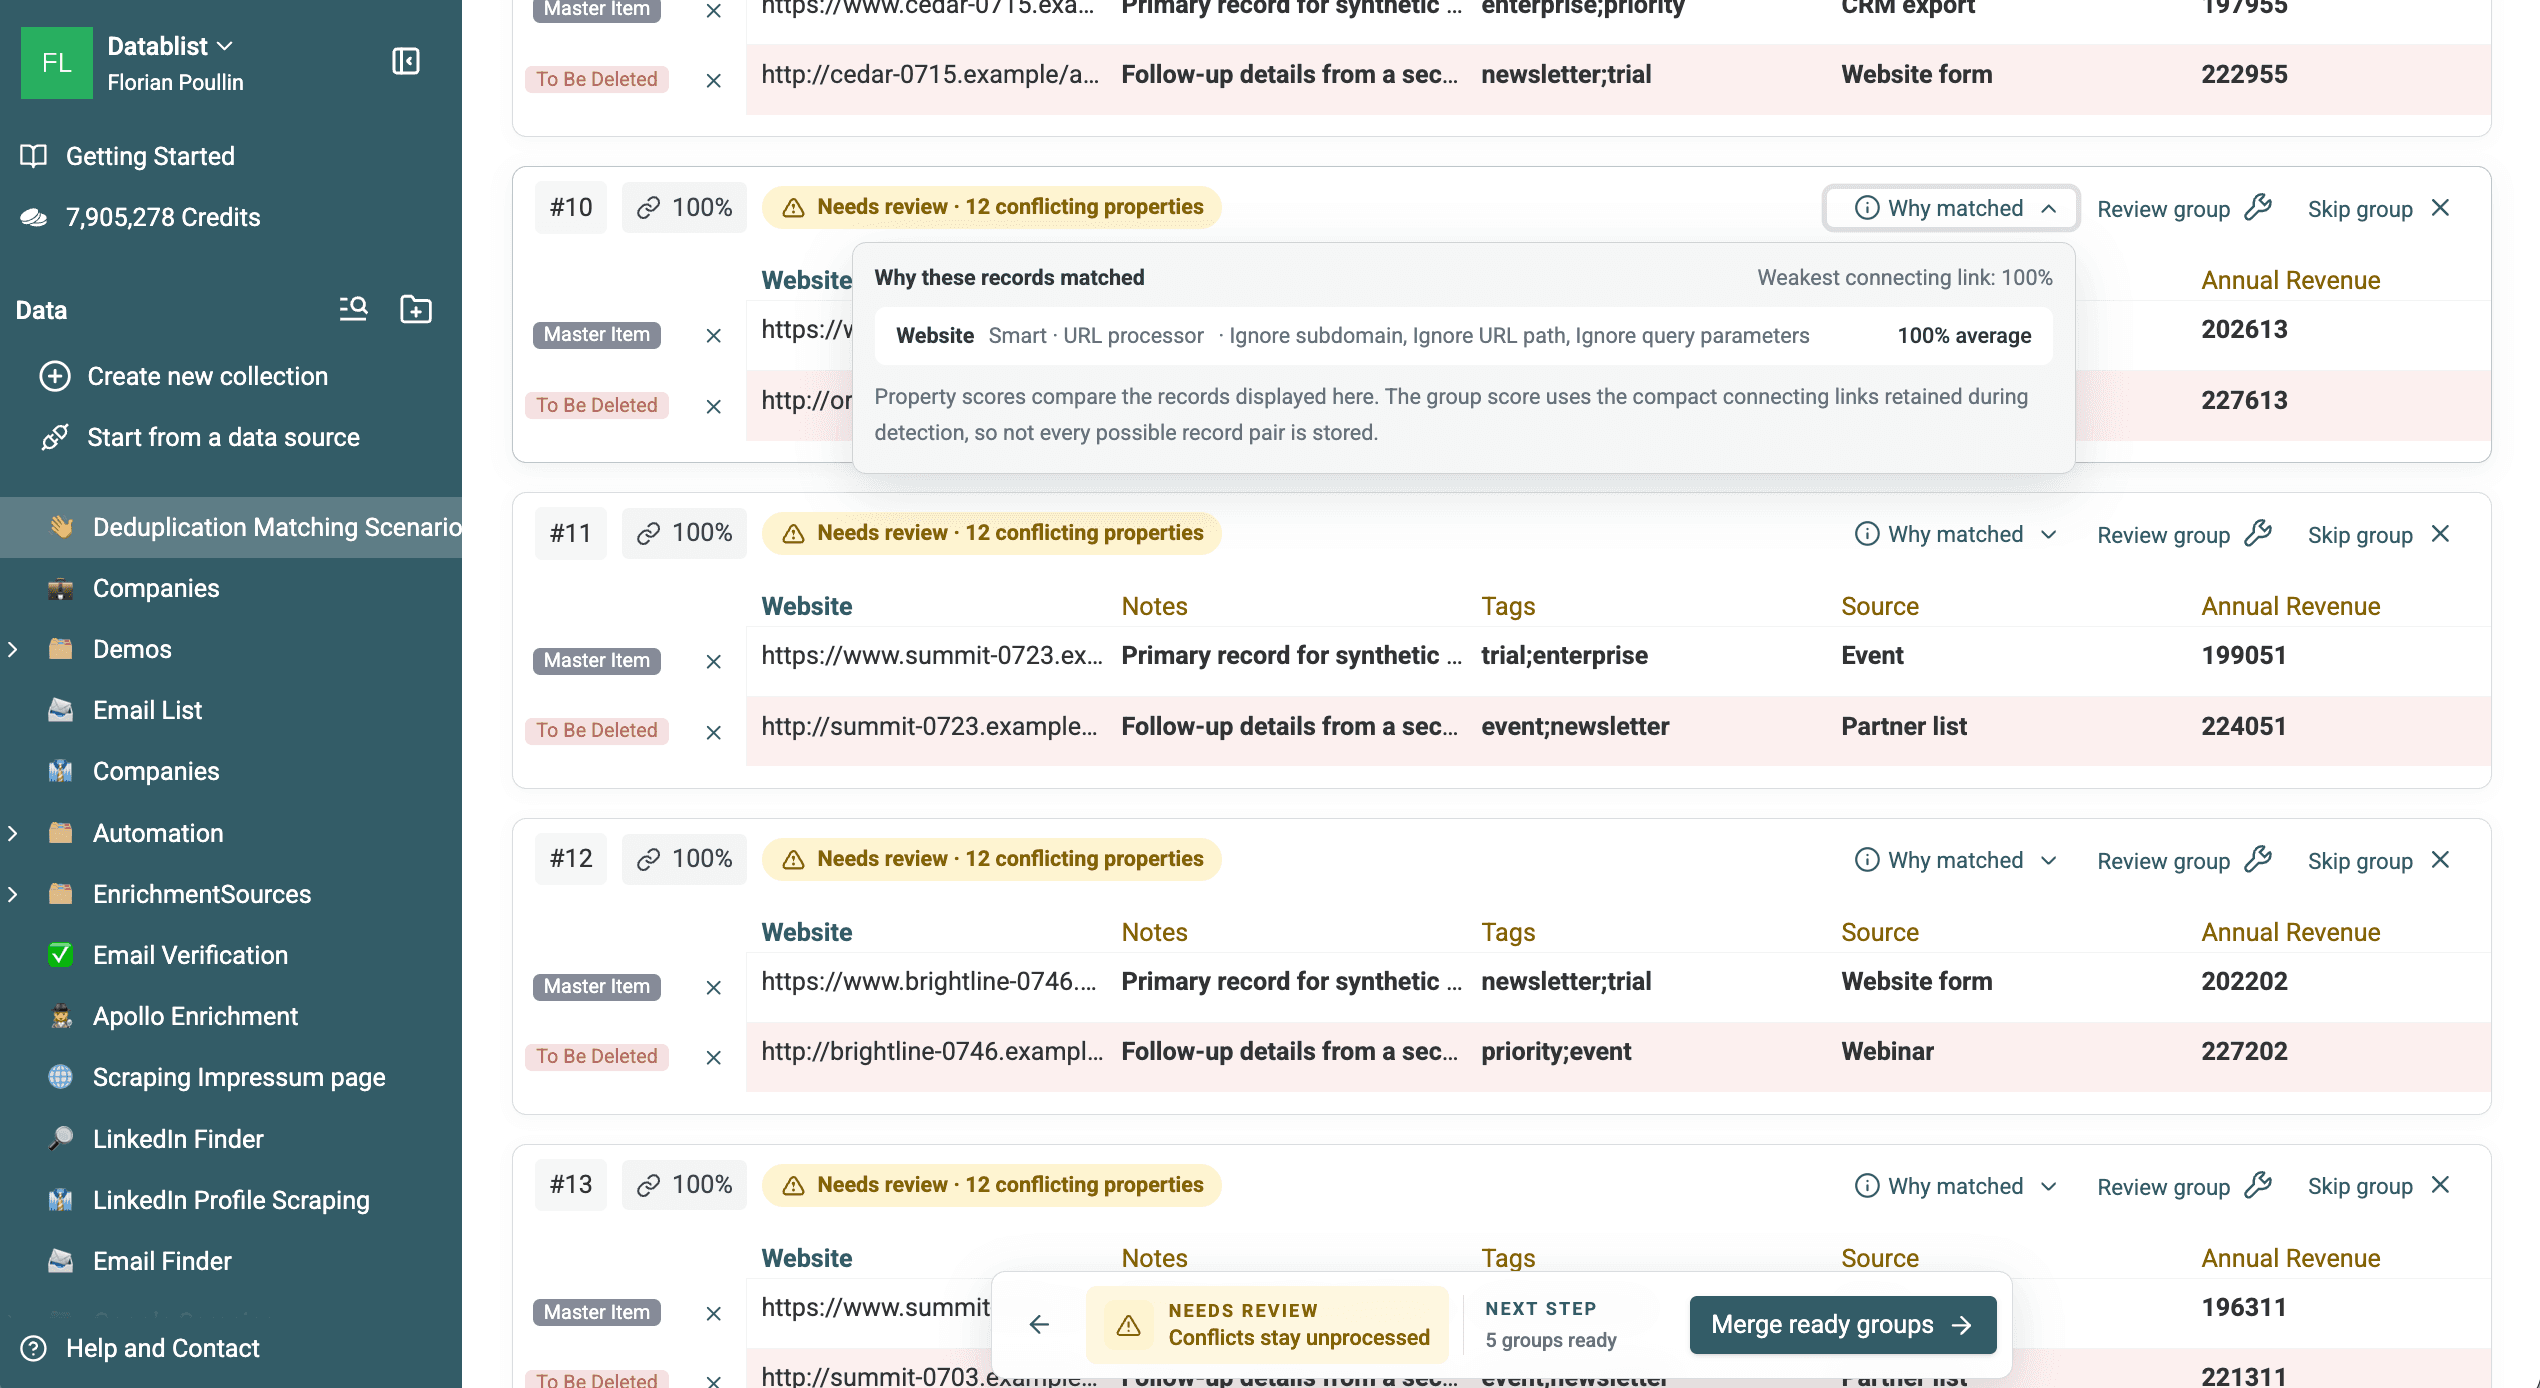
Apri Why matched prima di elaborare un gruppo. Qui trovi la proprietà Website, l’algoritmo Smart, il processor URL, le opzioni URL attive e il match score.
Scarica i 200 gruppi di duplicati trovati tramite Website per esaminare le righe associate.
Trova i nomi aziendali normalizzati corrispondenti
Seleziona Company per un secondo passaggio.
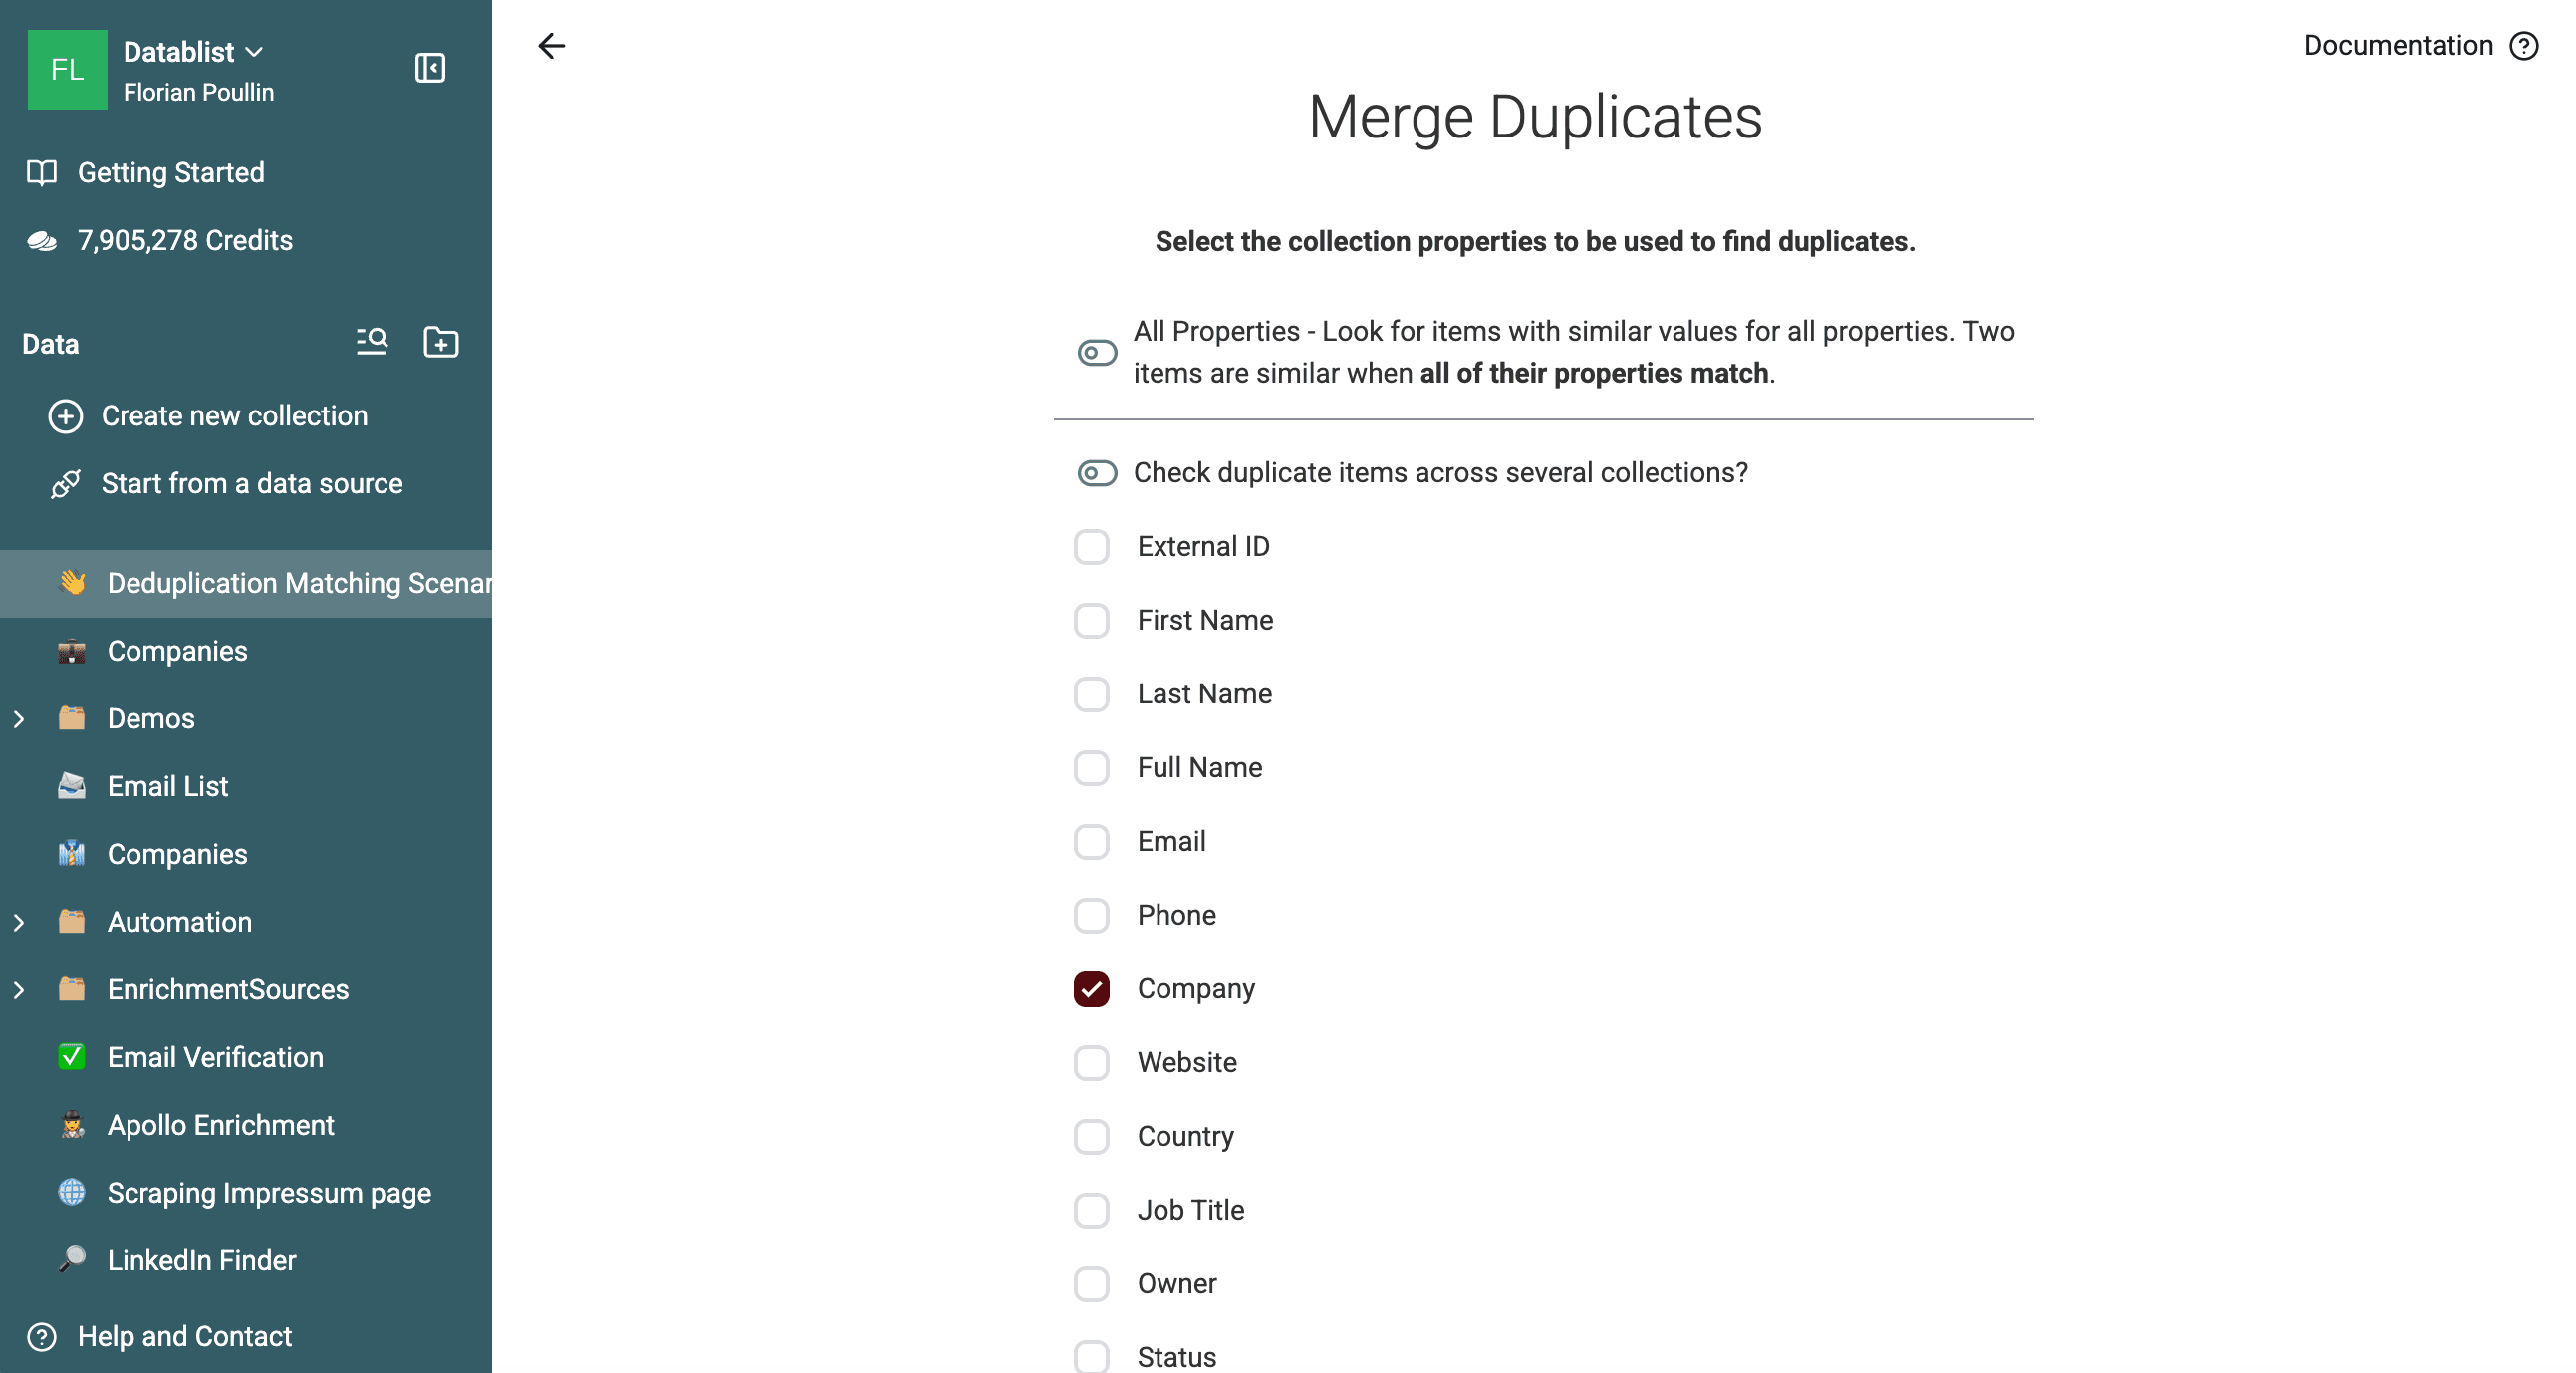
Scegli il metodo di confronto:
- Usa Smart con il processor Company Name per rimuovere i termini aziendali più comuni prima del confronto.
- Usa Jaro-Winkler o Levenshtein per le varianti ortografiche. Parti da una soglia elevata e mantieni i gruppi con una confidenza inferiore in Needs review.
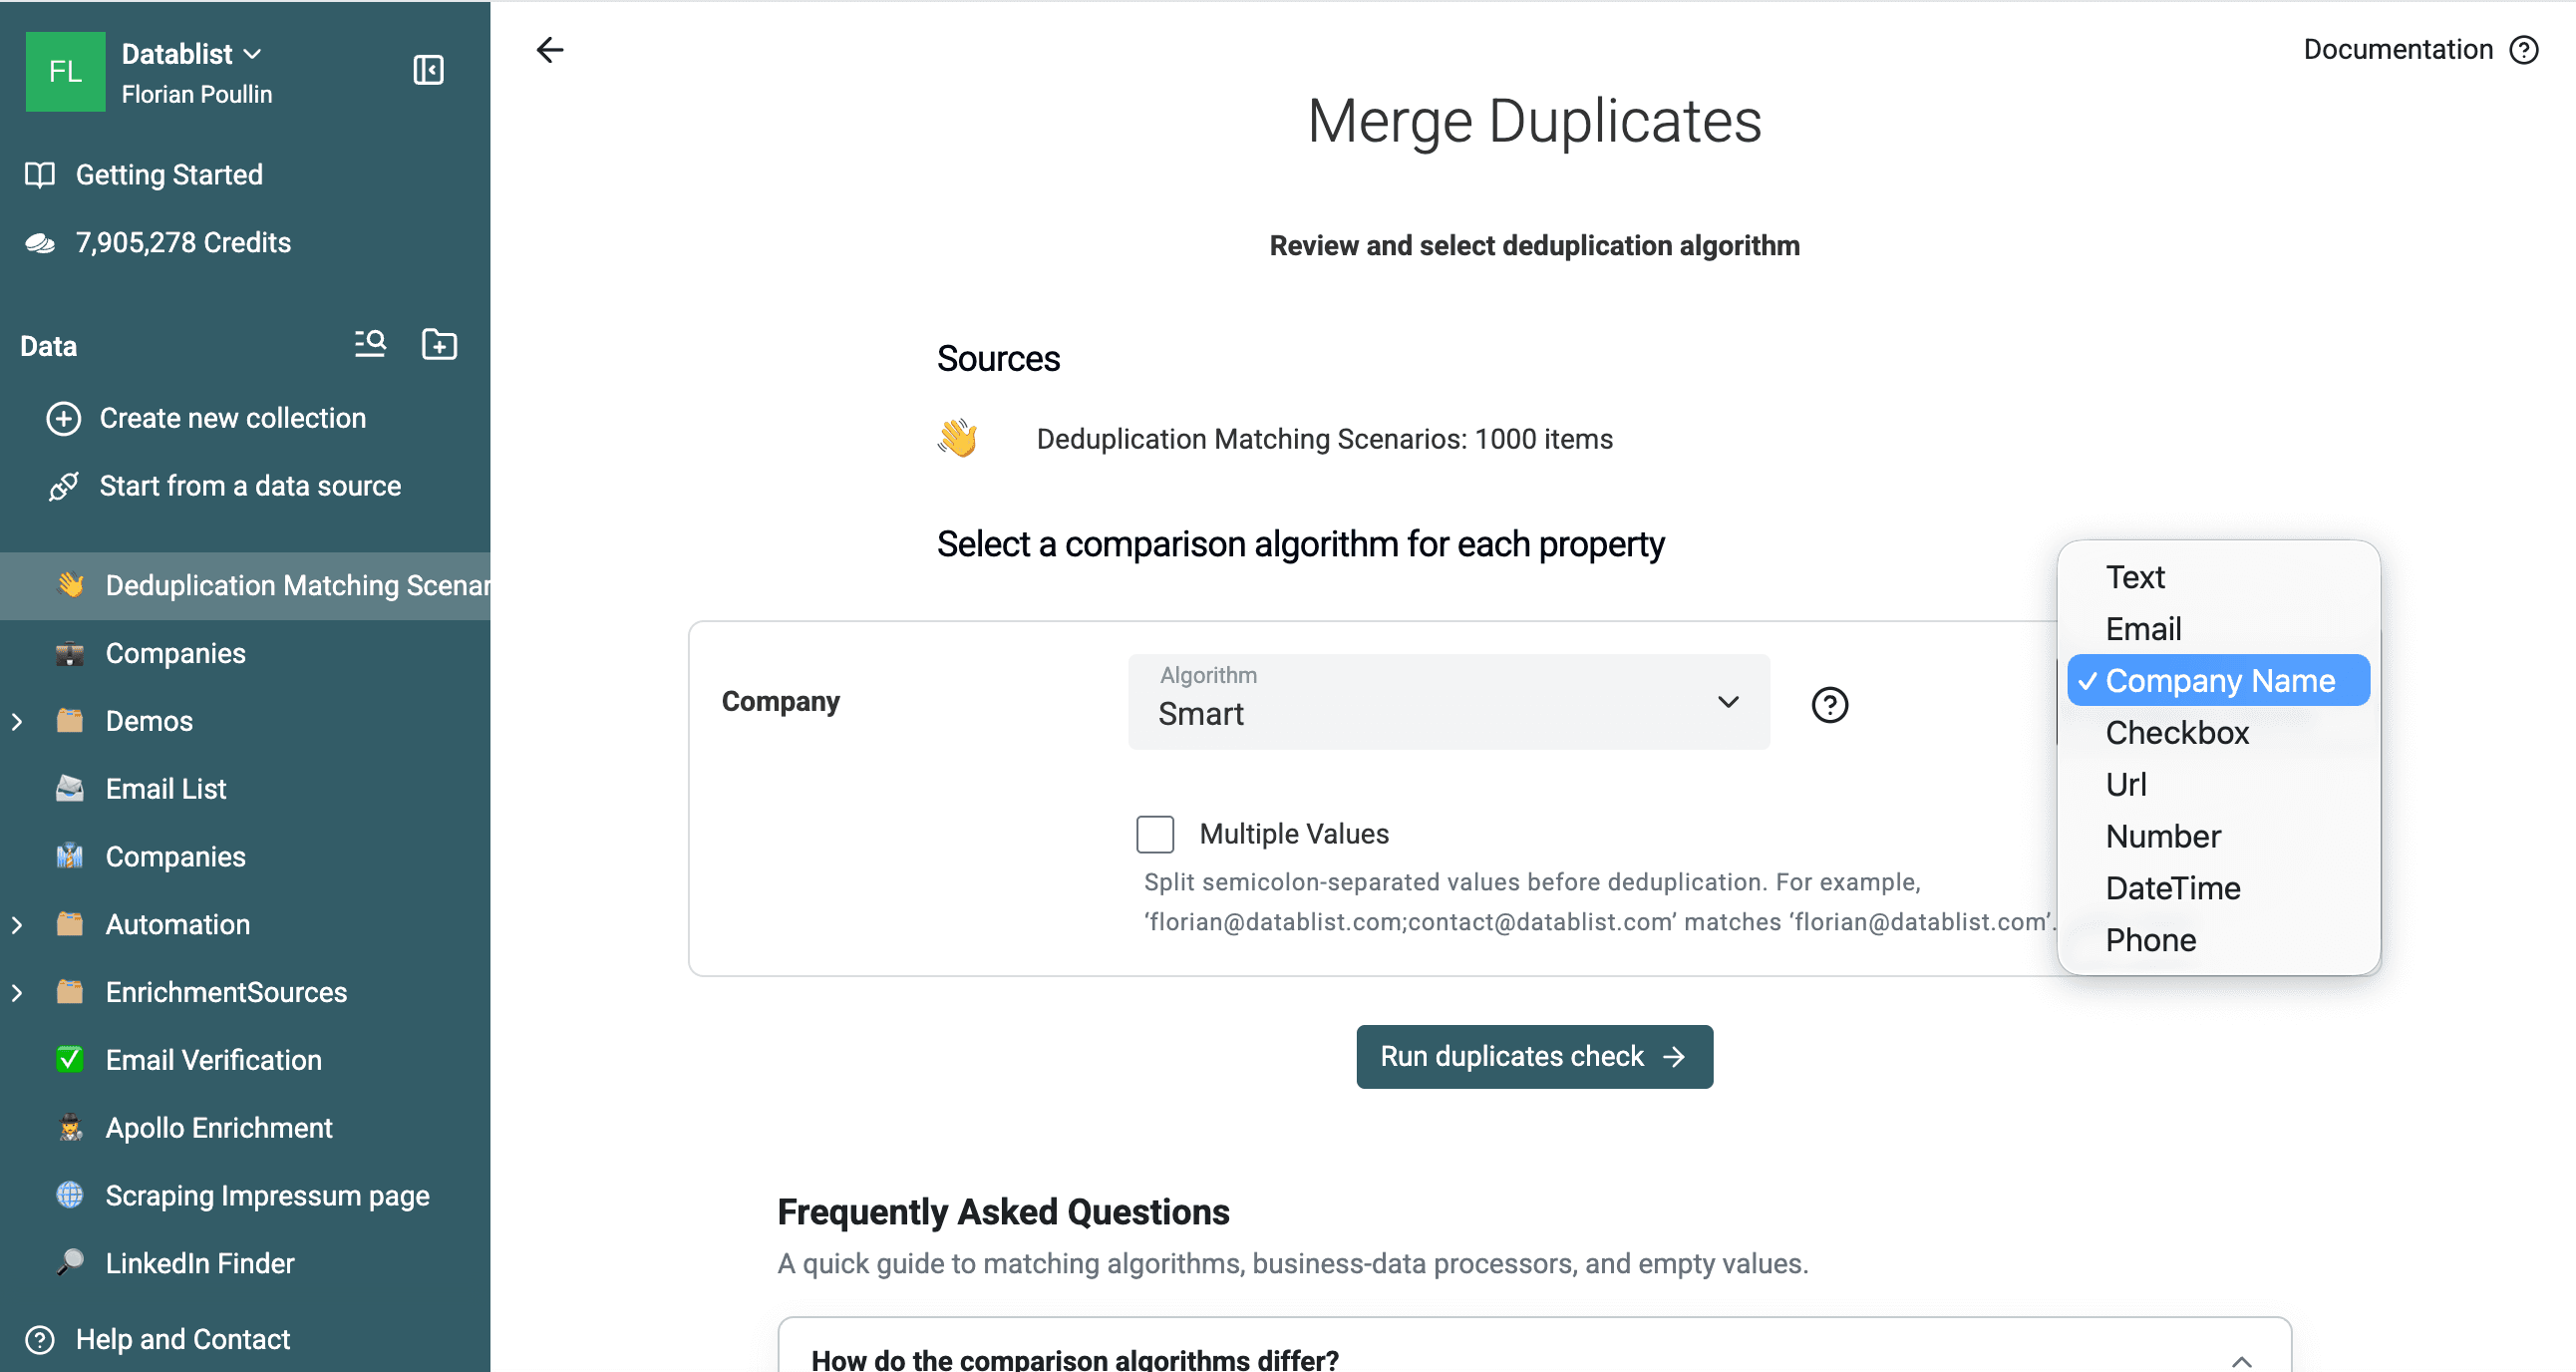
Avvia il controllo dei duplicati per individuare i record corrispondenti.
Come funziona il Company Name Processor
Il Company Name Processor è uno strumento specifico che normalizza i nomi delle aziende prima di rilevare i duplicati. È fondamentale perché nei tuoi dati la stessa azienda può comparire con diverse varianti del proprio nome.
Che cosa fa:
- Rimuove i suffissi societari: LLC, Inc., Ltd. ecc.
- Ignora i termini geografici: Europe, USA, UK ecc.
- Elimina le parole chiave aziendali: Partners, Group, Technologies ecc.
Esempio:
| Nome originale | Nome normalizzato |
|---|---|
| Apple Inc. | Apple |
| Apple USA LLC | Apple |
| Apple Technologies | Apple |
| Microsoft Corporation | Microsoft |
| Microsoft Ltd. UK | Microsoft |
Questi valori possono diventare potenziali corrispondenze. Il processor Company Name è una funzionalità a pagamento e, prima di procedere con l’unione, devi comunque verificare che il gruppo rappresenti la stessa azienda.
Risultati misurati sul campione da 1.000 righe
Il passaggio Company Name ha restituito 200 gruppi di due righe su 1.000 record verificati:
- 50 coppie contengono varianti del nome aziendale create appositamente, come
Cedar 0715, Inc.eCedar 0715 Group LLC. - Altre 150 coppie di duplicati create per il test condividono già un valore Company identico.
In questo test, tutti i 200 gruppi corrispondono alle entità sintetiche corrette. Nessun gruppo combina record appartenenti a entità diverse. Si tratta del risultato ottenuto sul campione generato, non di una garanzia generale di accuratezza.
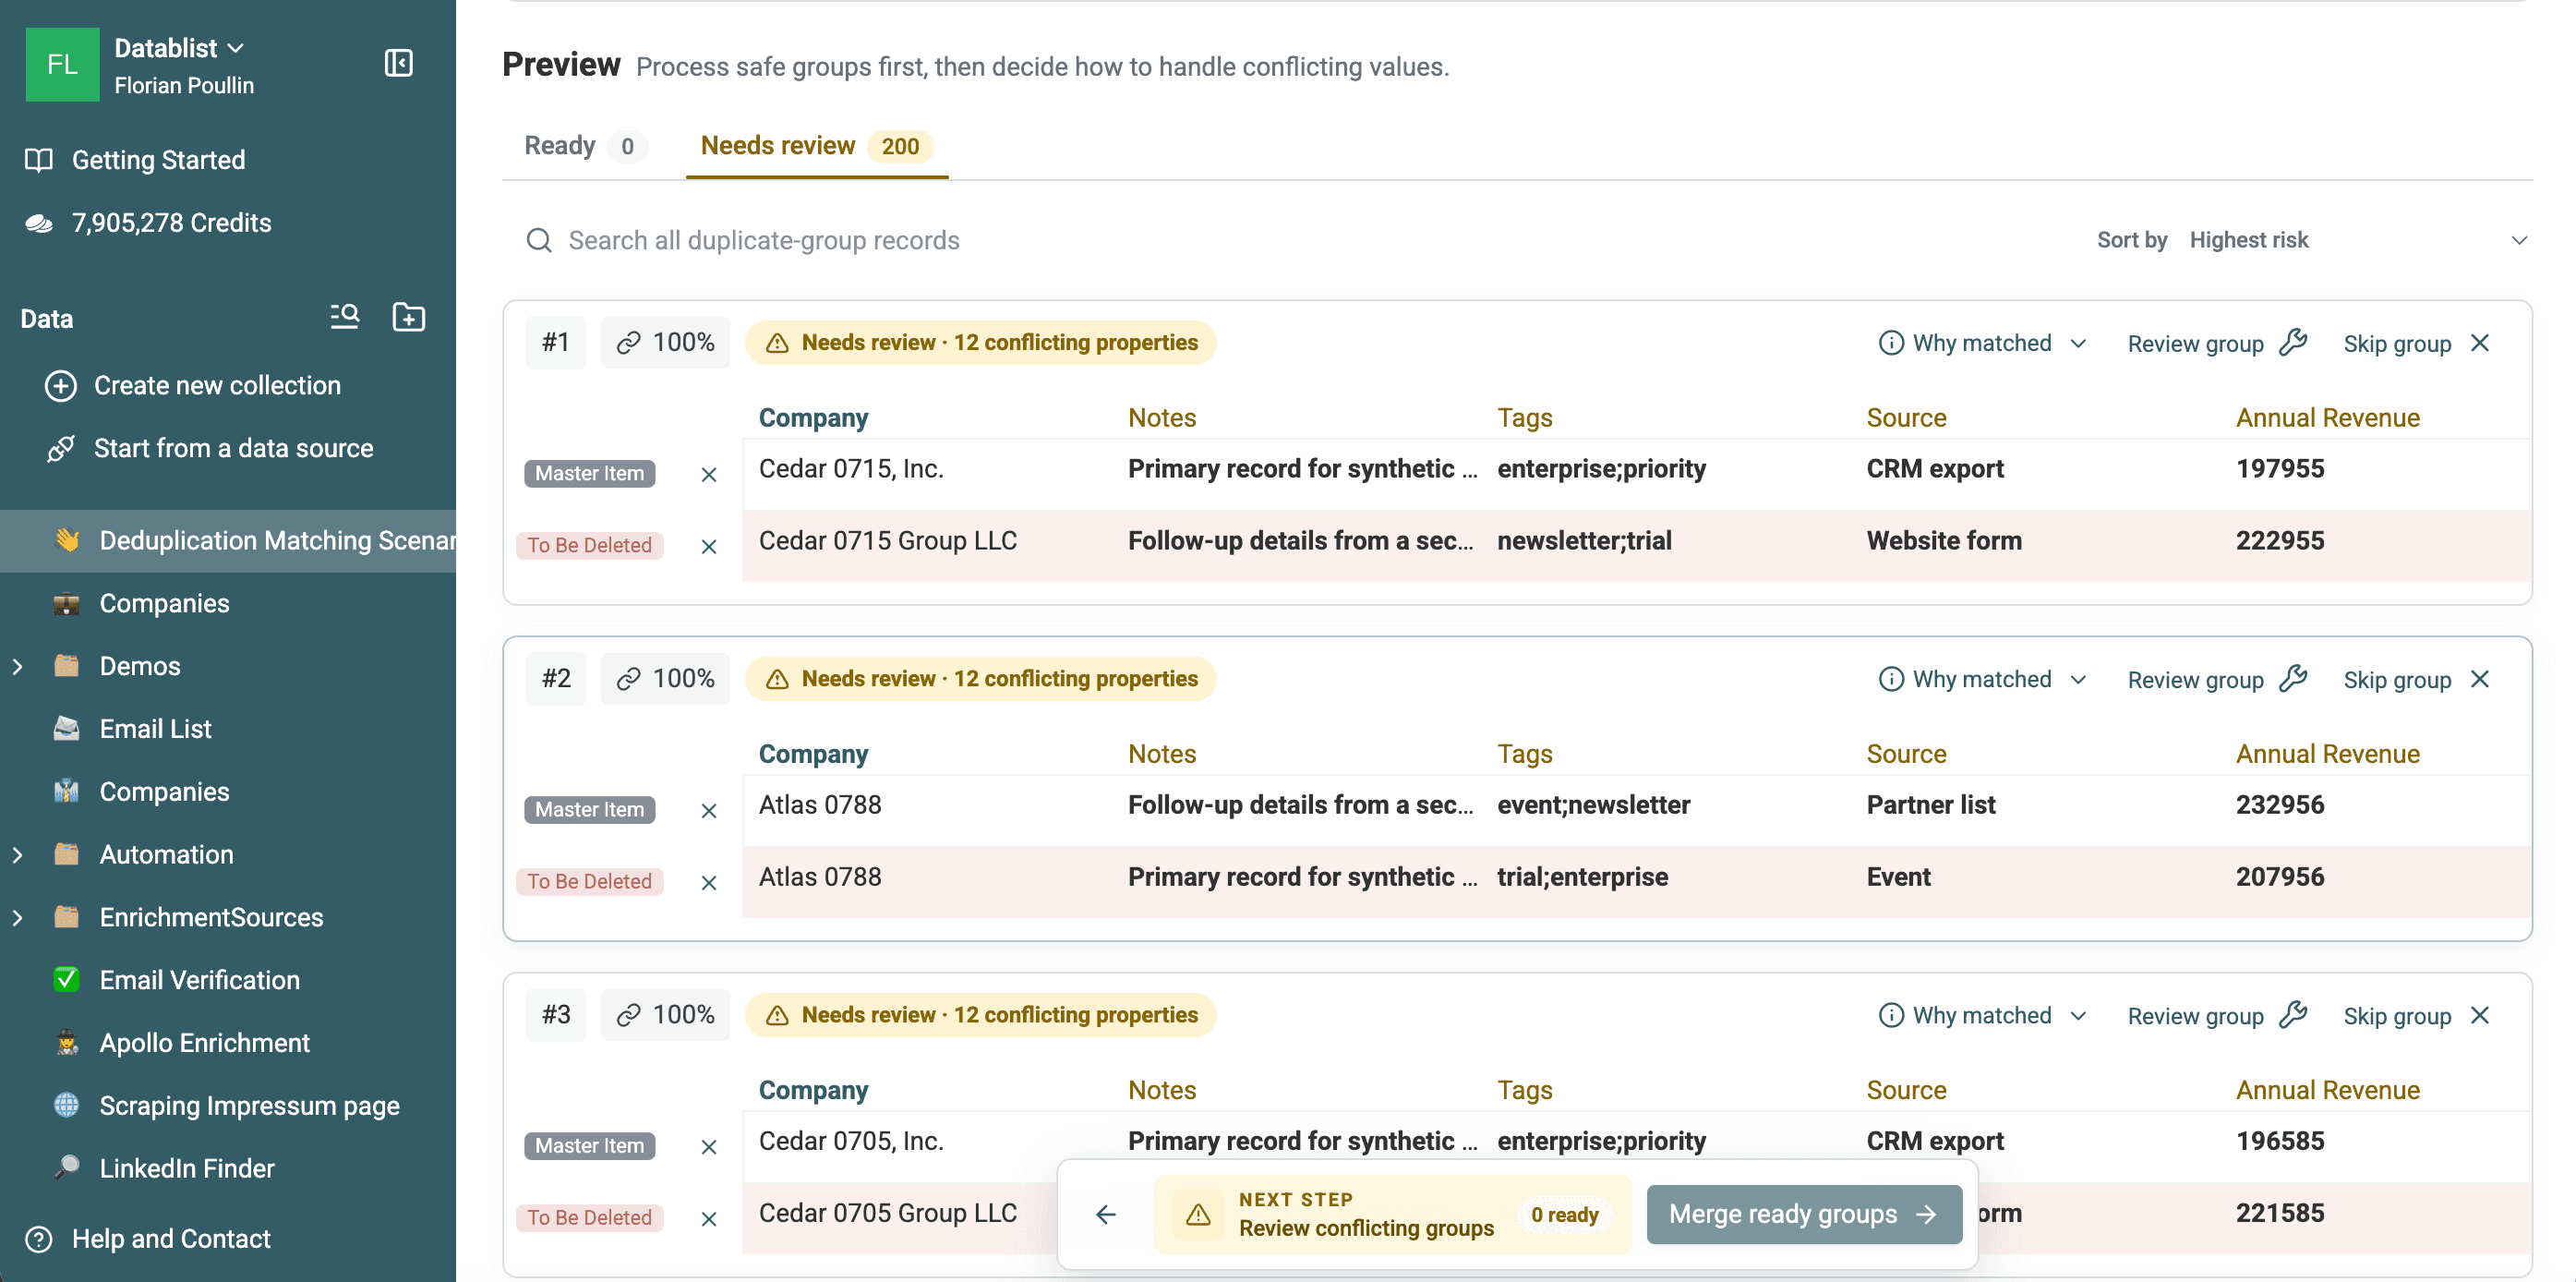
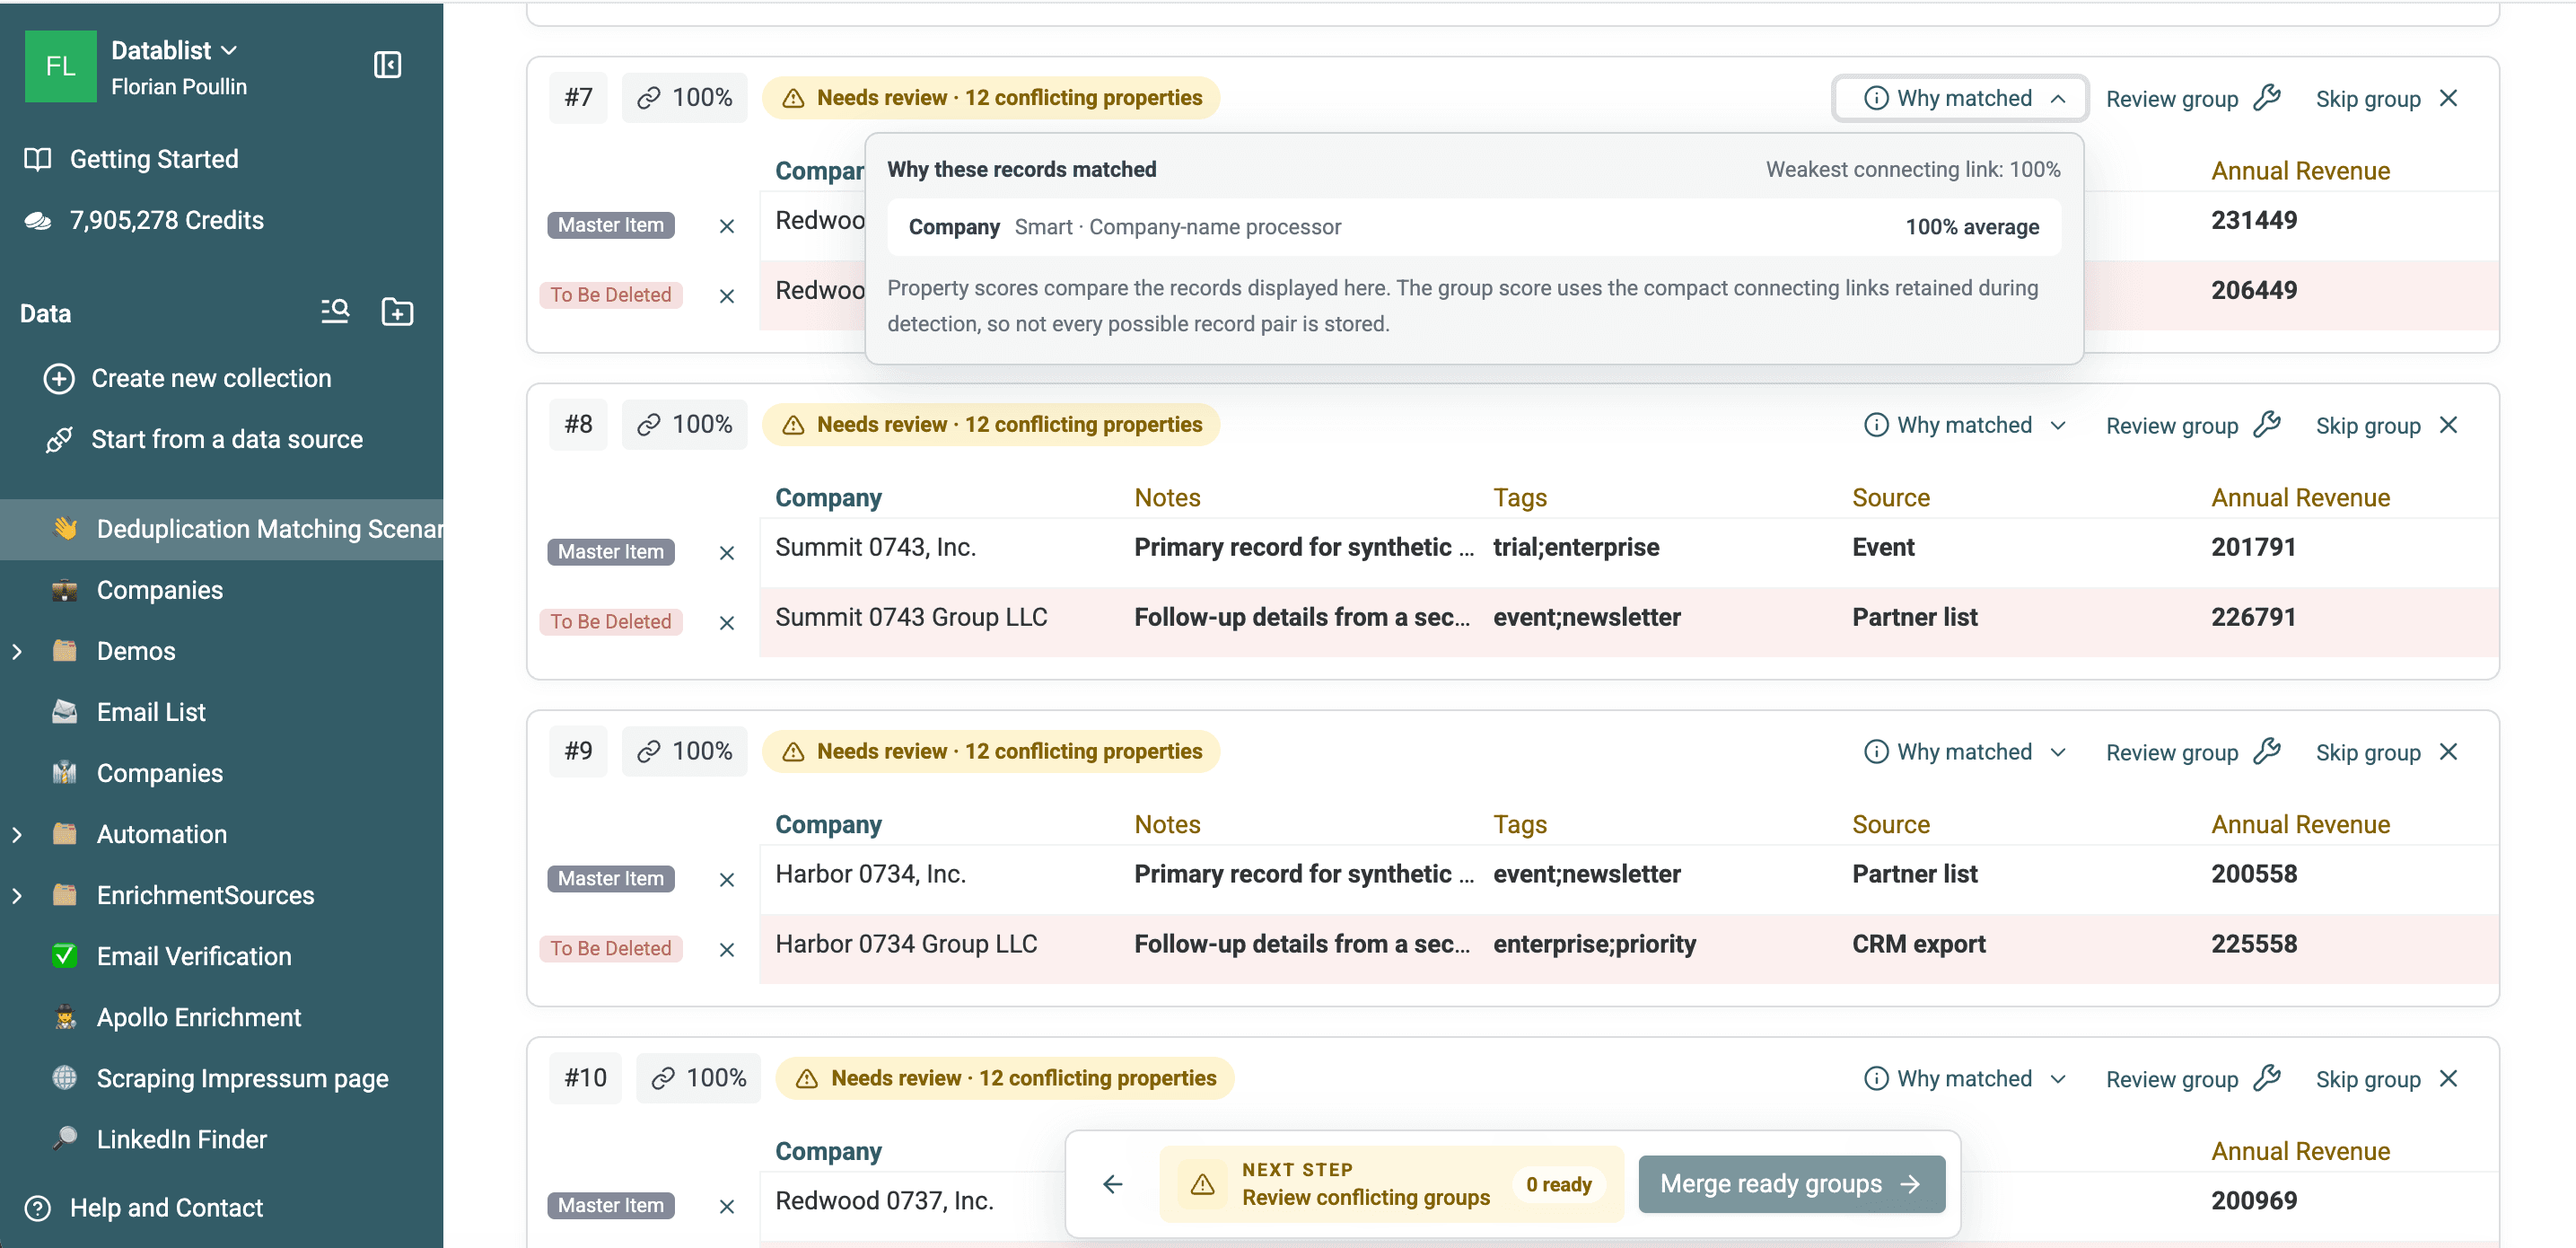
I gruppi mostrano un match score del 100%. Compaiono in Needs review perché altre proprietà sono in conflitto, non perché il matching del nome aziendale abbia una confidenza bassa.
Apri Why matched per verificare la proprietà, l’algoritmo, il processor e lo score utilizzati per un gruppo.
Scarica i 200 gruppi di duplicati esportati
per esaminare le righe associate e i valori DuplicateGroupId.
Passaggio 3: unisci i record aziendali duplicati
Se ti serve soltanto un elenco delle corrispondenze, usa Download groups e interrompi il processo prima dell’elaborazione. Prosegui se vuoi consolidare i record in Datablist.
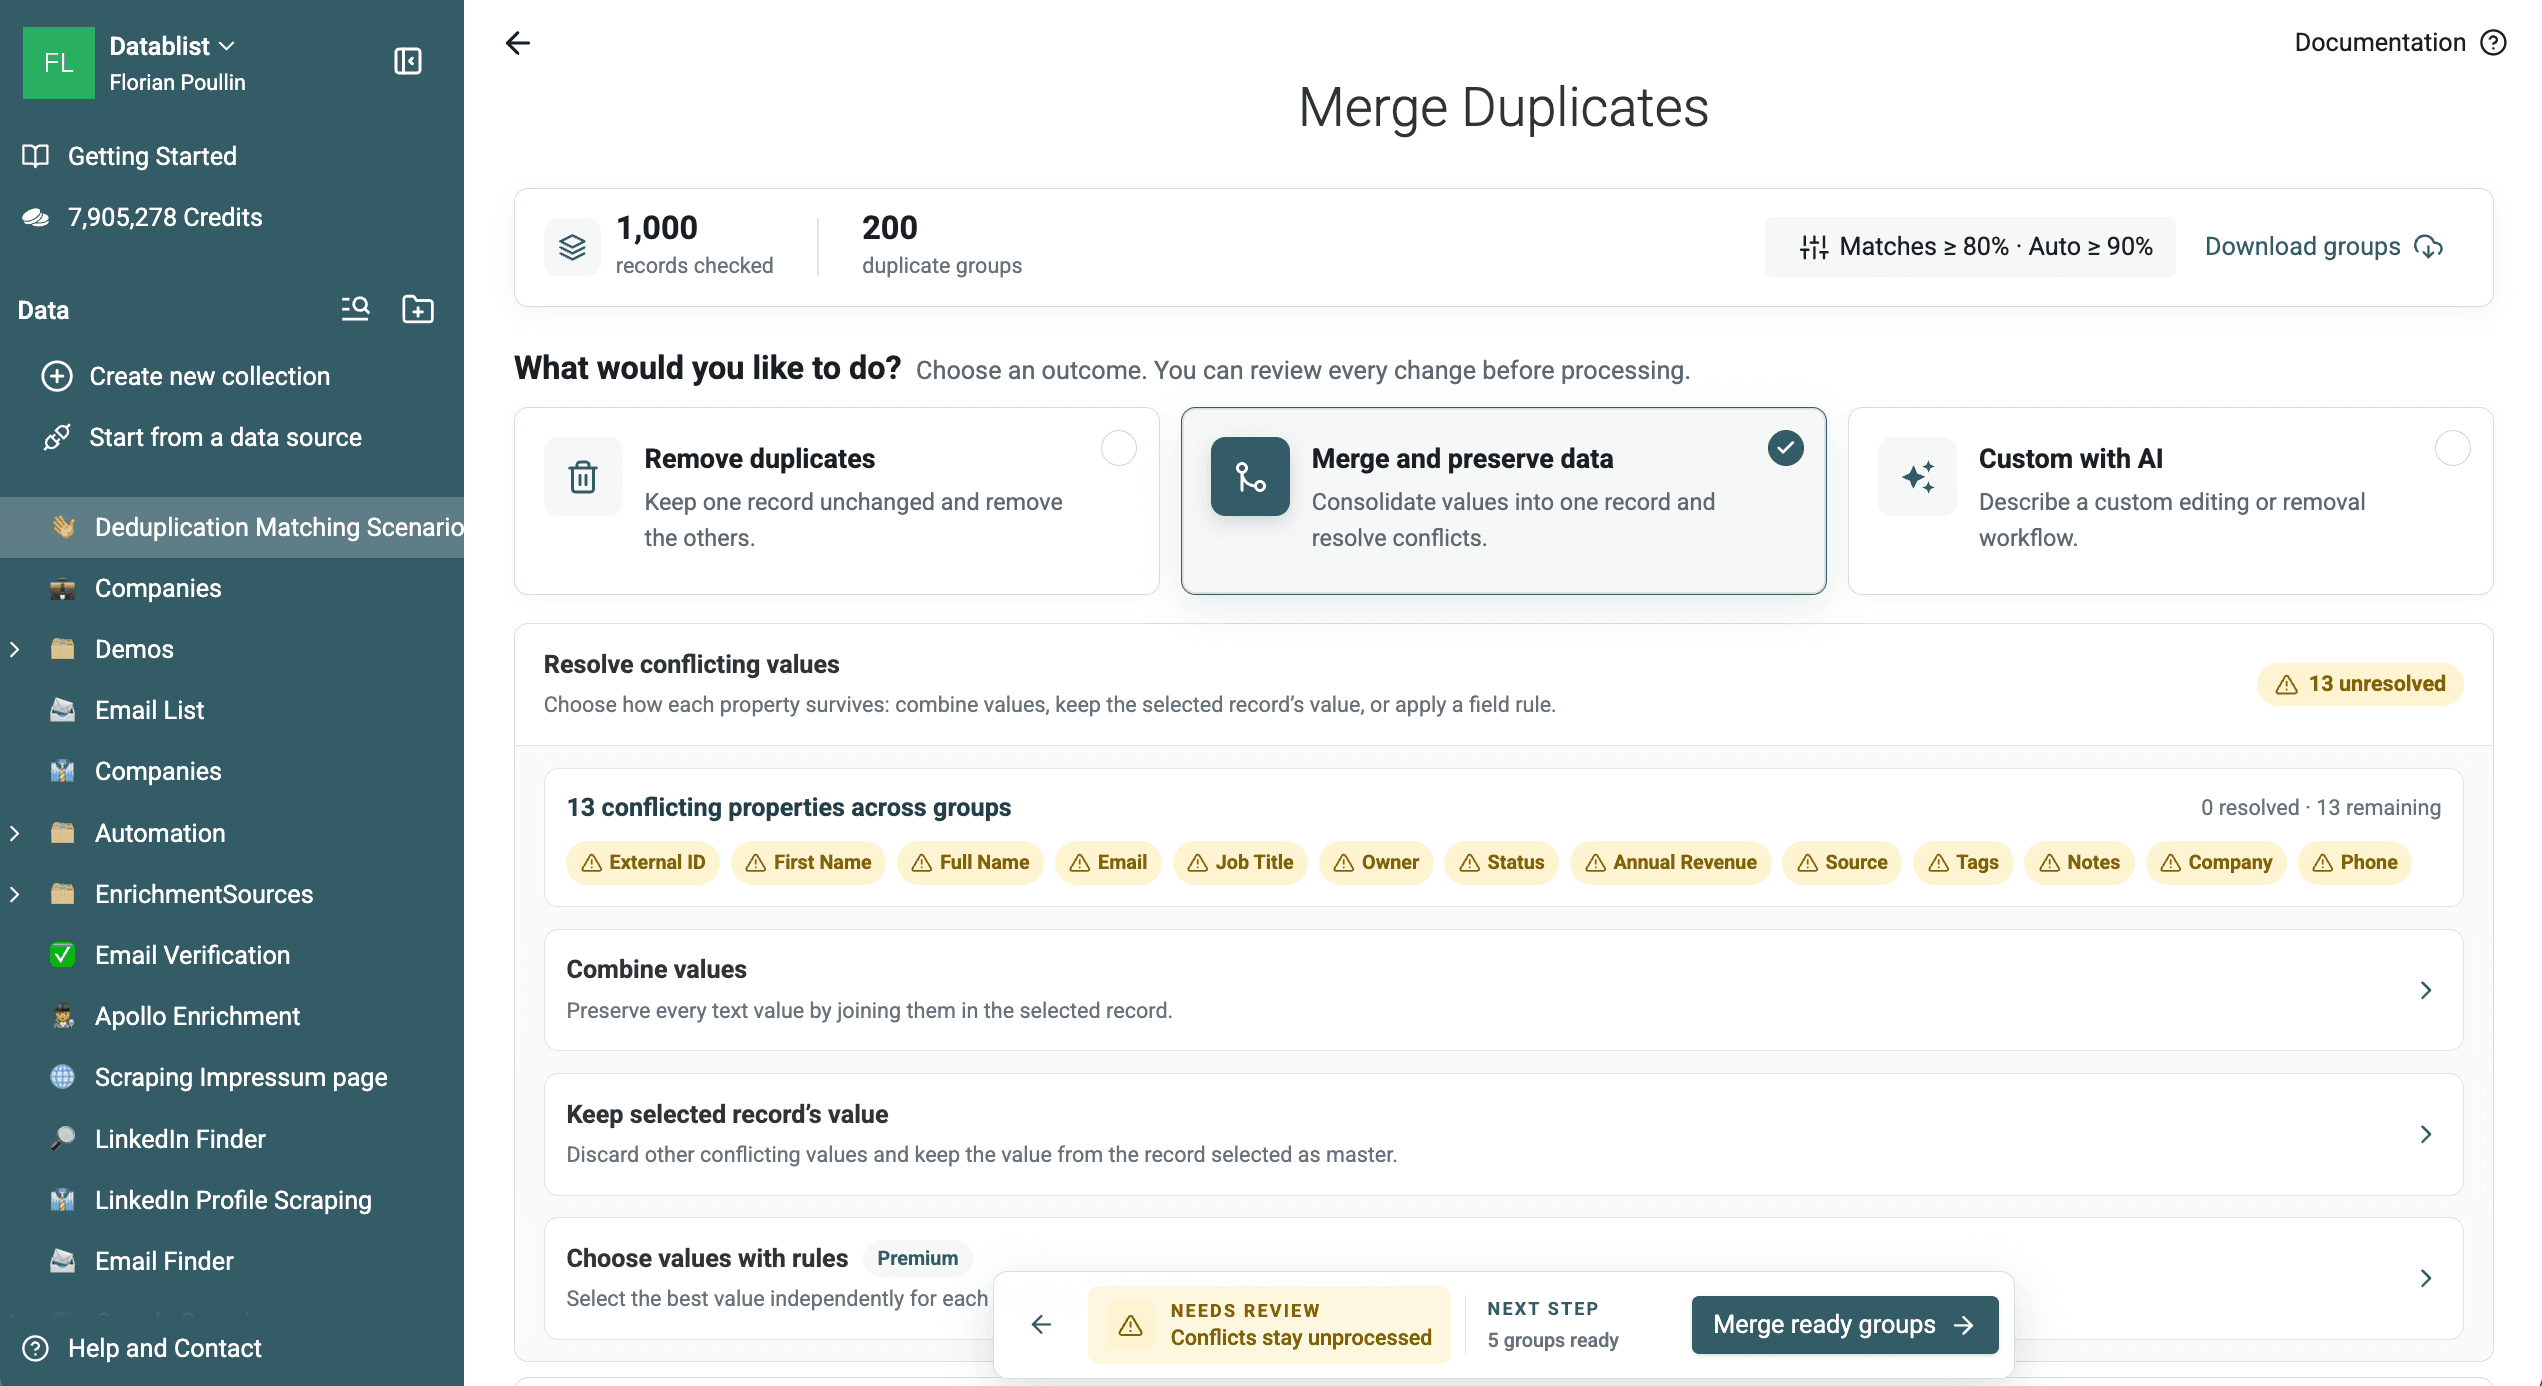
Risolvi i conflitti tra i dati
Una proprietà in conflitto indica che lo stesso campo contiene valori diversi nei record identificati come duplicati.
Se i record duplicati presentano valori differenti nei vari campi, devi decidere come unirli.
Scegli una regola per ogni proprietà in conflitto:
- Combine conserva i diversi valori testuali separandoli con un delimitatore.
- Keep the selected record's value elimina gli altri valori.
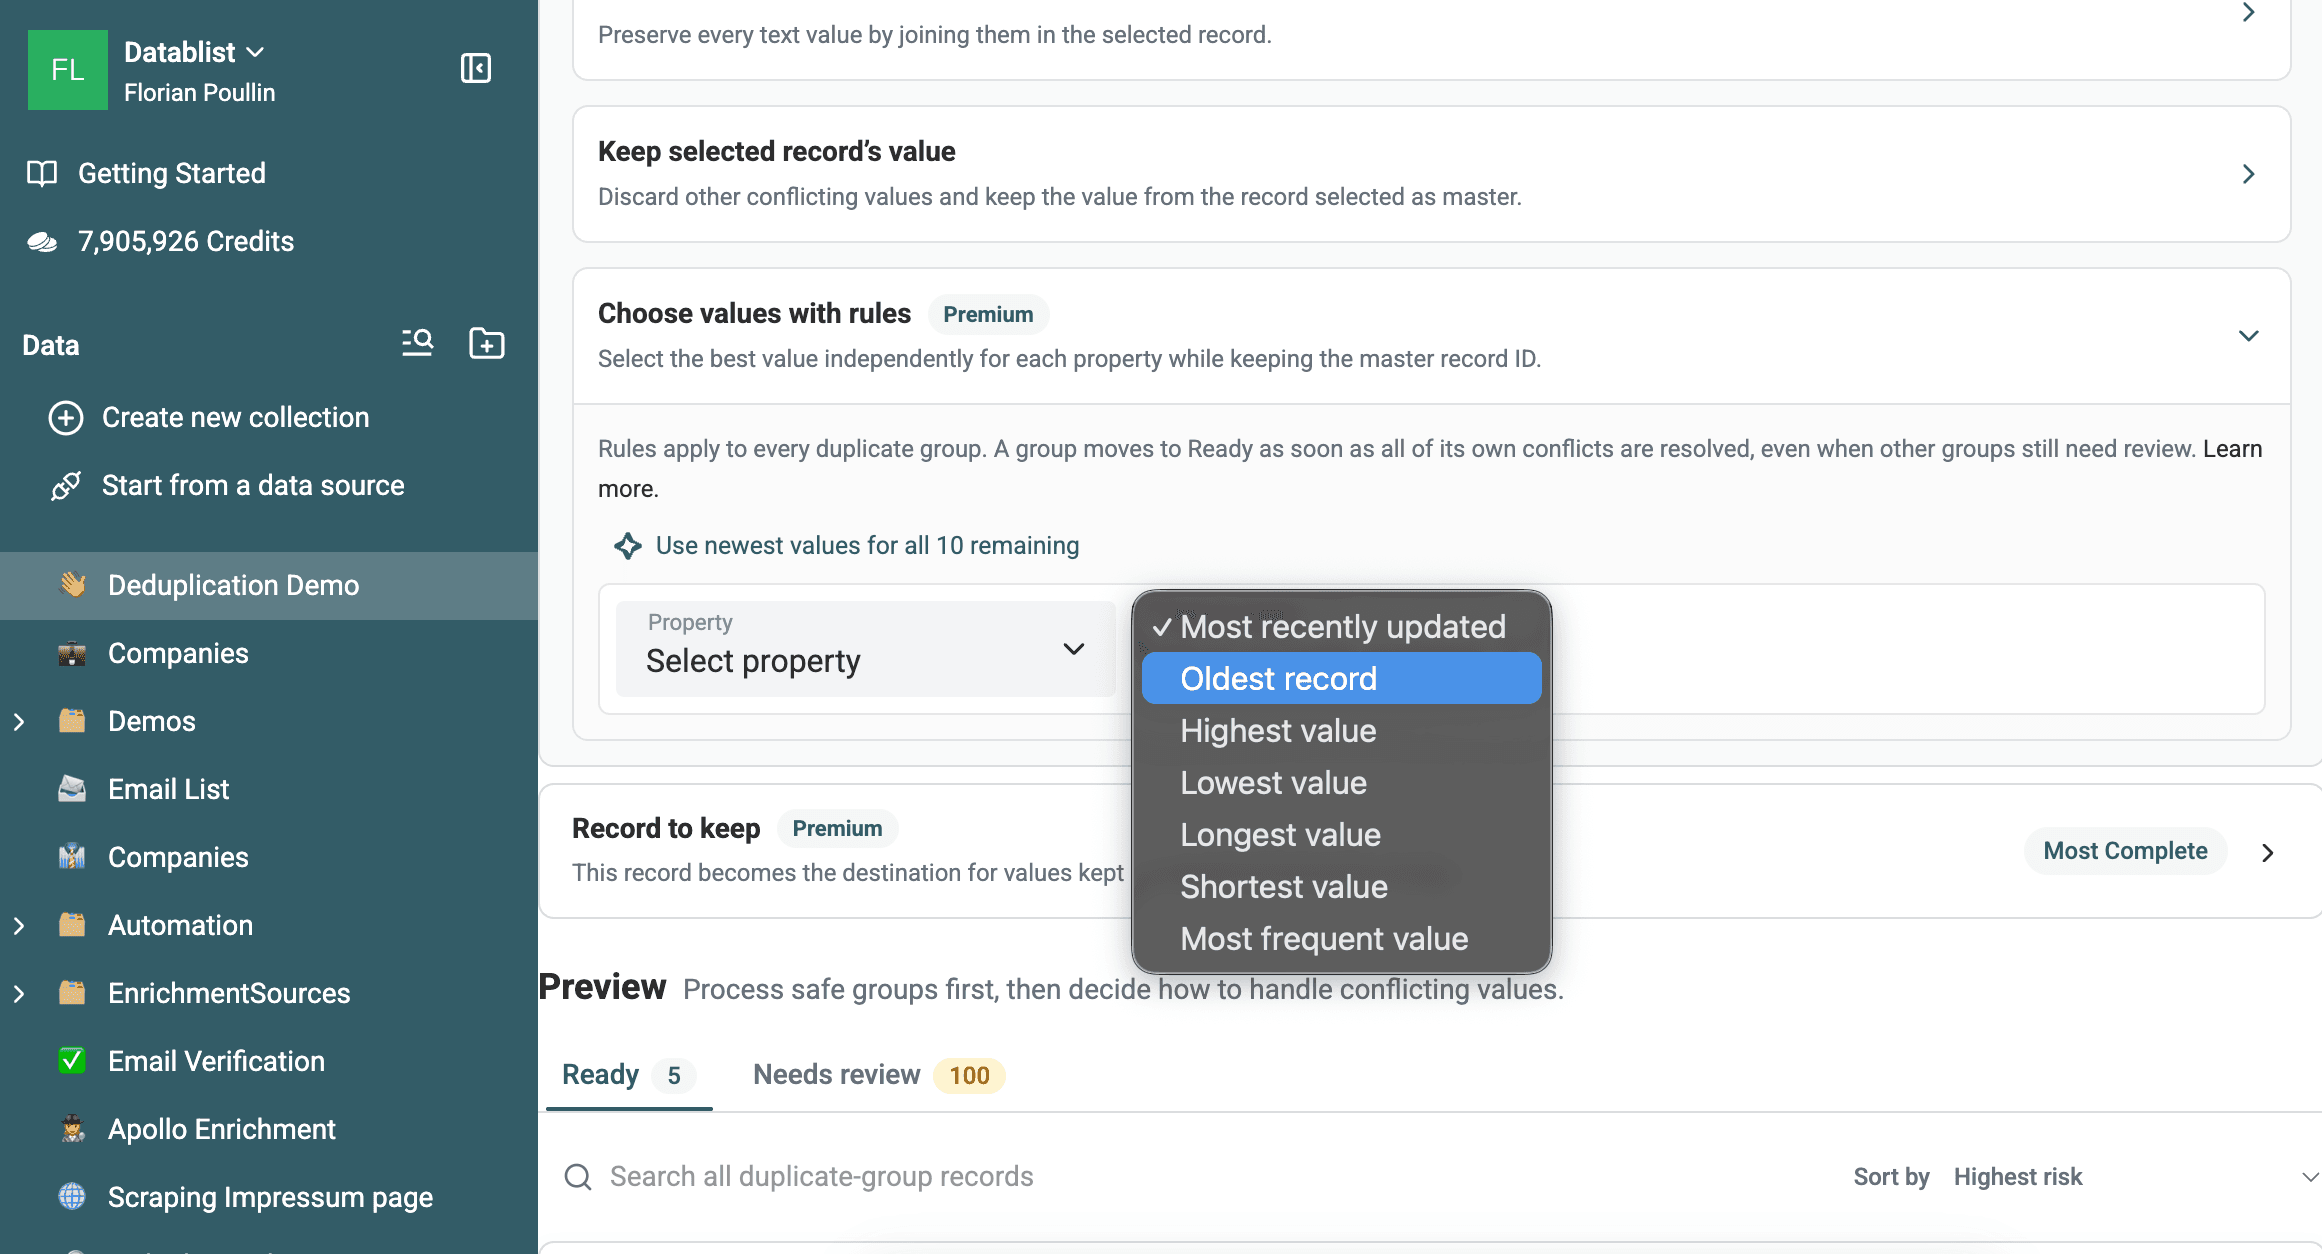
- Nei piani a pagamento, le regole di sopravvivenza dei campi possono selezionare il valore più recente, meno recente, più lungo, più corto, più alto, più basso o più frequente.
Usa il comando rapido per applicare la stessa regola a più proprietà in conflitto, poi modifica i singoli campi dove necessario.
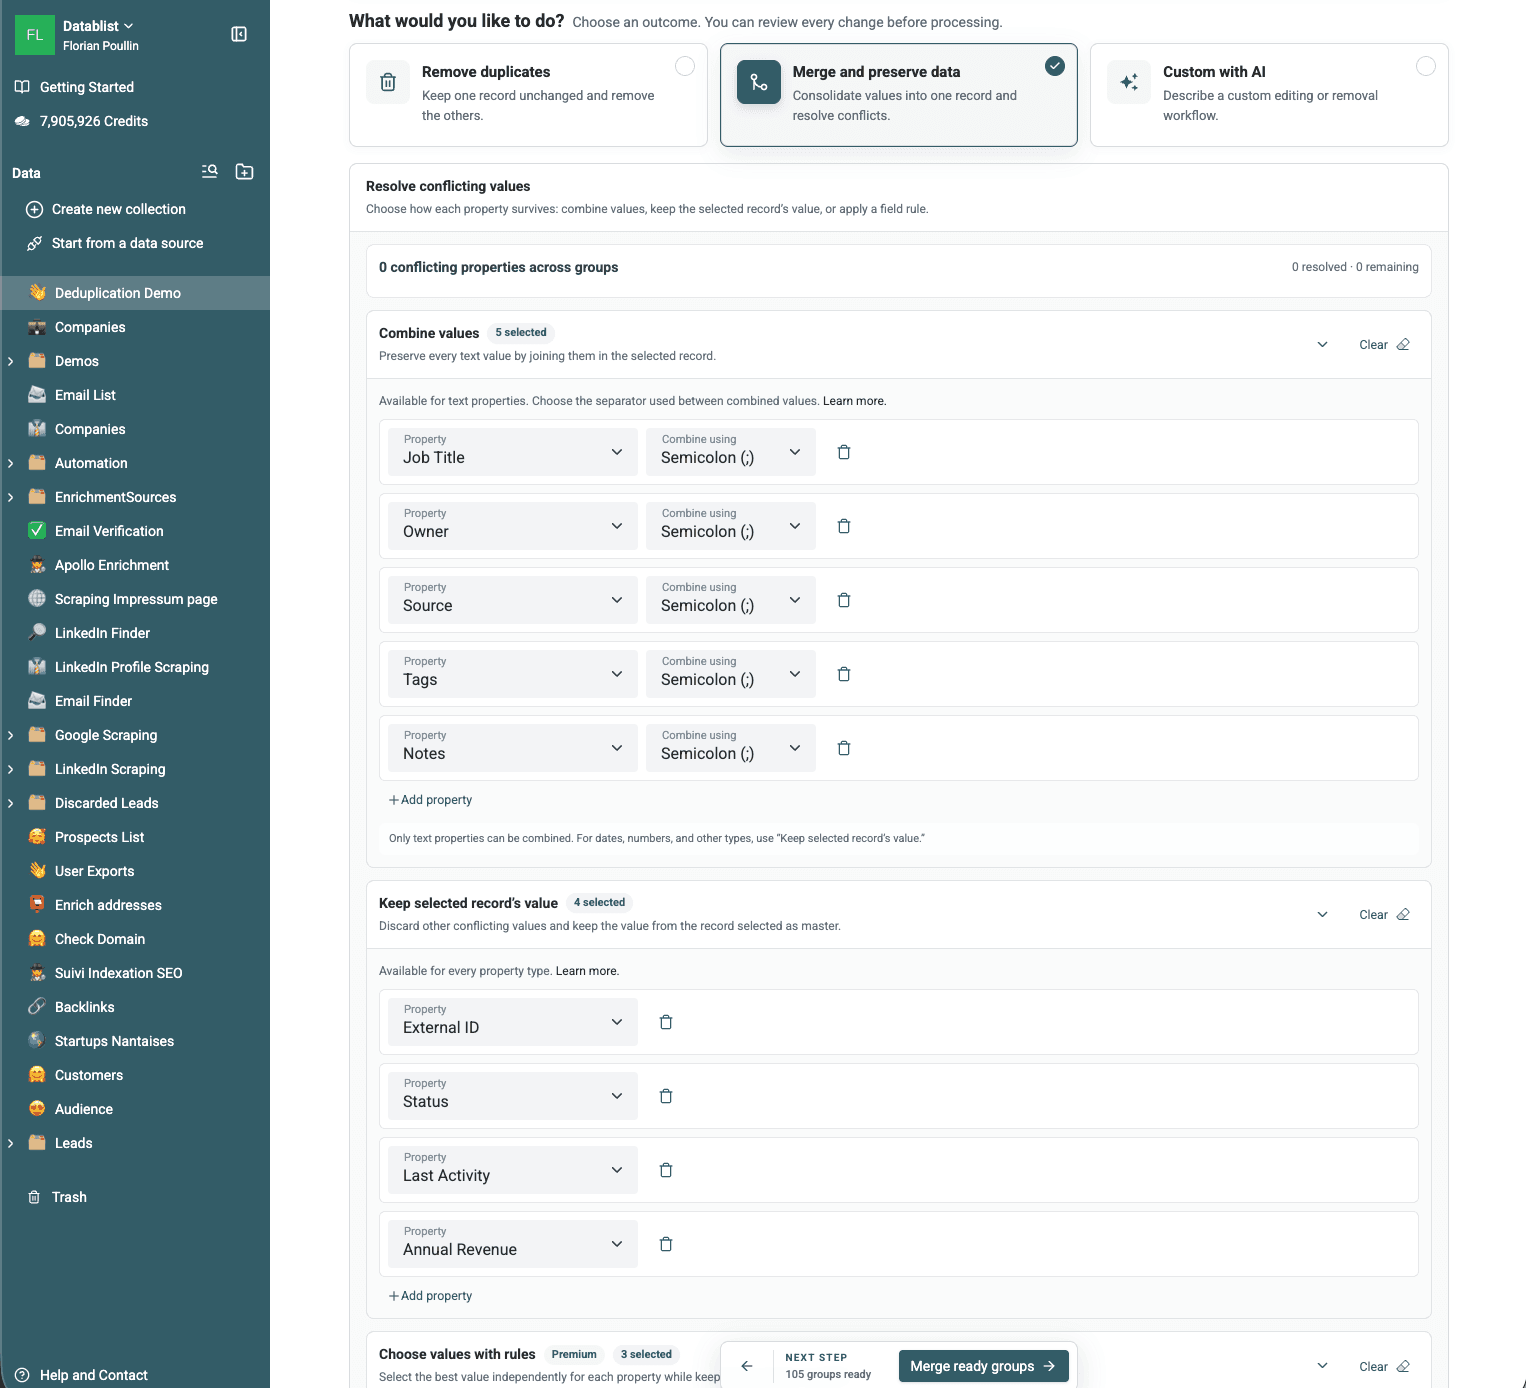
Scegli il record master
Un record diventa quello di destinazione e conserva il proprio ID Datablist.
Puoi selezionarlo in base a questi criteri:
- Most Complete: conserva il record con il maggior numero di proprietà valorizzate.
- Last Updated: conserva il record modificato più di recente.
- First Created: conserva il record meno recente.
- Highest Value o Lowest Value: confronta una proprietà selezionata.
- Matching Value: conserva il record che contiene uno specifico valore per una proprietà.
Dopo aver configurato le regole di unione e la selezione del record master, aggiorna l’anteprima per visualizzare il risultato dell’operazione prima di applicare le modifiche.
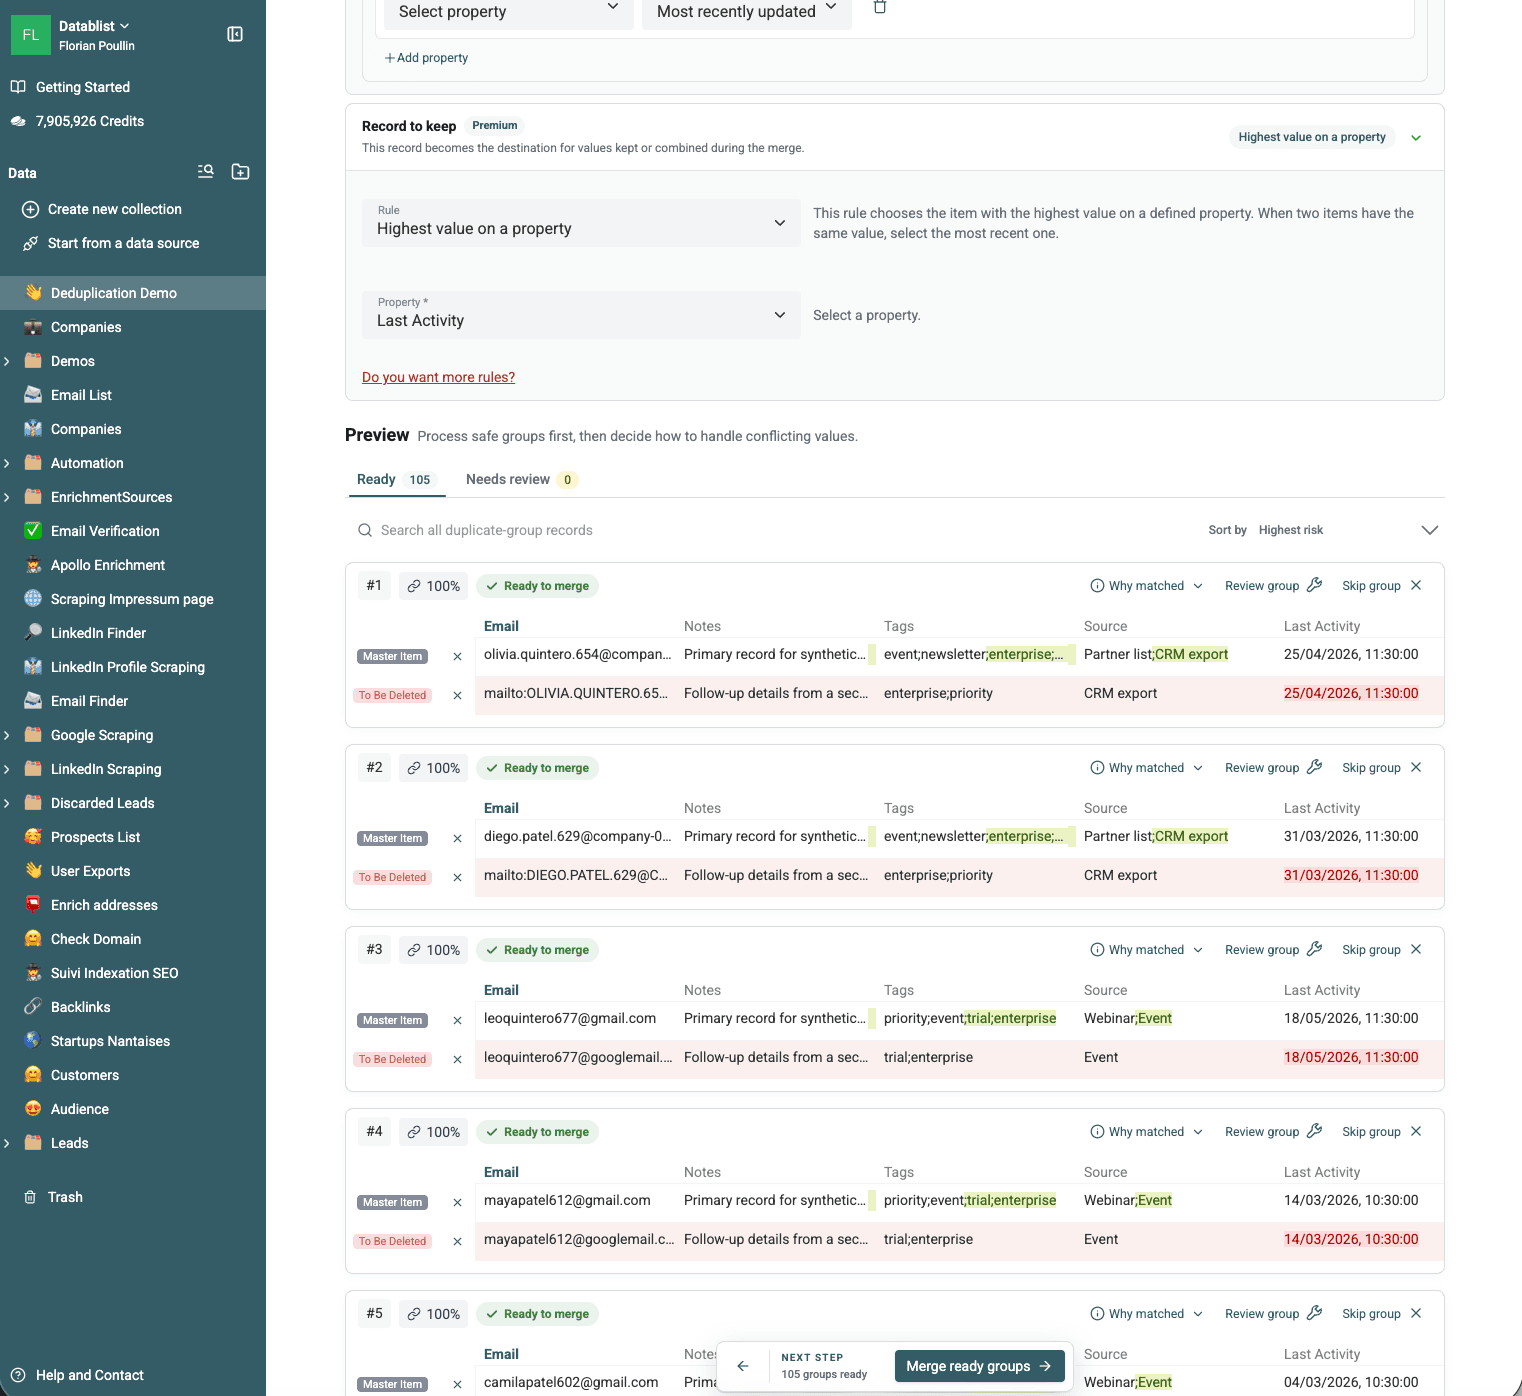
L’anteprima mostra i valori che verranno eliminati o combinati e il record master scelto per ogni gruppo di duplicati.
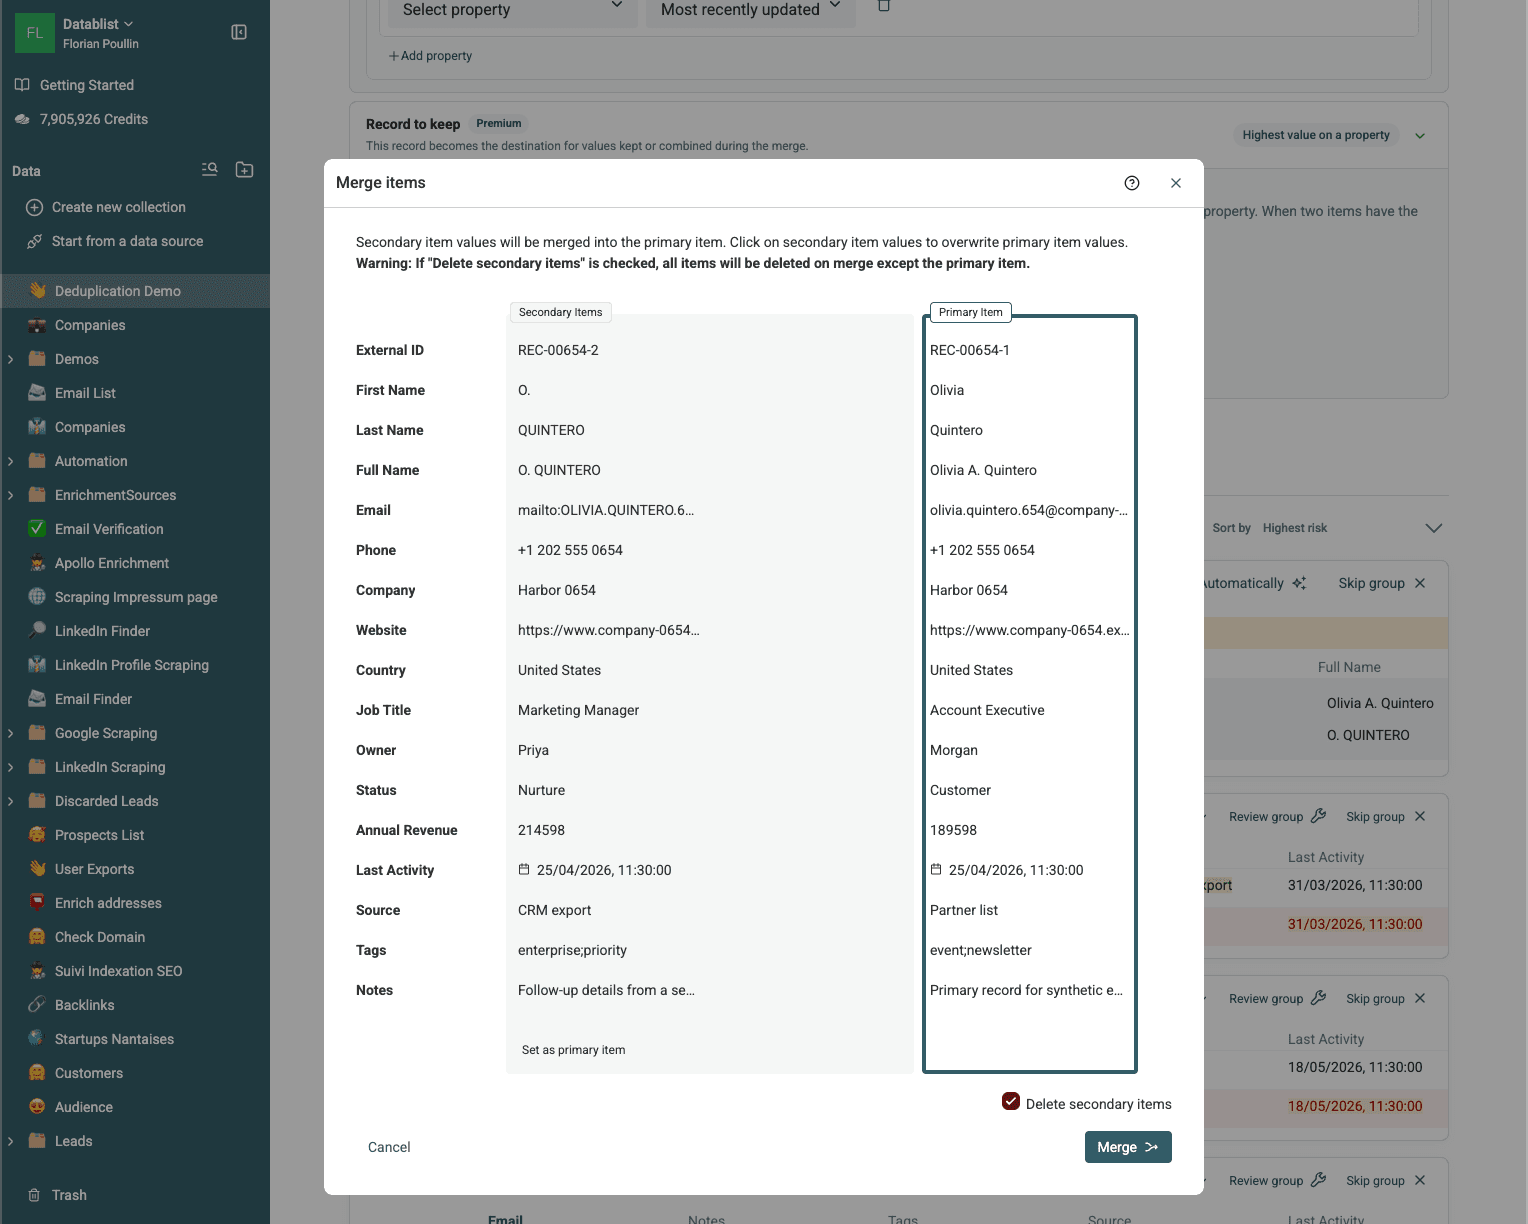
Per gestire le eccezioni, apri Review group e scegli manualmente i valori.
Elabora i gruppi Ready. Quelli ancora contrassegnati come Needs review rimangono invariati.
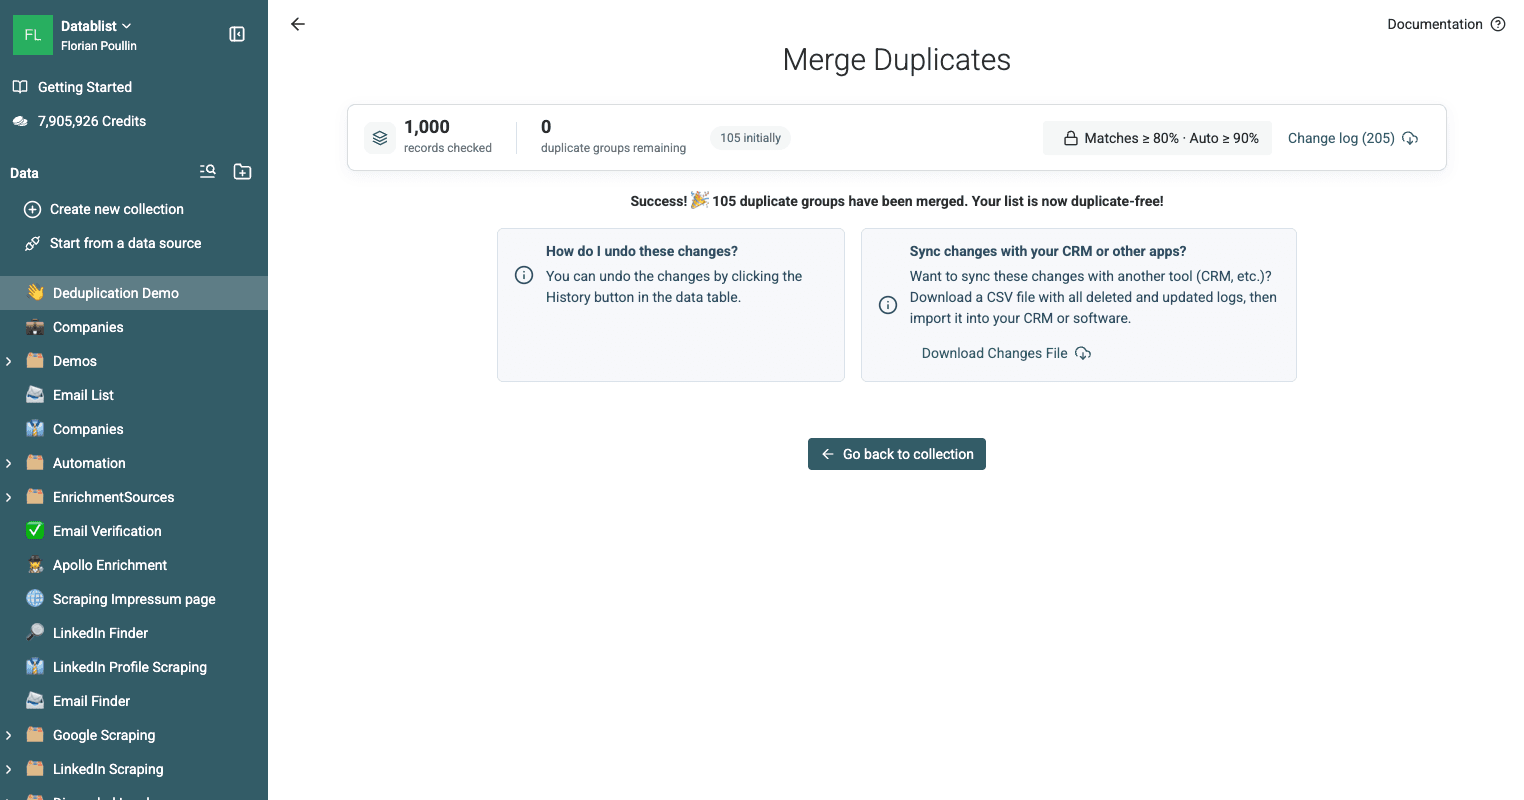
Dopo l’unione, usa Export nell’header della collection per scaricare l’elenco pulito in formato CSV o Excel. Il change log generato dopo l’elaborazione registra gli ID eliminati e aggiornati, utile quando ti serve una traccia per l’audit.
Per conoscere tutte le impostazioni di matching, revisione e unione, consulta la documentazione di Duplicate Finder.