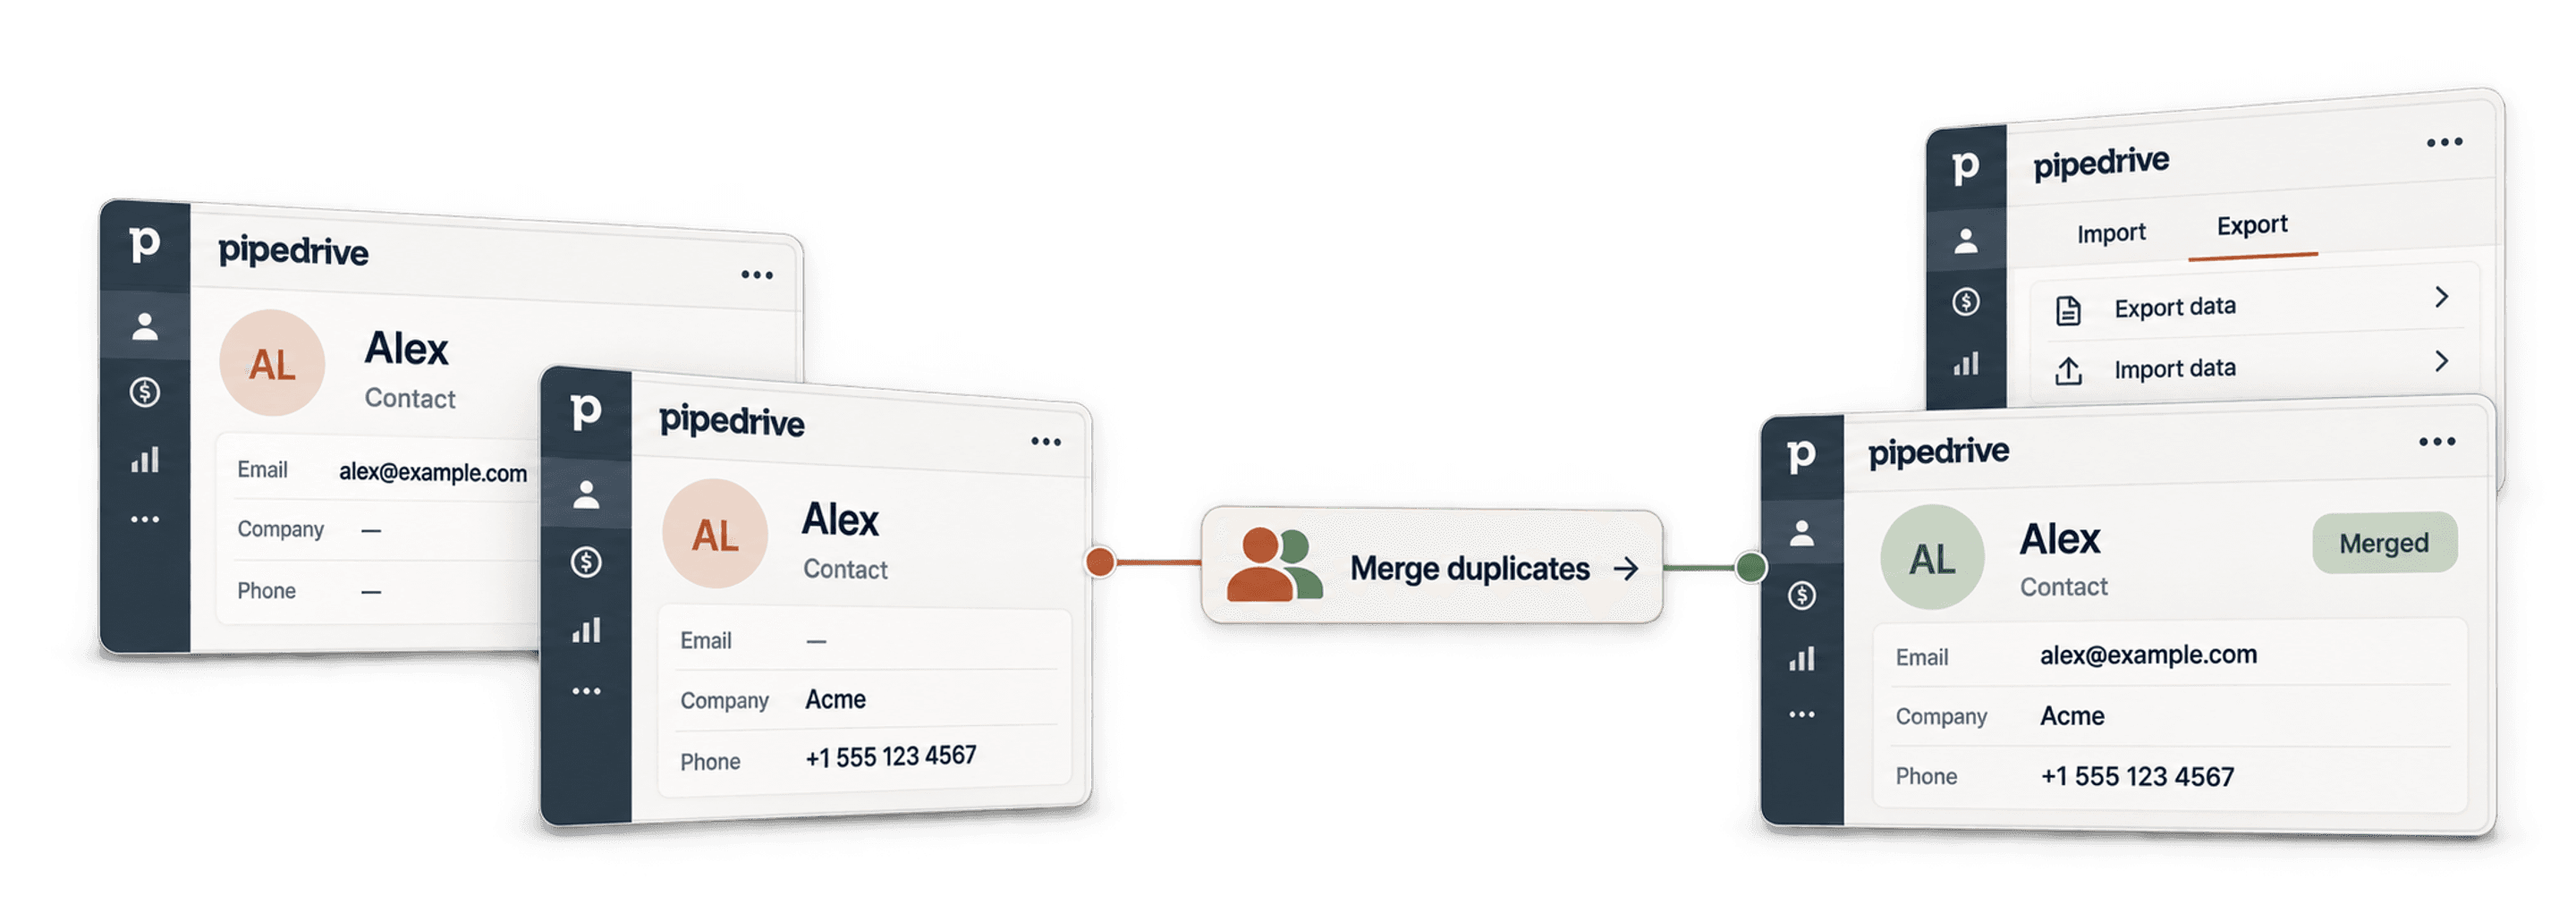
Per unire in blocco i duplicati in Pipedrive con Datablist, importa People o Organizations, individua i gruppi candidati usando una chiave affidabile, controlla il record master e i valori in conflitto, quindi sincronizza su Pipedrive le modifiche approvate. Conserva una copia del file delle modifiche esportato per verificare i record risultanti.
Pipedrive offre già una funzione Merge Duplicates, che vale la pena controllare per prima. Le sue regole di corrispondenza cercano persone con lo stesso nome e la stessa email, lo stesso telefono o la stessa organizzazione, oppure organizzazioni con lo stesso nome e indirizzo. Questo approccio può non rilevare record in cui il nome dell’azienda varia o la chiave più utile è il sito web.
In questa guida useremo Datablist per verificare le corrispondenze partendo da email o sito web e, quando opportuno, dalla somiglianza tra i nomi delle aziende. Potrai esportare le modifiche e applicarle a Pipedrive dopo aver controllato quale record conservare.
Se queste regole non coprono i tuoi dati, Duplicates Finder di Datablist offre chiavi di corrispondenza aggiuntive e diverse opzioni per gestire i conflitti. Il processo prevede tre passaggi, seguiti da un confronto con la funzione nativa di Pipedrive:
- Importa People e/o Organizations di Pipedrive in Datablist
- Trova e unisci i duplicati con algoritmi avanzati
- Sincronizza in blocco le unioni su Pipedrive
- Limiti della funzione Merge Duplicates di Pipedrive
Passaggio 1: importa i contatti Pipedrive
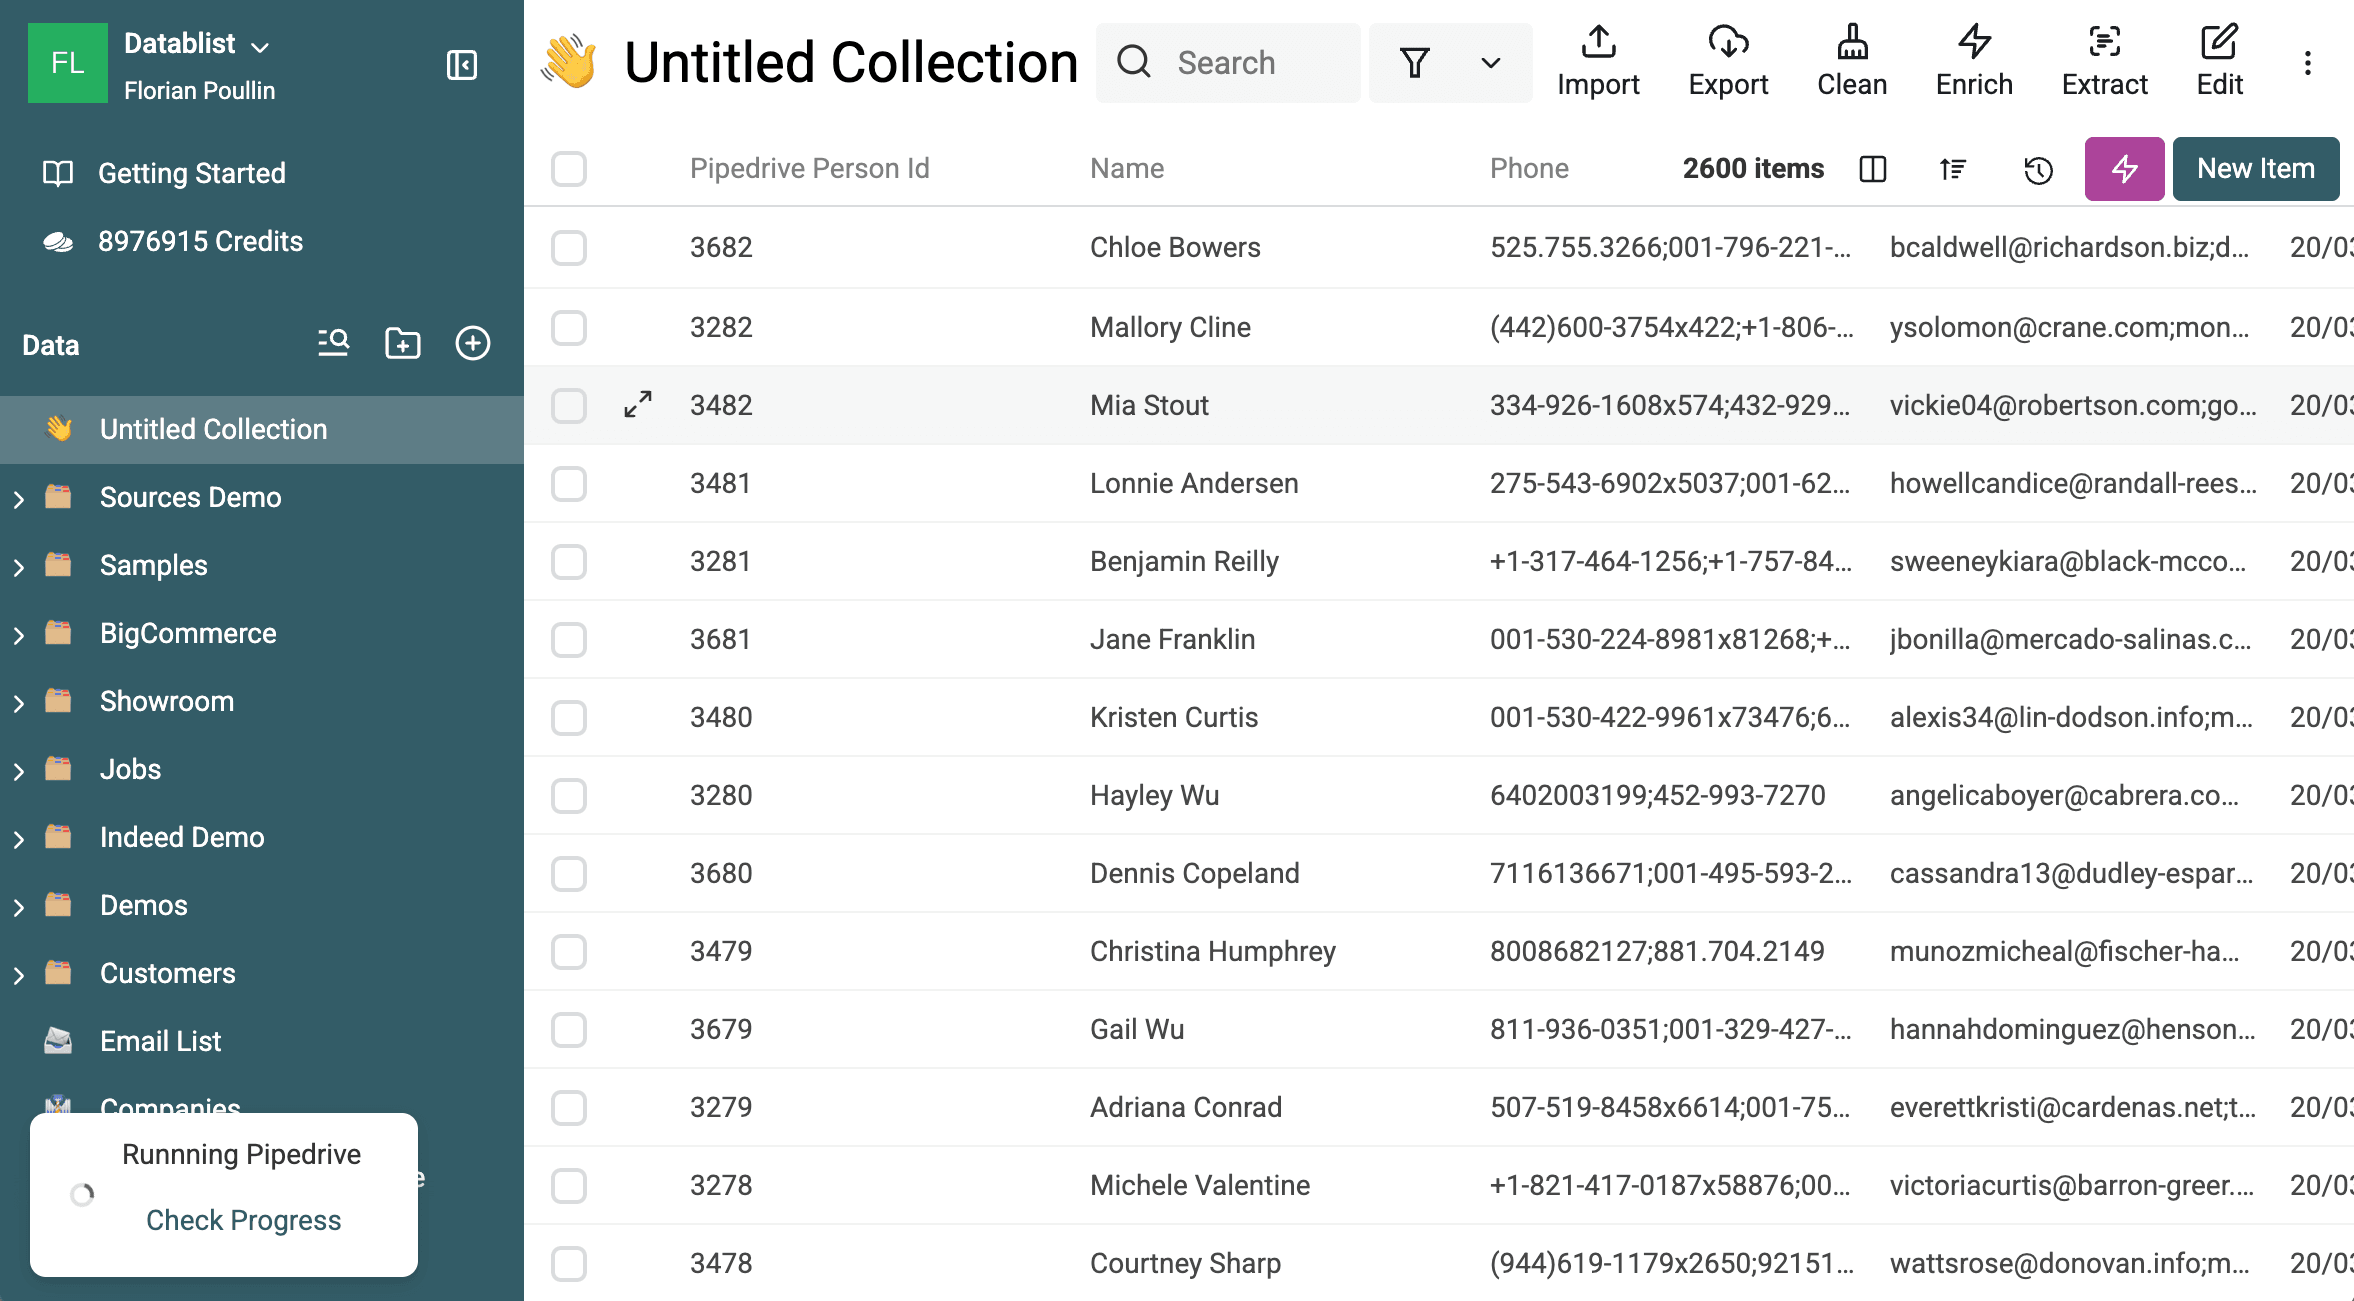
Per prima cosa, importa i dati di Pipedrive in Datablist. Mantieni People e Organizations in collection separate, così ogni elaborazione utilizzerà l’identificativo e i campi di corrispondenza corretti.
1. Crea una nuova collection Datablist
Una collection di Datablist è simile a un foglio di calcolo in cui puoi archiviare e pulire i dati. Ogni collection conterrà i contatti (People) o le aziende (Organizations) di Pipedrive.
- Per deduplicare People, crea una collection dedicata a People.
- Per deduplicare Organizations, crea una collection dedicata a Organizations.
- Se devi pulire entrambi, crea due collection separate: una per People e una per Organizations.
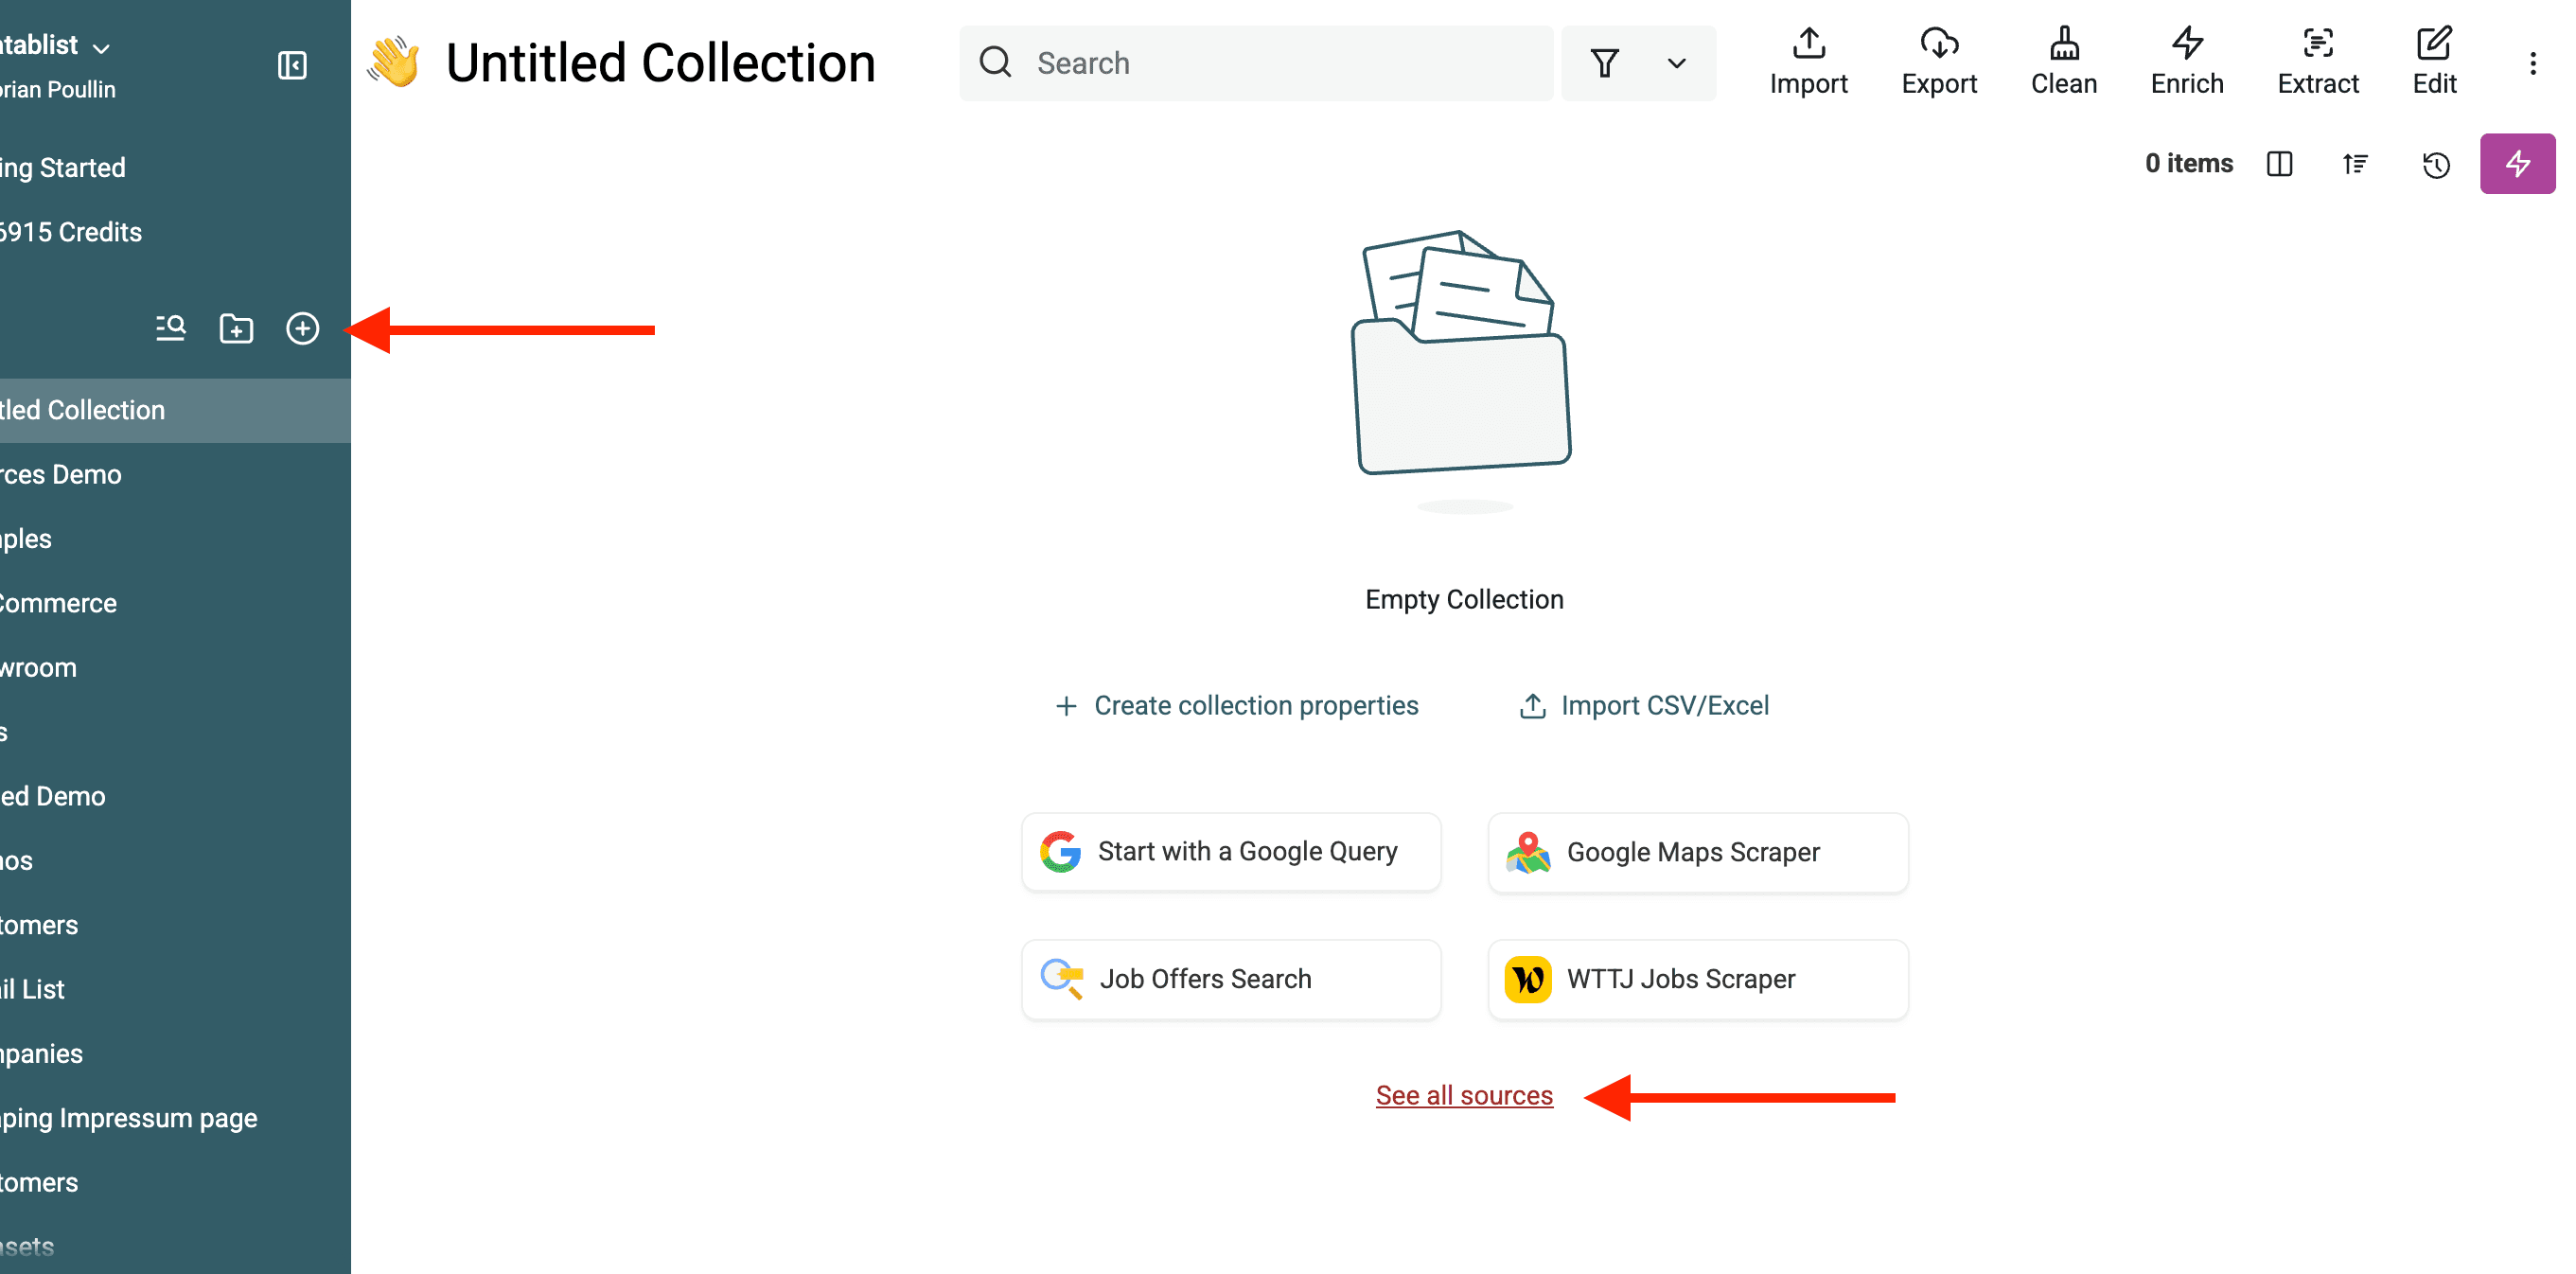
2. Seleziona “Source → Pipedrive”
Datablist si collega direttamente al tuo account Pipedrive tramite API.
Nella collection Datablist, vai su Import → seleziona Source → scegli Pipedrive. In alternativa, usa direttamente il link "See all sources" nella schermata iniziale della collection.
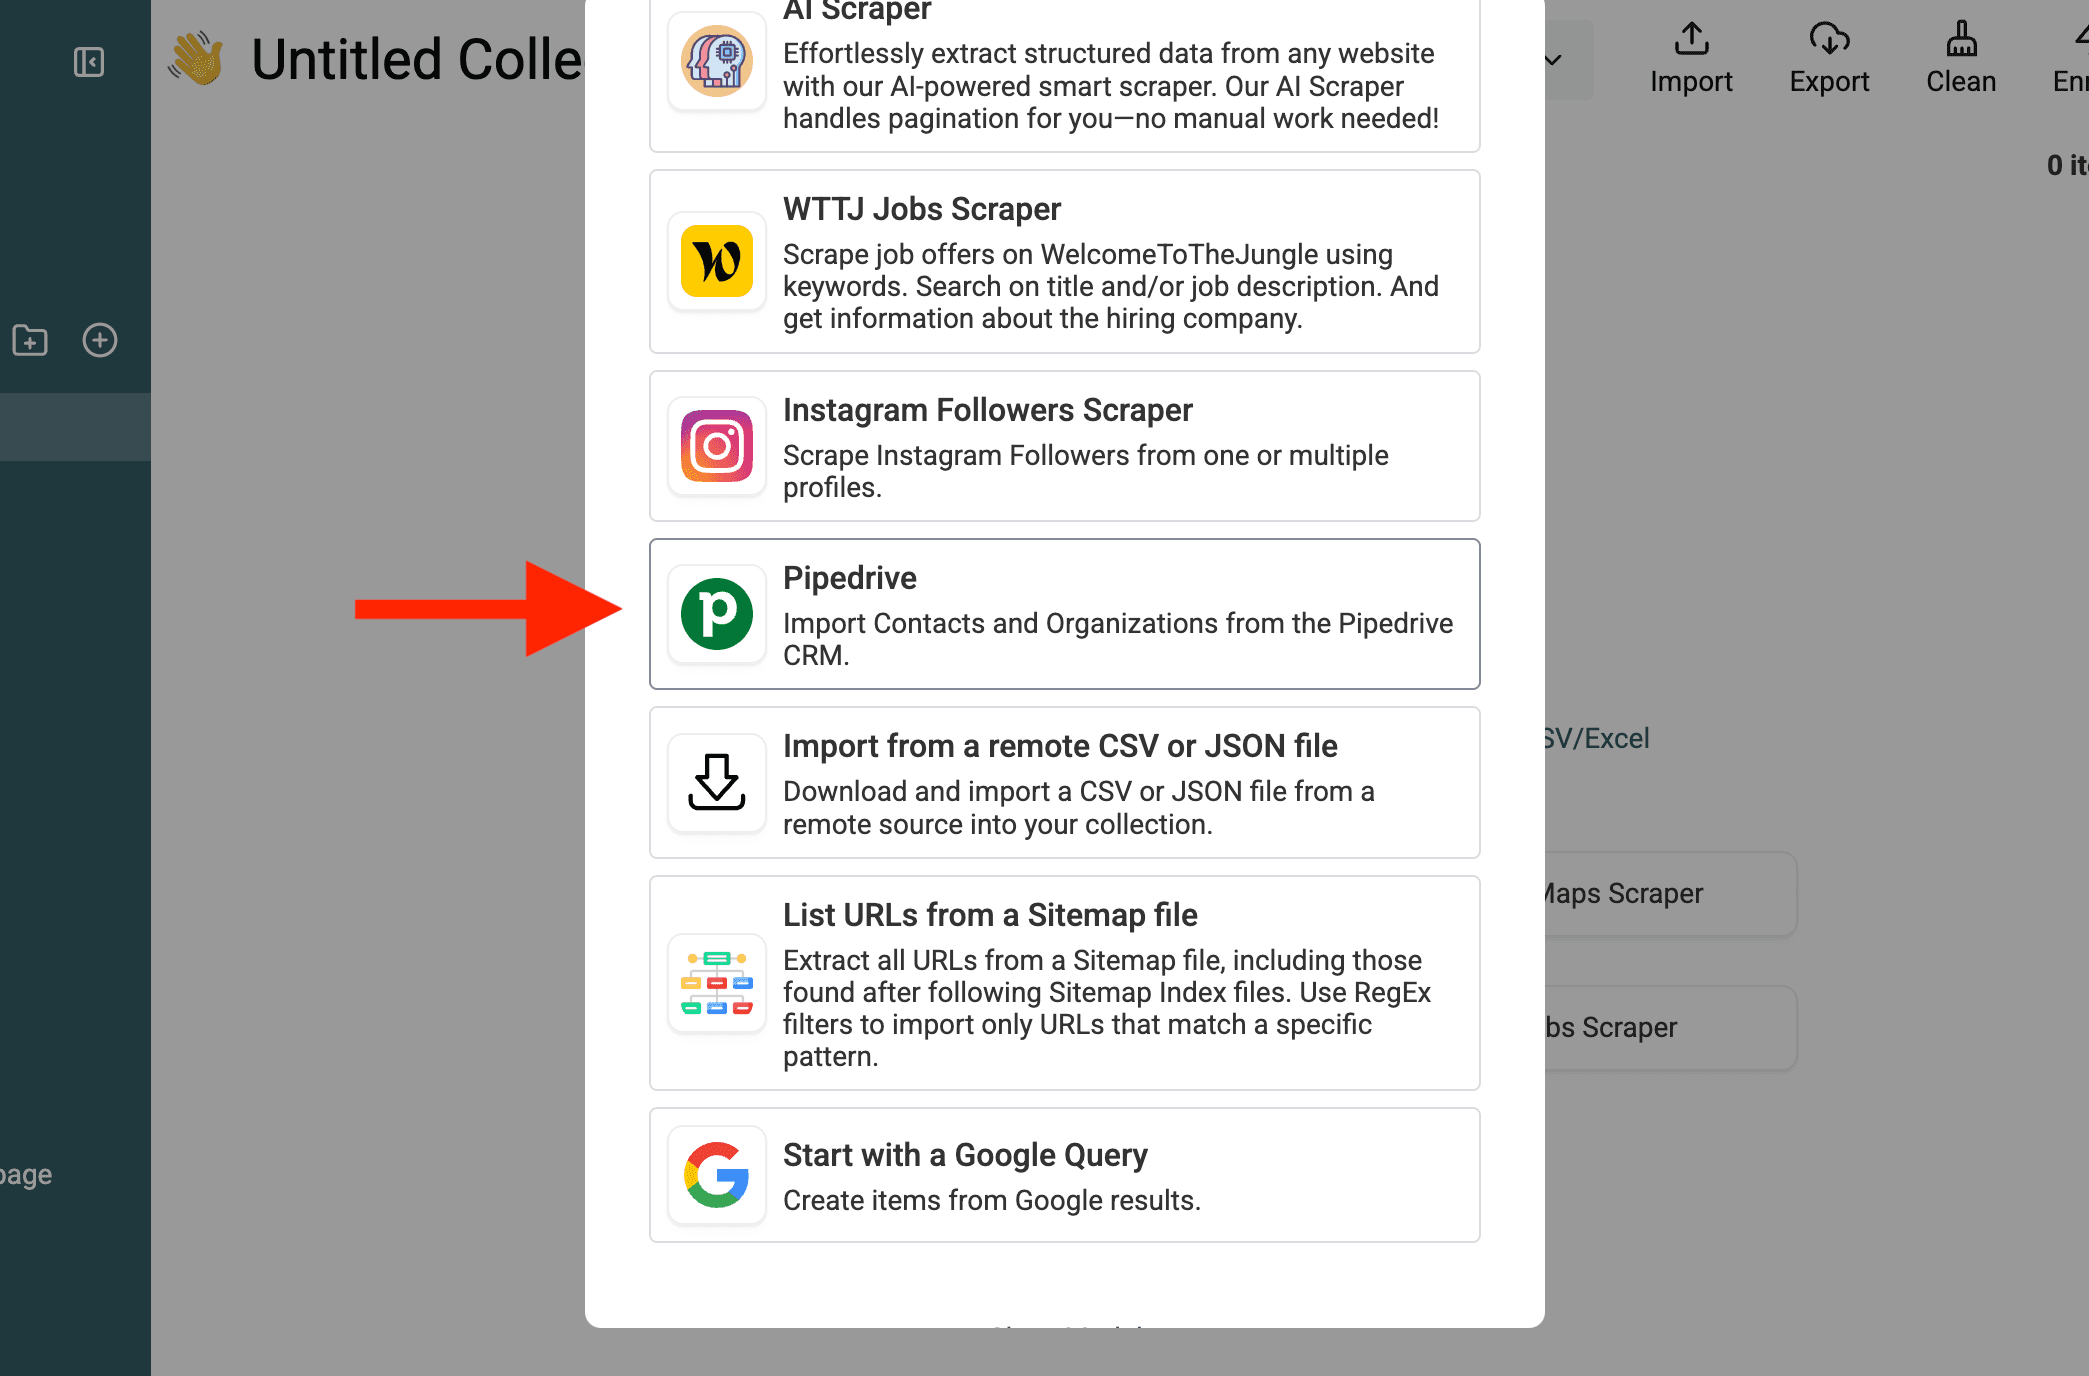
3. Trova la tua chiave API Pipedrive
Ti verrà chiesto di inserire la chiave API di Pipedrive.
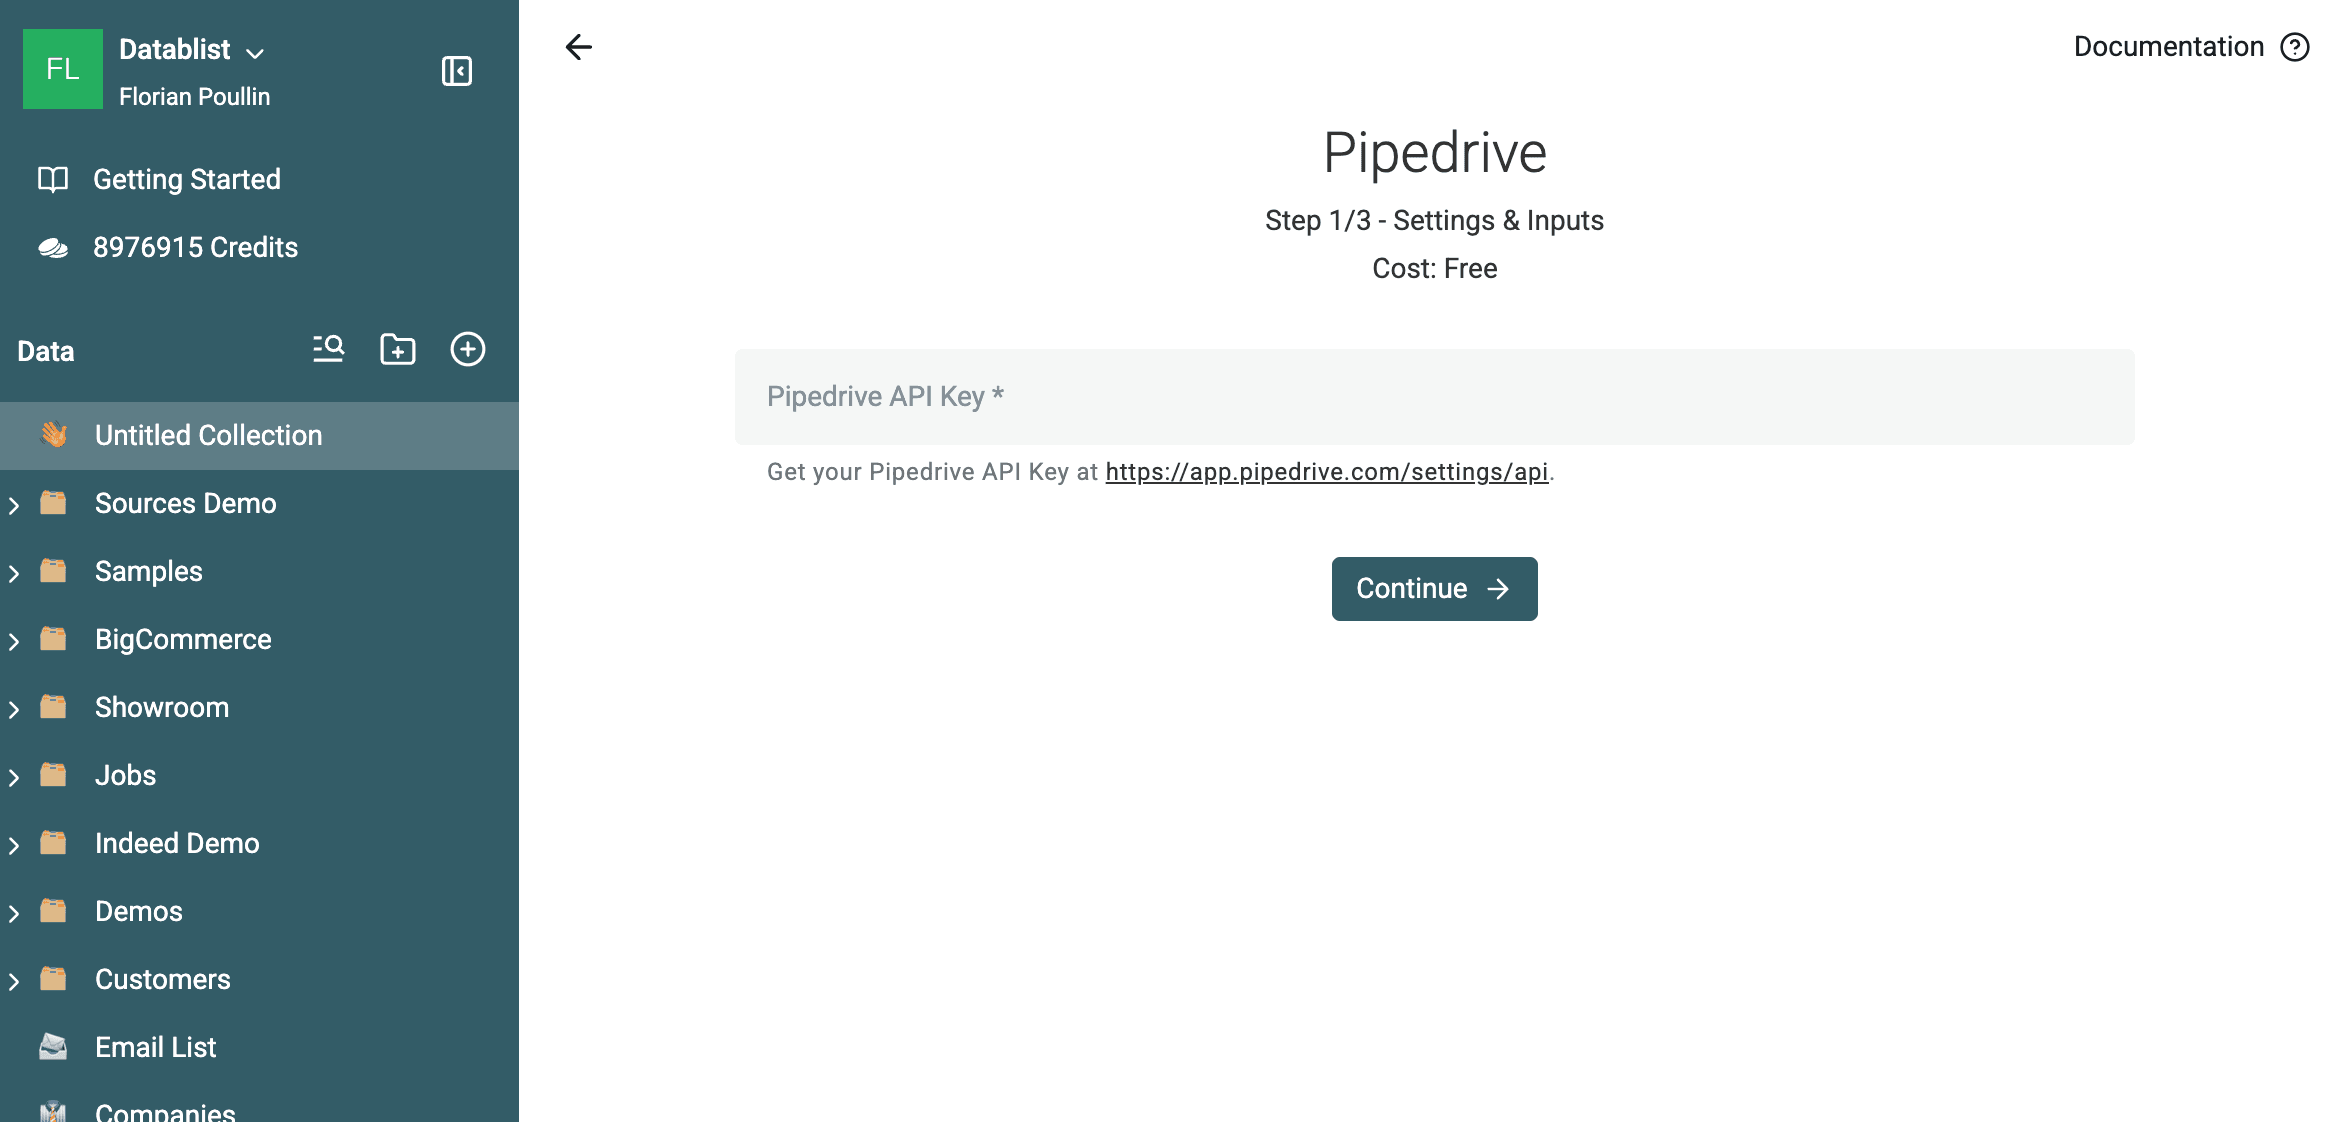
La chiave API di Pipedrive è obbligatoria per collegare Datablist al tuo account. Apri le impostazioni API di Pipedrive, copia la tua chiave API personale e incollala in Datablist.
4. Scegli People o Organizations
Una volta stabilita la connessione, scegli cosa importare:
- Se vuoi eliminare i contatti duplicati, seleziona People.
- Se vuoi eliminare le aziende duplicate, seleziona Organizations.
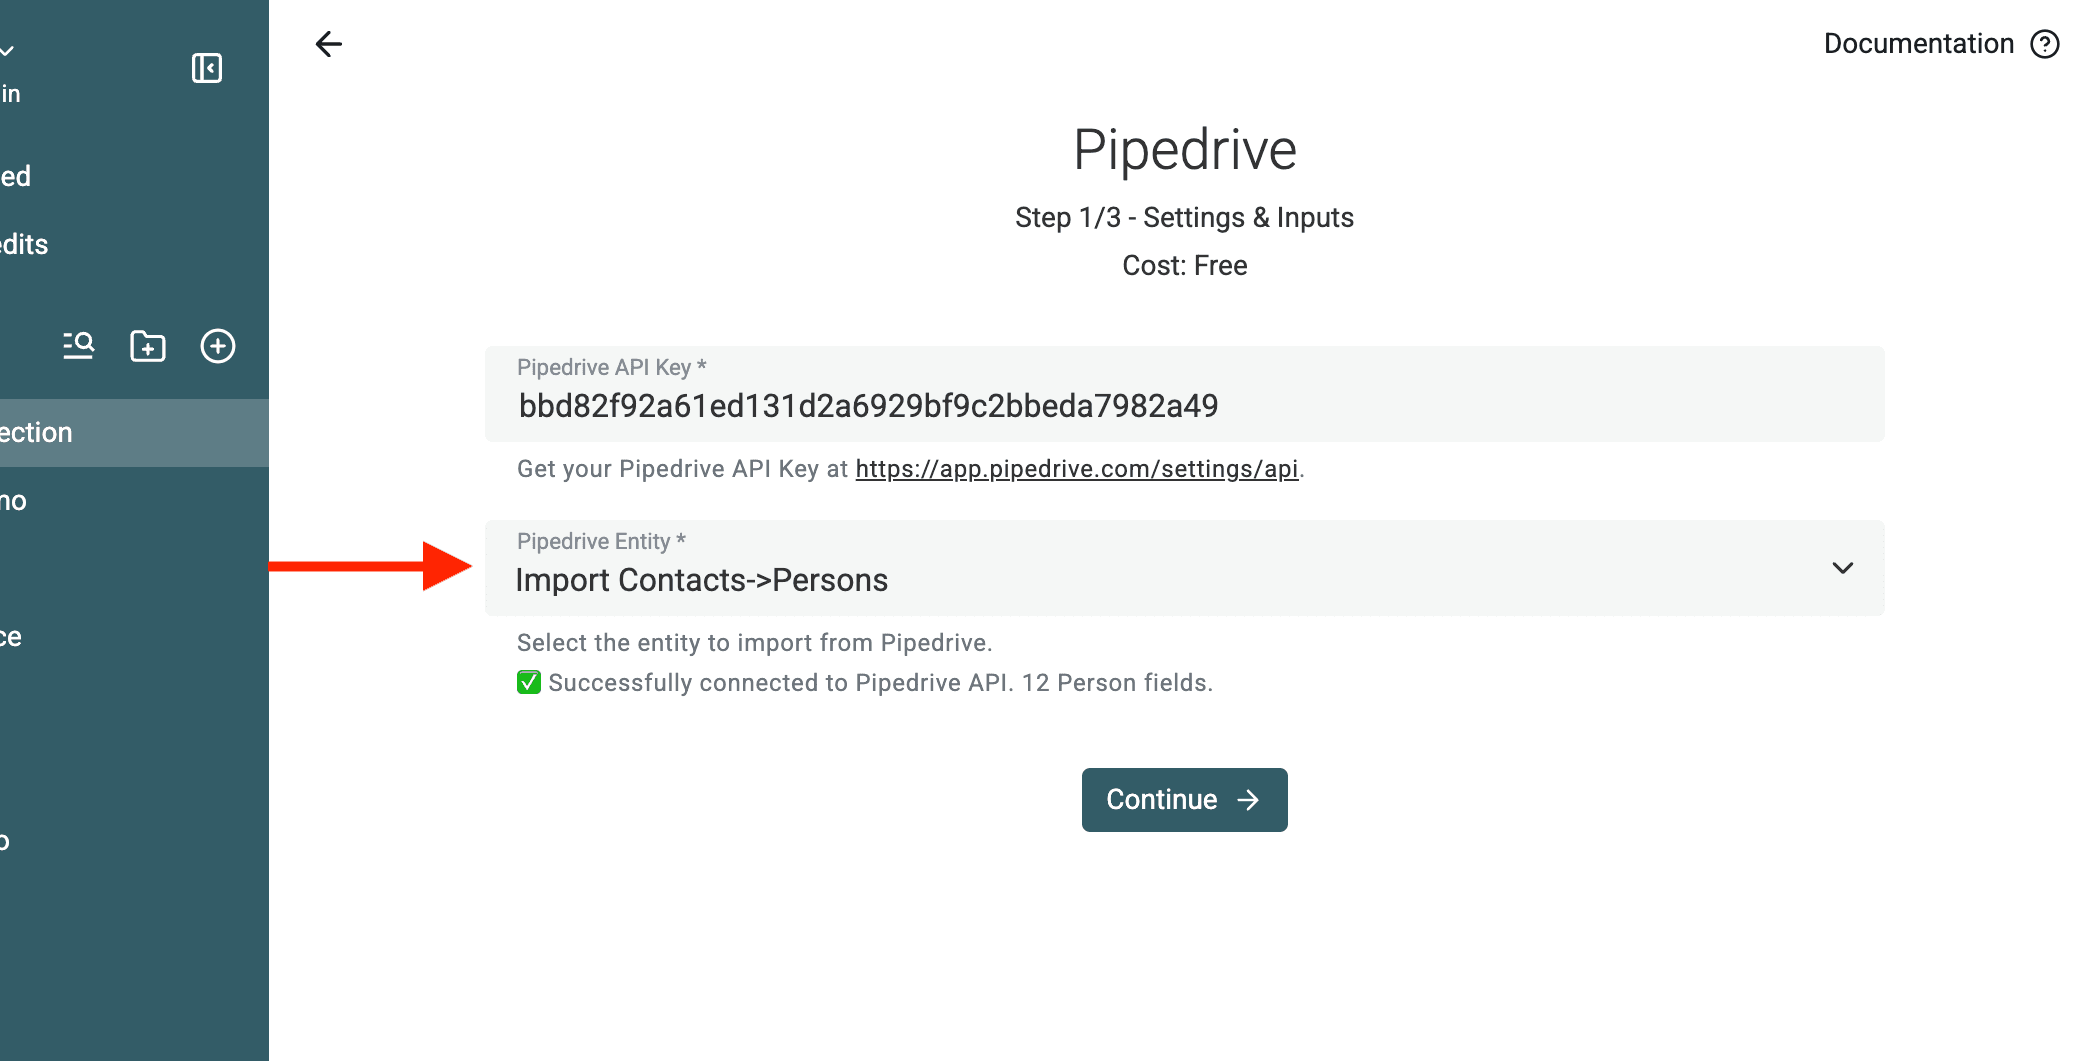
Nota: se ti servono entrambi, importali separatamente in due collection diverse.
Perché usare collection separate? - Pipedrive archivia People e Organizations in modo diverso. Non puoi deduplicare contemporaneamente un insieme di entrambi. Separarli garantisce risultati accurati.
5. Datablist recupera tutti i campi di Pipedrive
Dopo aver selezionato People o Organizations, Datablist importerà:
- I campi standard di Pipedrive (Name, Email, Phone, Website e così via).
- I campi personalizzati che hai creato in Pipedrive.
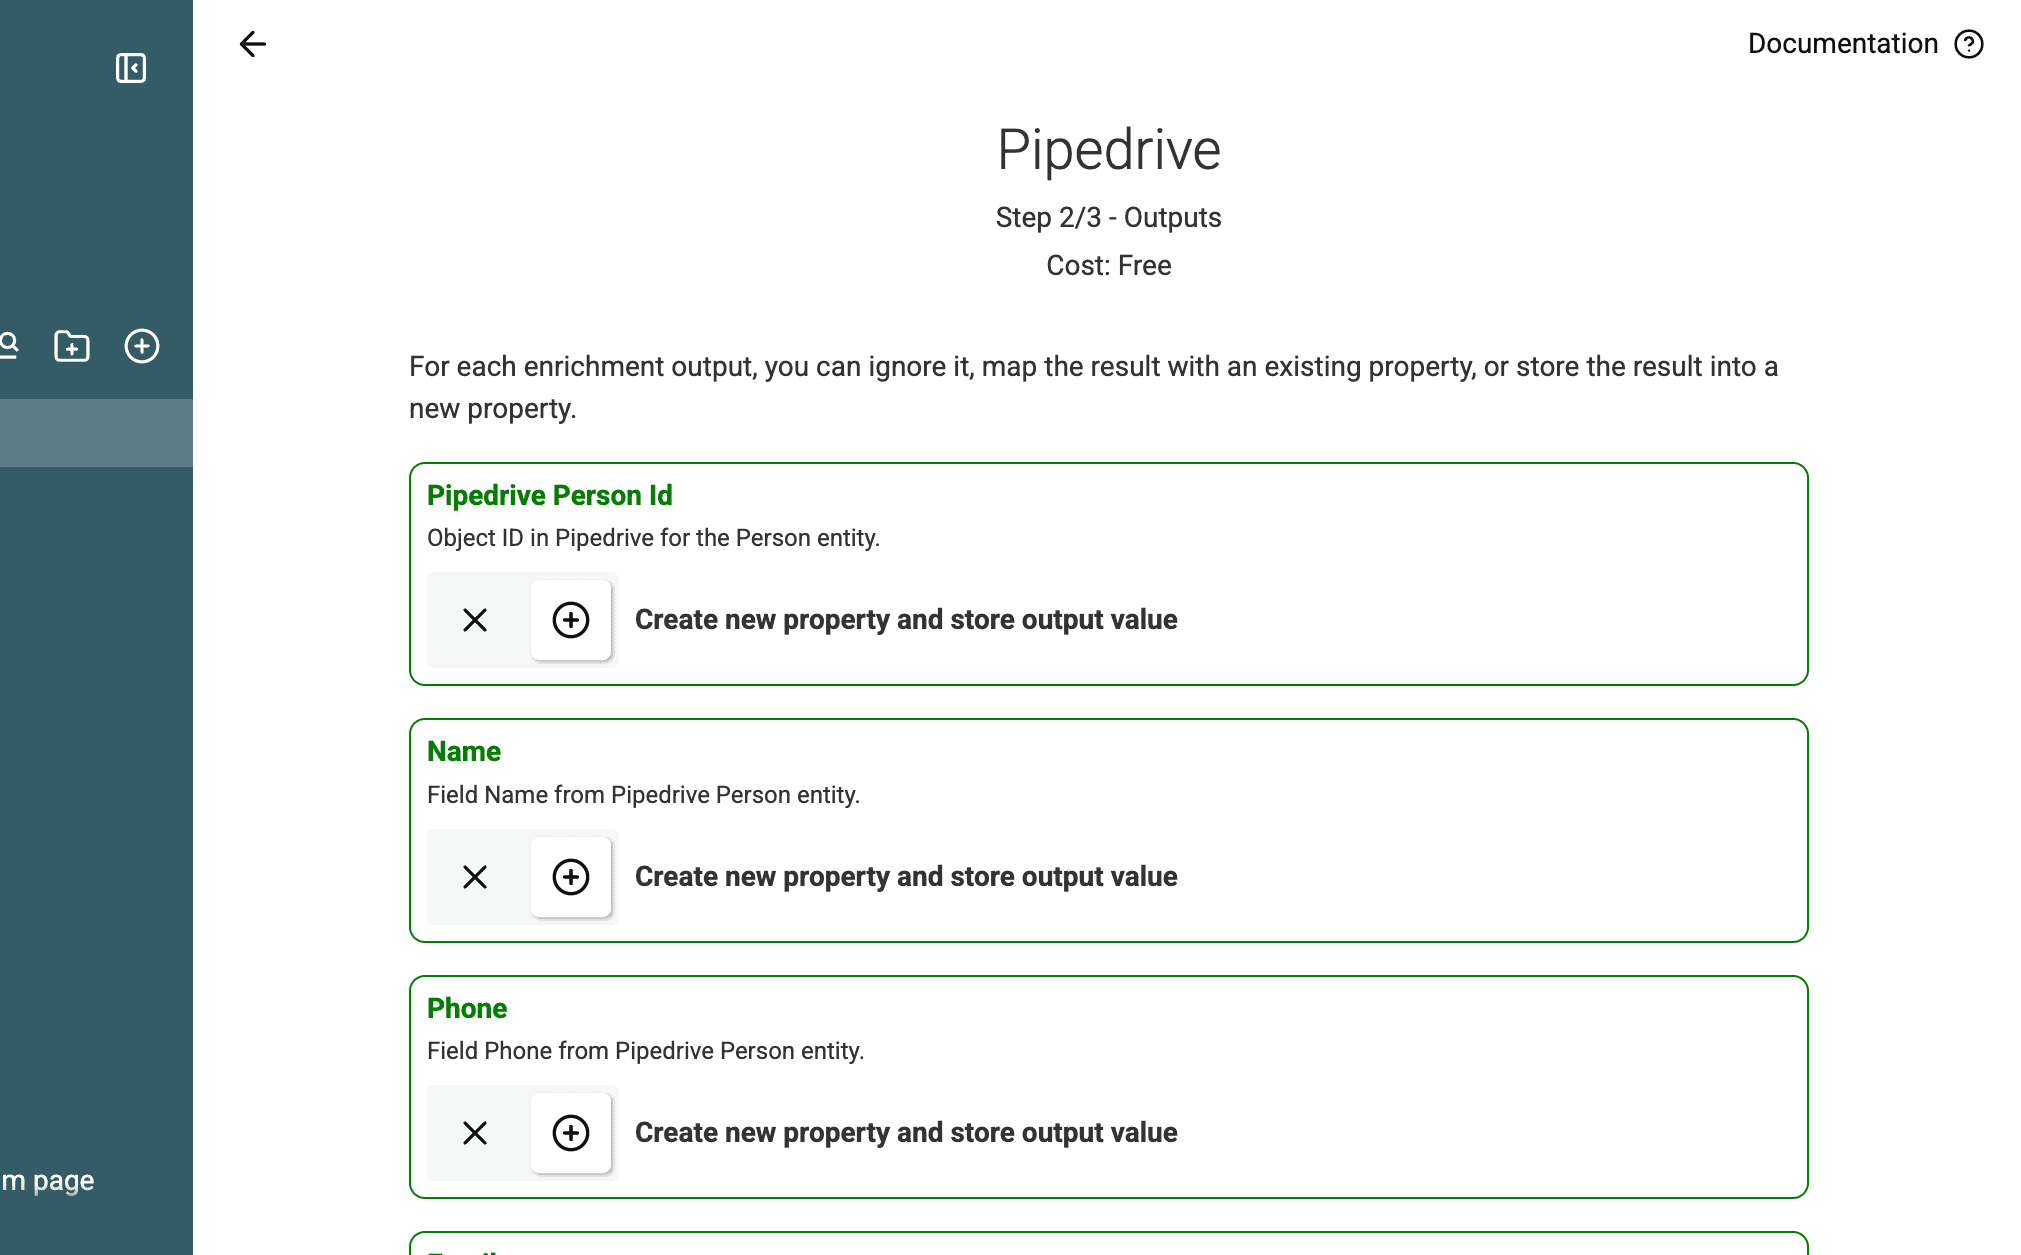
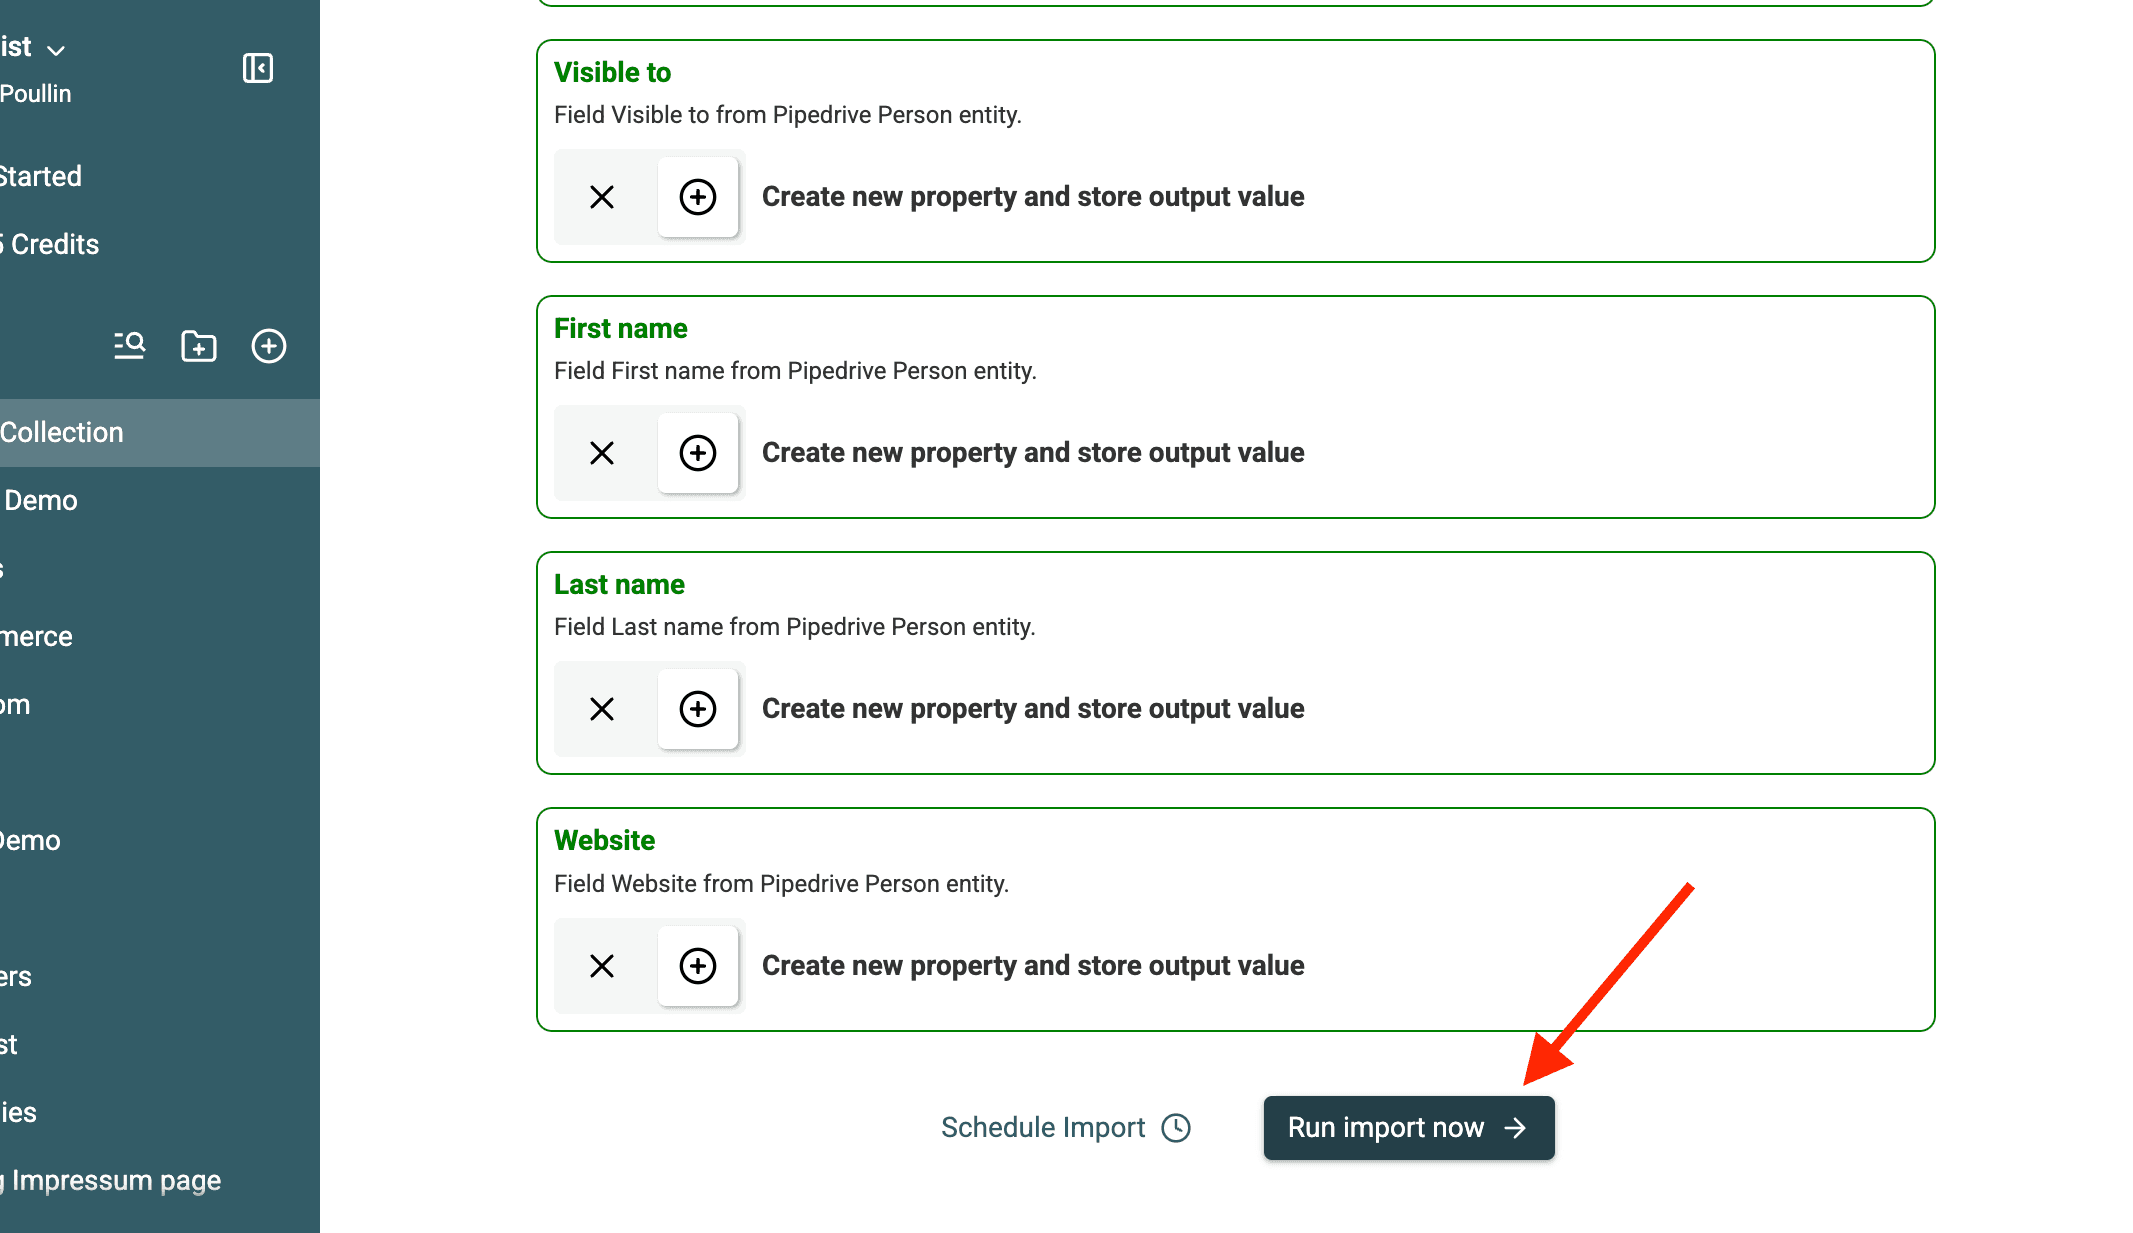
In questo modo, tutti i dati utili saranno disponibili per la deduplicazione.
6. Avvia l’importazione
Fai clic su Import per iniziare a recuperare i dati. Il tempo necessario dipende dal numero di record.
Datablist elabora i contatti e li struttura per la deduplicazione.
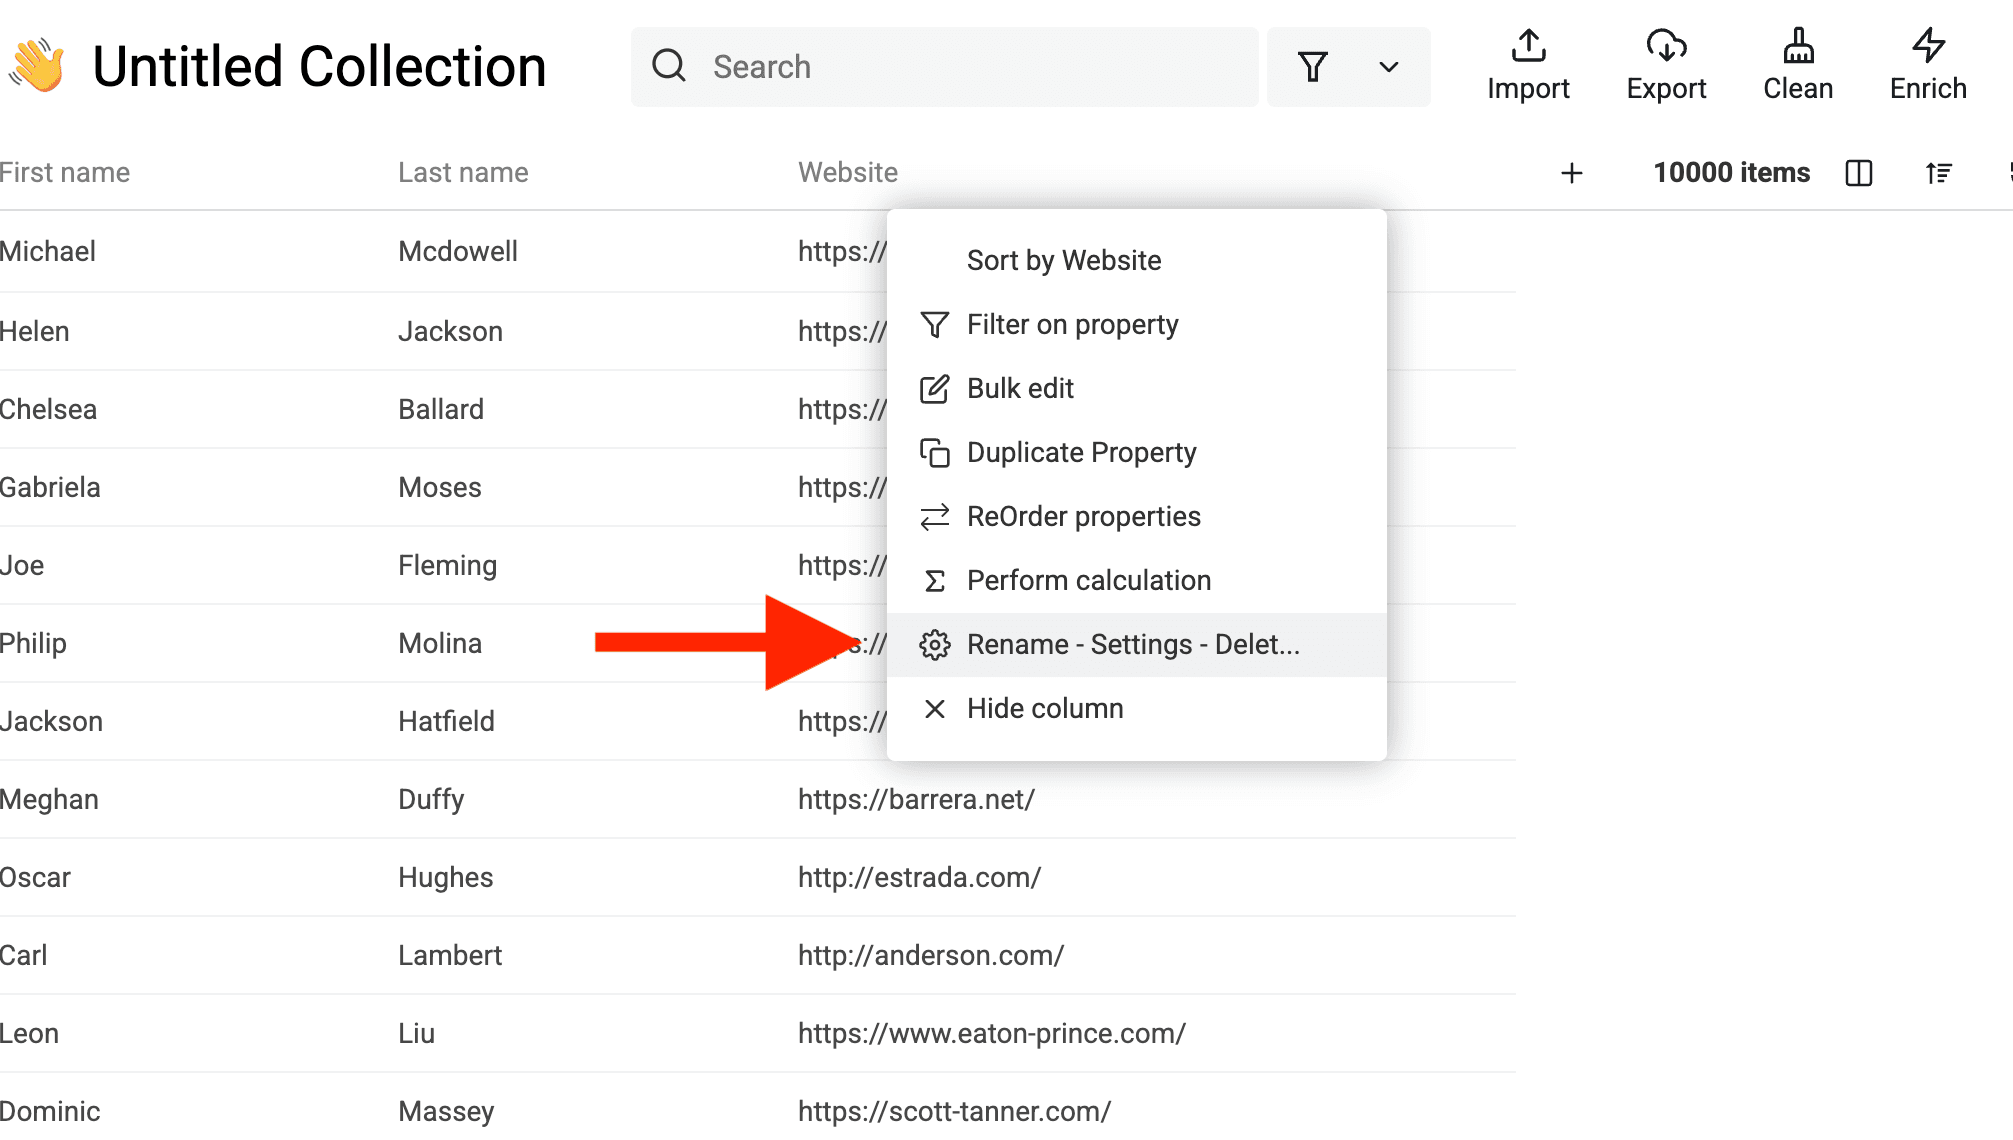
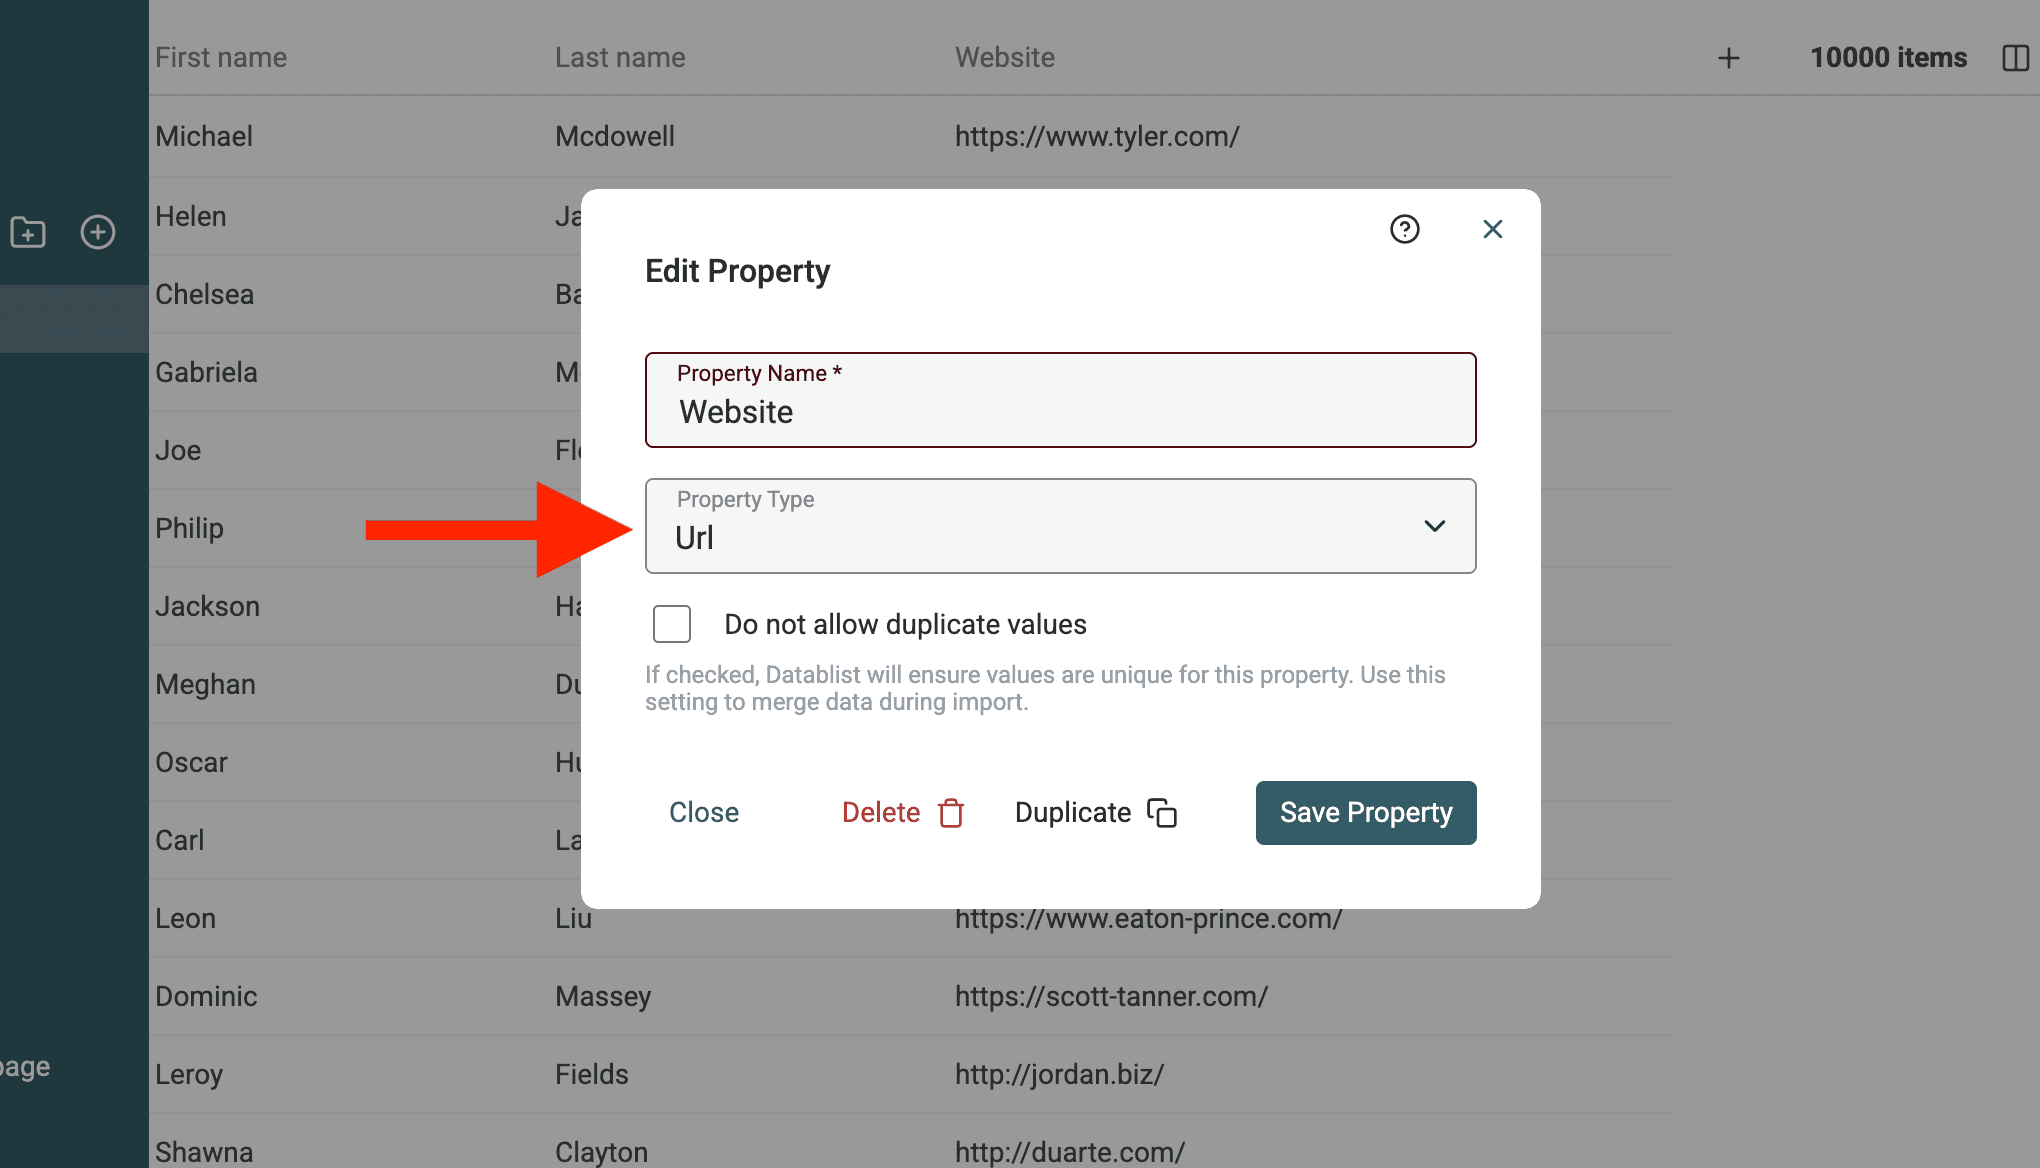
Modifica il tipo di dato degli URL
Duplicates Finder di Datablist dispone di processor specifici per gestire Emails, URLs e altri tipi di dati. Se nei tuoi dati sono presenti siti web, imposta il tipo della relativa property su URL.
Più indirizzi email e numeri di telefono
Se un contatto ha più indirizzi email o numeri di telefono in Pipedrive, questi vengono concatenati in un unico campo e separati da un punto e virgola ;.
Esempio:
- John Doe ha due email in Pipedrive:
john@company.comej.doe@gmail.com. - In Datablist apparirà così: Email:
john@company.com;j.doe@gmail.com
Questo permette a Datablist di gestire correttamente più valori durante la deduplicazione.
Se in seguito avrai bisogno di una sola email o di un solo numero di telefono per ogni riga del CSV, dopo aver esportato il file pulito usa CSV Rows Splitter.
Al termine dell’importazione, i dati saranno pronti per la deduplicazione. Nel prossimo passaggio individueremo i duplicati con tecniche di matching avanzate.
Passaggio 2: trova i duplicati in Pipedrive
Ora che i contatti o le organizzazioni di Pipedrive sono in Datablist, è il momento di trovare i duplicati. A differenza dello strumento nativo di Pipedrive, Datablist utilizza algoritmi di matching avanzati per rilevare record simili, anche quando i nomi presentano piccole differenze o i dati di contatto sono incompleti.
Ecco come procedere:
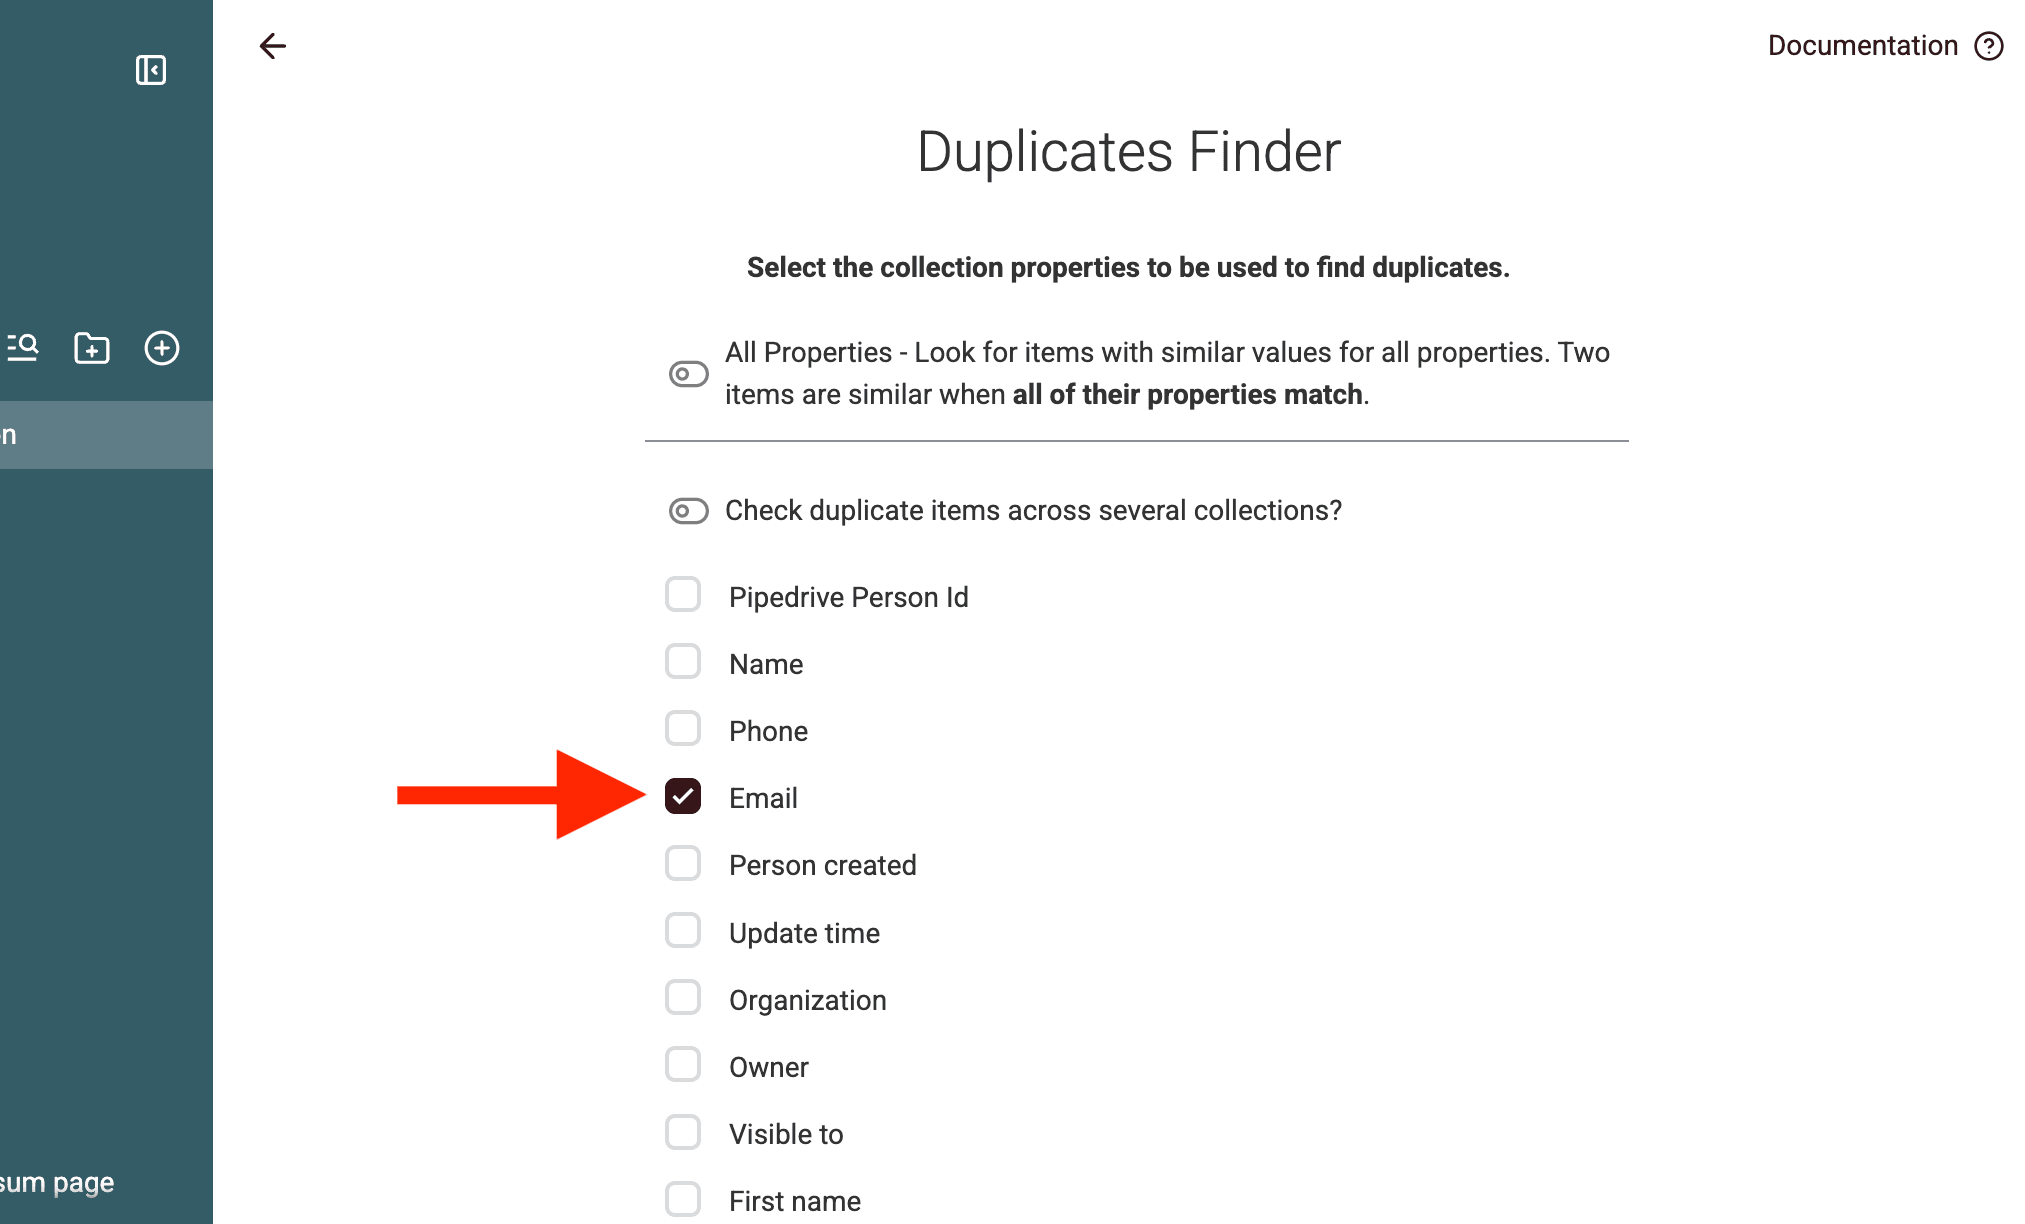
1. Apri Duplicates Finder e scegli una property di deduplicazione
Nella tua collection Datablist, vai su Clean → Duplicates Finder.
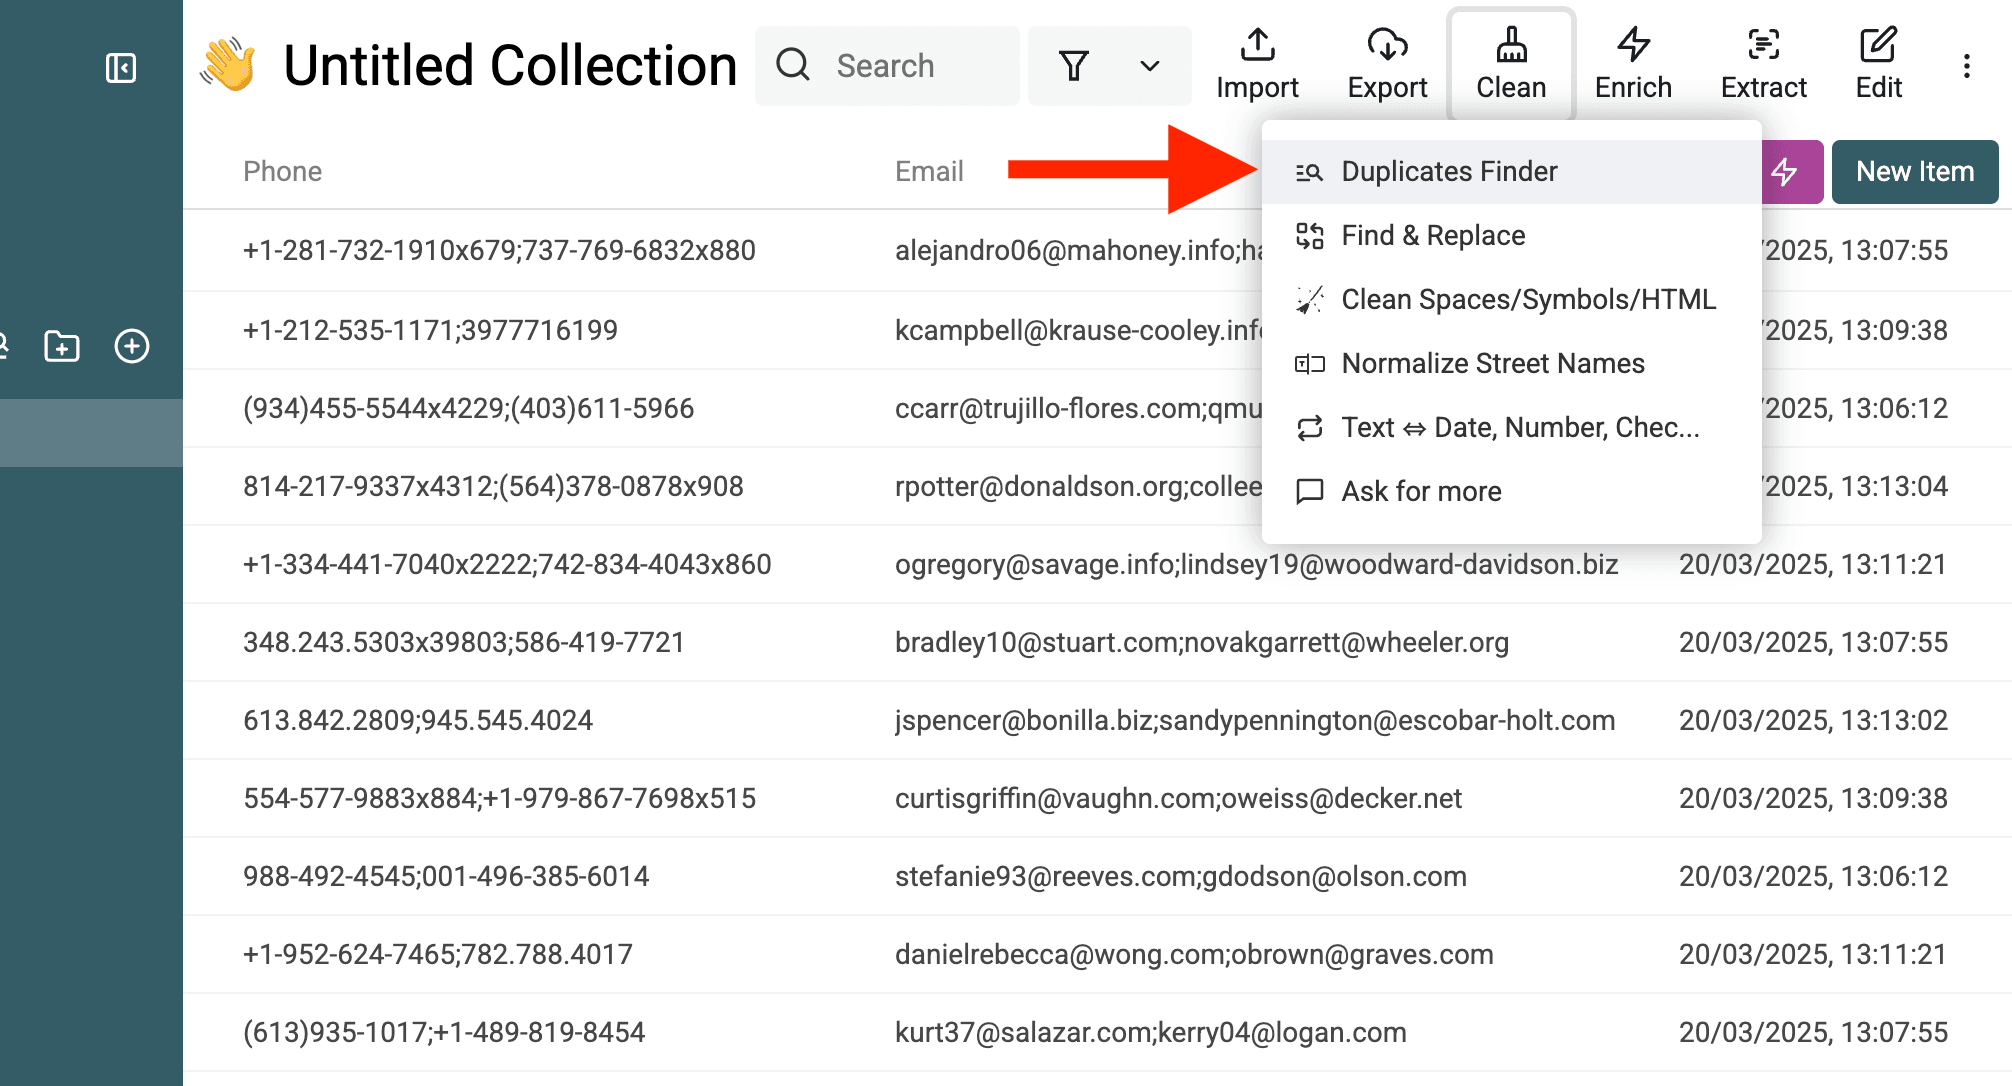
Una property di deduplicazione è il campo che Datablist userà per trovare i duplicati. La scelta migliore dipende dal tipo di dati:
- Per People: usa Email (l’opzione più affidabile) o Name (se le email mancano o non sono coerenti).
- Per Organizations: usa Website (l’opzione migliore) o Name (se il sito web non è disponibile).
💡 Esempio:
- Se esistono due record per "Google", uno denominato
Google LLCe l’altroGoogle, Datablist li rileverà come duplicati perché i nomi sono simili.
2. Avvia la deduplicazione
Per ottenere risultati migliori, non unire tutto in una sola volta. Esegui la deduplicazione per iterazioni:
1️⃣ Primo passaggio: usa Email per People o Website per Organizations. In questo modo troverai i duplicati evidenti. 2️⃣ Secondo passaggio: usa Name per People o Organizations, così da intercettare i duplicati che potrebbero avere email diverse ma riferirsi alla stessa entità.
🔹 Perché procedere in due passaggi?
- Se utilizzi contemporaneamente Email + Name, piccole variazioni nel nome, come "John Doe" e "Johnathan Doe", potrebbero impedire la corrispondenza.
- Partire dall’email permette di gestire prima le corrispondenze esatte, riducendo il rischio di errori.
Attenzione alle email multiple e ai nomi delle aziende
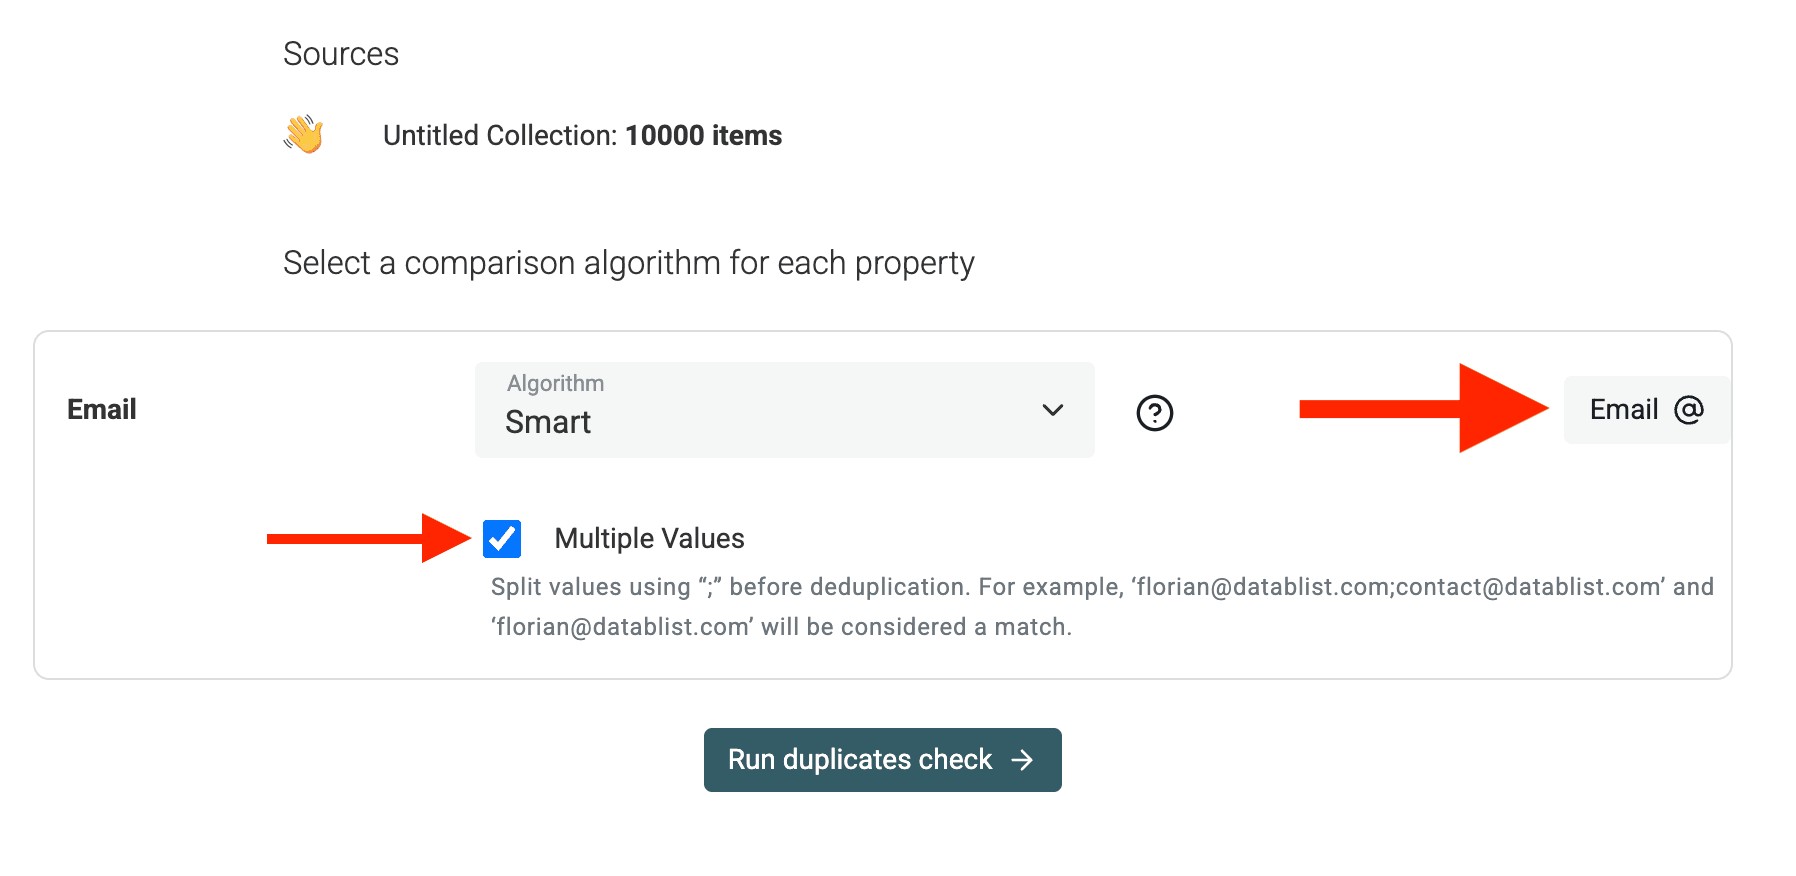
Alcuni campi di Pipedrive contengono più valori, come email e numeri di telefono.
Se deduplichi campi come Emails o Phones che contengono più valori separati da ;, attiva la modalità "Multiple Values" in Datablist. Così, se un record contiene john@company.com; j.doe@gmail.com e un altro soltanto john@company.com, i due contatti verranno comunque associati correttamente.
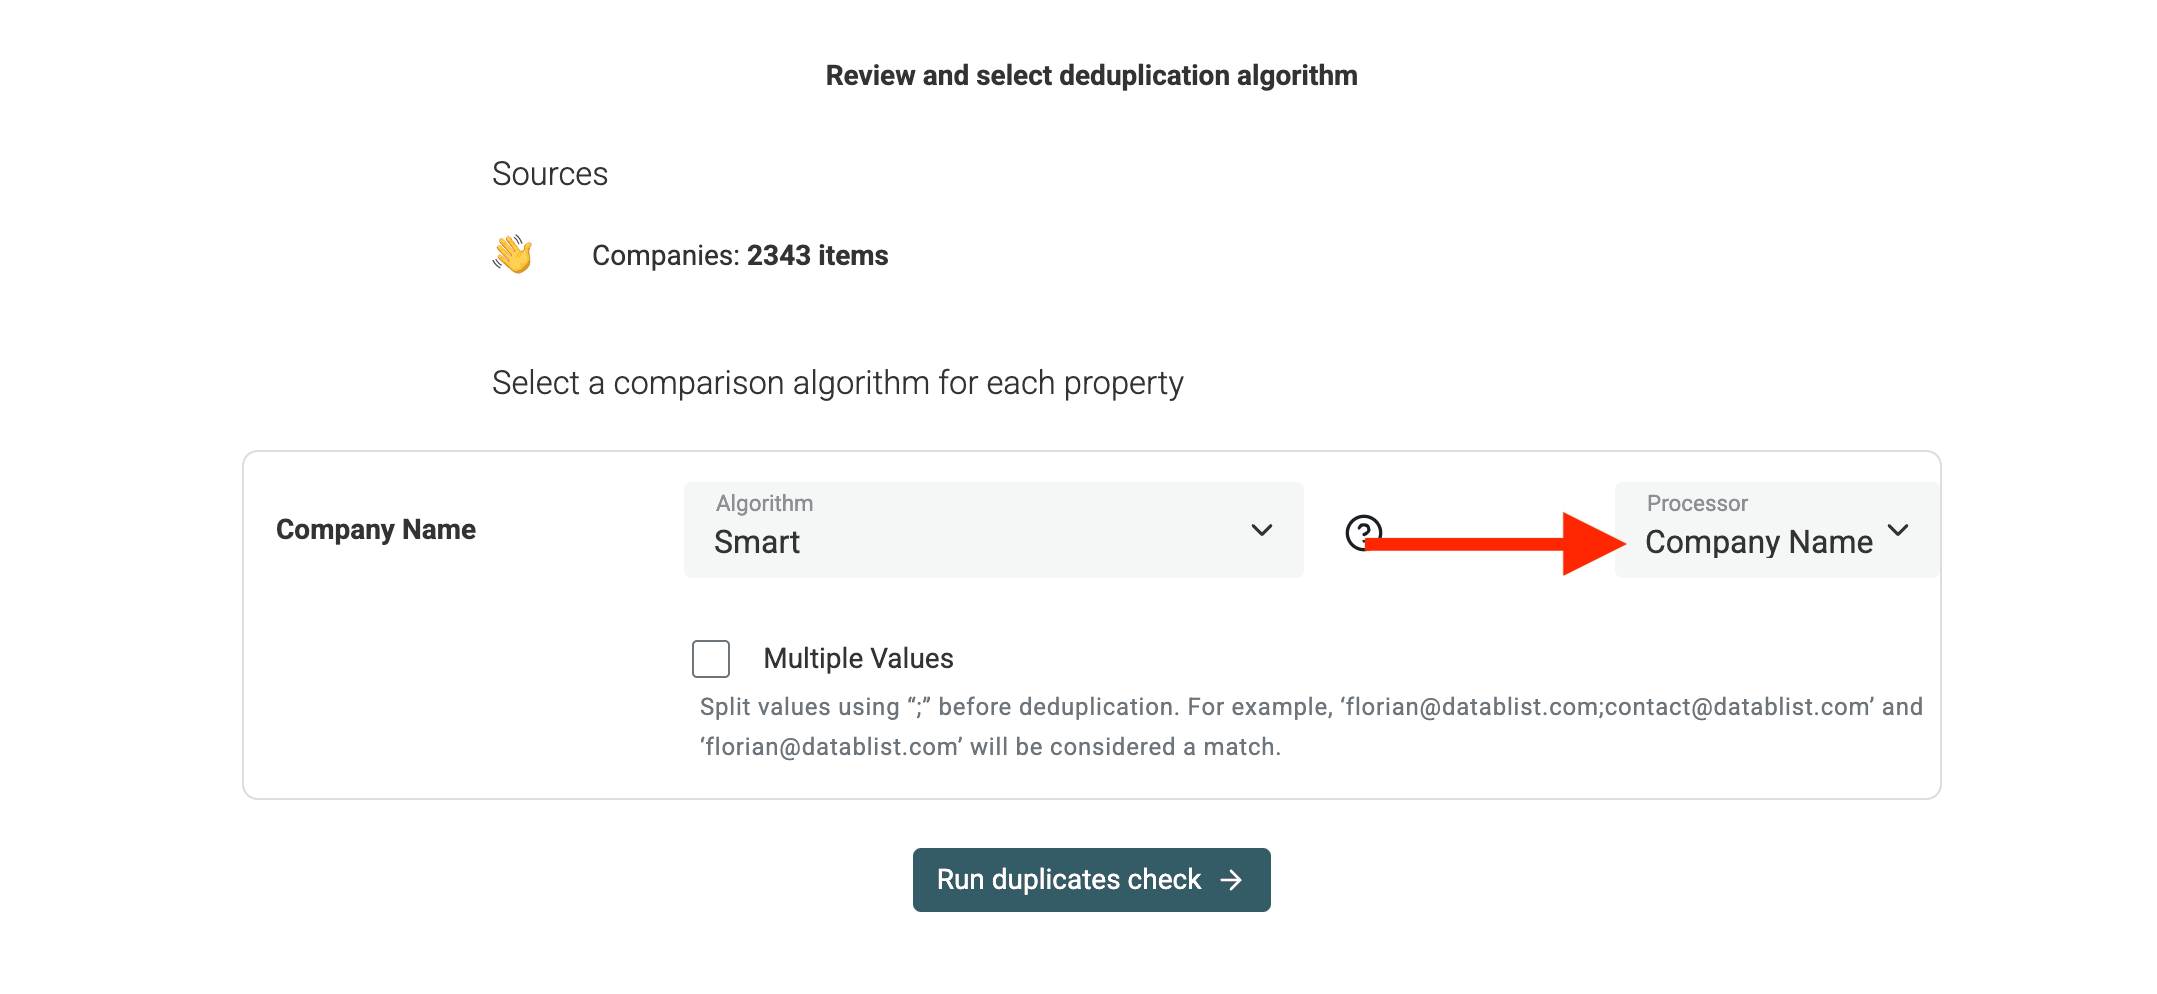
Se deduplichi in base ai nomi delle aziende, Datablist Duplicates Finder offre un processor specifico per gestire suffissi societari e parole superflue.
Se deduplichi in base ai siti web, usa il processor
URL.
3. Controlla i duplicati rilevati e i valori in conflitto
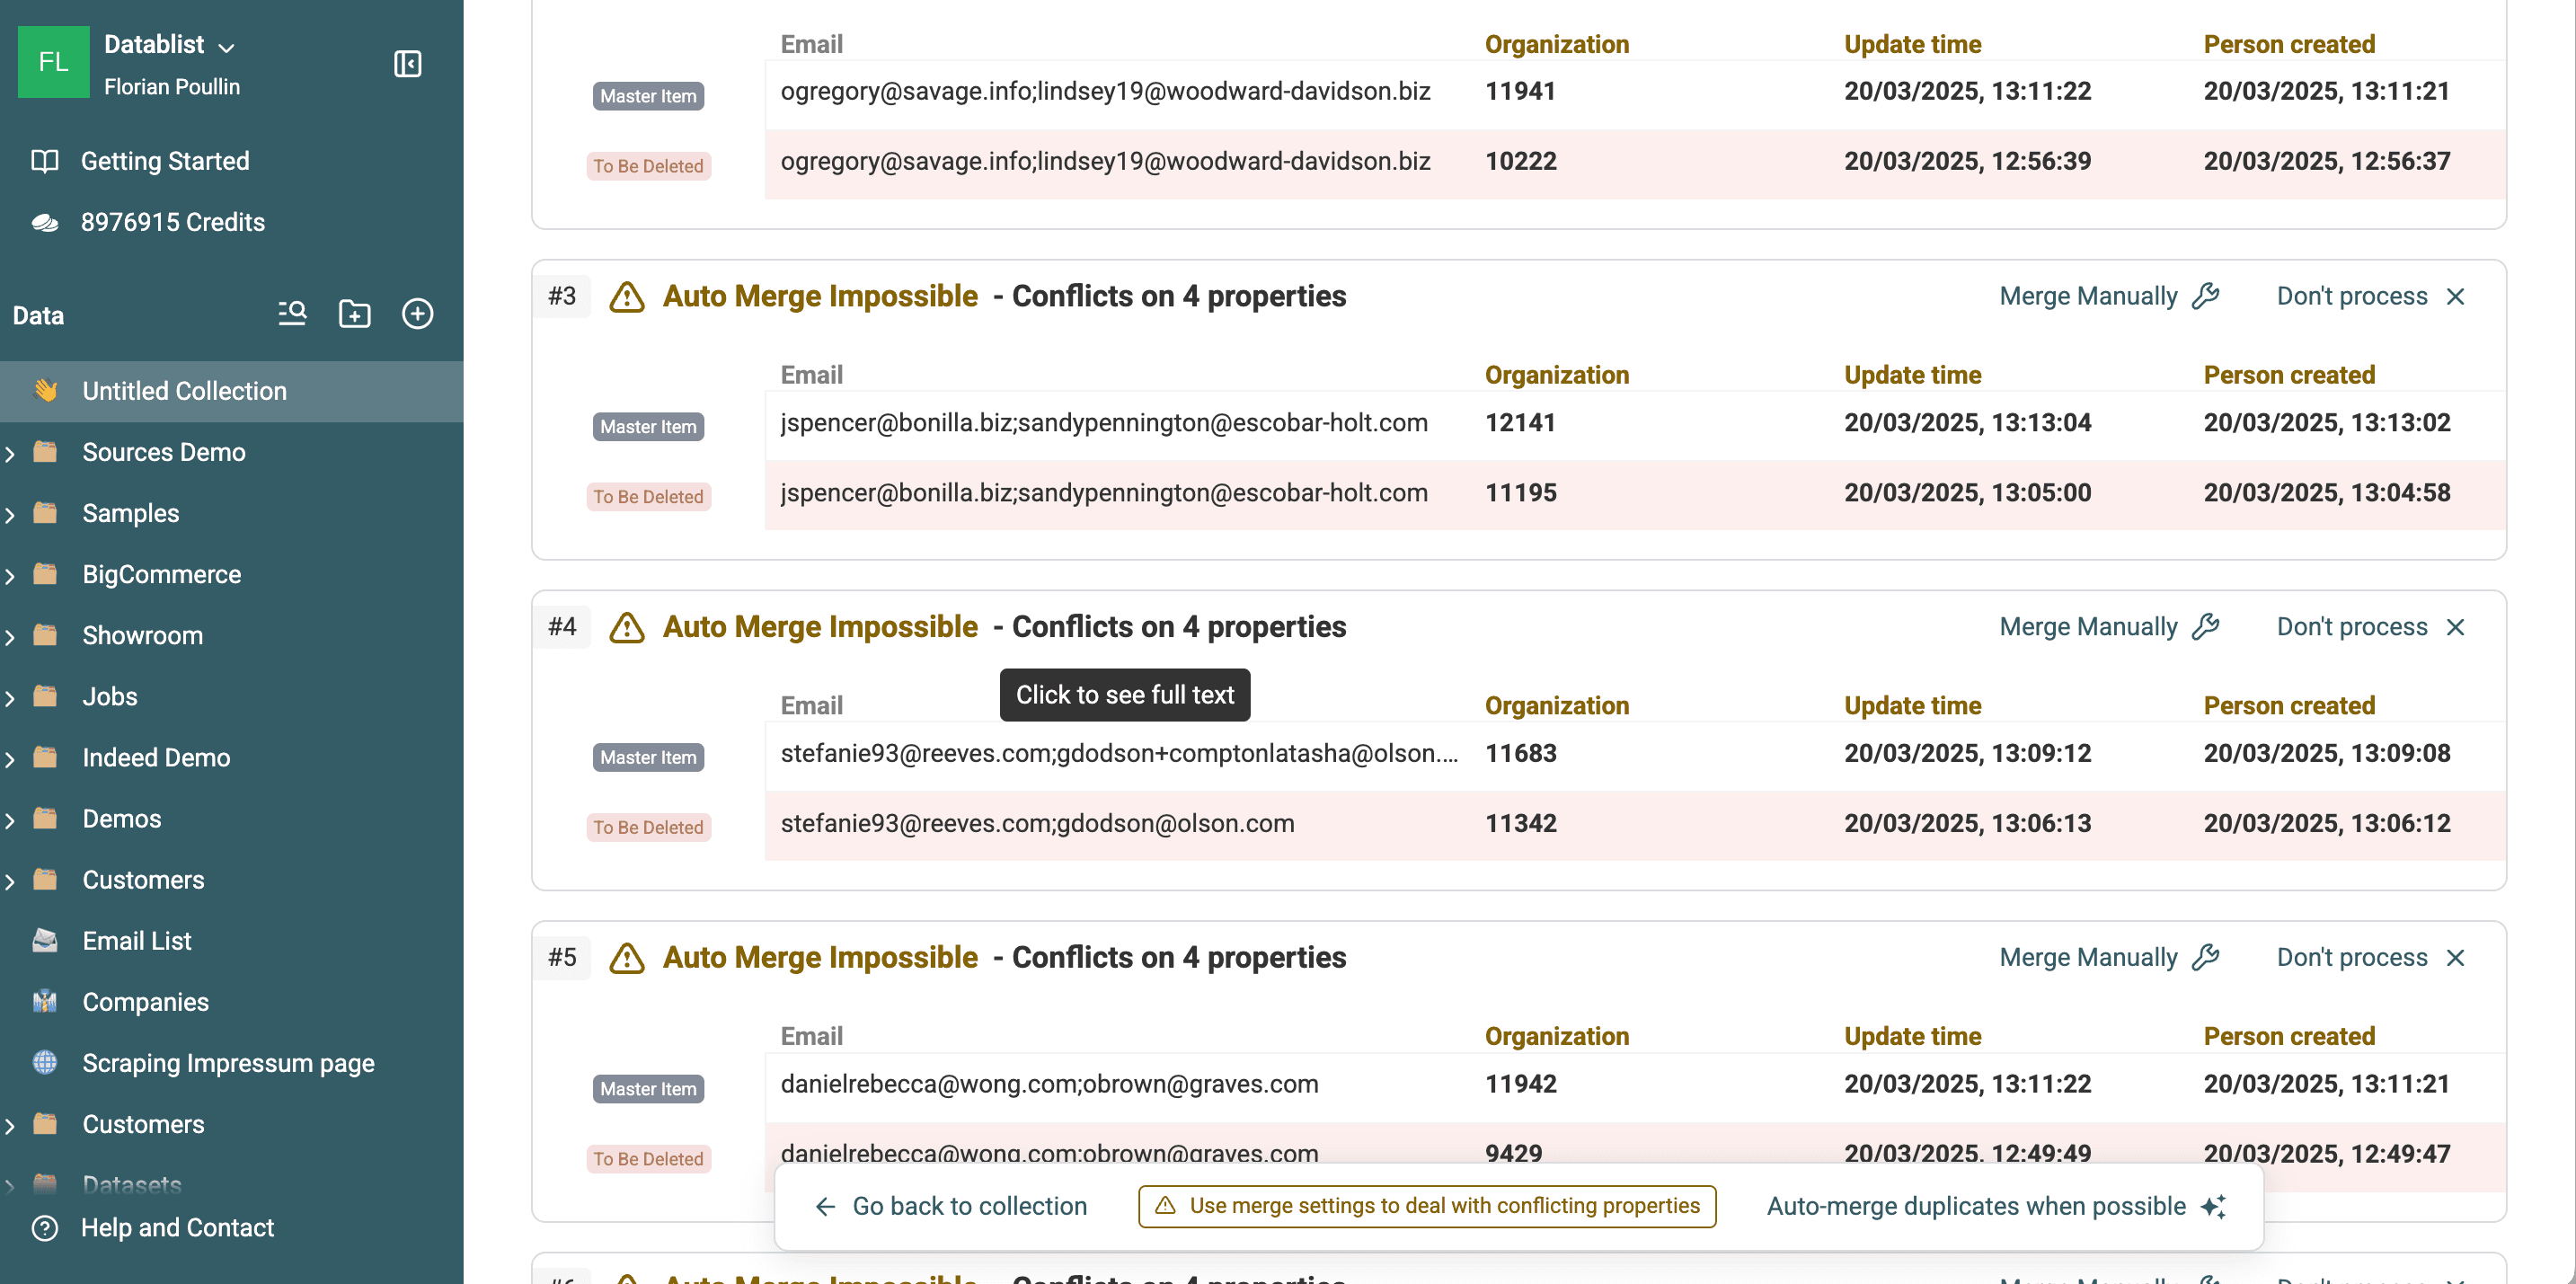
Al termine della scansione, Datablist raggruppa i duplicati.
- Vedrai dei cluster di People o Organizations simili. Li chiamiamo "Duplicate Groups".
- Ogni gruppo mostrerà il criterio di corrispondenza (email, nome o sito web) e l’eventuale presenza di dati in conflitto.
3.a. Come funzionano i Duplicate Groups
Ogni Duplicate Group contiene più record considerati come la stessa entità.
- Alcuni gruppi possono essere uniti automaticamente perché contengono dati identici o complementari.
- Altri richiedono una verifica manuale perché presentano informazioni in conflitto.
💡 Esempio:
- Se due record di “John Doe” hanno la stessa email ma numeri di telefono diversi, Datablist li rileverà come duplicati, segnalando però il numero di telefono come campo in conflitto.
3.b. Configura le regole di unione per i valori in conflitto
Capire i conflitti
Un conflitto si verifica quando due contatti duplicati hanno valori diversi nello stesso campo. Per esempio, due record potrebbero riportare ruoli professionali o numeri di telefono differenti. Datablist evidenzia questi conflitti per permetterti di scegliere quale valore conservare.
Come gestire i conflitti
Datablist mette a disposizione un’interfaccia intuitiva per risolvere i conflitti in modo efficiente e mantenere dati puliti e accurati.
- Combine Values: se i valori sono complementari, come più numeri di telefono o note, combinali.
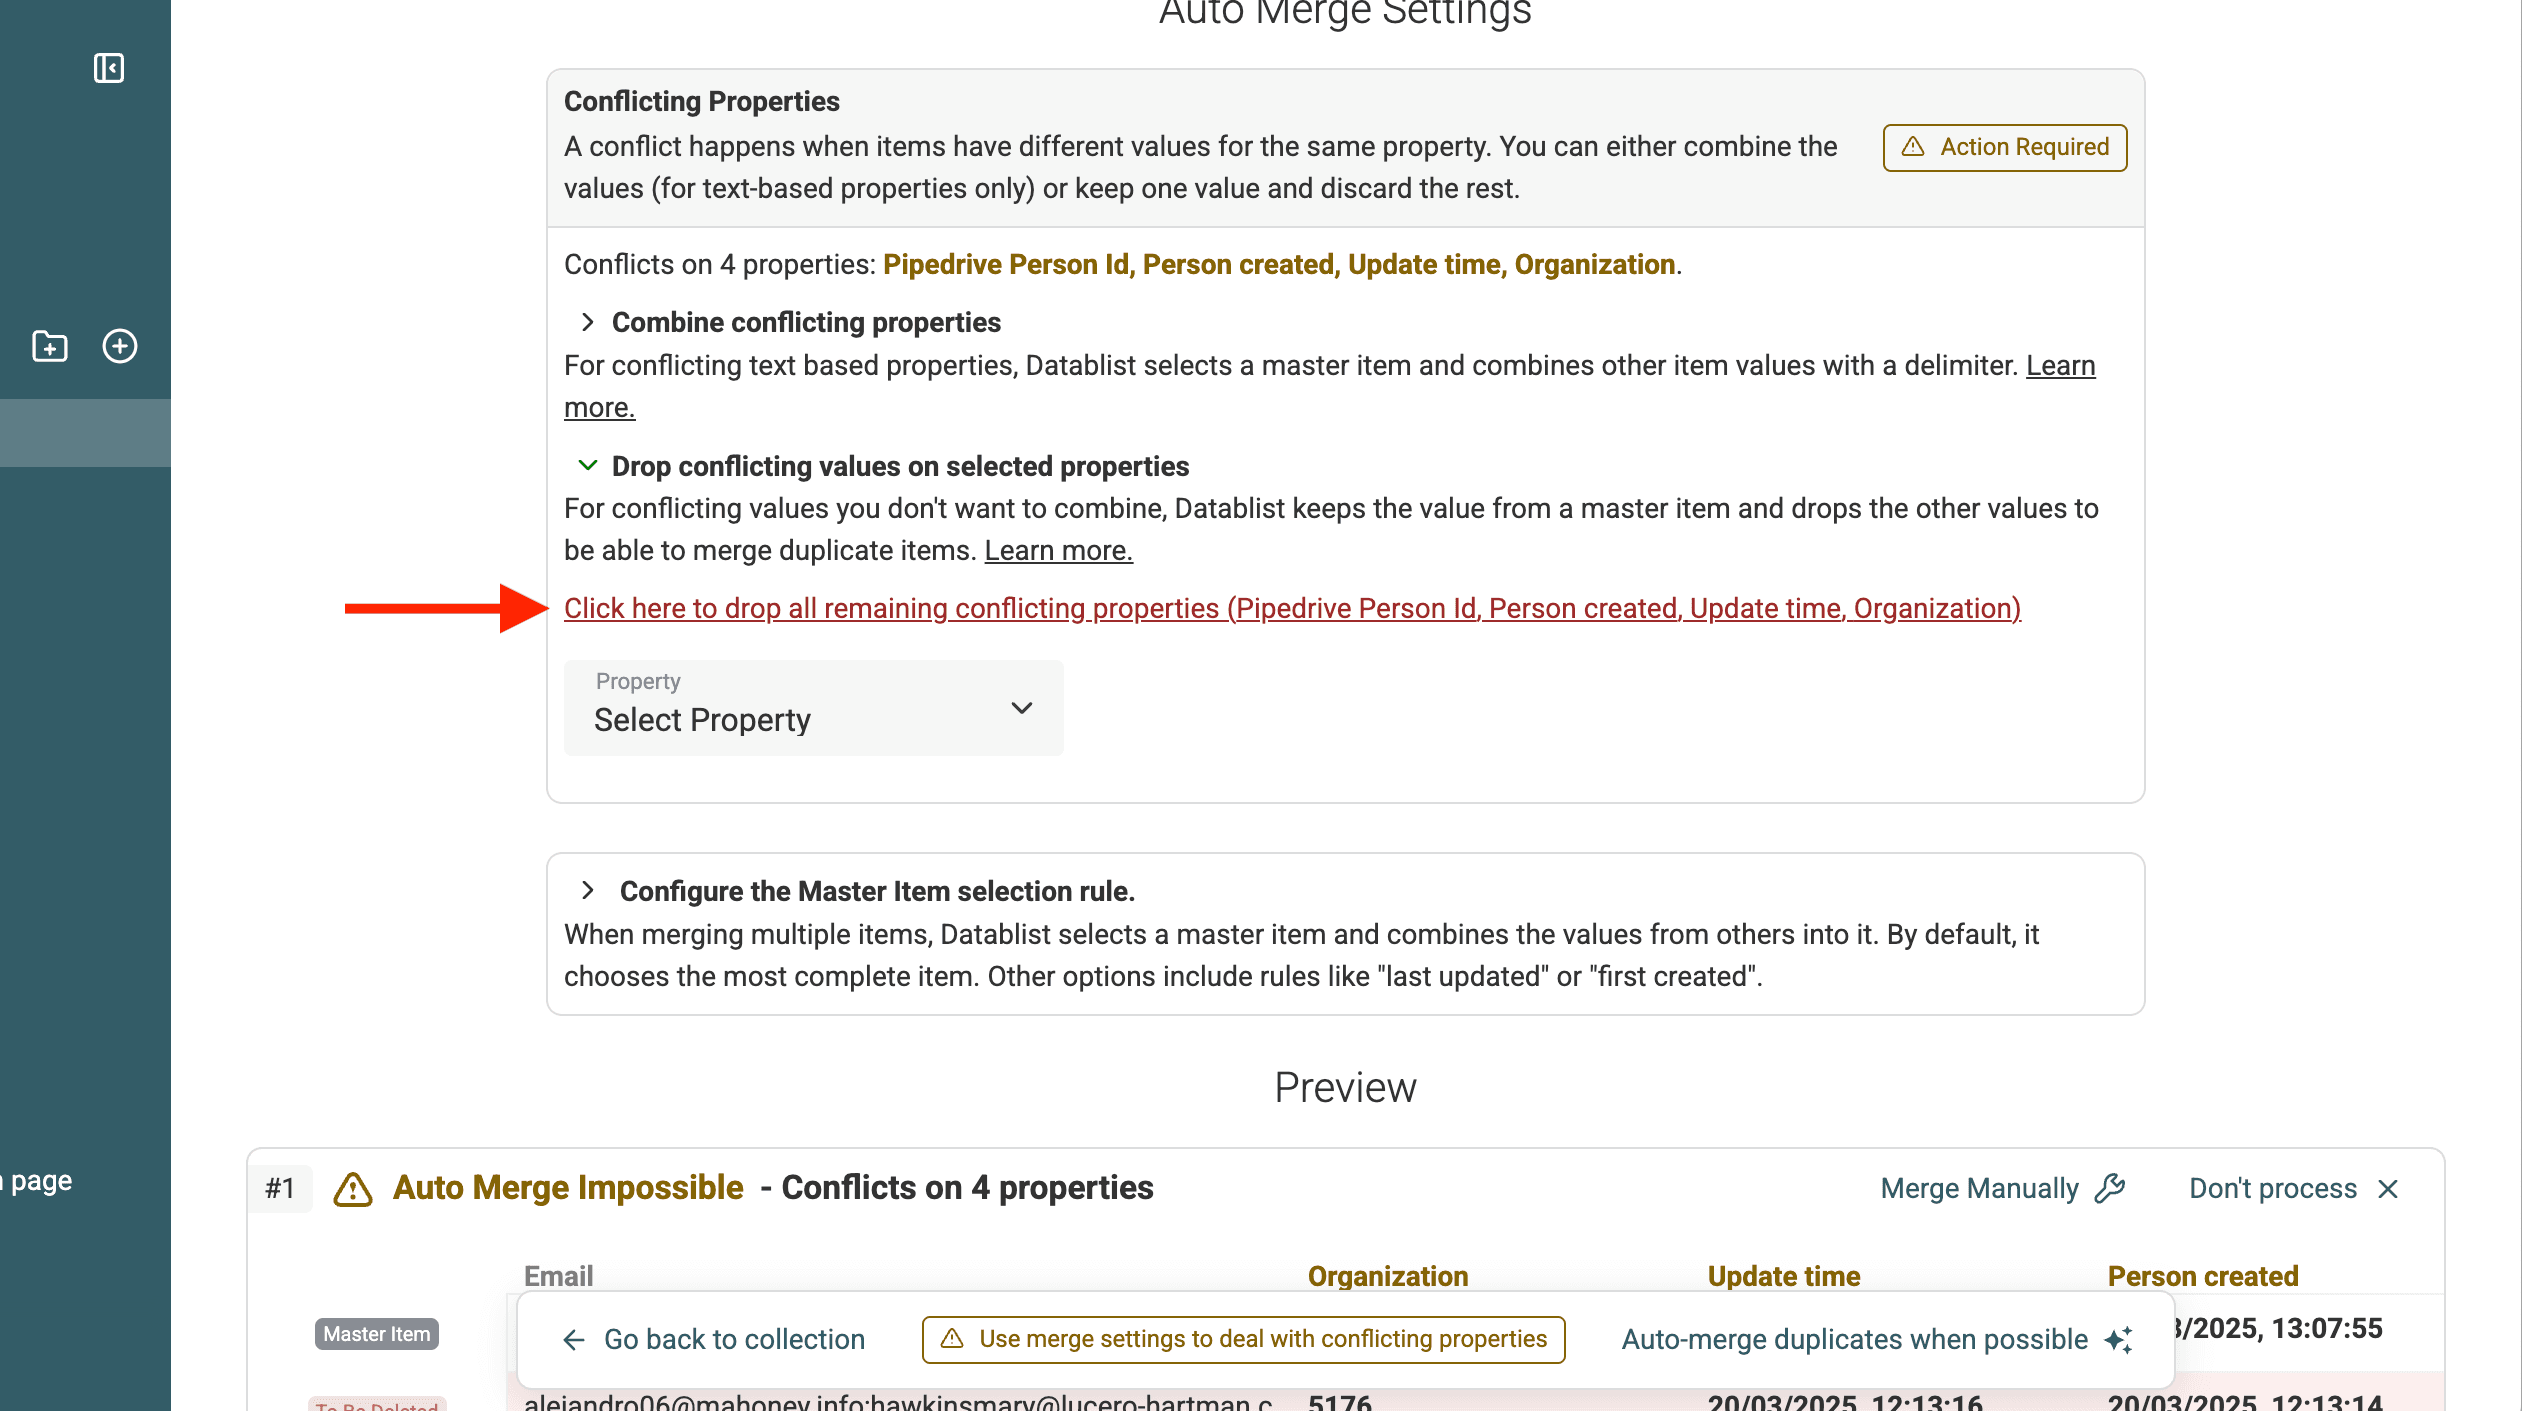
- Keep One Value and delete the others: se un contatto è chiaramente più completo e vuoi scartare gli altri valori, seleziona "Drop conflicting values...".
Per le impostazioni Combine conflicting values e Drop conflicting values, è disponibile un link rapido che seleziona automaticamente tutte le property in conflitto.
Seleziona un record master
Puoi anche configurare il modo in cui Datablist seleziona il record master. Quando unisce record duplicati, Datablist ne conserva uno, ne aggiorna i campi ed elimina gli altri, lasciando un solo record finale.
Puoi controllare la selezione del record master scegliendo tra diverse regole:
- Most Complete: sceglie il record con il maggior numero di campi compilati.
- Last Updated: sceglie il record modificato più di recente.
- First Created: sceglie il record meno recente in base alla data di creazione.
- Highest Value: sceglie il record con il valore più alto per una property selezionata. Se più record hanno lo stesso valore, seleziona quello più recente.
- Lowest Value: sceglie il record con il valore più basso per una property selezionata. Se più record hanno lo stesso valore, seleziona quello più recente.
- Matching Value: sceglie il record che contiene un valore specifico nella property selezionata. Se nessun record corrisponde, i record non verranno uniti.
Datablist mostra un elenco di anteprima delle modifiche previste. Puoi vedere quali record saranno eliminati, quali valori verranno combinati e così via.
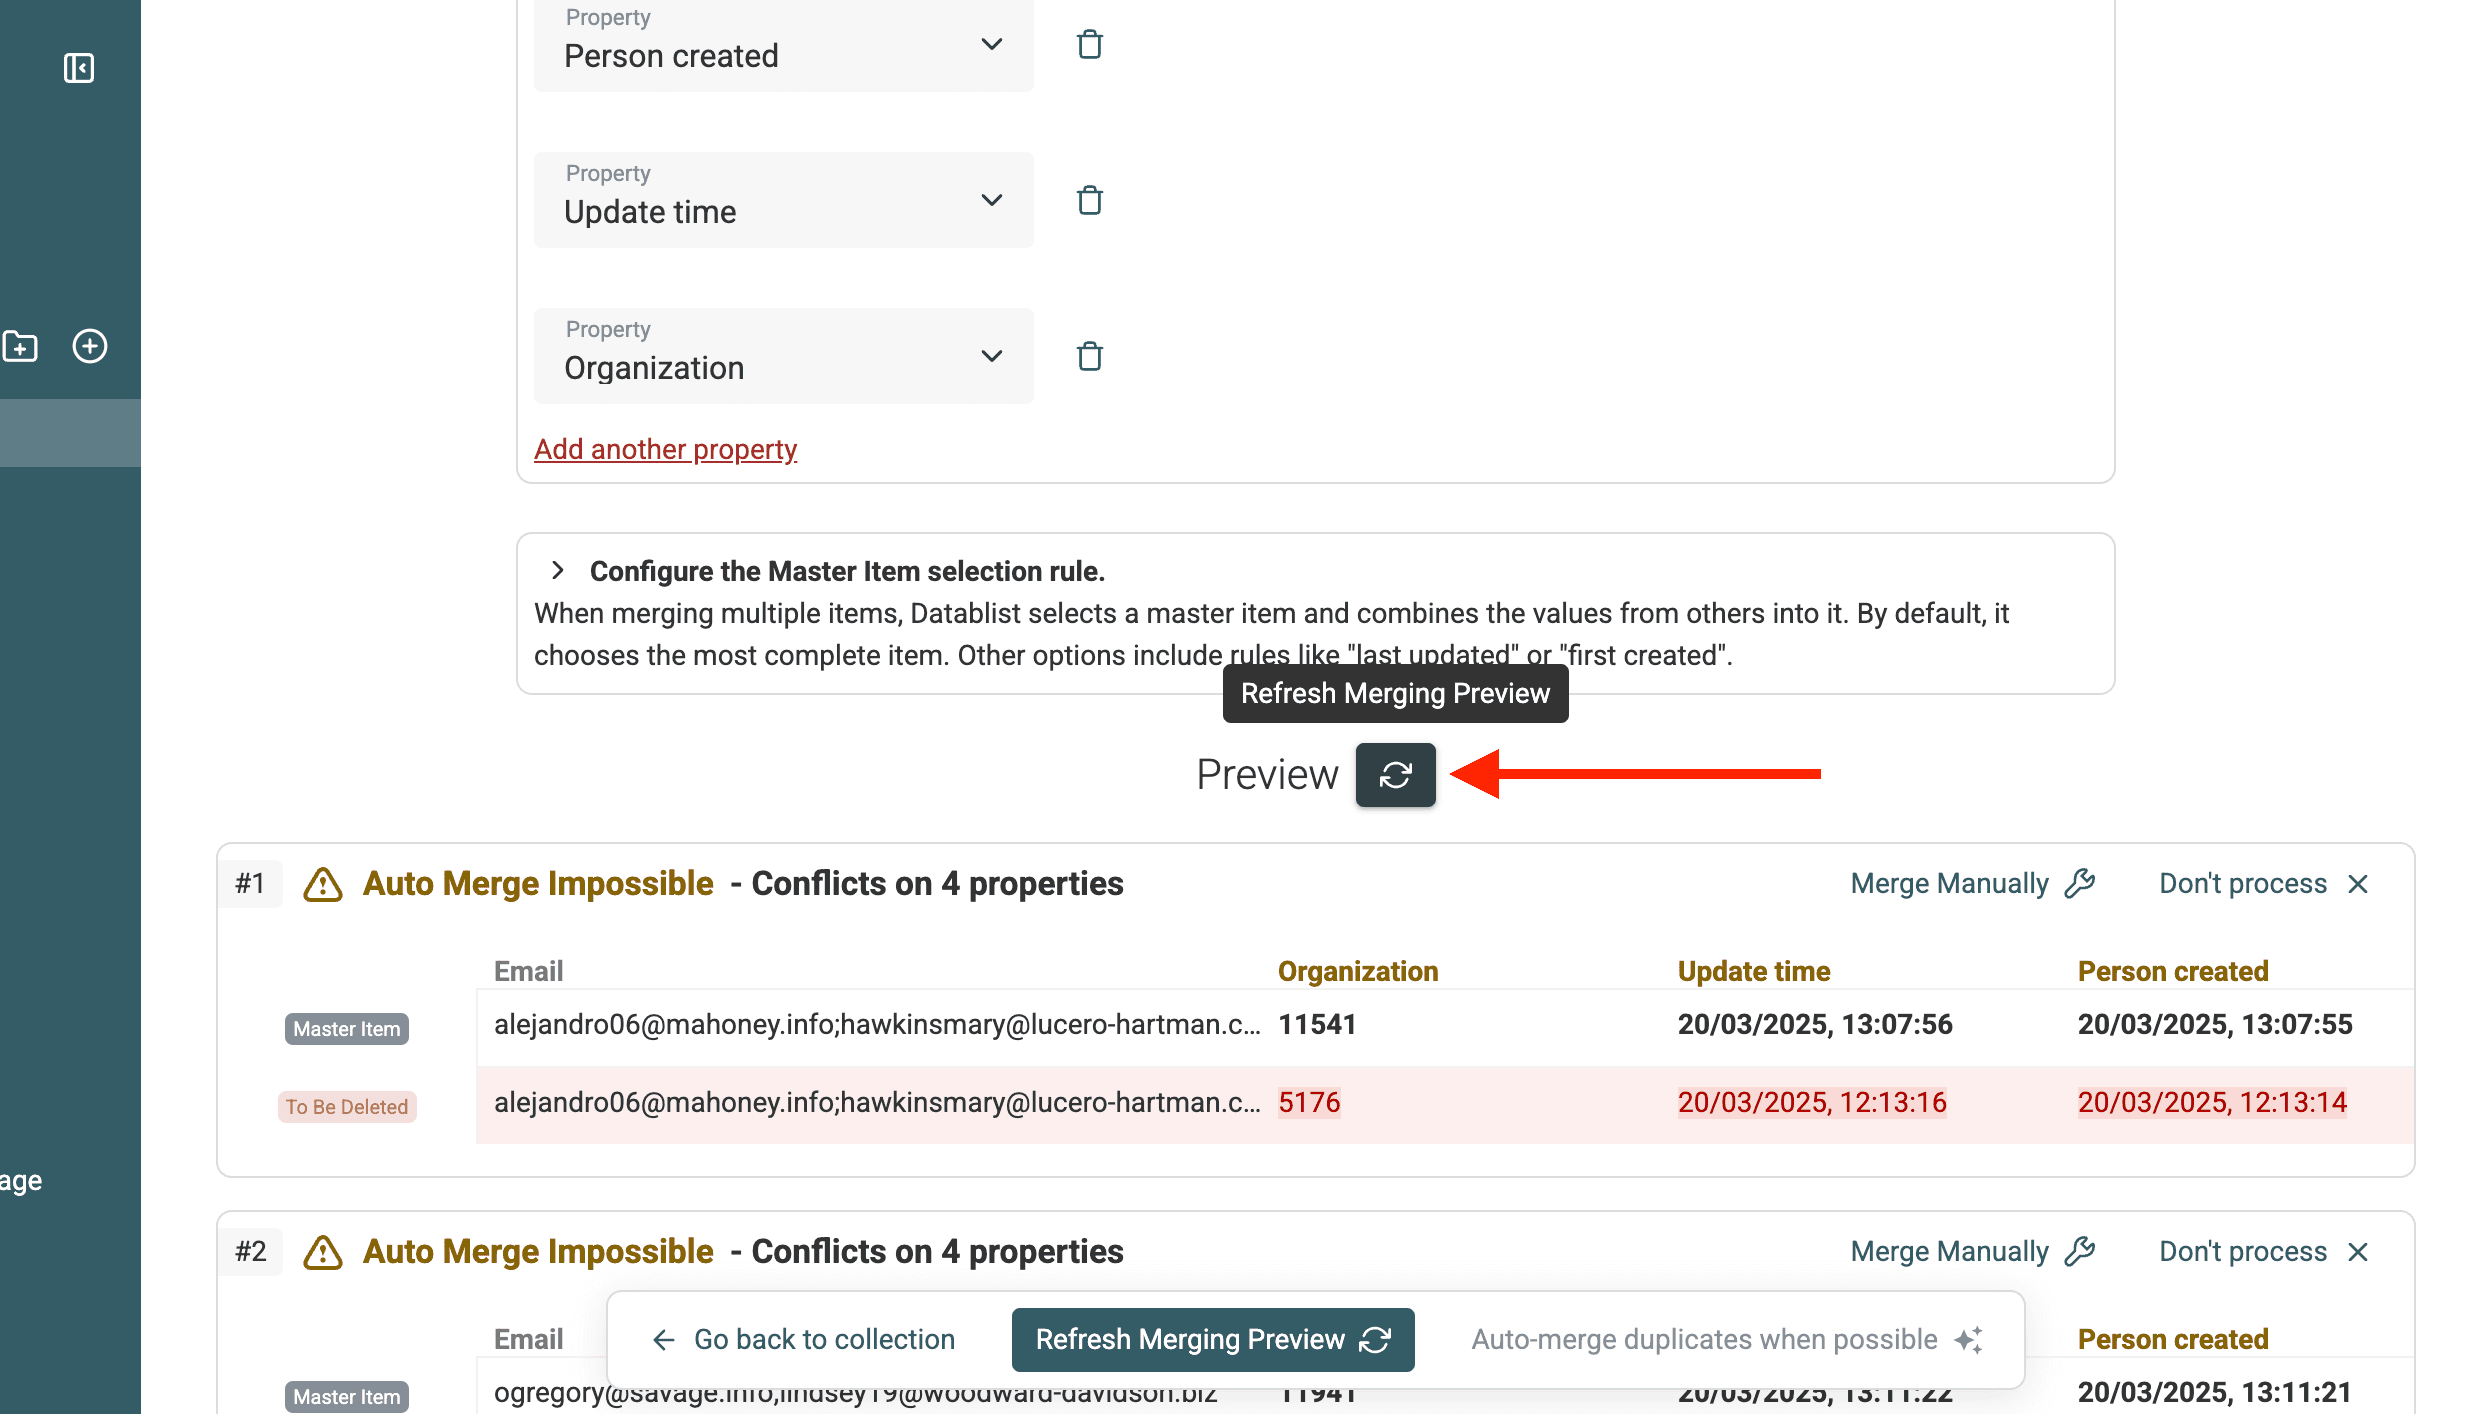
Dopo aver configurato le impostazioni di unione, fai clic su "Refresh" nell’anteprima.
🔹 Esempio: unione di due contatti
L’esempio seguente mostra il risultato di queste regole di unione:
- Drop Conflicting values nel campo
Name. - Combine Conflicting values nel campo
Phone.
| Campo | Contatto 1 | Contatto 2 | Risultato dell’unione |
|---|---|---|---|
| Nome | John Doe | Johnathan Doe | John Doe |
| john@company.com | john@company.com | john@company.com | |
| Telefono | 555-1234 | 555-5678 | 555-1234; 555-5678 |
3.c. Unisci automaticamente i duplicati
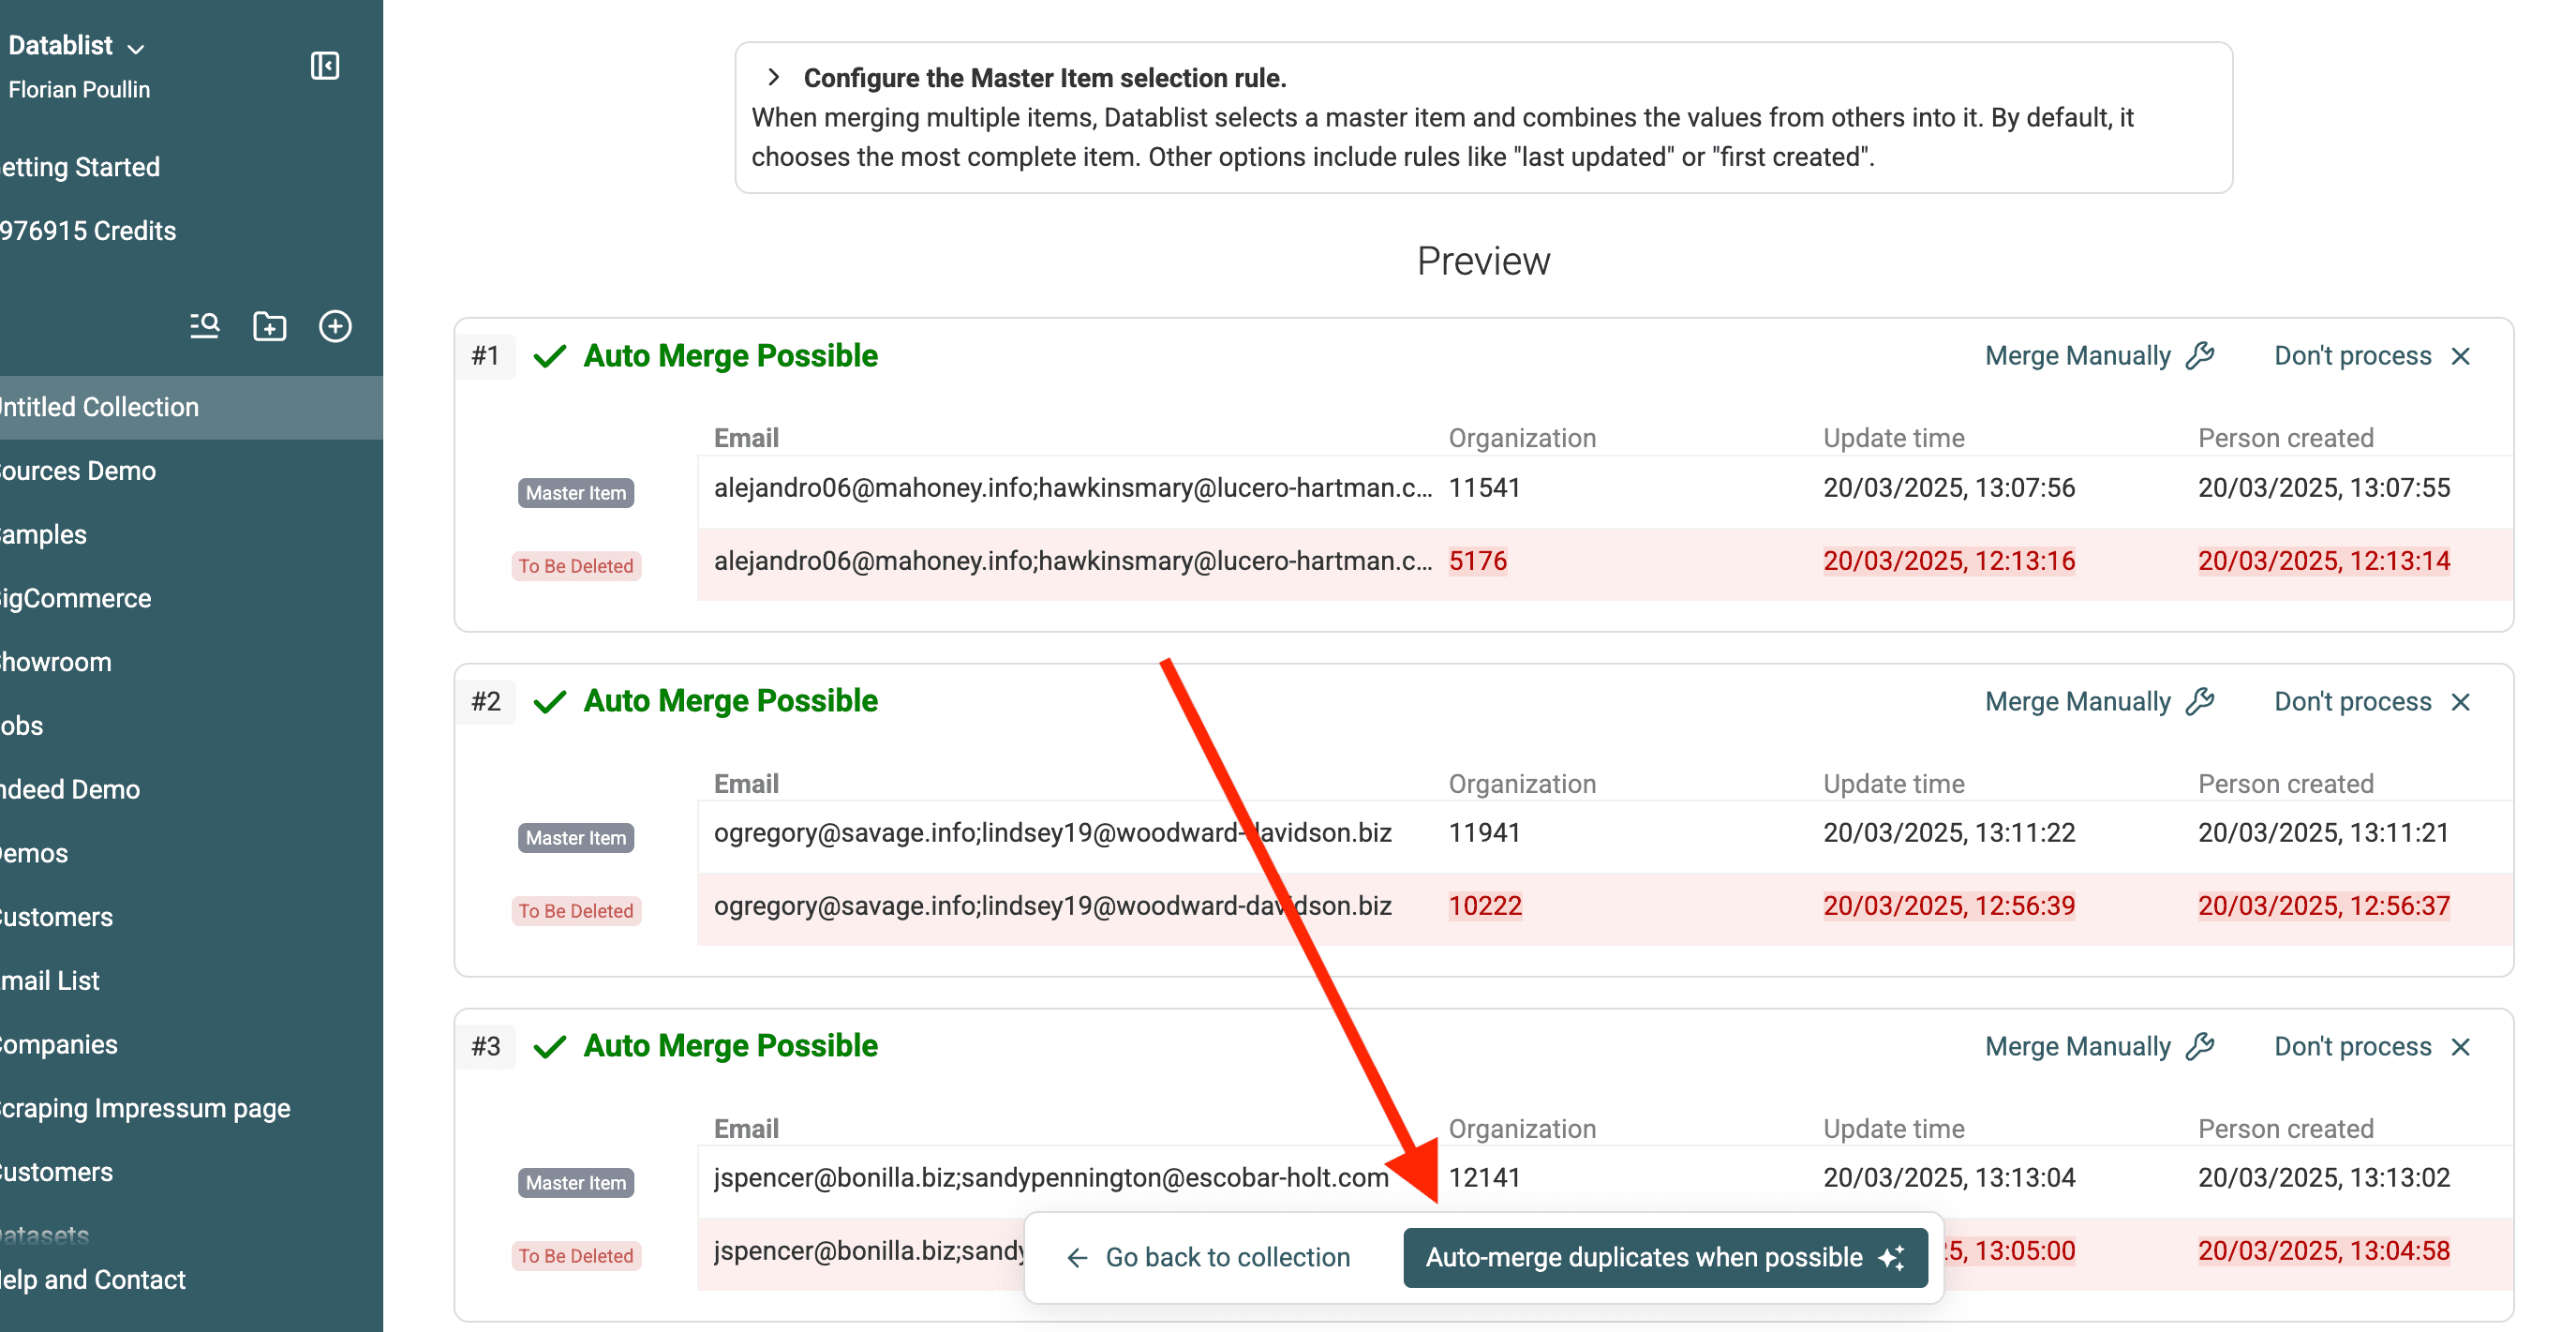
Quando l’anteprima ti soddisfa, fai clic su "Auto-merge duplicates when possible". Datablist applicherà le regole di unione a tutti i Duplicate Groups.
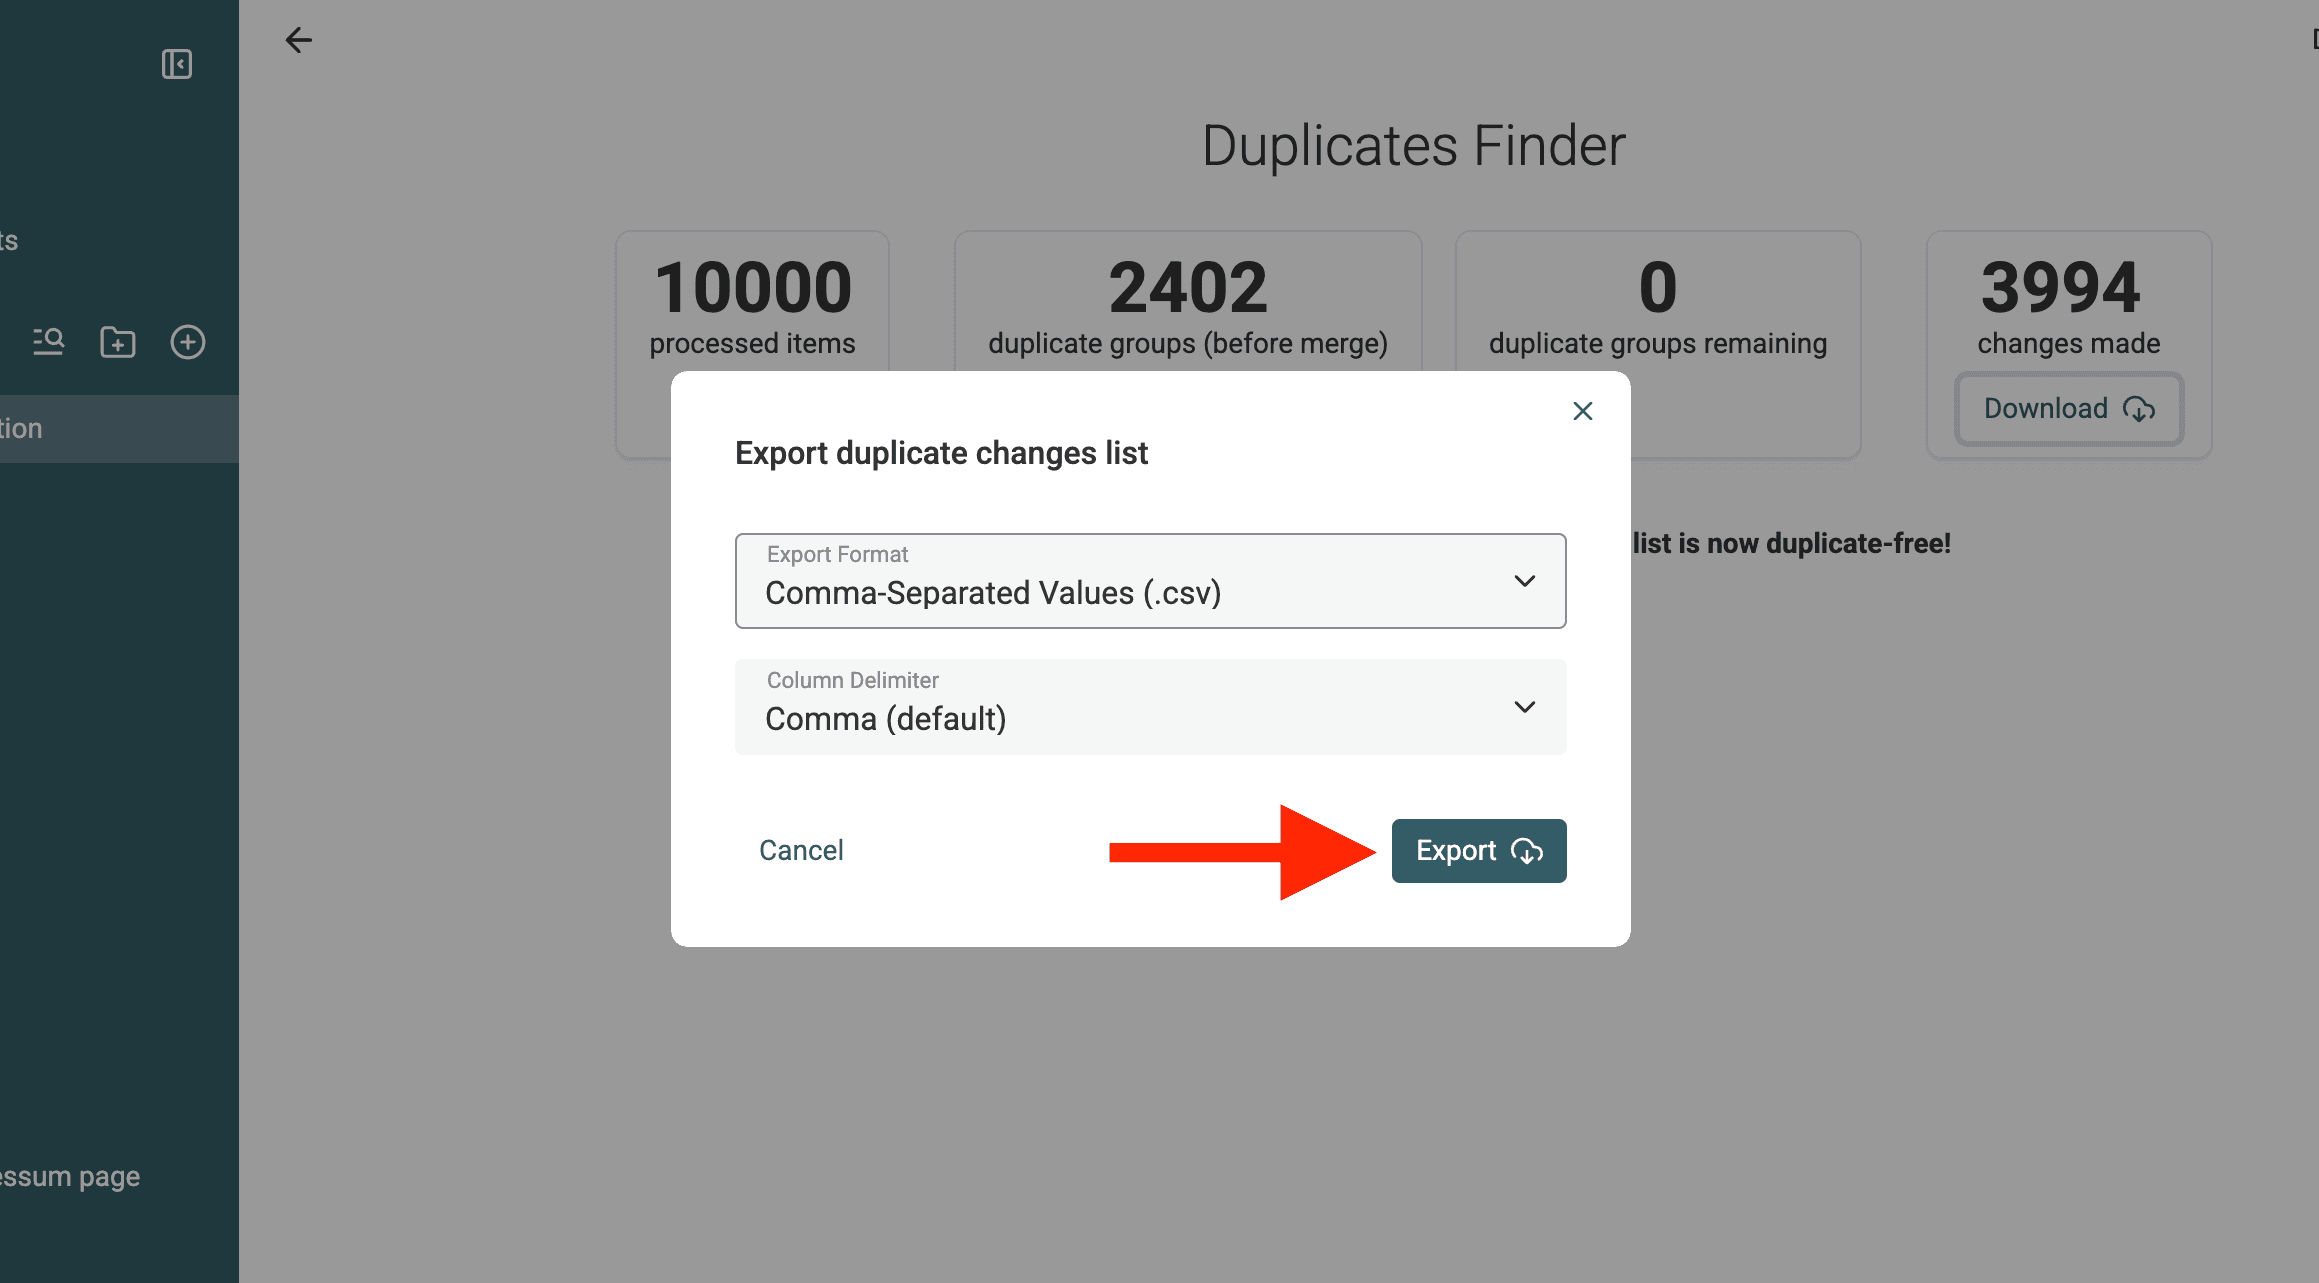
3.d. Scarica il file delle modifiche
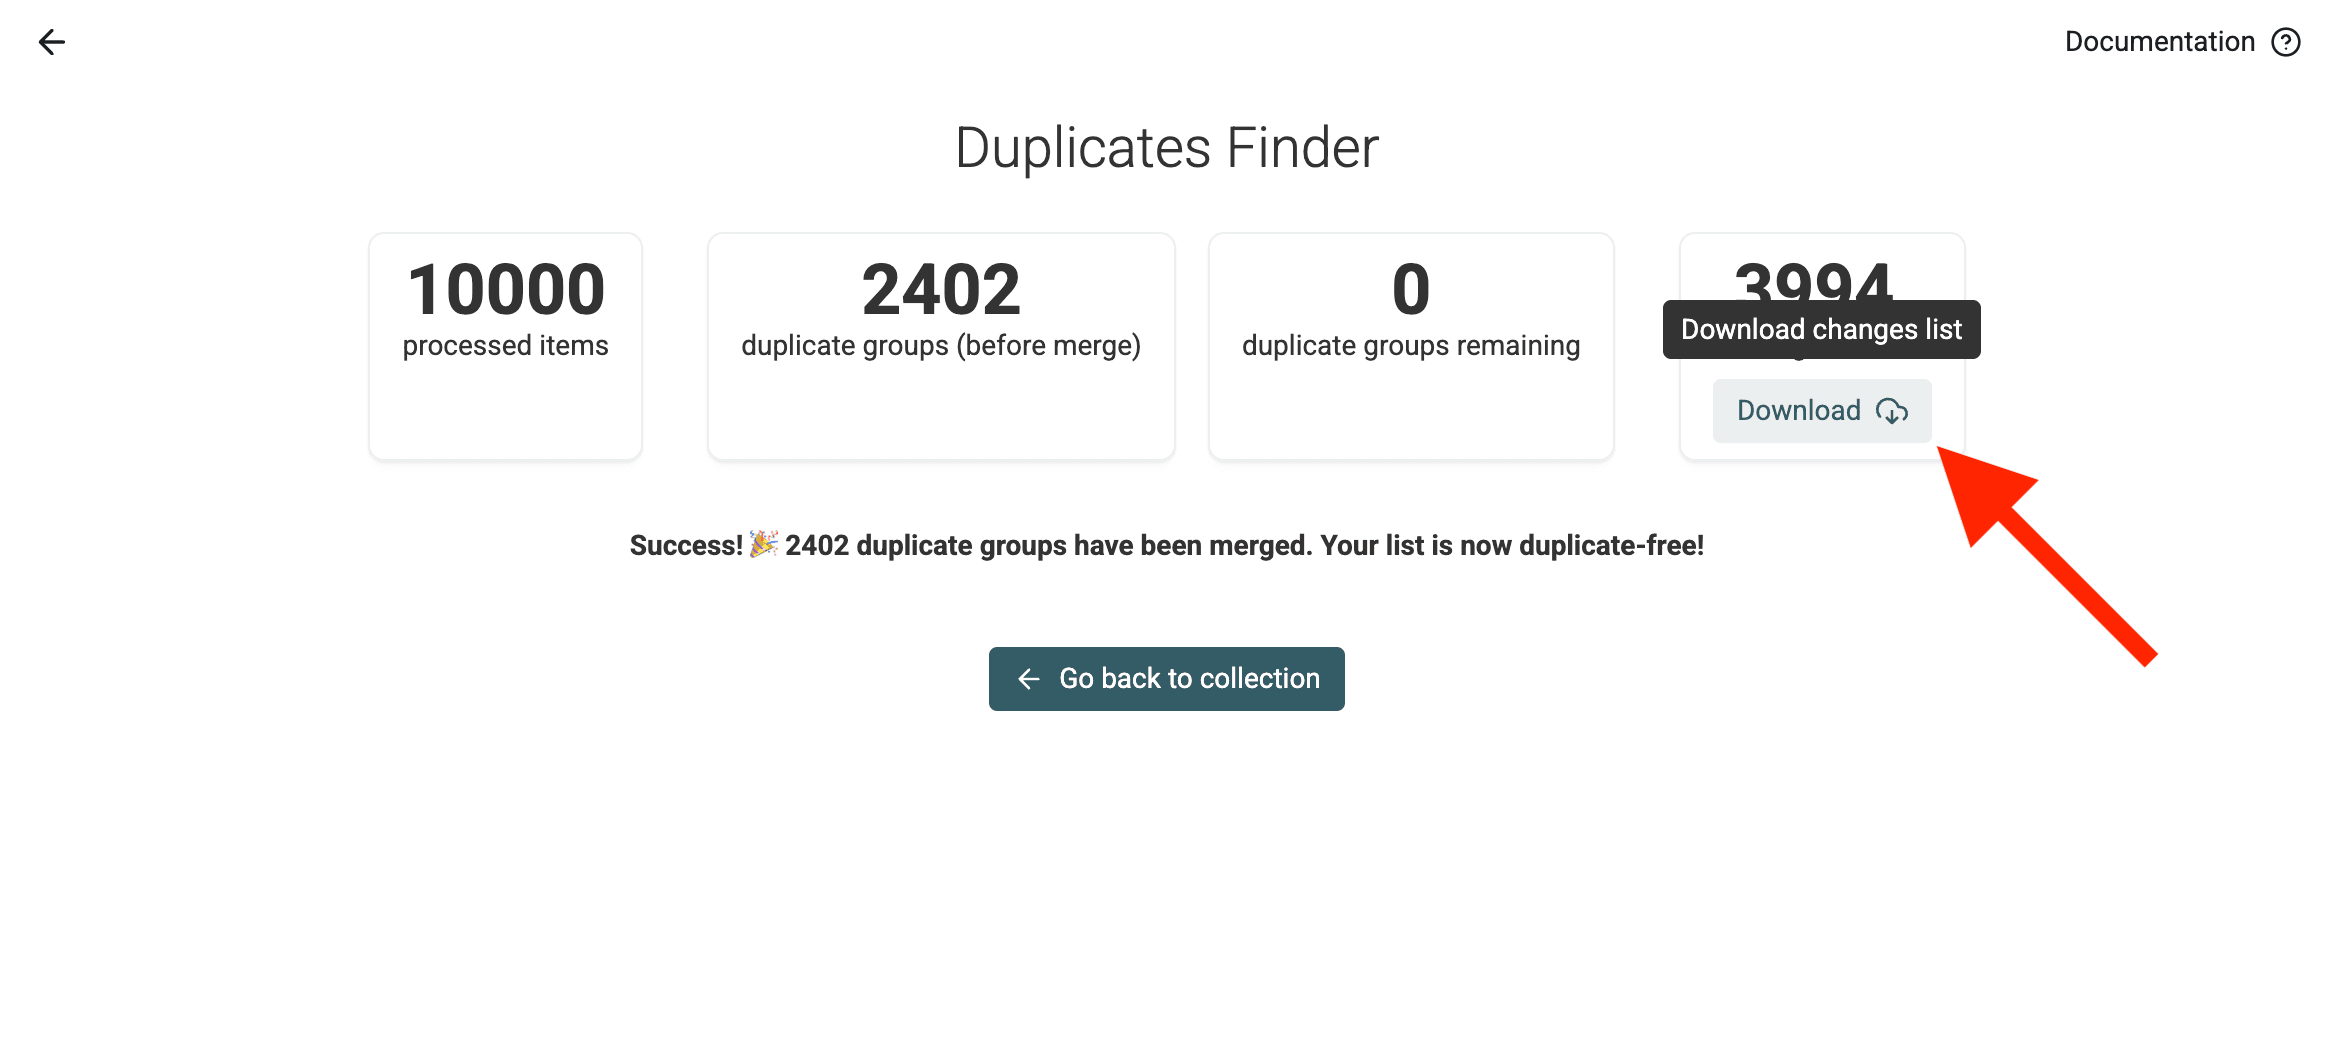
⚠️ Questo file delle modifiche è INDISPENSABILE per unire e aggiornare i record nel tuo CRM Pipedrive.
Passaggio 3: sincronizza le unioni su Pipedrive
I duplicati sono ora uniti in Datablist. L’ultimo passaggio consiste nel sincronizzare i dati puliti con Pipedrive, così il CRM resterà aggiornato.
A questo scopo useremo il Changes File scaricato nel passaggio precedente (vedi 3.d. Scarica il file delle modifiche). Il file elenca tutti i record uniti, i duplicati eliminati e i campi aggiornati.
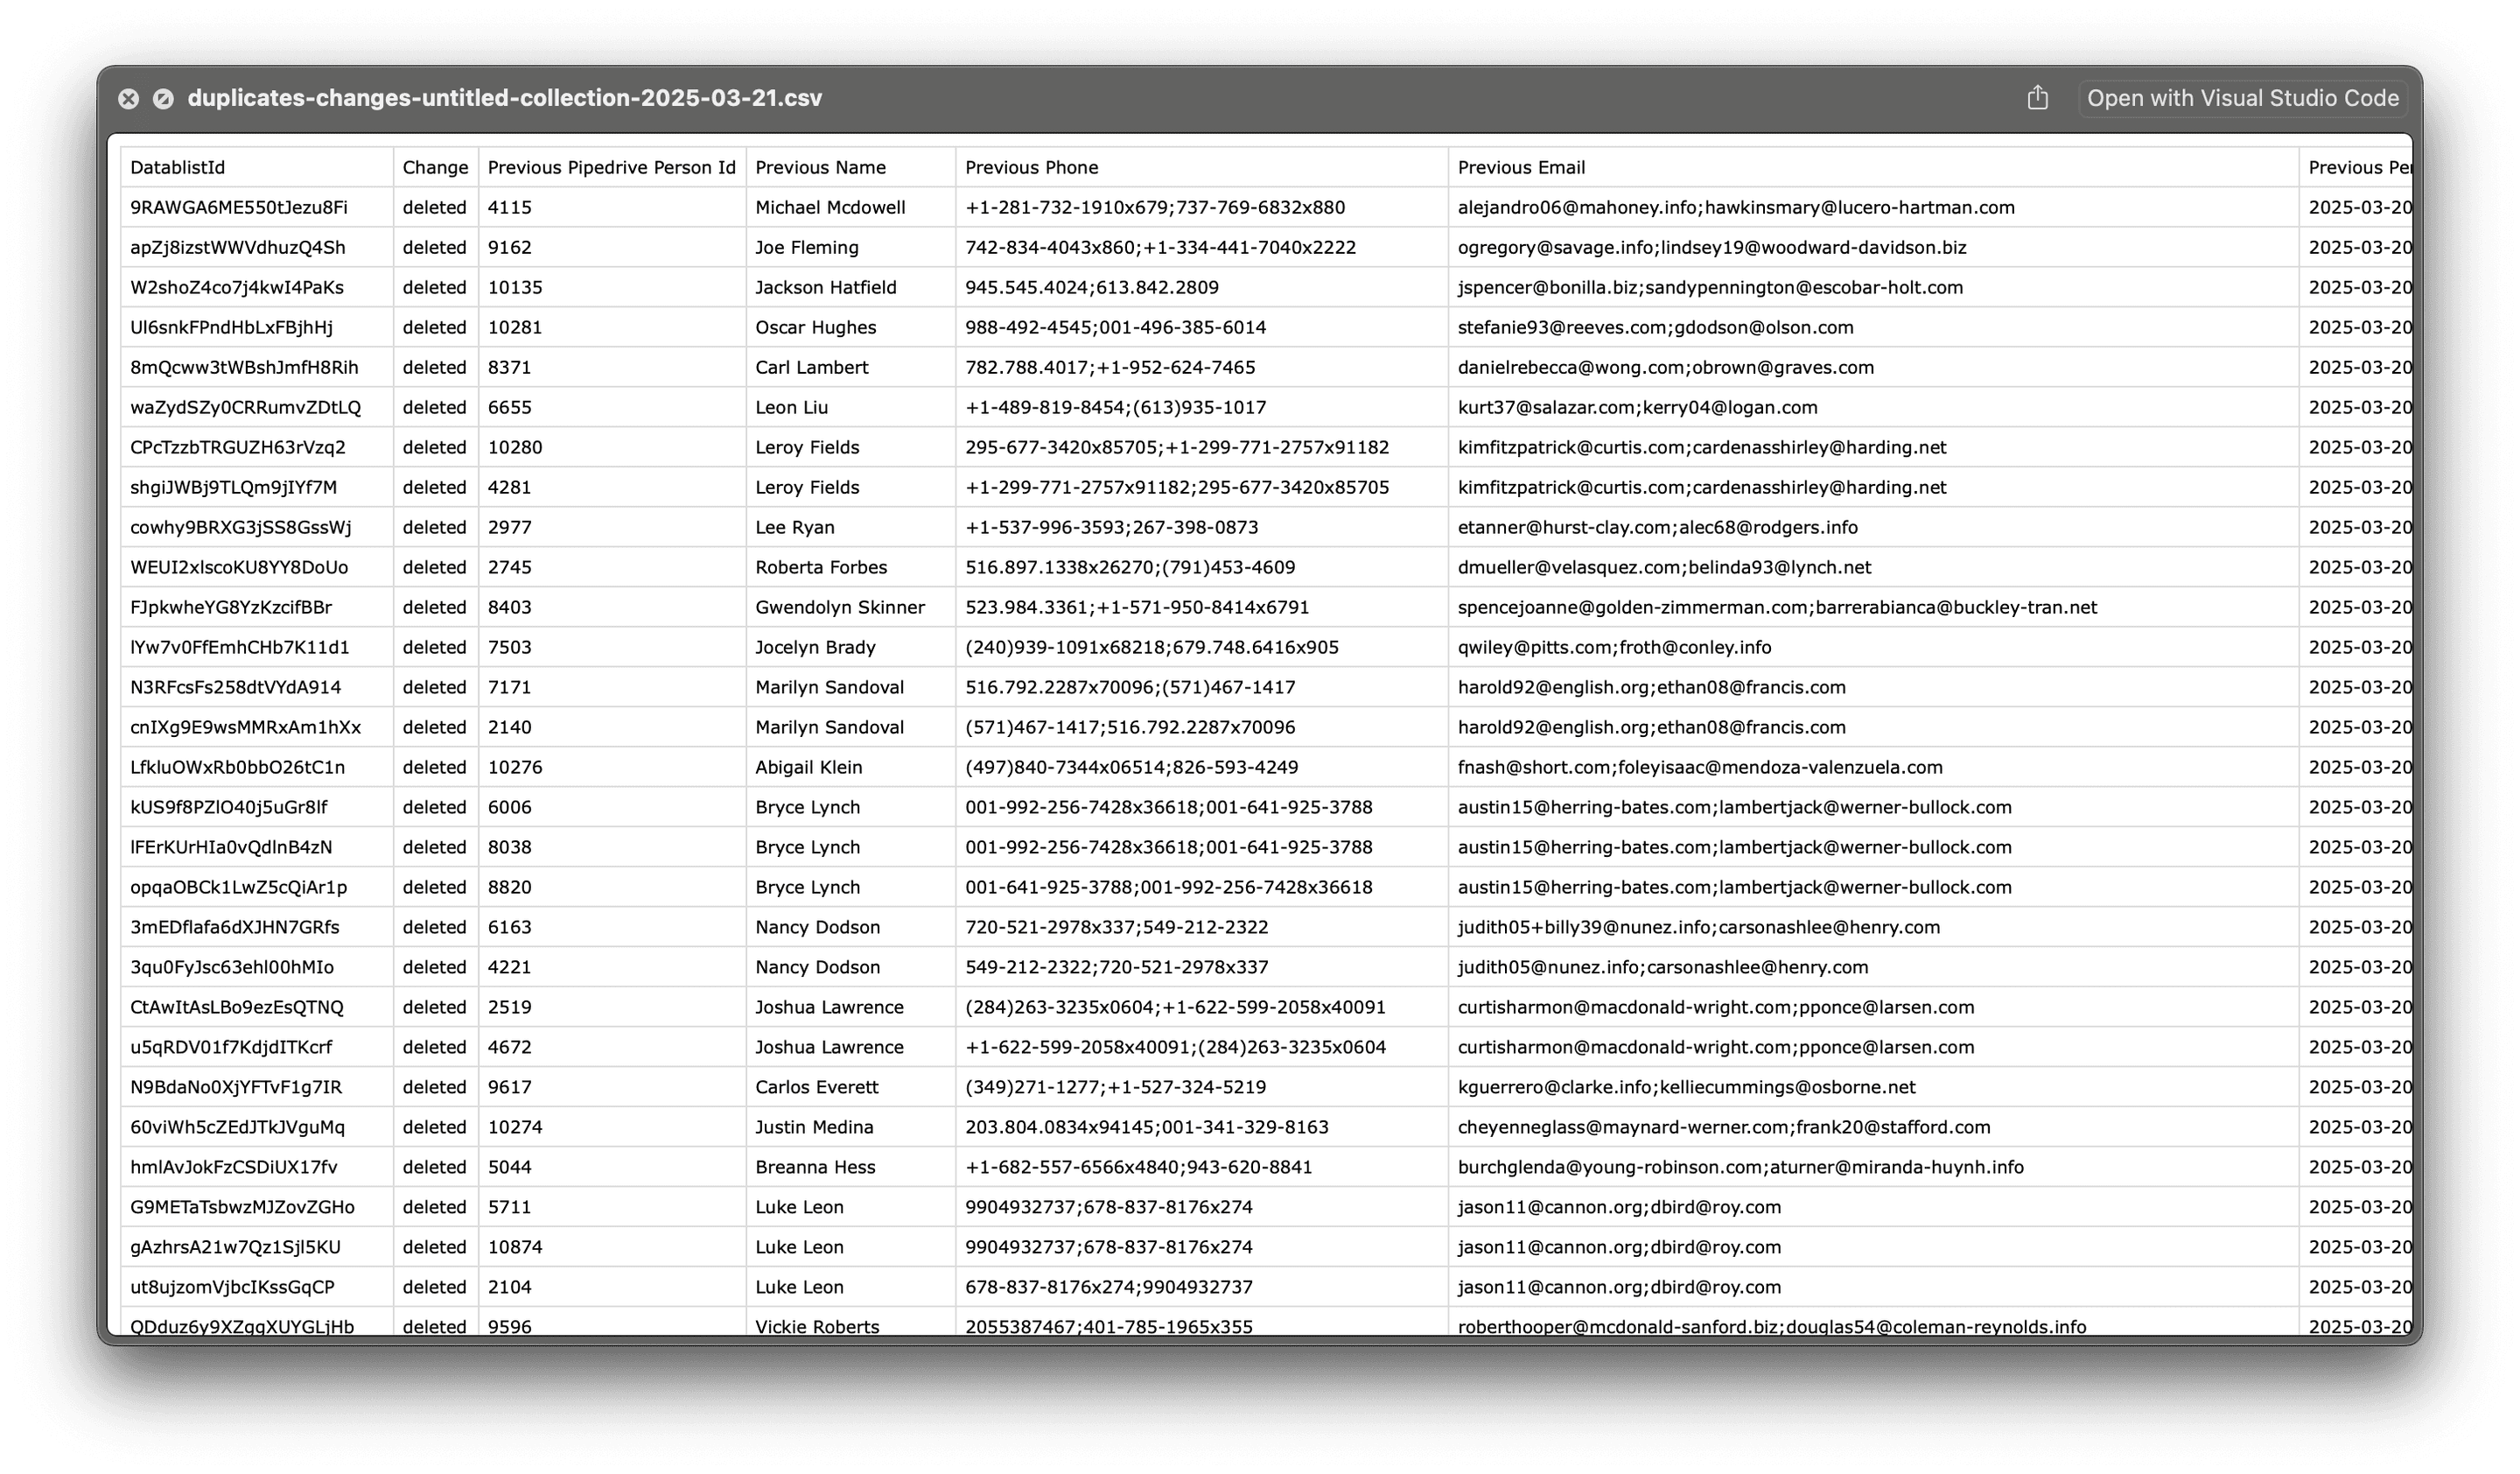
Nel Changes Log troverai:
✅ Updated Records → contatti o Organizations modificati, per esempio con email, numeri di telefono o nomi combinati. Sono riportati sia i dati precedenti sia quelli aggiornati.
✅ Deleted Records → record duplicati uniti al record master. Sono indicati l’id del record eliminato e l’id del record master che lo ha sostituito. Questi record devono essere eliminati da Pipedrive.
3.a. Importa il Changes File in una nuova collection
Per applicare le modifiche in Pipedrive, crea una nuova collection e carica il Changes File.
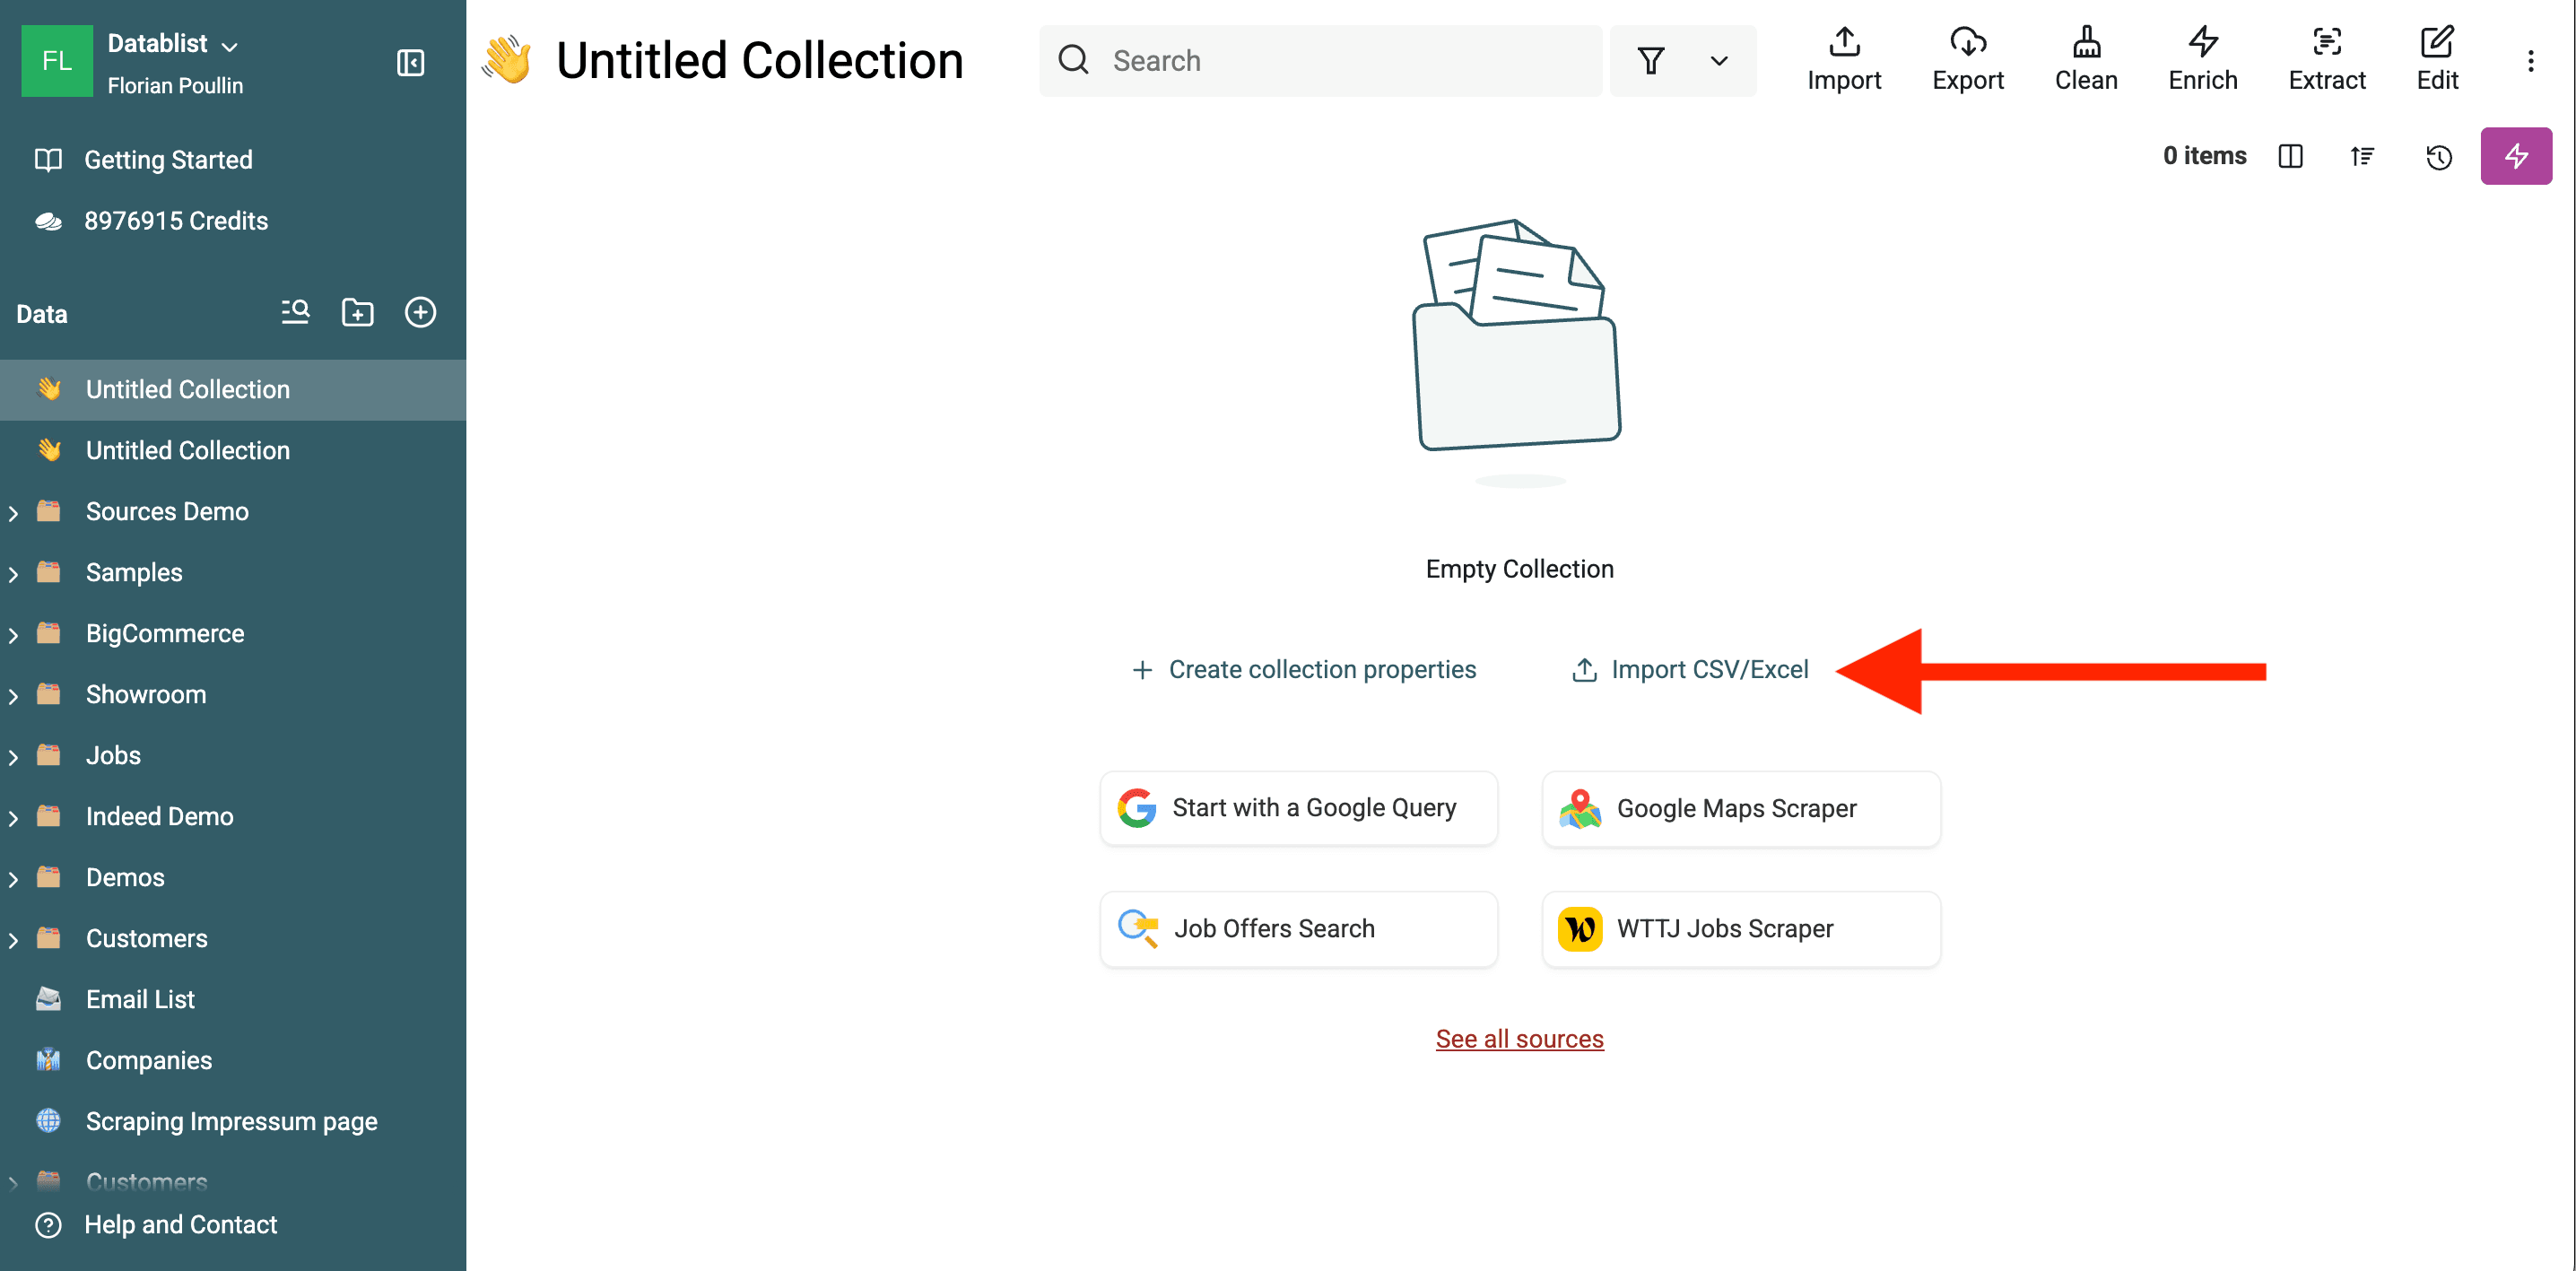
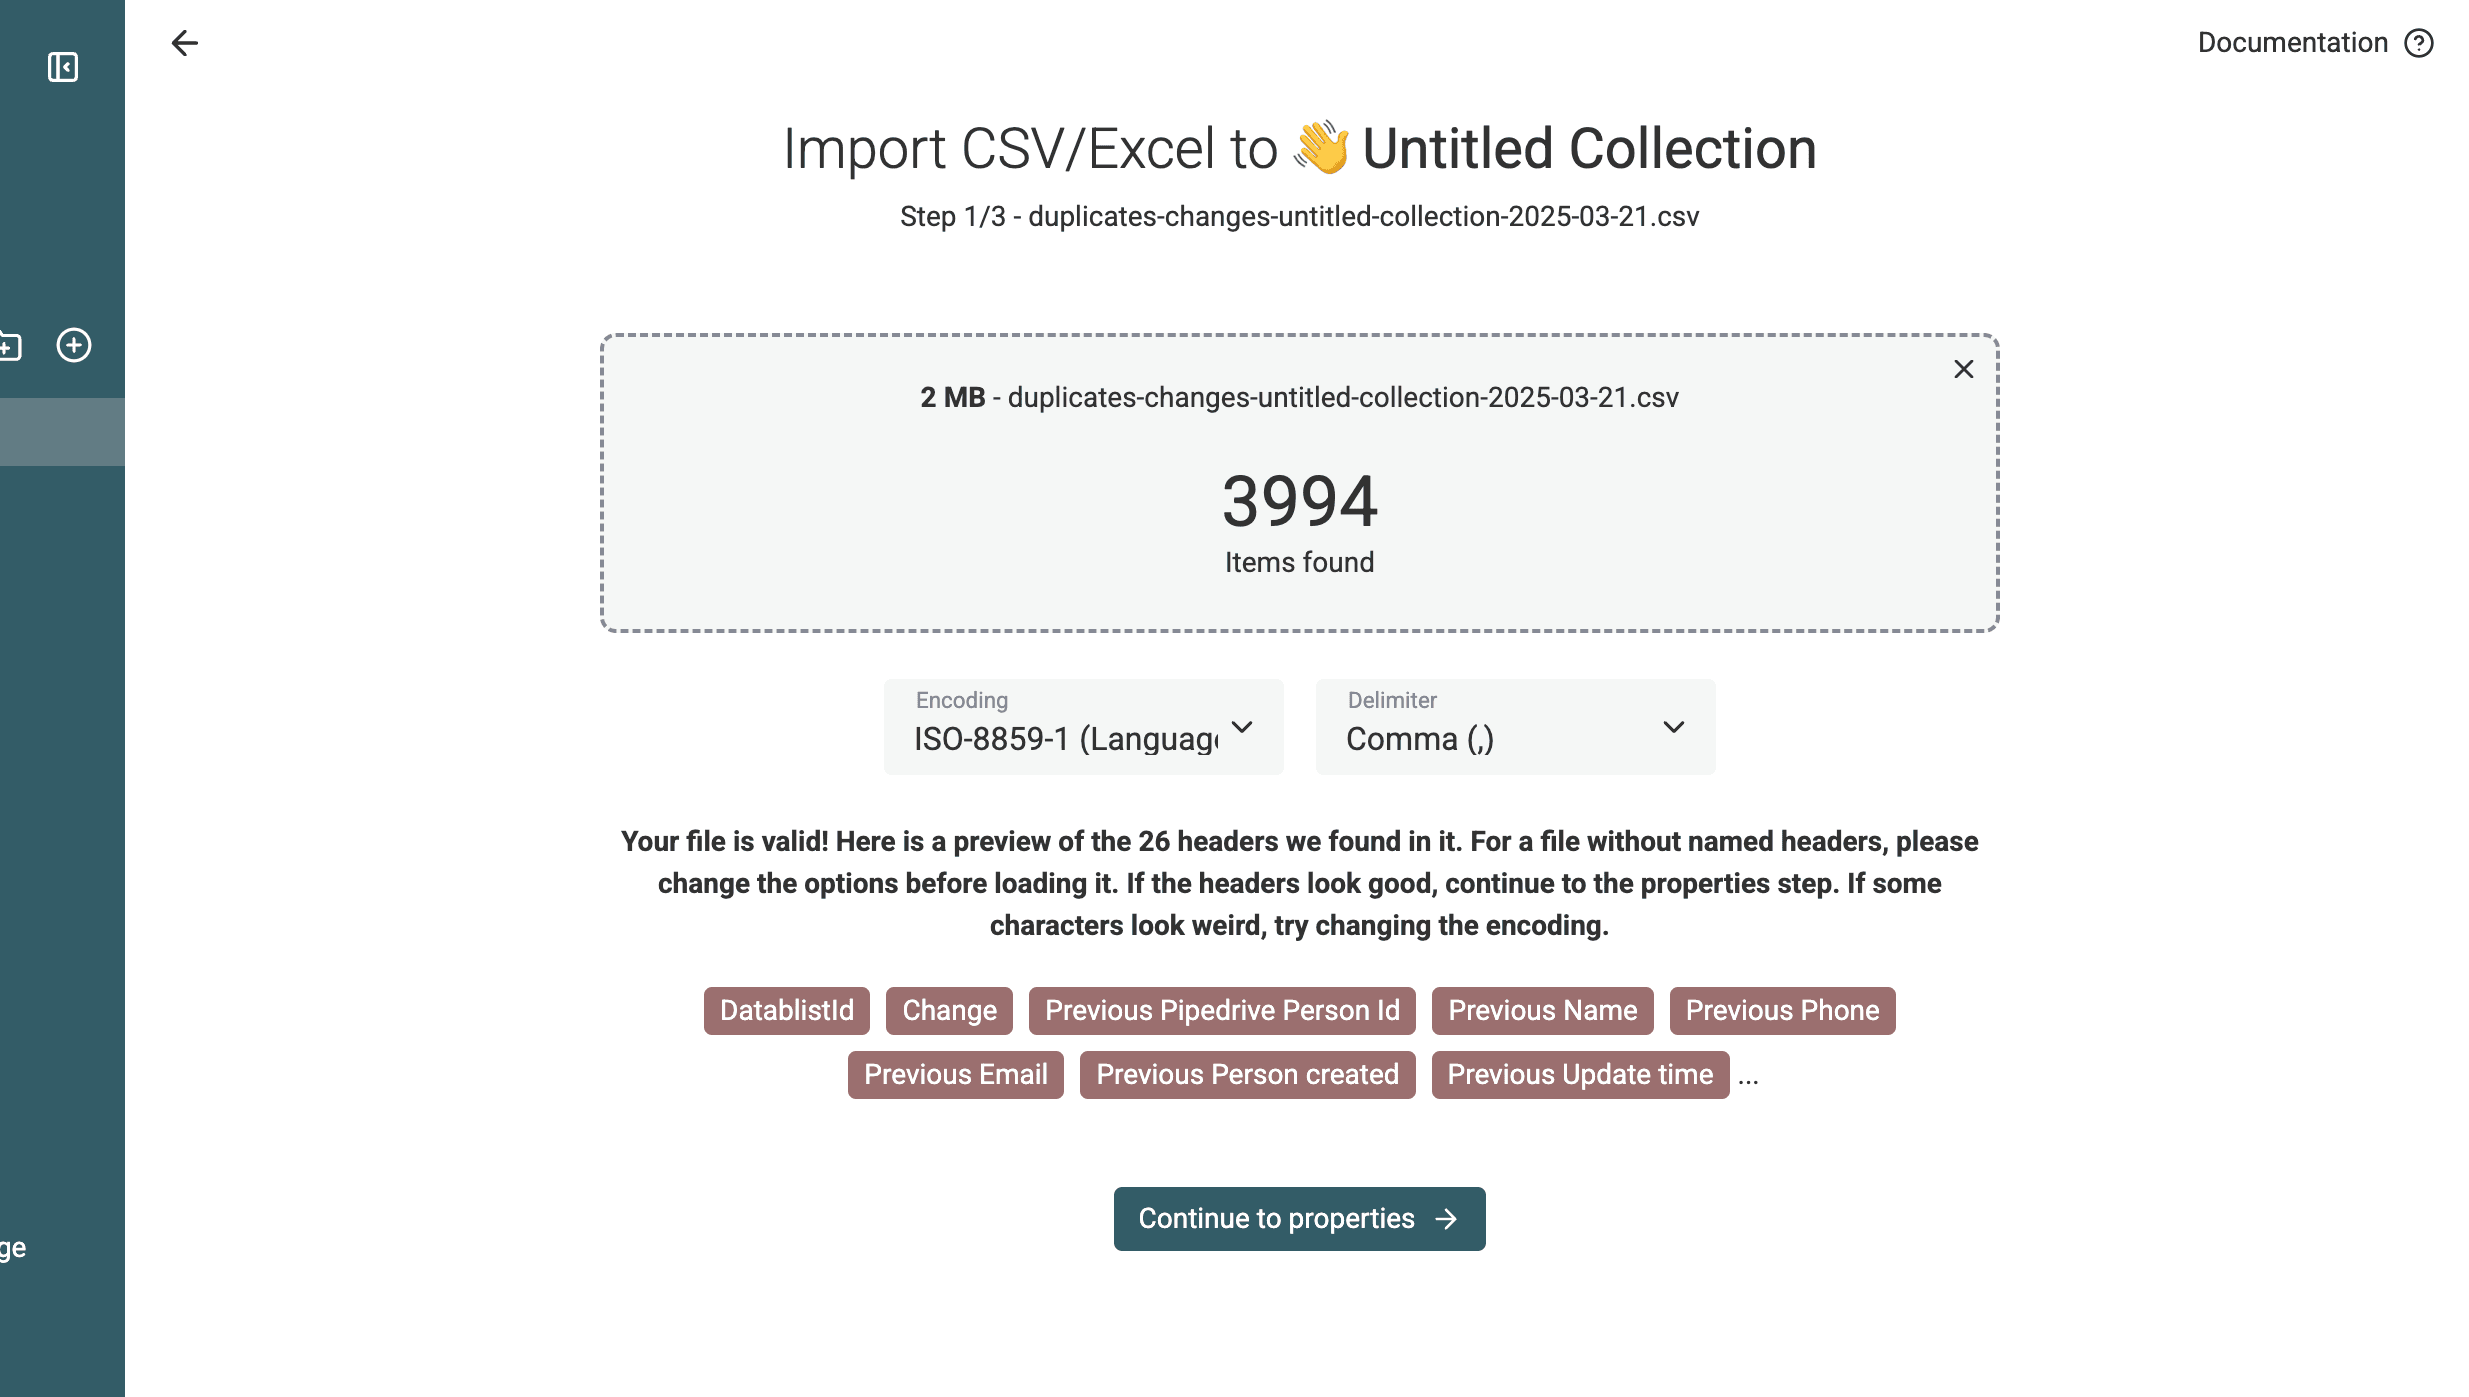
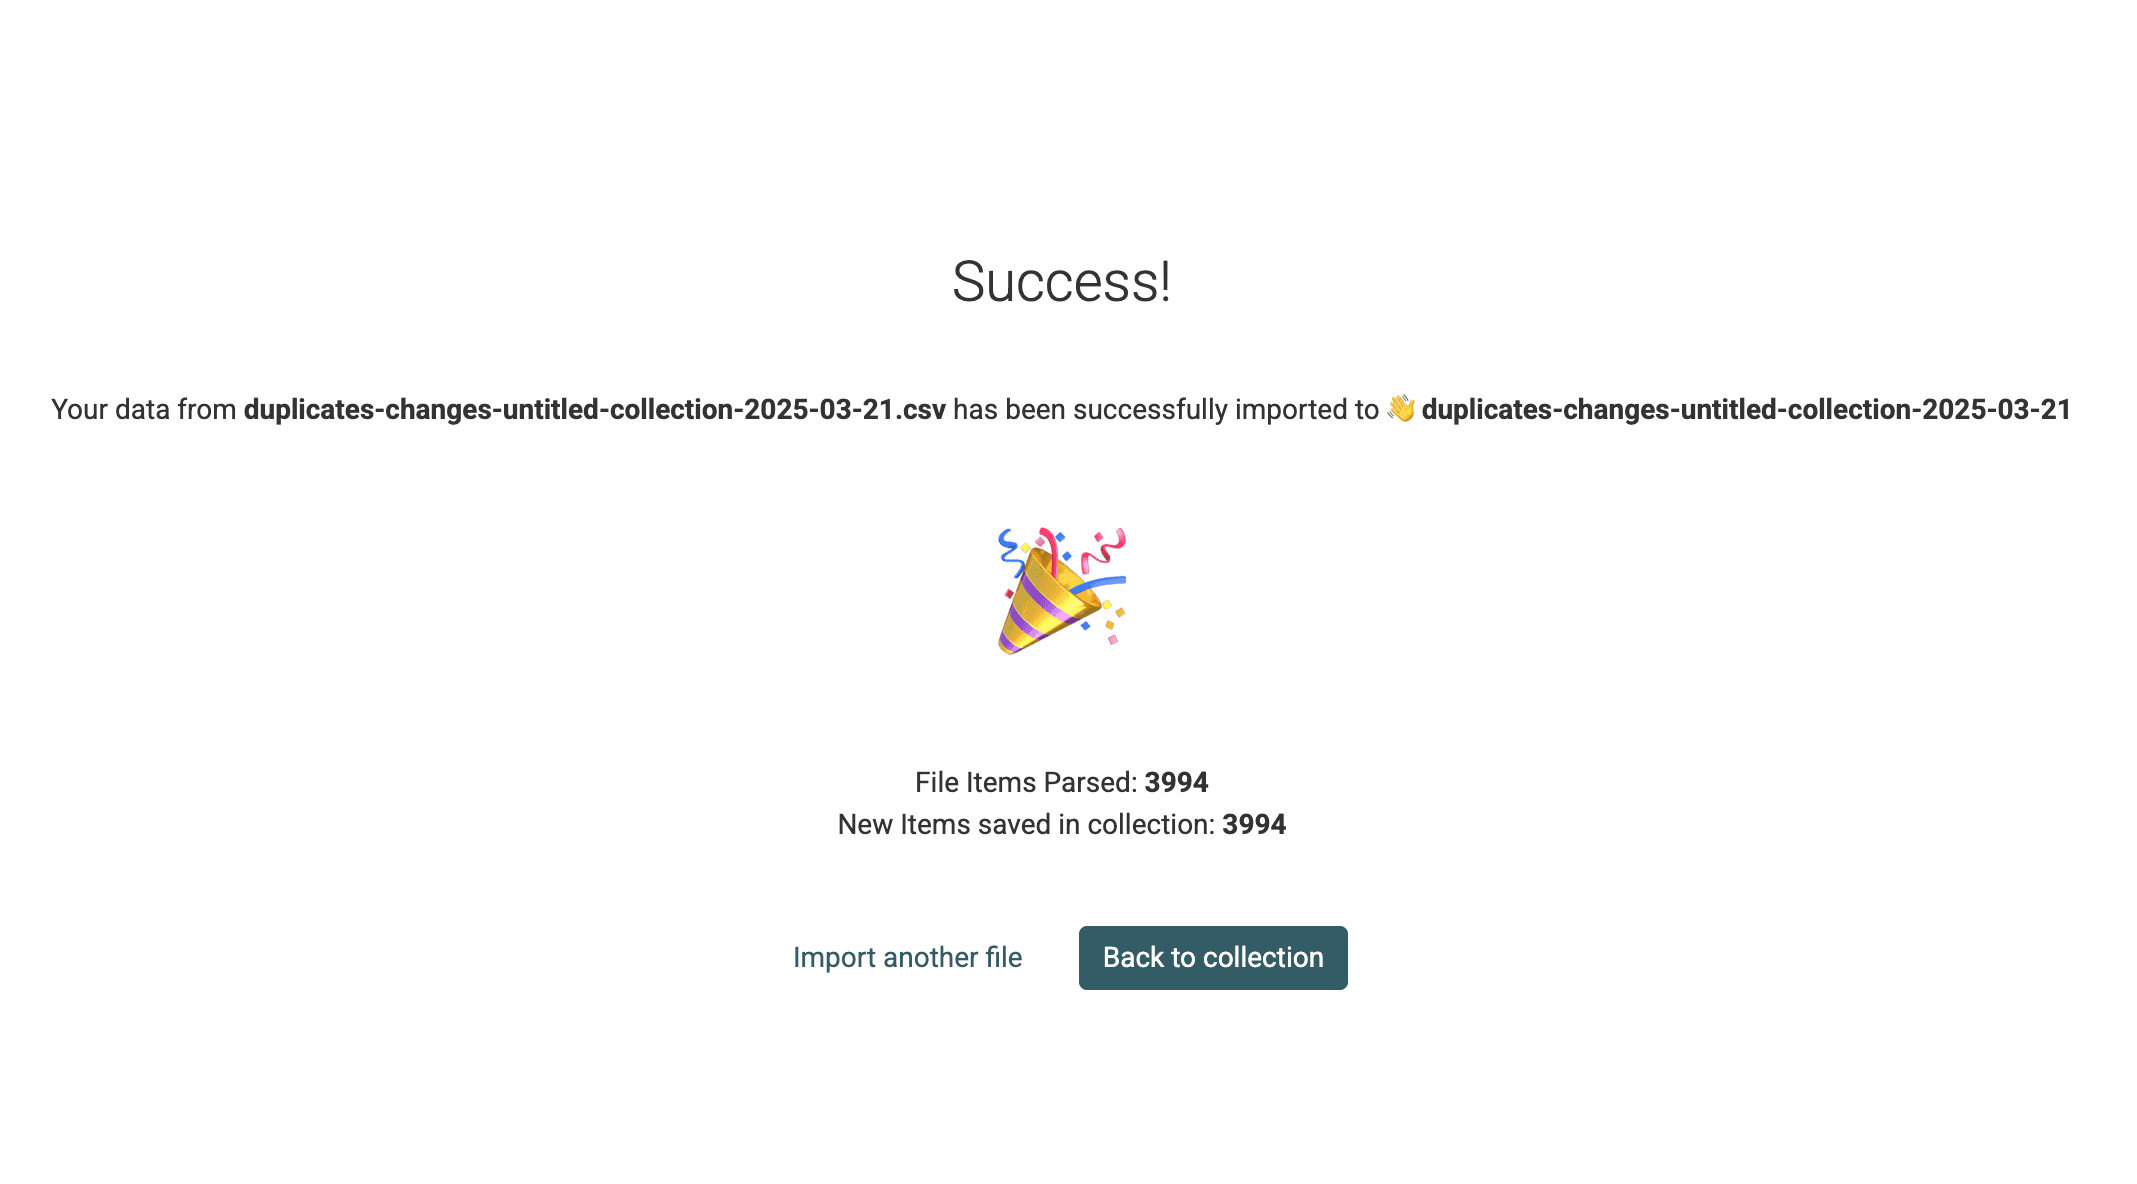
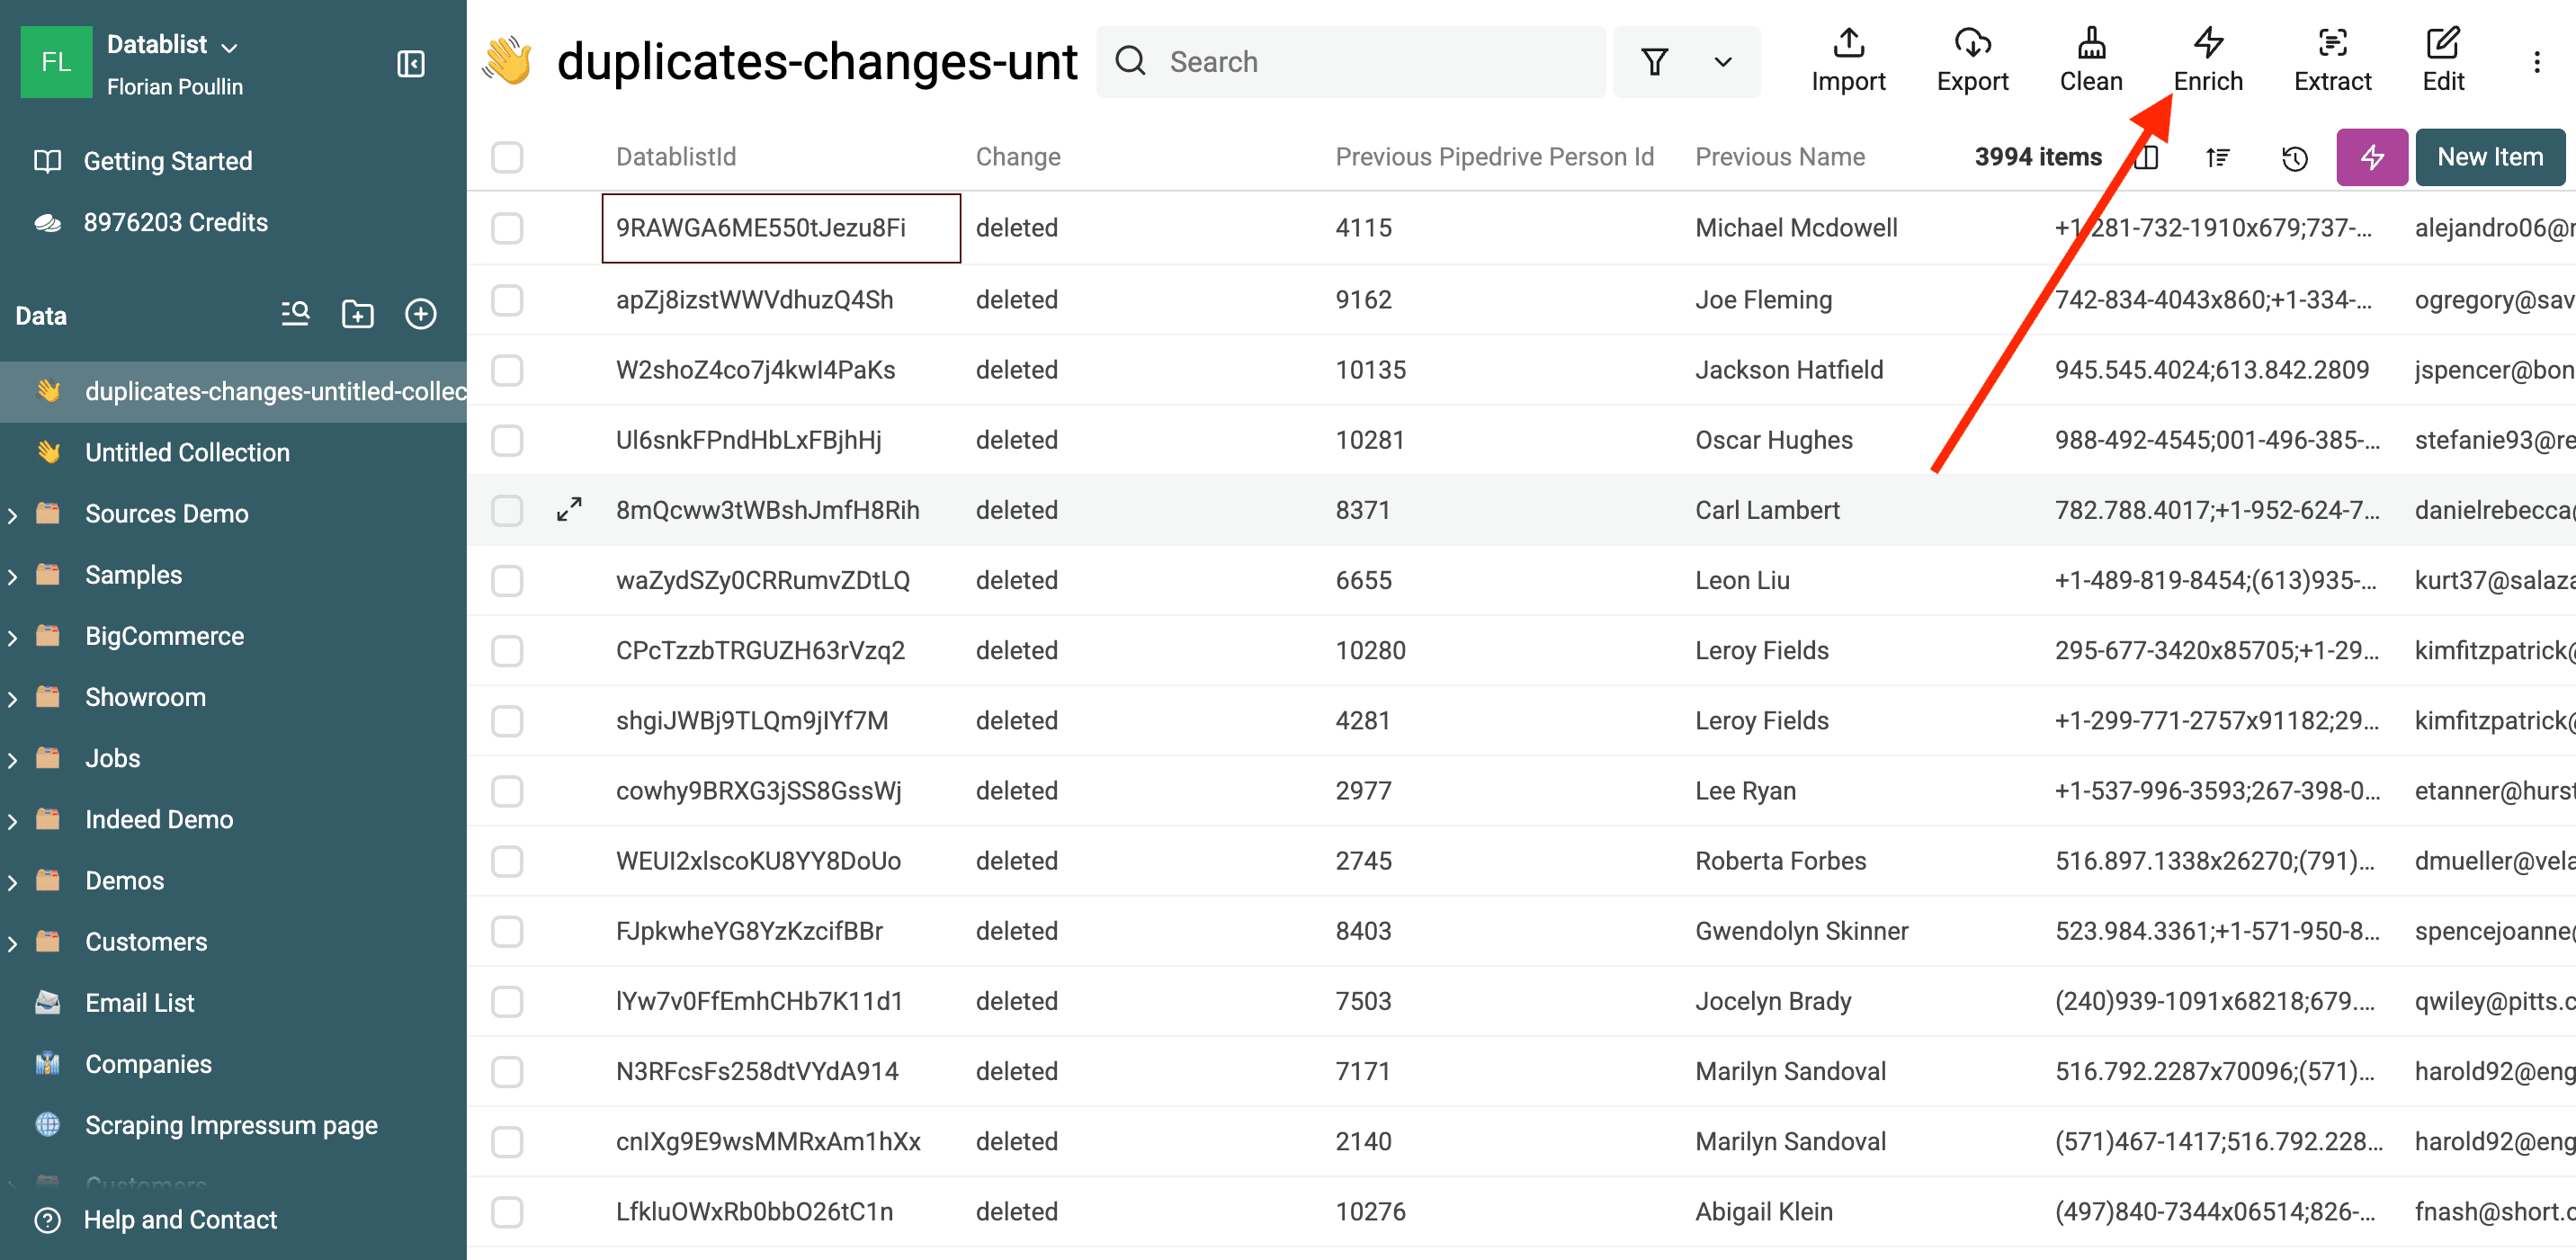
Otterrai una collection contenente le operazioni di unione.
3.b. Unisci ed elimina i record duplicati
Per prima cosa, devi indicare a Pipedrive di unire i record "deleted" ai rispettivi record "master".
Pipedrive mette a disposizione una merge API per consolidare i record duplicati. È quella che useremo.
Per chi è interessato agli aspetti tecnici, ecco come funziona l’API di Pipedrive:
- Usa l’endpoint
/organizations/:id/mergeper Organizations. - Usa l’endpoint
/persons/:id/mergeper People. - Il record duplicato viene eliminato e i suoi dati vengono trasferiti al record master.
💡 Esempio di richiesta API:
PUT https://api.pipedrive.com/v1/persons/{duplicate_id}/merge?api_token=YOUR_API_KEY
{
  "merge_with_id": "{master_record_id}"
}
🔹 Perché usare la Merge API?
- Garantisce che tutti i deal, le attività e le note collegate rimangano associati al record master.
- I dati non in conflitto, come numeri di telefono o email aggiuntivi, vengono conservati automaticamente.
Niente panico - Datablist offre un enrichment nativo che richiama questo endpoint di Pipedrive al posto tuo.
Per prima cosa, seleziona soltanto gli elementi con operazione di modifica deleted.
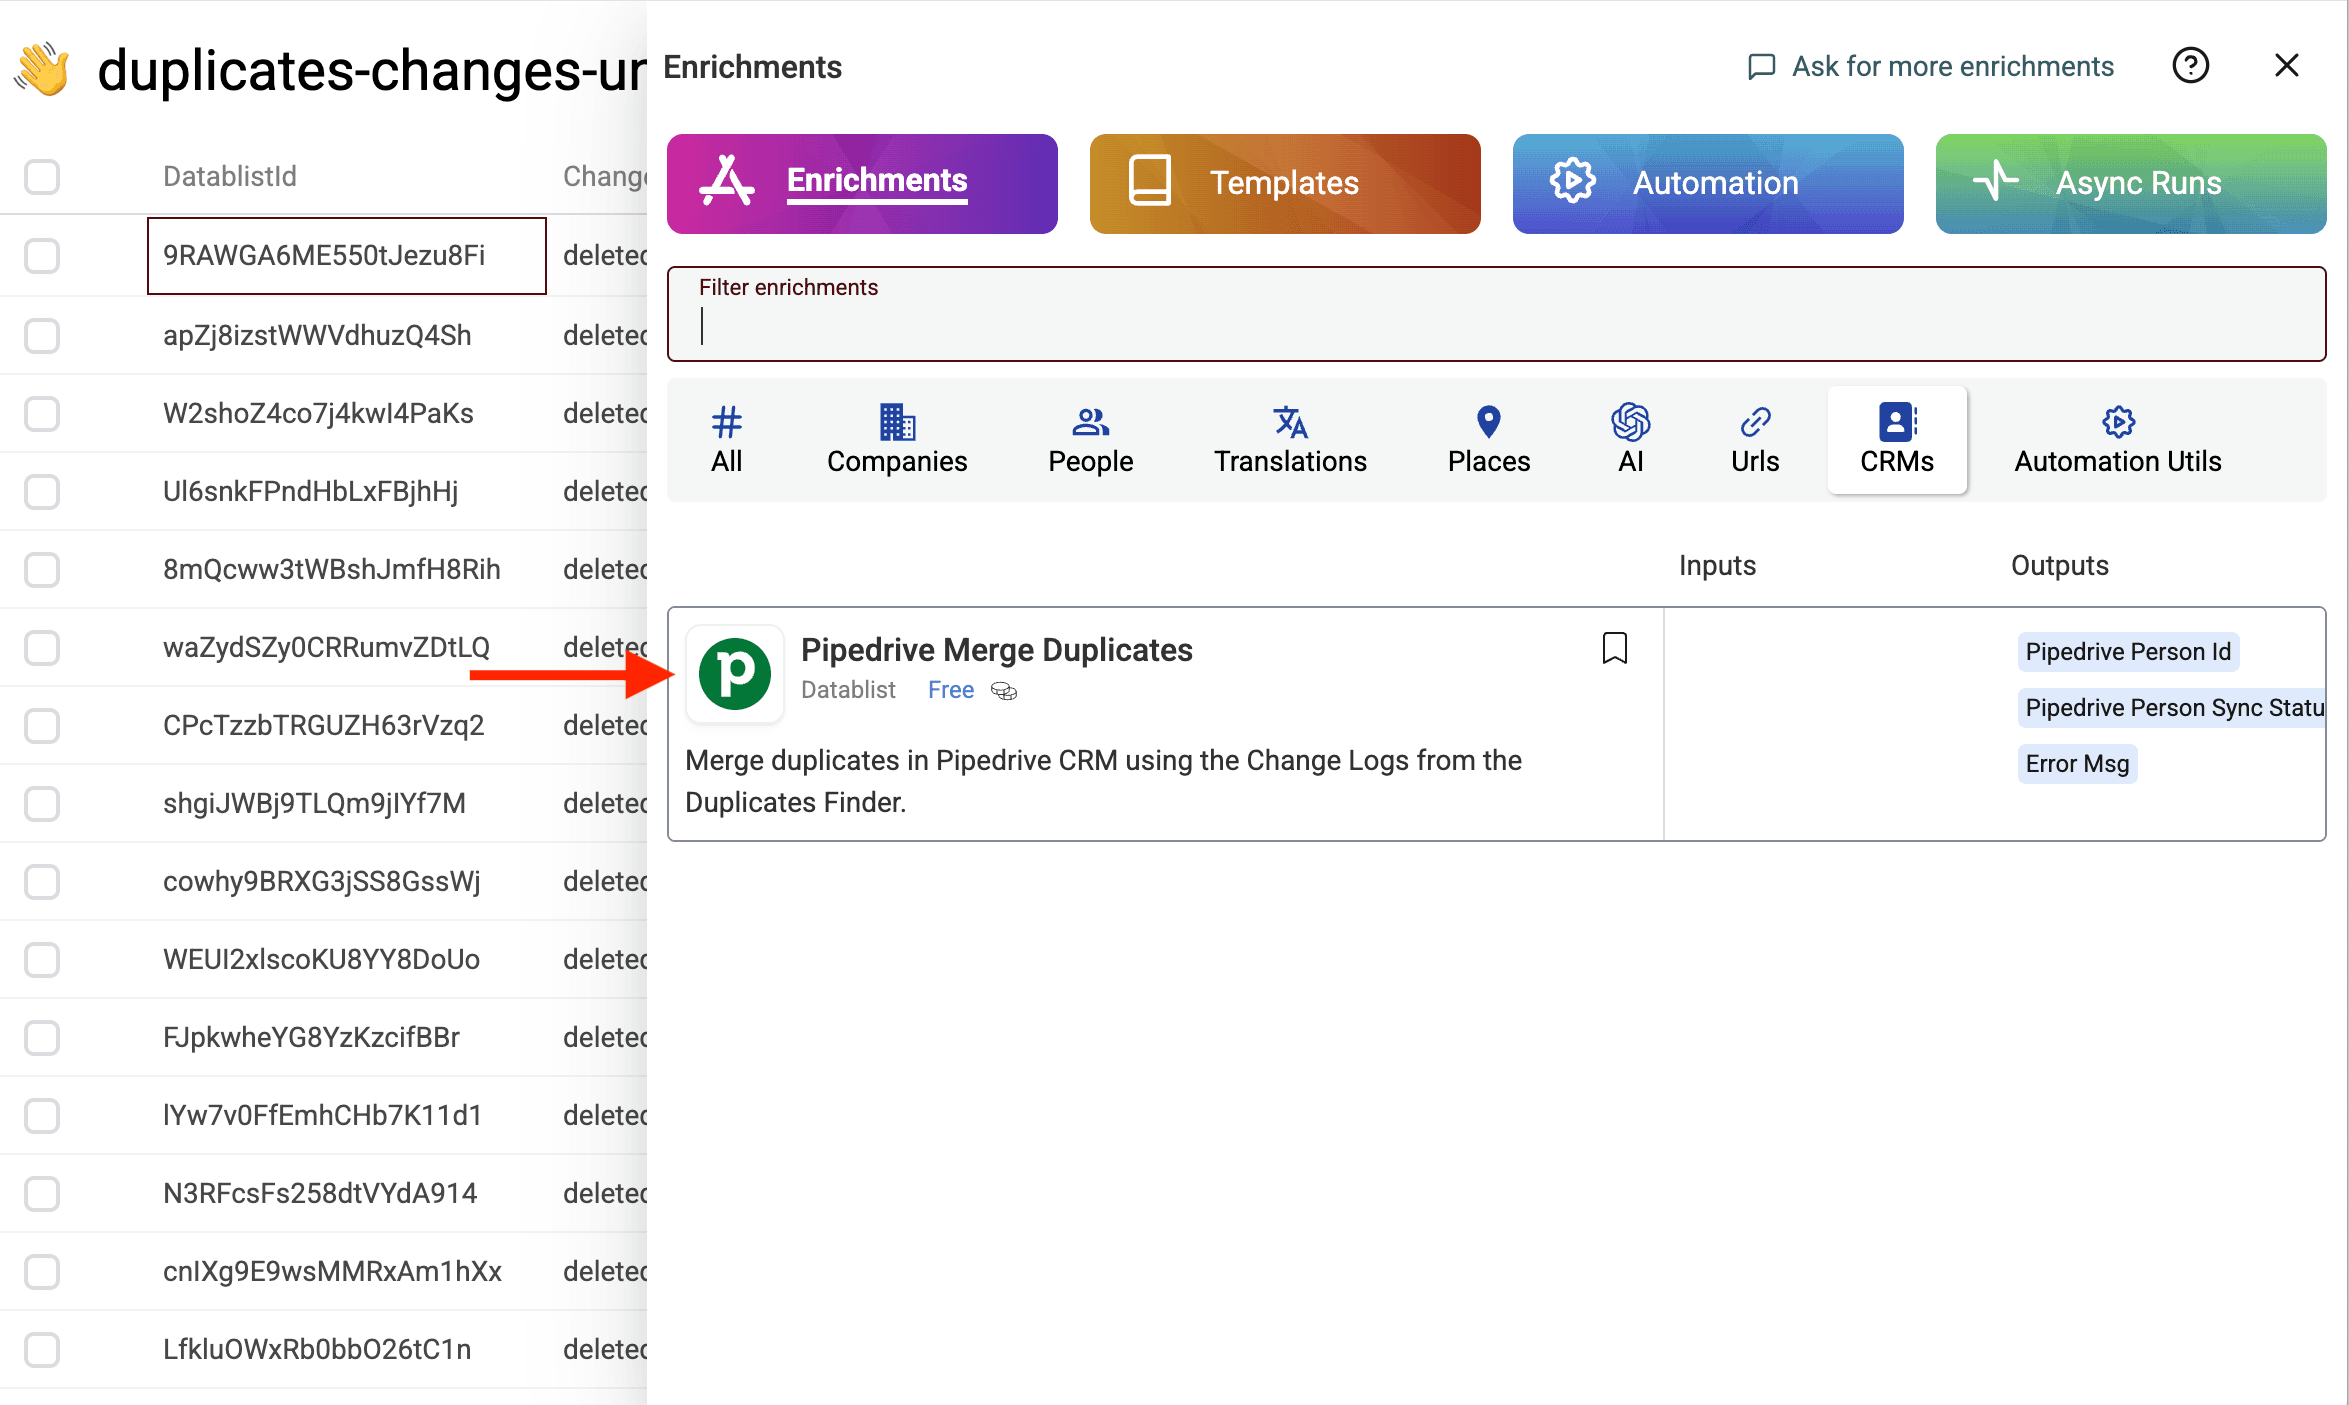
Poi, nel menu Enrich, seleziona Pipedrive Merge Duplicates.
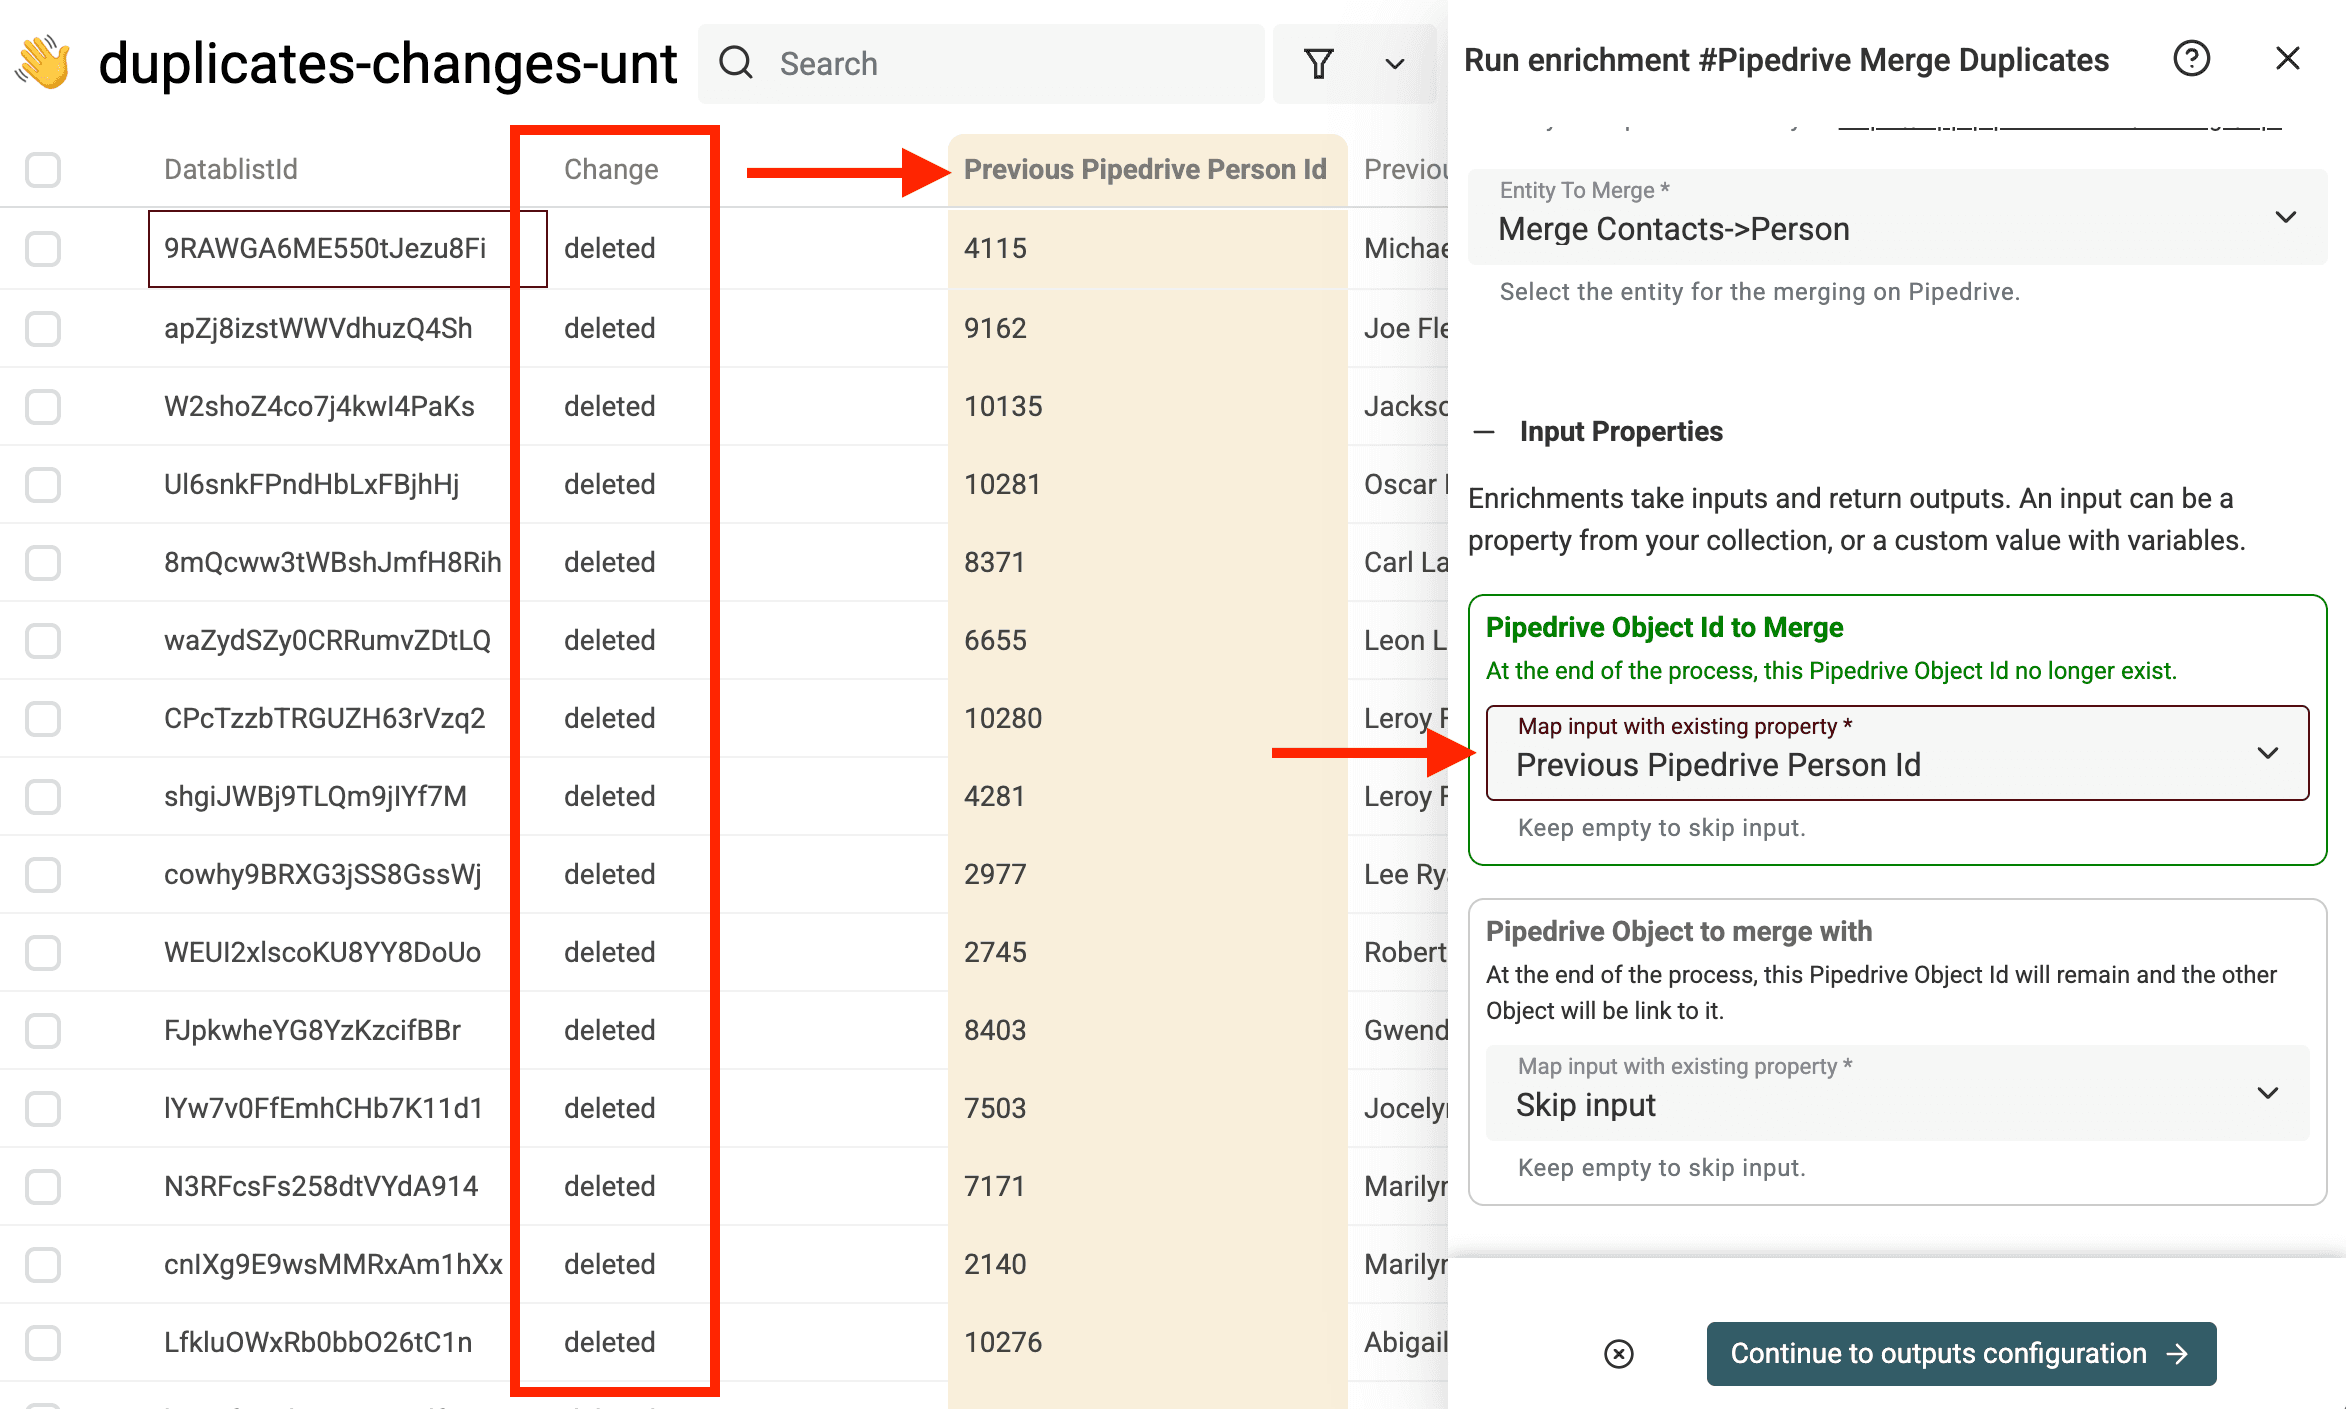
Prima di eseguire l’enrichment Pipedrive Merge Duplicates, assicurati che nella colonna delle modifiche sia visibile soltanto "deleted".
Inserisci la chiave API di Pipedrive e configura l’entità Pipedrive da unire.
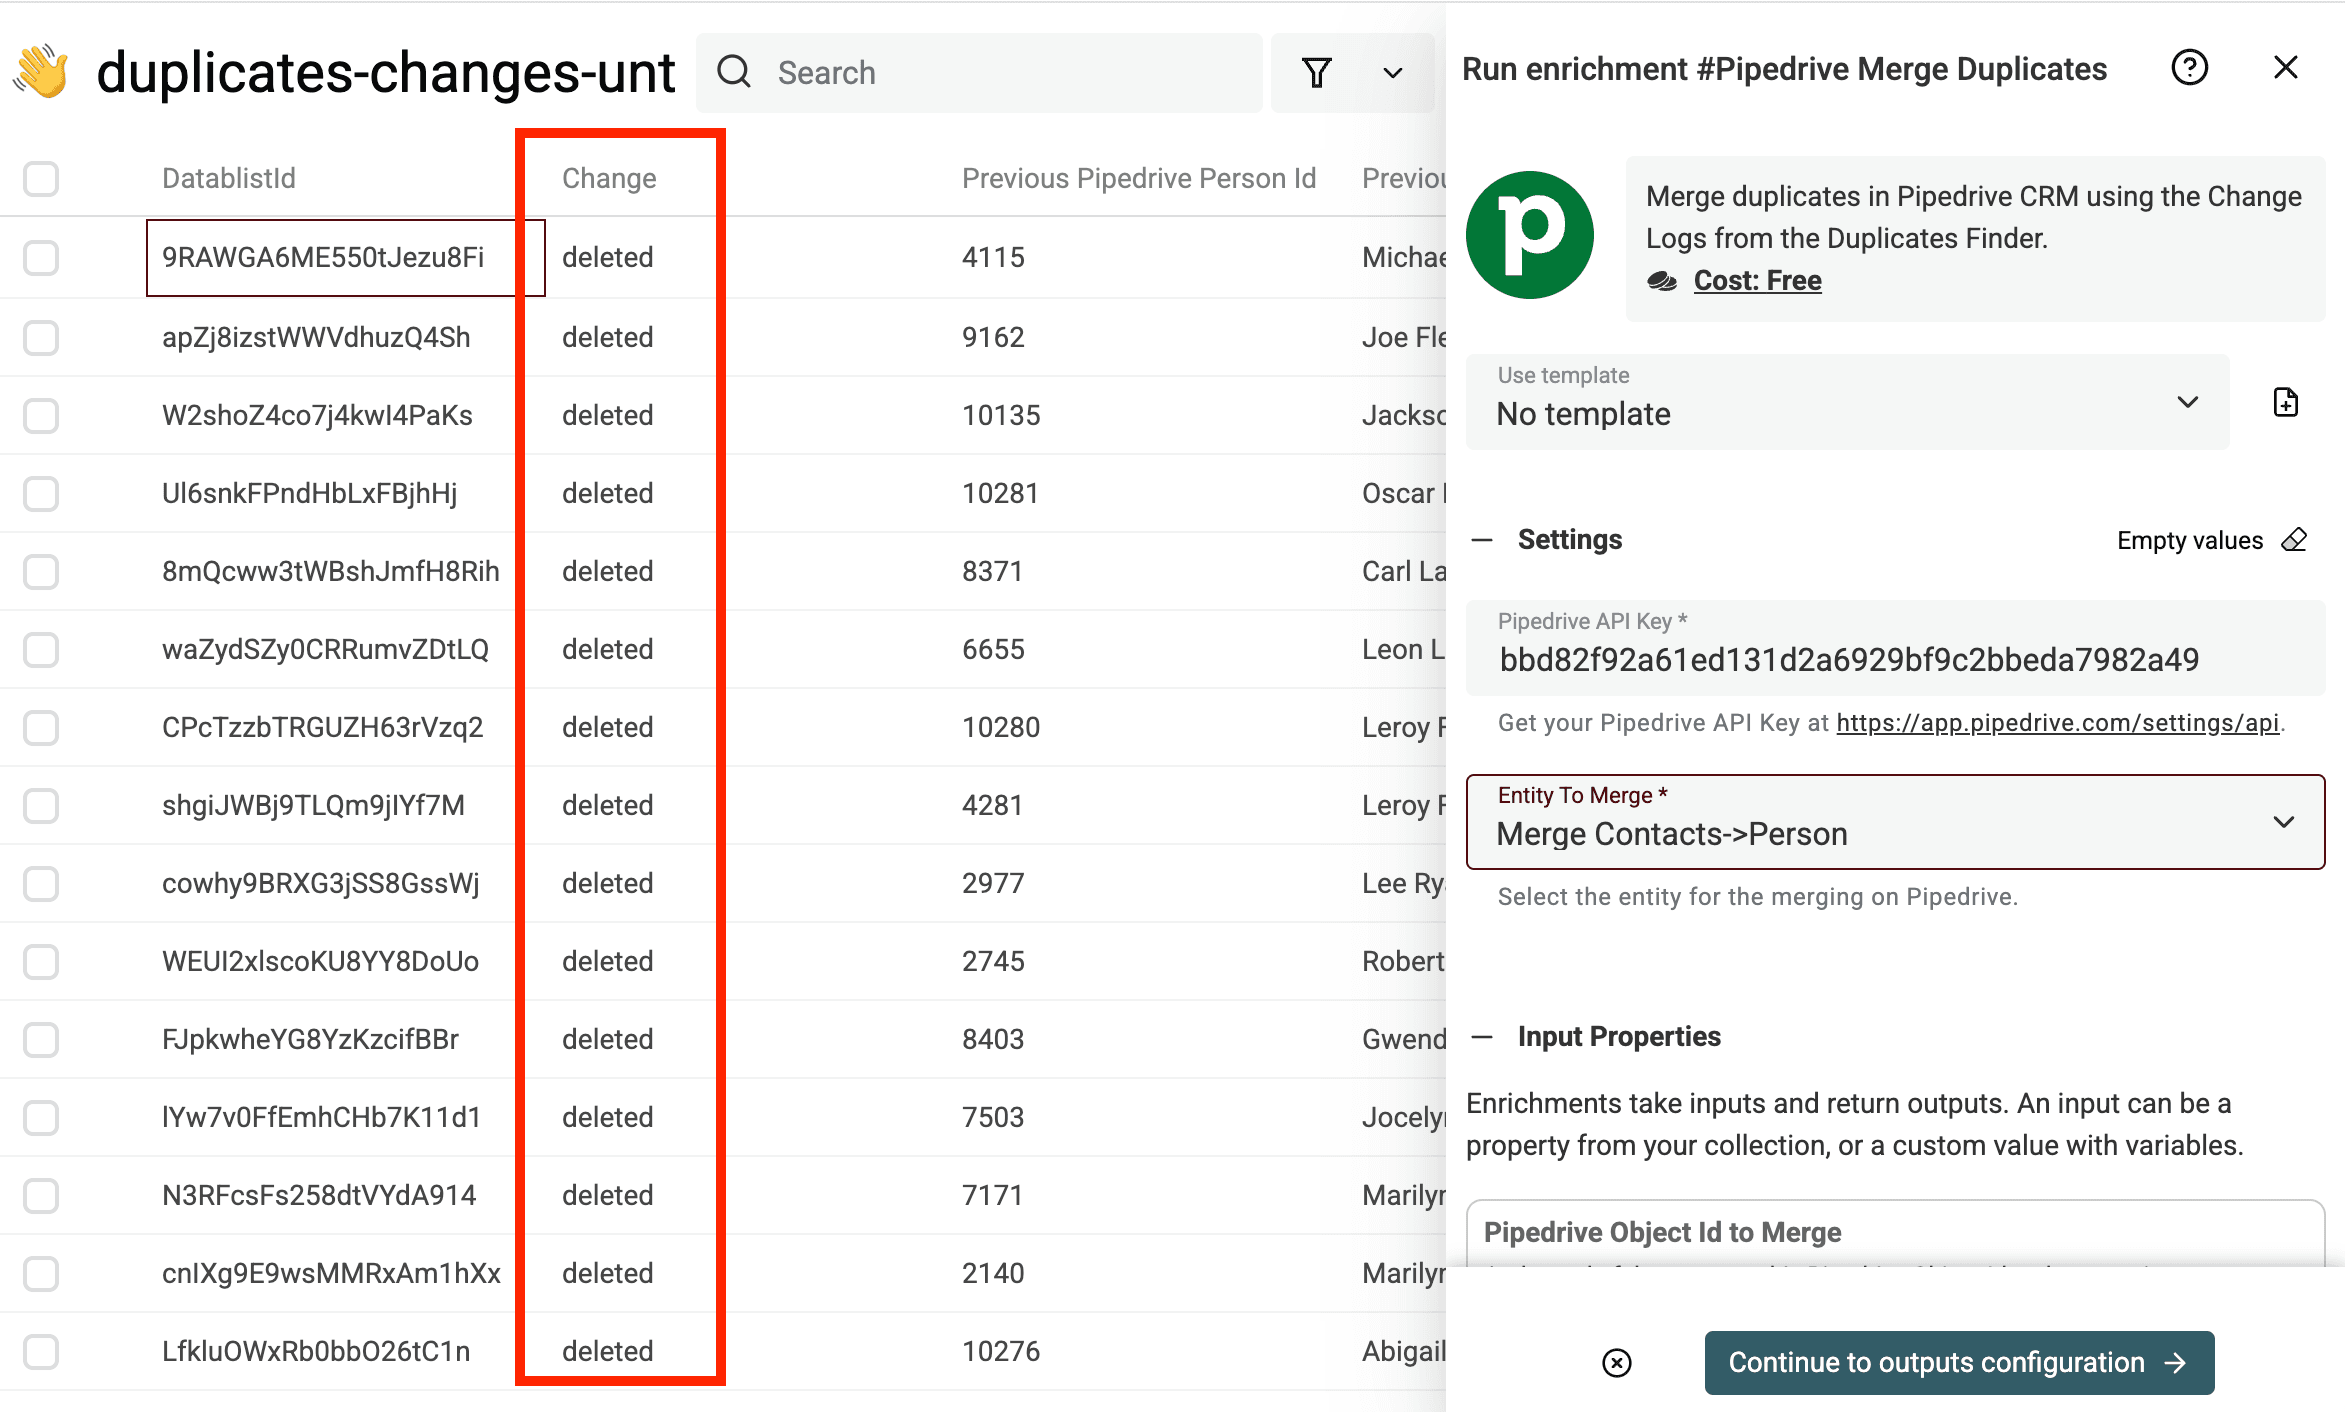
Negli input, associa Pipedrive Object Id to Merge al campo Previous Pipedrive Person Id.
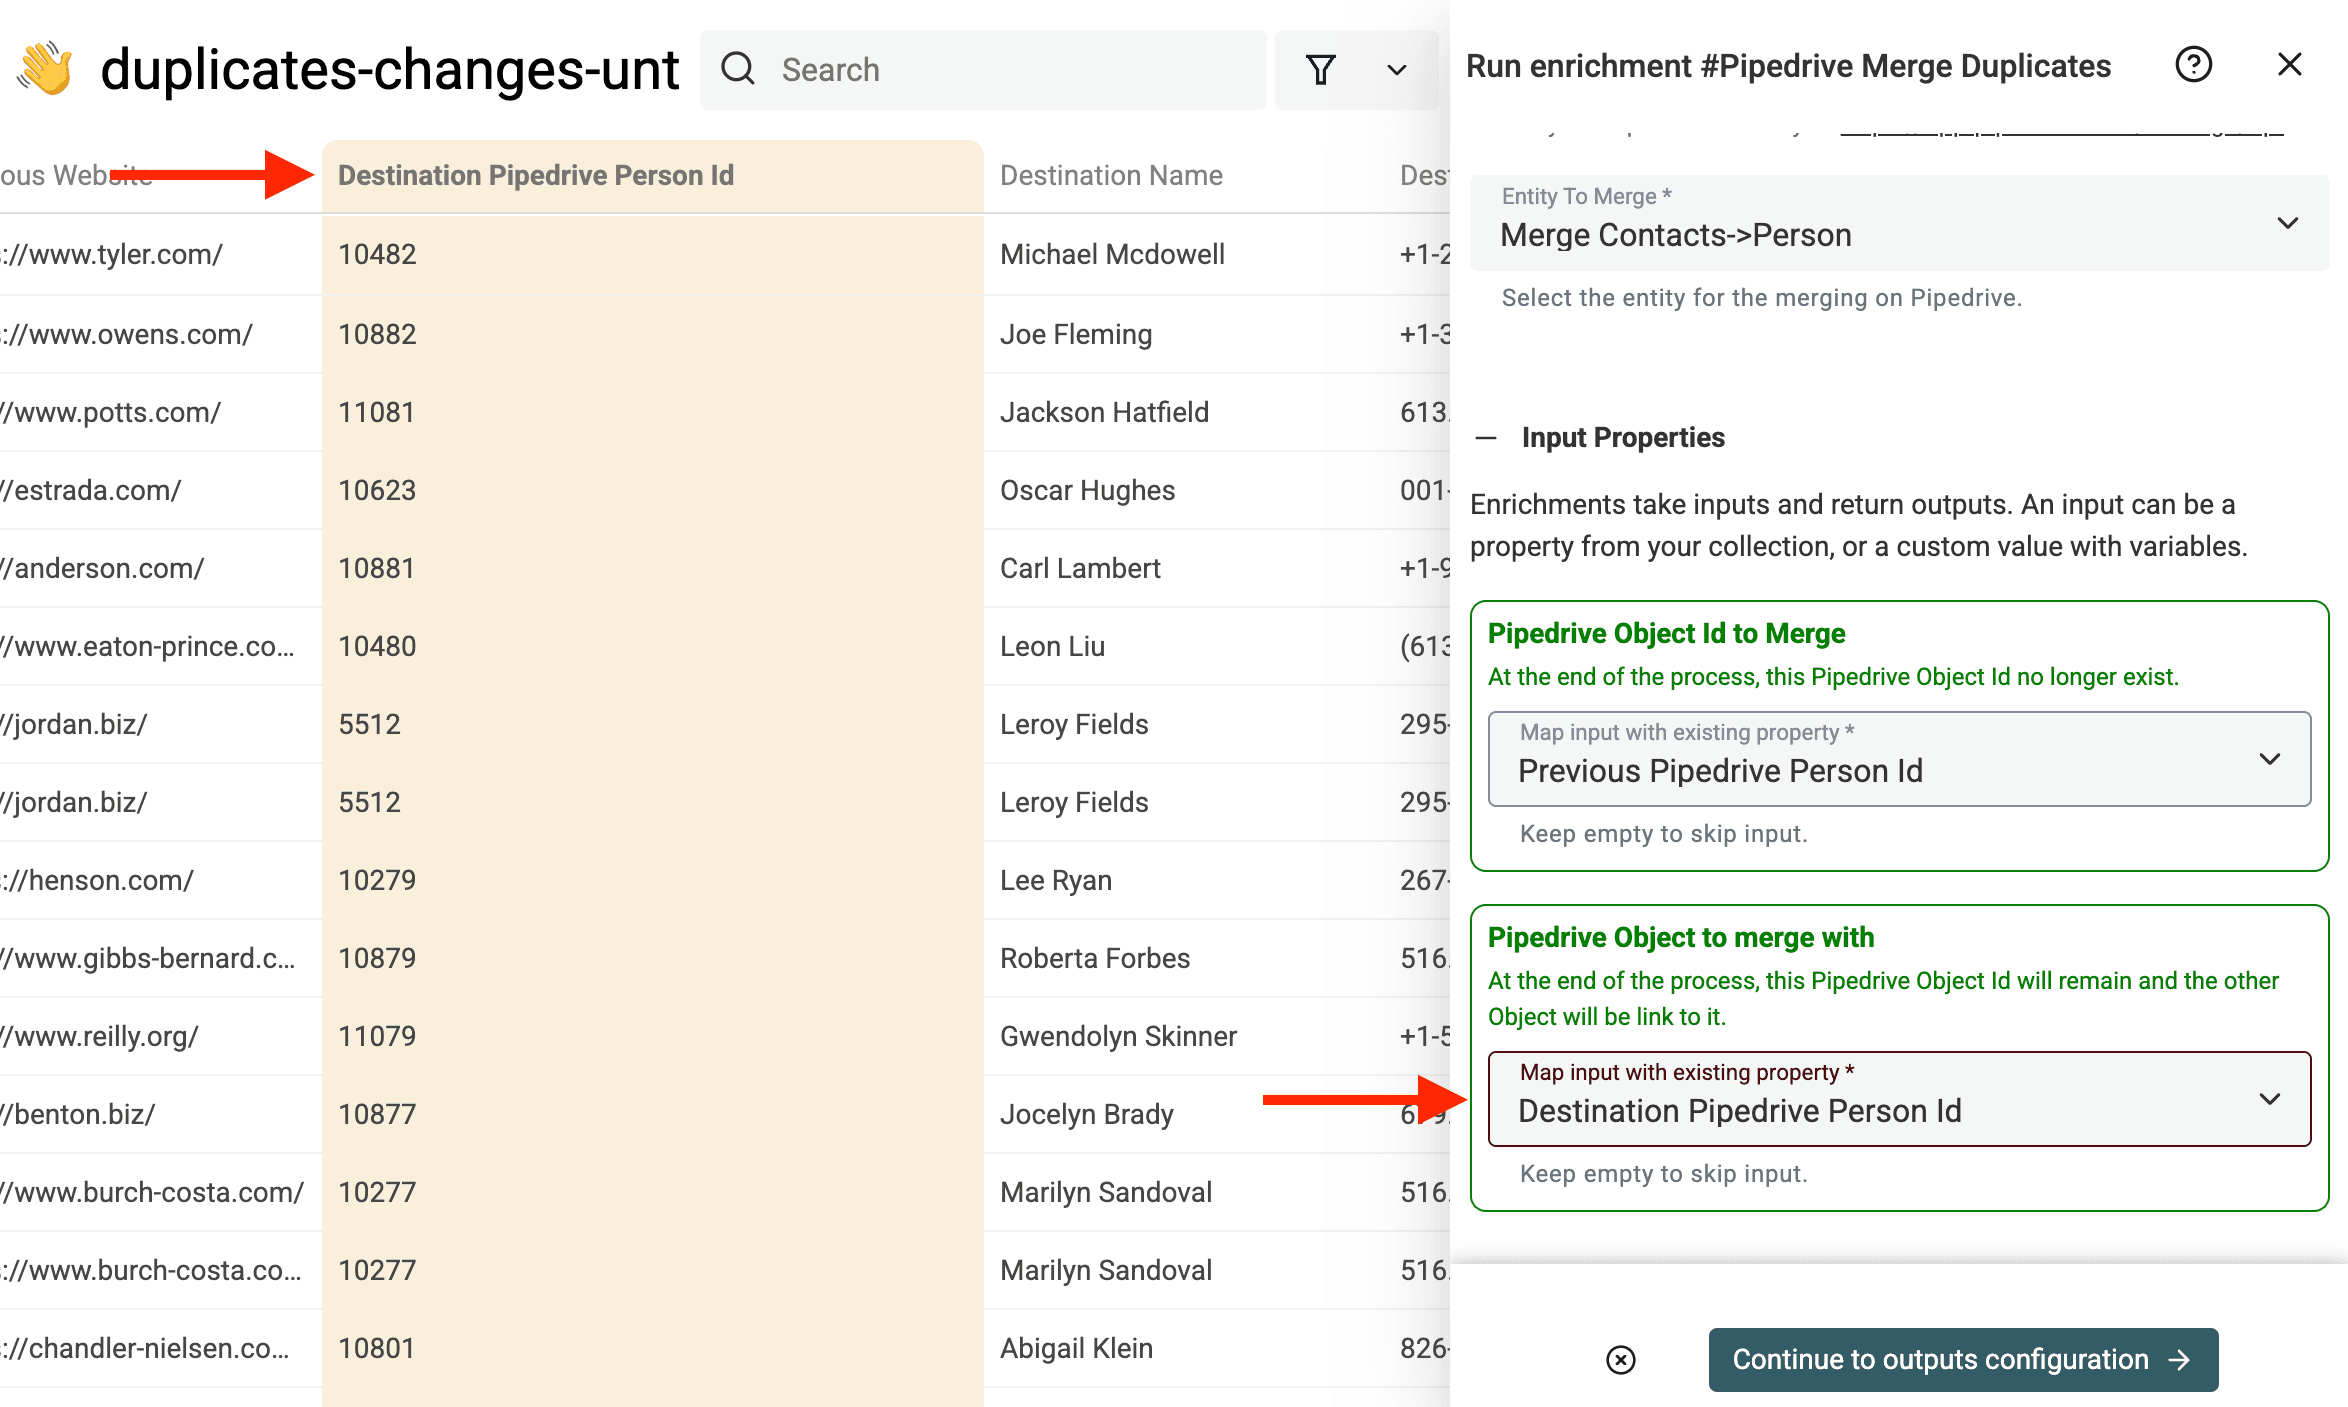
Per Pipedrive Object to merge with, associa il campo Destination Pipedrive Person Id.
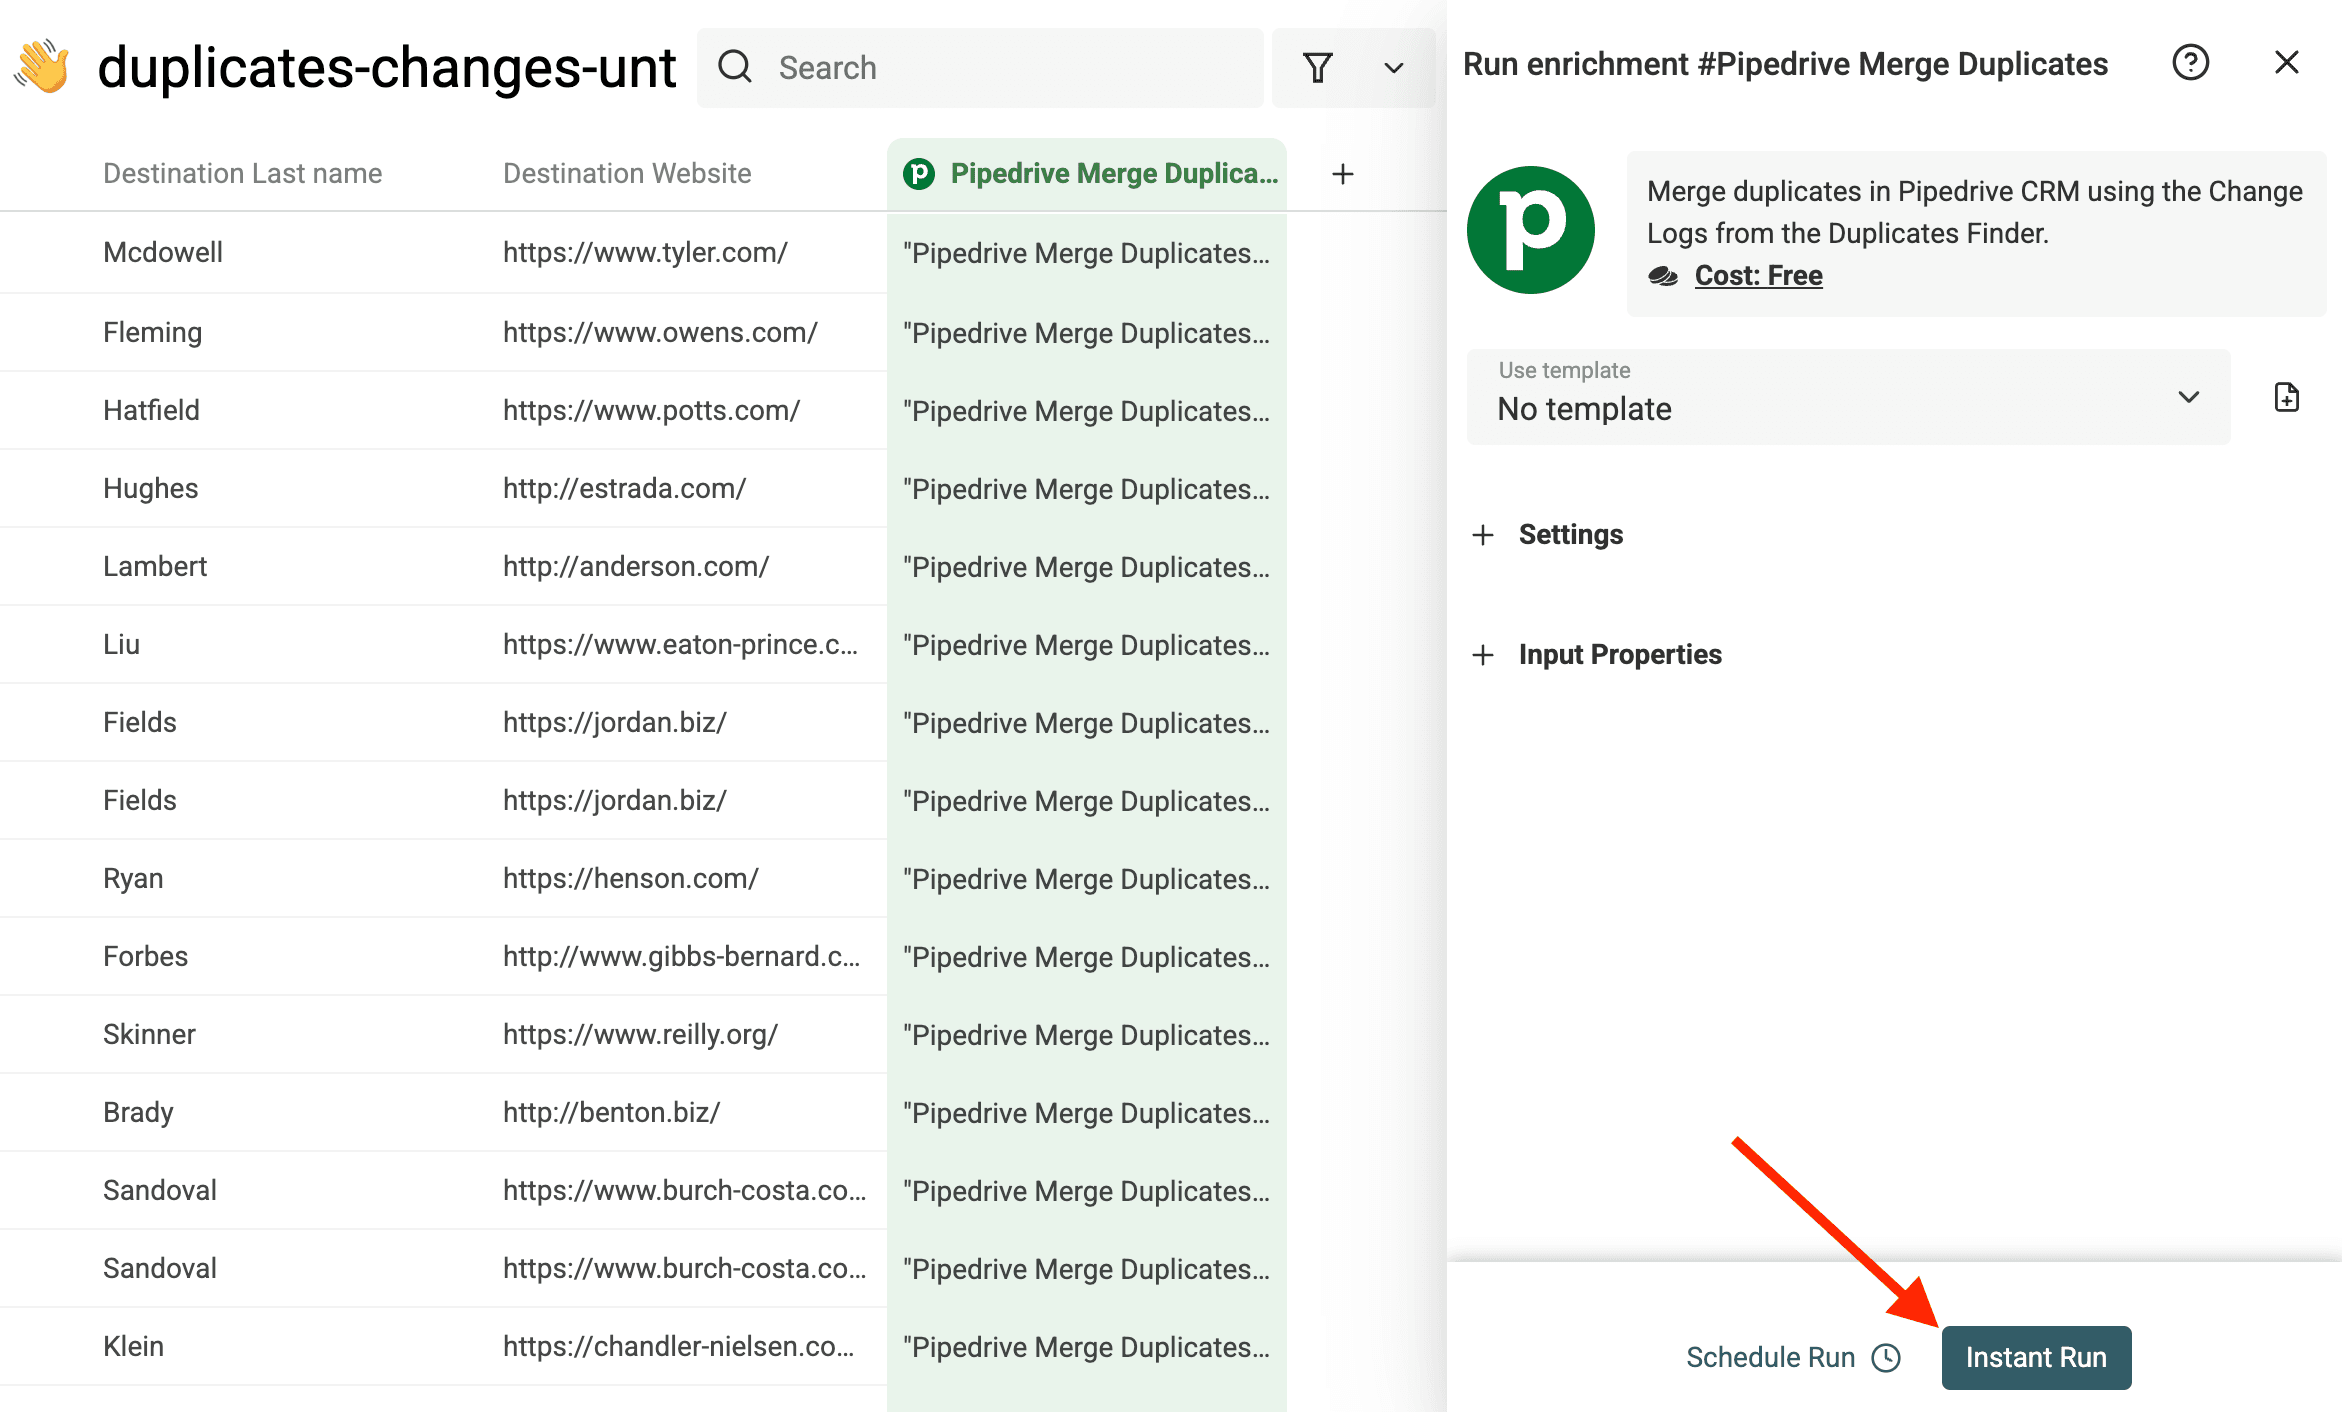
A questo punto, avvia il processo di unione.
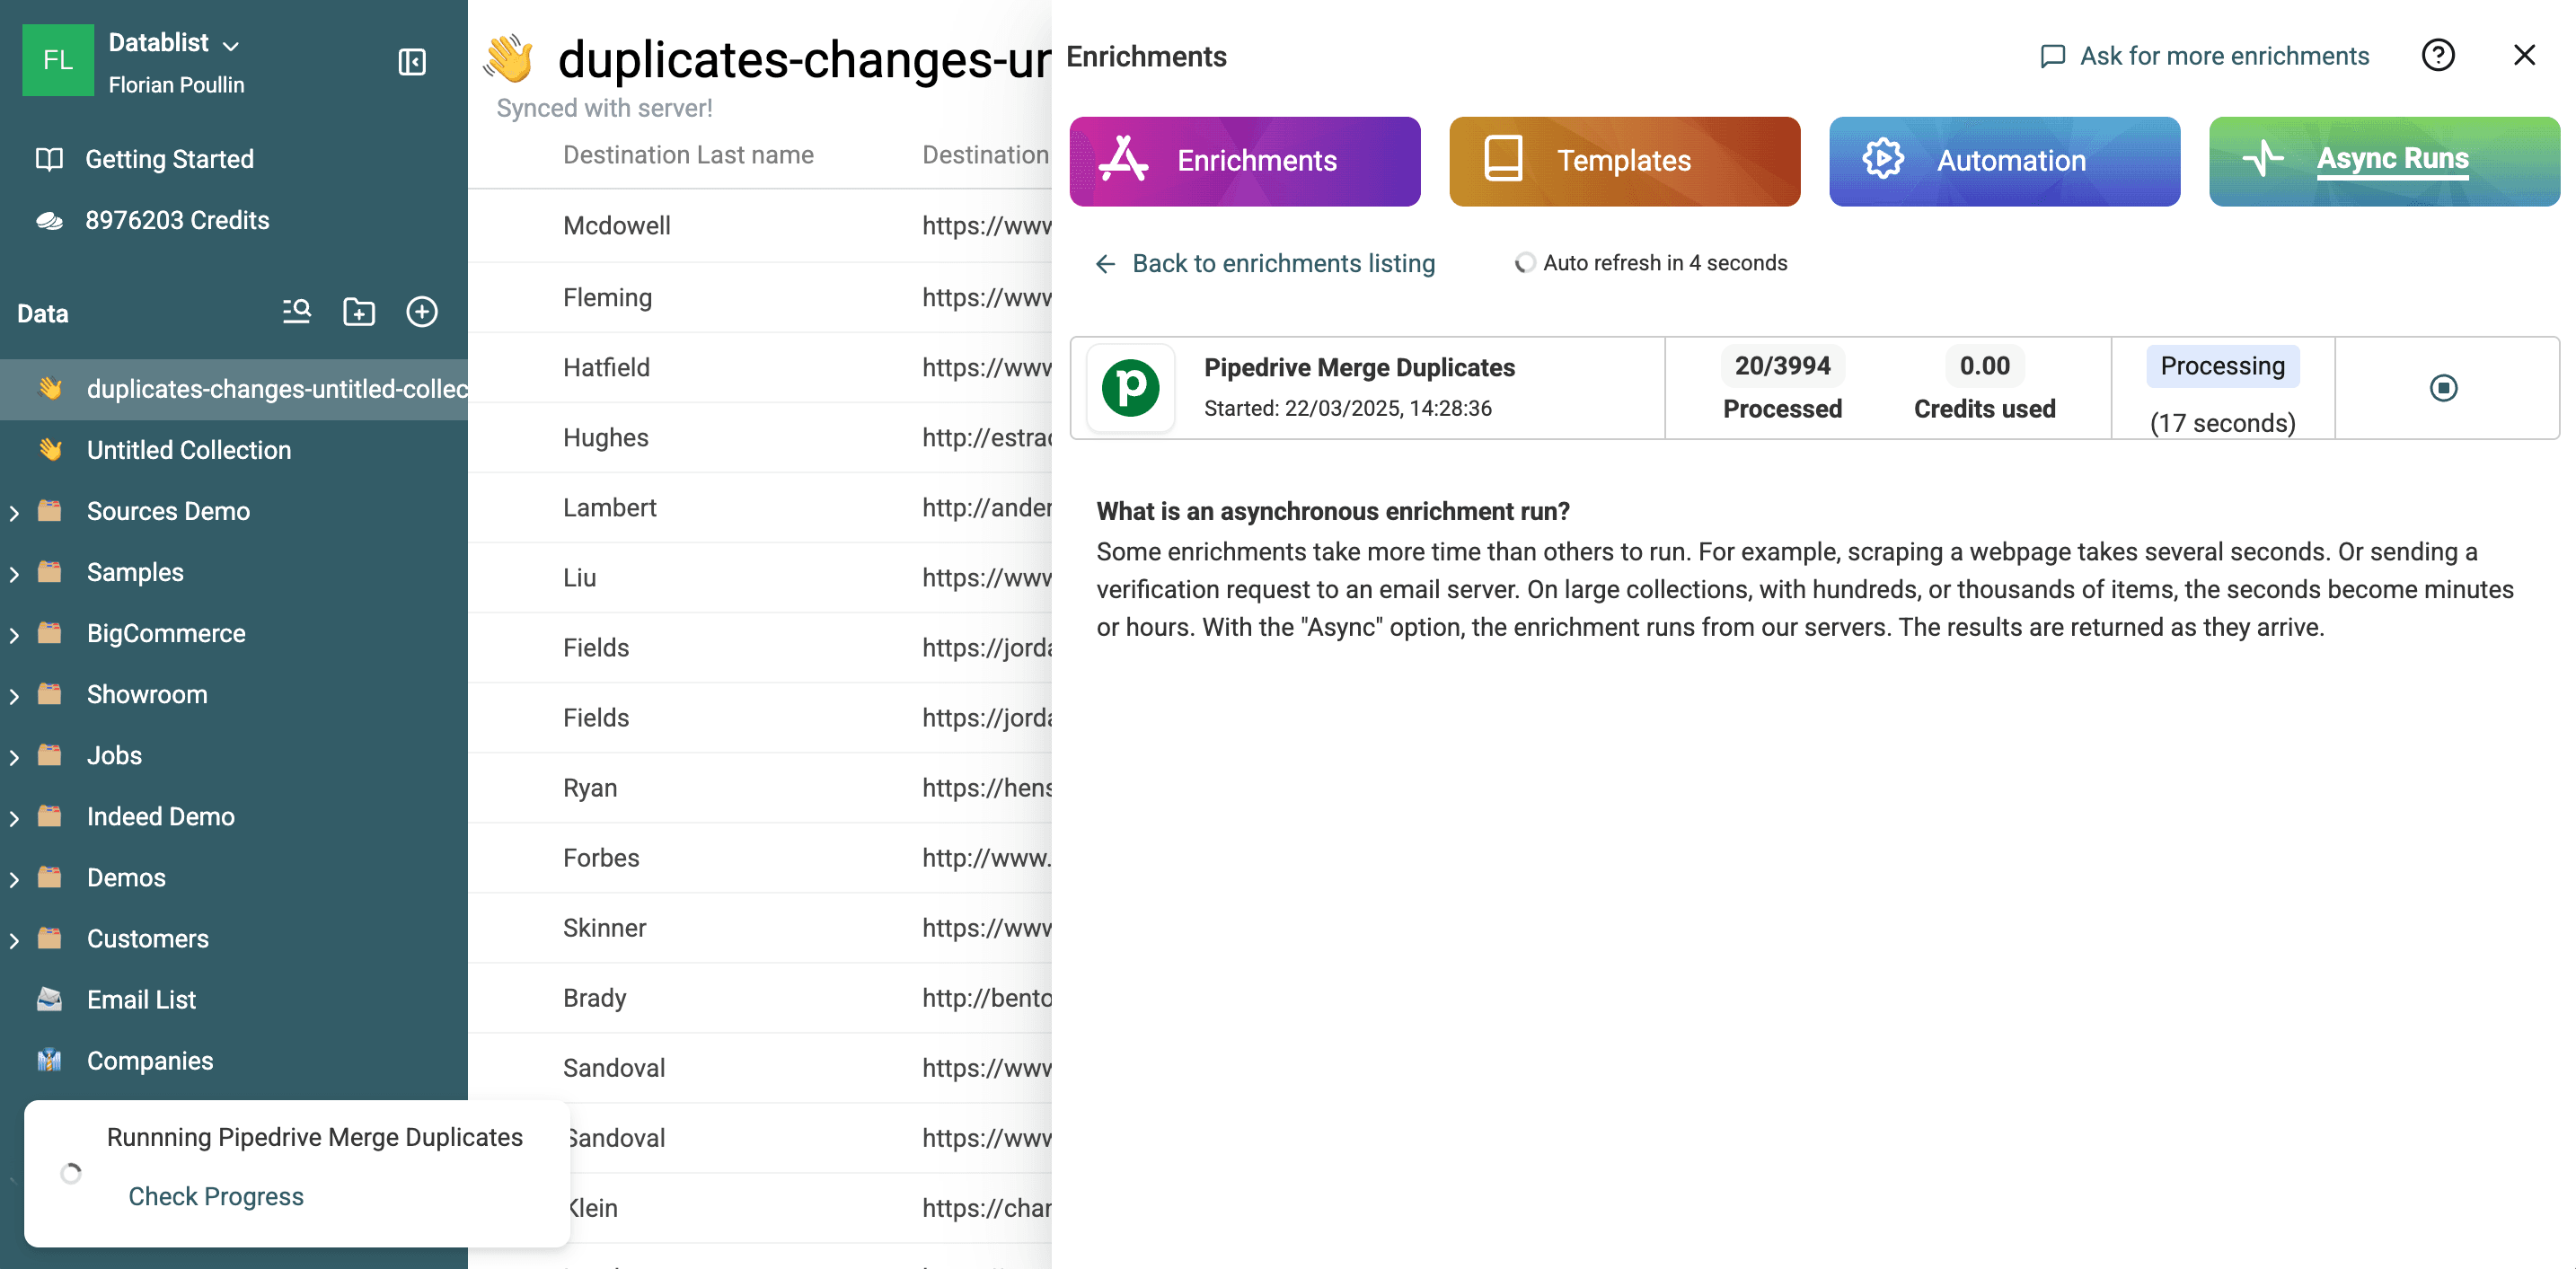
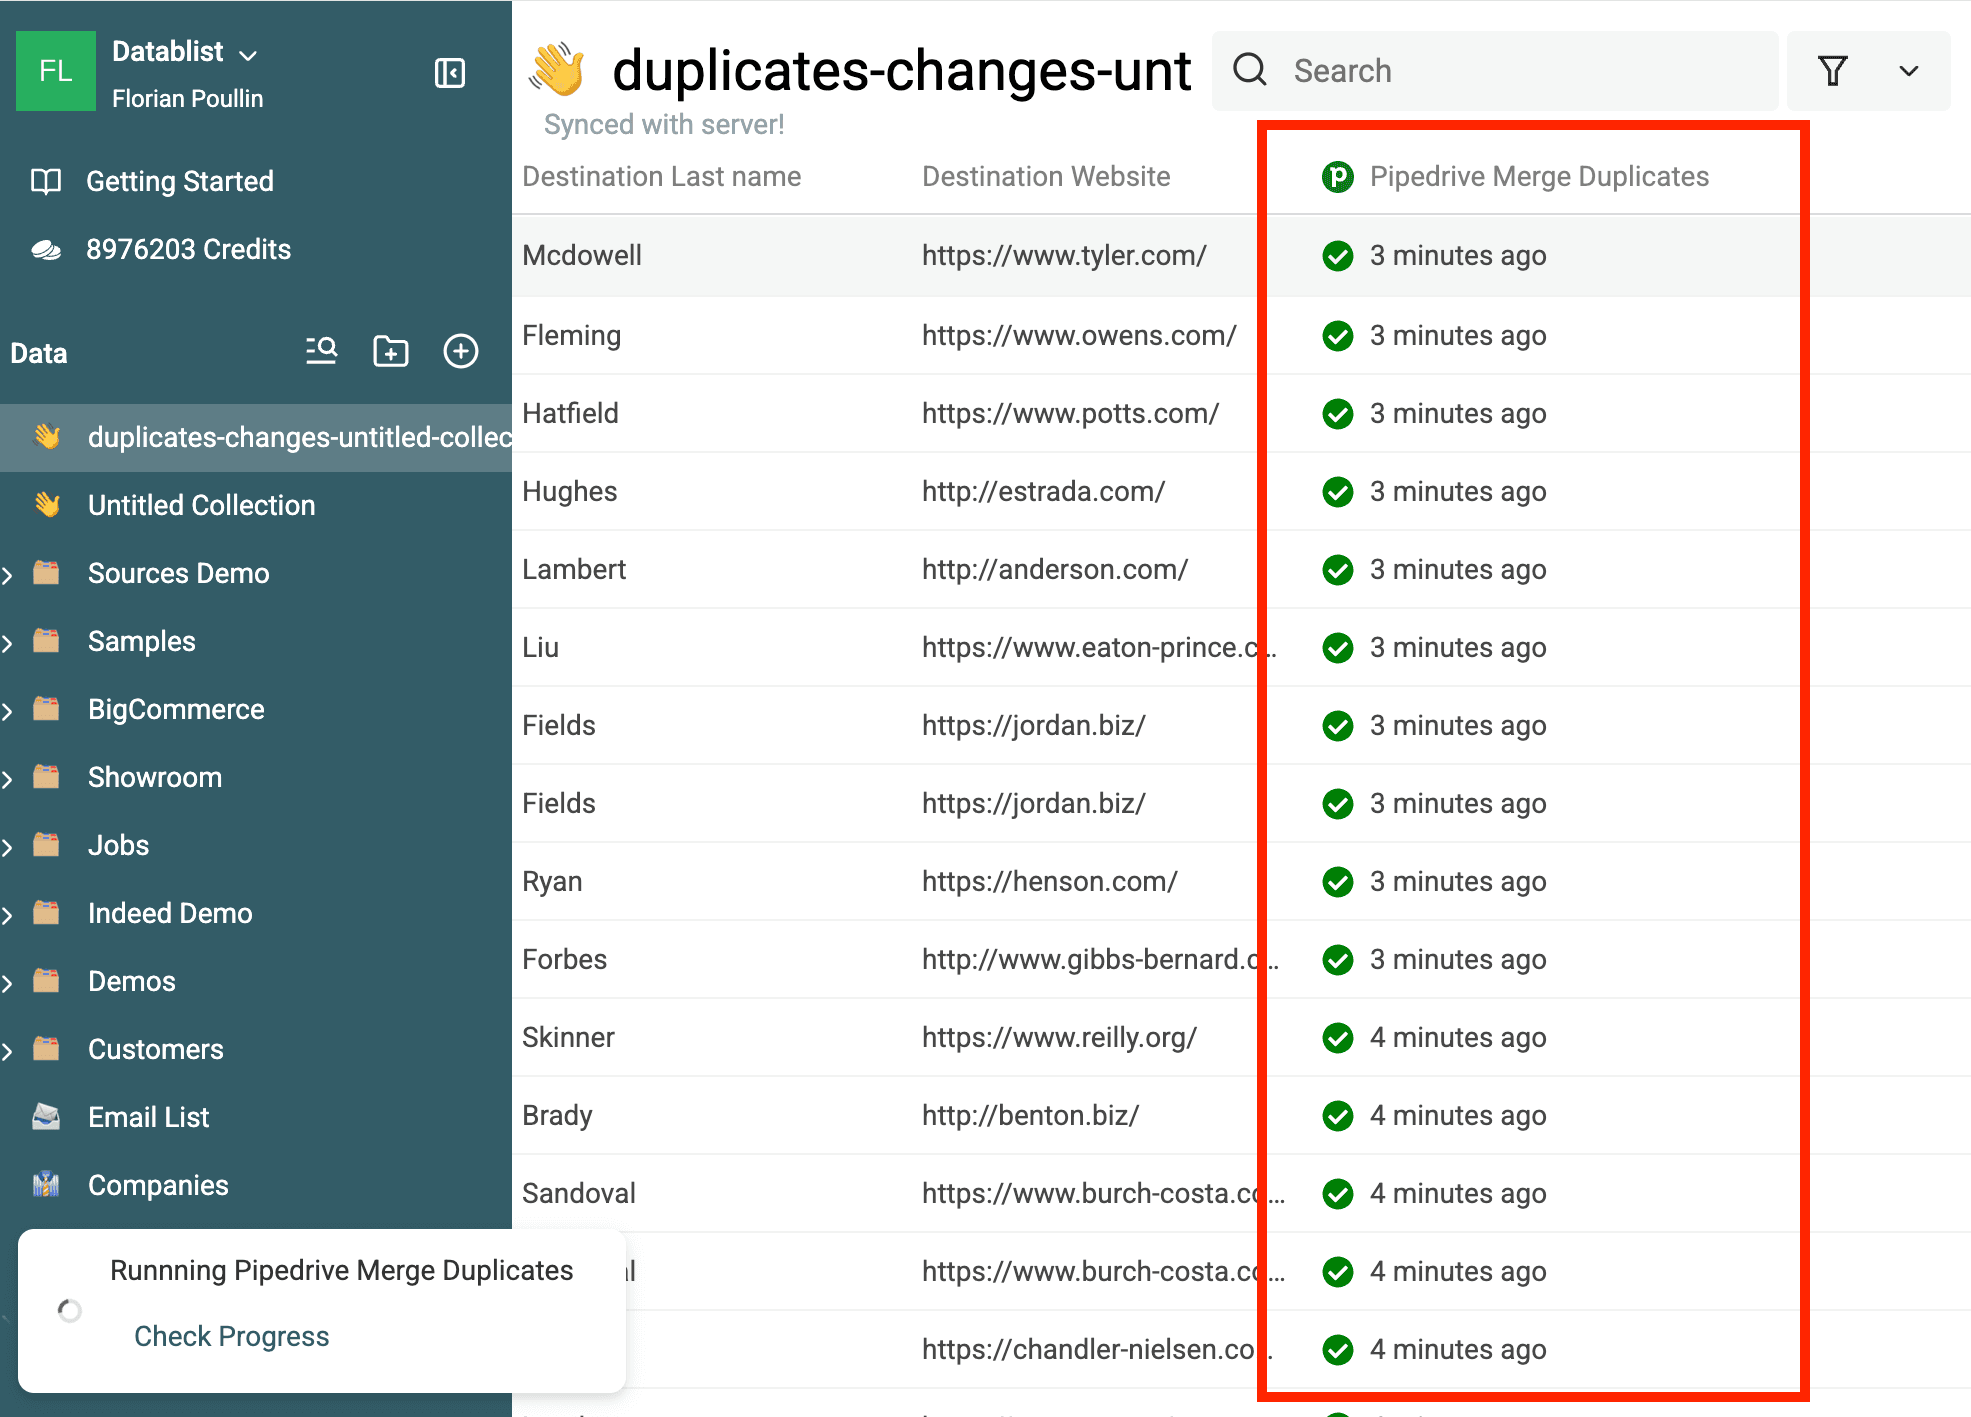
Puoi seguirne l’avanzamento direttamente in Datablist.
Per ogni riga della collection vedrai lo stato dell’unione.
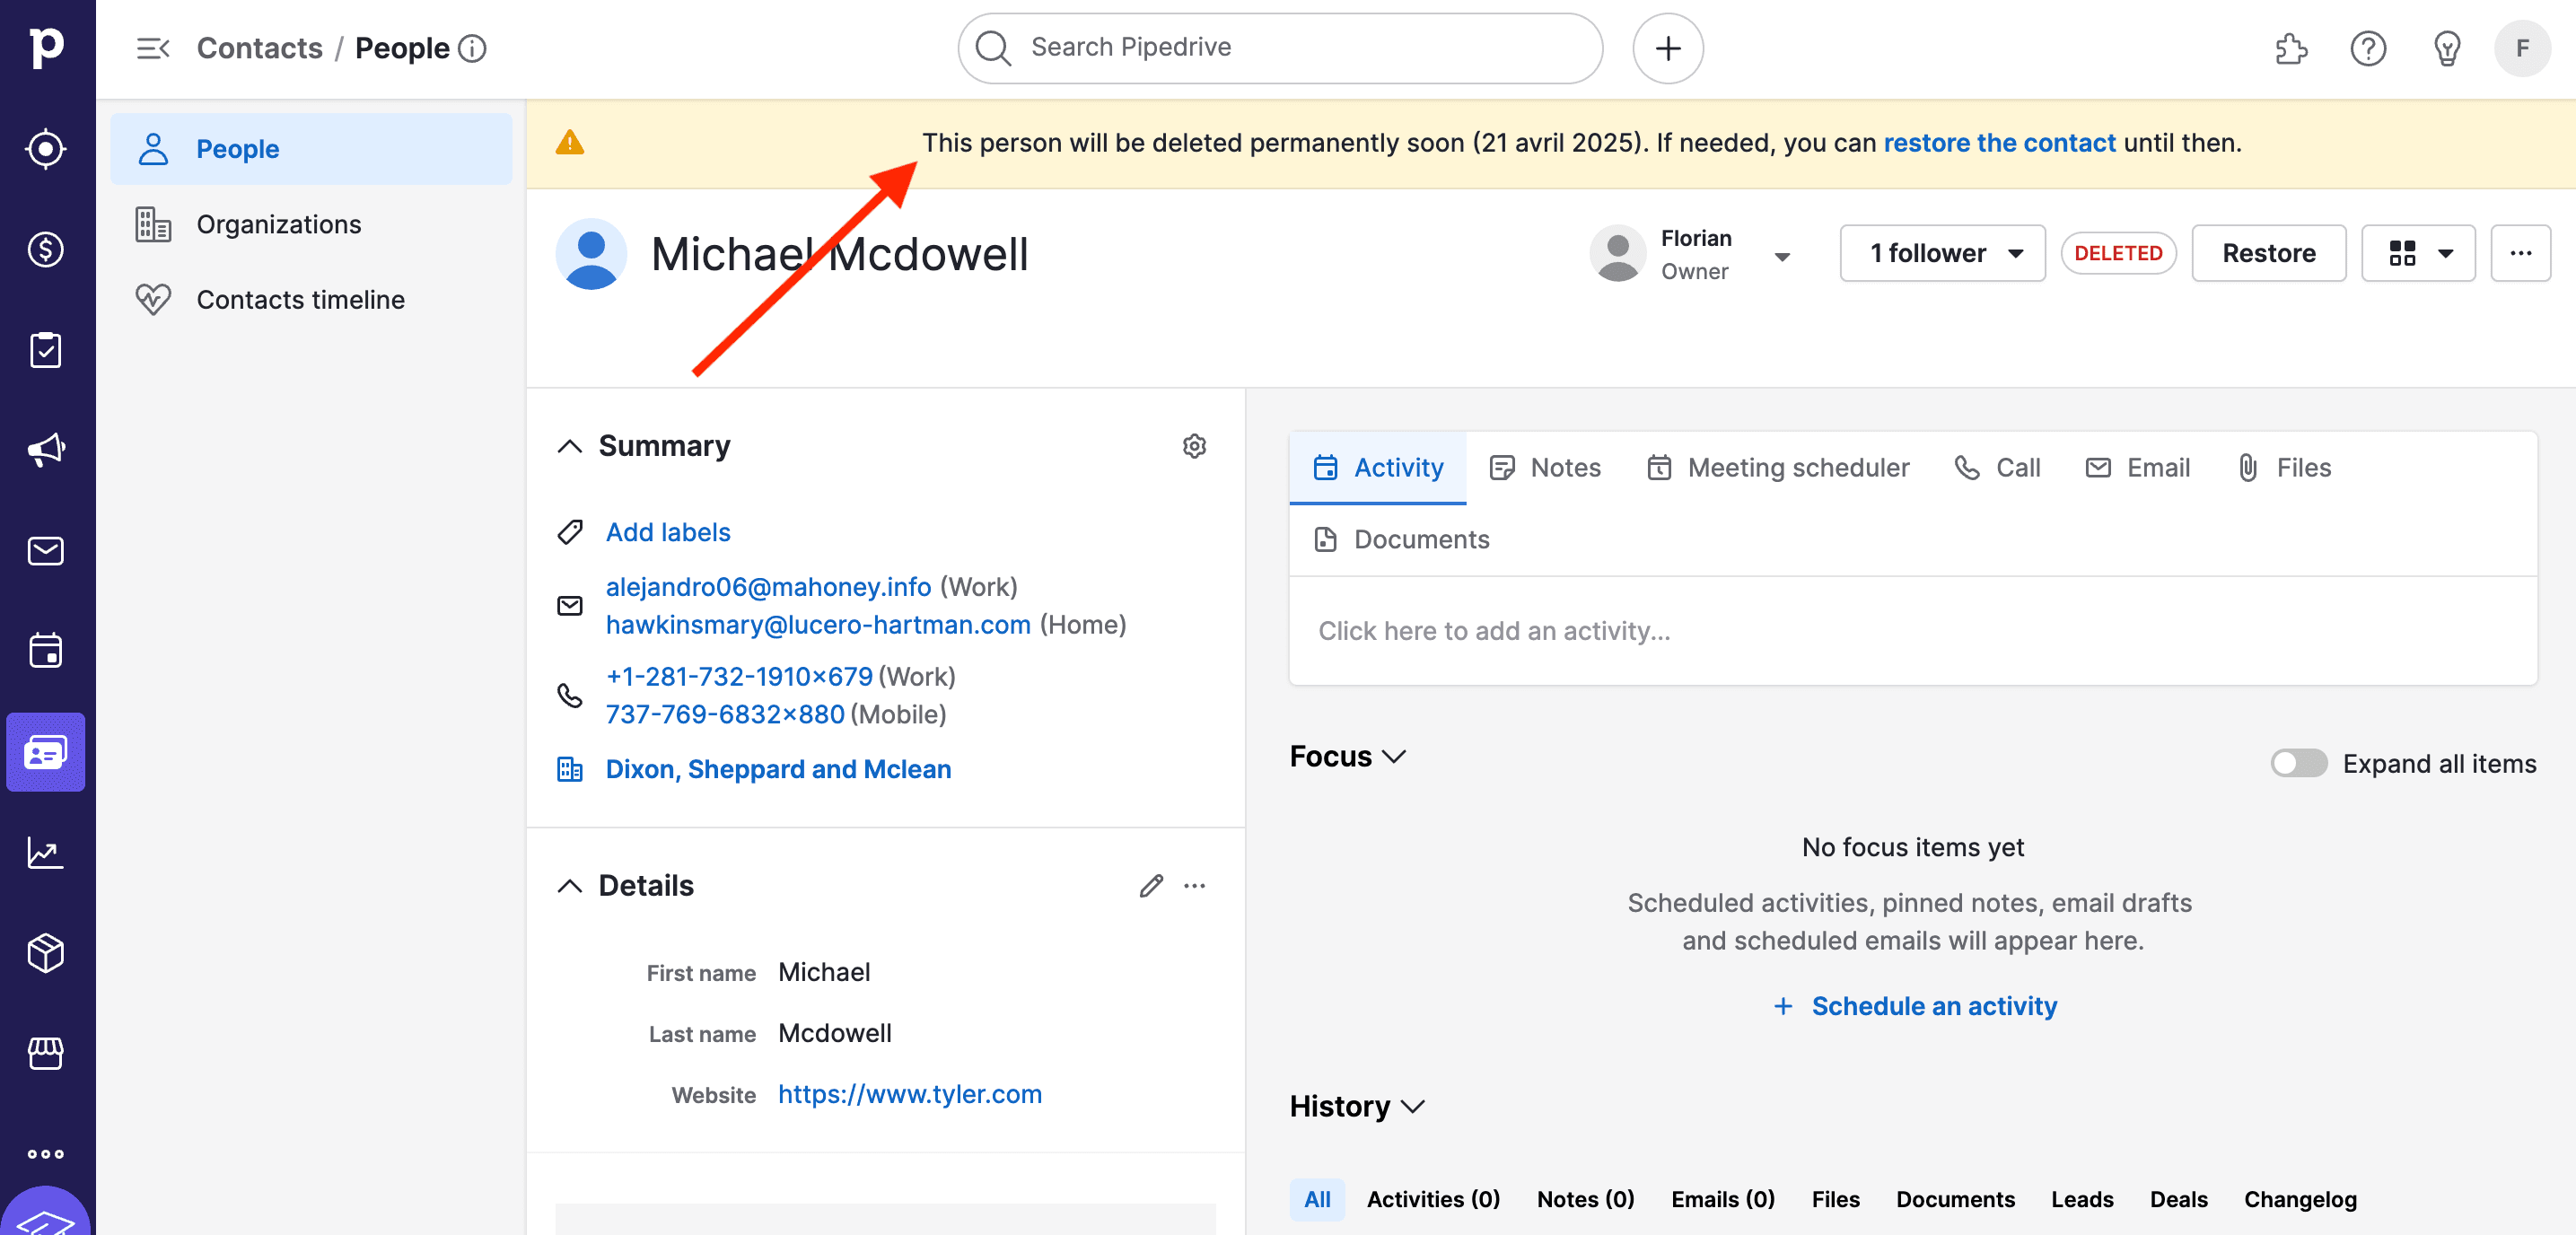
Puoi controllare il record Pipedrive che verrà eliminato. Apri il record; per People, l’URL è https://app.pipedrive.com/person/:ID. Nella parte superiore dello schermo comparirà un messaggio.
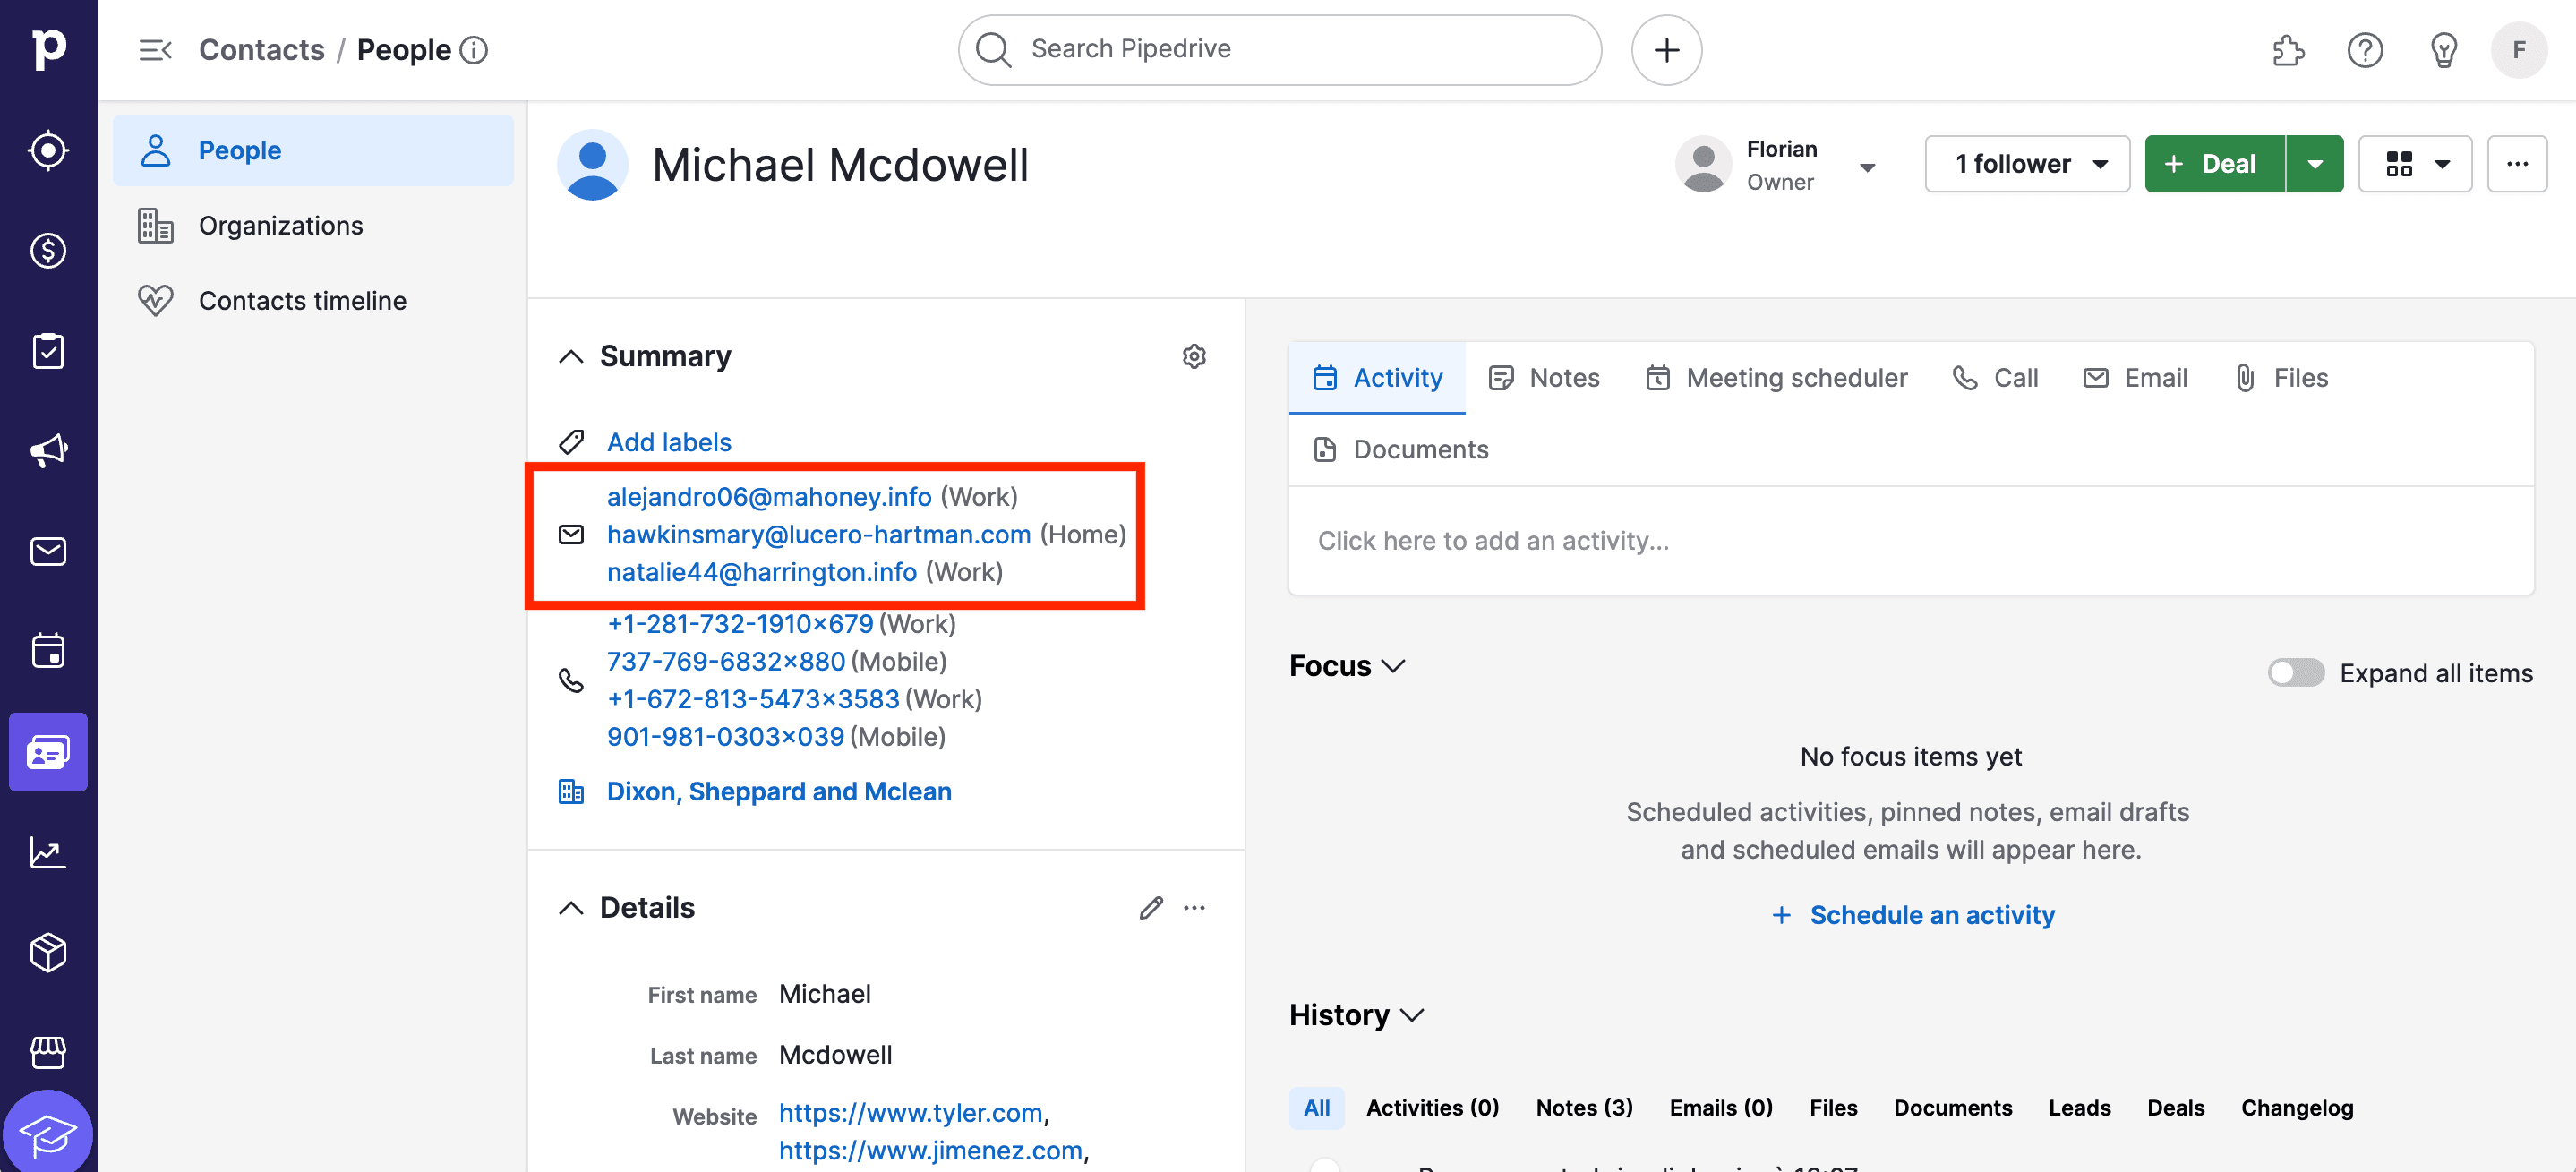
Nei record master vedrai anche i dati uniti.
3.c. Sincronizza i record aggiornati in Pipedrive
Nel passaggio precedente abbiamo usato la merging API di Pipedrive per unire i record duplicati al record master.
Purtroppo, durante questo processo Pipedrive aggiunge al record master i valori del record duplicato. Potresti quindi ritrovarti con più siti web simili o altri valori ripetuti.
Per risolvere il problema, aggiorneremo i record master rimasti usando i dati puliti ottenuti dopo l’unione in Datablist.
Nella stessa collection del "Changes File", filtra la colonna change per visualizzare soltanto l’operazione updated.
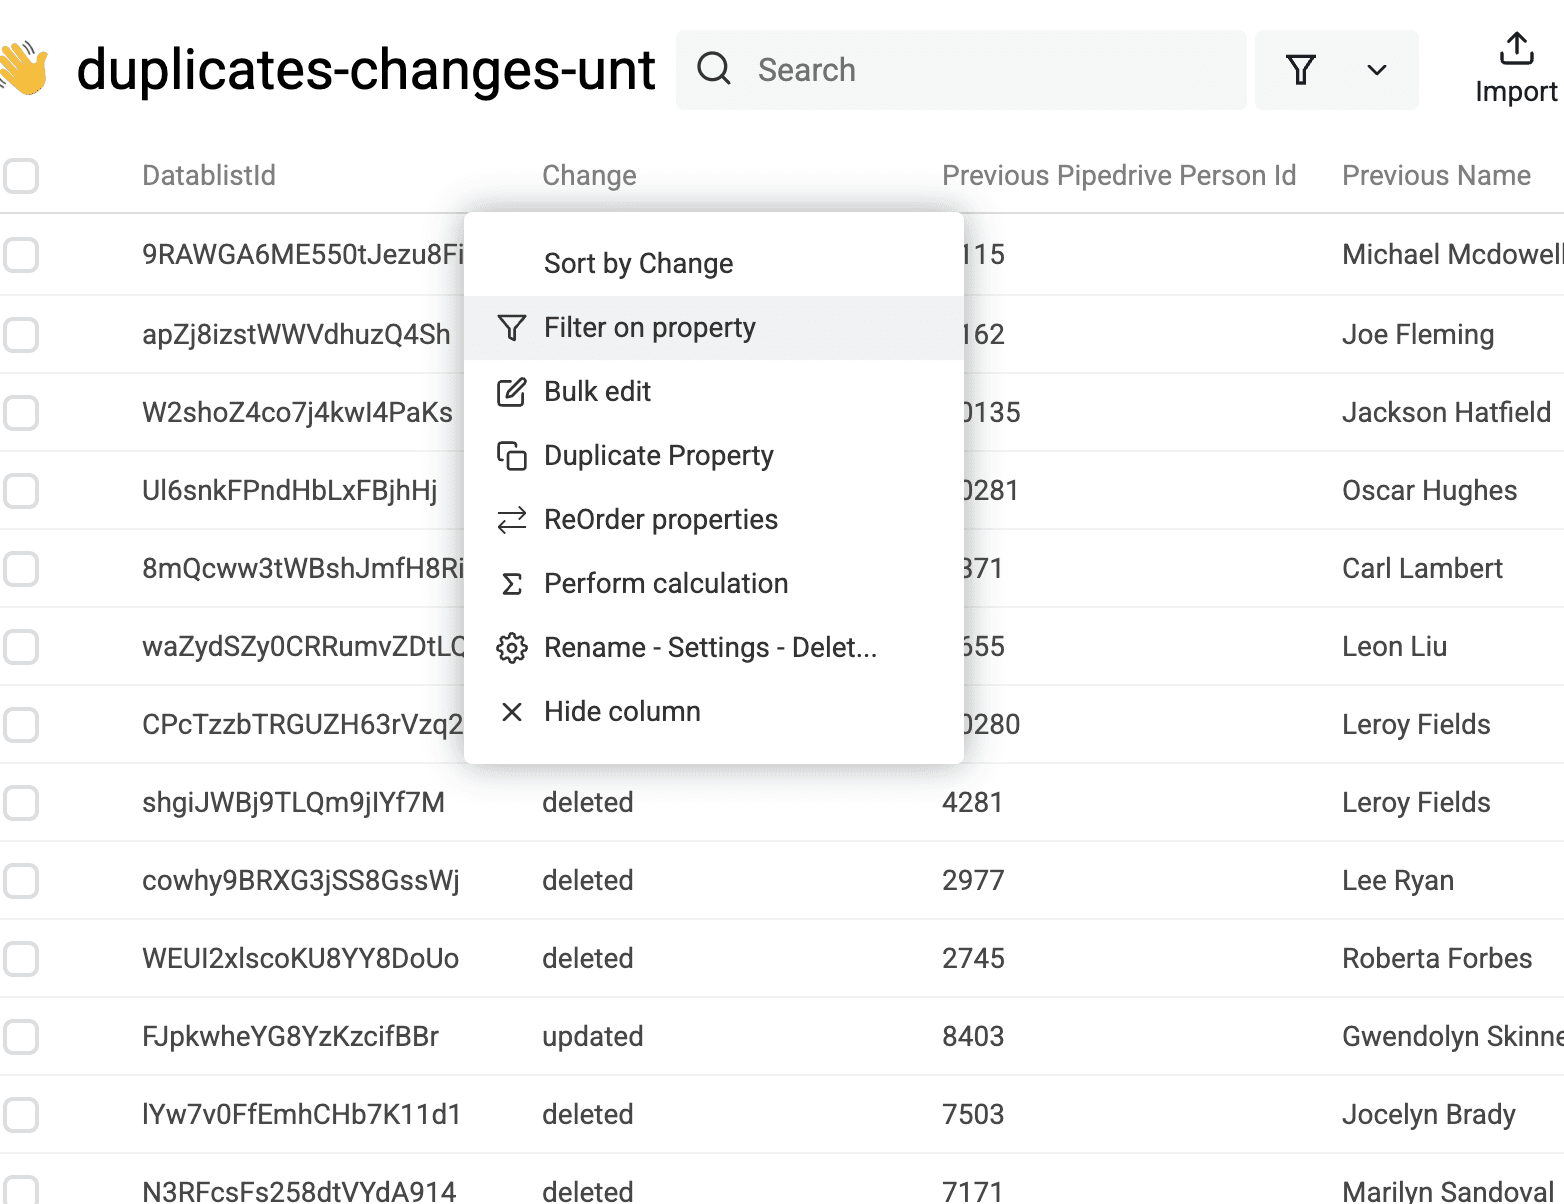
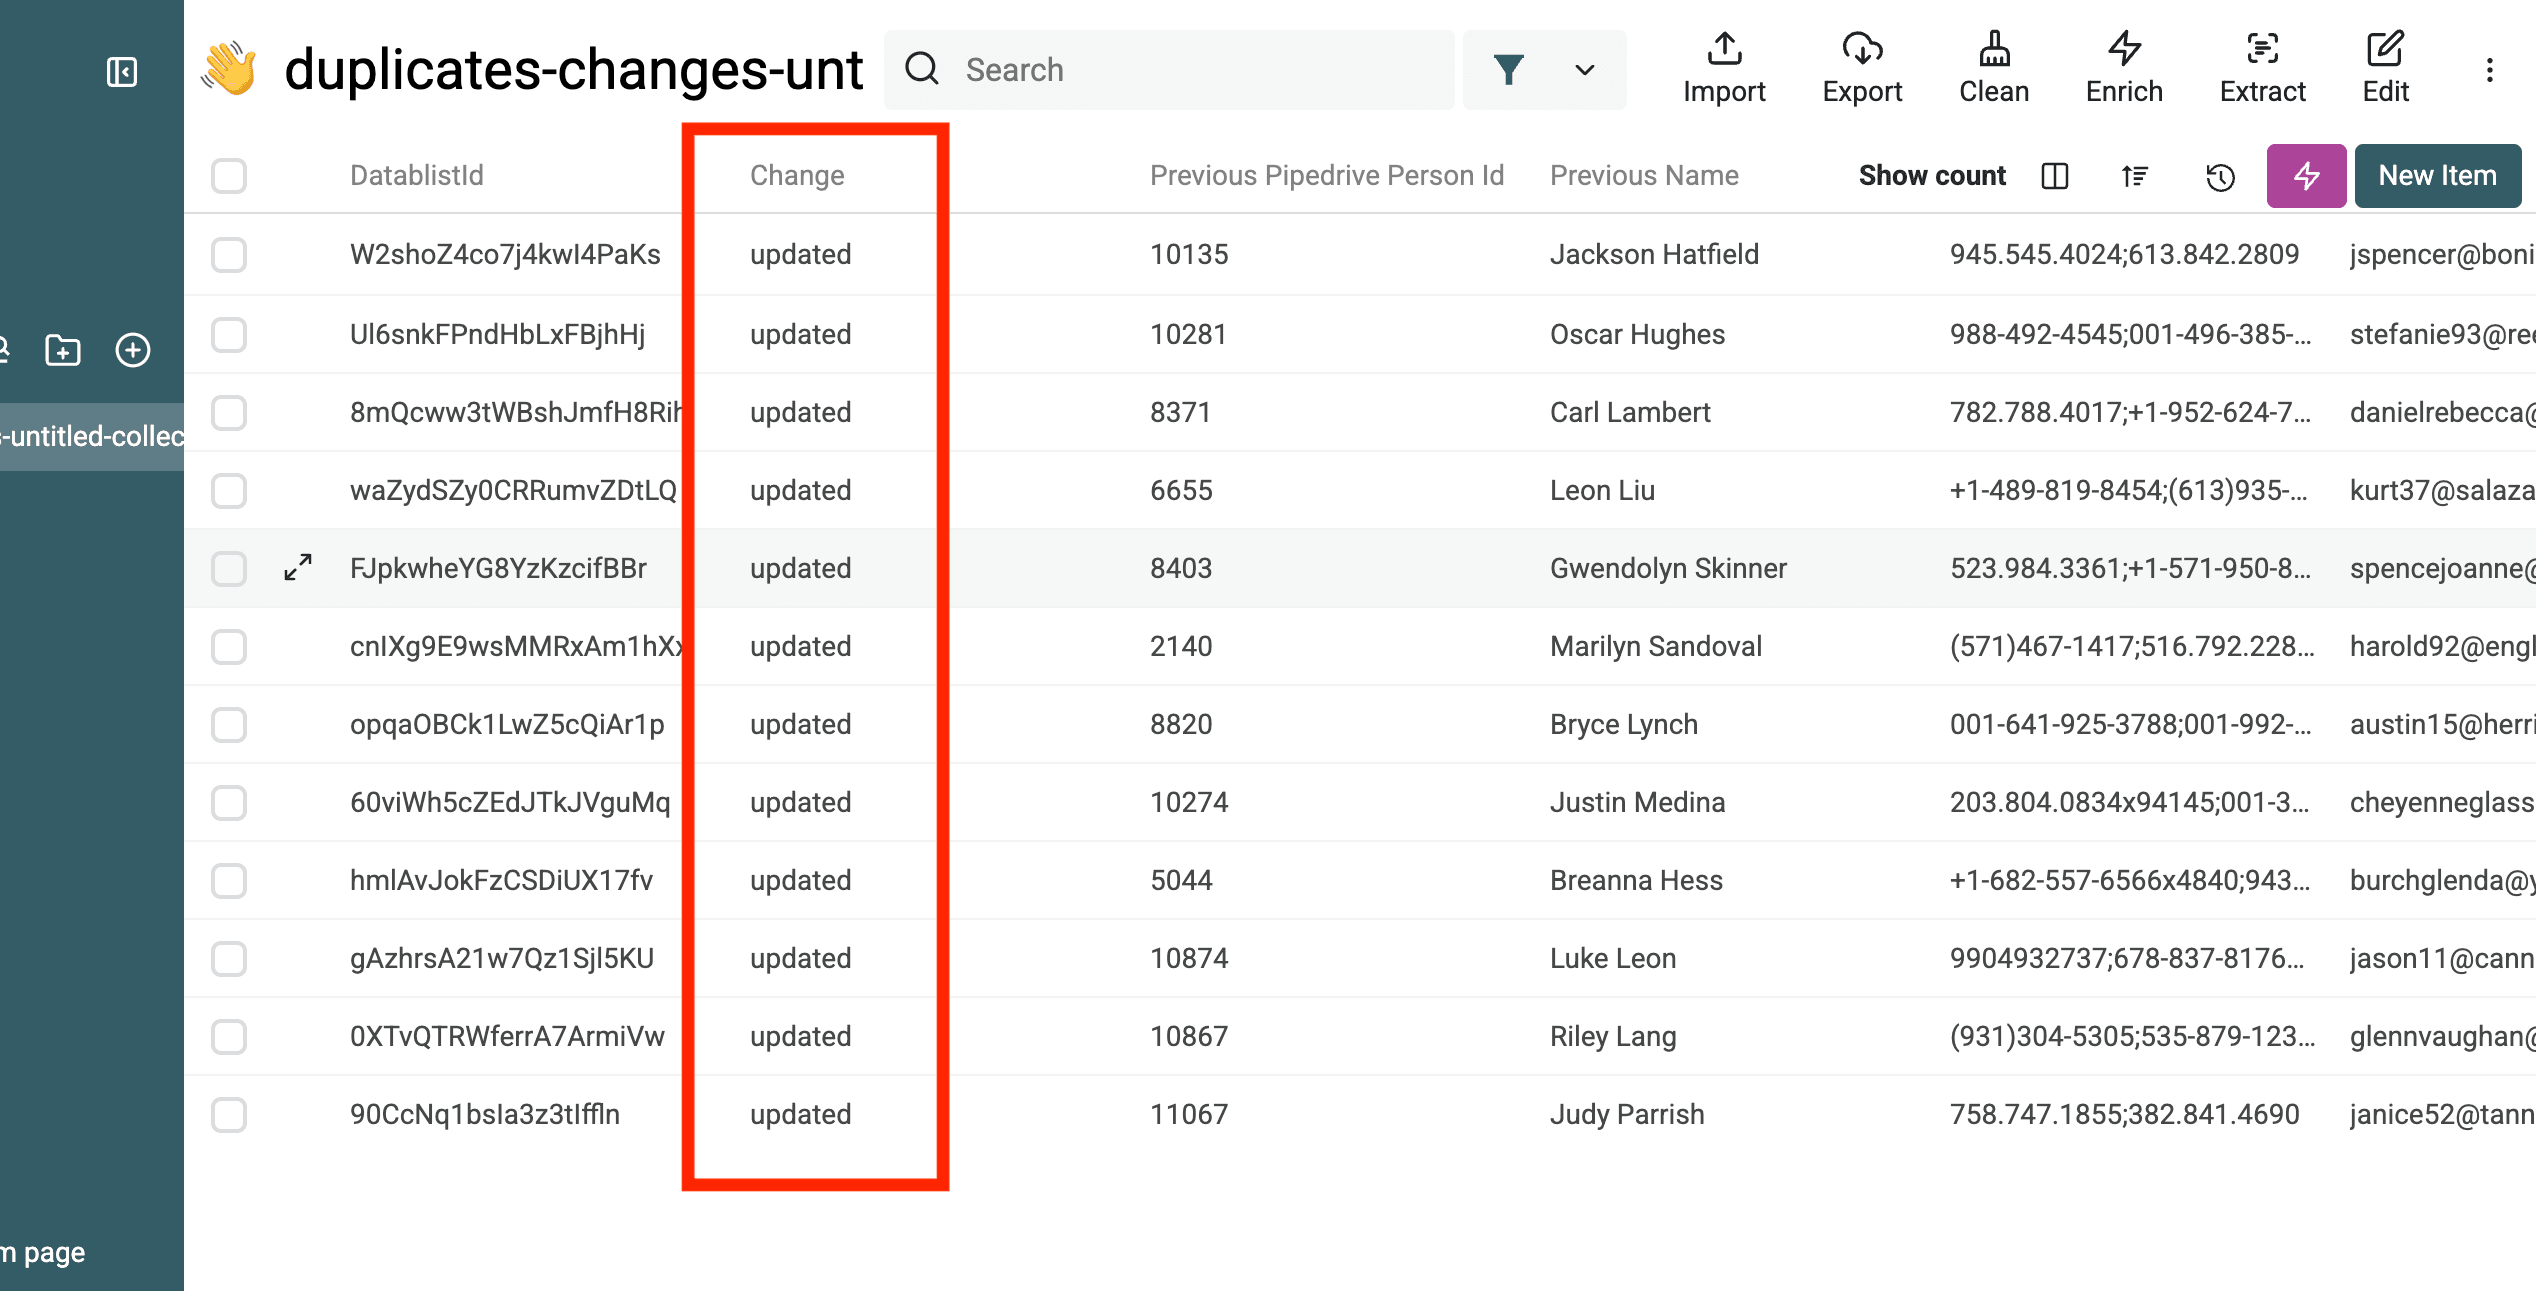
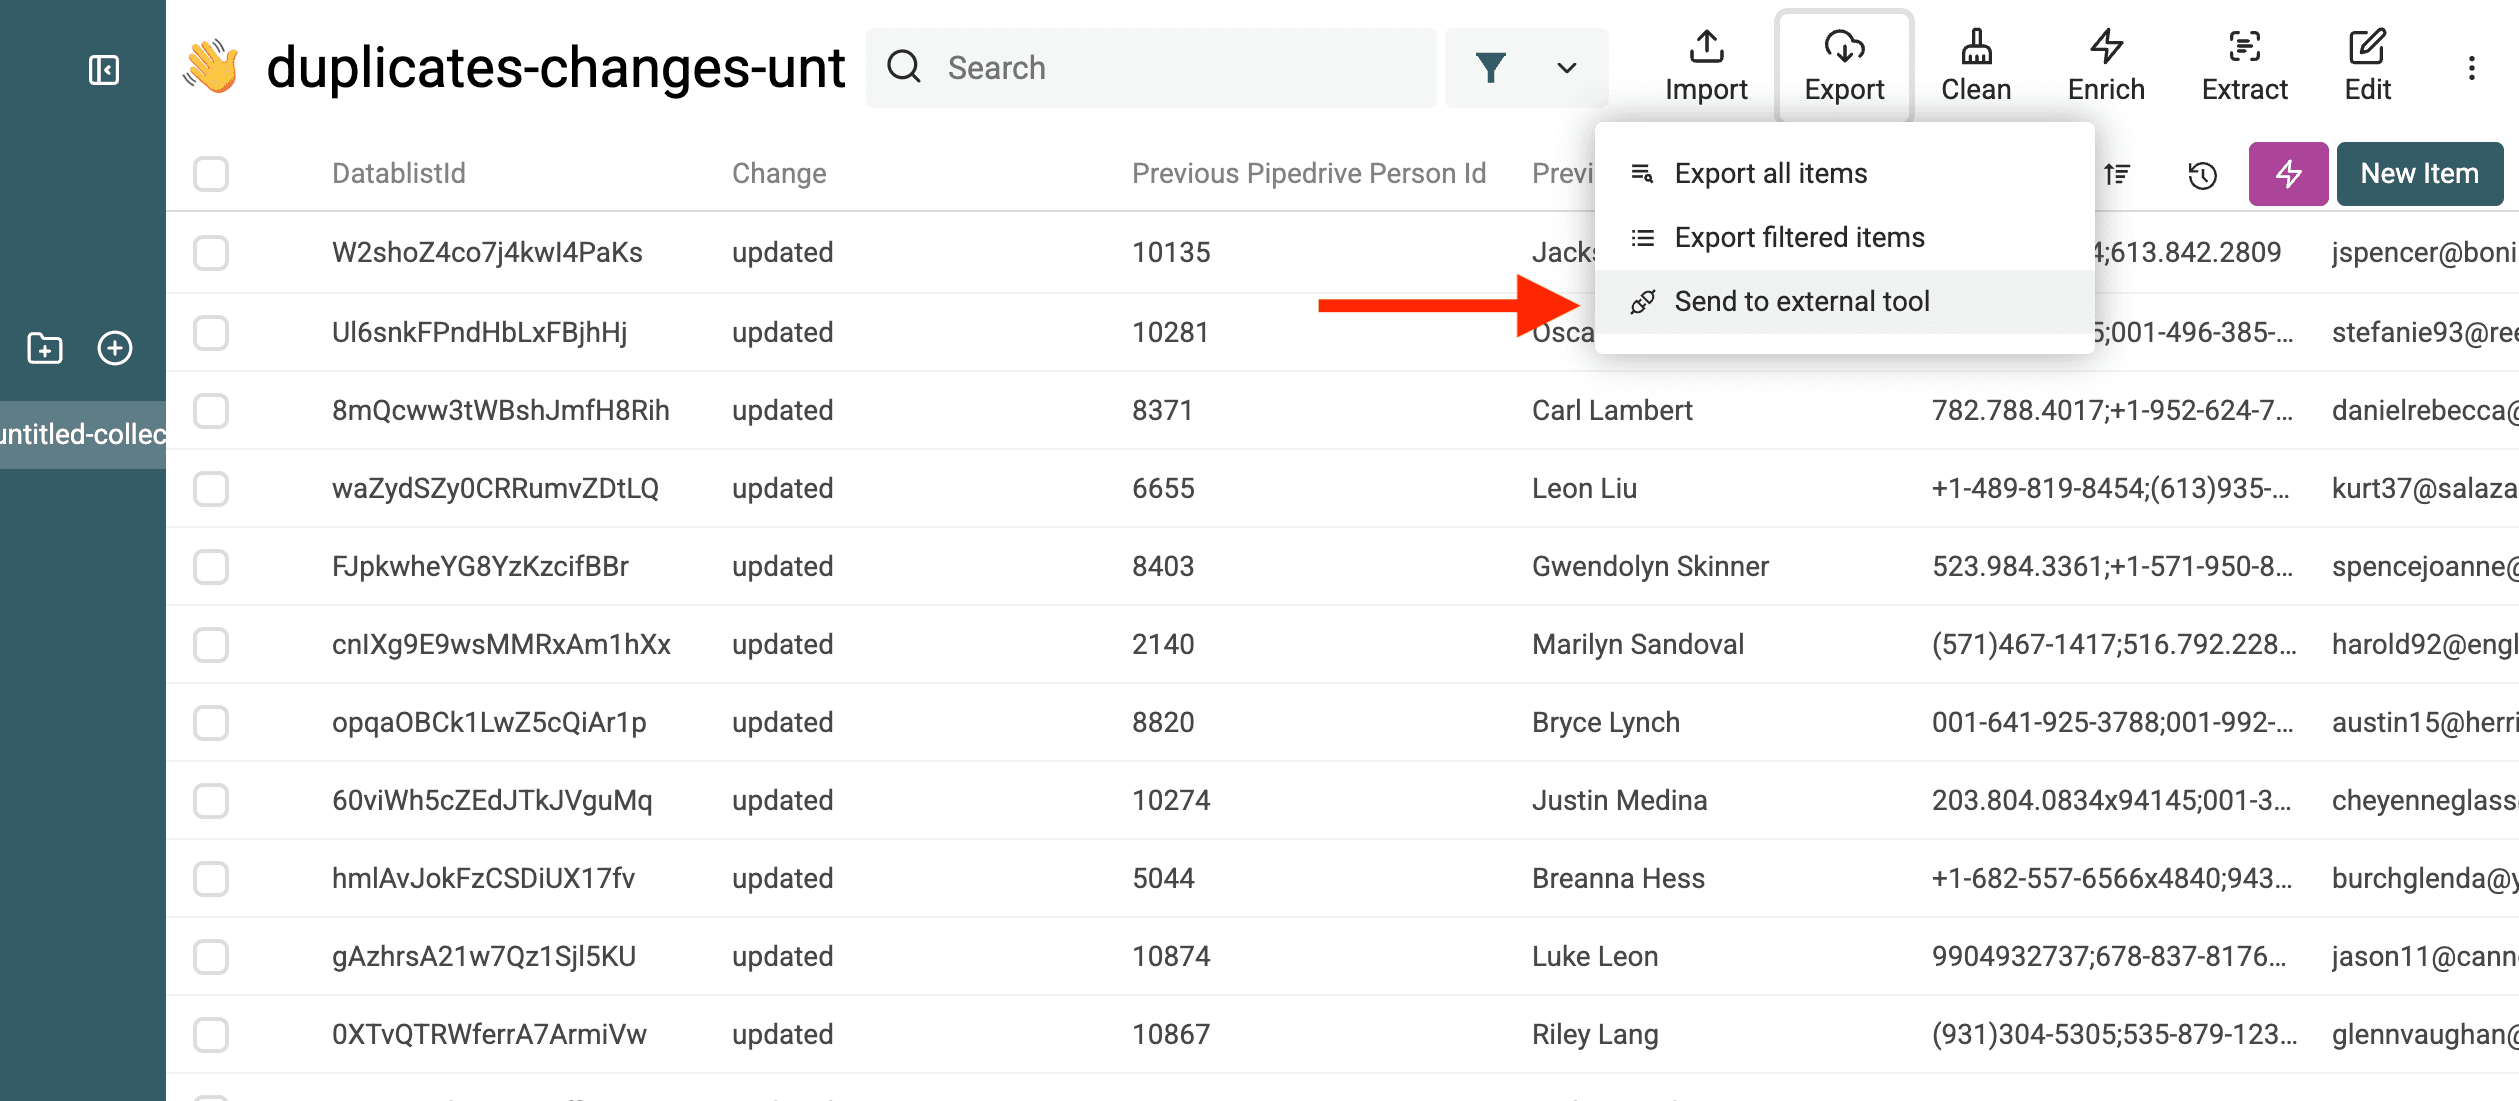
Poi fai clic su Export → Send to external tool.
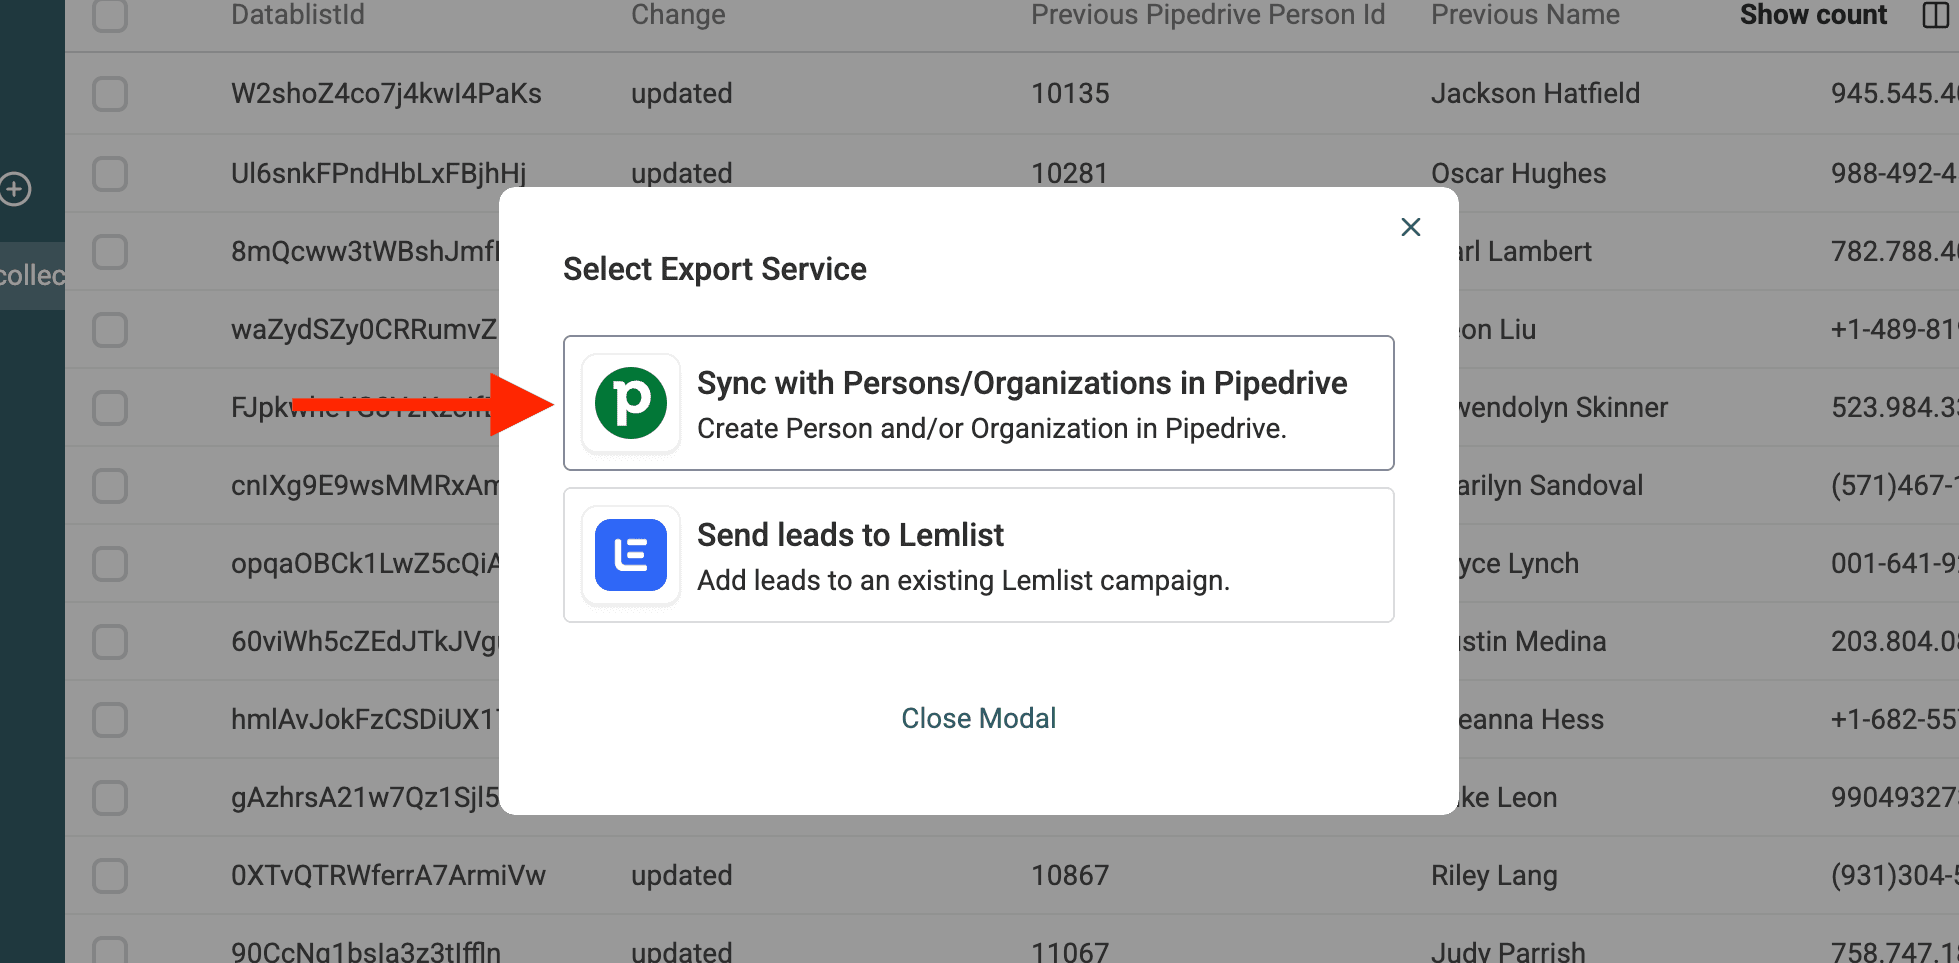
Seleziona quindi Sync with Persons/Organizations in Pipedrive.
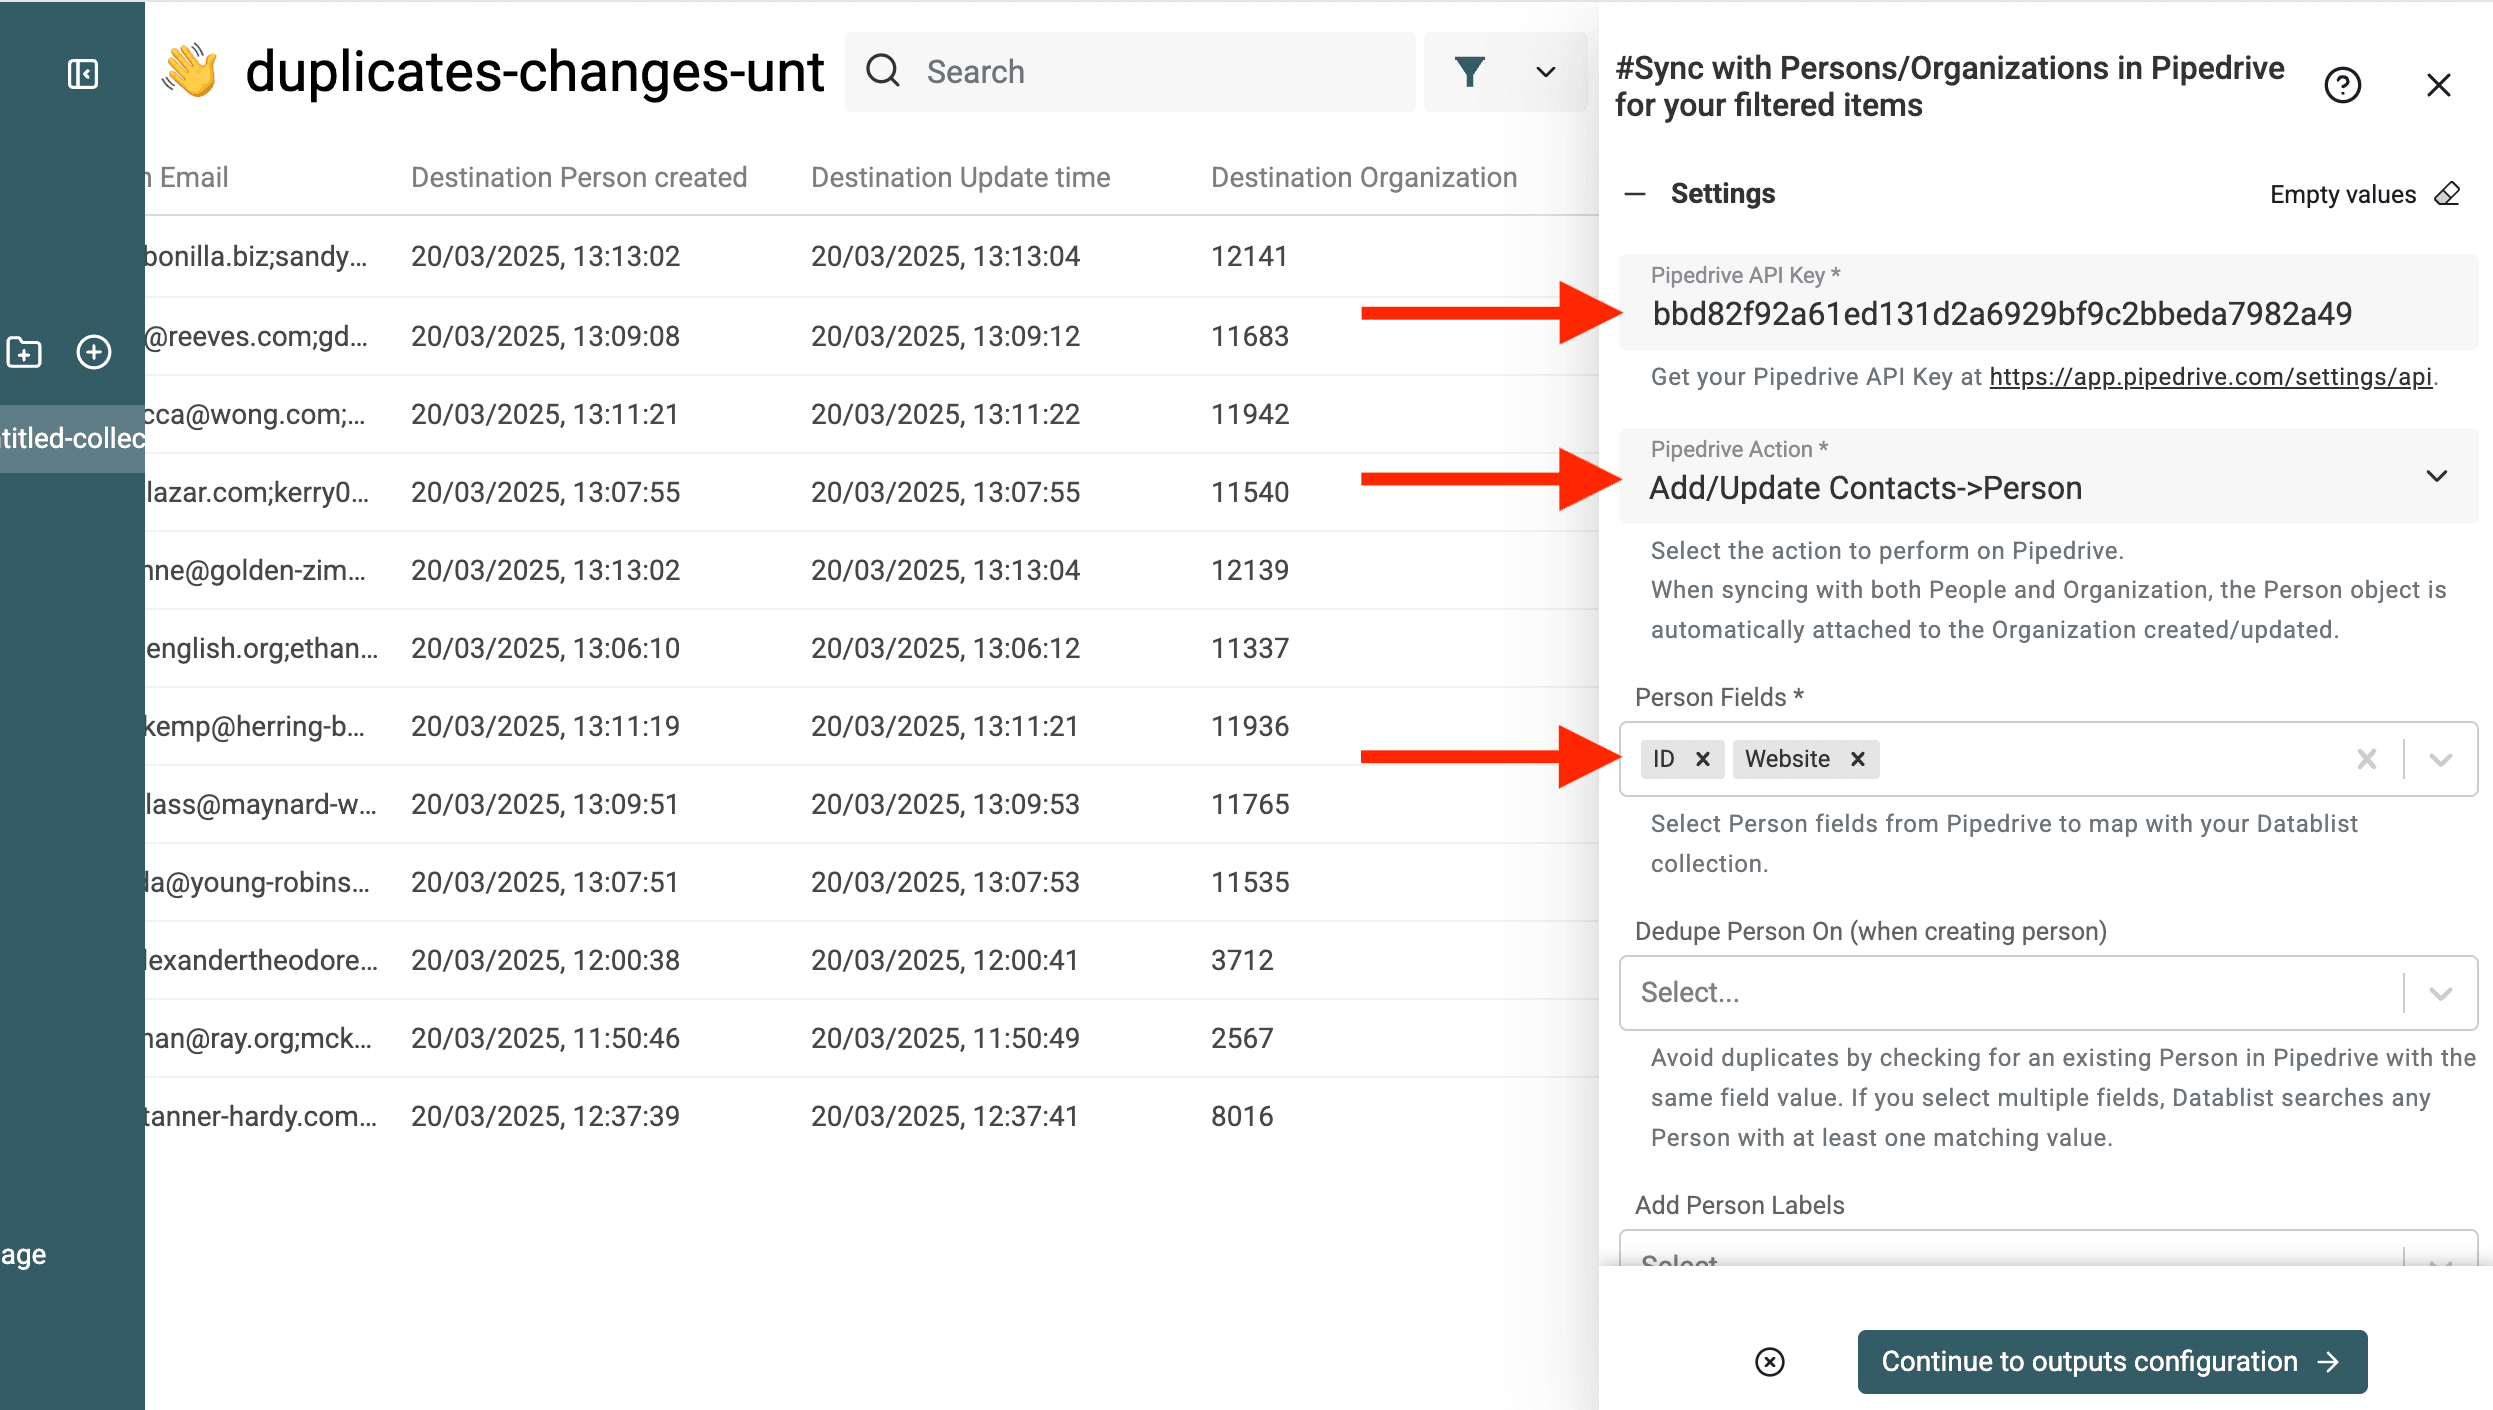
Inserisci la chiave API di Pipedrive e seleziona l’entità da aggiornare, People o Organizations.
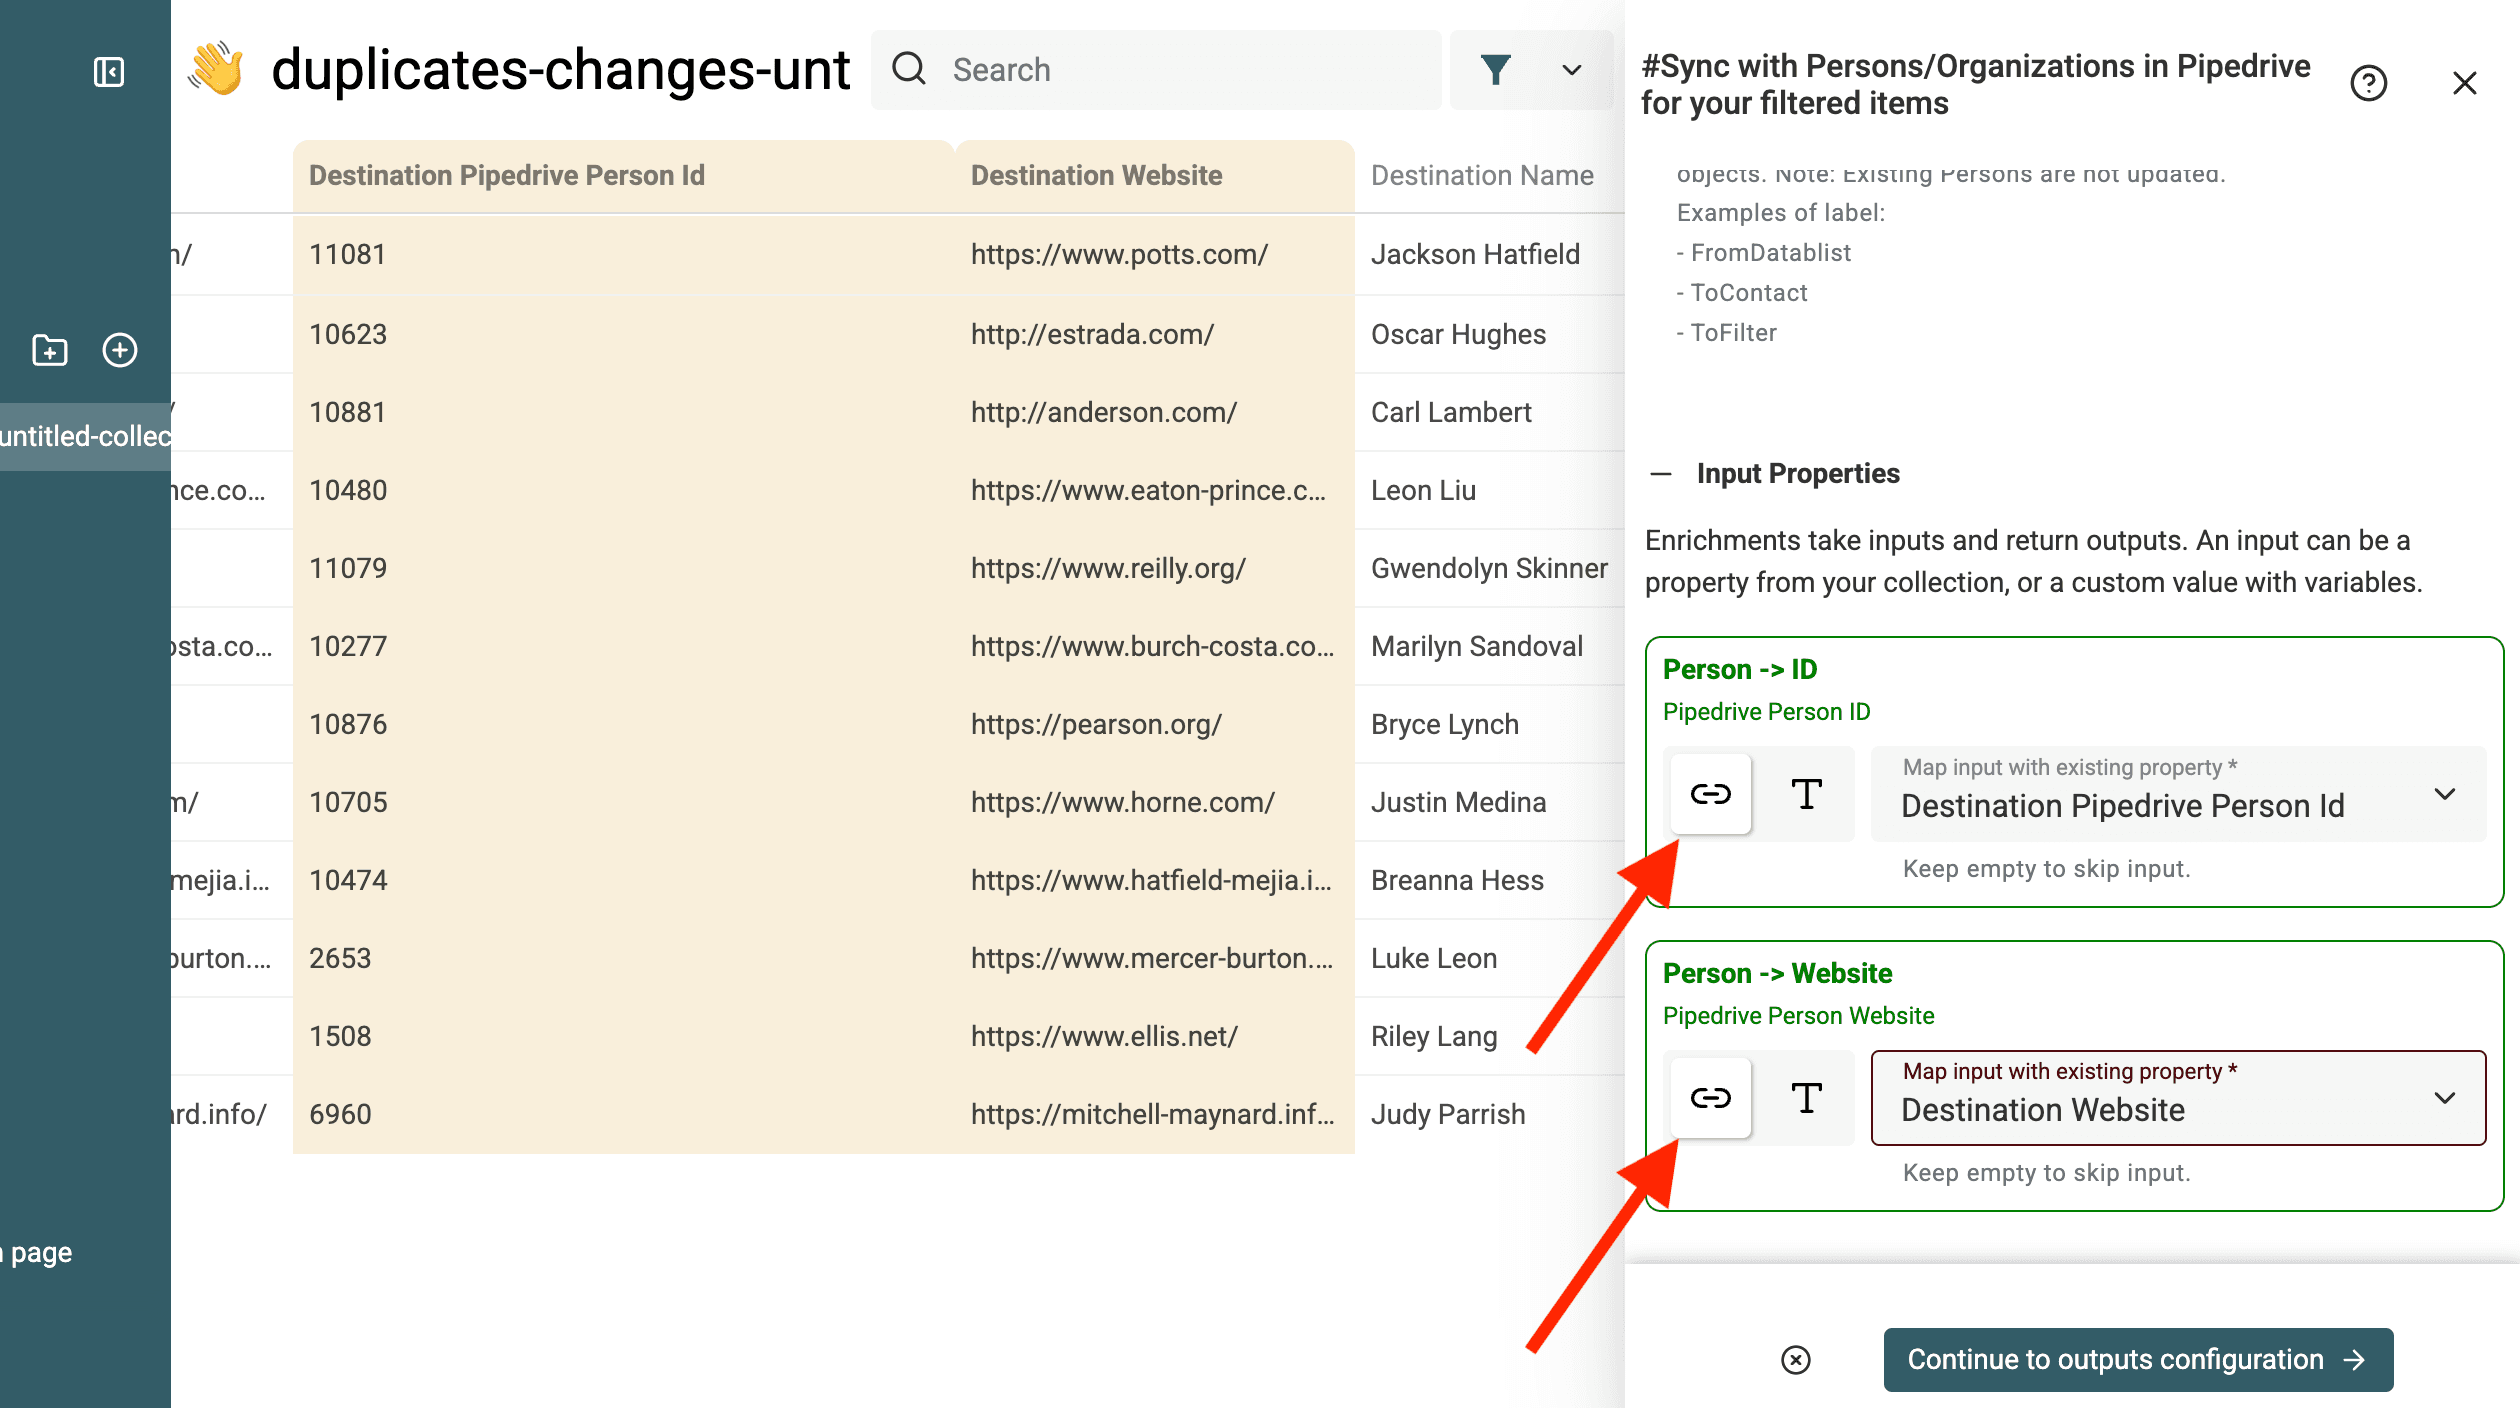
Seleziona il campo ID e i campi che vuoi aggiornare con i valori puliti.
Importante - Devi selezionare il campo
IDper aggiornare i dati ed evitare di creare nuovi record.
In questo esempio aggiornerò soltanto il campo del sito web. Seleziono quindi ID e Website.
Nella sezione Inputs, associa i campi Destination XX.
Configura gli output per ottenere lo stato dell’aggiornamento.
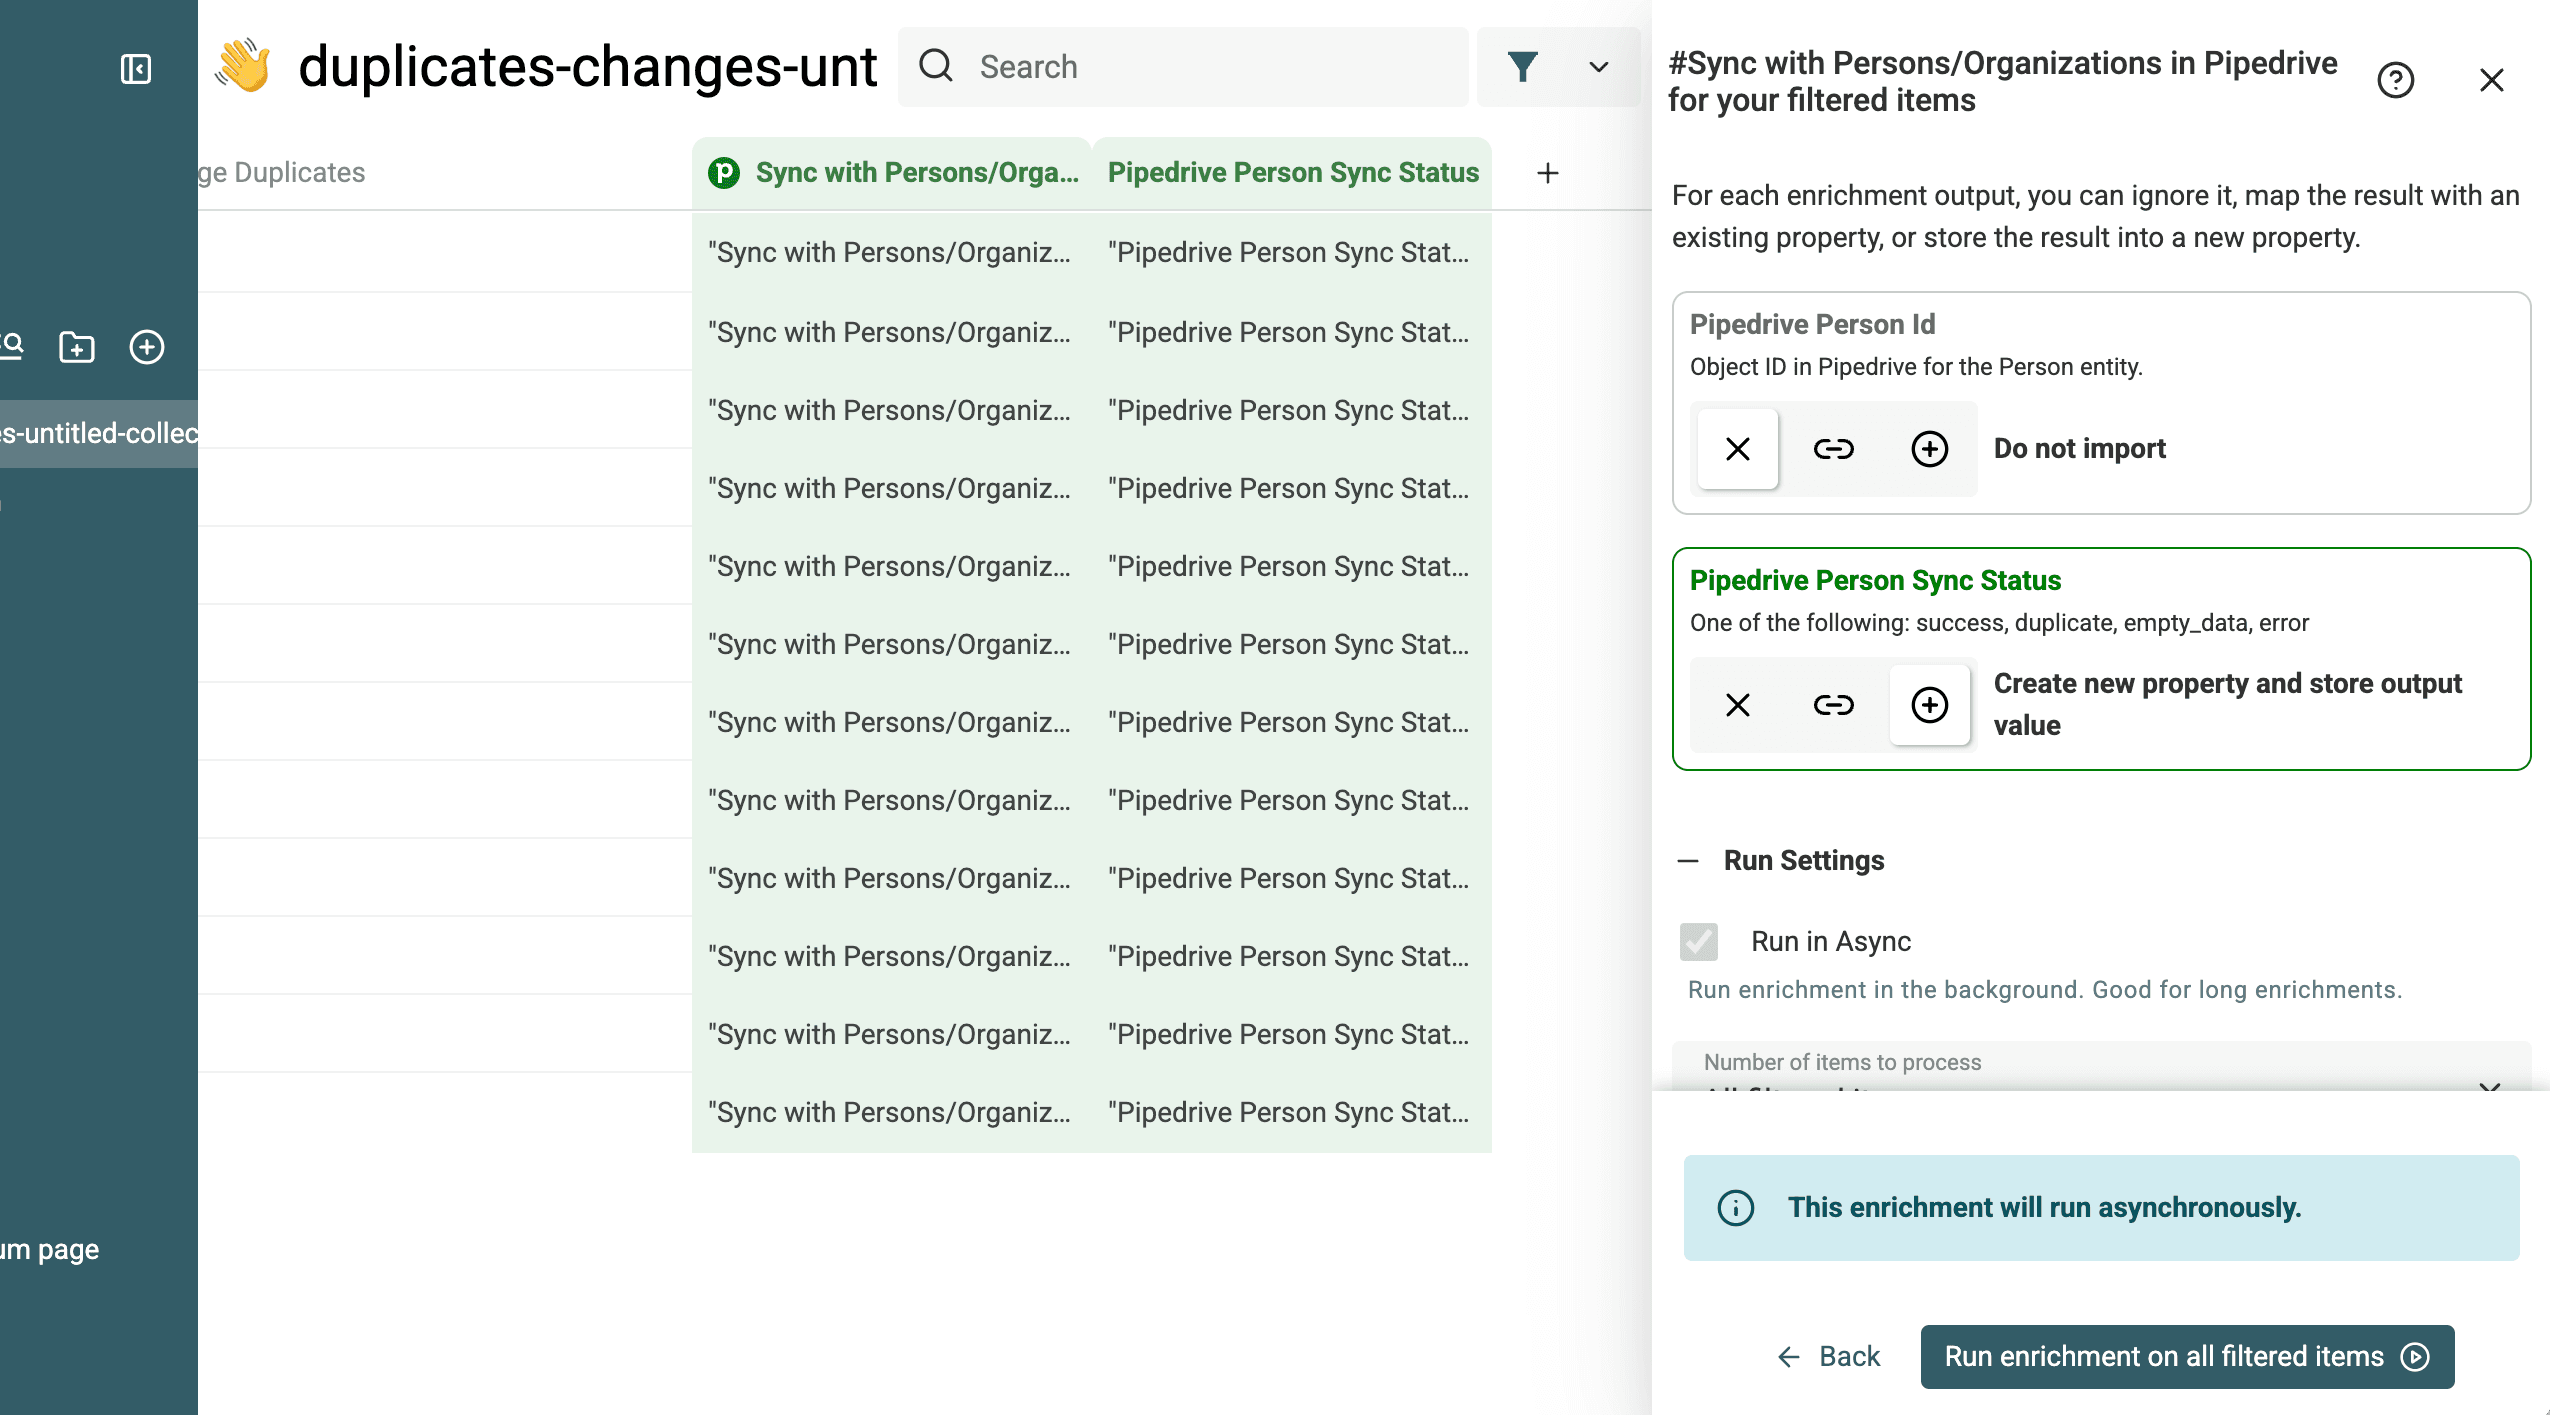
Infine, avvia il processo.
Puoi verificarne il risultato aprendo l’elenco Changelog nel record Pipedrive.
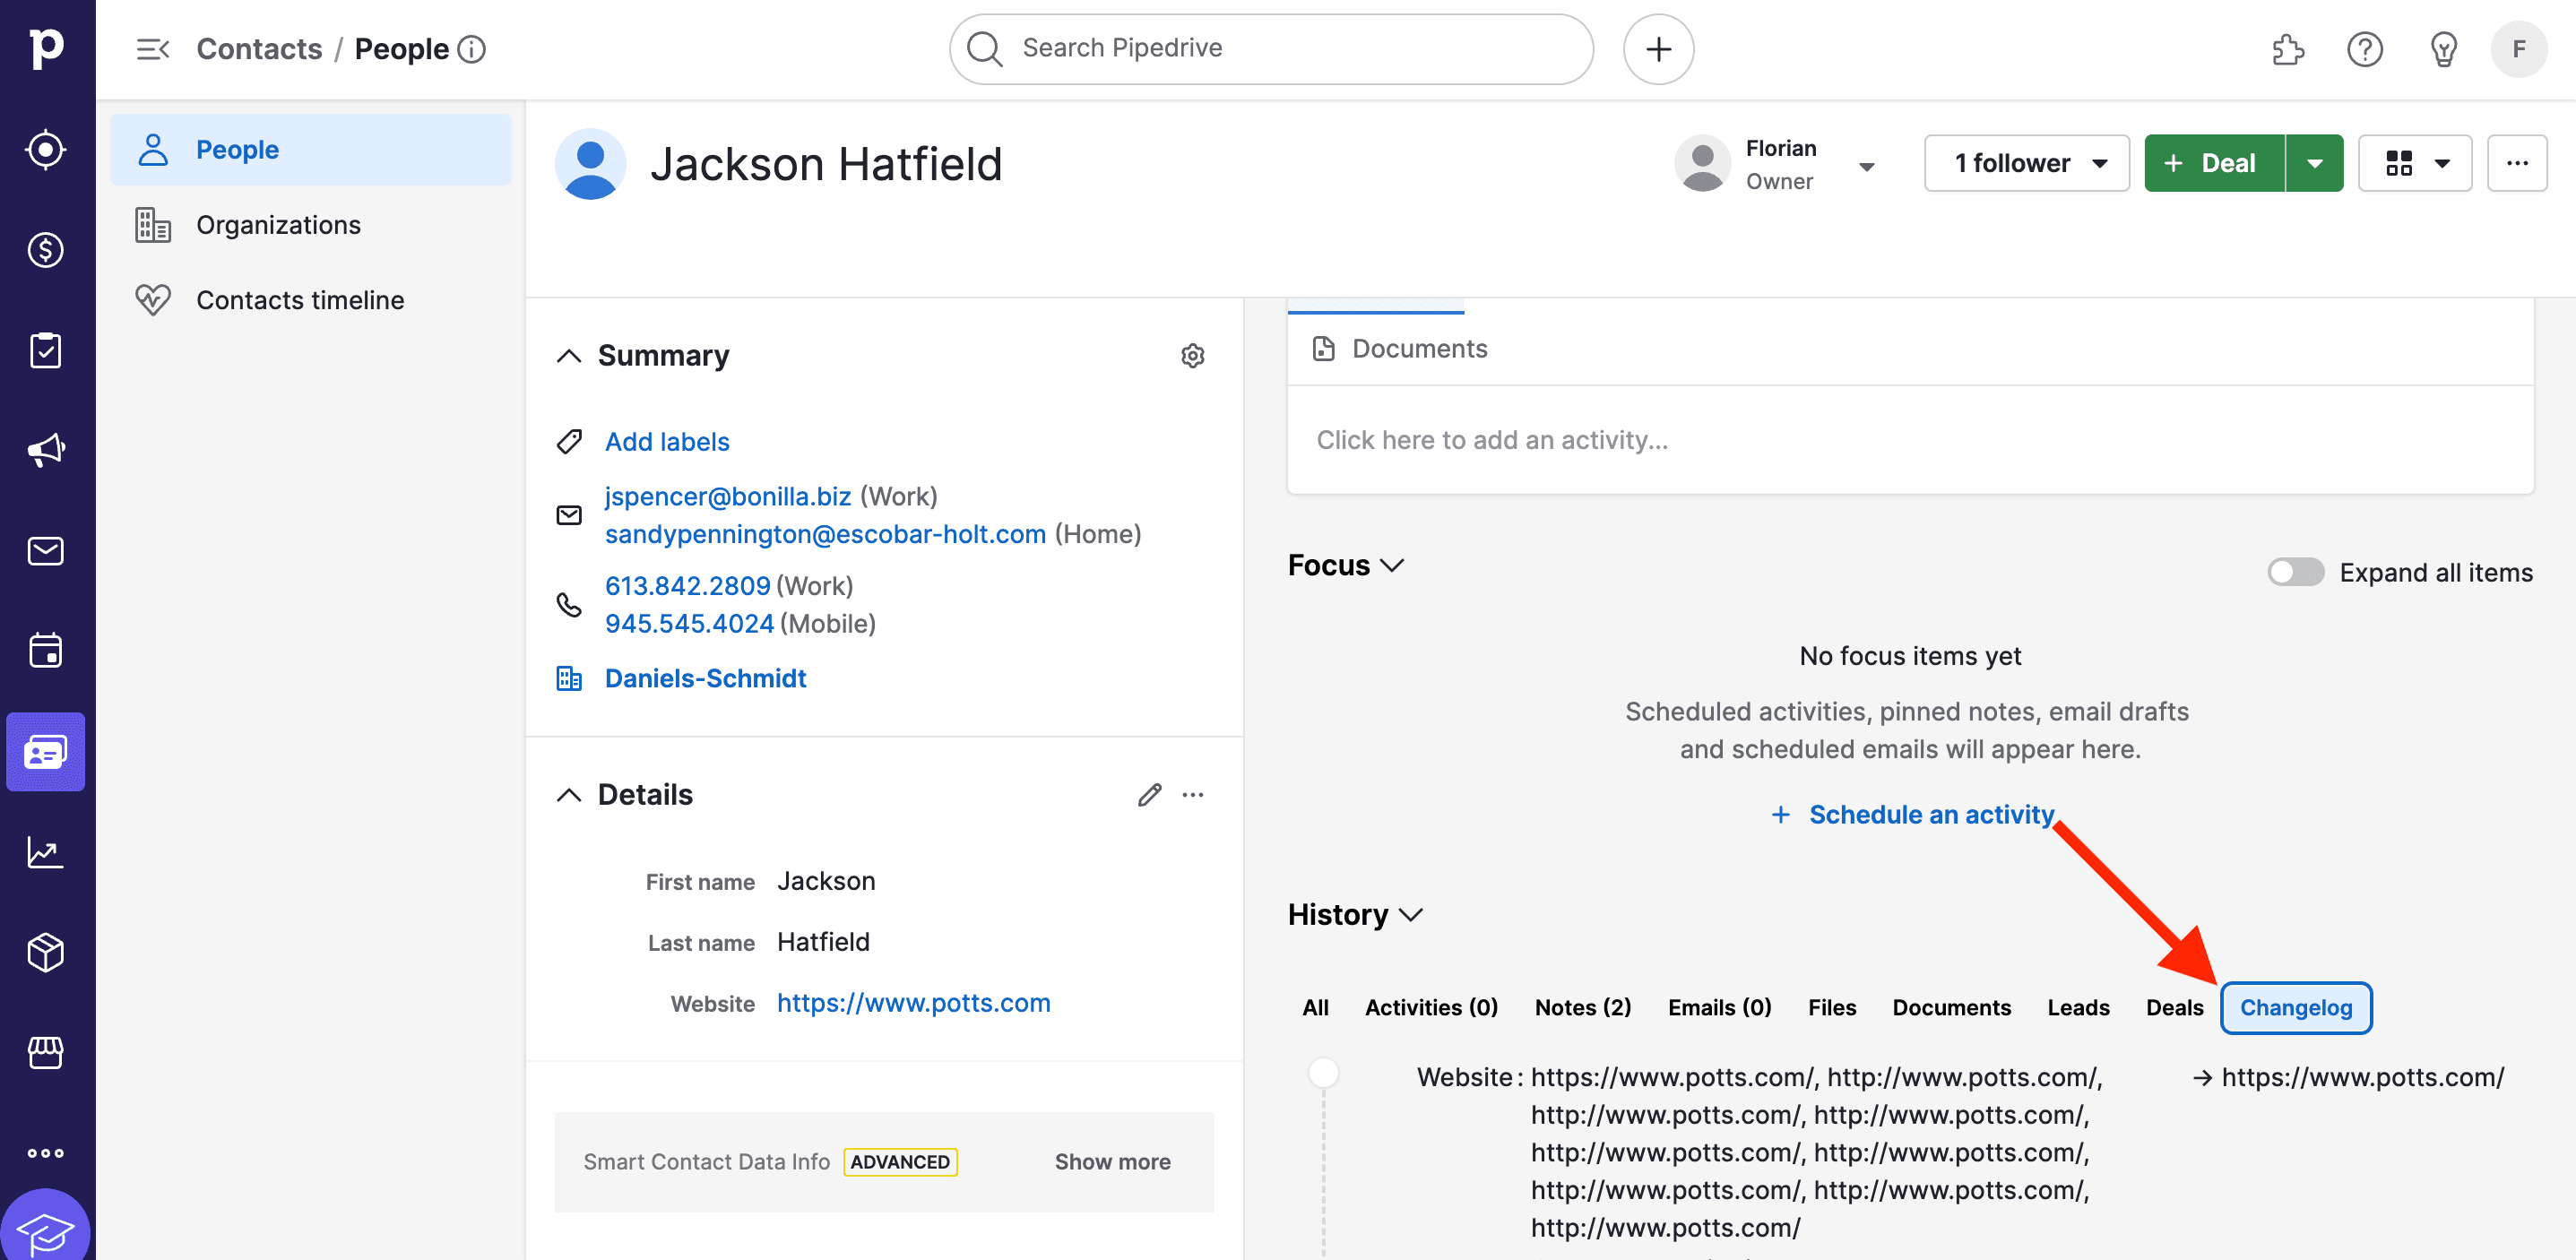
3.d. Controlla i record uniti in Pipedrive
Fatto! Hai completato tutte le operazioni: ✅ Hai importato i dati in Datablist. ✅ Hai trovato e unito i duplicati con algoritmi intelligenti. ✅ Hai sincronizzato i dati puliti con Pipedrive.
Controlla diversi record di destinazione in Pipedrive, soprattutto quelli con campi in conflitto. Prima di considerare conclusa l’elaborazione, verifica che le attività e i valori di contatto previsti siano rimasti correttamente associati.
Limiti della funzione Merge Duplicates di Pipedrive
Lo strumento nativo di Pipedrive è utile per i duplicati che rispettano le regole di corrispondenza pubblicate. Usa Datablist quando devi confrontare un’altra chiave o verificare i gruppi prima di applicare numerose unioni.
1. Chiavi di corrispondenza
Per People, Pipedrive considera il nome insieme all’email, al telefono o all’organizzazione. Per Organizations, considera nome e indirizzo. La sola condivisione dello stesso sito web non rientra tra i criteri documentati. In Datablist puoi partire dall’email per People o dal sito web per Organizations, quindi controllare separatamente i gruppi candidati basati sul nome. Non unire due persone soltanto perché appartengono alla stessa organizzazione o hanno un nome comune.
2. Verifica di un batch più ampio
Pipedrive propone un elenco di potenziali contatti duplicati da controllare. Il processo Datablist descritto in questa guida consente di esaminare i gruppi, esportare un file delle modifiche e poi eseguire l’azione di unione di Pipedrive sulle righe selezionate. Controlla l’anteprima e prova prima con un piccolo batch, poi procedi con un numero maggiore di unioni.
3. Conflitti tra campi
Datablist ti permette di scegliere un record master e vedere in anteprima come verranno gestiti i valori in conflitto. Conferma queste scelte prima di eseguire l’unione in Pipedrive. L’unione effettuata da Pipedrive può aggiungere al record di destinazione i valori del duplicato: se devi impostare i valori puliti definitivi, usa il successivo passaggio di sincronizzazione.
4. Conserva un file delle modifiche
Salva il file delle modifiche esportato da Datablist prima di applicare le unioni. Il file registra gli ID di origine e destinazione usati in questo processo, aiutandoti a verificare i risultati e analizzare in seguito i singoli record. Non sostituisce un backup dei dati di Pipedrive.
Se i suggerimenti nativi di Pipedrive coprono tutti i tuoi duplicati, controllali direttamente nella piattaforma. Se invece ti servono il matching per sito web, la pulizia dei nomi aziendali o regole per gestire in blocco i conflitti, segui il processo Datablist descritto sopra e verifica le modifiche in Pipedrive.