
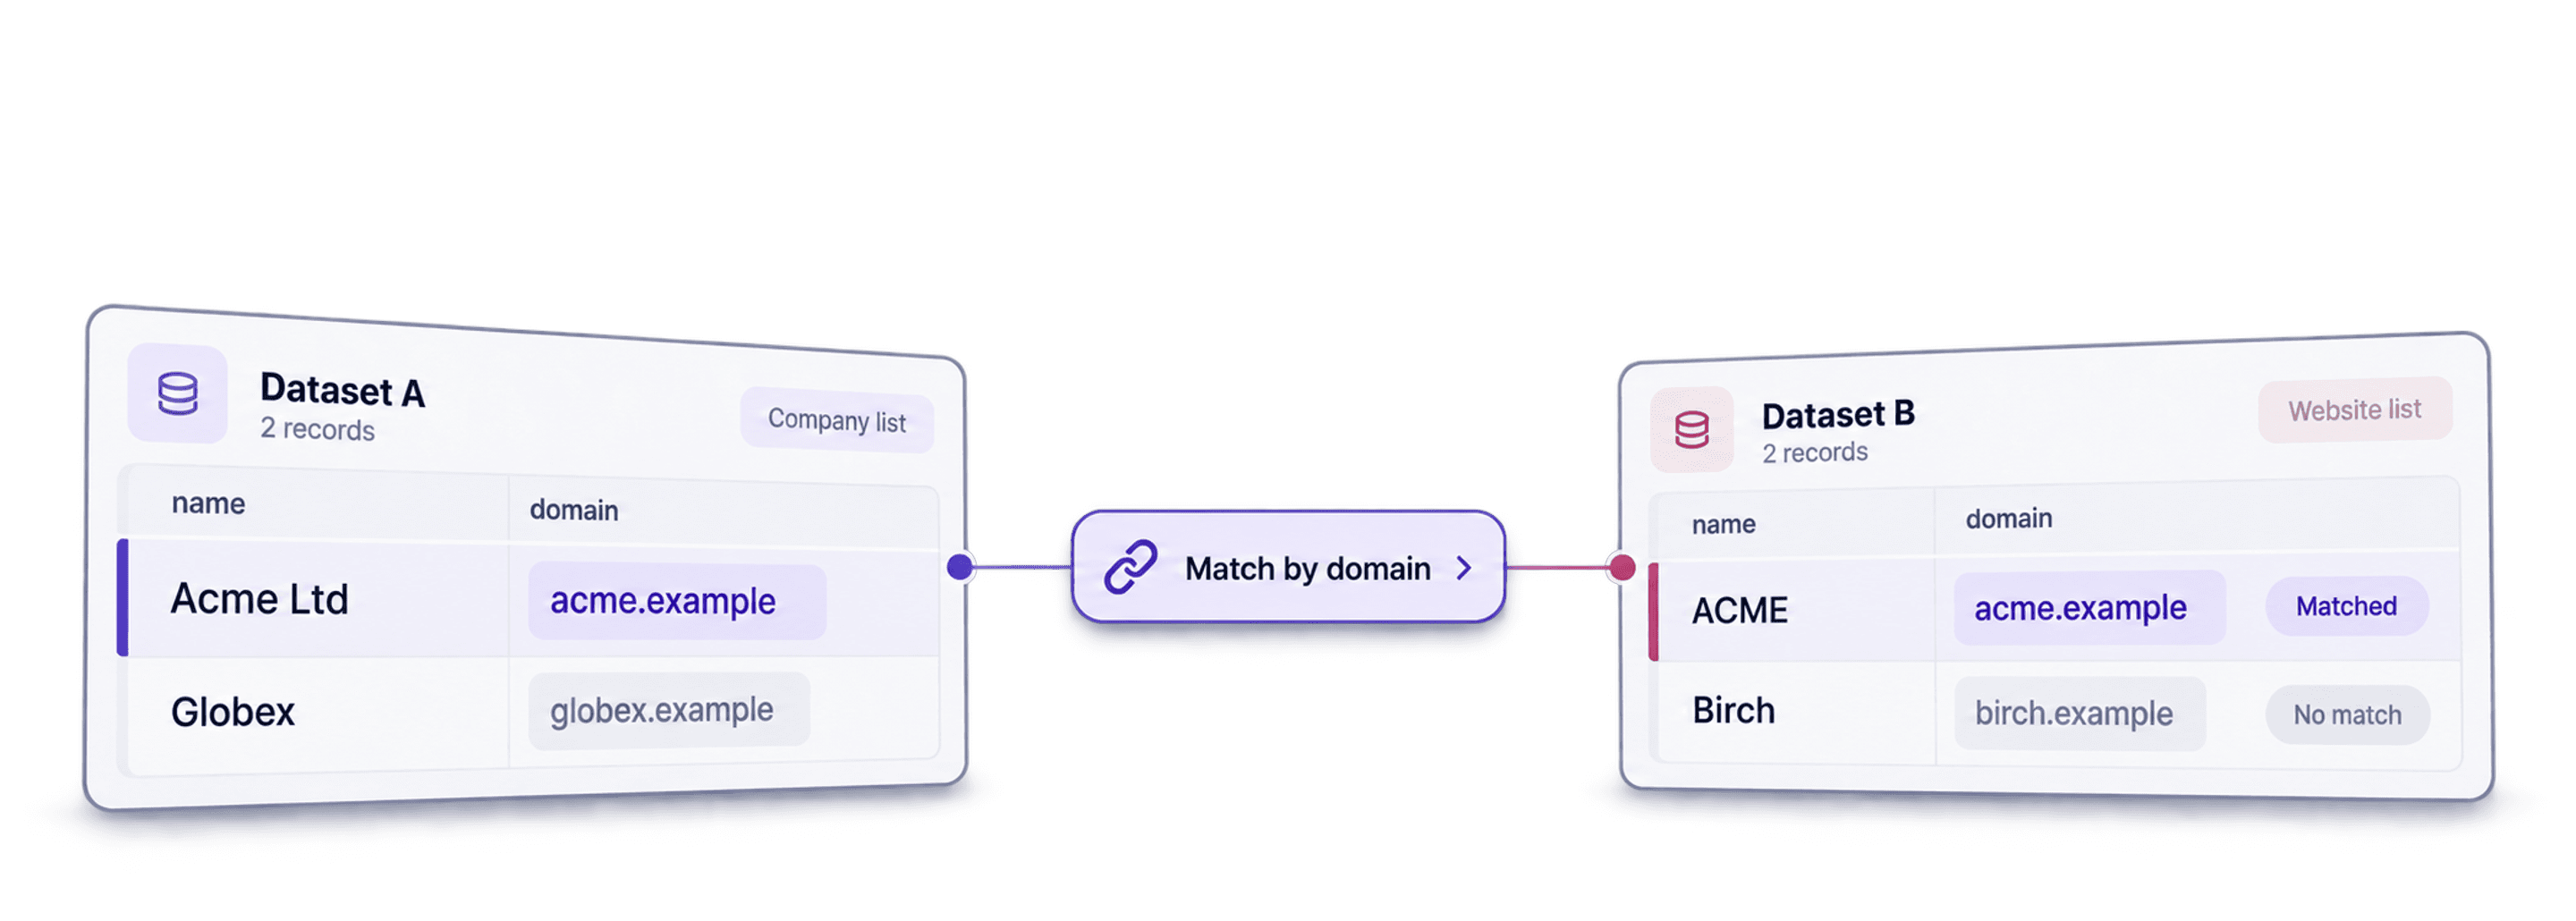
Usa un tool di data matching quando due liste possono contenere le stesse persone o aziende con nomi leggermente diversi. In Datablist, importa le liste nelle collection, associa le colonne da confrontare, scegli un algoritmo di matching e verifica i gruppi proposti prima di unirli o esportarli. Parti da un identificatore esatto, come un indirizzo email o il dominio aziendale. Ricorri al fuzzy matching sui nomi solo quando manca un identificatore stabile e verifica i risultati confrontando un secondo campo.
Per esempio, una lista di Lead potrebbe contenere Acme Ltd con dominio acme.com, mentre un'altra potrebbe riportare ACME con lo stesso dominio. La corrispondenza del dominio è un motivo più solido per collegare le due righe rispetto alla sola somiglianza dei nomi. Duplicates Finder di Datablist può confrontare i record all'interno di una collection o tra più collection, mostrando poi i gruppi da verificare. Gli algoritmi avanzati di matching fonetico e fuzzy matching sono disponibili nei piani a pagamento.
Ecco una sintesi dei principali aspetti del Data Matching trattati nell'articolo:
- Caricare i dataset
- Preparare, pulire e normalizzare i dati
- Confrontare record in una o più collection
- Deduplicare: eliminare o unire i gruppi
Verifica le corrispondenze prima di unire i record. Nomi simili possono indicare persone o aziende diverse, soprattutto quando sono brevi o abbreviati.
Step 1: caricare i dataset
Il primo step consiste nel caricare i dataset in Datablist. Datablist è un tool online per la gestione delle liste. Puoi visualizzare e modificare file CSV e file Excel. È lo strumento ideale per gestire una lista di Lead, pulire i dati dei clienti o ripulire i dati estratti dal web.
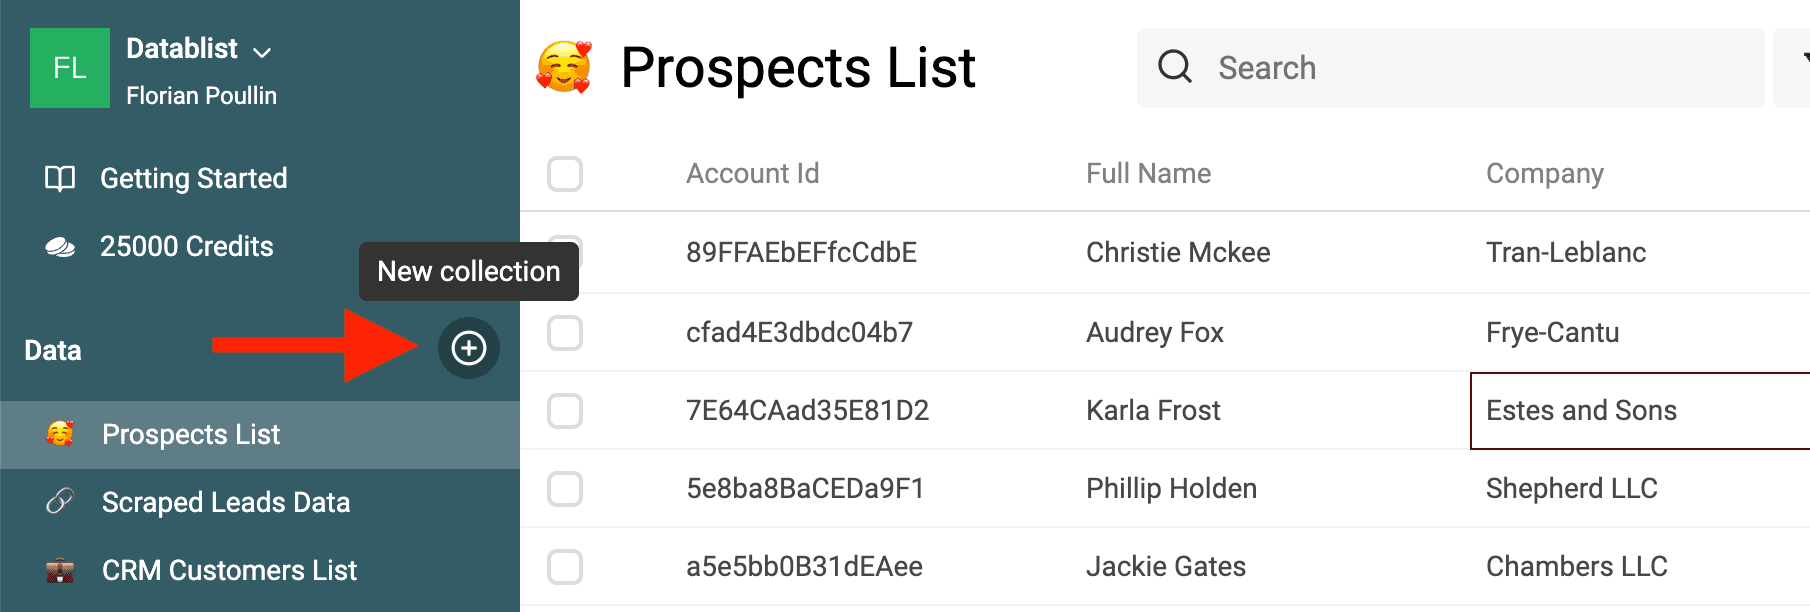
Per iniziare, crea una collection in cui caricare il primo dataset.
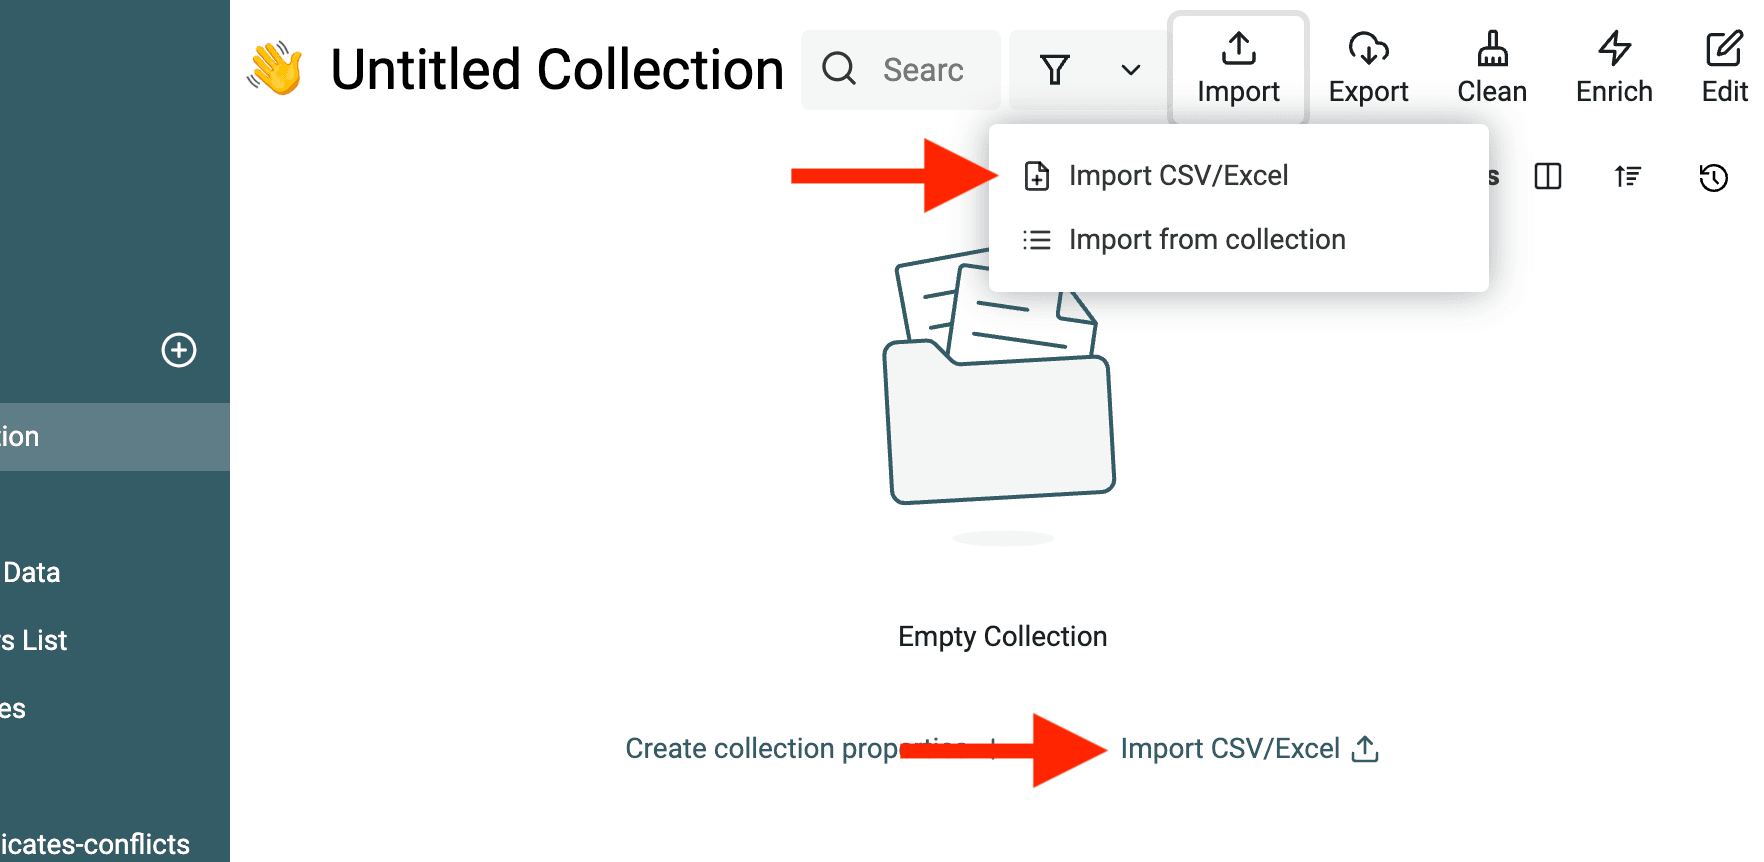
Poi fai clic sul pulsante Import.
Dopo aver importato il primo dataset, puoi:
- Importare nella stessa collection altri dataset con una struttura dati comune.
- Importare in nuove collection i dataset con strutture dati differenti.
Duplicates Finder di Datablist individua i record corrispondenti all'interno di una singola collection oppure tra collection con strutture dati diverse.
Step 2: pulire e normalizzare i dati
Il secondo step è il Data Cleansing. La pulizia dei dati è un requisito essenziale per il data matching, perché garantisce precisione e affidabilità durante il confronto. Dati sporchi o non normalizzati possono produrre corrispondenze errate e risultati poco attendibili. In sostanza, la pulizia dei dati crea le condizioni per un data matching efficace.
Quando compaiono nei nomi di persone o aziende, gli elementi superflui non aggiungono informazioni e possono impedire all'algoritmo di deduplicazione di rilevare i duplicati.
Datablist include diversi tool per la pulizia dei dati:
- Rimuovere simboli e punteggiatura - I testi estratti dal web possono contenere emoticon, simboli ASCII o nomi con segni di punteggiatura. L'algoritmo di matching di Datablist li ignora durante il confronto, ma potrebbero impedire l'unione automatica nel processo di deduplicazione.
- Rimuovere gli spazi superflui - Basta uno spazio in più tra due parole per rendere differenti due stringhe. Gli algoritmi di matching di Datablist pre-elaborano i valori testuali eliminando gli spazi aggiuntivi, che potrebbero però impedire l'unione automatica durante il processo di deduplicazione.
- Estrarre indirizzi email, URL e altri dati dai testi - Se i dati includono testo non strutturato con indirizzi email, URL, menzioni, tag o altri elementi, usa Data Extractor per estrarre queste entità e strutturare i dati. Con entità strutturate da confrontare, il Data Matching sarà più semplice.
- Rimuovere i tag HTML - Un'altra funzione di pulizia consente di ricavare testo semplice da stringhe contenenti tag HTML. In questo modo puoi confrontare liste estratte dal web che includono codice HTML con gli altri dataset.
- Convertire il testo in DateTime, Number, Boolean e altri formati - Datablist offre una vera struttura dati con formati nativi DateTime, Number, Boolean e altri ancora. Un passaggio importante del data cleansing consiste nel convertire il testo grezzo in un formato nativo. DateTime, numeri e altri tipi nativi sono fondamentali per le regole di unione avanzate, quando occorre selezionare il record principale confrontando i valori, per esempio scegliendo la data più recente.
- Modificare maiuscole e minuscole per uniformare il formato - La trasformazione di maiuscole e minuscole è semplice ma necessaria. Datablist include diversi algoritmi per modificare il case del testo).
- Dividere o unire le proprietà - Questa funzione è perfetta per gestire dati con più valori. Se una proprietà contiene diversi indirizzi email separati da virgole, punti e virgola o spazi, il tool Split Property di Datablist creerà più proprietà contenenti un solo indirizzo email ciascuna.
- Rimuovere o sostituire i valori vuoti - Usa le funzioni di filtro di Datablist per filtrare valori o righe vuote.
Consulta la nostra guida alla pulizia dei dati per altri esempi e istruzioni sul data cleansing.
Normalizzare i nomi delle persone
Lavorare con dataset di persone è frequente nella Data Deduplication. Clienti, Lead e dataset di prospect sono esempi tipici. Nel migliore dei casi, il matching dei dataset di persone si basa su identificatori univoci, come indirizzi email o numeri identificativi. Se questi identificatori mancano, oppure se devi confrontare persone tra dataset diversi, dovrai usare i loro nomi nel processo di data matching.
La pre-elaborazione dei nomi garantisce un formato uniforme e riduce gli errori durante la deduplicazione.
Rimuovere gli elementi superflui dai nomi
I nomi delle persone possono presentare molte varianti. Soprannomi, abbreviazioni, grafie alternative e caratteri speciali sono molto comuni.
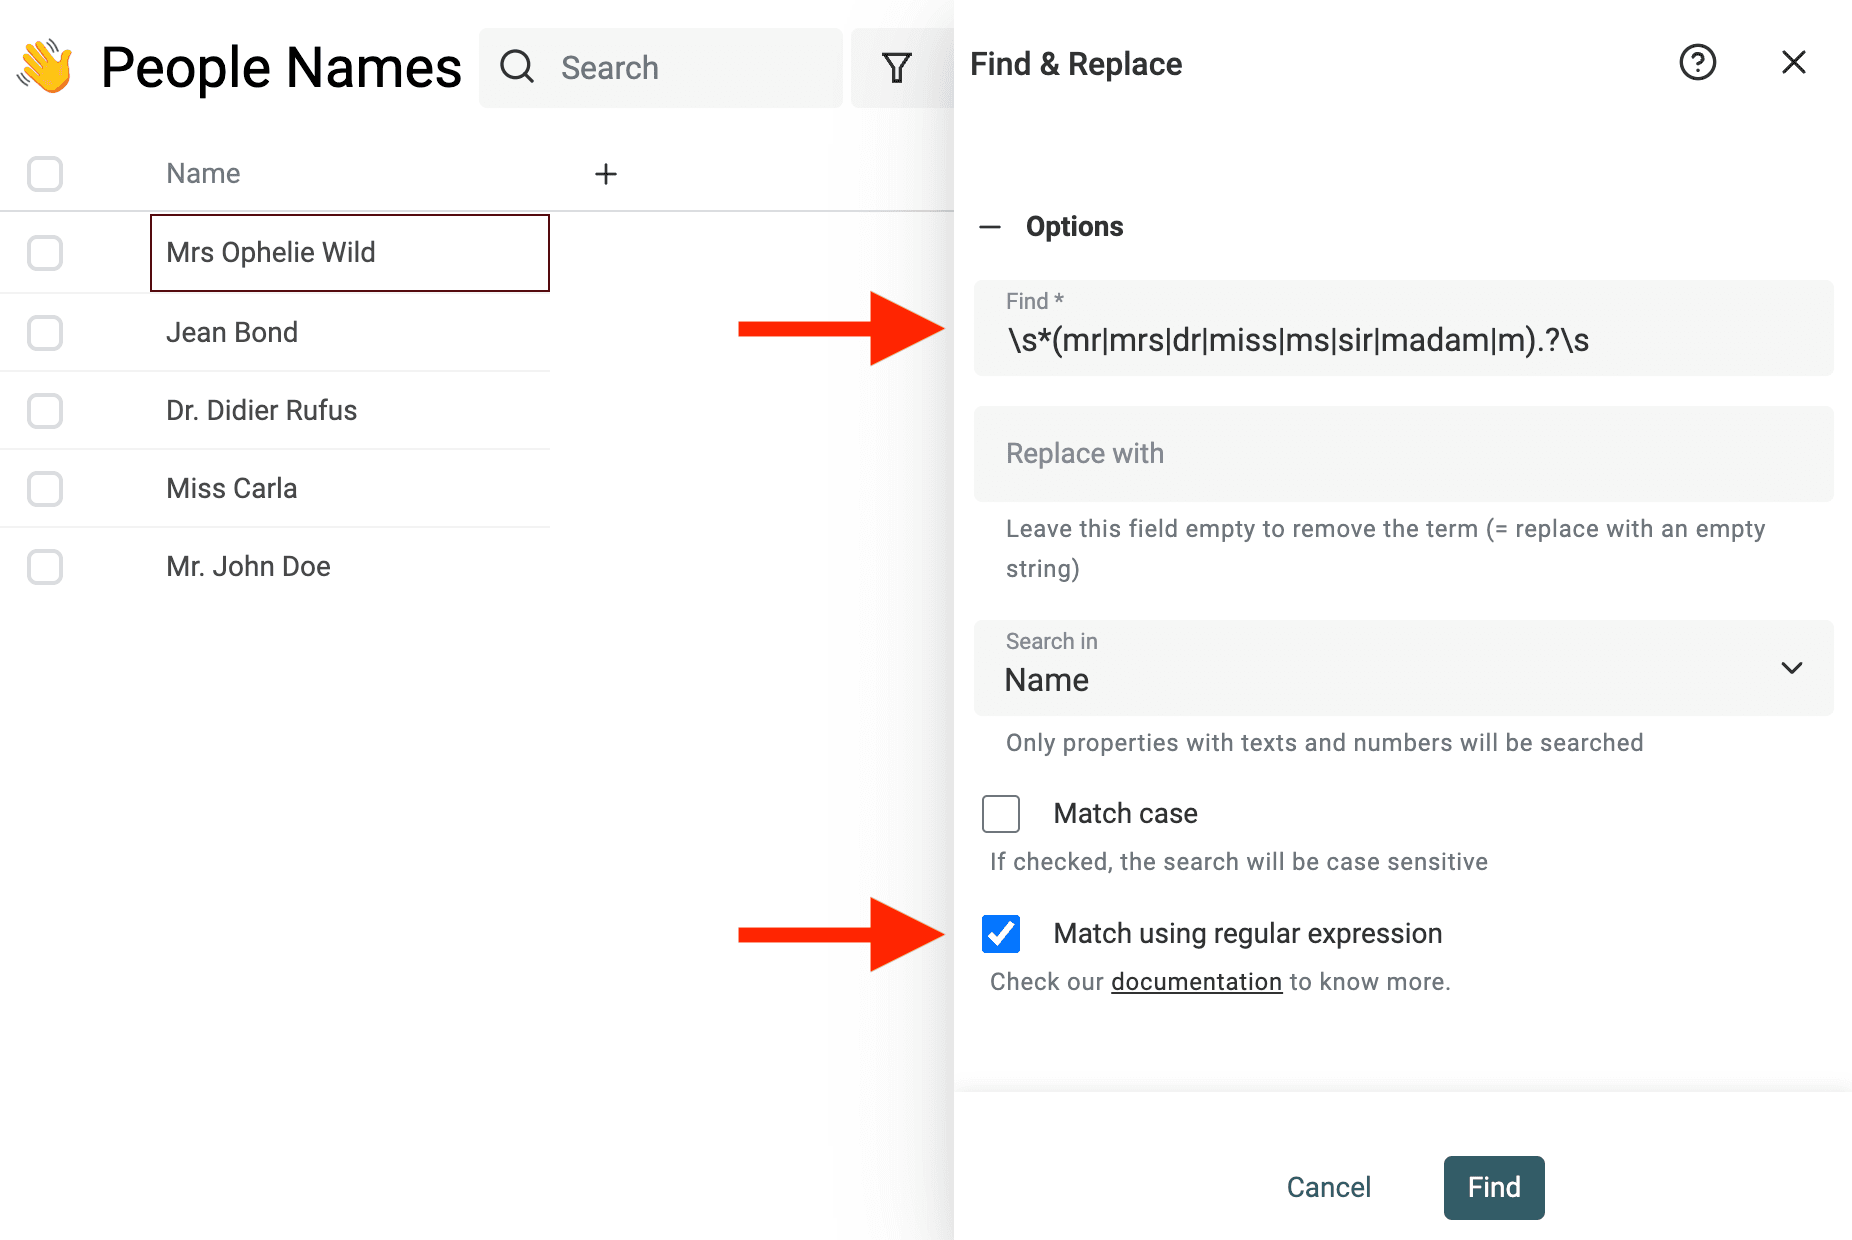
Usa il potente tool Find & Replace per rimuovere prefissi, suffissi, stop word, indicazioni geografiche e altri termini inutili.
Per esempio, per eliminare i titoli dai nomi puoi usare questa espressione regolare:
^\s*(mr|mrs|dr|miss|ms|sir|madam|m).?\s
Sostituiscila quindi con una stringa vuota.
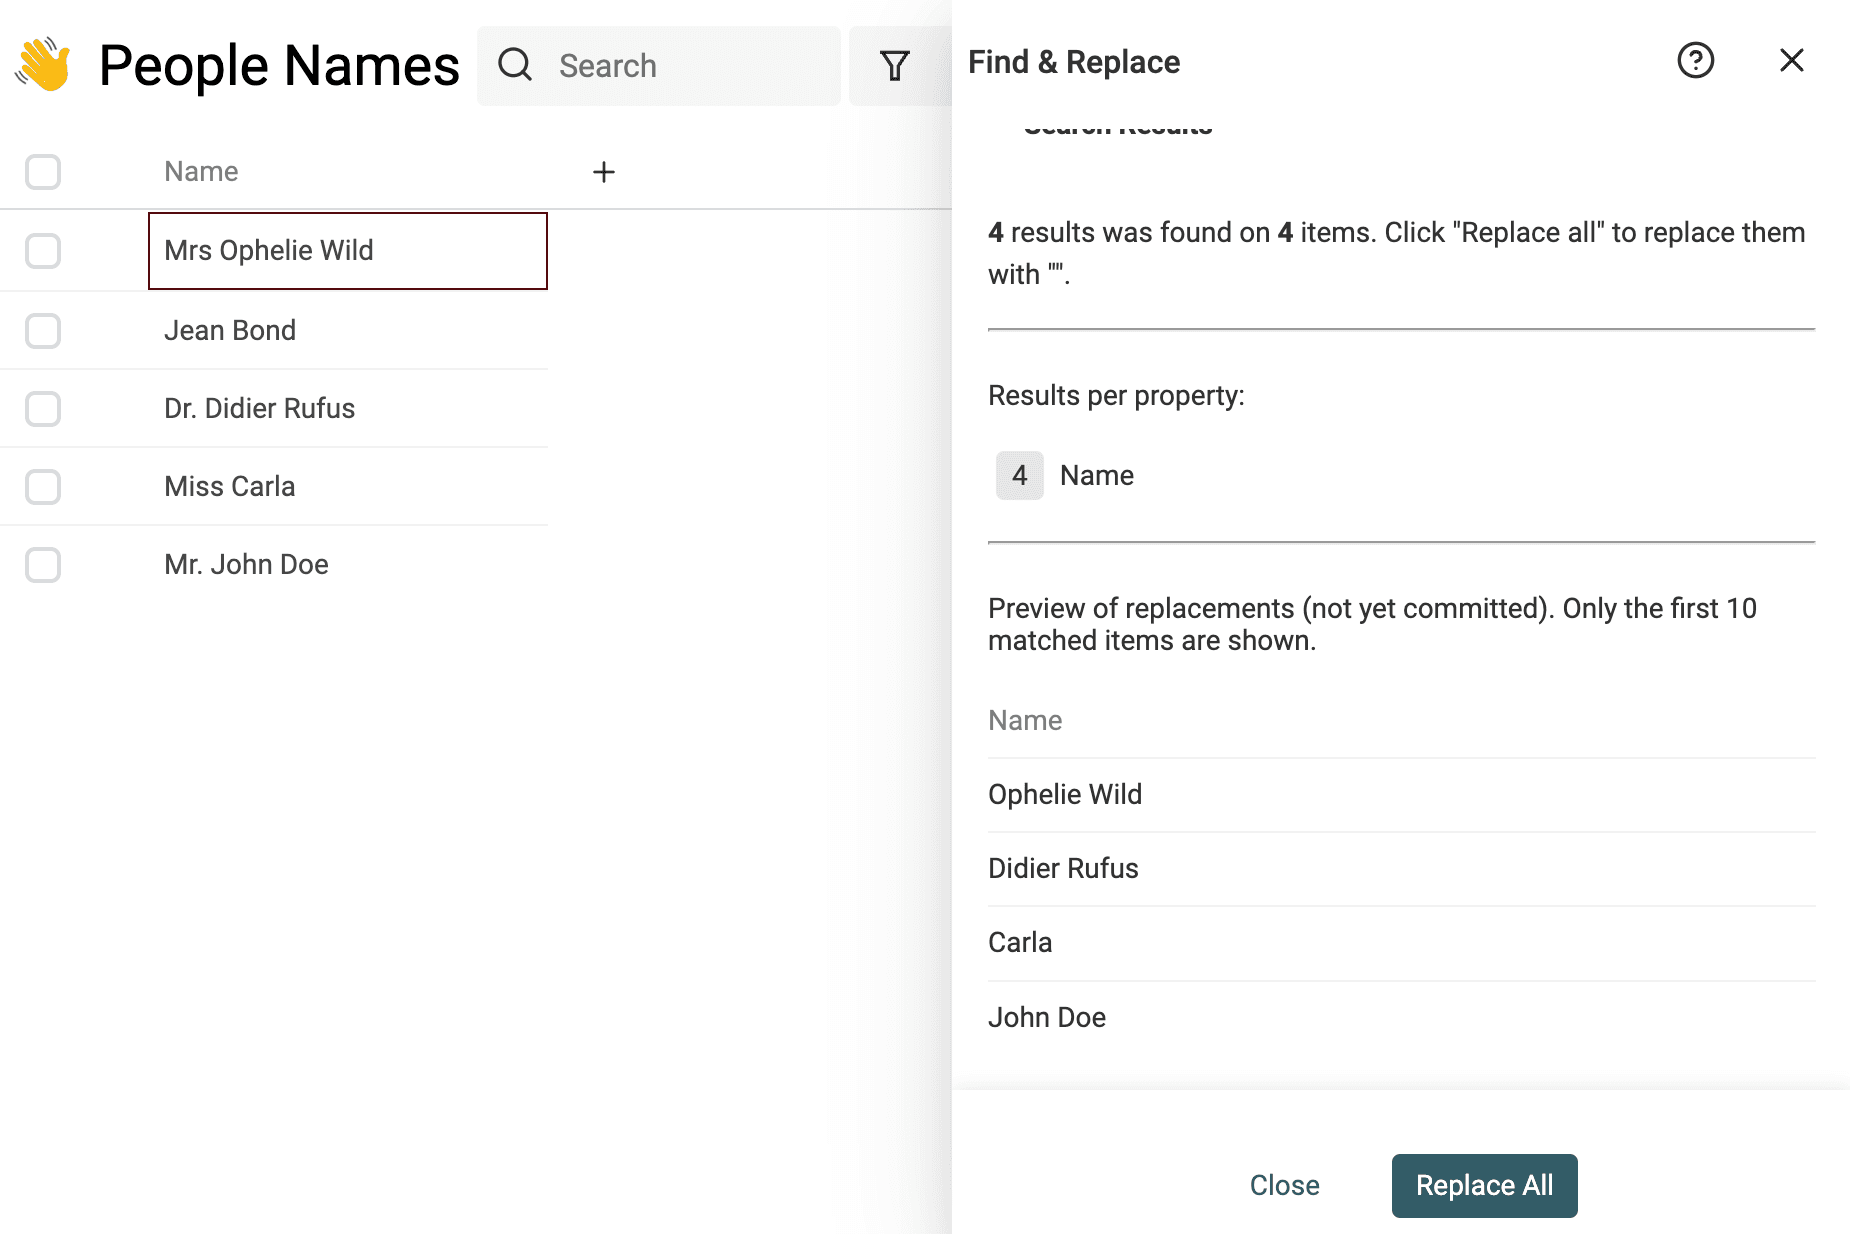
Nota Se non conosci le espressioni regolari, contattaci: ti aiuteremo a pulire i dati.
Suddividere il nome completo
Datablist non è soltanto un tool di pulizia, ma offre anche funzioni di data enrichment, come il lead enrichment o la traduzione di file CSV con DeepL.
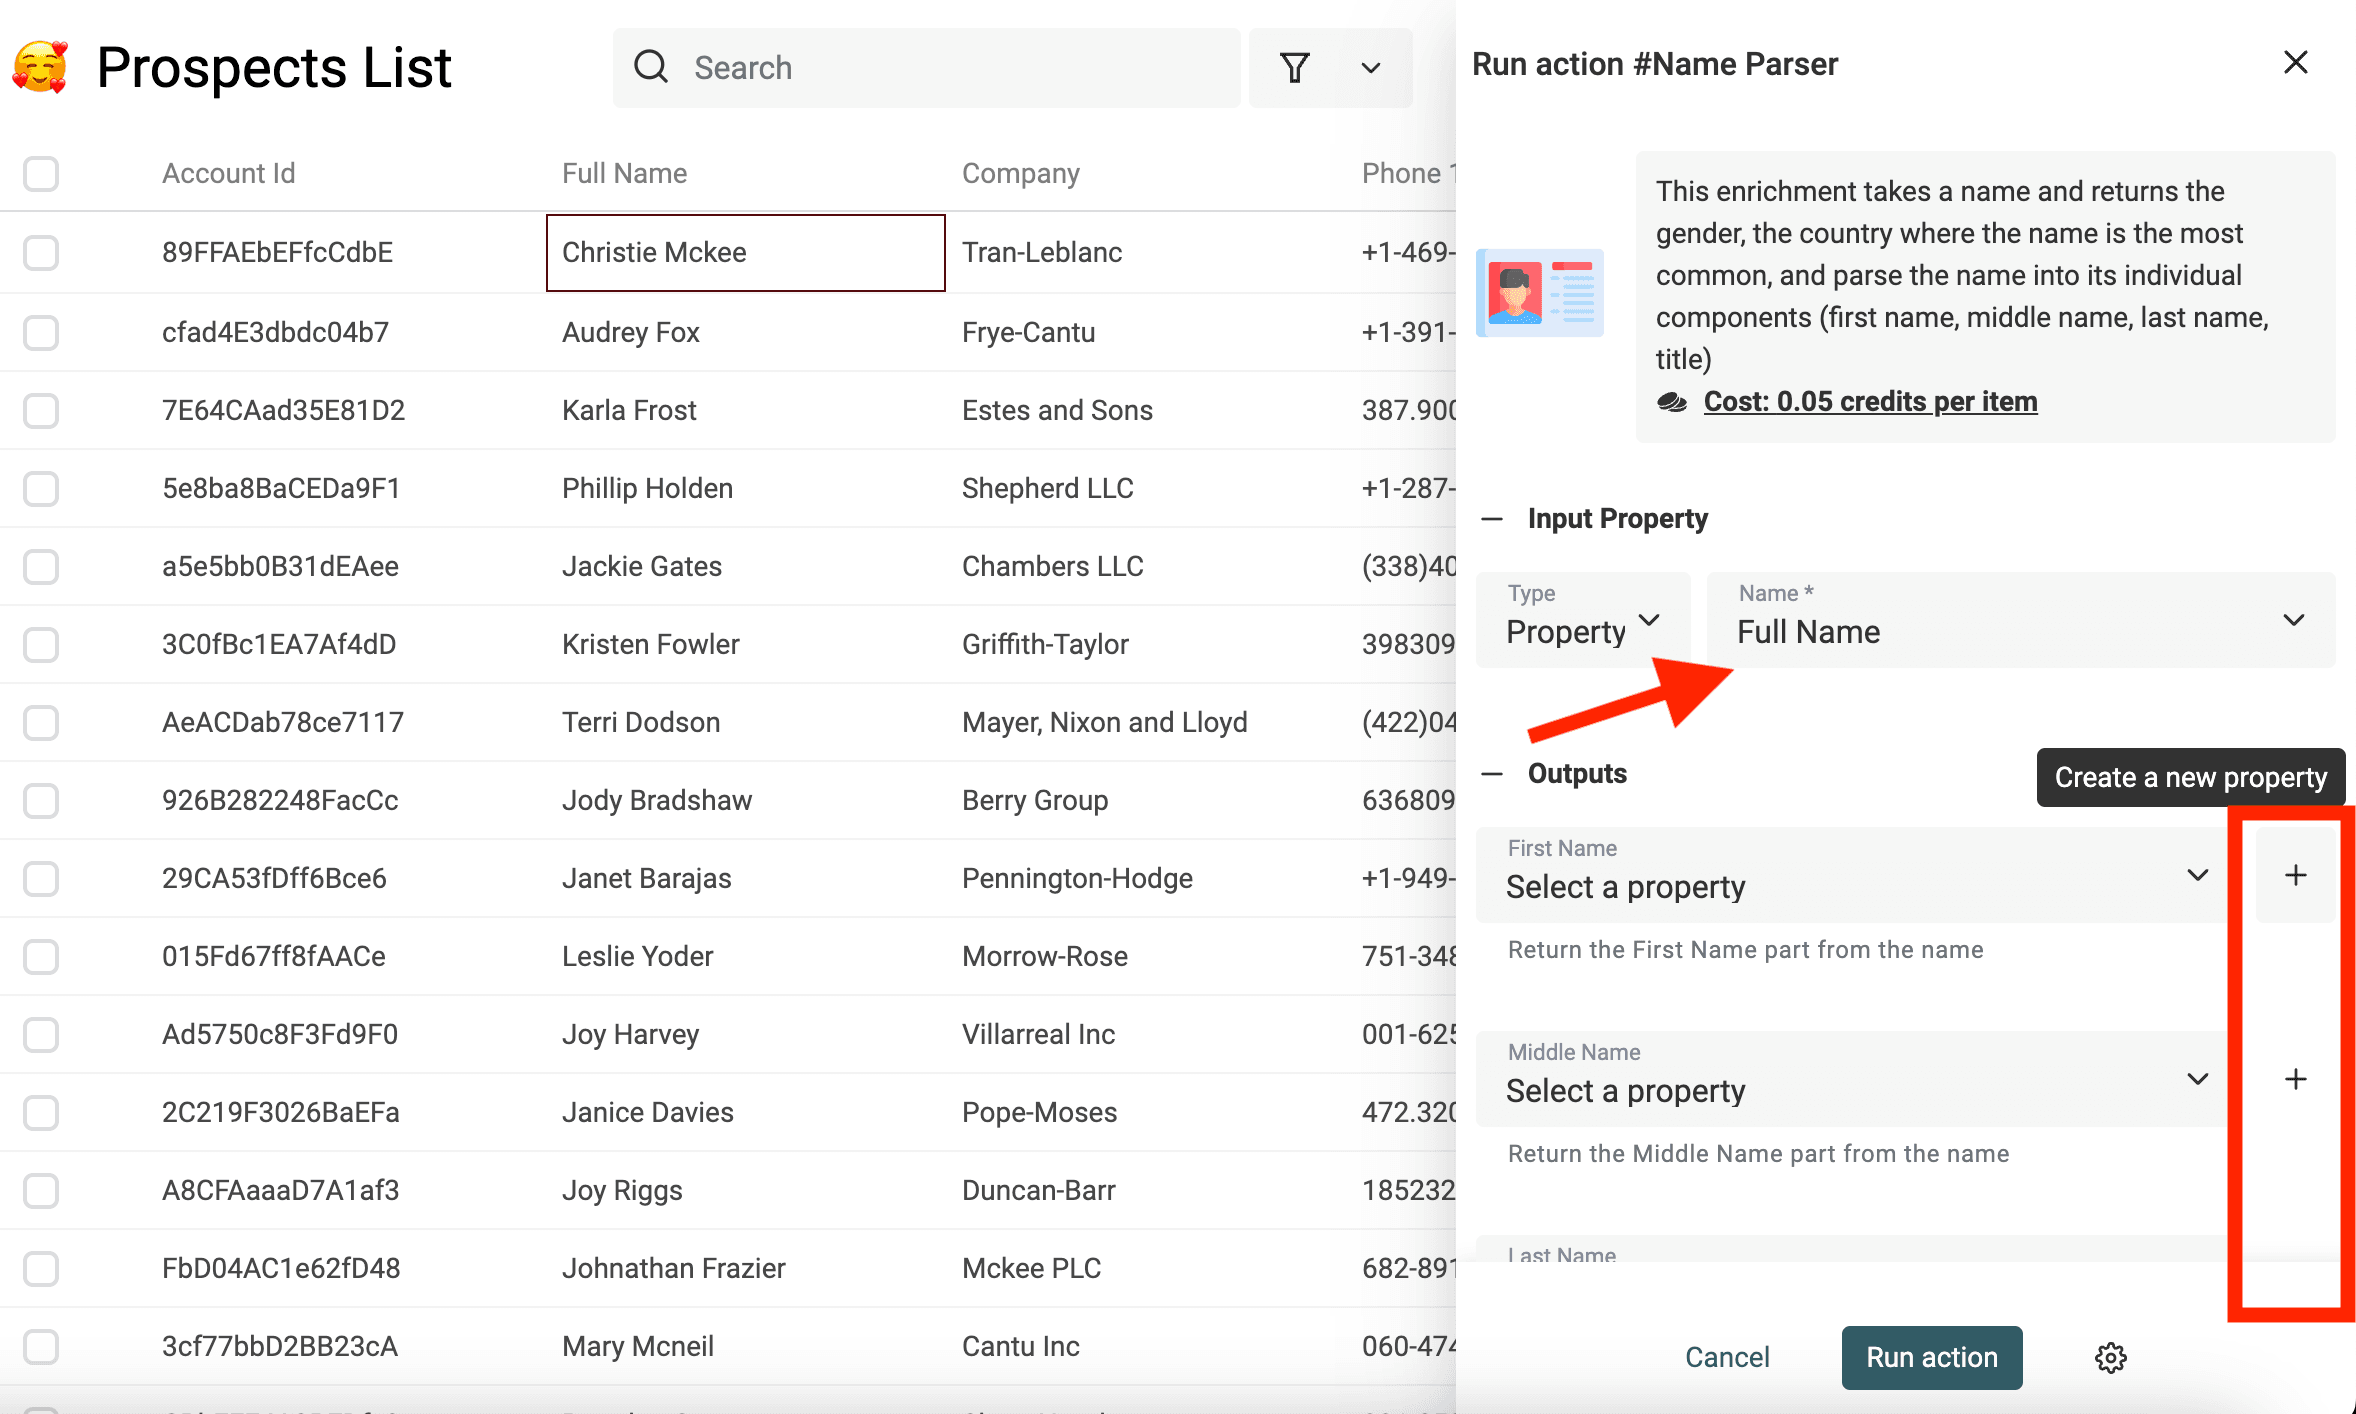
Name Parser è l'enrichment ideale per pulire i nomi delle persone. Riceve un nome completo e ne restituisce le diverse parti: nome, secondo nome e cognome. Restituisce inoltre il genere e il Paese più comuni associati al nome.
Per suddividere i nomi completi usa dati statistici.
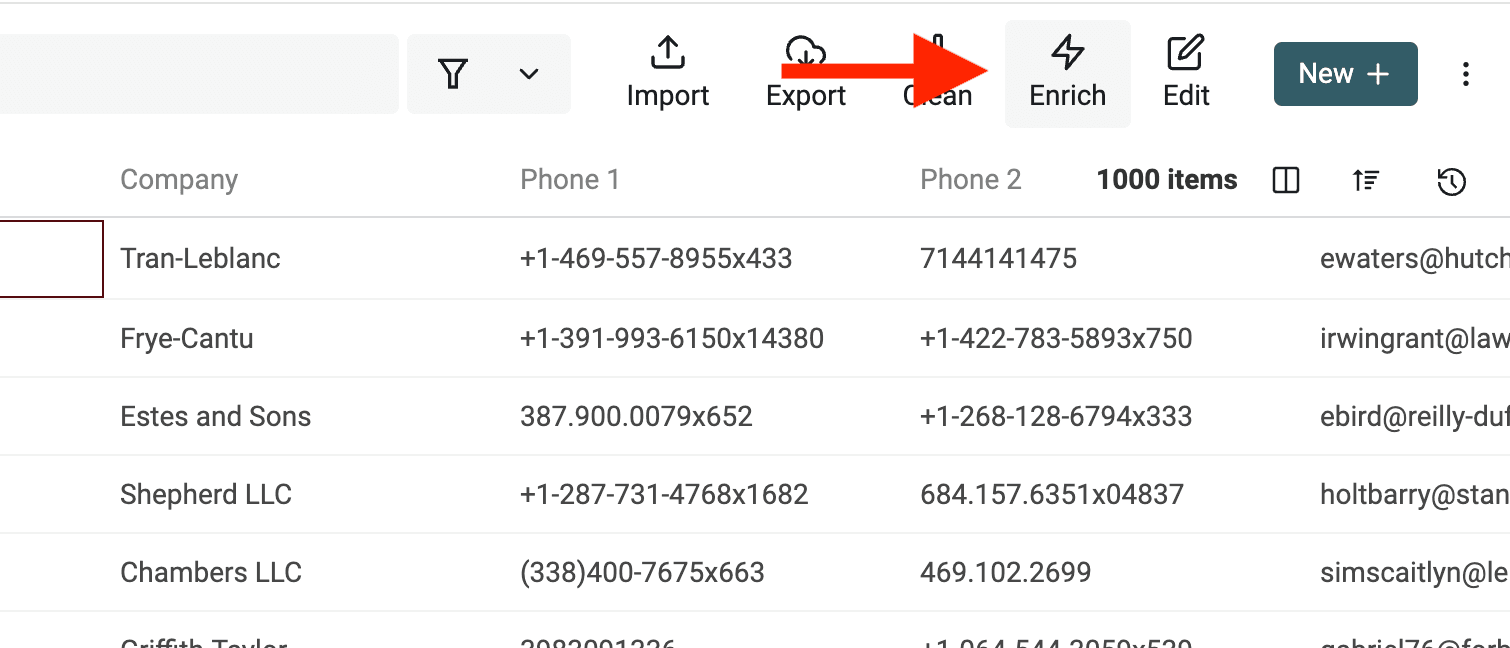
Per utilizzarlo, apri "Enrich Menu" dai pulsanti in alto.
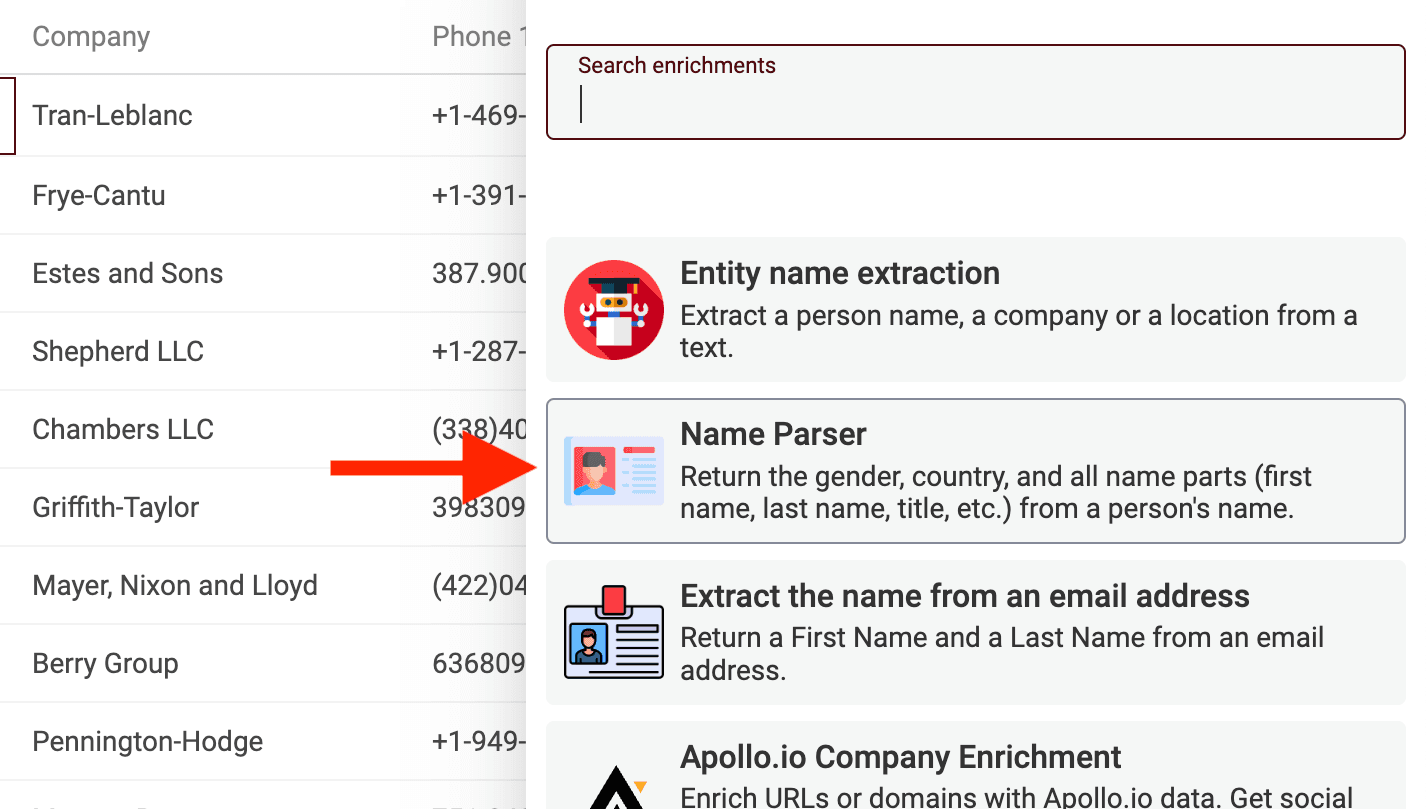
Poi seleziona "Name Parser".
Seleziona quindi la proprietà contenente i nomi e associa o crea nuove proprietà in cui salvare i risultati. La proprietà con il nome completo non verrà modificata: soltanto le proprietà di output saranno aggiornate con i risultati.
Normalizzare i nomi delle aziende
Puoi rimuovere gli elementi superflui anche dai nomi delle aziende, per esempio prefissi, suffissi, stop word, indicazioni geografiche o altri termini che ostacolano il matching.
Un tipico intervento di pulizia consiste nell'eliminare dai nomi aziendali suffissi come "Inc." o "GmbH".
Usa questa espressione regolare nel tool Find & Replace:
,?\s(llc|inc|incorporated|corporation|corp|co|gmbh|ltd).?$
Sostituiscila quindi con una stringa vuota.
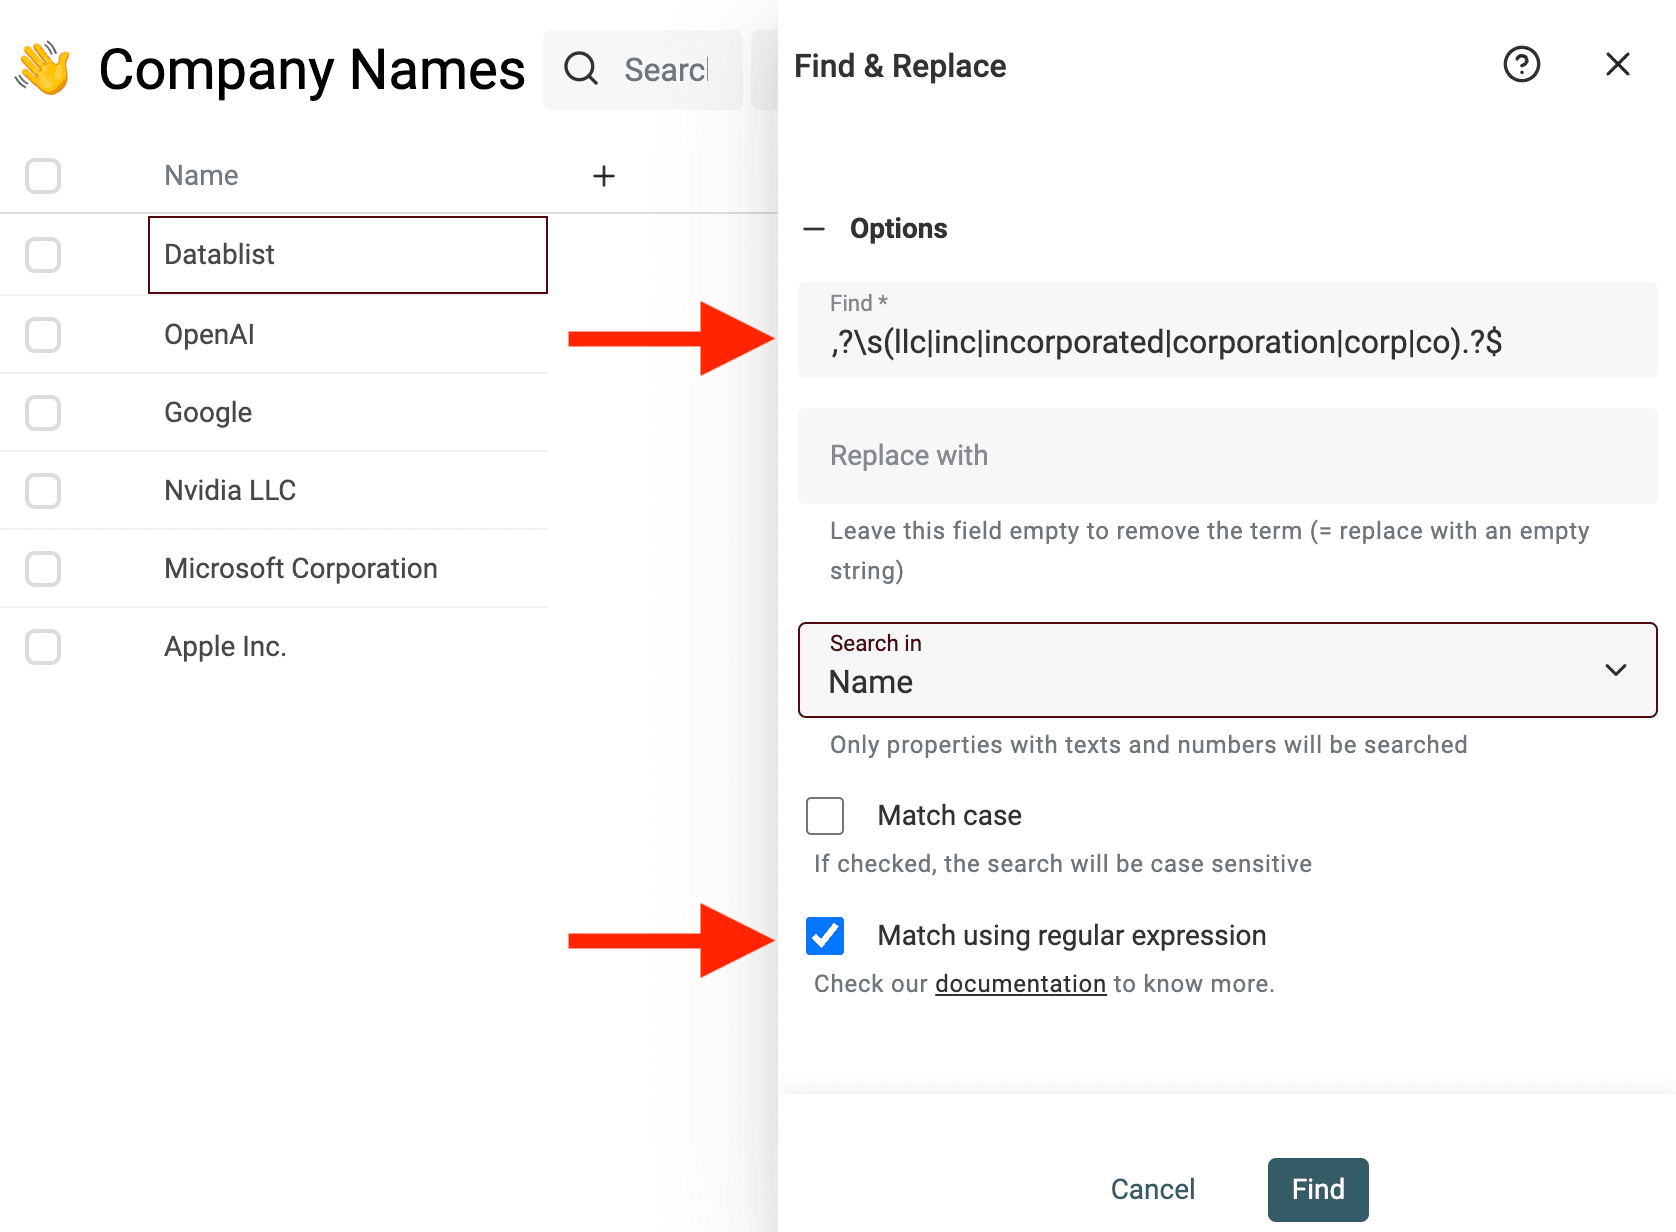
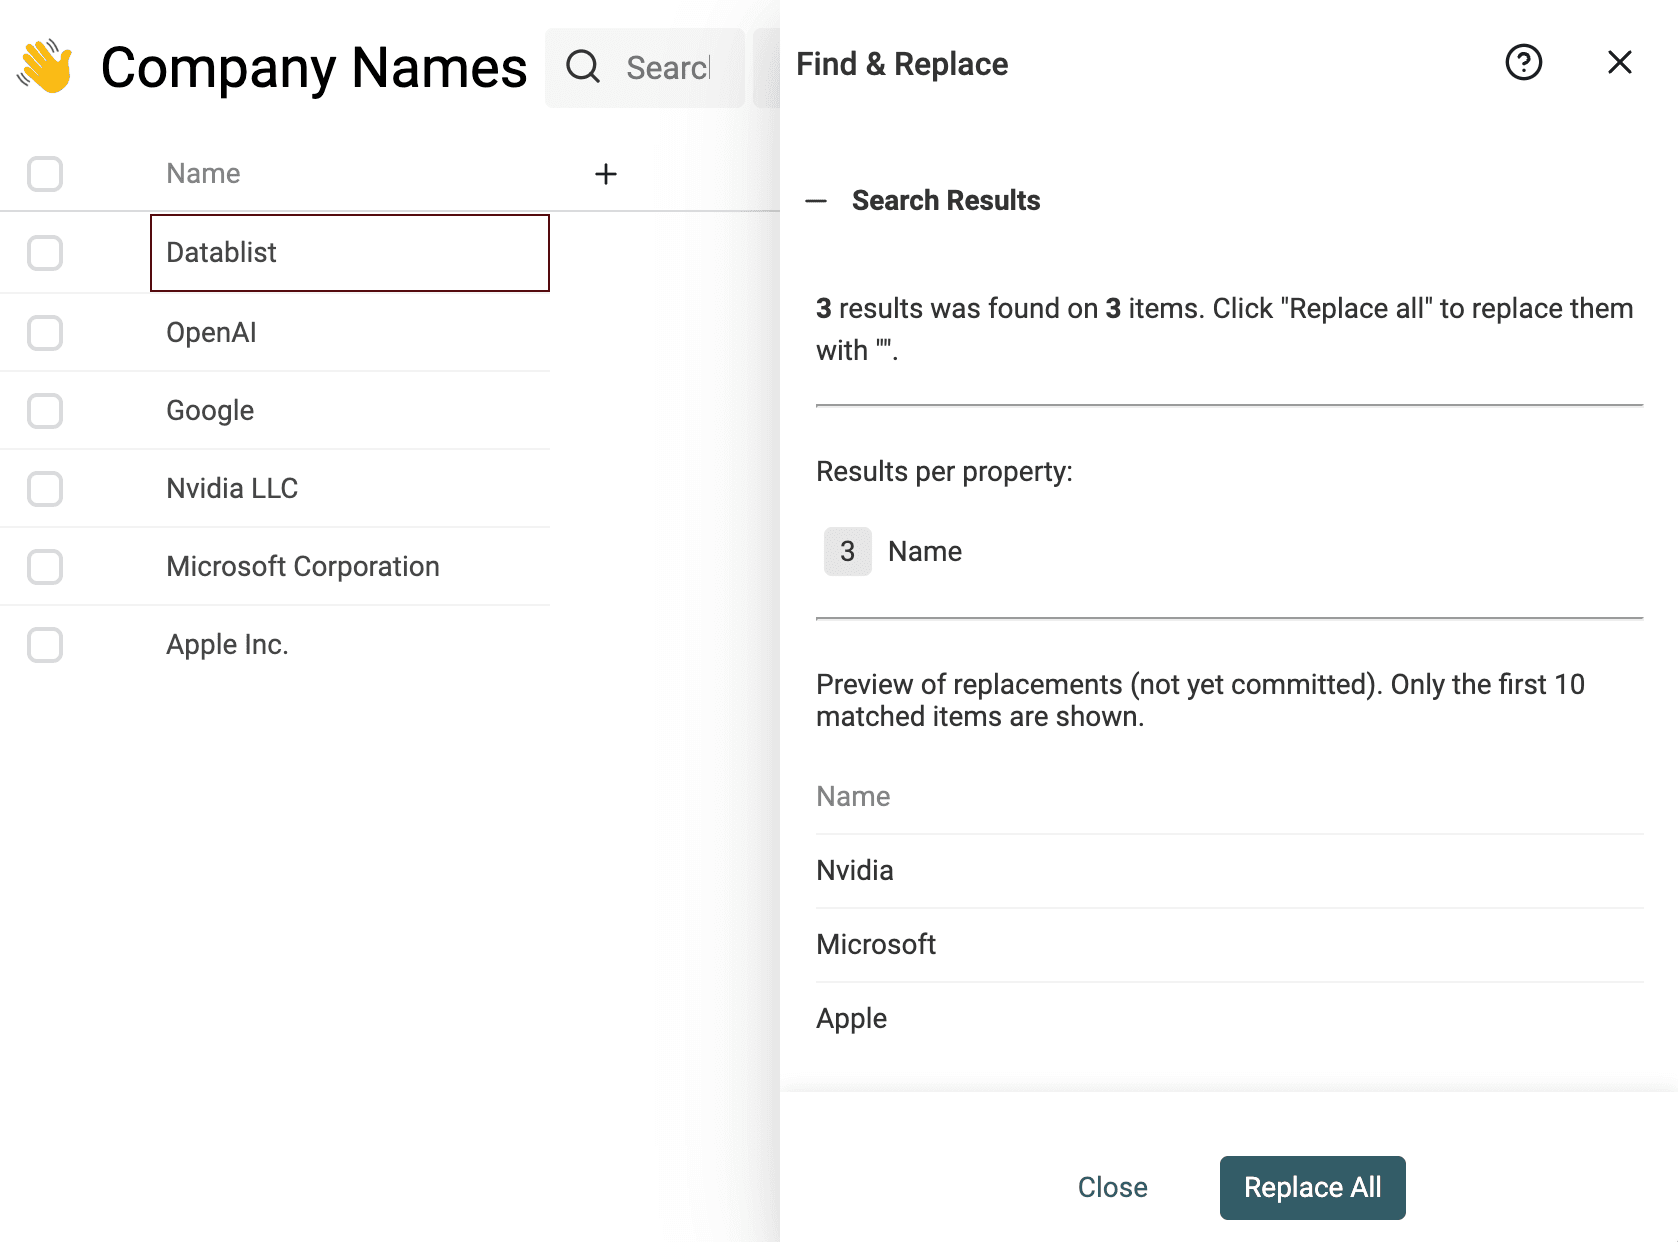
È importante normalizzare nomi e indirizzi aziendali in tutti i dataset, così da ottenere un formato standard.
Normalizzare i nomi delle strade
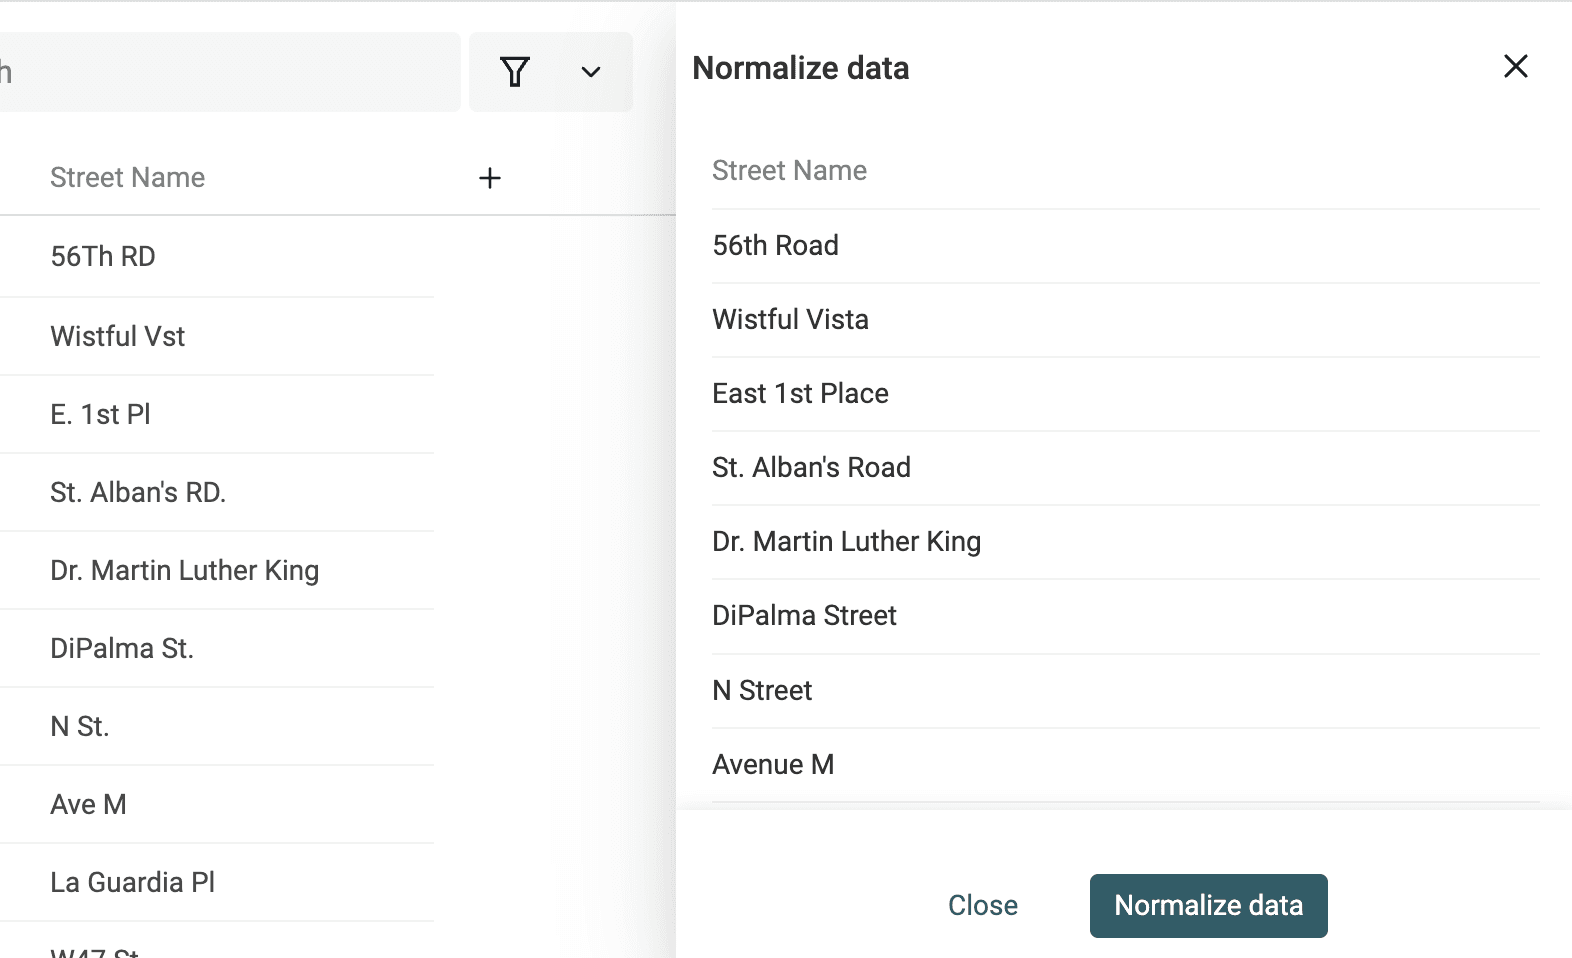
Se esegui il Data Matching sugli indirizzi postali, normalizzare i nomi delle strade è fondamentale. Gli indirizzi possono contenere abbreviazioni, prefissi direzionali o suffissi numerali. Senza normalizzazione, la stessa strada può comparire più volte in forme diverse, rendendo molto più difficile il data matching.
Per esempio, Main 9 St, Main 9TH St. e Main 9th Street indicano la stessa strada, così come Washington Blvd e Washington Boulevard.
Usare algoritmi fuzzy per gestire queste differenze è poco efficiente. Per passare da Washington Blvd a Washington Boulevard servono diverse modifiche alle lettere, quindi la distanza di similarità calcolata con gli algoritmi di fuzzy matching risulterebbe elevata.
È preferibile normalizzare i nomi delle strade: adottare un formato standard rende i dati coerenti.
Datablist offre la normalizzazione dei nomi delle strade in formato inglese, uniformando abbreviazioni, numeri civici e altri elementi.
Nota
La normalizzazione dei nomi delle strade funziona con indirizzi suddivisi. Il nome della strada deve trovarsi in una proprietà distinta. I valori contenenti l'indirizzo completo non sono compatibili.
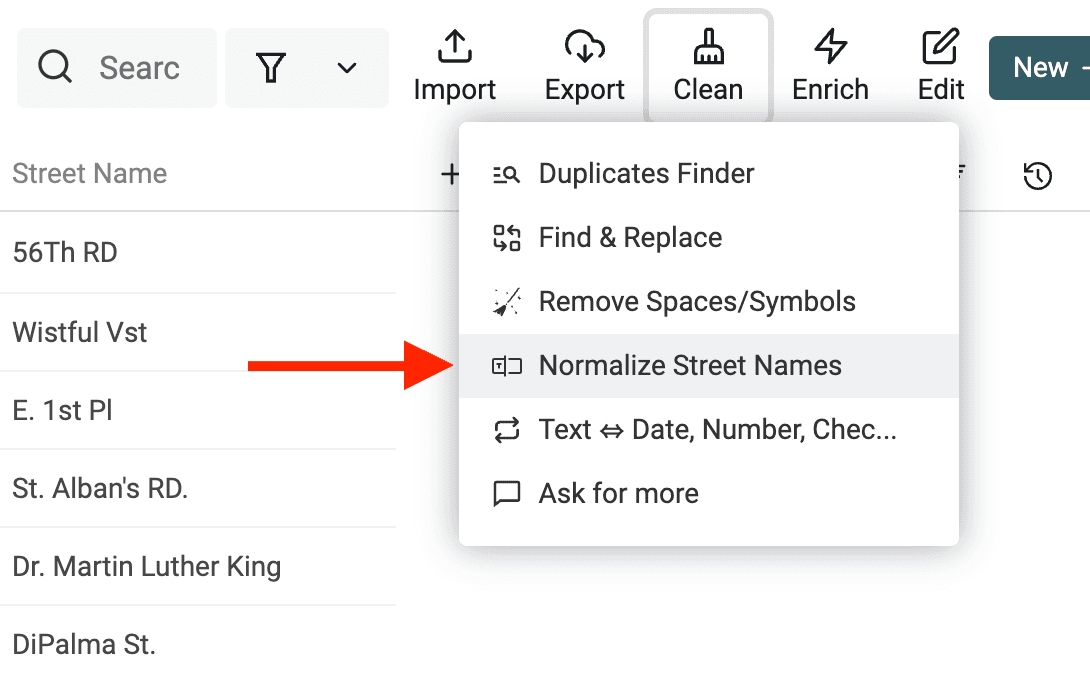
Fai clic su "Normalize Street Names" nel menu "Clean".
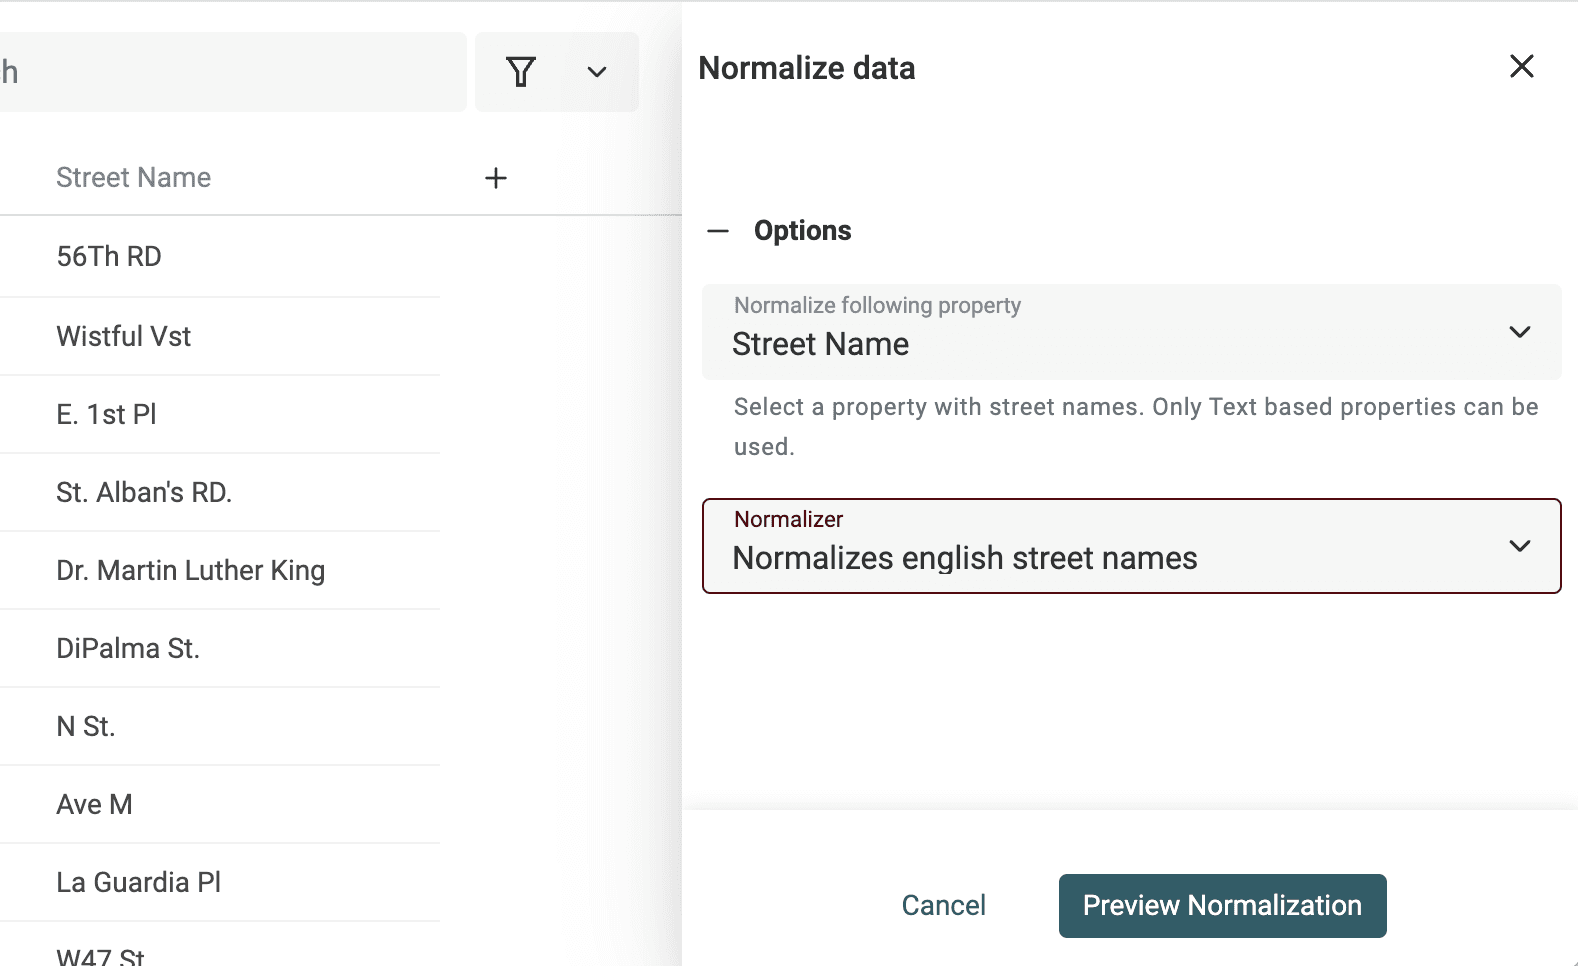
Seleziona quindi la proprietà contenente i nomi delle strade e scegli "Normalize english street names".
Controlla le modifiche nell'anteprima e fai clic su "Run".
Step 3: confrontare record in una o più collection
Ora che i dati sono puliti e normalizzati, puoi passare al data matching. In questo step raggrupperemo i record simili.
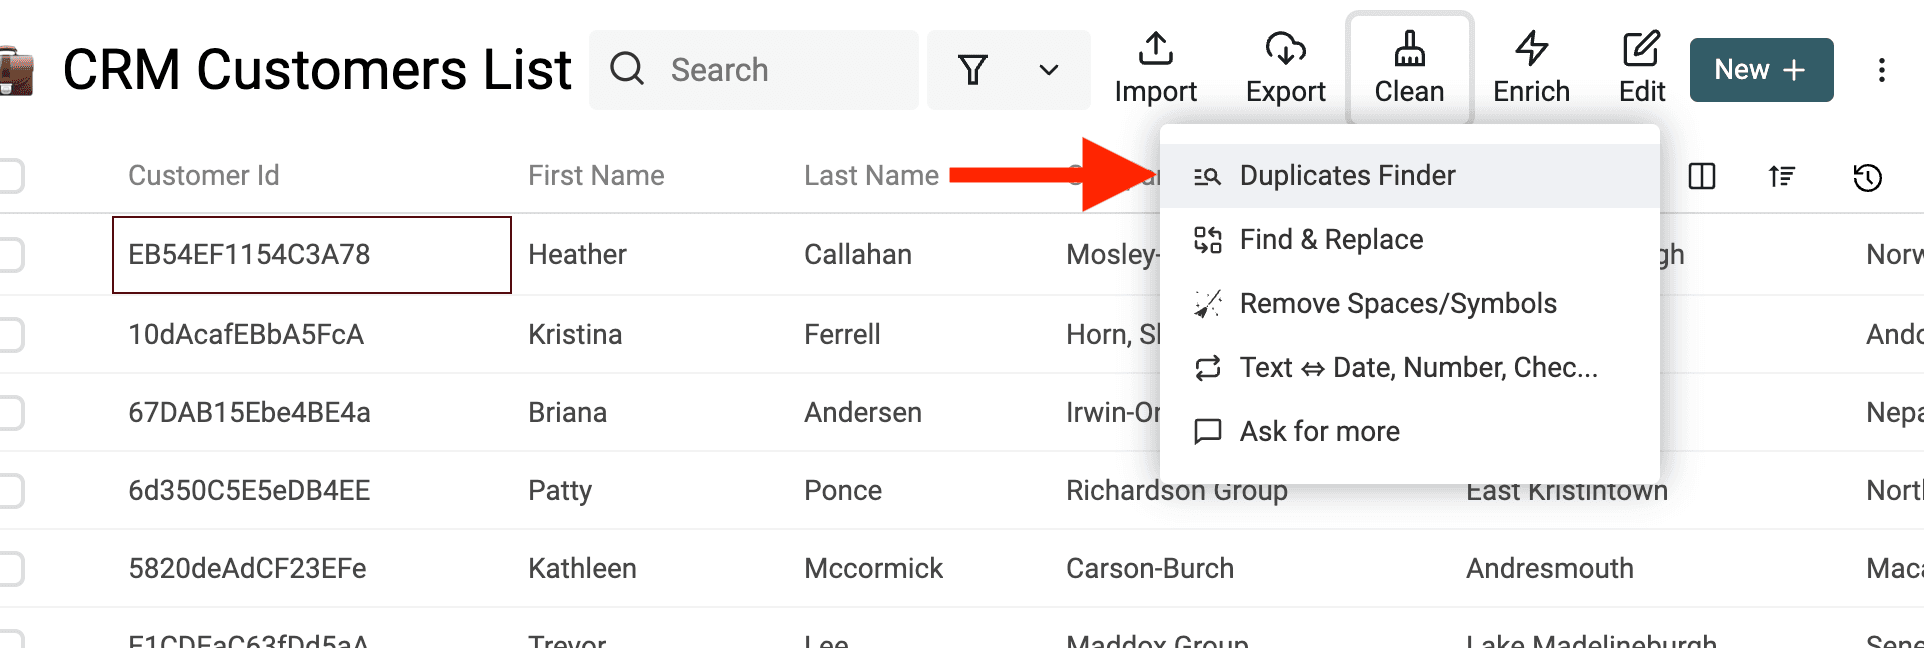
Datablist offre tre modalità iniziali:
- Selected Properties confronta i campi scelti all'interno di una collection.
- All Properties confronta i record completi all'interno di una collection.
- Match across collections associa e confronta le proprietà di più collection.
Se hai due file di Lead con i campi Email e Company, associa prima le proprietà email. Se gli indirizzi email non sono disponibili, confronta i nomi delle aziende e, quando possibile, aggiungi un campo relativo al sito web o alla località. L'output è un insieme di potenziali gruppi corrispondenti, non una lista sicuramente pulita. Apri alcuni gruppi e controlla i valori originali prima di unire i record.
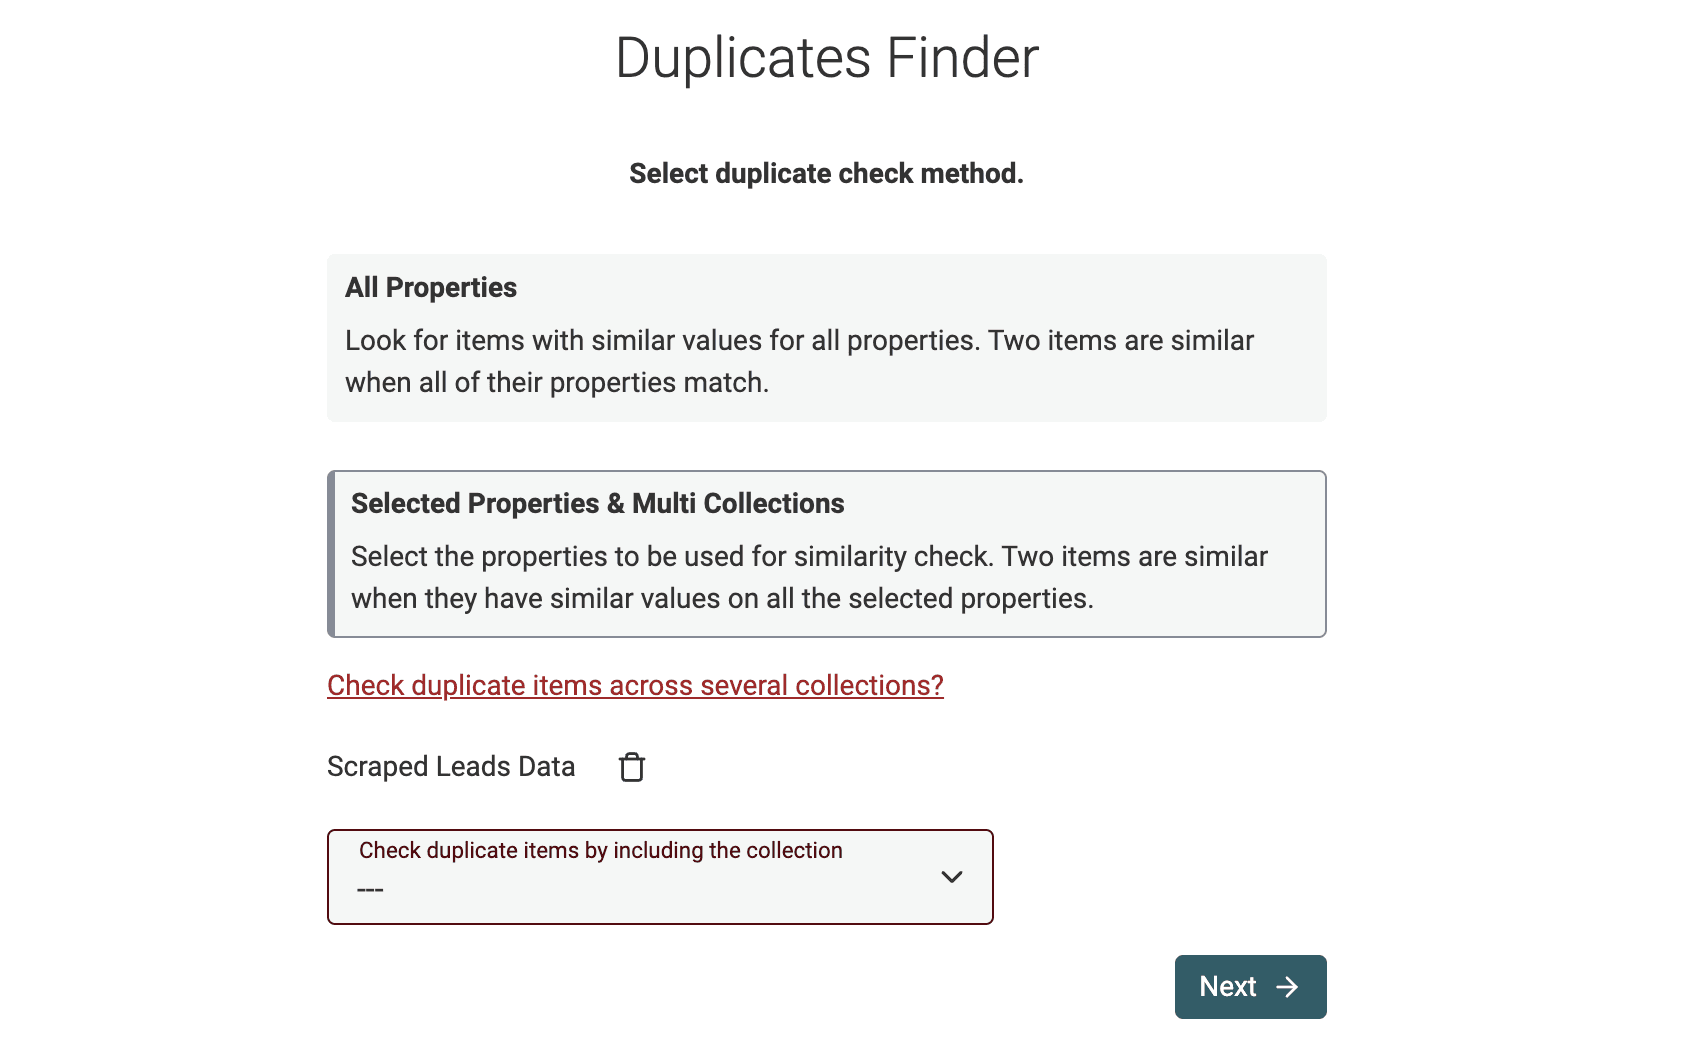
Selezionare le proprietà da confrontare
Per il resto di questa guida usa Match across collections.
Lo step successivo consiste nel selezionare le proprietà da usare per il data matching. Se nello step precedente hai scelto più collection, dovrai selezionare una proprietà da associare per ciascuna di esse.
Nota
Datablist proverà ad associare automaticamente le proprietà delle diverse collection in base al loro nome.
Scegliere l'algoritmo di matching
Nello step successivo vengono elencate le proprietà selezionate e dovrai configurare gli algoritmi di confronto.
Datablist implementa i seguenti algoritmi di matching:
-
Exact - È l'algoritmo consigliato per proprietà non testuali come DateTime, Number e Boolean. Quando viene usato con proprietà testuali, un'opzione consente di stabilire se il confronto debba distinguere maiuscole e minuscole. L'algoritmo Exact elimina gli spazi iniziali e finali dai testi.
-
Smart - L'algoritmo Smart pre-elabora gli elementi per individuare dati con piccole differenze. Riconosce URL con protocolli diversi e gestisce anche l'ordine delle parole e la punteggiatura. Per esempio, "John-Doe" e "Doe John" risulteranno corrispondenti.
-
Phonetic with Double Metaphone algorithm - Per il matching fonetico, Datablist implementa l'algoritmo Double Metaphone. L'algoritmo converte le parole in codici che ne rappresentano la pronuncia: due parole dal suono simile ricevono lo stesso codice Double Metaphone.
-
Fuzzy matching with distance algorithms - Datablist supporta anche il fuzzy matching con le distanze Jaro-Winkler e Levenshtein. Quando selezioni questa opzione devi impostare una soglia di similarità: più alta è la soglia, minori saranno le variazioni ammesse.
Consulta la documentazione per maggiori dettagli sugli algoritmi di matching.
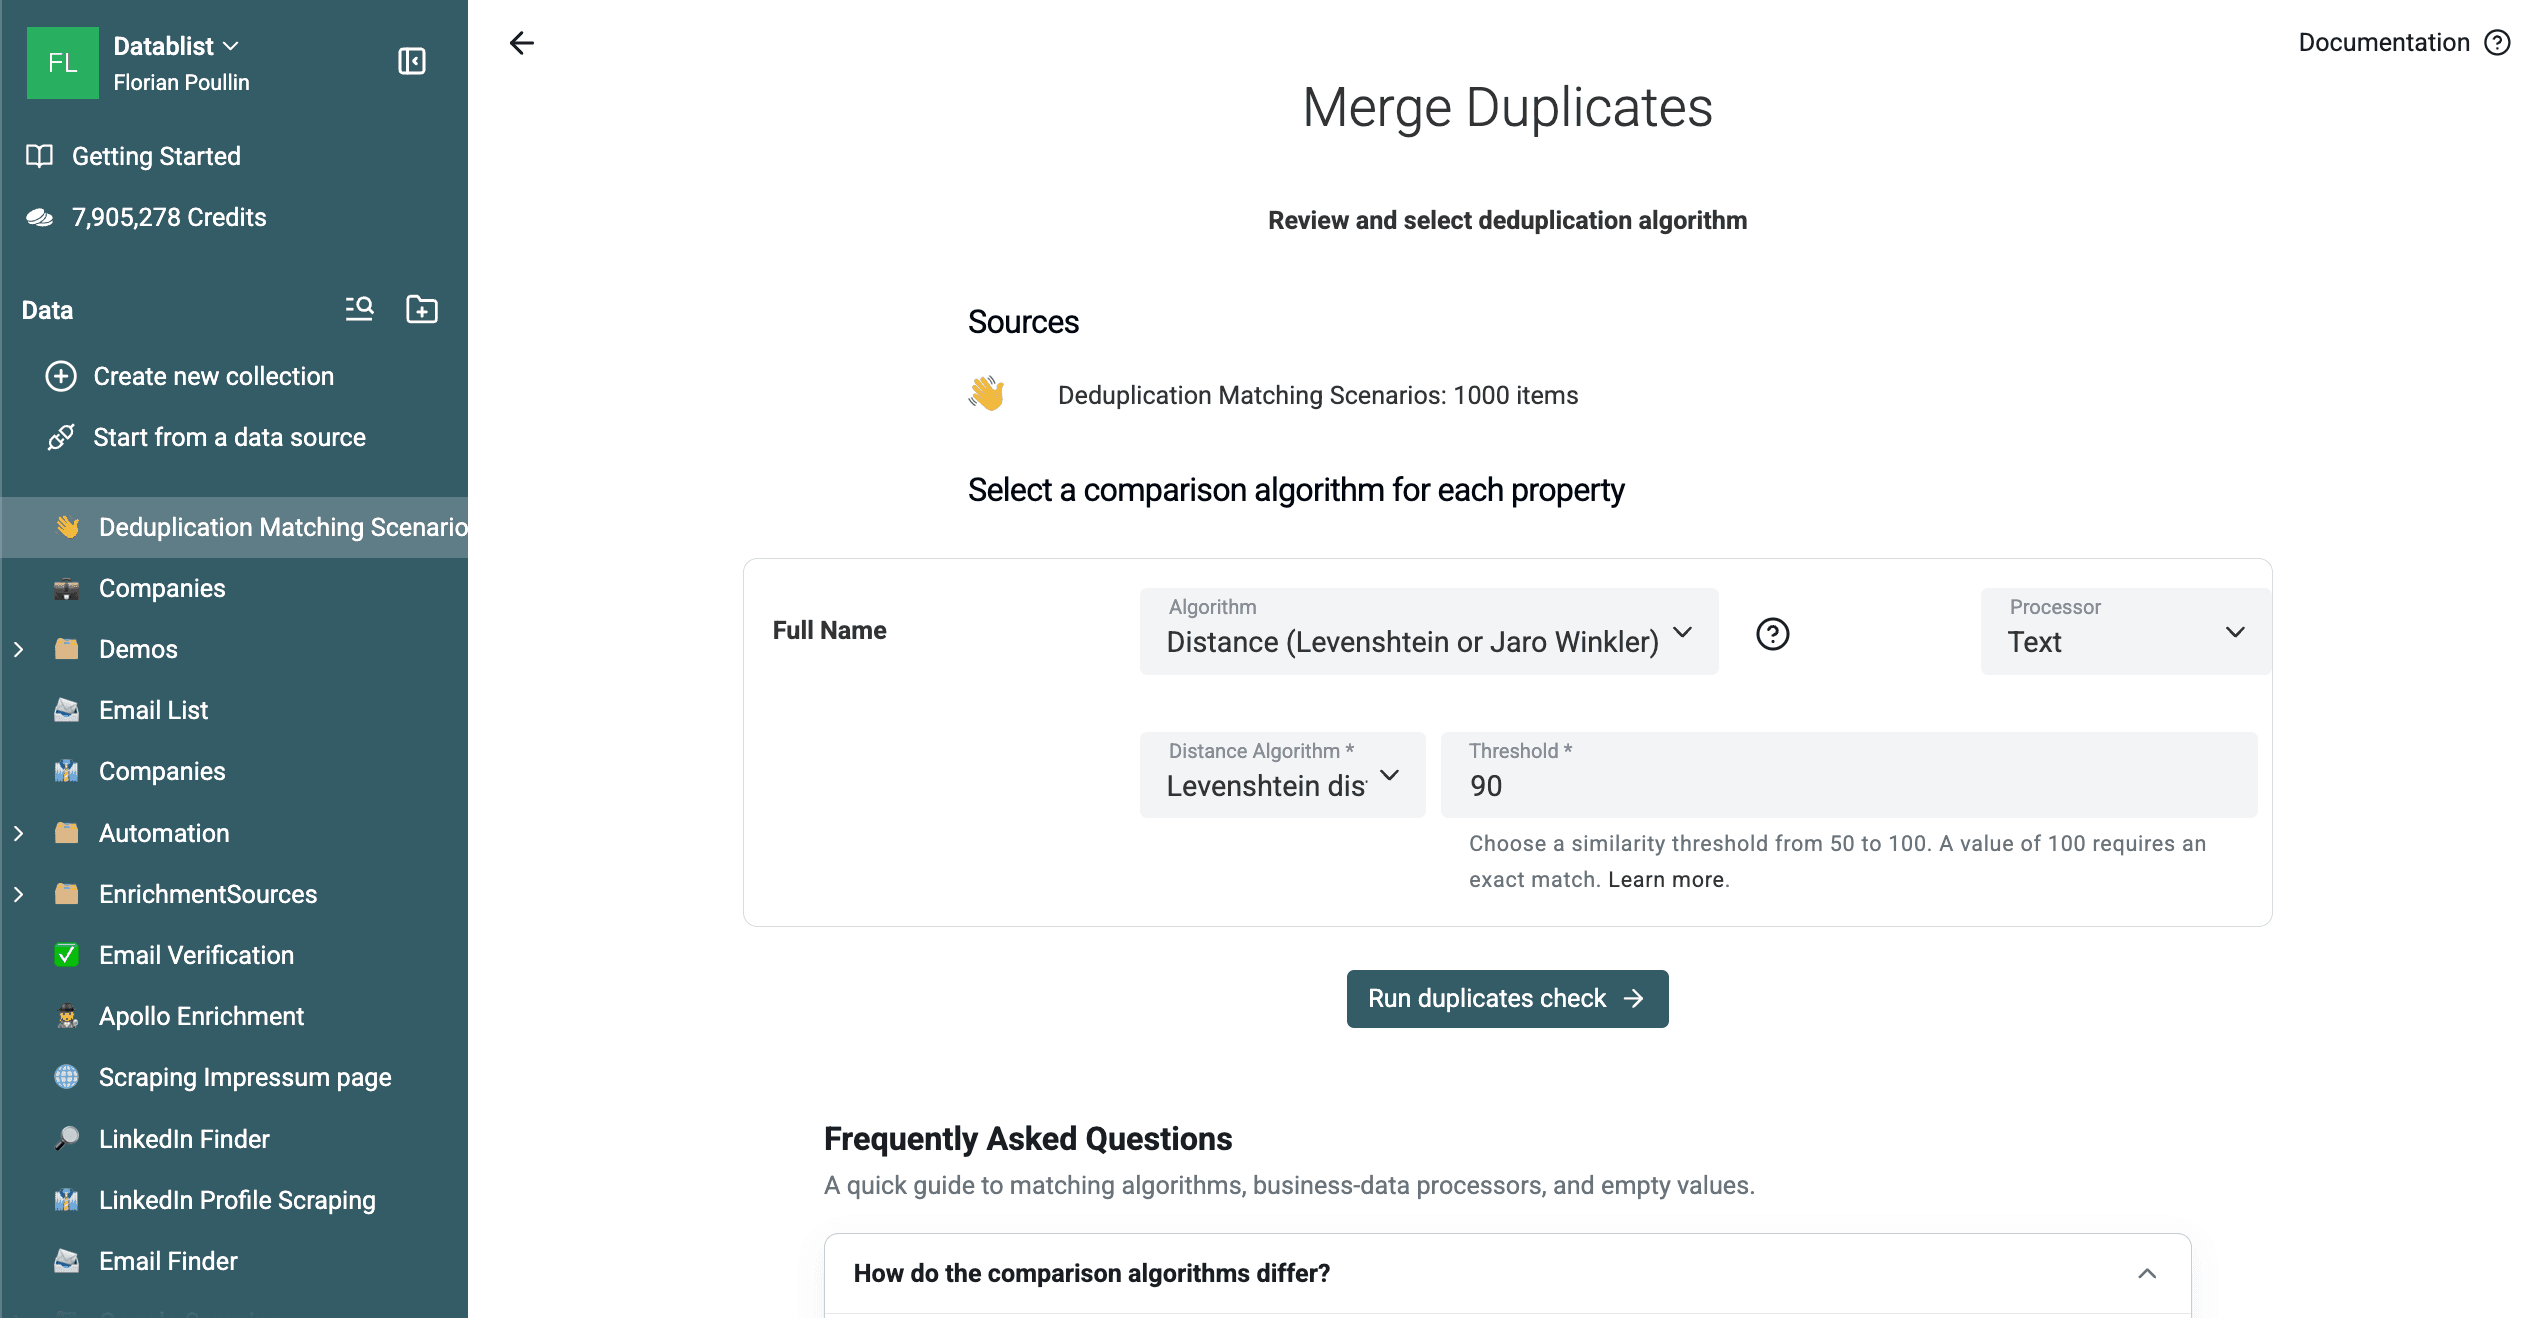
Nel campione di deduplicazione da 1.000 righe, questa configurazione di Full Name ha restituito 77 gruppi di due righe. La verifica con i dati di riferimento ha rilevato 21 gruppi relativi alla stessa entità e 56 gruppi che univano entità differenti. La maggior parte dei falsi positivi era composta da abbreviazioni brevi e identiche, come G. Rossi.
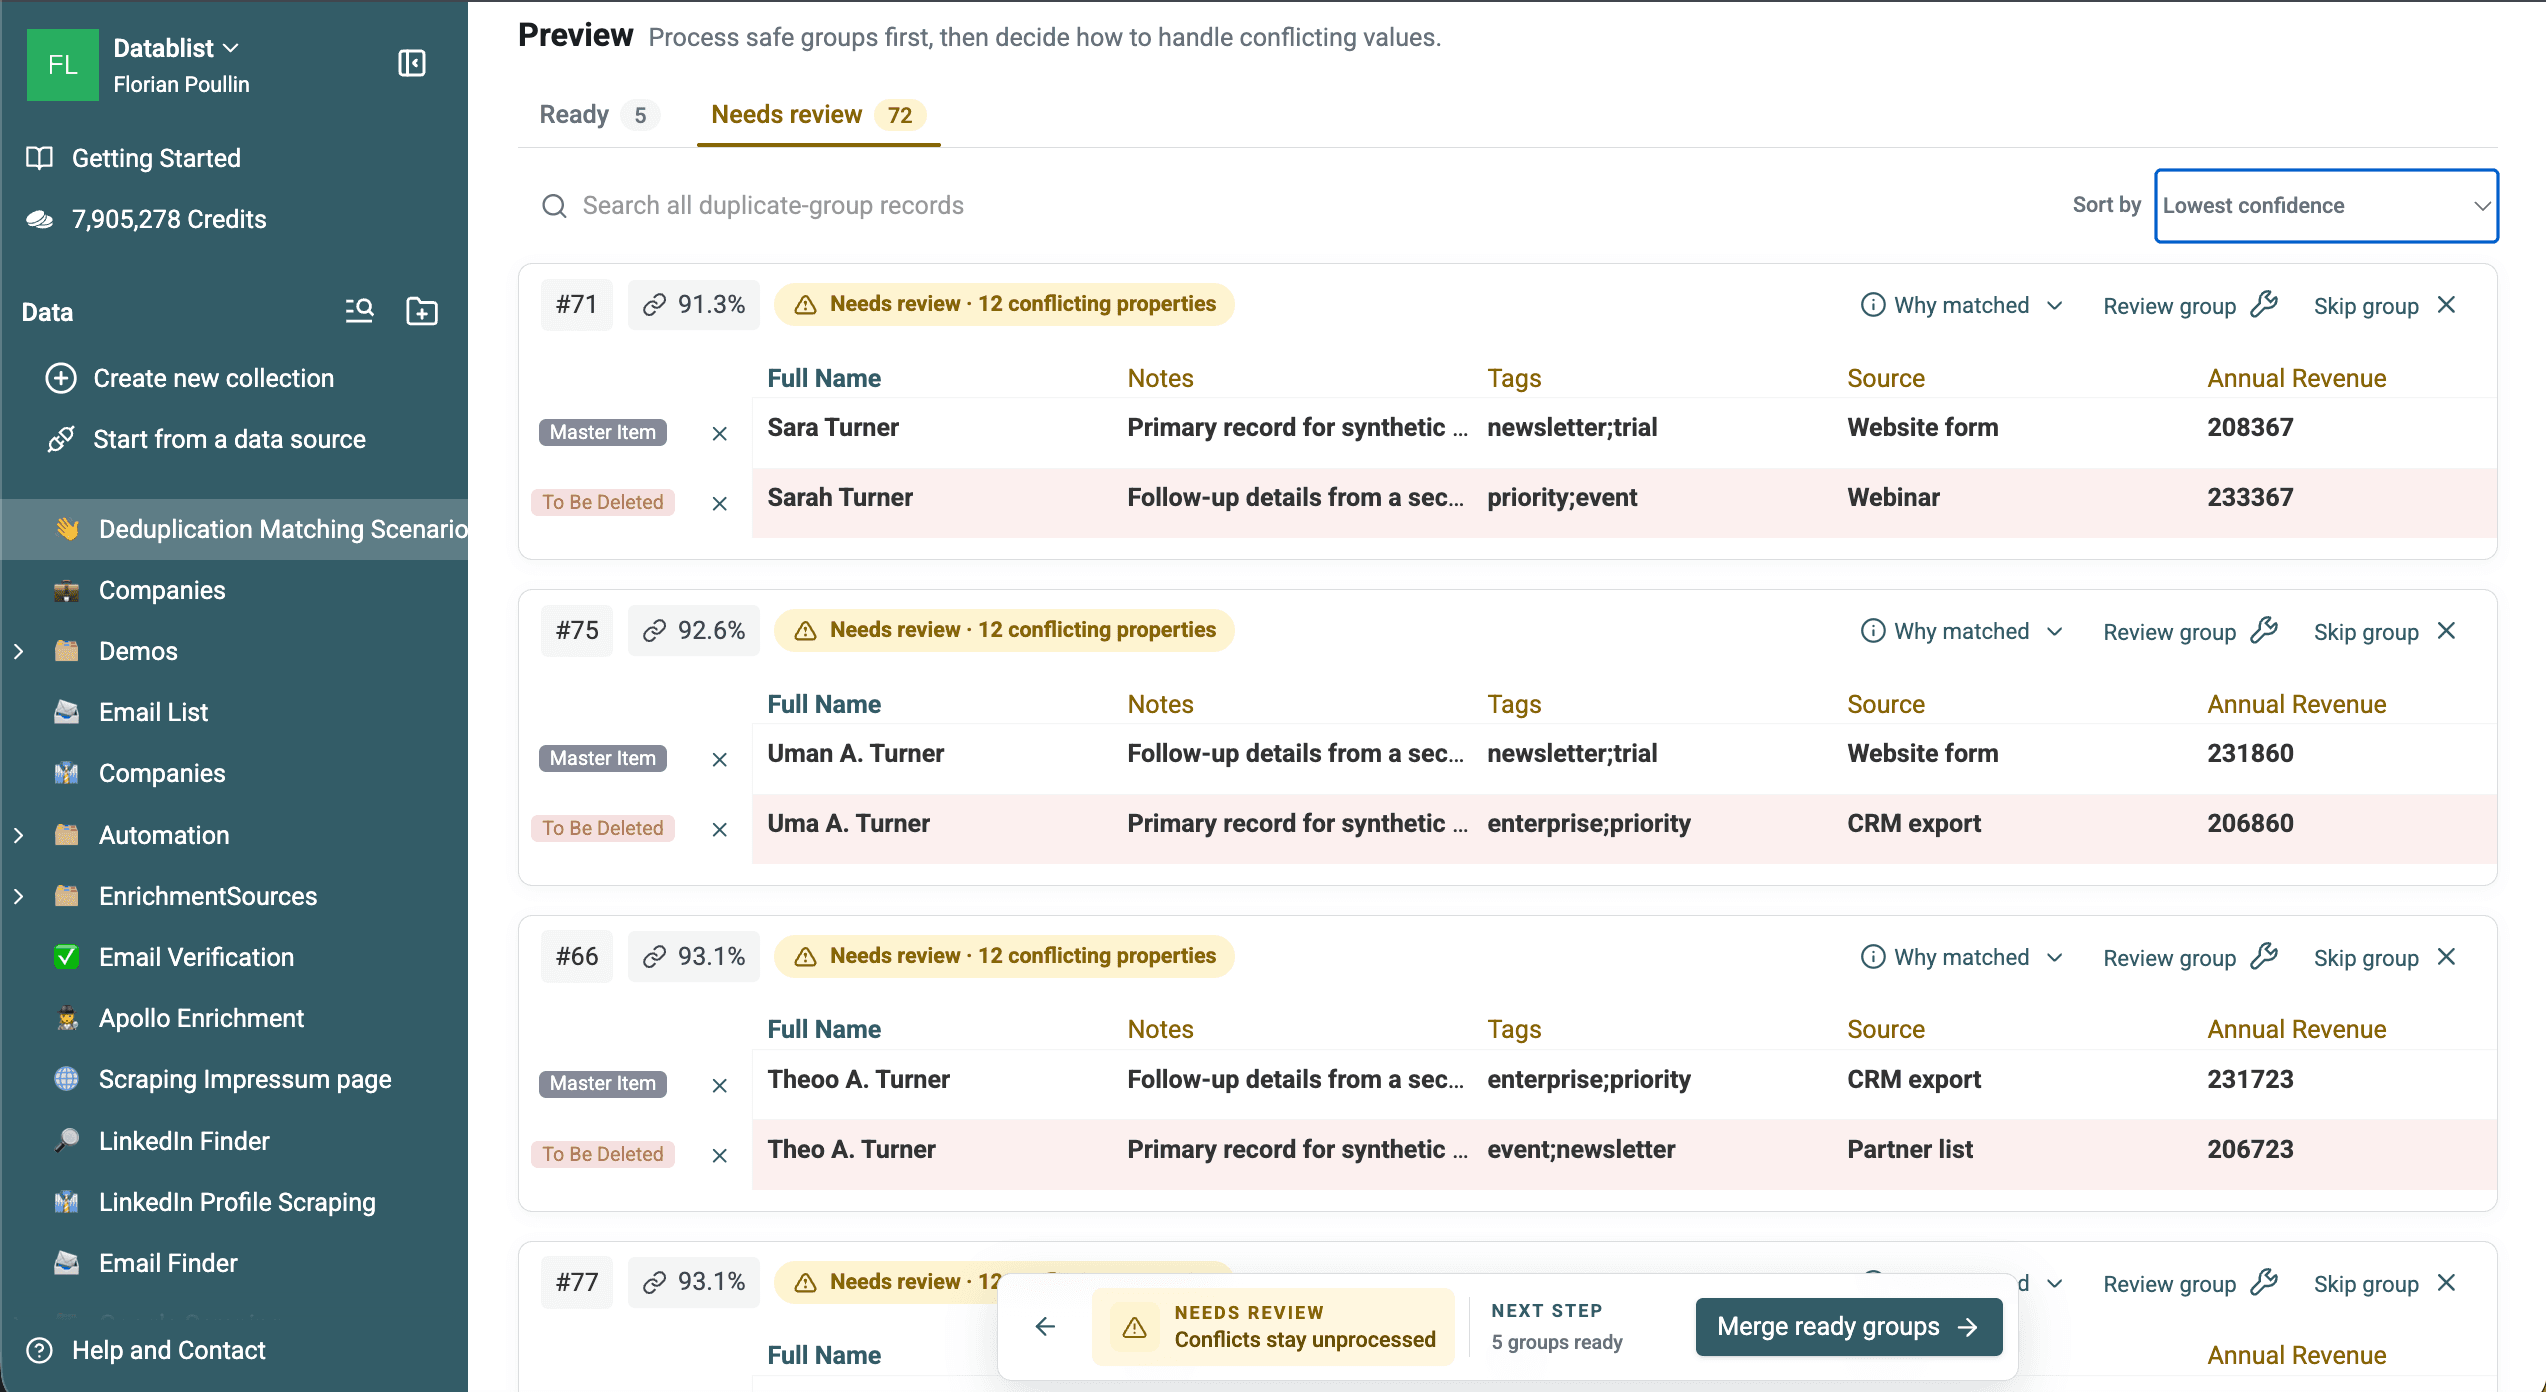
Prima di elaborare corrispondenze ambigue basate sui nomi, usa un secondo identificatore, come email, telefono, azienda o sito web. Scarica i 77 gruppi esportati per esaminare il risultato.
Sullo stesso campione, impostando Metaphone con il processor Text per Full Name, sono stati ottenuti 69 gruppi e 188 righe raggruppate. La verifica con i dati di riferimento ha individuato 19 gruppi composti esclusivamente dalla stessa entità e 50 gruppi contenenti persone diverse.
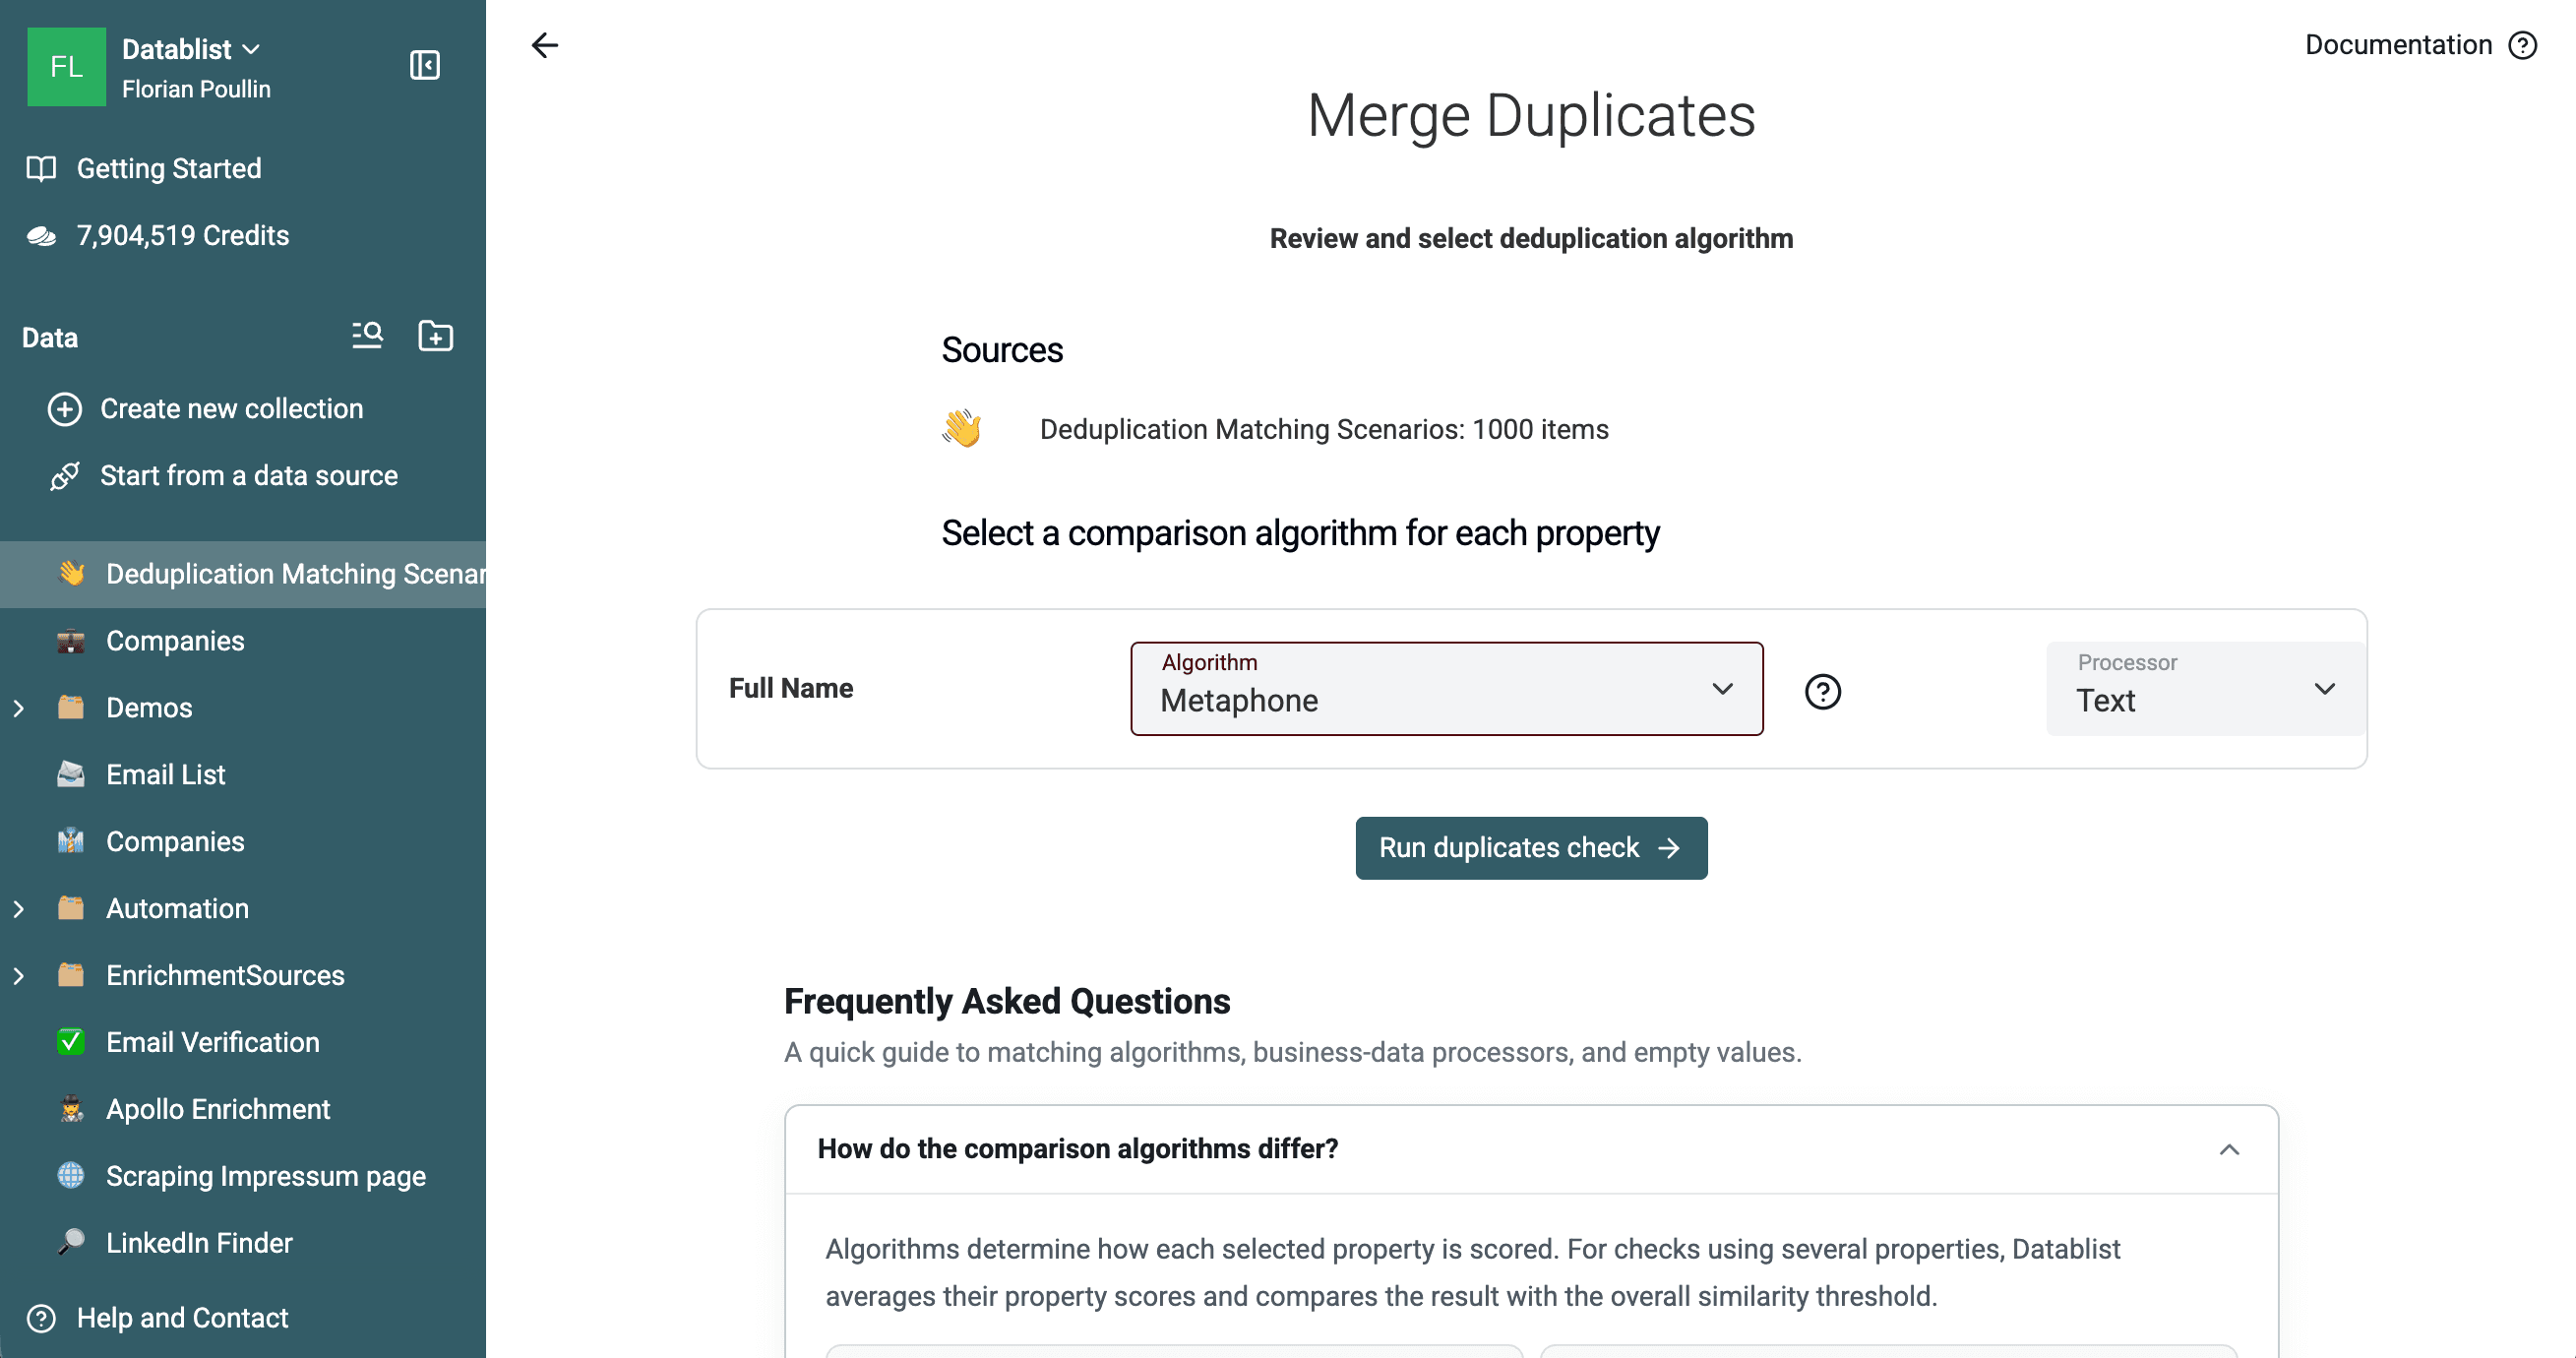
Il risultato includeva gruppi numerosi di nomi abbreviati con lo stesso cognome. La somiglianza fonetica è utile per trovare potenziali corrispondenze, ma non dimostra che due righe appartengano alla stessa persona.
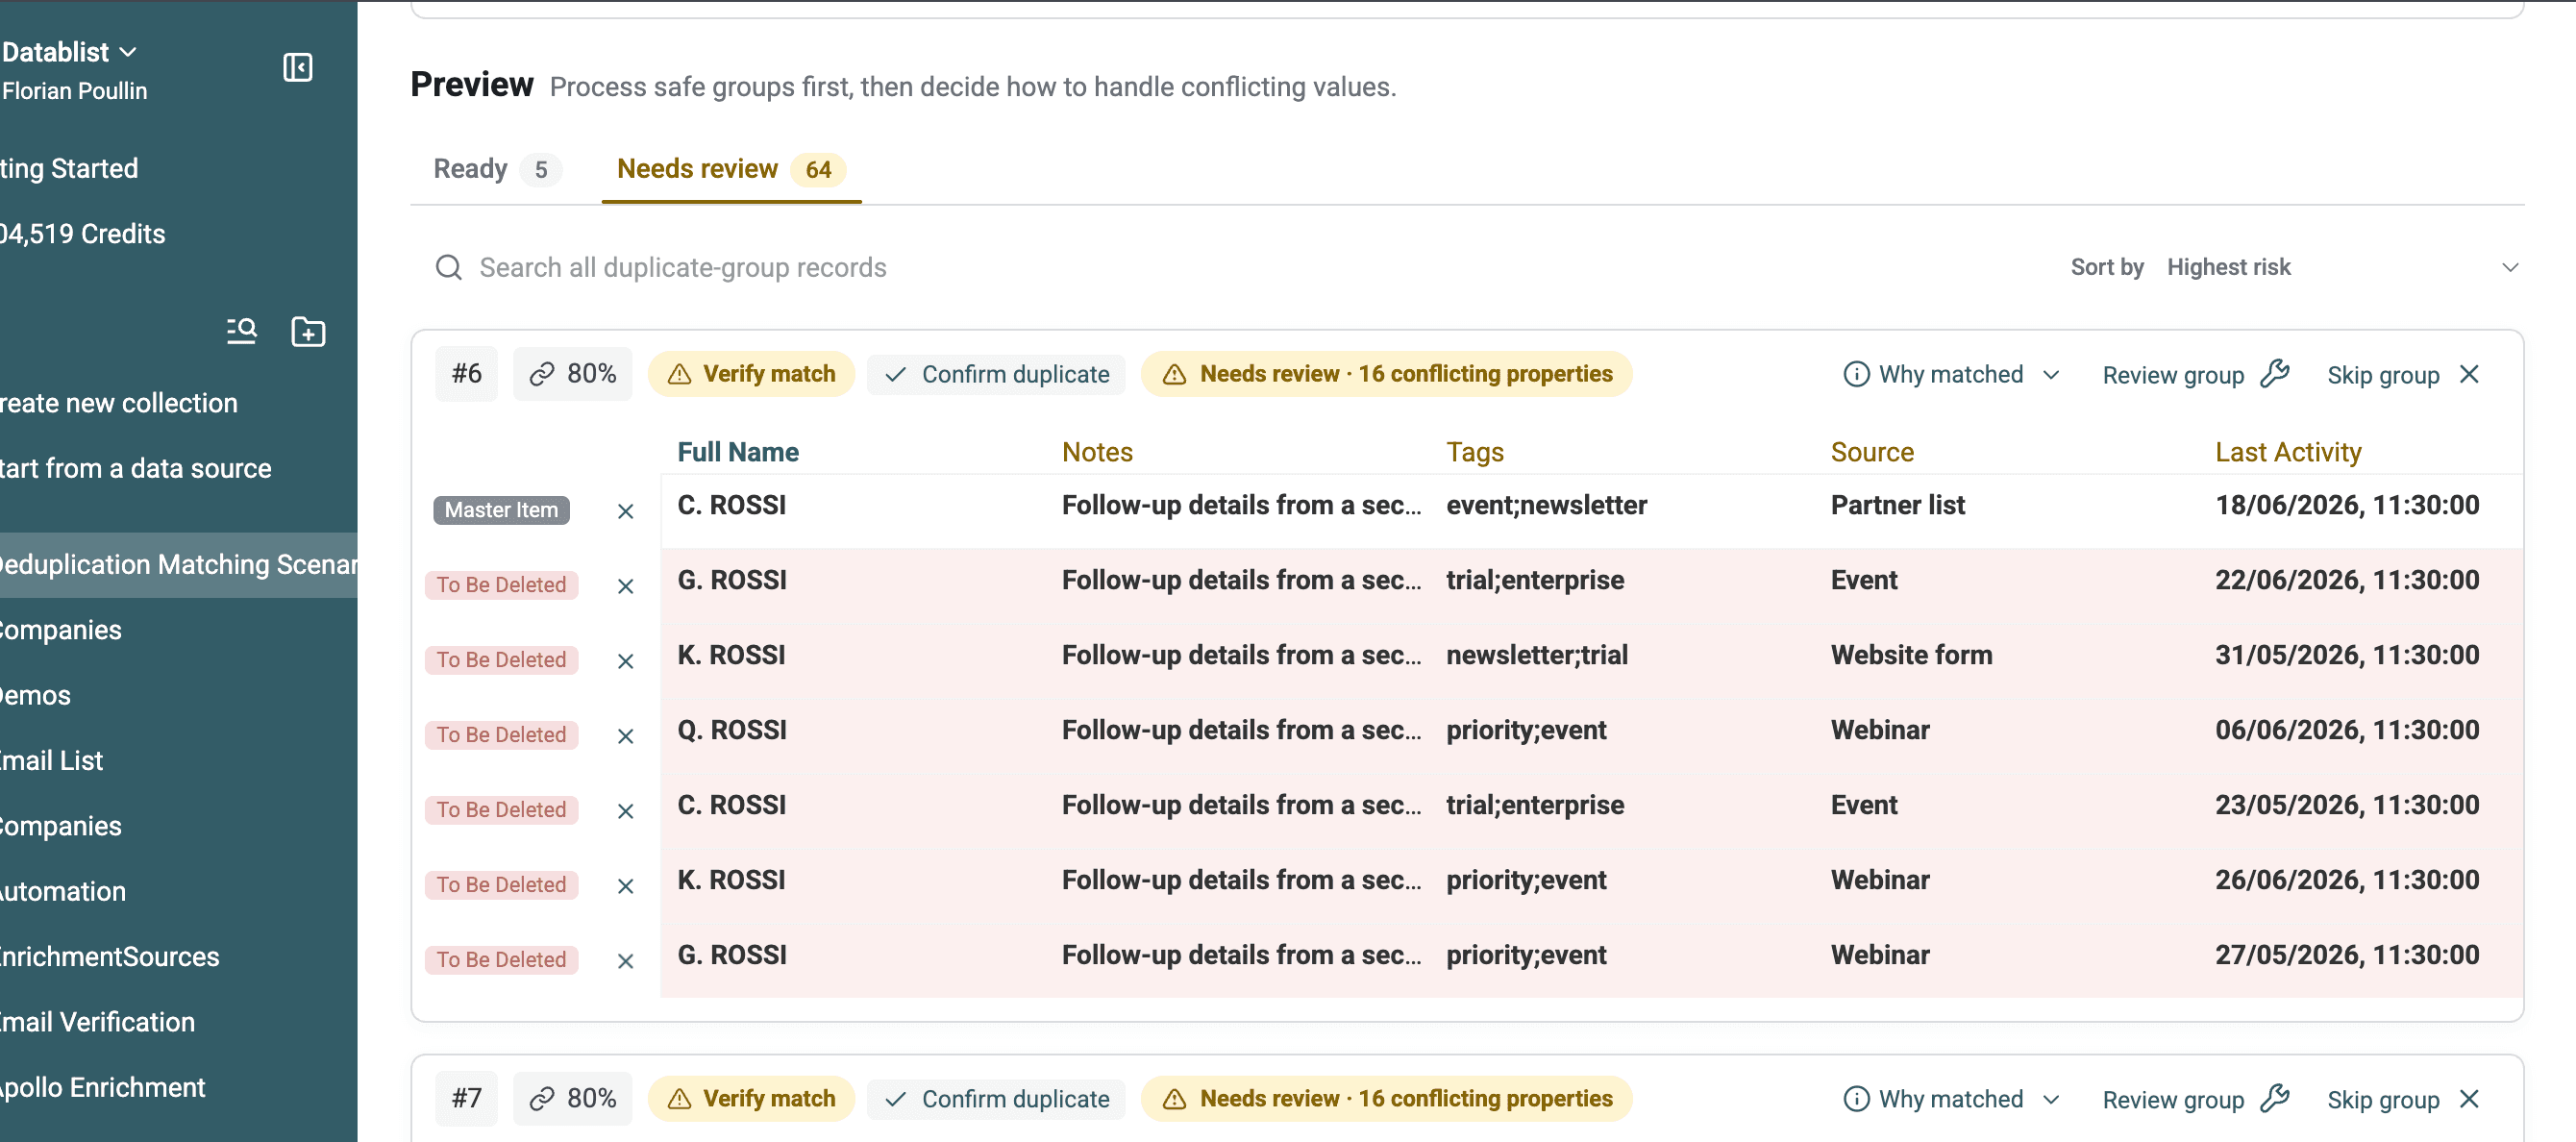
Scarica i 69 gruppi Metaphone esportati per verificare i gruppi da due a sette righe e confrontare le corrispondenze utili con i falsi positivi.
Nota
- Gli algoritmi Smart, Phonetic e fuzzy si applicano soltanto alle proprietà testuali, incluse Email, Text e LongText.
- Le proprietà URL sono compatibili soltanto con gli algoritmi Exact e Smart.
Step 4: deduplicare, eliminare o unire i gruppi
Duplicates Finder di Datablist restituisce i gruppi corrispondenti da verificare. La pagina dei risultati spiega perché le righe sono state associate e separa i gruppi Ready da quelli che richiedono una revisione.
Unione automatica dei duplicati in una collection
Per una singola collection, seleziona Merge and preserve data. Datablist completa le proprietà vuote e applica le regole configurate per i conflitti e il Record da conservare.
Nota:
Questa funzione è disponibile soltanto per la deduplicazione di una singola collection. Nella deduplicazione tra più collection, le strutture dati potrebbero essere differenti.
Unione automatica senza conflitti tra i dati
Datablist contrassegna un gruppo come Ready quando l'unione produce un risultato definito e non restano requisiti irrisolti.
Il processo funziona così:
- Se tutti gli elementi duplicati hanno gli stessi valori nelle proprietà, ne viene mantenuto uno solo e gli altri vengono eliminati.
- Se gli elementi duplicati sono complementari, quello con più informazioni viene selezionato come elemento principale e le sue proprietà vengono completate con i valori degli altri elementi. Tutti gli elementi tranne quello principale vengono quindi eliminati.
- Se i valori sono in conflitto, configura una regola oppure lascia il gruppo in Needs review.
Unione automatica con risoluzione dei conflitti
Durante l'esecuzione dell'algoritmo di Auto-Merging, Duplicates Finder di Datablist rileva automaticamente le proprietà in conflitto. Si verifica un conflitto quando due elementi presentano valori diversi per la stessa proprietà. Per unirli devi scegliere tra le seguenti opzioni:
- Combine concatena i valori testuali distinti usando il separatore scelto.
- Keep the selected record's value elimina gli altri valori.
- Le regole di field survivorship disponibili a pagamento possono selezionare, per ciascuna proprietà, il valore più recente, meno recente, più lungo, più corto, più alto, più basso o più frequente.
Regole di pulizia per il matching tra più collection
Quando esegui il Data Matching di Datablist su più dataset, l'unione automatica non è disponibile. Le collection potrebbero infatti avere strutture dati e proprietà differenti.
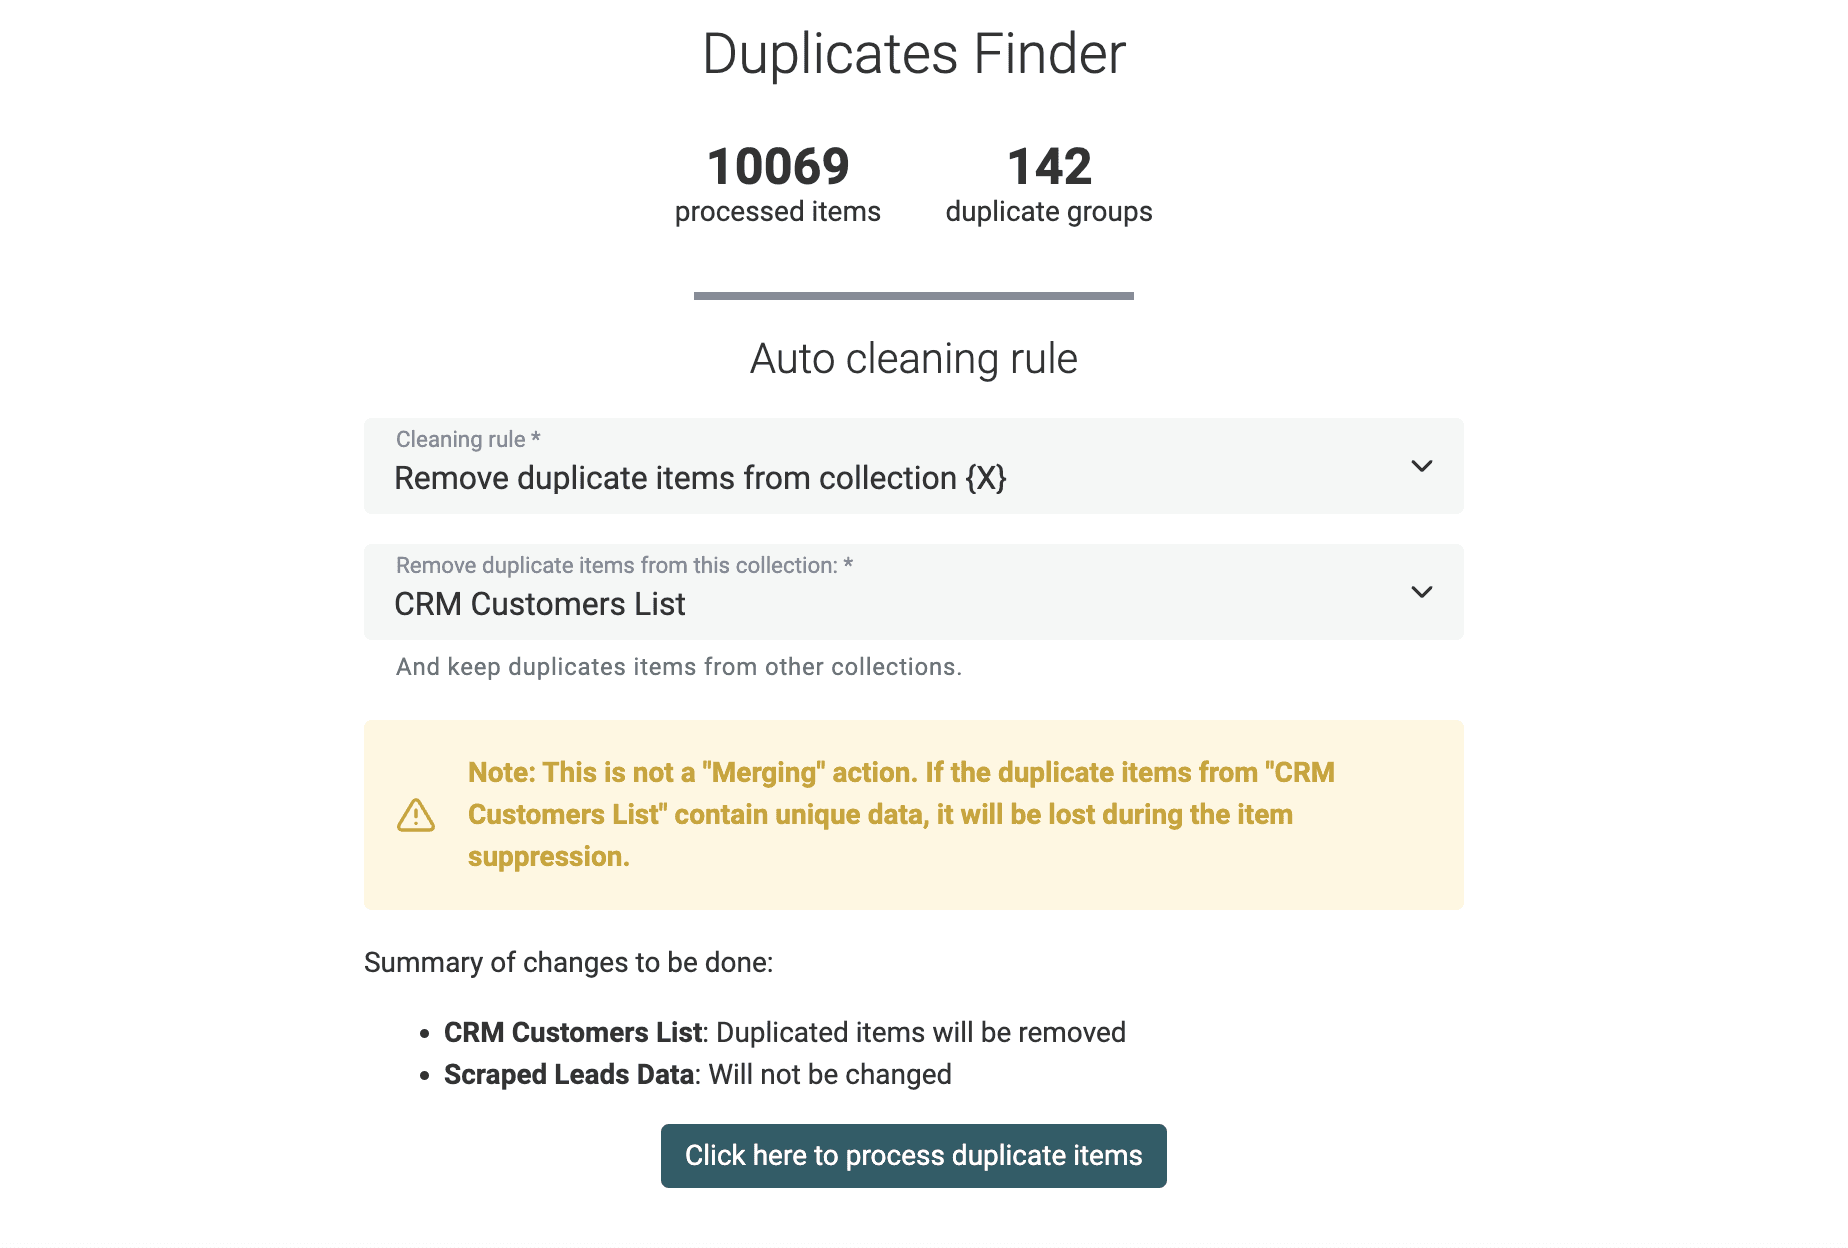
Datablist offre invece una funzione di pulizia che elimina gli elementi duplicati da tutte le collection tranne una. Usa questo tool per garantire l'unicità degli elementi nei diversi dataset.
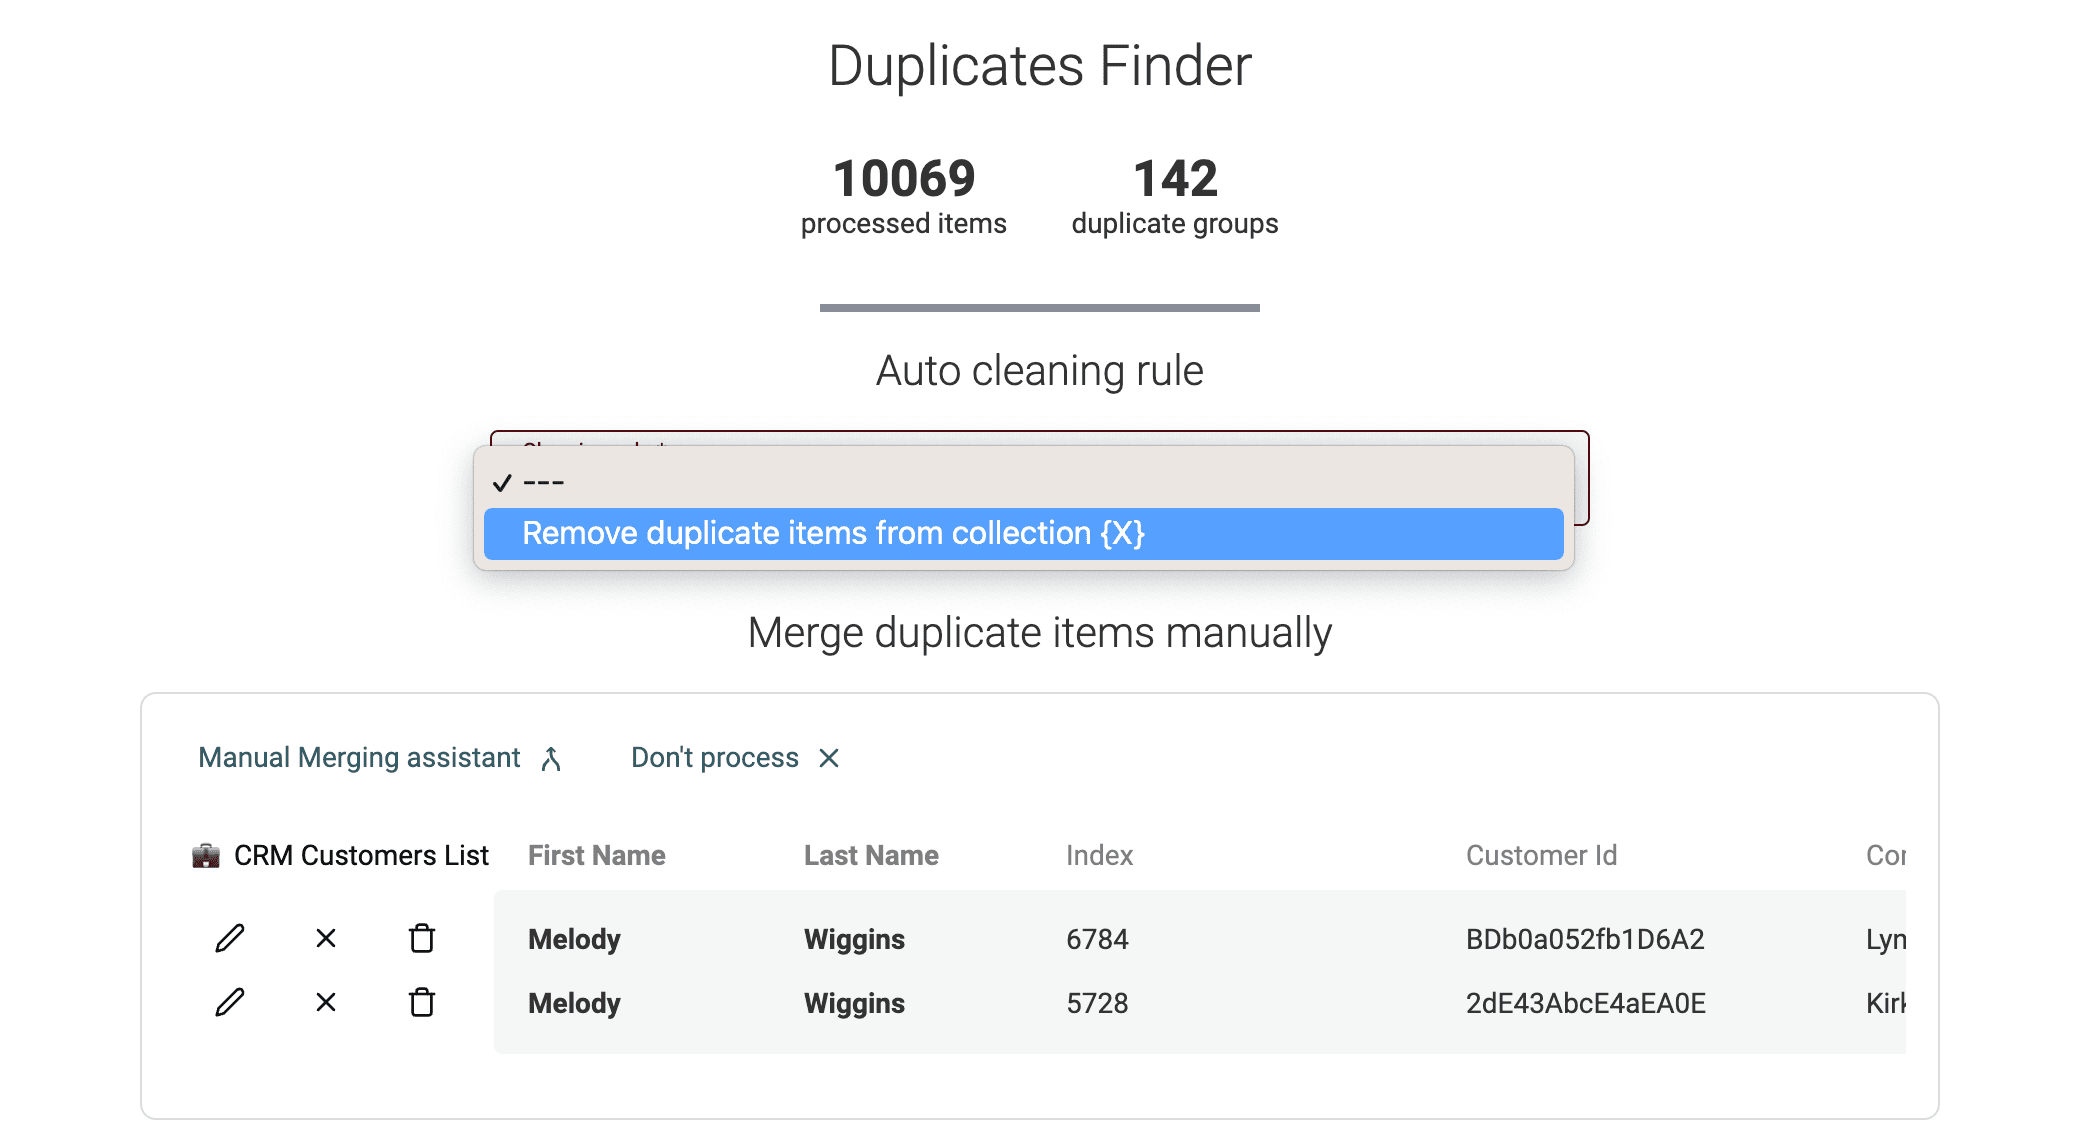
Prima di avviare l'algoritmo di pulizia viene mostrata un'anteprima delle modifiche da apportare.
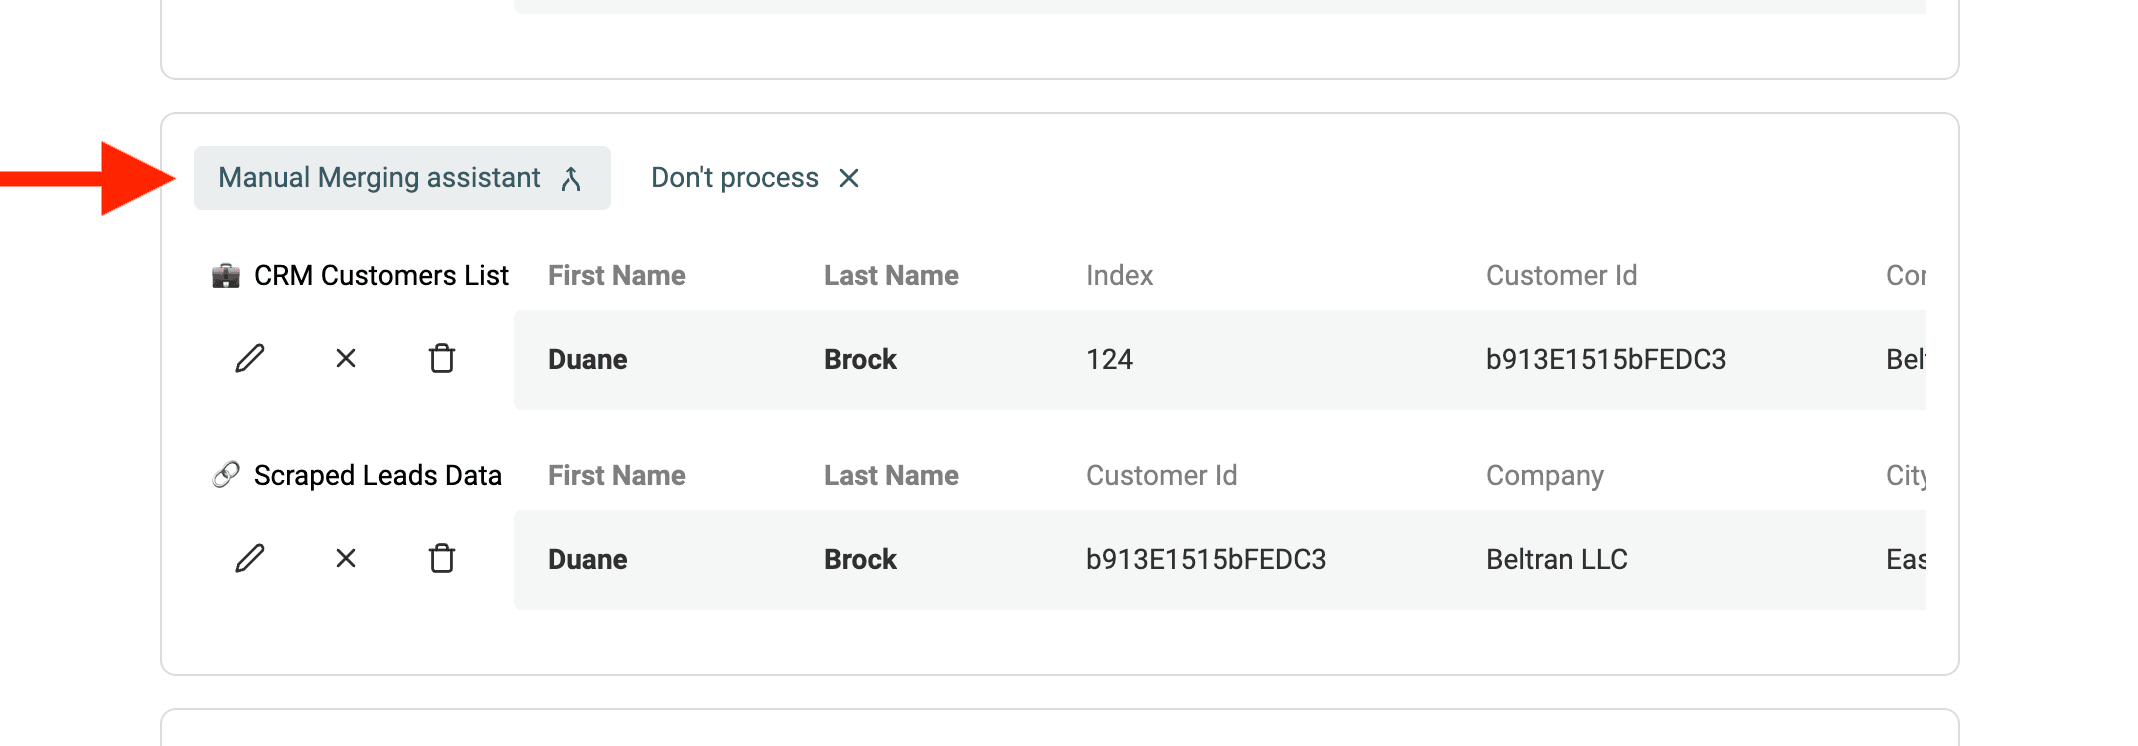
Unione manuale con Merging Assistant
Per i record duplicati rimanenti è disponibile un assistente per l'unione manuale.
Fai clic su Review group e apri Manual Merging Assistant.
Si aprirà un tool di unione. A destra viene mostrato il "Primary Item", mentre a sinistra gli altri elementi duplicati sono definiti "Secondary Items". Datablist sceglie come "Primary Item" l'elemento con il maggior numero di dati.
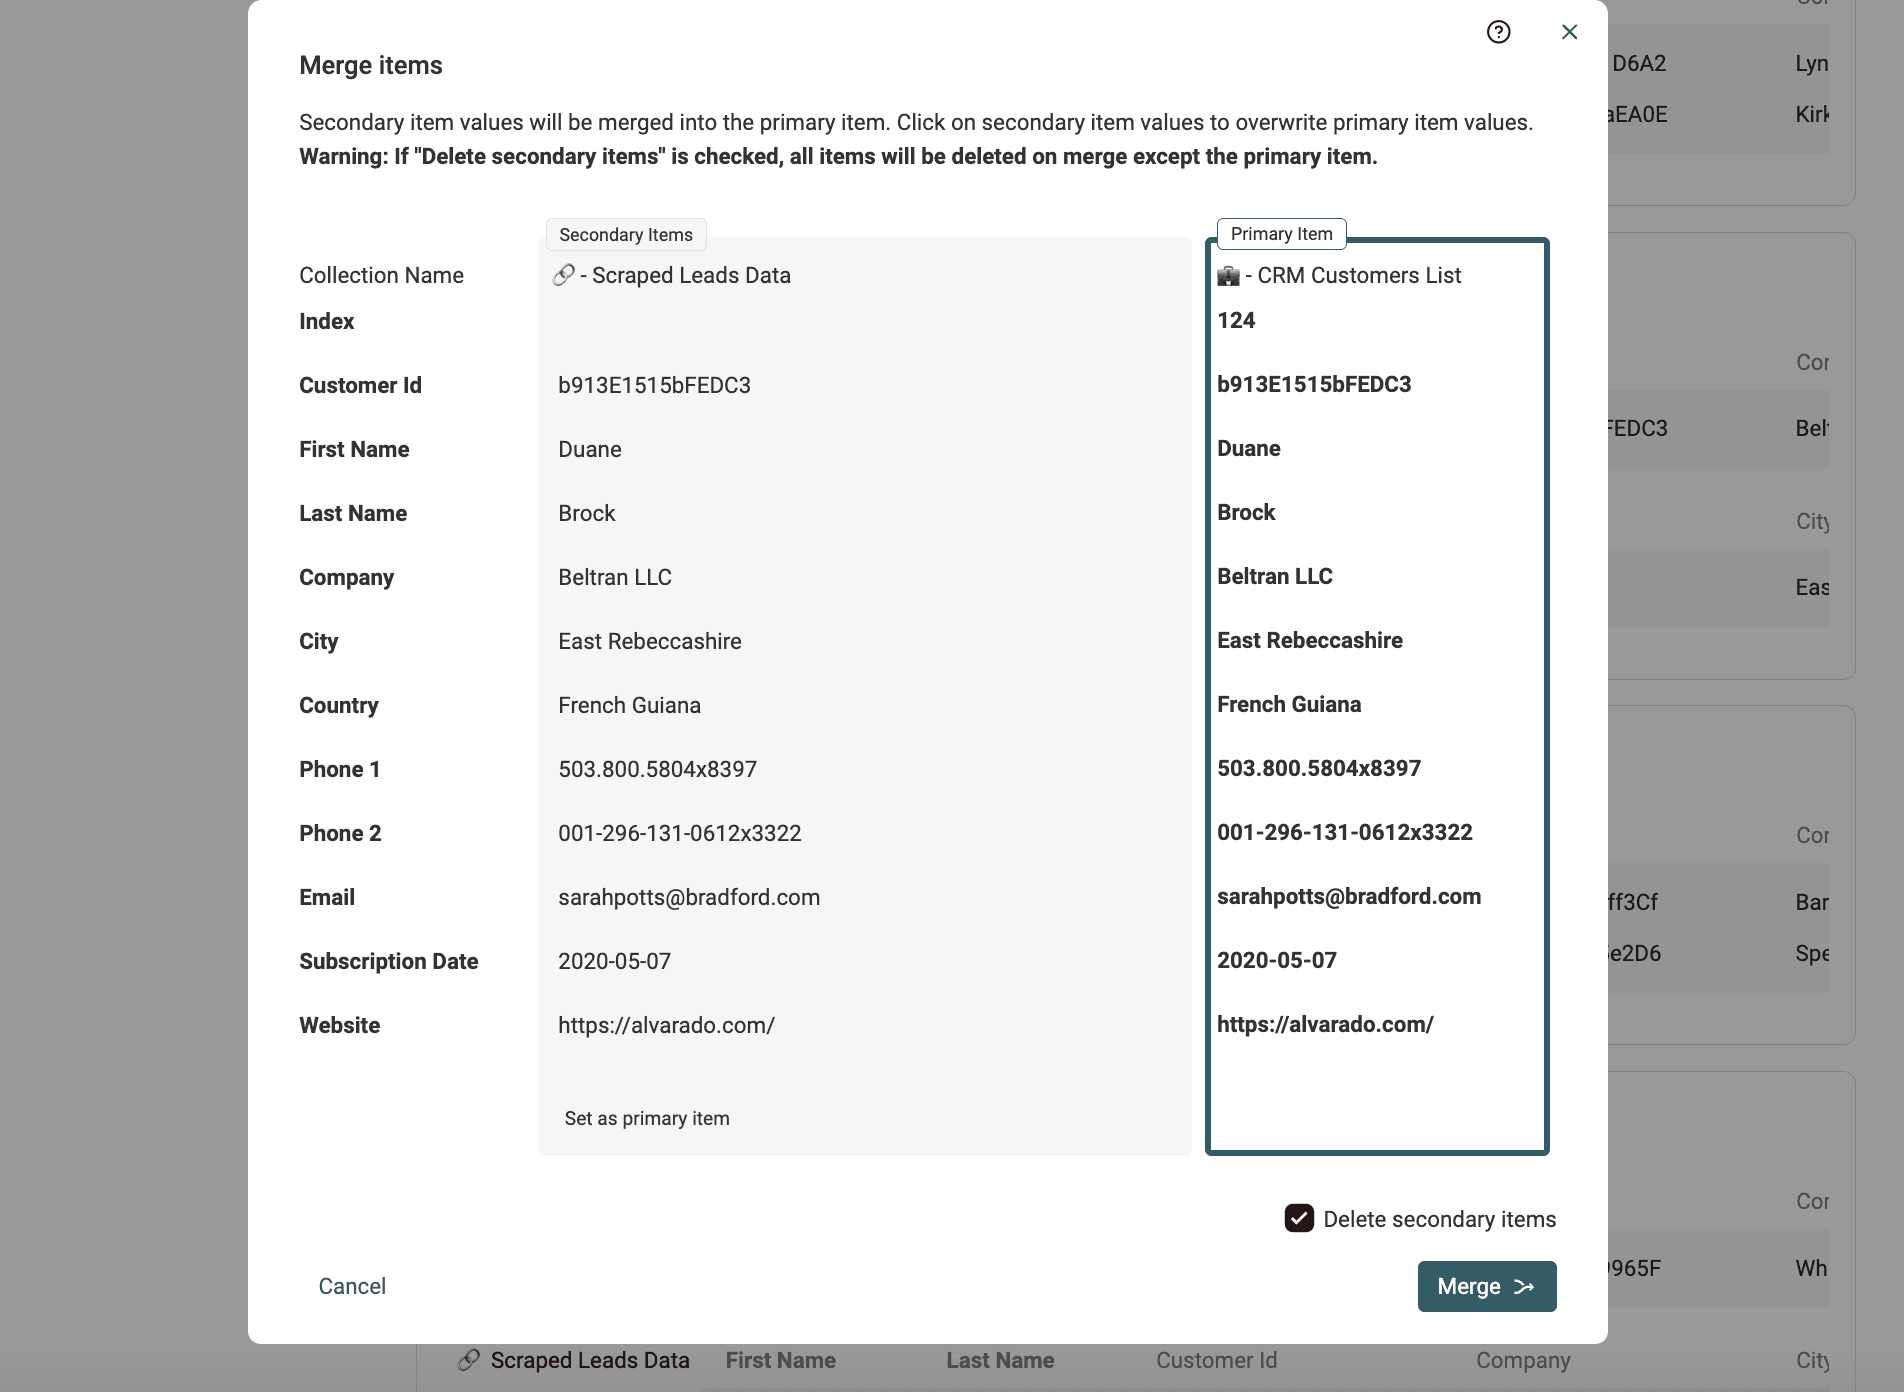
Quando possibile, i valori delle proprietà dei Secondary Items vengono selezionati automaticamente per essere uniti al Primary Item. Se più valori sono in conflitto, dovrai decidere quale conservare.
Se il "Primary Item" risultante è corretto, fai clic sul pulsante Merge per confermare l'unione. Tutti i Secondary Items verranno eliminati, lasciando un unico elemento combinato.
Nota Manual Merging Assistant è disponibile nella deduplicazione tra più collection quando queste hanno una struttura dati simile, con le stesse proprietà.
Esportare i gruppi duplicati per unirli con un tool esterno
Infine, il Data Matching di Datablist permette di esportare i gruppi duplicati rilevati. Puoi generare un file CSV o Excel in cui tutti gli elementi duplicati sono elencati consecutivamente.
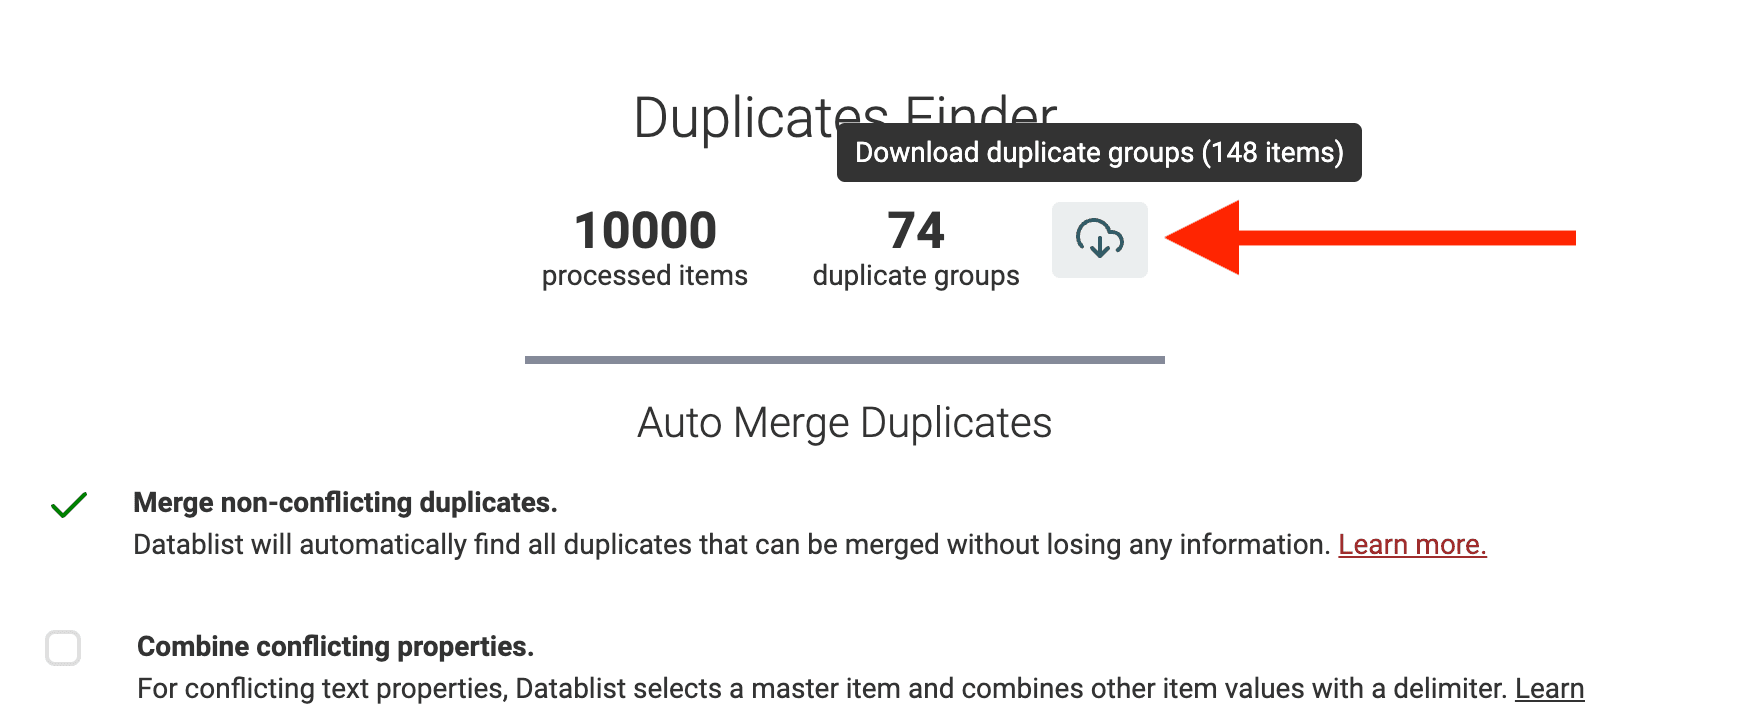
Usa il file esportato per pulire i record con un altro tool, per esempio un foglio di calcolo, oppure per svolgere analisi più complesse.
FAQ
Che cos'è il data matching?
Il data matching, noto anche come record linkage o deduplicazione, è il processo con cui si identificano e collegano record correlati all'interno di uno o più dataset. Il suo obiettivo principale è migliorare qualità, precisione e coerenza dei dati, riconoscendo e consolidando voci duplicate o simili che rappresentano le stesse entità, persone od oggetti.
Questo processo è utile per pulire dataset in cui si accumulano record duplicati nel tempo o per combinare più dataset con campi simili o sovrapposti.
Il data matching può utilizzare campi distintivi, come indirizzi email, URL di siti web, stringhe o numeri identificativi. In alternativa, può combinare attributi non univoci, come nome, data di nascita, ragione sociale o località, per calcolare un punteggio di similarità tra i record.
Quanto è veloce il Data Matching di Datablist?
Il Data Matching di Datablist carica i dataset in memoria per eseguire l'analisi delle corrispondenze. È adatto a dataset con meno di un milione di record ed esegue la maggior parte delle analisi di data matching in pochi minuti.
Servono competenze tecniche per il Data Matching?
No. Datablist è una soluzione no-code pensata per tutti, dai data analyst ai professionisti del marketing e delle vendite.
Quando usare il data matching?
Il data matching trova applicazione in numerosi settori, tra cui finanza, sanità, marketing e gestione clienti, dove dati affidabili sono essenziali per prendere decisioni informate o integrare le informazioni con altri tool.
Questo processo agevola attività come il rilevamento delle frodi, il consolidamento dei profili utente e il data enrichment da più fonti.
I prossimi step
Se ti interessa il data cleansing, potrebbero esserti utili anche queste guide: