企業のテックスタックは、購買準備度を判断するうえで、ほかのほとんどのデータポイントより多くのことを教えてくれます。データウェアハウスを導入したばかりの企業は、まもなくそれと連携するツールを必要とします。用途が重複するプロジェクト管理アプリを3つも運用している企業では、誰かが不満を抱え、代替製品を探している可能性があります。
Technographic Targetingを活用すれば、Firmographicsだけに頼って推測するのではなく、こうしたシグナルからアカウントを継続的に発見し、優先順位を付けられます。
この記事では、Technographic Dataとは何か、どこから取得できるのか、どのようにスコアリングモデルを構築するのか、そして営業チームの時間をひそかに奪うよくあるミスについて解説します。
📌 お急ぎの方向けの要約
この記事で分かること: Technographic Targetingでは、企業のテックスタック、つまりCRM、マーケティングツール、インフラを分析し、購入準備度の高いアカウントを見つけて優先順位を付けます。
主なポイント:
- スタックデータからは、FirmographicsやIntent Dataだけでは捉えられない購買準備度が見えてきます。
- スタック全体を網羅できる単一の情報源はありません。Webサイトスキャナー、求人情報、ベンダーデータベースは、それぞれ異なる情報の空白を補います。
- シンプルなポイント制のスコアリングモデルを使えば、検出したツールの生データを、優先順位付きの実用的なアカウントリストに変換できます。
結論: Technographic Targetingで最大の成果を上げるのは、データをクリーンかつ最新の状態に保ち、一貫した基準でスコアリングしているチームです。
Technographic Targetingとは
Technographicsとは、企業が利用しているソフトウェア、プラットフォーム、インフラに関するデータです。CRM、マーケティングオートメーション、決済サービス、分析ツール、CDN、ECプラットフォームなど、多岐にわたるカテゴリーが含まれます。
Technographic Targetingでは、こうしたスタックデータを基に、どの企業へ、どの順番で営業するかを決めます。これは、アカウントベースの優先順位付けを支える次の3要素の一つです。
- Firmographics:業界、従業員数、売上高
- Intent Data:コンテンツのダウンロード、Webサイトへの訪問
- Technographics:実際に稼働しているツール
大きな違いは、情報の具体性です。Firmographicsは企業の属性を表し、Intent Dataは企業の関心を表します。一方、Technographicsが示すのは実際の業務環境です。そのため、具体的でアプローチ可能な課題を、より正確に捉えられます。
テックスタックが企業属性より有効な理由
Firmographicsで分かるのは購入可能性
「北米の従業員50〜500名のSaaS企業」といったフィルターを使えば、購入候補となる企業を幅広く抽出できます。しかし、そのうちどの企業が実際に自社製品で解決できる課題を抱えているかまでは分かりません。
Firmographicsがまったく同じ2社でも、購入を検討する状況は大きく異なります。一方はすでに成熟したソリューションを導入済みで、もう一方はスプレッドシートとパートタイムの業務委託スタッフを組み合わせて、どうにか同じ業務を回しているかもしれません。
そのため、Firmographicsだけで作ったリストでは、返信率が伸びにくくなります。「従業員50〜500名のSaaS企業」というリストを担当する営業は、すでに課題を解決した企業と、今まさに苦戦している企業とで会話の切り口を変えられません。リスト自体に、両者を見分けるシグナルがないからです。結果として、すべてのアカウントに同じ一般的な初回メッセージを送ることになります。
Technographicsで分かる今すぐ買う企業
スタックデータは、この情報の空白を埋めてくれます。Shopifyプラグインを販売しているなら、企業がBigCommerceではなくShopify Plusを使っているという情報は、あれば便利な情報ではなく、明確な選定条件です。自社ツールがSnowflakeと連携する場合、前四半期にSnowflakeを導入した企業は、オンプレミスのデータウェアハウスを使い続けている企業より、はるかに確度の高いアカウントです。
Technographic Dataからは、競合製品からの乗り換え機会も見つかります。自社と同じカテゴリーのレガシーツール、特に主要アップデートが止まっている製品を使う企業は、初回導入だけでなく、リプレイスの有力候補です。
Technographic Dataの入手先
企業のスタック全体を正確に把握できる唯一の情報源はありません。実用的なアプローチでは、次のような情報源をいくつか組み合わせます。
- Webサイトスキャンツール(BuiltWith、Wappalyzer): サイト上で公開されているコードを読み取り、分析ピクセル、CDN、CMS、決済ウィジェットなどのフロントエンド技術を検出します
- ベンダー提供データ(HG Insights、G2、Datanyze): IT資産管理ツール、ベンダーとのパートナーシップ、ユーザーが投稿したレビューなどから集約されたデータです
- 求人情報: 「Salesforce管理者」や「Snowflakeデータエンジニア」の募集は、その企業が現在利用しているもの、そして多くの場合は拡張しようとしているものを直接示す、鮮度の高いシグナルです
- DNS・SSLレコード: ホスティング事業者、メールインフラ、セキュリティベンダーを把握できます
- 導入事例・プレスリリース: ベンダーが公開する顧客ロゴは、網羅性こそないものの、信頼性の高い情報です
- サポートフォーラム・コミュニティスレッド: エンジニアが公開の場でトラブルを相談する際、利用中のスタックを具体的に明かすことがあります
一つの情報源ですべてをカバーすることはできません。Webサイトスキャナーでは、CRMやデータウェアハウスなど、フロントエンドに現れない社内ツールを検出できません。求人情報は、実際の導入より遅れて掲載されることがあります。2〜3種類の情報源を組み合わせれば、一つだけを使う場合より、カバレッジを大きく高められます。
カバレッジと鮮度は別の課題
混同されがちな次の2つの問いは、分けて考えると分かりやすくなります。情報源がそのツールを検出できるか、そして検出された情報がどれほど最新か、という問いです。
Webサイトスキャナーは毎週再クロールできるため、一般的に鮮度は高いものの、公開コードから確認できる範囲に限られるため情報は浅くなります。つまり、バックオフィス系ソフトウェアの大半は対象外です。ベンダー提供のデータベースは、CRMやデータウェアハウスなどの社内ツールまで捉えられることが多く、情報の深さでは優れています。一方、ライブクロールではなく、パートナー連携や定期調査からデータを得ることが多いため、更新は遅く、四半期ごとの場合もあります。
実務上は、高速で浅い情報源をタイミングシグナルの把握に使いましょう。たとえば、今月追加された新しいピクセルやCDNを検出できます。一方、低速でも深い情報源は、基本となるスタックの把握に適しています。どちらか一方だけでは、正確かつ最新の全体像は得られません。
Technographicシグナルの設計方法
スタックの生データは、実行可能なシグナルとして整理するまでは、単なるツール名の一覧にすぎません。
カテゴリーと個別ツールのシグナル
まず、重視するのがカテゴリーなのか、特定のベンダーなのかを決めます。自社ツールが「あらゆるCRM」と接続できるなら、カテゴリー単位の検出、つまりCRMを利用しているという情報だけで十分です。HubSpotとのみ連携するなら、ベンダーを特定できる検出が必要です。
カテゴリー単位のシグナルは対象を広く捉えられ、精度の高い検出も比較的容易です。ベンダー固有のシグナルはより鋭い一方、クリーンなデータが欠かせません。企業が使うCRMを誤分類すると、気付かないうちにリスト全体の質を損ねてしまいます。
スタックの不足を商談機会に変える
不足しているツールは、導入済みツールと同じくらい価値のある情報です。データエンリッチメント基盤を販売している場合、CRMとマーケティングオートメーションはあるものの、エンリッチメントツールがない企業なら、その不足自体が営業ストーリーになります。単純な一致だけでなく、「XとYはあるが、Zがない」という検出ロジックを構築しましょう。
テックスタックの時系列変化
企業のスタックを一時点で捉えたスナップショットも役立ちますが、変更履歴はさらに価値があります。ツールの導入と削除を時系列で追跡すれば、次のシグナルを検出できます。
- 新しいツールの導入:購買のタイミングが訪れたシグナル
- ツールの削除:解約や不満のシグナルであり、競合製品に関係している可能性もあります
- 同一カテゴリーで複数ツールを併用:比較検討または移行が進行中である可能性
変化を基にしたシグナルは、Outreachのタイミングを判断するうえで、静的なシグナルを一貫して上回ります。チームが実際に意思決定を行っている具体的な時点を示すからです。
テックスタックによるアカウントスコアリング
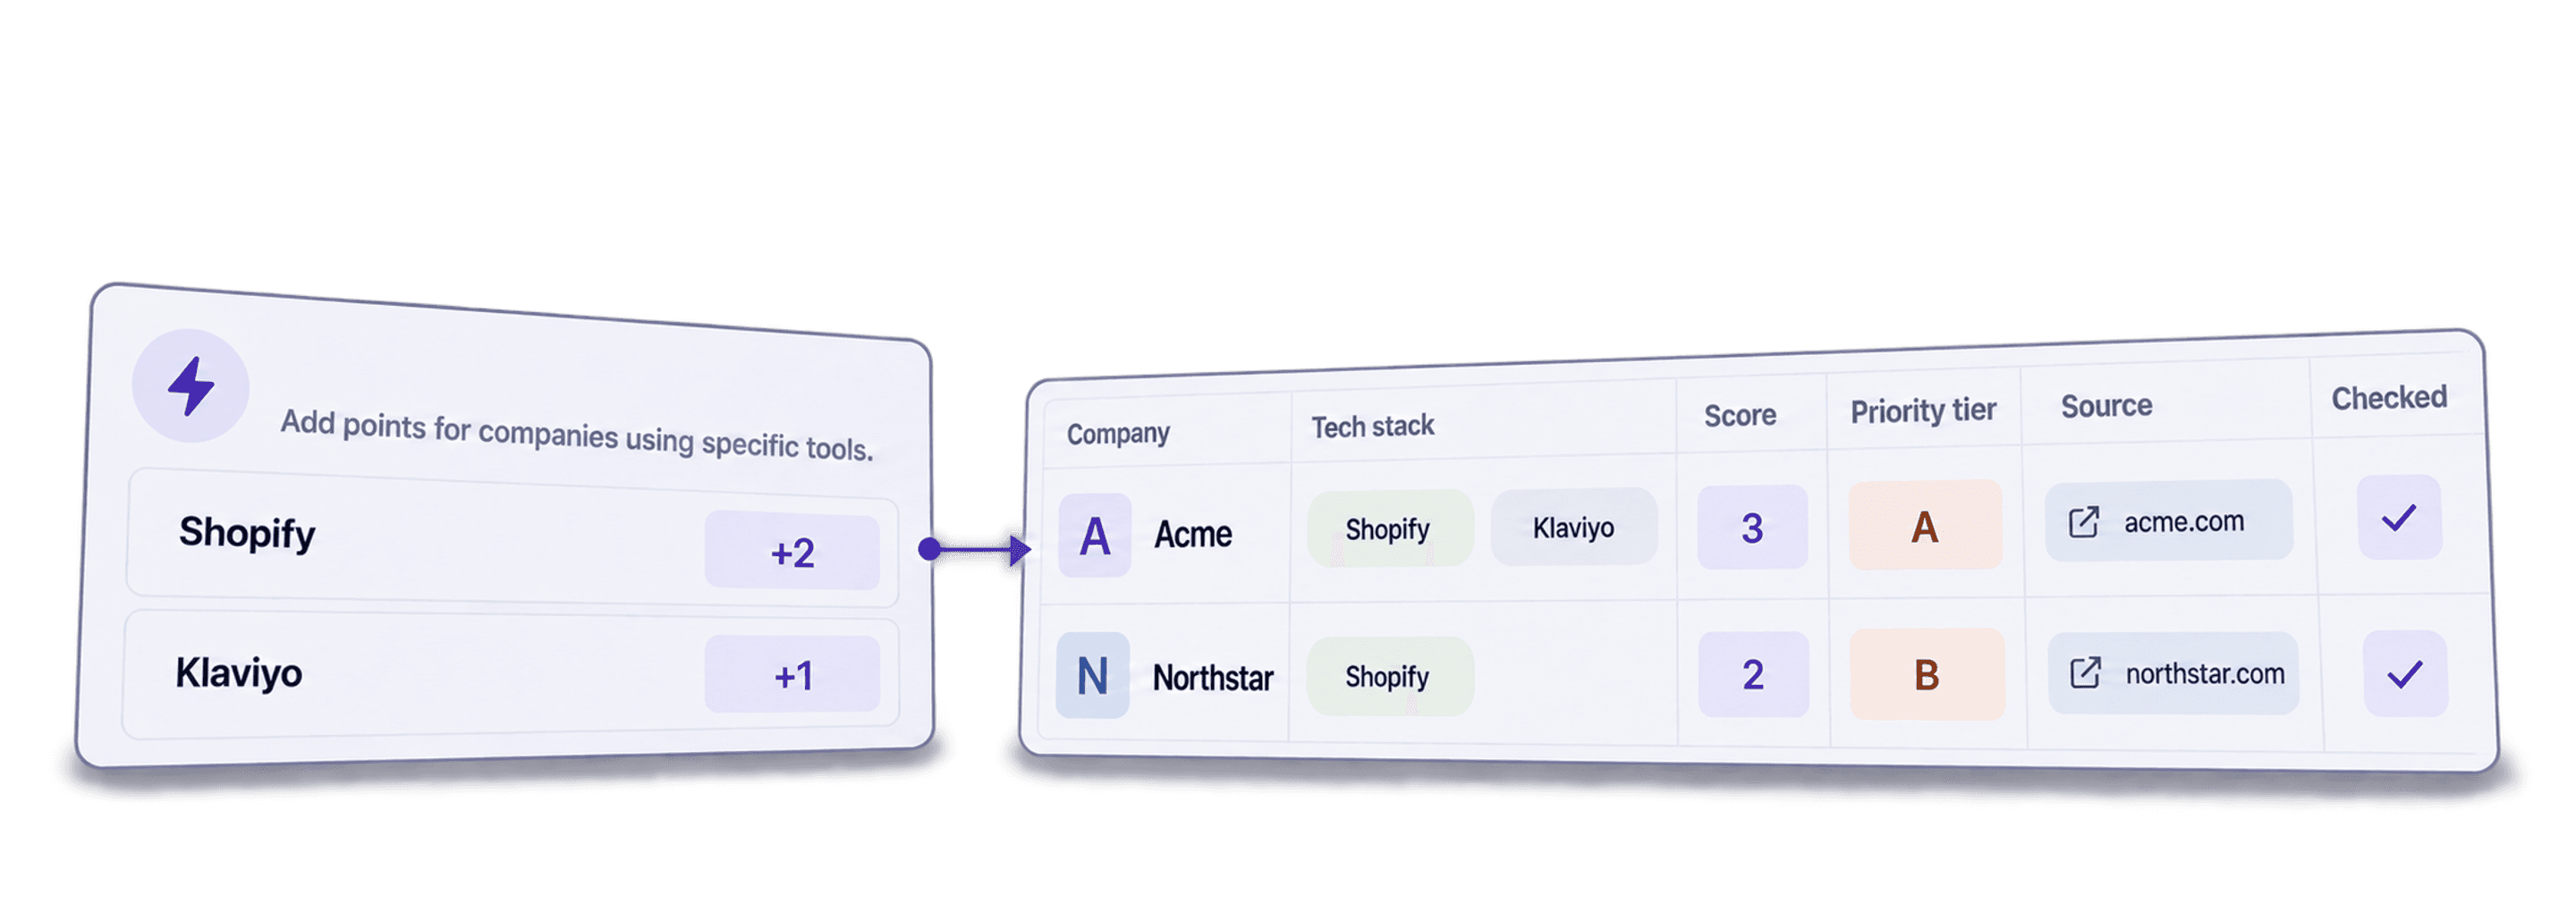
シグナルを集めたら、横並びのリストではなく、優先順位付きのリストへ変換します。シンプルなポイント制モデルが効果的です。
- +30:自社製品と直接連携するツールを利用している
- +20:特定分野に既知の弱点がある競合製品を利用している
- +15:自社の主要ユースケースに合致するカテゴリーの不足がある
- +10:過去90日以内に関連ツールを追加または削除している
- +10:自社製品のカテゴリーに関係する職種が求人情報に記載されている
- −15:自社製品を不要にするツールを利用している
購買意欲に応じたシグナルの重み付け
すべてのシグナルを同じ重みで評価する必要はありません。求人情報は将来に向けた動き、つまり関連人材を採用する計画を示します。一方、導入済みツールは現在の状態を示す事実です。セールスサイクルが短い場合は、現在稼働しているツールの重みを高くします。長期的なアカウントプランニングを行う場合は、求人情報をより高く評価しましょう。
Technographics・企業属性・行動データの統合
Technographicsは、単独のフィルターではなく、ほかのデータに重ねるレイヤーとして使うと最も効果を発揮します。実用的なモデルでは、次の3つの要素を組み合わせます。
- Firmographic Fit(業界、規模、地域)で対象となる母集団を定めます。
- Technographic Scoreで、スタックから見た購買準備度に基づき、その母集団を順位付けします。
- Intent Data(訪問、ダウンロード)で同点のアカウントに差を付け、現在情報収集を行っている企業を特定します。
3つすべてで高いスコアを獲得したアカウントが最優先層です。Technographic Fitは高いものの、まだエンゲージメントがないアカウントも、Outboundの価値があります。ただし、すでに料金ページを訪問した企業とは、会話の始め方を変える必要があります。
この階層分けは、優先順位だけでなく、チャネルやメッセージにも影響します。Firmographic FitとTechnographic Fitが高く、エンゲージメントが低いアカウントには、スタックへ具体的に言及したCold Emailが適しています。先方が関心を示す前でも、具体的なメッセージを作れるだけの情報があるからです。一方、エンゲージメントが高くてもTechnographic Fitが低いアカウントは、営業が対応する必要さえないかもしれません。単に競合調査をしている、または偶然そのカテゴリーに触れるブログ記事を書いているだけの可能性があります。
Technographic Targetingのよくある失敗
- 検出結果を確定情報として扱う。スキャナーには誤検知や検出漏れがあります。6か月前に検出されたツールは、すでに使われていないかもしれません。データを定期的に更新し、単一の情報源による検出は事実ではなく仮説として扱いましょう。
- 一つのプロバイダーに依存しすぎる。カバレッジは業界や企業規模によって異なります。大企業向けSaaSに強いプロバイダーでも、中堅EC企業には弱い場合があります。
- ネガティブシグナルを無視する。ターゲットリストは作っても、同じくらい有用な「優先度を下げるリスト」を作らないチームがあります。たとえば、自社製品を不要にするツールをすでに使っているアカウントです。
- すべての連携を同じ点数で評価する。最重要の連携パートナーを利用する企業は、コンバージョンがめったに発生しないパートナーを利用する企業より、適合度が高いと判断できます。
- リストを古いまま放置する。スタックデータは常に変化しています。少なくとも四半期ごとに更新すれば、スコアと現状のずれを抑えられます。
- 検出されたツールの利用理由を確認しない。多くのツールでは、評価目的のトライアルアカウントも、全社的な本番利用も同じように見えます。価値の高い検出結果を確定情報として扱う前に、求人情報や導入事例など、別のシグナルと照合しましょう。
Technographicターゲットリストの作成手順
- シグナル群を定義します。現在の優良顧客が実際に使っているスタックを基に、重要なツール、カテゴリー、組み合わせを洗い出します。
- 2つ以上の情報源から生データを取得し、フロントエンド(Webサイトスキャン)とバックエンド(求人情報、ベンダーデータ)の両方のシグナルをカバーします。
- ベンダー名をクリーニングして標準化します。先に正規化しなければ、生データでは「Salesforce」「Salesforce.com」「Salesforce CRM」が別々の項目として記録されます。
- 統合・クリーニング済みのリストにスコアリングモデルを適用し、順位を付けます。
- スコア階層に応じて振り分けます。高スコアは営業担当者による直接のOutreachへ、中スコアはナーチャリングシーケンスへ回し、低スコアは除外します。
Technographicプロジェクトの多くが行き詰まるのは、ステップ3です。スキャンツール、求人サイトのスクレイパー、ベンダーデータベースから出力したデータを統合すると、通常は表記が不統一で、重複を含む乱雑な名前が並びます。最初にこれらを整理してこそ、その後のモデル全体を信頼できるものにできます。
Technographicスコアリングの具体例
SegmentおよびSnowflakeとネイティブ連携するCustomer Data Platform(CDP)を販売する架空の企業を例に考えてみましょう。
- SegmentとSnowflakeに加え、レガシーなメールツールを使っているもののCDPは未導入のアカウントは、高スコアです。必要な2つの連携環境がそろい、主要ユースケースに合致する明確な不足もあります。
- Segmentと競合CDPを利用しているアカウントは、中程度のスコアです。連携面の相性は良いものの、すでにカテゴリーの製品が導入されているため、提案の軸はリプレイスへ移ります。
- SegmentもSnowflakeも使っていないものの、過去1か月に「データエンジニア、データウェアハウス移行」に関する求人を3件掲載したアカウントは、将来見込み層として評価します。現時点では準備が整っていませんが、次の四半期に再確認する価値があります。
この3社を一つの「CDP見込み客」リストにまとめず、それぞれ異なる順位を付けることこそ、Technographic Scoringの価値です。
Technographic Targetingの実践ポイント
Technographic Targetingは、FirmographicsやIntent Dataに取って代わるものではありません。それらに重ねることで、対象をより鮮明に捉えるレンズです。最大の成果を上げるのは、最も高機能な検出ツールを持つチームではありません。データを定期的に更新し、スコアリング前にベンダー名を正規化し、自社製品や連携機能の進化に合わせてシグナルの重みを見直せるチームです。
まずは小さく始めましょう。現在の顧客を最も正確に予測できるツールまたはカテゴリーを2〜3個選び、先にその検出ロジックを構築します。実際に商談の質が向上したことを確認してから、モデルを拡張してください。