
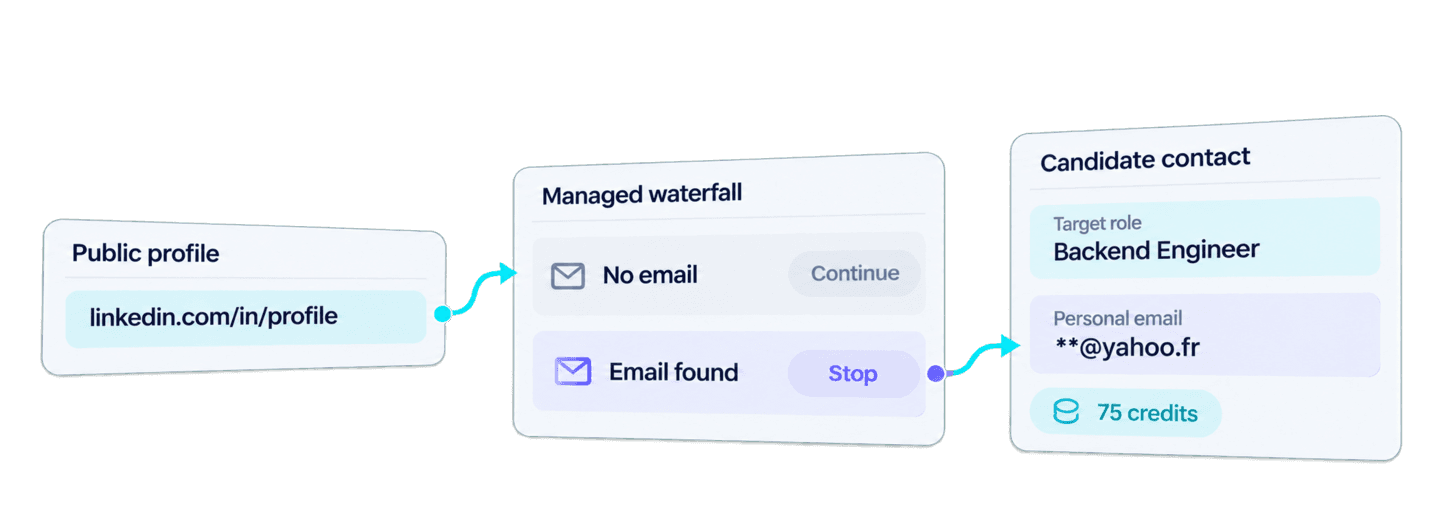
Met Python kun je persoonlijke e-mailadressen vinden via LinkedIn door openbare profiel-URL's in de vorm linkedin.com/in/... naar de Waterfall Personal Email Finder API van Datablist te sturen. De API doorloopt automatisch een reeks geschikte e-mailproviders en retourneert een persoonlijk adres zodra een van deze providers een resultaat vindt.
Het volledige Requests-voorbeeld hieronder maakt één achtergrondtaak aan, wacht totdat deze is voltooid en haalt alle resultaatpagina's op. Zodra de zoekopdracht werkt, gebruik je de geretourneerde objecten om contactrecords voor recruitment samen te stellen. Daarbij blijven de naam, LinkedIn-URL en beoogde functie van iedere kandidaat gekoppeld aan het gevonden e-mailadres.
Deze workflow zoekt naar een persoonlijk e-mailadres dat losstaat van de huidige werkgever van de kandidaat. Heb je juist een adres nodig dat aan het bedrijf van die persoon is gekoppeld? Volg dan de aparte handleiding om een zakelijk e-mailadres via een LinkedIn-profiel te vinden.
🔑 Samenvatting voor wie weinig tijd heeft
Voeg namen van kandidaten, openbare LinkedIn-profiel-URL's en beoogde functies toe. De Python-workflow vindt beschikbare persoonlijke e-mailadressen en houdt elk adres gekoppeld aan de recruitmentgegevens waarmee je bent begonnen.
- Input: Namen van kandidaten, openbare
linkedin.com/in/...-profiel-URL's en beoogde functies.- Output: Gevonden persoonlijke e-mailadressen, gekoppeld aan de juiste kandidaatgegevens.
💡 Liever een no-code oplossing? Gebruik Datablist's Waterfall Personal Email Finder om persoonlijke e-mailadressen te vinden zonder code te schrijven.
Bevat je bronbestand wel namen, maar geen profiel-URL's? Vind dan eerst openbare LinkedIn-profielen met Python en stuur die URL's vervolgens naar deze API.
Python, Requests en je Datablist API-key instellen
Voor dit voorbeeld gebruik ik Python met het pakket requests. Maak een bestand met de naam find_personal_emails.py en installeer vervolgens Requests:
python -m pip install requestsMaak in je Datablist-account een Personal API Key aan en exporteer deze als omgevingsvariabele:
export DATABLIST_API_KEY='your-api-key'Toegang tot de REST API is beschikbaar met het Growth-abonnement. Voor een succesvol gevonden persoonlijk e-mailadres worden ook credits verbruikt. In het kostengedeelte hieronder bereken ik hoeveel.
Een persoonlijk e-mailadres vinden met één Python-functie
De aanpasbare lijst candidates in dit script bevat één recruitmentrecord. target_role is een voorbeeldwaarde uit de bron die lokaal binnen de recruitmentworkflow blijft. Alleen candidate_id en linkedin_url worden in de API-payload opgenomen.
import json
import os
import time
import uuid
import requests
def find_personal_emails(candidates, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": candidate["candidate_id"],
"data": {"profileUrl": candidate["linkedin_url"]},
}
for candidate in candidates
]
unique_id = str(uuid.uuid4())
print(f"Recovery uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-personal-email-finder",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(f"Task {task_id} {task['status']}: {task.get('error')}")
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
candidates = [
{
"candidate_id": "candidate-florian-poullin",
"name": "Florian Poullin",
"linkedin_url": "https://www.linkedin.com/in/florianpoullin/",
"target_role": "Backend Engineer",
}
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
personal_email_results = find_personal_emails(candidates, api_key)
for result in personal_email_results:
print(json.dumps(result, indent=2))Voer het bestand uit vanuit dezelfde terminal:
python find_personal_emails.pyJe kunt ook het onderhouden synchrone Requests-voorbeeld downloaden. Het bovenstaande script gebruikt dezelfde reeks voor verzenden, pollen en pagineren, met kandidaat-ID's uit de bronrecords.
De zoekopdracht verzenden
De functie zet iedere kandidaat om in API-input. inputId bevat de vaste kandidaat-ID en data.profileUrl de openbare URL van het persoonlijke LinkedIn-profiel. Hiervoor is een standaard-URL in de vorm linkedin.com/in/... vereist. Sales Navigator-URL's, bedrijfspagina's, lege waarden en namen zonder profiel-URL zijn geen geldige input voor deze enrichment.
Het verzoek gebruikt waterfall-personal-email-finder als enrichmentId en een leeg settings-object, zoals beschreven in de API-documentatie van Waterfall Personal Email Finder. Voor verzending print het script de gegenereerde uniqueId. Bewaar deze waarde: hiermee kun je een bestaande taak terugvinden als de verbinding wegvalt nadat de API het verzoek heeft geaccepteerd.
Dit is de volledige request body voor het voorbeeld met één profiel:
{
  "enrichmentId": "waterfall-personal-email-finder",
  "uniqueId": "55001d29-4fb9-4fe2-9497-80f4b346eed7",
  "settings": {},
  "inputs": [
    {
      "inputId": "candidate-florian-poullin",
      "data": {
        "profileUrl": "https://www.linkedin.com/in/florianpoullin/"
      }
    }
  ]
}
Bij een geslaagde verzending retourneert de API HTTP 202 Accepted, met de taak-ID in @id. Na deze response gaat de verwerking verder op de servers van Datablist.
Wachten op de achtergrondtaak
Het Requests-script blokkeert lokaal terwijl de server de achtergrondtaak uitvoert. Het controleert de taak iedere drie seconden en blijft dit doen zolang de status queued of running is. Een taak met de status completed gaat door naar het ophalen van de resultaten. Bij failed of stopped wordt een fout gegenereerd met de taak-ID en, indien beschikbaar, de foutmelding.
Alle resultaatpagina's ophalen
Het resultatenendpoint retourneert voor iedere rij de bron-ID, status, output, credits en eventuele fout. Het eerste verzoek vraagt maximaal 100 resultaten op. Daarna wordt steeds de volgende pagina opgehaald totdat nextCursor gelijk is aan null.
De taakresultaten behouden de volgorde van de input. Via inputId blijft ieder resultaat bovendien expliciet gekoppeld aan het bijbehorende kandidaatrecord, ook wanneer er meerdere resultaatpagina's zijn.
Pas je het voorbeeld aan voor meer records, zorg er dan voor dat iedere candidate_id vanuit het bronsysteem stabiel blijft. Zo kun je de gegevens betrouwbaar samenvoegen wanneer een taak meerdere resultaatpagina's heeft.
Zo vindt de personal-email waterfall een resultaat
Datablist schoont de ingediende openbare LinkedIn-profiel-URL op en stuurt het nog niet gevonden profiel achtereenvolgens langs de beschikbare personal-email providers. Levert een provider geen bruikbaar adres op, dan kan het profiel doorgaan naar de volgende geschikte provider. Zodra een provider een bruikbaar e-mailadres vindt, stopt de reeks voor dat profiel en wordt het adres geretourneerd als outputs.emailFound.
Datablist beheert welke providers in aanmerking komen. Je integratie heeft daardoor geen providerspecifieke verzoeken of fallbackcode nodig. Het openbare resultaat toont de uitkomst van de e-mailzoekopdracht, niet een vaste providervolgorde of de geschiedenis van alle pogingen.
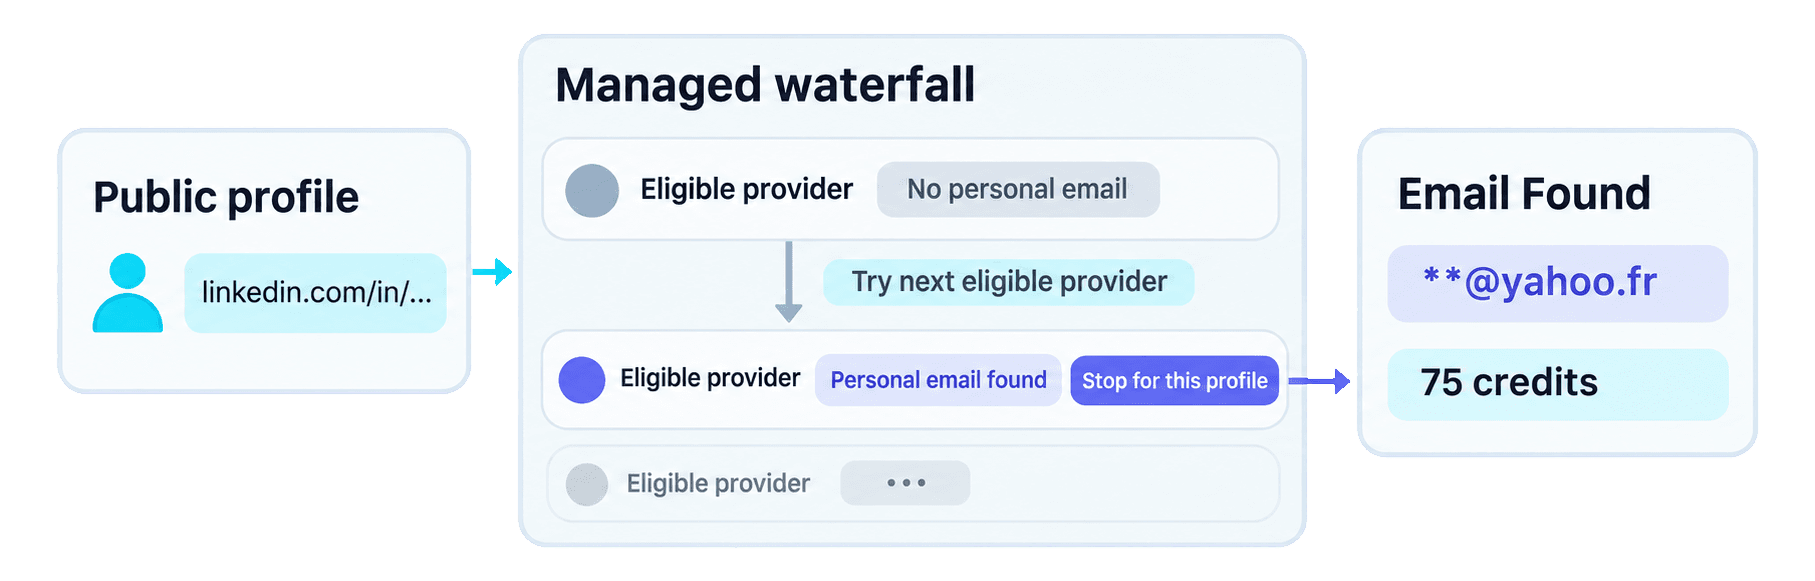
De waterfall is de zoekmethode. Pollen heeft een andere functie: daarmee wacht de Python-client totdat het achtergrondproces is afgerond.
Waarom een waterfall internationale recruitmentteams helpt
Providers van persoonlijke e-mailadressen gebruiken verschillende databronnen. Hun dekking verschilt daardoor per land en markt. Heeft de eerste provider geen e-mailadres voor een kandidaat, dan kan een andere provider binnen de waterfall het mogelijk wel vinden.
Recruitmentteams die in meerdere landen actief zijn, krijgen via één API-integratie toegang tot een bredere providerdekking. Datablist beheert de reeks, zodat het team contacten kan vinden die bij een zoekopdracht via één provider mogelijk gemist worden, zonder zelf meerdere provider-API's te koppelen en onderhouden.
Het volledige resultaat uitlezen
📘 Gemaskeerd e-mailadres: Het lokale deel van het adres is hieronder vervangen door
**. Je API-resultaat bevat de volledige waarde.
Dit is de volledige resultaatpagina voor de ingevoerde kandidaat:
{
  "taskId": "b5de73ffaa3f4f349c125d7c85125bb4",
  "results": [
    {
      "inputId": "candidate-florian-poullin",
      "status": "success",
      "outputs": {
        "emailFound": "**@yahoo.fr"
      },
      "creditsUsed": "75",
      "error": null
    }
  ],
  "nextCursor": null
}
De inputId is de sleutel waarmee je het resultaat aan de kandidaat uit het bronbestand koppelt. outputs.emailFound bevat het persoonlijke e-mailadres. creditsUsed toont de definitieve kosten voor deze rij en error: null betekent dat de API geen fout op rijniveau heeft geretourneerd. De null-cursor bevestigt dat er na deze response geen volgende resultaatpagina is.
Behandel het adres als een mogelijke contactoptie die bij het ingediende profiel hoort en controleer het voordat je het voor recruitment gebruikt.
Contactrecords voorbereiden voor review door recruiters
Zodra de zoekopdracht resultaten oplevert, kun je zonder nieuw API-verzoek een lokale lijst voorbereiden die recruiters kunnen beoordelen. Het volgende codeblok hergebruikt de bestaande variabelen candidates en personal_email_results:
results_by_id = {
result["inputId"]: result for result in personal_email_results
}
prepared_contacts = []
for candidate in candidates:
result = results_by_id.get(candidate["candidate_id"])
if not result or result.get("status") != "success":
continue
email_found = result.get("outputs", {}).get("emailFound")
if not email_found:
continue
prepared_contact = candidate.copy()
prepared_contact["result"] = result
prepared_contacts.append(prepared_contact)
print(json.dumps(prepared_contacts, indent=2))Voor candidate-florian-poullin vindt de dictionary lookup het resultaat met dezelfde inputId. Het gekopieerde record behoudt de naam van Florian Poullin, zijn LinkedIn-URL en de voorbeeldfunctie Backend Engineer. Vervolgens wordt het volledige API-object toegevoegd onder result, waar de recruiter het adres kan uitlezen via result.outputs.emailFound.
De loop begint bij de kandidatenlijst uit de bron. Als er later geen resultaat is, een fout op rijniveau optreedt, een resultaat ontbreekt of emailFound leeg is, blijft die bronlijst ongewijzigd en wordt de kandidaat niet aan prepared_contacts toegevoegd.
Lees voor een uitgebreider reviewproces en andere contactkanalen de handleiding over het vinden van het e-mailadres van een kandidaat als recruiter.
Kosten van de Personal Email Finder API berekenen
Ieder gevonden persoonlijk e-mailadres kost 75 credits. Een zoekopdracht zonder resultaat kost 0 credits. Gebruik voor de werkelijke kosten de waarde creditsUsed van elk resultaat, in plaats van het totale aantal ingediende profielen met een vast bedrag te vermenigvuldigen.
De formule voor je kostenraming is:
gevonden persoonlijke e-mailadressen × 75 credits
Dien je bijvoorbeeld 100 profielen in en leveren 20 daarvan een persoonlijk e-mailadres op, dan gebruikt de taak 20 × 75 = 1.500 credits. Dit is alleen een rekenvoorbeeld voor je planning, geen verwacht succespercentage. Voor grotere budgetten geldt: 100 gevonden adressen kosten 7.500 credits en 1.000 gevonden adressen 75.000 credits.
Op basis van het huidige standaardtarief voor opwaarderen in USD geldt: $20 / 20.000 credits = $0,001 per credit. Eén gevonden e-mailadres verbruikt dus $0,075 aan credits en 100 gevonden adressen $7,50. Deze raming geeft alleen de waarde van de verbruikte credits weer. Het Growth-abonnement dat voor toegang tot de REST API nodig is, staat hier los van. Bekijk de actuele abonnementen en creditbundels op de pagina met Datablist-prijzen.
Veelvoorkomende fouten oplossen en taken herstellen
De meeste problemen ontstaan vóór de verzending, tijdens het HTTP-verzoek of binnen een afzonderlijk resultaat. Bepaal aan de hand van de foutlocatie wat je vervolgens moet doen:
DATABLIST_API_KEYontbreekt: het script stopt lokaal voordat er een verzoek wordt verstuurd. Exporteer de omgevingsvariabele en voer het bestand opnieuw uit.- HTTP-authenticatie mislukt: controleer de Personal API Key in
DATABLIST_API_KEY. De functie verstuurt deze in de headerX-API-Key. Corrigeer de key voordat je een nieuw verzoek indient. - Niet-ondersteunde profiel-URL: vervang een Sales Navigator-URL, bedrijfspagina, lege waarde of ongeldige URL door een openbaar persoonlijk profiel in de vorm
linkedin.com/in/.... - Onvoldoende credits: controleer het accountsaldo en het beschikbare aantal credits voordat je meer opdrachten verstuurt.
- De taak heeft de status
failedofstopped: controleer de taakfout, beschikbare resultaten en het creditverbruik voordat je bepaalt wat nog moet worden uitgevoerd. - Een rij heeft geen resultaat of bevat een fout: bewaar de kandidaat uit de bron voor review of een ander contactkanaal. Een mislukte zoekopdracht verklaart niet waarom een adres niet beschikbaar was.
Gaat de POST-response verloren, bekijk dan eerst je taken voordat je een nieuwe taak aanmaakt. Zoek in de response naar de uniqueId die het script heeft geprint en kopieer vervolgens de @id van de bijbehorende taak:
curl "https://api.datablist.com/v1/enrichments/tasks?enrichmentId=waterfall-personal-email-finder&limit=100" \
--header "X-API-Key: $DATABLIST_API_KEY"
TASK_ID='paste-matching-task-id'
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID" \
--header "X-API-Key: $DATABLIST_API_KEY"
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID/results" \
--header "X-API-Key: $DATABLIST_API_KEY"Staat de bijbehorende taak niet in de eerste response met de taakgeschiedenis, volg dan de geretourneerde paginatiecursor en controleer de volgende pagina. Blijf de herstelde taak controleren of haal de beschikbare resultaten op, in plaats van automatisch een nieuwe betaalde taak te maken. De taakdocumentatie beschrijft de levenscyclus, paginatie en bewaartermijn van resultaten.
Volgende stappen
Je hebt nu één herbruikbare Python Requests-functie voor openbare LinkedIn-profiel-URL's en een merge op basis van stabiele ID's. Daarmee combineer je gevonden persoonlijke e-mailadressen met de oorspronkelijke context van iedere kandidaat.
Vervang de voorbeeldlijst door een kleine selectie van je eigen kandidaatrecords en bewaar voor ieder record een stabiele ID en beoogde functie. Controleer vervolgens elk voorbereid contact voordat je het in je recruitmentproces gebruikt. Heeft je applicatie non-blocking concurrency nodig? Gebruik dan het onderhouden async HTTPX-voorbeeld als volgende implementatiestap.