
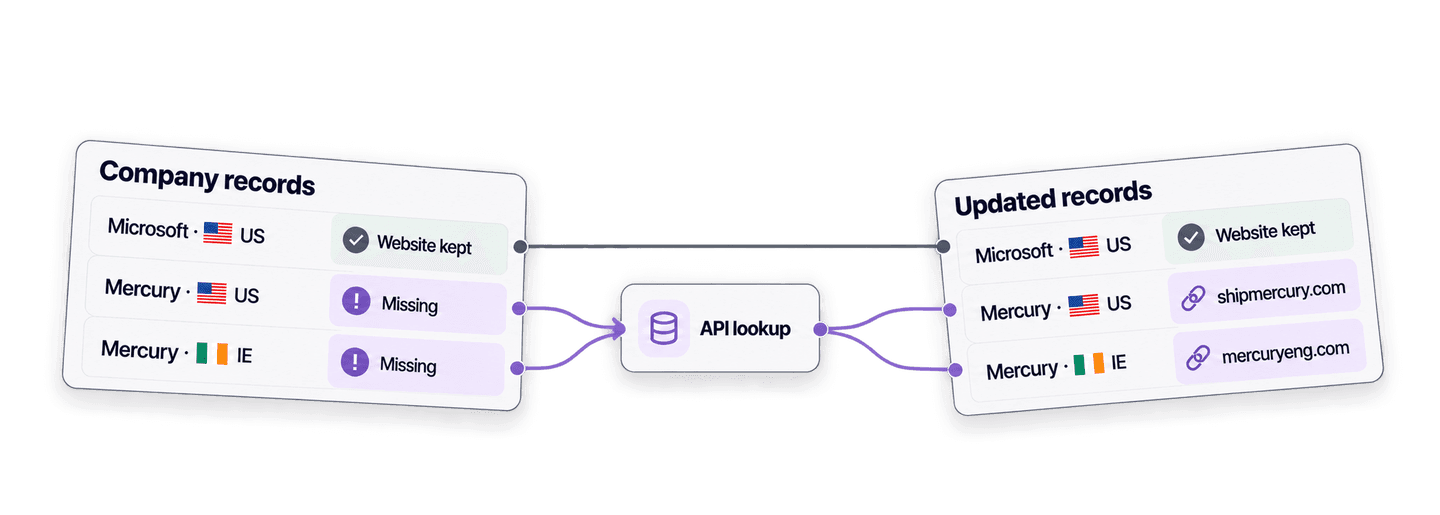
Slik finner du et bedriftsnettsted ut fra et firmanavn i Python: Send navnet og eventuell landinformasjon til Datablists Company Name to Domain API. API-et behandler oppslaget i bakgrunnen og returnerer deretter domenet og hele nettadressen.
Først viser jeg deg en enkel API-forespørsel i Python. Deretter bruker jeg den samme funksjonen til å fylle ut bare de manglende nettstedene i en liste med bedriftsposter, uten å overskrive nettadresser som allerede finnes.
Foretrekker du et regnearklignende grensesnitt, kan du følge veiledningen for å finne bedriftsnettsteder fra firmanavn i bulk.
💡 Kort oppsummert for deg som har det travelt
Lag én Python-funksjon som finner nettsteder fra firmanavn, og bruk den til å fylle ut poster med tomme nettstedfelt uten å erstatte kjente nettadresser.
- Input: firmanavn med valgfri landinformasjon.
- Output: domene, full nettadresse, konfidensnivå, resultatstatus og brukte credits.
Konfigurer Python og Datablist API-nøkkelen
I dette eksempelet bruker jeg Requests-pakken til å utføre synkrone HTTP-kall. Installer den i et virtuelt miljø:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requestsDu trenger også et Datablist Growth-abonnement, fordi tilgang til REST API-et er en Growth-funksjon. Opprett en Personal API Key på API-kontosiden i Datablist, og legg den deretter i en miljøvariabel:
export DATABLIST_API_KEY="exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2"🔑 Har du allerede en API-nøkkel? Eldre nøkler bruker formatet
auth0|<userId>:<accountId>:<secret>:1. De støttes fortsatt. Fortsett å bruke den eksisterende nøkkelen nøyaktig slik den ble generert. Du trenger ikke å erstatte eller endre formatet på den.
Erstatt eksempelverdien ovenfor med nøkkelen som ble generert på kontosiden din. Oppslag etter bedriftsnettsteder bruker credits. Før vi skalerer scriptet, forklarer jeg alternativene som koster 1 og 2,5 credits. Gjeldende abonnementsverdier finner du på Datablists prisside.
Finn ett bedriftsnettsted med Python
Opprett en fil med navnet find_company_websites.py. Scriptet sender inn navnene, venter på oppgaven og henter resultatene i én funksjon. Hver input bruker den stabile post-ID-en din som inputId. Dermed kan du koble hvert resultat til riktig post selv om rekkefølgen i svaret endres.
import json
import os
import time
import uuid
import requests
API_BASE_URL = "https://api.datablist.com/v1"
def find_domains(companies, api_key):
headers = {
"Accept": "application/json",
"Content-Type": "application/json",
"X-API-Key": api_key,
}
inputs = [
{
"inputId": company["id"],
"data": {
"companyName": company["company_name"],
"targetCountry": company.get("country", ""),
},
}
for company in companies
]
unique_id = f"python-domain-lookup-{uuid.uuid4().hex}"
payload = {
"enrichmentId": "company-name-to-domain",
"uniqueId": unique_id,
"settings": {
"workflow": "dataset_google",
"countryOverwrite": True,
"acceptNonRoot": True,
},
"inputs": inputs,
}
print(f"Task uniqueId: {unique_id}")
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} ended with status {task['status']}: {task.get('error')}"
)
results = []
cursor = None
while True:
params = {"limit": 100}
if cursor is not None:
params["cursor"] = cursor
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}/results",
headers=headers,
params=params,
)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
break
return results
api_key = os.environ["DATABLIST_API_KEY"]
companies = [
{
"id": "direct-microsoft-us",
"company_name": "Microsoft",
"country": "US",
}
]
lookup_results = find_domains(companies, api_key)
for result in lookup_results:
print(json.dumps(result, indent=2))Kjør det fra terminalen der du eksporterte nøkkelen:
python find_company_websites.pyHer er resultatet for Microsoft:
{
  "inputId": "direct-microsoft-us",
  "status": "success",
  "outputs": {
    "companyUrl": "https://microsoft.com",
    "companyDomain": "microsoft.com",
    "domainConfidence": "High"
  },
  "creditsUsed": "1",
  "error": null
}
Bruk inputId til å koble resultatet til den opprinnelige posten. status er success, no_result, error eller skipped. Et vellykket resultat kan inneholde companyDomain, hele companyUrl og domainConfidence. creditsUsed viser kostnaden for denne inputen, mens error forklarer en feil på elementnivå.
Funksjonen utfører tre typer API-kall i en bestemt rekkefølge.
Først sender den inn oppslaget. Payloaden inneholder innstillingene og bedriftspostene. POST-kallet returnerer 202 Accepted, og @id er oppgave-ID-en som de neste kallene trenger:
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]Hvis DATABLIST_API_KEY ikke er angitt, utløser Python en KeyError ved oppslaget i miljøvariabelen, før det utføres en HTTP-forespørsel. Eksporter variabelen og kjør scriptet på nytt. Hvis variabelen inneholder en ugyldig nøkkel, når POST-kallet API-et og returnerer HTTP 401. Kopier en gyldig Personal API Key fra kontosiden din, og erstatt den ugyldige verdien.
Deretter poller den oppgaven. POST-kallet starter arbeidet i bakgrunnen. Derfor leser scriptet oppgaven hvert tredje sekund til den får statusen completed, failed eller stopped:
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)Hvis oppgaven mislykkes fordi du ikke har nok credits, vil feilen ha årsaken credits_error. Legg til credits, eller vent til de månedlige creditene fornyes. Kontroller eventuelle resultater som allerede er returnert, og send deretter bare uferdige inputs i en ny oppgave.
Til slutt henter den alle resultatsidene. Hvert svar legger resultater til listen og oppgir cursoren for neste forespørsel:
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
breakDen henter neste side helt til nextCursor er null.
Scriptet skriver ut den genererte uniqueId-verdien før POST-kallet. Hvis forbindelsen brytes før du mottar svaret om at oppgaven er opprettet, bør du først liste opp oppgavene dine og kontrollere statusen deres før du oppretter en ny:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-name-to-domain"Finn oppgaven der uniqueId samsvarer med verdien scriptet genererte, og kopier deretter oppgavens @id. Liste-endepunktet kan filtrere etter enrichmentId, men ikke etter uniqueId. Bruk @id med de samme URL-ene for status og resultater som scriptet bruker. Fortsett pollingen hvis oppgaven fortsatt er aktiv. Hvis den har stoppet eller mislyktes, må du se etter delresultater før du sender inn inputene på nytt.
Forstå datasettmatching og fallback med land
Scriptet bruker dataset_google, som er den anbefalte standardinnstillingen. Datablist søker først i sine egne bedriftsdatasett. Hvis treffet mangler eller resultatene er motstridende, kan Google brukes som fallback. Mulige treff kontrolleres før et konfidensnivå returneres.
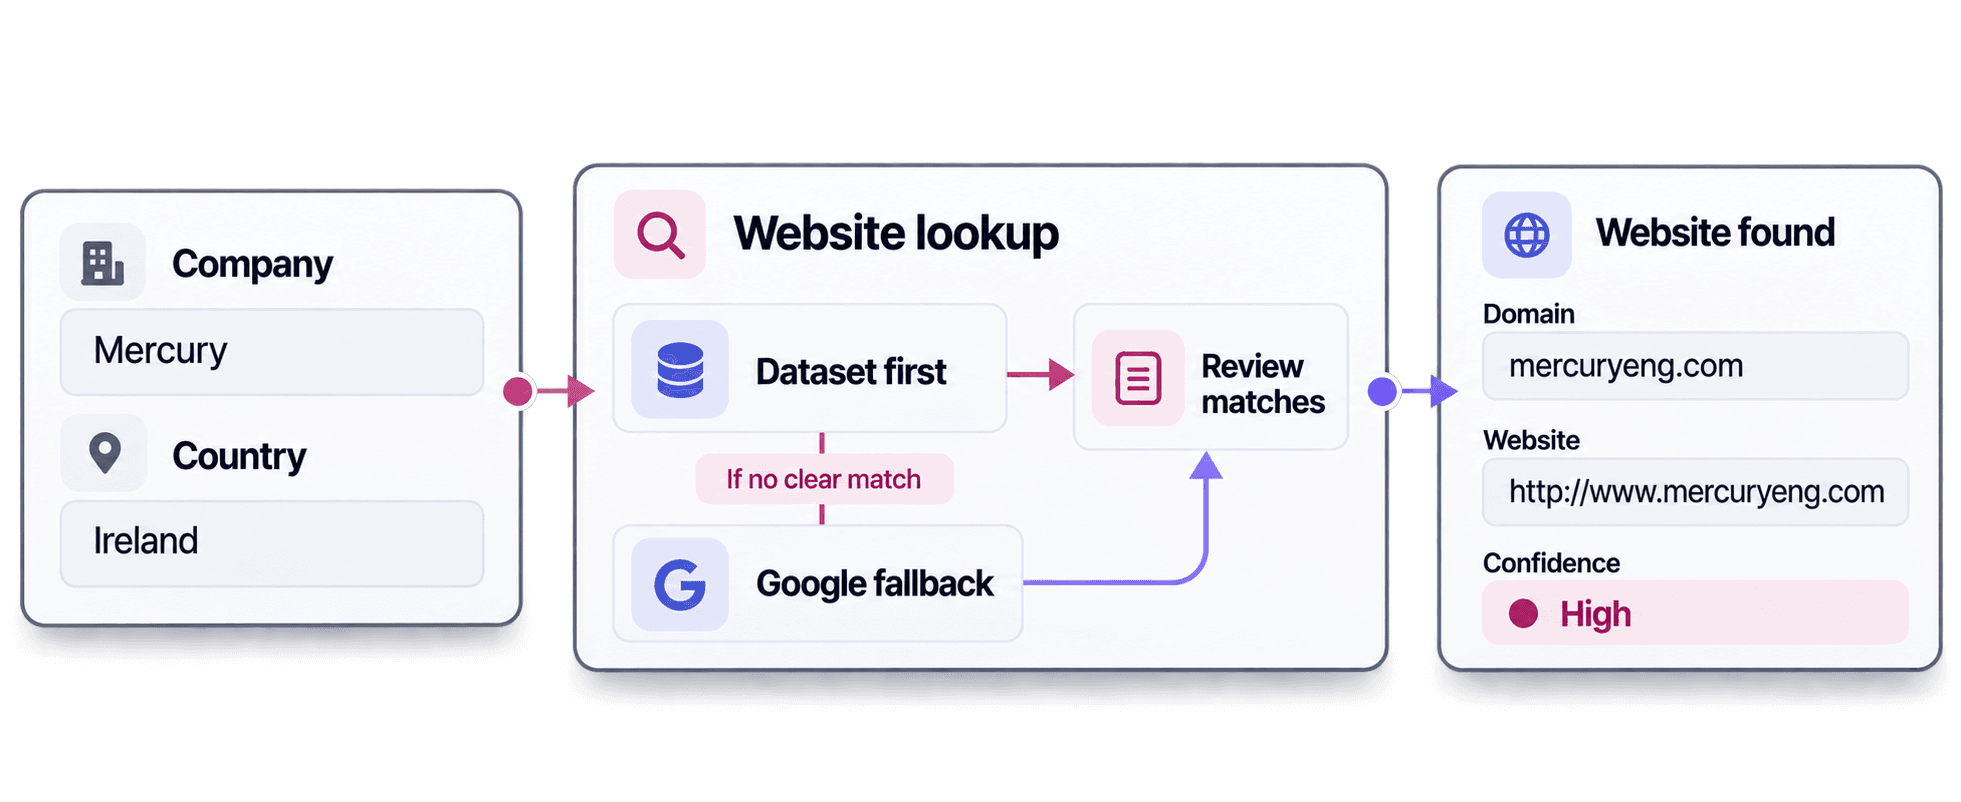
Landinformasjon er nyttig når navn kan vise til flere bedrifter. I dette eksempelet ga det samme firmanavnet ulike resultater:
MercurymedUSreturnerteshipmercury.comoghttps://www.shipmercury.com/.MercurymedIEreturnertemercuryeng.comoghttp://www.mercuryeng.com.
Begge hadde konfidensnivået High. Landinformasjonen hjelper oppslaget med å skille mellom bedrifter med samme navn, mens konfidensnivået gjør det enklere å avgjøre hvilke resultater som bør kontrolleres.
Når treffet også avhenger av bransje, bedriftsstørrelse eller annen forretningskontekst, kan du bruke AI Agent-workflowen for research. Legg til disse opplysningene i prompten til AI Agent, slik at den kan undersøke riktig bedrift med mer utfyllende forretningskontekst.
Fyll bare ut manglende nettsteder i postene
Nå som find_domains() kan finne et nettsted fra et firmanavn, kan du bruke funksjonen på nytt for å fylle ut bare de manglende nettstedene i bedriftspostene dine. Poster som allerede har et nettsted, sendes ikke til API-et. Verdiene forblir dermed uendret, og oppslaget bruker ingen credits.
I find_company_websites.py erstatter du alt fra companies = [ til og med den siste utskriftsløkken med blokken nedenfor. Behold tilordningen av api_key over den. Kontrollen for tomme verdier håndterer None, en tom streng og mellomrom. Det utføres ingen API-kall hvis alle nettstedfeltene er utfylt.
records = [
{
"id": "crm-001",
"company_name": "Microsoft",
"country": "US",
"website": "https://www.microsoft.com",
},
{
"id": "crm-002",
"company_name": "boulangerie du palais lyon",
"country": "FR",
"website": "",
},
{
"id": "crm-003",
"company_name": "Mercury Engineering",
"country": "IE",
"website": None,
},
{
"id": "crm-004",
"company_name": "Mercury",
"country": "US",
"website": " ",
},
{
"id": "crm-005",
"company_name": "Datablist",
"country": "FR",
"website": "https://www.datablist.com",
},
{
"id": "crm-006",
"company_name": "Mercury",
"country": "IE",
"website": None,
},
]
def website_is_missing(value):
return not isinstance(value, str) or not value.strip()
records_to_lookup = [
record for record in records if website_is_missing(record.get("website"))
]
lookup_results = (
find_domains(records_to_lookup, api_key) if records_to_lookup else []
)
results_by_id = {result["inputId"]: result for result in lookup_results}
for record in records:
if not website_is_missing(record.get("website")):
record["website_lookup"] = {"status": "not_requested"}
continue
result = results_by_id.get(record["id"])
if result is None:
record["website_lookup"] = {
"status": "missing_result",
"domain": None,
"confidence": None,
"credits": None,
"error": {
"code": "missing_result",
"message": "No result was returned for this inputId.",
},
}
continue
outputs = result.get("outputs") or {}
if result["status"] == "success" and outputs.get("companyUrl"):
record["website"] = outputs["companyUrl"]
record["website_lookup"] = {
"status": result["status"],
"domain": outputs.get("companyDomain"),
"confidence": outputs.get("domainConfidence"),
"credits": result.get("creditsUsed"),
"error": result.get("error"),
}
print(json.dumps(records, indent=2))Koden indekserer resultatene etter inputId og går deretter gjennom de opprinnelige postene i riktig rekkefølge. Objektet website_lookup lagrer resultatet og opplysningene som trengs for kontroll, ved siden av hver post det ble gjort et forsøk for. Dette gjelder også mislykkede og manglende resultater.
For crm-001 returnerer website_is_missing() verdien False, fordi Microsoft-URL-en allerede finnes. Posten legges ikke til i records_to_lookup, så API-et mottar den aldri. Sammenslåingen beholder nettstedet og registrerer statusen som not_requested.
For crm-002 er nettstedfeltet tomt, så forespørselen sender bakeriet med inputId: crm-002. API-et returnerer samme inputId. results_by_id bruker den til å finne riktig resultat, og sammenslåingen skriver https://boulangerie-du-palais-lyon.eatbu.com til denne posten uten å være avhengig av rekkefølgen på resultatene.
| ID | Bedrift | Nettsted etter sammenslåing | Status | Domene | Konfidens | Credits |
|---|---|---|---|---|---|---|
crm-001 | Microsoft · US | https://www.microsoft.com | not_requested | |||
crm-002 | boulangerie du palais lyon · FR | https://boulangerie-du-palais-lyon.eatbu.com | success | boulangerie-du-palais-lyon.eatbu.com | High | 1 |
crm-003 | Mercury Engineering · IE | https://mercuryeng.com | success | mercuryeng.com | High | 1 |
crm-004 | Mercury · US | https://www.shipmercury.com/ | success | shipmercury.com | High | 1 |
crm-005 | Datablist · FR | https://www.datablist.com | not_requested | |||
crm-006 | Mercury · IE | http://www.mercuryeng.com | success | mercuryeng.com | High | 1 |
Bakeriet bruker et bedriftsspesifikt subdomene, boulangerie-du-palais-lyon.eatbu.com. Behold denne verdien i stedet for å redusere den til eatbu.com, og lagre den nøyaktige adressen fra companyUrl. Innstillingen acceptNonRoot: true tillater også en hostet bedriftsside der adressen inneholder en sti etter vertsnavnet. Derfor er hele URL-en viktig i begge tilfeller.
En fullført oppgave kan fortsatt inneholde elementer med no_result, error eller skipped. Eksempelet endrer website bare når statusen er success og companyUrl finnes. Ved no_result forblir nettstedfeltet tomt, og statusen er fortsatt synlig i website_lookup. Kontroller først firmanavnet og landet. Hvis en av inputverdiene er feil, retter du den og sender posten i en ny oppgave. Ellers lar du det tomme nettstedfeltet være synlig, slik at det kan kontrolleres manuelt.
Beregn credits før du skalerer scriptet
Alle de fem eksempeloppslagene returnerte success med konfidensnivået High og brukte til sammen 5 credits.
Et oppslag som løses via datasettet, koster 1 credit. Et oppslag som behandles med Google, koster 2,5 credits. Du betaler for metoden som brukes, ikke for begge. For 1 000 inputs betyr det 1 000 credits hvis alle løses via datasettet, eller 2 500 credits hvis alle bruker Google. Dette er beregningseksempler, ikke en garanti for at hvert oppslag lykkes.
Flytt glidebryteren for å sammenligne creditforbruket for listen din.
Med en pris på 20 dollar for 20 000 credits koster disse scenarioene henholdsvis 1 og 2,50 dollar. Growth-abonnementet betales separat og inkluderer for øyeblikket 20 000 credits per måned, som brukes før eventuelle tilleggspakker. Sjekk gjeldende priser, fordi abonnementer og pakkeverdier kan endres.
Én oppgave kan ta imot opptil 10 000 inputs, med en grense på 16 KiB per input og 10 MiB per forespørsel. Dette eksempelet bruker blokkerende Requests-kall til å sende inn, polle og hente resultatene fra én liten asynkron Datablist-oppgave. Det vedlikeholdte repositoriet inneholder også eksempler på CSV-batching og ikke-blokkerende klienter.
Neste steg
Når du har bekreftet at et returnert nettsted tilhører riktig bedrift, kan du scrape nettstedets Impressum med Python for å legge til juridiske selskapsopplysninger og URL-en til den juridiske kildesiden i samme leverandørpost. Hold kontrollen av nettstedstreffet adskilt fra den senere datauttrekkingen.
Erstatt eksempelpostene med et lite utvalg av dine egne data. Kjør deretter scriptet og kontroller de sammenslåtte postene. Behold stabile ID-er og landinformasjon, og skaler først opp når scriptet bevarer kjente nettsteder og fyller ut de forventede tomme feltene. Du kan ta utgangspunkt i de vedlikeholdte eksemplene for Company Name to Domain API på GitHub hvis du vil ha et nedlastbart script, CSV-batching eller en asynkron versjon.