
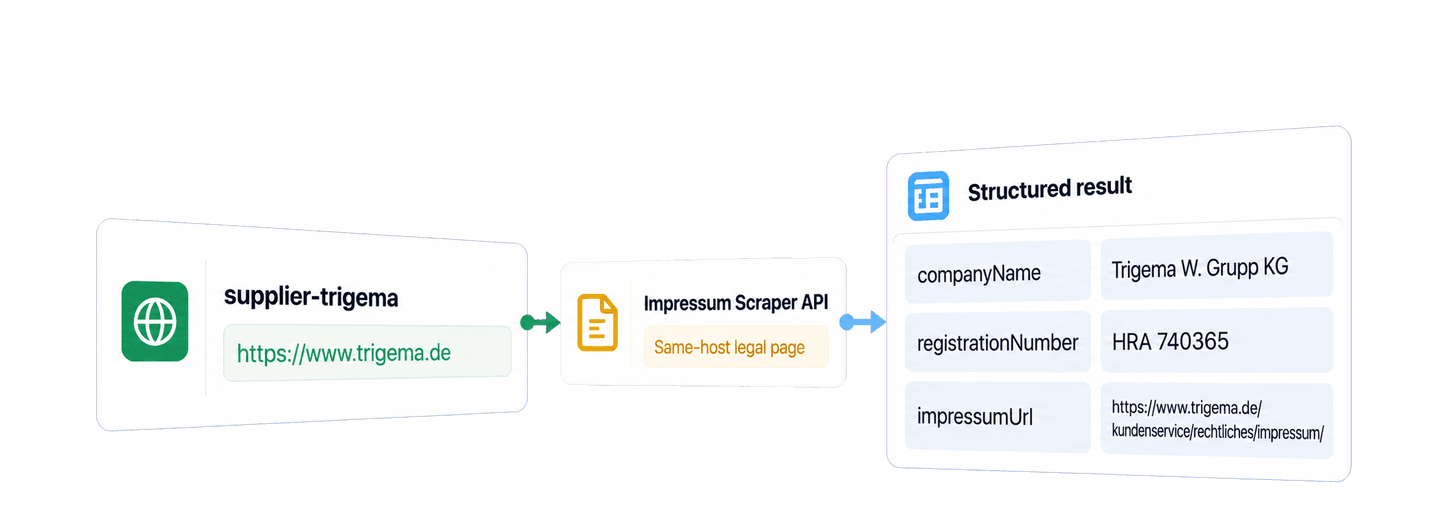
For å hente Impressum-data med Python uten å bygge en egen crawler kan du bruke Datablists Impressum Scraper API sammen med Requests-biblioteket. Du sender inn URL-ene til bedriftenes nettsteder, API-et finner Impressum-siden på hvert nettsted og trekker ut strukturerte bedrifts- og kontaktopplysninger.
I dette eksemplet bruker jeg to veletablerte tyske merkevarer: klesprodusenten Trigema og friluftsmerket VAUDE. Et lite, kjørbart Python-eksempel utfører oppslaget og lagrer både de uthentede opplysningene og URL-en til Impressum-kilden sammen med hver leverandørpost.
📌 Kort oppsummert
Bruk Datablists Impressum Scraper API til å gjøre tyske bedriftsnettsteder om til strukturerte bedrifts- og kontaktdata. Python-eksemplet sender inn to nettsteder, venter på bakgrunnsoppgaven, henter alle resultatsidene og lagrer URL-en til den juridiske kildesiden sammen med hver post.
- Input: URL-er til tyske bedriftsnettsteder.
- Output: Bedrifts- og kontaktopplysninger samt lenken til Impressum-kilden.
💡 Foretrekker du en no-code-løsning? Bruk Datablists Impressum Scraper til å hente ut disse bedriftsopplysningene uten å skrive kode.
Konfigurer API-nøkkelen og Python-miljøet
Opprett en Datablist-konto, og lag deretter en Personal API Key. Tilgang til REST API-et er tilgjengelig med Growth-abonnementet. Slik ser formatet til en nøkkel ut:
auth0|exampleuser:exampleaccount:EXAMPLE_TOKEN_NOT_VALID:1Eksporter din egen nøkkel som DATABLIST_API_KEY:
export DATABLIST_API_KEY="your-personal-api-key"I dette Python-eksemplet bruker jeg pakken requests. Opprett en fil med navnet
scrape_impressum.py, og installer pakken:
python -m pip install requestsHvert nettsted du sender inn, bruker 10 credits. Eksemplet med to nettsteder nedenfor bruker 20 credits når begge inputene behandles.
Bygg funksjonen scrape_impressums()
Lim inn hele dette scriptet i scrape_impressum.py:
import json
import os
import time
import uuid
import requests
def scrape_impressums(suppliers, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]
payload = {
"enrichmentId": "impressum-scraper",
"uniqueId": str(uuid.uuid4()),
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
suppliers = [
{
"id": "supplier-trigema",
"label": "Trigema",
"website_url": "https://www.trigema.de",
},
{
"id": "supplier-vaude",
"label": "VAUDE",
"website_url": "https://www.vaude.com",
},
]
impressum_results = scrape_impressums(suppliers, api_key)
for result in impressum_results:
print(json.dumps(result, ensure_ascii=False))Kjør hele scriptet med:
python scrape_impressum.pyFunksjonen følger API-prosessen i tre trinn. Den sender inn nettstedsadressene, venter til oppgaven er ferdig og henter deretter alle resultatsidene.
Send inn nettstedsadressene
Scriptet gjør hver leverandør om til en API-input på denne måten:
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]inputId er din egen stabile identifikator. data.websiteUrl er bedriftens hjemmeside, som scraperen skal undersøke. Bruk bedriftens eget nettsted, ikke en katalog eller profil i sosiale medier. Payloaden velger den offentlige enrichments-funksjonen impressum-scraper og bruker et tomt settings-objekt fordi dette API-et ikke krever offentlige innstillinger.
POST-forespørselen oppretter en bakgrunnsoppgave. Datablist godtar forespørselen og returnerer et oppgaveobjekt der @id identifiserer denne kjøringen. Funksjonen bruker denne ID-en til å bygge URL-ene for status og resultater.
En forkortet respons ved opprettelse ser slik ut:
{
  "@id": "task-id",
  "enrichmentId": "impressum-scraper",
  "status": "queued",
  "links": {
    "self": "https://api.datablist.com/v1/enrichments/tasks/task-id",
    "results": "https://api.datablist.com/v1/enrichments/tasks/task-id/results"
  }
}
queued betyr at forespørselen er godtatt, ikke at resultatet er klart. Scriptet tar med den returnerte @id-verdien videre til de neste to trinnene, slik at du slipper å kopiere oppgave-URL-er manuelt. Det kaller også raise_for_status() før hver respons leses. En autentiserings- eller valideringsfeil stopper derfor ved HTTP-forespørselen som mislyktes, i stedet for å bli tolket som et fullført oppslag.
Vent på bakgrunnsoppgaven
Datablist behandler oppgaven i bakgrunnen. Eksemplet kontrollerer statusen hvert tredje sekund til den blir completed, failed eller stopped. Requests er et blokkerende Python-bibliotek, så det lokale scriptet venter under disse kallene selv om selve API-oppgaven kjører i bakgrunnen.
Hvis oppgaven avsluttes med failed eller stopped, utløser funksjonen en feil som inneholder oppgave-ID-en og sluttstatusen. Ta vare på ID-en når du undersøker den eksisterende oppgaven, i stedet for umiddelbart å sende inn det samme betalte arbeidet på nytt.
Hent alle resultatsidene
Når oppgaven er fullført, ber scriptet om opptil 100 resultater om gangen. Regelen for paginering er enkel: Hent neste side til nextCursor er null. Når cursoren inneholder en verdi, sender scriptet den med neste forespørsel.
Ikke koble de returnerte postene til applikasjonen etter plasseringen i listen. Resultatene kan komme i en annen rekkefølge enn inputene. Bruk inputId som koblingsnøkkel.
Slik finner API-et en Impressum-side
Hjemmesiden er utgangspunktet, ikke siden API-et forventer å hente data fra. Impressum Scraper bruker AI til å undersøke interne lenker på det angitte domenet og finne en Impressum-side eller en tilsvarende juridisk side eller kontaktside. Dette er viktig fordi lenken kan ligge under navn som Rechtliches, Kontakt eller Legal, i stedet for å finnes på /impressum.
Hvis AI ikke finner en egnet intern lenke, prøver scraperen de vanlige stiene /impressum og /imprint på samme domene. Når den har nådd en kildeside, bruker den AI til å trekke ut juridisk selskapsnavn, adresse, kontaktopplysninger, registreringsdata, VAT-nummer og kildefelter i ett resultat. Den bruker ikke en søkemotor og går heller ikke videre til en ekstern katalog.
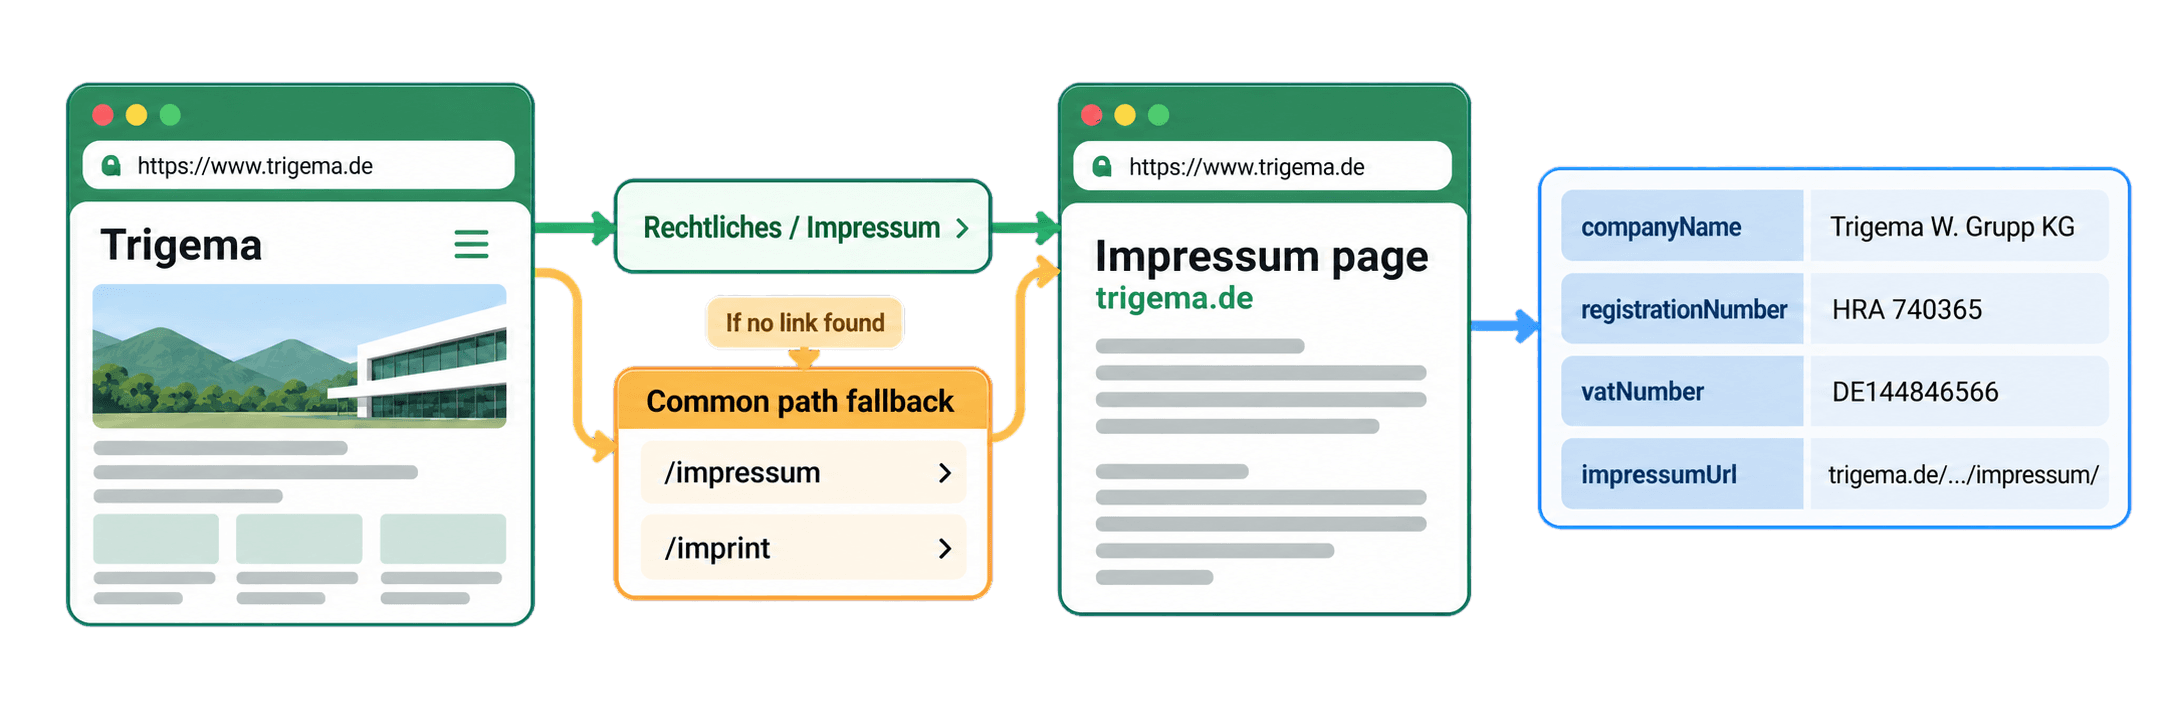
De to resultatene viser hvordan URL-stiene kan variere i praksis. Trigema returnerte /kundenservice/rechtliches/impressum/, mens VAUDE returnerte /de/de/impressum.html. Behold impressumUrl sammen med hvert resultat, siden feltet dokumenterer den nøyaktige kildesiden opplysningene ble hentet fra.
Les resultatene for Trigema og VAUDE
Her er et kompakt utdrag fra de to eksempelresultatene.
📘 Eksempel på e-postadresser: E-postadressene er maskert med
**nedenfor. API-et returnerer de fullstendige adressene.
[
  {
    "inputId": "supplier-trigema",
    "status": "success",
    "outputs": {
      "firstName": "Wolfgang",
      "lastName": "Grupp",
      "companyName": "Trigema W. Grupp KG",
      "postalAddress": "Josef-Mayer-Str. 31-35, D-72393 Burladingen",
      "emailAddress": "b**@trigema.de",
      "registrationNumber": "HRA 740365",
      "vatNumber": "DE144846566",
      "impressumUrl": "https://www.trigema.de/kundenservice/rechtliches/impressum/",
      "agentConfidenceScore": 90
    },
    "creditsUsed": "10",
    "error": null
  },
  {
    "inputId": "supplier-vaude",
    "status": "success",
    "outputs": {
      "firstName": "Antje",
      "lastName": "von Dewitz",
      "companyName": "VAUDE Sport GmbH & Co. KG",
      "postalAddress": "Vaude Straße 2, 88069 Tettnang",
      "emailAddress": "s**@service.vaude.com",
      "registrationNumber": "HRA 631071",
      "vatNumber": "DE203894755",
      "impressumUrl": "https://www.vaude.com/de/de/impressum.html",
      "agentConfidenceScore": 95
    },
    "creditsUsed": "10",
    "error": null
  }
]
Begynn med navnene. Trigema er leverandørnavnet i Python-inputen, mens Trigema W. Grupp KG er det juridiske selskapsnavnet som er hentet fra Impressum-siden. Det samme skillet gjelder VAUDE: Navnet i inputen er VAUDE, mens selskapet som returneres, er VAUDE Sport GmbH & Co. KG. Ved å beholde begge verdiene kan du ta vare på det gjenkjennelige navnet teamet ditt bruker, samtidig som du legger til den juridiske enheten som står på selskapets eget nettsted. Dette er spesielt nyttig når du sammenligner en leverandørpost med en faktura, kontrakt eller et annet selskapsdatasett som kan bruke det lengre juridiske navnet.
De returnerte feltene besvarer ulike research-spørsmål:
firstNameoglastNameinneholder navnet på daglig leder eller grunnlegger når dette finnes på siden. Her er navnene Wolfgang Grupp og Antje von Dewitz.postalAddressviser forretningsadressen som er hentet fra den juridiske siden, mens e-post- og telefonfeltene inneholder kontaktopplysningene som er publisert der.registrationNumberogvatNumberbevarer identifikatorene som står på siden. For Trigema er verdieneHRA 740365ogDE144846566, mens de for VAUDE erHRA 631071ogDE203894755. Dermed får du konkrete verdier du kan sammenligne med identifikatorene som allerede finnes i leverandørdataene dine.impressumUrlidentifiserer siden som ble brukt til uthentingen. Den holdes adskilt fra hjemmesiden du sendte inn, fordi den ene viser bedriften du startet med, mens den andre dokumenterer kilden til de juridiske selskapsopplysningene.
Begge postene har status: success og brukte 10 credits. agentConfidenceScore er et signal fra 0 til 100 som hjelper deg med å prioritere manuell kontroll. Det er ikke en prosentangivelse av nøyaktigheten. Output-felter kan fortsatt være tomme når en verdi mangler på siden eller ikke kan hentes ut. Behold derfor statusen for hvert element, og åpne den returnerte Impressum-URL-en når en opplysning er viktig for neste trinn.
Den dokumenterte outputen kan også inneholde kjønn, telefonnummer og andre kontaktopplysninger. Se API-dokumentasjonen for Impressum Scraper for gjeldende skjema.
Gjør outputen om til leverandørdata
Det direkte API-kallet fungerer allerede. Nå kan du sette det inn i en konkret leverandørresearch. Når du finner eller onboarder leverandører, har du gjerne en stabil ID, kortnavnet teamet bruker og en hjemmeside. Impressum-resultatet legger til den juridiske virksomheten bak nettstedet, publiserte identifikatorer og kontaktopplysninger samt siden der verdiene ble funnet.
Følgende kodebit indekserer resultatene etter inputId og bygger lokale poster for selskapsresearch. Legg den til etter kallet til scrape_impressums() i det fullstendige scriptet:
results_by_id = {
result["inputId"]: result for result in impressum_results
}
company_research = []
for supplier in suppliers:
result = results_by_id[supplier["id"]]
company_research.append(
{
"supplier_id": supplier["id"],
"supplier_label": supplier["label"],
"website_url": supplier["website_url"],
"status": result["status"],
"outputs": result.get("outputs", {}),
"credits_used": result["creditsUsed"],
"error": result.get("error"),
}
)
print(json.dumps(company_research, indent=2, ensure_ascii=False))For Trigema beholder posten supplier-trigema, visningsnavnet Trigema og https://www.trigema.de. Det nestede outputs-objektet legger til Trigema W. Grupp KG, adressen og identifikatorene, det returnerte navnet Wolfgang Grupp og URL-en til Impressum-kilden. VAUDE-posten følger den samme kjeden fra navnet VAUDE og hjemmesiden til VAUDE Sport GmbH & Co. KG og selskapets egen kildeside. Nå kan du sammenligne eller gruppere poster etter juridisk selskap uten å miste den opprinnelige leverandøridentiteten som utløste researchen.
Posten samler de returnerte opplysningene, vellykket API-status, forbruket på 10 credits og den offentlige feilverdien sammen med leverandørens ID, navn og nettsted.
Den viktigste regelen for sammenslåing er oppslaget i dictionary-objektet basert på leverandør-ID. Det kobler fortsatt riktig resultat selv om API-et returnerer VAUDE før Trigema. Kodebiten beholder også elementer som ikke var vellykkede, i company_research, fordi den ikke filtrerer etter status. Et element med no_result eller error forblir tilgjengelig med ID og feilmelding i stedet for å forsvinne fra kontrollkøen.
Denne koden klargjør lokale research-poster. Du kan serialisere listen eller sende den videre til din egen kode uten å legge til et nytt API-kall.
Beregn kostnaden for API-et
Impressum Scraper bruker fast 10 credits per nettsted som sendes inn. De to eksempelnettstedene brukte totalt 20 credits. Med samme sats bruker 1 000 nettsteder 10 000 credits.
Growth-abonnementet gir tilgang til REST API-et og inkluderer credits i abonnementet. Du kan kjøpe ekstra credits når du trenger flere. Tilgang til abonnementet, inkluderte credits og tilleggskjøp er separate deler av kostnaden. Sjekk derfor Datablists gjeldende priser før du planlegger en større kjøring.
Løs vanlige problemer uten å betale dobbelt
Scriptet stopper før en forespørsel sendes
Hvis DATABLIST_API_KEY mangler, utløser scriptet feilen Set DATABLIST_API_KEY before running this script. Eksporter variabelen i den samme terminalen, og kjør filen på nytt:
export DATABLIST_API_KEY="your-personal-api-key"
python scrape_impressum.pyAPI-et avviser forespørselen
response.raise_for_status() stopper ved en HTTP-feil. Kontroller at du har oppgitt en gyldig Personal API Key, og at kontoen har tilgang til REST API-et. Dette skiller seg fra tilfellet der variabelen mangler: En ugyldig verdi når frem til API-et og mottar en HTTP-respons.
Oppgaven mislykkes eller stopper
Feilen som utløses, inneholder oppgave-ID-en og statusen. Undersøk den eksisterende oppgaven, resultatene og credit-feltene før du oppretter en ny oppgave. En mislykket eller stoppet oppgave kan fortsatt inneholde resultater og credit-forbruk, så en umiddelbar gjentakelse kan føre til at du betaler for det samme arbeidet to ganger.
Ett resultat er ufullstendig
En fullført oppgave kan inneholde no_result, error eller ufullstendig output på elementnivå. Behold postens inputId, status, impressumUrl når den er tilgjengelig, og den offentlige error-verdien. Kontroller at inputen er selskapets egen hjemmeside eller rotdomene, og undersøk deretter nettstedet før du avgjør om et nytt oppslag er nyttig.
Dokumentasjonen for oppgaver forklarer statuser, paginering av resultater, oppgavehistorikk, grenser og lagringstid mer detaljert.
Neste steg
Du har nå en kjørbar Python-integrasjon med Requests som sender inn tyske bedriftsnettsteder, venter på Impressum Scraper-oppgaven, henter alle resultatsidene og lagrer strukturerte bedriftsopplysninger sammen med kilde-URL-ene i lokale poster for leverandørresearch.
Bytt ut de to eksempelleverandørene med dine egne stabile ID-er og nettstedsadresser. Kontroller deretter hver returnerte impressumUrl før du bruker de uthentede feltene videre i prosessen. Du kan laste ned det vedlikeholdte
synkrone Requests-eksemplet
eller bytte til repoets
asynkrone HTTPX-eksempel
når du trenger ikke-blokkerende parallellitet.