
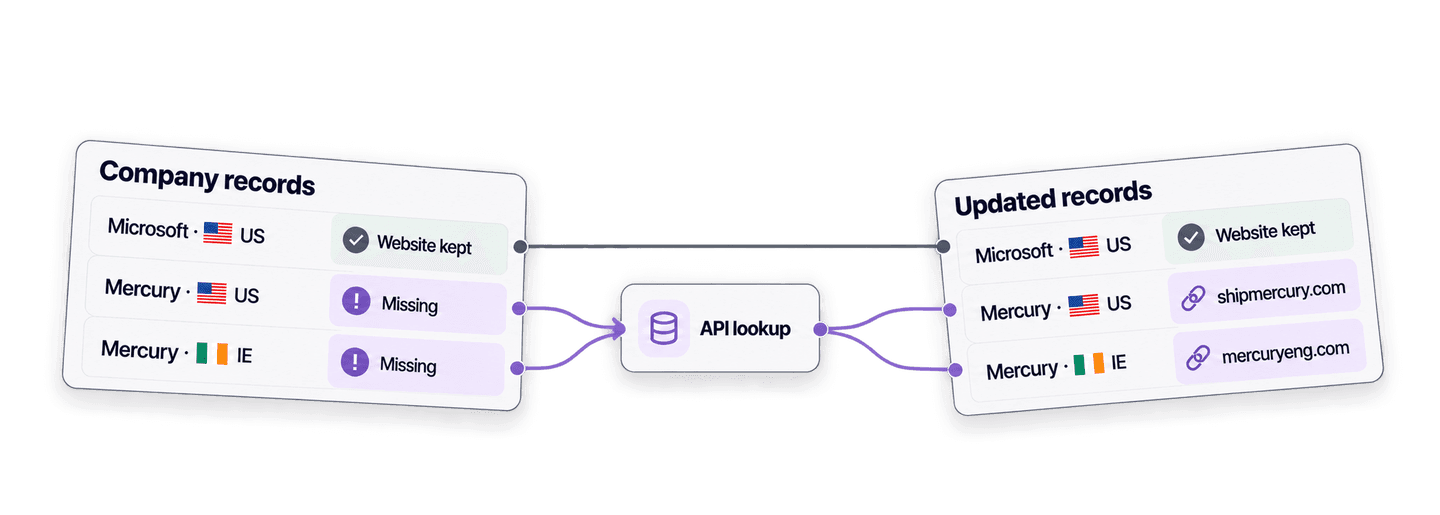
Aby znaleźć stronę internetową firmy na podstawie jej nazwy w Pythonie, wyślij nazwę oraz dostępne informacje o kraju do Company Name to Domain API Datablist. API przetworzy wyszukiwanie w tle, a następnie zwróci domenę i pełny adres URL strony.
Najpierw pokażę proste zapytanie API w Pythonie. Następnie użyję tej samej funkcji, aby uzupełnić wyłącznie brakujące strony internetowe na liście firm, zachowując adresy URL, które już znajdują się w rekordach.
Jeśli wolisz interfejs przypominający arkusz kalkulacyjny, skorzystaj z poradnika zbiorczego wyszukiwania stron firm na podstawie nazw.
💡 Podsumowanie dla zabieganych
Utwórz jedną funkcję w Pythonie, która wyszukuje strony na podstawie nazw firm, a następnie wykorzystaj ją do uzupełniania rekordów z pustym polem strony bez zastępowania znanych adresów URL.
- Dane wejściowe: nazwy firm z opcjonalną informacją o kraju.
- Dane wyjściowe: domena, pełny adres URL strony, poziom pewności, status wyniku i liczba wykorzystanych kredytów.
Skonfiguruj Pythona i klucz API Datablist
W tym przykładzie używam pakietu Requests do wykonywania synchronicznych wywołań HTTP. Zainstaluj go w środowisku wirtualnym:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requestsPotrzebujesz również planu Datablist Growth, ponieważ dostęp do REST API jest funkcją tego planu. Utwórz Personal API Key na stronie API swojego konta Datablist, a następnie zapisz go w zmiennej środowiskowej:
export DATABLIST_API_KEY="exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2"🔑 Masz już klucz API? Starsze klucze mają format
auth0|<userId>:<accountId>:<secret>:1i nadal są obsługiwane. Korzystaj z dotychczasowego klucza dokładnie w takiej postaci, w jakiej został wygenerowany — nie musisz go wymieniać ani zmieniać jego formatu.
Zastąp powyższą przykładową wartość kluczem wygenerowanym na stronie konta. Wyszukiwanie stron firm zużywa kredyty. Przed przejściem do większej skali wyjaśnię warianty kosztujące 1 oraz 2,5 kredytu. Aktualne wartości dla poszczególnych planów znajdziesz na stronie cennika Datablist.
Wyszukaj stronę jednej firmy w Pythonie
Utwórz plik o nazwie find_company_websites.py. Skrypt przesyła nazwy, czeka na zakończenie zadania i pobiera wyniki za pomocą jednej funkcji. Każdy element wejściowy wykorzystuje stały identyfikator rekordu jako inputId, dzięki czemu można przypisać każdy wynik do właściwego rekordu, nawet jeśli zmieni się kolejność odpowiedzi.
import json
import os
import time
import uuid
import requests
API_BASE_URL = "https://api.datablist.com/v1"
def find_domains(companies, api_key):
headers = {
"Accept": "application/json",
"Content-Type": "application/json",
"X-API-Key": api_key,
}
inputs = [
{
"inputId": company["id"],
"data": {
"companyName": company["company_name"],
"targetCountry": company.get("country", ""),
},
}
for company in companies
]
unique_id = f"python-domain-lookup-{uuid.uuid4().hex}"
payload = {
"enrichmentId": "company-name-to-domain",
"uniqueId": unique_id,
"settings": {
"workflow": "dataset_google",
"countryOverwrite": True,
"acceptNonRoot": True,
},
"inputs": inputs,
}
print(f"Task uniqueId: {unique_id}")
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} ended with status {task['status']}: {task.get('error')}"
)
results = []
cursor = None
while True:
params = {"limit": 100}
if cursor is not None:
params["cursor"] = cursor
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}/results",
headers=headers,
params=params,
)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
break
return results
api_key = os.environ["DATABLIST_API_KEY"]
companies = [
{
"id": "direct-microsoft-us",
"company_name": "Microsoft",
"country": "US",
}
]
lookup_results = find_domains(companies, api_key)
for result in lookup_results:
print(json.dumps(result, indent=2))Uruchom skrypt w terminalu, w którym wcześniej ustawiono zmienną z kluczem:
python find_company_websites.pyOto wynik dla firmy Microsoft:
{
  "inputId": "direct-microsoft-us",
  "status": "success",
  "outputs": {
    "companyUrl": "https://microsoft.com",
    "companyDomain": "microsoft.com",
    "domainConfidence": "High"
  },
  "creditsUsed": "1",
  "error": null
}
Użyj inputId, aby przypisać wynik do pierwotnego rekordu. Pole status może przyjmować wartość success, no_result, error albo skipped. Pomyślny wynik może zawierać companyDomain, pełny adres companyUrl oraz domainConfidence. Pole creditsUsed pokazuje koszt danego elementu, a error opisuje błąd dotyczący konkretnego rekordu.
Funkcja wykonuje kolejno trzy rodzaje wywołań API.
Najpierw przesyła zapytanie. Payload zawiera ustawienia oraz rekordy firm. Żądanie POST zwraca 202 Accepted, a @id jest identyfikatorem zadania potrzebnym w kolejnych wywołaniach:
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]Jeśli zmienna DATABLIST_API_KEY nie jest ustawiona, Python zgłosi KeyError podczas odczytu środowiska, jeszcze przed wykonaniem żądania HTTP. Ustaw zmienną i ponownie uruchom skrypt. Jeśli zawiera ona nieprawidłowy klucz, żądanie POST dotrze do API, które zwróci HTTP 401. Skopiuj aktualny Personal API Key ze strony konta i zastąp nim błędną wartość.
Następnie sprawdza status zadania. Żądanie POST uruchamia pracę w tle, dlatego skrypt odczytuje stan zadania co trzy sekundy, aż pojawi się status completed, failed albo stopped:
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)Jeśli zadanie nie powiedzie się z powodu braku kredytów, przyczyną błędu będzie credits_error. Dokup kredyty lub poczekaj na odnowienie miesięcznego limitu, sprawdź wszystkie zwrócone już wyniki, a następnie prześlij w nowym zadaniu wyłącznie nieukończone elementy.
Na końcu pobiera wszystkie strony wyników. Każda odpowiedź dodaje wyniki do listy i przekazuje kursor potrzebny do kolejnego zapytania:
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
breakSkrypt pobiera kolejne strony, dopóki nextCursor nie przyjmie wartości null.
Przed wykonaniem żądania POST skrypt wyświetla wygenerowany uniqueId. Jeśli połączenie zostanie przerwane przed otrzymaniem odpowiedzi o utworzeniu zadania, najpierw wyświetl listę zadań i sprawdź ich status, zanim utworzysz kolejne:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-name-to-domain"Znajdź zadanie, którego uniqueId odpowiada wartości wygenerowanej przez skrypt, a następnie skopiuj jego @id. Endpoint listy pozwala filtrować po enrichmentId, ale nie po uniqueId. Użyj @id z tymi samymi adresami URL statusu i wyników, z których korzysta skrypt. Jeśli zadanie jest nadal aktywne, dalej sprawdzaj jego status. Jeśli zostało zatrzymane lub zakończyło się błędem, przed ponownym przesłaniem elementów sprawdź wyniki częściowe.
Jak działa dopasowanie i fallback uwzględniający kraj
Skrypt korzysta z dataset_google, czyli zalecanego ustawienia domyślnego. Datablist najpierw sprawdza własne zbiory danych firm. Jeśli brakuje dopasowania lub wyniki są sprzeczne, może użyć Google jako fallbacku. Przed zwróceniem poziomu pewności weryfikuje potencjalne dopasowania.
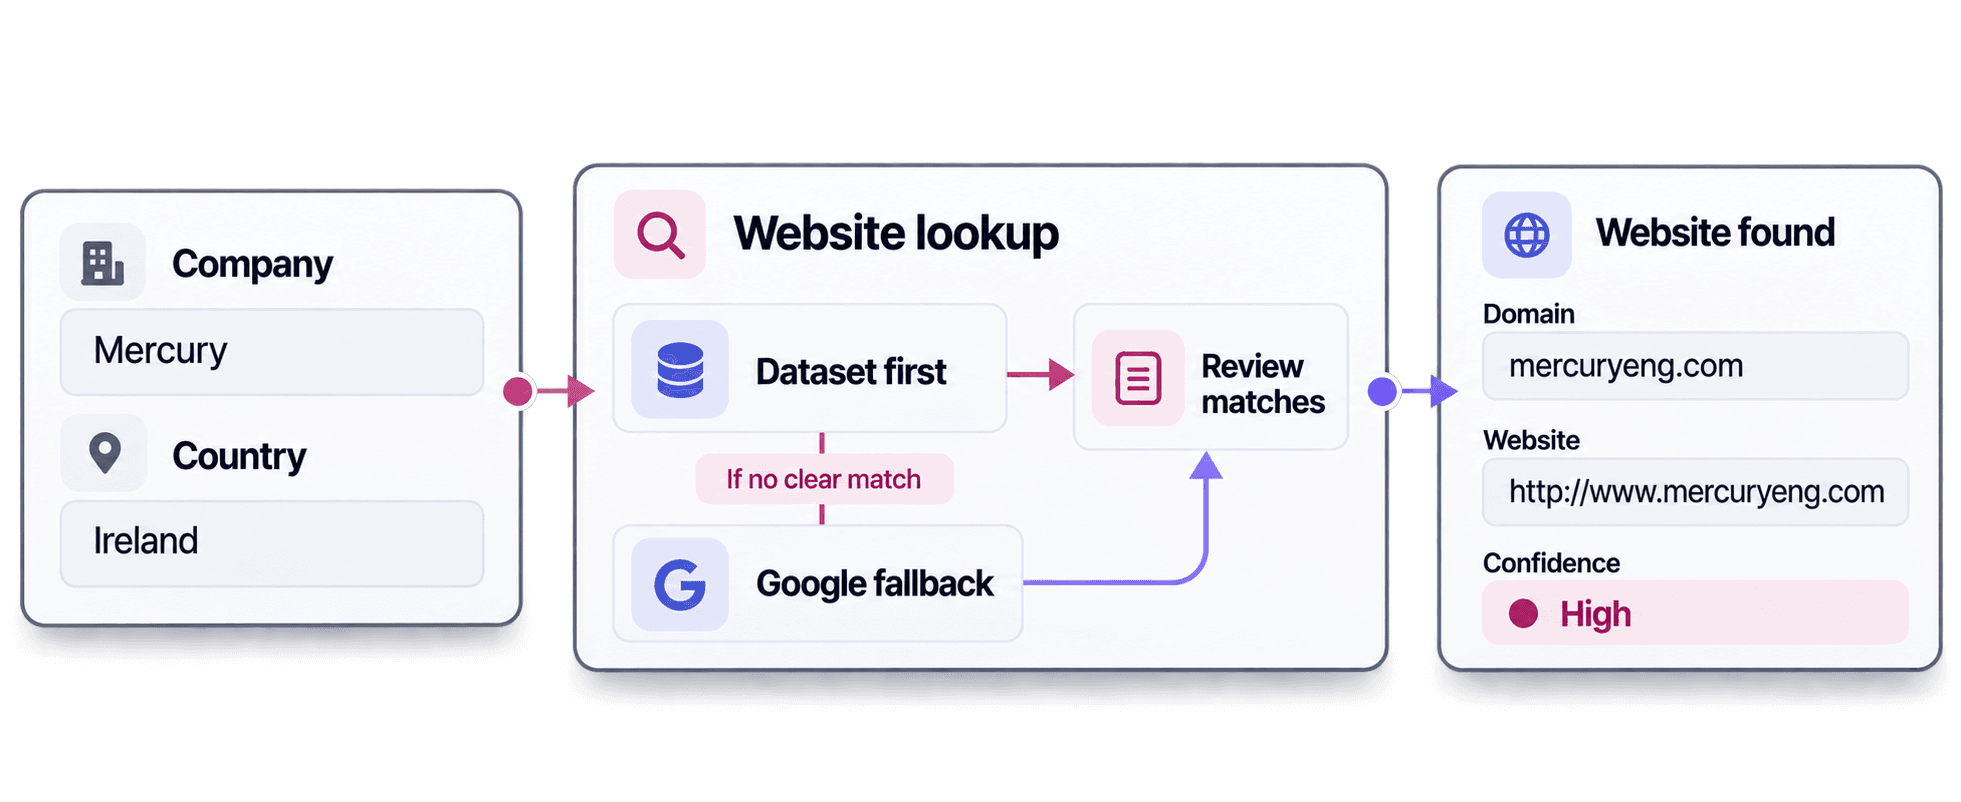
Informacja o kraju pomaga przy niejednoznacznych nazwach. W tym przykładzie ta sama nazwa firmy dała różne wyniki:
Mercuryz krajemUSzwróciłoshipmercury.comorazhttps://www.shipmercury.com/.Mercuryz krajemIEzwróciłomercuryeng.comorazhttp://www.mercuryeng.com.
Oba wyniki miały poziom pewności High. Informacja o kraju pomaga wybrać właściwą firmę spośród podmiotów o tej samej nazwie, natomiast poziom pewności ułatwia określenie, które wyniki wymagają weryfikacji.
Jeśli dopasowanie zależy również od branży, wielkości firmy lub innego kontekstu biznesowego, skorzystaj z workflow researchu z AI Agent. Dodaj te informacje do promptu AI Agent, aby mógł wyszukać właściwą firmę na podstawie bogatszego kontekstu biznesowego.
Uzupełnij tylko brakujące strony w rekordach
Skoro funkcja find_domains() potrafi znaleźć stronę na podstawie nazwy firmy, wykorzystaj ją ponownie do uzupełnienia wyłącznie brakujących adresów w rekordach. Rekordy, które już zawierają stronę, omijają API, dzięki czemu ich wartości pozostają bez zmian i nie zużywają kredytów.
W pliku find_company_websites.py zastąp wszystko od companies = [ aż po końcową pętlę wyświetlającą wyniki poniższym blokiem. Pozostaw znajdujące się wyżej przypisanie api_key. Kontrola pustej wartości obsługuje None, pusty ciąg znaków oraz same białe znaki. Jeśli wszystkie strony są uzupełnione, skrypt nie wykonuje żadnego wywołania API.
records = [
{
"id": "crm-001",
"company_name": "Microsoft",
"country": "US",
"website": "https://www.microsoft.com",
},
{
"id": "crm-002",
"company_name": "boulangerie du palais lyon",
"country": "FR",
"website": "",
},
{
"id": "crm-003",
"company_name": "Mercury Engineering",
"country": "IE",
"website": None,
},
{
"id": "crm-004",
"company_name": "Mercury",
"country": "US",
"website": " ",
},
{
"id": "crm-005",
"company_name": "Datablist",
"country": "FR",
"website": "https://www.datablist.com",
},
{
"id": "crm-006",
"company_name": "Mercury",
"country": "IE",
"website": None,
},
]
def website_is_missing(value):
return not isinstance(value, str) or not value.strip()
records_to_lookup = [
record for record in records if website_is_missing(record.get("website"))
]
lookup_results = (
find_domains(records_to_lookup, api_key) if records_to_lookup else []
)
results_by_id = {result["inputId"]: result for result in lookup_results}
for record in records:
if not website_is_missing(record.get("website")):
record["website_lookup"] = {"status": "not_requested"}
continue
result = results_by_id.get(record["id"])
if result is None:
record["website_lookup"] = {
"status": "missing_result",
"domain": None,
"confidence": None,
"credits": None,
"error": {
"code": "missing_result",
"message": "No result was returned for this inputId.",
},
}
continue
outputs = result.get("outputs") or {}
if result["status"] == "success" and outputs.get("companyUrl"):
record["website"] = outputs["companyUrl"]
record["website_lookup"] = {
"status": result["status"],
"domain": outputs.get("companyDomain"),
"confidence": outputs.get("domainConfidence"),
"credits": result.get("creditsUsed"),
"error": result.get("error"),
}
print(json.dumps(records, indent=2))Kod indeksuje wyniki według inputId, a następnie przechodzi kolejno przez pierwotne rekordy. Obiekt website_lookup przechowuje rezultat i informacje potrzebne do weryfikacji obok każdego przetwarzanego rekordu, również w przypadku niepowodzenia lub braku wyniku.
Dla crm-001 funkcja website_is_missing() zwraca False, ponieważ adres URL Microsoftu jest już zapisany. Rekord nie trafia do records_to_lookup, więc API nigdy go nie otrzymuje. Podczas scalania strona pozostaje bez zmian, a zapisany status to not_requested.
Dla crm-002 pole strony jest puste, dlatego zapytanie wysyła nazwę piekarni z inputId: crm-002. API zwraca ten sam inputId. Obiekt results_by_id używa go do znalezienia właściwego wyniku, a podczas scalania do rekordu trafia https://boulangerie-du-palais-lyon.eatbu.com — niezależnie od kolejności wyników.
| ID | Firma | Strona po scaleniu | Status | Domena | Pewność | Kredyty |
|---|---|---|---|---|---|---|
crm-001 | Microsoft · US | https://www.microsoft.com | not_requested | |||
crm-002 | boulangerie du palais lyon · FR | https://boulangerie-du-palais-lyon.eatbu.com | success | boulangerie-du-palais-lyon.eatbu.com | High | 1 |
crm-003 | Mercury Engineering · IE | https://mercuryeng.com | success | mercuryeng.com | High | 1 |
crm-004 | Mercury · US | https://www.shipmercury.com/ | success | shipmercury.com | High | 1 |
crm-005 | Datablist · FR | https://www.datablist.com | not_requested | |||
crm-006 | Mercury · IE | http://www.mercuryeng.com | success | mercuryeng.com | High | 1 |
Piekarnia korzysta z subdomeny przypisanej do konkretnej firmy: boulangerie-du-palais-lyon.eatbu.com. Zachowaj tę wartość zamiast skracać ją do eatbu.com i zapisz dokładny adres z pola companyUrl. Ustawienie acceptNonRoot: true pozwala również zwrócić hostowaną stronę firmy, której adres zawiera ścieżkę po nazwie hosta, dlatego w obu przypadkach istotny jest pełny URL.
Ukończone zadanie nadal może zawierać elementy ze statusem no_result, error albo skipped. Przykład zmienia pole website tylko wtedy, gdy status to success i dostępne jest companyUrl. Przy statusie no_result strona pozostaje pusta, a status nadal jest widoczny w website_lookup. Najpierw sprawdź nazwę firmy i kraj. Jeśli któreś dane są błędne, popraw je i prześlij rekord w nowym zadaniu. W przeciwnym razie pozostaw puste pole strony do ręcznej weryfikacji.
Oszacuj zużycie kredytów przed skalowaniem
Wszystkie pięć przykładowych wyszukiwań zwróciło success z poziomem pewności High i zużyło łącznie 5 kredytów.
Wyszukiwanie rozstrzygnięte na podstawie zbioru danych kosztuje 1 kredyt. Wyszukiwanie przetworzone przez Google kosztuje 2,5 kredytu. Płacisz tylko za wykorzystaną ścieżkę, a nie za obie. Dla 1000 elementów oznacza to 1000 kredytów, jeśli wszystkie zostaną znalezione w zbiorze danych, albo 2500 kredytów, jeśli wszystkie zostaną przetworzone przez Google. Są to scenariusze przydatne do planowania, a nie gwarancja powodzenia każdego wyszukiwania.
Przesuń suwak, aby porównać zużycie kredytów dla swojej listy.
Przy cenie 20 USD za 20 000 kredytów te scenariusze kosztują odpowiednio 1 USD oraz 2,50 USD. Subskrypcja Growth jest rozliczana osobno i obecnie obejmuje 20 000 kredytów miesięcznie, które są wykorzystywane przed dodatkowymi pakietami. Sprawdź aktualny cennik, ponieważ wartości planów i pakietów mogą się zmieniać.
Jedno zadanie może zawierać maksymalnie 10 000 elementów, przy limicie 16 KiB na element i 10 MiB na całe żądanie. W tym przykładzie blokujące wywołania Requests służą do przesłania zadania, sprawdzania jego statusu i pobrania wyników z jednego niewielkiego, asynchronicznego zadania Datablist. Utrzymywane repozytorium zawiera również przykłady przetwarzania CSV w partiach oraz nieblokującego klienta.
Co dalej
Gdy potwierdzisz, że zwrócona strona należy do właściwej firmy, możesz pobrać dane z Impressum za pomocą Pythona, aby dodać dane prawne firmy oraz adres źródłowej strony prawnej do tego samego rekordu dostawcy. Weryfikację dopasowania strony przeprowadź niezależnie od późniejszej ekstrakcji.
Zastąp przykładowe rekordy niewielką próbką własnych danych, uruchom skrypt i sprawdź scalone rekordy. Zachowaj stałe identyfikatory oraz informacje o kraju. Zwiększaj skalę dopiero wtedy, gdy upewnisz się, że skrypt zachowuje znane strony i prawidłowo uzupełnia oczekiwane braki. Jeśli potrzebujesz gotowego skryptu do pobrania, przetwarzania CSV w partiach lub wersji asynchronicznej, zacznij od utrzymywanych przykładów Company Name to Domain API na GitHubie.