
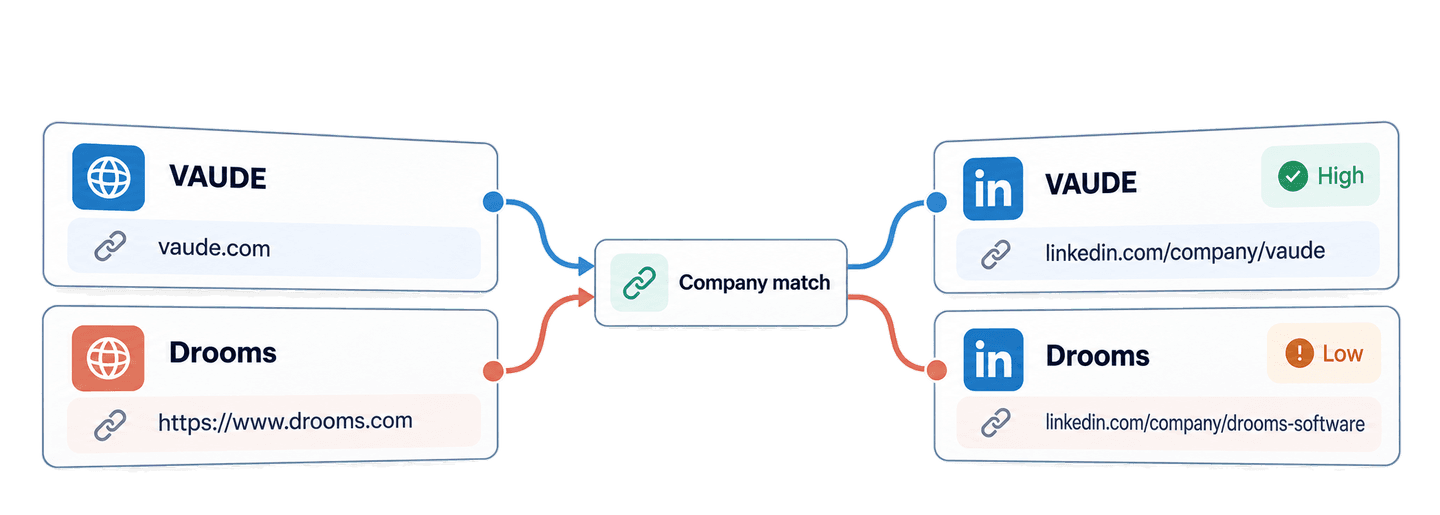
Use a API Company to LinkedIn da Datablist para encontrar a página de uma empresa no LinkedIn a partir de um site usando Python. Você pode enviar apenas o domínio ou a URL completa do site, aguardar a conclusão da tarefa de correspondência e receber o nome da empresa, o site, a URL da página no LinkedIn e um indicador de confiança.
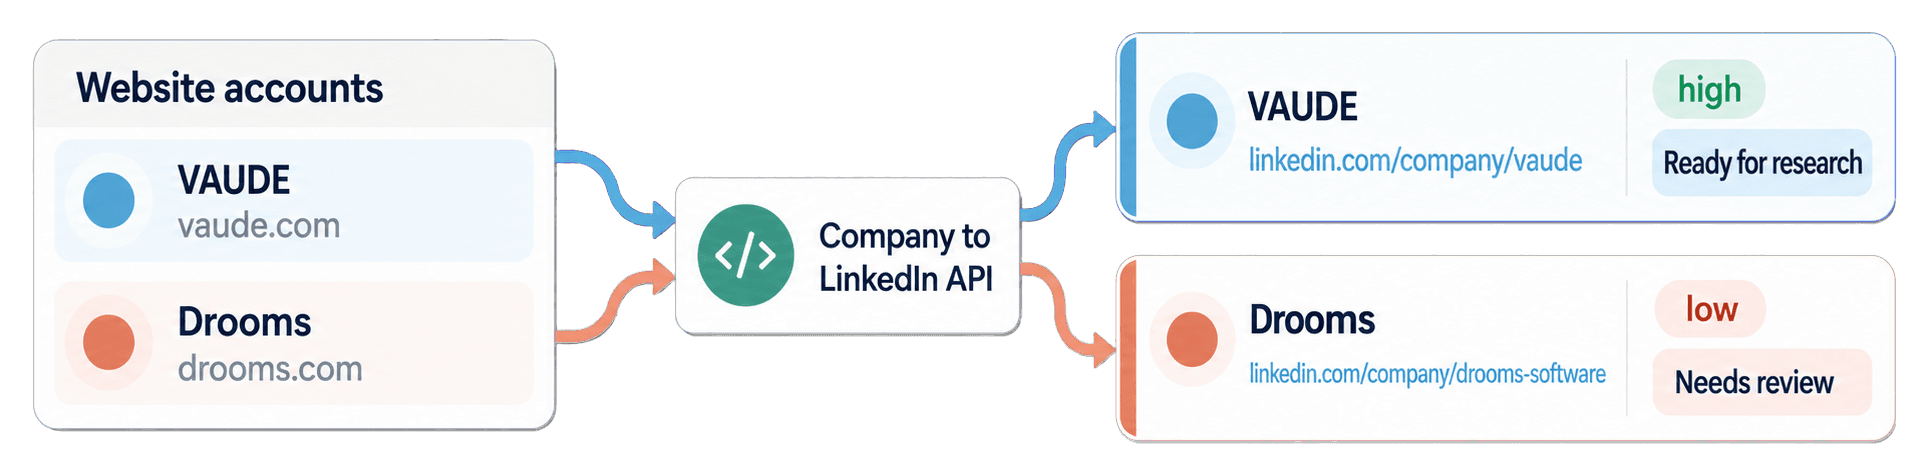
Neste guia, uso Python e a biblioteca Requests para buscar correspondências para cinco sites de empresas. A lista inclui empresas de software conhecidas, além da VAUDE, fabricante de equipamentos para atividades ao ar livre, e da Drooms, especializada em data rooms virtuais. Depois, organizo os resultados em duas filas locais: correspondências prontas para pesquisa de empresas e correspondências que exigem verificação manual.
🔑 Resumo para quem está com pressa
Envie os sites da sua lista de contas para a API Company to LinkedIn da Datablist. A API retorna as URLs das páginas das empresas no LinkedIn e indicadores de confiança que ajudam a decidir quais correspondências usar e quais revisar.
- Input: domínios simples e URLs completas de sites de empresas.
- Output: nomes das empresas, sites correspondentes, URLs das páginas no LinkedIn e confiança
highoulow, organizados nas filasReady for researcheNeeds review.
💡 Prefere uma solução no-code? Use o enrichment LinkedIn Company Pages & Domain Lookup da Datablist para relacionar sites e páginas de empresas no LinkedIn sem escrever código.
Configure o Python e sua chave de API da Datablist
Neste exemplo, uso o pacote requests. Como a API funciona via HTTP, você poderá adaptar a mesma sequência de requisições para outra linguagem posteriormente.
Você precisa de uma conta Datablist com acesso à REST API, disponível no plano Growth. As buscas bem-sucedidas também consomem créditos de enrichment. Mais adiante, mostro o cálculo exato dos créditos.
Crie um diretório de trabalho e um arquivo chamado find_linkedin_company_pages.py. Em seguida, crie um ambiente virtual e instale o Requests:
mkdir company-linkedin-matcher
cd company-linkedin-matcher
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
touch find_linkedin_company_pages.pyCrie uma Personal API Key na sua conta Datablist e exporte-a como variável de ambiente:
export DATABLIST_API_KEY="your-api-key"O script lê esse valor e o envia no header X-API-Key.
Encontre páginas de empresas no LinkedIn com uma função Python
O exemplo usa estas cinco contas de origem:
account-datablist:datablist.comaccount-posthog:posthog.comaccount-n8n:https://n8n.ioaccount-vaude:vaude.comaccount-drooms:https://www.drooms.com
Cada account_id se torna o inputId da API. Isso é importante porque os resultados não precisam chegar na mesma ordem dos inputs. Um ID estável permite associar cada resultado à conta de origem correta.
Cole o script completo abaixo em find_linkedin_company_pages.py:
import json
import os
import time
import uuid
import requests
def match_companies(accounts, api_key, matching_direction):
"""Submit one matching task, wait for it, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"sourceUrl": account["source_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "company-to-linkedin",
"uniqueId": unique_id,
"settings": {"matchingDirection": matching_direction},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "datablist.com",
},
{
"account_id": "account-posthog",
"company_name": "PostHog",
"source_url": "posthog.com",
},
{
"account_id": "account-n8n",
"company_name": "n8n",
"source_url": "https://n8n.io",
},
{
"account_id": "account-vaude",
"company_name": "VAUDE",
"source_url": "vaude.com",
},
{
"account_id": "account-drooms",
"company_name": "Drooms",
"source_url": "https://www.drooms.com",
},
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
match_results = match_companies(
accounts, api_key, matching_direction="domain_to_linkedin"
)
print(json.dumps(match_results, indent=2))Execute o script com:
python find_linkedin_company_pages.pyA função faz três tipos de chamadas, nesta ordem.
Primeiro, o POST envia os cinco sites com matchingDirection definido como domain_to_linkedin. A API responde com 202 Accepted e um ID de tarefa, pois a correspondência é executada em background. Mesmo assim, o script com Requests mantém um fluxo sequencial, já que aguarda a conclusão antes de avançar para a próxima etapa.
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]Em seguida, a requisição de status verifica a tarefa até que ela passe para completed, failed ou stopped. A pausa de três segundos impede que o script envie requisições de status sem parar.
Por fim, a requisição de resultados lê páginas com até 100 resultados. Se nextCursor contiver um valor, o loop o enviará como cursor na requisição seguinte. A execução só termina quando nextCursor for null.
Analise as correspondências e identifique o que revisar
Esta é a lista completa de resultados para os cinco inputs:
[
  {
    "inputId": "account-datablist",
    "status": "success",
    "outputs": {
      "companyWebsite": "datablist.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/datablist",
      "companyName": "datablist"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-posthog",
    "status": "success",
    "outputs": {
      "companyWebsite": "posthog.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/posthog",
      "companyName": "PostHog"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-n8n",
    "status": "success",
    "outputs": {
      "companyWebsite": "n8n.io",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/n8n",
      "companyName": "n8n"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-vaude",
    "status": "success",
    "outputs": {
      "companyWebsite": "vaude.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/vaude",
      "companyName": "vaude"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-drooms",
    "status": "success",
    "outputs": {
      "companyWebsite": "drooms.com",
      "confidence": "low",
      "companyLinkedInUrl": "https://www.linkedin.com/company/drooms-software",
      "companyName": "Drooms"
    },
    "creditsUsed": "1.5",
    "error": null
  }
]
Analise status e confidence separadamente. A API retorna um objeto de resultado para cada input, inclusive para os que não forem processados com sucesso. O status success indica que ela encontrou uma página de empresa candidata. O valor de outputs.confidence informa se a correspondência com o site foi validada. O inputId associa o objeto à conta de origem, enquanto creditsUsed registra o custo daquela linha e error contém uma falha estruturada, quando houver.
Mantenha o objeto outputs completo na sua aplicação, mesmo que a primeira tela exiba apenas a URL do LinkedIn e a confiança. companyName e companyWebsite agilizam a revisão manual, sobretudo quando o nome retornado usa letras maiúsculas e minúsculas de forma diferente ou quando o input era uma URL completa. Esses campos também fornecem contexto útil sem exigir outra chamada à API.
O processo de correspondência começa normalizando o site enviado e verificando em bases de dados de empresas se já existe uma relação conhecida entre o site e o LinkedIn. Depois, compara o domínio informado com o site publicado na página candidata da empresa no LinkedIn. Quando os domínios registrados coincidem, a confiança retornada é high.
Quando as bases de dados não fornecem uma URL do LinkedIn, a busca pode executar uma pesquisa direcionada no Google por páginas de empresas candidatas. Se não for possível validar uma candidata com base em um site publicado, o resultado poderá ter confiança low. Uma incompatibilidade conhecida entre sites não é aceita.
Use a confiança como uma instrução de revisão. A VAUDE retornou https://www.linkedin.com/company/vaude com confiança high, portanto pode entrar na fila de pesquisa. Já a Drooms retornou https://www.linkedin.com/company/drooms-software com confiança low. Abra o site da Drooms e a página no LinkedIn antes de confiar nessa relação.
Datablist, PostHog e n8n também retornaram correspondências com alta confiança. Essa API identifica a relação entre o site e a página da empresa. Se, após revisar a URL, você precisar do porte da empresa, setor ou outros dados da página, siga o guia da API de scraping de empresas no LinkedIn.
Prepare uma fila de pesquisa de contas com os resultados
Agora, reutilize match_results para preparar uma fila local de pesquisa manual de empresas. Este bloco não chama a API novamente. Ele indexa os resultados por inputId e percorre a lista original de contas para que todas permaneçam visíveis, mesmo que algum resultado futuro esteja ausente.
results_by_id = {result["inputId"]: result for result in match_results}
ready_for_research = []
needs_review = []
for account in accounts:
result = results_by_id.get(account["account_id"])
if result is not None:
outputs = result.get("outputs", {})
else:
outputs = {}
research_record = {
**account,
"companyLinkedInUrl": outputs.get("companyLinkedInUrl"),
"confidence": outputs.get("confidence"),
"api_result": result,
}
is_ready = (
result is not None
and result["status"] == "success"
and outputs.get("companyLinkedInUrl")
and outputs.get("confidence") == "high"
)
if is_ready:
ready_for_research.append(research_record)
else:
needs_review.append(research_record)
print("Ready for research:")
print(json.dumps(ready_for_research, indent=2))
print("Needs review:")
print(json.dumps(needs_review, indent=2))O dicionário de resultados torna a associação independente da ordem da resposta. account-vaude conecta o registro original de vaude.com à página da VAUDE encontrada e entra em ready_for_research. account-drooms mantém a URL completa do input e o resultado integral da API, mas entra em needs_review, pois a confiança é baixa, embora o status do resultado seja success.
A mesma lógica mantém na fila de revisão qualquer linha ausente, com no_result ou com erro. As duas listas exibidas oferecem à equipe um ponto de partida claro para a pesquisa manual de empresas.
Você também pode baixar o exemplo síncrono mantido com Requests. O repositório inclui um exemplo assíncrono com HTTPX para aplicações que precisam de HTTP não bloqueante, mas a versão bloqueante acima é mais fácil de acompanhar em uma primeira integração.
Faça a busca inversa do LinkedIn para o site da empresa
A mesma função aceita páginas de empresas no LinkedIn quando você altera a direção da correspondência. Isso pode ser útil quando sua lista de origem contém URLs de páginas de empresas e você precisa dos sites antes de executar um enrichment compatível de empresas ou e-mails profissionais.
linkedin_accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "https://www.linkedin.com/company/datablist",
}
]
website_results = match_companies(
linkedin_accounts,
api_key,
matching_direction="linkedin_to_domain",
)Uma busca padrão a partir da página de uma empresa no LinkedIn usa a tarifa normal de correspondência. IDs numéricos de empresas e URLs de empresas no Sales Navigator podem consumir 10 créditos porque seguem um fluxo diferente de busca inversa. Para usar essa direção sem código, veja como obter URLs de sites a partir de páginas de empresas no LinkedIn.
Calcule os créditos da busca de sites no LinkedIn
Cada busca padrão bem-sucedida de site para LinkedIn consome 1,5 crédito. Portanto, as cinco correspondências exibidas consumiram 7,5 créditos. Com a mesma tarifa, 1.000 correspondências bem-sucedidas consomem 1.500 créditos. Inputs inválidos e linhas sem resultado podem consumir zero crédito; consulte o valor creditsUsed de cada resultado para verificar o uso real.
O acesso à REST API faz parte do plano Growth, e a assinatura mensal é separada dos créditos adicionais. Uma recarga de US$ 20 oferece 20.000 créditos, portanto cada crédito custa US$ 0,001. Com 1,5 crédito por correspondência bem-sucedida, 1.000 correspondências consomem 1.500 créditos, equivalentes a US$ 1,50. Consulte os preços da Datablist para conhecer os planos e pacotes atuais.
Corrija problemas comuns de input, tarefa e resultado
DATABLIST_API_KEYestá ausente: o script é interrompido antes de enviar uma requisição. Exporte a variável de ambiente e execute o comando novamente.- A API rejeita a chave: confirme que você copiou uma Personal API Key e que a requisição a envia apenas no header
X-API-Key. - O input não é compatível: use o site ou domínio de uma empresa para
domain_to_linkedin. Na direção inversa, use uma URL compatível de página de empresa, não um perfil pessoal nem um valor em branco. - Os créditos são insuficientes: verifique seu saldo e use os créditos incluídos ou faça uma recarga antes de criar outra tarefa.
- A tarefa está como
failedoustopped: verifique o status, o erro, os resultados existentes e o consumo de créditos antes de decidir se deve reenviá-la. - Um resultado tem baixa confiança,
no_resultou erro: mantenha o site de origem e o resultado completo emneeds_review. Abra a página candidata quando houver uma e não tente adivinhar por que um resultado está ausente.
Se a conexão cair durante a criação da tarefa, use o uniqueId exibido antes do POST. Liste suas tarefas e procure esse valor antes de criar outra:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-to-linkedin" \
--data-urlencode "limit=100"A lista de tarefas não pode ser filtrada por uniqueId. Portanto, verifique cada tarefa retornada e acompanhe nextCursor, se necessário. Ao encontrar o valor correspondente, use seu @id com as mesmas URLs de status e resultados utilizadas pelo script.
Uma tarefa pode conter até 10.000 inputs. Para consultar todos os limites de requisição, retenção de tarefas e paginação, acesse a documentação da API Company to LinkedIn.
Próximos passos
Agora você tem uma função Python reutilizável com Requests que transforma sites de empresas em páginas candidatas no LinkedIn. A fila local mantém as correspondências de alta confiança prontas para pesquisa e deixa os registros incertos ou malsucedidos visíveis para revisão.
Substitua os cinco exemplos por uma pequena lista de contas, revise cada candidata de baixa confiança e use as URLs aprovadas na pesquisa manual de empresas ou como inputs para a API de scraping de empresas no LinkedIn. Se sua lista de origem contiver nomes de empresas em vez de sites, comece pelo guia da API para encontrar sites de empresas.