
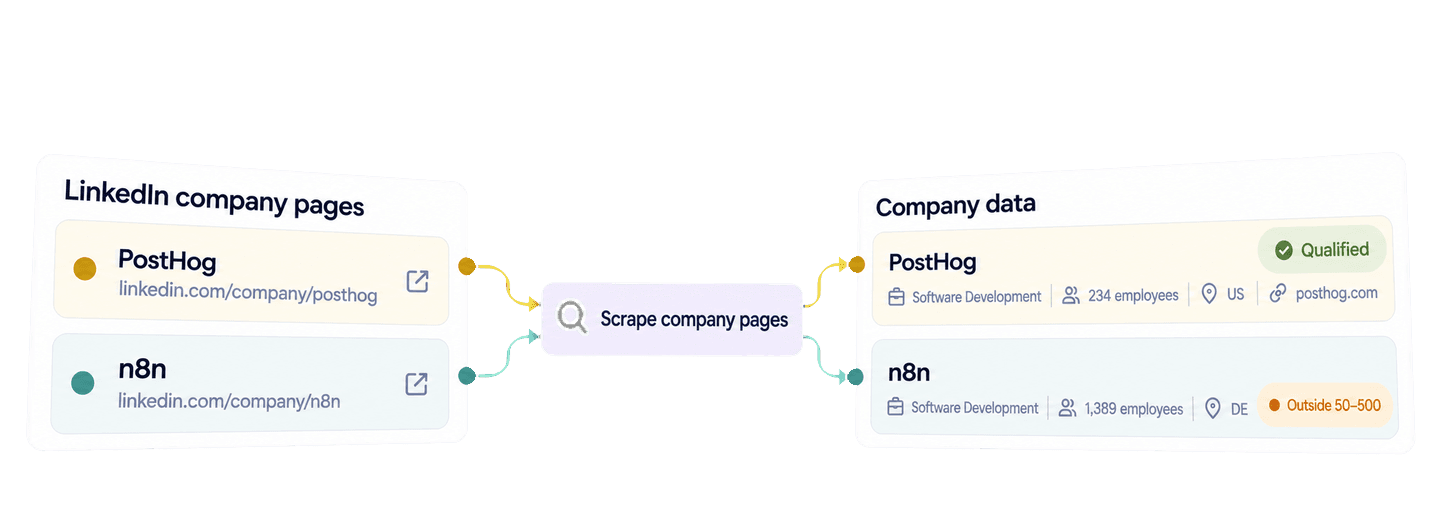
Você pode extrair dados de empresas do LinkedIn em Python enviando uma lista de URLs de páginas de empresas para a API da Datablist com a biblioteca Requests. A API retorna registros estruturados com campos como setor, número de funcionários, sede, site e descrição, quando essas informações estão disponíveis na página pública da empresa.
Neste guia, uso uma única função Python, fácil de entender, para obter registros da n8n, PostHog, Back Market e Datablist. Depois, reutilizo esses resultados para qualificar contas de empresas de software com 50 a 500 funcionários nos Estados Unidos ou na Alemanha. O registro qualificado mantém o site e a descrição para uma pesquisa comercial mais aprofundada.
🔑 Resumo para quem tem pressa
A Datablist transforma URLs verificadas de páginas de empresas no LinkedIn em registros estruturados que você pode usar em um fluxo de pesquisa comercial. O exemplo em Python abaixo recupera todas as páginas de resultados e aplica um filtro local de qualificação de contas, sem fazer uma segunda chamada à API.
- Input: URLs de páginas de empresas no LinkedIn.
- Output: dados disponíveis da empresa e uma decisão local de qualificação, mantendo a URL original junto ao resultado completo da empresa.
💡 Prefere uma solução no-code? Use o LinkedIn Company Page Scraper da Datablist para extrair campos de empresas a partir de URLs conhecidas de páginas do LinkedIn, sem escrever código.
Configure o Python e sua chave da API Datablist
Neste exemplo em Python, uso o pacote requests. A REST API da Datablist está disponível no plano Growth, e cada consulta a uma página de empresa consome créditos de enrichment.
Crie uma Personal API Key na página da API da sua conta Datablist.
Crie um arquivo chamado scrape_linkedin_companies.py. Em seguida, prepare um ambiente virtual e instale o Requests:
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
export DATABLIST_API_KEY="your-api-key"O script lê a chave de DATABLIST_API_KEY e a envia no header X-API-Key.
Extraia páginas de empresas com uma função Python
A lista de origem abaixo contém empresas de diferentes setores, portes e países-sede. Cada account_id se torna o inputId da API. Os resultados não são associados pela posição que ocupam na resposta. Por isso, esse ID estável é o que conecta cada resultado à URL de origem correta.
Cole este script completo em scrape_linkedin_companies.py:
import json
import os
import time
import uuid
import requests
accounts = [
{
"account_id": "account-n8n",
"linkedin_company_url": "https://www.linkedin.com/company/n8n/",
},
{
"account_id": "account-posthog",
"linkedin_company_url": "https://www.linkedin.com/company/posthog/",
},
{
"account_id": "account-back-market",
"linkedin_company_url": "https://www.linkedin.com/company/back-market/",
},
{
"account_id": "account-datablist",
"linkedin_company_url": "https://www.linkedin.com/company/datablist/",
},
]
def scrape_companies(accounts, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"companyLinkedInUrl": account["linkedin_company_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Request ID: {unique_id}")
payload = {
"enrichmentId": "linkedin-company-enrichment",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
company_results = scrape_companies(accounts, api_key)
print(json.dumps(company_results, indent=2, ensure_ascii=False))Execute o script com:
python scrape_linkedin_companies.pyOs principais valores que você precisa alterar são os registros em accounts. Mantenha cada account_id estável e único e substitua linkedin_company_url pela página verificada da empresa no LinkedIn. A função converte esses registros para o formato inputs da API e envia a URL da empresa como companyLinkedInUrl. O objeto settings permanece vazio porque esse enrichment não tem configurações públicas.
O POST cria uma tarefa de enrichment em background. A API responde com 202 Accepted e um ID de tarefa, enquanto o cliente Requests aguarda consultando periodicamente a URL de status. Esse código Python bloqueante é prático para um script pequeno, embora a tarefa continue sendo executada de forma assíncrona pela Datablist.
O primeiro GET consulta a própria tarefa. Ela pode terminar com o status completed, failed ou stopped. O script só continua após completed; caso contrário, gera um erro que inclui o ID da tarefa e o erro retornado pela API. Guarde esse ID durante a investigação, pois uma tarefa com status failed ou stopped ainda pode ter resultados e consumo de créditos para análise.
Quando a tarefa termina, o loop final busca as páginas de resultados com um limite de 100. Ele continua carregando a página seguinte até que nextCursor seja null. Cada resultado mantém o inputId informado. Assim, o loop de qualificação posterior consegue associar corretamente os resultados mesmo quando a ordem da resposta é diferente da ordem dos inputs.
Entenda o resultado e o método de coleta
A URL do LinkedIn identifica diretamente a empresa. A Datablist normaliza essa URL da organização e recupera os dados públicos disponíveis na página da empresa, em vez de pesquisar e pontuar várias empresas possíveis. A partir da URL de uma empresa específica, o processo começa pela página pública e pode preencher campos não resolvidos com fontes alternativas gerenciadas, preservando os dados úteis já encontrados.
Essa diferença é importante ao interpretar o resultado. Os campos opcionais dependem das informações disponíveis publicamente. Um endereço de sede nulo ou uma especialidade ausente não significa que toda a consulta da empresa falhou.
Esta é a página completa de resultados retornada para as quatro URLs:
{
  "taskId": "69516a973dc34481920f41ade748e917",
  "results": [
    {
      "inputId": "account-n8n",
      "status": "success",
      "outputs": {
        "companyName": "n8n",
        "companyHQPostalCode": "10115",
        "companyDescription": "n8n is a workflow automation platform that uniquely combines AI capabilities with business process automation. The platform enables connection to any app or API while maintaining the flexibility of code with the speed of no-code.\n\nReleased under a fair-code license, n8n can be self-hosted and is supported by a vibrant community of developers and builders. Users can start simple and layer complexity as needed - utilizing the visual builder for quick wins, and adding custom Javascript or Python code where more control is required, enabling the connection of anything to everything.\n\nn8n is privately held, with funding from Sequoia, Felicis Ventures, Firstminute Capital, Harpoon Ventures, and others. Individual investors include Eventbrite's Kevin Hartz and Supercell's IIkka Paananen. n8n was founded in 2019 and is headquartered in Berlin.",
        "companyTagline": "Flexible AI workflow automation for technical teams.",
        "companyIndustry": "Software Development",
        "companySpecialities": "AI, SOAR, Workflow Automation, and AI agents",
        "companyWebsite": "https://n8n.io",
        "companyHQCity": "Berlin",
        "linkedInCompanyId": "28491094",
        "companyType": "Privately Held",
        "companyHQCountry": "DE",
        "companySize": 1389,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4D0BAQEgEphZqatXwA/company-logo_200_200/B4DaFY.Sa2JcAE-/0/1792494086070/n8n_logo?e=2147483647&v=beta&t=NTL4C6f5QAd_o9nXd15PO8pOMSSEoms_tJdDHEo6eLk",
        "companyHQAddress": "Novalisstraße 10",
        "companyFoundedYear": 2019,
        "companyFollowerCount": 442229
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-posthog",
      "status": "success",
      "outputs": {
        "companyName": "PostHog",
        "companyHQPostalCode": null,
        "companyDescription": "At PostHog, we're working to increase the number of successful products in the world.\n\nUntil now, tools for building products have been fragmented. Product analytics, heatmaps, session recording, web analytics, feature flags, and A/B testing are all helpful, but no one wants to buy, send data to, and integrate multiple products.\n\nPostHog offers these tools (and more) in an integrated, open source platform which can be hosted in either the US or EU. Both versions are SOC2 certified, GDPR-ready, and HIPAA compliant. \n\nWe started PostHog during Y Combinator's W20 cohort and had the most successful B2B software launch on Hacker News since 2012 - with a product that was just 4 weeks old.\n\nWith over 100,000 users, we're default alive, growing 97% through word of mouth, and we are in the top 0.01% most popular repos on GitHub.",
        "companyTagline": "Your product's context layer. Get started with npx @posthog/wizard",
        "companyIndustry": "Software Development",
        "companySpecialities": "analytics, open source, product analytics, product, data, engineering, self-driving product, session replay, context warehouse, AI, product context, and error tracking",
        "companyWebsite": "https://posthog.com/",
        "companyHQCity": "San Francisco",
        "linkedInCompanyId": "37415928",
        "companyType": "Privately Held",
        "companyHQCountry": "US",
        "companySize": 234,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D560BAQGQUyE_CXUxIw/company-logo_200_200/B56aCMWEgaJAAE-/0/1789060991251/posthog_logo?e=2147483647&v=beta&t=WfTGRSqp5UfYL33sBXx3tZ1zmFUECfUPf7JtEGPAvbA",
        "companyHQAddress": null,
        "companyFoundedYear": 2020,
        "companyFollowerCount": 59696
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-back-market",
      "status": "success",
      "outputs": {
        "companyName": "Back Market",
        "companyHQPostalCode": null,
        "companyDescription": "The world is waking up to what fast tech costs. Back Market is where the revolution shops. \nWe make refurbished tech the smart, confident choice by building trust in quality, repair and circularity. New is not always better. Smarter is.\n\nAs a certified B Corp, our mission is to create a world that does more with what we already have by prolonging the lifespan of electronic devices through circularity and repair. We have grown by double digits year over year and now serve 18 million customers across 17 markets, avoiding more than 2 million tons of CO2 emissions*\n*Back Market calculation based on ADEME 2022 methodology.\n\nFounded in Paris in 2014 by Thibaud Hug de Larauze, Quentin Le Brouster and Vianney Vaute, Back Market is a leading global marketplace where people can buy professionally refurbished technology or trade in their devices.\n\nAre you ready to join us?",
        "companyTagline": "Where the world shops refurbished tech.",
        "companyIndustry": "Internet Marketplace Platforms",
        "companySpecialities": "refurbished tech, marketplace, sustainability, circularity, Right to Repair, sustainable solutions, refurbished marketplace, circular economy, and sustainable alternatives",
        "companyWebsite": "http://www.backmarket.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "4793443",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 1054,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4E0BAQHRv6UClt5D2g/company-logo_200_200/B4EZnoUG3tKgAI-/0/1760539209613/back_market_logo?e=2147483647&v=beta&t=Pywpeu1Qs3h0Cl8kgvYurmBfXbImm5QIIc-aQog1MqM",
        "companyHQAddress": null,
        "companyFoundedYear": 2014,
        "companyFollowerCount": 101878
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-datablist",
      "status": "success",
      "outputs": {
        "companyName": "Datablist",
        "companyHQPostalCode": null,
        "companyDescription": "When people hear \"data,\" they think of something complicated. We will change this.\n\nDatablist is an AI-powered spreadsheet that helps you: get, manipulate, or clean data and create workflows that run automatically while you focus on what matters most.\n\nIf you want to separate Datablist.com into its main parts, you can say we have:\n\n- Deduplicating, grouping, and labeling data\n- Cleaning and editing data\n- Managing data and automated workflows\n- 50+ B2B data sources and scrapers\n- 3 AI agents:\n    - Editing assistant\n    - AI Research agent\n    - Deduplication assistant\n\nThe top 3 reasons why companies choose Datablist.com are:\n\n1. Simplicity: you don't need to have technical knowledge or experience with formulas to get everything out of it.\n2. Flexibility that allows you to do (almost) everything with your data and AI while keeping everything under your control.\n3. Scalability that no other solution can match. Up to 2 million rows—forget Excel.\n\nGo on try it for free!\n\nhttps://www.Datablist.com",
        "companyTagline": "Let your tasks become workflows: automated workflows.",
        "companyIndustry": "Information Technology & Services",
        "companyWebsite": "https://www.datablist.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "69842428",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 3,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/C4E0BAQFNFlMb8KEPRQ/company-logo_200_200/company-logo_200_200/0/1630622803412?e=2147483647&v=beta&t=UVkk7BOerChiWgS9Y06zOpT08SlK4kpAWGDYiVvUEVU",
        "companyFollowerCount": 134,
        "companyFoundedYear": 2020,
        "companyHQAddress": null
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
Os quatro registros foram processados com sucesso e consumiram 25 créditos cada. A PostHog retornou Software Development, 234 funcionários, sede nos Estados Unidos, além do site e da descrição. A n8n também é uma empresa de software em um dos países selecionados, mas o número de funcionários retornado foi 1.389. A Back Market retornou Internet Marketplace Platforms, 1.054 funcionários e sede na França. Já a Datablist retornou Information Technology & Services, 3 funcionários e sede na França.
O objeto completo é útil porque uma pesquisa de contas raramente se limita a um único campo. Você pode qualificar empresas por setor, número de funcionários e país, preservando o site e a descrição exatamente como foram retornados para a próxima etapa da pesquisa.
Nesta resposta, companySize representa o número de funcionários retornado, não uma faixa de porte do LinkedIn. companyHQCountry indica a localização da sede, e não todos os países onde a empresa atua. Essas diferenças são importantes ao adaptar os filtros de porte e país ao seu perfil de cliente ideal.
Nem todos os campos opcionais precisam estar presentes para que a qualificação seja possível. Um endereço ou uma especialidade ausente pode permanecer em branco quando o setor, o número de funcionários e o país da sede estão disponíveis. Mantenha companyWebsite como retornado, sem presumir que a API o converterá em um domínio simples. A descrição ajuda o profissional de vendas a entender o produto da empresa e a preparar uma pesquisa específica sobre a conta antes do outreach. Ao revisar ou armazenar o registro, mantenha status, creditsUsed e error junto aos campos da empresa.
Qualifique contas para pesquisa comercial
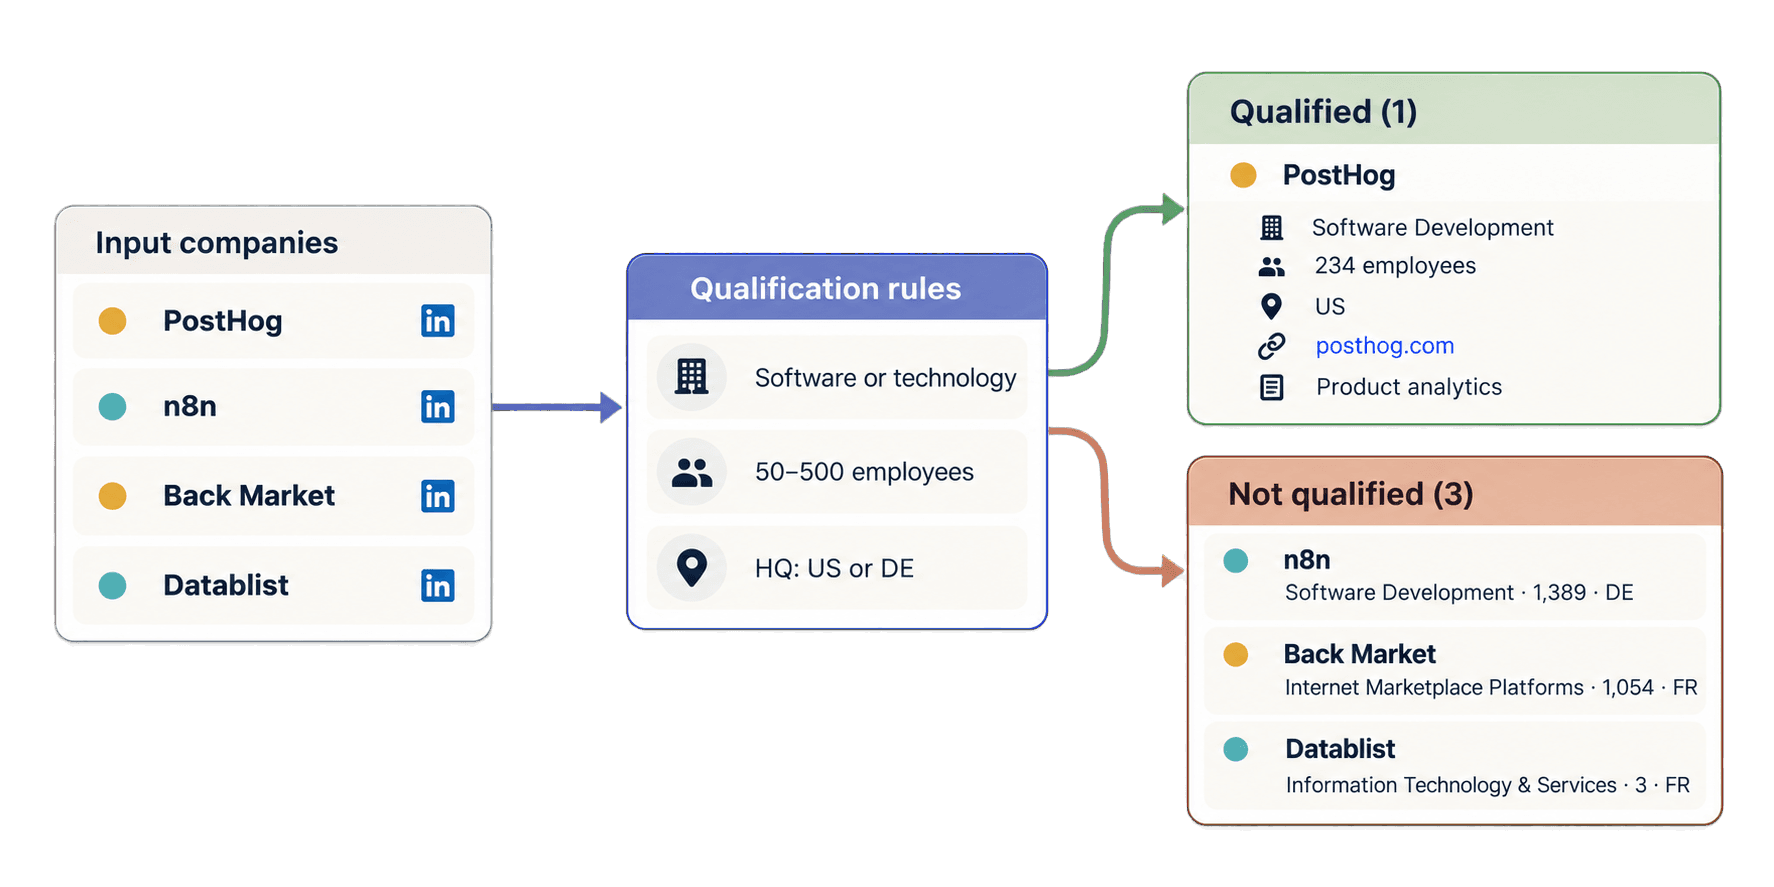
Suponha que seu público-alvo seja formado por empresas de software ou tecnologia com 50 a 500 funcionários e sede nos Estados Unidos ou na Alemanha. Adicione o loop abaixo após o script completo. Ele reutiliza company_results, portanto não envia outra tarefa:
accounts_by_id = {account["account_id"]: account for account in accounts}
qualified_accounts = []
other_accounts = []
for result in company_results:
account = accounts_by_id.get(result["inputId"])
qualification = "needs_review"
if result["status"] == "success":
outputs = result["outputs"]
industry = outputs.get("companyIndustry")
company_size = outputs.get("companySize")
country = outputs.get("companyHQCountry")
if industry and isinstance(company_size, (int, float)) and country:
industry_matches = any(
keyword in industry.lower()
for keyword in ("software", "technology")
)
size_matches = 50 <= company_size <= 500
country_matches = country in {"US", "DE"}
if industry_matches and size_matches and country_matches:
qualification = "qualified"
else:
qualification = "not_qualified"
source_url = None
if account is not None:
source_url = account["linkedin_company_url"]
reviewed_account = dict(result)
reviewed_account["sourceLinkedInUrl"] = source_url
reviewed_account["qualification"] = qualification
if qualification == "qualified":
qualified_accounts.append(reviewed_account)
else:
other_accounts.append(reviewed_account)
print(json.dumps(qualified_accounts, indent=2, ensure_ascii=False))A PostHog é associada novamente a account-posthog mesmo que a API retorne os registros em outra ordem. Ela se qualifica porque Software Development, 234 funcionários e US atendem aos três critérios. O loop copia o resultado original com o objeto outputs completo, o site retornado https://posthog.com/, a descrição, creditsUsed e error. Ele acrescenta apenas a URL de origem e o rótulo local de qualificação.
A n8n é associada a account-n8n, mas não se qualifica porque seus 1.389 funcionários ultrapassam o limite máximo. A Back Market não atende aos critérios de setor, porte e país, enquanto a Datablist está abaixo da faixa de porte e fora dos países selecionados. Futuros registros incompletos ou sem sucesso recebem needs_review, em vez de serem descartados silenciosamente.
Você pode baixar o exemplo síncrono com Requests, que recebe manutenção contínua, ou usar a alternativa assíncrona com HTTPX do repositório quando precisar de código não bloqueante na sua aplicação.
Calcule os créditos para extrair empresas do LinkedIn
Uma página padrão de empresa identificada pelo nome no LinkedIn consome 25 créditos. Uma URL com ID numérico da empresa pode consumir 75 créditos quando a última fonte alternativa é necessária, mas isso não significa que toda URL numérica custe 75 créditos. Consultas sem correspondência ou que falham também podem consumir créditos. Por isso, use o total da tarefa e o valor creditsUsed de cada resultado como registro do consumo real.
As quatro URLs com nomes usadas neste guia consumiram 100 créditos no total. Pela tarifa padrão, 1.000 páginas de empresas consomem 25.000 créditos. Inputs com muitos IDs numéricos exigem uma margem maior para o possível cenário de 75 créditos.
O acesso à REST API exige o plano Growth. O plano mensal inclui 20.000 créditos, e os créditos adicionais são comprados separadamente. Considerando o valor-base atual de US$ 20 por 20.000 créditos adicionais, cada crédito custa US$ 0,001. Nessa tarifa, 25.000 créditos equivalem a US$ 25. Consulte os preços da Datablist para conferir o plano e o catálogo de créditos atuais.
Corrija problemas de input, tarefa e resultado
DATABLIST_API_KEYestá ausente: o script para antes de enviar uma requisição. Exporte a variável e execute o arquivo novamente.- A API rejeita a chave: verifique sua Personal API Key e mantenha-a no header
X-API-Keyusado pelo exemplo. - A URL de origem é inválida: substitua perfis pessoais, sites não relacionados, valores em branco ou URLs malformadas por uma URL pública compatível do LinkedIn — de empresa, instituição de ensino, showcase, ID numérico ou empresa no Sales Navigator.
- Os créditos são insuficientes: consulte seu saldo e use os créditos incluídos ou compre créditos adicionais antes de criar outra tarefa.
- A tarefa está como
failedoustopped: analise o erro, os resultados existentes e o consumo de créditos antes de decidir se deve enviar outra tarefa paga. - Um resultado tem poucos dados,
no_resultouerror: mantenha a URL de origem, o status, os créditos e o erro para análise. Antes de reenviar, confirme que o input corresponde a uma página pública de empresa, sem tentar adivinhar por que os dados não estavam disponíveis.
Se você perder a resposta de criação, use o request ID que o script exibiu antes do POST. Primeiro, liste as tarefas e localize esse valor em uniqueId:
curl "https://api.datablist.com/v1/enrichments/tasks?limit=100" \
-H "X-API-Key: $DATABLIST_API_KEY"O @id da tarefa correspondente é o ID da tarefa. Use-o para continuar consultando /v1/enrichments/tasks/{taskId} ou buscar /v1/enrichments/tasks/{taskId}/results, em vez de criar automaticamente outra tarefa. Uma única requisição pode conter até 10.000 inputs e 10 MiB. Consulte a documentação de tarefas para saber mais sobre retenção e outras etapas do ciclo de vida.
Próximos passos
Agora você tem uma função Python reutilizável com Requests que transforma uma lista de URLs de páginas de empresas no LinkedIn em registros estruturados. Também tem um loop local de qualificação que preserva todo o output da API para a pesquisa comercial.
Substitua os quatro exemplos por uma pequena lista de contas verificadas, mantenha IDs estáveis e ajuste as regras de setor, número de funcionários e país ao seu perfil de cliente ideal. Se seus pontos de partida forem pessoas, e não empresas, consulte o guia da API para extrair perfis do LinkedIn. Se você tiver apenas os nomes das empresas, comece por encontrar os sites das empresas em Python.