
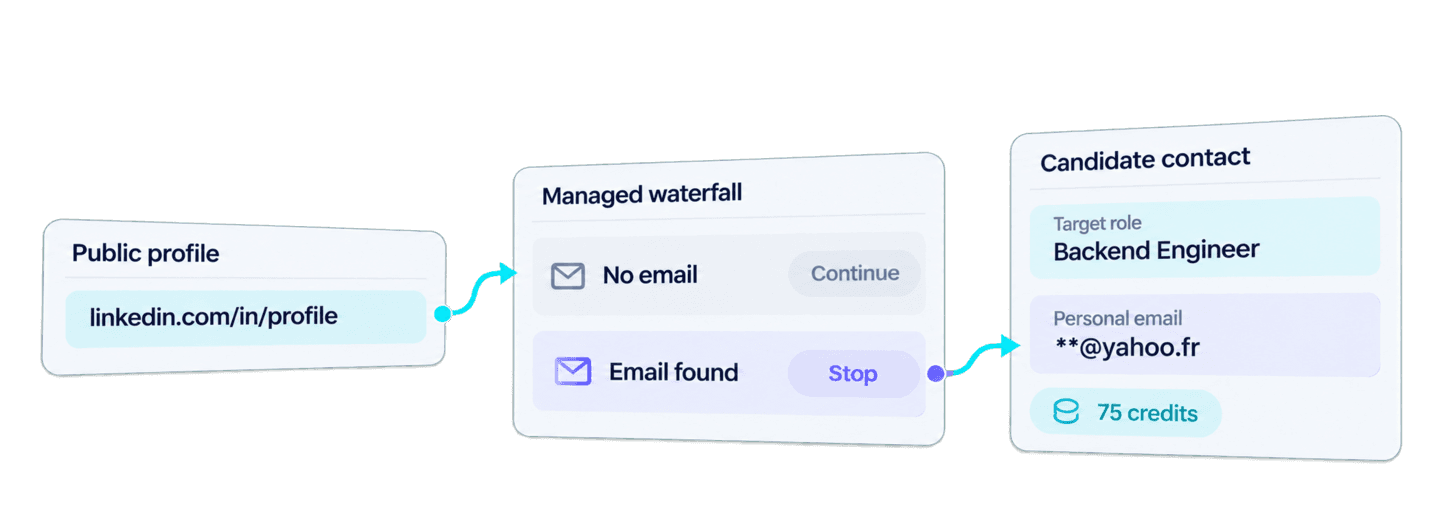
Você pode encontrar e-mails pessoais do LinkedIn no Python enviando URLs públicas de perfis linkedin.com/in/... para a API Waterfall Personal Email Finder da Datablist. A API executa uma sequência gerenciada de provedores de e-mail elegíveis e retorna um endereço pessoal quando um deles encontra um resultado.
O exemplo completo com Requests abaixo envia uma tarefa em segundo plano, aguarda sua conclusão e recupera todas as páginas de resultados. Depois que a busca funcionar, você reutilizará os objetos retornados para preparar registros de contato para recrutamento, mantendo o nome, a URL do LinkedIn e a vaga-alvo de cada candidato junto ao e-mail encontrado.
Este fluxo busca um endereço de e-mail pessoal que não dependa do atual empregador do candidato. Se você precisar de um endereço vinculado à empresa da pessoa, consulte o guia específico para encontrar um e-mail profissional a partir de um perfil do LinkedIn.
🔑 Resumo para quem está com pressa
Informe os nomes dos candidatos, as URLs públicas dos perfis no LinkedIn e as vagas-alvo. O fluxo em Python encontra os e-mails pessoais disponíveis e mantém cada endereço associado aos dados de recrutamento fornecidos inicialmente.
- Entrada: nomes dos candidatos, URLs públicas
linkedin.com/in/...e vagas-alvo.- Saída: e-mails pessoais encontrados junto aos dados dos respectivos candidatos.
💡 Prefere uma solução no-code? Use o Waterfall Personal Email Finder da Datablist para encontrar e-mails pessoais sem escrever código.
Se sua fonte contém nomes, mas não URLs de perfis, primeiro encontre perfis públicos do LinkedIn no Python e depois envie essas URLs para esta API.
Configure Python, Requests e sua chave API da Datablist
Neste exemplo, uso Python com o pacote requests. Crie um arquivo chamado find_personal_emails.py e instale o Requests:
python -m pip install requestsCrie uma Personal API Key em sua conta Datablist e exporte-a como variável de ambiente:
export DATABLIST_API_KEY='your-api-key'O acesso à REST API está disponível no plano Growth. Cada e-mail pessoal encontrado também consome créditos, conforme calculado na seção de custos abaixo.
Encontre um e-mail pessoal com uma função Python
A lista editável candidates deste script contém um registro de recrutamento. target_role é um exemplo de valor da fonte que permanece local no fluxo de recrutamento. Somente candidate_id e linkedin_url são enviados no payload da API.
import json
import os
import time
import uuid
import requests
def find_personal_emails(candidates, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": candidate["candidate_id"],
"data": {"profileUrl": candidate["linkedin_url"]},
}
for candidate in candidates
]
unique_id = str(uuid.uuid4())
print(f"Recovery uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-personal-email-finder",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(f"Task {task_id} {task['status']}: {task.get('error')}")
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
candidates = [
{
"candidate_id": "candidate-florian-poullin",
"name": "Florian Poullin",
"linkedin_url": "https://www.linkedin.com/in/florianpoullin/",
"target_role": "Backend Engineer",
}
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
personal_email_results = find_personal_emails(candidates, api_key)
for result in personal_email_results:
print(json.dumps(result, indent=2))Execute o arquivo no mesmo terminal:
python find_personal_emails.pyVocê também pode baixar o exemplo síncrono mantido com Requests. O script acima mantém a mesma sequência de envio, polling e paginação, usando os IDs dos candidatos presentes nos registros de origem.
Envie a busca
A função transforma cada candidato em uma entrada da API. inputId recebe o ID estável do candidato, enquanto data.profileUrl recebe a URL pública do perfil pessoal no LinkedIn. É obrigatória uma URL padrão no formato linkedin.com/in/.... URLs do Sales Navigator, páginas de empresas, valores em branco e nomes sem URLs de perfil não são entradas válidas para este enrichment.
A requisição usa waterfall-personal-email-finder como enrichmentId e um objeto settings vazio, conforme apresentado na documentação da API Waterfall Personal Email Finder. O script exibe o uniqueId gerado antes do envio. Guarde esse valor, pois ele permite identificar uma tarefa existente caso a conexão caia depois que a API aceitar a requisição.
Veja o corpo completo da requisição para o exemplo com um perfil:
{
  "enrichmentId": "waterfall-personal-email-finder",
  "uniqueId": "55001d29-4fb9-4fe2-9497-80f4b346eed7",
  "settings": {},
  "inputs": [
    {
      "inputId": "candidate-florian-poullin",
      "data": {
        "profileUrl": "https://www.linkedin.com/in/florianpoullin/"
      }
    }
  ]
}
Um envio bem-sucedido retorna HTTP 202 Accepted, com o ID da tarefa em @id. Depois dessa resposta, o processamento continua nos servidores da Datablist.
Aguarde a tarefa em segundo plano
O script com Requests fica bloqueado localmente enquanto o servidor executa a tarefa em segundo plano. Ele consulta a tarefa a cada três segundos e continua enquanto o status for queued ou running. Uma tarefa completed avança para a recuperação dos resultados. Uma tarefa failed ou stopped gera um erro com o ID da tarefa e a mensagem de erro disponível.
Recupere todas as páginas de resultados
O endpoint de resultados retorna o ID de origem, o status, os outputs, os créditos e o erro de cada linha. A primeira requisição solicita até 100 resultados. Ela busca a página seguinte até que nextCursor seja null.
Os resultados da tarefa preservam a ordem das entradas. O inputId continua fornecendo uma ligação explícita entre cada resultado e o registro do respectivo candidato, inclusive quando há várias páginas de resultados.
Ao adaptar o exemplo para mais registros, mantenha cada candidate_id estável em relação ao sistema de origem. Esse valor torna o join previsível quando a tarefa contém várias páginas de resultados.
Como o waterfall de e-mail pessoal encontra resultados
A Datablist limpa a URL pública do perfil do LinkedIn enviada e encaminha o perfil ainda sem resultado, em sequência, aos provedores de e-mail pessoal elegíveis no momento. Se um provedor não retornar um endereço utilizável, o perfil poderá seguir para o próximo provedor elegível. Quando um deles encontra um e-mail válido, a sequência é interrompida para esse perfil e o endereço é retornado em outputs.emailFound.
Os provedores elegíveis são gerenciados pela Datablist. Portanto, sua integração não precisa de requisições específicas para cada provedor nem de código de fallback. O resultado público informa o e-mail encontrado, e não uma ordem fixa de provedores ou um histórico das tentativas.
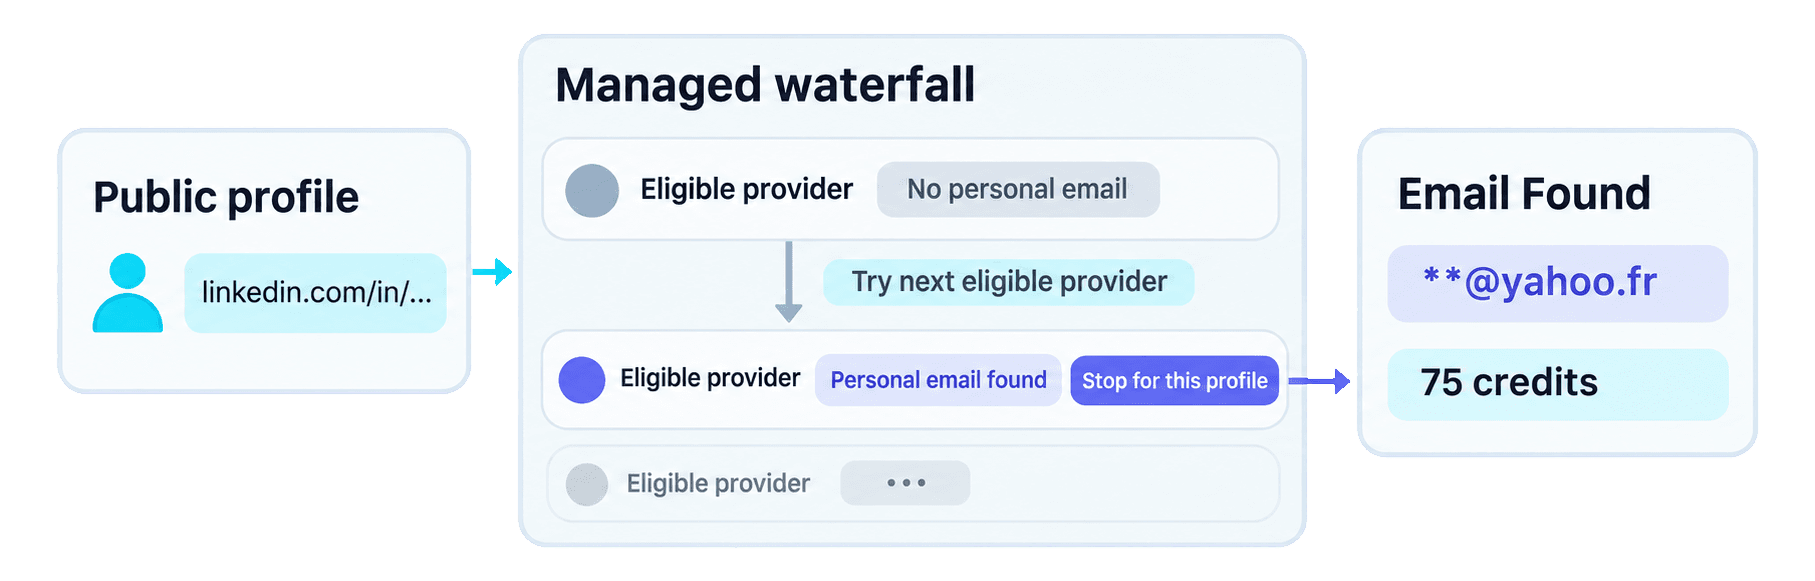
O waterfall é o método de busca. O polling tem outra função: permitir que o cliente Python aguarde a conclusão desse processamento em segundo plano.
Por que o waterfall ajuda equipes globais de recrutamento
Os provedores de e-mail pessoal usam bases de dados diferentes, por isso o desempenho varia entre países e mercados. Quando o primeiro provedor não tem o e-mail de um candidato, outro provedor no waterfall pode encontrá-lo.
Equipes de recrutamento que atuam em vários países obtêm uma cobertura mais ampla de provedores com uma única integração de API. A Datablist gerencia a sequência, permitindo recuperar contatos que uma busca com apenas um provedor poderia deixar passar, sem a necessidade de conectar e manter várias APIs.
Analise o resultado completo
📘 E-mail mascarado: A parte local do endereço foi substituída por
**abaixo. O resultado da sua API contém o valor completo.
Veja a página completa de resultados para a entrada do candidato:
{
  "taskId": "b5de73ffaa3f4f349c125d7c85125bb4",
  "results": [
    {
      "inputId": "candidate-florian-poullin",
      "status": "success",
      "outputs": {
        "emailFound": "**@yahoo.fr"
      },
      "creditsUsed": "75",
      "error": null
    }
  ],
  "nextCursor": null
}
O inputId é a chave de join com o candidato da fonte. outputs.emailFound contém o endereço pessoal. creditsUsed representa a cobrança oficial dessa linha, e error: null significa que a API não retornou nenhum erro no nível da linha. O cursor nulo confirma que essa resposta não tem uma próxima página de resultados.
Trate o endereço como uma opção de contato associada ao perfil enviado e revise-o antes de usá-lo em ações de recrutamento.
Prepare contatos de candidatos para revisão
Depois que a busca retornar, você poderá preparar uma lista local para a revisão do recrutador sem fazer outra requisição à API. O bloco abaixo reutiliza as variáveis candidates e personal_email_results existentes:
results_by_id = {
result["inputId"]: result for result in personal_email_results
}
prepared_contacts = []
for candidate in candidates:
result = results_by_id.get(candidate["candidate_id"])
if not result or result.get("status") != "success":
continue
email_found = result.get("outputs", {}).get("emailFound")
if not email_found:
continue
prepared_contact = candidate.copy()
prepared_contact["result"] = result
prepared_contacts.append(prepared_contact)
print(json.dumps(prepared_contacts, indent=2))Para candidate-florian-poullin, a consulta ao dicionário encontra o resultado com o mesmo inputId. O registro copiado mantém o nome de Florian Poullin, a URL do LinkedIn e a vaga-alvo de exemplo Backend Engineer. Em seguida, ele anexa o objeto completo da API em result, onde o recrutador pode consultar result.outputs.emailFound.
O loop parte da lista de candidatos da fonte. No futuro, um resultado não encontrado, um erro de linha, um resultado ausente ou um emailFound vazio manterá essa lista de origem inalterada e não será incluído em prepared_contacts.
Para conhecer um processo de revisão mais amplo e outros canais de contato, consulte o guia sobre como encontrar o endereço de e-mail de um candidato como recrutador.
Calcule os custos da API Waterfall Personal Email Finder
Cada e-mail pessoal encontrado consome 75 créditos. Uma busca sem resultado consome 0 crédito. Para calcular o gasto real, consulte creditsUsed em cada resultado, em vez de multiplicar o número total de perfis enviados.
A fórmula de planejamento é:
e-mails pessoais encontrados × 75 créditos
Por exemplo, se você enviar 100 perfis e 20 deles retornarem um e-mail pessoal, a tarefa consumirá 20 × 75 = 1.500 créditos. Esse cálculo serve para planejamento e não representa uma taxa de sucesso esperada. Para orçamentos maiores, 100 e-mails encontrados consomem 7.500 créditos, enquanto 1.000 e-mails encontrados consomem 75.000 créditos.
Considerando a tarifa básica atual de recarga em dólares, $20 / 20.000 créditos = $0,001 por crédito. Portanto, um e-mail encontrado consome o equivalente a $0,075 em créditos, e 100 e-mails encontrados consomem $7,50. Essa estimativa considera o valor dos créditos utilizados. A assinatura Growth exigida para acessar a REST API é cobrada separadamente. Consulte os preços da Datablist para conhecer os planos e pacotes de créditos atuais.
Corrija erros comuns e recupere uma tarefa existente
A maioria dos problemas ocorre antes do envio, na requisição HTTP ou em um resultado individual. Use o local do erro para escolher a próxima ação:
DATABLIST_API_KEYausente: o script para localmente antes de fazer uma requisição. Exporte a variável de ambiente e execute o arquivo novamente.- Falha de autenticação HTTP: verifique a Personal API Key em
DATABLIST_API_KEY. A função a envia no headerX-API-Key. Corrija a credencial antes de realizar um novo envio. - URL de perfil incompatível: substitua URLs do Sales Navigator, páginas de empresas, valores em branco ou URLs malformadas por um perfil público de pessoa no formato
linkedin.com/in/.... - Créditos insuficientes: confira o saldo da conta e os créditos disponíveis antes de enviar mais tarefas.
- A tarefa está
failedoustopped: analise o erro da tarefa, os resultados disponíveis e o uso de créditos antes de decidir o que ainda precisa ser executado. - Uma linha não tem resultado ou apresenta erro: mantenha o candidato da fonte para revisão ou para uso em outro canal de contato. Uma busca malsucedida não informa por que o endereço estava indisponível.
Se a resposta do POST for perdida, liste suas tarefas antes de criar uma nova. Procure na resposta o uniqueId exibido pelo script e copie o @id da tarefa correspondente:
curl "https://api.datablist.com/v1/enrichments/tasks?enrichmentId=waterfall-personal-email-finder&limit=100" \
--header "X-API-Key: $DATABLIST_API_KEY"
TASK_ID='paste-matching-task-id'
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID" \
--header "X-API-Key: $DATABLIST_API_KEY"
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID/results" \
--header "X-API-Key: $DATABLIST_API_KEY"Se a tarefa correspondente não estiver na primeira resposta do histórico, siga o cursor de paginação retornado e consulte a página seguinte. Continue verificando a tarefa recuperada ou obtenha os resultados disponíveis, em vez de criar automaticamente outra tarefa paga. A documentação de tarefas explica o ciclo de vida, a paginação e os detalhes de retenção dos resultados.
Próximos passos
Agora você tem uma função Python reutilizável com Requests para URLs públicas de perfis do LinkedIn e um merge por ID estável que prepara os e-mails pessoais encontrados junto ao contexto original de cada candidato.
Substitua a lista de exemplo por um pequeno conjunto de registros dos seus candidatos, mantenha um ID estável e uma vaga-alvo para cada pessoa e revise todos os contatos preparados antes de usá-los no processo de recrutamento. Quando sua aplicação precisar de concorrência sem bloqueio, use o exemplo assíncrono mantido com HTTPX como próxima etapa da implementação.