
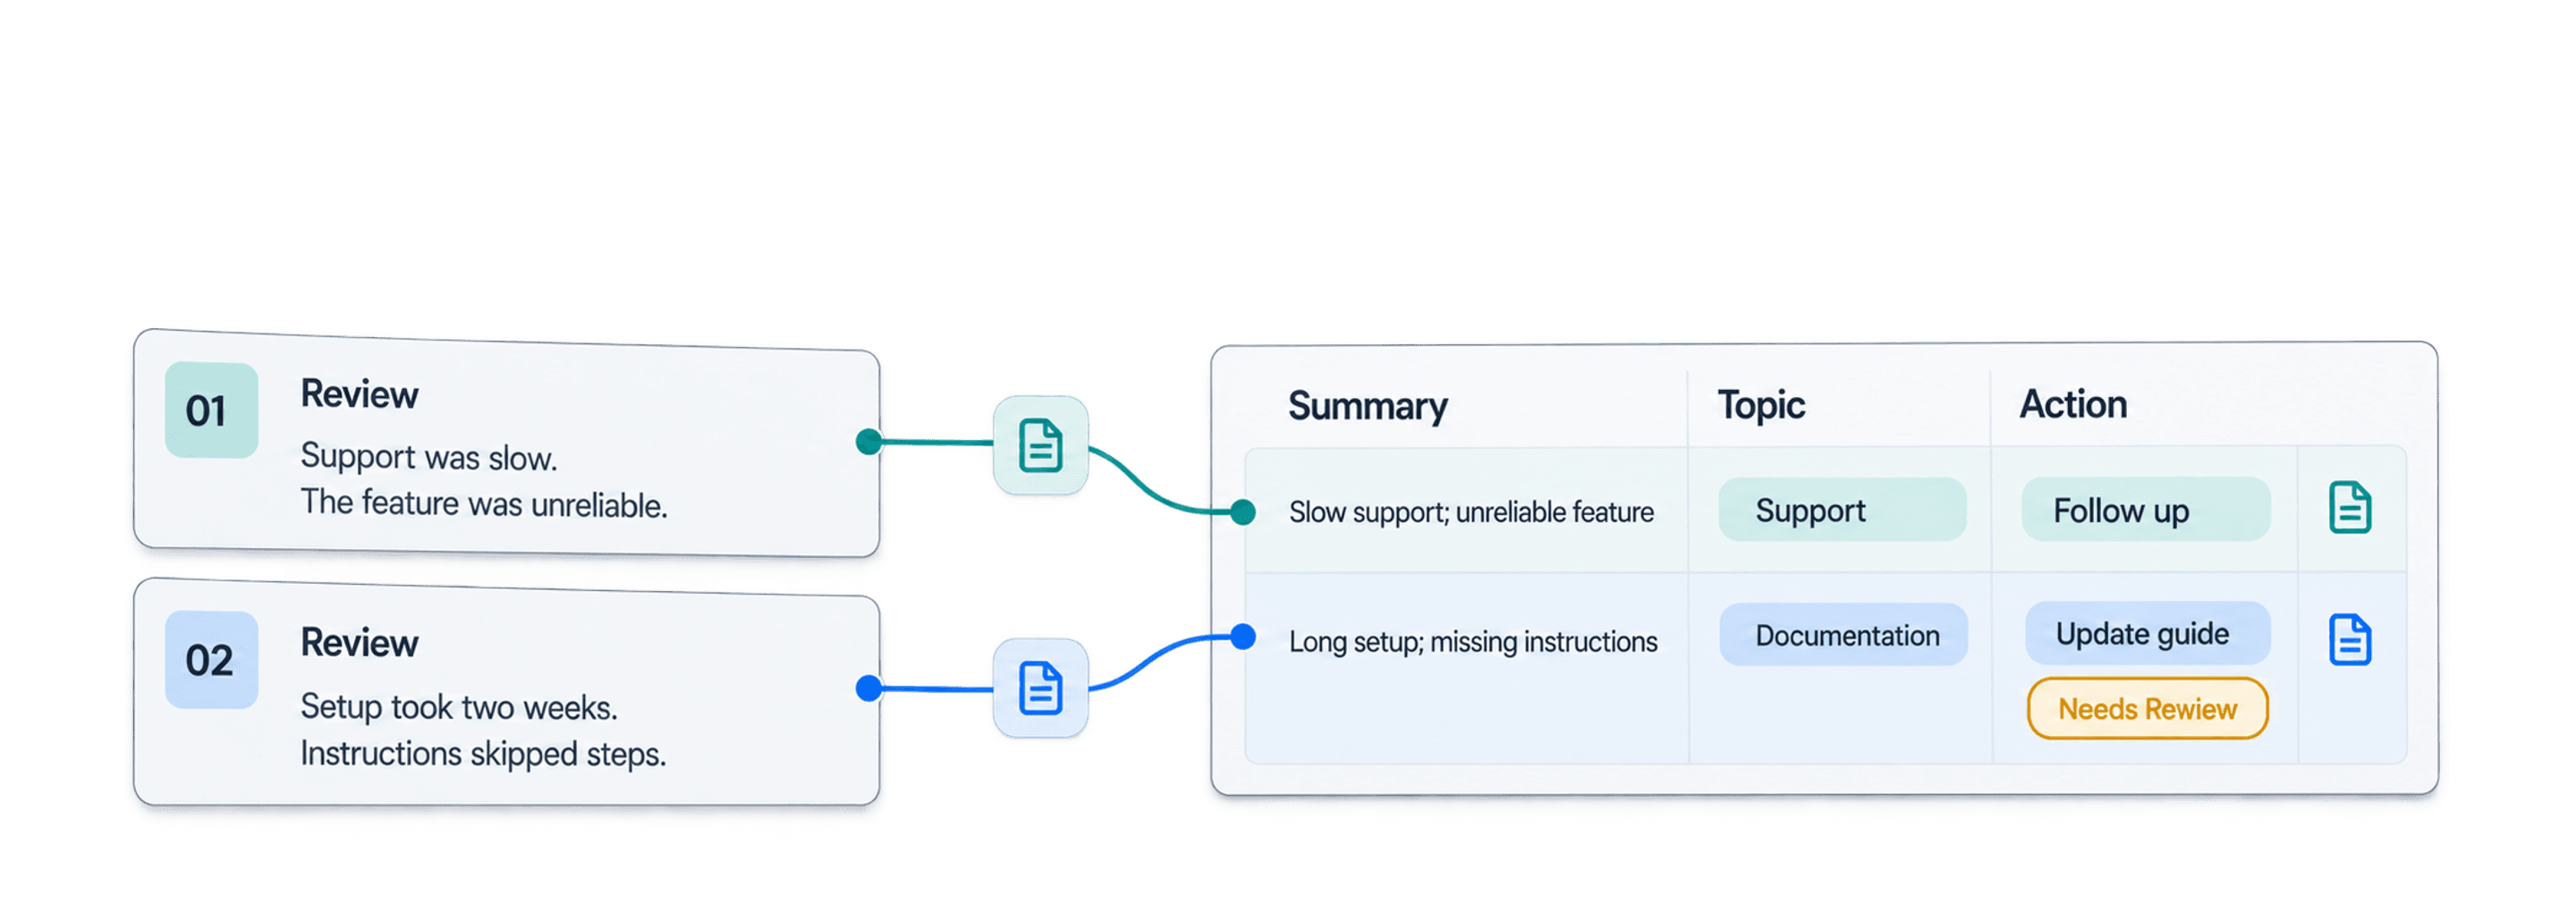
Ler centenas de avaliações leva tempo. Ler milhares — ou centenas de milhares — de forma consistente e manual é inviável. As avaliações por estrelas mostram uma nota, mas raramente explicam a reclamação, o problema recorrente no produto ou o que sua equipe deve fazer em seguida.
Com o Datablist, você pode resumir avaliações de clientes com IA em um arquivo CSV ou Excel inteiro. Um único prompt estruturado analisa cada avaliação e adiciona as colunas Review Summary, Sentiment, Main Topic, Issue Type, Urgency, Recommended Action e Needs Review. Em vez de trabalhar com uma pequena amostra de comentários, você obtém uma base de avaliações que sua equipe pode filtrar, revisar e transformar em ações.
Neste guia, uso um arquivo com 100 linhas para que você possa reproduzir o exemplo. O mesmo processo funciona quando seu arquivo contém milhares ou centenas de milhares de avaliações: teste o prompt em uma amostra variada, processe as linhas restantes, examine os resultados incertos e exporte os campos originais e gerados juntos.
O resultado mais útil não é um resumo longo, mas uma planilha de avaliações que você pode filtrar, revisar e transformar em ações. Esta primeira etapa analisa as avaliações linha por linha. A contagem de temas e um resumo executivo do arquivo inteiro vêm depois, após a validação dos rótulos.
O que a IA gera ao resumir avaliações
Divido a análise de avaliações em três partes.
Primeiro, o modelo cria um resumo curto de cada avaliação. Um bom resumo preserva a intenção e o tom do cliente sem copiar todos os detalhes. Depois, retorna campos controlados, como sentimento, tema, tipo de problema e urgência. Esses campos permitem comparar avaliações diferentes. Por fim, sugere uma ação fundamentada no texto e sinaliza as linhas ambíguas para revisão manual.
Manter os dados em colunas separadas faz diferença. Um parágrafo escrito pela IA pode ser fácil de ler, mas é difícil de filtrar. A saída estruturada de IA permite isolar reclamações urgentes, comparar a nota com o sentimento ou agrupar avaliações por tema sem precisar interpretar novamente cada resposta.
🔑 Analise cada avaliação antes de agregar o arquivo
Manter cada avaliação gerada ao lado do texto original facilita a amostragem e a correção. Rótulos consistentes permitem fazer contagens posteriormente, mas, por si só, não criam um relatório estatisticamente válido.
Se você precisa apenas de um rótulo controlado e um valor de confiança, Classification with ChatGPT/OpenAI é a opção mais específica. O processo deste guia usa Ask ChatGPT/OpenAI porque uma única solicitação precisa preencher sete campos.
Exemplo de CSV com avaliações de clientes
Usei uma amostra sintética com 100 avaliações de clientes. Ela contém Index, Review ID, Product Name, Rating e Review Text. Você pode seguir o mesmo processo com seu próprio arquivo CSV ou Excel, desde que cada linha contenha uma avaliação.
| Review ID | Product Name | Rating | Trecho de Review Text |
|---|---|---|---|
7wQDdSKxrw | Smart Clock Lock | 3 | Cumpre sua função, mas não funciona bem para uma equipe remota; entrei em contato com o suporte duas vezes. |
9xSyNNTkPZ | Mini Phone Scooter | 2 | O suporte demorou e o recurso necessário não era confiável. |
b3RFuoVRvJ | Mixer Grill | 4 | Funcionou bem assim que saiu da caixa, mas a configuração inicial levou uma semana. |
ZjmazxYl87 | Advanced Microphone Lamp Speaker Smart | 1 | O suporte demorou, as instruções pularam etapas e a configuração levou duas semanas. |
Review Text é o único campo de entrada obrigatório. Rating e Product Name fornecem contexto útil ao modelo, enquanto Review ID permite rastrear cada resultado até sua origem. Mantenho as quatro colunas na exportação final.
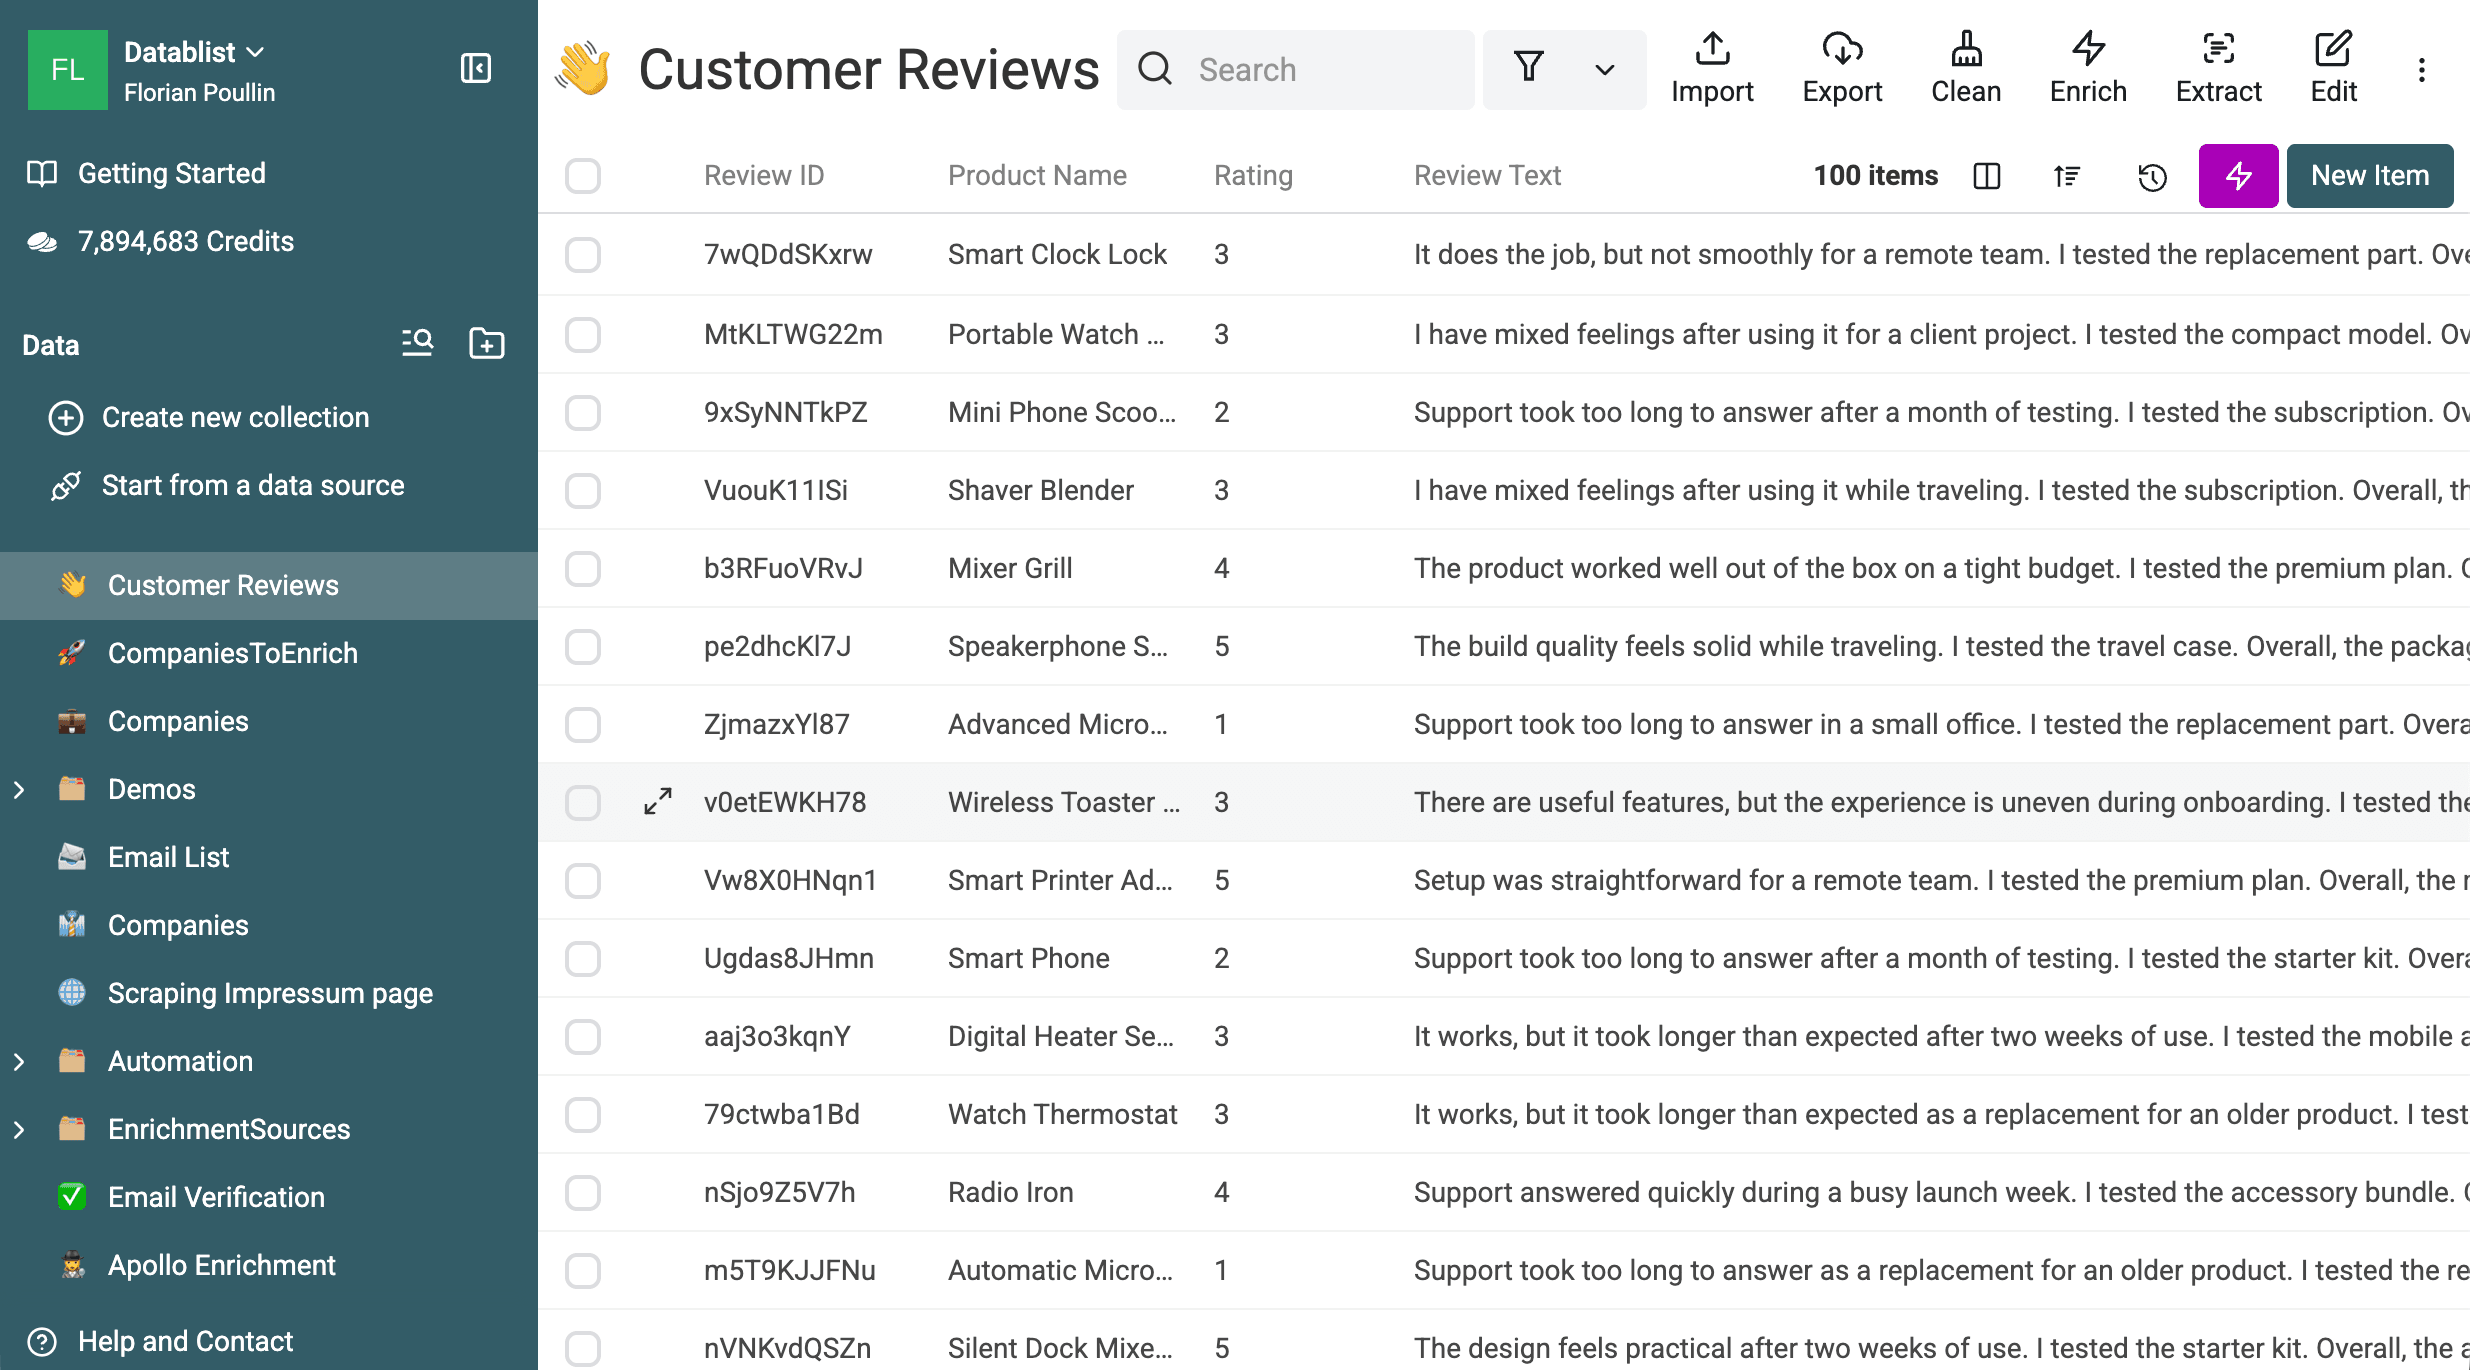
O processo adiciona os sete campos de análise, além de um indicador de processamento e o status da execução. Se você ainda precisa coletar os dados de origem, consulte os guias específicos para coletar avaliações do Trustpilot ou coletar avaliações do Trusted Shops. Este tutorial começa quando as avaliações já estão em um arquivo.
Prepare as avaliações antes de enviá-las à IA
Antes de abrir o enrichment, verifique o próprio arquivo:
- Filtre as linhas em que
Review Textestá vazio. Sem texto, não é possível gerar um resumo ou uma classificação confiável. - Verifique se há duplicatas. Solicitações idênticas podem se beneficiar do cache, mas ainda recomendo remover duplicatas acidentais antes de analisar tendências.
- Normalize
Ratingem uma única escala, como de 1 a 5. Use esse campo como sinal de diagnóstico, não como verdade absoluta. - Identifique avaliações muito longas ou em vários idiomas. Talvez elas exijam um limite de saída maior, uma instrução de idioma ou um lote separado.
- Crie uma amostra de 10 a 20 avaliações variadas. Inclua notas baixas, médias e altas, textos curtos e longos e feedbacks que abordem vários temas.
💡 Teste primeiro as linhas mais difíceis
Uma amostra variada revela mais do que as dez primeiras linhas. Ela expõe rótulos vagos, conflitos com as notas e regras pouco eficazes de sinalização antes que você pague para processar o arquivo inteiro.
Entenda o prompt e os campos da análise
O prompt tem quatro funções: resumir uma linha, escolher rótulos controlados, recomendar uma ação fundamentada na avaliação e sinalizar informações que precisam ser examinadas por uma pessoa. Ele usa somente o nome do produto, a nota e o texto da avaliação. Não deve inventar detalhes sobre o produto ou a intenção do cliente.
Prefiro um campo Needs Review a forçar uma certeza inexistente. Uma avaliação que aborda vários assuntos pode se encaixar corretamente em dois temas. Encaminhar essa linha para inspeção é mais seguro do que esconder a ambiguidade atrás de um rótulo aparentemente definitivo.
Para adaptar as regras, veja como escrever um prompt confiável para análise de dados e como inserir valores de uma planilha em um prompt. Rótulos controlados tornam as linhas comparáveis; Needs Review mantém visíveis as análises incertas.
O template Analyze customer reviews já traz esse prompt configurado. A versão completa abaixo ainda é útil caso você queira examinar ou alterar sua taxonomia.
Você analisa avaliações de clientes para uma equipe de produto. Baseie cada campo somente na avaliação, na nota e no nome do produto fornecidos. Mantenha os resumos objetivos. Use apenas os rótulos permitidos. Se o texto estiver vazio, for contraditório, vago demais ou não fornecer informações suficientes para preencher um campo, use o valor alternativo e marque a linha para revisão. Não invente detalhes sobre o produto nem sobre a intenção do cliente.
Tarefa
Analise uma avaliação de cliente. Retorne um resumo de uma frase com no máximo 25 palavras. Recomende uma próxima ação curta para a equipe de produto, suporte ou marketing. A ação deve decorrer da avaliação fornecida.
Regras de saída
Review Summary: uma frase objetiva, com no máximo 25 palavras.
Sentiment: Positive, Neutral, Negative ou Mixed.
Main Topic: Product quality, Setup and onboarding, Ease of use, Performance and reliability, Support, Pricing and value, Documentation, Features, Delivery and packaging ou Other.
Issue Type: Praise, Complaint, Feature request, Question ou No clear issue.
Urgency: High, Medium, Low ou None.
Recommended Action: uma ação curta e fundamentada, ou uma resposta alternativa neutra quando não houver informações suficientes para recomendar uma ação.
Needs Review: Yes quando o texto for vago, contraditório, contiver vários temas igualmente importantes, divergir muito da nota ou não permitir uma classificação confiável. Caso contrário, retorne No.
Dados desta linha
Product Name: {{Product Name}}
Rating: {{Rating}} de 5
Review Text: {{Review Text}}
Coloque as instruções fixas no início e as variáveis de cada linha no fim. Isso mantém o prefixo repetido consistente quando o modelo e a solicitação selecionados aceitam prompt caching, sem garantir que haverá um cache hit.
Propriedades de saída que você deve confirmar
| Propriedade | Tipo | Valor aceito ou regra |
|---|---|---|
Review Summary | Texto longo | Uma frase objetiva, com no máximo 25 palavras |
Sentiment | Texto ou seleção | Positive, Neutral, Negative ou Mixed |
Main Topic | Texto ou seleção | Um dos dez temas definidos no prompt |
Issue Type | Texto ou seleção | Praise, Complaint, Feature request, Question ou No clear issue |
Urgency | Texto ou seleção | High, Medium, Low ou None |
Recommended Action | Texto longo | Uma ação curta e fundamentada na avaliação |
Needs Review | Checkbox | Yes para análises ambíguas ou sem evidências suficientes; caso contrário, No |
O prompt e as descrições das saídas devem repetir os mesmos conjuntos de rótulos. Essa pequena duplicação evita que as instruções e o schema deixem de corresponder.
Selecione o template Analyze customer reviews
Importe o arquivo de avaliações
Importe seu arquivo CSV ou Excel no Datablist. Confirme se Review Text, Rating, Product Name e Review ID foram associados às propriedades esperadas. Se precisar de instruções mais amplas, consulte o guia para executar um prompt do ChatGPT em cada linha de um CSV ou Excel.
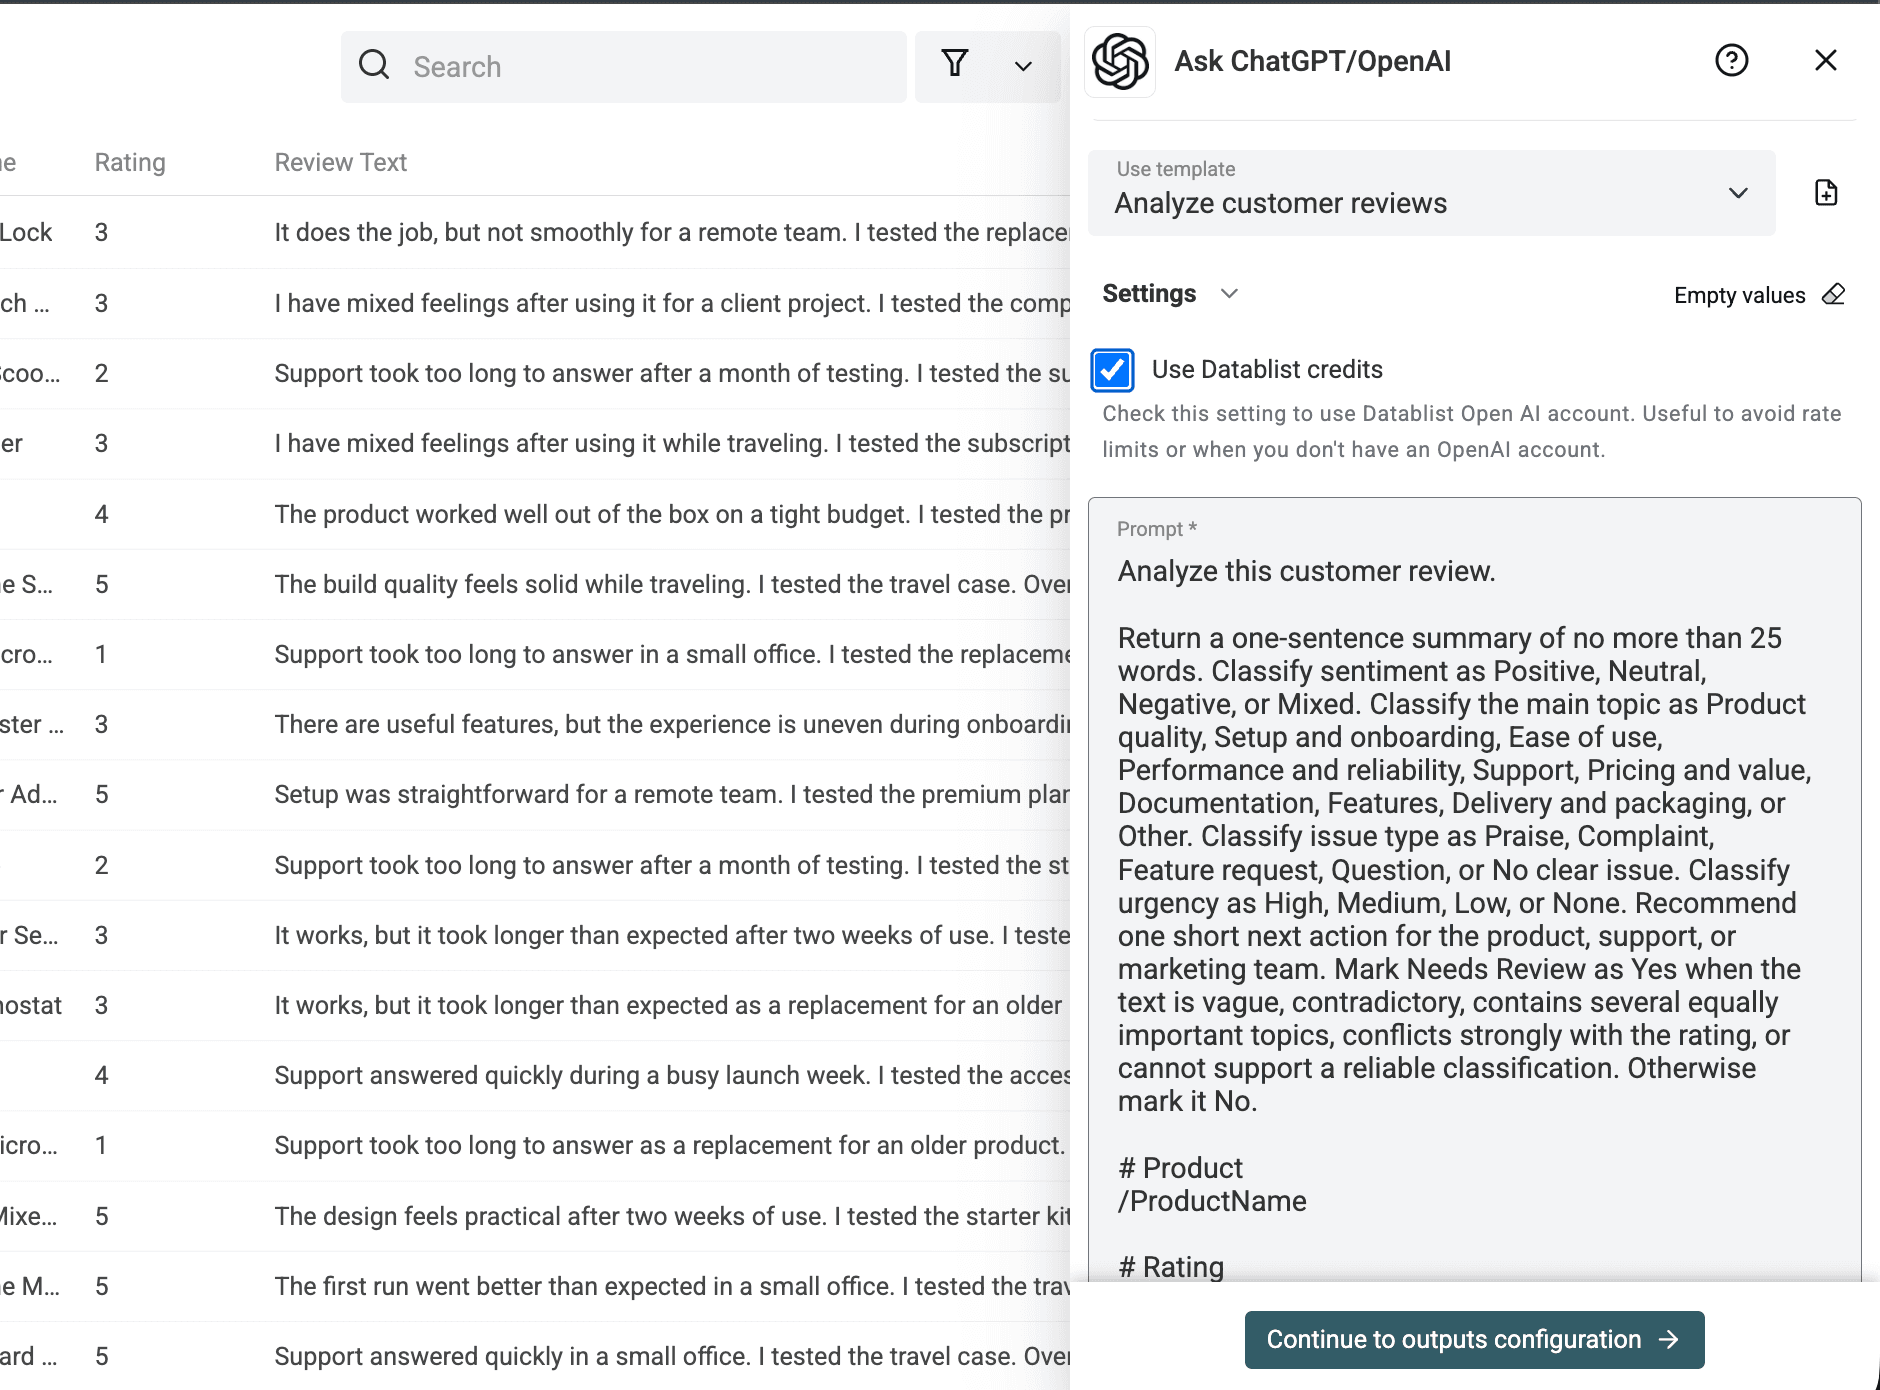
Abra Ask ChatGPT/OpenAI e escolha o template
Abra Enrich e selecione o enrichment Ask ChatGPT/OpenAI.
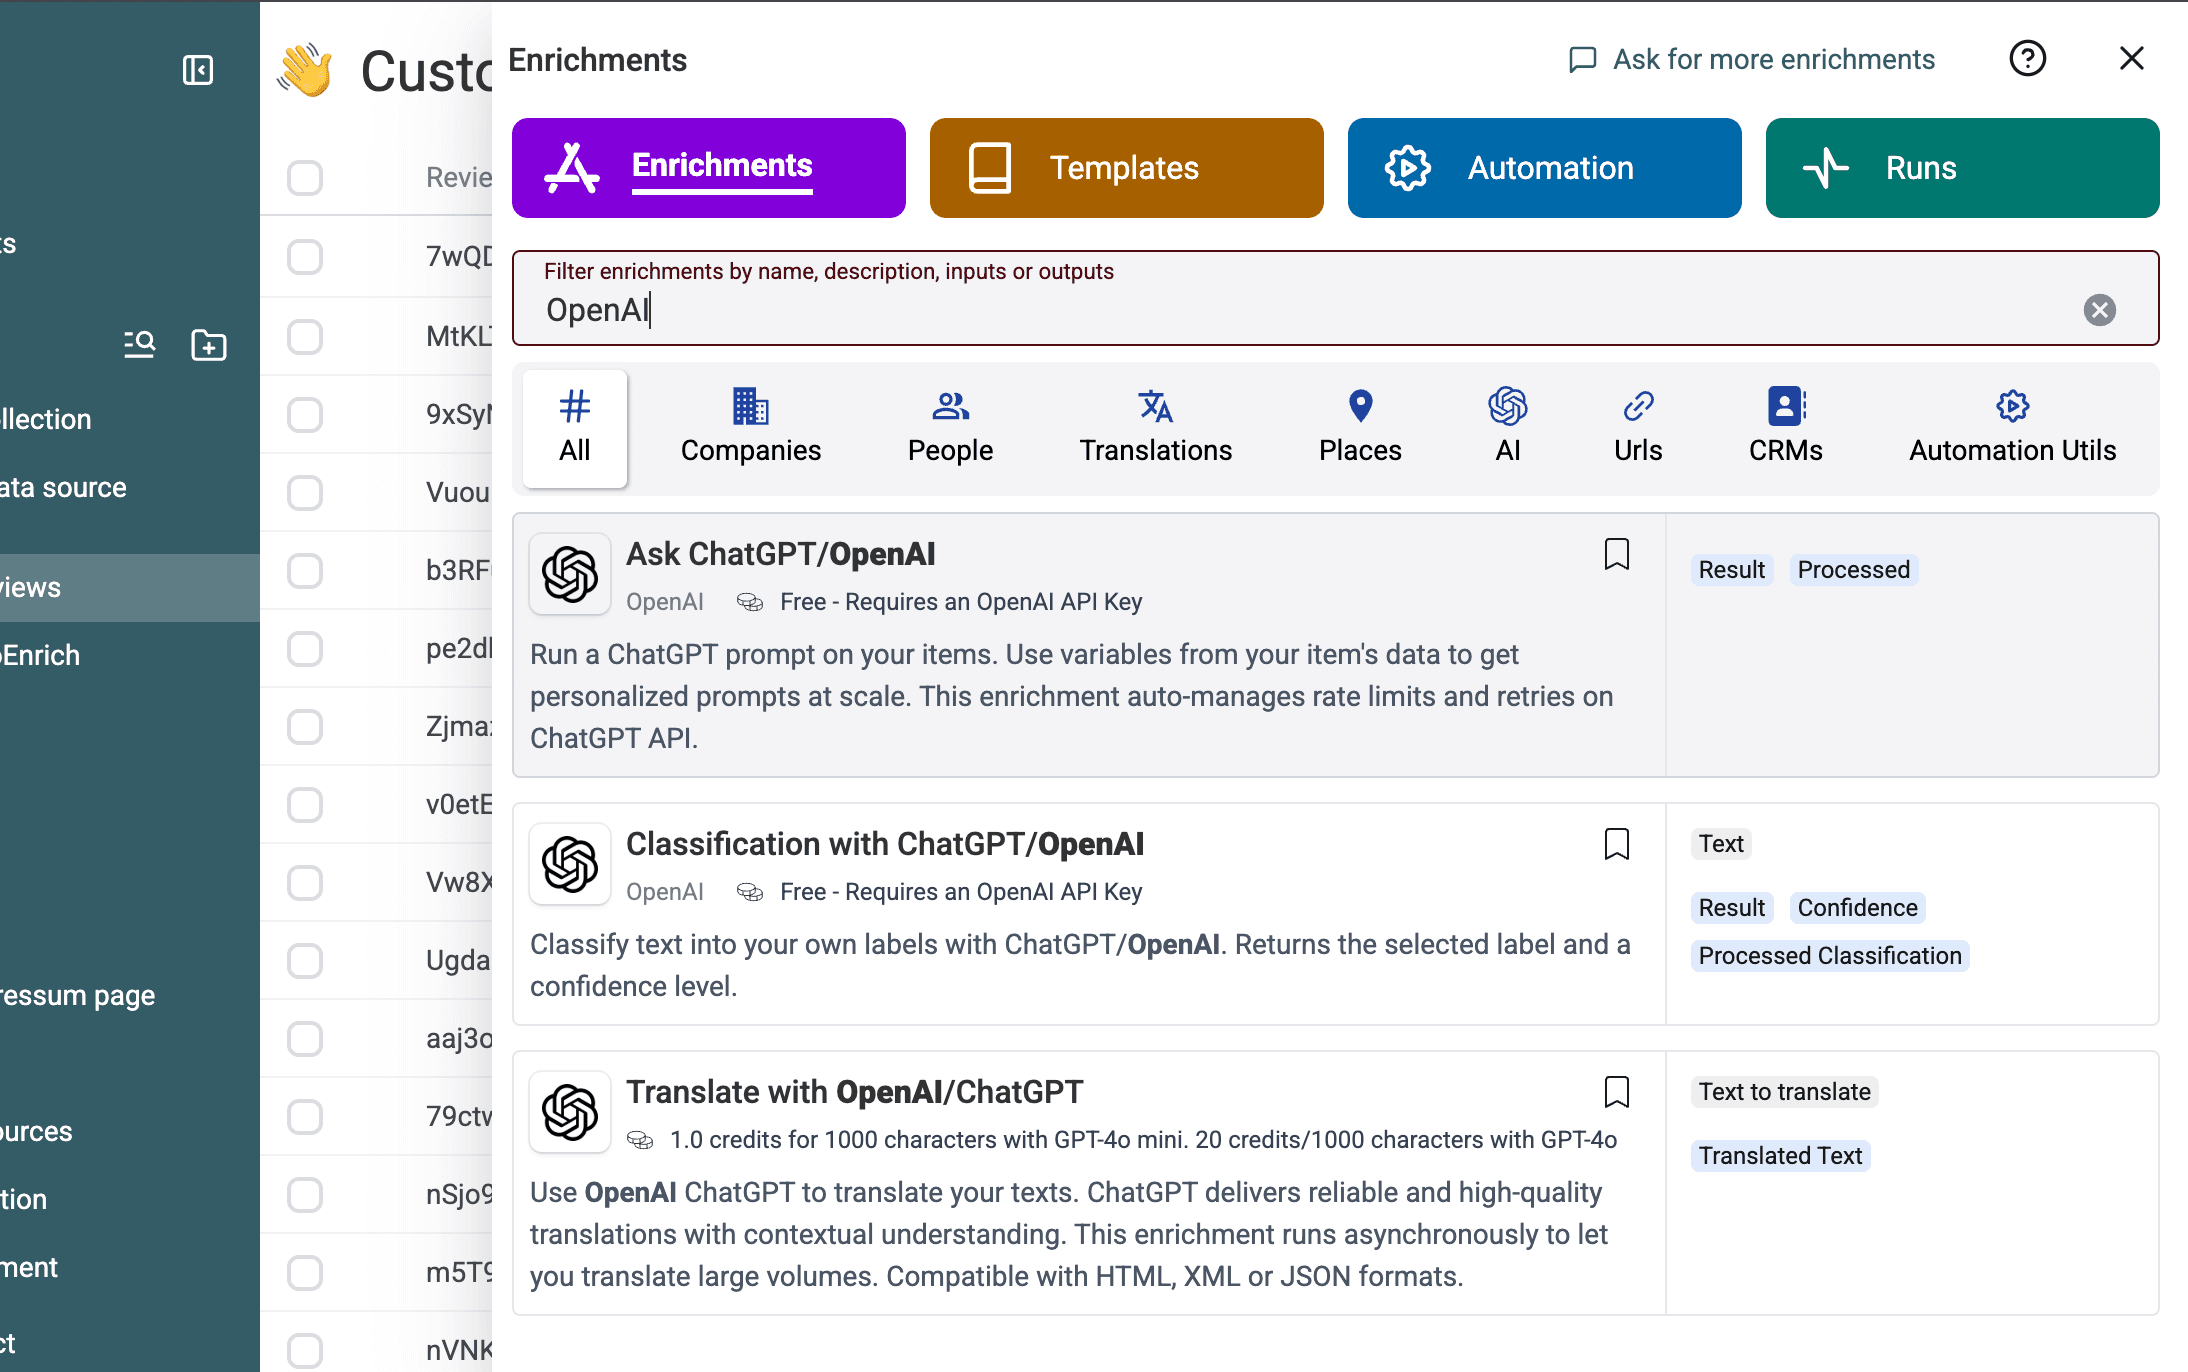
Abra Use template. O seletor vazio aparece antes que você escolha um template.
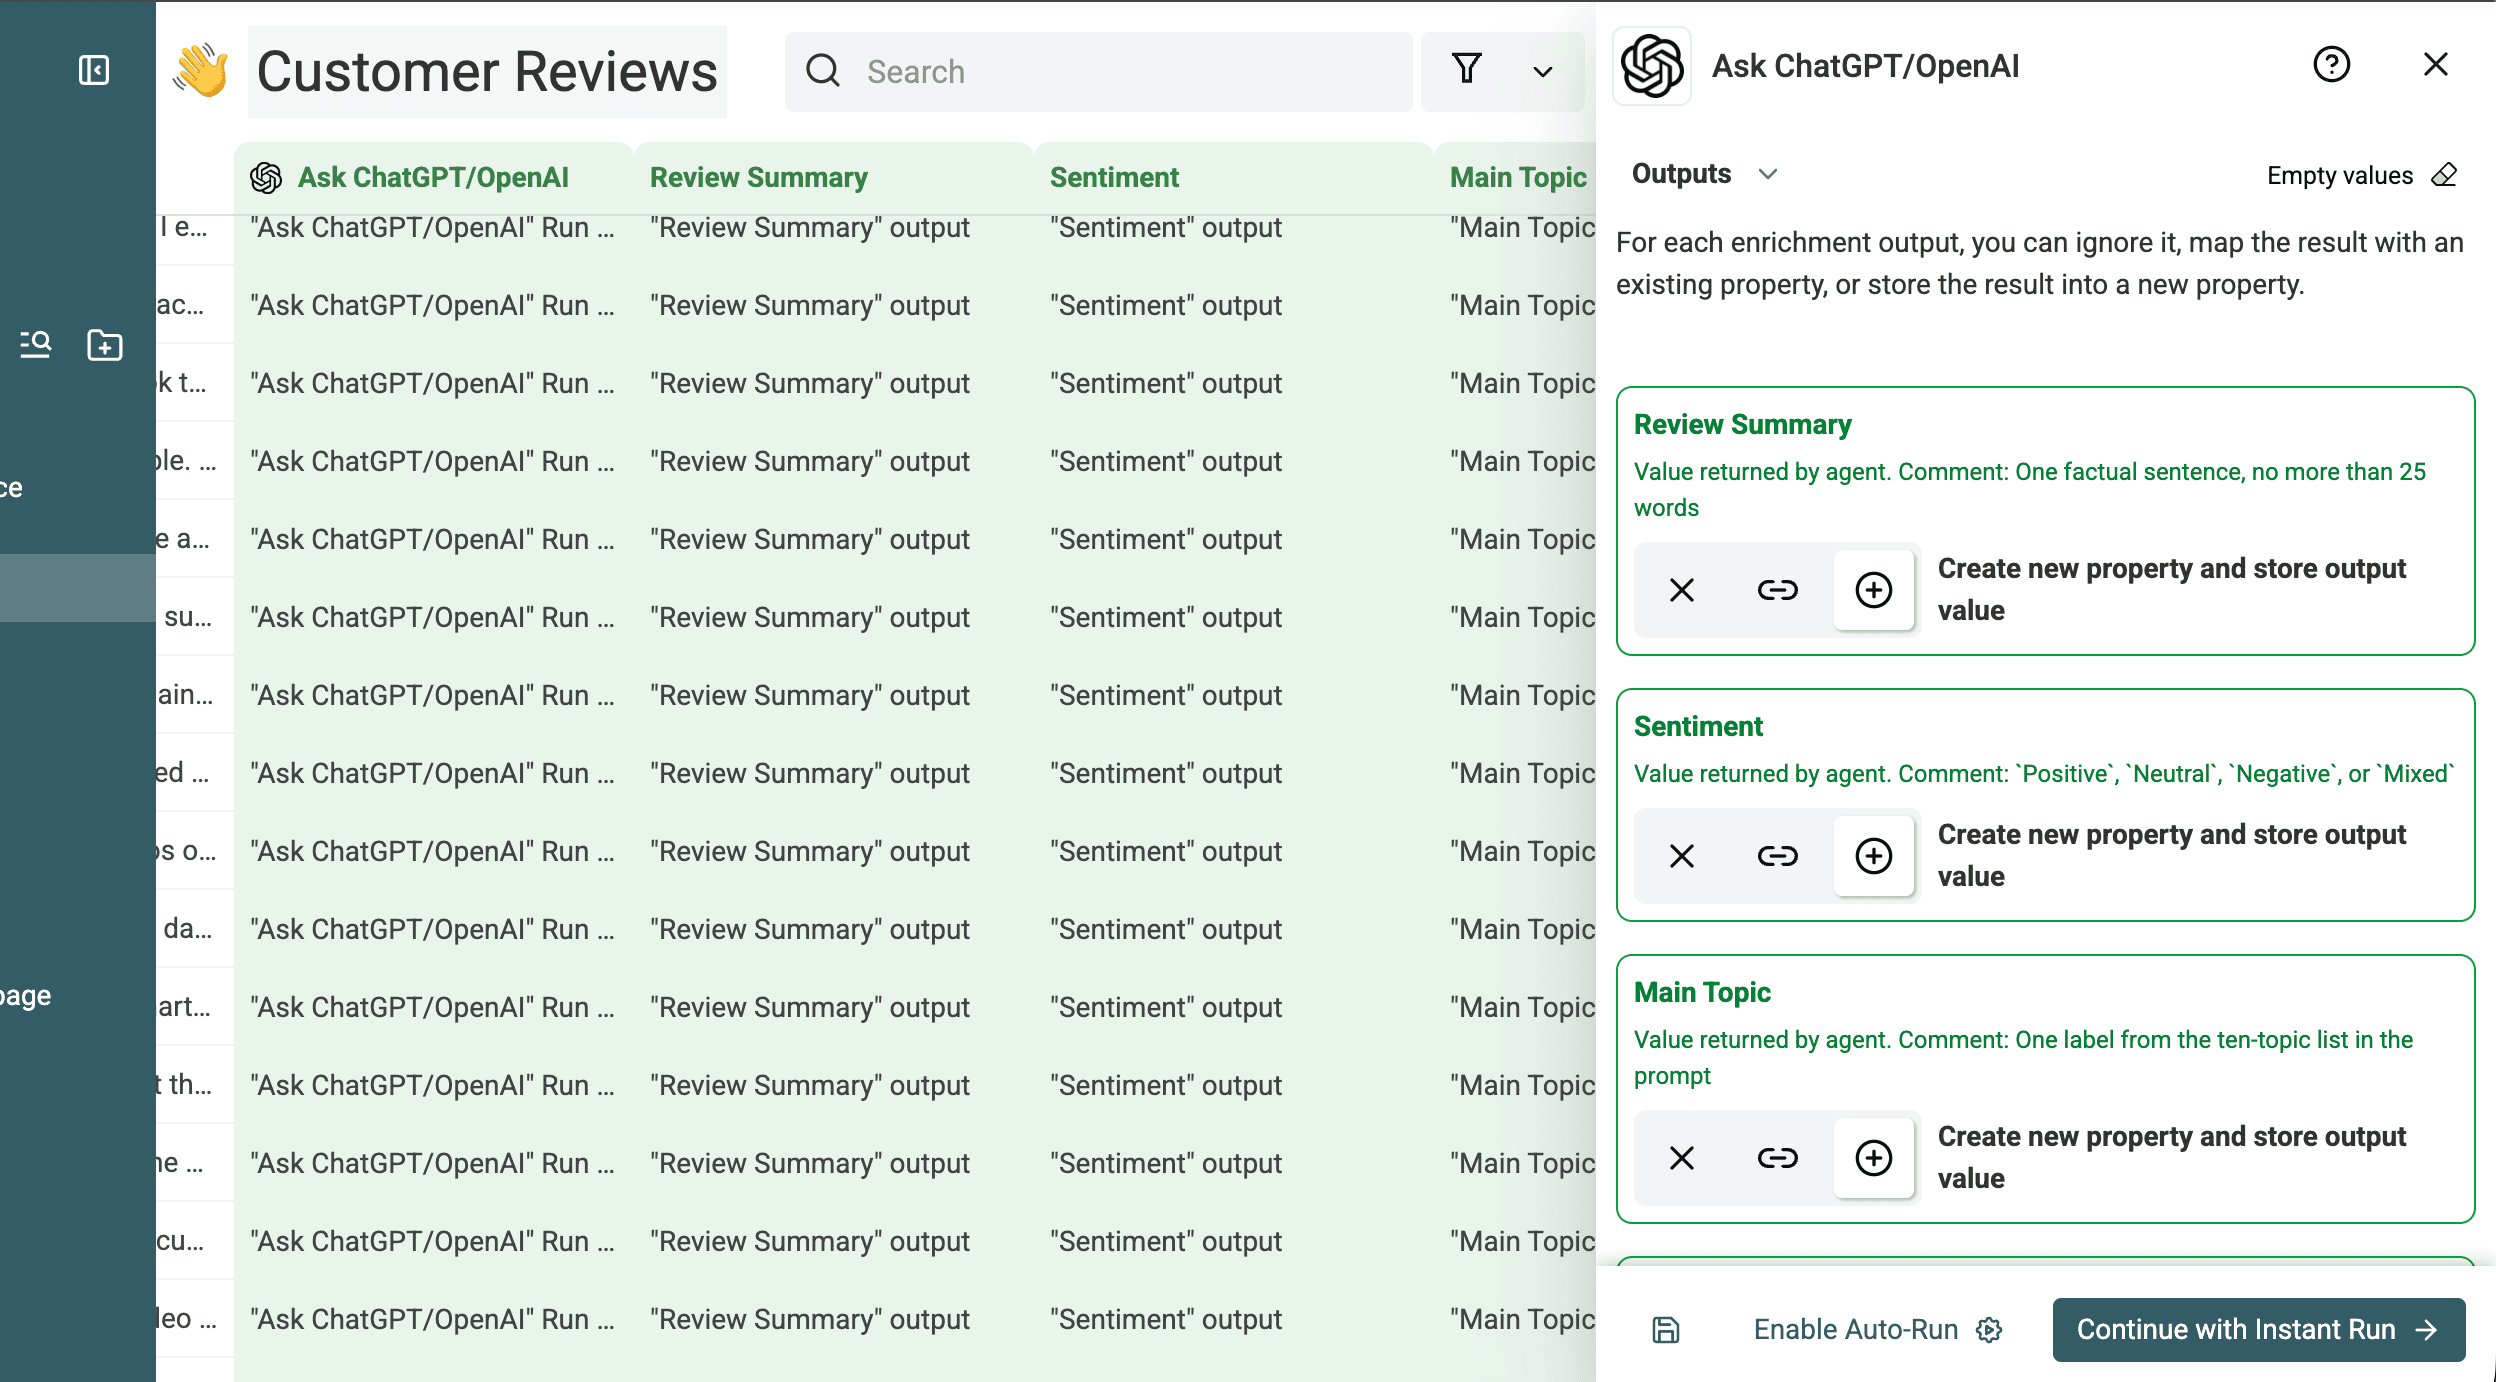
Selecione Analyze customer reviews. O Datablist preenche o prompt e suas saídas estruturadas, evitando que você precise recriar as sete definições de saída.
Substitua as variáveis e confira as saídas
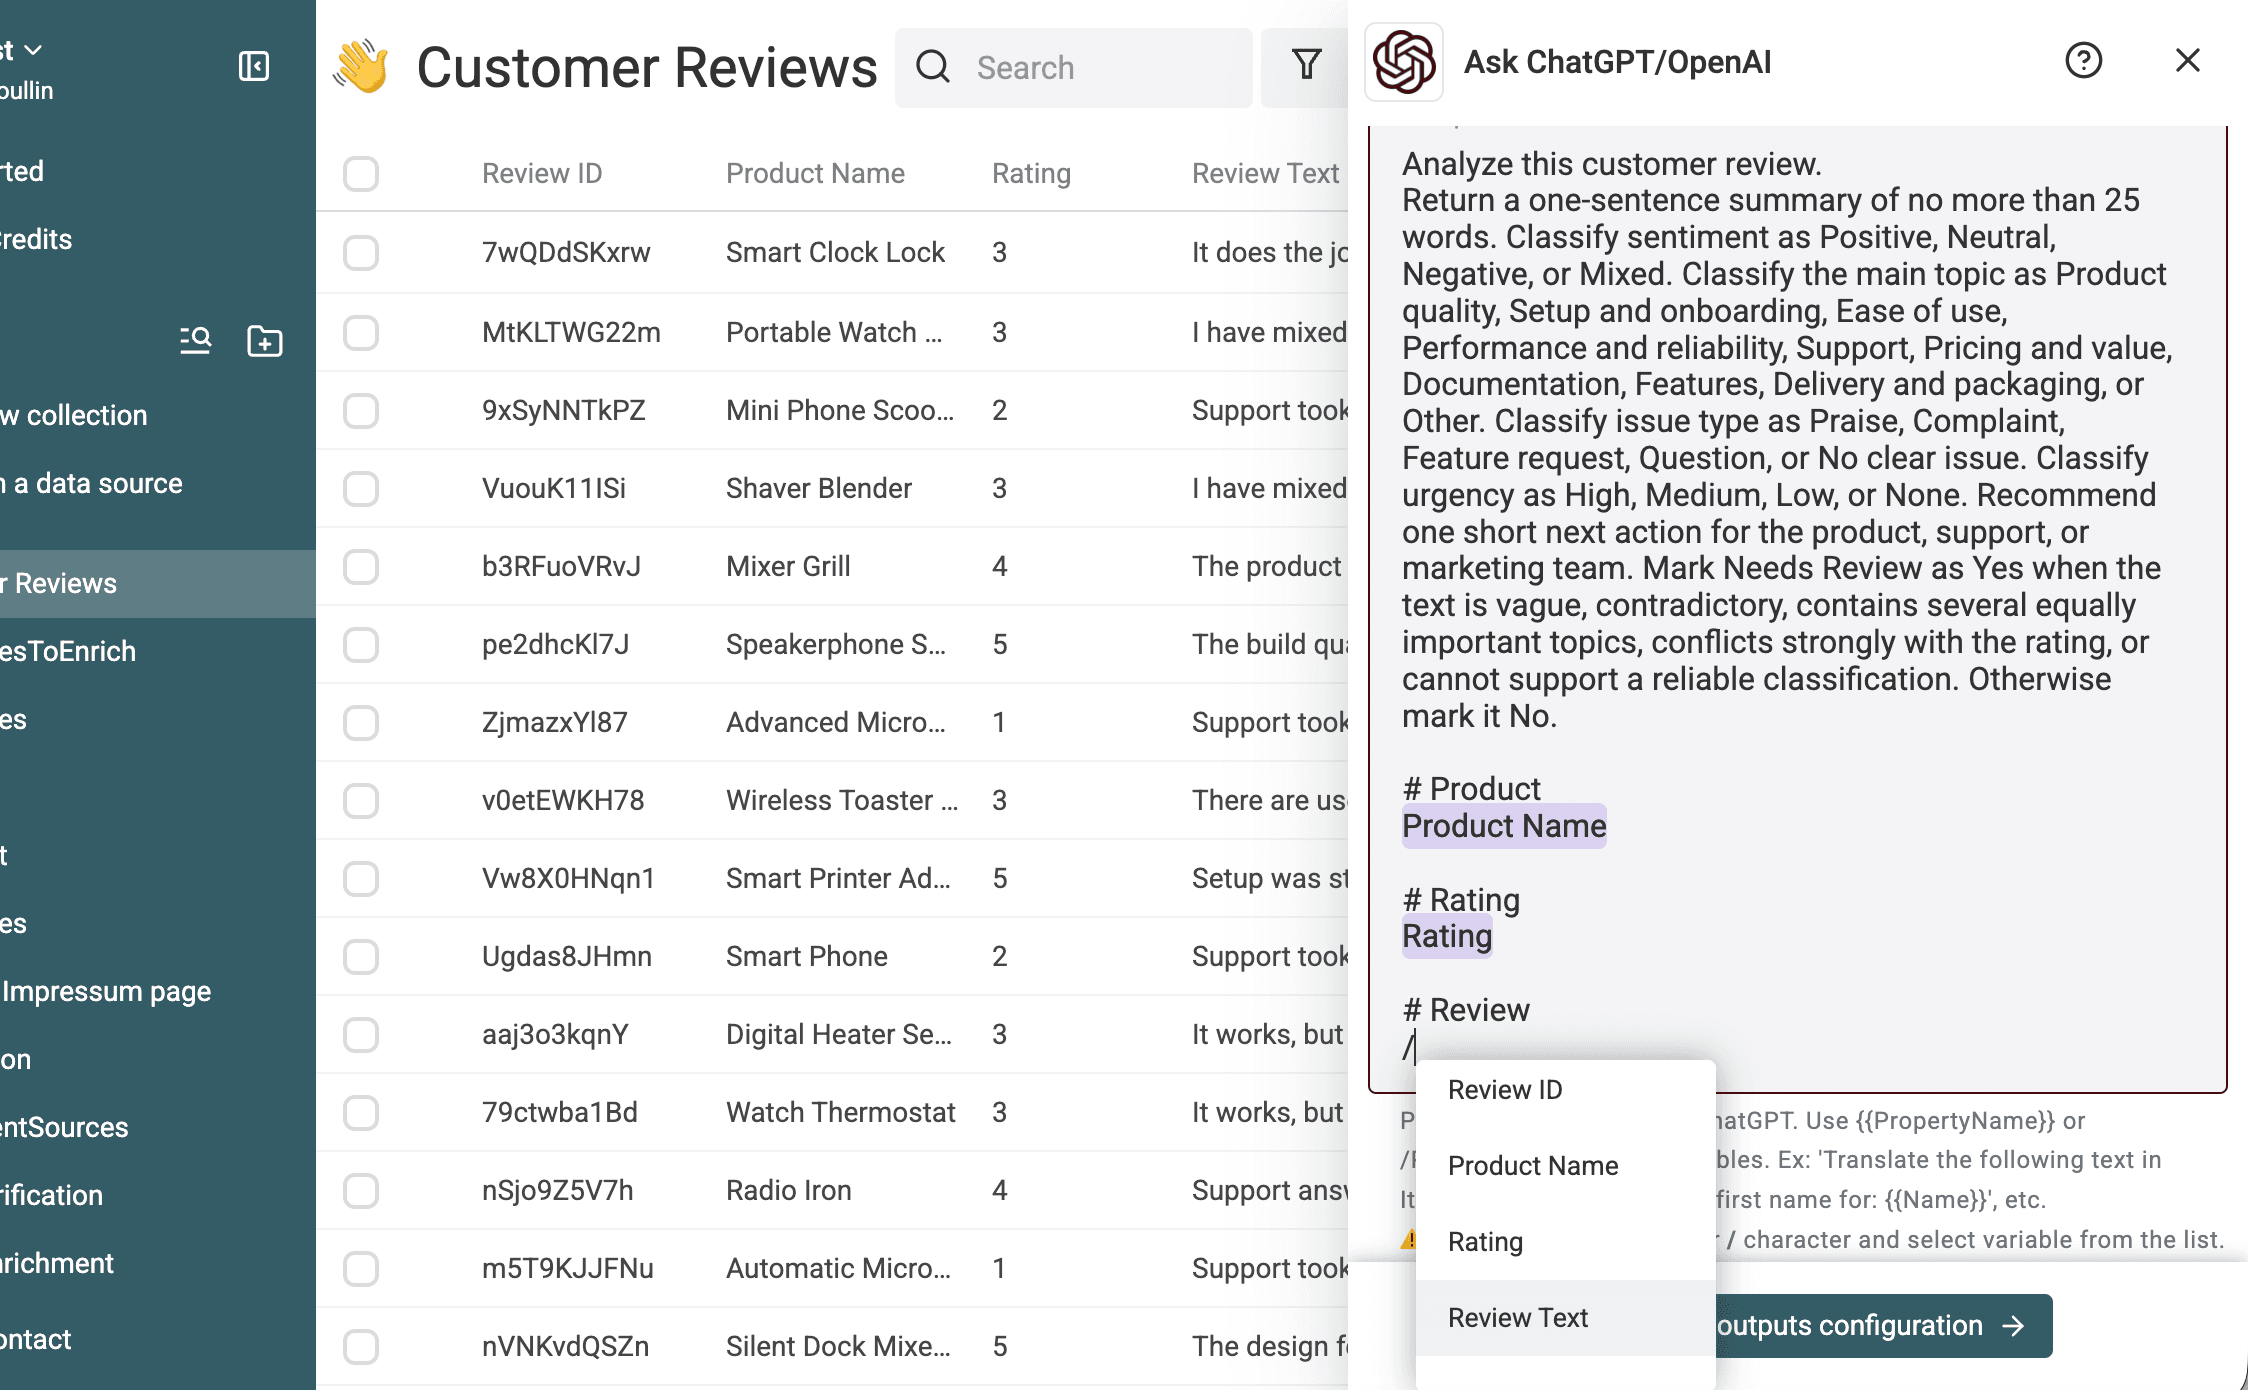
Substitua os três placeholders pelas propriedades da sua collection correspondentes a Product Name, Rating e Review Text. Sempre verifico os chips das variáveis um por um, pois um prompt associado à coluna de texto errada ainda pode ser executado sem apresentar erro.
Em seguida, confira as saídas estruturadas. As capturas de tela abaixo mostram o resumo, o sentimento, o tema principal, o tipo de problema e o indicador de revisão configurados. Elas também registram os tipos e as descrições dos valores controlados usados no teste.
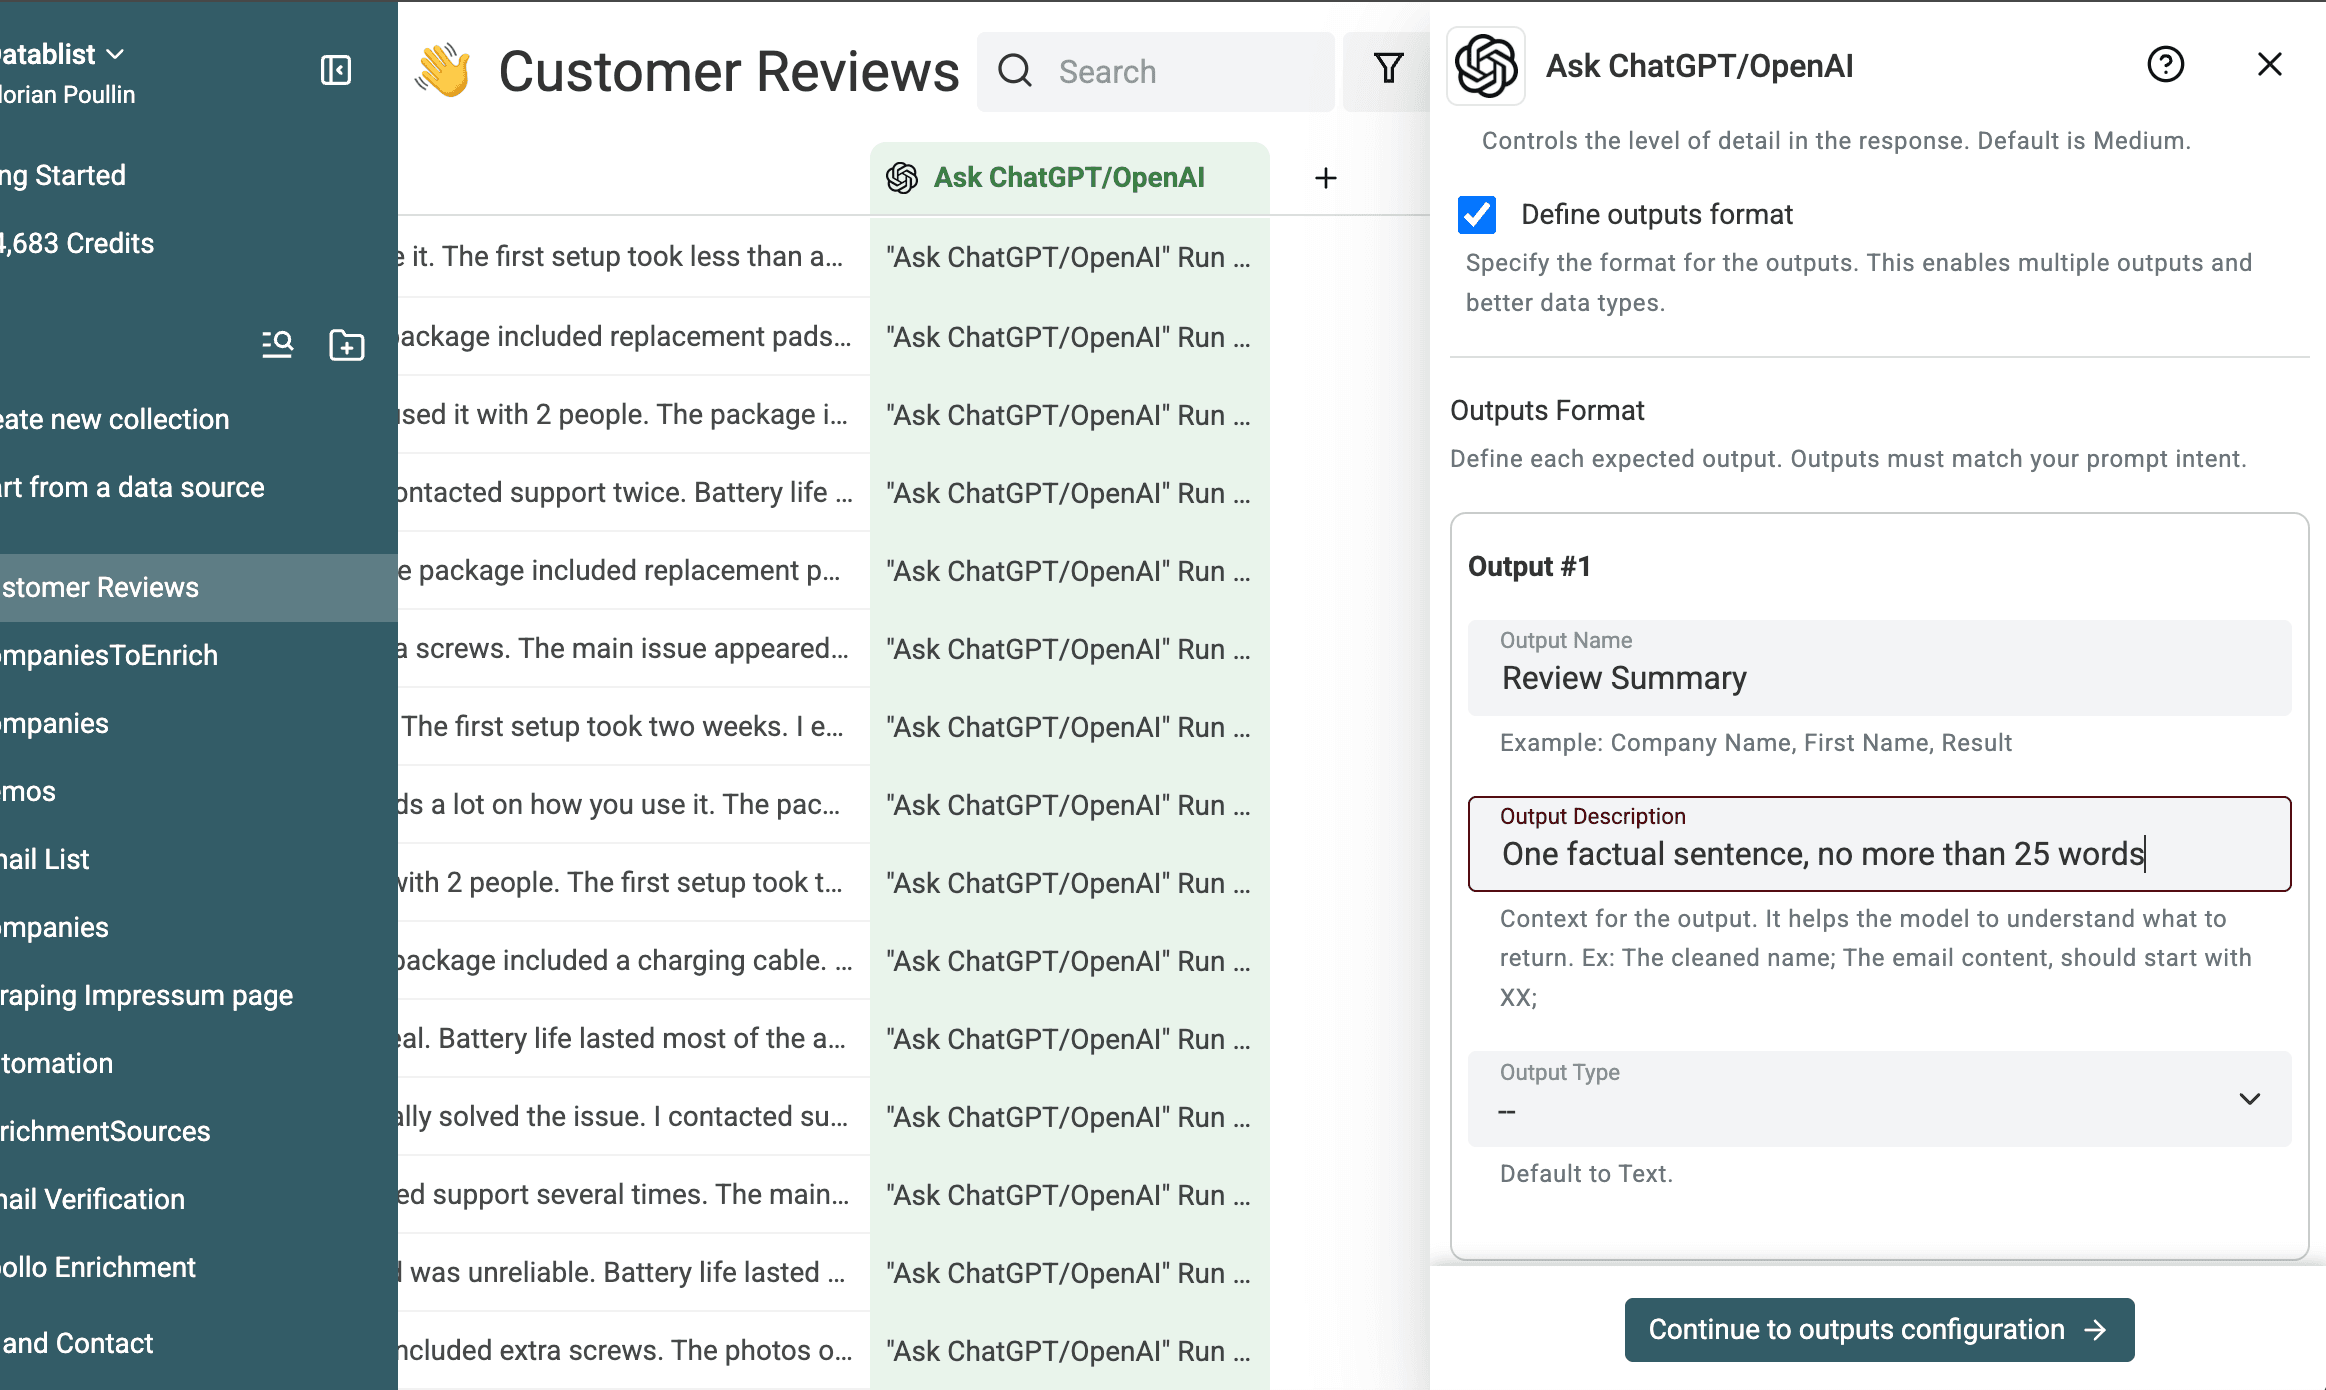
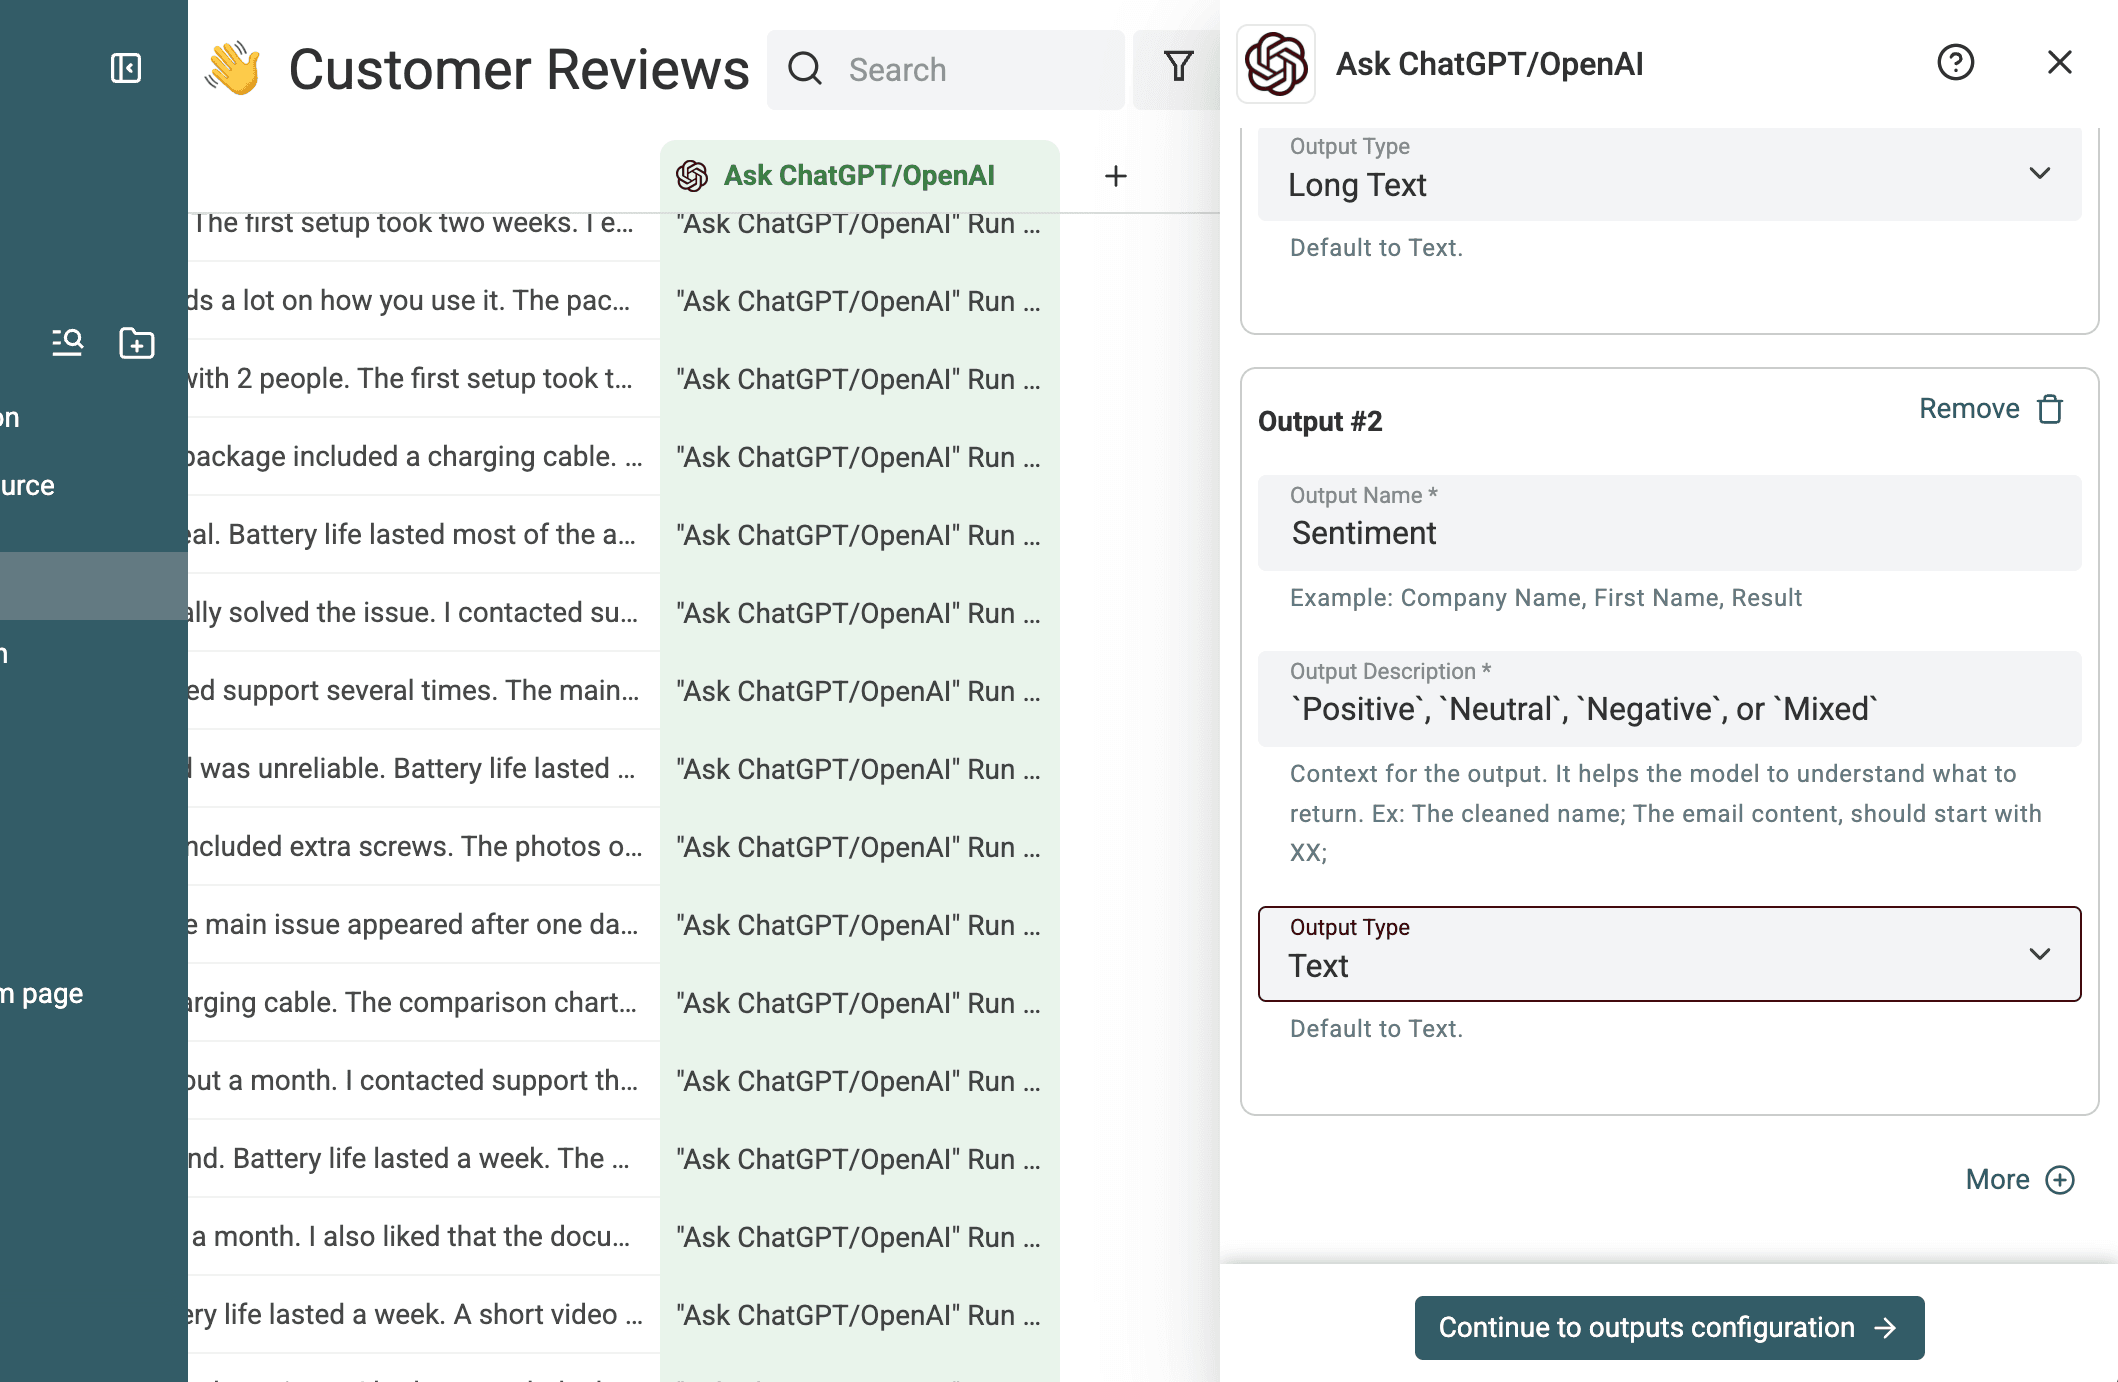
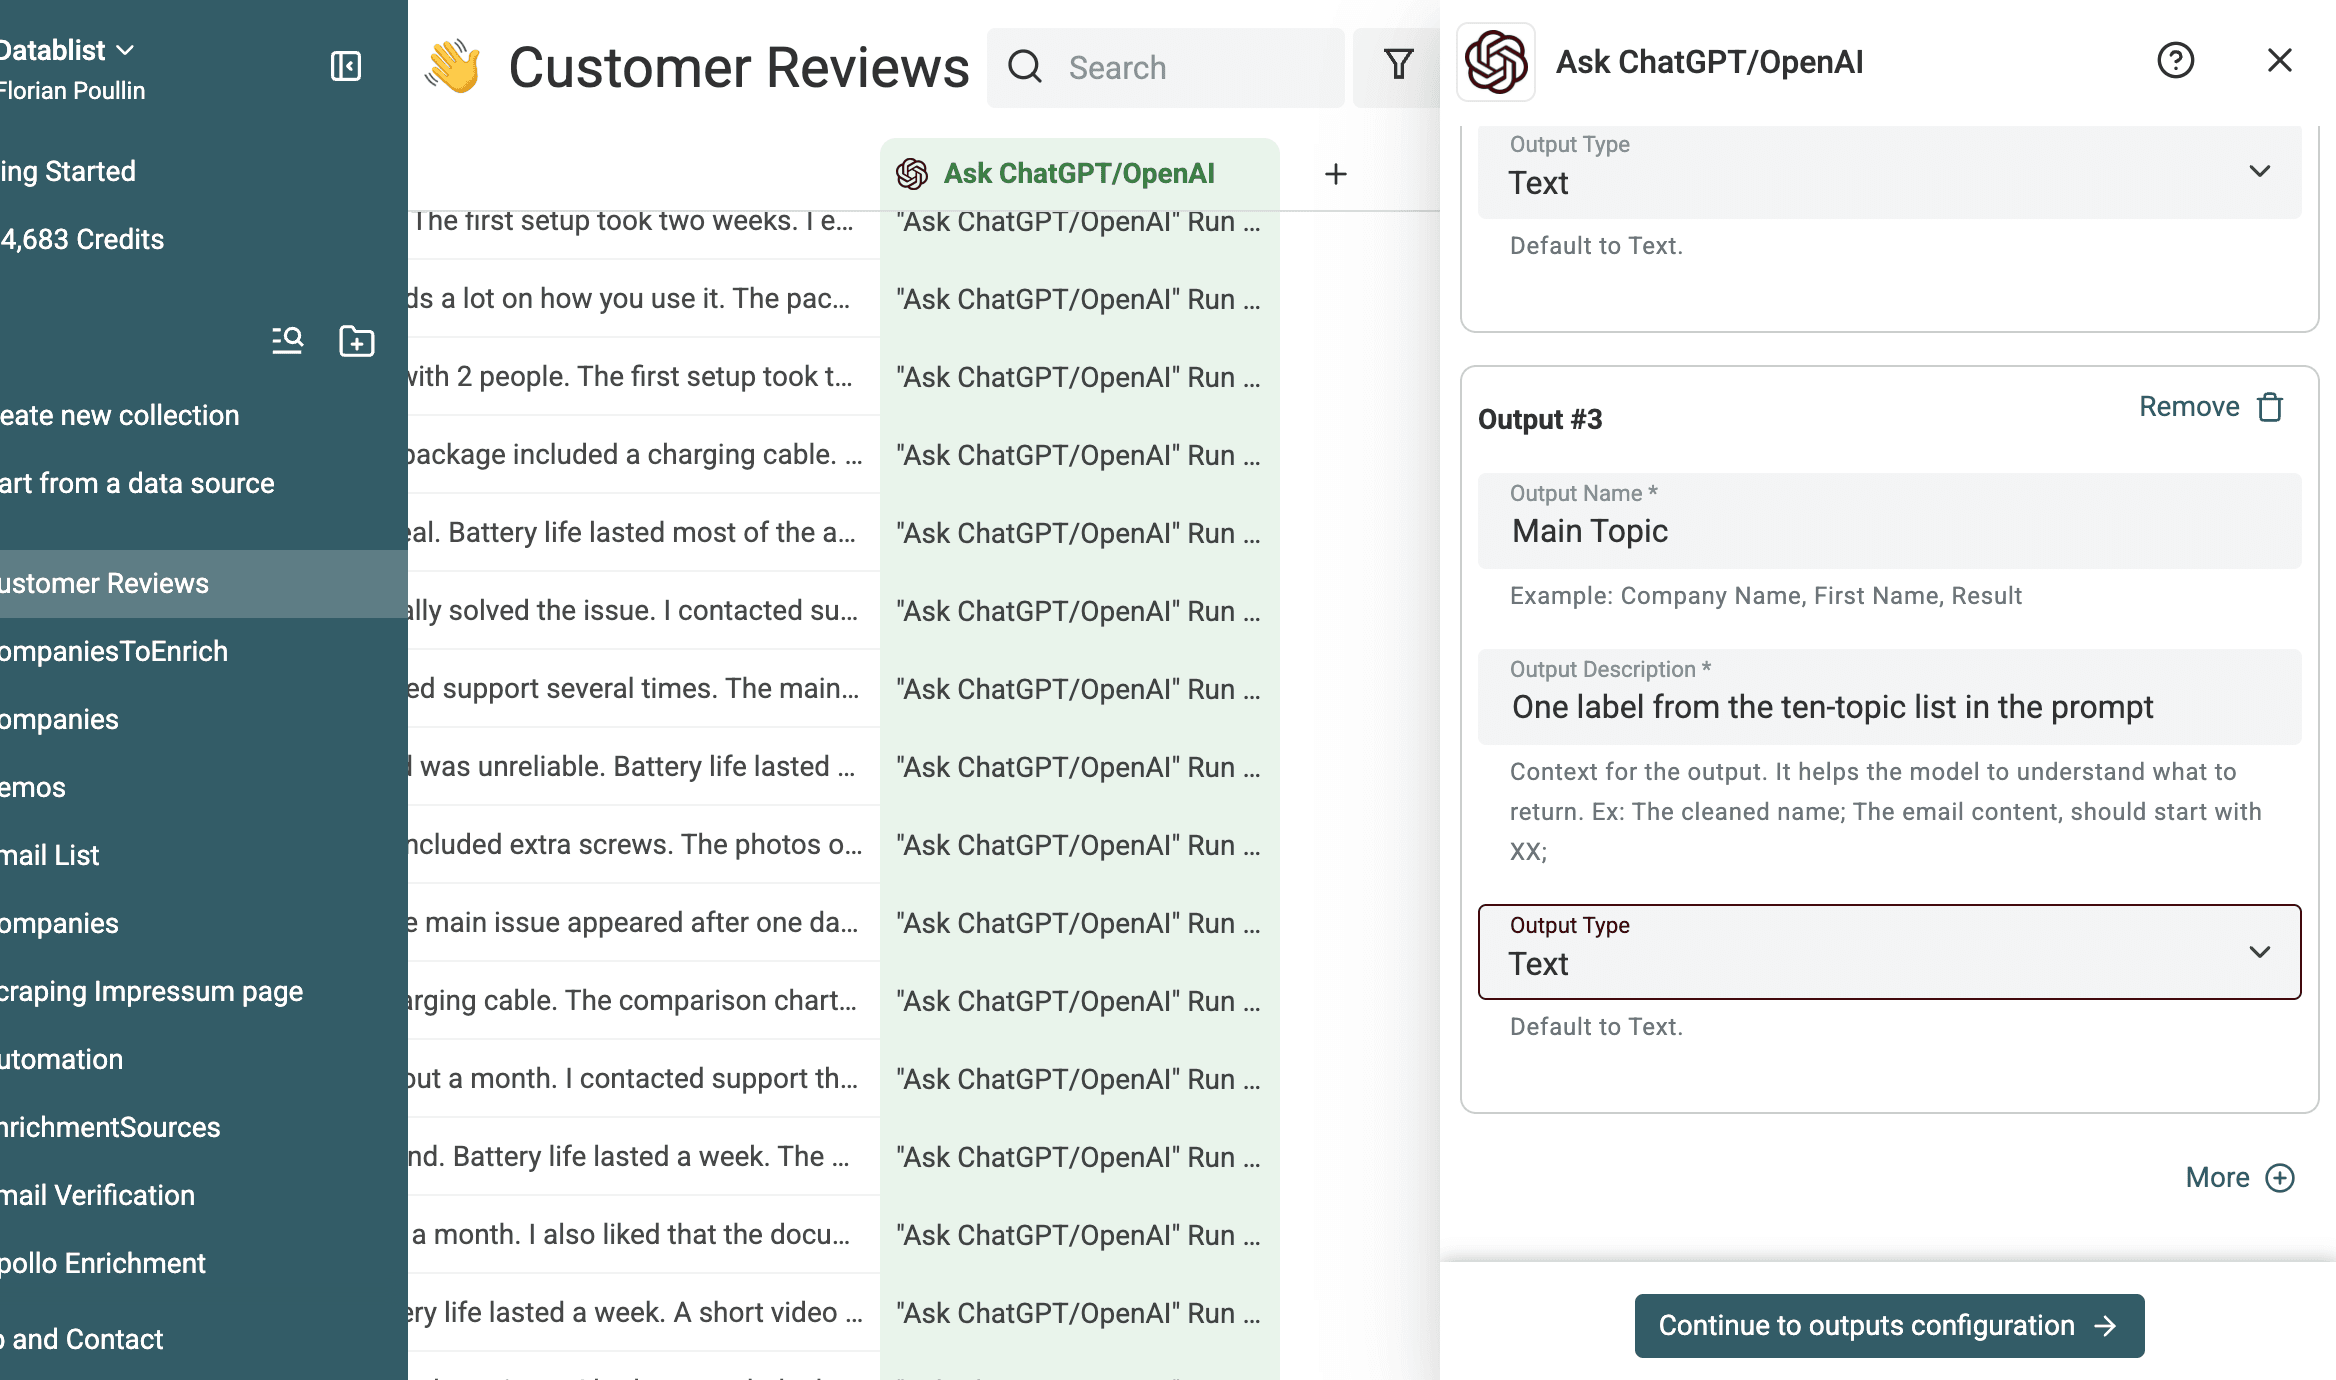
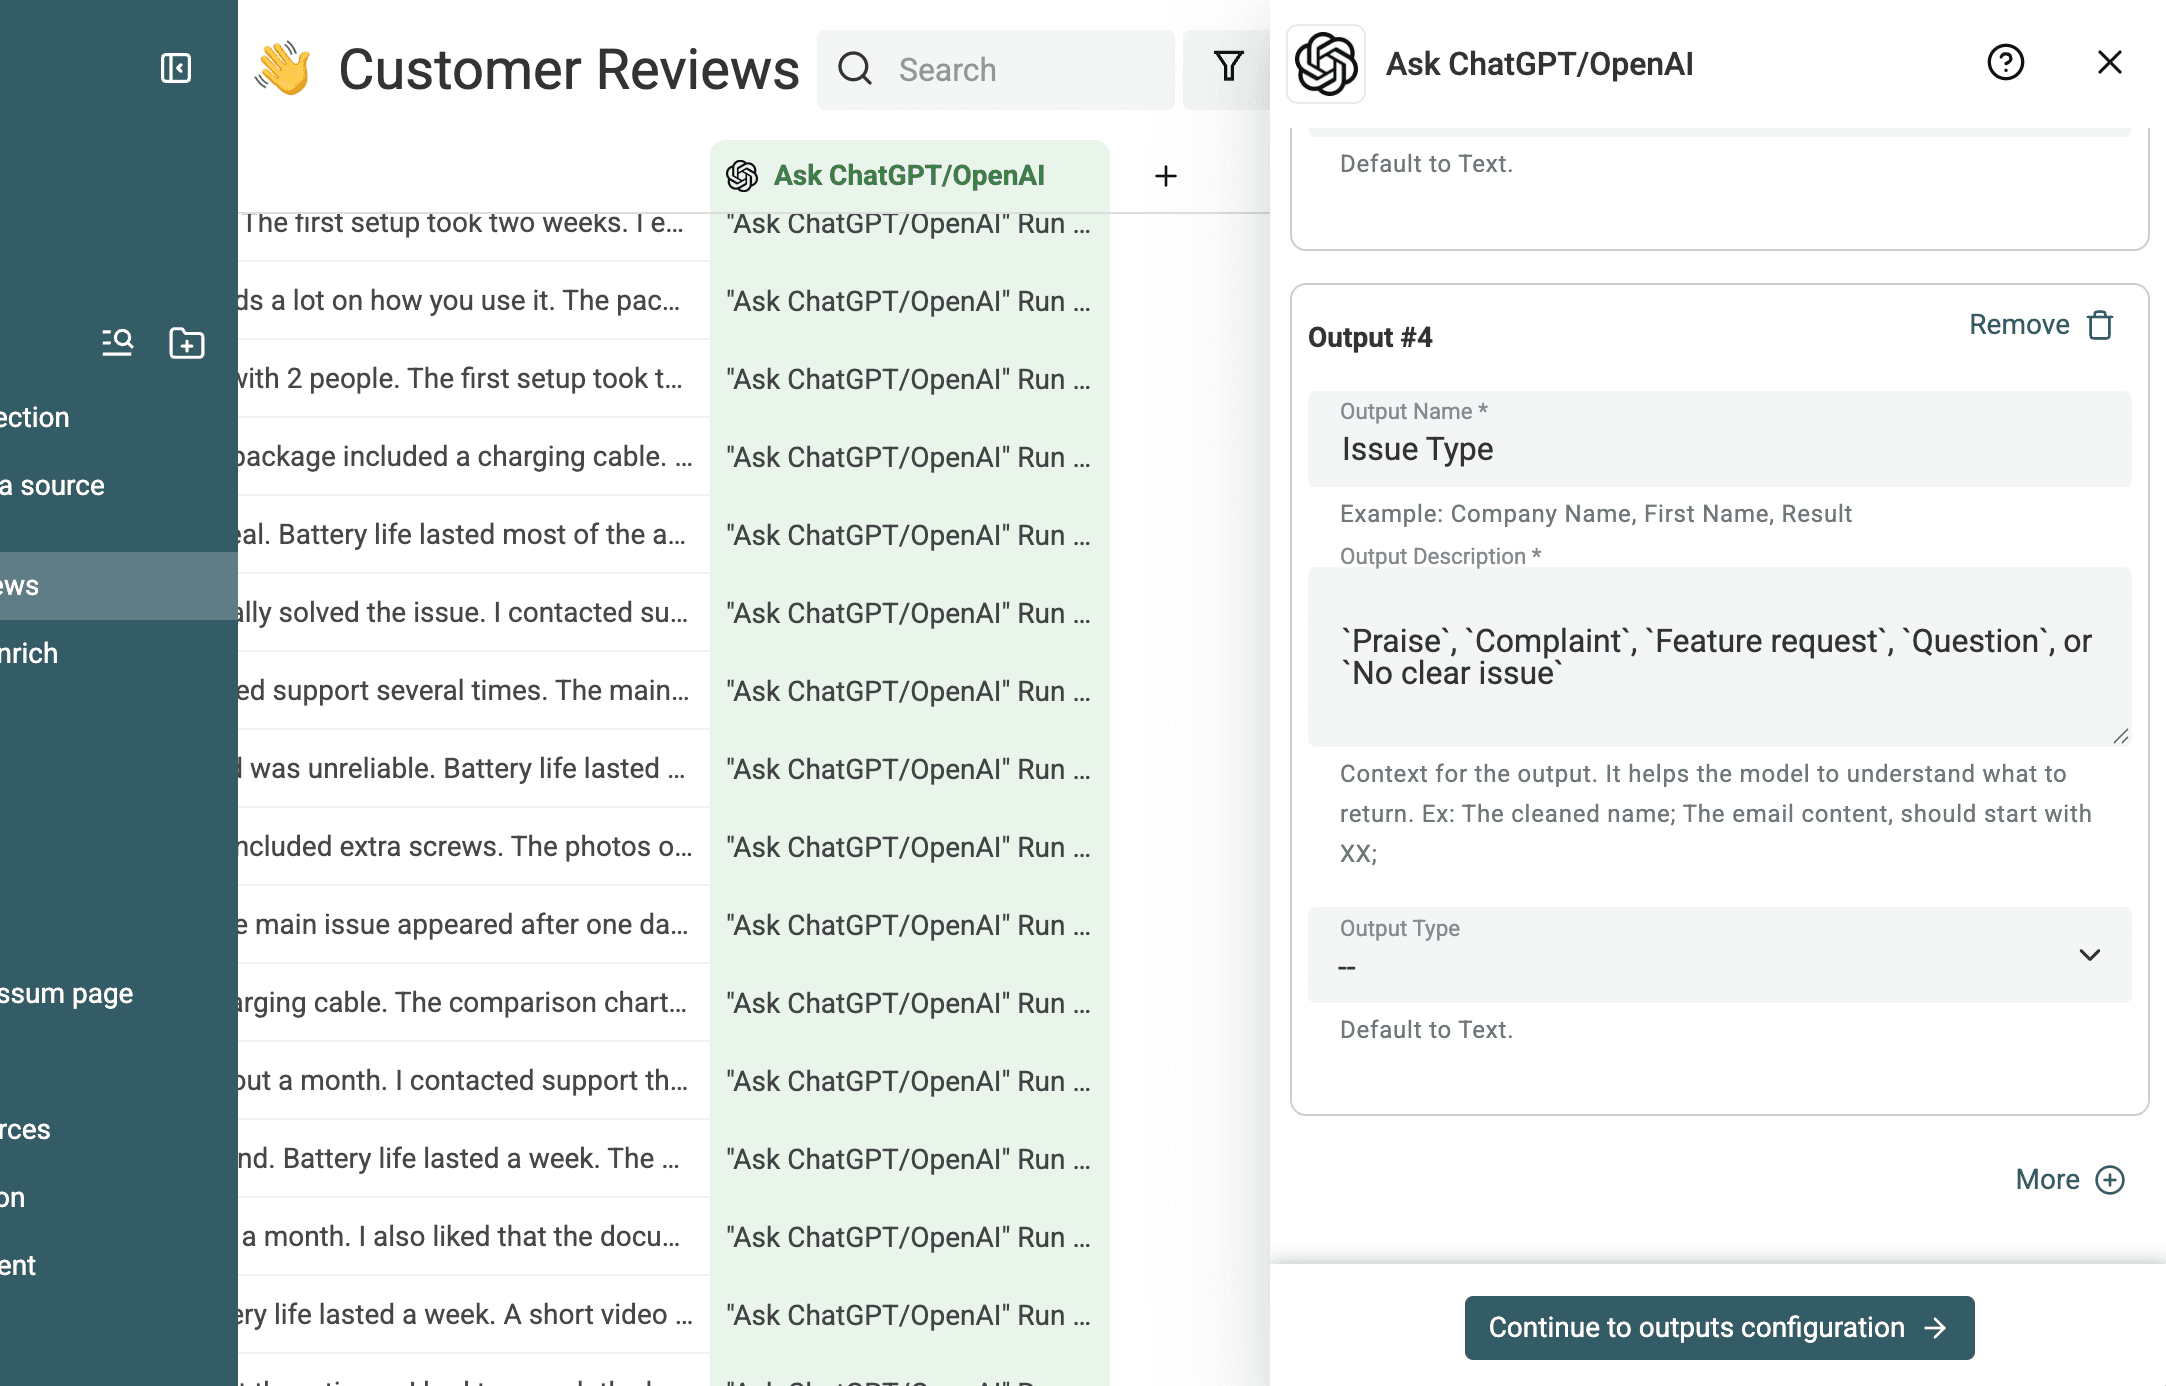
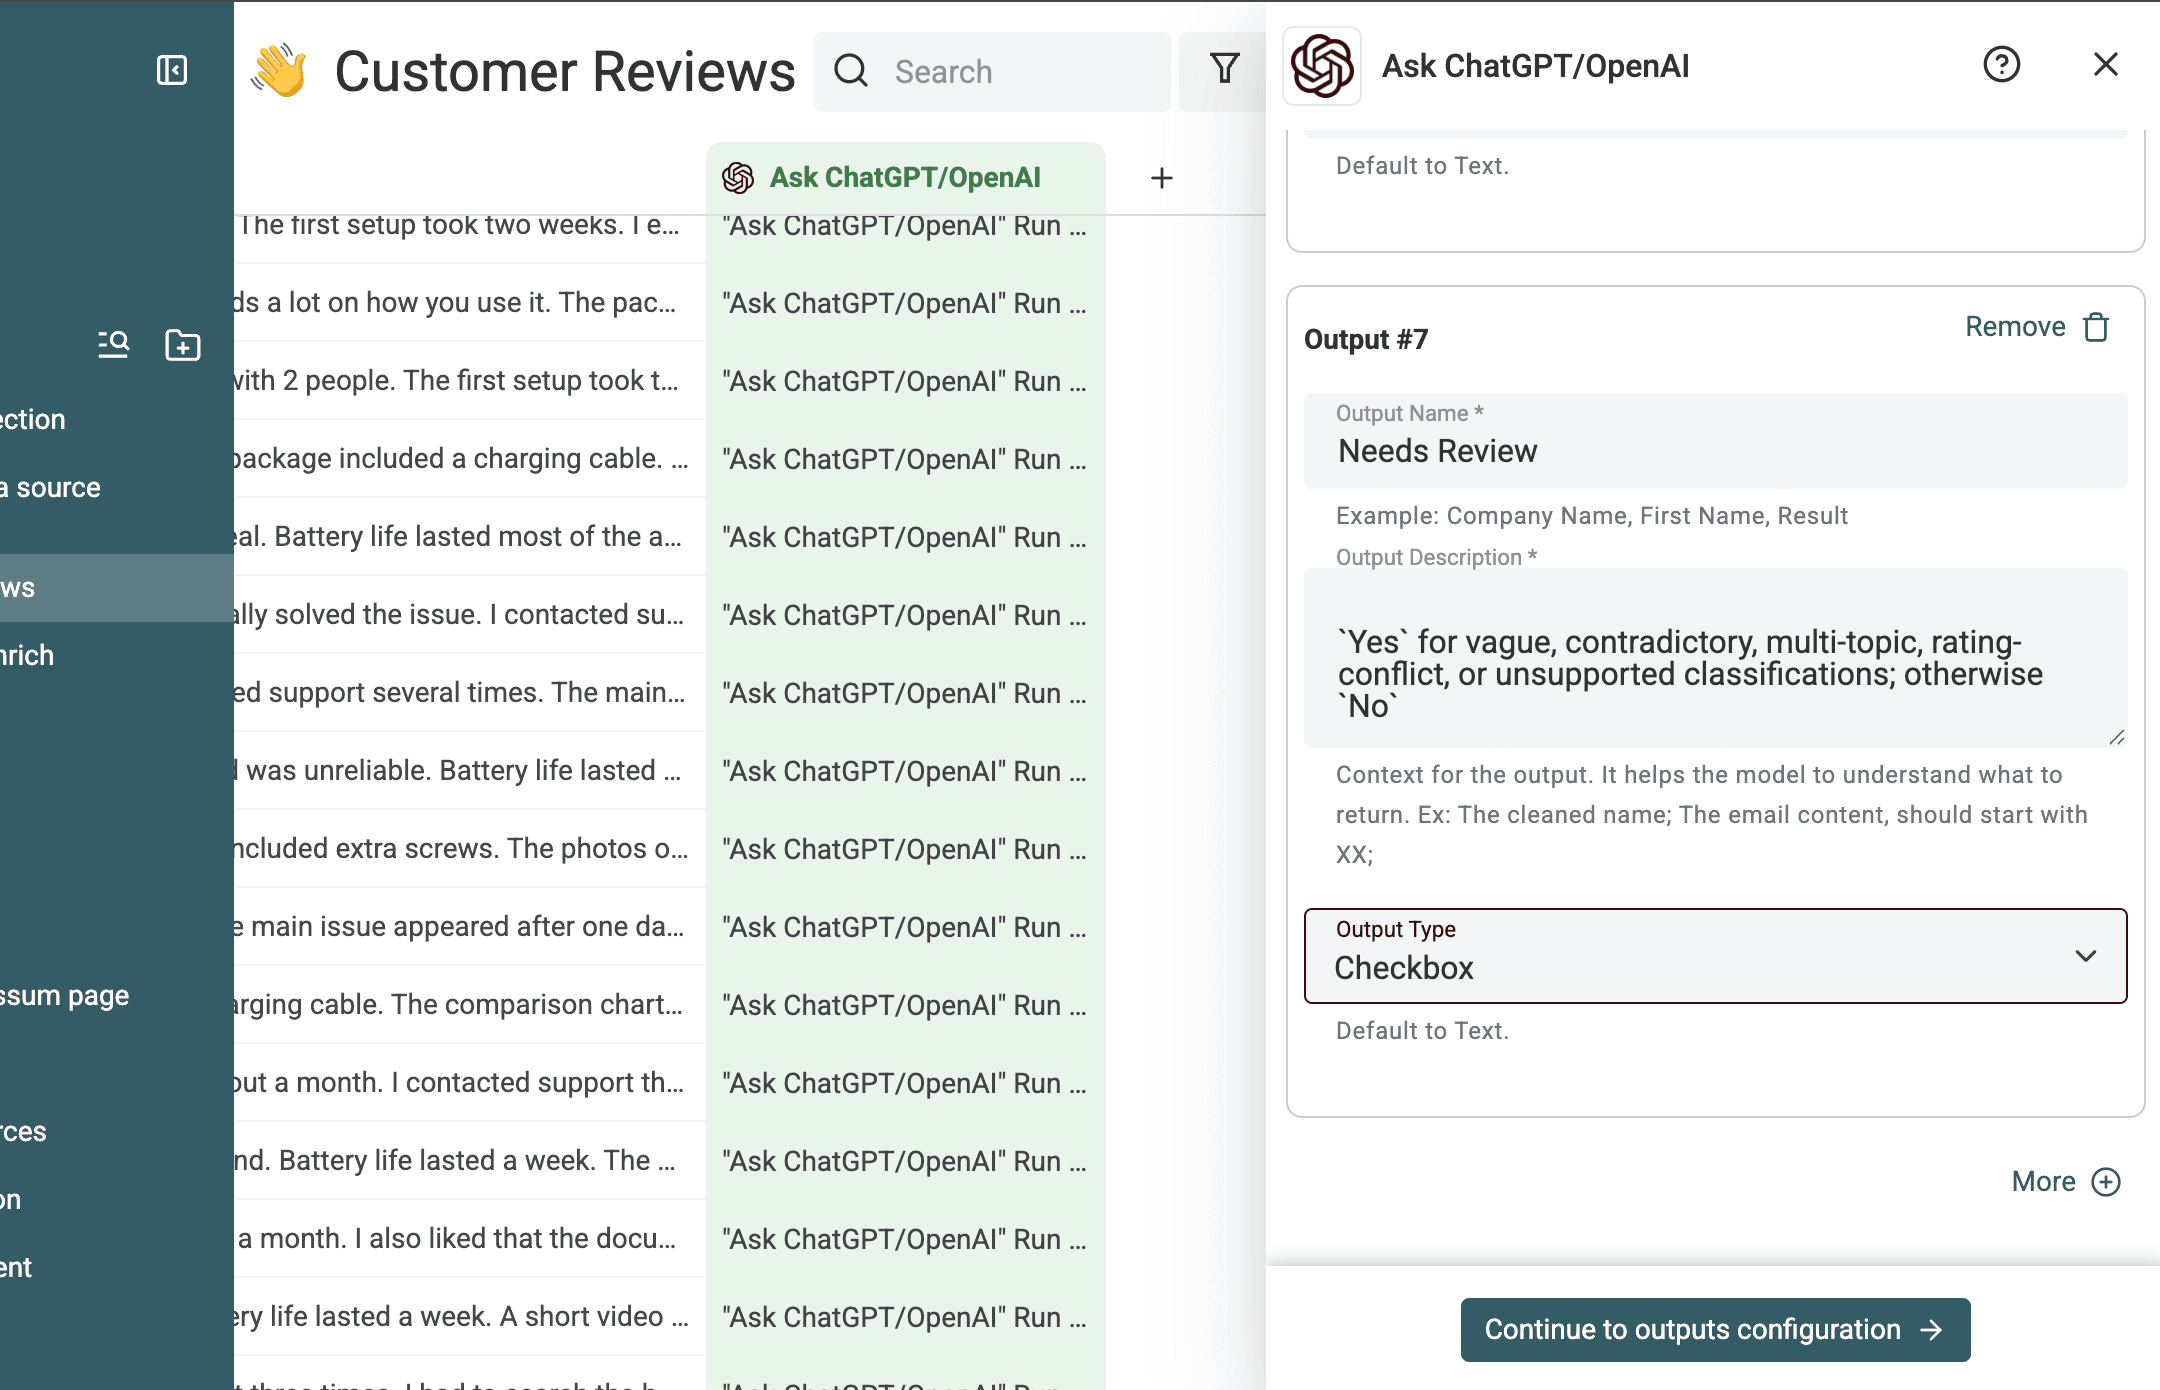
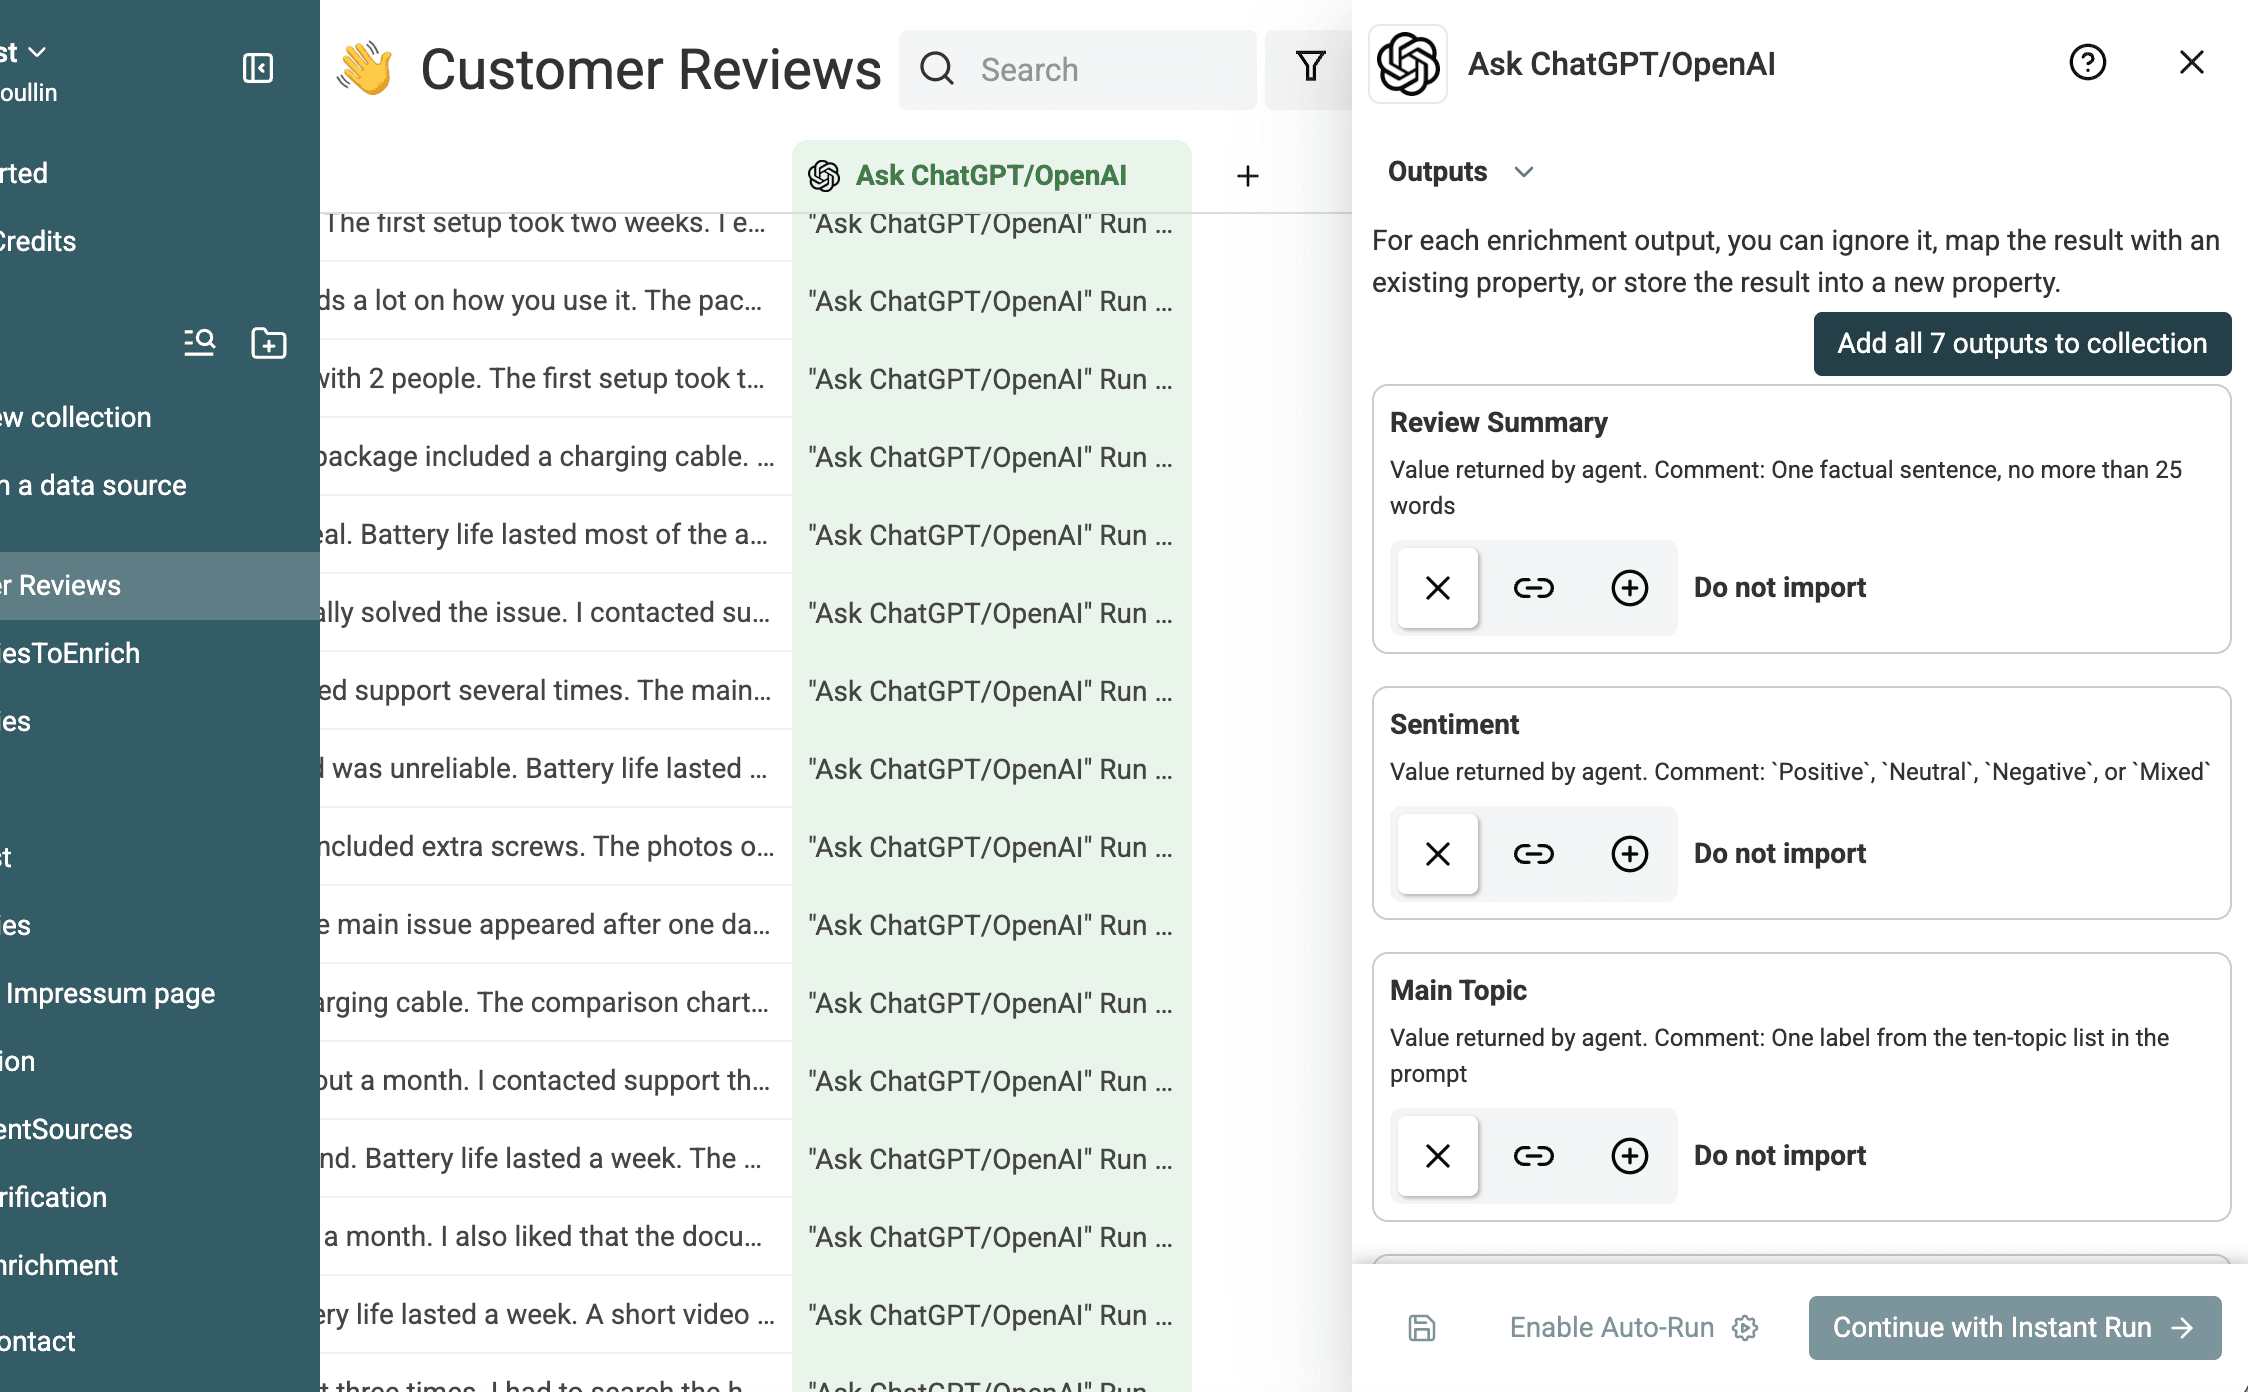
Associe cada valor retornado a uma propriedade existente ou crie uma nova propriedade de destino.
Registre as configurações da execução
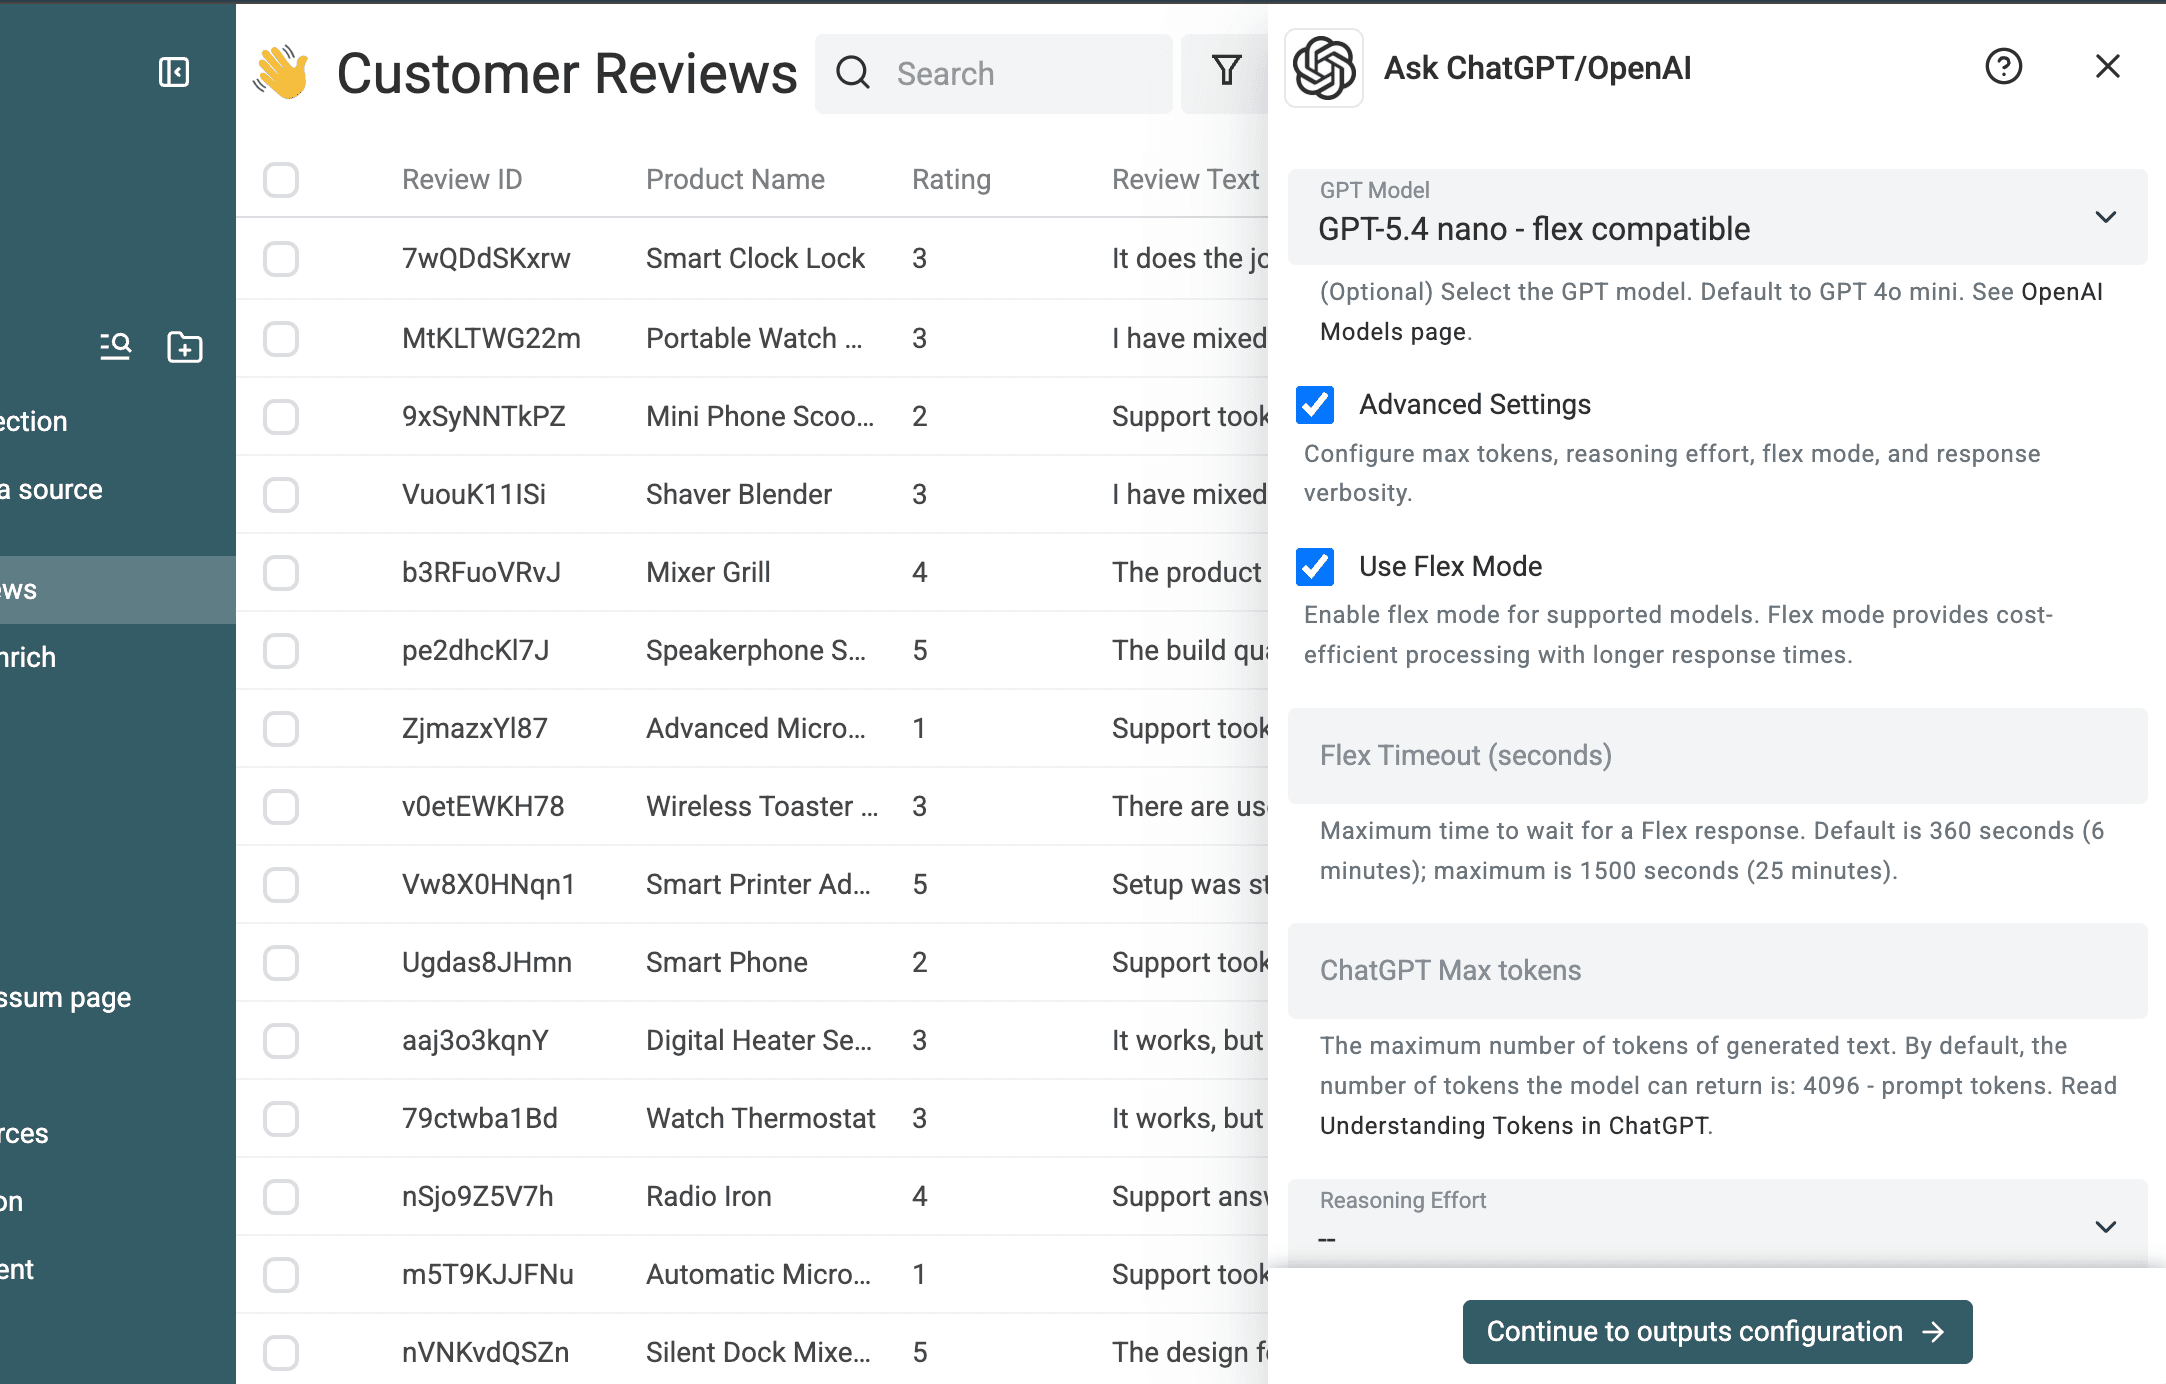
A execução usada como evidência utilizou GPT 5.4 nano, Flex mode e Datablist Credits. Essas são as configurações deste teste, não uma recomendação universal. Ask ChatGPT/OpenAI também aceita outros modelos, uma configuração de limite máximo de tokens de saída, caching e cobrança por meio da sua própria OpenAI API key.
Flex mode é uma das vantagens de executar esse processo no Datablist. Nos modelos da OpenAI compatíveis, esse modo pode reduzir o custo de processamento pela metade em comparação com o Standard mode quando o job aceita respostas mais lentas e menos previsíveis. O Datablist disponibiliza a opção diretamente no enrichment, permitindo usar a faixa de preço mais econômica sem criar um fluxo separado por API. Consulte o guia sobre o OpenAI Flex mode para verificar modelos compatíveis, comparar custos e entender as recomendações de timeout.
Teste um lote pequeno e processe o arquivo
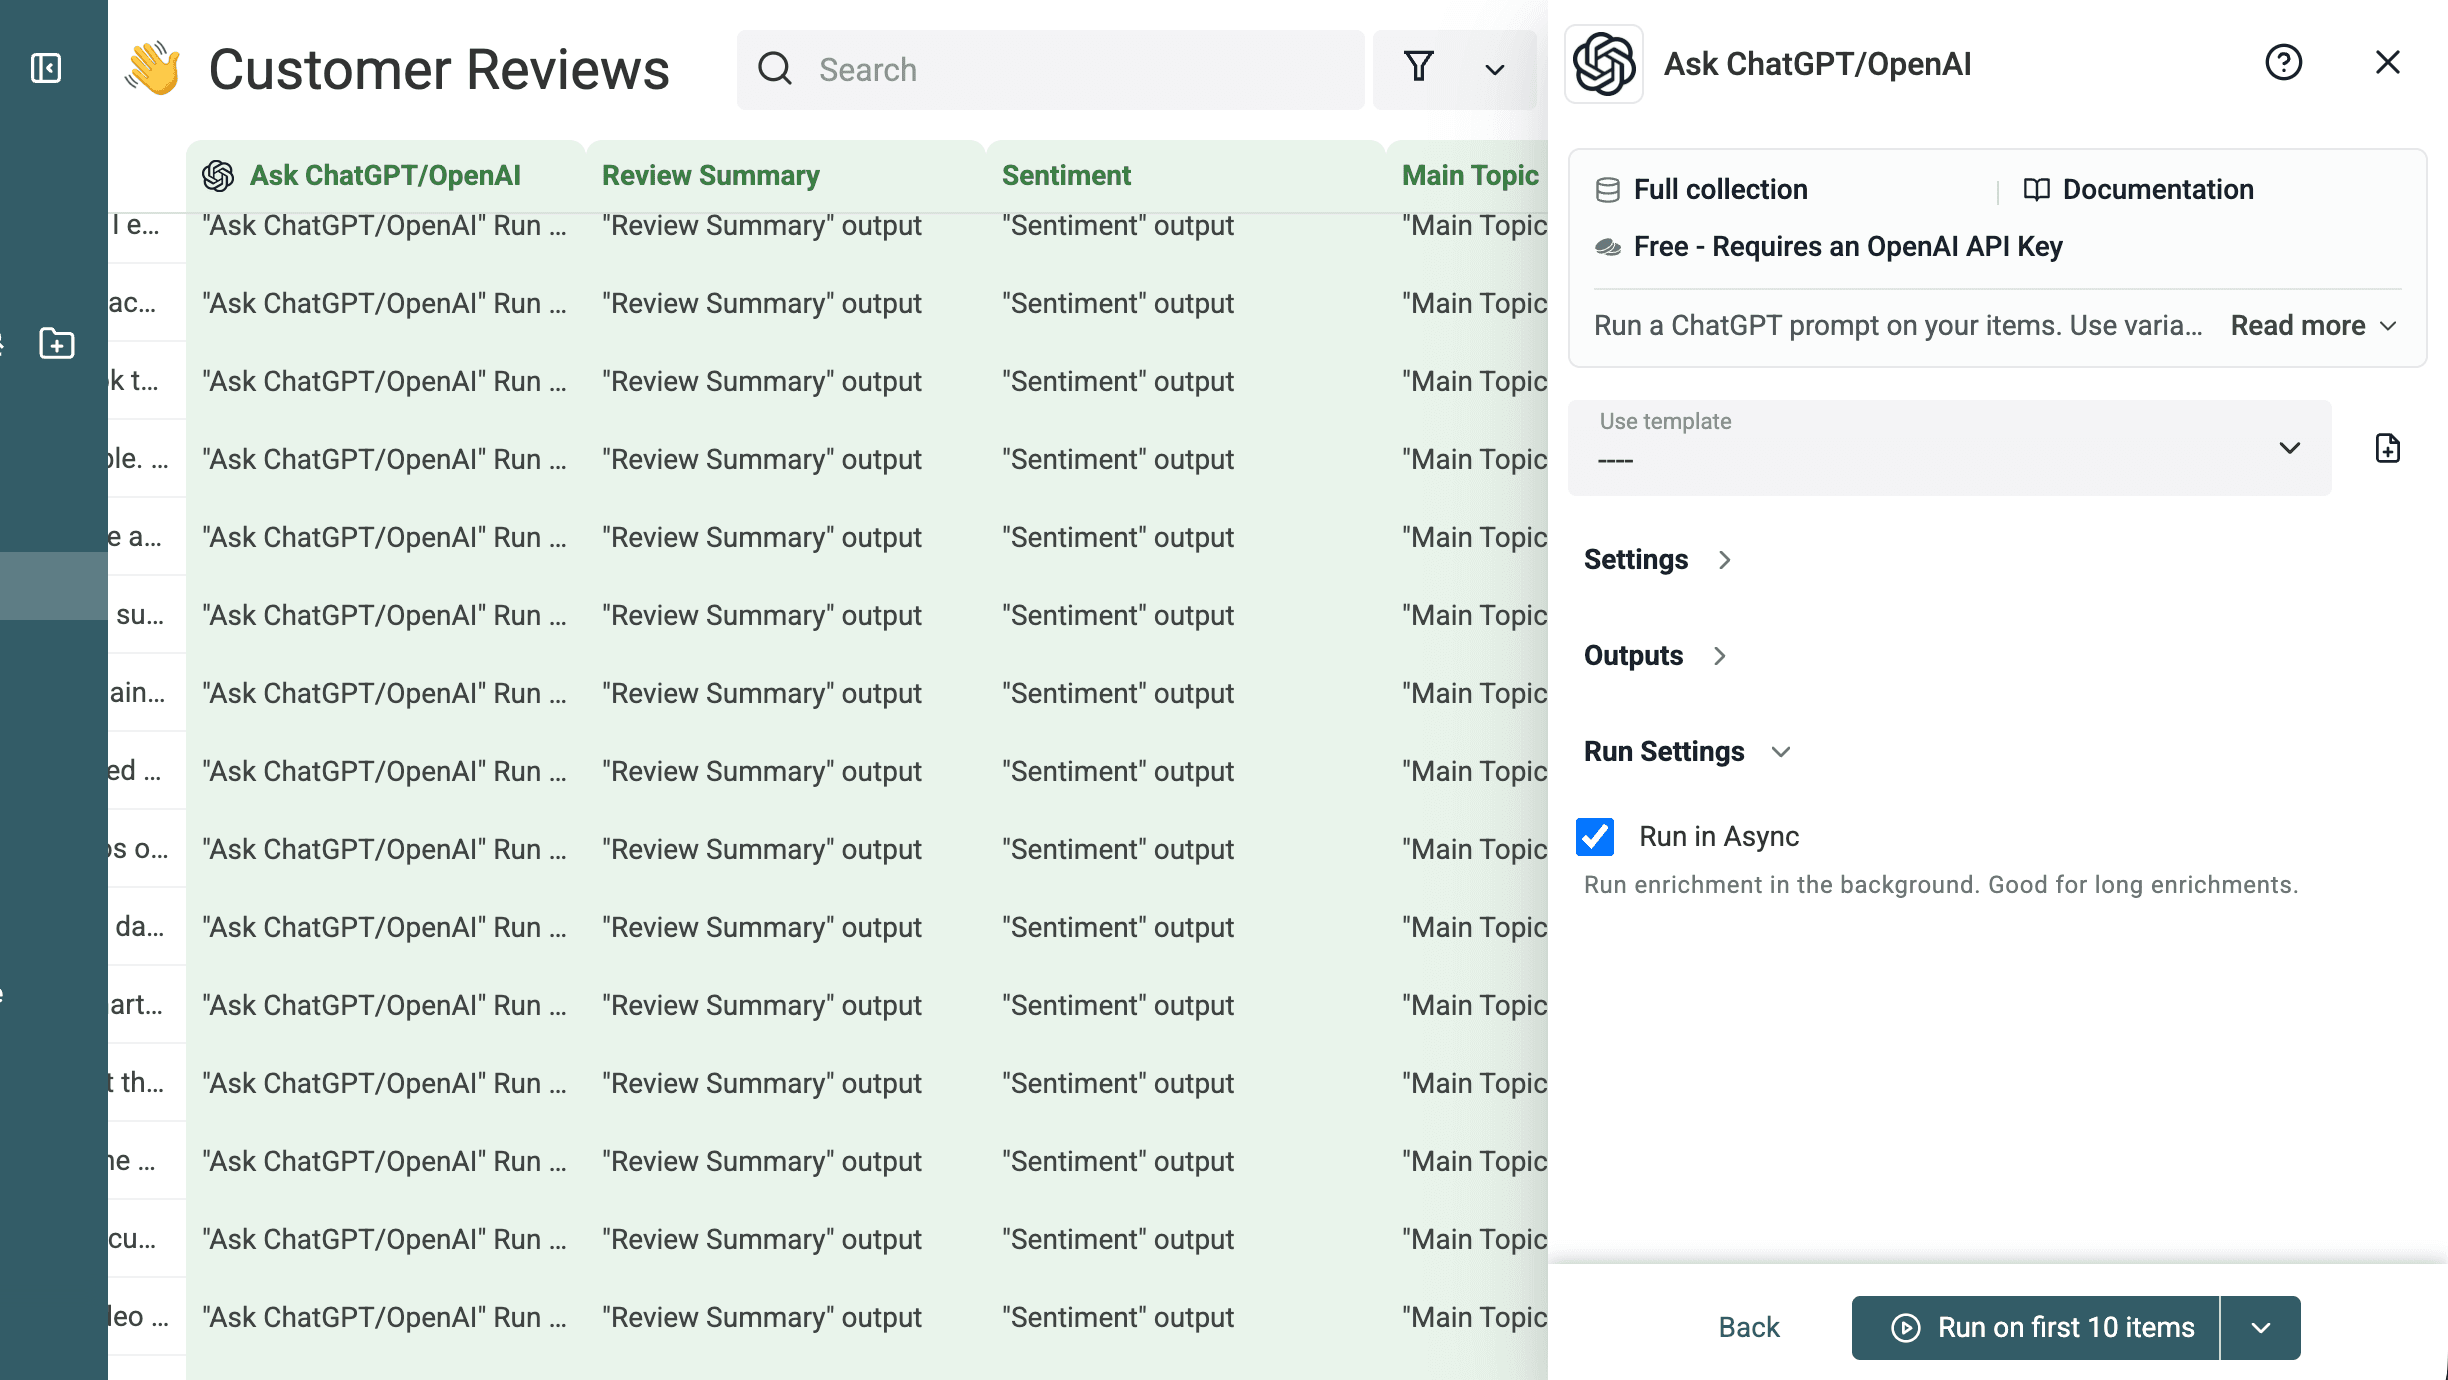
Teste de 10 a 20 avaliações variadas
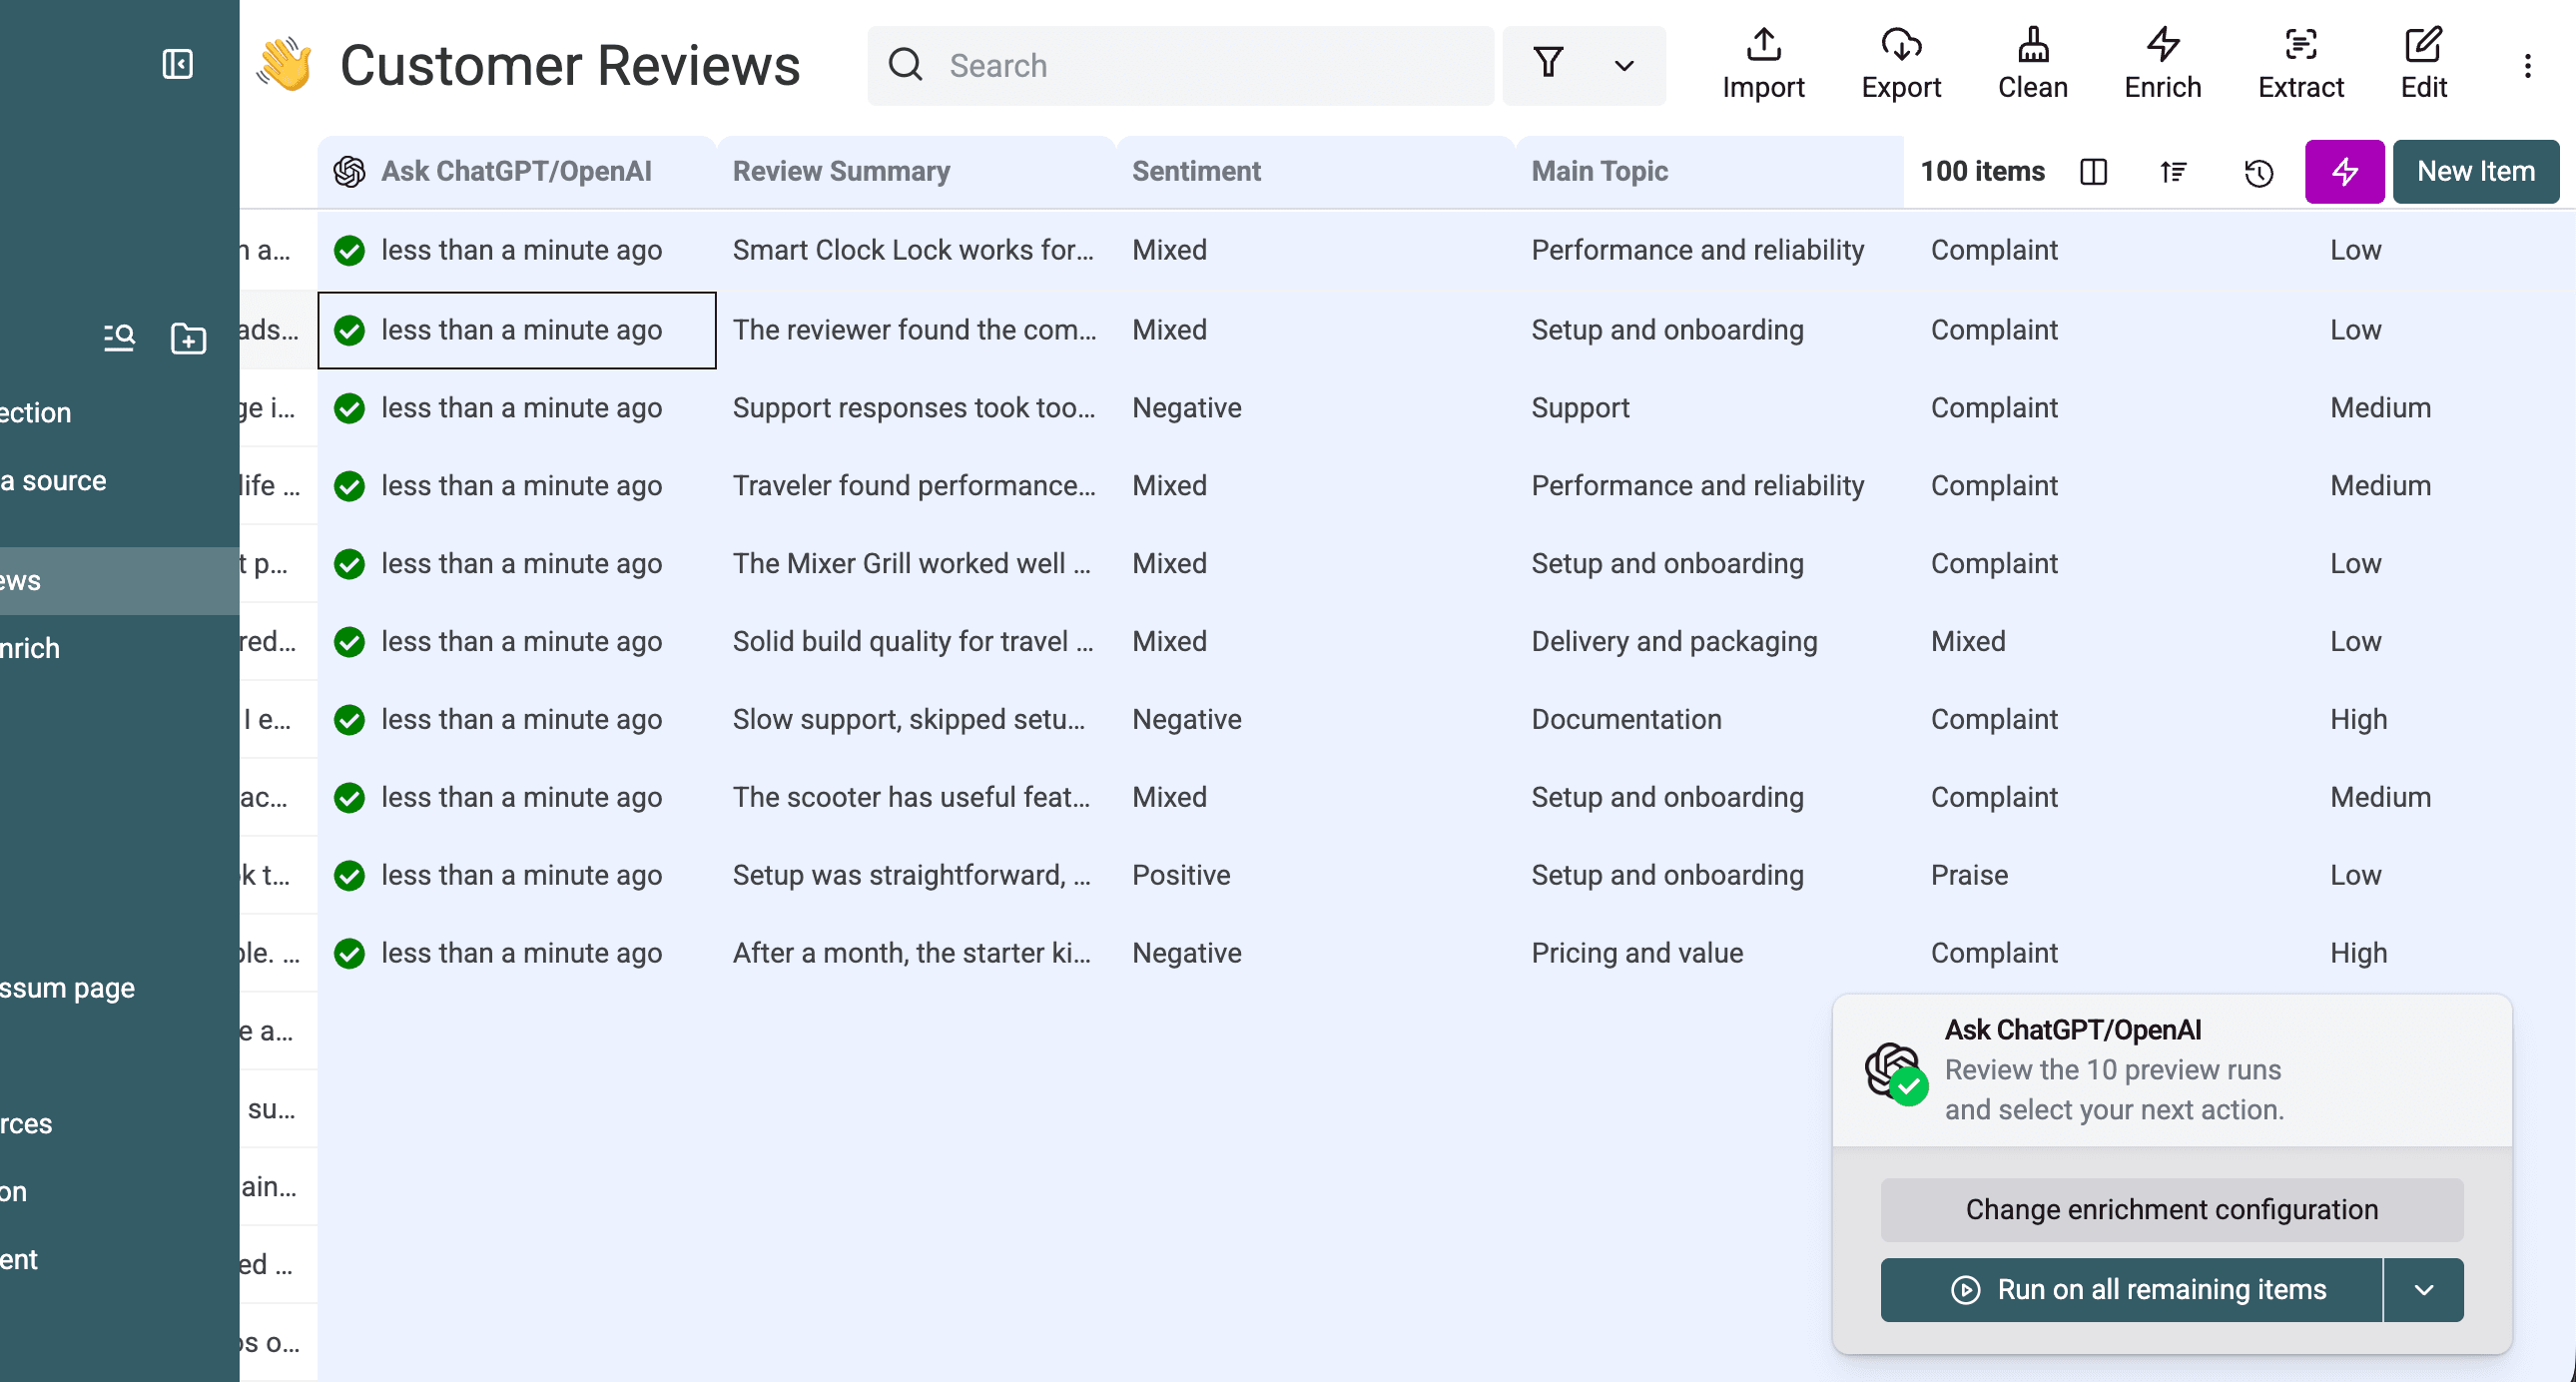
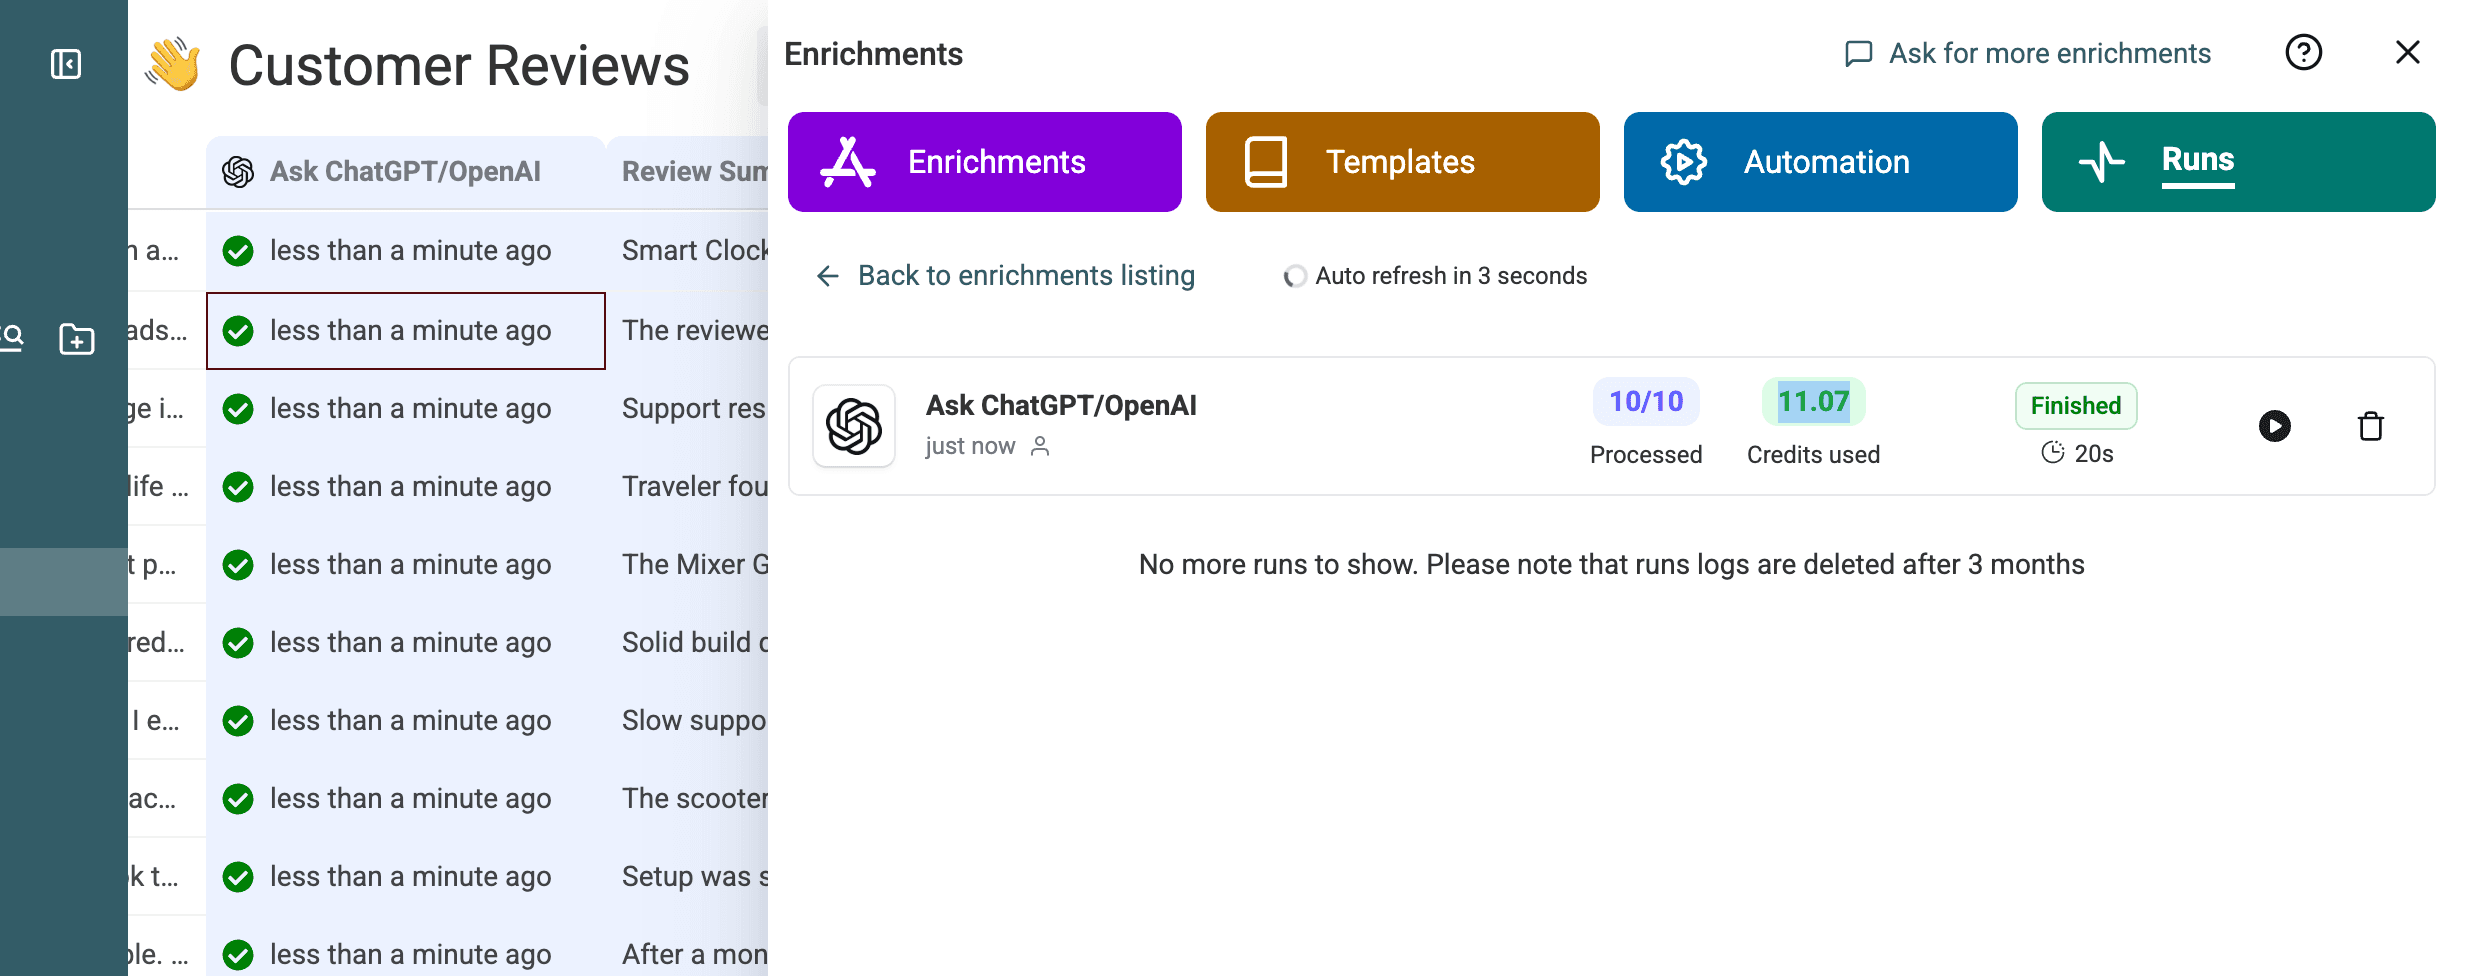
Use Run on first 10 items ou selecione suas próprias linhas representativas. Neste teste, o primeiro lote continha 10 avaliações. Verifiquei a fidelidade dos resumos, os rótulos permitidos, a urgência, as ações recomendadas e se as avaliações ambíguas foram sinalizadas.
O autor aprovou um resumo quando ele preservava a intenção e o tom do cliente. O resultado da amostra foi satisfatório, portanto o prompt e a configuração das saídas foram mantidos sem alterações.
A amostra processou as 10 linhas em 20 segundos e consumiu 11,07 créditos.
Processe as avaliações restantes
Depois de aprovar a amostra, execute o processo nas linhas restantes. Mantenha o indicador de processamento para que o primeiro lote não seja enviado novamente. Se uma solicitação falhar, filtre os status com erro e tente processar novamente apenas essas linhas.
📌 Execução testada
O exemplo de 100 linhas foi processado em dois lotes: uma amostra de 10 linhas, seguida pelas 90 linhas restantes com o mesmo prompt e as mesmas configurações.
O segundo lote processou as 90 linhas em 34 segundos e consumiu 110,49 créditos.
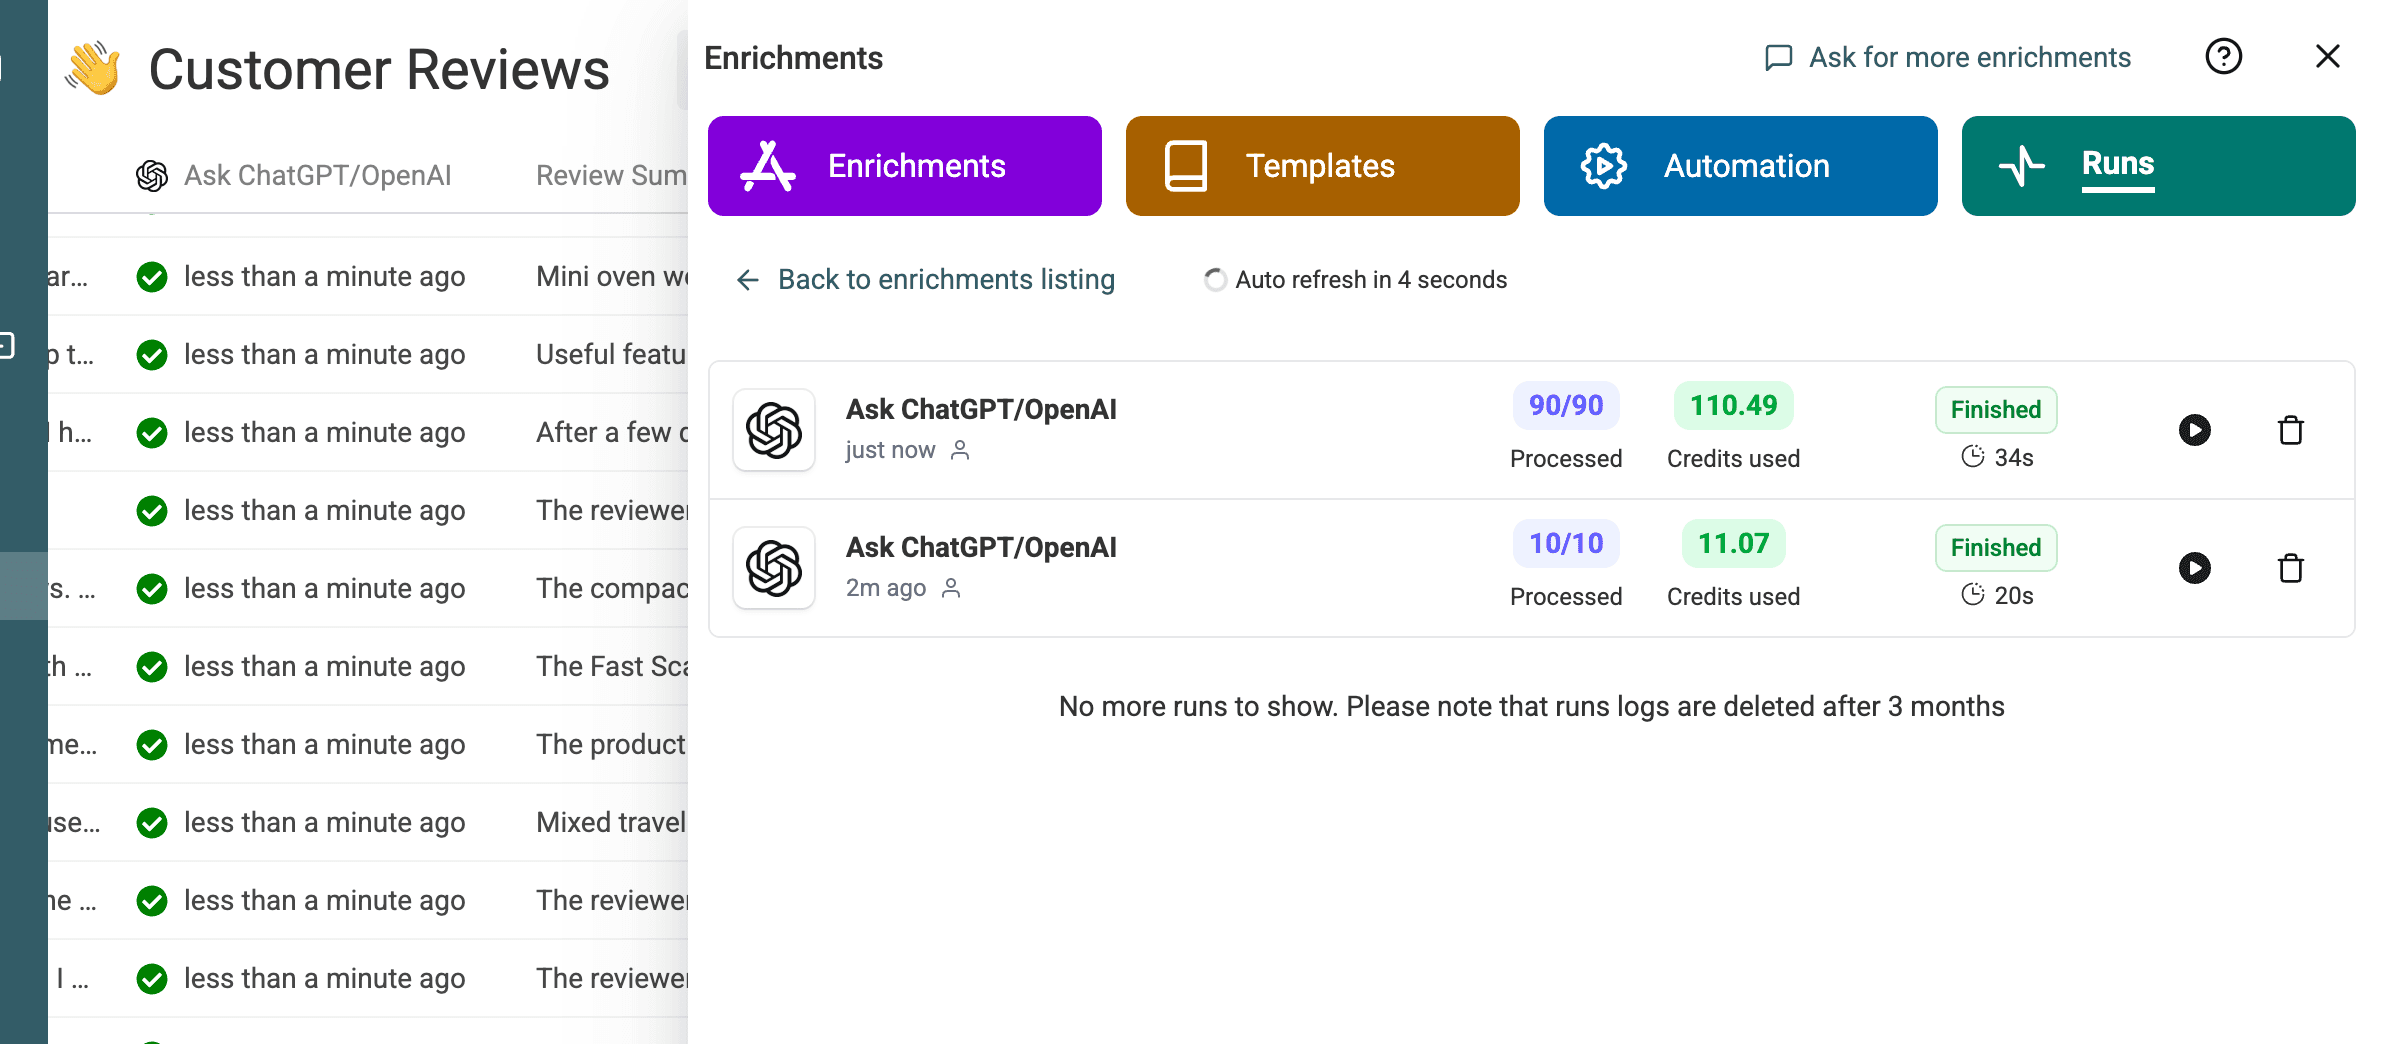
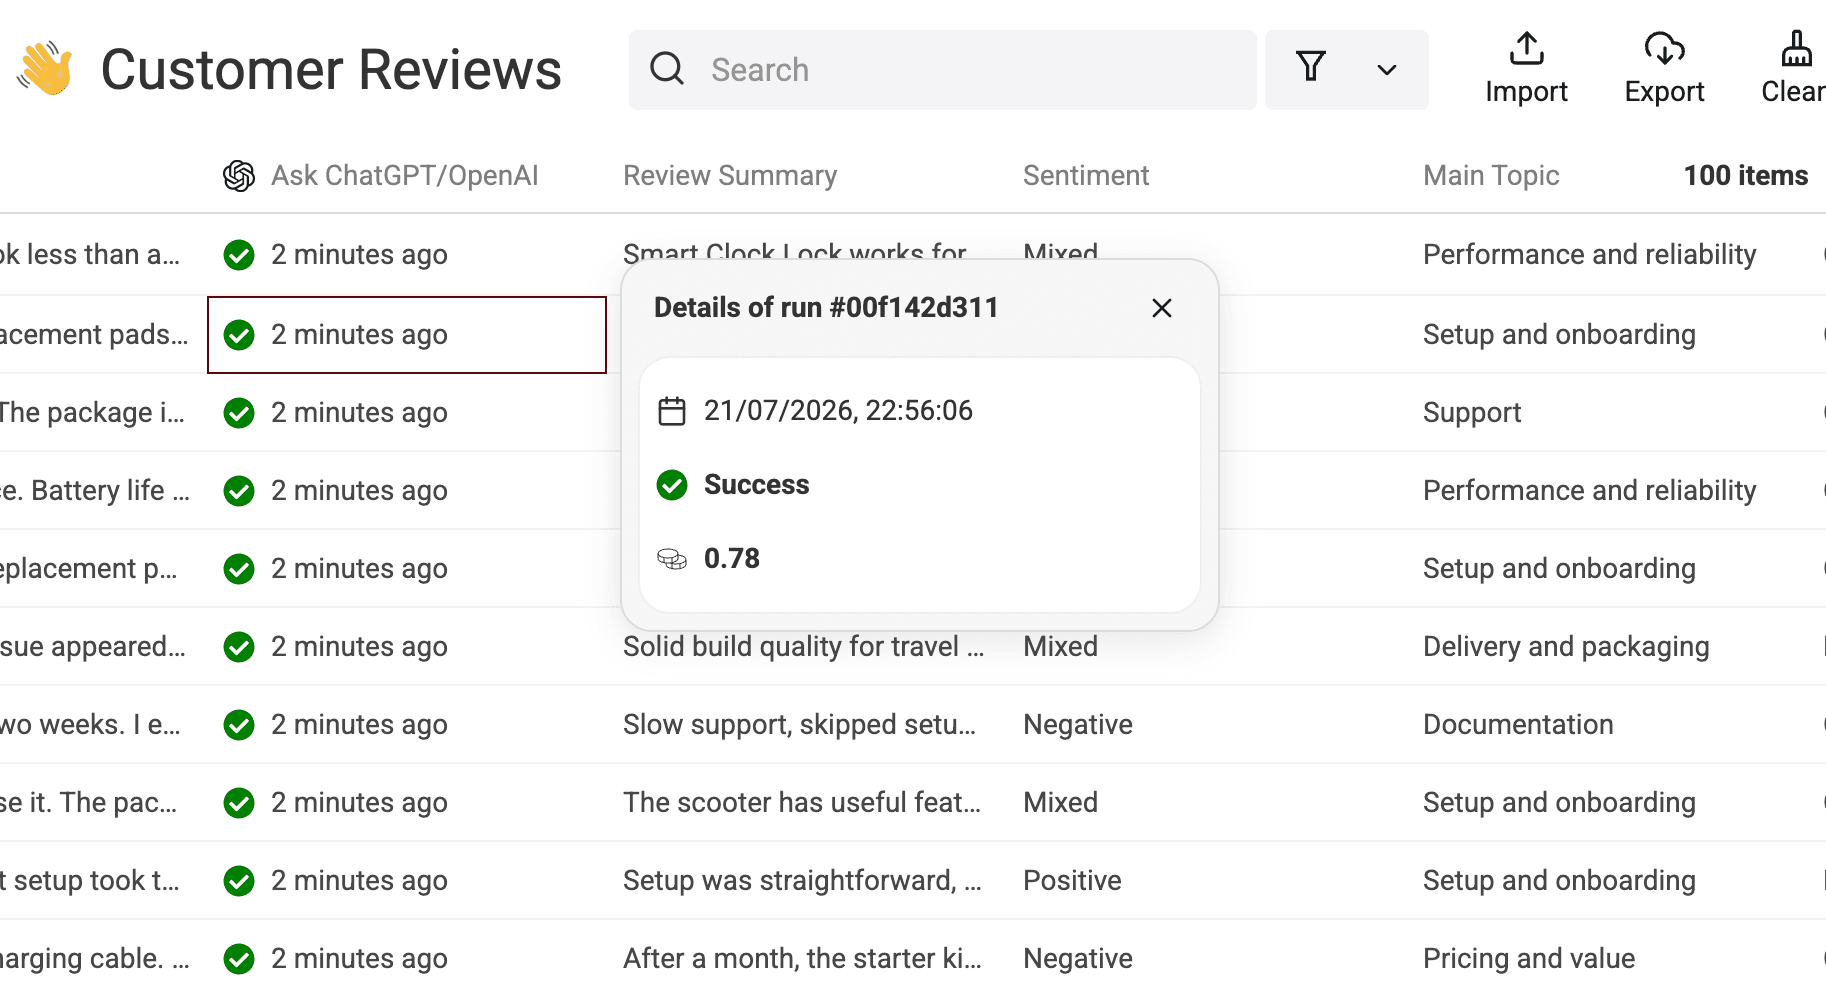
Você também pode abrir os detalhes de execução de uma linha para confirmar seu status e consumo de créditos.
Revise os resultados e as métricas do teste
Compare os campos originais e gerados
Não revise os campos gerados de forma isolada. Mantenha o trecho original e o Review ID visíveis para que cada análise continue auditável.
| Review ID | Trecho original | Resumo | Sentimento | Tema principal | Tipo de problema | Urgência | Ação recomendada | Precisa de revisão |
|---|---|---|---|---|---|---|---|---|
7wQDdSKxrw | O uso pela equipe remota não foi simples; o suporte foi contatado duas vezes. | O Smart Clock Lock funciona para substituições e configuração inicial, mas o desempenho para equipes remotas não é satisfatório e exigiu suporte duas vezes. | Mixed | Performance and reliability | Complaint | Low | Investigar os problemas de uso por equipes remotas e publicar orientações de solução de problemas mais claras para reduzir a dependência do suporte. | No |
9xSyNNTkPZ | O suporte demorou e o recurso necessário não era confiável. | As respostas do suporte demoraram demais e o recurso necessário pareceu pouco confiável, embora as atualizações por e-mail e a bolsa de transporte fossem claras. | Negative | Support | Complaint | Medium | Entrar em contato com o cliente para resolver a demora no suporte e documentar melhorias na confiabilidade do recurso necessário. | No |
ZjmazxYl87 | Suporte lento, etapas ausentes e configuração de duas semanas. | O suporte lento, as etapas ausentes e as duas semanas de configuração inicial geraram expectativas negativas sobre a qualidade após o teste de uma peça substituta. | Negative | Documentation | Complaint | High | Atualizar as instruções completas de configuração passo a passo e priorizar respostas mais rápidas para tickets de suporte sobre peças substitutas. | Yes |
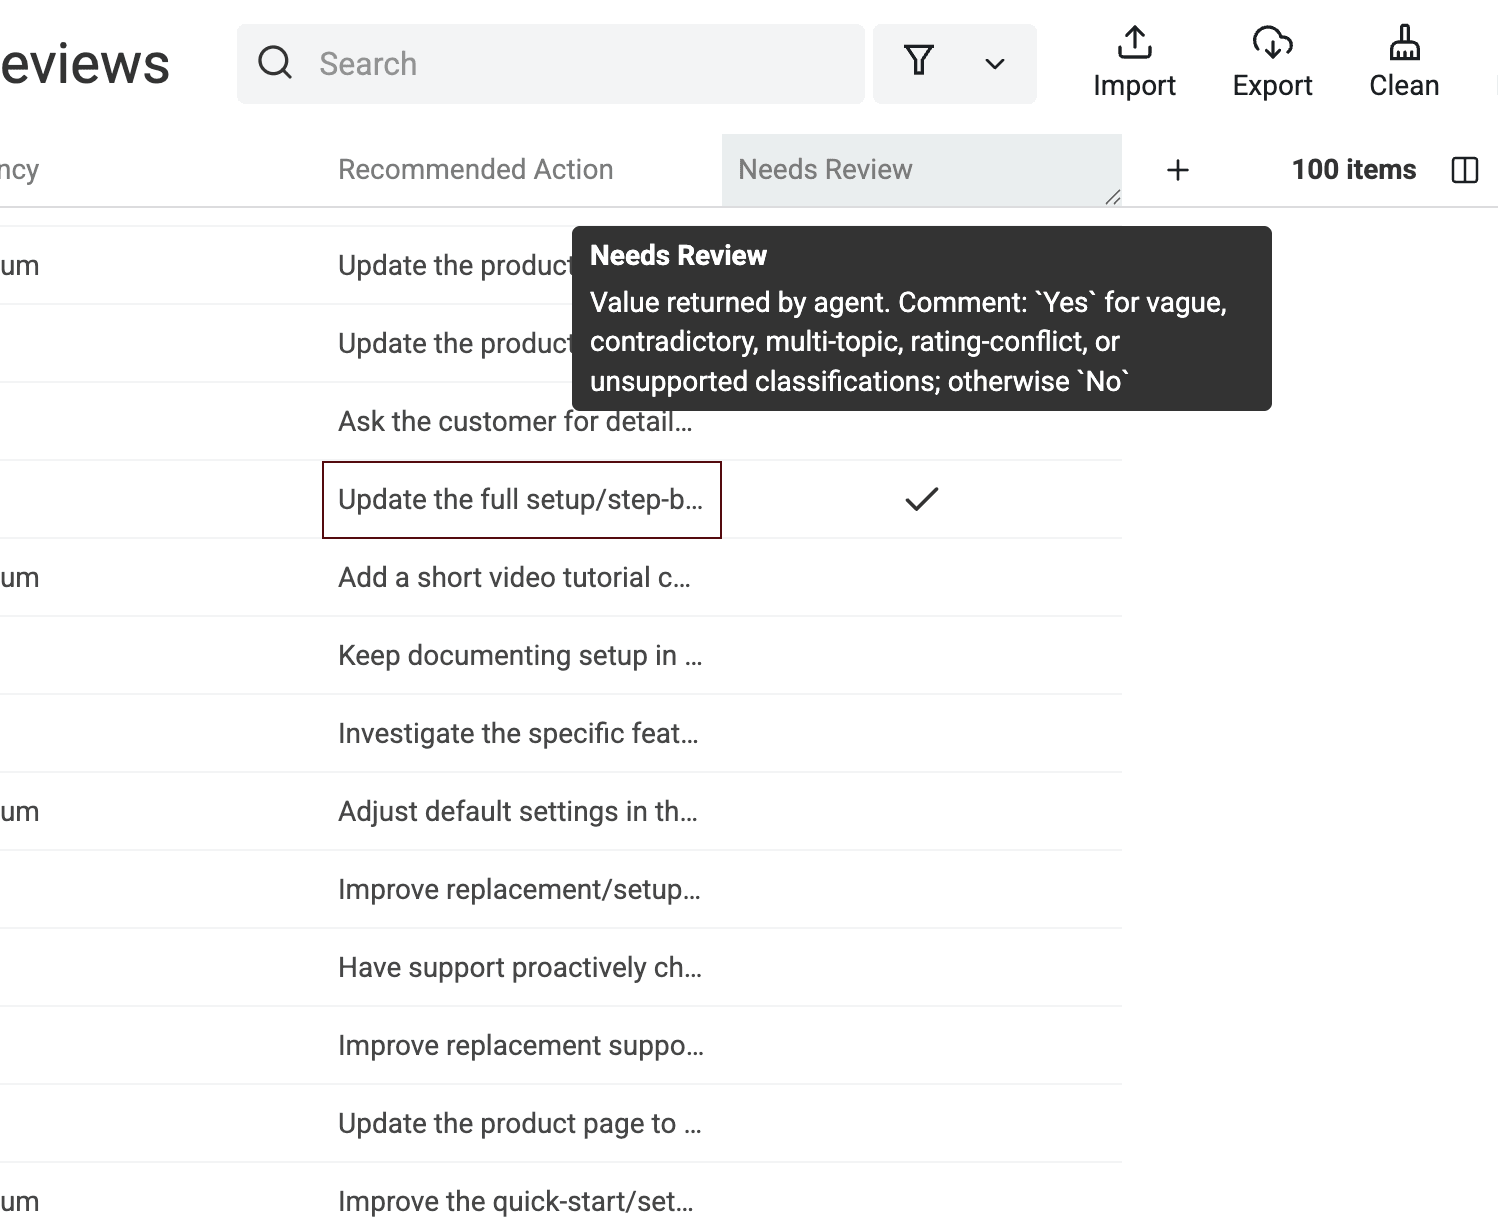
As colunas de resultados gerados permitem visualizar as diferentes análises em conjunto. É nesse ponto que procuro rótulos que parecem inconsistentes com o texto original.
Apresente as métricas sem generalizar
A medição abrange um único CSV sintético com 100 avaliações. Foram usados GPT 5.4 nano, Flex mode e Datablist Credits. O arquivo foi processado em uma amostra de 10 linhas, seguida por um lote de 90 linhas.
Todas as 100 linhas apresentaram status de execução bem-sucedido. Os dois resumos de execução registraram 20 e 34 segundos, totalizando 54 segundos. O consumo foi de 11,07 mais 110,49 créditos, ou 121,56 créditos no total.
Este teste processou 100 de 100 linhas em 54 segundos, distribuídas em duas execuções, e consumiu 121,56 Datablist Credits. Considere esses números como evidência para este arquivo e esta configuração, não como uma garantia para outros modelos, prompts ou datasets.
Filtre as linhas que exigem revisão humana
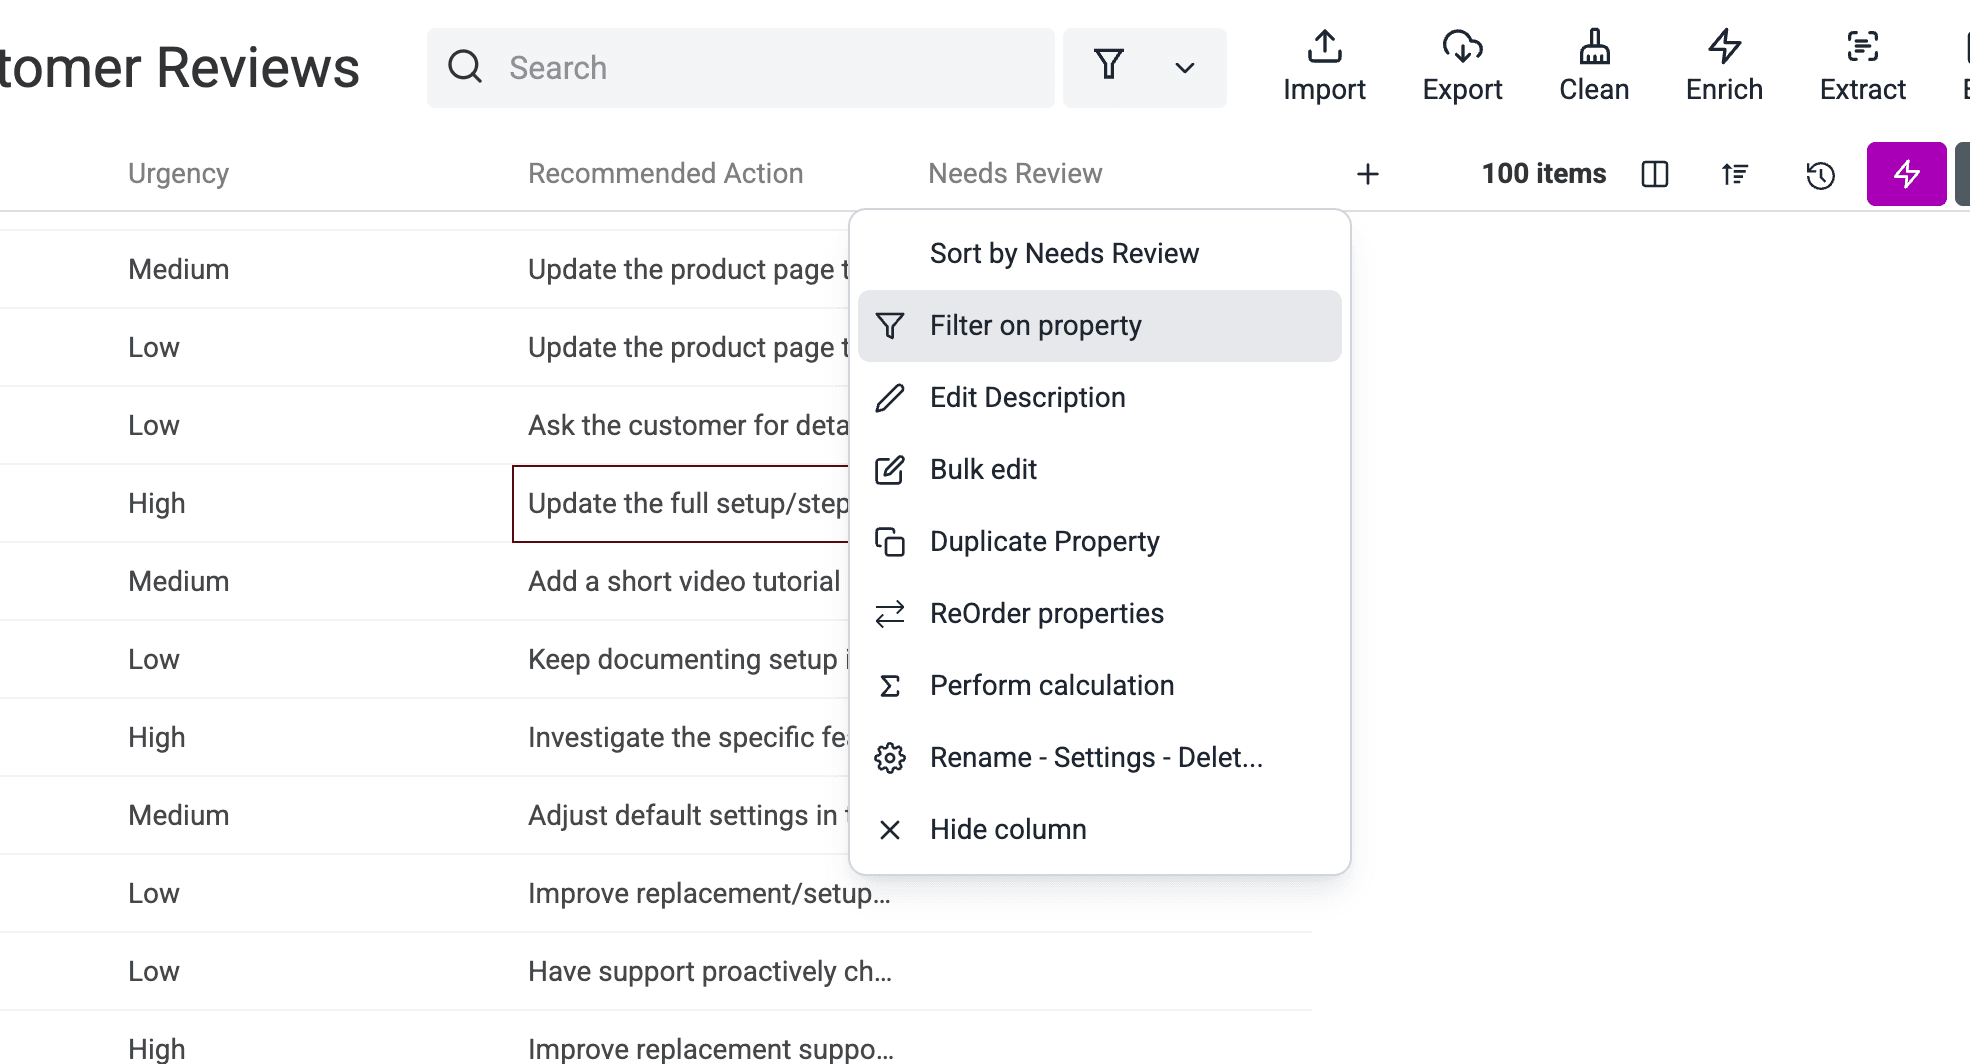
A exportação contém cinco linhas com Needs Review = Yes. Para isolá-las, abra o menu da propriedade Needs Review e escolha Filter on property.
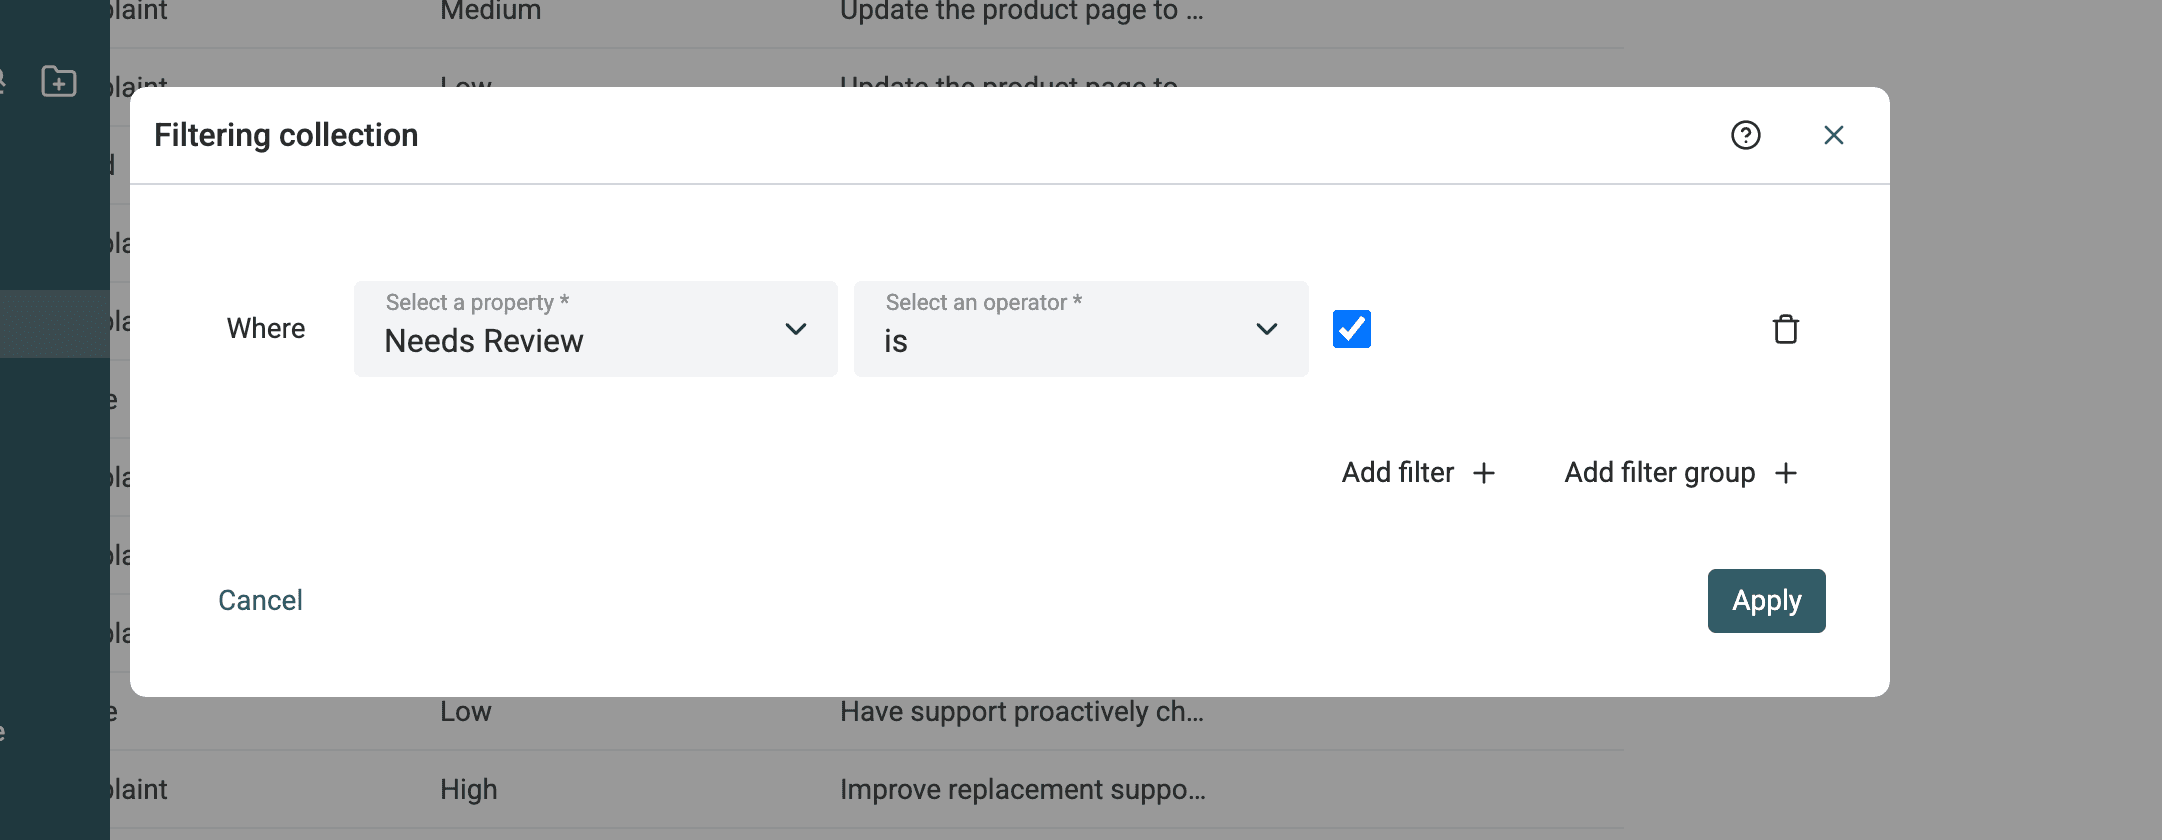
Defina o filtro como Needs Review is checked e aplique-o.
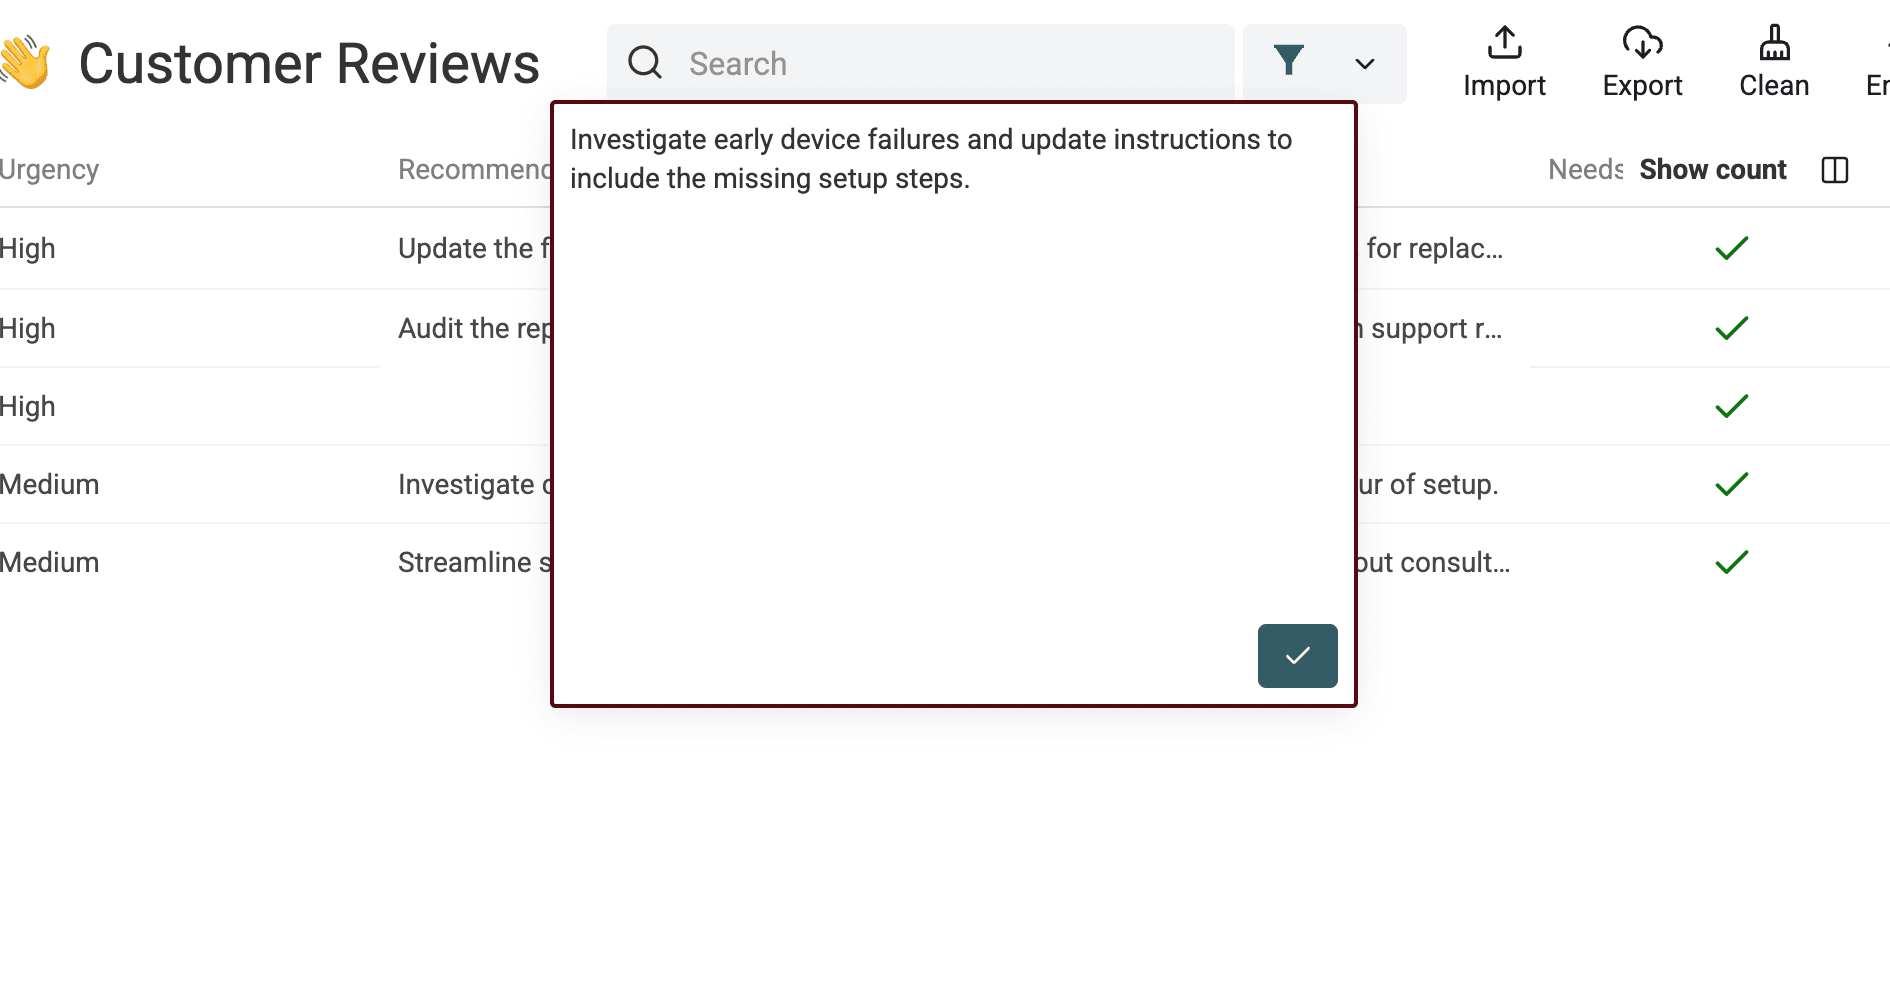
Leia em conjunto o texto original, as classificações e a ação. O autor verificou manualmente duas linhas sinalizadas, ZjmazxYl87 e nMtoYjtzgk, e aprovou ambas sem alterações. Cada uma continha vários problemas relevantes, portanto manter o indicador de revisão ainda foi a decisão correta.
Compare também Sentiment com Rating. Uma divergência pode revelar nuances ou ambiguidades, mas não significa automaticamente que o sentimento esteja incorreto.
Transforme avaliações em uma lista de ações
Depois de validar os rótulos, combine filtros em vez de ler a planilha do início ao fim. Três visualizações são suficientes para a maioria das equipes:
- Produto: filtre reclamações de alta urgência e agrupe-as por
Main Topicpara fazer a triagem. - Suporte: isole reclamações sobre o suporte e examine o follow-up sugerido ao lado de cada avaliação original.
- Marketing ou ecommerce: separe elogios de problemas relacionados à página do produto, ao valor, à entrega ou à embalagem.
Verifique a consistência dos rótulos antes de contar os temas. Uma contagem baseada em rótulos inconsistentes cria uma falsa precisão. Mantenha Review ID e Review Text na exportação para que cada ação possa ser rastreada até sua evidência.
O Datablist permite filtrar essas linhas e exportar os campos originais e gerados para CSV ou Excel. Se você precisa de um resumo executivo, primeiro agrupe ou conte as linhas validadas e depois use os dados agregados como entrada de uma segunda etapa de resumo. A execução linha por linha não cria essa narrativa automaticamente.
Falhas, limitações e validação dos resultados
O que o teste revelou
Duas avaliações sinalizadas combinavam vários problemas relevantes. Ambas foram processadas com sucesso, e suas classificações foram aprovadas após revisão manual. O indicador cumpriu sua função: encaminhou linhas subjetivas para uma pessoa sem descartar a saída da IA.
A exportação também revelou um problema mais direto no schema. A avaliação pe2dhcKl7J retornou Issue Type = Mixed, embora Mixed não fosse um rótulo permitido para esse campo. O status da execução foi bem-sucedido e Needs Review estava como falso.
⚠️ Sucesso não significa validade
Um status de execução bem-sucedido confirma o processamento, não a exatidão de cada rótulo. Valide a taxonomia e a fundamentação antes de contar temas ou atribuir tarefas.
Há ainda outras limitações relacionadas aos dados de entrada. Textos vazios ou vagos podem não fornecer informações suficientes para todos os campos. Avaliações contraditórias ou com vários temas tornam subjetiva a escolha do rótulo principal. A nota pode divergir do texto. Alterações no prompt podem afetar a consistência dos rótulos entre os lotes. Datasets em vários idiomas podem exigir uma instrução explícita sobre o idioma de saída ou testes separados.
Resumos, temas, níveis de urgência e ações gerados por IA são análises do modelo, não verdades definitivas para o negócio. Use-os para estruturar e encaminhar o trabalho, mantendo uma revisão humana sempre que um rótulo incorreto puder alterar uma decisão.
Checklist de validação antes da exportação
- Confirme se toda linha com texto de avaliação apresenta status bem-sucedido ou uma tentativa documentada de reprocessamento.
- Verifique se os resumos preservam a intenção e o tom da avaliação sem acrescentar informações.
- Valide todos os valores de sentimento, tema, tipo de problema e urgência em relação aos rótulos permitidos.
- Compare o sentimento com a nota para encontrar contradições que mereçam leitura, tratando a nota apenas como um sinal de diagnóstico.
- Confirme se cada ação recomendada decorre da avaliação original.
- Examine todas as linhas com
Needs Reviewe uma amostra das linhas bem-sucedidas não sinalizadas, principalmente avaliações com vários temas. - Mantenha
Review ID, texto original, nota, campos gerados, estado de processamento e status da execução na exportação.
Analise seu arquivo de avaliações no Datablist
Importe seu arquivo CSV ou Excel com avaliações de clientes no Datablist, selecione Analyze customer reviews, associe as três entradas e teste de 10 a 20 linhas variadas. Quando os rótulos e indicadores de revisão estiverem úteis, processe o restante e exporte o resultado validado.
FAQ
O ChatGPT analisa avaliações de clientes em CSV?
Sim. O Datablist envia os valores de cada linha ao modelo selecionado e grava a resposta estruturada em novas propriedades. Em comparação com o upload de um arquivo em um chat, o processo por linha mantém cada resumo, rótulo, ação e status associado à avaliação original.
Como resumir milhares de avaliações de clientes?
Comece com uma amostra representativa, valide os rótulos e indicadores e depois processe as linhas restantes em lotes. Preserve os IDs e status originais para tentar novamente as linhas com erro sem perder a rastreabilidade. O tempo de execução e o consumo de créditos variam conforme o modelo, o prompt, o tamanho dos textos e as configurações. Por isso, teste sua própria amostra antes de estimar o processamento completo.
O processo analisa avaliações em vários idiomas?
Ele pode processar textos nos idiomas aceitos pelo modelo selecionado, mas arquivos com vários idiomas precisam ser testados. Adicione uma regra explícita sobre o idioma de saída se quiser todos os resumos em uma única língua, ou processe cada idioma em um lote separado quando a consistência for importante.
O sentimento deve sempre corresponder à nota?
Não. Uma nota positiva pode incluir uma reclamação séria, enquanto uma nota baixa ainda pode mencionar um bom atendimento ou uma devolução simples. Use as divergências para encontrar linhas que merecem ser lidas e avalie o rótulo com base no texto da avaliação.
A análise com IA substitui a revisão manual?
Não. A IA facilita a organização e a inspeção de um arquivo grande de avaliações. Revise as linhas sinalizadas, valide os rótulos controlados e examine uma amostra dos resultados bem-sucedidos antes de usá-los em decisões de produto, suporte ou marketing.