
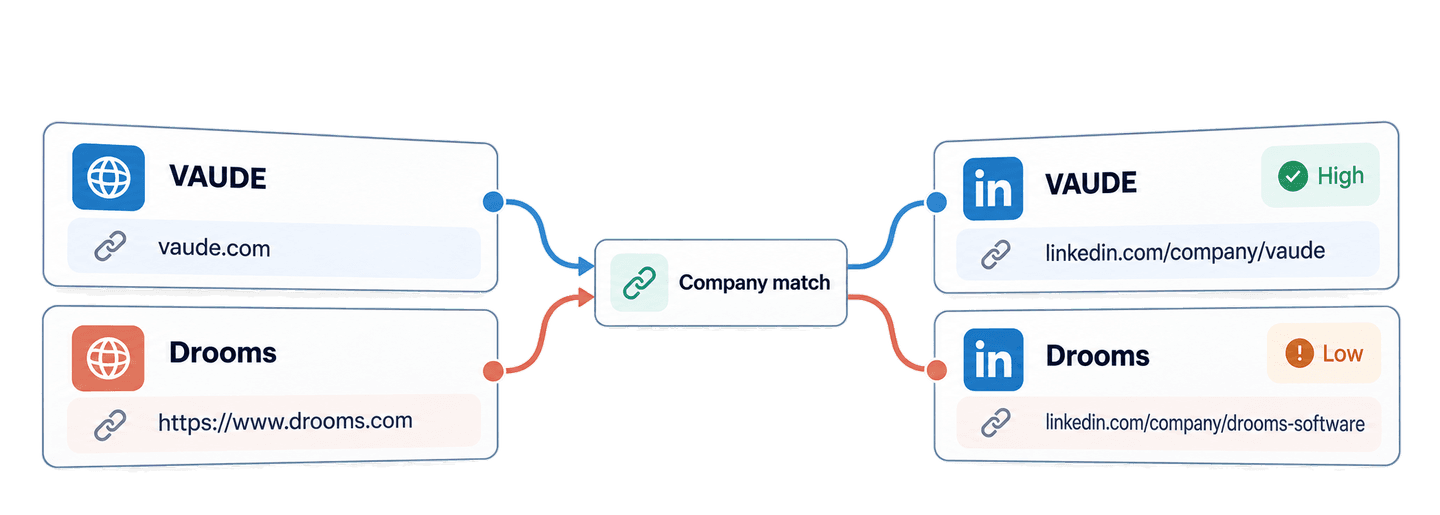
استخدم Company to LinkedIn API من Datablist للعثور على صفحة شركة على LinkedIn انطلاقًا من موقعها الإلكتروني باستخدام Python. يمكنك إرسال نطاق مجرد أو عنوان URL كامل للموقع، وانتظار اكتمال مهمة المطابقة، ثم الحصول على اسم الشركة وموقعها ورابط صفحتها على LinkedIn ومؤشر الثقة.
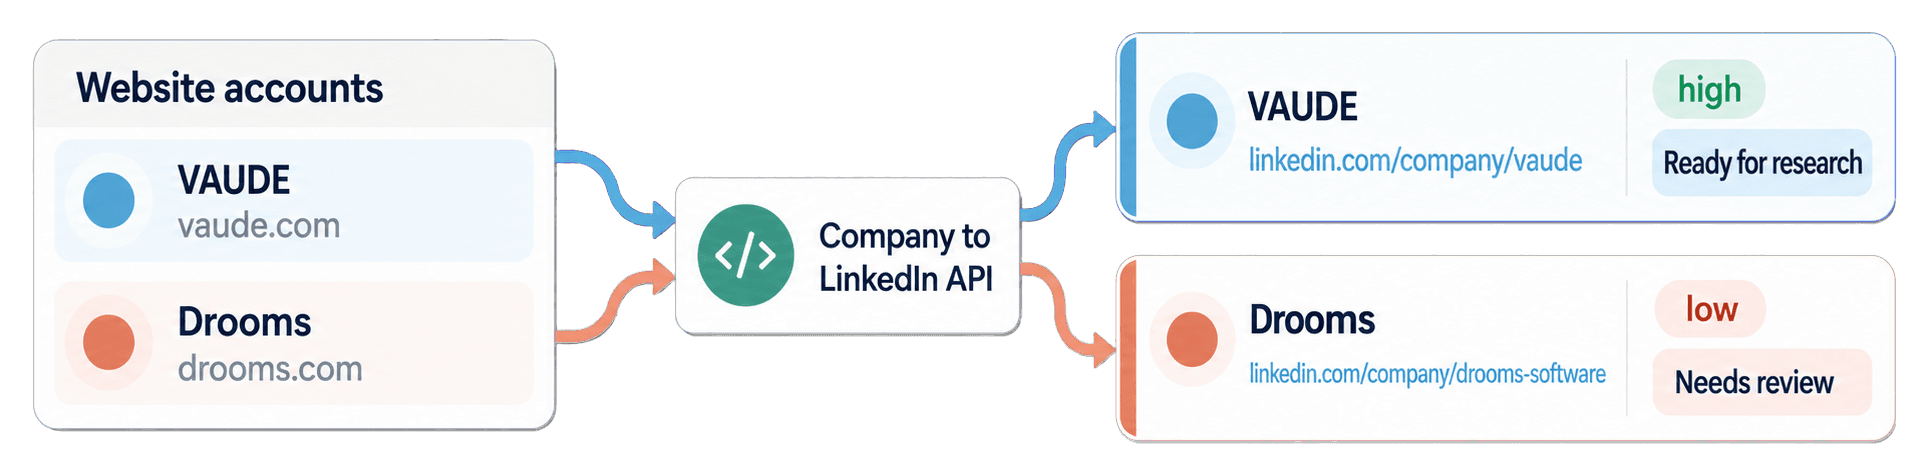
في هذا الدليل، أستخدم Python ومكتبة Requests لمطابقة مواقع خمس شركات. تشمل القائمة شركات برمجيات معروفة، إلى جانب VAUDE المتخصصة في معدات الأنشطة الخارجية، وDrooms التي توفر غرف بيانات افتراضية. بعد ذلك، أحوّل النتائج إلى قائمتَي انتظار محليتين: مطابقات جاهزة للبحث عن الشركات، وأخرى تتطلب مراجعة يدوية.
🔑 ملخص لمن لا يملكون وقتًا
أرسل مواقع الشركات من قائمة حساباتك إلى Company to LinkedIn API من Datablist. تعيد API روابط صفحات الشركات على LinkedIn ومؤشرات ثقة تساعدك على تحديد العلاقات التي يمكن اعتمادها وتلك التي تحتاج إلى مراجعة.
- المدخلات: نطاقات مجردة وعناوين URL كاملة لمواقع الشركات.
- المخرجات: أسماء الشركات والمواقع المطابَقة وروابط صفحات الشركات على LinkedIn ومستوى ثقة
highأوlow، موزعة بين قائمتَيReady for researchوNeeds review.
💡 هل تفضل حلًا من دون كود؟ استخدم LinkedIn Company Pages & Domain Lookup من Datablist لمطابقة مواقع الشركات بصفحاتها على LinkedIn من دون كتابة أي كود.
إعداد Python ومفتاح Datablist API
في هذا المثال، أستخدم حزمة requests. تعمل API عبر HTTP، لذا يمكنك لاحقًا تطبيق تسلسل الطلبات نفسه بلغة برمجة أخرى.
تحتاج إلى حساب Datablist يتيح الوصول إلى REST API، وهي ميزة متوفرة ضمن خطة Growth. تستهلك عمليات البحث الناجحة أيضًا أرصدة enrichment. وسأوضح طريقة حساب التكلفة بدقة لاحقًا في الدليل.
أنشئ مجلد عمل وملفًا باسم find_linkedin_company_pages.py، ثم أنشئ بيئة افتراضية وثبّت Requests:
mkdir company-linkedin-matcher
cd company-linkedin-matcher
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
touch find_linkedin_company_pages.pyأنشئ Personal API Key من حسابك على Datablist، ثم صدّره كمتغير بيئة:
export DATABLIST_API_KEY="your-api-key"يقرأ السكربت هذه القيمة ويرسلها ضمن الترويسة X-API-Key.
العثور على صفحات شركات LinkedIn بدالة Python واحدة
يستخدم المثال حسابات المصدر الخمسة التالية:
account-datablist:datablist.comaccount-posthog:posthog.comaccount-n8n:https://n8n.ioaccount-vaude:vaude.comaccount-drooms:https://www.drooms.com
تتحول كل قيمة account_id إلى inputId في API. وهذا مهم لأن النتائج قد لا تصل بالترتيب نفسه الذي أُرسلت به المدخلات. يتيح لك المعرّف الثابت ربط كل نتيجة بحساب المصدر الصحيح.
الصق السكربت الكامل التالي في find_linkedin_company_pages.py:
import json
import os
import time
import uuid
import requests
def match_companies(accounts, api_key, matching_direction):
"""Submit one matching task, wait for it, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"sourceUrl": account["source_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "company-to-linkedin",
"uniqueId": unique_id,
"settings": {"matchingDirection": matching_direction},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "datablist.com",
},
{
"account_id": "account-posthog",
"company_name": "PostHog",
"source_url": "posthog.com",
},
{
"account_id": "account-n8n",
"company_name": "n8n",
"source_url": "https://n8n.io",
},
{
"account_id": "account-vaude",
"company_name": "VAUDE",
"source_url": "vaude.com",
},
{
"account_id": "account-drooms",
"company_name": "Drooms",
"source_url": "https://www.drooms.com",
},
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
match_results = match_companies(
accounts, api_key, matching_direction="domain_to_linkedin"
)
print(json.dumps(match_results, indent=2))شغّله باستخدام:
python find_linkedin_company_pages.pyتنفذ الدالة ثلاثة أنواع من الاستدعاءات بالترتيب.
أولًا، يرسل طلب POST المواقع الخمسة مع ضبط matchingDirection على domain_to_linkedin. تستجيب API بالحالة 202 Accepted ومعرّف للمهمة لأن المطابقة تُنفّذ كمهمة في الخلفية. ومع ذلك، يبدو سكربت Requests تسلسليًا لأنه ينتظر قبل الانتقال إلى الخطوة التالية.
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]ثانيًا، يتحقق طلب الحالة من المهمة حتى تصبح completed أو failed أو stopped. وتمنع مهلة الثلاث ثوانٍ السكربت من إرسال طلبات حالة بصورة متواصلة.
ثالثًا، يقرأ طلب النتائج صفحات تضم كل منها ما يصل إلى 100 نتيجة. إذا احتوى nextCursor على قيمة، ترسلها الحلقة كمعامل cursor في الطلب التالي. ولا تتوقف إلا عندما تصبح قيمة nextCursor هي null.
قراءة المطابقات وتحديد ما يحتاج إلى مراجعة
فيما يلي قائمة النتائج الكاملة للمدخلات الخمسة:
[
  {
    "inputId": "account-datablist",
    "status": "success",
    "outputs": {
      "companyWebsite": "datablist.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/datablist",
      "companyName": "datablist"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-posthog",
    "status": "success",
    "outputs": {
      "companyWebsite": "posthog.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/posthog",
      "companyName": "PostHog"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-n8n",
    "status": "success",
    "outputs": {
      "companyWebsite": "n8n.io",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/n8n",
      "companyName": "n8n"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-vaude",
    "status": "success",
    "outputs": {
      "companyWebsite": "vaude.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/vaude",
      "companyName": "vaude"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-drooms",
    "status": "success",
    "outputs": {
      "companyWebsite": "drooms.com",
      "confidence": "low",
      "companyLinkedInUrl": "https://www.linkedin.com/company/drooms-software",
      "companyName": "Drooms"
    },
    "creditsUsed": "1.5",
    "error": null
  }
]
اقرأ status وconfidence كلًا على حدة. تعيد API كائن نتيجة لكل مدخل، بما في ذلك المدخلات غير الناجحة. تعني الحالة success أنها عثرت على صفحة شركة مرشحة. أما قيمة outputs.confidence فتوضح ما إذا كانت مطابقة الموقع قد خضعت للتحقق. يربط inputId الكائن بحساب المصدر، بينما يسجل creditsUsed تكلفة ذلك الصف، ويحمل error تفاصيل منظمة عند حدوث خطأ.
احتفظ بكائن outputs كاملًا في تطبيقك، حتى إذا كانت الشاشة الأولى لا تحتاج إلا إلى رابط LinkedIn ومستوى الثقة. يسرّع companyName وcompanyWebsite المراجعة اليدوية، لا سيما عندما يختلف استخدام الأحرف الكبيرة والصغيرة في اسم الشركة المُعاد، أو عندما يكون المدخل عنوان URL كاملًا. كما يوفران سياقًا مفيدًا من دون استدعاء API مرة أخرى.
تبدأ عملية المطابقة بتوحيد صيغة الموقع المُرسل والبحث في بيانات الشركات عن علاقة معروفة بين الموقع وLinkedIn. ثم تقارن نطاق المدخل بالموقع المنشور على صفحة الشركة المرشحة في LinkedIn. وتنتج مطابقة النطاق المسجل مستوى ثقة high.
عندما لا تتضمن مجموعات البيانات رابط LinkedIn، يمكن لعملية البحث إجراء بحث موجّه على Google عن صفحات شركات مرشحة. وقد تعود الصفحة المرشحة التي يتعذر التحقق منها مقابل موقع منشور بمستوى ثقة low. أما عدم التطابق المؤكد بين المواقع فلا يُقبل.
تعامل مع مستوى الثقة بوصفه توجيهًا للمراجعة. أعادت VAUDE الرابط https://www.linkedin.com/company/vaude بمستوى ثقة high، لذا يمكن إضافته إلى قائمة انتظار البحث. أما Drooms فأعادت الرابط https://www.linkedin.com/company/drooms-software بمستوى ثقة low. افتح موقع Drooms وصفحتها على LinkedIn قبل الاعتماد على هذه العلاقة.
أعادت Datablist وPostHog وn8n أيضًا مطابقات عالية الثقة. تعثر هذه API على العلاقة بين الموقع وصفحة الشركة. وإذا احتجت إلى حجم الشركة أو قطاعها أو بيانات أخرى من الصفحة بعد مراجعة الرابط، فاستخدم دليل LinkedIn company scraper API كخطوة تالية.
إعداد قائمة انتظار للبحث عن الشركات من النتائج
أعد الآن استخدام match_results لإعداد قائمة انتظار محلية للبحث اليدوي عن الشركات. لا تستدعي هذه الكتلة API مرة أخرى. فهي تفهرس النتائج حسب inputId، ثم تمر على قائمة الحسابات الأصلية كي يظل كل حساب مصدر ظاهرًا حتى إذا غابت نتيجة في المستقبل.
results_by_id = {result["inputId"]: result for result in match_results}
ready_for_research = []
needs_review = []
for account in accounts:
result = results_by_id.get(account["account_id"])
if result is not None:
outputs = result.get("outputs", {})
else:
outputs = {}
research_record = {
**account,
"companyLinkedInUrl": outputs.get("companyLinkedInUrl"),
"confidence": outputs.get("confidence"),
"api_result": result,
}
is_ready = (
result is not None
and result["status"] == "success"
and outputs.get("companyLinkedInUrl")
and outputs.get("confidence") == "high"
)
if is_ready:
ready_for_research.append(research_record)
else:
needs_review.append(research_record)
print("Ready for research:")
print(json.dumps(ready_for_research, indent=2))
print("Needs review:")
print(json.dumps(needs_review, indent=2))يجعل قاموس النتائج عملية الربط مستقلة عن ترتيب الاستجابة. يربط account-vaude سجل vaude.com الأصلي بصفحة VAUDE التي تم العثور عليها، ثم يضيفه إلى ready_for_research. ويحتفظ account-drooms بعنوان URL الكامل للمدخل ونتيجة API الكاملة، لكنه يُضاف إلى needs_review لأن مستوى الثقة منخفض رغم أن حالة النتيجة هي success.
يُبقي المنطق نفسه أي صف مفقود أو بحالة no_result أو يتضمن خطأ ضمن قائمة المراجعة. وتمنح القائمتان المطبوعتان الفريق نقطة انطلاق واضحة للبحث اليدوي عن الشركات.
يمكنك أيضًا تنزيل مثال Requests المتزامن الذي تتم صيانته باستمرار. ويتضمن المستودع مثال HTTPX غير متزامن للتطبيقات التي تحتاج إلى HTTP غير حاجب، لكن النسخة الحاجبة أعلاه أسهل في المتابعة عند تنفيذ التكامل للمرة الأولى.
البحث العكسي من صفحة شركة LinkedIn إلى موقعها
تقبل الدالة نفسها صفحات الشركات على LinkedIn عند تغيير اتجاه المطابقة. يفيد ذلك عندما تحتوي قائمة المصدر على روابط صفحات الشركات وتحتاج إلى مواقعها قبل تنفيذ enrichment متوافق لبيانات الشركات أو عناوين البريد المهني.
linkedin_accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "https://www.linkedin.com/company/datablist",
}
]
website_results = match_companies(
linkedin_accounts,
api_key,
matching_direction="linkedin_to_domain",
)تستخدم عملية البحث القياسية انطلاقًا من صفحة شركة على LinkedIn سعر المطابقة المعتاد. وقد تستهلك معرّفات الشركات الرقمية وروابط شركات Sales Navigator عشرة أرصدة لأنها تتبع مسار بحث عكسي مختلفًا. ولتنفيذ هذا الاتجاه من دون كود، راجع كيفية الحصول على روابط المواقع من صفحات الشركات على LinkedIn.
تقدير أرصدة البحث من الموقع إلى LinkedIn
تستهلك كل عملية بحث قياسية ناجحة من موقع إلى LinkedIn مقدار 1.5 رصيد. لذلك استهلكت المطابقات الخمس المعروضة 7.5 أرصدة. وبالسعر نفسه، تستهلك 1,000 مطابقة ناجحة 1,500 رصيد. وقد لا تستهلك المدخلات غير الصالحة والصفوف التي لا تعيد نتيجة أي رصيد، لذا تحقق من قيمة creditsUsed في كل نتيجة لمعرفة الاستهلاك الفعلي.
يأتي الوصول إلى REST API ضمن خطة Growth، ويكون الاشتراك الشهري منفصلًا عن أرصدة التعبئة الإضافية. تمنحك تعبئة بقيمة 20 دولارًا 20,000 رصيد، أي إن تكلفة الرصيد الواحد 0.001 دولار. وبمعدل 1.5 رصيد لكل مطابقة ناجحة، تستهلك 1,000 مطابقة 1,500 رصيد بقيمة 1.50 دولار. راجع أسعار Datablist للاطلاع على الخطط والباقات الحالية.
حل مشكلات المدخلات والمهام والنتائج الشائعة
- متغير
DATABLIST_API_KEYمفقود: يتوقف السكربت قبل إرسال أي طلب. صدّر متغير البيئة ثم شغّل الأمر مجددًا. - ترفض API المفتاح: تأكد من أنك نسخت Personal API Key، وأن الطلب يرسله في
X-API-Keyفقط. - المدخل غير مدعوم: استخدم موقع شركة أو نطاقًا مع
domain_to_linkedin. وفي الاتجاه العكسي، استخدم رابطًا مدعومًا لصفحة شركة بدلًا من ملف شخصي أو قيمة فارغة. - الأرصدة غير كافية: تحقق من رصيدك، ثم استخدم الأرصدة المتضمنة أو أضف تعبئة قبل إنشاء مهمة أخرى.
- حالة المهمة
failedأوstopped: افحص حالة المهمة والخطأ والنتائج الموجودة واستهلاك الأرصدة قبل اتخاذ قرار بإعادة الإرسال. - مستوى ثقة النتيجة منخفض أو حالتها
no_resultأو تتضمن خطأ: احتفظ بموقع المصدر والنتيجة الكاملة فيneeds_review. افتح الصفحة المرشحة إن وُجدت، ولا تفترض سبب غياب النتيجة.
إذا انقطع الاتصال أثناء إنشاء المهمة، فاستخدم قيمة uniqueId المطبوعة قبل طلب POST. اعرض قائمة مهامك وابحث عن تلك القيمة قبل إنشاء مهمة أخرى:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-to-linkedin" \
--data-urlencode "limit=100"لا يمكن تصفية قائمة المهام حسب uniqueId، لذا افحص كل مهمة مُعادة واتبع nextCursor عند الحاجة. وبعد العثور على القيمة المطابقة، استخدم @id الخاص بها مع روابط الحالة والنتائج نفسها التي يستخدمها السكربت.
يمكن أن تحتوي المهمة الواحدة على ما يصل إلى 10,000 مدخل. ولمعرفة الحدود الكاملة للطلبات والاحتفاظ بالمهام وتقسيم النتائج إلى صفحات، راجع وثائق Company to LinkedIn API.
الخطوات التالية
لديك الآن دالة Python Requests قابلة لإعادة الاستخدام تحوّل مواقع الشركات إلى صفحات شركات مرشحة على LinkedIn. تُبقي قائمة الانتظار المحلية المطابقات عالية الثقة جاهزة للبحث، مع إبقاء السجلات غير المؤكدة أو غير الناجحة ظاهرة للمراجعة.
استبدل الأمثلة الخمسة بقائمة حسابات صغيرة، وراجع كل مرشح منخفض الثقة، ثم استخدم الروابط المقبولة للبحث اليدوي عن الشركات أو كمدخلات إلى LinkedIn company scraper API. وإذا كانت قائمة المصدر تحتوي على أسماء شركات بدلًا من مواقعها، فابدأ بـدليل company website finder API.