
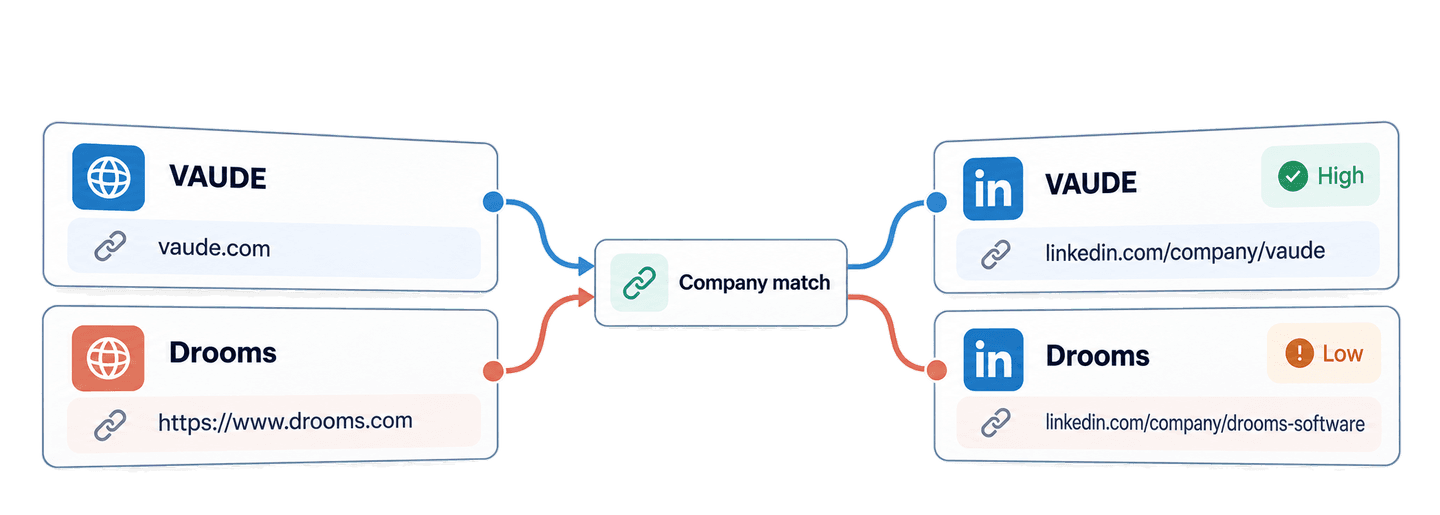
Brug Datablists Company to LinkedIn API til at finde en virksomheds LinkedIn-side ud fra dens website med Python. Du kan sende et rent domæne eller en komplet website-URL, vente på matching-opgaven og få virksomhedens navn, website, LinkedIn-URL og et confidence-signal retur.
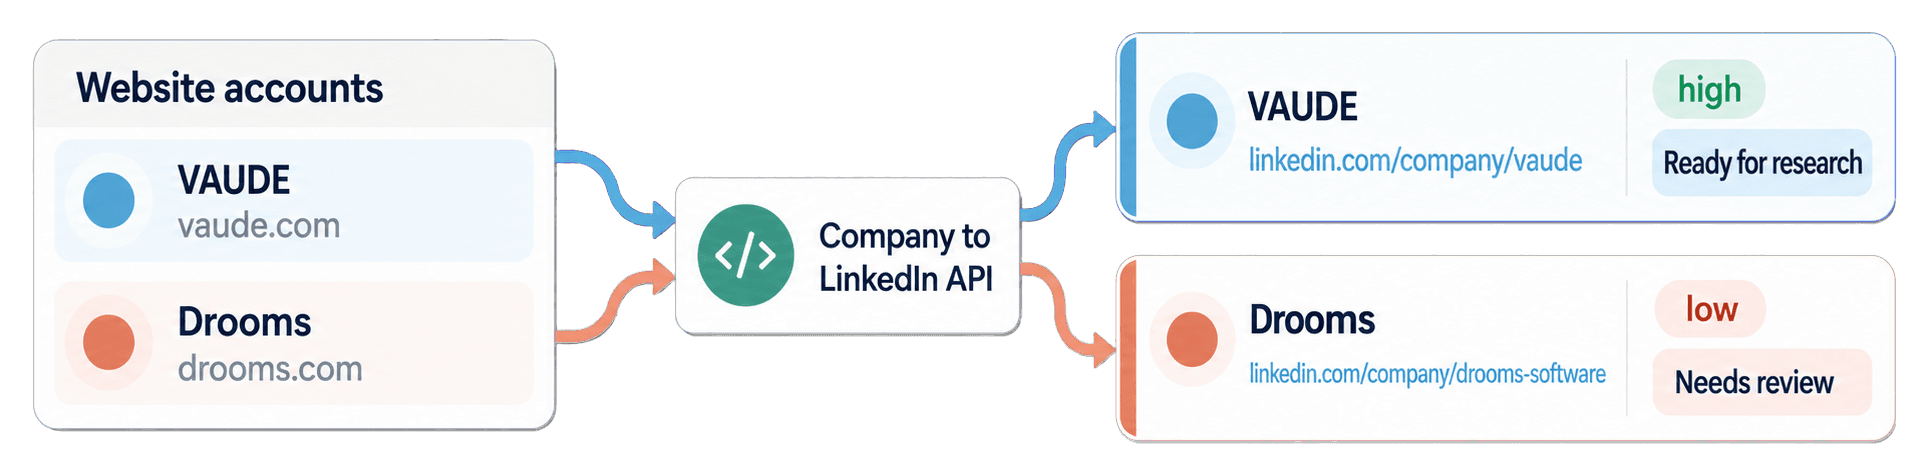
I denne guide bruger jeg Python og Requests-biblioteket til at matche fem virksomhedswebsites. Listen omfatter velkendte softwarevirksomheder samt VAUDE, der producerer outdoorudstyr, og Drooms, der tilbyder virtuelle datarum. Derefter opdeler jeg resultaterne i to lokale køer: matches, der er klar til virksomhedsresearch, og matches, der kræver manuel kontrol.
🔑 Kort fortalt til dig, der har travlt
Send websites fra din account-liste til Datablists Company to LinkedIn API. API'et returnerer URL'er til LinkedIn-virksomhedssider og confidence-signaler, så du kan afgøre, hvilke matches du kan bruge direkte, og hvilke du bør kontrollere.
- Input: rene domæner og komplette URL'er til virksomhedswebsites.
- Output: virksomhedsnavne, matchede websites, URL'er til LinkedIn-virksomhedssider samt
highellerlowconfidence, opdelt i køerneReady for researchogNeeds review.
💡 Foretrækker du en no-code-løsning? Brug Datablists LinkedIn Company Pages & Domain Lookup til at matche virksomhedswebsites og LinkedIn-sider uden at skrive kode.
Opsæt Python og din Datablist API key
I dette eksempel bruger jeg pakken requests. Selve API'et fungerer via HTTP, så du kan senere overføre den samme rækkefølge af requests til et andet programmeringssprog.
Du skal have en Datablist-konto med adgang til REST API, som er inkluderet i Growth-abonnementet. Vellykkede opslag bruger også enrichment credits. Den præcise beregning af credits gennemgår jeg senere i guiden.
Opret en arbejdsmappe og filen find_linkedin_company_pages.py. Opret derefter et virtuelt miljø, og installer Requests:
mkdir company-linkedin-matcher
cd company-linkedin-matcher
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
touch find_linkedin_company_pages.pyOpret en Personal API Key på din Datablist-konto, og eksporter den som en miljøvariabel:
export DATABLIST_API_KEY="your-api-key"Scriptet læser denne værdi og sender den i headeren X-API-Key.
Find LinkedIn-virksomhedssider med én Python-funktion
Eksemplet bruger disse fem accounts som kildedata:
account-datablist:datablist.comaccount-posthog:posthog.comaccount-n8n:https://n8n.ioaccount-vaude:vaude.comaccount-drooms:https://www.drooms.com
Hvert account_id bliver til API-feltet inputId. Det er vigtigt, fordi resultaterne ikke nødvendigvis ankommer i samme rækkefølge som inputtene. Med et stabilt ID kan du koble hvert resultat til den korrekte account i kildedataene.
Indsæt hele dette script i find_linkedin_company_pages.py:
import json
import os
import time
import uuid
import requests
def match_companies(accounts, api_key, matching_direction):
"""Submit one matching task, wait for it, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"sourceUrl": account["source_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "company-to-linkedin",
"uniqueId": unique_id,
"settings": {"matchingDirection": matching_direction},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "datablist.com",
},
{
"account_id": "account-posthog",
"company_name": "PostHog",
"source_url": "posthog.com",
},
{
"account_id": "account-n8n",
"company_name": "n8n",
"source_url": "https://n8n.io",
},
{
"account_id": "account-vaude",
"company_name": "VAUDE",
"source_url": "vaude.com",
},
{
"account_id": "account-drooms",
"company_name": "Drooms",
"source_url": "https://www.drooms.com",
},
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
match_results = match_companies(
accounts, api_key, matching_direction="domain_to_linkedin"
)
print(json.dumps(match_results, indent=2))Kør det med:
python find_linkedin_company_pages.pyFunktionen foretager tre typer API-kald i en fast rækkefølge.
Først sender POST-kaldet de fem websites med matchingDirection sat til domain_to_linkedin. API'et svarer med 202 Accepted og et opgave-ID, fordi matchingen kører som en baggrundsopgave. Requests-scriptet opleves stadig som sekventielt, fordi det venter, før det går videre til næste trin.
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]Dernæst kontrollerer status-requestet opgaven, indtil dens status bliver completed, failed eller stopped. Pausen på tre sekunder forhindrer scriptet i at sende status-requests konstant.
Til sidst henter resultat-requestet sider med op til 100 resultater ad gangen. Hvis nextCursor indeholder en værdi, sender loopet den som cursor i næste request. Det stopper først, når nextCursor er null.
Læs matches, og afgør, hvad der skal kontrolleres
Her er den komplette resultatliste for de fem input:
[
  {
    "inputId": "account-datablist",
    "status": "success",
    "outputs": {
      "companyWebsite": "datablist.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/datablist",
      "companyName": "datablist"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-posthog",
    "status": "success",
    "outputs": {
      "companyWebsite": "posthog.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/posthog",
      "companyName": "PostHog"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-n8n",
    "status": "success",
    "outputs": {
      "companyWebsite": "n8n.io",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/n8n",
      "companyName": "n8n"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-vaude",
    "status": "success",
    "outputs": {
      "companyWebsite": "vaude.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/vaude",
      "companyName": "vaude"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-drooms",
    "status": "success",
    "outputs": {
      "companyWebsite": "drooms.com",
      "confidence": "low",
      "companyLinkedInUrl": "https://www.linkedin.com/company/drooms-software",
      "companyName": "Drooms"
    },
    "creditsUsed": "1.5",
    "error": null
  }
]
Læs status og confidence hver for sig. API'et returnerer et resultatobjekt for hvert input, også når opslaget ikke lykkes. Statussen success betyder, at API'et har fundet en mulig virksomhedsside. Værdien i outputs.confidence fortæller, om website-match'et er valideret. inputId forbinder objektet med din account i kildedataene, mens creditsUsed registrerer prisen for rækken, og error indeholder strukturerede fejloplysninger, hvis der opstår en fejl.
Gem hele outputs-objektet i din applikation, selv hvis den første visning kun skal bruge LinkedIn-URL'en og confidence. companyName og companyWebsite gør manuel kontrol hurtigere, især når det returnerede virksomhedsnavn bruger andre store og små bogstaver, eller inputtet var en komplet URL. Felterne giver dig også nyttig kontekst uden endnu et API-kald.
Matchingprocessen begynder med at normalisere det indsendte website og kontrollere virksomhedsdatasæt for en kendt relation mellem websitet og LinkedIn. Derefter sammenlignes inputdomænet med det website, der er angivet på den mulige LinkedIn-virksomhedsside. Et match på det registrerede domæne giver high confidence.
Når datasættene ikke indeholder en LinkedIn-URL, kan opslaget foretage en målrettet Google-søgning efter mulige virksomhedssider. En kandidat, der ikke kan valideres mod et offentliggjort website, kan blive returneret med low confidence. Et kendt mismatch mellem websites accepteres ikke.
Brug confidence som en anvisning til kontrol. VAUDE returnerede https://www.linkedin.com/company/vaude med high confidence og kan derfor føjes til research-køen. Drooms returnerede https://www.linkedin.com/company/drooms-software med low confidence. Åbn Drooms' website og LinkedIn-side, før du stoler på denne relation.
Datablist, PostHog og n8n gav også matches med høj confidence. API'et finder relationen mellem websitet og virksomhedssiden. Hvis du efter kontrollen af URL'en har brug for virksomhedsstørrelse, branche eller andre sidedata, kan du fortsætte med guiden til LinkedIn company scraper API.
Opret en kø til account research fra resultaterne
Genbrug nu match_results til at oprette en lokal kø til manuel virksomhedsresearch. Denne kodeblok kalder ikke API'et igen. Den indekserer resultaterne efter inputId og gennemgår derefter den oprindelige account-liste, så alle accounts i kildedataene forbliver synlige, selv hvis et fremtidigt resultat mangler.
results_by_id = {result["inputId"]: result for result in match_results}
ready_for_research = []
needs_review = []
for account in accounts:
result = results_by_id.get(account["account_id"])
if result is not None:
outputs = result.get("outputs", {})
else:
outputs = {}
research_record = {
**account,
"companyLinkedInUrl": outputs.get("companyLinkedInUrl"),
"confidence": outputs.get("confidence"),
"api_result": result,
}
is_ready = (
result is not None
and result["status"] == "success"
and outputs.get("companyLinkedInUrl")
and outputs.get("confidence") == "high"
)
if is_ready:
ready_for_research.append(research_record)
else:
needs_review.append(research_record)
print("Ready for research:")
print(json.dumps(ready_for_research, indent=2))
print("Needs review:")
print(json.dumps(needs_review, indent=2))Resultat-dictionaryen gør sammenkædningen uafhængig af svarrækkefølgen. account-vaude forbinder den oprindelige post med vaude.com til den fundne VAUDE-side og føjes til ready_for_research. account-drooms beholder både sin komplette input-URL og hele API-resultatet, men føjes til needs_review, fordi confidence er lav, selvom resultatets status er success.
Den samme logik bevarer en manglende række eller en række med no_result eller fejl i kontrolkøen. De to udskrevne lister giver teamet et klart udgangspunkt for manuel virksomhedsresearch.
Du kan også downloade det vedligeholdte synkrone Requests-eksempel. Repositoriet indeholder desuden et asynkront HTTPX-eksempel til applikationer, der har brug for non-blocking HTTP. Den blokerende version ovenfor er dog lettere at følge i din første integration.
Find websitet ud fra en LinkedIn-virksomhedsside
Den samme funktion accepterer LinkedIn-virksomhedssider, når du ændrer matchingretningen. Det er nyttigt, hvis din kildeliste indeholder URL'er til virksomhedssider, og du skal bruge websites før en kompatibel virksomheds- eller arbejdsmail-enrichment.
linkedin_accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "https://www.linkedin.com/company/datablist",
}
]
website_results = match_companies(
linkedin_accounts,
api_key,
matching_direction="linkedin_to_domain",
)Et almindeligt opslag på en LinkedIn-virksomhedsside bruger den normale matchingpris. Numeriske virksomheds-ID'er og Sales Navigator-virksomheds-URL'er kan koste 10 credits, fordi de følger en anden reverse lookup-proces. Se sådan finder du website-URL'er fra LinkedIn-virksomhedssider, hvis du vil bruge denne retning uden kode.
Beregn credits til website-to-LinkedIn-opslag
Et vellykket, almindeligt website-to-LinkedIn-opslag bruger 1,5 credits. De fem viste matches brugte derfor 7,5 credits. Med samme pris bruger 1.000 vellykkede matches 1.500 credits. Ugyldige input og rækker uden resultat kan bruge nul credits, så kontrollér værdien creditsUsed i hvert resultat for at se det faktiske forbrug.
Adgang til REST API er en del af Growth-abonnementet, og månedsabonnementet er adskilt fra top-up credits. En top-up til 20 USD giver 20.000 credits, så én credit koster 0,001 USD. Ved 1,5 credits pr. vellykket match bruger 1.000 matches 1.500 credits til en værdi af 1,50 USD. Se Datablists priser for aktuelle abonnementer og pakker.
Løs typiske problemer med input, opgaver og resultater
DATABLIST_API_KEYmangler: Scriptet stopper, før det sender et request. Eksportér miljøvariablen, og kør kommandoen igen.- API'et afviser nøglen: Kontrollér, at du har kopieret en Personal API Key, og at requestet kun sender den i
X-API-Key. - Inputtet understøttes ikke: Brug et virksomhedswebsite eller domæne til
domain_to_linkedin. I den modsatte retning skal du bruge en understøttet URL til en virksomhedsside frem for en personlig profil eller en tom værdi. - Der er ikke nok credits: Kontrollér din saldo, og brug derefter inkluderede credits, eller køb en top-up, før du opretter en ny opgave.
- Opgaven har statussen
failedellerstopped: Undersøg opgavens status, fejl, eksisterende resultater og creditforbrug, før du beslutter, om den skal indsendes igen. - Et resultat har lav confidence,
no_resulteller en fejl: Bevar kildewebsitet og hele resultatet ineeds_review. Åbn den mulige side, hvis den findes, og gæt ikke på, hvorfor et resultat mangler.
Hvis forbindelsen afbrydes under oprettelsen af opgaven, skal du bruge det uniqueId, der blev udskrevet før POST-kaldet. Hent din opgaveliste, og søg efter værdien, før du opretter en ny opgave:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-to-linkedin" \
--data-urlencode "limit=100"Opgavelisten kan ikke filtreres efter uniqueId, så gennemgå hver returneret opgave, og følg om nødvendigt nextCursor. Når du har fundet den matchende værdi, bruger du dens @id med de samme status- og resultat-URL'er som i scriptet.
Én opgave kan indeholde op til 10.000 input. Du finder alle grænser for requests, opbevaring af opgaver og paginering i dokumentationen til Company to LinkedIn API.
Næste skridt
Du har nu én genanvendelig Python Requests-funktion, der omdanner virksomhedswebsites til mulige LinkedIn-virksomhedssider. Den lokale kø holder matches med høj confidence klar til research og sikrer, at usikre eller mislykkede poster fortsat er synlige til kontrol.
Erstat de fem eksempler med en mindre account-liste, kontrollér alle kandidater med lav confidence, og brug derefter de godkendte URL'er til manuel virksomhedsresearch eller som input til LinkedIn company scraper API. Hvis din kildeliste indeholder virksomhedsnavne i stedet for websites, kan du begynde med guiden til Company Website Finder API.