
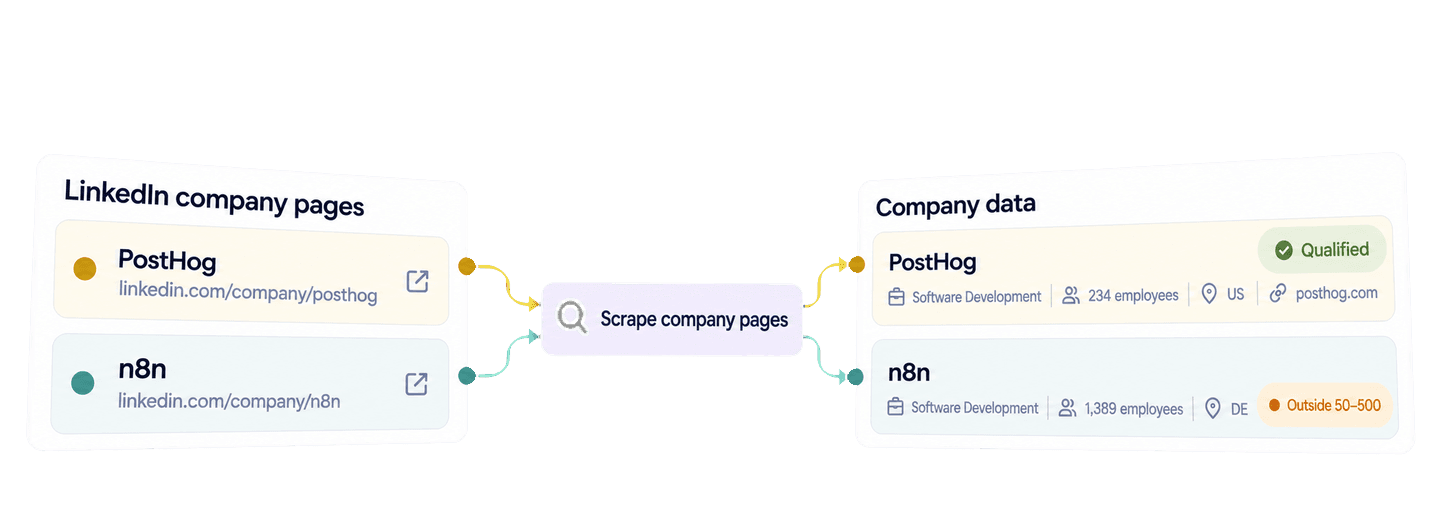
Du kan scrape virksomhedsdata fra LinkedIn i Python ved at sende en liste med URL'er til virksomhedssider til Datablists API via Requests-biblioteket. API'et returnerer strukturerede virksomhedsprofiler med felter som branche, antal medarbejdere, hovedkontor, website og beskrivelse, når oplysningerne findes på den offentlige virksomhedsside.
I denne guide bruger jeg én overskuelig Python-funktion til at hente virksomhedsprofiler for n8n, PostHog, Back Market og Datablist. Derefter genbruger jeg resultaterne til at kvalificere softwarevirksomheder med 50 til 500 medarbejdere og hovedkontor i USA eller Tyskland. Den kvalificerede virksomhedsprofil beholder både website og beskrivelse, så den kan bruges til mere dybdegående salgsresearch.
🔑 Kort fortalt til dig, der har travlt
Datablist omdanner kvalitetssikrede URL'er til LinkedIn-virksomhedssider til strukturerede virksomhedsprofiler, som du kan bruge i dit workflow til salgsresearch. Python-eksemplet nedenfor henter alle resultatsider og anvender derefter et lokalt account-filter uden et ekstra API-kald.
- Input: URL'er til LinkedIn-virksomhedssider.
- Output: Tilgængelige virksomhedsoplysninger og en lokal kvalificeringsbeslutning, hvor den oprindelige URL og alle virksomhedsdata bevares samlet.
💡 Foretrækker du en no-code-løsning? Brug Datablists LinkedIn Company Page Scraper til at udtrække virksomhedsdata fra kendte URL'er til LinkedIn-virksomhedssider uden at skrive kode.
Opsæt Python og din Datablist API-nøgle
I dette Python-eksempel bruger jeg pakken requests. Datablists REST API er tilgængeligt med Growth-abonnementet, og hvert opslag på en virksomhedsside bruger enrichment credits.
Opret en Personal API Key på din Datablist API-kontoside.
Opret filen scrape_linkedin_companies.py, klargør derefter et virtuelt miljø, og installer Requests:
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
export DATABLIST_API_KEY="your-api-key"Scriptet læser nøglen fra DATABLIST_API_KEY og sender den i headeren X-API-Key.
Scrape LinkedIn-virksomhedssider med én Python-funktion
Kildelisten nedenfor indeholder virksomheder fra forskellige brancher, i forskellige størrelser og med hovedkontorer i forskellige lande. Hvert account_id bliver til API'ets inputId. Resultaterne sammenkædes ikke ud fra deres placering i svaret. Derfor er dette stabile ID forbindelsen mellem hvert resultat og den korrekte kilde-URL.
Indsæt hele dette script i scrape_linkedin_companies.py:
import json
import os
import time
import uuid
import requests
accounts = [
{
"account_id": "account-n8n",
"linkedin_company_url": "https://www.linkedin.com/company/n8n/",
},
{
"account_id": "account-posthog",
"linkedin_company_url": "https://www.linkedin.com/company/posthog/",
},
{
"account_id": "account-back-market",
"linkedin_company_url": "https://www.linkedin.com/company/back-market/",
},
{
"account_id": "account-datablist",
"linkedin_company_url": "https://www.linkedin.com/company/datablist/",
},
]
def scrape_companies(accounts, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"companyLinkedInUrl": account["linkedin_company_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Request ID: {unique_id}")
payload = {
"enrichmentId": "linkedin-company-enrichment",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
company_results = scrape_companies(accounts, api_key)
print(json.dumps(company_results, indent=2, ensure_ascii=False))Kør det med:
python scrape_linkedin_companies.pyDet vigtigste, du skal ændre, er posterne i accounts. Sørg for, at hvert account_id er stabilt og unikt, og erstat derefter linkedin_company_url med en kvalitetssikret LinkedIn-virksomhedsside. Funktionen konverterer posterne til API'ets inputs-format og sender virksomheds-URL'en som companyLinkedInUrl. settings forbliver tom, fordi denne enrichment ikke har nogen offentlige indstillinger.
POST-kaldet opretter en enrichment-task, der kører i baggrunden. API'et svarer med 202 Accepted og et task-ID, mens Requests-klienten venter ved løbende at forespørge status-URL'en. Denne blokerende Python-kode er praktisk i et mindre script, men tasken kører stadig asynkront hos Datablist.
Det første GET-kald kontrollerer selve tasken. En task kan slutte med statussen completed, failed eller stopped. Scriptet fortsætter kun efter completed. Ellers udløser det en fejl, som indeholder task-ID'et og API'ets task-fejl. Gem ID'et under fejlsøgningen, da en task med statussen failed eller stopped stadig kan have resultater og credit-forbrug, der bør gennemgås.
Når tasken er fuldført, henter det sidste loop resultatsider med en grænse på 100. Det fortsætter med at hente sider, indtil nextCursor er null. Hvert resultat beholder det angivne inputId. Derfor kan det efterfølgende kvalificeringsloop sammenkæde resultaterne korrekt, selv når rækkefølgen i svaret afviger fra rækkefølgen i inputtet.
Læs virksomhedsresultatet og forstå hentemetoden
LinkedIn-URL'en identificerer virksomheden direkte. Datablist normaliserer organisationens URL og henter de tilgængelige offentlige data fra virksomhedssiden i stedet for at søge efter og rangere flere mulige virksomheder. Med en URL til en navngiven virksomhed tager processen udgangspunkt i den offentlige side og kan udfylde manglende felter via administrerede fallback-kilder, samtidig med at brugbare værdier, der allerede er fundet, bevares.
Denne forskel er vigtig, når du læser resultatet. Valgfrie felter afhænger af, hvilke oplysninger der er offentligt tilgængelige. En null-værdi for hovedkontorets adresse eller et manglende speciale betyder ikke, at hele virksomhedsopslaget mislykkedes.
Her er hele resultatsiden for de fire URL'er:
{
  "taskId": "69516a973dc34481920f41ade748e917",
  "results": [
    {
      "inputId": "account-n8n",
      "status": "success",
      "outputs": {
        "companyName": "n8n",
        "companyHQPostalCode": "10115",
        "companyDescription": "n8n is a workflow automation platform that uniquely combines AI capabilities with business process automation. The platform enables connection to any app or API while maintaining the flexibility of code with the speed of no-code.\n\nReleased under a fair-code license, n8n can be self-hosted and is supported by a vibrant community of developers and builders. Users can start simple and layer complexity as needed - utilizing the visual builder for quick wins, and adding custom Javascript or Python code where more control is required, enabling the connection of anything to everything.\n\nn8n is privately held, with funding from Sequoia, Felicis Ventures, Firstminute Capital, Harpoon Ventures, and others. Individual investors include Eventbrite's Kevin Hartz and Supercell's IIkka Paananen. n8n was founded in 2019 and is headquartered in Berlin.",
        "companyTagline": "Flexible AI workflow automation for technical teams.",
        "companyIndustry": "Software Development",
        "companySpecialities": "AI, SOAR, Workflow Automation, and AI agents",
        "companyWebsite": "https://n8n.io",
        "companyHQCity": "Berlin",
        "linkedInCompanyId": "28491094",
        "companyType": "Privately Held",
        "companyHQCountry": "DE",
        "companySize": 1389,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4D0BAQEgEphZqatXwA/company-logo_200_200/B4DaFY.Sa2JcAE-/0/1792494086070/n8n_logo?e=2147483647&v=beta&t=NTL4C6f5QAd_o9nXd15PO8pOMSSEoms_tJdDHEo6eLk",
        "companyHQAddress": "Novalisstraße 10",
        "companyFoundedYear": 2019,
        "companyFollowerCount": 442229
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-posthog",
      "status": "success",
      "outputs": {
        "companyName": "PostHog",
        "companyHQPostalCode": null,
        "companyDescription": "At PostHog, we're working to increase the number of successful products in the world.\n\nUntil now, tools for building products have been fragmented. Product analytics, heatmaps, session recording, web analytics, feature flags, and A/B testing are all helpful, but no one wants to buy, send data to, and integrate multiple products.\n\nPostHog offers these tools (and more) in an integrated, open source platform which can be hosted in either the US or EU. Both versions are SOC2 certified, GDPR-ready, and HIPAA compliant. \n\nWe started PostHog during Y Combinator's W20 cohort and had the most successful B2B software launch on Hacker News since 2012 - with a product that was just 4 weeks old.\n\nWith over 100,000 users, we're default alive, growing 97% through word of mouth, and we are in the top 0.01% most popular repos on GitHub.",
        "companyTagline": "Your product's context layer. Get started with npx @posthog/wizard",
        "companyIndustry": "Software Development",
        "companySpecialities": "analytics, open source, product analytics, product, data, engineering, self-driving product, session replay, context warehouse, AI, product context, and error tracking",
        "companyWebsite": "https://posthog.com/",
        "companyHQCity": "San Francisco",
        "linkedInCompanyId": "37415928",
        "companyType": "Privately Held",
        "companyHQCountry": "US",
        "companySize": 234,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D560BAQGQUyE_CXUxIw/company-logo_200_200/B56aCMWEgaJAAE-/0/1789060991251/posthog_logo?e=2147483647&v=beta&t=WfTGRSqp5UfYL33sBXx3tZ1zmFUECfUPf7JtEGPAvbA",
        "companyHQAddress": null,
        "companyFoundedYear": 2020,
        "companyFollowerCount": 59696
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-back-market",
      "status": "success",
      "outputs": {
        "companyName": "Back Market",
        "companyHQPostalCode": null,
        "companyDescription": "The world is waking up to what fast tech costs. Back Market is where the revolution shops. \nWe make refurbished tech the smart, confident choice by building trust in quality, repair and circularity. New is not always better. Smarter is.\n\nAs a certified B Corp, our mission is to create a world that does more with what we already have by prolonging the lifespan of electronic devices through circularity and repair. We have grown by double digits year over year and now serve 18 million customers across 17 markets, avoiding more than 2 million tons of CO2 emissions*\n*Back Market calculation based on ADEME 2022 methodology.\n\nFounded in Paris in 2014 by Thibaud Hug de Larauze, Quentin Le Brouster and Vianney Vaute, Back Market is a leading global marketplace where people can buy professionally refurbished technology or trade in their devices.\n\nAre you ready to join us?",
        "companyTagline": "Where the world shops refurbished tech.",
        "companyIndustry": "Internet Marketplace Platforms",
        "companySpecialities": "refurbished tech, marketplace, sustainability, circularity, Right to Repair, sustainable solutions, refurbished marketplace, circular economy, and sustainable alternatives",
        "companyWebsite": "http://www.backmarket.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "4793443",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 1054,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4E0BAQHRv6UClt5D2g/company-logo_200_200/B4EZnoUG3tKgAI-/0/1760539209613/back_market_logo?e=2147483647&v=beta&t=Pywpeu1Qs3h0Cl8kgvYurmBfXbImm5QIIc-aQog1MqM",
        "companyHQAddress": null,
        "companyFoundedYear": 2014,
        "companyFollowerCount": 101878
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-datablist",
      "status": "success",
      "outputs": {
        "companyName": "Datablist",
        "companyHQPostalCode": null,
        "companyDescription": "When people hear \"data,\" they think of something complicated. We will change this.\n\nDatablist is an AI-powered spreadsheet that helps you: get, manipulate, or clean data and create workflows that run automatically while you focus on what matters most.\n\nIf you want to separate Datablist.com into its main parts, you can say we have:\n\n- Deduplicating, grouping, and labeling data\n- Cleaning and editing data\n- Managing data and automated workflows\n- 50+ B2B data sources and scrapers\n- 3 AI agents:\n    - Editing assistant\n    - AI Research agent\n    - Deduplication assistant\n\nThe top 3 reasons why companies choose Datablist.com are:\n\n1. Simplicity: you don't need to have technical knowledge or experience with formulas to get everything out of it.\n2. Flexibility that allows you to do (almost) everything with your data and AI while keeping everything under your control.\n3. Scalability that no other solution can match. Up to 2 million rows—forget Excel.\n\nGo on try it for free!\n\nhttps://www.Datablist.com",
        "companyTagline": "Let your tasks become workflows: automated workflows.",
        "companyIndustry": "Information Technology & Services",
        "companyWebsite": "https://www.datablist.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "69842428",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 3,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/C4E0BAQFNFlMb8KEPRQ/company-logo_200_200/company-logo_200_200/0/1630622803412?e=2147483647&v=beta&t=UVkk7BOerChiWgS9Y06zOpT08SlK4kpAWGDYiVvUEVU",
        "companyFollowerCount": 134,
        "companyFoundedYear": 2020,
        "companyHQAddress": null
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
Alle fire poster blev hentet korrekt og brugte hver 25 credits. PostHog returnerede Software Development, 234 medarbejdere, hovedkontor i USA, website og beskrivelse. n8n er også en softwarevirksomhed i et af de valgte lande, men det returnerede medarbejderantal er 1.389. Back Market returnerede Internet Marketplace Platforms, 1.054 medarbejdere og hovedkontor i Frankrig. Datablist returnerede Information Technology & Services, 3 medarbejdere og hovedkontor i Frankrig.
Det komplette objekt er nyttigt, fordi account research sjældent stopper ved ét felt. Du kan kvalificere virksomheder ud fra branche, medarbejderantal og land og samtidig beholde det returnerede website og beskrivelsen til næste researchtrin.
I dette svar er companySize det returnerede medarbejderantal og ikke et LinkedIn-interval for virksomhedsstørrelse. companyHQCountry angiver hovedkontorets placering og ikke alle de lande, hvor virksomheden opererer. De forskelle er vigtige, når du tilpasser filtre for størrelse og land til din ideelle kundeprofil.
Alle valgfrie felter behøver ikke at være udfyldt for at kvalificere en virksomhed. En manglende adresse eller et manglende speciale kan forblive tomt, når branche, medarbejderantal og hovedkontorets land er tilgængelige. Behold companyWebsite, præcis som det returneres, i stedet for at gå ud fra, at API'et konverterer URL'en til et rent domæne. Beskrivelsen kan hjælpe en salgsmedarbejder med at forstå virksomhedens produkt og forberede virksomhedsspecifik research før outreach. status, creditsUsed og error på resultatniveau bør opbevares sammen med virksomhedsfelterne, når du gennemgår eller gemmer posten.
Kvalificer accounts til salgsresearch
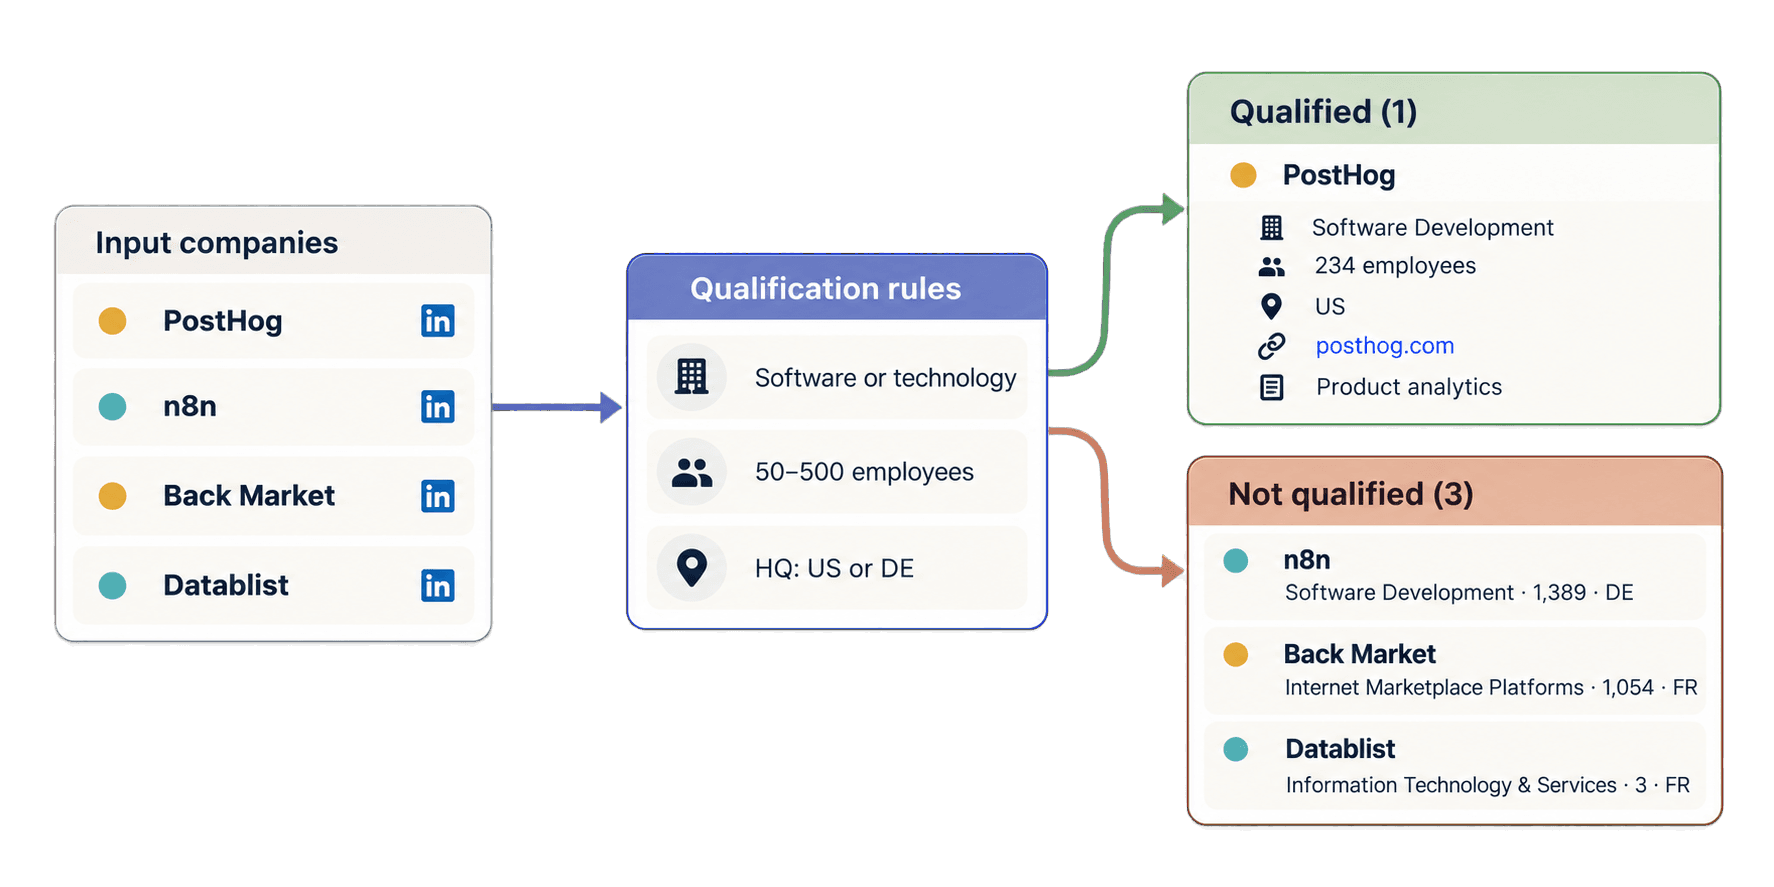
Antag, at din målgruppe er software- eller teknologivirksomheder med 50 til 500 medarbejdere og hovedkontor i USA eller Tyskland. Tilføj dette loop under hele scriptet. Det genbruger company_results og opretter derfor ikke en ny task:
accounts_by_id = {account["account_id"]: account for account in accounts}
qualified_accounts = []
other_accounts = []
for result in company_results:
account = accounts_by_id.get(result["inputId"])
qualification = "needs_review"
if result["status"] == "success":
outputs = result["outputs"]
industry = outputs.get("companyIndustry")
company_size = outputs.get("companySize")
country = outputs.get("companyHQCountry")
if industry and isinstance(company_size, (int, float)) and country:
industry_matches = any(
keyword in industry.lower()
for keyword in ("software", "technology")
)
size_matches = 50 <= company_size <= 500
country_matches = country in {"US", "DE"}
if industry_matches and size_matches and country_matches:
qualification = "qualified"
else:
qualification = "not_qualified"
source_url = None
if account is not None:
source_url = account["linkedin_company_url"]
reviewed_account = dict(result)
reviewed_account["sourceLinkedInUrl"] = source_url
reviewed_account["qualification"] = qualification
if qualification == "qualified":
qualified_accounts.append(reviewed_account)
else:
other_accounts.append(reviewed_account)
print(json.dumps(qualified_accounts, indent=2, ensure_ascii=False))PostHog kobles tilbage til account-posthog, selv hvis API'et returnerer posterne i en anden rækkefølge. Virksomheden kvalificeres, fordi Software Development, 234 medarbejdere og US opfylder alle tre kriterier. Loopet kopierer det oprindelige resultat med hele objektet outputs, det returnerede website https://posthog.com/, beskrivelsen, creditsUsed og error. Det tilføjer kun kilde-URL'en og den lokale kvalificeringsetiket.
n8n kobles til account-n8n og kvalificeres ikke, fordi 1.389 medarbejdere overstiger den øvre grænse. Back Market opfylder hverken kriterierne for branche, størrelse eller land, mens Datablist ligger under størrelsesintervallet og uden for de valgte lande. Fremtidige poster med fejl eller ufuldstændige data får værdien needs_review i stedet for at blive fjernet uden videre.
Du kan downloade det vedligeholdte synkrone Requests-eksempel eller bruge repositoriets asynkrone HTTPX-alternativ, når din applikation kræver ikke-blokerende kode.
Beregn credits til scraping af LinkedIn-virksomheder
En almindelig navngiven LinkedIn-virksomhedsside bruger 25 credits. En virksomheds-URL med et numerisk ID kan bruge 75 credits, når den sidste fallback er nødvendig, men 75 credits er ikke prisen for alle numeriske URL'er. Mislykkede opslag eller opslag uden match kan også bruge credits. Brug derfor taskens samlede forbrug og værdien creditsUsed for hvert resultat som dokumentation for det faktiske forbrug.
De fire navngivne URL'er i denne guide brugte i alt 100 credits. Med standardprisen bruger 1.000 virksomhedssider 25.000 credits. Input med mange numeriske ID'er kræver ekstra råderum til den mulige løsning med 75 credits.
Adgang til REST API'et kræver Growth-abonnementet. Månedsabonnementet omfatter 20.000 credits, mens ekstra credits købes separat. Med den aktuelle grundpris i USD på 20 $ for 20.000 ekstra credits koster én credit 0,001 $. Ved den pris har 25.000 credits en værdi på 25 $. Se Datablists priser for de aktuelle abonnementer og credit-pakker.
Løs typiske problemer med input, tasks og resultater
DATABLIST_API_KEYmangler: Scriptet stopper, før det sender en request. Eksportér variablen, og kør filen igen.- API'et afviser nøglen: Kontrollér din Personal API Key, og behold den i headeren
X-API-Key, som eksemplet bruger. - Kilde-URL'en er ugyldig: Erstat en personlig profil, en uvedkommende side, en tom værdi eller en forkert formateret URL med en understøttet offentlig LinkedIn-URL til en virksomhed, skole, showcase-side, et numerisk ID eller en Sales Navigator-virksomhed.
- Der er ikke nok credits: Kontrollér din saldo, og brug derefter inkluderede credits eller køb ekstra credits, før du opretter endnu en task.
- Tasken har statussen
failedellerstopped: Gennemgå fejlen, eksisterende resultater og credit-forbruget, før du beslutter, om du vil oprette endnu en betalt task. - Et resultat er mangelfuldt eller har statussen
no_resultellererror: Gem kilde-URL, status, credits og fejl til gennemgang. Bekræft, at inputtet er en offentlig virksomhedsside, før du sender det igen, uden at gætte på, hvorfor dataene ikke var tilgængelige.
Hvis svaret fra oprettelsen går tabt, kan du bruge det request-ID, som scriptet udskrev før POST-kaldet. Hent først listen over tasks, og find den tilsvarende værdi i uniqueId:
curl "https://api.datablist.com/v1/enrichments/tasks?limit=100" \
-H "X-API-Key: $DATABLIST_API_KEY"Værdien @id for den matchende task er task-ID'et. Brug det til fortsat at kontrollere /v1/enrichments/tasks/{taskId} eller hente /v1/enrichments/tasks/{taskId}/results i stedet for automatisk at oprette endnu en task. En enkelt request kan indeholde op til 10.000 inputs og 10 MiB. Se task-dokumentationen for oplysninger om opbevaringsperioder og andre detaljer om livscyklussen.
Næste skridt
Du har nu én genanvendelig Python Requests-funktion, som omdanner en liste med URL'er til LinkedIn-virksomhedssider til strukturerede virksomhedsprofiler. Du har også et lokalt kvalificeringsloop, der bevarer hele API-outputtet til salgsresearch.
Erstat de fire eksempler med en mindre, kvalitetssikret liste over accounts, behold stabile ID'er, og tilpas reglerne for branche, medarbejderantal og land til din ideelle kundeprofil. Hvis dit udgangspunkt er personer frem for virksomheder, kan du bruge guiden til LinkedIn profile scraper API. Hvis du kun har virksomhedsnavne, kan du begynde med at finde virksomhedswebsites i Python.