
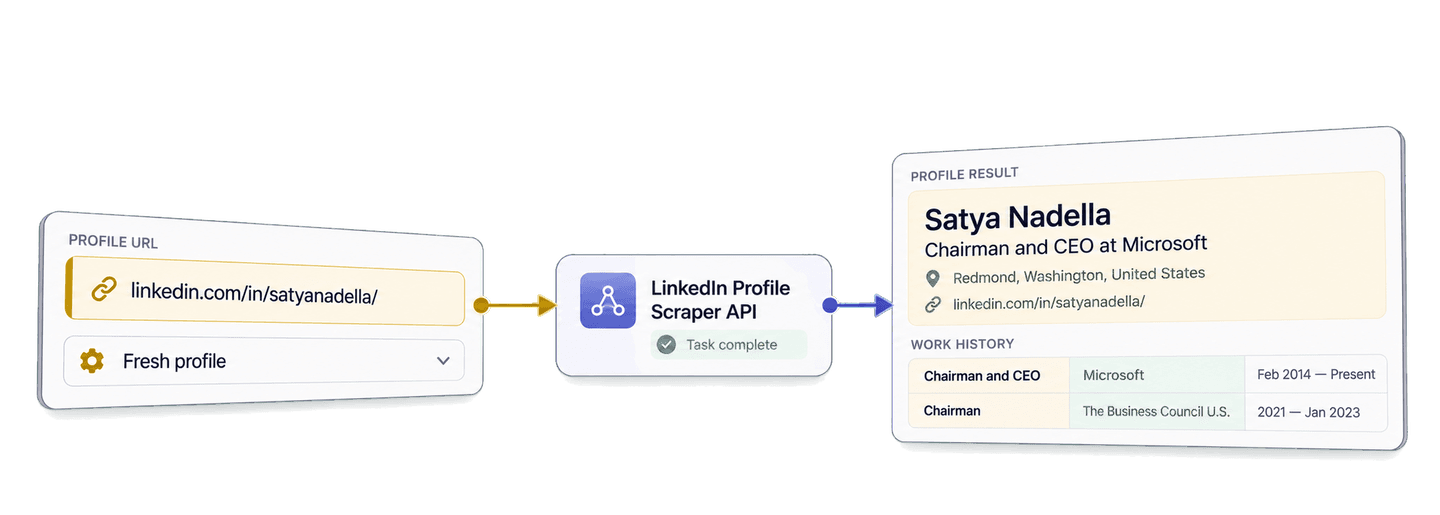
Du kan scrape LinkedIn-profiler i Python ved at sende kendte offentlige profil-URL'er til Datablists LinkedIn Profile Scraper API med Requests-biblioteket. API'et returnerer strukturerede felter med identitet, lokation, arbejdshistorik, uddannelse og virksomhedsoplysninger, som du kan bruge til at opbygge leadlister og personalisere outreach med relevant kontekst om rolle og virksomhed.
Denne guide bruger URL'en til Satya Nadellas offentlige profil som et kort eksempel. Du gennemfører en komplet scraping-opgave, fortolker den returnerede Microsoft-rolle og de daterede jobposter og gemmer derefter resultatet sammen med dit oprindelige lead, inden du forbereder din outreach.
🔑 Kort fortalt: Send kendte URL'er til personprofiler på LinkedIn til Datablist, og hent tilgængelige profiloplysninger, lokation, arbejdshistorik, uddannelse og virksomhedsdata som struktureret JSON. Python-eksemplet nedenfor gemmer oplysningerne sammen med hvert oprindeligt lead, så du kan kvalificere listen og forberede mere relevant outreach.
- Input: Kendte URL'er til personprofiler på LinkedIn.
- Output: Strukturerede profiloplysninger gemt sammen med hver oprindelig kontakt.
💡 Foretrækker du en no-code-løsning? Brug Datablists LinkedIn Profile Scraper til at hente oplysninger fra kendte profil-URL'er uden at skrive kode.
Opsæt Datablist API og dit Python-miljø
Adgang til Datablist REST API er inkluderet i Growth-abonnementet. Hentning af profiler bruger også enrichment credits, som jeg gennemgår i afsnittet om omkostninger.
Opret en Personal API Key på din Datablist API-kontoside. Dette eksempel viser formatet for en Personal API Key:
exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2🔑 Har du allerede en API key? Ældre nøgler bruger
auth0|<userId>:<accountId>:<secret>:1. De understøttes stadig. Fortsæt med at bruge din eksisterende nøgle præcis, som den blev genereret. Du behøver ikke at udskifte den eller ændre formatet.
Scriptet læser din nøgle fra miljøvariablen DATABLIST_API_KEY og sender den i headeren X-API-Key.
I dette Python-eksempel bruger jeg pakken requests. Opsætningskommandoerne nedenfor er beregnet til en macOS- eller Linux-shell. Opret en projektmappe, åbn den i din terminal, og kør:
python -m venv .venv
source .venv/bin/activate
python -m pip install requestsOpret derefter en fil med navnet scrape_linkedin_profiles.py, og eksportér din nøgle:
export DATABLIST_API_KEY="your-personal-api-key"Scrape en komplet LinkedIn-profil i Python
Kildeposten i denne gennemgang indeholder et stabilt kontakt-ID og én kendt profil-URL:
{
  "contact_id": "contact-satya-nadella",
  "profile_url": "https://www.linkedin.com/in/satyanadella/"
}
Scriptet sender contact_id som API'ets inputId. Resultaterne kommer ikke nødvendigvis i samme rækkefølge som inputtene, så dette ID giver dig en pålidelig måde at matche hvert resultat med den oprindelige kontakt på.
Indsæt følgende komplette script i scrape_linkedin_profiles.py:
import json
import os
import time
import uuid
import requests
def scrape_profiles(source_contacts, api_key):
"""Submit one task, wait for completion, and return every result page."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": contact["contact_id"],
"data": {"profileUrl": contact["profile_url"]},
}
for contact in source_contacts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "linkedin-profile-scraper",
"uniqueId": unique_id,
"settings": {
"experiencesNb": "5",
"educationsNb": "3",
"acceptCachedProfiles": False,
"includeUrn": False,
"includePictures": False,
},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
source_contacts = [
{
"contact_id": "contact-satya-nadella",
"profile_url": "https://www.linkedin.com/in/satyanadella/",
}
]
profile_results = scrape_profiles(source_contacts, api_key)
print(json.dumps(profile_results, indent=2))Kør det med:
python scrape_linkedin_profiles.pyIndstillingerne anmoder om fem jobposter og tre uddannelsesposter. API'et forventer disse antal som strings. acceptCachedProfiles: false anmoder om en ny hentning, mens indstillingerne for billeder og interne ID'er er slået fra, fordi dette workflow bruger holdbare tekst- og URL-felter.
Brug en almindelig offentlig /in/-profil-URL eller en Sales Navigator-lead-URL til hvert input. En persons navn, en LinkedIn-søgeside og en virksomhedsside identificerer andre typer opgaver og er ikke gyldige profilinput til denne scraper. Hvis din kilde indeholder Sales Navigator-links, kan den returnerede profileUrl være den normaliserede offentlige profil-URL. Ved større lister skal hvert inputId være unikt og stabilt i stedet for at blive afledt af rækkens placering.
Antallet af historikposter styrer, hvor mange flade, nummererede felter med job- og uddannelsesdata API'et kan returnere. Det ændrer ikke prisen i credits pr. profil. Anmod om nok historik til din research, men undgå at vælge ti jobposter, hvis du kun vil gennemgå de seneste roller.
Hvad de tre API-kald gør
POST-kaldet sender de valgte indstillinger og profilinput. Datablist accepterer arbejdet som en baggrundsopgave og returnerer dens @id. Scriptet udskriver både det genererede uniqueId og det returnerede opgave-ID, så du har de værdier, der skal bruges til at undersøge opgaven senere.
Det første GET-kald kontrollerer opgavens status hvert tredje sekund. Python-klienten blokerer, mens den venter, men API-opgaven fortsætter i baggrunden. Løkken stopper ved completed, failed eller stopped.
Det andet GET-kald henter resultater i sider med op til 100 poster. Når nextCursor indeholder en værdi, henter scriptet næste side. Det stopper, når nextCursor er null.
Læs profilresultatet, og vælg de rette indstillinger
Den indsendte URL afgør, hvilken profil scraperen henter. Datablist accepterer offentlige URL'er til personprofiler og Sales Navigator-lead-URL'er, normaliserer profil-URL'en efter behov og overfører de tilgængelige offentlige data til flade felter for profil, arbejde, uddannelse og virksomhed.
Den nye hentning i denne guide blev gennemført og brugte 25 credits. Her er det komplette resultat:
{
  "inputId": "contact-satya-nadella",
  "status": "success",
  "outputs": {
    "profileUrl": "https://www.linkedin.com/in/satyanadella/",
    "fullName": "Satya Nadella",
    "firstName": "Satya",
    "lastName": "Nadella",
    "linkedInHeadline": "Chairman and CEO at Microsoft",
    "linkedInSummary": "As chairman and CEO of Microsoft, I define my mission and that of my company as empowering every person and every organization on the planet to achieve more.",
    "linkedInProfilePicture": "https://media.licdn.com/dms/image/v2/C5603AQHHUuOSlRVA1w/profile-displayphoto-shrink_800_800/profile-displayphoto-shrink_800_800/0/1579726625483?e=1794441600&v=beta&t=I1sL---bTuvjxqb1vdbNsNy-fAsLCpBj3-WtJjOGbOc",
    "linkedInInternalIdentifier": "ACoAAAEkwwAB9KEc2TrQgOLEQ-vzRyZeCDyc6DQ",
    "linkedInLocation": "Redmond, Washington, United States",
    "linkedInCity": "Redmond",
    "linkedInState": "Washington",
    "linkedInCountryName": "United States",
    "linkedInCountryCode": "US",
    "linkedInLanguages": "",
    "linkedInConnections": 832,
    "linkedInlastExpTitle": "Chairman and CEO",
    "linkedInlastExpCompany": "Microsoft",
    "linkedInlastExpEmploymentType": null,
    "linkedInlastExpLocation": "Greater Seattle Area",
    "linkedInlastExpStartsAt": "2014-02-01",
    "linkedInlastExpEndsAt": null,
    "linkedInlastExpDescription": null,
    "linkedInlastExpCompanyWebsite": "https://news.microsoft.com/",
    "linkedInlastExpCompanyPage": "https://www.linkedin.com/company/microsoft/",
    "linkedInlastExpCompanyIndustry": "Software Development",
    "linkedInlastExpCompanyRange": "10001+",
    "linkedInlastExpCompanyDescription": "Every company has a mission. What's ours? To empower every person and every organization to achieve more. We believe technology can and should be a force for good and that meaningful innovation contributes to a brighter world in the future and today. Our culture doesn’t just encourage curiosity; it embraces it. Each day we make progress together by showing up as our authentic selves. We show up with a learn-it-all mentality. We show up cheering on others, knowing their success doesn't diminish our own. We show up every day open to learning our own biases, changing our behavior, and inviting in differences. Because impact matters. \n\nMicrosoft operates in 190 countries and is made up of approximately 228,000 passionate employees worldwide.",
    "linkedInlastExpCompanyLogo": "https://media.licdn.com/dms/image/v2/D560BAQH32RJQCl3dDQ/company-logo_200_200/B56ZYQ0mrGGoAM-/0/1744038948046/microsoft_logo?e=1793836800&v=beta&t=4wXD40LQU4IfLY4DiEvT2bwvjUoPQPGgi5_T-vPsbQ8",
    "linkedIn2ExpTitle": "Chairman",
    "linkedIn2ExpCompanyName": "The Business Council U.S.",
    "linkedIn2ExpEmploymentType": null,
    "linkedIn2ExpStartsAt": "2021-01-01",
    "linkedIn2ExpEndsAt": "2023-01-01",
    "linkedIn2ExpDescription": null,
    "linkedIn2ExpLogo": "https://media.licdn.com/dms/image/v2/C4D0BAQGcnaZNpjMvrw/company-logo_200_200/company-logo_200_200/0/1630557702704/the_business_council_us_logo?e=1793836800&v=beta&t=Ejb0D8lV5sMTFwcz_-FKdfQvIvq-mKx_Nl8vRMib53k",
    "linkedIn3ExpTitle": "Member Board Of Trustees",
    "linkedIn3ExpCompanyName": "University of Chicago",
    "linkedIn3ExpEmploymentType": null,
    "linkedIn3ExpStartsAt": "2018-01-01",
    "linkedIn3ExpEndsAt": null,
    "linkedIn3ExpDescription": null,
    "linkedIn3ExpLogo": "https://media.licdn.com/dms/image/v2/D4E0BAQGDP-PXY3u8dw/company-logo_200_200/B4EaENqZTQGoAM-/0/1791230580227/uchicago_logo?e=1793836800&v=beta&t=NJGoETr0tY868Z2pvlyXeh939iXwW0WbSFwRctabEVU",
    "linkedIn4ExpTitle": "Board Member",
    "linkedIn4ExpCompanyName": "Starbucks",
    "linkedIn4ExpEmploymentType": null,
    "linkedIn4ExpStartsAt": "2017-01-01",
    "linkedIn4ExpEndsAt": "2024-01-01",
    "linkedIn4ExpDescription": null,
    "linkedIn4ExpLogo": "https://media.licdn.com/dms/image/v2/C4D0BAQEQxk9y2rk7Hw/company-logo_200_200/company-logo_200_200/0/1631316692275?e=1793836800&v=beta&t=NVjljhe0oI5KzvJHodAJjss5EdvxaOIzQQ2rAGyh_AQ",
    "linkedIn5ExpTitle": "Board Member",
    "linkedIn5ExpCompanyName": "Fred Hutch",
    "linkedIn5ExpEmploymentType": null,
    "linkedIn5ExpStartsAt": "2016-01-01",
    "linkedIn5ExpEndsAt": "2022-01-01",
    "linkedIn5ExpDescription": null,
    "linkedIn5ExpLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQGF4eOou62nvQ/company-logo_200_200/company-logo_200_200/0/1664795263764/fredhutch_logo?e=1793836800&v=beta&t=dJWSO-KkuBPd6I6aRYBoIcQVzcSEmGLwqYy-VMFXJQc",
    "linkedInlastEduSchool": "The University of Chicago Booth School of Business",
    "linkedInlastEduDegree": null,
    "linkedInlastEduField": null,
    "linkedInlastEduStartsAt": "1994-01-01",
    "linkedInlastEduEndsAt": "1996-01-01",
    "linkedInlastEduPage": "https://www.linkedin.com/school/universityofchicagoboothschoolofbusiness/",
    "linkedInlastEduLogo": "https://media.licdn.com/dms/image/v2/D560BAQFZO05jhYKSkw/company-logo_200_200/company-logo_200_200/0/1692627816910/universityofchicagoboothschoolofbusiness_logo?e=2147483647&v=beta&t=BTjFA4UVU5iKIIyicg8d44rhoiuMbetNDB97BmqpwhQ",
    "linkedIn2EduSchool": "Manipal Institute of Technology",
    "linkedIn2EduDegree": "Bachelor’s Degree",
    "linkedIn2EduField": "Electrical Engineering",
    "linkedIn2EduStartsAt": null,
    "linkedIn2EduEndsAt": null,
    "linkedIn2EduPage": "https://www.linkedin.com/school/manipal-institute-of-technology/",
    "linkedIn2EduLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQHodG_7cUqs6w/company-logo_200_200/B4DZ8hC8AUJQAE-/0/1782965846314/manipal_institute_of_technology_logo?e=2147483647&v=beta&t=jqJK15_r7lxUNgWdbbzdMq47aLa_PqnkDYxg4Jun4Zo",
    "linkedIn3EduSchool": "University of Wisconsin-Milwaukee",
    "linkedIn3EduDegree": "Master’s Degree",
    "linkedIn3EduField": "Computer Science",
    "linkedIn3EduStartsAt": null,
    "linkedIn3EduEndsAt": null,
    "linkedIn3EduPage": "https://www.linkedin.com/school/uwmilwaukee/",
    "linkedIn3EduLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQE47QlO_LG8SQ/company-logo_200_200/company-logo_200_200/0/1729615751602/uwmilwaukee_logo?e=2147483647&v=beta&t=l-w3ttd1mZRc-_j5aCPXEzNiYJzl1iJjMGw7q8B3eRI"
  },
  "creditsUsed": "25",
  "error": null
}
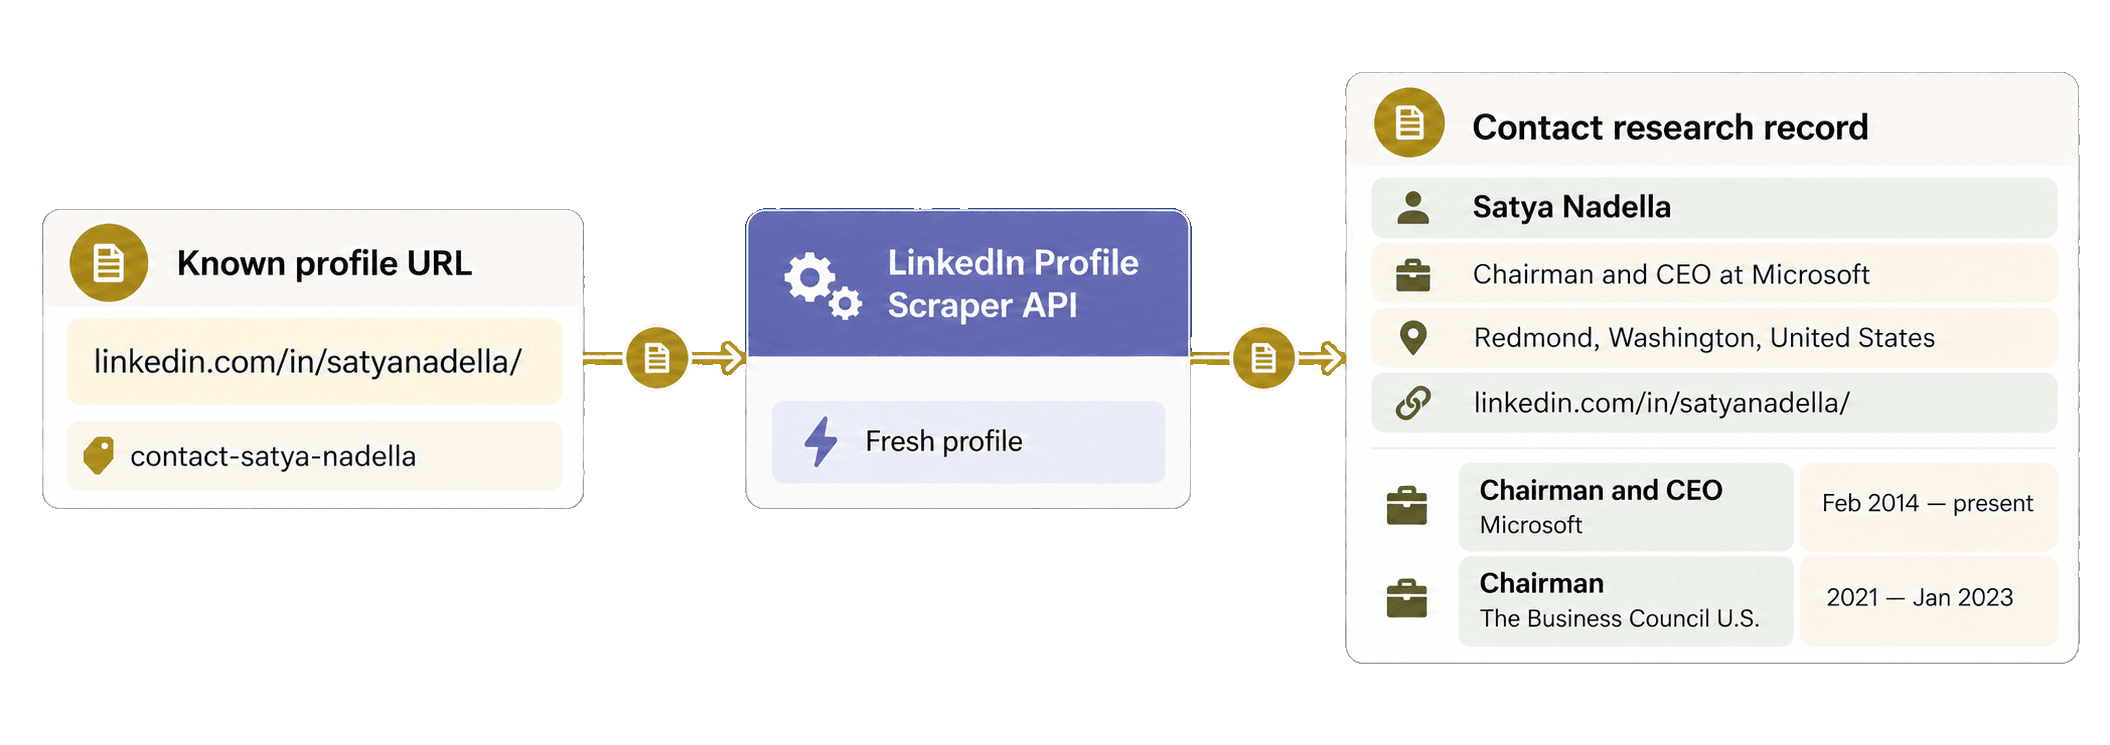
Læs titel, arbejdsgiver, startdato og slutdato samlet. Microsoft-posten starter i februar 2014 og har ingen slutdato. Posten hos The Business Council U.S. løber fra 2021 til januar 2023. Datoerne viser forskellen mellem en igangværende og en afsluttet post og illustrerer samtidig, hvordan roller kan overlappe.
linkedInlastExpTitle og linkedInlastExpCompany indeholder den aktuelle eller senest registrerede erfaring. Den første registrerede post kan indeholde mere detaljerede virksomhedsoplysninger såsom virksomhedsside, website, branche, beskrivelse og antal medarbejdere. De nummererede poster tilføjer tidligere titler, arbejdsgivere og datoer. I dette svar er det returnerede Microsoft-website https://news.microsoft.com/. URL'en giver leadposten en nyttig virksomhedskilde sammen med personens rollehistorik.
Felterne linkedInlastEduSchool, linkedIn2EduSchool og linkedIn3EduSchool angiver The University of Chicago Booth School of Business, Manipal Institute of Technology og University of Wisconsin-Milwaukee. Manipal-posten indeholder en bachelorgrad i Electrical Engineering, mens Wisconsin-Milwaukee-posten indeholder en kandidatgrad i Computer Science. Værdierne for grad og fagområde ved Chicago er tomme.
Brug værdierne "3", "5" eller "10" for experiencesNb og "1", "3" eller "5" for educationsNb til at vælge, hvor meget historik du har brug for. Læs felterne direkte fra outputs, når de er relevante for din research. En tom valgfri værdi betyder ikke, at hele resultatet er mislykket.
Fresh mode er velegnet til klargøring af leadlister, når du ønsker en ny hentning af profilens tilgængelige offentlige data. Cached mode kan returnere en tilgængelig gemt profil for færre credits og skifte til en ny hentning, hvis der ikke findes en cachet profil. Vælg ud fra dit behov for aktualitet og dit creditbudget.
Klargør leaddata til outreach
Når profile_results er tilgængelig, kan du knytte hvert svar til den oprindelige kontakt uden at indsende en ny opgave. Følgende blok genbruger de variabler, der blev oprettet af det komplette script:
results_by_input_id = {
result["inputId"]: result
for result in profile_results
}
contact_research = []
for contact in source_contacts:
result = results_by_input_id[contact["contact_id"]]
contact_research.append(
{
"contact_id": contact["contact_id"],
"source_profile_url": contact["profile_url"],
"result_status": result["status"],
"profile": result.get("outputs", {}),
"credits_used": result["creditsUsed"],
"error": result.get("error"),
}
)
research_record = contact_research[0]
profile = research_record["profile"]
print("Contact:", profile.get("fullName"))
print("Headline:", profile.get("linkedInHeadline"))
print("Location:", profile.get("linkedInLocation"))
print(
"First work entry:",
profile.get("linkedInlastExpTitle"),
"at",
profile.get("linkedInlastExpCompany"),
)Ordbogen med inputId som nøgle håndterer svar, der kommer i en anden rækkefølge. contact-satya-nadella forbliver både kilde-ID og API-ID, den kendte LinkedIn-URL forbliver source_profile_url, og profile bevarer det oprindelige outputs-objekt uændret.
Denne wrapper samler hele den returnerede profil med kilde-URL'en, API-status og creditforbruget. Du kan bruge den udskrevne headline, lokation og første jobpost til at kvalificere leadet og tilføje relevant kontekst om rolle eller virksomhed til din outreach. Mislykkede API-rækker beholder deres returnerede status og fejl, så de fortsat er synlige på leadlisten.
Du kan downloade det vedligeholdte blokkerende Requests-eksempel eller bruge det asynkrone HTTPX-alternativ, når du har styr på det blokkerende flow.
Beregn prisen på scraping af LinkedIn-profiler
En ny hentning bruger 25 credits pr. profil. Når cachede profiler er aktiveret, bruger et tilgængeligt cachet resultat 20 credits, mens et cache miss stadig kan føre til en ny hentning til 25 credits. Det nye opslag af Satya Nadella brugte 25 credits.
For 1.000 profiler bruger hentningen derfor 20.000 credits, hvis alle de ønskede cachede profiler er tilgængelige, eller op til 25.000 credits ved nye hentninger. Adgang til Datablist REST API kræver Growth-abonnementet. Abonnementet, de inkluderede credits og eventuelle ekstra creditpakker er separate dele af prisen. Se de aktuelle priser på prissiden.
Med den nuværende basispris i USD på $20 for 20.000 ekstra credits som planlægningseksempel svarer de brugte credits til cirka $20 for en kørsel med 1.000 profiler, der alle findes i cachen, eller $25 for en kørsel med nye hentninger. Estimaterne er eksklusive prisen på Growth-abonnementet.
Løs typiske fejl, og gendan en opgave
DATABLIST_API_KEYmangler: Scriptet stopper, før det sender en request. Eksportér variablen, og kør derefter filen igen.- API'et afviser nøglen: Kontrollér din Personal API Key, og send kun den
X-API-Key-credential, der bruges i dette eksempel. - Profil-URL'en mangler eller har et forkert format: Brug en offentlig URL til en LinkedIn-personprofil eller en understøttet Sales Navigator-lead-URL. En persons navn, en søgeside eller en virksomhedsside er ikke et gyldigt profilinput.
- Der er ikke nok credits: Kontrollér din saldo, og brug derefter inkluderede credits, eller køb ekstra credits, før du opretter en ny opgave.
- Opgaven er
failedellerstopped: Undersøg fejlen, de tilgængelige resultater og creditforbruget, før du beslutter, om en ny betalt indsendelse er nødvendig. - Et resultat er mangelfuldt,
no_resultellererror: Undersøg status og den offentlige fejlmeddelelse, og kontrollér derefter URL'en og indstillingerne. De tilgængelige felter kan variere afhængigt af profilen, dens synlighed og hentningen.
Hvis forbindelsen afbrydes under POST-kaldet, skal du bruge det uniqueId, der blev udskrevet før indsendelsen. Hent en liste over de seneste scraper-opgaver, og sammenlign deres værdier, før du opretter en ny opgave:
response = requests.get(
"https://api.datablist.com/v1/enrichments/tasks",
headers={"X-API-Key": api_key},
params={"enrichmentId": "linkedin-profile-scraper", "limit": 100},
)
response.raise_for_status()
printed_unique_id = "paste-the-printed-unique-id"
tasks = response.json()["tasks"]
matching_task = None
for task in tasks:
if task["uniqueId"] == printed_unique_id:
matching_task = task
break
if matching_task:
print("Task ID:", matching_task["@id"])Opgavelisten kan filtreres efter enrichmentId, men ikke efter uniqueId. Følg dens nextCursor, hvis opgaven ikke findes på den første side. Når du har opgave-ID'et, kan du fortsætte med de samme URL'er til status og resultater, som hovedfunktionen bruger. Dokumentationen til task-API'et forklarer livscyklus, paginering og afbrydelsesadfærd mere detaljeret.
Næste skridt
Du har nu en genanvendelig Python Requests-funktion, der omdanner kendte LinkedIn-profil-URL'er til strukturerede resultater, samt leadposter, der er matchet via stabile ID'er. Erstat eksemplet med et mindre, gennemgået sæt URL'er, vælg en ny eller cachet hentning ud fra dit behov for aktualitet og creditforbrug, og brug den returnerede kontekst om rolle og virksomhed til at kvalificere leads eller personalisere outreach.
Hvis dine input er URL'er til virksomhedssider, skal du i stedet følge Python-guiden til scraping af LinkedIn-virksomhedsdata.
Hvis du stadig skal finde profil-URL'er ud fra navne og et virksomheds- eller skolekeyword, skal du først følge den separate guide til at finde LinkedIn-profiler i Python med et API, før du kører denne scraper.