
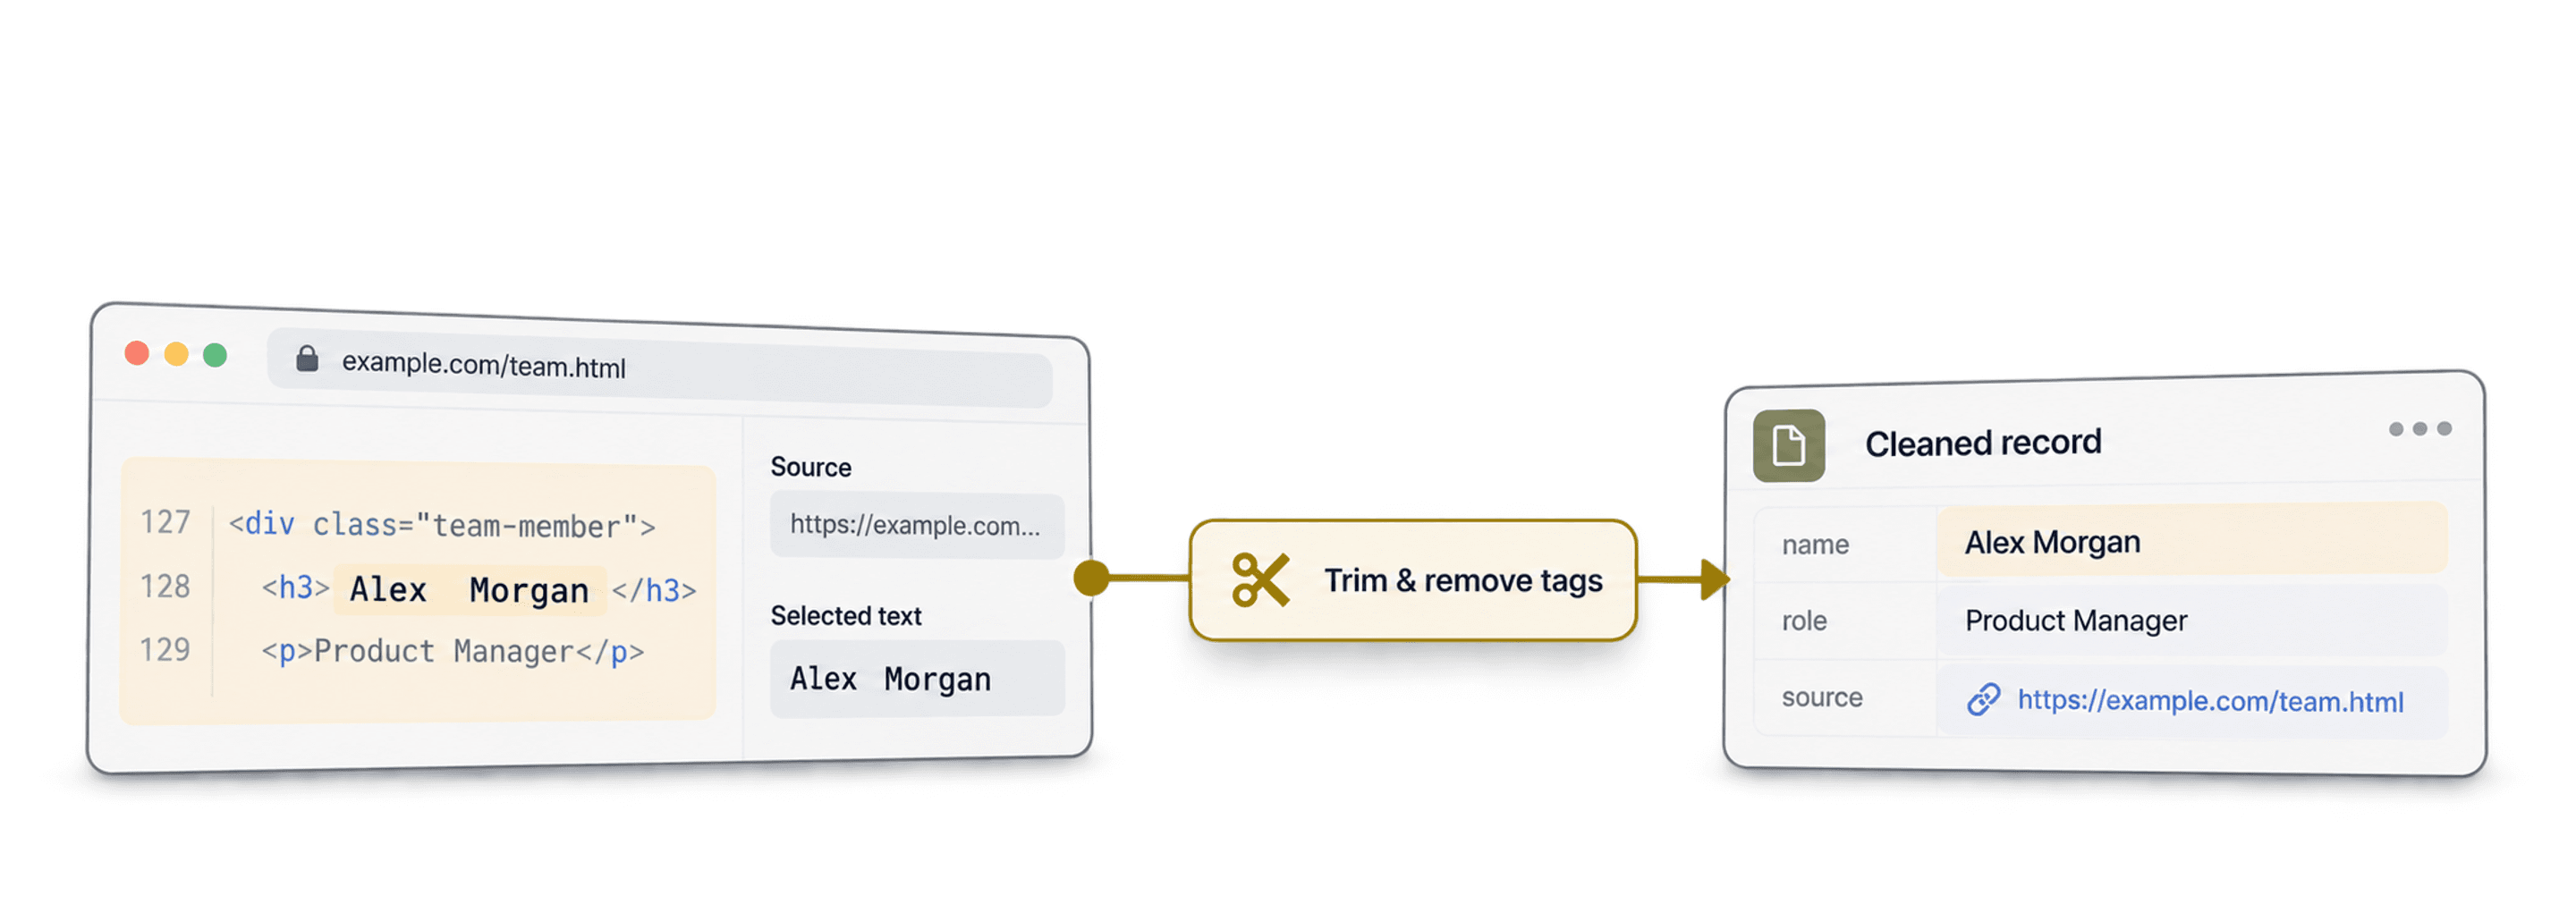
Pour nettoyer des données de web scraping, commencez par conserver les valeurs brutes, normalisez les champs que vous utiliserez, examinez les doublons et validez les coordonnées avant l’export.
Je travaille toujours sur une copie distincte du fichier source, car une valeur plus propre en apparence peut avoir perdu des informations. Les paramètres d’une URL peuvent identifier une variante de produit, tandis qu’un zéro initial peut faire partie d’un identifiant de compte. Conservez donc l’URL source et le texte d’origine à côté des champs nettoyés.
Pour une liste de contacts issue du scraping, procédez dans cet ordre :
- Importez les données et vérifiez les types de colonnes suggérés. Conservez les identifiants au format Text.
- Supprimez le HTML et les espaces superflus des textes descriptifs, puis standardisez uniquement les champs nécessaires au filtrage ou au rapprochement.
- Convertissez les dates et les quantités après avoir vérifié leur format.
- Recherchez les doublons à l’aide d’un identifiant fiable, comme l’adresse email, puis choisissez les valeurs à conserver.
- Vérifiez la syntaxe des emails et les informations du domaine, examinez les exceptions, puis exportez la liste nettoyée.
Les outils ci-dessous vous permettent de réaliser chaque étape dans Datablist, sans formule. Les exemples indiquent les valeurs à vérifier avant d’appliquer une transformation à toute la collection.
Voici un récapitulatif des opérations de nettoyage présentées dans cet article :
- Convertir du texte en Datetime, Number ou Boolean
- Convertir du HTML en texte et supprimer les balises
- Supprimer les espaces superflus
- Normaliser vos données
- Supprimer les symboles des textes
- Séparer le nom complet en prénom et nom
- Supprimer les doublons
- Valider les adresses email
- Extraire les noms de personnes ou d’entreprises
Importer un CSV ou copier-coller des données
Datablist est l’outil idéal pour nettoyer vos données. Cet éditeur CSV en ligne propose des fonctionnalités de nettoyage, de modification en masse et d’enrichissement. Et chaque collection peut contenir plusieurs millions d’éléments.
Ouvrez Datablist, créez une collection et chargez le fichier CSV contenant vos données scrapées.
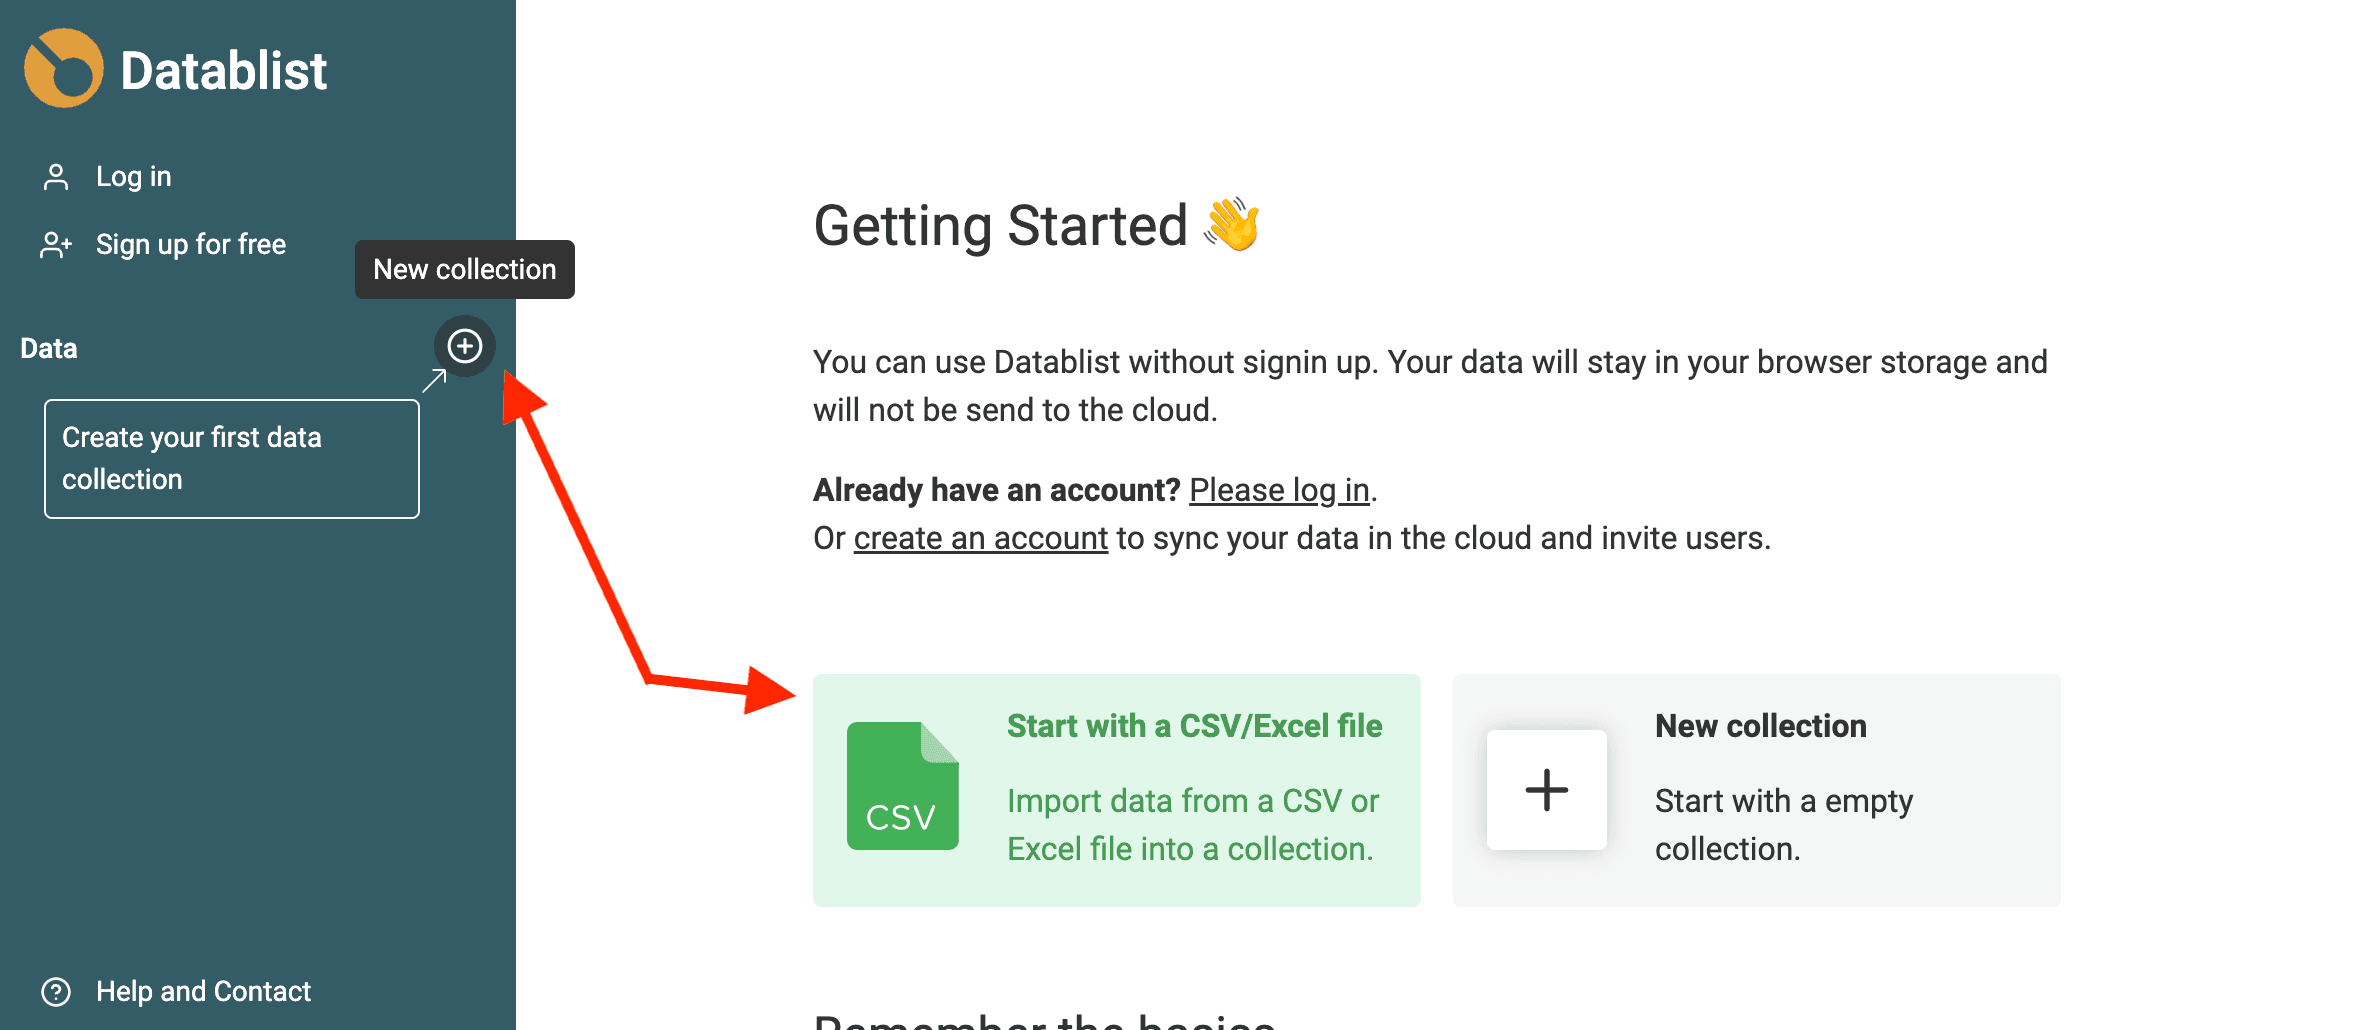
Pour créer une collection, cliquez sur le bouton + dans la barre latérale, puis sur « Import CSV/Excel » pour charger votre fichier. Vous pouvez également utiliser le raccourci de la page de démarrage pour accéder directement à l’étape d’import.
Détecter automatiquement le format
L’assistant d’import de Datablist détecte automatiquement les adresses email, les Datetimes au format ISO 8601, les Booleans, les Numbers, les URLs, etc., lorsque leur format est correct.
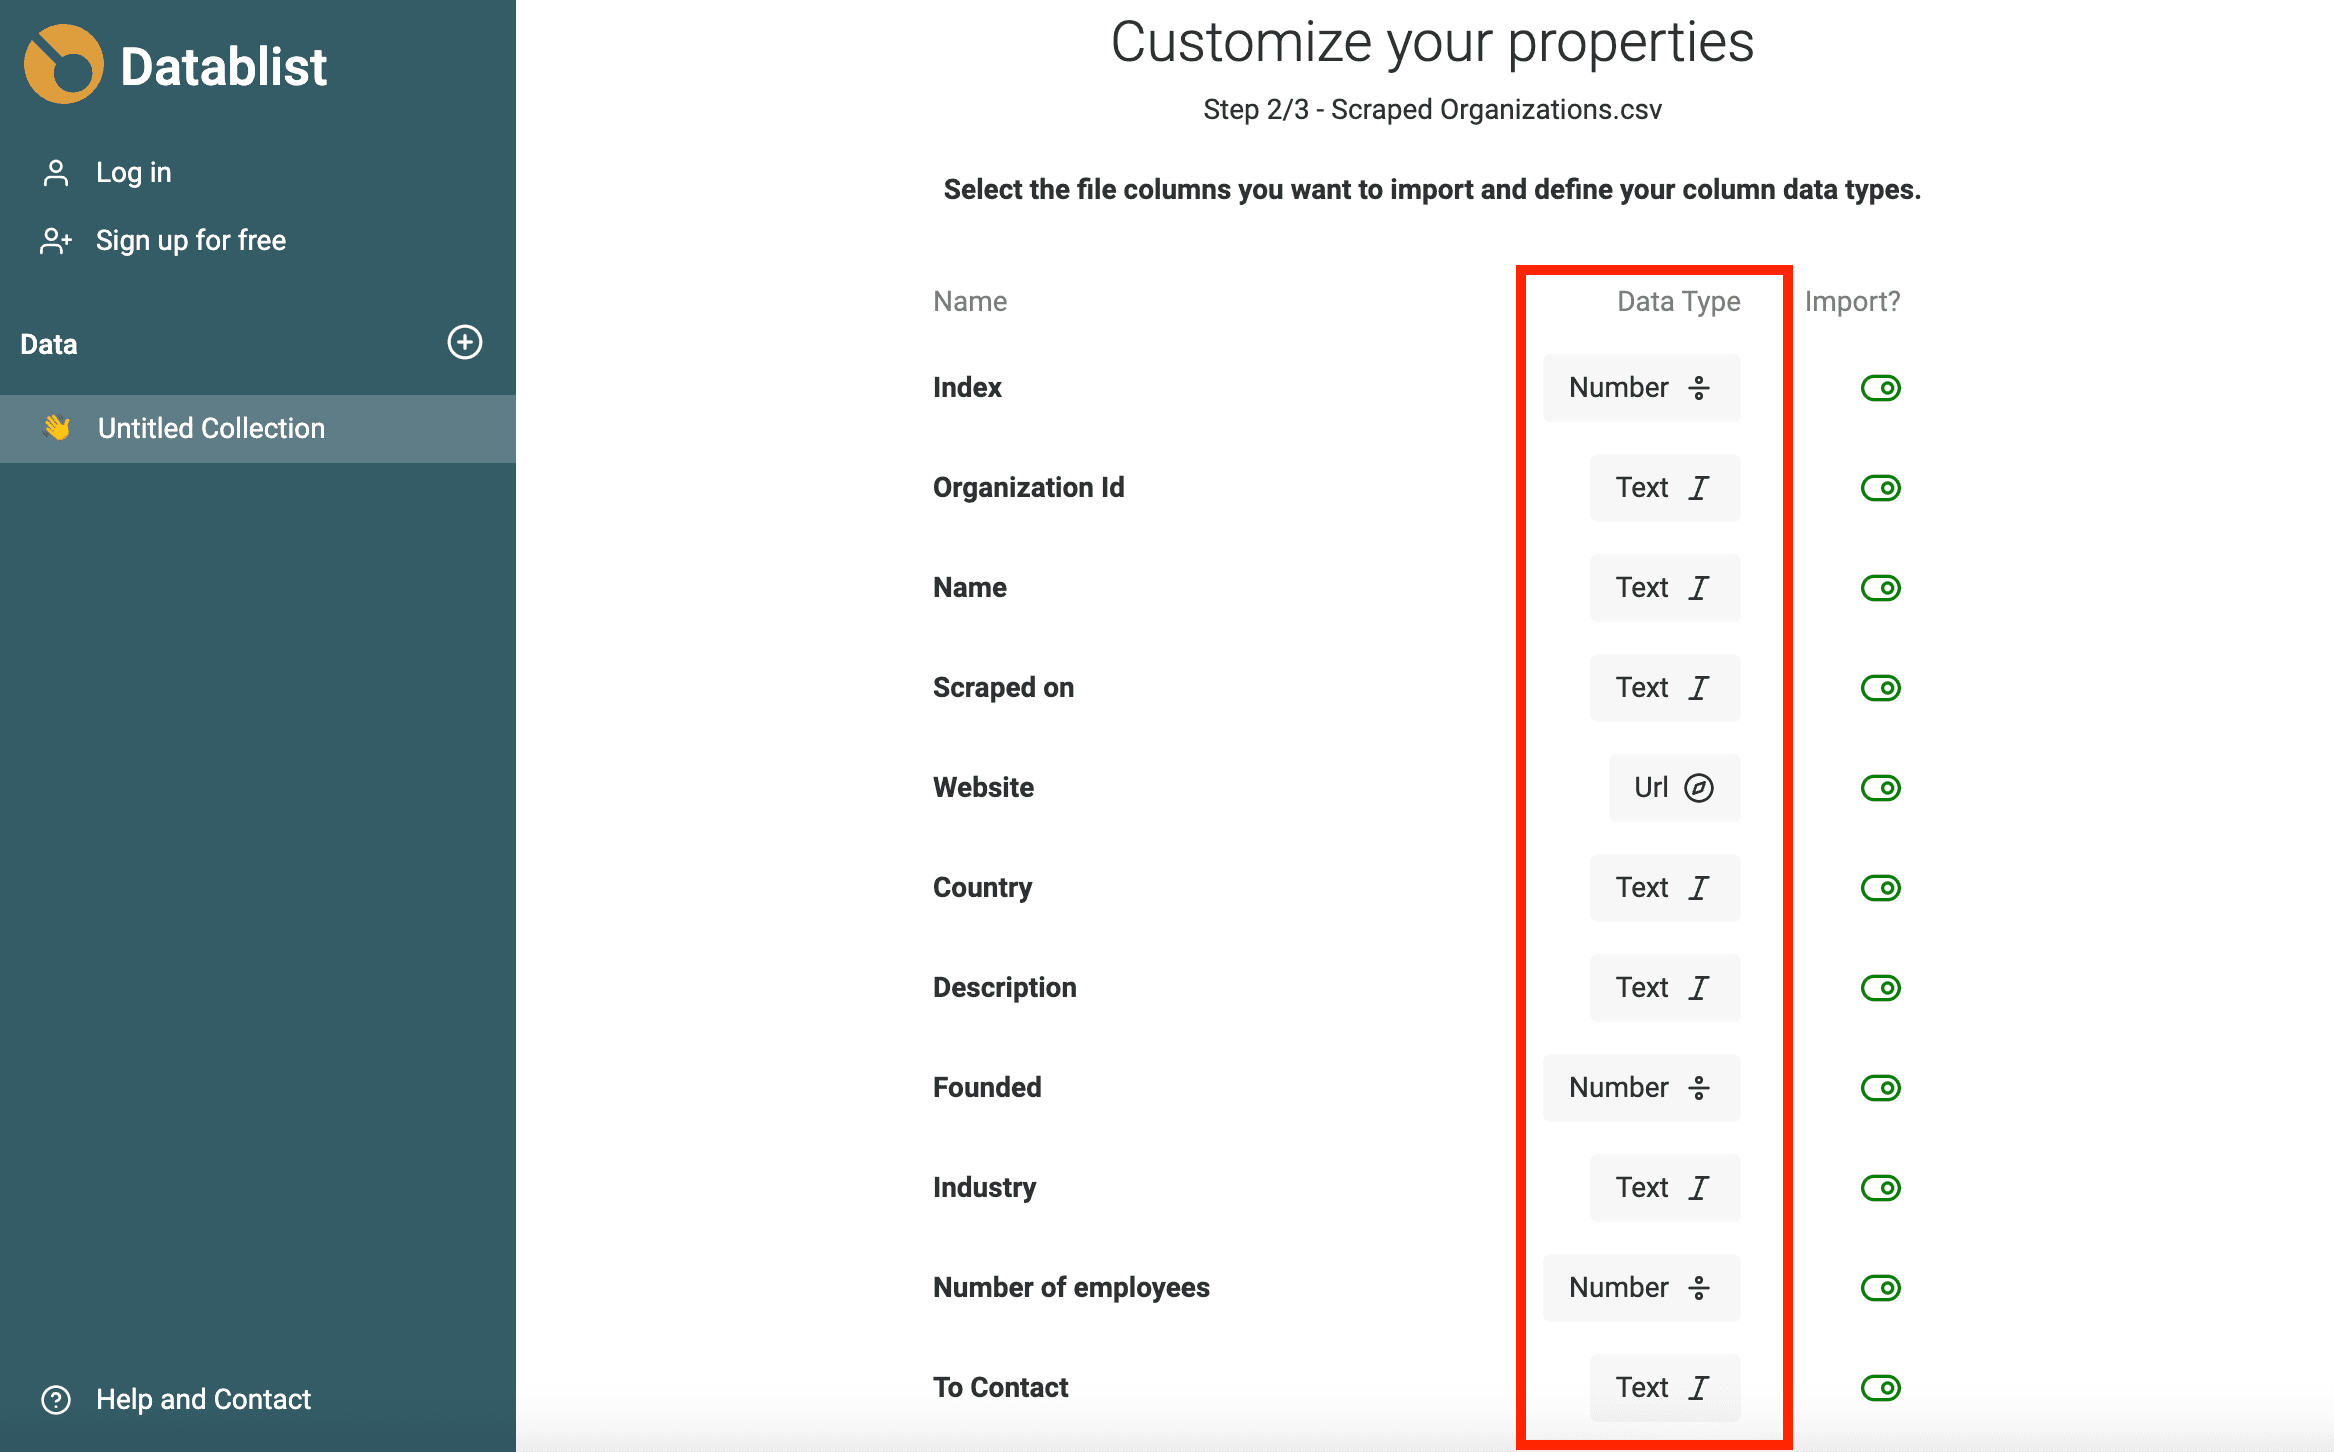
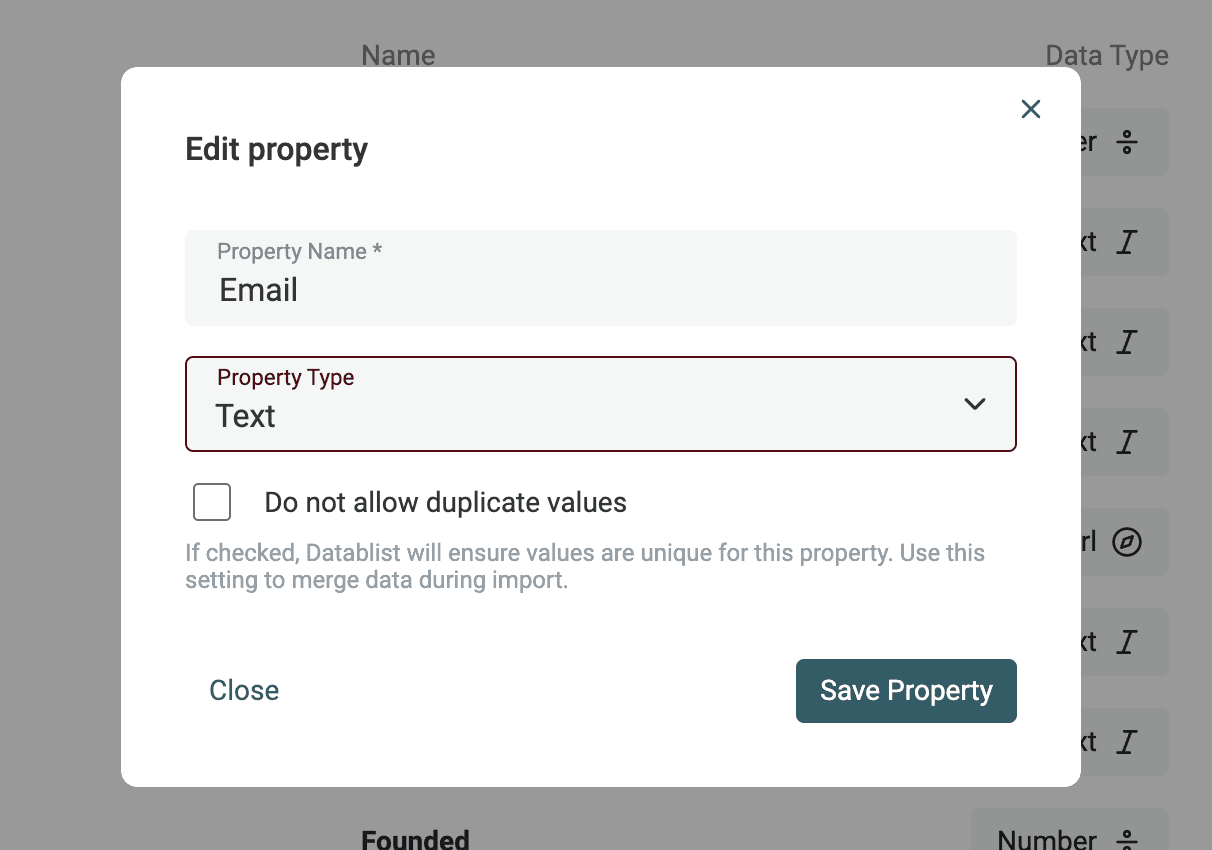
Si vos données nécessitent une analyse plus poussée — format de date différent, faute dans une URL ou une adresse email — importez-les en tant que propriété Text. La section suivante explique comment convertir ces propriétés en Datetime, Boolean ou Number.
Convertir du texte en Datetime, Boolean ou Number
Marie Kondo affirme que « la vie ne commence vraiment qu’après avoir mis de l’ordre chez soi ». Il en va de même pour vos données scrapées : « les ventes ne commencent vraiment qu’après avoir mis de l’ordre dans vos données » ! 😅
Filtrer une date (date de création, date de levée de fonds, etc.), un nombre (prix, effectif) ou un booléen est bien plus simple lorsque ces valeurs sont des objets natifs et non du simple texte.
Ouvrez l’outil « Text to Datetime, Number, Checkbox » depuis le menu « Clean ».
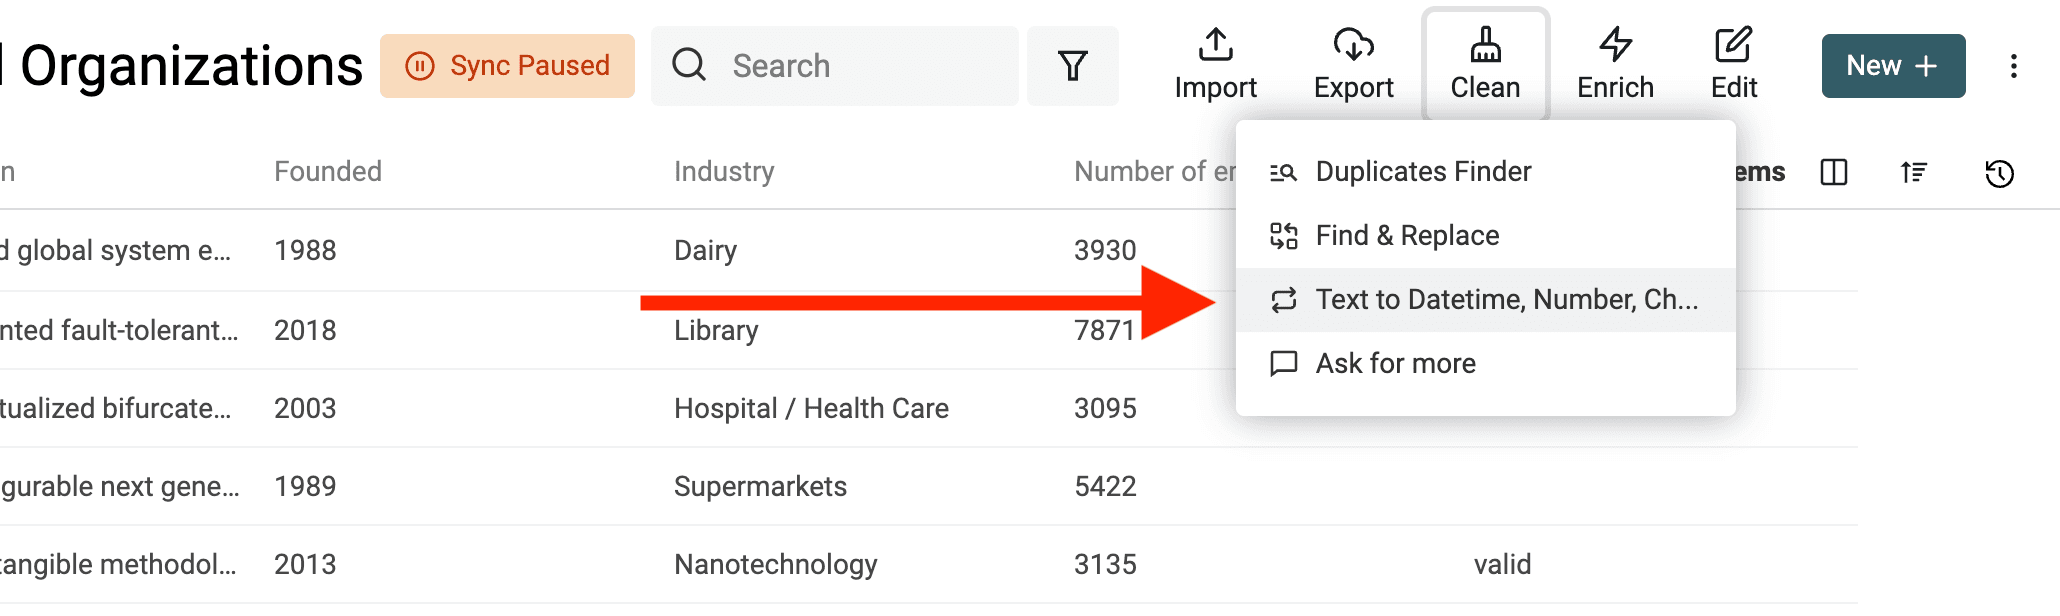
Convertir n’importe quel texte au format Datetime
Datetime dispose d’un format international appelé ISO 8601, fondé sur une structure précise. Si vos données respectent ce format, une propriété Datetime sera automatiquement créée lors de l’import.
Pour les valeurs Date et Datetime présentées dans d’autres formats, vous devez préciser le format utilisé afin que Datablist puisse les convertir en valeurs Datetime structurées.
Sélectionnez la propriété à convertir, puis « Convert to Datetime ».
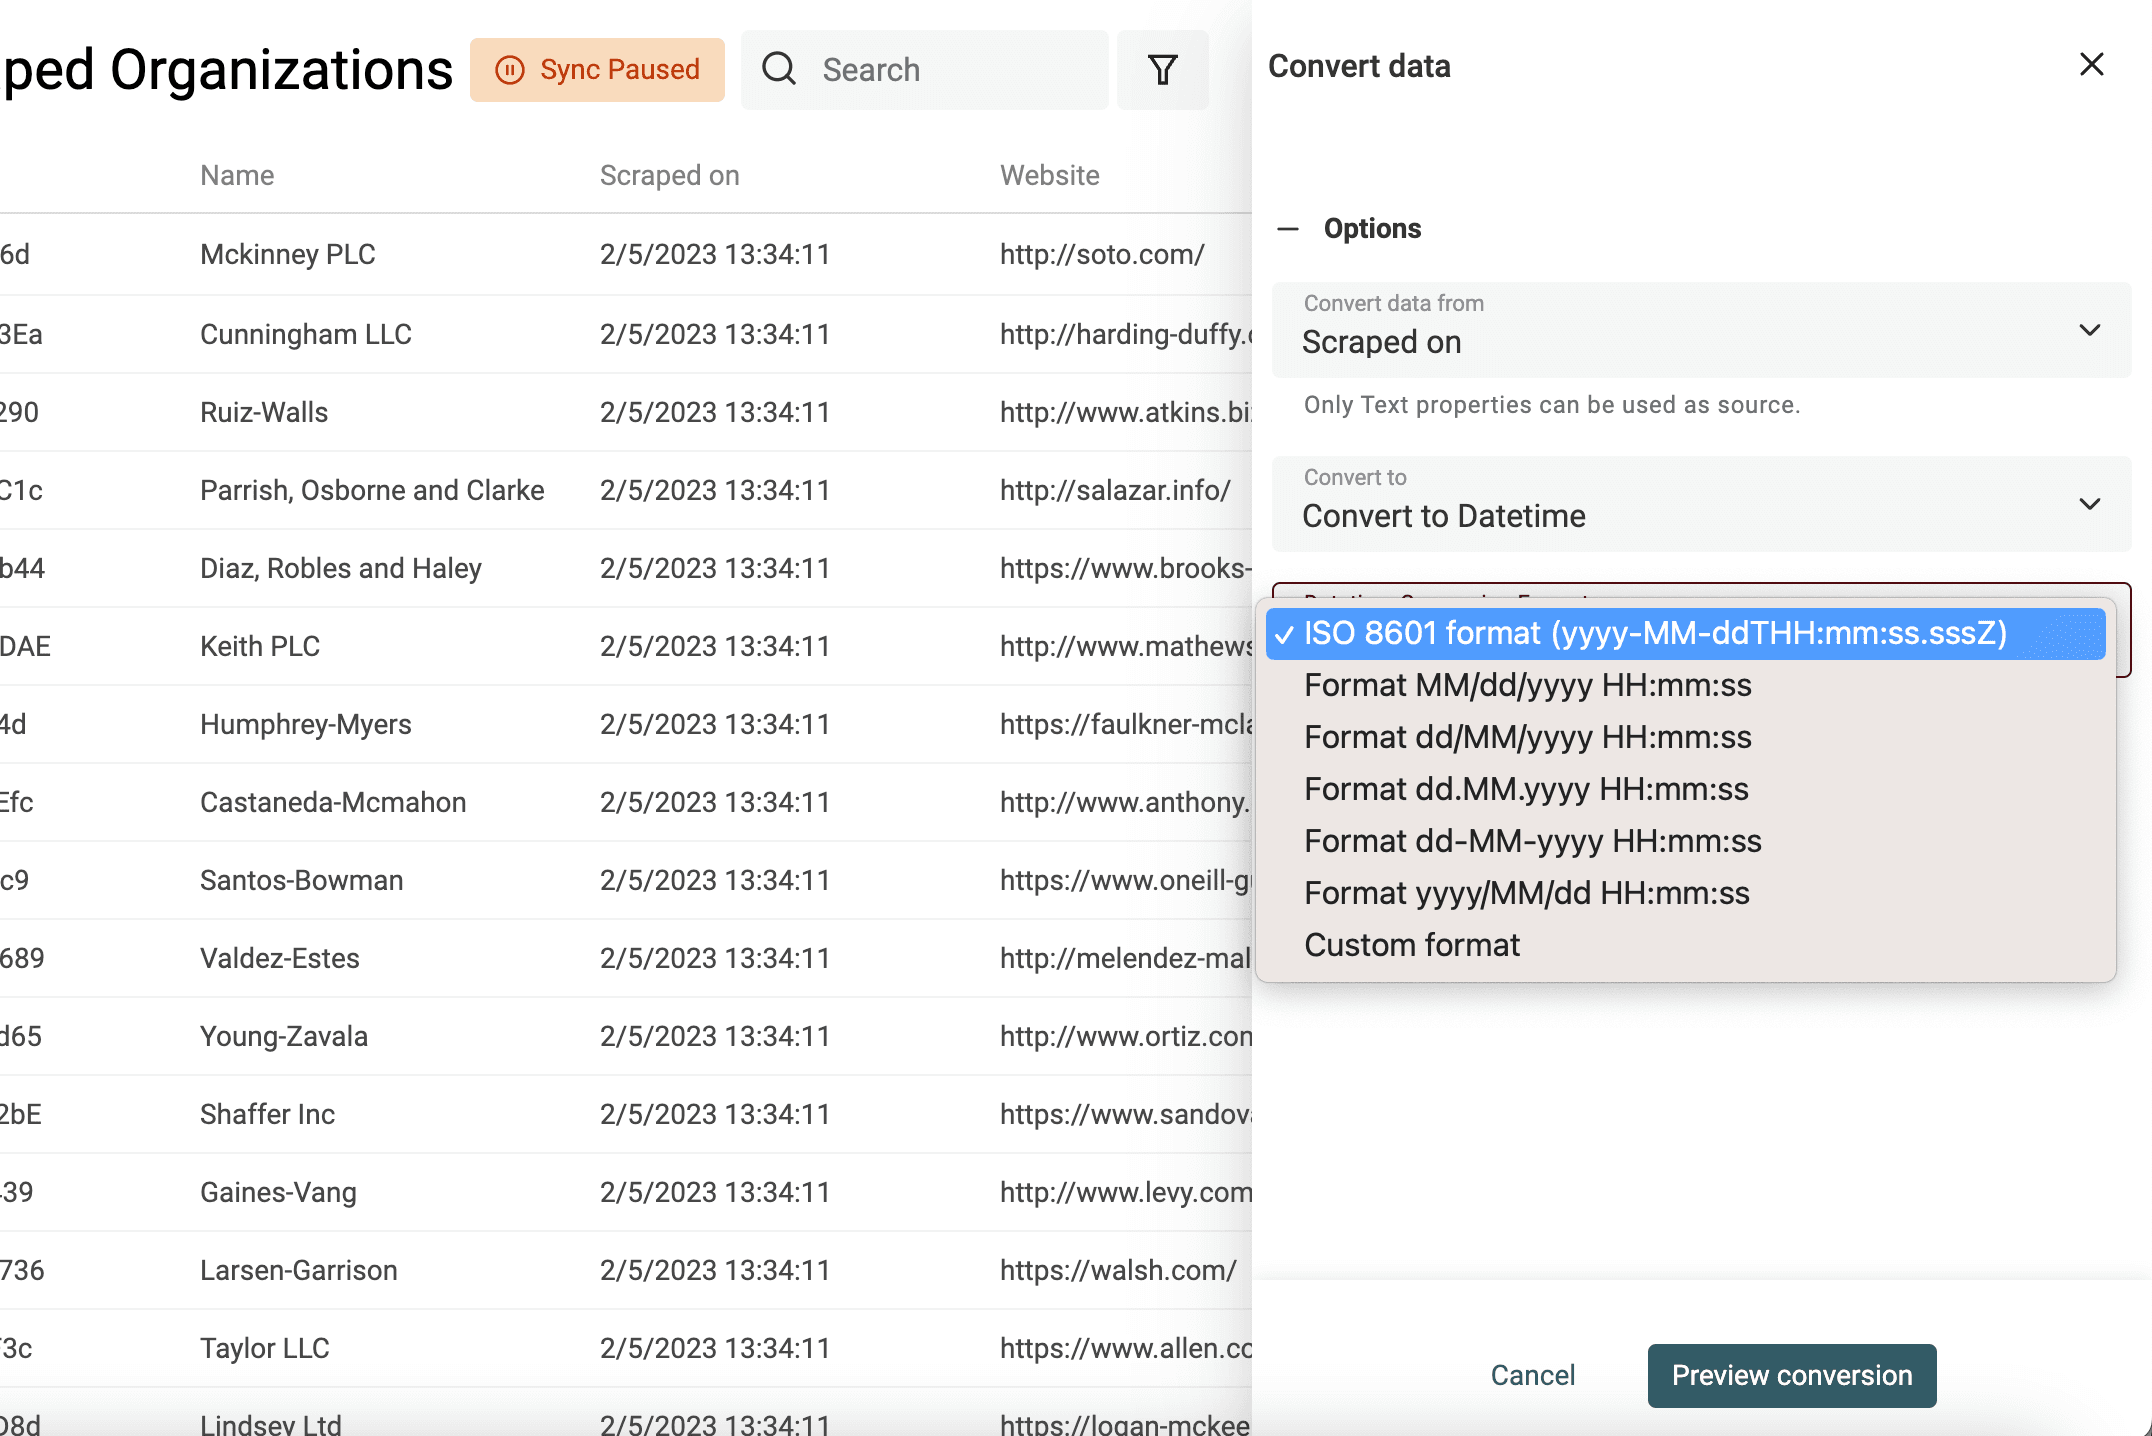
Les formats courants sont proposés — notamment ceux utilisés par Google Sheets et Excel. Vous pouvez aussi sélectionner « Custom format » pour définir votre propre format de date et d’heure.
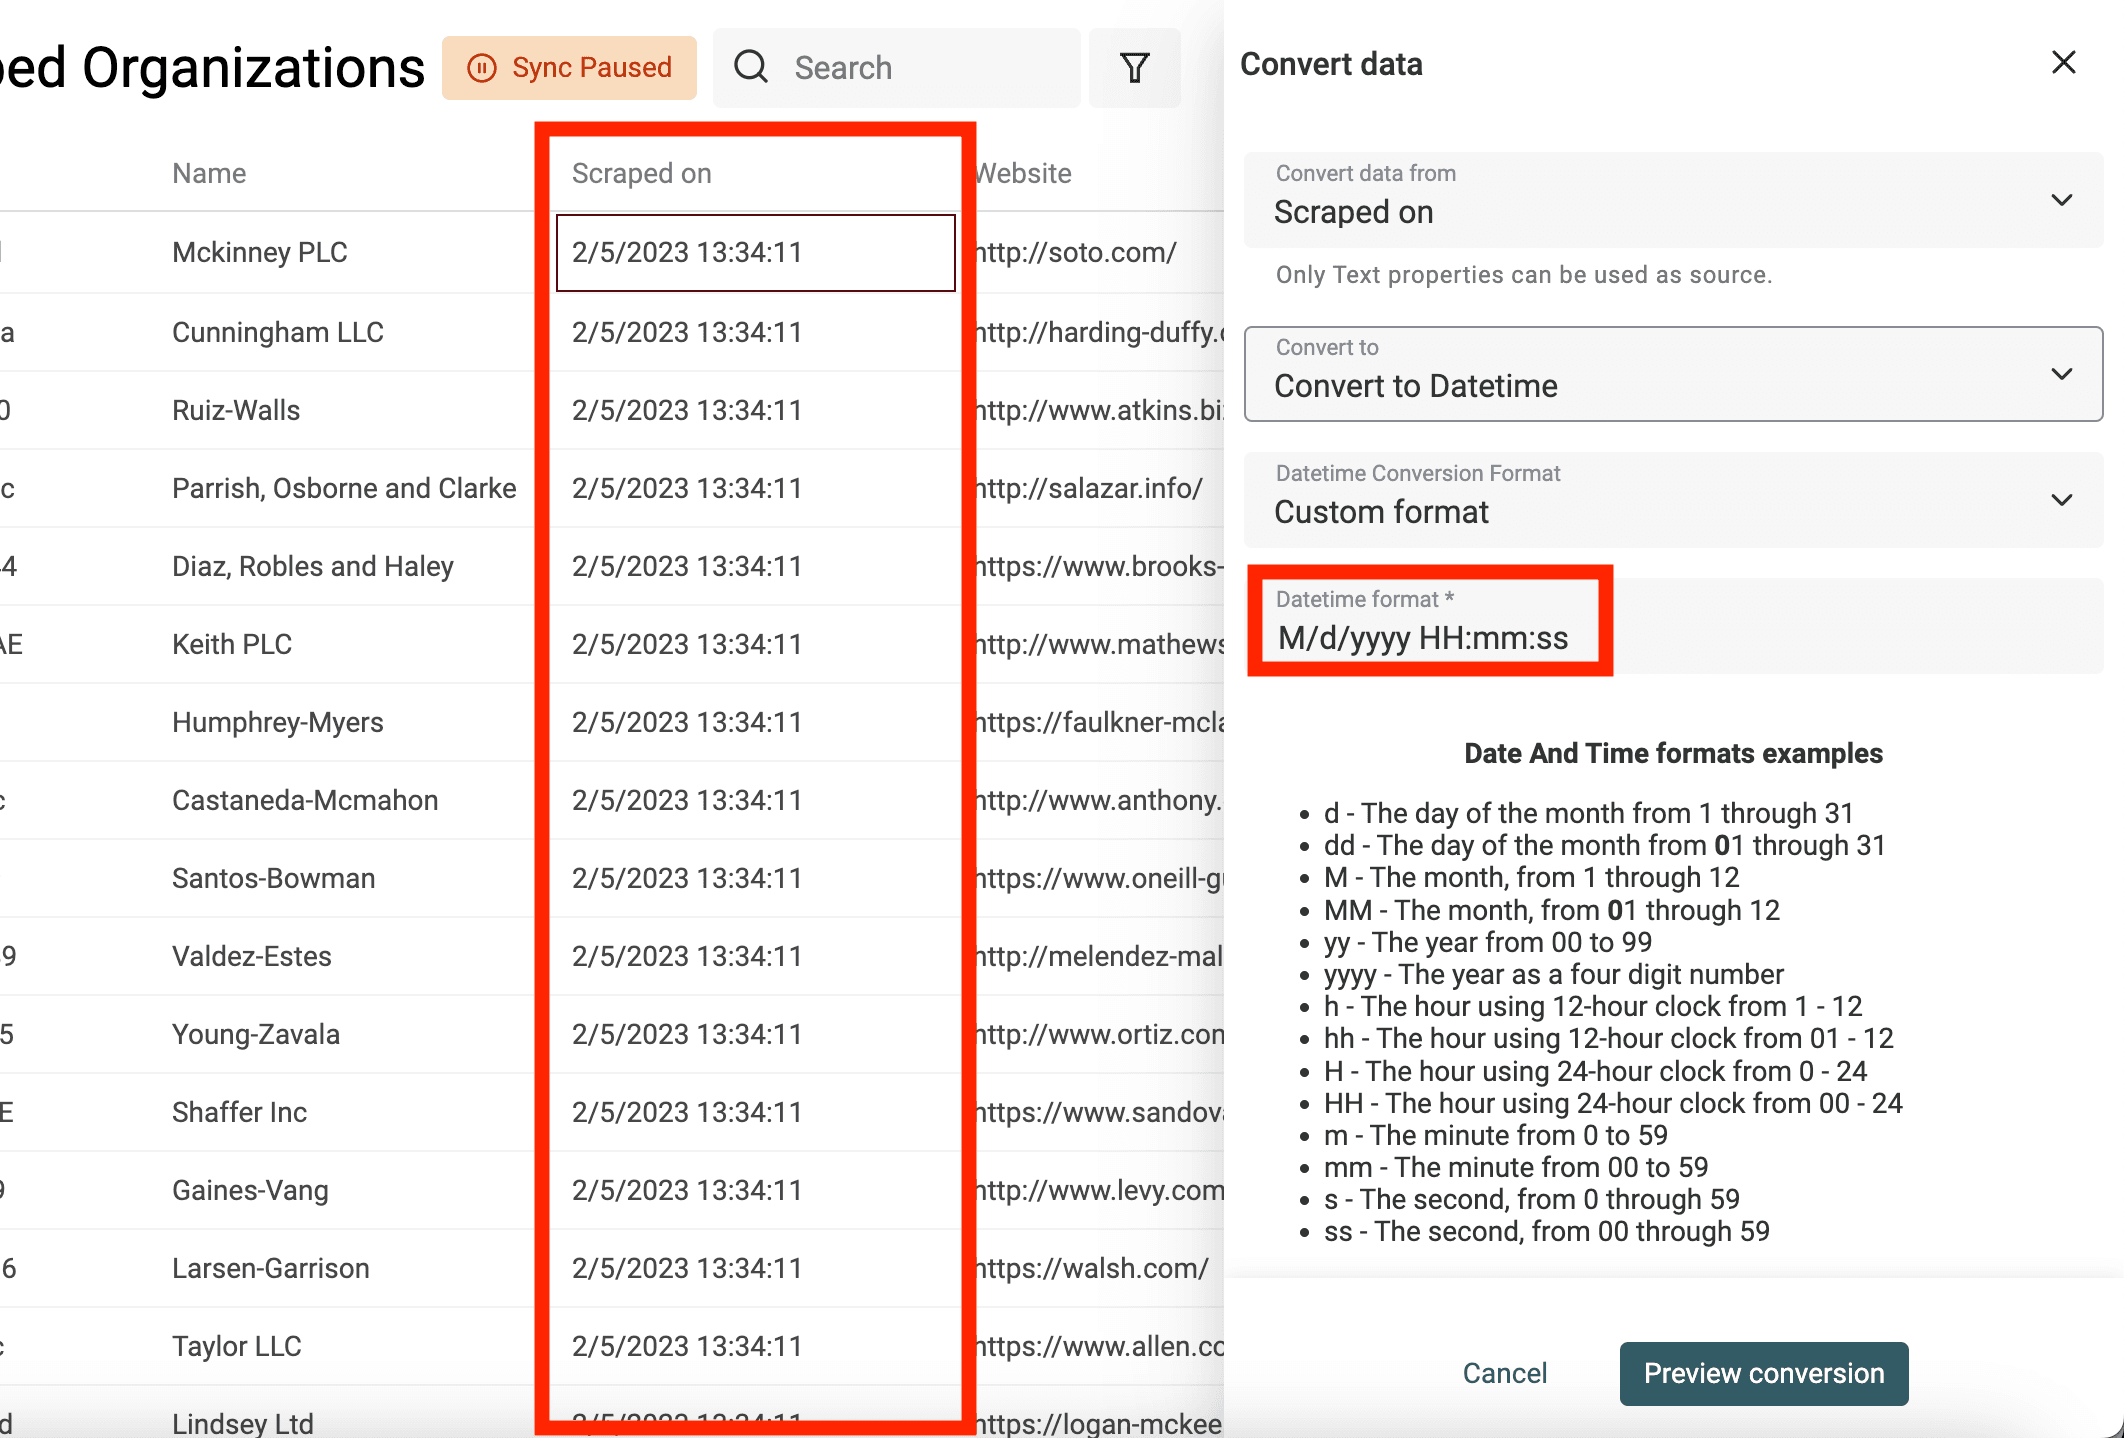
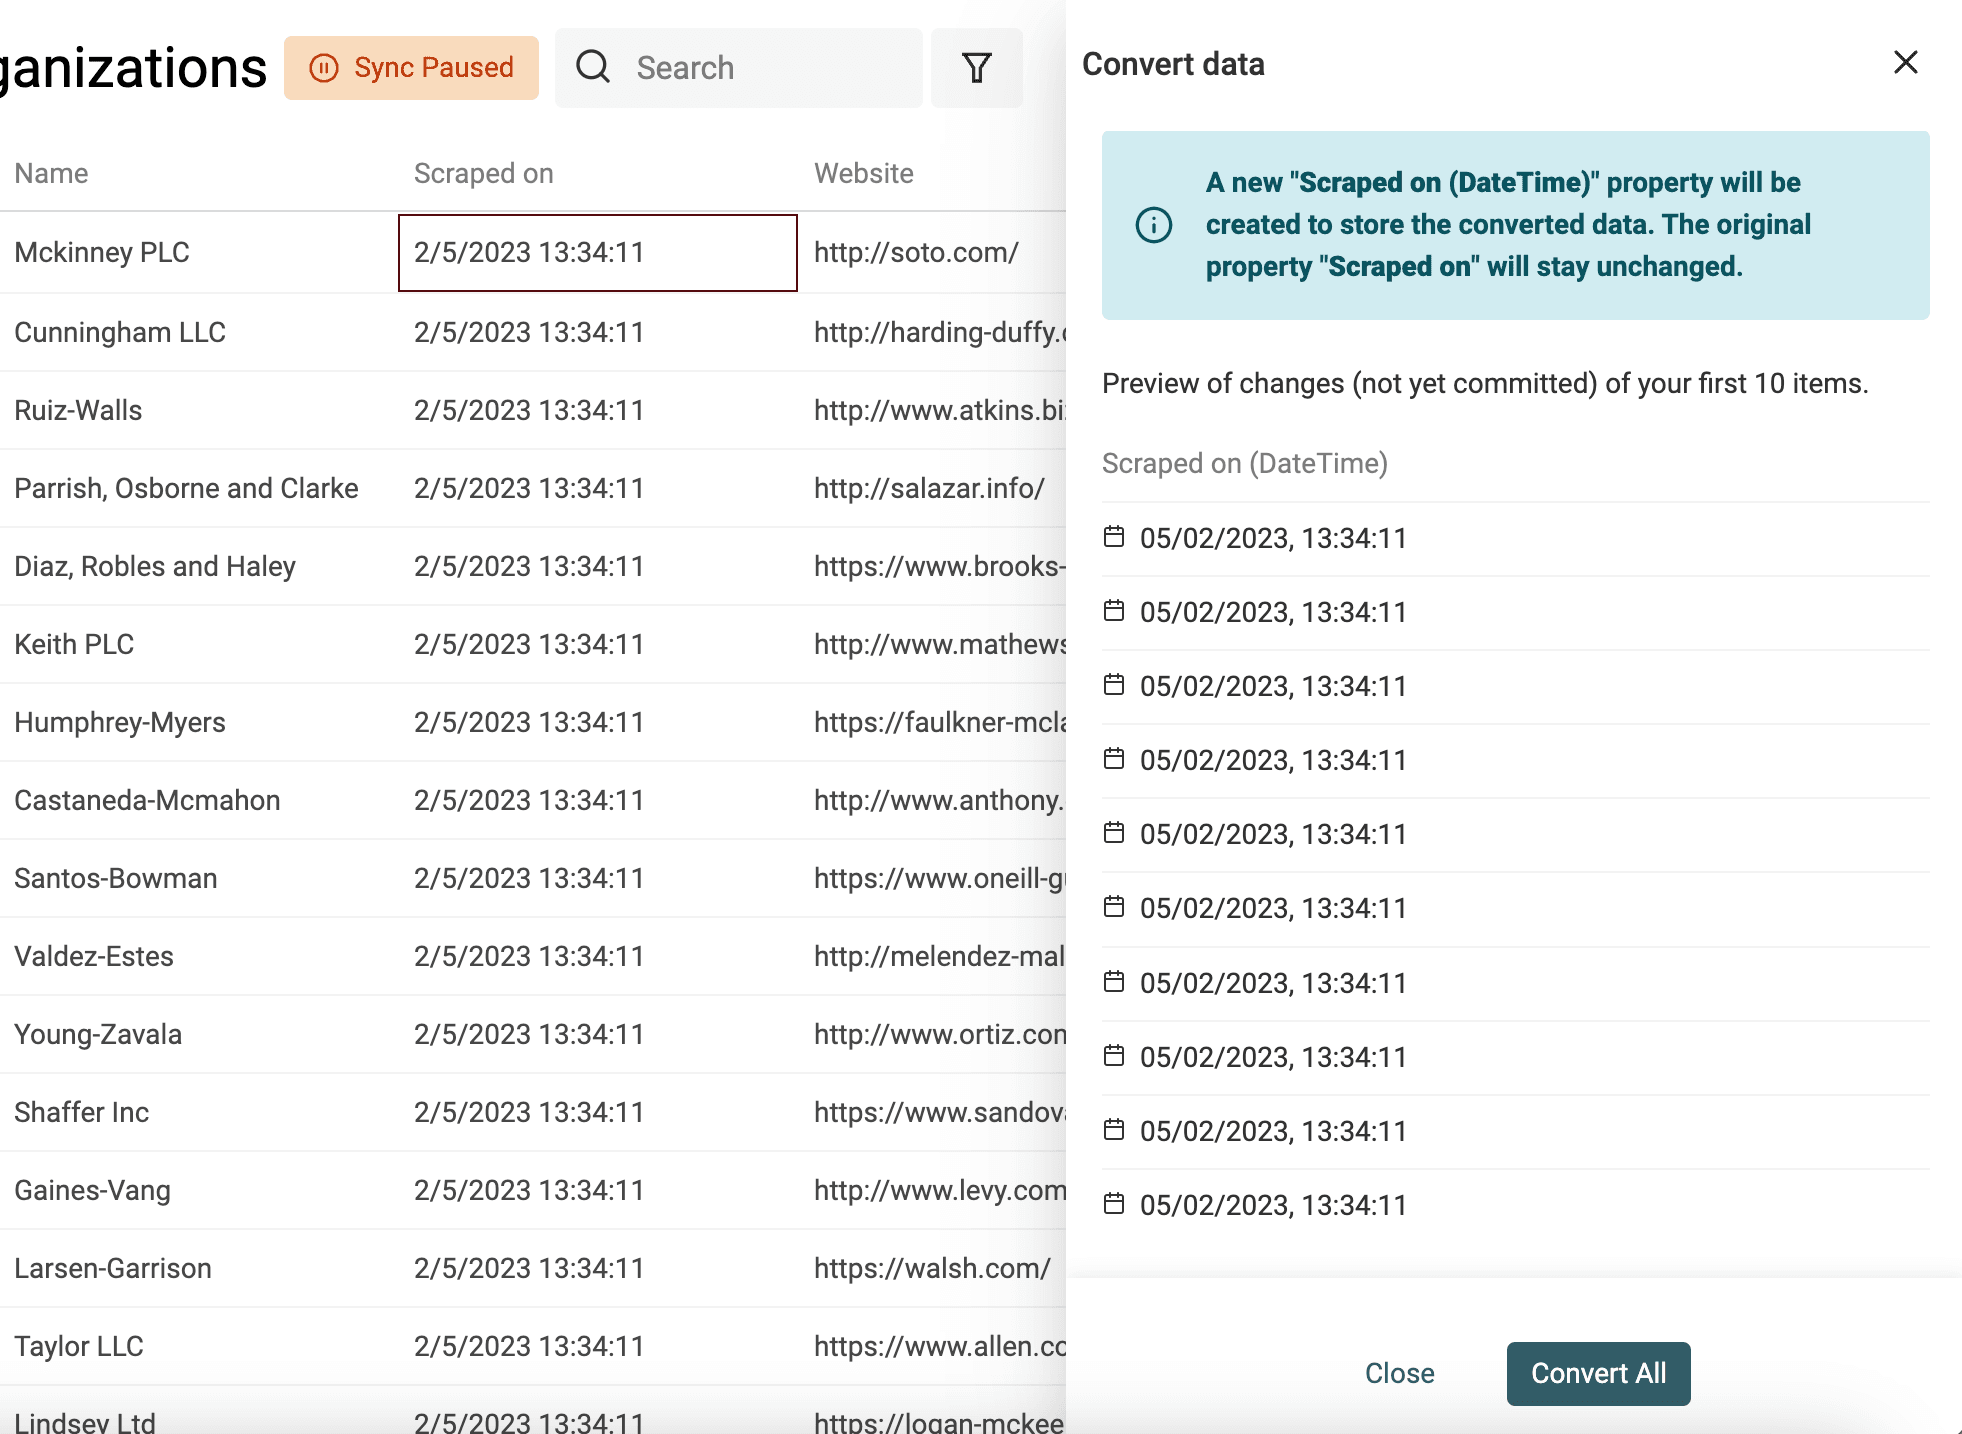
👉 Consultez notre documentation pour en savoir plus sur les formats Datetime personnalisés.
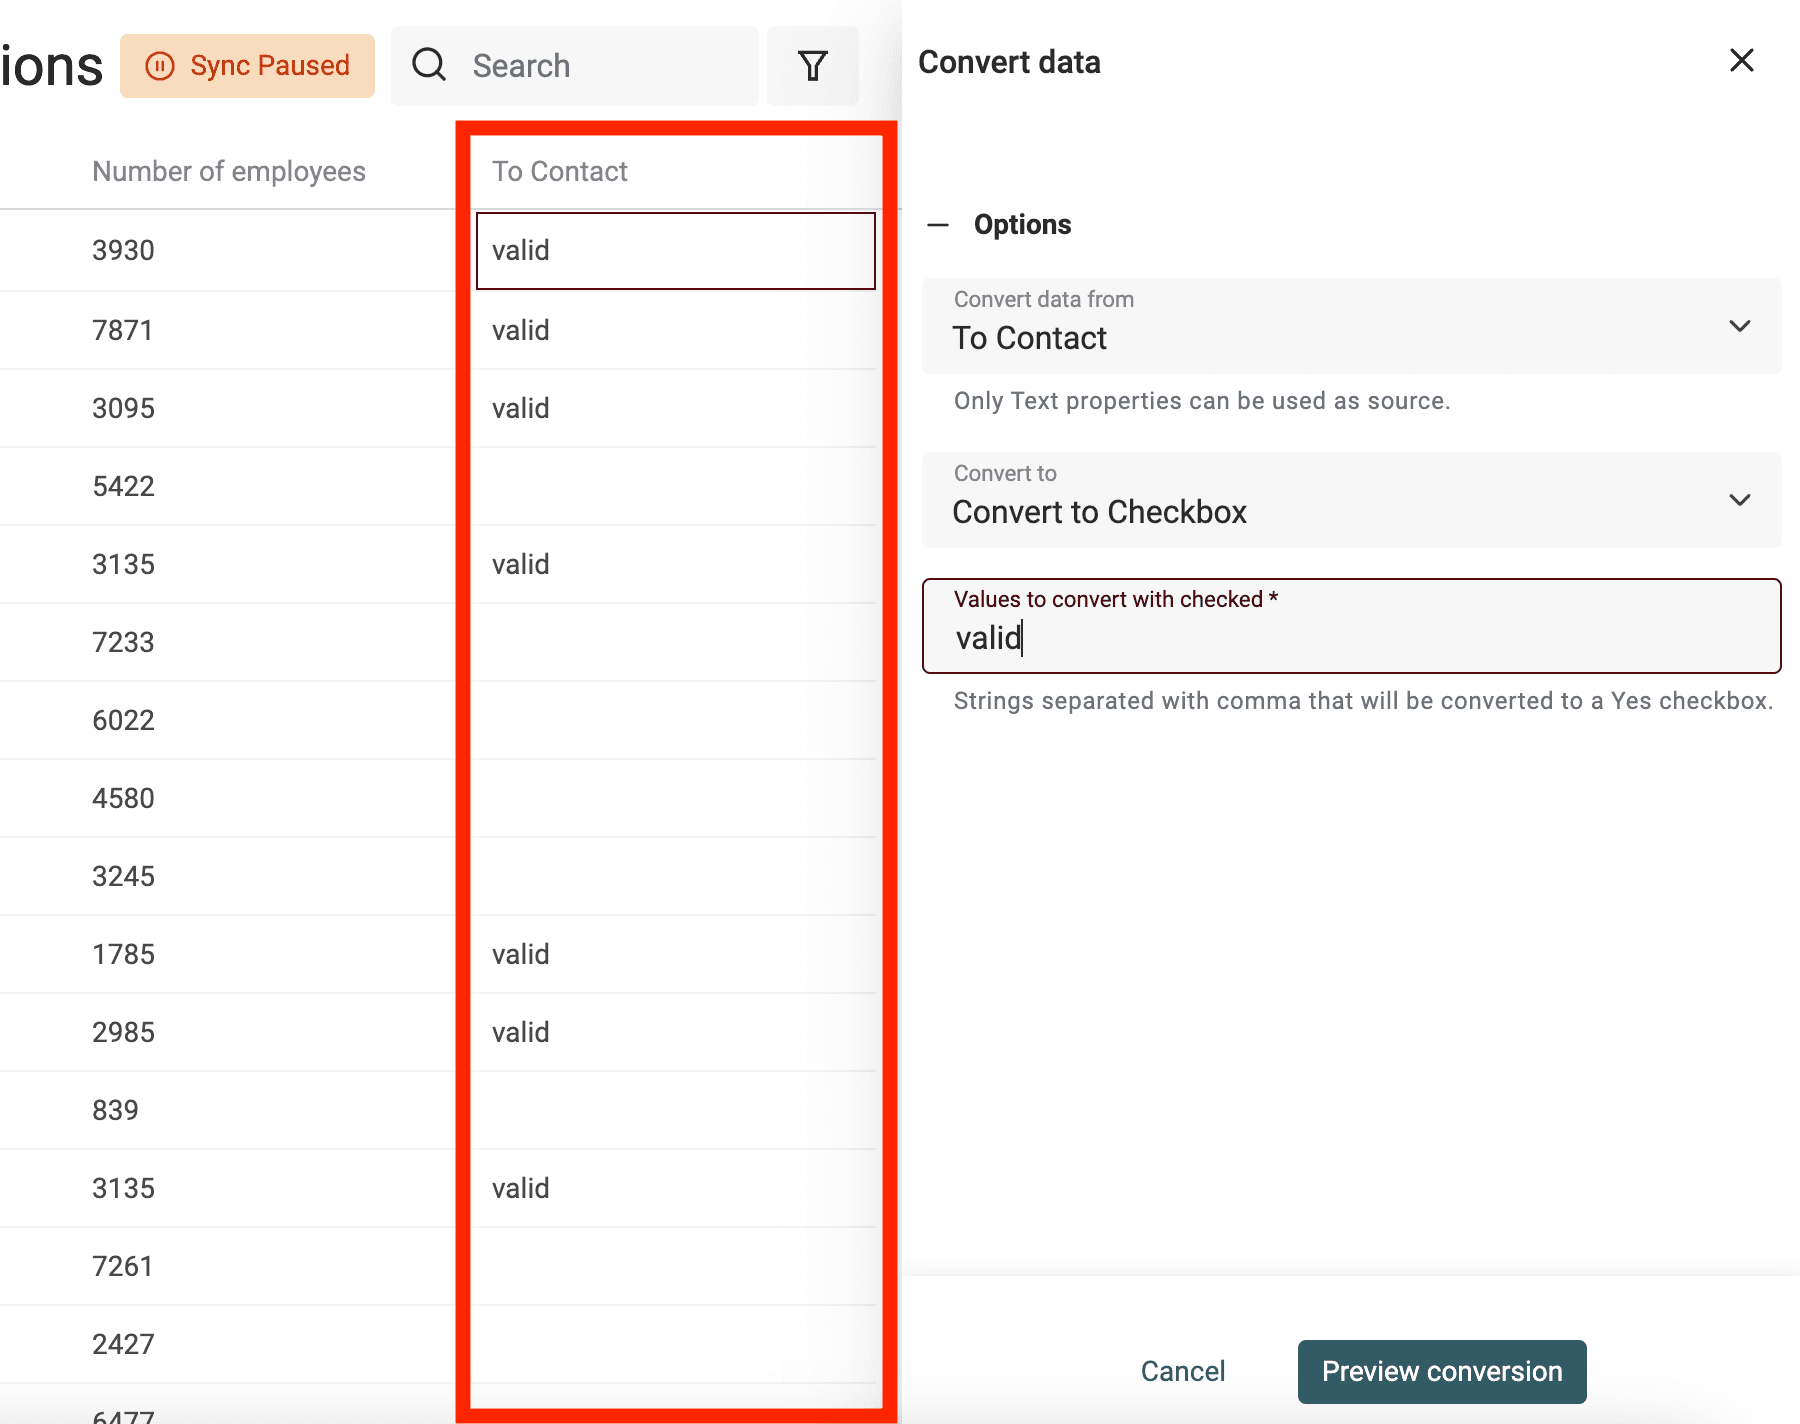
Créer des Checkboxes à partir de valeurs textuelles
Lors de l’import, Datablist convertit automatiquement les colonnes contenant « Yes, No », « TRUE, FALSE », etc. en propriétés Checkbox. Utilisez le convertisseur pour les cas plus complexes.
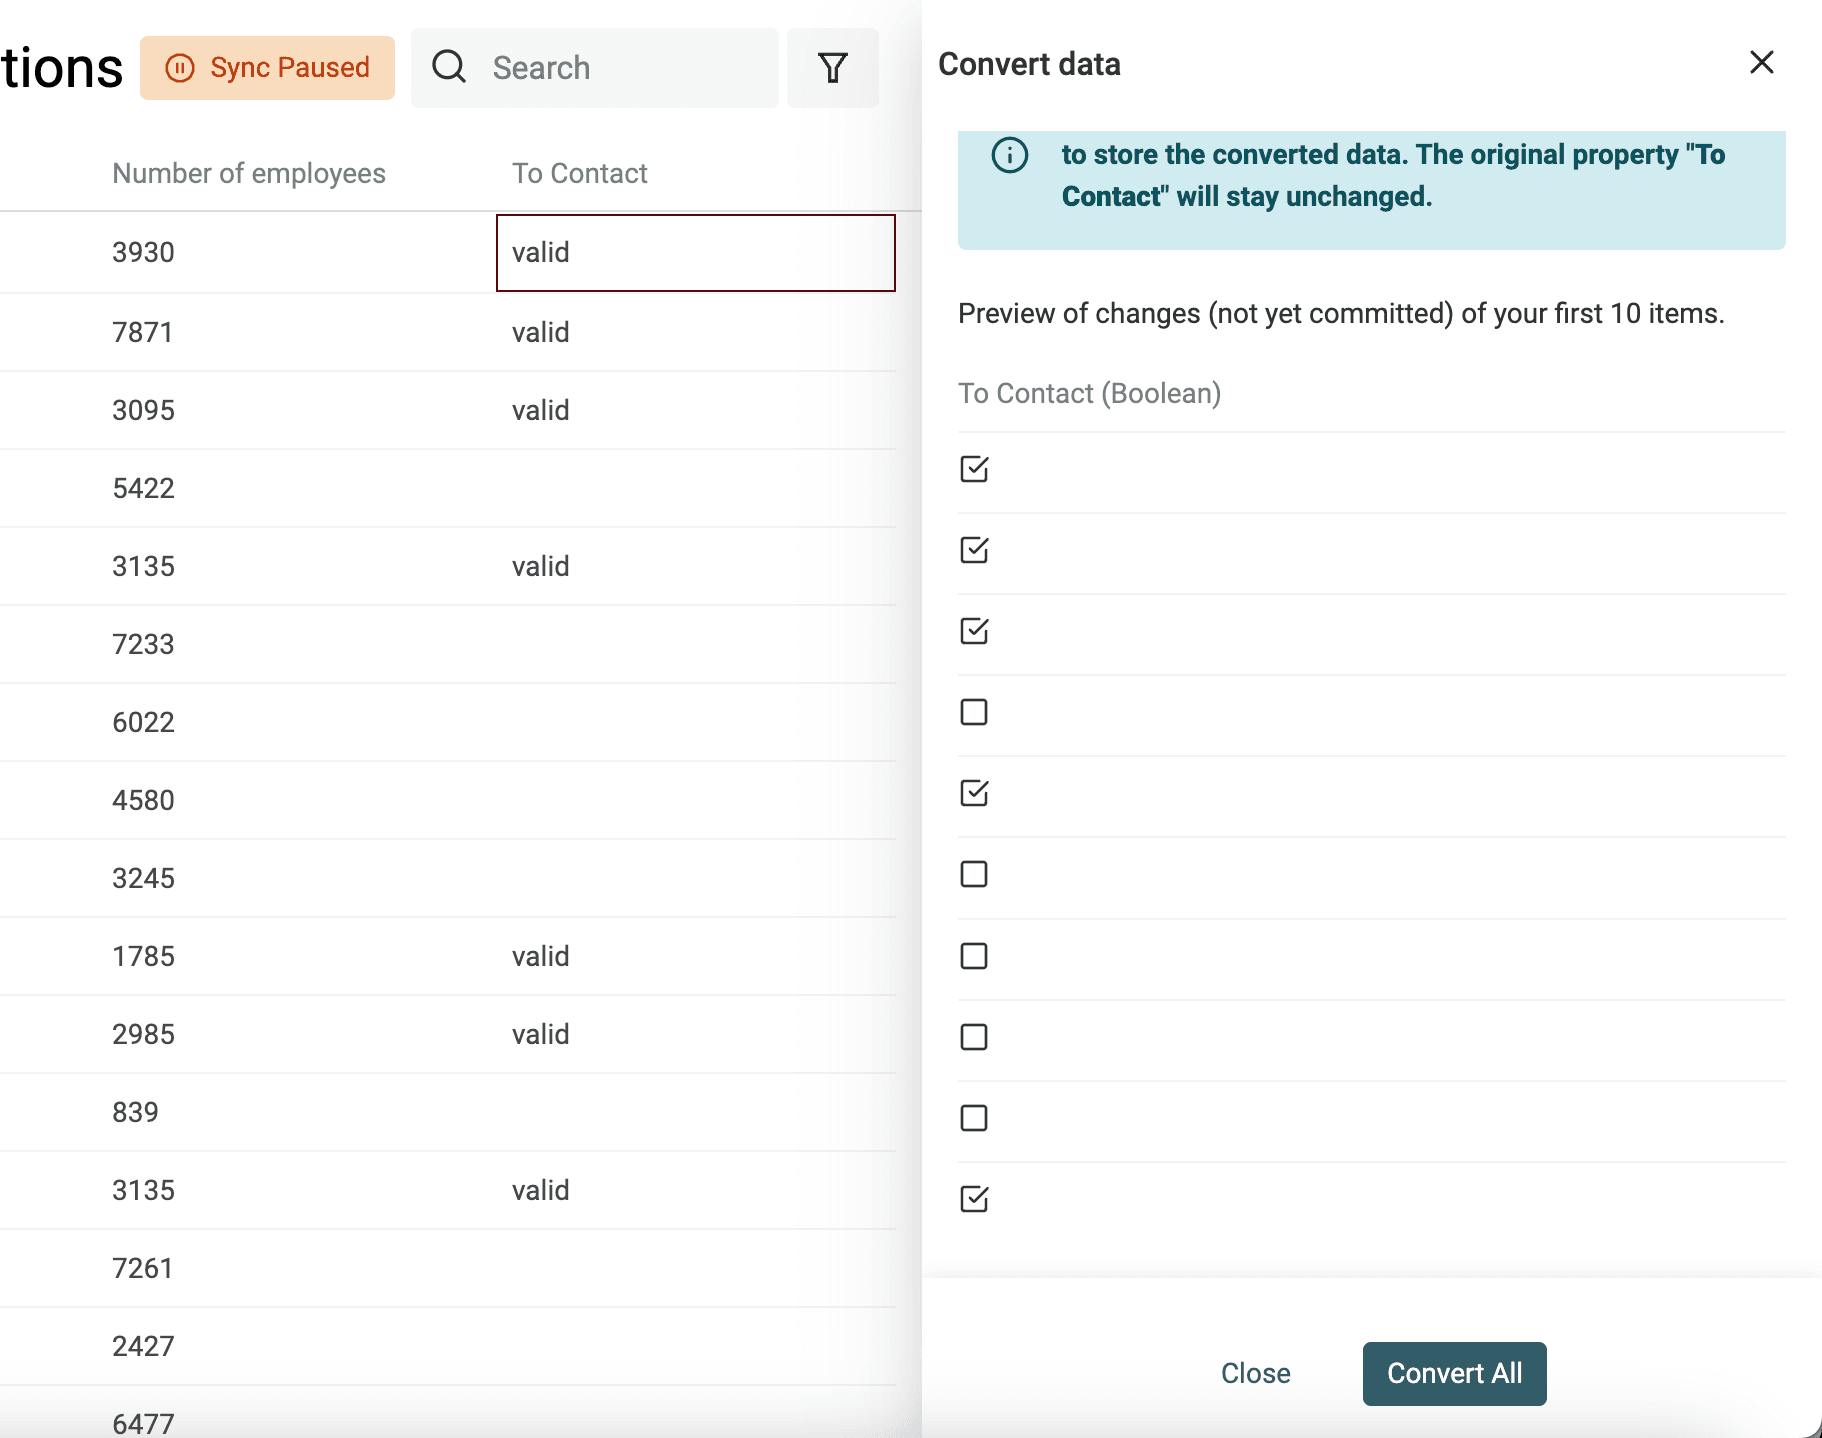
Définissez les valeurs, séparées par des virgules, qui produiront une case cochée. Toutes les autres valeurs laisseront la case décochée.
Extraire des nombres depuis du texte
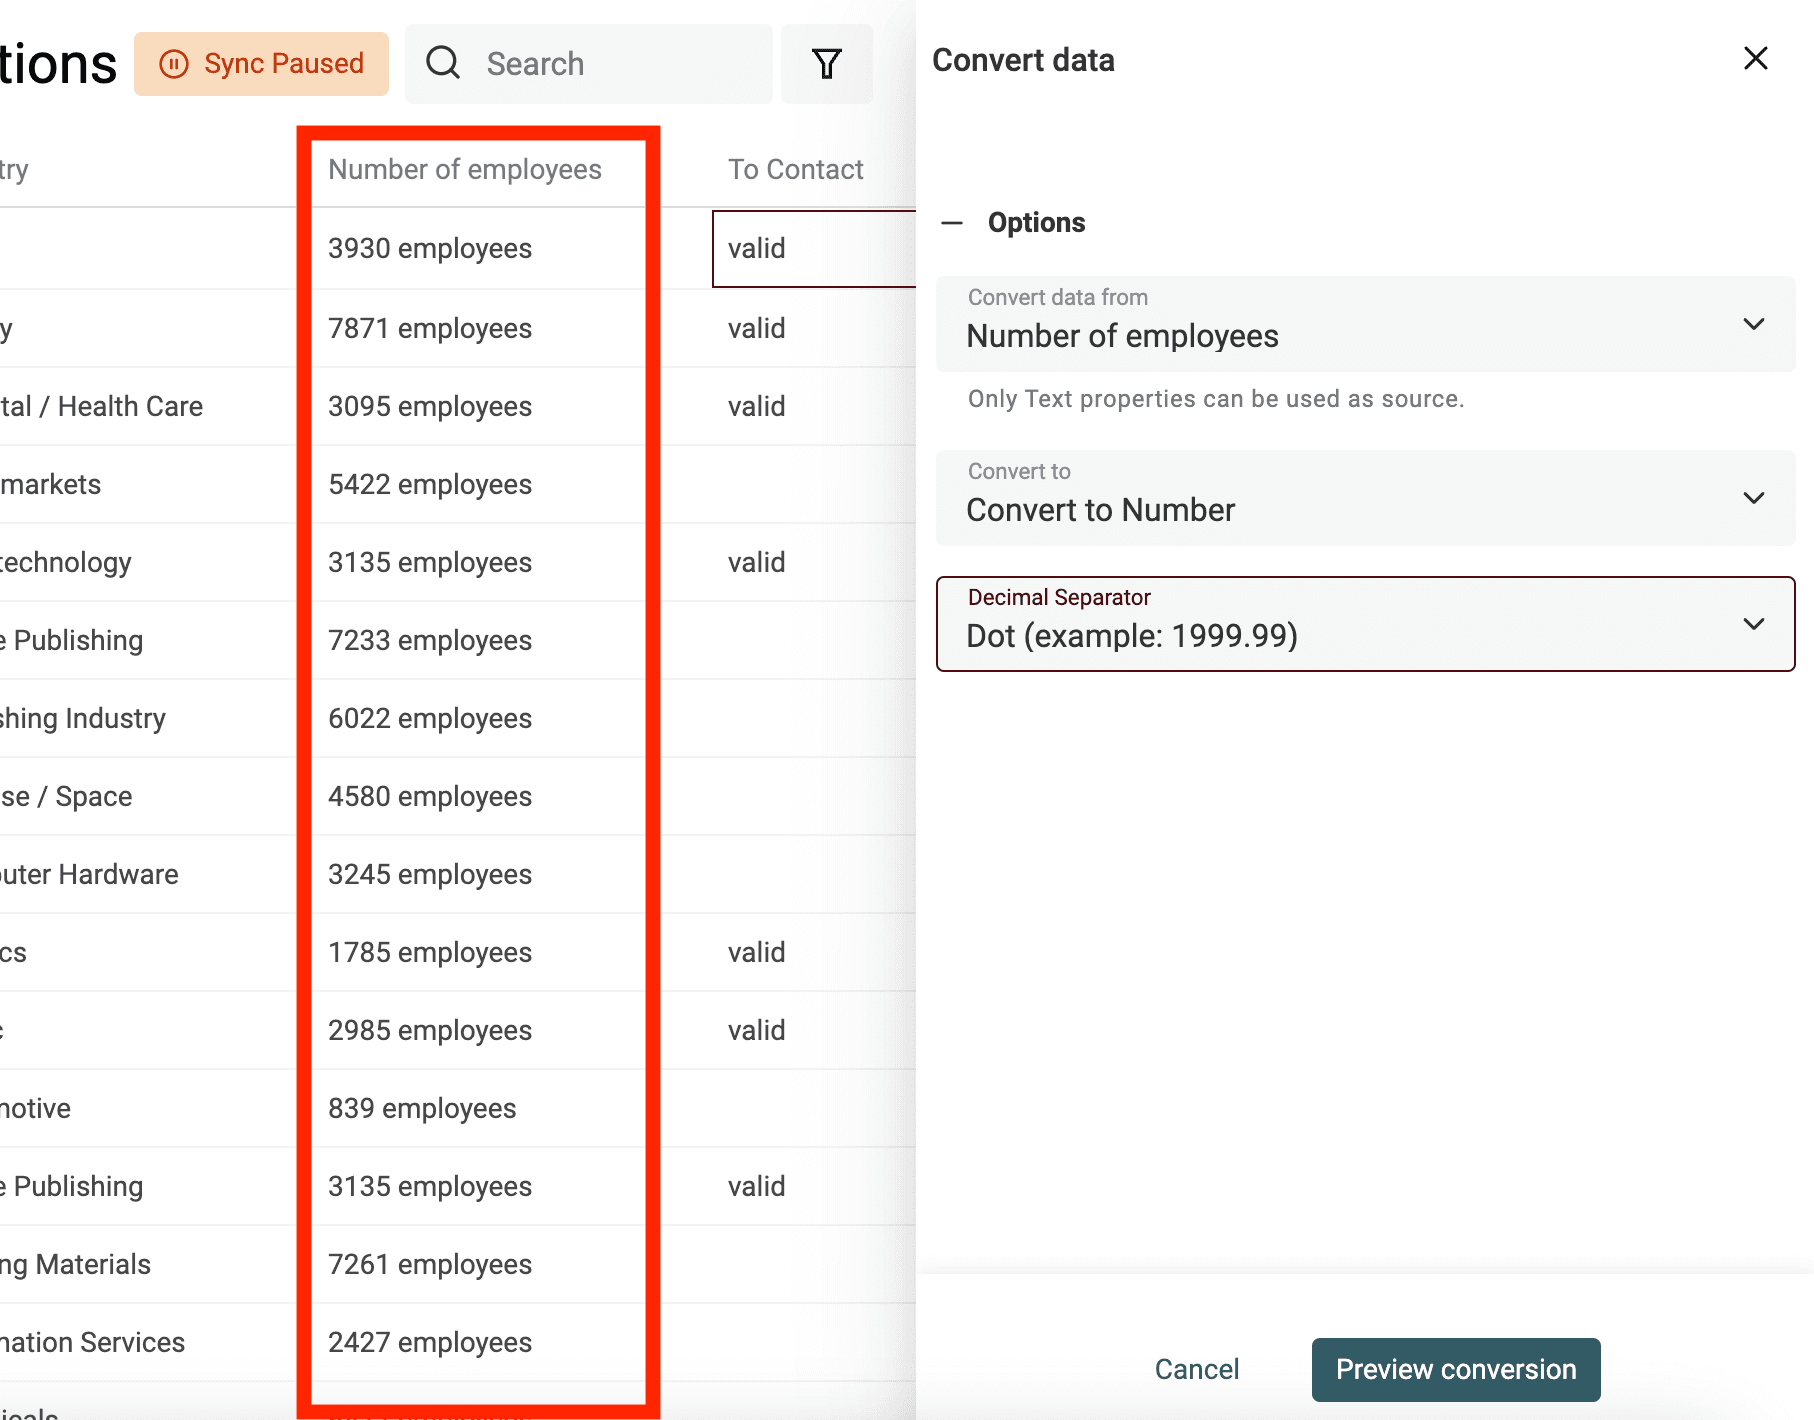
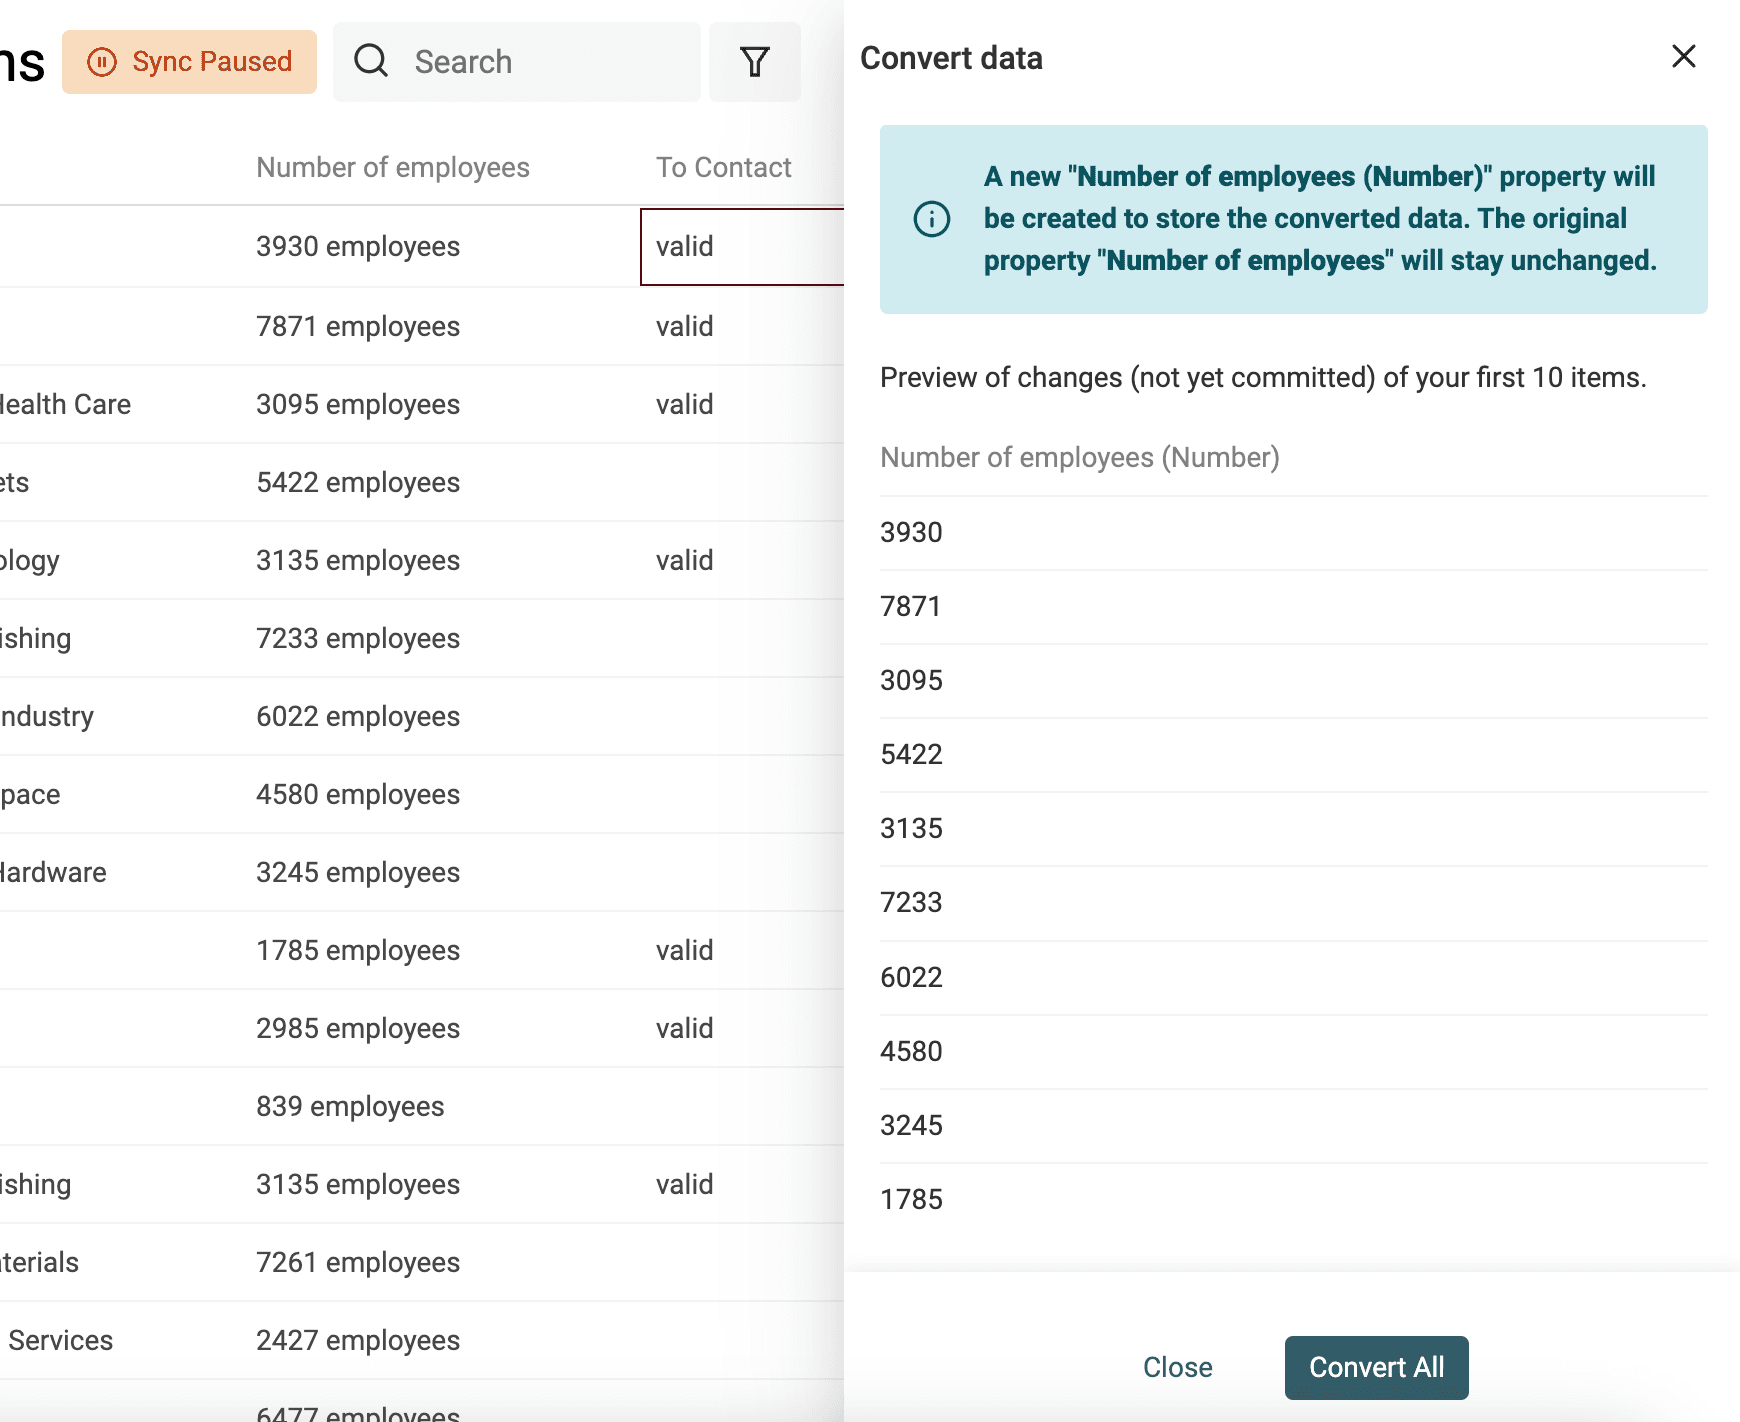
Utilisez le convertisseur « Text to number » pour :
- Normaliser les nombres avec des séparateurs décimaux et de milliers personnalisés
- Extraire les nombres de textes contenant des lettres
👉 Consultez notre documentation pour en savoir plus sur la conversion des nombres.
Nettoyer les données de web scraping
Convertir du HTML en texte
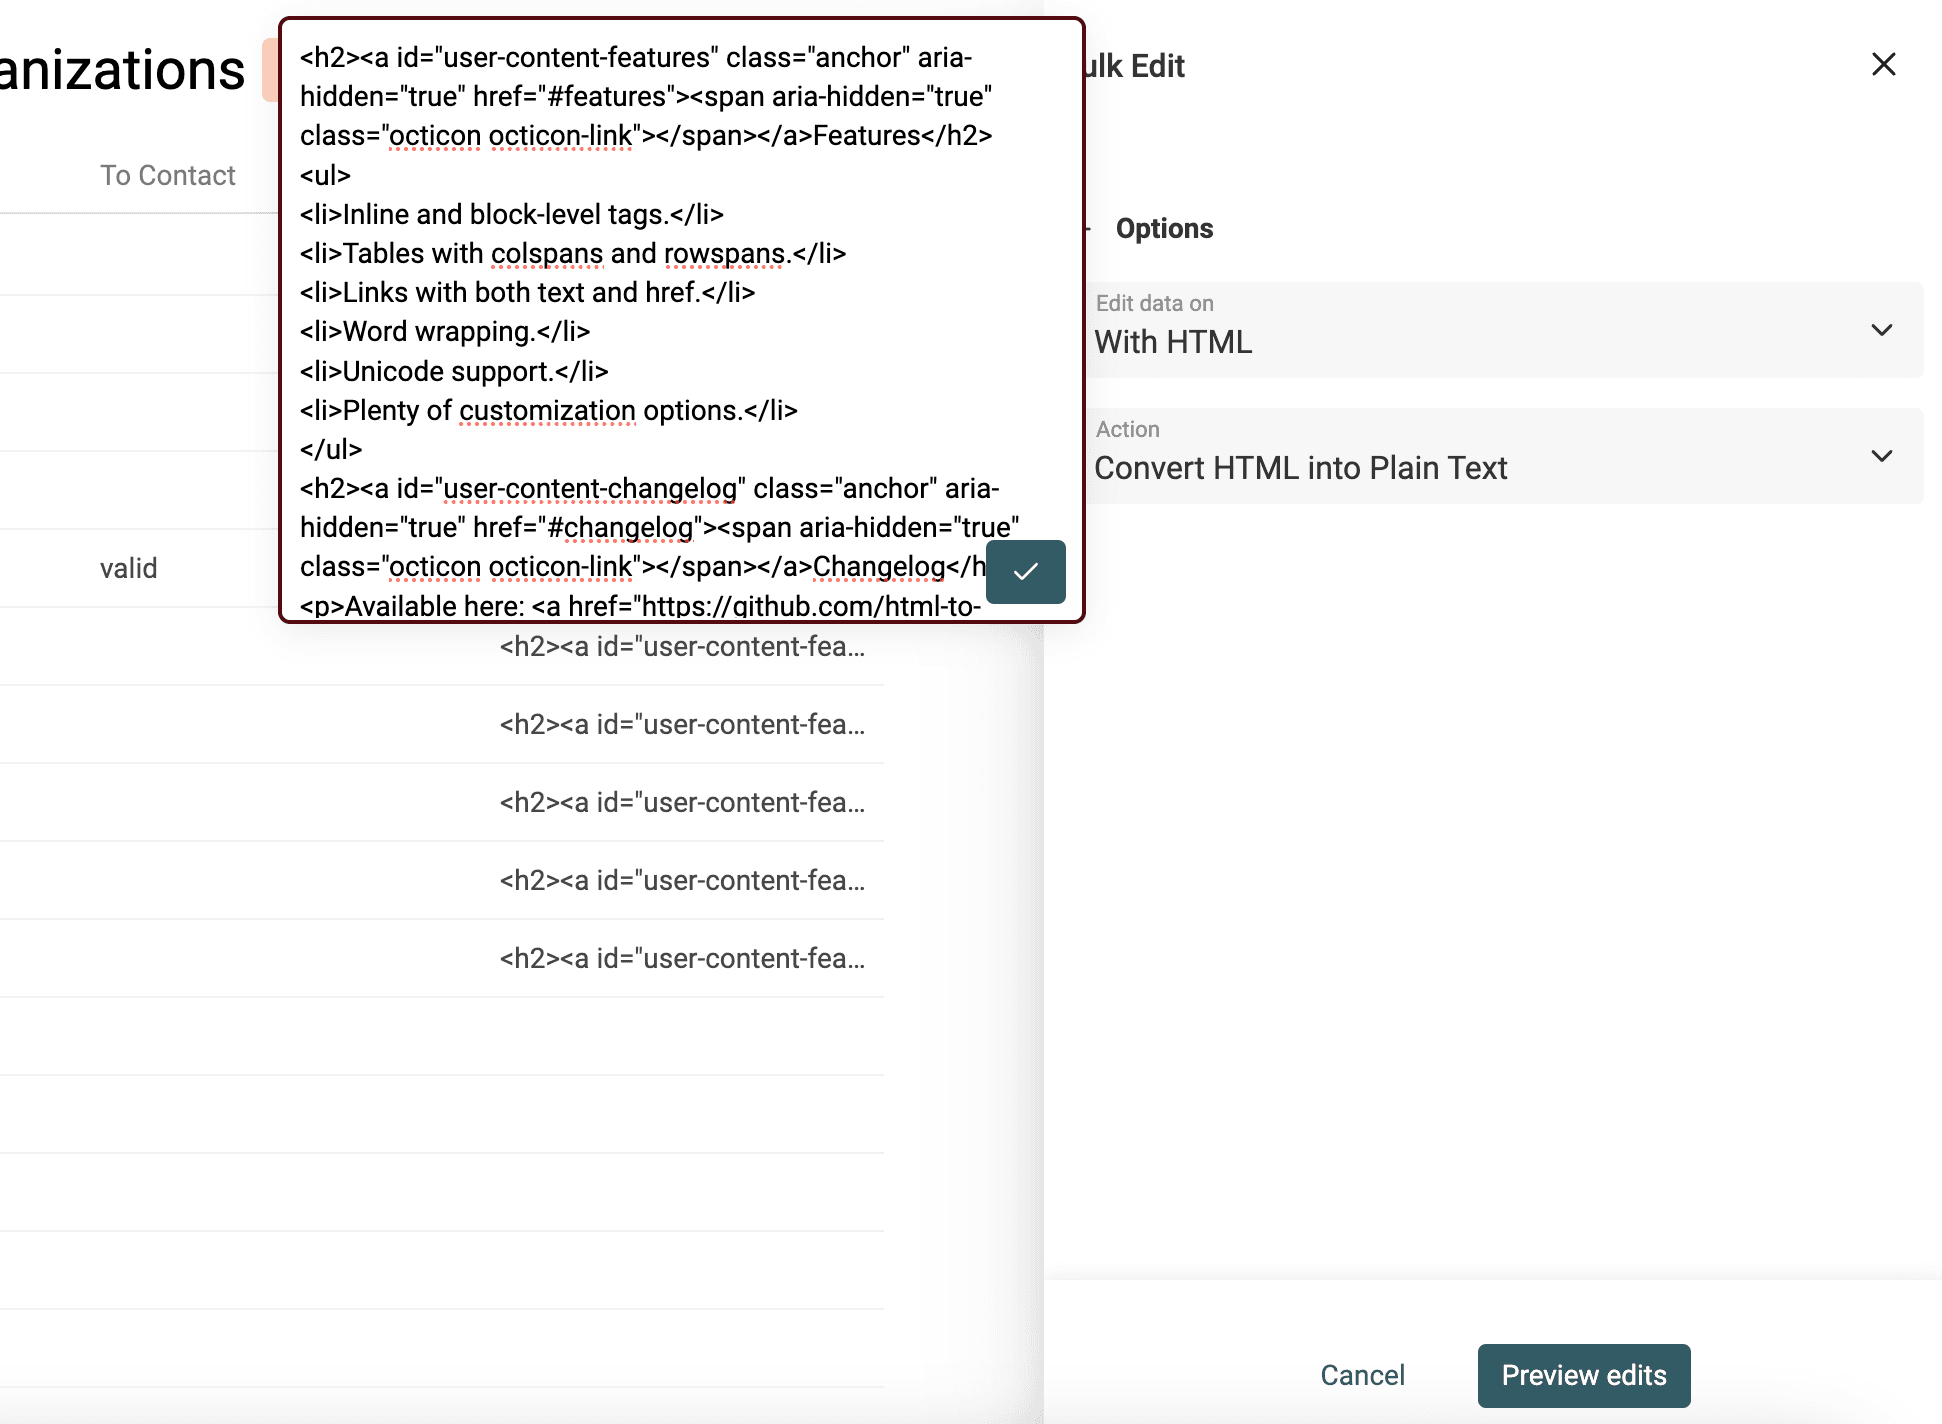
Les outils de scraping analysent le code HTML, si bien que vos textes peuvent contenir des balises HTML.
Le code HTML intègre des liens, des images et des listes à puces. Il est également structuré en paragraphes et sur plusieurs lignes.
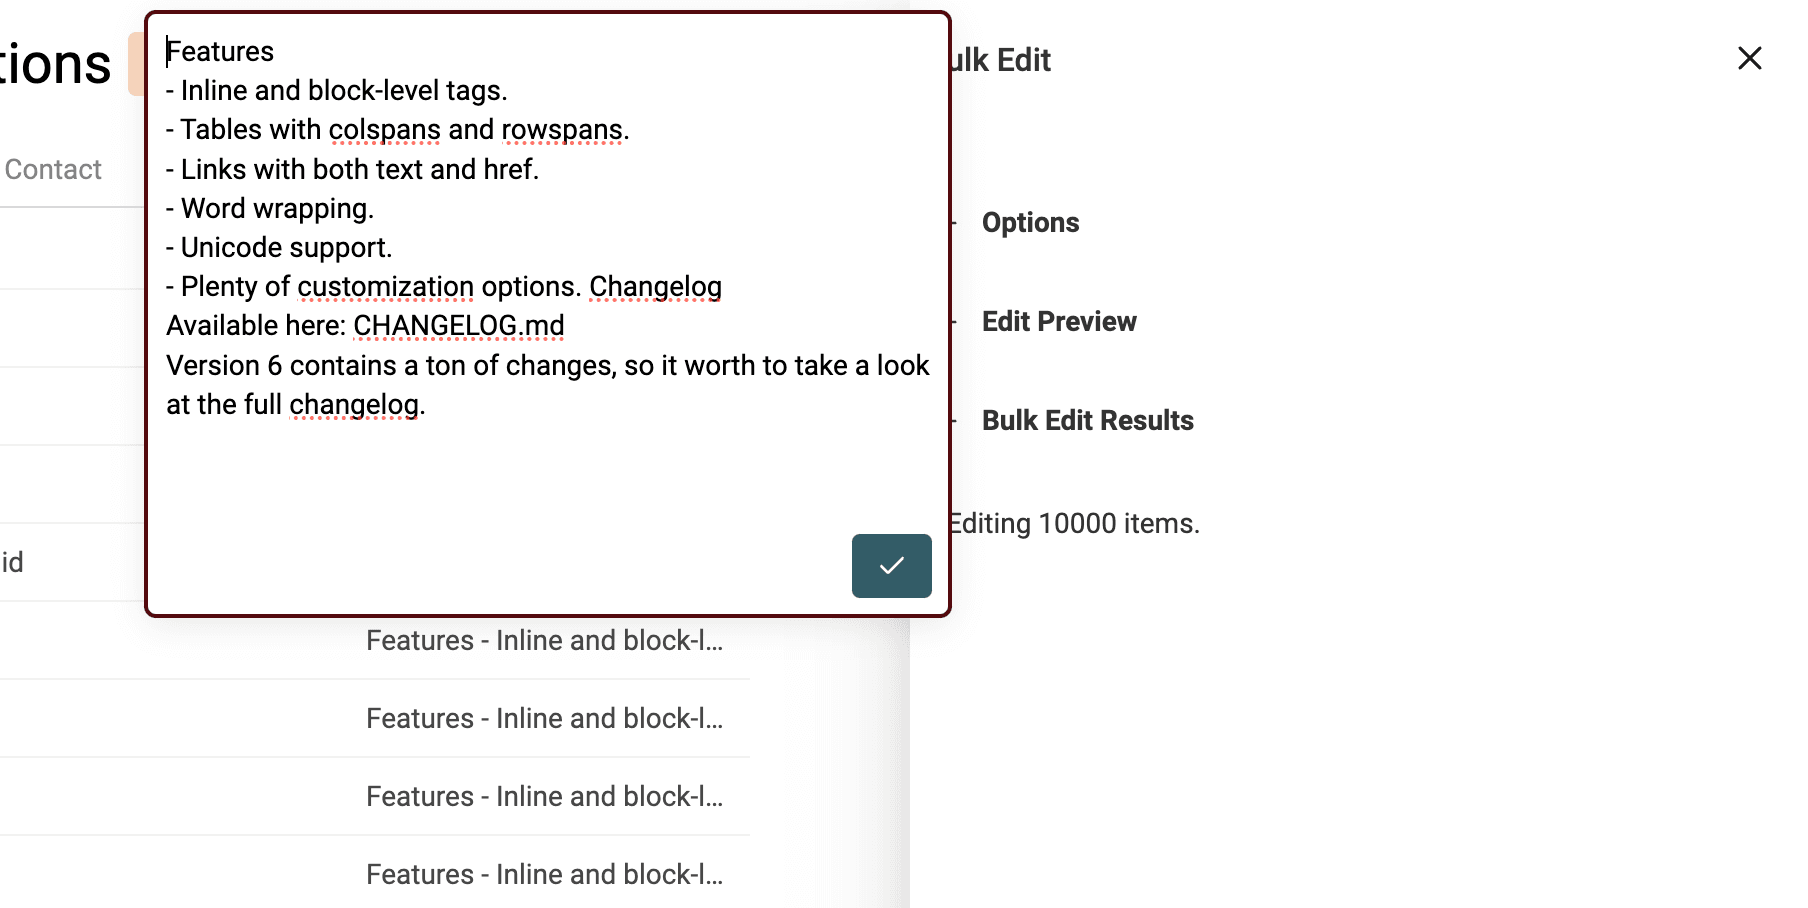
L’objectif est de conserver une partie de cette structure tout en transformant le code illisible en texte brut.
Le convertisseur HTML to Text de Datablist conserve les retours à la ligne et transforme les puces en listes préfixées par -.
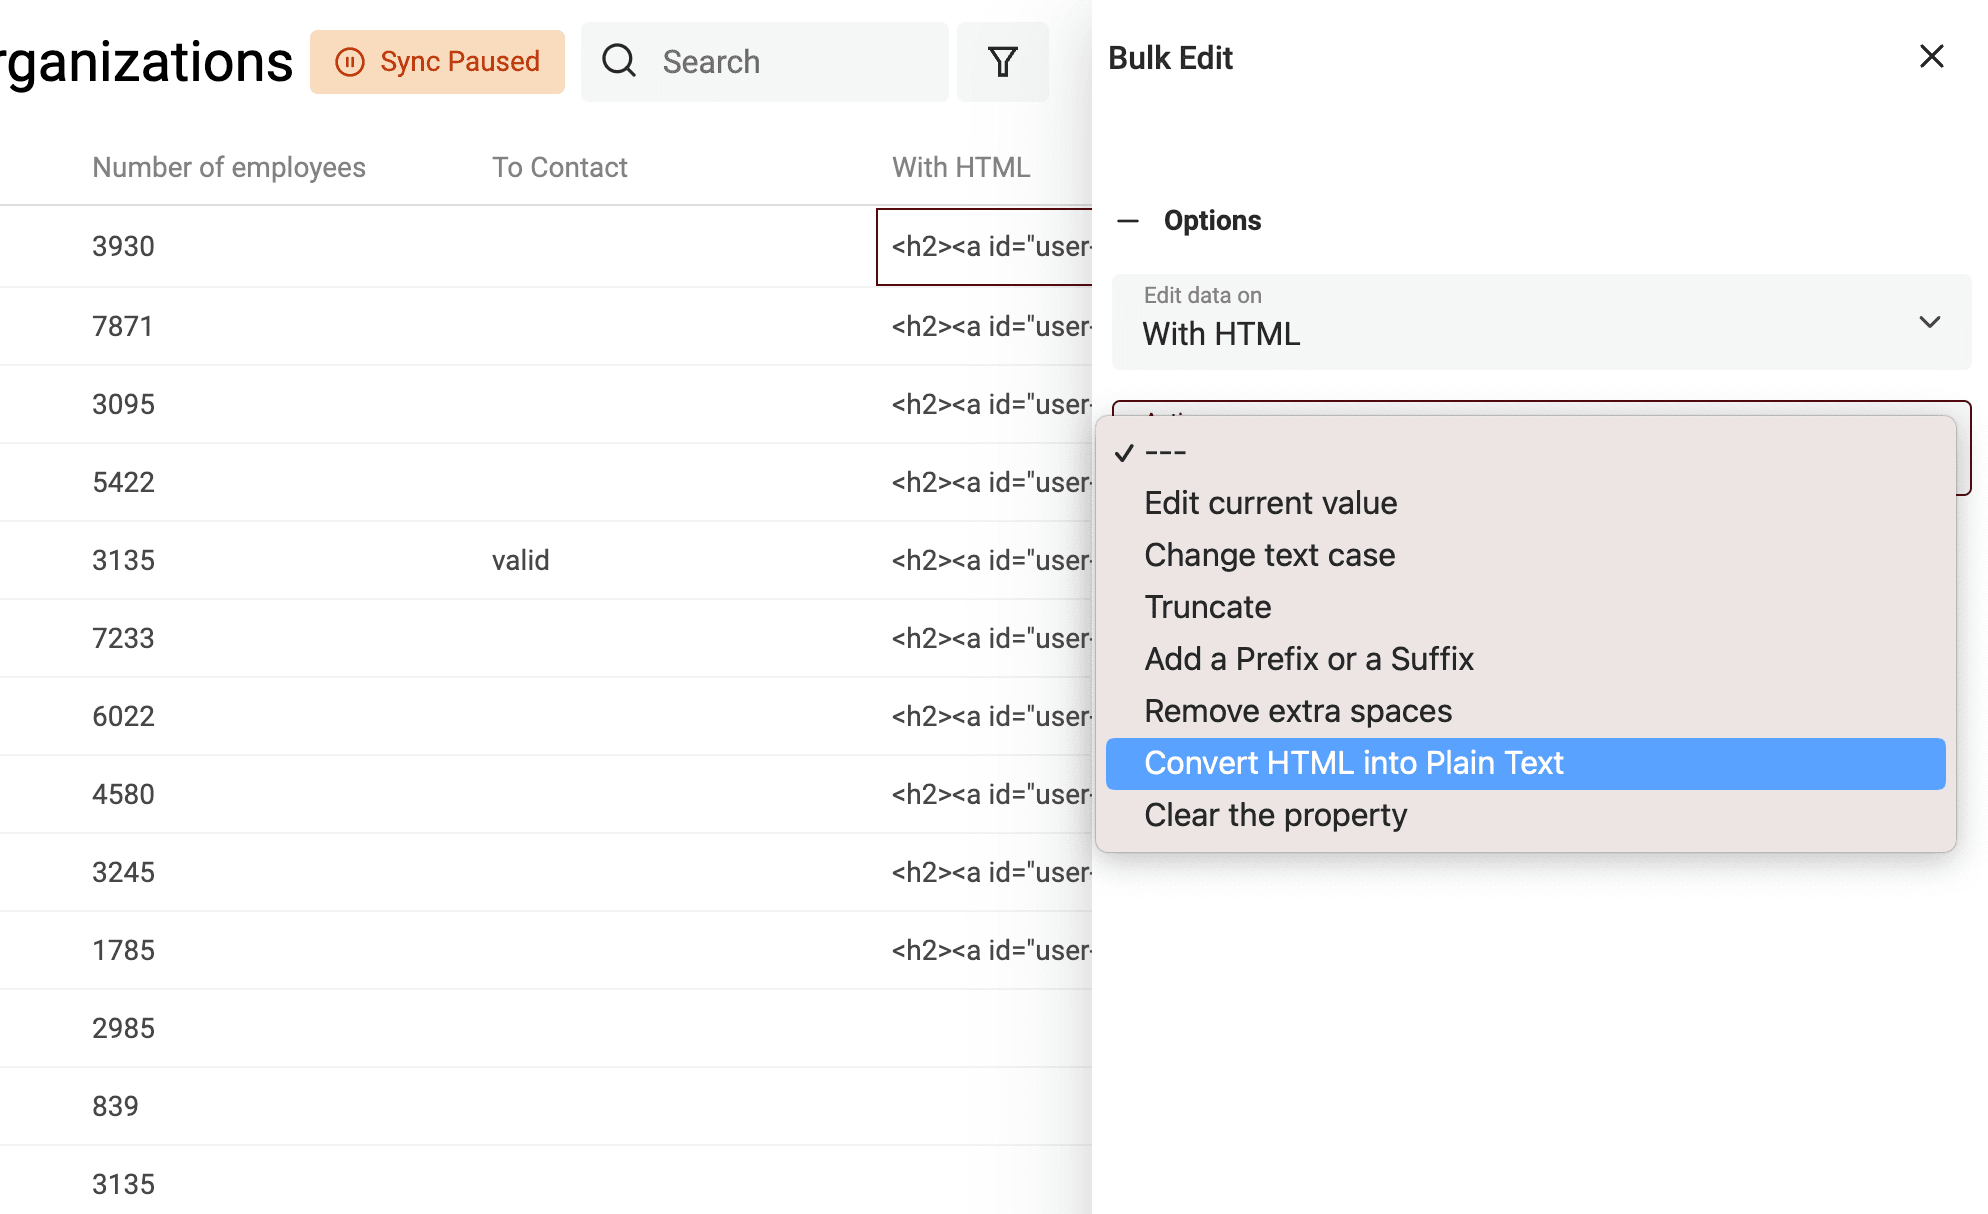
Pour convertir un texte contenant des balises HTML en texte brut, ouvrez l’outil Bulk Edit dans le menu Edit.
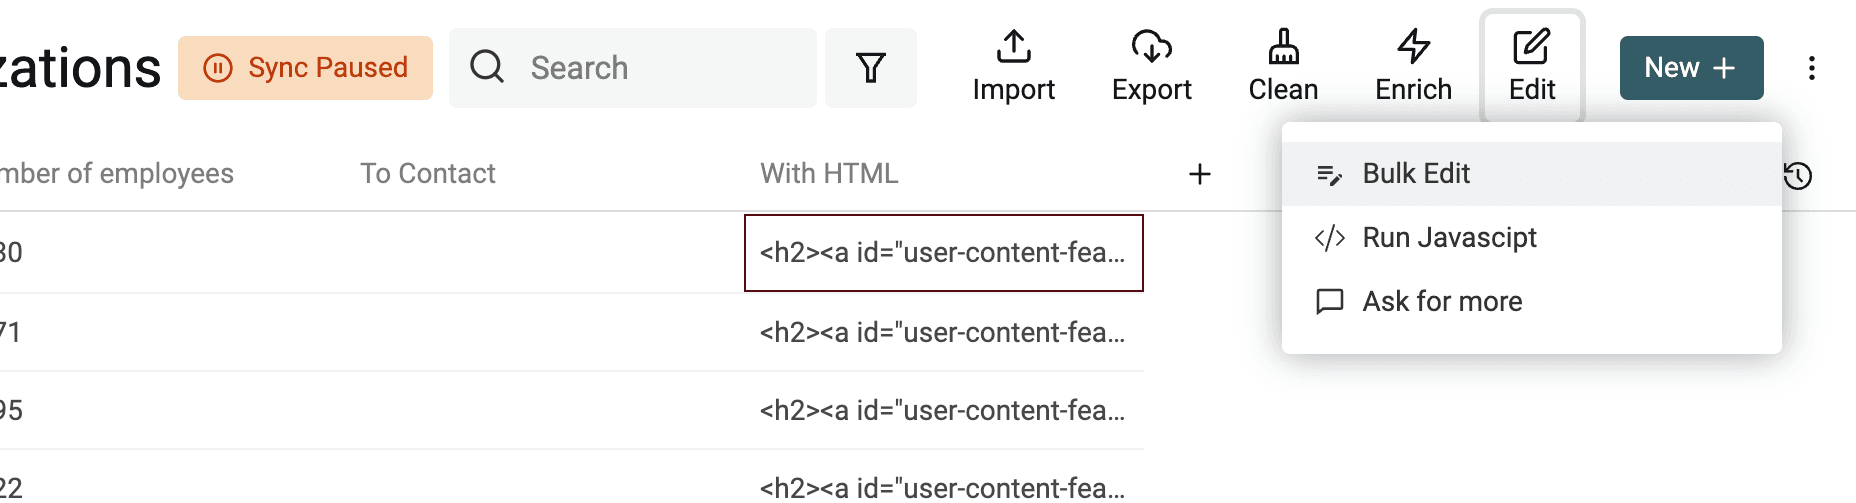
Sélectionnez la propriété contenant les balises HTML, puis « Convert HTML into plain text ».
Supprimer les espaces superflus
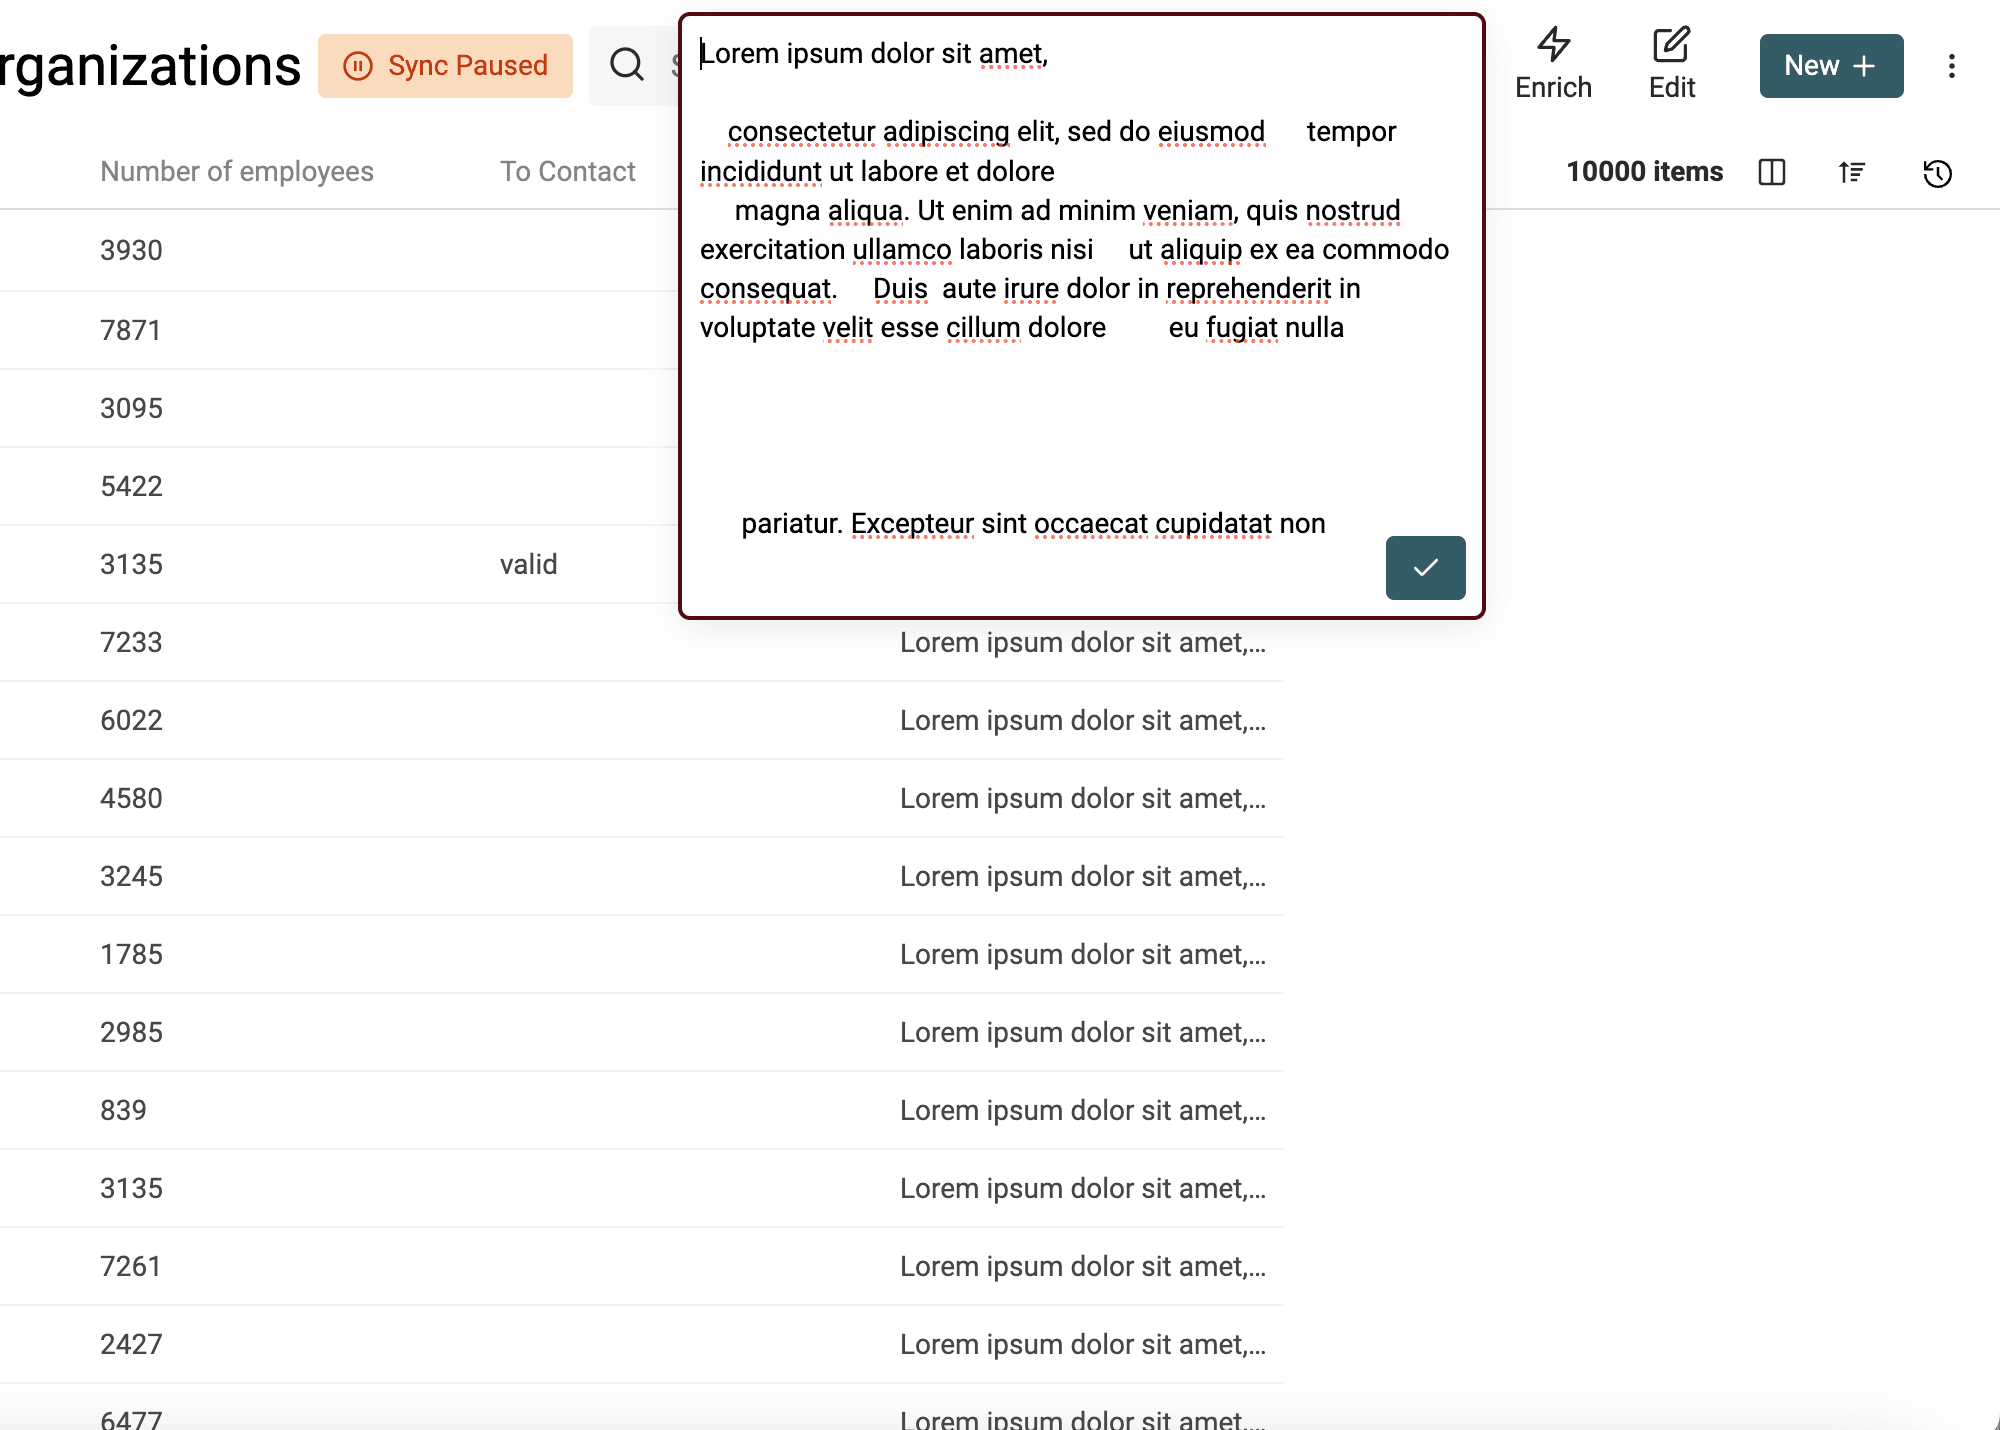
Les espaces superflus constituent un autre problème fréquent dans les données scrapées. Ils proviennent des retours à la ligne, des caractères Tab et d’autres caractères représentant une espace en HTML.
Datablist intègre un outil de nettoyage permettant de les supprimer.
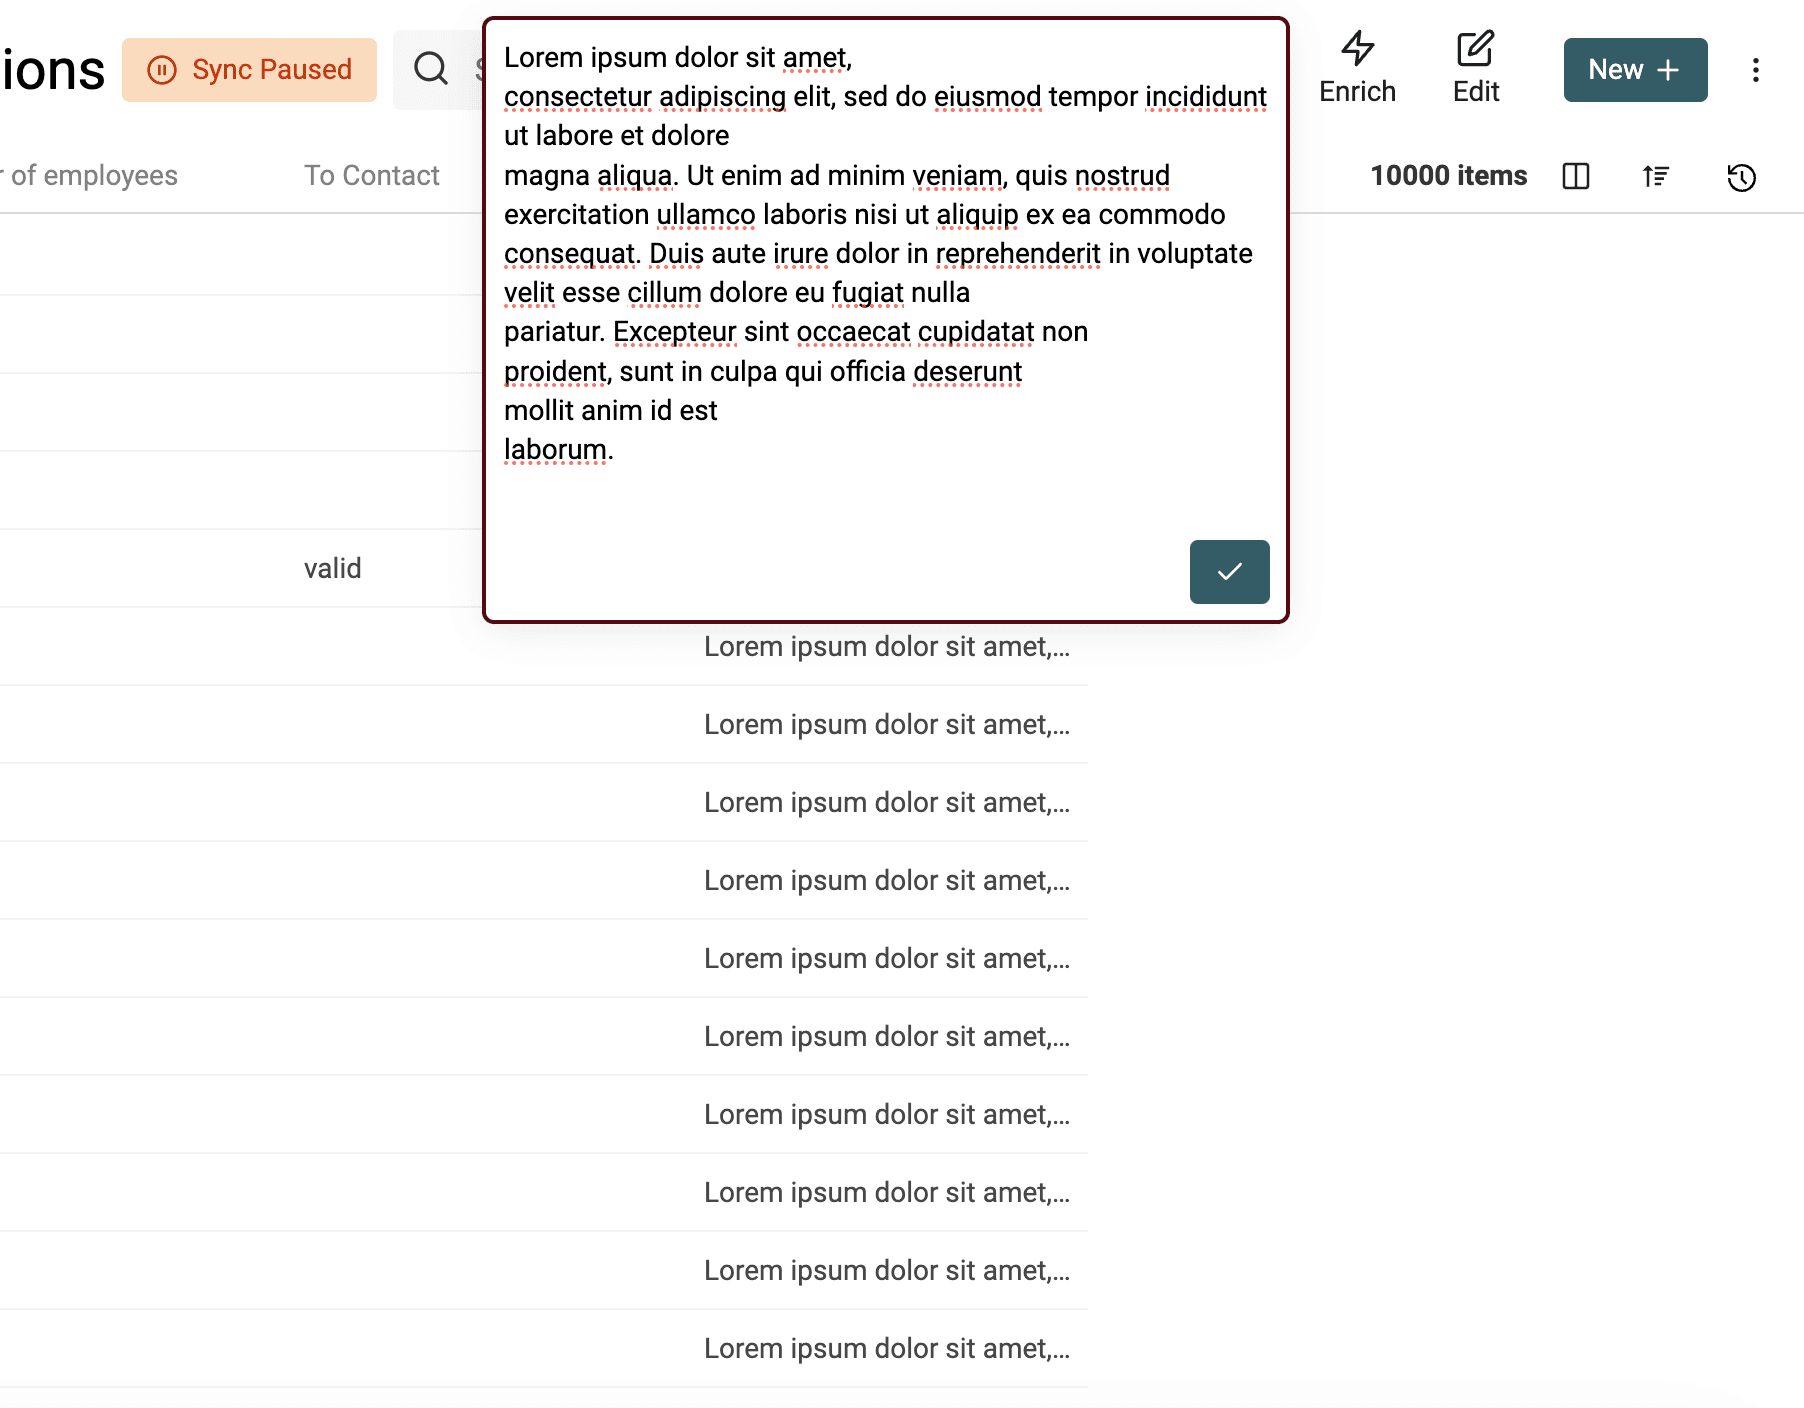
- Il supprime les espaces superflus entre les mots
- Il supprime les lignes vides
- Il supprime les espaces au début et à la fin de chaque ligne
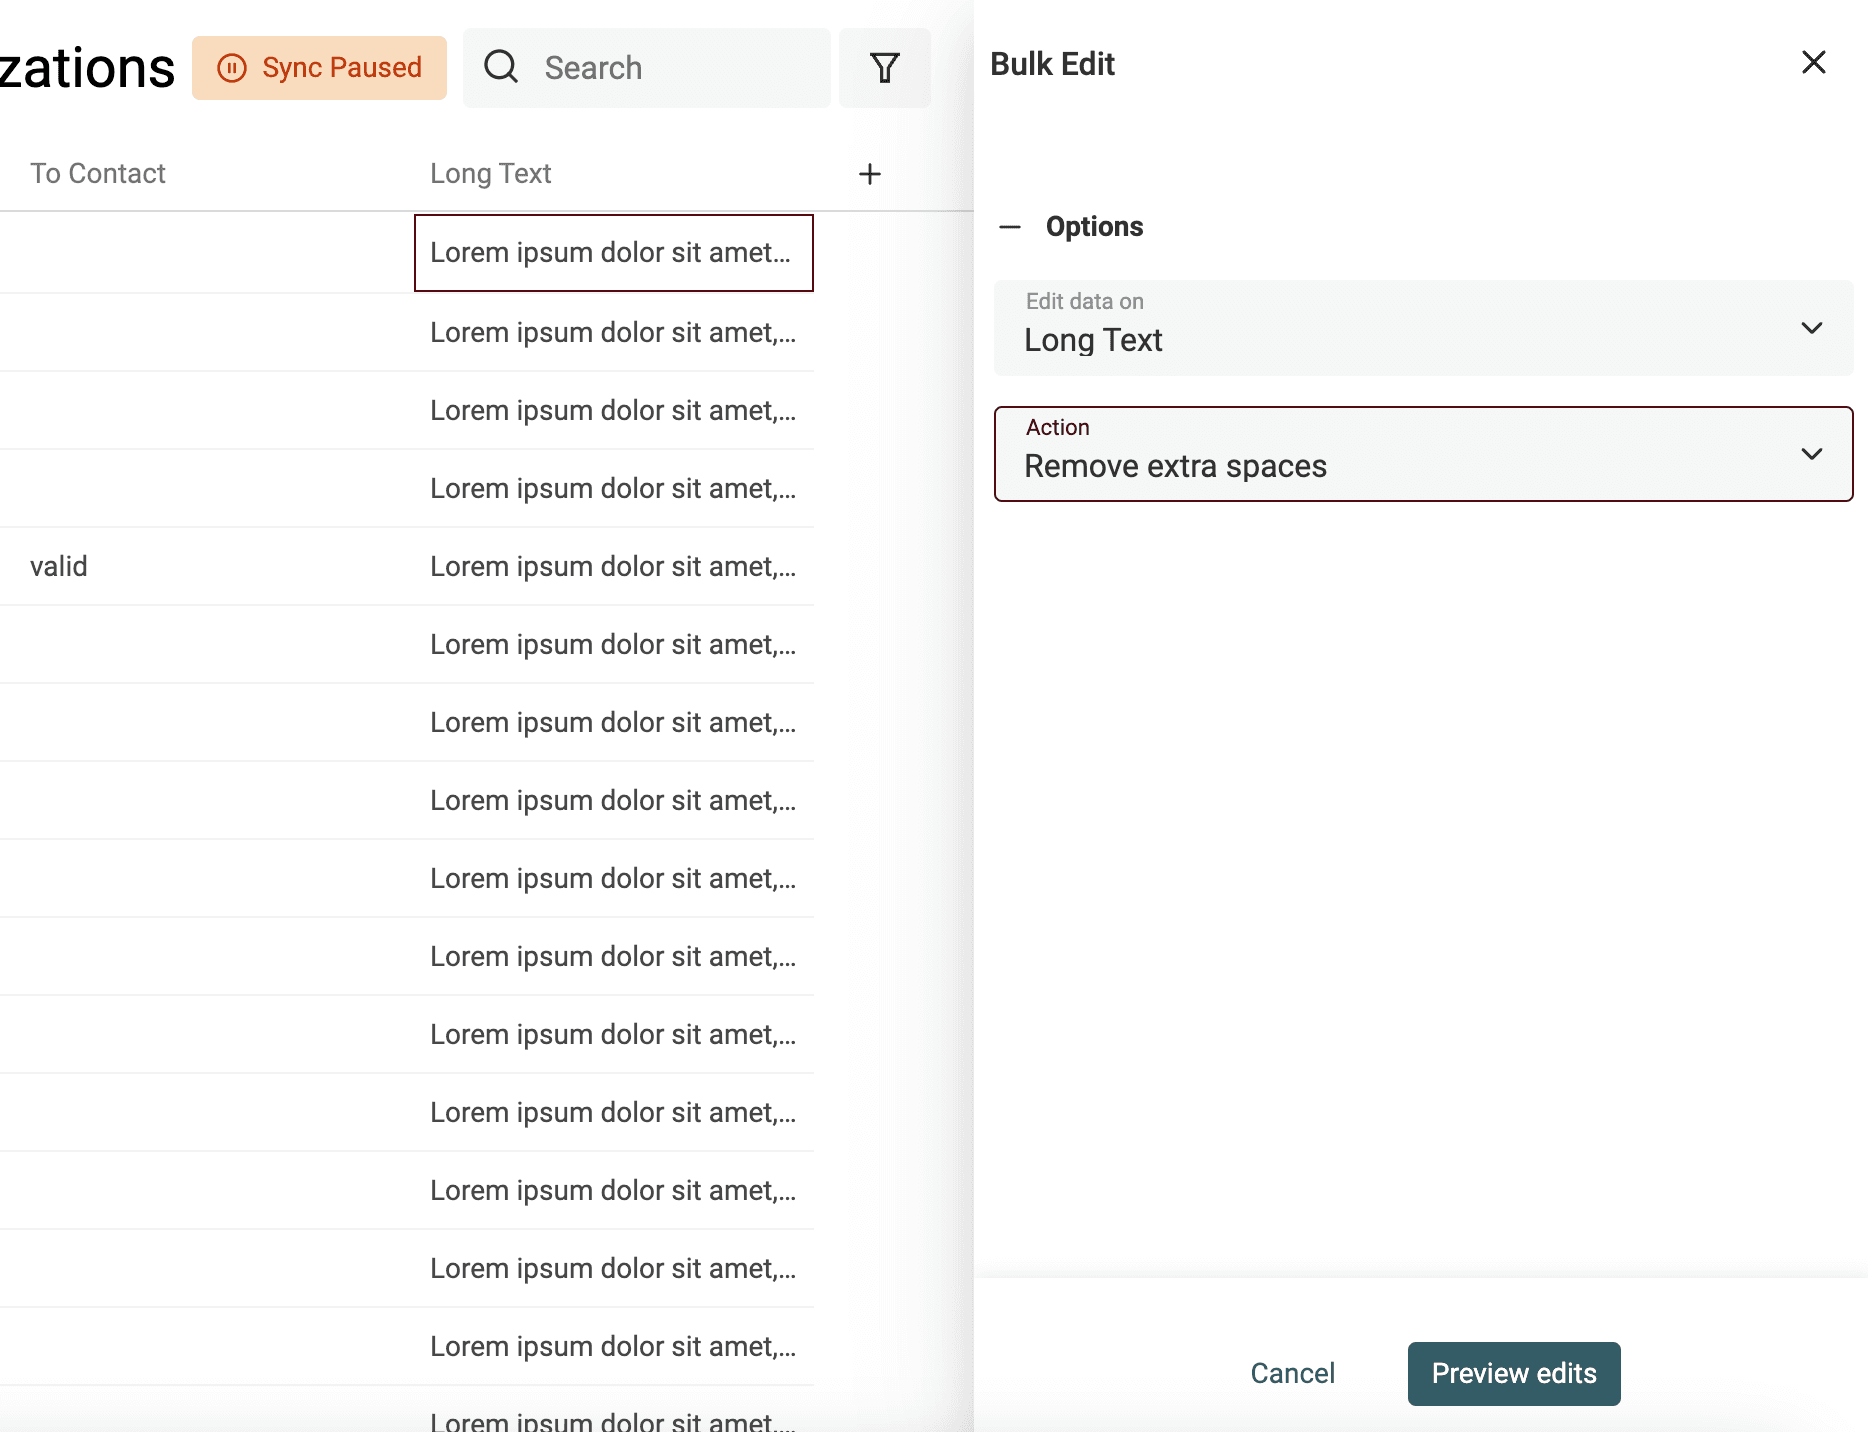
Pour supprimer ces espaces, ouvrez l’outil « Bulk Edit » depuis le menu « Edit ». Sélectionnez votre propriété, puis l’action « Remove extra spaces ».
Corriger la casse du texte
Modifier la casse de votre texte est très simple. Ouvrez l’outil « Bulk Edit » dans le menu « Edit ».
Sélectionnez la propriété à traiter, puis l’action « Change text case ».
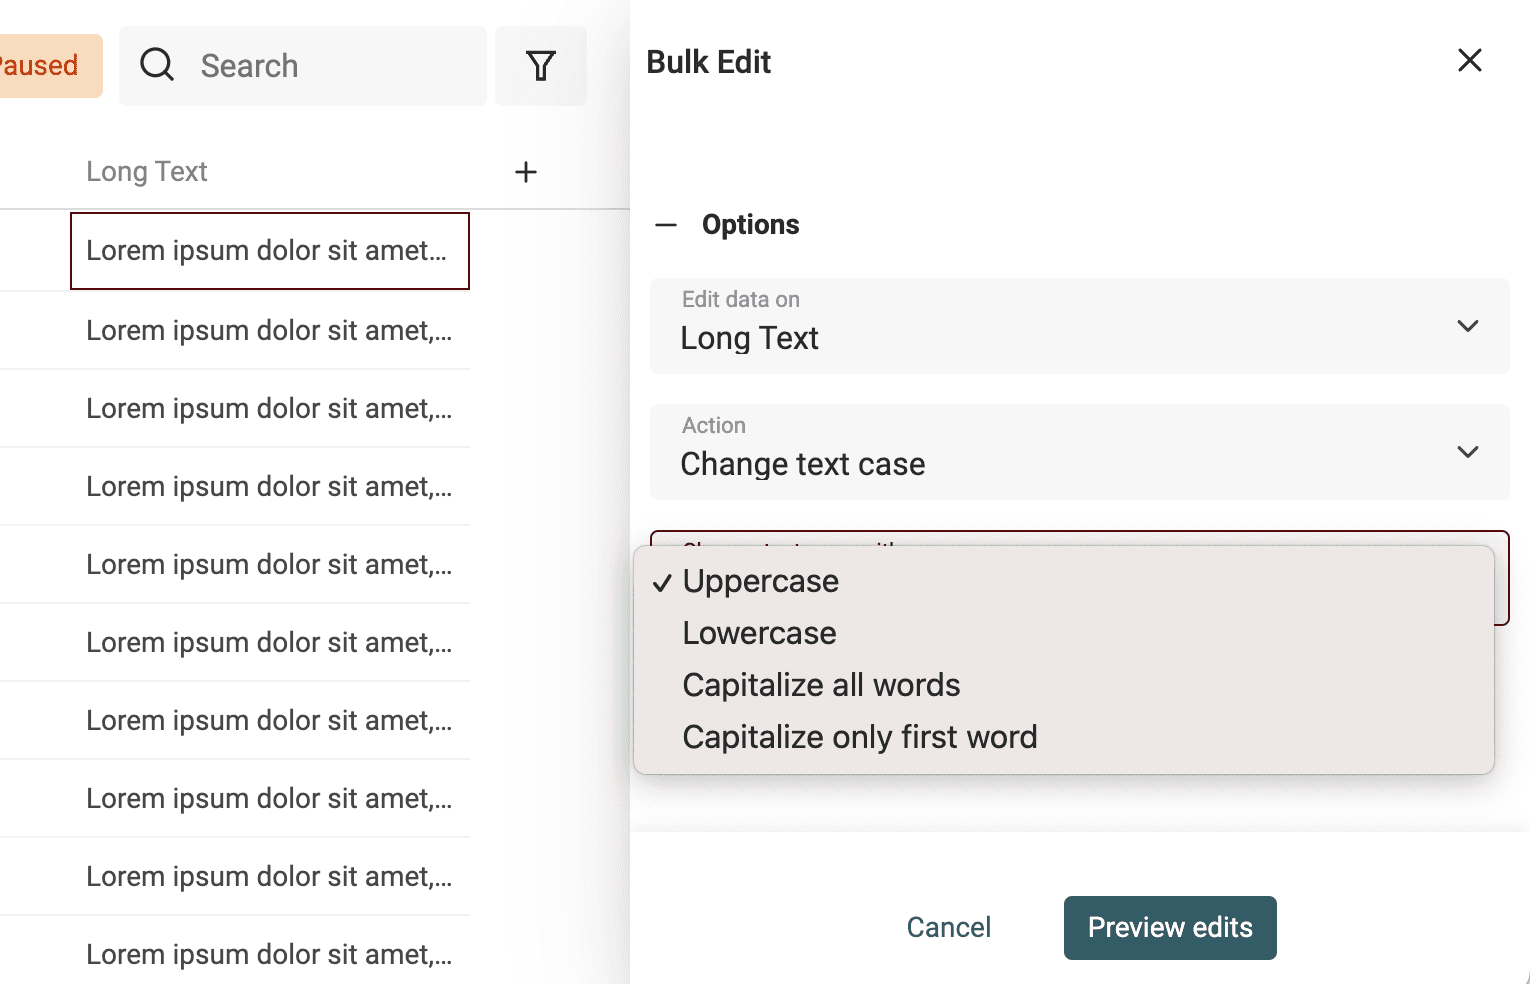
Quatre modes sont disponibles :
- Uppercase - Toutes les lettres passent en majuscules. Exemple :
john=>JOHN - Lowercase - Toutes les lettres passent en minuscules. Exemple :
API=>api - Capitalize - La première lettre de chaque mot passe en majuscule. Exemple :
john is a good man=>John Is A Good Man - Capitalize only the first word - Seule la première lettre du premier mot passe en majuscule. Exemple :
john is a good man=>John is a good man
Supprimer les symboles des textes
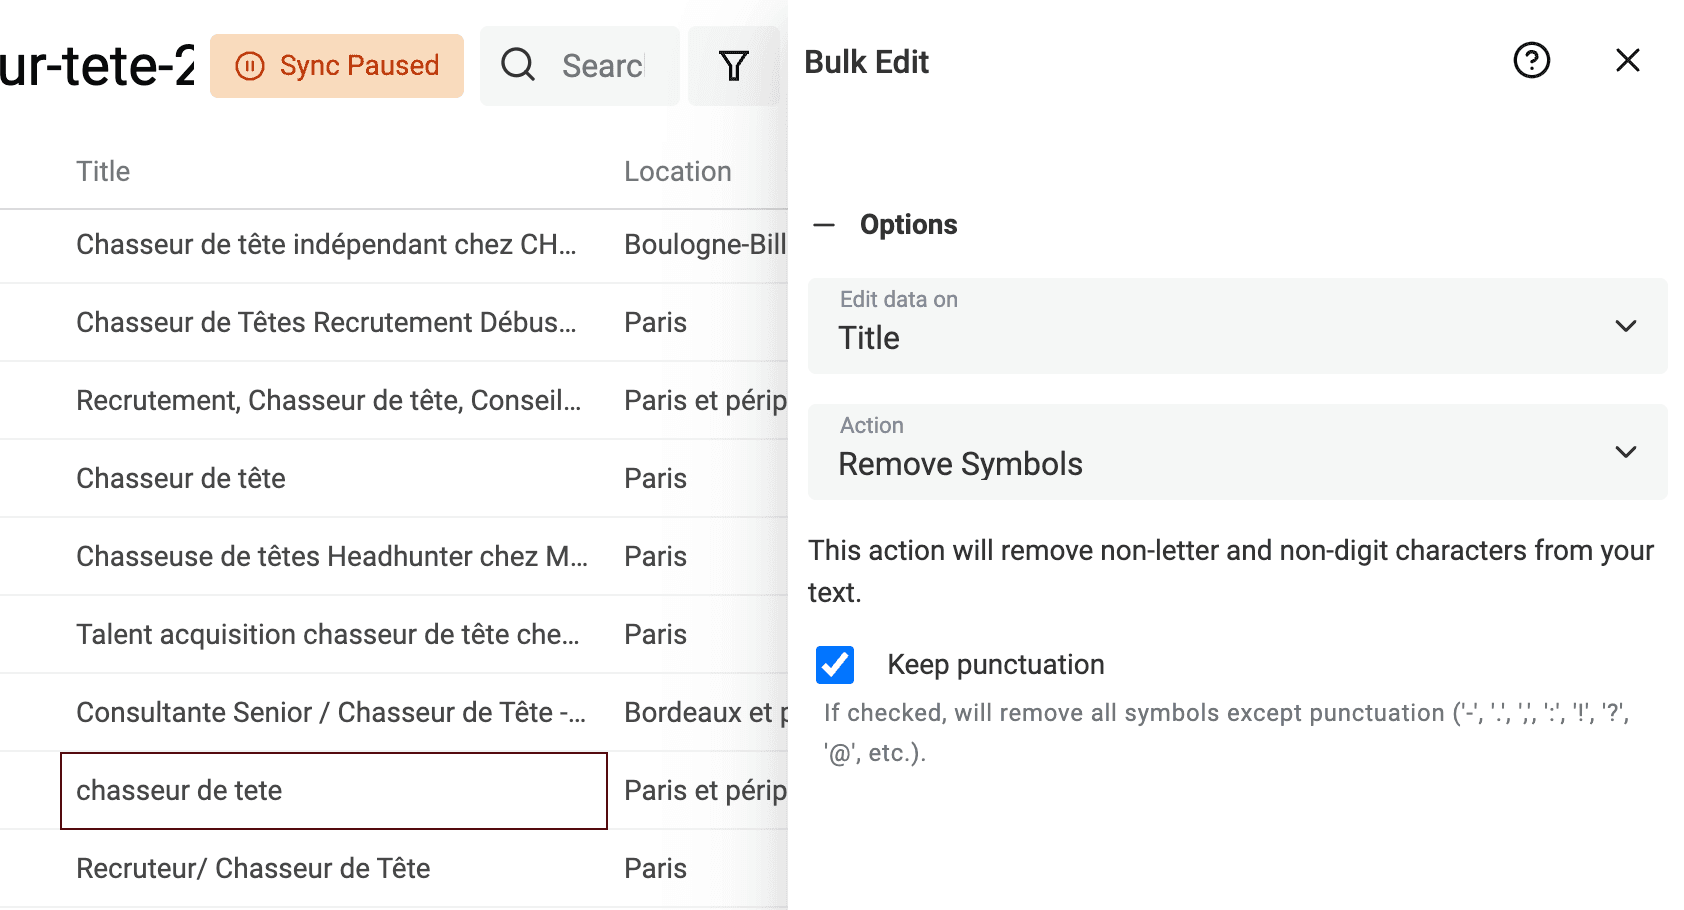
Les textes récupérés depuis des pages HTML ou saisis par des utilisateurs — par exemple, les intitulés de profils LinkedIn — peuvent contenir des symboles, comme des smileys, qui perturbent le traitement des données. Un simple smiley placé après un nom peut empêcher sa détection par un algorithme de déduplication.
Datablist intègre un processeur capable de supprimer tous les symboles non textuels de vos données.
Cliquez sur « Bulk Edit » dans le menu « Edit », sélectionnez une propriété textuelle, puis la transformation « Remove symbols ».
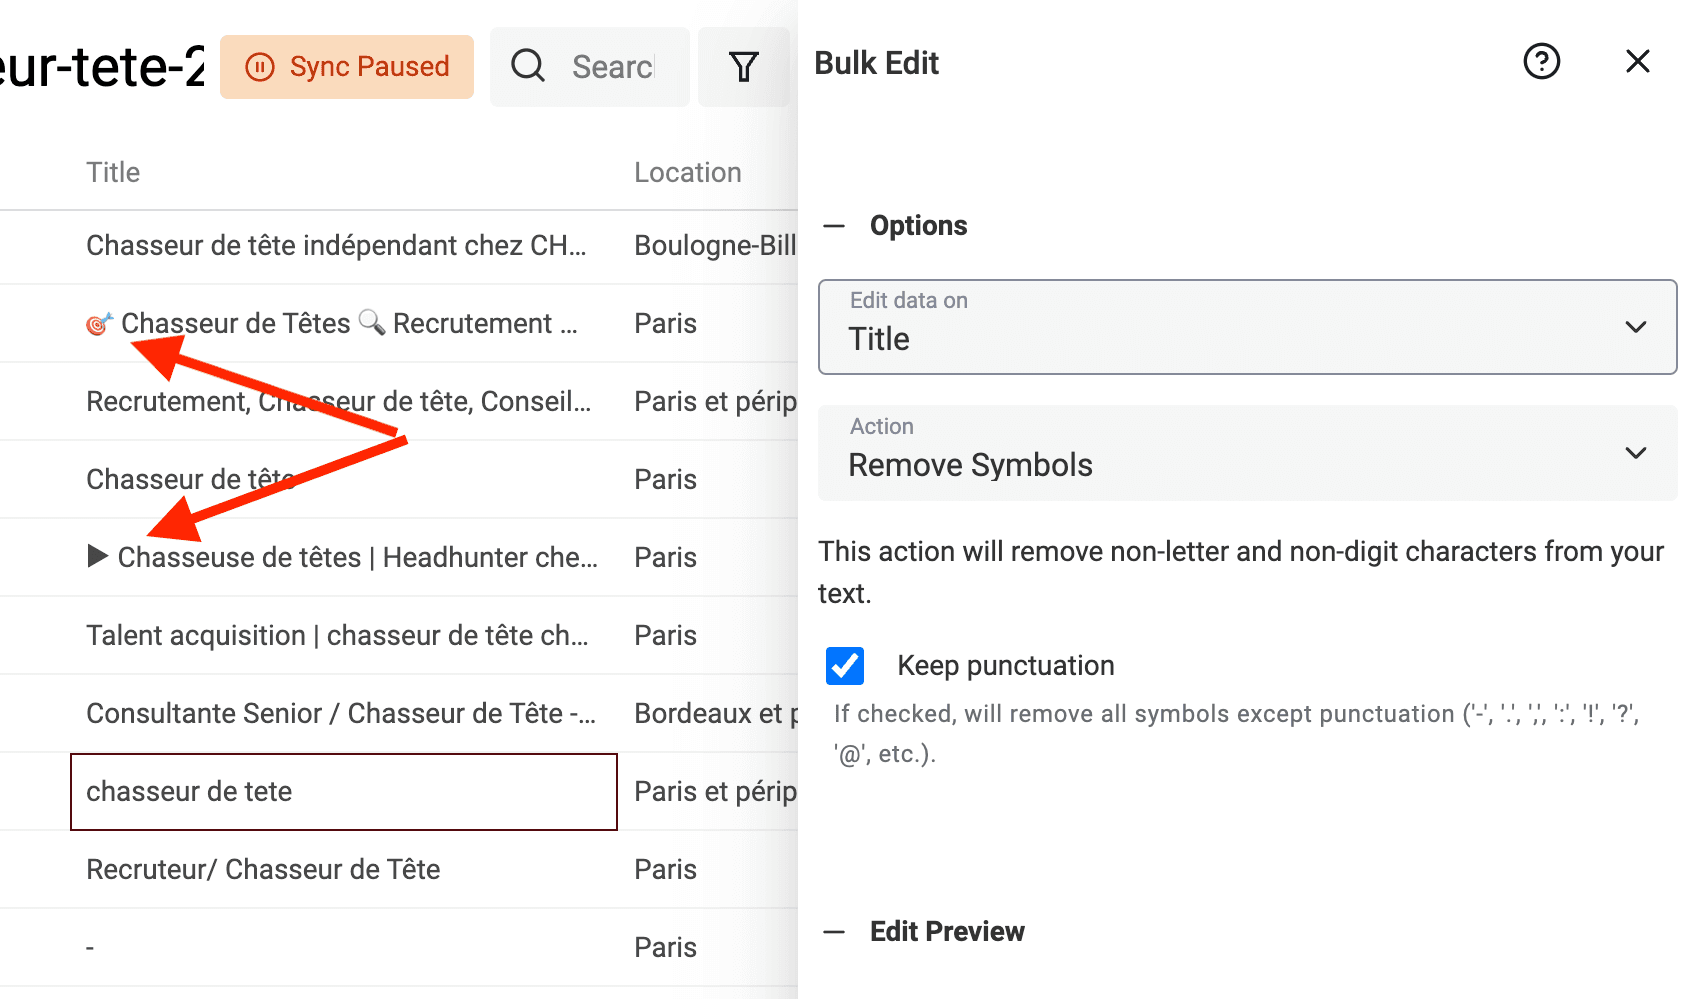
Si l’aperçu vous convient, lancez la transformation pour traiter vos éléments.
Normaliser avec Find and Replace
Pour créer des segments dans vos listes de prospects, vous devez normaliser vos données.
- Normaliser les intitulés de poste
- Normaliser les pays et les villes
- Normaliser les URLs
- Etc.
Votre objectif consiste à transformer une propriété en texte libre en une propriété proposant un nombre limité de choix. Vous pouvez aussi simplifier vos textes, par exemple en réduisant une URL avec un chemin à son seul domaine.
Datablist propose un puissant outil Find and Replace. Il fonctionne aussi bien avec du texte simple qu’avec des expressions régulières.
Les expressions régulières sont complexes, mais extrêmement puissantes.
Voici quelques exemples d’utilisation des RegEx pour nettoyer vos données.
Supprimer les paramètres d’une URL
Certains paramètres d’URL servent à suivre une campagne ; d’autres désignent un produit, une variante, un résultat de recherche ou un numéro de page. Les supprimer systématiquement peut regrouper à tort plusieurs enregistrements sous une même URL.
Commencez par dupliquer la propriété contenant l’URL source. Utilisez l’expression ci-dessous uniquement après avoir vérifié que tous les paramètres de requête de cette colonne peuvent être supprimés. Elle retire par exemple ?utm_source=newsletter d’une URL de page, mais supprimerait également ?variant=blue d’une URL de produit. Si la variante doit être conservée, gardez la requête ou supprimez uniquement les paramètres de tracking concernés au moyen d’une transformation distincte.
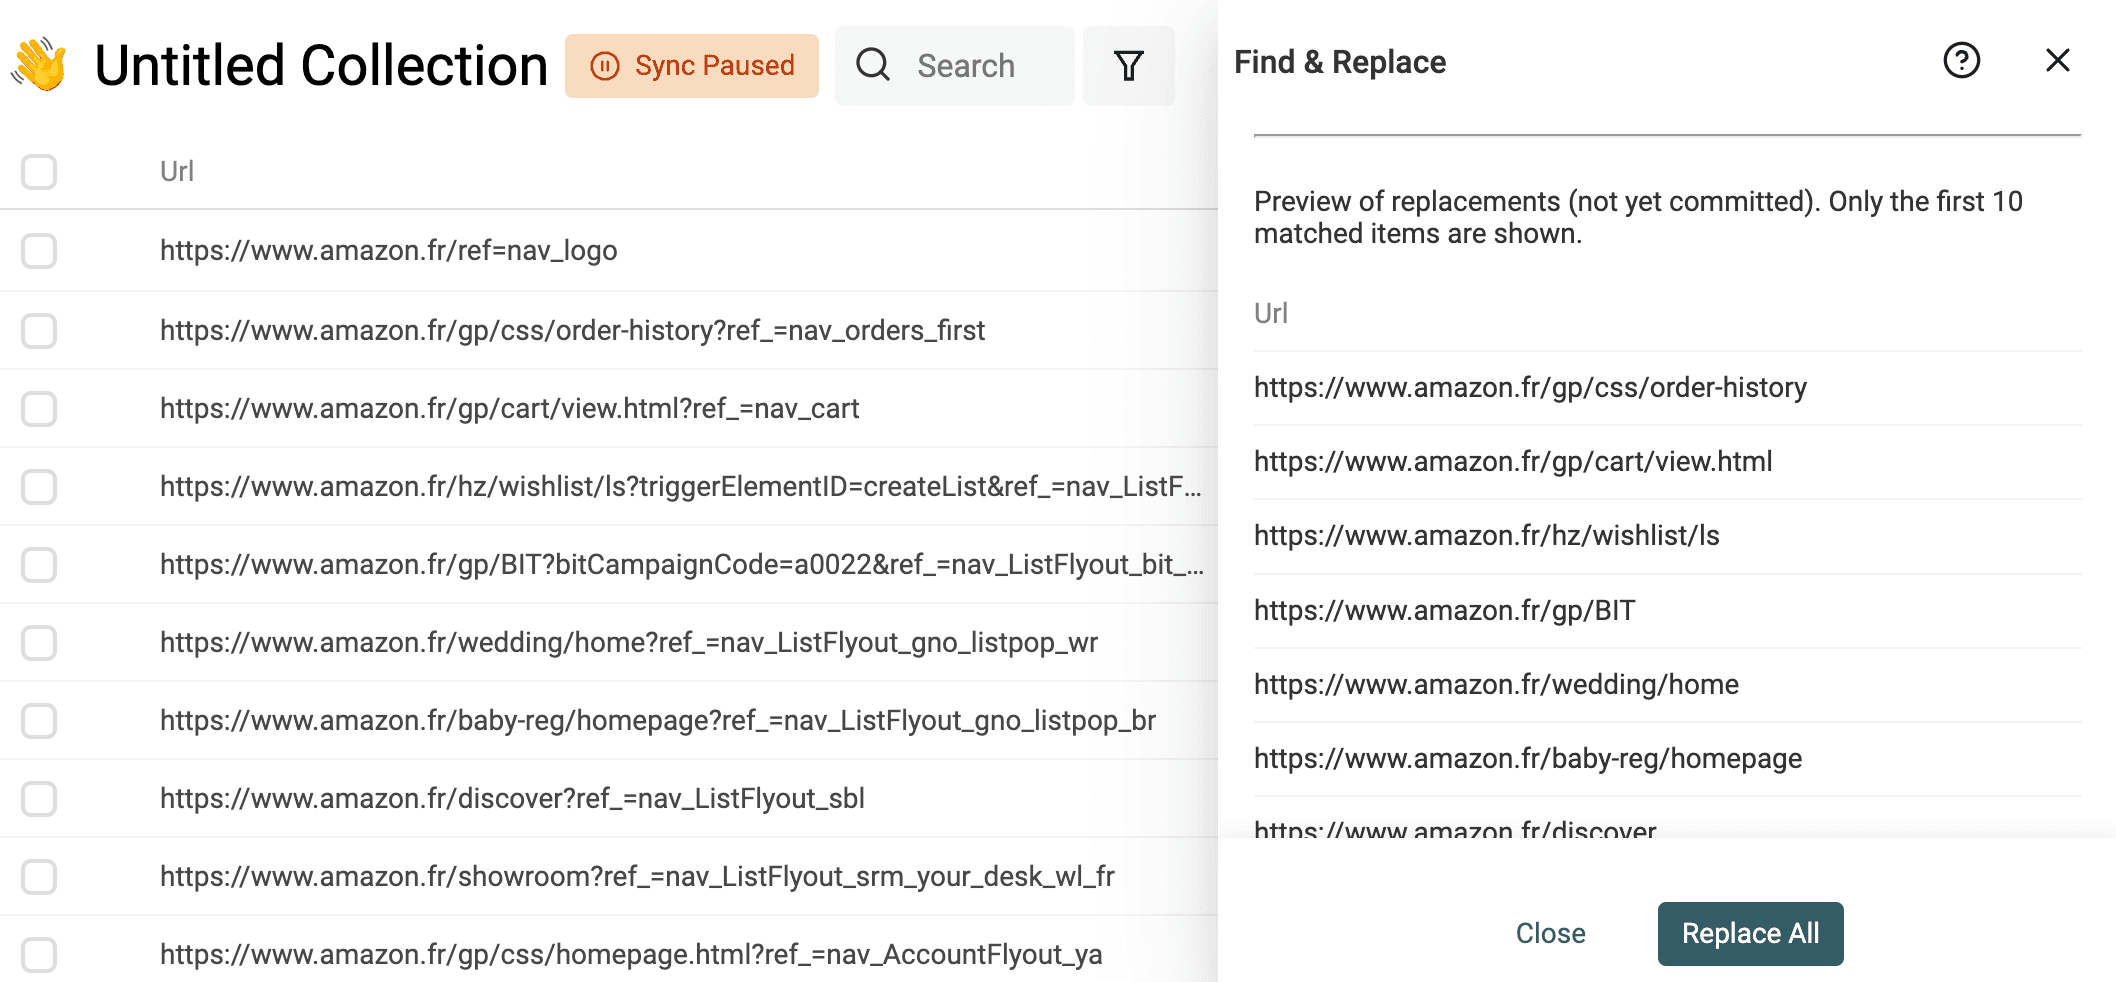
Pour supprimer l’intégralité de la requête, cochez Match using regular expression et utilisez l’expression suivante en laissant le remplacement vide :
\?.*$
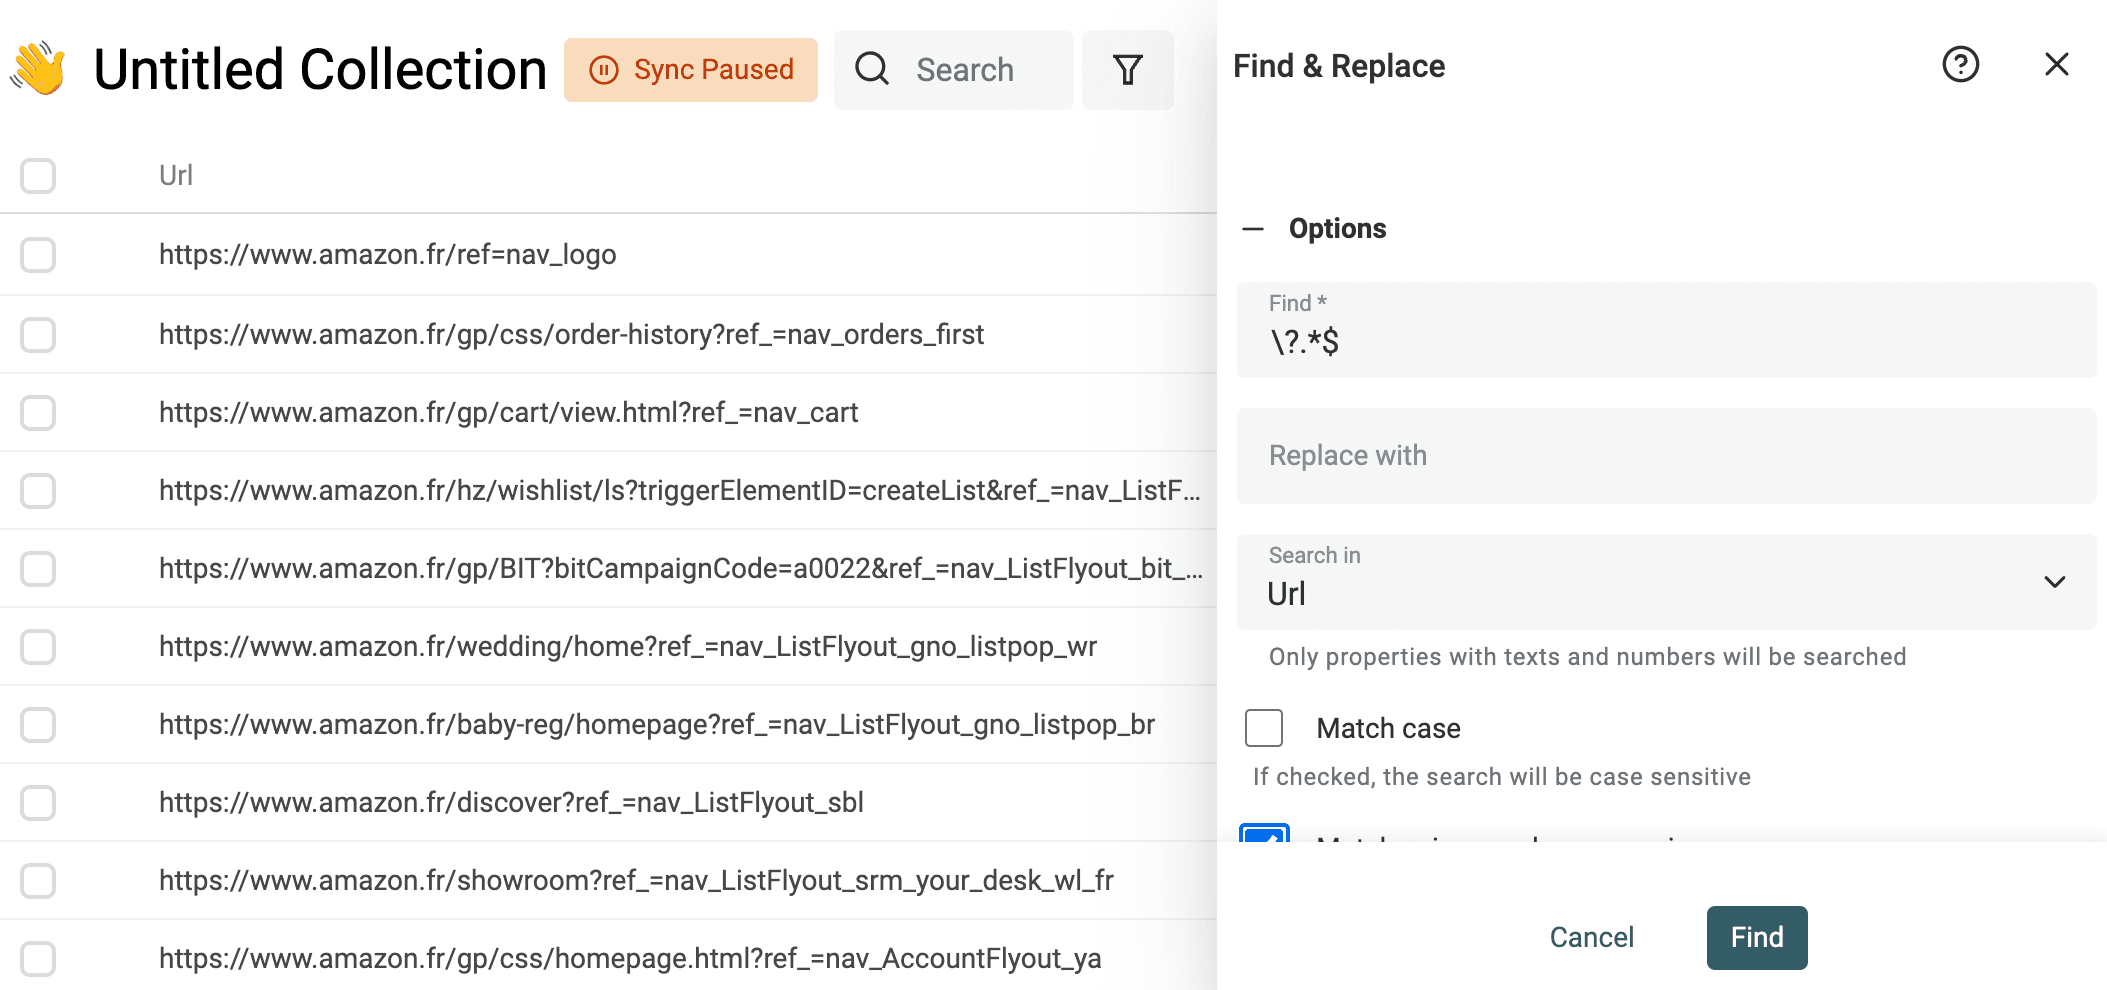
Examinez dans l’aperçu les URLs avec et sans paramètres, puis appliquez la transformation uniquement à la copie de la propriété si les URLs désignent toujours les pages voulues.
Extraire le domaine d’une adresse email
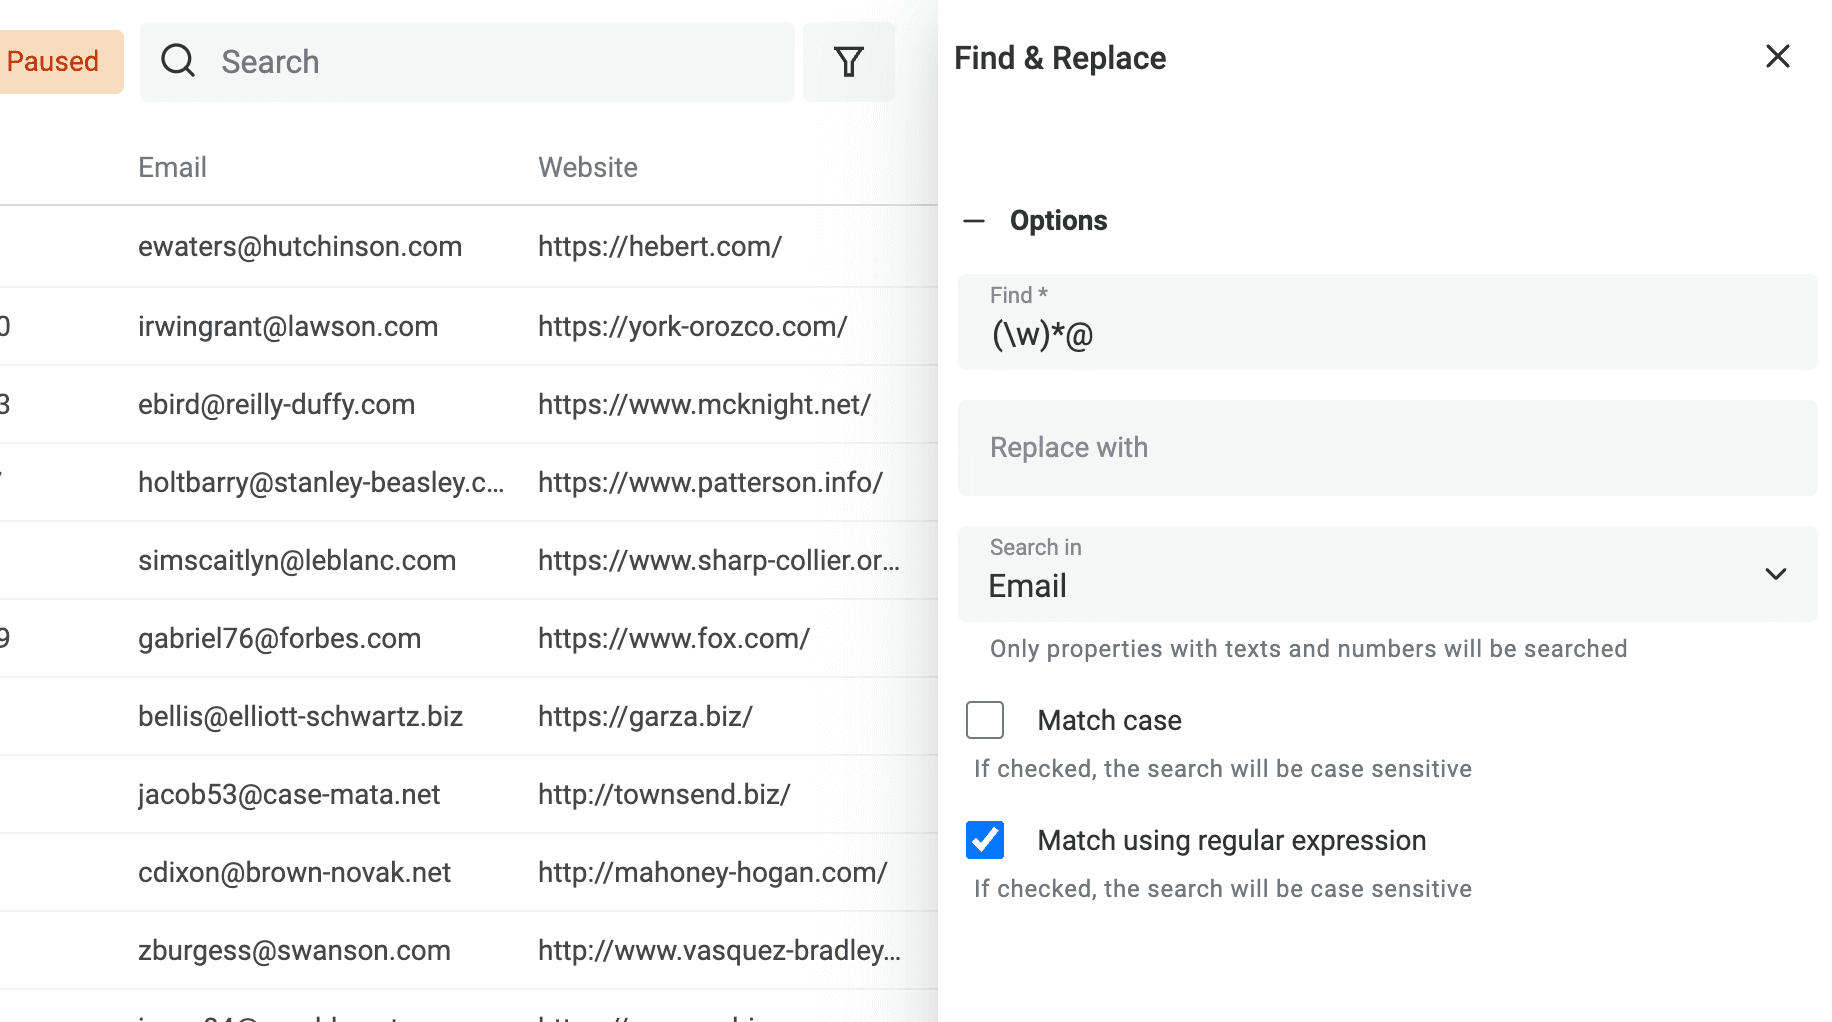
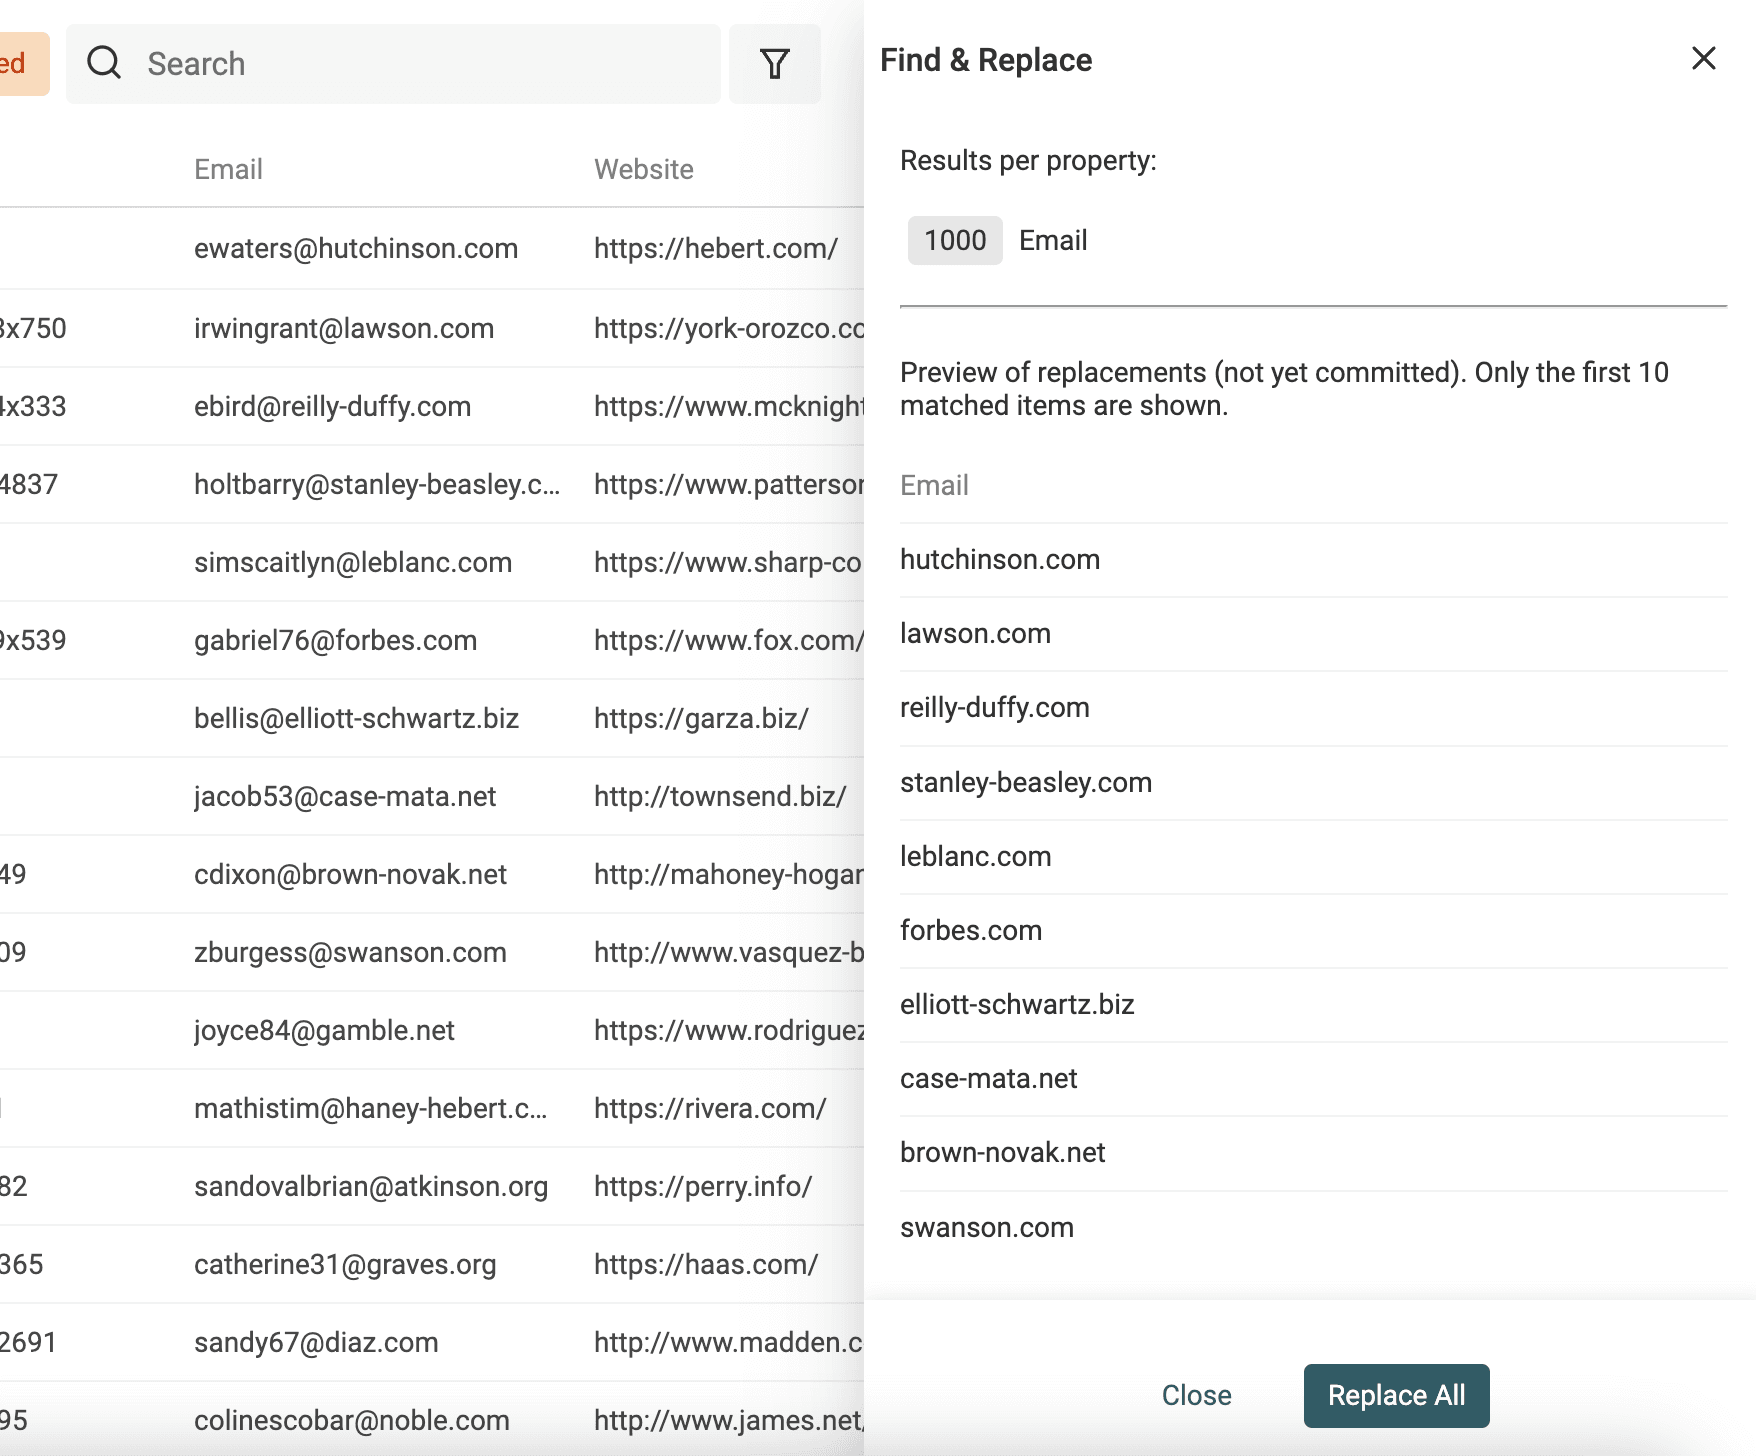
Find and Replace permet également d’extraire le domaine d’un email. Vous obtenez ainsi la partie située après @, qui ne correspond pas toujours au site de l’entreprise : un contact peut utiliser une messagerie personnelle.
Dupliquez la propriété email afin de préserver la valeur source. Pour les cellules contenant une seule adresse email en texte brut, utilisez cette expression régulière en laissant le remplacement vide :
^[^@\s]+@(?=[^@\s]+$)
Cette expression gère les parties locales contenant des points, des signes plus et des traits d’union. Par exemple, jane.smith+sales@example.com devient example.com. L’ancienne capture d’écran ci-dessous présente une expression plus restrictive ; utilisez celle indiquée ci-dessus.
Commencez par supprimer les espaces autour de l’adresse. Les cellules comprenant un nom d’affichage, plusieurs adresses ou un email mal formé nécessitent un nettoyage distinct. Cette transformation extrait un domaine ; elle ne valide pas l’existence de la boîte mail.
👉 Pour en savoir plus, consultez notre documentation sur Find and Replace.
Séparer le nom complet en prénom et nom
Lorsque vous scrapez des listes de leads, vous récupérez souvent un champ « Full Name » qu’il faut séparer en « First Name » et « Last Name ». Savoir décomposer correctement le nom d’une personne est une étape essentielle.
La séparation des champs facilite la personnalisation des messages et le mapping des données vers un CRM. Conservez le nom complet pour pouvoir contrôler les séparations incorrectes : un nom seul ne permet pas de déterminer le genre ou la civilité d’une personne.
La séparation des noms peut s’avérer complexe. Heureusement, Datablist propose un outil simple qui divise le champ « Name » en deux valeurs en utilisant l’espace comme séparateur.
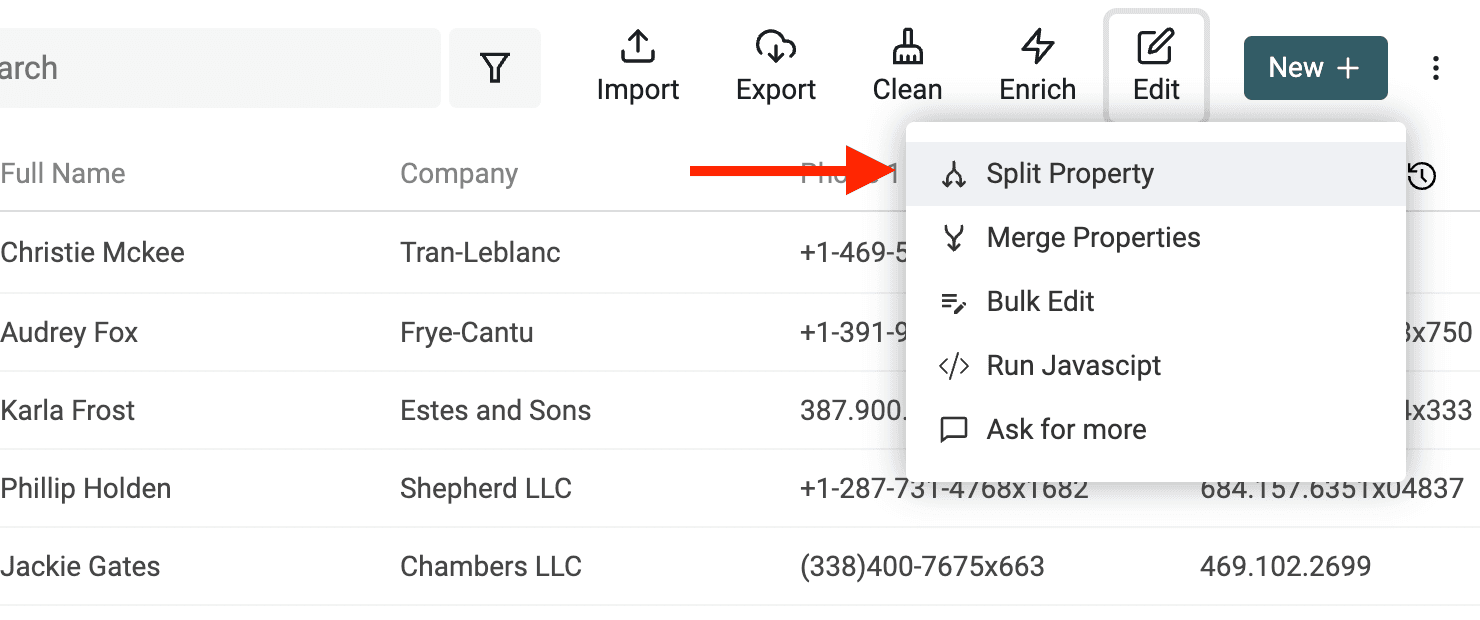
Pour commencer, ouvrez l’outil « Split Property » dans le menu « Edit ».
Sélectionnez ensuite la propriété contenant les noms à analyser. Choisissez Space comme séparateur et fixez le nombre maximal de parties à 2.
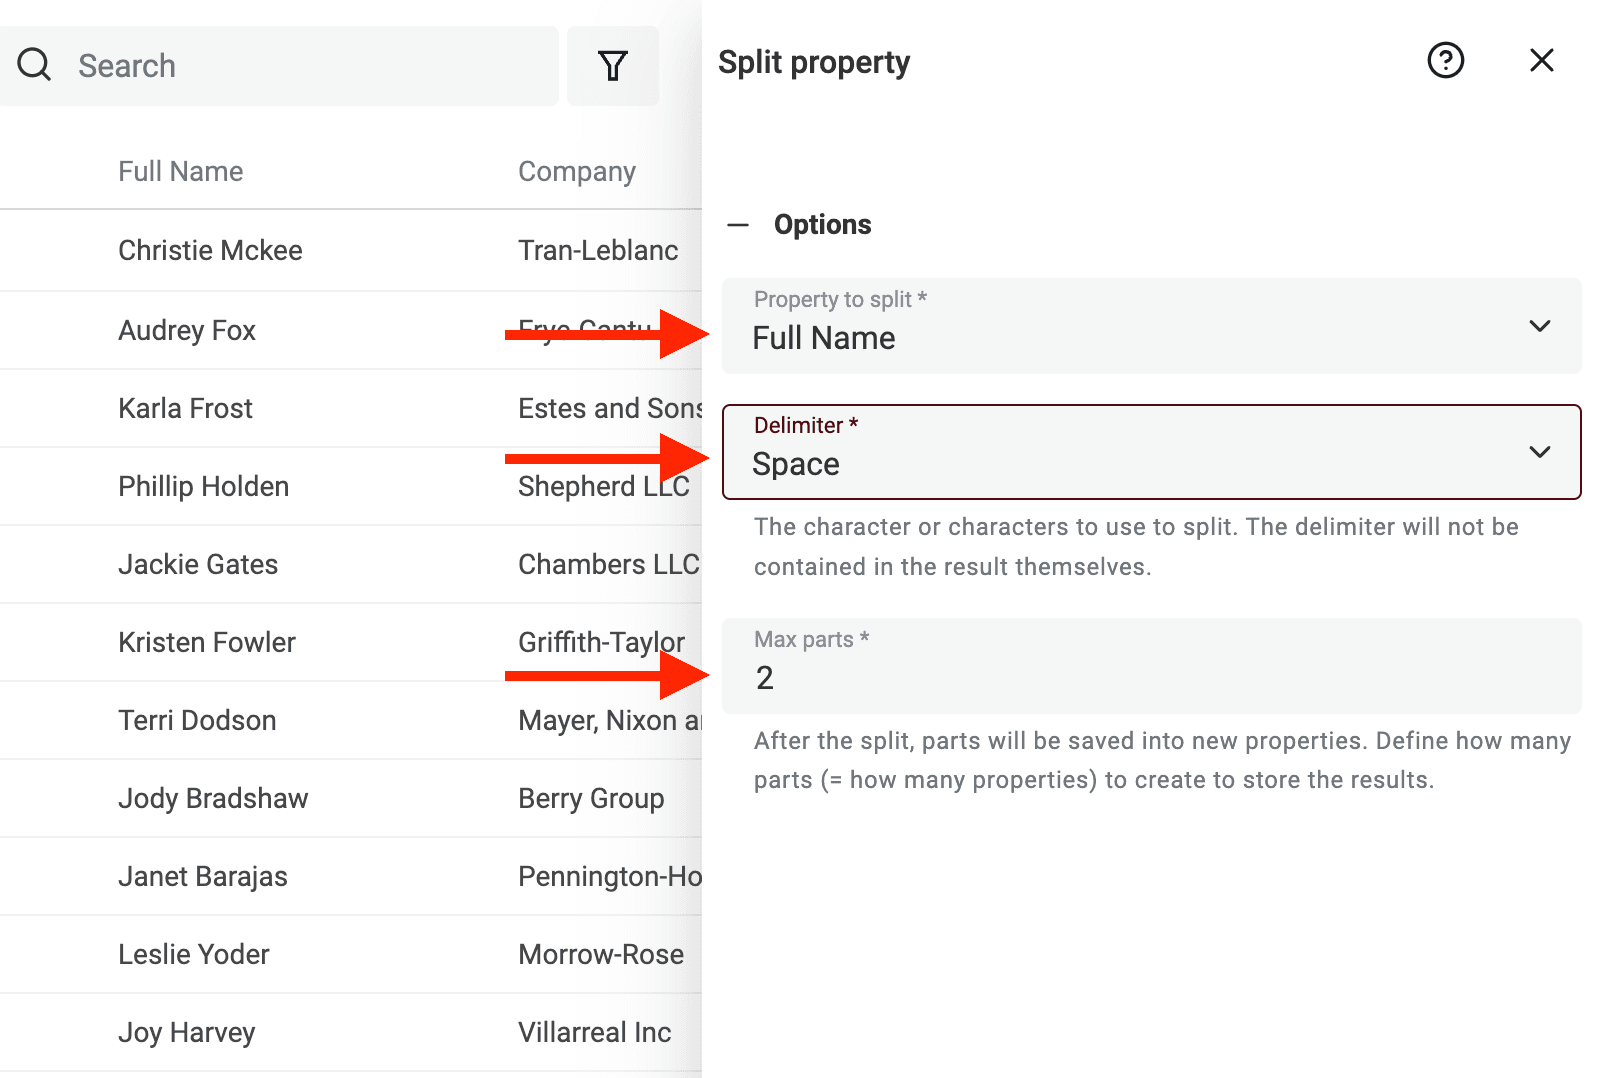
Lancez l’aperçu. Datablist analysera vos 10 premiers éléments afin de générer un aperçu. Si le résultat vous convient, cliquez sur « Split Property » pour exécuter l’algorithme sur tous les éléments actuels.
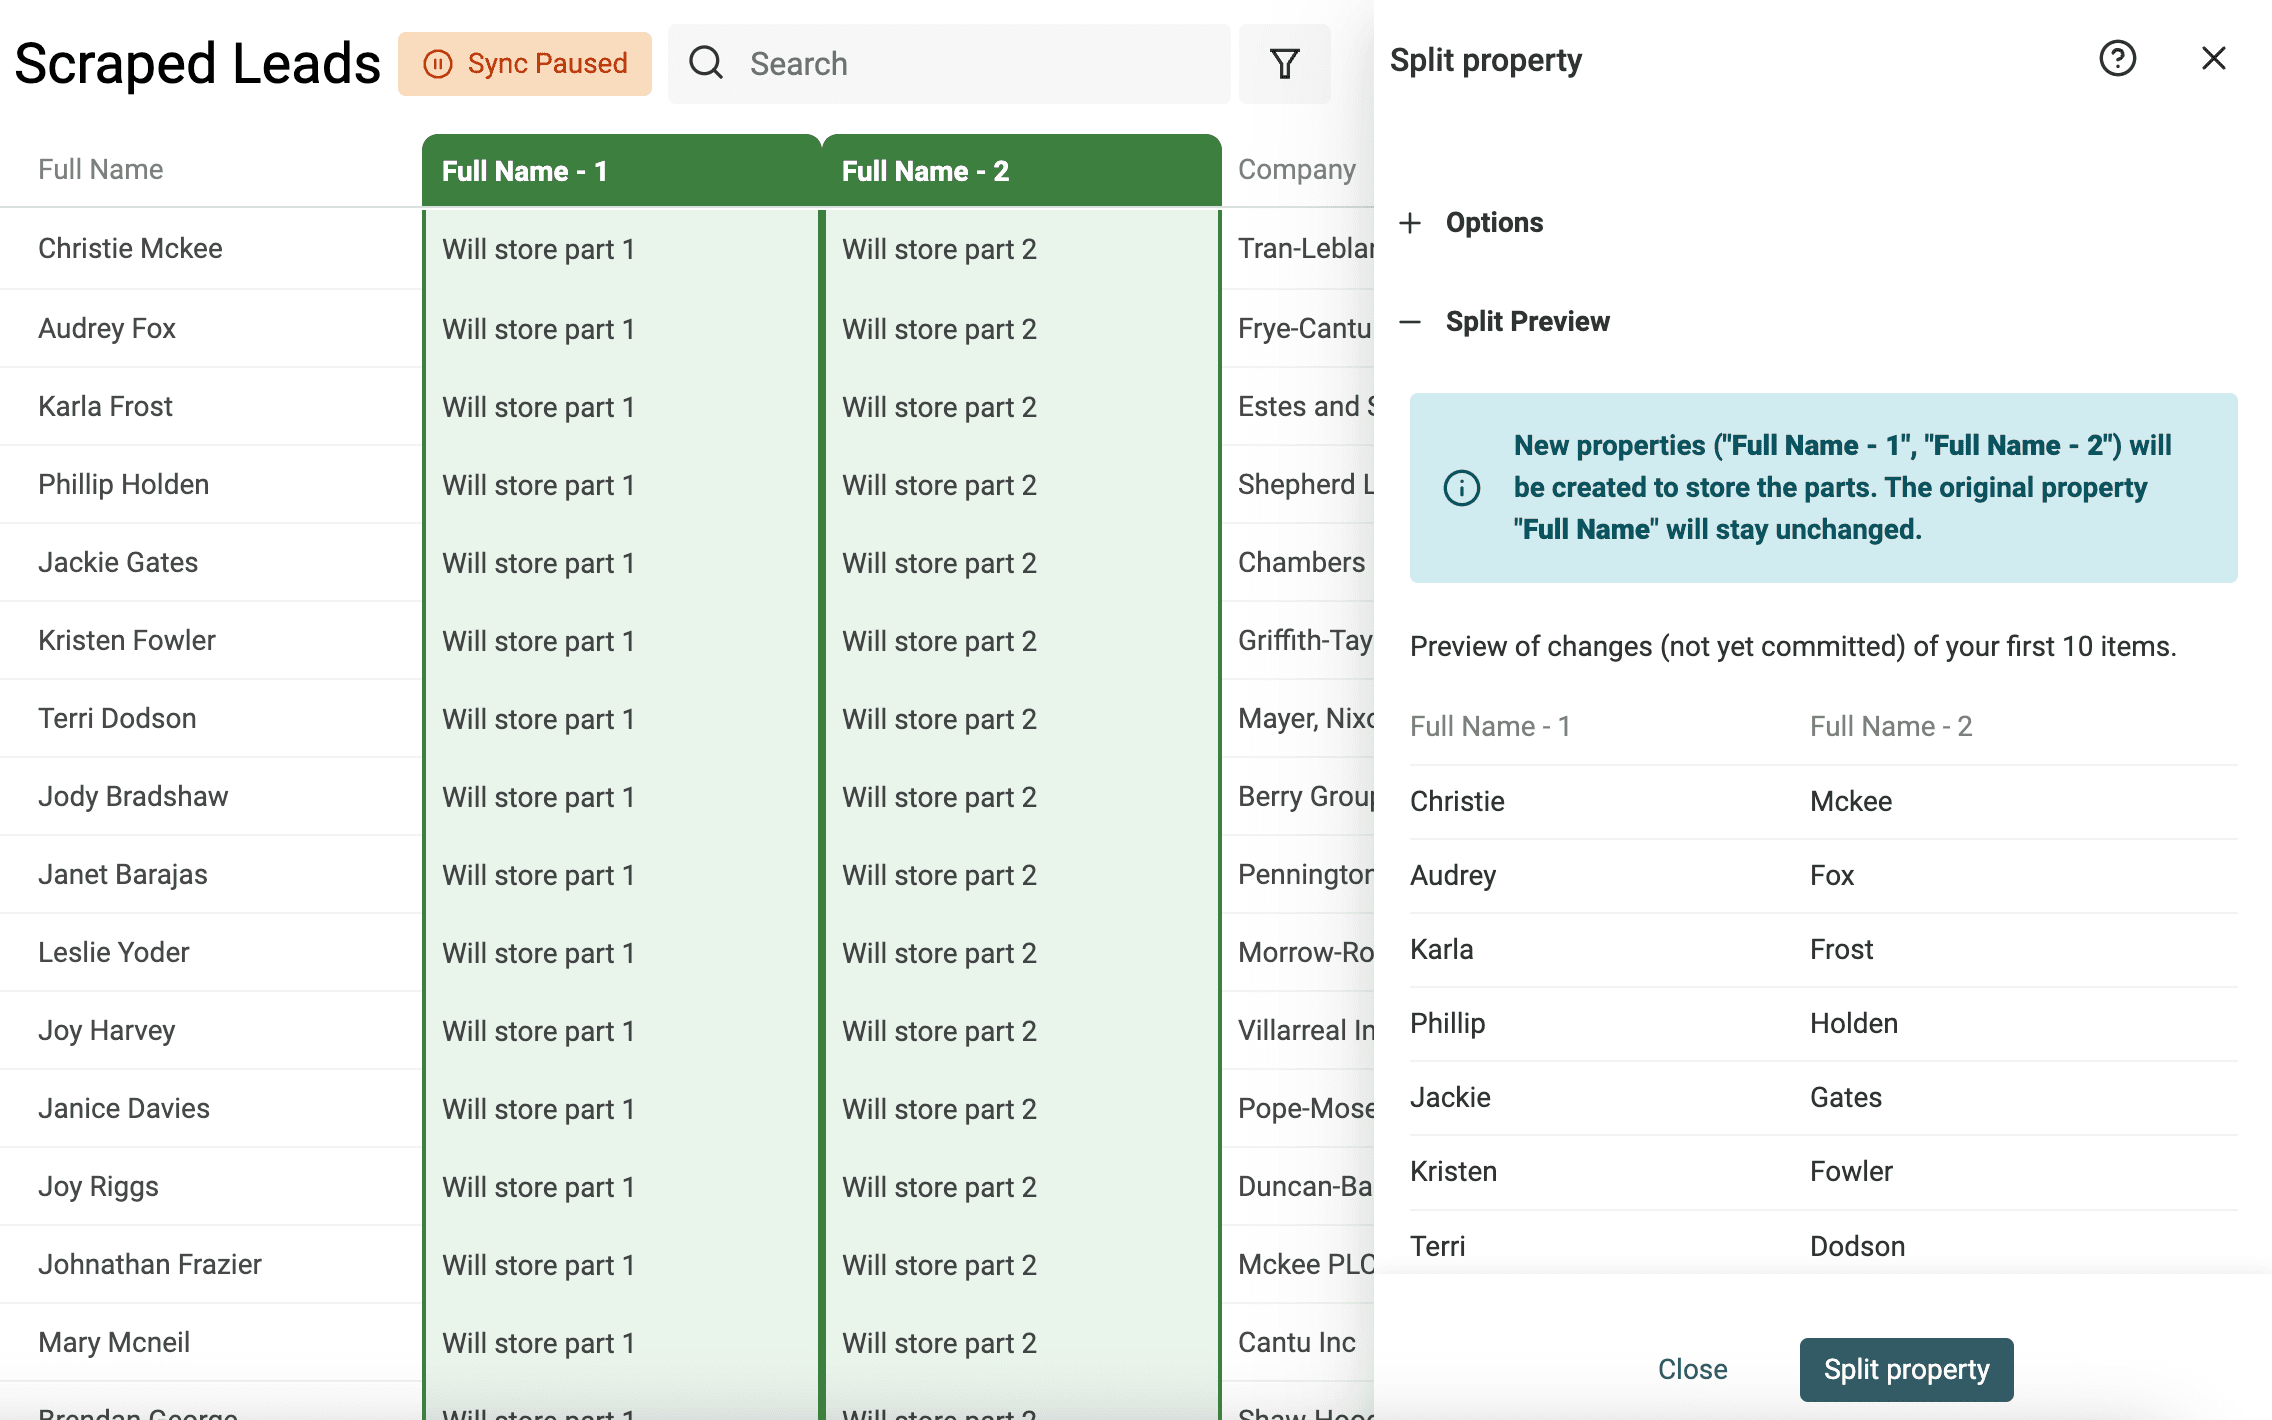
Une fois la séparation terminée, renommez les deux propriétés créées « First Name » et « Last Name ».
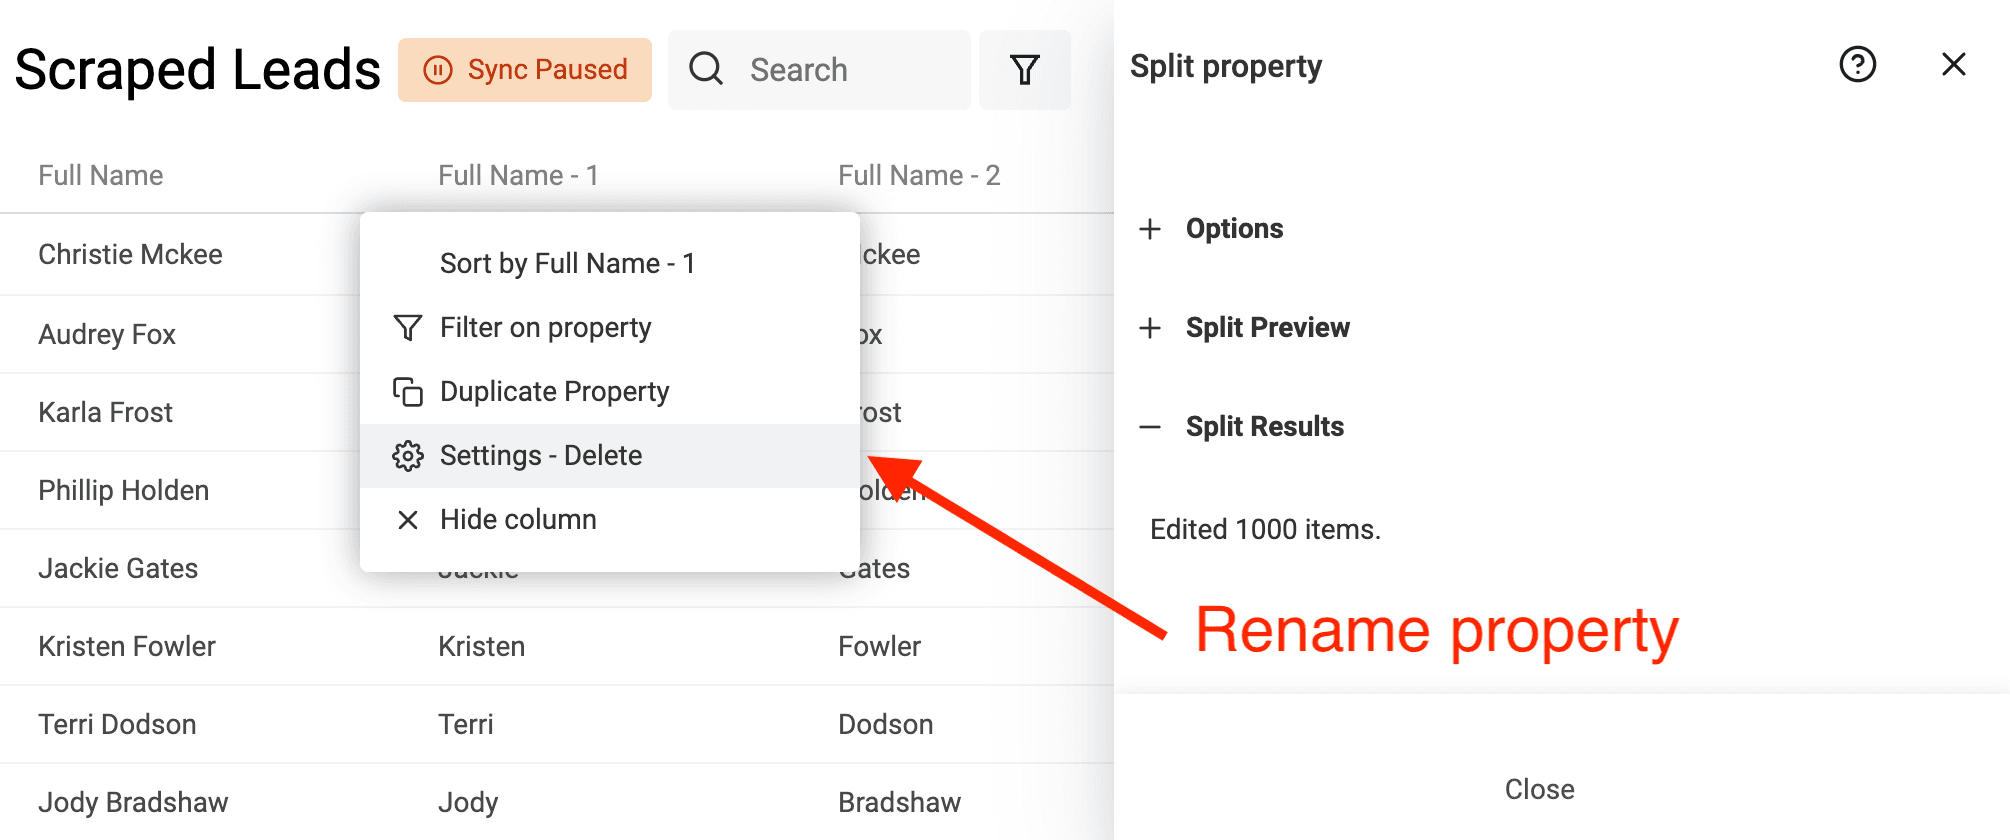
Cet exemple porte sur les conventions de nom occidentales, qui comprennent généralement un prénom et un nom de famille. L’opération devient plus complexe avec des noms issus d’autres cultures, notamment lorsqu’ils comportent plusieurs prénoms ou noms de famille, ou encore des titres et des suffixes.
Dédupliquer les données
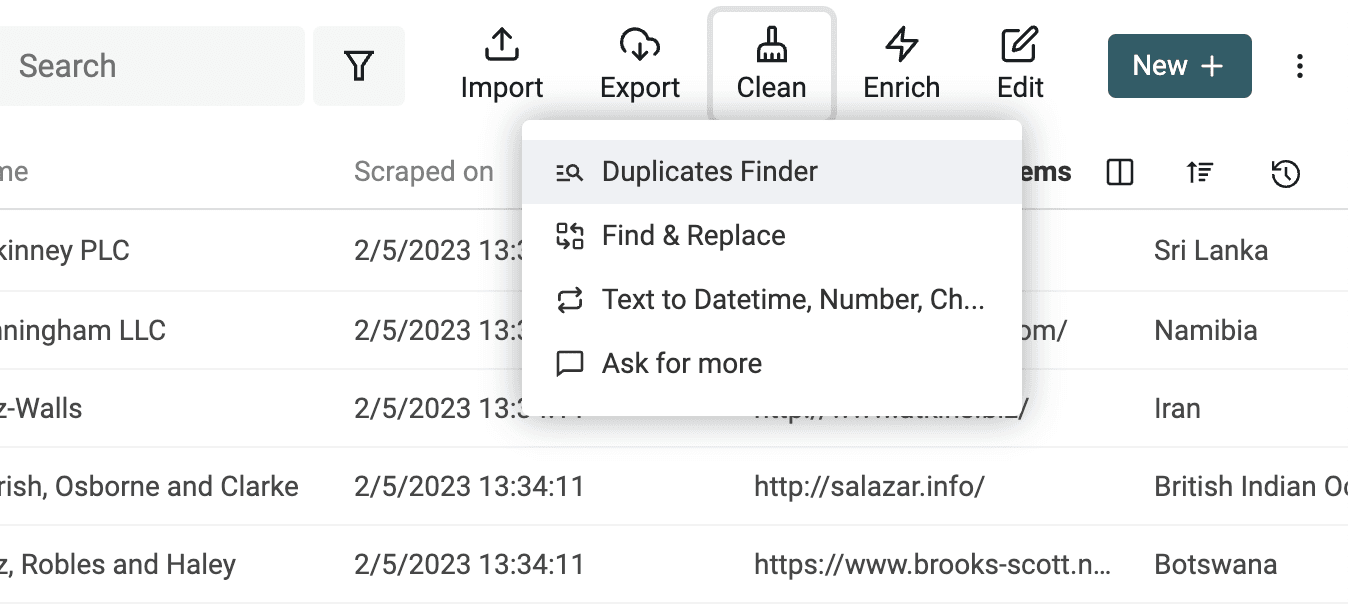
Ouvrez Clean > Merge duplicates lorsque plusieurs lignes contiennent des informations que vous souhaitez conserver. Utilisez Remove duplicates si vous voulez garder une ligne inchangée et supprimer les autres. La capture ci-dessous présente une ancienne version du menu.
Sélectionnez les propriétés permettant d’identifier un enregistrement. Je commence généralement par l’email d’un contact ou l’URL d’un produit plutôt que par le seul nom d’une entreprise. Il est inutile de normaliser tous les champs lorsqu’une clé de rapprochement fiable existe déjà.
La vérification crée des groupes à examiner sans modifier vos données. Dans l’espace de résultats, choisissez Merge and preserve data, vérifiez Record to keep et configurez les règles sous Resolve conflicting values. Combinez les valeurs textuelles lorsque vous devez toutes les conserver ; ne gardez qu’une seule valeur si vous acceptez de supprimer les autres.
Vérifiez les groupes Ready avant de cliquer sur Merge ready groups. Si vous optez plutôt pour la suppression, examinez les lignes supprimées afin de repérer d’éventuelles données supplémentaires, car ce mode ne modifie pas la ligne conservée.
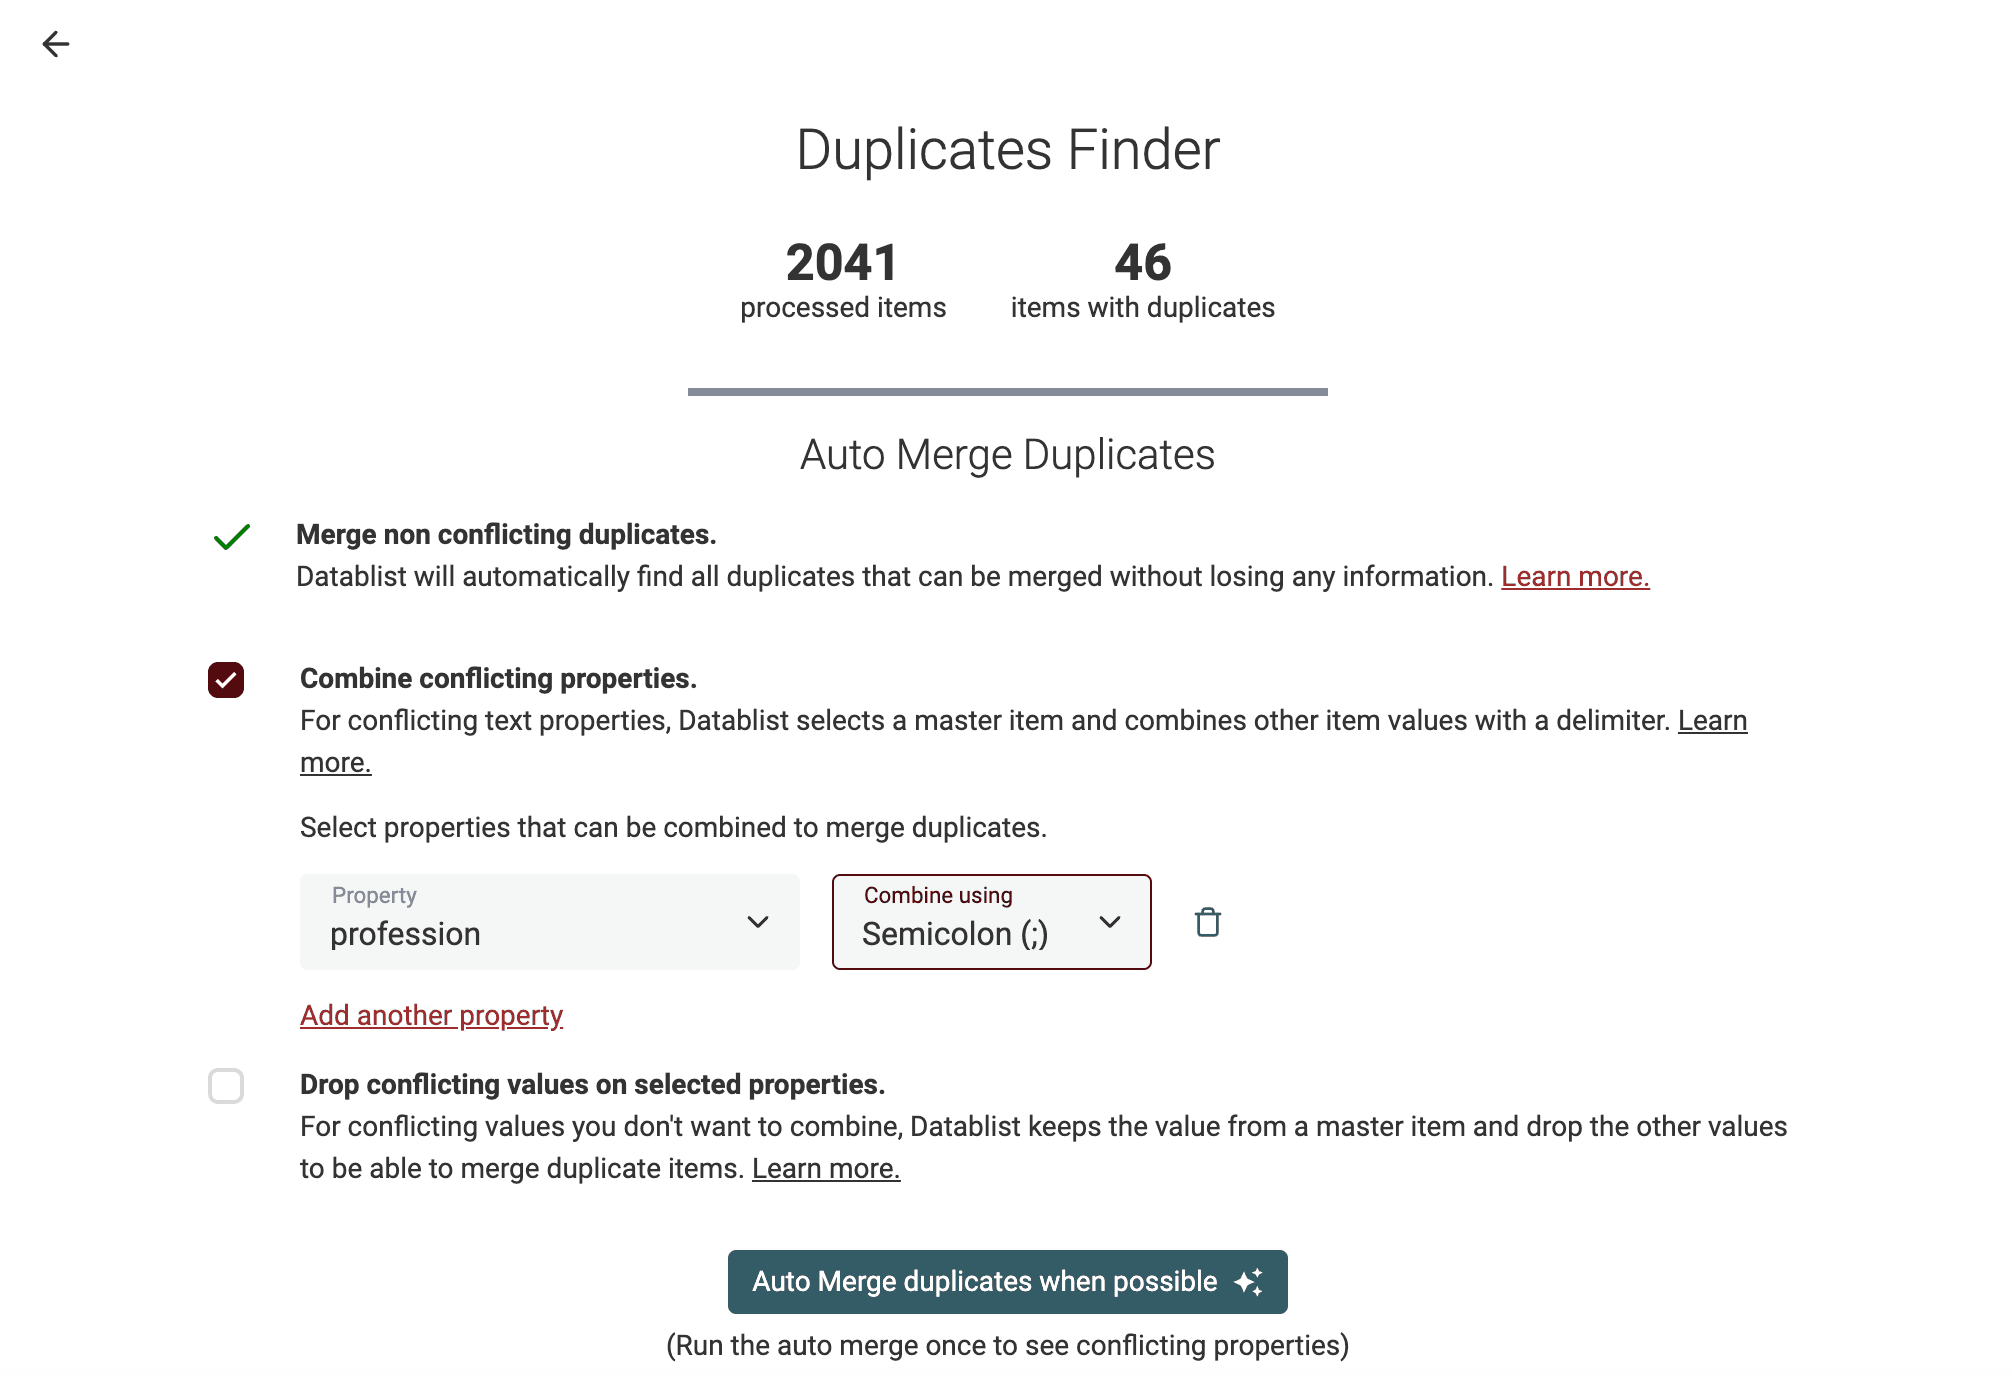
👉 Consultez notre guide pour fusionner les doublons d’un fichier CSV.
Valider les adresses email
Les données issues du scraping peuvent être anciennes, comporter des fautes ou être invalides. C’est particulièrement fréquent pour les adresses email récupérées par scraping.
Lorsque les données sont saisies par les utilisateurs, votre base peut contenir de fausses adresses ou des emails provenant de services temporaires.
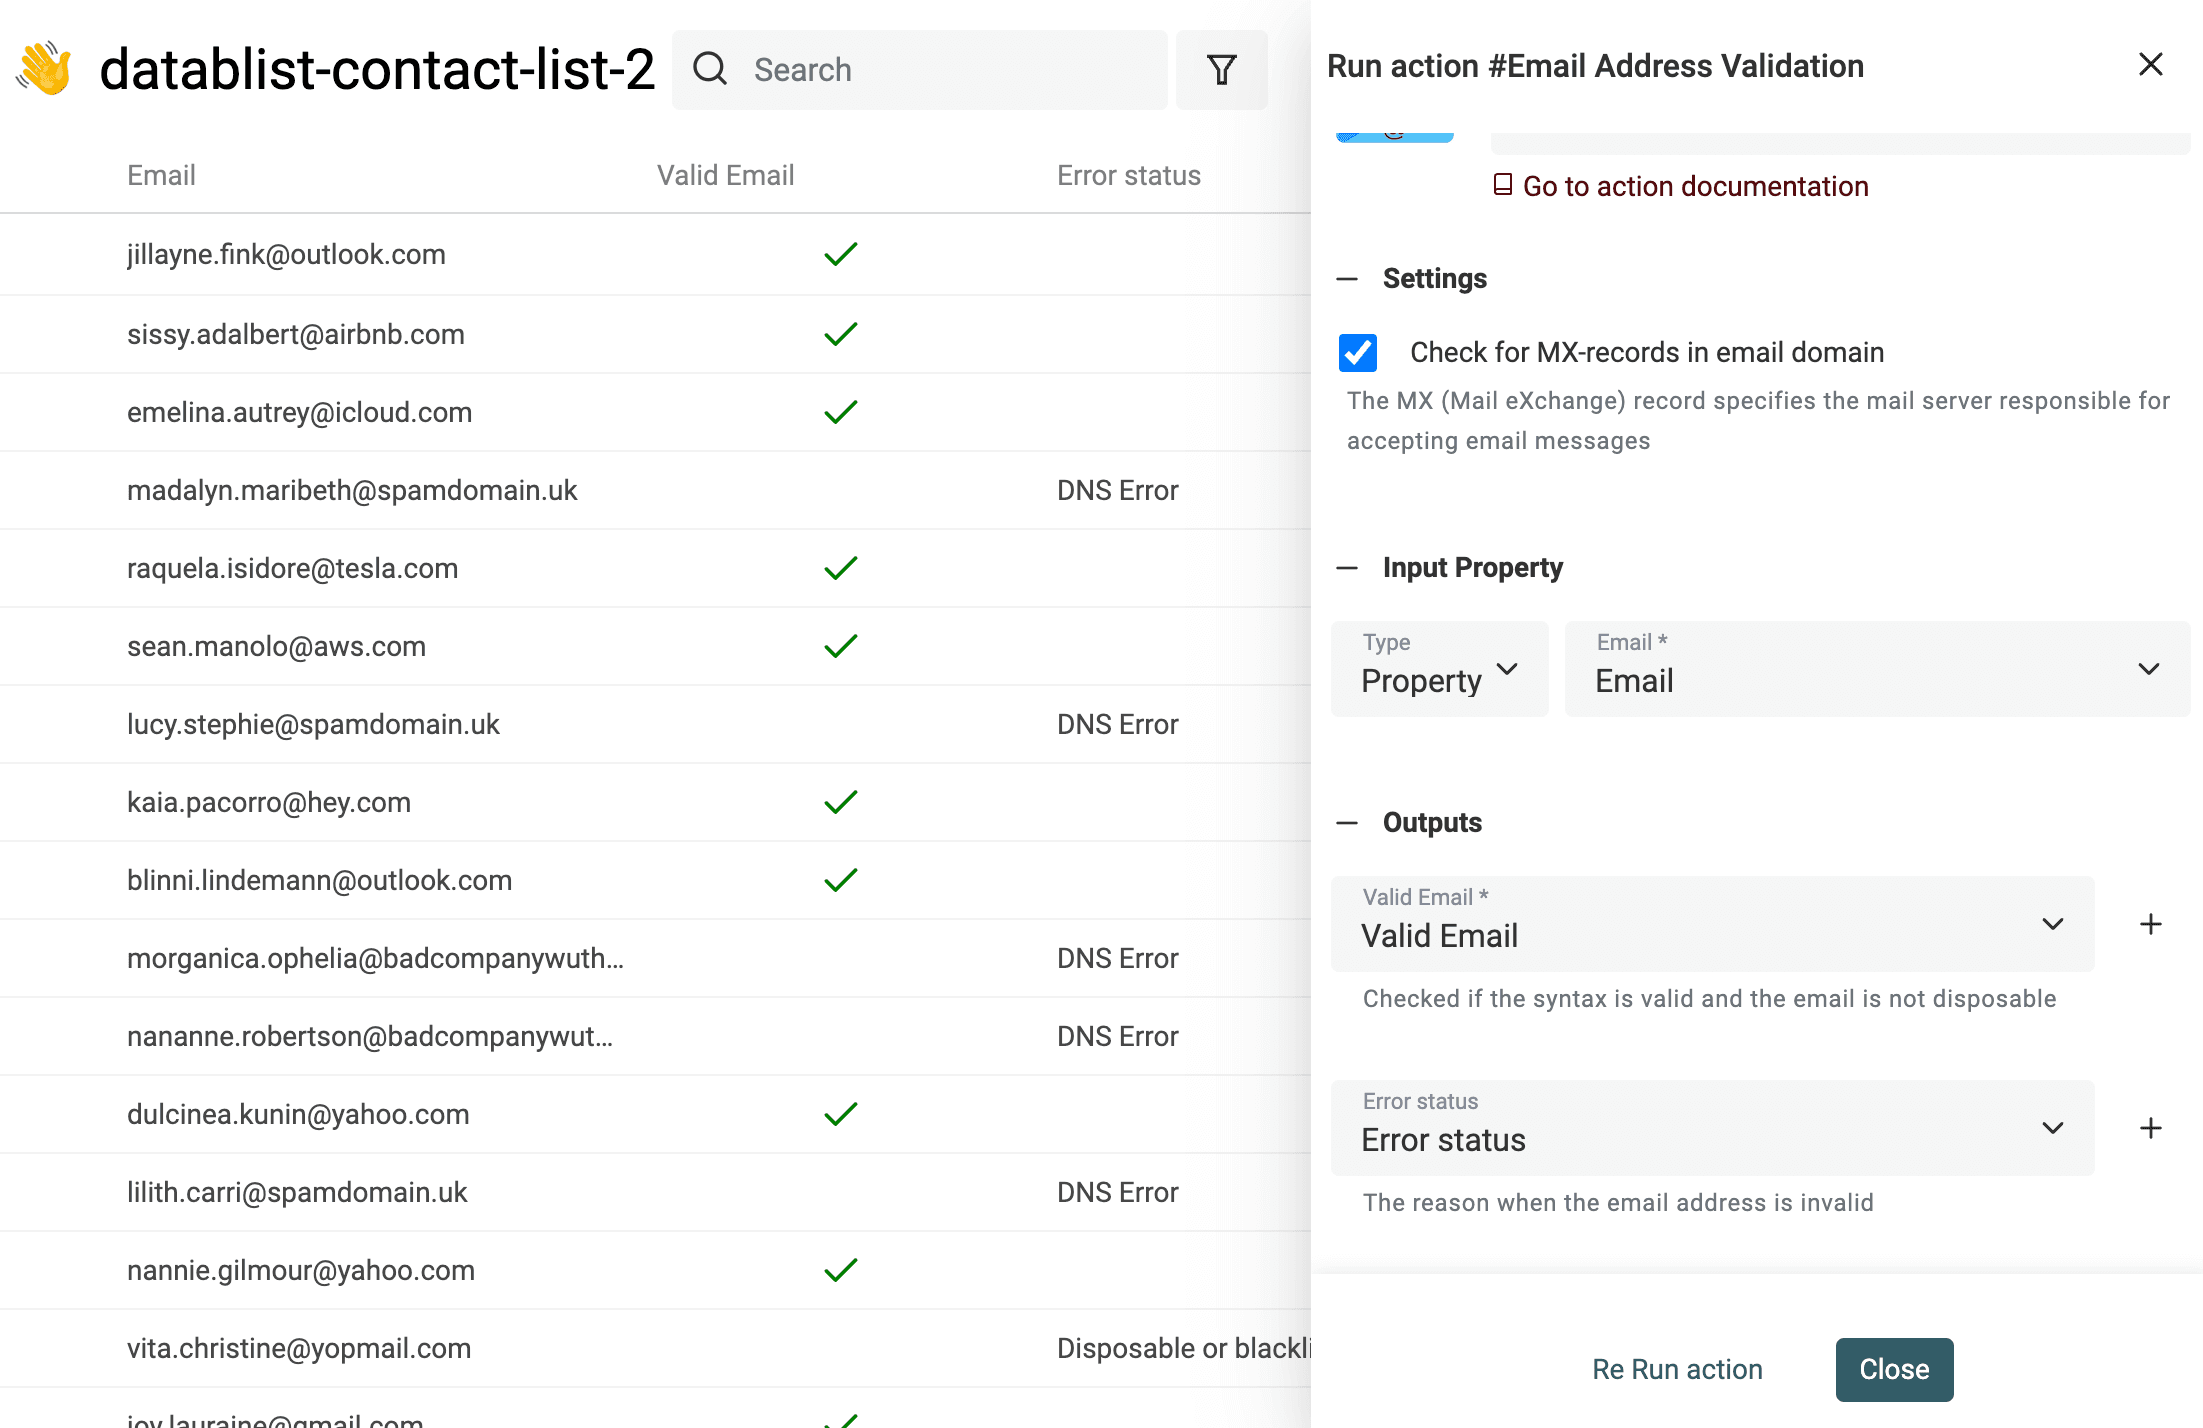
Datablist intègre un outil de validation des emails capable de vérifier des milliers d’adresses.
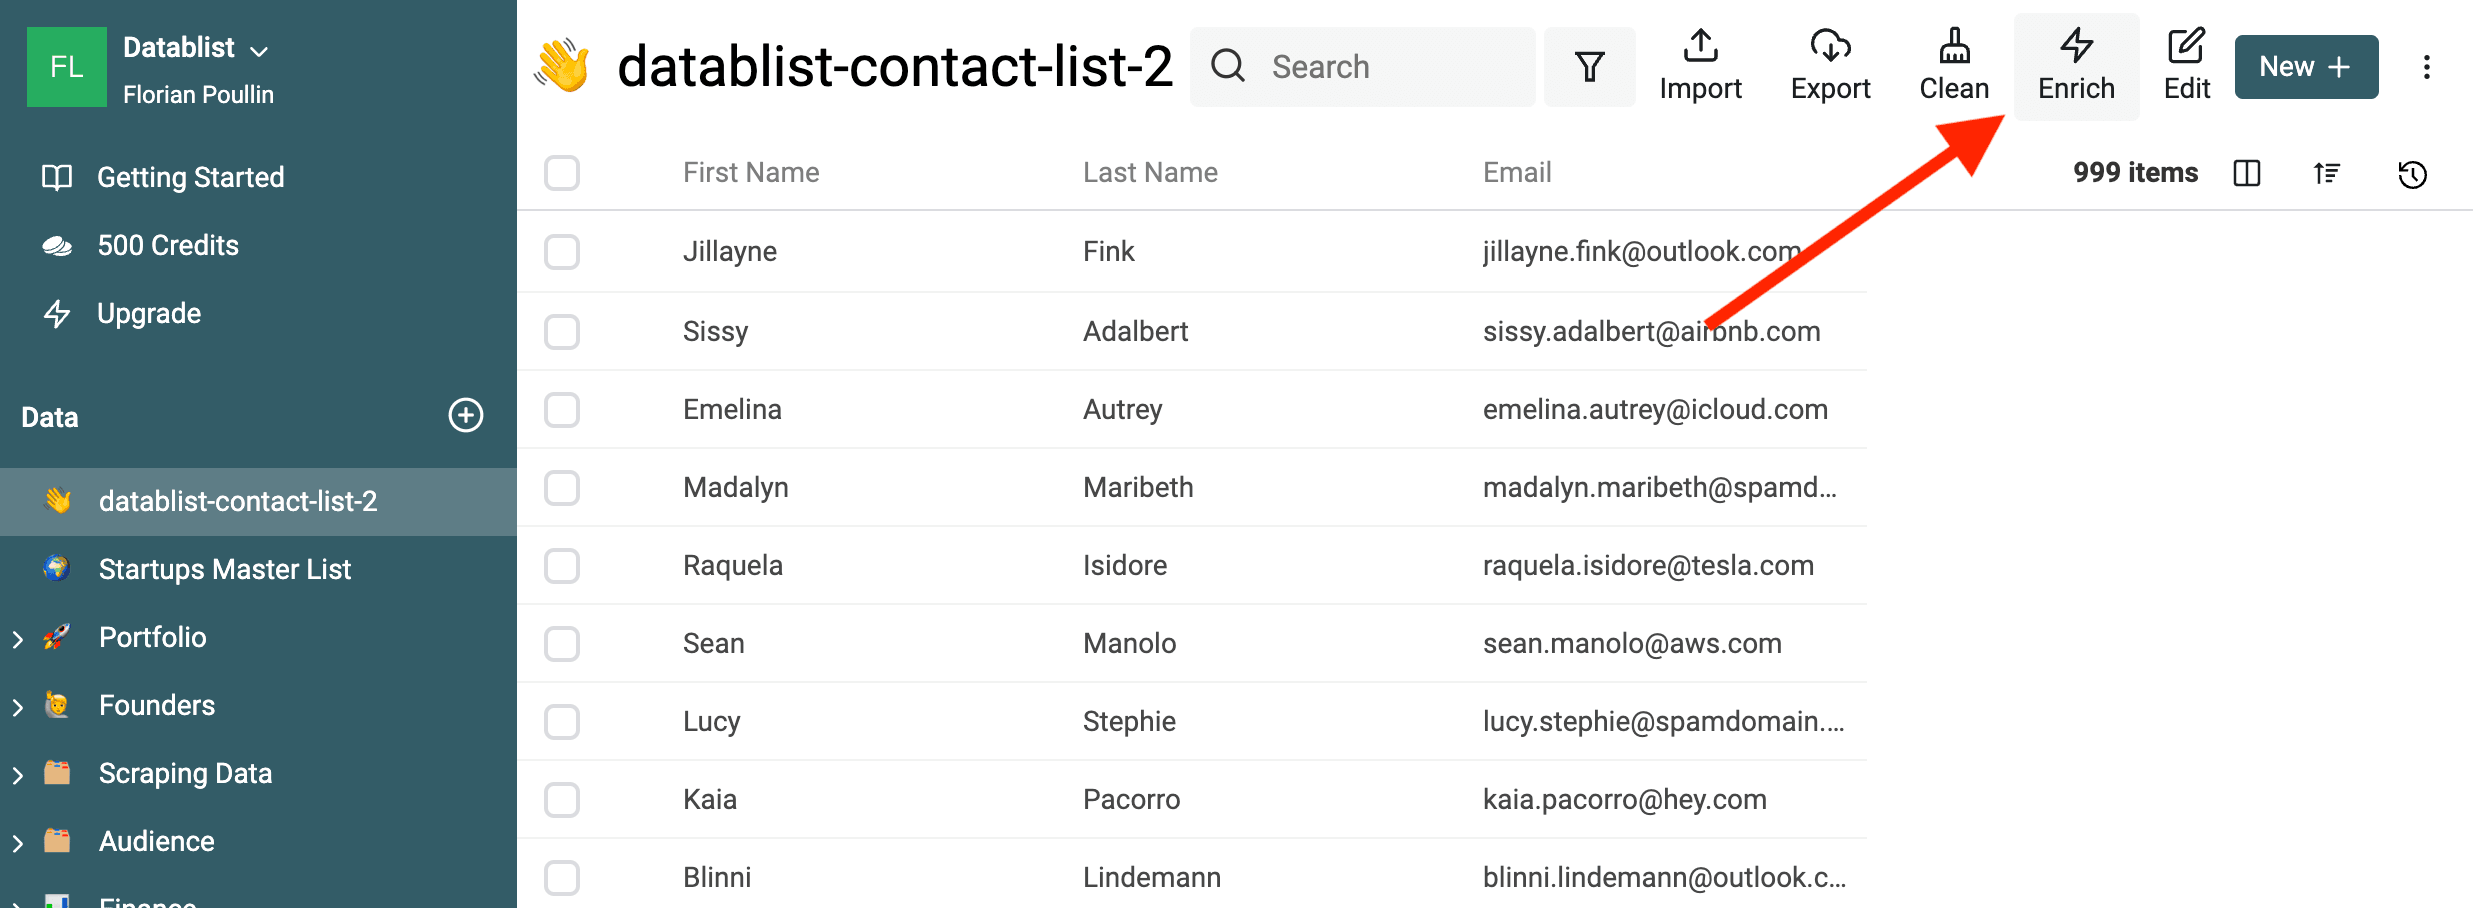
Le service gratuit de nettoyage des emails vérifie la syntaxe, les domaines jetables et, lorsque cette option est activée, les enregistrements MX du domaine. Ces contrôles ne prouvent ni qu’une boîte mail précise existe, ni qu’un message sera délivré. Conservez le statut ou le motif retourné afin d’examiner les exceptions.
Le service propose :
- Analyse de la syntaxe des emails - Signale les adresses mal formées, par exemple un texte sans signe
@ou avec un domaine au format invalide. - Détection des services d’emails jetables - Ce deuxième contrôle repère les emails temporaires. Le service recherche les domaines appartenant à des fournisseurs de Disposable Email Address (DEA), comme Mailinator, Temp-Mail ou YopMail.
- Vérification des enregistrements MX du domaine - Recherche les enregistrements des serveurs de messagerie du domaine, sauf si vous activez Disable MX-records analysis. Examinez les résultats DNS absents ou en échec séparément des erreurs de syntaxe : ce contrôle concerne le domaine, pas la boîte mail individuelle.
- Segmentation des adresses email professionnelles et personnelles - Pour qualifier les prospects issus de lead magnets ou segmenter votre base d’utilisateurs, vous pouvez distinguer les emails professionnels des emails personnels. Le service de validation fournit cette information pour enrichir les données de vos contacts.
Extraire les noms de personnes ou d’entreprises
Lorsque vous scrapez du texte depuis des sites web ou d’autres sources, il est souvent utile d’en extraire les noms de personnes ou d’entreprises. Ces informations peuvent servir à de nombreux usages, comme la génération de leads ou l’analyse concurrentielle. L’extraction de noms depuis des textes non structurés reste toutefois délicate : les noms peuvent prendre des formes très variées et se trouver au milieu de longs blocs de texte.
L’une des principales difficultés tient à la diversité des conventions et formats de noms selon les cultures et les langues. Dans certaines cultures, le nom de famille précède le prénom ; dans d’autres, c’est l’inverse. Certaines personnes ont plusieurs prénoms, tandis que d’autres n’en ont aucun. Les noms peuvent aussi être mal orthographiés, abrégés ou écrits dans un format non standard, ce qui complique leur identification par une simple recherche de motifs.
Une méthode courante consiste à utiliser la reconnaissance d’entités nommées, ou Named Entity Recognition (NER), une technique de traitement automatique du langage qui identifie et classe les entités nommées dans un texte. Les modèles NER peuvent apprendre à reconnaître différents types d’entités, comme les personnes, les organisations et les lieux. Ils peuvent également être adaptés à diverses conventions et variations de noms.
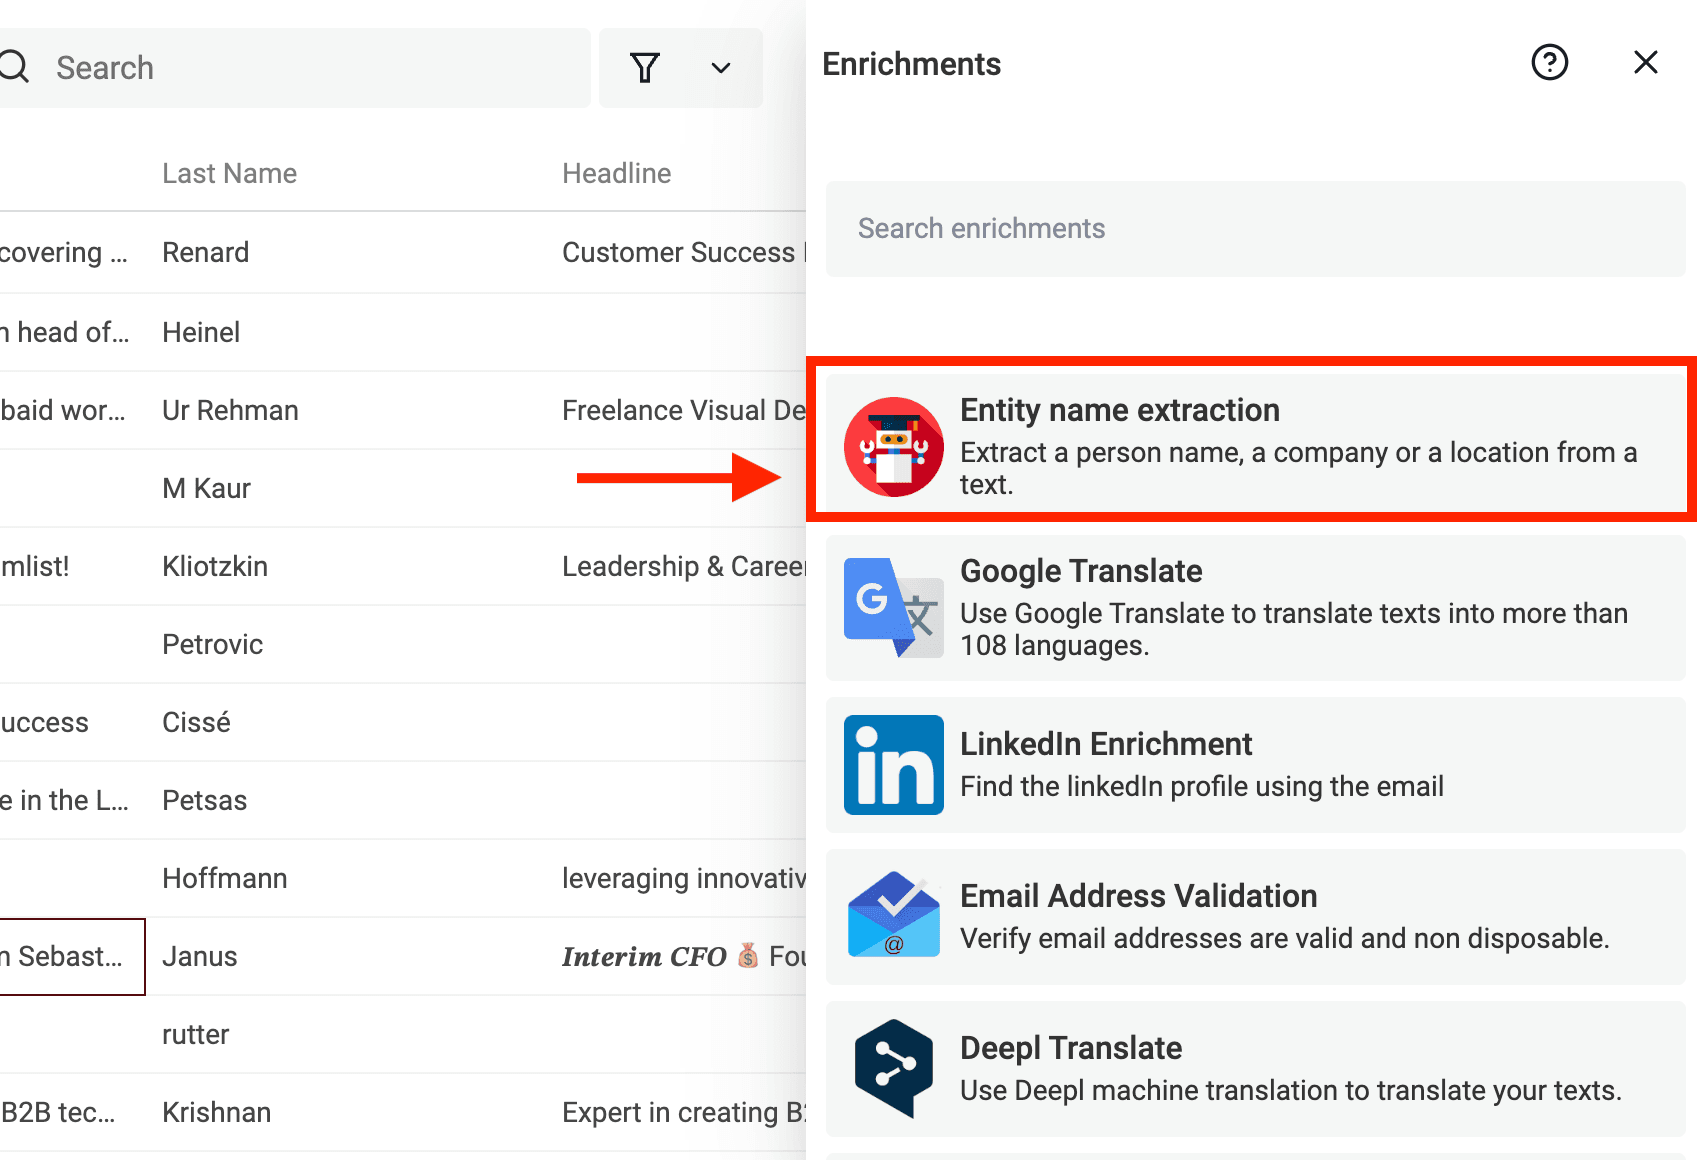
Datablist intègre un puissant modèle « Named Entity Recognition » (NER), que vous pouvez exécuter directement sur vos textes. Il prend en charge l’arabe, l’allemand, l’anglais, l’espagnol, le français, l’italien, le letton, le néerlandais, le portugais et le chinois.
Sélectionnez « Entity name extraction » dans le menu « Enrichments ».
Dans les options d’entrée, sélectionnez ensuite la propriété contenant le texte dont vous souhaitez extraire les noms.
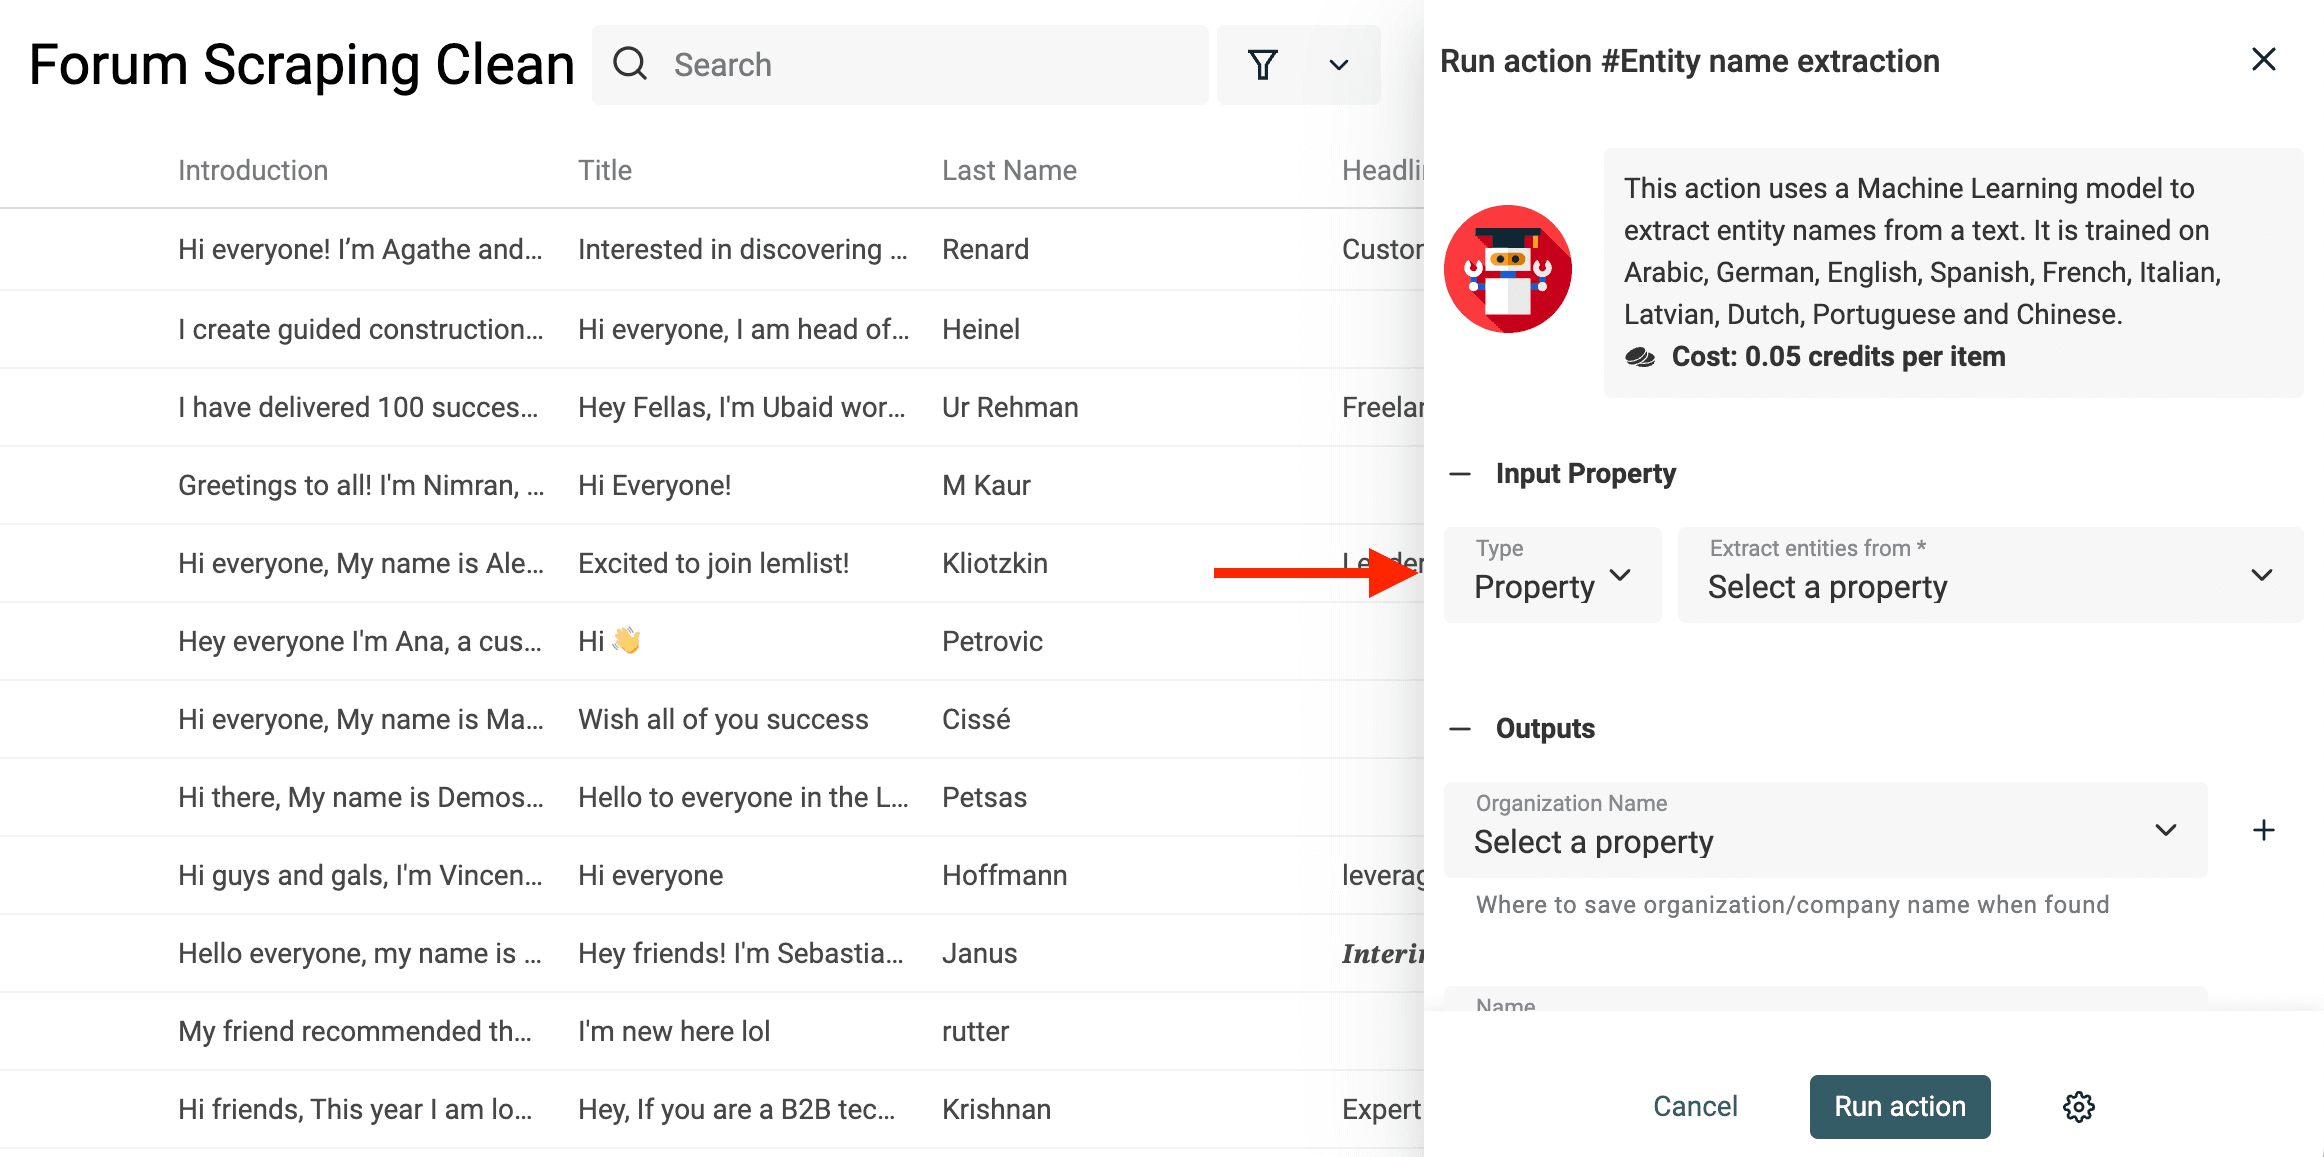
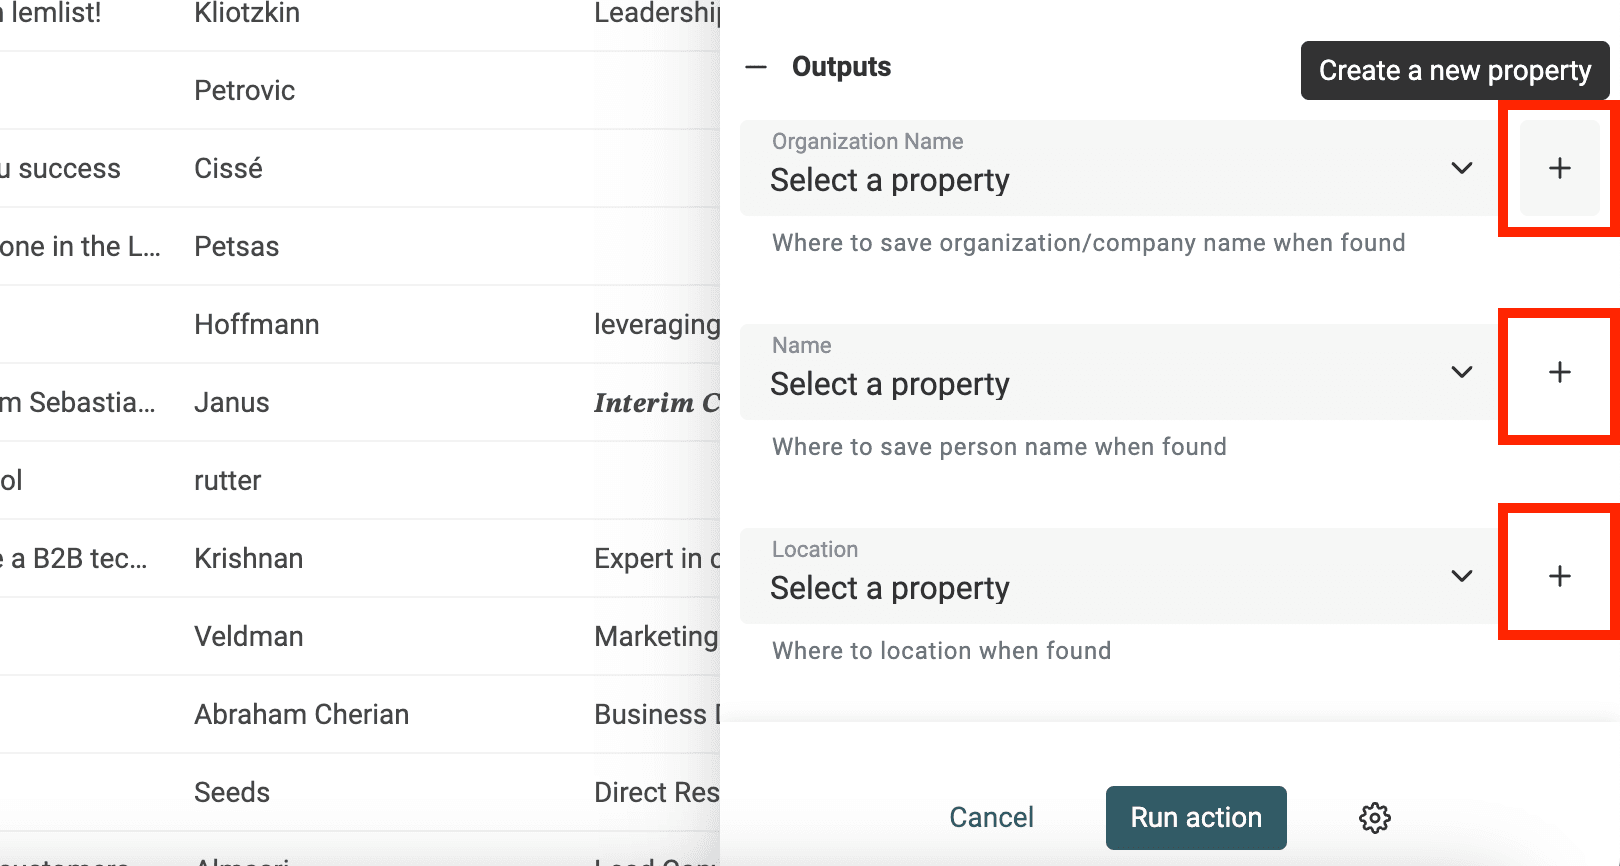
Dans les sorties, cliquez sur le bouton « Create a new property » pour chaque type de nom à extraire.
Datablist Entity Name extractor recherche :
- Organization Name : par exemple, les entreprises.
- Person Name : nom complet ou First Name/Last Name.
- Location : villes, pays et lieux.
Lancez ensuite l’enrichissement.
Besoin d’aide pour nettoyer vos données ?
Je suis toujours à la recherche de retours et de nouveaux problèmes de nettoyage de données à résoudre. N’hésitez pas à me contacter pour me présenter votre cas d’usage.