
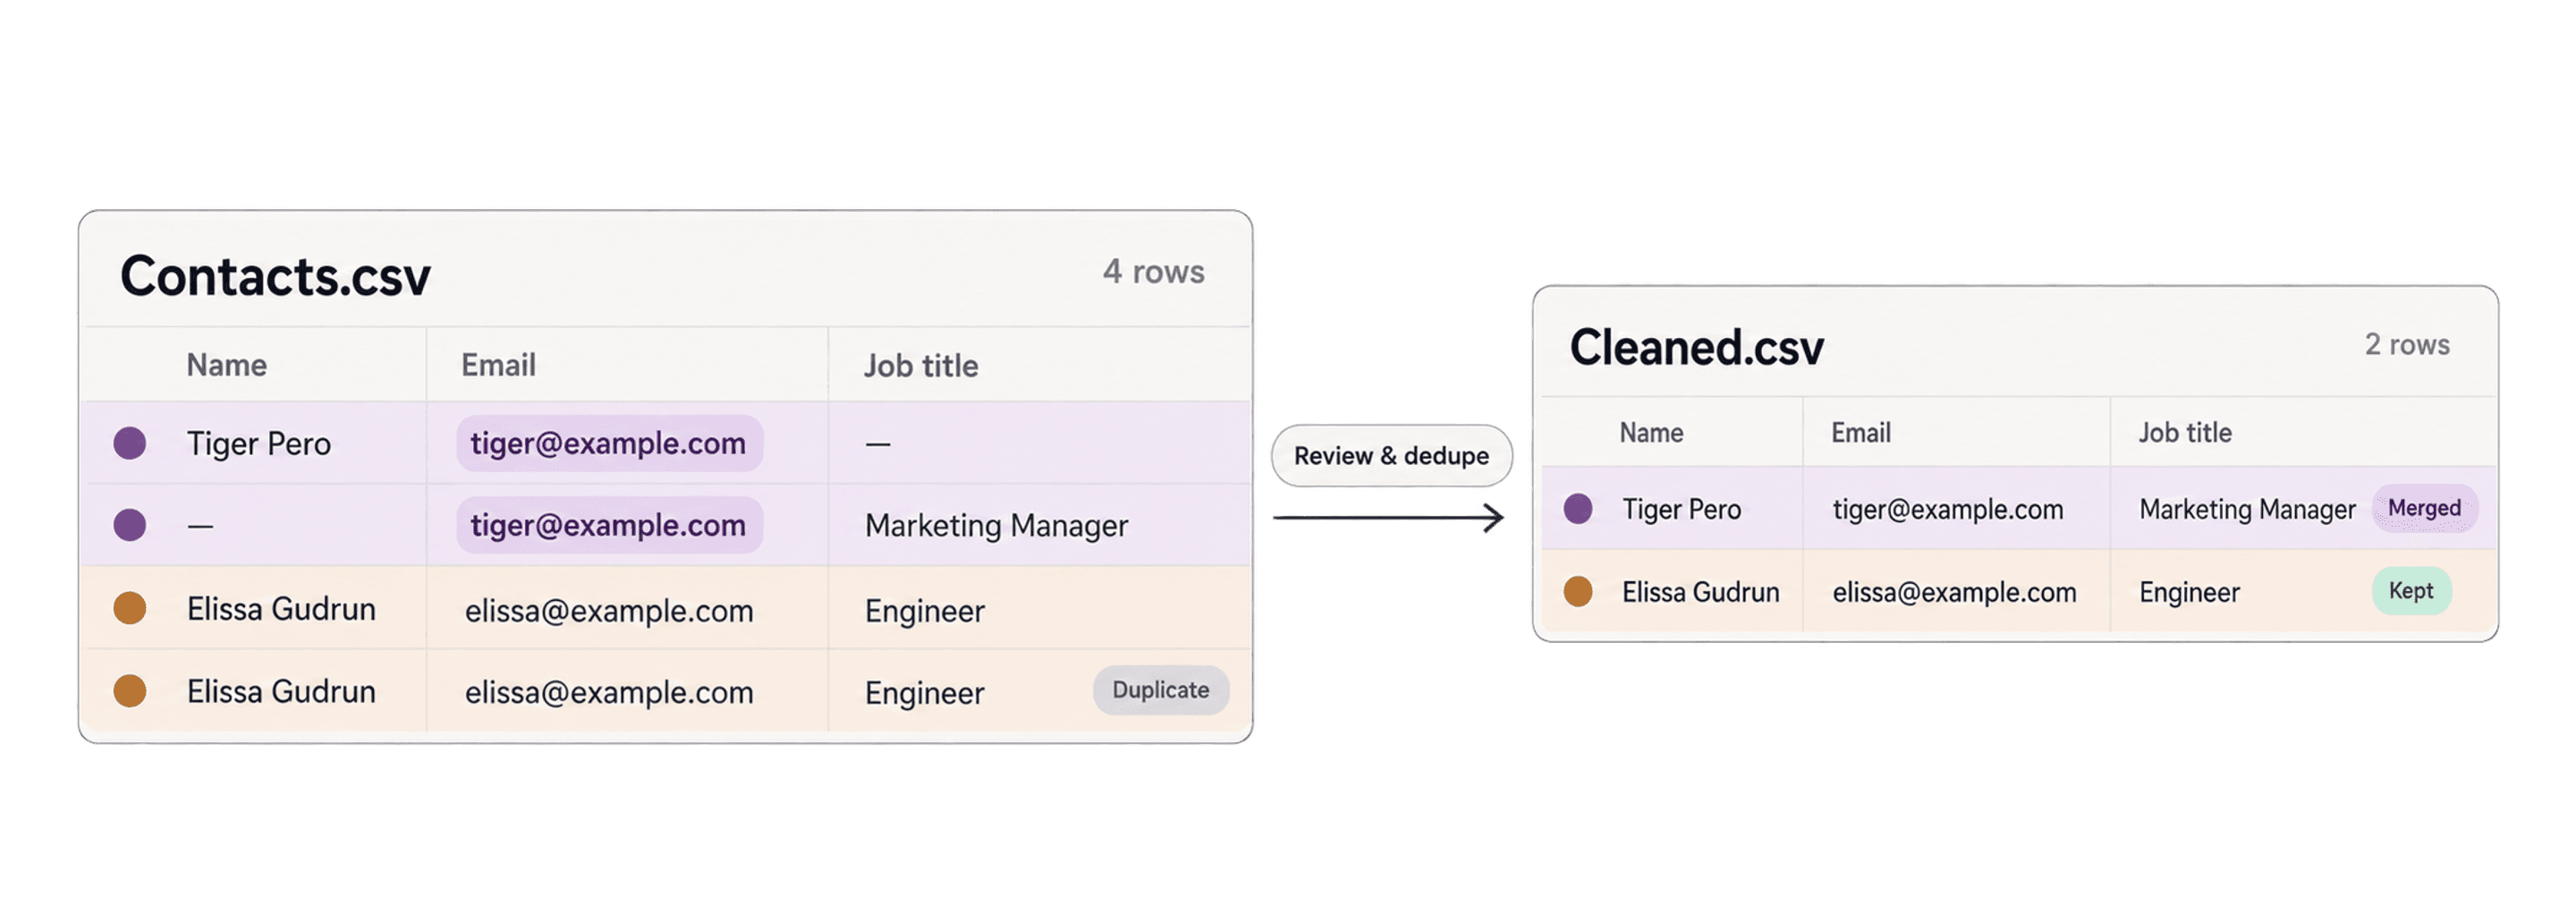
Pour supprimer les lignes CSV en double sans risque, sélectionnez la colonne qui identifie chaque enregistrement, vérifiez les groupes proposés, puis supprimez les lignes redondantes ou fusionnez les valeurs à conserver. Cette méthode fonctionne avec un seul fichier CSV comme avec plusieurs fichiers importés dans une même collection Datablist.
Pour une première analyse, utilisez l’adresse email, le numéro de téléphone, le site web de l’entreprise, le SKU ou tout autre identifiant stable. Si les valeurs présentent des différences d’orthographe ou de format, utilisez la correspondance Smart, fuzzy ou phonetic et conservez les groupes incertains pour les examiner.
Fusionner les doublons de fichiers CSV
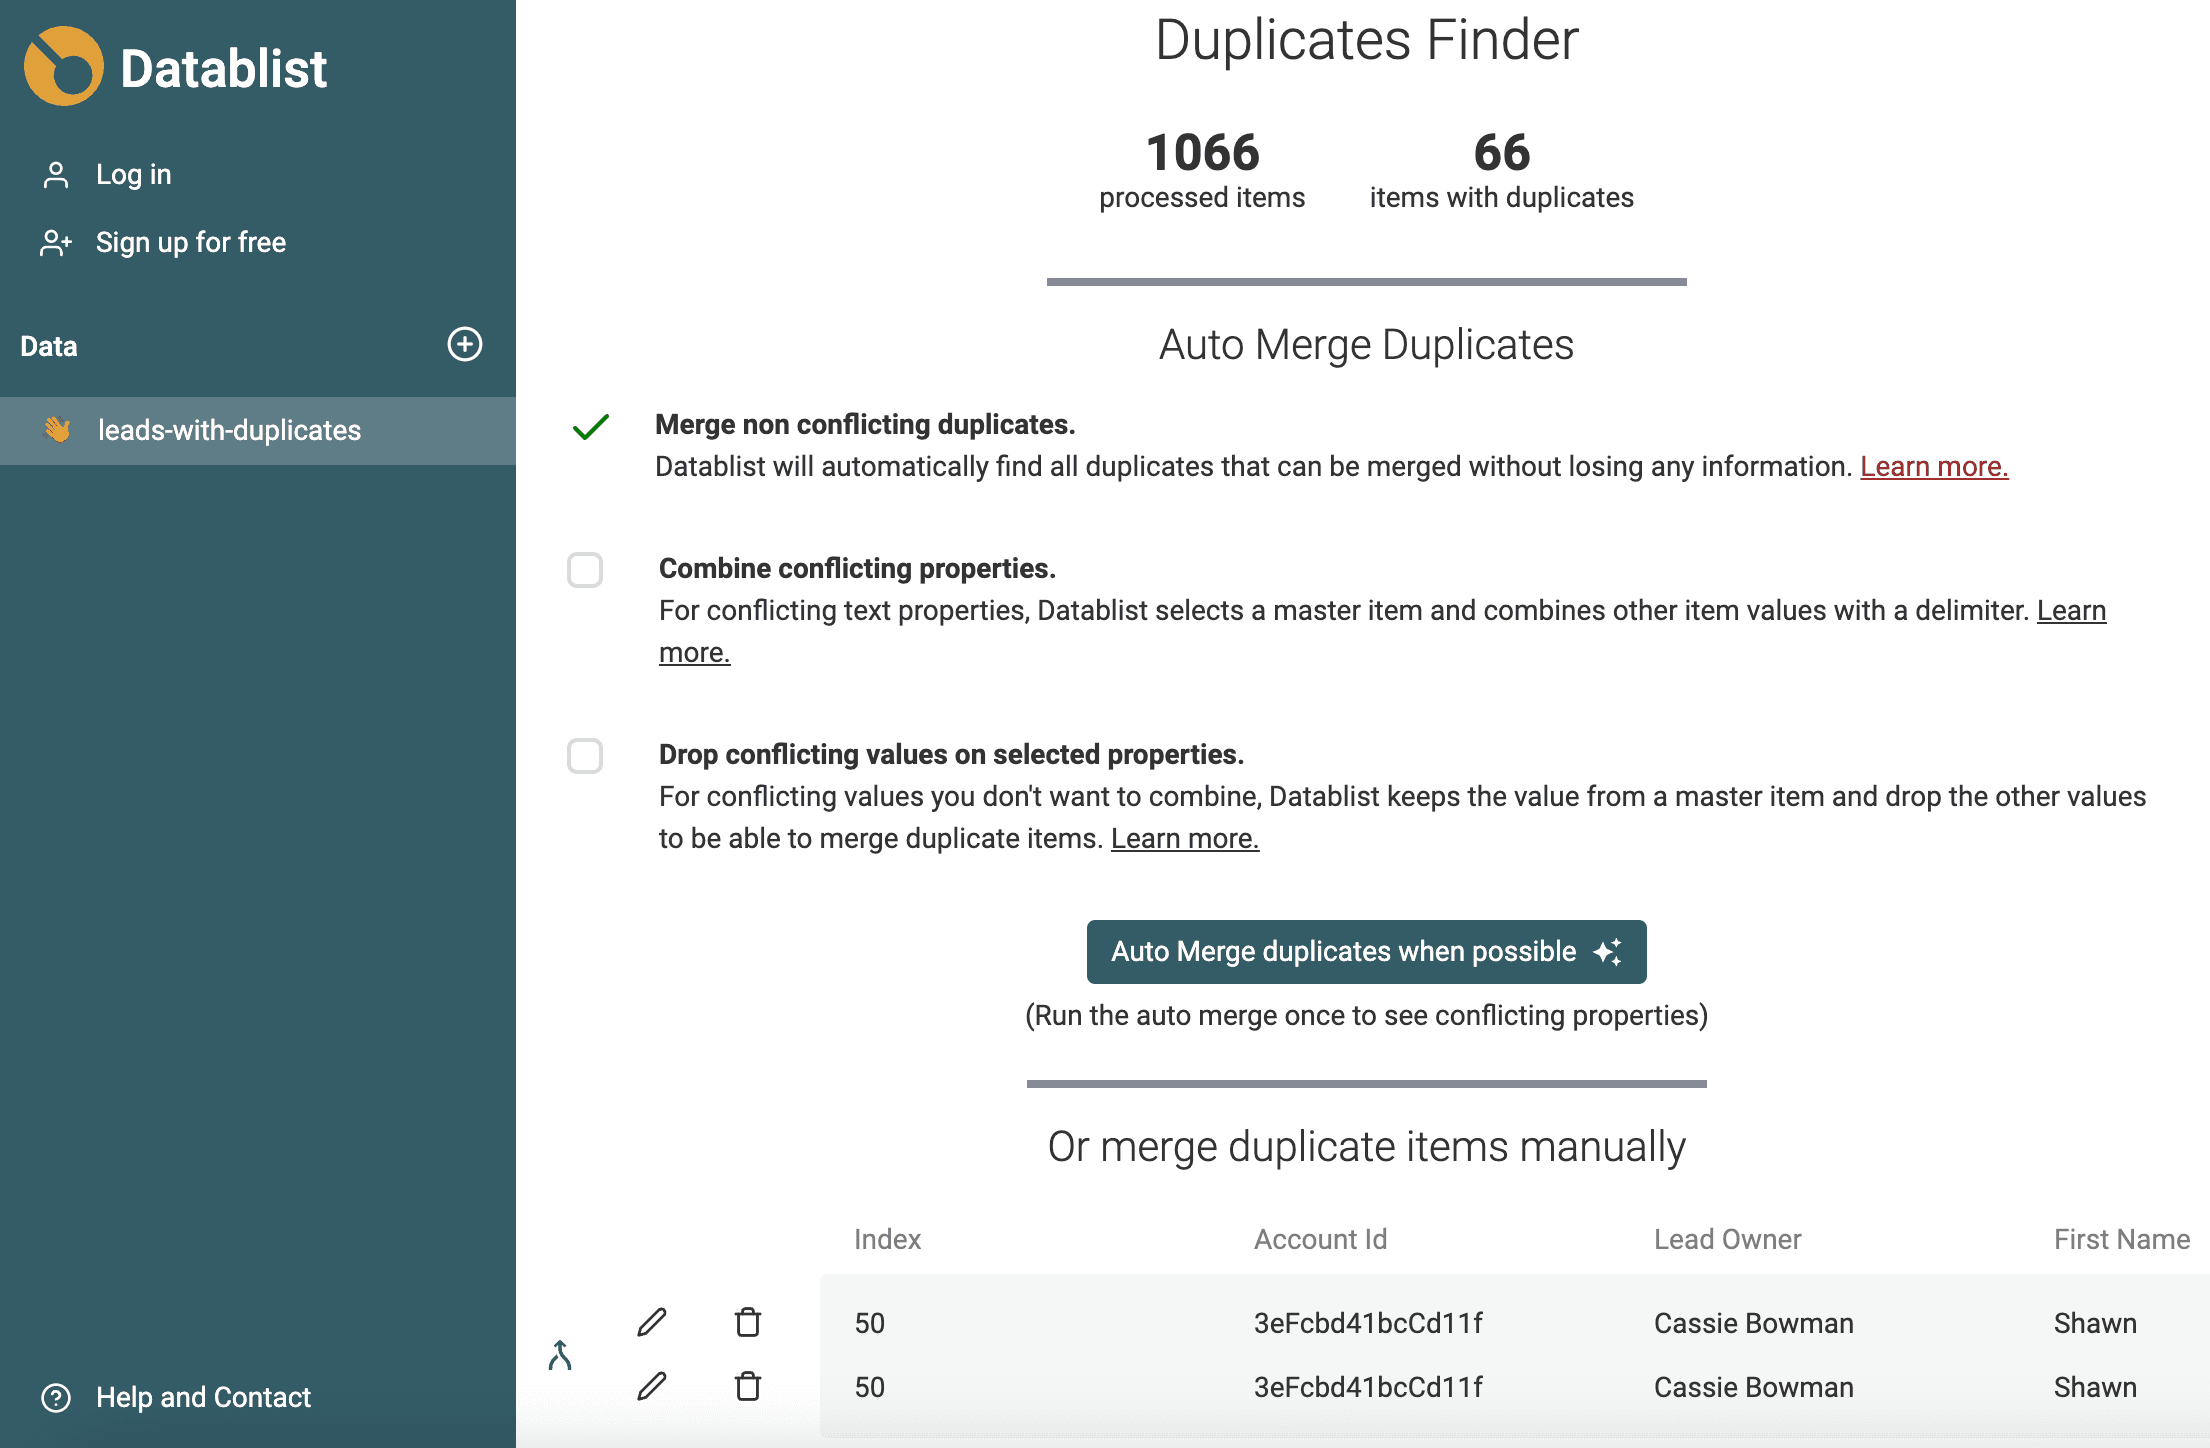
Datablist est idéal pour effectuer des opérations sur vos données qui seraient difficiles, voire impossibles, avec un tableur. Utilisez-le si vous recherchez un excellent éditeur CSV en ligne.
Dans ce guide, nous allons travailler avec deux fichiers CSV contenant des milliers d’entrées. Nous les importerons dans une même collection avant de dédupliquer les enregistrements à partir de l’une des quatre colonnes. La déduplication fonctionne également sur un seul fichier CSV.
Pour télécharger les fichiers CSV du tutoriel : Fichier CSV 1 et Fichier CSV 2
Les fichiers à télécharger comportent quatre en-têtes : firstname, lastname, email et profession (intitulé du poste). Le fichier 1 contient 1 000 lignes de données et le fichier 2 en contient 1 003, soit 2 003 lignes avant déduplication. Notre objectif est de fusionner les enregistrements qui partagent la même adresse email.
Si votre champ email contient plusieurs adresses dans une même cellule, commencez par répartir les cellules CSV multivaleurs sur plusieurs lignes avant de lancer la détection des doublons. Si le fichier exporté est trop volumineux pour être importé ou vérifié sereinement, divisez le fichier CSV volumineux avant la déduplication.
Le processus de fusion des doublons se résume ainsi :
- Importez vos fichiers CSV dans une collection Datablist
- Sélectionnez les propriétés utilisées pour détecter les doublons
- Fusionnez automatiquement les doublons sans conflit
- Fusionnez manuellement les doublons restants
Étape 1 : importer vos fichiers CSV dans une collection Datablist
Créer une nouvelle collection
La première étape consiste à importer le fichier CSV dans Datablist. Pour commencer, ouvrez Datablist sans inscription.
Pour créer une collection, cliquez sur le bouton "New collection" accompagné du symbole +. Une fois la collection créée, attribuez-lui un nom et une icône.
Cliquez ensuite sur le bouton Import CSV.
Créer les propriétés de votre fichier CSV
Une fois le fichier CSV chargé, vous pouvez créer les propriétés de votre collection à partir des noms de ses colonnes. Datablist répertorie toutes les colonnes détectées dans le fichier afin que vous puissiez créer une propriété pour chacune d’elles.
Les fichiers CSV ne précisent pas le type de chaque colonne. Datablist suggère des types à partir des valeurs importées afin de faciliter leur tri et leur filtrage. Vérifiez ces suggestions avant de lancer l’import.
Conservez les identifiants tels que les SKU, les identifiants de compte ou les codes postaux au format Text. Par exemple, convertir 00127 en Number supprime les zéros initiaux et modifie la clé de correspondance. Consultez le guide des types de propriétés si vous ne savez pas quel type choisir.
Vérifier et importer les données
Lors de l’étape de vérification, les lignes apparaissent telles qu’elles figurent dans le fichier CSV. Assurez-vous que les données sont correctement formatées et cohérentes. Cliquez ensuite sur le bouton "Import items" : c’est terminé ! 💪
Répéter l’opération pour les autres fichiers CSV
Maintenant que votre collection et ses propriétés sont configurées, répétez le processus "Import CSV/Excel" pour importer vos autres fichiers CSV ou Excel dans cette même collection.
Étape 2 : trouver les doublons
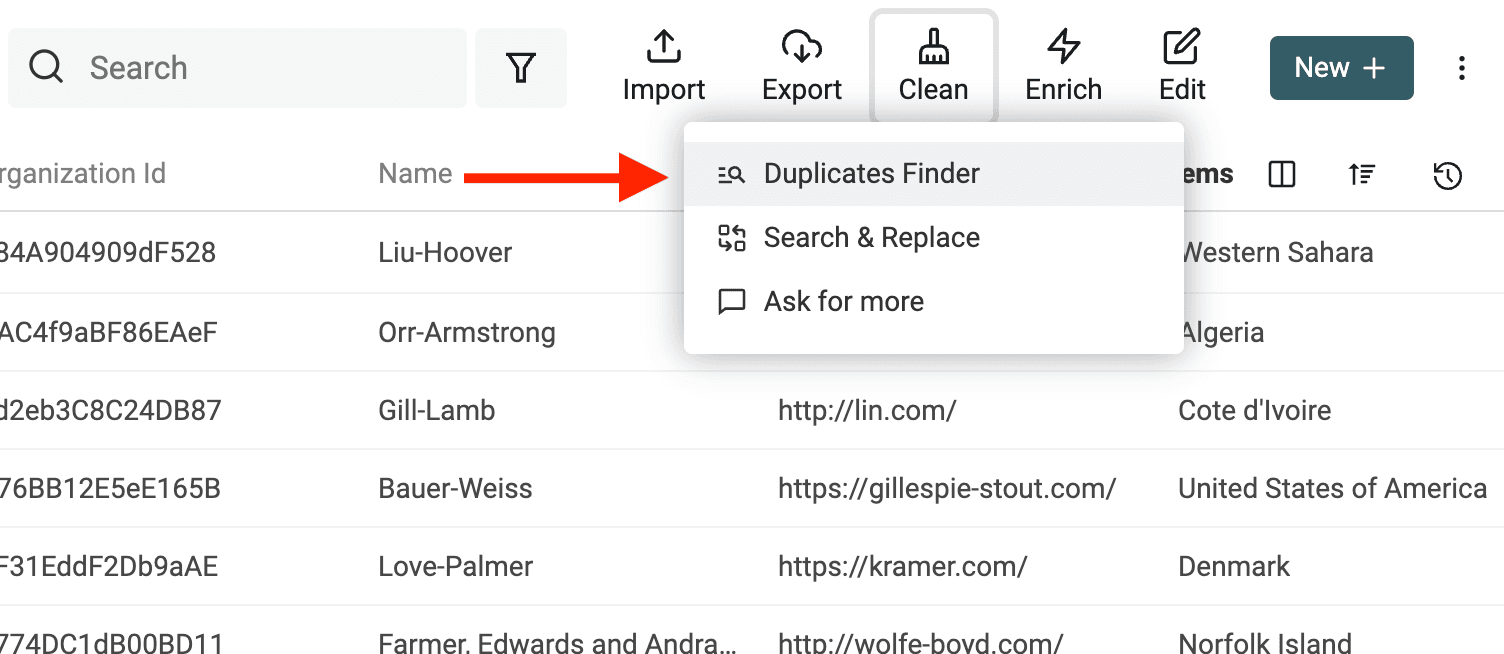
Après avoir importé les fichiers CSV, ouvrez Clean > Merge duplicates. Choisissez plutôt Remove duplicates si les lignes supplémentaires ne contiennent aucune donnée à conserver.
Deux modes sont disponibles :
- All Properties compare les lignes dans leur intégralité.
- Selected Properties compare uniquement les colonnes qui identifient l’enregistrement.
Ici, la propriété email suffit pour identifier un contact. Vous pouvez donc choisir le mode Selected Properties, puis la propriété email.
Pour reproduire le contrôle du nombre de lignes avec les deux fichiers du tutoriel, choisissez la correspondance Exact sur email : huit groupes de doublons contiennent chacun deux lignes. Après avoir réduit chaque groupe à une seule ligne, le fichier CSV exporté doit contenir 1 995 lignes de données, sans compter l’en-tête. Si vous obtenez un autre résultat, vérifiez que chaque fichier n’a été importé qu’une seule fois, que la colonne de correspondance est bien email et qu’aucun groupe n’attend encore d’être traité.
Si des alias ou des adresses intermédiaires créent des variantes, suivez le processus dédié aux emails pour dédupliquer ces adresses.
L’analyse est effectuée en lecture seule. L’espace de résultats affiche les groupes, explique pourquoi les lignes correspondent et sépare les groupes Ready des correspondances qui doivent être vérifiées.
Supprimer les lignes CSV en double sans les fusionner
Pour supprimer uniquement les doublons, choisissez Remove duplicates dans l’espace de résultats :
- Vérifiez Record to keep. La règle sélectionnée par défaut est Most Complete ; les autres règles de sélection nécessitent un abonnement payant. La ligne retenue reste inchangée.
- Ouvrez quelques groupes et comparez les lignes marquées Keep et Remove. Vérifiez si les lignes à supprimer contiennent un numéro de téléphone, une note ou une valeur plus récente dont vous avez encore besoin.
- Si ces valeurs sont importantes, choisissez Merge and preserve data et suivez l’étape 3 ci-dessous. La suppression ne copie pas les valeurs supplémentaires dans la ligne conservée.
- Lorsque les groupes Ready correspondent à votre intention, cliquez sur Remove ready duplicates. Lisez attentivement tout avertissement concernant une éventuelle perte de données avant de confirmer.
Par exemple, deux lignes identiques associées au même email peuvent être réduites à une seule. En revanche, si deux lignes partagent le même email, mais contiennent des numéros de téléphone différents, vous devez choisir entre conserver un enregistrement inchangé ou fusionner les numéros dans l’enregistrement de destination.
Choisissez les colonnes de correspondance avant de décider quelle ligne conserver. All Properties repère les lignes entièrement identiques. Selected Properties peut regrouper un même contact même si son intitulé de poste ou son numéro de téléphone diffère. Utiliser uniquement le site web de l’entreprise est trop imprécis lorsque plusieurs contacts travaillent dans la même société.
Conservez vos fichiers CSV d’origine. Après le traitement, comparez le nombre de lignes supprimées avec les groupes vérifiés, contrôlez les identifiants conservés, puis exportez la collection nettoyée au format CSV. Les lignes qui attendent encore une vérification peuvent rester dans la collection : terminer un lot ne signifie donc pas que tous les doublons potentiels ont été résolus.
Étape 3 : fusionner et combiner automatiquement les doublons
Choisissez Merge and preserve data lorsque les lignes CSV secondaires contiennent des informations utiles. Datablist sélectionne un enregistrement de destination, complète ses propriétés vides, applique vos règles de gestion des conflits, puis supprime les lignes secondaires.
L’aperçu distingue les groupes Ready de ceux qui présentent encore des conflits non résolus. Consultez la documentation de Duplicate Finder pour découvrir tous les paramètres de vérification, de survivorship et de sélection des enregistrements.
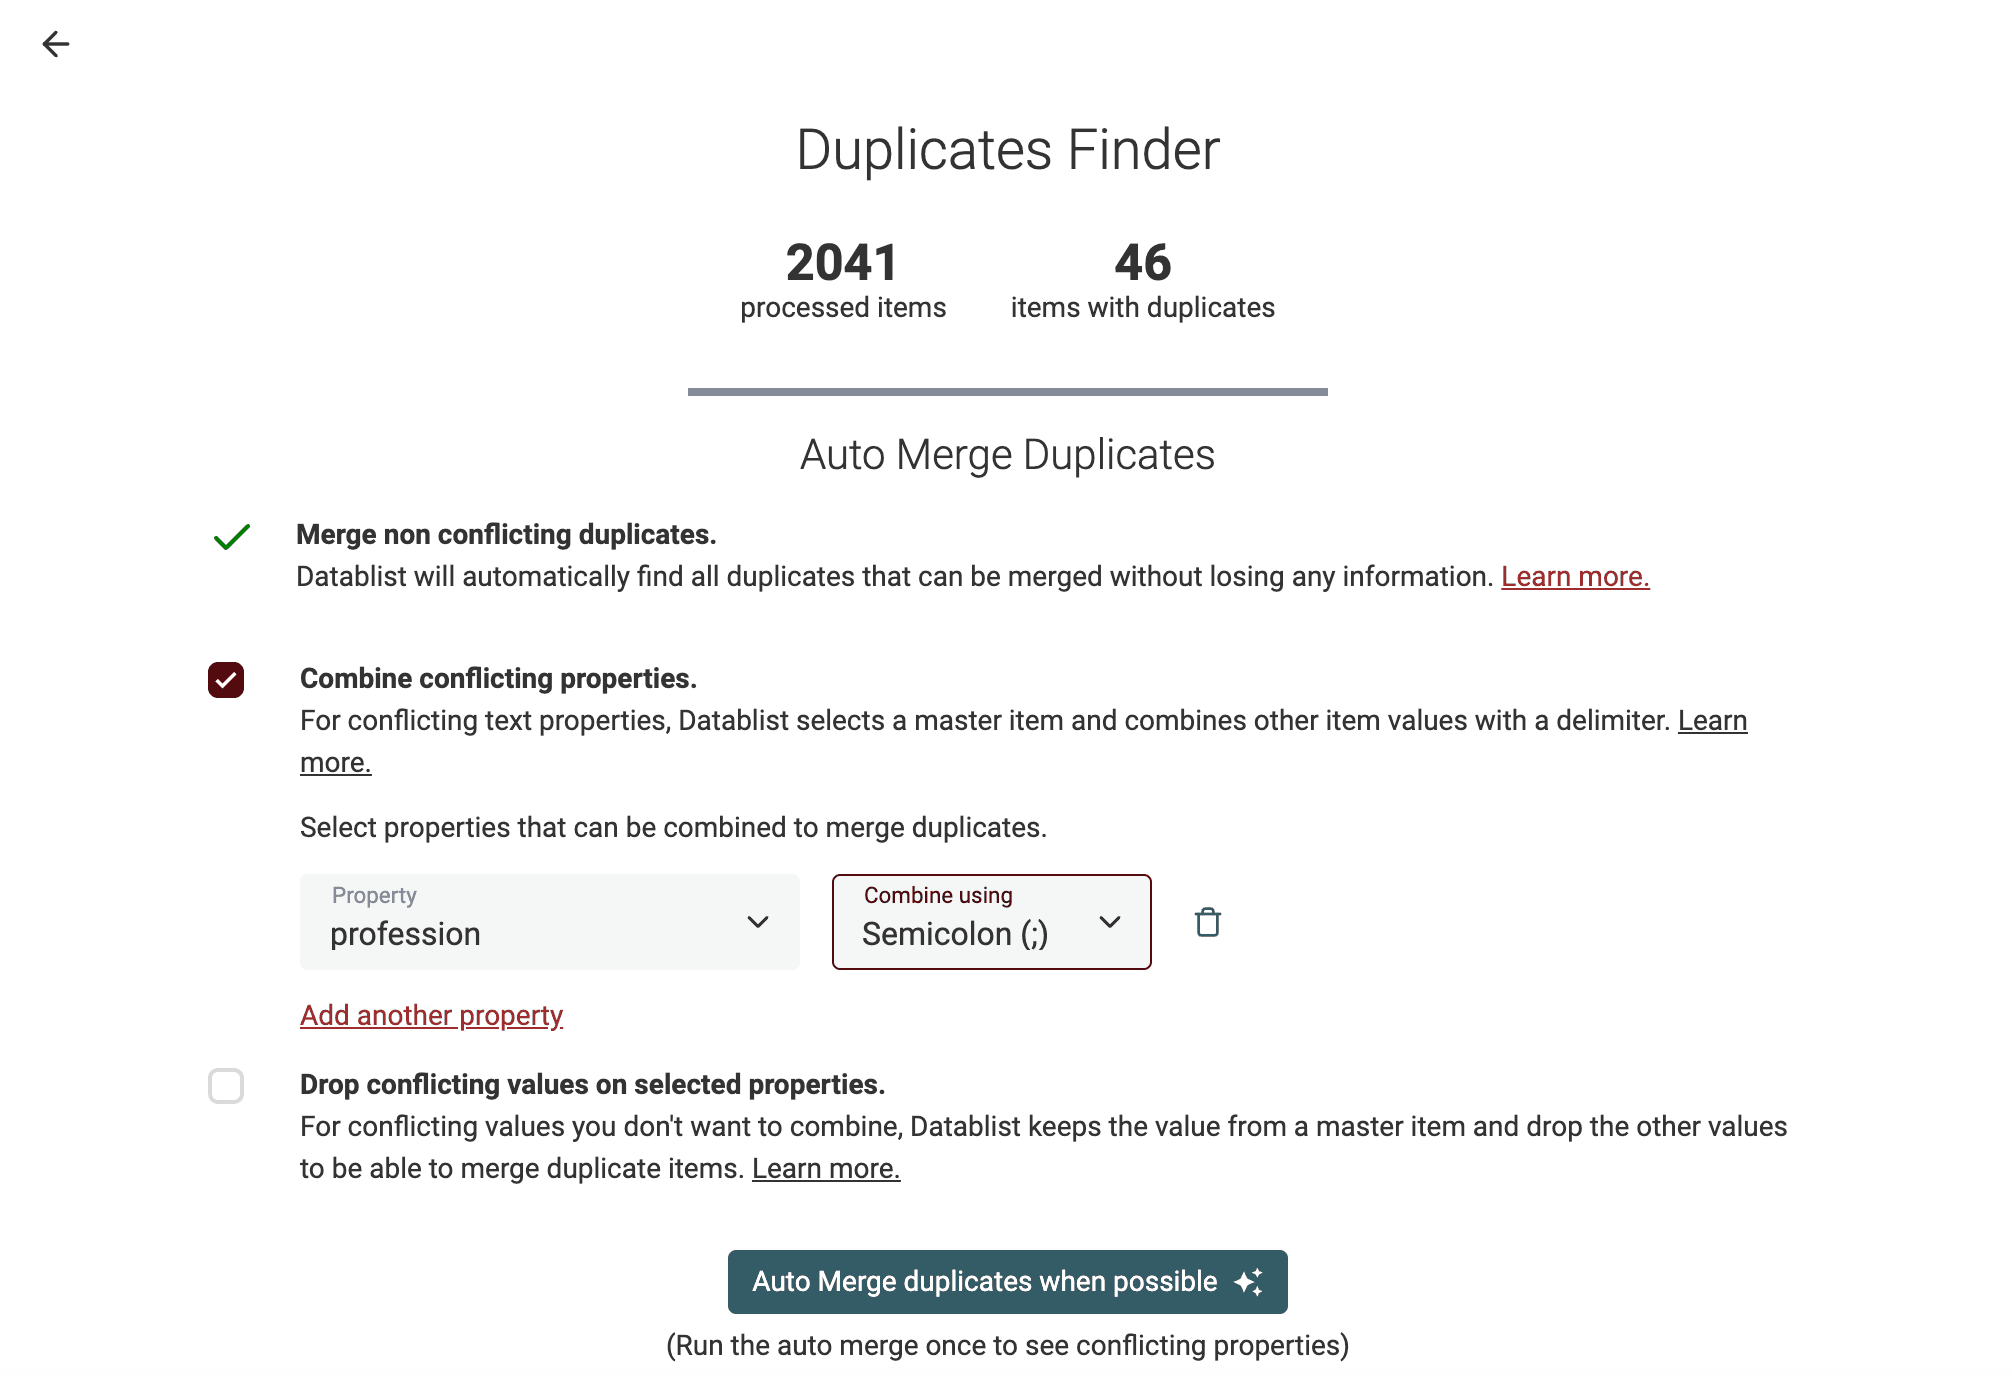
Développez Resolve conflicting values pour identifier les propriétés auxquelles une règle doit encore être appliquée.
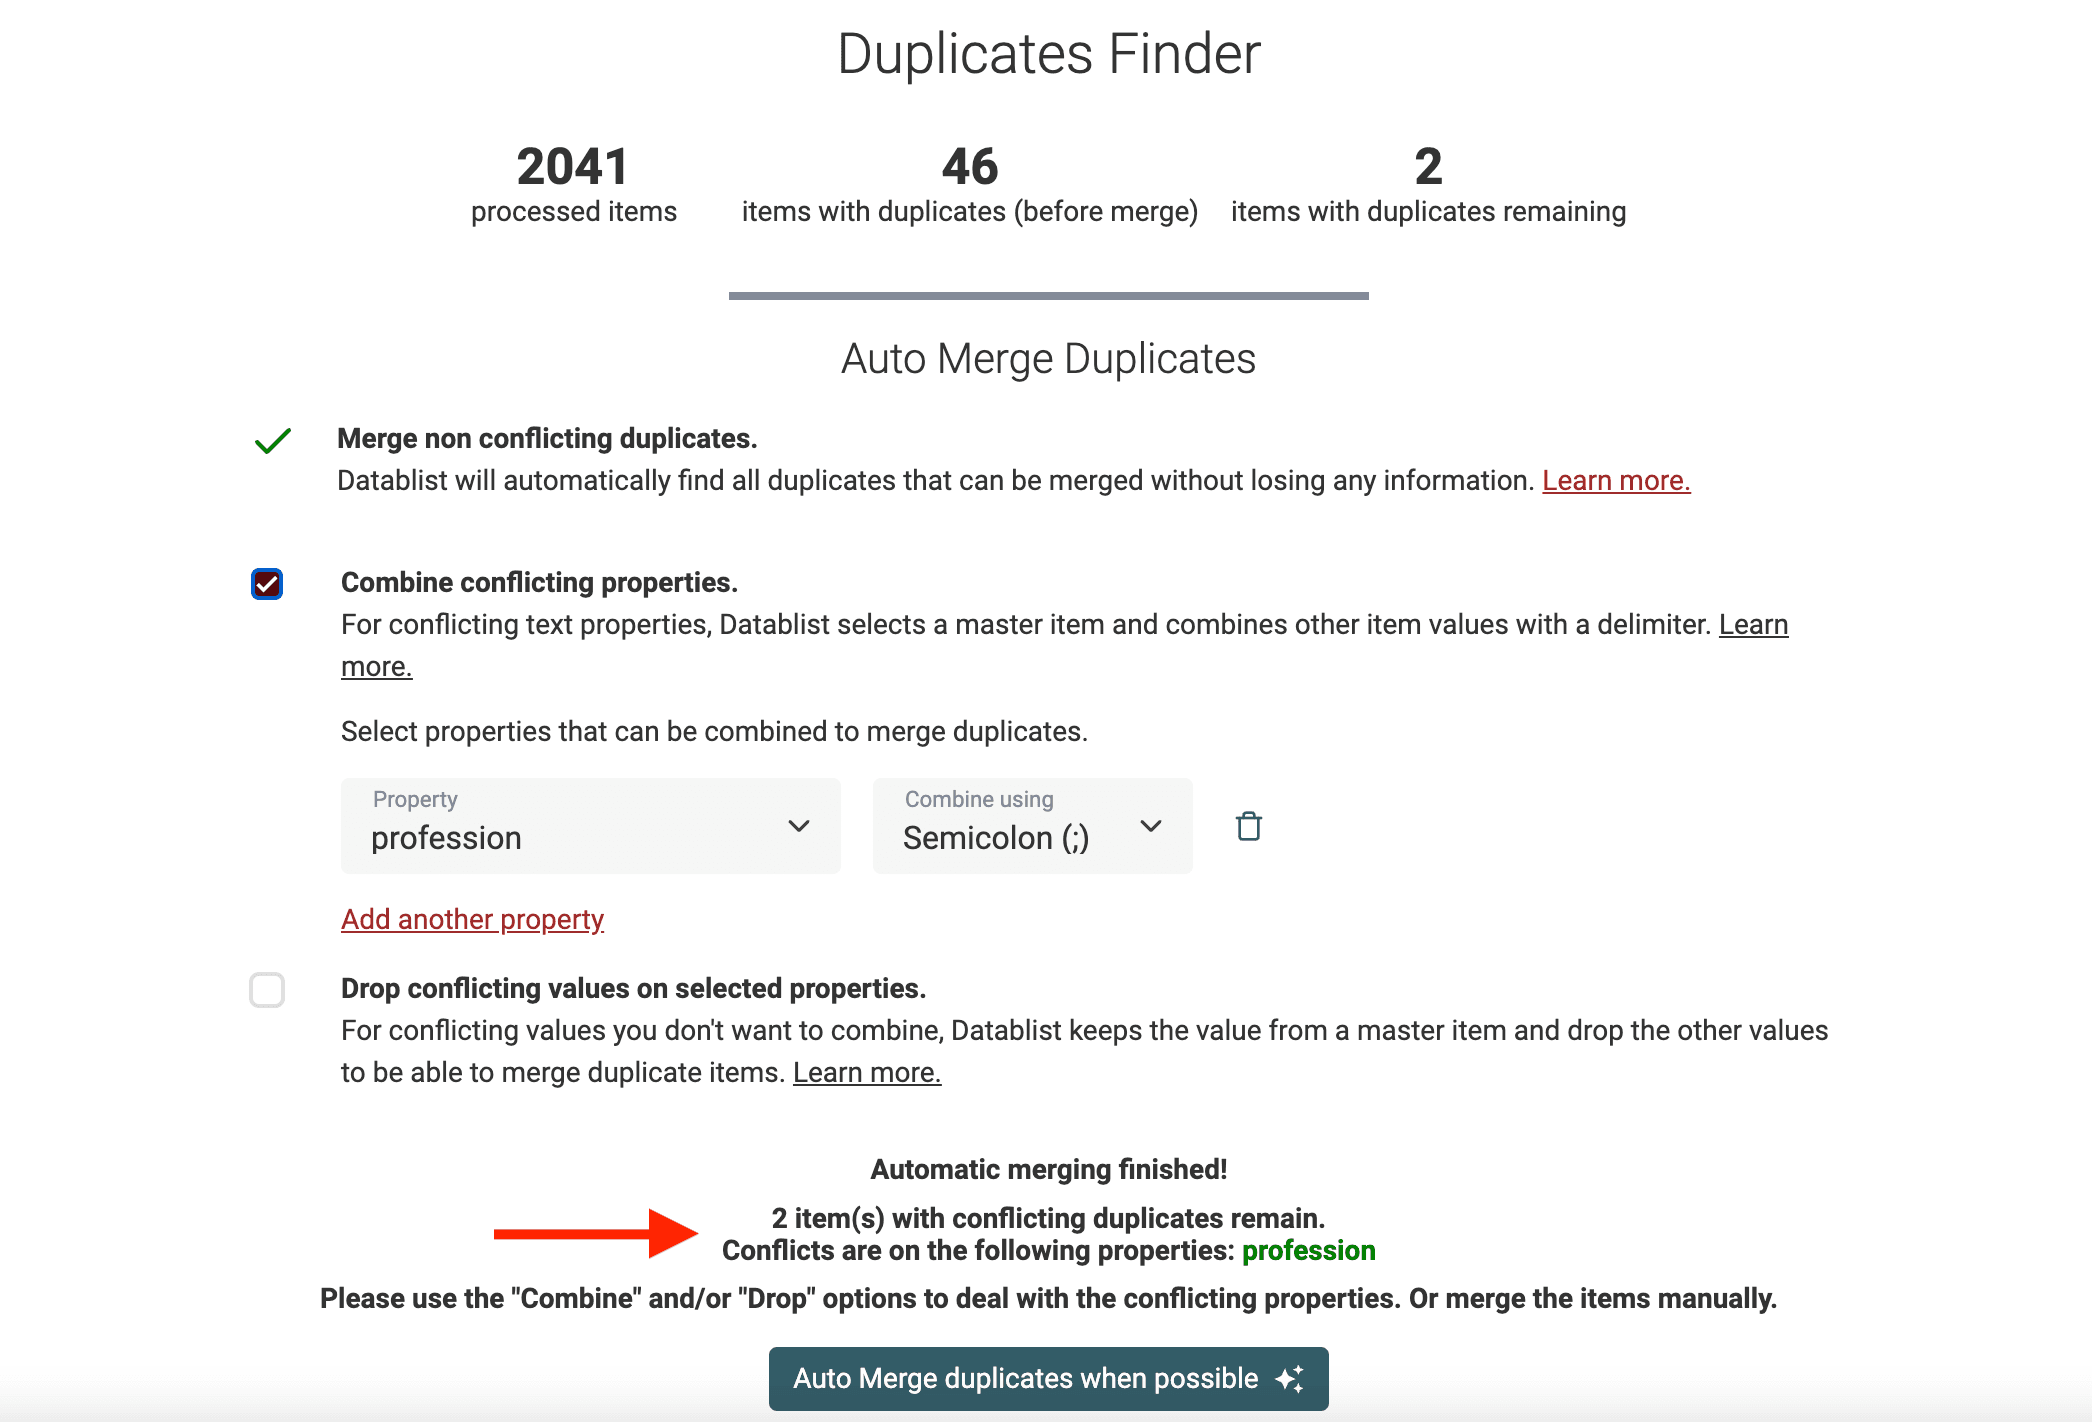
Fusionner les lignes sans conflit
L’algorithme "Merge non-conflicting duplicates" effectue une fusion intelligente. Il regroupe les enregistrements dont les valeurs sont similaires ou complémentaires.
Par exemple, les doublons suivants :
email            |     Prénom       |    Nom
james@gmail.com  |     James
james@gmail.com  |                  |     Bond
Seront fusionnés ainsi :
email            |     Prénom       |    Nom
james@gmail.com  |     James        |     Bond
Combiner les valeurs en double
La combinaison, ou consolidation, des valeurs est idéale lorsque vos doublons présentent des conflits, mais que vous souhaitez tout de même les fusionner sans perdre de données.
Par exemple, en combinant la propriété Phone avec un point-virgule :
email            |       Téléphone    |     Prénom       |    Nom
james@gmail.com  |  +33 1 34 65 23   |      James       |
james@gmail.com  |  06 13 42 78 23   |                  |     Bond
Vous obtiendrez :
email            |   Téléphone                     |     Prénom       |    Nom
james@gmail.com  |  +33 1 34 65 23;06 13 42 78 23  |     James        |     Bond
Toute propriété contenant du texte peut être combinée. Les séparateurs disponibles sont line break, semi-colon, comma et space. Vous pouvez combiner une ou plusieurs propriétés pendant la fusion.
La fusion des entrées en double et la combinaison des valeurs sont particulièrement utiles pour le nettoyage des leads et des CRM. Fusionnez tous vos leads en double et combinez les propriétés Phone, Email et Notes afin d’obtenir une liste propre. Après avoir exporté votre fichier CSV nettoyé, il ne vous reste plus qu’à le réimporter dans votre CRM.
Conserver la valeur de l’enregistrement sélectionné
Cette règle conserve la valeur de l’enregistrement de destination sélectionné et ignore les autres valeurs en conflit.
Most Complete est la règle Record to keep appliquée par défaut. Les abonnements payants permettent de choisir d’autres règles ou de sélectionner séparément les valeurs des champs grâce aux règles de survivorship.
Utilisez l’option drop conflicting values pour :
- Les propriétés techniques comme
Account Id, qui ne peuvent contenir qu’une seule valeur. - Les propriétés de type "Relation", qui ne peuvent pas contenir plusieurs valeurs, comme
Lead ownerouAccount. - Les propriétés autres que textuelles qui ne peuvent pas être combinées, par exemple les dates et heures comme
Last ActivityouContacted on, ainsi que les cases à cocher.
Étape 4 : utiliser l’Assistant de fusion manuelle
Ouvrez Review group lorsqu’un groupe de doublons nécessite une décision manuelle. Le Merging Assistant vous permet de choisir l’enregistrement de destination et la valeur à conserver pour chaque propriété.
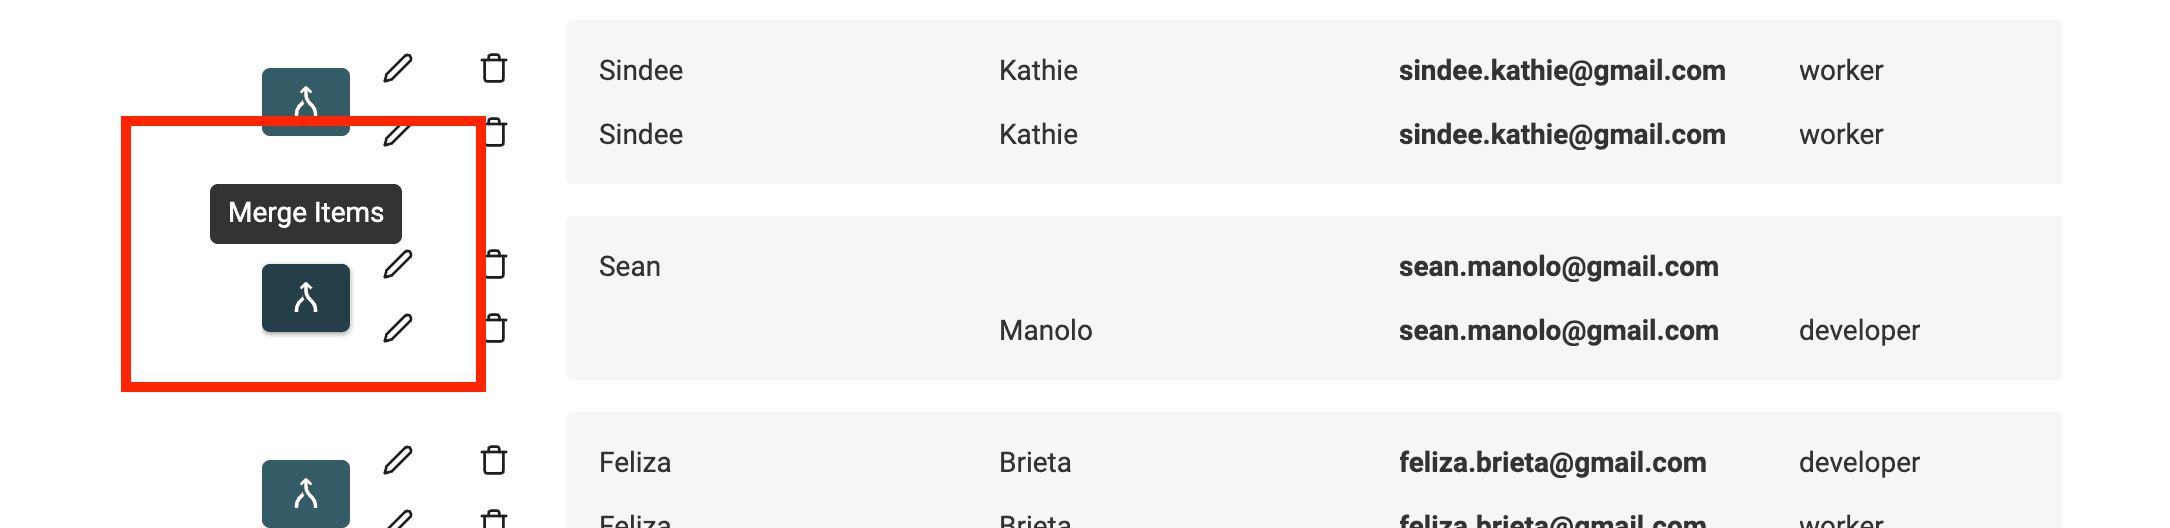
L’enregistrement de destination choisi manuellement conserve son identifiant Datablist. Les autres lignes deviennent des enregistrements secondaires.
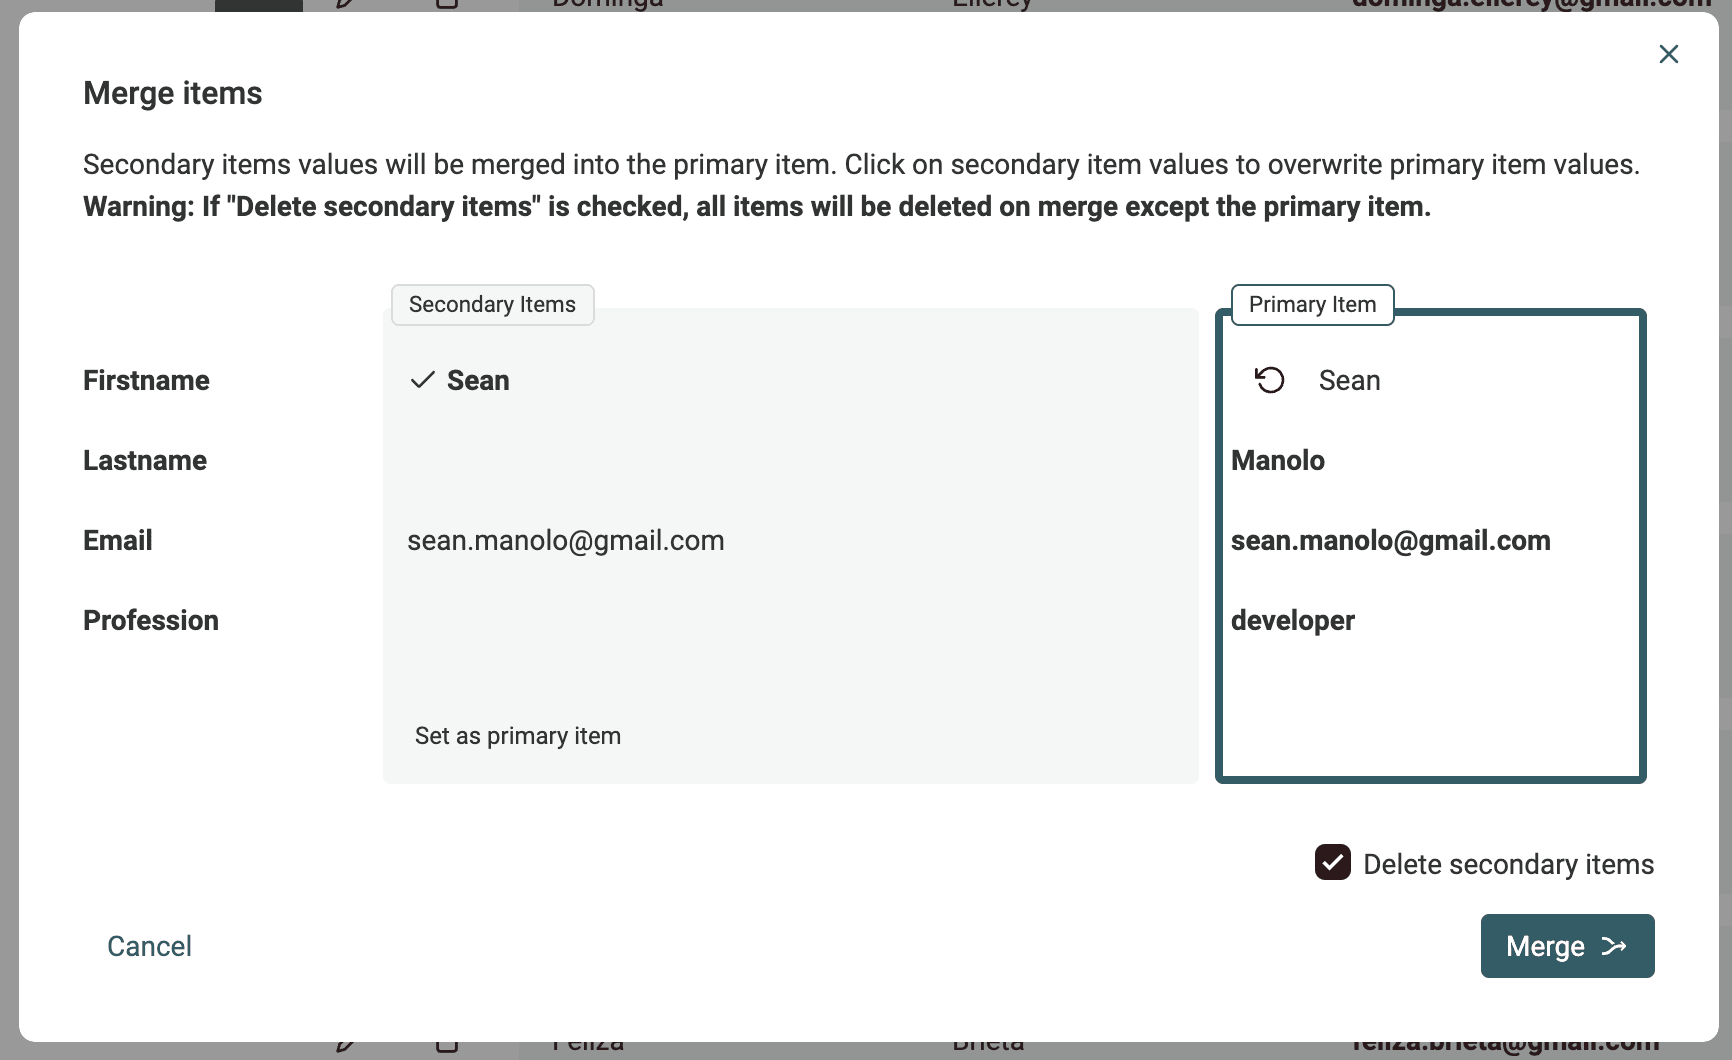
Examinez chaque propriété, sélectionnez les valeurs à conserver, puis confirmez la fusion. Vous pouvez également exclure une ligne du groupe de doublons ou ignorer l’ensemble du groupe.
Exporter le résultat au format CSV
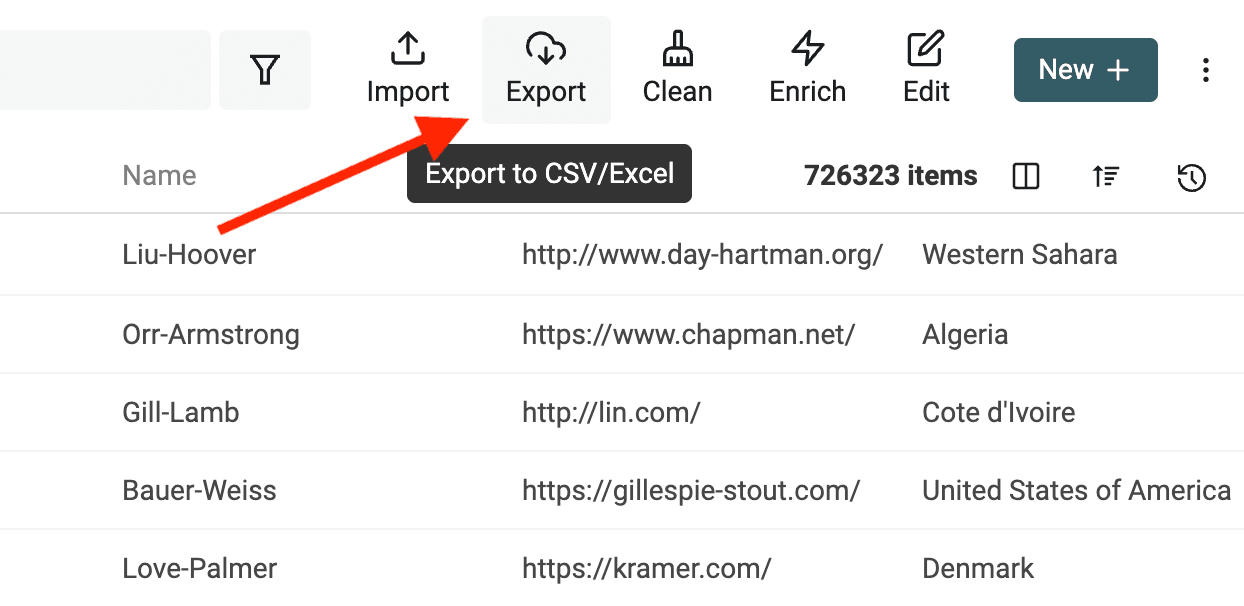
Félicitations, vous avez dédupliqué vos fichiers CSV ! Si vous souhaitez utiliser le résultat dans un autre outil, cliquez sur le bouton "Export" pour exporter la collection dans un nouveau fichier CSV.
FAQ
Quelles autres manipulations de données peut-on effectuer avec Datablist ?
Les fichiers CSV sont omniprésents pour structurer les données utilisées par les applications et les jeux de données. Malgré leur popularité, manipuler des fichiers CSV reste complexe et demande souvent des connaissances techniques.
Pour les opérations simples, les tableurs suffisent. Ils montrent toutefois rapidement leurs limites lorsqu’il faut :
Si vous souhaitez réunir plusieurs fichiers CSV à l’aide d’une colonne unique, consultez le guide pour joindre des fichiers CSV.
Datablist peut-il traiter des fichiers CSV volumineux ?
Le plan Free prend en charge jusqu’à un million d’entrées par collection dans le stockage du navigateur. Les abonnements payants permettent d’importer jusqu’à deux millions d’entrées par collection. Les opérations locales volumineuses dépendent néanmoins des performances du navigateur et de l’appareil. Découvrez comment modifier de gros fichiers CSV.
L’algorithme de déduplication est-il meilleur que les fonctions de suppression des doublons d’Excel et Google Sheets ?
Les tableurs comme Microsoft Excel et Google Sheets proposent un outil de déduplication. Celui-ci se contente de supprimer les lignes similaires, ce qui est rarement idéal dans un contexte professionnel.
Datablist affiche les groupes de doublons avant de modifier le fichier. Vous pouvez supprimer les lignes redondantes, fusionner les valeurs complémentaires, résoudre les conflits ou laisser les groupes incertains intacts.
Pour toute question, n’hésitez pas à nous contacter.