
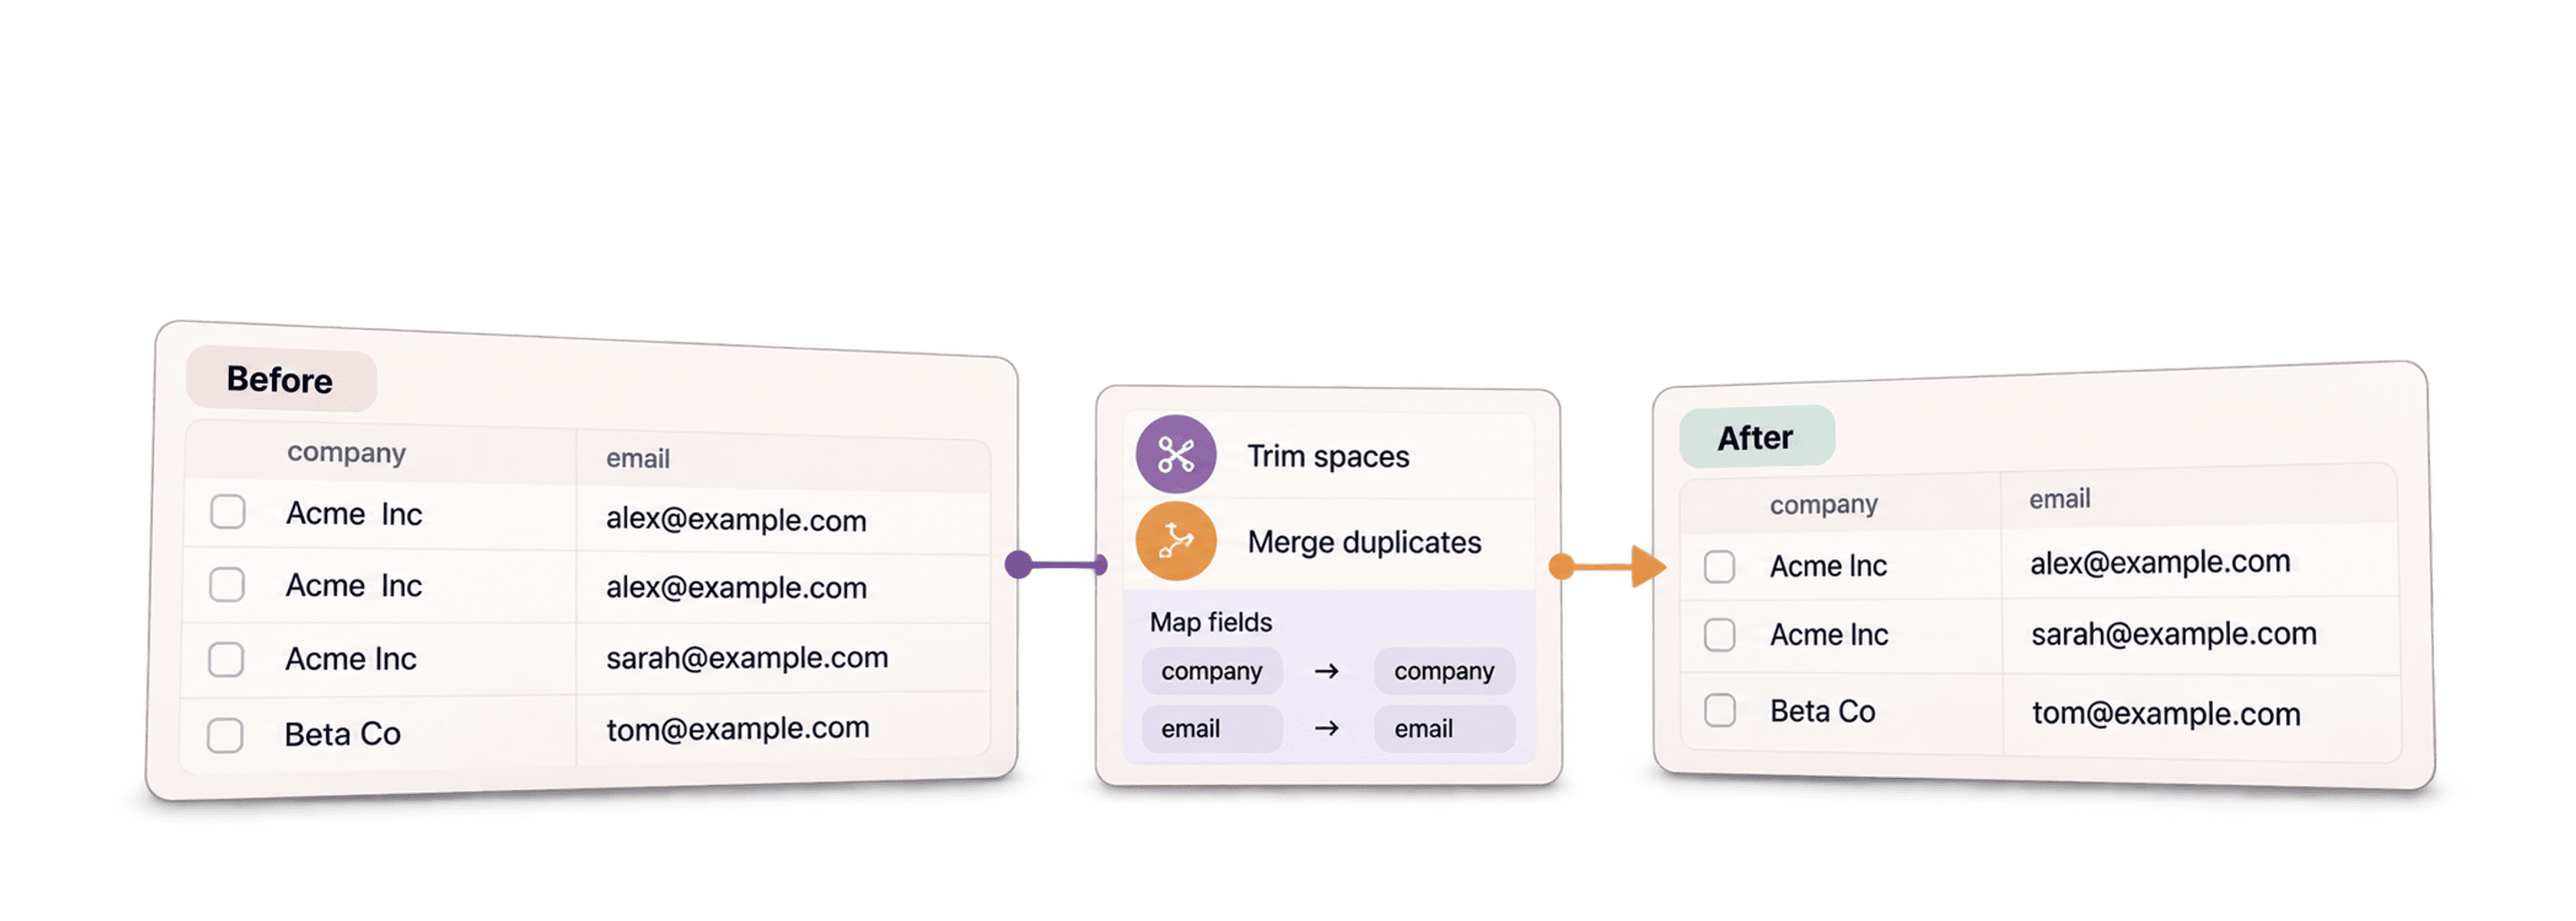
Le data cleaning consiste à repérer et corriger les erreurs d’un jeu de données avant de l’utiliser. Dans une liste de leads, cela peut signifier corriger les dates, supprimer les espaces superflus, séparer les noms complets et fusionner les contacts en double. Ce guide vous montre comment effectuer ces opérations dans Datablist et vérifier le résultat avant d’exporter ou d’enrichir votre liste.
Commencez par les colonnes qui permettent d’identifier un enregistrement, comme l’adresse email ou le domaine de l’entreprise. Uniformisez leur format, examinez les doublons, puis convertissez ou extrayez les autres valeurs dont vous avez besoin. Vérifiez un échantillon de lignes après chaque opération afin de vous assurer qu’une règle de formatage ne modifie pas des données valides.
Voici un récapitulatif des opérations de nettoyage présentées dans cet article :
- Convertir du texte en date et heure, nombre ou booléen
- Convertir du HTML en texte et supprimer les balises
- Supprimer les espaces superflus
- Normaliser vos données
- Supprimer les symboles des textes
- Séparer un nom complet en prénom et nom
- Dédupliquer les enregistrements
- Extraire des adresses email, des URL, etc.
- Utiliser des expressions régulières pour filtrer et valider les données
- Créer des transformations personnalisées en JavaScript
- Valider des adresses email
Importer un CSV ou copier-coller des données
Datablist est l’outil idéal pour nettoyer vos données. Cet éditeur CSV en ligne propose des fonctionnalités de nettoyage, de modification en masse et d’enrichissement. Et chaque collection peut contenir plusieurs millions d’éléments.
Pour les champs de texte multilingues, vous pouvez ajouter une langue à chaque ligne d’un jeu de données multilingue avant de filtrer, d’orienter ou de traduire les données.
Ouvrez Datablist, puis chargez vos sources de données dans des collections.
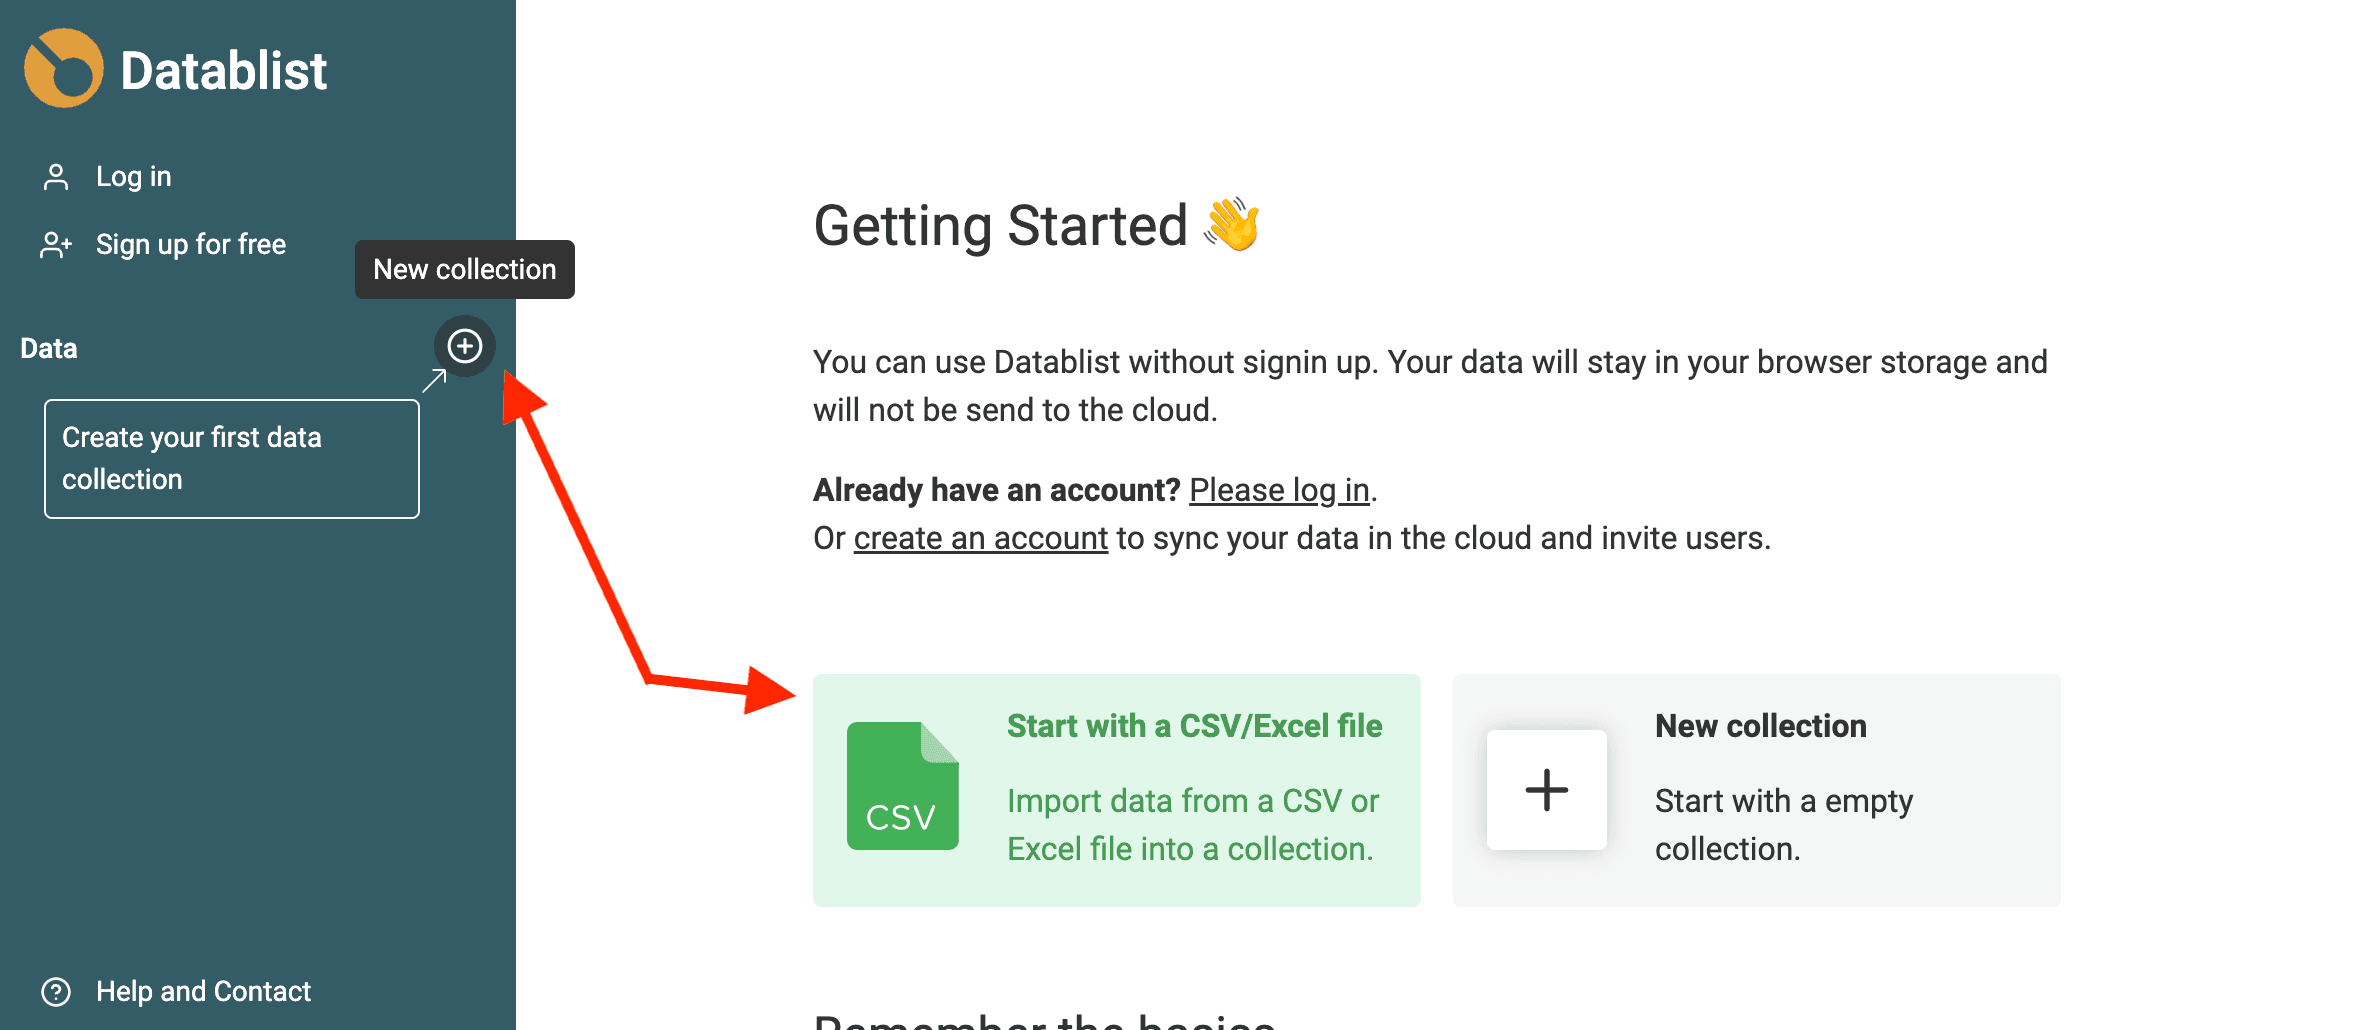
Pour créer une collection, cliquez sur le bouton + dans la barre latérale. Cliquez ensuite sur « Import CSV/Excel » pour charger votre fichier. Vous pouvez également utiliser le raccourci de la page de démarrage pour accéder directement à l’étape d’importation.
Détecter automatiquement le format
L’assistant d’importation de Datablist détecte automatiquement les adresses email, les dates et heures au format ISO 8601, les booléens, les nombres, les URL, etc. lorsqu’ils sont correctement formatés.
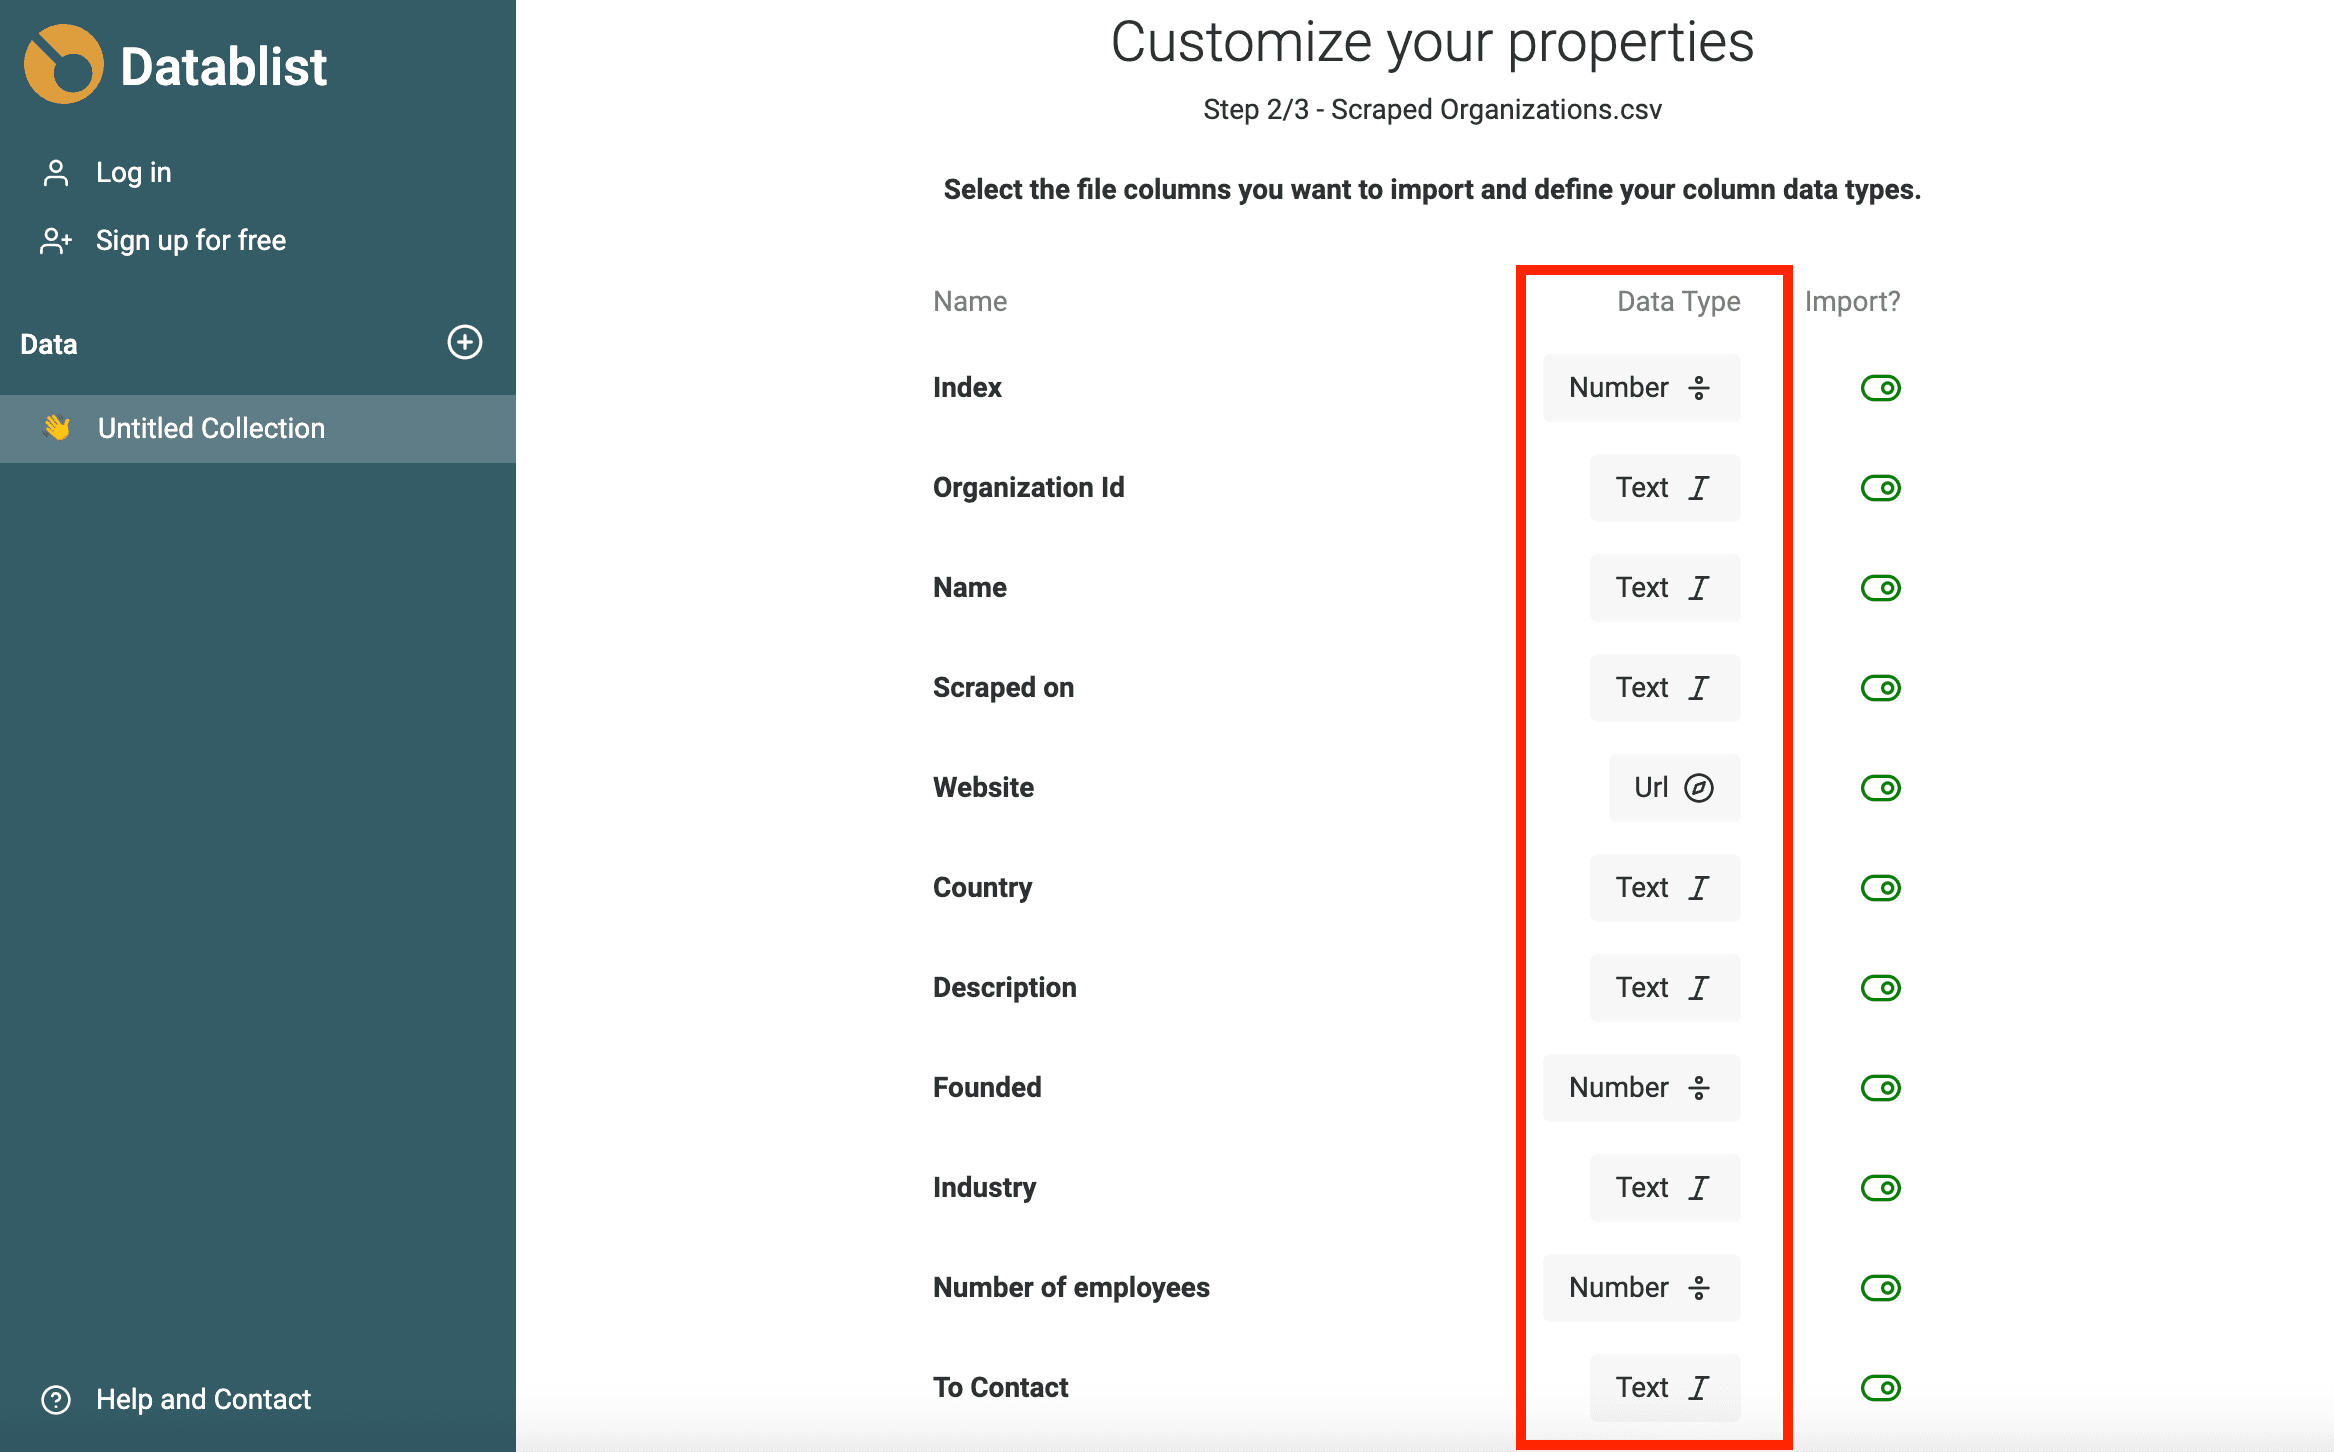
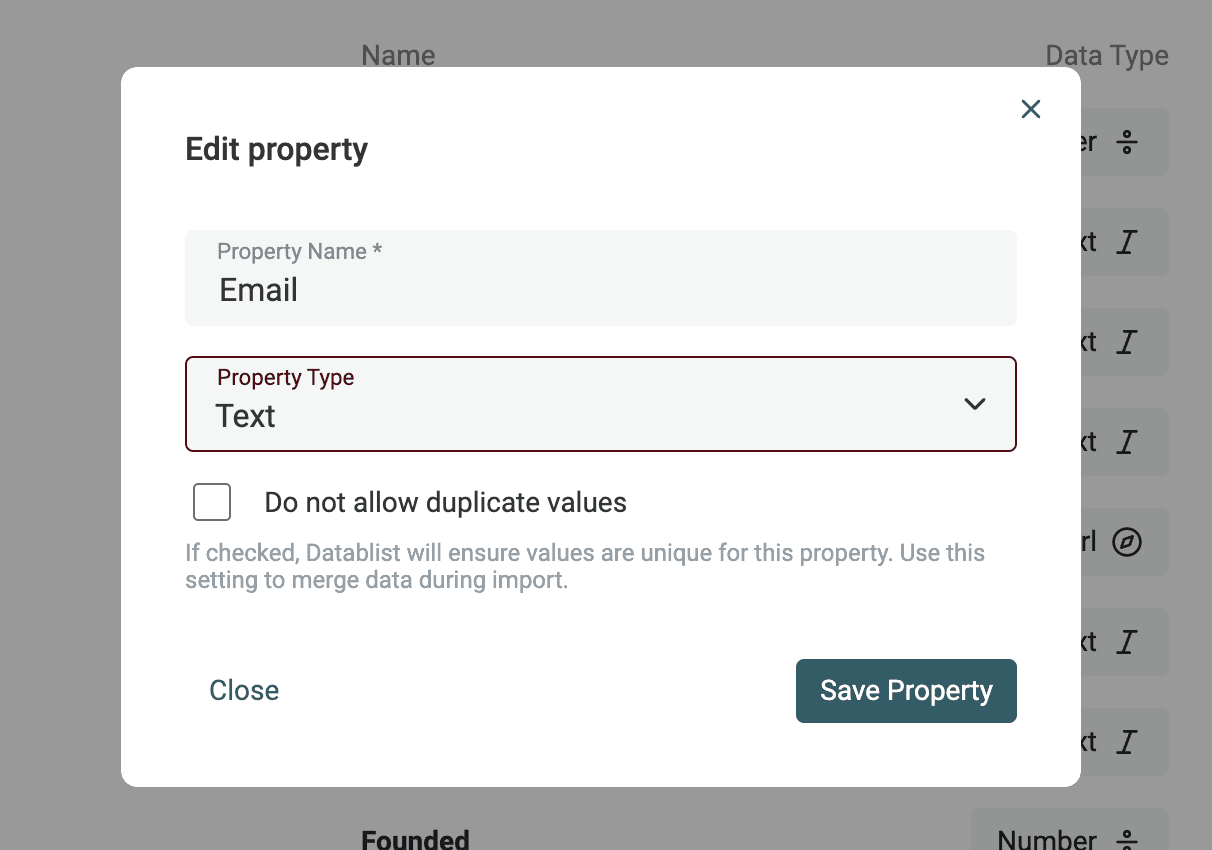
Si vos données nécessitent une analyse plus complexe — format de date différent, faute dans une URL ou une adresse email — importez-les comme propriété Text. La section suivante vous explique comment convertir ces propriétés en Datetime, Boolean ou Number.
Convertir du texte en date, booléen ou nombre
Marie Kondo affirme que « la vie ne commence vraiment qu’après avoir mis de l’ordre chez soi ». Il en va de même pour vos données : « les ventes ne commencent vraiment qu’après avoir mis de l’ordre dans vos données » ! 😅
Filtrer une date — date de création, date de financement, etc. —, un nombre — prix, effectif — ou un booléen est bien plus simple lorsqu’il s’agit d’objets natifs et non de simples textes.
Ouvrez l’outil « Text to Datetime, Number, Checkbox » depuis le menu « Clean ».
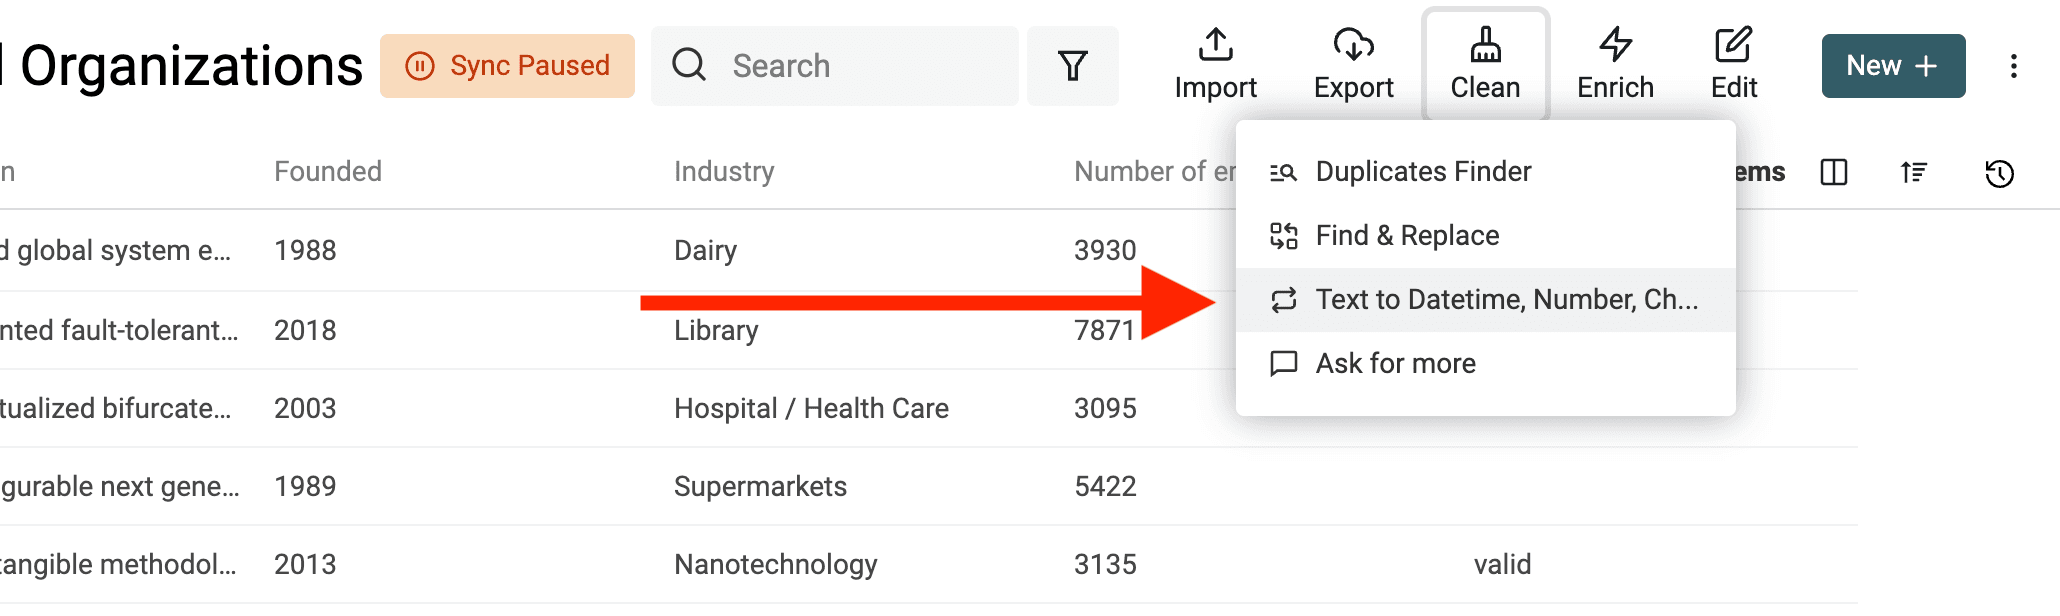
Convertir n’importe quel texte au format Datetime
Le format international des dates et heures, ISO 8601, repose sur une structure définie. Si vos données respectent ce format, une propriété Datetime est automatiquement créée lors de l’importation pour les stocker.
Pour les dates et heures présentées dans d’autres formats, vous devez indiquer le format utilisé afin que Datablist puisse les convertir en valeurs Datetime structurées.
Sélectionnez la propriété à convertir, puis « Convert to Datetime ».
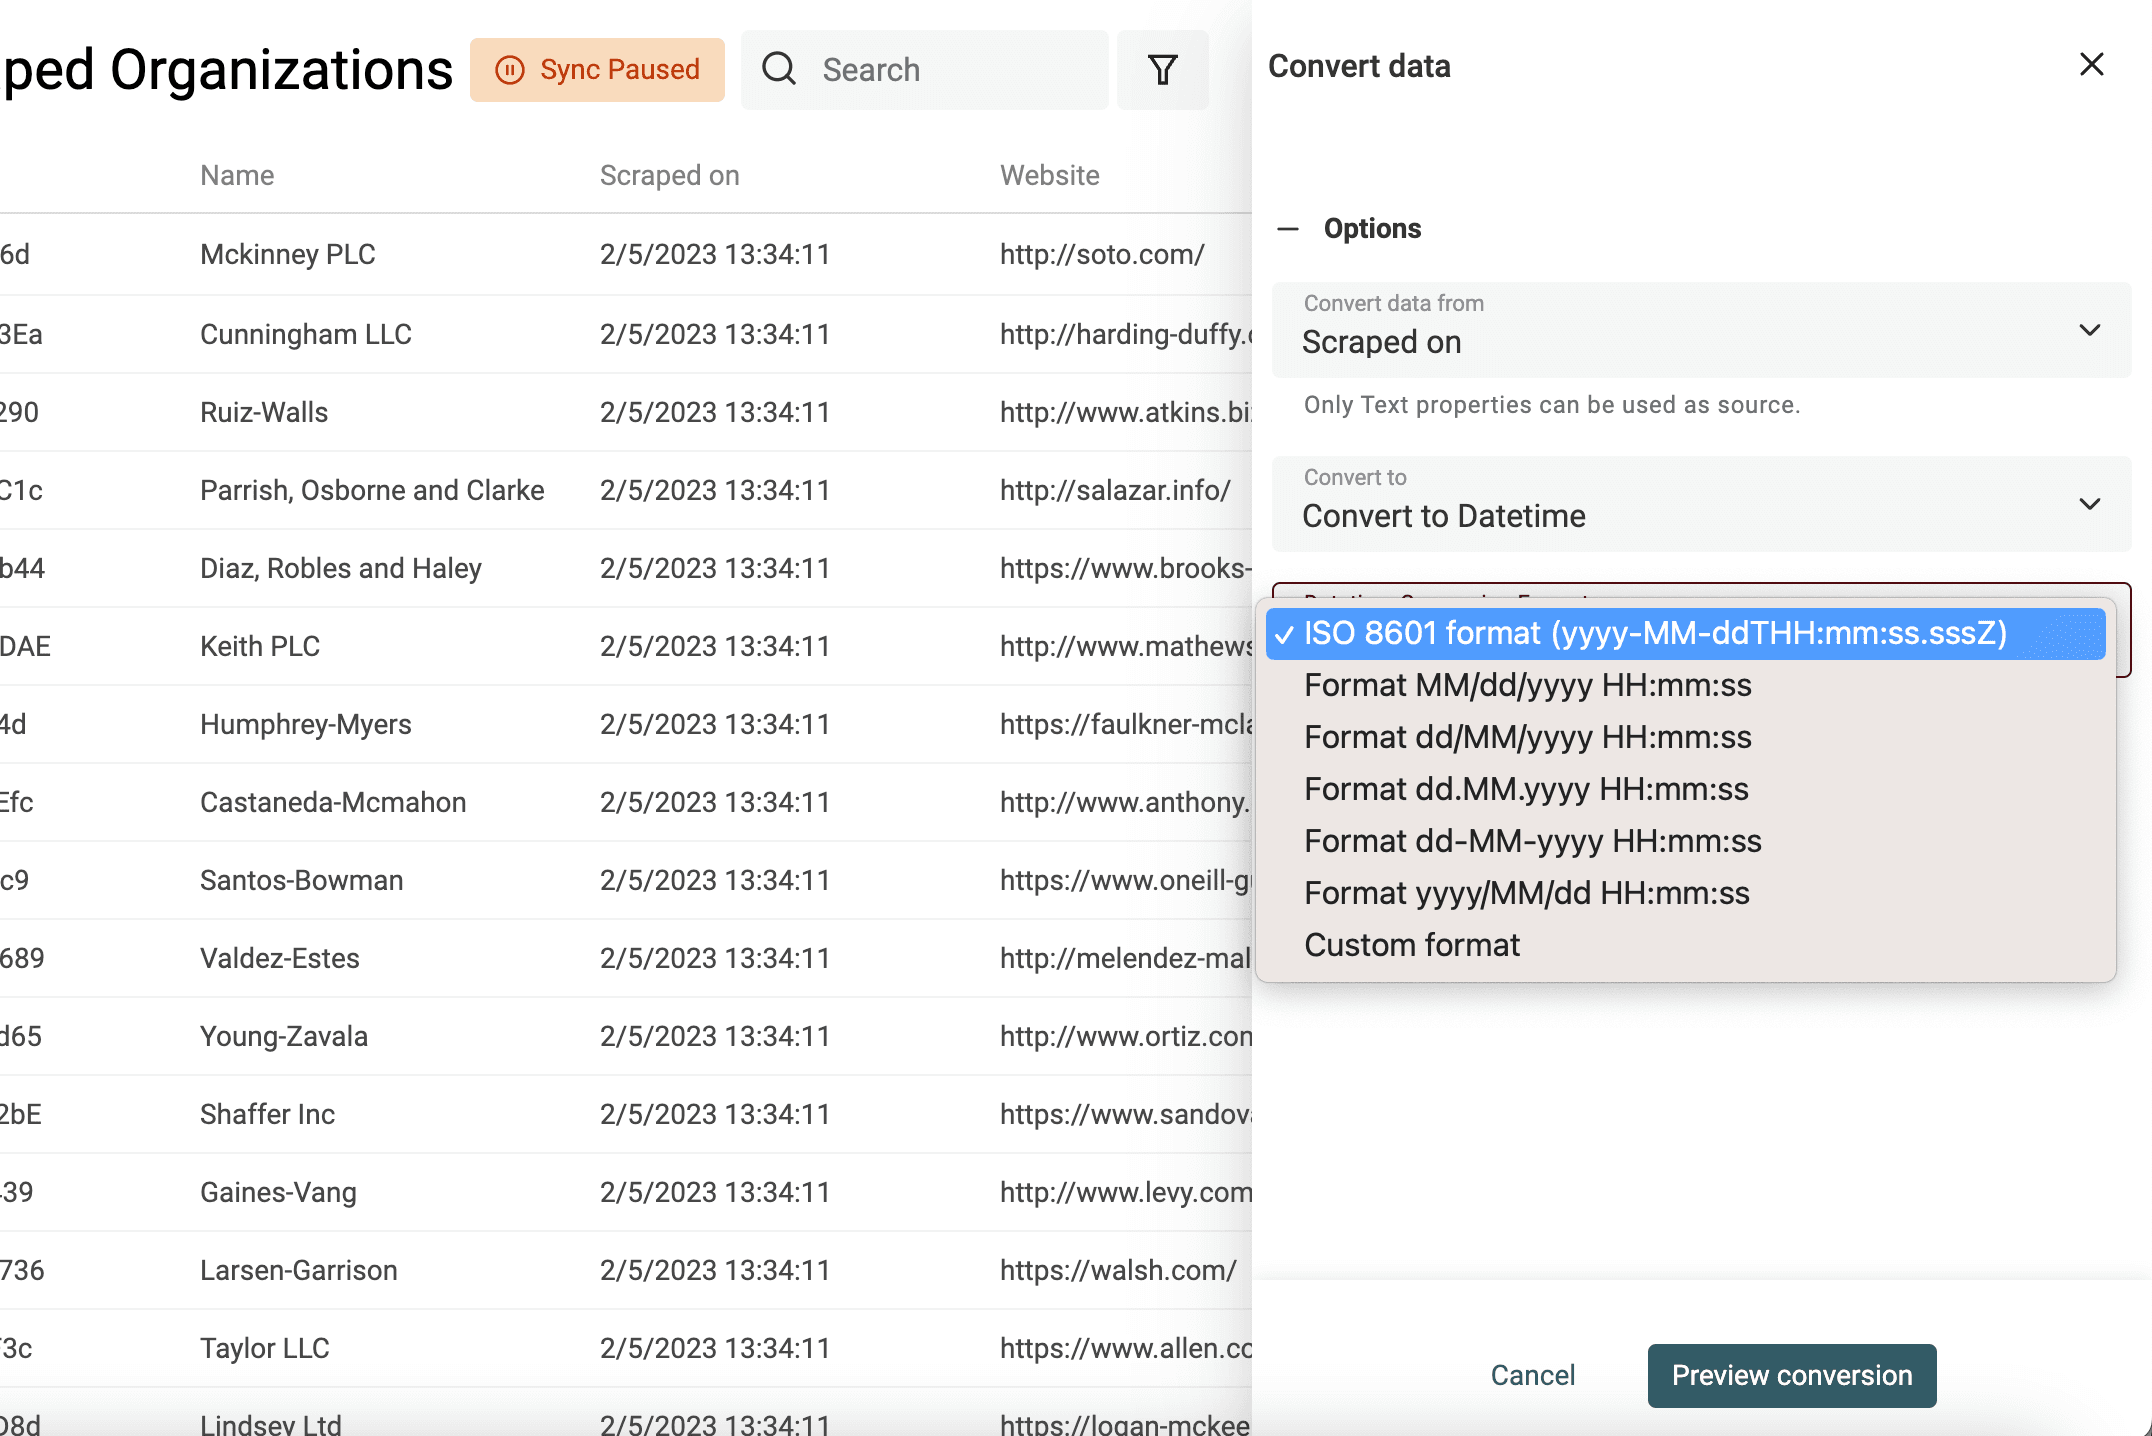
Les formats courants, notamment ceux utilisés par Google Sheets et Excel, sont proposés dans la liste. Vous pouvez aussi sélectionner « Custom format » pour définir votre propre format de date et heure.
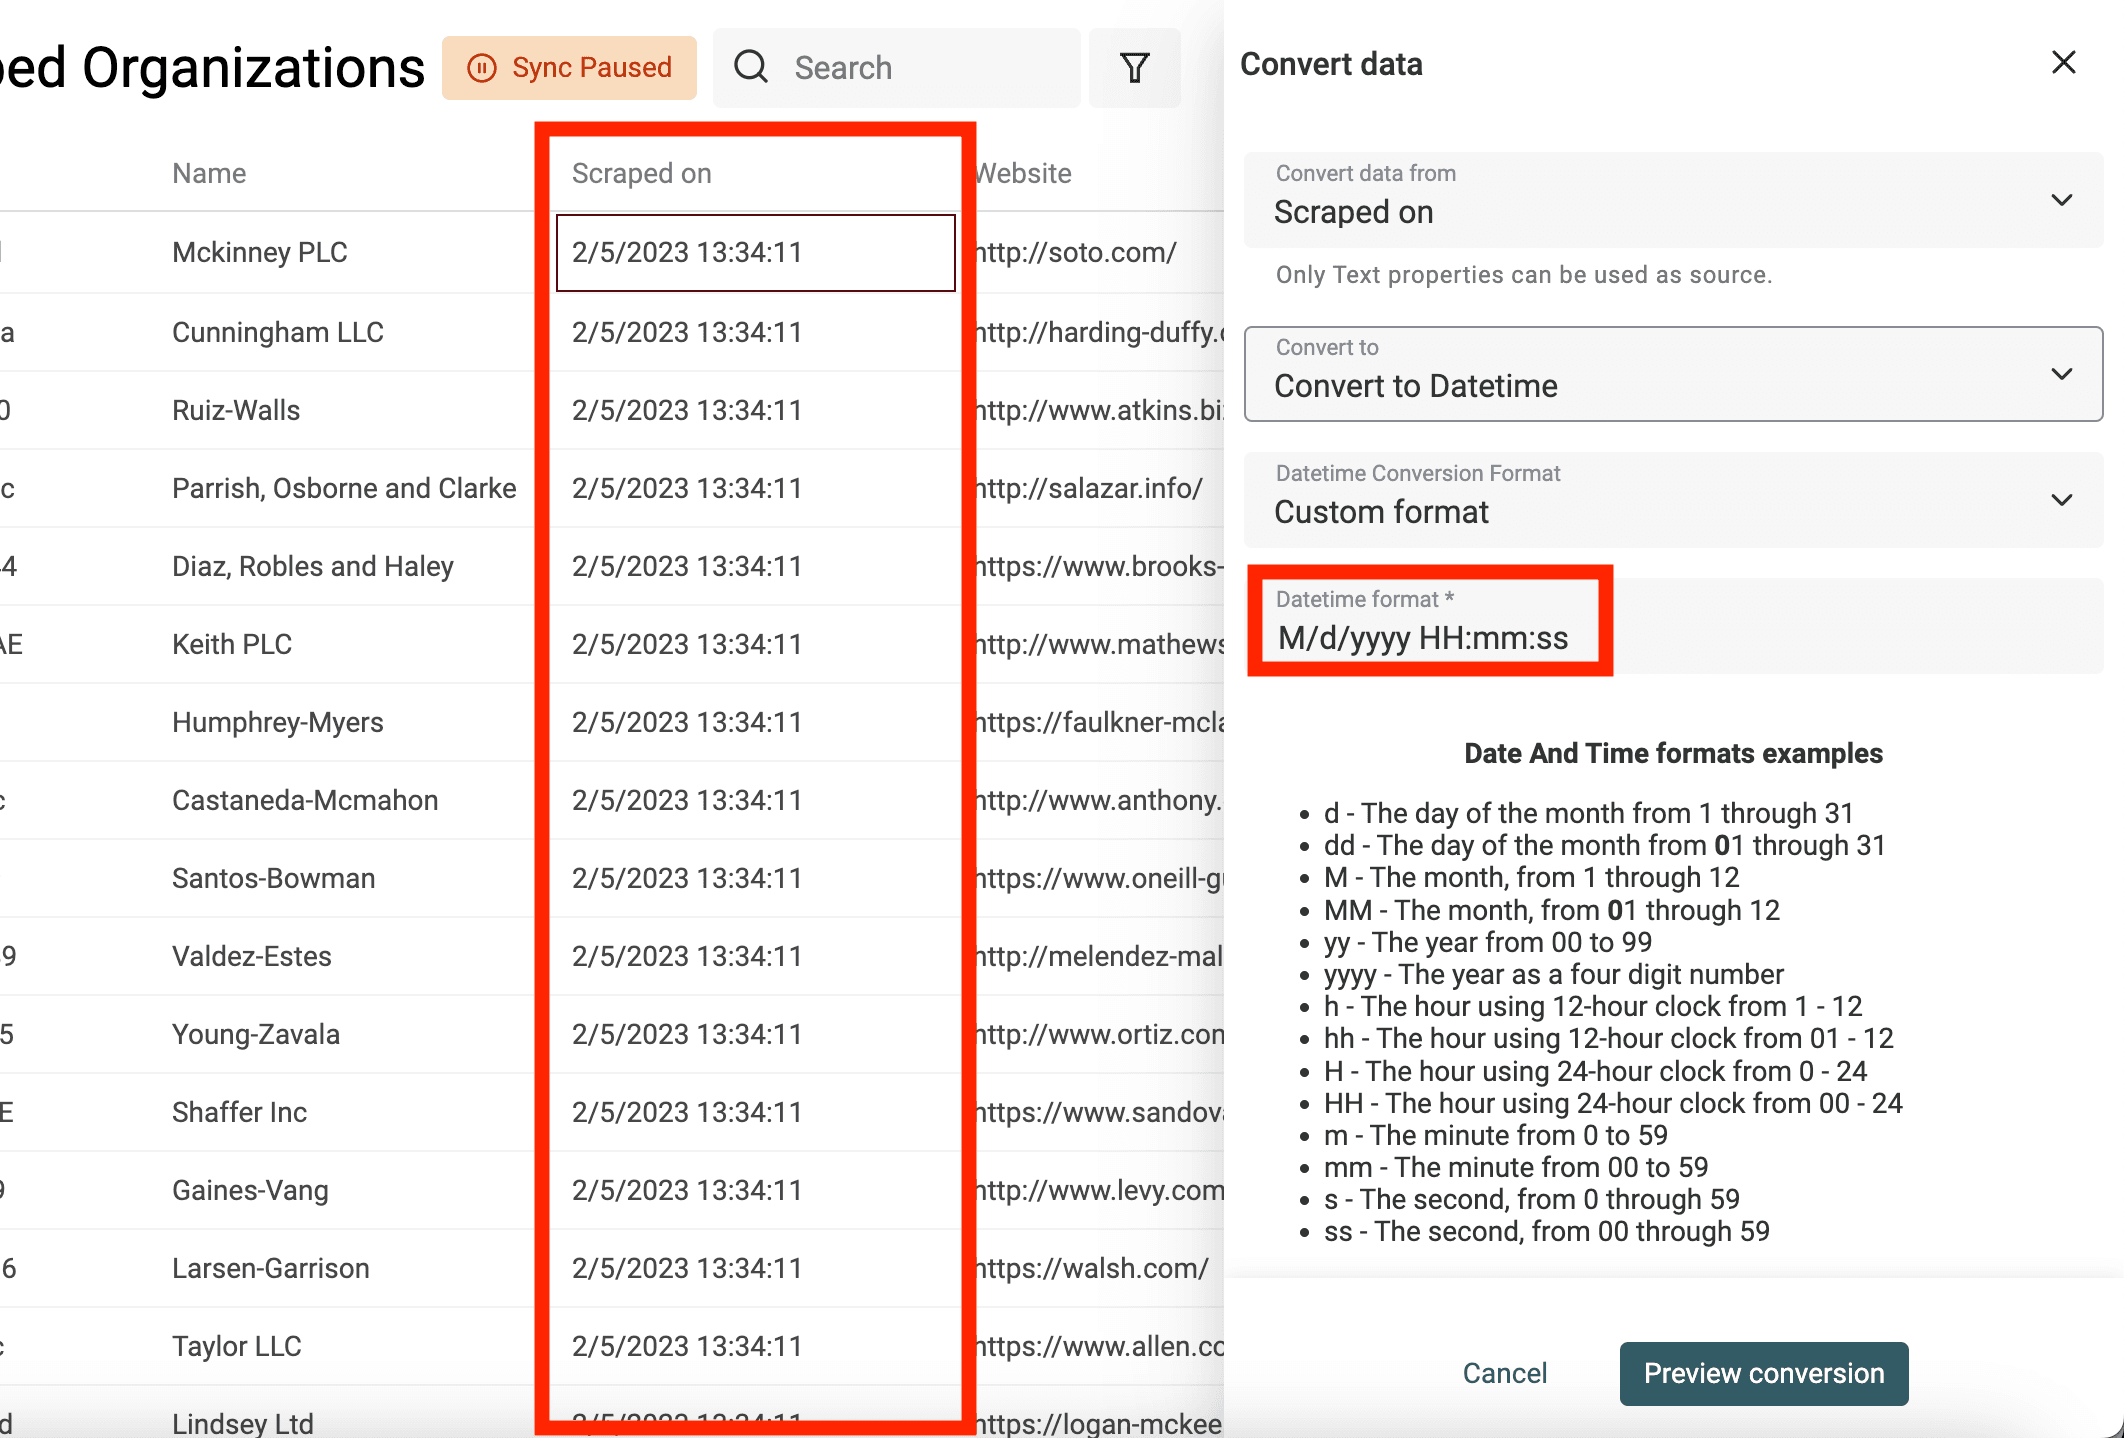
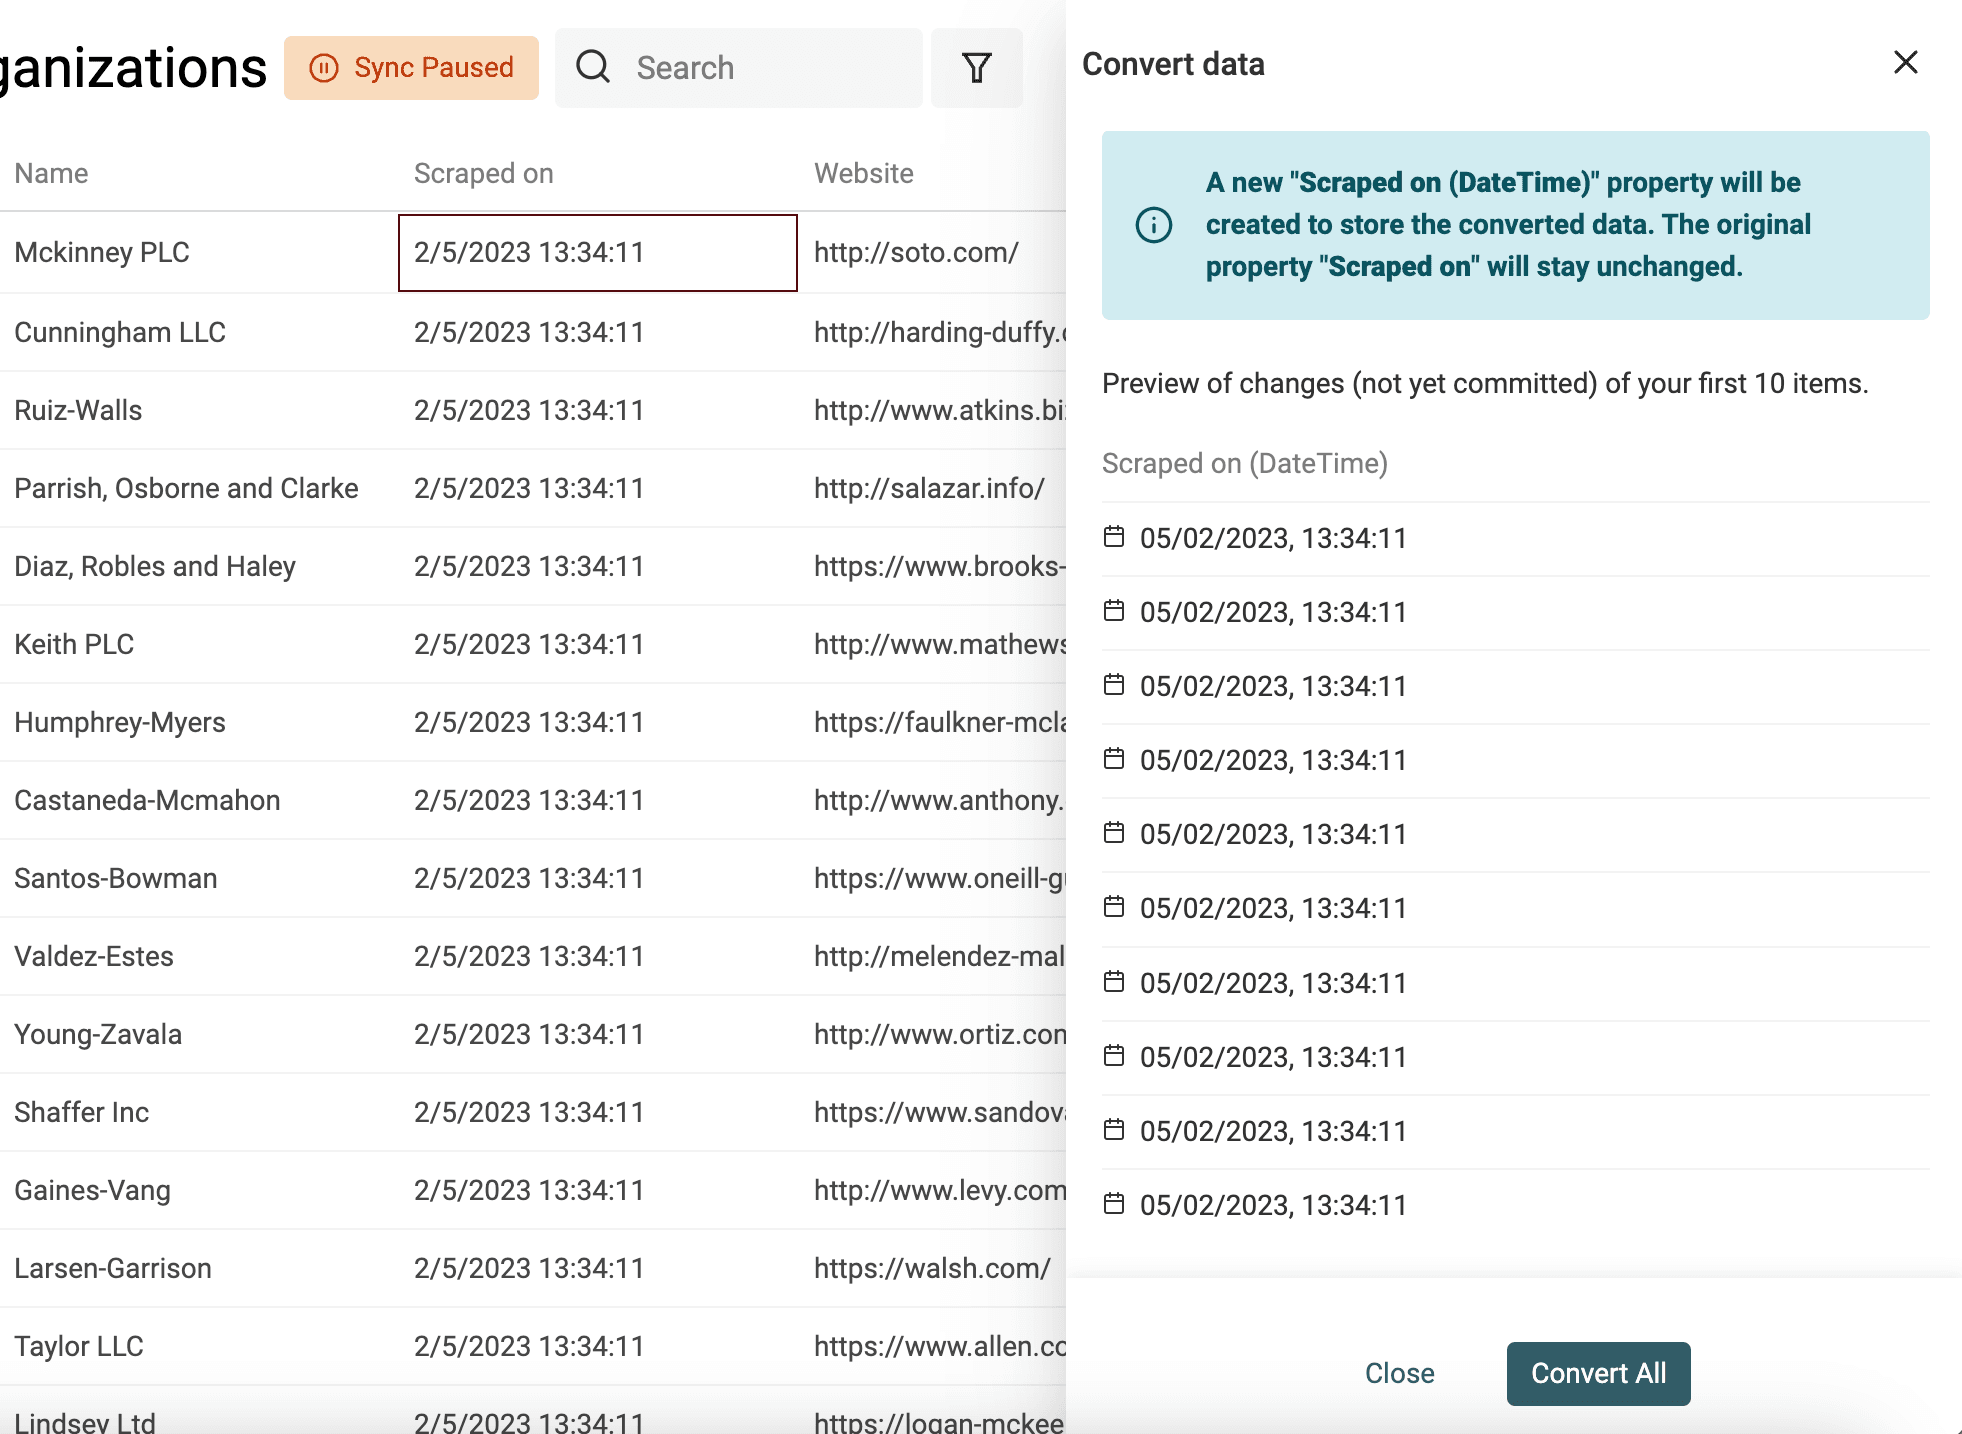
Si une même propriété contient plusieurs formats de date ou de date et heure, sélectionnez « Custom or multiple formats » dans « Datetime Conversion Format ». Saisissez ensuite un format par ligne. Datablist les testera dans l’ordre, à partir de la première ligne, jusqu’à obtenir une date valide.
👉 Consultez notre documentation pour en savoir plus sur les formats Datetime personnalisés.
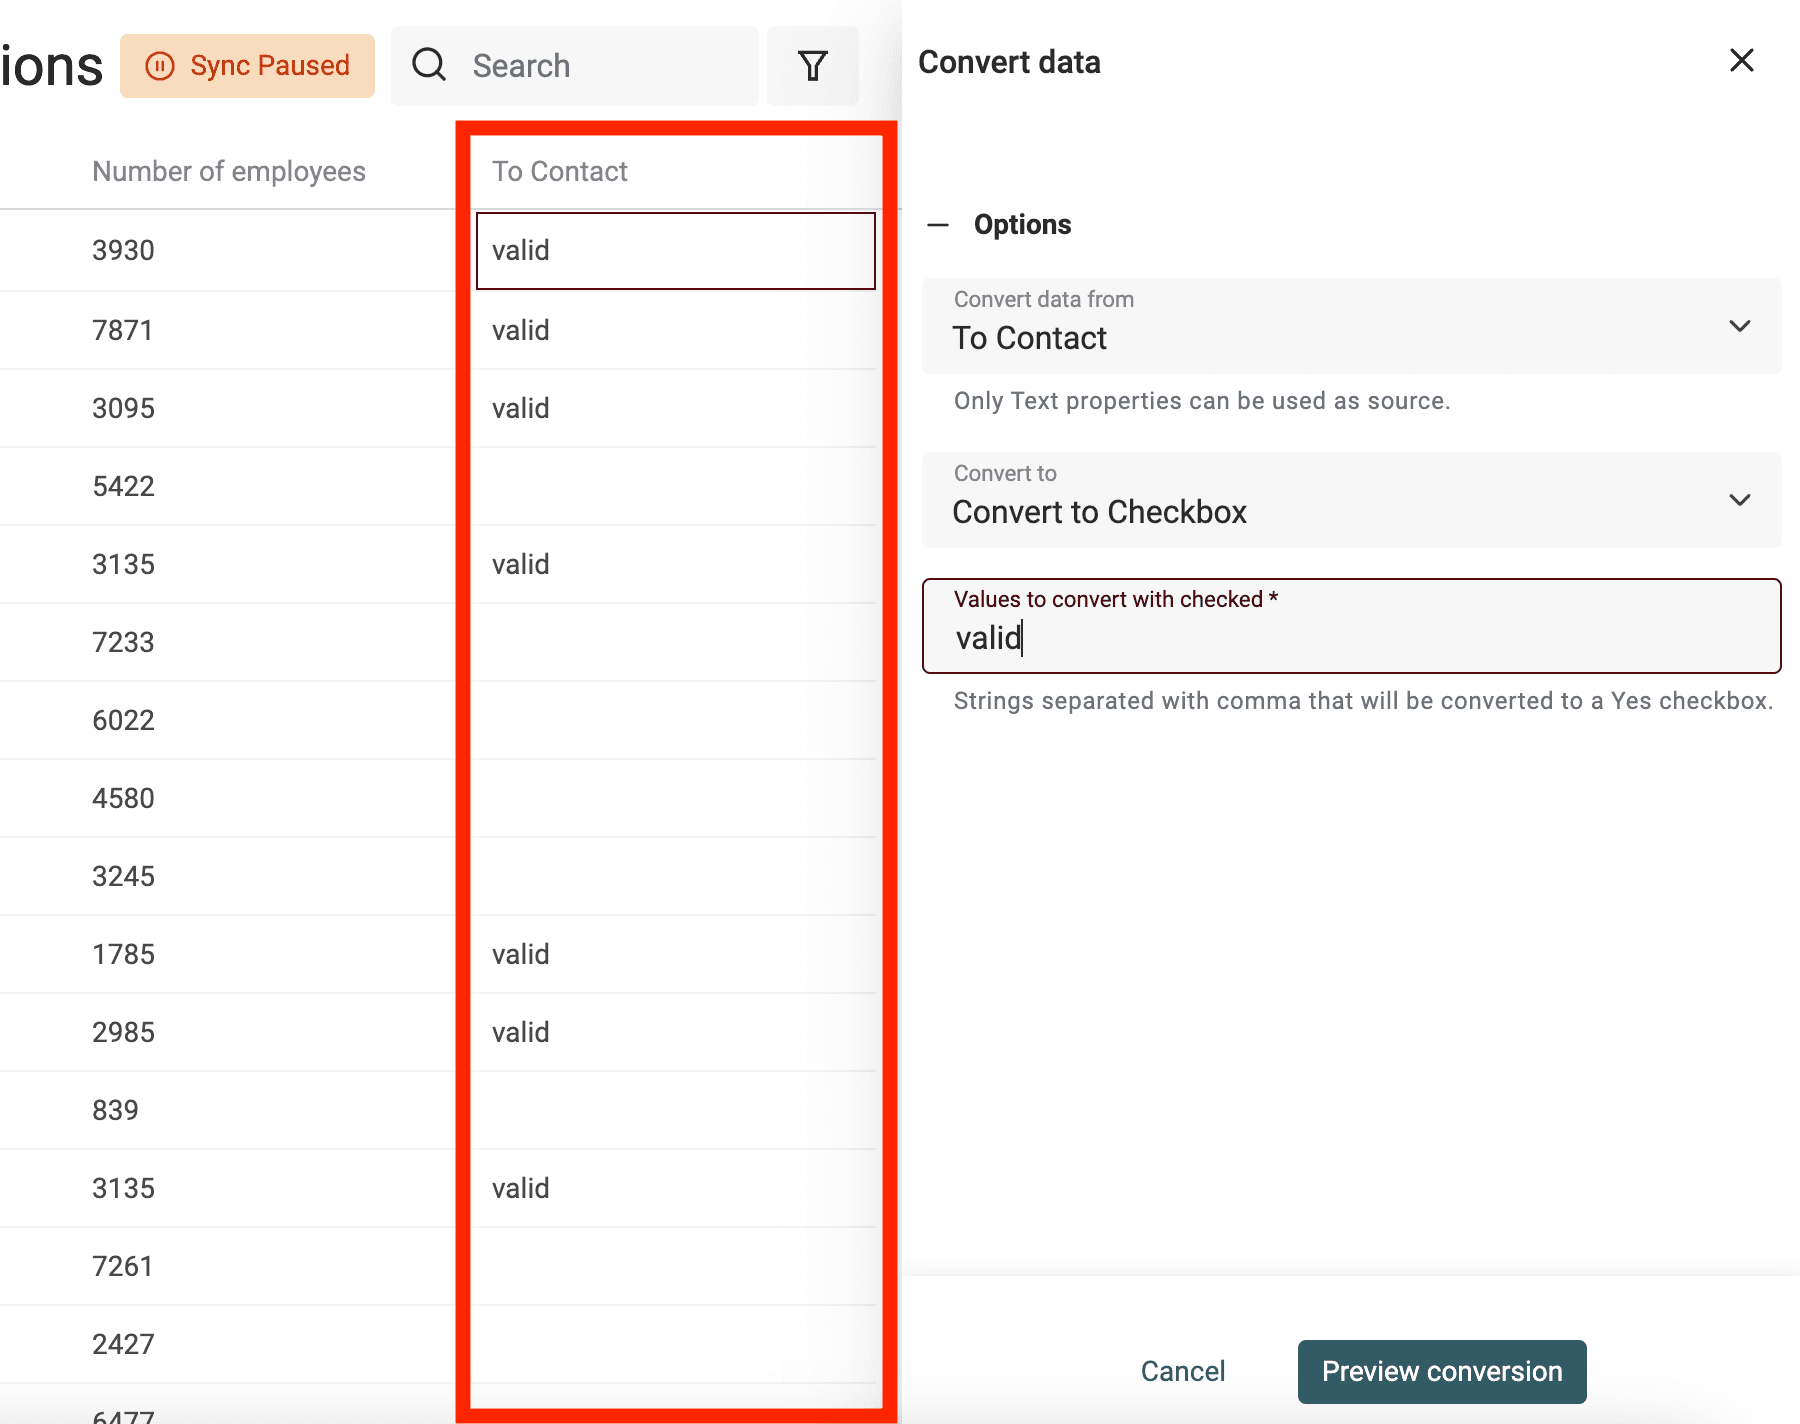
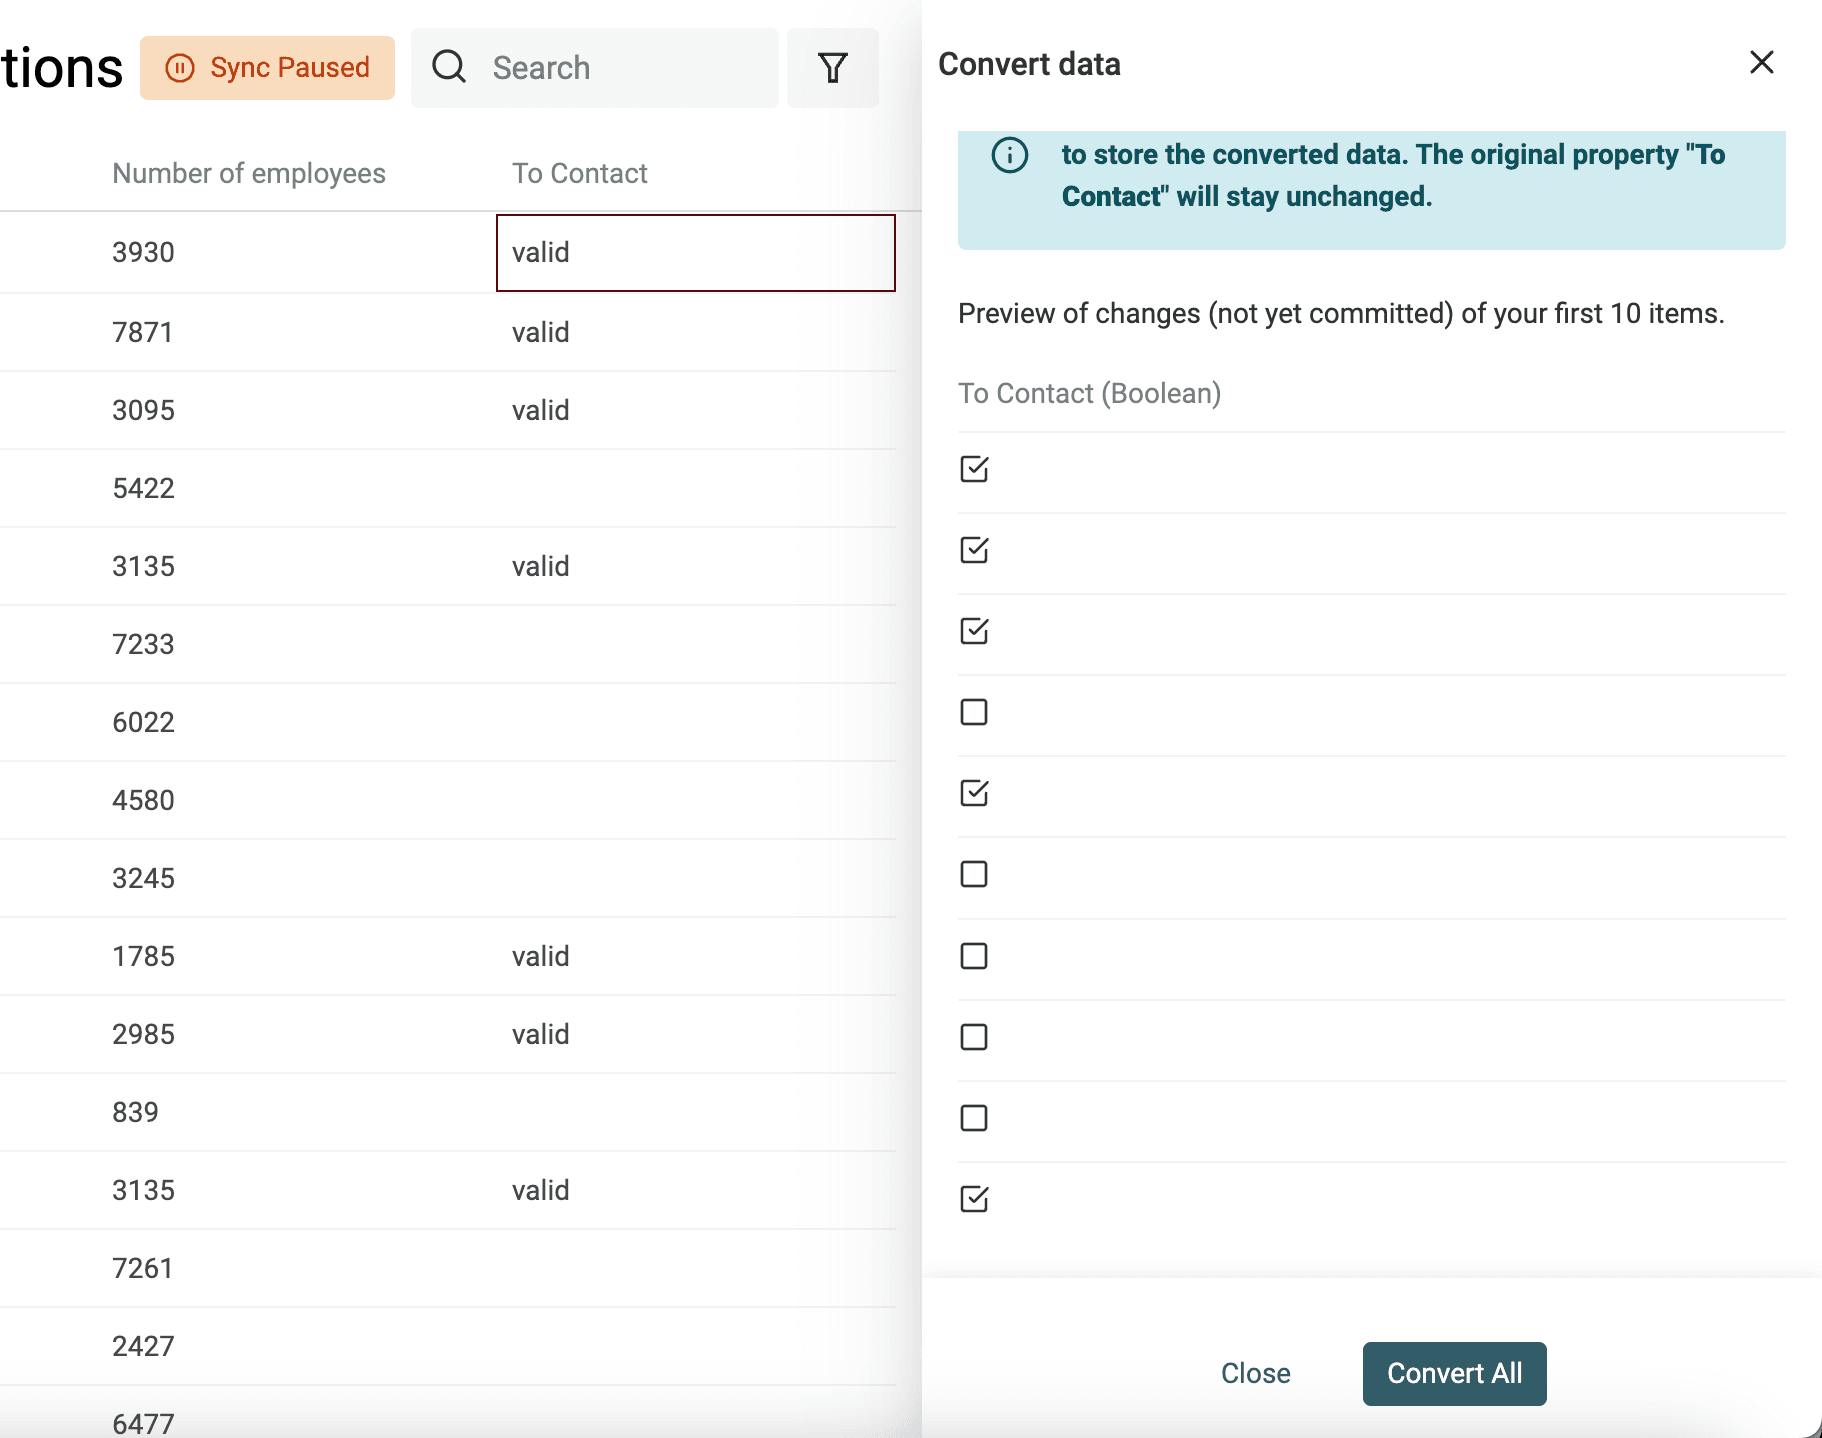
Créer des cases à cocher à partir de textes
Lors de l’importation, Datablist convertit automatiquement les colonnes contenant « Yes, No », « TRUE, FALSE », etc. en propriétés Checkbox. Pour les conversions plus complexes, utilisez le convertisseur.
Définissez les valeurs, séparées par des virgules, qui produiront une case cochée. Les autres valeurs resteront décochées.
Extraire des nombres depuis des textes
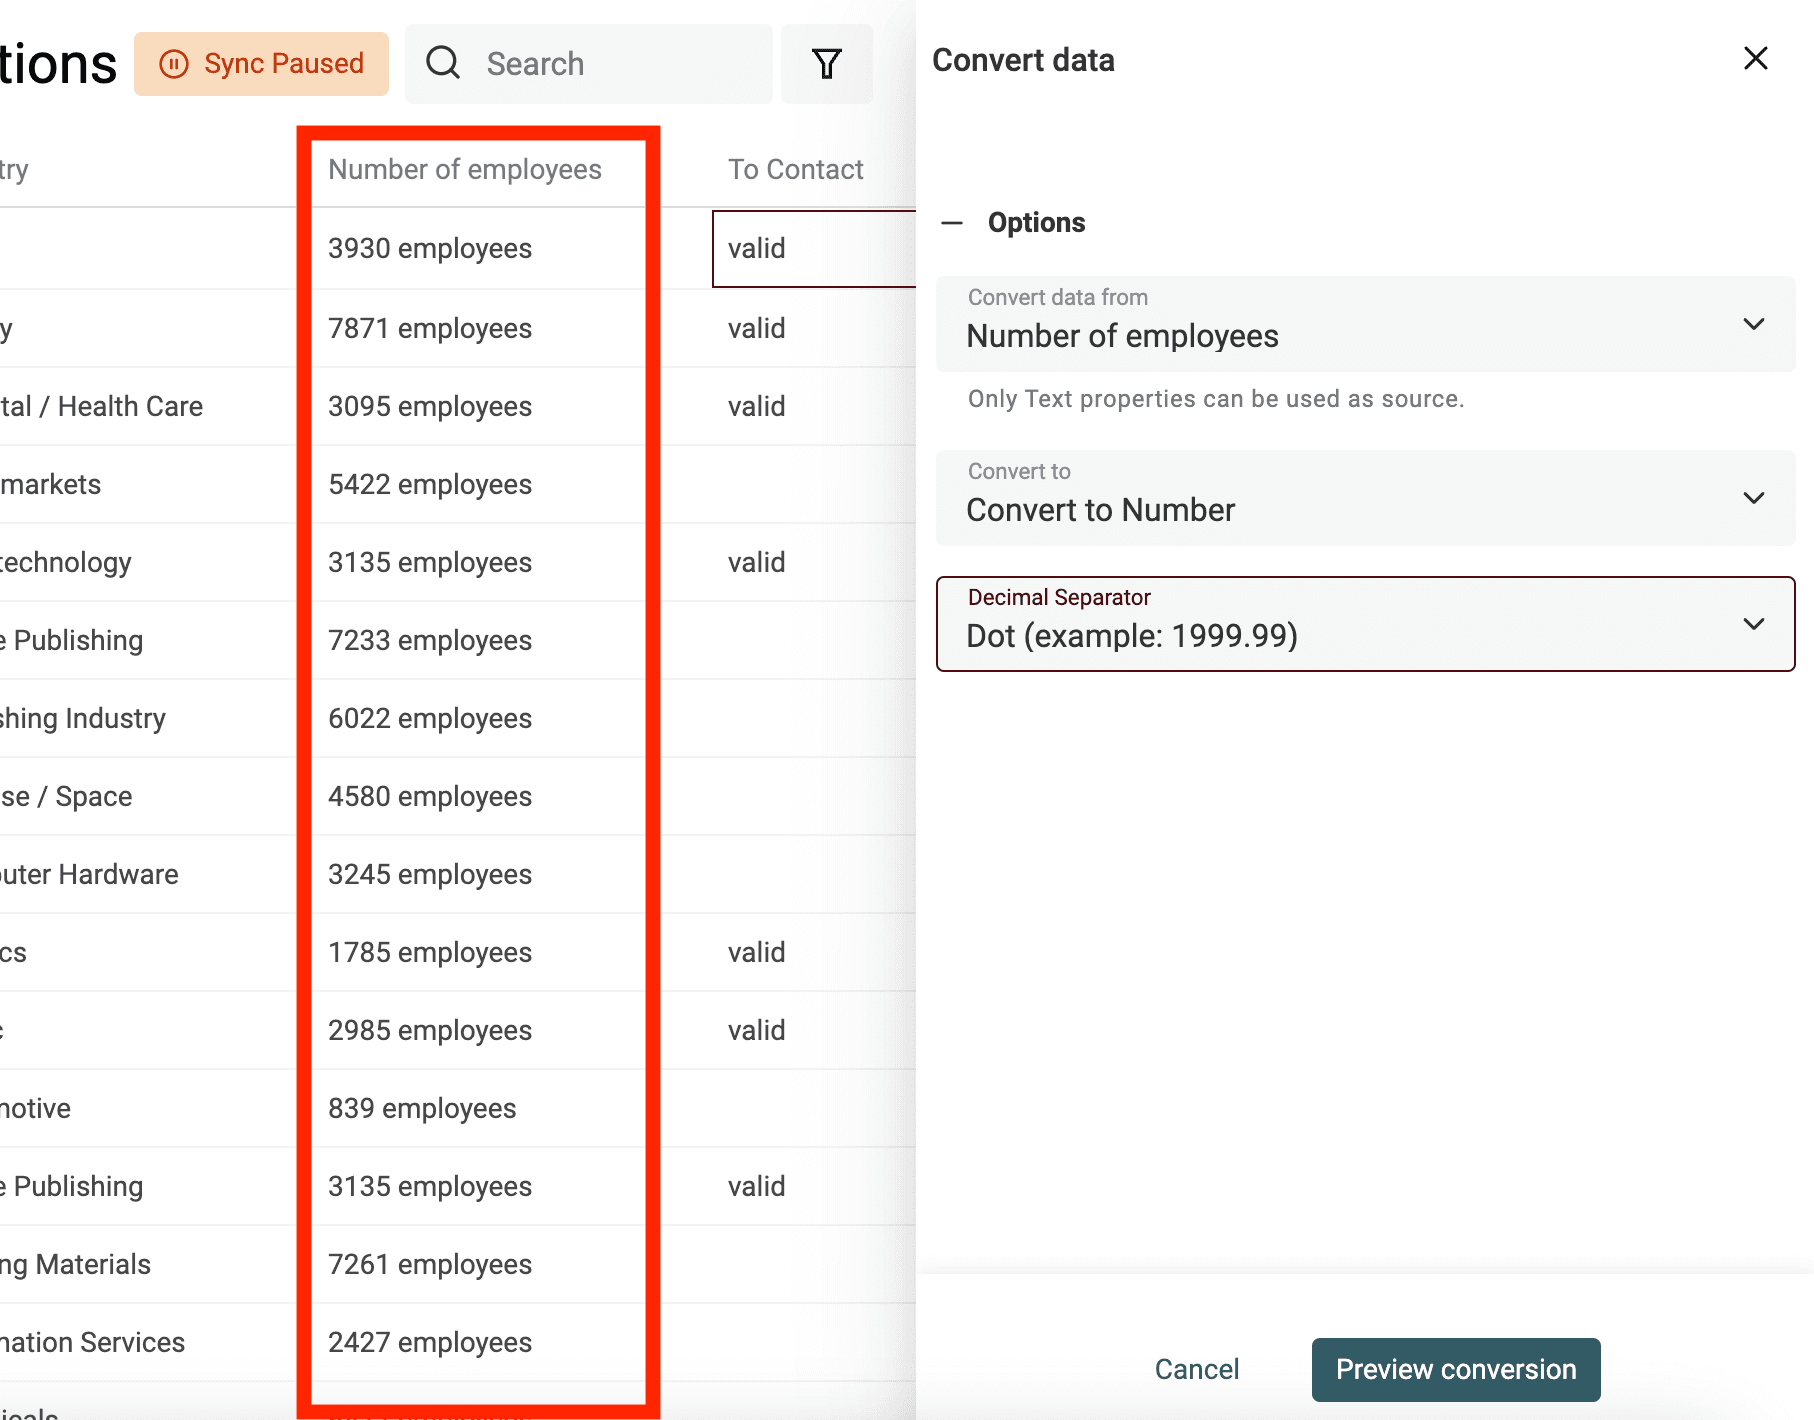
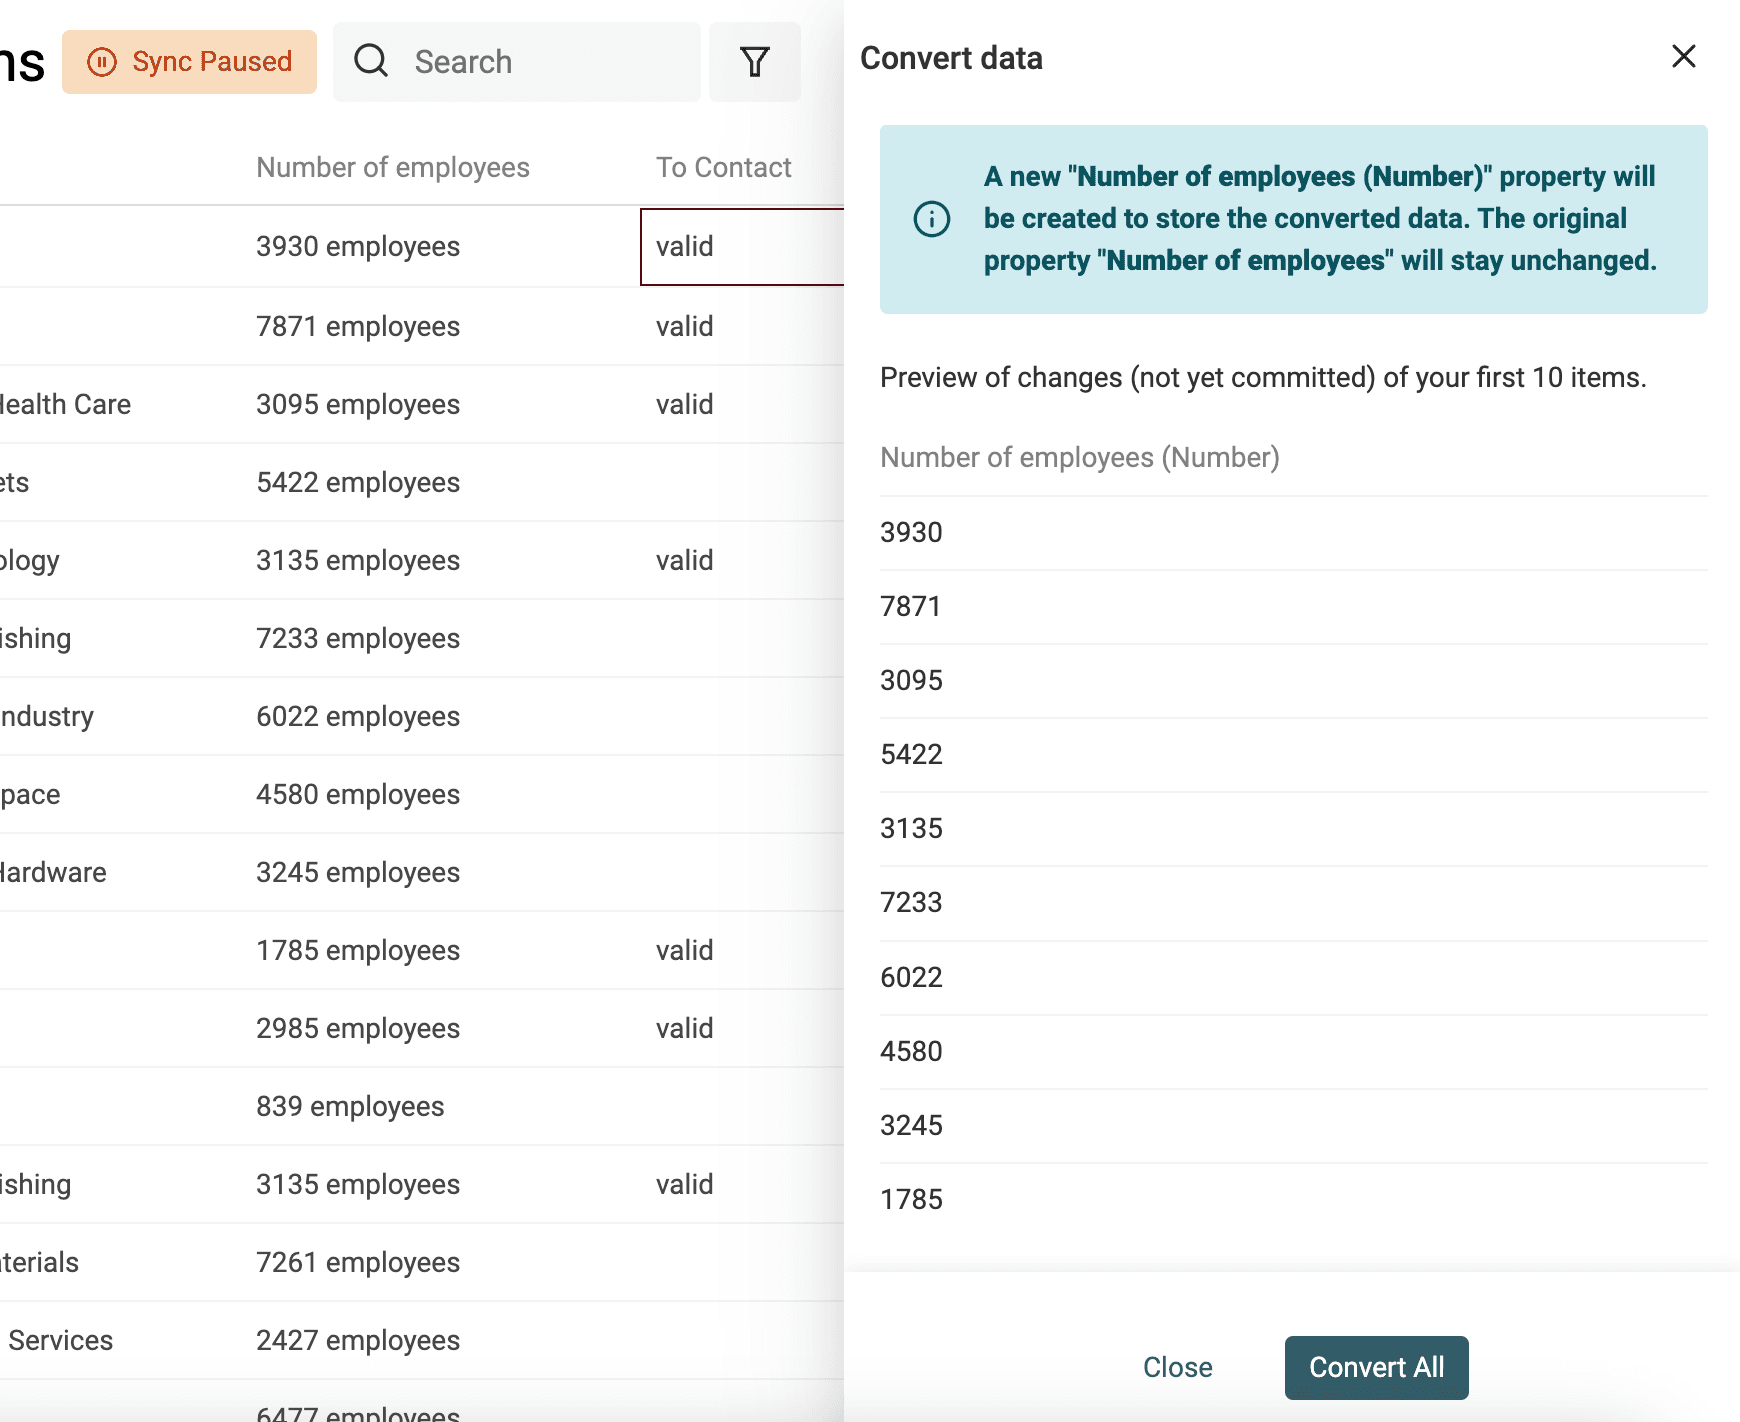
Utilisez le convertisseur « Text to number » pour :
- Normaliser les nombres avec des séparateurs de décimales et de milliers personnalisés
- Extraire les nombres de textes contenant des lettres
👉 Consultez notre documentation pour en savoir plus sur la conversion des nombres.
Nettoyer les données
Convertir du HTML en texte
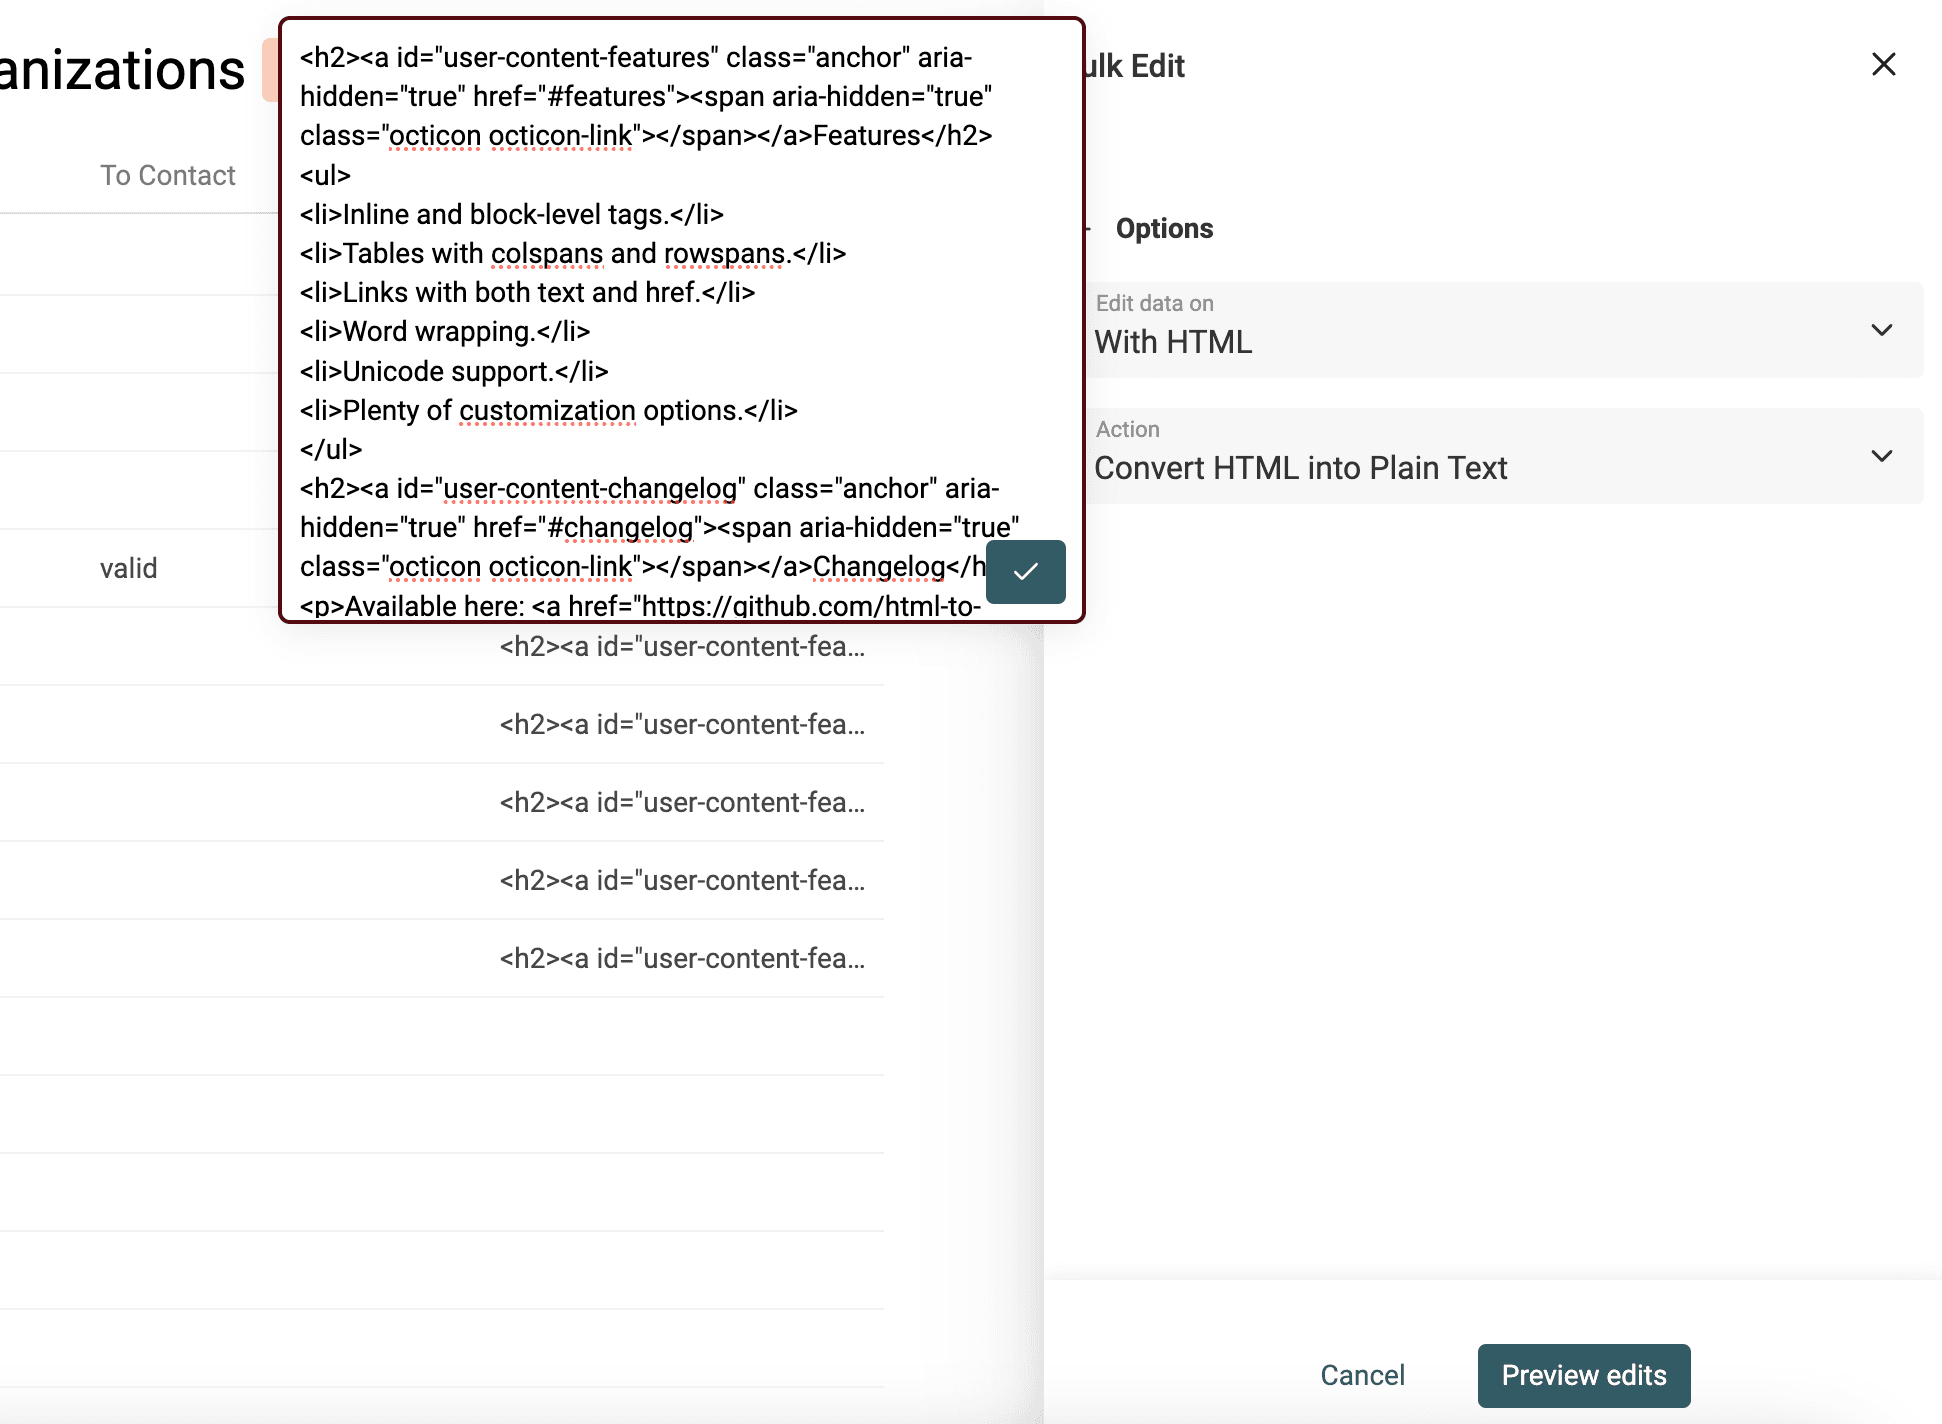
Les outils de scraping analysent le code HTML, si bien que vos textes peuvent contenir des balises HTML.
Le code HTML inclut des liens, des images et des listes à puces, organisés en paragraphes et sur plusieurs lignes.
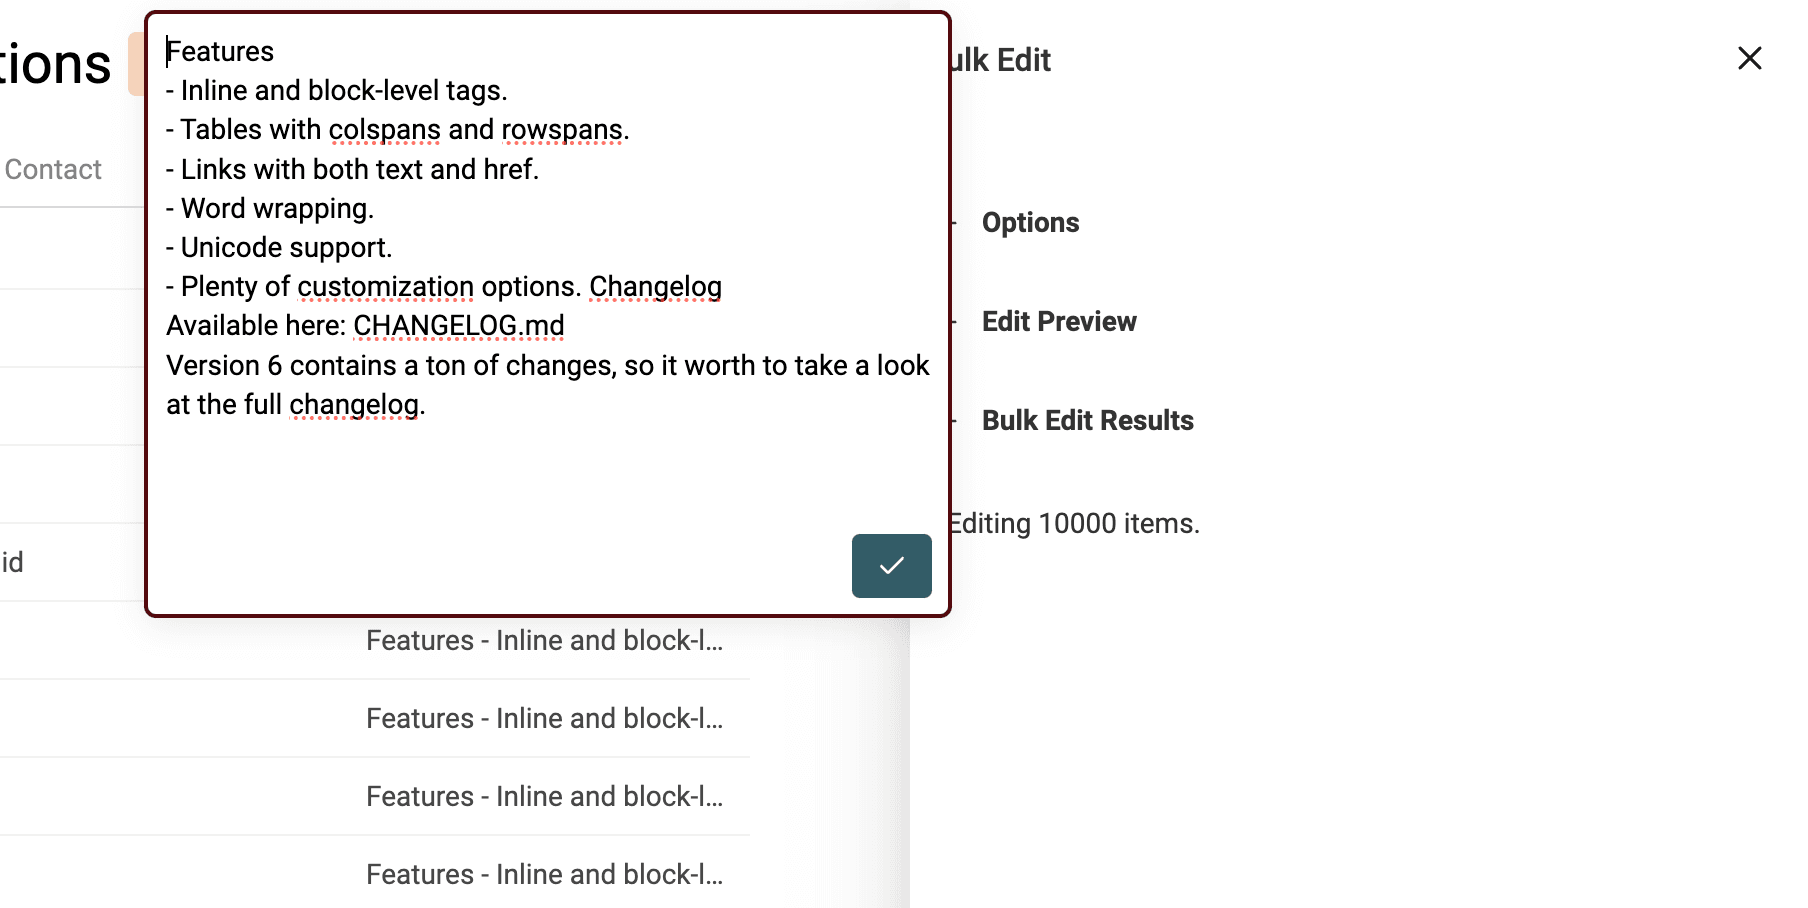
L’objectif est de conserver une partie de cette structure tout en transformant un code illisible en texte brut.
Le convertisseur HTML to Text de Datablist préserve les retours à la ligne et transforme les puces en éléments de liste précédés de -.
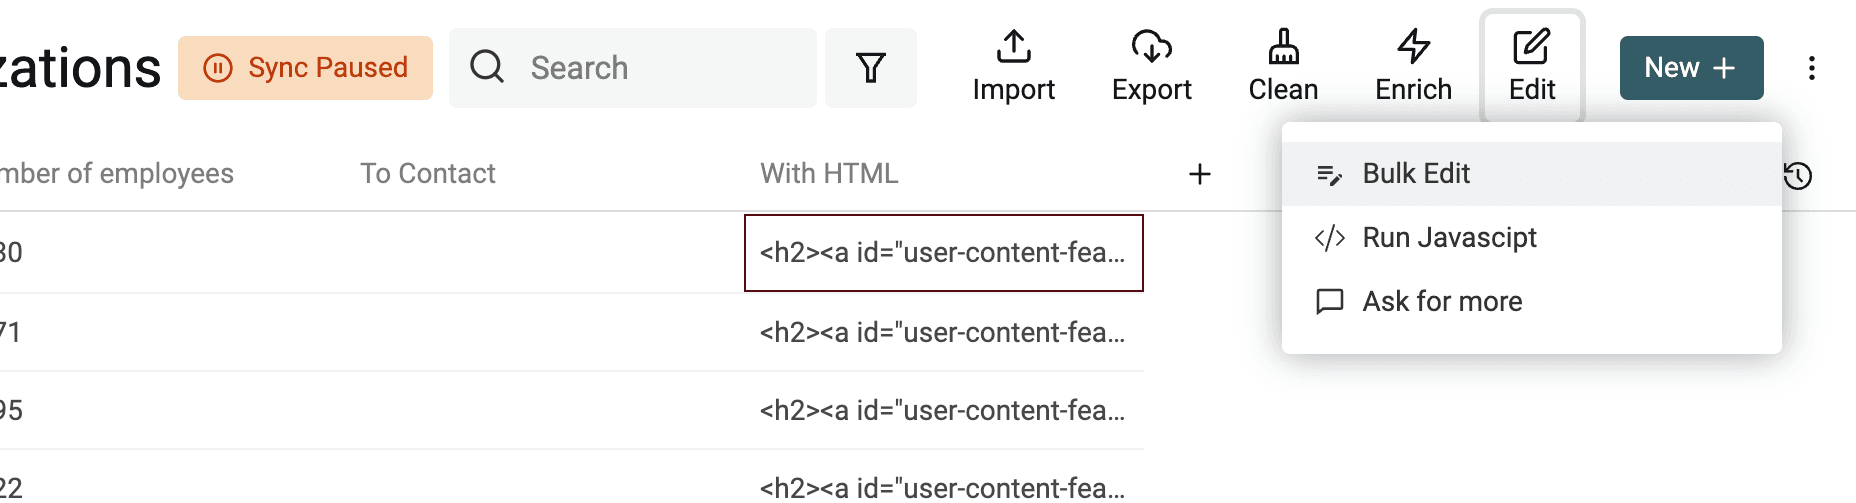
Pour convertir un texte contenant des balises HTML en texte brut, ouvrez l’outil Bulk Edit depuis le menu Edit.
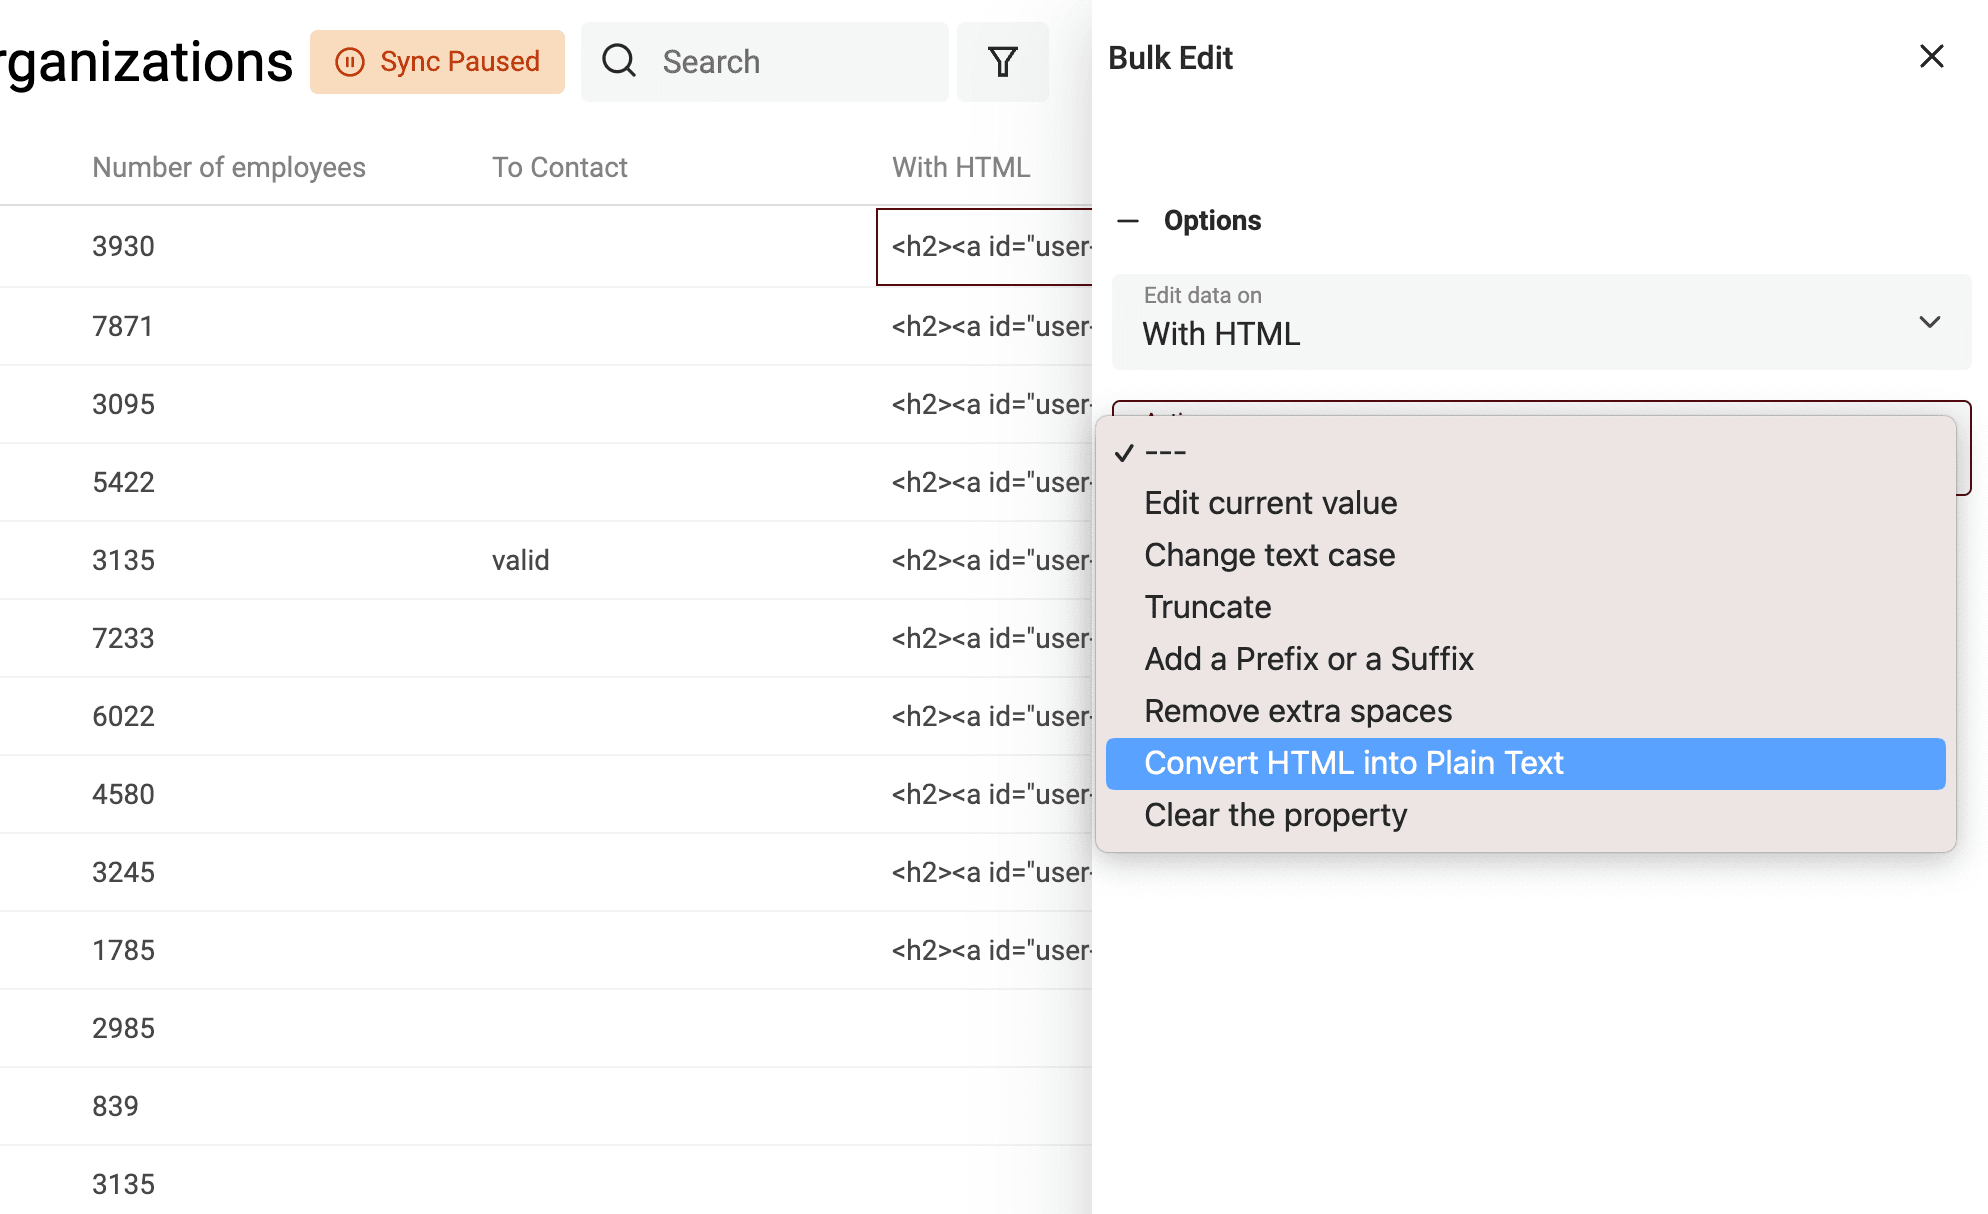
Sélectionnez la propriété contenant les balises HTML, puis « Convert HTML into plain text ».
Supprimer les espaces superflus
Les espaces superflus sont un autre problème fréquent dans les données désordonnées. Ils peuvent provenir de retours à la ligne, de caractères Tab ou d’autres caractères représentant un espace en HTML.
Datablist intègre un outil de nettoyage pour les éliminer.
Deux modes sont disponibles :
- Mode 1 : supprimer tous les espaces — Ce mode retire chaque caractère d’espacement. Il convient au nettoyage des numéros de téléphone, des prix, etc., lorsque vous souhaitez ne conserver que des lettres, des chiffres ou d’autres caractères utiles.
- Mode 2 : supprimer uniquement les « espaces superflus ».
Dans le second mode, l’algorithme :
- Supprime les espaces superflus entre les mots
- Supprime les lignes vides
- Supprime les espaces au début et à la fin de chaque ligne
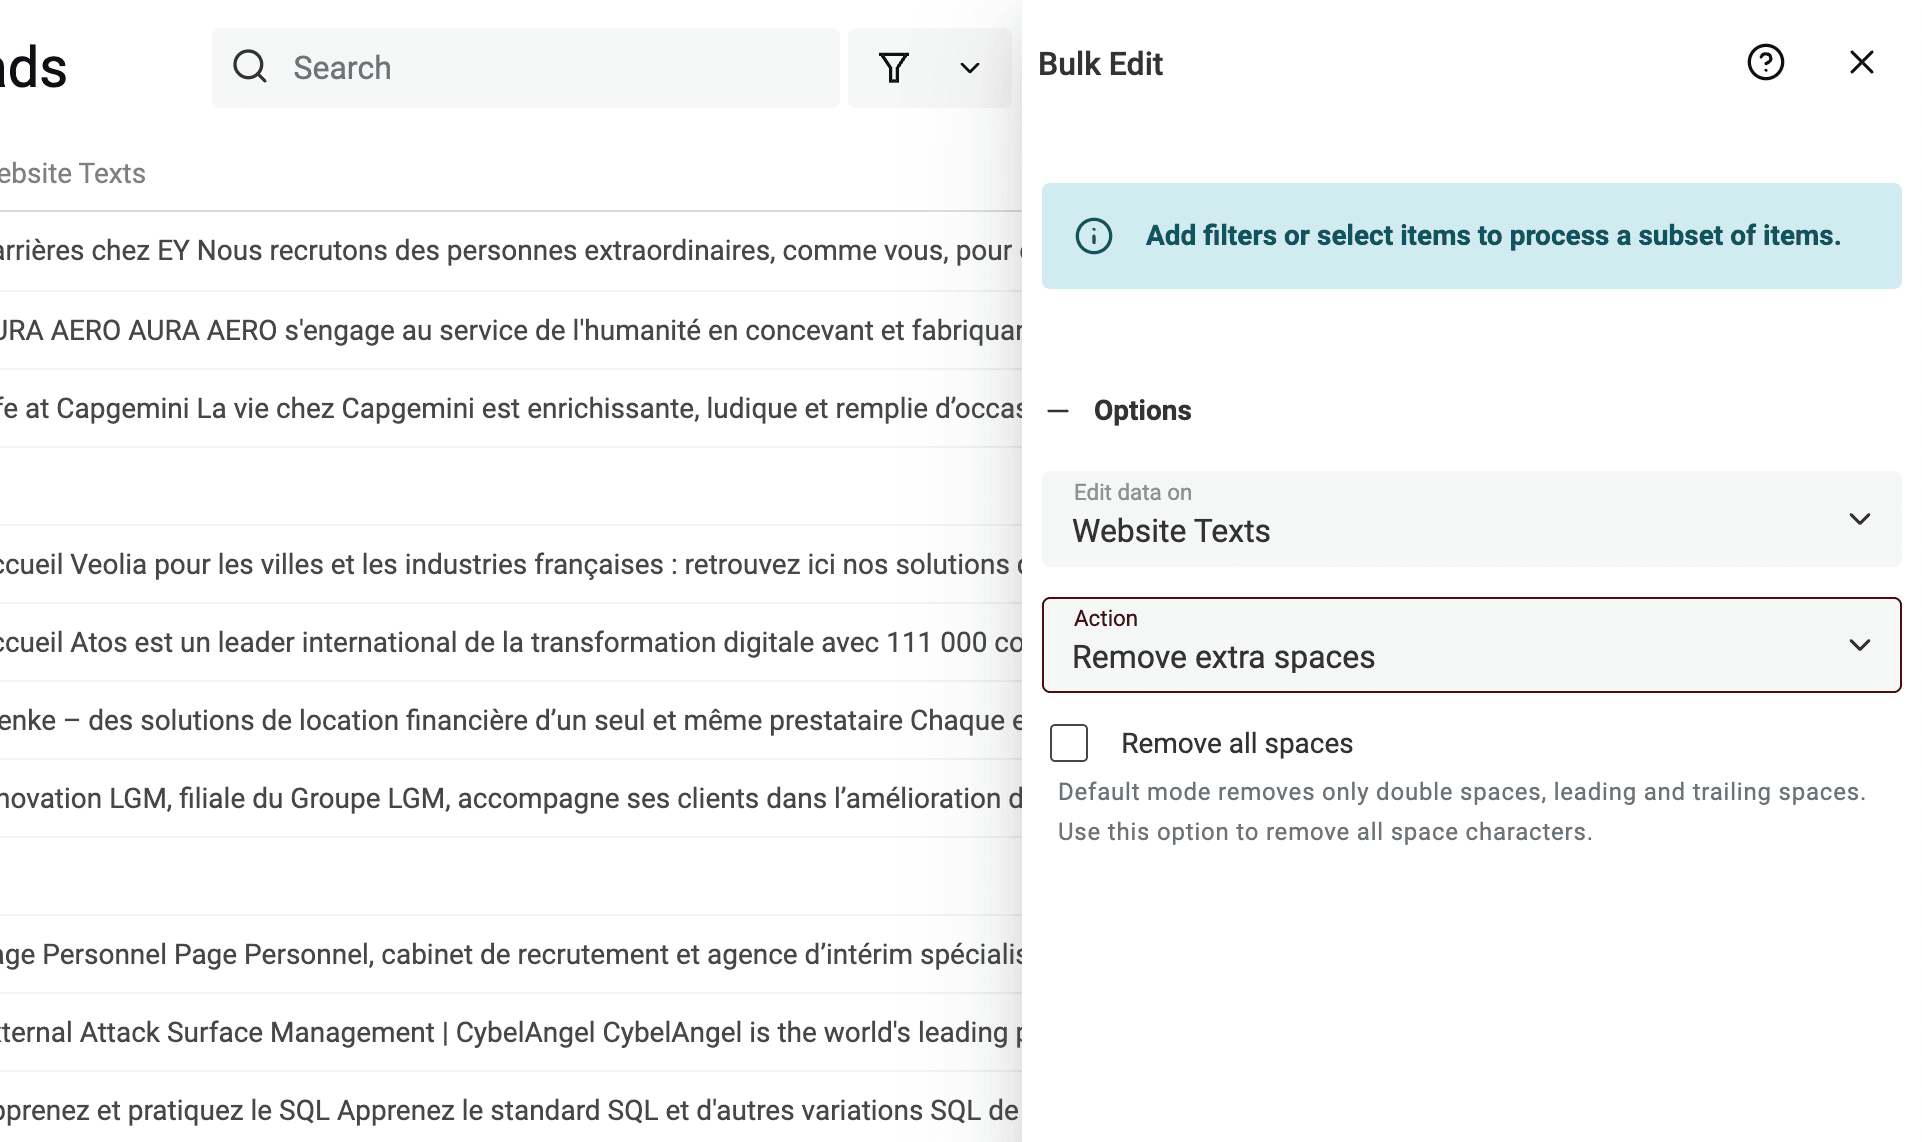
Pour supprimer les espaces superflus, ouvrez l’outil « Bulk Edit » depuis le menu « Edit ». Sélectionnez votre propriété, puis l’action « Remove extra spaces ».
Cochez l’option « Remove all spaces » pour retirer tous les caractères d’espacement. Laissez-la désactivée pour ne supprimer que les espaces superflus.
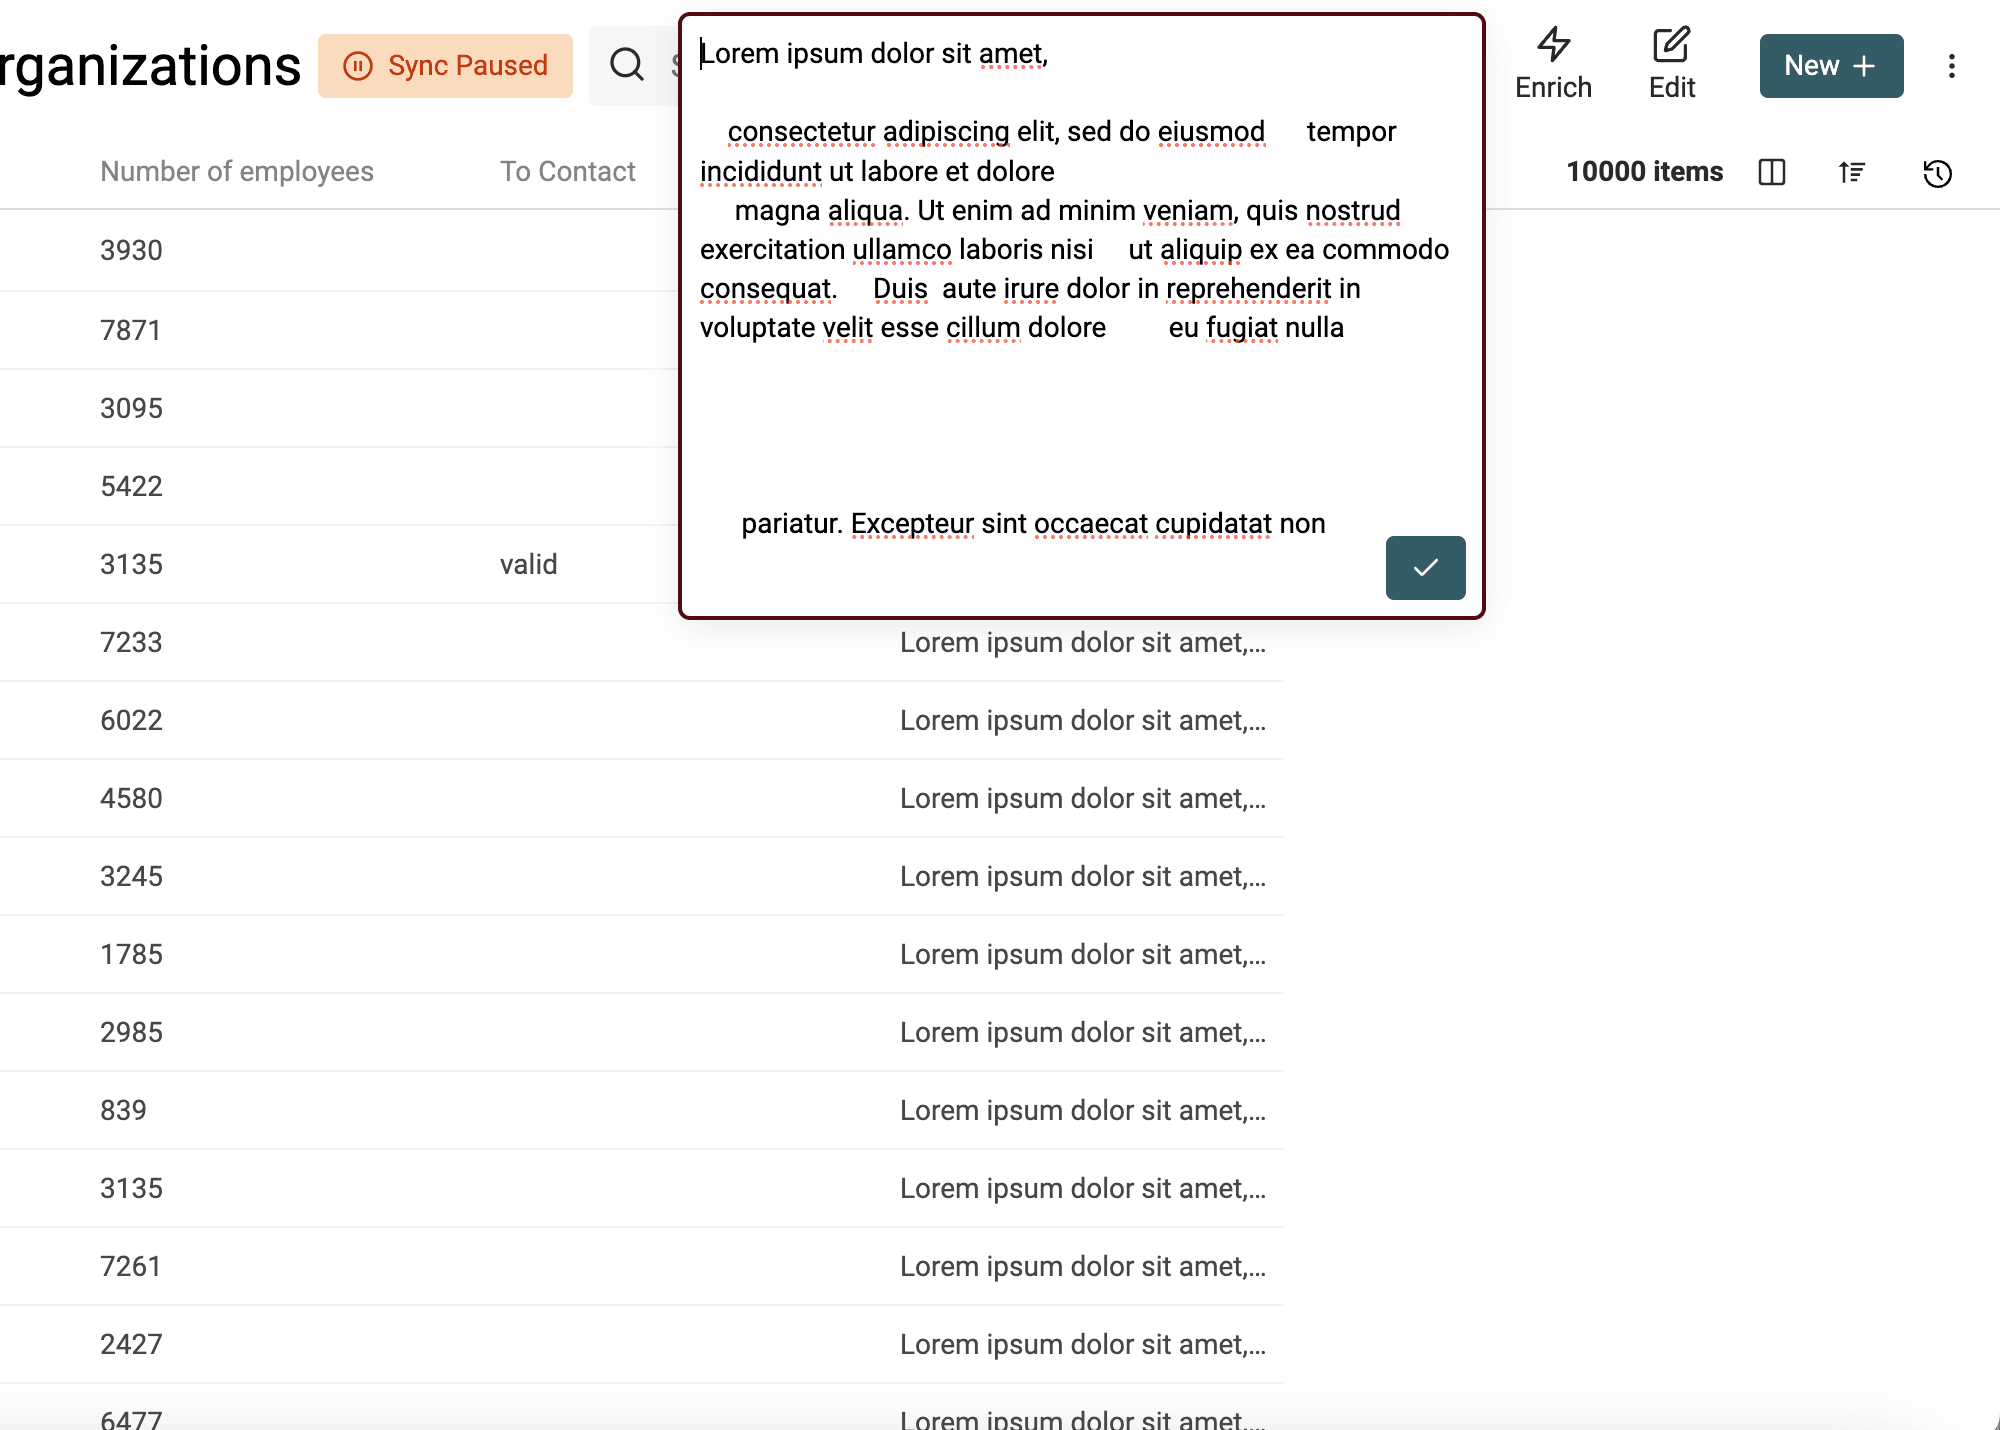
Voici un exemple avant le passage de l’algorithme :
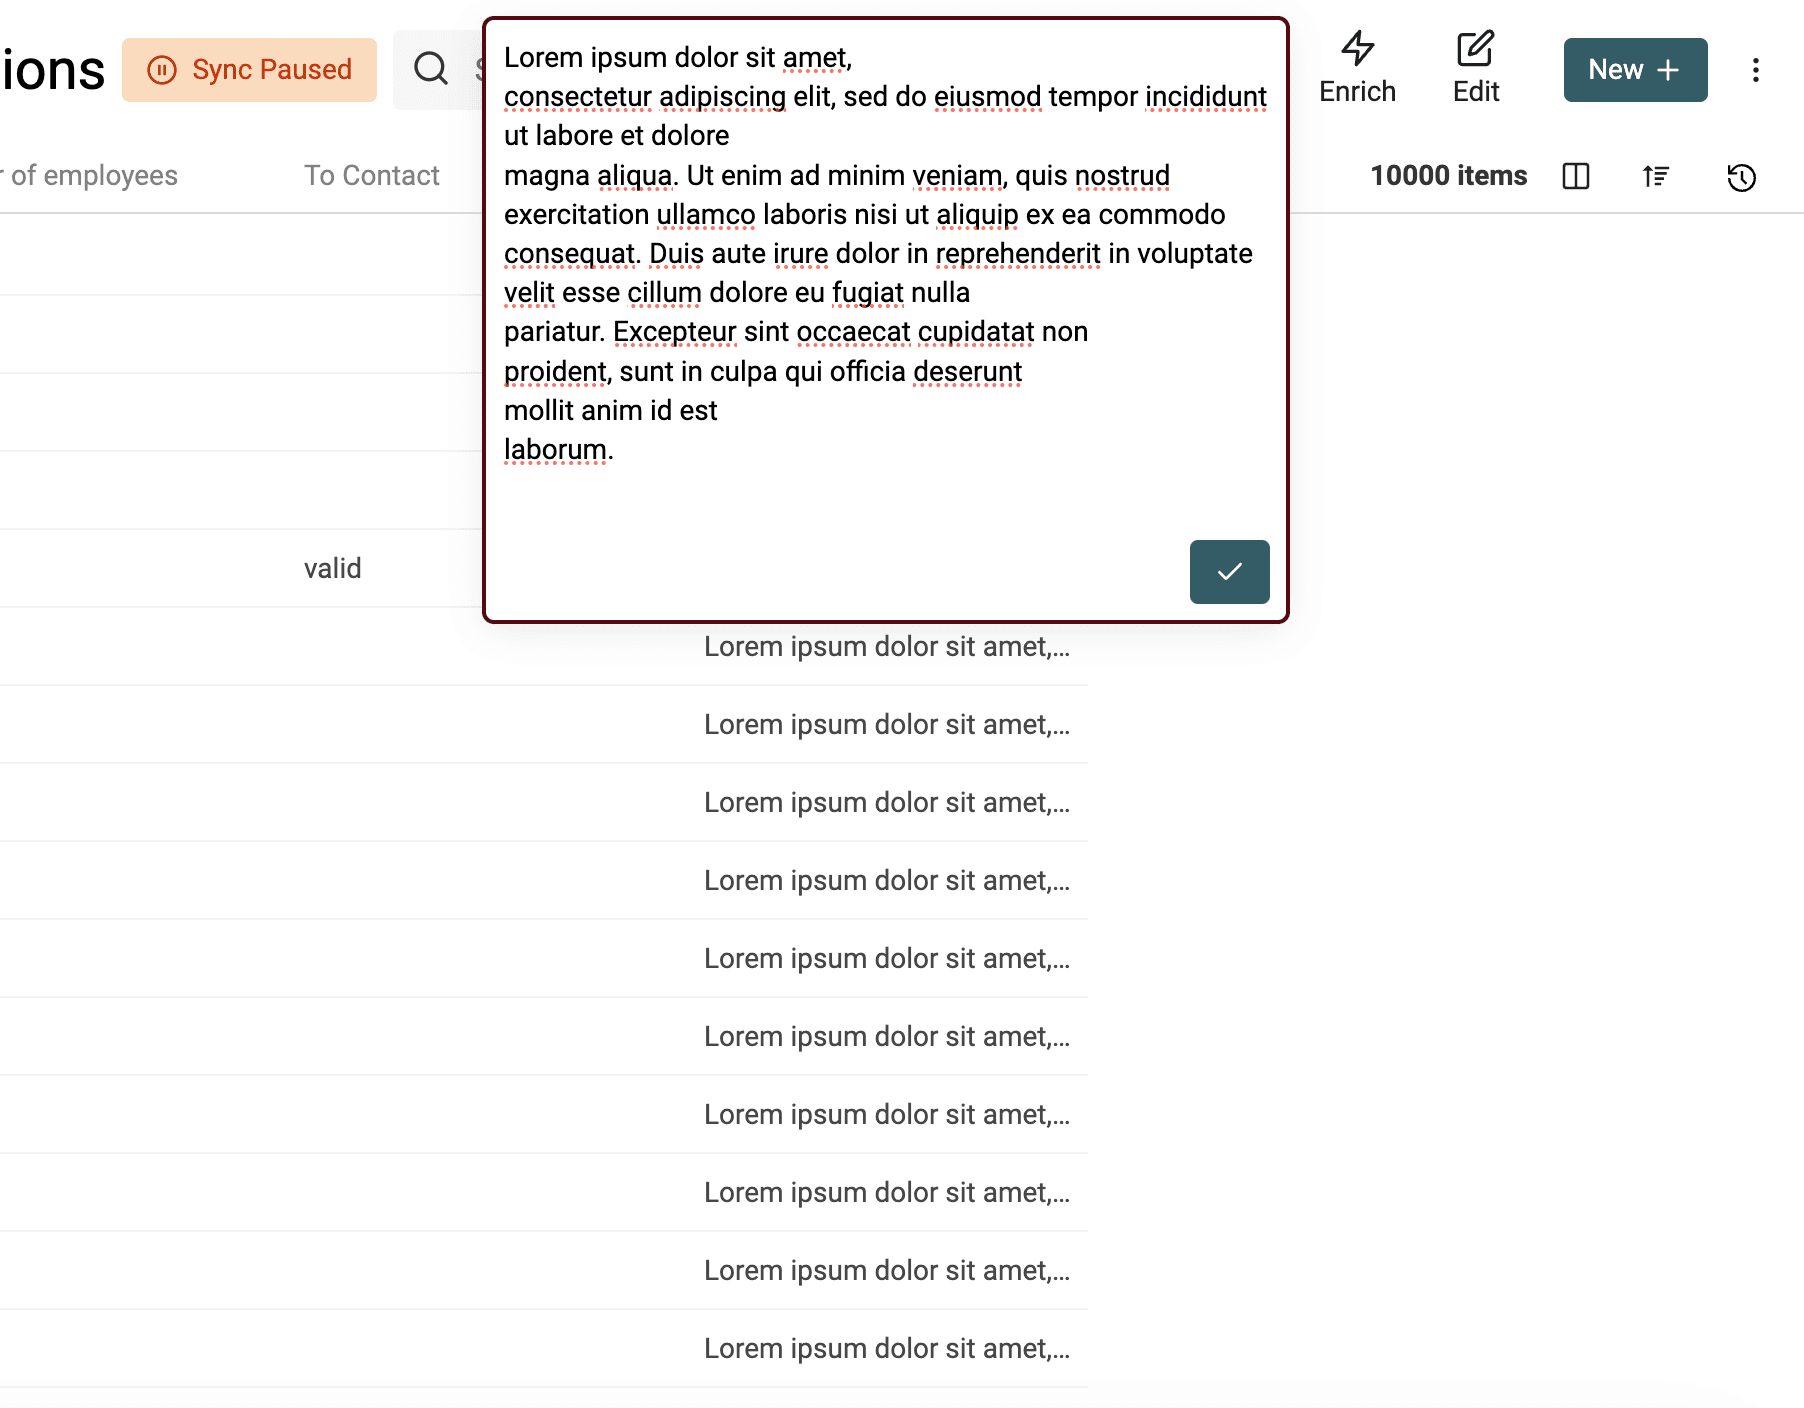
Après le nettoyage, les espaces superflus ont disparu :
Uniformiser la casse du texte
Modifier la casse d’un texte est très simple. Ouvrez l’outil « Bulk Edit » depuis le menu « Edit ».
Sélectionnez la propriété à traiter, puis l’action « Change text case ».
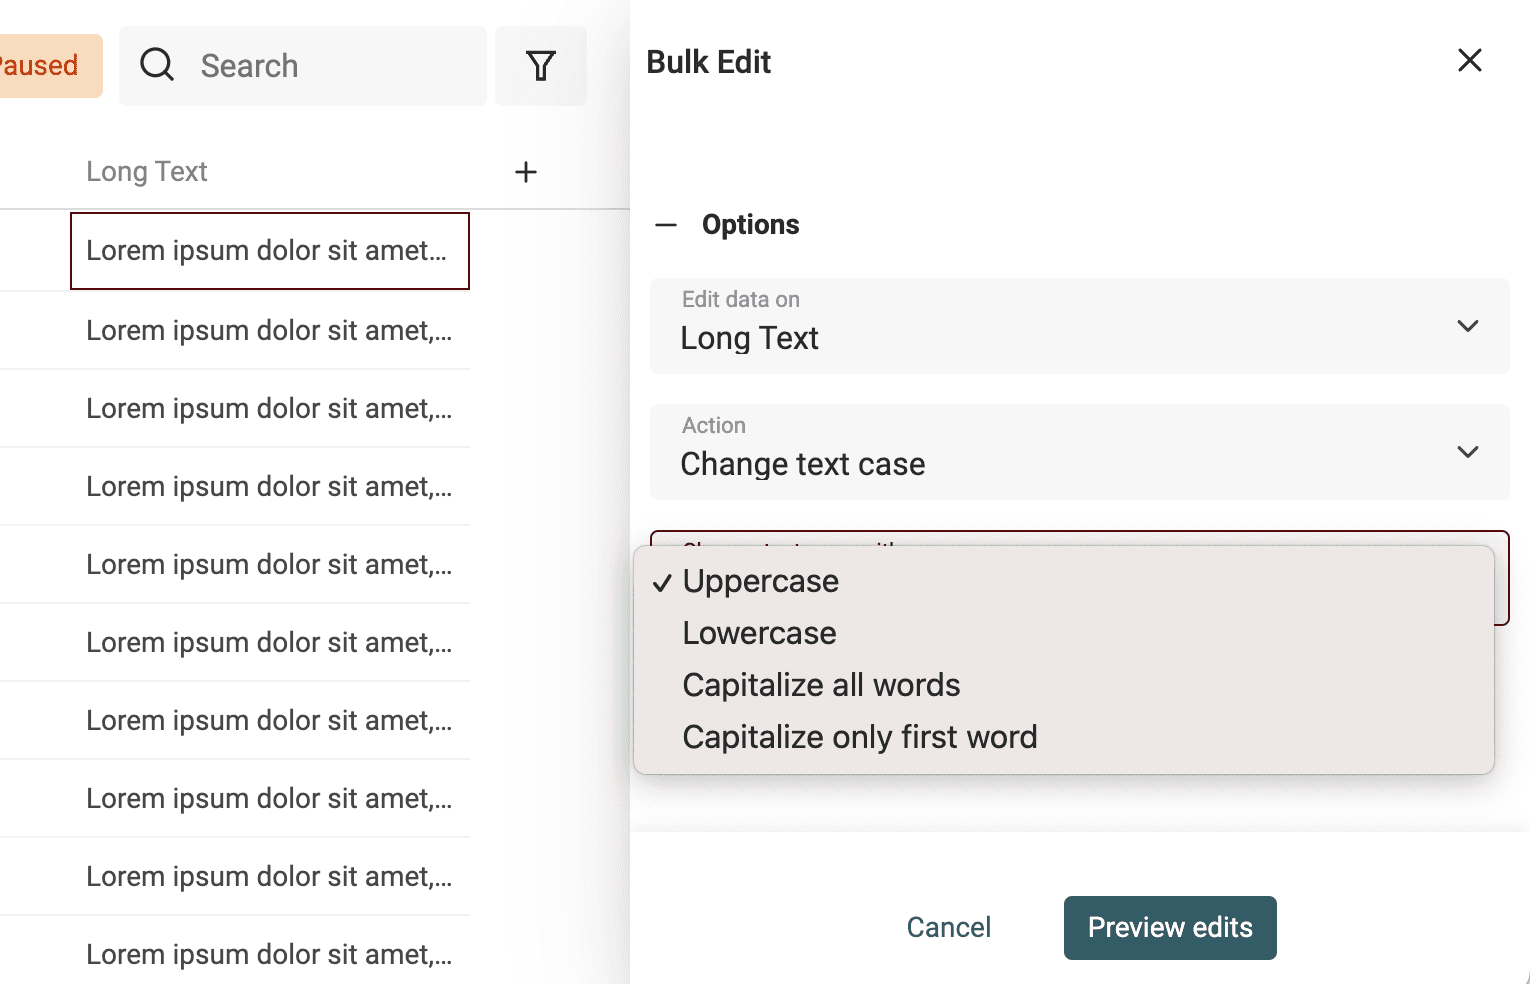
Quatre modes sont disponibles :
- Uppercase — Toutes les lettres passent en majuscules. Exemple :
john=>JOHN - Lowercase — Toutes les lettres passent en minuscules. Exemple :
API=>api - Capitalize — La première lettre de chaque mot passe en majuscule. Exemple :
john is a good man=>John Is A Good Man - Capitalize only the first word — Seule la première lettre du premier mot passe en majuscule. Exemple :
john is a good man=>John is a good man
Supprimer les symboles des textes
Les textes extraits de pages HTML ou saisis par des utilisateurs — les titres de profils LinkedIn, par exemple — peuvent contenir des symboles, des smileys ou d’autres caractères susceptibles de perturber le traitement de vos données. Un simple smiley à la fin d’un nom peut empêcher sa détection par un algorithme de déduplication.
Datablist intègre un processeur qui supprime de vos données tous les symboles qui ne font pas partie du texte.
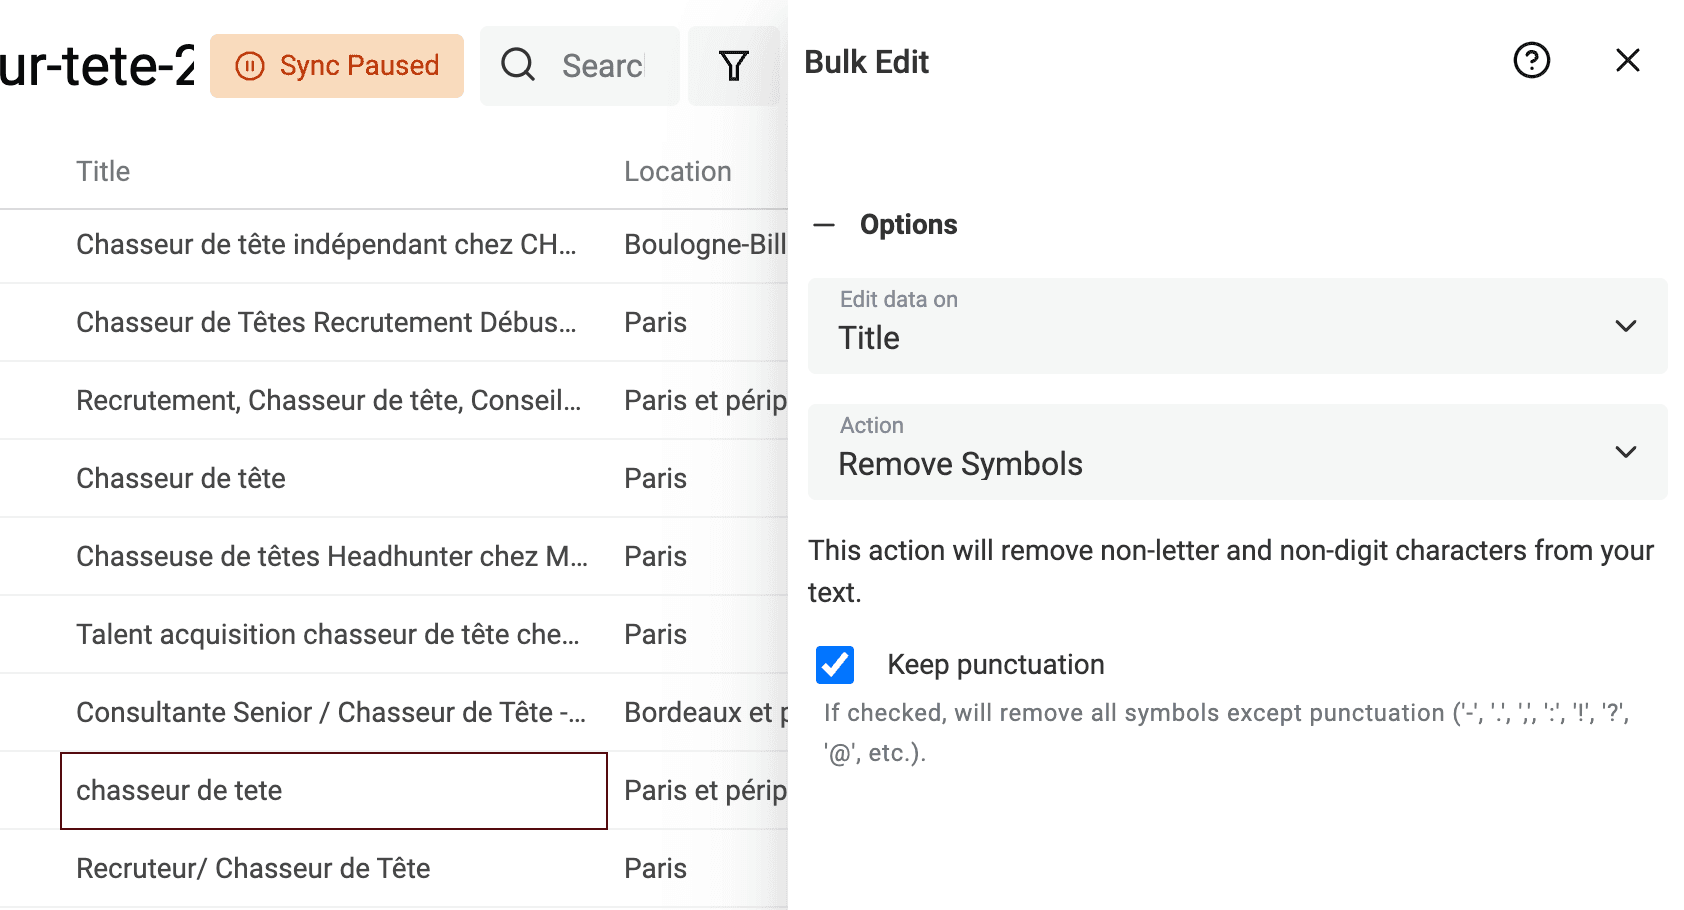
Cliquez sur « Bulk Edit » dans le menu « Edit », sélectionnez une propriété textuelle, puis la transformation « Remove symbols ».
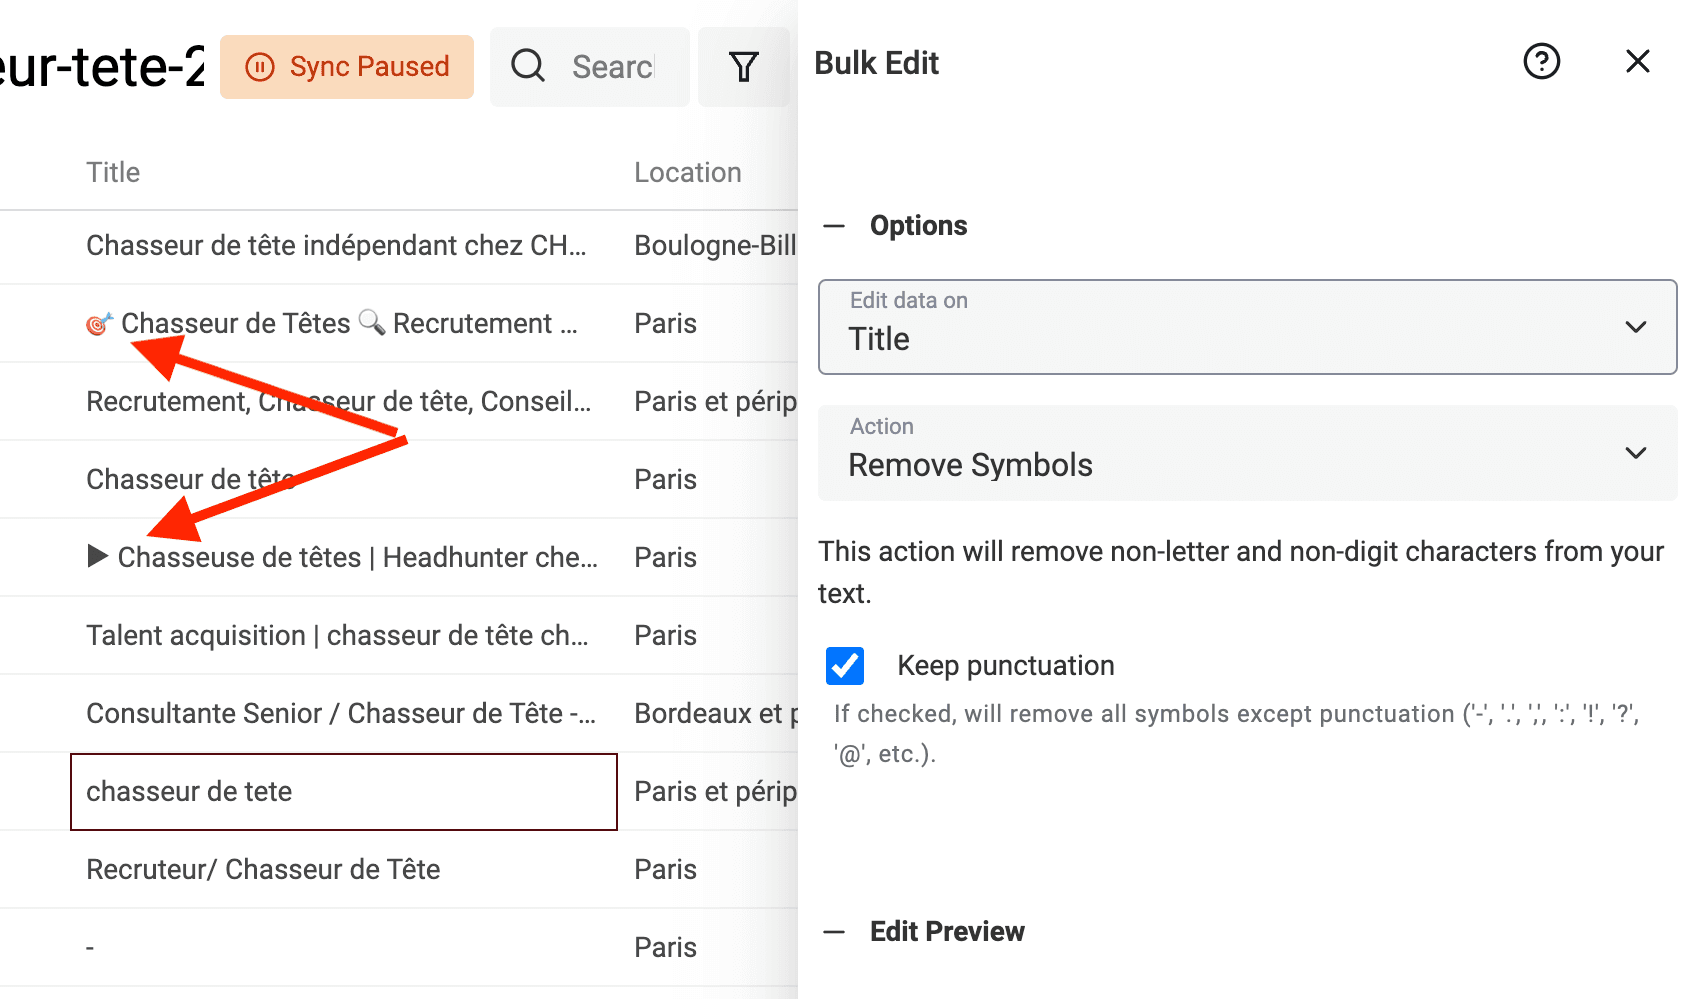
Si l’aperçu vous convient, lancez la transformation pour traiter vos éléments.
Normaliser les données avec Find and Replace
Pour créer des segments dans vos listes de prospects, vous devez normaliser vos données.
- Normaliser les intitulés de poste
- Normaliser les pays et les villes
- Normaliser les URL
- Etc.
Votre objectif est de transformer une propriété en texte libre en une propriété offrant un nombre limité de choix. Vous pouvez aussi simplifier vos textes, par exemple en ramenant une URL avec un chemin à son seul domaine.
Datablist propose un puissant outil Find and Replace, compatible avec le texte simple comme avec les expressions régulières.
Les expressions régulières sont complexes, mais très puissantes.
Voici quelques exemples d’utilisation des RegEx pour nettoyer vos données.
Supprimer les paramètres d’une URL
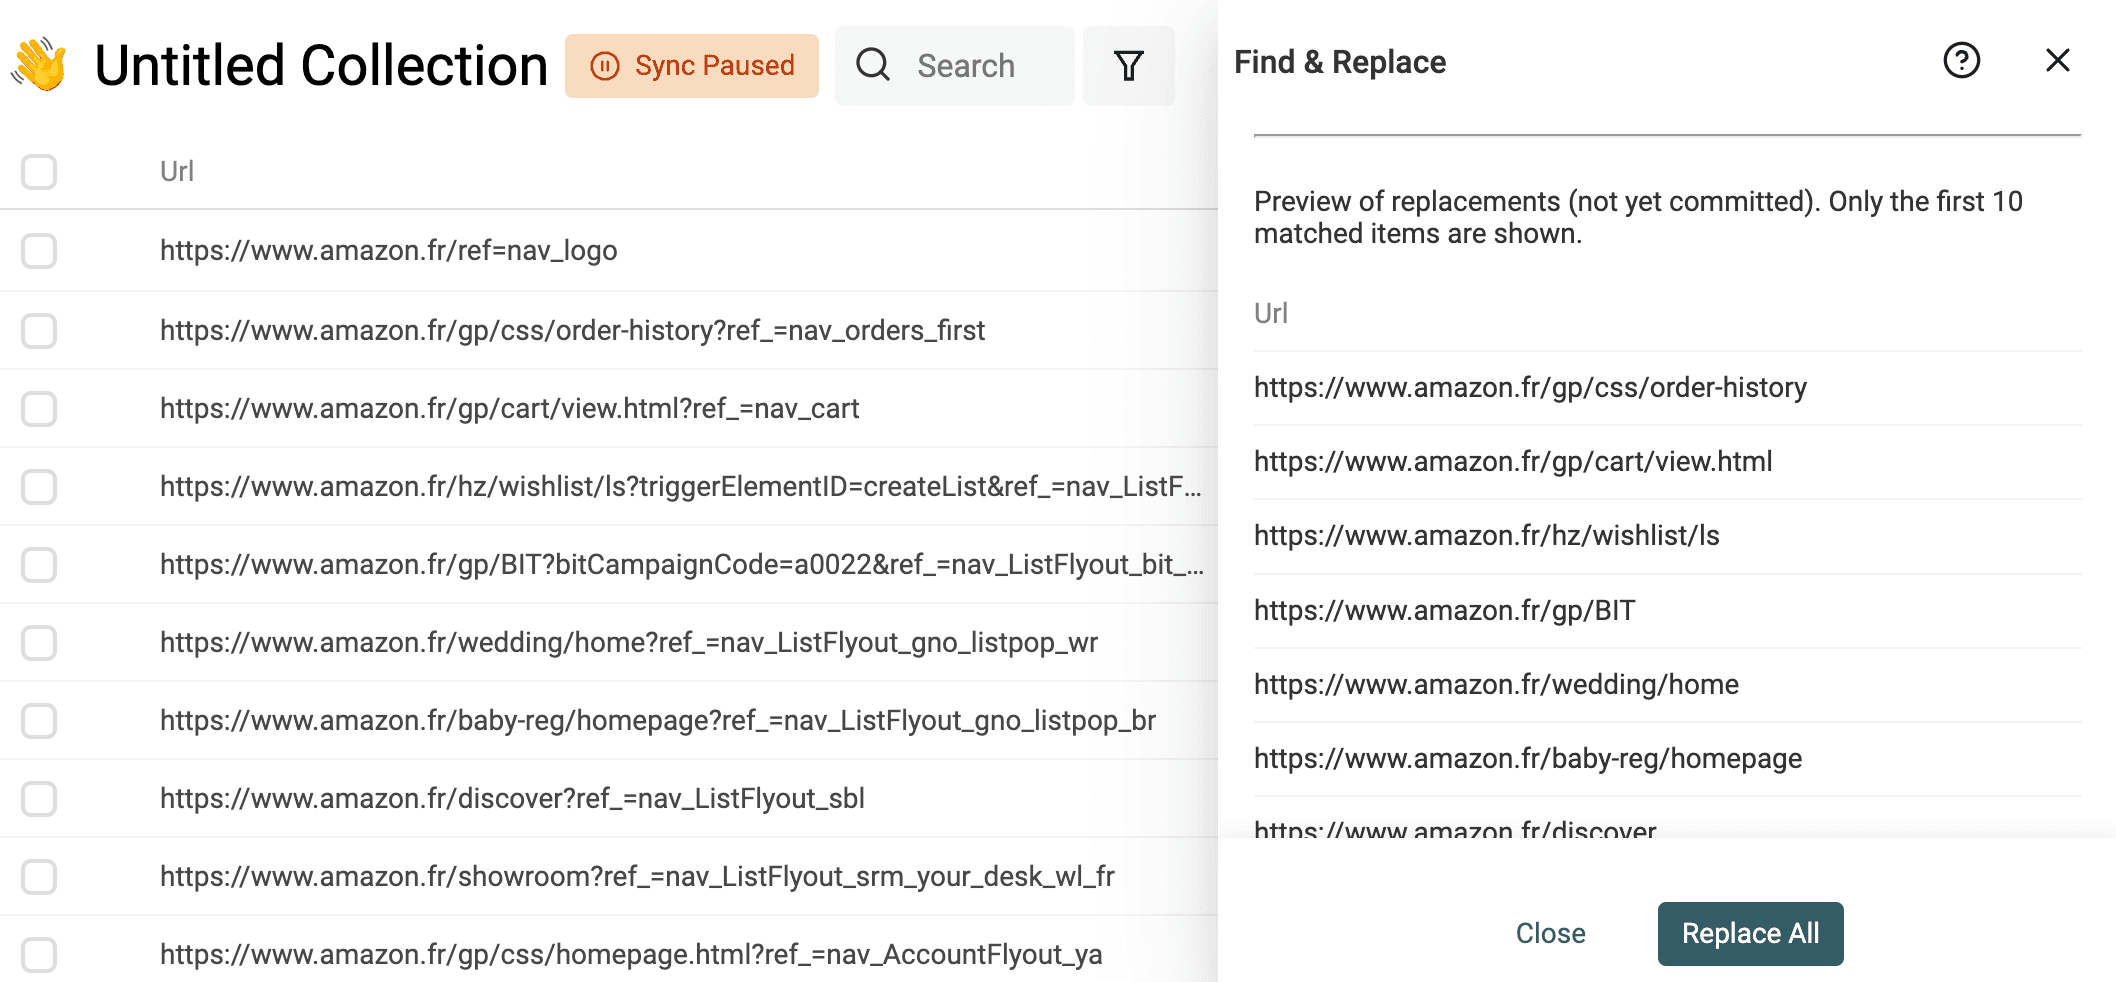
Les URL obtenues par scraping contiennent parfois des paramètres de requête inutiles, ajoutés à des fins de tracking ou de marketing. En les supprimant, vous obtenez des URL propres et facilitez la déduplication lorsque vous utilisez l’URL pour repérer les enregistrements en double.
Pour retirer les paramètres de vos URL, cochez l’option « Match using regular expression ». Utilisez ensuite l’expression régulière suivante en laissant le texte de remplacement vide :
\?.*$
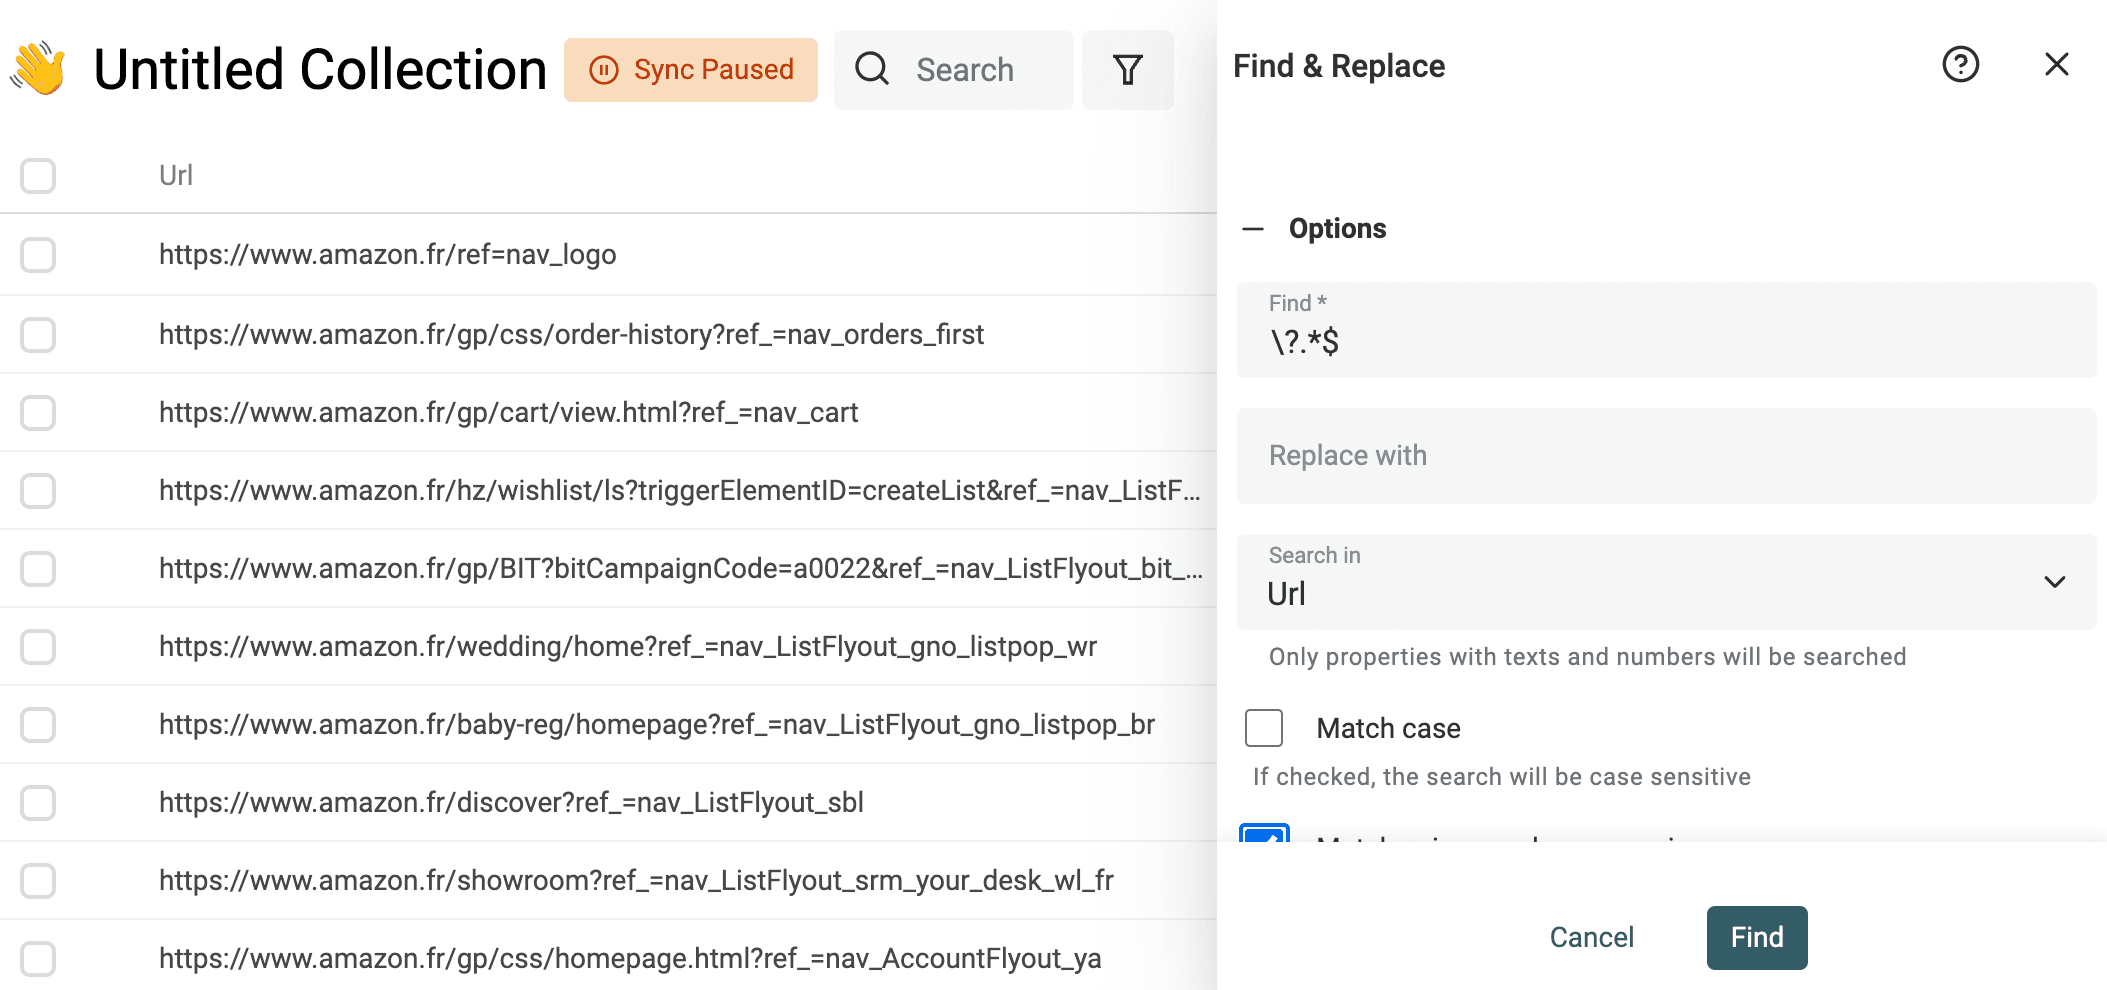
Appliquez-la ensuite à votre propriété URL.
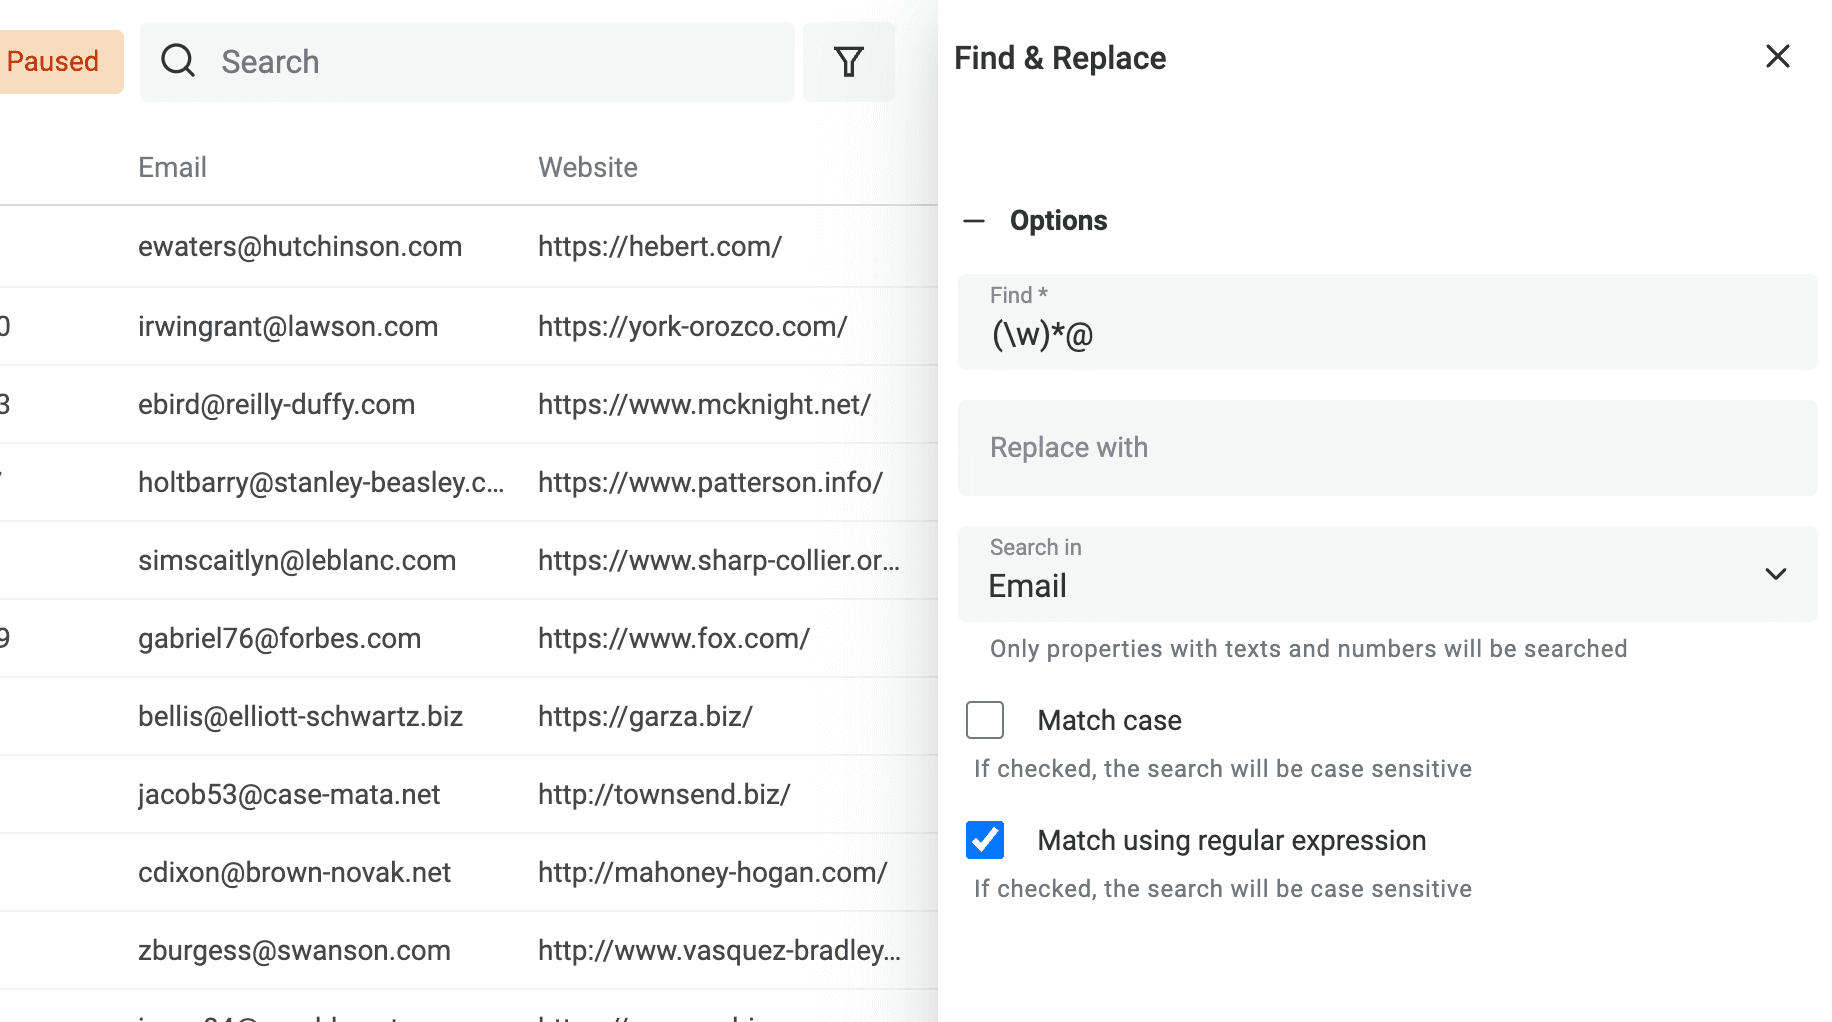
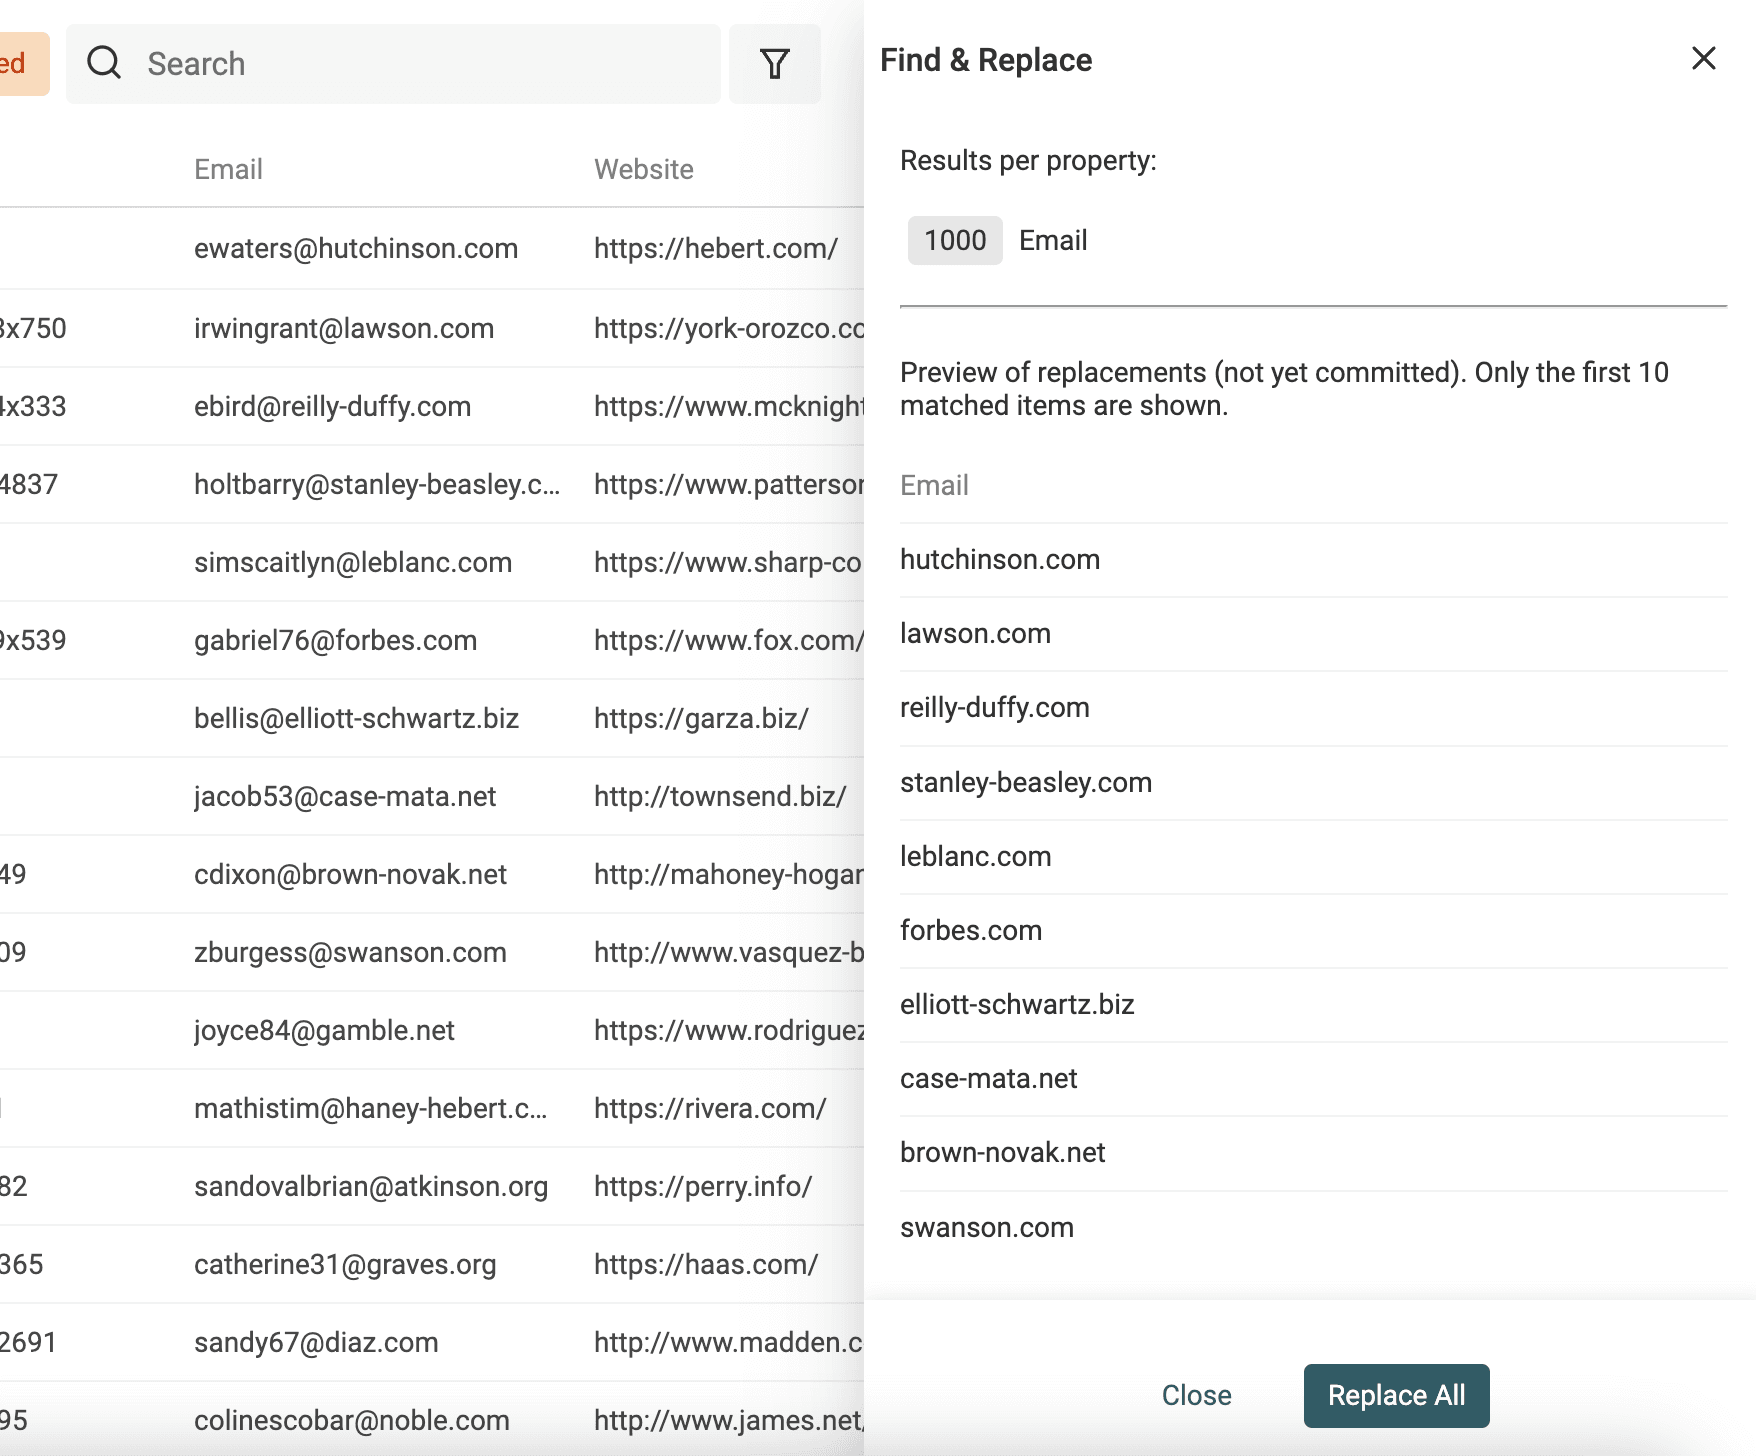
Extraire le domaine d’une adresse email
Find and Replace et les expressions régulières peuvent également servir à extraire le domaine d’un site web depuis une adresse email.
Dupliquez votre propriété email afin de préserver les données sources. Utilisez ensuite l’expression régulière suivante en laissant le texte de remplacement vide :
^(\w)*@
👉 Pour en savoir plus, consultez notre documentation sur Find and Replace.
Séparer un nom complet en prénom et nom
Lorsque vous scrapez des listes de leads, vous obtenez souvent des contacts avec un champ « Full Name » qu’il faut séparer en « First Name » et « Last Name ». Savoir décomposer précisément le nom d’une personne est une étape essentielle.
Séparer le prénom du nom vous permet de personnaliser davantage vos campagnes de Cold Emailing, d’identifier le genre de votre contact et de récupérer son titre académique.
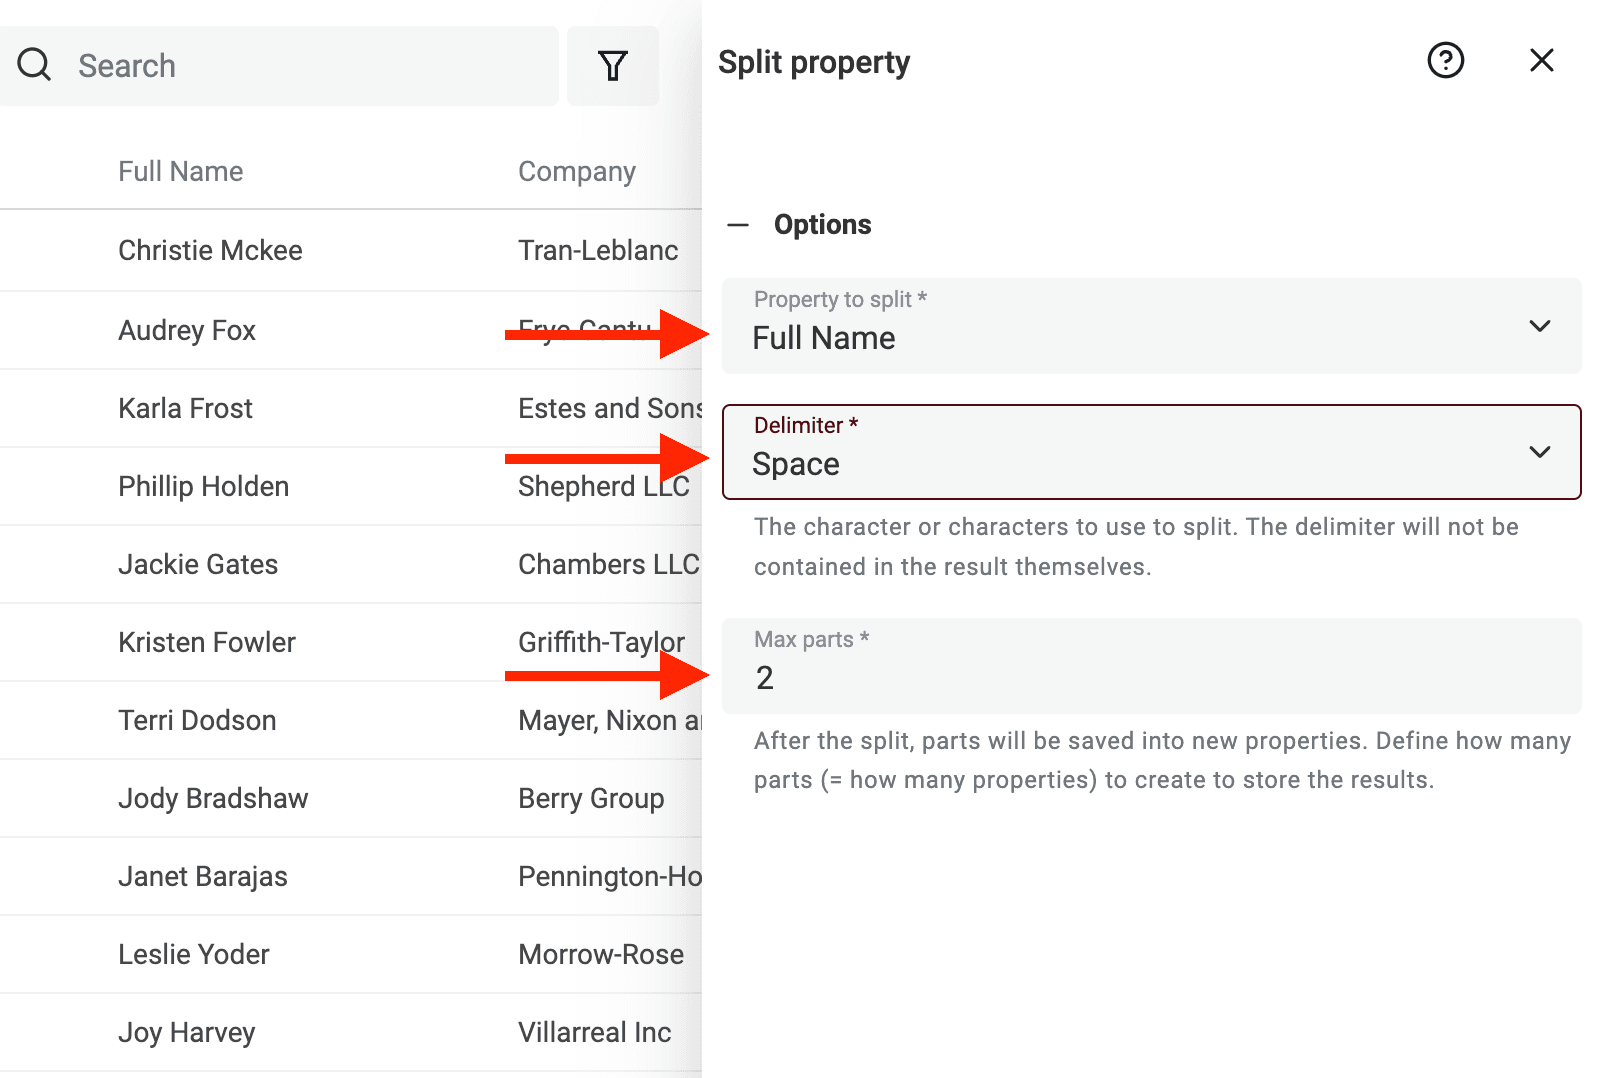
Cette opération peut être complexe. Heureusement, Datablist propose un outil simple pour diviser le champ « Name » en deux valeurs en utilisant l’espace comme séparateur.
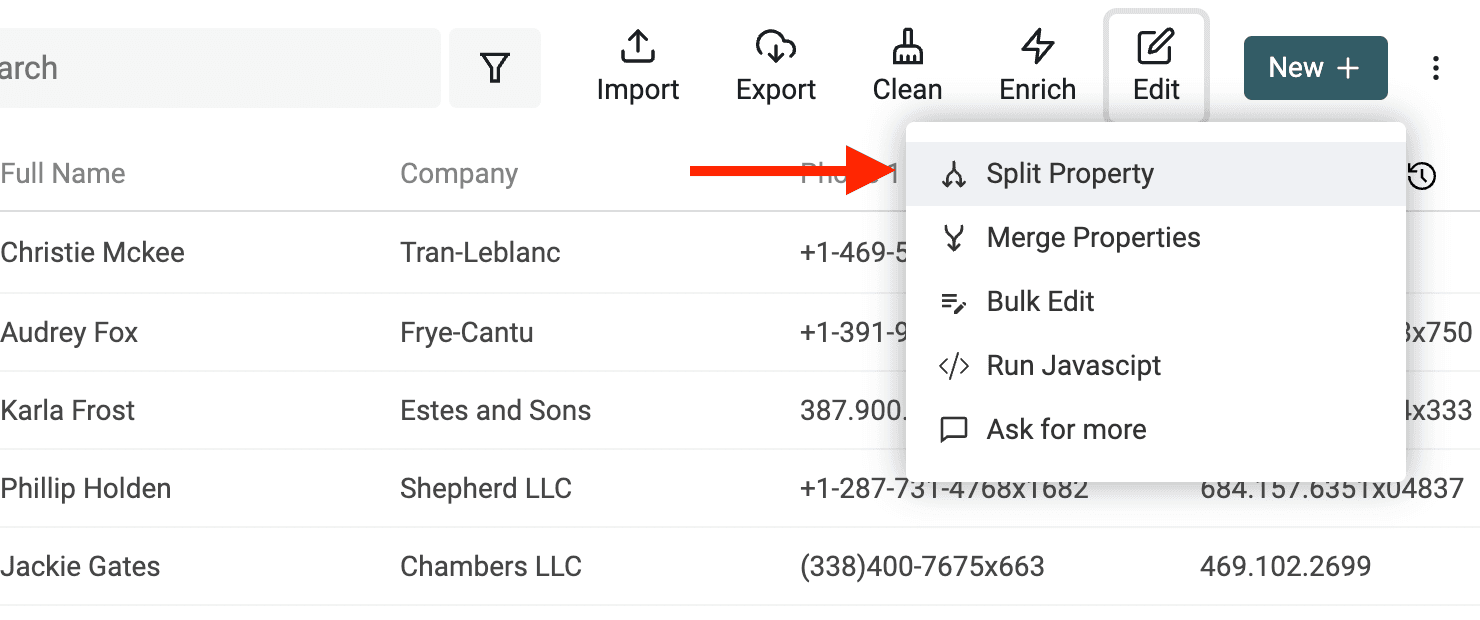
Pour commencer, ouvrez l’outil « Split Property » depuis le menu « Edit ».
Sélectionnez ensuite la propriété contenant les noms à analyser. Choisissez Space comme séparateur et fixez le nombre maximal de parties à 2.
Lancez l’aperçu. Datablist analysera vos 10 premiers éléments pour générer un aperçu. Si le résultat vous convient, cliquez sur « Split Property » pour appliquer l’algorithme à tous les éléments affichés.
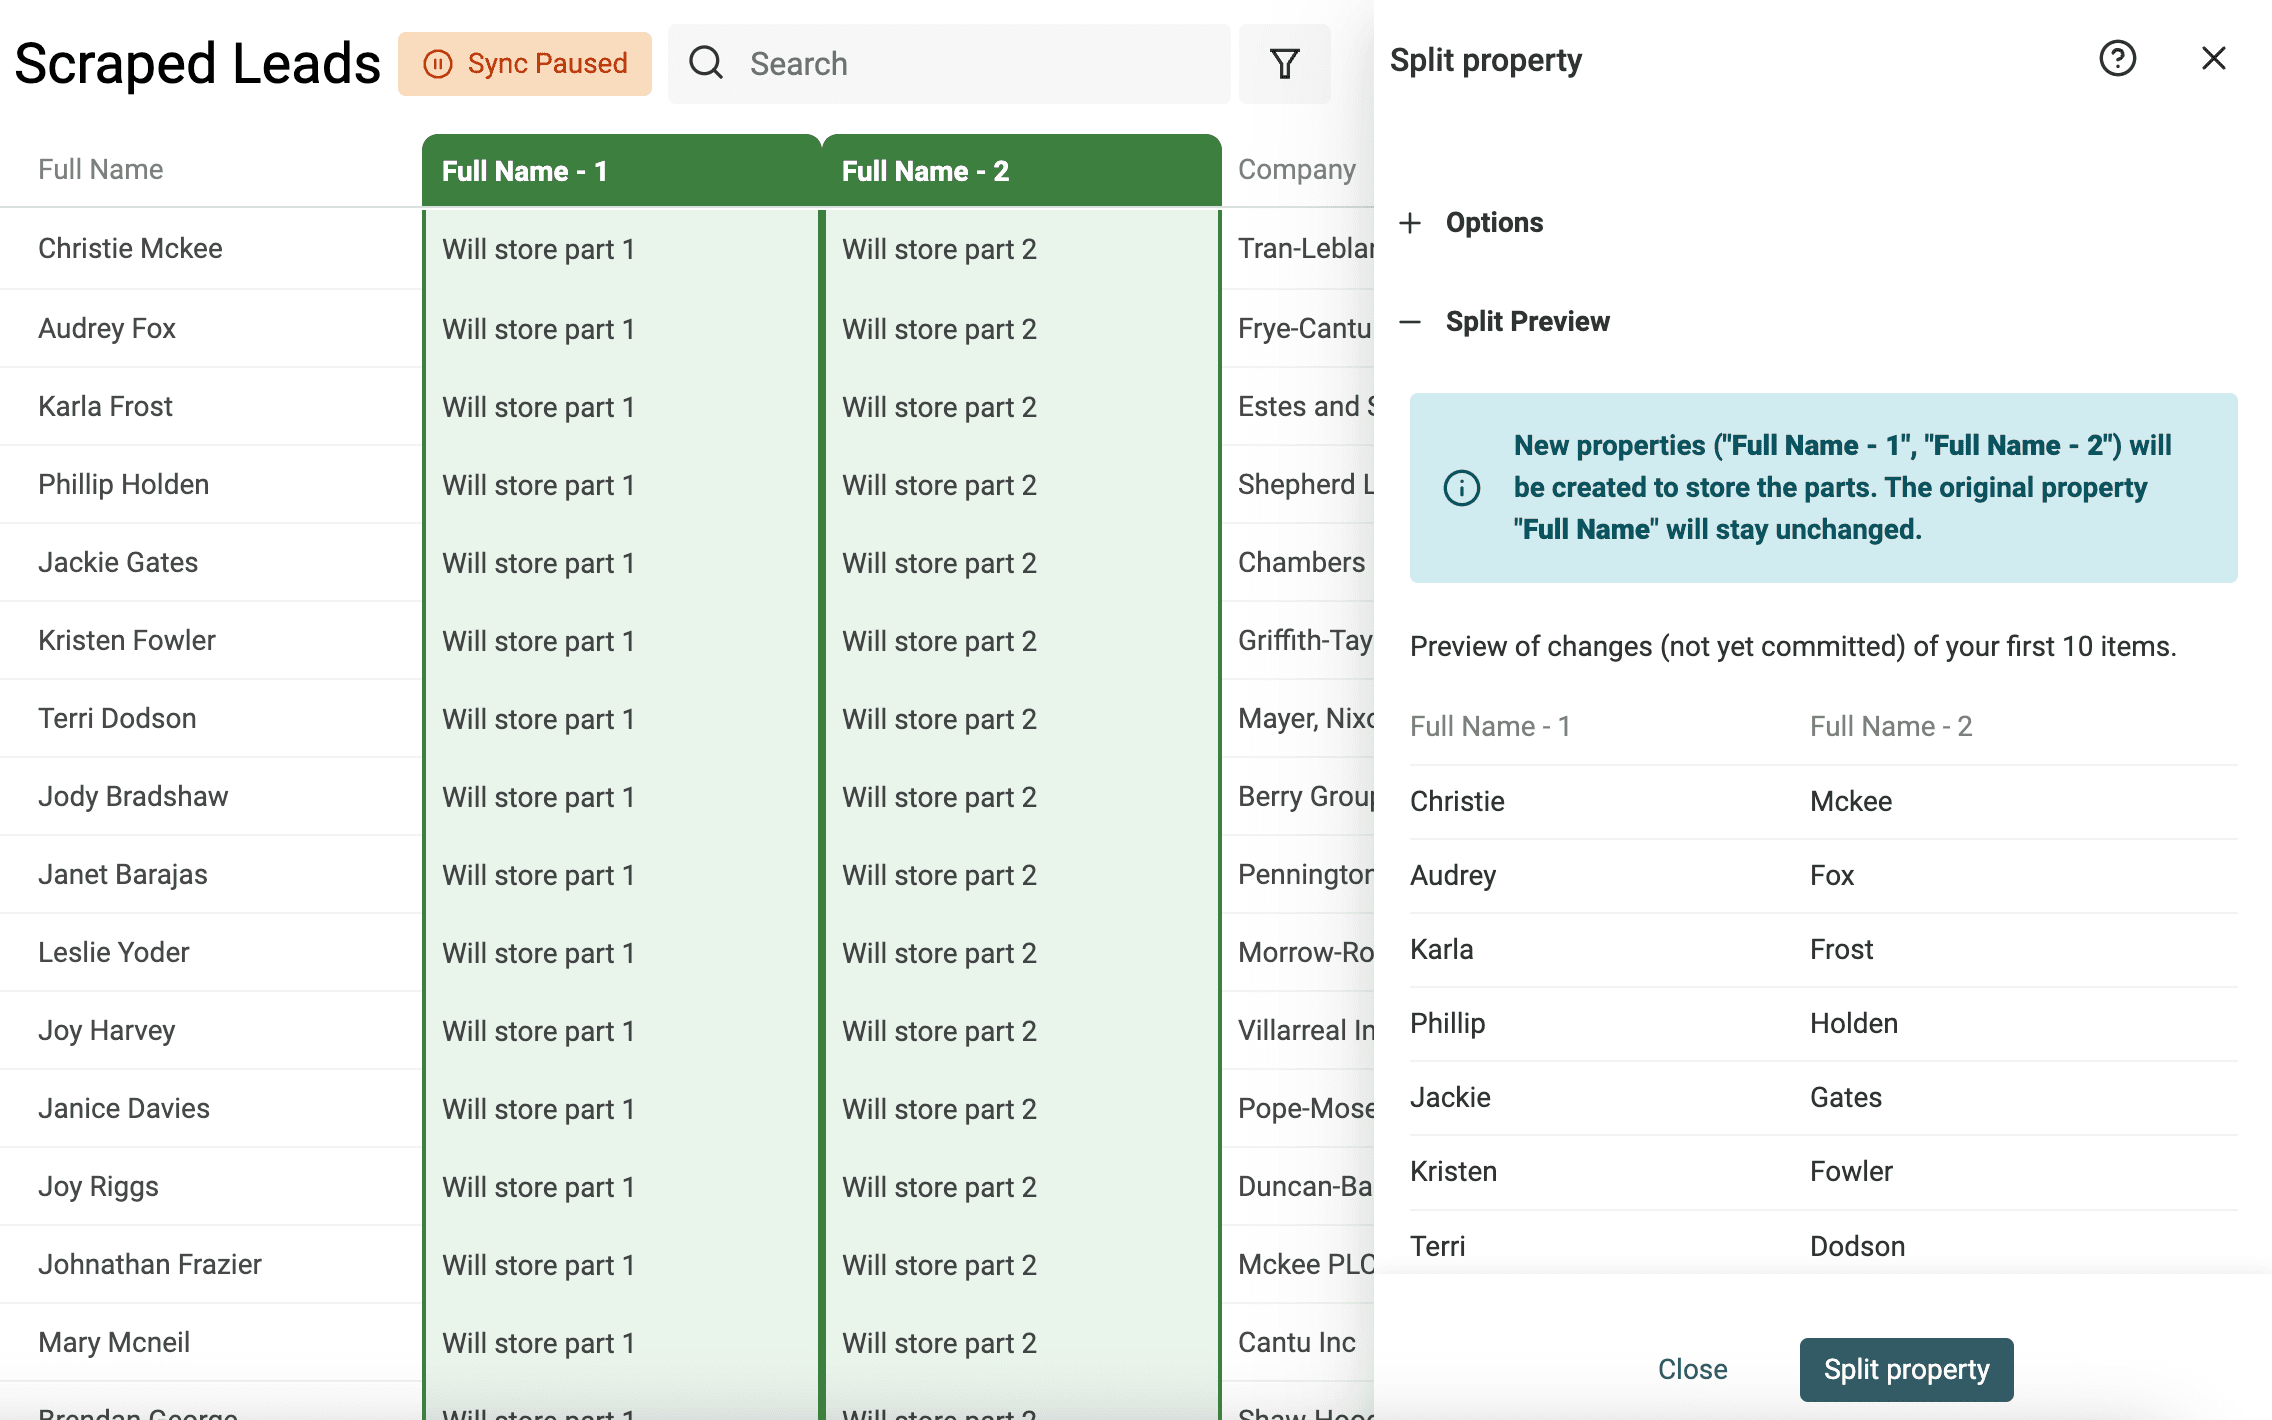
Une fois la séparation terminée, renommez les deux propriétés créées « First Name » et « Last Name ».
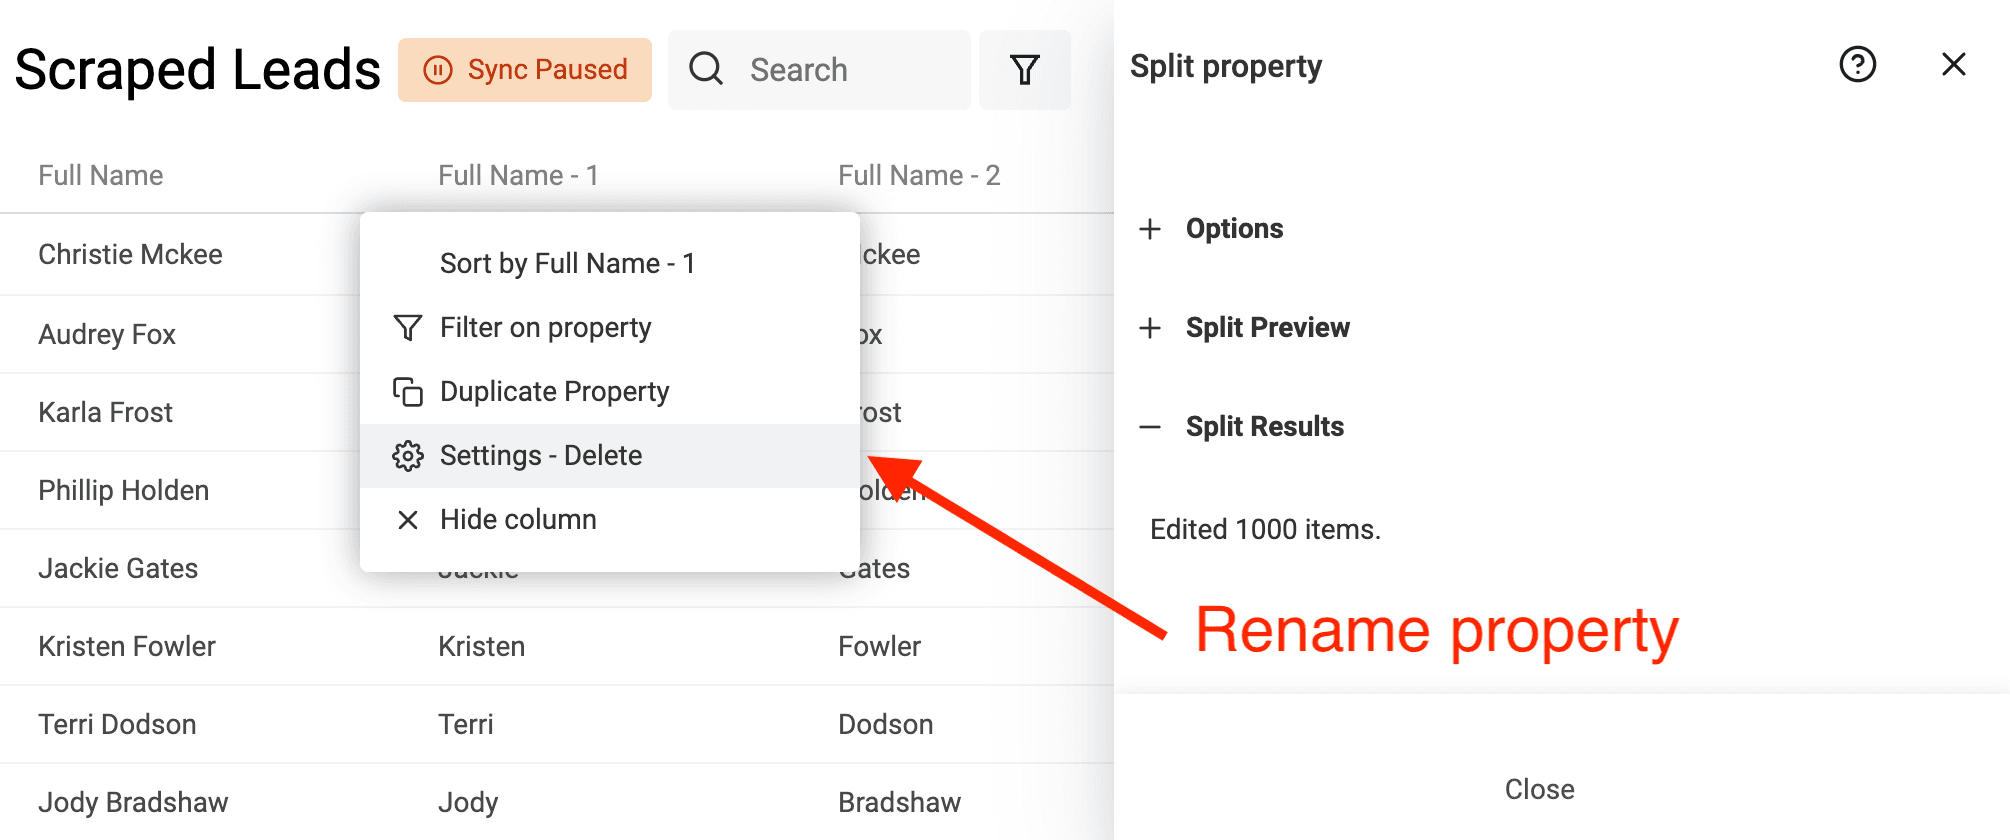
Cet exemple se concentre sur les conventions occidentales, où le nom complet comprend généralement un prénom et un nom de famille. Le traitement se complique avec les noms issus d’autres conventions, qui peuvent comporter plusieurs prénoms ou noms de famille, ainsi qu’avec les titres et les suffixes.
Déduplication des données
Datablist dispose d’un puissant algorithme de déduplication pour supprimer les doublons. Il repère les éléments similaires à partir d’une ou de plusieurs propriétés, puis les fusionne automatiquement sans perdre de données.
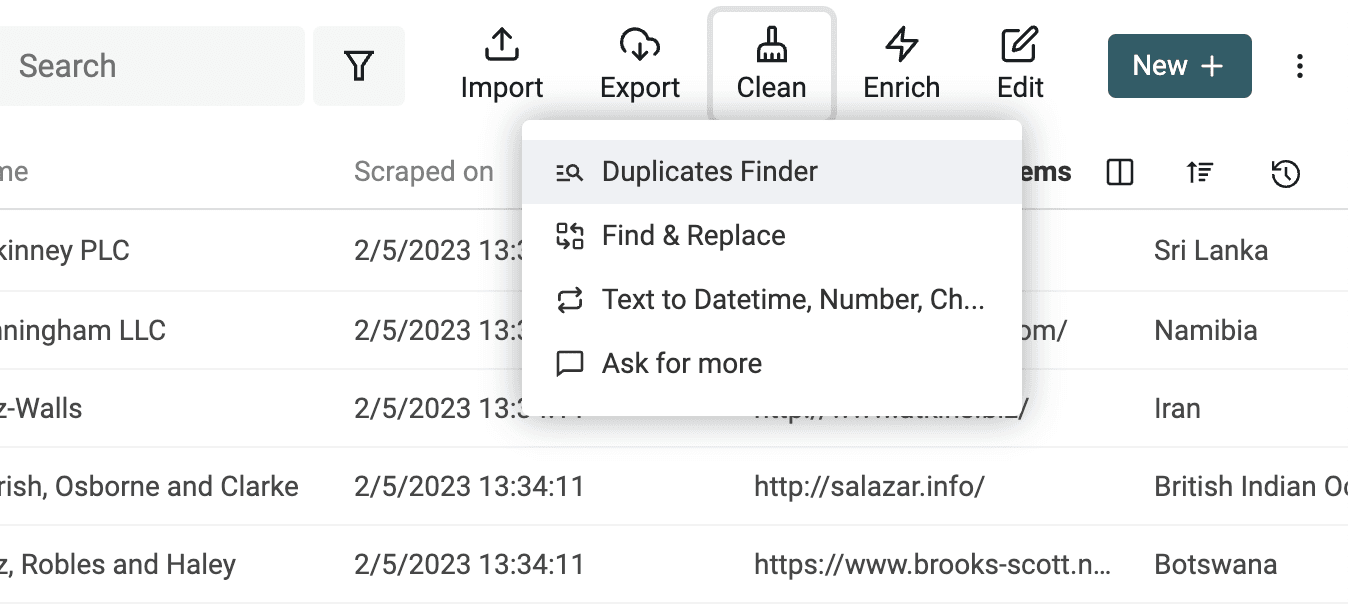
Pour lancer l’algorithme de déduplication, cliquez sur « Duplicate Finder » dans le menu « Clean ».
Sélectionnez les propriétés à utiliser pour établir les correspondances.
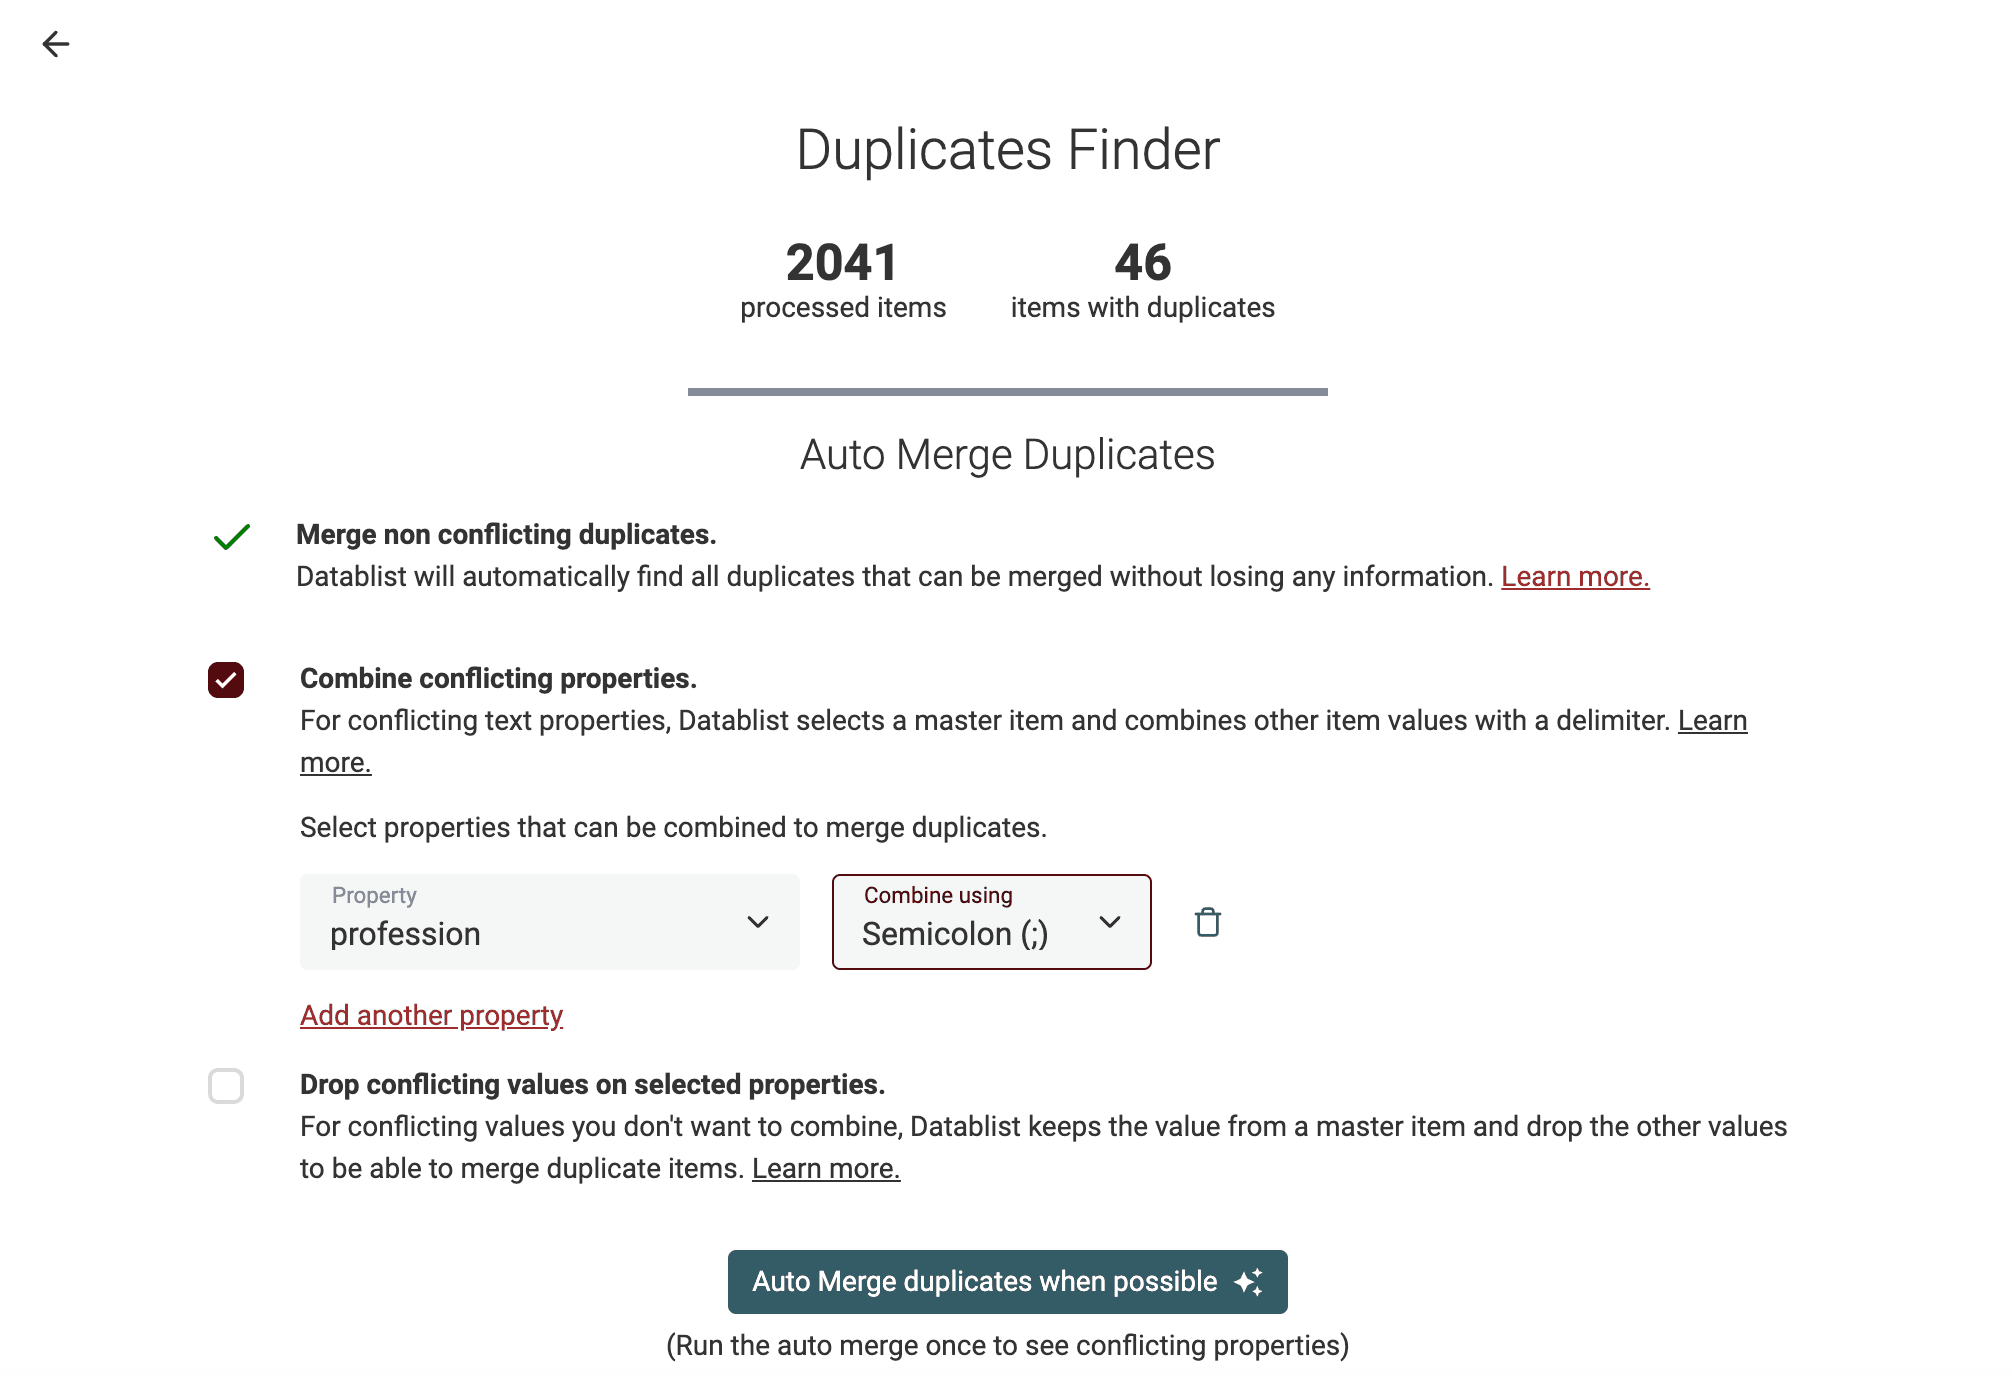
Sur la page de résultats, lancez une première fois l’algorithme « Auto Merge » en activant uniquement l’option « Merge non-conflicting duplicates ». Il fusionnera les doublons faciles à regrouper et répertoriera les propriétés présentant des conflits.
L’algorithme de déduplication propose deux méthodes pour traiter les données conflictuelles. Vous pouvez choisir « Combine conflicting properties » afin de combiner les valeurs avec un séparateur, ou ignorer les valeurs conflictuelles pour ne conserver qu’un enregistrement principal.
👉 Découvrez comment fusionner les doublons de fichiers CSV. Consultez également notre guide pour repérer et fusionner les doublons à partir du nom des entreprises.
Extraire des adresses email et des URL de textes
Data Extractor de Datablist est un outil qui analyse les textes non structurés pour en extraire des entités.
Il s’appuie sur la reconnaissance de motifs pour détecter :
- Les adresses email présentes dans un texte
- Les URL présentes dans un texte
- Le domaine d’une URL
- Le domaine d’une adresse email
- Les mentions, par exemple @nom, présentes dans un texte
- Les tags, par exemple #tag, présents dans un texte
Data Extractor est idéal pour analyser et structurer vos données. Avec des adresses email, des URL et d’autres valeurs correctement formatées, vous pouvez connecter vos données à d’autres outils et créer des workflows automatisés.
Une fois les adresses email récupérées, vous pouvez par exemple les enrichir pour trouver les coordonnées de vos contacts. À partir du domaine des URL, vous pouvez aussi rechercher leur classement de trafic, avec Alexa par exemple.
Data Extractor est accessible depuis « Edit Menu -> Extract url, email, tag, etc. ».
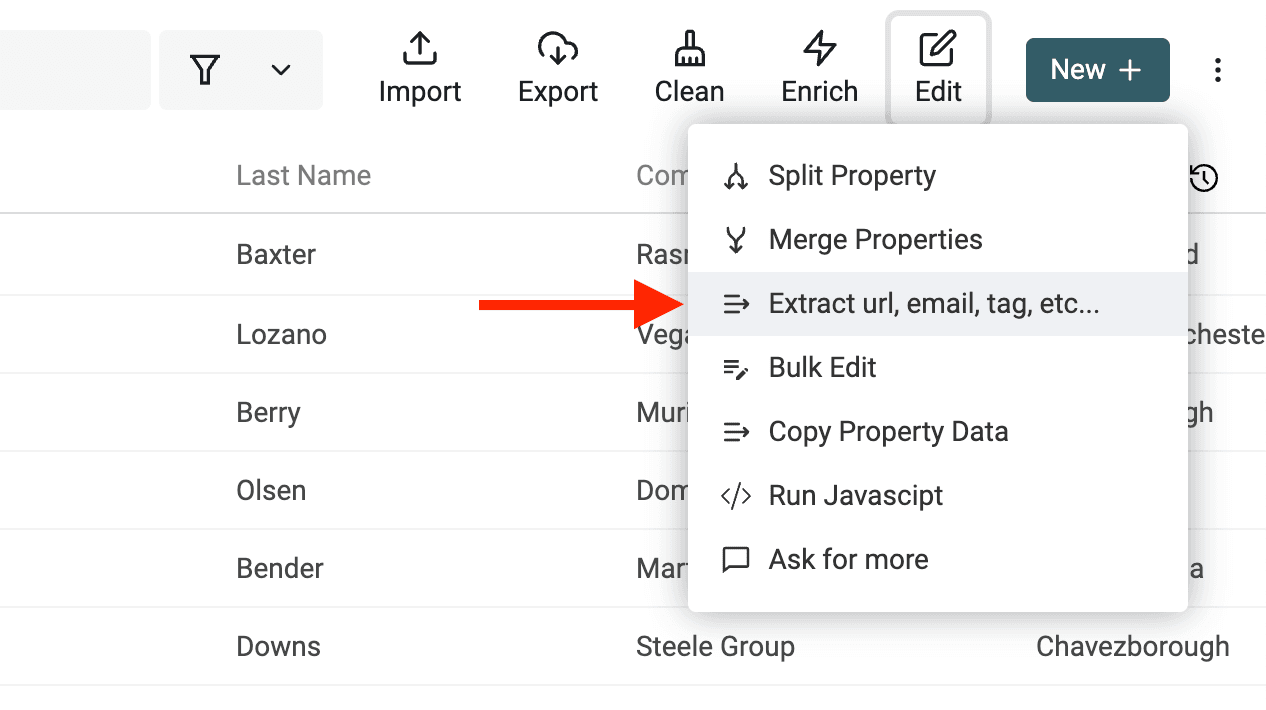
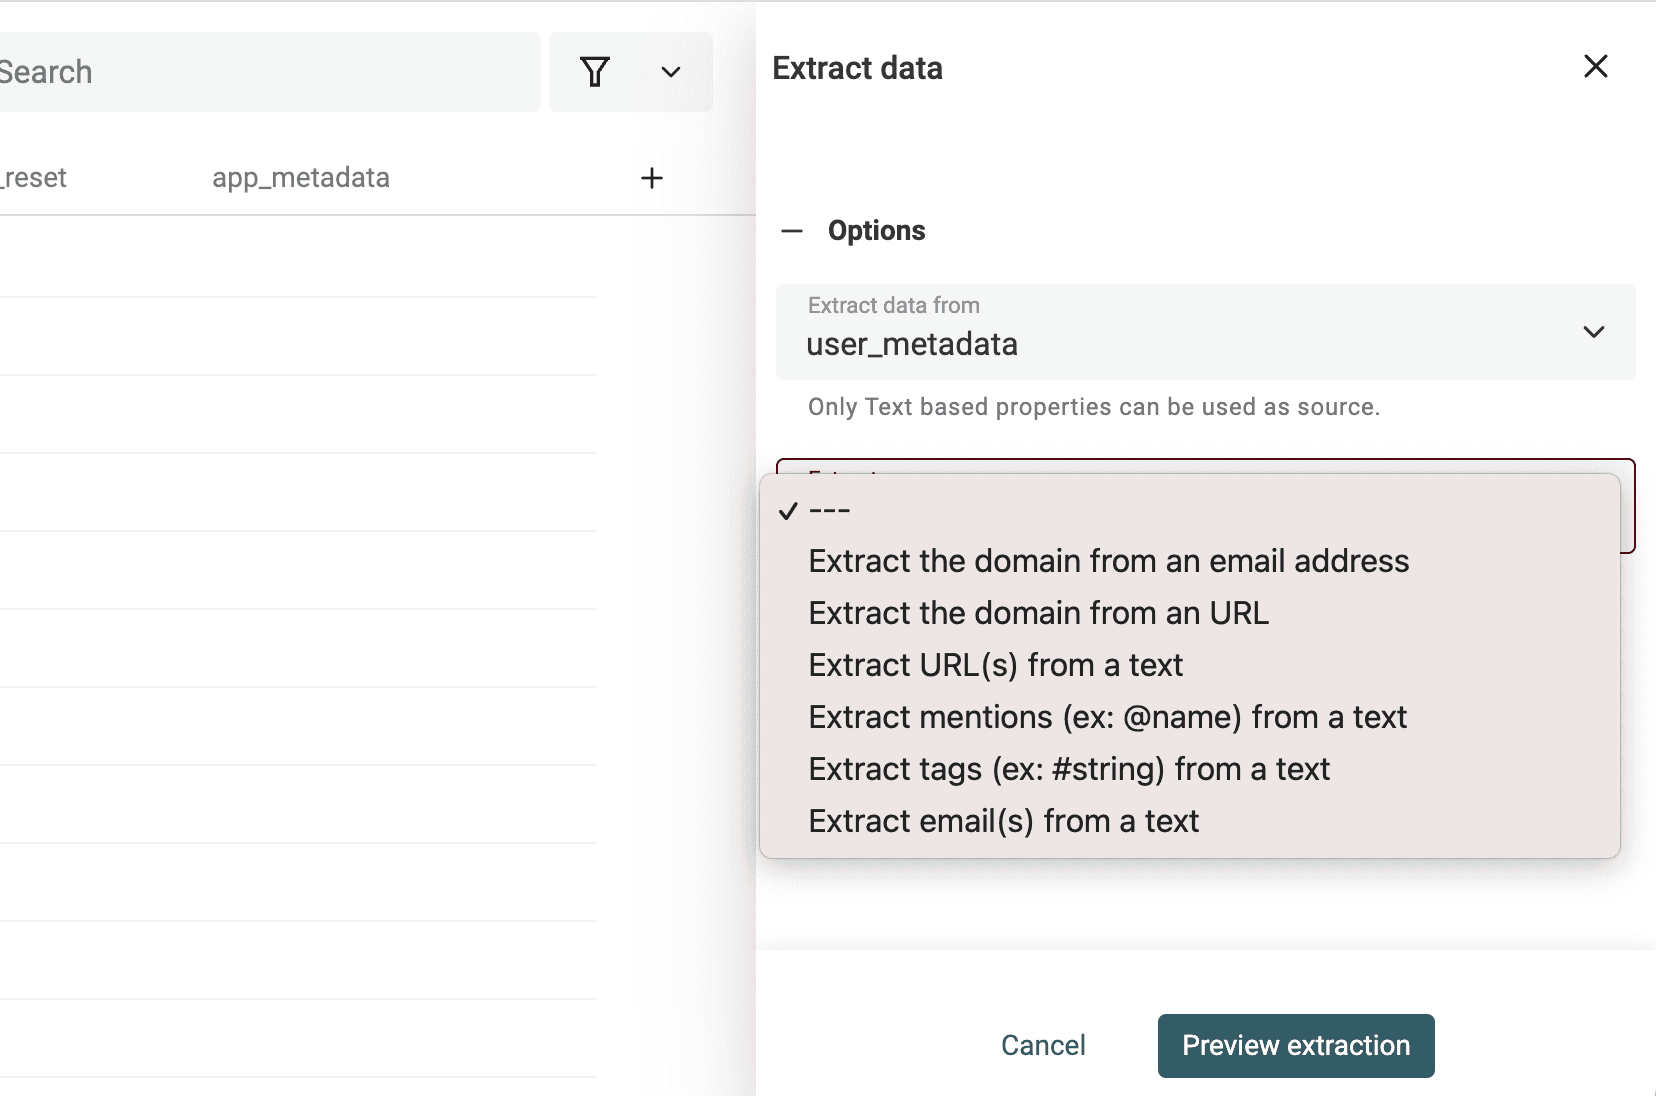
Sélectionnez la propriété contenant le texte non structuré, puis choisissez un parser.
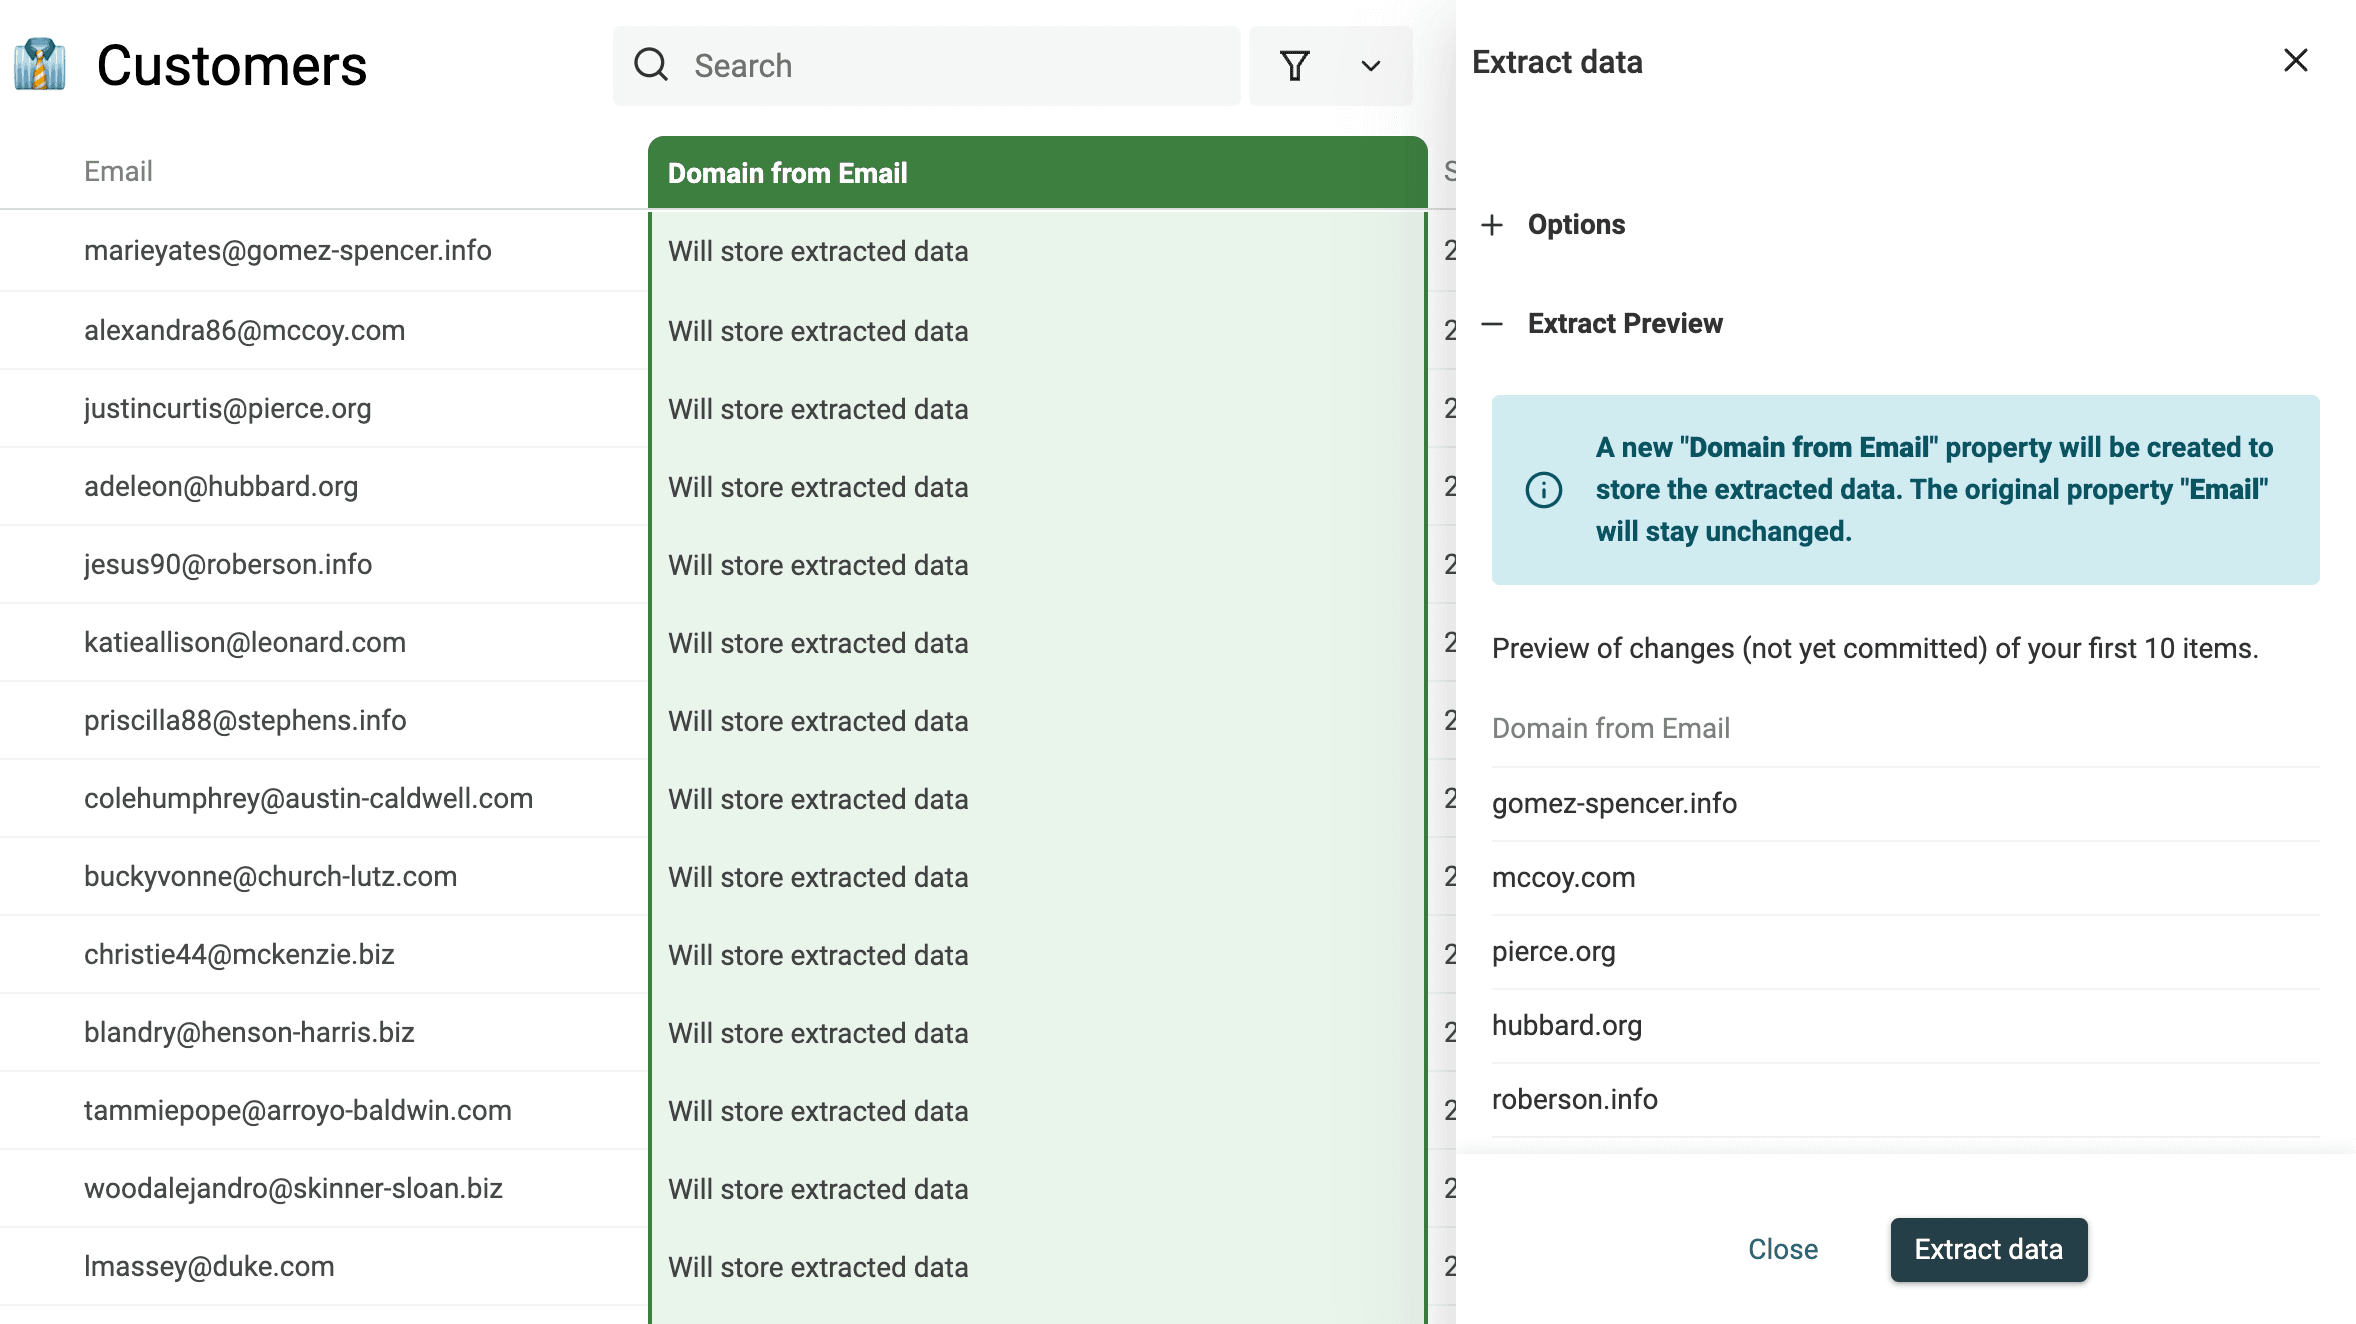
Lancez le parser pour afficher un aperçu. Si le résultat vous convient, cliquez sur « Extract » pour traiter vos éléments.
Utiliser les RegEx pour filtrer et valider les données
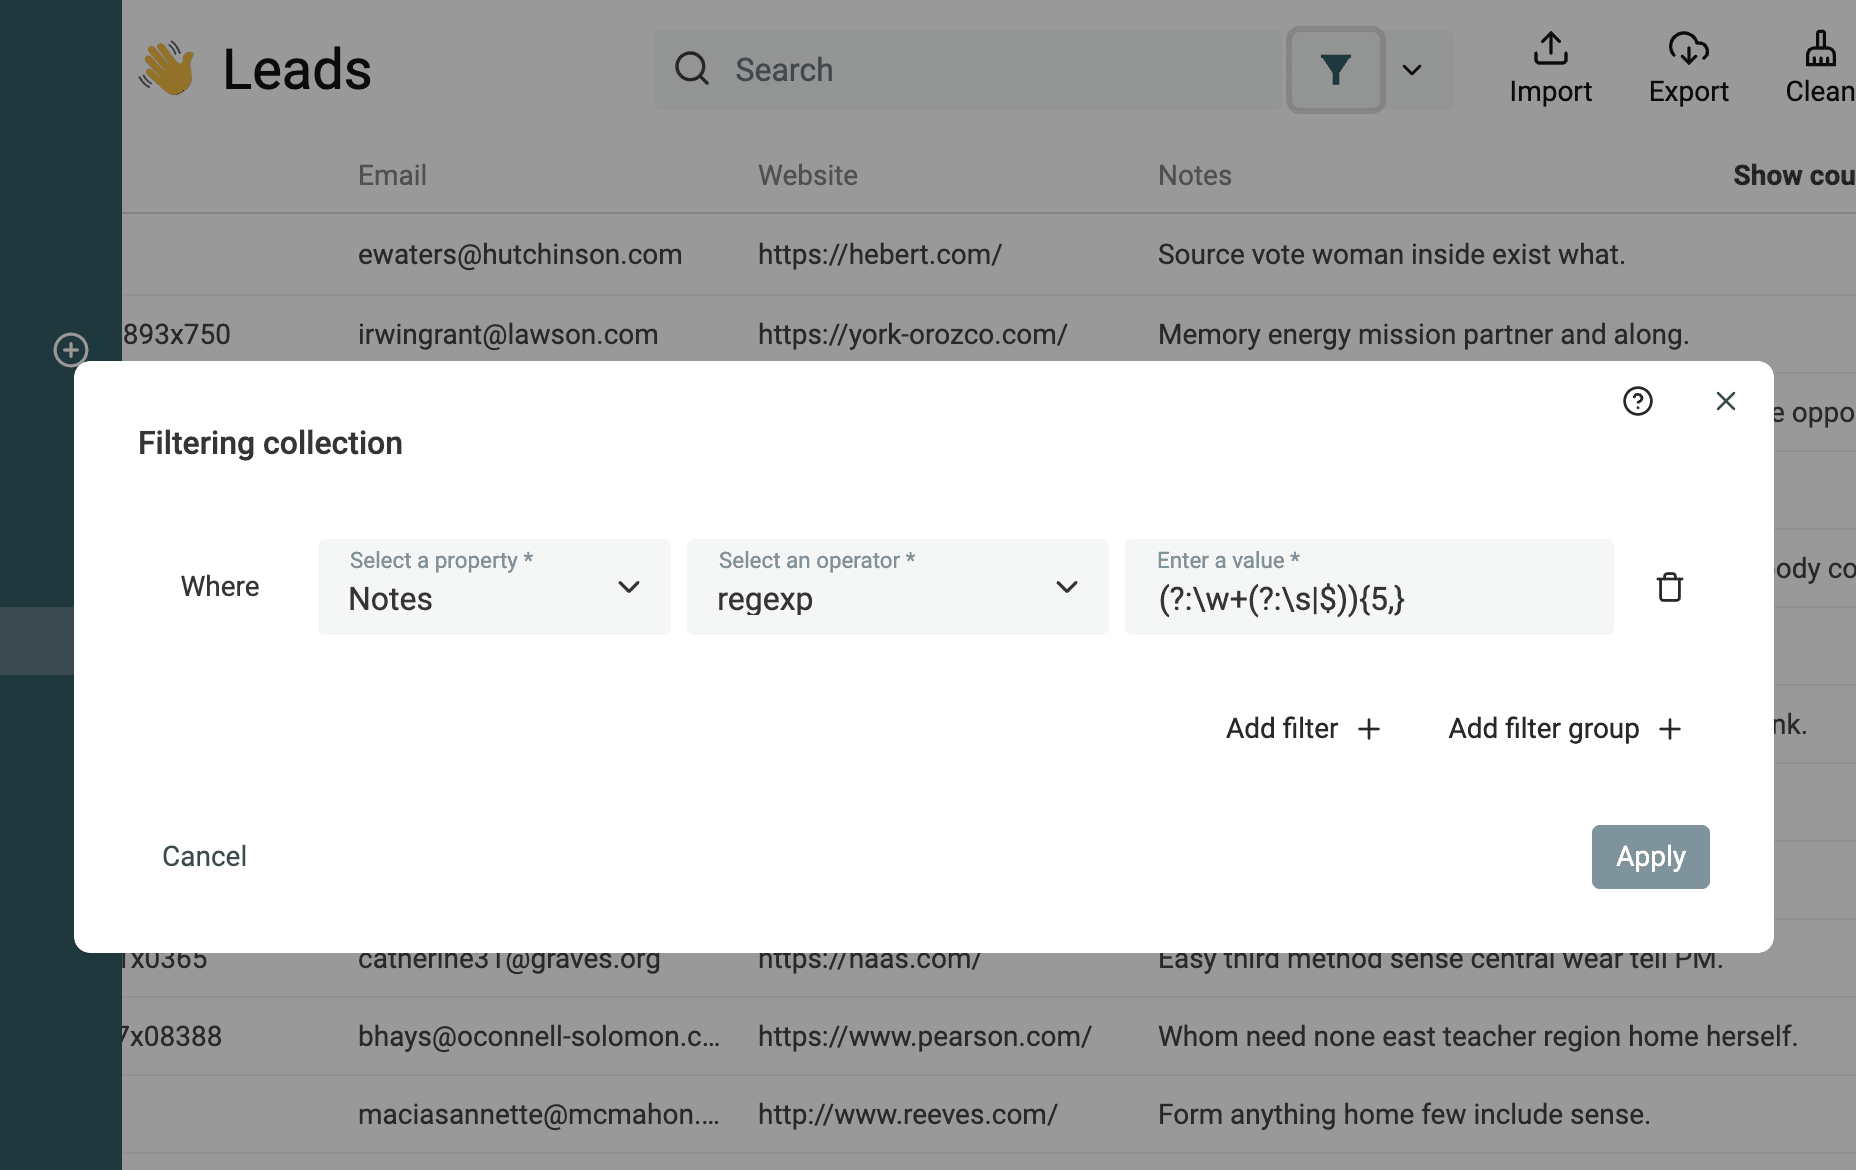
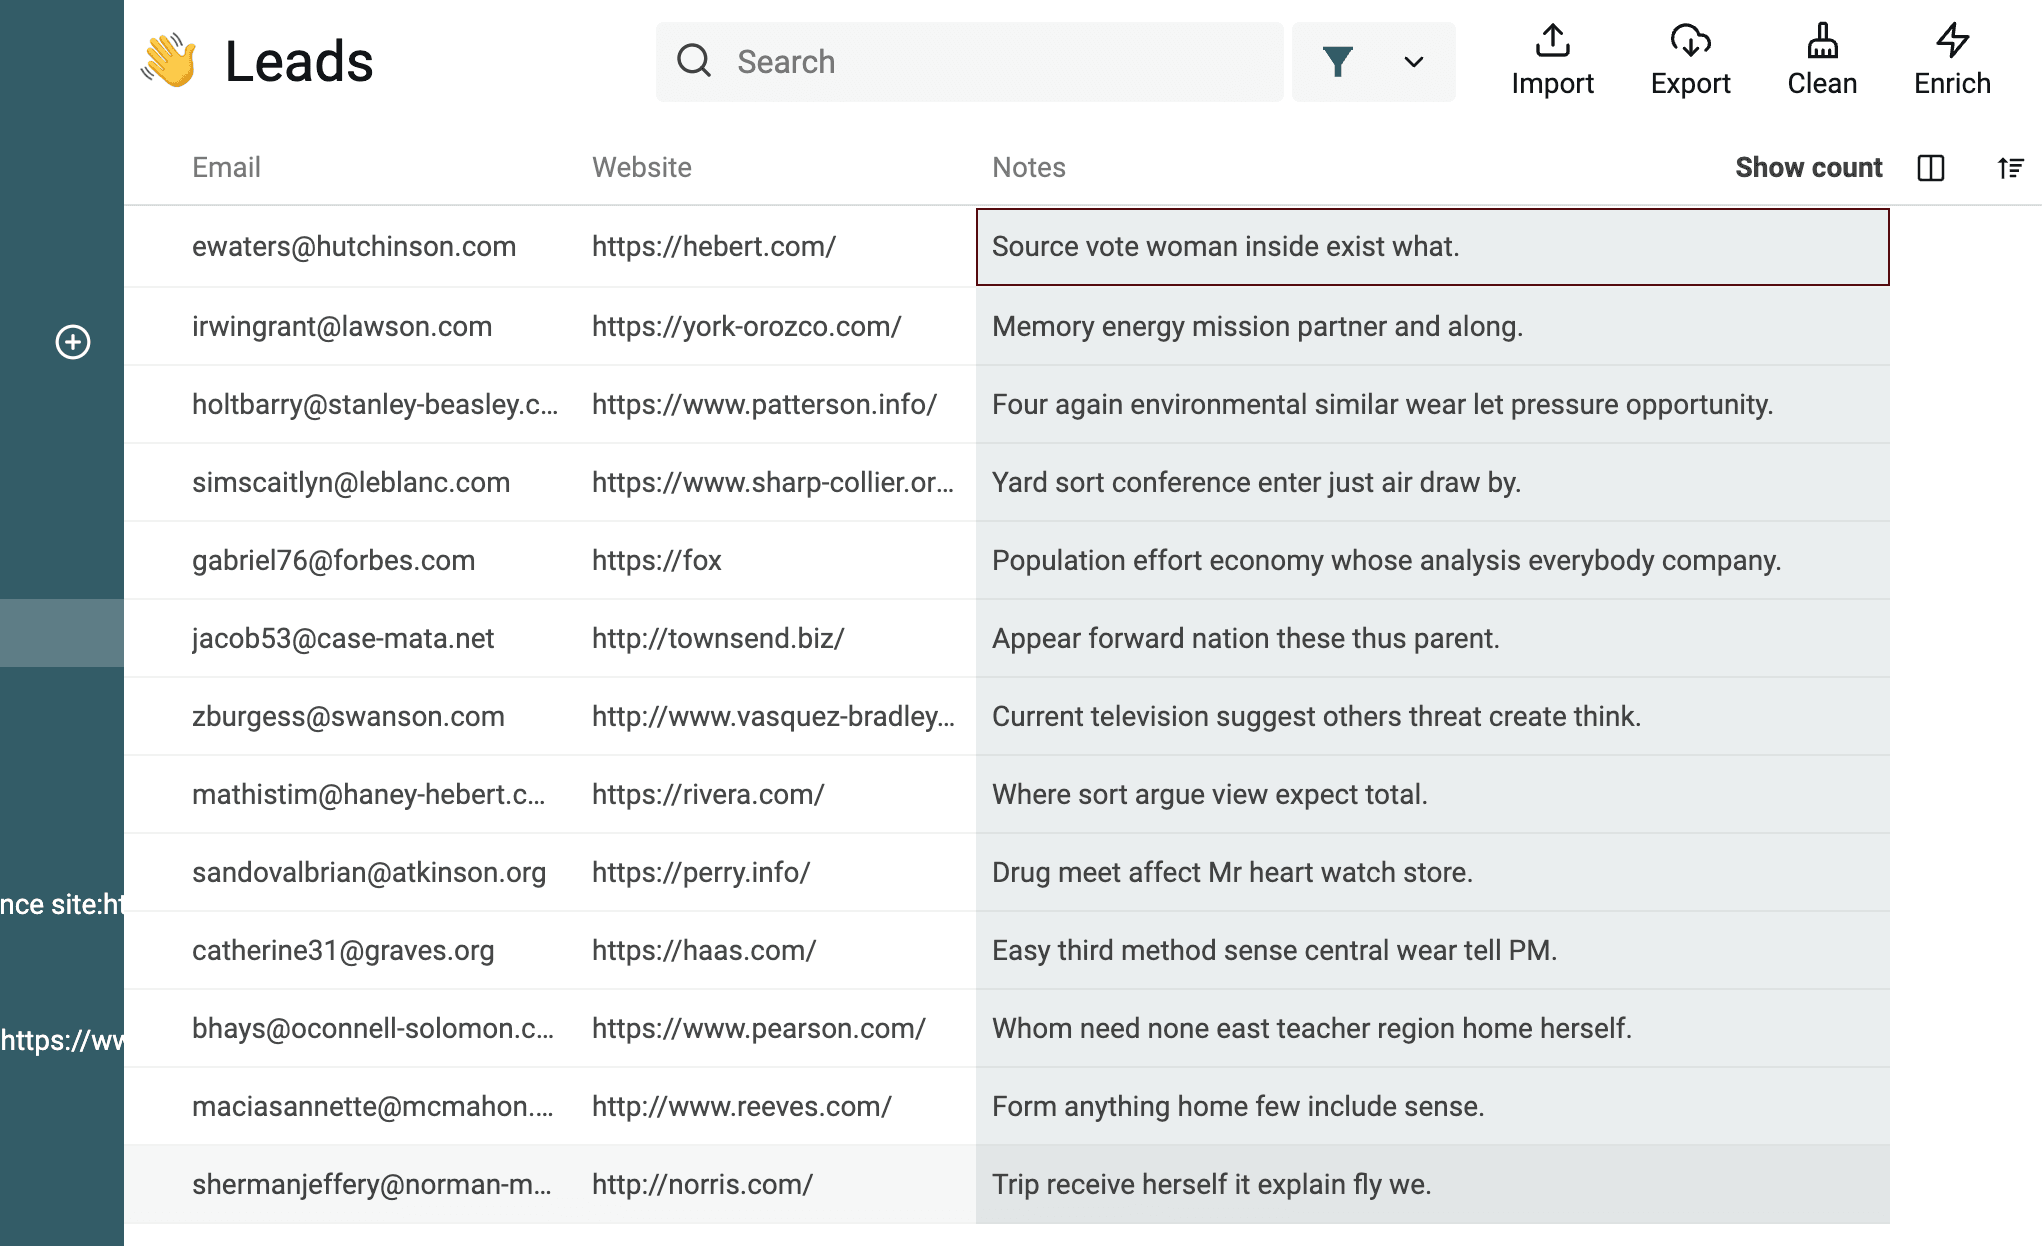
Datablist vous permet d’utiliser des expressions régulières pour filtrer vos données.
Filtrer du texte selon le nombre de mots
Cette expression régulière permet de filtrer les textes contenant au moins {n} mots :
(?:\w+(?:\s|$)){5,} (remplacez 5 par le nombre de votre choix)
Voici d’autres variantes de cette RegEx :
(?:\w+(?:\s|$)){,5}: textes contenant au maximum 5 mots, y compris ceux qui en contiennent exactement 5(?:\w+(?:\s|$)){5,10}: textes contenant entre 5 et 10 mots
Filtrer les URL non valides
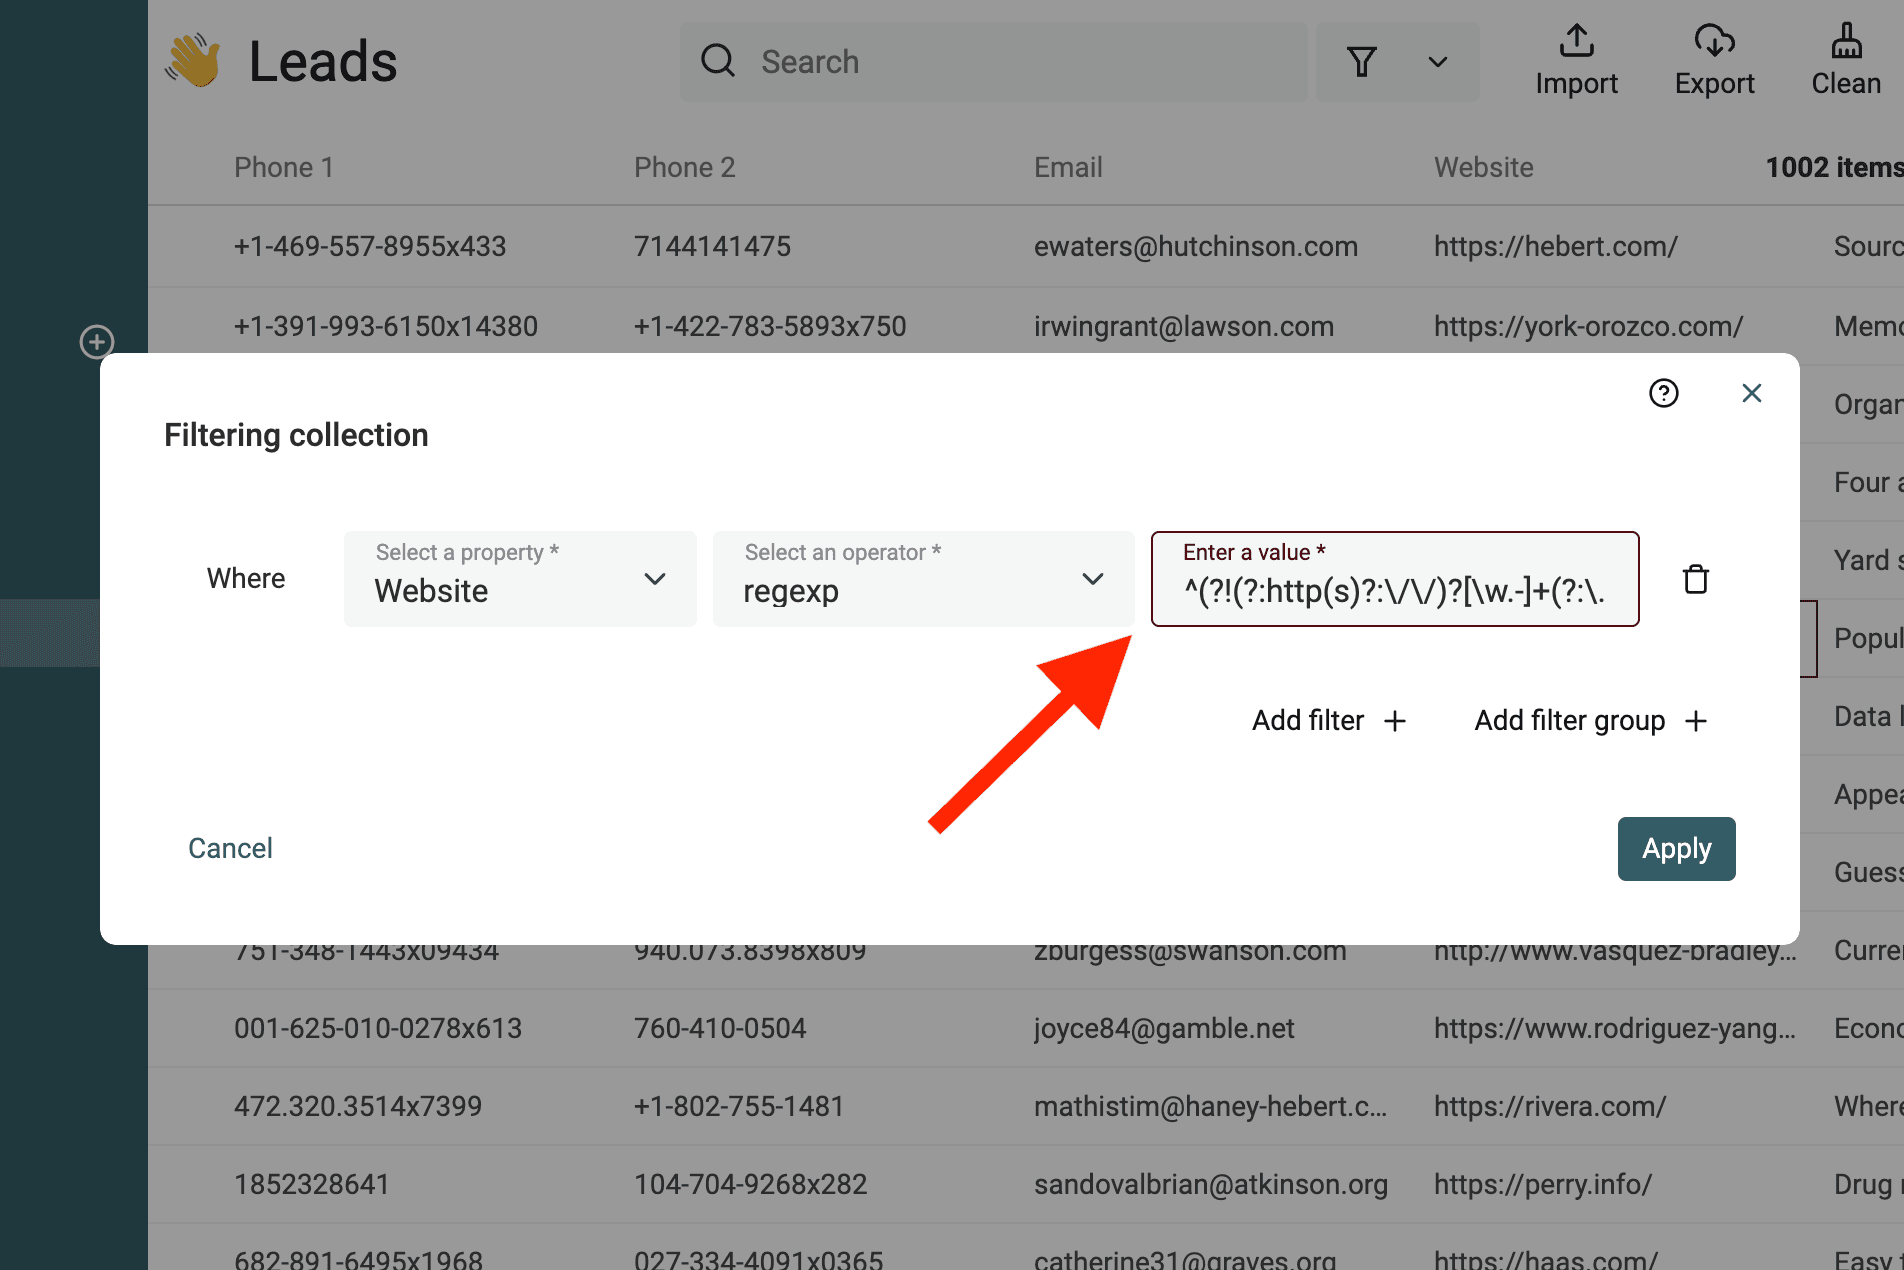
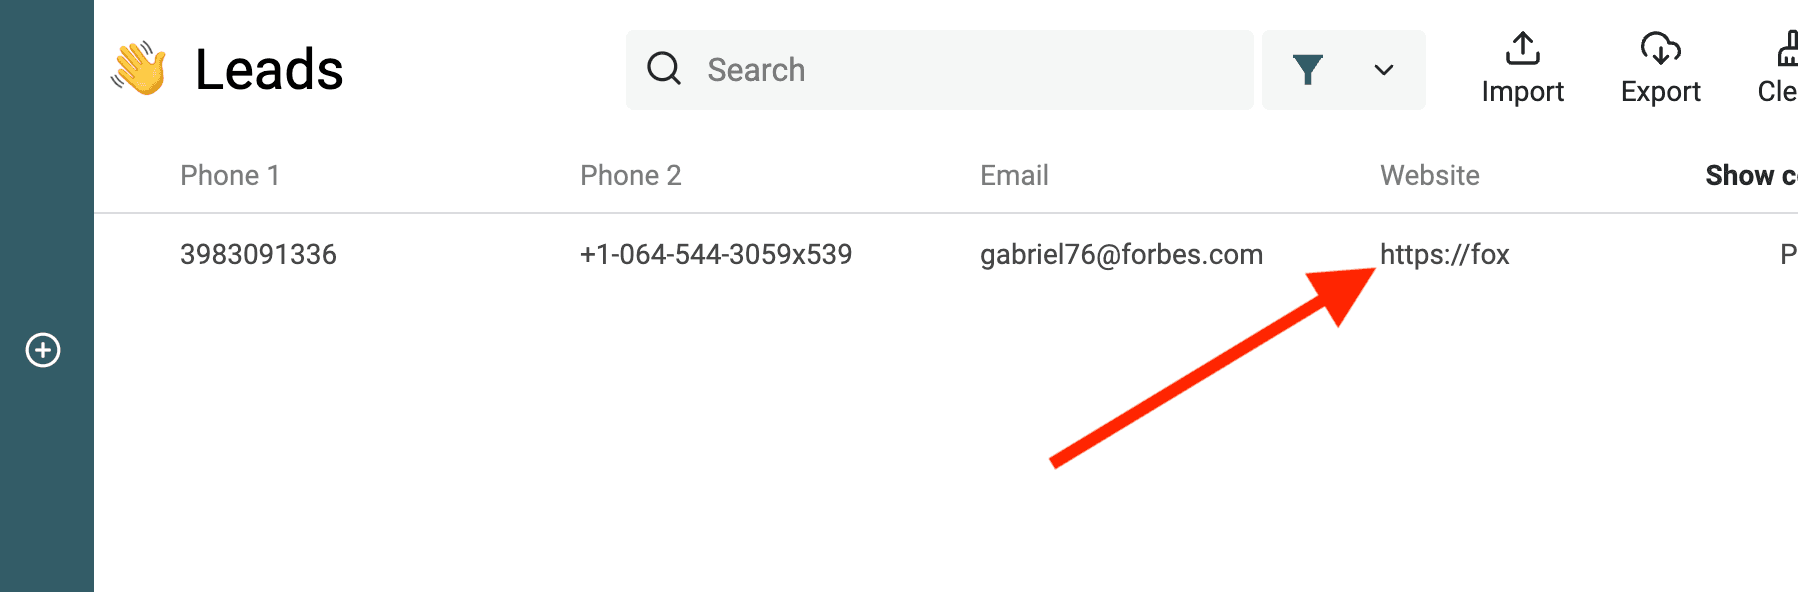
La RegEx suivante détecte les URL non valides :
^(?!(?:http(s)?:\/\/)?[\w.-]+(?:\.[\w\.-]+)+[\w\-\._~:/?#[\]@!\$&'\(\)\*\+,;=.]+).*$
Filtrer les adresses email non valides
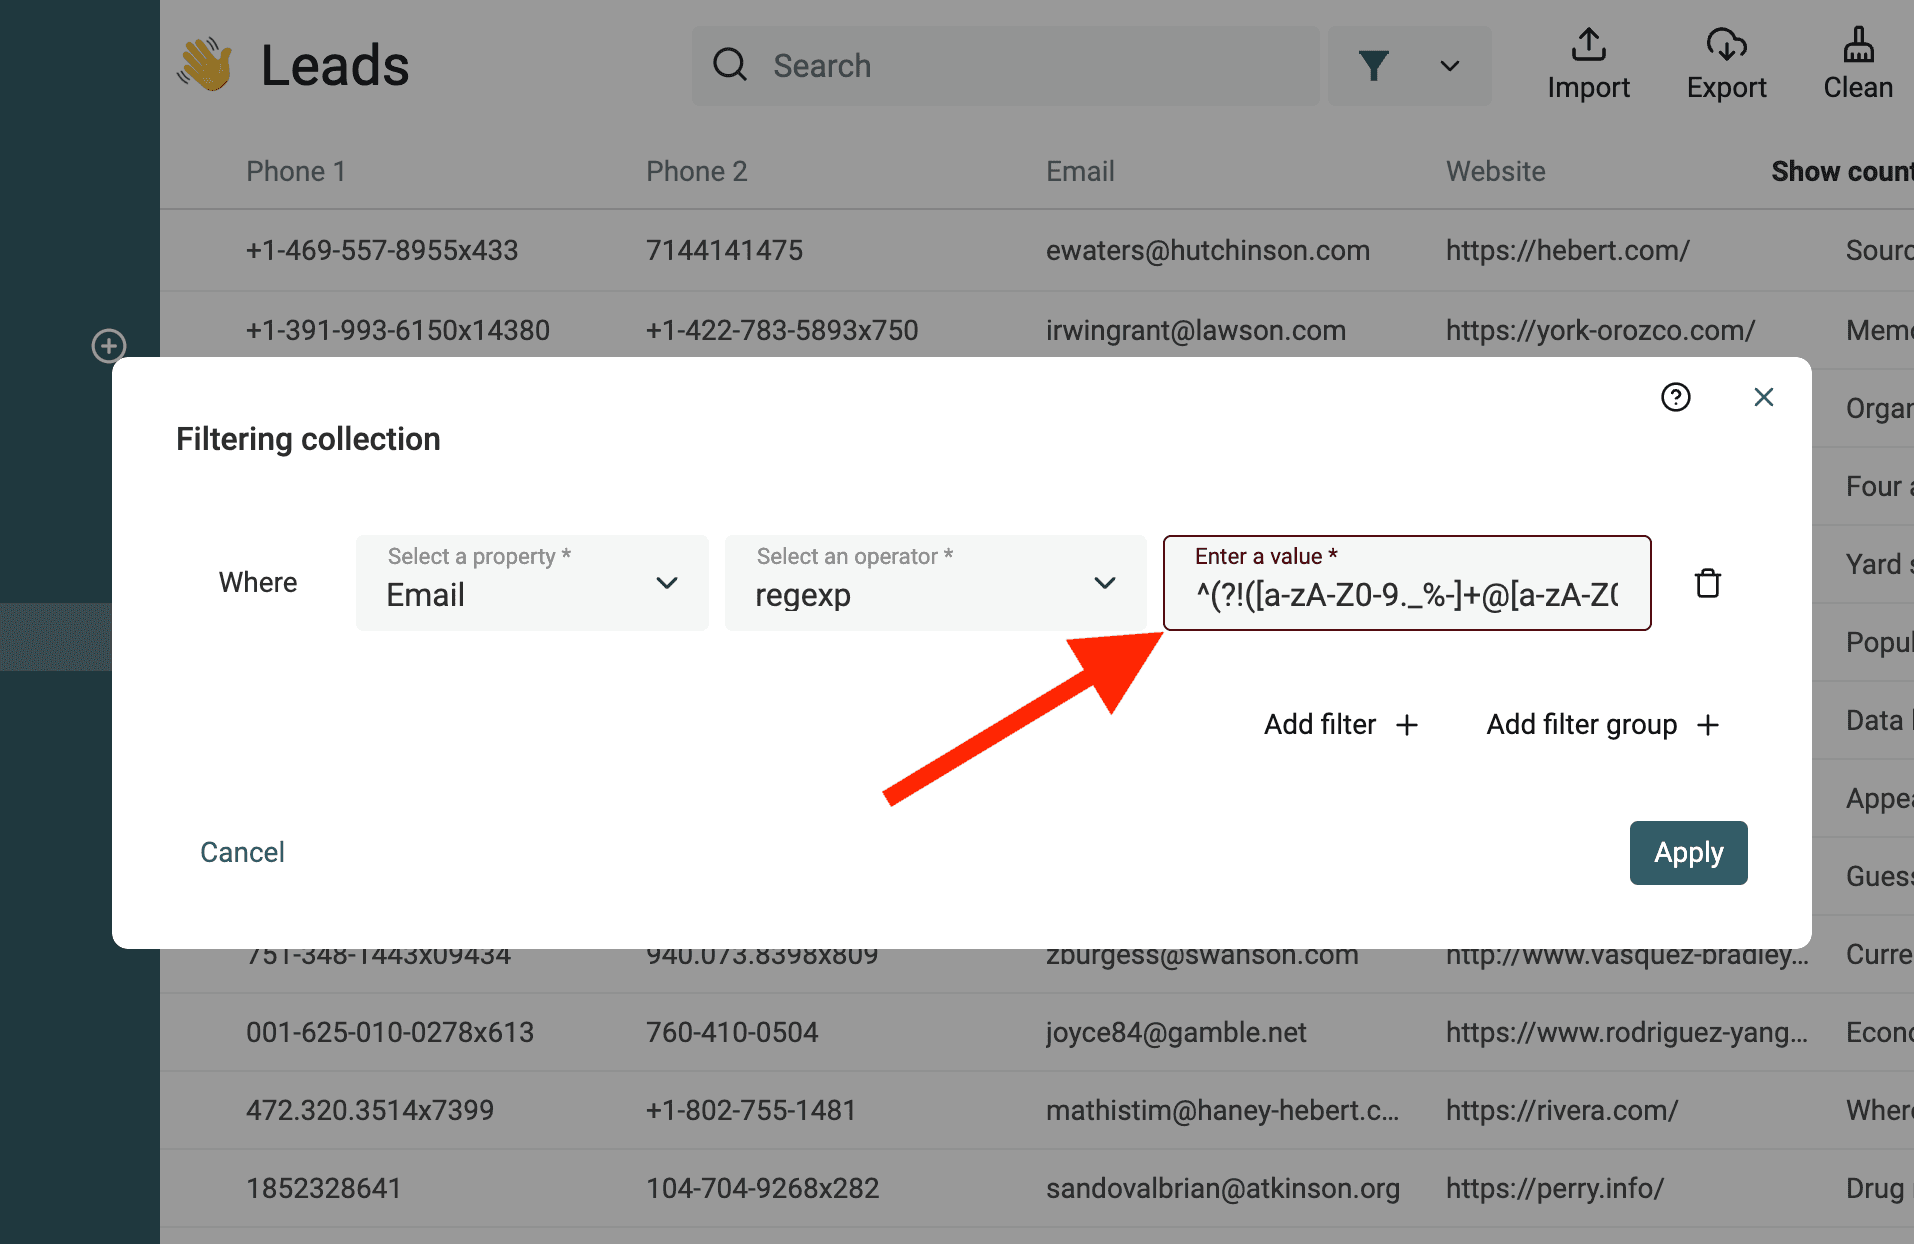
La RegEx suivante détecte les adresses email non valides :
^(?!([a-zA-Z0-9._%-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,})).*$
Créer des transformations personnalisées en JavaScript
Datablist vous permet d’exécuter du code JavaScript personnalisé sur vos données. Vous pouvez ainsi répondre à des besoins spécifiques, prendre en charge des formats particuliers, effectuer des calculs complexes et appliquer des transformations avancées.
Cette fonctionnalité puissante vous permet d’exploiter pleinement votre expertise en manipulation et en transformation de données. Vous pouvez appliquer une logique personnalisée, créer des boucles et des conditions, ou utiliser de nombreuses fonctions JavaScript pour mener à bien les opérations de data cleaning les plus complexes.
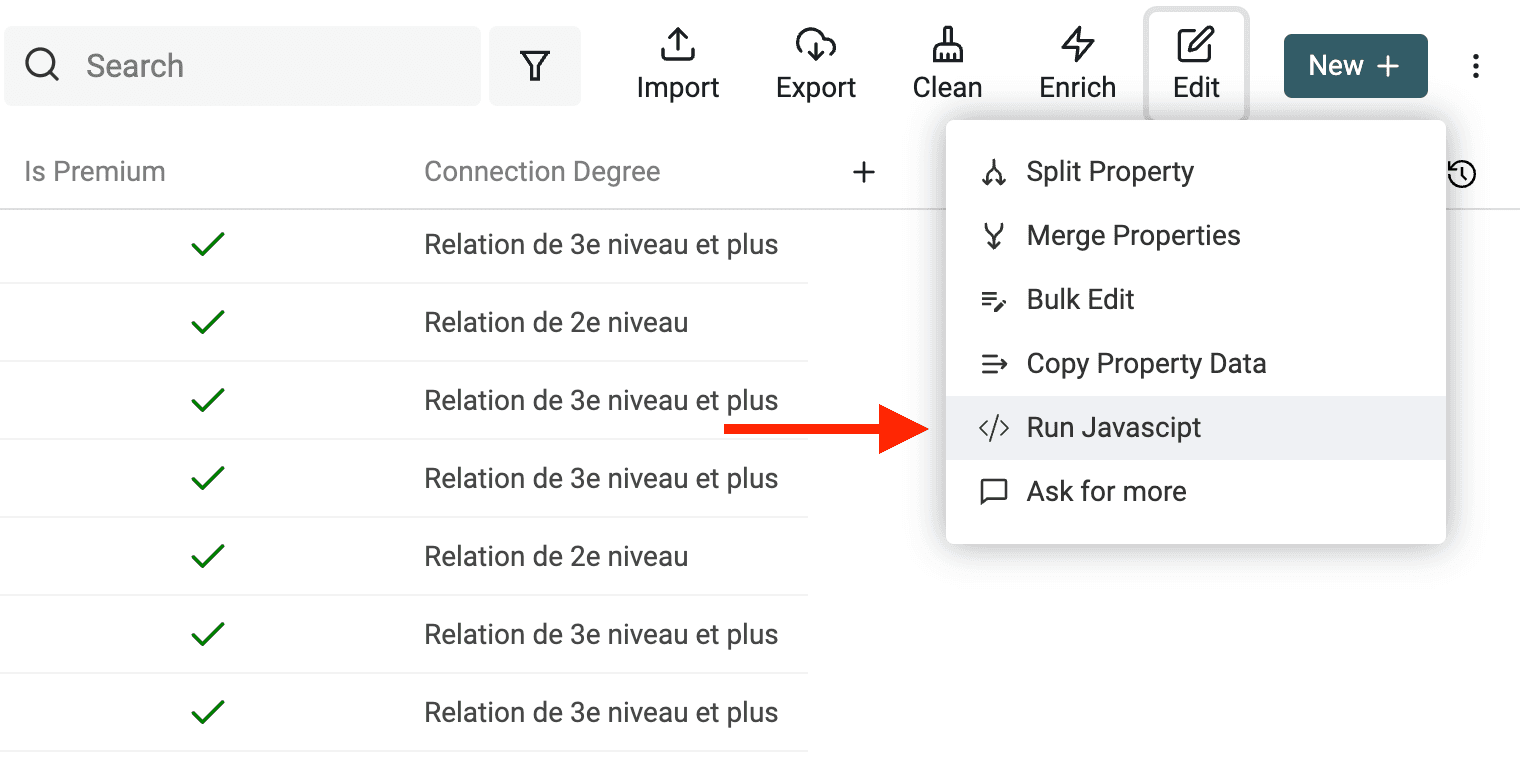
Ouvrez l’éditeur JavaScript en cliquant sur « Run JavaScript » dans le menu « Edit ».
👉 Consultez notre documentation pour apprendre à écrire du code JavaScript.
Valider les adresses email
Les données issues du scraping peuvent être anciennes, contenir des fautes ou être tout simplement invalides. C’est particulièrement vrai pour les adresses email récupérées par scraping.
Lorsque les données sont saisies par les utilisateurs, votre base peut aussi contenir de fausses adresses ou des emails provenant de services jetables.
Datablist intègre un outil de validation qui permet de vérifier des milliers d’adresses email.
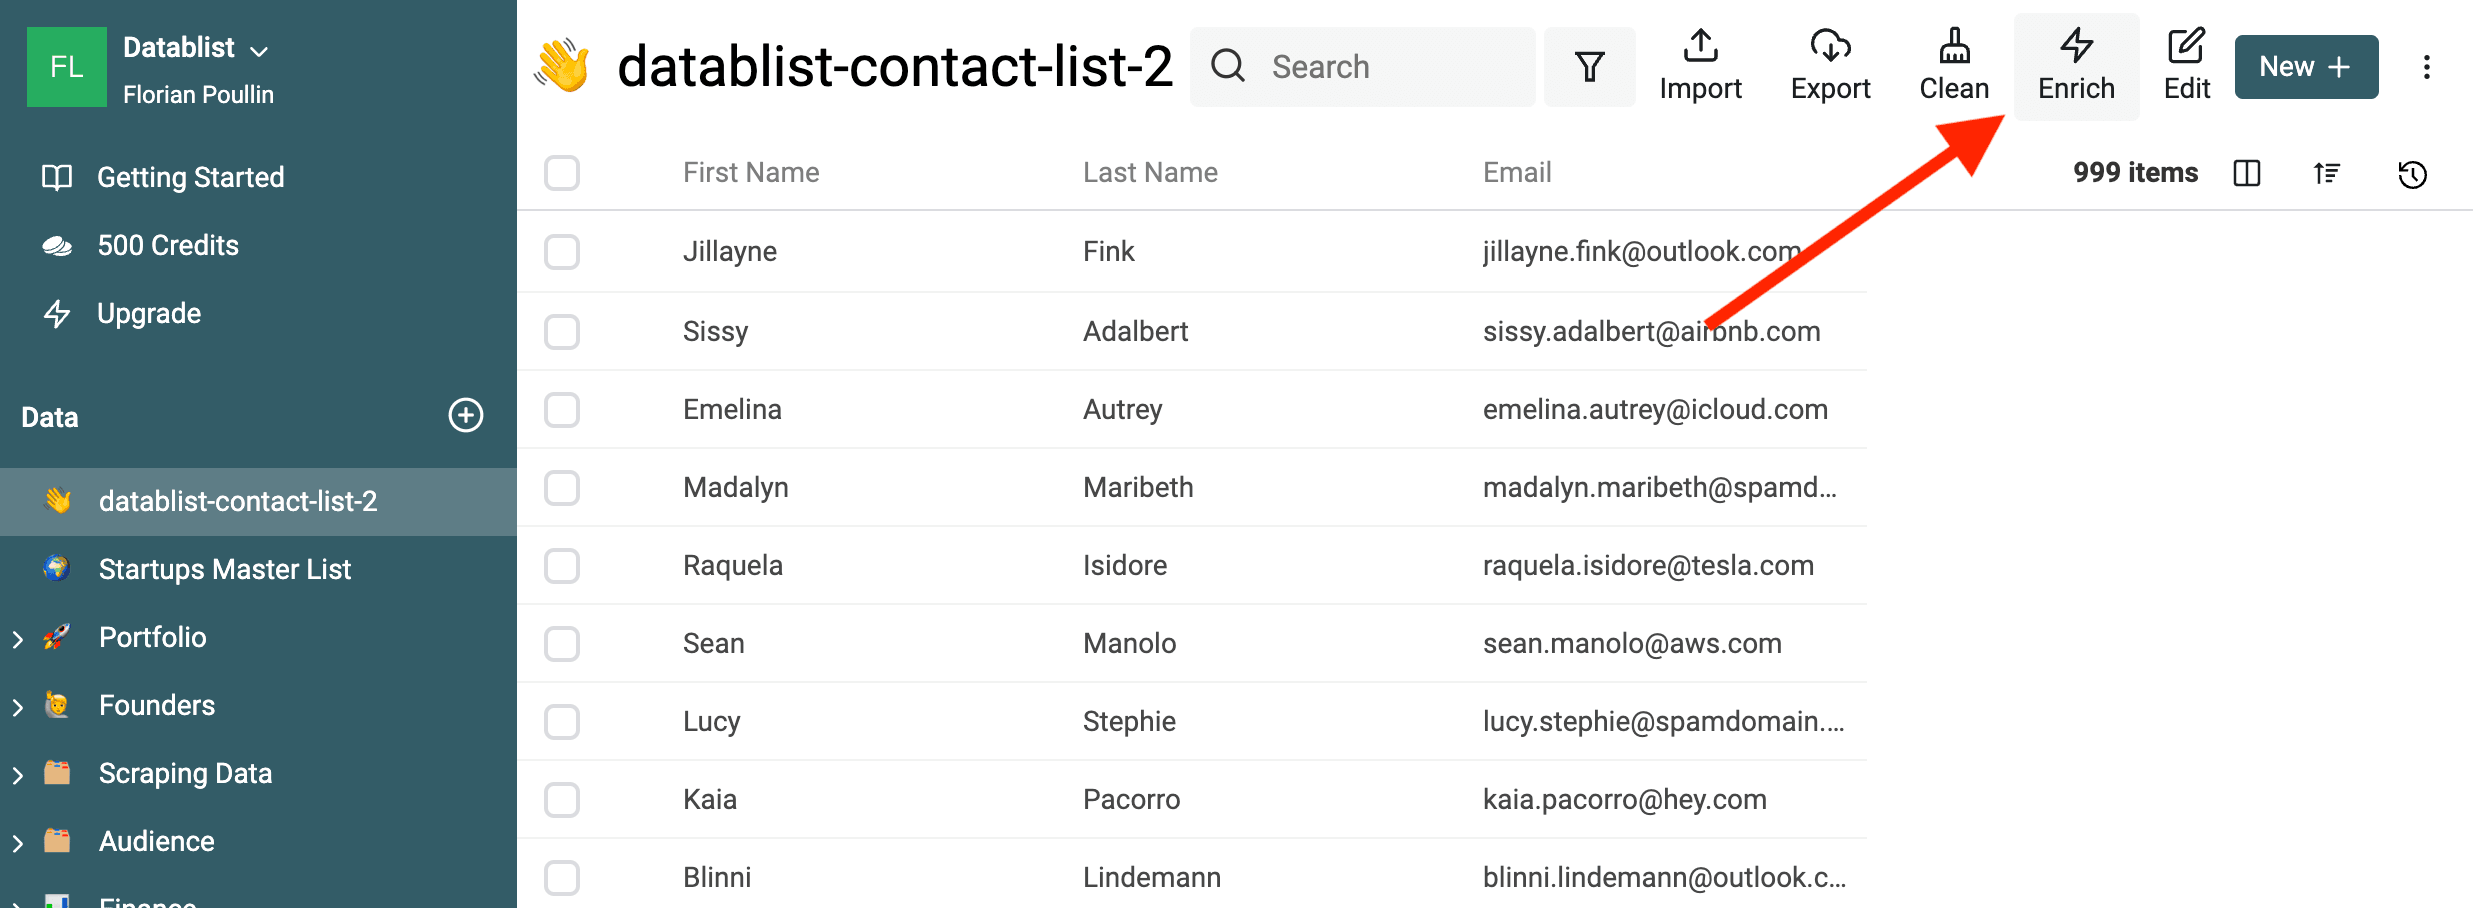
Le service de validation des emails comprend :
- Analyse de la syntaxe de l’email — Le premier contrôle vérifie que l’adresse respecte la norme IETF et effectue une analyse syntaxique complète. Les adresses dépourvues d’arobase (@), associées à un domaine non valide, etc. sont signalées.
- Détection des fournisseurs d’emails jetables — Le deuxième contrôle détecte les adresses temporaires. Le service recherche les domaines appartenant à des fournisseurs de Disposable Email Address (DEA), comme Mailinator, Temp-Mail ou YopMail.
- Vérification des enregistrements MX du domaine — Une adresse email valide doit être associée à un nom de domaine disposant d’enregistrements MX configurés. Ces enregistrements désignent le serveur chargé de recevoir les emails du domaine. Leur absence indique que l’adresse email n’est pas valide. Pour chaque domaine d’adresse email, le service vérifie les enregistrements DNS et recherche les entrées MX. Si le domaine n’existe pas, l’email est signalé comme non valide. Il en va de même si le domaine existe, mais ne possède aucun enregistrement MX valide.
- Segmentation des adresses email professionnelles et personnelles — Avec des prospects issus de lead magnets, ou pour segmenter votre base d’utilisateurs, vous pouvez distinguer les emails professionnels des adresses personnelles. Le service de validation vous fournit cette information afin d’enrichir les données de vos contacts.
👉 Consultez notre guide pour savoir comment nettoyer une liste d’emails.
FAQ
Qu’est-ce que le data cleaning et pourquoi est-il important ?
Le data cleaning, également appelé data cleansing ou nettoyage des données, désigne le processus qui consiste à repérer puis à corriger ou supprimer les erreurs, incohérences et imprécisions d’un jeu de données. Il permet de traiter les valeurs manquantes, les doublons, les erreurs de formatage, les valeurs aberrantes et les différences de représentation des données.
Le nettoyage est une étape essentielle du traitement des données : il garantit que celles-ci sont exactes, fiables et adaptées à l’analyse ou à leur utilisation dans différentes applications.
Quels sont les autres outils gratuits de data cleaning ?
Le marché du data cleaning va des outils généralistes, comme les tableurs, aux applications spécialisées. Voici une sélection d’outils gratuits autres que Datablist que vous pouvez utiliser pour nettoyer vos données.
OpenRefine
OpenRefine, anciennement Google Refine, est un outil open source conçu pour explorer, nettoyer et transformer des données désordonnées ou incohérentes.
OpenRefine est une application desktop autonome compatible avec les fichiers tabulaires CSV et TSV, les fichiers Microsoft Excel ainsi que d’autres formats structurés, comme JSON et XML.
OpenRefine est particulièrement utile pour traiter les fichiers CSV non valides :
- Il gère très bien les problèmes d’encodage CSV
- Il propose des options pour corriger les erreurs de format CSV
Du côté des limites, OpenRefine demande un temps d’apprentissage important et manque de fonctionnalités métier. Il ne propose ni fonction de déduplication ni workflow simple permettant de joindre un jeu de données à une autre liste pour mettre à jour ou consolider les informations. Les fonctionnalités collaboratives, les enrichissements métier et les intégrations sont également limités.
Microsoft Excel et Google Sheets
Microsoft Excel et Google Sheets sont des tableurs puissants qui peuvent servir au nettoyage et à la préparation des données. Malgré quelques différences, ces deux outils offrent de nombreuses fonctionnalités utiles pour nettoyer et transformer des informations.
Vous pouvez utiliser des formules pour transformer et manipuler les données. La mise en forme conditionnelle permet également de mettre en évidence les valeurs non valides qui nécessitent une correction manuelle.
Besoin d’aide pour nettoyer vos données ?
Je suis toujours à la recherche de retours et de nouveaux problèmes de data cleaning à résoudre. N’hésitez pas à me contacter pour partager votre cas d’usage.