
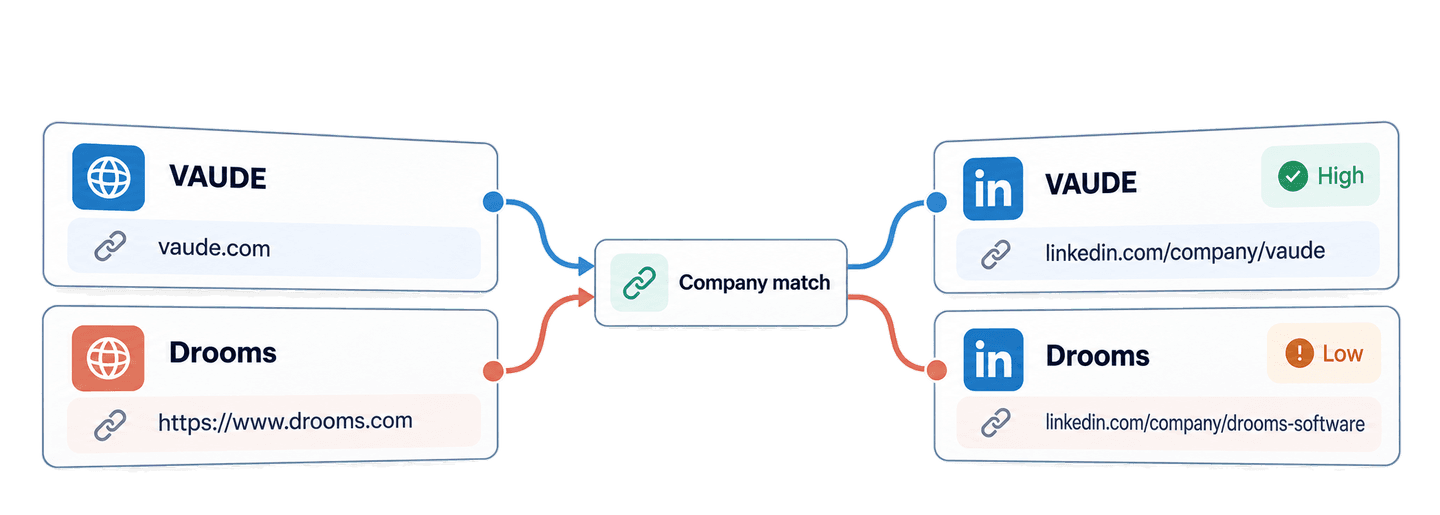
Gebruik Datablists Company to LinkedIn API om met Python vanaf een website de LinkedIn-bedrijfspagina te vinden. Je kunt een los domein of een volledige website-URL versturen, wachten tot de matchingtaak is afgerond en vervolgens de bedrijfsnaam, website, LinkedIn-bedrijfs-URL en een confidence-indicatie ontvangen.
In deze handleiding gebruik ik Python en de Requests-library om vijf bedrijfswebsites te matchen. De lijst bevat bekende softwarebedrijven, maar ook VAUDE, een fabrikant van outdooruitrusting, en Drooms, een aanbieder van virtual data rooms. Daarna verwerk ik de resultaten in twee lokale wachtrijen: matches die klaar zijn voor bedrijfsonderzoek en matches die handmatig moeten worden gecontroleerd.
🔑 Samenvatting voor wie weinig tijd heeft
Stuur de websites uit je accountlijst naar Datablists Company to LinkedIn API. De API retourneert URL’s van LinkedIn-bedrijfspagina’s en confidence-indicaties, zodat je kunt bepalen welke relaties je direct gebruikt en welke je eerst controleert.
- Input: losse domeinen en volledige URL’s van bedrijfswebsites.
- Output: bedrijfsnamen, gematchte websites, URL’s van LinkedIn-bedrijfspagina’s en een
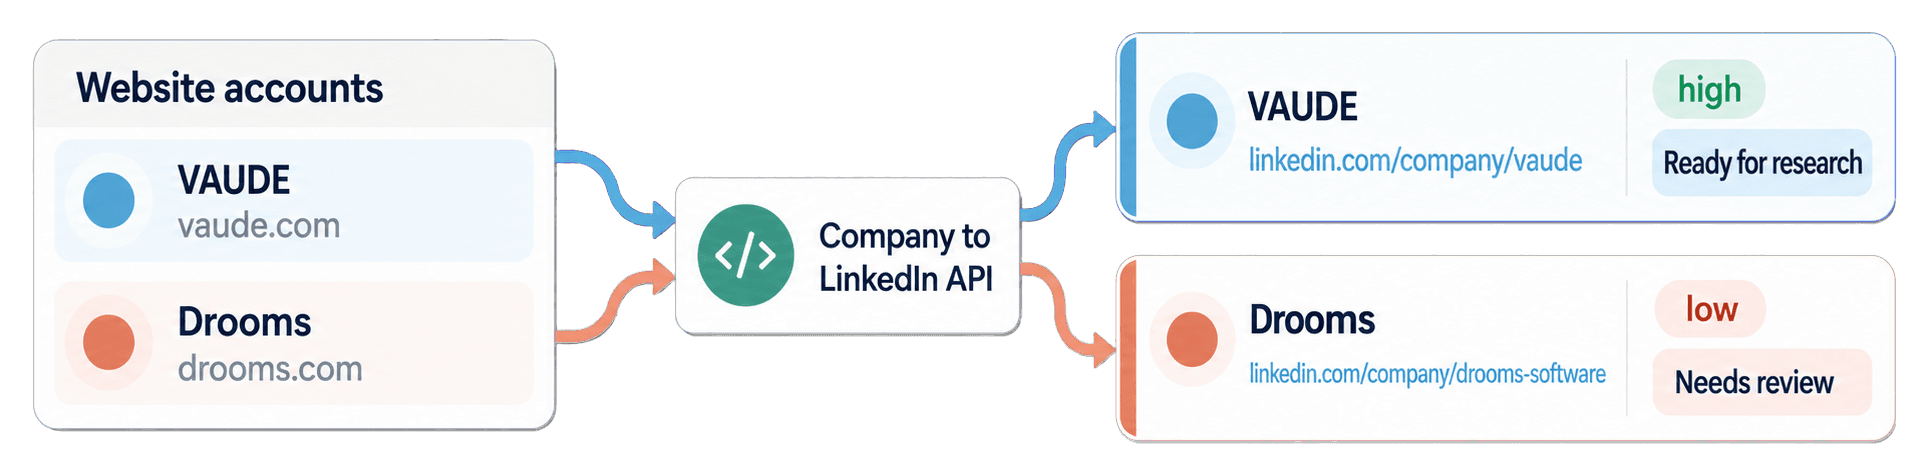
highoflowconfidence, verdeeld over de wachtrijenReady for researchenNeeds review.
💡 Liever een no-code oplossing? Gebruik Datablists LinkedIn Company Pages & Domain Lookup om bedrijfswebsites en LinkedIn-pagina’s te matchen zonder code te schrijven.
Python en je Datablist API-key instellen
Voor dit voorbeeld gebruik ik het package requests. De API werkt via HTTP, dus je kunt dezelfde volgorde van requests later eenvoudig in een andere programmeertaal toepassen.
Je hebt een Datablist-account met toegang tot de REST API nodig. Die toegang is inbegrepen bij het Growth-abonnement. Geslaagde lookups verbruiken daarnaast enrichment credits. Verderop in deze handleiding leg ik de exacte berekening uit.
Maak een werkmap en een bestand met de naam find_linkedin_company_pages.py. Maak vervolgens een virtual environment aan en installeer Requests:
mkdir company-linkedin-matcher
cd company-linkedin-matcher
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
touch find_linkedin_company_pages.pyMaak via je Datablist-account een Personal API Key aan en exporteer deze als environment variable:
export DATABLIST_API_KEY="your-api-key"Het script leest deze waarde uit en verstuurt hem in de X-API-Key-header.
LinkedIn-bedrijfspagina’s vinden met één Python-functie
Het voorbeeld gebruikt deze vijf bronaccounts:
account-datablist:datablist.comaccount-posthog:posthog.comaccount-n8n:https://n8n.ioaccount-vaude:vaude.comaccount-drooms:https://www.drooms.com
Elke account_id wordt de inputId voor de API. Dat is belangrijk, omdat resultaten niet per se in dezelfde volgorde binnenkomen als de input. Met een stabiele ID kun je elk resultaat aan het juiste bronaccount koppelen.
Plak het volgende volledige script in find_linkedin_company_pages.py:
import json
import os
import time
import uuid
import requests
def match_companies(accounts, api_key, matching_direction):
"""Submit one matching task, wait for it, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"sourceUrl": account["source_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "company-to-linkedin",
"uniqueId": unique_id,
"settings": {"matchingDirection": matching_direction},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "datablist.com",
},
{
"account_id": "account-posthog",
"company_name": "PostHog",
"source_url": "posthog.com",
},
{
"account_id": "account-n8n",
"company_name": "n8n",
"source_url": "https://n8n.io",
},
{
"account_id": "account-vaude",
"company_name": "VAUDE",
"source_url": "vaude.com",
},
{
"account_id": "account-drooms",
"company_name": "Drooms",
"source_url": "https://www.drooms.com",
},
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
match_results = match_companies(
accounts, api_key, matching_direction="domain_to_linkedin"
)
print(json.dumps(match_results, indent=2))Voer het script uit met:
python find_linkedin_company_pages.pyDe functie doet achtereenvolgens drie soorten calls.
Eerst verstuurt de POST de vijf websites, met matchingDirection ingesteld op domain_to_linkedin. De API antwoordt met 202 Accepted en een taak-ID, omdat de matching als achtergrondtaak wordt uitgevoerd. Het Requests-script blijft toch sequentieel aanvoelen, omdat het wacht voordat het naar de volgende stap gaat.
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]Vervolgens controleert de statusrequest de taak totdat de status completed, failed of stopped wordt. De pauze van drie seconden voorkomt dat het script continu statusrequests verstuurt.
Tot slot leest de resultatenrequest pagina’s met maximaal 100 resultaten uit. Als nextCursor een waarde bevat, stuurt de loop die bij de volgende request mee als cursor. De loop stopt pas wanneer nextCursor null is.
Matches beoordelen en bepalen wat controle nodig heeft
Hieronder staat de volledige resultatenlijst voor de vijf inputs:
[
  {
    "inputId": "account-datablist",
    "status": "success",
    "outputs": {
      "companyWebsite": "datablist.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/datablist",
      "companyName": "datablist"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-posthog",
    "status": "success",
    "outputs": {
      "companyWebsite": "posthog.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/posthog",
      "companyName": "PostHog"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-n8n",
    "status": "success",
    "outputs": {
      "companyWebsite": "n8n.io",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/n8n",
      "companyName": "n8n"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-vaude",
    "status": "success",
    "outputs": {
      "companyWebsite": "vaude.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/vaude",
      "companyName": "vaude"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-drooms",
    "status": "success",
    "outputs": {
      "companyWebsite": "drooms.com",
      "confidence": "low",
      "companyLinkedInUrl": "https://www.linkedin.com/company/drooms-software",
      "companyName": "Drooms"
    },
    "creditsUsed": "1.5",
    "error": null
  }
]
Lees status en confidence afzonderlijk. De API retourneert voor elke input een resultaatobject, ook als de input geen succesvol resultaat oplevert. De status success betekent dat er een mogelijke bedrijfspagina is gevonden. De waarde van outputs.confidence geeft aan of de match met de website is gevalideerd. inputId koppelt het object aan je bronaccount, creditsUsed registreert de kosten voor die rij en error bevat bij een fout gestructureerde informatie over de oorzaak.
Bewaar het volledige outputs-object in je applicatie, zelfs als je in het eerste scherm alleen de LinkedIn-URL en confidence nodig hebt. companyName en companyWebsite versnellen de handmatige controle, vooral als de geretourneerde bedrijfsnaam anders is geschreven of de input een volledige URL was. Bovendien geven ze nuttige context zonder dat je opnieuw een API-call hoeft te doen.
Het matchingproces normaliseert eerst de ingestuurde website en controleert bedrijfsdatasets op een bekende relatie tussen de website en LinkedIn. Daarna vergelijkt het systeem het inputdomein met de website die op de mogelijke LinkedIn-bedrijfspagina staat. Een match op het geregistreerde domein levert een high confidence op.
Als de datasets geen LinkedIn-URL bevatten, kan de lookup een gerichte Google-zoekopdracht uitvoeren naar mogelijke bedrijfspagina’s. Een kandidaat die niet kan worden gevalideerd aan de hand van een gepubliceerde website, kan met een low confidence worden teruggestuurd. Een bekende mismatch tussen websites wordt niet geaccepteerd.
Beschouw confidence als een instructie voor controle. VAUDE retourneerde https://www.linkedin.com/company/vaude met een high confidence en kan dus direct naar de onderzoekswachtrij. Drooms retourneerde https://www.linkedin.com/company/drooms-software met een low confidence. Open de website en LinkedIn-pagina van Drooms voordat je op deze relatie vertrouwt.
Ook Datablist, PostHog en n8n leverden matches met een hoge confidence op. Deze API vindt de relatie tussen een website en een bedrijfspagina. Heb je na controle van de URL ook de bedrijfsgrootte, branche of andere paginagegevens nodig? Gebruik dan als volgende stap de handleiding voor de LinkedIn company scraper API.
Wachtrij voor account research maken
Gebruik match_results nu opnieuw om een lokale wachtrij voor handmatig bedrijfsonderzoek te maken. Dit codeblok doet geen nieuwe API-call. Het indexeert de resultaten op inputId en loopt daarna door de oorspronkelijke accountlijst, zodat elk bronaccount zichtbaar blijft, zelfs als een toekomstig resultaat ontbreekt.
results_by_id = {result["inputId"]: result for result in match_results}
ready_for_research = []
needs_review = []
for account in accounts:
result = results_by_id.get(account["account_id"])
if result is not None:
outputs = result.get("outputs", {})
else:
outputs = {}
research_record = {
**account,
"companyLinkedInUrl": outputs.get("companyLinkedInUrl"),
"confidence": outputs.get("confidence"),
"api_result": result,
}
is_ready = (
result is not None
and result["status"] == "success"
and outputs.get("companyLinkedInUrl")
and outputs.get("confidence") == "high"
)
if is_ready:
ready_for_research.append(research_record)
else:
needs_review.append(research_record)
print("Ready for research:")
print(json.dumps(ready_for_research, indent=2))
print("Needs review:")
print(json.dumps(needs_review, indent=2))Dankzij de resultatendictionary is de koppeling niet afhankelijk van de volgorde waarin de response binnenkomt. account-vaude koppelt het oorspronkelijke record voor vaude.com aan de gevonden VAUDE-pagina en komt in ready_for_research terecht. account-drooms behoudt de volledige input-URL en het volledige API-resultaat, maar gaat naar needs_review, omdat de confidence laag is, ook al is de resultaatstatus success.
Met dezelfde logica blijft ook een ontbrekende rij of een rij met no_result of een fout in de controlewachtrij staan. De twee geprinte lijsten geven het team een duidelijk vertrekpunt voor handmatig bedrijfsonderzoek.
Je kunt ook het onderhouden synchrone Requests-voorbeeld downloaden. De repository bevat daarnaast een asynchroon HTTPX-voorbeeld voor applicaties die non-blocking HTTP nodig hebben. Voor een eerste integratie is de blocking versie hierboven echter makkelijker te volgen.
Van LinkedIn-bedrijfspagina naar website zoeken
Dezelfde functie accepteert LinkedIn-bedrijfspagina’s wanneer je de matchingrichting wijzigt. Dat is handig als je bronlijst URL’s van bedrijfspagina’s bevat en je eerst websites nodig hebt voor een compatibele bedrijfs- of werkmail-enrichment.
linkedin_accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "https://www.linkedin.com/company/datablist",
}
]
website_results = match_companies(
linkedin_accounts,
api_key,
matching_direction="linkedin_to_domain",
)Voor een standaardlookup van een LinkedIn-bedrijfspagina geldt het normale matchingtarief. Numerieke bedrijfs-ID’s en bedrijfs-URL’s uit Sales Navigator kunnen 10 credits kosten, omdat ze een ander reverse-lookuptraject volgen. Bekijk voor een no-code versie van deze richting hoe je website-URL’s uit LinkedIn-bedrijfspagina’s haalt.
Credits voor website-naar-LinkedIn-lookups berekenen
Een geslaagde reguliere website-naar-LinkedIn-lookup kost 1,5 credits. De vijf getoonde matches hebben dus 7,5 credits verbruikt. Tegen hetzelfde tarief kosten 1.000 geslaagde matches 1.500 credits. Ongeldige inputs en rijen zonder resultaat kunnen nul credits kosten. Controleer daarom bij elk resultaat de waarde van creditsUsed voor het werkelijke verbruik.
Toegang tot de REST API maakt deel uit van het Growth-abonnement. Het maandabonnement staat los van aanvullende credits. Met een top-up van $ 20 krijg je 20.000 credits, waardoor één credit $ 0,001 kost. Bij 1,5 credits per geslaagde match kosten 1.000 matches 1.500 credits, oftewel $ 1,50. Bekijk de prijzen van Datablist voor de actuele abonnementen en pakketten.
Veelvoorkomende problemen met input, taken en resultaten oplossen
DATABLIST_API_KEYontbreekt: het script stopt voordat het een request verstuurt. Exporteer de environment variable en voer het commando opnieuw uit.- De API weigert de key: controleer of je een Personal API Key hebt gekopieerd en of de request deze uitsluitend in
X-API-Keyverstuurt. - De input wordt niet ondersteund: gebruik voor
domain_to_linkedineen bedrijfswebsite of domein. Gebruik voor de omgekeerde richting een ondersteunde URL van een bedrijfspagina, geen persoonlijk profiel of lege waarde. - Je hebt onvoldoende credits: controleer je saldo en gebruik daarna de inbegrepen credits of voeg een top-up toe voordat je een nieuwe taak aanmaakt.
- De taak heeft de status
failedofstopped: bekijk de taakstatus, foutmelding, bestaande resultaten en het creditverbruik voordat je besluit de taak opnieuw in te sturen. - Een resultaat heeft een lage confidence,
no_resultof een fout: bewaar de bronwebsite en het volledige resultaat inneeds_review. Open de mogelijke pagina als die bestaat en ga niet speculeren over de oorzaak van een ontbrekend resultaat.
Als de verbinding tijdens het aanmaken van de taak wegvalt, gebruik je de uniqueId die vóór de POST is geprint. Vraag je takenlijst op en zoek naar die waarde voordat je een nieuwe taak aanmaakt:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-to-linkedin" \
--data-urlencode "limit=100"Je kunt de takenlijst niet filteren op uniqueId. Controleer daarom elke geretourneerde taak en volg indien nodig nextCursor. Zodra je de bijbehorende waarde hebt gevonden, gebruik je de @id met dezelfde status- en resultaat-URL’s als in het script.
Eén taak kan maximaal 10.000 inputs bevatten. Raadpleeg de Company to LinkedIn API-documentatie voor alle limieten voor requests, taakretentie en paginering.
Volgende stappen
Je hebt nu één herbruikbare Python Requests-functie die bedrijfswebsites omzet in mogelijke LinkedIn-bedrijfspagina’s. In de lokale wachtrij blijven matches met een hoge confidence klaarstaan voor onderzoek, terwijl onzekere of mislukte records zichtbaar blijven voor controle.
Vervang de vijf voorbeelden door een kleine accountlijst en controleer elke kandidaat met een lage confidence. Gebruik de goedgekeurde URL’s daarna voor handmatig bedrijfsonderzoek of als input voor de LinkedIn company scraper API. Bevat je bronlijst bedrijfsnamen in plaats van websites? Begin dan met de handleiding voor de company website finder API.