
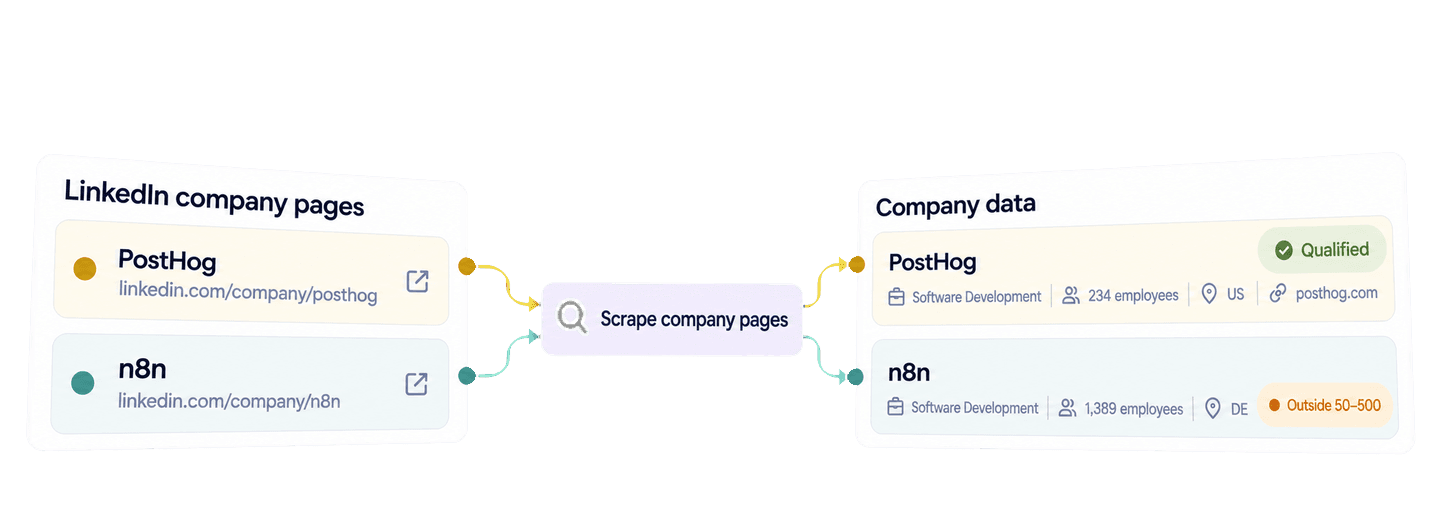
Je kunt LinkedIn-bedrijfsgegevens scrapen in Python door met de Requests-library een lijst met URL's van bedrijfspagina's naar de API van Datablist te sturen. De API retourneert gestructureerde bedrijfsrecords met beschikbare velden zoals branche, aantal medewerkers, hoofdkantoor, website en beschrijving.
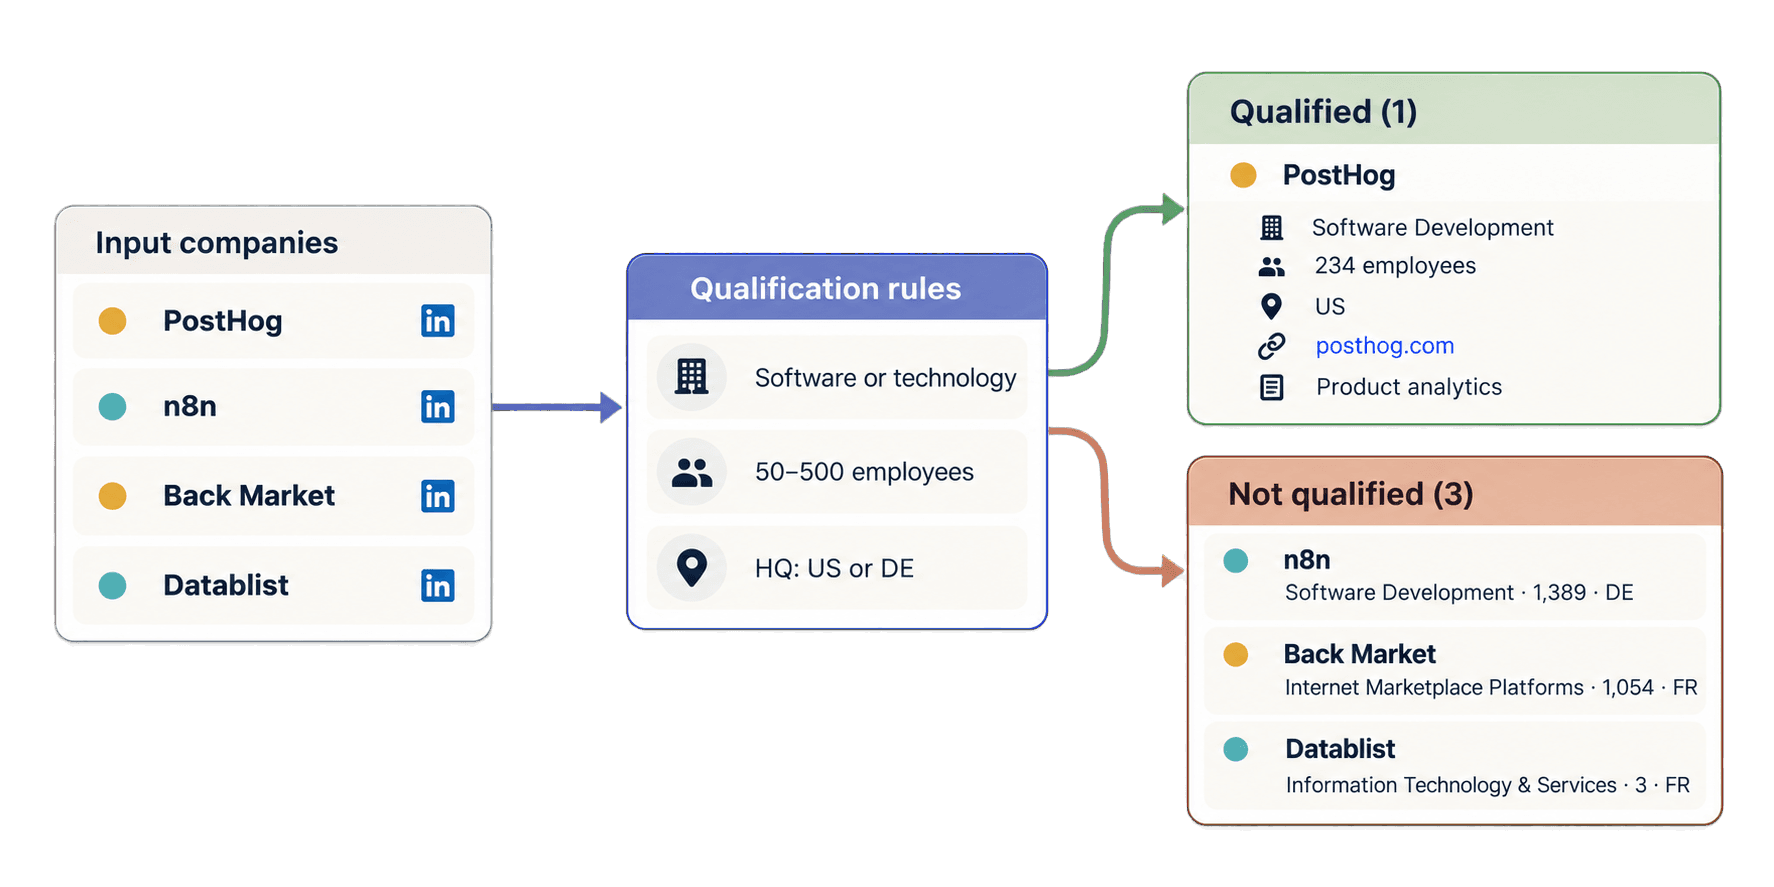
In deze handleiding gebruik ik één overzichtelijke Python-functie om records voor n8n, PostHog, Back Market en Datablist op te halen. Vervolgens hergebruik ik die resultaten om softwarebedrijven met 50 tot 500 medewerkers en een hoofdkantoor in de Verenigde Staten of Duitsland te kwalificeren. Het gekwalificeerde record behoudt de website en beschrijving voor uitgebreider salesonderzoek.
🔑 Samenvatting voor wie weinig tijd heeft
Datablist zet gecontroleerde URL's van LinkedIn-bedrijfspagina's om in gestructureerde bedrijfsrecords die je in een workflow voor salesonderzoek kunt gebruiken. Het onderstaande Python-voorbeeld haalt alle resultaatpagina's op en past daarna lokaal een accountfilter toe, zonder een tweede API-call.
- Input: URL's van LinkedIn-bedrijfspagina's.
- Output: Beschikbare bedrijfsgegevens en een lokale kwalificatiebeslissing, waarbij de oorspronkelijke URL en de volledige bedrijfsoutput bij elkaar blijven.
💡 Liever een no-code-oplossing? Gebruik Datablist's LinkedIn Company Page Scraper om zonder code bedrijfsvelden uit bekende URL's van LinkedIn-bedrijfspagina's te halen.
Python en je Datablist API-key instellen
Voor dit Python-voorbeeld gebruik ik het package requests. Datablist's REST API is beschikbaar binnen het Growth-abonnement en elke zoekopdracht voor een bedrijfspagina verbruikt enrichment credits.
Maak een Personal API Key aan via de API-accountpagina van Datablist.
Maak een bestand met de naam scrape_linkedin_companies.py, bereid daarna een virtual environment voor en installeer Requests:
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
export DATABLIST_API_KEY="your-api-key"Het script leest de key uit DATABLIST_API_KEY en verstuurt deze in de X-API-Key-header.
LinkedIn-bedrijfspagina's scrapen met één Python-functie
De onderstaande bronlijst bevat bedrijven uit verschillende branches, van uiteenlopende omvang en met hoofdkantoren in verschillende landen. Elke account_id wordt de inputId van de API. Resultaten worden niet op basis van hun positie in de response gekoppeld. Deze stabiele ID verbindt daarom elk resultaat met de juiste bron-URL.
Plak dit volledige script in scrape_linkedin_companies.py:
import json
import os
import time
import uuid
import requests
accounts = [
{
"account_id": "account-n8n",
"linkedin_company_url": "https://www.linkedin.com/company/n8n/",
},
{
"account_id": "account-posthog",
"linkedin_company_url": "https://www.linkedin.com/company/posthog/",
},
{
"account_id": "account-back-market",
"linkedin_company_url": "https://www.linkedin.com/company/back-market/",
},
{
"account_id": "account-datablist",
"linkedin_company_url": "https://www.linkedin.com/company/datablist/",
},
]
def scrape_companies(accounts, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"companyLinkedInUrl": account["linkedin_company_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Request ID: {unique_id}")
payload = {
"enrichmentId": "linkedin-company-enrichment",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
company_results = scrape_companies(accounts, api_key)
print(json.dumps(company_results, indent=2, ensure_ascii=False))Voer het script uit met:
python scrape_linkedin_companies.pyDe belangrijkste waarden die je moet aanpassen, zijn de records in accounts. Houd elke account_id stabiel en uniek en vervang linkedin_company_url vervolgens door een gecontroleerde LinkedIn-bedrijfspagina. De functie zet deze records om in het inputs-formaat van de API en verstuurt de bedrijfs-URL als companyLinkedInUrl. settings blijft leeg, omdat deze enrichment geen openbare instellingen heeft.
De POST maakt een enrichment task op de achtergrond aan. De API antwoordt met 202 Accepted en een task-ID, terwijl de Requests-client wacht door regelmatig de status-URL op te vragen. Deze blokkerende Python-code is handig voor een klein script, maar aan de kant van Datablist wordt de task nog steeds asynchroon uitgevoerd.
De eerste GET controleert de task zelf. Een task kan eindigen als completed, failed of stopped. Het script gaat alleen verder na completed; anders wordt een fout gegenereerd met de task-ID en de taskfout van de API. Bewaar die ID tijdens je onderzoek, want een mislukte of gestopte task kan nog steeds resultaten en te controleren creditverbruik bevatten.
Zodra de task is voltooid, haalt de laatste loop resultaatpagina's op met een limiet van 100. De volgende pagina wordt opgehaald totdat nextCursor null is. Elk resultaat behoudt de door jou aangeleverde inputId. Daardoor kan de latere kwalificatieloop resultaten correct koppelen, zelfs als de volgorde in de response afwijkt van de inputvolgorde.
Bedrijfsresultaten en de ophaalmethode begrijpen
De LinkedIn-URL identificeert het bedrijf rechtstreeks. Datablist normaliseert deze organisatie-URL en haalt de beschikbare openbare gegevens van de bedrijfspagina op, in plaats van meerdere mogelijke bedrijven te zoeken en te beoordelen. Bij een URL van een specifiek bedrijf begint het proces bij de openbare pagina. Niet-gevonden velden kunnen vanuit beheerde fallback-bronnen worden aangevuld, terwijl bruikbare, eerder gevonden waarden behouden blijven.
Dat onderscheid is belangrijk bij het lezen van het resultaat. Optionele velden hangen af van wat openbaar beschikbaar is. Een null-adres voor het hoofdkantoor of een ontbrekende specialisatie betekent niet dat de volledige bedrijfszoekopdracht is mislukt.
Dit is de volledige resultaatpagina die voor de vier URL's werd geretourneerd:
{
  "taskId": "69516a973dc34481920f41ade748e917",
  "results": [
    {
      "inputId": "account-n8n",
      "status": "success",
      "outputs": {
        "companyName": "n8n",
        "companyHQPostalCode": "10115",
        "companyDescription": "n8n is a workflow automation platform that uniquely combines AI capabilities with business process automation. The platform enables connection to any app or API while maintaining the flexibility of code with the speed of no-code.\n\nReleased under a fair-code license, n8n can be self-hosted and is supported by a vibrant community of developers and builders. Users can start simple and layer complexity as needed - utilizing the visual builder for quick wins, and adding custom Javascript or Python code where more control is required, enabling the connection of anything to everything.\n\nn8n is privately held, with funding from Sequoia, Felicis Ventures, Firstminute Capital, Harpoon Ventures, and others. Individual investors include Eventbrite's Kevin Hartz and Supercell's IIkka Paananen. n8n was founded in 2019 and is headquartered in Berlin.",
        "companyTagline": "Flexible AI workflow automation for technical teams.",
        "companyIndustry": "Software Development",
        "companySpecialities": "AI, SOAR, Workflow Automation, and AI agents",
        "companyWebsite": "https://n8n.io",
        "companyHQCity": "Berlin",
        "linkedInCompanyId": "28491094",
        "companyType": "Privately Held",
        "companyHQCountry": "DE",
        "companySize": 1389,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4D0BAQEgEphZqatXwA/company-logo_200_200/B4DaFY.Sa2JcAE-/0/1792494086070/n8n_logo?e=2147483647&v=beta&t=NTL4C6f5QAd_o9nXd15PO8pOMSSEoms_tJdDHEo6eLk",
        "companyHQAddress": "Novalisstraße 10",
        "companyFoundedYear": 2019,
        "companyFollowerCount": 442229
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-posthog",
      "status": "success",
      "outputs": {
        "companyName": "PostHog",
        "companyHQPostalCode": null,
        "companyDescription": "At PostHog, we're working to increase the number of successful products in the world.\n\nUntil now, tools for building products have been fragmented. Product analytics, heatmaps, session recording, web analytics, feature flags, and A/B testing are all helpful, but no one wants to buy, send data to, and integrate multiple products.\n\nPostHog offers these tools (and more) in an integrated, open source platform which can be hosted in either the US or EU. Both versions are SOC2 certified, GDPR-ready, and HIPAA compliant. \n\nWe started PostHog during Y Combinator's W20 cohort and had the most successful B2B software launch on Hacker News since 2012 - with a product that was just 4 weeks old.\n\nWith over 100,000 users, we're default alive, growing 97% through word of mouth, and we are in the top 0.01% most popular repos on GitHub.",
        "companyTagline": "Your product's context layer. Get started with npx @posthog/wizard",
        "companyIndustry": "Software Development",
        "companySpecialities": "analytics, open source, product analytics, product, data, engineering, self-driving product, session replay, context warehouse, AI, product context, and error tracking",
        "companyWebsite": "https://posthog.com/",
        "companyHQCity": "San Francisco",
        "linkedInCompanyId": "37415928",
        "companyType": "Privately Held",
        "companyHQCountry": "US",
        "companySize": 234,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D560BAQGQUyE_CXUxIw/company-logo_200_200/B56aCMWEgaJAAE-/0/1789060991251/posthog_logo?e=2147483647&v=beta&t=WfTGRSqp5UfYL33sBXx3tZ1zmFUECfUPf7JtEGPAvbA",
        "companyHQAddress": null,
        "companyFoundedYear": 2020,
        "companyFollowerCount": 59696
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-back-market",
      "status": "success",
      "outputs": {
        "companyName": "Back Market",
        "companyHQPostalCode": null,
        "companyDescription": "The world is waking up to what fast tech costs. Back Market is where the revolution shops. \nWe make refurbished tech the smart, confident choice by building trust in quality, repair and circularity. New is not always better. Smarter is.\n\nAs a certified B Corp, our mission is to create a world that does more with what we already have by prolonging the lifespan of electronic devices through circularity and repair. We have grown by double digits year over year and now serve 18 million customers across 17 markets, avoiding more than 2 million tons of CO2 emissions*\n*Back Market calculation based on ADEME 2022 methodology.\n\nFounded in Paris in 2014 by Thibaud Hug de Larauze, Quentin Le Brouster and Vianney Vaute, Back Market is a leading global marketplace where people can buy professionally refurbished technology or trade in their devices.\n\nAre you ready to join us?",
        "companyTagline": "Where the world shops refurbished tech.",
        "companyIndustry": "Internet Marketplace Platforms",
        "companySpecialities": "refurbished tech, marketplace, sustainability, circularity, Right to Repair, sustainable solutions, refurbished marketplace, circular economy, and sustainable alternatives",
        "companyWebsite": "http://www.backmarket.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "4793443",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 1054,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4E0BAQHRv6UClt5D2g/company-logo_200_200/B4EZnoUG3tKgAI-/0/1760539209613/back_market_logo?e=2147483647&v=beta&t=Pywpeu1Qs3h0Cl8kgvYurmBfXbImm5QIIc-aQog1MqM",
        "companyHQAddress": null,
        "companyFoundedYear": 2014,
        "companyFollowerCount": 101878
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-datablist",
      "status": "success",
      "outputs": {
        "companyName": "Datablist",
        "companyHQPostalCode": null,
        "companyDescription": "When people hear \"data,\" they think of something complicated. We will change this.\n\nDatablist is an AI-powered spreadsheet that helps you: get, manipulate, or clean data and create workflows that run automatically while you focus on what matters most.\n\nIf you want to separate Datablist.com into its main parts, you can say we have:\n\n- Deduplicating, grouping, and labeling data\n- Cleaning and editing data\n- Managing data and automated workflows\n- 50+ B2B data sources and scrapers\n- 3 AI agents:\n    - Editing assistant\n    - AI Research agent\n    - Deduplication assistant\n\nThe top 3 reasons why companies choose Datablist.com are:\n\n1. Simplicity: you don't need to have technical knowledge or experience with formulas to get everything out of it.\n2. Flexibility that allows you to do (almost) everything with your data and AI while keeping everything under your control.\n3. Scalability that no other solution can match. Up to 2 million rows—forget Excel.\n\nGo on try it for free!\n\nhttps://www.Datablist.com",
        "companyTagline": "Let your tasks become workflows: automated workflows.",
        "companyIndustry": "Information Technology & Services",
        "companyWebsite": "https://www.datablist.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "69842428",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 3,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/C4E0BAQFNFlMb8KEPRQ/company-logo_200_200/company-logo_200_200/0/1630622803412?e=2147483647&v=beta&t=UVkk7BOerChiWgS9Y06zOpT08SlK4kpAWGDYiVvUEVU",
        "companyFollowerCount": 134,
        "companyFoundedYear": 2020,
        "companyHQAddress": null
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
Alle vier de rijen waren succesvol en verbruikten elk 25 credits. Voor PostHog werden Software Development, 234 medewerkers, een hoofdkantoor in de VS, de website en de beschrijving geretourneerd. n8n is eveneens een softwarebedrijf in een geselecteerd land, maar het geretourneerde aantal medewerkers is 1.389. Voor Back Market werden Internet Marketplace Platforms, 1.054 medewerkers en een hoofdkantoor in Frankrijk geretourneerd. Voor Datablist waren dat Information Technology & Services, 3 medewerkers en een hoofdkantoor in Frankrijk.
Het volledige object is nuttig, omdat account research zelden bij één veld stopt. Je kunt kwalificeren op branche, aantal medewerkers en land, terwijl je de exact geretourneerde website en beschrijving bewaart voor de volgende onderzoeksstap.
In deze response is companySize het geretourneerde aantal medewerkers, niet een LinkedIn-categorie voor bedrijfsgrootte. companyHQCountry is de locatie van het hoofdkantoor, niet elk land waarin het bedrijf actief is. Deze verschillen zijn belangrijk wanneer je de filters voor grootte en land aanpast aan je ideal customer profile.
Niet alle optionele velden hoeven aanwezig te zijn om een account te kwalificeren. Een ontbrekend adres of specialisme kan leeg blijven als de branche, het aantal medewerkers en het land van het hoofdkantoor wel beschikbaar zijn. Bewaar companyWebsite zoals deze is geretourneerd, in plaats van ervan uit te gaan dat de API de URL omzet naar een kaal domein. De beschrijving helpt een sales researcher om het product van een bedrijf te begrijpen en accountspecifiek onderzoek voor te bereiden vóór de outreach. Bewaar bij het controleren of opslaan van het record ook status, creditsUsed en error op resultaatniveau naast de bedrijfsvelden.
Accounts kwalificeren voor salesonderzoek
Stel dat je doelgroep bestaat uit software- of technologiebedrijven met 50 tot 500 medewerkers en een hoofdkantoor in de VS of Duitsland. Voeg deze loop onder het volledige script toe. De loop hergebruikt company_results en verstuurt dus geen nieuwe task:
accounts_by_id = {account["account_id"]: account for account in accounts}
qualified_accounts = []
other_accounts = []
for result in company_results:
account = accounts_by_id.get(result["inputId"])
qualification = "needs_review"
if result["status"] == "success":
outputs = result["outputs"]
industry = outputs.get("companyIndustry")
company_size = outputs.get("companySize")
country = outputs.get("companyHQCountry")
if industry and isinstance(company_size, (int, float)) and country:
industry_matches = any(
keyword in industry.lower()
for keyword in ("software", "technology")
)
size_matches = 50 <= company_size <= 500
country_matches = country in {"US", "DE"}
if industry_matches and size_matches and country_matches:
qualification = "qualified"
else:
qualification = "not_qualified"
source_url = None
if account is not None:
source_url = account["linkedin_company_url"]
reviewed_account = dict(result)
reviewed_account["sourceLinkedInUrl"] = source_url
reviewed_account["qualification"] = qualification
if qualification == "qualified":
qualified_accounts.append(reviewed_account)
else:
other_accounts.append(reviewed_account)
print(json.dumps(qualified_accounts, indent=2, ensure_ascii=False))PostHog wordt weer aan account-posthog gekoppeld, zelfs als de API de rijen in een andere volgorde retourneert. Het account wordt gekwalificeerd omdat Software Development, 234 medewerkers en US aan alle drie de voorwaarden voldoen. De loop kopieert het oorspronkelijke resultaat met de volledige outputs, de geretourneerde website https://posthog.com/, de beschrijving, creditsUsed en error. Alleen de bron-URL en het lokale kwalificatielabel worden toegevoegd.
n8n wordt gekoppeld aan account-n8n en kwalificeert niet, omdat 1.389 medewerkers boven de bovengrens ligt. Back Market voldoet niet aan de gekozen branche-, grootte- en landcriteria, terwijl Datablist onder het vereiste aantal medewerkers zit en buiten de geselecteerde landen valt. Toekomstige mislukte of onvolledige rijen krijgen needs_review in plaats van stilzwijgend te worden verwijderd.
Je kunt het onderhouden synchrone Requests-voorbeeld downloaden of het asynchrone HTTPX-alternatief uit de repository gebruiken wanneer je niet-blokkerende applicatiecode nodig hebt.
Credits voor LinkedIn-bedrijfsdata berekenen
Een standaard LinkedIn-bedrijfspagina met een bedrijfsnaam kost 25 credits. Een bedrijfs-URL met een numerieke ID kan 75 credits kosten wanneer de laatste fallback nodig is, maar niet elke numerieke URL kost 75 credits. Ook mislukte zoekopdrachten of zoekopdrachten zonder match kunnen credits verbruiken. Gebruik daarom het tasktotaal en de waarde creditsUsed van elk resultaat als registratie van het werkelijke verbruik.
De vier URL's met bedrijfsnamen in deze handleiding verbruikten samen 100 credits. Tegen het standaardtarief kosten 1.000 bedrijfspagina's 25.000 credits. Bij input met veel numerieke ID's moet je meer ruimte reserveren voor het mogelijke traject van 75 credits.
Voor toegang tot de REST API heb je het Growth-abonnement nodig. Het maandabonnement bevat 20.000 credits en extra top-up credits koop je afzonderlijk. Bij het huidige basistarief in Amerikaanse dollars van $ 20 voor 20.000 top-up credits kost één credit $ 0,001. Tegen dat tarief zijn 25.000 credits $ 25 waard. Bekijk de prijzen van Datablist voor de actuele abonnementen en creditbundels.
Veelvoorkomende problemen met input, tasks en resultaten oplossen
DATABLIST_API_KEYontbreekt: het script stopt voordat er een request wordt verstuurd. Exporteer de variabele en voer het bestand opnieuw uit.- De API weigert de key: controleer je Personal API Key en laat deze in de
X-API-Key-header staan die in het voorbeeld wordt gebruikt. - De bron-URL is ongeldig: vervang een persoonlijk profiel, een niet-gerelateerde website, een lege waarde of een verkeerd opgemaakte URL door een ondersteunde openbare URL van een LinkedIn-bedrijf, school, showcase, numerieke bedrijfs-ID of Sales Navigator-bedrijf.
- Er zijn onvoldoende credits: controleer je saldo en gebruik daarna de inbegrepen credits of voeg een top-up toe voordat je een nieuwe task aanmaakt.
- De task heeft de status
failedofstopped: controleer de fout, bestaande resultaten en het creditverbruik voordat je besluit nog een betaalde task te versturen. - Een resultaat is beperkt,
no_resultoferror: bewaar de bron-URL, status, credits en fout voor controle. Bevestig vóór een nieuwe poging dat de input een openbare bedrijfspagina is, zonder te gokken waarom de gegevens niet beschikbaar waren.
Als de response bij het aanmaken verloren gaat, gebruik je de request-ID die het script vóór de POST heeft weergegeven. Vraag eerst de lijst met tasks op en zoek de bijbehorende waarde in uniqueId:
curl "https://api.datablist.com/v1/enrichments/tasks?limit=100" \
-H "X-API-Key: $DATABLIST_API_KEY"De @id van de overeenkomende task is de task-ID. Gebruik deze om /v1/enrichments/tasks/{taskId} te blijven controleren of om /v1/enrichments/tasks/{taskId}/results op te halen, in plaats van automatisch een nieuwe task aan te maken. Eén request kan maximaal 10.000 inputs en 10 MiB bevatten. Raadpleeg de taskdocumentatie voor bewaartermijnen en andere details over de lifecycle.
Volgende stappen
Je hebt nu één herbruikbare Python Requests-functie die een lijst met URL's van LinkedIn-bedrijfspagina's omzet in gestructureerde bedrijfsrecords. Daarnaast heb je een lokale kwalificatieloop die de volledige API-output voor salesonderzoek bewaart.
Vervang de vier voorbeelden door een kleine, gecontroleerde accountlijst, behoud stabiele ID's en pas de regels voor branche, aantal medewerkers en land aan je ideal customer profile aan. Zijn personen in plaats van bedrijven je uitgangspunt? Gebruik dan de API-handleiding voor de LinkedIn profile scraper. Heb je alleen bedrijfsnamen, begin dan met het vinden van bedrijfswebsites in Python.