
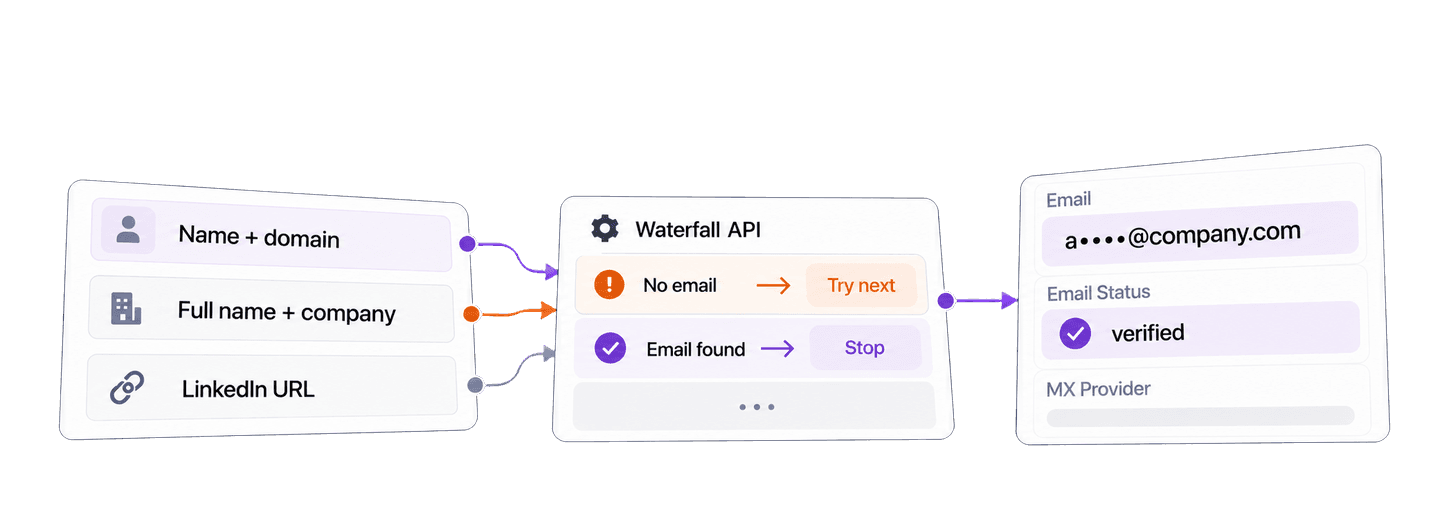
For å finne jobb-e-postadresser i Python sender du personens navn og bedriftsinformasjon, eller URL-en til en offentlig LinkedIn-profil, til Datablists Waterfall Email Finder API ved hjelp av Requests-biblioteket. API-et returnerer jobb-e-postadressen det finner, leveringsstatusen for adressen og e-postleverandøren.
Det komplette eksemplet nedenfor søker etter Satya Nadella hos microsoft.com og Reid Hoffman hos greylock.com. Det venter på bakgrunnsoppgaven og henter alle resultatsidene. Deretter bruker jeg resultatene til å lage en lokal liste over verifiserte kontakter som kan gjennomgås før en kampanje.
📌 Kort oppsummert for deg som har det travelt
Bruk én Python-funksjon til å sende kjente kontakter til Waterfall Email Finder API, vent på at oppgaven fullføres, og hent jobb-e-postadressene som blir funnet. Klargjør deretter verifiserte kontakter for kampanjegjennomgang, samtidig som uløste kontakter beholdes i kildelisten.
- Input: Fornavn og etternavn med et bedriftsdomene, fullt navn med bedriftsnavn eller URL-en til en offentlig LinkedIn-profil.
- Output: En jobb-e-postadresse med
emailStatusogmxProvider, etterfulgt av en lokal gjennomgangsliste som bare inneholder kontakter med e-postadresse.
💡 Foretrekker du en no-code-løsning? Bruk Datablists Waterfall Email Finder til å finne jobb-e-postadresser fra en samling uten å skrive kode.
Konfigurer Python, Requests og API-nøkkelen din
I dette Python-eksemplet bruker jeg pakken requests. Opprett en fil med navnet find_work_emails.py, og installer deretter Requests:
python -m pip install requestsOpprett en Personal API Key på API-kontosiden din hos Datablist. Tilgang til REST API krever Growth-abonnementet. Eksporter nøkkelen i terminalen der du skal kjøre skriptet:
export DATABLIST_API_KEY="your-api-key"Vellykkede resultater fra Waterfall Email Finder bruker også credits. Kostnadsdelen nedenfor skiller disse creditsene fra abonnementet som gir API-tilgang.
Finn jobb-e-poster med én Python-funksjon
Lim inn hele skriptet nedenfor i find_work_emails.py:
import json
import os
import time
import uuid
import requests
def find_emails(people, api_key, settings):
"""Submit one email-finder task, wait, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-email-finder",
"uniqueId": unique_id,
"settings": settings,
"inputs": people,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
},
{
"inputId": "contact-reid-hoffman",
"data": {
"firstName": "Reid",
"lastName": "Hoffman",
"companyNameOrDomain": "greylock.com",
},
},
]
lookup_results = find_emails(people, api_key, settings)
for result in lookup_results:
print(json.dumps(result, indent=2))Kjør det fra den samme terminalen:
python find_work_emails.pyDu kan også laste ned det vedlikeholdte Requests-eksemplet. Når du har forstått den blokkerende versjonen, finner du også et asynkront HTTPX-alternativ i repositoryet.
Funksjonen utfører tre typer kall i denne rekkefølgen.
Først sender den inn oppgaven. Hver inputId er den stabile kontakt-ID-en din. Det nestede data-objektet inneholder feltene som brukes i søket. POST-kallet returnerer 202 Accepted med @id, oppgave-ID-en som brukes av senere kall. Koden skriver ut uniqueId før innsending, slik at du fortsatt har en verdi for gjenoppretting dersom svaret går tapt.
Deretter sjekker den oppgavestatusen. Datablist behandler oppgaven i bakgrunnen. Denne Requests-klienten venter og sjekker oppgaven hvert tredje sekund til statusen er completed, failed eller stopped. Requests blokkerer mens klienten venter, men selve API-oppgaven forblir asynkron.
Til slutt henter den resultatene. En oppgave kan ha flere resultatsider. Løkken fortsetter å hente sider til nextCursor er null. Bruk inputId, ikke rekkefølgen i svaret, for å koble hvert resultat til riktig kildekontakt.
Velg riktig input for kontaktdataene dine
Én oppgave bruker én inputmodus. Behold den samme find_emails()-funksjonen, og erstatt verdiene for settings og people med alternativet som passer kildedataene dine.
Velg en inputId som er unik i oppgaven, og som allerede tilhører kildekontakten når det er mulig. En post-ID fra CRM-et eller en annen varig Lead-ID fungerer godt. Datablist returnerer verdien sammen med resultatet, slik at du kan koble poster uten å sammenligne navn eller anta at svaret følger samme rekkefølge som inputen.
Når du har separate navnefelt og et bedriftsdomene, bruker du sourceKind: "name_company". Et kjent domene er den tydeligste identifikatoren for bedriften:
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
}
]
lookup_results = find_emails(people, api_key, settings)Når kilden din har ett navnefelt og et bedriftsnavn, aktiverer du useFullName:
settings = {"sourceKind": "name_company", "useFullName": True}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"fullName": "Satya Nadella",
"companyNameOrDomain": "Microsoft",
},
}
]
lookup_results = find_emails(people, api_key, settings)Når du har URL-en til en offentlig personprofil, bruker du LinkedIn-alternativet:
settings = {"sourceKind": "linkedin"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"linkedInProfile": "https://www.linkedin.com/in/satyanadella/"
},
}
]
lookup_results = find_emails(people, api_key, settings)Dette alternativet godtar URL-en til en offentlig linkedin.com/in/...-profil som personkontekst for e-postsøket. Profil-URL-er fra Sales Navigator godtas ikke.
Hvis du må velge leverandørnøkler og rekkefølgen deres, kan du lese veiledningen for egendefinert waterfall. Den administrerte waterfall-løsningen som brukes her, krever ikke leverandørspesifikt oppsett.
Slik finner den administrerte waterfall-løsningen e-post
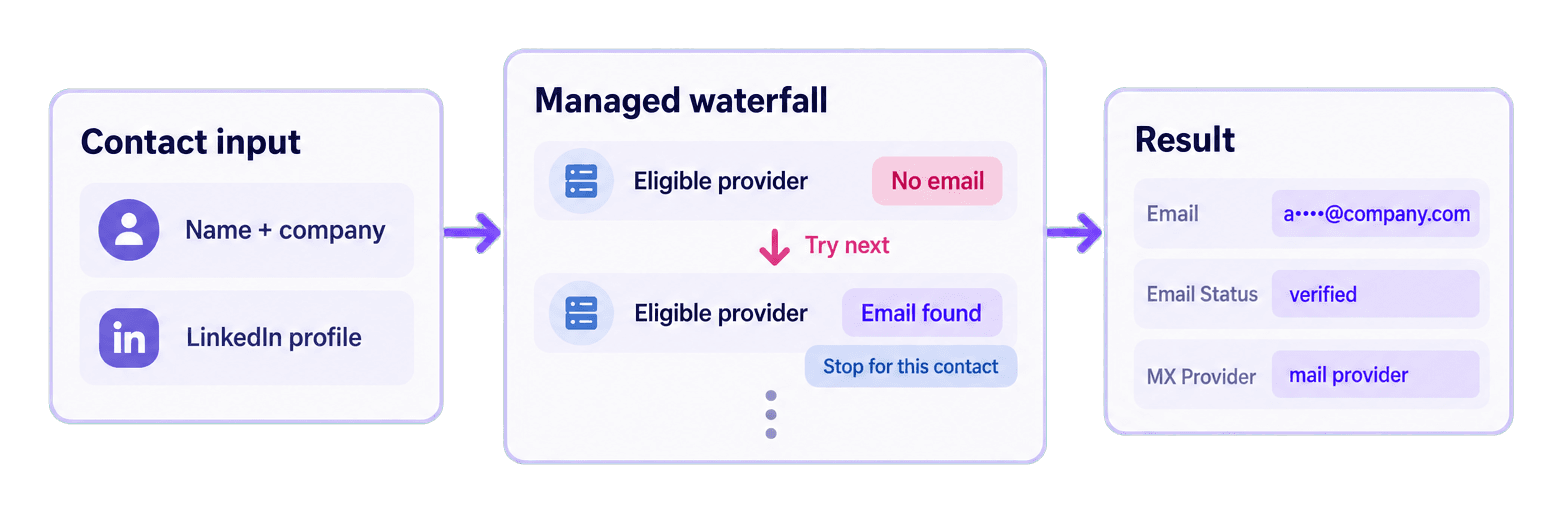
Ved søk med navn og bedrift bruker API-et et oppgitt domene direkte. Hvis du oppgir et bedriftsnavn, prøver det først å finne et brukbart bedriftsdomene for dette navnet. Ved et LinkedIn-søk rydder det opp i URL-en til den offentlige profilen og gjør tilgjengelig person- og bedriftsinformasjon om til konteksten kvalifiserte e-postleverandører trenger.
Den administrerte waterfall-løsningen sender en uløst kontakt til en kvalifisert leverandør. Hvis den ikke returnerer en brukbar e-postadresse, kan en annen kvalifisert leverandør prøve den samme kontakten. Sekvensen stopper for kontakten så snart en jobb-e-postadresse godtas. Standardsvaret oppgir ikke hvilken finder som ble brukt.
Derfor er waterfall nyttig for internasjonal outreach
Leverandører av jobb-e-postadresser bruker ulike datasett, og dekningen varierer derfor mellom land og markeder. Én leverandør kan mangle et resultat for en kontakt i én region, mens en annen har dataene som trengs for å finne adressen.
For salgs- og growth-team gir waterfall hver uløste kontakt en ny mulighet til å bli funnet før den utelates fra outreach-listen. Det kan hente inn kontakter som en arbeidsflyt med bare én leverandør ville gått glipp av, samtidig som den tekniske prosessen forblir enhetlig for teamet.
Datablist administrerer rekkefølgen av kvalifiserte leverandører bak én API-integrasjon. Du sender inn kontakten én gang og mottar ett resultatformat, i stedet for å bygge og vedlikeholde en separat integrasjon for hver leverandør og slå sammen svarene selv.
Les de fullstendige resultatene
Eksempeloppgaven returnerte to vellykkede resultater. E-postadressene er maskert nedenfor.
{
  "taskId": "2286103ce43748828e27ce71b9cc526b",
  "results": [
    {
      "inputId": "contact-satya-nadella",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "microsoft",
        "emailFound": "s*******@microsoft.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "contact-reid-hoffman",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "mimecast",
        "emailFound": "r*******@greylock.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
emailFound er jobb-e-postadressen som returneres. emailStatus beskriver leveringsstatusen da søket ble utført, mens mxProvider identifiserer e-postleverandøren når denne informasjonen er tilgjengelig. Begge postene er verified, og hver av dem brukte 25 credits.
Kampanjekoden nedenfor legger verified-resultater i campaign_contacts og beholder andre adresser som ble funnet, i needs_verification. Verdien creditsUsed er den autoritative kostnaden for hvert resultat.
Det administrerte standardresultatet inneholder ikke finderProvider. Dette feltet er et betinget output for en gyldig arbeidsflyt med egendefinert nøkkel og navn og bedrift. Skriptet bør derfor ikke utlede feltet fra mxProvider.
Klargjør e-postene for kampanjegjennomgang
Når det direkte søket fungerer, legger du til denne blokken nederst i skriptet, etter at lookup_results er returnert. Den klargjør lokale kontakter for kampanjegjennomgang basert på søket du allerede har kjørt.
results_by_id = {result["inputId"]: result for result in lookup_results}
campaign_contacts = []
needs_verification = []
for person in people:
result = results_by_id.get(person["inputId"])
if result is None:
continue
if result["status"] != "success":
continue
if not result["outputs"].get("emailFound"):
continue
contact = person.copy()
contact["result"] = result
if result["outputs"].get("emailStatus") == "verified":
campaign_contacts.append(contact)
else:
needs_verification.append(contact)
print(json.dumps({
"campaign_contacts": campaign_contacts,
"needs_verification": needs_verification,
}, indent=2))results_by_id gjør rekkefølgen i svaret irrelevant. For Satya leser løkken contact-satya-nadella fra den opprinnelige people-listen, finner resultatet med samme inputId, kopierer kildeposten og legger ved hele API-objektet under result. Fordi adressen finnes og statusen er verified, legges kontakten i campaign_contacts. Reid følger den samme flyten selv om API-resultatet hans kommer først.
De tre betingelsene gjør avgjørelsen lett å forstå. Den første hopper over en kontakt hvis det ikke ble returnert et samsvarende resultat. Den andre hopper over feil på radnivå og andre statuser enn success. Den tredje krever at det faktisk finnes en emailFound-verdi. Ved å legge ved hele result-objektet bevares status, output, creditsbruk og feilfelt for senere gjennomgang.
En e-postadresse som blir funnet med en annen leveringsstatus, legges i needs_verification. Et manglende resultat, en radfeil eller et resultat uten emailFound holdes utenfor begge de klargjorte listene. Den opprinnelige people-listen forblir tilgjengelig for korrigering eller videre research.
Beregn kostnaden for Waterfall Email Finder API
Den administrerte standardløsningen bruker 25 credits for hver jobb-e-postadresse som blir funnet. Et mislykket standardsøk bruker 0 credits. Les creditsUsed fra hvert resultat i stedet for å multiplisere det totale antallet innsendte kontakter.
En e-postadresse med statusen unverified bruker fortsatt 25 credits, selv om den lokale kampanjekoden legger den i needs_verification i stedet for campaign_contacts.
De to e-postadressene som ble funnet i dette eksemplet, brukte 50 credits. Til budsjettering:
- 100 jobb-e-postadresser bruker 2 500 credits.
- 1 000 jobb-e-postadresser bruker 25 000 credits.
- En større inputliste kan bruke færre credits enn
kontakter × 25, fordi søk uten resultat ikke belastes.
Tilgang til REST API krever Growth-abonnementet. Med dagens påfyllingspris i USD gir 20 dollar 20 000 credits, altså 0,001 dollar per credit. Med denne satsen har 25 000 credits en verdi på 25 dollar. Abonnementet kommer i tillegg til denne beregningen. Se Datablists prisside for oppdaterte detaljer om abonnementer og pakker.
Løs vanlige feil og gjenopprett en oppgave
API-nøkkelen mangler. Skriptet utløser Set DATABLIST_API_KEY before running this script. før det sender en forespørsel. Eksporter variabelen i den aktive terminalen, og kjør filen på nytt.
API-et returnerer en autentiseringsfeil. raise_for_status() rapporterer HTTP-feilen. Kopier en gyldig Personal API Key, bekreft at X-API-Key-headeren bruker denne, og kjør skriptet på nytt først etter at påloggingsinformasjonen er rettet.
Kontoen har for få credits. Kontroller kontosaldoen. Legg til credits, eller vent på neste tildeling i abonnementet før du sender inn flere oppgaver.
Inputfeltene samsvarer ikke med valgt modus. Bruk separate navnefelt eller fullName med name_company, eller bruk linkedInProfile med linkedin. Korriger kontakten, og send den inn med én konsekvent modus.
Oppgaven har statusen failed eller stopped. Skriptet utløser en RuntimeError som inneholder oppgave-ID-en, sluttstatusen og en eventuell oppgavefeil. Undersøk oppgaven og alle tilgjengelige resultater før du avgjør hvilke kontakter som fortsatt trenger et søk.
POST-svaret gikk tapt. Kopier uniqueId som ble skrevet ut før innsending. List opp oppgavene dine med den samme nøkkelen:
curl "https://api.datablist.com/v1/enrichments/tasks" \
-H "X-API-Key: $DATABLIST_API_KEY"Finn oppgaven med den utskrevne uniqueId-verdien, kopier dens @id, og fortsett deretter med URL-en for oppgavestatus eller resultater. Slik kan du gjenopprette den eksisterende oppgaven uten automatisk å sende inn kontaktene på nytt. Dokumentasjonen for task API beskriver livssyklusen og endepunktene for resultater.
Neste steg
Du har nå én blokkerende Python Requests-funksjon for de tre støttede inputalternativene og et lokalt filter som klargjør e-postadresser som er funnet og verifisert, for kampanjegjennomgang.
Erstatt de to eksempelkontaktene med et lite utvalg av kontaktene du har gjort research på. Velg inputalternativet som passer dataene dine, kjør søket, og kontroller emailStatus før du bruker en adresse. For en arbeidsflyt med større lister kan du lese slik finner du e-postadresser i stor skala. Det vedlikeholdte GitHub-repositoryet inneholder nedlastbare blokkerende og asynkrone Python-eksempler.