
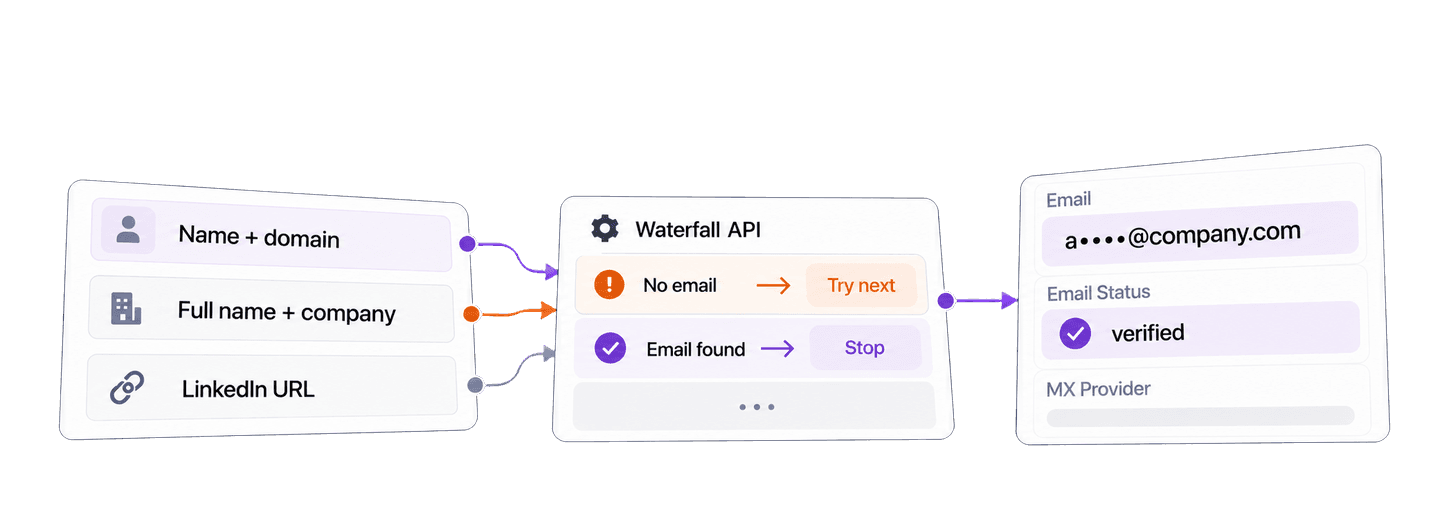
Aby znaleźć służbowe adresy e-mail w Pythonie, prześlij imię i nazwisko danej osoby wraz z informacjami o firmie albo URL jej publicznego profilu LinkedIn do Waterfall Email Finder API od Datablist, korzystając z biblioteki Requests. API zwróci znaleziony służbowy e-mail, status dostarczalności adresu oraz dostawcę poczty.
Poniższy kompletny przykład wyszukuje adresy Satyi Nadelli z microsoft.com i Reida Hoffmana z greylock.com. Skrypt czeka na zakończenie zadania w tle i pobiera wszystkie strony wyników. Następnie wykorzystamy te dane do przygotowania lokalnej listy zweryfikowanych kontaktów do przeglądu przed kampanią.
📌 Podsumowanie dla zabieganych
Użyj jednej funkcji w Pythonie, aby przesłać znane kontakty do Waterfall Email Finder API, poczekać na zakończenie zadania i zebrać znalezione służbowe adresy e-mail. Następnie przygotuj zweryfikowane kontakty do przeglądu przed kampanią, pozostawiając nierozpoznane osoby na liście źródłowej.
- Dane wejściowe: imię i nazwisko wraz z domeną firmy, pełne imię i nazwisko wraz z nazwą firmy albo URL publicznego profilu LinkedIn.
- Dane wyjściowe: służbowy e-mail z polami
emailStatusimxProvider, a następnie lokalna lista do weryfikacji zawierająca wyłącznie kontakty z adresem e-mail.
💡 Wolisz rozwiązanie no-code? Skorzystaj z Waterfall Email Finder od Datablist, aby znajdować służbowe adresy e-mail w kolekcji bez pisania kodu.
Konfiguracja Pythona, Requests i klucza API
W tym przykładzie używamy pakietu requests. Utwórz plik o nazwie find_work_emails.py, a następnie zainstaluj Requests:
python -m pip install requestsUtwórz Personal API Key na stronie konta API Datablist. Dostęp do REST API wymaga planu Growth. Wyeksportuj klucz w terminalu, z którego uruchomisz skrypt:
export DATABLIST_API_KEY="your-api-key"Pomyślne wyniki Waterfall Email Finder również zużywają kredyty. W sekcji poświęconej kosztom oddzielamy je od abonamentu zapewniającego dostęp do API.
Wyszukiwanie e-maili za pomocą jednej funkcji
Wklej poniższy kompletny skrypt do pliku find_work_emails.py:
import json
import os
import time
import uuid
import requests
def find_emails(people, api_key, settings):
"""Submit one email-finder task, wait, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-email-finder",
"uniqueId": unique_id,
"settings": settings,
"inputs": people,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
},
{
"inputId": "contact-reid-hoffman",
"data": {
"firstName": "Reid",
"lastName": "Hoffman",
"companyNameOrDomain": "greylock.com",
},
},
]
lookup_results = find_emails(people, api_key, settings)
for result in lookup_results:
print(json.dumps(result, indent=2))Uruchom skrypt z tego samego terminala:
python find_work_emails.pyMożesz również pobrać aktualizowany przykład wykorzystujący Requests. Gdy poznasz już wersję blokującą, w repozytorium znajdziesz także asynchroniczny wariant oparty na HTTPX.
Funkcja wykonuje kolejno trzy rodzaje wywołań.
Najpierw przesyła zadanie. Każde inputId jest stałym identyfikatorem kontaktu. Zagnieżdżony obiekt data zawiera pola używane podczas wyszukiwania. Żądanie POST zwraca 202 Accepted oraz @id, czyli identyfikator zadania wykorzystywany w kolejnych wywołaniach. Kod wyświetla uniqueId przed wysłaniem danych, dzięki czemu zachowujesz wartość umożliwiającą odzyskanie zadania, nawet jeśli odpowiedź zaginie.
Następnie sprawdza status zadania. Datablist przetwarza je w tle. Ten klient Requests czeka i co trzy sekundy sprawdza status, aż zadanie osiągnie stan completed, failed lub stopped. Requests blokuje wykonywanie kodu podczas oczekiwania, ale samo zadanie API pozostaje asynchroniczne.
Na końcu pobiera wyniki. Zadanie może zwrócić kilka stron wyników. Pętla pobiera kolejne strony, dopóki nextCursor nie przyjmie wartości null. Aby dopasować każdy wynik do kontaktu źródłowego, używaj inputId, a nie kolejności odpowiedzi.
Wybór danych wejściowych dla kontaktów
Jedno zadanie korzysta z jednego trybu danych wejściowych. Zachowaj tę samą funkcję find_emails(), a wartości settings i people zastąp wariantem pasującym do Twoich danych źródłowych.
Wybierz inputId, które jest unikalne w obrębie zadania i — jeśli to możliwe — już należy do kontaktu źródłowego. Dobrze sprawdzi się identyfikator rekordu CRM lub inny trwały identyfikator Leada. Datablist zwraca tę wartość razem z wynikiem, dlatego możesz dopasować rekordy bez porównywania nazwisk i bez zakładania, że kolejność odpowiedzi będzie taka sama jak kolejność danych wejściowych.
Jeśli masz osobne pola z imieniem i nazwiskiem oraz domenę firmy, użyj sourceKind: "name_company". Znana domena jest najbardziej jednoznacznym identyfikatorem firmy:
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
}
]
lookup_results = find_emails(people, api_key, settings)Jeśli źródło zawiera jedno pole z pełnym imieniem i nazwiskiem oraz nazwę firmy, włącz useFullName:
settings = {"sourceKind": "name_company", "useFullName": True}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"fullName": "Satya Nadella",
"companyNameOrDomain": "Microsoft",
},
}
]
lookup_results = find_emails(people, api_key, settings)Jeśli masz URL publicznego profilu danej osoby, wybierz wariant LinkedIn:
settings = {"sourceKind": "linkedin"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"linkedInProfile": "https://www.linkedin.com/in/satyanadella/"
},
}
]
lookup_results = find_emails(people, api_key, settings)Ten wariant przyjmuje URL publicznego profilu linkedin.com/in/... jako źródło informacji o osobie podczas wyszukiwania adresu e-mail. Adresy URL profili z Sales Navigator nie są obsługiwane.
Jeśli chcesz samodzielnie wybrać klucze dostawców i ustalić ich kolejność, przeczytaj przewodnik po niestandardowym waterfall. Używany tutaj zarządzany waterfall nie wymaga konfiguracji właściwej dla poszczególnych dostawców.
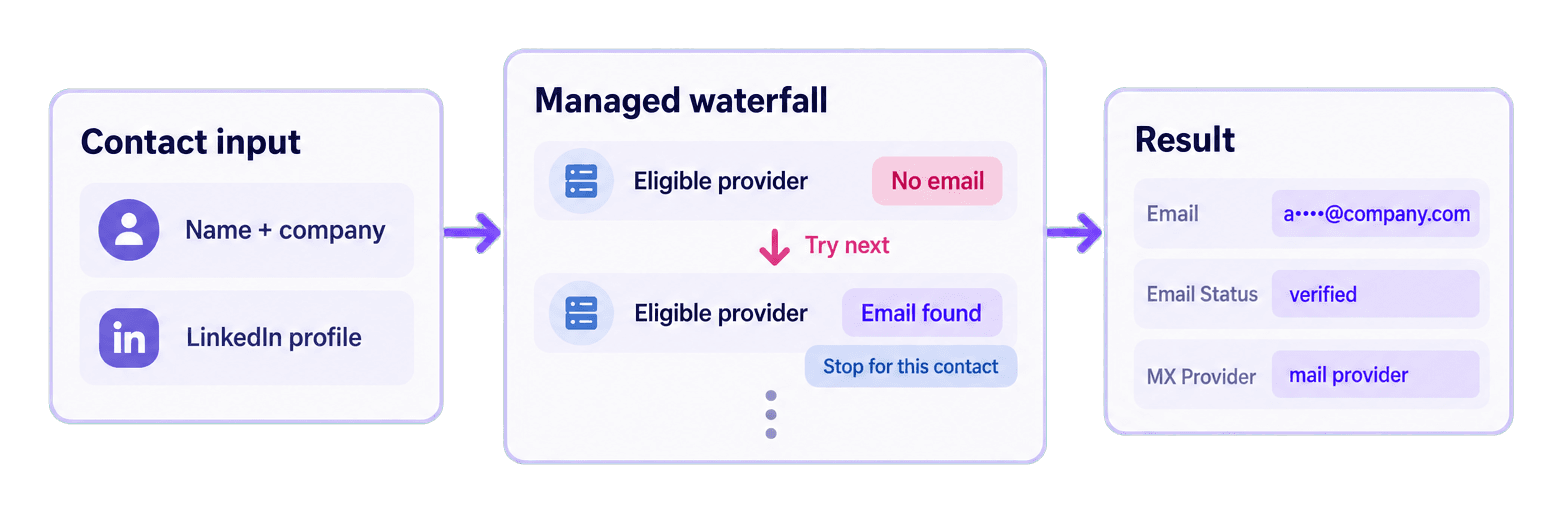
Jak zarządzany waterfall znajduje e-mail
W przypadku zapytania opartego na imieniu, nazwisku i firmie API bezpośrednio wykorzystuje podaną domenę. Jeśli przekażesz nazwę firmy, najpierw spróbuje powiązać ją z odpowiednią domeną firmową. W przypadku zapytania z LinkedIn oczyści URL publicznego profilu i przekształci dostępne dane o osobie i firmie w kontekst wymagany przez kwalifikujących się dostawców adresów e-mail.
Zarządzany waterfall wysyła nierozpoznany kontakt do odpowiedniego dostawcy. Jeśli nie otrzyma użytecznego adresu, ten sam kontakt może zostać sprawdzony przez kolejnego dostawcę. Sekwencja zatrzymuje się dla danego kontaktu natychmiast po zaakceptowaniu służbowego e-maila. Domyślna odpowiedź nie wskazuje dostawcy, który znalazł adres.
Dlaczego waterfall wspiera międzynarodowy outreach
Dostawcy służbowych adresów e-mail korzystają z różnych zbiorów danych, dlatego ich zasięg różni się w zależności od kraju i rynku. Jeden dostawca może nie znaleźć kontaktu w danym regionie, podczas gdy inny dysponuje danymi potrzebnymi do ustalenia adresu.
Dzięki waterfall każdy nierozpoznany kontakt otrzymuje kolejną szansę na odnalezienie, zanim zostanie pominięty na liście outreach. Pozwala to odzyskać kontakty, których nie znalazłby proces oparty na jednym dostawcy, a jednocześnie zachować spójny proces techniczny dla całego zespołu sprzedaży lub growth.
Datablist zarządza sekwencją kwalifikujących się dostawców w ramach jednej integracji API. Przesyłasz kontakt tylko raz i otrzymujesz wyniki w jednym formacie, zamiast tworzyć oraz utrzymywać osobną integrację dla każdego dostawcy i samodzielnie scalać odpowiedzi.
Jak odczytać kompletne wyniki
Przykładowe zadanie zwróciło dwa pomyślne wyniki. Adresy e-mail zostały poniżej zamaskowane.
{
  "taskId": "2286103ce43748828e27ce71b9cc526b",
  "results": [
    {
      "inputId": "contact-satya-nadella",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "microsoft",
        "emailFound": "s*******@microsoft.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "contact-reid-hoffman",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "mimecast",
        "emailFound": "r*******@greylock.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
emailFound to zwrócony służbowy adres e-mail. emailStatus opisuje jego dostarczalność w momencie wyszukiwania, a mxProvider wskazuje dostawcę hostingu poczty, jeśli ta informacja jest dostępna. Oba rekordy mają status verified, a każdy z nich zużył 25 kredytów.
Poniższy kod kampanii umieszcza wyniki verified w campaign_contacts, a pozostałe znalezione adresy w needs_verification. Wartość creditsUsed jest wiążącą informacją o opłacie za każdy wynik.
Domyślny wynik zarządzanego procesu nie zawiera pola finderProvider. Jest ono warunkowym elementem wyniku w prawidłowym workflow opartym na własnych kluczach oraz danych osoby i firmy, dlatego skrypt nie powinien wyprowadzać go z wartości mxProvider.
Przygotowanie e-maili do przeglądu kampanii
Gdy bezpośrednie wyszukiwanie już działa, dodaj poniższy blok na końcu skryptu, po zwróceniu lookup_results. Przygotuje on lokalne kontakty do przeglądu przed kampanią na podstawie wykonanego wcześniej wyszukiwania.
results_by_id = {result["inputId"]: result for result in lookup_results}
campaign_contacts = []
needs_verification = []
for person in people:
result = results_by_id.get(person["inputId"])
if result is None:
continue
if result["status"] != "success":
continue
if not result["outputs"].get("emailFound"):
continue
contact = person.copy()
contact["result"] = result
if result["outputs"].get("emailStatus") == "verified":
campaign_contacts.append(contact)
else:
needs_verification.append(contact)
print(json.dumps({
"campaign_contacts": campaign_contacts,
"needs_verification": needs_verification,
}, indent=2))Dzięki results_by_id kolejność odpowiedzi nie ma znaczenia. W przypadku Satyi pętla odczytuje contact-satya-nadella z pierwotnej listy people, znajduje wynik z tym samym inputId, kopiuje rekord źródłowy i dołącza pełny obiekt API w polu result. Ponieważ adres istnieje i ma status verified, kontakt trafia do campaign_contacts. Reid przechodzi tę samą ścieżkę, nawet jeśli jego wynik z API pojawi się jako pierwszy.
Trzy warunki sprawiają, że logika decyzji pozostaje czytelna. Pierwszy pomija kontakt, jeśli nie zwrócono pasującego wyniku. Drugi pomija błędy na poziomie wiersza i inne stany niż success. Trzeci wymaga rzeczywistej wartości emailFound. Dołączenie kompletnego obiektu result zachowuje status, dane wyjściowe, zużycie kredytów i pole błędu do późniejszej analizy.
Znaleziony e-mail o innym statusie dostarczalności trafia do needs_verification. Brak wyniku, błąd wiersza lub wynik bez emailFound nie zostaną dodane do żadnej z przygotowanych list. Pierwotna lista people pozostaje dostępna do poprawienia danych lub dalszego researchu.
Szacowanie kosztów Waterfall Email Finder API
Domyślny zarządzany waterfall zużywa 25 kredytów za każdy znaleziony służbowy adres e-mail. Nieudane wyszukiwanie w trybie domyślnym zużywa 0 kredytów. Zamiast mnożyć całkowitą liczbę przesłanych kontaktów, odczytaj creditsUsed z każdego wyniku.
Znaleziony adres o statusie unverified również zużywa 25 kredytów, mimo że lokalny kod kampanii umieszcza go w needs_verification, a nie w campaign_contacts.
Dwa adresy znalezione w tym przykładzie zużyły 50 kredytów. Na potrzeby planowania:
- 100 znalezionych służbowych e-maili zużywa 2500 kredytów.
- 1000 znalezionych służbowych e-maili zużywa 25 000 kredytów.
- Większa lista wejściowa może zużyć mniej kredytów niż
liczba kontaktów × 25, ponieważ wyszukiwania bez wyniku są bezpłatne.
Dostęp do REST API wymaga planu Growth. Przy aktualnej stawce doładowania w USD za 20 USD otrzymasz 20 000 kredytów, czyli jeden kredyt kosztuje 0,001 USD. Przy tej stawce wartość 25 000 kredytów wynosi 25 USD. Abonament jest rozliczany oddzielnie. Aktualne informacje o planach i pakietach znajdziesz na stronie cennika Datablist.
Typowe błędy i odzyskiwanie zadania
Brakuje klucza API. Przed wysłaniem żądania skrypt zgłasza komunikat Set DATABLIST_API_KEY before running this script.. Wyeksportuj zmienną w bieżącym terminalu i ponownie uruchom plik.
API zwraca błąd uwierzytelniania. raise_for_status() zgłasza błąd HTTP. Skopiuj aktualny Personal API Key, upewnij się, że używa go nagłówek X-API-Key, i uruchom skrypt ponownie dopiero po poprawieniu danych uwierzytelniających.
Na koncie brakuje kredytów. Sprawdź saldo konta. Dodaj kredyty lub zaczekaj na kolejną pulę przyznawaną w ramach planu, zanim prześlesz następne zadania.
Pola wejściowe nie pasują do wybranego trybu. Użyj oddzielnych pól imienia i nazwiska albo fullName z name_company. W przypadku trybu linkedin użyj linkedInProfile. Popraw kontakt i prześlij go w jednym, spójnym trybie.
Zadanie ma status failed lub stopped. Skrypt zgłasza RuntimeError zawierający identyfikator zadania, jego stan końcowy oraz dostępny opis błędu. Sprawdź zadanie i wszystkie dostępne wyniki, zanim zdecydujesz, które kontakty nadal wymagają wyszukania.
Odpowiedź na żądanie POST zaginęła. Skopiuj uniqueId wyświetlone przed przesłaniem danych. Wyświetl listę zadań przy użyciu tego samego klucza:
curl "https://api.datablist.com/v1/enrichments/tasks" \
-H "X-API-Key: $DATABLIST_API_KEY"Znajdź zadanie z wyświetlonym wcześniej uniqueId, skopiuj jego @id, a następnie przejdź do adresu URL statusu zadania lub wyników. W ten sposób odzyskasz istniejące zadanie bez automatycznego ponownego przesyłania kontaktów. Dokumentacja task API opisuje cykl życia zadań i endpointy wyników.
Kolejne kroki
Masz już jedną blokującą funkcję Python Requests obsługującą trzy wspierane warianty danych wejściowych oraz lokalny filtr, który przygotowuje znalezione i zweryfikowane adresy e-mail do przeglądu przed kampanią.
Zastąp dwa przykładowe kontakty niewielką próbką kontaktów z własnego researchu. Wybierz wariant danych wejściowych pasujący do Twoich danych, uruchom wyszukiwanie i sprawdź emailStatus, zanim wykorzystasz adres. Jeśli pracujesz z większą listą, przeczytaj, jak znajdować adresy e-mail na dużą skalę. W aktualizowanym repozytorium GitHub znajdziesz gotowe do pobrania przykłady blokującego i asynchronicznego kodu w Pythonie.