
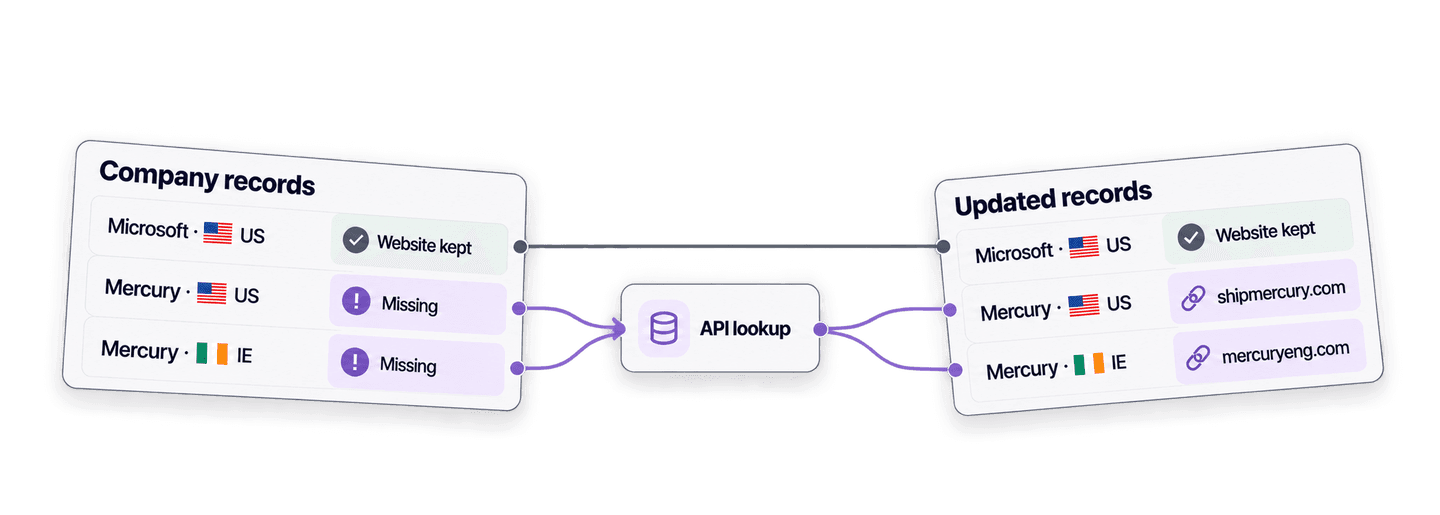
Чтобы найти сайт компании по её названию с помощью Python, передайте название и, если известно, страну в Company Name to Domain API от Datablist. API обработает запрос в фоновом режиме, а затем вернёт домен и полный URL сайта.
Сначала разберём простой API-запрос на Python. Затем используем ту же функцию, чтобы заполнить только отсутствующие сайты в списке компаний, сохранив уже имеющиеся URL.
Если вам удобнее интерфейс в виде таблицы, воспользуйтесь инструкцией по массовому поиску сайтов по названиям компаний.
💡 Кратко для тех, кто спешит
Создайте одну функцию на Python для поиска сайтов по названиям компаний, а затем используйте её, чтобы заполнить записи с пустыми полями, не заменяя уже известные URL.
- Входные данные: названия компаний и, при наличии, страны.
- Результат: домен, полный URL сайта, уровень уверенности, статус результата и количество использованных кредитов.
Настройка Python и API-ключа Datablist
В этом примере для синхронных HTTP-запросов используется пакет Requests. Установите его в виртуальном окружении:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requestsТакже понадобится тариф Datablist Growth, поскольку доступ к REST API входит в возможности этого тарифа. Создайте Personal API Key на странице API вашего аккаунта Datablist, а затем сохраните его в переменной окружения:
export DATABLIST_API_KEY="exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2"🔑 Уже есть API-ключ? Старые ключи имеют формат
auth0|<userId>:<accountId>:<secret>:1. Они по-прежнему поддерживаются. Продолжайте использовать существующий ключ именно в том виде, в котором он был создан: заменять или менять его формат не нужно.
Замените значение из примера на ключ, созданный на странице вашего аккаунта. Поиск сайтов компаний расходует кредиты. Перед масштабированием скрипта мы разберём сценарии стоимостью 1 и 2,5 кредита. Актуальные условия тарифов приведены на странице цен Datablist.
Поиск сайта одной компании через API в Python
Создайте файл find_company_websites.py. Скрипт отправляет названия, дожидается завершения задачи и получает результаты в рамках одной функции. Для каждого входного объекта ваш постоянный ID записи передаётся как inputId. Благодаря этому результат можно сопоставить с нужной записью, даже если порядок ответа изменится.
import json
import os
import time
import uuid
import requests
API_BASE_URL = "https://api.datablist.com/v1"
def find_domains(companies, api_key):
headers = {
"Accept": "application/json",
"Content-Type": "application/json",
"X-API-Key": api_key,
}
inputs = [
{
"inputId": company["id"],
"data": {
"companyName": company["company_name"],
"targetCountry": company.get("country", ""),
},
}
for company in companies
]
unique_id = f"python-domain-lookup-{uuid.uuid4().hex}"
payload = {
"enrichmentId": "company-name-to-domain",
"uniqueId": unique_id,
"settings": {
"workflow": "dataset_google",
"countryOverwrite": True,
"acceptNonRoot": True,
},
"inputs": inputs,
}
print(f"Task uniqueId: {unique_id}")
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} ended with status {task['status']}: {task.get('error')}"
)
results = []
cursor = None
while True:
params = {"limit": 100}
if cursor is not None:
params["cursor"] = cursor
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}/results",
headers=headers,
params=params,
)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
break
return results
api_key = os.environ["DATABLIST_API_KEY"]
companies = [
{
"id": "direct-microsoft-us",
"company_name": "Microsoft",
"country": "US",
}
]
lookup_results = find_domains(companies, api_key)
for result in lookup_results:
print(json.dumps(result, indent=2))Запустите его из терминала, в котором вы экспортировали ключ:
python find_company_websites.pyВот результат для Microsoft:
{
  "inputId": "direct-microsoft-us",
  "status": "success",
  "outputs": {
    "companyUrl": "https://microsoft.com",
    "companyDomain": "microsoft.com",
    "domainConfidence": "High"
  },
  "creditsUsed": "1",
  "error": null
}
Используйте inputId, чтобы сопоставить результат с исходной записью. Поле status принимает значения success, no_result, error или skipped. Успешный результат может содержать companyDomain, полный адрес companyUrl и уровень уверенности domainConfidence. Поле creditsUsed показывает стоимость обработки этого объекта, а error объясняет причину ошибки на уровне отдельной записи.
Функция последовательно выполняет три типа API-запросов.
Сначала она отправляет запрос на поиск. Payload содержит настройки и записи компаний. POST-запрос возвращает 202 Accepted, а поле @id содержит ID задачи, необходимый для следующих запросов:
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]Если переменная DATABLIST_API_KEY не задана, Python выдаст KeyError при обращении к переменной окружения ещё до отправки HTTP-запроса. Экспортируйте переменную и снова запустите скрипт. Если в переменной указан недействительный ключ, POST-запрос дойдёт до API, но вернёт HTTP 401. Скопируйте актуальный Personal API Key со страницы аккаунта и замените неверное значение.
Затем функция опрашивает статус задачи. POST-запрос запускает фоновую обработку, поэтому скрипт проверяет задачу каждые три секунды, пока она не перейдёт в статус completed, failed или stopped:
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)Если задача завершается с ошибкой из-за нехватки кредитов, в поле причины будет указано credits_error. Пополните баланс или дождитесь ежемесячного обновления кредитов, проверьте уже полученные результаты, а затем отправьте в новой задаче только необработанные записи.
Наконец, функция получает все страницы с результатами. Каждый ответ добавляет результаты в список и передаёт cursor для следующего запроса:
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
breakСкрипт загружает следующие страницы, пока nextCursor не станет равен null.
Перед POST-запросом скрипт выводит созданный uniqueId. Если соединение прервётся до получения ответа о создании задачи, сначала запросите список задач и проверьте их статус, прежде чем создавать новую:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-name-to-domain"Найдите задачу, у которой uniqueId совпадает со значением, созданным скриптом, и скопируйте её @id. Endpoint списка поддерживает фильтрацию по enrichmentId, но не по uniqueId. Используйте @id в тех же URL статуса и результатов, что и скрипт. Если задача всё ещё выполняется, продолжайте проверять её статус. Если она остановлена или завершилась с ошибкой, проверьте частичные результаты перед повторной отправкой записей.
Сопоставление данных и поиск с учётом страны
Скрипт использует dataset_google — рекомендуемый вариант по умолчанию. Сначала Datablist проверяет собственные датасеты компаний. Если совпадение не найдено или данные противоречат друг другу, сервис может использовать Google как резервный источник. Перед возвратом уровня уверенности он проверяет возможные совпадения.
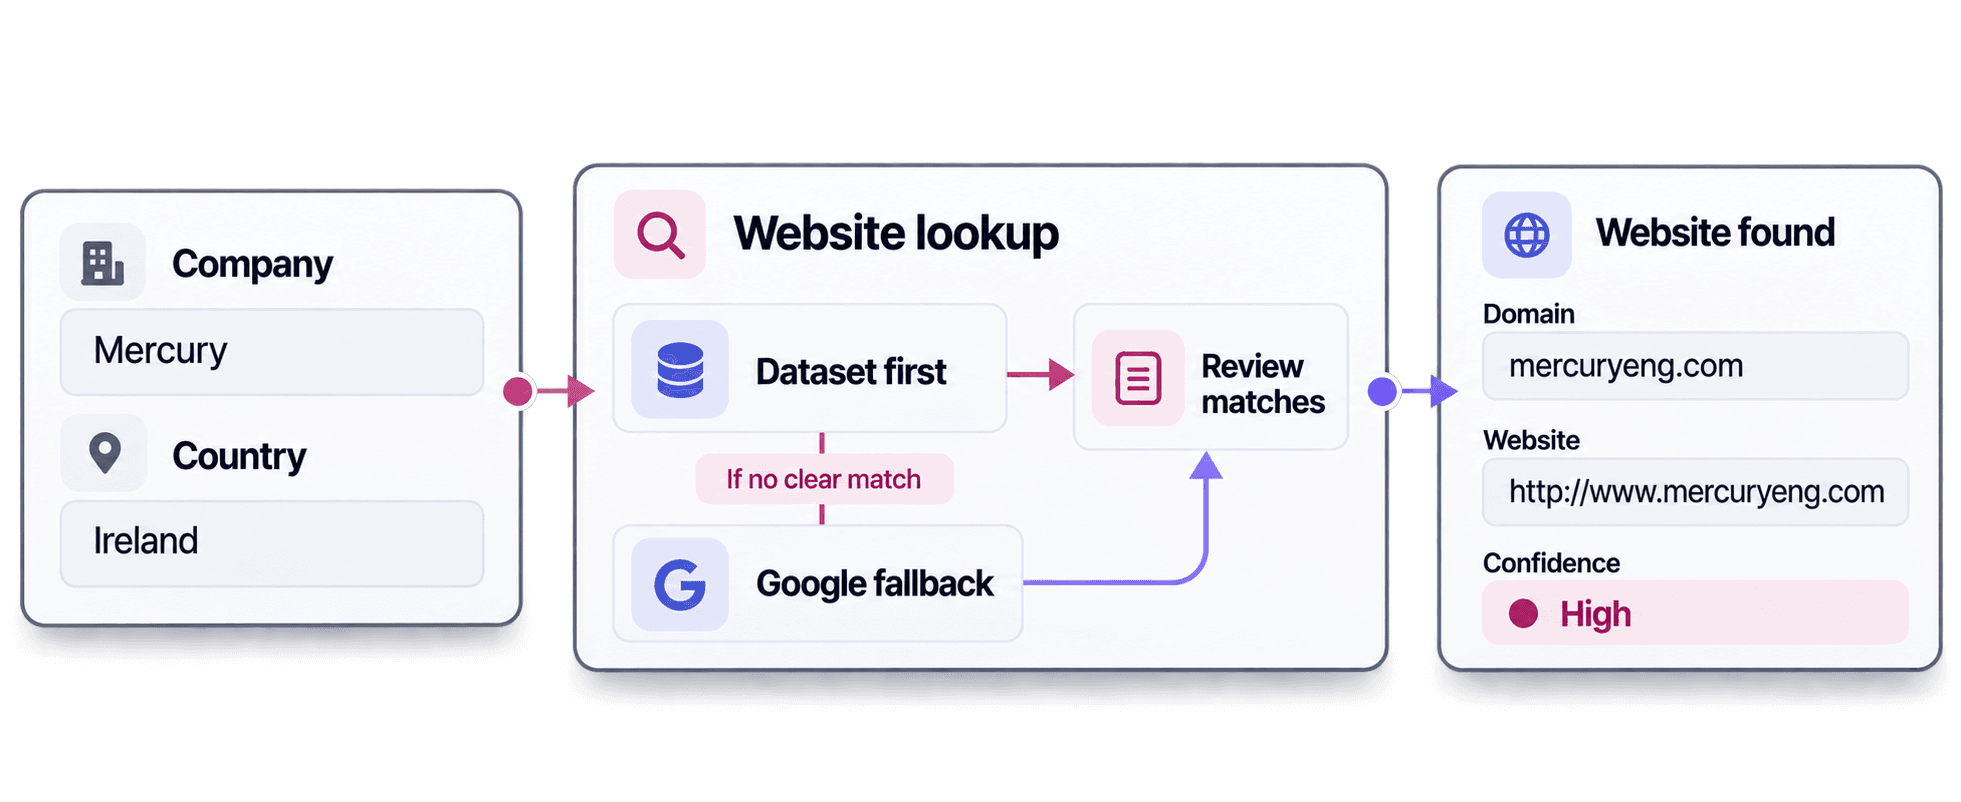
Страна помогает уточнить поиск для неоднозначных названий. В этом примере одно и то же название компании дало разные результаты:
- Для
Mercuryсо странойUSбыли возвращеныshipmercury.comиhttps://www.shipmercury.com/. - Для
Mercuryсо странойIEбыли возвращеныmercuryeng.comиhttp://www.mercuryeng.com.
В обоих случаях уровень уверенности был High. Страна помогает выбрать нужную компанию среди организаций с одинаковыми названиями, а уровень уверенности — определить, какие результаты требуют проверки.
Если совпадение также зависит от отрасли, размера компании или другого бизнес-контекста, используйте процесс исследования с AI Agent. Добавьте эти сведения в prompt для AI Agent, чтобы он мог найти нужную компанию с учётом более подробного бизнес-контекста.
Заполнение только отсутствующих сайтов в записях
Теперь, когда find_domains() умеет находить сайт по названию компании, используйте эту функцию для заполнения только отсутствующих сайтов в записях. Записи, в которых сайт уже указан, не отправляются в API: их значения остаются неизменными, а кредиты не расходуются.
В файле find_company_websites.py замените весь код от companies = [ до последнего цикла вывода на приведённый ниже блок. Оставьте расположенное выше присваивание api_key. Проверка пустого значения учитывает None, пустую строку и строку из пробелов. Если сайты заполнены во всех записях, API-запрос не выполняется.
records = [
{
"id": "crm-001",
"company_name": "Microsoft",
"country": "US",
"website": "https://www.microsoft.com",
},
{
"id": "crm-002",
"company_name": "boulangerie du palais lyon",
"country": "FR",
"website": "",
},
{
"id": "crm-003",
"company_name": "Mercury Engineering",
"country": "IE",
"website": None,
},
{
"id": "crm-004",
"company_name": "Mercury",
"country": "US",
"website": " ",
},
{
"id": "crm-005",
"company_name": "Datablist",
"country": "FR",
"website": "https://www.datablist.com",
},
{
"id": "crm-006",
"company_name": "Mercury",
"country": "IE",
"website": None,
},
]
def website_is_missing(value):
return not isinstance(value, str) or not value.strip()
records_to_lookup = [
record for record in records if website_is_missing(record.get("website"))
]
lookup_results = (
find_domains(records_to_lookup, api_key) if records_to_lookup else []
)
results_by_id = {result["inputId"]: result for result in lookup_results}
for record in records:
if not website_is_missing(record.get("website")):
record["website_lookup"] = {"status": "not_requested"}
continue
result = results_by_id.get(record["id"])
if result is None:
record["website_lookup"] = {
"status": "missing_result",
"domain": None,
"confidence": None,
"credits": None,
"error": {
"code": "missing_result",
"message": "No result was returned for this inputId.",
},
}
continue
outputs = result.get("outputs") or {}
if result["status"] == "success" and outputs.get("companyUrl"):
record["website"] = outputs["companyUrl"]
record["website_lookup"] = {
"status": result["status"],
"domain": outputs.get("companyDomain"),
"confidence": outputs.get("domainConfidence"),
"credits": result.get("creditsUsed"),
"error": result.get("error"),
}
print(json.dumps(records, indent=2))Код индексирует результаты по inputId, а затем последовательно обходит исходные записи. Объект website_lookup хранит результат и сведения для проверки рядом с каждой обработанной записью, включая неудачные и отсутствующие результаты.
Для crm-001 функция website_is_missing() возвращает False, поскольку URL Microsoft уже указан. Запись не добавляется в records_to_lookup, поэтому API её не получает. При объединении сайт сохраняется, а статус записывается как not_requested.
У crm-002 поле сайта пустое, поэтому в запрос отправляется пекарня с inputId: crm-002. API возвращает тот же inputId. По нему results_by_id находит нужный результат, после чего при объединении в запись добавляется https://boulangerie-du-palais-lyon.eatbu.com — независимо от порядка результатов.
| ID | Компания | Сайт после объединения | Статус | Домен | Уверенность | Кредиты |
|---|---|---|---|---|---|---|
crm-001 | Microsoft · US | https://www.microsoft.com | not_requested | |||
crm-002 | boulangerie du palais lyon · FR | https://boulangerie-du-palais-lyon.eatbu.com | success | boulangerie-du-palais-lyon.eatbu.com | High | 1 |
crm-003 | Mercury Engineering · IE | https://mercuryeng.com | success | mercuryeng.com | High | 1 |
crm-004 | Mercury · US | https://www.shipmercury.com/ | success | shipmercury.com | High | 1 |
crm-005 | Datablist · FR | https://www.datablist.com | not_requested | |||
crm-006 | Mercury · IE | http://www.mercuryeng.com | success | mercuryeng.com | High | 1 |
Для пекарни используется бизнес-поддомен boulangerie-du-palais-lyon.eatbu.com. Сохраните это значение, не сокращая его до eatbu.com, и записывайте точный адрес из companyUrl. Настройка acceptNonRoot: true также разрешает возвращать страницу компании на сторонней платформе, адрес которой содержит путь после имени хоста. Поэтому в обоих случаях важен полный URL.
Даже завершённая задача может содержать объекты со статусами no_result, error или skipped. В примере поле website изменяется только при статусе success и наличии companyUrl. При статусе no_result сайт остаётся пустым, а статус сохраняется в website_lookup. Сначала проверьте название компании и страну. Если какое-либо из этих значений неверно, исправьте его и отправьте запись в новой задаче. В противном случае оставьте поле сайта пустым для ручной проверки.
Расчёт кредитов перед масштабированием скрипта
Все пять запросов из примера вернули статус success с уровнем уверенности High и суммарно использовали 5 кредитов.
Поиск по датасету стоит 1 кредит, а поиск через Google — 2,5 кредита. Вы платите только за использованный способ, а не за оба. Поэтому для 1 000 записей потребуется 1 000 кредитов, если все совпадения будут найдены в датасете, или 2 500 кредитов, если все запросы будут обработаны через Google. Это сценарии для планирования, а не гарантия успешного результата для каждого запроса.
Перемещайте ползунок, чтобы сравнить расход кредитов для своего списка.
При цене $20 за 20 000 кредитов эти сценарии обойдутся соответственно в $1 и $2,50. Подписка Growth оплачивается отдельно и сейчас включает 20 000 ежемесячных кредитов, которые расходуются до купленных дополнительно. Проверяйте актуальные цены, поскольку условия тарифов и пакетов могут меняться.
Одна задача принимает до 10 000 входных объектов. Лимит на один объект составляет 16 КиБ, а на запрос — 10 МиБ. В этом примере блокирующие вызовы Requests используются для отправки, проверки статуса и получения результатов одной небольшой асинхронной задачи Datablist. В поддерживаемом репозитории также есть примеры пакетной обработки CSV и неблокирующих клиентов.
Следующие шаги
Убедившись, что найденный сайт принадлежит нужной компании, вы можете собрать данные из Impressum с помощью Python, чтобы добавить юридические сведения о компании и URL страницы-источника в ту же запись поставщика. Проверяйте совпадение сайта отдельно от последующего извлечения данных.
Замените тестовые записи небольшим фрагментом собственных данных, запустите скрипт и проверьте объединённые записи. Используйте постоянные ID и указывайте страну. Масштабируйте обработку только после того, как убедитесь, что скрипт сохраняет известные сайты и заполняет нужные пустые поля. Если вам нужен готовый к скачиванию скрипт, пакетная обработка CSV или асинхронная версия, начните с поддерживаемых примеров Company Name to Domain API на GitHub.