
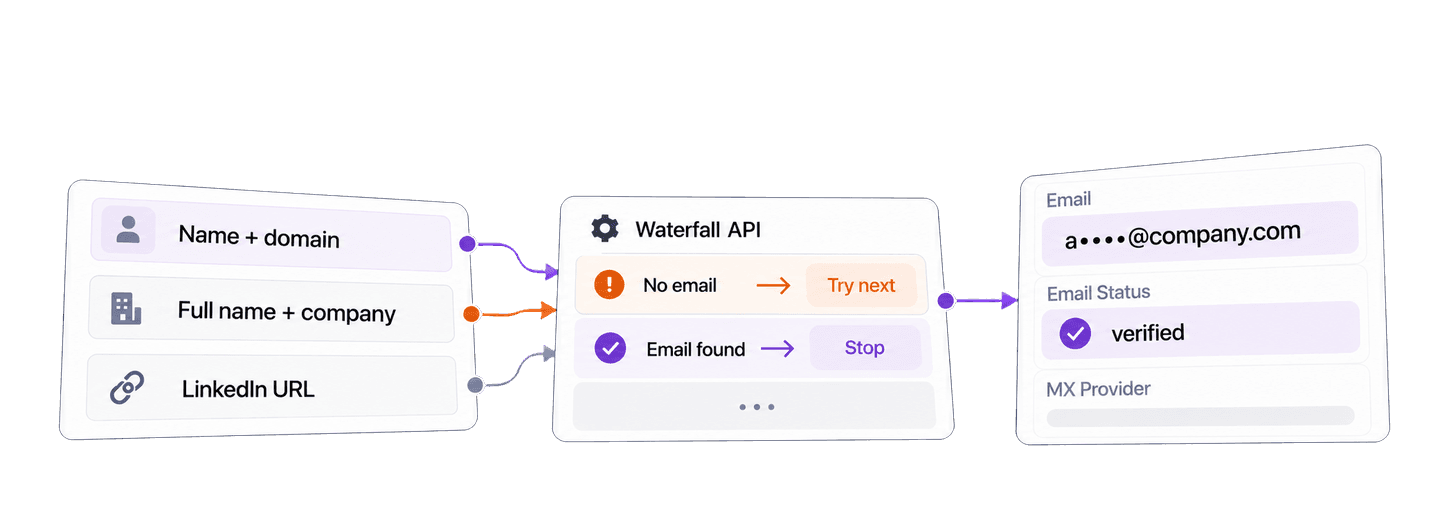
Чтобы находить рабочие email в Python, передайте имя человека и сведения о компании либо URL его публичного профиля LinkedIn в Waterfall Email Finder API от Datablist с помощью библиотеки Requests. API вернёт найденный рабочий email, статус доставляемости адреса и почтового провайдера.
В полном примере ниже мы найдём email Сатьи Наделлы из microsoft.com и Рида Хоффмана из greylock.com. Скрипт дождётся завершения фоновой задачи и получит все страницы результатов. Затем мы используем эти данные, чтобы подготовить локальный список проверенных контактов для ревью перед запуском кампании.
📌 Кратко для тех, кто спешит
Используйте одну функцию Python, чтобы отправить известные контакты в Waterfall Email Finder API, дождаться выполнения задачи и получить найденные рабочие email. Затем подготовьте проверенные контакты к ревью перед кампанией, сохранив при этом контакты без найденного адреса в исходном списке.
- Входные данные: имя и фамилия с доменом компании, полное имя с названием компании или URL публичного профиля LinkedIn.
- Результат: рабочий email с
emailStatusиmxProvider, а также локальный список для ревью, содержащий только контакты с email.
💡 Предпочитаете no-code решение? Используйте Waterfall Email Finder от Datablist, чтобы находить рабочие email в коллекции без написания кода.
Настройте Python, Requests и API-ключ
В этом примере на Python используется пакет requests. Создайте файл find_work_emails.py, затем установите Requests:
python -m pip install requestsСоздайте Personal API Key на странице API-аккаунта Datablist. Для доступа к REST API нужен тариф Growth. Экспортируйте ключ в терминале, из которого будете запускать скрипт:
export DATABLIST_API_KEY="your-api-key"За успешные результаты Waterfall Email Finder также списываются кредиты. В разделе о стоимости ниже мы отдельно рассмотрим кредиты и подписку, предоставляющую доступ к API.
Найдите рабочие email одной функцией Python
Вставьте следующий полный скрипт в find_work_emails.py:
import json
import os
import time
import uuid
import requests
def find_emails(people, api_key, settings):
"""Submit one email-finder task, wait, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-email-finder",
"uniqueId": unique_id,
"settings": settings,
"inputs": people,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
},
{
"inputId": "contact-reid-hoffman",
"data": {
"firstName": "Reid",
"lastName": "Hoffman",
"companyNameOrDomain": "greylock.com",
},
},
]
lookup_results = find_emails(people, api_key, settings)
for result in lookup_results:
print(json.dumps(result, indent=2))Запустите его из того же терминала:
python find_work_emails.pyТакже можно скачать поддерживаемый пример на Requests. Разобравшись с блокирующей версией, вы можете перейти к асинхронному варианту на HTTPX из того же репозитория.
Функция последовательно выполняет три типа запросов.
Сначала она отправляет задачу. Каждый inputId — это постоянный идентификатор вашего контакта. Вложенный объект data содержит поля, используемые для поиска. POST-запрос возвращает 202 Accepted и @id — ID задачи для последующих запросов. Перед отправкой код выводит uniqueId, поэтому в случае потери ответа у вас останется значение для восстановления задачи.
Затем она проверяет статус задачи. Datablist обрабатывает задачу в фоновом режиме. Этот клиент на Requests ждёт и проверяет её каждые три секунды, пока статус не изменится на completed, failed или stopped. Во время ожидания Requests блокирует выполнение кода, но сама задача API остаётся асинхронной.
Наконец, она получает результаты. У задачи может быть несколько страниц результатов. Цикл загружает их, пока значение nextCursor не станет null. Чтобы сопоставить результат с исходным контактом, используйте inputId, а не порядок ответов.
Выберите способ передачи данных контактов
В рамках одной задачи можно использовать только один режим входных данных. Оставьте функцию find_emails() без изменений и замените значения settings и people на вариант, соответствующий вашим исходным данным.
По возможности используйте inputId, который уникален в пределах задачи и уже связан с исходным контактом. Хорошо подойдёт ID записи в CRM или другой постоянный ID лида. Datablist возвращает это значение вместе с результатом, поэтому записи можно сопоставлять без сравнения имён и без предположений о порядке ответов.
Если имя и фамилия хранятся отдельно и вам известен домен компании, используйте sourceKind: "name_company". Известный домен — самый однозначный идентификатор компании:
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
}
]
lookup_results = find_emails(people, api_key, settings)Если в исходных данных полное имя хранится в одном поле вместе с названием компании, включите useFullName:
settings = {"sourceKind": "name_company", "useFullName": True}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"fullName": "Satya Nadella",
"companyNameOrDomain": "Microsoft",
},
}
]
lookup_results = find_emails(people, api_key, settings)Если у вас есть URL публичного профиля человека, используйте вариант с LinkedIn:
settings = {"sourceKind": "linkedin"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"linkedInProfile": "https://www.linkedin.com/in/satyanadella/"
},
}
]
lookup_results = find_emails(people, api_key, settings)В этом режиме публичный URL профиля вида linkedin.com/in/... используется как контекст для поиска email. URL профилей Sales Navigator не поддерживаются.
Если вам нужно самостоятельно выбрать ключи провайдеров и их порядок, изучите руководство по настройке waterfall. Для управляемого waterfall из этого примера отдельная настройка провайдеров не требуется.
Как управляемый waterfall находит email
При запросе по имени и компании API напрямую использует переданный домен. Если указано название компании, сервис сначала пытается сопоставить его с рабочим доменом. При запросе через LinkedIn он очищает URL публичного профиля и преобразует доступные сведения о человеке и компании в контекст, необходимый подходящим email-провайдерам.
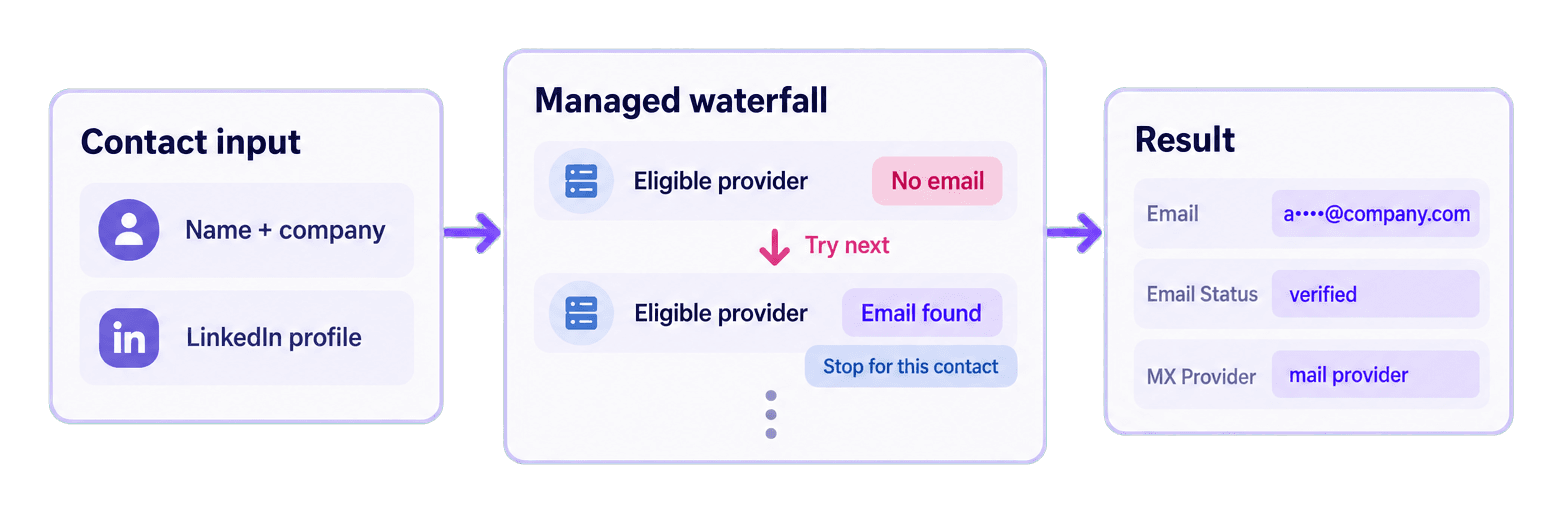
Управляемый waterfall передаёт контакт без найденного адреса подходящему провайдеру. Если тот не возвращает пригодный email, этот же контакт может проверить следующий провайдер. Как только рабочий email найден и принят, последовательность для контакта прекращается. В стандартном ответе не указывается сервис, который нашёл адрес.
Почему waterfall полезен для международного Outbound
Провайдеры рабочих email используют разные наборы данных, поэтому их покрытие зависит от страны и рынка. Один провайдер может не найти контакт в определённом регионе, тогда как у другого будут необходимые данные.
Waterfall даёт sales- или growth-команде ещё один шанс найти каждый контакт, прежде чем исключать его из списка для Outbound. Так можно вернуть в работу контакты, которые пропустил бы процесс с одним провайдером, сохранив при этом единый технический процесс для всей команды.
Datablist управляет последовательностью подходящих провайдеров через одну API-интеграцию. Вы отправляете контакт один раз и получаете результат в едином формате — без отдельных интеграций с каждым провайдером и самостоятельного объединения ответов.
Получите все результаты
В примере задача вернула два успешных результата. Адреса email ниже скрыты.
{
  "taskId": "2286103ce43748828e27ce71b9cc526b",
  "results": [
    {
      "inputId": "contact-satya-nadella",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "microsoft",
        "emailFound": "s*******@microsoft.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "contact-reid-hoffman",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "mimecast",
        "emailFound": "r*******@greylock.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
emailFound — найденный рабочий email. emailStatus описывает его доставляемость на момент поиска, а mxProvider, если доступен, указывает провайдера почтового хостинга. Обе записи имеют статус verified, и на каждую было израсходовано 25 кредитов.
Код подготовки кампании ниже помещает результаты со статусом verified в campaign_contacts, а остальные найденные адреса — в needs_verification. Значение creditsUsed содержит точную сумму списания за каждый результат.
Стандартный результат управляемого waterfall не содержит finderProvider. Это поле возвращается при определённых условиях в корректном процессе поиска по имени и компании с пользовательскими ключами, поэтому скрипт не должен определять его на основе mxProvider.
Подготовьте найденные email к ревью кампании
После того как прямой поиск заработает, добавьте этот блок в конец скрипта — после получения lookup_results. Он подготовит локальные контакты к ревью перед кампанией на основе уже выполненного поиска.
results_by_id = {result["inputId"]: result for result in lookup_results}
campaign_contacts = []
needs_verification = []
for person in people:
result = results_by_id.get(person["inputId"])
if result is None:
continue
if result["status"] != "success":
continue
if not result["outputs"].get("emailFound"):
continue
contact = person.copy()
contact["result"] = result
if result["outputs"].get("emailStatus") == "verified":
campaign_contacts.append(contact)
else:
needs_verification.append(contact)
print(json.dumps({
"campaign_contacts": campaign_contacts,
"needs_verification": needs_verification,
}, indent=2))Благодаря results_by_id порядок ответов не имеет значения. Для Сатьи цикл считывает contact-satya-nadella из исходного списка people, находит результат с тем же inputId, копирует исходную запись и добавляет полный объект API в поле result. Поскольку адрес присутствует и имеет статус verified, контакт попадает в campaign_contacts. Рид проходит тот же путь, даже если его результат от API пришёл первым.
Три условия делают логику принятия решения понятной. Первое пропускает контакт, если соответствующий результат не был возвращён. Второе отбрасывает ошибки на уровне строки и другие статусы, отличные от успешного. Третье требует наличия значения emailFound. Сохранение полного объекта result позволяет оставить для последующего ревью статус, выходные данные, расход кредитов и поле ошибки.
Найденный email с другим статусом доставляемости попадает в needs_verification. Контакт без результата, с ошибкой строки или без emailFound не включается ни в один из подготовленных списков. Исходный список people остаётся доступным для исправлений или дальнейшего поиска.
Рассчитайте стоимость Waterfall Email Finder API
Стандартный управляемый waterfall расходует 25 кредитов за каждый найденный рабочий email. Если email найти не удалось, кредиты не списываются. Вместо умножения общего числа отправленных контактов проверяйте creditsUsed в каждом результате.
За найденный email со статусом unverified также списывается 25 кредитов, даже если локальный код подготовки кампании помещает его в needs_verification, а не в campaign_contacts.
Два найденных email в этом примере израсходовали 50 кредитов. Для планирования бюджета:
- 100 найденных рабочих email потребуют 2 500 кредитов.
- 1 000 найденных рабочих email потребуют 25 000 кредитов.
- Для большого исходного списка может потребоваться меньше, чем
число контактов × 25, поскольку за запросы без результата плата не взимается.
Для доступа к REST API нужен тариф Growth. По текущему тарифу пополнения в долларах США за $20 можно купить 20 000 кредитов — по $0,001 за кредит. При такой цене стоимость 25 000 кредитов составляет $25. Подписка оплачивается отдельно и не входит в этот расчёт. Актуальные тарифы и пакеты указаны на странице цен Datablist.
Исправьте частые ошибки и восстановите задачу
API-ключ отсутствует. До отправки запроса скрипт выдаёт ошибку Set DATABLIST_API_KEY before running this script.. Экспортируйте переменную в текущем терминале и снова запустите файл.
API возвращает ошибку аутентификации. Метод raise_for_status() сообщает об ошибке HTTP. Скопируйте актуальный Personal API Key, убедитесь, что он передаётся в заголовке X-API-Key, исправьте учётные данные и только после этого повторите запуск.
На аккаунте недостаточно кредитов. Проверьте баланс. Пополните его или дождитесь следующего начисления кредитов по тарифу, прежде чем отправлять новые задачи.
Входные поля не соответствуют выбранному режиму. Для name_company используйте отдельные поля имени и фамилии либо fullName, а для linkedin — linkedInProfile. Исправьте контакт и отправьте его в одном согласованном режиме.
Задача получила статус failed или stopped. Скрипт выдаёт RuntimeError, содержащую ID задачи, её конечный статус и доступное описание ошибки. Проверьте задачу и все доступные результаты, прежде чем решать, для каких контактов нужно повторить поиск.
Ответ на POST-запрос был потерян. Скопируйте uniqueId, выведенный перед отправкой. Получите список задач с тем же ключом:
curl "https://api.datablist.com/v1/enrichments/tasks" \
-H "X-API-Key: $DATABLIST_API_KEY"Найдите задачу с выведенным uniqueId, скопируйте её @id, а затем продолжите работу через URL статуса задачи или результатов. Так вы восстановите существующую задачу, не отправляя контакты повторно. В документации Task API описаны жизненный цикл и endpoints для получения результатов.
Следующие шаги
Теперь у вас есть одна блокирующая функция Python на Requests для трёх поддерживаемых вариантов входных данных, а также локальный фильтр, который готовит найденные и проверенные email к ревью перед кампанией.
Замените два контакта из примера небольшой выборкой из вашей базы. Выберите подходящий вариант входных данных, запустите поиск и проверьте emailStatus, прежде чем использовать адрес. Для работы с большими списками изучите руководство о том, как находить email в больших объёмах. В поддерживаемом репозитории GitHub доступны блокирующий и асинхронный примеры на Python.