
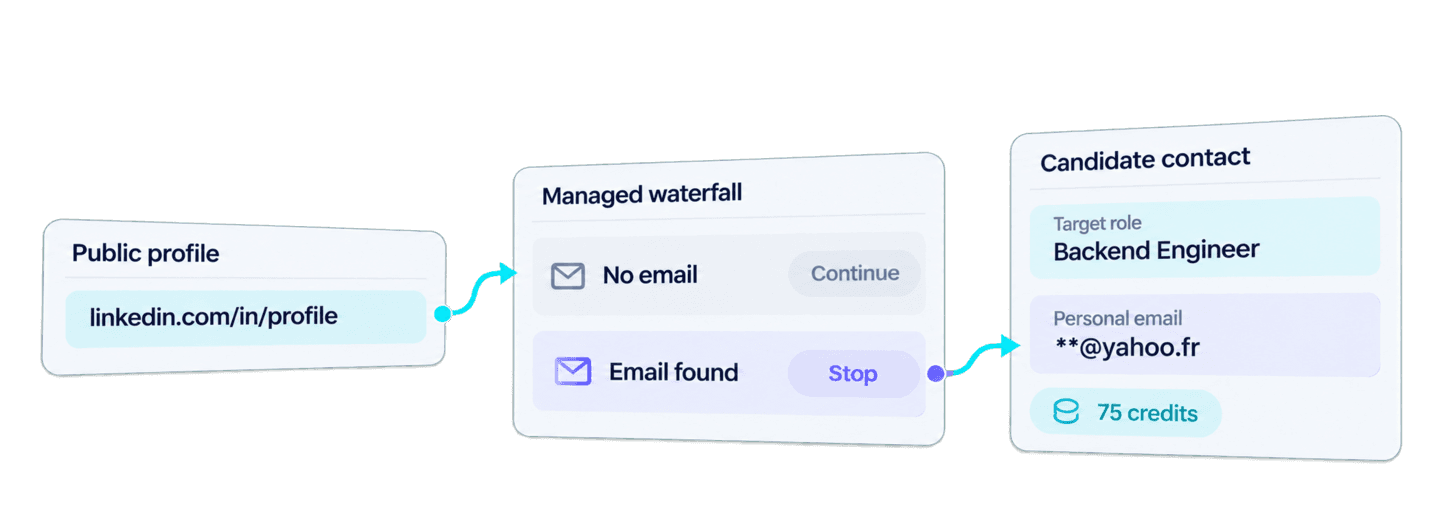
Найти личные email по LinkedIn в Python можно, отправив публичные URL профилей вида linkedin.com/in/... в API Waterfall Personal Email Finder от Datablist. API последовательно обращается к подходящим email-провайдерам и возвращает личный адрес, как только один из них находит результат.
Полный пример с Requests ниже создаёт одну фоновую задачу, дожидается её завершения и загружает все страницы результатов. После успешного поиска вы сможете использовать возвращённые объекты для подготовки записей с контактами кандидатов, сохранив рядом с найденным email имя, URL профиля LinkedIn и целевую должность.
Этот процесс предназначен для поиска личного email, не связанного с текущим работодателем кандидата. Если вам нужен корпоративный адрес, воспользуйтесь отдельной инструкцией о том, как найти рабочий email по профилю LinkedIn.
🔑 Кратко для тех, кто спешит
Укажите имена кандидатов, публичные URL их профилей LinkedIn и целевые должности. Python-скрипт найдёт доступные личные email и сохранит каждый адрес вместе с исходными данными для рекрутинга.
- Входные данные: имена кандидатов, публичные URL профилей
linkedin.com/in/...и целевые должности.- Результат: найденные личные email вместе с данными соответствующих кандидатов.
💡 Предпочитаете no-code решение? Используйте Waterfall Personal Email Finder от Datablist, чтобы находить личные email без написания кода.
Если в исходных данных есть имена, но нет URL профилей, сначала найдите публичные профили LinkedIn с помощью Python, а затем передайте эти URL в API.
Настройка Python, Requests и API-ключа Datablist
В этом примере используется Python с пакетом requests. Создайте файл find_personal_emails.py, затем установите Requests:
python -m pip install requestsСоздайте Personal API Key в аккаунте Datablist и экспортируйте его как переменную окружения:
export DATABLIST_API_KEY='your-api-key'Доступ к REST API входит в тариф Growth. За каждый успешно найденный личный email также списываются кредиты. Расчёт стоимости приведён ниже в соответствующем разделе.
Поиск личного email одной функцией Python
Редактируемый список candidates в этом скрипте содержит одну запись кандидата. target_role — пример исходного значения, которое остаётся внутри рекрутингового процесса. В payload API передаются только candidate_id и linkedin_url.
import json
import os
import time
import uuid
import requests
def find_personal_emails(candidates, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": candidate["candidate_id"],
"data": {"profileUrl": candidate["linkedin_url"]},
}
for candidate in candidates
]
unique_id = str(uuid.uuid4())
print(f"Recovery uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-personal-email-finder",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(f"Task {task_id} {task['status']}: {task.get('error')}")
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
candidates = [
{
"candidate_id": "candidate-florian-poullin",
"name": "Florian Poullin",
"linkedin_url": "https://www.linkedin.com/in/florianpoullin/",
"target_role": "Backend Engineer",
}
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
personal_email_results = find_personal_emails(candidates, api_key)
for result in personal_email_results:
print(json.dumps(result, indent=2))Запустите файл в том же терминале:
python find_personal_emails.pyТакже можно скачать поддерживаемый разработчиками синхронный пример с Requests. Приведённый выше скрипт использует ту же последовательность — создание задачи, опрос статуса и постраничную загрузку — и передаёт ID кандидатов из исходных записей.
Отправка запроса на поиск
Функция преобразует данные каждого кандидата во входной объект API. В inputId записывается постоянный ID кандидата, а в data.profileUrl — публичный URL личного профиля LinkedIn. Требуется стандартный адрес вида linkedin.com/in/.... URL Sales Navigator, страницы компаний, пустые значения и имена без URL профиля не подходят для этого enrichment.
В запросе указывается waterfall-personal-email-finder в качестве enrichmentId и пустой объект settings, как показано в документации API Waterfall Personal Email Finder. Перед отправкой скрипт выводит сгенерированный uniqueId. Сохраните это значение: по нему можно найти существующую задачу, если соединение прервётся после того, как API примет запрос.
Полное тело запроса для примера с одним профилем:
{
  "enrichmentId": "waterfall-personal-email-finder",
  "uniqueId": "55001d29-4fb9-4fe2-9497-80f4b346eed7",
  "settings": {},
  "inputs": [
    {
      "inputId": "candidate-florian-poullin",
      "data": {
        "profileUrl": "https://www.linkedin.com/in/florianpoullin/"
      }
    }
  ]
}
При успешной отправке сервер возвращает HTTP 202 Accepted с ID задачи в поле @id. После этого обработка продолжается на серверах Datablist.
Ожидание фоновой задачи
Пока сервер выполняет фоновую задачу, скрипт Requests ожидает её завершения. Он проверяет статус каждые три секунды и продолжает опрос, пока задача находится в состоянии queued или running. После статуса completed начинается загрузка результатов. При статусе failed или stopped скрипт выдаёт ошибку с ID задачи и доступным сообщением об ошибке.
Загрузка всех страниц результатов
Endpoint результатов возвращает для каждой строки исходный ID, статус, выходные данные, количество кредитов и ошибку. Первый запрос загружает до 100 результатов. Затем скрипт запрашивает следующую страницу, пока значение nextCursor не станет null.
Результаты задачи сохраняют порядок входных данных. Поле inputId явно связывает каждый результат с записью кандидата, в том числе при наличии нескольких страниц.
Когда будете адаптировать пример для большего количества записей, сохраняйте постоянный candidate_id из исходной системы. Это обеспечит предсказуемое объединение данных, если результаты задачи займут несколько страниц.
Как Waterfall находит личный email
Datablist очищает переданный публичный URL профиля LinkedIn и последовательно отправляет необработанный профиль доступным провайдерам личных email. Если один провайдер не возвращает подходящий адрес, профиль может перейти к следующему. Как только провайдер находит пригодный email, цепочка для этого профиля останавливается, а адрес возвращается в поле outputs.emailFound.
Списком доступных провайдеров управляет Datablist, поэтому вашей интеграции не нужны отдельные запросы к каждому сервису или собственный fallback-код. Публичный результат содержит итог поиска email, а не фиксированный порядок провайдеров или историю попыток.
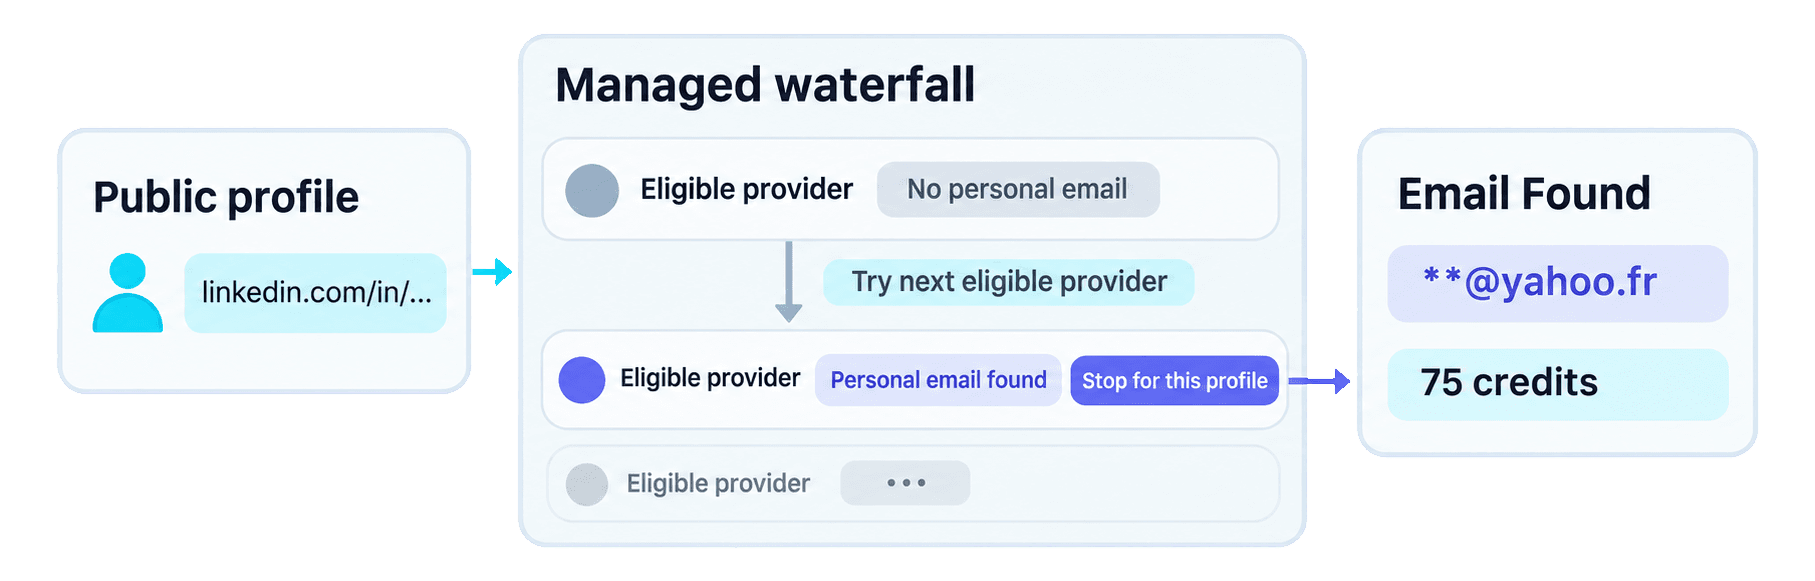
Waterfall — это метод поиска. Опрос статуса решает другую задачу: он позволяет Python-клиенту дождаться завершения фоновой обработки.
Преимущества Waterfall для международного рекрутинга
Провайдеры личных email используют разные наборы данных, поэтому их эффективность зависит от страны и рынка. Если у первого провайдера нет email кандидата, адрес может найти следующий сервис в цепочке.
Рекрутинговые команды, работающие в нескольких странах, получают более широкий охват провайдеров через одну API-интеграцию. Datablist управляет последовательностью и помогает находить контакты, которые мог бы пропустить отдельный провайдер, без подключения и поддержки нескольких API.
Полная структура результата API
📘 Замаскированный email: В примере ниже локальная часть адреса заменена на
**. В результате API вы получите полное значение.
Полная страница результатов для переданного кандидата:
{
  "taskId": "b5de73ffaa3f4f349c125d7c85125bb4",
  "results": [
    {
      "inputId": "candidate-florian-poullin",
      "status": "success",
      "outputs": {
        "emailFound": "**@yahoo.fr"
      },
      "creditsUsed": "75",
      "error": null
    }
  ],
  "nextCursor": null
}
inputId служит ключом для объединения с исходной записью кандидата. В outputs.emailFound находится личный адрес. Поле creditsUsed содержит точную стоимость этой строки в кредитах, а error: null означает, что API не вернул ошибку на уровне строки. Нулевой курсор подтверждает, что следующей страницы результатов нет.
Рассматривайте найденный адрес как один из вариантов связи с владельцем переданного профиля и проверяйте его перед использованием в рекрутинге.
Подготовка контактов кандидатов для рекрутера
После завершения поиска можно подготовить локальный список для проверки рекрутером без дополнительного API-запроса. Следующий блок повторно использует существующие переменные candidates и personal_email_results:
results_by_id = {
result["inputId"]: result for result in personal_email_results
}
prepared_contacts = []
for candidate in candidates:
result = results_by_id.get(candidate["candidate_id"])
if not result or result.get("status") != "success":
continue
email_found = result.get("outputs", {}).get("emailFound")
if not email_found:
continue
prepared_contact = candidate.copy()
prepared_contact["result"] = result
prepared_contacts.append(prepared_contact)
print(json.dumps(prepared_contacts, indent=2))Для candidate-florian-poullin поиск по словарю находит результат с тем же inputId. В скопированной записи сохраняются имя Florian Poullin, URL профиля LinkedIn и пример целевой должности Backend Engineer. Затем к ней добавляется полный объект API в поле result, где рекрутер сможет увидеть result.outputs.emailFound.
Цикл начинается с исходного списка кандидатов. Если в будущем поиск не даст результата, возникнет ошибка строки, результат будет отсутствовать или emailFound окажется пустым, исходный список останется без изменений, а запись не попадёт в prepared_contacts.
Подробнее о комплексной проверке и других каналах связи читайте в руководстве о том, как рекрутеру найти email кандидата.
Расчёт стоимости API Waterfall Personal Email Finder
Каждый найденный личный email стоит 75 кредитов. Если адрес не найден, кредиты не списываются. Чтобы определить фактические расходы, суммируйте creditsUsed для каждого результата, а не умножайте общее количество отправленных профилей.
Формула для планирования:
количество найденных личных email × 75 кредитов
Например, если отправить 100 профилей и для 20 из них найдутся личные email, задача израсходует 20 × 75 = 1 500 кредитов. Это лишь расчёт для планирования, а не ожидаемый процент успешных результатов. При больших объёмах 100 найденных email потребуют 7 500 кредитов, а 1 000 адресов — 75 000 кредитов.
При текущей базовой стоимости пополнения в долларах США $20 / 20 000 кредитов = $0.001 за кредит. Таким образом, один найденный email расходует кредиты на сумму $0.075, а 100 найденных адресов — на $7.50. Эта оценка отражает только стоимость использованных кредитов. Подписка Growth, необходимая для доступа к REST API, оплачивается отдельно. Актуальные тарифы и пакеты кредитов указаны на странице цен Datablist.
Частые ошибки и восстановление существующей задачи
Большинство проблем возникает до отправки, на этапе HTTP-запроса или в отдельном результате. Определите, где появилась ошибка, и выберите подходящее действие:
- Отсутствует
DATABLIST_API_KEY: скрипт остановится локально до выполнения запроса. Экспортируйте переменную окружения и снова запустите файл. - Ошибка HTTP-аутентификации: проверьте Personal API Key в
DATABLIST_API_KEY. Функция отправляет его в заголовкеX-API-Key. Исправьте учётные данные перед повторной отправкой. - Неподдерживаемый URL профиля: замените URL Sales Navigator, страницу компании, пустое значение или некорректный адрес на публичный личный профиль в формате
linkedin.com/in/.... - Недостаточно кредитов: проверьте баланс аккаунта и доступное количество кредитов перед отправкой новых задач.
- Задача получила статус
failedилиstopped: изучите ошибку задачи, доступные результаты и расход кредитов, прежде чем решать, какие записи нужно обработать повторно. - Для строки нет результата или возникла ошибка: сохраните исходную запись кандидата для проверки или связи через другой канал. Неудачный поиск не объясняет, почему адрес оказался недоступен.
Если ответ на POST-запрос потерян, сначала получите список задач и только потом создавайте новую. Найдите в ответе uniqueId, который вывел скрипт, и скопируйте @id соответствующей задачи:
curl "https://api.datablist.com/v1/enrichments/tasks?enrichmentId=waterfall-personal-email-finder&limit=100" \
--header "X-API-Key: $DATABLIST_API_KEY"
TASK_ID='paste-matching-task-id'
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID" \
--header "X-API-Key: $DATABLIST_API_KEY"
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID/results" \
--header "X-API-Key: $DATABLIST_API_KEY"Если нужной задачи нет на первой странице истории, перейдите по возвращённому курсору пагинации и проверьте следующую страницу. Продолжайте отслеживать восстановленную задачу или загрузите доступные результаты вместо автоматического создания ещё одной платной задачи. В документации по задачам описаны жизненный цикл, пагинация и сроки хранения результатов.
Что делать дальше
Теперь у вас есть универсальная Python-функция на базе Requests для обработки публичных URL профилей LinkedIn, а также объединение по постоянному ID, которое связывает найденные личные email с исходными данными каждого кандидата.
Замените тестовый список небольшой подборкой своих кандидатов, сохраните постоянный ID и целевую должность для каждой записи, а затем проверяйте каждый подготовленный контакт перед использованием в рекрутинге. Если приложению нужна неблокирующая параллельная обработка, следующим шагом возьмите поддерживаемый разработчиками асинхронный пример с HTTPX.