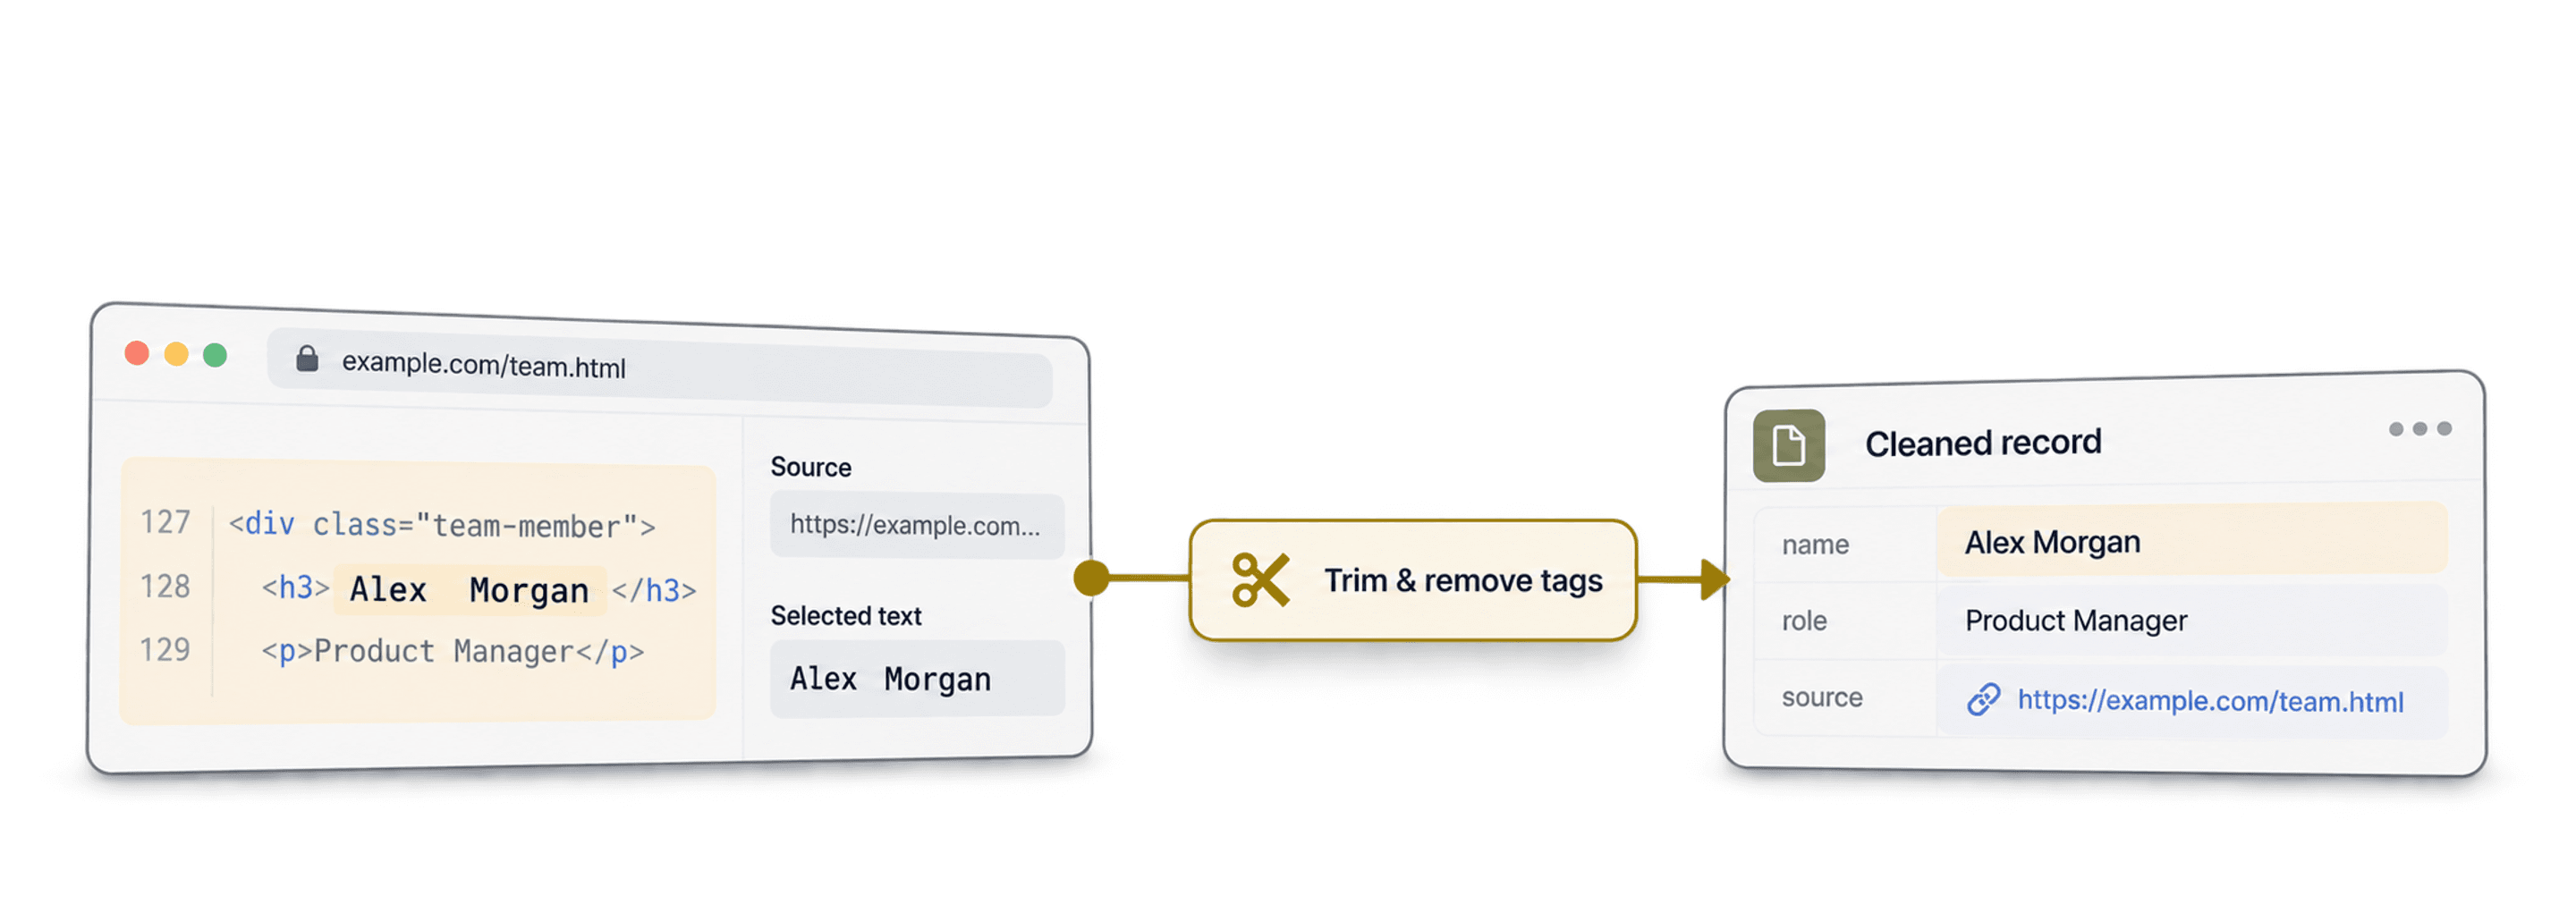
Para limpiar datos de web scraping, conserve primero los valores originales, normalice los campos que vaya a utilizar, revise los registros duplicados y valide los datos de contacto antes de exportar.
Yo empiezo trabajando con una copia separada del archivo de origen, porque un valor aparentemente más limpio puede haber perdido información. Los parámetros de una URL pueden identificar una variante de producto, y un cero inicial puede formar parte de un ID de cuenta. Conserve la URL de origen y el texto original junto a los campos depurados.
Para limpiar una lista de contactos obtenida mediante scraping, siga este orden:
- Importe los datos y compruebe los tipos de columna sugeridos. Mantenga los identificadores como Text.
- Elimine el HTML y los espacios sobrantes del texto descriptivo. Después, estandarice únicamente los campos necesarios para filtrar o encontrar coincidencias.
- Convierta las fechas y cantidades después de revisar sus formatos.
- Busque duplicados mediante un identificador fiable, como el email, y decida qué valores desea conservar.
- Compruebe la sintaxis de los emails y la información de sus dominios, revise las excepciones y exporte la lista limpia.
Las siguientes herramientas le permiten completar cada paso en Datablist sin utilizar fórmulas. Los ejemplos indican qué valores conviene revisar antes de aplicar una transformación a toda la colección.
Este es un resumen rápido de las operaciones de limpieza incluidas en el artículo:
- Convertir texto a Datetime, Number o Boolean
- Convertir HTML en texto y eliminar etiquetas
- Eliminar espacios sobrantes
- Normalizar sus datos
- Eliminar símbolos de los textos
- Separar el nombre completo en nombre y apellidos
- Eliminar registros duplicados
- Validar direcciones de email
- Extraer nombres de personas o empresas de textos obtenidos mediante scraping
Importar datos desde CSV o mediante copiar y pegar
Datablist es una herramienta ideal para limpiar datos. Es un editor de CSV online con funciones de limpieza, edición masiva y enriquecimiento. Además, admite millones de elementos en cada colección.
Abra Datablist, cree una colección y cargue el archivo CSV con los datos obtenidos mediante scraping.
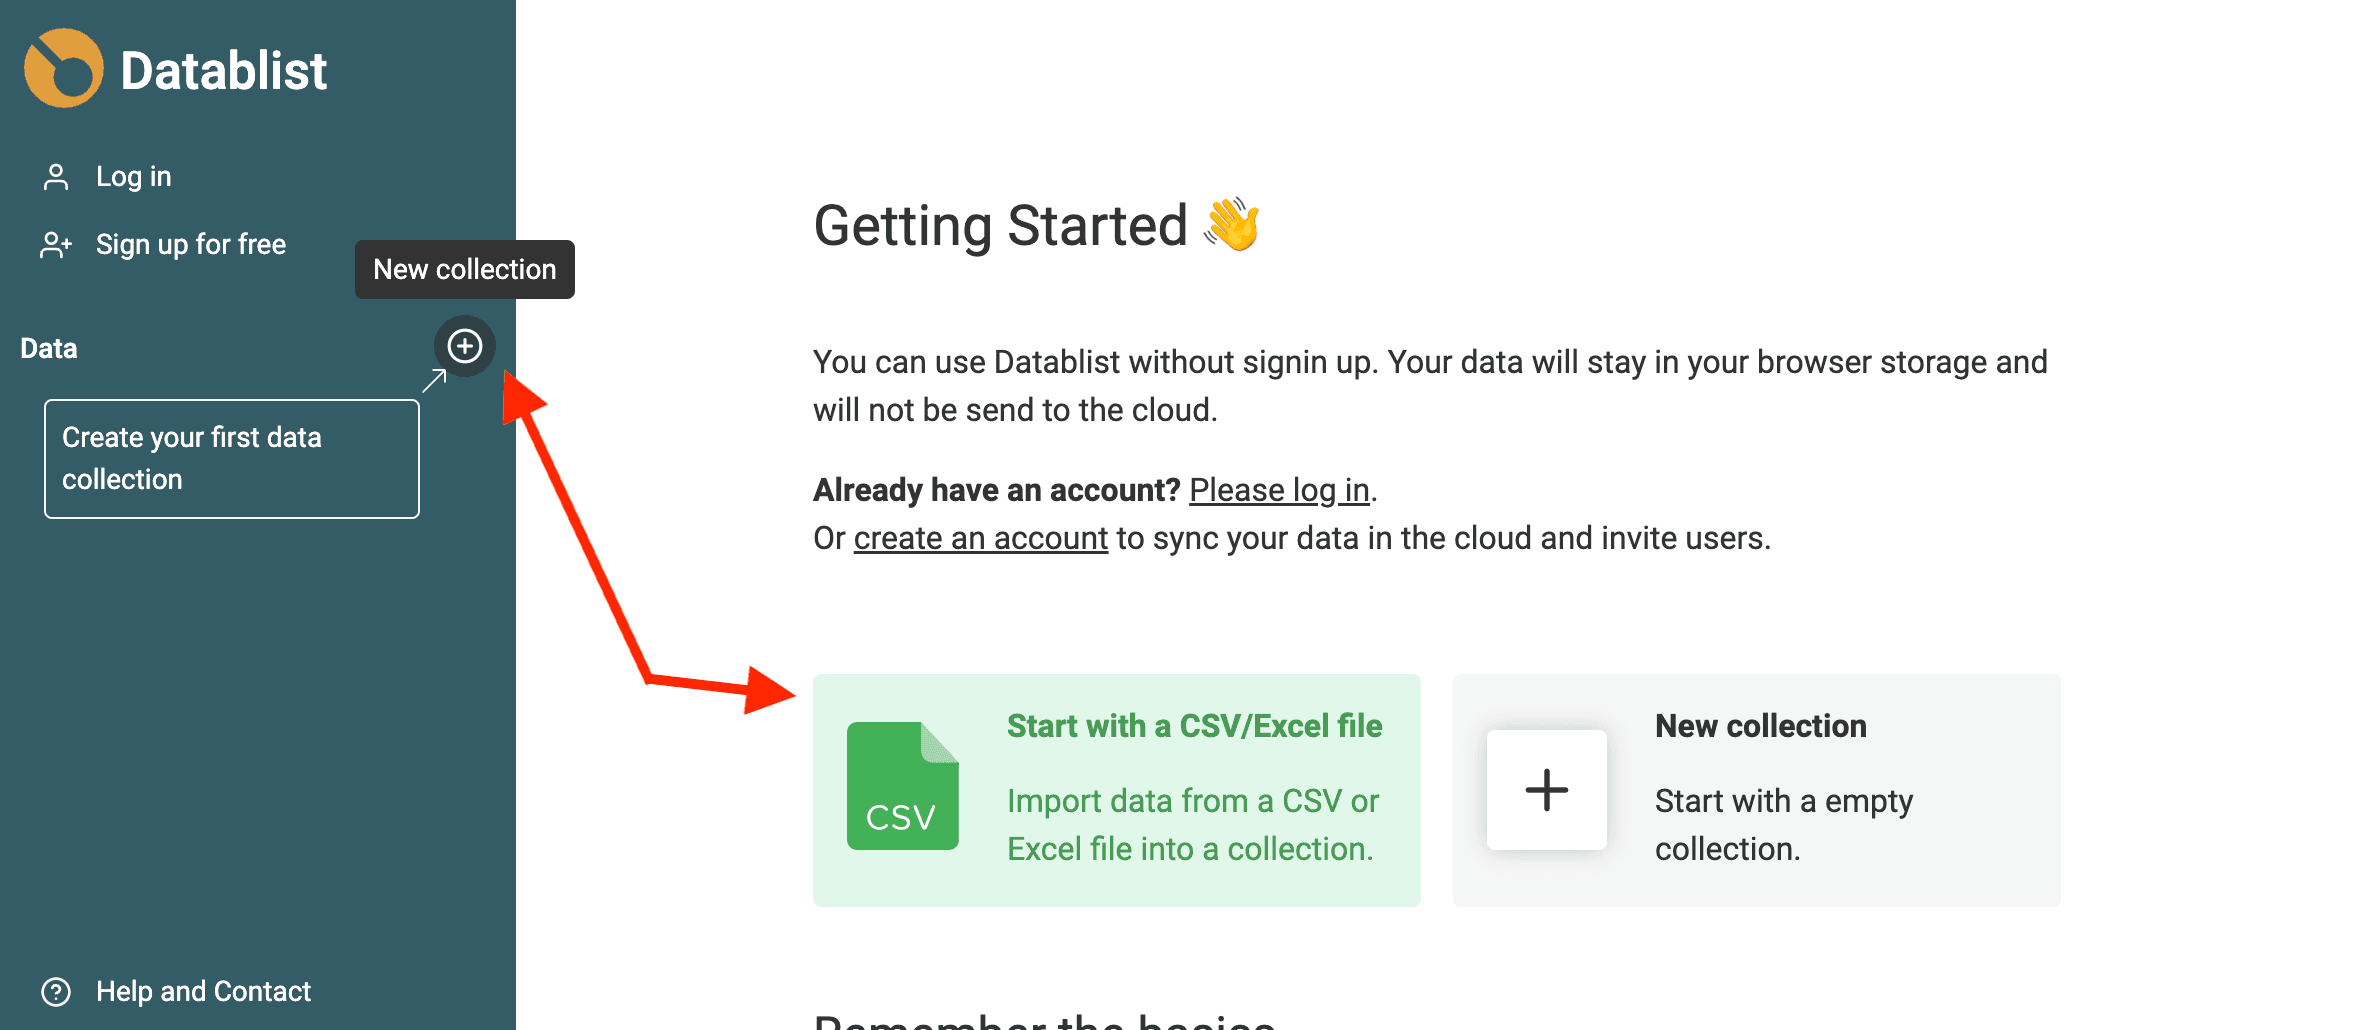
Para crear una colección, haga clic en el botón + de la barra lateral. Después, seleccione "Import CSV/Excel" para cargar el archivo. También puede utilizar el acceso directo de la página de introducción para ir directamente al paso de importación.
Detectar el formato automáticamente
El asistente de importación de Datablist detecta automáticamente direcciones de email, valores Datetime en formato ISO 8601, Boolean, Number, URL y otros tipos de datos cuando tienen el formato correcto.
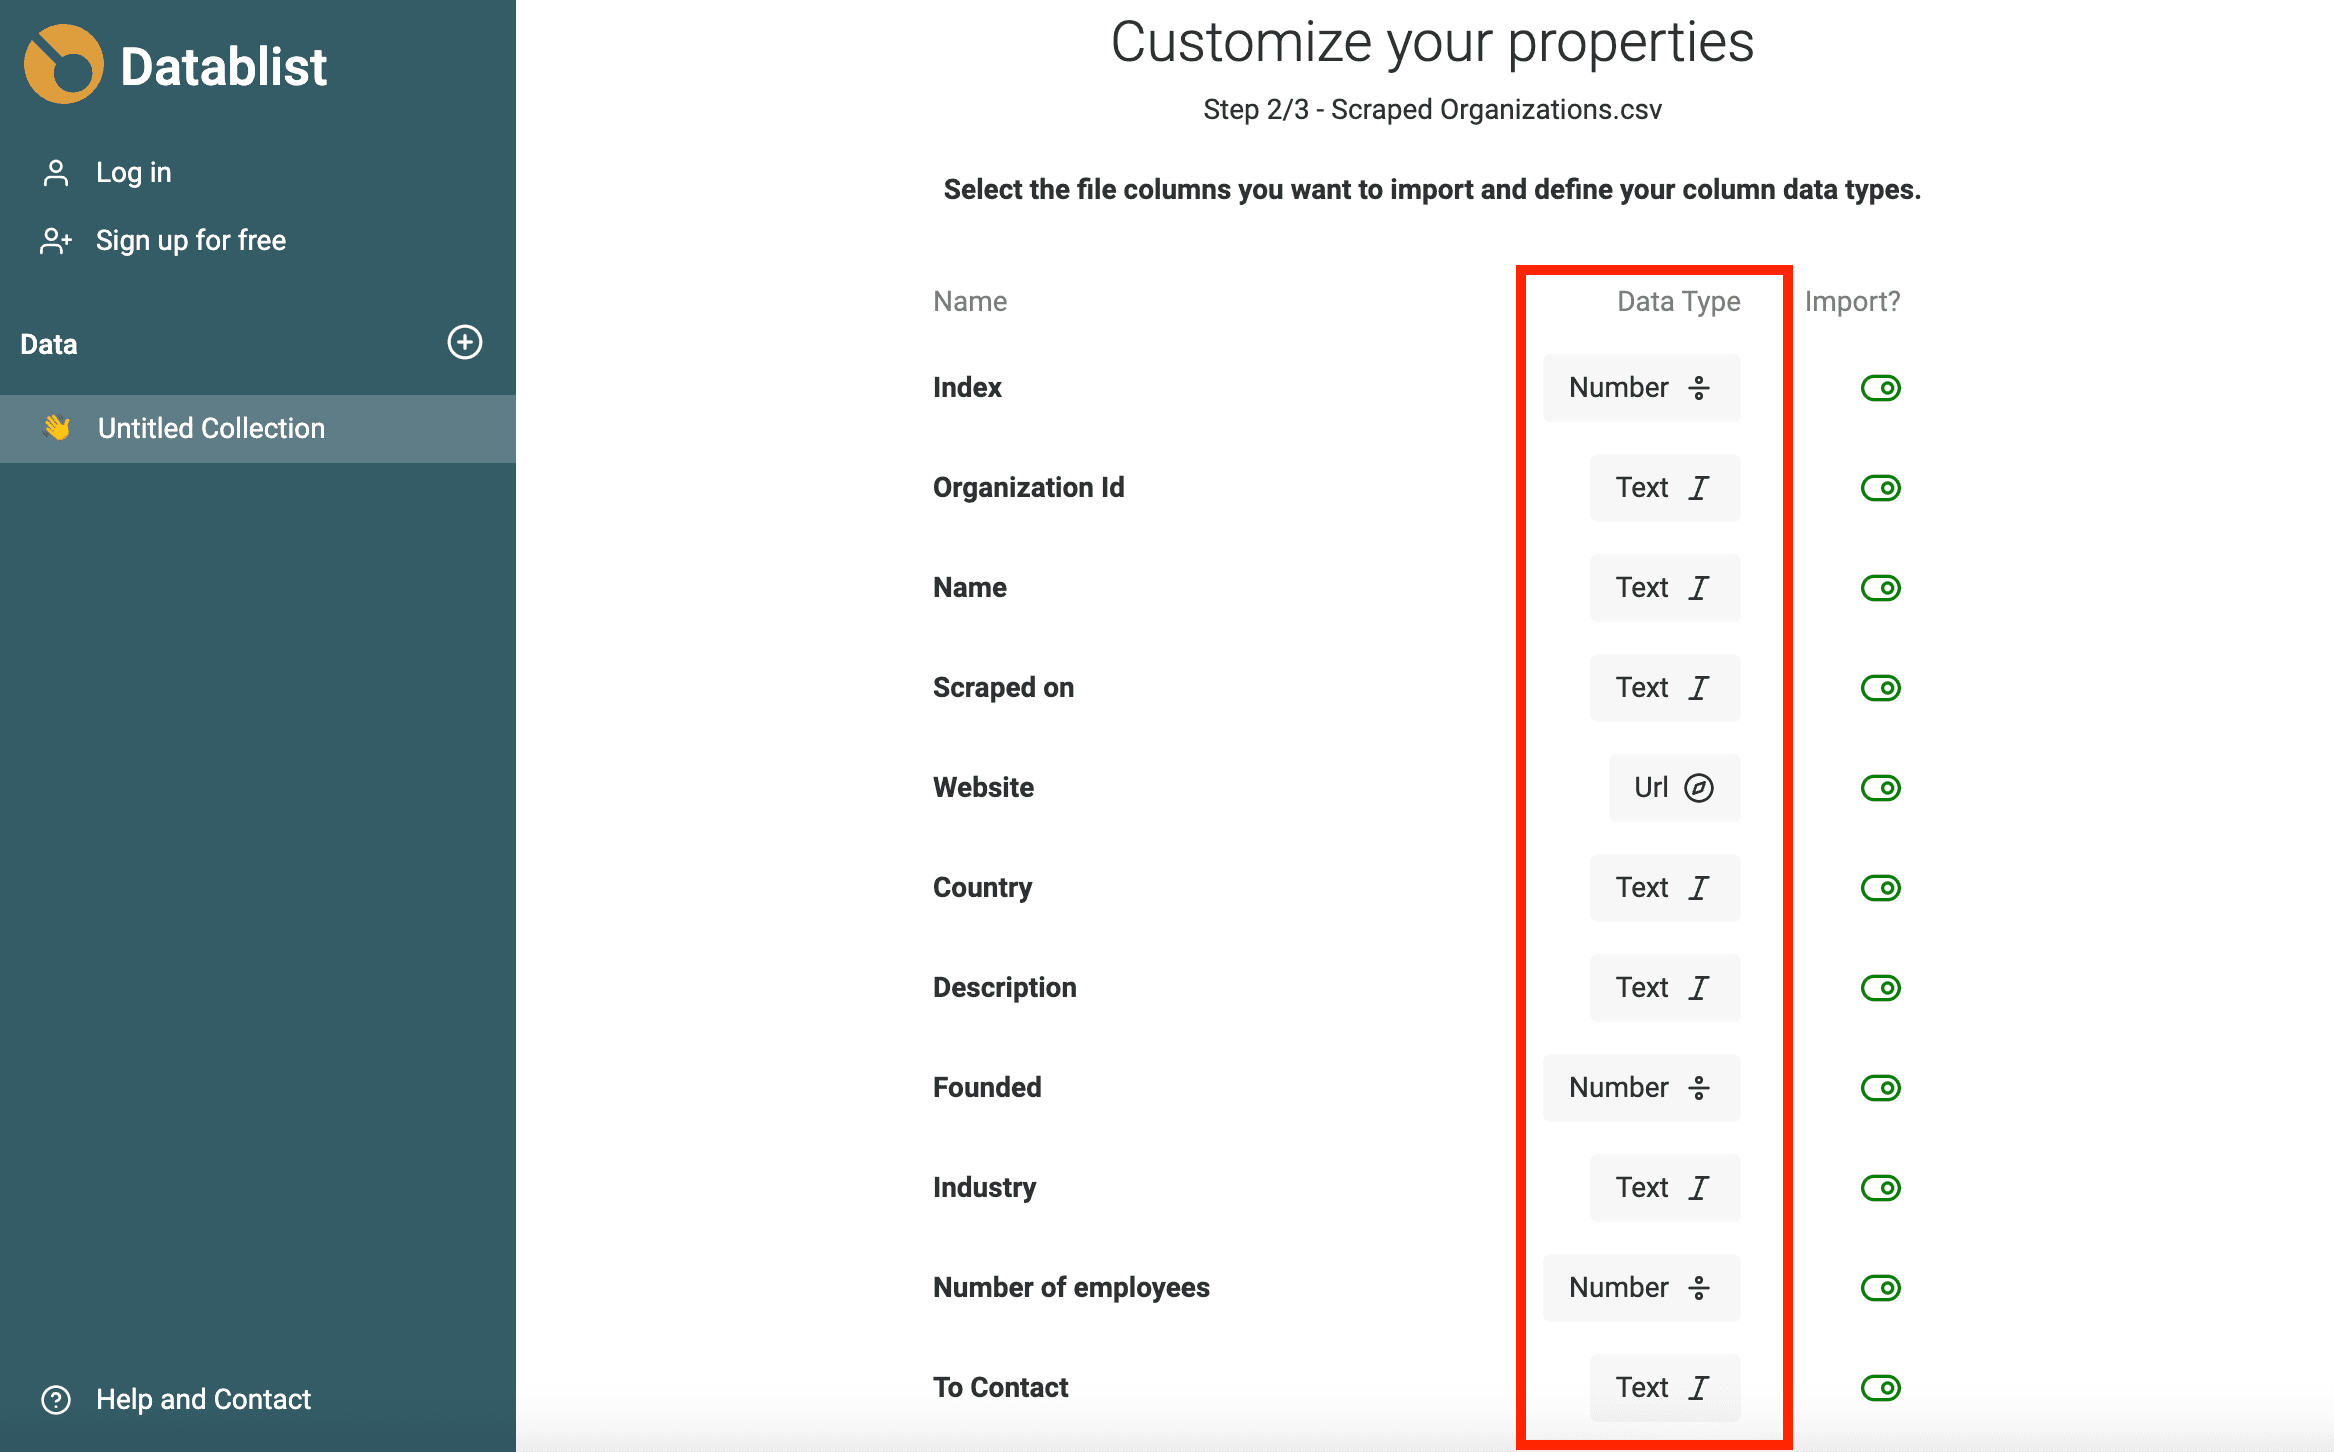
Si sus datos requieren un análisis más complejo —por ejemplo, porque utilizan otro formato de fecha o contienen errores en una URL o dirección de email—, impórtelos como una propiedad Text. En la siguiente sección verá cómo convertir propiedades Text en Datetime, Boolean o Number.
Convertir texto a Datetime, Boolean y Number
Marie Kondo dice que «la vida comienza de verdad después de poner la casa en orden». Lo mismo sucede con los datos obtenidos mediante scraping: «¡las ventas empiezan de verdad cuando pone sus datos en orden!». 😅
Filtrar por una fecha (fecha de creación, fecha de financiación, etc.), un número (precio, número de empleados) o un booleano resulta mucho más sencillo cuando son objetos nativos y no simples textos.
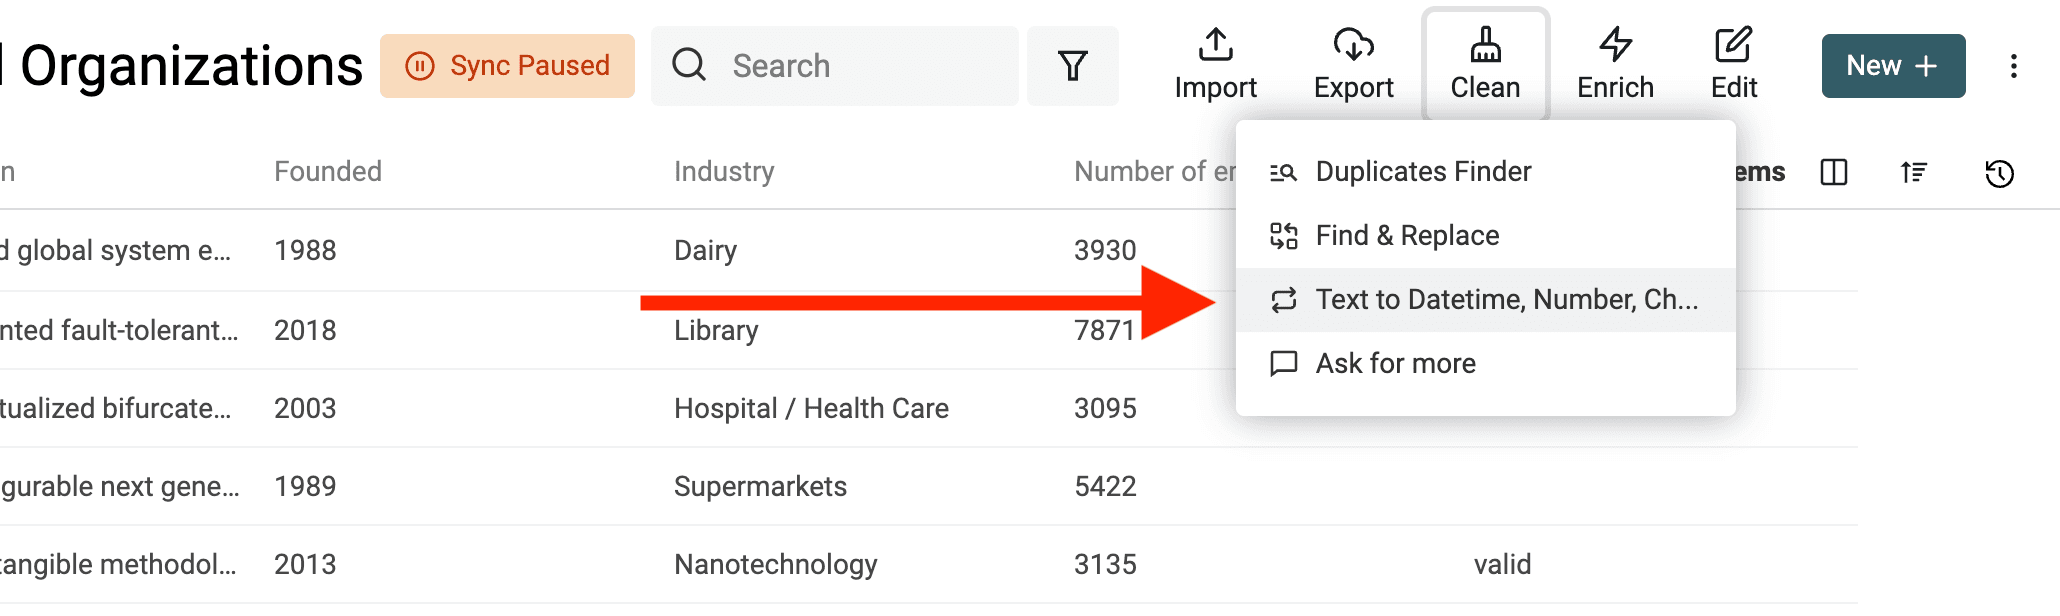
Abra la herramienta "Text to Datetime, Number, Checkbox" desde el menú "Clean".
Convertir cualquier texto al formato Datetime
Datetime dispone de un formato internacional denominado ISO 8601, con una estructura definida. Si sus datos utilizan este formato, durante la importación se creará automáticamente una propiedad Datetime para almacenarlos.
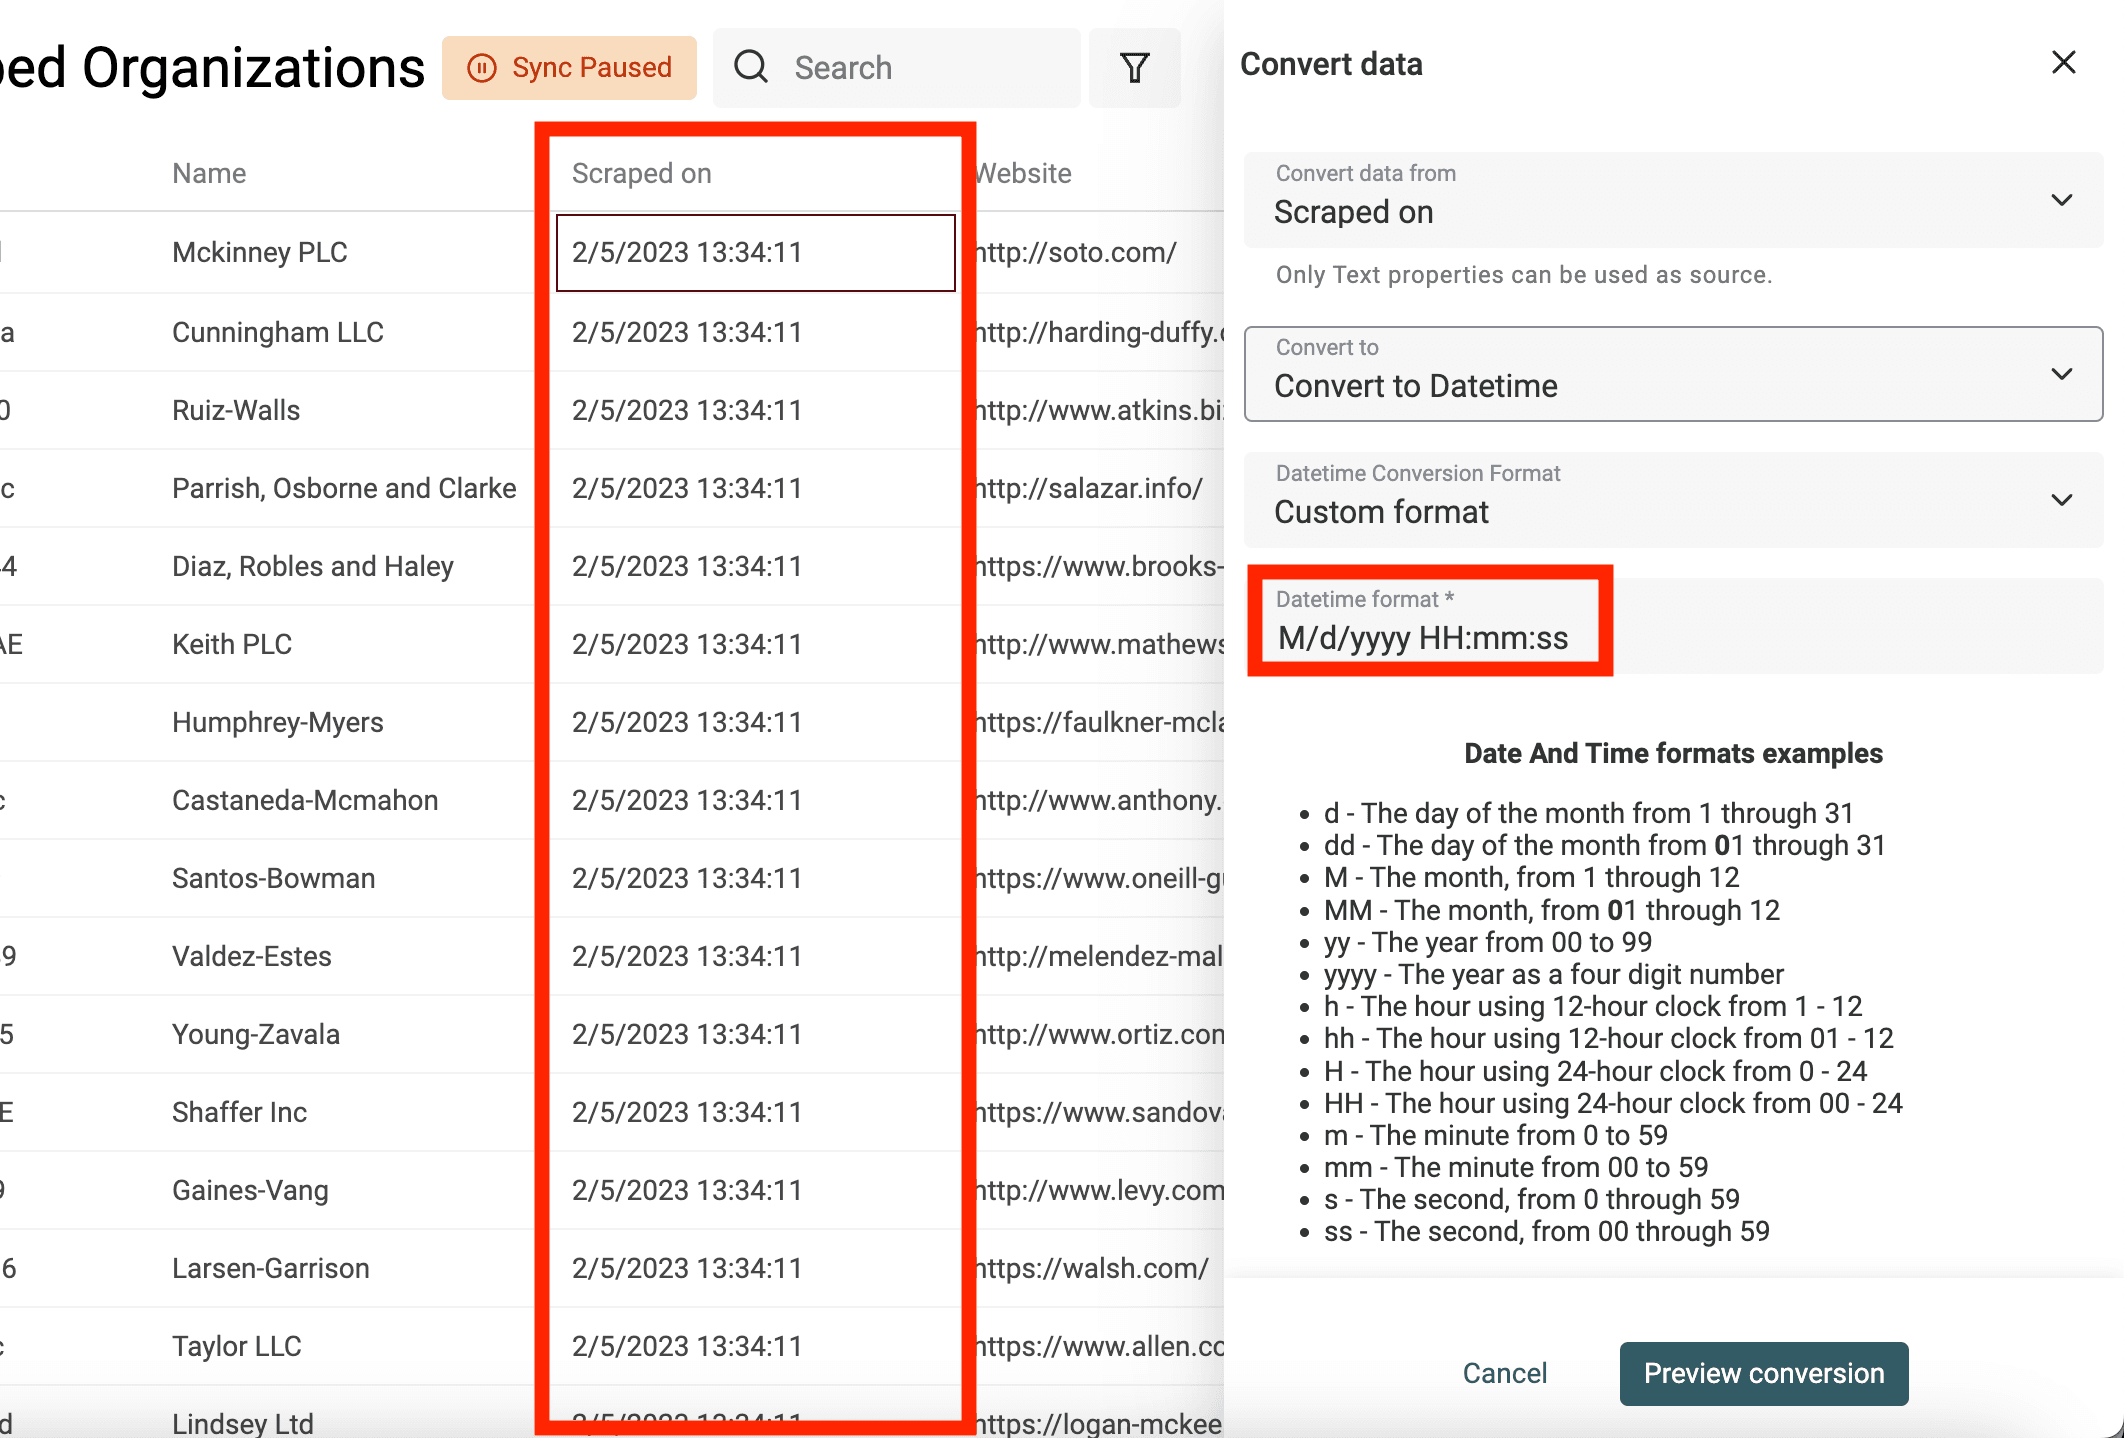
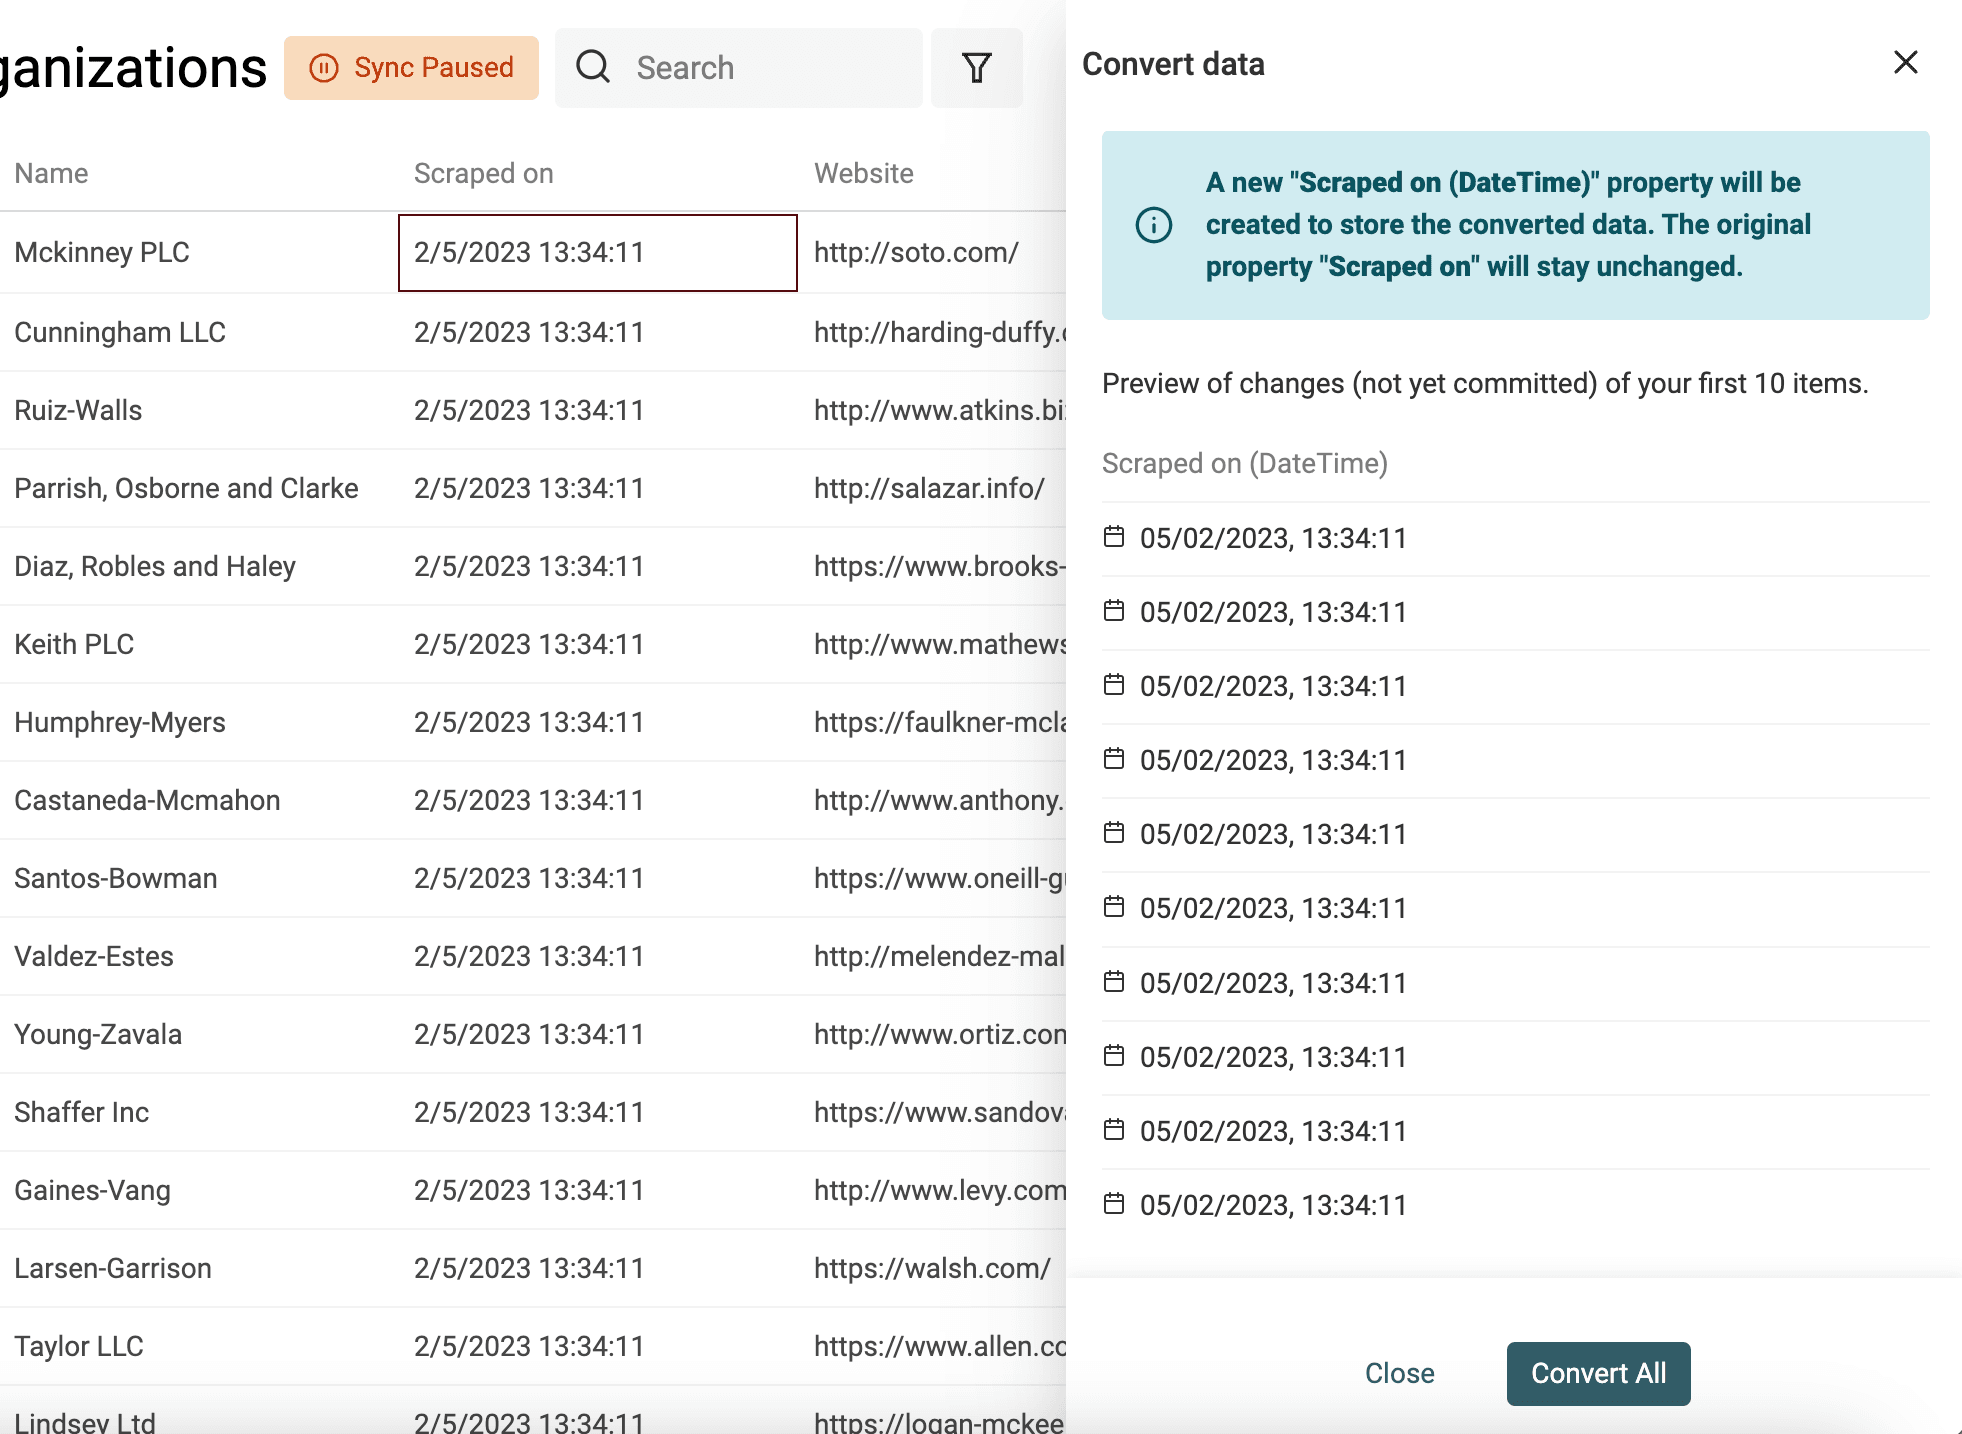
Para valores Date y Datetime con otros formatos, tendrá que indicar el formato utilizado para que Datablist pueda convertirlos en valores Datetime estructurados.
Seleccione la propiedad que desea convertir y elija "Convert to Datetime".
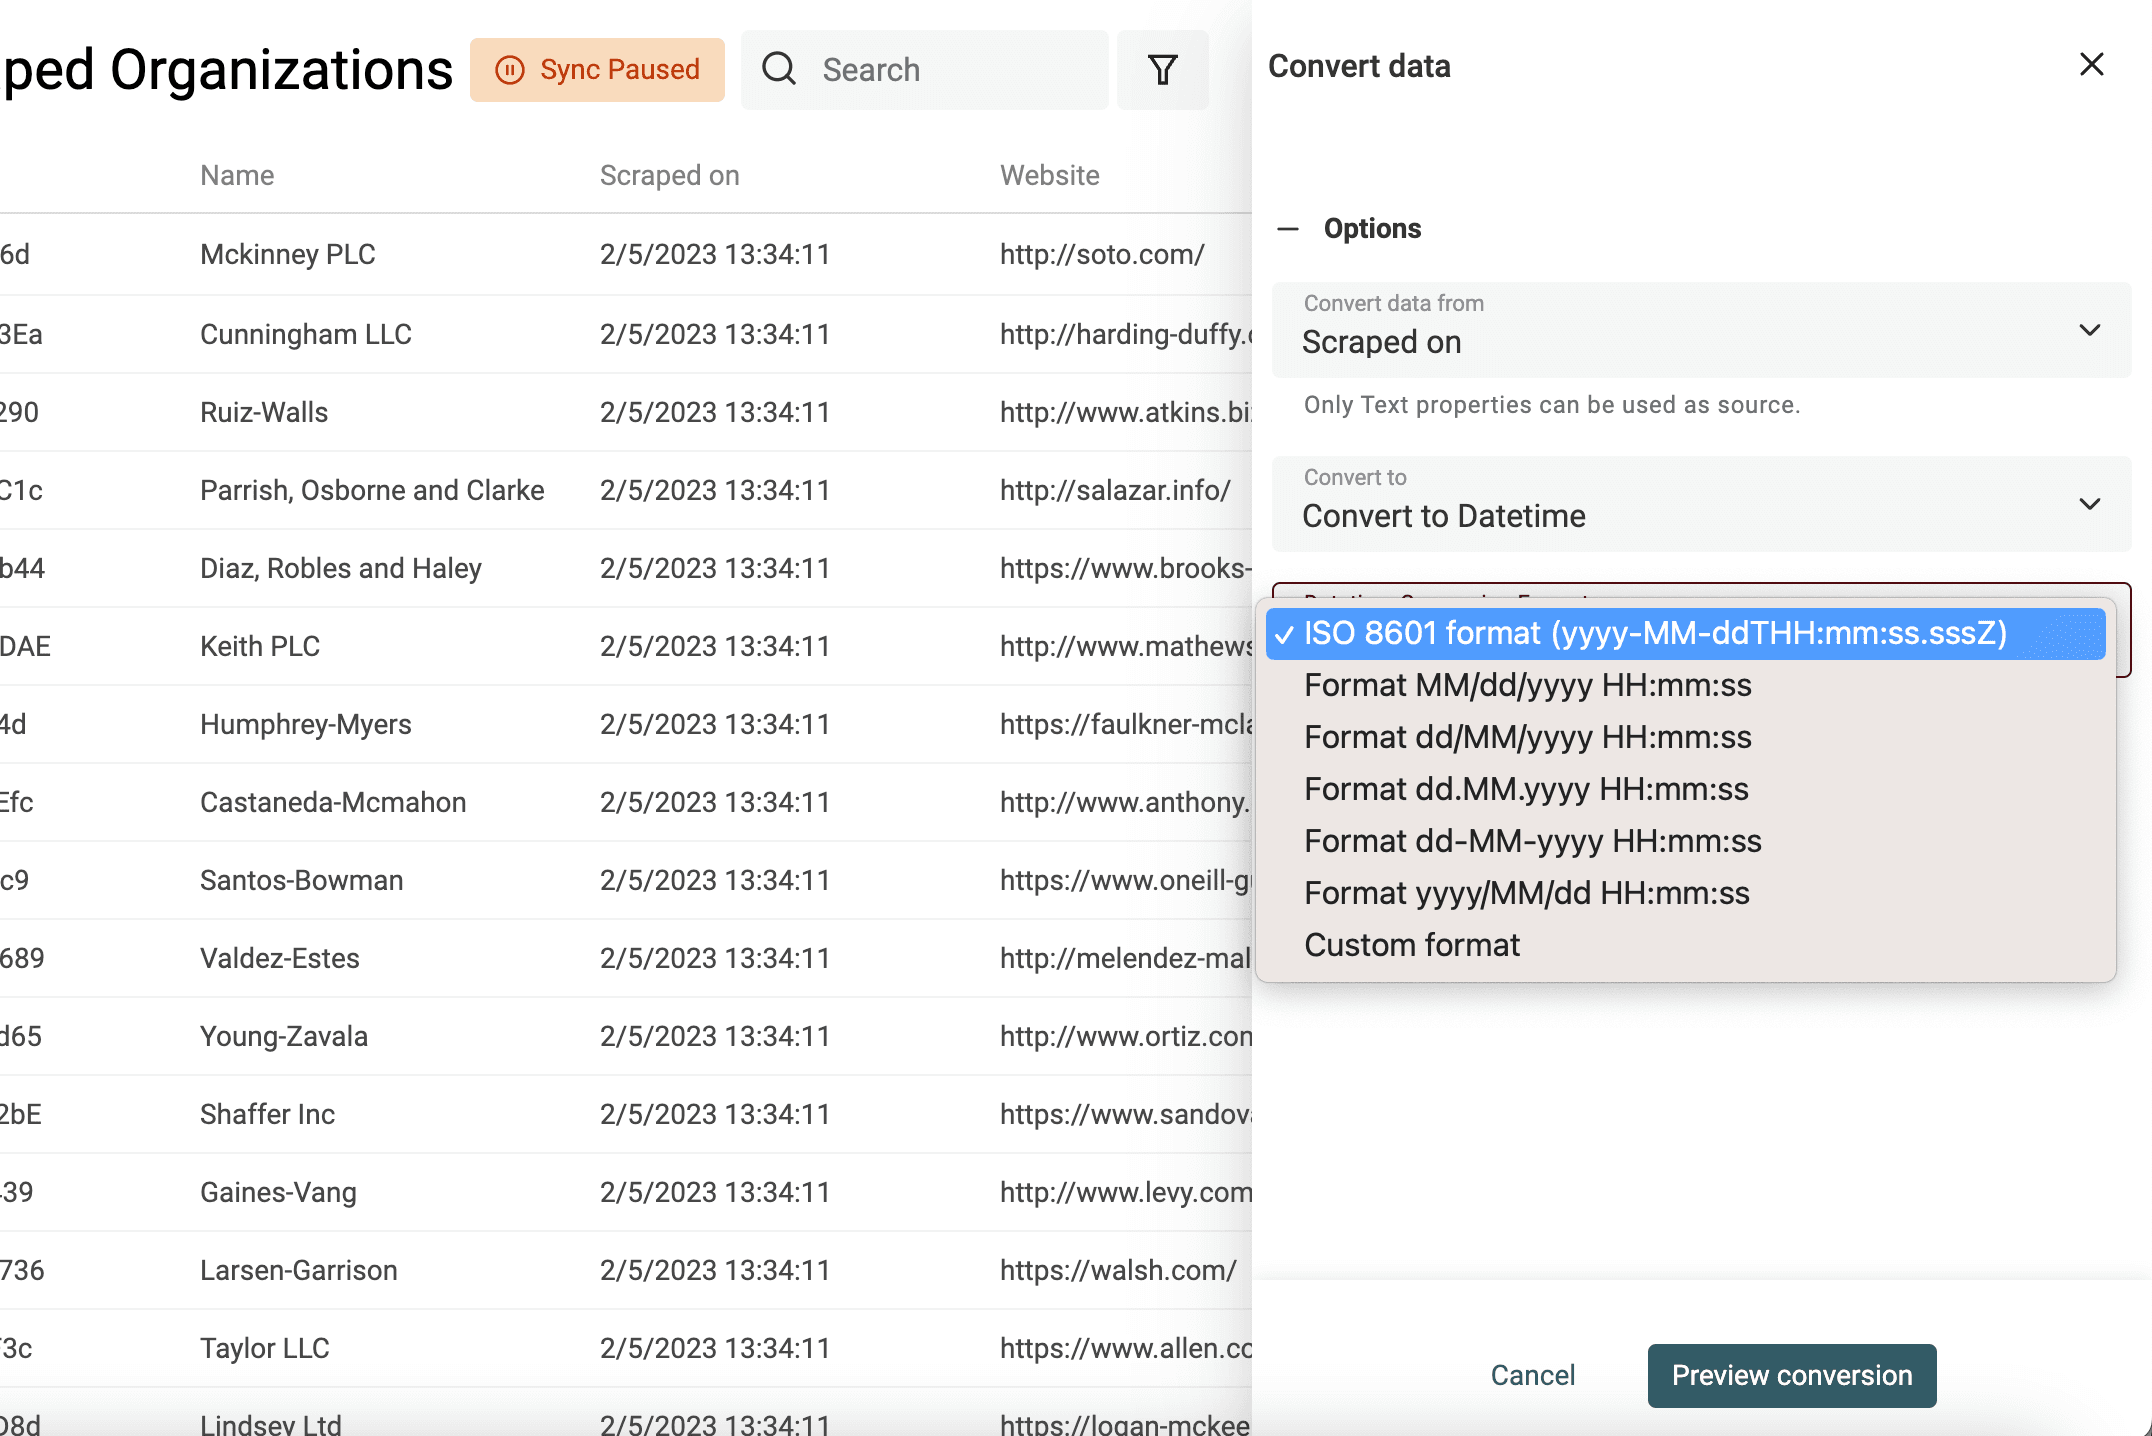
La herramienta incluye una lista de formatos habituales —como los utilizados por Google Sheets y Excel—. También puede seleccionar "Custom format" para definir su propio formato Datetime.
Crear Checkboxes (Boolean) a partir de texto
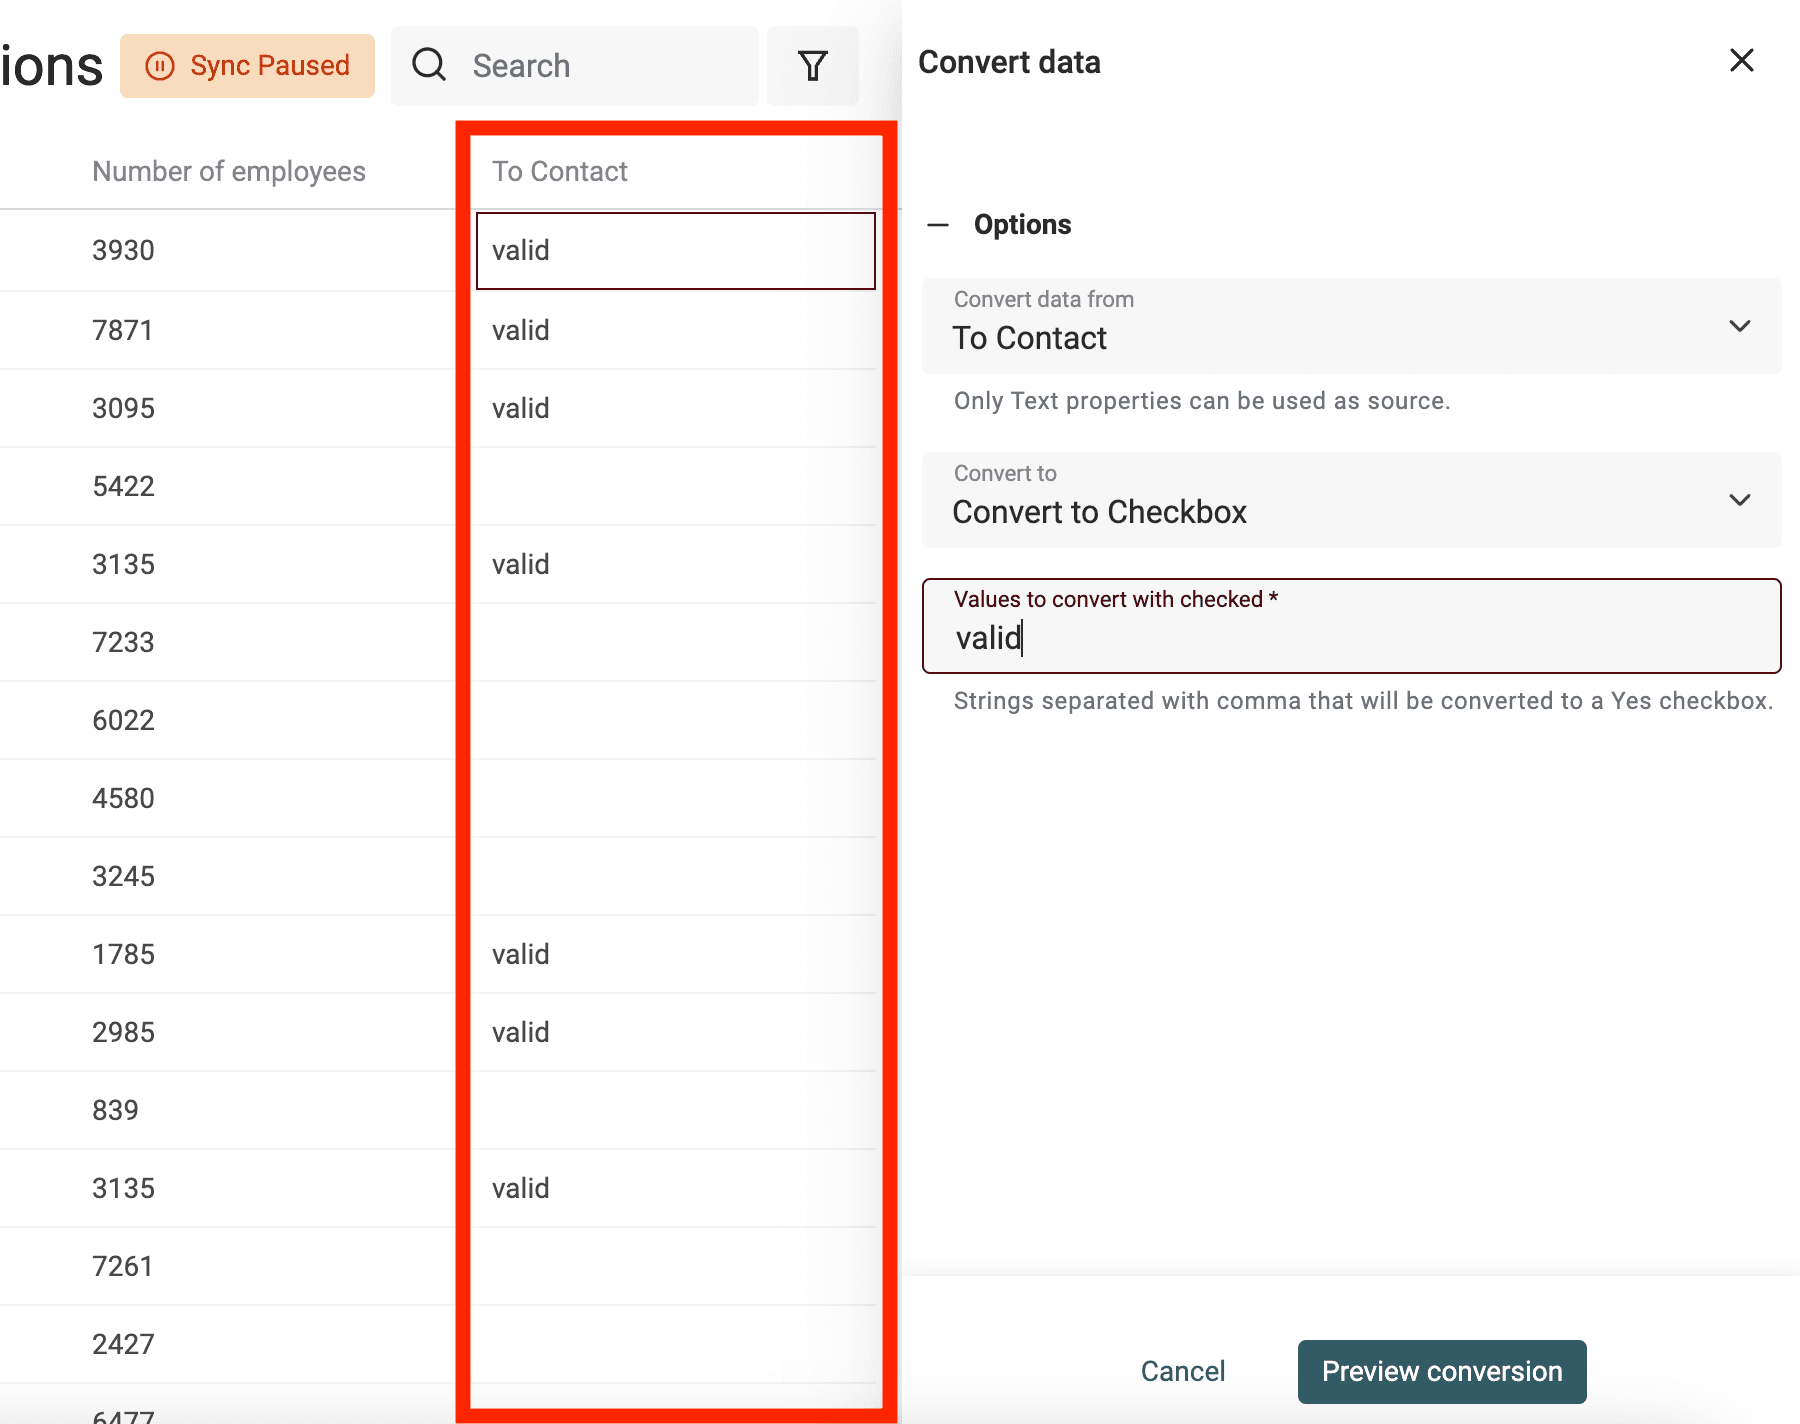
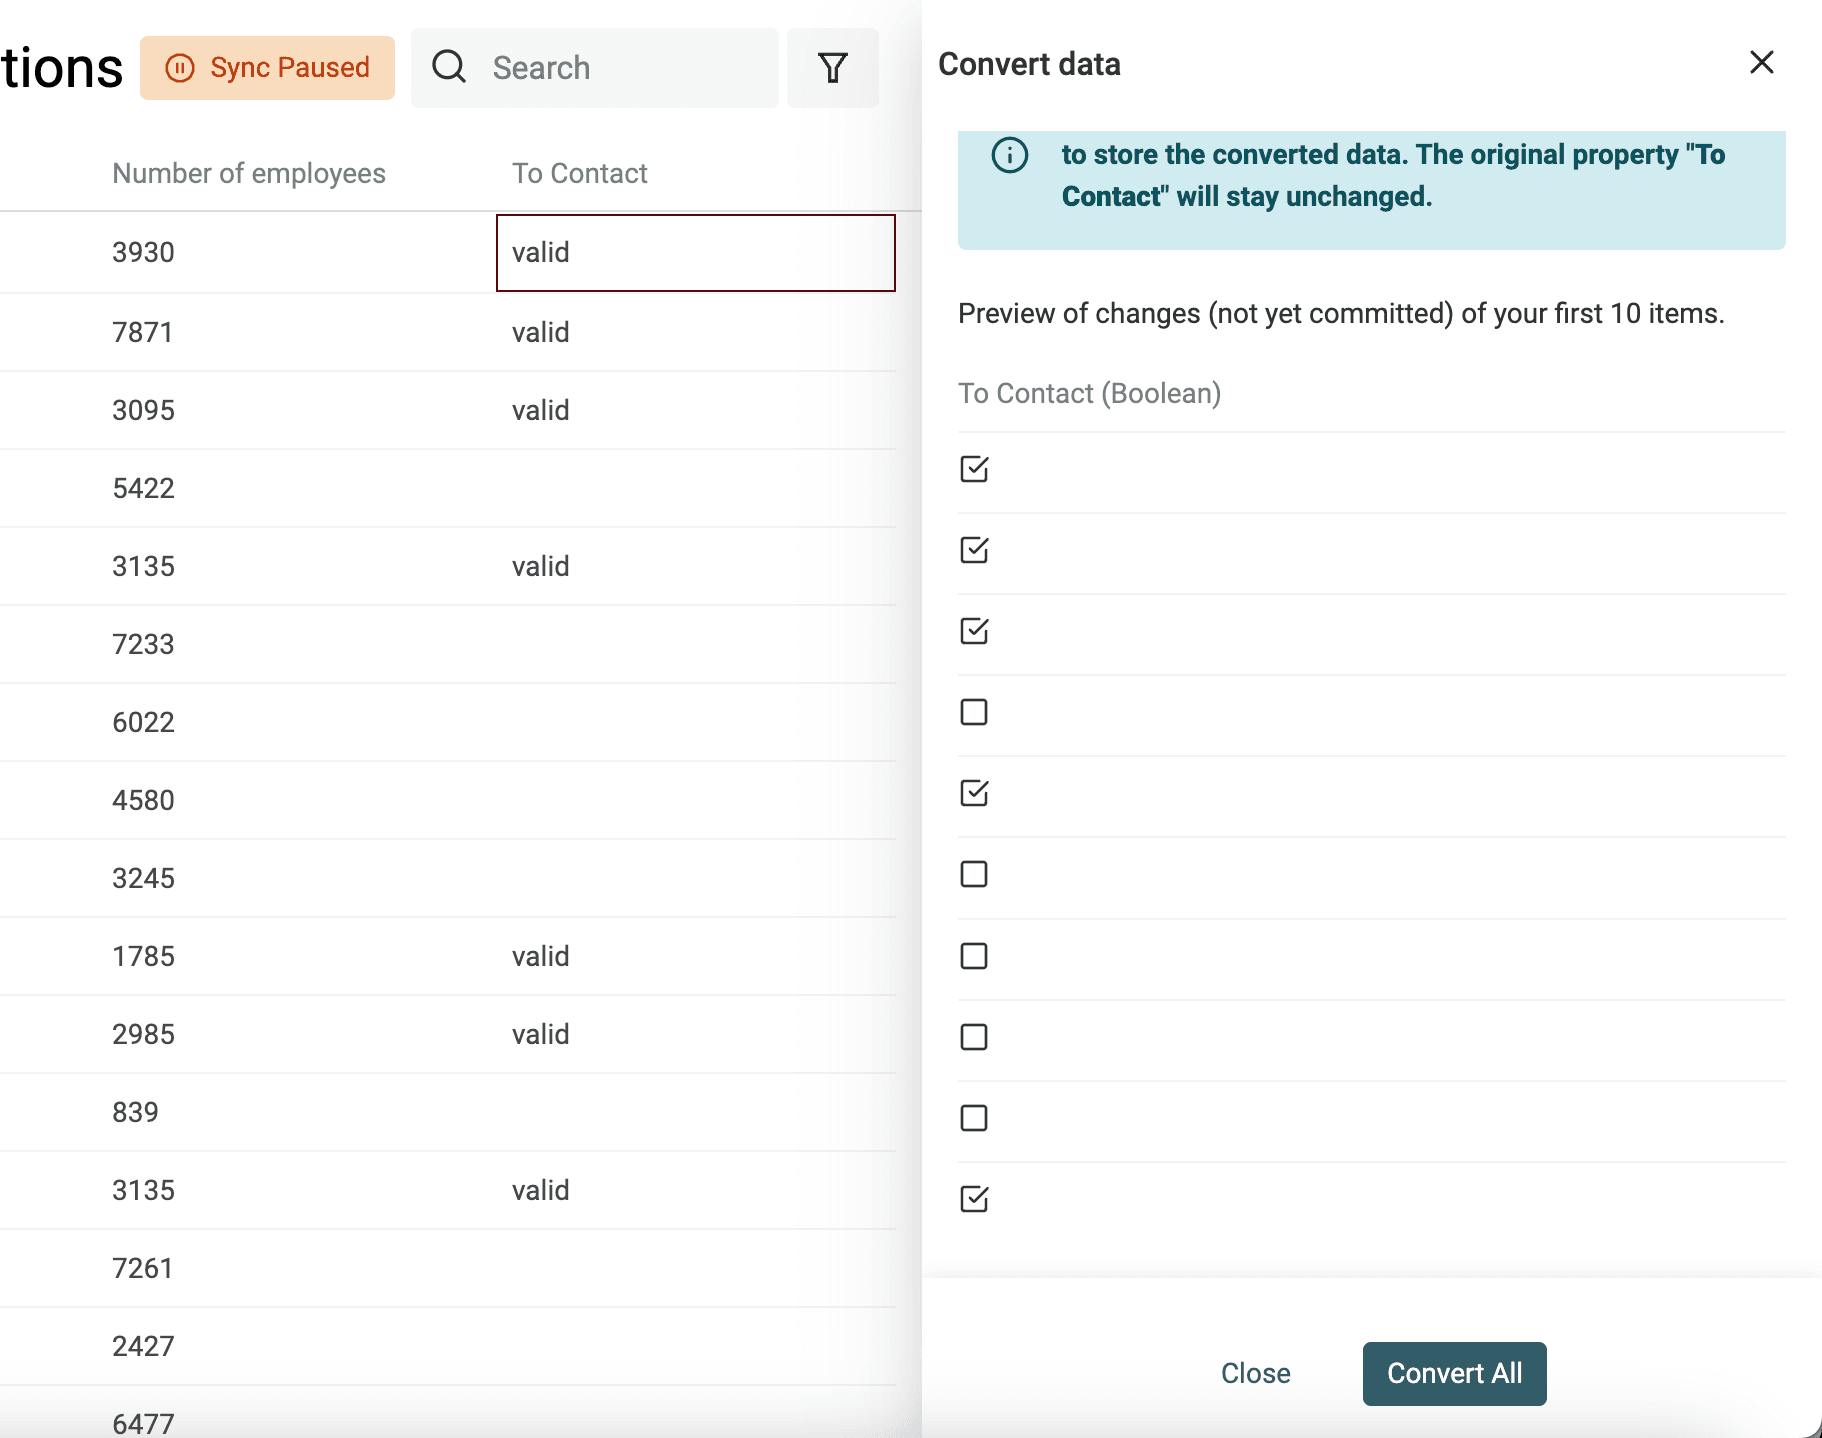
Al importar, Datablist convierte automáticamente las columnas con valores como "Yes, No" o "TRUE, FALSE" en propiedades Checkbox. Utilice el conversor para casos más complejos.
Defina los valores —separados por comas— que se convertirán en una casilla marcada. Los demás valores permanecerán sin marcar.
Extraer números de un texto
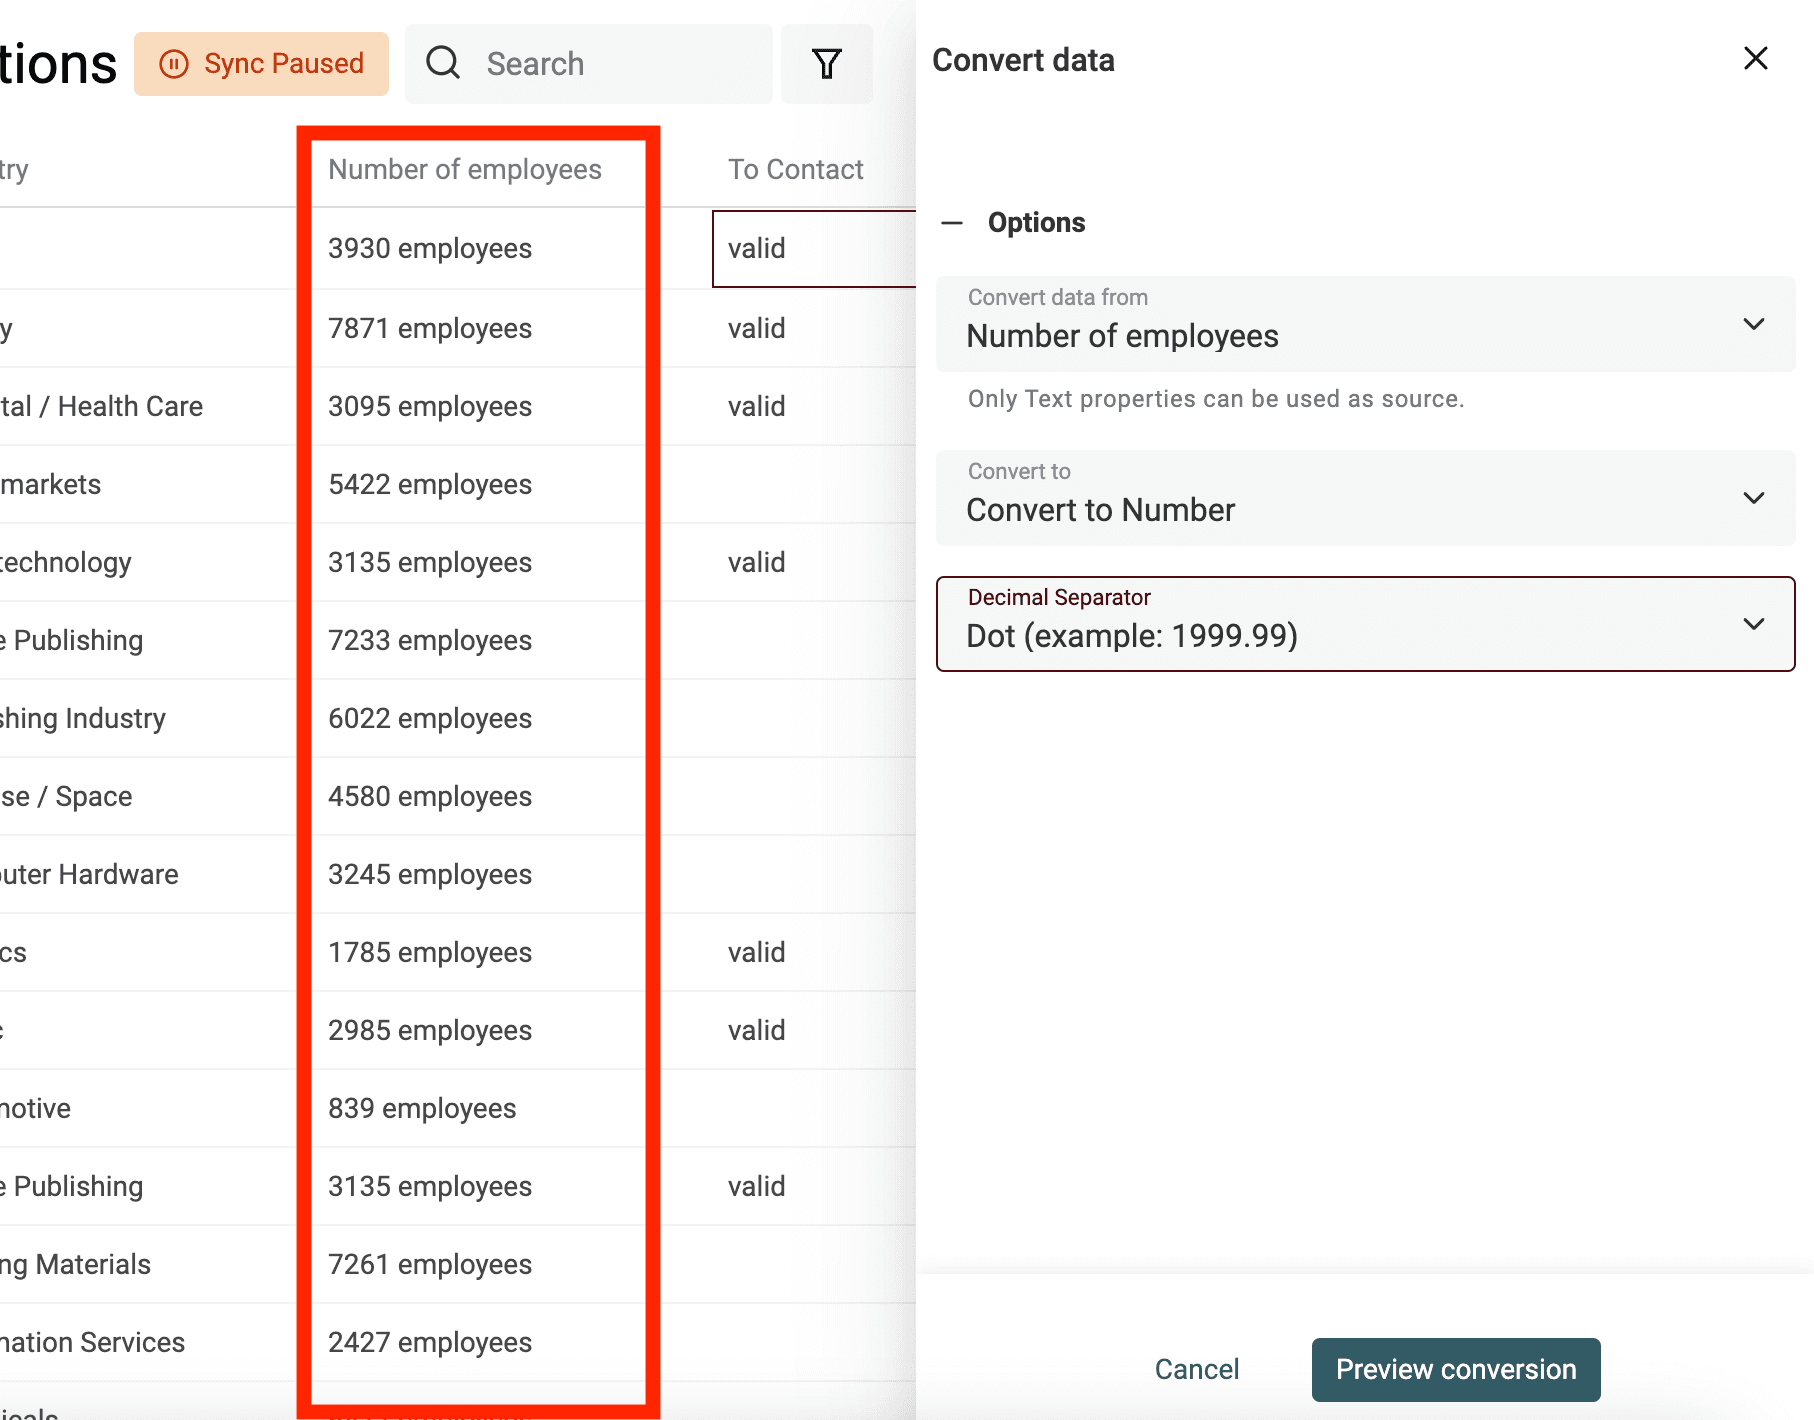
Utilice el conversor "Text to number" para:
- Normalizar números con separadores decimales y de millares personalizados
- Extraer números de textos que contienen letras
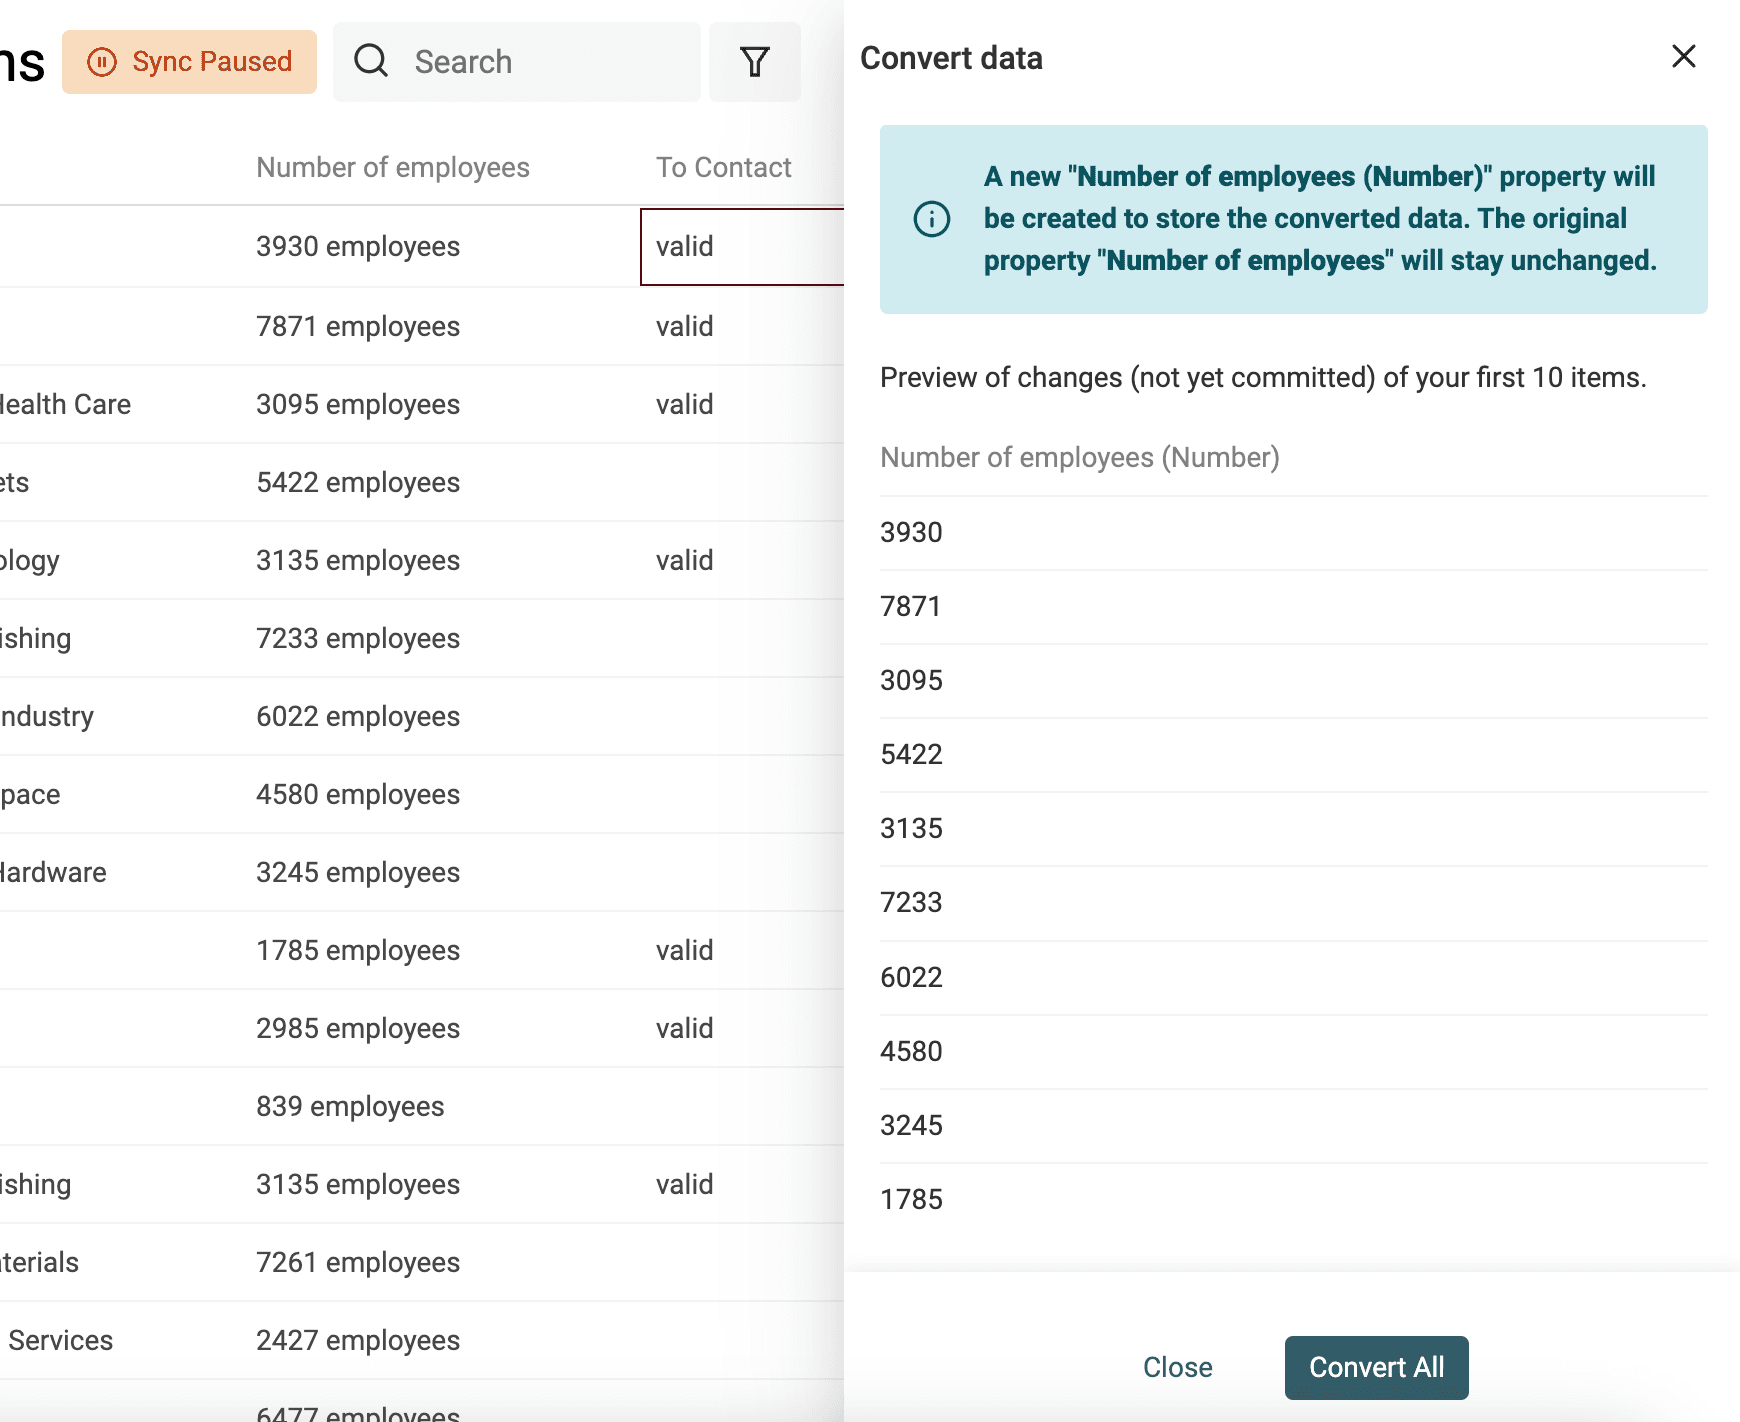
👉 Consulte nuestra documentación para obtener más información sobre la conversión de números.
Limpiar los datos
Convertir HTML en texto
Las herramientas de scraping analizan código HTML, por lo que sus textos pueden incluir etiquetas HTML.
El código HTML contiene enlaces, imágenes y listas con viñetas, además de utilizar párrafos y varias líneas.
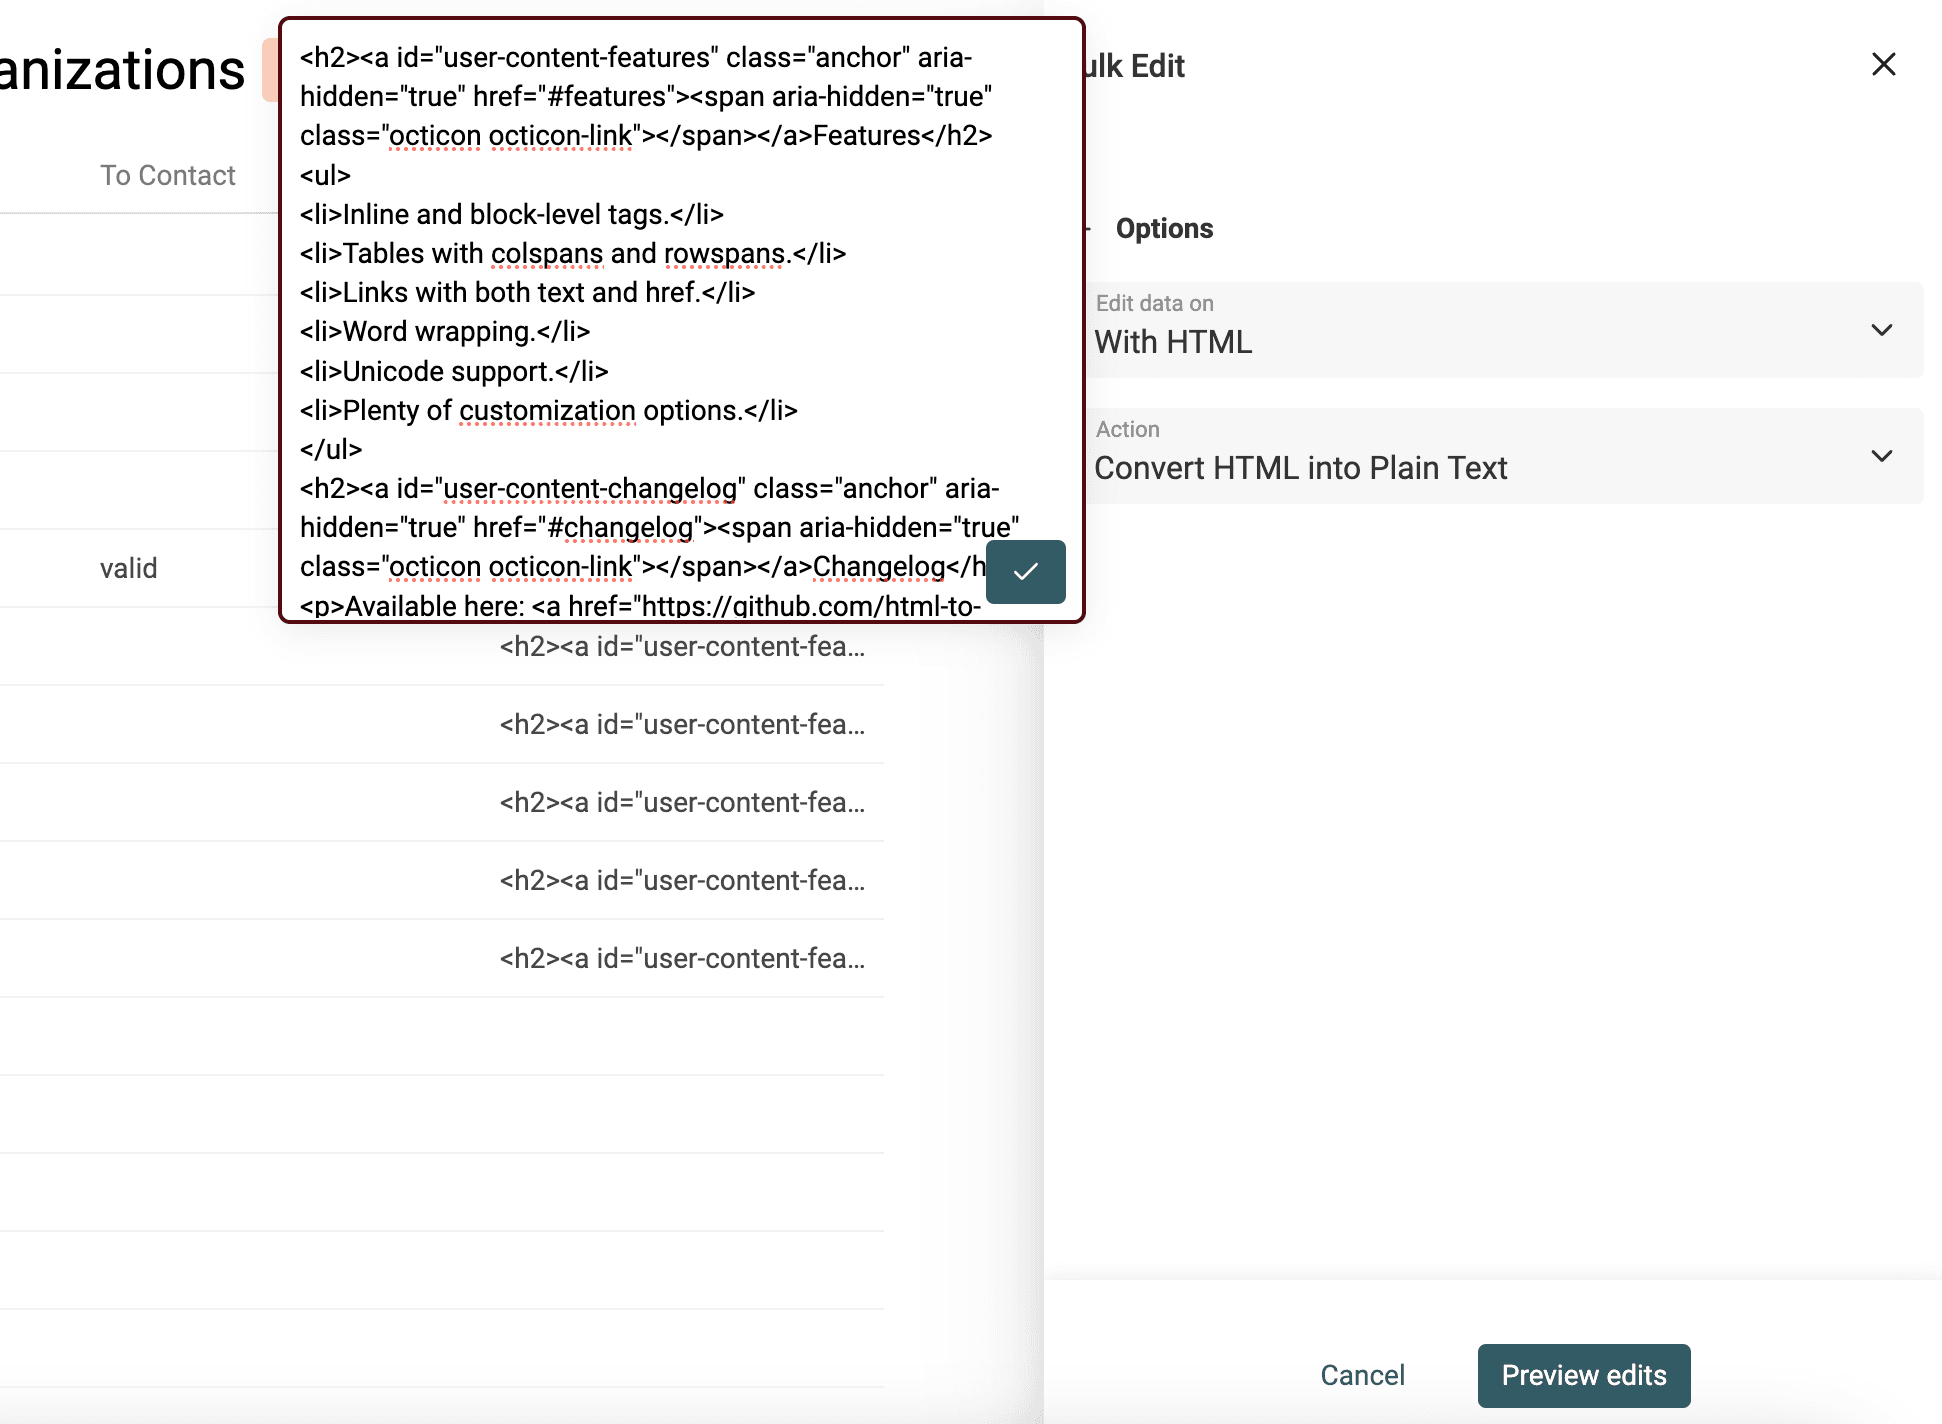
El objetivo es mantener parte de la estructura que aporta el HTML y, al mismo tiempo, convertir un código difícil de leer en texto plano.
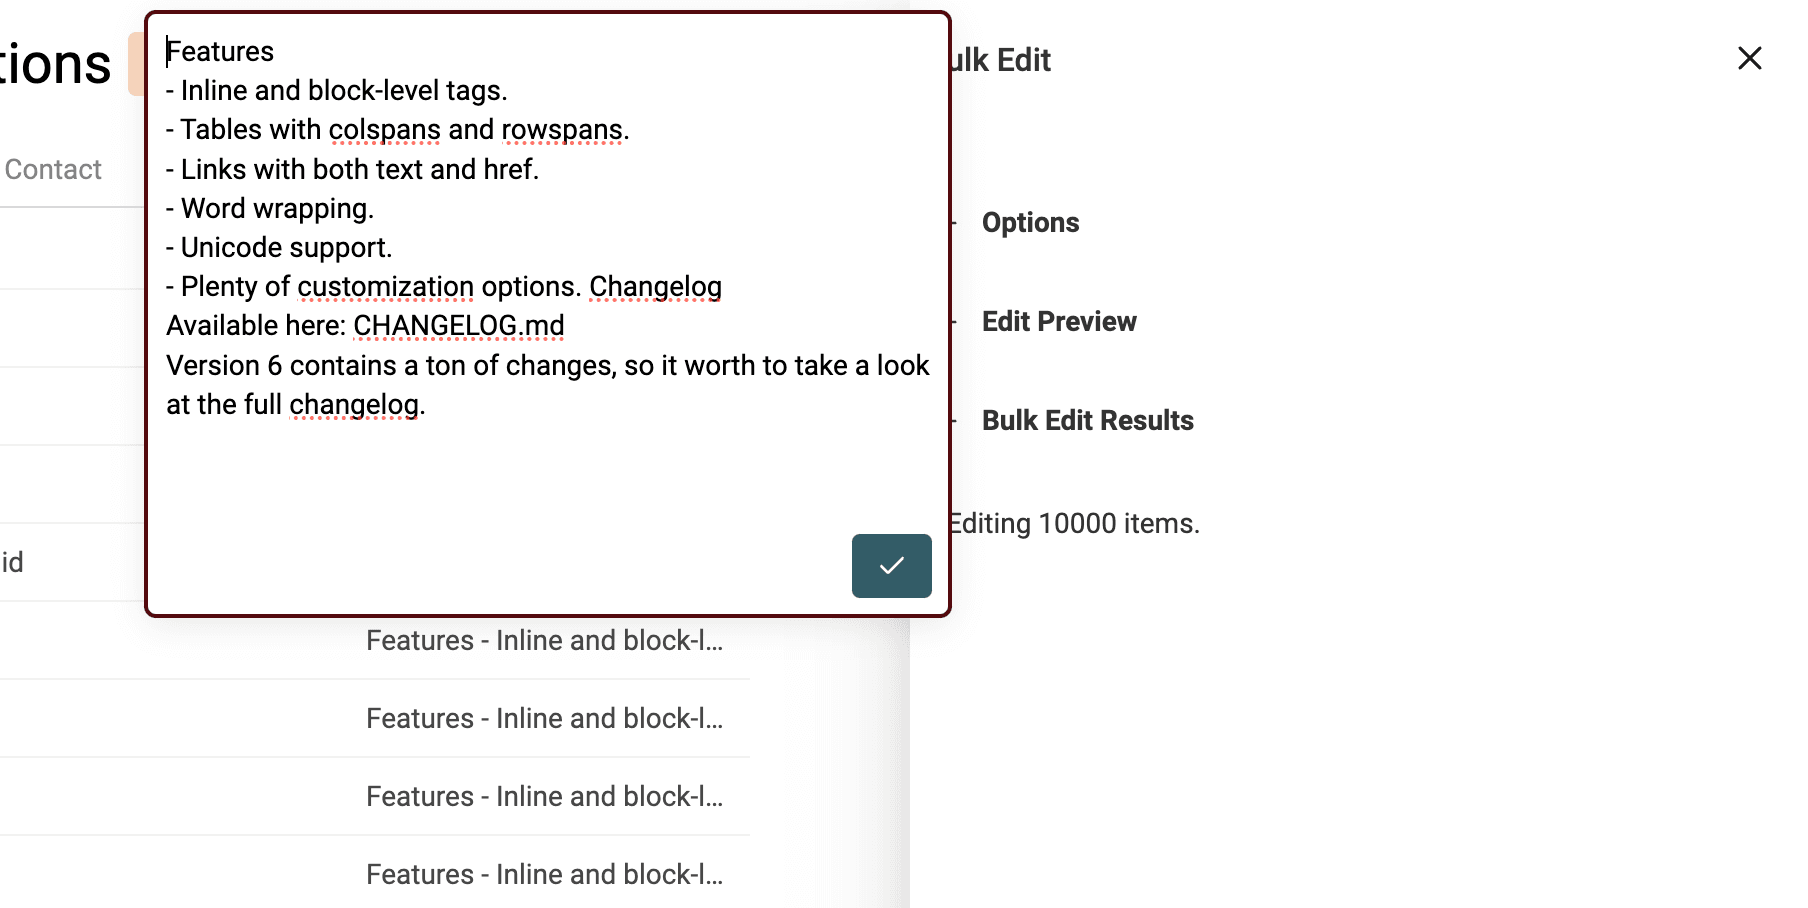
El conversor HTML to Text de Datablist conserva los saltos de línea y transforma las viñetas en una lista cuyos elementos comienzan por -.
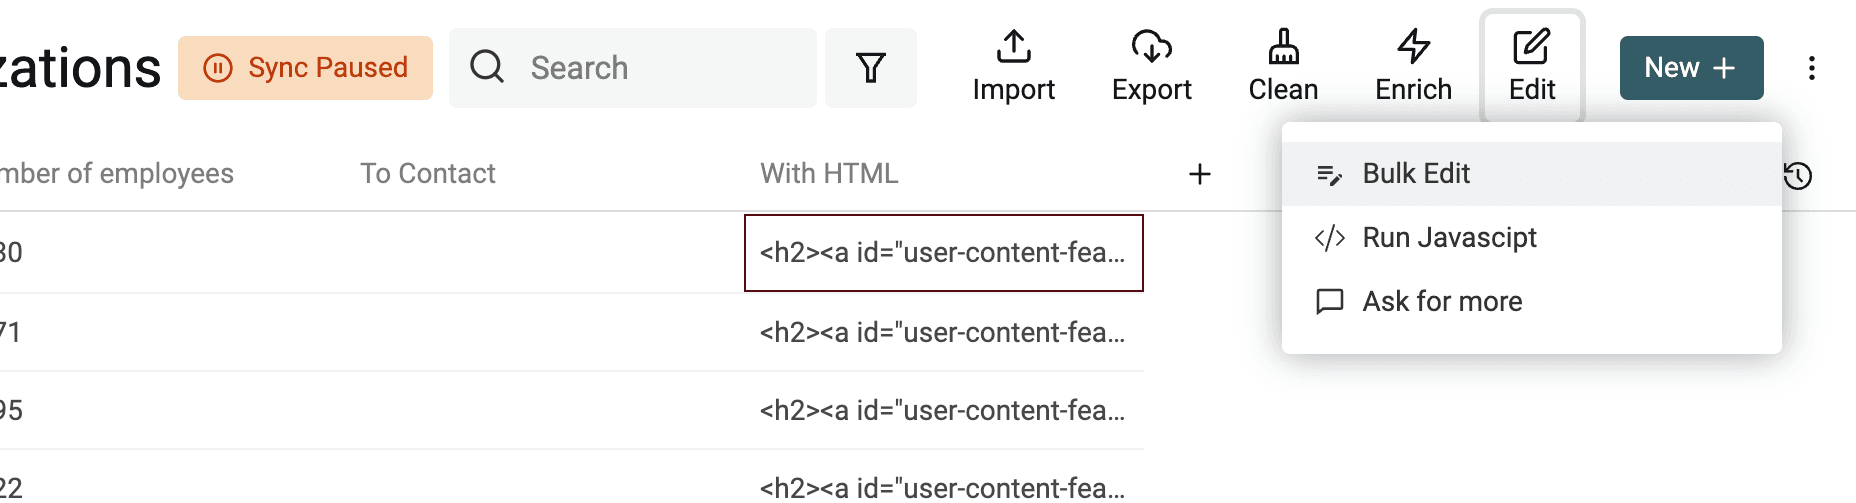
Para convertir un texto con etiquetas HTML en texto plano, abra la herramienta Bulk Edit desde el menú Edit.
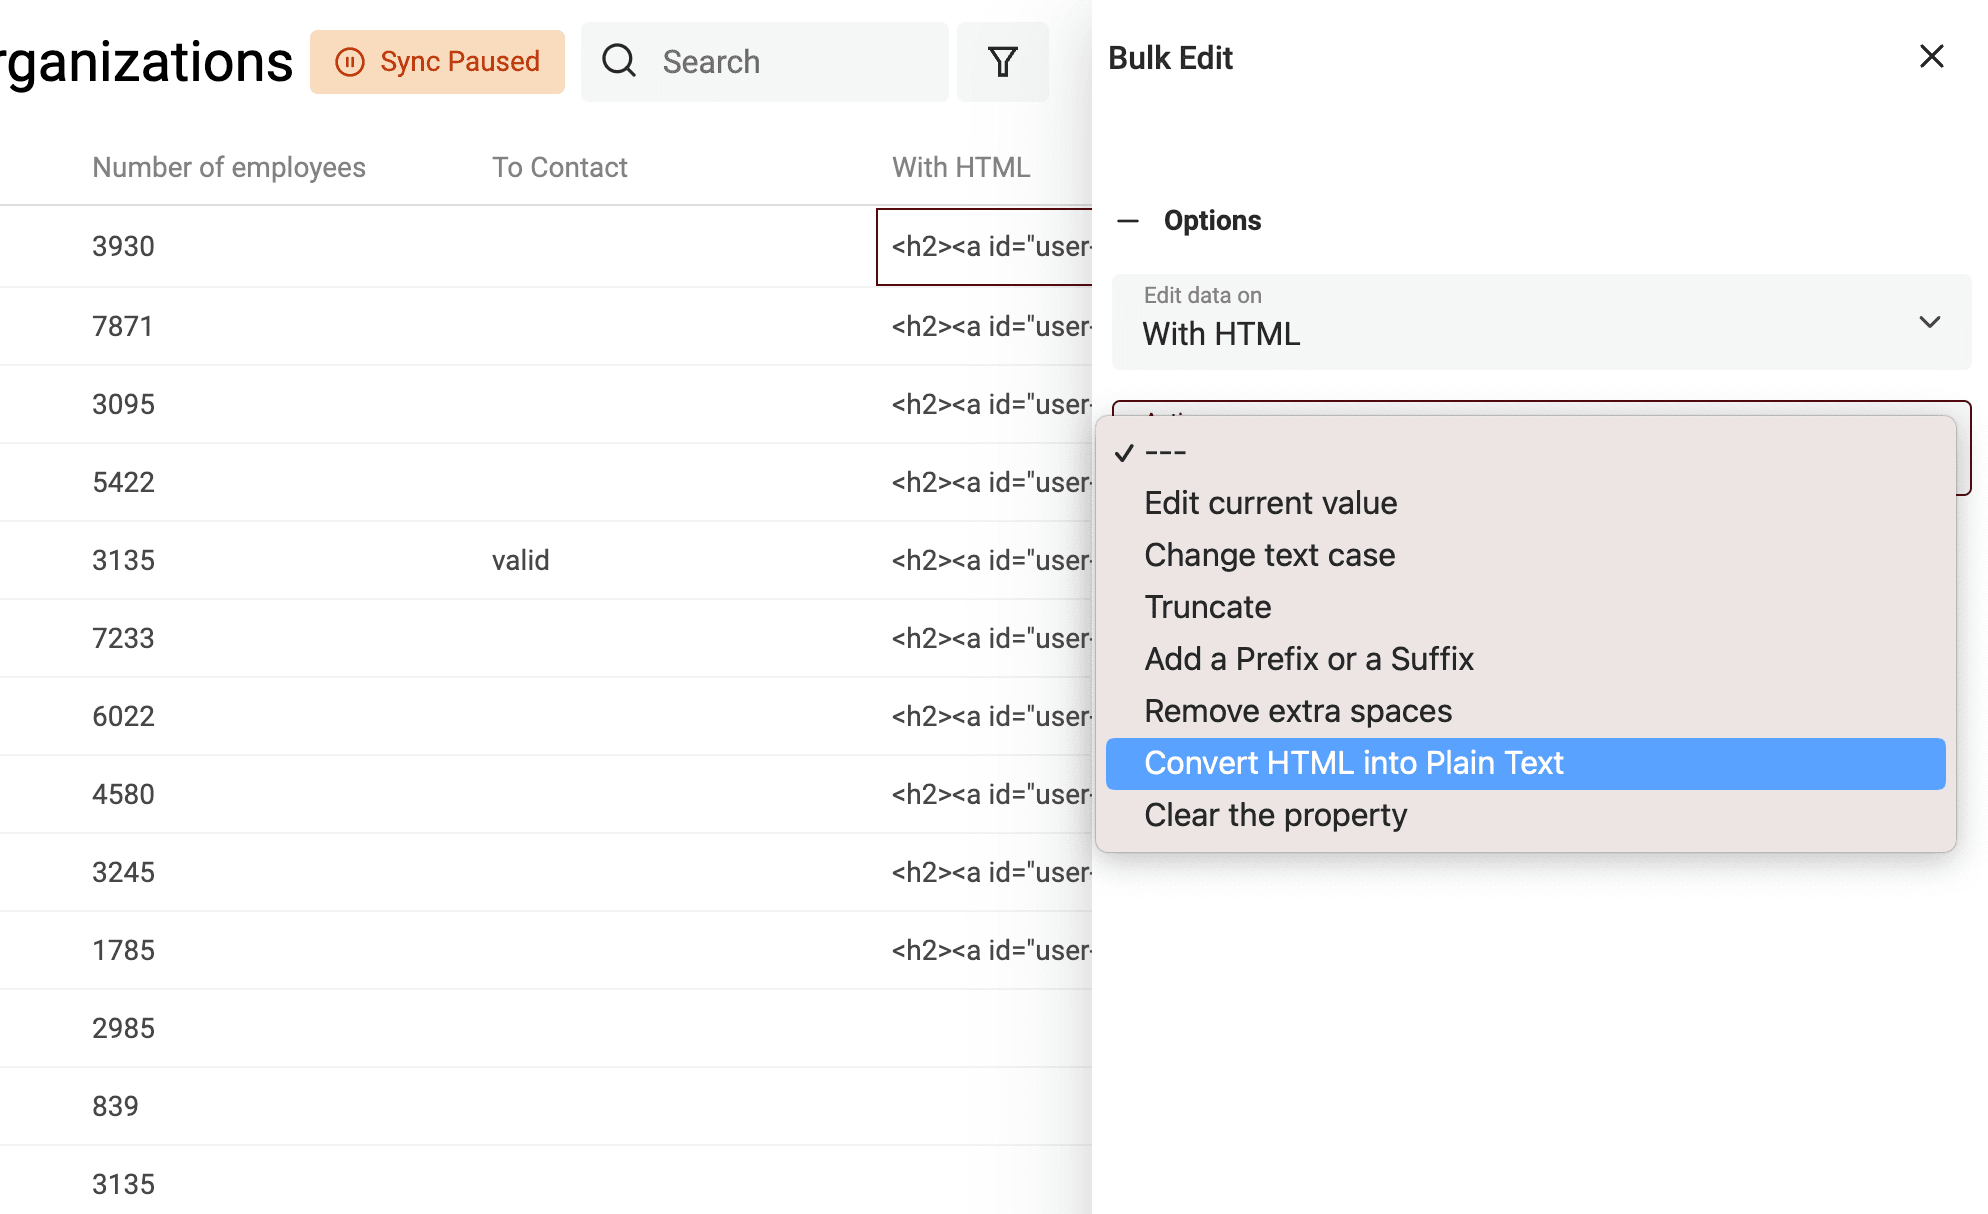
Seleccione la propiedad que contiene las etiquetas HTML y elija "Convert HTML into plain text".
Eliminar espacios sobrantes
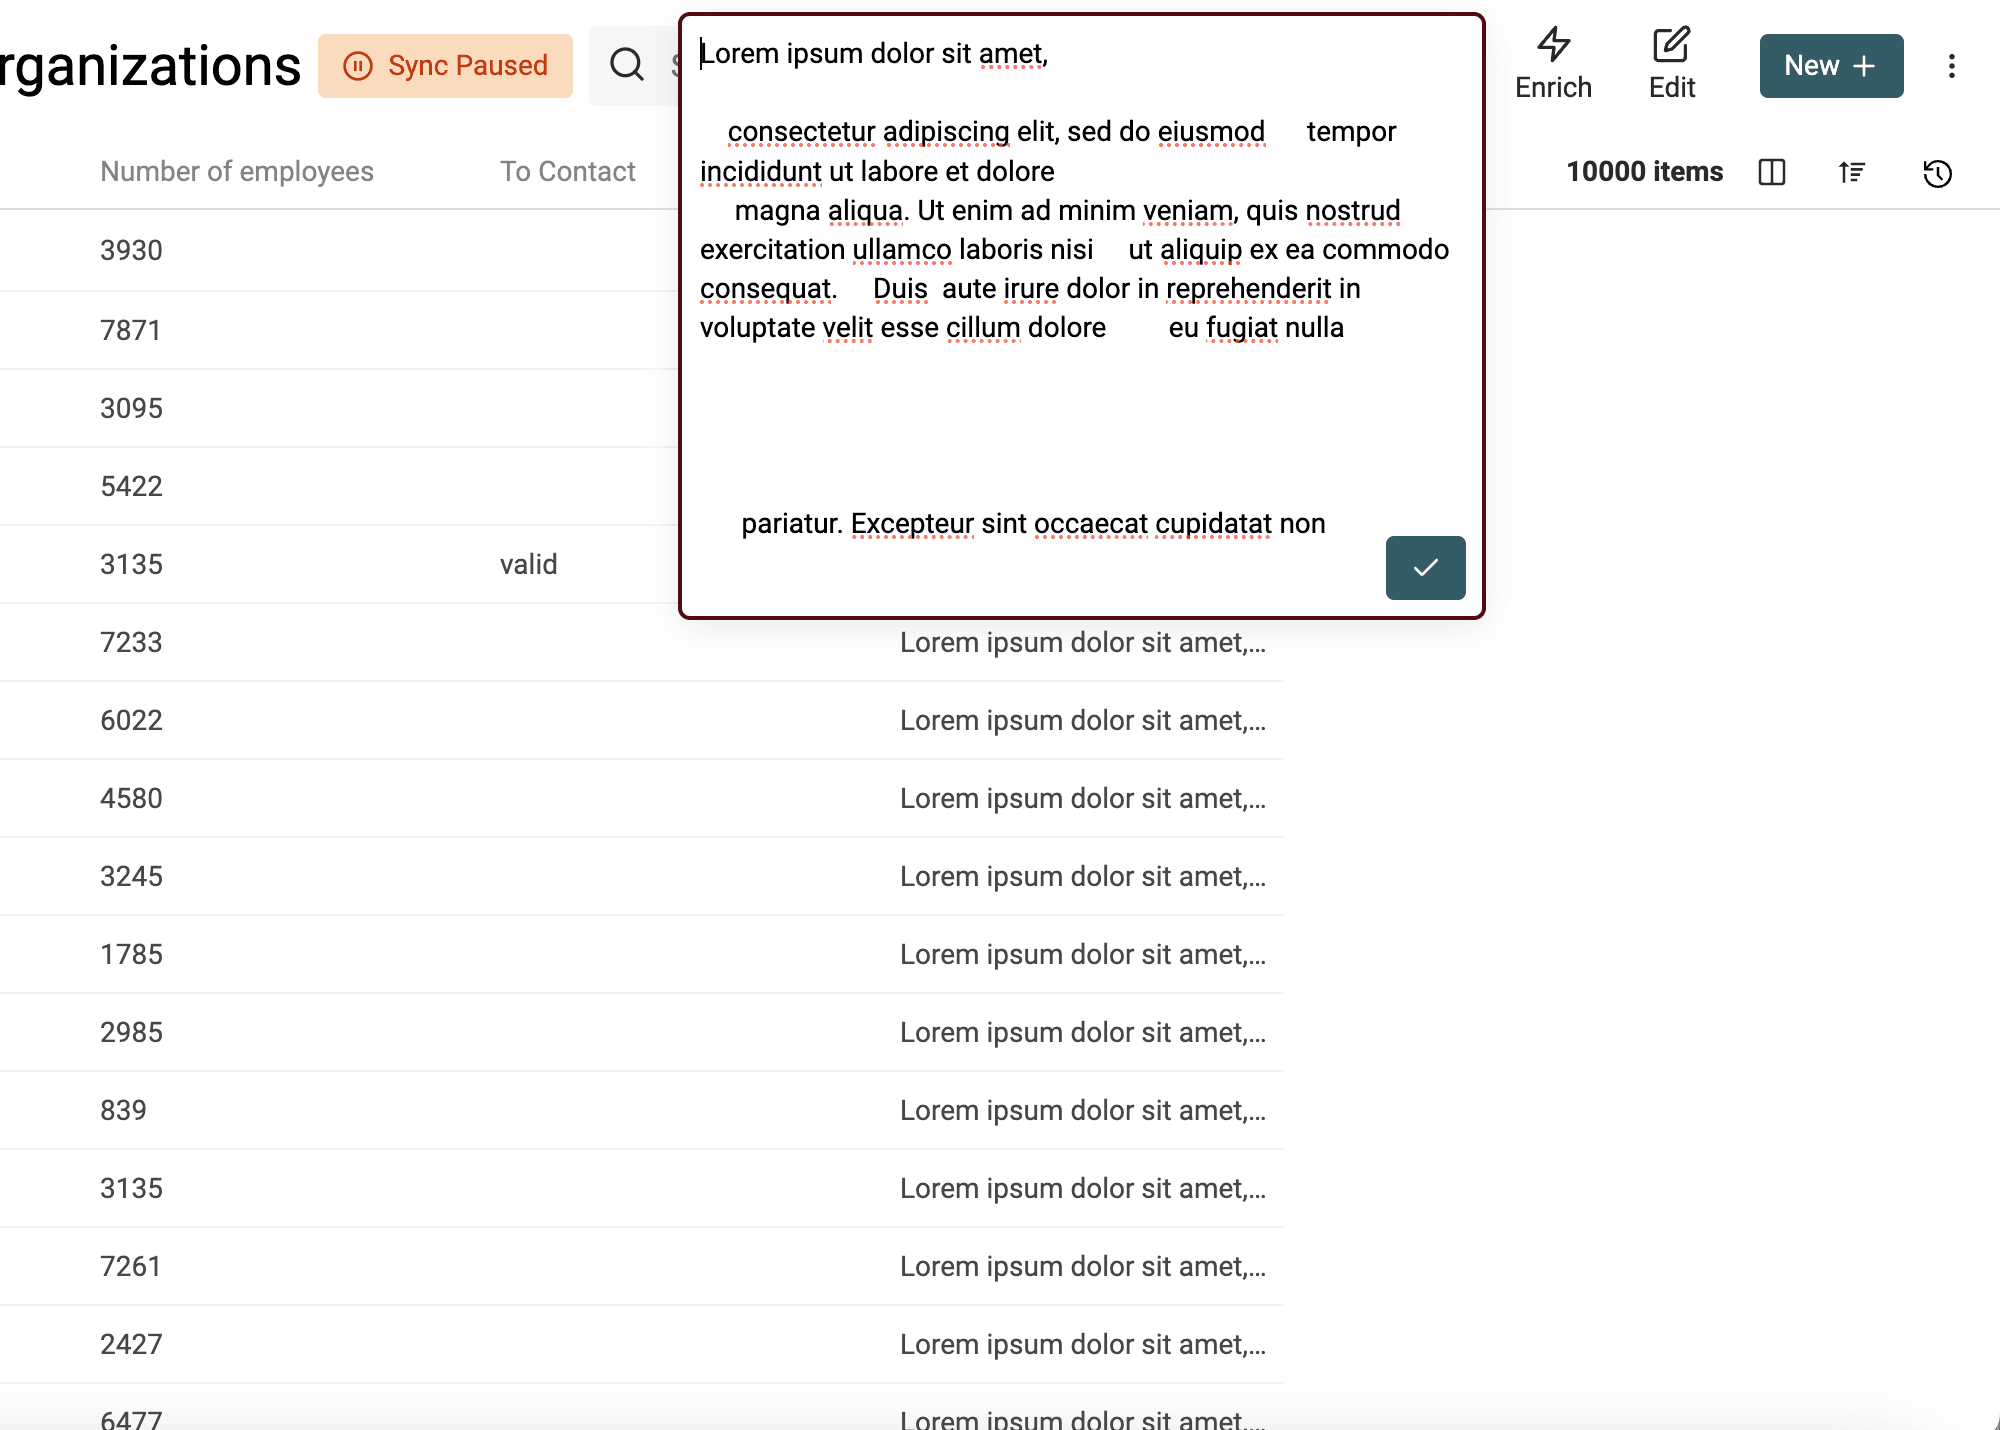
Otro problema frecuente en los datos obtenidos mediante scraping son los espacios sobrantes. Estos pueden proceder de saltos de línea, caracteres Tab y otros caracteres que representan espacios en HTML.
Datablist incluye una herramienta de limpieza para eliminarlos.
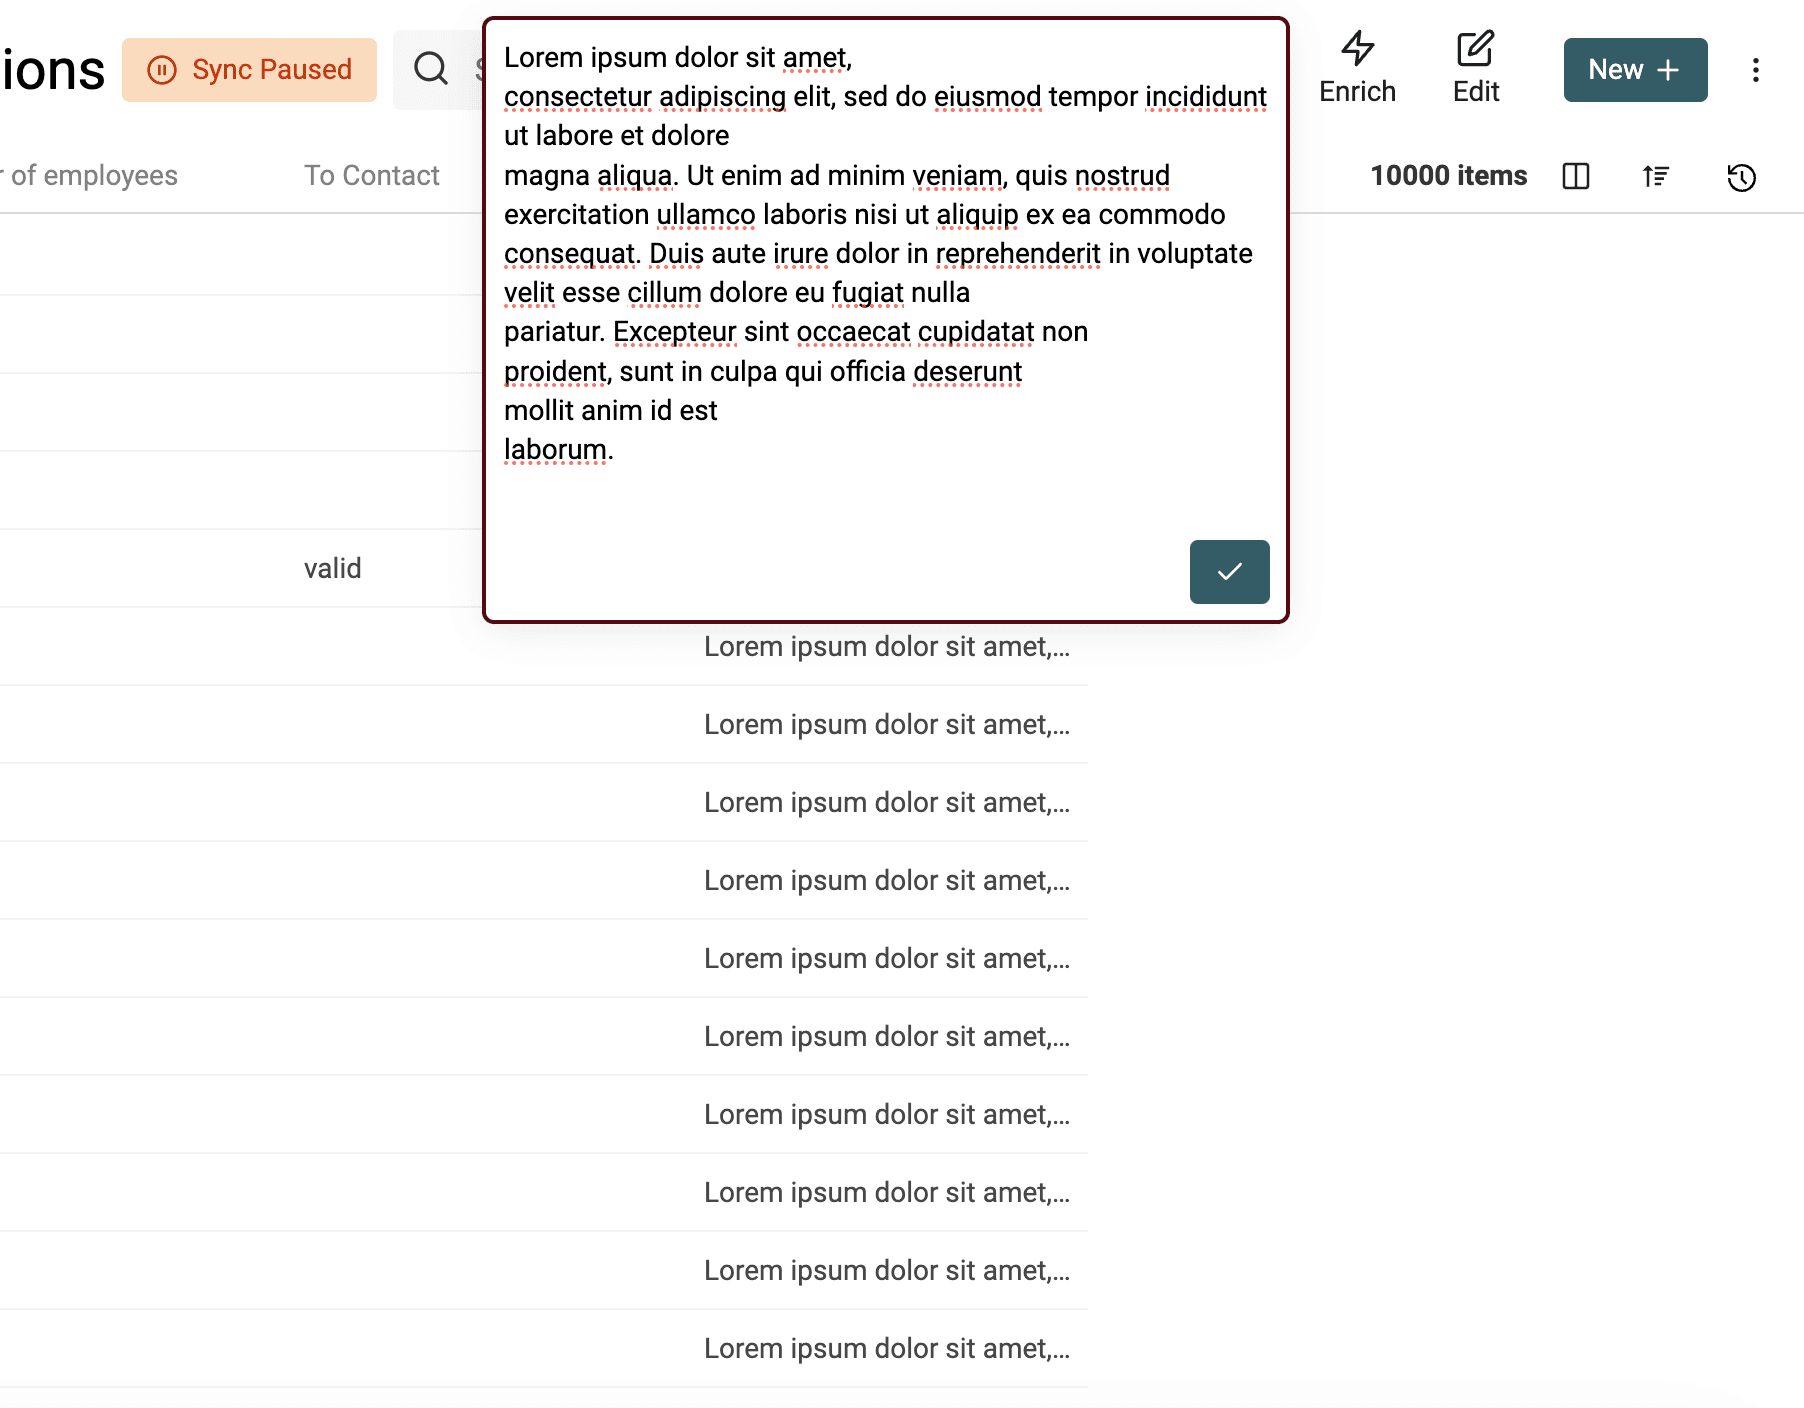
- Elimina los espacios sobrantes entre palabras
- Elimina las líneas vacías
- Elimina los espacios al principio y al final de cada línea
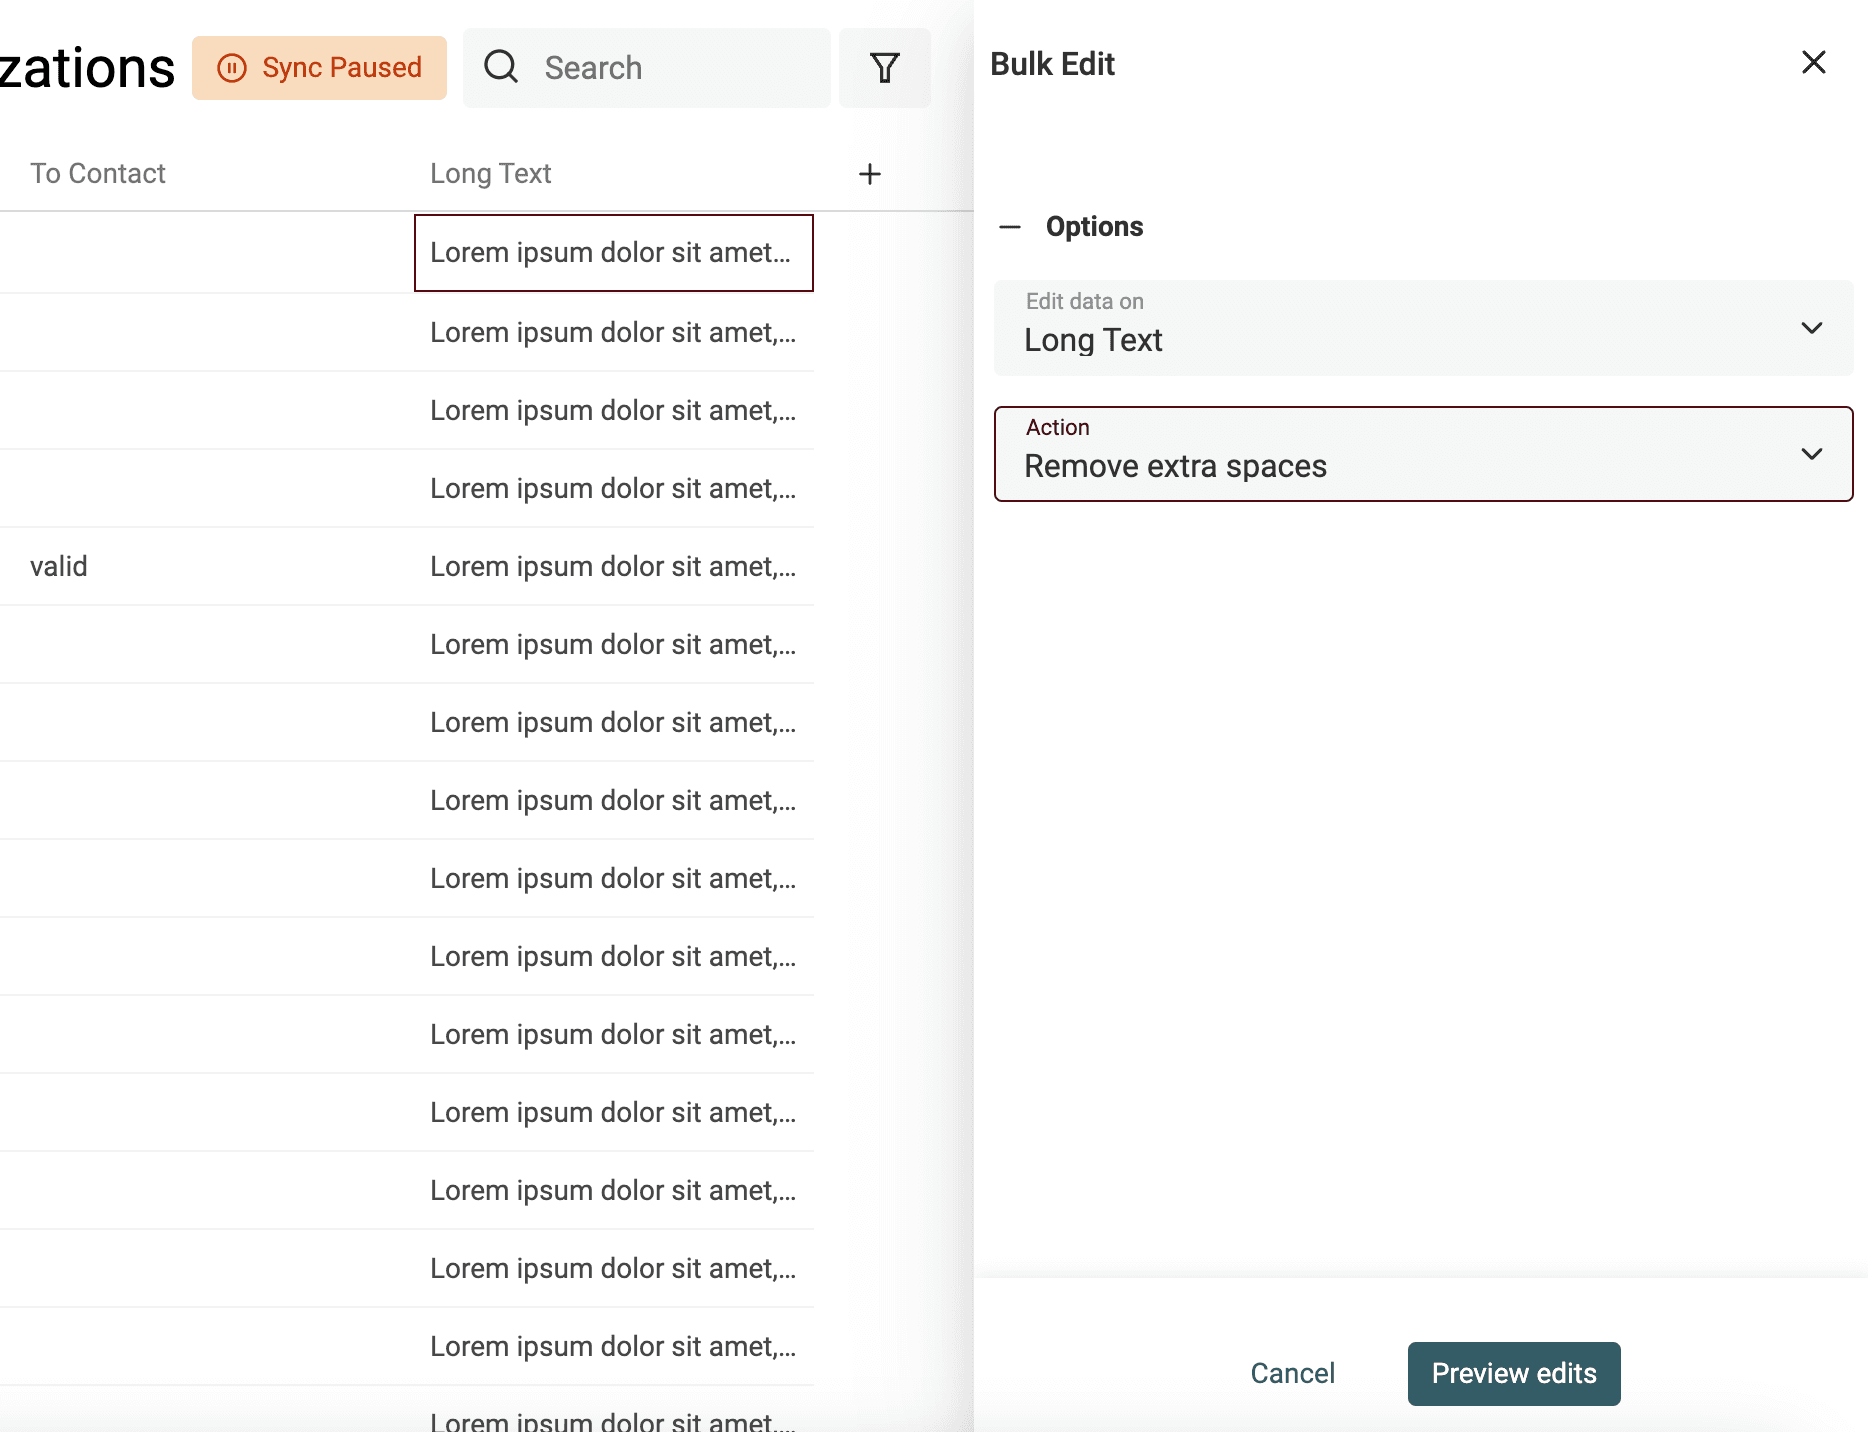
Para eliminar los espacios sobrantes, abra la herramienta "Bulk Edit" desde el menú "Edit". Seleccione la propiedad y la acción "Remove extra spaces".
Normalizar mayúsculas y minúsculas
Cambiar las mayúsculas y minúsculas de un texto es muy sencillo. Abra la herramienta "Bulk Edit" desde el menú "Edit".
Seleccione la propiedad que desea procesar y utilice la acción "Change text case".
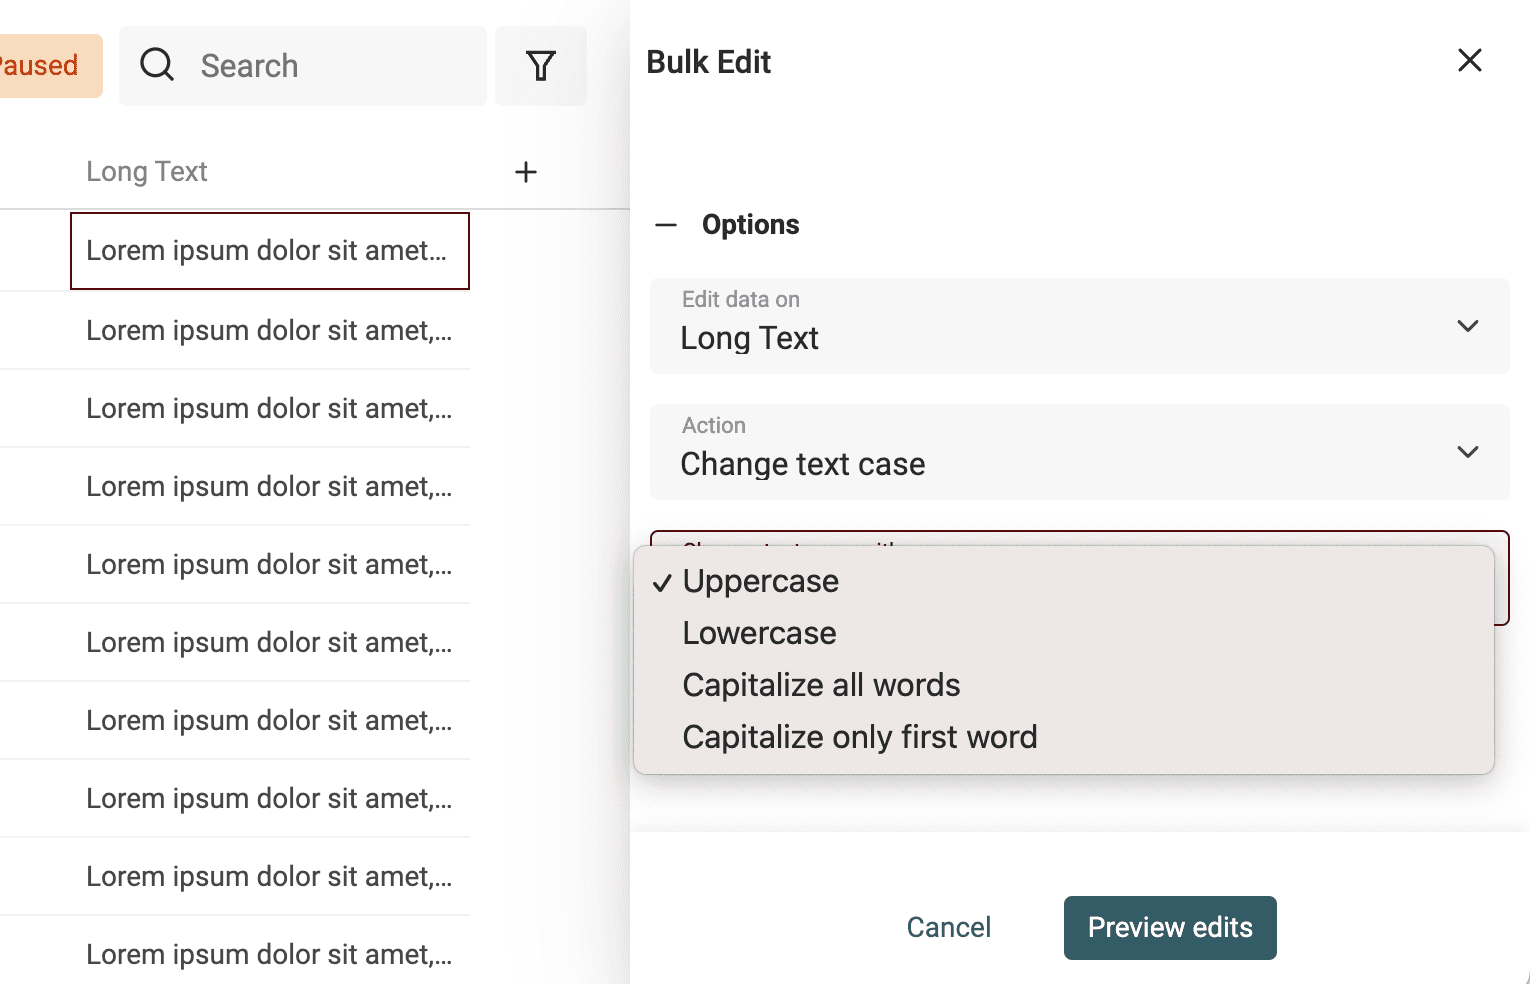
Hay cuatro modos disponibles:
- Uppercase - Convierte todas las letras a mayúsculas. Ejemplo:
john=>JOHN - Lowercase - Convierte todas las letras a minúsculas. Ejemplo:
API=>api - Capitalize - Escribe en mayúscula la primera letra de cada palabra. Ejemplo:
john is a good man=>John Is A Good Man - Capitalize only the first word - Solo escribe en mayúscula la primera letra de la primera palabra. Ejemplo:
john is a good man=>John is a good man
Eliminar símbolos de los textos
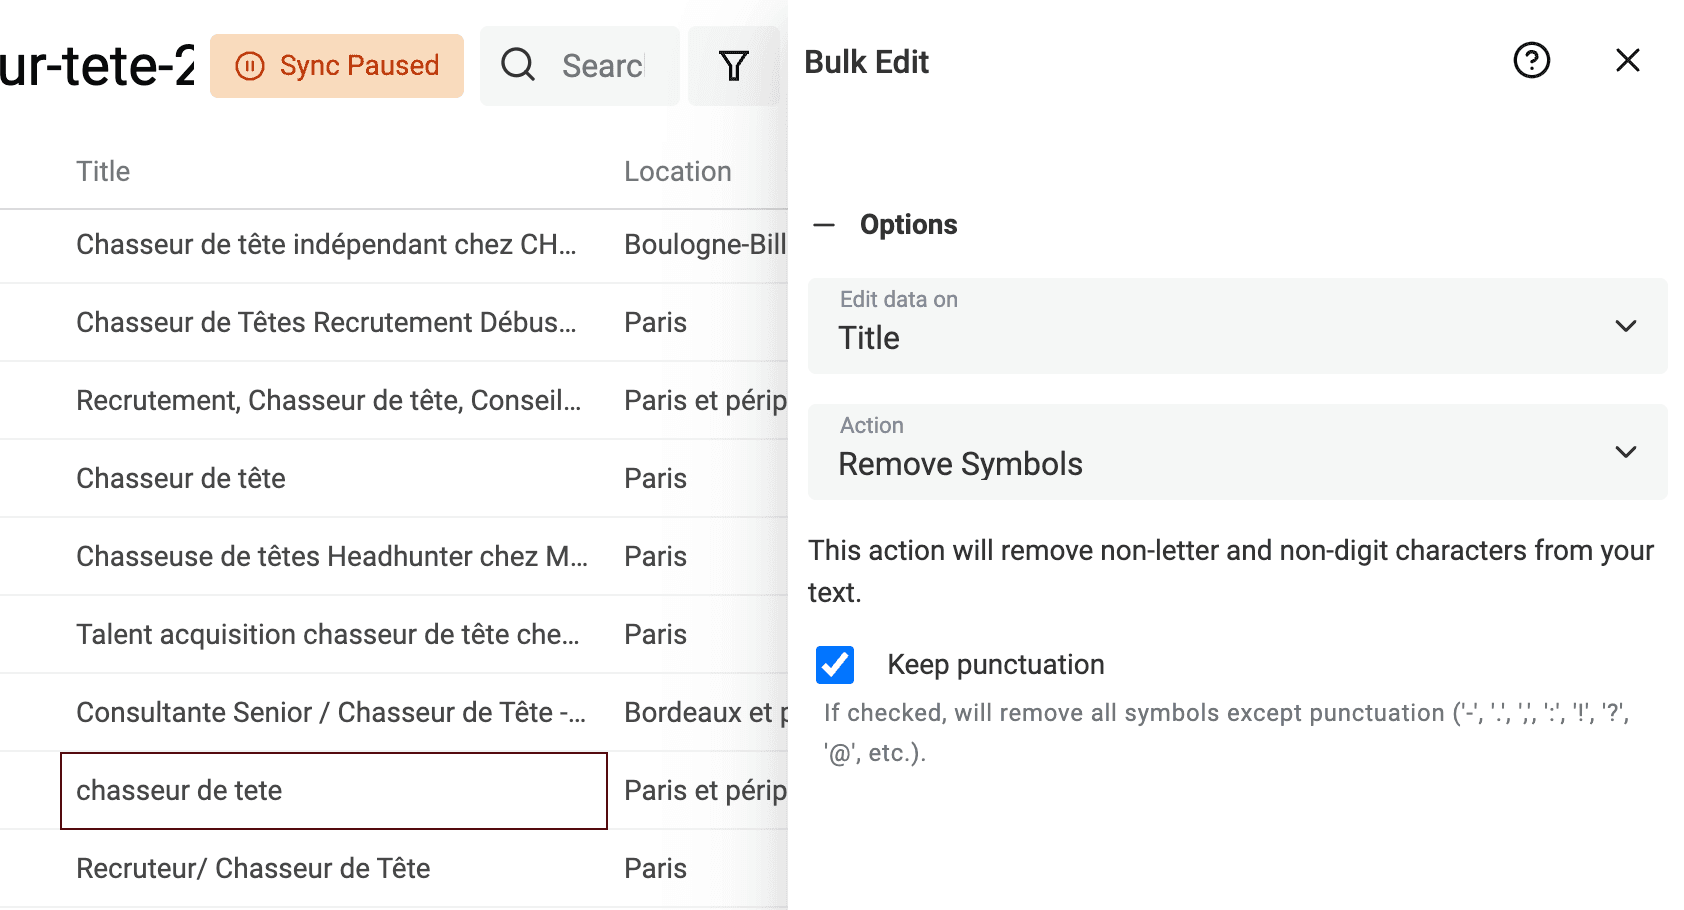
Los textos obtenidos de páginas HTML o introducidos por usuarios —por ejemplo, los cargos de perfiles de LinkedIn— pueden contener símbolos, emoticonos y otros caracteres que afecten al procesamiento de los datos. Un simple emoticono al final de un nombre puede impedir que un algoritmo de deduplicación lo detecte.
Datablist incorpora un procesador capaz de eliminar de sus datos cualquier símbolo que no sea texto.
Haga clic en "Bulk Edit" dentro del menú "Edit", seleccione una propiedad de texto y elija la transformación "Remove symbols".
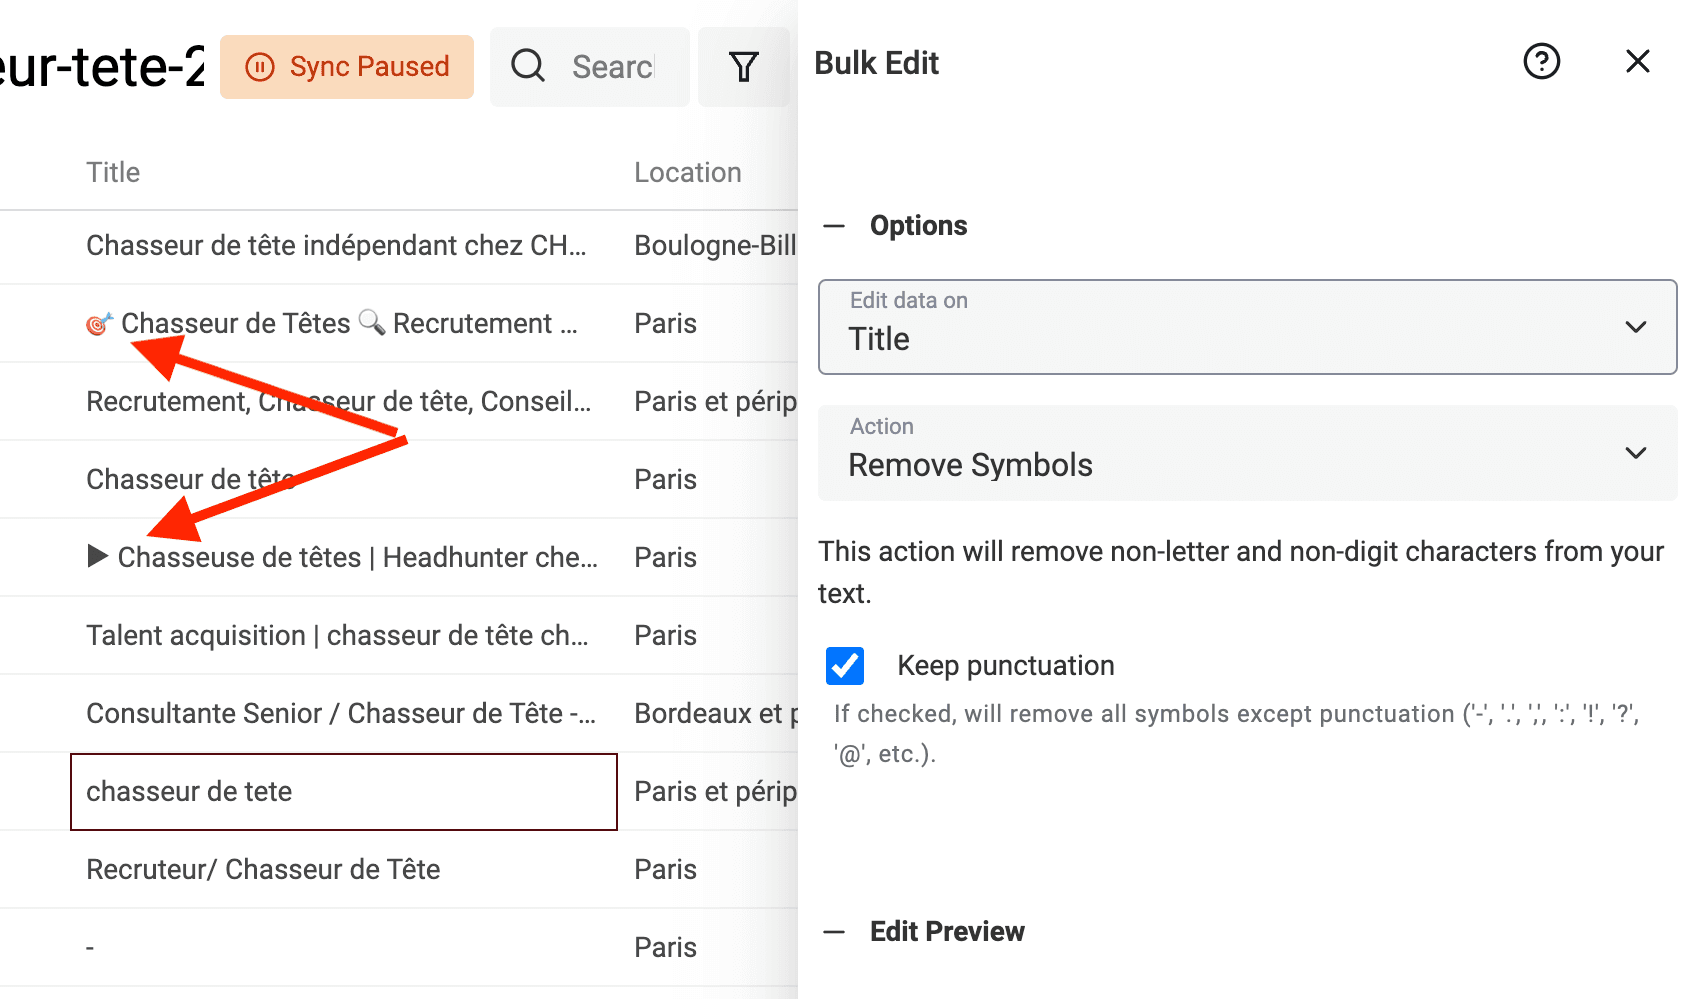
Si la vista previa es correcta, ejecute la transformación para procesar los elementos.
Normalizar datos con Find and Replace
Para crear segmentos en sus listas de prospectos, debe normalizar los datos.
- Normalice los cargos profesionales
- Normalice los países y ciudades
- Normalice las URL
- Etc.
Su objetivo es convertir una propiedad de texto libre en otra con un conjunto limitado de opciones. También puede transformar los textos en una versión más básica, por ejemplo, convirtiendo una URL con rutas en un dominio sencillo.
Datablist incluye una potente herramienta Find and Replace. Funciona tanto con texto sencillo como con expresiones regulares.
Las expresiones regulares son complejas, pero también muy potentes.
Estos son algunos ejemplos de cómo utilizar RegEx para limpiar sus datos.
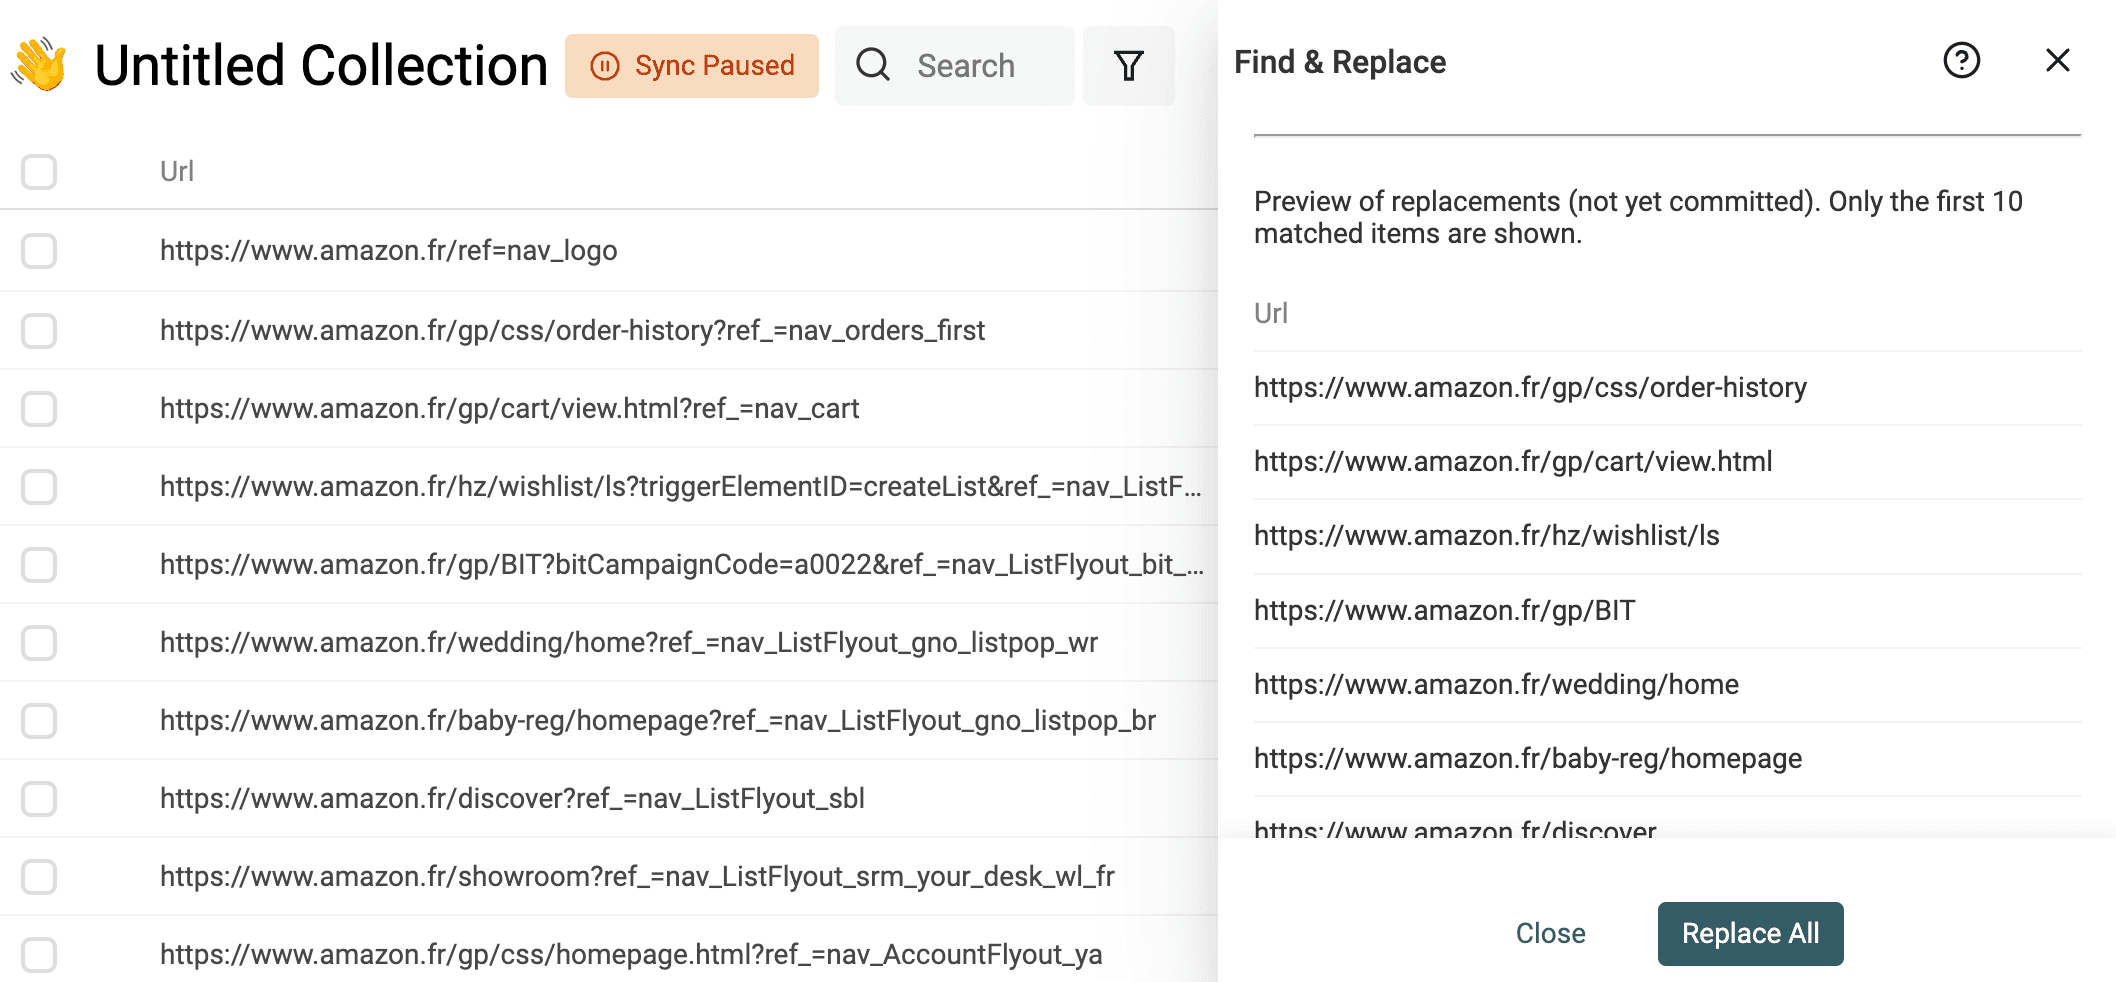
Eliminar los parámetros de consulta de una URL
Algunos parámetros de URL permiten hacer seguimiento de una campaña; otros seleccionan un producto, una variante, un resultado de búsqueda o un número de página. Si los elimina todos, podría agrupar por error registros diferentes bajo una misma URL.
Duplique primero la propiedad que contiene la URL de origen. Utilice la siguiente expresión únicamente después de confirmar que puede descartar todos los parámetros de consulta de esa columna. Por ejemplo, eliminará ?utm_source=newsletter de la URL de una página, pero también borrará ?variant=blue de la URL de un producto. Si necesita conservar la variante, mantenga la consulta o elimine únicamente los parámetros de seguimiento mediante otra transformación.
Para eliminar toda la consulta, marque Match using regular expression y utilice esta expresión dejando vacío el campo de sustitución:
\?.*$
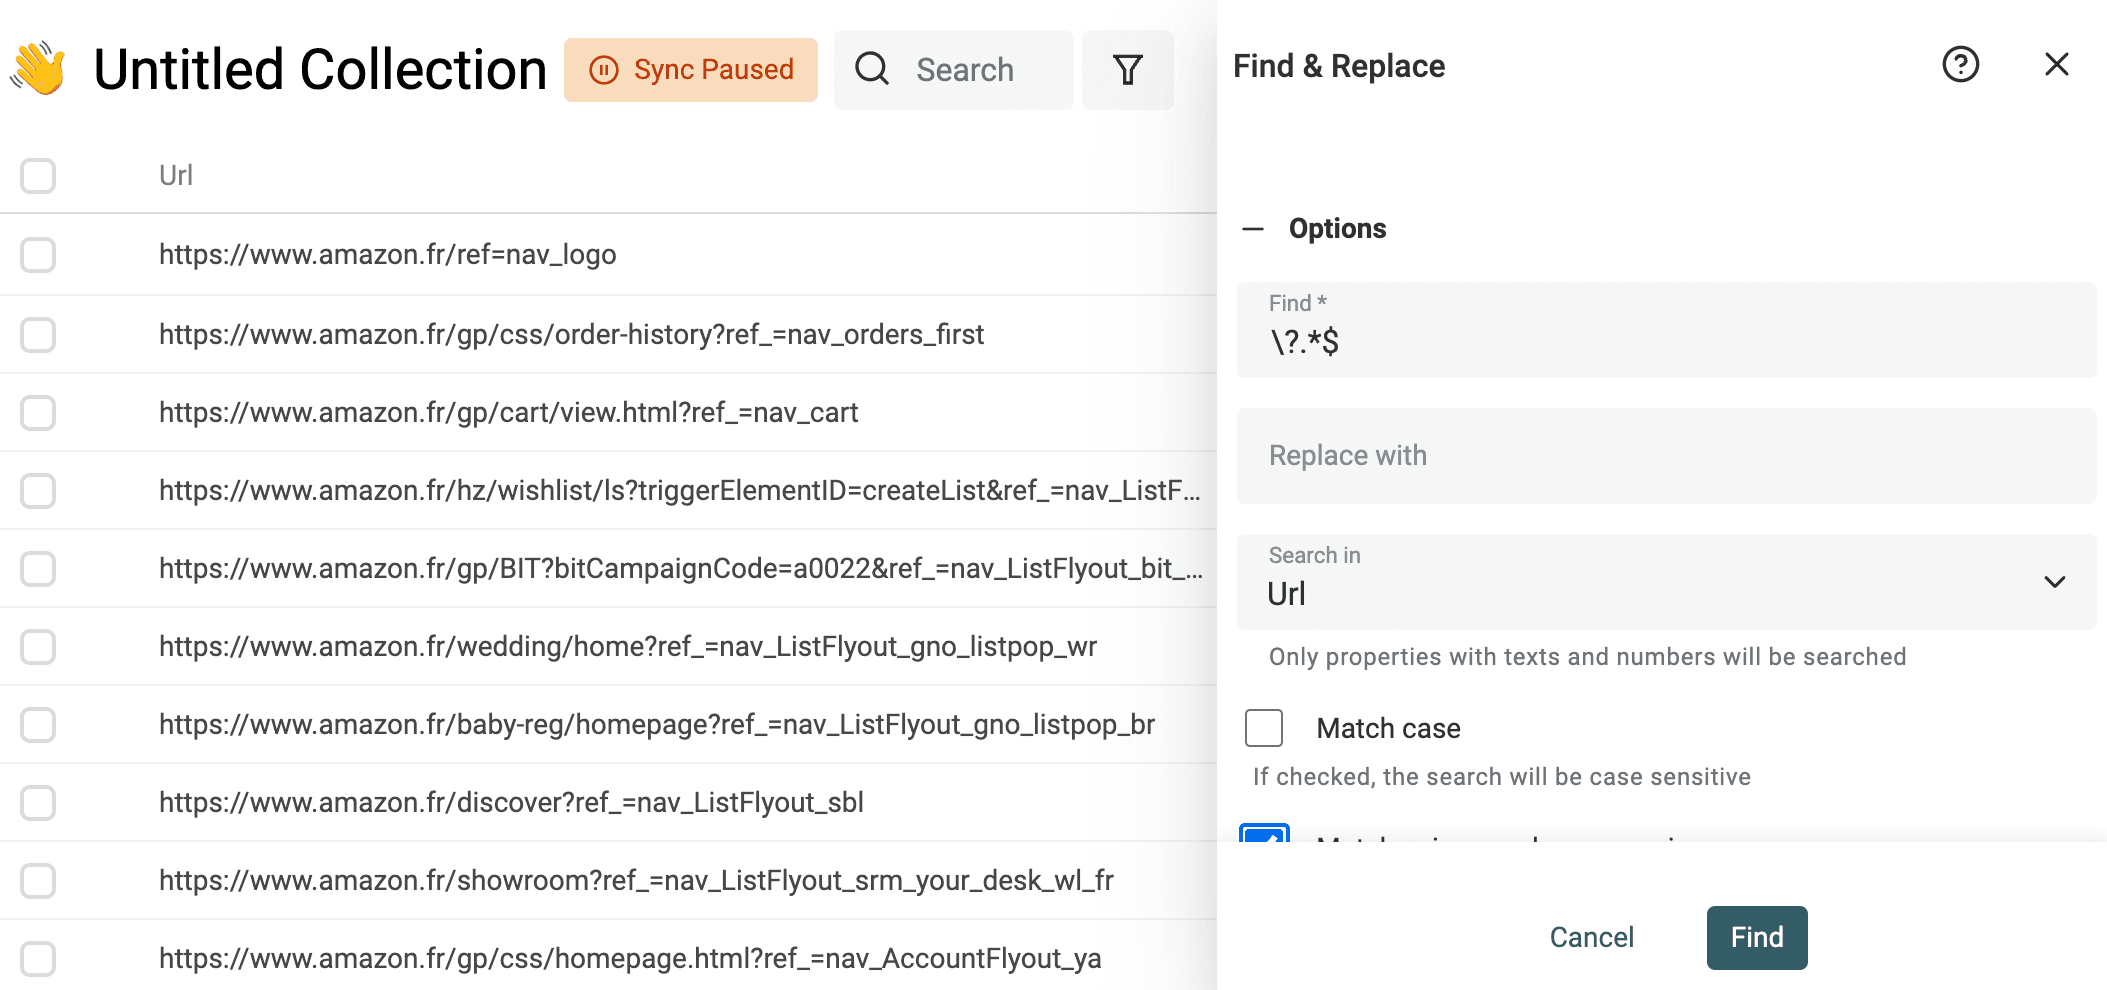
Revise en la vista previa las URL con y sin cadenas de consulta. Después, aplique la transformación únicamente a la copia de la propiedad si las URL resultantes siguen identificando las páginas correctas.
Obtener el dominio de una dirección de email
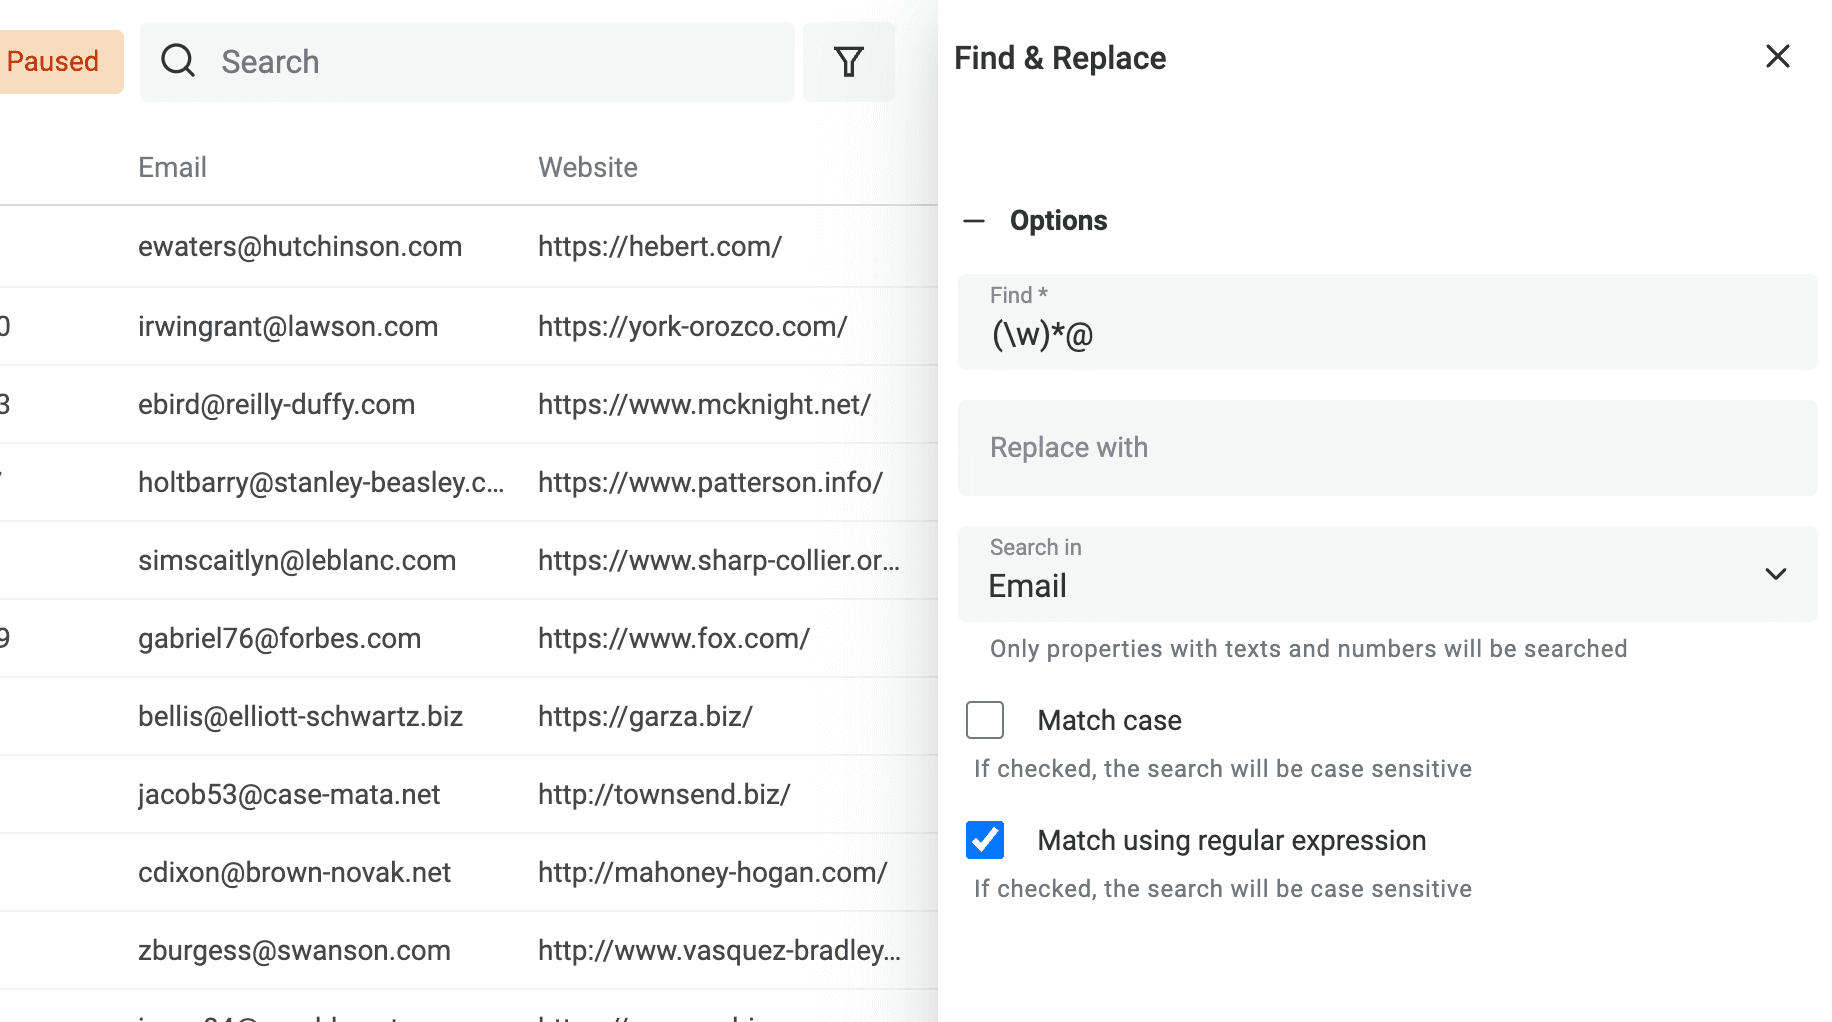
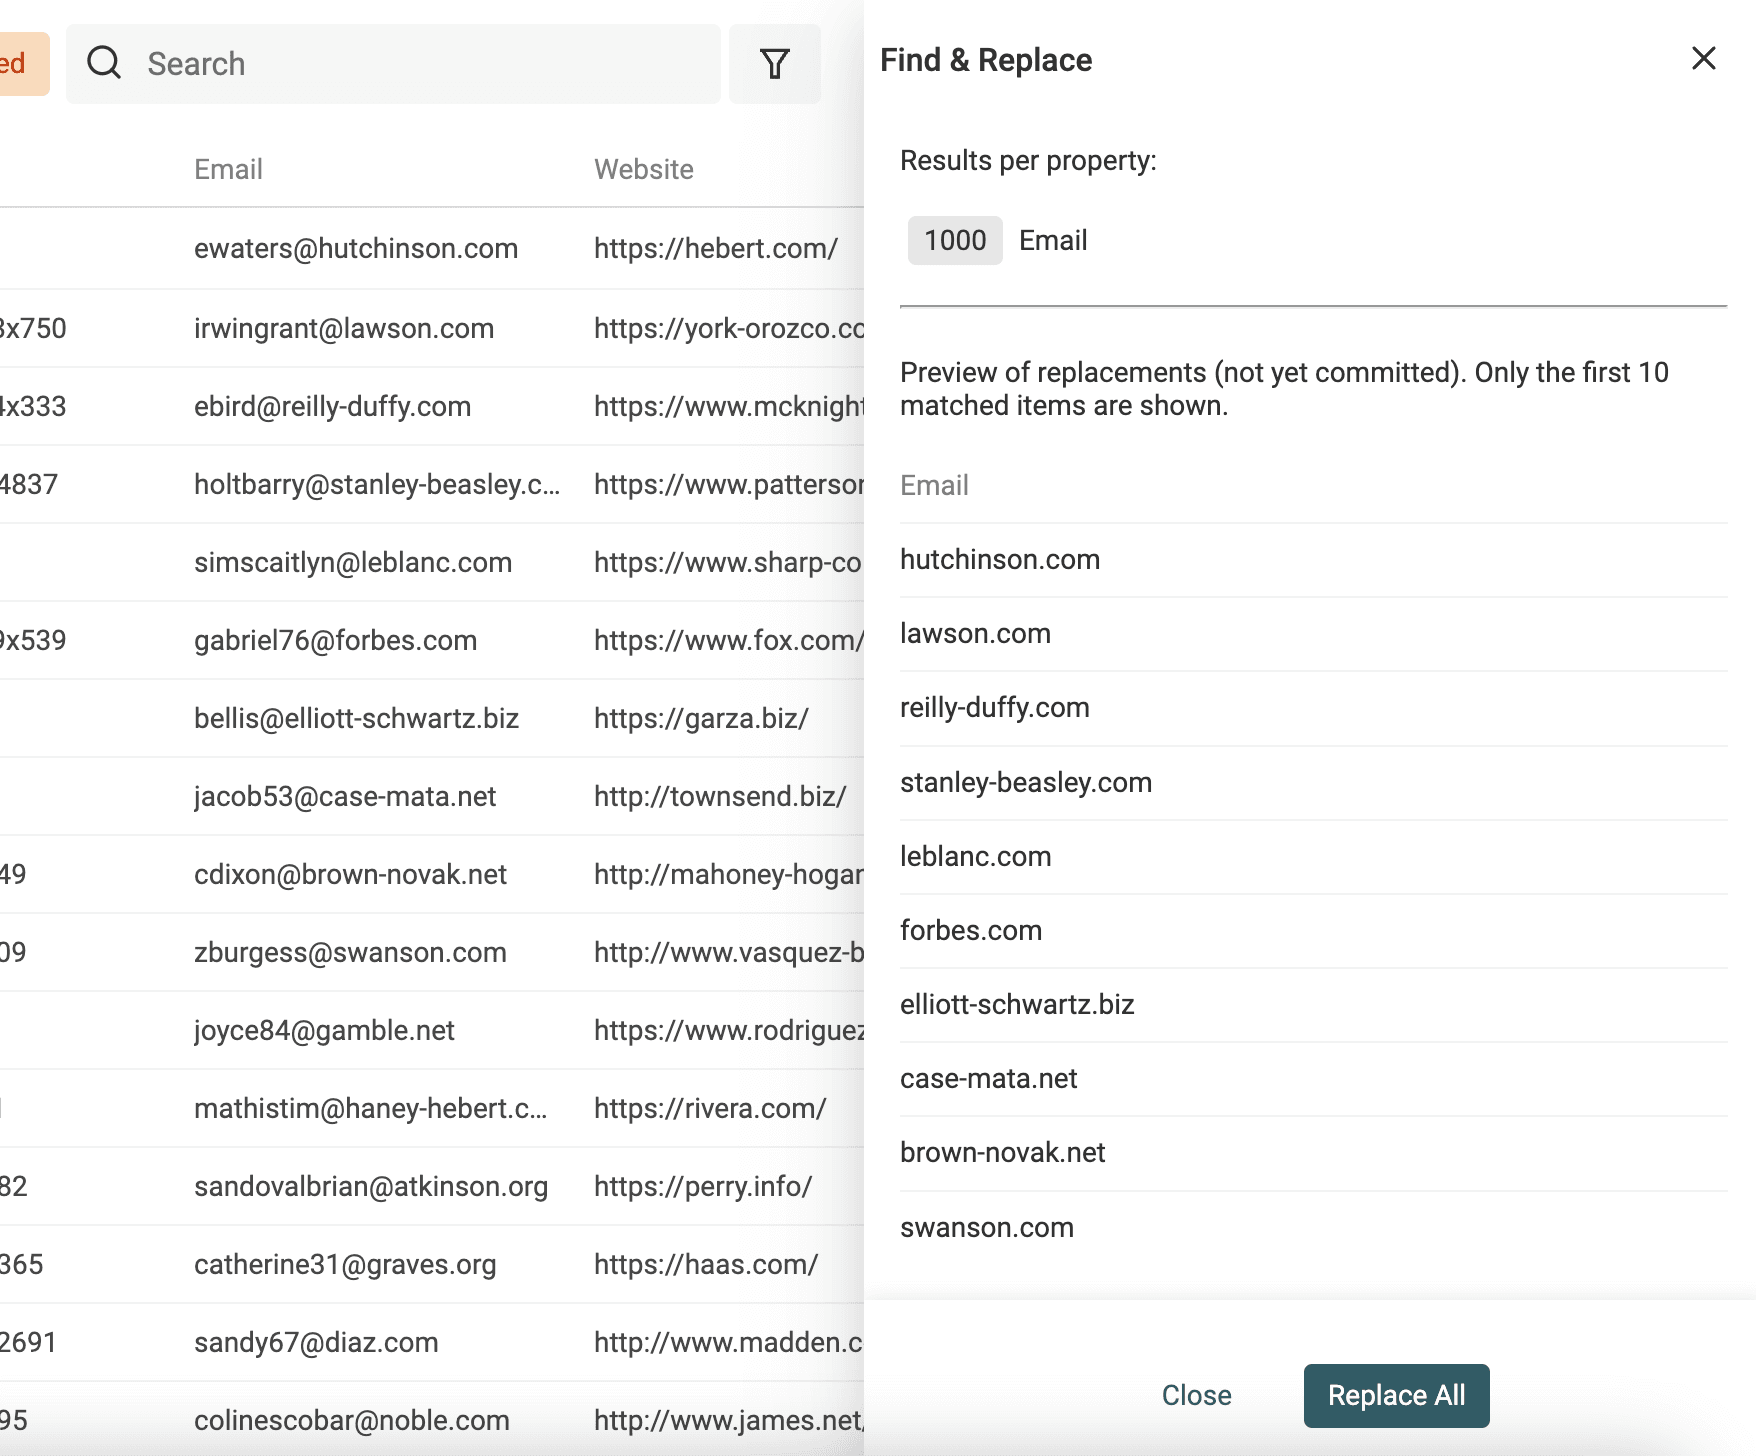
Otro uso de Find and Replace consiste en extraer el dominio de un email. Así obtendrá el dominio situado después de @, aunque este no siempre coincidirá con la web de la empresa, ya que un contacto podría utilizar un proveedor de correo personal.
Duplique la propiedad de email para conservar los datos de origen. En las celdas que contengan una única dirección de email en texto plano, utilice la siguiente expresión regular dejando vacío el campo de sustitución:
^[^@\s]+@(?=[^@\s]+$)
Esta expresión admite partes locales con puntos, signos más y guiones. Por ejemplo, jane.smith+sales@example.com se convierte en example.com. La captura de pantalla antigua que aparece a continuación utiliza un patrón más restrictivo; utilice la expresión anterior.
Elimine primero los espacios que rodeen al texto. Las celdas con un nombre visible, varias direcciones o emails mal formados necesitarán una limpieza independiente. Esta transformación extrae un dominio, pero no valida el buzón.
👉 Para obtener más información, consulte nuestra documentación sobre Find and Replace.
Separar el nombre completo en nombre y apellidos
Al extraer listas de leads, suele obtener contactos con un "Full Name" que debe separar en "First Name" y "Last Name". Dividir correctamente el nombre de una persona en sus diferentes componentes es un paso fundamental.
Separar los campos del nombre facilita el tratamiento personalizado de los contactos y la asignación de datos a un CRM. Conserve el nombre completo para poder revisar las divisiones incorrectas; un nombre por sí solo no permite determinar el género ni el tratamiento de una persona.
Separar nombres puede ser complicado. Por suerte, Datablist ofrece una herramienta fácil de usar que divide "Name" en dos valores utilizando el espacio como delimitador.
Para empezar, abra la herramienta "Split Property" desde el menú "Edit".
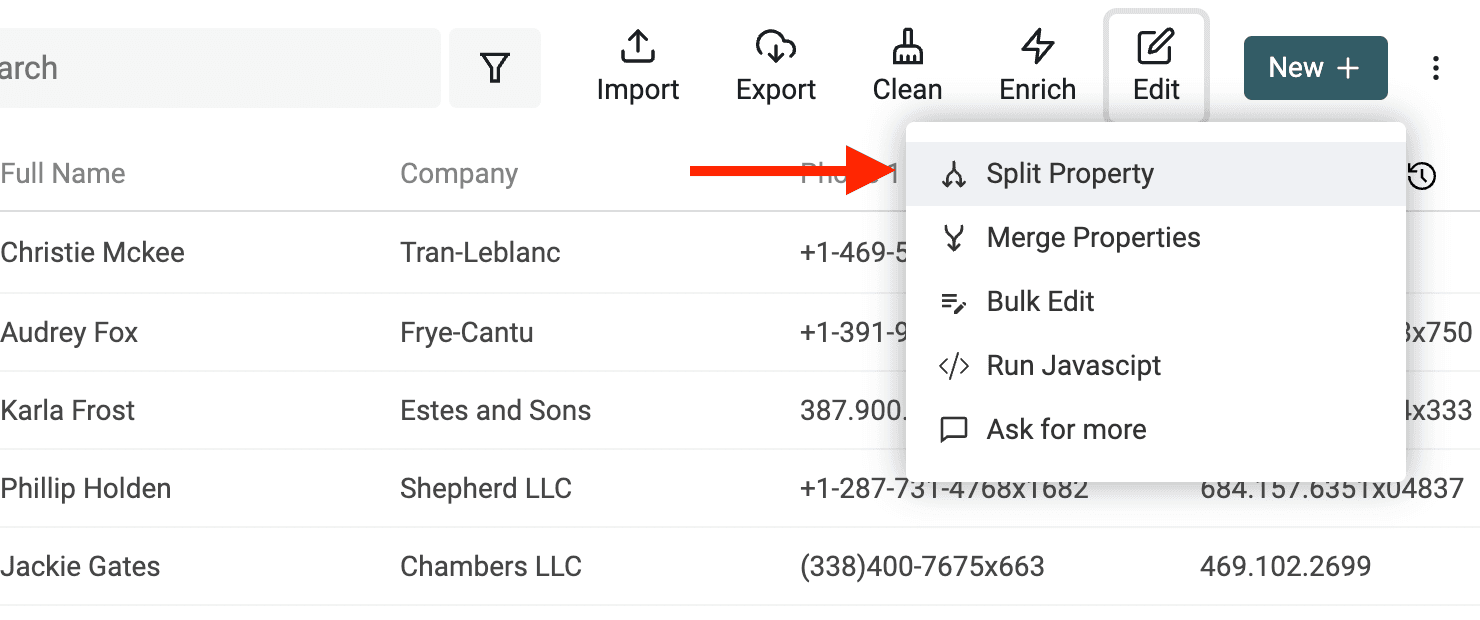
A continuación, seleccione la propiedad que contiene los nombres que desea procesar. Elija Space como delimitador y establezca en 2 el número máximo de partes.
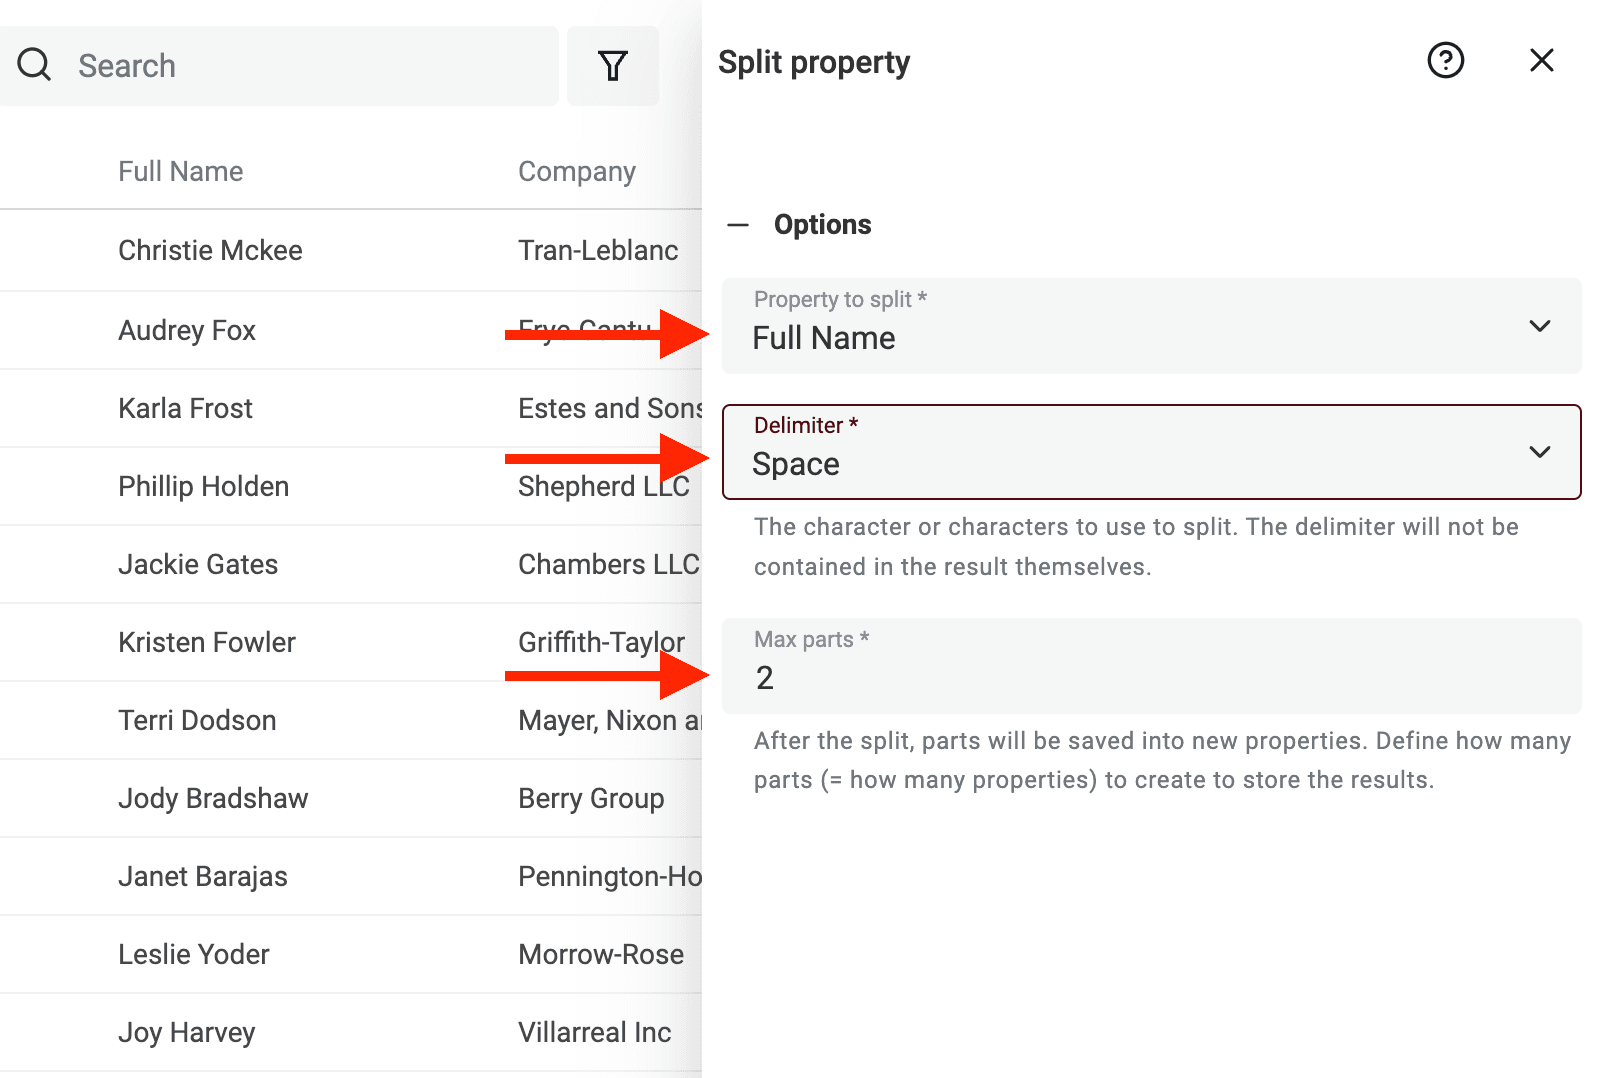
Ejecute la vista previa. Datablist procesará los diez primeros elementos para generar una muestra del resultado. Si es correcto, haga clic en "Split Property" para ejecutar el algoritmo sobre todos los elementos actuales.
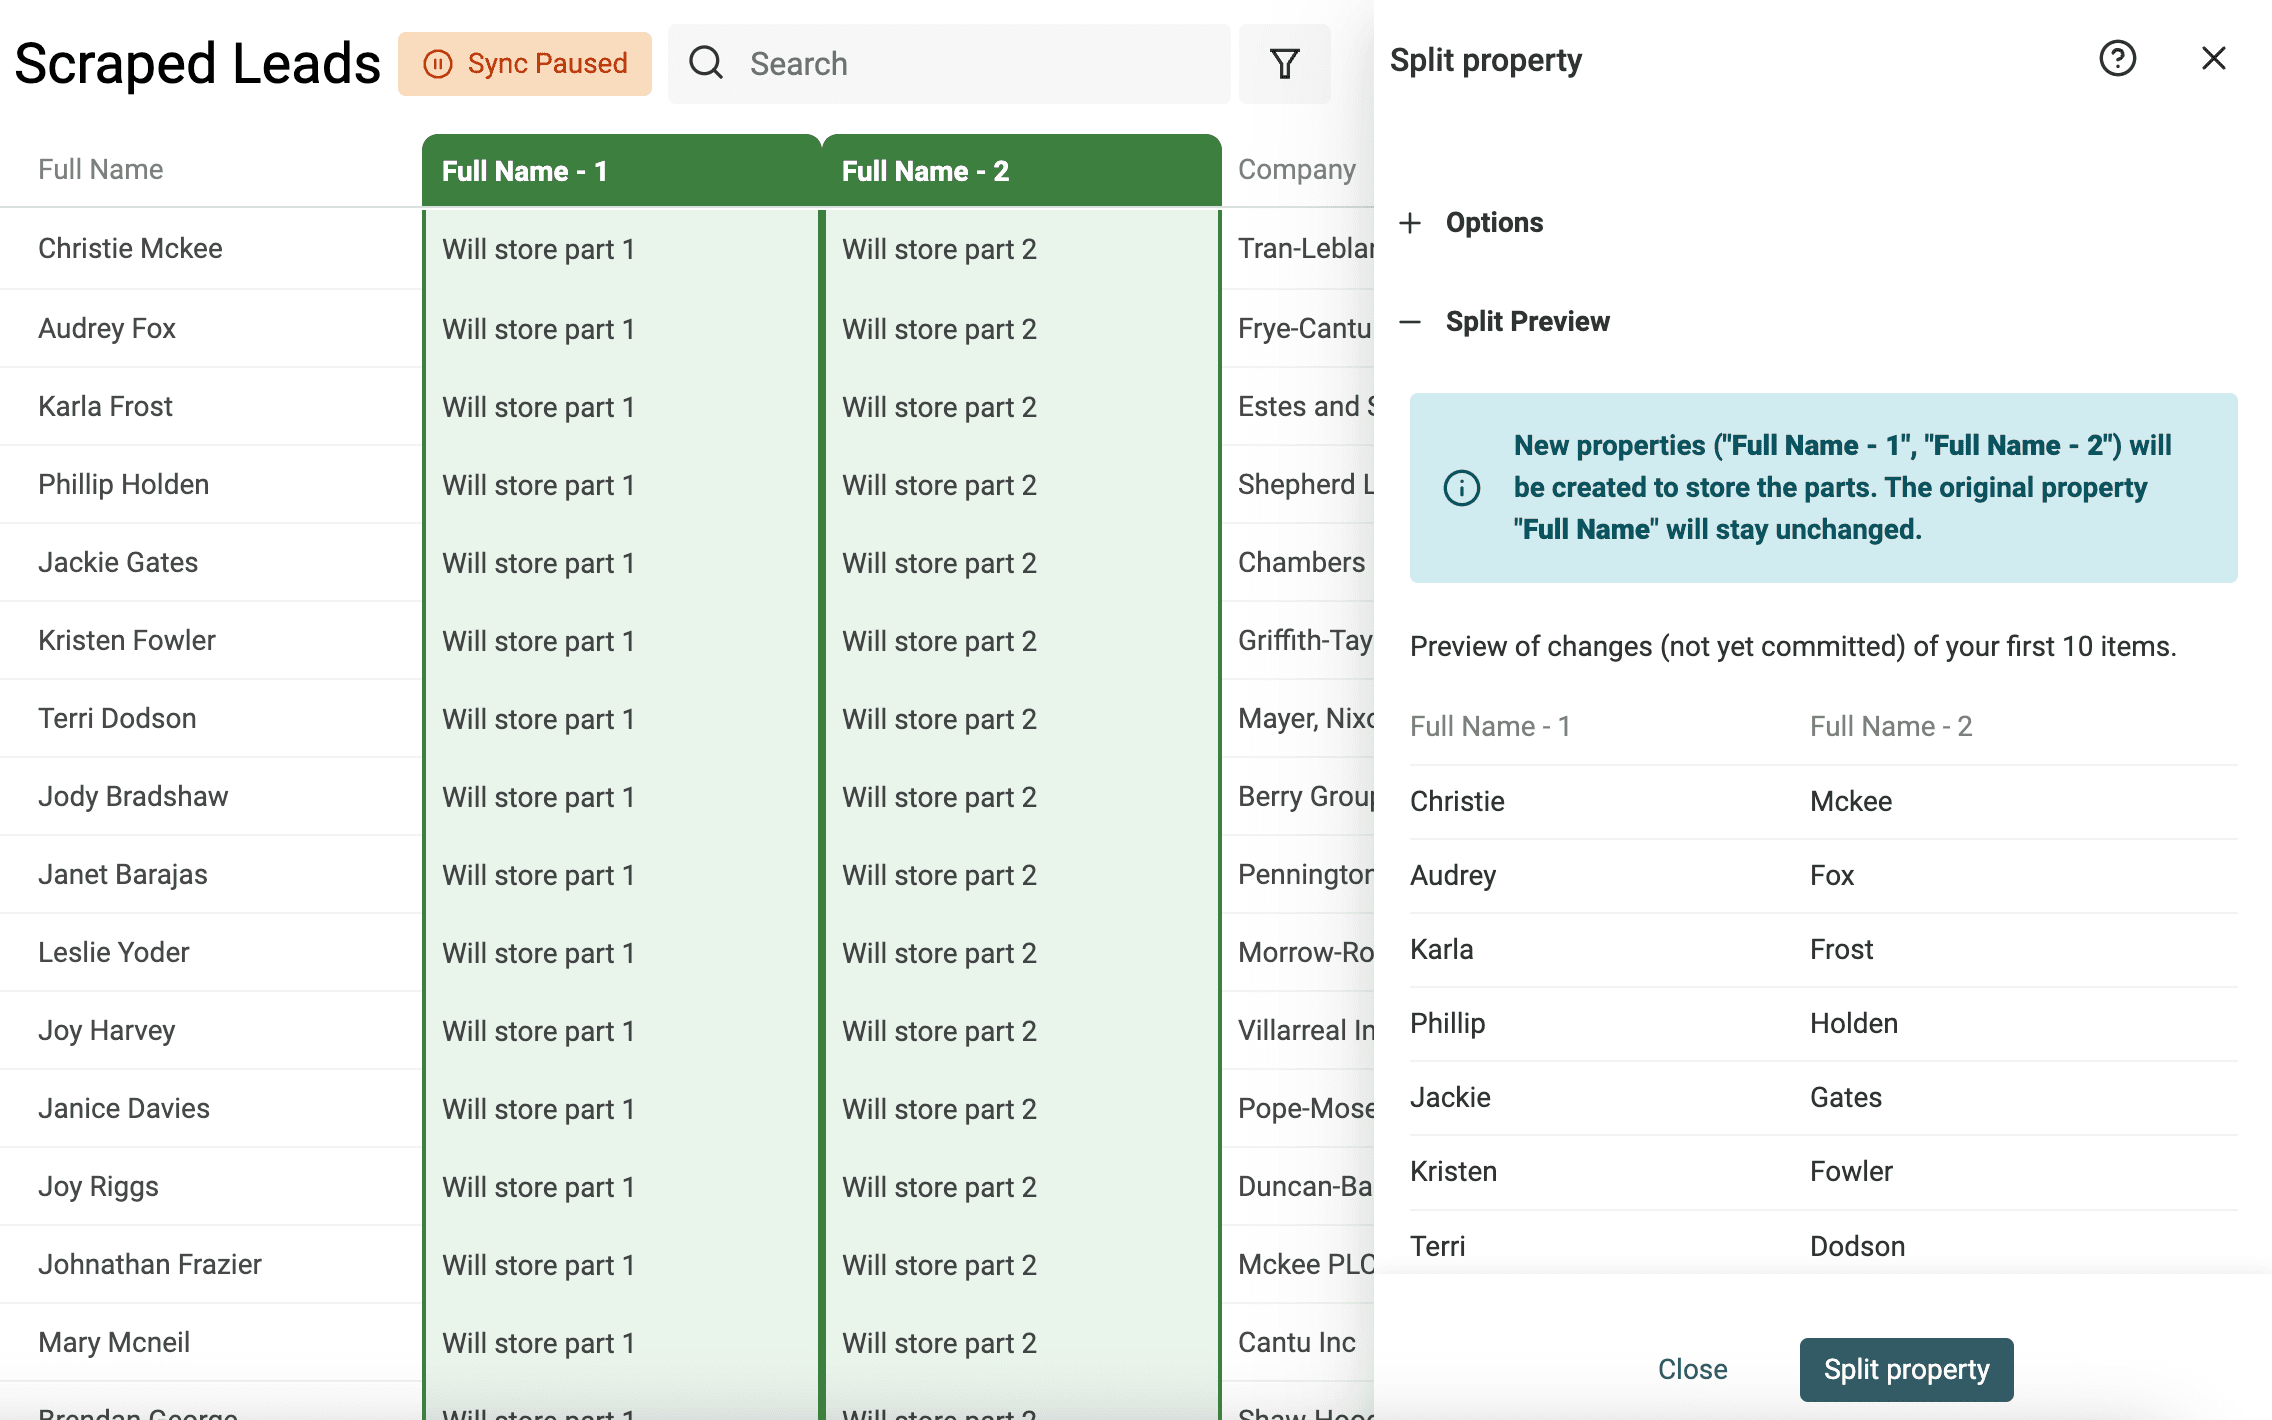
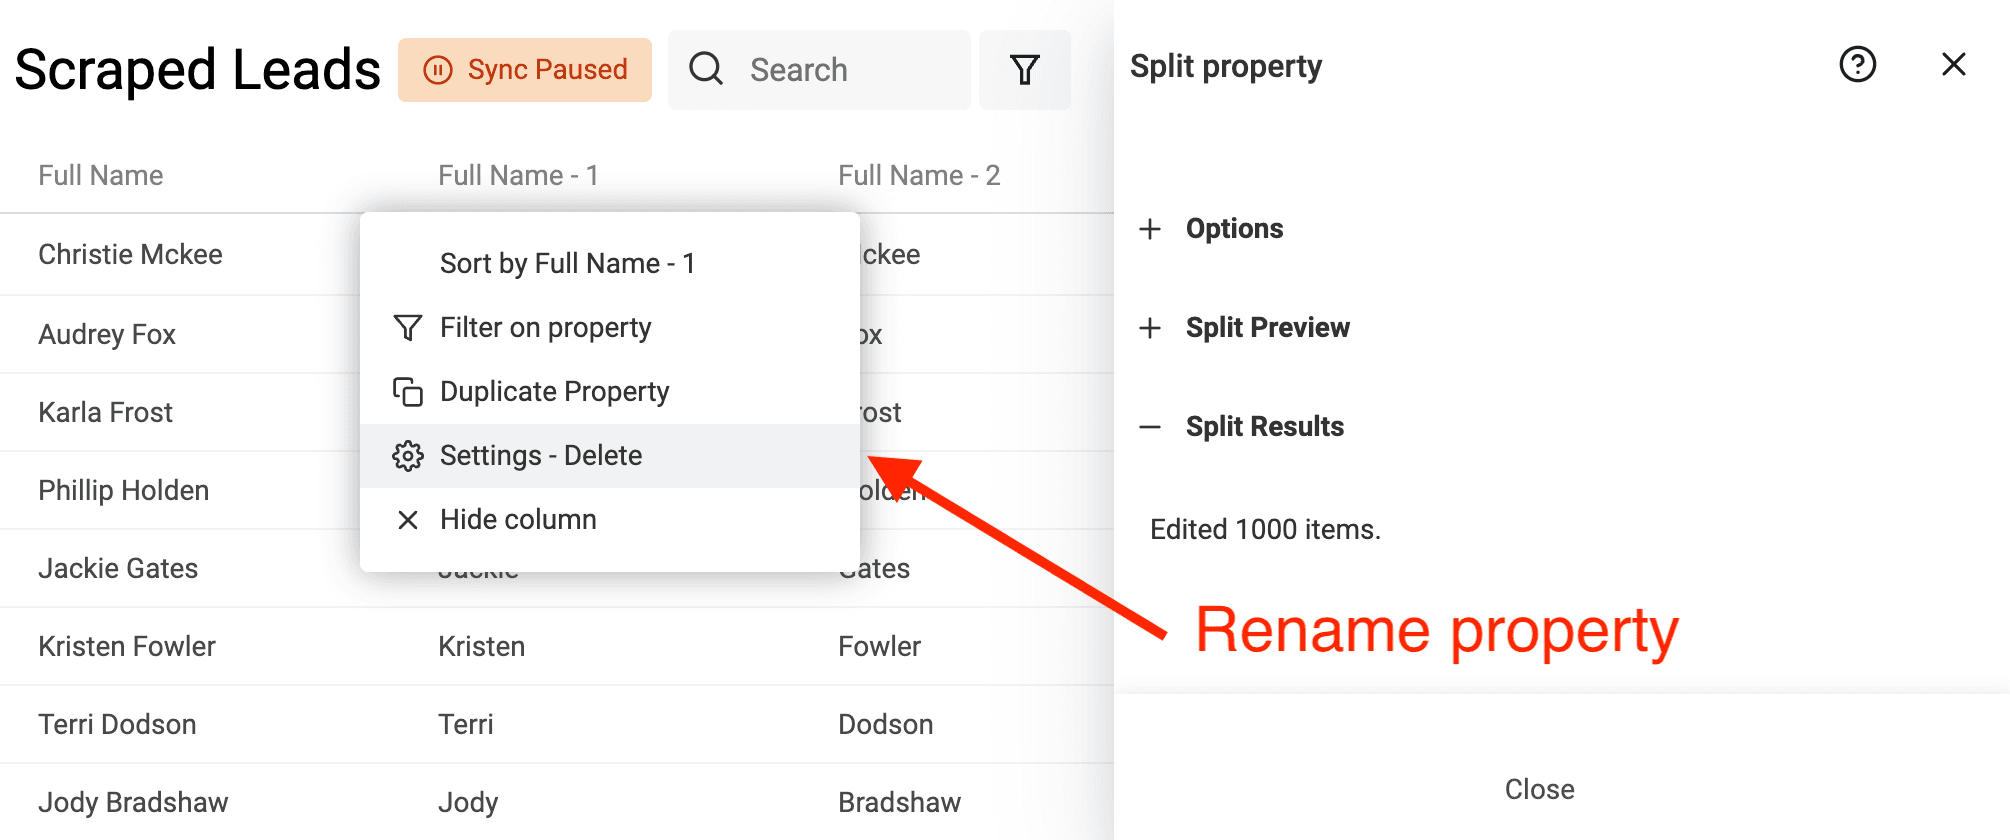
Después de ejecutar el algoritmo, cambie el nombre de las dos propiedades creadas a "First Name" y "Last Name".
Este ejemplo se centra en nombres que siguen la convención occidental, normalmente formada por un nombre y un apellido. El proceso puede resultar más complejo con nombres de otras culturas, incluidos aquellos con varios nombres o apellidos, o cuando incorporan tratamientos o sufijos.
Eliminar registros duplicados
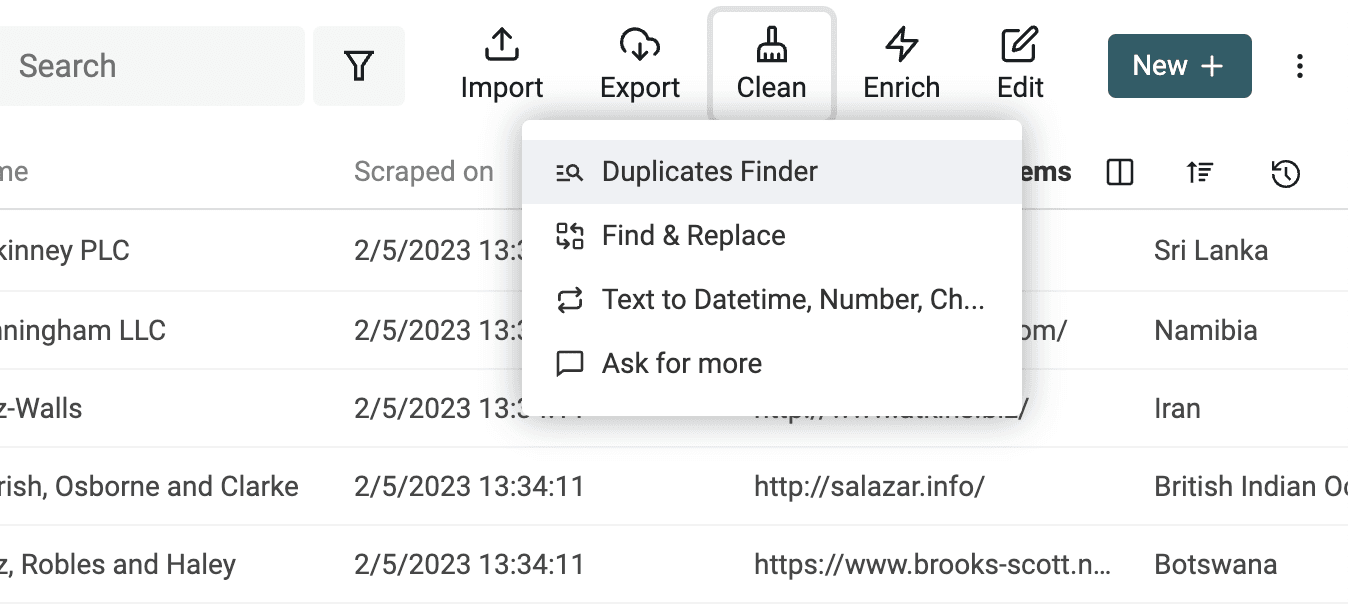
Abra Clean > Merge duplicates cuando varias filas contengan información que desee conservar. Utilice Remove duplicates si quiere mantener una fila sin modificar y eliminar las demás. La siguiente captura muestra una versión anterior del menú.
Seleccione las propiedades que identifican un registro. Yo empiezo con el email de un contacto o la URL de un producto, en lugar de utilizar únicamente el nombre de una empresa. No es necesario normalizar todos los campos si ya dispone de una clave de coincidencia fiable.
La comprobación crea grupos para su revisión sin modificar los datos. En el espacio de resultados, elija Merge and preserve data, revise Record to keep y configure las reglas en Resolve conflicting values. Combine los valores de texto cuando necesite conservarlos todos; mantenga uno solo cuando esté dispuesto a descartar los demás.
Revise los grupos Ready antes de hacer clic en Merge ready groups. Si opta por eliminar registros, compruebe que las filas descartadas no contienen información adicional, ya que este modo no modifica la fila conservada.
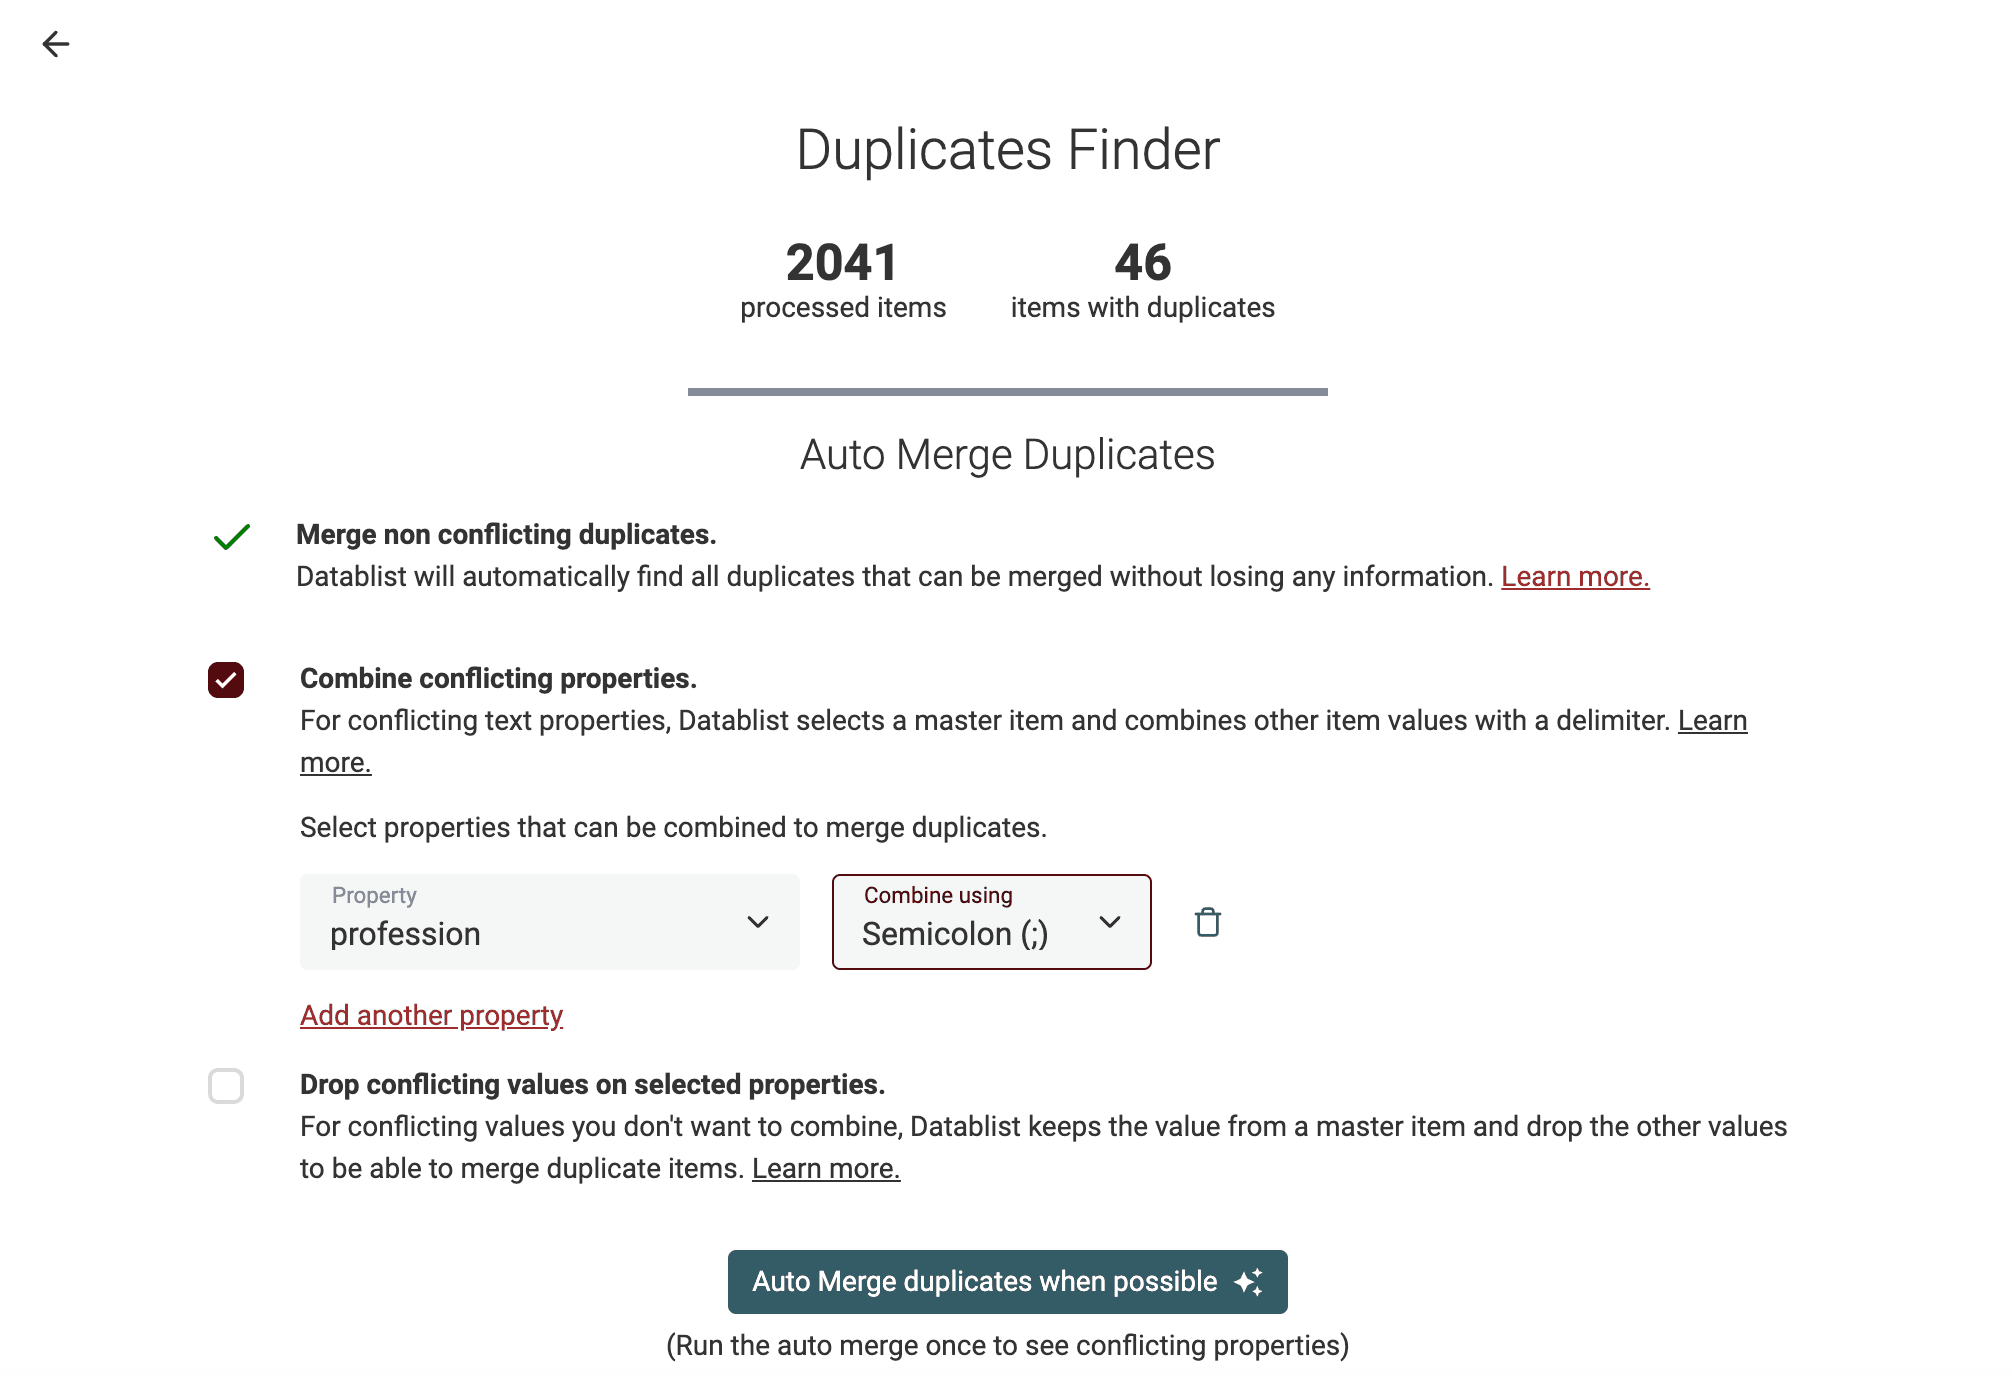
👉 Consulte nuestra guía para combinar duplicados en archivos CSV.
Validar direcciones de email
Los datos obtenidos mediante scraping pueden estar desactualizados, contener errores tipográficos o no ser válidos. Esto ocurre especialmente con las direcciones de email extraídas mediante scraping.
Cuando los datos proceden de usuarios, es posible que su base de datos incluya direcciones falsas o emails de proveedores temporales.
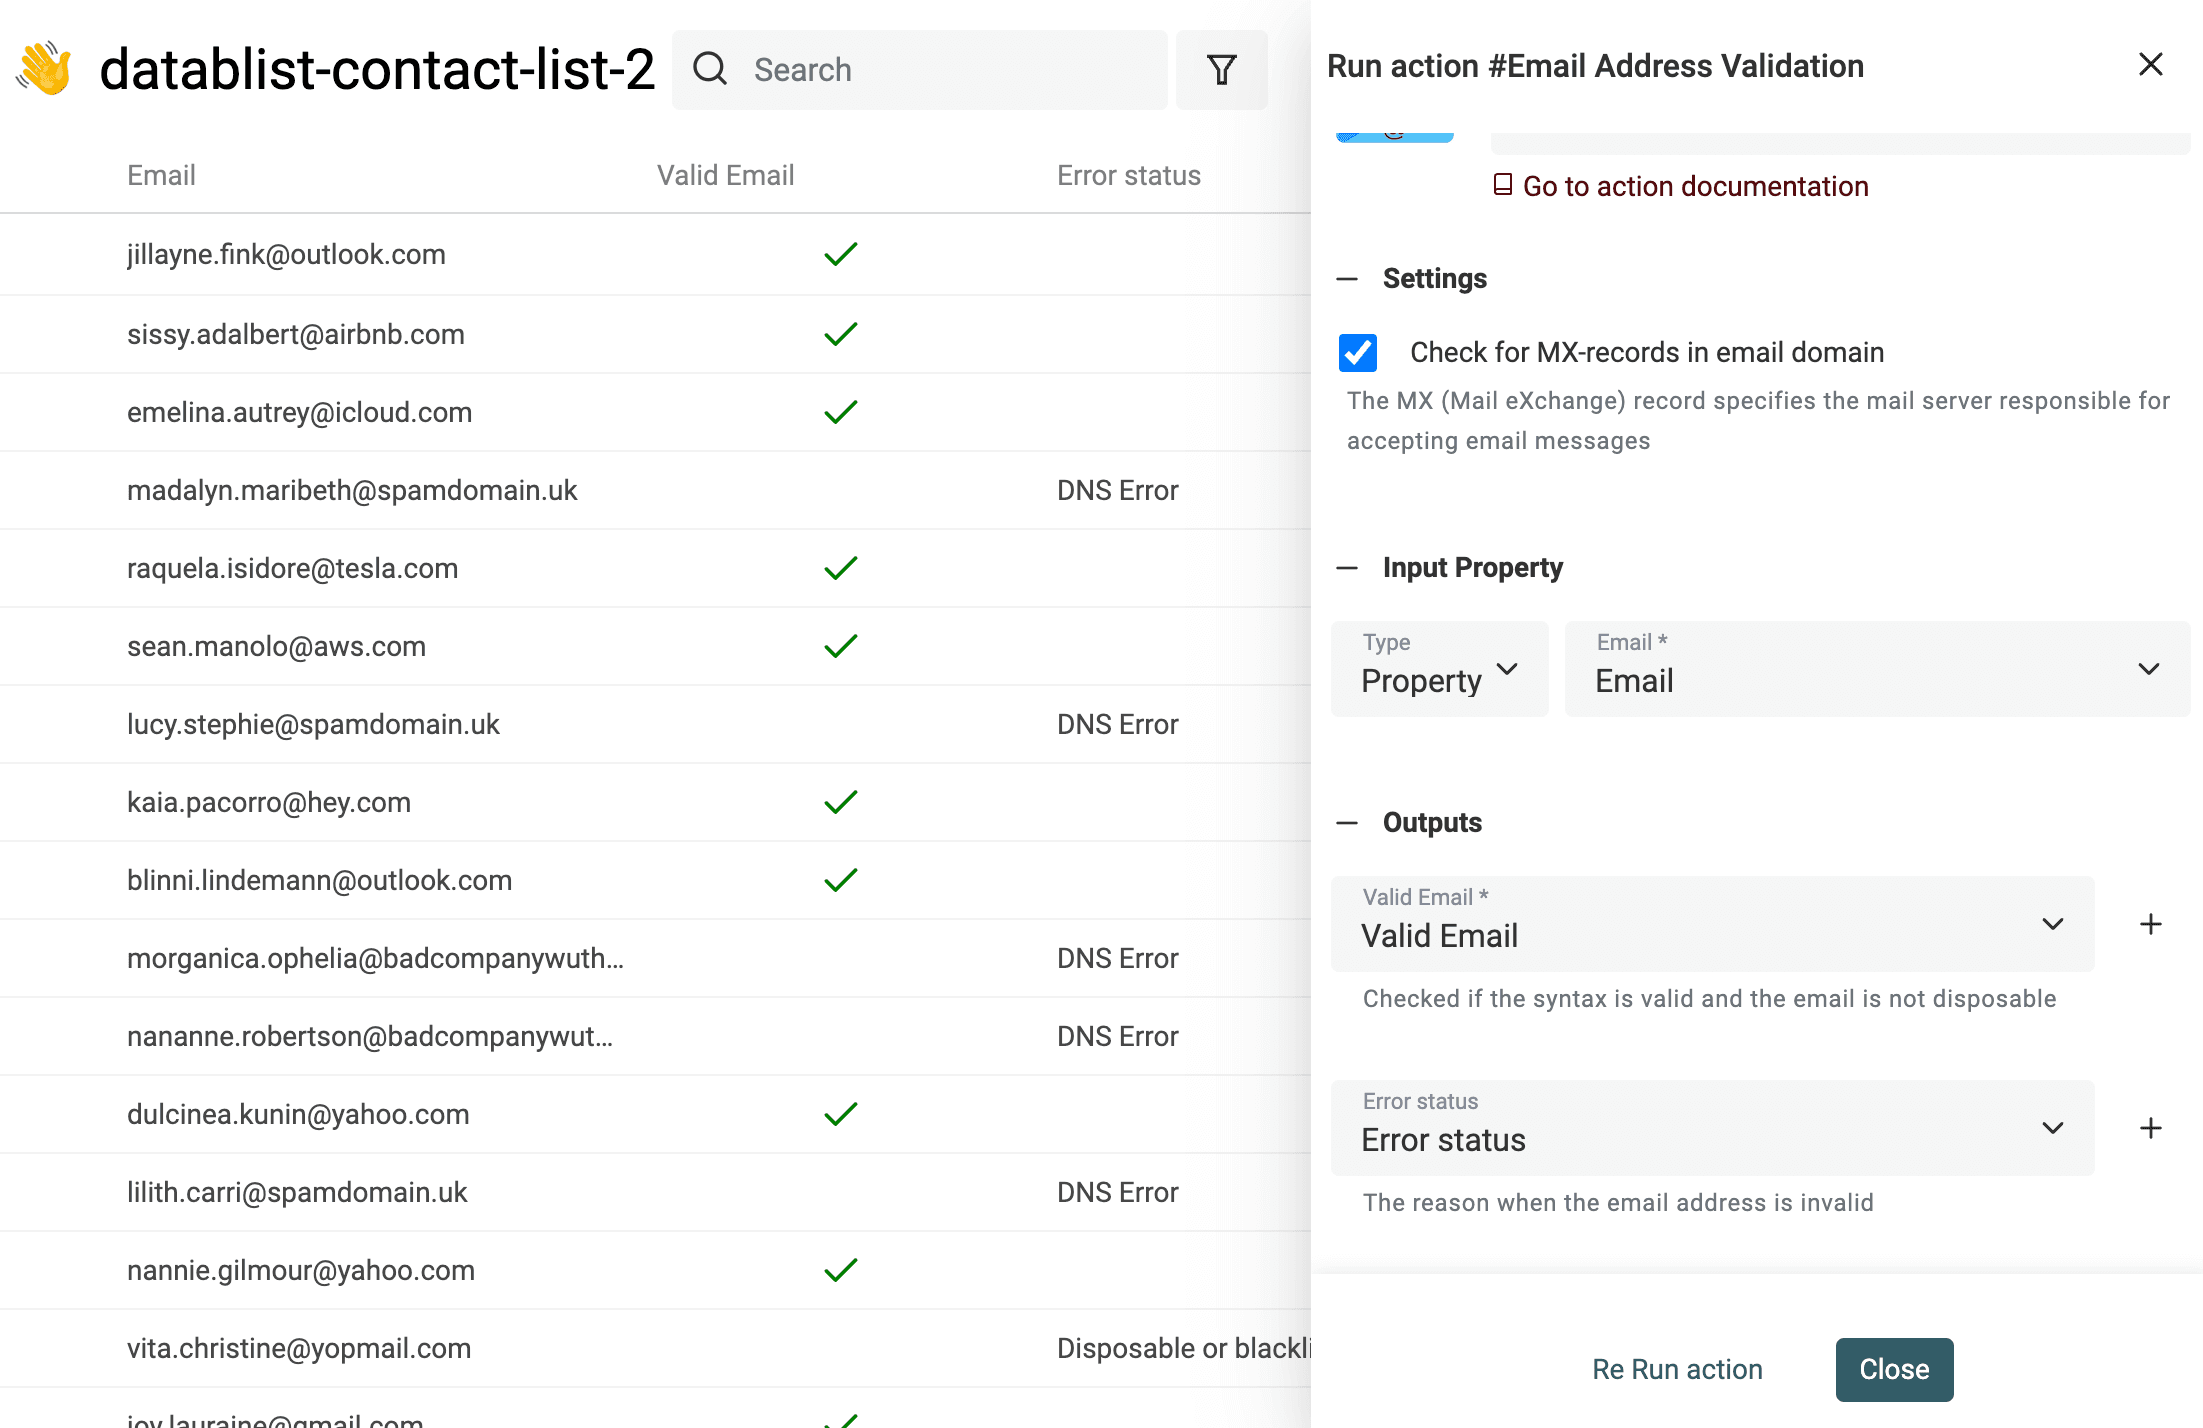
Datablist incorpora una herramienta de validación de emails que permite comprobar miles de direcciones.
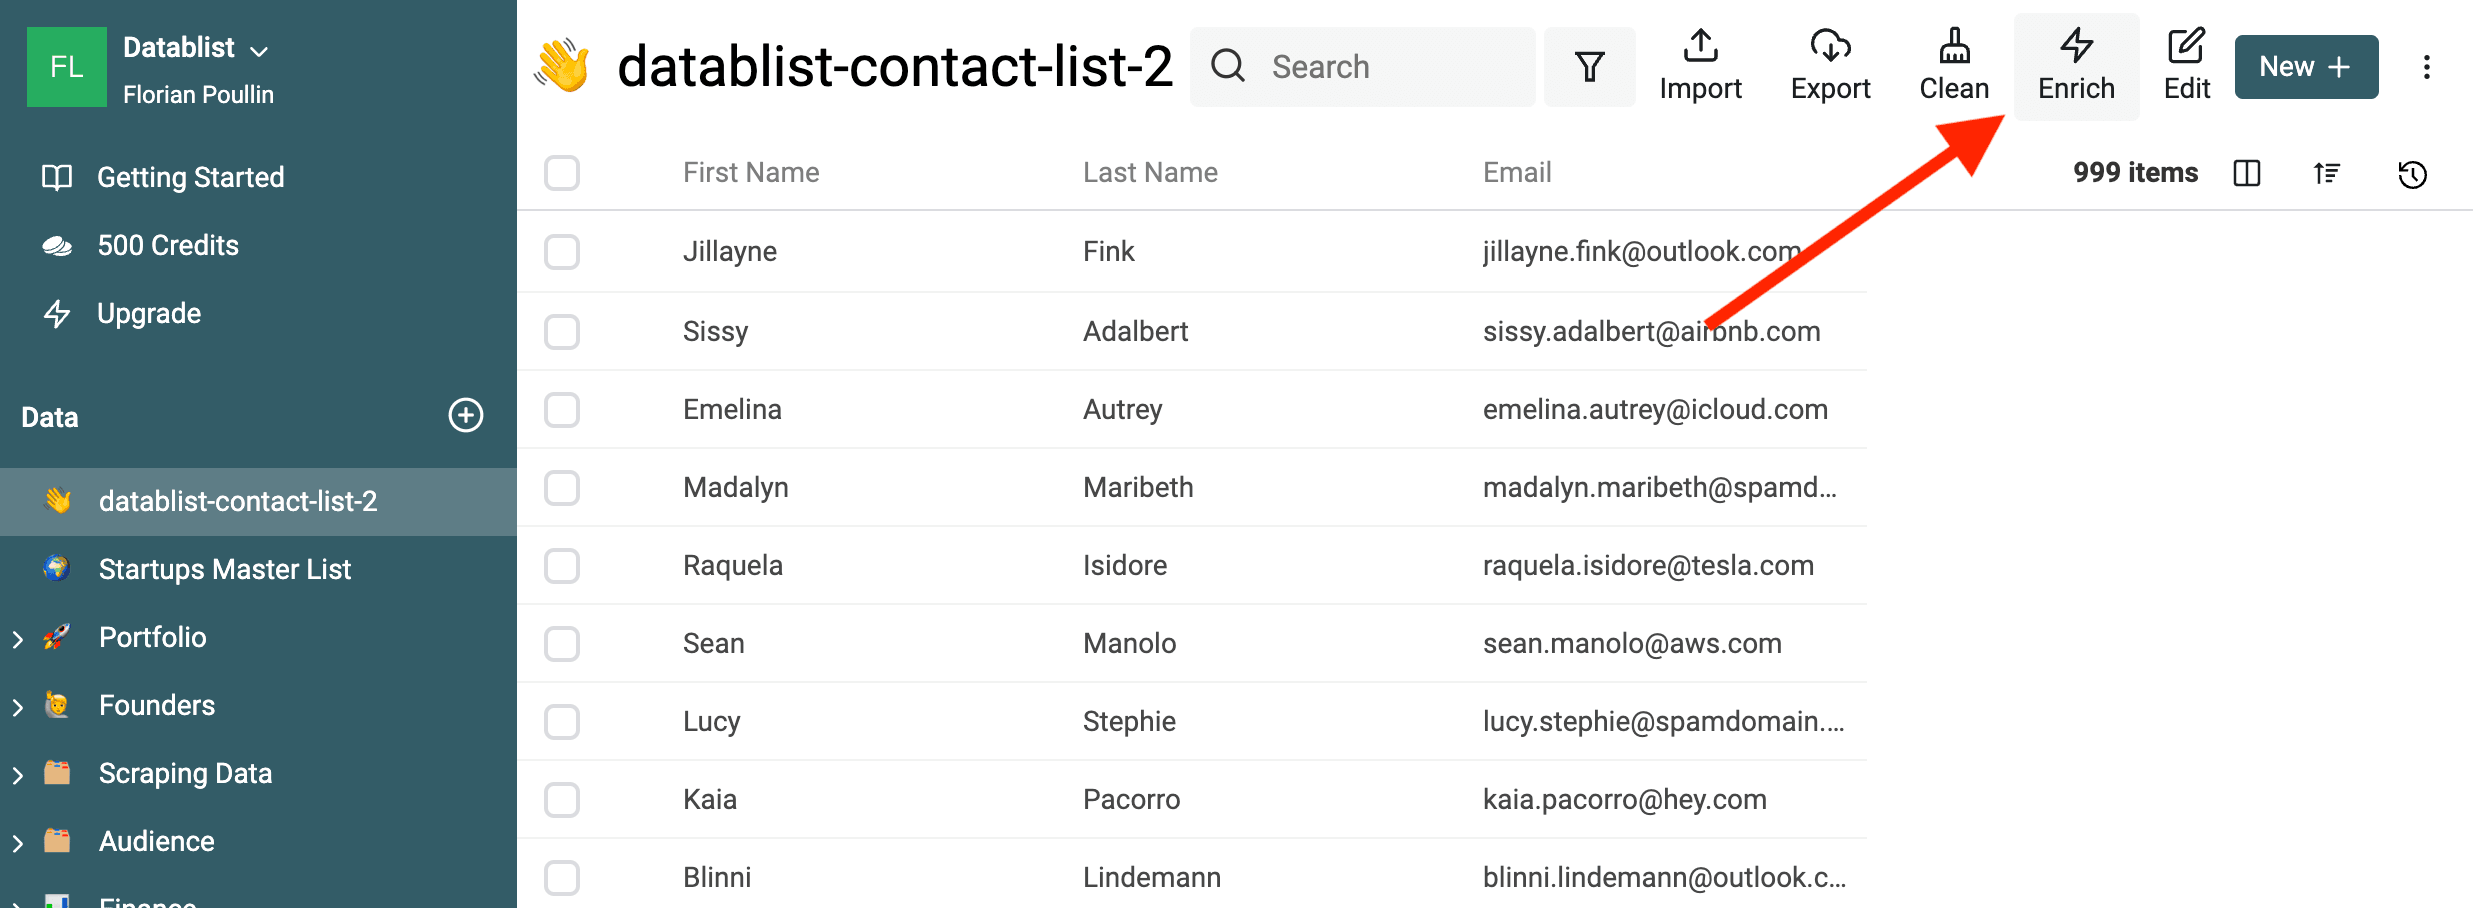
El servicio gratuito de limpieza de emails comprueba la sintaxis, los dominios temporales y, cuando se activa la opción correspondiente, los registros MX del dominio. Estas comprobaciones no demuestran que un buzón concreto exista ni que un mensaje vaya a entregarse. Conserve el estado o motivo devuelto para poder revisar las excepciones.
El servicio ofrece:
- Análisis de la sintaxis del email - Detecta direcciones mal formadas, como textos sin el signo
@o con un formato de dominio no válido. - Comprobación de proveedores temporales - Esta segunda comprobación detecta emails temporales. El servicio busca dominios pertenecientes a proveedores de direcciones de email desechables (DEA), como Mailinator, Temp-Mail o YopMail.
- Comprobación de registros MX del dominio - Consulta los registros de los servidores de correo del dominio, salvo que active Disable MX-records analysis. Revise los resultados DNS fallidos o ausentes por separado de los errores de sintaxis: esta comprobación afecta al dominio, no al buzón individual.
- Segmentación de direcciones de email profesionales y personales - Si consigue prospectos mediante lead magnets o necesita segmentar su base de usuarios, quizá quiera distinguir los emails profesionales de los personales. El servicio de validación le proporciona esta información para enriquecer los datos de sus contactos.
Extraer nombres de personas o empresas
Al extraer texto de páginas web u otras fuentes, suele resultar útil identificar los nombres de personas o empresas. Esta información puede emplearse para distintos fines, como la generación de leads o el análisis de la competencia. Sin embargo, extraer nombres de textos no estructurados puede ser complicado, ya que adoptan formas muy diversas y pueden aparecer dentro de bloques de texto más extensos.
Uno de los principales retos es la gran variedad de convenciones y formatos que existen entre culturas e idiomas. Por ejemplo, algunas culturas sitúan el apellido antes del nombre, mientras que otras hacen lo contrario. Algunas personas tienen varios nombres y otras no tienen ninguno. Además, los nombres pueden contener errores, estar abreviados o utilizar formatos no convencionales, lo que dificulta su identificación mediante simples técnicas de reconocimiento de patrones.
Un método habitual consiste en utilizar Named Entity Recognition (NER), una técnica de procesamiento del lenguaje natural que identifica y clasifica entidades con nombre dentro de un texto. Los modelos NER pueden entrenarse para reconocer diferentes clases de entidades, como personas, organizaciones y ubicaciones, y adaptarse a distintas convenciones y variantes de nombres.
Datablist incluye un potente modelo "Named Entity Recognition" (NER) que puede ejecutar directamente sobre sus textos. Está entrenado en árabe, alemán, inglés, español, francés, italiano, letón, neerlandés, portugués y chino.
Seleccione "Entity name extraction" en el menú "Enrichments".
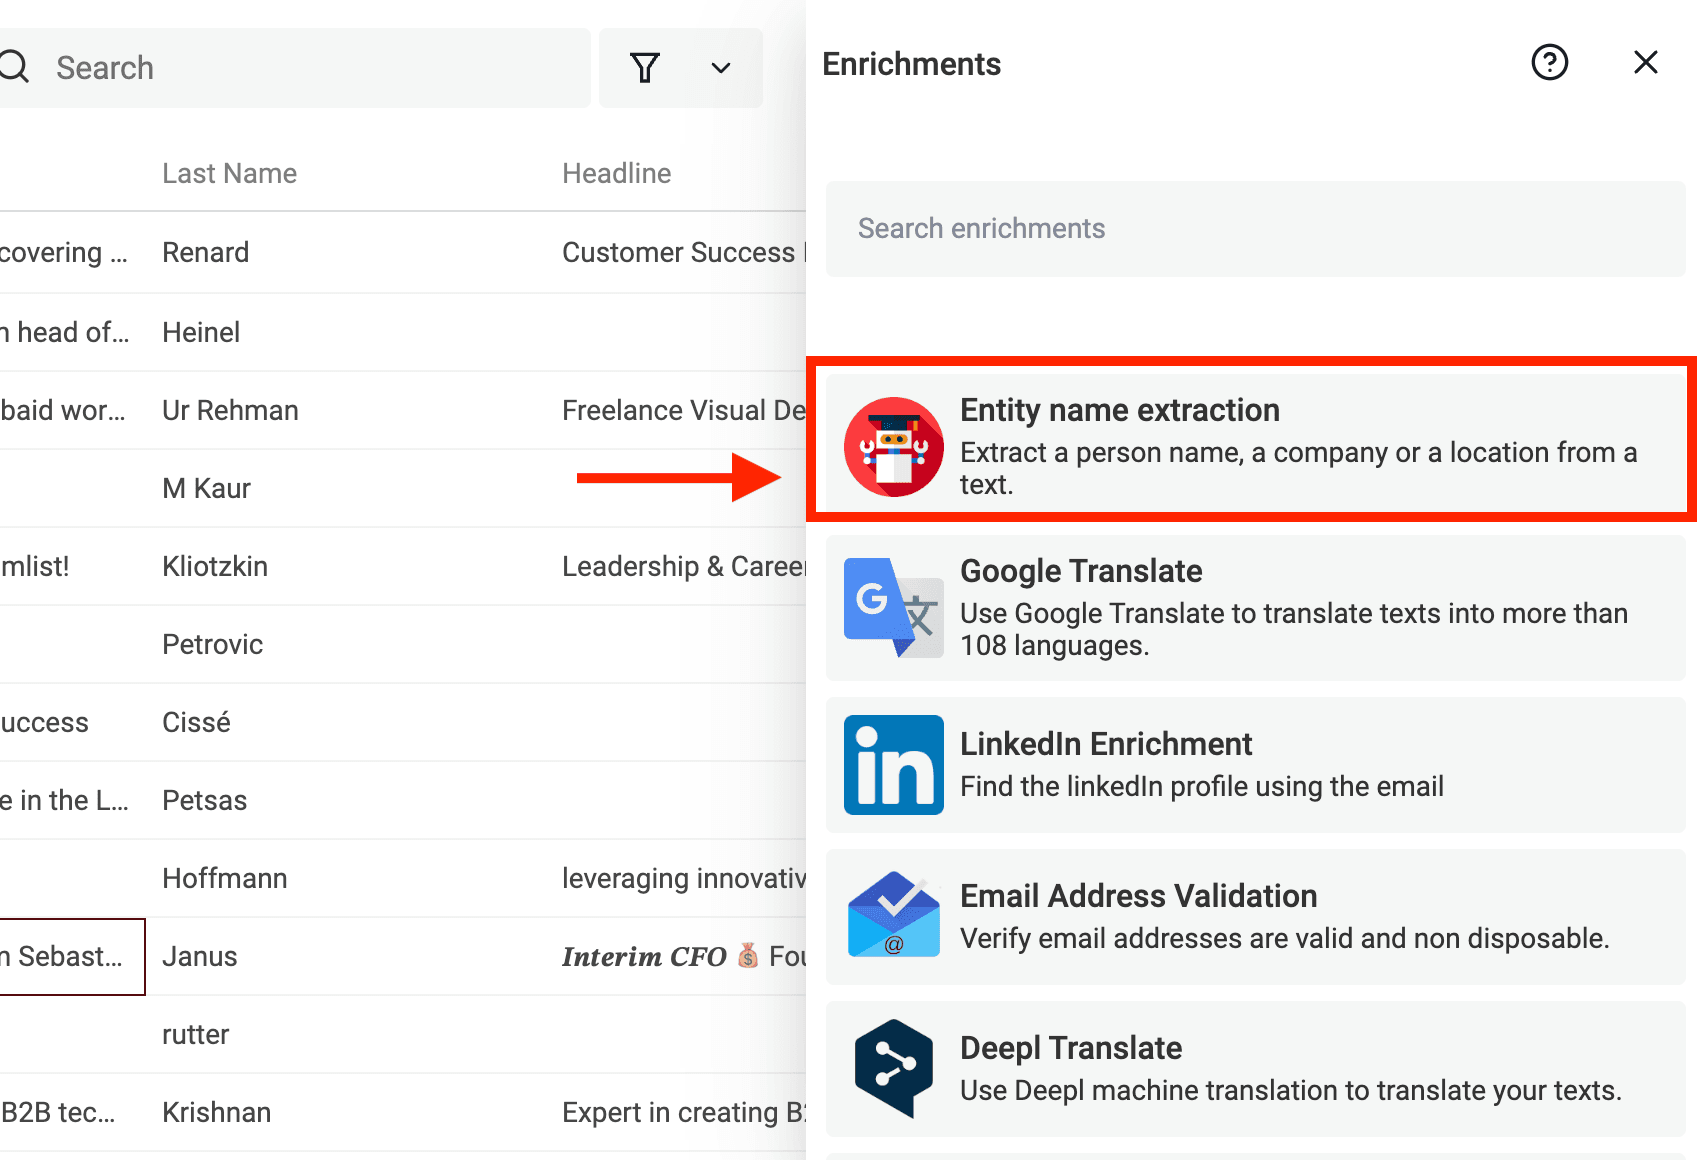
A continuación, en las opciones de entrada, seleccione la propiedad que contiene el texto del que desea extraer nombres.
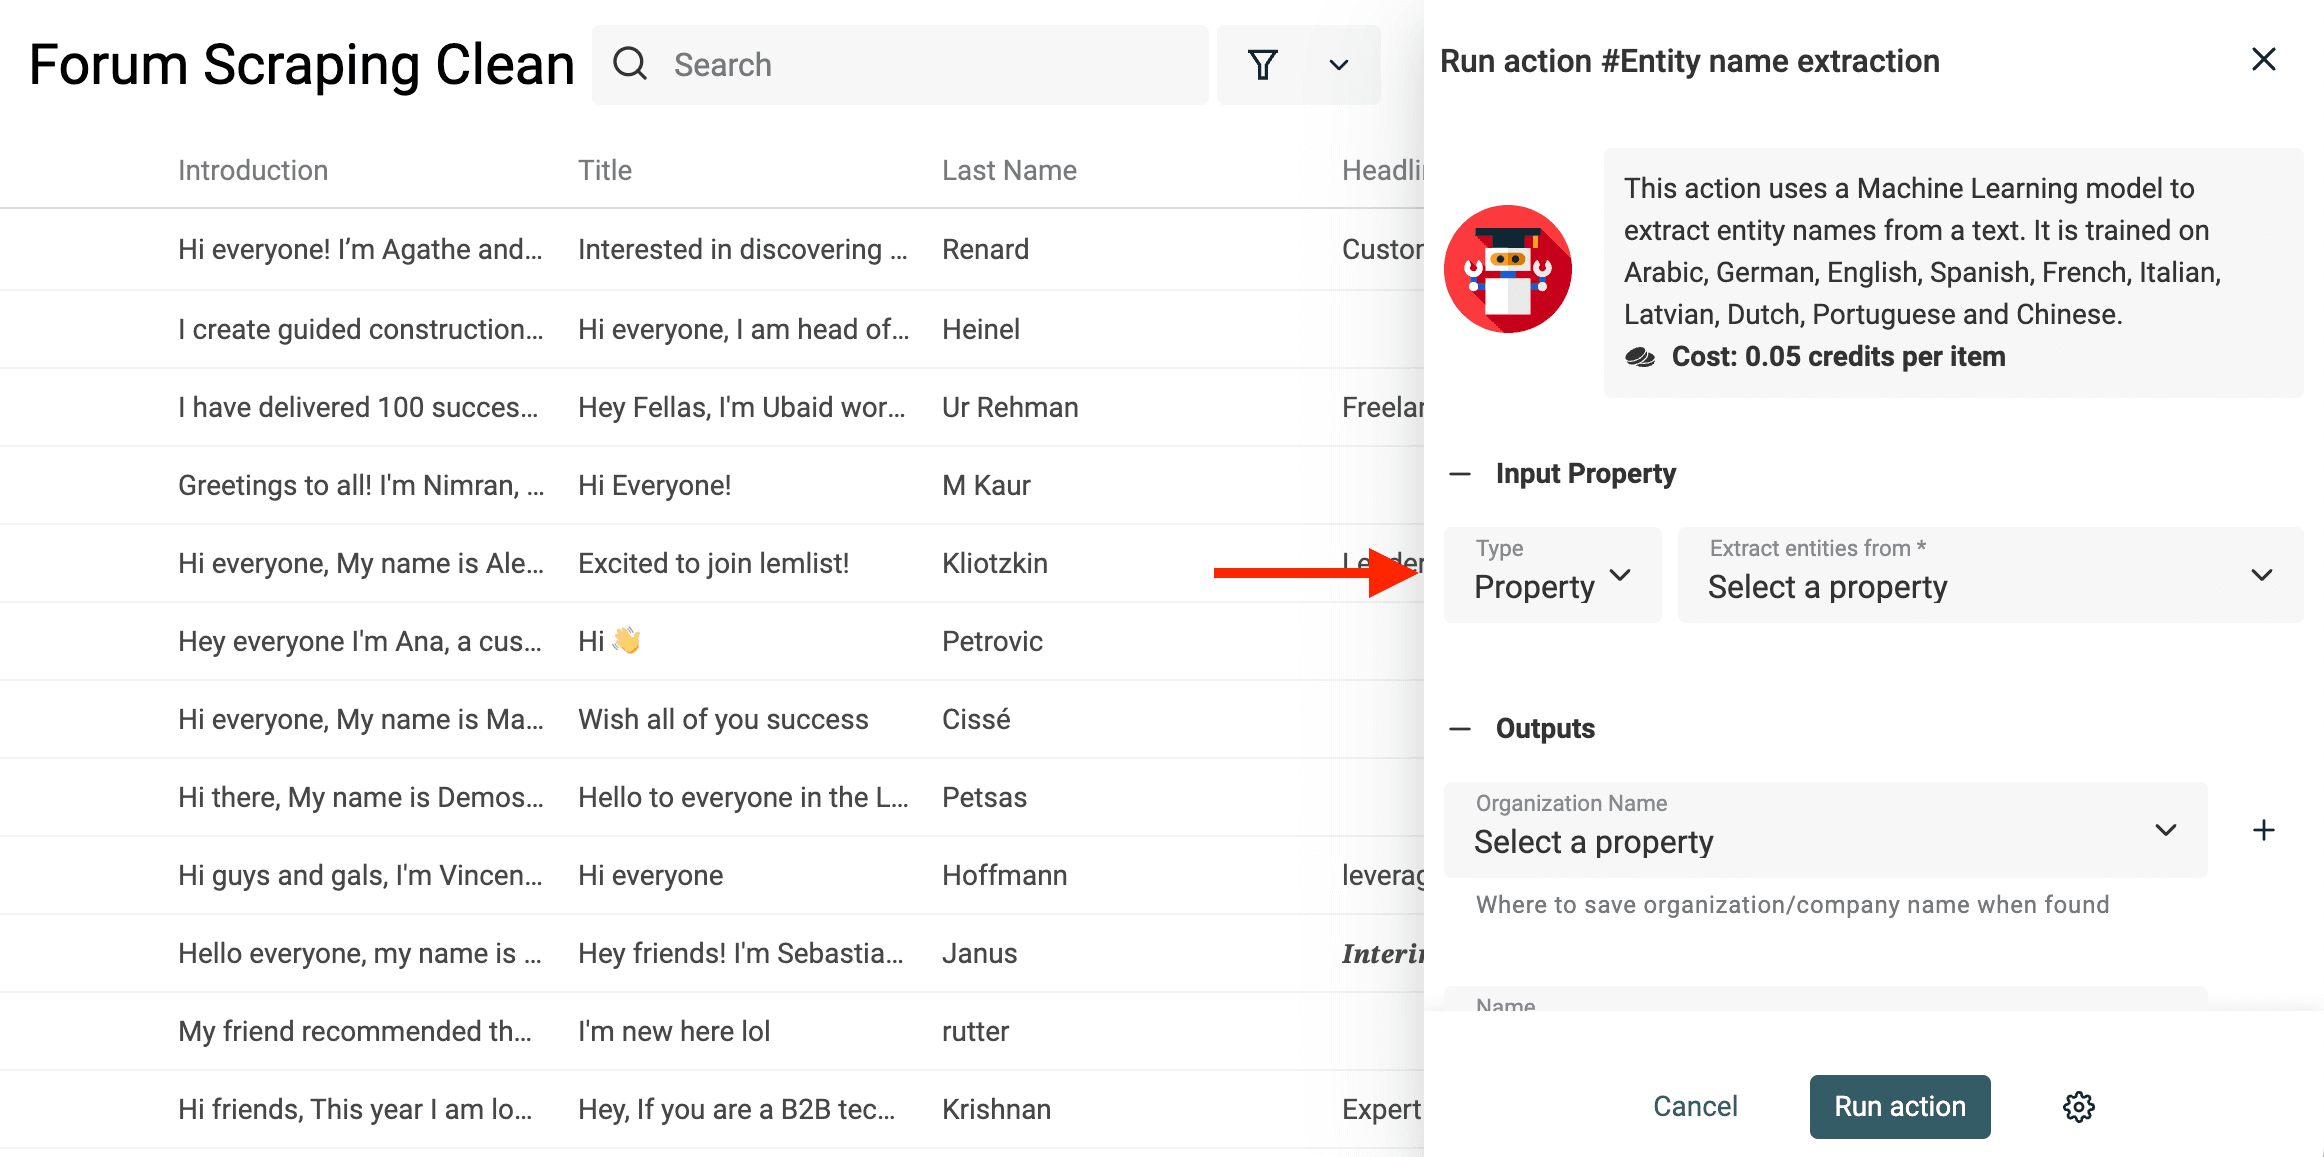
En los resultados, haga clic en el botón "Create a new property" para cada tipo de nombre que quiera extraer.
Entity Name Extractor de Datablist busca:
- Organization Name: por ejemplo, empresas.
- Person Name: nombre completo o First Name/Last Name.
- Location: extrae ciudades, países y lugares.
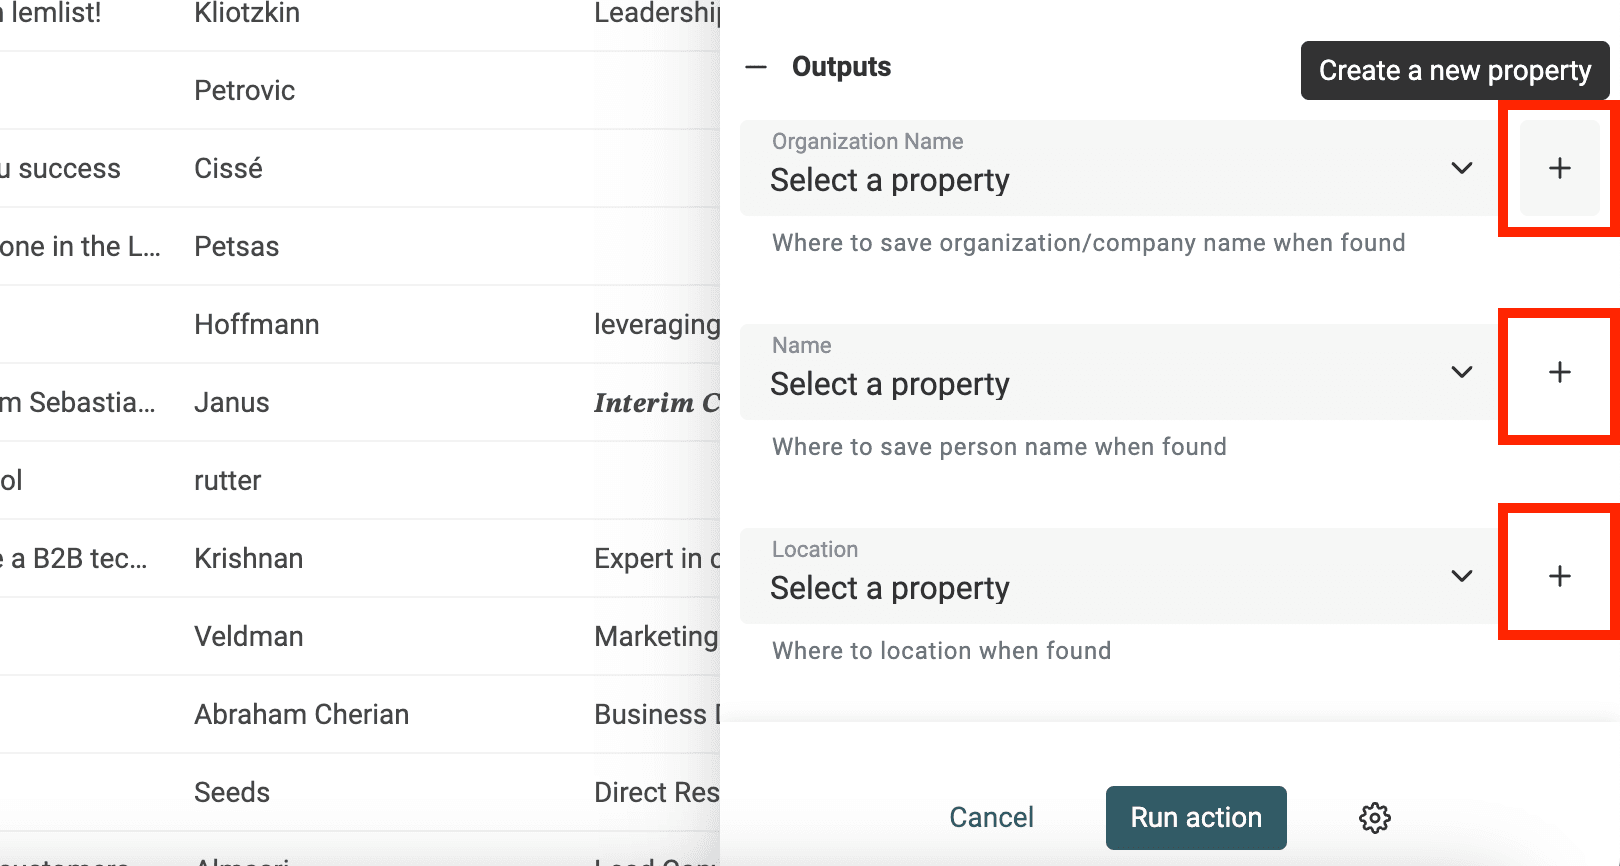
Después, ejecute el enriquecimiento.
¿Necesita ayuda para limpiar sus datos?
Siempre busco comentarios y nuevos problemas de limpieza de datos que resolver. Póngase en contacto conmigo para compartir su caso de uso.