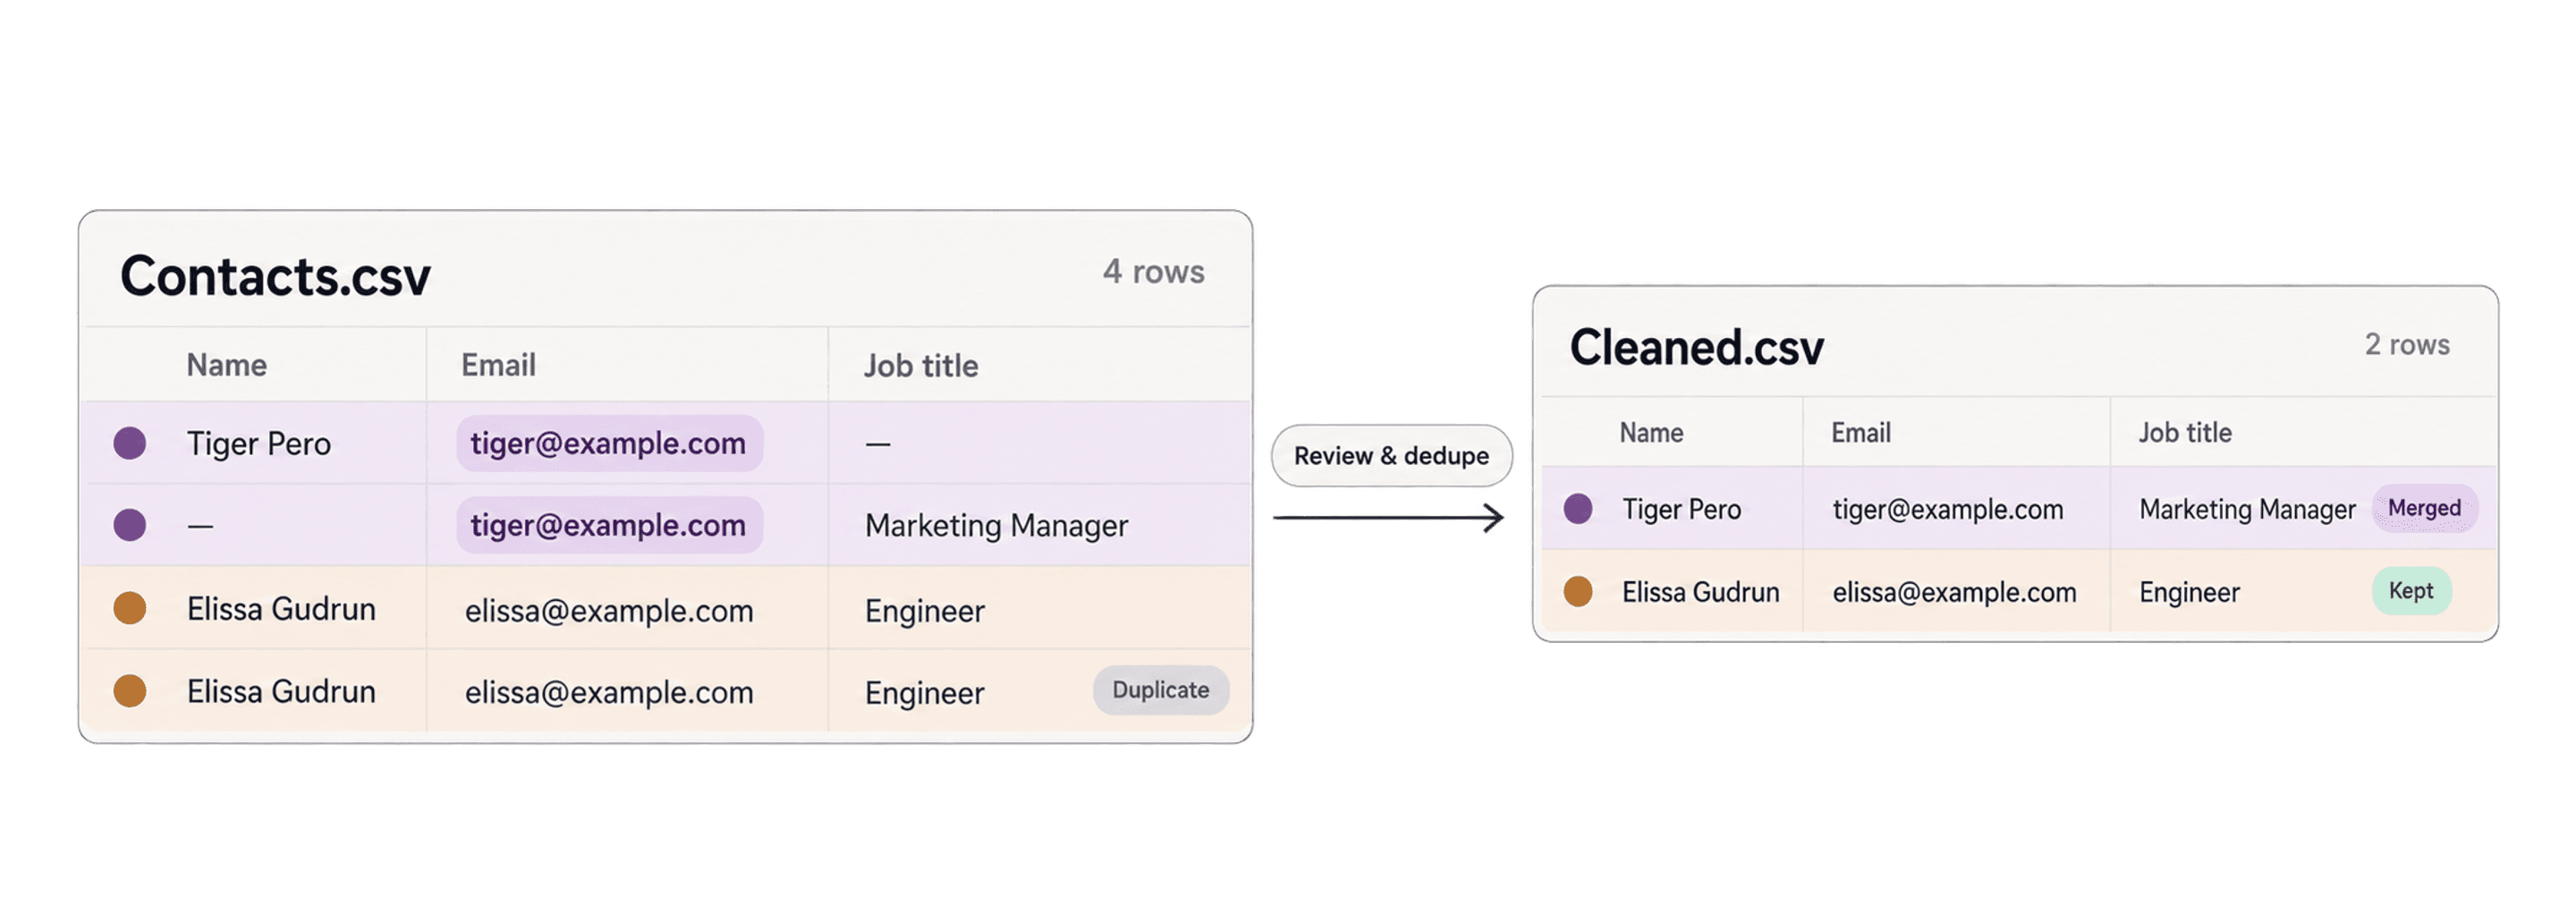
Para eliminar de forma segura las filas duplicadas de un CSV, compare la columna que identifica cada registro, revise los grupos propuestos y, después, elimine las filas redundantes o fusione los valores que quiera conservar. Este método funciona tanto con un único archivo CSV como con varios archivos importados en una misma colección de Datablist.
Utilice el email, el teléfono, el sitio web de la empresa, el SKU u otro identificador estable en la primera pasada. Si los valores presentan diferencias ortográficas o de formato, utilice la coincidencia Smart, difusa o fonética y revise los grupos dudosos.
Fusionar duplicados de archivos CSV
Datablist es ideal para realizar operaciones con datos que no son posibles en una hoja de cálculo. Utilícelo si busca un buen editor de CSV online.
En esta guía trabajaremos con dos archivos CSV que contienen miles de registros. Los cargaremos en una única colección y deduplicaremos los registros a partir de una de sus cuatro columnas. La deduplicación también funciona con un solo archivo CSV.
Para descargar los archivos CSV del tutorial: Archivo CSV 1 y Archivo CSV 2
Los archivos CSV contienen cuatro columnas: First Name, Last Name, Email y Job Title. Queremos fusionar los registros que compartan la misma dirección de email.
Si el campo de email contiene varias direcciones en una sola celda, divida las celdas CSV con varios valores en filas antes de buscar duplicados. Si la exportación original es demasiado grande para importarla o revisarla con seguridad, divida el archivo CSV grande antes de deduplicarlo.
El proceso para fusionar duplicados se resume así:
- Cargue sus archivos CSV en una colección de Datablist
- Seleccione las propiedades para buscar duplicados
- Fusione automáticamente los duplicados sin conflictos
- Fusione manualmente los duplicados restantes
Paso 1: Cargar archivos CSV en una colección de Datablist
Crear una colección
El primer paso consiste en cargar el archivo CSV en Datablist. Para empezar, abra Datablist (no es necesario registrarse).
Para crear una colección, haga clic en el botón "New collection" con el símbolo +. Una vez creada, asígnele un nombre y un icono.
Después, haga clic en el botón Import CSV.
Crear propiedades para el archivo CSV
Una vez cargado el archivo CSV, puede crear las propiedades de la colección a partir de los nombres de sus columnas. Datablist muestra todas las columnas detectadas en el CSV para que pueda crear una propiedad por cada una.
Los archivos CSV no especifican los tipos de columna. Datablist los sugiere a partir de los valores importados para facilitar su ordenación y filtrado. Revise estas sugerencias antes de importar los datos.
Conviene mantener identificadores como el SKU, el ID de cuenta o el código postal con el tipo Text. Por ejemplo, convertir 00127 a Number elimina los ceros iniciales y modifica la clave de coincidencia. Consulte la guía sobre tipos de propiedades si no sabe qué tipo utilizar.
Revisar e importar
En el paso de revisión, las filas aparecerán directamente tal como figuran en el archivo CSV. Compruebe que los datos tengan un formato correcto y coherente. Después, haga clic en el botón "Import items". ¡Eso es todo! 💪
Repetir el proceso con los demás archivos CSV
Ahora que ya tiene una colección con las propiedades configuradas, repita el proceso "Import CSV/Excel" para importar los demás archivos CSV o Excel en esa misma colección.
Paso 2: Buscar duplicados
Después de cargar los archivos CSV, abra Clean > Merge duplicates. Si las filas adicionales no contienen ningún dato que necesite conservar, seleccione Remove duplicates.
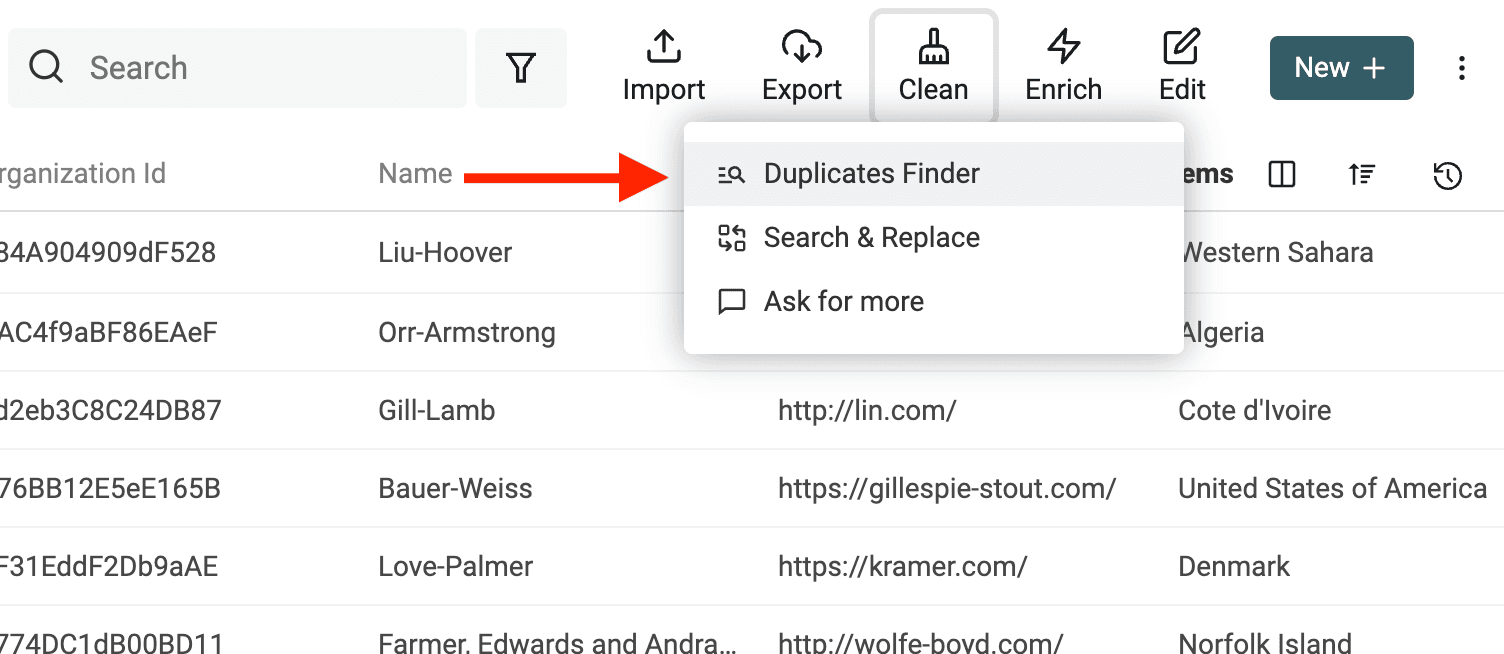
Hay dos modos disponibles:
- All Properties compara las filas completas.
- Selected Properties compara únicamente las columnas que identifican el registro.
En este caso, la propiedad email basta para identificar un contacto. Por tanto, puede seleccionar el modo Selected Properties y elegir la propiedad email.
Si los alias o wrappers hacen que los valores sean distintos, utilice el proceso específico para email con el fin de deduplicar esas variantes.
La comprobación es de solo lectura. El espacio de resultados muestra los grupos, explica por qué se han considerado coincidentes y separa los grupos Ready de las coincidencias que requieren revisión.
Eliminar filas duplicadas del CSV sin fusionarlas
Si solo quiere eliminar duplicados, seleccione Remove duplicates en el espacio de resultados:
- Compruebe Record to keep. La opción predeterminada es Most Complete; las demás reglas de selección de registros requieren un plan de pago. La fila elegida se conserva sin cambios.
- Abra algunos grupos y compare las filas marcadas como Keep y Remove. Compruebe si las filas que se eliminarán contienen un teléfono, una nota o un valor más reciente que aún necesite.
- Si esos valores son importantes, seleccione Merge and preserve data y siga el paso 3. La eliminación no copia los valores adicionales en la fila conservada.
- Cuando los grupos Ready coincidan con lo que quiere hacer, haga clic en Remove ready duplicates. Revise cualquier advertencia sobre pérdida de datos antes de confirmar.
Por ejemplo, dos filas idénticas con el mismo email pueden reducirse a una sola. En cambio, si dos filas tienen el mismo email pero distintos números de teléfono, deberá decidir si conserva un registro sin modificar o fusiona los teléfonos en el registro de destino.
Elija las columnas de coincidencia antes de decidir qué fila se conserva. All Properties detecta filas completas idénticas. Selected Properties puede agrupar al mismo contacto aunque el cargo o el teléfono sean diferentes. Utilizar únicamente el sitio web compartido de una empresa es demasiado genérico si varias personas trabajan en ella.
Conserve los archivos CSV originales. Tras procesarlos, compare el número de filas eliminadas con los grupos revisados, compruebe los identificadores conservados y exporte la colección limpia en formato CSV. Las filas que aún requieran revisión pueden permanecer en la colección, por lo que completar un lote no significa que se hayan resuelto todos los posibles duplicados.
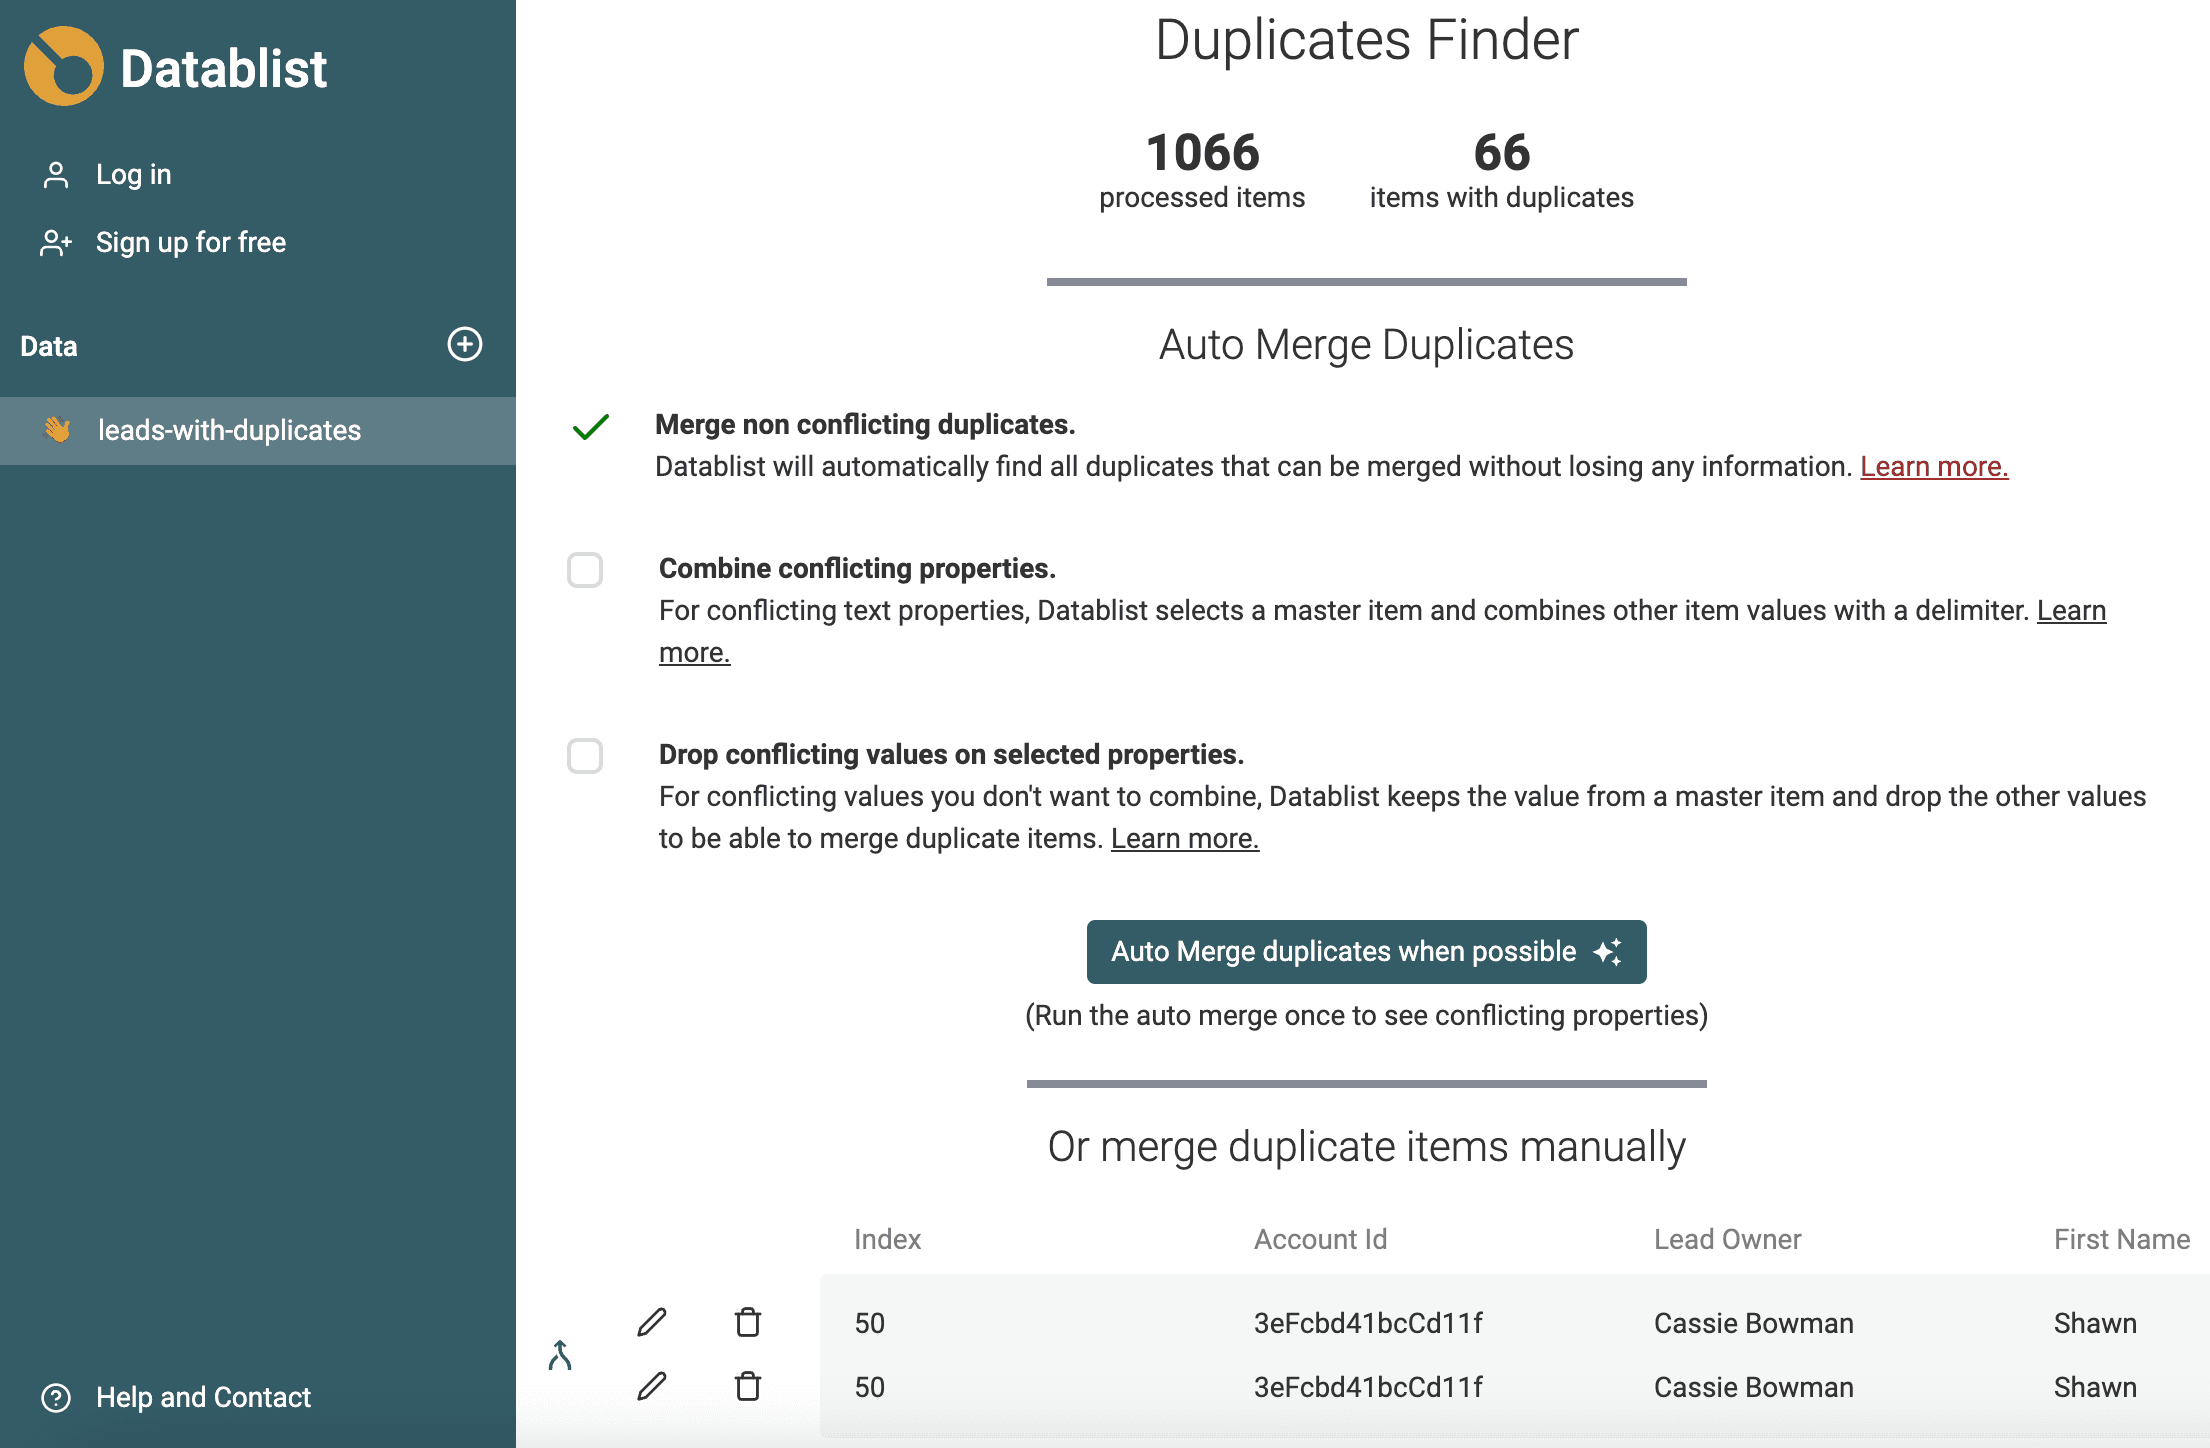
Paso 3: Fusionar y combinar duplicados automáticamente
Seleccione Merge and preserve data cuando las filas secundarias del CSV contengan valores útiles. Datablist elige un registro de destino, completa las propiedades vacías y aplica sus reglas para resolver conflictos antes de eliminar las filas secundarias.
La vista previa separa los grupos Ready de aquellos que aún presentan conflictos sin resolver. Consulte la documentación de Duplicate Finder para conocer todas las opciones de revisión, supervivencia y selección de registros.
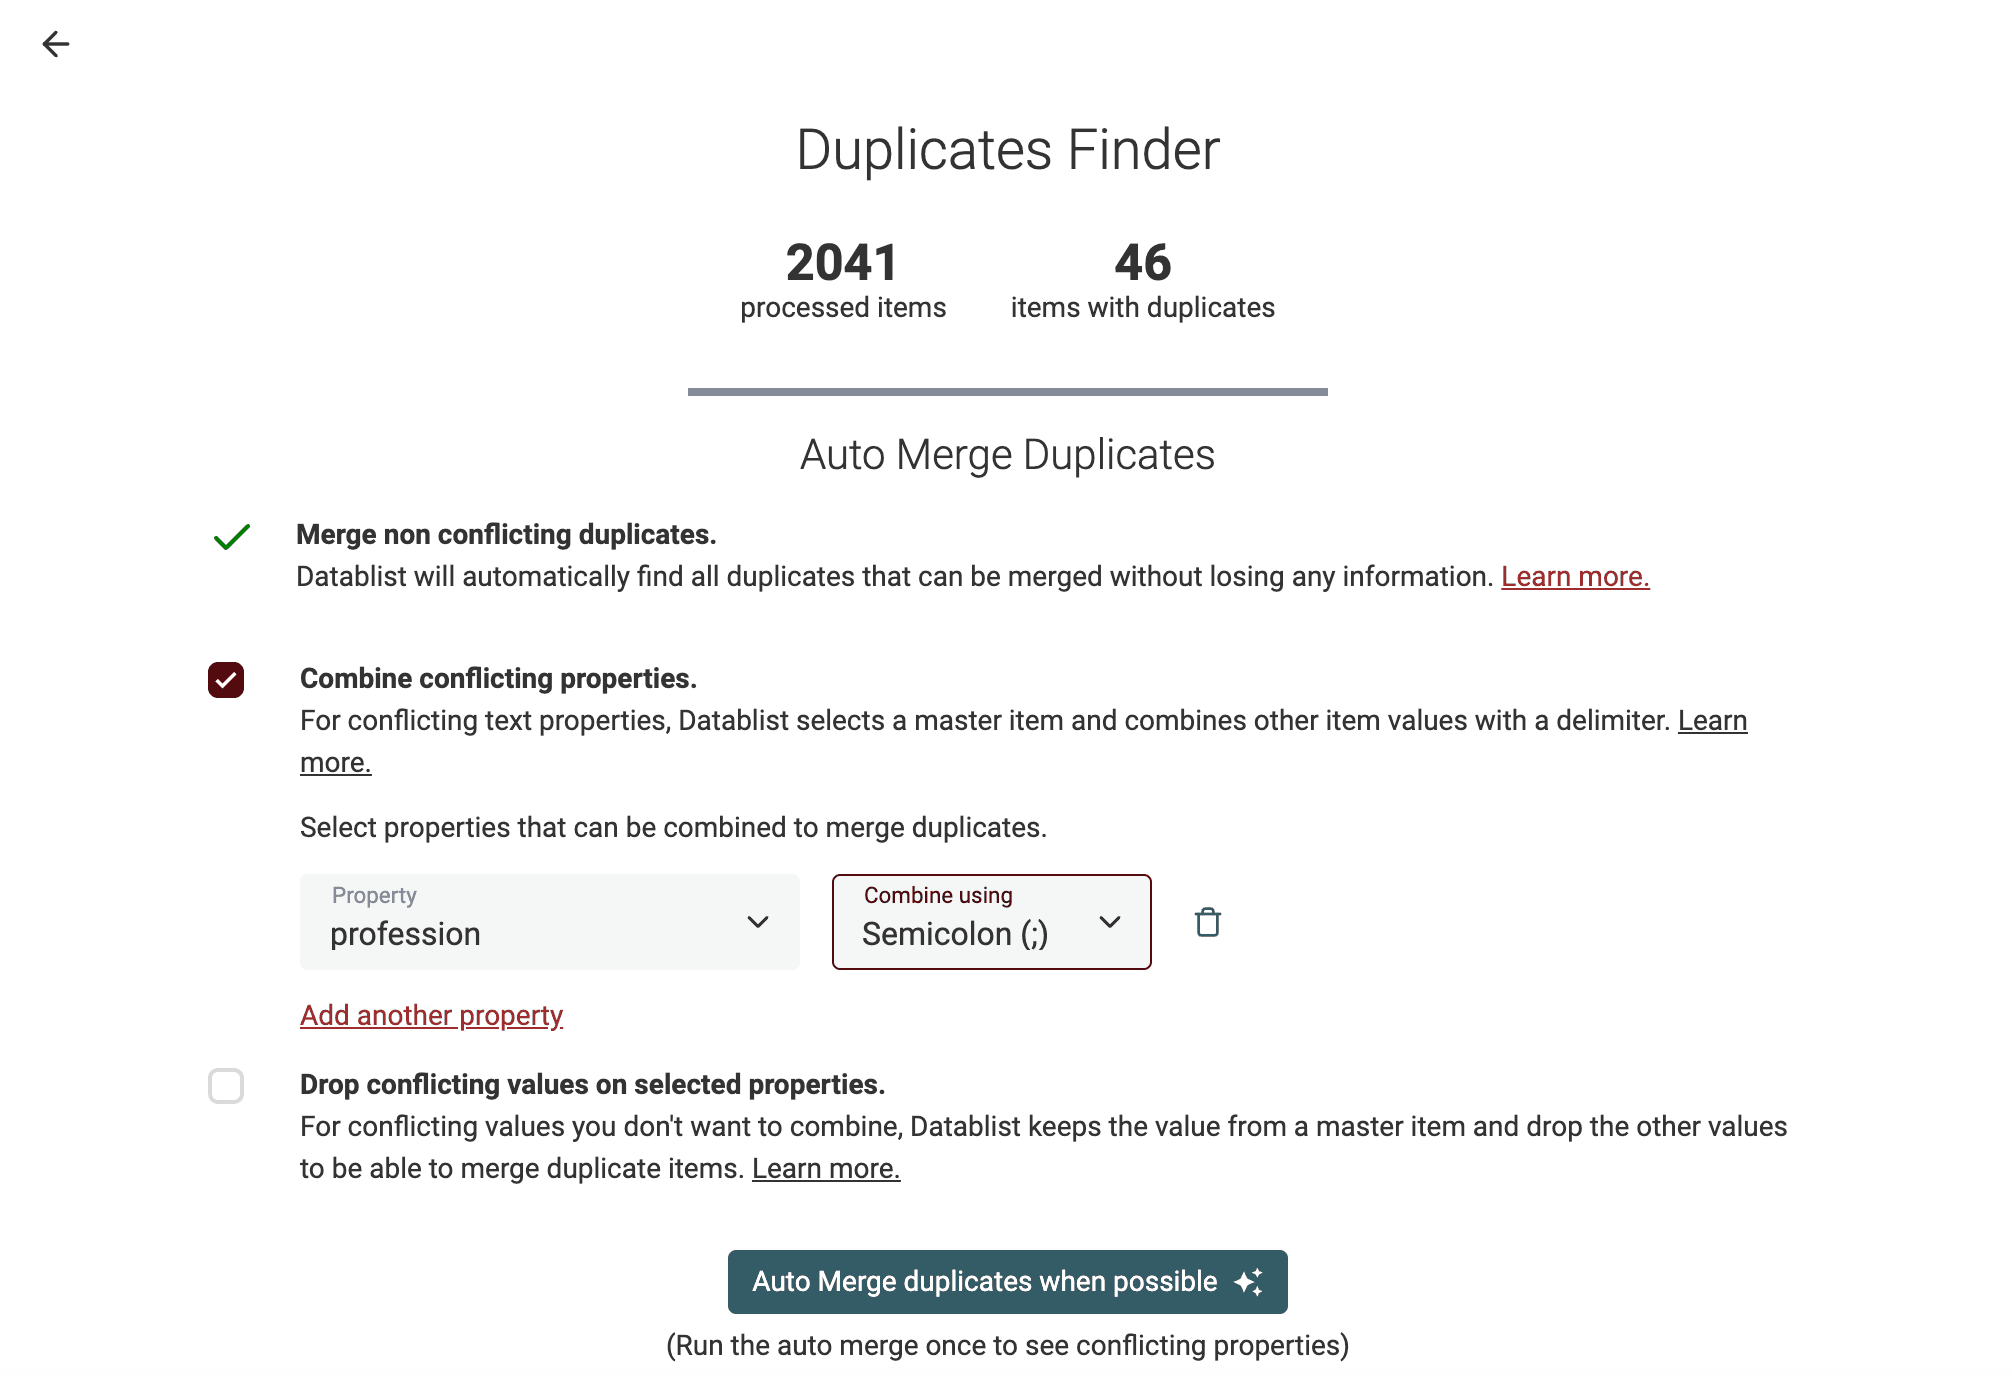
Despliegue Resolve conflicting values para ver qué propiedades todavía necesitan una regla.
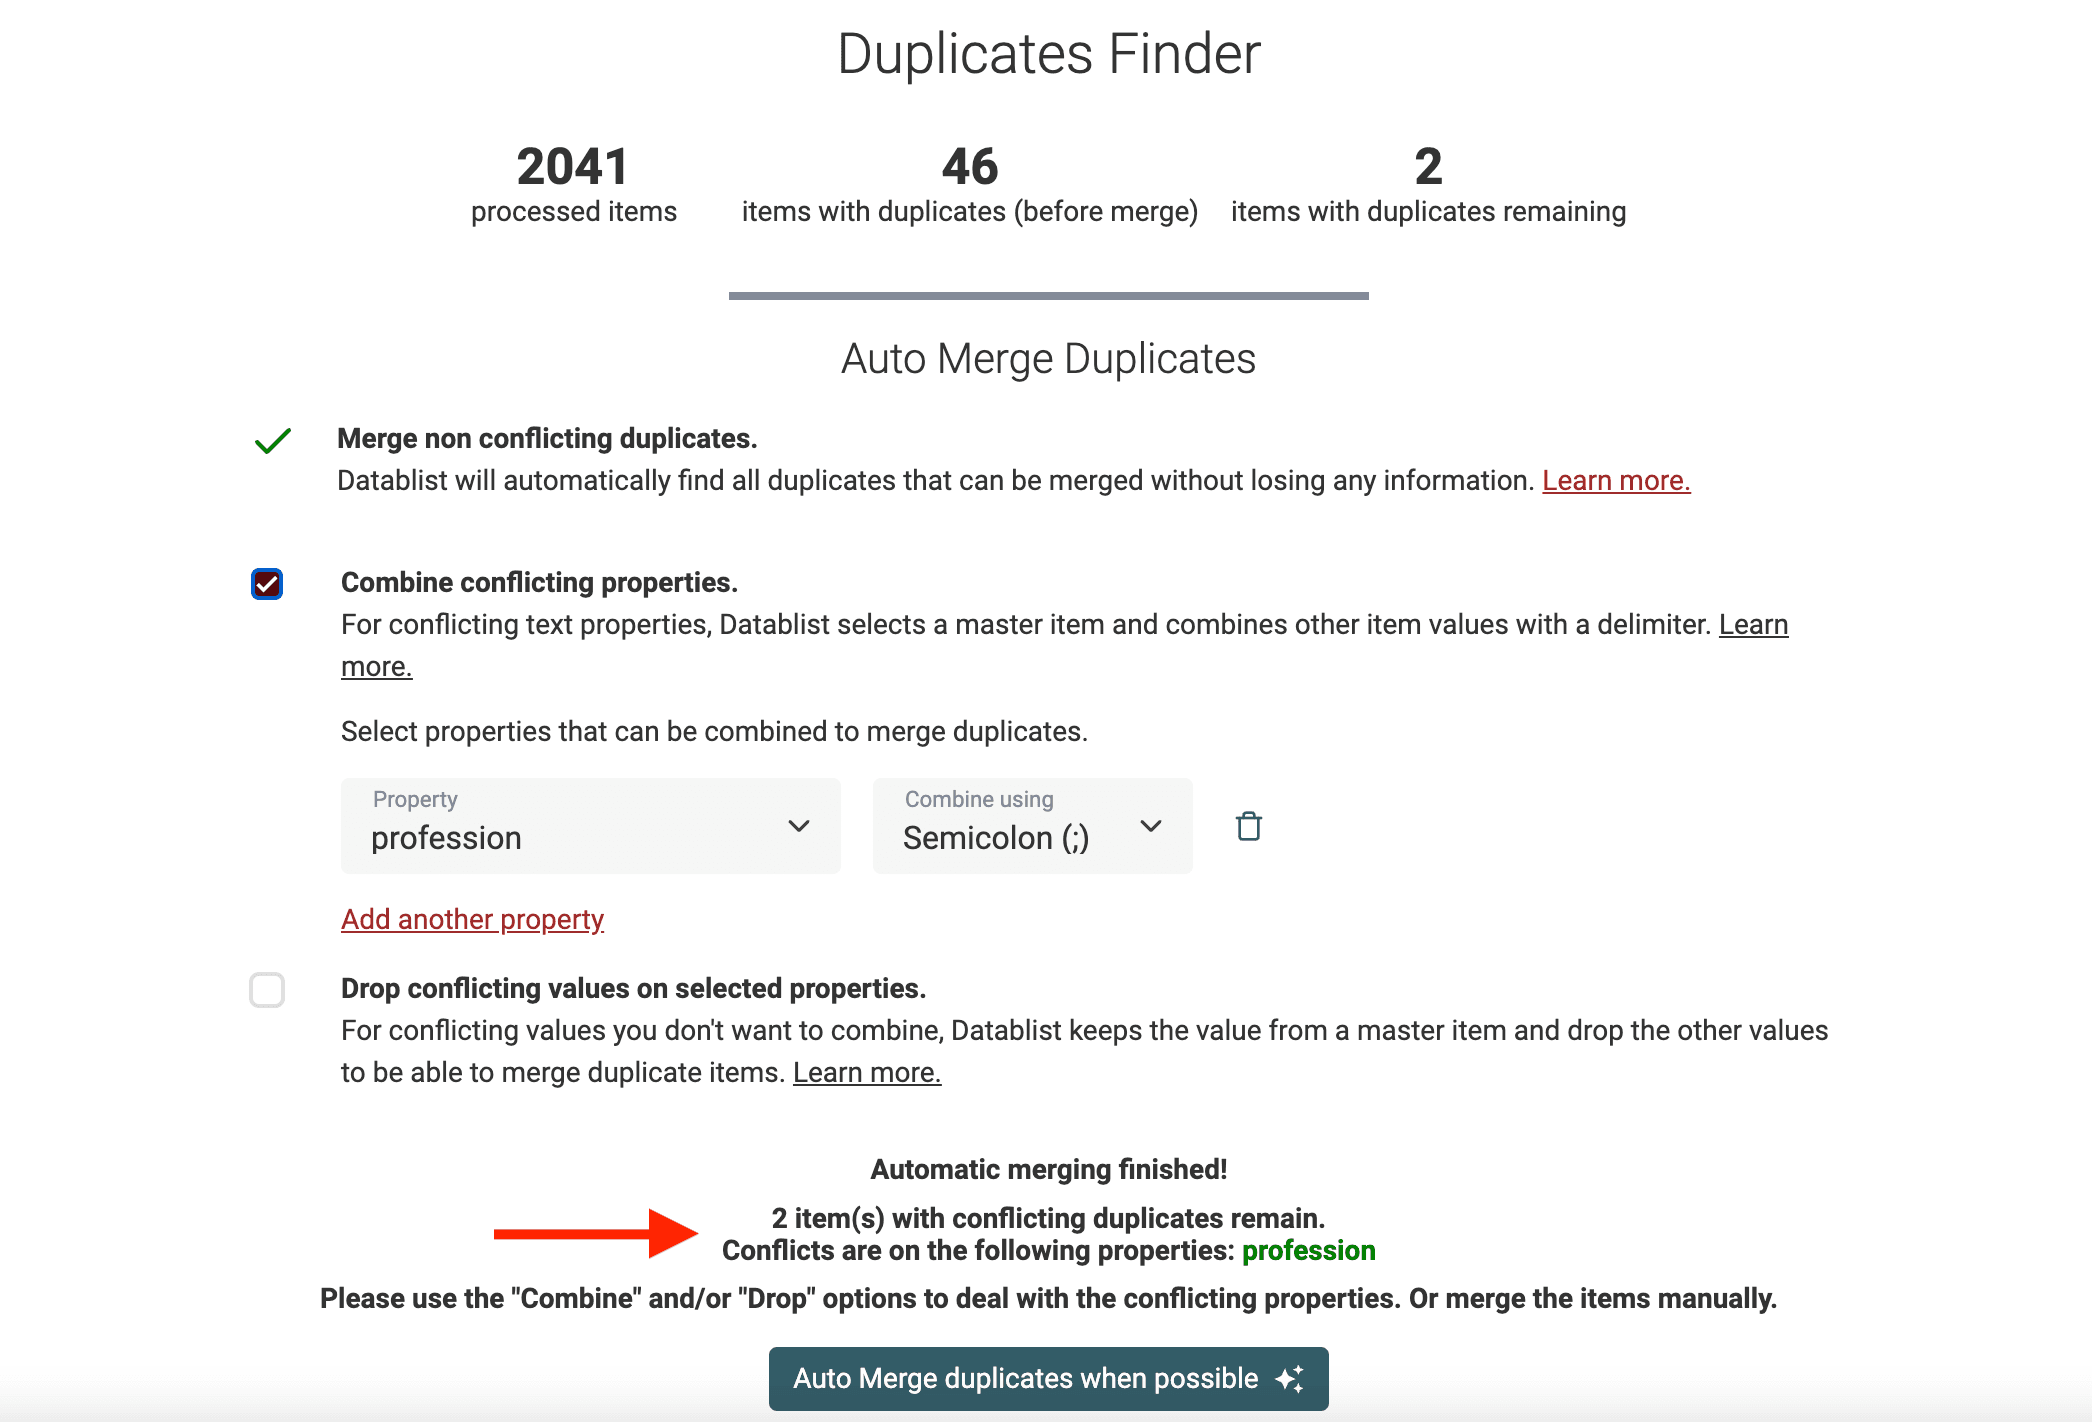
Fusionar filas sin conflictos
El algoritmo "Merge non-conflicting duplicates" realiza una fusión inteligente. Combina registros cuyos valores son similares o complementarios.
Por ejemplo, estos duplicados:
email            |     First Name   |    Last Name
james@gmail.com  |     James
james@gmail.com  |                  |     Bond
Se fusionarán así:
email            |     First Name   |    Last Name
james@gmail.com  |     James        |     Bond
Combinar valores duplicados
Combinar —o consolidar— valores duplicados es perfecto cuando existen valores en conflicto, pero quiere fusionar los registros sin perder datos.
Por ejemplo, al combinar la propiedad Phone con un punto y coma:
email            |       Phone       |     First Name   |    Last Name
james@gmail.com  |  +33 1 34 65 23   |      James       |
james@gmail.com  |  06 13 42 78 23   |                  |     Bond
El resultado será:
email            |   Phone                         |     First Name   |    Last Name
james@gmail.com  |  +33 1 34 65 23;06 13 42 78 23  |     James        |     Bond
Puede combinar cualquier propiedad que contenga texto. Los separadores disponibles son line break, semi-colon, comma y space. Es posible combinar una o varias propiedades durante la fusión.
Fusionar elementos duplicados y combinar valores resulta ideal para la limpieza de leads y del CRM. Fusione todos sus leads duplicados y combine las propiedades Phone, Email y Notes para obtener una lista limpia. Después de exportar el CSV depurado, solo tendrá que volver a importarlo en su CRM.
Conservar el valor del registro seleccionado
Esta regla conserva el valor del registro de destino seleccionado y descarta los demás valores en conflicto.
Most Complete es la regla predeterminada de Record to keep. Los planes de pago permiten elegir otras reglas o seleccionar de forma independiente los valores de los campos mediante reglas de supervivencia.
Utilice la opción drop conflicting values para:
- Propiedades técnicas, como
Account Id, que requieren un único valor. - Propiedades de tipo "Relation" que no admiten varios valores, como
Lead owneroAccount. - Propiedades que no sean de texto y no puedan combinarse, como campos de fecha y hora —
Last ActivityoContacted on— y casillas de verificación.
Paso 4: Asistente de fusión manual
Abra Review group cuando un grupo de duplicados requiera una decisión manual. Merging Assistant le permite elegir el registro de destino y el valor que conservará en cada propiedad.
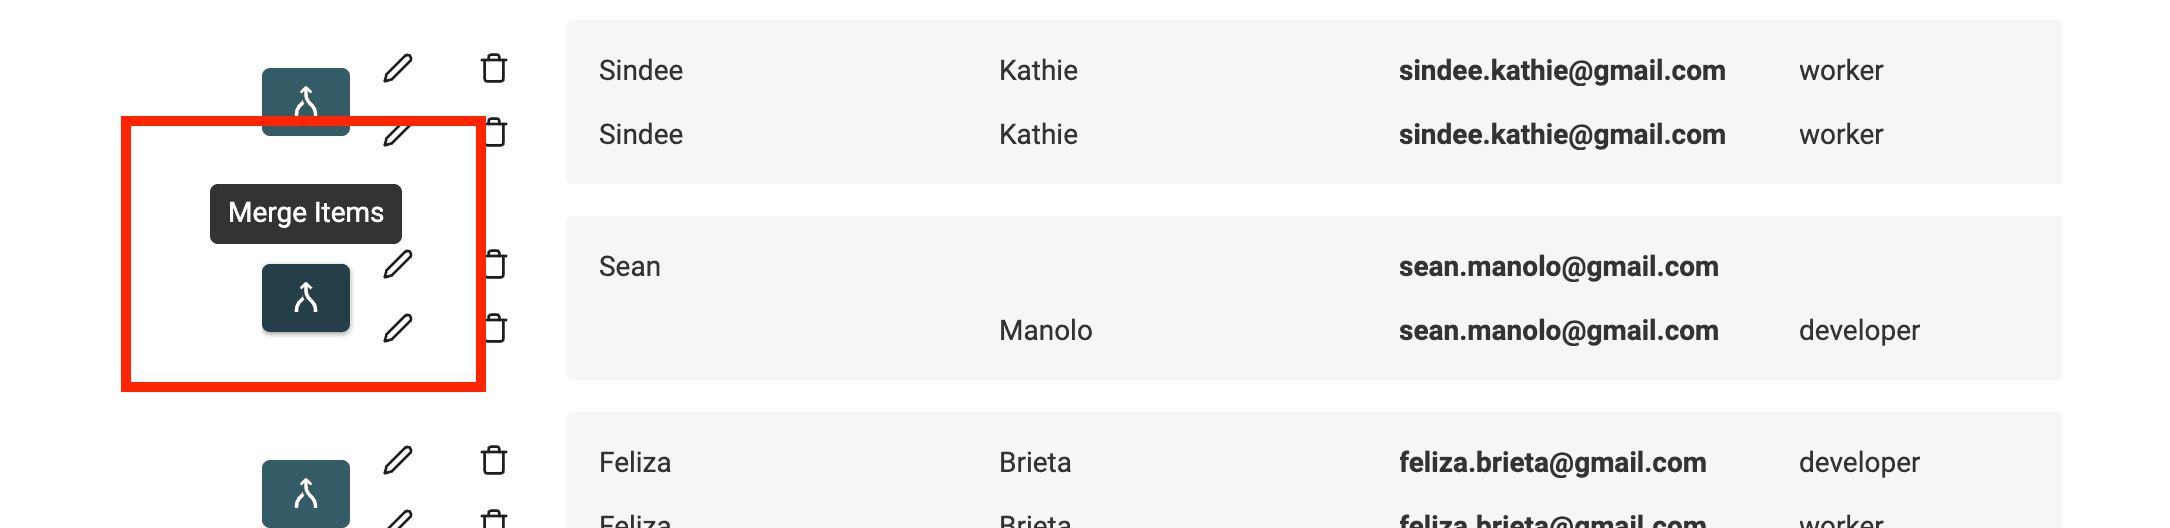
El registro de destino seleccionado manualmente conserva su ID de Datablist. Las demás filas pasan a ser registros secundarios.
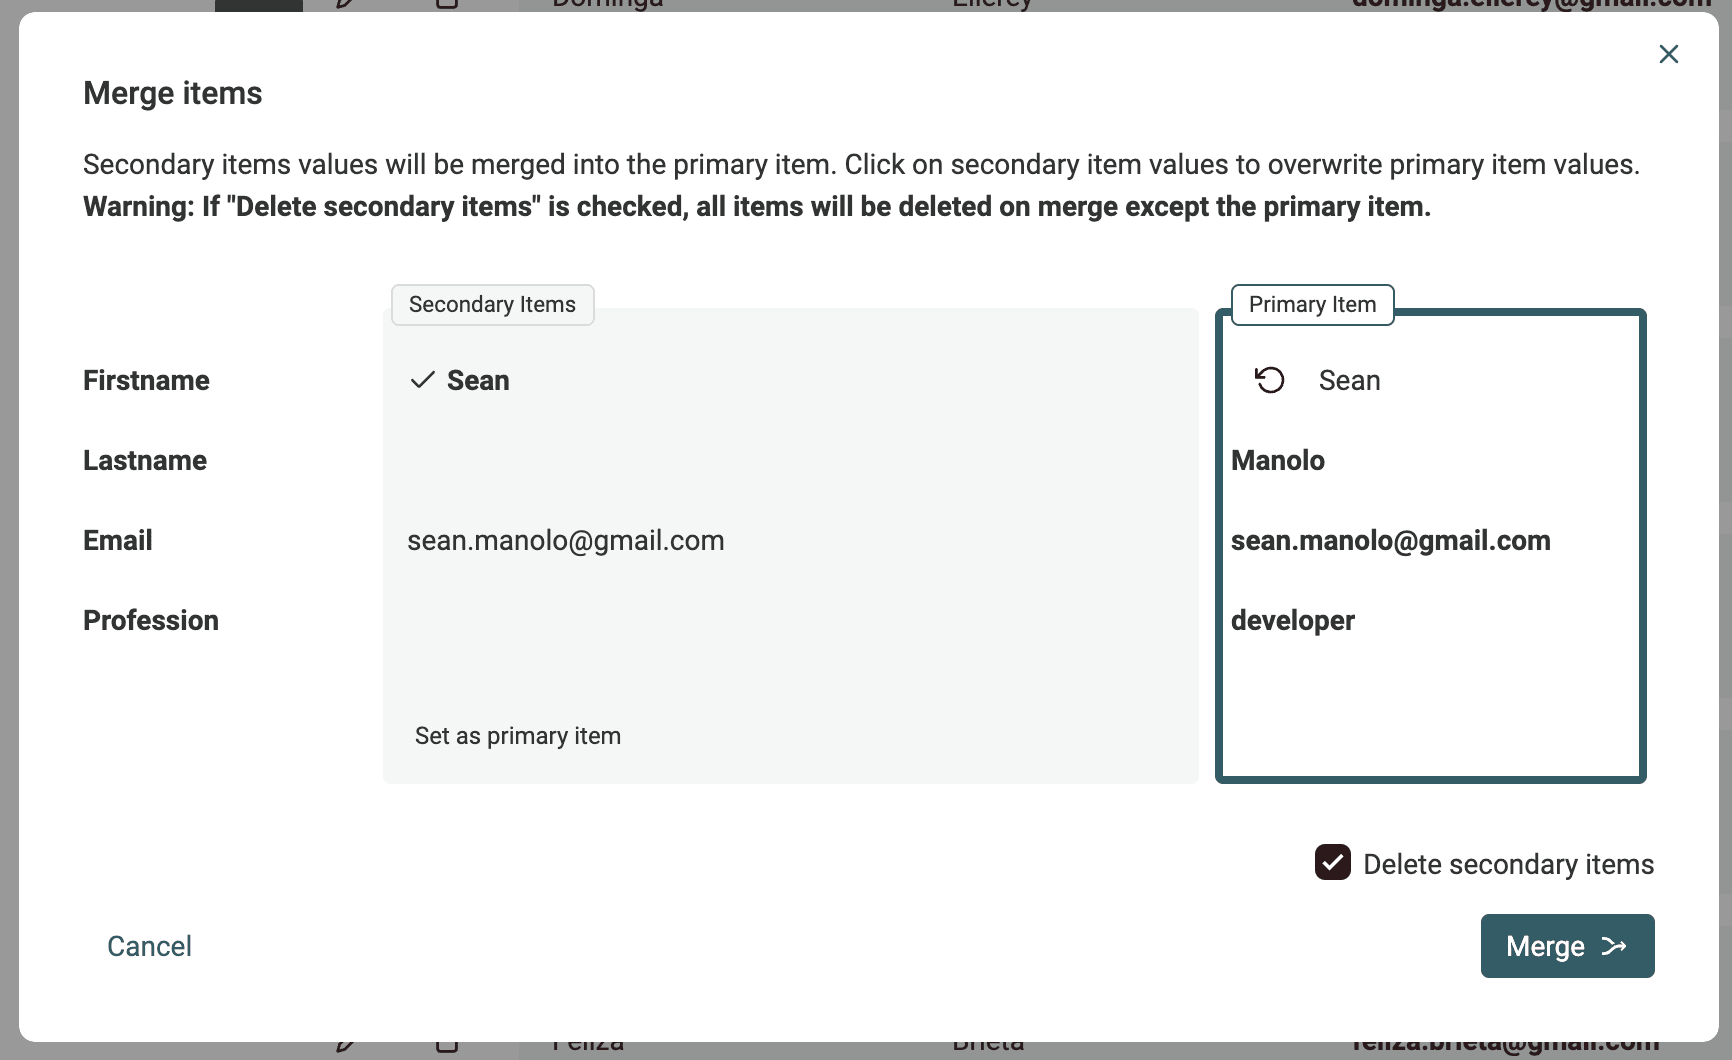
Revise cada propiedad, seleccione los valores que quiera conservar y confirme la fusión. También puede excluir una fila del grupo de duplicados u omitir el grupo completo.
Exportar a CSV si es necesario
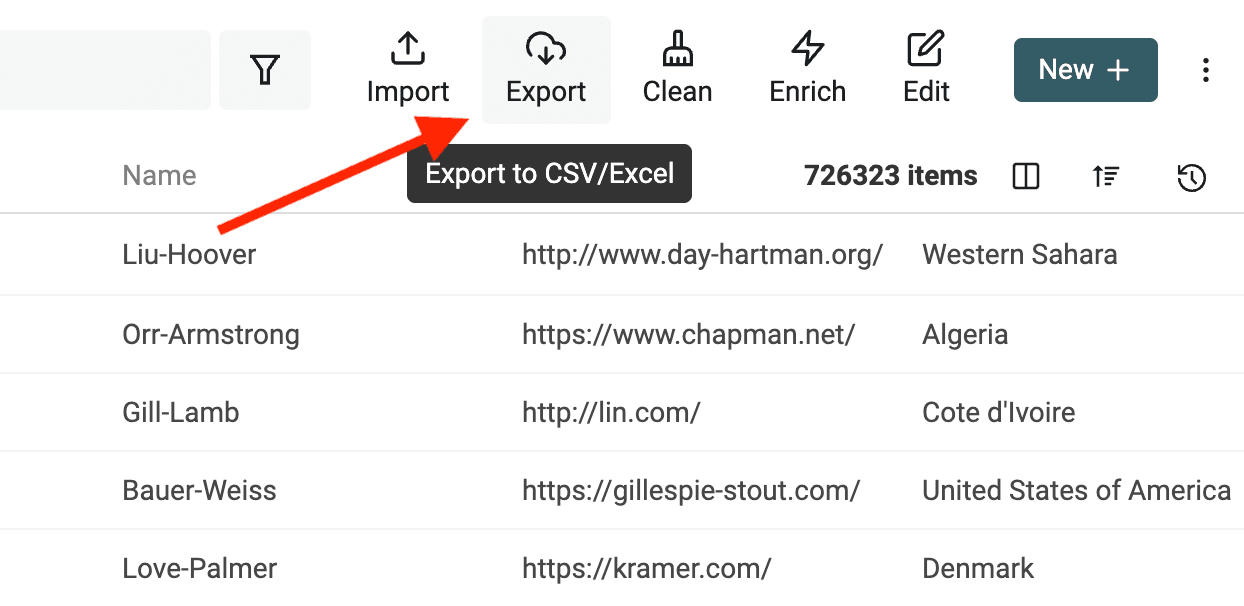
¡Enhorabuena! Ha eliminado correctamente los duplicados de sus archivos CSV. Si necesita utilizar el resultado en otra herramienta, haga clic en el botón "Export" para exportar la colección como un nuevo archivo CSV.
FAQ
¿Qué otras operaciones de datos ofrece Datablist?
Los archivos CSV están presentes en todas partes para representar datos estructurados utilizados por aplicaciones de software o conjuntos de datos. Sin embargo, pese a ser tan habituales, manipularlos resulta complicado y suele requerir conocimientos técnicos.
Para operaciones sencillas, las hojas de cálculo son suficientes. No obstante, tienen limitaciones a la hora de:
Si tiene varios archivos CSV que quiere unir mediante una columna única, consulte la guía para unir archivos CSV.
¿Puede Datablist procesar archivos CSV grandes?
El plan Free admite hasta un millón de elementos por colección en el almacenamiento del navegador. Los planes de pago permiten importar hasta dos millones de elementos por colección. Las operaciones locales de gran volumen siguen dependiendo del navegador y del dispositivo. Descubra cómo editar archivos CSV grandes.
¿Es mejor el algoritmo de deduplicación que las funciones para eliminar duplicados de Microsoft Excel y Google Sheets?
Las hojas de cálculo, como Microsoft Excel y Google Sheets, incluyen una herramienta para eliminar duplicados. Esta funciona suprimiendo filas similares. Para casos de uso empresariales, limitarse a eliminar filas no suele ser la mejor opción.
Datablist muestra los grupos de duplicados antes de modificar el archivo. Puede eliminar filas redundantes, fusionar valores complementarios, resolver conflictos o dejar intactos los grupos dudosos.
Si tiene alguna pregunta, puede contactarnos.