El formato CSV es un estándar para intercambiar datos estructurados entre empresas o distintas aplicaciones de software. Se basa en texto y utiliza signos de puntuación como delimitadores para separar las columnas.
Este es un ejemplo de los datos de un archivo CSV:
firstName, lastName, email
Joe, Vaughn, vaugh@hotmail.com
Bob, Cunnighan, bobc@gmail.com
Los archivos CSV se pueden exportar desde la mayoría de las herramientas que trabajan con datos, como CRM, sistemas de gestión de pedidos, hojas de cálculo (Google Sheets o Microsoft Excel) y aplicaciones financieras. Quizá en el futuro dispongamos de modelos de datos unificados para transferir información estructurada entre aplicaciones. Mientras tanto, debemos seguir utilizando archivos CSV.
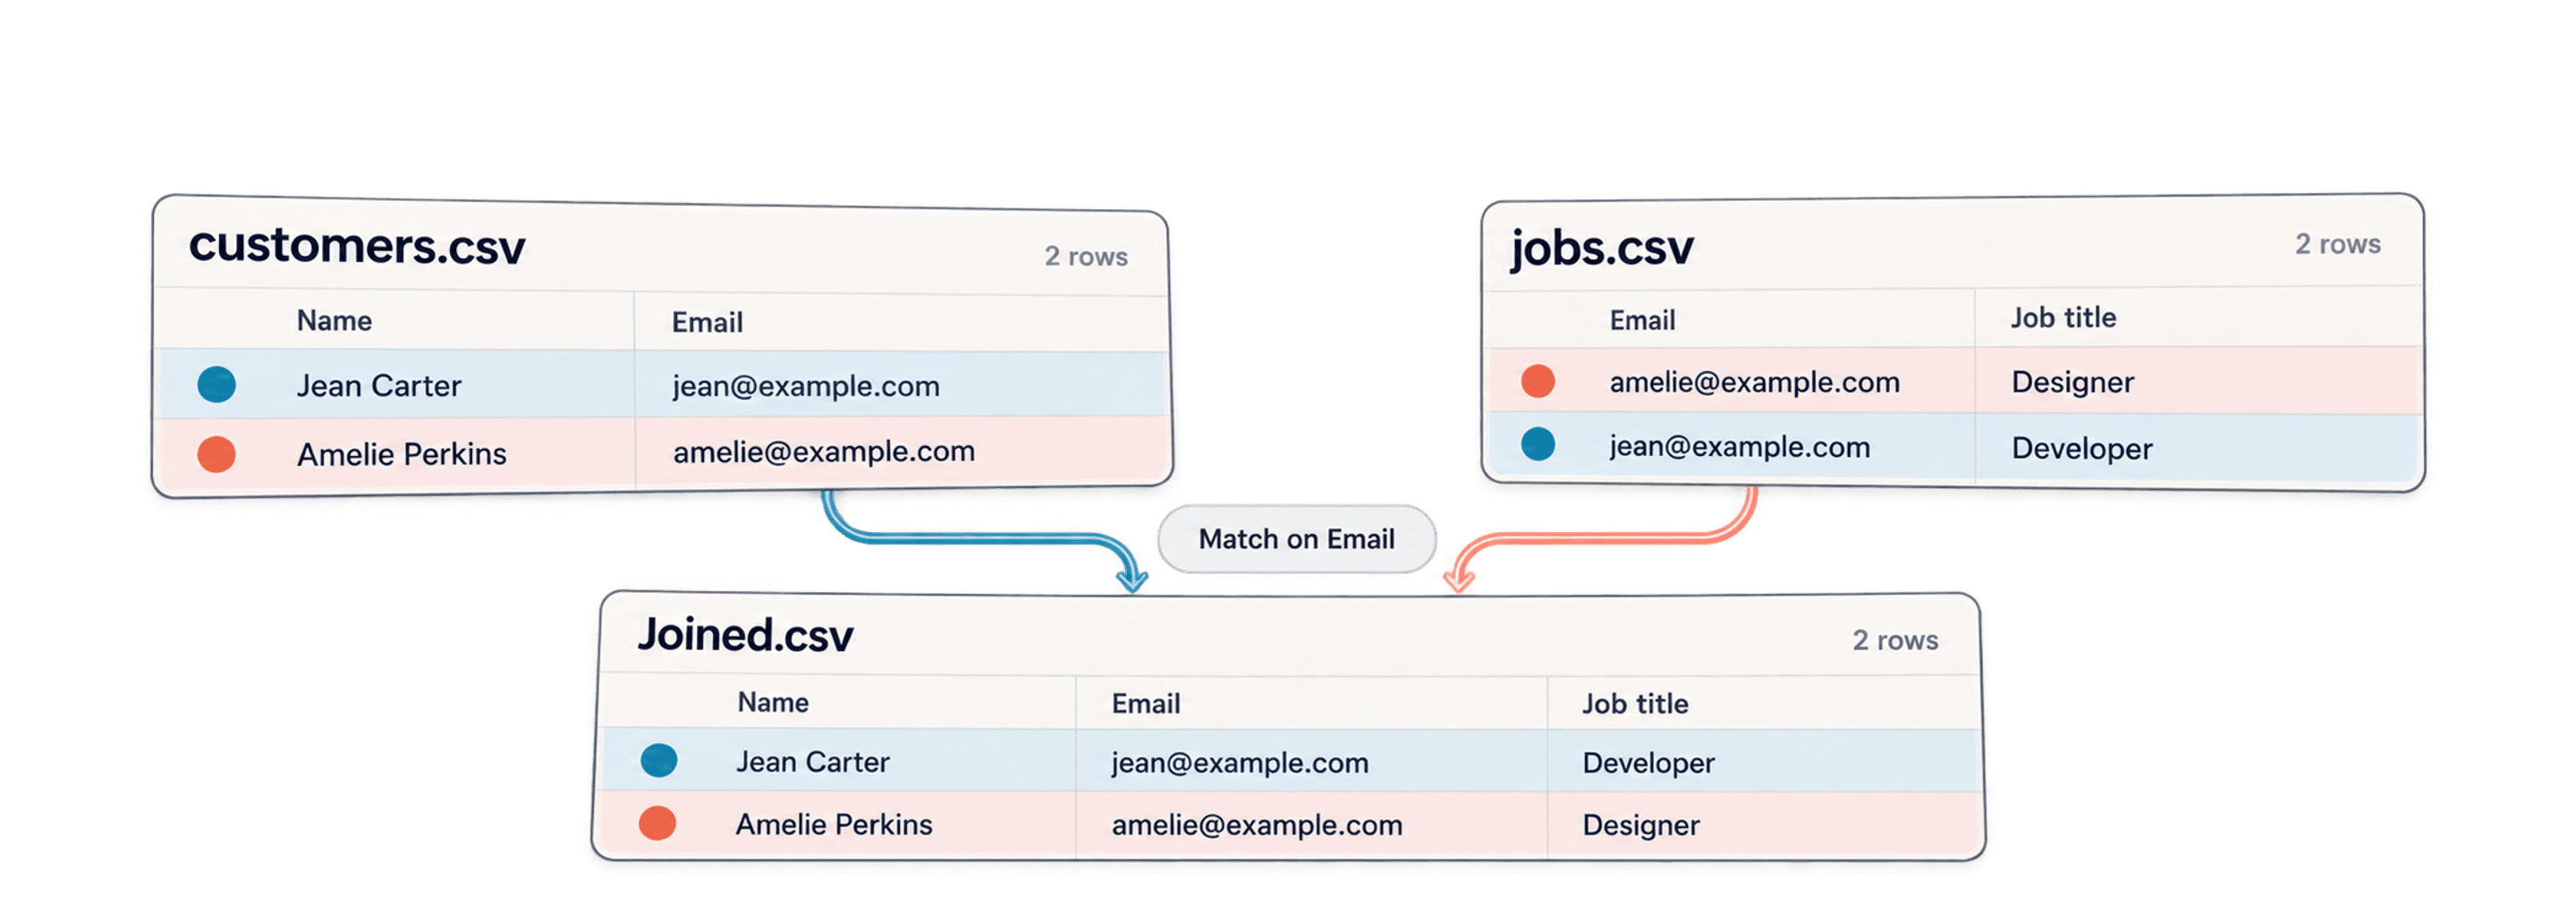
Para unir dos archivos CSV mediante una columna compartida, importe el primero, marque la columna de coincidencia como única y, a continuación, importe el segundo en la misma colección utilizando una opción de fusión. La colección resultante conserva las filas originales y añade los valores coincidentes del segundo archivo. Por ejemplo, puede unir customers.csv (Email, Name) con jobs.csv (Email, Job Title) mediante Email; si el email de un cliente coincide, se añadirá su Job Title sin crear una segunda fila para ese cliente.
A la hora de manipular archivos CSV, la solución habitual es recurrir a una hoja de cálculo. Cargar un CSV en Google Sheets o Microsoft Excel es sencillo. Sin embargo, estas herramientas presentan limitaciones en dos operaciones básicas:
- Unir archivos CSV mediante una columna única
- Eliminar duplicados y fusionar registros CSV mediante una restricción de columna única
Si solo necesita comparar dos exportaciones CSV para detectar filas añadidas, eliminadas o modificadas, utilice CSV Diff Tool en lugar de unirlas.
Al realizar una operación de unión, se utiliza una columna común para combinar datos procedentes de varias fuentes. Las hojas de cálculo no permiten definir una restricción única en una columna, por lo que ofrecen funciones limitadas para unir archivos CSV o eliminar duplicados.
Esta guía se divide en dos partes:
- Unir archivos CSV por una columna común con Datablist
- Unir archivos CSV con Google Sheets o Microsoft Excel
En este tutorial utilizaremos dos archivos CSV de ejemplo:
Solución 1: Unir archivos CSV por una columna común con Datablist
Manipular datos con Datablist es muy sencillo. Veamos cómo puede unir archivos CSV mediante un identificador único. Para empezar, abra Datablist (no requiere registro).
Paso 1: Cargue el primer archivo CSV
El primer paso consiste en crear una colección que reúna todos sus datos CSV. Haga clic en el botón + de la barra lateral para crear una colección.
Una vez creada, vaya a la sección "Import CSV".
Nota: La primera línea de su archivo CSV debe contener los nombres de las columnas.
Arrastre y suelte un archivo CSV, o haga clic para seleccionarlo en su ordenador. Cuando se haya cargado, compruebe que el número de filas y columnas de la vista previa sea correcto antes de continuar.
Asocie las columnas del CSV con las propiedades de la colección o cree propiedades nuevas.
Por último, haga clic en el botón "Import" para iniciar el proceso. ¡Ya ha importado su primer archivo CSV!
Paso 2: Defina la columna que servirá como identificador único
Ahora que ha importado su primer archivo CSV, puede definir una restricción "Unique Values" en una propiedad de la colección. Con esta información, Datablist fusionará las nuevas importaciones CSV respetando dicha restricción. Abra la configuración de columnas y edite la propiedad que utilizará como identificador único. Marque el atributo "Unique Values" y guarde los cambios.
Paso 3: Cargue uno o varios archivos CSV
Después de establecer una restricción única en una propiedad de la colección, importe los demás archivos CSV, uno a uno, en la colección existente. Si es necesario, cree nuevas propiedades durante la asociación de columnas del CSV.
Cuando la colección ya contiene elementos y tiene una restricción única, el proceso de importación le permite seleccionar un tipo de unión y un modo de fusión. Elija Import only matching rows si solo desea enriquecer los clientes que ya están en la colección. Elija Import all rows and match when possible si quiere que las filas sin coincidencias del nuevo archivo se conviertan en elementos nuevos.
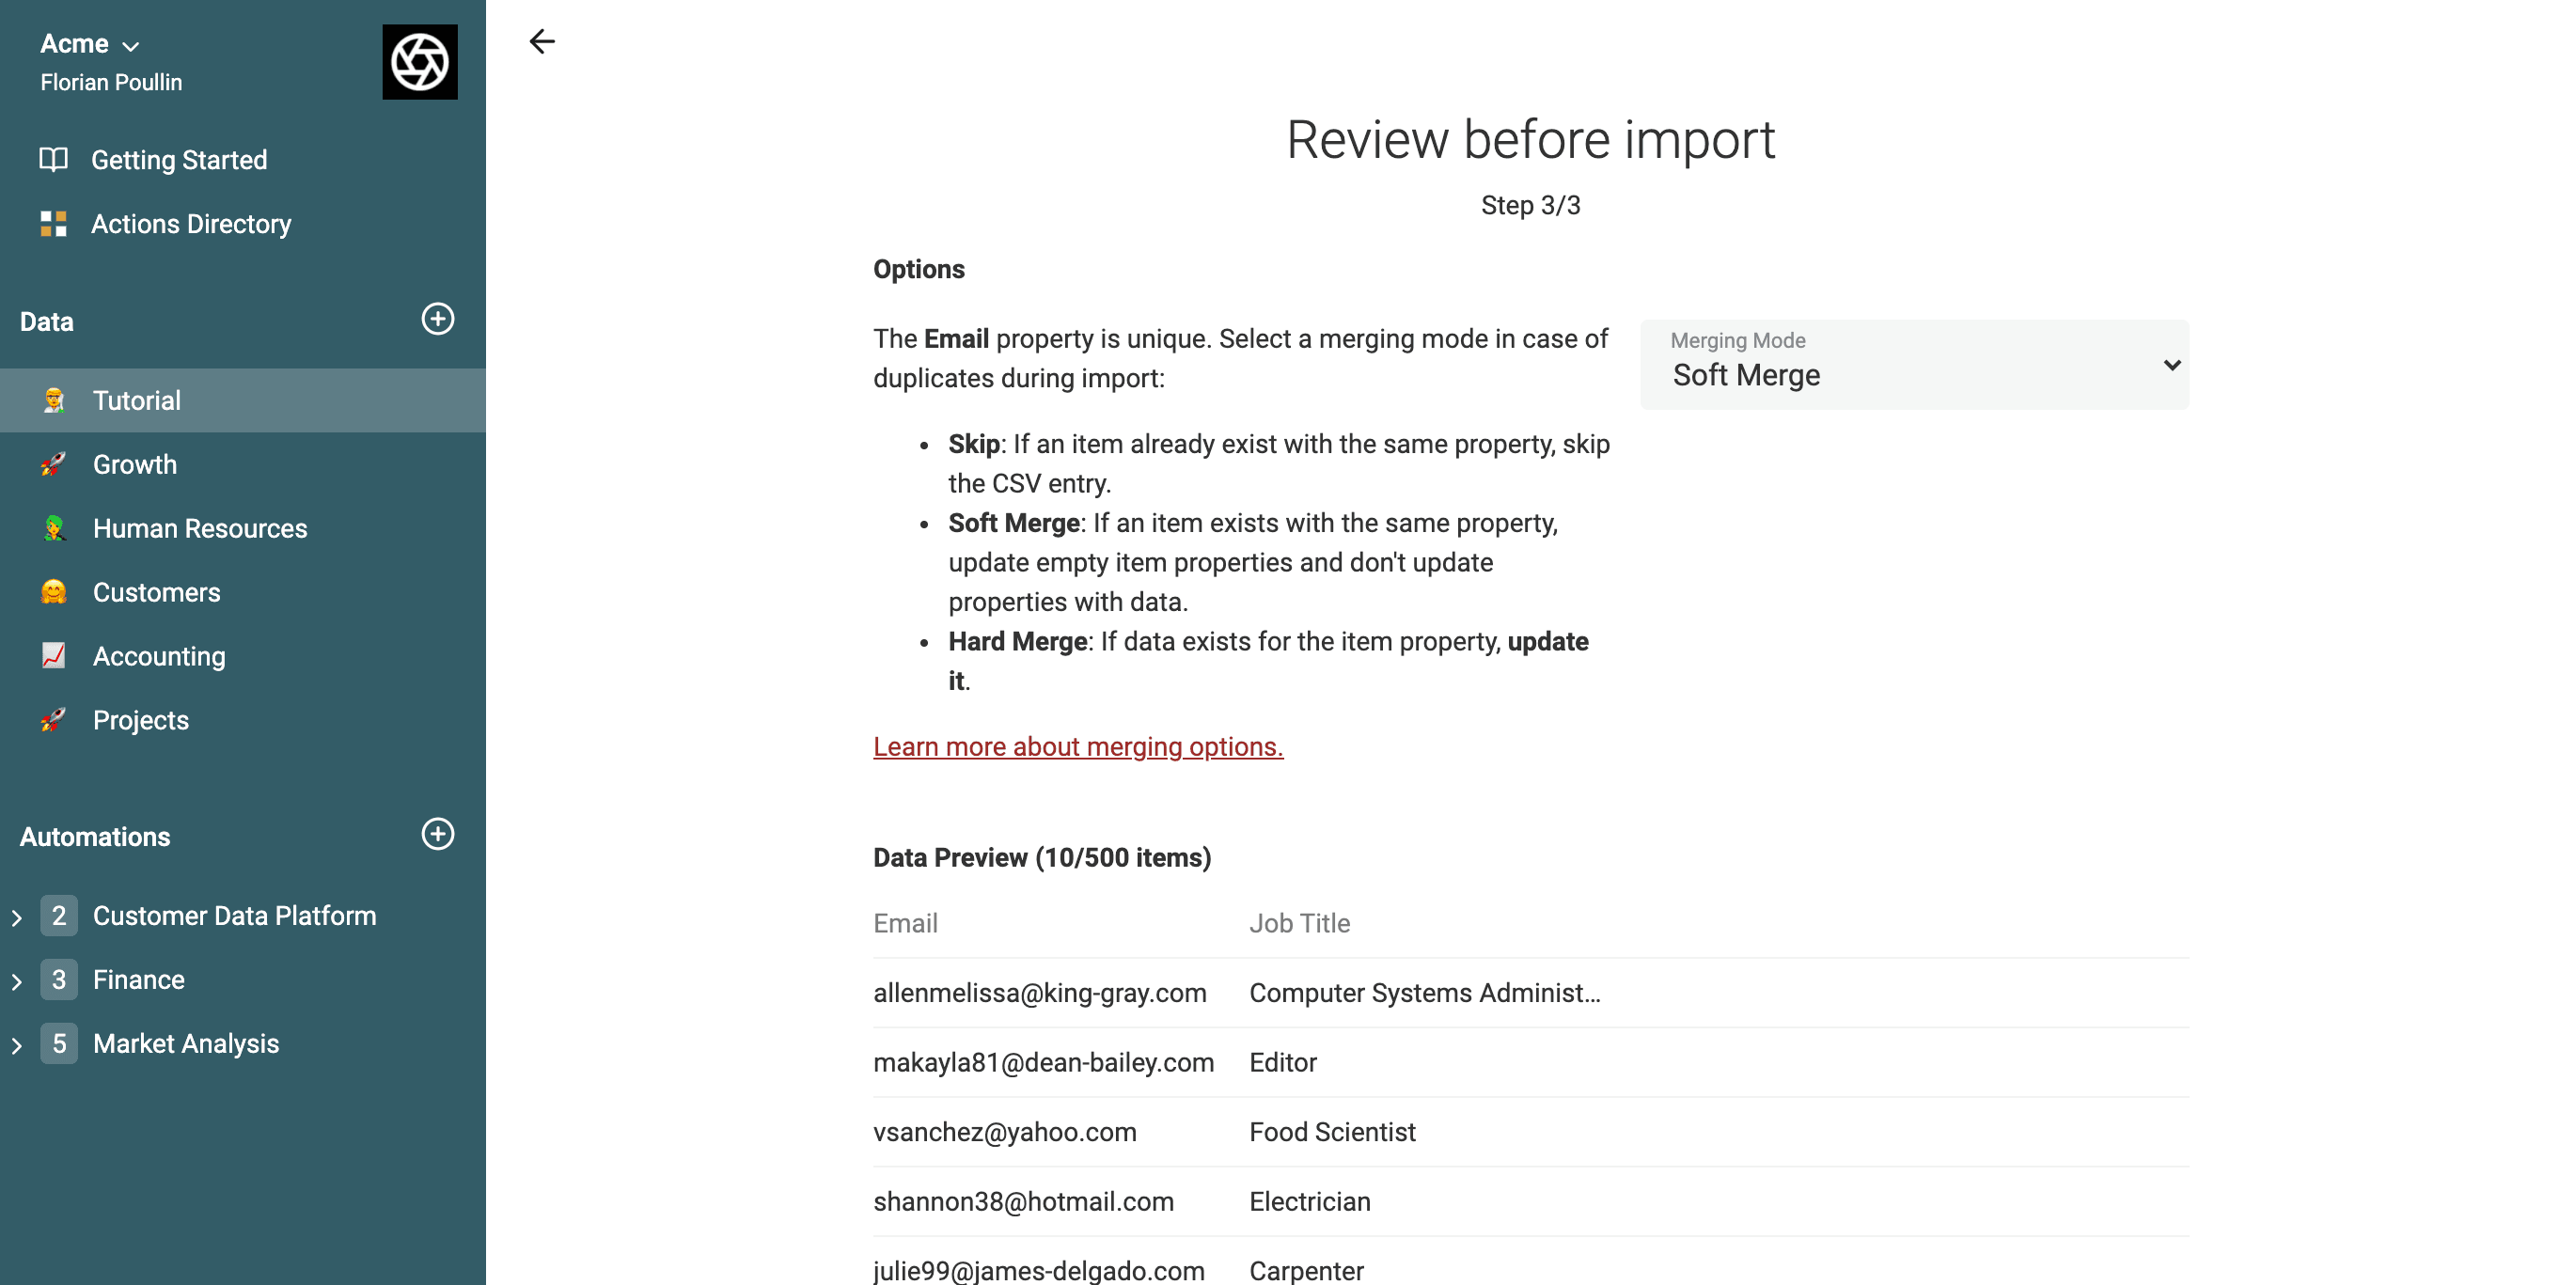
Seleccione cómo se fusionarán los datos en la colección:
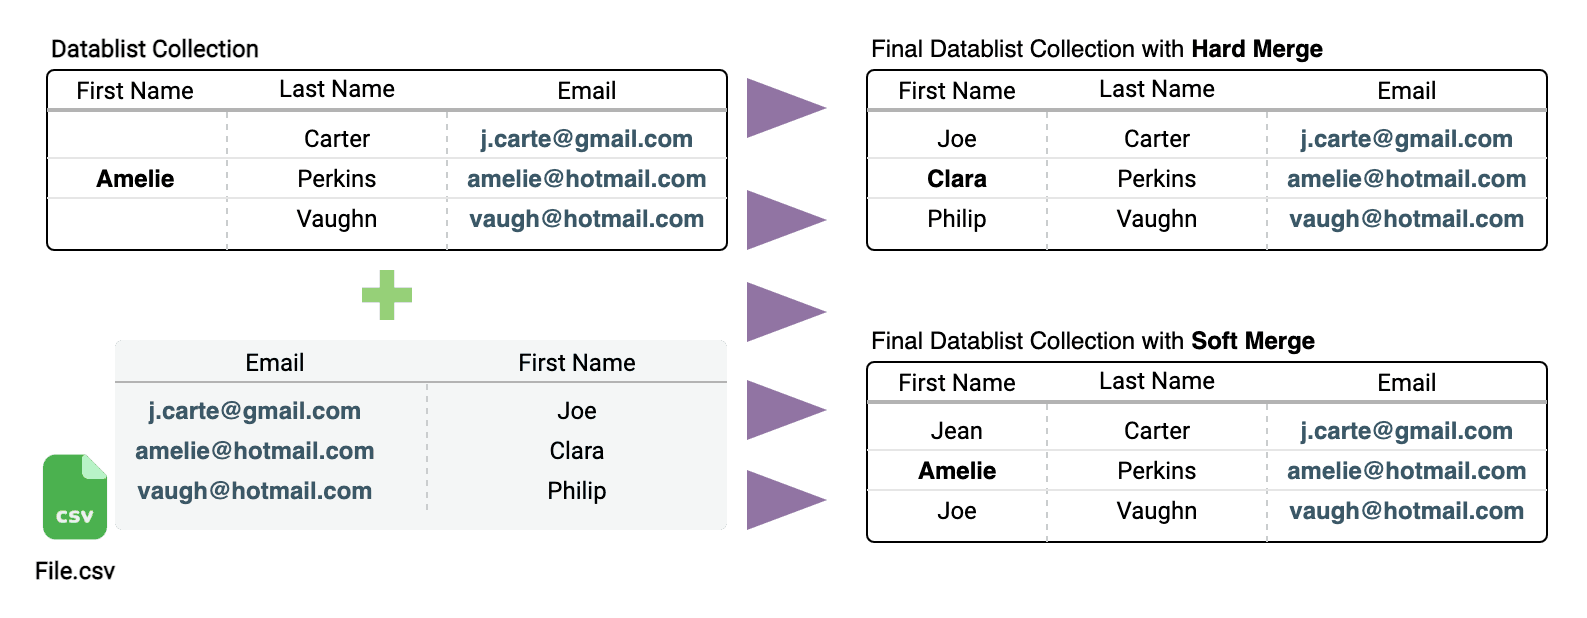
- Soft Merge: Completa las propiedades vacías del elemento coincidente, pero conserva los valores existentes. Elija esta opción si el primer archivo debe seguir siendo la fuente de referencia.
- Hard Merge: Sustituye los valores existentes de las propiedades por los de la fila coincidente del nuevo archivo. Elija esta opción si el segundo archivo contiene datos más recientes.
Importante: La opción "Skip item" omite la fila cuando encuentra en la colección un registro con el mismo identificador. No debe seleccionarla si quiere unir archivos CSV.
Revise la vista previa antes de importar. La propiedad Email de cada archivo debe asociarse con la misma propiedad de la colección. Los identificadores vacíos no permiten encontrar coincidencias fiables, y conviene revisar los identificadores duplicados de un archivo de origen antes de utilizarlos como clave única. Tras la importación, compruebe algunos emails coincidentes y confirme que el Job Title esperado aparezca en la fila existente.
Paso 4: Exporte el resultado a CSV si lo necesita
¡Enhorabuena! 🎉 Ya ha combinado correctamente varios archivos CSV mediante una columna común. Si necesita utilizar el resultado en otra herramienta, haga clic en el botón "Export" para exportar la colección como un nuevo archivo CSV.
Vídeo completo: cómo unir archivos CSV con Datablist
En el siguiente vídeo, el ajuste "Unique Values" se configura directamente al crear la propiedad.
Solución 2: Unir archivos CSV con Google Sheets o Microsoft Excel
Las hojas de cálculo ofrecen funciones limitadas para fusionar archivos CSV mediante una columna común. Sin embargo, una fórmula puede localizar en otra tabla una fila que coincida con un valor. Al aplicarla a cada fila de una tabla, puede buscar en otra tabla y devolver el valor de cualquier columna de la fila coincidente.
La fórmula es VLOOKUP y está disponible en Microsoft Excel y Google Sheets.
Limitaciones
- Con las hojas de cálculo, uno de los archivos CSV se utiliza como tabla principal y debe contener todos los valores posibles de la columna de unión.
- En todas las tablas secundarias, la columna de unión debe ocupar la primera posición.
Paso 1: Cargue sus archivos CSV
Nota: En este tutorial utilizamos Google Sheets. La fórmula
VLOOKUPfunciona de manera similar en Microsoft Excel.
De todos sus archivos CSV, elija como tabla principal el que contenga más valores. Los demás serán los archivos CSV secundarios.
Primero, cargue el CSV principal mediante File -> Import y seleccione su archivo. Abra la pestaña Upload para cargar un CSV desde su ordenador.
En Import Location, seleccione Insert new sheet(s).
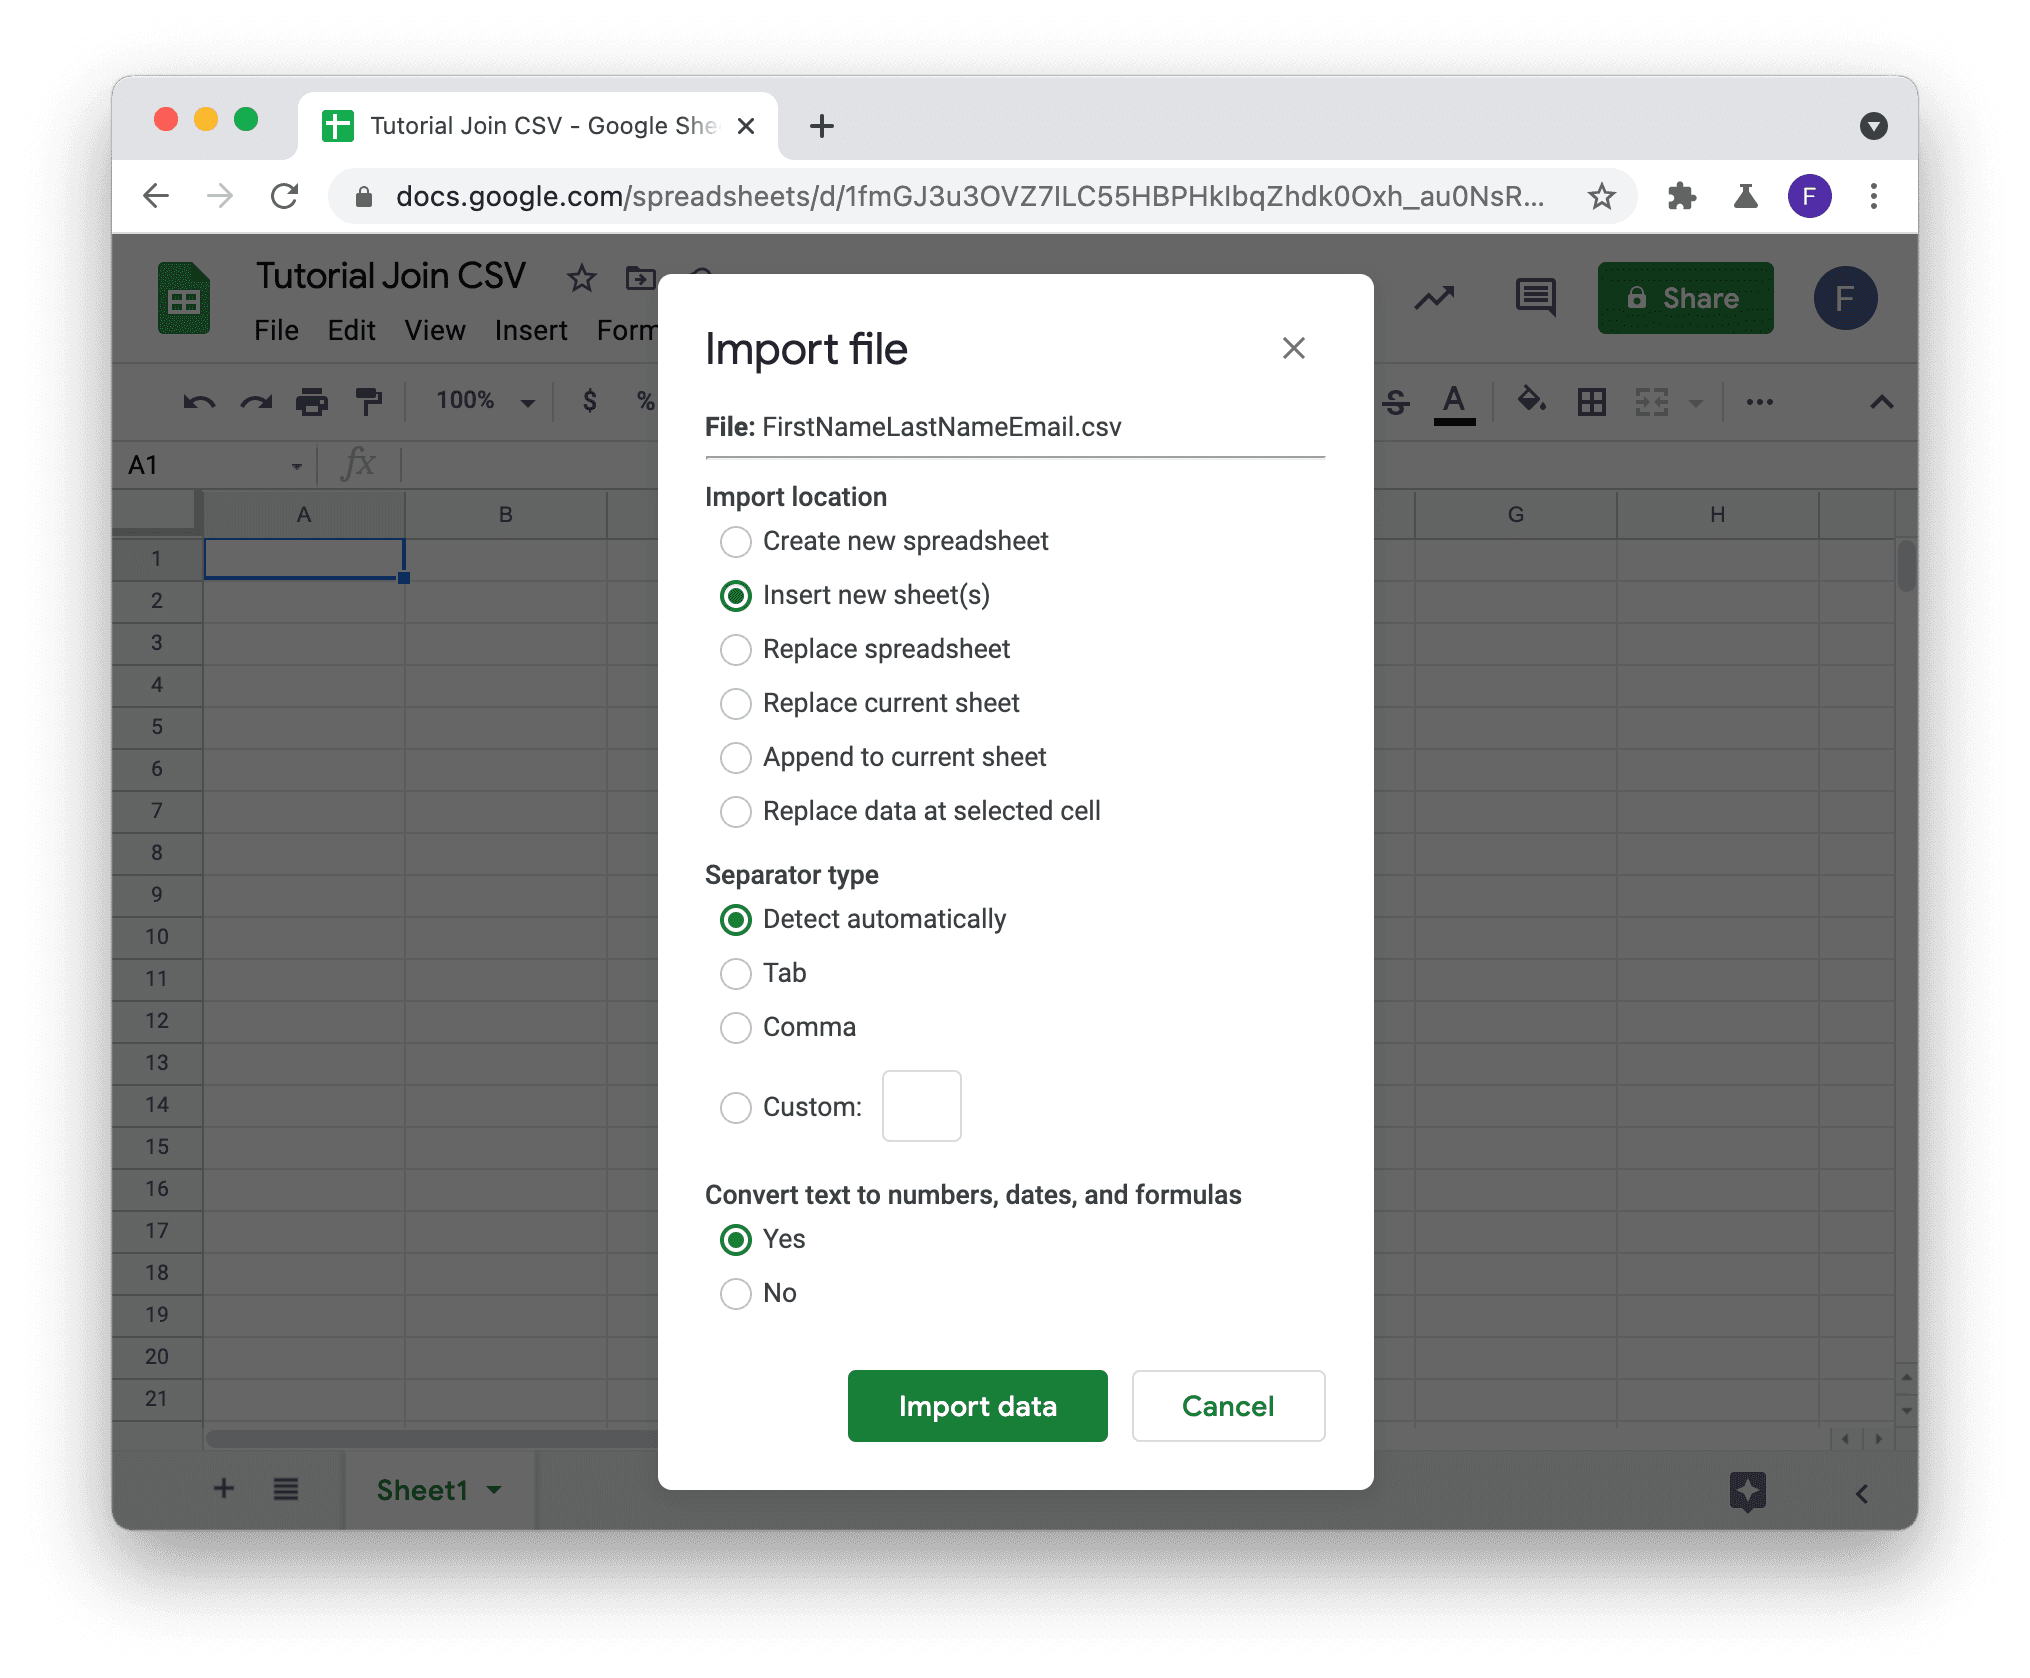
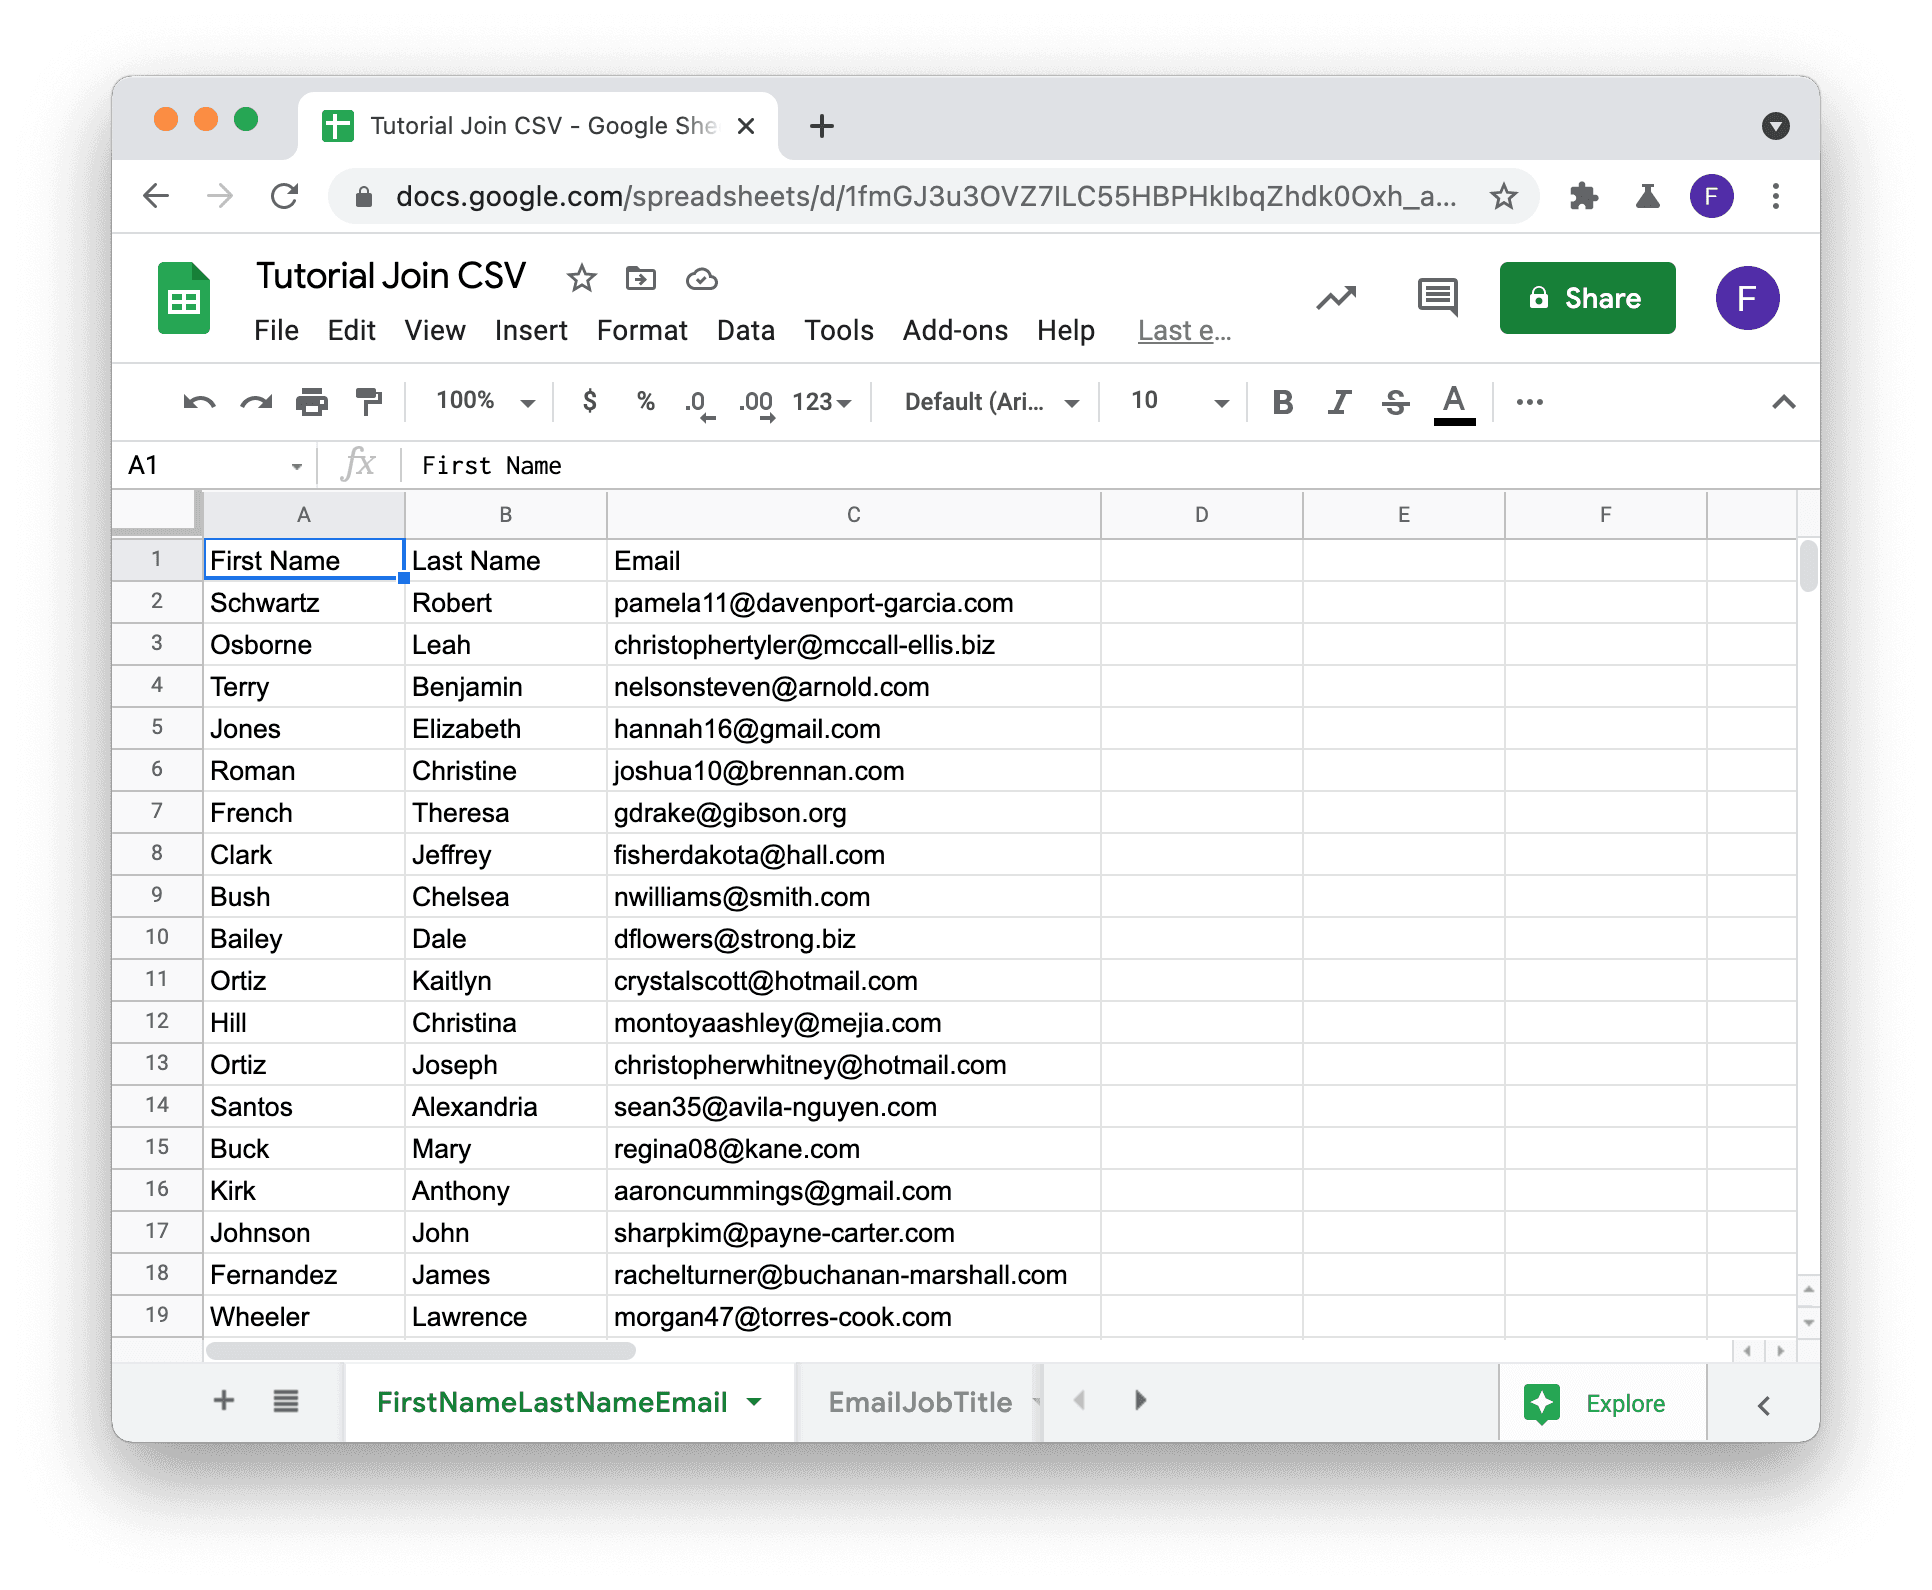
Repita esta operación con los archivos CSV secundarios. Cada archivo CSV debe cargarse en una tabla independiente dentro de la hoja de cálculo.
Paso 2: Cree nuevas columnas en la hoja principal
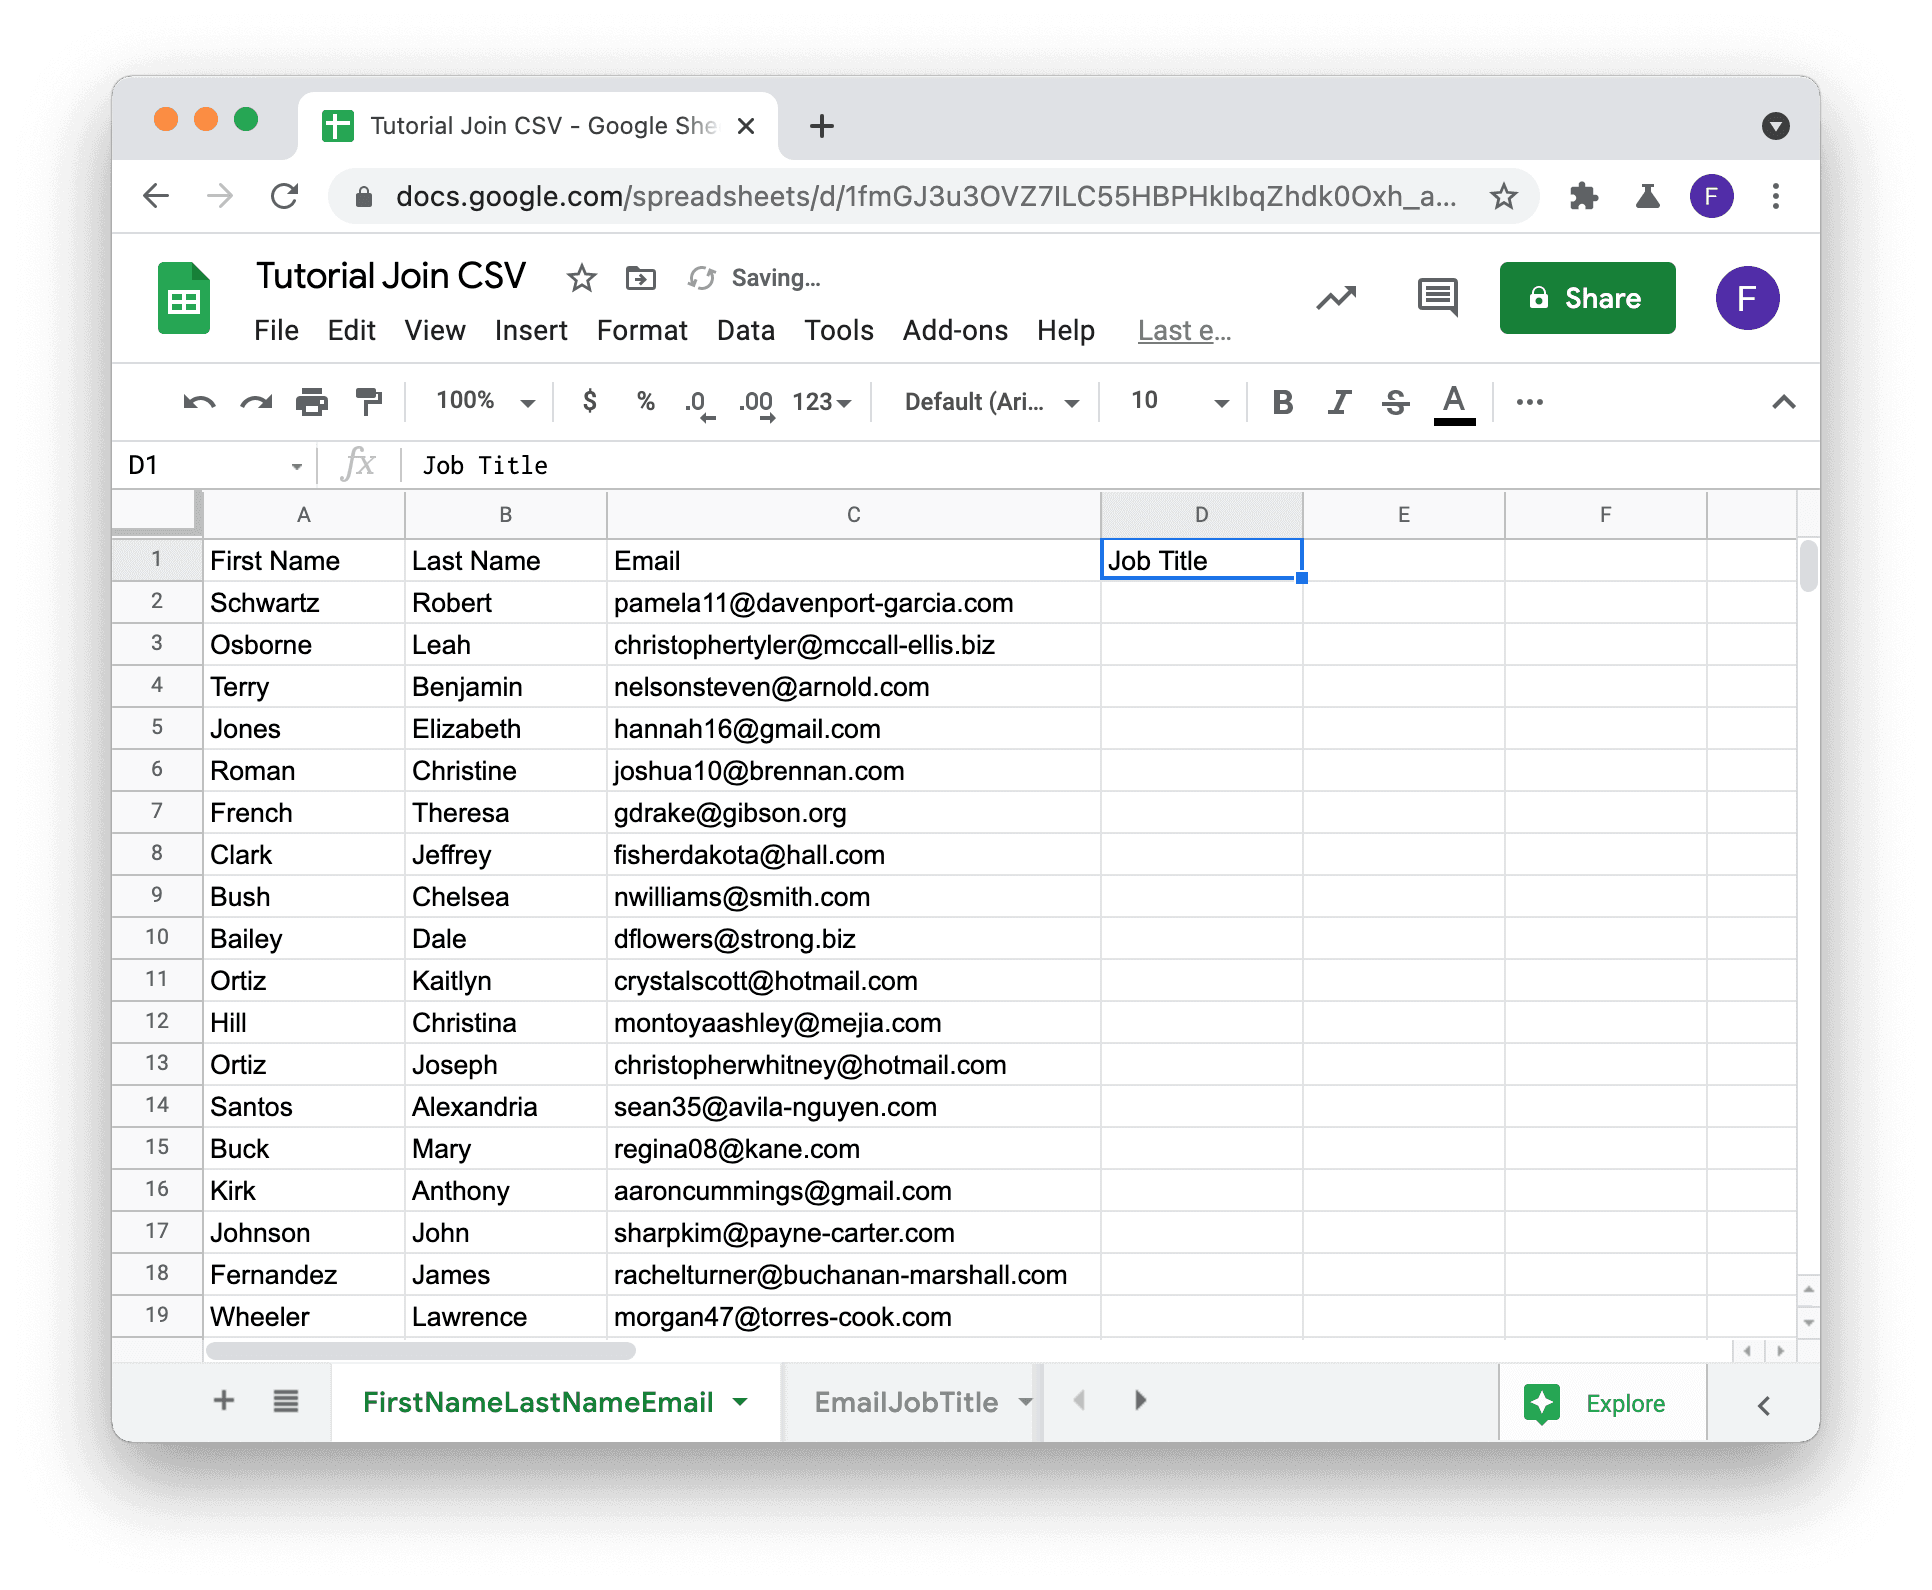
La tabla que contiene el CSV principal será su tabla de referencia y recibirá los valores de las demás tablas. En ella, cree nuevas columnas para almacenar los datos procedentes de las otras tablas.
En este tutorial queremos incorporar a la tabla principal el dato Job Title de la tabla secundaria, por lo que añadiremos una columna Job Title vacía.
Paso 3: Coloque la columna única en primer lugar en las tablas secundarias
La fórmula VLOOKUP busca en la primera columna de la tabla consultada. En todas las tablas secundarias (no es necesario hacerlo en la tabla principal), mueva a la primera posición la columna que utilizará para la unión.
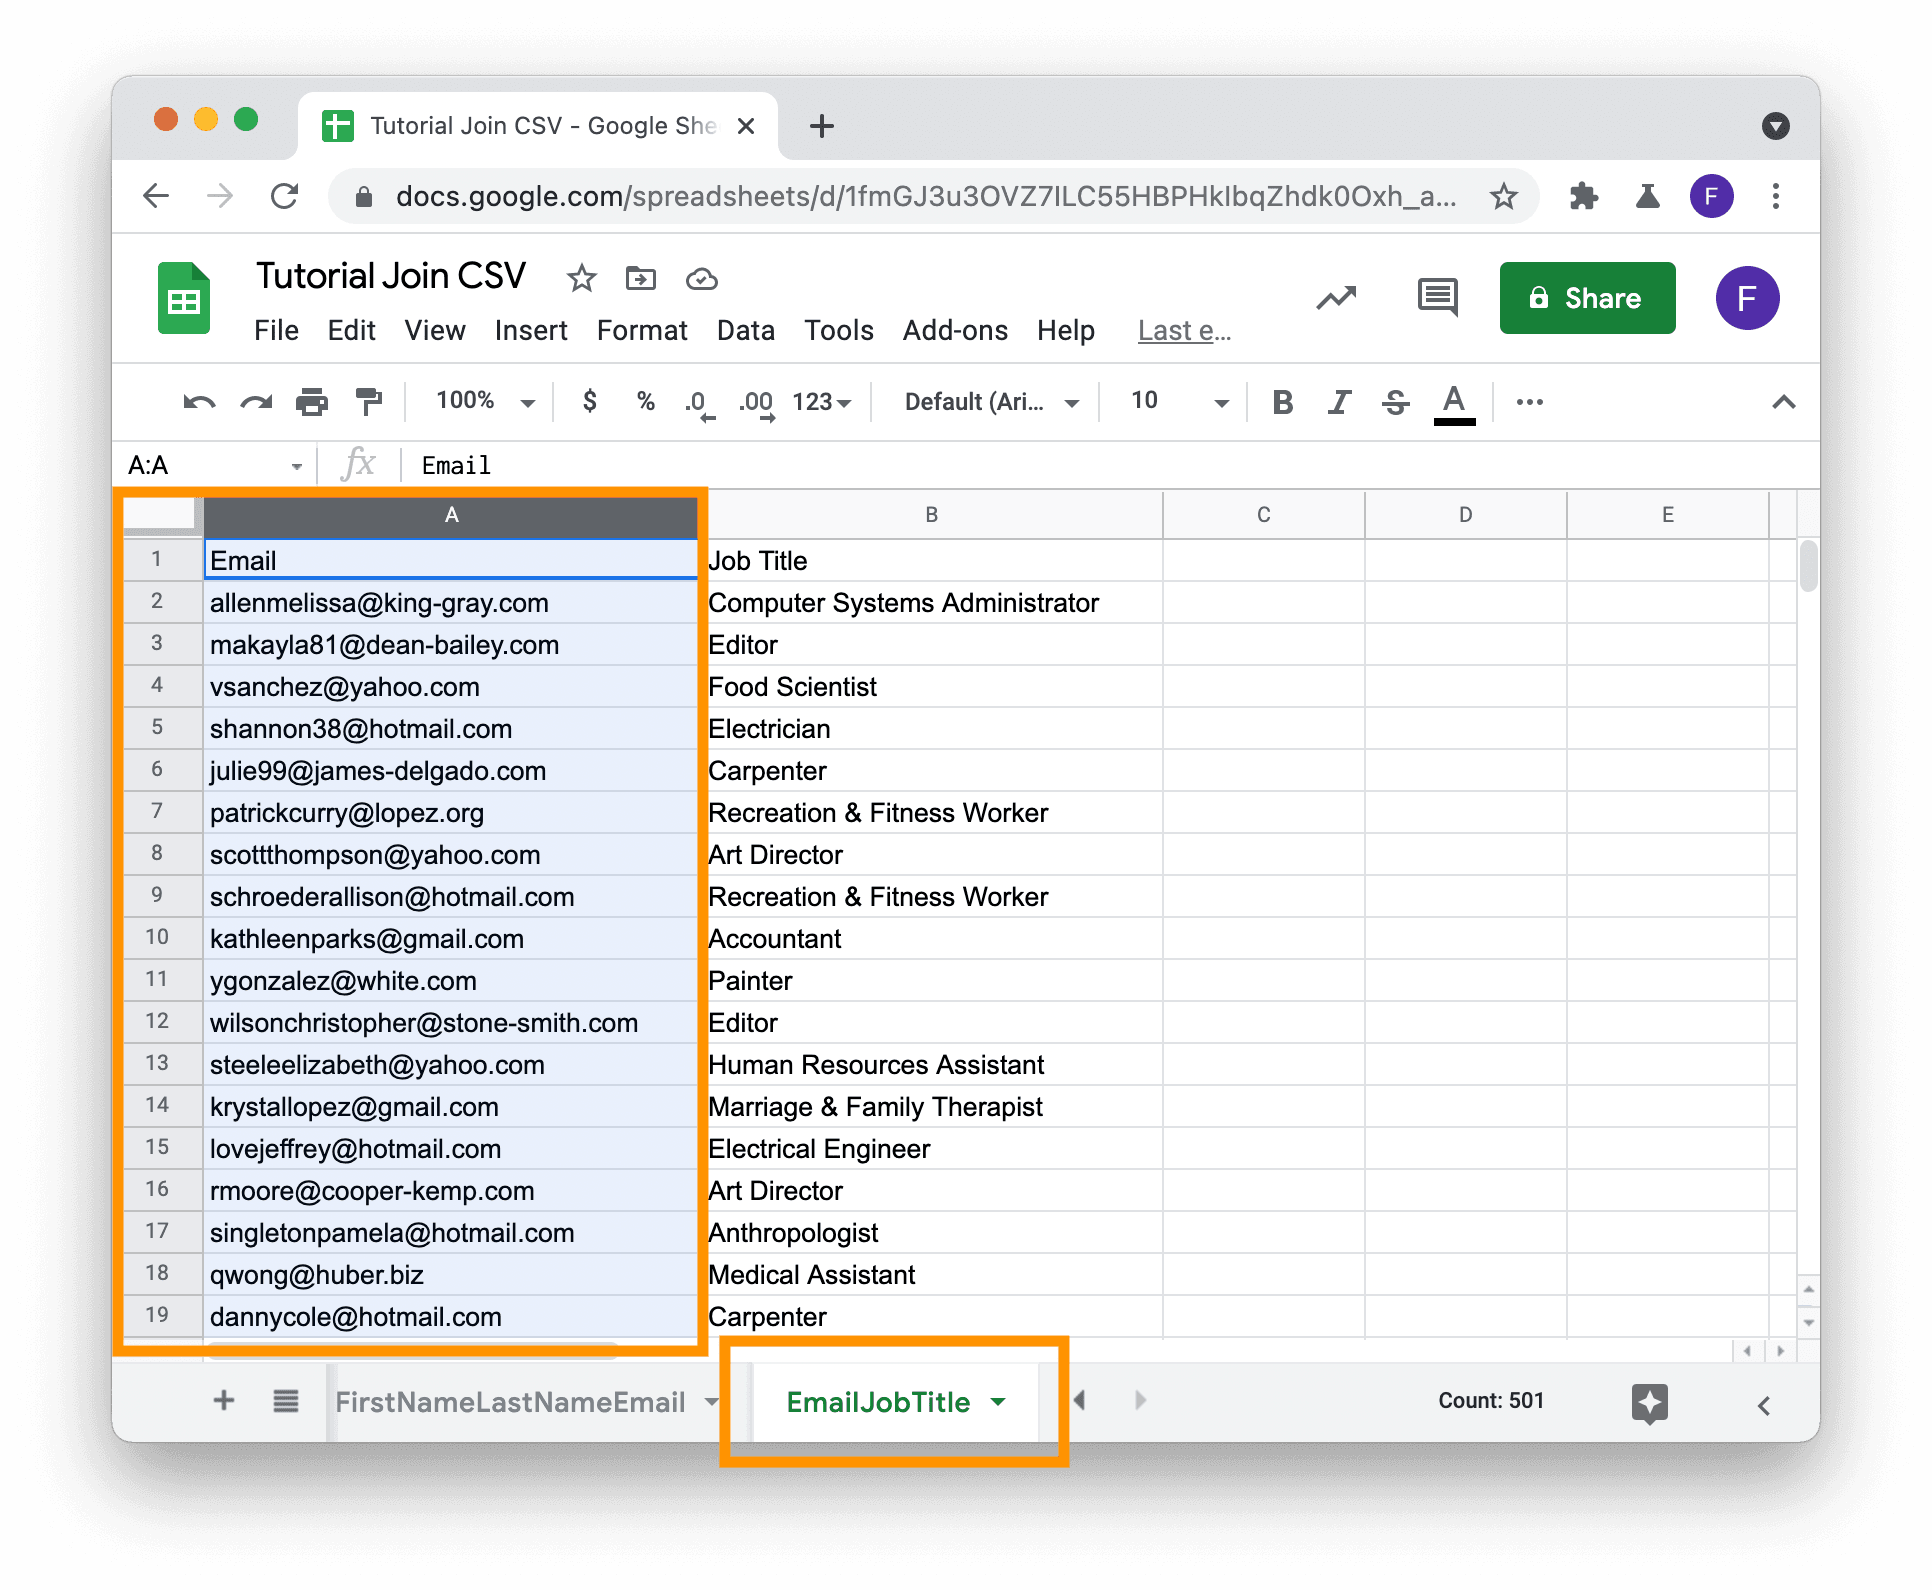
Paso 3: Utilice la fórmula VLOOKUP
El último paso consiste en utilizar la fórmula VLOOKUP para encontrar filas en las demás tablas y mostrar una columna de la fila coincidente.
La fórmula admite cuatro argumentos; el último determina si la búsqueda presupone que los datos están ordenados:
- search_key - El valor que se buscará. Corresponde al identificador único de la fila.
- range - El intervalo en el que se realizará la búsqueda. La clave indicada en search_key se busca en la primera columna del intervalo. Defina toda la tabla secundaria como intervalo (consulte el vídeo).
- index - El índice de la columna de la fila cuyo valor se devolverá. La primera columna del intervalo se numera como 1.
- is_sorted - [TRUE de forma predeterminada] - Indica si la columna donde se realiza la búsqueda —la primera del intervalo especificado— está ordenada. Se recomienda utilizar FALSE en la mayoría de los casos. Si el valor es True y sus datos no están ordenados, obtendrá resultados incorrectos.
VLOOKUP(search_key, range, index, [is_sorted])
En el siguiente vídeo puede ver cómo utilizar VLOOKUP para unir datos mediante una columna única:
Consulte más información sobre la fórmula VLOOKUP en la documentación de Google Sheets.
Repita la operación con cada una de las demás columnas de sus tablas secundarias 💪.