El stack tecnológico de una empresa revela mejor su predisposición de compra que casi cualquier otro dato. Una empresa que acaba de incorporar un data warehouse pronto necesitará herramientas que se integren con él. Y si utiliza tres aplicaciones de gestión de proyectos que se solapan, probablemente haya alguien frustrado buscando una alternativa.
El targeting tecnográfico convierte estas señales en un método repetible para encontrar y priorizar cuentas, en lugar de basarse únicamente en conjeturas a partir de datos firmográficos.
En este artículo verá qué son los datos tecnográficos, dónde obtenerlos, cómo crear un modelo de scoring y qué errores consumen silenciosamente el tiempo de los equipos de ventas.
📌 Resumen para quienes tienen prisa
Qué aprenderá en este artículo: El targeting tecnográfico utiliza el stack tecnológico de una empresa —su CRM, sus herramientas de marketing y su infraestructura— para encontrar y priorizar las cuentas con mayor predisposición de compra.
Puntos clave:
- Los datos del stack muestran señales de compra que los datos firmográficos y de intención no pueden captar por sí solos.
- Ninguna fuente cubre todo el stack: los escáneres web, las ofertas de empleo y las bases de datos de proveedores aportan información complementaria.
- Un sencillo modelo de scoring por puntos convierte las herramientas detectadas en una lista de cuentas priorizada y lista para usar.
En resumen: Los equipos que más partido sacan al targeting tecnográfico mantienen los datos limpios y actualizados, y aplican criterios de scoring coherentes.
Qué significa realmente el targeting tecnográfico
Los datos tecnográficos describen el software, las plataformas y la infraestructura que utiliza una empresa: CRM, automatización de marketing, procesadores de pagos, herramientas de analítica, CDN, plataformas de e-commerce y muchas otras categorías.
El targeting tecnográfico utiliza estos datos del stack para decidir a quién vender y en qué orden. Es uno de los tres pilares de la priorización de cuentas:
- Datos firmográficos: sector, plantilla, facturación
- Datos de intención: descargas de contenido, visitas al sitio web
- Datos tecnográficos: las herramientas que funcionan entre bastidores
La diferencia está en el nivel de precisión. Los datos firmográficos describen el perfil de una empresa. Los datos de intención reflejan dónde centra su atención. Los datos tecnográficos muestran su entorno operativo real, lo que le acerca mucho más a un problema concreto que su producto puede resolver.
Por qué el stack supera a los datos firmográficos
Los datos firmográficos indican quién podría comprar
Un filtro como «empresas SaaS de Norteamérica con entre 50 y 500 empleados» genera un amplio grupo de compradores potenciales. Pero no indica cuáles tienen realmente el problema que resuelve su producto.
Dos empresas pueden compartir exactamente el mismo perfil firmográfico y encontrarse en situaciones de compra completamente distintas. Una ya cuenta con una solución consolidada. La otra intenta cubrir la misma necesidad con hojas de cálculo y un profesional externo a tiempo parcial.
Por eso, las listas basadas únicamente en datos firmográficos suelen igualar a la baja las tasas de respuesta. Un comercial que trabaja con una lista de «empresas SaaS de 50 a 500 empleados» no puede iniciar de la misma forma una conversación con una empresa que ya resolvió el problema y con otra que está lidiando activamente con él. La propia lista no aporta ninguna señal para distinguirlas. Todas las cuentas reciben el mismo primer mensaje genérico.
Los datos tecnográficos revelan quién está listo ahora
Los datos del stack cubren ese vacío. Si vende un plugin para Shopify, saber que una empresa utiliza Shopify Plus en lugar de BigCommerce es un criterio de calificación decisivo, no un simple dato adicional. Si su herramienta se integra con Snowflake, una empresa que lo adoptó el trimestre pasado es una cuenta mucho más receptiva que otra que todavía opera un data warehouse on-premise.
Los datos tecnográficos también permiten detectar oportunidades para sustituir a la competencia. Una empresa que utiliza una herramienta legacy de su categoría —sobre todo si ha dejado de recibir actualizaciones importantes— no solo es candidata a realizar una primera compra, sino también a cambiar de solución.
De dónde proceden los datos tecnográficos
No existe una única fuente fiable para conocer todo el stack de una empresa. Una estrategia sólida combina varias de las siguientes:
- Herramientas de escaneo web (BuiltWith, Wappalyzer): detectan tecnologías de front-end, como píxeles de analítica, CDN, plataformas CMS y widgets de pago, mediante el análisis del código público de un sitio web
- Datos proporcionados por proveedores (HG Insights, G2, Datanyze): agregados a partir de herramientas de gestión de activos de TI, acuerdos con proveedores y reseñas publicadas por los propios usuarios
- Ofertas de empleo: una vacante para «administrador de Salesforce» o «ingeniero de datos de Snowflake» es una señal directa y actual de lo que utiliza una empresa y, a menudo, de lo que pretende ampliar
- Registros DNS y SSL: revelan proveedores de hosting, infraestructura de email y soluciones de seguridad
- Casos de éxito y comunicados de prensa: los proveedores publican los logotipos de sus clientes, una fuente fiable aunque incompleta
- Foros de soporte y comunidades: los ingenieros que buscan soluciones públicamente suelen mencionar su stack exacto
Ninguna fuente lo cubre todo. Los escáneres web no detectan herramientas internas que nunca interactúan con el front-end, como los CRM o los data warehouses. Las ofertas de empleo pueden ir por detrás de la adopción real. Combinar dos o tres fuentes ofrece una cobertura mucho más completa que depender de una sola.
Cobertura y actualización son problemas distintos
Conviene separar dos preguntas que suelen confundirse: ¿una fuente puede detectar una herramienta y, una vez detectada, hasta qué punto está actualizado ese dato?
Los escáneres web suelen ofrecer datos recientes —pueden volver a rastrear un sitio cada semana—, pero poco profundos, ya que solo ven lo expuesto en el código público. Esto excluye la mayoría del software de back office. Las bases de datos proporcionadas por proveedores llegan más lejos y suelen detectar herramientas internas como CRM y data warehouses, pero se actualizan con menor frecuencia, a veces trimestralmente, porque sus datos suelen proceder de integraciones con partners o encuestas periódicas, no de un rastreo continuo.
La conclusión práctica es sencilla: utilice fuentes rápidas pero superficiales para detectar señales vinculadas al momento de compra —como un nuevo píxel o CDN incorporado este mes— y fuentes más lentas pero profundas para establecer el stack de referencia. Ninguna de ellas ofrece por sí sola una visión actualizada y precisa.
Cómo crear un sistema de señales tecnográficas
Los datos brutos del stack no son más que una lista de herramientas hasta que se organizan como señales sobre las que se puede actuar.
Señales por categoría frente a herramientas concretas
Empiece por decidir si le interesa la categoría o un proveedor concreto. Si su herramienta se conecta con «cualquier CRM», basta con detectar la categoría —es decir, que la empresa dispone de un CRM—. Si solo se integra con HubSpot, necesita identificar al proveedor específico.
Las señales por categoría abarcan un mercado más amplio y son más fáciles de detectar de forma fiable. Las señales asociadas a un proveedor son más precisas, pero exigen datos más limpios: clasificar erróneamente el CRM de una empresa contaminará su lista sin que resulte evidente.
Las carencias del stack como oportunidades
Una carencia puede ser tan valiosa como una coincidencia. Si vende una capa de enriquecimiento de datos y una empresa dispone de un CRM y una plataforma de automatización de marketing, pero no de una herramienta de enriquecimiento, esa ausencia es el argumento comercial. Cree una lógica de detección del tipo «tiene X e Y, pero le falta Z», en lugar de buscar únicamente coincidencias positivas.
Cambios del stack a lo largo del tiempo
Una instantánea del stack de una empresa resulta útil. Un historial de sus cambios tiene aún más valor. Las herramientas que registran instalaciones y eliminaciones a lo largo del tiempo permiten detectar:
- Adopciones de nuevas herramientas: acaba de abrirse una ventana de compra
- Eliminaciones de herramientas: una señal de churn o insatisfacción que puede apuntar a un competidor
- Varias herramientas simultáneas de una misma categoría: probablemente haya una evaluación o migración en curso
Las señales basadas en cambios superan de forma sistemática a las señales estáticas a la hora de elegir el momento del outreach, porque señalan una fase concreta en la que el equipo ya está tomando decisiones.
Cómo puntuar y priorizar cuentas por su stack
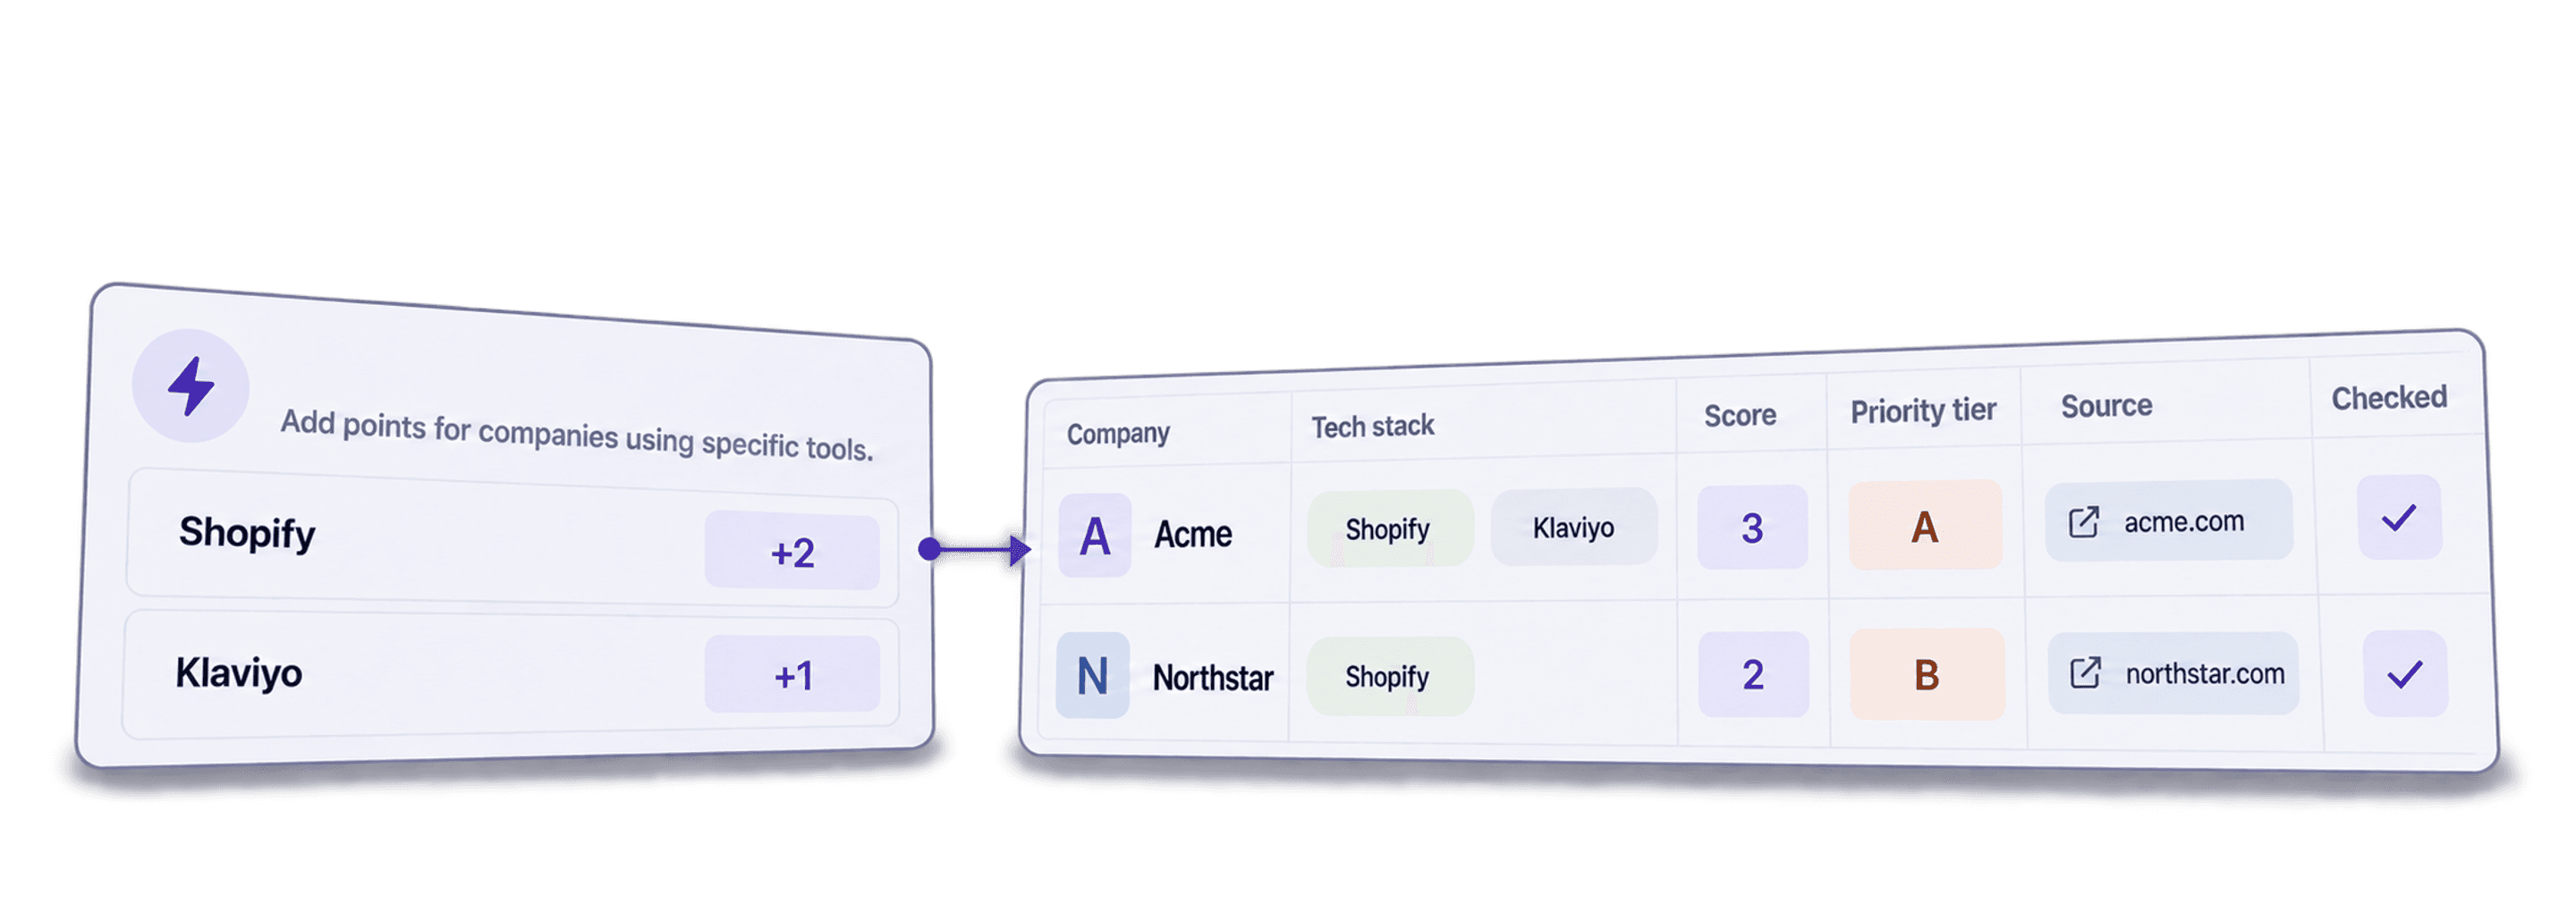
Una vez identificadas las señales, conviértalas en una lista ordenada, no en una lista plana. Un modelo sencillo basado en puntos funciona bien:
- +30: utiliza una herramienta con la que su producto se integra directamente
- +20: utiliza un competidor con puntos débiles conocidos en un área concreta
- +15: presenta una carencia en una categoría que encaja con su principal caso de uso
- +10: ha incorporado o eliminado recientemente una herramienta relevante —en los últimos 90 días—
- +10: una oferta de empleo menciona un puesto relacionado con la categoría de su producto
- −15: utiliza una herramienta que hace innecesario su producto
Cómo ponderar señales según la intención de compra
No todas las señales merecen el mismo peso. Una oferta de empleo mira hacia el futuro —la empresa planea contratar a alguien para esa función—, mientras que una herramienta instalada refleja una situación presente. Dé más peso a las herramientas activas e instaladas si su ciclo de ventas es corto. Priorice las ofertas de empleo si planifica las cuentas a más largo plazo.
Cómo combinar datos tecnográficos, firmográficos y de comportamiento
Los datos tecnográficos funcionan mejor como una capa adicional, no como un filtro independiente. Un modelo práctico combina tres variables:
- El encaje firmográfico —sector, tamaño y ubicación— define el grupo de cuentas aptas.
- El score tecnográfico ordena ese grupo según su predisposición de compra basada en el stack.
- Los datos de intención —visitas y descargas— deshacen empates e identifican a quienes investigan activamente.
Las cuentas con una puntuación alta en los tres criterios forman su nivel prioritario. Aquellas con un gran encaje tecnográfico, pero sin engagement, también merecen acciones de Outbound. Simplemente requieren un inicio distinto al de una empresa que ya ha visitado su página de precios.
Esta clasificación también determina el canal y el mensaje, no solo el orden de prioridad. Una cuenta con gran encaje firmográfico y tecnográfico, pero poco engagement, es idónea para un Cold Email preciso que haga referencia a su stack: dispone de suficiente contexto para personalizarlo sin esperar a que muestre interés. En cambio, una cuenta con mucho engagement y poco encaje tecnográfico quizá no merezca la intervención de ventas. Puede que solo esté investigando a la competencia o preparando un artículo de blog que menciona su categoría.
Errores habituales del targeting tecnográfico
- Tratar una detección como una certeza. Los escáneres generan falsos positivos y negativos. Una herramienta detectada hace seis meses puede haber desaparecido. Actualice los datos con regularidad y considere las detecciones procedentes de una única fuente como una hipótesis, no como un hecho.
- Depender demasiado de un solo proveedor. La cobertura varía según el sector y el tamaño de la empresa. Un proveedor sólido en SaaS enterprise puede ofrecer resultados mediocres en e-commerce mid-market.
- Ignorar las señales negativas. Los equipos crean listas de cuentas objetivo, pero omiten otra lista igual de útil: la de cuentas que deben perder prioridad porque ya utilizan una herramienta que hace innecesaria la suya.
- Puntuar todas las integraciones por igual. Una empresa que utiliza su principal partner de integración encaja mejor que otra que usa un partner cuyos usuarios rara vez convierten.
- Dejar que las listas queden obsoletas. Los datos del stack cambian constantemente. Como mínimo, una actualización trimestral evita que los scores pierdan precisión.
- Omitir el «porqué» de una herramienta detectada. En la mayoría de las plataformas, una cuenta de prueba creada para evaluar una solución parece idéntica a un despliegue en producción para toda la empresa. Antes de dar por confirmada una detección de alto valor, contrástela con una segunda señal, como una oferta de empleo o un caso de éxito.
Flujo para crear una lista tecnográfica de cuentas
- Defina el conjunto de señales. Enumere las herramientas, categorías y combinaciones relevantes basándose en los stacks reales de sus mejores clientes actuales.
- Extraiga datos brutos de dos o más fuentes que cubran tanto señales de front-end —escaneo web— como de back-end —ofertas de empleo y datos de proveedores—.
- Limpie y estandarice los nombres de los proveedores. Si no los normaliza primero, los datos brutos mostrarán «Salesforce», «Salesforce.com» y «Salesforce CRM» como tres entradas distintas.
- Aplique su modelo de scoring para ordenar la lista combinada y depurada.
- Asigne un flujo a cada nivel. Envíe las puntuaciones altas a los comerciales para un outreach directo, incluya las medias en secuencias de nurturing y descarte las bajas.
El paso 3 es donde fracasan la mayoría de los proyectos tecnográficos. Combinar exportaciones de una herramienta de escaneo, un scraper de ofertas de empleo y una base de datos de proveedores suele generar nombres desordenados, duplicados y con formatos incoherentes. Limpiarlos antes de continuar es lo que aporta fiabilidad al resto del modelo.
Ejemplo práctico de scoring tecnográfico
Imagine una empresa que vende una customer data platform (CDP) con integraciones nativas para Segment y Snowflake.
- Una cuenta que utiliza Segment, Snowflake y una herramienta de email legacy, pero ninguna CDP, obtiene una puntuación alta: cuenta con las dos integraciones necesarias y presenta una carencia clara que encaja con el principal caso de uso.
- Una cuenta que utiliza Segment y una CDP de la competencia obtiene una puntuación media: existe un buen encaje de integración, pero la categoría ya está cubierta, por lo que el discurso debe centrarse en sustituir la solución actual.
- Una cuenta sin Segment ni Snowflake, pero con tres ofertas de «ingeniero de datos para migración del data warehouse» publicadas durante el último mes, se clasifica como oportunidad futura: hoy no está preparada, pero merece un nuevo contacto el próximo trimestre.
El verdadero valor del scoring tecnográfico consiste en priorizar estas tres cuentas de forma distinta, en lugar de agruparlas en una única lista de «prospectos para CDP».
Cómo ponerlo en práctica
El targeting tecnográfico no sustituye a los datos firmográficos ni a los de intención. Es una lente más precisa que se añade sobre ellos. Los equipos que más partido le sacan no son los que disponen de las herramientas de detección más sofisticadas, sino los que actualizan los datos con disciplina, normalizan los nombres de los proveedores antes de aplicar el scoring y ajustan el peso de las señales a medida que evolucionan su producto y sus integraciones.
Empiece poco a poco: elija las dos o tres herramientas o categorías que mejor predicen quiénes son sus clientes actuales, cree primero la lógica necesaria para detectarlas y amplíe el modelo cuando ya esté generando mejores conversaciones.