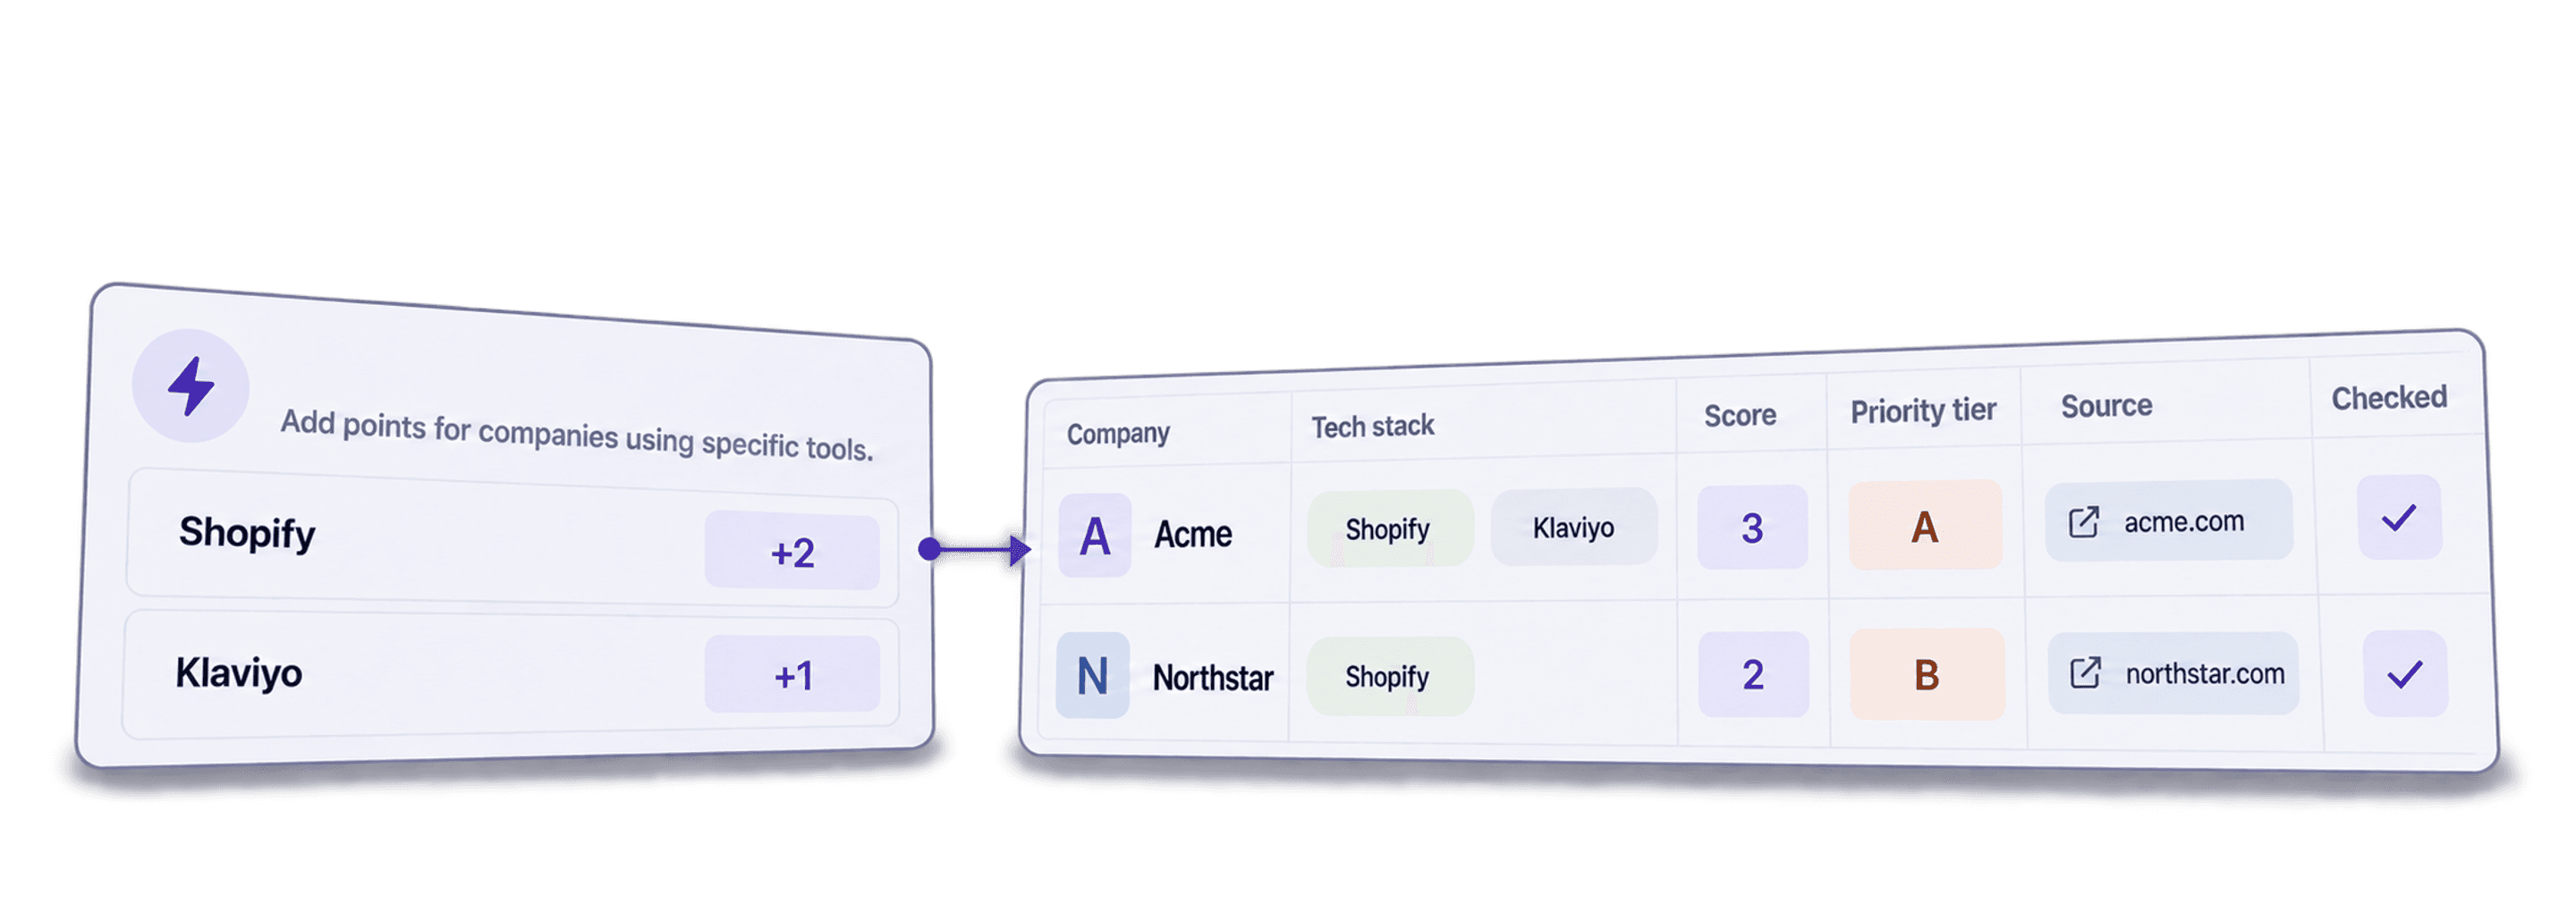
La stack technologique d’une entreprise en dit plus sur sa propension à acheter que presque n’importe quelle autre donnée. Une entreprise qui vient d’ajouter un data warehouse aura bientôt besoin d’outils capables de s’y connecter. Une autre qui utilise trois applications de gestion de projet aux fonctions redondantes compte probablement une personne insatisfaite, déjà en quête d’une alternative.
Le ciblage technographique transforme ces signaux en une méthode reproductible pour identifier et classer les comptes, au lieu de s’appuyer uniquement sur des suppositions firmographiques.
Cet article explique ce que sont les données technographiques, où les trouver, comment bâtir un modèle de scoring et quelles erreurs font discrètement perdre du temps aux équipes commerciales.
📌 Résumé pour les plus pressés
Ce que couvre cet article : le ciblage technographique exploite la stack technologique d’une entreprise — son CRM, ses outils marketing et son infrastructure — pour identifier et classer les comptes les plus susceptibles d’acheter.
À retenir :
- Les données sur la stack révèlent une propension à acheter que les données firmographiques et d’intention ne peuvent pas détecter seules.
- Aucune source ne couvre toute la stack : les scanners de sites web, les offres d’emploi et les bases de données fournisseurs comblent chacun des lacunes différentes.
- Un modèle de scoring simple, fondé sur des points, transforme les outils détectés en une liste de comptes classée et directement exploitable.
En bref : les équipes qui tirent le meilleur parti du ciblage technographique sont celles qui conservent des données propres et à jour, avec une méthode de scoring cohérente.
Qu’est-ce que le ciblage technographique ?
Les données technographiques décrivent les logiciels, plateformes et infrastructures qu’une entreprise utilise : CRM, marketing automation, solutions de paiement, outils analytics, CDN, plateformes e-commerce et des dizaines d’autres catégories.
Le ciblage technographique s’appuie sur ces données pour déterminer à qui vendre et dans quel ordre. Il complète les deux autres piliers de la priorisation des comptes :
- Données firmographiques : secteur, effectif, chiffre d’affaires
- Données d’intention : téléchargements de contenus, visites du site web
- Données technographiques : outils utilisés en coulisses
La différence tient à la précision. Les données firmographiques décrivent le profil d’une entreprise. Les données d’intention reflètent son attention. Les données technographiques révèlent son environnement opérationnel réel, ce qui vous rapproche bien davantage d’un problème concret auquel votre offre peut répondre.
Pourquoi la stack tech dépasse la firmographie
La firmographie indique qui pourrait acheter
Un filtre comme « entreprises SaaS de 50 à 500 salariés en Amérique du Nord » produit un vaste vivier d’acheteurs potentiels. Mais il ne vous dit pas lesquelles rencontrent réellement le problème résolu par votre produit.
Deux entreprises peuvent présenter des données firmographiques identiques tout en se trouvant dans des situations d’achat totalement différentes. L’une dispose déjà d’une solution mature. L’autre tente d’obtenir le même résultat avec des feuilles de calcul et un prestataire à temps partiel.
C’est pourquoi les listes fondées uniquement sur la firmographie ont tendance à uniformiser les taux de réponse vers le bas. Un commercial travaillant sur une liste d’« entreprises SaaS de 50 à 500 salariés » ne peut pas aborder de la même manière une société qui a déjà résolu le problème et une autre qui y est activement confrontée. La liste ne fournit aucun signal permettant de les distinguer. Tous les comptes reçoivent donc le même premier message générique.
La technographie révèle qui est prêt à acheter
Les données sur la stack comblent ce manque. Si vous vendez un plugin Shopify, savoir qu’une entreprise utilise Shopify Plus plutôt que BigCommerce constitue un critère de qualification décisif, pas un simple bonus. Si votre outil s’intègre à Snowflake, une entreprise ayant adopté Snowflake le trimestre dernier est un compte bien plus prometteur qu’une société utilisant encore un data warehouse on-premise.
Les données technographiques font également ressortir les possibilités de remplacement d’un concurrent. Une entreprise qui utilise un outil legacy dans votre catégorie — surtout si celui-ci ne reçoit plus de mises à jour majeures — est une candidate au changement, et pas seulement à un premier achat.
D’où viennent les données technographiques ?
Aucune source unique ne permet de connaître toute la stack d’une entreprise. Une approche solide combine plusieurs des sources suivantes :
- Outils d’analyse de sites web (BuiltWith, Wappalyzer) : ils détectent les technologies front-end, comme les pixels analytics, les CDN, les CMS et les widgets de paiement, en lisant le code public d’un site
- Données déclarées par les fournisseurs (HG Insights, G2, Datanyze) : elles sont agrégées à partir d’outils de gestion des actifs IT, de partenariats fournisseurs et d’avis publiés par les utilisateurs
- Offres d’emploi : une annonce recherchant un « administrateur Salesforce » ou un « data engineer Snowflake » constitue un signal direct et récent des outils utilisés par l’entreprise, et souvent de ceux qu’elle développe
- Enregistrements DNS et SSL : ils révèlent les hébergeurs, l’infrastructure email et les fournisseurs de solutions de sécurité
- Études de cas et communiqués de presse : les fournisseurs publient les logos de leurs clients, une information fiable même si elle reste incomplète
- Forums de support et discussions communautaires : lorsqu’ils cherchent publiquement à résoudre un problème, les ingénieurs citent souvent leur stack exacte
Aucune source ne couvre tout. Les scanners de sites web ne voient pas les outils internes qui n’apparaissent jamais sur le front-end, comme les CRM ou les data warehouses. Les offres d’emploi peuvent être en décalage avec l’adoption réelle. Combiner deux ou trois sources offre une couverture nettement supérieure à celle d’une source isolée.
Couverture et fraîcheur : deux enjeux distincts
Il est utile de distinguer deux questions souvent confondues : une source peut-elle détecter un outil et, une fois celui-ci identifié, à quel point l’information est-elle récente ?
Les scanners de sites web sont généralement à jour — ils peuvent relancer leur crawl chaque semaine — mais leur couverture reste superficielle puisqu’ils ne voient que le code exposé publiquement. La plupart des logiciels de back-office leur échappent donc. Les bases de données alimentées par les fournisseurs vont plus loin et identifient souvent des outils internes comme les CRM et les data warehouses. Elles sont toutefois actualisées moins fréquemment, parfois chaque trimestre, car leurs données proviennent généralement d’intégrations partenaires ou d’enquêtes périodiques plutôt que d’un crawl continu.
En pratique, utilisez les sources rapides mais superficielles pour repérer les signaux liés au timing — par exemple, l’ajout récent d’un pixel ou d’un CDN — et les sources plus lentes mais plus approfondies pour établir la stack de référence. Aucune ne permet, à elle seule, d’obtenir une vision à la fois exacte et actuelle.
Construire un framework de signaux technographiques
Des données brutes sur la stack ne sont qu’une liste d’outils tant que vous ne les organisez pas en signaux exploitables.
Signaux par catégorie ou par outil précis
Commencez par déterminer si la catégorie vous suffit ou si vous devez connaître le fournisseur précis. Si votre outil se connecte à « n’importe quel CRM », une détection au niveau de la catégorie — l’entreprise possède un CRM — suffit. Si votre intégration fonctionne uniquement avec HubSpot, vous devez identifier précisément le fournisseur.
Les signaux par catégorie couvrent un périmètre plus large et sont plus faciles à détecter de façon fiable. Les signaux propres à un fournisseur sont plus précis, mais exigent des données plus propres : attribuer le mauvais CRM à une entreprise peut discrètement fausser toute votre liste.
Les lacunes de la stack comme opportunités
Une absence peut être aussi précieuse qu’une correspondance. Si vous vendez une couche d’enrichissement de données et qu’une entreprise possède un CRM ainsi qu’une plateforme de marketing automation, mais aucun outil d’enrichissement, cette lacune devient votre argument commercial. Créez une logique de détection du type « possède X et Y, mais pas Z », au lieu de rechercher uniquement des correspondances positives.
L’évolution de la stack dans le temps
Un instantané de la stack d’une entreprise est utile. L’historique de ses changements l’est encore davantage. Les outils qui suivent les installations et les suppressions dans le temps permettent d’identifier :
- Adoption d’un nouvel outil : une fenêtre d’achat vient de s’ouvrir
- Suppression d’un outil : un signal de churn ou d’insatisfaction, qui peut concerner un concurrent
- Utilisation simultanée de plusieurs outils d’une même catégorie : une évaluation ou une migration est probablement en cours
Les signaux liés aux changements surpassent régulièrement les données statiques lorsqu’il s’agit de choisir le bon moment pour prospecter, car ils correspondent à une période précise où l’équipe prend déjà des décisions.
Scorer et prioriser les comptes selon leur stack
Une fois vos signaux identifiés, utilisez-les pour produire un classement plutôt qu’une liste uniforme. Un modèle simple fondé sur des points fonctionne bien :
- +30 : utilise un outil auquel votre produit s’intègre directement
- +20 : utilise un concurrent présentant des faiblesses connues dans un domaine précis
- +15 : présente une lacune dans une catégorie correspondant à votre principal use case
- +10 : a récemment ajouté ou supprimé un outil pertinent, au cours des 90 derniers jours
- +10 : une offre d’emploi mentionne un poste lié à la catégorie de votre produit
- −15 : utilise un outil qui rend votre produit superflu
Pondérer les signaux selon l’intention d’achat
Tous les signaux ne méritent pas le même poids. Une offre d’emploi est prospective — l’entreprise prévoit de recruter pour ce besoin — tandis qu’un outil installé décrit la situation actuelle. Accordez davantage de poids aux outils effectivement utilisés si votre cycle de vente est court. Privilégiez les offres d’emploi si vous travaillez sur une planification de comptes à plus long terme.
Combiner technographie, firmographie et comportement
La technographie est plus efficace comme couche supplémentaire que comme filtre autonome. Un modèle pratique combine trois types de données :
- L’adéquation firmographique — secteur, taille, zone géographique — définit le vivier éligible.
- Le score technographique classe ce vivier selon la propension à acheter révélée par la stack.
- Les données d’intention — visites, téléchargements — départagent les comptes et signalent ceux qui effectuent activement des recherches.
Les comptes qui obtiennent un score élevé sur les trois dimensions constituent votre priorité absolue. Ceux dont l’adéquation technographique est forte, mais qui n’ont pas encore interagi avec votre marque, restent de bonnes cibles pour l’Outbound. Ils nécessitent simplement une accroche différente de celle destinée à une personne ayant déjà consulté votre page de tarifs.
Cette segmentation détermine aussi le canal et le message, pas seulement l’ordre des priorités. Un compte à forte adéquation firmographique et technographique, mais à faible engagement, se prête bien à un cold email précis faisant référence à sa stack : vous disposez d’assez de contexte pour être pertinent sans attendre qu’il manifeste d’abord son intérêt. À l’inverse, un compte très engagé mais peu compatible sur le plan technographique ne mérite pas forcément l’intervention d’un commercial. Il peut simplement mener une veille concurrentielle ou rédiger un article de blog mentionnant votre catégorie.
Erreurs fréquentes du ciblage technographique
- Considérer une détection comme une certitude. Les scanners produisent des faux positifs et des faux négatifs. Un outil détecté il y a six mois peut avoir disparu depuis longtemps. Actualisez régulièrement les données et considérez toute détection provenant d’une seule source comme une hypothèse, pas comme un fait.
- Dépendre excessivement d’un seul fournisseur. La couverture varie selon le secteur et la taille des entreprises. Un fournisseur performant sur le SaaS enterprise peut être moins fiable sur l’e-commerce mid-market.
- Ignorer les signaux négatifs. Les équipes créent des listes de comptes cibles, mais négligent une liste tout aussi utile : celle des comptes à déprioriser parce qu’ils utilisent déjà un outil rendant le vôtre superflu.
- Attribuer le même score à toutes les intégrations. Une entreprise qui utilise votre principal partenaire d’intégration présente une meilleure adéquation qu’une autre utilisant un partenaire qui convertit rarement.
- Laisser les listes vieillir. Les stacks évoluent en permanence. Une actualisation trimestrielle, au minimum, empêche les scores de perdre leur pertinence.
- Négliger le « pourquoi » derrière un outil détecté. Dans la plupart des solutions, un compte d’essai ouvert pour une évaluation ressemble à un déploiement en production à l’échelle de l’entreprise. Avant de valider une détection à forte valeur, recoupez-la avec un second signal, comme une offre d’emploi ou une étude de cas.
Créer une liste de comptes technographique
- Définissez les signaux. Dressez la liste des outils, catégories et combinaisons qui comptent, à partir des stacks réellement utilisées par vos meilleurs clients actuels.
- Collectez des données brutes auprès d’au moins deux sources, en couvrant à la fois les signaux front-end — analyse de sites web — et back-end — offres d’emploi, données fournisseurs.
- Nettoyez et standardisez les noms des fournisseurs. Sans normalisation préalable, les données brutes considéreront « Salesforce », « Salesforce.com » et « Salesforce CRM » comme trois entrées distinctes.
- Appliquez votre modèle de scoring pour classer la liste fusionnée et nettoyée.
- Orientez les comptes selon leur niveau. Transmettez les scores élevés aux commerciaux pour une prospection directe, intégrez les scores intermédiaires à des séquences de nurturing et excluez les scores faibles.
L’étape 3 est celle où la plupart des projets technographiques échouent. La fusion des exports d’un scanner, d’un scraper d’offres d’emploi et d’une base de données fournisseurs génère généralement des noms désordonnés, dupliqués et formatés de manière incohérente. Les nettoyer en amont est indispensable pour rendre le reste du modèle fiable.
Exemple concret de scoring technographique
Prenons une entreprise fictive qui commercialise une customer data platform (CDP) avec des intégrations natives à Segment et Snowflake.
- Un compte utilisant Segment, Snowflake et un ancien outil d’emailing, mais aucune CDP, obtient un score élevé : les deux intégrations requises sont présentes et une lacune claire correspond au principal use case.
- Un compte utilisant Segment avec une CDP concurrente obtient un score intermédiaire : l’adéquation avec l’intégration est bonne, mais la catégorie est déjà couverte. Le pitch doit donc se concentrer sur le remplacement de la solution en place.
- Un compte qui n’utilise ni Segment ni Snowflake, mais qui a publié trois offres de « data engineer, migration de data warehouse » le mois dernier, rejoint la catégorie des opportunités futures : il n’est pas prêt aujourd’hui, mais mérite une relance au prochain trimestre.
Classer ces trois comptes différemment, au lieu de les regrouper dans une même liste de « prospects CDP », résume toute la valeur du scoring technographique.
Passer à l’action
Le ciblage technographique ne remplace ni les données firmographiques ni les données d’intention. Il ajoute une grille de lecture plus précise. Les équipes qui en tirent le plus de valeur ne sont pas celles qui disposent des outils de détection les plus sophistiqués. Ce sont celles qui actualisent rigoureusement leurs données, normalisent les noms des fournisseurs avant le scoring et ajustent la pondération des signaux à mesure que leur produit et leurs intégrations évoluent.
Commencez simplement : sélectionnez les deux ou trois outils ou catégories qui prédisent le mieux la qualité de vos clients actuels, créez d’abord les règles de détection correspondantes, puis enrichissez le modèle lorsqu’il génère réellement de meilleures conversations.