
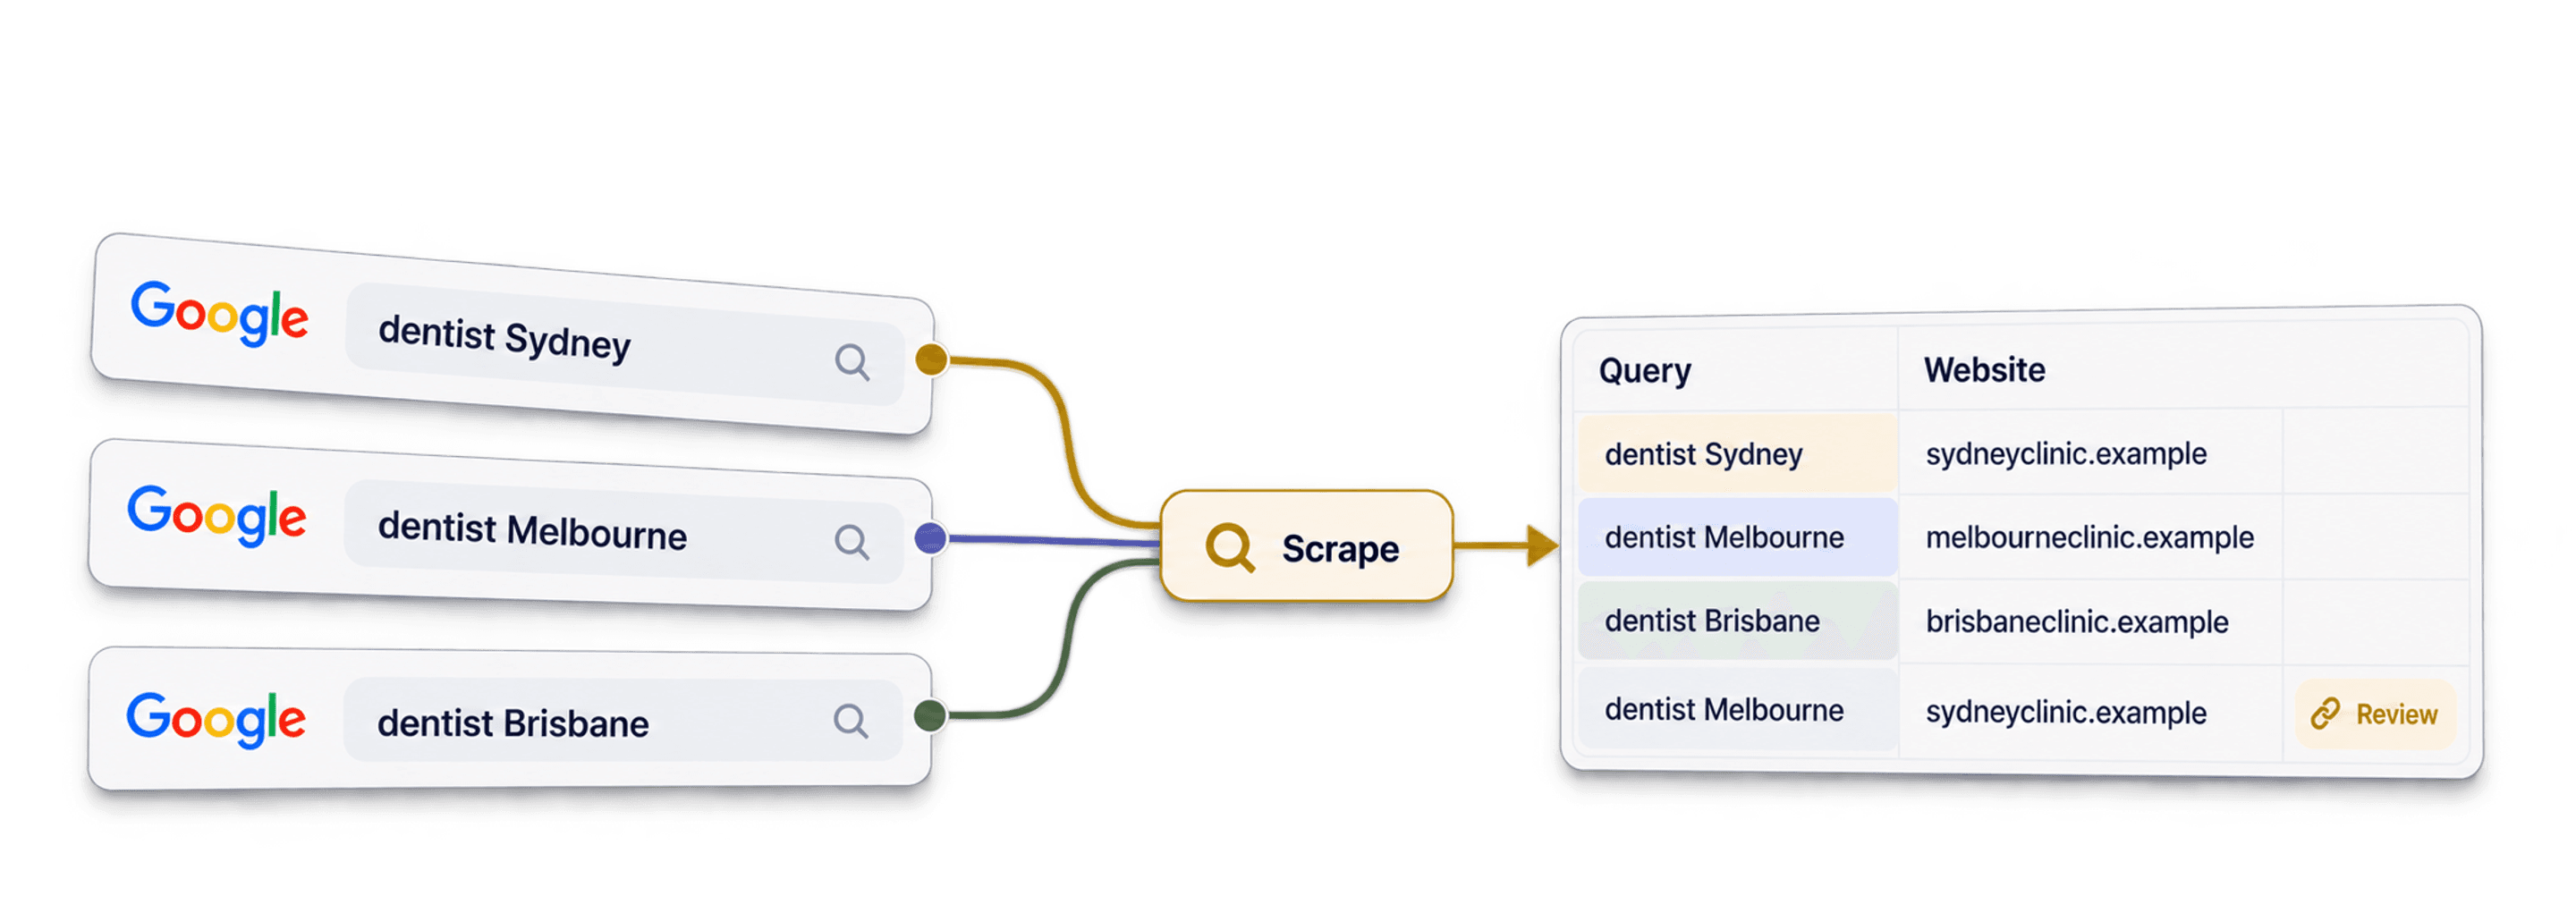
Per estrarre risultati Google da più query, prepara un elenco di ricerche specifiche, incollalo nella source Start with Google Search Queries di Datablist, scegli Paese, lingua e limite per query, quindi controlla gli URL ottenuti. Ad esempio, cerca dentista Milano, dentista Roma e dentista Napoli invece di affidarti a un’unica query generica come dentista Italia.
Ogni query può restituire un insieme diverso di pagine. I risultati dipendono da ciò che Google rende disponibile per quella ricerca e le varianti possono sovrapporsi: il totale finale, quindi, non corrisponde al numero di query moltiplicato per il limite impostato. Con il piano gratuito viene elaborata solo la prima query, fino a un massimo di 200 risultati; per eseguire più query in batch serve un run a pagamento idoneo. Controlla la stima prima di utilizzare i crediti.
📌 Esempi di utilizzo
- Creare una lista di Lead con profili LinkedIn
- Cercare profili Instagram tramite keyword
- Individuare aziende che utilizzano specifiche tecnologie web
- Creare database di aziende locali in centinaia di città
Link rapidi alle sezioni:
- Perché una query generica non trova tutti i risultati
- La strategia multi-query e come usare l’AI per variare le query
- Guida allo scraping in batch delle query Google
- Pulire ed eliminare i duplicati
- Arricchire i risultati di ricerca
- Analisi dei costi: scraping con un budget limitato
Perché una query generica non trova tutti i risultati
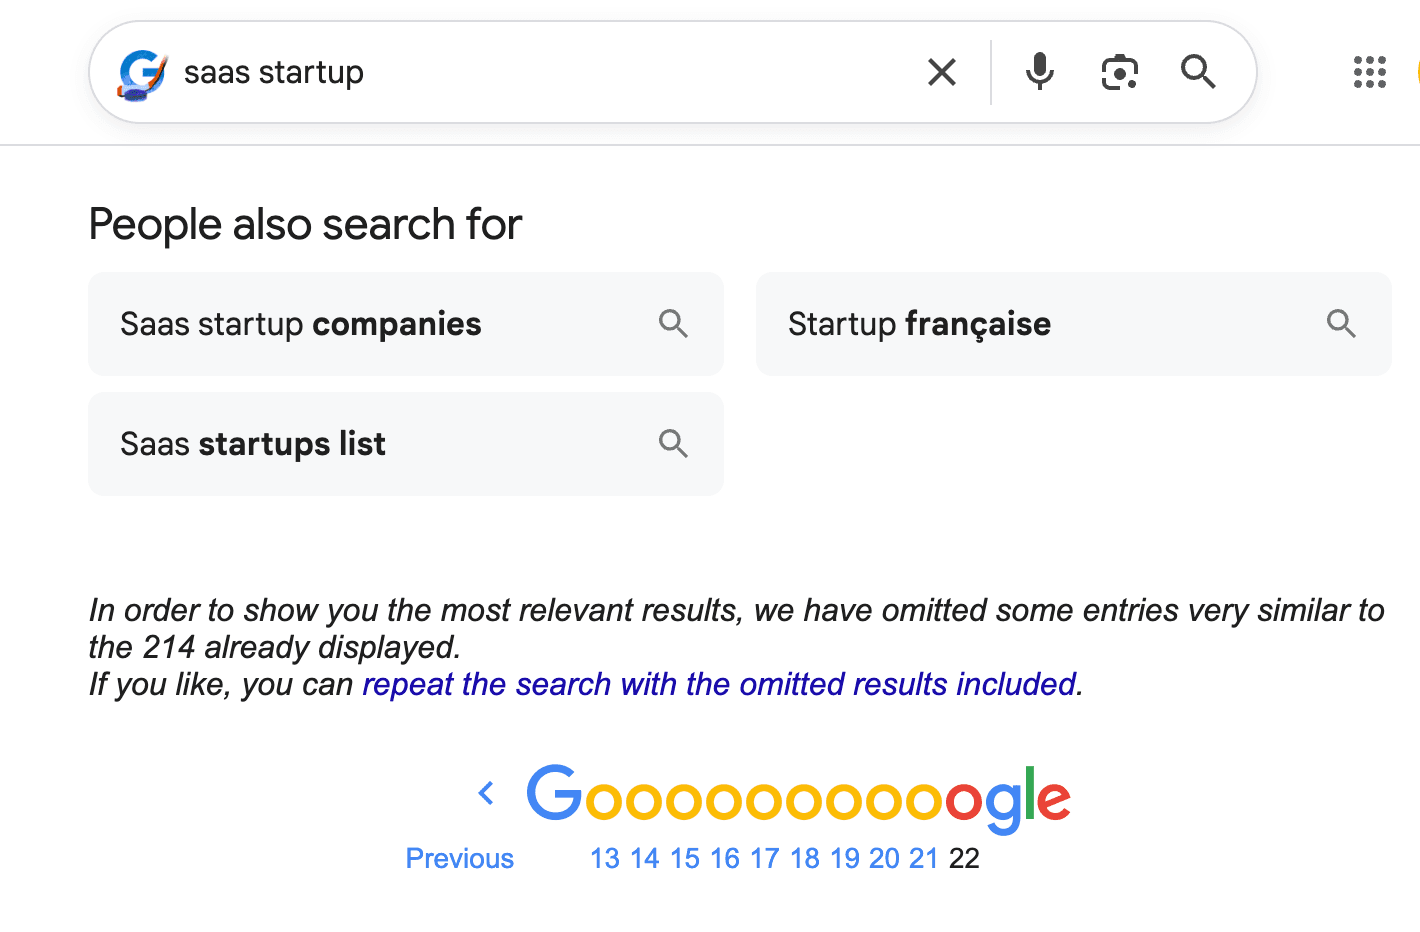
Il numero stimato mostrato per una ricerca generica non rappresenta necessariamente un elenco di pagine che puoi recuperare per intero. Le pagine disponibili cambiano in base alla query.
Scorrendo molte pagine di una ricerca generica, Google può omettere i risultati simili o smettere di mostrare nuove pagine. Il numero effettivamente disponibile varia da una query all’altra.
Nella lead generation, una query troppo ampia può escludere nicchie rilevanti. Una ricerca come avvocato Italia potrebbe privilegiare le grandi directory, mentre avvocato del lavoro Bologna può far emergere studi locali diversi.
Rendi le ricerche più specifiche indicando località, servizio o settore. Otterrai un insieme più ampio di URL da valutare, non un elenco completo di tutte le aziende esistenti.
La strategia multi-query
Lo scraping multi-query consiste nel suddividere una ricerca ampia in numerose query più piccole e parzialmente sovrapposte. Invece di cercare “Avvocati in Italia”, puoi cercare “Avvocati a Milano”, “Avvocati a Roma”, “Avvocati a Torino”, “Avvocati a Bologna” e “Avvocati a Napoli”.
Ogni ricerca per città può restituire pagine diverse, anche se uno stesso studio potrebbe posizionarsi in più località vicine. Conserva le proprietà di output Search Query e Result Link: ti permetteranno di capire perché è comparsa una pagina e di confrontare i risultati sovrapposti.
Le varianti cambiano ciò che chiedi a Google di trovare, ma non garantiscono un determinato posizionamento né uno specifico numero di aziende uniche.
Usare l’AI per variare le query
Creare manualmente 100 varianti di una query richiede tempo. Un LLM può preparare una prima lista, ma verifica località e termini prima di incollarla in un run a pagamento. Elimina le ricerche quasi identiche e quelle che intercettano un intento sbagliato.
Strategia basata sulla località
La località è il modo più semplice per moltiplicare i risultati. Ogni Paese dispone di elenchi di città, province o regioni.
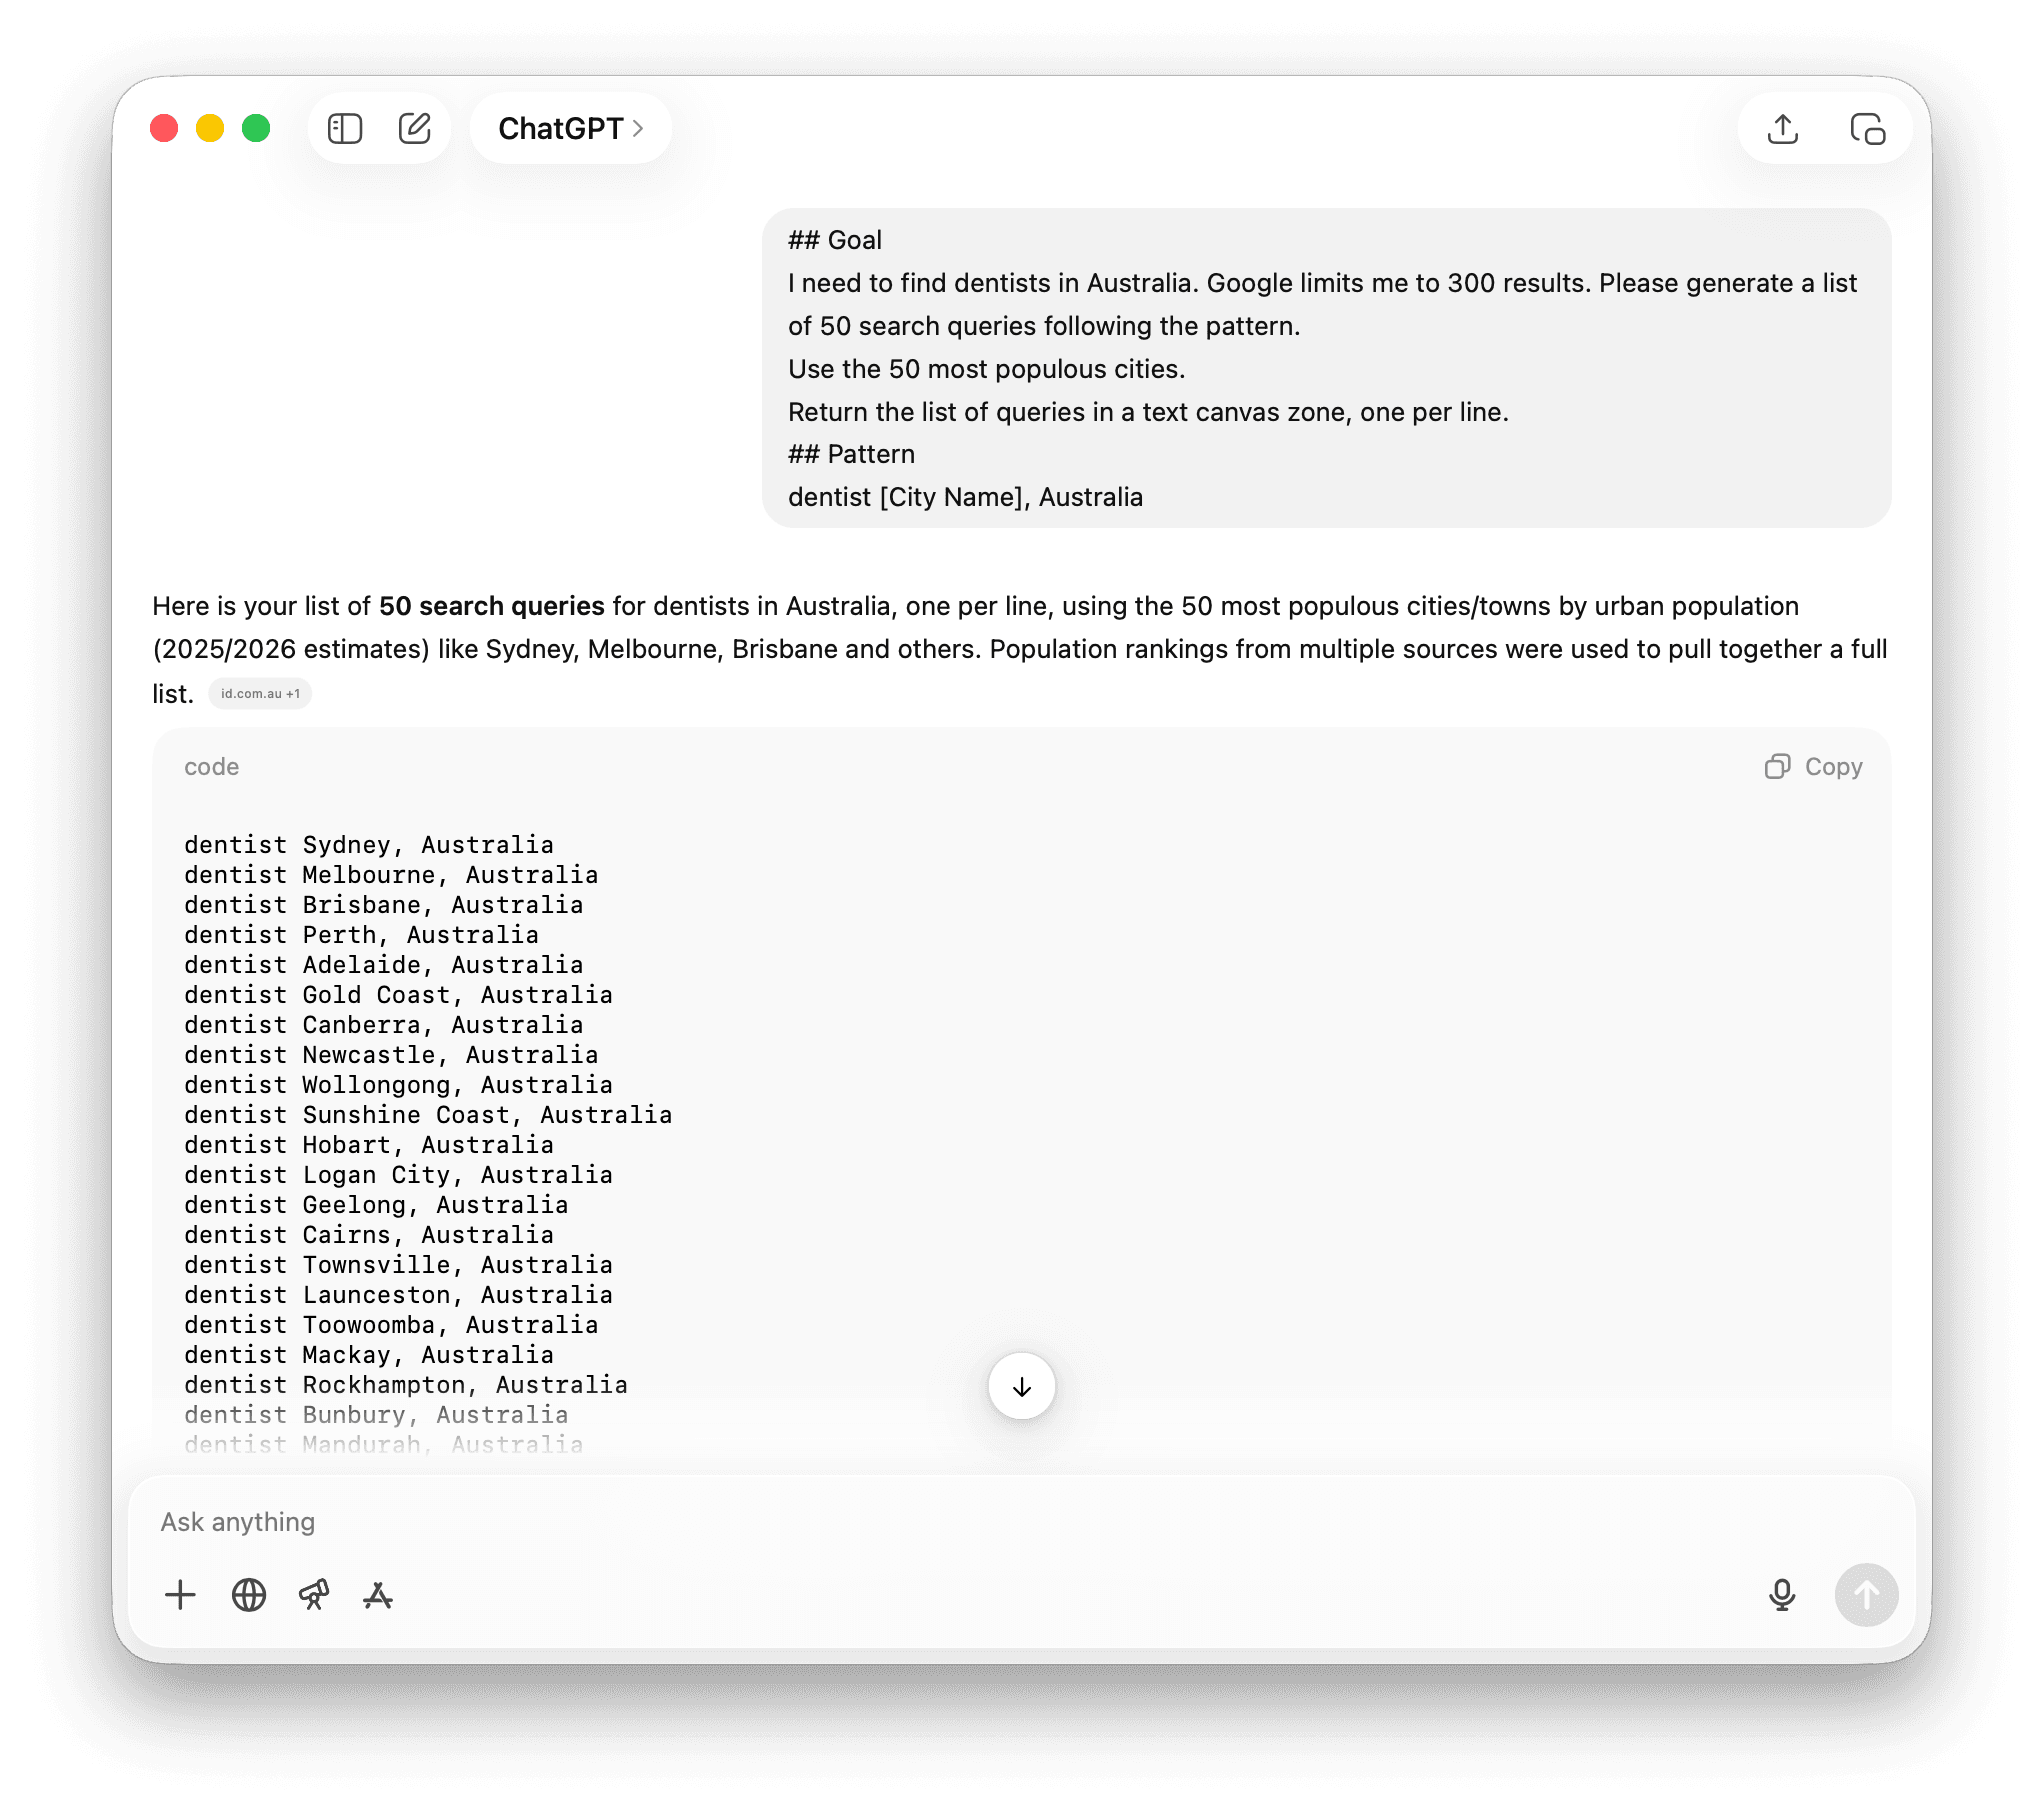
{#section-5} Devo trovare dentisti in Italia. Genera query di ricerca per le principali città italiane seguendo questo modello.
Usa nomi di città reali, inserisci una query per riga e non ripetere le città. Restituisci esclusivamente le query.
## Modello
{#section-6} dentista [Nome città], Italia
Strategia basata sulle keyword
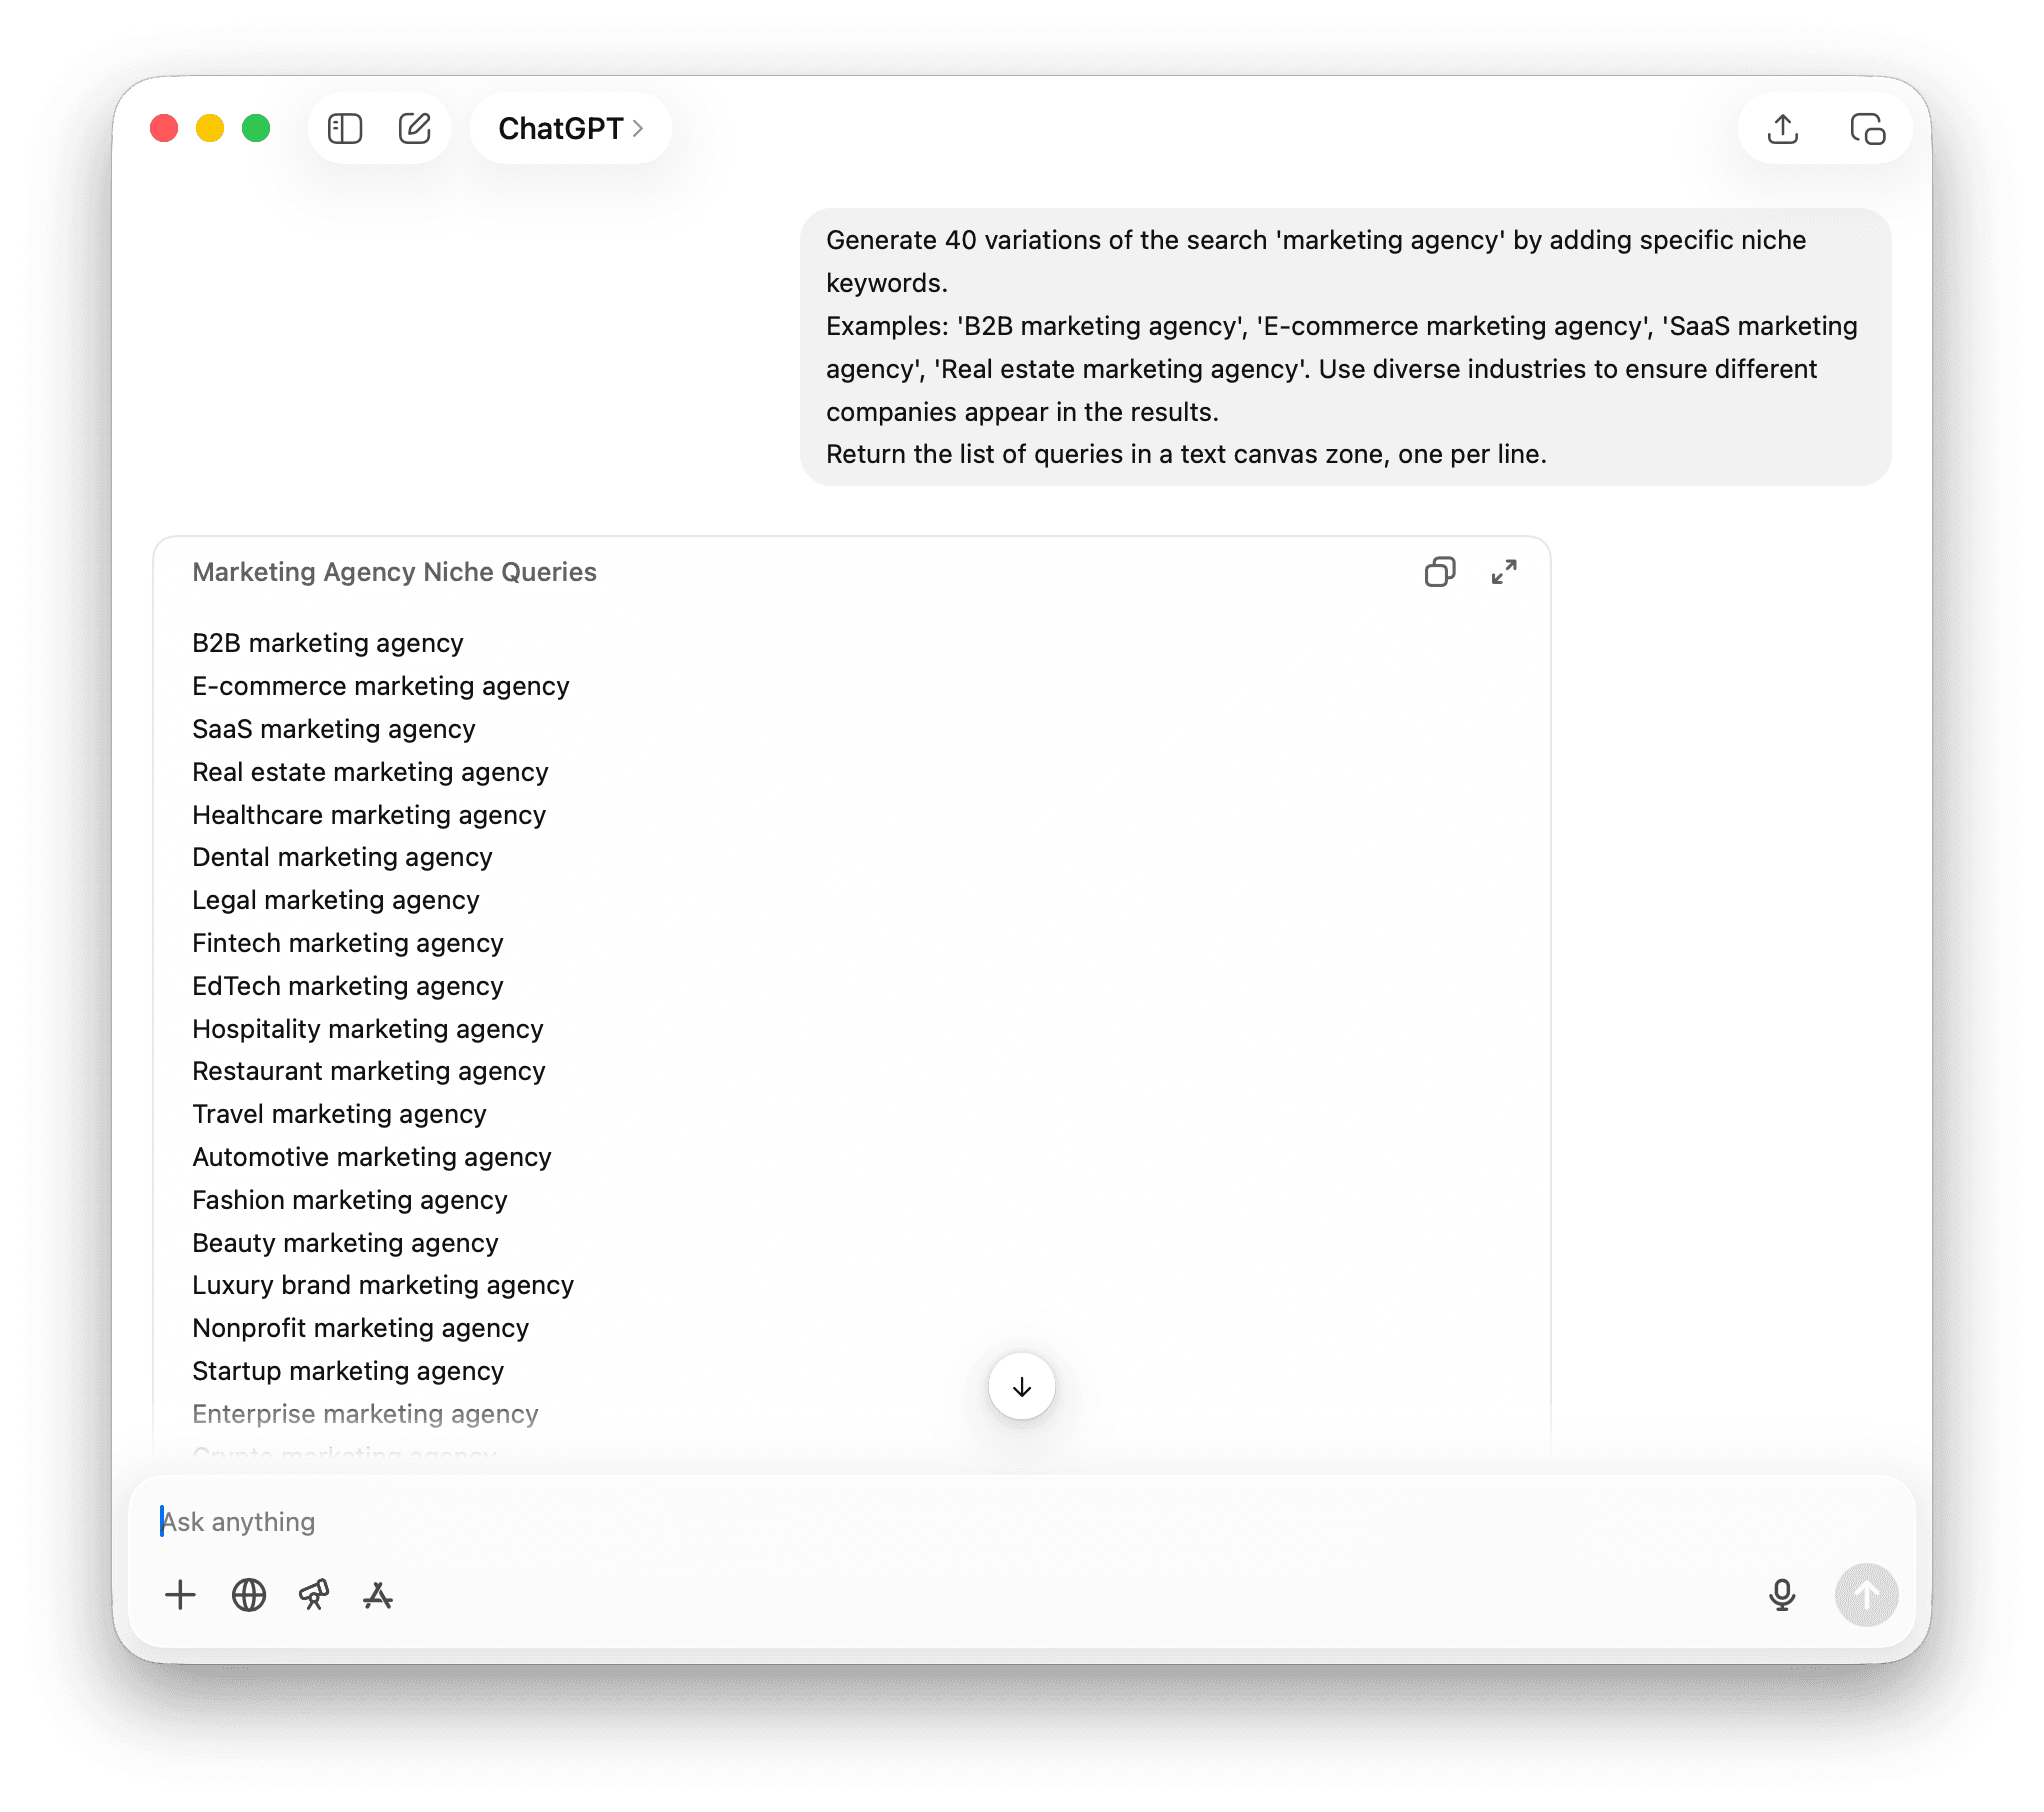
A volte la località non è rilevante. Se cerchi “Agenzie di marketing da remoto”, puoi variare le keyword.
Esempi: “agenzia di marketing B2B”, “agenzia di marketing e-commerce”, “agenzia di marketing SaaS”, “agenzia di marketing immobiliare”. Usa settori diversi per far emergere aziende differenti nei risultati.
Restituisci l’elenco delle query in un’area di testo, una per riga.
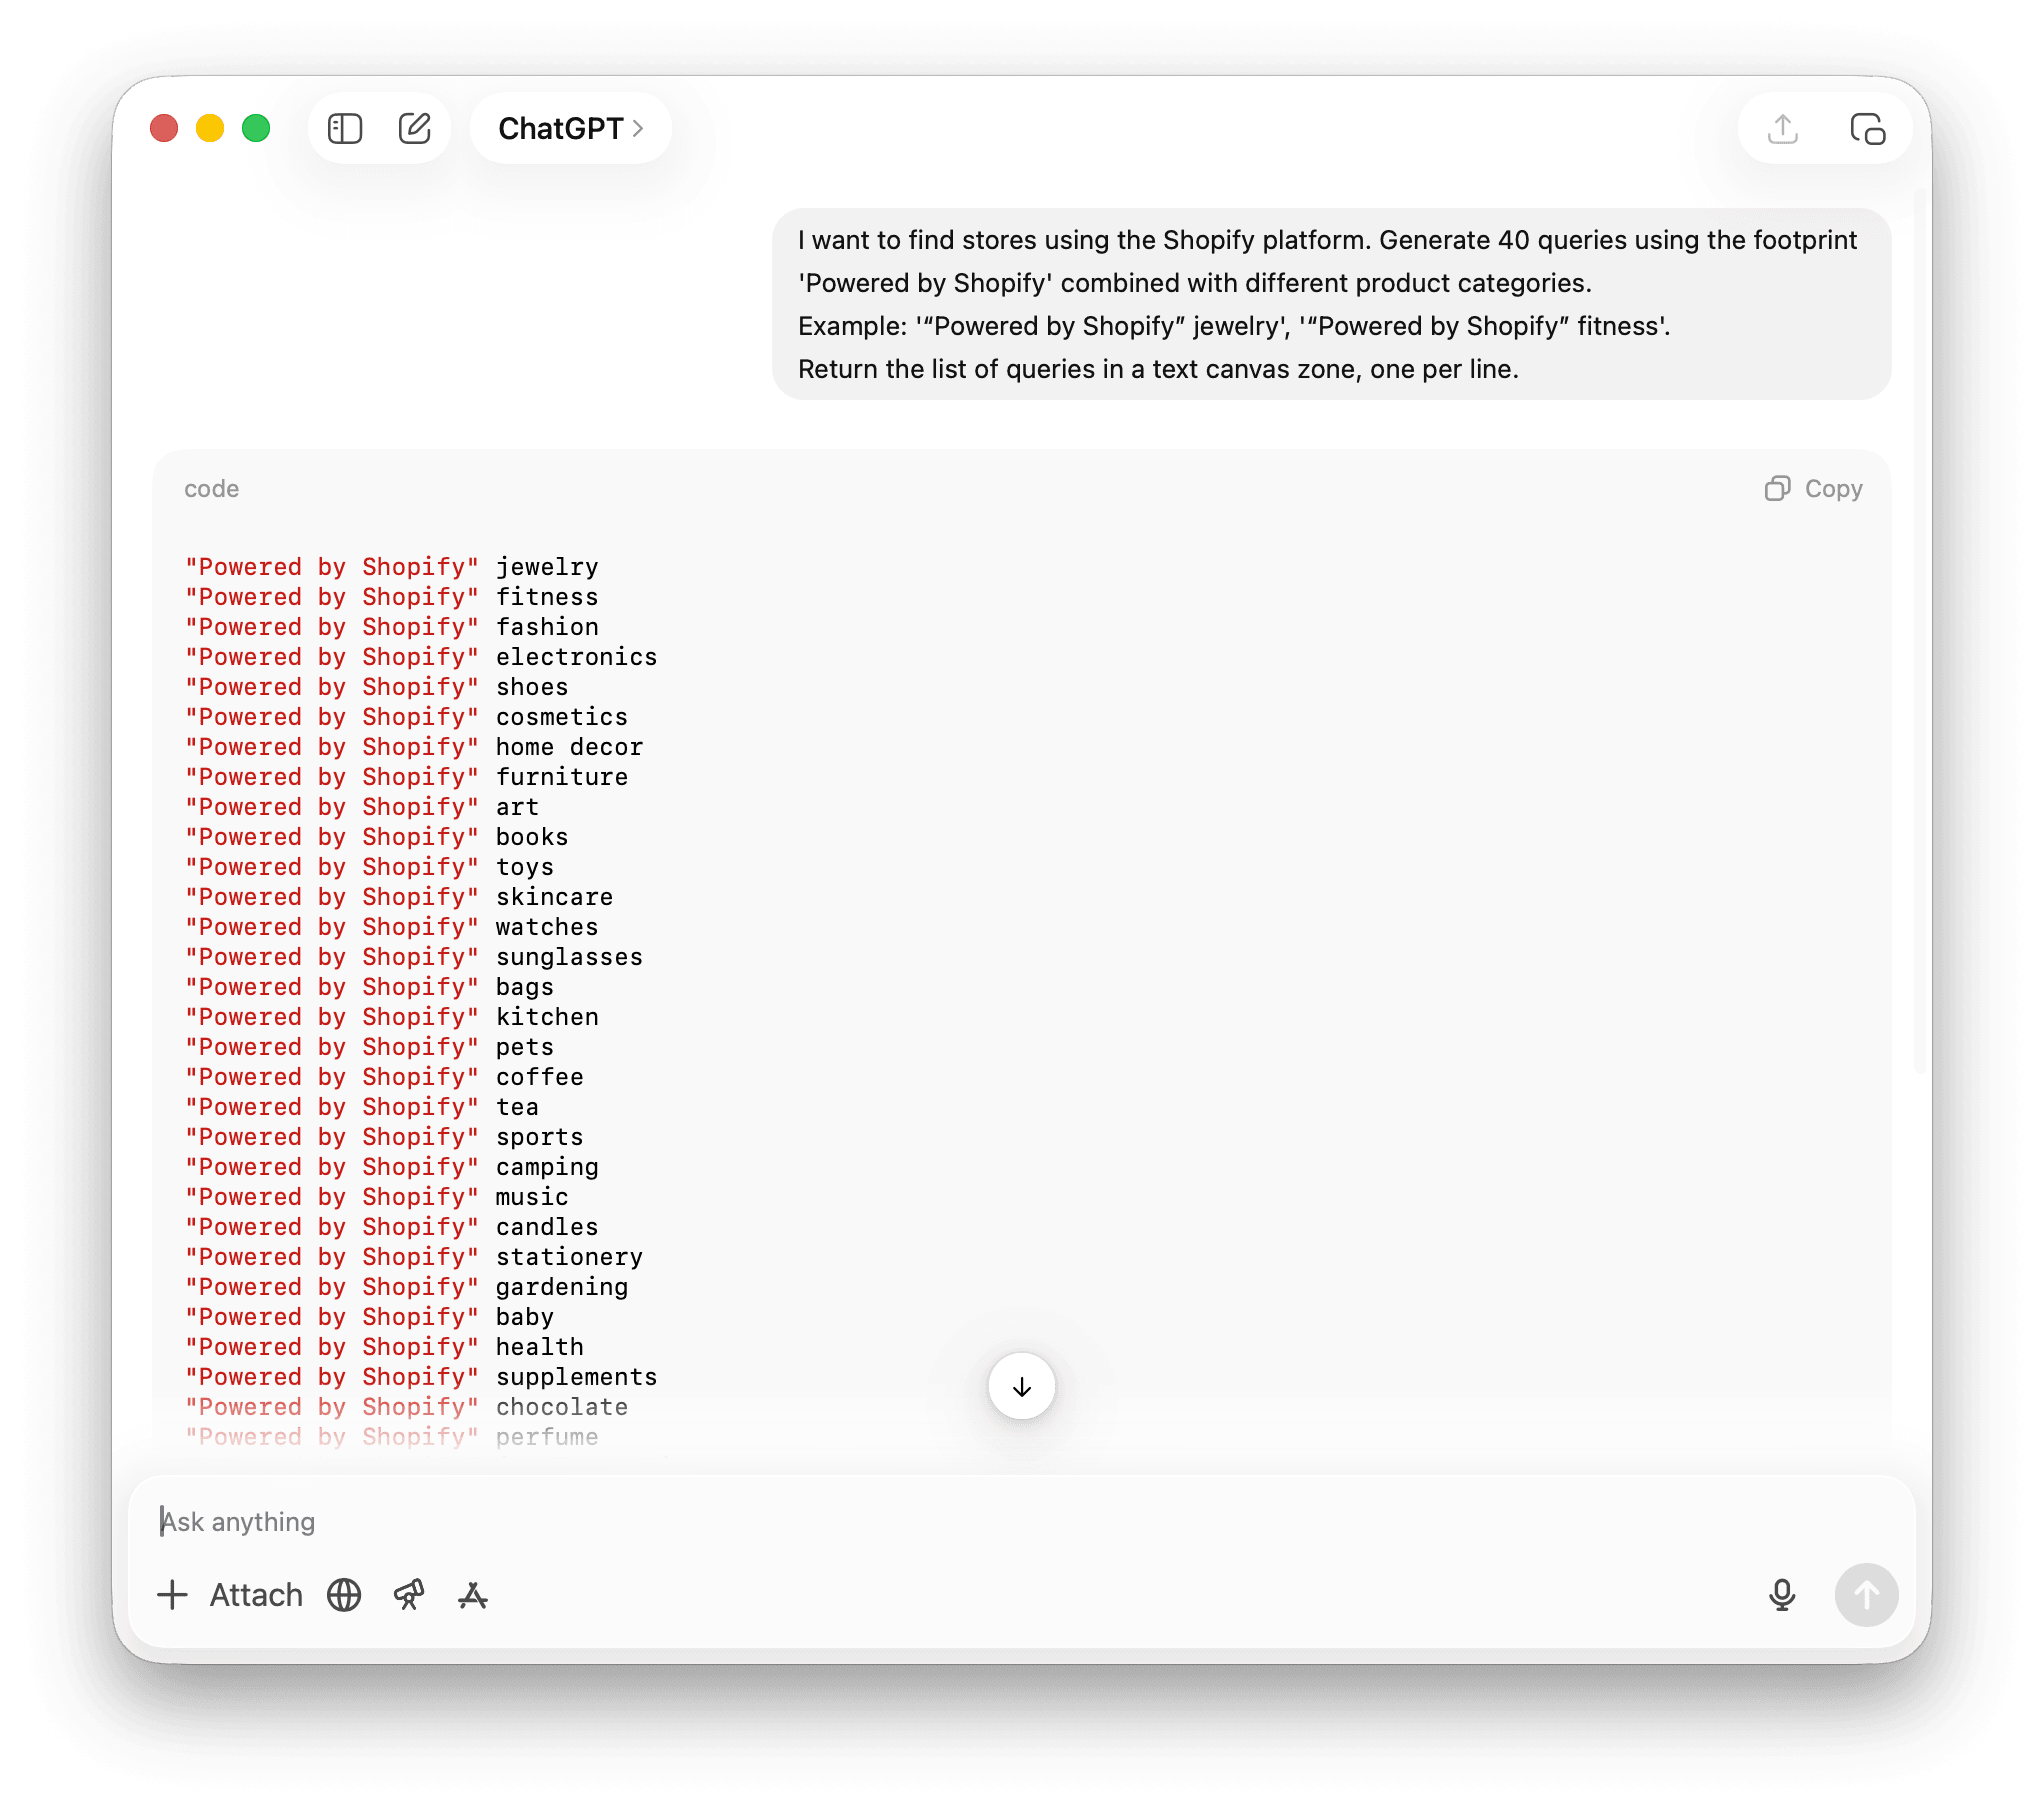
Strategia del “fingerprint”
Molti siti web utilizzano software specifici, che spesso lasciano una traccia nel codice HTML o nel footer. Google indicizza questi testi.
Esempio: “Powered by Shopify” gioielli, “Powered by Shopify” fitness.
Restituisci l’elenco delle query in un’area di testo, una per riga.
Guida allo scraping in batch delle query Google
Dopo aver verificato le query, puoi eseguirle tramite la source di Datablist senza dover creare uno scraper per browser. Parti da un batch ridotto, così potrai controllare l’output e il consumo di crediti.
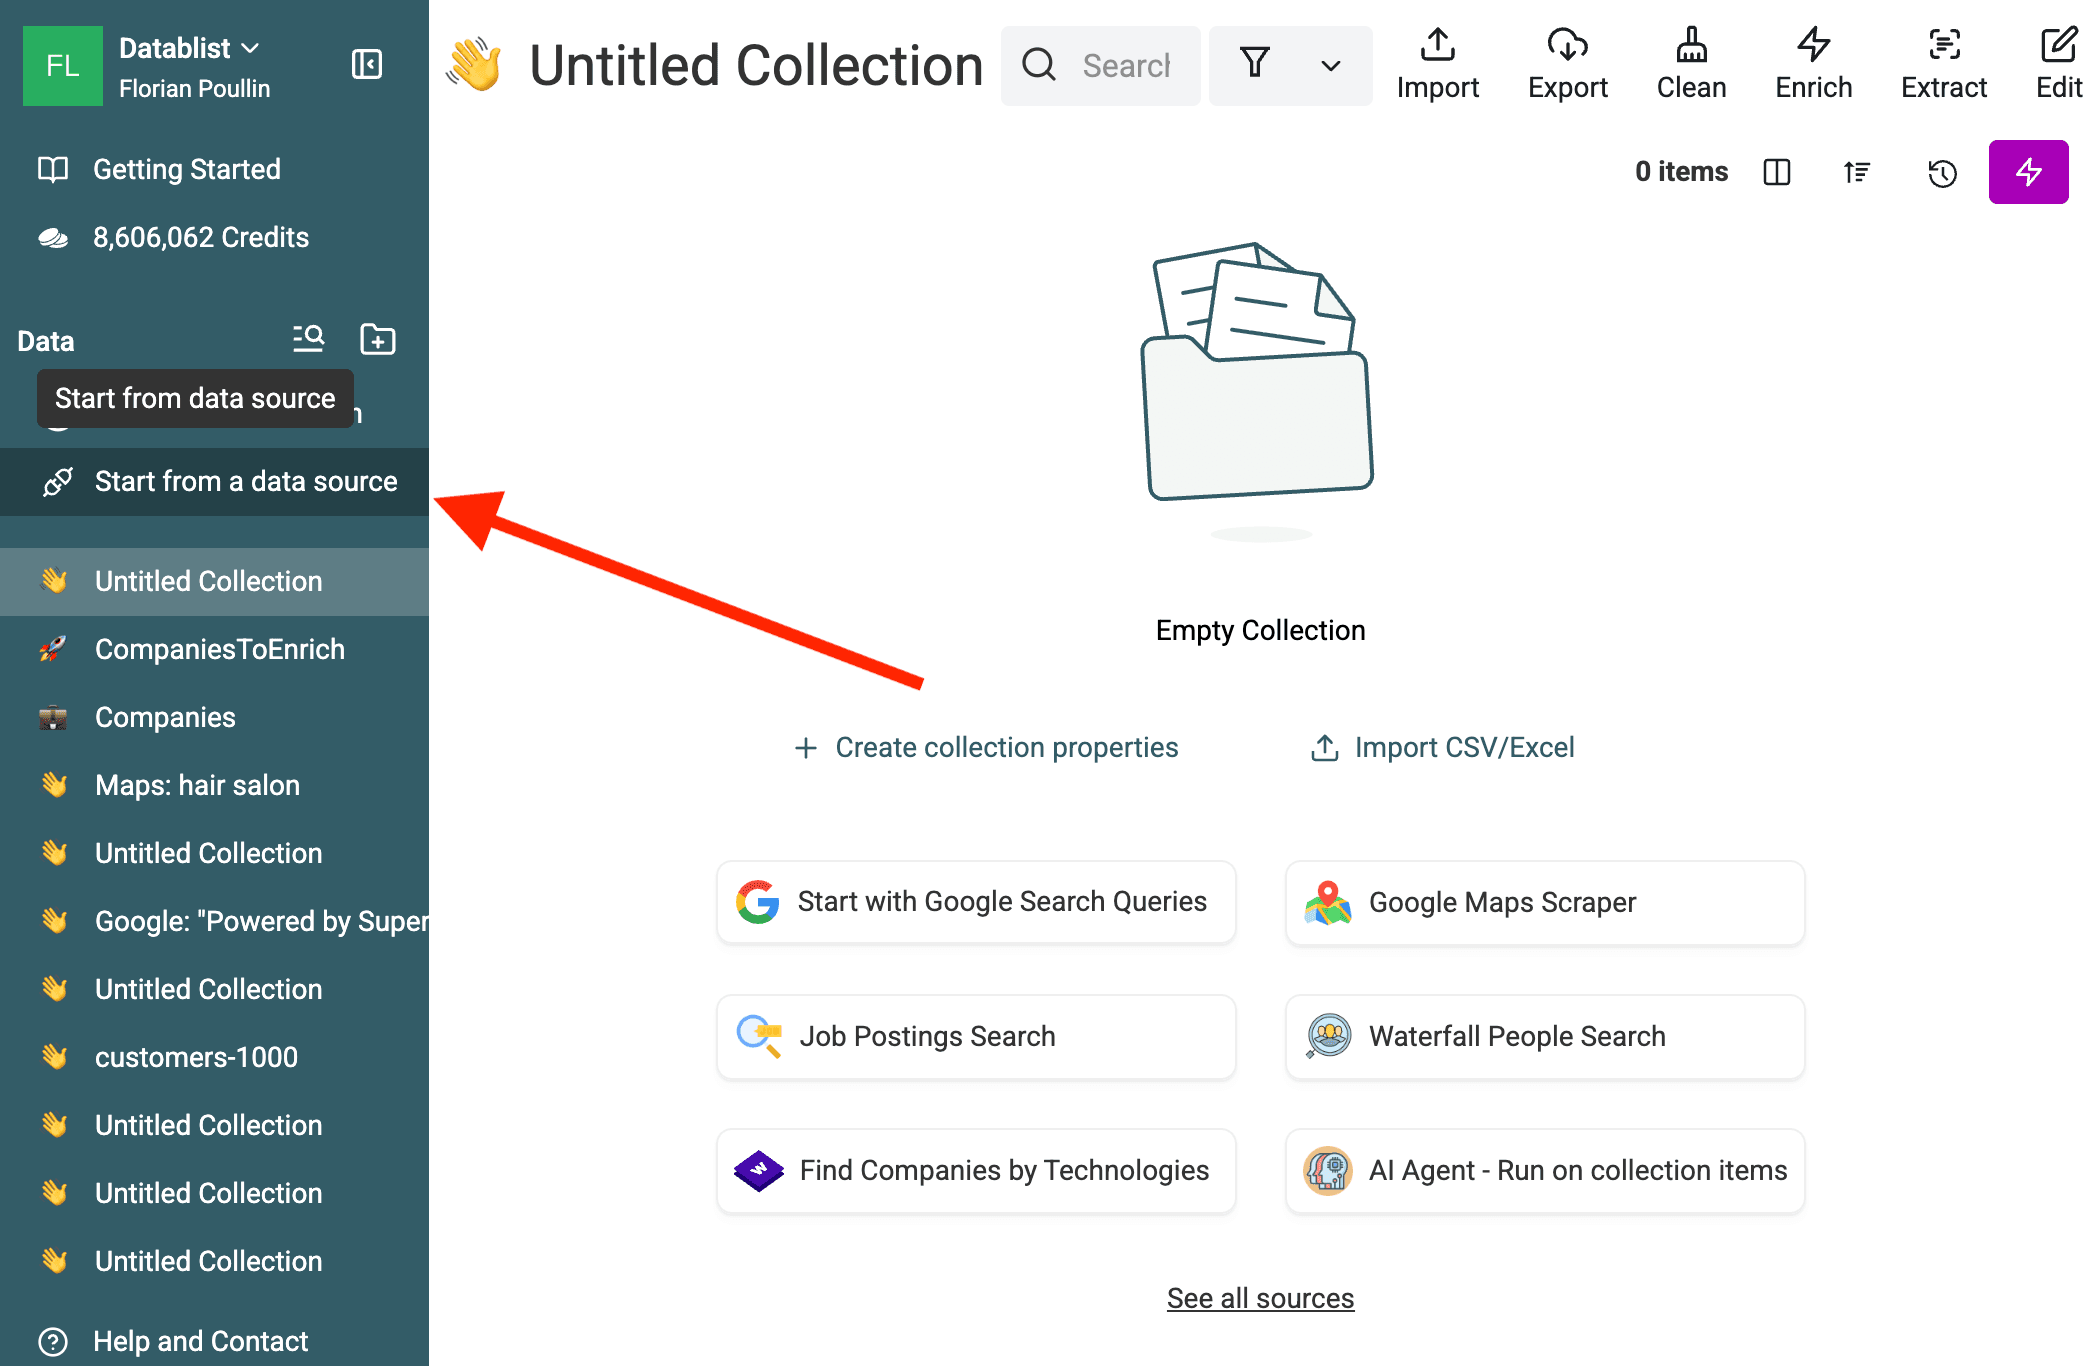
1. Accedi alla source dei dati
Apri Datablist e fai clic su Start from a data source nella barra laterale.
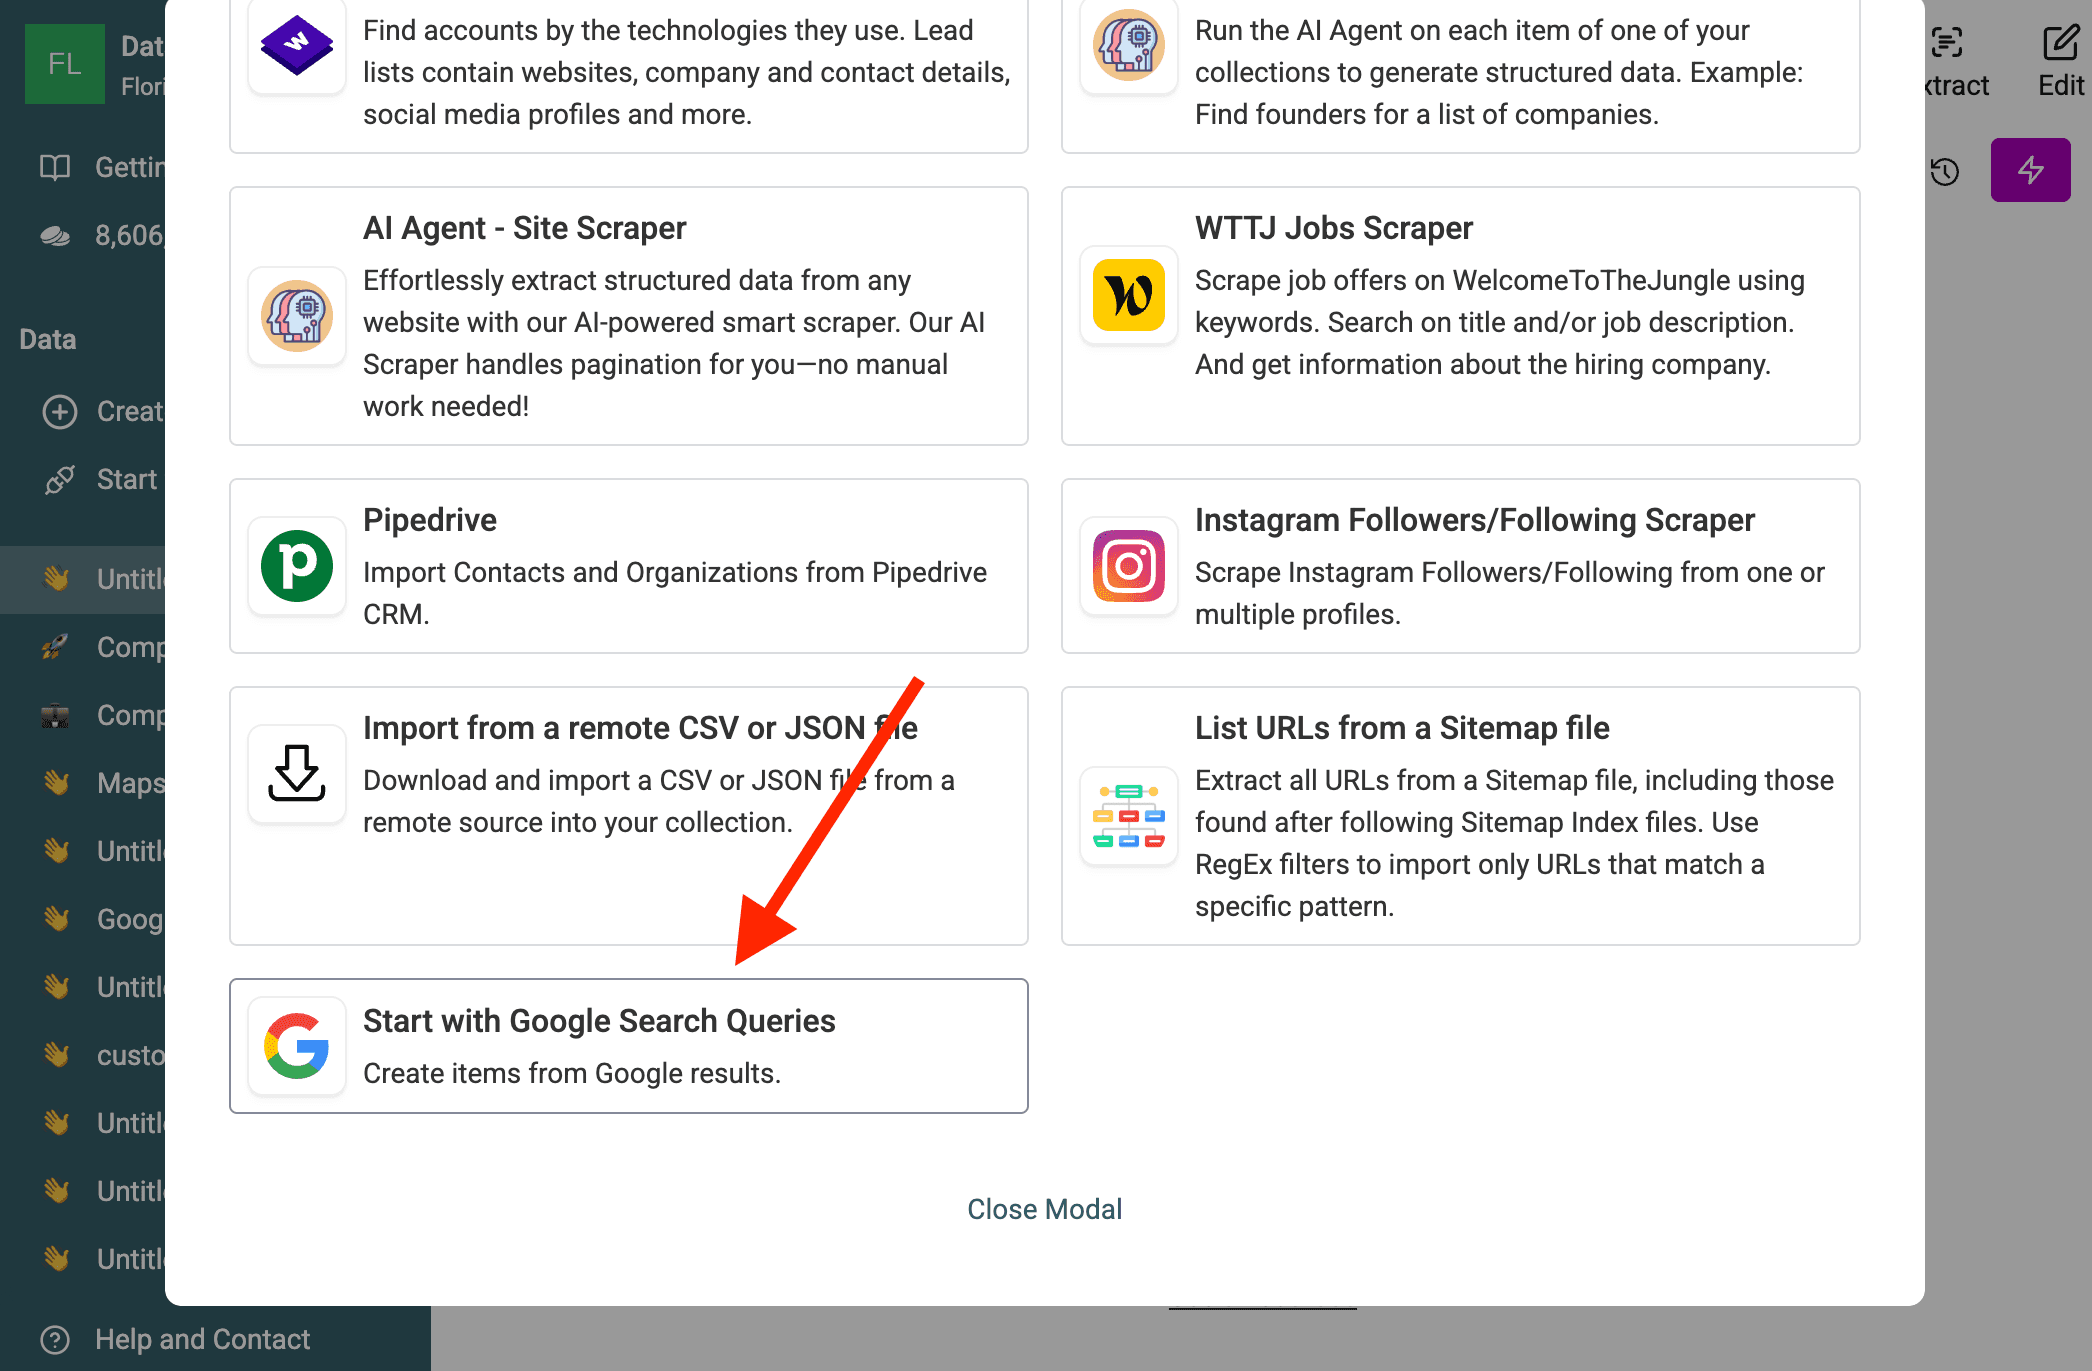
Nel catalogo delle source, scegli Start with Google Search Queries.
2. Incolla le query e configura i parametri
Incolla l’elenco verificato nel campo Google Search Queries, inserendo una query per riga. Con il piano gratuito viene elaborata soltanto la prima query: prima di aspettarti un batch multi-query, controlla il tuo piano e la modalità di esecuzione selezionata.
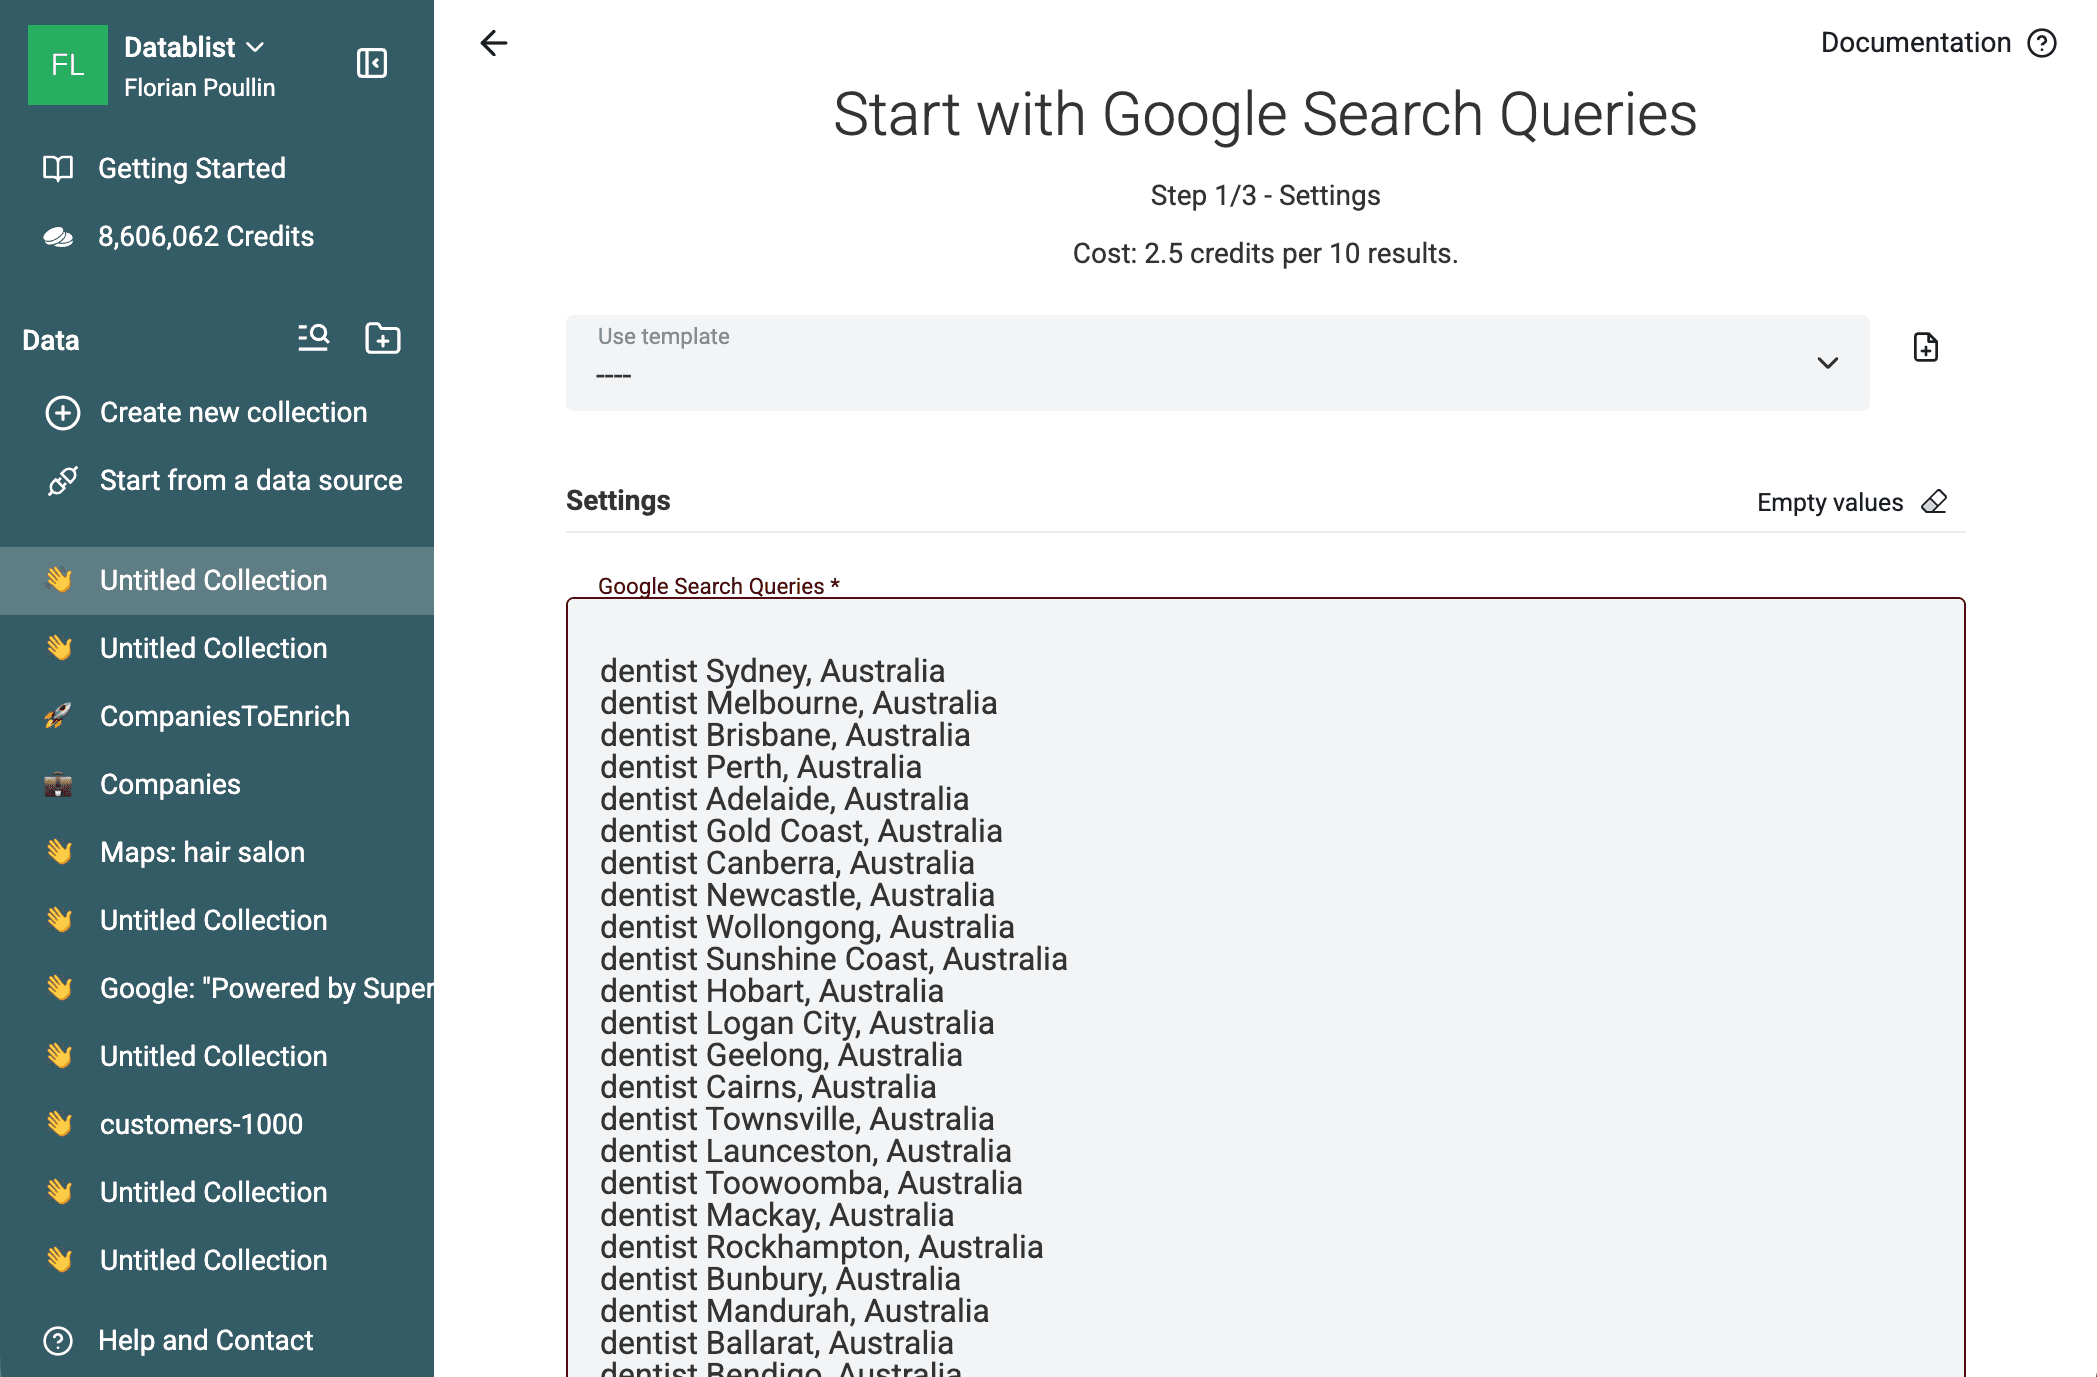
Imposta Search Country e Search Language in base al mercato che vuoi analizzare. Usa Time Period quando la data di pubblicazione è importante e Limit Per Query per stabilire un limite al run. L’intervallo temporale filtra la finestra di ricerca, ma non verifica che ogni azienda restituita sia ancora attiva.
4. Avvia il run e attendi
Controlla il consumo stimato di crediti, quindi avvia un piccolo batch. Datablist elabora le query e aggiunge le pagine restituite a una collection.
Puoi vedere gli elementi comparire nella collection in tempo reale.
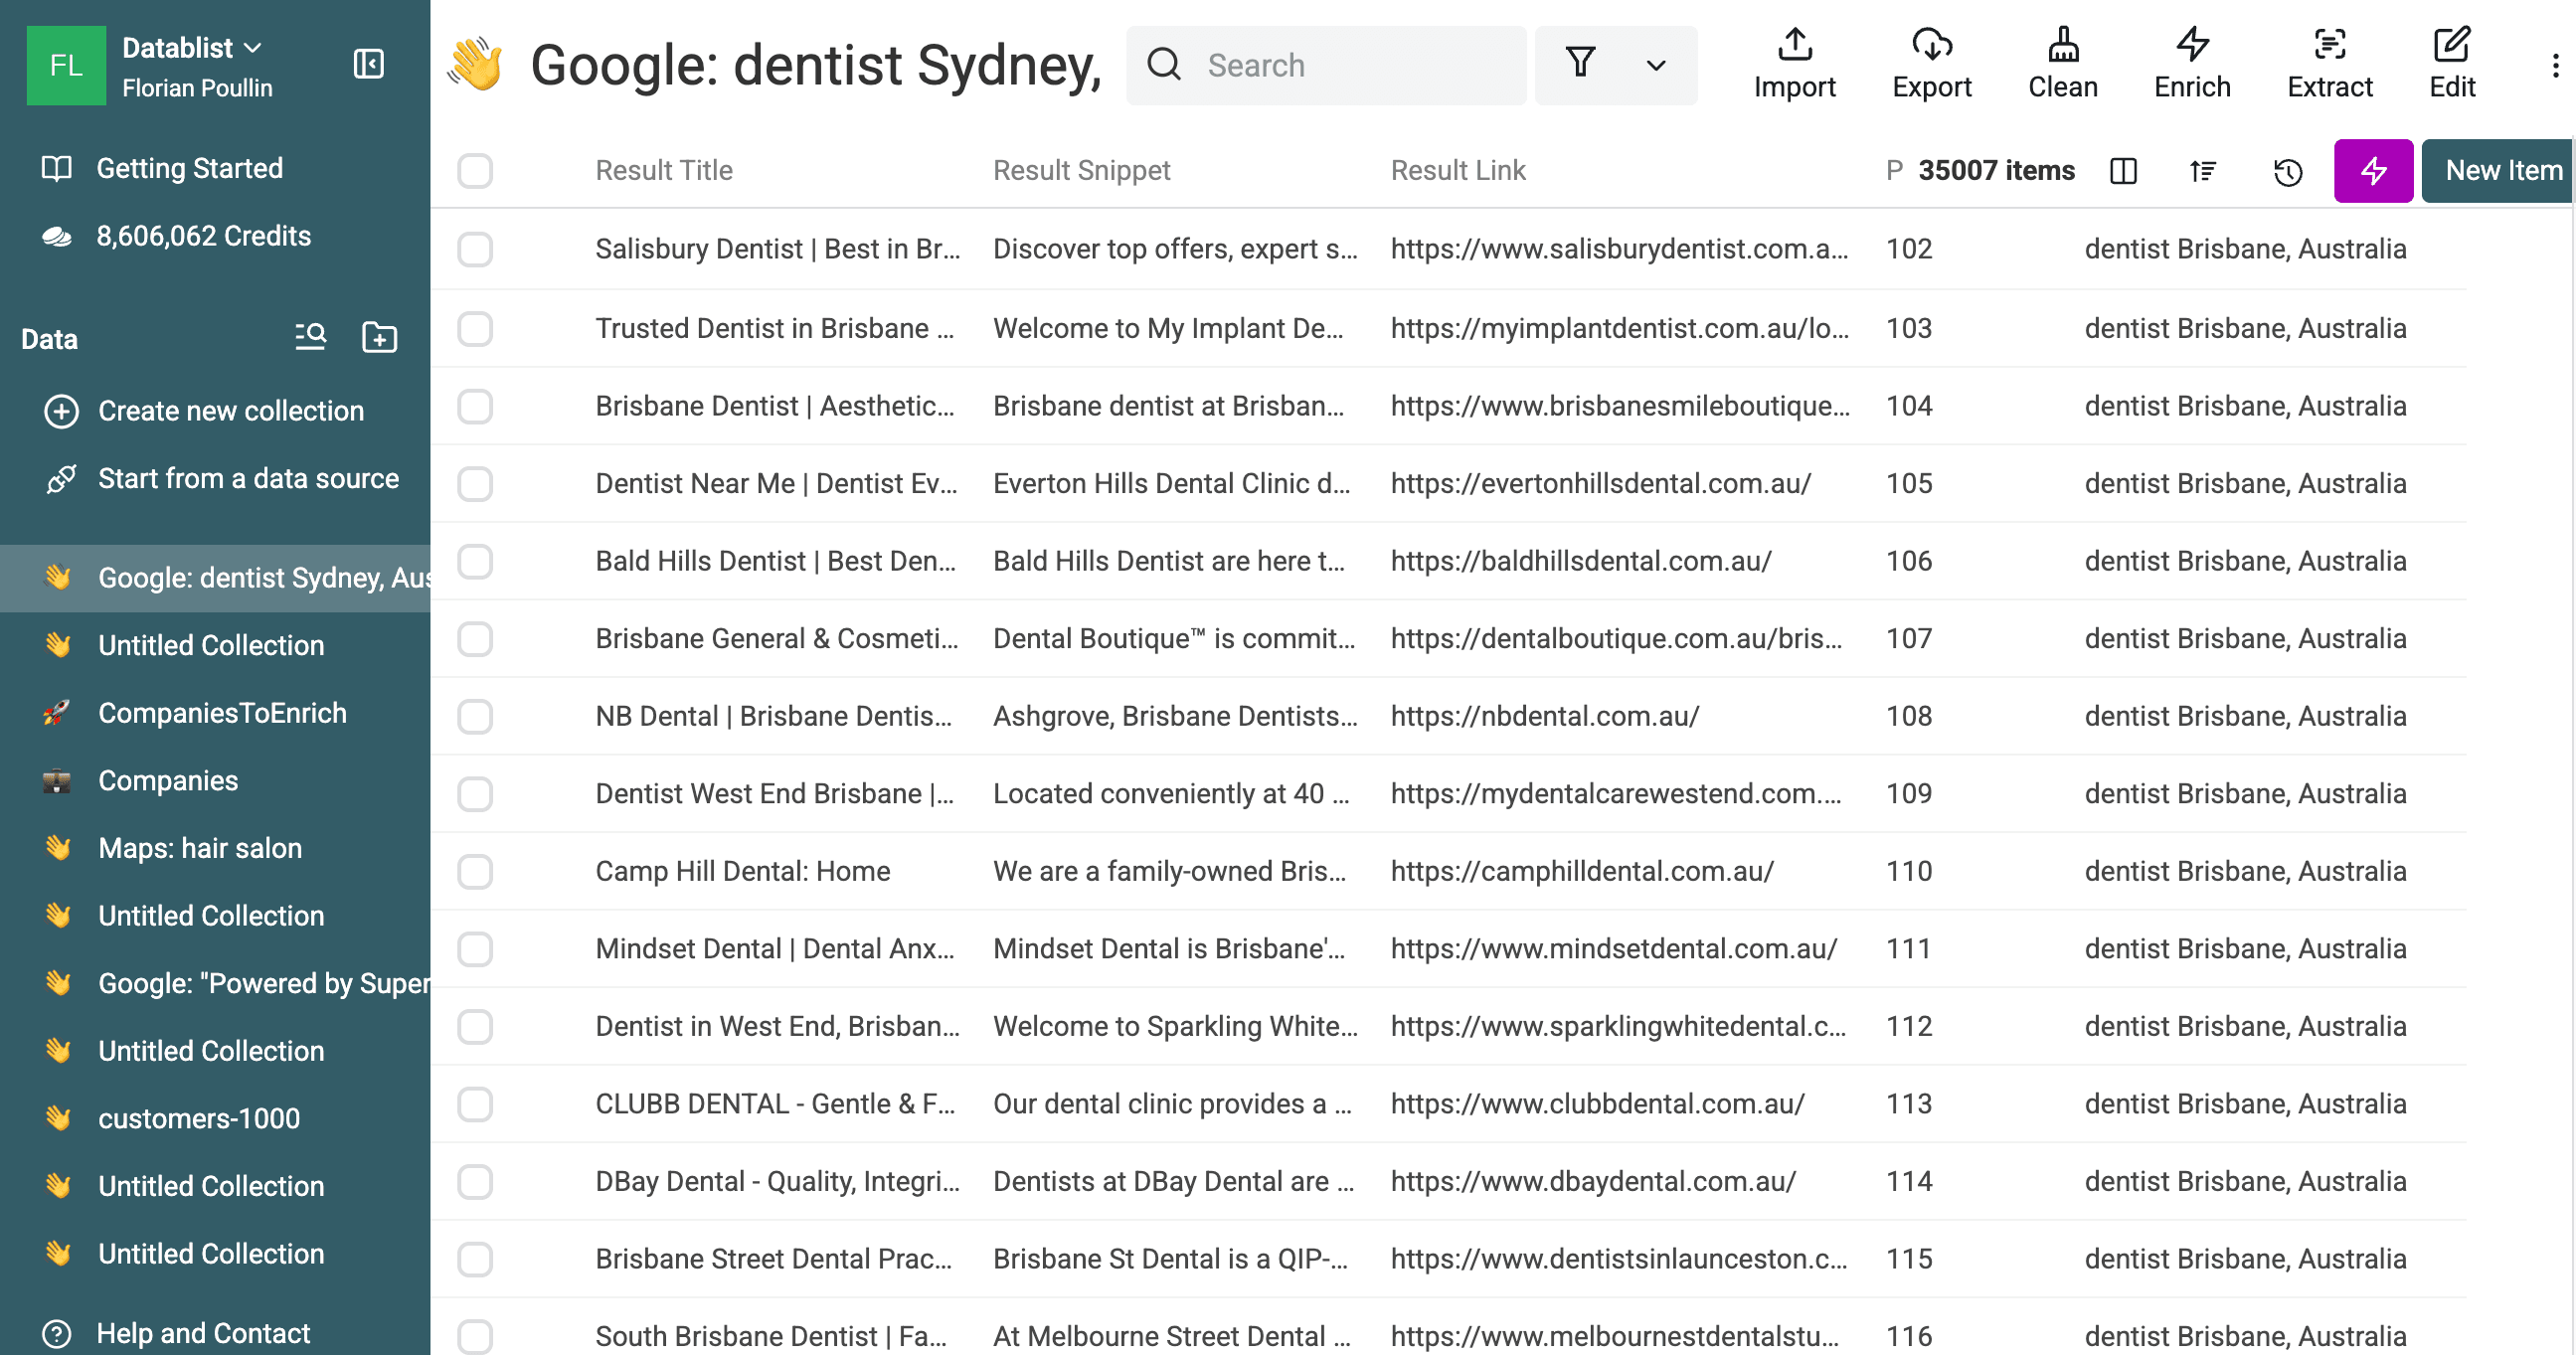
Pulire ed eliminare i duplicati
Eliminare i duplicati
Uno dei principali effetti collaterali dell’esecuzione di 50 query simili è la presenza di dati duplicati. Uno studio legale noto potrebbe posizionarsi per “Avvocato Milano”, “Avvocato Italia” e “Avvocato commerciale”. Riunendo questi risultati in un’unica collection di Datablist, ti ritroveresti con tre righe relative allo stesso studio.
Prima di avviare attività di Outbound, devi eliminare i duplicati. Datablist include il potente Duplicates Finder.
- Apri il menu "Clean".
- Seleziona "Duplicates Finder".
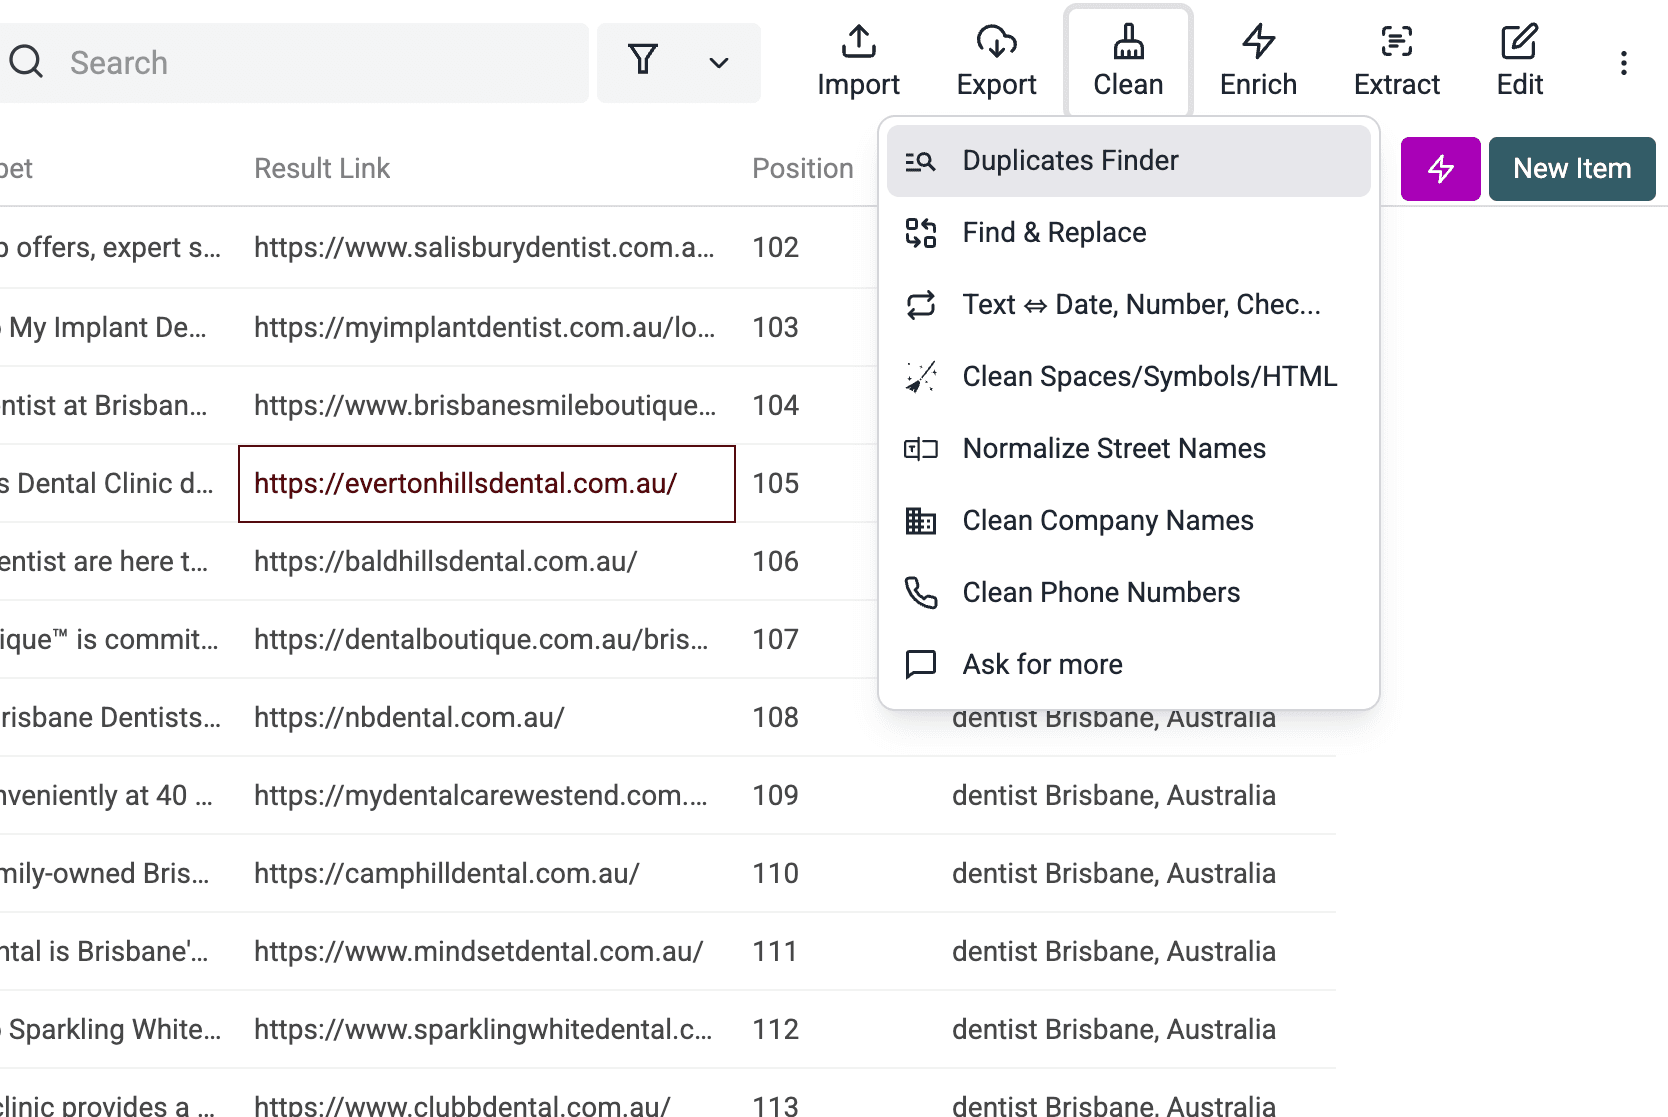
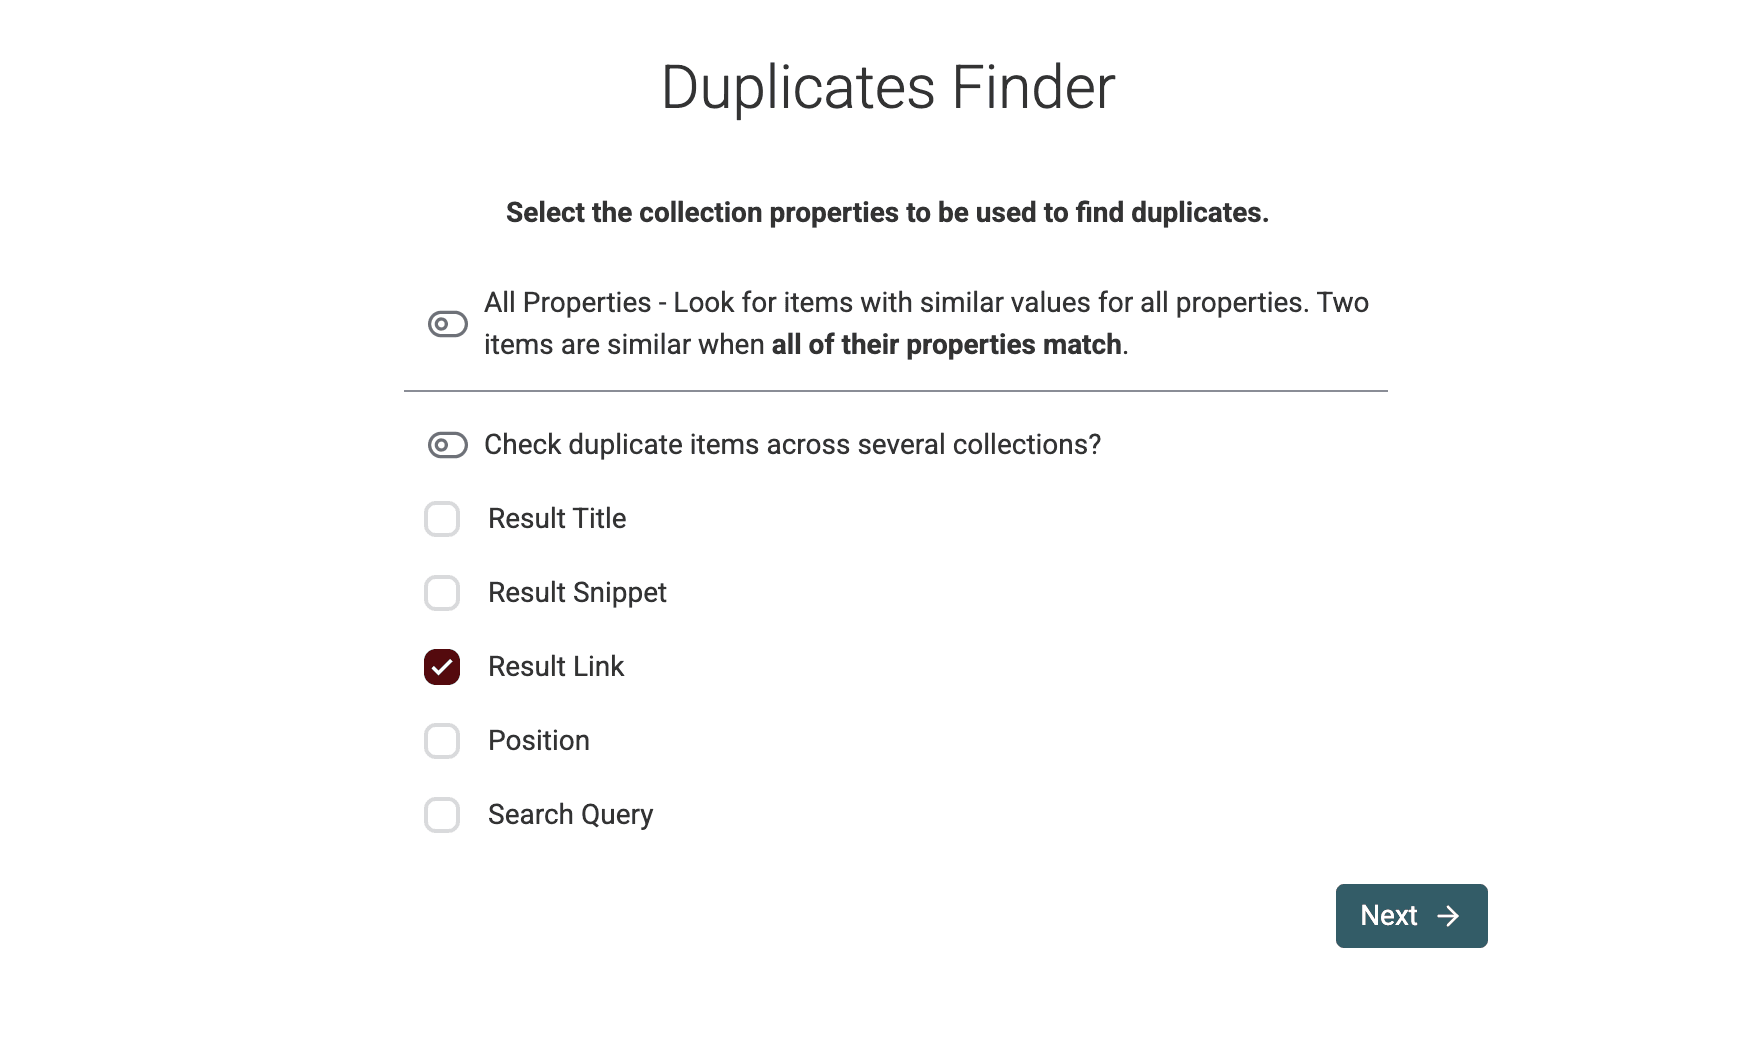
- Scegli la proprietà da confrontare. Usa
Result Linkper rimuovere una stessa pagina restituita da più query.
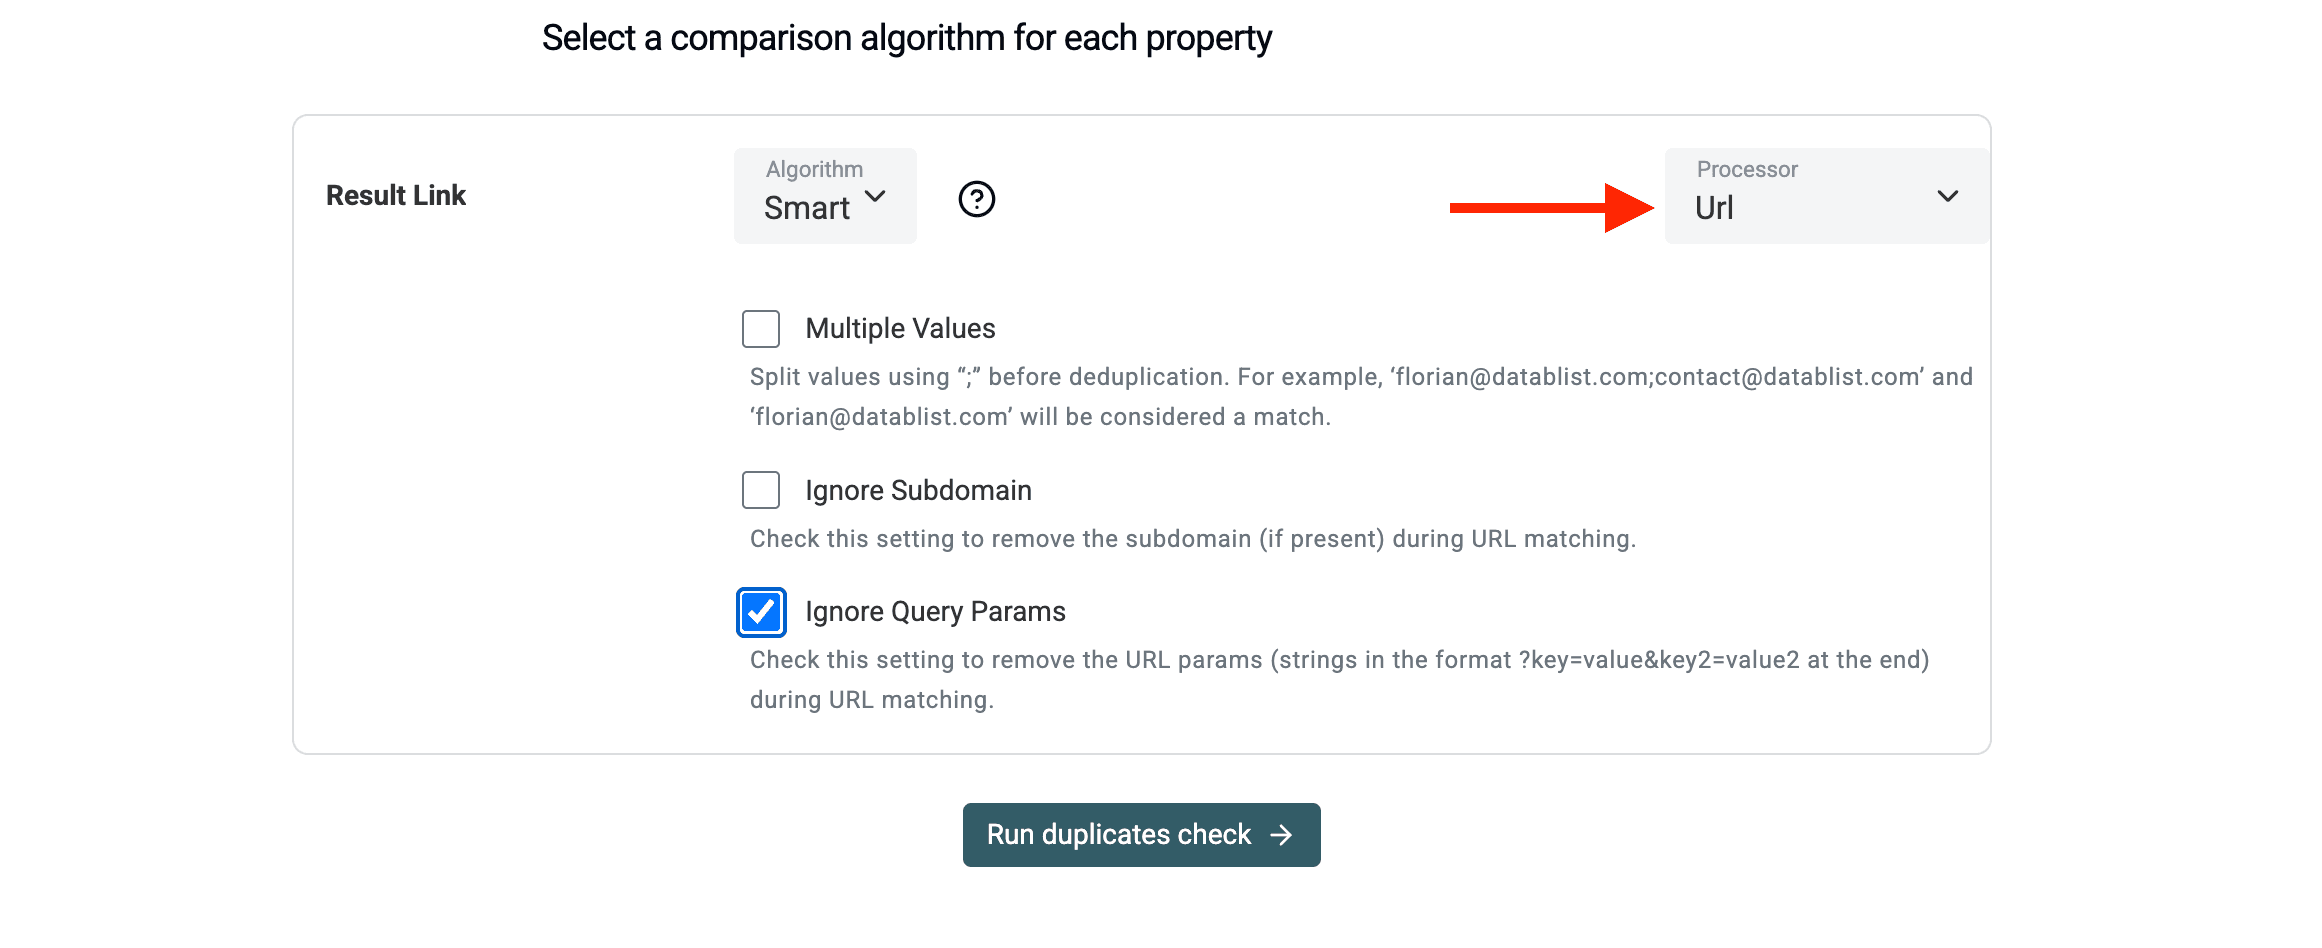
- Seleziona il processor URL. Mantieni i path se possono essere utili pagine diverse dello stesso dominio. Attiva Ignore Path soltanto se desideri un unico record per dominio e controlla i gruppi prima di unirli.
- Lascia che lo strumento identifichi le righe corrispondenti, quindi uniscile o elimina quelle in eccesso.
Rimuovere i risultati irrilevanti
Pulire i dati significa anche rimuovere i risultati irrilevanti. Alcuni risultati Google saranno aggregatori come Yelp, Pagine Gialle o Tripadvisor. Probabilmente vorrai escluderli per concentrarti sui siti ufficiali delle aziende.
Usa i filtri per escludere i domini delle directory più comuni. Trovi tutti i passaggi per gestire questi dati in questa guida alla pulizia dei dati.
Arricchire i risultati di ricerca
Un URL o il titolo di una pagina raramente bastano per una campagna commerciale. Una volta ottenuto un elenco di siti web unici, servono informazioni di contatto. Datablist funziona come un hub di enrichment, nel quale puoi inviare i dati raccolti ad altri servizi.
Trovare indirizzi email
-
Ottenere email dai domini aziendali
Se lo scraping restituisce domini aziendali, usa l’enrichment "Waterfall People Search" di Datablist. Trova le persone che lavorano in quelle aziende e restituisce i dettagli dei loro profili insieme a indirizzi email verificati. È la soluzione ideale per creare liste mirate di contatti B2B. -
Ottenere email dagli URL dei profili LinkedIn
Se lo scraping restituisce link a profili LinkedIn, usa Waterfall Email Finder di Datablist. Trova l’indirizzo email professionale utilizzando soltanto l’URL del profilo LinkedIn. Puoi seguire la nostra guida dettagliata: Trovare indirizzi email dall’URL di un profilo LinkedIn.
Trovare le pagine LinkedIn aziendali dai domini
Se parti dai siti web delle aziende, puoi trasformarli in risorse LinkedIn con un solo clic. Usa l’enrichment "LinkedIn Company Page Matcher". Trova la pagina LinkedIn aziendale ufficiale di ogni attività presente nella lista.
È un passaggio molto efficace: un semplice risultato Google diventa un profilo aziendale completo di settore, dimensioni e dati sull’attività.
Dopo aver trovato le corrispondenze, puoi recuperare informazioni aziendali dettagliate con:
In pochi passaggi, trasformi URL grezzi in dati B2B strutturati.
AI Agent per visitare i siti web
A volte le informazioni più interessanti sono nascoste nel sito. È qui che entra in gioco AI Agent.
AI Agent visita ogni sito web al posto tuo e ne legge le pagine come farebbe una persona.
Può:
- Classificare le aziende in base ai contenuti del loro sito
- Etichettare i Lead come "High Priority" o "Low Priority"
- Estrarre informazioni di contatto dalle pagine Contact o About Us
Anziché aprire 500 schede e leggerle una alla volta, puoi affidare il lavoro più impegnativo all’agent.
Esempio: dalle query locali a una lista verificabile
Immagina di cercare studi dentistici in Italia. Parti da tre query: dentista Milano, dentista Roma e dentista Napoli. Esegui un piccolo campione e controlla Result Link, Result Title e Search Query. Se ti servono i siti degli studi, escludi le directory; poi confronta gli URL esatti prima di stabilire se pagine dello stesso dominio rappresentino la medesima attività.
Aggiungi altre città soltanto dopo aver verificato che il primo batch abbia restituito siti pertinenti. L’esempio illustra il processo, ma non permette di prevedere quanti risultati o studi unici troverai.
Analisi dei costi: scraping con un budget limitato
Confronta il costo del run con il valore delle pagine che ti servono davvero. I risultati di ricerca sono URL potenzialmente interessanti, non Lead qualificati; inoltre, un batch ampio può includere directory o ripetere gli stessi domini.
Quando un’API restituisce dati JSON ma ti serve un foglio di calcolo, JSON to CSV Converter può appiattire la risposta prima delle operazioni di pulizia o enrichment.
Il catalogo delle source indica un costo di 2,5 crediti ogni 10 risultati Google. Come stima indicativa, 1.000 risultati a questa tariffa corrispondono a 250 crediti; la stima effettiva del run dipende dalle query e dal limite selezionati. Una ricarica attualmente disponibile da 20 $ fornisce 20.000 crediti. Non è possibile acquistare una ricarica da 1 $ e né un lungo elenco di query né un limite elevato garantiscono un numero equivalente di Lead utili.
Esegui prima un piccolo batch. Controlla gli URL restituiti, i duplicati e il consumo di crediti prima di aggiungere altre query.
Consigli: usa gli operatori di ricerca Google
Per migliorare la qualità dei dati estratti, puoi utilizzare alcuni operatori di ricerca Google nella creazione delle query.
Questi simboli indicano a Google esattamente dove cercare le keyword.
- site: Usalo per estrarre risultati da una piattaforma specifica. Per trovare profili LinkedIn, usa
site:linkedin.com/in/. - inurl: Cerca determinate parole all’interno dell’URL. Per trovare pagine di contatto, usa
inurl:contatti. - intitle: Trova le parole presenti nel titolo della pagina.
intitle:"Index of"permette spesso di individuare directory aperte. - filetype: Usalo per trovare documenti.
filetype:pdf "piano marketing"trova documenti strategici pubblici. - - (segno meno): Esclude determinate parole. Se cerchi avvocati ma non agenzie di recruiting, usa
avvocato -recruiting.
Combinando questi operatori con lo scraping multi-query ottieni uno strumento estremamente preciso. Ad esempio:
site:instagram.com "concept store" -inurl:/p/
Questa ricerca può far emergere pagine Instagram che menzionano concept store, escludendo gli URL dei post con il path /p/. Verifica ogni risultato: una pagina corrispondente non è necessariamente un influencer, un concorrente o un Lead qualificato.
📘 Consulta la guida Cercare ed estrarre profili Instagram per categoria e keyword per approfondire la ricerca di profili Instagram tramite Google
FAQ
Perché una query Google generica non trova tutti i risultati?
I risultati di ricerca sono ordinati e suddivisi in pagine, mentre il conteggio stimato non garantisce che ogni pagina corrispondente sia accessibile. Le ricerche più specifiche possono far emergere pagine diverse, ma possono anche sovrapporsi e continuare a escludere siti pertinenti.
Lo scraping di Google è legale?
Prima di raccogliere o utilizzare risultati di ricerca, verifica i termini del sito e gli obblighi in materia di privacy applicabili al tuo caso d’uso, soprattutto se i risultati contengono informazioni personali.
Posso estrarre dati da Google Maps con questo strumento?
La source "Start with Google Search Queries" si concentra sul motore di ricerca standard. Se ti servono dati sulle attività locali, come recensioni, orari di apertura e coordinate geografiche precise, utilizza lo scraper dedicato a Google Maps. I risultati di ricerca sono più adatti a siti web e profili digitali, mentre quelli di Maps funzionano meglio per le sedi fisiche.
Come vengono gestiti i CAPTCHA?
Datablist esegue la source Google Search Queries senza chiederti di configurare uno scraper per browser. Una query può comunque restituire meno risultati del previsto o non riuscire: controlla lo stato del run e l’output prima di considerare completa la collection.
Posso usare questi risultati nel mio CRM?
Sì. Controlla gli URL ed elimina i duplicati, conserva la query di origine, quindi esporta i campi selezionati in formato CSV o Excel per importarli nel CRM. Prima dell’importazione, verifica i campi obbligatori del CRM e associali correttamente.