
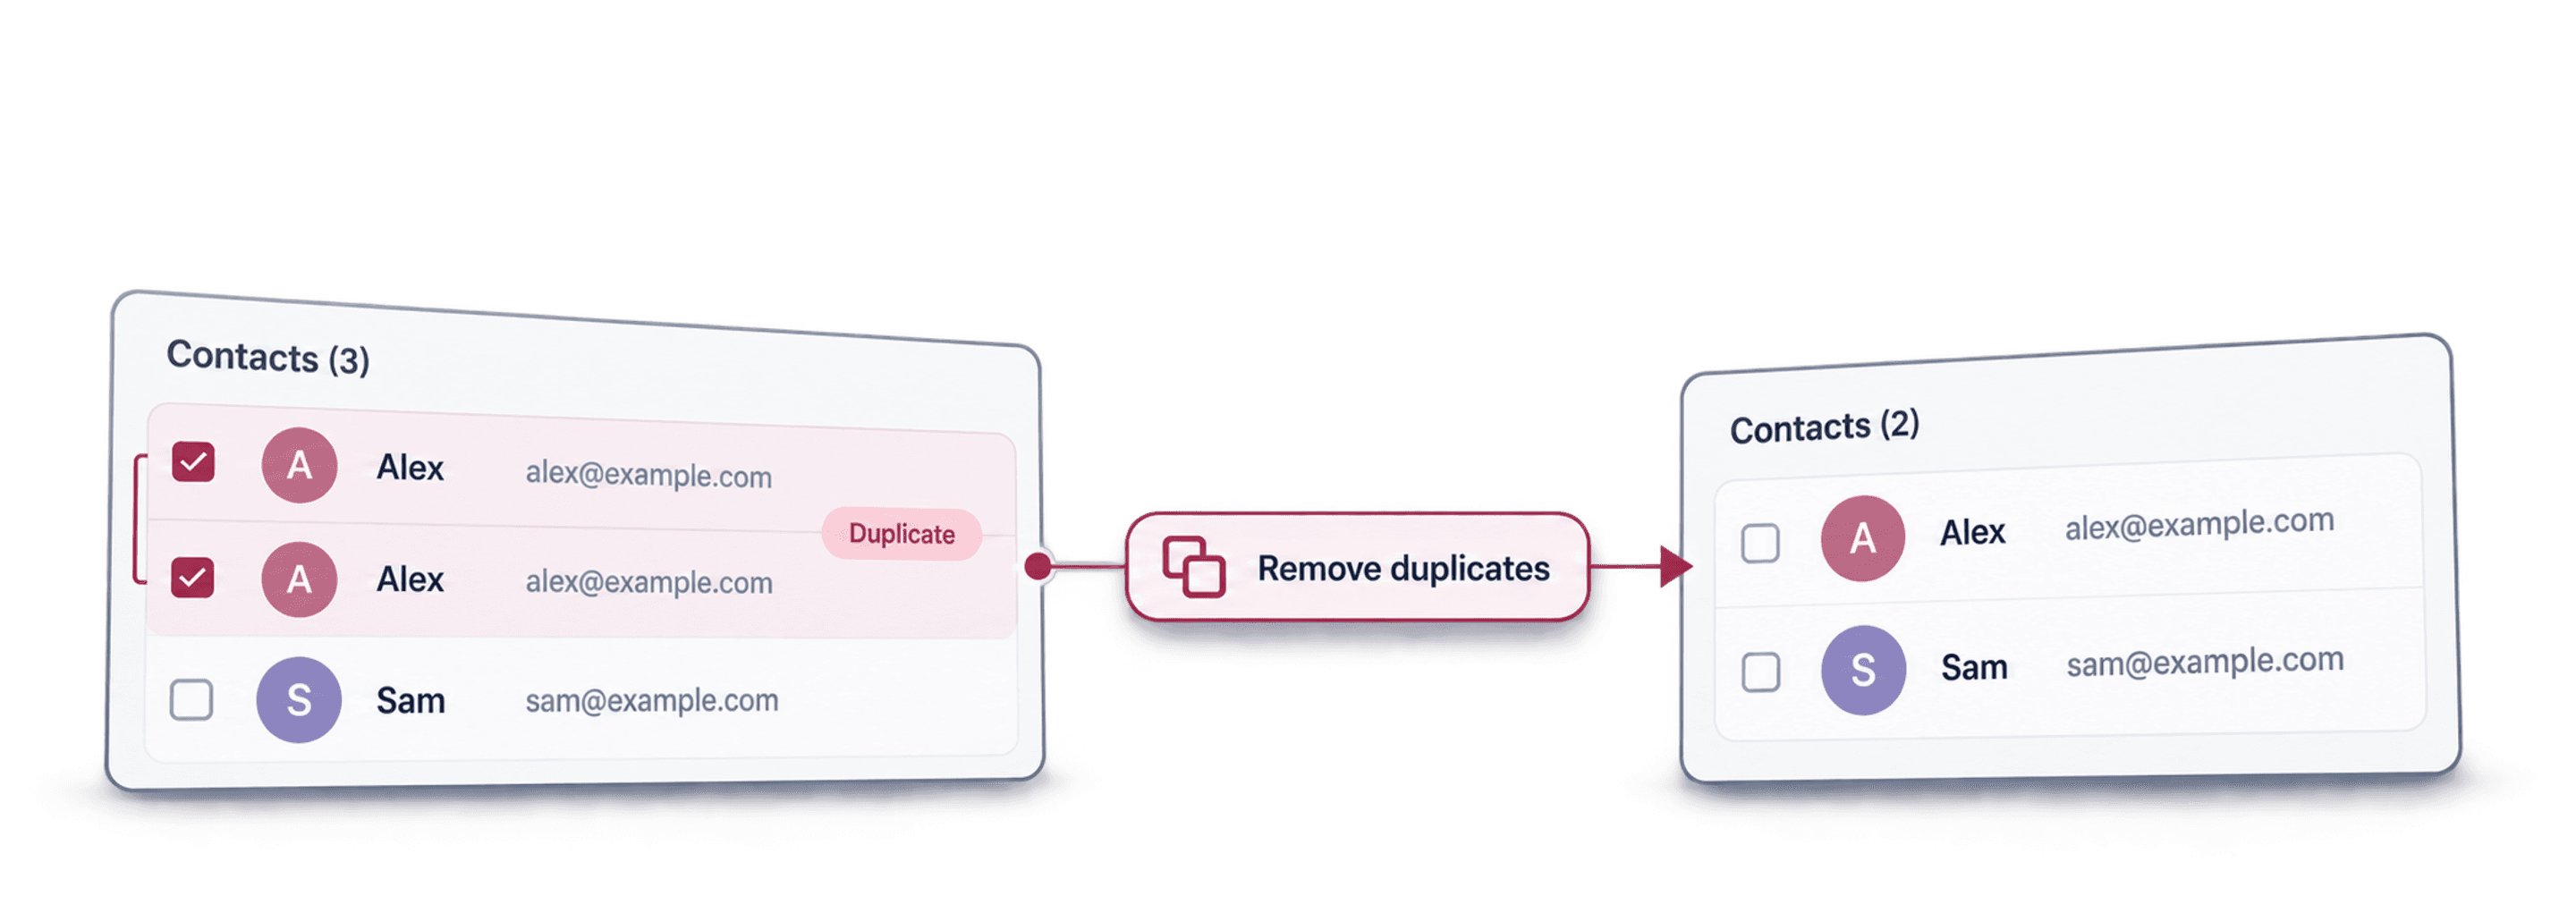
オンラインでリストの重複を排除するには、まず人物、企業、商品を一意に識別するフィールドを決めます。次に厳密なマッチングを実行し、検出された重複グループを確認したうえで、有用な値をマージするか、追加情報のない行を削除します。この手順なら、似ている値をすべて同一とみなすことなく、効率よくデータをクリーンアップできます。
Datablistなら、この作業をブラウザ上の1つのワークフローで完結できます。CSVまたはExcelファイルをインポートし、マッチング対象のプロパティを選択して行を比較し、結果を確認して、クリーンなリストを書き出します。重複チェックは、Remove、Merge、またはカスタム処理を開始するまで読み取り専用です。
このガイドでは、1,000行のダウンロード可能なサンプルを使用します。完全なコピー、メールエイリアス、会社名の表記揺れ、URLの違い、基本的な電話番号の書式差、スペルミス、値の競合、相互に情報を補完するレコードが含まれています。
🔑 安全に重複排除するための原則
信頼できる最小限の識別子でマッチングし、何を残すかは行全体を見て判断してください。
シンプルな値のリストから重複を削除する
1行に1つの値が並ぶリストの場合は、Email、Domain、Valueなどのヘッダーを付け、1列のCSVとして保存します。Datablistにインポートし、その列を選んでClean > Remove duplicatesを開き、Exactを実行してください。グループを確認し、残すレコードを選択して重複行を処理したら、残った値を書き出します。
たとえば、alpha.example、beta.example、alpha.exampleを含むサンプルリストでは、重複行を削除するとalphaとbetaが1件ずつ残ります。これは入出力を説明するための例であり、ダウンロード可能なサンプルから取得した別の測定結果ではありません。
識別子だけのリストなら、この方法が適しています。複数の列があるファイルでは、重複レコードそのものを整理する必要があります。行を削除すると、その行に含まれるほかの値も消えるためです。同じメールアドレスを持つ2行目に有用な電話番号やメモがある場合は、後述するマージのワークフローを使用してください。
識別子が空欄のレコードは別に扱います。デフォルトの選択プロパティ比較では、テキスト識別子が欠けていても一致とは判定されません。空の行を削除したい場合は、重複排除に判断を任せず、明示的にクリーンアップしてください。
レコードを一意にする条件を決める
最初にマッチングアルゴリズムを選ぶのではなく、まず対象となるエンティティを定義します。
連絡先、企業、商品、取引では、それぞれ適切な識別子が異なります。
| リスト | 最初に使うべき強い識別子 | 2回目のチェックに有効な条件 |
|---|---|---|
| 連絡先 | メール、電話番号、LinkedIn URL | 氏名と会社名 |
| 企業 | Webサイトのドメイン、会社ID | 正規化した会社名 |
| 商品 | SKU、EAN、GTIN、商品URL | 商品名とブランド |
| CRM Lead | メール、電話番号、CRM ID | 氏名と会社ドメイン |
| 注文 | 注文ID | 顧客IDと注文日 |
1回の処理ですべての重複が見つかるとは限りません。ある連絡先は2行で同じメールアドレスを使用している一方、別の連絡先はメールアドレスが変わっても同じ電話番号を使っていることがあります。すべてのプロパティを1つのルールに詰め込まず、識別子ごとに分けてチェックしてください。
たとえば、次の順番で進めます。
- メールアドレスで連絡先をマッチングします。
- 確認済みのグループを処理します。
- 電話番号を正規化し、クリーンアップしたプロパティに対してExactチェックを実行します。
- 氏名と会社名を組み合わせ、慎重にfuzzyチェックを実行します。
メール、電話番号、氏名、会社名を1回のチェックに追加すると、マッチング条件は厳しくなります。行が設定全体を満たす必要があるため、値が1つ欠けているだけで実際の重複を見逃す可能性があります。
識別子ごとに正規化が必要な場合は、専用ガイドをご覧ください。
1,000行のサンプルリストをダウンロードする
重複排除のデモCSVをダウンロードできます。800件の想定エンティティを表す1,000行が含まれています。
このファイルには、複数のテストケースが混在しています。
| 想定ケース | 重複グループ数 | マッチング方法 |
|---|---|---|
| 行全体が完全に同じコピー | 5 | All PropertiesとExact |
| メールエイリアスとラッパー表記 | 100 | EmailにSmartとEmail processorを使用 |
| 会社名とURLの表記揺れ | 50 | Company NameまたはURL processing |
| 米国式電話番号の基本的な書式差 | 25 | PhoneにSmartを使用(書式のみ) |
| 意図的に加えた氏名のスペルミス | 15 | Jaro-WinklerまたはLevenshtein |
| 発音が似た名の表記揺れ | 5 | Metaphone |
| 重複を想定していないレコード | 600 | 別々のまま残るべきレコード |
これらは設計時に定めた正解データの件数であり、どのfuzzyしきい値でも同じ結果になることを保証するものではありません。Distance matchingでは、しきい値を低くすると候補が余分に含まれる場合があります。処理前に必ずグループを確認してください。
ファイルに含まれる3組の例をご紹介します。
| ユースケース | 1つ目の保存値 | 2つ目の保存値 |
|---|---|---|
| メールエイリアス | felix.patel.605@company-0605.example | felix.patel.605+newsletter@company-0605.example |
| 会社名とURL | Redwood 0727, Inc.https://www.redwood-0727.example/ | Redwood 0727 Group LLChttp://redwood-0727.example/about?utm_source=event |
| 電話番号の基本的な書式差 | +1 (202) 555-0768 | 1 202 555 0768 |
各行では、役職、担当者、ステータス、売上、ソース、タグ、メモなどのフィールドにも相違があります。こうした競合があるため、マスターレコードの選択やフィールドのsurvivorshipルールをテストする際にも役立ちます。
Datablistにリストをインポートする
Datablistを開き、CSVまたはExcelファイルをcollectionにインポートします。collectionは構造化されたスプレッドシートのようなもので、行がitem、列がpropertyに相当します。
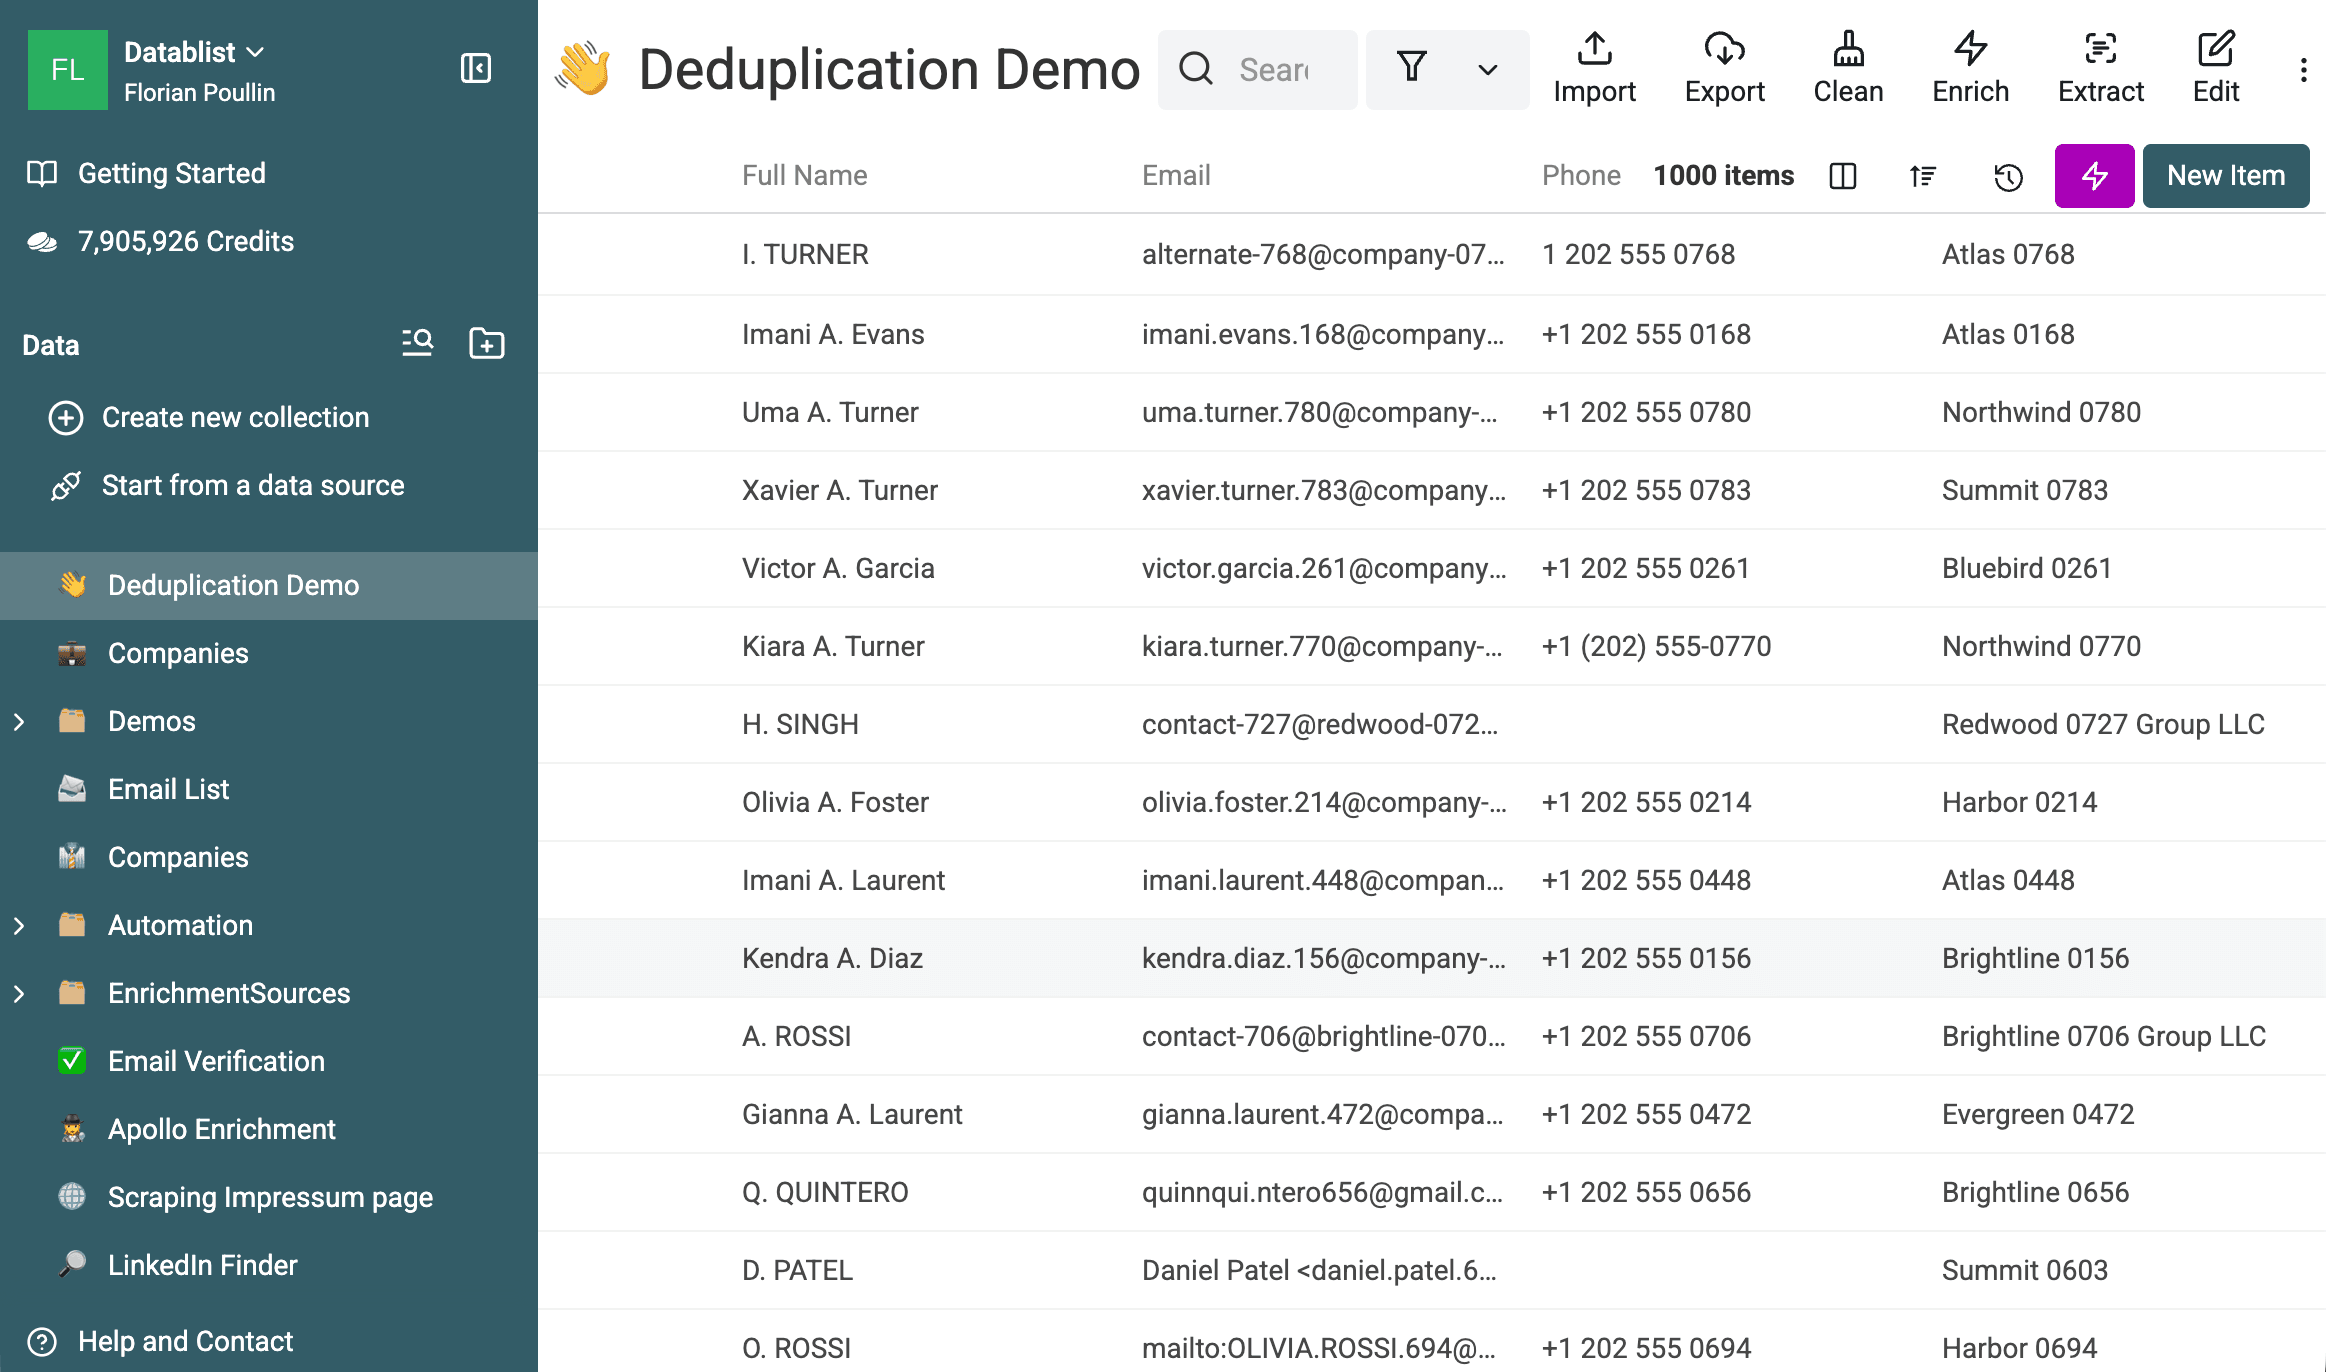
インポート時に検出されたproperty typeを確認してください。
- メールアドレスの列にはEmail typeを使用します。
- Webサイトの列にはURLを使用します。
- 電話番号の列にはPhoneを使用します。
- 売上や数量の列にはNumberを使用します。
- アクティビティ日や作成日にはDateTimeを使用します。
ID、ソース、担当者、メモ、ステータスの列もcollectionに残してください。残すべきレコードを選び、マージで何が保持されるかを確認する際に役立ちます。
Exact・Smart・fuzzy matchingを実行する
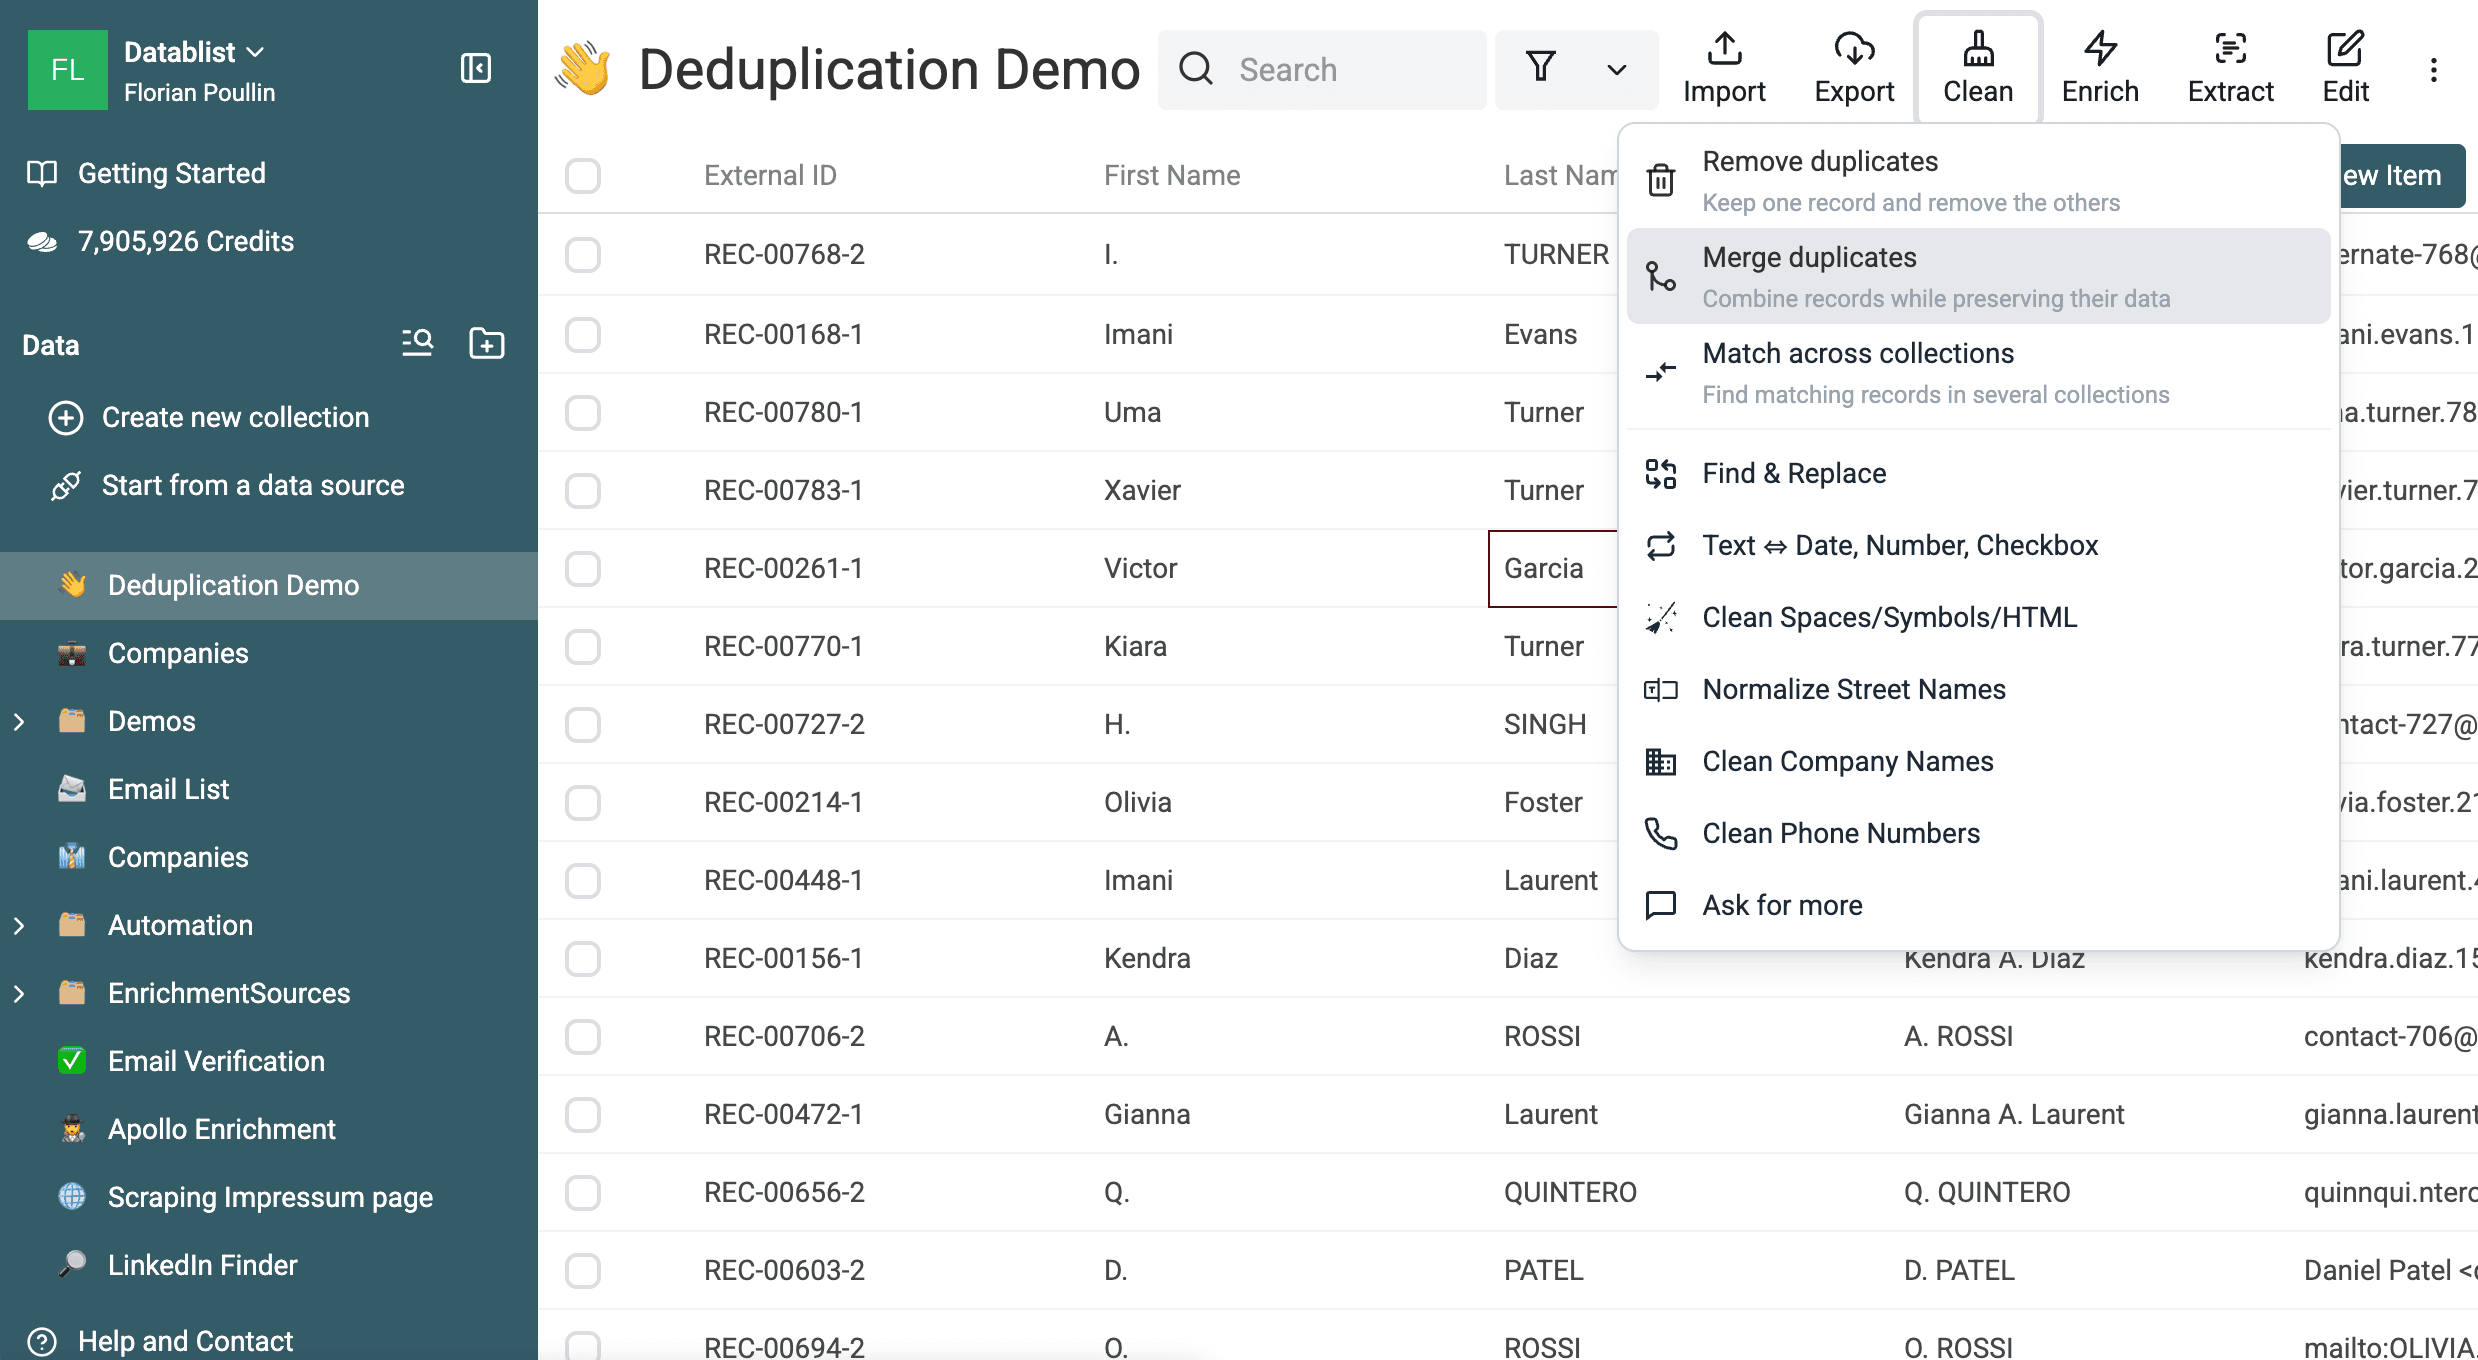
Cleanを開き、目的に合うactionを選択します。
- 2行目以降を破棄できる場合はRemove duplicates。
- 各行に残すべき情報がある場合はMerge duplicates。
- レコードが別々のcollectionにある場合はMatch across collections。
最初の2つのactionは、同じ検出エンジンを使用します。結果workspaceを開いたときに選択されている処理モードだけが異なります。
まずExact matchingを実行する
変更されずに二重登録された行を見つけるには、All PropertiesとExactを使用します。外部IDなど、特定のフィールドが完全に一致する必要がある場合はSelected Propertiesを使用してください。
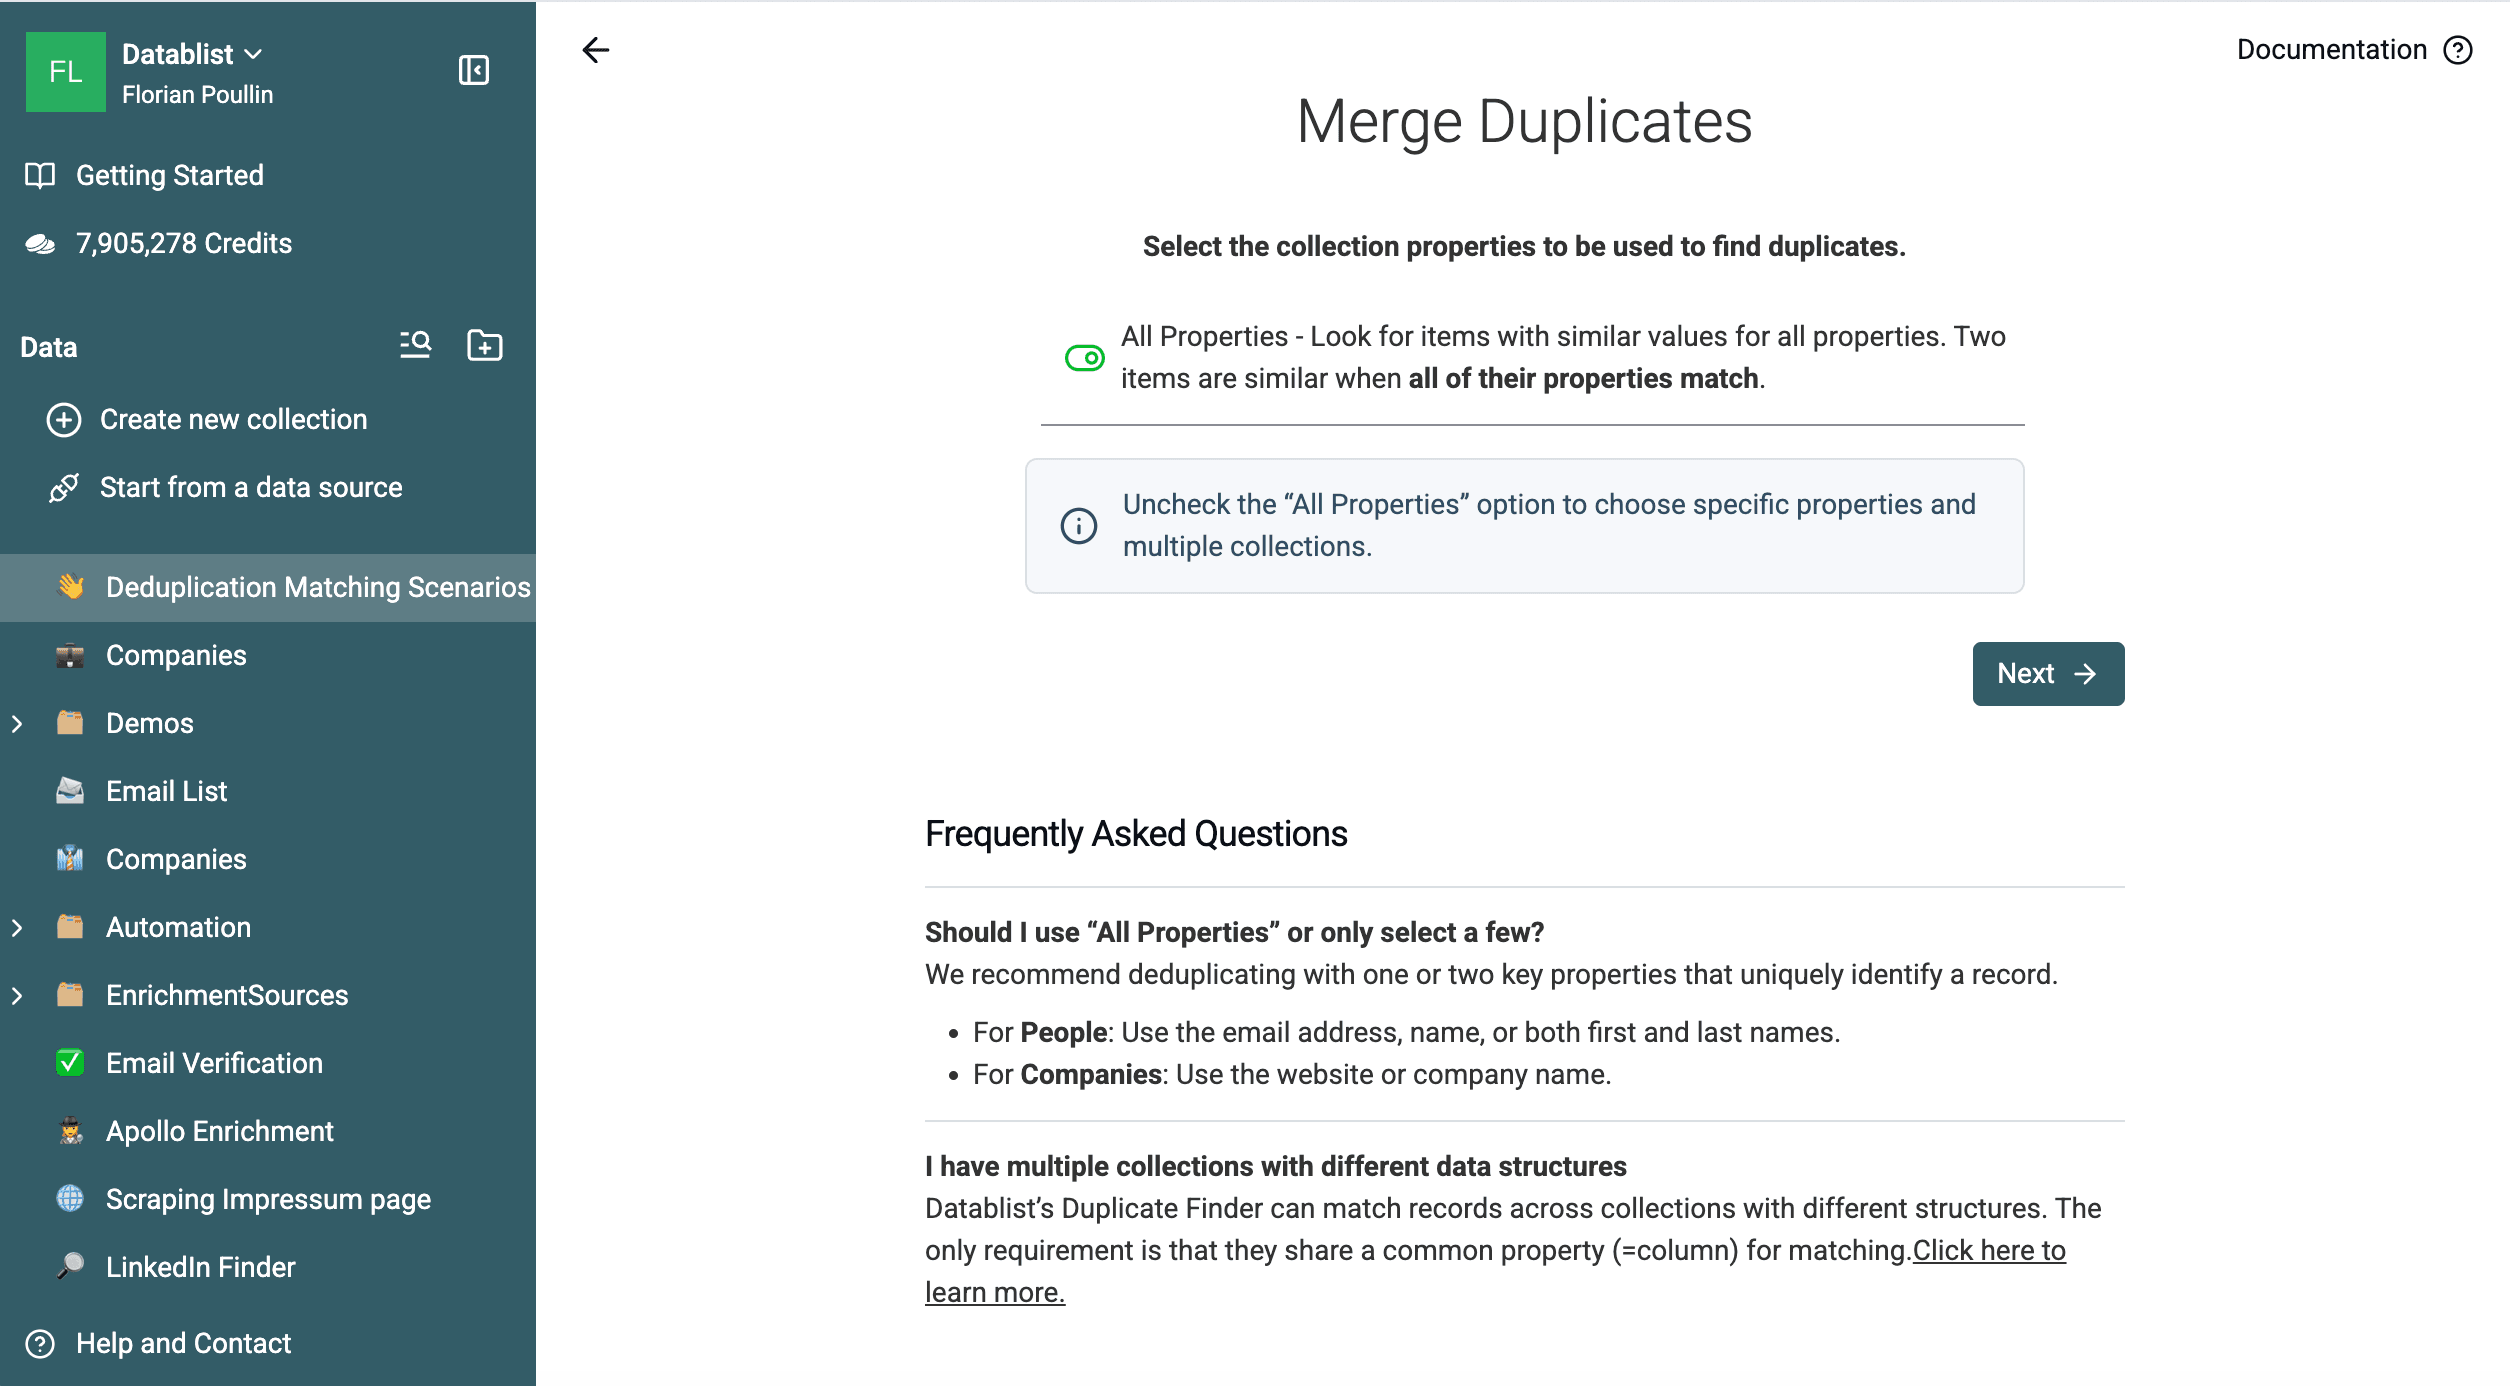
1,000行のサンプルでは、このチェックで5つの重複グループが返されます。各グループには、すべてのプロパティで同じ値を持つ2行が含まれます。
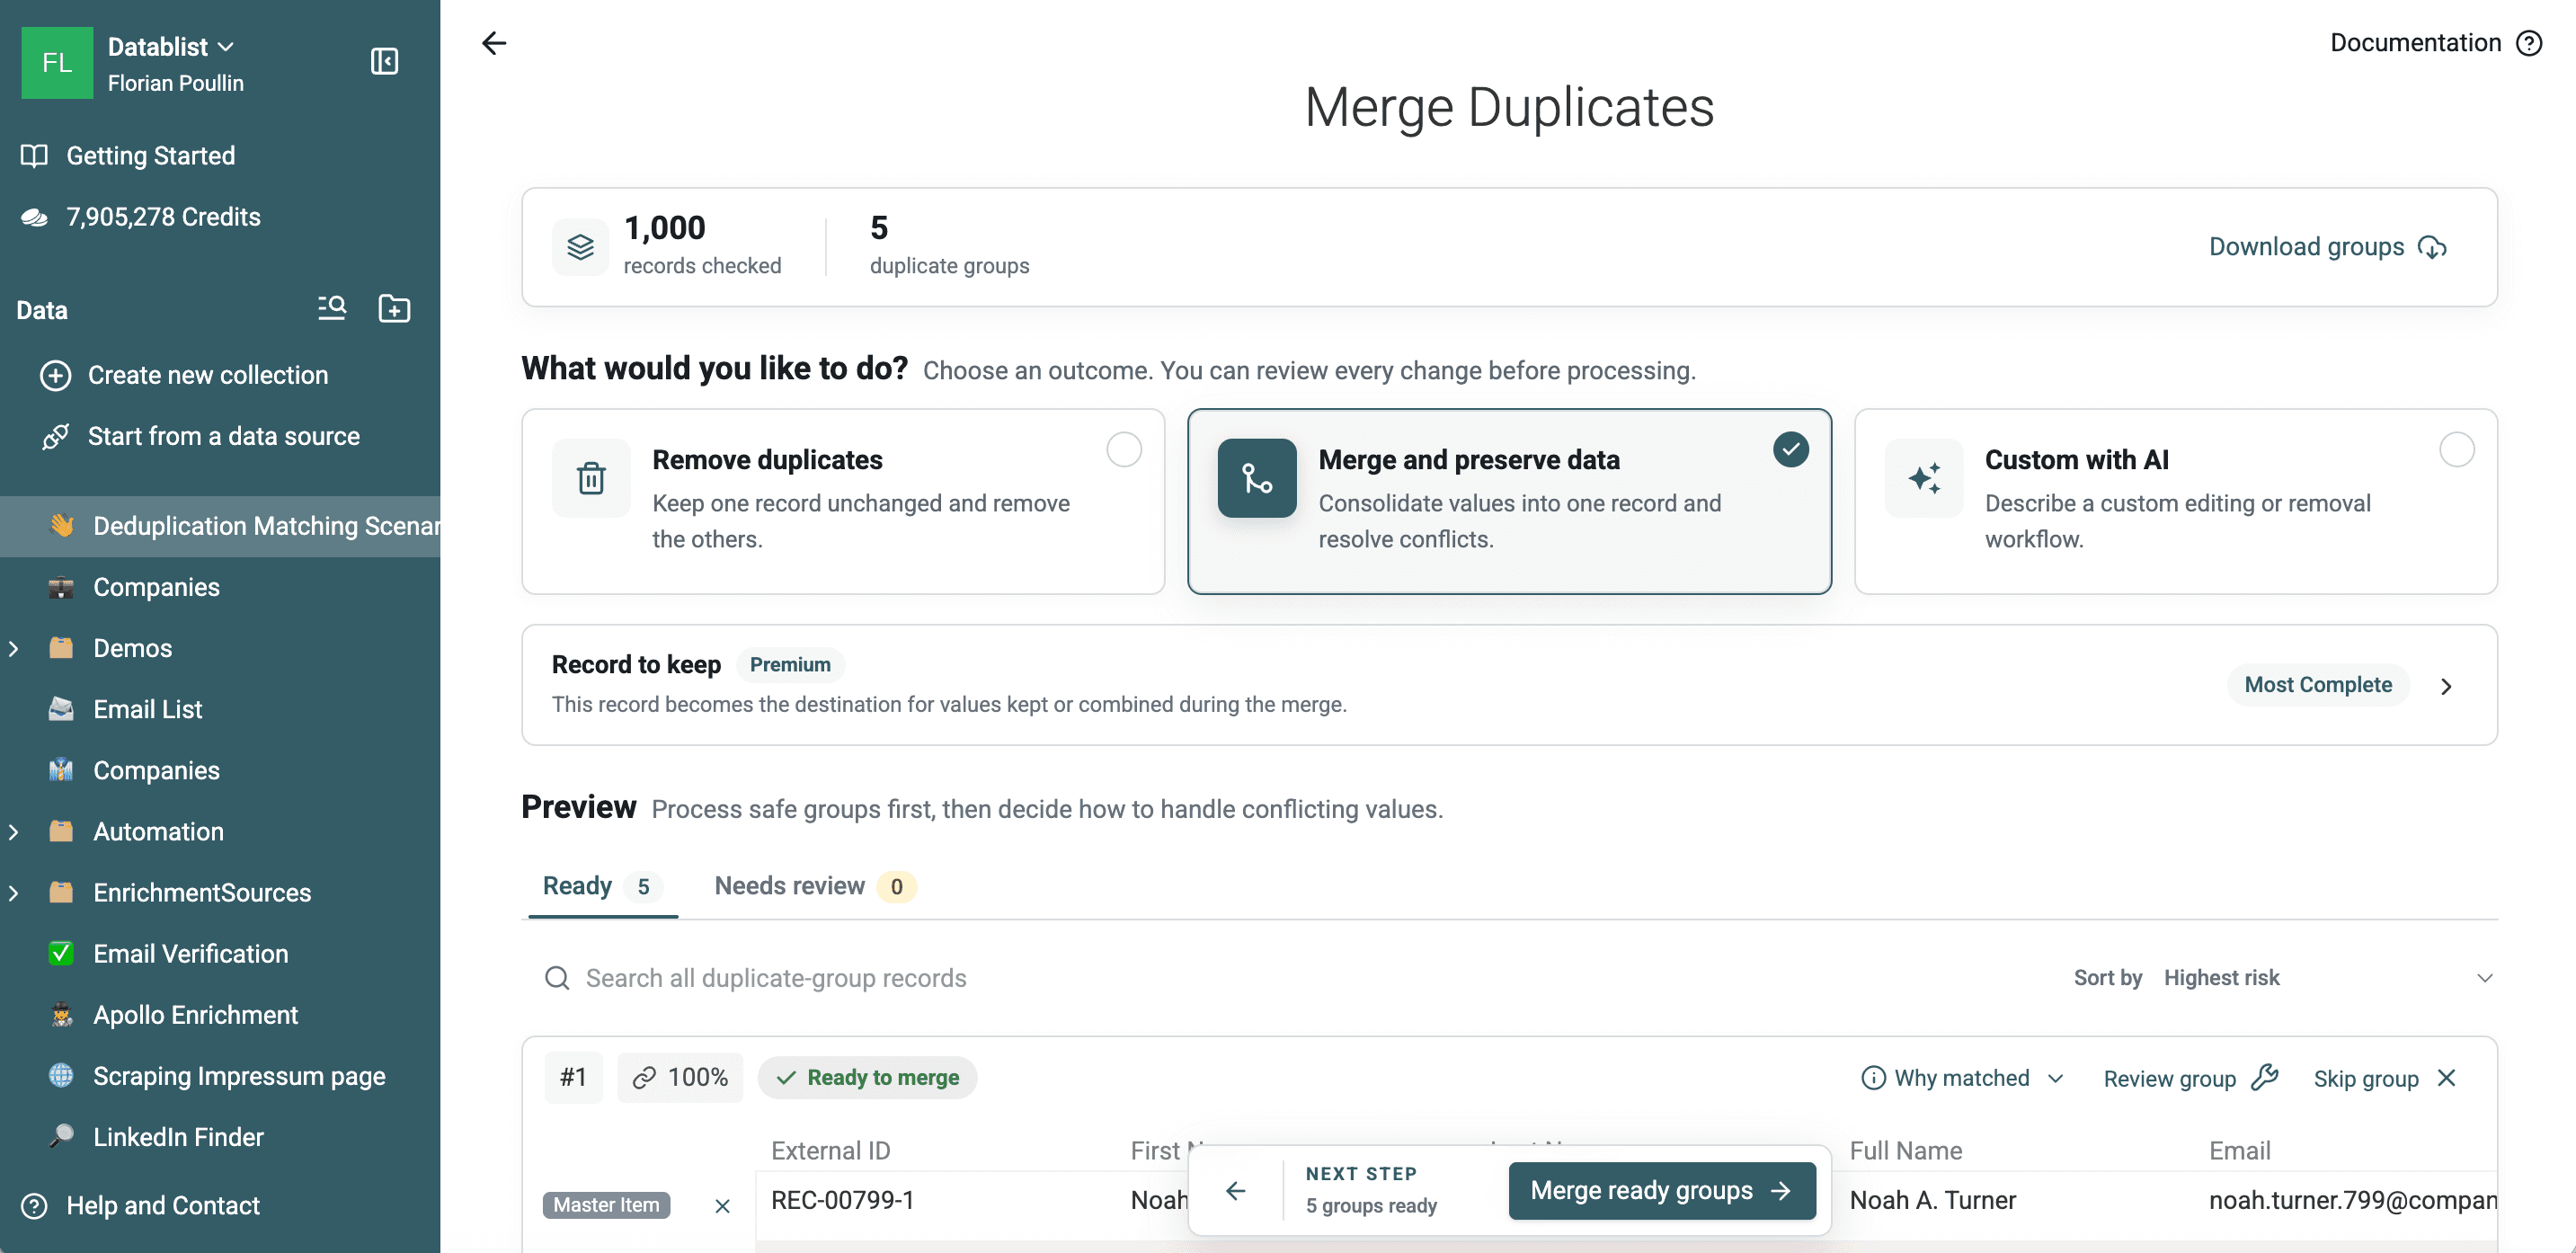
Exactは、保持されたすべての一致が厳密な比較条件を満たすため、最初に実行する方法として最も安全です。一方、保存されている値が異なる場合、Acme Inc.とAcme、書式の異なる電話番号、メールエイリアスなどは検出できません。
未登録の訪問者でもExactによる重複チェックを実行できます。無料アカウントを作成すると、Smart comparisonなどFree planの機能を利用できます。
ビジネスデータにはSmart matchingを使う
Smart matchingは、保存されているセルを書き換えずに、比較用の値を標準化します。プロパティに合うprocessorを選択してください。
- Emailでは、大文字と小文字、前後の空白、プラスエイリアス、Gmailのドット、
googlemail.com、表示名付きの表記、mailto:値を処理します。 - URLでは、プロトコルと末尾のスラッシュを無視できます。サブドメイン、パス、クエリパラメータを対象外にするオプションもあります。
- Phoneでは、書式用の記号を無視します。番号の有効性確認、Country propertyの参照、不足している国番号の推測は行いません。
- Company Nameでは、一般的な法人種別、業種、地域を表す語を除外します。
- Textでは、アクセント記号、スペース、句読点、記号、大文字と小文字、語順を無視します。
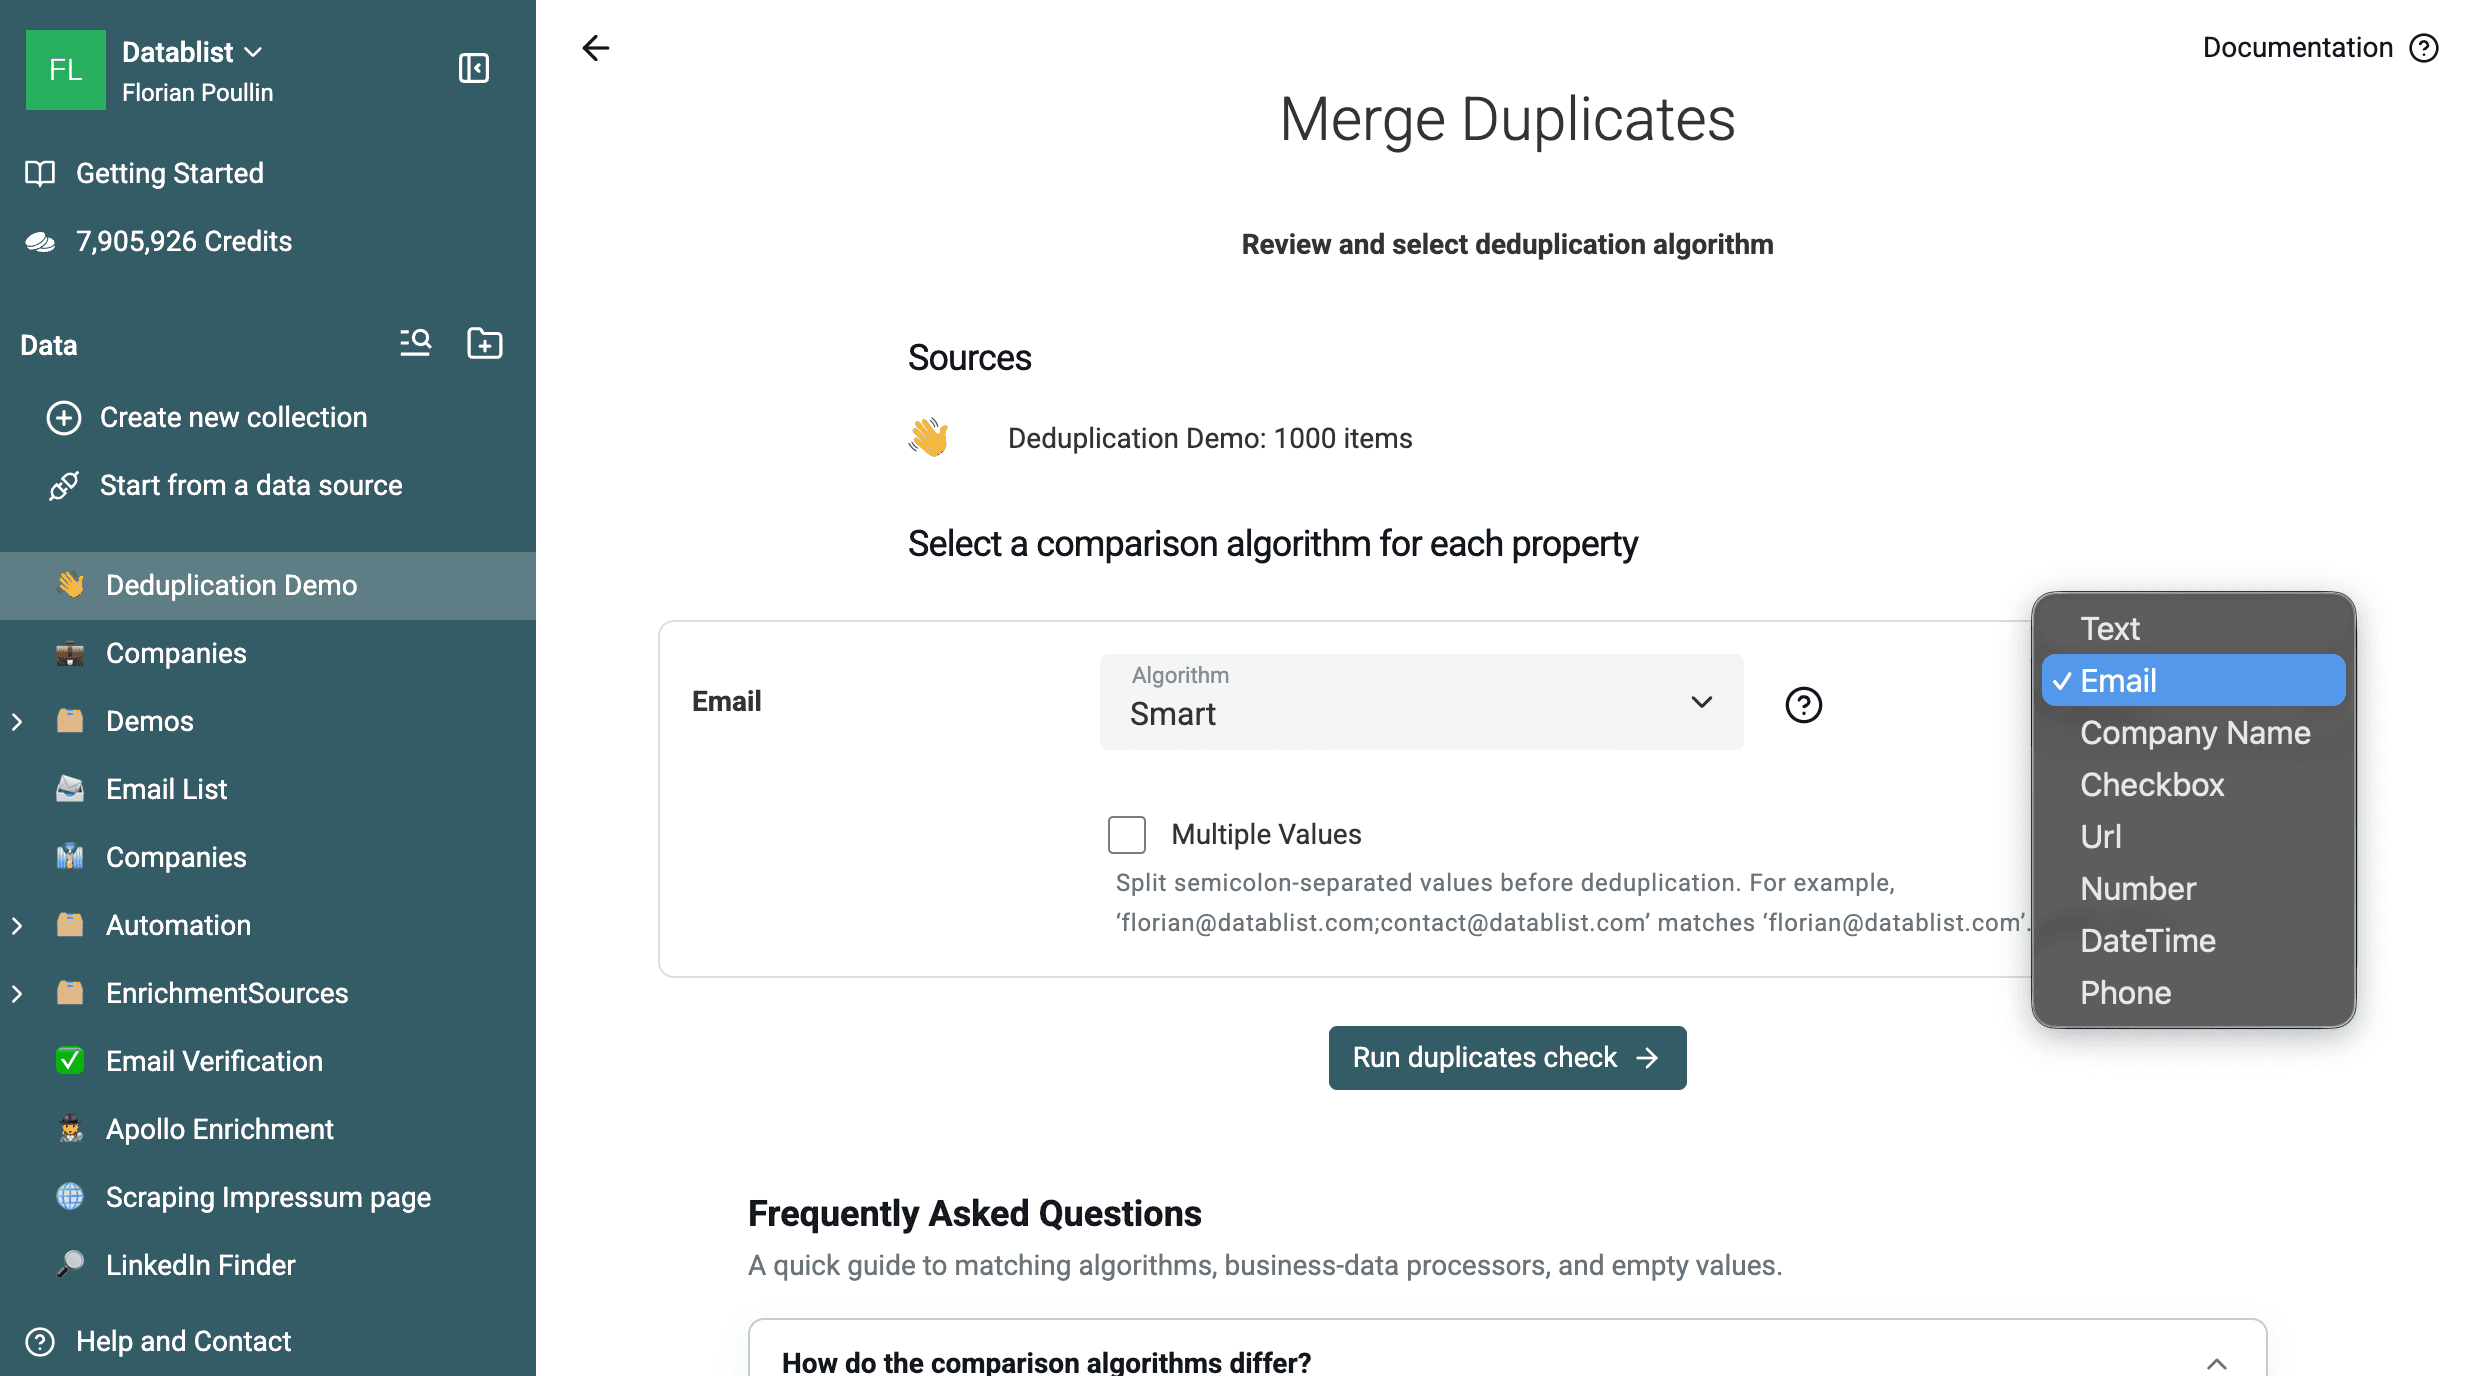
Company Name processor、複数値のマッチング、高度なアルゴリズムには有料プランが必要です。単一collectionのExactとSmartはFree planで利用できますが、Smartには無料アカウントが必要です。
1つのセルにセミコロン区切りの識別子が複数含まれる場合は、Multiple Valuesを有効にします。Datablistは各要素を比較し、少なくとも1組が一致すれば、そのプロパティを一致と判定します。たとえば、primary@example.com;shared@example.comを含むセルは、shared@example.comを含む別のセルと一致します。
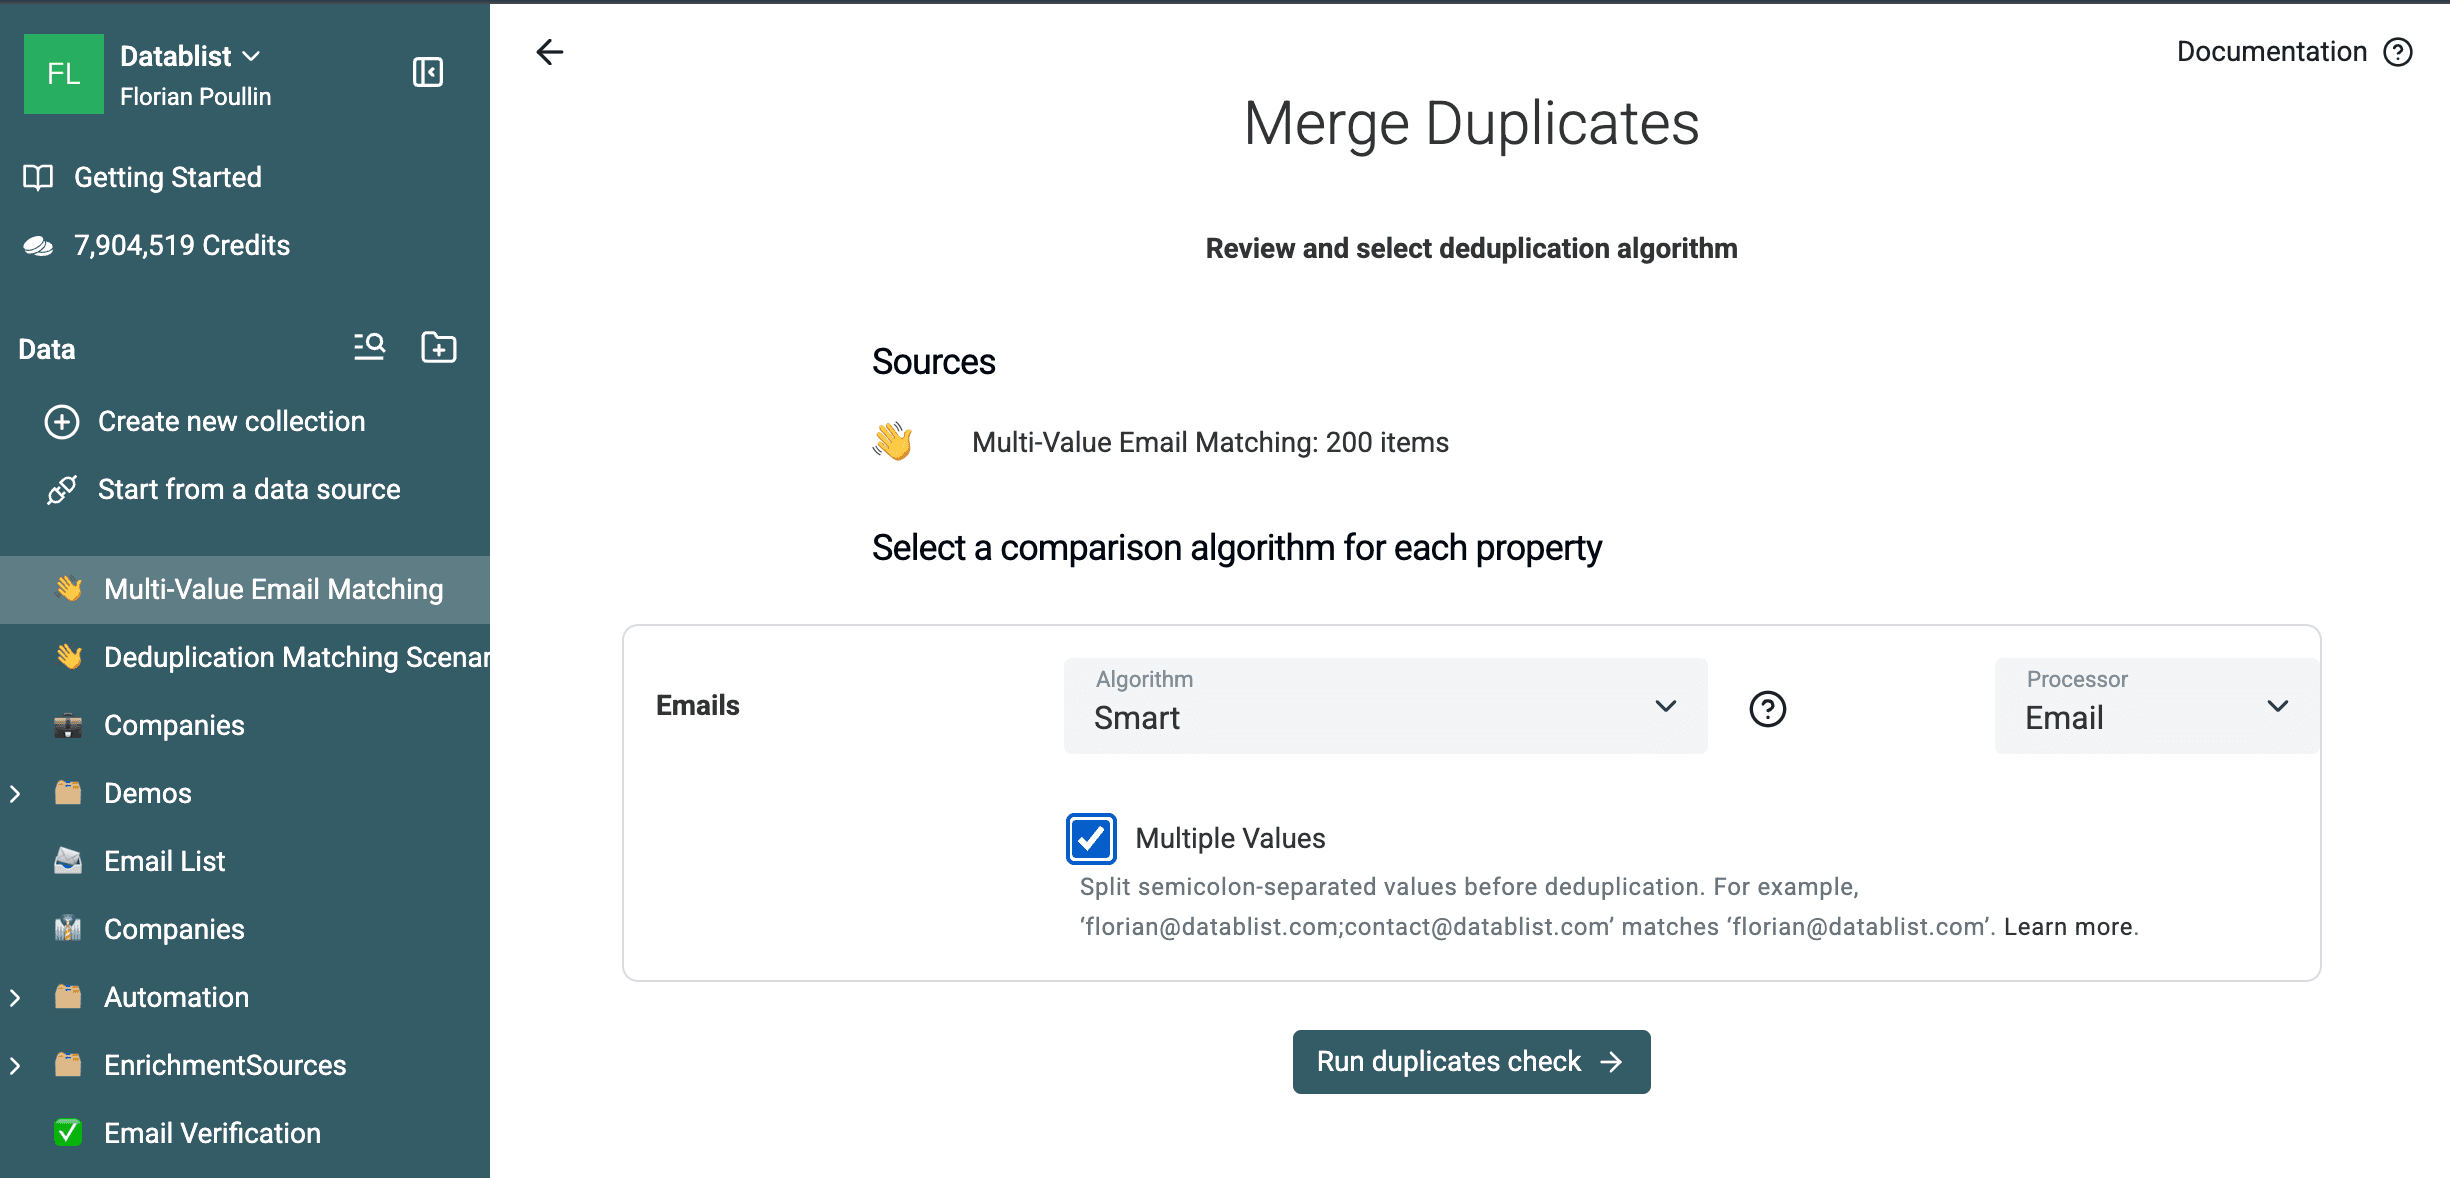
専用の200行サンプルでは、この設定で2行構成のグループが60件返されました。正解データとの照合により、想定した60組をすべて検出し、80件の対照レコードはすべて除外できたことを確認しています。サンプルファイル、結果CSV、マージ方法については、複数値フィールドの重複排除ワークフローをご覧ください。
このメールチェックでは、2行構成のグループが105件返されました。内訳は、メール正規化を想定した100組と、同じメールアドレスを持つ完全コピー5組です。
マッチング前に電話番号を正規化する
Smart Phone processorが有効なのは、数字が同じで、スペース、括弧、ハイフン、記号だけが異なるケースです。たとえば、(415) 555-0123と4155550123を一致させられます。
国内形式と国際形式の電話番号が同じであるかは判断できません。たとえば、06 12 34 50 08と+33 6 12 34 50 08を比較するには、事前に国情報が必要です。
電話番号で重複排除する前に、Phone Number Cleanerを使用してください。
- 元の
Phonepropertyをマッピングします。 - 1か国のみのリストでは、Local Phone Countriesで国を選択します。複数国のリストではDefine country per itemを有効にし、
Countrypropertyをマッピングします。 - 元の値を上書きせず、enrichmentの結果を
Clean Phone Numberに書き込みます。 - 失敗または空欄になった出力を確認します。これらは電話番号のマッチング対象に含めないでください。
Clean Phone Numberに対して、Exactを使ってDuplicates Finderを実行します。
電話番号専用の200行サンプルをダウンロードできます。米国、フランス、英国、ドイツ、スペインの国内・国際形式50組と、一致しない100件の対照レコードが含まれています。本番用cleanerのロジックで検証した結果、200行すべてで正規化済みの電話番号が1件ずつ返されました。想定した50組は50個の共通する国際形式に収束し、対照レコードは一意のままです。
この前処理では電話番号の書式も検証されます。マージ前に各レコードを確認できるよう、元のPhoneとCountry propertyはクリーンアップ済みの出力と並べて残してください。国番号と国際形式の役割については、電話番号の正規化とはをご覧ください。
企業レコードでは、Websiteに対して別のチェックを実行します。SmartとURL processorを選択してください。Ignore Subdomain、Ignore Path、Ignore Query Paramsは、URLの該当部分が別企業や別拠点を識別する要素ではない場合に限って有効にします。
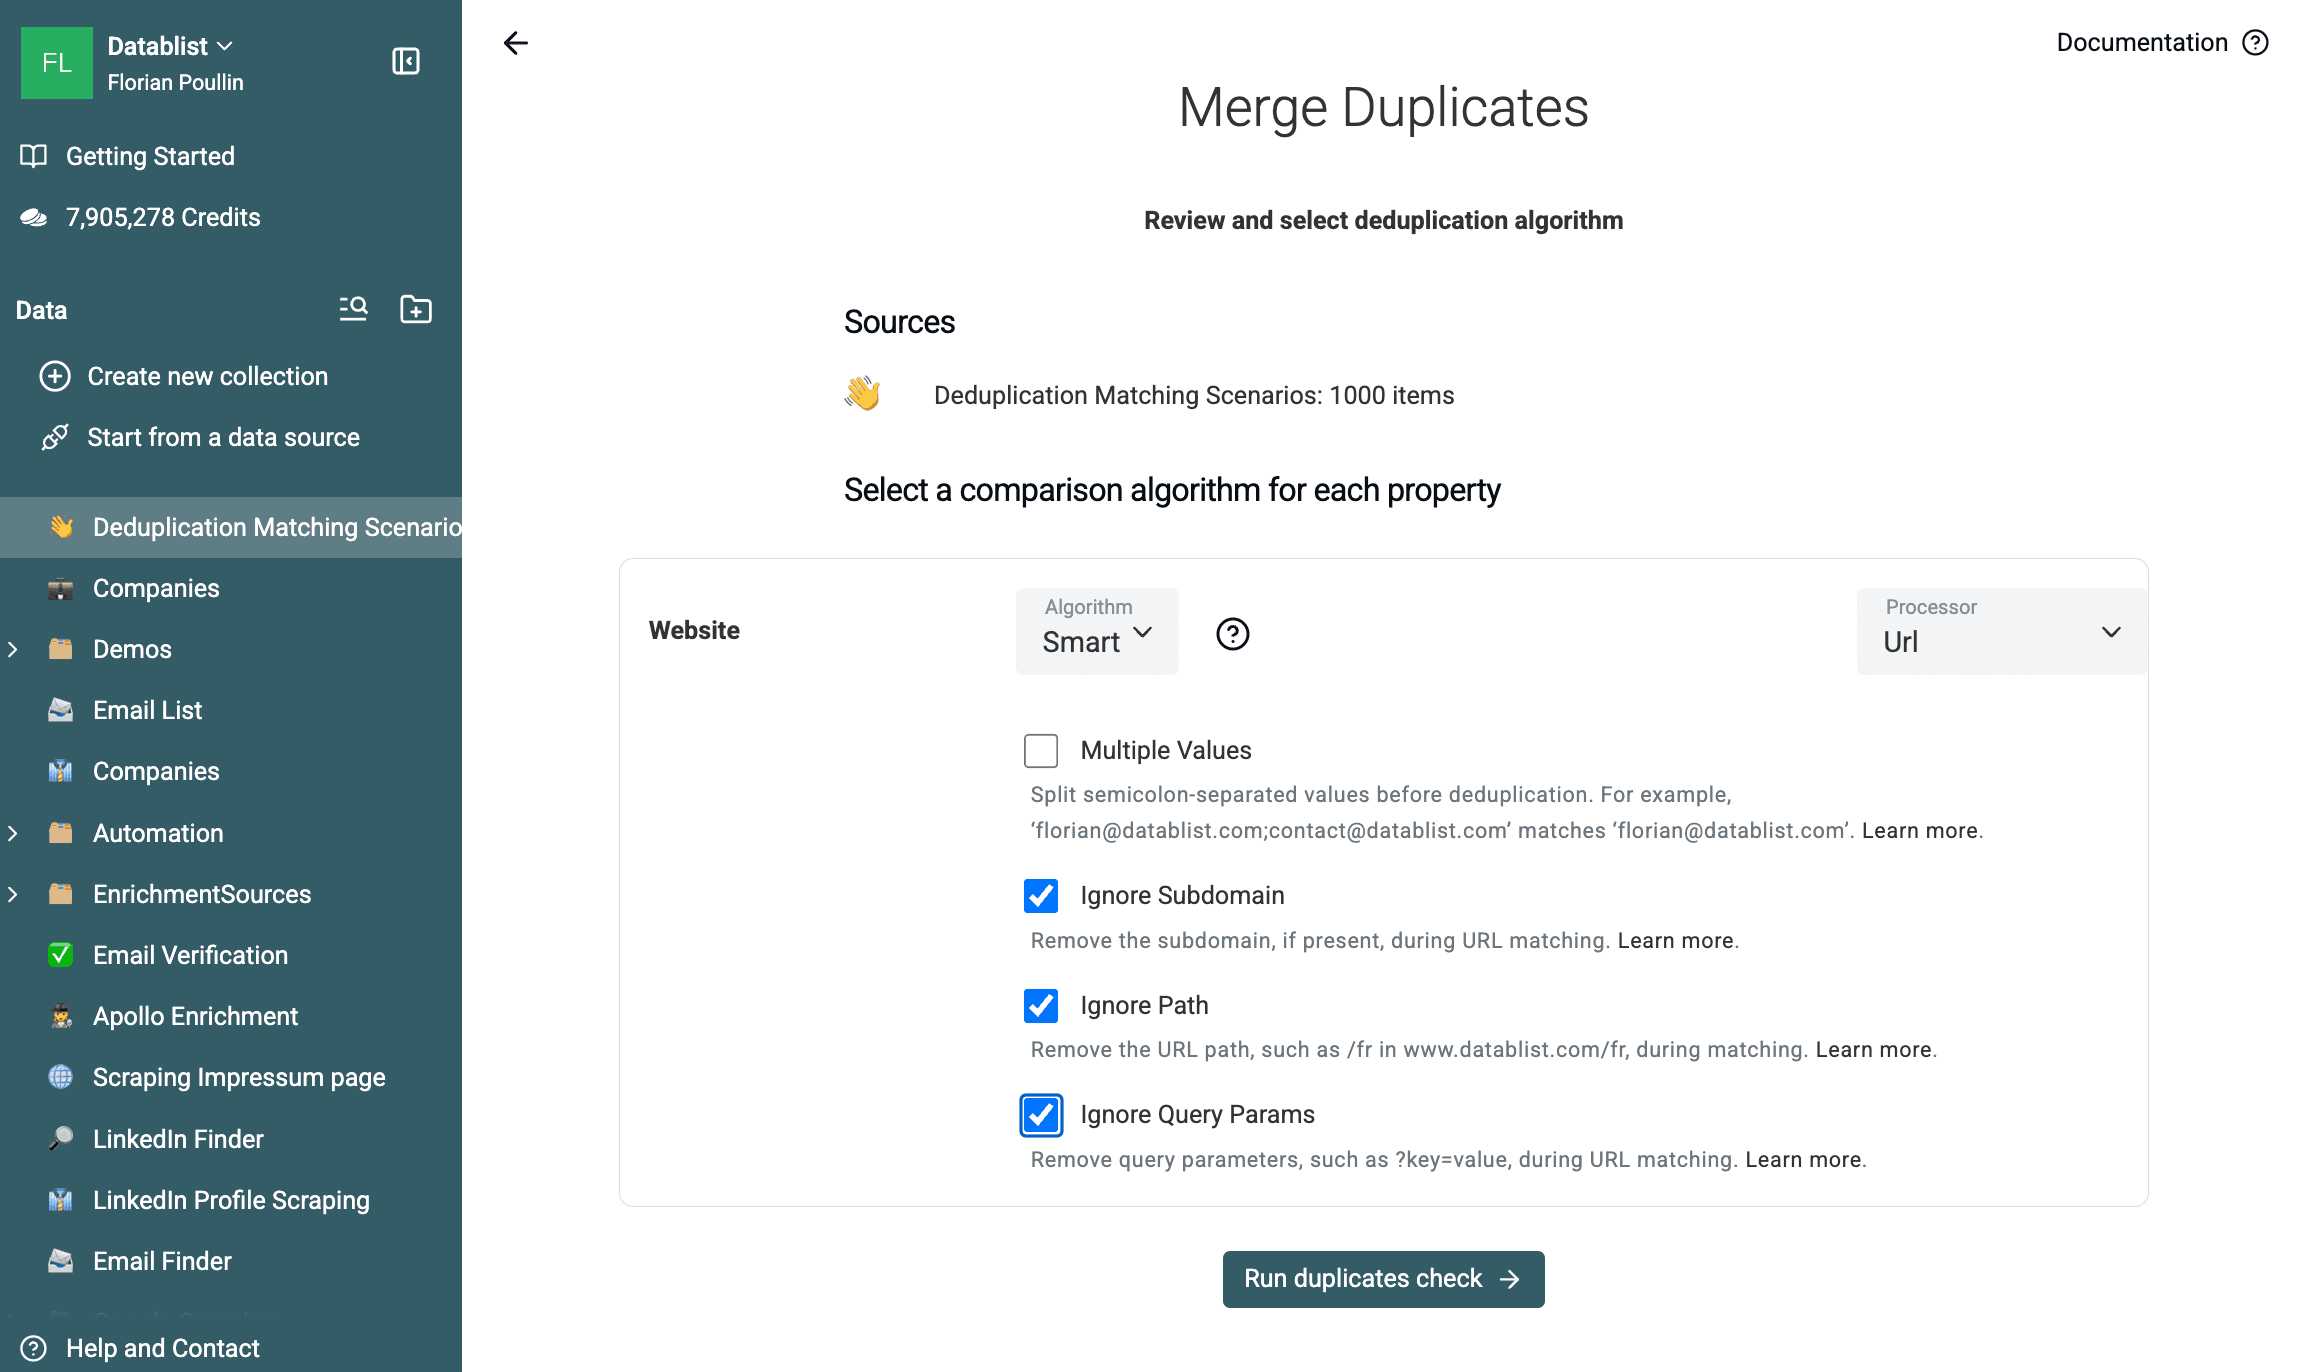
同じ1,000行のサンプルでは、この設定で2行構成のグループが200件返されました。50組は想定したURLの表記揺れで、残りの150組は最初から同じWebサイトを共有しています。このテストでは、書き出したすべてのペアが同一の正規化済みホストに解決されました。
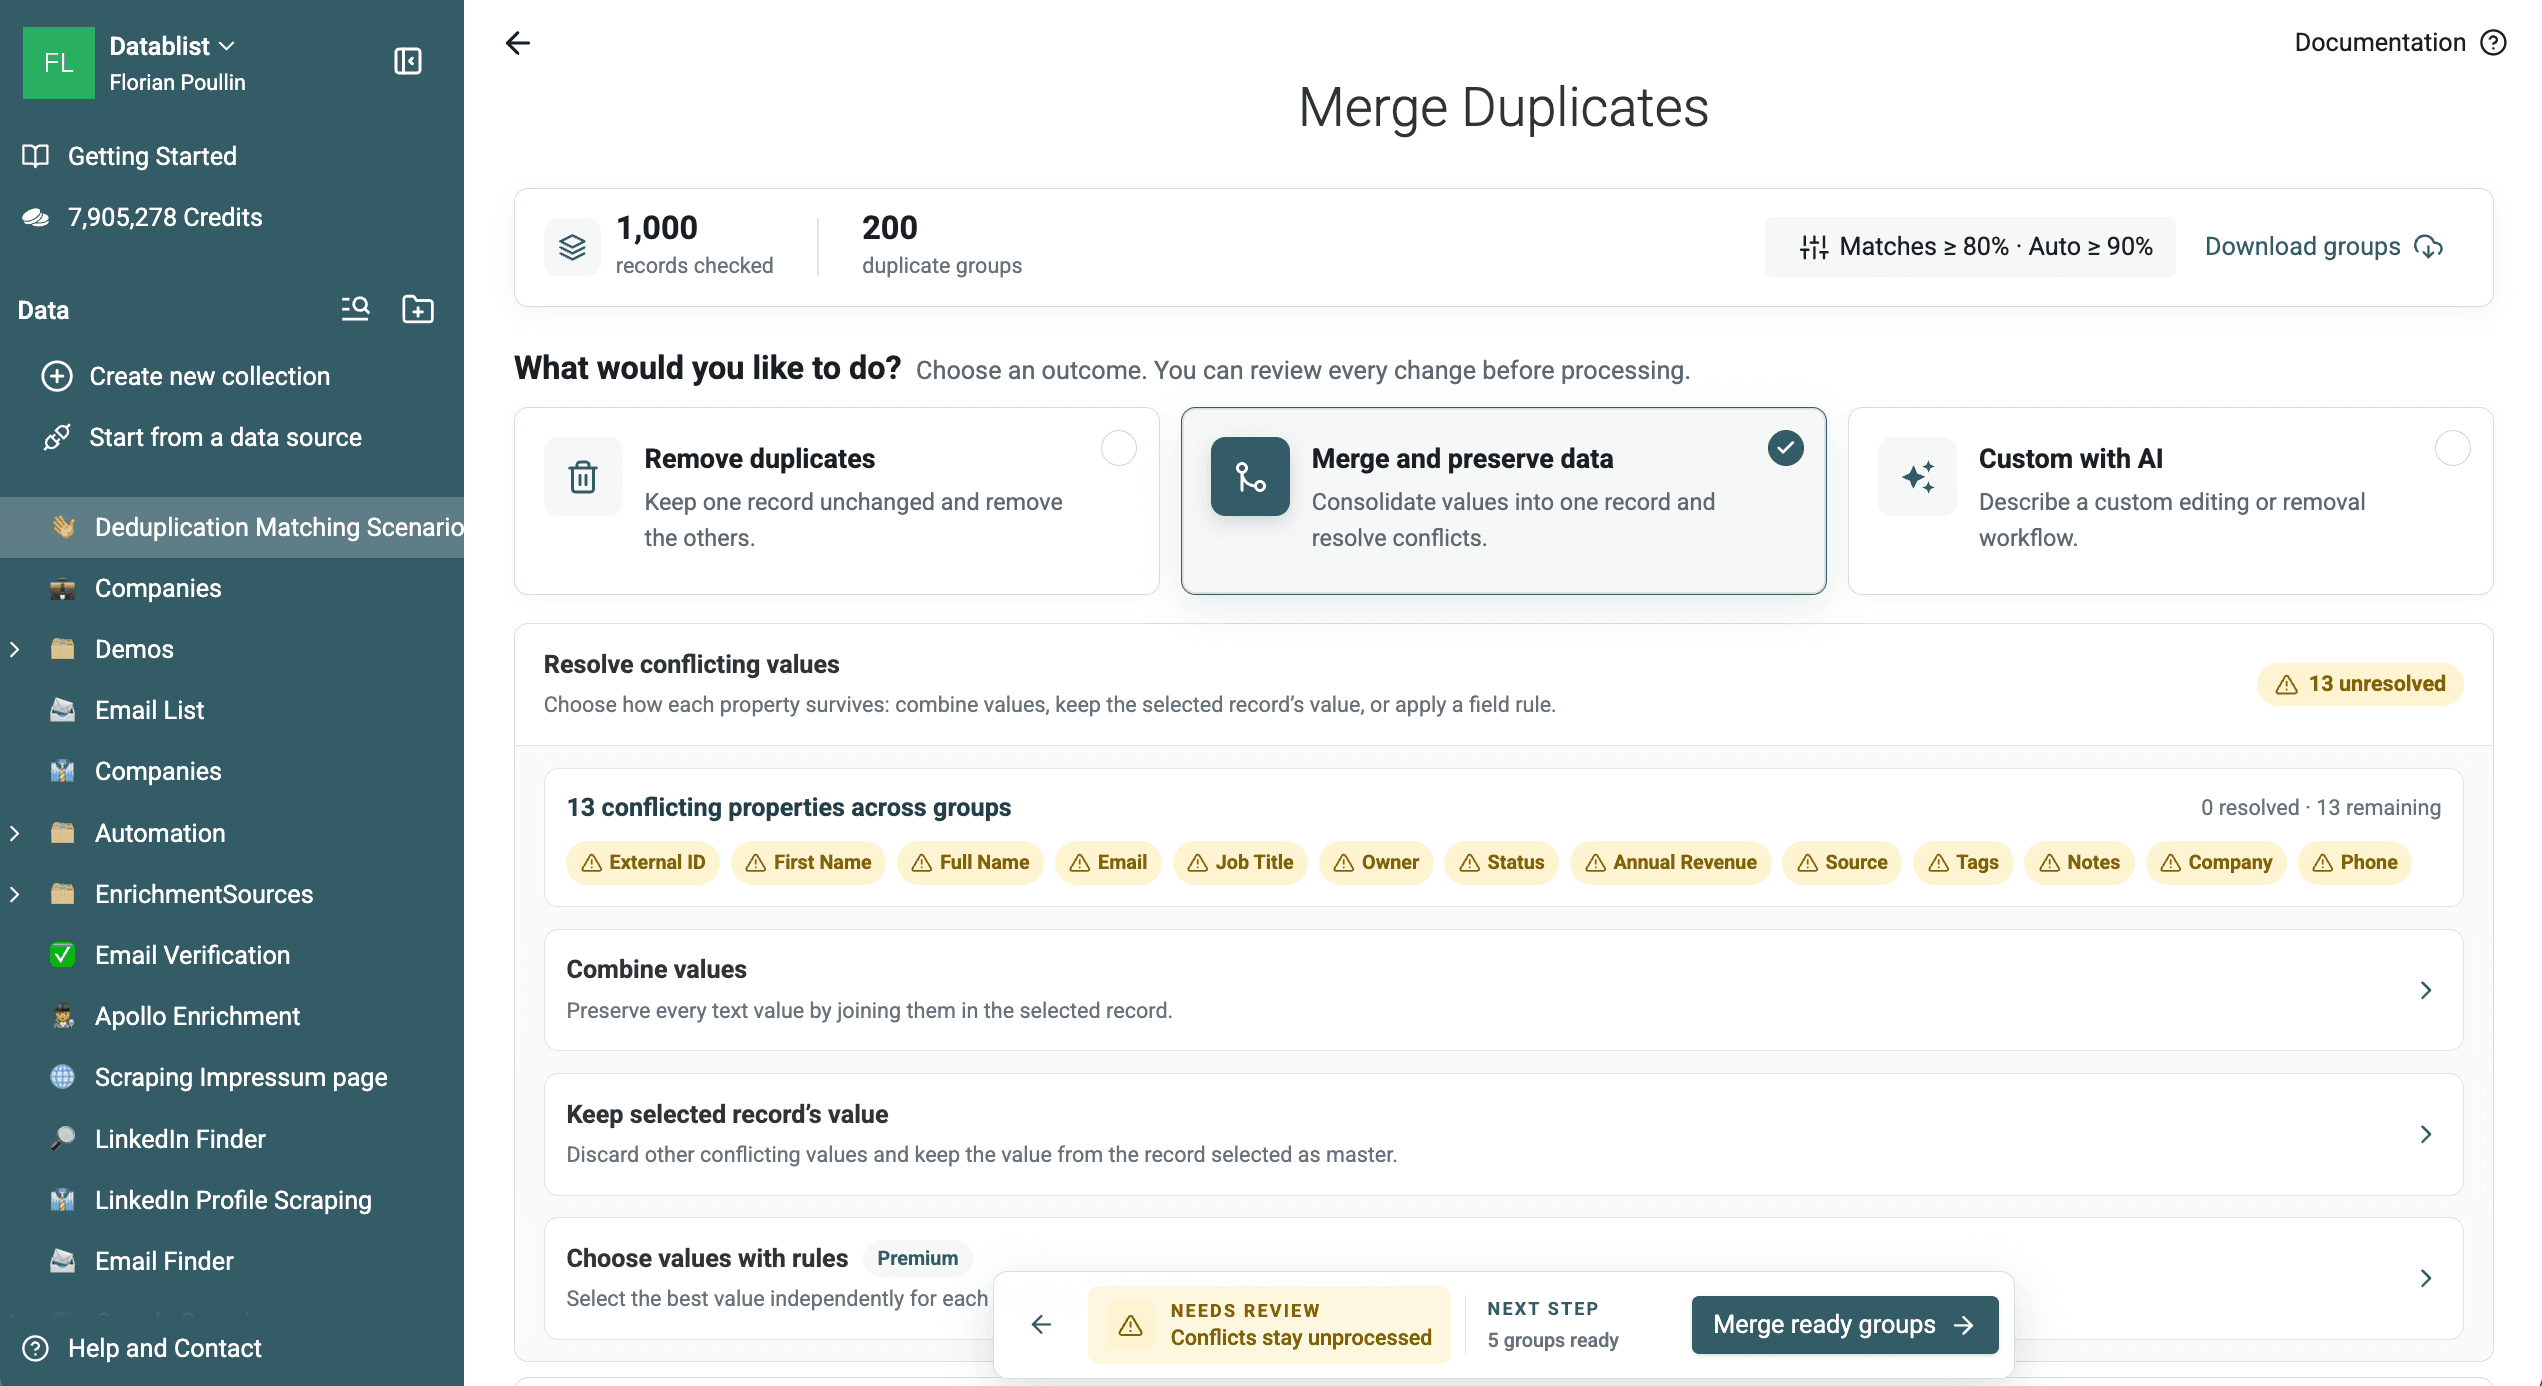
200件のWebsite重複グループをダウンロードするか、ドメインを優先する方法について企業データの重複排除ワークフローをご覧ください。
fuzzy・phonetic matchingは確認用に使う
Metaphoneはテキストの発音を比較します。Jaro-WinklerとLevenshteinは類似度スコアを計算し、Uma TurnerとUman Turnerのようなスペルの違いを見つけるのに役立ちます。
fuzzy matchは候補であり、重複が確定したわけではありません。高いしきい値から始め、信頼度の低いグループを確認し、精度を維持できる場合に限って結果のしきい値を下げてください。
測定済みのfuzzyチェックを再現するには、Full Nameを選択し、DistanceとLevenshteinを指定します。Text processorはそのままにし、しきい値を90%に設定してください。
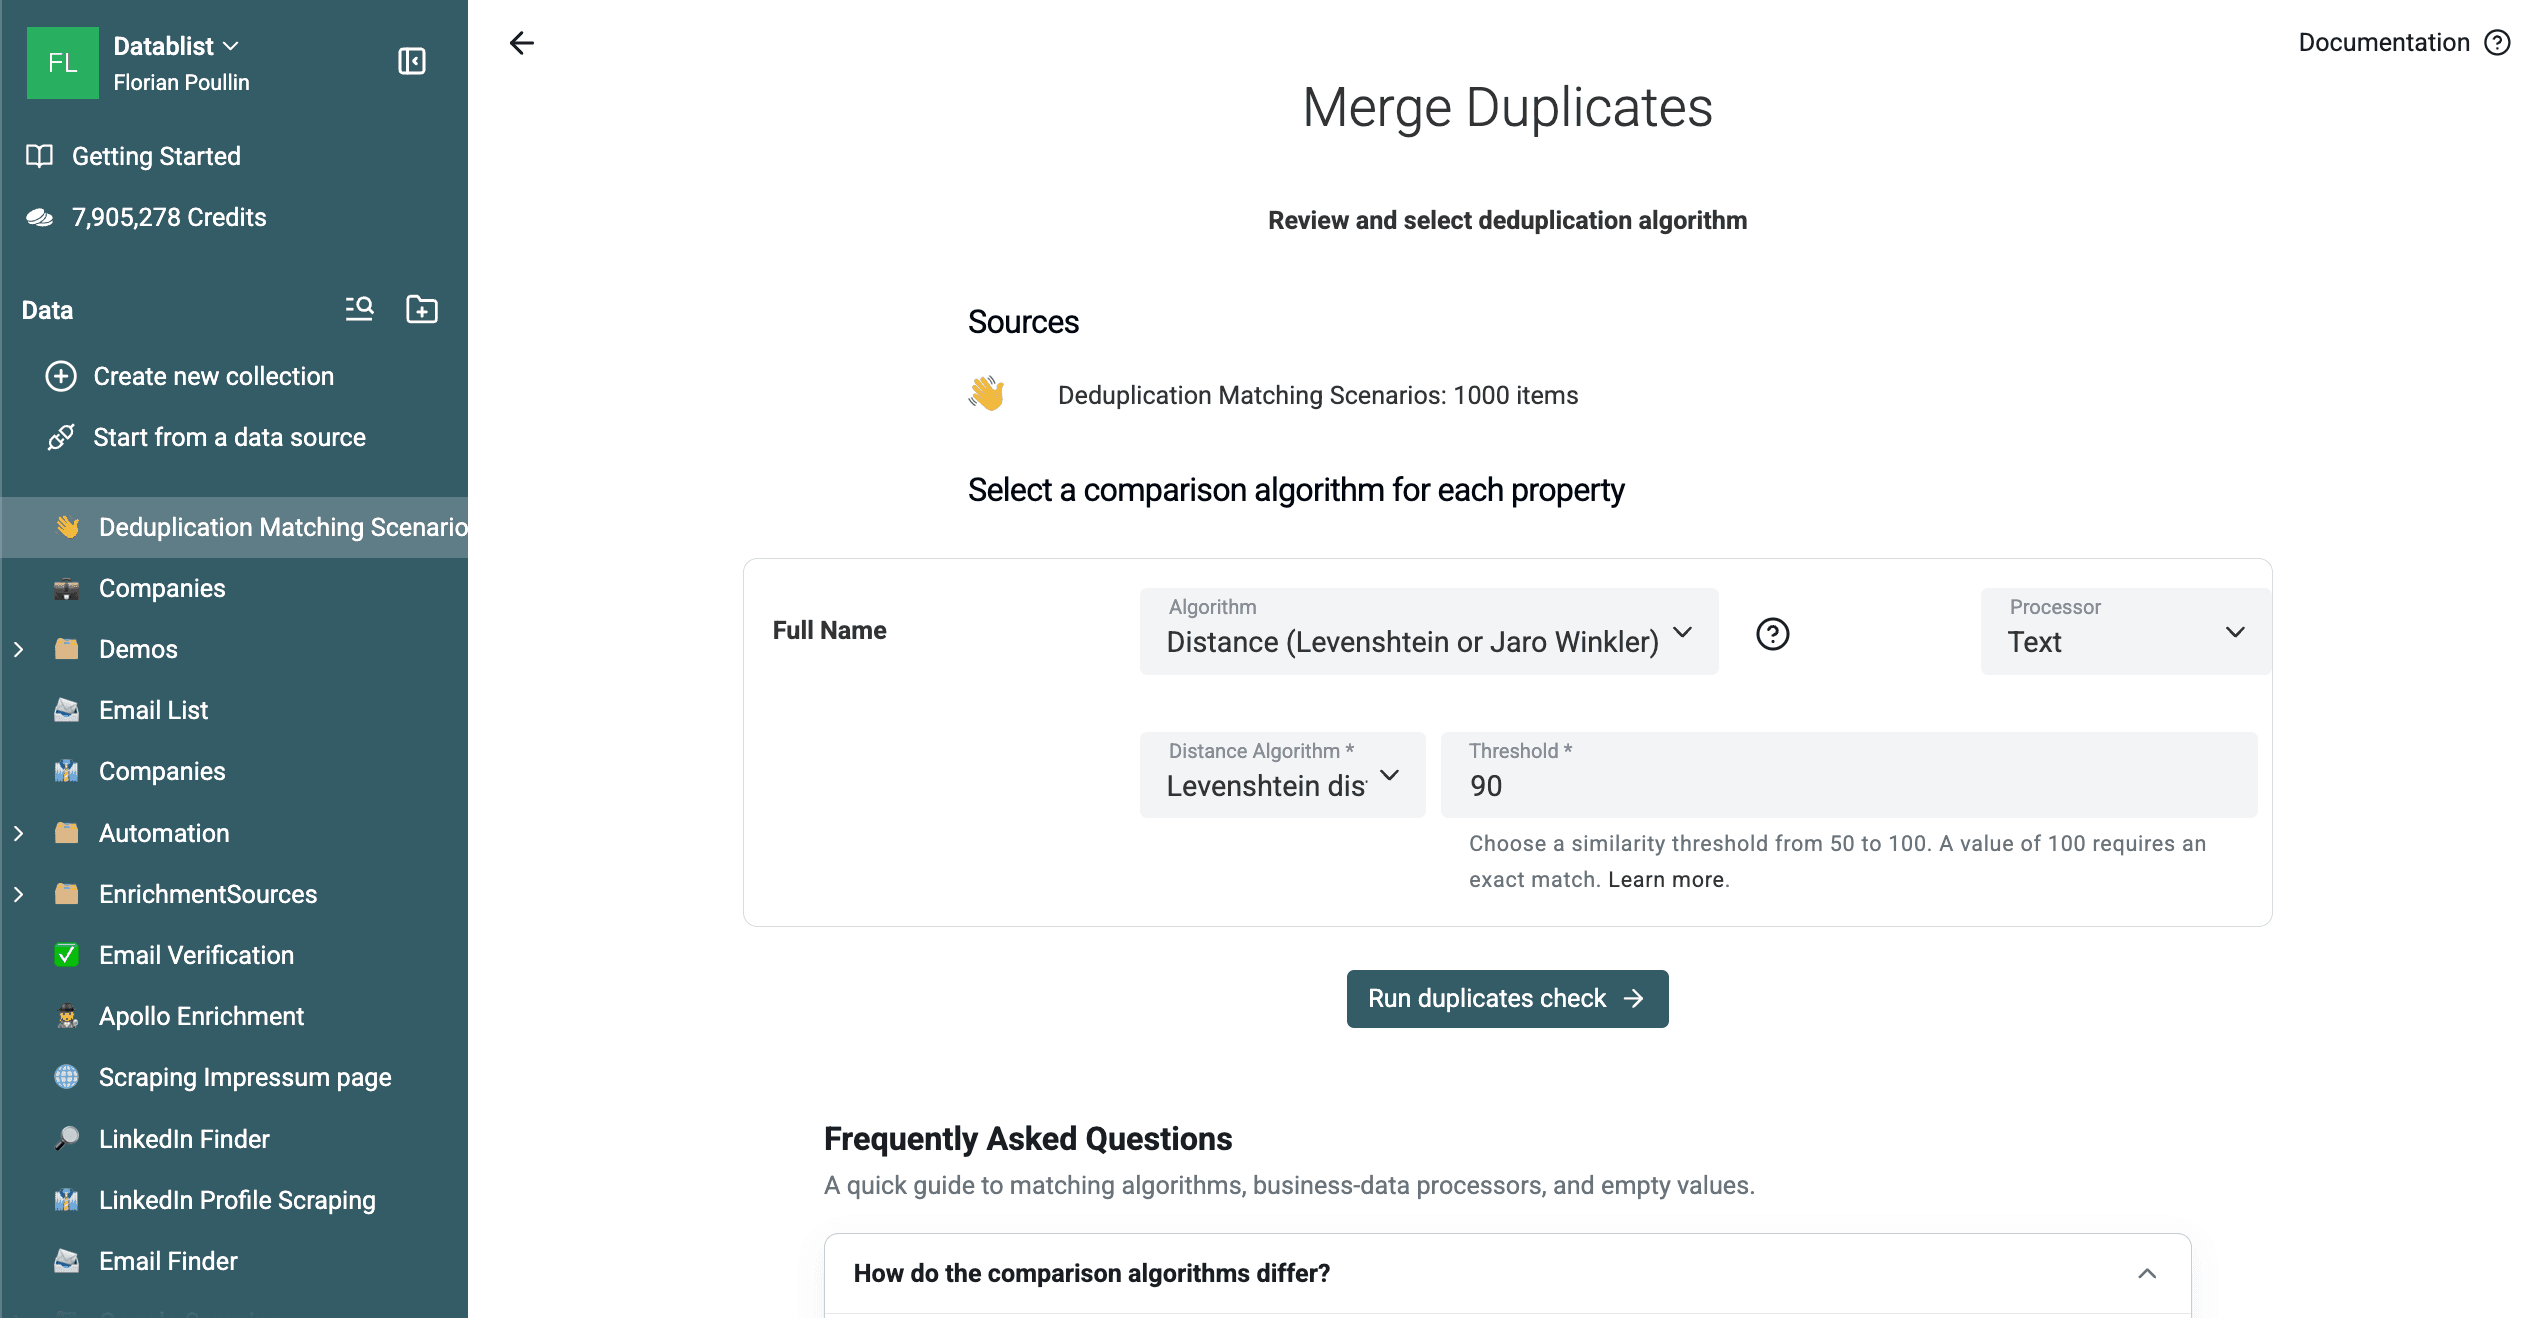
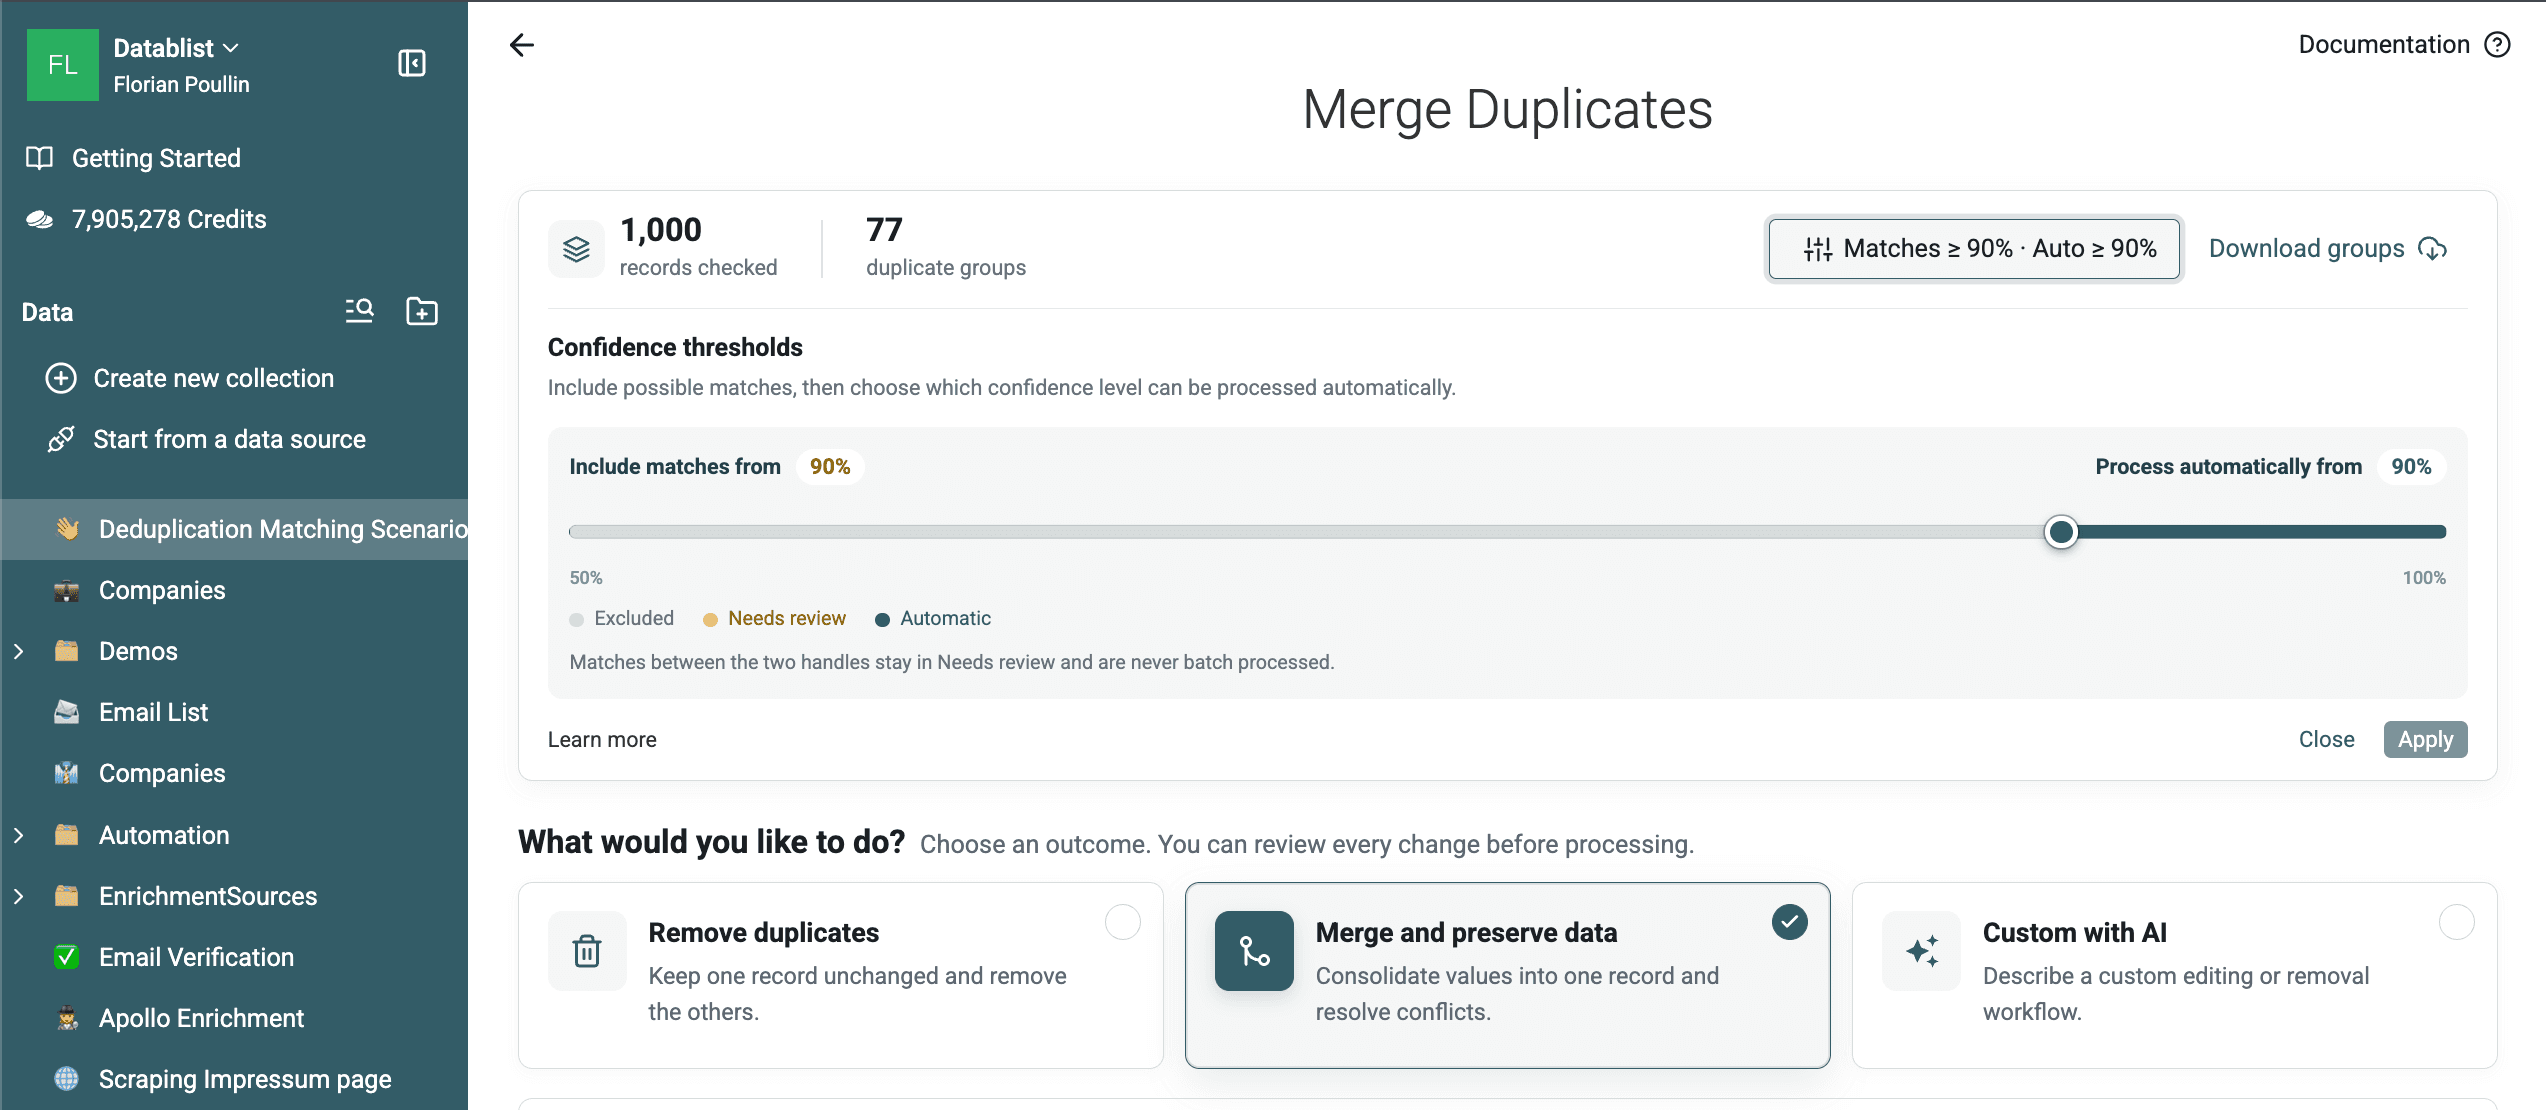
このチェックでは、1,000行のサンプルから2行構成のグループが77件返されました。正解データとの照合では、同じ想定エンティティを結び付けたグループが21件、異なるエンティティを結び付けたグループが56件でした。誤検出の多くはG. Rossiのような略称で、Full Nameの値だけでは別人を区別できません。
このチェックでは、Uma A. TurnerとUman A. Turnerのような意図したスペルの違いを検出できます。一方で、氏名だけを使ったfuzzy matchに確認が欠かせない理由も分かります。
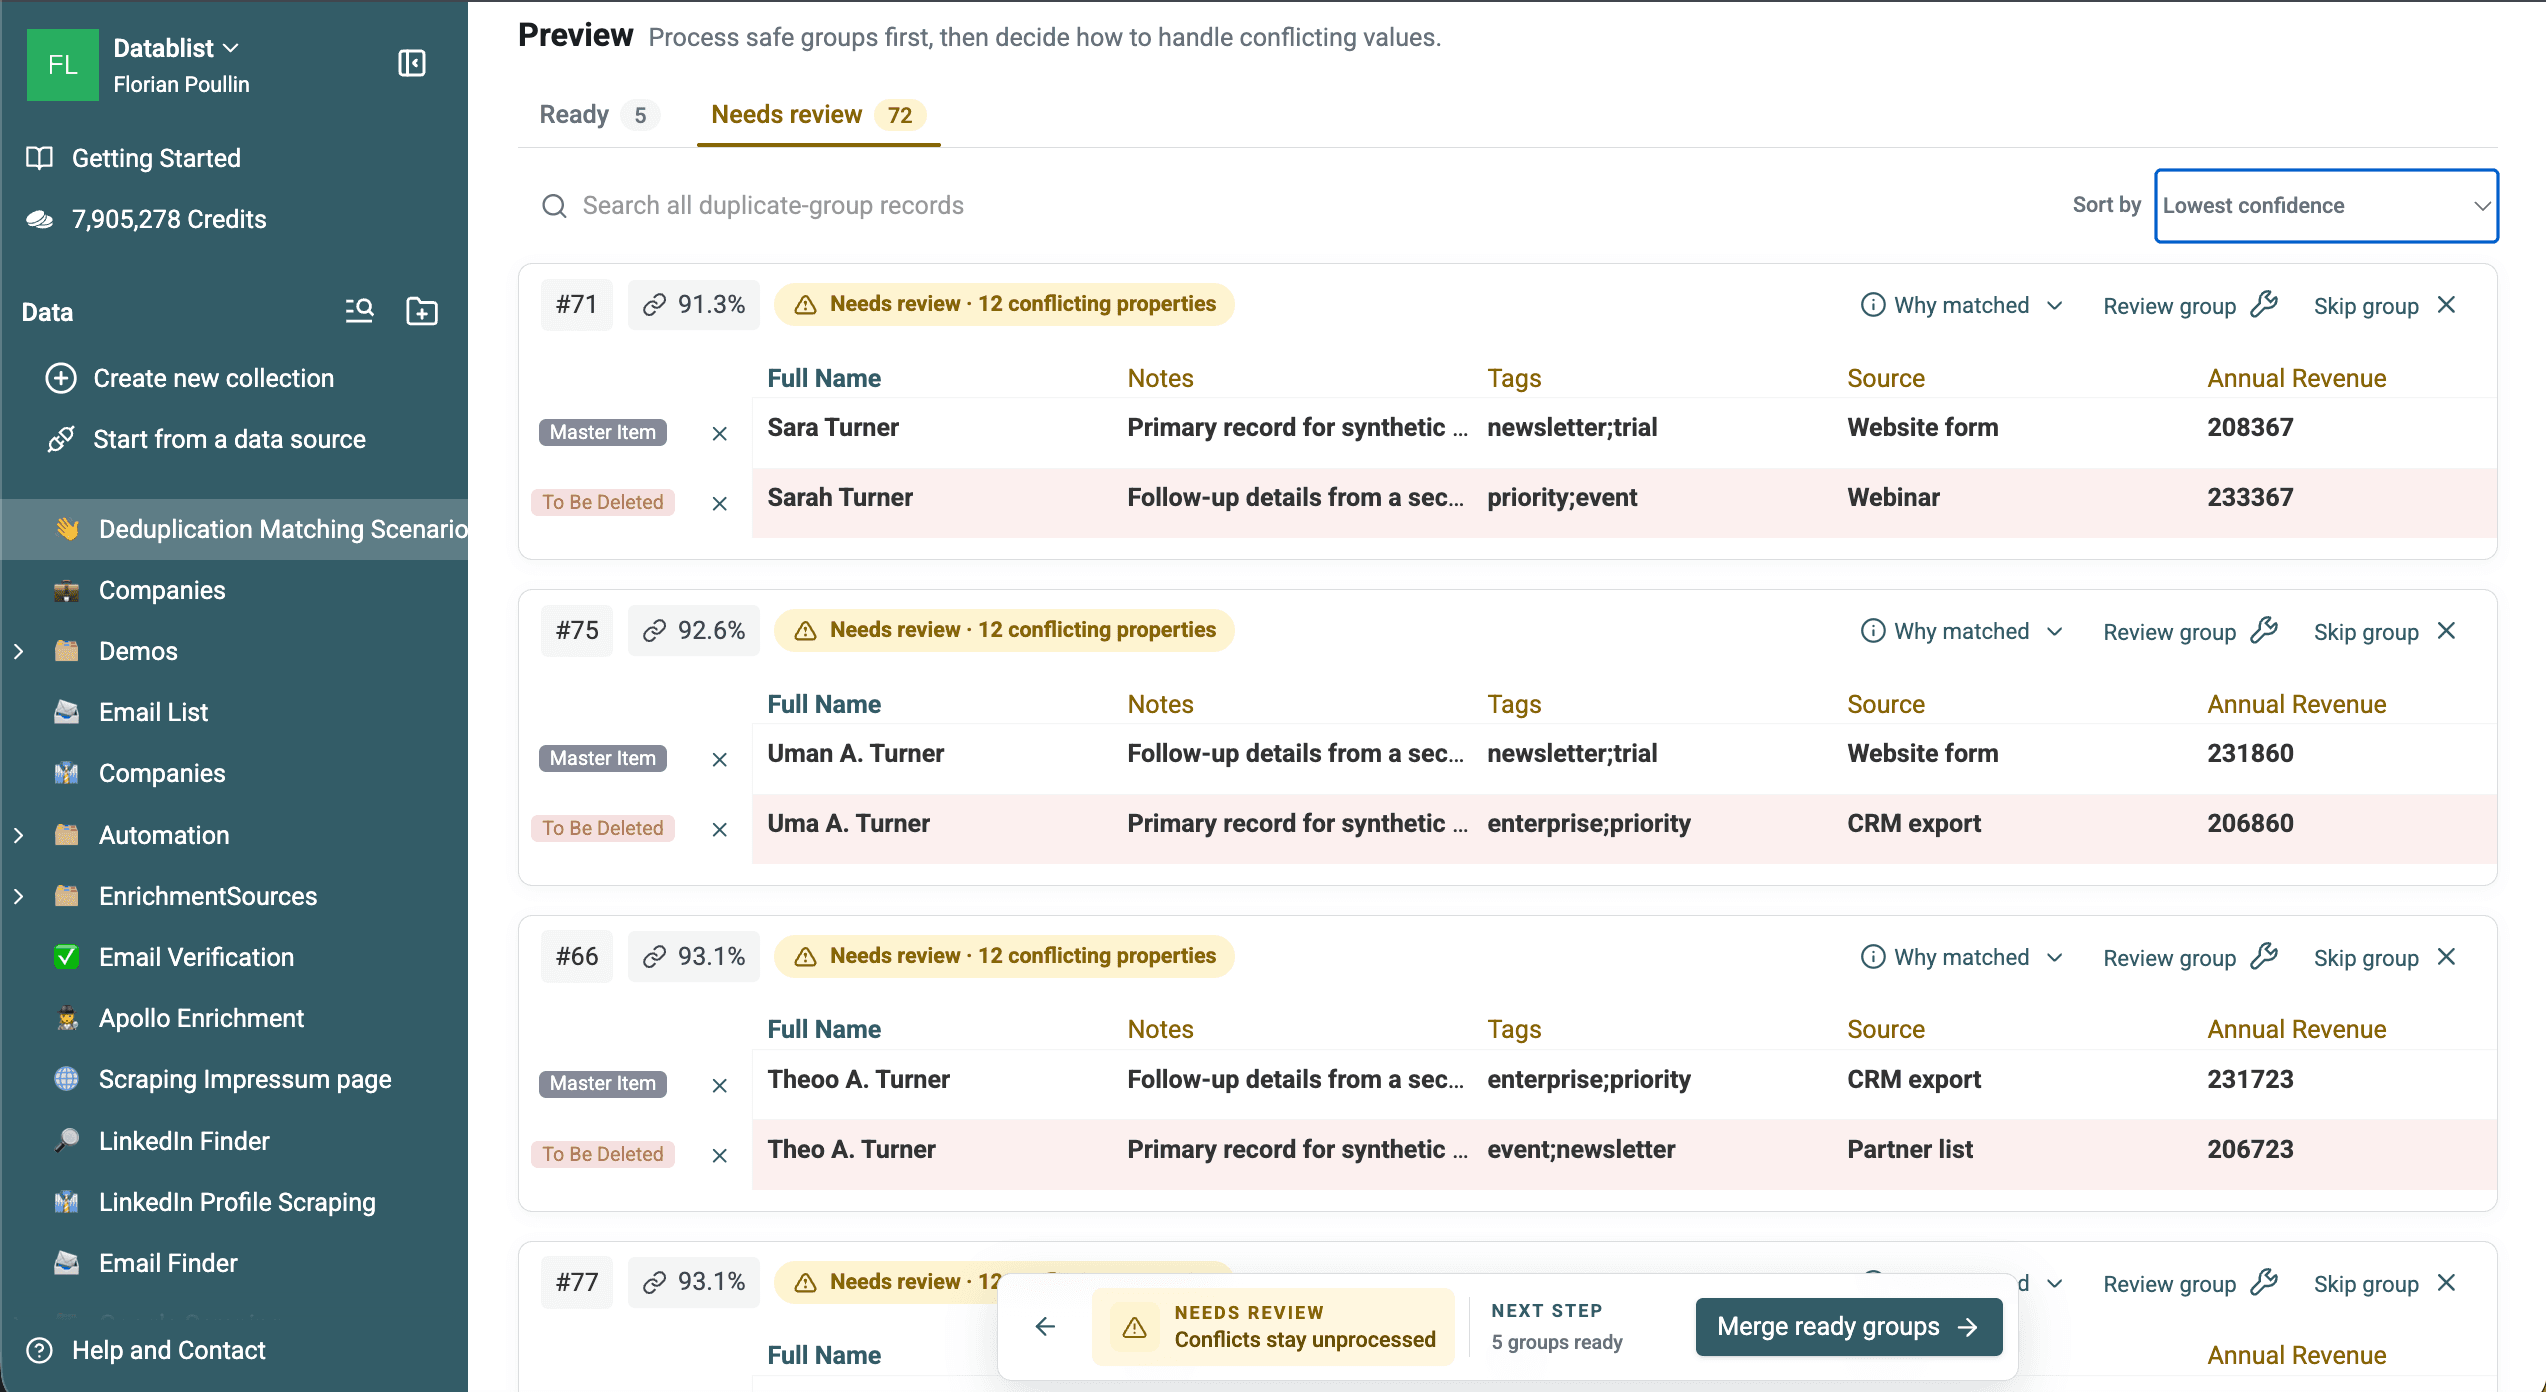
書き出した77件のLevenshteinグループをダウンロードすると、有効な一致と誤検出の両方を確認できます。
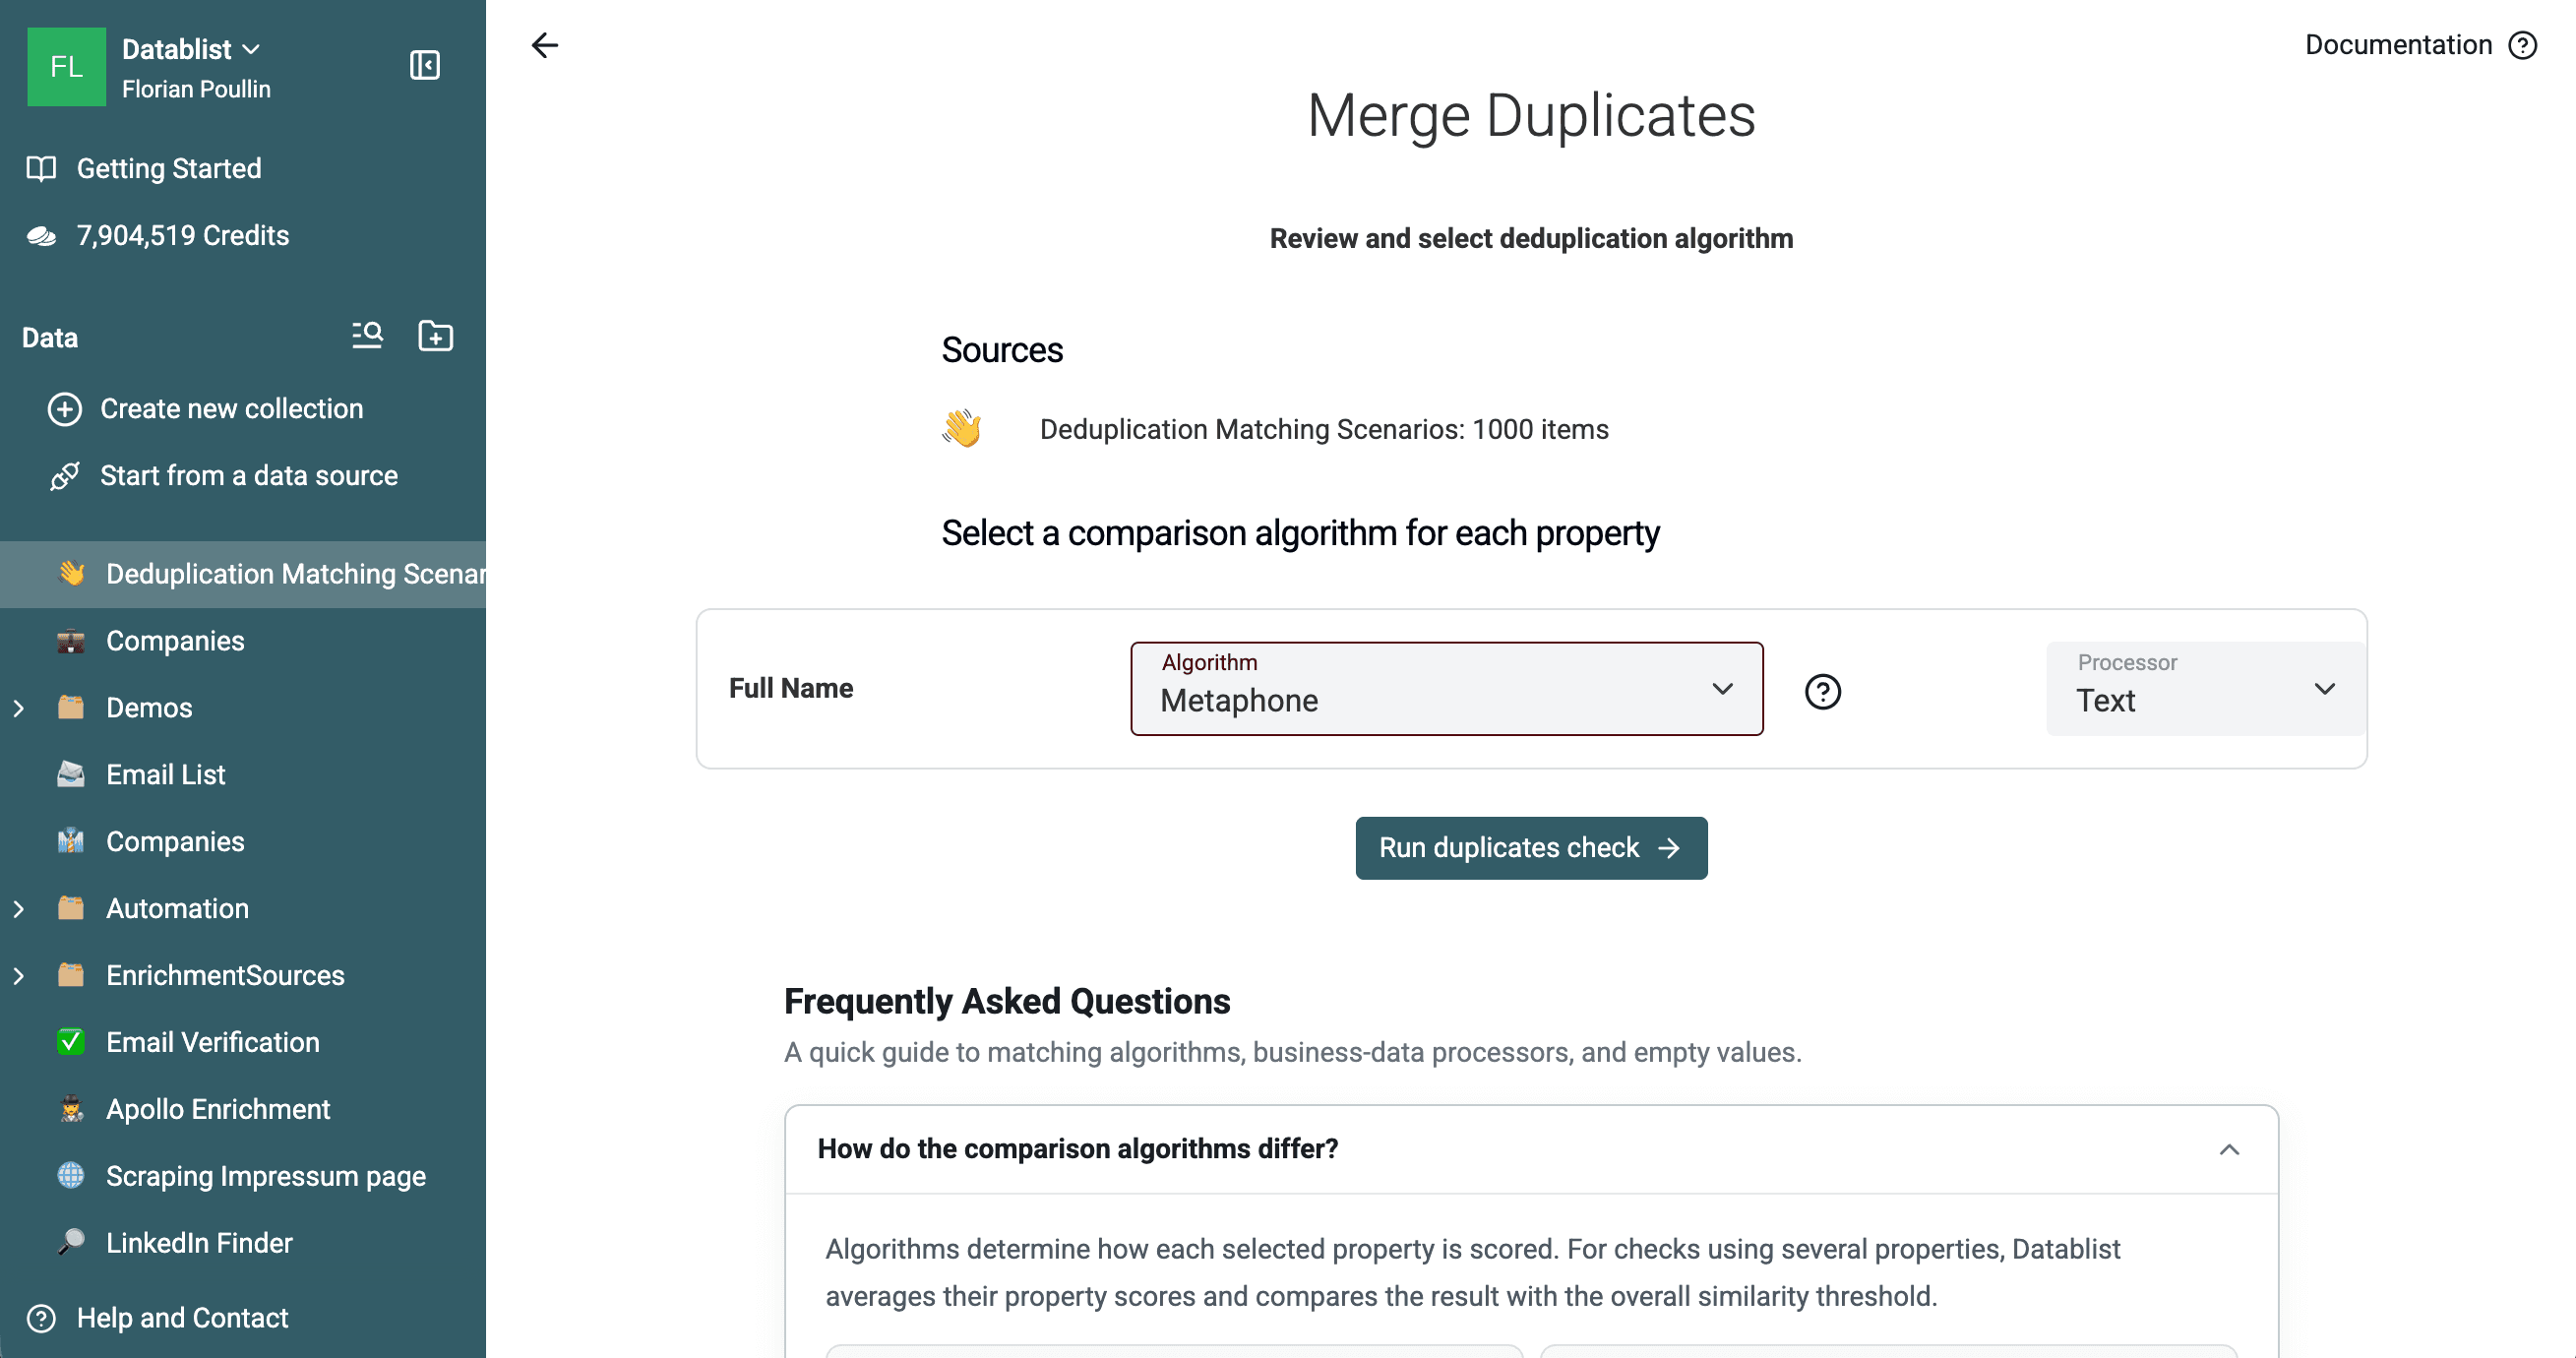
phonetic matchingでは、Full Nameを選択し、Metaphoneを指定して、Text processorをそのまま使用します。
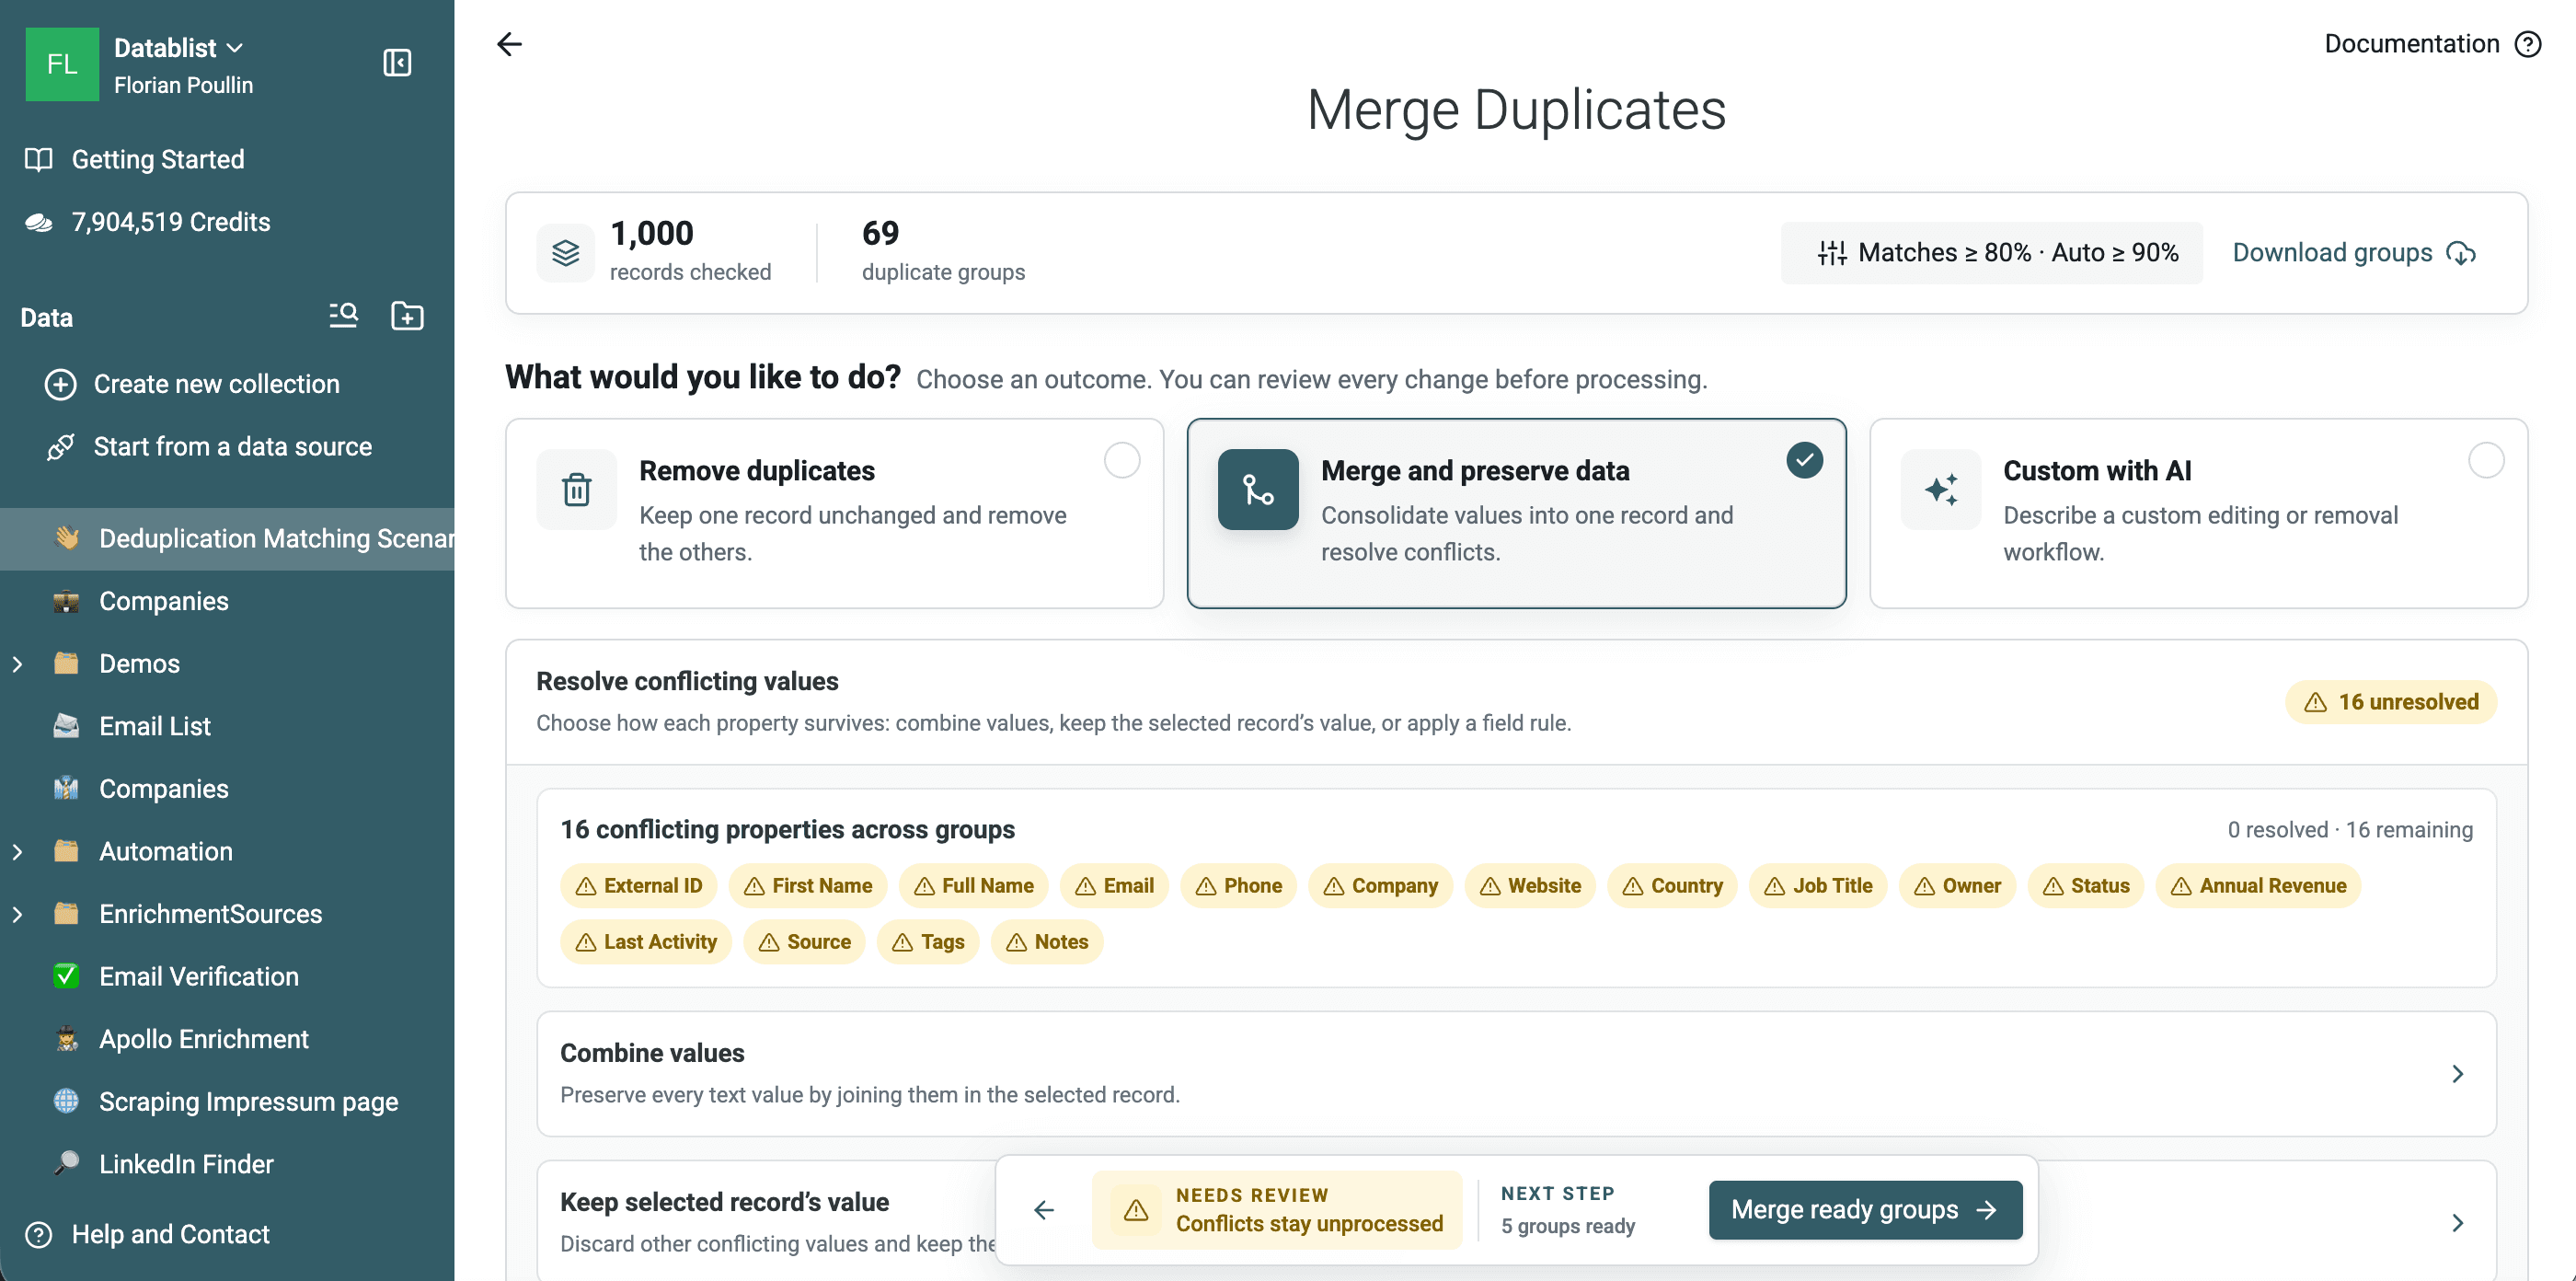
このチェックでは69グループが表示されました。内訳はReadyが5件、Needs reviewが64件です。書き出したグループには188行が含まれています。サンプルの既知のエンティティと照合したところ、同一エンティティだけで構成されるグループが19件、異なる人物が混在するグループが50件でした。各グループの行数は2~7行です。
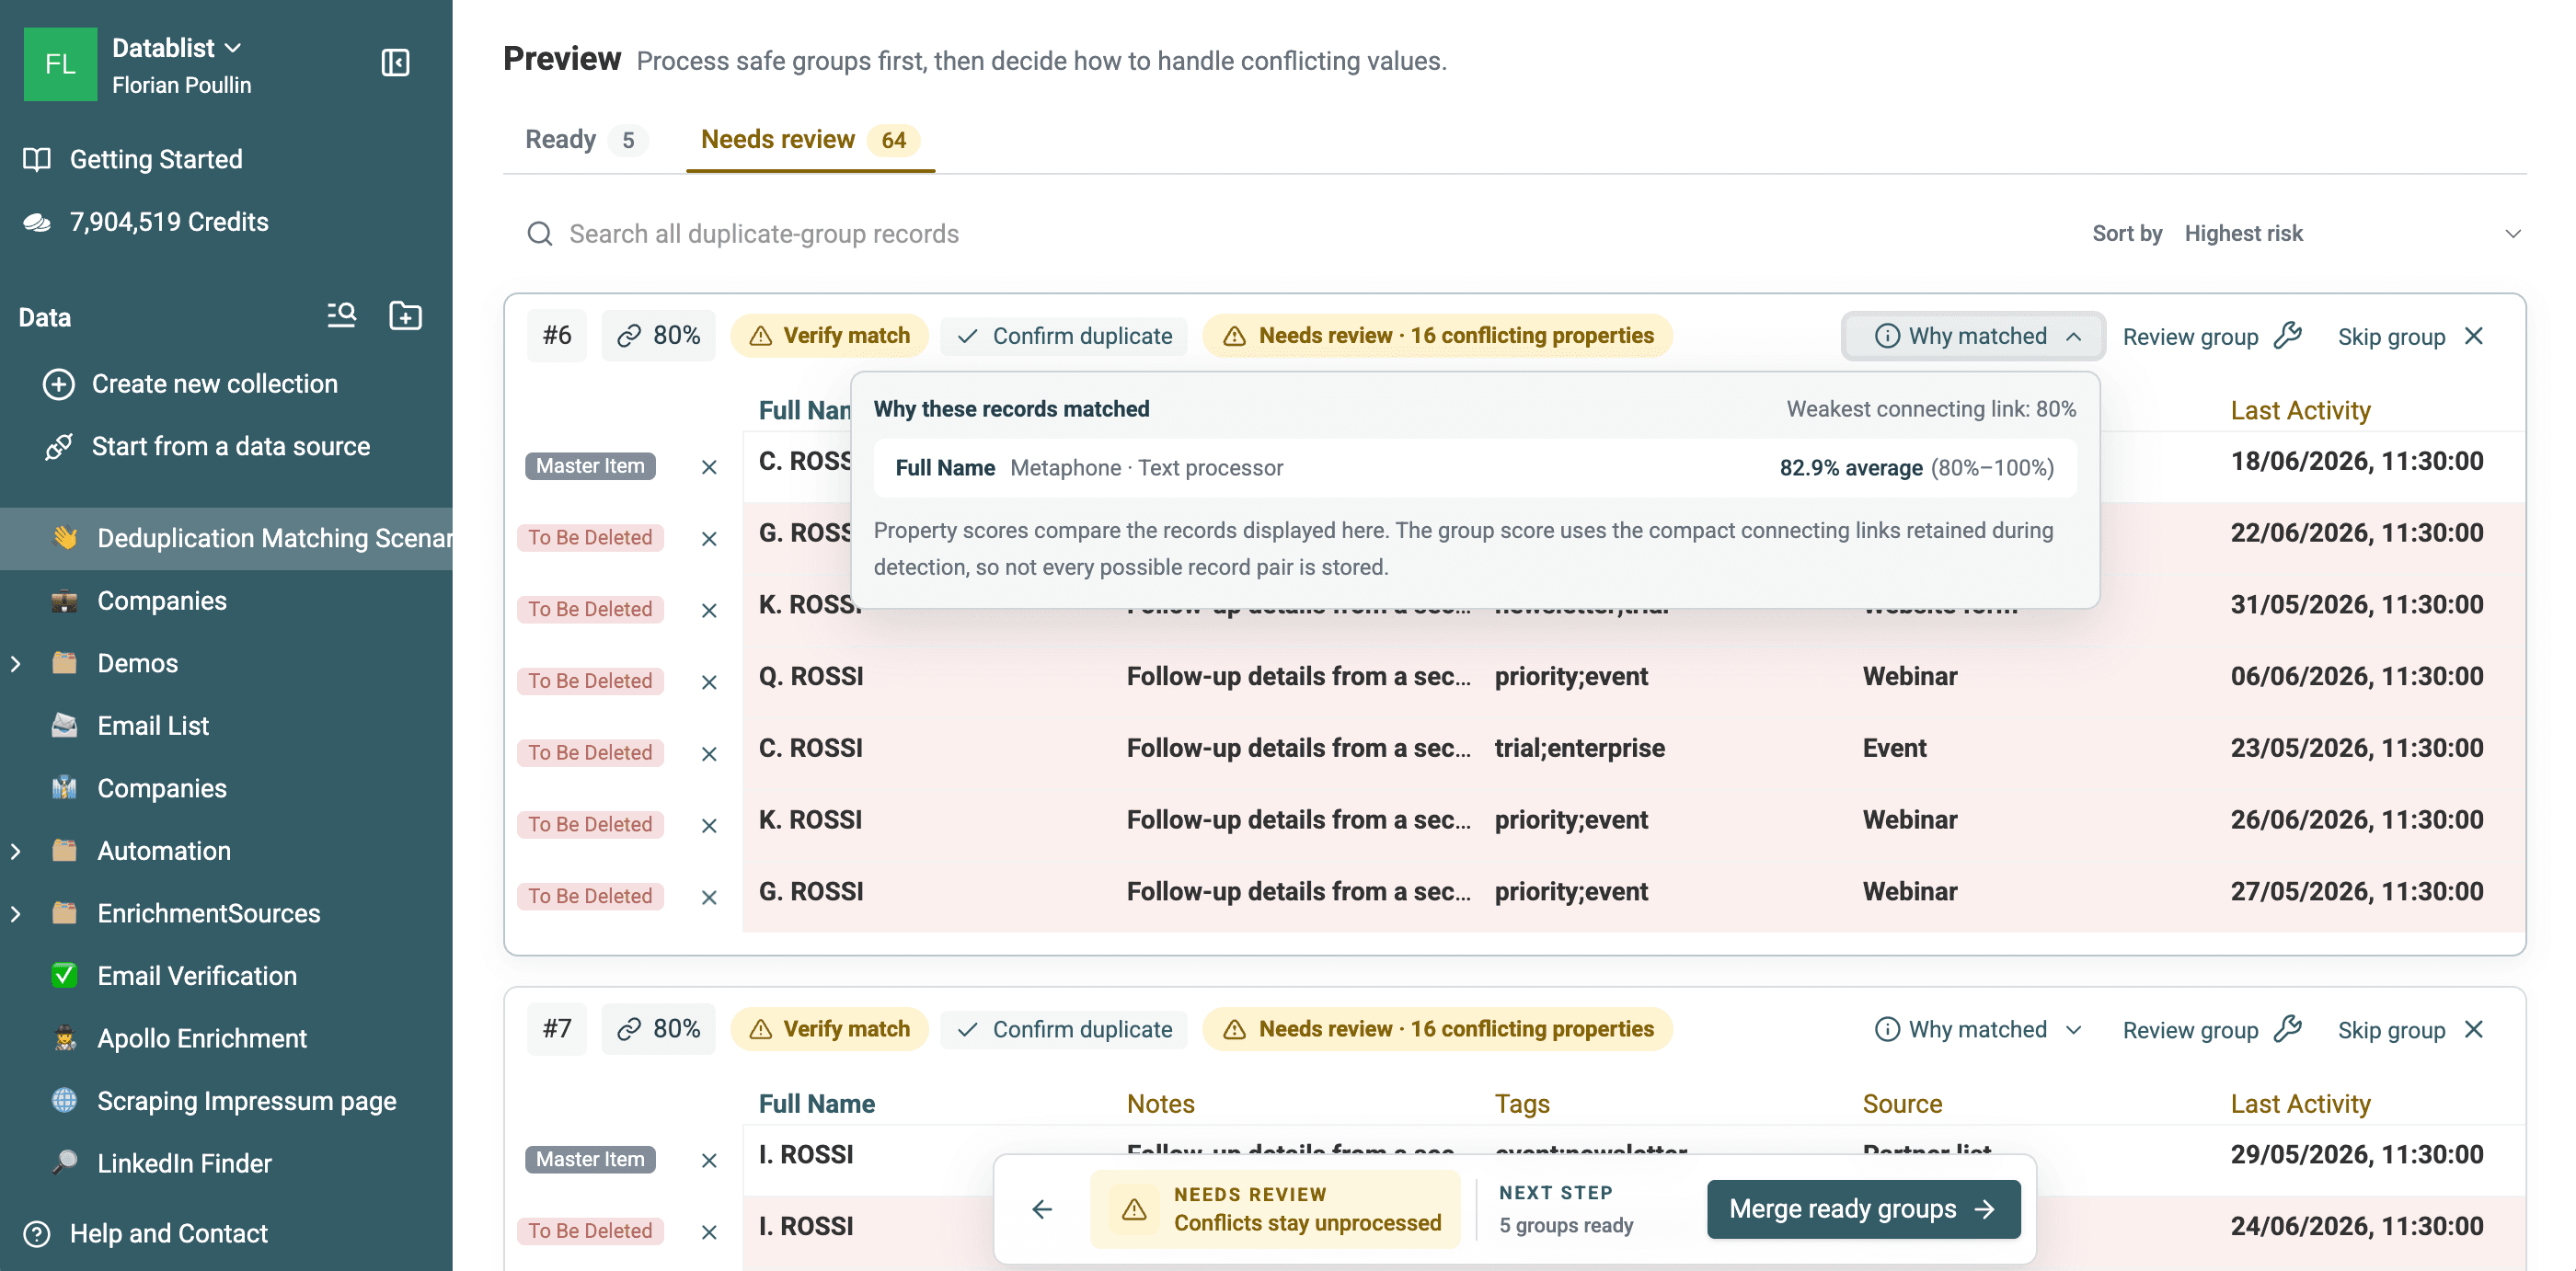
Why matchedでは、Full Name property、Metaphone algorithm、Text processor、グループスコアを確認できます。この情報は比較内容の監査に使用し、本人確認の代わりにはしないでください。
書き出した69件のMetaphoneグループをダウンロードすると、有効なphonetic matchと誤検出を確認できます。規模の大きい誤検出グループでは、略された複数のRossiのように、イニシャルと一般的な姓が結び付いていることがよくあります。phonetic codeは重なりますが、氏名だけでは自動マージに必要な本人確認の根拠が足りません。
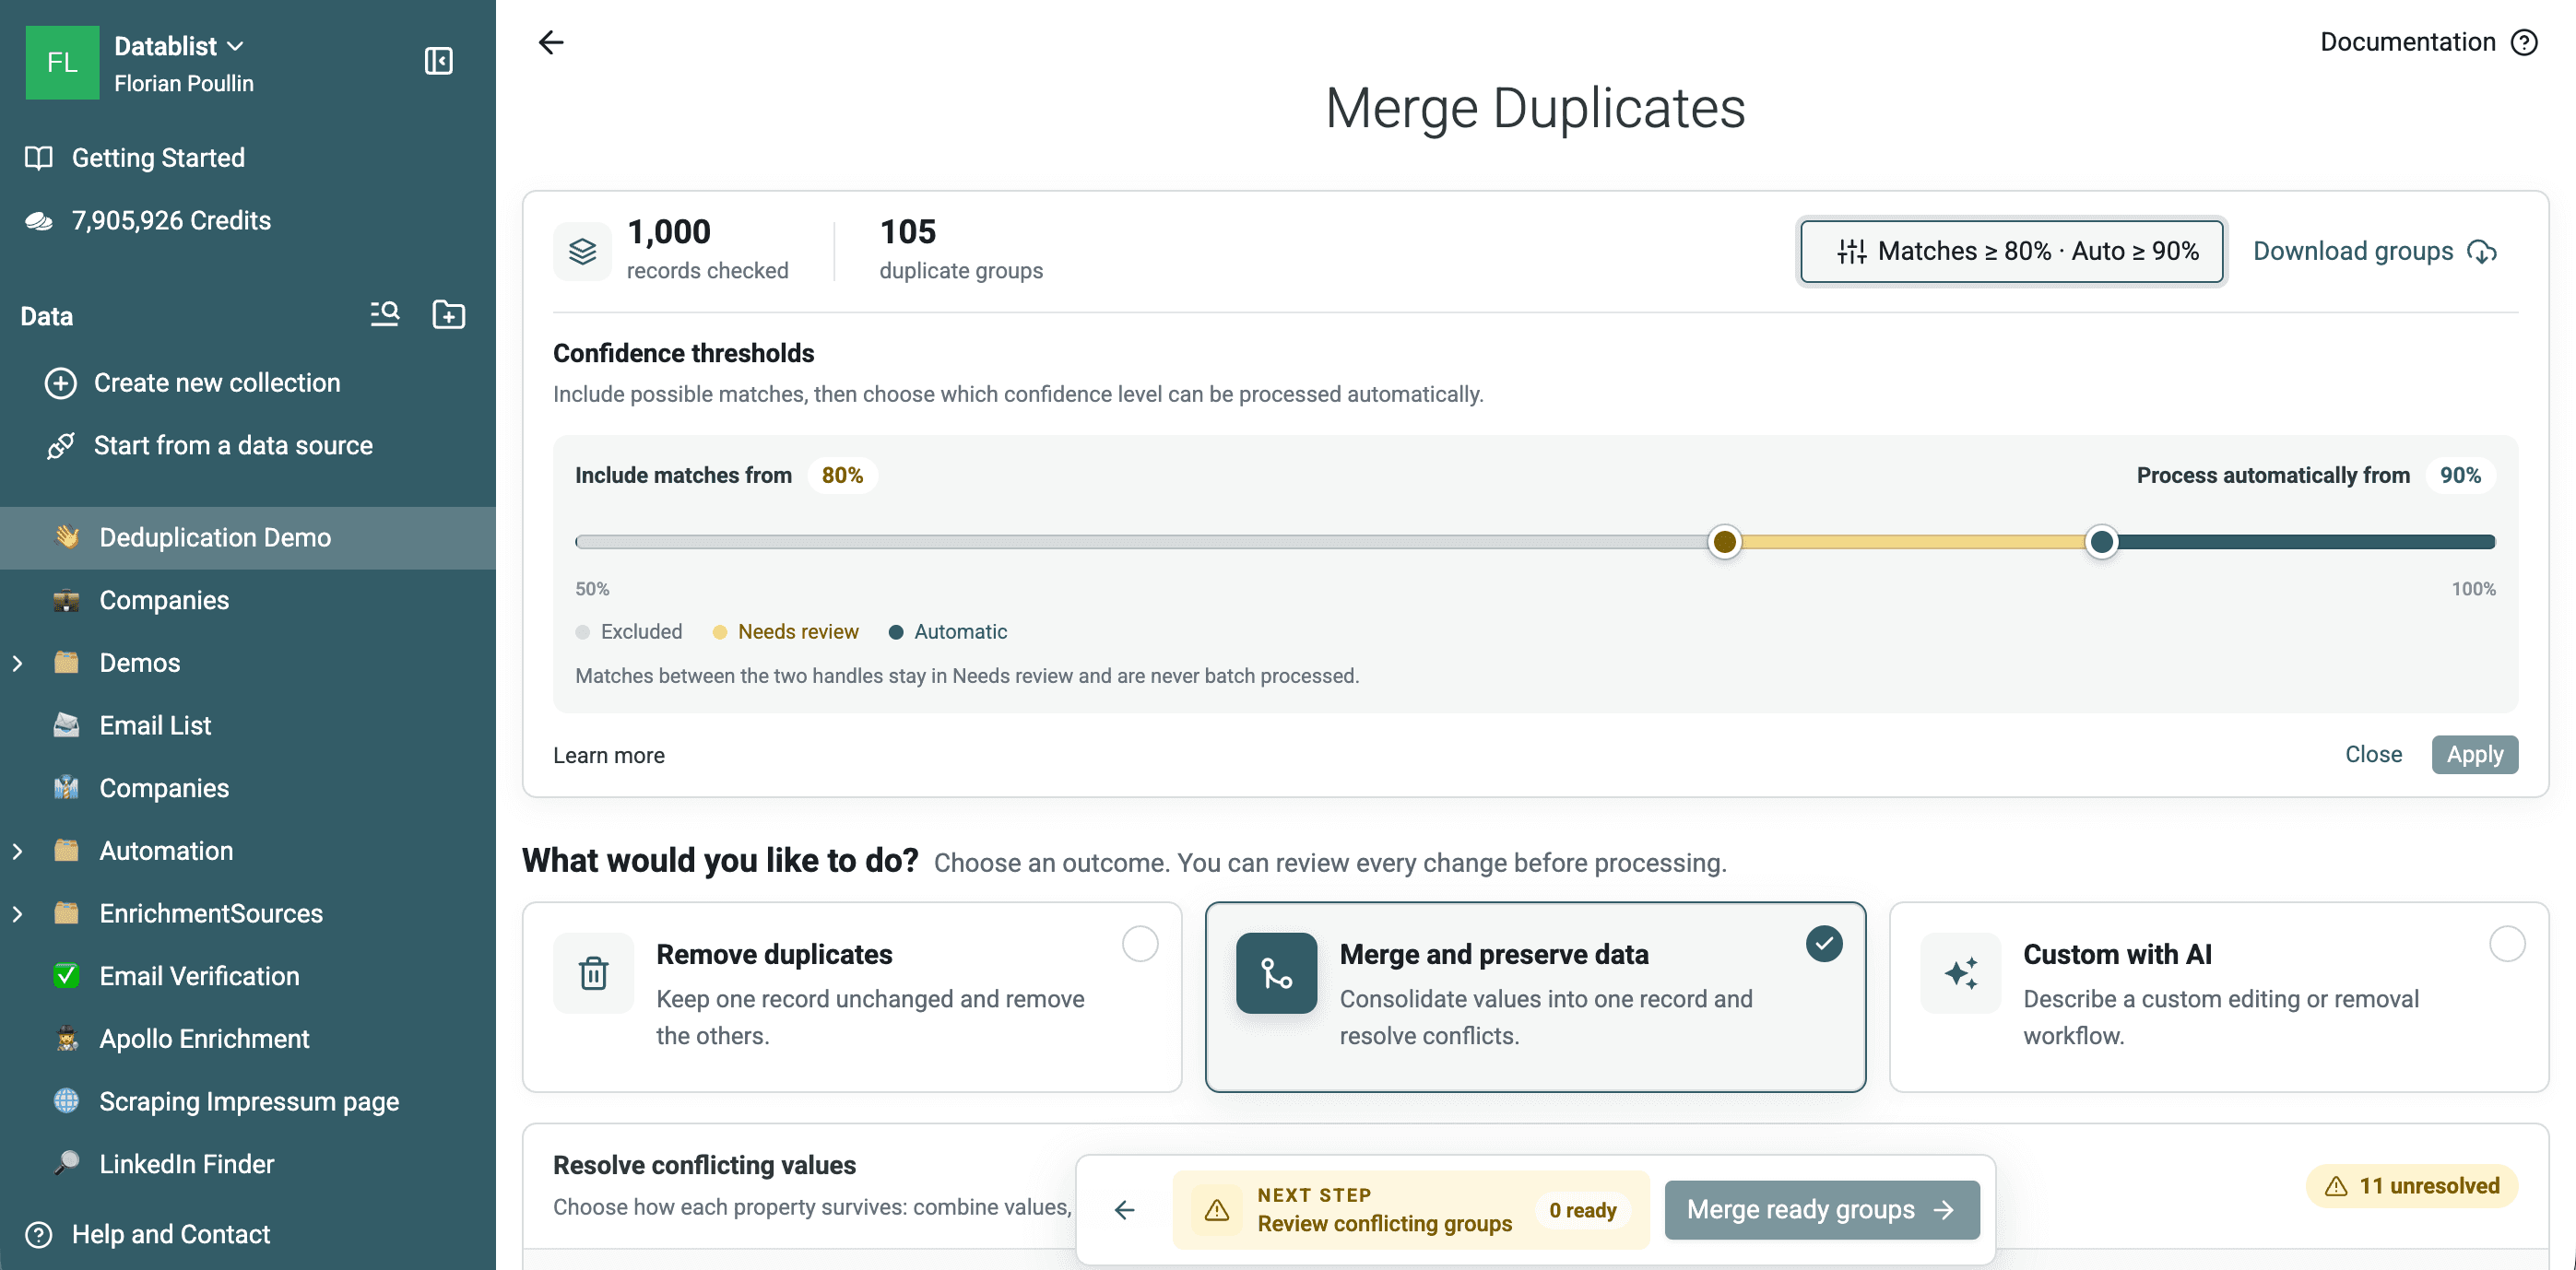
結果ページには2つの設定があります。
- Include matches fromは、表示するグループの範囲を決めます。
- Process automatically fromは、信頼度の低いグループをNeeds reviewに残し、一括処理の対象外にします。
この2つを分けることで、広い範囲の候補を確認しながら、すべてに同じ自動化ルールを適用せずに済みます。
重複グループを確認する
結果workspaceでは、重複グループがReadyとNeeds reviewに分けられます。
- Readyグループには具体的な処理結果があり、自動処理の信頼度しきい値を満たしています。
- Needs reviewグループは、信頼度が低い、マージの競合が未解決、レコード選択ルールに一致しない、またはカスタムルールによってスキップされたグループです。
判断が難しいグループでは、次の点を確認してください。
- すべての行が同じ人物、企業、商品を表していますか?
- どの識別子によって一致しましたか?
- 相互に補完できる値はありますか?
- どのソースが信頼できますか?
- 行を削除すると電話番号、ID、ステータス、日付、メモが失われませんか?
- 信頼性の低い3件目のレコードを介してグループ化されていませんか?
Why matchedでは、マッチングに使用したproperties、algorithms、processors、スコア範囲を確認できます。fuzzyチェックにおけるグループの類似度は、そのグループを結び付けておくために必要な保持済みリンクのうち、最も弱いものを示します。
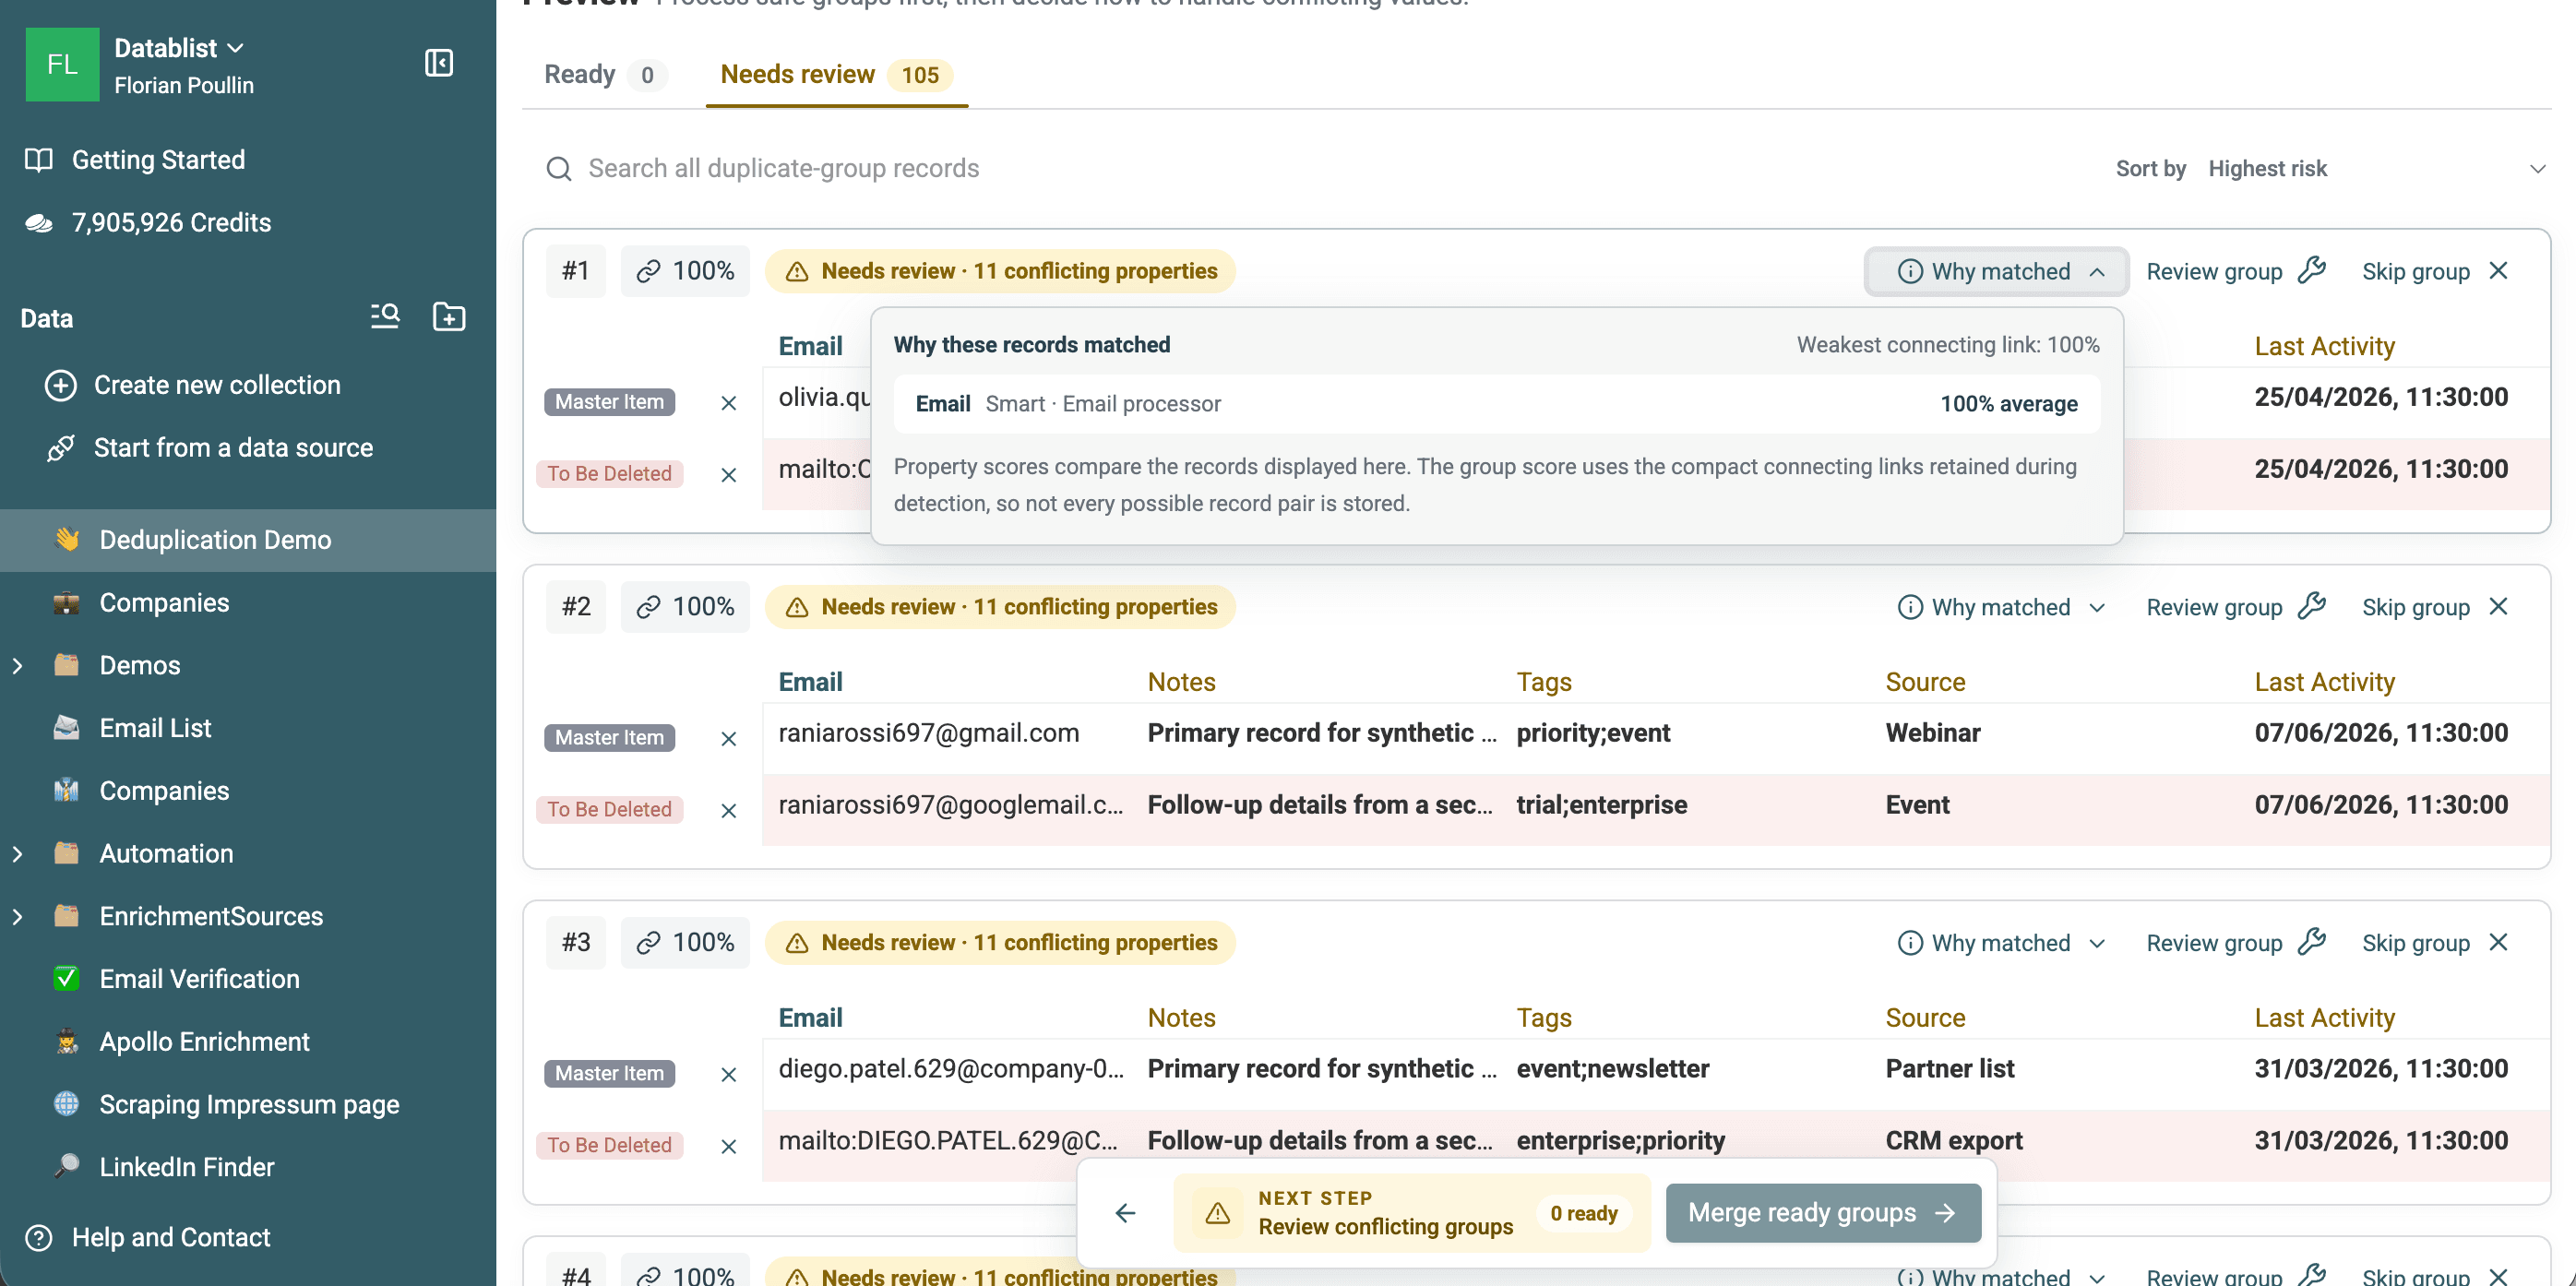
次の操作も可能です。
- 信頼度の低い一致を承認する。
- レコードを削除せずにグループから外す。
- グループをスキップする。
- レコードを開いて編集する。
- Merging Assistantでグループを確認する。
- 残りの全グループを検索し、リスクの高い候補から並べ替える。
⚠️ fuzzyグループをパーセンテージだけで処理しないでください
似た氏名でも別人の場合があります。グループを承認する前に、識別子と周辺のフィールドを確認してください。
マージ前に共有・欠損識別子を確認する
info@company.exampleのような共有受信箱は、複数の連絡先が利用している場合があります。同じアドレスを持つ2人がEmailで一致しても、別人かもしれません。同様に、会社ドメインは1社を識別できても、多数の従業員レコードに表示されます。
別の識別子が一致を裏付けるまでは、このようなグループを人物単位の自動マージから除外することをおすすめします。一方、1社につき1行にまとめることが目的なら、共有ドメインは適切なグループ化キーになり得ます。結果を判断する前に、対象となるエンティティを定義してください。
空値のルールも、選択プロパティによる比較結果を左右します。Exact以外の方法で複数プロパティをチェックする場合、高度なEmpty Value Rule設定でValue required (default)またはMatch on empty valueを選択できます。デフォルトではテキスト識別子に値が必要ですが、空値での一致を許可すると、この条件が緩和されます。ほかのマッチングフィールドに十分な本人確認の根拠がある場合に限って使用してください。メールアドレスが両方とも空欄であることは、2人が同一人物である根拠にはなりません。
たとえば、Emailが空欄でFull Nameが異なる2行を、単に行数を減らす目的でマージすべきではありません。メールアドレスがない行にも、保持または後からenrichすべき連絡先が含まれている可能性があります。
重複を削除・マージ・カスタム処理する
重複を見つけることと、その重複をどう処理するかは別の判断です。2行目以降に何が含まれているかを確認してから、処理モードを選択してください。
信頼できる行が1つなら重複を削除する
Remove duplicatesでは、選択した1件のレコードを変更せずに残し、各Readyグループのほかの行を削除します。
コピーされた行、一時的なインポート、または2行目以降の値を破棄できるレコードに適しています。削除対象のレコードに追加情報や競合する情報が含まれる場合は、プレビューに警告が表示されます。これらの値は、残すレコードにはコピーされません。
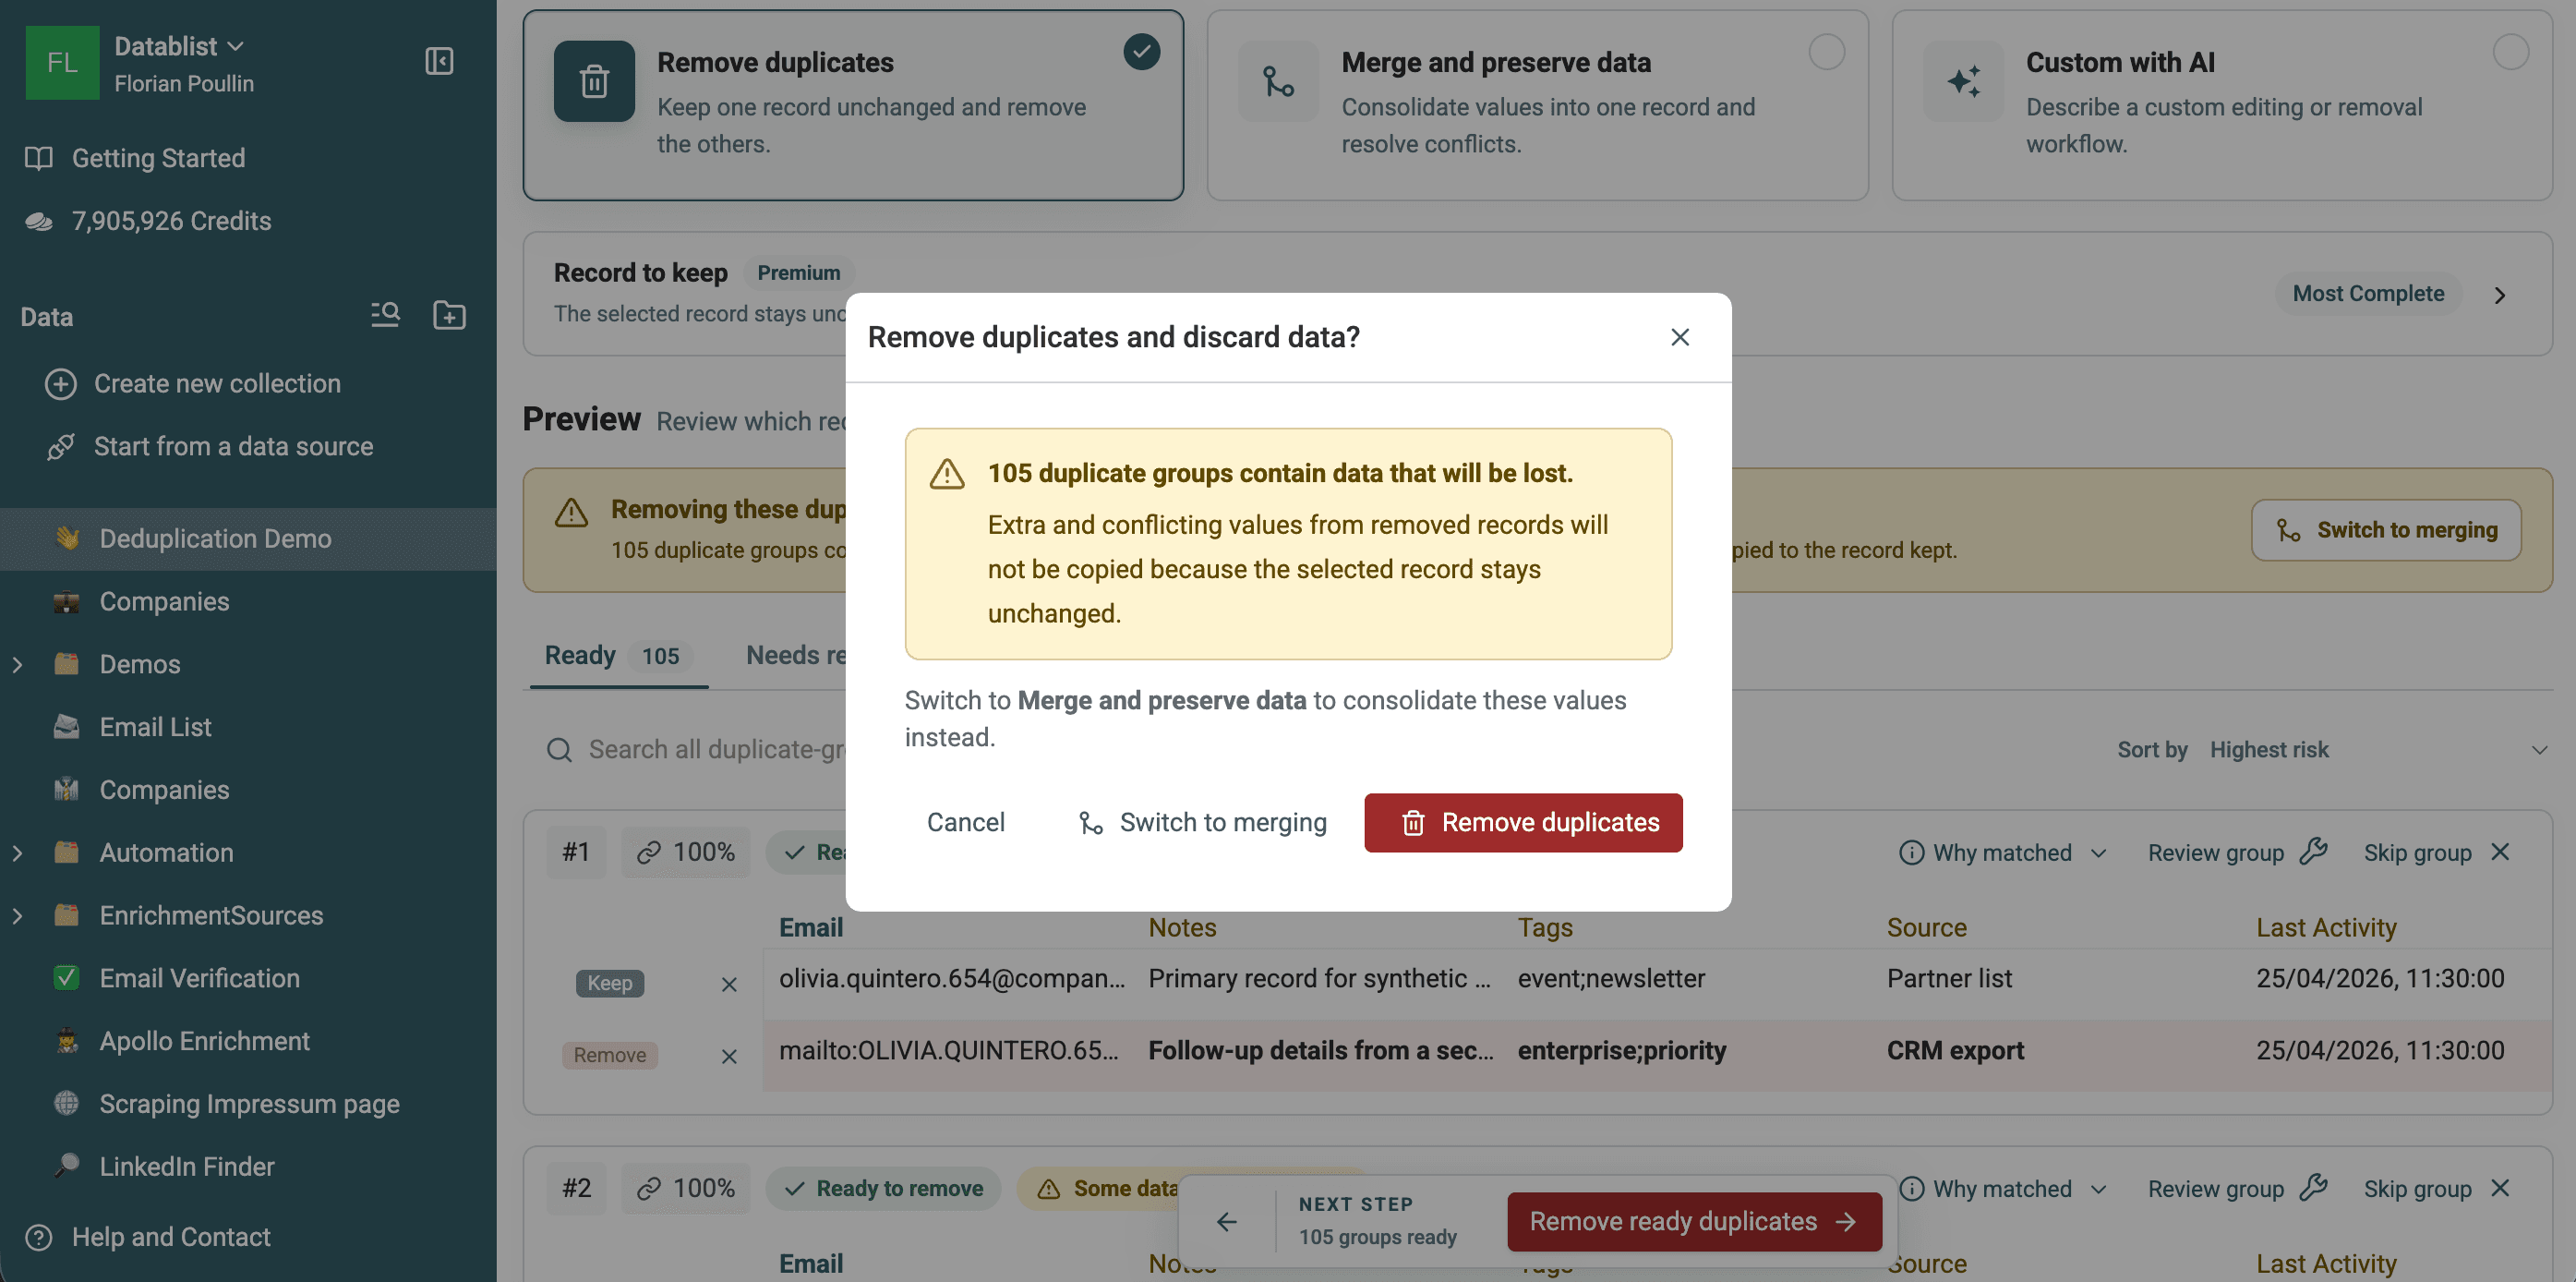
有用なデータがある行はマージする
Merge and preserve dataでは、選択したレコードの空欄を補完し、設定に従って競合を解決してから、2行目以降を削除します。
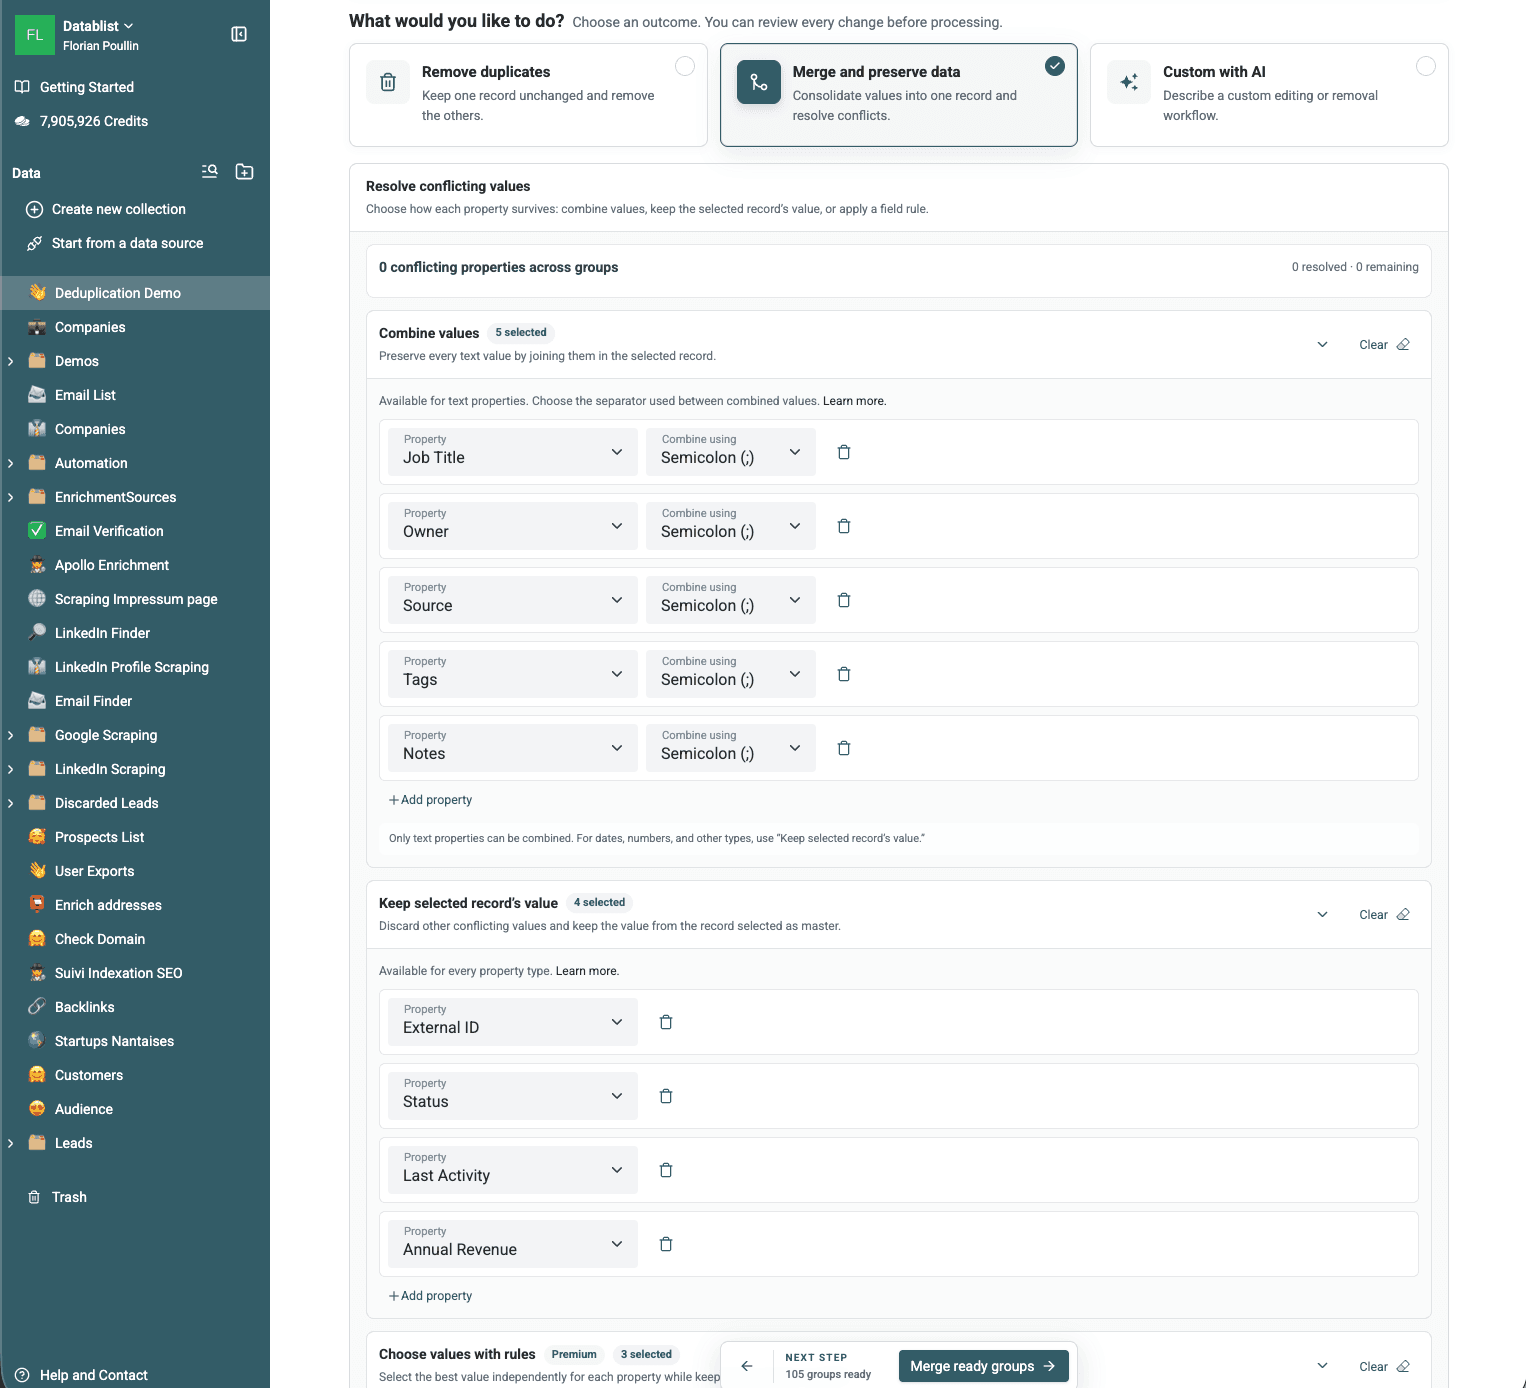
まずRecord to keepルールを設定します。デフォルトはMost Completeです。有料プランでは、作成日時、更新日時、property valueの最大・最小、必須property valueなどに基づくルールを選択できます。
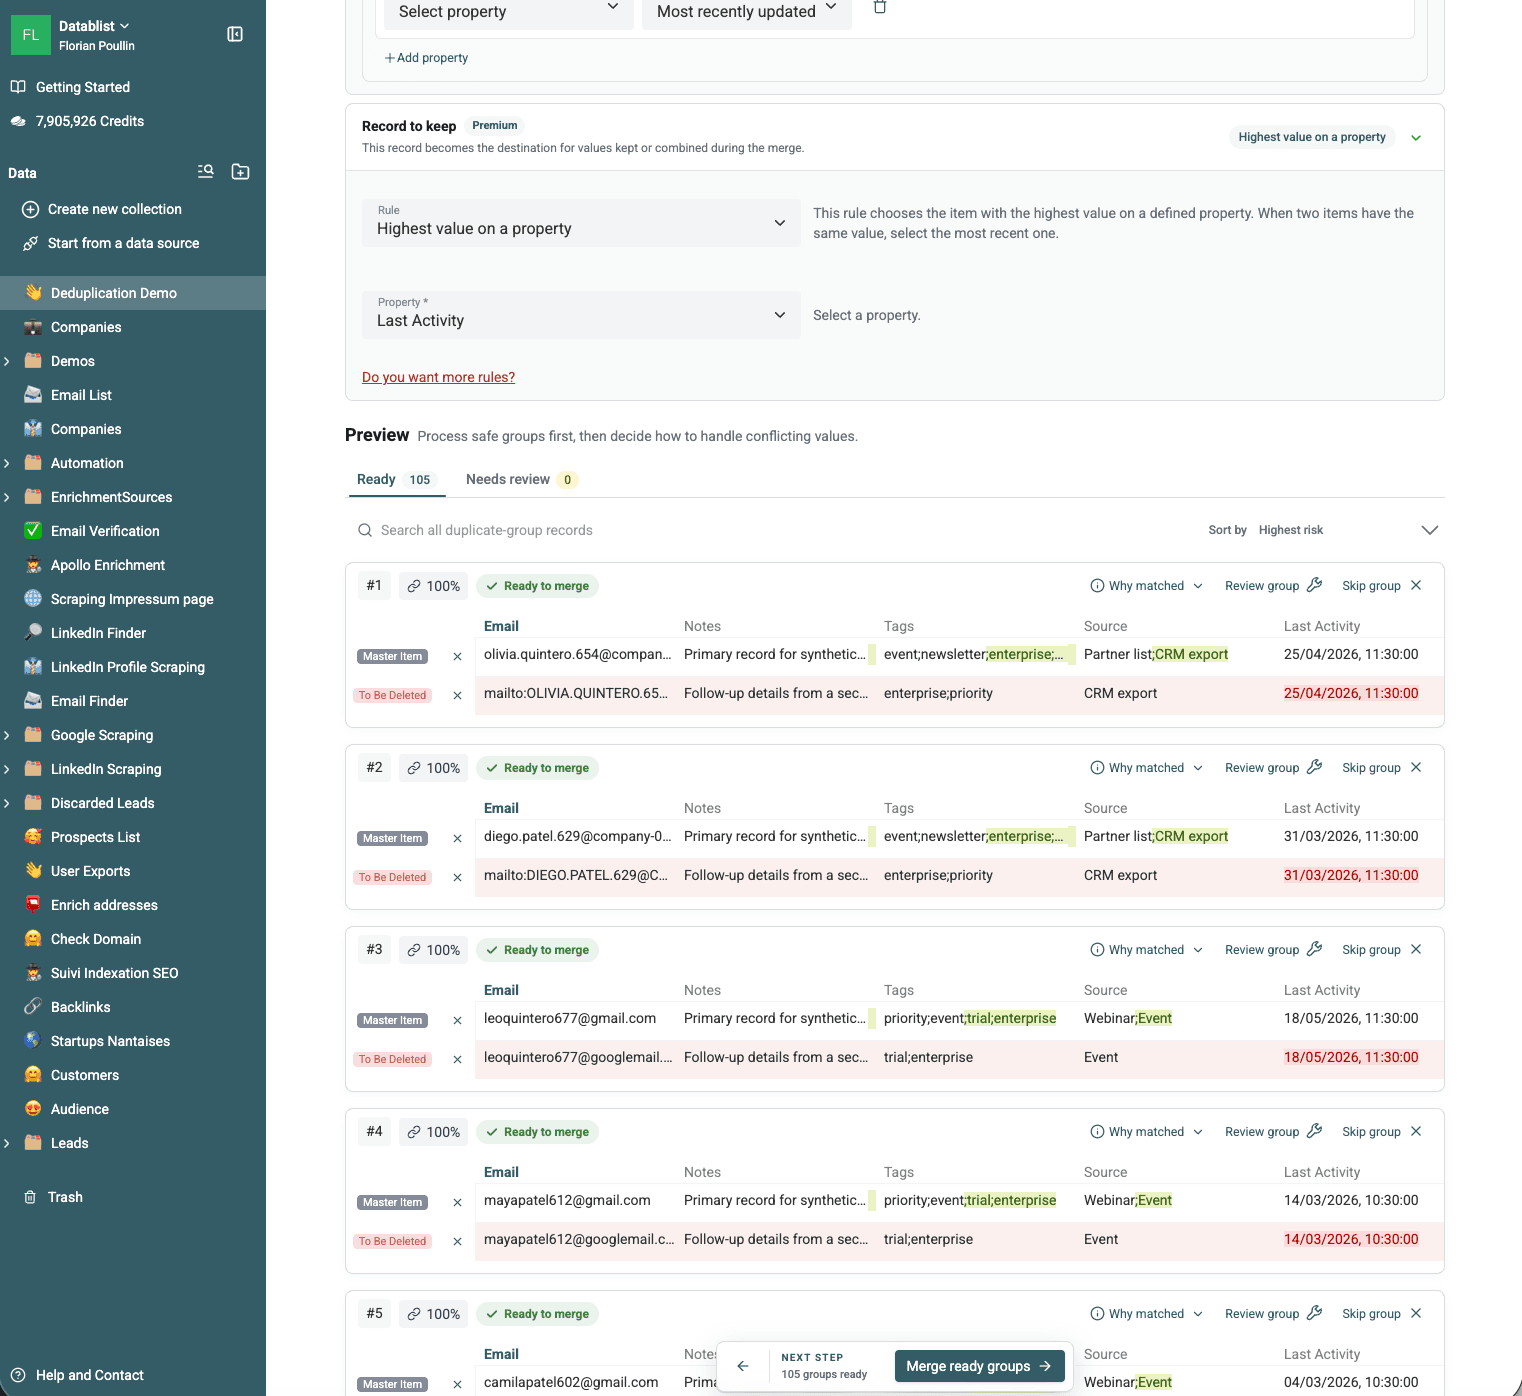
次に、競合する各propertyをどのように残すか決めます。
- 異なるテキスト値を区切り文字で連結する。
- 選択したレコードの値を残す。
- 有料プランでは、最新、最古、最長、最短、最大、最小、最頻などのルールで値を個別に選ぶ。
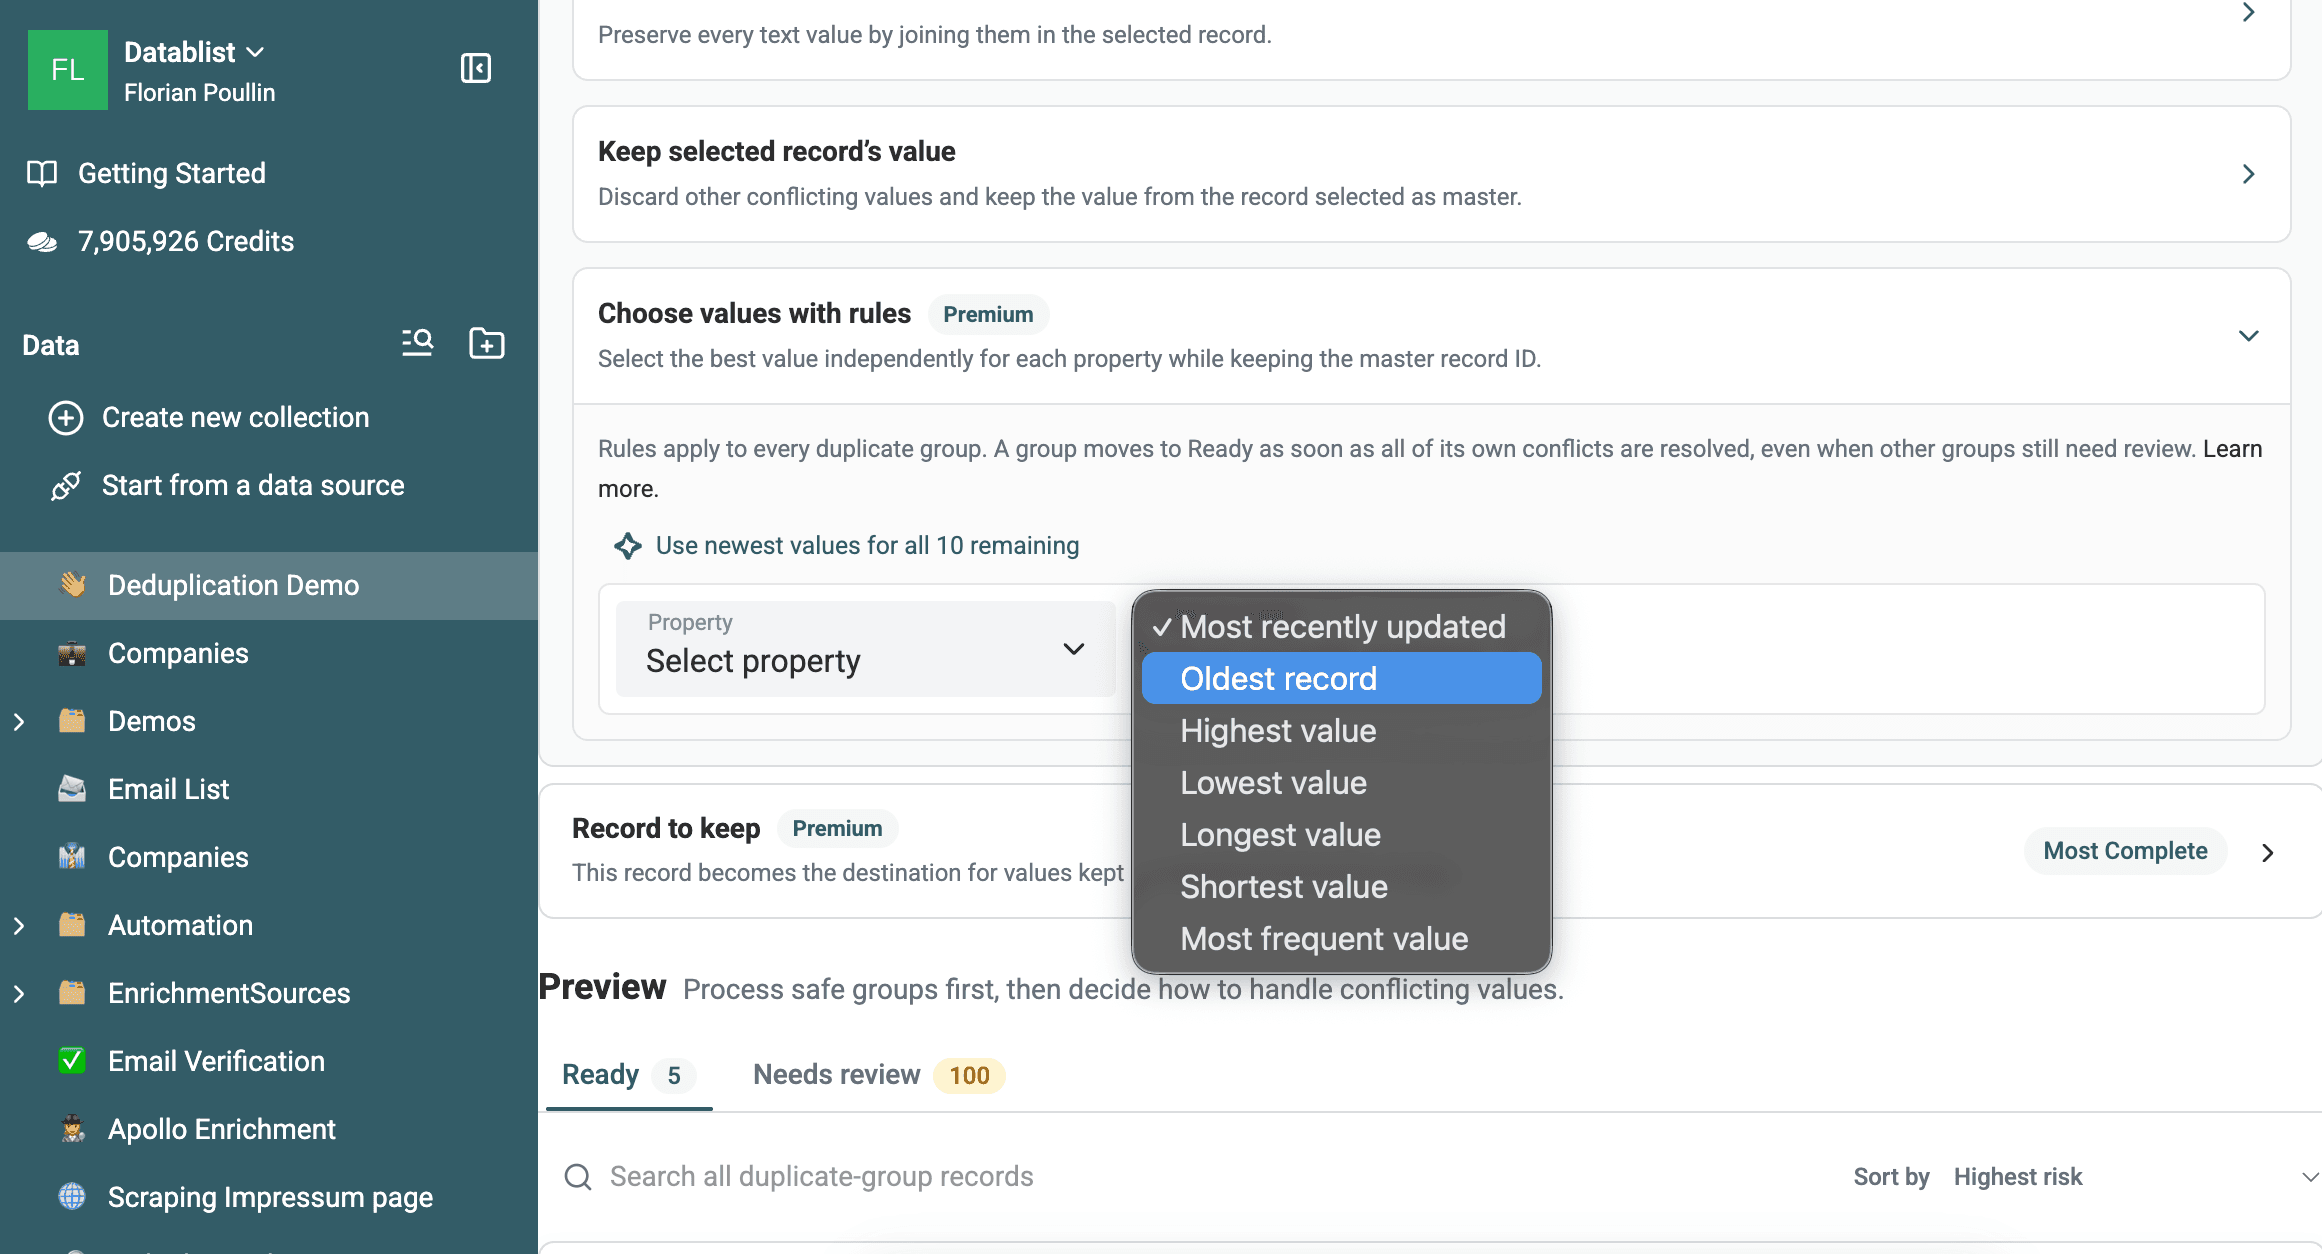
どの行にも全プロパティの最適な値がそろっていない場合は、フィールド単位のルールを使用します。選択したレコードのIDを保持しつつ、ほかの行から新しい役職、より完全な会社名、最も多く使われているステータスを取得できます。
しきい値、workflow、グループの構成、競合設定、レコード選択ルールを変更した後は、プレビューを更新してください。
Custom with AIでグループ別のロジックを適用する
Custom with AIは、自然言語の指示からグループ処理workflowを生成します。レコードの選択、値のコピーや正規化、ステータスpropertyの追加、グループ合計の計算、2行目以降の削除、条件を満たさないグループのスキップなどが可能です。
たとえば、次のように指示できます。
SourceがCRM exportのレコードを残してください。最新レコードからJob Titleをコピーし、異なるNotesを改行で連結して、Duplicate Reviewedチェックボックスを追加した後、2行目以降のレコードを削除してください。
collection propertyは/Propertyまたは{{Property}}で参照します。実行前にworkflowを生成し、プレビューで確認してください。Custom with AIは、認証済みの有料プランユーザーが利用できます。
個別の例外には、一括ルールを複雑にするのではなく、Review groupを開いてMerging Assistantを使用してください。
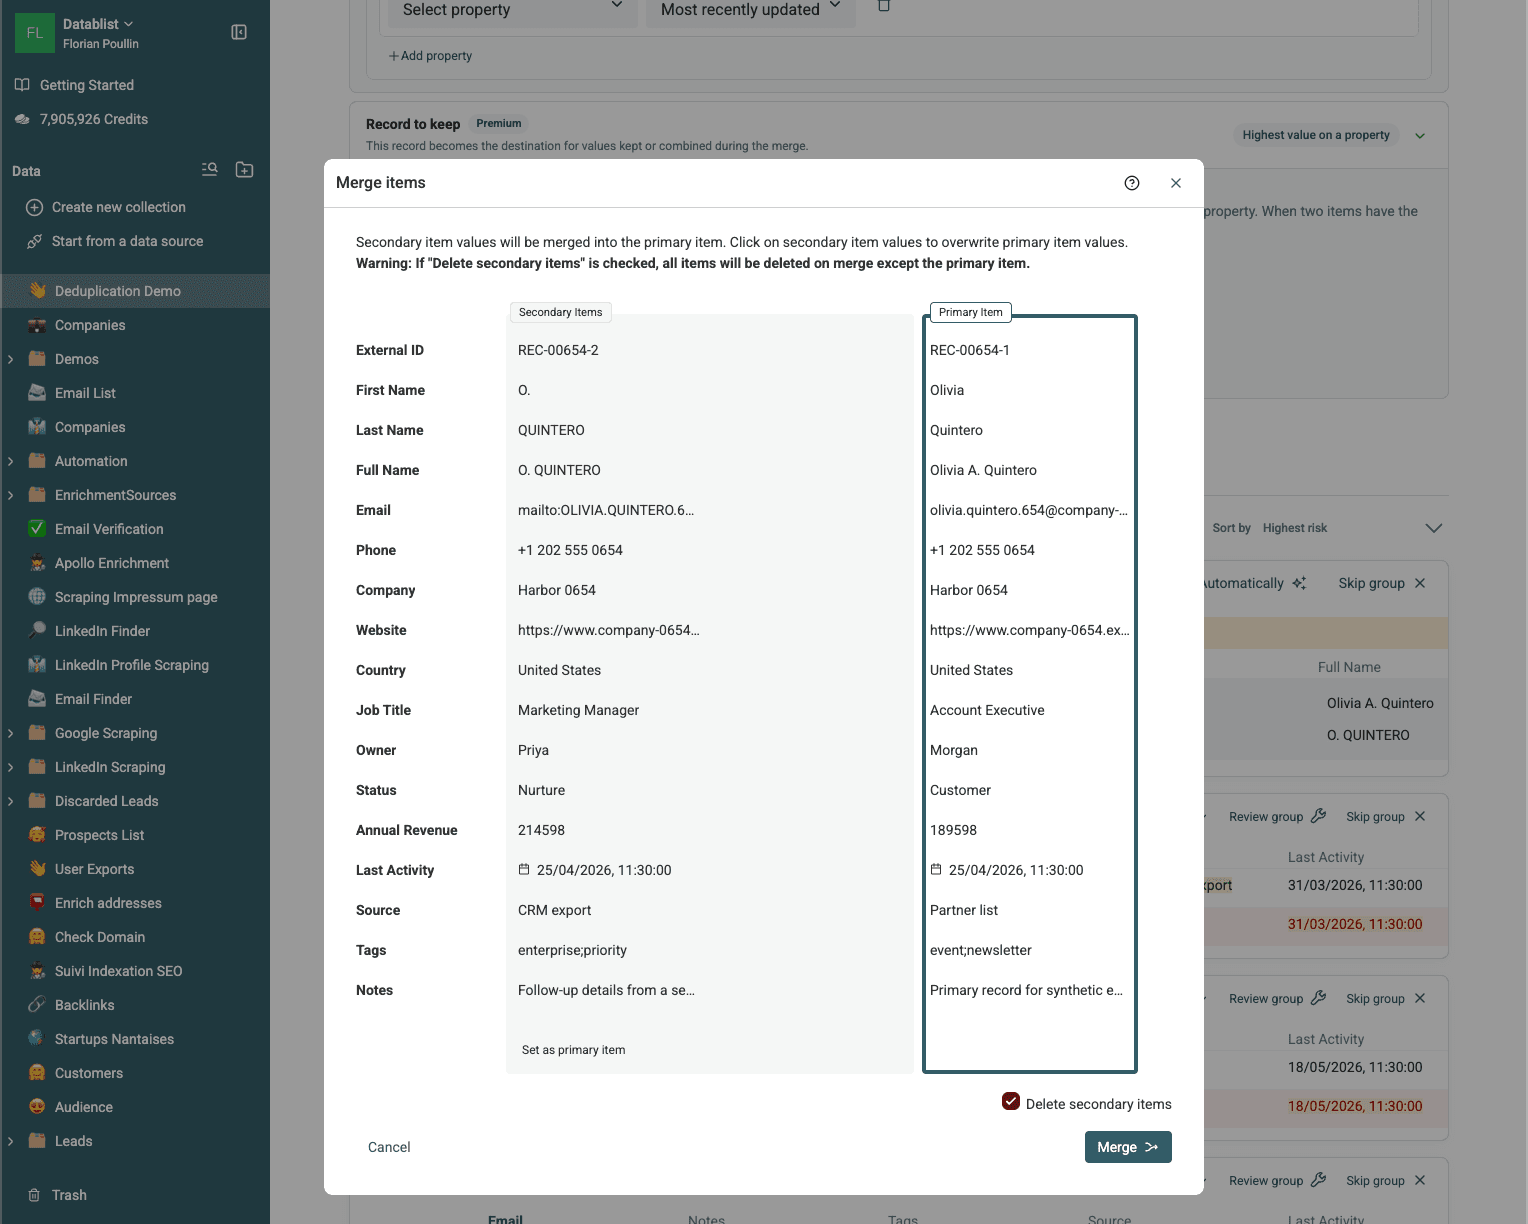
クリーンなリストを検証して書き出す
Readyグループを処理する前に、次の点を確認してください。
- プレビューに現在の設定が反映されている。
- 信頼度の低いグループと共有識別子のグループを確認した。
- 選択したレコードに保持すべきIDがある。
- 一意の電話番号、ソース、メモ、ステータスが残る。
- 1つの値だけが許されるフィールドで値が連結されない。
- 表示されているReadyの件数が、処理したい範囲と一致する。
処理後は、次の式で行数を照合します。
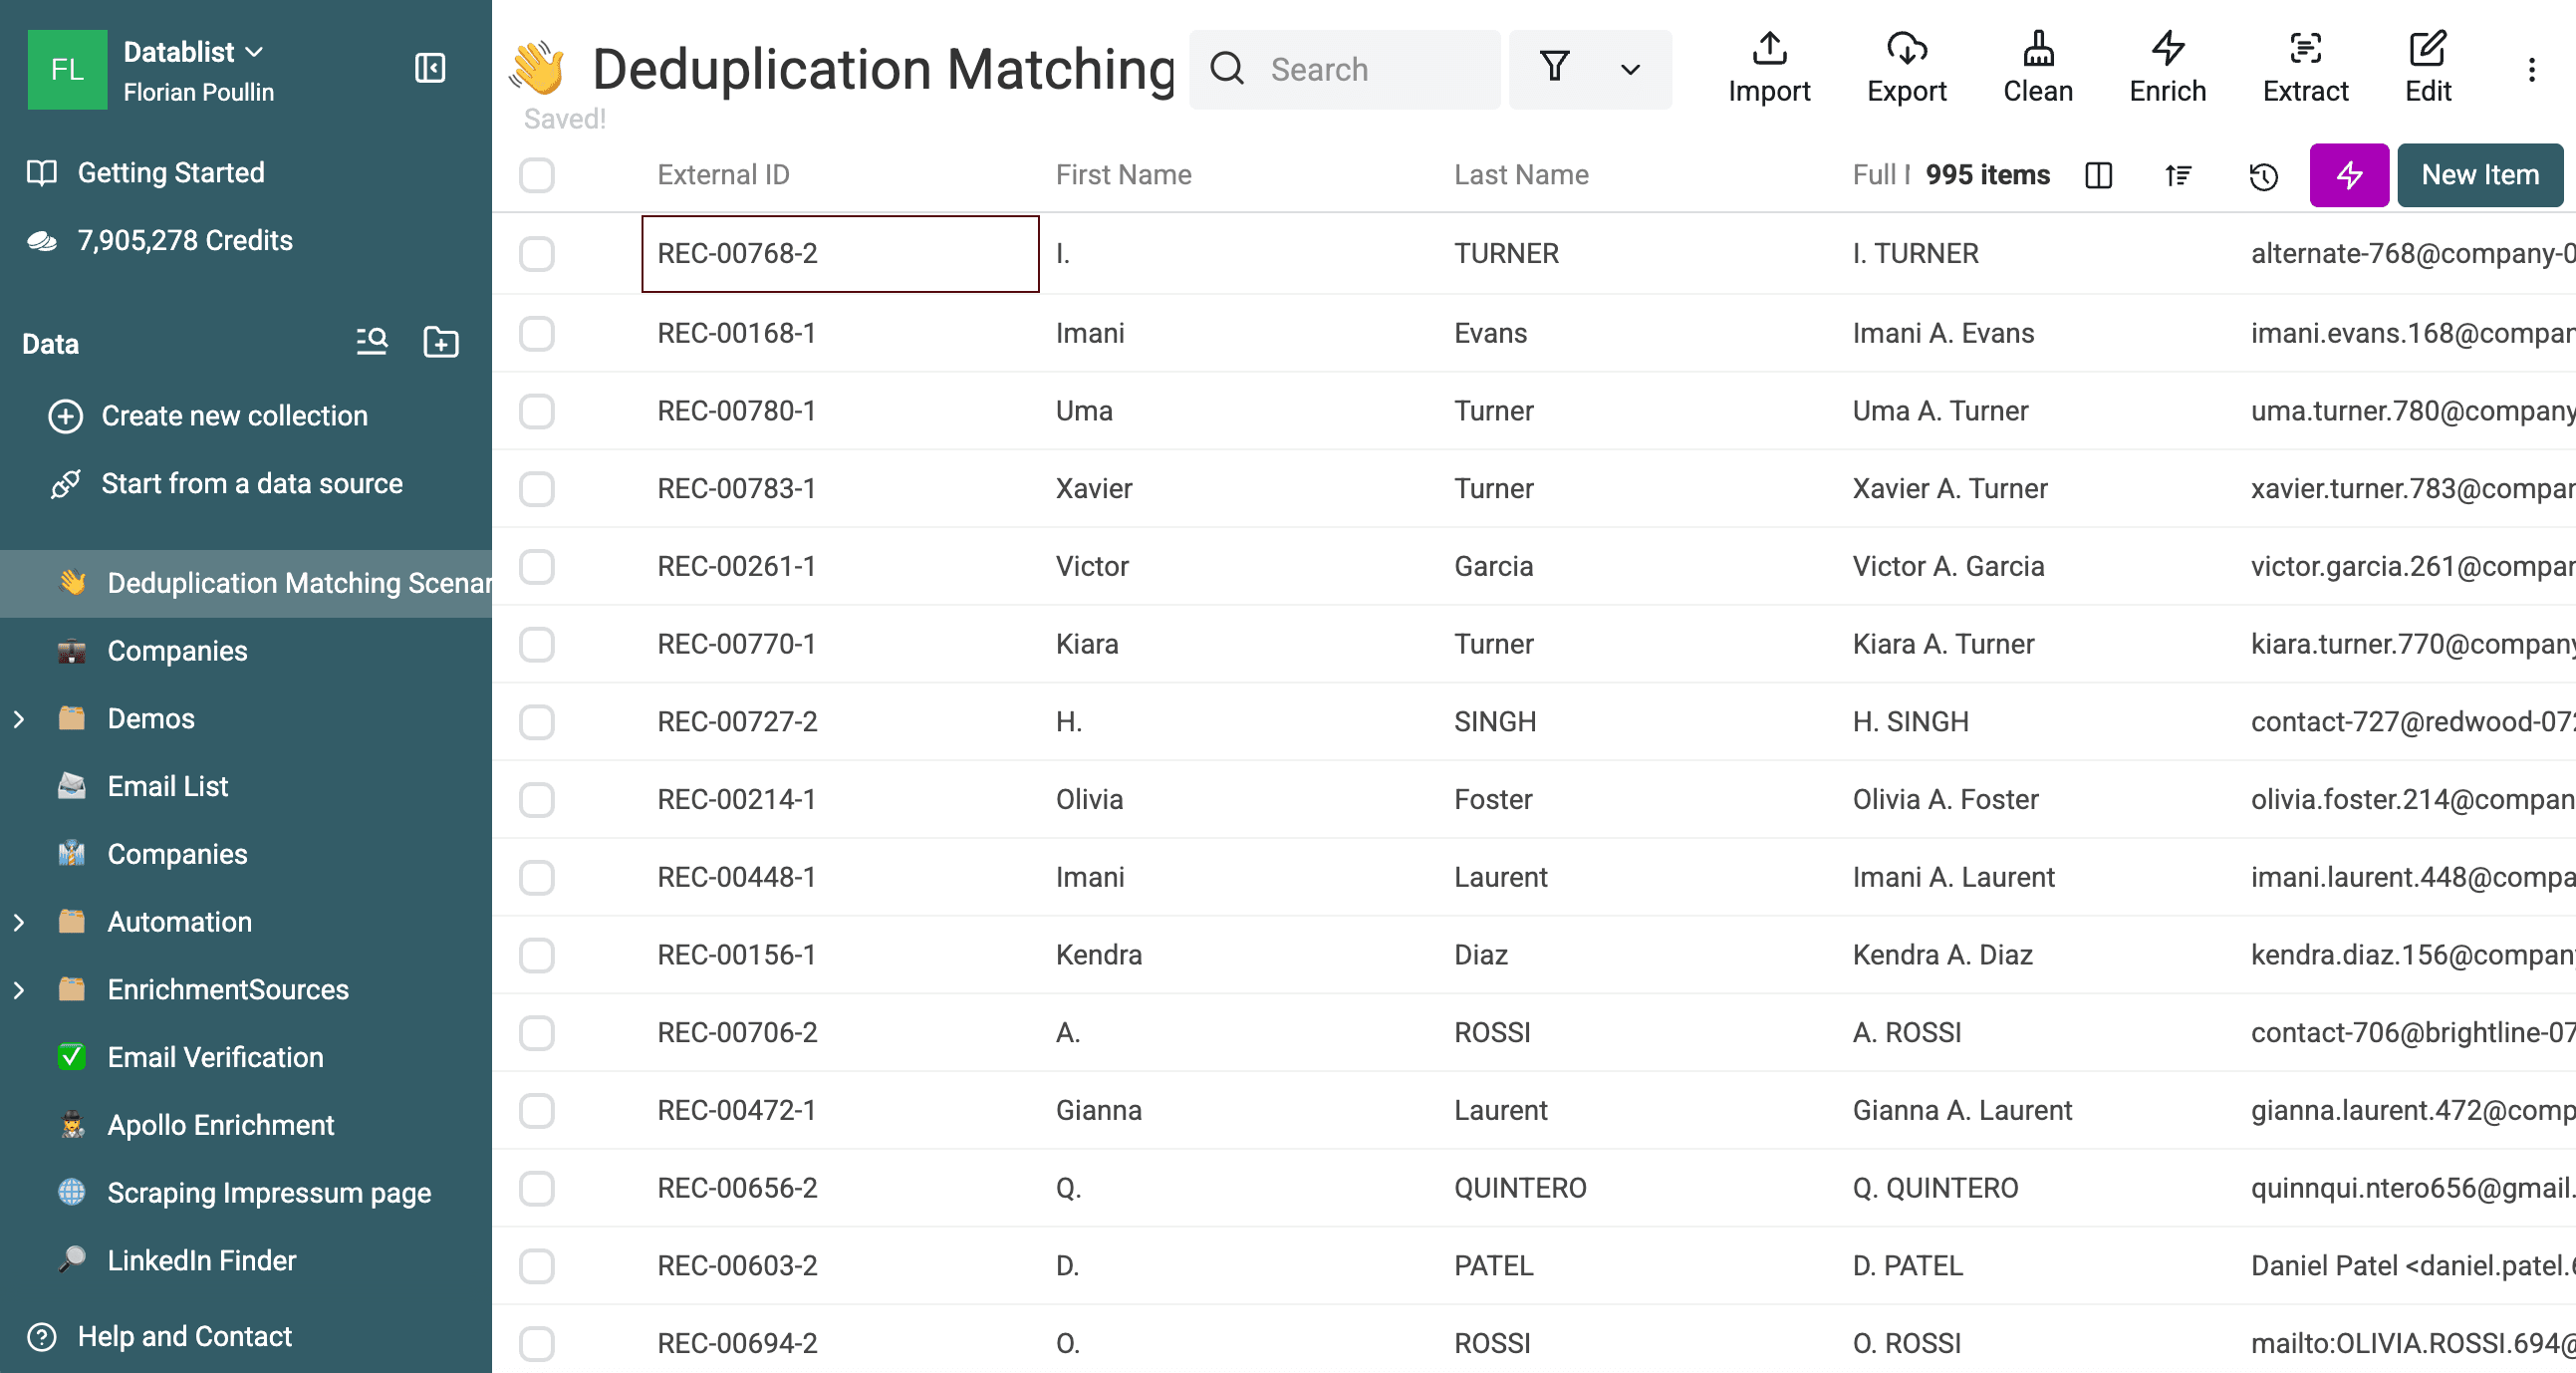
開始時の行数 - 削除した2行目以降の行数 = 最終的な行数
このガイドのExactチェックでは、Datablistが2行構成の5グループをマージしました。そのため、collectionは1,000件から995件になりました。
外部で確認するファイルが必要な場合は、処理前に重複グループをダウンロードしてください。有料プランでは、利用可能な重複グループIDと処理後の変更ログが提供されます。変更ログには、削除・更新されたDatablist IDと、変更前および変更先の値が記録されます。
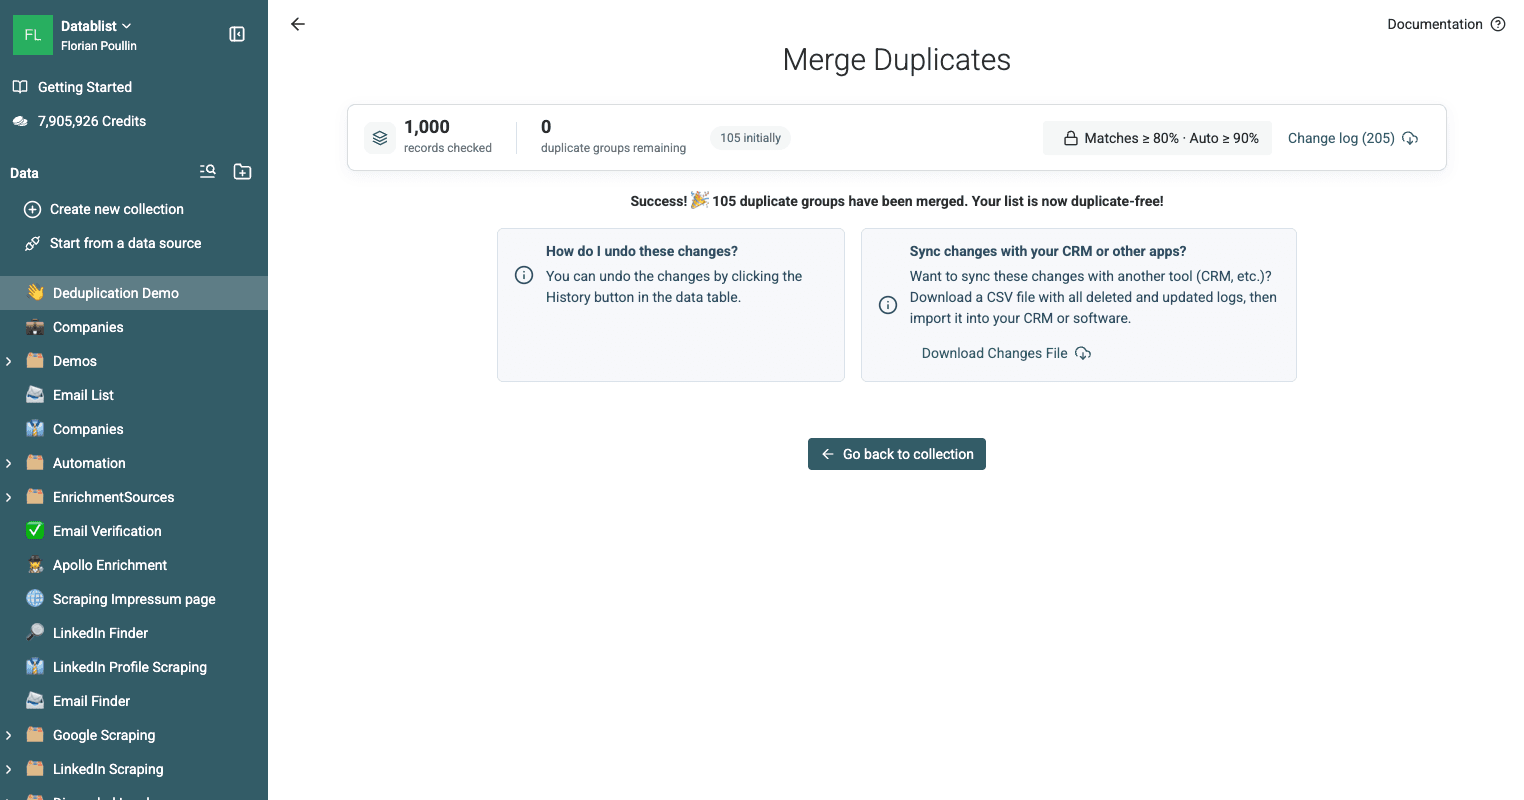
自動削除とマージの操作はcollection Historyにも記録され、元に戻すことができます。
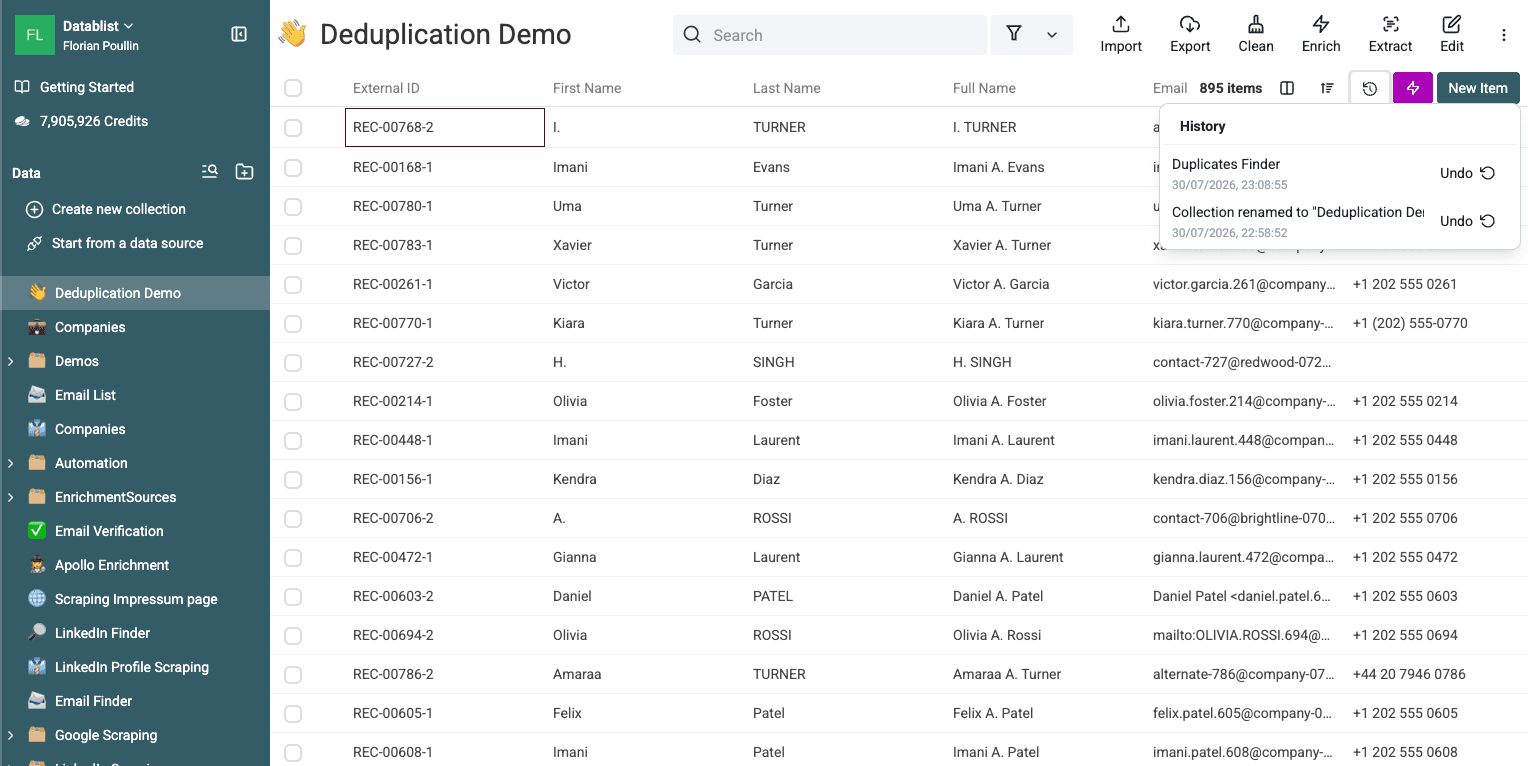
collectionに戻ってExportを開き、クリーンアップ済みのCSVまたはExcelファイルをダウンロードします。
複数のリストから重複を排除する
新しいLeadファイルをCRMのexportデータと比較する場合は、collection間のマッチングを使用します。CRMを参照リストとして扱い、一致したレコードをインポート前に受信リストから削除します。
デモ用CRMファイルとデモ用イベントファイルをダウンロードすると、このworkflowをテストできます。2つのファイルは異なるヘッダーを使用し、想定したメールアドレスの重複が100件あります。各ファイルの開始時の行数は250行です。
各ファイルを別々のcollectionにインポートし、Clean > Match across collectionsを開きます。両方のcollectionを追加し、EmailとAttendee Emailのように、対応するpropertiesをマッピングしてください。
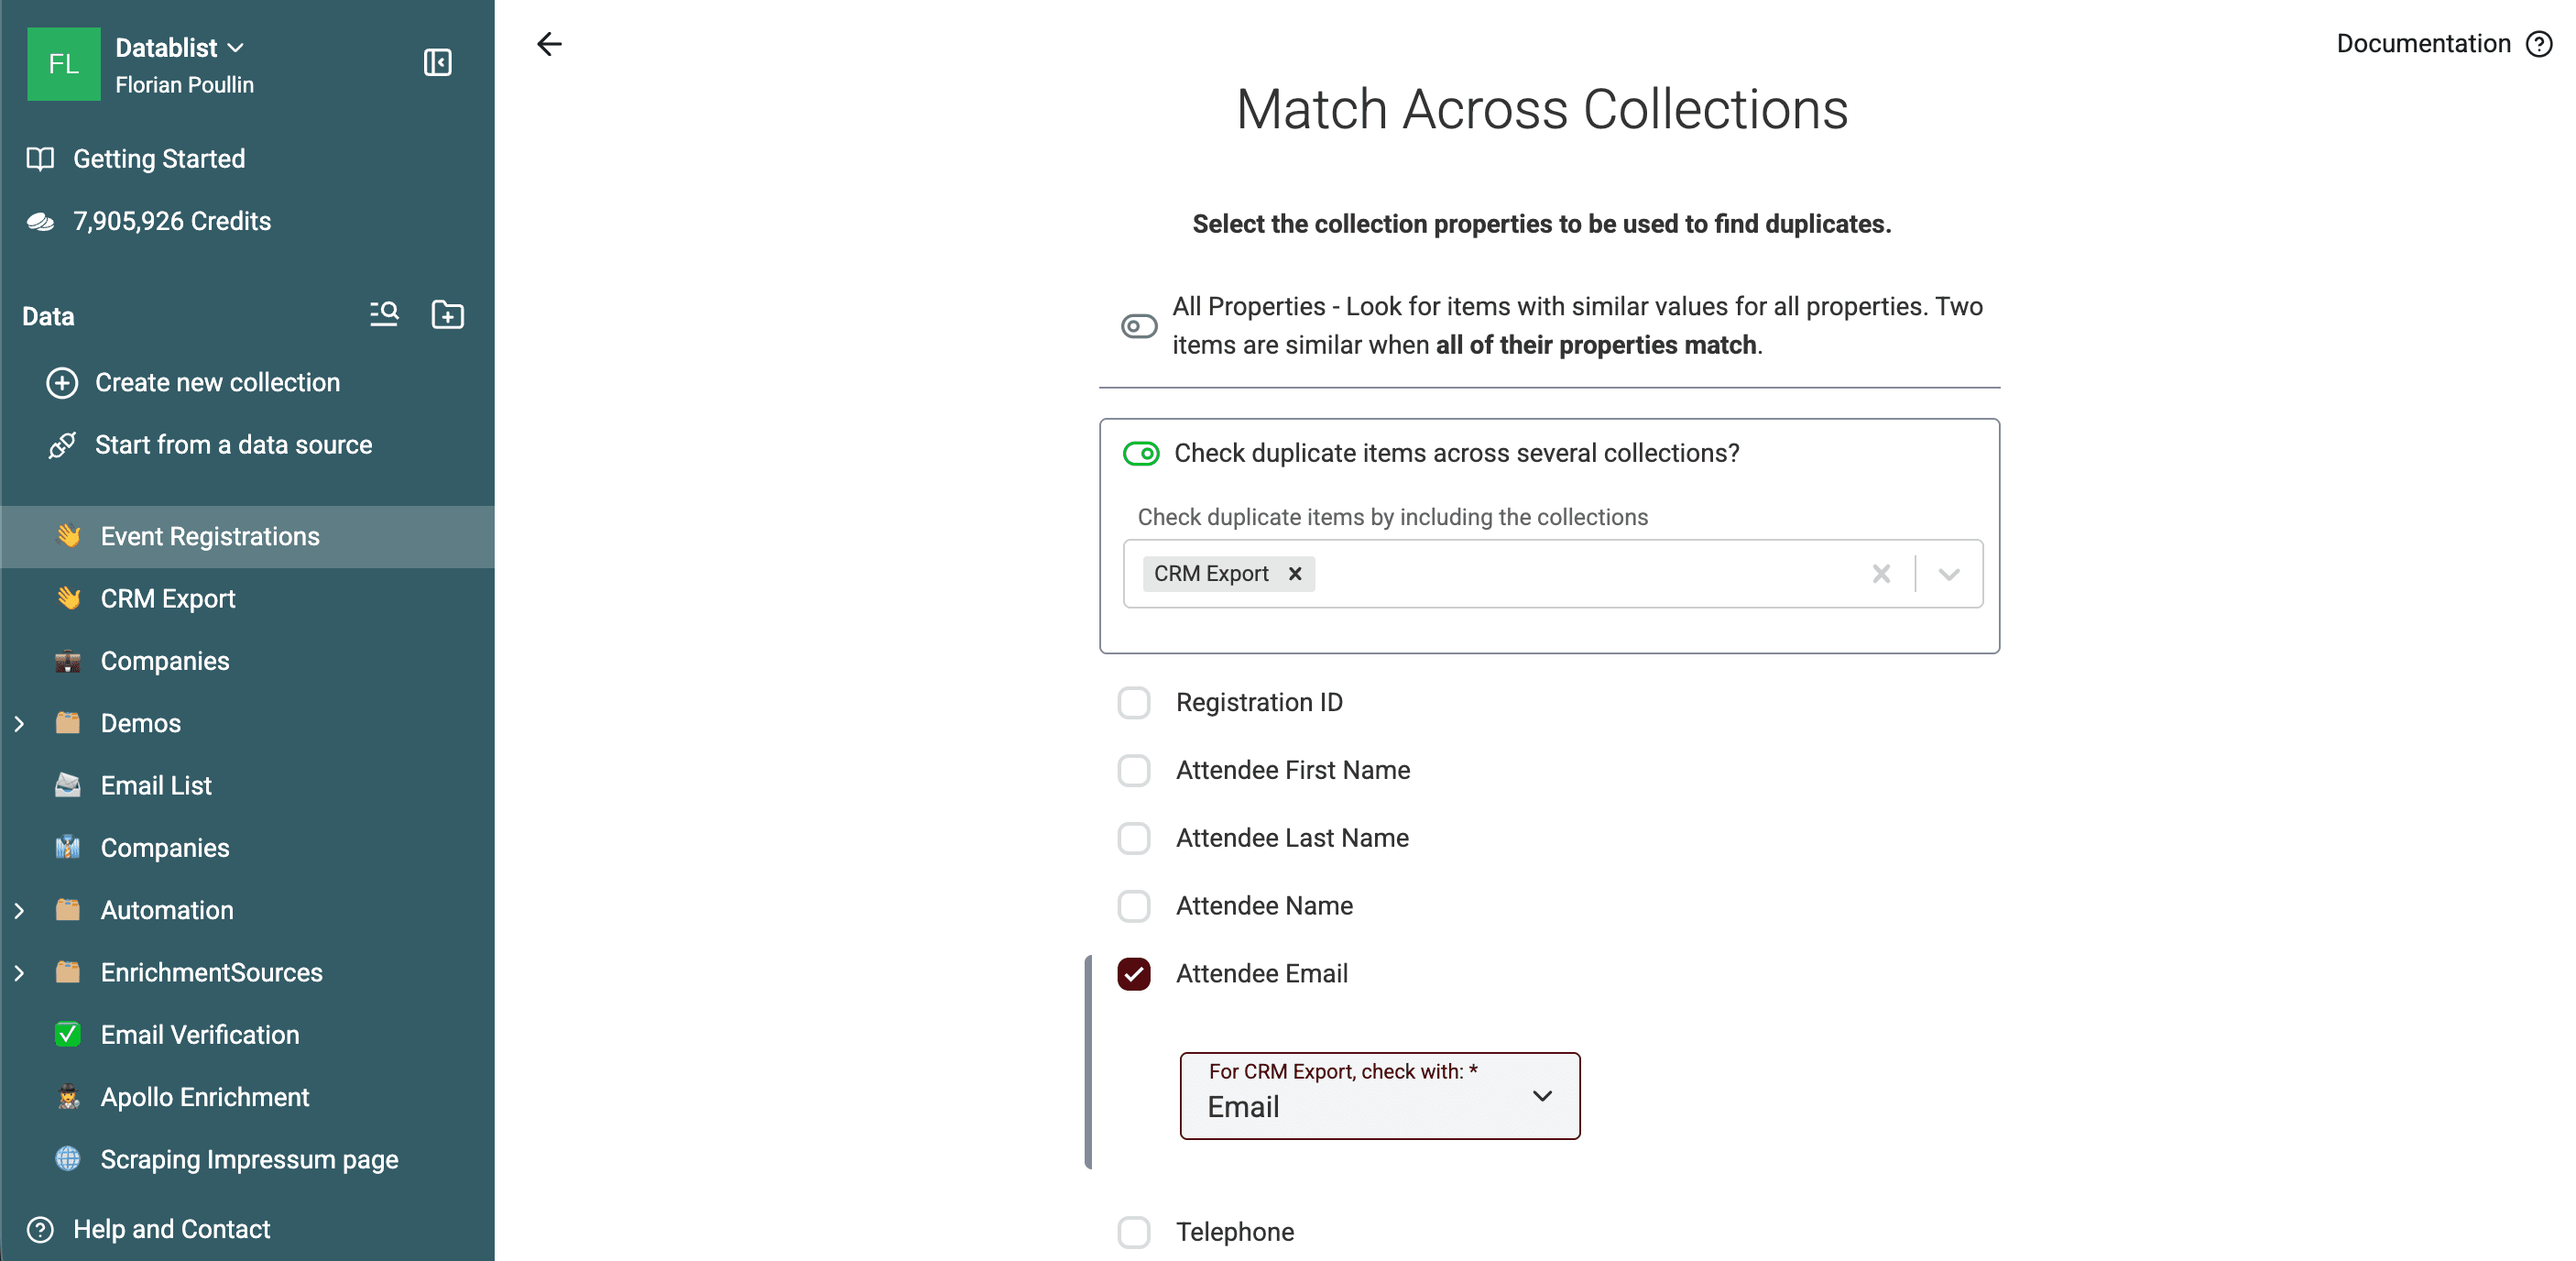
このテストでは、Email processorを使用したSmart matchingにより、チェックした500件のレコードからcollection間のグループが100件返されました。CRMを変更せず、イベントリストから一致するレコードを除外するには、***Remove duplicate items from collection {X}***でEvent Registrationsを選択します。
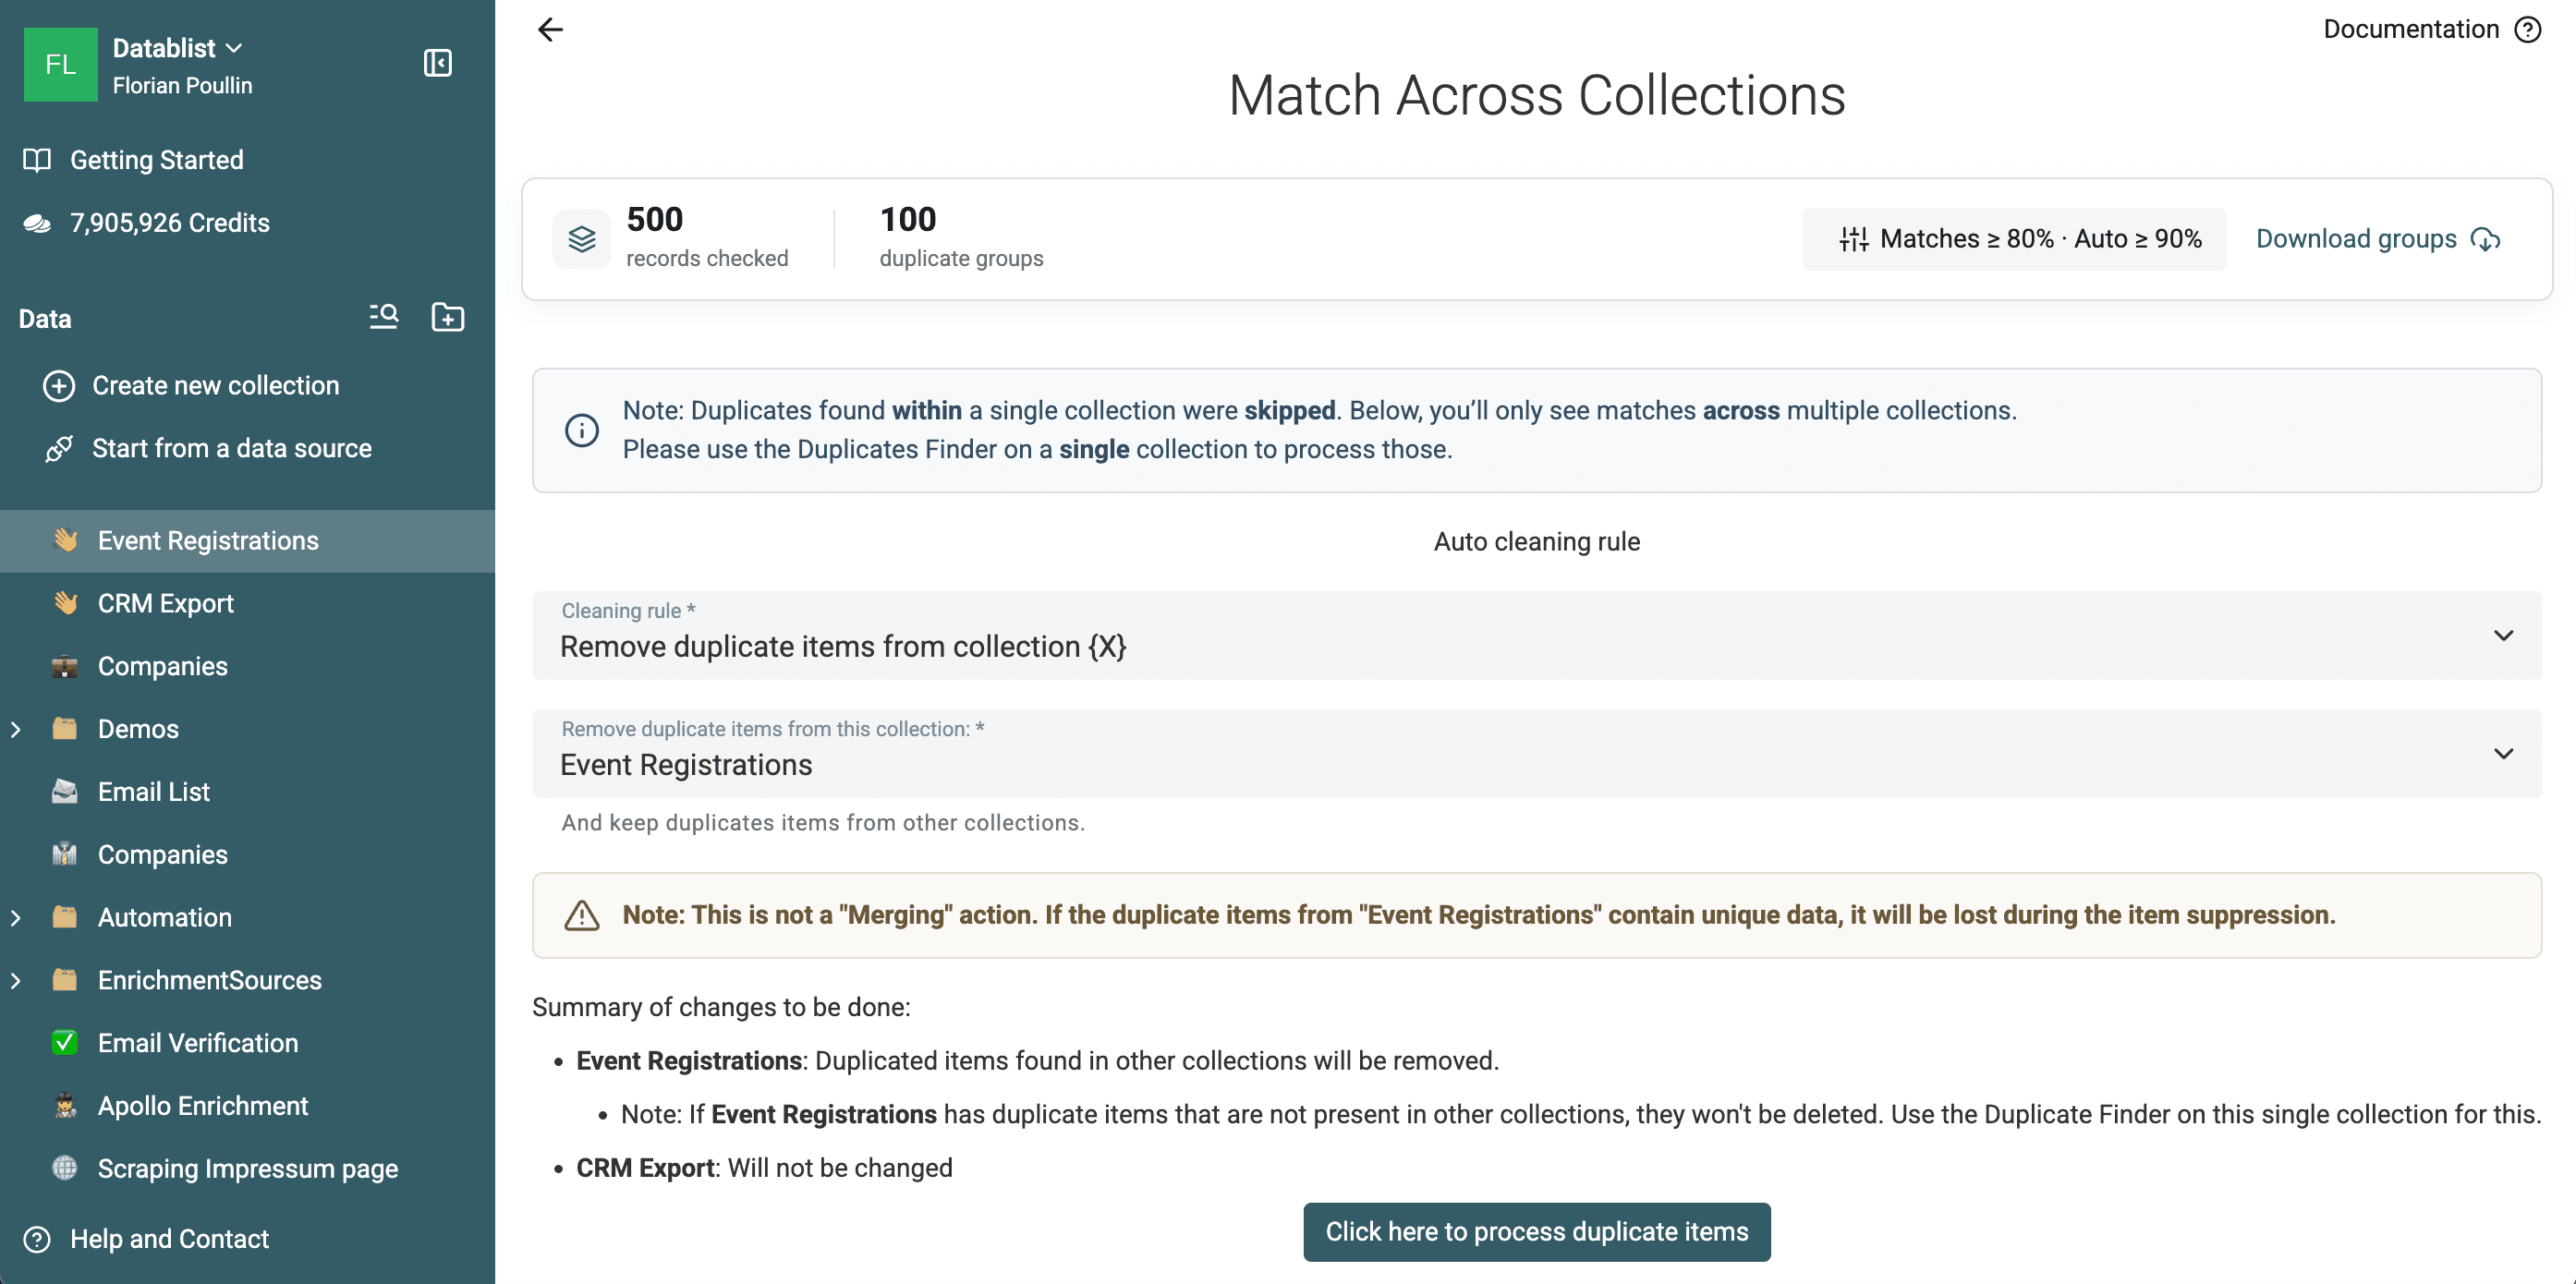
collection間の自動クリーンアップでは行が削除されます。イベント側にしかない値をCRMへマージすることはありません。受信レコードに残すべき情報が含まれる場合は、先にグループを書き出すか確認してください。
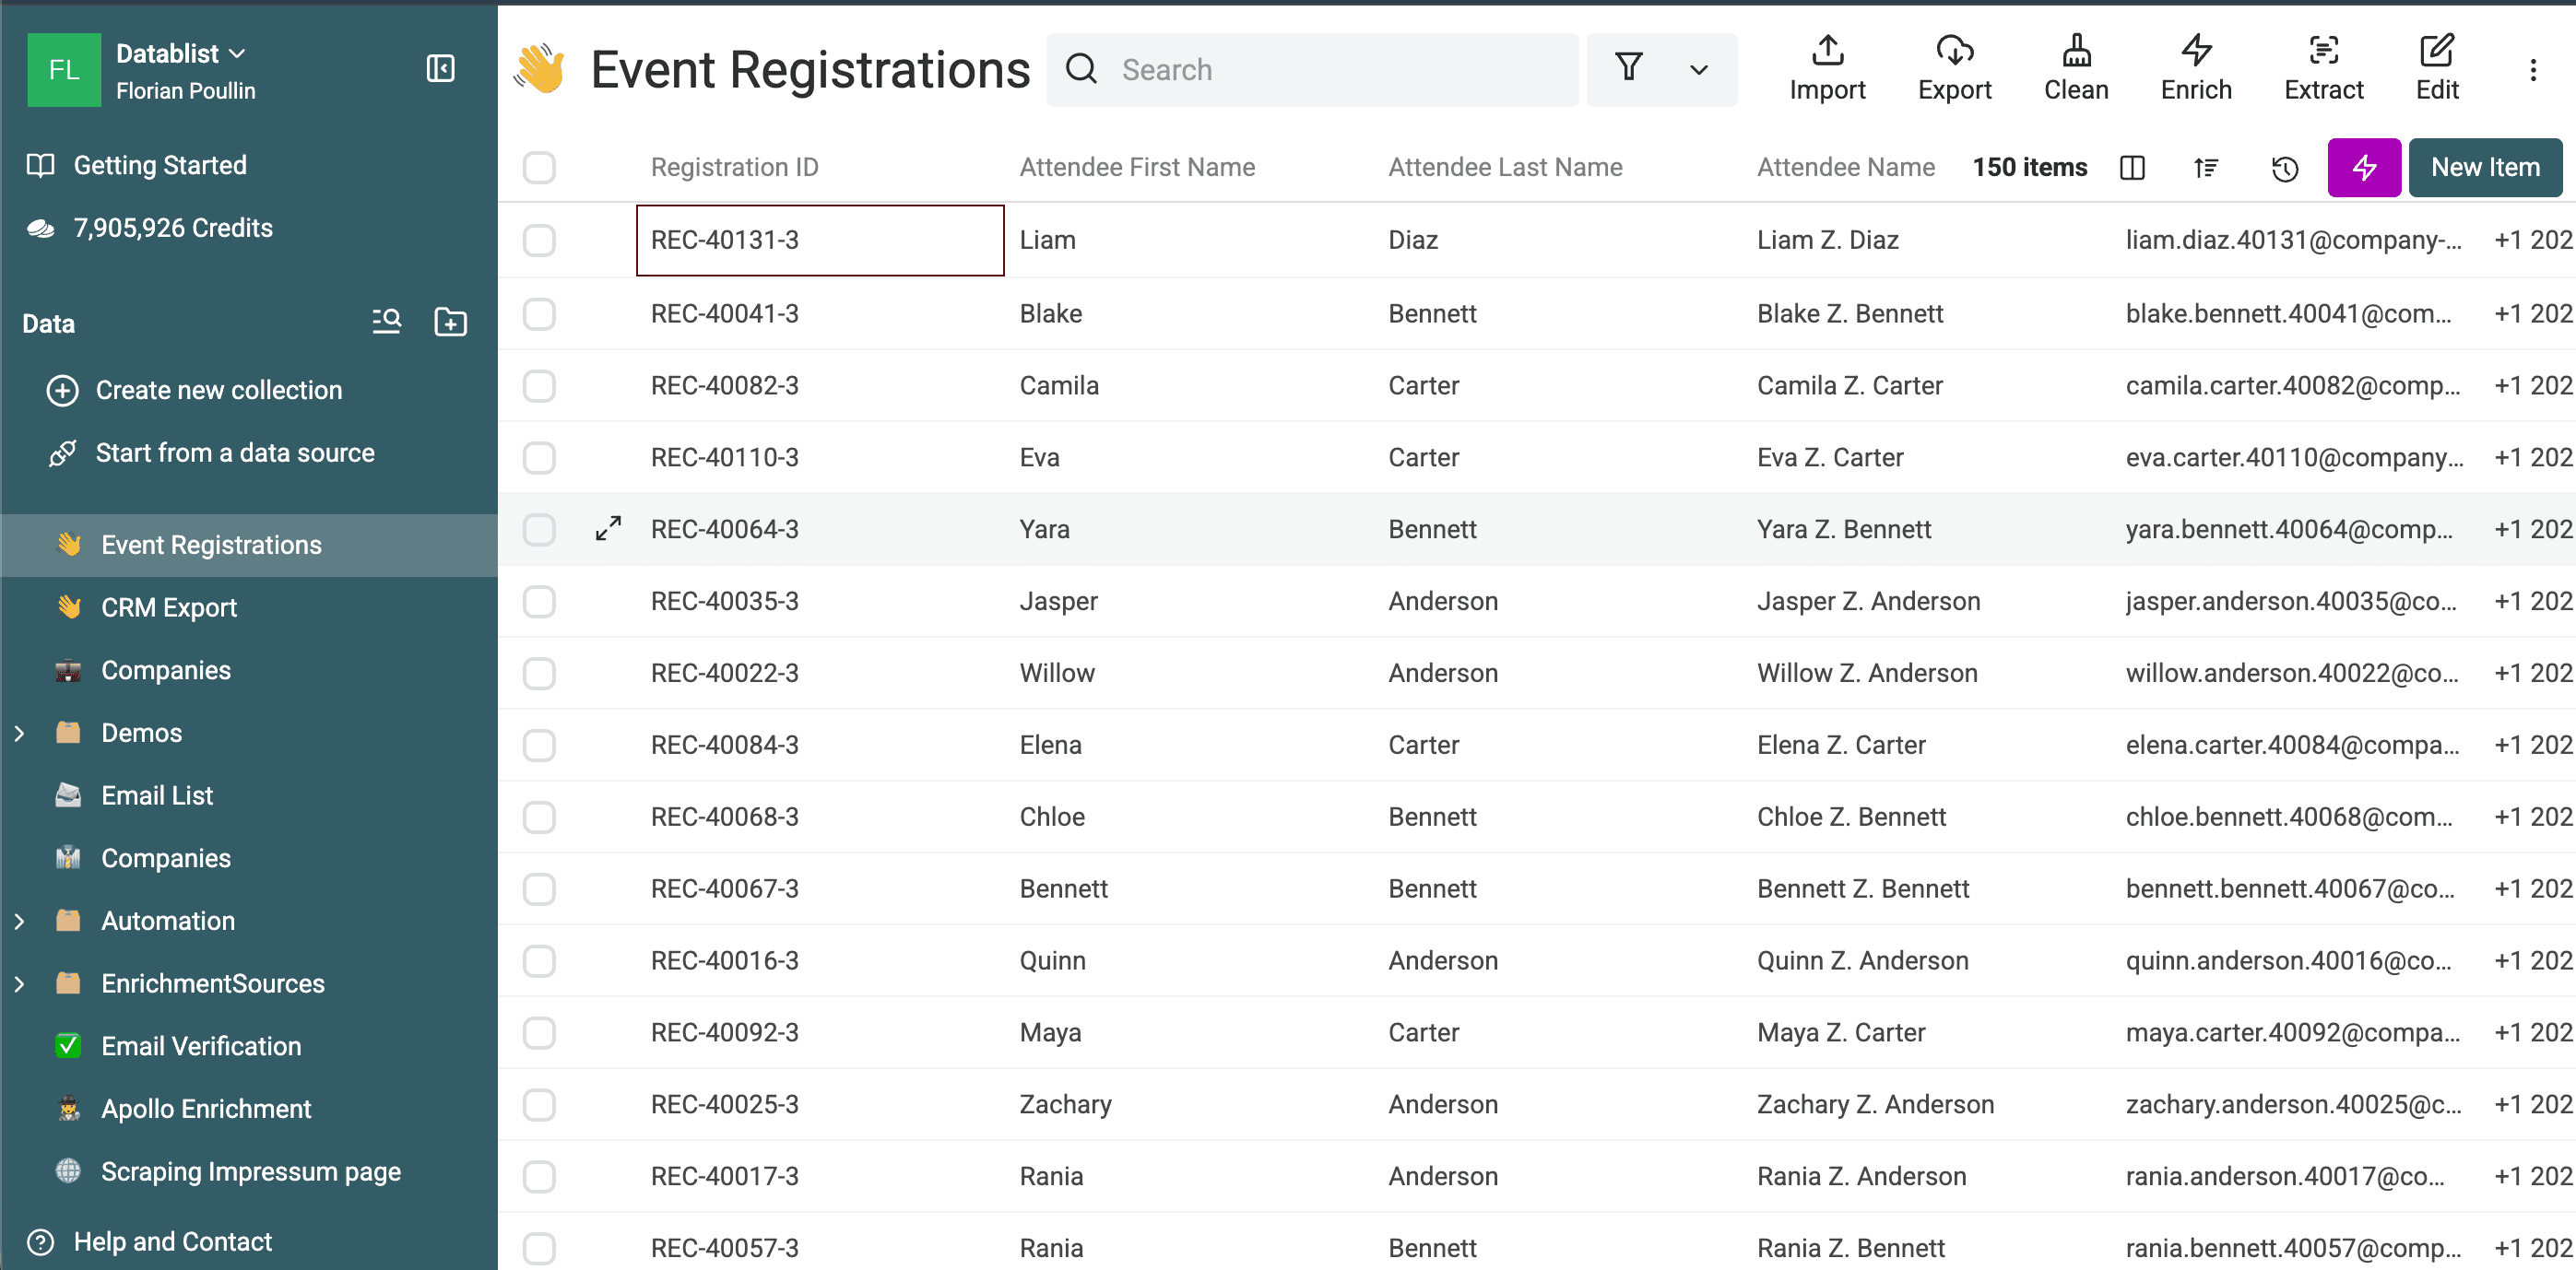
100件の重複を処理すると、Event Registrationsには新規の連絡先が150件残ります。
collection間のマッチングはPremium機能です。collectionのマッピングと処理オプションについては、複数のCSV・Excelファイルの重複を排除する詳しいガイドをご覧ください。
よくある質問
オンラインで無料のリスト重複排除はできますか?
はい。未登録の訪問者でもExactチェックを実行できます。無料アカウントを作成すると、Smart matchingなど、単一collection向けのFree plan機能を利用できます。fuzzy・phonetic algorithms、高度なprocessors、collection間のマッチング、設定可能なsurvivorship、Custom with AIには有料プランが必要です。
重複行は削除とマージのどちらが適切ですか?
信頼できるレコードが1件あり、ほかに必要な情報が含まれていない場合は削除します。2行目以降に有用な値がある場合はマージしてください。データが失われる場合は、Removeのプレビューに警告が表示されます。
スペルミスがある重複も検出できますか?
はい。Jaro-WinklerとLevenshteinはテキストの類似度を比較し、Metaphoneは発音を比較します。これらの高度なアルゴリズムには有料プランが必要で、検出された一致は確認が必要です。
データを失わずに重複行をマージできますか?
Datablistでは、空のフィールドの補完、テキスト値の連結、選択したレコードの値の保持、フィールド単位のsurvivorshipルールの適用が可能です。破棄するよう選択した値はマージ後のレコードに残らないため、必ずプレビューを確認してください。
リストは何件まで処理できますか?
Free planでは、ブラウザストレージ上で1つのcollectionにつき最大100万itemを扱えます。有料プランでは、1つのcollectionにつき最大200万itemをインポートできます。大規模なローカル処理の性能は、ブラウザと端末にも左右されます。
リストを変更せずに重複を確認できますか?
はい。検出処理は読み取り専用です。処理actionを開始する前に、グループの確認、しきい値の調整、Why matchedの参照、結果の検索・並べ替え、重複行のダウンロードができます。
すべての設定と制限については、Duplicate Finderの完全なドキュメントをご覧ください。